ZGCM-1:一個完全開放、極致高效、面向數學與代理式搜尋的基礎模型
原始論文:ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search 作者:Jiyan He, Guang Liang, Hao Liu, Haoxiang Guan, Jinbo Sun, Junyi Guo, Wenjun Feng, Yantai Xie, Yifei Shen, Bin Shao, Chuyang Wei, Kai Chen, Kexin Zhou, Minghang Zhu, Shuxin Zheng, Tie-Yan Liu, Taine Zhao, Wenhui Zhu, Xueyin Xu, Xiaoqing Zhang, Yatao Li, Yuxuan Ren arXiv ID:2609.13356v1 日期:2026-09-11 標籤:基礎模型 開源模型 數學推理 代理式搜尋 混合注意力 FP8 Muon 長上下文
摘要
當基礎模型持續推進數學推理與代理式問題求解 (Agentic Problem Solving) 的前沿之際,更廣大的學術社群卻因為高不可攀的算力需求與封閉的訓練配方,大體被排除在這波進展之外。本文提出 ZGCM-1——一個完全開放、以極致的資料、系統與演算法效率從零訓練 (From Scratch) 的 7B 稠密 (Dense) 基礎模型。ZGCM-1 立基於一個核心前提:緊湊模型無法被動地把整個開放網路背下來,但可以透過**「刻意的內部思考」與「主動的外部工具使用」相耦合**,來突破參數容量的限制。為了在 256K 上下文下支撐這個範式,我們發展出一條端到端、高效率的開放訓練配方:
- 架構與系統協同設計 (Co-design):交錯 (interleave) 帶閘門的滑動視窗注意力 (Gated Sliding-Window Attention) 與全域注意力 (Full Attention),並搭配一個穩定的 FP8 Muon 最佳化器;
- 漸進式課程 (Progressive Curriculum) 與 MDP 中訓練 (Mid-Training):把上下文跨 16K、64K、256K 逐步擴張,並把互動軌跡重新表述成馬可夫決策過程 (Markov Decision Process, MDP)。
此外,我們建立了一套 AI 原生 (AI-native) 研發工作流,讓代理群 (Agent Swarms) 自主管理叢集運維、資料整理與快速的診斷式評測。大量評測顯示:ZGCM-1-7B 在通用基準上於 7B 家族中具競爭力;在若干具挑戰性的數學推理與代理式搜尋套件上,它甚至能與大它一個數量級的前沿模型(如 Qwen3-235B-A22B 與 GLM-5.1)一較高下。我們也證明預訓練設計在「16K 預訓練達到目標損失所需時間」上帶來約 4.2 倍的效率提升。橫跨完整開發生命週期,我們提煉出八條可操作的經驗發現。為促進社群研究,我們開源了預訓練、中訓練、後訓練各階段的模型權重、中間檢查點、訓練程式碼、各階段資料與資料配方,以及 W&B logs。
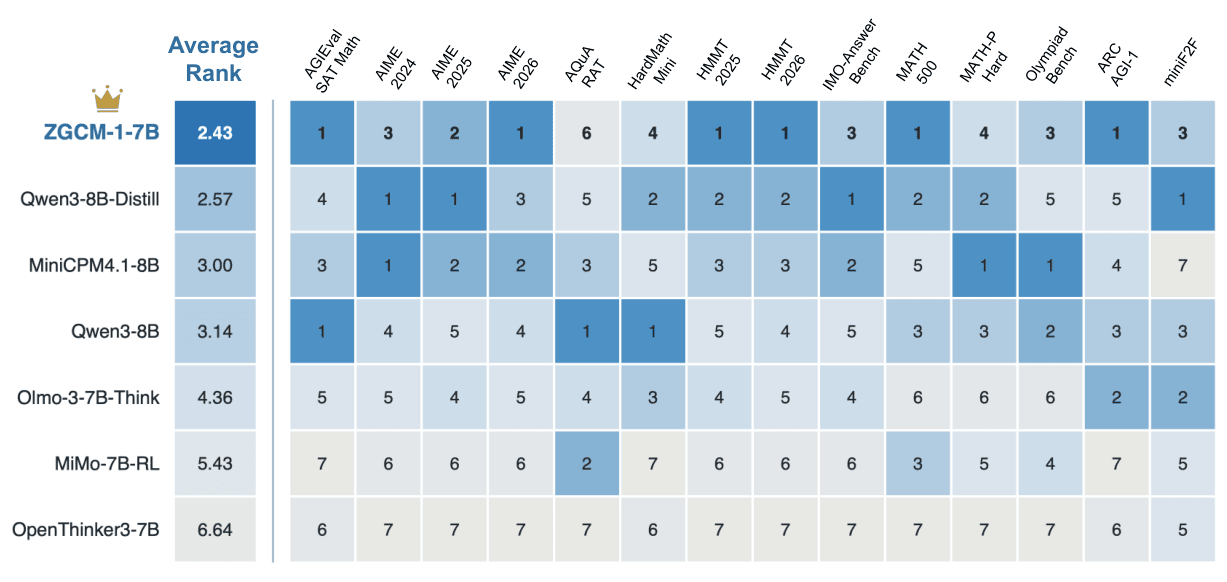
圖 1:ZGCM-1-7B 與同規模模型在 14 個推理基準上的逐基準排名,完整結果見第 5 節。
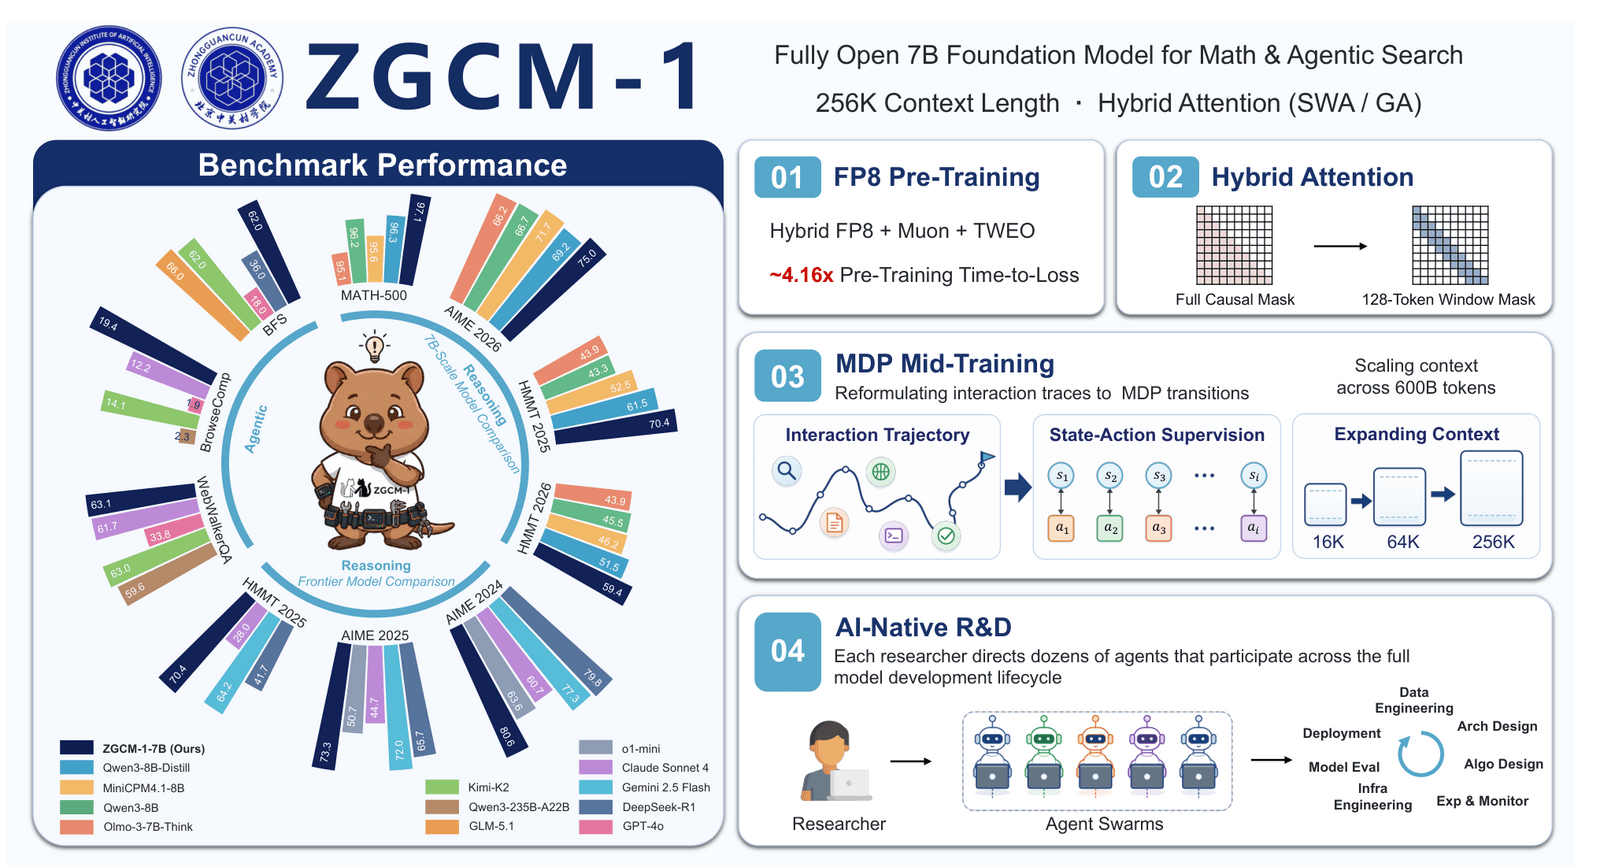
圖 2:ZGCM-1 總覽。左:跨推理與代理任務、與 7B 規模及前沿模型的基準效能對比。右:四項技術亮點——(1) 用 Muon 與 TWEO 的 FP8 預訓練達成 ~4.2× time-to-loss 加速;(2) 混合滑動視窗/全域注意力;(3) 把互動軌跡重述為 state-action 監督、上下文擴到 256K 的 MDP 中訓練;(4) 每位研究員指揮代理群跨越完整開發生命週期的 AI 原生研發。BFS 指 Binary Function Search。
1 引言
基礎模型正以驚人速度推進長時程推理 (Long-horizon Reasoning) 與真實環境中工具增強的代理能力。儘管有這些突破,基礎研究仍受兩個實務瓶頸所困:
- 規模壁壘 (Scale Barrier):前沿推理與深度代理式搜尋被普遍視為千億參數系統的專屬領域,把算力受限的研究者鎖在門外。
- 不透明壁壘 (Opacity Barrier):多數具競爭力的模型只以開放權重 (open-weight) 而非完全開源 (fully open-source) 釋出。上游過濾配方、中訓練課程、長上下文排程與多輪代理軌跡仍是專有黑箱,阻礙了對訓練動態與容量極限的系統性研究。
動機與核心論點。 我們提出 ZGCM-1,一個在透明、開放科學範式下從零訓練的 7.39B 稠密基礎模型。我們挑戰「進階智慧嚴格需要龐大參數規模」的觀念,把設計圍繞一個直白的論點:
緊湊模型天生受靜態參數容量所限,但它們能透過「刻意的內部思考」與「主動的外部尋求」這組雙引擎超越此限制。
ZGCM-1 不依賴對開放網路的被動記憶,而是把長時程思維鏈 (Chain-of-Thought) 推理與自主工具使用耦合起來——主動蒐集網路證據、與系統終端互動、分析被剝除符號的二進位程式——以此彌合知識缺口。
高效率的開放配方。 為讓訓練與推論在學術算力預算下可行,我們在 256K 上下文上打造了高效的全棧管線:
- 混合注意力架構:以 5:1 的比例交錯帶閘門的滑動視窗注意力 (SWA) 與全域注意力,把每 token 的 KV 快取足跡降低 6.4×,並在 256K 上下文下相對標準全域注意力帶來 3.94× 的吞吐加速。
- 系統-演算法協同設計:結合 Muon 最佳化器、混合 FP8 精度與 TWEO 離群值正則化,相對 AdamW/BF16 基線達成約 4.2× 的預訓練 time-to-loss 加速。
- 帶 MDP 監督的課程式中訓練:跨 600B token 逐步擴張上下文(16K → 64K → 256K),同時把互動軌跡重述成 MDP 的 state-action 轉移,提供密集的、逐步的監督。
- 執行接地 (Execution-Grounded) 對齊與混合 SFT:對經執行驗證的軌跡施加混合的 think/no-think 微調,平衡深度推理與直接回應的效率。
實證可行性。 跨 20 個標準基準的評測證實了我們的論點:推理與數學——ZGCM-1-7B 在 7B–8B 規模、14 個推理基準上平均排名第一,AIME 2026 得 75.0%、MATH-500 得 97.1%、HMMT 2025 得 70.4%;代理式搜尋與系統代理——刻意思考結合工具互動,讓 ZGCM-1 能與大它一個數量級的前沿模型(如 Claude 4 Sonnet、Kimi-K2、GLM-5.1)競爭,WebWalkerQA 得 63.1%、BrowseComp 得 19.4%、Binary Function Search 得 62.0%。
AI 原生研發。 我們在整個模型開發生命週期中整合「研究員指揮的 AI 代理」,從資料處理、實驗到評測與部署。一個共享的代理 harness 把人類的情境成品與經驗證的腳本、工作流、除錯經驗結合,讓代理能執行任務、檢視回饋並迭代。我們的原子能力評測 (Atomic Capability Evaluation, ACE) 套件提供快速的診斷回饋來引導開發。九位核心貢獻者的評估刻畫了這套工作流的效益與限制:實驗、監控與部署獲得較高的自主性評分,而架構與學習演算法設計仍更依賴人類判斷。
2 架構
2.1 模型總覽
ZGCM-1 採用只有 decoder 的 Transformer 架構,配 Grouped-Query Attention (GQA)、RMSNorm、SwiGLU 激活與 Rotary Position Embedding (RoPE)。模型約 73.9 億參數、32 個 Transformer 層、隱藏維度 4,096、SwiGLU 中間維度 11,008、32 個 query head 與 8 個 key-value head(head 維度 128),最大上下文長度 256K token。
架構使用一個混合因果注意力骨幹,以 5:1 的 local-to-global 比例交錯「帶閘門的滑動視窗注意力 (SWA)」與全域注意力(此比例先前已由 Gemma 3 在生產規模採用)。32 層中,27 層用 128-token 視窗的 gated SWA,5 層用全域因果注意力;全域層置於第 6、12、18、24、30 層——即五個「五個 local 層後接一個 global 層」的重複區塊,再加兩個尾端 local 層。模型還套用以 RMSNorm 實作的 QK 正規化,以及旋轉分數 0.33 的 Partial RoPE。
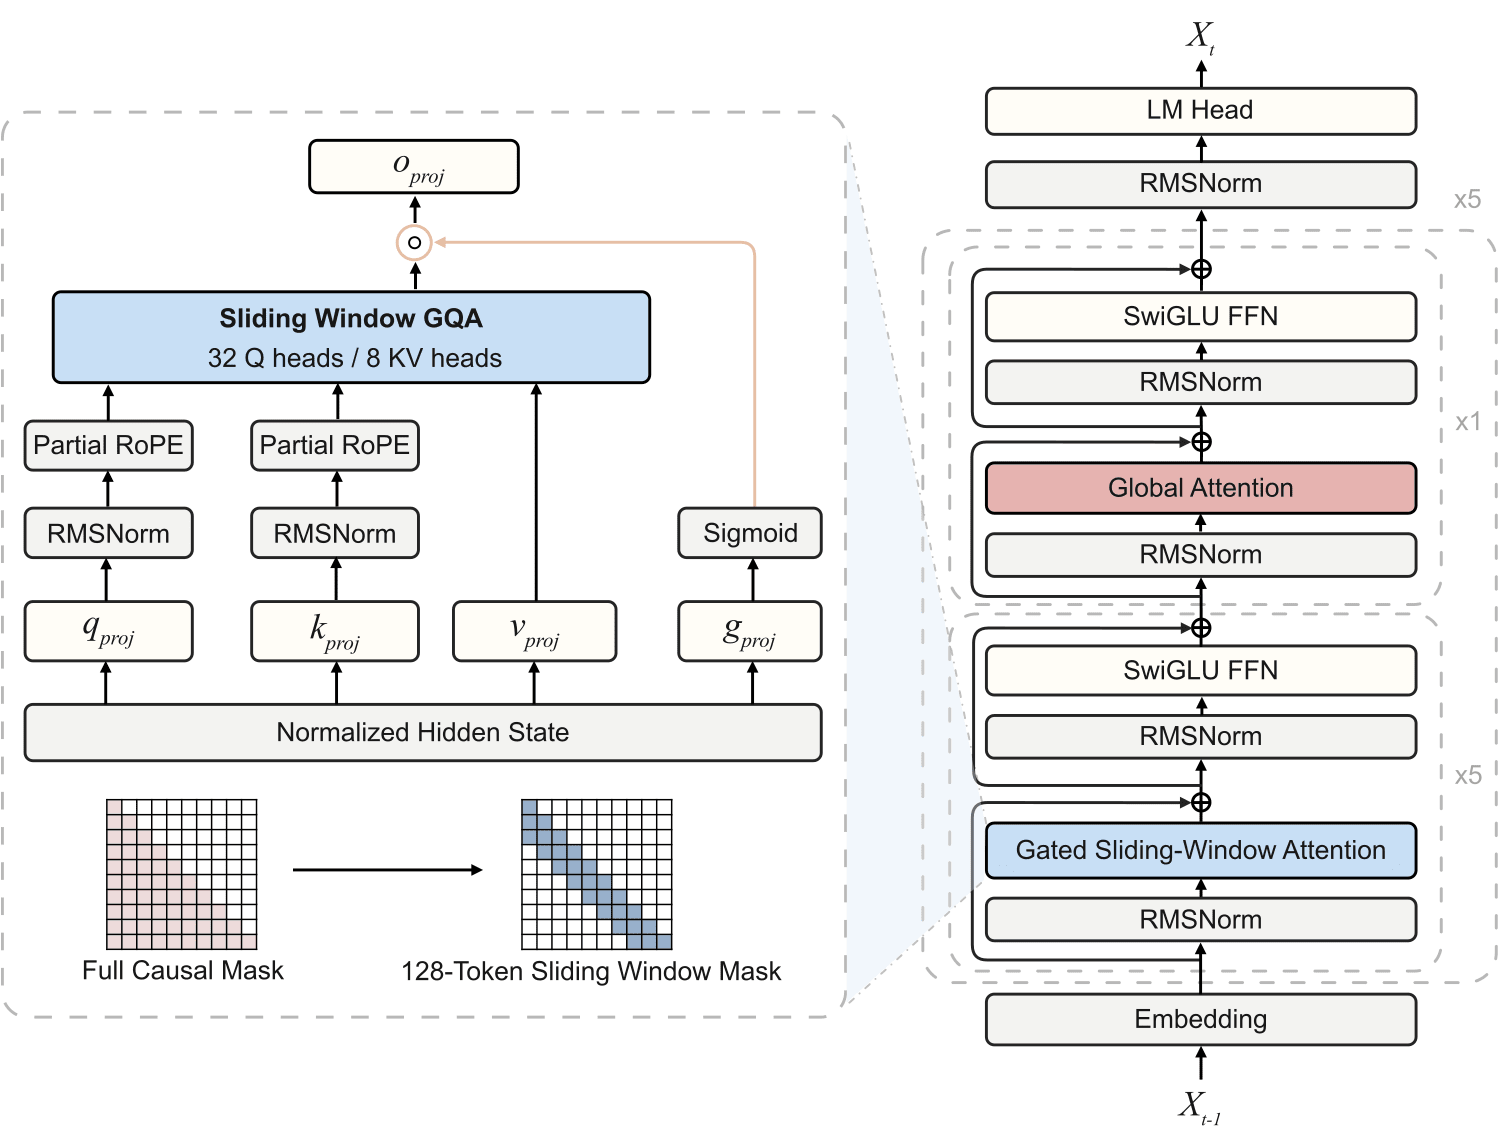
圖 3:ZGCM-1 的混合注意力架構。對一個正規化後的隱藏狀態 $h$,gated SWA 模組平行地做 query、key、value、gate 投影;RMS 正規化與 Partial RoPE 施加於 query/key 分支。若 $A_{\mathrm{SWA}}(q,k,v)$ 表示 128-token 滑動視窗 GQA 輸出,gated 注意力輸出為 $\mathrm{GatedSWA}(h)=o_{\text{proj}}(A_{\mathrm{SWA}}(q,k,v)\odot\sigma(g_{\text{proj}}(h)))$。學到的 sigmoid 閘門在輸出投影前對 local 注意力輸出逐元素調變;全域層省略此閘門、對整個上下文做注意力。
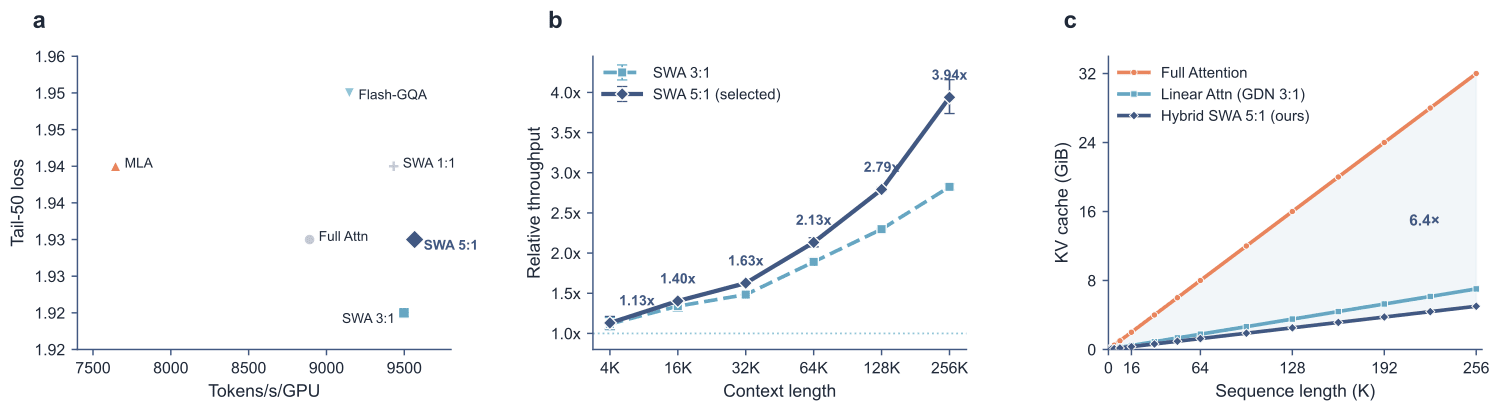
圖 4:架構實驗。(a) 非參數對齊的 7B 注意力配置訓練 10B token 的品質-吞吐權衡;(b) SWA 排程相對全域注意力、上下文從 4K 到 256K 的吞吐加速;(c) 三種等參數架構的 KV 快取記憶體足跡(batch=1、bf16)。
2.2 混合注意力實驗
為選定生產用注意力排程,我們比較全域注意力、帶 FlashAttention-2 的 GQA、MLA,以及 local-to-global 比例為 1:1、3:1、5:1 的三種 SWA 排程;全部在 8 張 H100 上、序列長度 4,096、共同預算下訓練 10B token。
以「最後 50 個訓練步的平均損失」衡量最佳化品質、以「每 GPU 每秒 token 數」衡量效率。如圖 4a:SWA 5:1 達到最高吞吐(9,566 tokens/s/GPU),同時匹配全域注意力基線的尾端損失(1.93);SWA 3:1 以略低吞吐達到最低尾端損失(1.92);MLA 吞吐大幅受罰(7,645 tokens/s/GPU)卻無對應的損失改善。我們為生產模型採用 SWA 5:1。進一步在同一 7B 骨幹上把上下文從 4K 增到 256K:SWA 5:1 相對全域注意力的吞吐優勢隨上下文擴大,從 4K 的 1.13× 增到 256K 的 3.94×。
2.3 KV 快取分析
混合架構在推論時帶來可觀的記憶體節省。由於 27 個 SWA 層在 KV 快取中只保留固定的 128-token 視窗、只有 5 個全域層存整個序列,每 token 的 KV 足跡從全域注意力的 128 KiB 降到 20 KiB。在 256K 上下文下:全域注意力需 32.0 GiB KV 快取,GDN 3:1 需 7.0 GiB,而我們的混合架構只需 5.0 GiB(相對全域注意力減少 6.4×)。由於自迴歸解碼受記憶體頻寬限制,更小的 KV 足跡直接轉化為更高的解碼吞吐。
3 預訓練
預訓練由兩個連續階段組成:通用預訓練 (General Pre-Training) 跨兩個資料階段建立廣泛的語言、知識、數學與程式碼能力;中訓練 (Mid-Training) 則保留全序列因果語言建模目標,同時引入更密集的推理、指令與代理資料,並把上下文從 16K 漸進擴到 64K、256K。
3.1 通用預訓練
資料混合。 我們先用一個 0.3B 參數的代理模型(proxy model,訓練約 30B token)搜尋資料混合,以降低在目標規模上探索混合的成本。資料來源家族涵蓋:Web 資料(以 curated 英文網路語料為主、加受控比例的中文)、學術與 OCR 資料(教育過濾的 PDF 檢視 + Ai2 的 olmOCR 科學內容 + arXiv 自建管線)、程式碼資料(code-rich 網頁 + 開源 repo)、數學資料(高品質層 + 分類器過濾的網路數學與教科書,保式子完整)、LaTeX 論文(RedPajama-1T 的 arXiv LaTeX 切片 + 過濾的近期 TeX)、專門推理資料(Nemotron-Pretraining-Specialized-v1 的高品質推理檢視)。所有來源正規化為共同 record schema、以 GLM-5.1 tokenizer 索引,並做跨階段去重。最終通用預訓練語料 Stage 1 約 0.99T token、Stage 2 約 3.20T token;Stage 2 提高程式碼與數學的相對比重、引入專門推理成分。
課程式預訓練。 我們把 0.99T token 的 Stage 1 當作課程式預訓練階段:通用語言文件按詞彙複雜度 (Lexical Complexity) 由低到高呈現,程式碼與數學則獨立交錯。我們發現詞彙複雜度對通用語言便宜好算,但不能可靠反映程式碼或數學的內在難度。因此只對非程式碼、非數學資料排序,並移除通常是亂碼的極端高複雜度離群值。在 7B probe 中,此排程把 coding BPB 從 1.99 降到 0.81、mathematics BPB 從 0.97 降到 0.94,而通用基準 BPB 只升 0.03–0.09。
發現 1(課程式預訓練):詞彙複雜度是通用語言文本便宜的語料級排序訊號,但對程式碼與數學是差勁的難度代理——在那裡表面統計追蹤的是樣板而非演算法/推理深度。「對通用語言排序、對程式碼與數學獨立交錯」的排程改善了兩個技術領域的 BPB,以 0.03–0.09 BPB 的通用領域擬合換取集中在目標處的增益。
超參數。 用 NVIDIA Megatron Core 在 H100 上分散式訓練。矩陣參數用 Muon(momentum 0.9、譜縮放、5 步 Newton–Schulz、固定學習率 $2\times10^{-4}$、weight decay 0.1、梯度裁剪 1.0),標量參數用 Adam。矩陣乘法用 Transformer Engine 混合 FP8(E4M3 forward、E5M2 backward)加延遲縮放;TWEO 作為激活正則器抑制極端中間值。16K 生產 run 維持約 585 model TFLOP/s/GPU(約 60% BF16-等效 MFU)。
發現 2(TWEO 讓 FP8 預訓練可行):抑制中間激活離群值對 FP8 訓練穩定性至關重要;把延遲縮放與 TWEO 正則化結合可防止數值發散,同時在規模上維持 60% BF16-等效 MFU。
訓練效率。 相對可比的 OLMo 3 式 7B BF16/AdamW 基線估計「16K 預訓練 time-to-loss」:SWA 5:1 在 16K 帶來 1.4× 吞吐增益、FP8 精度與系統配置貢獻約 1.5×、Muon 提供約 1.8× 的 step-to-loss 效率、Pre-LN 估計貢獻約 1.1× 資料效率。相乘 $1.4\times1.5\times1.8\times1.1\approx 4.2$,約為四倍改善。
發現 3(預訓練效率增益):混合 SWA(1.4×)、FP8 混合精度系統(1.5×)、Muon 最佳化器(1.8×)與 Pre-LN(1.1×)的協同設計,相對標準 BF16/AdamW 基線帶來累計約 4.2× 的 16K 預訓練 time-to-loss 加速。
3.2 中訓練
中訓練是能力導向的續預訓練。從去重後的 2.86T token 候選池中,我們構造出一個 600.51B token 的取樣排程,組織成 16K、64K、256K 三個上下文階段。每個後續階段是累積的而非取代較短序列:例如 64K 階段含 180.89B token(≤16K)與 59.11B token(16K–64K 範圍)。程式碼與數學在整個課程中各維持在約 20%;隨上下文增長,知識資料從 10.50% 增到 14.23%、代理資料從 1.50% 增到 3.30%;預訓練 replay 從 13.00% 降到 9.00% 但持續存在以維持覆蓋。
- 推理資料:來源正規化為共同 schema,依自足性、答案證據與推理價值路由到 accepted/rewrite/pending/holdout/rejected 檢視;價值高但原軌跡不宜訓練的題目被抽為獨立問題、由教師模型重建。
- 指令資料:收集含 Tulu 與 FLAN 衍生資料的大規模指令語料,轉成與預訓練相容的 raw context;把選定的單輪範例改寫為多輪討論。
- 代理資料:保留高品質完整互動,並依循代理式續預訓練把一般軌跡重述為 MDP 式、state-conditioned 的 next-action 預測範例,把全軌跡情境與更密集的局部決策監督結合;軟體工程軌跡則做執行感知過濾。
超參數。 所有中訓練階段用全序列因果語言建模(有別於 SFT 的 assistant-only 監督)。三個階段皆維持每最佳化步約 12.6M token(16K/64K/256K 的全域批量分別為 768/192/48);學習率 $10^{-4}$,256K 階段用 10M 的 RoPE base 與全激活重算。我們比較「直接 256K 路線(30B token)」與「分階段路線(64K 先 10B、再 256K 20B)」,分階段路線最終損失略低。
3.3 訓練期間的監控
在通用預訓練與中訓練全程,我們持續監控訓練動態、數值穩定性、硬體/系統狀態、訓練效率與資源使用。我們直接用固定能力套件(涵蓋知識、QA、數學、推理、程式碼與基本符號運算)評測保存的 base 檢查點,不做任何後訓練適配;同時監控困惑度、bits-per-byte (BPB)、正規化損失、關鍵 token logits 與最佳化器統計。
一個實例:某次恢復訓練後,持續吞吐監控揭露約 80 步的匹配窗內從 585 降到 554 model TFLOP/s/GPU 的漸進下滑;釋放 overlap buffer 減緩但未消除,而每 100 次迭代加上週期性的 CUDA allocator 快取清理與垃圾回收,把吞吐恢復到穩定的 585——此修法被部署進生產訓練迴圈。
4 後訓練
後訓練管線是「監督微調 (SFT)」後接「混合強化學習 (RL)」。SFT 用通用與代理資料建立回應模式,RL 則在數學、程式碼等單領域任務上帶來能力增益。
4.1 監督微調
SFT 語料結合開源資料集與內部蒸餾資料,含 4,921,933 個範例,組織為通用與代理資料。
表 1:SFT 語料組成。
| 成分 | 佔比 | 主要角色 |
|---|---|---|
| 通用資料 | 96.46% | 指令遵循、知識、數學、科學、程式碼、對話與推理 |
| 代理資料 | 3.54% | 透過結構化工具進行深度研究、軟體工程與終端互動 |
| 合計 | 100.00% | 全部 SFT 資料 |
資料品質過濾與分層整理。 先用規則檢查系統性地剔除結構缺陷(缺輪、無效角色、重複生成、模板洩漏、畸形推理軌跡),再用一個對齊人工標註的模型評估器,沿教育價值、邏輯健全性、逐步推理連貫性、事實一致性與安全合規等軸打分,把範例分成離散品質層。實證比較顯示:積極的分層過濾(剪掉約 50% 的原始候選)在總體上勝過用未整理的完整語料訓練。
發現 4(後訓練中資料品質勝過數量):SFT 品質比資料量更重要。在受控比較中,剪掉約一半候選池把六基準平均從 67.78 提升到 68.83,增益集中在推理(BBH +10.10),損失侷限於一部分任務。
去汙染。 對整個候選 SFT 語料,用 8-gram 滑動視窗比對所有下游評測與驗證集;任何與評測 prompt 或參考回應有 >50% 8-gram 重疊的樣本都被永久清除。
發現 5(Long-CoT 的權衡與校準):長思維鏈監督呈現非單調效用——過度飽和訓練混合中的長推理軌跡會降低通用指令遵循。動態校準資料混合比例可緩解此退化,在不犧牲 long-CoT 推理增益的前提下維持強的指令遵循。
統一的 think 與 direct-response 監督。 SFT 語料刻意交織 think 範例(含結構化推理標籤包裹的端到端推理鏈)與 no-think 範例(簡潔即時回應)。這種雙模設計讓單一組權重能依系統指令或執行預算在「完整思辨」與「高效零樣本回應」間切換。中間檢查點評測證實聯合訓練誘發正向的跨模轉移:接觸結構化推理軌跡直接銳化了 no-think 回應在程式碼、數學與邏輯推理上的準確度(見附錄)。
代理資料 分三個平行分支:深度研究、軟體工程、終端互動。構造時把每個任務家族的訓練 schema 與其下游推論環境對齊(系統指令、訊息角色、工具定義、結構化呼叫、觀察值放置、最終答案慣例)——實驗顯示 schema 不匹配會顯著降低下游代理效能。我們比較「先通用後代理」的順序排程與「全程交錯」的聯合排程,聯合排程下游更強,作為最終 run。
發現 6(代理訓練需要通用資料):只用代理資料微調會降低互動保真度,因為代理熟練度本質上仰賴廣泛的通才能力。與通用指令資料共訓練提供了逐步推理與精確約束遵循的不可或缺基礎。
- 深度研究軌跡:收集 20,217 條多步研究軌跡,正規化為含 search/visit 工具的共享互動環境;每條以對齊的 think 與 no-think 兩種形式提供。
- 軟體工程軌跡:保留 30,014 條執行接地 (execution-grounded) 與 30,000 條執行無關 (execution-free) 軌跡,投影到 GLM-5.1 結構化工具格式。
- 終端軌跡:從隔離的 Docker 環境(持久 shell + 結構化 bash 工具 + 環境端驗證器)收集;為一項受控 Agent-SFT 實驗物化了 22,309 條軌跡的配對來源檢視與 15,748 條驗證成功子集(此為消融用途,非主 SFT run 所用)。
訓練目標與超參數。 SFT 以共同 GLM-5.1 對話格式呈現、施加 assistant-only 監督:助手推理、回應與結構化工具呼叫計入損失;系統/使用者訊息與工具觀察值維持為遮罩情境。訓練兩個長度變體(最大序列 65,536 與 262,144 token):256K 變體訓練 10 個 epoch、共 19.46B packed token,為釋出模型。兩者全域批量 48,矩陣參數用 layer-wise Muon、標量用 Adam,學習率 cosine 從 $1\times10^{-4}$ 衰減到 $1\times10^{-6}$、無 warmup、weight decay 0.01、梯度裁剪 1.0。
發現 7(長代理式中訓練可繞過超長 SFT):中訓練期間建立的長上下文基礎,讓穩健的推理與代理行為只需用中等長度的 SFT 資料就能在 256K 尺度可靠誘發,有效繞過後訓練期昂貴的 256K 長推理軌跡需求。
4.2 混合強化學習
RL 資料整理。 構造涵蓋數學、程式碼與通用能力任務的混合 RL 語料;透過初始策略的 rollout 估計題目難度,移除模型已頻繁解出的題目,把訓練集中在仍能提供有用學習訊號的 prompt。
獎勵設計。 獎勵遵循各領域的評測語意:數學用二元答案正確性、程式碼用通過測試比例、通用任務用對應的正確性或指令遵循準則;無效或截斷回應不得正獎勵。在 64K 最大回應長度下,進一步探索把 outcome 獎勵與 GRPO 的參考策略 KL 正則化及溫和長度懲罰結合。
超參數。 用 GRPO 最佳化策略:每題取樣多個回應、在對應回應組內構造相對優勢;零獎勵變異的組不提供有效訊號,由動態取樣過濾替換。actor 學習率 $2\times10^{-6}$。探索兩種取樣尺度:(1) 每步 24 題 × 16 回應 = 384 軌跡;(2) 每步 384 題 × 8 回應 = 3,072 軌跡。rollout 允許每次最多 65,536 個新生成 token,總 prompt–response 情境 98,304 token。
5 評測
我們以 think 模式評測 ZGCM-1,用釋出的 256K SFT 檢查點。非代理與 web 深度研究 run 用 temperature 1.0、top-$p$ 1.0,總情境預算 262,144 token;非代理基準報告 32 次 run 的 pass@1 平均。非代理套件涵蓋 20 個基準,分數學/抽象推理、程式碼、知識、指令遵循四類。
表 2:ZGCM-1-7B 與同規模模型的 think 模式基準結果 (%)。(粗體=最佳,次佳為第二名)
| 基準 | ZGCM-1-7B | DeepSeek-R1-0528-Qwen3-8B | MiniCPM4.1-8B | Qwen3-8B | Olmo-3-7B-Think | MiMo-7B-RL | OpenThinker3-7B |
|---|---|---|---|---|---|---|---|
| 推理與通用 | |||||||
| MATH-500 | 97.13 | 96.32 | 95.60 | 96.20 | 95.10 | 96.20 | 88.40 |
| AIME 2024 | 80.62 | 83.33 | 83.33 | 80.00 | 71.60 | 66.67 | 43.33 |
| AIME 2025 | 73.33 | 75.21 | 73.33 | 63.33 | 64.60 | 53.33 | 43.33 |
| AIME 2026 | 75.00 | 69.17 | 71.67 | 66.67 | 66.16 | 56.67 | 40.00 |
| HMMT 2025 | 70.42 | 61.50 | 52.50 | 43.33 | 43.89 | 40.00 | 23.33 |
| HMMT 2026 | 59.48 | 51.52 | 46.21 | 45.45 | 43.94 | 39.39 | 21.21 |
| AGIEval SAT Math | 99.09 | 91.14 | 98.98 | 99.09 | 90.45 | 58.64 | 68.64 |
| AQuA-RAT | 90.57 | 90.88 | 91.39 | 92.62 | 90.98 | 91.80 | 81.15 |
| HARDMath-mini | 56.34 | 61.92 | 51.89 | 63.31 | 58.90 | 37.41 | 37.45 |
| IMO-AnswerBench | 53.00 | 55.00 | 54.25 | 45.00 | 45.25 | 41.50 | 26.00 |
| MATH-P-Hard | 79.21 | 82.53 | 84.41 | 82.08 | 77.42 | 78.14 | 59.50 |
| OlympiadBench | 76.06 | 74.75 | 82.75 | 82.47 | 69.55 | 74.89 | 56.37 |
| ARC-AGI-1 | 3.50 | 1.69 | 2.58 | 3.00 | 3.25 | 0.50 | 1.50 |
| miniF2F | 2.87 | 5.12 | 0.00 | 2.87 | 3.28 | 1.23 | 1.23 |
| 程式碼 | |||||||
| HumanEval+ | 90.24 | 88.87 | 89.63 | 80.20 | 89.90 | 88.95 | 87.40 |
| MBPP+ | 63.23 | 65.54 | 63.96 | 69.10 | 64.70 | 63.96 | 61.40 |
| LiveCodeBench v6 | 46.86 | 53.57 | 52.14 | 52.20 | 49.26 | 47.42 | 42.43 |
| 知識 | |||||||
| MMLU | 73.88 | 82.09 | 83.51 | 85.40 | 77.80 | 78.39 | 77.40 |
| GPQA-Diamond | 47.87 | 60.10 | 47.98 | 59.09 | 49.94 | 54.40 | 53.70 |
| 指令遵循 | |||||||
| IFEval | 75.42 | 72.37 | 73.24 | 87.40 | 88.20 | 61.00 | 51.70 |
ZGCM-1-7B 在 MATH-500、AIME 2026、HMMT 2025/2026、HumanEval+ 與 ARC-AGI-1 上取得同規模最佳;在知識密集(MMLU、GPQA)與嚴格指令遵循(IFEval)上落後於較大的 Qwen3-8B,這與「7.39B 稠密規模的靜態記憶容量有限」的限制一致。
5.3 代理式評測
表 3:Web 環境深度研究結果 (%)。(—表示無可用回報值)
| 模型/系統 | WebWalkerQA | BrowseComp | GAIA text-only |
|---|---|---|---|
| ZGCM-1-7B(本模型) | 63.09 | 19.43 | 42.52 |
| WebDancer-32B(開源研究代理) | 38.40 | 2.50 | 40.70 |
| Qwen3-235B-A22B(開放權重+工具) | 59.60 | 2.30 | 45.60 |
| Kimi-K2 | 63.00 | 14.10 | 57.30 |
| DeepSeek-R1 | 10.00 | 2.00 | 31.10 |
| QwQ-32B | 4.30 | 0.50 | 22.30 |
| GPT-4o(專有+工具) | 33.80 | 1.90 | 34.60 |
| GPT-5 | – | 54.90 | 76.40 |
| Claude 4 Sonnet | 61.70 | 12.20 | 68.30 |
Binary Function Search(二進位函式搜尋):評估代理能否僅憑行為描述,從一個被剝除符號的 ELF 二進位中還原目標函式。從數千個開源 C/C++ 專案構造,目前驗證池含 11,000+ 個任務;評測用 50 任務子集(從 10 個代表性專案各隨機抽 5 個,10 個專案全部從訓練資料留出)。透過 Ghidra 後端介面,代理列舉函式、搜尋字面量與錯誤訊息、反編譯候選、追蹤參照、檢視組合語言,最後提交精確的函式入口 ELF 虛擬位址,對照隱藏 oracle 驗證(須精確匹配才判對)。
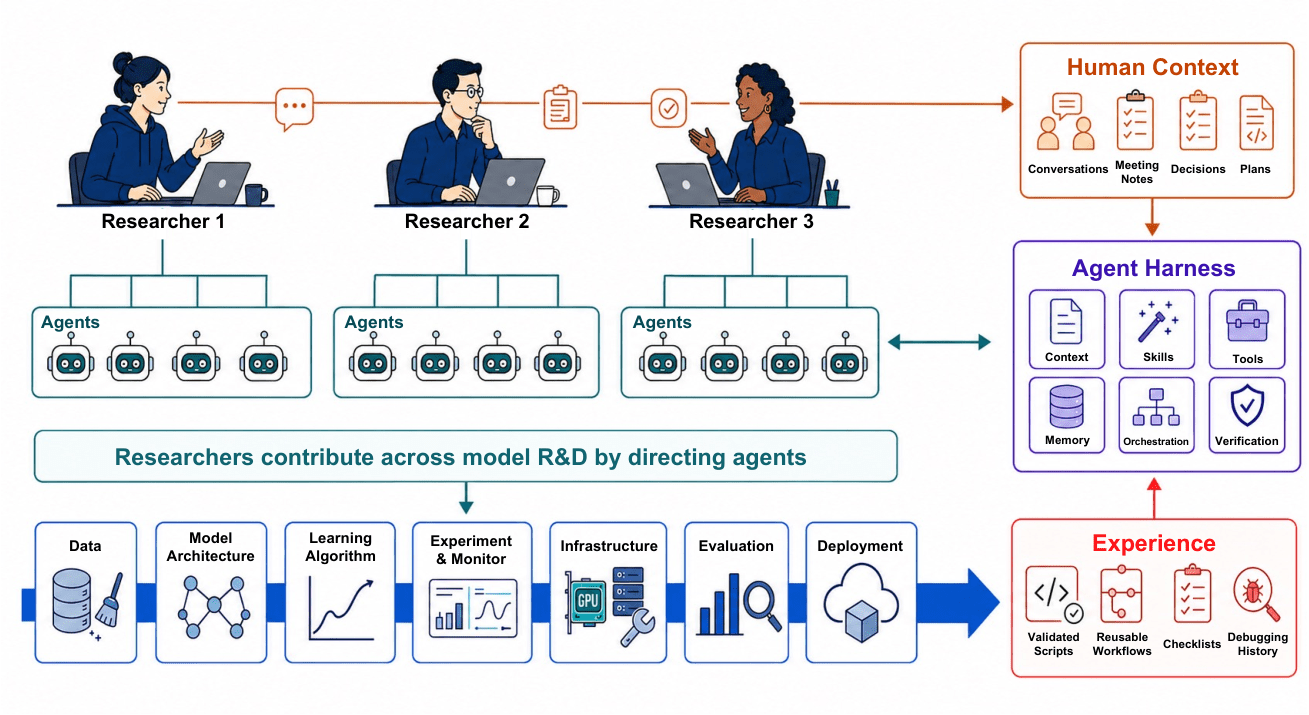
表 4:Binary Function Search 50 任務結果。 Valid submissions 計「符合所需格式」的答案,Correct 計精確 oracle 匹配,Accuracy = Correct/50。
| 模型/系統 | Valid submissions | Correct | Accuracy (%) |
|---|---|---|---|
| 較大的前沿模型 | |||
| DeepSeek-V4 Flash | 50/50 | 38/50 | 76.00 |
| Qwen3.5-397B-A17B | 50/50 | 38/50 | 76.00 |
| GLM-5.1 | 50/50 | 33/50 | 66.00 |
| ZGCM-1-7B | 50/50 | 31/50 | 62.00 |
| Kimi-K2 | 50/50 | 31/50 | 62.00 |
| DeepSeek-R1 | 46/50 | 18/50 | 36.00 |
| GPT-4o | 50/50 | 9/50 | 18.00 |
| 同規模模型 | |||
| ZGCM-1-7B | 50/50 | 31/50 | 62.00 |
| Qwen3-8B | 50/50 | 6/50 | 12.00 |
ZGCM-1-7B 達 62% 準確率,遠超同規模基線(Qwen3-8B 12%、其餘 0%),並逼近 GLM-5.1(66%)、勝過 DeepSeek-R1 與 GPT-4o。
6 AI 原生研發
6.1 AI 協助貫穿研發生命週期
我們在整個模型開發生命週期採用 AI 原生方法:每位研究員指揮 LLM 代理,貢獻於資料工程、架構設計、學習演算法、實驗、基礎設施、評測與部署等所有階段。研究員討論產生人類情境成品(對話、會議記錄、決策、計畫),完成的代理工作產生可重用經驗(經驗證的腳本、工作流、檢查清單、除錯歷史),兩者都餵入一個共享的代理 harness。
- 資料清理:代理先寫啟發式過濾/轉換腳本、執行、檢視資料組成統計,發現差異就自動迭代腳本,直到分布滿足所有要求。
- 叢集管理:與代理共同開發一個完整技能包,暴露「建立開發機、提交訓練 job、修改資源設定、串流 logs、過濾狀態欄位」等結構化介面,讓代理自主啟動實驗、監控、從 logs 診斷失敗並調參。
- 自動研究:代理可探索演算法替代與超參數配置、啟動訓練 run、分析結果並迭代。例如代理曾剖析儲存叢集的資料傳輸特性、對訓練框架 I/O 管線做針對性調整,純靠自主代理工作就帶來可觀的訓練速度改善。
- 評測:使用 ACE(原子能力評測)——一個細粒度診斷基準,把 2,503 個 probe 組織成 183 個原子能力、18 個類別;一次完整 ACE run 約 2–3 分鐘,非常適合消融研究中頻繁評測。
- 人類情境:把自研代理平台 ZGent 整合進團隊常規會議頻道,記錄並提煉每次討論、隨時間累積情境,並自動把衍生任務派給合適的代理。
6.2 AI4AI:跨研發生命週期的自主性
AI4AI(AI for AI)指用 AI 系統來建構、評測與改進其他 AI 系統。為評估代理能在研發生命週期各處承擔多少責任,九位核心貢獻者各對 11 個任務類別依五級量表評分,共 99 筆評分。L4/L5 邊界是自主目標形成:L4 在人類定義的目標內獨立執行,L5 還能自行辨識研究目標並跨階段協調。
表 5:研發工作流的 AI 自主性層級。(描述的是自主性,而非生產力增益或產出品質;L5 是完全自主的參照,非已展示能力的斷言)
| 層級 | 名稱 | 定義準則 |
|---|---|---|
| L1 | 基本協助 | 人類主導並執行工作流;AI 協助個別步驟 |
| L2 | 部分自動化 | AI 執行預定工作流;人類指定程序並處理例外 |
| L3 | 有條件自主 | AI 調適並管理常規工作流;重大決策需人類核准 |
| L4 | 高度自主 | AI 在人類定義的目標與約束內獨立規劃、執行、迭代 |
| L5 | 完全自主 | AI 還能辨識研究目標、跨研發階段協調持續改進,無需常規人類指揮 |
團隊以共識給每個任務指派層級:實驗與監控、部署工程為 L4;模型架構設計、學習演算法設計為 L2(且皆無任何評分高於 L3);其餘七項為 L3。99 筆評分中只有一筆是 L5,且無任何任務被指派超過 L4。
發現 8(AI 自主性依任務而定):共享情境、可重用技能與整合工具讓代理能以有限的人類介入迭代,但自主性參差不齊:實驗與部署等操作性任務達 L4,而模型架構與學習演算法設計落在 L2、從不超過 L3。
7 結論、限制與未來方向
7.1 結論
我們introduce了 ZGCM-1——一個為複雜數學推理與 256K 上下文代理式搜尋優化的、完全開源的 7.39B 稠密基礎模型。它挑戰「前沿推理嚴格需要千億參數」的假設,立基於清楚的核心論點:緊湊模型可透過耦合刻意的內部推理與主動的外部工具使用,突破固有的參數容量限制。為在可及的學術算力上實現此願景,我們發展出端到端高效率開放配方:系統-架構協同設計(5:1 gated SWA + 全域注意力帶來 3.94× 吞吐與 6.4× KV 快取縮減,配 FP8/Muon/TWEO 達 ~4.2× 預訓練加速)、漸進課程與 MDP 中訓練、校準後訓練與 AI 原生研發。大量評測顯示 ZGCM-1-7B 在 sub-10B 模型中於挑戰性基準上取得具競爭力或 SOTA 的結果(AIME 2026 75.0%、WebWalkerQA 63.1%、Binary Function Search 62.0%)。
7.2 限制
- 參數知識界限:純閉卷、無檢索支援的高召回任務上,ZGCM-1 的 7.39B 稠密靜態記憶容量自然落後於龐大前沿系統。
- 指令遵循 vs. 推理冗長:如 ACE 與資料混合消融所揭示,若不持續校準,重推理監督會誘發冗長、略損嚴格的非推理指令遵循(如 IFEval)。
- 通用軟體與終端代理仍在萌芽:ZGCM-1 在 web 深度研究與二進位分析等結構化代理環境表現優異,但更廣的 repo 層級工程(SWE-bench Verified)與非結構化 Linux 終端導覽(Terminal-Bench 2.0)完成率仍偏低。
- 環境與協定脆弱性:代理執行高度依賴嚴格 schema 對齊與穩定環境回饋;極端觀察雜訊、工具呼叫格式偏差或外部搜尋 API 延遲仍可能破壞多步 rollout。
7.3 未來方向
- 擴展到稀疏 MoE 架構:把混合 SWA、Muon、MDP 中訓練配方擴到稀疏 MoE 骨幹,在維持低推論 FLOPs 下擴展參數容量。
- 端到端互動式代理 RL:從 token 級 SFT 與 outcome 獎勵轉向真實執行沙箱(終端、web、compiler)內的多輪互動式強化學習。
- 自主動態知識檢索:進一步統一預訓練表示與即時自主檢索,讓模型在偵測到參數不確定性時動態觸發搜尋子程序。
- 自我演化的 AI4AI 研發生態:把 AI 原生代理 harness 從叢集遙測、資料整理與原子評測,延伸到自主假設形成、自動 kernel 最佳化與閉環合成環境設計。
8 貢獻
- 專案負責人:Jiyan He。
- 核心貢獻者(依字母序):Guang Liang, Hao Liu, Haoxiang Guan, Jinbo Sun, Junyi Guo, Wenjun Feng, Yantai Xie, Yifei Shen。
- 貢獻者(依字母序):Bin Shao, Chuyang Wei, Kai Chen, Kexin Zhou, Minghang Zhu, Shuxin Zheng, Tie-Yan Liu, Taine Zhao, Wenhui Zhu, Xueyin Xu, Xiaoqing Zhang, Yatao Li, Yuxuan Ren。
附錄:實作細節與補充評測
原論文附錄 §9–14 詳述了預訓練、後訓練、代理評測協定、原子能力評測與自主性評估的完整實作。以下摘其關鍵資料與結論。
課程式預訓練 BPB 比較(§9.4)
在 7B probe 上,比較「隨機取樣」與「課程式排序」對各領域 bits-per-byte (BPB) 的影響(越低越好):
| 領域 | Random | Curriculum |
|---|---|---|
| Coding | 1.99 | 0.81 |
| Math | 0.97 | 0.94 |
(通用基準 BPB 隨排序上升 0.03–0.09,是刻意以少量通用擬合換取技術領域的集中增益,見發現 1。)
混合 SFT 的「思考→直接回應」轉移(§10.4)
混合 SFT 前後在各基準的變化,展示「接觸結構化推理軌跡」對 no-think 回應的正向跨模轉移:
| 基準 | 混合 SFT 前 | 混合 SFT 後 | 變化 |
|---|---|---|---|
| AIME 2025 | 10.00 | 43.33 | +33.33 |
| AIME 2024 | 6.67 | 33.33 | +26.66 |
| MBPP+ | 55.03 | 75.93 | +20.90 |
| BBH | 58.49 | 69.48 | +10.99 |
| LiveCodeBench v3 | 28.00 | 34.31 | +6.31 |
| IFEval | 72.64 | 78.00 | +5.36 |
| MMLU | 72.63 | 70.03 | -2.60 |
| HumanEval+ | 73.78 | 66.46 | -7.32 |
原子能力評測框架 ACE(§12)
ACE 把 2,503 個 probe 組織成 183 個原子能力、18 個類別,用來在開發中快速診斷(一次 run 約 2–3 分鐘)。18 個類別與其能力數/probe 數如下:
| 類別 | 能力數 | Probe 數 | 主要評測範圍 |
|---|---|---|---|
| Agent | 8 | 120 | 環境互動、長時程執行、恢復、記憶與協調行動 |
| Arithmetic | 13 | 135 | 數值運算、比較、轉換、排序與精確計算 |
| Causal | 5 | 75 | 機制、介入、反事實與潛在狀態推論 |
| Code | 26 | 389 | 程式理解、生成、除錯、最佳化、測試與成品編輯 |
| Dialogue | 6 | 90 | 多輪一致性、澄清、共指、意圖、人設與言外之意 |
| Instruction | 13 | 195 | 格式、長度、詞彙、結構、風格與多約束遵循 |
| Knowledge | 8 | 96 | 事實、公式、API、慣例與常見機制的回憶與應用 |
| Language | 27 | 321 | 詞彙、句法、語意、多語與字元級語言處理 |
| Logic | 10 | 102 | 布林、演繹、歸納、約束、集合、策略與結構推理 |
| Long Context | 3 | 45 | 位置穩健檢索、多跨度整合與多文件綜合 |
| Mathematics | 11 | 165 | 代數、離散數學、極限、最佳化、幾何、數論與證明 |
| Metacognition | 6 | 90 | 歧義與錯誤偵測、自我檢查、不確定性與計畫修正 |
| Output | 7 | 105 | 最終答案控制、精確格式、流暢散文、單位與結構化成品 |
| Planning | 6 | 90 | 子目標分解、前向/後向推理、狀態追蹤、實驗設計與堅持 |
| Reading | 11 | 141 | 目標檢索、干擾項過濾、段落整合、結構化查找與跨文件閱讀 |
| Tool Use | 7 | 105 | 工具選擇、參數抽取、schema 合規、呼叫與多工具協調 |
| Truthfulness | 8 | 119 | 校準棄答、抗幻覺、來源忠實、不可行偵測與抗迷思 |
| World Modeling | 8 | 120 | 物理、空間、時間、社會、程序與心智理論推理 |
| 合計 | 183 | 2,503 |
ACE 結果(§12.4):ZGCM-7B 最強的類別是數學(98.18%)、規劃(97.78%)、邏輯(96.08%)、因果推理(96.00%)與閱讀(95.04%);最弱的是指令遵循(49.74%)、真實性(68.91%)、程式碼(72.24%)與語言(79.75%)。相對同規模的 Qwen3-8B-256K,最大優勢在長上下文處理(+31.11 個百分點)、算術(+20.74)、規劃(+14.45)與世界建模(+10.00)。ACE 的精修需要人類專家裁決分歧、驗證能力邊界——純模型驅動的迭代不足以勝任。
AI 自主性評估(§13)
九位核心貢獻者對 11 個研發任務類別(資料清理、資料取得、合成資料生成、模型架構設計、學習演算法設計、實驗與監控、operator 設計、訓練/推論框架設計、資源平台管理、模型評測、部署工程)依 L1–L5 量表評分,共 99 筆。共識指派:實驗與監控、部署工程為 L4;架構與學習演算法設計為 L2;其餘為 L3(詳見發現 8 與表 5)。
參考文獻
【依原文順序;作者-年份引用制,保留原文英文。】
- Ainslie et al. (2023) Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. GQA: Training generalized multi-query transformer models from multi-head checkpoints. arXiv:2305.13245.
- Allal et al. (2025) Loubna Ben Allal et al. SmolLM2: When smol goes big — data-centric training of a small language model. arXiv:2502.02737.
- Allen Institute for AI (2025) olmOCR-peS2o. Hugging Face dataset release.
- Anthropic (2026) Discovering cryptographic weaknesses with Claude. Blog post.
- Azerbayev et al. (2023) Zhangir Azerbayev et al. Llemma / Proof-Pile-2: An open language model for mathematics.
- Beltagy et al. (2020) Iz Beltagy, Matthew E. Peters, Arman Cohan. Longformer: The long-document transformer. arXiv:2004.05150.
- Child et al. (2019) Rewon Child et al. Generating long sequences with sparse transformers. arXiv:1904.10509.
- Chollet (2019) François Chollet. On the measure of intelligence (ARC-AGI). arXiv:1911.01547.
- Dao (2023) Tri Dao. FlashAttention-2: Faster attention with better parallelism and work partitioning. arXiv:2307.08691.
- DeepSeek-AI (2024) DeepSeek-V2 / MLA technical report.
- DeepSeek-AI (2026) DeepSeek reasoning model technical report.
- Dehghani et al. (2023) Mostafa Dehghani et al. Scaling vision transformers to 22 billion parameters (QK normalization).
- Fan et al. (2024) HARDMath: A benchmark of challenging mathematics problems.
- Gemma Team (2025) Gemma 3 technical report.
- GLM-5-Team (2026) GLM-5 technical report.
- GLM-5.1 (2026) GLM-5.1 model release.
- Harvard–MIT Mathematics Tournament (2026) HMMT 2025/2026 problem sets.
- He et al. (2024) Chaoqun He et al. OlympiadBench.
- Hendrycks et al. (2021) Dan Hendrycks et al. Measuring massive multitask language understanding (MMLU). arXiv:2009.03300.
- Huang et al. (2025) MATH-P-Hard: Perturbed hard mathematics benchmark.
- Jain et al. (2024) Naman Jain et al. LiveCodeBench. arXiv:2403.07974.
- Jordan et al. (2024) Keller Jordan et al. Muon optimizer.
- Kimi Team (2026) Kimi reasoning model technical report.
- Kydlíček et al. (2025) Hynek Kydlíček et al. Educationally filtered PDF views.
- Lambert et al. (2024) Nathan Lambert et al. Tulu 3: Pushing frontiers in open language model post-training. arXiv:2411.15124.
- Lee et al. (2022) Katherine Lee et al. Deduplicating training data makes language models better. ACL 2022.
- Liang et al. (2025) Guang Liang et al. TWEO outlier regularization for FP8 training.
- Lightman et al. (2023) Hunter Lightman et al. Let's verify step by step (MATH-500 / PRM800K). arXiv:2305.20050.
- Ling et al. (2017) Wang Ling et al. Program induction by rationale generation (AQuA-RAT). arXiv:1705.04146.
- Liu et al. (2023) Jiawei Liu et al. Is your code generated by ChatGPT really correct? (HumanEval+/MBPP+, EvalPlus). arXiv:2305.01210.
- Liu et al. (2024) Proxy-model data mixture optimization.
- Liu et al. (2025) Jingyuan Liu et al. Muon is scalable for LLM training / layer-wise Muon.
- LLM-Core-Team Xiaomi (2025) MiMo technical report.
- Luong et al. (2025) IMO-AnswerBench.
- Mathematical Association of America (2026) AIME 2024/2025/2026 competition problems.
- Mialon et al. (2024) Grégoire Mialon et al. GAIA: A benchmark for general AI assistants. arXiv:2311.12983.
- Micikevicius et al. (2022) Paulius Micikevicius et al. FP8 formats for deep learning. arXiv:2209.05433.
- National Security Agency (2019) Ghidra software reverse engineering framework.
- NVIDIA Corporation (2025a) Code-rich web pages release.
- NVIDIA Corporation (2025b) Open-source repository files release.
- NVIDIA Corporation (2025c) Nemotron-Pretraining-Specialized-v1.
- NVIDIA Corporation (2026) Megatron Core.
- OpenAI (2026) OpenAI frontier model technical report.
- Poznanski et al. (2025) olmOCR pipeline.
- Qiu et al. (2025) Gated attention.
- Qwen Team (2026) Qwen3 technical report.
- Rein et al. (2024) David Rein et al. GPQA: A graduate-level Google-proof Q&A benchmark. arXiv:2311.12022.
- Shao et al. (2024) Zhihong Shao et al. DeepSeekMath / GRPO. arXiv:2402.03300.
- Shazeer (2020) Noam Shazeer. GLU variants improve transformer (SwiGLU). arXiv:2002.05202.
- Su et al. (2024) Jianlin Su et al. RoFormer: Enhanced transformer with rotary position embedding (RoPE). arXiv:2104.09864.
- Su et al. (2025) Agentic continual pre-training.
- Suzgun et al. (2023) Mirac Suzgun et al. Challenging BIG-Bench tasks (BBH). arXiv:2210.09261.
- Team Olmo (2025) OLMo 3 technical report.
- Together Computer (2023) RedPajama-1T dataset.
- Wang et al. (2019) Alex Wang et al. SuperGLUE. arXiv:1905.00537.
- Wang et al. (2025) Curated English web corpus release.
- Wei et al. (2022) Jason Wei et al. Finetuned language models are zero-shot learners (FLAN). arXiv:2109.01652.
- Wei et al. (2025) BrowseComp benchmark.
- Wu et al. (2025a) WebDancer: research-agent baseline.
- Wu et al. (2025b) WebWalkerQA benchmark.
- Yang et al. (2025a) Qwen long-context technical report.
- Yang et al. (2025b) Qwen2.5-1M: multi-stage context expansion.
- Yao et al. (2023) Shunyu Yao et al. ReAct: Synergizing reasoning and acting in language models. arXiv:2210.03629.
- Yu et al. (2025) DAPO / dynamic sampling and length penalty for RL.
- Zhang and Sennrich (2019) Biao Zhang, Rico Sennrich. Root mean square layer normalization (RMSNorm). arXiv:1910.07467.
- Zhang et al. (2026) Curriculum ordering for pretraining efficiency.
- Zheng et al. (2022) Kunhao Zheng et al. miniF2F: A cross-system benchmark for formal Olympiad-level mathematics. arXiv:2109.00110.
- Zhong et al. (2023) Wanjun Zhong et al. AGIEval: A human-centric benchmark for evaluating foundation models. arXiv:2304.06364.
- Zhou et al. (2023) Jeffrey Zhou et al. Instruction-following evaluation for large language models (IFEval). arXiv:2311.07911.
- Zhou et al. (2022) Yanqi Zhou et al. Mixture-of-Experts with Expert Choice routing. arXiv:2202.09368.
- Zhou et al. (2026) Chuyue Zhou et al. UltraData-Math. Hugging Face dataset release.
- (其餘條目——GDN/linear attention、額外 web/agent 基準與資料集釋出——見原論文 References 完整書目。)
術語對照表
| English | 繁體中文 |
|---|---|
| Foundation model | 基礎模型 |
| Dense model | 稠密模型 |
| From scratch | 從零(訓練) |
| Agentic problem solving / search | 代理式問題求解 / 搜尋 |
| Agent swarm | 代理群 |
| Sliding-Window Attention (SWA) | 滑動視窗注意力 |
| Gated attention | 帶閘門的注意力 |
| Full / Global attention | 全域注意力 |
| Grouped-Query Attention (GQA) | 分組查詢注意力 |
| KV cache | KV 快取 |
| Muon optimizer | Muon 最佳化器 |
| FP8 mixed precision | FP8 混合精度 |
| TWEO | TWEO 離群值正則化 |
| Time-to-loss | 達到目標損失所需時間 |
| Mid-Training | 中訓練 |
| Curriculum | 課程 |
| Lexical complexity | 詞彙複雜度 |
| Bits-per-byte (BPB) | 每位元組位元數 |
| Markov Decision Process (MDP) | 馬可夫決策過程 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Supervised Fine-Tuning (SFT) | 監督微調 |
| Assistant-only loss/supervision | 僅對助手計損 / 監督 |
| think / no-think | 思考 / 直接回應(兩種模式) |
| Execution-grounded / -free | 執行接地 / 執行無關 |
| GRPO | 組相對策略最佳化 |
| Decontamination | 去汙染 |
| Atomic Capability Evaluation (ACE) | 原子能力評測 |
| Binary Function Search | 二進位函式搜尋 |
| AI-native / AI4AI | AI 原生 / AI4AI |
| Open-weight vs. fully open-source | 開放權重 vs. 完全開源 |