交錯頭注意力機制
原始論文:Interleaved Head Attention 作者:Sai Surya Duvvuri, Chanakya Ekbote, Rachit Bansal, Rishabh Tiwari, Devvrit Khatri, David Brandfonbrener, Paul Liang, Inderjit Dhillon, Manzil Zaheer arXiv ID:2602.21371v1 日期:2026-02-24 標籤:LLM Attention Mechanism Transformer Multi-Head Attention Reasoning 長上下文 架構設計
目錄
摘要
標準多頭注意力 (Multi-Head Attention, MHA) 為每個頭分配獨立的查詢、鍵和值投影,使得頭之間的資訊交換受到限制。這在組合推理中帶來了可證明的效率瓶頸:例如,計算 $k$ 階多項式濾波器(多跳推理的標準代理任務)需要 $k$ 個獨立的 MHA 頭。我們提出交錯頭注意力 (Interleaved Head Attention, IHA),透過學習 $P$ 個偽查詢 (pseudo-queries)、偽鍵 (pseudo-keys) 和偽值 (pseudo-values) 作為原始頭的線性組合,來克服 MHA 的線性擴展限制。偽查詢與偽鍵之間的交互每頭可產生多達 $P^2$ 種注意力模式。我們的理論證明,IHA 在多項式濾波器上僅需 $\Theta(\sqrt{k} \cdot n^2)$ 個參數(MHA 需要 $\Theta(k \cdot n^2)$),且在順序敏感的 CPM-3 任務上僅需 $\lceil\sqrt{N_{\max}}\rceil$ 個頭(MHA 需要 $N_{\max}$ 個)。在大規模語言模型訓練實驗中,以 2.4B 參數模型在 240B tokens 上進行 FLOP 匹配預訓練,IHA 在 RULER 多鍵檢索上比全注意力提高了 10-20%(4k-16k 上下文),經過 OpenThoughts 微調後,在 GSM8K 上提高 5.8%、在 MATH-500 上提高 2.8%(多數投票 (Majority Vote))。
1 引言
考慮以下問題:「《乞丐王子》的作者出生在哪裡?」回答此問題需要兩個步驟:先確認作者是 Mark Twain,然後查找他的出生地是 Missouri 州 Florida 市。更一般地說,許多自然語言推理任務(多跳問答 (Multi-hop QA)、數學推導、程式碼理解)需要將多個中間事實按正確順序組合起來。這種組合推理 (Compositional Reasoning) 是語言理解的核心。
標準 Transformer 架構使用多頭注意力 (MHA),其中每個頭獨立操作其自己的查詢、鍵和值投影。雖然多個頭可以平行捕捉不同的關係模式,但頭之間的資訊在注意力計算內不會直接混合。最近的理論結果形式化了這一限制:計算 $k$ 階多項式圖濾波器(多跳資訊傳播 (Multi-hop Information Propagation) 的標準代理任務)需要 $k$ 個 MHA 頭,每個頭產生一個不同的冪次 $A^i$。
我們引入交錯頭注意力 (Interleaved Head Attention, IHA),讓每個頭內的注意力計算能夠利用來自所有頭的查詢、鍵和值。具體而言,對於 $H$ 個頭中的每個頭 $h$,IHA 透過學習到的混合係數 (Mixing Coefficients) $\alpha^Q, \alpha^K, \alpha^V \in \mathbb{R}^{H \times H \times P}$,構造 $P$ 個偽查詢、偽鍵和偽值,作為所有 $H$ 個頭的原始投影的線性組合。偽查詢與偽鍵之間的成對交互每頭可產生多達 $P^2$ 種不同的注意力模式(而 MHA 每頭僅一種),同時保持與標準注意力核心(如 FlashAttention)的相容性。
我們從三個層面分析 IHA:
表達能力。 我們證明 IHA 嚴格泛化 MHA(定理 2):MHA 可計算的任何函數,IHA 也可計算,但反之不然。分離的關鍵在於,在重複 token 輸入上,每個 MHA 頭化簡為線性映射,而 IHA 即使只有 $P=2$ 個偽頭也能產生非線性輸出。
效率分離。 在兩個受控的組合推理代理任務上,我們建立了 MHA 與 IHA 之間的平方根效率差距:
- 多項式濾波器(定理 3)。 MHA 需要 $k$ 個頭來計算所有 $k$ 階冪次 $X, AX, \ldots, A^{k-1}X$;IHA 僅需 $\lceil\sqrt{k}\rceil$ 個頭。
- CPM-3(定理 4)。 一個需要 $N_{\max}$ 個 MHA 頭的順序敏感計數任務,IHA 僅用 $\lceil\sqrt{N_{\max}}\rceil$ 個頭即可解決。
實證驗證。 在 2.4B 參數語言模型上進行 FLOP 匹配預訓練(240B tokens),IHA 在 RULER 長上下文基準上持續提升檢索能力(多鍵檢索提高 10-20%),經過 OpenThoughts 監督式微調後,在推理基準上也有提升(GSM8K 多數投票 +5.8%,MATH-500 多數投票 +2.8%)。
2 相關工作
已有多項工作記錄了標準 Transformer 在組合推理中的困難。例如,有研究證明了注意力架構在涉及多位元素追蹤的多步推理問題中的困難,也有工作指出計算 $k$ 跳二元關係組合需要 $\Theta(k)$ 個 MHA 頭或 $\Theta(N^3)$ 個參數。
幾種注意力變體透過跨頭耦合或差分加權來豐富頭的交互。Talking-Heads 注意力在 softmax 前後學習混合注意力 logits。Diff Transformer 將注意力定義為兩個 softmax 注意力圖的差,透過對比加權來銳化或抑制模式。Multi-Query Attention (MQA) 和 Grouped Query Attention (GQA) 透過共享鍵值投影來降低推理成本。Multi-Token Attention 引入跨小 token 組混合資訊的機制。
IHA 與這些方法互補:它保留標準注意力算子,透過將 Q、K、V 表示混合成偽頭來實現跨頭交互,從而產生豐富的二次交互模式系列,同時保持與 FlashAttention 等優化核心的相容性。
3 背景知識
3.1 多頭注意力與多項式濾波器
符號表示。 令 $\mathbf{X} \in \mathbb{R}^{N \times D}$ 為輸入序列($N$ 個 token,每個 $D$ 維)。MHA 使用 $H$ 個頭,每頭維度 $d = D/H$。第 $m$ 個頭的投影矩陣為 $\mathbf{W}_Q^{(m)}, \mathbf{W}_K^{(m)}, \mathbf{W}_V^{(m)} \in \mathbb{R}^{D \times d}$。
定義 1(多頭注意力)。 在 MHA 中,每個頭 $m \in \{1, \ldots, H\}$ 獨立計算:
$$\text{head}_m = \text{softmax}\!\left(\frac{\mathbf{X}\mathbf{W}_Q^{(m)} (\mathbf{X}\mathbf{W}_K^{(m)})^\top}{\sqrt{d}}\right) \mathbf{X}\mathbf{W}_V^{(m)}$$
輸出為 $\text{MHA}(\mathbf{X}) = [\text{head}_1, \ldots, \text{head}_H]$。
定義 2(多項式濾波器)。 給定鄰接矩陣 $\mathbf{A} \in \mathbb{R}^{N \times N}$ 和節點特徵 $\mathbf{X} \in \mathbb{R}^{N \times d}$,$k$ 階多項式圖濾波器為 $[\mathbf{X}, \mathbf{A}\mathbf{X}, \ldots, \mathbf{A}^{k-1}\mathbf{X}]$。第 $i$ 項 $\mathbf{A}^i \mathbf{X}$ 聚合來自 $i$ 跳鄰域的資訊。
定理 1。 任何只有 $k$ 個頭的單層 MHA(無 softmax)最多只能表示 $k$ 個不同的注意力算子。因此,要在單層中同時產生所有 $k$ 個冪次 $\mathbf{A}^0, \ldots, \mathbf{A}^{k-1}$,至少需要 $k$ 個頭。
證明概要。 在線性注意力(無 softmax)下,每個 MHA 頭產生恰好一個注意力算子 $\mathbf{S}_h \in \mathbb{R}^{N \times N}$。要平行表示所有 $k$ 個不同冪次 $\mathbf{A}^0, \ldots, \mathbf{A}^{k-1}$,需要 $k$ 個獨立參數化的頭。
4 交錯頭注意力 (IHA)
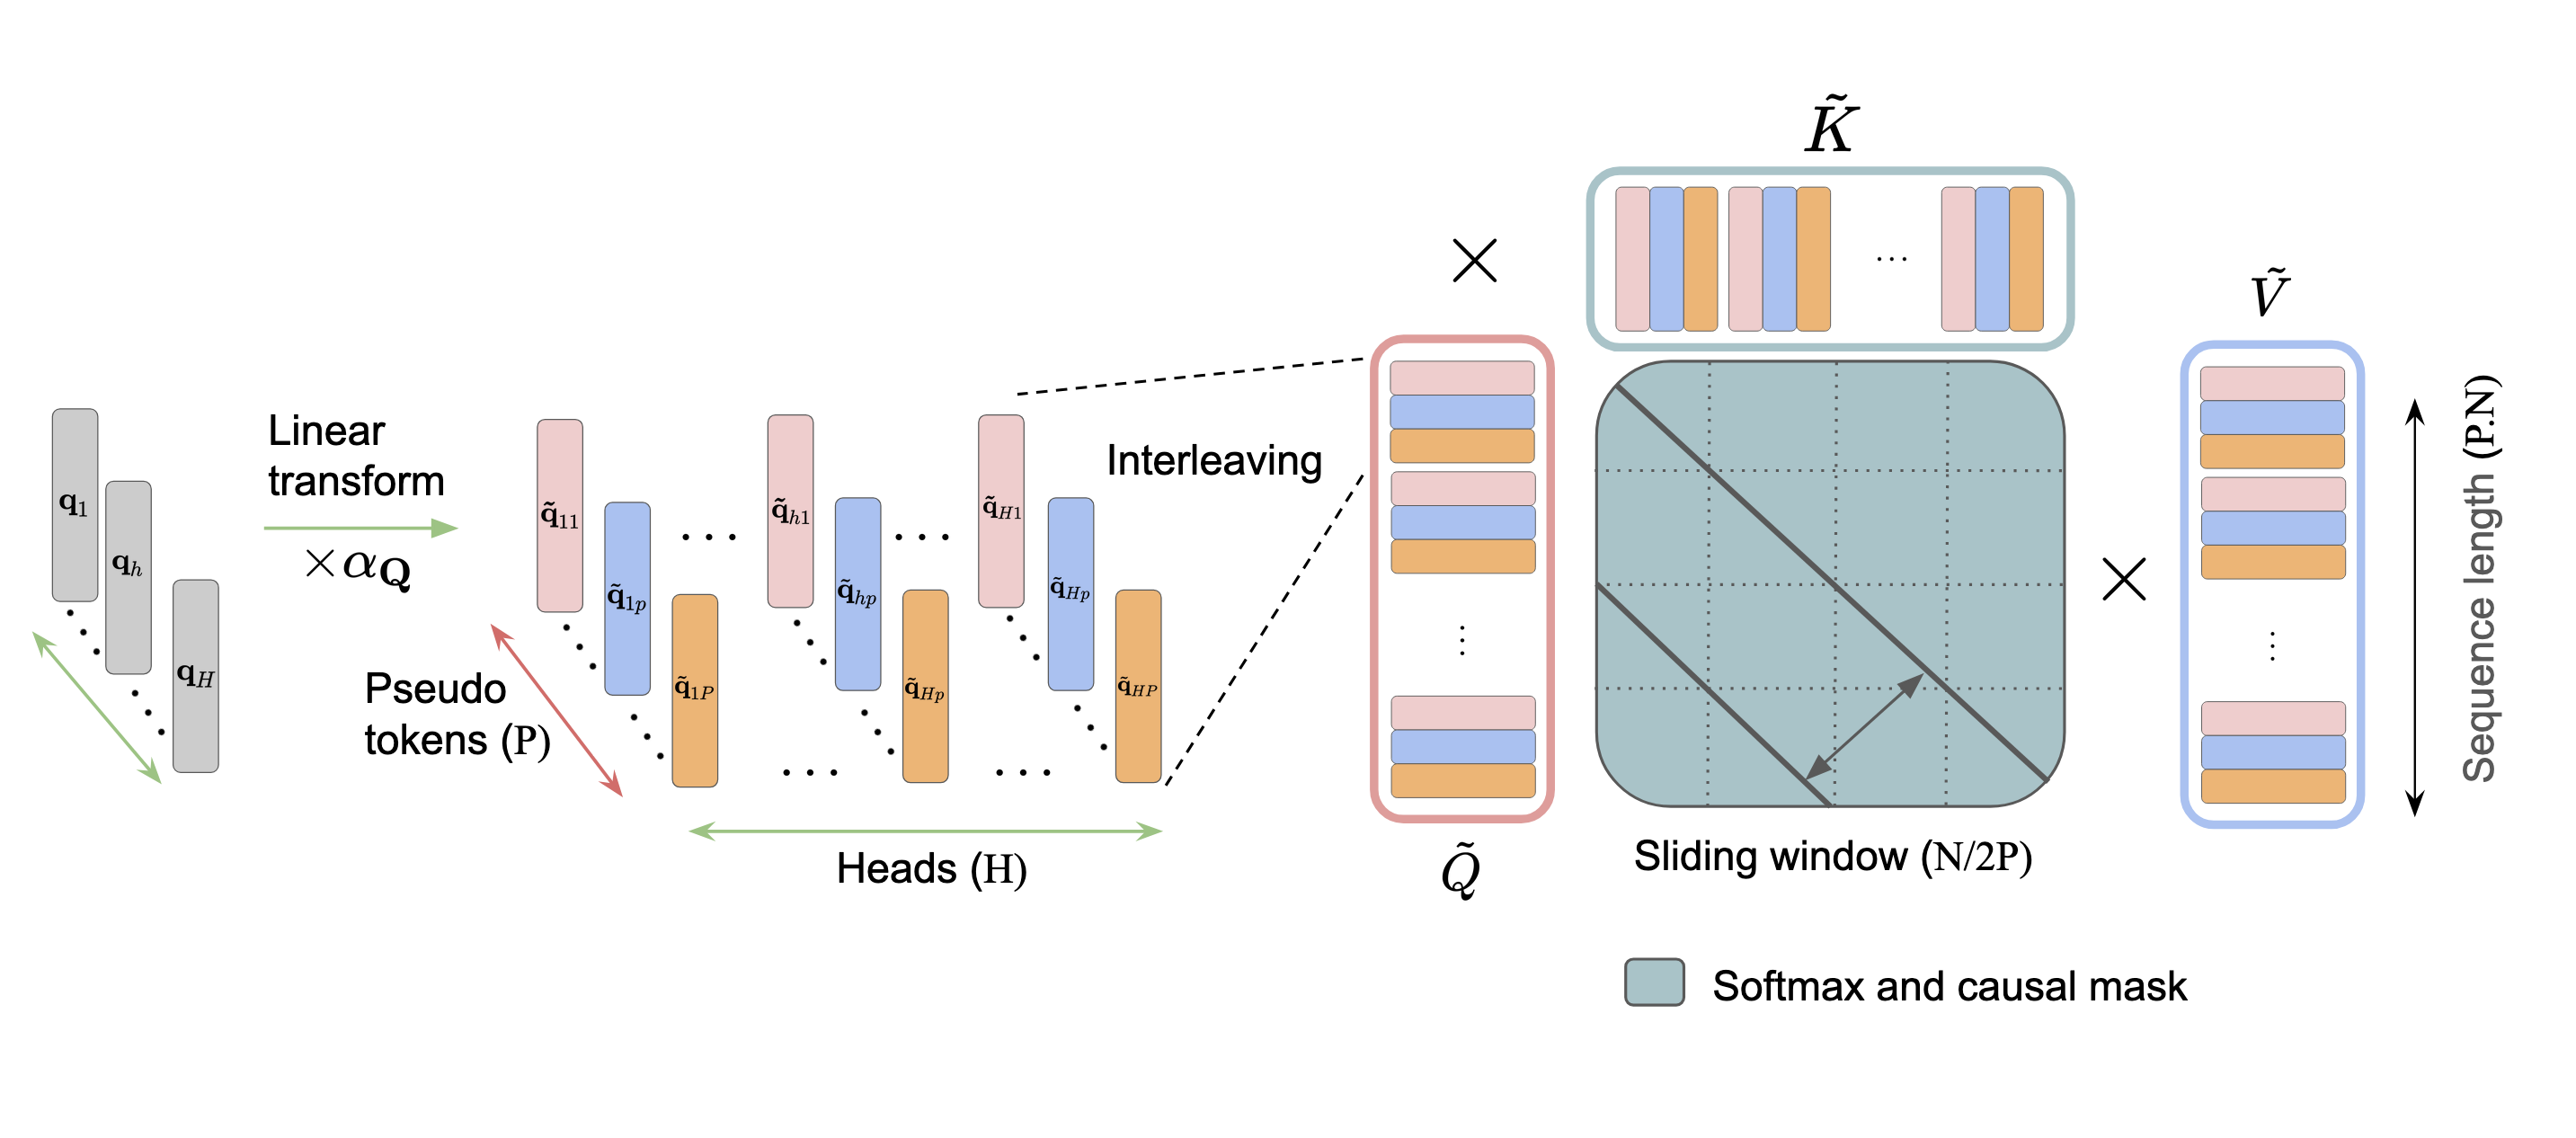
圖 1:交錯頭注意力 (IHA) 的架構圖。 原始查詢透過學習到的混合係數 $\alpha^Q$ 線性變換,產生 $P$ 個偽 token,然後在所有 $H$ 個頭之間交錯排列。交錯後的偽查詢 $\tilde{Q}$ 與對應的偽鍵 $\tilde{K}$ 和偽值 $\tilde{V}$ 進行滑動視窗注意力計算(視窗大小 $N/(2P)$),最後透過收縮映射 $\mathbf{R}$ 從 $HP$ 個偽輸出收縮回 $H$ 個頭。
IHA 的完整流程如演算法 1 所述:
演算法 1:交錯頭注意力 (IHA)
輸入: 序列 $\mathbf{X} \in \mathbb{R}^{N \times D}$,$H$ 個頭,每頭 $P$ 個偽頭,權重 $\{\mathbf{W}_Q^{(m)}, \mathbf{W}_K^{(m)}, \mathbf{W}_V^{(m)}\}_{m=1}^H$,混合張量 $\alpha^Q, \alpha^K, \alpha^V \in \mathbb{R}^{H \times H \times P}$,收縮映射 $\mathbf{R} \in \mathbb{R}^{H \times HP}$
偽頭混合(跨頭線性組合):
對所有 $h = 1, \ldots, H$ 和 $j = 1, \ldots, P$:
$$\tilde{\mathbf{Q}}_{h,j} := \sum_{m=1}^{H} \alpha_{m,h,j}^Q \mathbf{X}\mathbf{W}_Q^{(m)} \in \mathbb{R}^{N \times d}$$
$$\tilde{\mathbf{K}}_{h,j} := \sum_{m=1}^{H} \alpha_{m,h,j}^K \mathbf{X}\mathbf{W}_K^{(m)} \in \mathbb{R}^{N \times d}$$
$$\tilde{\mathbf{V}}_{h,j} := \sum_{m=1}^{H} \alpha_{m,h,j}^V \mathbf{X}\mathbf{W}_V^{(m)} \in \mathbb{R}^{N \times d}$$
偽主堆疊(行拼接至長度 $PN$):
對所有 $h = 1, \ldots, H$:
$$\bar{\mathbf{Q}}_h := [\tilde{\mathbf{Q}}_{h,1}^\top; \ldots; \tilde{\mathbf{Q}}_{h,P}^\top]^\top \in \mathbb{R}^{PN \times d}$$
($\bar{\mathbf{K}}_h$ 和 $\bar{\mathbf{V}}_h$ 同理)
注意力計算(逐頭):
對所有 $h = 1, \ldots, H$:
$$\mathbf{S}_h := \frac{1}{\sqrt{d}} \bar{\mathbf{Q}}_h \bar{\mathbf{K}}_h^\top \in \mathbb{R}^{PN \times PN}$$
$$\bar{\mathbf{P}}_h := \text{softmax}(\mathbf{S}_h) \bar{\mathbf{V}}_h \in \mathbb{R}^{PN \times d}$$
反堆疊與收縮($HP \to H$):
對所有 $h = 1, \ldots, H$ 和 $t = 1, \ldots, N$:
$$\mathbf{O}_h[t,:] := \sum_{h'=1}^{H} \sum_{j=1}^{P} \mathbf{R}_{h,(h'-1)P+j} \mathbf{P}_{h',j}[t,:] \in \mathbb{R}^d$$
拼接頭:
$$\tilde{\mathbf{X}} := [\mathbf{O}_1, \mathbf{O}_2, \ldots, \mathbf{O}_H] \in \mathbb{R}^{N \times D}$$
4.1 IHA 嚴格泛化 MHA
定理 2(IHA 超集性質)。 對任意 $P \geq 1$,$\mathcal{P}_P$ 中的每個模組有 $Q + 4H^2P$ 個參數(其中 $Q$ 來自查詢、鍵、值投影,$3H^2P$ 來自 $\alpha^Q, \alpha^K, \alpha^V$,$H^2P$ 來自 $\mathbf{R}$)。此外,對所有 $P \geq 1$,$\mathcal{M} \subseteq \mathcal{P}_P$;對所有 $P \geq 2$,包含關係是嚴格的:$\mathcal{M} \subsetneq \mathcal{P}_P$。
證明概要。
包含性。 對任意 MHA 實例,可以構造一個等價的 IHA 實例:將所有混合係數設為 $\alpha_{m,i,j}^Q = \alpha_{m,i,j}^K = \alpha_{m,i,j}^V = \mathbf{1}_{(m=i)}$(即只使用自己頭的投影),收縮映射 $\mathbf{R}$ 只選取每個頭的第一個偽塊。這樣 IHA 退化為 MHA。
嚴格性。 考慮重複 token 子空間 $\mathcal{S} = \{\mathbf{X} = \mathbf{1}_N \mathbf{x}^\top : \mathbf{x} \in \mathbb{R}^d\}$。在 $\mathcal{S}$ 上,每個 MHA 頭有相同的查詢/鍵/值,注意力分數矩陣每行相同,softmax 後為均勻分佈,因此每個頭的輸出為 $\mathbf{1}_N \mathbf{x}^\top \mathbf{W}_V^{(m)}$,這是 $\mathbf{x}$ 的線性函數。因此所有 MHA 模組在 $\mathcal{S}$ 上是線性的。然而,$P = 2$ 的 IHA 可以透過設定兩個偽查詢/鍵具有相反符號($\alpha_{m,i,2}^Q = \alpha_{m,i,2}^K = -\mathbf{1}_{(m=i)}$),使堆疊注意力在 $\mathcal{S}$ 上產生非線性函數(涉及 softmax 歸一化項的差值,產生類 tanh 的依賴關係)。由於沒有任何 MHA 能在 $\mathcal{S}$ 上非線性,故 $\mathcal{M} \subsetneq \mathcal{P}_P$。
4.2 使用 IHA 表示多項式濾波器
定理 3(表示多項式濾波器)。 給定圖鄰接矩陣 $\mathbf{A} \in \mathbb{R}^{N \times N}$ 和輸入特徵 $\mathbf{X} \in \mathbb{R}^{N \times d}$($d < N$),我們將輸入與單位矩陣拼接 $\hat{\mathbf{X}} = [\mathbf{X}, \mathbf{I}]$。對於能表示所有 $k$ 階多項式濾波器構造的單層無 softmax 注意力多頭架構,存在等價的單層無 softmax IHA 架構,僅需 $\lceil\sqrt{k}\rceil$ 個頭。
參數複雜度方面:MHA 需要 $2N(N+d)k + d(N+d)k$ 個參數,而等價的 IHA 需要 $2N(N+d)\lceil\sqrt{k}\rceil + d(d+N)\lceil\sqrt{k}\rceil^2 + 4\lceil\sqrt{k}\rceil^3$ 個參數。
證明概要。
為什麼 MHA 需要 $k$ 個頭。 在線性 MHA 中,每個頭產生恰好一個注意力算子 $\mathbf{S}_h$。要平行表示所有 $k$ 個不同冪次,需要 $k$ 個獨立頭。
為什麼 IHA 只需 $\lceil\sqrt{k}\rceil$ 個頭。 令 $H = \lceil\sqrt{k}\rceil$,設偽頭數 $P = H$。IHA 利用因式分解:
$$\mathbf{A}^i = \mathbf{A}^{(h-1)H + (j-1)}, \quad h, j \in \{1, \ldots, H\}$$
因此 $H^2 \geq k$ 個不同冪次可透過成對的查詢-鍵交互產生。IHA 為頭分配冪次區塊:選擇 $H$ 個查詢矩陣和 $H$ 個鍵矩陣:
$$\mathbf{W}_{Q,\text{IHA}}^{(h)} = \begin{bmatrix} \mathbf{0}_{d \times N} \\ \mathbf{A}^{(h-1)H} \end{bmatrix}, \quad \mathbf{W}_{K,\text{IHA}}^{(j)} = \begin{bmatrix} \mathbf{0}_{d \times N} \\ (\mathbf{A}^{j-1})^\top \end{bmatrix}$$
當查詢頭 $h$ 與鍵頭 $j$ 交互時,產生的注意力矩陣為 $\mathbf{S}_{h,j} = \mathbf{A}^{(h-1)H+(j-1)}$。偽頭混合確保在每個頭 $h$ 內,單個查詢能參與所有 $H$ 個鍵/值分支,一次性產生整個區塊 $[\mathbf{A}^{(h-1)H}\mathbf{X}, \ldots, \mathbf{A}^{(h-1)H+(H-1)}\mathbf{X}]$。拼接 $H$ 個頭即可恢復完整的多項式濾波器庫,主導參數成本從 $\Theta(kN^2)$ 降至 $\Theta(\lceil\sqrt{k}\rceil N^2)$。
4.3 使用 IHA 表示 CPM-3
多項式濾波器提供了多步檢索的受控代理任務。為了探索互補的領域,我們引入計數排列匹配-3 (Count Permutation Match-3, CPM-3),它隔離了順序敏感的組合和計數能力。
CPM-3 任務定義。 輸入為長度 $N$ 的自然數序列 $(x_1, \ldots, x_N)$,$N \leq N_{\max}$。對每個位置 $i$,目標輸出為:
$$\text{CPM}_i(3) = |\{(j_1, j_2) \in [N]^2 : \phi(x_i, x_{j_1}, x_{j_2}) = 0\}|$$
其中謂詞為順序敏感的模運算:$\phi(x_i, x_{j_1}, x_{j_2}) := x_i + Gx_{j_1} + x_{j_2} \mod M$,模數 $M \in \mathbb{N}$,係數 $G > 2M$。條件 $G > 2M$ 確保謂詞不是排列不變的。
定理 4(計數排列匹配-3)。 存在使用 IHA 的單層 Transformer,能用 $\lceil\sqrt{N_{\max}}\rceil$ 個注意力頭表示 CPM-3。相比之下,已知最佳的 MHA 構造需要 $N_{\max}$ 個注意力頭。
證明概要。 CPM-3 的輸出依賴於所有有序對 $(j_1, j_2)$,因此一種方便的單層策略是先用注意力在每個位置 $i$ 建立「工作空間」(Workspace),以固定已知順序包含所有 token 值 $\{x_j\}_{j=1}^{N_{\max}}$。
MHA 需要 $N_{\max}$ 個頭:使用位置編碼 $\hat{\mathbf{X}} = [\mathbf{X}, \mathbf{I}]$ 和硬注意力,每個 MHA 頭可實現序列的一個循環位移 $\mathbf{P}^{h-1}$。產生所有 $N_{\max}$ 個位移需要 $N_{\max}$ 個頭。
IHA 只需 $\lceil\sqrt{N_{\max}}\rceil$ 個頭:令 $H = \lceil\sqrt{N_{\max}}\rceil$,$P = H$。IHA 將每個位移索引 $t$ 因式分解為 $t = (h-1)H + (j-1)$。透過偽頭混合,每個頭 $h$ 可一次產生 $H$ 個循環位移的區塊。跨 $H$ 個頭拼接即可得到所有 $N_{\max}$ 個位移,頭數從 $N_{\max}$ 降至 $\lceil\sqrt{N_{\max}}\rceil$。
5 實驗
我們在大規模語言模型訓練中評估 IHA,回答兩個問題:(i) IHA 是否改善超越預訓練視窗的長上下文檢索和長度泛化?(ii) IHA 是否在監督式微調前後改善數學和程式碼基準上的推理能力?
5.1 實驗設定
模型架構。 所有實驗使用 2.4B 參數的解碼器 Transformer,隱藏維度 2560,26 層,$H = 20$ 個注意力頭(頭維度 128)。使用 $4\times$ FFN 擴展(FFN 大小 10,240),詞彙表大小 128,256(Llama 3 分詞器),RoPE 位置編碼($\theta = 500,000$)。預訓練上下文長度為 8,192 tokens。
訓練。 所有模型訓練 240,000 步(240B tokens),超參數相同:峰值學習率 $8 \times 10^{-4}$,1,000 步預熱,餘弦衰減至 $8 \times 10^{-6}$,AdamW($\beta_1 = 0.9$,$\beta_2 = 0.95$,權重衰減 0.1),梯度裁剪 1.0,BF16 混合精度。訓練使用 FSDP,128 張 H200 GPU。
基線方法。 比較五種注意力機制:(1) 全域注意力 (Global Attention):標準 MHA;(2) 全域+局部 (Global+Local):交替局部滑動視窗注意力(視窗 512)與週期性全域注意力層(4:1 比例);(3) Talking Heads:在 softmax 前後學習跨頭混合;(4) Diff Transformer:注意力定義為兩個 softmax 圖的差;(5) IHA(本文):帶偽頭的交錯頭注意力。
由於交錯將有效序列長度從 $N$ 擴展到 $NP$,全域 IHA 的每頭複雜度為 $O(P^2 N^2 d)$。我們使用混合局部-全域排程(四層滑動視窗 IHA 加一層全域層)來匹配 FLOP。
基準測試。 長上下文:RULER。推理和程式碼:GSM8K、MATH-500、MBPP、HumanEval。
5.2 長上下文評估
所有模型在 64k 上下文長度(超越預訓練視窗)上微調後,在 RULER 上評估。IHA 在檢索任務上持續更強:在多鍵檢索 (Multi-Key Retrieval) 上,相比全域注意力提高了 +27%(4k)、+32%(8k)和 +112%(16k)。在整個 RULER 套件上,IHA 達到最佳平均精確匹配 (EM) 44.0%,優於 Global+Local(40.6%)、Diff Transformer(37.2%)和全域注意力(35.0%)。
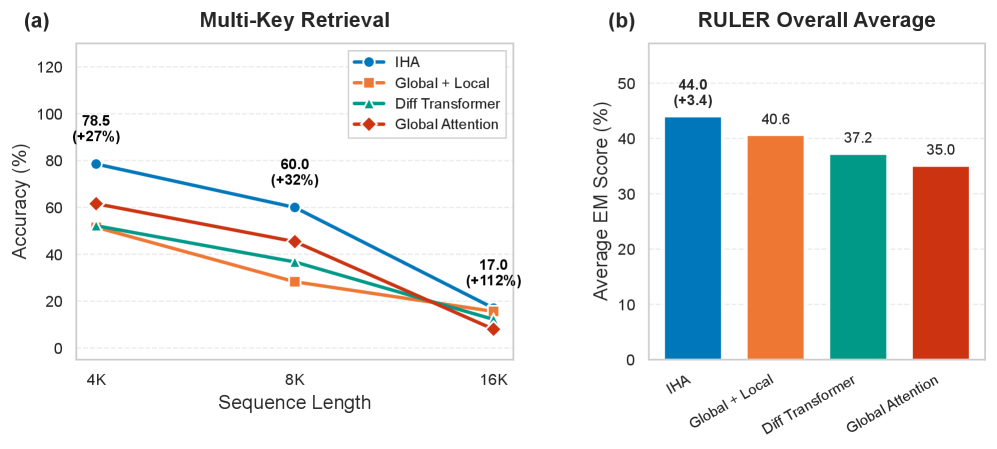
圖 2:64k 微調後的 RULER 長上下文結果。 (a) 多鍵檢索在 4k/8k/16k 上下文長度的準確率(橘色:IHA 相對滑動視窗的提升)。(b) 整體 RULER 精確匹配 (EM) 顯示使用 IHA 的顯著改善。
5.3 推理能力評估
預訓練模型(5-shot)。 IHA 在核心推理基準上持續優於全域注意力:GSM8K 達到最佳分數(8.34% EM 和 8.42% Maj@5,+2.73/+2.81),MATH-500 EM 也以 3.54%(+0.66)領先。程式碼結果混合,MBPP 有適度提升至 24.5%,HumanEval 接近持平。IHA 是所有報告指標中最一致的方法,最佳平均排名 $\downarrow = 1.4$。
表 2:預訓練模型評估(5-shot)。 $\Delta$ 為相對全域注意力的差異。
| 模型 | GSM8K EM | $\Delta$ | GSM8K Maj@5 | $\Delta$ | MATH-500 EM | $\Delta$ | MBPP P@1 | $\Delta$ | HumanEval P@1 | $\Delta$ | 平均排名 $\downarrow$ |
|---|---|---|---|---|---|---|---|---|---|---|---|
| IHA(本文) | 8.34% | +2.73 | 8.42% | +2.81 | 3.54% | +0.66 | 24.5% | +1.1 | 17.1% | -0.1 | 1.4 |
| 全域注意力 | 5.61% | — | 5.61% | — | 2.88% | — | 23.4% | — | 17.2% | — | 2.9 |
| 全域+局部 | 6.82% | +1.21 | 6.90% | +1.29 | 2.26% | -0.62 | 23.6% | +0.2 | 16.0% | -1.2 | 2.9 |
| Talking Heads | 5.46% | -0.15 | 5.38% | -0.23 | — | — | 23.8% | +0.4 | 16.0% | -1.2 | 4.0 |
| Diff Transformer | 5.46% | -0.15 | 5.61% | — | — | — | 25.0% | +1.6 | 15.4% | -1.8 | 3.5 |
監督式微調。 所有變體在 OpenThoughts(8B tokens)上微調,以溫度 0.6 使用 16 次生成評估。IHA 達到最佳整體性能,在所有推理指標上領先(GSM8K Maj@16 54.2%,+5.8;MATH-500 Maj@16 18.4%,+2.8)。在程式碼方面,Talking Heads 最佳(MBPP P@1 15.9%,P@10 43.1%),IHA 第二(P@1 15.5%,P@10 41.6%),表明 IHA 的表達能力在數學邏輯狀態追蹤上表現突出,而頭混合更適合函數級程式碼生成。
表 1:SFT 評估。 IHA 達到最佳整體性能,比預訓練階段的優勢更大。
| 模型 | GSM8K P@1 | $\Delta$ | GSM8K Maj@16 | $\Delta$ | MATH-500 P@1 | $\Delta$ | MATH-500 Maj@16 | $\Delta$ | MBPP P@1 | $\Delta$ | MBPP P@10 | $\Delta$ | 平均排名 $\downarrow$ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| IHA(本文) | 34.3% | +4.8 | 54.2% | +5.8 | 10.0% | +1.2 | 18.4% | +2.8 | 15.5% | +0.8 | 41.6% | +0.4 | 1.5 |
| 全域注意力 | 29.5% | — | 48.4% | — | 8.8% | — | 15.6% | — | 14.7% | — | 41.2% | — | 3.8 |
| 全域+局部 | 26.5% | -3.0 | 46.9% | -1.5 | 7.6% | -1.2 | 15.0% | -0.6 | 15.0% | +0.3 | 41.9% | +0.7 | 4.3 |
| Talking Heads | 29.3% | -0.2 | 49.4% | +1.0 | 7.8% | -1.0 | 18.2% | +2.6 | 15.9% | +1.2 | 43.1% | +1.9 | 2.5 |
| Diff Transformer | 31.6% | +2.1 | 53.5% | +5.1 | 9.0% | +0.2 | 18.0% | +2.4 | 15.3% | +0.6 | 39.2% | -2.0 | 2.8 |
6 結論
我們引入了交錯頭注意力 (IHA),透過為每個頭學習 $P$ 個偽查詢、偽鍵和偽值作為原始頭的線性組合,來克服 MHA 的線性擴展限制。偽查詢與偽鍵的交互每頭可產生多達 $P^2$ 種注意力模式。我們的理論證明了在多項式濾波器和 CPM-3 任務上的參數效率改善。實驗上,在 FLOP 匹配訓練下,IHA 在 RULER 多鍵檢索上提高 10-20%(4k-16k),經 OpenThoughts 微調後,GSM8K 提高 5.8%、MATH-500 提高 2.8%(多數投票)。
局限性。 全域 IHA 可能增加注意力成本(擴展為 $O(P^2 N^2)$),我們透過滑動視窗排程來緩解;未來工作包括自適應偽頭分配以及擴展到編碼器-解碼器和視覺架構。
致謝。 感謝 Rohan Anil 對 IHA 演算法的評論,以及 Niladri S. Chatterji 協助實驗設定。
附錄 A 擴展相關工作
組合推理的困難性結果。 最近的理論開始形式化標準 MHA 何時是組合多步推理的低效機制。有研究證明了二元關係組合和函數組合的困難性結果,也有工作指出 Match-3 在標準注意力構造下需要 $\Theta(N^3)$ 個參數。我們透過兩個受控代理任務來研究這些挑戰:多項式濾波器提供譜圖神經網路中的標準 $k$ 跳聚合原語,CPM-3 隔離順序敏感的組合和計數。
高階和多 token 注意力。 數項工作透過超越成對查詢-鍵注意力來豐富 token 交互。2-Simplicial Transformer 將注意力泛化為三線性交互。Strassen 式注意力構造使用快速矩陣乘法思想。Multi-Token Attention 引入跨小 token 組混合資訊的機制。IHA 與之互補:保留標準注意力算子,透過跨頭 Q/K/V 混合來產生有效的高階行為。
透過深度或遞迴的迭代計算。 另一種多步推理方法是增加連續變換的次數。迴圈 Transformer (Looped Transformers) 表明重複 $k$ 層區塊 $L$ 次可匹配 $kL$ 層模型。IHA 的方法互補:透過每頭構造 $P$ 個偽頭來增加層內交互容量,不增加序列深度。
高效和跨頭注意力變體。 MQA 和 GQA 透過共享鍵值投影降低推理成本。Talking-Heads 和 Knocking-Heads 透過混合注意力 logits 或權重來耦合頭。Diff Transformer 透過注意力圖差異來塑造注意力圖。IHA 透過將 Q/K/V 混合成偽頭來實現注意力內的跨頭交互,保持與 FlashAttention 等高效核心的相容性。
附錄 B IHA 的理論性質
B.1 IHA 超集性質
定理 5(IHA 超集性質,參數感知版)。 固定序列長度 $n$ 和頭數 $h$。令 $\mathcal{M}$ 為所有單層 $h$ 頭 MHA 模組的集合(共 $Q$ 個參數),$\mathcal{P}_p$ 為對應的 IHA 模組集合(每頭 $p$ 個偽頭,額外引入 $4h^2p$ 個參數)。則對所有 $p \geq 1$,$\mathcal{M} \subseteq \mathcal{P}_p$;對所有 $p \geq 2$,$\mathcal{M} \subsetneq \mathcal{P}_p$。
證明。
包含性($\mathcal{M} \subseteq \mathcal{P}_p$)。 對任意 MHA 實例,設混合係數為單位矩陣式:$\alpha_{m,i,j}^Q = \alpha_{m,i,j}^K = \alpha_{m,i,j}^V = \mathbf{1}_{(m=i)}$,收縮矩陣 $R$ 只選取每個頭的第一個偽塊。此時 IHA 精確重現 MHA 輸出。
嚴格性($p \geq 2$)。 在重複 token 子空間 $\mathcal{S} = \{\mathbf{1}_n \mathbf{x}^\top : \mathbf{x} \in \mathbb{R}^d\}$ 上,MHA 的每個頭在所有位置有相同的查詢/鍵/值,注意力分數矩陣每行相同,softmax 為均勻分佈,因此頭輸出為 $\mathbf{1}_n \mathbf{x}^\top \mathbf{W}_V^{(m)}$——$\mathbf{x}$ 的線性函數。
而 IHA 在 $p = 2$ 時,透過設定 $\alpha_{m,i,1}^Q = \alpha_{m,i,1}^K = \mathbf{1}_{(m=i)}$,$\alpha_{m,i,2}^Q = \alpha_{m,i,2}^K = -\mathbf{1}_{(m=i)}$,可構造出堆疊的查詢/鍵:
$$\bar{\mathbf{Q}}_h = \begin{bmatrix} \mathbf{Q}_h \\ -\mathbf{Q}_h \end{bmatrix}, \quad \bar{\mathbf{K}}_h = \begin{bmatrix} \mathbf{K}_h \\ -\mathbf{K}_h \end{bmatrix}, \quad \bar{\mathbf{V}}_h = \begin{bmatrix} \mathbf{V}_h \\ \mathbf{V}_h \end{bmatrix}$$
注意力計算產生:
$$\bar{\mathbf{P}}_h = \text{softmax}\left(\begin{bmatrix} \mathbf{Q}_h \mathbf{K}_h^\top & -\mathbf{Q}_h \mathbf{K}_h^\top \\ -\mathbf{Q}_h \mathbf{K}_h^\top & \mathbf{Q}_h \mathbf{K}_h^\top \end{bmatrix}\right) \begin{bmatrix} \mathbf{V}_h \\ \mathbf{V}_h \end{bmatrix}$$
由於 softmax 中正負交錯的分數,整體 IHA 層計算出輸入的非線性函數,因此無法被任何 MHA 表示。$\square$
B.2 表示多項式濾波器
定理 6(表示多項式濾波器,完整版)。 完整構造如下:
令 $H = \lceil\sqrt{k}\rceil$,$P = H$。對每個基頭索引 $m \in \{1, \ldots, H\}$ 定義:
$$\mathbf{W}_{K,\text{IHA}}^{(1,m)} = \begin{bmatrix} \mathbf{0}_{d \times N} \\ (A^{m-1})^\top \end{bmatrix}, \quad \mathbf{W}_{Q,\text{IHA}}^{(1,m)} = \begin{bmatrix} \mathbf{0}_{d \times N} \\ A^{(m-1) \cdot H} \end{bmatrix}$$
值矩陣將 $\mathbf{X}$ 路由到 $dH$ 維頭空間的第 $m$ 個 $d$ 塊:
$$\mathbf{W}_{V,\text{IHA}}^{(1,m)} = \begin{bmatrix} \mathbf{L}^{(1,m)}_{d \times dH} \\ \mathbf{0}_{N \times dH} \end{bmatrix}$$
偽頭混合係數設為 one-hot 路由器:$\alpha_{m,h,j}^Q = \mathbb{1}[m=h] \cdot \mathbb{1}[j=1]$,$\alpha_{m,h,j}^K = \mathbb{1}[m=j]$,$\alpha_{m,h,j}^V = \mathbb{1}[m=j]$。
範例($k = 4$)。 令 $H = P = 2$。頭 $h=1$ 的第一偽頭輸出包含 $[\mathbf{X}, \mathbf{A}\mathbf{X}]$,頭 $h=2$ 包含 $[\mathbf{A}^2\mathbf{X}, \mathbf{A}^3\mathbf{X}]$。拼接得到:
$$\tilde{\mathbf{X}}^{(1)} = [\mathbf{X}, \mathbf{A}\mathbf{X}, \mathbf{A}^2\mathbf{X}, \mathbf{A}^3\mathbf{X}]$$
B.3 表示 CPM-3
定理 7(CPM-3,完整版)。 IHA 構造的三個組件:(i) 編碼器/位置編碼映射($\hat{\mathbf{X}} = [\mathbf{X}, \mathbf{I}]$);(ii) 一層 IHA 注意力層,透過結構化循環位移將所有符號帶入每個位置的單一向量空間;(iii) MLP 層,列舉有序對 $(j_1, j_2)$,形成 $x_i + Gx_{j_1} + x_{j_2}$,測試模約束,聚合計數得到 $\text{CPM}_i(3)$。
IHA 構造的總參數量上界為 $37N_{\max}^{2}\sqrt{N_{\max}} + N_{\max}^2(N_{\max}-1) + N_{\max}^2$。MHA 構造的參數量下界為 $3N_{\max}^3 + N_{\max}^2(N_{\max}-1) + N_{\max}^2$。
範例($N_{\max} = 4$)。 輸入 token 為 $1, 2, 3, 4$,$H = P = 2$。注意力層後的表示為:
$$\hat{\mathbf{X}}^{(1)} = \begin{bmatrix} 1 & 2 & 3 & 4 \\ 2 & 3 & 4 & 1 \\ 3 & 4 & 1 & 2 \\ 4 & 1 & 2 & 3 \end{bmatrix}$$
每個 token 位置現在以固定已知順序包含所有符號(循環排列),後續 MLP 可列舉有序對、計算模測試、聚合計數。
附錄 C IHA 的計算量與 FLOP 匹配
全域複雜度。 交錯將有效序列長度從 $N$ 增至 $NP$,全域 IHA 的每頭複雜度為 $O(P^2 N^2 d)$,是全域 MHA 的 $P^2$ 倍。
混合局部-全域排程。 使用 4:1 的局部-全域比例:四層滑動視窗 IHA(視窗 $W = N/(2P^2)$),一層全域注意力。滑動視窗 IHA 層的成本為 $O(H \cdot (NP) \cdot (WP) \cdot d) = O(H N^2 d / 2)$。平均四層局部加一層全域:
$$\frac{4 \cdot O(HN^2d/2) + O(HN^2d)}{5} = \frac{3}{5} O(HN^2d) \approx O(HN^2d)$$
與全域注意力基線匹配(常數因子內)。
附錄 D 合成推理任務
D.1 資料與任務定義
兩個合成多跳推理任務,基於布林矩陣組合:
二元關係組合(2 跳)。 給定 $R$,目標為 $R \circ R$:$(R \circ R)_{ij} = 1$ 當且僅當 $\exists k$ 使得 $R_{ik} = 1 \land R_{kj} = 1$。矩陣大小 $m \sim \text{Uniform}\{6, \ldots, 10\}$,$P = 0.325$。
三元關係組合(3 跳)。 目標為 $R \circ R \circ R$:$(R \circ R \circ R)_{ij} = 1$ 當且僅當 $\exists k, l$ 使得 $R_{ik} = 1 \land R_{kl} = 1 \land R_{lj} = 1$。矩陣大小 $m \sim \text{Uniform}\{5, \ldots, 8\}$,$P = 0.264$。
D.2 資料集構造
每個任務使用 40,000 個訓練範例、5,000 個驗證範例、5,000 個測試範例。
D.3 超參數搜索與訓練方案
評估 MHA、IHA 和 Simplicial Attention。所有模型使用單層注意力($L = 1$)、8 個頭($H = 8$),搜索兩個學習率 $\eta \in \{10^{-3}, 10^{-4}\}$,早停耐心為 10 個 epoch。IHA 的偽鍵和偽值數為 8。
IHA 在兩個任務和兩個學習率上持續優於其他變體,在二元關係組合上提高達 4.7%,三元關係組合上提高達 3.3%(相對最強基線 Simplicial Attention)。
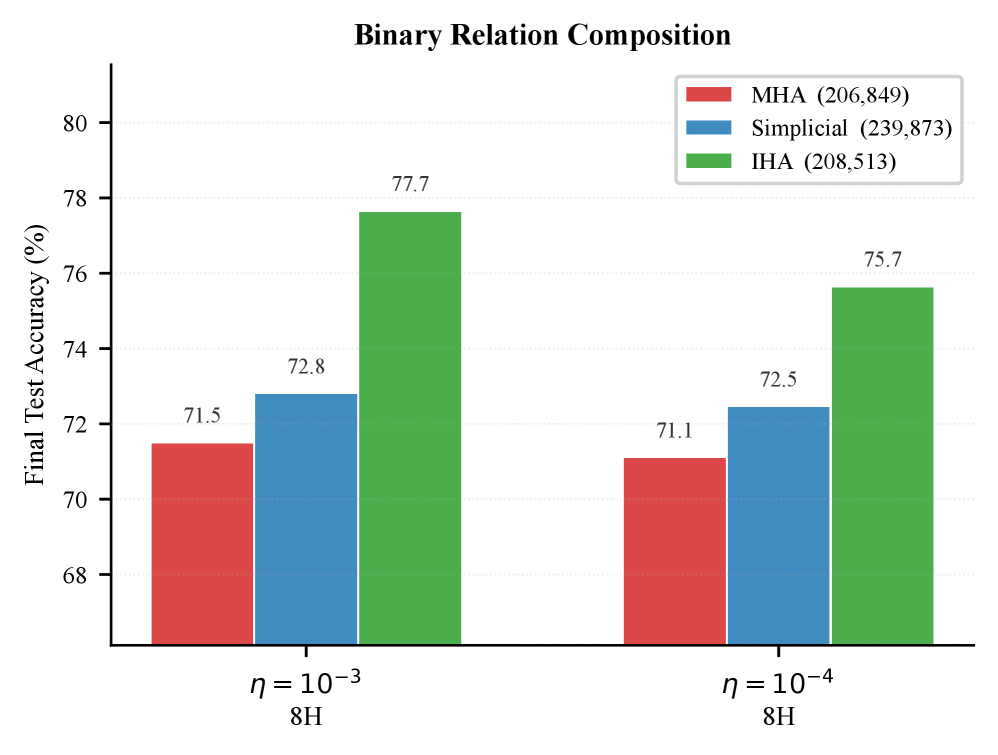
圖 3:二元和三元關係組合的最終測試準確率摘要。 長條圖比較 MHA、IHA 和 Simplicial Attention($L=1$,$H=8$,$\eta \in \{10^{-3}, 10^{-4}\}$)。
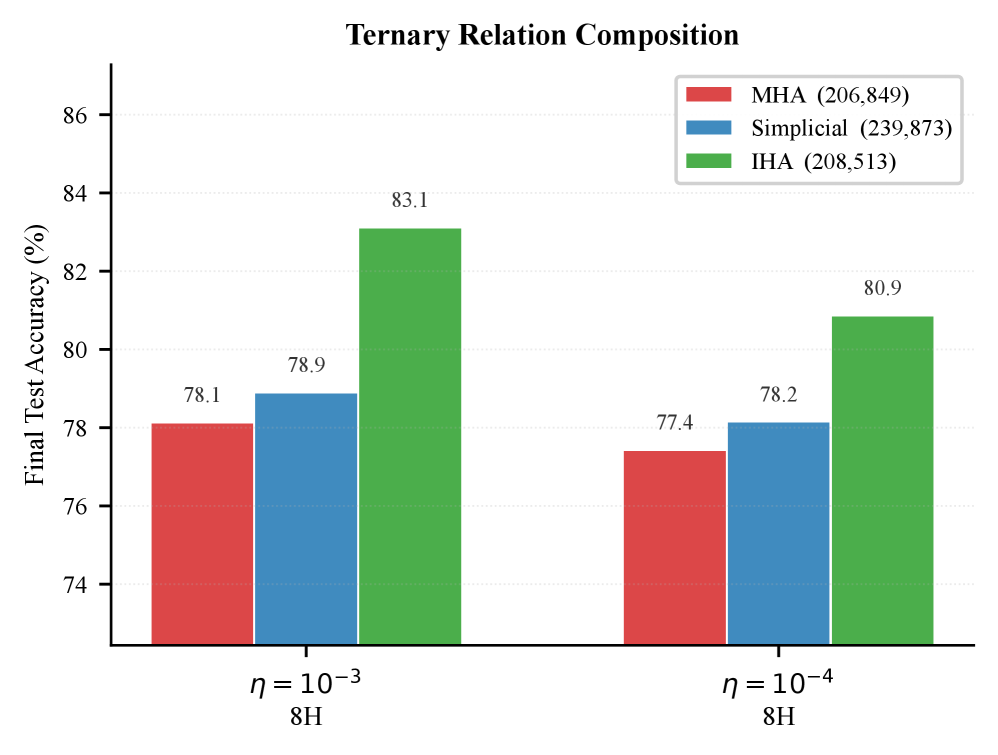
圖 4:二元關係組合的學習曲線。 每個面板顯示 MHA、IHA 和 Simplicial Attention 在單層八頭 Transformer 下的訓練、驗證和測試準確率隨 epoch 的變化。
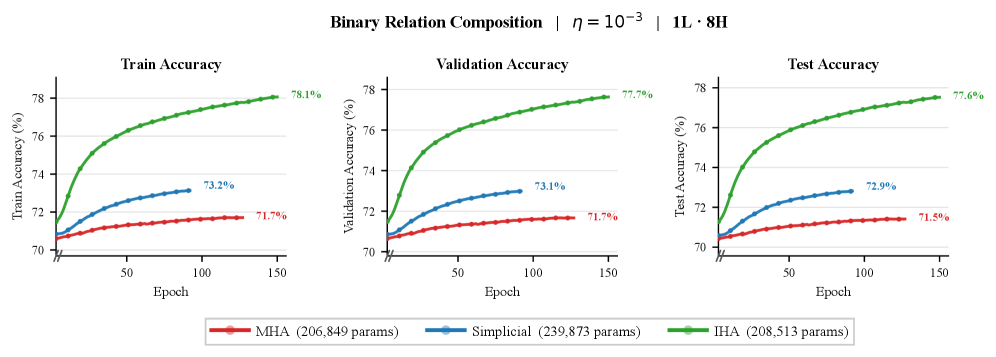
圖 5:三元關係組合的學習曲線。 每個面板顯示 MHA、IHA 和 Simplicial Attention 在單層八頭 Transformer 下的訓練、驗證和測試準確率隨 epoch 的變化。
參考文獻
- Vaswani, A., et al. (2017). Attention is all you need.
- Shazeer, N. (2020). Talking-heads attention.
- Ye, Z., et al. (2024). Differential Transformer.
- Shazeer, N. (2019). Fast transformer decoding: One write-head is all you need. (MQA)
- Ainslie, J., et al. (2023). GQA: Training generalized multi-query transformer models from multi-head checkpoints.
- Golovneva, O., et al. (2025). Multi-Token Attention.
- Dao, T. (2022). FlashAttention: Fast and memory-efficient exact attention with IO-awareness.
- Hsieh, C.-Y., et al. (2024). RULER: What's the real context size of your long-context language models?
- Cobbe, K., et al. (2021). Training verifiers to solve math word problems. (GSM8K)
- Hendrycks, D., et al. (2021). Measuring mathematical problem solving with the MATH dataset.
- Austin, J., et al. (2021). Program synthesis with large language models. (MBPP)
- Chen, M., et al. (2021). Evaluating large language models trained on code. (HumanEval)
- Guha, N., et al. (2025). OpenThoughts.
- Dubey, A., et al. (2024). The Llama 3 herd of models.
- Su, J., et al. (2021). RoFormer: Enhanced transformer with rotary position embedding.
- Loshchilov, I. & Hutter, F. (2017). SGDR: Stochastic gradient descent with warm restarts.
- Loshchilov, I. & Hutter, F. (2019). Decoupled weight decay regularization. (AdamW)
- Zhao, Y., et al. (2023). PyTorch FSDP: Experiences on scaling fully sharded data parallel.
- Micikevicius, P., et al. (2018). Mixed precision training.
- Weston, J., et al. (2016). Towards AI-complete question answering: A set of prerequisite toy tasks. (bAbI)
- Defferrard, M., et al. (2016). Convolutional neural networks on graphs with fast localized spectral filtering. (ChebNet)
- Chien, E., et al. (2021). Adaptive universal generalized PageRank graph neural network. (GPR-GNN)
- Kozachinskiy, A. & Perez, T. (2025). Strassen-style attention constructions.
- Sanford, C., et al. (2023). Representational strengths and limitations of transformers.
- Clift, J., et al. (2019). The 2-Simplicial Transformer.
- Roy, A., et al. (2025). FastSimplex.
- Zhou, H., et al. (2025). Knocking-Heads.
- Saunshi, N., et al. (2025). Looped transformers.
- Ekbote, C., et al. Piecewise polynomial filter learning approach.
- Lingam, V., et al. (2021). Piecewise polynomial filtering approach.
術語對照表
| 英文 | 中文 |
|---|---|
| Interleaved Head Attention (IHA) | 交錯頭注意力 |
| Multi-Head Attention (MHA) | 多頭注意力 |
| Pseudo-head | 偽頭 |
| Pseudo-query / Pseudo-key / Pseudo-value | 偽查詢 / 偽鍵 / 偽值 |
| Mixing Coefficients | 混合係數 |
| Collapse Map | 收縮映射 |
| Polynomial Filter | 多項式濾波器 |
| Compositional Reasoning | 組合推理 |
| Multi-hop Information Propagation | 多跳資訊傳播 |
| Multi-hop QA | 多跳問答 |
| Count Permutation Match-3 (CPM-3) | 計數排列匹配-3 |
| Cyclic Permutation Matrix | 循環排列矩陣 |
| Sliding Window Attention | 滑動視窗注意力 |
| Hard Attention | 硬注意力 |
| FLOP Matching | FLOP 匹配 |
| Majority Vote | 多數投票 |
| Exact Match (EM) | 精確匹配 |
| Multi-Key Retrieval | 多鍵檢索 |
| Talking-Heads Attention | Talking-Heads 注意力 |
| Differential Attention / Diff Transformer | 差分注意力 / 差分 Transformer |
| Multi-Query Attention (MQA) | 多查詢注意力 |
| Grouped Query Attention (GQA) | 分組查詢注意力 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Binary Relation Composition | 二元關係組合 |
| Ternary Relation Composition | 三元關係組合 |
| Simplicial Attention | 單純注意力 |
| Workspace | 工作空間 |
| One-hot Router | One-hot 路由器 |
| Pseudo-major Stacking | 偽主堆疊 |
| Decoder-only Transformer | 純解碼器 Transformer |
| Rotary Position Embedding (RoPE) | 旋轉位置編碼 |
| Fully Sharded Data Parallel (FSDP) | 完全分片資料並行 |
| Graph Adjacency Matrix | 圖鄰接矩陣 |
| Positional Encoding | 位置編碼 |
| Expressivity Separation | 表達能力分離 |