Puro-2B:窮實驗室在 5090 美元內、用 RTX 5090 訓出的 Qwen2-1.5B
原始論文:Puro-2B: Poor Lab's Qwen2-1.5B Trained on RTX 5090 within $5090 作者:Kairong Luo、Jiarui Cui、Yaorui Yin、Shengqi Chen 等(清華大學、鵬城實驗室;通訊作者 Kaifeng Lyu、Wenguang Chen) arXiv ID:2608.27370v2 日期:2026 年 8 月 27 日 標籤:Pretraining Low-Cost Training RTX 5090 FP8 Muon Open Recipe Scaling Law 開源模型 授權:CC BY-SA 4.0;本譯文為原文的衍生作品,依相同條款釋出。
【譯註】本文(清華 / 鵬城實驗室)給出一份低成本、消費級硬體可及、完全開放的預訓練配方,並用它從頭訓出 Puro-2B(普羅-2B)模型集。標題的雙關:用消費級 RTX 5090 顯示卡、把整套預訓練的租用等值算力成本壓在 5090 美元上下,訓出能追上 Qwen2-1.5B(甚至逼近 Qwen2.5-1.5B)的 2B 模型。相比之下,訓 Llama-3.2-3B 要 150 萬美元、重現 SmolLM3-3B 要 70 萬美元。配方由五個效率支柱組成:硬體選擇、FP8 低精度、MuonH(Hyperball)優化器、課程模型平均 (CMA)、資料配方。模型/資料/程式碼以 Apache 2.0 釋出。授權 CC BY-SA 4.0,站上公開。
摘要
語言模型預訓練幾乎已成為「高昂成本」的同義詞,把它推到大部分學術與開源社群的能力範圍之外。雖然已有強大的開源努力(含開放權重模型與開源訓練配方),一個「成本高效、硬體可及、開源」的預訓練配方長期缺席。即使在小規模,訓練 Llama-3.2-3B 也要超過 150 萬美元、重現 SmolLM3-3B 需超過 70 萬美元。在本報告中,我們提出一份設計來降低這道門檻的開放預訓練配方。用這份配方,我們在消費級 RTX 5090 GPU 上以 FP8 精度、從頭訓練了一系列 Puro-2B(普罗-2B)模型,最多用到 1.4 兆 token。集合中的模型在 token 預算與所選配方變體上各有不同。我們最好的模型以低於 6.9K 美元的算力成本訓練,並在我們的評估協定下逼近 Qwen2.5-1.5B 的效能。這種成本效率由一組方法共同促成,包括硬體選擇、低精度訓練、hyperball 優化、課程模型平均、以及資料配方。除了配方本身,我們還提供兩個額外結果。第一,跨 Puro-2B 集合,我們推導出一條 Puro 成本 Scaling Law,把訓練成本與平均模型效能連結起來;擬合出的定律暗示約 **4.4K 美元(低於 5,090 美元)**就足以達到 Qwen2-1.5B 的效能。第二,作為一個端到端案例研究,我們檢視預訓練資料課程如何在後訓練 (post-training) 後塑造下游效能——這類受控研究之所以可能,是因為我們能取用完整的預訓練流程、而不只是模型權重。我們把 Puro-2B 的完整訓練配方(含資料、程式碼、模型權重)以 Apache 2.0 釋出於 https://huggingface.co/collections/thu-pacman/puro-2b 。
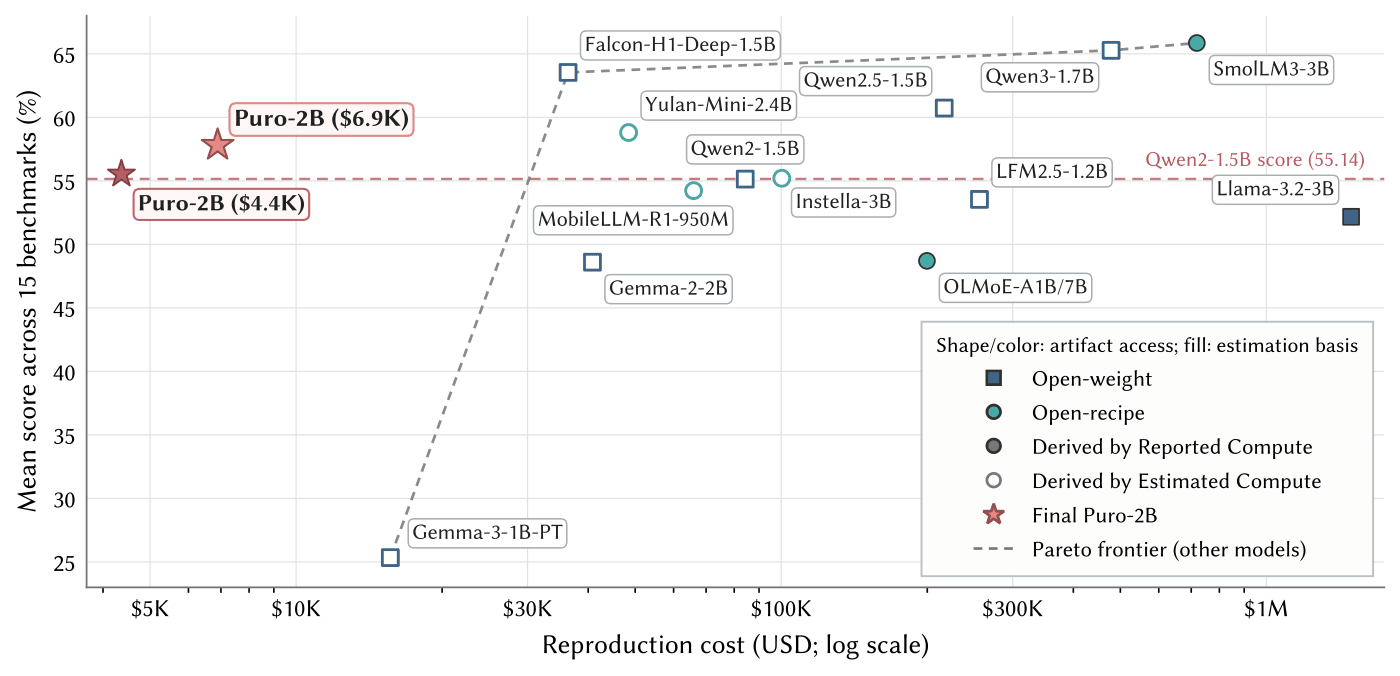
圖 1: 在第 2.2 與 4.3.2 節的計費協定下,模型效能 vs 重現成本。效能以表 3、4 中 15 個數學、程式、推理、知識基準的平均分衡量(MiniMax-M1 此處用 MiniMax-M1-80k)。Puro-2B 在所繪模型中以最低的重現成本達到具競爭力的效能,位在基準成本-效能前緣之外(左上方)。
1 引言
擴展模型參數與訓練資料,已大幅改善大型語言模型 (LLM) 的能力 [Hoffmann et al., 2022; Kaplan et al., 2020]。然而,預訓練的成本限制了學術與開源研究者研究訓練行為、重現完整流程、並在有意義規模上測試替代方案的能力。降低這道門檻不僅需要開放的模型權重,也需要可重現的資料、軟體、基礎設施、訓練細節、以及透明的成本計算。
現有的模型釋出橫跨三個開放層級。閉源模型(如 GPT、Claude、Gemini)透過託管服務與技術報告展現能力,但不釋出權重或檢視預訓練所需的產物。開放權重模型(Qwen、Gemma、Llama 家族)釋出能做本地評估、部署、後訓練的檢查點,但通常不公開確切的預訓練資料、樣本順序、與完整訓練狀態。開放配方模型則更進一步,釋出可重建的資料混合、訓練程式碼、配置與檢查點——OLMo/OLMoE、SmolLM、YuLan、Marin、Instella 等專案因此讓預訓練過程本身可供科學研究。
然而,更高的開放度本身並不讓預訓練變得可負擔地重現。即使在小規模,預訓練的算力成本也可能高得令人卻步。在圖 1 與附錄 B 的租用等值計費下,我們估計訓練 Llama3.2-3B 超過 150 萬美元。對開放配方模型,重現 OLMoE-1B-7B 要 20 萬美元、SmolLM3-3B 估計升到 71.9 萬美元。因此,即使是透明的開放配方釋出,也可能「對全世界開放、卻對許多小型與資源受限的實驗室——窮實驗室 (poor labs)——遙不可及」,在可重現性與可及性之間留下一道實際落差。
為橋接這道落差,我們提出一份涵蓋系統、演算法、資料設計的系統性可重現配方,用來訓練 Puro-2B(普罗-2B)檢查點集合。配方針對「稠密十億參數/兆 token 預訓練」的低成本、可及基礎設施,產生一個在我們協定下效能對標 Qwen2-1.5B 與 Qwen2.5-1.5B 的 2B 模型。這些檢查點共用相同的 2B 參數架構,但在訓練預算與配方變體上不同,訓練主要用開源資料集、在消費級 RTX 5090 GPU 叢集上進行。如表 1 所示,正式排程用 438.8B 的 Phase 1 token 與 960.0B 的 Phase 2 token,兩階段共 1.4T 排定 token、22,514 個活躍訓練 GPU 小時,對應約 6.9K 美元算力成本、17.6 天實際時間。
我們以 Apache 2.0 授權釋出以下產物(除非另有註明;上游資料條款仍依各元件而定):模型權重(Puro-2B-Base 及變體,共 10 個版本的檢查點)、資料清單與物化元件、訓練程式碼(Puro-Megatron)、資料處理程式碼(Kaiyuan-Spark)。
表 1:兩次 Puro-2B 執行的成本帳(圖 1 摘要)。 兩次共用 Phase 1、用不同的 Phase 2 配方變體。4.4K 美元的用均勻排序加 LR 衰減 (UD),正式的 6.9K 美元用 CMA。Phase 1 用 24 GPU、Phase 2 擴到 96 GPU。
配方圍繞五個以效率為導向的元件,橫跨硬體、數值精度、優化、資料排序、資料選擇:
- 消費級 RTX 5090 GPU 作為可及的訓練平台,在我們的設定下提供有利的成本效率權衡(第 3.1 節)。
- 分塊 FP8 (blockwise FP8) 訓練降低每 token 執行時間,同時維持與 bfloat16 (BF16) 相當的模型品質(第 3.2 節)。
- MuonH 優化器——把 Muon 優化器用 hyperball 約束擴展到參數權重與更新——搭配精心設計的學習率排程(第 3.3 節)。
- 課程模型平均 (Curriculum Model Averaging, CMA) 依配置的來源本地偏好把訓練組織在粗粒度資料塊上、並平均選定的檢查點 [Luo et al., 2026](第 3.4 節)。
- 代理實驗 (proxy experiments) 在大型候選資料池下為資料集選擇與混合設計提供經驗訊號(第 3.6 節)。
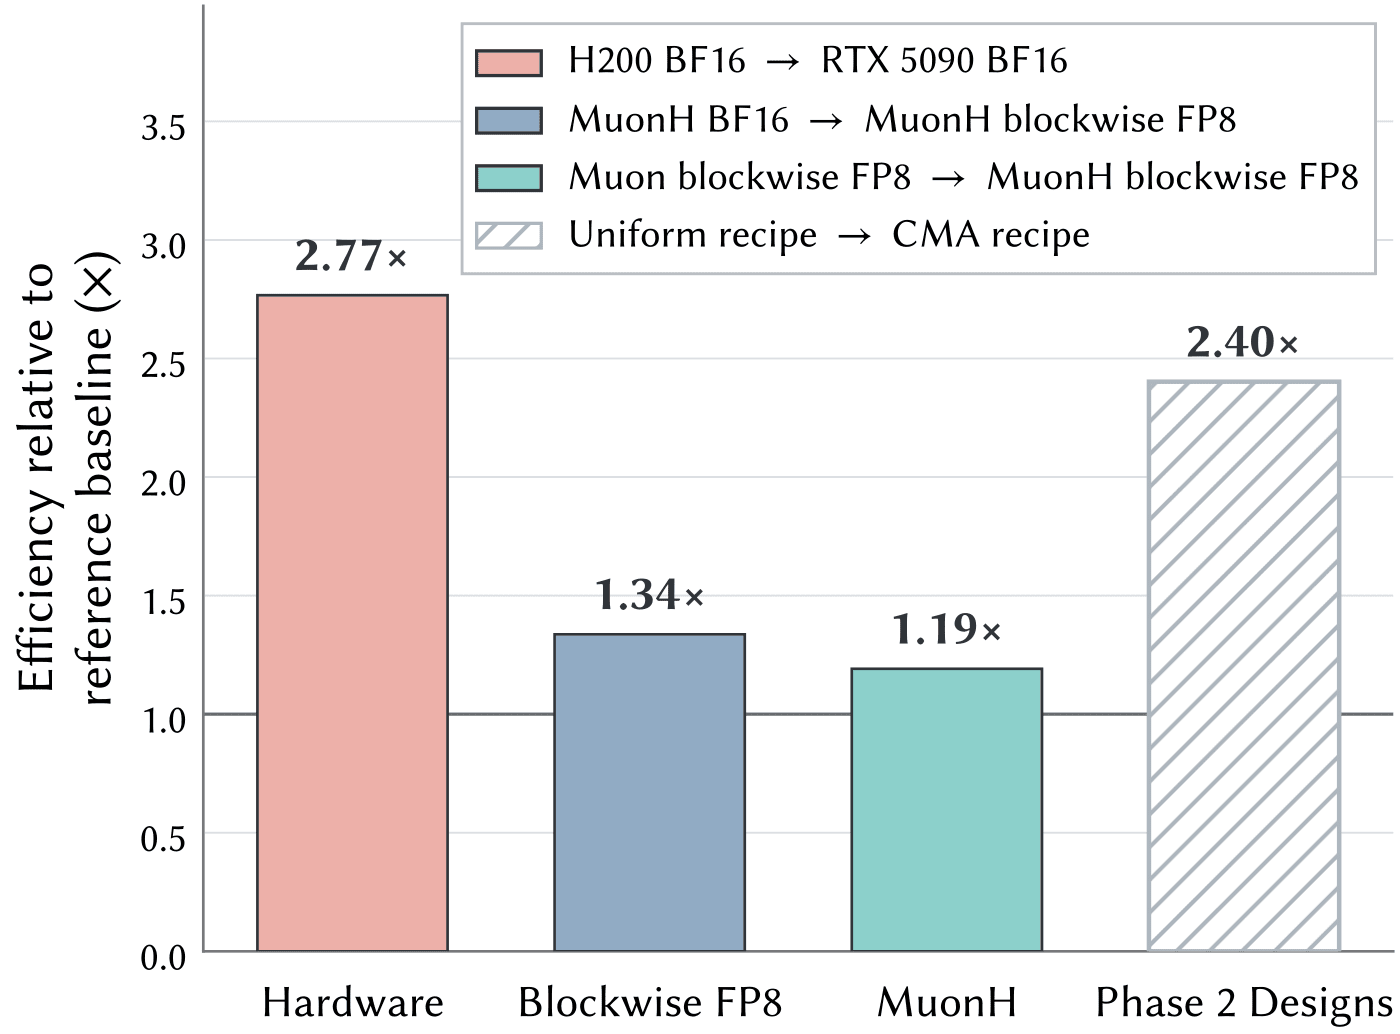
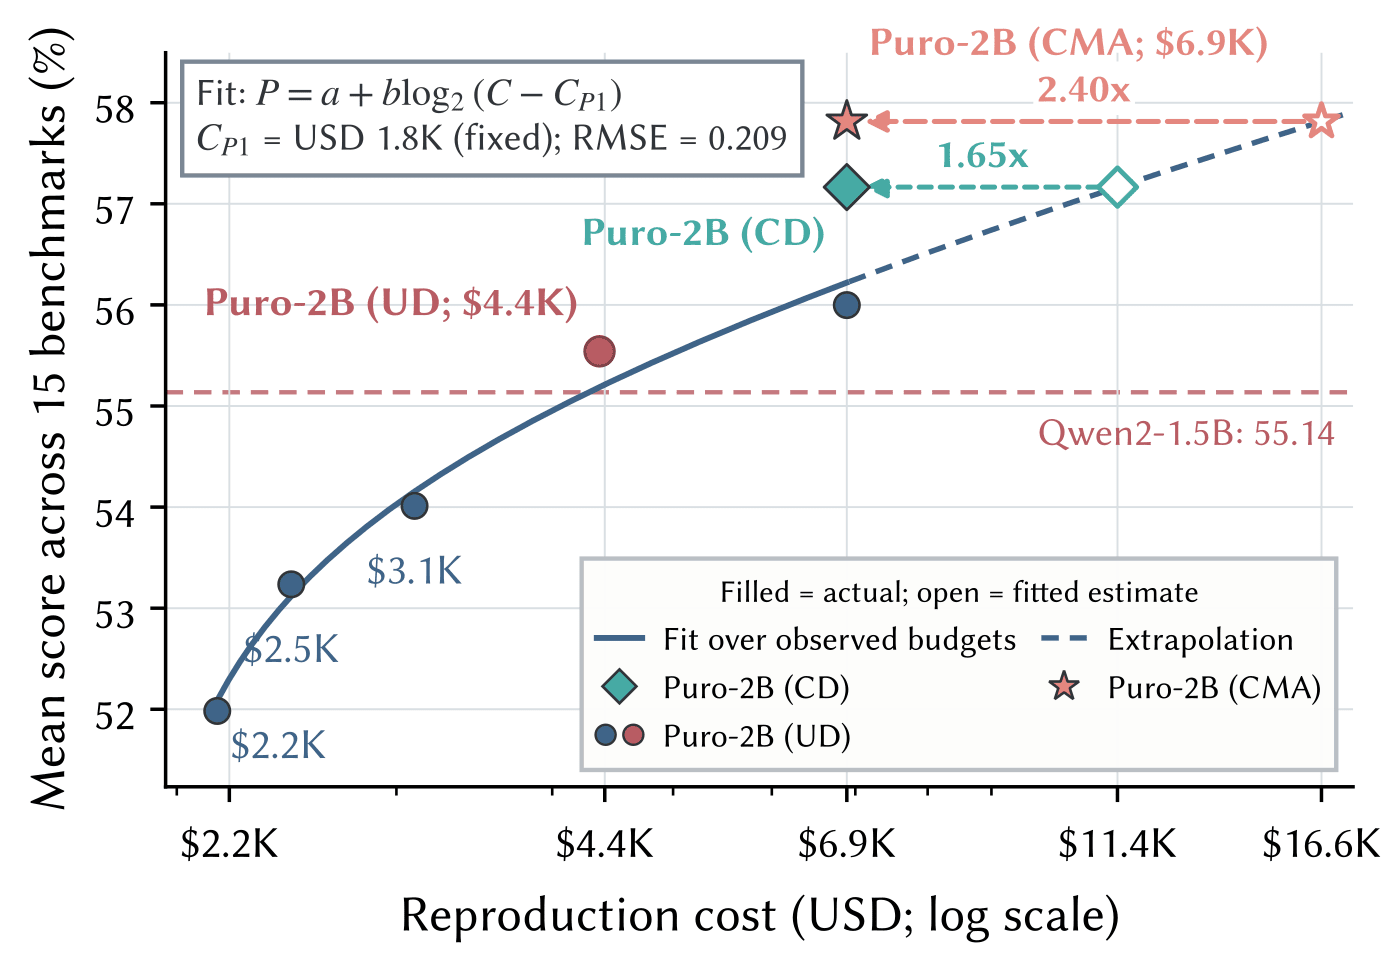
圖 2: (a) 硬體、FP8 精度、MuonH、與各種 Phase 2 設計的相對成本效率改善——增益來自不同來源,但都被轉換成等值的美元節省;每根長條用自己的基準,數字不可直接相乘。(b) Puro 成本 Scaling Law 由 Phase 2 在不同 token 預算下用均勻資料訓練的結果擬合。UD 表示「均勻資料排序加 LR 衰減」。4.4K 美元的 UD 檢查點在 15 個基準的平均效能上超過 Qwen2-1.5B。在 6.9K 美元的重現成本下,Phase 2 用「資料課程加 LR 衰減 (CD)」達到相對均勻配方 1.65 倍的成本效率增益;納入更多聯合設計(CMA)產生我們的正式 Puro-2B,達到相對均勻縮放曲線 2.40 倍的成本效率增益。實心標記為實際重現成本、空心標記為擬合的均勻等值成本。
我們的系統性配方涵蓋預訓練的完整效率堆疊:資料選擇降低所需 token 預算、MuonH 與 CMA 配方藉由從訓練 token 榨出更多能力來改善 token 效率、FP8 藉由提高運算吞吐量改善硬體利用率、硬體選擇降低每單位運算的成本。重要的是,這些元件不是各自獨立的優化拼在一起,而是一個協同設計 (co-designed) 的訓練系統,跨流程不同層有交互作用:RTX 5090 的 Blackwell 架構為高效 FP8 訓練提供硬體基礎;MuonH 與 CMA 都涉及精心的學習率排程設計;資料課程仰賴決定來源本地資料塊排序的前處理決策。
我們也提出 Puro 成本 Scaling Law,一個配方特定、「租用等值訓練預算 vs 模型能力」的 scale-down 關係(圖 2b),為算力與時間預算有限的使用者服務。有趣的是,這條定律暗示我們的配方能在 4.4K 美元的成本下越過 Qwen2-1.5B 的效能總和。此外,後訓練實驗顯示 CMA 與 UD 的 Phase 2 配方差異在配對的監督式調校後仍然持續:在 GSM8K-based SFT 與 Math&Code SFT 中,CMA-based SFT 在重複執行中產生更高的 GSM8K 準確度;在 Tulu-3 混合領域 SFT 中,CMA-based SFT 也改善綜合能力與指令遵循。
貢獻: (1) 提供一份成本高效、從頭的預訓練配方並訓練 Puro-2B 集合——集合中的模型在約 4.4K 美元超過 Qwen2-1.5B、最佳檢查點在 6.9K 美元逼近 Qwen2.5-1.5B;更廣泛地,我們的主要貢獻是證明可負擔、開放的預訓練今天就實際可行。(2) 評估主要配方選擇(RTX 5090 基礎設施、分塊 FP8、MuonH、CMA)並附消融實驗;提出 Puro 成本 Scaling Law。(3) 釋出資料集、模型權重、中間檢查點、訓練配置與實作,並附一個後訓練案例研究。
2 總覽
流程從公開來源構建訓練語料、選擇成本高效且廣泛可及的硬體開始,接著經過兩階段預訓練(含優化與資料課程設計),然後模型平均、後訓練、評估。整體流程見圖 3。
- 模型架構與預訓練系統(第 3.1、3.2 節)。 我們從頭訓練一個稠密的 decoder-only Transformer,經過兩個連續的預訓練階段。模型採用 Qwen3-1.7B 的架構配置,但把輸入嵌入矩陣與輸出語言模型頭 (LM head) 解綁,總計約 20 億參數。訓練用 Megatron Core 實作、適配到 RTX 5090 叢集。為利用 GPU 的 Blackwell FP8 支援,主要 Transformer 線性層 GEMM 用分塊 FP8,而數值敏感操作與持久訓練狀態(含 master weight 與優化器狀態)維持 BF16 或 FP32。Phase 1 在 24 GPU 上、Phase 2 從 Phase 1 終點在 96 GPU 上續訓。
- 兩階段預訓練、課程、優化(第 3.3、3.4 節)。 Phase 1 用 Phase 1 混合處理 438.8B token,Phase 2 共消耗 960.0B token。正式執行對 Phase 2 資料池套用資料課程,把每個評分來源中更偏好的部分放在訓練後期。我們不定義跨資料集的全域品質分數,而主要用來源資料集提供的品質標籤:在每個有可用分數標籤的資料集內,樣本從低分到高分排序、切成粗塊;沒有可用分數的資料集則隨機排序。跨兩階段,我們對約略尺度不變 (scale-invariant) 的矩陣用 Hyperball 優化——MuonH 更新這些矩陣、並在每步後把每個投影回其初始 Frobenius 半徑,其餘參數用 AdamW。兩階段序列長度 4,096、全域批次 1,536 序列。
- 資料獲取、過濾、混合(第 3.6 節)。 我們從「授權或條款允許使用」的公開資料集構建語料,涵蓋網頁文本、程式、數學,也含合成範例。先用 Kaiyuan-Spark 框架對大規模網頁部分去重。由於可用資料遠超訓練預算,我們必須選擇來源、在各來源內過濾樣本、並組合保留部分。由於「單一跨領域可比的樣本級品質分數」難以設計,我們改為在候選來源與代表性資料切片上跑代理實驗:訓練受控小模型、在下游任務評估,得到的基準分數向量定義每個來源/切片的代理輪廓,用來引導來源選擇與混合設計。
- 評估與後訓練(第 3.5、4 節)。 我們先把 Puro-2B 對照可比規模的開放權重與開放配方模型評估,接著用 SFT 作為「Phase 2 配方如何透過後訓練傳遞」的探針。三個設定:GSM8K-based SFT、Math&Code SFT with replay、Tulu-3 混合領域 SFT。
重現成本邊界(§2.2)。 本報告中,重現成本特指「把最終兩階段預訓練配方重跑一次」的算力成本。計費邊界從「階段特定的訓練 shard 已物化之後」開始,只含 Phase 1 與 Phase 2 正式執行的運算時間。我們分別報告量測到的 GPU 小時、並用第 4.3 節與附錄 B 指定的正規化 RTX 5090 租用等值費率換算。頭條成本排除資料獲取與前處理、代理模型實驗、縮放與消融研究、失敗或探索性執行、後訓練、評估、檢查點平均、與研究人力,也排除 CPU/儲存/網路等非加速器資源。這個數字應被理解為「重現最終預訓練執行」的狹義邊際加速器成本,而非開發模型或從頭重建每個產物的總成本。
3 訓練配方
3.1 訓練基礎設施
3.1.1 RTX 5090 作為成本高效的 GPU 選擇
為讓配方成本高效、硬體對更廣社群可及,我們做了一個非標準的基礎設施選擇:所有預訓練與後訓練都在配備消費級 GPU(RTX 5090)的叢集上跑,而非租用傳統資料中心導向的加速器。雖然資料中心 GPU 一般被預期更穩定、運算更高效,我們的成本分析顯示 RTX 5090 更適合這個工作負載。RTX 5090 在絕對峰值吞吐量上與資料中心 GPU 有明顯差距(尤其它的 Tensor Core 在用 FP32 累加時被人為限制到實際峰值的一半),但它低得多的有效價格帶來顯著更高的每美元運算:其 BF16 與 FP8 成本效率約為 H200 的 2.7 倍。RTX 5090 仍有顯著硬體限制(較小記憶體、缺 NVLink),但我們的目標模型夠小,配合下述硬體配置與平行訓練設定,RTX 5090 叢集在指定的精度加權峰值慣例下達到約 73% 的混合精度有效 MFU。
3.1.2 硬體設定與調校
叢集由多台 x86 GPU 伺服器組成,每台雙 CPU、八張 RTX 5090(每個 CPU socket 四張)。
- 節點內頻寬。 RTX 5090 沒有 NVLink,節點內唯一互連是 PCIe。NVIDIA 在非資料中心 GPU 上停用 PCIe P2P,迫使 GPU 通訊經主機記憶體中轉(「ping-pong」傳輸)。但這個限制看來是 NVIDIA 驅動程式強制的、而非硬體限制。我們用了一個修改版的開源 NVIDIA 驅動、加上必要的平台配置變更(停用 IOMMU 與 PCIe ACS、調整 NPS)來啟用 GPU P2P。在我們硬體上,啟用 P2P 把單向頻寬從 31.5 GB/s 提到 56 GB/s、雙向從 32 GB/s 提到 111 GB/s、通訊延遲從 14.3 μs 大幅降到 0.4 μs。
- 節點間頻寬。 我們在伺服器間架設 400 Gbps InfiniBand 網路(100 GB/s 雙向)。即使啟用 PCIe P2P,非資料中心 GPU 仍不支援 GPUDirect RDMA (GDR);我們發現這個限制也是軟體強制的,對 CUDA user-space driver 做最小的二進位修改就能在 RTX 5090 上啟用 GDR(因 EULA 約束無法揭露細節)。啟用 GDR 把 24-GPU AllReduce 頻寬從約 8.87 GB/s 提到 19.93 GB/s。
- 注意事項。 這些修改應謹慎使用:修改驅動不受廠商支援、須自負風險;無法超越實體 PCIe 頻寬上限;P2P 與 GDR 不應盲目啟用,最佳設定取決於實際硬體拓撲。
3.1.3 高效訓練系統
我們的訓練系統建在 Megatron Core (v0.16.0) 上,配 Transformer Engine,原生支援分塊 FP8 與 Muon。關鍵系統調校:通訊感知平行——只用通訊需求適中的平行維度:結合資料平行 (DP) 與管線平行 (PP),不用會在每層引入頻繁集合通訊的張量平行 (TP);並用 pp-dp 排序把每個 PP 組放在節點內拓撲更近的 GPU。適當的 micro-batch 大小——FP8 kernel 更快但更易受記憶體限制,我們擴展 Megatron-LM 的 FLOP 估計器來選最小的、超過它 FLOP/s 不再實質增加的 MBS。克服負載不平衡——大詞彙表使嵌入與 LM head 佔可觀運算,FP8 加速內部層進一步拉大它與 LM head 的差距,我們把較少 Transformer 層分給含 LM head 的階段以平衡管線。Phase 1 正式執行在 24 GPU(3 節點)上維持每 GPU 中位 238 TFLOP/s,最佳配置為 MBS=2、PP=2 佈局 (18|10)、DP=12。
3.2 FP8 混合精度訓練
我們從隨機初始化就用 FP8 混合精度,不用 BF16 暖身或後期精度切換。訓練狀態與數值敏感操作保留標準 BF16/FP32 路徑,而 Transformer 線性層用 E4M3 運算元。FP8 因此是線上的運算與激活儲存格式、而非整個模型的持久 dtype。E4M3 比 E5M2 有更多尾數位但動態範圍較窄;用一個 scale 對整個張量時,少數離群值會擴大量化間隔。我們改為線上計算局部群組的 scale:激活與激活梯度用沿 GEMM 縮減維度的 128 個連續值的一維群組,權重用 128×128 的二維塊(跟隨 DeepSeek-V3 的細粒度數值設計)。在 RTX 5090 (SM 120) 上,每個邏輯塊 scale 被約束為 2 的冪、透過 Blackwell 原生 MXFP8 路徑實作。FP8 加速操作佔整體運算的 72%。在匹配的「每參數 20 token」縮放梯 (ladder) 中,分塊 FP8 相對 BF16 讓驗證損失增加 0.0031–0.0039(跨五個模型尺寸),對應 98.0% 的 BF16 等值運算保留;但在 1.7B 尺度,分塊 FP8 把中位訓練吞吐量提升 1.36 倍,得到品質調整後 1.34 倍的淨增益。
3.3 Hyperball 優化
我們採用帶 Hyperball wrapper 的 Muon(MuonH,由 Wen et al. [2026] 提出)作為選定權重矩陣的優化器。我們對約略尺度不變的權重(含注意力與 MLP 矩陣)套用 MuonH,而嵌入、正規化層、LM head、其餘參數用 AdamW。對每個被包裹的矩陣 $W_t$,MuonH 把半徑固定在 $R=\lVert W_0\rVert_F$、把 Muon 更新 $u_t$ 正規化為 $\widehat{u}_t=u_t/\lVert u_t\rVert_F$,然後套用:
$$\widetilde{W}_{t+1}=W_t-\eta_t R\widehat{u}_t,\qquad W_{t+1}=R\,\operatorname{Normalize}(\widetilde{W}_{t+1}) \tag{1}$$
其中 $\operatorname{Normalize}(A)=A/\lVert A\rVert_F$。第一個操作正規化更新尺度,第二個把更新後的權重矩陣投影回其初始 Frobenius 半徑。
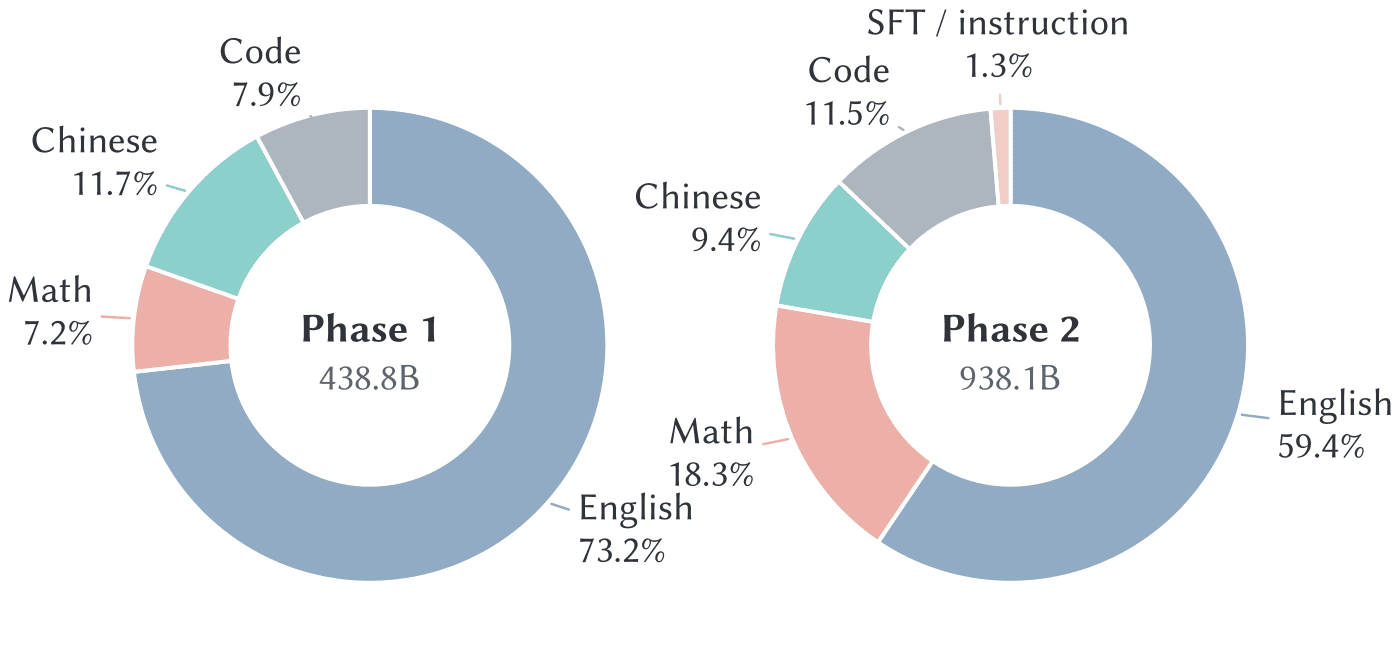
【譯註】原論文圖 4 為 MuonH 有效學習率控制示意圖(普通 Muon vs MuonH);此處版位以圖 8(兩階段資料領域組成)替代呈現——圖 8 詳見第 3.6 節。原圖請見原論文。
3.3.1 有效學習率 (Effective Learning Rate, ELR)
尺度不變激發有效學習率。 對選定的權重矩陣 $W$,當正向縮放它對模型函式或損失幾乎沒有影響($\mathcal{L}(cW)\approx\mathcal{L}(W),\ c>0$)時,我們稱該參數約略尺度不變。這時更新幅度自然地相對於當前權重尺度來詮釋,我們考慮逐矩陣的有效學習率 (ELR)。對普通 Muon(更新 $u_t$、純量學習率 $\eta_t$、解耦權重衰減 $\lambda$):$W_{t+1}=(1-\lambda\eta_t)W_t-\eta_t u_t$,忽略權重衰減的徑向收縮,有效學習率為
$$\rho_t(W)=\frac{\eta_t\lVert u_t\rVert_F}{\lVert W_t\rVert_F} \tag{4}$$
因此普通 Muon 的有效學習率不只由純量學習率決定,因為權重範數與更新範數在訓練中都會演變。
MuonH 讓有效學習率排程顯式化。 在 Hyperball 更新(方程式 1)下,投影前位移 $\eta_t R\widehat{u}_t$ 範數為 $\eta_t R$、被包裹矩陣範數為 $R$,其有效學習率為 $\rho_t(W)=\eta_t R/R=\eta_t$,數值上等於 Hyperball 權重學習率。因此普通 Muon 間接透過純量學習率與演變範數誘導其有效學習率,而 MuonH 直接透過學習率排程控制有效學習率排程。正式執行中我們用 $\eta_t^H=m\,\eta_t^{\text{base}}$,$m=10$。
匹配有效學習率排程也對齊驗證損失。 我們比較三個 170M BF16 執行:MuonH(用預定義有效學習率排程)、普通-LR Muon(用 MuonH 的 base LR 排程當學習率、不補償演變範數)、以及有效-LR 對齊 Muon(用普通 Muon 但線上調整純量學習率去跟隨同一條有效學習率曲線)。普通-LR Muon 的有效學習率早期快速衰減、幾乎歸零;雖然它訓練早期驗證損失較低,MuonH 在末段反超(最終驗證損失 3.029 vs 普通-LR Muon 3.073)。有效-LR 對齊 Muon 達到 3.030,接近 MuonH——這支持有效學習率排程是 MuonH 訓練行為的重要因子。
3.3.2 學習率排程設計
實務上總 token 預算開頭常未定,因此持續預訓練是實際設定。我們想在套用受控的末端衰減前保留一個開放式排程。用 Warmup-Stable-Decay (WSD) 掃描選擇衰減時長,並採線性衰減函式。兩個觀察:(1) 更大的峰值學習率需要更長的衰減;(2) 更長的訓練時距也需要更長的衰減。 正式排程結合三個實用特徵:Phase 1 用開放式冪排程(438.8B token 上從約 $5\times10^{-2}$ 降到 $1.04\times10^{-2}$),Phase 2 在約 $10^{-2}$ 接上、用 960.0B token 的長線性衰減。此外我們用多冪律 (Multi-Power Law, MPL) 作為「有限算力下跨排程的粗估診斷」,只用兩個端點排程就能恢復遞增的「峰值-到-衰減」趨勢。
3.4 課程模型平均 (CMA)
當開源資料集提供可用的樣本級分數時,我們在每個來源內排序樣本、構建一個「保持混合比例」的課程,把更偏好的樣本放在訓練後期以改善高品質樣本的資料效率。然而傳統的末端學習率衰減會與此目標抵觸:課程末段呈現的樣本,恰好是在參數更新已變小時被處理。課程模型平均 (CMA) [Luo et al., 2026] 藉由「升序資料課程 + 常數 LR 訓練 + 平均末期檢查點」解決這個衝突。正式配方在 Phase 2 採用此原則:先跟隨排定的學習率軌跡,然後從選定的後期檢查點續訓、把 base 學習率固定、平均續訓中的六個檢查點。
Phase 2 變體: UD(均勻資料 + LR 衰減,全域重洗)、CD(課程資料 + LR 衰減)、CDC(課程資料、LR 衰減後接常數 LR、報告最終檢查點)、CMA(正式變體,平均 CDC 配方的最後幾個檢查點)。我們把正規化 rank 範圍切成 376 個區間,每個課程 bucket 從每個元件取對應區間、約 2.5B token、保留跨元件混合。正式的 CMA 從步 218,000 續訓(base LR 固定在 $4.08\times10^{-5}$、Hyperball 權重 LR $4.08\times10^{-4}$)、平均六個間隔約 100 步(約 0.63B token)的檢查點。
消融(15 基準端點分數,圖 13b): 課程排序在無模型平均時勝過均勻排序 1.18 分(CD 57.17 vs UD 55.99);模型平均在兩種排序條件下都不獨立有益(無常數-LR 續訓時 UD 端點 −0.42、CD 端點 +0.01);最終選 218k 平均分支(結合課程排序、後期常數-LR 續訓、六檢查點平均)作為正式 CMA 端點(57.81)。
3.5 後訓練配方
一個自然但少被探討的問題:預訓練配方的選擇會影響 SFT 後的模型效能嗎? 光有釋出的檢查點通常不足以回答,因為完整訓練配方與資料常不可得;小規模消融較容易,但欠訓練的基礎模型可能太弱、顯示不出穩定的後訓練效能。我們的低成本、完全開放配方讓我們能在最終模型的規模上研究這個問題。我們比較兩個 Phase 2 配方(UD 與 CMA)的 SFT 結果,用三個資料設定:(1) GSM8K-based SFT、(2) Math&Code SFT with replay(含來自 Phase 2 課程末段最高品質資料的小型重播集)、(3) Tulu-3 混合領域 SFT。所有設定都去重、丟棄空序列,並用「與評測樣本共享 13-gram 就移除」做去汙染。
3.6 資料配方
目標是選出一組精簡的高品質、多樣資料來源、同時保持廣泛領域覆蓋。由於來源級中繼資料不足以做資料選擇,我們用代理基準 (proxy benchmarking):每個執行都從同一個 Qwen3-0.6B 檢查點開始、跟隨同一個續訓排程,續訓後在固定的 15 基準套件評估,得到的分數向量作為候選切片的能力輪廓。
- 細粒度資料切片選擇。 依來源大小與樣本級分數可用性構建候選切片:超過 50B token 且有可用分數的資料集,按分數排序、取 0/25/50/75 百分位附近的四個局部切片;5B–50B token 或無可用分數的較大資料集,隨機取一個 4B-token 切片。例如 DCLM-Dedup 的 q00 切片平均代理效能排第三、q25 排第十一——顯示同來源不同區域的訓練價值可能差很多。
- 特徵引導的資料選擇。 用量測到的能力輪廓引導來源選擇與資料分配:MegaMath-Web-Pro 在數學與通用上強、MegaMath-Code 提供最強程式訊號,故在 Phase 2 給更大份額;DCLM-Dedup 頂分區域遠優於低分區域,故保留約前 5%(34B token);FineWeb-Edu-CN 在中文能力最高,故增加份額以保留中文效能。
- 跨領域能力平衡。 我們對能力向量做 PCA:General 主要沿 PC1、Code 指相反方向、Math 主要沿 PC2。Code 與 General 的權衡比 Math 更強。這指引兩階段角色:Phase 1 保留廣泛覆蓋(英文佔 438.8B 的 73.2%),Phase 2 加更多專門資料、但給數學略大於程式的份額。
前處理與 shard 重現。 用 Kaiyuan-Spark(基於 Spark 的資料前處理框架,MinHash 去重用原生 C++ kernel、約 2.5 倍加速)把候選集合變成固定訓練 shard。Phase 1 到 Phase 2 的轉換橫跨約 43.9B token:Phase 1 重播混合的取樣權重線性下降、Phase 2 混合線性上升。完整預訓練約消耗 1.4T token。
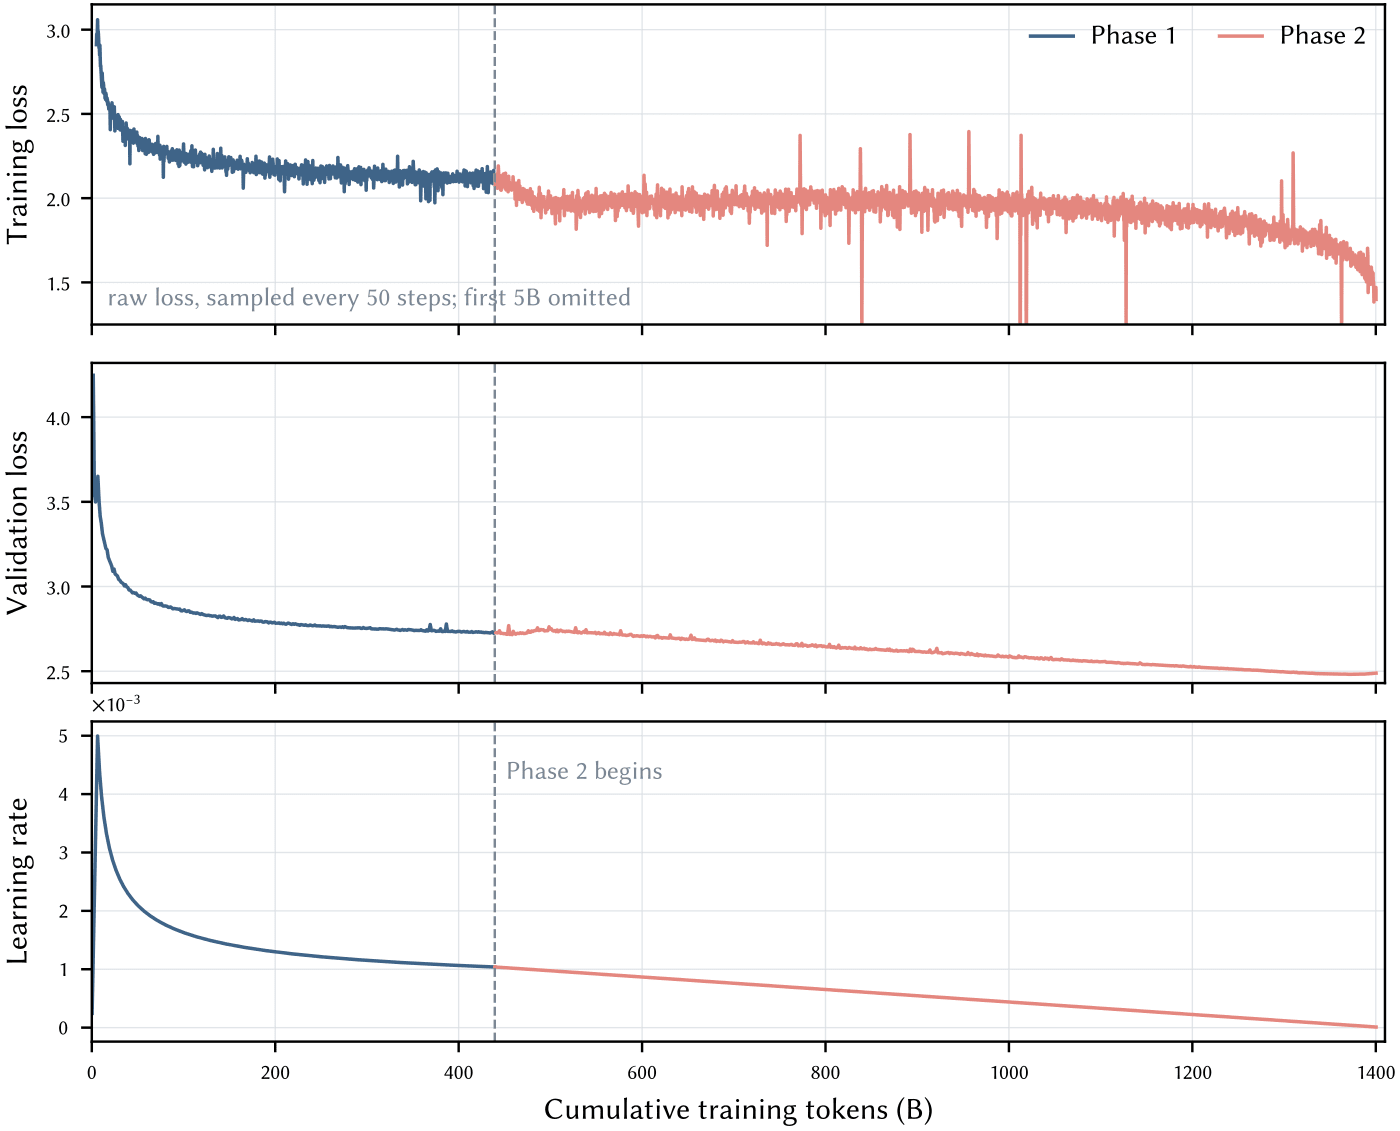
【譯註】上圖為原論文圖 12(串接的正式訓練曲線:訓練損失與驗證損失,垂直線標記 Phase 1/Phase 2 邊界)。圖 8(兩階段領域組成表與視覺化)詳見原論文。
4 評估
4.1 評估設定
模型選擇。 我們把 Puro-2B 對照 1B–3B 範圍的近期模型比較。開放權重:Qwen2/2.5/3/3.5、Gemma-2/3/4、Llama-3.2-3B、LFM2.5、Falcon-H1。開放配方:Instella-3B、OLMoE-1B-7B、Yulan-Mini-2.4B、SmolLM3-3B、MiniCPM5-1B、MobileLLM-R1-950M。所有模型都評估其預訓練/基礎版本。
基準(15 個,分兩組): 數學與程式——GSM8K、MATH、sanitized-MBPP、HumanEval;推理與知識——MMLU、MMLU-Pro、ARC-C、ARC-E、BoolQ、CommonsenseQA、HellaSwag、PIQA、SocialIQA、WinoGrande、Big-Bench Hard。全部用 OpenCompass、固定協定評估。GEN(生成式)評估用貪婪解碼;PPL(困惑度)評估對候選答案依 token log-likelihood 排序。整體效能 $P$ 為 15 基準的未加權算術平均。
4.2 結果效能
數學與程式(表 3)。 Puro-2B 在四個生成式基準上平均 43.50,超過 Qwen2-1.5B 3.21 分、與 Qwen2.5-1.5B 相差 4.02 分內。在開放配方基準中,Puro-2B 勝過 Instella-3B、OLMoE、MiniCPM5,而 Yulan-Mini-2.4B、SmolLM3-3B、MobileLLM-R1 更高。
表 3:數學與程式核心能力(%)。 Avg 為四基準未加權算術平均。(節錄關鍵對照)
| 模型 | 參數 | GSM8K | MATH | MBPP | HumanEval | Avg |
|---|---|---|---|---|---|---|
| Qwen2-1.5B | 1.5B | 59.82 | 23.70 | 50.19 | 27.44 | 40.29 |
| Qwen2.5-1.5B | 1.5B | 67.70 | 32.28 | 58.37 | 31.71 | 47.52 |
| Gemma-2-2B | 2B | 33.81 | 14.84 | 38.52 | 20.12 | 26.82 |
| Instella-3B(開放配方) | 3B | 64.44 | 13.30 | 41.25 | 14.63 | 33.41 |
| SmolLM3-3B-Base(開放配方) | 3B | 81.73 | 56.12 | 60.31 | 37.80 | 58.99 |
| Yulan-Mini-2.4B(開放配方) | 2.4B | 68.99 | 27.18 | 62.26 | 50.00 | 52.11 |
| Puro-2B(本文) | 2B | — | — | — | — | 43.50 |
推理與知識(表 4)。 Puro-2B 在 11 個基準上平均 63.02,超過 Qwen2-1.5B 2.48 分、與 Qwen2.5-1.5B 相差 2.51 分內。在開放配方組中,Puro-2B 勝過 OLMoE、Yulan-Mini、MiniCPM5、MobileLLM-R1,僅以 0.11 分落後較大的 Instella-3B。
表 4:推理與知識能力(%,11 基準)。(節錄關鍵對照)
| 模型 | 參數 | MMLU | MMLU-Pro | ARC-C | ARC-E | HellaSwag | BBH | Avg |
|---|---|---|---|---|---|---|---|---|
| Qwen2-1.5B | 1.5B | 56.39 | 23.62 | 69.83 | 83.77 | 59.91 | 31.73 | 60.54 |
| Qwen2.5-1.5B | 1.5B | 61.56 | 30.43 | 79.32 | 90.48 | 64.18 | 42.64 | 65.53 |
| Instella-3B(開放配方) | 3B | 58.55 | 25.32 | 74.92 | 87.30 | 59.92 | 39.11 | 63.13 |
| SmolLM3-3B-Base(開放配方) | 3B | 62.24 | 39.02 | 79.32 | 89.95 | 70.23 | 37.52 | 68.35 |
| Puro-2B(本文) | 2B | — | — | — | — | — | — | 63.02 |
4.3 成本估計
成本節省因子(各自基準,不可直接相乘): (1) RTX 5090 提供 H200 每單位價格 2.77 倍的峰值 BF16 運算、2.74 倍的 FP8 運算,配合 73% MFU。(2) MuonH 在匹配縮放梯上估計 1.19 倍的運算等值乘數(在匹配驗證損失下少 16.1% 理論運算)。(3) 分塊 FP8 在五個尺度損失差穩定、$\rho_C=98.0\%$ 運算保留,1.7B 尺度吞吐量提升 1.36 倍、品質調整後淨 1.34 倍(匹配品質下少 25.2% GPU 小時)。(4) Phase 2 聯合配方:CD 達 1.65 倍、CMA 達 2.40 倍成本效率。
Puro 成本 Scaling Law。 從同一 Phase 1 檢查點、用 UD 在幾個預算下續訓 Phase 2,擬合 $P=a+b\log_2(C-C_{\text{P1}})$($P$ 為 15 基準平均、$C$ 為總重現成本、$C_{\text{P1}}=1.84\text{K}$ 美元)。約 4.4K 美元的 UD 檢查點已在無 CMA 下超過 Qwen2-1.5B。
跨模型重現成本(表 6)。 在指定的加速器成本假設下,Puro-2B 位在對照模型前緣的上方左側(更高平均效能、更低估計重現成本),相對開放配方模型優勢最明顯。
表 6:圖 1 用的成本與效能座標。 Avg 分數為 15 任務未加權平均。(節錄)
| 模型 | 證據 | 價格基準 | GPU 小時 | 成本 (USD) | Avg 分數 |
|---|---|---|---|---|---|
| Qwen2-1.5B | 6ND, 模型 token | H100 等值 | 25,939 | 84,302 | 55.14 |
| Qwen2.5-1.5B | 6ND, 家族 token | H100 等值 | 66,700 | 216,776 | 60.73 |
| Qwen3-1.7B-Base | 6ND, 模型 token | H100 等值 | 147,261 | 478,597 | 65.27 |
| Llama-3.2-3B | 回報 GPU 小時 | H100 | 460,000 | 1,495,000 | 52.17 |
| SmolLM3-3B-Base | 回報數/時間 | H100 | 221,184 | 718,848 | 65.85 |
| Instella-3B | 6ND, 模型 token | H100 等值 | 30,851 | 100,265 | 55.20 |
| OLMoE-1B-7B-0125 | 回報數/時間 | H100 | 61,440 | 199,680 | 48.70 |
| Puro-2B | 量測 GPU 小時 | RTX 5090 | 22,514 | 6,891 | 57.81 |
4.4 後訓練結果與分析
我們對兩個 Phase 2 設計(UD 與 CMA)做消融,檢視預訓練配方如何影響 SFT 後結果:
- GSM8K-based SFT。 SFT 後 UD-based 模型 66.89%、CMA-based 68.66%(三種子平均,CMA 領先 1.77pp)。比對兩模型答對的題目集,CMA-based 仍解出更多 UD-based 錯的題——優勢更可歸因於更強的數學能力、而非答案格式。
- Math&Code SFT with replay。 更長的 SFT、不同資料分布後,UD-based 74.10%、CMA-based 76.12%(領先 2.02pp)。CMA 優勢在更多 SFT 更新後仍持續,且比 GSM8K 設定稍大。
- Tulu-3 混合領域 SFT。 CMA-based 平均高 1.17 分、在 15 基準中 10 個更好;在 IFEval 指令遵循上高 1.36 分。
三個實驗一起顯示:兩個預訓練配方的差異在越來越廣的 SFT 後仍然持續。由於任務級增益不均勻,這不表示 CMA 均勻改善每個能力——這使更受控的課程設計成為未來重要方向。
5 相關研究
【譯註】第 5 節分兩部分:5.1 開放配方語言模型——回顧從閉源、開放權重到開放配方的光譜,以及 OLMo/OLMoE、SmolLM、YuLan、Marin、Instella 等把完整預訓練流程開放供研究的專案。5.2 低成本語言模型預訓練——回顧在演算法(優化器、學習率排程、資料效率)、系統(低精度訓練、平行策略)、與硬體層面降低預訓練成本的努力。Puro-2B 的差異在於把「系統 + 演算法 + 資料 + 消費級硬體」協同設計成一個完整、可重現、可負擔的配方。詳見原論文。
6 結論與未來方向
在本報告中,我們提出一份成本高效、硬體可及的語言模型預訓練可重現配方,並用它在消費級 RTX 5090 GPU 上從頭訓練 Puro-2B 模型集。集合中的一個模型在約 4.4K 美元達到 Qwen2-1.5B 的效能,我們最佳的檢查點在約 6.9K 美元(正式的僅加速器成本)逼近 Qwen2.5-1.5B。基於這些執行,我們進一步提出 Puro 成本 Scaling Law 刻畫「模型能力如何隨訓練成本 scale down」。更廣泛地,這些結果證明十億參數規模、有用的從頭預訓練,用適度預算與可及硬體今天就可行。
未來方向:(1) 把可重現配方從預訓練延伸到後訓練,特別強調開發並研究代理 (agentic) 能力;(2) 把架構空間拓展到標準稠密 Transformer 之外,包括 looped Transformer、線性注意力模型、MoE 架構等;(3) 把硬體配方拓展到 RTX 5090 之外、涵蓋更廣的訓練預算。我們把 Puro-2B 視為「可負擔、可檢視的模型訓練今天就實際可行」的證據,以及未來把前緣推向更低成本、更廣可及、更高效率的基準。
附錄概覽
【譯註】原論文附錄 A–I 內容豐富,以下為摘要,逐字全文(含完整訓練細節、學習率排程診斷、後訓練逐任務結果、資料配方全表)請參閱原論文。
- 附錄 A 限制。 汙染與處理資料出處、中文能力範圍、過度訓練的稠密設定、放大與架構範圍。
- 附錄 B 重現成本假設。 成本-效能圖的構建、效能座標、成本證據層級、表 6 的公開來源、Pareto 前緣。
- 附錄 C 正式訓練細節。 正式執行設定、Phase 1/Phase 2 學習率排程、FP8 實作流程。
- 附錄 D MuonH 縮放梯分析。 實驗設定、運算等值擬合、精度與吞吐量分解、MuonH 診斷軌跡。
- 附錄 E 後訓練細節。 共享構建與評估協定、三種 SFT 設定(GSM8K-based、Math&Code with replay、Tulu-3 混合領域)的資料、預算、逐執行結果。
- 附錄 F 學習率排程診斷。 有效學習率排程的多冪律 (MPL)、WSD 掃描與有限算力排程估計、「規定的有效 LR 能在普通 Muon 中誘導出丘狀 (hill-like) 純量 LR」。
- 附錄 G Puro-2B 縮放檢查點帳本。
- 附錄 H 課程構建與模型平均。 元件本地課程 bucket 的可擴展構建、階段轉換與 UD 控制、常數-LR 續訓與檢查點平均。
- 附錄 I 資料配方細節。 元件計數與授權範圍、代理量測協定、代理能力維度(各資料來源/切片在 15 基準上的完整代理分數表)。
參考文獻
【譯註】本論文採作者-年份引用、共 121 筆參考文獻,涵蓋 LLM scaling law、開源模型與配方(OLMo、SmolLM、Qwen、Gemma、Llama、Instella、Yulan-Mini 等)、優化器(Muon、Hyperball/MuonH、AdamW)、低精度訓練(FP8、DeepSeek-V3/MXFP8)、資料集與基準等。完整書目請見原論文。以下列出正文引用的主要條目:
- Hoffmann et al. (2022). Training compute-optimal large language models (Chinchilla).
- Kaplan et al. (2020). Scaling laws for neural language models.
- Wen et al. (2026). Hyperball optimization / MuonH.
- Luo et al. (2026). Curriculum Model Averaging (CMA).
- Luo et al. (2025b). Multi-Power Law (MPL) for learning-rate schedules.
- Luo et al. (2025a). Kaiyuan-Spark data preprocessing framework.
- DeepSeek-AI et al. (2024). DeepSeek-V3 (blockwise FP8 recipe).
- Micikevicius et al. (2022). FP8 formats for deep learning (E4M3/E5M2).
- Hu et al. (2024). MiniCPM / Warmup-Stable-Decay (WSD) schedule.
- Shen et al. (2024b). Power learning-rate schedule.
- Shoeybi et al. (2019); Narayanan et al. (2021). Megatron-LM / pipeline parallelism.
- Muennighoff et al. (2025). OLMoE. · Walsh et al. (2025). OLMo 2. · Allal et al. (2025). SmolLM. · Bakouch et al. (2025). SmolLM3. · Yiwen et al. (2025). YuLan-Mini. · Liu et al. (2025). Instella. · Hall et al. (2025). Marin.
- Yang et al. (2024a/b, 2025a). Qwen2 / Qwen2.5 / Qwen3. · Rivière et al. (2024); Gemma Team (2025). Gemma-2 / Gemma-3. · Meta AI (2024b). Llama 3.2.
- Cobbe et al. (2021). GSM8K. · Hendrycks et al. (2021a/b). MMLU / MATH. · Austin et al. (2021). MBPP. · Chen et al. (2021). HumanEval. · Wang et al. (2024b). MMLU-Pro. · Suzgun et al. (2023). Big-Bench Hard. · Lambert et al. (2024). Tulu-3. · Contributors (2023). OpenCompass. · Gu et al. (2025). OLMES.
術語對照表
| English | 繁體中文 |
|---|---|
| Pretraining | 預訓練 |
| Reproduction cost | 重現成本 |
| Rental-equivalent accounting | 租用等值計費 |
| Open-weight / open-recipe model | 開放權重 / 開放配方模型 |
| Consumer-grade GPU | 消費級 GPU |
| MFU (Model FLOPs Utilization) | 模型 FLOPs 利用率 |
| Blockwise FP8 | 分塊 FP8 |
| E4M3 / E5M2 / MXFP8 | E4M3 / E5M2 / MXFP8(FP8 格式) |
| BF16 / FP32 | BF16 / FP32 |
| Muon / MuonH / Hyperball | Muon / MuonH / Hyperball(優化器) |
| Effective learning rate (ELR) | 有效學習率 |
| Scale invariance | 尺度不變 |
| Frobenius radius / norm | Frobenius 半徑 / 範數 |
| AdamW | AdamW |
| Learning rate schedule | 學習率排程 |
| Warmup-Stable-Decay (WSD) | 暖身-穩定-衰減 |
| Power schedule | 冪排程 |
| Multi-Power Law (MPL) | 多冪律 |
| Curriculum Model Averaging (CMA) | 課程模型平均 |
| Data curriculum | 資料課程 |
| Checkpoint averaging | 檢查點平均 |
| Two-phase pretraining | 兩階段預訓練 |
| Replay | 重播 |
| Proxy experiment / benchmarking | 代理實驗 / 代理基準 |
| Capability profile | 能力輪廓 |
| Data mixture / recipe | 資料混合 / 配方 |
| Deduplication (MinHash) | 去重(MinHash) |
| Supervised fine-tuning (SFT) | 監督式微調 |
| Post-training | 後訓練 |
| Data / pipeline / tensor parallelism | 資料 / 管線 / 張量平行 |
| Micro-batch size (MBS) | micro-batch 大小 |
| GEMM | GEMM(通用矩陣乘法) |
| PCIe P2P / GPUDirect RDMA (GDR) | PCIe 點對點 / GPUDirect RDMA |
| Cost scaling law | 成本 scaling law |
| Compute-equivalent multiplier | 運算等值乘數 |
| Token-per-parameter (TPP) | 每參數 token 數 |