Muon 可以擴展到 LLM 訓練
原始論文:Muon is Scalable for LLM Training 作者:Jingyuan Liu、Jianlin Su、Xingcheng Yao、Zhejun Jiang、Guokun Lai、Yulun Du、Yidao Qin、Weixin Xu、Enzhe Lu、Junjie Yan、Yanru Chen、Huabin Zheng、Yibo Liu、Shaowei Liu、Bohong Yin、Weiran He、Han Zhu、Yuzhi Wang、Jianzhou Wang、Mengnan Dong、Zheng Zhang、Yongsheng Kang、Hao Zhang、Xinran Xu、Yutao Zhang、Yuxin Wu、Xinyu Zhou、Zhilin Yang 機構:Moonshot AI、UCLA 日期:2025 年 2 月 24 日 標籤:LLM Muon Optimizer MoE Scaling Law 開源模型
程式碼與權重:github.com/MoonshotAI/Moonlight 授權:MIT License;Copyright © 2025 Moonshot AI。完整授權條款見附錄 G。
【譯註 — 來源與授權】這篇與 Kimi K3 一樣,同一份文件存在兩份授權不同的拷貝:
- arXiv 版(2502.16982v1)是
CC BY-NC-ND 4.0,ND 條款禁止衍生作品,不能翻譯。- GitHub 版(
MoonshotAI/Moonlight的Moonlight.pdf)隨附 MIT License,其授權標的原文就寫著 "this software and associated documentation files",並授予 modify/publish/distribute 的權利。本譯文依據的是 GitHub 那份拷貝,並依 MIT 的要求於附錄 G 附上完整的版權與授權聲明。
目錄
- 摘要
- 1 引言
- 2 方法
- 3 實驗
- 4 討論
- 5 結論
- 附錄 A Update RMS
- 附錄 B AdamW 基準的 scaling law
- 附錄 C 模型架構
- 附錄 D 訓練穩定性
- 附錄 E 與更高算力模型的比較
- 附錄 F 權重矩陣的奇異值分布
- 附錄 G 原始授權條款
- 參考文獻
- 術語對照表
摘要
近來,基於矩陣正交化的 Muon 優化器 (K. Jordan et al. 2024) 在訓練小規模語言模型上展現了強勁的成果,但它能否擴展到更大的模型尚未被證明。我們指出把 Muon 擴大規模的兩項關鍵技術:(1) 加入權重衰減 (Weight Decay),(2) 謹慎地調整逐參數的更新尺度。這些技術讓 Muon 在大規模訓練上開箱即用,不需要調超參數。Scaling law 實驗顯示,在計算最佳 (compute optimal) 的訓練下,Muon 相對於 AdamW 達到約 2 倍的計算效率。基於這些改良,我們推出 Moonlight——一個以 Muon 訓練、3B/16B 參數的混合專家 (MoE) 模型,訓練了 5.7T tokens。我們的模型改進了當前的 Pareto 前沿,以遠少的訓練 FLOPs 取得比先前模型更好的效能。我們開源了記憶體最佳、通訊高效的分散式 Muon 實作,也釋出預訓練、指令微調與中間檢查點,以支持後續研究。
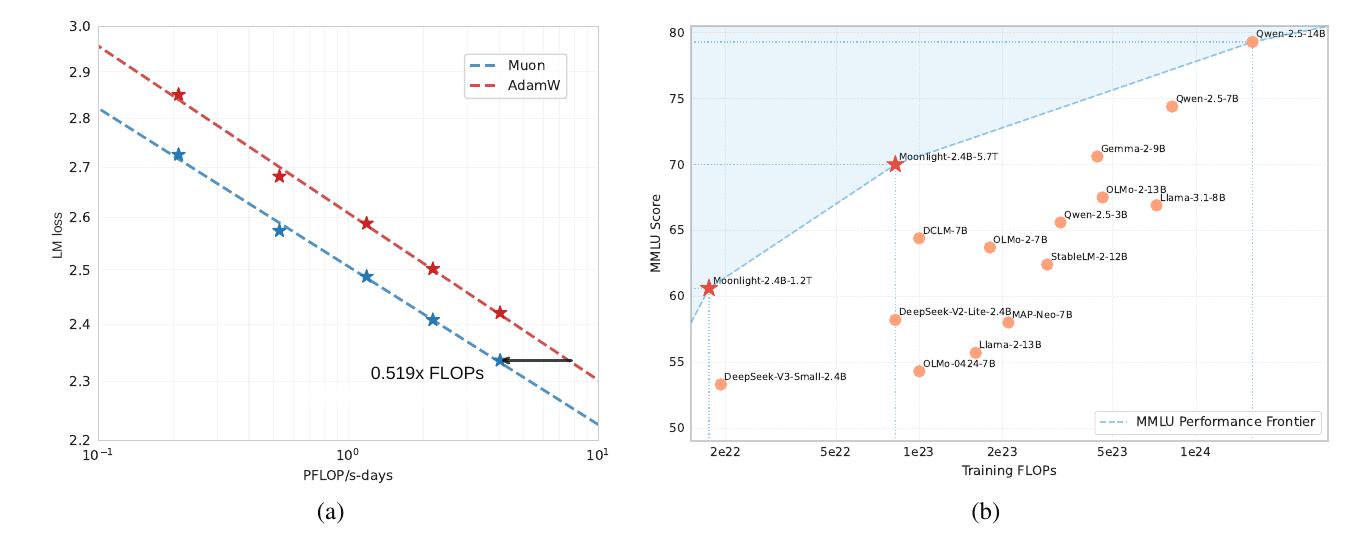
圖 1:用 Muon 擴大規模。(a) 比較 Muon 與 Adam 的 scaling law 實驗。在計算最佳訓練下,Muon 的樣本效率是 Adam 的約 2 倍。(b) 我們以 Muon 優化的 Moonlight 模型與其他可比模型的 MMLU 表現。Moonlight 推進了「效能對訓練 FLOPs」的 Pareto 前沿。
1 引言
大型語言模型 (LLM) 的快速進展 (OpenAI et al. 2024; DeepSeek-AI et al. 2024; Grattafiori et al. 2024; Gemini Team et al. 2024) 大幅推動了通用人工智慧的發展。然而,由於 scaling law 的存在 (Kaplan et al. 2020; Hoffmann et al. 2022),訓練有能力的 LLM 仍然是一個計算密集、資源吃重的過程。優化器在高效且有效地訓練 LLM 上扮演關鍵角色,而 Adam (Kingma et al. 2015) 及其變體 AdamW (Loshchilov et al. 2019) 是絕大多數大規模訓練的標準選擇。
近期優化演算法的發展顯示出超越 AdamW 的訓練效率潛力 (Liu et al. 2024; K. Jordan et al. 2024; Yuan et al. 2024; Vyas et al. 2025; 等)。其中,K. Jordan et al. 2024 提出了 Muon,它用 Newton–Schulz 迭代把梯度動量正交化來更新矩陣參數。Muon 的初步實驗在小規模語言模型訓練上展現了很有希望的結果。然而,如該篇部落格 (K. Jordan et al. 2024) 所討論的,仍有幾個關鍵挑戰未被解決:(1) 如何把基於矩陣正交化的優化器有效地擴展到用數兆 token 訓練的數十億參數模型;(2) 如何在分散式環境下計算近似正交化;(3) 這類優化器能否跨越不同訓練階段(包含預訓練與監督式微調 SFT)而通用。
在這份技術報告中,我們針對這些挑戰提出一份完整的研究。我們的工作建立在 Muon 之上,並系統性地指出與解決它在大規模訓練情境下的限制。我們的技術貢獻包括:
- 對 Muon 有效擴展的分析:透過大量分析,我們指出權重衰減對 Muon 的可擴展性扮演關鍵角色。此外,我們對 Muon 的逐參數更新規則提出尺度調整。這些調整讓 Muon 不需調超參數就能開箱即用,也顯著改善訓練穩定性。
- 高效的分散式實作:我們開發了 ZeRO-1 (Rajbhandari et al. 2020) 風格的分散式版本 Muon,在保留演算法數學性質的同時,達成最佳的記憶體效率與更低的通訊開銷。
- Scaling law 驗證:我們進行了把 Muon 與強力 AdamW 基準相比的 scaling law 研究,展現 Muon 的優越表現(圖 1a)。根據 scaling law 的結果,Muon 只需要約 52% 的訓練 FLOPs 就能達到與 AdamW 訓練版本相當的效能。
我們的完整實驗證明 Muon 能有效取代 AdamW 成為大規模 LLM 訓練事實上的優化器,在訓練效率與模型效能上都帶來顯著改善。作為這項工作的成果,我們釋出 Moonlight——一個以 Muon 訓練的 16B 參數 MoE 模型——連同我們的實作與中間訓練檢查點,以促進 LLM 可擴展最佳化技術的後續研究。
2 方法
2.1 背景
Muon 優化器。 Muon (K. Jordan et al. 2024) 近期被提出,用來最佳化可表示成矩陣的神經網路權重。在迭代 $t$,給定當前權重 $W_{t-1}$、動量 $\mu$、學習率 $\eta_t$ 與目標函數 $L_t$,Muon 的更新規則如下:
$$M_t = \mu M_{t-1} + \nabla L_t(W_{t-1})$$
$$O_t = \mathrm{Newton\text{-}Schulz}(M_t)$$
$$W_t = W_{t-1} - \eta_t O_t \tag{1}$$
其中 $M_t$ 是迭代 $t$ 的梯度動量,在 $t = 0$ 時設為零矩陣。在式 1 中,採用 Newton–Schulz 迭代流程 (Bernstein et al. 2024) 來近似求解 $(M_t M_t^{\top})^{-1/2}M_t$。令 $U\Sigma V^{\top} = M_t$ 為 $M_t$ 的奇異值分解 (SVD),則 $(M_t M_t^{\top})^{-1/2}M_t = UV^{\top}$,也就是把 $M_t$ 正交化。直覺上,正交化能確保更新矩陣是同構的,防止權重只沿少數幾個主導方向學習 (K. Jordan et al. 2024)。
實務上,我們遵循 (K. Jordan et al. 2024) 使用 Nesterov 式動量:把 $\mu M_t + \nabla L_t(W_{t-1})$ 而不是 $M_t$ 送進 Newton–Schulz 迭代。
用於矩陣正交化的 Newton–Schulz 迭代。 式 1 以迭代流程計算。一開始設 $X_0 = M_t/\lVert M_t \rVert_F$,接著在每次迭代 $k$,從 $X_{k-1}$ 更新 $X_k$:
$$X_k = aX_{k-1} + b\left(X_{k-1}X_{k-1}^{\top}\right)X_{k-1} + c\left(X_{k-1}X_{k-1}^{\top}\right)^2 X_{k-1} \tag{2}$$
其中 $X_N$ 是 $N$ 次迭代之後的結果,$a, b, c$ 為係數。為了確保式 2 正確收斂,我們需要調整這些係數,讓多項式 $f(x) = ax + bx^3 + cx^5$ 在 1 附近有一個不動點。在 K. Jordan et al. 2024 的原始設計中,係數設為 $a = 3.4445$、$b = -4.7750$、$c = 2.0315$,好讓迭代流程對較小的初始奇異值收斂得更快。本工作沿用相同的係數設定。
範數約束下的最陡下降。 Bernstein et al. 2024 提出把深度學習的最佳化過程視為範數約束下的最陡下降。從這個觀點看,Muon 與 Adam (Kingma et al. 2015; Loshchilov et al. 2019) 的差別就是範數約束的差別。Adam 是在一個由 Max-of-Max 範數動態調整而來的範數約束下做最陡下降,而 Muon 提供的範數約束則落在某個大 $p$ 的 Schatten-$p$ 範數的靜態範圍內 (Franz 2024)。當式 1 被精確計算時,Muon 提供的範數約束就是譜範數 (spectral norm)。神經網路的權重是作用在輸入空間或隱藏空間上的算子,而這些空間通常是(局部)歐氏的 (Cesista 2024),所以權重上的範數約束應該是一個誘導算子範數(對權重矩陣而言就是譜範數)。從這個意義上說,Muon 提供的範數約束比 Adam 提供的更合理。
2.2 把 Muon 擴展到大規模
權重衰減。 雖然 K. Jordan et al. 2024 顯示 Muon 在小規模上明顯優於 AdamW,我們發現當我們擴大到用更多 token 訓練更大的模型時,效能增益會縮水。我們觀察到權重與層輸出的 RMS 都持續成長到很大的尺度,超出 bf16 的高精度範圍,這可能損害模型效能。為了解決這個問題,我們把標準的 AdamW (Loshchilov et al. 2019) 權重衰減機制引入 Muon:
$$W_t = W_{t-1} - \eta_t\left(O_t + \lambda W_{t-1}\right) \tag{3}$$
我們對有無權重衰減的 Muon 都做了實驗,以理解它對 LLM 訓練動態的影響。根據 3.2 節的 scaling law 研究,我們訓練了一個 800M 參數的模型、用 100B tokens(約為最佳訓練 token 數的 5 倍)。圖 2 顯示以 AdamW、原版 Muon(無權重衰減)、以及帶權重衰減的 Muon 訓練的模型的驗證損失曲線。雖然原版 Muon 一開始收斂較快,我們觀察到部分模型權重隨時間長得過大,可能限制模型的長期表現。加入權重衰減解決了這個問題——結果顯示帶權重衰減的 Muon 同時勝過原版 Muon 與 AdamW,在過度訓練 (over-train) 區間取得更低的驗證損失。因此我們把更新規則調整成式 3,其中 $\lambda$ 是權重衰減比例。
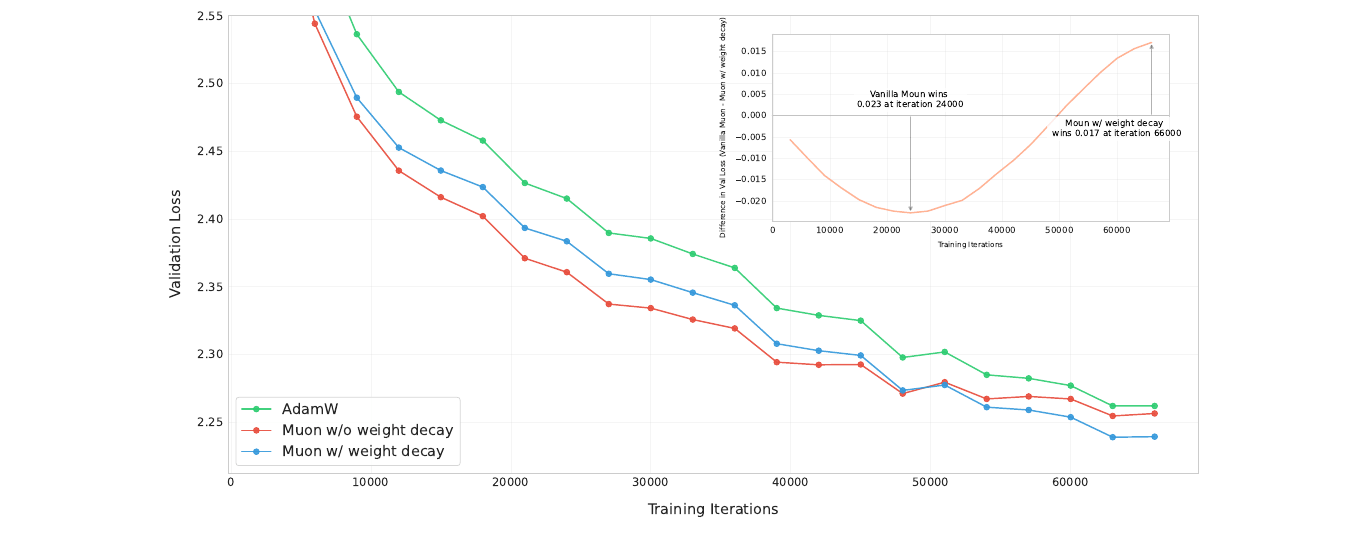
圖 2:AdamW(綠)、無權重衰減的 Muon(紅)與帶權重衰減的 Muon(藍)的驗證損失曲線。內嵌小圖是「原版 Muon 減去帶權重衰減 Muon」的驗證損失差:原版 Muon 在第 24000 步領先 0.023,而帶權重衰減的 Muon 在第 66000 步領先 0.017。
一致的 update RMS。 Adam 與 AdamW (Kingma et al. 2015; Loshchilov et al. 2019) 的一個重要性質,是它們維持約為 1 的理論 update RMS。然而我們指出,Muon 的 update RMS 會隨參數形狀而變,如下列引理所述:
引理 1. 對形狀為 $[A, B]$ 的滿秩矩陣參數,其理論 Muon update RMS 為 $1/\sqrt{\max(A,B)}$。
證明見附錄 A。我們在訓練期間監控 Muon 的 update RMS,發現它通常接近上述理論值。我們注意到這種不一致在擴大模型規模時會出問題:
- 當 $\max(A,B)$ 太大時(例如密集的 MLP 矩陣),更新會變得太小,因而限制模型的表徵能力、導致次佳的表現;
- 當 $\max(A,B)$ 太小時(例如把 GQA (Shazeer 2019) 或 MLA (DeepSeek-AI et al. 2024) 中的每個 KV head 當成獨立參數),更新會變得太大,造成訓練不穩定,同樣導致次佳的表現。
匹配 AdamW 的 update RMS。 Muon 是為了更新矩陣式參數而設計的。實務上,AdamW 用來處理非矩陣式參數,例如 RMSNorm、LM head 與 embedding 參數。我們希望 Muon 的 update RMS 與 AdamW 相近。從經驗觀察,AdamW 的 update RMS 通常在 0.2 到 0.4 之間。因此我們用以下調整把 Muon 的 update RMS 縮放到這個範圍:
$$W_t = W_{t-1} - \eta_t\left(0.2 \cdot O_t \cdot \sqrt{\max(A,B)} + \lambda W_{t-1}\right) \tag{4}$$
我們用實證結果驗證了這個選擇(細節見附錄 A)。此外,我們要強調:有了這項調整,Muon 可以直接沿用為 AdamW 調好的學習率。
其他超參數。 Muon 還有兩個可調的超參數:Newton–Schulz 迭代步數 $N$ 與動量 $\mu$。我們實證觀察到,把 $N$ 設在 5 到 10 之間時,迭代過程會產生更精確的正交化結果($N \approx 5$ 時已經不會再帶來更好的表現)。因此為了效率我們在本工作中設 $N = 5$。我們並未觀察到一致的效能增益,所以沿用 K. Jordan et al. 2024 的 0.95 動量。
2.3 Distributed Muon
ZeRO-1 與 Megatron-LM。 Rajbhandari et al. 2020 提出 ZeRO-1 技術,把昂貴的優化器狀態(例如主權重、動量)切分到整個叢集上。Megatron-LM (Shoeybi et al. 2020) 把 ZeRO-1 整合進其原生的平行設計中。基於 Megatron-LM 精緻的平行策略(例如張量平行 TP、流水線平行 PP、專家平行 EP 與資料平行 DP),ZeRO-1 的通訊工作量可以從「在整個分散式世界中收集」縮減成「只在資料平行群組內收集」。
方法。 ZeRO-1 對 AdamW 很有效率,因為 AdamW 是以逐元素的方式計算更新。然而 Muon 需要完整的梯度矩陣才能算出更新,因此原版 ZeRO-1 無法直接套用在 Muon 上。
我們基於 ZeRO-1 為 Muon 提出一個新的分散式方案,稱為 Distributed Muon。Distributed Muon 遵循 ZeRO-1 把優化器狀態切分在 DP 上,並相對於原版 ZeRO-1 AdamW 優化器引入兩項額外操作:
- DP Gather。 對一個本地 DP 切分的主權重(大小為模型權重的 1/DP),這個操作把對應的切分梯度收集成一個完整的梯度矩陣。
- 計算完整更新。 上述收集之後,對完整梯度矩陣執行 2.1 節所述的 Newton–Schulz 迭代步驟。注意我們接著會丟棄完整更新矩陣的一部分,因為我們只需要對應本地參數的那一份切分來執行更新。
Distributed Muon 的實作見演算法 1。
演算法 1:Distributed Muon
輸入:完整梯度 G、DP 切分的動量 m、DP 切分的參數 p、動量係數 μ

 1: // 在 DP 上 reduce-scatter G 以取得正確的梯度
 2: g = reduce_scatter(G, dp_group)
 3: // 用本地切分的動量 m 對 g 施加動量
 4: g' = update_with_momentum(g, m, μ)
 5: // DP Gather:把 g' 跨 DP 收集成完整矩陣 G
 6: G = gather(g', dp_group)                        ← Distributed Muon 新增
 7: // 計算 Muon 更新
 8: U = Newton-Schulz(G)                            ← Distributed Muon 新增
 9: // 丟棄 U 其餘部分,只保留本地切分 u,然後套用更新規則
10: p' = apply_update(p, u)
11: // 把更新後的 p' all-gather 成 P
12: P = all_gather(p', dp_group)
13: // 回傳 update RMS 供記錄
14: return sqrt(u².mean())
分析。 我們從幾個面向把 Distributed Muon 與經典的 ZeRO-1 分散式 AdamW(以下簡稱 Distributed AdamW)比較:
- 記憶體用量。 Muon 只用一個動量緩衝區,而 AdamW 用兩個。因此 Muon 優化器所用的額外記憶體是 Distributed AdamW 的一半。
- 通訊開銷。 對每個裝置而言,額外的 DP gather 只需要針對本地 DP 切分的參數 $p$。因此其通訊成本小於 $G$ 的 reduce-scatter 或 $P$ 的 all-gather。此外,Muon 只需要以 bf16 執行 Newton–Schulz 迭代步驟,相較 fp32 進一步把這部分的通訊開銷降到 50%。整體而言,Distributed Muon 的通訊工作量是 Distributed AdamW 的 $(1, 1.25]$ 倍。上界的計算是:Distributed Muon 的通訊為 4(fp32 的 $G$ reduce-scatter)+ 2(bf16 的 Muon gather)+ 4(fp32 的 $P$ all-gather),而 Distributed AdamW 為 4 + 4。實務上由於我們通常以多個 DP 訓練,經驗上的額外成本通常更接近下界 1。
- 延遲。 Distributed Muon 的端到端延遲比 Distributed AdamW 大,因為它引入額外通訊並需要執行 Newton–Schulz 迭代步驟。但這不是顯著問題,因為 (a) 只需要約 5 次 Newton–Schulz 迭代就有好結果(見 2.2 節討論),而且 (b) 優化器造成的端到端延遲相對於模型的前向—反向傳遞時間可以忽略(通常只有 1% 到 3%)。此外,若干工程技巧——例如把 gather 與計算重疊、把優化器的 reduce-scatter 與參數 gather 重疊——還能進一步降低延遲。
在我們的分散式叢集上訓練大規模模型時,Distributed Muon 相對於其 AdamW 對應版本沒有明顯的延遲開銷。(若啟用 TP,Distributed Muon 需要在 TP 群組上多做一次 bf16 的 TP gather。)
3 實驗
3.1 一致的 update RMS
如 2.2 節所述,我們希望讓所有矩陣參數的 update RMS 彼此一致,並與 AdamW 的一致。我們實驗了兩種控制 Muon update RMS 的方法,並與一個「只維持與 AdamW 一致 RMS」的基準比較:
- Baseline。 我們把更新矩陣乘上 $0.2\cdot\sqrt{H}$($H$ 是模型隱藏維度),以維持與 AdamW 一致的 update RMS。注意對大多數矩陣而言 $\max(A,B)$ 等於 $H$。
$$W_t = W_{t-1} - \eta_t\left(0.2 \cdot O_t \cdot \sqrt{H} + \lambda W_{t-1}\right) \tag{5}$$
- Update Norm。 我們可以直接把 Newton–Schulz 迭代算出的更新正規化,讓它的 RMS 嚴格變成 0.2:
$$W_t = W_{t-1} - \eta_t\left(0.2 \cdot O_t / \mathrm{RMS}(O_t) + \lambda W_{t-1}\right) \tag{6}$$
- Adjusted LR。 對每個更新矩陣,我們可以依其形狀,把它的學習率乘上 $0.2\cdot\sqrt{\max(A,B)}$:
$$W_t = W_{t-1} - \eta_t\left(0.2 \cdot O_t \cdot \sqrt{\max(A,B)} + \lambda W_{t-1}\right) \tag{7}$$
分析。 我們設計實驗來說明 update RMS 在訓練早期的影響,因為我們觀察到在較大規模訓練時,非預期的行為很快就會出現。我們用 3.2 節所述的 800M 小規模模型做實驗。當矩陣維度之間的差距越大,update RMS 不一致的問題就越明顯。為了凸顯這個問題以便進一步研究,我們稍微修改模型架構,把 SwiGLU MLP 換成標準的 2 層 MLP,使其矩陣參數的形狀從 $[H, 2.6H]$ 變成 $[H, 4H]$。我們評估模型的損失,並監控其中幾個參數的 RMS,具體來說是注意力的 query(形狀 $[H,H]$)與 MLP(形狀 $[H,4H]$)。我們在 20B token 排程中訓練 4B token 之後評估模型。從表 1 我們觀察到幾項有趣的發現:
- Update Norm 與 Adjusted LR 都取得比 Baseline 更好的表現;
- 對形狀 $[H, 4H]$ 的 MLP 權重矩陣,Update Norm 與 Adjusted LR 得到的權重 RMS 大約是 Baseline 的兩倍。這是合理的,因為 $\sqrt{\max(H,4H)}/\sqrt{H} = 2$,所以 Update Norm 與 Adjusted LR 的 update RMS 大約是 Baseline 的兩倍;
- 對形狀 $[H, H]$ 的注意力 query 權重矩陣,Update Norm 仍然會把更新正規化,而 Adjusted LR 不會,因為 $\sqrt{\max(H,H)}/\sqrt{H} = 1$。結果 Adjusted LR 得到與 Baseline 相近的權重 RMS,而 Update Norm 的權重 RMS 則像它的 MLP 一樣偏大。
基於這些發現,我們在後續實驗中選用 Adjusted LR,因為它的成本較低。
表 1:在不同模型參數上控制 Muon 的 update RMS。
| 方法 | 訓練損失 | 驗證損失 | query 權重 RMS | MLP 權重 RMS |
|---|---|---|---|---|
| Baseline | 2.734 | 2.812 | 3.586e-2 | 2.52e-2 |
| Update Norm | 2.720 | 2.789 | 4.918e-2 | 5.01e-2 |
| Adjusted LR | 2.721 | 2.789 | 3.496e-2 | 4.89e-2 |
3.2 Muon 的 scaling law
為了與 AdamW 公平比較,我們在一系列 Llama (Grattafiori et al. 2024) 架構的密集模型上進行 scaling law 實驗。在優化器研究中,建立一個強力的基準至關重要。因此我們依循計算最佳的訓練設定 (Kaplan et al. 2020) 對 AdamW 的超參數做網格搜尋(網格搜尋實驗見附錄 B)。模型架構與超參數的細節見表 2。至於 Muon,如 2.2 節所述,由於我們已把 Muon 的 update RMS 匹配到 AdamW,我們直接沿用對 AdamW 基準最佳的那組超參數。
擬合出的 scaling law 曲線見圖 3,擬合方程式詳列於表 3。如圖 1a 所示,在計算最佳設定下,Muon 只需要約 52% 的訓練 FLOPs 就能追平 AdamW 的表現。
表 2:Scaling law 的模型與超參數。(批次大小以 8K 上下文長度的樣本數計。)
| 非 embedding 參數量 | Head | 層數 | Hidden | Tokens | 學習率 | 批次大小 |
|---|---|---|---|---|---|---|
| 399M | 12 | 12 | 1536 | 8.92B | 9.503e-4 | 96 |
| 545M | 14 | 14 | 1792 | 14.04B | 9.143e-4 | 128 |
| 822M | 16 | 16 | 2048 | 20.76B | 8.825e-4 | 160 |
| 1.1B | 18 | 18 | 2304 | 28.54B | 8.561e-4 | 192 |
| 1.5B | 20 | 20 | 2560 | 38.91B | 8.305e-4 | 256 |
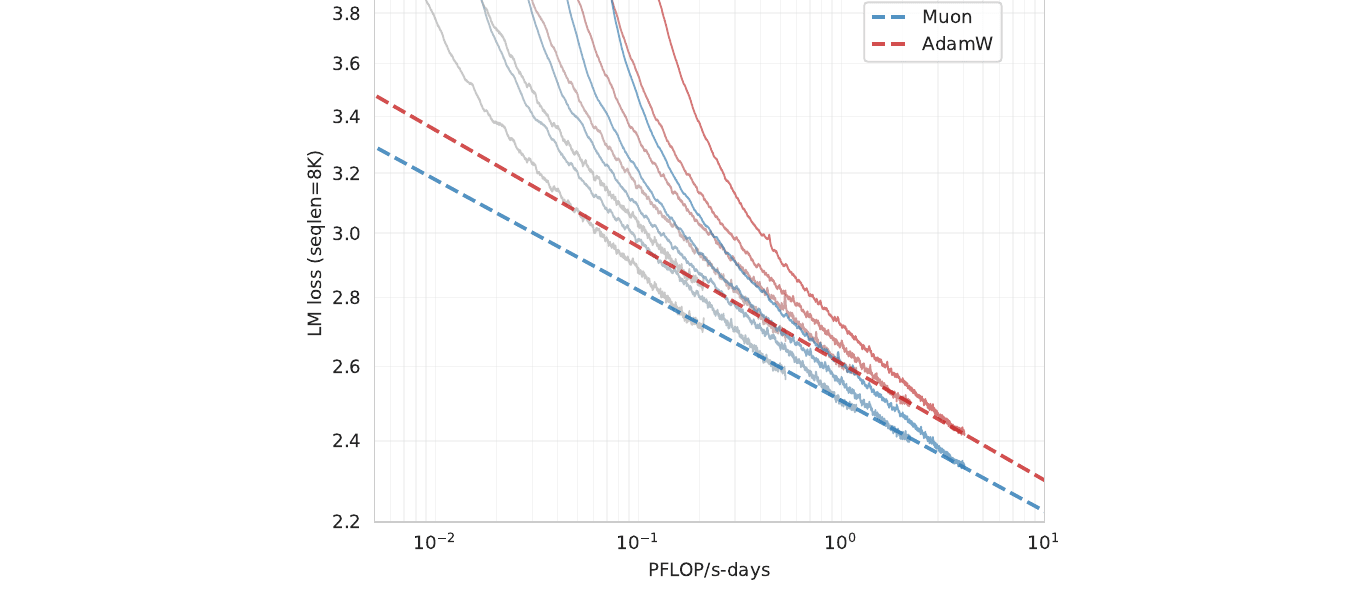
圖 3:Muon 與 AdamW 優化器的 scaling law 擬合曲線。
表 3:Scaling law 曲線的擬合參數。
| Muon | AdamW | |
|---|---|---|
| LM loss (seqlen=8K) | $2.506 \times C^{-0.052}$ | $2.608 \times C^{-0.054}$ |
3.3 用 Muon 做預訓練
模型架構。 為了在當代模型架構上評估 Muon,我們從零開始用 deepseek-v3-small 架構 (DeepSeek-AI et al. 2024) 預訓練,因為它表現強勁,且其原始結果可作為比較的參照。我們預訓練的模型有 2.24B 啟用參數與 15.29B 總參數(若計入 embedding 則是 3B 啟用/16B 總參數)。對架構的小幅修改詳見附錄 C。
預訓練資料。 預訓練資料的細節見 K. Team 2025。預訓練期間的最大上下文長度為 8K。
預訓練。 模型分幾個階段訓練。我們在階段 1 與 2 使用 1e-3 的 auxfree bias 更新率,階段 3 使用 0.0。權重衰減全程設為 0.1。更多訓練細節與討論見附錄 D。
- 0 到 33B tokens:學習率在 2k 步內線性上升到 4.2e-4,批次大小維持 2048 個樣本;
- 33B 到 5.2T tokens:學習率以餘弦方式從 4.2e-4 衰減到 4.2e-5。批次大小在 200B tokens 之前維持 2048,之後加倍為 4096;
- 5.2T 到 5.7T tokens(也稱 cooldown 階段):學習率在 100 步內升到 1e-4,然後在 500B tokens 內線性衰減到 0,批次大小固定為 4096。這個階段使用品質最高的資料,聚焦於數學、程式碼與推理。
評測基準。 我們的評測涵蓋四大類基準,各自評估模型不同的能力:
- 英文語言理解與推理:MMLU(5-shot)、MMLU-pro(5-shot)、BBH(3-shot)、TriviaQA(5-shot)
- 程式碼生成:HumanEval(pass@1)、MBPP(pass@1)
- 數學推理:GSM8K(4-shot)、MATH、CMATH
- 中文語言理解與推理:C-Eval(5-shot)、CMMLU(5-shot)
效能。 我們把以 Muon 訓練的模型命名為 Moonlight。我們先在 1.2T tokens 處評估 Moonlight,並與以下架構相同、訓練 token 數相當的模型比較:
- Deepseek-v3-Small (DeepSeek-AI et al. 2024):2.4B/16B 參數的 MoE 模型,訓練 1.33T tokens;
- Moonlight-A:訓練設定與 Moonlight 完全相同,只是改用 AdamW 優化器。
對 Moonlight 與 Moonlight-A,我們使用總計 5.7T 預訓練中 1.2T token 處的中間檢查點——此時學習率尚未衰減到最小值,模型也還沒經過 cooldown 階段。
表 4:約 1.2T tokens 處不同模型的比較。(參數量不含 embedding。)
| 基準(指標) | DSV3-Small | [email protected] | [email protected] |
|---|---|---|---|
| 啟用參數量 | 2.24B | 2.24B | 2.24B |
| 總參數量 | 15.29B | 15.29B | 15.29B |
| 訓練 tokens | 1.33T | 1.2T | 1.2T |
| 優化器 | AdamW | AdamW | Muon |
| 英文 MMLU | 53.3 | 60.2 | 60.4 |
| MMLU-pro | – | 26.8 | 28.1 |
| BBH | 41.4 | 45.3 | 43.2 |
| TriviaQA | – | 57.4 | 58.1 |
| 程式碼 HumanEval | 26.8 | 29.3 | 37.2 |
| MBPP | 36.8 | 49.2 | 52.9 |
| 數學 GSM8K | 31.4 | 43.8 | 45.0 |
| MATH | 10.7 | 16.1 | 19.8 |
| CMath | – | 57.8 | 60.2 |
| 中文 C-Eval | – | 57.2 | 59.9 |
| CMMLU | – | 58.2 | 58.8 |
如表 4 所示,我們以 AdamW 訓練的基準模型 Moonlight-A 相對於類似的公開模型已展現強勁表現。而 Moonlight 明顯優於 Moonlight-A,證明了 Muon 擴展的有效性。我們觀察到 Muon 在數學與程式碼相關任務上特別出色,並鼓勵研究社群進一步探究這個現象。在 Moonlight 完整訓練到 5.7T tokens 之後,我們把它與同規模的公開模型比較,結果見表 5:
- LLAMA3-3B (Grattafiori et al. 2024):3B 參數的密集模型,訓練 9T tokens。
- Qwen2.5-3B (Yang et al. 2024):3B 參數的密集模型,訓練 18T tokens。
- Deepseek-v2-Lite (DeepSeek-AI 2024):2.4B/16B 參數的 MoE 模型,訓練 5.7T tokens。
表 5:不同模型在各項基準上的比較。(參數量不含 embedding;TriviaQA 以完整測試集評測。)
| 基準(指標) | Llama3.2-3B | Qwen2.5-3B | DSV2-Lite | Moonlight |
|---|---|---|---|---|
| 啟用參數量 | 2.81B | 2.77B | 2.24B | 2.24B |
| 總參數量 | 2.81B | 2.77B | 15.29B | 15.29B |
| 訓練 tokens | 9T | 18T | 5.7T | 5.7T |
| 優化器 | AdamW | 未知 | AdamW | Muon |
| 英文 MMLU | 54.7 | 65.6 | 58.3 | 70.0 |
| MMLU-pro | 25.0 | 34.6 | 25.5 | 42.4 |
| BBH | 46.8 | 56.3 | 44.1 | 65.2 |
| TriviaQA | 59.6 | 51.1 | 65.1 | 66.3 |
| 程式碼 HumanEval | 28.0 | 42.1 | 29.9 | 48.1 |
| MBPP | 48.7 | 57.1 | 43.2 | 63.8 |
| 數學 GSM8K | 34.0 | 79.1 | 41.1 | 77.4 |
| MATH | 8.5 | 42.6 | 17.1 | 45.3 |
| CMath | – | 80.0 | 58.4 | 81.1 |
| 中文 C-Eval | – | 75.0 | 60.3 | 77.2 |
| CMMLU | – | 75.0 | 64.3 | 78.2 |
如表 5 所示,Moonlight 勝過那些架構相似、訓練 token 數相當的模型。即使與那些在大得多的資料集上訓練的密集模型相比,Moonlight 也維持競爭力。更詳細的比較見附錄 E。Moonlight 與其他知名語言模型在 MMLU 與 GSM8k 上的比較,見圖 1b 與附錄 E 的圖 8。值得注意的是,Moonlight 落在「模型效能對訓練預算」的 Pareto 前沿上,勝過許多不同規模的其他模型。
3.4 奇異值譜的動態
為了驗證「Muon 能在更多樣的方向上最佳化權重矩陣」這個直覺,我們對以 Muon 與 AdamW 訓練的權重矩陣做了譜分析。對一個奇異值為 $\sigma = (\sigma_1, \sigma_2, \cdots, \sigma_n)$ 的權重矩陣,我們計算其 SVD 熵 (Alter et al. 2000; Roy et al. 2007):
$$H(\sigma) = -\frac{1}{\log n}\sum_{i=1}^{n}\frac{\sigma_i^2}{\sum_{j=1}^{n}\sigma_j^2}\log\frac{\sigma_i^2}{\sum_{j=1}^{n}\sigma_j^2}$$
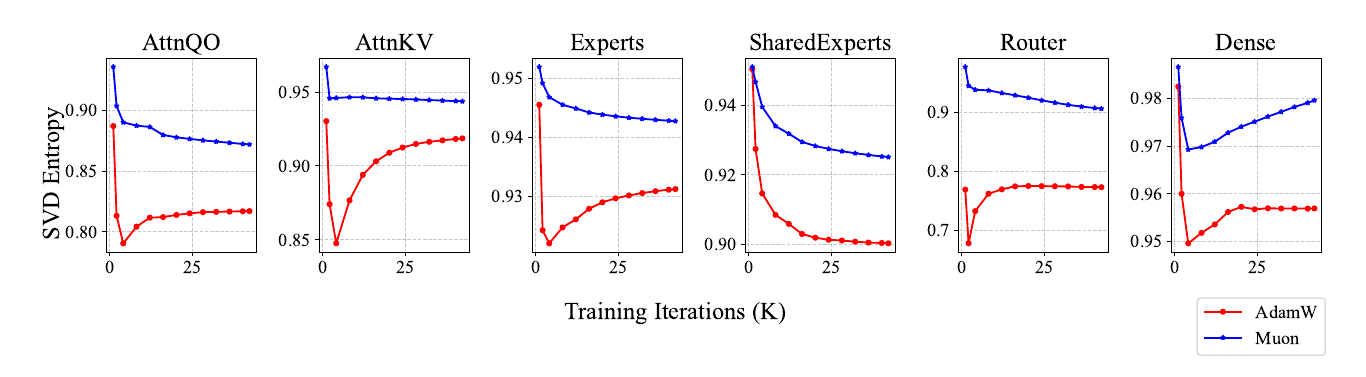
圖 4:不同訓練迭代下權重矩陣的 SVD 熵。我們把權重矩陣分成 6 組:1) AttnQO 為注意力層中 query 與 output 投影相關的權重矩陣;2) AttnKV 為 key 與 value 投影相關的權重矩陣;3) Experts 為專家模型中的權重矩陣;4) SharedExperts 為共享專家模型中的權重矩陣;5) Router 為 router 中的權重矩陣;6) Dense 為第一個密集層中的權重矩陣。SVD 熵取各組跨所有層的權重矩陣的巨觀平均。對專家模型中的權重,為了效率我們只計算不同層中 64 個專家裡的 3 個。
如圖 4 所示,我們視覺化了以 1.2T tokens 預訓練期間、不同訓練檢查點上權重矩陣的平均 SVD 熵。可以看到在所有訓練檢查點與所有權重矩陣分組上,Muon 的 SVD 熵都高於 AdamW,這驗證了「Muon 能為權重矩陣提供更多樣的更新譜」這個直覺。這個差距在專家選擇的 router 權重上尤其顯著,顯示混合專家模型可能從 Muon 獲益更多。
此外,我們把 1.2T tokens 檢查點上每個權重矩陣的奇異值分布視覺化,見附錄 F。我們發現對超過 90% 的權重矩陣而言,以 Muon 最佳化時的 SVD 熵高於 AdamW,為 Muon 在探索多樣最佳化方向上的優越能力提供了強力的實證支持。
3.5 用 Muon 做監督式微調
本節呈現 Muon 優化器在 LLM 訓練標準 SFT 階段的消融研究。我們的發現顯示 Muon 帶來的好處在 SFT 階段仍然存在:具體來說,一個同時以 Muon 預訓練、以 Muon 微調的模型在消融研究中表現最佳。然而我們也觀察到,當 SFT 的優化器與預訓練的優化器不同時,用 Muon 做 SFT 相對於 AdamW 並沒有明顯優勢。這顯示仍有相當大的探索空間,我們留待未來工作。
3.5.1 預訓練與 SFT 優化器可互換性的消融研究
為了進一步探究 Muon 的潛力,我們用 Muon 與 AdamW 兩種優化器分別微調 [email protected] 與 [email protected]。這些模型在開源的 tulu-3-sft-mixture 資料集 (Lambert et al. 2024) 上微調兩個 epoch,該資料集含 4k 序列長度的資料。學習率遵循線性衰減排程,從 $5\times10^{-5}$ 逐步降到 0。結果見表 6,凸顯了 [email protected] 相對於 [email protected] 的優越表現。
表 6:檢視預訓練與 SFT 階段之間優化器可互換性的影響。
| 基準(指標) | # Shots | Muon→Muon | AdamW→Muon | Muon→AdamW | AdamW→AdamW |
|---|---|---|---|---|---|
| 預訓練優化器 | – | Muon | AdamW | Muon | AdamW |
| SFT 優化器 | – | Muon | Muon | AdamW | AdamW |
| MMLU (EM) | 0-shot (CoT) | 55.7 | 55.3 | 50.2 | 52.0 |
| HumanEval (Pass@1) | 0-shot | 57.3 | 53.7 | 52.4 | 53.1 |
| MBPP (Pass@1) | 0-shot | 55.6 | 55.5 | 55.2 | 55.2 |
| GSM8K (EM) | 5-shot | 68.0 | 62.1 | 64.9 | 64.6 |
3.5.2 在公開預訓練模型上用 Muon 做 SFT
我們進一步把 Muon 套用在一個公開預訓練模型的監督式微調上,具體來說是 Qwen2.5-7B base 模型 (Yang et al. 2024),使用開源的 tulu-3-sft-mixture 資料集 (Lambert et al. 2024)。資料以 8k 序列長度打包,我們採用餘弦衰減學習率排程,從 $2\times10^{-5}$ 逐步降到 $2\times10^{-6}$。結果見表 7。作為對照,我們顯示 Muon 微調的模型與 Adam 微調的模型表現相當。這些結果顯示:若要獲得最佳表現,把 Muon 用在預訓練階段比用在監督式微調階段更有效。
表 7:Adam 與 Muon 優化器套用在 Qwen2.5-7B 預訓練模型 SFT 上的比較。
| 基準(指標) | # Shots | Adam-SFT | Muon-SFT |
|---|---|---|---|
| 預訓練模型 | – | Qwen2.5-7B | Qwen2.5-7B |
| MMLU (EM) | 0-shot (CoT) | 71.4 | 70.8 |
| HumanEval (Pass@1) | 0-shot | 79.3 | 77.4 |
| MBPP (Pass@1) | 0-shot | 71.9 | 71.6 |
| GSM8K (EM) | 5-shot | 89.8 | 85.8 |
4 討論
有幾個可能的未來研究方向,能進一步探索與擴展目前的發現。
把所有參數納入 Muon 框架。 目前 Muon 優化器是與 Adam 優化器搭配使用的,某些參數仍歸 Adam 最佳化。這種混合做法雖然可行,卻留下了改進空間。把所有參數的最佳化完全整合進 Muon 框架,是一個很有研究價值的主題。
把 Muon 延伸到 Schatten 範數。 Muon 可以被解讀為譜範數下的最陡下降法。鑑於 Schatten 範數的廣泛適用性與多樣性,把 Muon 延伸到一般的 Schatten 範數是一個有希望的方向。這個延伸可能解鎖額外的最佳化能力,並可能產生比目前基於譜範數的實作更好的結果。
理解並解決預訓練—微調的不匹配。 實務上觀察到的一個顯著現象是:以 AdamW 預訓練的模型用 Muon 微調時表現次佳,反之亦然。這種優化器不匹配,構成了「有效利用龐大 AdamW 預訓練檢查點資產」的重大障礙,因此需要嚴謹的理論研究。精確理解其背後機制,對設計穩健有效的解法至關重要。
5 結論
在這份技術報告中,我們針對 Muon 在 LLM 訓練上的可擴展性提出了一份完整的研究。透過系統性的分析與改良,我們成功地把 Muon 套用在一個以 5.7 兆 token 訓練的 3B/16B 參數 MoE 模型上。我們的結果證明 Muon 能有效取代 AdamW 成為大規模 LLM 訓練的標準優化器,在訓練效率與模型效能上都提供顯著優勢。透過開源我們的實作、Moonlight 模型與中間訓練檢查點,我們希望促進可擴展最佳化技術的後續研究,並加速 LLM 訓練方法的發展。
附錄 A Update RMS
引理 1 的證明。
不失一般性,考慮正交矩陣 $U \in \mathbb{R}^{n \times n}$ 與 $V \in \mathbb{R}^{m \times m}$,其中 $n \geq m \geq r$。我們將證明對 $X = U_{[:,:r]}V_{[:r,:]}$(Muon 的更新具有相同形式),其 RMS 值為 $\sqrt{r/mn}$。由矩陣乘法的定義:
$$X_{i,j} = \sum_{k=1}^{r} U_{i,k}V_{k,j}$$
RMS 可表示為:
$$\mathrm{RMS}(X)^2 = \frac{1}{mn}\sum_{i=1}^{n}\sum_{j=1}^{m}\sum_{k=1}^{r}U_{i,k}^2 V_{k,j}^2 = \frac{1}{mn}\sum_{k=1}^{r}\left(\sum_{i=1}^{n}U_{i,k}^2\right)\left(\sum_{j=1}^{m}V_{k,j}^2\right) = \frac{1}{mn}\sum_{k=1}^{r}1 = \frac{r}{mn}$$
因此 $\mathrm{RMS}(X) = \sqrt{r/mn}$。對常見的滿秩情形,$r = m$,於是 $\mathrm{RMS}(X) = \sqrt{1/n}$。$\square$
讓 Muon 與 AdamW 的 update RMS 一致。 如 2.2 節所述,我們希望匹配 Muon 與 AdamW 的 update RMS。這在小規模模型上以實驗驗證:我們把 Muon 的 update RMS 設在 $[0.05, 0.1, 0.2, 0.4, 0.8]$,並以 AdamW 為基準。我們回報 2k 步(約 2B tokens)時的損失與代表性權重矩陣的 RMS,見表 8。從結果可見,0.2 RMS 與 0.4 RMS 表現相近,且明顯優於其他設定。這些發現與我們「AdamW 的 update RMS 落在 0.2 ~ 0.4」的經驗觀察一致。我們選擇把 Muon 的 update RMS 控制在 0.2。
表 8:Muon update RMS 實驗。(除第一欄外,其餘都是使用受控 RMS 的 Muon。)
| 優化器 | AdamW | 0.05 RMS | 0.1 RMS | 0.2 RMS | 0.4 RMS | 0.8 RMS |
|---|---|---|---|---|---|---|
| LM 訓練損失 | 3.512 | 3.355 | 3.239 | 3.198 | 3.199 | 3.386 |
| LM 驗證損失 | 3.679 | 3.503 | 3.374 | 3.325 | 3.314 | 3.543 |
| AttnQ 權重 RMS | 1.01e-2 | 5.74e-3 | 8.44e-3 | 1.57e-2 | 2.95e-2 | 7.23e-2 |
| MLP 權重 RMS | 1.25e-2 | 8.01e-3 | 1.27e-2 | 2.35e-2 | 4.51e-2 | 8.73e-2 |
附錄 B AdamW 基準的 scaling law
為了確保實驗的公平性與準確性,我們在自有資料集上進行了一系列實驗,導出對 AdamW 最佳的 scaling law 參數。這包括在受限的計算預算(FLOPs,$C$)下決定最佳的模型大小 $N$、訓練 token 數 $D$、學習率 $\eta$ 與批次大小 $B$ (Kaplan et al. 2020; Hoffmann et al. 2022; Bi et al. 2024)。表 9 呈現我們系統性參數搜尋的結果。
表 9:Scaling law 參數與計算預算(FLOPs)之間的經驗關係。
| $N(C)$ | $D(C)$ | $\eta(C)$ | $B(C)$ |
|---|---|---|---|
| $0.0483359 \cdot C^{0.5112684}$ | $3.4480927 \cdot C^{0.4887316}$ | $0.0127339 \cdot C^{-0.0574752}$ | $0.0065202 \cdot C^{0.4137915}$ |
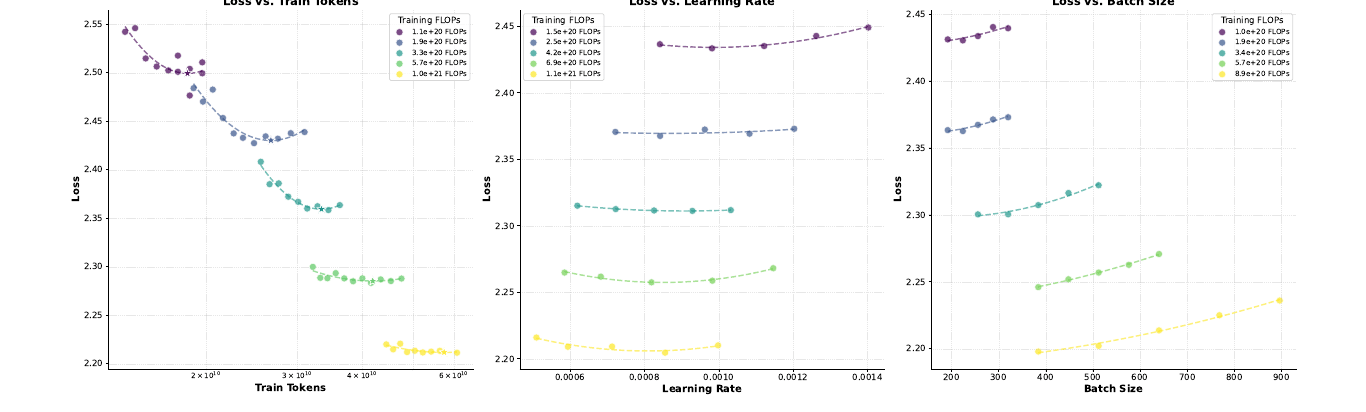
圖 5:跨 FLOPs 預算的 scaling law 超參數最佳化地景(損失對訓練 tokens、學習率、批次大小)。
超參數搜尋。 為了系統性地找出 AdamW 基準的最佳 scaling law 超參數,我們採用多階段的搜尋協定。首先,我們選定數個計算預算(FLOPs 等級),並依先前研究的經驗指引初始化模型大小、學習率與批次大小。對每個固定的 FLOPs 約束,我們變動模型大小 $N$,同時反向調整訓練 token 數 $D$ 以維持 $C = 6ND$,藉此探索模型容量與資料效率之間的取捨。每個配置都訓練到收斂,並記錄驗證損失,以決定 $N$ 與 $D$ 的 Pareto 最優組合。接著在固定最佳的 $N\text{–}D$ 配對後,我們透過網格搜尋精修學習率與批次大小,確保各配置的穩定性與收斂性。為了減輕局部極小值並提升穩健性,這個迭代流程重複 2–3 次,逐步縮小超參數空間。
這個最佳化過程在圖 5 中進一步說明:它描繪了損失地景如何隨訓練 tokens、學習率與批次大小變化,並橫跨不同的 FLOPs 預算。每條碗狀曲線代表某個 FLOPs 等級的損失曲面,各有一個對應最佳超參數配置的明確全域最小值。
附錄 C 模型架構
Muon 與模型架構無關,我們使用了類似 DeepSeek-V3-Small (DeepSeek-AI et al. 2024) 的模型,因為它是一個有開放權重的強力基準。我們在 Moonlight 模型上做了幾項小修改,列舉如下:
多 token 預測 (MTP)。 在我們的實驗中,MTP 並未對預訓練展現顯著好處。為求簡潔,我們不在 Moonlight 模型中引入 MTP 層。
Auxfree bias 更新。 在 DeepSeek-AI et al. 2024 中,auxfree bias 的更新方式為 $b_i = b_i + u \times \mathrm{sign}(e_i)$,其中 $u$ 是更新比率、$b_i$ 是第 $i$ 個專家的偏置、$e_i$ 是該專家的違反比率。我們把更新規則稍作修改為 $b_i = b_i + u \times (\mathrm{sign}(e_i) - \overline{\mathrm{sign}(e)})$,其中 $\overline{\mathrm{sign}(e)}$ 是所有專家違反比率符號的平均,藉此控制偏置的量級,同時不改變 top-k 的選擇邏輯。
Gate scaling factor。 Deepseek-V2-Lite 沒有使用 gate scaling factor,而 Deepseek-V3 用了 2.5。我們使用 2.446,以控制與密集模型相近的輸出 RMS。計算 gate scaling factor 的程式碼見圖 6。
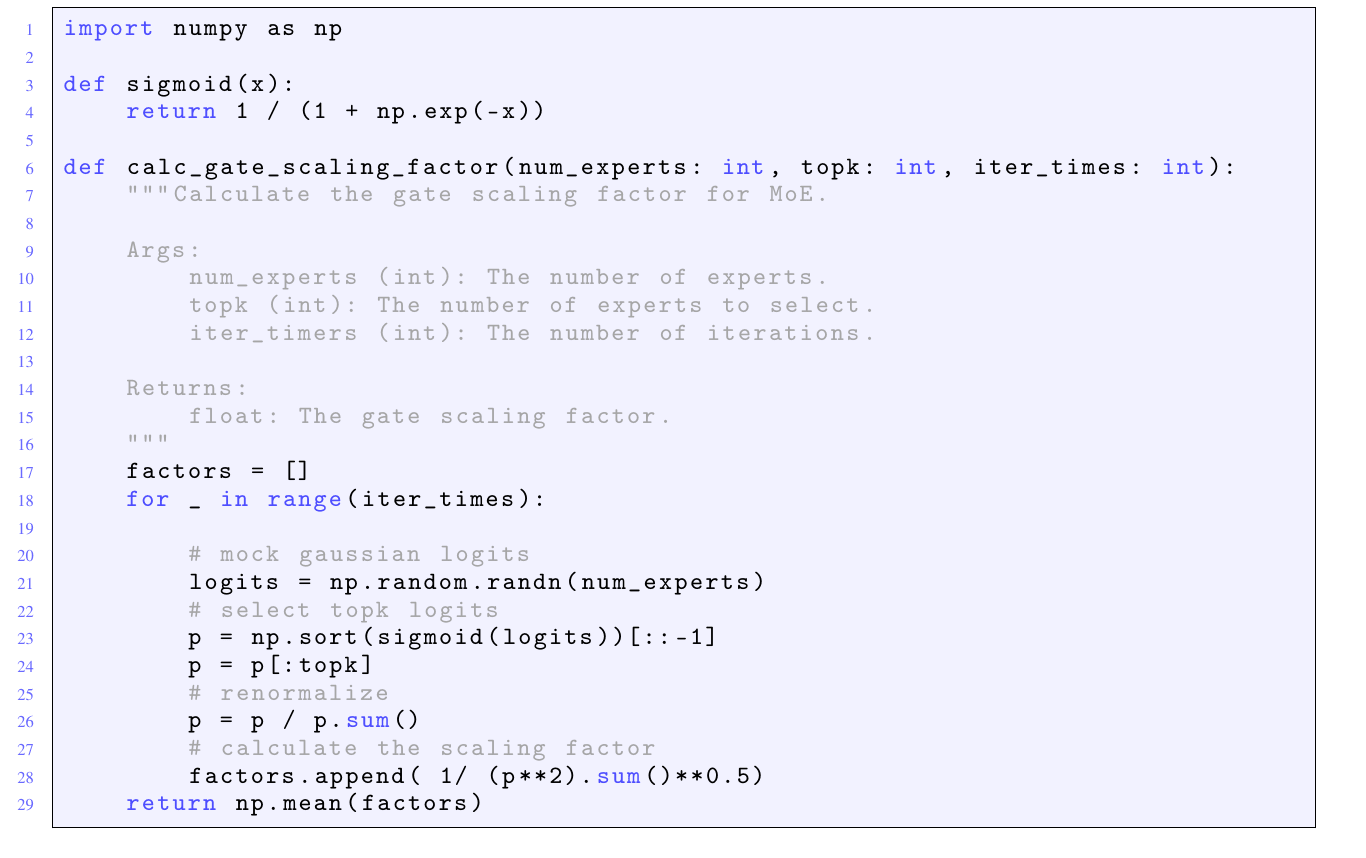
圖 6:計算 gate scaling factor 的 Python 實作。
附錄 D 訓練穩定性
沒有損失或梯度範數尖峰。 Moonlight 的訓練過程非常平順,我們沒有遇到任何損失尖峰或梯度範數尖峰。損失與梯度範數曲線見圖 7(Moonlight 為藍色,以 AdamW 訓練的 Moonlight-A 為紅色)。
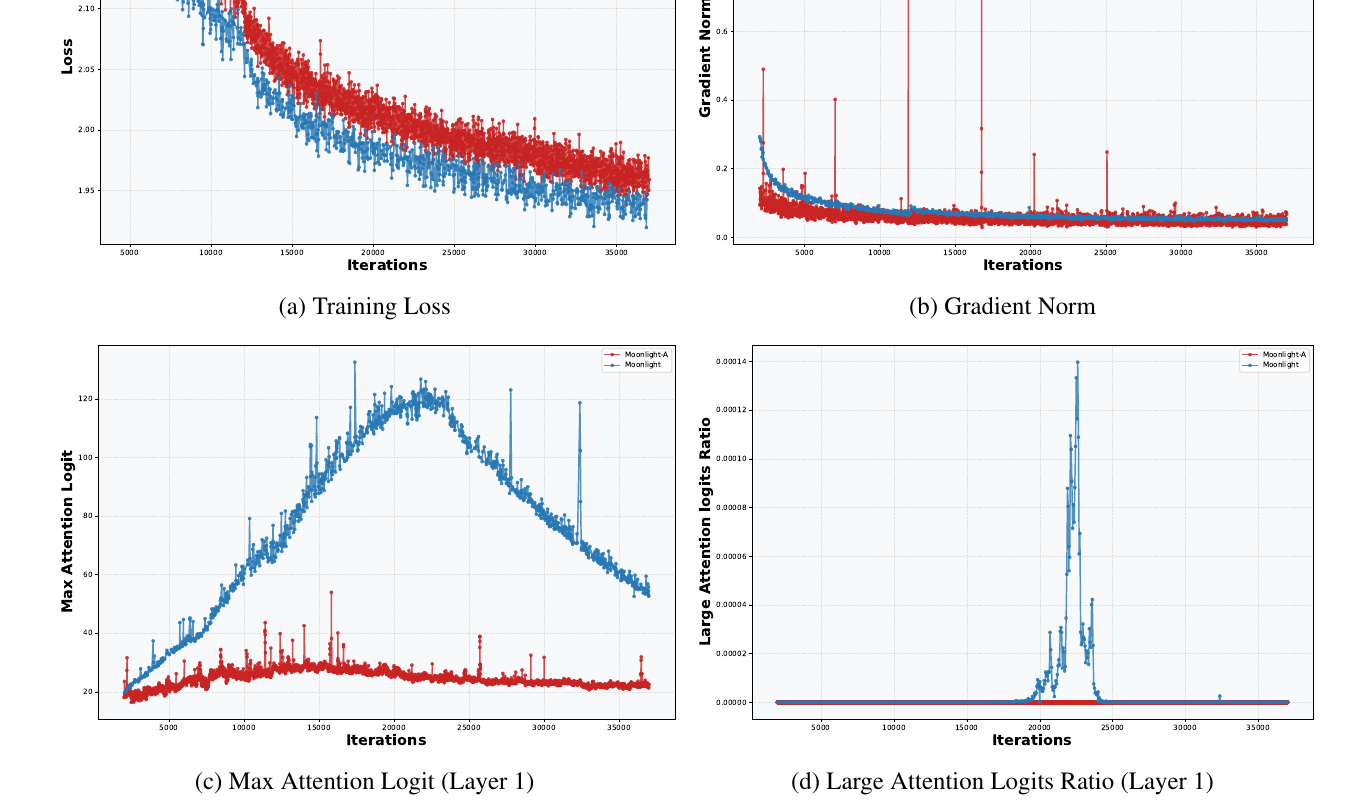
圖 7:Moonlight 與 Moonlight-A 的訓練動態比較。(a) 訓練損失;(b) 梯度範數;(c) 第 1 層的最大注意力 logit;(d) 第 1 層的大注意力 logits 比例。
最大注意力 logit。 訓練期間我們觀察到,雖然訓練損失與梯度範數全程保持穩定,但在初始訓練階段,特定層的最大注意力 logit(定義為全域批次中最大的單一 logit 值)呈現明顯的上升軌跡,超過 100 的門檻。值得注意的是,AdamW 在控制這個指標上比其他優化器表現得更健康。
為了進一步研究這個現象的影響,我們引入大注意力 logits 比例這個指標,定義為一個批次內超過 100 的注意力 logits 所佔的比例。如圖 7 所示,這個比例一直維持很低(約 $10^{-4}$),顯示極大的 logit 值是稀疏的。此外,最大 logit 值隨訓練推進而逐漸下降,顯示最佳化動態變得更健康。
RMSNorm gamma 的權重衰減。 值得注意的是,對 RMSNorm 的 gamma 參數施加權重衰減,對確保訓練穩定性至關重要,因為它能有效防止各層出現過高的輸出 RMS 值。
附錄 E 與更高算力模型的比較
表 10 呈現我們的 Moonlight 模型(以 Muon 最佳化)與那些用更多計算資源訓練的公開模型之間的比較分析,包括 LLama3.1-8B (Grattafiori et al. 2024)、Gemma-9B (Gemma Team et al. 2024) 與 Qwen2.5-7B (Yang et al. 2024)。圖 8 呈現 Moonlight 與同領域可比模型的 GSM8k 表現。
表 10:不同模型在各項基準上的比較。(參數量不含 embedding;TriviaQA 以完整測試集評測。)
| 基準(指標) | Moonlight | LLAMA3.1-8B | Gemma2-9B | Qwen2.5-7B |
|---|---|---|---|---|
| 啟用參數量 | 2.24B | 7.38B | 8.32B | 6.83B |
| 總參數量 | 15.29B | 7.38B | 8.32B | 6.83B |
| 訓練 tokens | 5.7T | 15T | 8T | 18T |
| 優化器 | Muon | AdamW | 未知 | 未知 |
| 英文 MMLU | 70.0 | 66.7 | 71.3 | 74.2 |
| MMLU-pro | 42.4 | 37.1 | 44.7 | 45.0 |
| BBH | 65.2 | 57.7 | 68.2 | 70.4 |
| TriviaQA | 66.3 | 70.3 | – | 60.0 |
| 程式碼 HumanEval | 48.1 | 37.2 | 37.8 | 57.9 |
| MBPP | 63.8 | 47.6 | 62.2 | 74.9 |
| 數學 GSM8K | 77.4 | 57.2 | 70.7 | 85.4 |
| MATH | 45.3 | 20.3 | 37.7 | 49.8 |
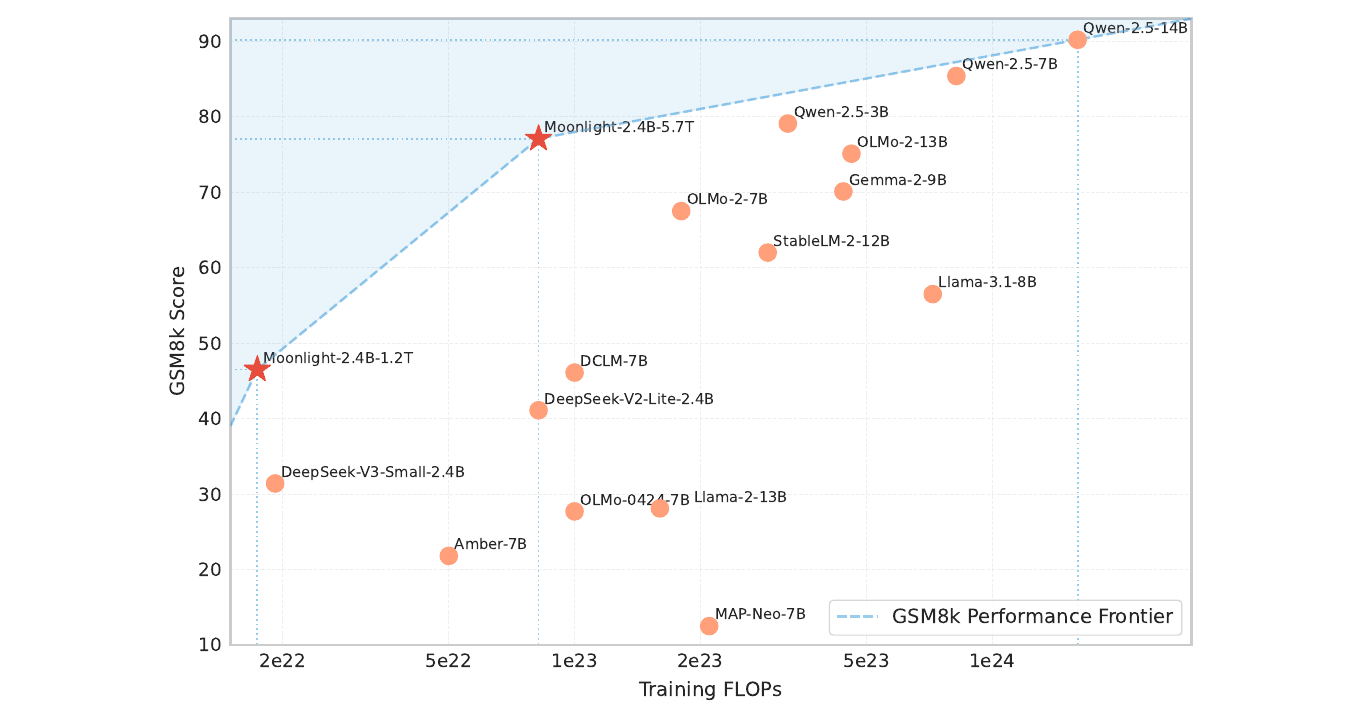
圖 8:以 Muon 最佳化的 Moonlight 模型與其他可比模型的 GSM8k 表現。
附錄 F 權重矩陣的奇異值分布
我們把每個權重矩陣的奇異值由大到小排序後、以最大值正規化,再畫成折線圖,藉此視覺化其奇異值分布。如圖 9 與圖 10 所示,我們發現對大多數權重矩陣而言,以 Muon 最佳化的奇異值分布比 AdamW 更平坦,這進一步證實了「Muon 能產生更多樣的更新譜」這個假設。
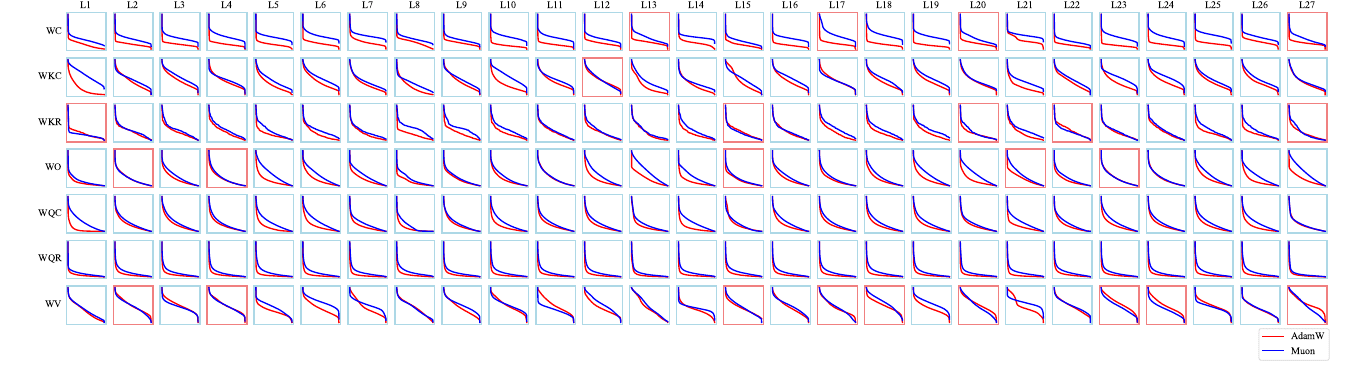
圖 9:注意力層中各權重矩陣的奇異值分布。我們以 WC 表示各層把隱藏狀態壓縮到 key 與 value 共享潛在空間的權重矩陣,WV 表示把 value 從潛在空間上投影的權重矩陣,WO 表示輸出投影矩陣,而 WKR、WKC、WQR、WQC 分別表示 key 與 query 中帶/不帶 RoPE 部分的投影矩陣。若某個權重矩陣以 Muon 最佳化時具有較低的奇異熵,我們把該折線圖的邊框設為紅色。
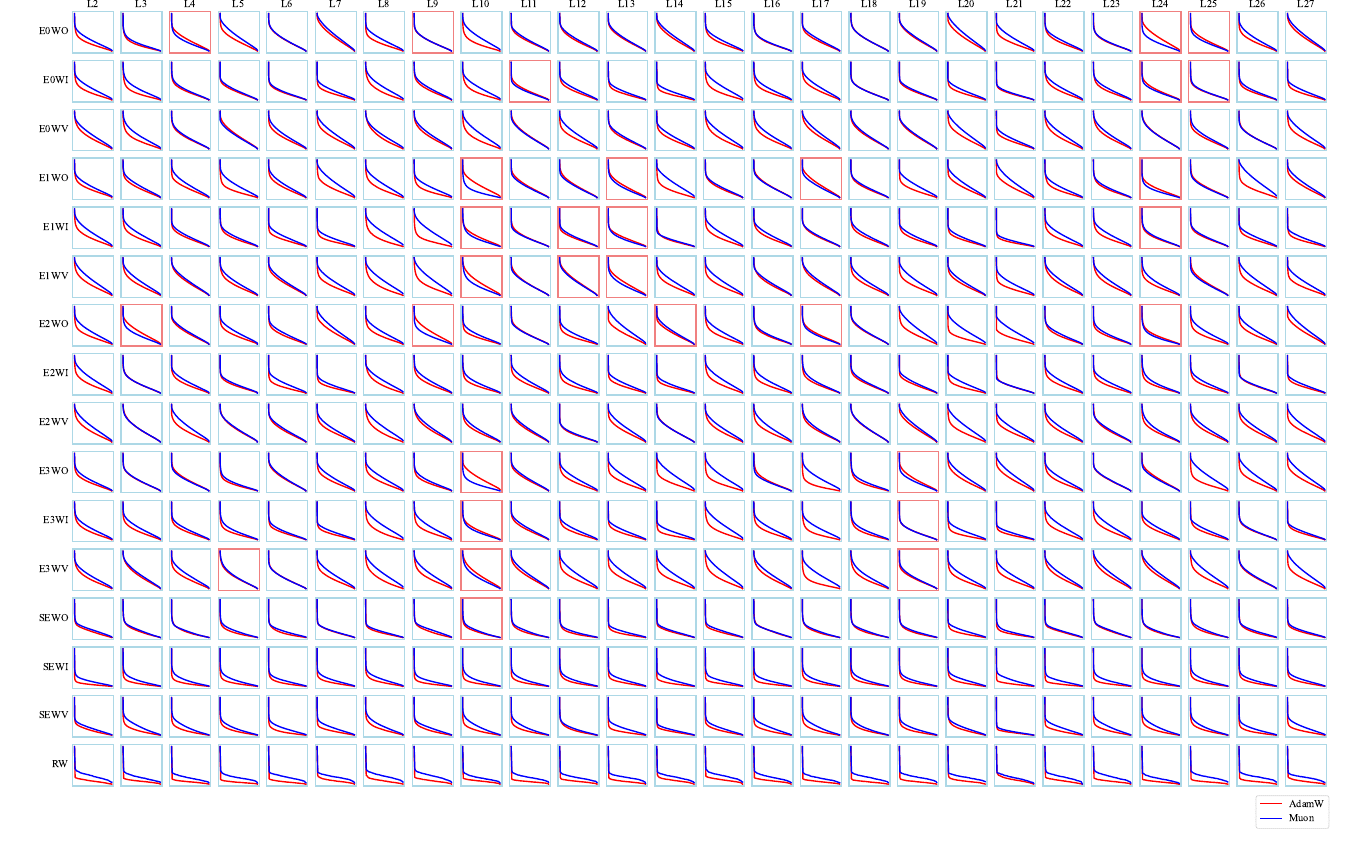
圖 10:前饋網路 (FFN) 層中各權重矩陣的奇異值分布。我們以 WI、WV、WO 表示採用 SwiGLU 激活函數的 FFN 層中的權重矩陣,其中 WI 代表送進 Swish 函數的輸入投影、WV 代表與 Swish 激活值互動的額外輸入投影、WO 代表輸出投影。我們以 E0、E2、E3 表示任意選出的三個專家模型,SE 表示共享專家模型中的權重,RW 表示 router 中的權重。
附錄 G 原始授權條款
本譯文為 Moonlight 技術報告的衍生作品,依 MIT License 的要求附上完整的版權與授權聲明原文如下(不翻譯,以原文為準)。
The MIT License (MIT)
Copyright © 2025 Moonshot AI

Permission is hereby granted, free of charge, to any person obtaining a copy of
this software and associated documentation files (the "Software"), to deal in
the Software without restriction, including without limitation the rights to
use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of
the Software, and to permit persons to whom the Software is furnished to do so,
subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS
FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR
COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER
IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN
CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.
參考文獻
依原文順序(作者姓氏字母序)編號。原文內文採用「作者 年份」的引用格式,譯文保留該格式;下列編號僅供查找對照之用。
- Alter, Orly, Patrick O. Brown, and David Botstein. “Singular value decomposition for genome-wide expression data processing and modeling”. In: Proceedings of the National Academy of Sciences 97.18 (2000), pp. 10101–10106. DOI : 10.1073/pnas.97.18.10101. eprint: https://www.pnas.org/doi/pdf/10.1073/pnas.97.18.10101. URL : https://www.pnas.org/doi/abs/10.1073/pnas.97.18.10101.
- Austin, Jacob et al. Program Synthesis with Large Language Models. 2021. arXiv: 2108 . 07732 [cs.PL]. URL: https://arxiv.org/abs/2108.07732.
- Bernstein, Jeremy and Laker Newhouse. Old Optimizer, New Norm: An Anthology. 2024. arXiv: 2409.20325 [cs.LG]. URL : https://arxiv.org/abs/2409.20325.
- Bi, Xiao et al. “Deepseek llm: Scaling open-source language models with longtermism”. In: arXiv preprint arXiv:2401.02954 (2024).
- Cesista, Franz Louis. Deep Learning Optimizers as Steepest Descent in Normed Spaces. 2024. URL: http://leloykun. github.io/ponder/steepest-descent-opt/.
- Chen, Mark et al. “Evaluating Large Language Models Trained on Code”. In: (2021). arXiv: 2107.03374 [cs.LG].
- Cobbe, Karl et al. Training Verifiers to Solve Math Word Problems. 2021. arXiv: 2110 . 14168 [cs.LG]. URL: https://arxiv.org/abs/2110.14168.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. arXiv: 2405.04434 [cs.CL]. DeepSeek-AI et al. DeepSeek-V3 Technical Report. 2024. arXiv: 2412.19437 [cs.CL]. URL: https://arxiv.org/ abs/2412.19437.
- Franz, Louis Cesista. The Case for Muon. Oct. 2024. URL: https : / / x . com / leloykun / status / 1846842887839125941 (visited on 02/18/2025).
- Grattafiori, Aaron et al. The Llama 3 Herd of Models. 2024. arXiv: 2407.21783 [cs.AI]. URL: https://arxiv. org/abs/2407.21783.
- Hendrycks, Dan, Collin Burns, Steven Basart, et al. Measuring Massive Multitask Language Understanding. 2021. arXiv: 2009.03300 [cs.CY]. URL: https://arxiv.org/abs/2009.03300.
- Hendrycks, Dan, Collin Burns, Saurav Kadavath, et al. Measuring Mathematical Problem Solving With the MATH
- Dataset. 2021. arXiv: 2103.03874 [cs.LG]. URL: https://arxiv.org/abs/2103.03874.
- Hoffmann, Jordan et al. Training Compute-Optimal Large Language Models. 2022. arXiv: 2203.15556 [cs.CL]. URL : https://arxiv.org/abs/2203.15556.
- Huang, Yuzhen et al. C-Eval: A Multi-Level Multi-Discipline Chinese Evaluation Suite for Foundation Models. 2023. arXiv: 2305.08322 [cs.CL]. URL: https://arxiv.org/abs/2305.08322.
- Jordan, Keller et al. Muon: An optimizer for hidden layers in neural networks. 2024. URL: https://kellerjordan. github.io/posts/muon/.
- Joshi, Mandar et al. TriviaQA: A Large Scale Distantly Supervised Challenge Dataset for Reading Comprehension. 2017. arXiv: 1705.03551 [cs.CL]. URL: https://arxiv.org/abs/1705.03551.
- Kaplan, Jared et al. Scaling Laws for Neural Language Models. 2020. arXiv: 2001.08361 [cs.LG]. URL: https: //arxiv.org/abs/2001.08361.
- Kingma, Diederik P. and Jimmy Ba. “Adam: A Method for Stochastic Optimization”. In: 3rd International Conference on Learning Representations, ICLR 2015, San Diego, CA, USA, May 7-9, 2015, Conference Track Proceedings.
- Ed. by Yoshua Bengio and Yann LeCun. 2015. URL: http://arxiv.org/abs/1412.6980.
- Lambert, Nathan et al. “Tülu 3: Pushing Frontiers in Open Language Model Post-Training”. In: (2024).
- Li, Haonan et al. CMMLU: Measuring massive multitask language understanding in Chinese. 2024. arXiv: 2306.09212 [cs.CL]. URL: https://arxiv.org/abs/2306.09212.
- Li, Xi-Lin. “Preconditioned Stochastic Gradient Descent”. In: IEEE Transactions on Neural Networks and Learning Systems 29.5 (May 2018), pp. 1454–1466. ISSN: 2162-2388. DOI: 10.1109/tnnls.2017.2672978. URL: http: //dx.doi.org/10.1109/TNNLS.2017.2672978. – Preconditioner on Matrix Lie Group for SGD. 2018. arXiv: 1809.10232 [stat.ML]. URL: https://arxiv.org/ abs/1809.10232. – Stochastic Hessian Fittings with Lie Groups. 2024. arXiv: 2402.11858 [stat.ML]. URL: https://arxiv.org/ abs/2402.11858.
- Li, Xilin. Black Box Lie Group Preconditioners for SGD. 2022. arXiv: 2211 . 04422 [stat.ML]. URL: https : //arxiv.org/abs/2211.04422.
- Liu, Hong et al. “Sophia: A Scalable Stochastic Second-order Optimizer for Language Model Pre-training”. In: The
- Twelfth International Conference on Learning Representations. 2024. URL: https://openreview.net/forum? id=3xHDeA8Noi.
- Loshchilov, Ilya and Frank Hutter. “Decoupled Weight Decay Regularization”. In: International Conference on Learning
- Representations. 2019. URL: https://openreview.net/forum?id=Bkg6RiCqY7.
- OLMo, Team et al. “2 OLMo 2 Furious”. In: arXiv preprint arXiv:2501.00656 (2024). OpenAI et al. GPT-4 Technical Report. 2024. arXiv: 2303.08774 [cs.CL]. URL: https://arxiv.org/abs/2303. 08774.
- Pethick, Thomas et al. Training Deep Learning Models with Norm-Constrained LMOs. 2025. arXiv: 2502.07529 [cs.LG]. URL: https://arxiv.org/abs/2502.07529.
- Pooladzandi, Omead and Xi-Lin Li. Curvature-Informed SGD via General Purpose Lie-Group Preconditioners. 2024. arXiv: 2402.04553 [cs.LG]. URL: https://arxiv.org/abs/2402.04553.
- Rajbhandari, Samyam et al. “ZeRO: Memory optimizations Toward Training Trillion Parameter Models”. In: (Nov. 2020), pp. 1–16. DOI: 10.1109/sc41405.2020.00024. URL: http://dx.doi.org/10.1109/SC41405.2020. 00024.
- Roy, Olivier and Martin Vetterli. “The effective rank: A measure of effective dimensionality”. In: 2007 15th European
- Signal Processing Conference. 2007, pp. 606–610.
- Shazeer, Noam. Fast Transformer Decoding: One Write-Head is All You Need. 2019. arXiv: 1911.02150 [cs.NE]. URL : https://arxiv.org/abs/1911.02150.
- Shoeybi, Mohammad et al. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. 2020. arXiv: 1909.08053 [cs.CL]. URL: https://arxiv.org/abs/1909.08053.
- Suzgun, Mirac et al. Challenging BIG-Bench Tasks and Whether Chain-of-Thought Can Solve Them. 2022. arXiv: 2210.09261 [cs.CL]. URL: https://arxiv.org/abs/2210.09261.
- Team, Gemini et al. Gemini: A Family of Highly Capable Multimodal Models. 2024. arXiv: 2312.11805 [cs.CL]. URL : https://arxiv.org/abs/2312.11805.
- Team, Gemma et al. “Gemma 2: Improving open language models at a practical size”. In: arXiv preprint arXiv:2408.00118 (2024).
- Team, Kimi. “Kimi k1.5: Scaling Reinforcement Learning with LLMs”. In: (2025).
- Vyas, Nikhil et al. “SOAP: Improving and Stabilizing Shampoo using Adam”. In: The Thirteenth International Conference on Learning Representations. 2025. URL: https://openreview.net/forum?id=IDxZhXrpNf.
- Wang, Yubo et al. MMLU-Pro: A More Robust and Challenging Multi-Task Language Understanding Benchmark. 2024. arXiv: 2406.01574 [cs.CL]. URL: https://arxiv.org/abs/2406.01574.
- Wei, Tianwen et al. CMATH: Can Your Language Model Pass Chinese Elementary School Math Test? 2023. arXiv: 2306.16636 [cs.CL]. URL: https://arxiv.org/abs/2306.16636.
- Yang, An et al. “Qwen2.5 Technical Report”. In: arXiv preprint arXiv:2412.15115 (2024).
- You, Jiacheng. Jiacheng You’s discussion on Muon’s Update RMS. 2025. URL: https://x.com/YouJiacheng/ status/1890094769386451309.
- Yuan, Huizhuo et al. MARS: Unleashing the Power of Variance Reduction for Training Large Models. 2024. arXiv: 2411.10438 [cs.LG].
術語對照表
| English | 繁體中文 |
|---|---|
| Auxfree Bias | 無輔助損失偏置 |
| Compute Optimal | 計算最佳 |
| Gate Scaling Factor | 閘縮放因子 |
| Grid Search | 網格搜尋 |
| Matrix Orthogonalization | 矩陣正交化 |
| Mixture-of-Experts (MoE) | 混合專家 |
| Momentum | 動量 |
| Newton–Schulz Iteration | Newton–Schulz 迭代 |
| Optimizer | 優化器 |
| Over-train Regime | 過度訓練區間 |
| Pareto Frontier | Pareto 前沿 |
| Schatten Norm | Schatten 範數 |
| Singular Value Decomposition (SVD) | 奇異值分解 |
| Spectral Norm | 譜範數 |
| Steepest Descent | 最陡下降 |
| SVD Entropy | SVD 熵 |
| Supervised Finetuning (SFT) | 監督式微調 |
| Update RMS | 更新的均方根 |
| Weight Decay | 權重衰減 |
| ZeRO-1 | (保留原名,優化器狀態分片技術) |