透過簡單且統一的擴展實現金牌級奧林匹亞推理
原始論文:Achieving Gold-Medal-Level Olympiad Reasoning via Simple and Unified Scaling 作者:Yafu Li, Runzhe Zhan, Haoran Zhang, Shunkai Zhang, Yizhuo Li, Zhilin Wang, Jiacheng Chen, Futing Wang, Xuyang Hu, Yuchen Fan, Bangjie Xu, Yucheng Su, Xinmiao Han, Chenxi Li, Haodi Lei, Yufeng Zhao, Zejin Lin, Qianjia Cheng, Tong Zhu, Xiaoye Qu, Ganqu Cui, Peng Ye, Yun Luo, Zhouchen Lin, Yu Qiao, Bowen Zhou, Ning Ding, Yu Cheng(Shanghai AI Laboratory、香港中文大學、清華大學、上海交通大學、北京大學) arXiv ID:2605.13301v1 日期:2026-05-13 標籤:LLM Reasoning RLVR SFT Test-time Scaling 數學推理 Olympiad
目錄
摘要
推理模型 (Reasoning Model) 近期的進展,大幅推進了長程 (long-horizon) 的數學與科學問題求解,已有數個系統在國際數學奧林匹亞 (International Mathematical Olympiad, IMO) 與國際物理奧林匹亞 (International Physics Olympiad, IPhO) 問題上達到金牌級表現。在本論文中,我們提出一套簡單且統一的配方 (recipe),用以將一個已經過後訓練 (post-trained) 的推理骨幹 (backbone) 轉化為嚴謹的奧林匹亞級求解器。此配方首先使用一個反向困惑度課程 (reverse-perplexity curriculum) 進行監督式微調 (Supervised Fine-Tuning, SFT),以灌注嚴謹的證明搜尋 (proof-search) 與自我檢查 (self-checking) 行為;接著透過一個兩階段的強化學習 (Reinforcement Learning, RL) 管線將這些行為擴展放大——該管線從帶有可驗證獎勵的 RL (RL with Verifiable Rewards) 推進到更細緻的證明層級 (proof-level) RL;最後再以測試時擴展 (Test-time Scaling, TTS) 提升求解表現。
套用此配方,我們以 SFT 在約 340K 條長度低於 8K token 的軌跡上訓練一個 30B-A3B 骨幹,隨後進行 200 步 RL。所得到的模型 SU-01,能在困難問題上穩定進行超過 100K token 的軌跡推理,同時在數學與物理奧林匹亞競賽上達到金牌級表現,包括 IMO 2025/USAMO 2026 以及 IPhO 2024/2025。它也展現了科學推理向數學與物理以外領域的強大泛化能力。
專案頁面(Project Page)

程式碼(Code)

模型(Models)
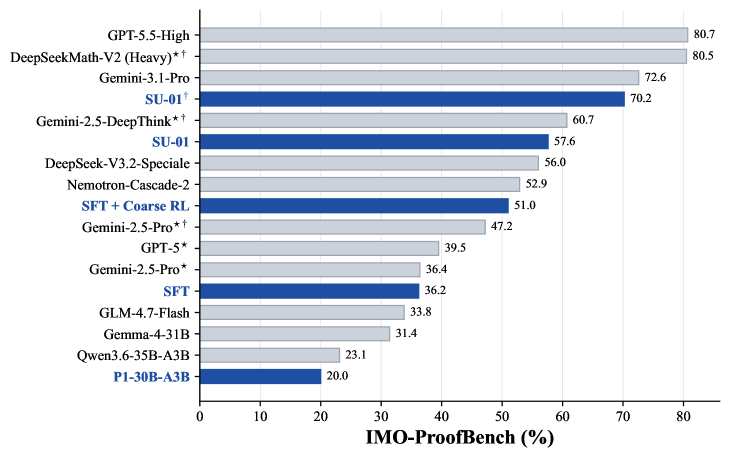
圖 1:在 IMO-ProofBench 上的整體比較。 $\star$ 表示原始論文中報告的結果,$\dagger$ 表示帶有測試時擴展的結果。藍色長條追蹤了我們管線的演進:從 30B-A3B 骨幹,經過嚴謹 SFT(第 2 節)、粗粒度 RL、精細化 RL(第 3 節)以及測試時擴展(第 4 節),最終達到金牌級奧林匹亞推理(第 5 節)。
1 引言
奧林匹亞競賽提供了對長程推理最清晰的壓力測試之一。與許多標準評測基準不同,這些問題要求模型在眾多可能的解題路徑中搜尋、精確控制各項假設、驗證中間論斷,並提出一個能在跨數學與科學情境的嚴格評分下存活下來的最終論證。近期的系統在此方向上取得了快速進展:AlphaGeometry 將神經引導 (neural guidance) 與符號搜尋 (symbolic search) 結合用於奧林匹亞幾何 (Trinh et al., 2024);而 AlphaProof、AlphaGeometry 2 與 Gemini Deep Think 則透過更大的搜尋與驗證預算,在國際數學奧林匹亞問題上達到銀牌或金牌標準 (Google DeepMind, 2024; 2025)。與此同時,通用推理模型也透過思維鏈 (Chain-of-Thought, CoT) 提示、數學專門化的後訓練,以及帶有可驗證獎勵的強化學習而獲得改善 (Wei et al., 2022; Shao et al., 2024; Yang et al., 2024; Guo et al., 2025; Yan et al., 2025; Zhan et al., 2025);科學奧林匹亞評測基準則測試了向建模、推導與競賽式論證的遷移能力 (He et al., 2024; Chen et al., 2025; Luo et al., 2026)。
因此,一個核心問題在於:能否以一套精簡、跨領域統一的配方,將推理骨幹推升至奧林匹亞級表現,並對數學與科學問題套用同一套以推理為核心的管線?我們使用一個 30B-A3B 模型,建立一條模組化管線:SFT 重塑推理行為、RL 擴展求解能力、TTS 將額外的推論計算分配給最困難的證明搜尋問題。這些階段共同將行為塑造 (behavior shaping)、獎勵設計、經驗回放 (experience replay) 與自我驗證 (self-verification) 對齊到一套用於嚴謹數學與科學推理的精簡配方中。此設計遵循一種「可專門化的通才 (specializable-generalist)」觀點:我們並非要打造一個狹隘的奧林匹亞求解器,而是將一個廣泛具備能力、已後訓練的模型專門化朝向專家級的證明推理,同時保留其跨科學領域的遷移能力。
第一階段旨在灌注一種更有紀律的證明搜尋模式。從一個在科學推理任務上已具競爭力的後訓練模型出發,我們整理來自數學、科學、程式碼與指令遵循 (instruction-following) 來源的長篇解答、自我驗證與自我精煉 (self-refinement) 軌跡。經過過濾後,SFT 混合資料包含 338K 條回應短於 8K token 的軌跡。在此嚴謹證明資料上進行 SFT,可灌注以證明搜尋、自我檢查與修復為核心的推理行為。接著我們依「反向困惑度」對範例排序,使每一輪訓練都從與初始策略最不匹配的軌跡開始,然後在較熟悉的範例上收斂鞏固。此課程有助於在重塑推理行為的同時,保留並回復後訓練模型的能力。
第二階段透過兩個層級的 RL 來擴展此行為。粗粒度 RL (Coarse RL) 使用可驗證的提示與高效的結果檢查,在可靠的二元獎勵下擴展 SFT 引入的推理行為,遵循更廣義的 RLVR 範式以高效提升推理能力 (Guo et al., 2025; Shao et al., 2024)。精細化 RL (Refined RL) 接著將目標從答案正確性轉移到證明品質。它結合了一個用於評分完整證明的證明層級生成式獎勵模型 (generative reward model)、用於訓練批判—修復 (critique-and-repair) 行為的自我精煉提示,以及用於在困難問題上保留稀有成功軌跡的經驗回放。最後,我們透過一個自我驗證與精煉迴圈 (self-verification-and-refinement loop) 套用測試時擴展,將訓練後的模型提升到奧林匹亞級推理 (Huang and Yang, 2025)。
在答案可驗證的評測基準上,所得到的模型 SU-01 在 AnswerBench、AMO-Bench、AIME 2025/2026 與 FrontierScience-Olympiad 上,幾乎匹敵最強的同尺寸基線 Qwen3.6-35B-A3B。在以證明為導向的評測上,SU-01 在 IMO-ProofBench 上以直接生成達到 57.6%,並在 TTS 下達到 70.2%,大幅超越同尺寸模型,並逼近具競爭力的商用系統如 Gemini 3.1 Pro Thinking。除了解競賽問題之外,SU-01 在 FrontierScience-Research 上取得同尺寸模型中最佳的整體分數,顯示此配方能將科學推理泛化到奧林匹亞評測基準之外的研究式問題。
在官方競賽問題上,SU-01 展現出超越評測基準式評估的強大端到端推理能力。直接生成的 SU-01 即已超越 2024 與 2025 兩年的 IPhO 金牌線,並跨越了 IMO 2025 與 USAMO 2026 的銅牌線。在測試時擴展下,它在兩場數學奧林匹亞上都達到 35 分,正好達到 IMO 2025 的金牌線,並以 10 分之差超越 USAMO 2026 的金牌線。值得注意的是,在 USAMO 2026 上,這個成績匹敵了 340 位參賽者中所報告的最高人類總分,顯示此整體配方能從一個精簡的 30B-A3B 模型中誘發出頂尖人類水準般的奧林匹亞推理。TTS 軌跡進一步展現了此能力如何在推論時湧現:SU-01 能維持超過 100K token 的推理軌跡、以自身的草稿與錯誤分析作為條件,並反覆驗證與修復候選證明。整體而言,這些結果支持了一種對精簡推理模型的「可專門化通才」觀點:只要有正確的訓練與推論配方,一個廣泛具備能力的骨幹便能被驅動朝向專家級的證明推理,同時保留有意義的科學遷移能力。
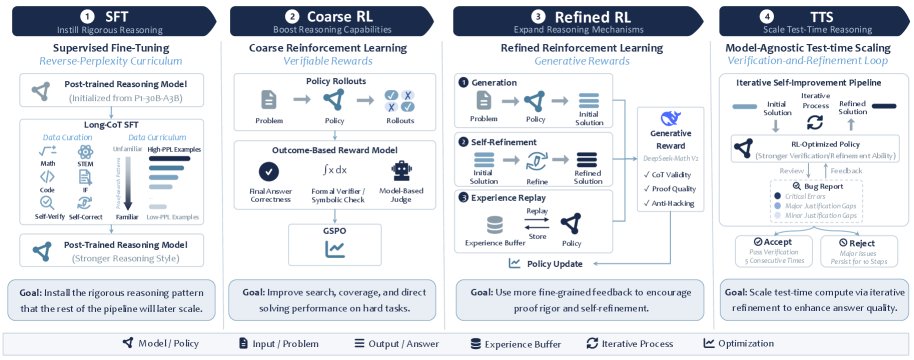
圖 2:SU-01 訓練與推論管線總覽。 此配方首先以嚴謹的長篇 SFT 重塑骨幹,接著透過粗粒度與精細化 RL 擴展所得到的行為,最後套用測試時驗證與精煉以進行奧林匹亞級的問題求解。
2 透過 SFT 灌注嚴謹推理
SU-01 管線的第一階段使用監督式微調來重塑模型的推理行為。我們選擇 P1-30B-A3B (Chen et al., 2025) 作為初始模型,因為它在科學推理(包括數學與物理)上已展現具競爭力的表現。儘管它在可驗證任務上有強勁結果,我們觀察到其解答並不總是圍繞著嚴謹的證明搜尋模式來組織。因此 SFT 的目的,是在盡可能保留其既有能力的同時,將其推理行為重塑為更明確、更有紀律、更以證明為導向的長篇推理。
我們在實證上發現,對一個後訓練骨幹套用 SFT,比從一個基礎模型 (base model) 訓練出相同的推理行為更為高效。一個後訓練模型已經包含有用的指令遵循行為、問題求解能力與廣泛的科學素養。從該檢查點出發,能讓 SFT 專注於改變推理模式,而非從頭重建這些能力。在此框架下,SFT 將通才骨幹專門化朝向嚴謹的證明搜尋行為,同時保留其廣泛的科學素養,為後續 RL 的擴展提供一個更強的起始策略。此階段的啟動配置與最佳化超參數總結於附錄 C。
2.1 SFT 資料整理
我們從數學、科學、指令遵循與程式碼等廣泛來源的混合中整理 SFT 提示。數學子集包含來自 Evan Chen 奧林匹亞教材[^1]、數之美論壇 (Shuzhimi Forum)[^2]、AoPS (Art of Problem Solving)[^3]、線上數學競賽訓練書籍[^4],以及 DeepMath 中難度至少為 6 的問題 (He et al., 2025)。對於科學推理,我們納入來自 NaturalReasoning (Yuan et al., 2025) 的提示。為了改善 SFT 模型在狹隘奧林匹亞式數學之外的泛化能力,我們也納入來自 Nemotron-Instruction-Following-Chat-v1[^5] 的對話提示,以及來自 Eurus-2-RL-Data (Cui et al., 2025a) 與 OpenCodeReasoning-2[^6] 的程式碼提示;後者延伸了用於競賽式程式設計的 OpenCodeReasoning 資料蒸餾路線 (Ahmad et al., 2025)。
[^1]: Evan Chen 奧林匹亞教材:https://web.evanchen.cc/ [^2]: 數之美論壇是一個線上中文數學解題社群。 [^3]: AoPS:https://artofproblemsolving.com/ [^4]: 書籍子集整理自公開可得的線上數學競賽訓練教材。 [^5]: Nemotron-Instruction-Following-Chat-v1 Hugging Face 資料集卡片。 [^6]: OpenCodeReasoning-2 Hugging Face 資料集卡片。
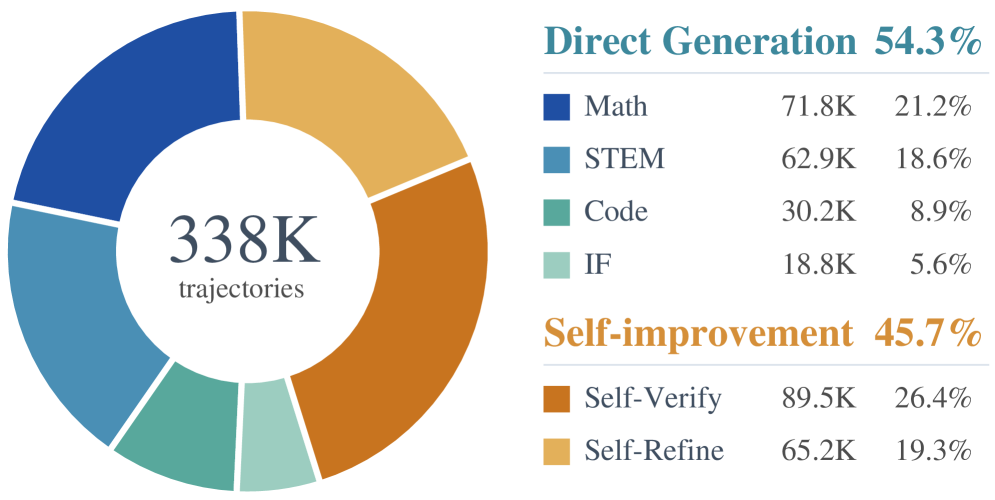
圖 3:過濾後 SFT 資料的組成。 Math、STEM、Code 與 IF 構成直接生成群組;Self-Verify 與 Self-Refine 構成自我改進群組。
在生成之前,我們先從提示池中過濾掉受汙染 (contaminated) 的問題。對於每個剩餘的提示,我們使用 DeepSeek-V3.2-Speciale (DeepSeek-AI, 2025a) 生成高品質的長篇推理軌跡。接著我們過濾有雜訊的生成內容,並移除長度超過 8,192 token 的軌跡。此過濾步驟使監督訊號聚焦於嚴謹且可用的推理軌跡,同時避免過長的輸出更容易引入截斷 (truncation) 或不穩定的最佳化。
除了直接的解答軌跡之外,我們進一步為模型配備自我驗證與自我精煉的行為。對於數學子集,我們要求 DeepSeek-V3.2-Speciale 為已生成的解答生成驗證軌跡,接著生成解決驗證過程中所發現問題的精煉軌跡。這些範例讓模型接觸到對奧林匹亞級推理特別重要的行為:檢查一個證明是否真的有充分理據,並在發現缺陷時改進論證。最終,我們得到一個經過過濾、包含 338K 條軌跡的 SFT 混合資料,如圖 3 所示。
2.2 用於 SFT 的反向困惑度課程
在後訓練推理模型上進行長思維鏈 (Long-CoT) SFT 是一個細膩的最佳化問題。該模型已經包含一個強大的指令遵循與推理策略,因此 SFT 並非單純地為一個空白骨幹加入新能力;而是在試圖保留既有能力的同時修改一個既有策略。如果監督訊號太過狹隘,或訓練停止得太早,即使模型開始模仿更明確的長篇推理,效能也可能大幅退化。此張力與 Luo et al. (2025) 所研究的「長思維鏈退化現象 (long-CoT degradation phenomenon)」一致:後訓練模型通常需要足夠的資料規模與足夠的 SFT 訓練輪數 (epoch),才能在不覆寫先前後訓練階段所安裝的有用能力的前提下,吸收新的推理風格。
在我們的設定中,能力的回復強烈取決於訓練時長與所得模型的長度行為 (length behavior) (Ren et al., 2026)。對於上限為 8,192 token 的軌跡,我們在實證上發現,只要資料混合與學習率受到良好控制,四個 epoch 通常足以在初始的行為轉變之後回復大部分的模型能力。我們也將驗證集截斷率 (validation truncation rate) 視為 SFT 是否充分的操作性指標。一個尚未充分適應嚴謹長思維鏈監督的後訓練模型,常常表現出淺層的推理行為:它在局部的啟發式 (heuristic) 周圍打轉、重複中間論斷,並在沒有取得決定性進展的情況下持續推理。這些重複且無止盡的推理模式自然會增加截斷。在實務上,我們發現截斷率低於 5% 是模型已大致適應目標推理風格的有用徵兆。
為了使長思維鏈 SFT 更穩定,我們使用一個反向困惑度訓練課程。令 $\mathcal{D}=\{(x_{i},y_{i})\}_{i=1}^{N}$ 為 SFT 資料集,其中 $x_{i}$ 是提示,$y_{i}=(y_{i,1},\ldots,y_{i,T_{i}})$ 是教師軌跡。給定初始策略 $\pi_{0}$,我們以每個範例的長度正規化困惑度 (length-normalized perplexity) 為其評分,$\mathrm{PPL}(x_{i},y_{i})=\exp\left(-\frac{1}{T_{i}}\sum_{t=1}^{T_{i}}\log\pi_{0}(y_{i,t}\mid x_{i},y_{i,<t})\right)$,然後依困惑度遞減 (descending PPL) 排序範例,使每一輪訓練都從初始策略最不熟悉(困惑度最高)的軌跡開始,再逐步收斂到較熟悉的範例上。我們在 6.3 節 中對此排序選擇進行消融分析。
3 以 RL 提升推理能力
一旦模型獲得了更強的長篇推理模式,強化學習便提供了可擴展的回饋機制,將此模式轉化為更強的專家行為。我們將此階段分為兩個層級。粗粒度 RL 在可靠、且大多可驗證的獎勵訊號下,將 SFT 的推理模式轉化為更強的尋答 (answer-seeking) 行為,改善在困難任務上的搜尋、覆蓋率與直接求解表現。精細化 RL 接著將策略專門化朝向完整、可稽核的證明建構,使用更細粒度的回饋來鼓勵證明的嚴謹性與自我精煉。共用的 RL 啟動配置與各階段特定的超參數總結於附錄 D。
3.1 RL 資料整理
RL 訓練使用與 SFT 不同的獨立提示池,其整理同時支援答案可驗證的最佳化與證明品質的精煉。物理子集衍生自與 P1 (Chen et al., 2025) 相關的奧林匹亞級物理資料。數學子集遵循與我們 SFT 資料相同的來源族系,包括 AoPS、線上競賽訓練書籍、Evan Chen 奧林匹亞教材與數之美論壇。來源歸屬請參見 §2.1。我們額外納入 OPC[^7]——一個經人工評估的高等數學證明語料庫 (Dekoninck et al., 2025),以增加以證明為導向的提示的覆蓋範圍。
[^7]: OPC 資料集卡片。
我們將所得的 RL 池切分為一個可驗證集與一個不可驗證集。可驗證集包含其最終答案或結構化輸出能被可靠檢查的提示,而不可驗證集則包含需要較柔性判斷(例如生成式獎勵)的、以證明為導向或開放式的推理提示。在訓練之前,我們先對提示池進行去重與去汙染 (decontaminate)。接著我們套用拒絕取樣 (rejection sampling) 來移除對當前策略而言已經太簡單或太困難的範例,並進一步過濾掉格式不良或其他不可靠的有雜訊提示。最終的 RL 池包含 8,967 個可驗證提示與 16,287 個不可驗證提示。
3.2 粗粒度 RL
粗粒度 RL 在上述 8,967 個可驗證提示上訓練 SFT 模型。我們將此階段表述為帶有可驗證獎勵的強化學習 (RLVR; Lambert et al. 2024; Guo et al. 2025),使用群組序列策略最佳化 (Group Sequence Policy Optimization, GSPO; Zheng et al. 2025)。GSPO 比 token 層級的 GRPO 更契合結果獎勵 (outcome-reward) 訓練,因為其獎勵分配與策略裁剪 (policy clipping) 都在完整回應的層級上運作。對於每個提示 $q\in\mathcal{D}_{\mathrm{ver}}$(可驗證提示集),rollout 策略 $\pi_{\theta_{\mathrm{old}}}$ 取樣出一組 $K$ 個候選解答 $\mathcal{G}_{q}=\{o_{i}\}_{i=1}^{K}$。驗證器將每個最終答案轉換為一個二元結果獎勵:若萃取出的最終答案被驗證為正確則 $r(q,o)=1$,否則 $r(q,o)=0$。
群組相對優勢 (group-relative advantage) 從提示內 (within-prompt) 的獎勵基線計算得出。我們使用未經群組標準差正規化的非正規化形式,$\widehat{A}_{i}=r(q,o_{i})-\mu_{\mathcal{G}_{q}}$,其中 $\mu_{\mathcal{G}_{q}}=\frac{1}{K}\sum_{j=1}^{K}r(q,o_{j})$。GSPO 的關鍵量是長度正規化的序列層級重要性比率 $s_{i}(\theta)=\exp\{\frac{1}{|o_{i}|}\sum_{t=1}^{|o_{i}|}\log\frac{\pi_{\theta}(o_{i,t}\mid q,o_{i,<t})}{\pi_{\theta_{\mathrm{old}}}(o_{i,t}\mid q,o_{i,<t})}\}$。
$$\mathcal{J}_{\mathrm{GSPO}}(\theta)=\mathbb{E}_{q,\{o_{i}\}}\left[\frac{1}{K}\sum_{i=1}^{K}\min\left(s_{i}(\theta)\widehat{A}_{i},\operatorname{clip}(s_{i}(\theta),1-\epsilon,1+\epsilon)\widehat{A}_{i}\right)\right]. \tag{1}$$
這些定義也是後續小節中經驗回放變體所使用的介面:被回放的軌跡可重用相同的獎勵、優勢與序列比率記號,僅需更改 $s_{i}(\theta)$ 分母中的來源策略。遵循 GSPO (Zheng et al., 2025) 中的路由回放 (routing-replay) 動機,我們在 RL 期間凍結 MoE 路由器,使被回放的軌跡在穩定的專家路由決策下被評估,從而降低回放引起的不穩定性。
獎勵系統刻意採用分層設計,使高精度的自動檢查先於更昂貴的模型式判斷。我們首先萃取最終答案並套用正規化的文字比對。未解決的情況接著由 Math-Verify[^8]——一個針對 LLM 輸出的、基於規則的數學表達式評估管線——進行檢查。仍然無法通過這些規則式檢查的樣本,會被送往 gpt-oss-120b[^9] (OpenAI, 2025) 進行生成式驗證。此排序使獎勵預設保守,同時仍能挽回那些最終答案等價、但僅靠規則式剖析器難以正規化的正確解答。
[^8]: Math-Verify 程式庫。 [^9]: gpt-oss-120b 模型卡片。
3.3 精細化 RL
在粗粒度 RL 建立了強大的搜尋行為之後,精細化 RL 將最佳化目標從答案正確性轉移到證明品質。核心問題在於:許多奧林匹亞解答可以達到正確的最終答案,但其中仍含有隱藏的缺口、未經證成的變換,或不完整的分類討論。因此,精細化 RL 使用一個更強的過程層級 (process-level) 獎勵,並加入兩種記憶機制:自我精煉,將近期的失敗轉化為修復任務;以及經驗回放,將稀有的成功證明保留足夠久,使策略得以從中學習。
生成式證明獎勵 (Generative proof reward)
我們使用 DeepSeekMath-V2 作為精細化 RL 的生成式獎勵模型 (DeepSeek-AI, 2025b),物理提示除外。對於來自可驗證與不可驗證子集的每一條 rollout,獎勵模型讀取問題與完整的解答或證明,然後輸出一個二元分數 $r_{\mathrm{proof}}(q,o)\in\{0,1\}$。與 §3.2 中的粗粒度驗證器不同,此分數並不侷限於檢查最終答案是否與參考答案相符。它評估的是整條推理路徑是否在數學上有效、是否充分嚴謹、是否完整。這使獎勵更契合奧林匹亞推理的最終目標,但也更昂貴、且更容易受到評判器假象 (judge artifact) 的影響。因此,我們在將回應送往獎勵模型之前套用反作弊 (anti-hack) 預處理:含有洩漏的對話模板 token、不平衡的思考分隔符 (thinking delimiter),或嚴重重複的格式異常生成內容,會被替換為一個安全的回退 (fallback) 答案。這可防止策略透過利用格式或驗證器輸入的病態情況,而非透過改善證明,來獲取獎勵。獎勵模型的服務配置總結於附錄 E。
自我精煉 (Self-refinement)
自我精煉讓策略接觸到我們在測試時所使用的相同修復模式:提出解答、檢視它、定位缺口,並產出修正後的證明。在每次 rollout 之後,回應依查詢分組。若某個查詢群組的平均證明獎勵低於閾值 $\tau_{\mathrm{ref}}=0.5$,該群組中失敗的回應會被轉換為精煉提示。每個提示包含原始問題、先前的錯誤解答,以及一條指示模型批判該論證、修正證明錯誤、補足缺失的證成 (justification),並輸出一個完整最終解答的指令。這些提示被儲存於一個自我精煉緩衝區,並以目標比例 $\eta_{\mathrm{ref}}=0.2$ 混入後續批次。被精煉查詢替換掉的正常樣本會被退回緩衝區,因此精煉不會默默地丟棄新鮮的訓練資料。我們也不會遞迴地將失敗的精煉嘗試重新入列,這避免了在仍處於當前策略可學習區域之外的範例上重複耗費更新。
經驗回放 (Experience replay)
在困難的證明問題上,即使策略通常在同一查詢上失敗,它偶爾仍可能發現一條有效的解答軌跡。立刻丟棄這樣的軌跡會浪費一個高價值的訓練訊號。遵循 ExGRPO (Zhan et al., 2025),我們維護一個以查詢為鍵 (key) 的回放緩衝區 $\mathcal{E}$,但我們的實作更為簡單:它使用相同的 GSPO 式更新,且不套用 ExGRPO 中引入的策略塑形 (policy-shaping) 變換。在每次 rollout 之後,只有當某查詢「困難但可解」時才被允許進入回放緩衝區,操作上定義為其成功率 $0<\bar{r}(q)<0.25$ (Zhan et al., 2025)。然而,在我們的精細化 RL 設定中,成功是由 DeepSeekMath-V2 證明獎勵所判定的,該獎勵檢視的是完整解答而非僅僅是最終答案。這並未消除獎勵模型的雜訊,但它使一條稀有的成功 rollout 大幅更可能編碼出一個可重用的證明模式,因而成為一個更安全的回放目標。被儲存的軌跡會經過去重,且一旦新鮮的同策略 (on-policy) rollout 足夠頻繁地解出某查詢(閾值 $n_{+}(q)\geq 4$),該查詢便被退役。
回放是與新鮮的證明獎勵訓練混合進行,而非作為一個獨立模式運行。一次回放 rollout 為選定的查詢注入一條已儲存的成功軌跡,而回放比例由在批次中非精煉部分上的 $\rho=0.25$ 所控制。當某查詢儲存了多條成功軌跡時,我們選擇熵最低的一條,$o^{*}=\arg\min_{o\in\mathcal{E}(q)}H(o;\pi_{\theta})$,使用 rollout 端的 top-$k$ 對數機率作為高效的熵估計,遵循 ExGRPO (Zhan et al., 2025) 中的軌跡選擇原則。所得到的精細化目標為
$$\mathcal{J}_{\mathrm{refined}}(\theta)=(1-\rho)\,\mathbb{E}_{\mathcal{B}_{\mathrm{fresh}}}\left[\mathcal{J}_{\mathrm{GSPO}}(q,\mathcal{G}_{q};\theta,\pi_{\theta_{\mathrm{old}}})\right]+\rho\,\mathbb{E}_{\mathcal{B}_{\mathrm{exp}}}\left[\mathcal{J}_{\mathrm{GSPO}}(q^{*},\{o^{*}\}\cup\mathcal{G}_{q^{*}};\theta,\pi_{\theta_{\mathrm{src}}})\right], \tag{2}$$
其中對於被回放的軌跡 $\pi_{\theta_{\mathrm{src}}}=\pi_{\theta_{\mathrm{past}}}$,對於新鮮的 rollout $\pi_{\theta_{\mathrm{src}}}=\pi_{\theta_{\mathrm{old}}}$。此回放設計是有針對性而非窮舉式的:它儲存稀有的有效證明、偏好最穩定的已儲存軌跡、以受控比例回放它,並在當前策略能可靠地以同策略重現該行為時將其移除。
4 透過測試時擴展達成金牌級推理
即使有了強大的推理策略,最困難的問題往往仍需要在推論時進行大量的搜尋與修訂。這不僅僅是取樣更多答案的問題。IMO 式的任務要求完整且嚴謹的證明,而一個擁有正確最終結論的解答,若含有隱藏缺口或邏輯謬誤,仍可能失敗。近期關於 IMO 2025 的工作明確指出了這一點:強大的前沿模型已經包含可觀的數學能力,但其單次通過 (single-pass) 的輸出,甚至是「多選最佳 (best-of-many)」的選擇,仍可能遠低於一個結構化的驗證—精煉管線所達到的水準 (Huang and Yang, 2025)。
對測試時擴展的需求也與推理預算 (reasoning budget) 有關。單次生成具有有限的脈絡與思考預算,而一個奧林匹亞證明可能需要數輪的探索、引理檢查、反例搜尋與論述修復。一個模型可能花費其大部分預算來發現一個有希望的方法,卻仍無法完全閉合 (close) 該證明。將推論拆解為反覆的「求解—驗證—精煉 (solve–verify–refine)」階段,能有效地為同一個問題分配額外的計算量,同時使每一步保持聚焦且可稽核。只有當模型能在反覆的草稿、批判與修復之間保持連貫時,這份額外預算才有用。在完整的訓練管線之後,SU-01 能夠在困難問題上有效地運用這份預算,在推論期間維持超過 100K token 的連貫推理軌跡。
我們的 TTS 程序遵循 Huang and Yang (2025) 的驗證—精煉範式,作為一個自我驗證與精煉迴圈。模型首先在一個優先考量證明嚴謹性、而非僅僅達到最終答案的求解器提示 (solver prompt) 下,產出一個初始解答。接著它進入精煉階段,重新審視草稿、修復薄弱步驟,並嘗試將一個有希望的論證轉化為完整證明。精煉後的候選接著透過一個驗證提示 (verification prompt) 被檢查:模型檢視完整解答並撰寫一份結構化的錯誤報告 (bug report),辨識諸如關鍵錯誤、未經證成的論斷或遺漏情況等問題。一個裁定 (verdict) 步驟解讀此報告,並決定該候選應被接受、拒絕,或退回再進行一輪精煉。此迴圈反覆進行,直到解答持續通過自我驗證,或精煉預算耗盡為止。多個獨立的運行 (run) 可以並行或串行執行,被接受的候選僅在證明於反覆驗證下保持穩定後才被選取。對應的推論設定總結於附錄 E。
5 實驗結果
實驗部分圍繞三個互補的評估視角來組織:答案可驗證的推理任務、不可驗證或以證明為導向的任務,以及官方奧林匹亞競賽問題。
5.1 評測基準
我們將評估組織為三個評測基準族系。第一個族系包含答案可驗證的推理任務,其正確性可由最終答案或高信心的自動驗證器來檢查。它包括 AMO-Bench (An et al., 2025)、AIME 2025 與 AIME 2026[^10]、來自 IMO-Bench 評估套件的 AnswerBench (Luong et al., 2025),以及 FrontierScience-Olympiad(FrontierScience 的奧林匹亞子集 (Wang et al., 2026))。這些評測基準主要測試模型能否在單次通過或固定預算的推論下產出正確的最終答案。
[^10]: AIME 官方競賽頁面:https://maa.org/math-competitions/aime
第二個族系包含不可驗證或以證明為導向的任務。我們納入來自 IMO-Bench 的 ProofBench (Luong et al., 2025),它強調證明品質而非僅是最終答案的比對;以及 FrontierScience-Research(FrontierScience 的研究子集 (Wang et al., 2026))。這些任務用於探測訓練是否改善了在答案可檢查設定之外的嚴謹推理與科學問題求解。
第三個族系包含官方奧林匹亞競賽問題,包括 IMO 2025^11、USAMO 2026^12 與 IPhO(2024、2025)^13。詳細的評分與驗證器設定總結於附錄 G。
表 1:答案可驗證推理任務上的表現。 AnswerBench、AMO-Bench、AIME 25/26 與 FrontierScience-Olympiad 的結果分別在 4、8、8 與 4 次運行上取平均。FrontierScience-Olympiad 是 FrontierScience 奧林匹亞子集的縮寫。Avg. 是 AnswerBench、AMO-Bench、AIME 2025、AIME 2026 與 FrontierScience-Olympiad 的平均值。在每個比較區塊內,粗體標示最佳分數,底線標示次佳分數。
| 模型 | AnswerBench | AMO-Bench | AIME 25/26 | FS-Olympiad (Physics) | (Chemistry) | (Biology) | (Overall) | Avg. |
|---|---|---|---|---|---|---|---|---|
| P1-30B-A3B | 69.3% | 41.3% | 90.4% / 89.6% | 57.5% | 57.5% | 27.5% | 54.5% | 69.0% |
| GLM-4.7-Flash | 73.8% | 53.8% | 91.3% / 88.3% | 54.5% | 60.0% | 17.5% | 53.0% | 72.0% |
| Nemotron-Cascade-2 | 80.5% | 40.8% | 94.2% / 90.0% | 56.0% | 56.3% | 30.0% | 53.5% | 71.8% |
| Qwen3.6-35B-A3B | 78.0% | 58.8% | 92.5% / 92.9% | 65.5% | 74.4% | 25.0% | 65.0% | 77.4% |
| Gemma-4-31B | 74.0% | 39.3% | 88.8% / 91.3% | 69.0% | 61.9% | 17.5% | 61.0% | 70.9% |
| SU-01 | 77.5% | 59.8% | 94.6% / 93.3% | 62.5% | 69.4% | 25.0% | 61.5% | 77.3% |
5.2 可驗證問題
如表 1 所示,SU-01 在 AnswerBench、AMO-Bench、AIME 2025、AIME 2026 與 FrontierScience-Olympiad 上達到 77.3% 的平均分數,幾乎匹敵最強的同尺寸基線 Qwen3.6-35B-A3B(77.4%)。重要的是,SU-01 以一套更簡單、統一的後訓練配方,並以大幅更低的訓練成本達到此水準,凸顯了我們方法的效率。
數學評測基準展現了此改善最為顯著之處。SU-01 在 AMO-Bench(59.8%)與 AIME 2025/2026(94.6%/93.3%)上取得同尺寸模型中的最佳結果,這些更接近競賽式的問題求解,而非例行的答案萃取。在 AnswerBench 上,SU-01 以 77.5% 維持競爭力,逼近 Qwen3.6-35B-A3B(78.0%),僅落後於 Nemotron-Cascade-2(80.5%)。
FrontierScience-Olympiad 測試此行為是否能遷移到純數學之外。儘管 RL 階段僅使用數學與物理訊號,SU-01 整體達到 61.5%,並展現對未訓練 STEM 領域的強大遷移,包括化學 69.4% 與生物 25.0%。此跨領域遷移支持了「可專門化通才」的框架:模型透過數學與物理推理訊號被專門化,但所得到的能力並未塌縮為一個狹隘的競賽求解器。
5.3 不可驗證問題
不可驗證評測基準測試訓練配方是否改善了完整推理軌跡的品質,而非僅僅最佳化最終答案的獎勵。在 IMO-ProofBench 上,表 3 顯示 SU-01 在直接生成下整體達到 57.6%,已是同尺寸模型中最強的結果。測試時擴展進一步將分數提升至 70.2%,包括基礎 (basic) 分項的 91.0% 與進階 (advanced) 分項的 49.5%,使一個 30B-A3B 模型逼近大得多的前沿系統如 Gemini 3.1 Pro。此改善顯示,當正確性取決於完整證明、而非僅是產出正確最終答案時,自我驗證與精煉特別有用。
表 2:物理奧林匹亞問題上的表現,於 8 次運行上取平均。 IPhO 2024/2025 的金牌線為 20.8/19.7 分。對於 SU-01,$x/y$ 報告的是不帶與帶有測試時擴展的分數。
| 模型 | IPhO 2024 | IPhO 2025 |
|---|---|---|
| 較大模型 | ||
| Gemini 3.1 Pro Thinking | 25.9 | 25.1 |
| GPT-5.5-High | 25.8 | 23.2 |
| DeepSeek-V3.2-Speciale | 25.1 | 21.9 |
| 同尺寸模型 | ||
| P1-30B-A3B | 23.1 | 17.7 |
| GLM-4.7-Flash | 22.2 | 19.5 |
| Nemotron-Cascade-2 | 21.2 | 16.7 |
| Qwen3.6-35B-A3B | 24.3 | 19.9 |
| Gemma-4-31B | 24.4 | 20.3 |
| SU-01 | 23.5 / 25.3 | 20.3 / 21.7 |
FrontierScience-Research 是 FrontierScience 中一個難度大幅提高、以研究為導向的子集,涵蓋需要科學建模與超越標準競賽形式的多步推理的物理、化學與生物問題。即使對前沿系統而言,絕對分數仍然很低,但 SU-01 取得了同尺寸模型中最佳的整體分數 11.7%。它也在同尺寸區塊的物理上領先、在化學上並列最佳,並在生物上排名第二,儘管我們的 RL 階段僅使用數學與物理訊號。此跨領域模式顯示,該配方學到的是一種更通用的科學推理行為,而非僅僅專門化於訓練領域,為精簡模型中可遷移的研究層級推理提供了早期證據。
表 3:不可驗證評測基準上的表現。 FrontierScience-Research 指 FrontierScience 的研究子集。對於 SU-01,$x/y$ 報告的是在 ProofBench 上不帶與帶有 TTS 的分數。
| 模型 | ProofBench-Basic | -Advanced | -Overall | FS-Research (Physics) | (Chemistry) | (Biology) | (Overall) |
|---|---|---|---|---|---|---|---|
| 較大模型 | |||||||
| Gemini 3.1 Pro Thinking | 95.2% | 50.0% | 72.6% | 0.0% | 30.0% | 10.0% | 13.3% |
| GPT-5.5-High | 96.7% | 64.8% | 80.7% | 25.0% | 40.0% | 45.0% | 36.7% |
| DeepSeek-V3.2-Speciale | 77.6% | 34.3% | 56.0% | 10.0% | 20.0% | 15.0% | 15.0% |
| 同尺寸模型 | |||||||
| P1-30B-A3B | 33.8% | 6.2% | 20.0% | 0.0% | 10.0% | 0.0% | 3.3% |
| GLM-4.7-Flash | 51.0% | 16.7% | 33.8% | 0.0% | 0.0% | 0.0% | 0.0% |
| Nemotron-Cascade-2 | 77.1% | 28.6% | 52.9% | 5.0% | 5.0% | 20.0% | 10.0% |
| Qwen3.6-35B-A3B | 39.1% | 7.1% | 23.1% | 0.0% | 5.0% | 10.0% | 5.0% |
| Gemma-4-31B | 46.7% | 16.2% | 31.4% | 0.0% | 10.0% | 5.0% | 5.0% |
| SU-01 | 77.1% / 91.0% | 38.1% / 49.5% | 57.6% / 70.2% | 10.0% | 10.0% | 15.0% | 11.7% |
5.4 奧林匹亞競賽問題
表 4:數學奧林匹亞競賽問題上的表現。 IMO 2025 的獎牌線為 35/28/19 分,USAMO 2026 的獎牌線為 25/18/11 分。⋆ 表示 TTS 結果由人類專家評估,而直接生成結果由自動方式評估(附錄 G)。
IMO 2025
| 模型 | P1 | P2 | P3 | P4 | P5 | P6 | 總分 |
|---|---|---|---|---|---|---|---|
| SU-01 | 1 | 7 | 1 | 6 | 6 | 0 | 21 |
| SU-01 w/ TTS | 7⋆ | 7⋆ | 7⋆ | 7⋆ | 7⋆ | 0⋆ | 35⋆(金牌) |
USAMO 2026
| 模型 | P1 | P2 | P3 | P4 | P5 | P6 | 總分 |
|---|---|---|---|---|---|---|---|
| SU-01 | 7 | 0 | 0 | 7 | 0 | 1 | 15 |
| SU-01 w/ TTS | 7⋆ | 0⋆ | 7⋆ | 7⋆ | 7⋆ | 7⋆ | 35⋆(金牌) |
即使不使用 TTS,SU-01 在 IPhO 2024 上平均 23.5 分、在 IPhO 2025 上平均 20.3 分,超越對應的金牌線 20.8 與 19.7 分,如表 2 所示。TTS 進一步將分數提升至 25.3 與 21.7 分,使 SU-01 成為兩年中、在有可得分數的模型裡最強的同尺寸模型。
表 4 報告最終的競賽式數學結果。在直接生成下,SU-01 在 IMO 2025 達到 21 分、在 USAMO 2026 達到 15 分,已跨越兩場競賽的銅牌線。直接模型在 IMO 2025 P2 與 USAMO 2026 P1/P4 上取得滿分,在 IMO 2025 P4/P5 上取得近乎完整的解答,但在單次通過下仍未能解出數道較困難的問題。這顯示基礎模型已獲得可觀的奧林匹亞推理能力,但在最脆弱的證明嘗試上,仍受益於額外的搜尋與自我修正。
在測試時擴展下,SU-01 在 IMO 2025 與 USAMO 2026 上都達到 35 分,恰好達到 IMO 金牌線,並以 10 分之差超越 USAMO 金牌線。TTS 將五道 IMO 2025 問題提升為滿分,而 P6 仍未解出;並在六道 USAMO 2026 問題中的五道上挽回滿分解答,而 P2 仍未解決。USAMO 2026 的分數摘要報告了 340 位參賽者、中位數分數為 6、前 12 名門檻為 26,以及最高分為 35^14。因此,SU-01 匹敵了此場競賽所報告的最高人類總分,同時仍在 P2 上暴露出一個具體的失敗模式。此結果顯示,我們的整體配方能從一個精簡的 30B-A3B 模型中誘發出頂尖人類水準般的奧林匹亞推理。
案例研究 (Case study)
我們在附錄 H 中納入對應的模型生成解答與專家裁定。在十二道 IMO 2025 與 USAMO 2026 問題中,模型對其中十道給出滿分解答,失敗於 IMO 2025 P6 與 USAMO 2026 P2。它的主要強項在於將奧林匹亞問題轉譯為形式化框架:對幾何使用座標或複數、對數論使用模 (modular) 分類、對函數方程使用遞迴關係,以及對數字問題使用基於自動機 (automata) 的動態規劃。一個特別引人注目的例子是 USAMO 2026 P3:模型並未遵循標準的綜合幾何 (synthetic geometry) 路線,而是優雅地使用複數,在單一代數框架中統一了單位圓、等邊三角形旋轉、弦關係與切線條件。這為一個奧林匹亞解題者通常會透過追角 (angle chasing) 與精心選取的輔助構造來處理的構型,提供了一個別出心裁的解析式重新表述。IMO 2025 P2 展現了互補的強項:模型將一個涉及兩個相交圓、一個垂心 (orthocenter) 與一個相切論斷的構型,化簡為座標與距離的計算。其他強力例子包括用於 USAMO P4 的進位狀態 (carry-state) 動態規劃方法,以及在 USAMO P6 中使用歐拉函數 (totient)、同餘、Vieta 跳躍 (Vieta jumping) 與費氏數 (Fibonacci) 結構的數論證明。然而,失敗案例顯示出一個明確的侷限:模型可能錯失微妙的結構性約束,如 IMO P6 中無效的行置換 (column-permutation) 化簡;或在精細的全域策略論證中留下缺口,如 USAMO P2。整體而言,當一個問題容許嚴格的形式化表示時,模型表現良好;但當核心挑戰是保留組合結構或證明一個微調的過程不變量 (process invariant) 時,模型則較不可靠。
6 分析與討論
6.1 漸進式嚴謹推理
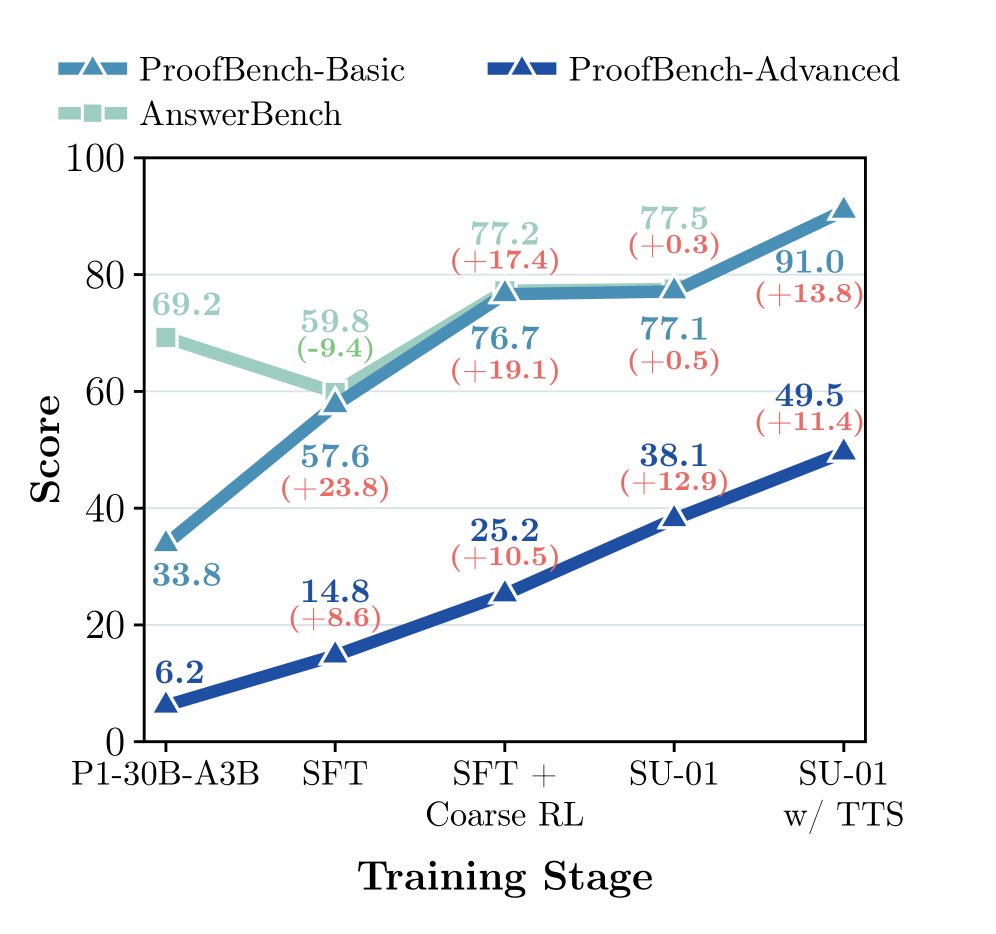
圖 4:跨訓練階段的漸進式推理表現。
圖 4 區分了兩種推理進展。AnswerBench 衡量模型能否在可驗證評估下回復出正確的最終答案,而 ProofBench 則對整個解答評分,因此暴露出在嚴謹性、證成與證明完成上的缺口。起始的 P1-30B-A3B 模型在 AnswerBench 上已經很強,但其 ProofBench 分數低得多,尤其在進階分項上,顯示僅有尋答能力並不意味著奧林匹亞式的證明可靠性。
分階段的趨勢與每個方法元件所預期的角色相符。SFT 將 AnswerBench 從 69.2 降至 59.8,但將 ProofBench-Basic 從 33.8 提升至 57.6、ProofBench-Advanced 從 6.2 提升至 14.8。這與行為塑造一致:模型被從短答案回復移開,轉向更長的證明搜尋、自我檢查與精煉模式。粗粒度 RL 接著使用可驗證獎勵來回復並改善直接求解能力,將 AnswerBench 提升至 77.2,同時也將 ProofBench-Basic 改善至 76.7、ProofBench-Advanced 改善至 25.2。這顯示 RLVR 將 SFT 引入的嚴謹推理行為擴展為更強的問題求解能力。
最終的 SU-01 模型使 AnswerBench 基本維持飽和於 77.5、ProofBench-Basic 幾乎不變於 77.1,但將 ProofBench-Advanced 從 25.2 改善至 38.1。因此,增益集中於更困難的不可驗證證明問題上,這與精細化 RL 的角色相符:證明層級的生成式獎勵提供了超越最終答案正確性的監督、自我精煉提示訓練模型批判並修復自身的解答,而經驗回放則使稀有的困難問題成功軌跡保持可得足夠久,讓策略得以學習更穩健的證明建構。測試時擴展接著進一步提升以證明為導向的評估,達到 ProofBench-Basic 91.0 與 ProofBench-Advanced 49.5,顯示出當額外的推論計算被花在檢查與修復候選證明時,所訓練出的自我驗證與精煉行為仍然有用。
6.2 刻畫推論時擴展
我們進一步檢視來自 USAMO 2026 的 TTS 軌跡,以理解在困難的證明搜尋期間,推論計算被花在何處。關鍵的區分不僅在於短回應與長回應之間,更在於本質上不同的推理脈絡之間:初始生成從問題陳述開始,而精煉則必須以一個既有解答連同驗證器回饋或錯誤報告作為條件,然後產出一個修訂後的證明。
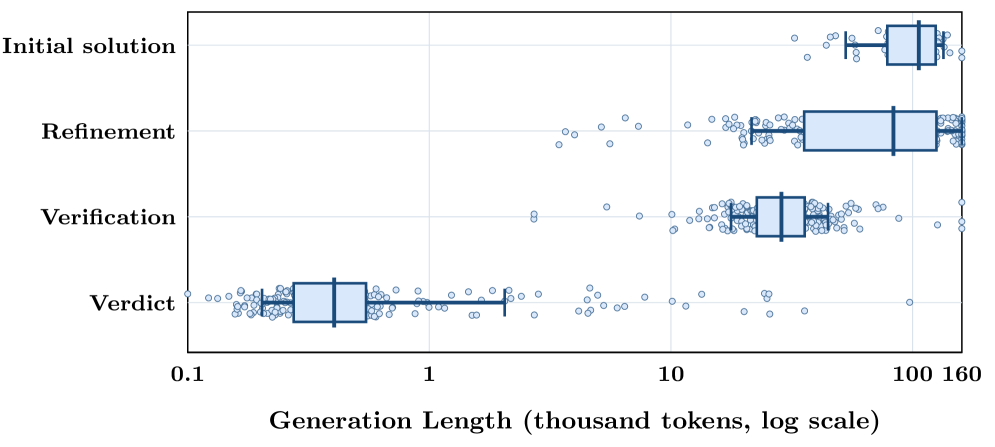
圖 5:在 USAMO 2026 上,TTS 管線中各動作的生成長度分布。
圖 5 顯示了計算量在各 TTS 動作之間的清晰分配。初始解答生成是最長的階段,中位長度為 106K token,反映出廣泛的證明搜尋與候選建構。精煉仍然是長度密集的,中位數為 83K token 且上尾 (upper tail) 較重,與大量的證明修復一致。驗證較短但仍然可觀,中位數為 28.7K token,反映出其在稽核完整論證以找出隱藏缺口上的角色。裁定剖析則很輕量,中位數僅 404 token。
長的精煉軌跡顯示模型能夠在複雜的條件脈絡上進行推理,而不僅僅是產出長的首次通過解答:給定一個候選證明與一份結構化批判,它常常維持另一條長推理軌跡,以定位缺陷、保留論證中有用的部分,並綜合出一個修正後的證明。因此,此模式顯示訓練配方使這個 30B 模型能泛化到超越直接解答生成之外,維持超過 100K token 的複雜推理,並反覆驗證與精煉自身的解答以邁向更強的候選。
6.3 反向困惑度排序
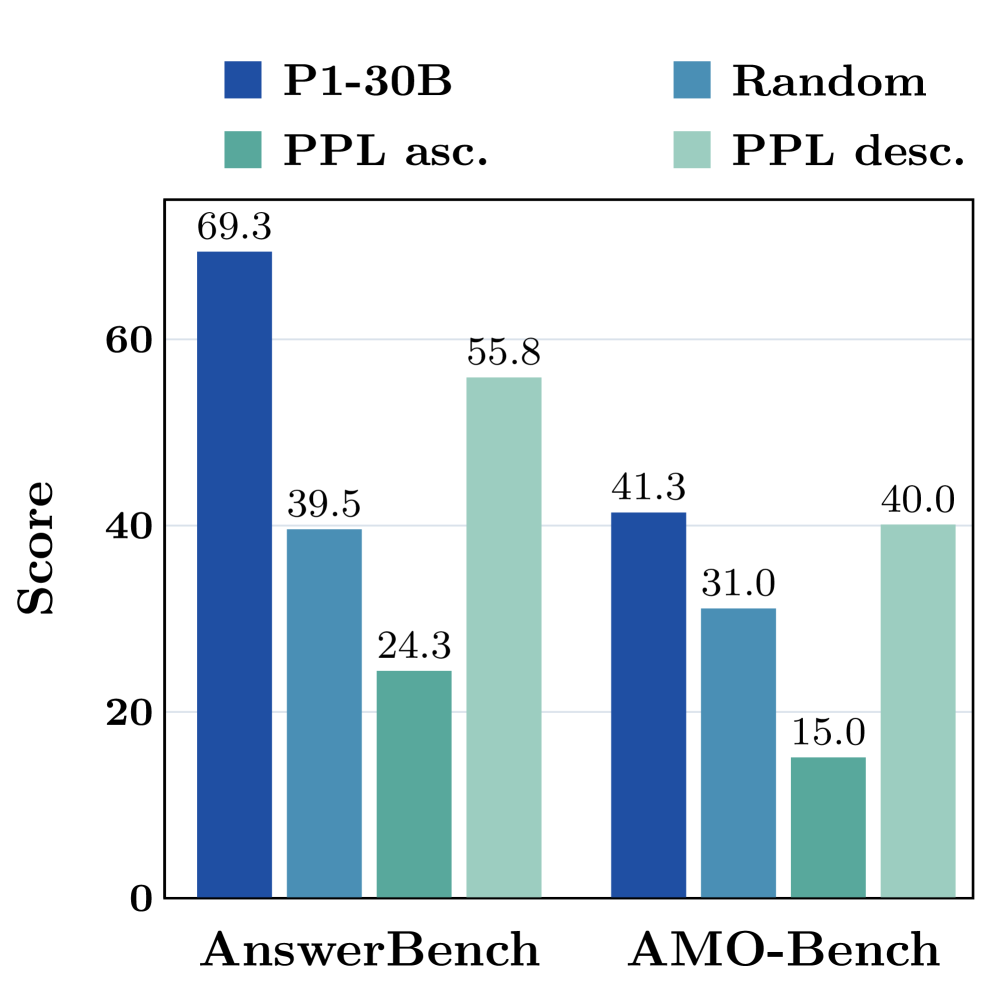
圖 6:SFT 資料排序的驗證結果。
我們比較不同 SFT 資料排序對驗證表現的影響,如圖 6 所示。這些結果來自一系列驗證實驗,其 SFT 訓練資料與用於 SU-01 的最終訓練混合不同。資料排序對分數回復與生成穩定性都有很大影響。隨機排序大幅未能回復 P1-30B 基線,在 AnswerBench 上僅達 39.5、AMO-Bench 上 31.0,截斷率分別為 7.3% 與 8.0%。困惑度遞減 (Descending-PPL) 排序回復了原始能力中更大的部分,在 AnswerBench 上達到 55.8、AMO-Bench 上 40.0,同時將截斷率降至 0.3% 與 0.0%。低困惑度優先 (low-PPL-first) 設定是最弱的課程,退化至 AnswerBench 24.3 與 AMO-Bench 15.0。這些結果顯示,困惑度遞減排序有助於在重塑後訓練模型推理行為的同時保留其能力,並防止訓練落入一種具有高截斷率的、膚淺的長生成體制中。
6.4 成本分析
SU-01 使用一套精簡且透明的後訓練設置。從一個 30B-A3B 骨幹出發,我們在 338K 條短於 8K token 的 SFT 軌跡上以批次大小 128 訓練四個 epoch。RL 階段使用 25K 個提示進行 200 步,批次大小 128、每個提示 8 條 rollout、最大回應長度 160K token。作為對照,DeepSeek-V3.2 (DeepSeek-AI, 2025a) 報告了在 2.1B token 上進行 1,000 步索引器暖身 (indexer warm-up)、在 943.7B token 上進行 15,000 步稀疏訓練 (sparse-training) 的繼續預訓練 (continued pre-training),隨後進行帶有專家蒸餾 (specialist distillation) 與混合 RL 的、跨越數千步繼續 RL 的後訓練;其高算力的 Speciale 變體進一步以 DeepSeekMath-V2 式的證明獎勵在推理資料上訓練。Nemotron-Cascade 2 (Yang et al., 2026) 是一個同尺寸的 30B-A3B 參考模型,報告了一個大幅更廣的 SFT 混合。將其揭露的類別計數加總,約得到橫跨數學、證明、程式碼、科學、長脈絡、對話、指令遵循、工具使用與軟體工程資料的 2,660 萬條 SFT 樣本,以打包 (packed) 的 256K token 序列訓練 33K 步。其後訓練接著以一個多階段的 Cascade RL 管線繼續,涵蓋 IF-RL、多領域 RL、同策略蒸餾 (on-policy distillation)、RLHF、長脈絡 RL、CodeRL 與 SWE RL。這些比較凸顯了 SU-01 的主要設計要點:一套簡單且統一的配方,便能從一個精簡的 30B-A3B 模型中誘發出強大的奧林匹亞級推理,同時保留科學遷移能力。
7 相關工作
大型推理模型的後訓練 (Post-training for Large Reasoning Models)
後訓練已成為將強大的預訓練語言模型轉化為可靠推理系統的主要機制。早期的自我改進 (self-improvement) 工作顯示模型能從自身成功的嘗試中自舉 (bootstrap) 出推理依據 (Zelikman et al., 2022),而開放的後訓練配方則結合指令微調、偏好最佳化 (preference optimization) 與強化學習以改善通用助理行為 (Lambert et al., 2024)。對於數學與長思維鏈推理,DeepSeekMath 引入了大規模數學預訓練連同 GRPO (Shao et al., 2024)、Qwen2.5-Math 強調數學專屬的自我改進與工具增強的資料建構 (Yang et al., 2024)、DeepSeek-R1 證明了大規模 RL 能誘發長推理軌跡與自我修正行為 (Guo et al., 2025),而 Kimi k1.5 則凸顯了長脈絡 RL、課程設計與基於取樣的推論 (Kimi Team, 2025)。近期工作進一步研究如何穩定並重用學習訊號:離策略 (off-policy) 引導與經驗回放改善了推理策略的樣本重用 (Yan et al., 2025; Zhan et al., 2025)、熵 (entropy) 分析解釋了 RLVR 中的探索、熵塌縮 (entropy collapse) 與選擇性熵正則化 (Cui et al., 2025b; Jiang et al., 2025),而 GSPO 則為 MoE 推理模型在序列層級進行最佳化 (Zheng et al., 2025)。MiniMax-M2.5、Kimi-K2.5 與 GLM-5 等當代技術報告也展現出代理式 (agentic) 後訓練、高效推理、長脈絡執行與工具導向 RL 日益增長的重要性 (MiniMax AI, 2026; Moonshot AI, 2026; Z.AI, 2026b)。
邁向奧林匹亞級推理 (Toward Olympiad-Level Reasoning)
奧林匹亞推理超越了評測基準式的數學準確率,因為解答必須完整、嚴謹,且對隱藏缺口具有穩健性。一條工作路線以專門化的符號或神經符號 (neuro-symbolic) 系統來應對此挑戰:AlphaGeometry 透過結合神經語言模型與符號演繹 (symbolic deduction) 來求解幾何問題 (Trinh et al., 2024),而 AlphaProof/AlphaGeometry 2 則透過形式化推理與搜尋達到銀牌級 IMO 表現 (Google DeepMind, 2024)。更近期的前沿系統已轉向更廣泛的自然語言推理與測試時搜尋,包括 Gemini Deep Think 的金牌級 IMO 結果 (Google DeepMind, 2025)。與此同時,與模型無關 (model-agnostic) 的驗證—精煉管線顯示,反覆的生成、批判、修復與接受決策,能在不依賴單次通過答案的情況下大幅改善證明品質 (Huang and Yang, 2025),而 DeepSeekMath-V2 則將自我可驗證的數學推理作為訓練與推論目標來研究 (DeepSeek-AI, 2025b)。Nemotron-Cascade 2 提供了另一個近期範例,展示一個精簡的 MoE 推理模型如何透過 cascade RL 與多領域同策略蒸餾逼近前沿的數學與奧林匹亞表現 (Yang et al., 2026)。我們的貢獻是一套簡單且統一的配方,使一個 30B-A3B 模型能透過後訓練發展出嚴謹的證明行為,並以自我驗證、精煉與測試時擴展達到奧林匹亞級表現。
8 結論
本報告提出一套簡單且統一的配方,用以將一個精簡的後訓練推理模型轉化為更強的數學與科學推理者。從一個廣泛具備能力的 30B-A3B 骨幹出發,SU-01 結合了反向困惑度課程 SFT、帶有結果驗證的高效粗粒度 RL、帶有證明層級獎勵的精細化 RL、自我精煉與經驗回放,以及透過自我驗證與精煉的測試時擴展。這些階段共同將嚴謹推理的改善分解為行為塑造、可擴展的獎勵回饋、證明層級的專門化,以及推論時的修復。所得到的模型在數學與物理奧林匹亞競賽上達到金牌級表現、在推論期間維持超過 100K token 的推理軌跡,並展現向主要數學與物理訓練訊號之外的科學領域的遷移能力。總而言之,SU-01 支持了一種對精簡推理模型的「可專門化通才」觀點:只要有正確的訓練與推論配方,一個廣泛具備能力的骨幹便能被驅動朝向專家級的證明推理,同時保留有意義的科學遷移能力。
致謝
本工作由上海人工智慧實驗室支持。我們感謝先前開放研究與基礎設施的作者與維護者,使本工作得以實現。我們特別感謝 DeepSeek 開源了強大的推理策略與生成式獎勵模型,為我們的工作提供了重要的參考點 (DeepSeek-AI, 2025a; b)。IMO-Bench、AMO-Bench 與 FrontierScience 透過提供具挑戰性的數學與科學推理評測基準與評估協定,協助引導了整體系統的最佳化 (Luong et al., 2025; An et al., 2025; Wang et al., 2026)。我們也感謝支援我們 SFT 與 RL 資料整理的先前資料工作,包括 DeepMath、NaturalReasoning、Eurus、OpenCodeReasoning、P1 與 OPC (He et al., 2025; Yuan et al., 2025; Cui et al., 2025a; Ahmad et al., 2025; Chen et al., 2025; Dekoninck et al., 2025),以及眾多無法在此一一列出的公開問題來源與社群。我們進一步感謝更廣泛的開源基礎設施生態系,包括用於訓練的 slime 與用於高效推論與服務的 SGLang (THUDM, 2026; SGLang Team, 2026)。
參考文獻
- W. U. Ahmad, S. Narenthiran, S. Majumdar, A. Ficek, S. Jain, J. Huang, V. Noroozi, and B. Ginsburg (2025). OpenCodeReasoning: advancing data distillation for competitive coding. arXiv preprint abs/2504.01943.
- S. An, X. Cai, X. Cao, X. Li, Y. Lin, J. Liu, X. Lv, D. Ma, X. Wang, Z. Wang, and S. Zhou (2025). AMO-Bench: large language models still struggle in high school math competitions. arXiv preprint abs/2510.26768.
- J. Chen, Q. Cheng, F. Yu, H. Wan, Y. Zhang, S. Zheng, J. Yao, Q. Zhang, H. He, Y. Luo, Y. Zhao, F. Wang, L. Sheng, C. Xie, Y. Zuo, Y. Li, W. Zeng, Y. Wu, R. Huang, D. Zhou, K. Chen, Y. Qiao, L. Bai, Y. Cheng, N. Ding, B. Zhou, P. Ye, and G. Cui (2025). P1: mastering physics olympiads with reinforcement learning. arXiv preprint abs/2511.13612.
- G. Cui, L. Yuan, Z. Wang, H. Wang, W. Li, B. He, Y. Fan, T. Yu, Q. Xu, W. Chen, et al. (2025a). Process reinforcement through implicit rewards. arXiv preprint arXiv:2502.01456.
- G. Cui, Y. Zhang, J. Chen, L. Yuan, Z. Wang, Y. Zuo, H. Li, Y. Fan, H. Chen, W. Chen, et al. (2025b). The entropy mechanism of reinforcement learning for reasoning language models. arXiv preprint abs/2505.22617.
- DeepSeek-AI (2025a). DeepSeek-v3.2: pushing the frontier of open large language models. arXiv preprint abs/2512.02556.
- DeepSeek-AI (2025b). DeepSeekMath-V2: towards self-verifiable mathematical reasoning. arXiv preprint abs/2511.22570.
- J. Dekoninck, I. Petrov, K. Minchev, M. Balunovic, M. Vechev, M. Marinov, M. Drencheva, L. Konova, M. Shumanov, K. Tsvetkov, et al. (2025). The open proof corpus: a large-scale study of llm-generated mathematical proofs. arXiv preprint abs/2506.21621.
- Google DeepMind (2024). AI achieves silver-medal standard solving international mathematical olympiad problems.
- Google DeepMind (2025). Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the international mathematical olympiad.
- Google DeepMind (2026). Gemini 3.1 Pro model card.
- Google (2026). Gemma 4 31B model card.
- D. Guo, D. Yang, H. Zhang, J. Song, R. Zhang, R. Xu, Q. Zhu, S. Ma, P. Wang, X. Bi, et al. (2025). Deepseek-r1: incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint abs/2501.12948.
- C. He, R. Luo, Y. Bai, S. Hu, Z. Thai, J. Shen, J. Hu, X. Han, Y. Huang, Y. Zhang, et al. (2024). OlympiadBench: a challenging benchmark for promoting agi with olympiad-level bilingual multimodal scientific problems. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pp. 3828–3850.
- Z. He, T. Liang, J. Xu, Q. Liu, X. Chen, Y. Wang, L. Song, D. Yu, Z. Liang, W. Wang, Z. Zhang, R. Wang, Z. Tu, H. Mi, and D. Yu (2025). DeepMath-103k: a large-scale, challenging, decontaminated, and verifiable mathematical dataset for advancing reasoning. arXiv preprint abs/2504.11456.
- Y. Huang and L. F. Yang (2025). Winning gold at IMO 2025 with a model-agnostic verification-and-refinement pipeline. arXiv preprint abs/2507.15855.
- Y. Jiang, Y. Li, G. Chen, D. Liu, Y. Cheng, and J. Shao (2025). Rethinking entropy regularization in large reasoning models. arXiv preprint abs/2509.25133.
- Kimi Team (2025). Kimi k1.5: scaling reinforcement learning with LLMs. arXiv preprint abs/2501.12599.
- N. Lambert, J. Morrison, V. Pyatkin, S. Huang, H. Ivison, F. Brahman, L. J. V. Miranda, A. Liu, N. Dziri, S. Lyu, et al. (2024). Tulu 3: pushing frontiers in open language model post-training. arXiv preprint abs/2411.15124.
- R. Luo, J. Li, C. Huang, and W. Lu (2025). Through the valley: path to effective long CoT training for small language models. In Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, pp. 4972–4992.
- Y. Luo, F. Wang, Q. Cheng, F. Yu, H. Lei, J. Yan, C. Li, J. Chen, Y. Zhao, H. Wan, Y. Zhang, S. Zheng, J. Yao, Q. Zhang, H. He, W. Zeng, L. Sheng, C. Xie, Y. Zuo, Y. Li, Y. Wu, R. Huang, D. Zhou, K. Chen, Y. Qiao, L. Bai, Y. Cheng, N. Ding, B. Zhou, P. Ye, and G. Cui (2026). P1-VL: bridging visual perception and scientific reasoning in physics olympiads. arXiv preprint abs/2602.09443.
- T. Luong, D. Hwang, H. H. Nguyen, G. Ghiasi, Y. Chervonyi, I. Seo, J. Kim, G. Bingham, J. Lee, S. Mishra, A. Zhai, C. Huiyi Hu, H. Michalewski, J. Kim, J. Ahn, J. Bae, X. Song, T. H. Trinh, Q. V. Le, and J. Jung (2025). Towards robust mathematical reasoning. arXiv preprint abs/2511.01846.
- MiniMax AI (2026). MiniMax-M2.5 model repository.
- Moonshot AI (2026). Kimi-K2.5 model card.
- OpenAI (2025). Gpt-oss-120b & gpt-oss-20b model card. arXiv:2508.10925.
- OpenAI (2026). GPT-5.5 system card.
- Qwen (2026). Qwen3.6-35B-A3B model card.
- Q. Ren, P. Wang, R. Cai, S. Shao, D. Guo, Y. Xie, Y. Li, Q. Zhang, X. Hu, J. Shao, and D. Liu (2026). Rethinking generalization in reasoning SFT: a conditional analysis on optimization, data, and model capability. arXiv preprint abs/2604.06628.
- SGLang Team (2026). SGLang: efficient execution of structured language model programs.
- Z. Shao, P. Wang, Q. Zhu, R. Xu, J. Song, X. Bi, H. Zhang, M. Zhang, Y. Li, Y. Wu, et al. (2024). Deepseekmath: pushing the limits of mathematical reasoning in open language models. arXiv preprint abs/2402.03300.
- THUDM (2026). SLiMe: an SGLang-Native post-training framework for reasoning models.
- T. H. Trinh, Y. Wu, Q. V. Le, H. He, and T. Luong (2024). Solving olympiad geometry without human demonstrations. Nature 625 (7995), pp. 476–482.
- vLLM Team (2026). vLLM: a high-throughput and memory-efficient inference and serving engine for llms.
- M. Wang, R. Lin, K. Hu, J. Jiao, N. Chowdhury, E. Chang, and T. Patwardhan (2026). FrontierScience: evaluating AI's ability to perform expert-level scientific tasks. arXiv preprint abs/2601.21165.
- J. Wei, X. Wang, D. Schuurmans, M. Bosma, B. Ichter, F. Xia, E. H. Chi, Q. V. Le, and D. Zhou (2022). Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems, NeurIPS.
- J. Yan, Y. Li, Z. Hu, Z. Wang, G. Cui, X. Qu, Y. Cheng, and Y. Zhang (2025). Learning to reason under off-policy guidance. arXiv preprint abs/2504.14945.
- A. Yang, B. Zhang, B. Hui, B. Gao, B. Yu, C. Li, D. Liu, J. Tu, J. Zhou, J. Lin, et al. (2024). Qwen2.5-math technical report: toward mathematical expert model via self-improvement. arXiv preprint abs/2409.12122.
- Z. Yang, Z. Liu, Y. Chen, W. Dai, B. Wang, S. Lin, C. Lee, Y. Chen, D. Jiang, J. He, R. Pi, G. Lam, N. Lee, A. Bukharin, M. Shoeybi, B. Catanzaro, and W. Ping (2026). Nemotron-Cascade 2: post-training LLMs with cascade RL and multi-domain on-policy distillation. arXiv preprint abs/2603.19220.
- W. Yuan, J. Yu, S. Jiang, K. Padthe, Y. Li, D. Wang, I. Kulikov, K. Cho, Y. Tian, J. E. Weston, and X. Li (2025). NaturalReasoning: reasoning in the wild with 2.8m challenging questions. arXiv preprint abs/2502.13124.
- Z.AI (2026a). GLM-4.7-Flash overview.
- Z.AI (2026b). GLM-5 overview.
- E. Zelikman, Y. Wu, J. Mu, and N. D. Goodman (2022). STaR: bootstrapping reasoning with reasoning. arXiv preprint arXiv:2203.14465.
- R. Zhan, Y. Li, Z. Wang, X. Qu, D. Liu, J. Shao, D. F. Wong, and Y. Cheng (2025). ExGRPO: learning to reason from experience. arXiv preprint abs/2510.02245.
- C. Zheng, S. Liu, M. Li, X. Chen, B. Yu, C. Gao, K. Dang, Y. Liu, R. Men, A. Yang, J. Zhou, and J. Lin (2025). Group sequence policy optimization. arXiv preprint abs/2507.18071.
附錄
附錄 A 實作與評估細節
本附錄彙整了解讀與重現所報告的訓練、推論、獎勵模型服務與評估程序所需的實作細節。我們總結了從對應的啟動腳本與評估協定中萃取出的有效建模、最佳化、解碼 (decoding)、服務與評分設定,同時略去不影響訓練目標、資料語義、推論行為、獎勵定義或評估標準的純基礎設施指令。
附錄 B 問題求解提示
除非另有說明,所有 RL 訓練與推論階段對 SU-01 都使用以下固定的問題求解提示:
請解決以下奧林匹亞問題。展示你完整的推理與證明。
- 請使用 LaTeX 格式來表示解題過程與結果中所使用的變數與公式。
- 如果問題要求你找出特定數值,請將最終答案放入
\boxed{}中。- 如果問題要求證明,請呈現一個清晰且嚴謹的論證。
附錄 C SFT 訓練細節
SFT 階段以 slime (THUDM, 2026) 實作,於 8 顆 GPU 上訓練,從 P1-30B 初始化,並最佳化 2.1 節 所述的反向困惑度排序混合資料;rollout 洗牌 (shuffling) 被停用,以使課程順序在整個訓練過程中得以保留。我們訓練四個 epoch、批次大小 128,使用 Adam,學習率 $1\times 10^{-5}$、以餘弦衰減 (cosine decay) 至最小學習率 $1\times 10^{-6}$、暖身比例 0.1、權重衰減 0.1,以及動量參數 $\beta_{1}=0.9$ 與 $\beta_{2}=0.95$。此配置將 SFT 視為一個受控的行為適應步驟:其目標並非直接最大化評測基準表現,而是讓後訓練骨幹接觸到一個穩定的嚴謹長篇軌跡序列,同時盡可能保留其既有的數學與科學素養。
附錄 D RL 訓練細節
RL 階段以 slime (THUDM, 2026) 實作,於 64 顆 GPU 上訓練,從 SFT 檢查點繼續,並以 GSPO 目標在可驗證提示、證明獎勵提示、自我精煉提示與被回放經驗的均衡混合上訓練。模型總共訓練 200 步 RL,由 96 步粗粒度 RL 接著 104 步精細化 RL 構成。每次 rollout 使用提示批次大小 128、每個提示 8 個樣本、最大回應長度 160K token、溫度 1.0,以及每次 rollout 4 次策略更新步。資料管線套用帶有非零標準差獎勵需求的動態取樣 (dynamic sampling)、部分 rollout (partial rollout) 與過取樣 (oversampling) 批次大小 160;過取樣與部分 rollout 機制在過濾下增大候選提示池,同時回收已完成的部分生成,而回放過濾則防止在已對當前策略變得太簡單的查詢上重複訓練。策略目標使用 GSPO 優勢估計器,KL 係數 0、熵係數 0、對稱裁剪範圍 $10^{-3}$,並啟用軌跡重要性取樣 (trajectory importance sampling)。
自我精煉機制使用一個包含原始問題與先前失敗答案的精煉提示模板。自我精煉比例設為 20%,表示從精煉資料中取樣的訓練查詢比例;群組獎勵閾值選取平均獎勵低於 0.5 的失敗或部分失敗 rollout 群組進行精煉。經驗回放大致遵循 ExGRPO 設定但不帶獎勵塑形,並在 slime 訓練框架中重新實作。我們使用線上 rollout 正確率低於 25% 的經驗准入閾值、每個回放查詢一條被回放軌跡,以及從 SGLang top-16 對數機率估計的基於熵的選擇。若某查詢只有一條取樣 rollout 成功,便被准入經驗池,使該成功軌跡成為一個困難正例 (hard positive)。當線上 rollout 正確率達到 50% 時,經驗被退役,表示模型在對應查詢上的表現已改善。最佳化使用 Adam,固定學習率 $1\times 10^{-6}$、權重衰減 0.1,以及動量參數 $\beta_{1}=0.9$ 與 $\beta_{2}=0.98$。
附錄 E 推論與獎勵模型服務細節
對於測試時擴展,推論預設以 SGLang (SGLang Team, 2026) 服務;Nemotron-Cascade-2 與 DeepSeek-V3.2-Speciale 模型則以 vLLM (vLLM Team, 2026) 服務^15。我們遵循與 Huang and Yang (2025) 相同的、與模型無關的驗證—精煉設定。
具體而言,推論被組織為一個迭代式的「求解—驗證—精煉」程序:求解器首先產出一個候選證明,候選由一個驗證器檢視並回傳一份結構化批判或錯誤報告,求解器接著以此回饋為條件修訂證明,直到候選被接受或精煉預算耗盡為止。除非另有說明,每次生成使用最大長度 160,000 token、溫度 1.0、top-p 0.95。我們對模型或評測基準特定的約束採用以下例外。對於 Nemotron 模型,我們將 top-p 設為 1.0。對於 AIME25/26、AMOBench、IPhO 與 FrontierScience-Olympic,最大生成長度設為 131K token;對於 IMO-AnswerBench、IMO-ProofBench 與 FrontierScience-Research 子集則設為 256K token。對於受 API 限制的模型,我們將最大解碼完成長度設為 API 請求約束所允許的最大值:GPT-5.5 API 為 128,000 token、Gemini 3.1-Pro 為 65,535 token。
TTS 迴圈遵循驗證—精煉協定使用明確的停止規則。在單一運行中,MAX_VERIFICATION_TRUE_ROUNDS=5 表示一個候選一旦連續五輪通過驗證便被接受,而 MAX_VERIFICATION_FALSE_ROUNDS=10 則在連續十輪驗證失敗後提前終止該運行。每次運行最多允許 MAX_EXPLORATION_ROUNDS=30 個「求解—驗證—精煉」循環,對應 TTS 管線中反覆的探索與修正迴圈。對於每個問題,我們設定 MAX_RUNS=10,因此最多啟動十次獨立運行。此設定刻意與精細化 RL 期間所使用的自我精煉行為對齊,使模型在與其訓練期間所見相同類型的證明修復工作流程下被評估。
對於精細化 RL 期間的證明獎勵評估,DeepSeekMath-V2 獎勵伺服器部署於 32 顆 GPU 上,最大脈絡長度 32K、資料並行度 (data-parallel degree) 64。伺服器端推論啟用了基於 MTP 配置的推測式解碼 (speculative decoding)。我們採用一個 3 步推測式解碼方案,搭配單一最高排名的 EAGLE 草稿候選,每步 4 個草稿 token。此設定在維持精細化 RL 訓練所需的評估正確性的同時,改善了驗證器的效率。
附錄 F 比較模型
比較表使用了公開技術報告、官方模型卡片與官方評測基準報告的混合。對於表 1 中答案可驗證的比較,較大模型群組包含 DeepSeek-V3.2 (DeepSeek-AI, 2025a)、GPT-5.5 (OpenAI, 2026) 與 Gemini 3.1 Pro Thinking (Google DeepMind, 2026)。同尺寸群組包含 GLM-4.7-Flash (Z.AI, 2026a)、Nemotron-Cascade-2-30B-A3B (Yang et al., 2026)、Qwen3.6-35B-A3B (Qwen, 2026) 與 Gemma-4-31B (Google, 2026),連同我們的 SU-01。這些相同的活躍比較族系也被重用於表 3 的不可驗證評測基準表中,缺失的評測基準項目以 – 標記。GPT-5.5-High 被視為 GPT-5.5 的高推理變體、Gemini 3.1 Pro Thinking 取自 Gemini 3.1 Pro 族系,而 DeepSeek V3.2 使用與上述相同的 DeepSeek-V3.2 來源。當無可得的論文式技術報告時,我們引用對應的官方模型卡片、程式庫或產品頁面。
附錄 G 評估細節
對於答案可驗證的任務,我們使用一個分層的自動評分管線。我們首先套用基於規則的驗證,包括正規化的答案比對,以及以 Math-Verify[^16] 進行的符號或表達式層級檢查。若某個回應未被這些檢查解決,我們將其送往 gpt-oss-120b 進行生成式驗證 (OpenAI, 2025)。對於 FrontierScience-O,我們使用相同的可驗證評分管線,但採用原始 FrontierScience 論文中所述的專用提示 (Wang et al., 2026)。
[^16]: Math-Verify 程式庫:https://github.com/huggingface/Math-Verify
對於不可驗證與以證明為導向的任務,我們遵循各評測基準的官方評估協定。ProofBench 遵循 IMO-Bench 框架 (Luong et al., 2025) 評估:解答以四級分數集 $\{0,1,6,7\}$ 評分,且我們使用 Gemini-2.5-Pro 作為評分模型以對齊官方所報告的設定。FrontierScience-R 以官方 FrontierScience 程序、使用 GPT-5-high 作為評判器來評估 (Wang et al., 2026)。
對於 IPhO,我們遵循 P1 與 P1-VL 中所使用的評估範式 (Chen et al., 2025; Luo et al., 2026),該範式結合了物理特定的評分提示與競賽式評分標準。對於 IMO 與 USAMO,我們從帶註解的參考解答,以及由曾在 IMO 或 CMO 等數學奧林匹亞奪得金牌的專家標註者所準備的評分指引中,構建一個 ProofBench 式的自動評分框架。對於最終裁定,三位金牌專家各自獨立地從 $\{0,1,6,7\}$ 中給分,我們報告三者中最低的分數作為保守的最終分數。
附錄 H IMO 2025 與 USAMO 2026 的模型解答
本節列出用於表 4 所報告人類專家評分的模型生成解答。每個解答後接其最終專家裁定。對於 USAMO 2026 Problem 2,由於原始回應比其他解答長得多,我們僅展示節錄。
【譯註:附錄 H 包含 SU-01 對全部十二道 IMO 2025/USAMO 2026 題目所生成的完整證明(多以 LaTeX 數學式呈現,總長約 6,000 行),以及各題的專家裁定分數。基於篇幅,以下保留各題的題目陳述(翻為繁體中文)與專家裁定分數摘要;完整的逐題模型證明請參閱原始論文 附錄 H。題目陳述本身為各奧林匹亞主辦方公開之競賽題目。】
H.1 IMO 2025
IMO 2025 Problem 1(專家裁定:7/7)。 平面上的一條直線若不平行於 $x$ 軸、$y$ 軸或直線 $x+y=0$,則稱為「sunny(陽光線)」。給定整數 $n\geq 3$。求所有非負整數 $k$,使得平面上存在 $n$ 條相異直線,同時滿足:(i) 對所有滿足 $a+b\leq n+1$ 的正整數 $a,b$,點 $(a,b)$ 至少落在其中一條直線上;且 (ii) 這 $n$ 條直線中恰有 $k$ 條為 sunny。模型證明對所有 $n\geq 3$,唯一可能的 $k$ 值為 $0,1,3$。
IMO 2025 Problem 2(專家裁定:7/7)。 涉及兩個相交圓、一個垂心與一個相切論斷的平面幾何構型;模型將其化簡為座標與距離計算後完成證明。
IMO 2025 Problem 3(專家裁定:7/7)。
IMO 2025 Problem 4(專家裁定:7/7)。
IMO 2025 Problem 5(專家裁定:7/7)。
IMO 2025 Problem 6(專家裁定:0/7)。 模型在行置換 (column-permutation) 化簡上採取了一個無效的步驟,錯失了微妙的結構性約束,導致證明失敗。
H.2 USAMO 2026
USAMO 2026 Problem 1(專家裁定:7/7)。
USAMO 2026 Problem 2(專家裁定:0/7,僅節錄)。 模型在精細的全域策略論證中留下缺口,未能證明一個微調的過程不變量。
USAMO 2026 Problem 3(專家裁定:7/7)。 模型未走標準綜合幾何路線,而以複數在單一代數框架中統一單位圓、等邊三角形旋轉、弦關係與切線條件,給出別出心裁的解析式重新表述。
USAMO 2026 Problem 4(專家裁定:7/7)。 模型採用進位狀態 (carry-state) 動態規劃方法求解此數字問題。
USAMO 2026 Problem 5(專家裁定:7/7)。
USAMO 2026 Problem 6(專家裁定:7/7)。 模型使用歐拉函數 (totient)、同餘、Vieta 跳躍 (Vieta jumping) 與費氏數結構完成數論證明;解集恰為 $(F_{2n-1},F_{2n+1})$(及對稱者,$n\geq 1$),連同退化對 $(1,1)$。
術語對照表
| English | 繁體中文 |
|---|---|
| Reasoning Model | 推理模型 |
| post-training / post-trained | 後訓練 |
| backbone | 骨幹 |
| recipe | 配方 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| reverse-perplexity curriculum | 反向困惑度課程 |
| proof-search | 證明搜尋 |
| self-checking | 自我檢查 |
| self-verification | 自我驗證 |
| self-refinement | 自我精煉 |
| Reinforcement Learning (RL) | 強化學習 |
| RL with Verifiable Rewards (RLVR) | 帶有可驗證獎勵的強化學習 |
| Test-time Scaling (TTS) | 測試時擴展 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Long-CoT | 長思維鏈 |
| long-horizon | 長程 |
| behavior shaping | 行為塑造 |
| experience replay | 經驗回放 |
| generative reward model | 生成式獎勵模型 |
| specializable-generalist | 可專門化的通才 |
| instruction-following | 指令遵循 |
| neural guidance | 神經引導 |
| symbolic search / deduction | 符號搜尋/演繹 |
| neuro-symbolic | 神經符號 |
| trajectory | 軌跡 |
| truncation | 截斷 |
| length-normalized perplexity | 長度正規化困惑度 |
| descending-PPL ordering | 困惑度遞減排序 |
| validation truncation rate | 驗證集截斷率 |
| epoch | 訓練輪數 |
| base model | 基礎模型 |
| coarse RL | 粗粒度 RL |
| refined RL | 精細化 RL |
| answer-seeking | 尋答 |
| Group Sequence Policy Optimization (GSPO) | 群組序列策略最佳化 |
| group-relative advantage | 群組相對優勢 |
| importance ratio | 重要性比率 |
| policy clipping | 策略裁剪 |
| outcome reward | 結果獎勵 |
| rollout | rollout(取樣展開) |
| on-policy | 同策略 |
| off-policy | 離策略 |
| rejection sampling | 拒絕取樣 |
| decontamination | 去汙染 |
| contaminated | 受汙染 |
| process-level reward | 過程層級獎勵 |
| critique-and-repair | 批判—修復 |
| anti-hack | 反作弊 |
| judge artifact | 評判器假象 |
| fallback | 回退 |
| routing-replay | 路由回放 |
| solve–verify–refine | 求解—驗證—精煉 |
| verdict | 裁定 |
| bug report | 錯誤報告 |
| solver prompt | 求解器提示 |
| verification prompt | 驗證提示 |
| reasoning budget | 推理預算 |
| single-pass | 單次通過 |
| best-of-many | 多選最佳 |
| benchmark | 評測基準 |
| verifiable | 可驗證 |
| justification | 證成 |
| entropy collapse | 熵塌縮 |
| preference optimization | 偏好最佳化 |
| self-improvement | 自我改進 |
| bootstrap | 自舉 |
| continued pre-training | 繼續預訓練 |
| specialist distillation | 專家蒸餾 |
| on-policy distillation | 同策略蒸餾 |
| speculative decoding | 推測式解碼 |
| data-parallel degree | 資料並行度 |
| dynamic sampling | 動態取樣 |
| partial rollout | 部分 rollout |
| oversampling | 過取樣 |
| hard positive | 困難正例 |
| cosine decay | 餘弦衰減 |
| medal line | 獎牌線 |
| angle chasing | 追角 |
| synthetic geometry | 綜合幾何 |
| Vieta jumping | Vieta 跳躍 |
| totient | 歐拉函數 |
| orthocenter | 垂心 |
| process invariant | 過程不變量 |
| automata | 自動機 |
| carry-state | 進位狀態 |
| sunny line | 陽光線 |