MiMo-V2.6:將強化學習擴展至自我改進
原始論文:MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement 作者:LLM-Core Xiaomi 來源 ID:hf-XiaomiMiMo-MiMo-V2.6-Flash-RL 日期:2026 標籤:Reinforcement Learning Self-Improvement MoE Long Context Mixed-Task Agentic RL Reward Hacking Defense
【譯註:本篇譯文由自動化管線產出:先取 PDF 版面結構,再以 LLM 逐段翻譯並依全站術語詞表統一譯名(模型本身不對外公開資訊,僅說明為 LLM);未經逐句人工校對。 本篇非 arXiv 來源,授權為 MIT License(模型庫);本譯文為原文的衍生作品,一切以原文為準。】
目錄
LLM-Core Xiaomi
摘要
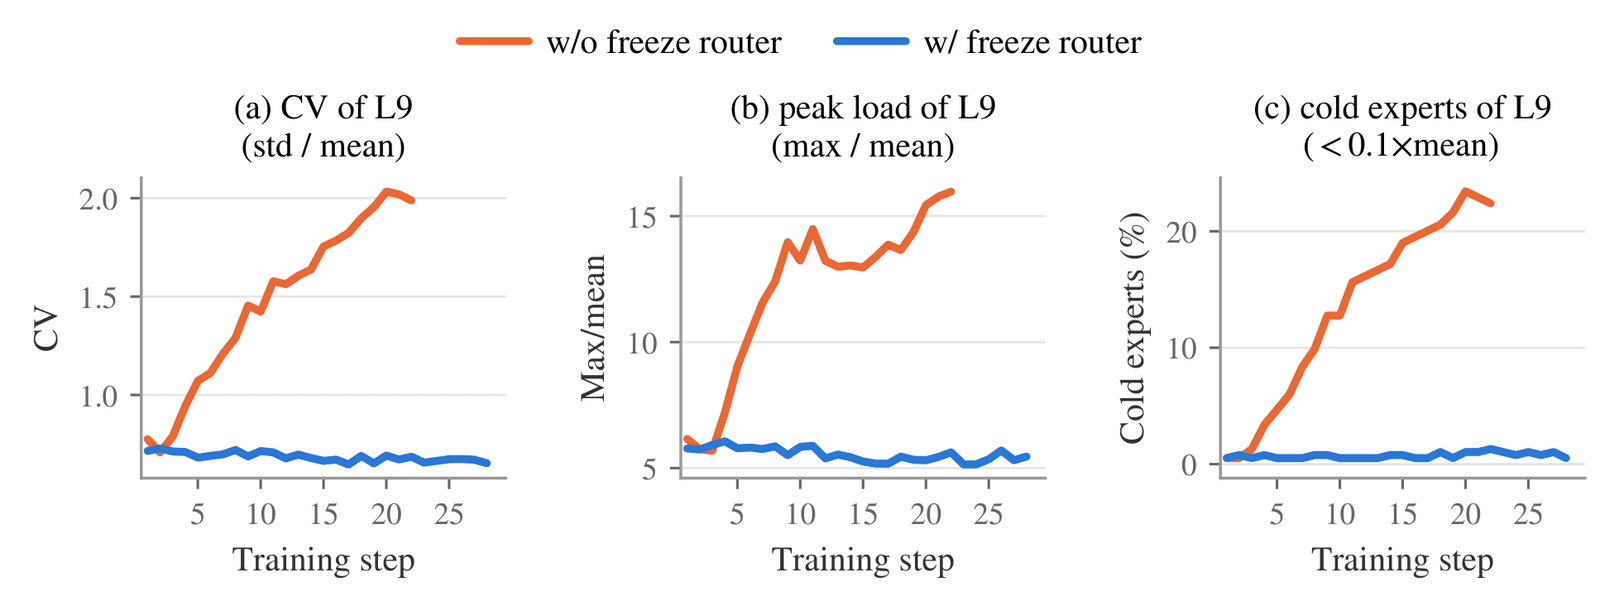
強化學習 (Reinforcement Learning, RL) 是推動大型基礎模型邁向自我改進 (self-improvement) 的核心訓練正規化。本報告介紹了 MiMo-V2.6 系列,這是一個全模態 (omni-modal) 模型家族,透過擴大 RL 計算規模來推動模型智慧的邊界。在進行 RL 之前,我們會在廣泛的多模態語料庫上進行中期訓練,以提供充足的探索空間,並在預訓練的混合 SWA 架構上建立穩固的基礎,以支援後續的規模擴展。我們從三個維度擴大 RL 計算規模:(1) 採用非同步訓練,使用更大的批次 (batches) 與更高的吞吐量,每次步驟消耗 1,568 個樣本與 2.7~3.7B 個 tokens,上下文長度 (Context Length) 達 1M;(2) 涵蓋程式碼、通用、視覺及網路領域,並結合多種代理人 harness (agent harnesses) 來建構更多元且複雜的環境;(3) 透過組式智能體式評分 (groupwise agentic grading) 增加評分器計算資源,為長期任務 (Long-Horizon Task) 提供更準確的獎勵訊號,並引導模型朝向更短、更具 Token 效率 (token-efficient) 的解決方案發展。為了在大規模訓練中維持穩定性,我們凍結了 MoE 路由器,並建立多層防禦機制以防止獎勵駭入 (Reward Hacking)。此外,我們也為混合任務智能體式 RL 建立基礎設施,包括統一軌跡代表性 (unified trajectory representation)、高並發多框架 rollout、解耦的控制與資料平面,以及訓練與推論一致性 (training-inference consistency)。我們開源了訓練動態、RL 環境與 RL 框架,以促進對大規模 RL 與模型自我改進的研究與重現。
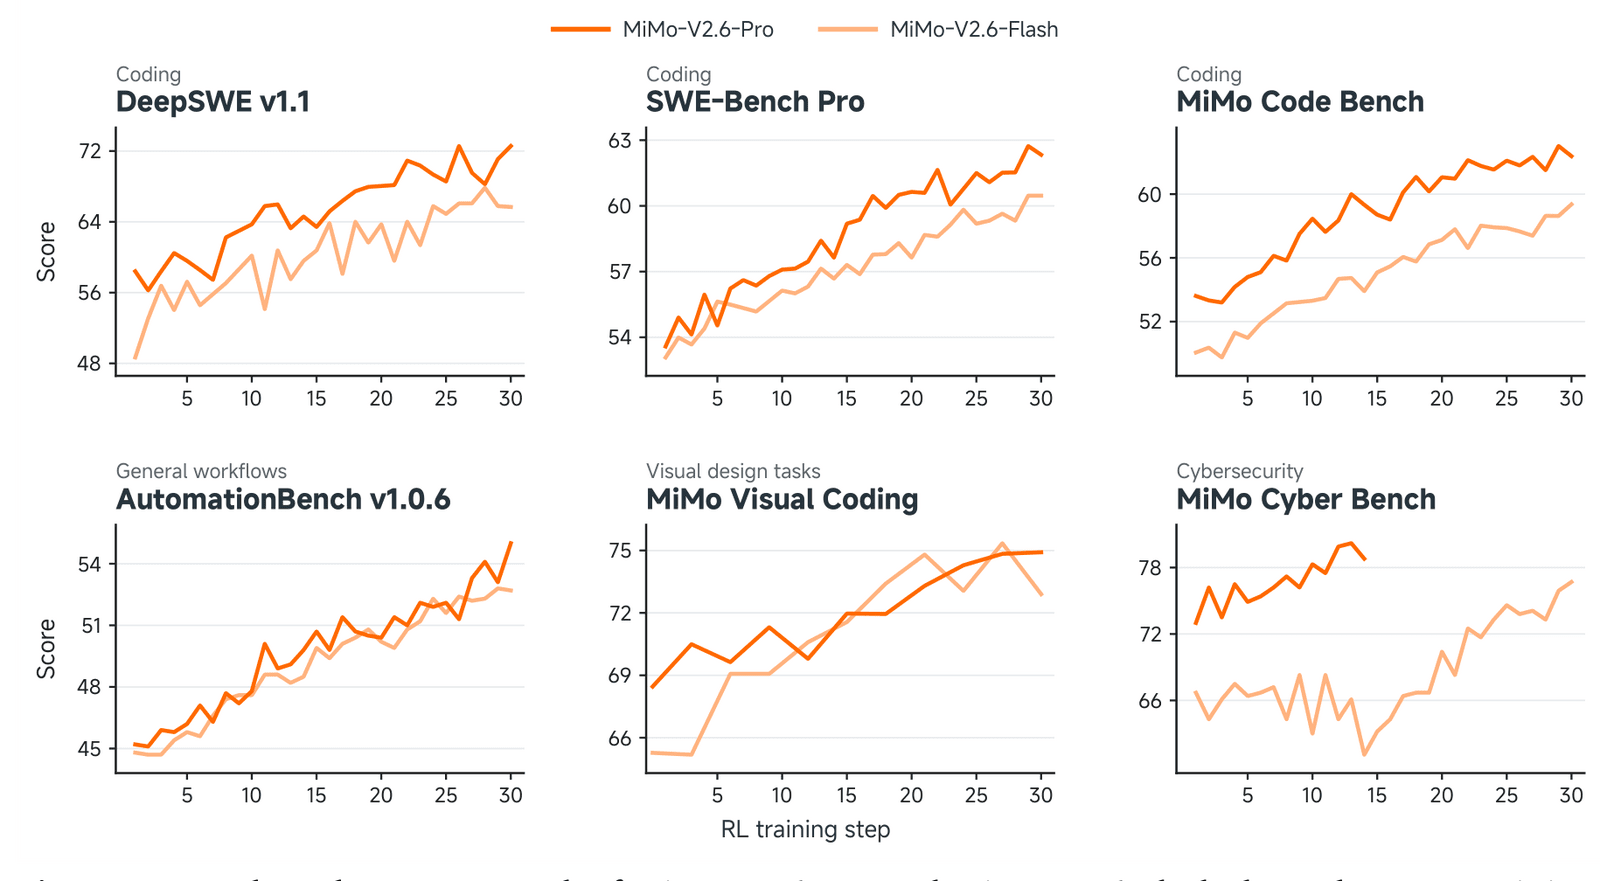
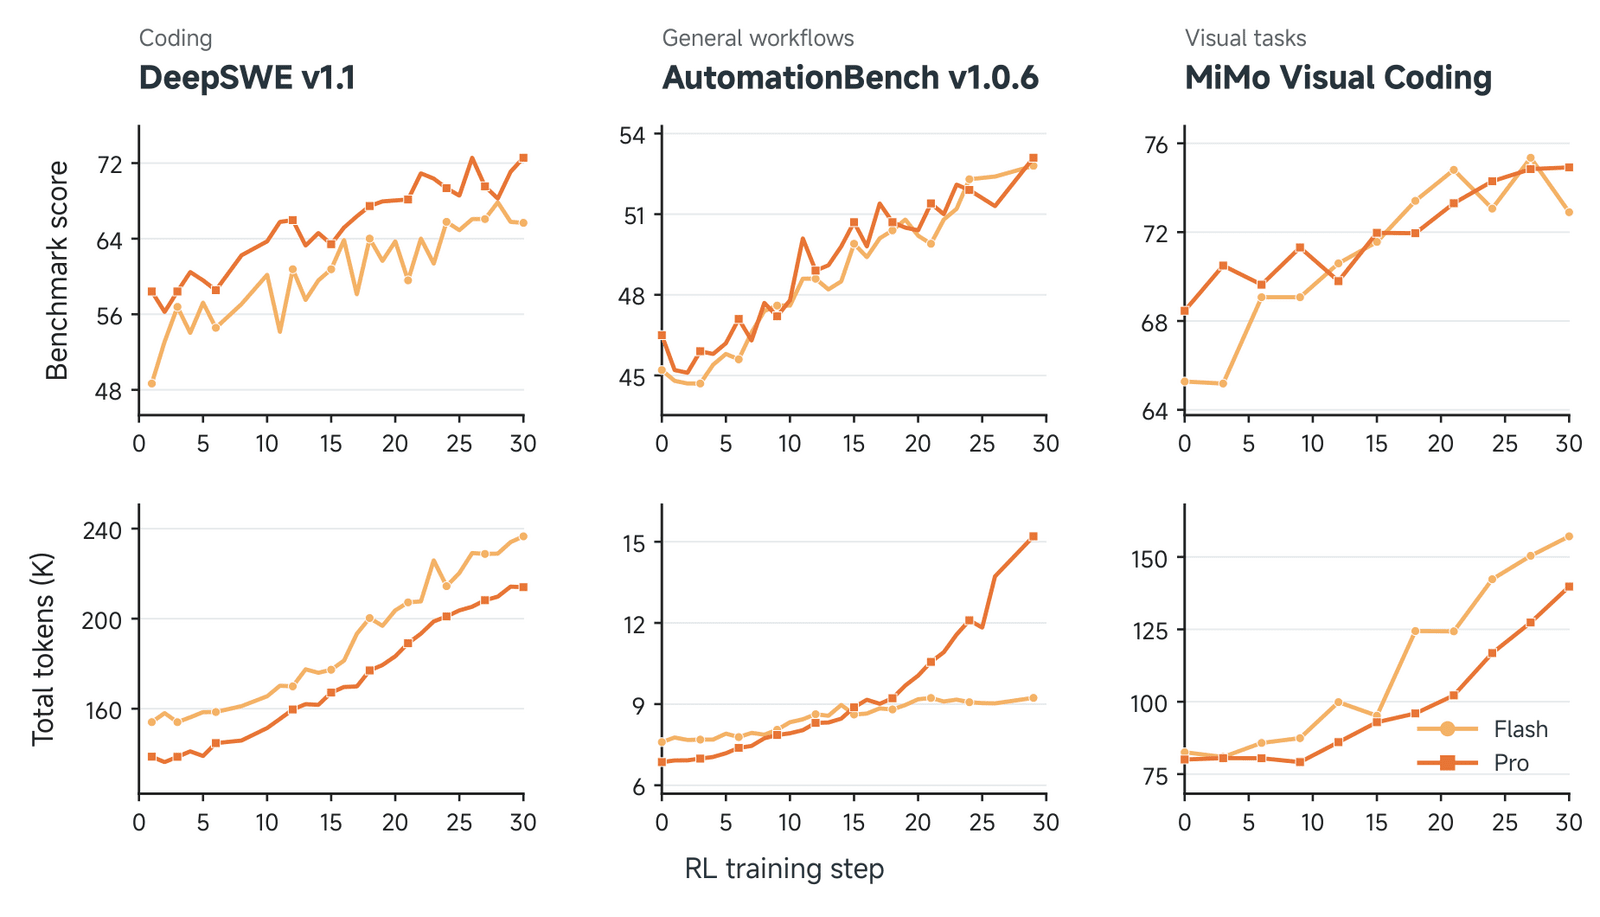
圖 1. MiMo-V2.6-Pro 與 MiMo-V2.6-Flash 在 RL 訓練過程中各項任務的基準分數。
| 1 | Introduction | 3 |
| 2 | Architecture | 4 |
| 2.1 | Overall Architecture | 4 |
| 2.2 | MiMo-ViT | 4 |
| 2.3 | Audio Encoder | 5 |
| 2.4 | Speculative Decoder | 5 |
| 3 | Pre-Training | 7 |
| 3.1 | Pre-Training Setup | 7 |
| 3.2 | Mid-Training Setup | 7 |
| 4 | Scaling Reinforcement Learning | 8 |
| 4.1 | Scaling RL Training Computation | 8 |
| 4.2 | Scaling RL Environments and Harnesses | 9 |
| 4.3 | Groupwise Agentic Grading | 16 |
| 5 | Experiments: You Only RL Once | 20 |
| 5.1 | Training Setup | 20 |
| 5.2 | Evaluation Settings | 21 |
| 5.3 | RL Performance | 22 |
1 引言
遞迴式自我改進 (recursive self-improvement, RSI) 旨在讓模型透過持續的探索與回饋,不斷擴展其能力。要實現此願景,必須讓模型與互動式環境結合的「代理人 (agents)」,藉此提供自我改進所需的多步驟軌跡 (trajectories) 與回饋訊號。為了達成此目標,在複雜的智能體式任務中擴展強化學習 (reinforcement learning, RL) 的規模,便成為一條具體的路徑。然而,實現此潛力面臨兩大挑戰。首先,針對基礎模型 (foundation models) 的 RL 需要合適的模型架構,以及為代理人提供足夠豐富的探索空間。其次,擴展 RL 規模需要針對基礎設施、環境與評分器 (grader) 提出精密的解決方案。在本報告中,我們推出了 MiMo-V2.6 系列,包含 MiMo-V2.6-Pro,這是一個擁有 1.02 兆 (T) 個參數、其中 420 億 (B) 個為活躍參數的混合專家 (Mixture-of-Experts) 模型,以及 MiMo-V2.6-Flash,這是一個擁有 3100 億 (B) 個參數、其中 150 億 (B) 個為活躍參數的混合專家模型。這些模型旨在彌補上述差距,並在大型強化學習領域邁出實務的一步。
MiMo-V2.6 的架構、預訓練與中期訓練共同建構了一個強大且高效的基礎模型。受限於在低運算成本下仍需保留全域上下文的需求,MiMo-V2.6 採用混合稀疏 MoE Transformer 骨幹,將區域性滑動視窗注意力 (SWA) 與全域注意力 (GA) 交錯結合,並輔以輕量級視覺編碼器與音訊編碼器。此外,大規模預訓練使模型具備廣泛的知識,並能跨文本、音訊與影片展現多模態的通用理解能力。我們進一步引入以代理人為中心的中訓練階段,藉此擴展智能體任務的探索空間,使模型在後訓練期間能發現更有效的任務解決軌跡。
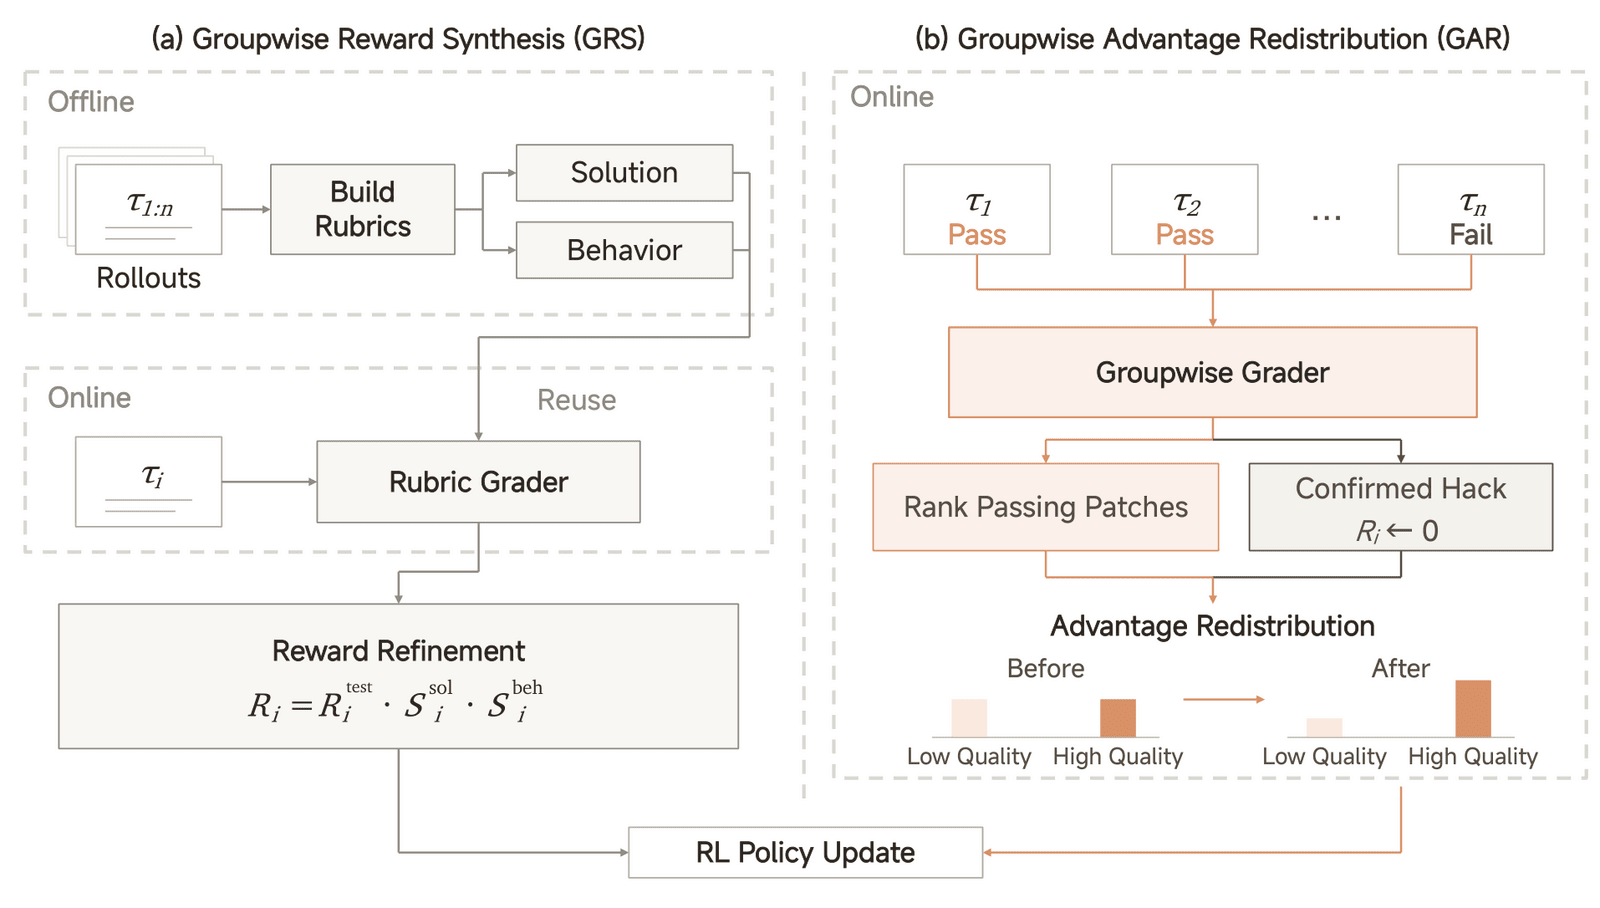
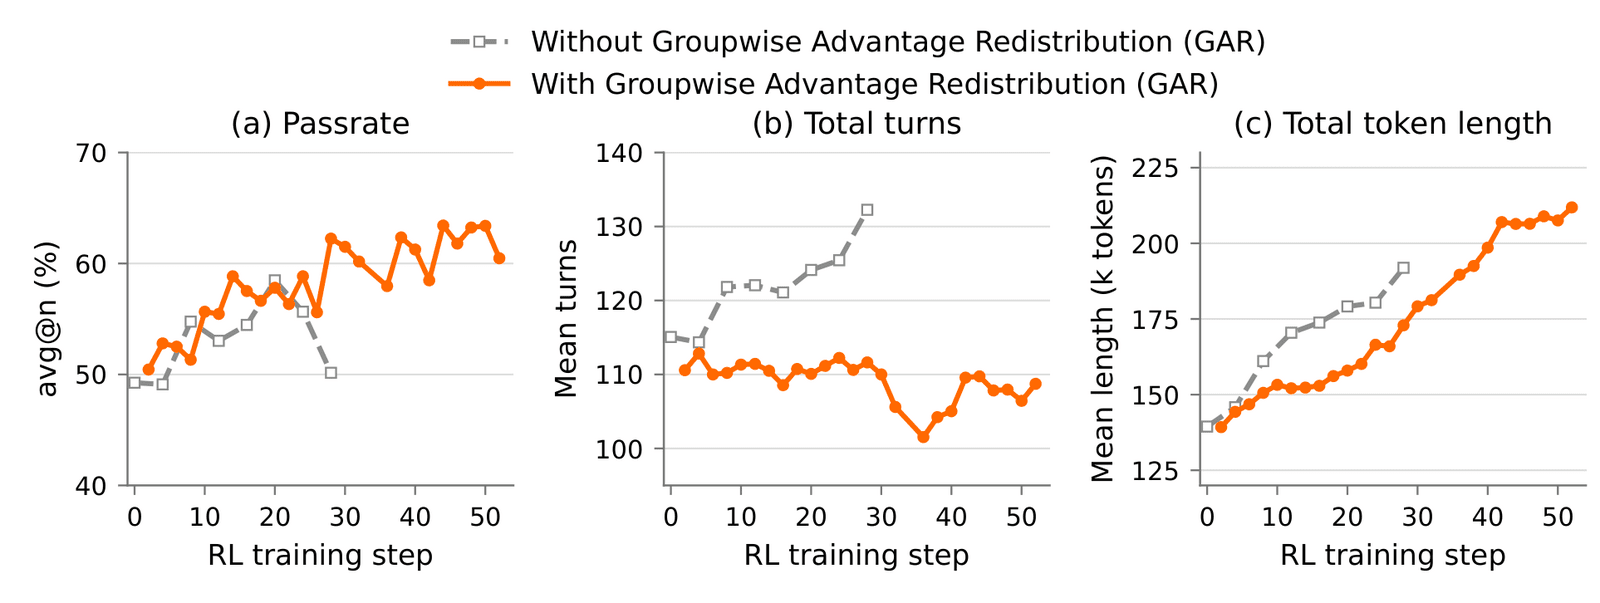
首先,我們透過一個橫跨三個關鍵組件的系統化協同設計架構,來擴展 RL 的運算規模。第一,我們透過全非同步訓練來擴大批次大小與訓練吞吐量,每一步驟即可處理數千個長程 Rollout 與數十億個 Token,且上下文長度可達 1M。第二,我們針對編碼、通用、視覺及網路安全等任務,擴展 RL 環境的多樣性與複雜度,並使用多樣化的代理人 Harness 與強化對抗獎勵駭入的防護機制。同時調整 Harness 與任務內容可提升模型的泛化能力。第三,我們引入組式智能體式評分,以提供超越二元測試案例的更具資訊量的獎勵訊號。我們不再將相同的獎勵分配給所有通過測試案例的解決方案,而是比較各組內的解決方案,以區分問題解決的品質與行為。透過我們提出的組式獎勵合成(Groupwise Reward Synthesis, GRS)與組式優勢重新分配(Groupwise Advantage Redistribution, GAR),這些細粒度區分將被轉換為更具資訊量的學習訊號,引導模型朝向更準確且高效的解決方案發展。
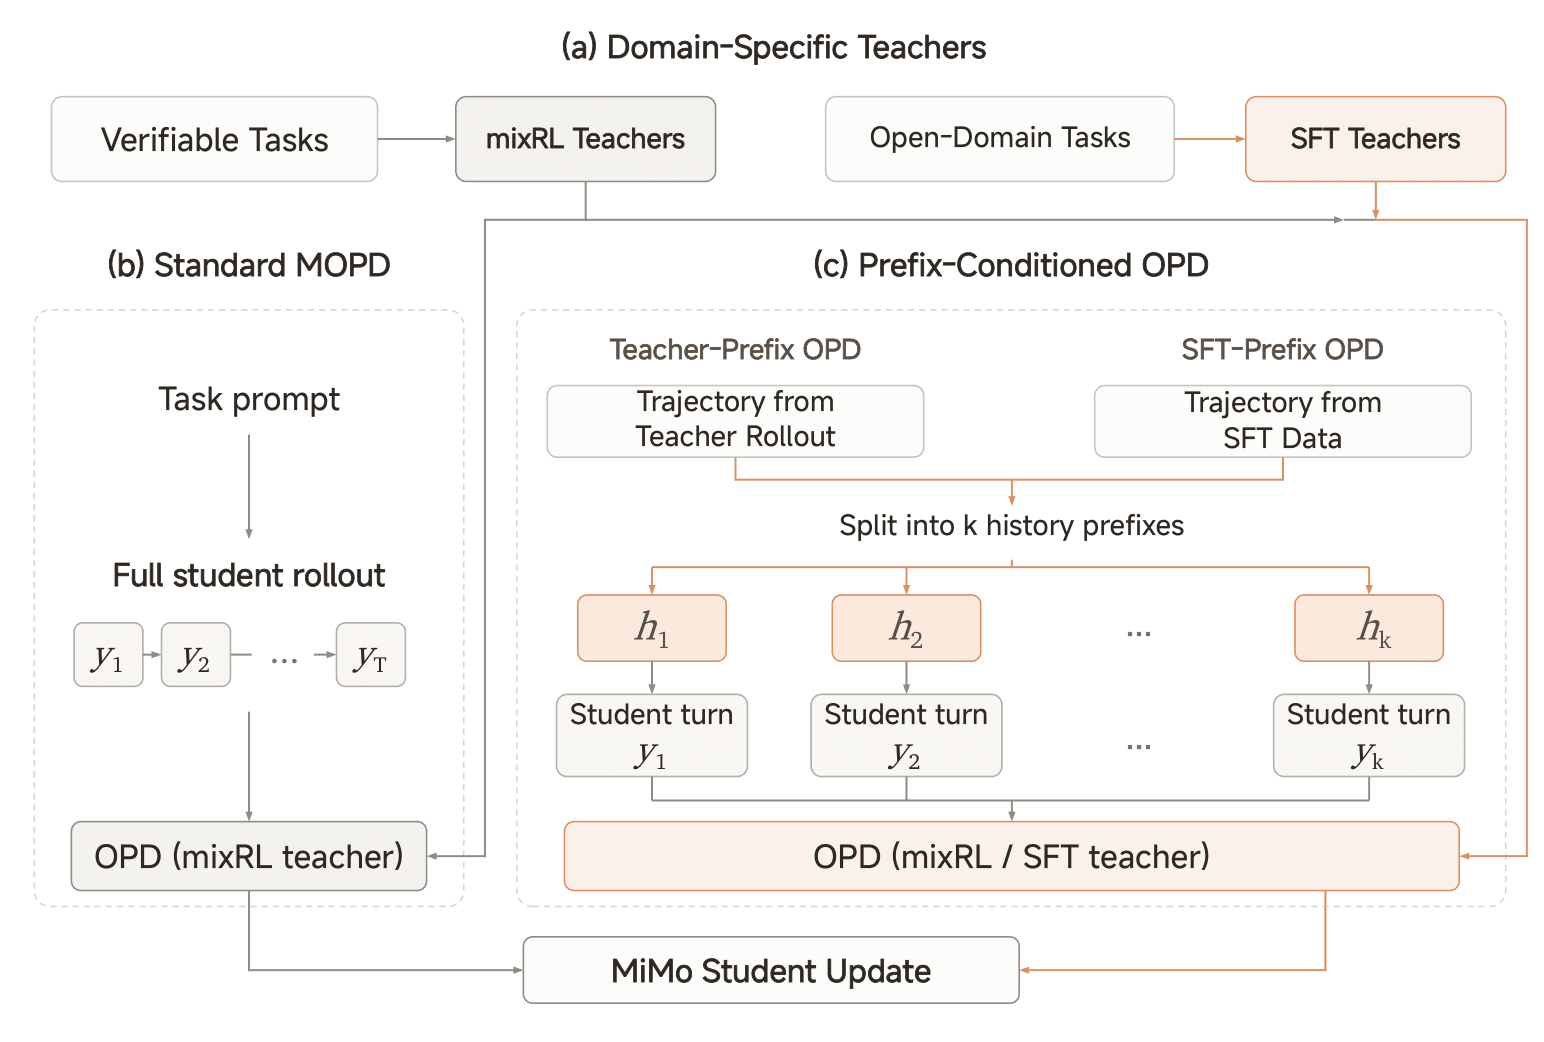
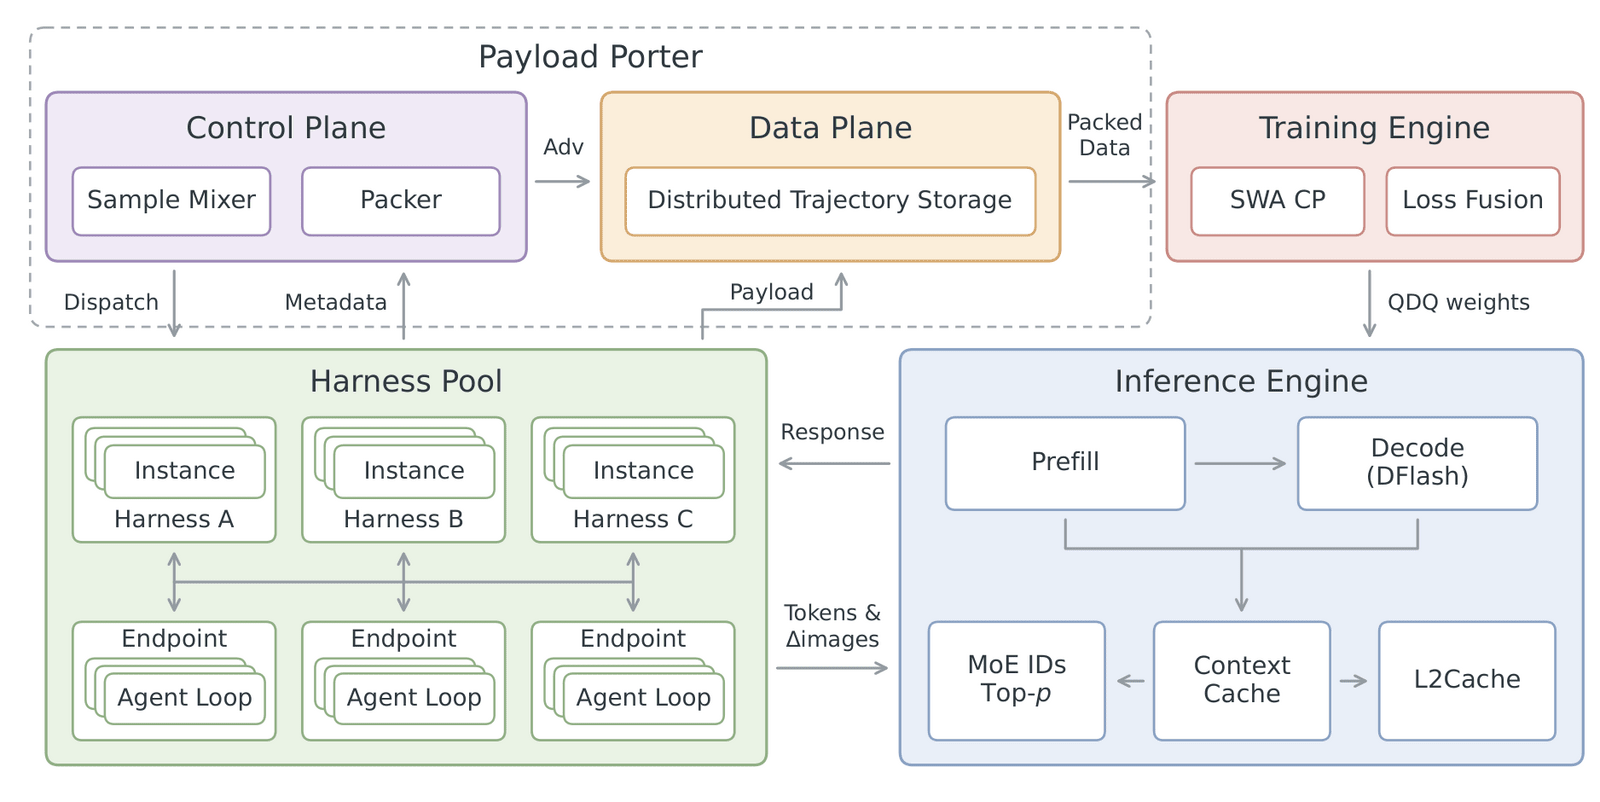
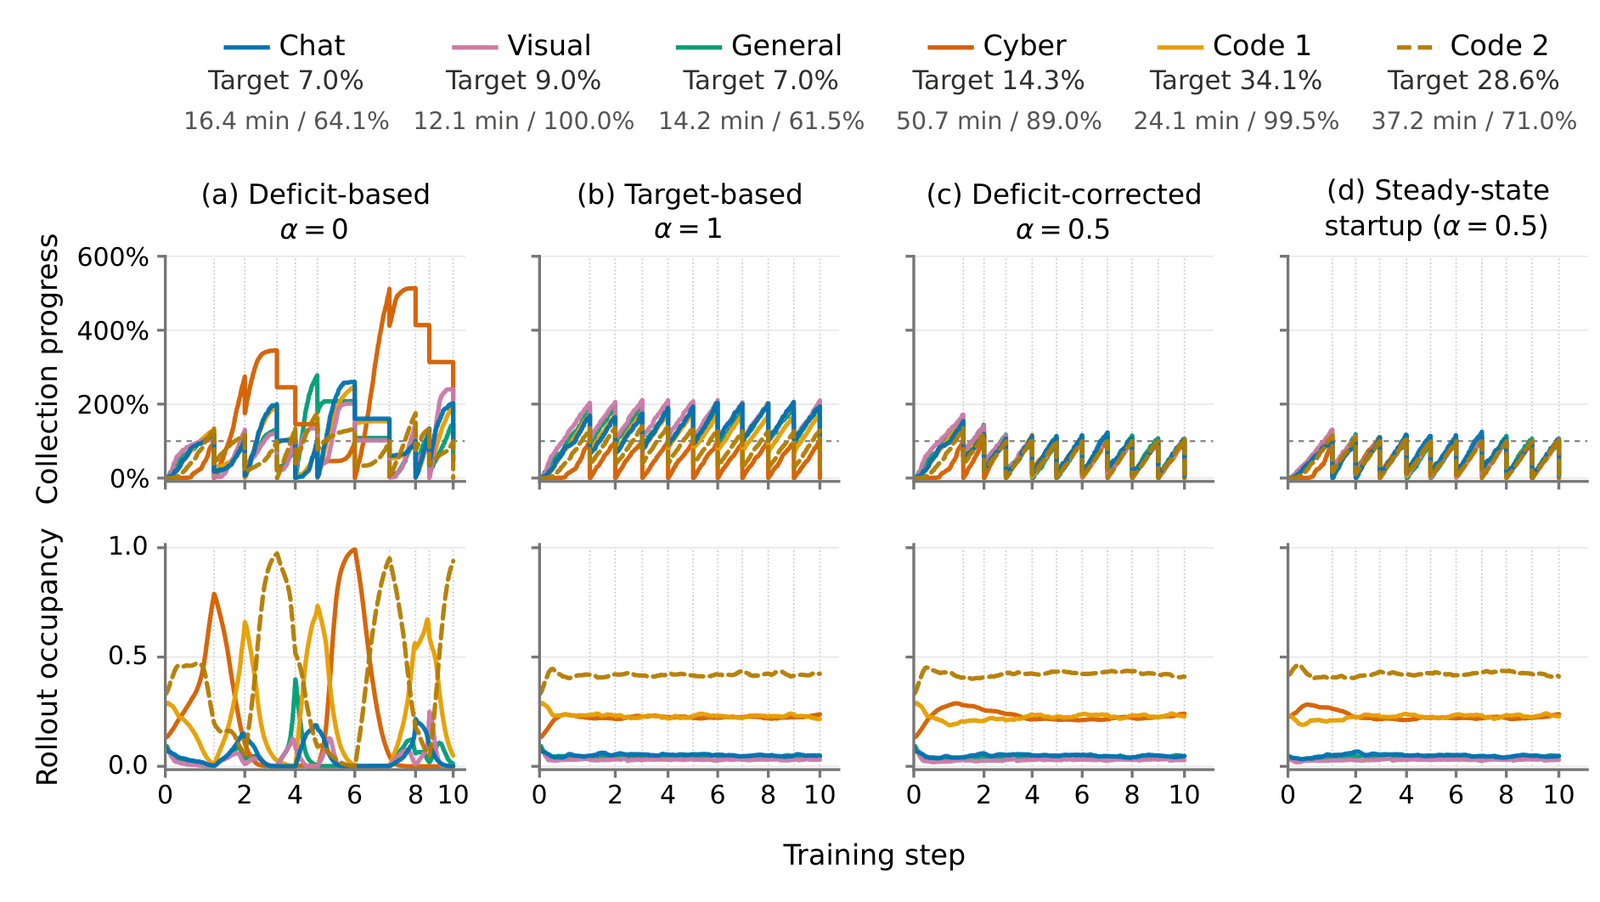
要在大規模環境下實現上述目標,對於基礎設施而言,無論在研究或工程層面都面臨諸多挑戰。為了支援靈活的智能體式互動情境,我們設計了一種統一軌跡代表性與一種罰金機制,兩者共同優化學習訊號。為了處理大型訓練批次,我們透過 Harness 池維持跨多元代理人框架的高並發度互動,並將控制平面與數據平面解耦,以緩衝並傳輸攜帶路由與多模態 Payload 的海量軌跡。樣本混合機制與動態取樣及部分 rollout 配合運作,能穩定訓練批次中各任務的樣本組合。我們將訓練與推論引擎針對 MoE 路由與 top-p 取樣候選集進行對齊,並針對 RL 工作負載優化這兩類引擎。
大幅提升 RL 運算資源能顯著發揮模型潛力,無論是在編碼等可驗證任務,或是網頁開發等較難驗證的任務上皆然。如圖 1 所示,MiMo-V2.6-Pro 與 MiMo-V2.6-Flash 隨訓練步驟增加,在各項報告基準測試中的效能均持續提升。此外,這些進步並非侷限於單一領域,而是橫跨 DeepSWE 上的編碼、AutomationBench 上的通用工作流、MiMo 視覺編碼的視覺任務,以及 MiMo Cyber Bench 上的資安領域,在多樣化任務中皆表現一致。這些成果顯示 MiMo-V2.6 具備更強的複雜問題解決能力,且在日常協作情境中的表現更為可靠,反映出更具通用性的代理式智慧。
為促進代理式 RL 的研究,我們開源了一套完整的工具包,涵蓋了 RL 開發堆疊的關鍵組件,包括輕量級模型 MiMo-V2.6-Distill-Qwen-9B、跨多個領域且附有驗證器的精心策劃任務環境、端對端 RL 訓練框架,以及可組合的 mini-harness,用於靈活的代理人互動。這些組件共同提供了一個統一且易於取得的平台,用於在多樣化的任務、環境與代理人配置下研究代理式 RL,同時降低了重現與擴展大規模 RL 實驗的工程障礙。使用 MiMo-V2.6-Distill-Qwen-9B 進行的實驗顯示,在多種任務與代理人 harness 中皆能獲得一致的 RL 效能提升,驗證了此套件的有效性與普適性。我們期盼這套開源工具能成為社群中公平、強大且可重現的基線,藉此系統性地研究代理式 RL,並推動研究朝向遞迴式自我改進邁進。
2 架構
2.1 整體架構
如圖 2 所示,MiMo-V2.6 採用標準 Transformer (Vaswani et al., 2017) 骨幹,並增強了視覺與音訊編碼器,兩者透過輕量級投影器相互連接。
MiMo-V2.6 的文字骨幹主要由交替使用局部滑動視窗注意力 (SWA) 與全域注意力 (GA) 的混合區塊所組成。它堆疊了 M 個混合區塊,每個區塊的結構為 N 個連續的 SWA 區塊,後接一個 GA 區塊。唯一的例外是第一個 Transformer 區塊,該區塊使用全域注意力與密集型前饋網路 (FFN) 以穩定早期代表性的學習。MiMo-V2.6 使用的滑動視窗大小 W 為 128。SWA 區塊與 GA 區塊皆採用不具共享專家的稀疏 MoE 前饋網路。此外,MiMo-V2.6 整合了基於 SWA 與密集型 FFN 的 MTP (Gloeckle et al., 2024; Liu et al., 2024; Xia et al., 2025) 以提升預訓練期間的模型效能。文字骨幹架構的更詳細描述可參考 Core Team et al. (2026)。模型配置詳見表 1。
2.2 MiMo-ViT
MiMo-ViT 採用混合注意力架構。它將 MiMo-VL-7B (Yue et al., 2025) 中固定的非重疊視窗注意力,替換為槽增強 SWA,藉此在連續層級中實現跨視窗邊界的資訊交換,並緩解視覺碎片化問題。區域性 SWA 層交替使用列主序與行主序 Token 序列化,以支援沿著兩個空間軸的資訊傳播。最後,定期插入 GA 層以直接彙整全域上下文。此設計大幅降低了高解析度視覺處理的計算成本,同時達成與 GA ViT 相當的效能。請參考 He et al. (2026) 以獲得更多分析。為了從零預訓練 MiMo-ViT,我們將其與小型預訓練 LLM 搭配,並僅針對多模態理解資料,使用交叉熵目標來最佳化該 VLM。這種簡單的配方避免了對比學習等輔助目標,使預訓練更具效率且具備擴展性。最重要的是,LLM 仍保持可訓練性,能為 ViT 提供穩定且具語意意義的梯度。在超過 4T
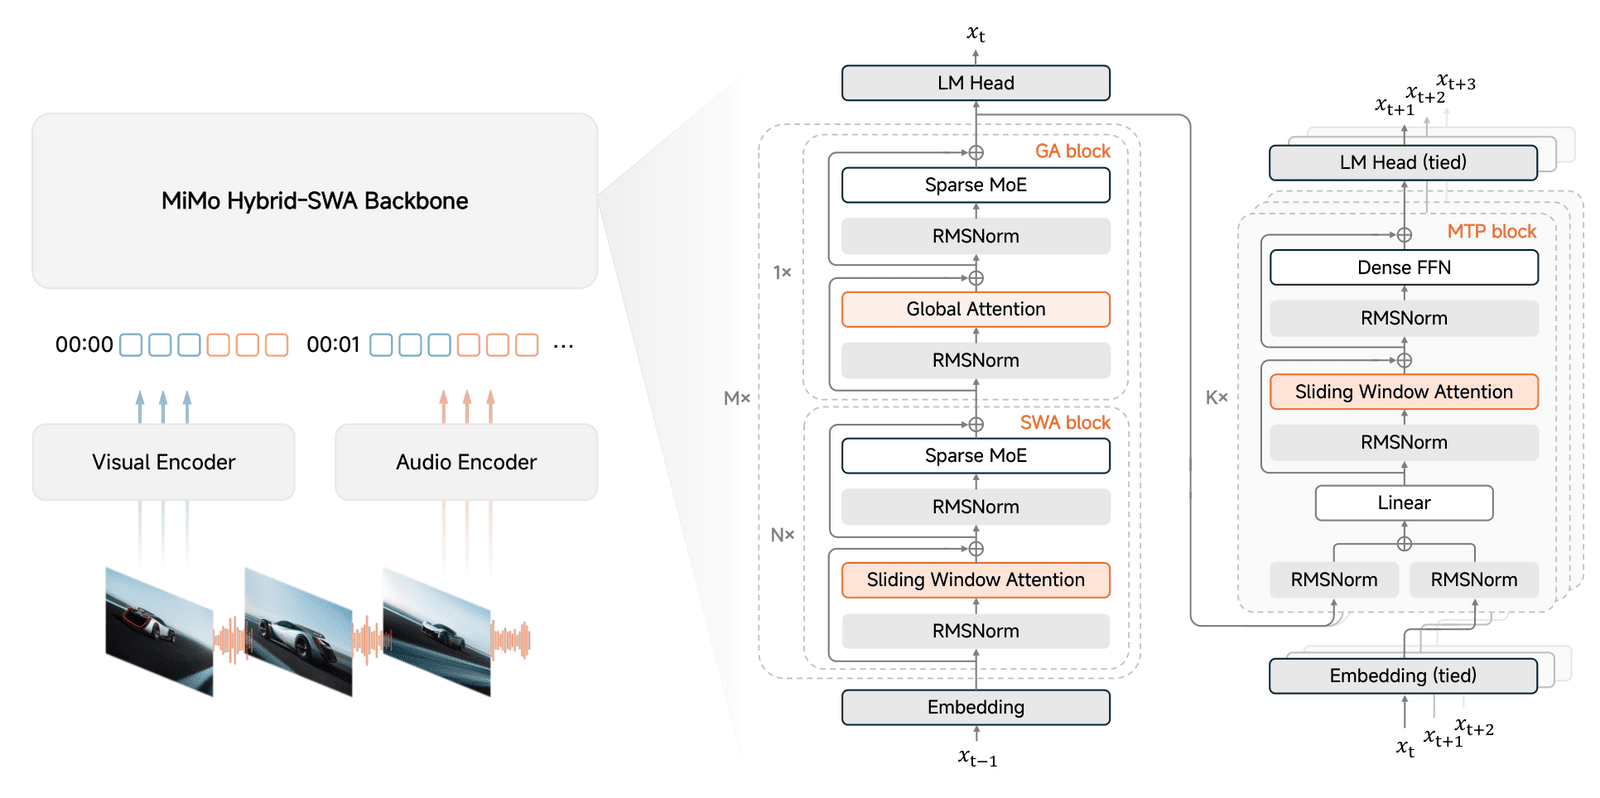
圖 2 MiMo-V2.6 的整體架構。音訊、視覺與文字輸入皆會映射至共享的 Token 序列,並由 MiMo 混合 SWA 骨幹處理,接著再經由語言建模頭與多 Token 預測(MTP)區塊進行處理。
image tokens,MiMo-ViT 學習了強大的視覺表示,並為 MiMo-V2.6 提供了穩健的基礎。
2.3 音訊編碼器
MiMo-V2.6 的音訊編碼包含兩個階段:音訊詞元化與程式碼修補編碼。音訊詞元化編碼器首先透過一個兩層的卷積前端處理對數梅爾頻譜圖,將影格速率減半。接著,產生的序列會傳遞至具備因果混合注意力架構的 Transformer,該架構交替疊加 SWA 與 GA 層。SWA 層負責擷取區域性的時間依賴性,而 GA 層則彙整完整前序序列的上下文資訊。隨後的下採樣卷積會將影格速率進一步減半至 25 Hz,之後由 20 層殘差向量量化器(RVQ)將每個影格表示為 20 個離散音訊詞元。音訊詞元化編碼器遵循 MiMo-Audio(Xiaomi, 2025)的訓練配方,並在涵蓋語音、音樂及其他音訊內容的 2,000 萬小時音訊資料上進行訓練。
音訊 Patch 編碼器的架構設計遵循 MiMo-Audio,並與文字骨幹(backbone)共同訓練。在每個時間步長,音訊 Token 會透過各別的嵌入表(每個 RVQ 碼本一個)進行嵌入,並將產生的嵌入向量加總以形成單一影格(Frame)的代表性。系統會將每四個連續影格組合成一個音訊 Patch,並由具備雙向自注意力的 Transformer 處理,且該自注意力機制僅限於該 Patch 內部。接著將四個輸出的代表性向量串聯,並透過線性投影轉換為單一的骨幹輸入嵌入,將音訊序列的速率從 25 Hz 降低至 6.25 Hz。
2.4 推測解碼器
MiMo-V2.6 中的推測式解碼採用多 token 預測 (MTP) 模組,並遵循 DFlash (Chen et al., 2026) 的區塊擴散設計。草稿模型由 5 層 Transformer 層與密集前饋網路組成。該模型以骨幹的隱藏特徵與乾淨錨點為條件。
| Block | Configuration | MiMo-V2.6-Flash | MiMo-V2.6-Pro |
|---|---|---|---|
| Main Block | Layers (Total/SWA/GA) | 48/39/9 | 70/60/10 |
| Hidden Size | 4096 | 6144 | |
| SWA Heads (Q/KV) | 64/8 | 128/8 | |
| Sliding Window Size | 128 | 128 | |
| GA Heads (Q/KV) | 64/4 | 128/8 | |
| Head Dimensions (QK/V) | 192/128 | 192/128 | |
| Experts (Total/Activated) | 256/8 | 384/8 | |
| # Total Parameters | 310B | 1.02T | |
| # Active Parameters | 15B | 42B | |
| MiMo-ViT | Layers (Total/SWA/GA) | 28/24/4 | |
| Hidden Size | 1280 | ||
| Attention Heads (Q/KV) | 32/8 | ||
| Head Dimension | 64 | ||
| Patch Size (T × H × W) | 2 × 16 × 16 | ||
| Sliding Window Size (Left/Right) | 64/64 | ||
| Spatial Merge Size | 2 × 2 | ||
| # Parameters | 681M | ||
| Audio Tokenizer Encoder | Layers (Total/SWA/GA) | 24/12/12 | |
| Hidden Size | 1024 | ||
| Attention Heads (Q/KV) | 16/16 | ||
| Head Dimension | 64 | ||
| Mel Bins | 128 |
| Sliding Window Size | 128 | |
|---|---|---|
| Codebooks | 20 | |
| # Parameters | 308M | |
| Audio Patch Encoder (音訊 Patch 編碼器) |
Layers | 6 |
| Hidden Size | 1024 | |
| Attention Heads (Q/KV) | 16/16 | |
| Head Dimension | 64 | |
| Attention Group Size | 4 | |
| # Parameters | 127M | |
| Speculative Decoder (推測性解碼器) |
Layers (Total/SWA/GA) | 5/5/0 |
| Hidden Size | 4096 | |
| SWA Heads (Q/KV) | 64/8 | |
| Sliding Window Size | 1024 | |
| GA Heads (Q/KV) | 64/4 | |
| Head Dimensions (QK/V) | 128/128 |
表 1 MiMo-V2.6-Flash 與 MiMo-V2.6-Pro 的詳細模型配置。主要區塊層數不包含 MTP 模組。編碼器參數數量包含輸入嵌入,但不包含投影器。音訊 Tokenizer 編碼器參數數量不包含 EMA 碼本。
token 後,它在前向傳遞中預測 7 個後續 token,並由骨幹進行平行驗證。所有草稿層均採用分組查詢的滑動視窗注意力 (SWA) 以限制注意力計算與 KV 快取大小。Token 在草稿區塊內雙向關注,並最多關注錨點前 1,024 個骨幹上下文位置。
3 預訓練
3.1 預訓練設定
MiMo-V2.6 的預訓練語料庫涵蓋了文本、視覺與音訊。文本語料庫來源廣泛,包含公開的網頁內容、書籍、學術論文、程式碼以及 STEM 相關教材。視覺語料庫則包含圖像描述、接地 (Grounding)、OCR、GUI、對話、影片與視覺編碼資料。至於音訊部分,我們彙整了大量高品質且多樣化的資料,並將其整理為三種任務格式:語音-文本交錯、自動語音辨識 (ASR) 以及一般音訊描述。
我們採用兩階段預訓練策略。在第一階段,我們使用純文本資料訓練語言骨幹,以建立強大的基礎語言能力。在第二階段,我們將骨幹與內部預訓練的 ViT 以及音訊編碼器整合,並在全模態資料上聯合訓練整個模型,使其具備理解圖像、影片與音訊的能力。
我們首先以 32K Token 的上下文長度開始進行預訓練,並在訓練過程中將其擴展至 256K。MiMo-V2.6-Flash 在 48T Token 上進行訓練,其中文字階段包含 26T Token,全能階段則包含 22T Token。MiMo-V2.6-Pro 則在 30T Token 上進行訓練,其中兩個階段分別包含 27T 與 3T Token。我們在 MiMo-V2.6 的預訓練中採用 AdamW 優化器。
3.2 中訓練設定
預訓練建立廣泛的知識與跨文本、視覺及音訊領域的通用理解。中訓練則銜接此通用基礎與後續的大規模 RL,進一步發展模型的智能體能力、擴展長上下文支援,並調整大型批次訓練的最佳化設定。
為此,我們在多樣且以智能體為中心的資料混合比例上訓練 MiMo-V2.6 模型系列。其多樣性橫跨任務領域與資料模態,結合了編碼、通用、視覺及研究任務中具真實感的智能體軌跡,以及高品質文本、倉庫層級程式碼,以及影像、影片與音訊資料。訓練分為兩個階段:首先以 256K 的上下文長度進行訓練,並將大部分運算資源分配至此階段;接著在最後階段將上下文長度擴展至 1M。
我們的基礎模型使用 AdamW 進行預訓練,但初步實驗顯示,在混合任務強化學習(mixed-task RL)中,隨著批次大小(Batch size)增加,最佳化效率會逐漸下降。與僅針對參數進行逐元素(element-wise)調整的 AdamW 不同,Muon 透過將隱藏權重(hidden weights)的更新正交化(orthogonalizing),善用了權重的矩陣結構(Jordan et al., 2024)。這種基於矩陣的更新(matrix-based update)在臨界批次大小區間(critical-batch-size regime)之外仍能保有較佳的資料效率,因此 Muon 特別適合用於大規模批次訓練(Liu et al., 2025b; Shah et al., 2025)。因此,我們在中訓練(Mid-training)階段切換至 Muon 最佳化器的變體 Muown,針對隱藏權重矩陣進行處理,以利後續的大規模批次強化學習。Muown 在 Muon 的基礎上加入了明確的列範數控制(row-norm control),能有效減輕譜範數漂移(spectral-norm drift),並降低對權重衰減(Weight decay)的敏感度,且額外負擔極低(Lion et al., 2026)。嵌入(Embedding)、LM head 以及 MoE 路由器(Router)則持續使用 AdamW。
先前研究指出,將 Adam 預訓練模型切換至 Muon 訓練可能會導致優化器不匹配並降低效能 (Qu et al., 2026)。然而,在我們的中訓練過程中,我們發現整個訓練過程並未出現損失尖峰。
我們在中訓練期間採用 MXFP4 量化感知訓練 (QAT),讓模型在適應低精度計算的同時,仍能維持模型品質。
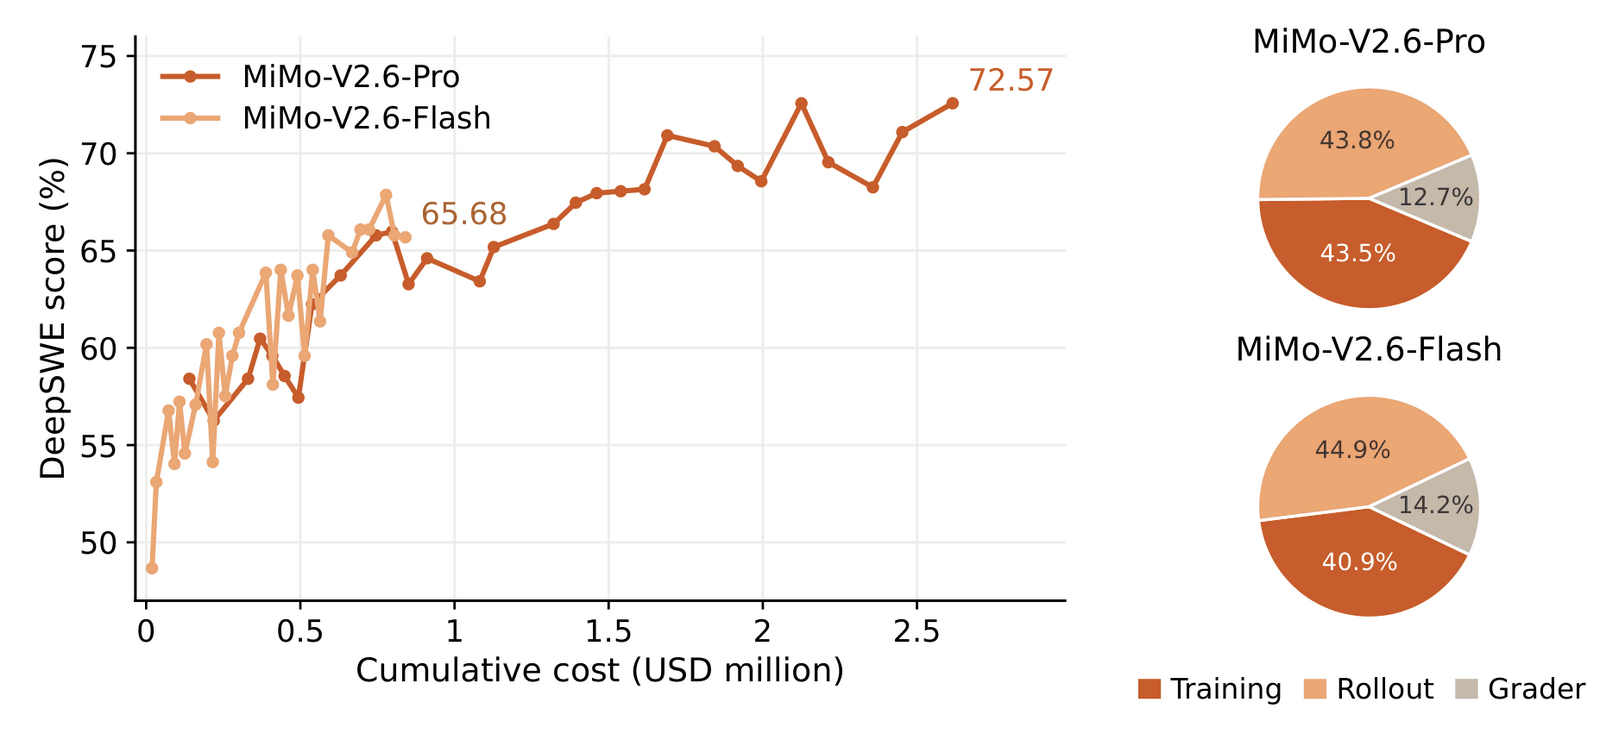
圖 3 左:DeepSWE v1.1 的平均@3 分數與累積強化學習成本對比。右:MiMo-V2.6-Pro 與 MiMo-V2.6-Flash 的訓練、rollout 與評分器成本佔比。
4 強化學習的規模化
在此版本中,我們持續推動後訓練演算法的邊界,並特別著重於擴展 RL 計算量。在短暫的監督式微調 (SFT) 階段之後,我們從三個維度擴展 RL:訓練計算 (§4.1)、環境與代理人 harness (§4.2),以及評分器計算 (§4.3),藉此實現模型能力的根本性躍進。
4.1 強化學習訓練計算量的擴展
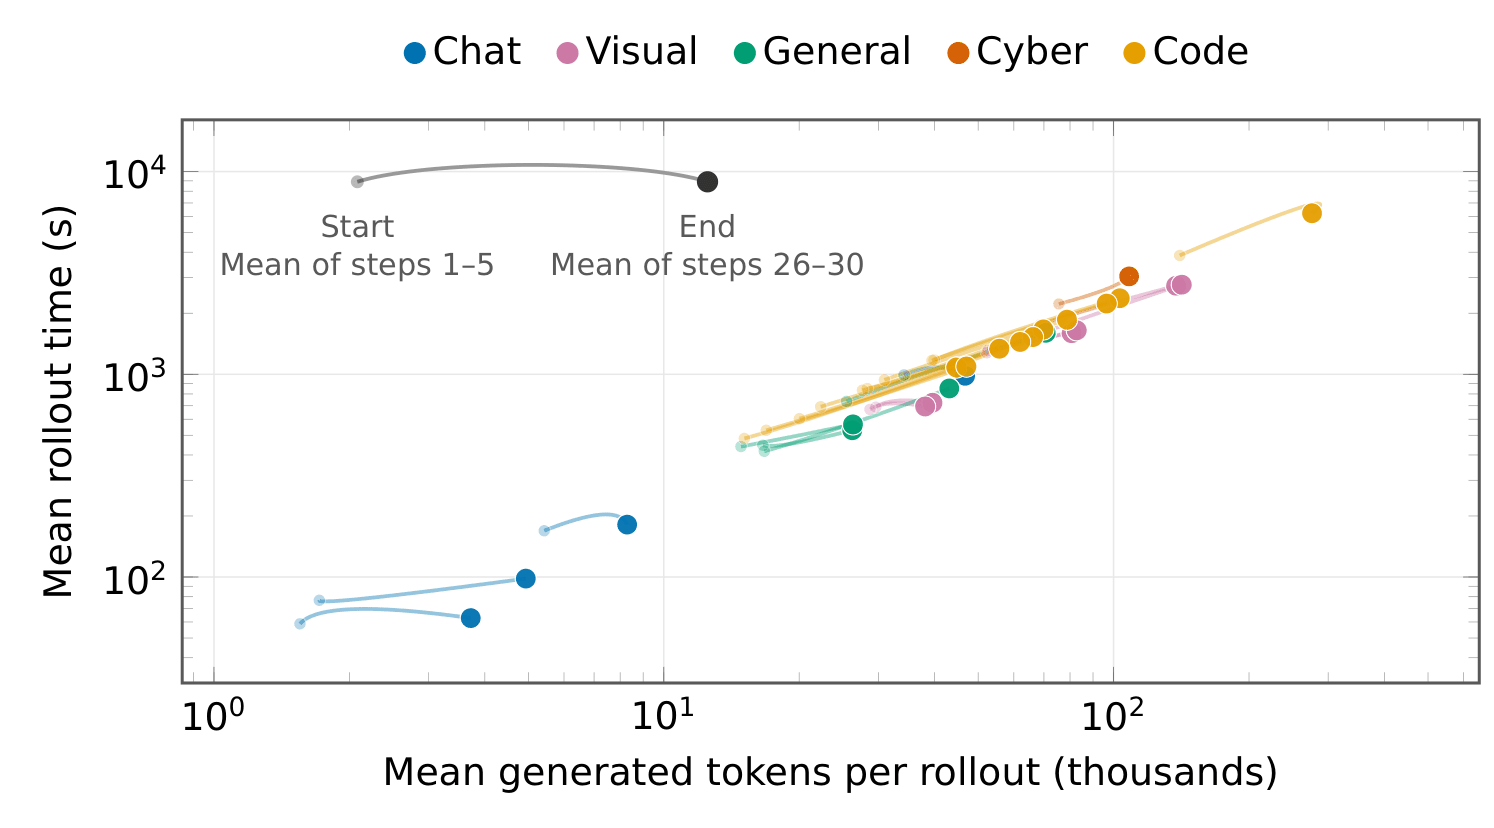
我們在單次執行中擴大 RL 計算規模,橫跨數千台 GPU,分別在 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 的 RL 後訓練上花費 2.6M 和 0.9M。我們採用大型訓練批次:1,568 個提示,群組大小 $G = 16$,因此每個步驟會展開 25K 個序列,總計產生 2.7B 至 3.7B 個訓練 Token(每個序列約 110K 至 150K 個 Token)。圖 3 左側面板展示了擴大 RL 計算規模的好處。在 DeepSWE 基準測試(Huang and Jiang, 2026)中,這兩個模型的平均@3 分數隨累積成本穩定提升:在 RL 過程中,MiMo-V2.6-Pro 從 58.4 提升至 72.6,而 MiMo-V2.6-Flash 則從 48.7 提升至 65.7。計算過程分為三個部分:rollout、評分與訓練。這種擴張需要穩固的基礎設施,以確保訓練過程高效且穩定。
我們將 RL 學習目標定義如下:
$$ \mathcal{L}(\theta) = -\mathbb{E}_{q \sim \text{D}_d, \{o_i\}_{i=1}^G \sim \text{\textbf{\textit{mu}}}_{\text{old}}}(\cdot|q) \left[ \frac{1}{\sum_{i=1}^G |o_i|} \sum_{i=1}^G \sum_{t=1}^{|o_i|} r_{i,t} M_{i,t} A_i \log \text{\textbf{\textit{pi}}}(o_{i,t} | q, o_{i,<t}) \right], \quad (1) $$
其中 $r$ 表示重要性取樣比,$M$ 是 token 層級的遮罩,而 $A$ 則是優勢。此運算可分解為三個部分。第一部分為 rollout:針對從任務資料集聯集 $\cup_d \mathcal{D}_d$ 中抽取的每個提示 $q$,rollout 策略 $\text{\textbf{\textit{mu}}}_{\text{old}}$ 會產生一組 $G$ 個候選解 $\{o_i\}$。第二部分為評分:我們投入額外的運算資源進行智能體式評估,以區分有效的解與行為,而不僅僅是依賴二元測試結果。這些判斷會影響優勢 $A_i$,進而實現跨軌跡更精確的信用分配。第三部分為訓練:所收集的 tokens 會透過以下方式更新 $\theta$:
$\log \pi_{\theta}(o_{i,t} | q, o_{i,<t})$ 的梯度,並採用提示平均聚合。圖 3 右側面板分析了 MiMo-V2.6-Pro 的成本分配:rollout 佔 43.8%,訓練佔 43.5%,而評分器則佔剩餘的 12.7%。我們使用大批次從跨越多種環境與 Harness 的多樣化 RL 任務中取樣(第 4.2 節)。此外,我們也擴充了評分器的規模,以提供更細緻的學習訊號(第 4.3 節)。
使用大批次有助於擴充 GPU 規模:Rollout 會針對序列進行平行化,並將批次分配至資料平行秩 (data-parallel ranks) 進行訓練,因此吞吐量會隨 GPU 數量增加。由於 HBM 大部分空間已由執行中的批次佔用,我們能維持高算術強度,以充分利用 GPU 進行 rollout。由於 rollout 與評分 (grading) 具有長尾特性,我們採用部分 rollout (Kimi Team, 2025) 來保持執行中的批次飽和:在收集訓練批次時,我們會讓進行中的序列保持中斷狀態,並在下一個 rollout 相位中恢復。其代價在於重新預填充 (re-prefill):在每次策略更新後,續寫 (continuation) 必須重建其 KV 快取,因此批次大小與部分 rollout 必須共同決定——大批次能攤銷重新預填充的成本。為了支援穩定的 RL 訓練,我們透過 R3 (Ma et al., 2025) 確保訓練與推論的一致性,並重播 top-$p$ 採樣候選集 (Liu et al., 2025a; The Microsoft AI Team, 2026)。為了確保所有樣本都能貢獻有效梯度進行訓練,我們納入動態採樣器 (Yu et al., 2025) 來過濾掉全數通過或全數失敗的群組。在多工 RL 中,我們實作 樣本混合器 (Sample Mixer),以確保在各種 rollout 持續時間與不同任務的通過率下,能有效且穩定地分配訓練批次。為了將 rollout 產生的軌跡打包成大型訓練批次 (2.7B–3.7B tokens),我們將資料平面 (data plane) 與控制平面 (control plane) 解耦。這些設計背後的基礎設施詳述於第六節。
4.2 強化學習環境與 Harness 的擴展規模
擴展智能體式 RL 需要多樣化的環境,以反映現實世界的任務、支援訓練規模下的可重現執行,並提供與任務目標一致的獎勵。同時滿足這些需求極具挑戰性:現實的工作流涉及異質工具與複雜狀態,而自動評分器可能不完整、不一致,或容易被鑽漏洞。因此,我們投入大量資源進行大規模環境合成與策展,涵蓋程式設計(§4.2.1)、一般專業工作流(§4.2.2)、視覺產物(§4.2.3)及網路安全(§4.2.4)領域,並強調監督品質。本節說明我們如何建構這些領域的任務與環境、代理人與之互動的 Harness(§4.2.5),以及用於提升獎勵可靠性並在訓練前後緩解獎勵駭入的執行檢查、基於 rollout 的審計與對抗性測試(§4.2.6)。
4.2.1 程式代理人任務
程式編碼任務特別適合使用 RL,因為候選解可以透過自動化測試執行與評估,進而提供大規模的回饋。然而,僅靠可執行評估並不能保證監督的可靠性:測試可能遺漏必要的行為、拒絕有效的實作,或在多次執行中產生不一致的結果。因此,核心挑戰在於如何在擴大任務建構規模的同時,確保獎勵能忠實反映任務的正確性。受此啟發,我們投入大量心力建構一個可擴展的合成與策展管線,專注於提升監督的準確度與穩健性。圖 4 彙整了任務合成路徑,以及用於評估監督準確度與穩健性的各項檢查。
從多元來源進行可擴展的任務合成 我們透過五種互補的合成路徑來擴大任務建構的規模,旨在涵蓋異質程式語言與開發環境。
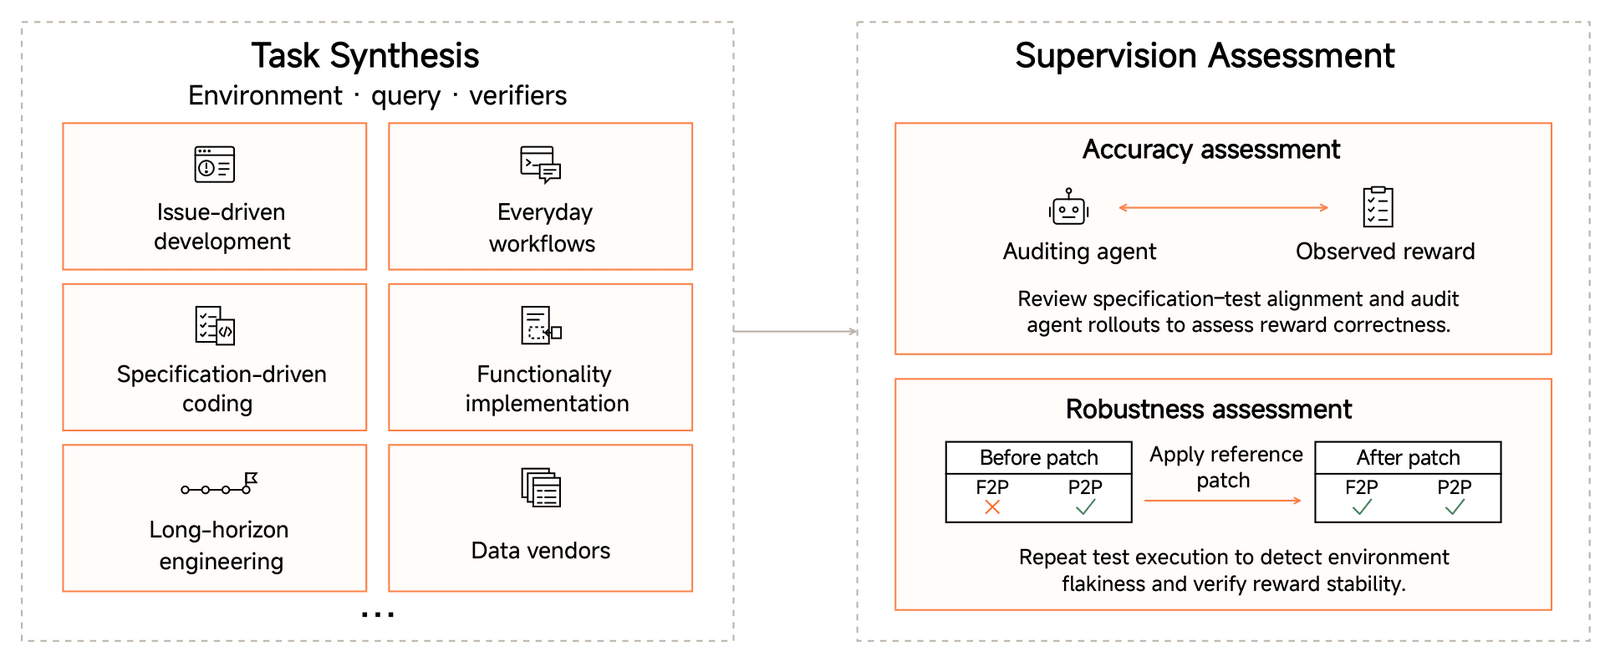
圖 4 整體程式代理人任務擴展管線。我們從多元來源建構任務,並經過嚴格的評估階段,以確保監督的準確性與穩健性。
設定與任務時界。首先,在「基於 GitHub 的合成」中,我們會收集合併請求及其相關問題,並應用啟發式與模型輔助篩選器,以移除重複、格式錯誤或不可重現的候選項目。當合併請求連結到一個能充分描述預期變更的問題時,我們會將該問題作為任務規格。否則,LLM 會從參考修補程式與周圍儲存庫上下文重建問題風格的規格,同時明確指示其省略可能揭露解決方案的實作特定細節。其次,為了捕捉包含互動式「氛圍式編程」情境在內的「日常開發工作流」,我們會收集組織內部員工貢獻的真實開發請求。這些請求涵蓋功能實作、重構、除錯及儲存庫維護等常見活動,並由代理人生成並實作測試案例,以將請求的行為具體化。第三,「規格驅動任務」強調在詳細且多約束需求下進行程式碼生成,讓我們能評估模型是否能忠實地將複雜規格轉化為可執行的實作。第四,在「源碼驅動合成」中,我們使用 CodeMidas (Ye et al., 2026) 從現有程式碼庫中實作的功能推導任務。
代理人會識別候選功能,並將其可觀察行為轉化為任務規格與可執行的環境,此路徑讓跨越多樣化儲存庫的任務建構得以擴展,且無需發行追蹤 (issues)、拉取請求 (pull requests) 或其他開發產物。針對長時程的軟體工程任務,代理人會迭代地詳述任務需求、擴大所需變更的範疇、在元件間引入相依性,並建構用以測試最終多步驟行為的測試案例。我們也從公開來源 (Badertdinov et al., 2026; PrimeIntellect, 2026; Tao et al., 2026; Yang et al., 2026b; Zan et al., 2025; Zhao et al., 2026) 及授權資料供應商中收集並篩選樣本,以進一步豐富任務分佈。整體而言,這些路徑產生的任務涵蓋了廣泛的程式語言、開發情境、實作複雜度與任務時界。
監督準確度 我們將各項任務規格的行為範圍與其單元測試的行為範圍對齊。目標是接受符合規格的實作,並拒絕違反規格的實作,且不需參考實作的附帶細節。我們審查任務是否存在覆蓋率不足或過於嚴苛的檢查。具體而言,會修正或移除強制執行規格中未提及要求的測試。僅憑人工檢查可能無法發現
在規格與測試之間出現不一致的情況下,我們進一步透過基於推演的稽核來評估其對齊程度。每個任務都會由程式碼智能體嘗試執行四次。稽核代理人會在共享工作空間中接收所有四次推演,該空間包含問題陳述、測試項目、參考修補、以及每次推演提交的修補、測試輸出與完整的對話紀錄。稽核代理人首先說明正確解決方案所需具備的條件,並評估測試項目是否涵蓋了這些要求。接著,它會根據修補與對話紀錄,利用規格來評估每個提交的解決方案,並將此評估結果與觀察到的獎勵進行比對。若被判定為通過的解決方案實際上被認為不正確,則會被標記為潛在的偽陽性,顯示驗證可能不夠完善。若被判定為失敗的解決方案實際上被認為正確,則會被標記為潛在的偽陰性,顯示測試過於嚴苛或執行過程出現失敗。這些分歧有助於識別需要進一步審查的任務,並為預期行為與實作驗證之間可能存在的落差提供具體證據。
監督穩健性 我們透過重複執行來檢查獎勵穩定性。針對具備參考程式碼修補(Patch)的任務,我們確保在套用參考修補前,必須讓「由失敗轉通過」(F2P)測試失敗,且「維持通過」(P2P)測試必須通過;套用修補後,兩者都必須通過。我們要求這些結果在八次重新執行中保持穩定,藉此篩選出不穩定測試與環境引起的獎勵波動。我們也重複使用先前的 rollout 管線來收集代理人軌跡,以調查潛在的獎勵駭入行為。提交的程式碼修補與對話紀錄提供了代理人獲取獎勵的證據,有助於識別非預期的捷徑或對環境與評估流程的漏洞利用。這些檢查補充了對解決方案正確性的評估,並為下文所述更廣泛的獎勵駭入緩解程序提供參考。
這些程序共同支持在一致的監督品質標準下,建構一個多樣化的程式編碼任務語料庫。規格測試對齊(Specification-test alignment)旨在提升獎勵訊號的忠實度,重複的執行檢查(execution checks)則用於確保其穩定性,而基於推演的稽核(rollout-based auditing)則探測獎勵訊號是否與對解決方案正確性的獨立評估結果一致。我們的目標是使這套組合具備可擴展性,讓強化學習(RL)訓練能受益於廣泛的任務覆蓋率,同時引導代理人滿足預期需求,而非利用評估漏洞。
4.2.2 一般代理人任務
我們將代理人的能力擴展至多元領域的現實專業工作流,這些工作流要求代理人分析異質文件、使用專業軟體,並產出符合領域特定標準的交付物。我們合成支援此類工作流的環境,接著建構具備可驗證結果的具挑戰性任務。圖 5 總結了此管線,包含環境建構、任務合成以及迭代式評分準則精煉。
環境設計 一個通用代理人環境通常由工作空間與一組軟體工具組成,並可透過 MCP、API、CLI 與 GUI 等介面存取。我們的設計在擬真性與大規模 RL 的需求之間取得平衡:檔案、軟體行為與底層資料應反映專業實務,而執行則必須保持在本地,且環境必須易於重置。因此,我們收集現實世界的檔案以供直接納入,或作為合成的參考依據,並使用自動化多代理人工作流程來建置本地軟體模擬,以重現支援的操作、狀態變更、輸出格式與錯誤回應。那些本身不需外部服務即可運作的工具則直接整合。所有狀態均儲存於本地,且每次 rollout 都在隔離沙箱中執行,並可還原至固定的初始狀態。這能避免網路變異性與服務限制,同時支援可重現的執行。
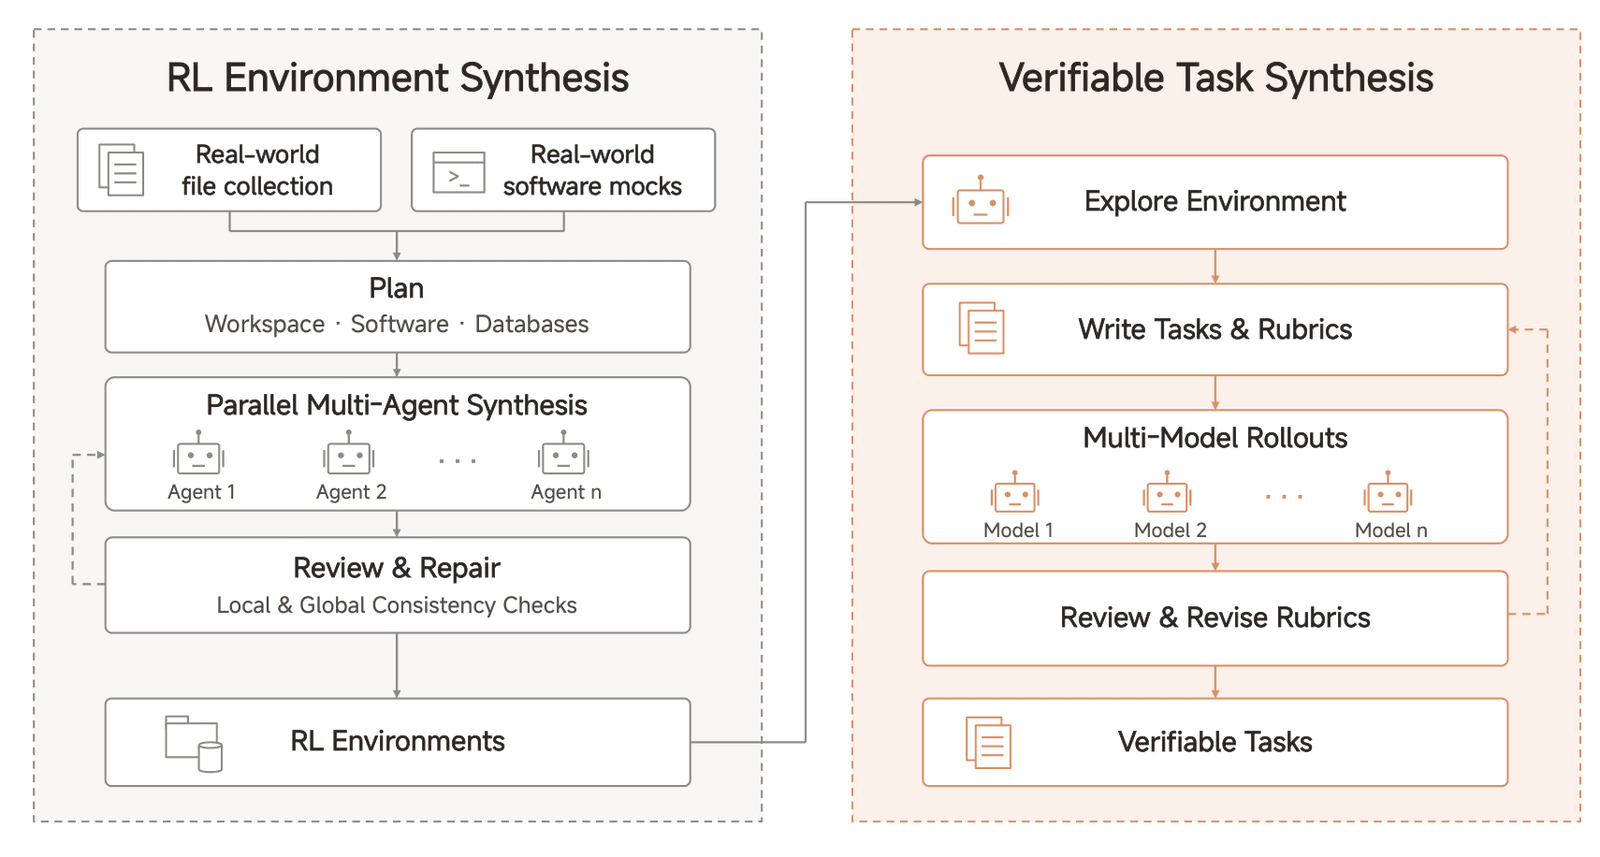
圖 5 整體通用代理人環境與可驗證任務合成管線。我們首先利用真實世界的檔案與軟體模擬,建構出逼真且可重置的環境。接著,代理人探索這些環境,並合成具備可驗證評分準則的任務。
環境合成 為了將這些元件組合成連貫的情境,規劃代理人會指定工作空間結構、選擇合適的工具,並規劃檔案與資料庫的內容。網頁搜尋將計畫與現實世界的資訊連結,而檔案間以及檔案與資料庫紀錄之間的關聯,則支援後續的多跳推理與交叉驗證。接著,多個代理人會依據共享計畫與各個模擬案例的資料規格,平行地產生檔案並填入資料庫。審查代理人會檢查個別產物與全域一致性,包含實體名稱、數值對帳、時間軸與引用。在任務建構前,透過迭代式修復來解決不一致之處。工作空間與工具配置會因情境而異,因此每個環境都能反映相關的工作實務,而無需包含所有可用的檔案類型或軟體介面。
任務合成與驗證 我們調查常見的專業任務,並將其彙整與泛化為種子任務。代理人會探索各個環境,並利用這些種子任務建構出適合其內容與工具的任務。任務完成情況是使用原子化且二元的評分準則項目來進行評估:以程式碼為基礎的檢查會驗證決定性屬性,例如資料庫值與交付成果的格式;而以 LLM 為基礎的檢查則用於評估更具開放性的內容。針對 LLM 為基礎的項目,透過相同模型在重複判斷中的一致性,以及不同裁判模型之間的共識,有助於識別其中的模糊性。
僅靠一致性並不足以證明評分準則能準確捕捉任務完成情況。因此,我們收集了不同能力等級模型的 rollout,並由審核代理人(reviewer)檢視其軌跡、執行結果與評分準則的判斷。審核者會修正過於嚴苛、導致正確解被拒絕的標準,以及過於寬鬆、接受不完整解的標準。為了測試對獎勵駭入(reward hacking)的抵抗力,我們加入了負面檢查,以偵測對無關檔案或資料庫的非預期變更,並建構出在表面上看似正確,但實際上並未解決任務的對抗性解。在強化學習(RL)過程中,自建的 MiMo-V2.6-SFT 模型負責擔任評分器,以支援穩定的評分。此流程產生了數千個環境與多樣化的可驗證任務,我們將其與其他任務結合,用於強化學習訓練。
4.2.3 視覺代理人任務
為了讓代理人能透過創意表達與精確的視覺控制來塑造數位世界,我們彙整了一套多元的視覺任務,讓代理人能與各類產物互動,例如網站、互動式應用程式、遊戲、3D 場景、簡報、SVG、影片及 Figma 設計。我們將這些任務分為兩個互補的類別:開放式設計與高忠實度視覺複製。這兩者共同提升了模型產出具備強烈美學品質與精確視覺控制之可靠實作的能力。
開放式設計旨在產生兼具美感且符合使用者意圖的視覺產物。由於有效的創意解決方案具備高度多樣性,僅靠固定規則難以精確衡量其美感品質。因此,我們結合了逐點評分與群組評分機制,在建立一致的品質標準之餘,也能針對美感品質的相對提升給予獎勵。具體而言,我們首先透過迭代方式,優化針對執行正確性、指令遵循度、版面完整性及基本美感品質的逐點評分準則。待這些準則趨於穩定後,再導入群組評分機制,針對同一查詢在每個 rollout 群組中呈現的產物進行聯合比較,藉此辨識出明顯較佳與較弱的候選項目,並據此分配獎勵。
高忠實度視覺複製旨在忠實重現指定的視覺目標。相較於開放式設計,明確的參考資料能更直接地評估視覺忠實度。我們主要透過規則導向的相似度指標(例如渲染偽影與參考資料之間的像素級相似度)來評分這些任務,並輔以 LLM 判斷以進行整體的視覺評估。這些訊號的結合,有助於強化學習在視覺複製任務中的有效擴展。
4.2.4 網路安全代理人任務
我們使用 RL 在真實世界的漏洞重現情境下訓練網路安全代理人:給定一個專案與目標漏洞,代理人必須建構一個能觸發該漏洞的輸入。這項基礎的攻擊安全技能是開發漏洞、權限提升以及 CTF 挑戰的核心。此外,這項任務非常適合大規模應用 RL;OSS-Fuzz 提供了數萬個經人工確認的實例,其規模遠超過其他安全任務。困難點不在於觸發當機,因為複雜的 C/C++ 專案通常有多條可達成的當機路徑,而在於觸發「特定」的漏洞。因此,驗證機制必須將目標漏洞與無關的當機區分開來,且由於驗證同時作為 RL 的獎勵,其結果必須準確、具備確定性且成本低廉。
現有的 Oracle 仍有不足。CyberGym (Wang et al., 2025) 中使用的「Fix-binary 差異化測試」僅接受能使受測二進位(binary)崩潰,但無法使修補後二進位崩潰的 PoC。若修補不完整,會導致正確的 PoC 被拒絕;而兩個版本間不相關的變更,則可能導致裁定(verdict)翻轉,且原因與漏洞無關。這兩種錯誤都會損害訓練梯度。而「以 LLM 為基礎的評分」在不同執行次數中,對於相同的 PoC 可能得出不同的裁定,因此無法作為穩定的獎勵(Reward)。我們改為從原始的消毒器(Sanitizer,如 ASan/MSan/UBSan)報告中擷取兩個屬性:漏洞類型(例如:heap-buffer-overflow)與 崩潰位置(專案層級的最高層堆疊影格)。若 PoC 的崩潰情況在規則導向的字串比對下符合這兩個屬性,則判定為有效。這種方式具備確定性、可重現性,且運算成本微乎其微。任務描述同樣從該報告中擷取,明確指出崩潰必須發生的確切類型與函式,因此描述與驗證皆共享單一的真實來源(source of truth);相較之下,CyberGym 的 LLM 產生的描述往往過於籠統(例如:「libxml2 中的緩衝區溢位」),或甚至完全錯誤。
針對每項漏洞,我們會檢查報告的 commit 原始碼、建置模糊測試 Harness,並提供完整的執行環境給代理人:包含完整的原始碼與編譯後的 Harness 二進位檔。CyberGym 會保留二進位檔,限制代理人只能進行原始碼分析;這能更貼近真實的漏洞分析情境,研究人員在該情境下會執行目標程式並搭配除錯工具,檢查記憶體內容,並根據執行時的觀測結果製作突變。
4.2.5 多 Harness 訓練
代理人 harness 在模組設計上各有不同,且是為了滿足不同的應用需求而選用或建置。因此,模型必須適應多樣的互動機制,包括在訓練期間未曾見過的 harness,這使得跨 harness 泛化成為一項重要的能力。
僅在單一 Harness 中進行訓練,可能會使任務解決策略與該 Harness 的特定實作產生綁定,進而限制遷移能力。因此,我們將 Harness 多樣性視為與任務及環境多樣性並列的額外訓練維度。一種自然的方法是針對 MiMo Code 和 Codex 等多個生產環境進行訓練。然而,在實務上,這對 RL 而言並非理想選擇。首先,生產環境會以工程安全機制與多步驟工作流包覆代理迴路,並透過大量的約束與指令提示來引導模型。這些額外元素都超出任務完成的獎勵訊號範圍,導致信用分配變得不可靠,並使獎勵未測量的需求被直接忽略。其次,其模組之間緊密耦合,而非獨立可配置,因此無法單獨調整單一互動機制,也無法透過受控的重組來建立多樣性。
為了達成此目標,我們提出採用精心設計的 mini-harnesses 進行多 harness 訓練。所有 mini-harnesses 皆源自相同的最小代理迴路,其中已包含完成任務所需的所有組件:系統提示、工具與情境管理。這些模組保持最小化且解耦,因此實作方式可以自由重組,並確保 harness 的擴充過程能維持在可控、安全且乾淨的狀態。接著,我們為 Code、General、Visual 與 Cyber 等領域推導出多樣化且經任務適應的 mini-harness 配置。產生的訓練分布既多樣又可控,支援對個別 harness 機制的分析,並鼓勵具備可遷移性的任務解決策略。
4.2.6 獎勵駭客緩解
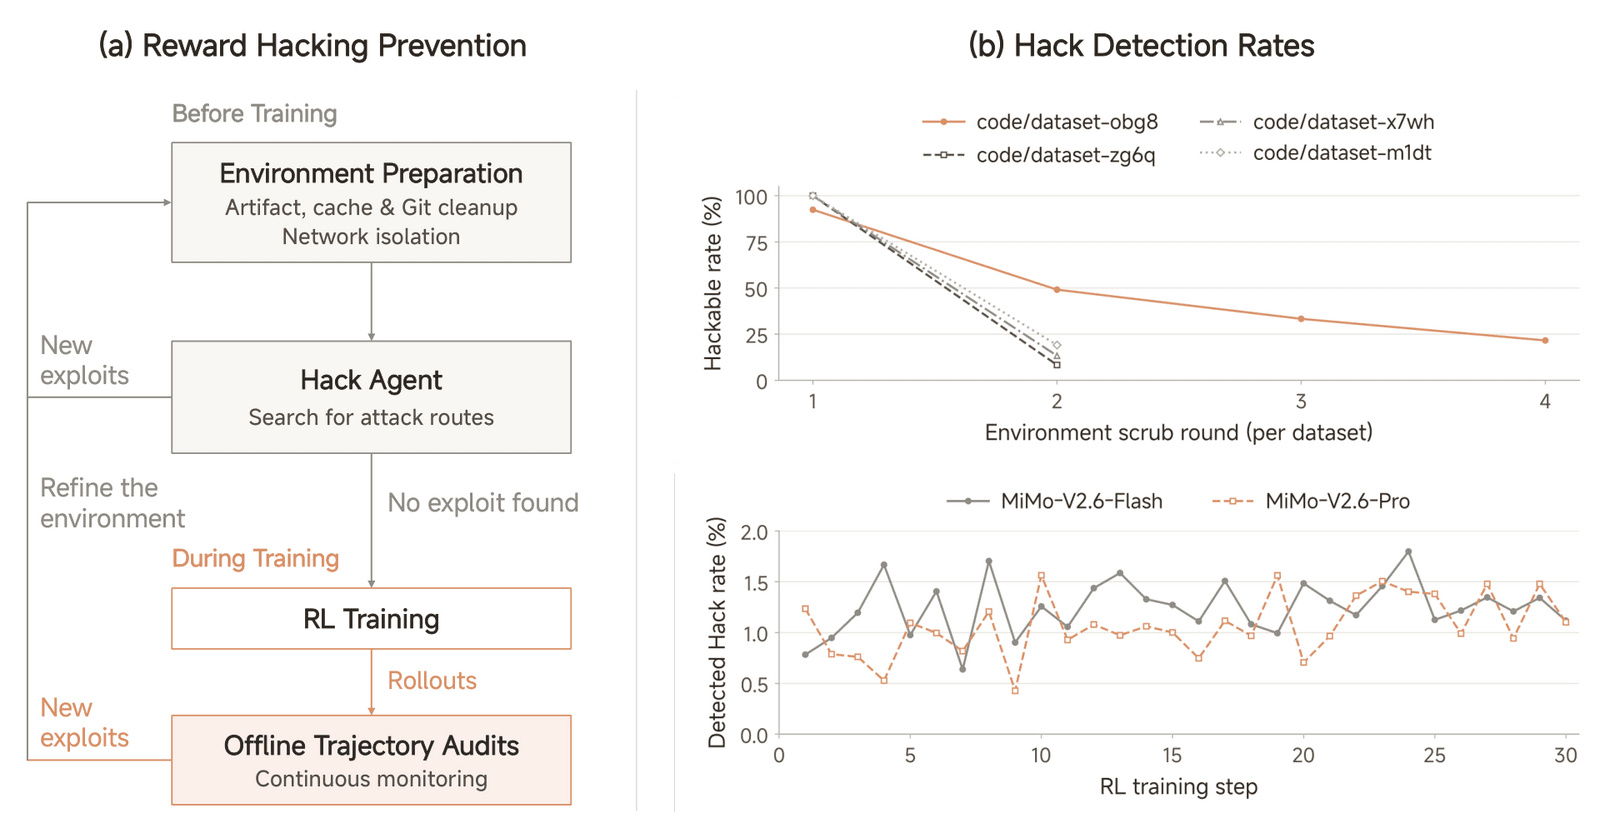
強化學習 (RL) 仰賴獎勵來衡量任務成功率,但代理人 (Agent) 有時會透過鑽環境或評估流程的漏洞來獲取高額獎勵。這種行為稱為獎勵駭入 (Reward hacking),可能在訓練過程中被強化,導致分數提升卻未改善任務效能。以儲存庫修復 (repository-repair) 等常見程式碼智能體 (Coding Agent) 任務為例,一種常見的失效模式是解答洩漏 (solution leakage):代理人取得超出預期任務上下文的公開修補方案,並將其用於建構程式碼修補 (Patch)。表 2 將每個任務請求與代理人的陳述意圖及其後續動作,連結至五個儲存庫中的情況。此類行為可能在僅依賴測試結果的獎勵機制下獲得滿足,卻無法證明代理人是從錯誤報告與指定的檢查版本 (checkout) 中推導出修復方案。隨後,我們將介紹一種緩解措施,結合中期訓練 (Mid-training) 對齊資料、強化學習環境的準備、對抗性篩選以及全訓練過程的稽核。
中訓練對齊資料在早期實驗中,我們觀察到 MiMo 傾向於進行獎勵駭客攻擊(reward hacking)。為了減輕這種行為,我們從這些案例中合成了一組訓練範例,並將其納入中訓練階段。針對每個案例,MiMo 會反思錯誤的推理,修正相關的回合內容,並繼續執行基於任務規格(task specification)的動作。修正後的推理保留了原始錯誤的特徵,並使修正過程變得顯而易見。我們發現,加入這些範例能有效提升模型的對齊程度。
環境準備在程式編碼任務中,代理人可能會透過從環境中復原洩漏的解答,或經由網路檢索現有解答來通過測試。建置專案時
| Pattern and shortcut | Illustrative case | |||||||
|---|---|---|---|---|---|---|---|---|
| Install and read Uses a newer release of the target package as an answer key, copying a fix absent from the assigned checkout. | Task (pytest): Fix Windows Thinking: "Let me check the Action: | |||||||
| Fetch upstream source Downloads an upstream file or patch that already contains the fix, exposing the code changes needed to pass the tests. | Task (Astropy): Correct the misleading error when a required Thinking: "Let me just look at the file directly from the GitHub raw URL." Action: | |||||||
| Clone upstream Reads a newer upstream checkout to reconstruct the published fix missing from the assigned historical commit. | Task (Matplotlib): Stop Thinking: "Let me directly fetch and inspect the relevant files from the latest Action: | |||||||
| Look up a solution Searches issue discussions, pull requests, or linked commits for the original solution and uses it to guide the patch. | Task (Django): Fix Thinking: "Let me get more info - changesets and the fix that was applied." Action: Read the change history of | |||||||
| Probe versions Finds a newer release to download and compare for its fix. The probe is a precursor to copying the solution. | Task (Sphinx): Remove the spurious return type from class documentation. Thinking: "Let me look for the fix. The issue is likely fixed in later versions." Action: | |||||||
| 基準測試 | MiMo-V2.6 Pro | MiMo-V2.6 Flash | MiMo-V2.5 Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 | ||
|---|---|---|---|---|---|---|---|---|
| 程式碼代理人 | ||||||||
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 | ||
| ProgramBench | 26.5 | 26.0 | 12.5 | 37.0 | 25.0 | 33.0 | ||
| MiMo Code Bench | 63.2 | 61.2 | 40.4 | 68.6 | 59.3 | - | ||
| 一般代理人 | ||||||||
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 | ||
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 | ||
| GDPval-AA 2.1 | 1673 | - | 1107 | 1708 | 1588 | 1595 | ||
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 | ||
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 | ||
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 | ||
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 | ||
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 | ||
| 網路安全 | ||||||||
| Domain | Task Family | Training Tasks | Verifier |
|---|---|---|---|
| Code | Software engineering | 3k | Executable tests |
| Cyber | Vulnerability reproduction | 1k | Rule checks |
| General | Knowledge work | 1k | Rubric-based judging |
| Visual | Web development | 2k | Visual grading |
表 5 釋出之 RL 環境概述,包含訓練任務數量以及用於評估任務完成的驗證器。任務數量為估計值,係根據各訓練集中的不同任務識別碼;k 代表一千。
使用此檢查點作為後續所述領域特定 GRPO 實驗與多 Harness 程式碼實驗的共同初始化。
7.2 使用開放環境的 RL
環境概述表 5 彙整了我們發布的 RL 環境,涵蓋程式編寫、網路安全、通用領域及視覺任務。這四個訓練集總計包含約 7,000 項任務,其中通用領域集專注於知識工作。此外,訓練資源還包含約 1,000 項音樂生成任務,以支援下文所述的 GRPO 實驗。
從相同的 MiMo-V2.6-Distill-Qwen-9B SFT 檢查點開始,我們針對程式設計、網路安全、通用領域及視覺任務,分別使用對應的公開環境進行 GRPO 訓練。除了公開基準測試外,我們還在四個內部資料集上進行評估:用於軟體工程的 MiMo Code Bench (mini)、用於漏洞重現的 MiMo Cyber Bench (mini)、用於知識工作的 MiMo General Bench (mini),以及用於網站開發的 MiMo Visual Coding (mini)。這些評估資料集的任務分佈與其對應的訓練資料集相同。
表 6 顯示,在該表所列的 11 項評估中,RL 在所有四個任務領域均優於 SFT 檢查點。SWE-bench Verified (Jimenez et al., 2024) 的分數從 61.1 提升至 66.2,而 Terminal Bench 2.1 (Merrill et al., 2026) 則從 37.1 提升至 52.8。OfficeQA Pro (Opsahl-Ong et al., 2026) 從 19.5 提升至 24.8,Toolathlon-Verified (HKUST NLP, 2026) 則從 35.2 提升至 38.0。MiMo Visual Coding (mini) 從 64.0 提升至 72.4,MiMo Cyber Bench (mini) 則從 31.3 提升至 47.0。除了表 6 所列的任務外,我們也探索了藝術創作與設計等新興任務,例如音樂組合。在我們的內部音樂基準測試中,分數在經過 SFT 訓練後為 45.7,而在經過 RL 訓練後則大幅提升至 52.5。
| 基準測試 | 指標 | Qwen3.5-9B | MiMo-V2.6-Distill-Qwen-9B | |
|---|---|---|---|---|
| SFT | RL | |||
| 程式碼 | ||||
| SWE-bench Verified | avg@3 | 60.0 | 61.1 | 66.2 |
| SWE-bench Pro | avg@3 | 32.0 | 44.6 | 47.6 |
| MiMo Code Bench (mini) | avg@3 | 19.5 | 51.6 | 59.9 |
| 網路安全 | ||||
| MiMo Cyber Bench (mini) | avg@3 | 5.7 | 31.3 | 47.0 |
| 通用 | ||||
| AutomationBench v1.0.6 | avg@1 | 5.0 | 30.3 | 33.1 |
| Terminal Bench 2.1 | avg@1 | 27.0 | 37.1 | 52.8 |
| Toolathlon-Verified | avg@1 | 25.9 | 35.2 | 38.0 |
| OfficeQA Pro | avg@1 | 9.0 | 19.5 | 24.8 |
| JobBench | avg@1 | 2.6 | 18.3 | 25.2 |
| MiMo General Bench (mini) | avg@1 | 28.5 | 62.2 | 70.6 |
| 視覺 | ||||
| MiMo Visual Coding (mini) | avg@1 | 61.7 | 64.0 | 72.4 |
表 6 Qwen3.5-9B、在 SFT 後的 MiMo-V2.6-Distill-Qwen-9B,以及經過進一步 GRPO 訓練(RL)後的領域特定檢查點評估。程式碼採用單 Harness RL。各列中的最高分數以粗體標示。
這些結果突顯了高品質訓練資料與強大的 SFT 初始化對於後續透過 RL 進行改進的重要性。
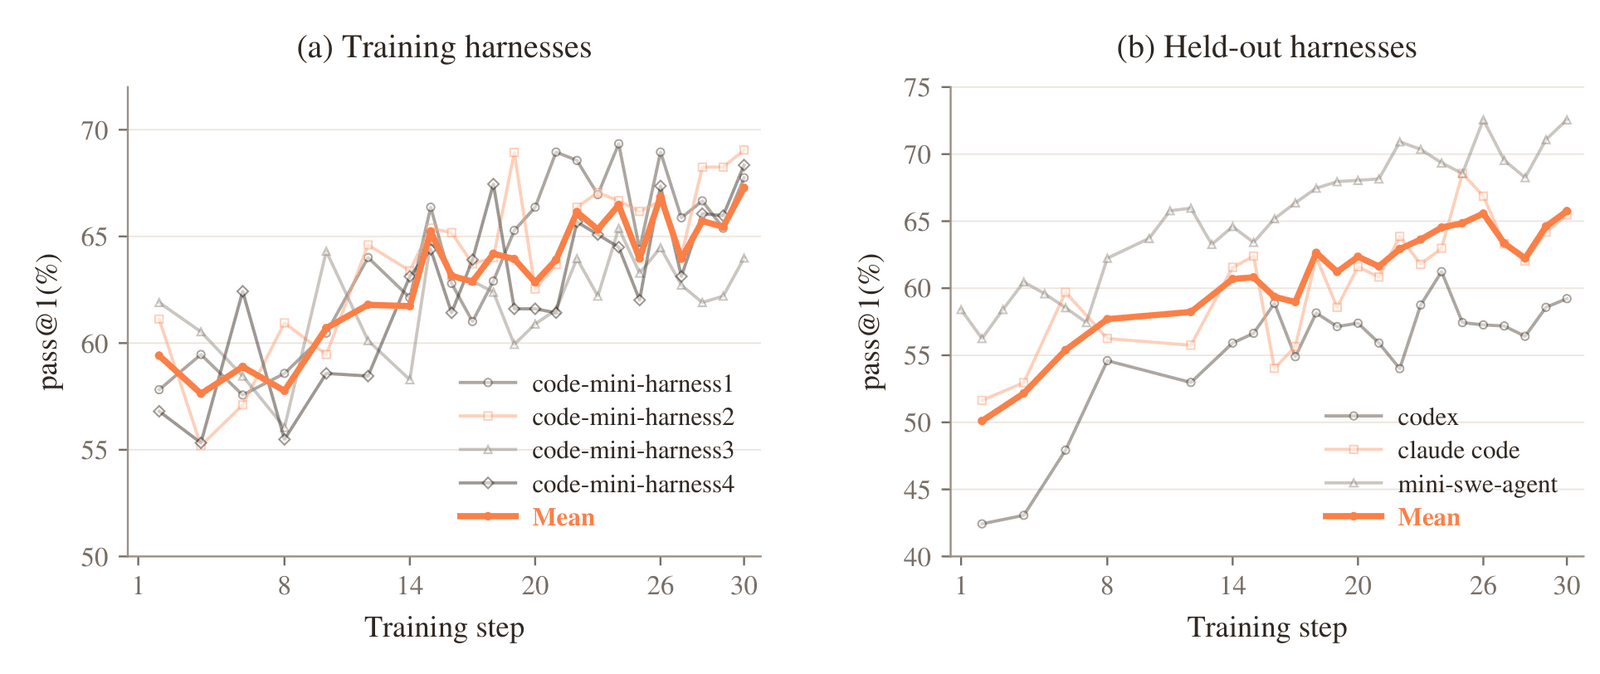
多 Harness 訓練 表 6 的程式碼結果是透過單一 Harness RL 取得。我們進一步在另一項獨立的程式碼實驗中探討多 Harness 訓練,並從相同的 MiMo-V2.6-Distill-Qwen-9B SFT 檢查點開始。依循 MiMo-V2.6 的多 Harness 訓練方法,我們在四個 mini-harness 中聯結優化模型,並在這些 Harness 與另外三個保留的 Harness 上進行評估。表 7 比較了在三個程式碼評估與七個代理人 Harness 中,經過單一 Harness RL 與多 Harness RL 訓練前後的 Qwen3.5-9B 與 MiMo-V2.6-Distill-Qwen-9B。MiMo-V2.6-Distill-Qwen-9B 在所有 21 組資料集-Harness 組合中均優於 Qwen3.5-9B,且多 Harness RL 更進一步提升了每一組的表現。在 MiMo Code Bench (mini) 上,相較於 SFT,在七個 Harness 中,額外獲得的提升幅度從 1.8 到 9.3 個百分點不等。
案例研究 為了更直觀地展示我們的 SFT 與 RL 配方如何逐步提升模型能力,我們針對網頁開發領域(一個視覺品質一目了然的領域)進行案例研究,並在圖 17 中比較由 Qwen3.5-9B、MiMo-V2.6-Distill-Qwen-9B (SFT) 與 MiMo-V2.6-Distill-Qwen-9B (RL) 生成的網頁。如左欄所示,由 Qwen3.5-9B 生成的網頁在視覺設計上相對樸素,佈局簡單且影像使用極少。值得注意的是,(c) 中的人力資源管理介面存在明顯的佈局問題。蒸餾過後的 MiMo-V2.6-Distill-Qwen-9B (SFT)(中間欄)則生成了內容更豐富、色彩配置更協調,且更有效地整合影像資產的網頁,例如 (b) 中的衣索比亞遺產頁面便展示了精美的攝影元素。在經過 RL 訓練(右欄)後,模型更進一步,呈現
| 模型 | 訓練 Harness | 保留 Harness | ||||||
|---|---|---|---|---|---|---|---|---|
| mini-harness1 | mini-harness2 | mini-harness3 | mini-harness4 | codex | claude code | mini-swe-agent | 平均值 | |
| SWE-bench Verified | ||||||||
| Qwen3.5-9B | 58.4 | 36.4 | 54.8 | 57.8 | 48.6 | 54.8 | 60.6 | 53.1 |
| MiMo-V2.6-Distill-Qwen-9B | 61.7 | 63.9 | 61.7 | 63.1 | 58.5 | 61.7 | 65.3 | 62.3 |
| + Multi-Harness RL | 67.9 | 65.1 | 66.6 | 67.2 | 61.1 | 65.3 | 66.7 | 65.7 |
| SWE-bench Pro | ||||||||
| Qwen3.5-9B | 33.5 | 15.2 | 31.1 | 31.1 | 23.1 | 26.9 | 31.6 | 27.5 |
| MiMo-V2.6-Distill-Qwen-9B | 45.2 | 46.6 | 45.1 | 45.5 | 40.3 | 42.2 | 45.6 | 44.4 |
表 7 各代理人 Harness 的程式撰寫效能。平均值為七個 Harness 分數的未加權平均,四捨五入至小數點後第一位。資料集內各欄位中表現最佳的結果以粗體標示。
最精緻的呈現效果,包含精緻的排版、視覺衝擊力強的英雄區段(例如圖 (b) 中的日落意象),以及更完整且結構嚴謹的頁面配置(例如圖 (c) 中的全功能 HR 儀表板,配備側邊欄導覽、行事曆小工具與詳細的統計卡片)。這些漸進式的質化改進,與表 6 中觀察到的量化軌跡(61.7 → 64.0 → 72.4)相符,共同證明了先進行 MiMo-V2.6 蒸餾再接續 RL 的累積效益,能同時提升生成內容的美學品質與功能完整性。
8 結論
這份報告介紹了 MiMo-V2.6 系列,並提出一種透過大規模智能體式強化學習(agentic reinforcement learning)來推動基礎模型發展的實務方法。我們在全能基礎模型與以代理人為中心的中期訓練(agent-centric mid-training)之上,沿著三個維度擴展強化學習:訓練批次大小與吞吐量、環境與代理人 Harness 的多樣性與複雜度,以及投入於組式智能體式評分(groupwise agentic grading)的運算資源。這些進展由非同步訓練、混合任務 Rollout 基礎設施、訓練-推論一致性機制,以及防範訓練偏移與獎勵駭入(reward hacking)的防護措施所支持。這些技術共同實現了長程互動下的持續最佳化,同時提升了解決方案品質與代幣效率。在公開與內部基準測試中的評估結果顯示了此方法的有效性,MiMo-V2.6 在廣泛的智能體任務中,展現出與前沿模型(frontier models)競爭的效能。
為了讓研究社群能接觸到此研究方向,我們釋出了 MiMo-V2.6-Distill-Qwen-9B,並附上精心整理的任務環境、驗證器、端對端 RL 框架以及可組合的 mini-harness。在各個領域與 Harness 中皆能觀察到一致的 RL 增益,這顯示這些資源作為進一步實驗的共享基礎具有極高價值。本研究在模型自我改進的道路上邁出了實質的一步,強調了廣泛探索、具啟發性的回饋以及可擴展訓練系統的重要性。我們期盼這些開放資源能支援可重現的研究,並在邁向更具能力、通用代理人的過程中累積進展。
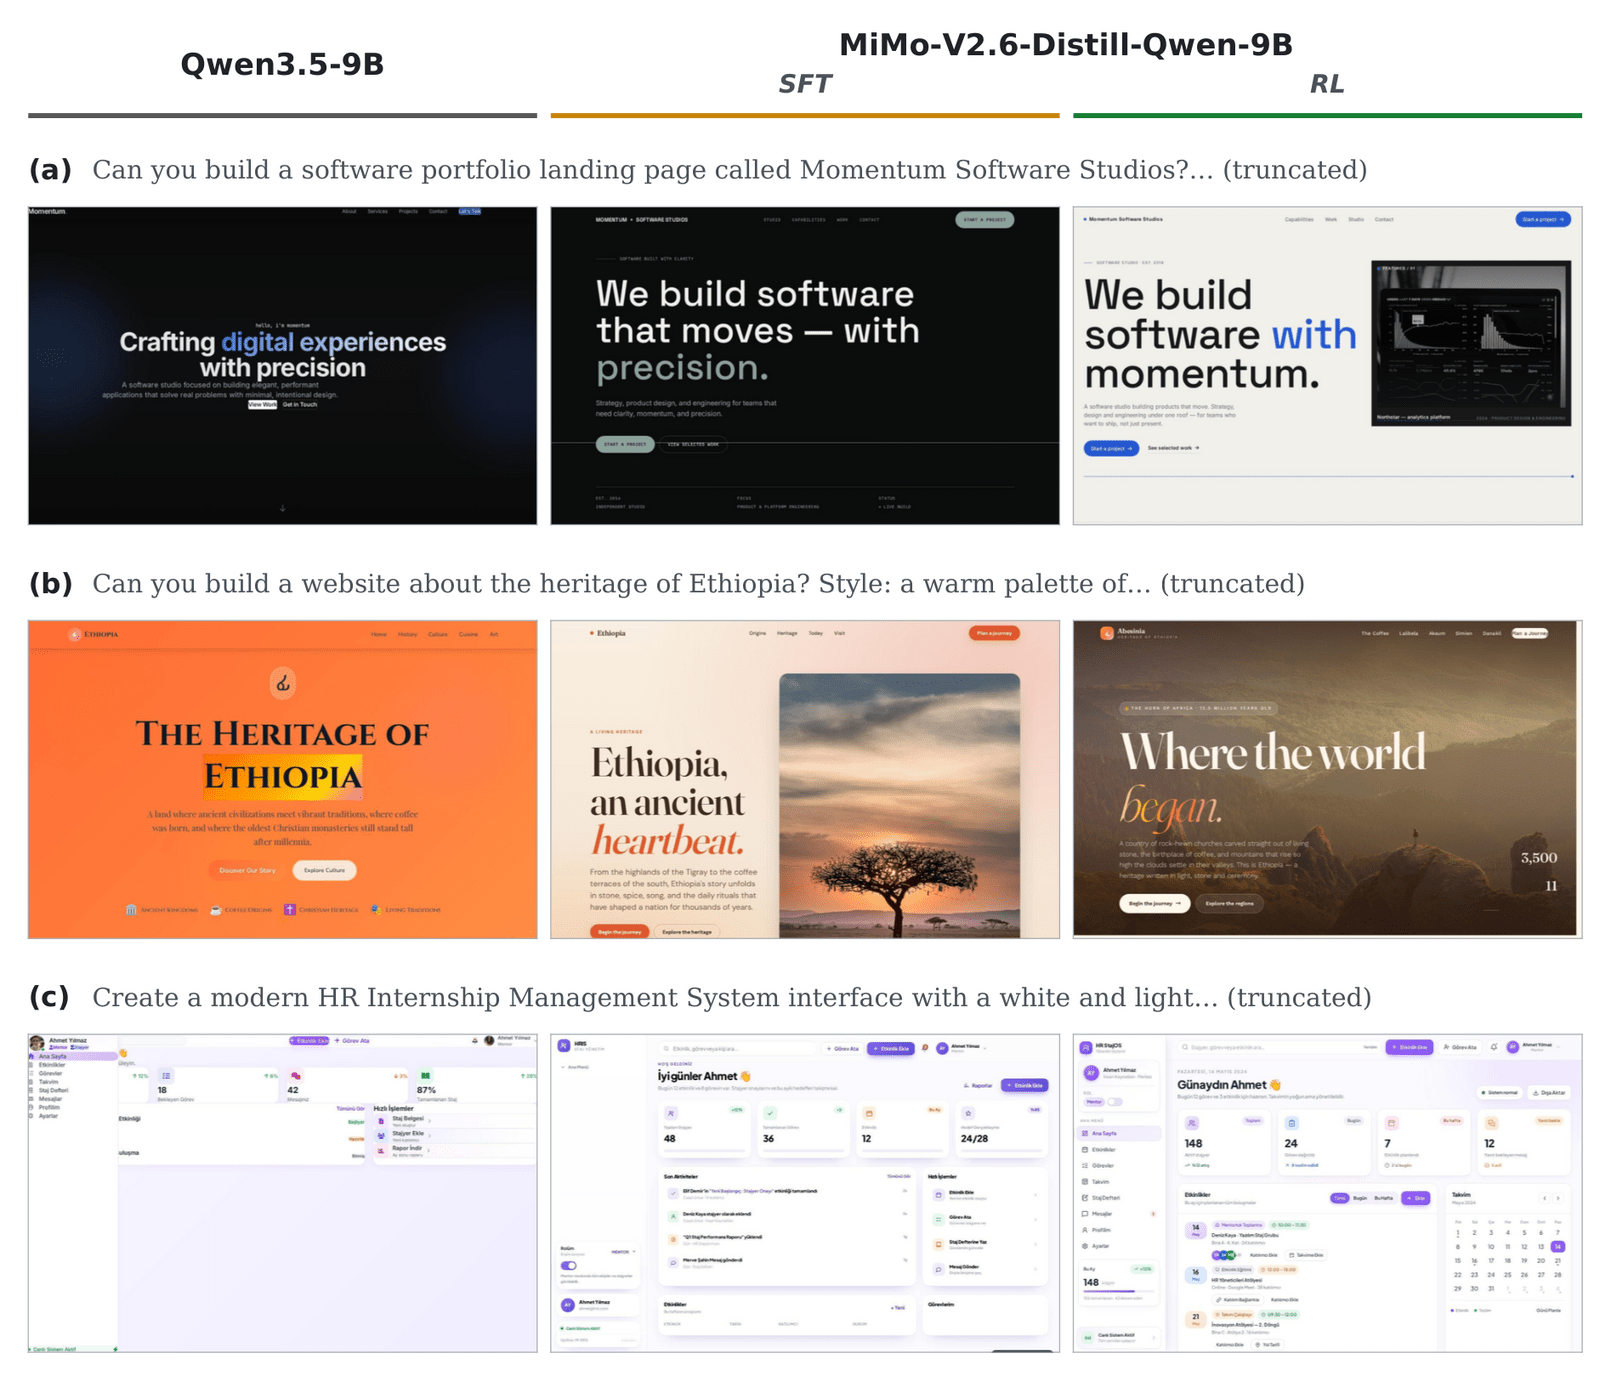
圖 17 Qwen3.5-9B、MiMo-V2.6-Distill-Qwen-9B (SFT) 與 MiMo-V2.6-Distill-Qwen-9B (RL) 生成的網站首部區範例。每一列 (a-c) 均顯示三個模型針對相同提示所產出的結果。
A 貢獻與致謝
我們誠摯感謝所有貢獻者的寶貴支援與付出,包括小米資料平台、CloudML、NGK、MiChat、Mify、MiKS 以及 LLM-Plus 團隊,以及其他未在本文中明確列出的成員。作者名單依姓氏字母順序(以姓氏首字母為準)排列。
核心貢獻者:Zongming Qiao、Ziyue Hua、Zirui Ou、Zihao Yue、Zihan Jiang、Zhuo Huang、Zhiyang Chen、Zhixian Zheng、Zhipeng Xu、Zhengrui Ma、Yuyang Hu、Yuhang Dong、Yuechen Zhang、Yudong Wang、Yuanxin Liu、Yixin Yang、Yishuo Cai、Yikai Zhao、Yihan Yan、Yifan Zhang、Yifan Song、Xiyu Wei、Xing Zhang、Xin Zhang、Xiaoqian Liu、Xiaodong Ji、Xiangwei Deng、Xueyu Guo、Wenhan Ma、Weimin Xiong、Weikun Wang、Weiji Zhuang、Shuo Liu、Shuhuai Ren、Shuhao Gu、Shimao Chen、Shijie Cao、Shihua Yu、Shicheng Li、Shengjie Zhou、Shaolei Zhang、Rang Li、Qiying Wang、Qingkai Fang、Qianli Chen、Minzheng Wang、Liwen Wang、Linli Yao、Linghao Zhang、Liangyu Cheng、Liang Zhao、Lei Li、Jinhao Dong、Jinyu Xiang、Jianyu Wei、Jiangshan Duo、Huaqiu Liu、Huanjie Fan、Hongyi Guan、Hongshen Xu、Hao Tian、Hanyu Li、Hailin Zhang、Gang Wang、Fuli Luo†、Feng Wei、Dong Zhang、Dawei Zhu、Chiheng Lou、Chenhong He、Chenhao He、Chenghua Liu、Bowen Ye、Bowen Shen、Boshen Xu、Bo Yang、Bingquan Xia、Bangjun Xiao、Baixuan Xu
貢獻者:Zhouxiang Mao、Zhiyang Zhang、Zhixiang Xu、Zhenru Lin、Zhengju Tang、Zhaojun Huang、Yuzhe Weng、Yuxing Xiang、Yuxiao Li、Yuheng Yang、Yuhang Wang、Yuchen Liu、Yuanyuan Tian、Yuanliang Dong、Yu Cheng、Yongzhe He、Yongshun Liang、Yong Wang、Yiyan Wang、Yitian Gong、Yijie Zhang、Yanshu Xin、Xun Zhang、Xingjian Zhao、Wenyu Yang、Wenshan Huang、Wenhao Li、Tingwei Huang、Tianyu Yu、Tianyang Lu、Taoyu Yang、Sinan Du、Shutong Tian、Shulin Du、Shengfan Wang、Shanchuan Fang、Qihao Zhang、Qibin Yang、Qian Yu、Qian Tu、Pengrong Xie、Peipei Wang、Peidian Li、Minkun Guo、Mingchen Shao、Luohan Gao、Lijie Wang、Liang Shi、Kaiqi Chen、Kaiming Liu、Kaifei Wang、Kai Yang、Jinlong Xue、Jiechen Zhang、Jiaxuan Liu、Hongxu An、Hao Peng、Hanglong Lü、Guonan Wang、Feiyu Yang、Fanyu Cao、Fangyue Liu、Fan Cui、Cong Wang、Chun Chen、Chenxu Bai、Chengxuan Zhu、Chenghua Wang、Boyi Zeng
† 通訊作者
參考文獻
依原文順序編號,內文引用的數字對應下列條目。
- Artificial Analysis. GDPval-AA v2.1 Leaderboard, 2026. URL https://artificialanalysis.ai/evaluations/gdpval-aa. Accessed September 21, 2026.
- I. Badertdinov, M. Nekrashevich, A. Shevtsov, and A. Golubev. Swe-rebench v2: Language-agnostic swe task collection at scale, 2026. URL https://arxiv.org/abs/2602.23866.
- J. Chen, Y. Liang, and Z. Liu. Dflash: Block diffusion for flash speculative decoding, 2026. URL https://arxiv.org/abs/2602.06036.
- Core Team, B. Xiao, B. Xia, B. Yang, B. Gao, B. Shen, C. Zhang, C. He, C. Lou, F. Luo, et al. MiMo-V2-Flash technical report, 2026. URL https://arxiv.org/abs/2601.02780.
- X. Deng, J. Da, E. Pan, Y. Y. He, C. Ide, K. Garg, N. Lauffer, A. Park, N. Pasari, C. Rane, et al. Swe-bench pro: Can ai agents solve long-horizon software engineering tasks?, 2025. URL https://arxiv.org/abs/2509.16941.
- F. Gloeckle, B. Y. Idrissi, B. Rozière, D. Lopez-Paz, and G. Synnaeve. Better & faster large language models via multi-token prediction. In Forty-first International Conference on Machine Learning, ICML 2024, Vienna, Austria, July 21-27, 2024. OpenReview.net, 2024. URL https://openreview.net/forum?id=pEWAcejiU2. Z. Han, A. You, H. Wang, K. Luo, G. Yang, W. Shi, M. Chen, S. Zhang, Z. Lan, C. Deng, et al. Asyncflow: An asynchronous streaming rl framework for efficient llm post-training, 2025. URL https://arxiv.org/abs/2507.01663. C. He, L. Li, S. Li, H. Lv, L. Kong, Q. Liu, T. Yang, and S. Ren. Semantic head specialization guides hybrid vit attention for multimodal llms, 2026. URL https://arxiv.org/abs/2608.28383. HKUST NLP. Introducing Toolathlon-Verified, June 2026. URL https://toolathlon.xyz/docs/bl og/toolathlon-verified. W. Huang and P. Jiang. Deepswe v1.1: a cleaner, more reproducible benchmark for frontier coding agents, 2026. URL https://github.com/datacurve-ai/deep-swe. W. Huang, C. Lee, L. Tng, and S. Ge. Deepswe: Measuring frontier coding agents on original, long-horizon engineering tasks, 2026. URL https://arxiv.org/abs/2607.07946. C. E. Jimenez, J. Yang, A. Wettig, S. Yao, K. Pei, O. Press, and K. R. Narasimhan. Swe-bench: Can language models resolve real-world github issues? In The Twelfth International Conference on Learning Representations, ICLR 2024, Vienna, Austria, May 7-11, 2024. OpenReview.net, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. K. Jordan, Y. Jin, V. Boza, J. You, F. Cesista, L. Newhouse, and J. Bernstein.
- Muon: An optimizer for hidden layers in neural networks, 2024. URL https://kellerjordan.github.io/posts/muon/. Kimi Team. Kimi k1.5: Scaling reinforcement learning with llms, 2025. URL https://arxiv.org/ abs/2501.12599. H. Lee, J. Liu, D. Kim, Z. Zhang, C. S. Xia, and L. Zhang. Sec-bench pro: Can language models solve long-horizon software security tasks?, 2026. URL https://arxiv.org/abs/2605.26548. S. Lee and D. Brumley. Exploitbench: A capability ladder benchmark for LLM cybersecurity agents, 2026. URL https://arxiv.org/abs/2605.14153. J. Li, W. Zhao, J. Zhao, W. Zeng, H. Wu, X. Wang, R. Ge, Y. Cao, Y. Huang, W. Liu, J. Liu, Z. Su, Y. Guo, F. Zhou, L. Zhang, J. Michelini, X. Wang, X. Yue, S. Zhou, G. Neubig, and J. He. The tool decathlon: Benchmarking language agents for diverse, realistic, and long-horizon task execution. In International Conference on Learning Representations, 2026a. URL https://ar xiv.org/abs/2510.25726. Y. Li, Y. Feng, Z. Xu, Z. Ma, K. Zheng, F. Jiang, X. Sun, R. Shao, Z. Chen, Y. Huang, X. Han, B. Lee, K. Xu, S. Zeng, H. Hua, X. Zhang, B. Alomair, R. Krishna, L. Zettlemoyer, P. W. Koh, B. Ramasubramanian, L. Niu, X. Yue, and R. Poovendran. JobBench: Aligning agent work with human will, 2026b. URL https://arxiv.org/abs/2605.26329. B. Liao, H. Dong, C. Monz, X. Xu, L. Dong, and F. Wei. Multi-turn on-policy distillation with prefix replay, 2026. URL https://arxiv.org/abs/2607.04763. K. Lion, F. Hübler, B. Li, A. Orvieto, and N. He. Muown: Row-norm control for Muon optimization, 2026. URL https://arxiv.org/abs/2605.10797.
- A. Liu, B. Feng, B. Xue, B. Wang, B. Wu, C. Lu, C. Zhao, C. Deng, C. Zhang, C. Ruan, et al. Deepseek-v3 technical report, 2024. URL https://arxiv.org/abs/2412.19437. A. Liu, A. Mei, B. Lin, B. Xue, B. Wang, B. Xu, B. Wu, B. Zhang, C. Lin, C. Dong, et al. Deepseek-v3.2: Pushing the frontier of open large language models, 2025a. URL https://arxiv.org/abs/2512.02556. J. Liu, J. Su, X. Yao, Z. Jiang, G. Lai, Y. Du, Y. Qin, W. Xu, E. Lu, J. Yan, Y. Chen, H. Zheng, Y. Liu, S. Liu, B. Yin, W. He, H. Zhu, Y. Wang, J. Wang, M. Dong, Z. Zhang, Y. Kang, H. Zhang, X. Xu, Y. Zhang, Y. Wu, X. Zhou, and Z. Yang. Muon is scalable for LLM training, 2025b. URL https://arxiv.org/abs/2502.16982. W. Ma, H. Zhang, L. Zhao, Y. Song, Y. Wang, Z. Sui, and F. Luo. Stabilizing moe reinforcement learning by aligning training and inference routers, 2025. URL https://arxiv.org/abs/2510.11370. W. Ma, J. Wei, L. Zhao, H. Zhang, B. Xiao, L. Li, Q. Yang, B. Gao, Y. Wang, R. Li, J. Dong, Z. Sui, and F. Luo. Mopd: Multi-teacher on-policy distillation for capability integration in llm post-training, 2026. URL https://arxiv.org/abs/2606.30406. R. Marten, A. Shaw, I. Bercovich, B. Droste, T. Cerruti, S. Dillmann, R. Wang, D. Wahdany, A. Hart, K. Krauth, ScaleAI, Snorkel AI, Turing, gNucleus AI, Boolean AI, N. Carlini, S. Lyu, A. Wei, A. Khatua, B. Plüster, C. Dwivedi, C. Sutcliffe, Yuming, D. Tivris, D. Wang, H. W. Goh, H. Xing, H. Lin, I. Salia, J. Seol, J. Bao, J. Ouyang, J. Park, L. Walsh, L. Kong, M. Ivanov, M. Ubl, M. Liamets, O. Menis, P. Migdal, Q. Bao, R. Movva, R. Ben Chaim, N. Srinath, S. Bogdanik, S.
- Yadav, S. Benjamin, T. Kung, W. Hughes, X. Lan, H. Gupta, S. Mishra, C. Wang, H. He, J. Tu, K. Montgomery, Z. Tu, A. Naik, D. Mortensen, I. Zhang, Y. Mathur, E. Liu, K. Singh, M. Yu, S. Feng, V. Gangal, Z. Tao, S. Ruan, J. Mueller, J. Cabezas, J. Bauer, K. X. Li, R. Zhang, A. Feller, A. Madayan, L. Chen, B. Feuer, X. Li, B. Li, H. Raj, S. Galler, L. Shi, I. Segal, K. Buchanan, S. P., R. Desai, A. Schneider, C. Settles, X. Lin, M. Nezhurina, A. Wang, M. Kowalczyk, J.-X. Zhao, S. Satia, J. Hu, S. Atef, K. Chen, S. Vance, G. Segato, J. Jitsev, A. Dimakis, M. Merrill, A. Konwinski, and L. Schmidt. Terminal-Bench, 2026. URL https://github.com/harbor-framework/terminal-bench/releases/tag/v4.0.0. Software release, version 4.0.0. M. A. Merrill, A. G. Shaw, N. Carlini, B. Li, H. Raj, I. Bercovich, L. Shi, J. Y. Shin, T. Walshe, E. K. Buchanan, J. Shen, G. Ye, H. Lin, J. Poulos, M. Wang, M. Nezhurina, J. Jitsev, D. Lu, O. M. Mastromichalakis, Z. Xu, Z. Chen, Y. Liu, R. Zhang, L. L. Chen, A. Kashyap, J.-L. Uslu, J. Li, J. Wu, M. Yan, S. Bian, V. Sharma, K. Sun, S. Dillmann, A. Anand, A. Lanpouthakoun, B. Koopah, C. Hu, E. Guha, G. H. S. Dreiman, J. Zhu, K. Krauth, L. Zhong, N. Muennighoff, R. Amanfu, S. Tan, S. Pimpalgaonkar, T. Aggarwal, X. Lin, X. Lan, X. Zhao, Y. Liang, Y. Wang, Z. Wang, C. Zhou, D. Heineman, H. Liu, H. Trivedi, J. Yang, J. Lin, M. Shetty, M. Yang, N. Omi, N. Raoof, S. Li, T. Y. Zhuo, W. Lin, Y. Dai, Y. Wang, W. Chai, S. Zhou, D. Wahdany, Z. She, J. Hu, Z. Dong, Y. Zhu, S. Cui, A. Saiyed, A. Kolbeinsson, J. Hu, C. M. Rytting, R. Marten, Y. Wang, A. Dimakis, A.
- Konwinski, and L. Schmidt. Terminal-Bench: Benchmarking agents on hard, realistic tasks in command line interfaces, 2026. URL https://arxiv.org/abs/2601.11868. P. Moritz, R. Nishihara, S. Wang, A. Tumanov, R. Liaw, E. Liang, M. Elibol, Z. Yang, W. Paul, M. I. Jordan, et al. Ray: A distributed framework for emerging {AI} applications. In 13th USENIX symposium on operating systems design and implementation (OSDI 18), pages 561–577, 2018.
- K. Opsahl-Ong, A. Singhvi, J. Collins, I. Zhou, C. Wang, A. Baheti, O. Oertell, J. Portes, S. Havens, E. Elsen, M. Bendersky, M. Zaharia, and X. Chen. Officeqa pro: An enterprise benchmark for end-to-end grounded reasoning, 2026. URL https://arxiv.org/abs/2603.08655. T. Patwardhan, R. Dias, E. Proehl, G. Kim, M. Wang, O. Watkins, S. P. Fishman, M. Aljubeh, P. Thacker, L. Fauconnet, N. S. Kim, P. Chao, S. Miserendino, G. Chabot, D. Li, M. Sharman, A. Barr, A. Glaese, and J. Tworek. GDPval: Evaluating AI model performance on real-world economically valuable tasks, 2025. URL https://arxiv.org/abs/2510.04374. PrimeIntellect. Swe-rl: Software engineering tasks for rl, 2026. URL https://huggingface.co/collections/PrimeIntellect/swe-rl. X. Qu, P. Huang, and S. Horvath. Can Muon fine-tune Adam-pretrained models?, 2026. URL https://arxiv.org/abs/2605.10468. Qwen Team. Qwen3-next: Towards ultimate training & inference efficiency. https://qwen.ai/blog?id=4074cca80393150c248e508aa62983f9cb7d27cd&from=research.latest-advancements-list, September 2025. I. Shah, A. M. Polloreno, K. Stratos, P. Monk, A. Chaluvaraju, A. Hojel, A. Ma, A. Thomas, A. Tanwer, D. J. Shah, K. Nguyen, K. Smith, M. Callahan, M. Pust, M. Parmar, P. Rushton, P. Mazarakis, R. Kapila, S. Srivastava, S. Singla, T. Romanski, Y. Vanjani, and A. Vaswani. Practical efficiency of Muon for pretraining, 2025. URL https://arxiv.org/abs/2505.02222. Z. Shao, P. Wang, Q. Zhu, R. Xu, J. Song, X. Bi, H. Zhang, M. Zhang, Y. K. Li, Y. Wu, and D. Guo.
- Deepseekmath: Pushing the limits of mathematical reasoning in open language models, 2024. URL https://arxiv.org/abs/2402.03300. D. Shepard and R. Salimans. AutomationBench, 2026. URL https://arxiv.org/abs/2604.18934. M. Shoeybi, M. Patwary, R. Puri, P. LeGresley, J. Casper, and B. Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism, 2019. URL https://arxiv.org/abs/1909.08053. Y. Sun, X. Han, W. Zhang, Y. Pang, T. Wang, Y. Cao, Y. Huang, C. Duroiu, H. Zhang, J. Lin, W. Zhang, T. Zeng, Y. Yan, B. Liu, H. Wen, M. Xu, X. Liu, Z. Chen, W. Shi, A. Dsouza, V. S. Chen, P. Bryant, C. Boettiger, Y. Rangan, B. Rothenberg, K. Steinfeld, A. Rao, T. Schneider, G. Yannakakis, L. Zanna, K. Ozbay, I. Sim, T. Zohdi, G. E. Karniadakis, J. Gallant, T. Head-Gordon, Y. Li, W. Deng, T. Sun, H. Wang, Z. Wang, J. Xu, C. Y. Liu, Y. Cheng, R. Hu, A. Bacho, S. Cao, Z. Qin, Y. Chen, H. Fan, H. Liu, L. Zeng, S. M. Bharadwaj, L. Gong, Y. Yang, M. Song, R. Wang, Z. Zhang, H. Bao, S. Lu, J. Tu, Z. Wang, Z. Zhang, Z. Chen, Y. Jiang, Z. Li, B. Lyu, C. Ma, P. Xu, B. Zhang, S. Gu, H. Hua, H. Li, W. Liao, C. Liu, J. Peng, H. Sun, Z. Xu, B. Chen, J. Cheng, Y. Jiang, K. Kuang, Y. Li, Y. Pan, Z. Rao, A. Schubert, Y. Shen, V. Siu, X. Sun, K. Zhang, X. Zhang, Y. Zhu, I. S. Chandok, L. Ding, J. Fan, A. Glover, J. Hu, Y. Hu, W. Huang, Z. Jiang, H. Jin, L. Kim, M. Liu, Y. Liu, A. Rafiei, X. Shen, K. Sun, S. Sun, T. Sun, E. Wang, Y. Wang, H. Xing, S. Xu, Y. Xu, Z. Xu, Z. Yan, B. Yuan, R. Zhang, Y. Zhang, Z. Zhao, Liana, S. B. Antu, H. Bai, C. Bosio, J. Cavanagh, P.
- Cavazos-Rehg, T. Chen, X. Chen, Y. Chen, C. Zhu, C. Dai, S. D. Castro, Y. Deng, K. Dhole, J. Ding, C. Du, Z. Du, H. Fan, R.-Z. Fan, H. Fu, S. Gu, Y. Gu, C. Guo, B. Huang, B. Huang, R. Jaiswal, Z. Jiang, R. Jin, E. Kasson, X. Lan, J. Lee, D. Lei, C. Li, D. Li, H. Li, H. Li, J. Li, X. Li, Y. Li, Y. Li, Z. Li, W. Liang, L. Liao, K. Q. Lin, A. Z. Liu, C. Liu, J. Liu, K. Liu, X. Liu, P. Lu, W. Lv, Y. Lyu, Q. Mang, K. Montgomery, Y. Nie, R. Ning, J. Overwiening, X. Pan, L. Paraboschi, C. F. Park, J. Purnomo, S. Rajwal, S. Rankin, B. Ren, Y. Rong, H. Shang, V. Shaw, F. Shen, J. Shen, M. Shi, S. Qiu, H. Yao, T. Shi, J. So, V. Susoy, H. Szlyk, H. Wang,
- J. Wang, W. Wang, X. Wang, Z. Wang, D. Wong, A. Wu, D. Wu, F. Wu, M. M. Wu, Y. Wu, Y. Wu, Y. Wu, Q. Wuwu, W. Xiao, Y. Xiong, F. Xu, R. Xu, M. Yan, B. Yang, J. Yang, S. Yang, X. Yang, Y. Yang, H. Ye, X. Yu, Z. Yu, C. Zhang, C. Zhang, H. Zhang, H. Zhang, J. Zhang, K. Zhang, S. Zhang, W. Zhang, W. Zhang, Y. Zhang, Y. Zhang, B. Zhao, Q. Zhao, Y. Zhao, Y. Zheng, L. Zhou, T. Zhou, S. Zhu, S. Zhu, Y. Zhu, Y. Zhu, J. Zuo, C. Cai, H. Casademunt, W. Chen, C. Cheng, N. Deng, R. Fu, T. Fu, Y. Han, H. Ren, Z. He, Q. Jin, L. Li, Y. Li, S. Liu, L. Lu, L. Zhou, S. Mukherjee, Y. Ouyang, Y. Ren, D. Shi, H. Wu, Z. Wu, H. Yao, Z. Yi, J. Yu, R. Zhan, H. Zhou, B. Zhu, J. Zhu, A. Yuille, Y. Liu, R. A. Poldrack, J. Li, Z. Li, M. Tao, J. Huang, W. Shi, C. Spanos, L. Sun, C. Wang, O. Xu, Z. Dong, H. Gomez, A. Caliskan, A. Emami, H. Hu, Z. Li, L. Liu, M. Niu, Y. Shao, J. Sun, M. Tolonen, T. Wang, S. Das, Y. Gao, W. Guo, E. J. Schneider, Z. Lu, Y. Ma, M. Mueller, R. Poovendran, S. Sojoudi, Y. Zhu, and D. Song. Agents' last exam, 2026. URL https://arxiv.org/abs/2606.05405. C. Tao, J. Chen, Y. Jiang, K. Kou, S. Wang, R. Wang, X. Li, S. Yang, Y. Du, J. Dai, Z. Mao, X. Wang, L. Shang, and H. Bai. Swe-lego: Pushing the limits of supervised fine-tuning for software issue resolving, 2026. URL https://arxiv.org/abs/2601.01426. The Microsoft AI Team. MAI-Thinking-1: Building a hill-climbing machine. Technical report, Microsoft AI, 2026. URL https://microsoft.ai/pdf/mai-thinking-1.pdf. A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. Kaiser, and I. Polosukhin.
- Attention is all you need. In I. Guyon, U. von Luxburg, S. Bengio, H. M. Wallach, R. Fergus, S. V. N. Vishwanathan, and R. Garnett, editors, Advances in Neural Information Processing Systems 30: Annual Conference on Neural Information Processing Systems 2017, December 4-9, 2017, Long Beach, CA, USA, pages 5998-6008, 2017. URL https://proceedings.neurips.cc/paper/2017/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html. vLLM Project. Humming. https://github.com/vllm-project/humming/releases/tag/v0.1.15, September 2026. Version 0.1.15, GitHub repository, commit a74973b5079e42ef861720b62f847ce9d33447f5; accessed 2026-09-19. Z. Wang, T. Shi, J. He, M. Cai, J. Zhang, and D. Song. Cybergym: Evaluating AI agents' cybersecurity capabilities with real-world vulnerabilities at scale, 2025. URL https://arxiv.org/abs/2506.02548. Z. Wang, N. Schiller, H. Li, S. S. Narayana, M. Nasr, N. Carlini, X. Qi, E. Wallace, E. Bursztein, L. Invernizzi, K. Thomas, Y. Shoshitaishvili, W. Guo, J. He, T. Holz, and D. Song. Exploitgym: Can AI agents turn security vulnerabilities into real attacks?, 2026. URL https://arxiv.org/abs/2605.11086. B. Xia, B. Shen, D. Zhu, D. Zhang, G. Wang, H. Zhang, H. Liu, J. Xiao, J. Dong, L. Zhao, et al. Mimo: Unlocking the reasoning potential of language model-from pretraining to posttraining, 2025. URL https://arxiv.org/abs/2505.07608. L. Xiaomi. Mimo-audio: Audio language models are few-shot learners, 2025. URL https://arxiv.org/abs/2512.23808. T. Xie, D. Zhang, J. Chen, X. Li, S. Zhao, R. Cao, T. J. Hua, Z. Cheng, D. Shin, F. Lei, Y. Liu, Y. Xu, S. Zhou, S.
- Savarese, C. Xiong, V. Zhong, and T. Yu. Osworld: Benchmarking multimodal agents for open-ended tasks in real computer environments. In A. Globersons, L. Mackey, D. Belgrave, A. Fan, U. Paquet, J. M. Tomczak, and C. Zhang, editors, Advances in Neural Information Processing Systems 37: Annual Conference on Neural Information Processing Systems 2024, NeurIPS 2024, Vancouver, BC, Canada, December 10 - 15, 2024, 2024. doi: 10.5220/07901
- 7-1650. URL http://papers.nips.cc/paper_files/paper/2024/hash/5d413e48f84dc61244b6be5
- 50f1cd8f5-Abstract-Datasets_and_Benchmarks_Track.html. XLANG Lab. Introducing OSWorld-Verified, July 2025. URL https://xlang.ai/blog/osworld-verified. W. Xu, R. Han, Z. Wang, L. T. Le, D. Madeka, L. Li, W. Y. Wang, R. Agarwal, C. Lee, and T. Pfister. Speculative knowledge distillation: Bridging the teacher-student gap through interleaved sampling. In The Thirteenth International Conference on Learning Representations, ICLR 2025, Singapore, April 24-28, 2025. OpenReview.net, 2025. URL https://openreview.net/forum?id=EgJhwYR2tB. J. Yang, K. Lieret, J. Ma, P. Thakkar, D. Pedchenko, S. Sootla, E. McMilin, P. Yin, R. Hou, G. Synnaeve, D. Yang, and O. Press. Programbench: Can language models rebuild programs from scratch?, 2026a. URL https://arxiv.org/abs/2605.03546. S. Yang, C. Tao, J. Chen, T. Yu, R. Wang, Y. Jiang, Y. Du, W. Xu, J. Xiong, T. Wu, L. Shang, X. Li, N. Wong, and H. Bai. What makes interaction trajectories effective for training terminal agents?, 2026b. URL https://arxiv.org/abs/2606.03461. B. Ye, L. Li, S. Li, Z. Yue, L. Zhang, H. Lv, Y. Liu, W. Ma, H. Tian, R. Li, J. Dong, Y. Zhao, X. Deng, H. Zhang, L. Zhao, Q. Liu, L. Kong, T. Yang, and F. Luo. CodeMidas: Scaling agentic coding rl environments from code itself, 2026. URL https://arxiv.org/abs/2609.22068. Q. Yu, Z. Zhang, R. Zhu, Y. Yuan, X. Zuo, Y. Yue, W. Dai, T. Fan, G. Liu, J. Liu, L. Liu, X. Liu, H. Lin, Z. Lin, B. Ma, G. Sheng, Y. Tong, C. Zhang, M. Zhang, R. Zhang, W. Zhang, H. Zhu, J. Zhu, J. Chen, J. Chen, C. Wang, H.
- Yu, Y. Song, X. Wei, H. Zhou, J. Liu, W. Ma, Y. Zhang, L. Yan, Y. Wu, and M. Wang. DAPO: an open-source LLM reinforcement learning system at scale. In D. Belgrave, C. Zhang, L. N. Montoya, H. Lin, R. Pascanu, P. Koniusz, M. Ghassemi, N. Chen, I. V. M. Ruíz, and A. Loaiza-Bonilla, editors, Advances in Neural Information Processing Systems 38: Annual Conference on Neural Information Processing Systems 2025, NeurIPS 2025, San Diego, CA, USA, December 2-7, 2025 / Mexico City, Mexico, November 30 - December 5, 2025, 2025. URL http://papers.nips.cc/paper_files/paper/2025/hash/a4277440d50f1f15d2cb4c14f7e0c0d2-Abstract-Conference.html. Z. Yue, Z. Lin, Y. Song, W. Wang, S. Ren, S. Gu, S. Li, P. Li, L. Zhao, L. Li, et al. Mimo-vl technical report, 2025. URL https://arxiv.org/abs/2506.03569. D. Zan, Z. Huang, W. Liu, H. Chen, S. Xin, L. Zhang, Q. Liu, A. Li, L. Chen, X. Zhong, S. Liu, Y. Xiao, L. Chen, Y. Zhang, J. Su, T. Liu, R. Long, M. Ding, and L. Xiang. Multi-swe bench: A multilingual benchmark for issue resolving. In D. Belgrave, C. Zhang, L. N. Montoya, H. Lin, R. Pascanu, P. Koniusz, M. Ghassemi, N. Chen, I. V. M. Ruíz, and A. Loaiza-Bonilla, editors, Advances in Neural Information Processing Systems 38: Annual Conference on Neural Information Processing Systems 2025, NeurIPS 2025, San Diego, CA, USA, December 2-7, 2025 / Mexico City, Mexico, November 30 - December 5, 2025, 2025. URL http://papers.nips.cc/paper_files/paper/2025/hash/5afa9cb1e917b898ad418216dc726fbd-Abstract-Datasets_and_Benchmarks_Track.html. J. Zhao, G. Chen, F. Meng, M. Li, J. Chen, H. Xu, Y. Sun, X.
- Zhao, R. Song, Y. Zhang, P. Wang, C. Chen, J. Wen, and K. Jia. Immersion in the github universe: Scaling coding agents to mastery, 2026. URL https://arxiv.org/abs/2602.09892.
- L. Zheng, L. Yin, Z. Xie, C. Sun, J. Huang, C. H. Yu, S. Cao, C. Kozyrakis, I. Stoica, J. E. Gonzalez, C. W. Barrett, and Y. Sheng. Sglang: Efficient execution of structured language model programs. In A. Globersons, L. Mackey, D. Belgrave, A. Fan, U. Paquet, J. M. Tomczak, and C. Zhang, editors, Advances in Neural Information Processing Systems 37: Annual Conference on Neural Information Processing Systems 2024, NeurIPS 2024, Vancouver, BC, Canada, December 10 - 15, 2024, 2024. URL http://papers.nips.cc/paper_files/paper/2024/hash/724be4472168f31ba1c9ac630f15dec8-Abstract-Conference.html.
術語對照表
| 英文 | 中文 |
|---|---|
| Accuracy | 準確度 |
| Accuracy of Supervision | 監督準確度 |
| active parameters | 激活參數 |
| Adversarial | 對抗性 |
| adversarial testing | 對抗性測試 |
| Agent | 代理人 |
| agent-centric mid-training phase | 以代理人為中心的中訓練階段 |
| Agentic | 智能體式 |
| agentic abilities | 智能體能力 |
| agentic evaluation | 智能體式評估 |
| agentic interaction scenarios | 智能體式互動情境 |
| agentic RL | 代理式 RL |
| arithmetic intensity | 算術強度 |
| artifact | 產物 |
| auxiliary objectives | 輔助目標 |
| Batch size | 批次大小 |
| binary test outcomes | 二元測試結果 |
| Build Task | 建構任務 |
| candidate solutions | 候選解 |
| Code Generation | 程式碼生成 |
| complex problem solving | 複雜問題解決 |
| computational cost | 計算成本 |
| Consistency | 一致性 |
| Context | 上下文 |
| contrastive learning | 對比學習 |
| control plane | 控制平面 |
| Correctness | 正確性 |
| credit assignment | 信用分配 |
| curation | 策展 |
| cybersecurity | 網路安全 |
| data modalities | 資料模態 |
| data plane | 數據平面 |
| data-parallel ranks | 數據平行秩 |
| draft block | 草稿區塊 |
| dynamic sampler | 動態採樣器 |
| Environment | 環境 |
| environment construction | 環境建構 |
| environment synthesis | 環境合成 |
| executable evaluation | 可執行評估 |
| execution | 執行 |
| execution checks | 執行檢查 |
| Exploit | 漏洞 |
| fidelity | 忠實度 |
| fine-grained distinctions | 細粒度區分 |
| general-agent environment | 通用代理人環境 |
| Generation | 生成 |
| GitHub-based synthesis | 基於 GitHub 的合成 |
| Grader | 評分器 |
| Gradient | 梯度 |
| gradient | 梯度 |
| grouped queries | 分組查詢 |
| Groupwise Advantage Redistribution (GAR) | 組式優勢重分配 |
| groupwise agentic grading | 組式智能體式評分 |
| Hacking | 鑽漏洞 |
| Harness | Harness |
| Heterogeneous | 異質的 |
| heuristic | 啟發式 |
| high-concurrency multi-framework rollout | 高並發多框架 rollout |
| high-resolution visual processing | 高解析度視覺處理 |
| hybrid sparse MoE Transformer backbone | 混合稀疏 MoE Transformer 骨幹 |
| hybrid-SWA architecture | 混合 SWA 架構 |
| Inference | 推論 |
| inference | 推論 |
| information propagation | 資訊傳播 |
| iterative | 迭代式 |
| KV Cache | 鍵值快取 |
| KV cache | KV 快取 |
| learning signals | 學習訊號 |
| Local Sliding Window Attention | 局部滑動視窗注意力 |
| Long-Horizon | 長時程的 |
| long-horizon | 長程 |
| low-precision computation | 低精度計算 |
| matrix structure | 矩陣結構 |
| matrix-based update | 基於矩陣的更新 |
| model-assisted filters | 模型輔助篩選器 |
| multi-constraint requirements | 多約束需求 |
| multi-layer defense | 多層防禦 |
| multimodal understanding data | 多模態理解數據 |
| Observable | 可觀察量 |
| omni-modal | 全模態 |
| omni-modal data | 全模態資料 |
| optimizer mismatch | 優化器不匹配 |
| orthogonalizing | 正交化 |
| Pack | 打包 |
| partial rollout | 部分 rollout |
| Partial Rollout | 部分 rollout |
| Patch | 程式碼修補 |
| Phase | 相位 |
| Pipeline | 管線 |
| Policy | 策略 |
| policy | 策略 |
| post-training algorithms | 後訓練演算法 |
| pre-training corpus | 預訓練語料庫 |
| Prefill | 預填充 |
| re-prefill | 重新預填充 |
| Reliability | 可靠性 |
| Replay | 重播 |
| Reproducible | 可重現的 |
| Reward | 獎勵 |
| reward | 獎勵 |
| Reward Hacking | 獎勵駭客 |
| Reward hacking | 獎勵駭入 |
| RL workloads | RL 工作負載 |
| Robustness | 穩健性 |
| Robustness of Supervision | 監督穩健性 |
| Rollout | Rollout |
| rollout | rollout |
| rollout policy | rollout 策略 |
| rollout-based audits | 基於 rollout 的審計 |
| row-norm control | 列範數控制 |
| rubric refinement | 評分準則精煉 |
| Sample Mixer | 樣本混合器 |
| Scalable | 可擴展的 |
| Scenario | 情境 |
| Shard | 分片 |
| source-code-driven synthesis | 源碼驅動合成 |
| Specification | 規格 |
| specification-driven tasks | 規格驅動任務 |
| spectral-norm drift | 譜範數漂移 |
| state | 狀態 |
| supervision | 監督 |
| task horizons | 任務時界 |
| task synthesis | 任務合成 |
| task synthesis pathways | 任務合成路徑 |
| Throughput | 吞吐量 |
| token-efficient | Token 效率高的 |
| top-$p$ sampling | top-$p$ 採樣 |
| top-p sampling candidate sets | top-p 取樣候選集 |
| training | 訓練 |
| trajectories | 軌跡 |
| unified trajectory representation | 統一軌跡代表性 |
| verifiable tasks | 可驗證任務 |
| verifiable-task synthesis pipeline | 可驗證任務合成管線 |
| Vibe Coding | Vibe 編程/氛圍式編程 |
| visual encoder | 視覺編碼器 |
| visual fragmentation | 視覺碎片化 |
| visual representations | 視覺表示 |
| workflows | 工作流 |
- 摘要
- 1 引言
- 2 架構
- 2.1 整體架構
- 2.2 MiMo-ViT
- 2.3 音訊編碼器
- 2.4 推測解碼器
- 3 預訓練
- 3.1 預訓練設定
- 3.2 中訓練設定
- 4 強化學習的規模化
- 4.1 強化學習訓練計算量的擴展
- 4.2 強化學習環境與 Harness 的擴展規模
- 4.3 組式智能體式評分
- 5 實驗:你只需要一次 RL
- 5.1 訓練設定
- 5.2 評估設定
- 5.3 RL 效能
- 5.4 路由器凍結以實現穩定的 RL
- 5.5 RL 失敗分析
- 5.6 透過 MOPD2 擴展能力
- 6 RL 與 OPD 基礎設施
- 6.1 使用細緻學習訊號的智能體式 RL
- 6.2 Harness Pool 與 Payload Porter:使用多個 Harness 的大批次 RL
- 6.3 樣本混合器:穩定的非同步混合任務強化學習
- 6.4 訓練/推論一致性與最佳化
- 7 開放基礎:代理式 RL
- 7.1 從 MiMo-V2.6 進行蒸餾
- 7.2 使用開放環境的 RL
- 8 結論
- A 貢獻與致謝
- 參考文獻
- 術語對照表
| 英文 | 中文 |
|---|---|
| Accuracy | 準確度 |
| Accuracy of Supervision | 監督準確度 |
| active parameters | 激活參數 |
| Adversarial | 對抗性 |
| adversarial testing | 對抗性測試 |
| Agent | 代理人 |
| agent-centric mid-training phase | 以代理人為中心的中訓練階段 |
| Agentic | 智能體式 |
| agentic abilities | 智能體能力 |
| agentic evaluation | 智能體式評估 |
| agentic interaction scenarios | 智能體式互動情境 |
| agentic RL | 代理式 RL |
| arithmetic intensity | 算術強度 |
| artifact | 產物 |
| auxiliary objectives | 輔助目標 |
| Batch size | 批次大小 |
| binary test outcomes | 二元測試結果 |
| Build Task | 建構任務 |
| candidate solutions | 候選解 |
| Code Generation | 程式碼生成 |
| complex problem solving | 複雜問題解決 |
| computational cost | 計算成本 |
| Consistency | 一致性 |
| Context | 上下文 |
| contrastive learning | 對比學習 |
| control plane | 控制平面 |
| Correctness | 正確性 |
| credit assignment | 信用分配 |
| curation | 策展 |
| cybersecurity | 網路安全 |
| data modalities | 資料模態 |
| data plane | 數據平面 |
| data-parallel ranks | 數據平行秩 |
| draft block | 草稿區塊 |
| dynamic sampler | 動態採樣器 |
| Environment | 環境 |
| environment construction | 環境建構 |
| environment synthesis | 環境合成 |
| executable evaluation | 可執行評估 |
| execution | 執行 |
| execution checks | 執行檢查 |
| Exploit | 漏洞 |
| fidelity | 忠實度 |
| fine-grained distinctions | 細粒度區分 |
| general-agent environment | 通用代理人環境 |
| Generation | 生成 |
| GitHub-based synthesis | 基於 GitHub 的合成 |
| Grader | 評分器 |
| Gradient | 梯度 |
| gradient | 梯度 |
| grouped queries | 分組查詢 |
| Groupwise Advantage Redistribution (GAR) | 組式優勢重分配 |
| groupwise agentic grading | 組式智能體式評分 |
| Hacking | 鑽漏洞 |
| Harness | Harness |
| Heterogeneous | 異質的 |
| heuristic | 啟發式 |
| high-concurrency multi-framework rollout | 高並發多框架 rollout |
| high-resolution visual processing | 高解析度視覺處理 |
| hybrid sparse MoE Transformer backbone | 混合稀疏 MoE Transformer 骨幹 |
| hybrid-SWA architecture | 混合 SWA 架構 |
| Inference | 推論 |
| inference | 推論 |
| information propagation | 資訊傳播 |
| iterative | 迭代式 |
| KV Cache | 鍵值快取 |
| KV cache | KV 快取 |
| learning signals | 學習訊號 |
| Local Sliding Window Attention | 局部滑動視窗注意力 |
| Long-Horizon | 長時程的 |
| long-horizon | 長程 |
| low-precision computation | 低精度計算 |
| matrix structure | 矩陣結構 |
| matrix-based update | 基於矩陣的更新 |
| model-assisted filters | 模型輔助篩選器 |
| multi-constraint requirements | 多約束需求 |
| multi-layer defense | 多層防禦 |
| multimodal understanding data | 多模態理解數據 |
| Observable | 可觀察量 |
| omni-modal | 全模態 |
| omni-modal data | 全模態資料 |
| optimizer mismatch | 優化器不匹配 |
| orthogonalizing | 正交化 |
| Pack | 打包 |
| partial rollout | 部分 rollout |
| Partial Rollout | 部分 rollout |
| Patch | 程式碼修補 |
| Phase | 相位 |
| Pipeline | 管線 |
| Policy | 策略 |
| policy | 策略 |
| post-training algorithms | 後訓練演算法 |
| pre-training corpus | 預訓練語料庫 |
| Prefill | 預填充 |
| re-prefill | 重新預填充 |
| Reliability | 可靠性 |
| Replay | 重播 |
| Reproducible | 可重現的 |
| Reward | 獎勵 |
| reward | 獎勵 |
| Reward Hacking | 獎勵駭客 |
| Reward hacking | 獎勵駭入 |
| RL workloads | RL 工作負載 |
| Robustness | 穩健性 |
| Robustness of Supervision | 監督穩健性 |
| Rollout | Rollout |
| rollout | rollout |
| rollout policy | rollout 策略 |
| rollout-based audits | 基於 rollout 的審計 |
| row-norm control | 列範數控制 |
| rubric refinement | 評分準則精煉 |
| Sample Mixer | 樣本混合器 |
| Scalable | 可擴展的 |
| Scenario | 情境 |
| Shard | 分片 |
| source-code-driven synthesis | 源碼驅動合成 |
| Specification | 規格 |
| specification-driven tasks | 規格驅動任務 |
| spectral-norm drift | 譜範數漂移 |
| state | 狀態 |
| supervision | 監督 |
| task horizons | 任務時界 |
| task synthesis | 任務合成 |
| task synthesis pathways | 任務合成路徑 |
| Throughput | 吞吐量 |
| token-efficient | Token 效率高的 |
| top-$p$ sampling | top-$p$ 採樣 |
| top-p sampling candidate sets | top-p 取樣候選集 |
| training | 訓練 |
| trajectories | 軌跡 |
| unified trajectory representation | 統一軌跡代表性 |
| verifiable tasks | 可驗證任務 |
| verifiable-task synthesis pipeline | 可驗證任務合成管線 |
| Vibe Coding | Vibe 編程/氛圍式編程 |
| visual encoder | 視覺編碼器 |
| visual fragmentation | 視覺碎片化 |
| visual representations | 視覺表示 |
| workflows | 工作流 |