共同演化策略蒸餾
原始論文:Co-Evolving Policy Distillation 作者:Naibin Gu, Chenxu Yang, Qingyi Si, Chuanyu Qin, Dingyu Yao, Peng Fu, Zheng Lin, Weiping Wang, Nan Duan, Jiaqi Wang arXiv ID:2604.27083v1 日期:2026-04-29 標籤:LLM RLVR Distillation On-Policy Distillation Multi-Capability Reasoning Multimodal
1. 引言
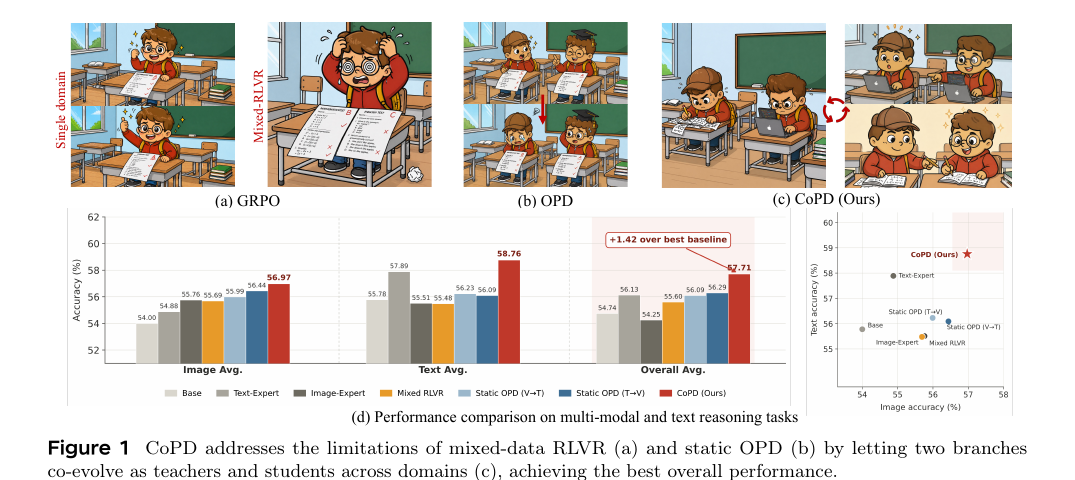
具可驗證獎勵的強化學習 (Reinforcement Learning with Verifiable Rewards, RLVR) 已成為大模型主流的後訓練範式,推動視覺推理、文字推理、影片理解等多種能力的進展。然而當把混合能力資料用 RLVR 一起訓練單一模型,常出現能力權衡 (capability trade-off):一個能力的進步往往以另一能力的退步為代價。本文稱此現象為能力發散 (capability divergence)。
由於單次 RLVR 無法同時掌握所有能力,業界轉向兩階段流程:先在每個能力資料上獨立訓練專家,再透過線上策略蒸餾 (On-Policy Distillation, OPD)——也稱多教師 OPD (Multi-teacher OPD, MOPD)——把專家整合到統一策略模型中。
但目前 OPD 用法留下一個未解問題:每個專家先在自己能力資料上訓到收斂,再作為固定教師蒸餾到分離的學生。本文主張此時教師已經偏離學生太遠,使蒸餾難以被有效吸收。透過top-k token 重疊沿線上策略軌跡量測教師-學生行為距離,作者的試點研究 (§2) 顯示:有效蒸餾需要教師與學生保持行為接近。當兩者距離太遠,教師的監督變得學生難以吸收——這正是靜態 OPD 流程的失敗點。
核心提議:教師與學生應共同演化 (co-evolve),整個訓練過程中行為距離保持在可吸收範圍內,而不是設置成靜態專家與被動學習者。
Co-Evolving Policy Distillation (CoPD) 將能力探索與整合統一為單一共同演化過程:
- 維持平行訓練分支,每個分支對應一種能力
- 不凍結任何分支當靜態教師
- 訓練過程中交替進行分支專屬 RLVR 與跨分支相互蒸餾
- 每個分支持續深化自己的專業,同時擔任另一分支不斷演化的教師
兩個階段緊密互補:RLVR 階段拉開分支間行為距離(蒸餾才有可傳授的新知識),相互 OPD 階段把雙方拉近(蒸餾才能被吸收)。所有分支共享同一基礎模型且持續相互蒸餾,參數不會劇烈分歧,最終可以透過簡單參數合併得到統一模型。
主要貢獻:
- 透過試點研究指出主流 RLVR-then-OPD 流程的關鍵限制:OPD 增益與教師-學生行為距離成反比
- 提出 CoPD:訓練過程中交替進行分支專屬 RLVR 與跨分支相互 OPD
- 在文字、影像、影片基準上一致超越 mixed RLVR、靜態 OPD、MOPD 基線。CoPD 打破「統一學生無法超越各領域專家」的傳統天花板
2. 釋放 RLVR 與 OPD 的潛力
2.1 既有範式的統一觀點
考慮把兩個能力(資料集 $\mathcal{D}_1$ 與 $\mathcal{D}_2$)整合進單一統一策略。設 $X(\mathcal{D}_1, \mathcal{D}_2)$ 為兩資料集中包含的全部最佳化訊號。一般範式 $\mathcal{P}$ 的效用形式為:
$$U_\mathcal{P} \approx a_\mathcal{P} \cdot X(\mathcal{D}_1, \mathcal{D}_2) + b_\mathcal{P}$$
其中 $a_\mathcal{P} \in [0, 1]$ 量測範式如何有效轉換 $X$ 為實際能力,$b_\mathcal{P} \leq 0$ 捕捉除了不完美轉換外的額外損失。
Mixed-data RLVR:能力發散即衝突。當單一模型在 $\mathcal{D}_1 \cup \mathcal{D}_2$ 上聯合最佳化時,每步更新平均了兩資料集導出的梯度。由於不同能力偏好不同最佳化方向,它們的梯度在能力專屬維度上不一致,造成參數更新內的梯度衝突:
$$U_{mix} \approx X(\mathcal{D}_1, \mathcal{D}_2) - \Phi(\mathcal{D}_1, \mathcal{D}_2)$$
其中 $\Phi(\mathcal{D}_1, \mathcal{D}_2) > 0$ 是能力發散成本。對應 $a_{mix} = 1$ 與 $b_{mix} = -\Phi < 0$。
靜態 OPD 流程:避開發散,但吸收差。靜態流程透過孤立訓練每個專家避開梯度衝突,發散成本 $\Phi$ 被消除。代價在整合階段:OPD 訓練學生在自己生成的線上策略軌跡 $y \sim \pi_\theta(\cdot \mid x)$ 上,教師 $\pi_T$ 在每個訪問狀態 $y_{<t}$ 提供 token 級監督:
$$\mathcal{L}_{OPD}(\theta) = \mathbb{E}_{x, y \sim \pi_\theta} \left[ \frac{1}{|y|} \sum_{t=1}^{|y|} D_{KL}(\pi_T(\cdot \mid x, y_{<t}) \| \pi_\theta(\cdot \mid x, y_{<t})) \right]$$
當教師-學生在線上策略軌跡上行為相似,token 級分佈大幅重疊,教師的預測強化學生已有可能產生的 token。但專家在孤立中訓到收斂後,已大幅偏離共同基礎,預測在學生軌跡上變得難以吸收:
$$U_{static} \approx \eta(\mathcal{O}_{low}) \cdot X(\mathcal{D}_1, \mathcal{D}_2)$$
其中 $\eta(\mathcal{O}) \in [0, 1]$ 是依教師-學生行為重疊 $\mathcal{O}$ 的吸收效率函數,$\mathcal{O}_{low}$ 是孤立收斂後的低重疊。$a_{static} = \eta(\mathcal{O}_{low})$ 為正但小,$b_{static} = 0$。
CoPD 目標:同時滿足兩個條件:(i) 能力專屬最佳化分離以消除發散成本;(ii) 維持教師-學生重疊在 $\eta(\mathcal{O})$ 高的水平。CoPD 透過交替能力專屬 RLVR 與跨分支相互 OPD 同時實現:
$$U_{CoPD} \approx \eta(\mathcal{O}_{mod}) \cdot X(\mathcal{D}_1, \mathcal{D}_2), \quad \eta(\mathcal{O}_{mod}) \gg \eta(\mathcal{O}_{low})$$
2.2 行為假說與可量測指標
行為一致性假說:教師-學生行為模式越相似,OPD 訊號越易被吸收,因為線上策略軌跡造訪相似狀態,且教師預測與學生可能產生的 token 更加吻合。
透過沿線上策略軌跡的 top-k token 重疊將行為相似性具體化:
$$\mathcal{O}_k(\pi_\theta, \pi_T) = \mathbb{E}_{x, y_{<t} \sim \mu_\theta} \left[ \frac{|\text{Top}_k(\pi_\theta(\cdot \mid x, y_{<t})) \cap \text{Top}_k(\pi_T(\cdot \mid x, y_{<t}))|}{k} \right]$$
其中 $\text{Top}_k(\cdot)$ 表示預測機率最高的 $k$ 個 token,$\mu_\theta$ 是學生引發的狀態訪問分佈。
2.3 試點研究
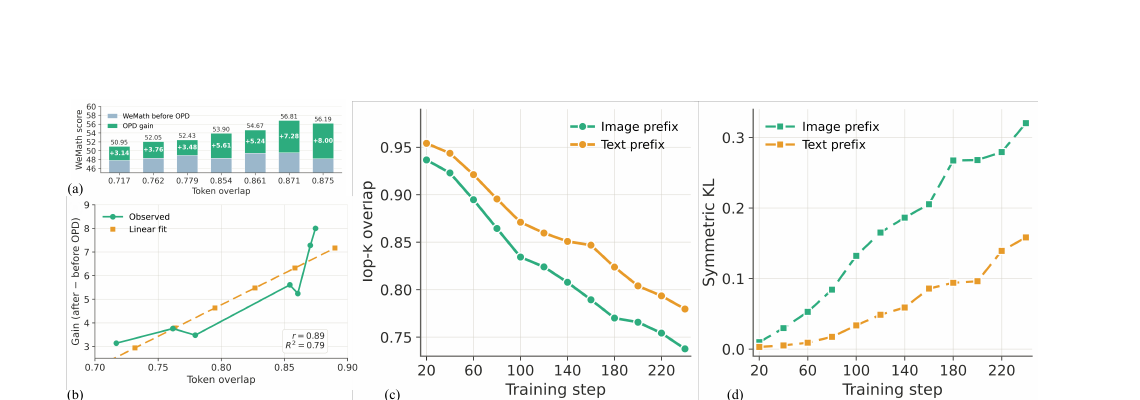
實驗 1:$\eta$ 隨教師-學生重疊上升。固定教師(在 $\mathcal{D}_{img}$ 上 RLVR 的影像領域專家),用不同抽樣溫度短期訓練基礎檢查點構造一系列具不同 $\mathcal{O}_k$ 的學生。每個學生用相同訓練配置與固定預算在 $\mathcal{D}_{img}$ 上跑 OPD,回報 OPD 前後 WeMath 分數。
結果:OPD 後增益隨 $\mathcal{O}_k$ 單調上升,在抽樣重疊範圍內展現 $r=0.89, R^2=0.79$ 的強線性相關。直接支持行為一致性假說:即使教師固定,行為更對齊的學生能更有效吸收 OPD 訊號。
實驗 2:標準 RLVR 把行為重疊驅入低 $\eta$ 區域。透過 RLVR 訓練兩個獨立專家,一個用文字推理資料 $\mathcal{D}_{txt}$、一個用影像推理資料 $\mathcal{D}_{img}$,都從共享基礎 $\pi_0$ 初始化。在固定間隔測量每個專家與 $\pi_0$ 的 top-k 重疊與對稱 KL。
結果:$\mathcal{O}_k$ 隨 RLVR 進行單調下降,對稱 KL 在同樣跨度上升一個數量級——影像與文字分支均一致。專家收斂時已遠離共享基礎,使行為重疊低於實驗 1 顯示 $\eta$ 最高的水平。
設計含意:要將 $\eta$ 從 $\eta(\mathcal{O}_{low})$ 提升到 $\eta(\mathcal{O}_{mod})$,有效範式必須滿足三個耦合需求:
- 蒸餾必須在專家訓練期間進行而非之後,使 $\mathcal{O}_k$ 沒有時間漂移到低 $\eta$ 區域
- 教師必須隨學生持續演化,使行為重疊主動維持
- 能力專屬訓練必須繼續推開兩端,使監督保留學生未具備的訊息
CoPD 透過跨分支相互 OPD(每個分支作為另一分支持續更新的教師)滿足 (1) 與 (2),並交替分支專屬 RLVR 滿足 (3)。
3. 共同演化策略蒸餾 (CoPD)
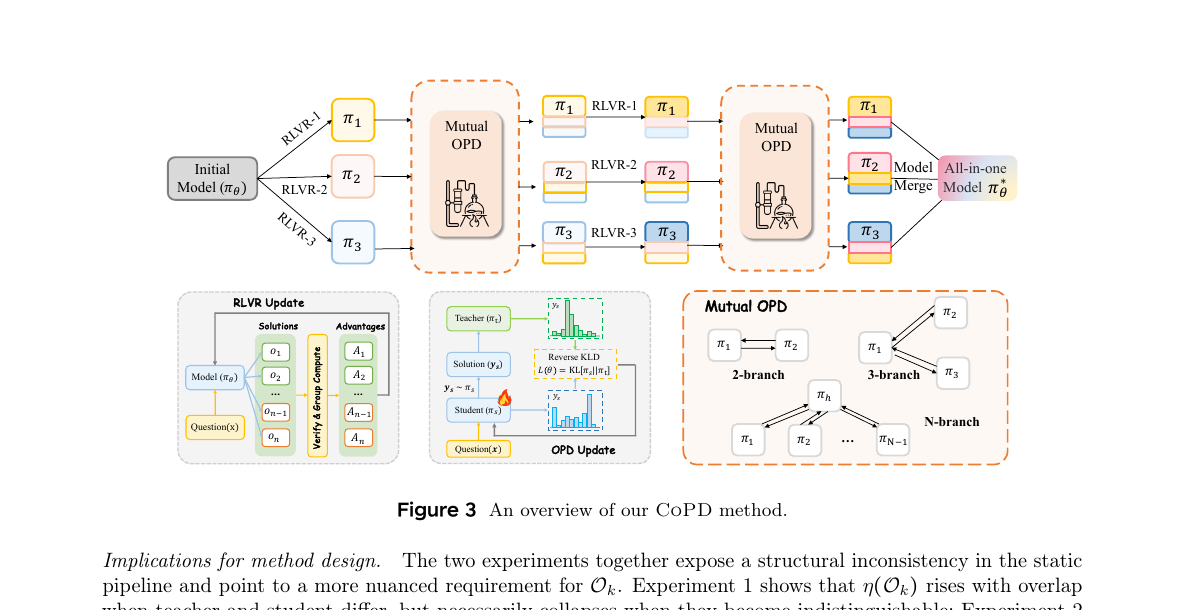
CoPD 框架支援多個專家分支共同演化,每個分支透過 RLVR 探索自己的能力,並透過相互線上策略蒸餾在適當間隔吸收他人知識。以兩分支為例:基礎模型 $\pi_0$,CoPD 初始化兩平行學習分支 $\pi_{\theta_j}$ 與 $\pi_{\theta_k}$,$\theta_j^{(0)} = \theta_k^{(0)} = \theta_0$,分別關聯能力資料集 $\mathcal{D}_j$ 與 $\mathcal{D}_k$。訓練在兩階段間交替。
3.1 分支專屬 RLVR
RLVR 階段中每個分支 $k$ 在能力 $k$ 對應資料上獨立執行 GRPO。對 prompt $x \sim \mathcal{D}_k$,分支 $k$ 從目前策略 $\pi_{\theta_k}$ 取樣一組 rollout $\{y_i^{(k)}\}_{i=1}^G$,由能力專屬可驗證獎勵函數 $r_k$ 評估。RLVR 目標為:
$$\mathcal{L}_{RLVR}^{(k)}(\theta_k) = \mathbb{E}_{x \sim \mathcal{D}_k}\left[ \frac{1}{G}\sum_{i=1}^G \frac{1}{|y_i^{(k)}|}\sum_{t=1}^{|y_i^{(k)}|} \min\left(\rho_{i,t}^{(k)} \hat{A}_i^{RL}, \text{clip}(\rho_{i,t}^{(k)}, 1-\epsilon, 1+\epsilon) \hat{A}_i^{RL}\right) \right]$$
此階段把兩分支推向不同能力前沿,打開知識差距——後續相互蒸餾能利用此差距進行跨能力傳輸。
3.2 相互 OPD
相互蒸餾階段中每個分支在另一分支資料上生成線上策略 rollout,並從另一分支接收 token 級監督。因兩分支從相同基礎開始且透過蒸餾週期性對齊,策略在訓練中保持行為接近,使監督落在每個分支熟悉且能有效吸收的狀態。
具體來說,分支 $k$ 從另一分支資料集取樣 prompt $x' \sim \mathcal{D}_j$ 並從 $\pi_{\theta_k}(\cdot \mid x')$ 生成 rollout。分支 $j$ 在 token 級評估這些 rollout。在每個位置 $t$,教師訊號定義為:
$$\delta_{i,t}^{(k \leftarrow j)} = \log \pi_{\theta_j}(y_{i,t}^{(k)} \mid x', y_{i,<t}^{(k)}) - \log \pi_{\theta_k}(y_{i,t}^{(k)} \mid x', y_{i,<t}^{(k)})$$
跨分支更新的 token 級優勢為 $\hat{A}_{i,t}^{(k)} = \beta_k \delta_{i,t}^{(k \leftarrow j)}$,$\beta_k$ 平衡跨分支蒸餾的相對貢獻。關鍵設計:分支專屬 RLVR 在相互 OPD 期間不暫停——兩個目標交織以更新模型。同樣程序對稱套用,兩分支在每一步都交替擔任教師與學生的角色,持續交換新獲得的知識。
3.3 交替訓練流程
CoPD 將兩階段組織為 $N$ 個交替循環。每個循環 $n = 1, \ldots, N$,所有分支依序執行兩階段:
Phase I:分支專屬 RLVR。每個分支 $k$ 在自己能力資料上執行 $S_{RL}$ 步 GRPO: $$\theta_k^{(n,1)} = \text{RLVR}(\theta_k^{(n-1)}; \mathcal{D}_k, r_k, S_{RL})$$
Phase II:相互 OPD。每個分支 $k$ 執行 $S_{OPD}$ 步相互蒸餾: $$\theta_k^{(n)} = \text{OPD}(\theta_k^{(n,1)}; \mathcal{D}_j, \pi_{\theta_j}, S_{OPD})$$
超參數 $S_{RL}$ 與 $S_{OPD}$ 決定兩階段節奏。較大 $S_{RL}$ 讓分支累積更多差異化的能力專屬發現;較大 $S_{OPD}$ 進行更徹底的知識傳輸。它們的平衡決定 CoPD 整體訓練動態。
最終透過跨分支簡單參數合併得到統一模型。值得注意的是,即使不合併,每個分支已達到與領域專屬專家相當的效能(見消融研究 §4.3)。
演算法 1:CoPD 完整流程
Input: Base π_θ₀, K capability datasets {D_k}, reward {r_k}, cycles N, RLVR steps S_RL, OPD steps S_OPD
1: Initialize K branches: θ_k ← θ_0 for all k
2: for n = 1, …, N do
3:   // Phase I: Branch-specific RLVR (all branches in parallel)
4:   for branch k = 0, …, K-1 in parallel do
5:     Optimize θ_k on D_k with GRPO (Eq. 7) for S_RL steps
6:   end for
7:   // Phase II: Mutual OPD (all branches in parallel)
8:   for branch k = 0, …, K-1 in parallel do
9:     for s = 1, …, S_OPD do
10:      Native: generate rollouts on D_k, update with GRPO using r_k
11:      Cross-branch: for each j ≠ k, generate rollouts on D_j from π_{θ_k}; compute teacher signal δ^(k←j) from π_{θ_j} (Eq. 8); set Â^(k) = β_k δ^(k←j)
12:      Combine native and cross-branch batches; update θ_k
13:    end for
14:  end for
15: end for
16: // Merge co-evolved branches
17: θ* ← Merge(θ_0, θ_1, …, θ_{K-1})
18: return θ*
擴展到 $K > 2$ 分支:採用 hub-and-spoke 拓撲避免完全成對蒸餾,一個分支作為共享 hub,與每個 spoke 分支進行相互 OPD。三分支設定中(§4.2)文字推理分支作為 hub,因為影像與影片分支都是視覺-語言模型,其推理能力大多奠基於底層 LLM。
4. 實驗
4.1 實驗設定
訓練資料與評估基準:
- 文字推理:Polaris-Dataset-53K,從 DeepScaleR-Preview-Dataset 與 AReal-boba-Data 過濾得來
- 影像推理:MMFineReason-123K
- 影片推理:從 OneThinker、VideoChat-R1、Video-R1 收集,用 Qwen3-8B-VL 過濾通過率 0% 或 100% 樣本,保留 40K 中等難度樣本
評估基準:
- 影像(7 個):MMMU、MMMU-Pro、MathVista、MathVision、ZeroBench、WeMath、MathVerse
- 文字(5 個):AIME 2024、AIME 2025、HMMT 2025、MATH-500、Minerva Math
- 影片(4 個,三分支設定):Video-Holmes、MVBench、MMVU、VideoMathQA
模型與基線:主要在 Qwen3-VL-4B-Instruct 上實驗。基線:
- Text-Expert / Image-Expert / Video-Expert:在各自能力資料上獨立 RLVR
- Mixed RLVR:所有資料混入單一池並透過 RLVR 訓練
- Static OPD (V→T / T→V):兩分支先獨立 RLVR,然後一個專家擔任固定教師單向 OPD 給另一個
- MOPD(三分支基線):所有領域專家聯合蒸餾到單一學生
- CoPD(本文):交替 RLVR 與雙向相互線上策略蒸餾
實作細節:在 EasyVideoR1 框架(基於 verl 與 EasyR1)上實作。最大輸入/輸出長度 16,384 tokens。學習率 $1 \times 10^{-6}$。Rollout batch size 256,每個 prompt 取樣 8 個 rollout,溫度 1.0。Clipping 邊界 $\epsilon_{low}=0.2$、$\epsilon_{high}=0.28$。Mixed RLVR 與 CoPD 使用兩個能力專家總步數和的訓練步數,確保資料吞吐量相同。
4.2 主要結果
Table 1:影像與文字推理基準主要結果(Qwen3-VL-4B 兩分支設定)
| 基準 | Base | Image-Expert | Text-Expert | Mixed RLVR | OPD V→T | OPD T→V | CoPD |
|---|---|---|---|---|---|---|---|
| Image Reasoning Avg. | 54.00 | 55.76 | 54.88† | 55.69 | 55.99 | 56.44 | 56.97 |
| MMMU | 65.06 | 65.28 | 65.72 | 66.39 | 65.94 | 67.50 | 66.94 |
| MMMU-Pro | 53.03 | 53.89 | 53.05 | 54.28 | 54.09 | 54.71 | 55.10 |
| MathVista | 73.20 | 75.10 | 73.90 | 75.10 | 74.20 | 76.05 | 75.75 |
| MathVision | 55.07 | 55.69 | 55.82 | 56.96 | 55.82 | 56.53 | 57.88 |
| ZeroBench | 21.41 | 21.41 | 22.01 | 21.86 | 21.41 | 21.71 | 24.40 |
| WeMath | 52.38 | 59.14 | 55.24 | 57.43 | 60.95 | 58.86 | 59.81 |
| MathVerse | 57.82 | 59.84 | 58.41 | 57.81 | 59.50 | 59.71 | 58.88 |
| Text Reasoning Avg. | 55.78 | 55.51 | 57.89 | 55.48† | 56.23 | 56.09 | 58.76 |
| AIME 2025 | 46.88 | 47.50 | 48.33 | 44.58 | 43.54 | 45.42 | 49.58 |
| AIME 2024 | 58.96 | 55.83 | 60.21 | 57.92 | 59.79 | 58.33 | 60.42 |
| HMMT 2025 | 25.83 | 21.67 | 27.50 | 24.17 | 25.83 | 26.67 | 30.83 |
| MATH-500 | 92.80 | 93.90 | 93.65 | 93.55 | 93.45 | 93.40 | 94.50 |
| Minerva Math | 54.41 | 58.64 | 59.74 | 57.17 | 58.55 | 56.62 | 58.46 |
| Overall Avg. | 54.74 | 55.65 | 56.13 | 55.60† | 56.09 | 56.29 | 57.71 |
CoPD 在 Image+Text 同時超越領域專家:Image Reasoning Avg. 56.97 > Image-Expert 55.76;Text Reasoning Avg. 58.76 > Text-Expert 57.89。Mixed RLVR 因能力發散傷害文字推理(55.48 vs 57.89 Text-Expert);靜態 OPD 部分緩解但仍遠不及專家。CoPD 同時改善影像與文字推理,雙邊都超越專屬專家。
Table 2:影像、文字、影片推理基準主要結果(三分支設定)
| 基準 | Base | Image-Expert | Text-Expert | Video-Expert | Mixed RLVR | MOPD | CoPD |
|---|---|---|---|---|---|---|---|
| Image Avg. | 54.00 | 55.76 | 54.88 | 54.71† | 56.17 | 56.37 | 57.12 |
| Text Avg. | 55.78 | 55.51 | 57.89 | 56.84 | 55.39† | 56.80 | 58.63 |
| Video Avg. | 56.22 | 58.27 | 55.54† | 58.75 | 59.62 | 58.32 | 59.21 |
| Overall Avg. | 55.11 | 56.31 | 55.98† | 56.39 | 56.79 | 56.99 | 58.12 |
CoPD 三分支設定延伸結論:跨主要能力群一致超越基線,凸顯跨能力傳輸的有效性能延伸到三分支設定。MOPD 在影片推理上低於 Video-Expert (58.32 vs 58.75),確認靜態多教師蒸餾隨能力分支增加而難以吸收所有專家知識。
4.3 分析
消融研究(Table 3,Qwen3-VL-4B):
| 方法 | Image Avg. | Text Avg. | All |
|---|---|---|---|
| CoPD | 56.97 | 58.76 | 57.71 |
| w/o I-OPD | 56.78 | 57.41 | 57.04 |
| w/o T-OPD | 56.48 | 57.71 | 57.02 |
| Text-Branch Only | 56.26 | 58.61 | 57.24 |
| Image-Branch Only | 56.78 | 57.17 | 56.94 |
移除 I-OPD 使文字推理從 58.76 降至 57.41;移除 T-OPD 使影像推理從 56.97 降至 56.48。雙向相互 OPD 不可或缺——每個分支的學習都受惠於接收另一分支的蒸餾訊號。
令人驚訝的發現:即使不合併,每個分支已超越 Table 1 兩個靜態 OPD 變體的整體效能(57.24 與 56.94 vs 56.09 與 56.29),證明單靠共同演化就能產生具全方位能力的分支。合併進一步整合互補強項,產出最佳整體結果。
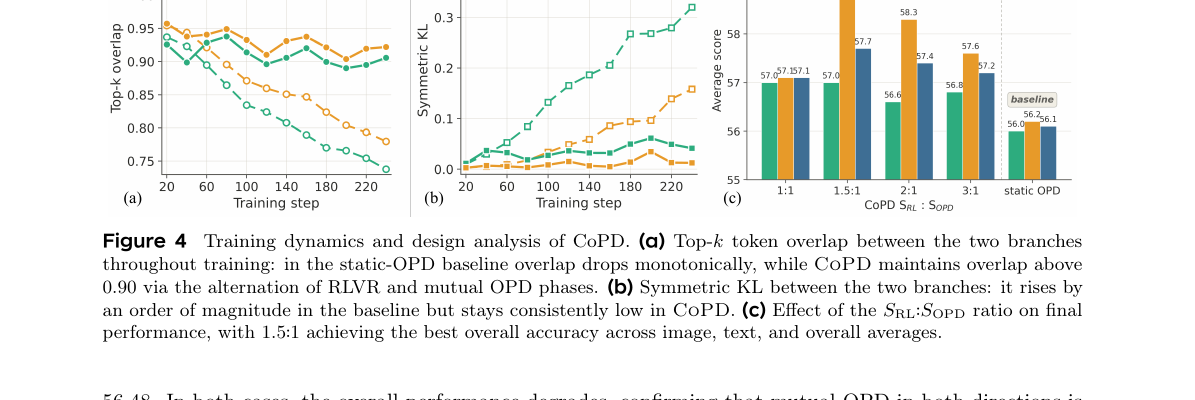
訓練中的行為模式一致性(Figure 4 (a)(b)):
- 基線(靜態 OPD):top-k 重疊單調下降,對稱 KL 上升一個數量級。當靜態 OPD 在專家訓練完成後套用,運作於兩專家最遠的點——確認 §2 預測的低吸收效率
- CoPD:top-k 重疊在每個 RLVR 階段下降但在相互 OPD 中恢復,整個訓練保持在 0.90 以上;對稱 KL 始終低。這證實 CoPD 的核心設計:RLVR 創造能讓蒸餾有資訊的分歧,相互 OPD 還原易吸收的接近性
$S_{RL}/S_{OPD}$ 比例的影響(Figure 4 (c)):在 1:1、1.5:1、2:1、3:1、static OPD 中,1.5:1 達到最佳整體準確率。建議:足夠的分支專屬探索創造有用的互補知識,過長的探索削弱分支間對齊,降低後續蒸餾的有效性。
5. 相關工作
RLVR for 大模型:GRPO 透過從群組級獎勵統計直接估計優勢,免去獨立價值網路,使 RLVR 訓練可大規模化。後續工作(DAPO、GSPO)進一步改善訓練穩定性與資料策展。RLVR 已廣泛應用於影像推理、影片推理、編碼、智能體任務。本文探索如何在 RLVR 框架內同時容納多種能力。
On-Policy Distillation:OPD 在學生自己生成的軌跡上提供教師監督,緩解 off-policy 方法固有的訓練-推理分佈不匹配。多教師 OPD (MOPD) 廣泛用於基礎模型後訓練。本文透過試點研究發現此範式存在教師-學生行為不匹配阻礙學生完全吸收教師能力。受 Li et al. 啟發採用 top-k token 重疊作為行為指標。CoPD 中專家相互擔任教師與學生,蒸餾在訓練期間而非之後進行,保持行為接近的同時保留互補知識差距。
自我啟發 RLVR 系列:本文是 Self-Taught RLVR 研究系列的第三部,探索 LLM 如何更好地從自己學習與自我演化:
- 第一部 RLSD:informed self——藉特權資訊增強的自己教導基礎模型
- 第二部 NPO (Near-future Policy Optimization):temporal self——近未來自己教導其過去自己
- 第三部 CoPD(本文):parallel self——平行自己相互教導
6. 結論
本文探索核心問題:如何更好地把多個專家能力吸收進單一模型?確認傳統方法(mixed RLVR 與靜態 OPD 流程)都受非可忽略的能力損失。提出核心想法:蒸餾應在專家訓練「期間」而非「之後」進行,多個專家模型應彼此擔任教師與學生協同共同演化。
每個專家對應分支在自己資料上執行 RLVR 探索能力前沿,與來自其他專家的相互 OPD 交織,使行為模式更接近、更易彼此學習。實驗驗證 CoPD 達成多專家能力的一體整合,甚至超越各自的領域專家模型。CoPD 的強效能暗示一個有趣視角:模型平行訓練 (model parallel training) 可作為進一步擴展模型能力邊界的有前景擴展範式。
參考文獻
[1] Shao, Z., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024.
[2] Liu, Z., et al. Understanding R1-Zero-Like Training: A Critical Perspective. 2025.
[3] Yu, Q., et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025.
[4] Zheng, C., et al. Group Sequence Policy Optimization. 2025.
[5] Huang, W., et al. Vision-R1: Incentivizing Reasoning Capability in Multimodal Large Language Models. 2026.
[6] Yao, H., et al. R1-ShareVL: Incentivizing Reasoning Capability of Multimodal Large Language Models via Share-GRPO. 2025.
[7] DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025.
[8] Yang, A., et al. Qwen3 Technical Report. 2025.
[9] Feng, K., et al. Video-R1: Reinforcing Video Reasoning in MLLMs. arXiv:2503.21776, 2025.
[10] Wang, Y., et al. Time-R1: Post-training Large Vision Language Model for Temporal Video Grounding. 2025.
[11] Kimi Team. Kimi K2.5: Visual Agentic Intelligence. 2026.
[12] GLM-5 Team. GLM-5: From Vibe Coding to Agentic Engineering. 2026.
[13] Shukor, M., et al. Scaling Laws for Optimal Data Mixtures. 2025.
[14] Lu, K. and Thinking Machines Lab. On-Policy Distillation. Connectionism, 2025.
[15] MiMo Team. MiMo-V2-Flash Technical Report. 2026.
[16] DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026.
[17] An, C., et al. Polaris: A Post-training Recipe for Scaling Reinforcement Learning on Advanced Reasoning Models. 2025.
[18] Luo, M., et al. DeepScaler: Surpassing O1-preview with a 1.5B Model by Scaling RL. 2025.
[19] Fu, W., et al. AReaL: A Large-scale Asynchronous Reinforcement Learning System for Language Reasoning. 2025.
[20] Lin, H., et al. MMFineReason: Closing the Multimodal Reasoning Gap via Open Data-Centric Methods. arXiv:2601.21821, 2026.
[21] Feng, K., et al. OneThinker: All-in-one Reasoning Model for Image and Video. arXiv:2512.03043, 2025.
[22] Li, X., et al. VideoChat-R1: Enhancing Spatio-temporal Perception via Reinforcement Fine-tuning. 2025.
[38] Bai, S., et al. Qwen3-VL Technical Report. 2025.
[39] Qin, C., et al. EasyVideoR1: Easier RL for Video Understanding. arXiv:2604.16893, 2026.
[40] Sheng, G., et al. HybridFlow: A Flexible and Efficient RLHF Framework. arXiv:2409.19256, 2024.
[41] Zheng, Y., et al. EasyR1: An Efficient, Scalable, Multi-modality RL Training Framework. 2025.
[42] OpenAI. OpenAI o1 System Card. arXiv:2412.16720, 2024.
[45] Agarwal, R., et al. On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes. ICLR, 2024.
[46] Gu, Y., et al. MiniLLM: On-Policy Distillation of Large Language Models. arXiv:2306.08543, 2026.
[47] Zhao, S., et al. Self-Distilled Reasoner: On-Policy Self-Distillation for Large Language Models. 2026.
[48] Hübotter, J., et al. Reinforcement Learning via Self-Distillation. 2026.
[49] Li, Y., et al. Rethinking On-Policy Distillation of Large Language Models: Phenomenology, Mechanism, and Recipe. 2026.
[50] Yang, C., et al. Self-Distilled RLVR. arXiv:2604.03128, 2026.
[51] Qin, C., et al. Near-Future Policy Optimization. arXiv:2604.20733, 2026.
[52] Schulman, J., et al. Proximal Policy Optimization Algorithms. arXiv:1707.06347, 2017.
完整參考文獻列表請參閱原始論文。
術語對照表
| 英文 | 中文 |
|---|---|
| Reinforcement Learning with Verifiable Rewards (RLVR) | 具可驗證獎勵的強化學習 |
| On-Policy Distillation (OPD) | 線上策略蒸餾 |
| Multi-teacher OPD (MOPD) | 多教師線上策略蒸餾 |
| Co-Evolving Policy Distillation (CoPD) | 共同演化策略蒸餾 |
| Capability Divergence | 能力發散 |
| Capability Trade-off | 能力權衡 |
| Mixed-data RLVR | 混合資料 RLVR |
| Static OPD Pipeline | 靜態 OPD 流程 |
| Behavioral Consistency | 行為一致性 |
| Top-k Token Overlap | top-k token 重疊 |
| Symmetric KL | 對稱 KL 散度 |
| Branch-specific RLVR | 分支專屬 RLVR |
| Mutual OPD | 相互線上策略蒸餾 |
| Group Relative Policy Optimization (GRPO) | 群組相對策略最佳化 |
| Token-level Supervision | token 級監督 |
| Verifiable Reward Function | 可驗證獎勵函數 |
| Knowledge Gap | 知識差距 |
| Behavioral Distance | 行為距離 |
| Absorption Efficiency | 吸收效率 |
| Hub-and-spoke Topology | 中心-輻射拓撲 |
| Model Parallel Training | 模型平行訓練 |
| Parameter Merging | 參數合併 |
| Capability Frontier | 能力前沿 |
| On-Policy Trajectory | 線上策略軌跡 |
| Capability-specific Training | 能力專屬訓練 |
| Cross-branch Mutual Distillation | 跨分支相互蒸餾 |
| Alternating Training | 交替訓練 |
| Self-Taught RLVR | 自我啟發 RLVR |
| Informed Self / Temporal Self / Parallel Self | 知情的自己 / 時間的自己 / 平行的自己 |