大型語言模型的混合策略蒸餾
原始論文:Hybrid Policy Distillation for LLMs 作者:Wenhong Zhu, Ruobing Xie, Rui Wang, Pengfei Liu arXiv ID:2604.20244v1 日期:2026-04-29 標籤:LLM Distillation RL Policy Distillation Reasoning KL Divergence On-policy
摘要
知識蒸餾 (Knowledge Distillation, KD) 是一種用於壓縮大型語言模型 (Large Language Models, LLMs) 的強大範式,其有效性取決於相互交織的選擇:散度方向 (divergence direction)、優化策略 (optimization strategy) 與資料機制 (data regime)。我們對既有 KD 方法的設計進行解構,並提出一個統一觀點,將 KD 重新表述為 token 層級上的重新加權對數似然 (reweighted log-likelihood) 目標,藉此建立各方法之間的關聯。我們進一步提出 Hybrid Policy Distillation (HPD),整合前向 (forward) 與反向 (reverse) KL 散度的互補優勢——分別在模式覆蓋 (mode coverage) 與模式尋找 (mode-seeking) 上的強項——並結合離策略 (off-policy) 資料以及輕量級、近似的在策略 (on-policy) 採樣。我們在長生成的數學推理 (math reasoning) 任務以及短生成的對話、程式碼任務上驗證 HPD,展示其在不同模型家族與規模下,於優化穩定性、計算效率與最終效能上的提升。本工作相關程式碼公開於 https://github.com/zwhong714/Hybrid-Policy-Distillation。
1. 引言
LLMs 的近期進展 (Vaswani et al., 2017; Achiam et al., 2023) 在文字生成任務上展現出卓越的效能,這在很大程度上得益於龐大的參數規模與高品質資料 (Kaplan et al., 2020)。然而,這些收益伴隨著相當可觀的運算與儲存成本 (Brown et al., 2020)。因此,透過減少參數量來壓縮 LLMs,同時保持效能,已成為這些強大模型實際部署中的關鍵課題 (Gemma et al., 2025)。
知識蒸餾 (KD) (Hinton et al., 2015) 已成為一個行之有據的範式,可將強大教師模型的知識轉移至輕量級的學生模型。在黑盒 (black-box) KD 中,學生只能取得教師的生成結果,蒸餾通常透過監督微調 (Supervised Fine-Tuning, SFT) 進行 (Guo et al., 2025)。相對地,白盒 (white-box) KD 可以利用教師的預測分佈,透過如 Kullback–Leibler 散度 (KLD) 這類分佈層級目標訓練學生,使其逼近教師輸出分佈 (Kim & Rush, 2016)。近期 LLM 蒸餾的研究進一步強調,選擇合適的散度度量對於有效的分佈匹配至關重要 (Cho & Hariharan, 2019; Mirzadeh et al., 2020; Ko et al., 2025)。
然而,僅靠散度的選擇並不充分 (Zhang et al., 2025)。LLMs 的散度型蒸餾受到幾個緊密耦合設計軸線的支配,包括:(i) 散度的方向(前向 vs. 反向)。實務上,有效的蒸餾需要平衡前向 KL 與反向 KL 的互補歸納偏差 (Binici et al., 2022; Wang et al., 2025)。前向 KL (Forward KL, FKLD) 促進模式覆蓋,但常產生過於平滑的預測 (Gu et al., 2023);反向 KL (Reverse KL, RKLD) 強調模式尋找與分佈塑形,但當師生差距過大時可能不穩定 (Lu & Lab, 2025)。(ii) 散度的優化策略(loss vs. reward),這會導致不同的優化動態與梯度偏差 (Amini et al., 2025; Shah et al., 2025)。(iii) 資料機制(在策略 vs. 離策略)。離策略蒸餾依賴外部資料來源讓學生模仿,但常出現訓練—推理行為失配 (Agarwal et al., 2024);而在策略蒸餾 (On-Policy Distillation, OPD) 從學生策略採樣 rollout,會在教師端引入分佈偏移以處理學生產出,並產生額外的運算開銷 (Ko et al., 2024)。這些因素往往相互交織,共同決定蒸餾行為。
由這些相互交織的設計軸線啟發,我們首先形式化一個重新加權對數似然目標 (reweighted log-likelihood objective),用以分析 SFT、FKLD 與 RKLD。在此觀點下,FKLD 與 RKLD 透過利用教師的完整預測分佈來提供密集監督,但代價是失去了 SFT 中 one-hot 目標的計算效率。我們接著提出 Hybrid Policy Distillation (HPD),同時兼顧散度方向以及在/離策略資料機制,將散度視為 token 層級的獎勵訊號,並保留 one-hot 監督的高效率。具體而言,HPD 利用負 $K_1$ 估計器 (Schulman, 2020) 在離策略 token 與學生採樣 token 上計算 token 層級重新加權訊號。對於離策略 token,正值表示真實 token 被低估(即學生對其機率指派過低),觸發前向 KL 學習;負值則用以抑制過度估計。對於學生採樣 token,過度估計同樣會被懲罰,並將被抑制的機率質量重新分配到離策略專家 token 上。這種 token 層級的混合化結合了前向與反向 KL 的指引以及 one-hot 監督的效率,並能自然地處理離策略資料與輕量在策略採樣。
我們在長生成的數學推理以及短生成的對話與程式碼任務上驗證 HPD,展示其在不同模型家族與規模下,於優化穩定性、計算效率與最終效能上皆有提升。總結而言,本研究的貢獻如下:
我們提出一個統一的重新加權對數似然觀點,有助於理解既有蒸餾方法,並系統性地促成跨散度方向、優化策略與資料機制的新方法開發。
我們提出 HPD,將前向與反向 KL 結合於離策略資料與輕量在策略採樣之中,同時保留 one-hot 監督的效率。
在數學推理、對話與程式碼任務上的實驗顯示,HPD 改進了優化穩定性與效率,並能以較低成本一致地匹配或超越標準 SFT + OPD 流程。此外,HPD 為 OPD 提供了強而有力的初始化,能進一步提升效能。
2. 問題形式化
自迴歸語言模型 (Auto-regressive Language Models)。 我們將下一個 token 生成建模為一個序列決策過程。令 $\tau = (s_1, a_1^*, s_2, a_2^*, \ldots, s_T, a_T^*)$ 表示從離線資料集 $\mathcal{D}$ 抽出的軌跡,其中每個狀態 $s_t = \mathbf{a}_{<t}^* = (a_1^*, \ldots, a_{t-1}^*)$ 代表真實前綴,$a_t^* \in \mathcal{V}$ 為步 $t$ 從有限詞彙 $\mathcal{V}$ 中抽出的專家 token。預訓練 LLM 引入策略 $q_\theta(a_t \mid s_t)$,由 $\theta$ 參數化,將專家軌跡的似然分解為:$q_\theta(\tau) = \prod_{t=1}^{T} q_\theta(a_t^* \mid s_t)$。模型透過教師強制 (teacher forcing) 預訓練,最小化 $\mathcal{D}$ 上的期望負對數似然 (NLL) (Ouyang et al., 2022):
$$ \mathcal{L}_{\text{pretrain}}(\theta) = -\mathbb{E}_{\tau \sim \mathcal{D}}\left[\sum_{t=1}^{T} \log q_\theta(a_t^* \mid s_t)\right]. \tag{1} $$
學生模型的有限表達力 (Limited Expressivity of the Student Model)。 多個有效後續輸出的存在,搭配標籤平滑 (label smoothing),導致監督訊號在本質上稀疏 (Zhu et al., 2024)。因此,在高度複雜的輸出空間中,教師分佈或離線資料分佈通常呈現顯著的多模性 (multimodality),超出容量受限學生所能表達的模式範圍 (Gu et al., 2023)。因此,蒸餾將機率質量稀釋於過多模式上,最終損害生成品質。
3. 預備知識
我們先回顧 SFT 作為 KD 的特例。雖然 SFT 對目標 token 提供稀疏監督,KD 則利用教師的完整預測分佈提供更密集的學習訊號。然而,在大詞彙設定下精確的散度最小化是不可行的,需要採用如蒙地卡羅 (Monte Carlo, MC) 估計這類實用近似。
3.1. 透過 SFT 的 KD
SFT 在離線資料集 $\mathcal{D} = \{(s_t, a_t^*)\}$ 上透過最小化交叉熵損失訓練模型。具體而言,監督訊號表示為 one-hot 分佈 $\mathbf{y}_t \in \{0, 1\}^{|\mathcal{V}|}$,其中 $y_{t, a_t^*} = 1$ 而 $y_{t, a} = 0$ 對所有 $a \neq a_t^*$ 成立。所得目標為:
$$ \min_\theta \mathcal{L}^{\text{SFT}}(\theta) = \min_\theta -\mathbb{E}_{\boldsymbol{s}}\mathbb{E}_{\boldsymbol{a} \sim \mathcal{D}}\left[\log q_\theta(\boldsymbol{a} \mid \boldsymbol{s})\right]. \tag{2} $$
雖然有效且穩定,SFT 僅提供單一目標動作的監督,產生稀疏學習訊號,忽略其他可能的合理動作。
3.2. 透過 KL 散度的 KD
藉由引入教師分佈層級的訊號,我們可最小化教師分佈與參數化學生分佈間的預測散度 $\mathbb{D}$。常見選擇為 FKLD 與 RKLD。
FKLD。 前向 KL 衡量學生分佈 $q_\theta(\boldsymbol{a} \mid \boldsymbol{s})$ 對教師分佈 $p(\boldsymbol{a} \mid \boldsymbol{s})$ 模式覆蓋的程度,定義如下 (Kim & Rush, 2016):
$$ \min_\theta \mathbb{D}_{\text{KL}}(p \| q_\theta) = \min_\theta \mathbb{E}_{\boldsymbol{s}}\mathbb{E}_{\boldsymbol{a} \sim p(\cdot|\boldsymbol{s})}\left[\log \frac{p(\boldsymbol{a} \mid \boldsymbol{s})}{q_\theta(\boldsymbol{a} \mid \boldsymbol{s})}\right]. \tag{3} $$
近期研究 (Agarwal et al., 2024; Ko et al., 2024) 透過最小化方程式 (4) 來近似分佈匹配,其前提假設教師分佈與其訓練資料集 $\mathcal{D}$ 相似以提升效率,並可分解為 token 層級蒸餾的總和:
$$ \begin{aligned} \min_\theta &\frac{1}{|\mathcal{D}|} \sum_{(\boldsymbol{s}, \boldsymbol{a}) \in \mathcal{D}}\left[p(\boldsymbol{a} \mid \boldsymbol{s}) \log \frac{p(\boldsymbol{a} \mid \boldsymbol{s})}{q_\theta(\boldsymbol{a} \mid \boldsymbol{s})}\right] \\ &= \min_\theta \frac{1}{|\mathcal{D}|} \sum_{(\boldsymbol{s}, \boldsymbol{a}) \in \mathcal{D}} \sum_t^{|\boldsymbol{a}|}\left[\sum_{a_t \in \mathcal{V}} p(a_t \mid s_t) \log \frac{p(a_t \mid s_t)}{q_\theta(a_t \mid s_t)}\right] \end{aligned} \tag{4} $$
方程式 (3) 的梯度為:
$$ \nabla_\theta \mathbb{D}_{\text{KL}}(p \| q_\theta) = -\mathbb{E}_{\boldsymbol{a} \sim p(\cdot|\boldsymbol{s})}\left[\nabla_\theta \log q_\theta(\boldsymbol{a} \mid \boldsymbol{s})\right]. \tag{5} $$
它鼓勵學生透過涵蓋教師認為可能的所有行為來獲取新知識,因為遺漏模式會被嚴重懲罰 (Song et al., 2020)。然而,若學生模型容量不足以匹配教師分佈的完整支撐 (full support),它可能在試圖涵蓋所有可能模式時產生過度平滑的分佈 (Gu et al., 2023; Wang et al., 2023)。
RKLD。 反向 KL 鼓勵學生聚焦於教師的高機率模式,可能忽略較不可能的輸出,計算如下:
$$ \min_\theta \mathbb{D}_{\text{KL}}(q_\theta \| p) = \min_\theta \mathbb{E}_{\boldsymbol{s}}\mathbb{E}_{\boldsymbol{a} \sim q_\theta(\cdot|\boldsymbol{s})}\left[\log \frac{q_\theta(\boldsymbol{a} \mid \boldsymbol{s})}{p(\boldsymbol{a} \mid \boldsymbol{s})}\right]. \tag{6} $$
梯度為:
$$ \nabla_\theta \mathbb{D}_{\text{KL}}(q_\theta \| p) = \mathbb{E}_{\boldsymbol{a} \sim q_\theta(\cdot|\boldsymbol{s})}\left[\nabla_\theta \log q_\theta(\boldsymbol{a} \mid \boldsymbol{s}) \cdot (\log q_\theta(\boldsymbol{a} \mid \boldsymbol{s}) - \log p(\boldsymbol{a} \mid \boldsymbol{s}))\right]. \tag{7} $$
此梯度結構讓學生偏向教師的主導模式,低估低機率但有效的輸出 (Wang et al., 2025),且因無界的對數比 (log-ratio) 引發高變異梯度,可能導致學生與教師對齊不佳的不穩定訓練 (Ko et al., 2024)。
3.3. 蒙地卡羅 KLD 近似
精確計算 KLD 通常難以處理,如方程式 (4) 所示,因為需要對完整詞彙、序列長度與批次大小求和。取而代之,KLD 可透過 MC 採樣近似。在給定時間步 $t$ 上最簡單的這類估計器,記為 $K_1$,為:
$$ K_1 \triangleq \frac{1}{N} \sum_{i=1}^{N} \log \frac{q_\theta(a_t^{(i)} \mid s_t)}{p(a_t^{(i)} \mid s_t)}, \quad a_t^{(i)} \sim q_\theta(\cdot \mid s_t), \tag{8} $$
它是 $\mathbb{D}_{\text{KL}}(q_\theta \| p)$ 的不偏估計器,但變異大,因為對相當比例的樣本而言,其對數比項為負 (Schulman, 2020)。
$K_1$ 估計器作為獎勵 (Reward)。 KLD 的不同變體估計器可整合到訓練中,作為 token 層級獎勵懲罰 (如 PPO 中 (Schulman et al., 2017)),或作為明確的損失項 (如 GRPO (Shao et al., 2024) 普及化的方式)。最近,OPD 框架透過評估從學生策略採樣的 token $a_t$ 上的教師對數機率,計算負 $K_1$ 作為獎勵 (Lu & Lab, 2025)。此方法能有效蒸餾、提供不偏梯度估計,並改善訓練穩定性 (Shah et al., 2025)。詳見附錄 B.1 的推導。
4. 我們的方法:HPD
4.1. 朝向蒸餾的統一觀點
從重新加權似然優化的角度,SFT 與 KL 蒸餾目標可以統一為:
$$ \mathcal{L}(\theta) = \min_\theta -\mathbb{E}_{(s_t, a_t) \sim \mathcal{D}^\pi}\left[w(a_t \mid s_t) \log q_\theta(a_t \mid s_t)\right], \tag{9} $$
其中 $\mathcal{D}^\pi$ 表示資料來源:對於在策略方法,$\mathcal{D}^{\pi_\theta}$ 從目前學生策略採樣;對於離策略方法,$\mathcal{D}^\pi$ 來自固定資料集 $\mathcal{D}$ 或教師策略 $\mathcal{D}^{\pi_T}$。重新加權項 $w(a_t \mid s_t)$ 在步 $t$ 處捕捉學生與教師策略間的局部差異,量化學生指派給動作 $a_t$ 的機率與教師在狀態 $s_t$ 下的偏離程度。為清晰起見,不同目標下 $w(a_t \mid s_t)$ 的具體選擇彙總於下表 1。
表 1. 經典 SFT 與 KD 方法的比較。
| 方法 | 資料來源 | 重新加權項 $w(a_t \mid s_t)$ |
|---|---|---|
| SFT | 離策略 ($\mathcal{D}$ 或 $\mathcal{D}^{\pi_T}$) | $\mathbf{1}[a_t = a_t^*]$ |
| FKLD | 離策略 ($\mathcal{D}$ 或 $\mathcal{D}^{\pi_T}$) | $p(a_t \mid s_t)$ |
| RKLD | 在策略 ($\mathcal{D}^{\pi_\theta}$) | $\log p(a_t \mid s_t) - \log q_\theta(a_t \mid s_t)$ |
正向與負向優化的有效性 (Effectiveness of Positive and Negative Optimization)。 透過審視方程式 (9),我們觀察到正權重會提升對應動作的似然,而負權重會抑制它們。對採樣 token $a_t$ 的合成梯度可以表示為:
$$ -\frac{\partial \mathcal{L}(\theta)}{\partial z_v} \propto \begin{cases} \hat{w}_t \cdot q_v \cdot (1 - q_v), & \text{若 } v = a_t, \\ -\hat{w}_t \cdot q_{a_t} \cdot q_v, & \text{若 } v \neq a_t, \end{cases} \tag{10} $$
其中 $z_v$ 為與 token $v$ 關聯的 logit,$\hat{w}_t$ 為 $w(a_t \mid s_t)$ 的縮寫。詳見附錄 D 的推導。此公式顯示,雖然目標直接針對單一 token,誘發的梯度卻散佈於整個預測分佈。特別地,當 $\hat{w}_t < 0$ 時,梯度主動抑制採樣 token,並按其當前機率比例將機率質量重新分配給其他 token。如 3.3 節所討論,反向 $K_1$ 估計器自然展現此行為。
4.2. Hybrid Policy Distillation
我們將專家 token (expert token) 定義為來自教師生成 (Kim & Rush, 2016) 或近似教師分佈的離線真實 (Hinton et al., 2015) 之 token,而非專家 token (non-expert token) 為從學生取樣得到。
Hybrid Forward–Reverse KL。 給定固定離線專家資料集 $\mathcal{D} = \{(s_t, a_t^*)\}$,我們採用負反向 $k_1$ 估計器:
$$ k_1 = q_\theta(a_t^* \mid s_t)\left[\log p(a_t^* \mid s_t) - \log q_\theta(a_t^* \mid s_t)\right], \tag{11} $$
以衡量學生與專家 token $a_t^*$(條件於狀態 $s_t$)之間的差距。正的 $k_1 > 0$ 表示學生低估了專家 token 的似然。為修正此問題,我們納入重新加權項 $p(a_t^* \mid s_t)$,並將專家 token 權重 $w_t^*$ 定義為:
$$ w_t^* = \begin{cases} p(a_t^* \mid s_t) + k_1, & \text{若 } k_1 > 0, \\ k_1, & \text{若 } k_1 \leq 0, \end{cases} \tag{12} $$
此設計可被詮釋為透過重新加權機制實作的前向與反向 KL 蒸餾混合。不像加權和散度方法以固定係數結合兩個 KL 方向,我們引入遮罩 (masking) 機制:當 $k_1 \leq 0$ 時,對應的前向 KL 權重被遮罩,反映學生已過度估計專家 token,避免衝突的梯度方向。
Hybrid Policy。 為改善離線自迴歸前綴下的分佈對齊,我們讓學生採樣不同 token:$a_t \sim q_\theta(\cdot \mid s_t)$,限制 $a_t \neq a_t^*$,給定真實離線前綴 $s_t$,並以方程式 (11) 中的 $k_1$ 估計器計算採樣 token 上的 $k_1'$。我們以下式遮罩 $k_1'$ 的正值:
$$ w_t \leftarrow \begin{cases} 0, & \text{若 } k_1' \geq 0, \\ k_1', & \text{若 } k_1' < 0, \end{cases} \tag{13} $$
這可避免增強非專家 token,同時抑制不合理的採樣。
如 4.1 節所述,負權重會將機率質量按目前模型分佈在詞彙上重新分配。當 $k_1' < 0$ 時,為了明確鼓勵專家動作,當 $k_1 > 0$ 時我們對專家 token 施加強化 (reinforcement),賦予兩倍的前向 KL 權重;當 $k_1 = 0$ 時,維持前向 KL 權重,得到下列專家權重:
$$ w_t^* \leftarrow \begin{cases} 2p(a_t^* \mid s_t) + k_1, & \text{若 } k_1 > 0 \text{ 且 } k_1' < 0, \\ k_1, & \text{若 } k_1 < 0, \\ p(a_t^* \mid s_t) + k_1, & \text{其他}. \end{cases} \tag{14} $$
最後,將兩個權重整合到重新加權似然優化中,並繫於對應的 token 上:
$$ \mathcal{L}_{\text{HPD}} = \min_\theta \mathbb{E}_{(s_t, a_t^*) \sim \mathcal{D}, a_t \sim q_\theta(\cdot \mid s_t)}\left[-w_t^* \log q_\theta(a_t^* \mid s_t) - w_t \log q_\theta(a_t \mid s_t)\right]. \tag{15} $$
HPD 的直覺解釋 (Intuitive Explanation of HPD)。 我們在演算法 1 中展示訓練流程。HPD 採用非對稱 token 層級設計。對每個離線狀態 $s_t$,專家 token $a_t^*$ 為主要優化目標,明確與教師對齊,同時抑制可能導致對專家 token 過度估計的不必要學習。學生採樣的非專家 token $a_t \sim q_\theta(\cdot \mid s_t)$ 僅用於識別與抑制不合理模型行為。當學生低估專家 token ($k_1 > 0$) 時,透過前向 KL 權重強化專家 token;若學生再過度估計採樣的非專家 token ($k_1' < 0$),此權重會進一步加強,確保被抑制的機率質量被重新導向至專家動作。
演算法 1 HPD 演算法
1: input  學生 q_θ、教師 p、資料集 D
2: output 更新後參數 θ
3: 採樣離線軌跡 T ~ D
4: for 每個 (s_t, a_t^*) ∈ T do
5:   計算對數機率:(log q*, log p*) ← (log q_θ, log p)(a_t^* | s_t)
6:   計算專家反向 KL 差距:
7:     k_1 ← q_θ(a_t^* | s_t)(log p* - log q*)
8:   採樣 a_t ~ q_θ(· | s_t)
9:   計算採樣 token 反向 KL 差距:
10:    k_1' ← q_θ(a_t | s_t)[log p(a_t | s_t) - log q_θ(a_t | s_t)]
11:  計算專家權重:
12:    w_t^* ← {  2p(a_t^* | s_t) + k_1, k_1 > 0, k_1' < 0
                 k_1, k_1 < 0
                 p(a_t^* | s_t) + k_1, 其他 }
13:  計算採樣 token 權重:
14:    w_t ← I[a_t ≠ a_t^*] · I[k_1' < 0] · k_1'
15: end for
16: 更新參數:
17:   θ ← θ - α∇_θ L_HPD
5. 實驗
本節中,我們針對長文本與短文本生成研究蒸餾。我們在數學推理任務上評估長生成蒸餾,在對話與程式碼任務上評估短生成蒸餾。額外實驗結果見第 7 節。為確保比較公平,我們分別考量離線與在策略資料。
基線 (Baselines)。 從統一觀點來看,本研究中考量的所有基線都可解釋為具有不同權重估計器選擇的重新加權對數似然目標近似。詳見附錄 E。實務上,由於記憶體與運算成本,直接在長自迴歸生成上優化完整 KL 目標通常不可行 (Zhang et al., 2025)。對於離策略資料,我們以下方式近似多個代表性方法:採用常數估計器 1 的 SFT;採用教師機率 $p$ 估計器的 SeqKD (Kim & Rush, 2016);採用 $q \cdot (\log q - \log p)$ 估計器的 RKLD (Gu et al., 2023);以及採用 $\frac{1}{2}q \cdot (\log q - \log \frac{p+q}{2})$ 估計器的 JSD (Agarwal et al., 2024)。詳見附錄 C。對於在策略資料,我們依照前人工作,研究 OPD 框架下不同初始化的影響 (Gu et al., 2023; Lu & Lab, 2025; Agarwal et al., 2024)。
5.1. 推理任務的離策略資料
5.1.1. 設定
(1) 模型與資料集。 我們的學生模型來自兩個不同參數規模的模型家族:Qwen2.5 系列 (1.5B、3B、7B) (Yang et al., 2025) 與 LLaMA3 系列 (1B、3B、8B) (Dubey et al., 2024)。對每個模型家族,我們選最大模型作為教師。我們聚焦於數學領域,透過長思維鏈 (long chain-of-thought, CoT) 推理增強通用 LLM 能力。具體而言,我們採用 OpenR1-Math-8192 資料集 (Face, 2025)。
(2) 實作細節。 為了生成效率,近期工作 (如 Ko et al., 2024; Agarwal et al., 2024) 常假設教師分佈下的分佈與其訓練資料集的經驗分佈密切對齊。因此,我們先在離線資料集上訓練教師模型,再使用 GRPO 進行精煉。學生模型微調約 2k 步,批次大小 256,最終檢查點根據驗證集效能選定。額外實作細節見附錄 F。
5.1.2. 結果與分析
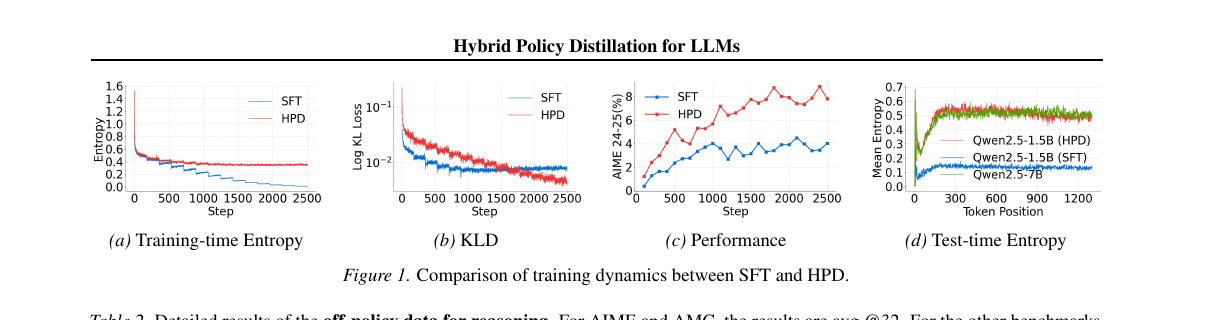
表 2. 推理任務離策略資料的詳細結果。AIME 與 AMC 結果為 avg.@32;其他基準為 avg.@8。* 表示效能在統計上顯著 (t-test, $p < 0.01$)。
| 方法 | Qwen2.5 (7B → 1.5B) AIME24 | AIME25 | AMC | Math | Obly. | GPQA | Avg. | LLaMA3 (8B → 1B) AIME24 | AIME25 | AMC | Math | Obly. | GPQA | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $\mathcal{M}_T$ | 28.13 | 27.19 | 71.72 | 87.48 | 58.50 | 43.43 | 52.74 | 14.27 | 18.02 | 55.23 | 77.78 | 47.74 | 36.23 | 41.55 |
| $\mathcal{M}_S$ | 2.19 | 1.04 | 21.17 | 46.78 | 16.52 | 23.04 | 18.46 | 0.73 | 0.10 | 8.98 | 24.93 | 5.02 | 9.41 | 8.20 |
| SFT | 2.81 | 6.04 | 28.83 | 55.25 | 24.87 | 19.02 | 22.80 | 0.83 | 1.04 | 17.34 | 33.30 | 12.52 | 18.24 | 13.88 |
| SeqKD | 5.31 | 5.31 | 33.83 | 60.28 | 29.48 | 23.42 | 26.27 | 0.42 | 0.94 | 21.09 | 36.45 | 12.94 | 20.01 | 15.31 |
| RKLD | 5.00 | 3.85 | 34.45 | 58.78 | 27.41 | 27.40 | 26.15 | 0.42 | 0.63 | 17.81 | 34.10 | 12.56 | 23.86 | 15.07 |
| JSD | 5.73 | 4.90 | 35.31 | 59.63 | 27.30 | 25.69 | 26.43 | 0.31 | 1.13 | 18.98 | 35.95 | 14.72 | 22.92 | 15.62 |
| HPD | 7.71* | 9.89* | 39.84* | 63.40* | 32.53* | 28.09* | 30.24* | 1.25* | 2.08* | 21.80* | 41.73* | 17.24* | 23.93 | 18.01 |
| $\mathcal{M}_S$ (3B) | 6.67 | 2.50 | 38.20 | 64.08 | 28.17 | 29.86 | 28.25 | 7.08 | 0.73 | 23.35 | 46.95 | 15.11 | 23.35 | 19.43 |
| SFT (3B) | 10.10 | 12.60 | 46.33 | 69.78 | 36.89 | 20.33 | 32.67 | 8.13 | 10.73 | 41.25 | 65.23 | 33.69 | 17.67 | 29.45 |
| SeqKD (3B) | 11.56 | 14.48 | 47.66 | 74.48 | 40.48 | 24.62 | 35.55 | 9.06 | 12.71 | 42.89 | 67.25 | 36.78 | 22.35 | 31.84 |
| RKLD (3B) | 9.38 | 12.29 | 46.25 | 69.58 | 37.35 | 19.51 | 32.39 | 7.19 | 6.56 | 42.66 | 65.63 | 33.48 | 26.96 | 30.43 |
| JSD (3B) | 10.31 | 14.90 | 50.70 | 73.88 | 40.69 | 29.17 | 36.61 | 6.67 | 7.40 | 41.56 | 64.75 | 33.65 | 25.69 | 29.95 |
| HPD (3B) | 13.75* | 18.13* | 54.14* | 76.30* | 45.33* | 31.31* | 39.83* | 10.94* | 12.71 | 48.28* | 69.25* | 39.02* | 27.15* | 34.56 |
HPD 達成連續蒸餾。 如圖 1a 所示,訓練期間 SFT 導致學生模型迅速過擬合資料集,產生 entropy 崩塌;而 HPD 維持穩定的 entropy 而無此崩塌。同樣地,圖 1b 顯示 HPD 漸進地縮小學生與教師分佈間的差距,生成效能在訓練過程中穩定提升 (圖 1c)。相對地,SFT 下 KL 散度差距停滯,模型效能改善甚少。HPD 使學生模型逐步與教師分佈對齊,持續提升其朝向教師的效能,直至學生模型本身的容量上限。
HPD 達成訓練—推理行為對齊。 我們從驗證集選取 1,000 個 prompt,追蹤推理時 entropy 動態,將每個 token 位置上的 entropy 平均,如圖 1d 所示。結果顯示,採用 HPD,學生模型在訓練與推理中都緊密與教師模型對齊,展現兩階段間一致的行為。
HPD 達成優異蒸餾效能。 從表 2 可見,蒸餾方法整體優於 SFT,展示其潛力。結果顯示 HPD 在 Qwen2.5 與 LLaMA 3 模型家族中皆一致優於所有基線蒸餾方法。最值得注意的是,HPD 使 3B 變體達到可與更大模型比擬的推理能力——將 Qwen2.5 3B 提升 41.0%(從 28.25 至 39.83),LLaMA 3 3B 提升 77.9%(從 19.43 至 34.56)。
5.2. 個人化的離策略資料
設定。 (1) 模型與資料集。 不同於 5.1 節需要大量離線生成計算的長 CoT 推理任務,本節我們使用相應模型的 Instruct 版本,透過 UltraFeedback 資料集 (Cui et al., 2023) 中的範例 prompt 生成離策略資料。(2) 實作細節。 所有評估檢查點皆從學生模型微調 2k 步、批次 256 中選取。(3) 評估。 詳見附錄 G。
表 3. 個人化離策略資料的詳細結果 (Qwen2.5 7B → 1.5B)。我們報告含長度控制的 AlpacaEval2 (AE-LC、AE-WR) 與 Arena-Hard 勝率,以及 MT-Bench 多輪對話基準 (MT-1T 與 MT-2T)。
| 方法 | AE-LC(%) | AE-WR(%) | Arena-WR(%) | MT-1T | MT-2T |
|---|---|---|---|---|---|
| $\mathcal{M}_T$ | 36.04 | 34.95 | 60.00 | 9.00 | 7.44 |
| $\mathcal{M}_S$ | 8.67 | 7.47 | 9.90 | 6.64 | 5.00 |
| SFT | 12.74 | 13.72 | 18.10 | 6.80 | 4.81 |
| SeqKD | 7.83 | 9.51 | 15.40 | 6.24 | 4.15 |
| RKLD | 11.26 | 12.00 | 17.80 | 6.96 | 5.19 |
| JSD | 13.48 | 13.89 | 20.20 | 6.96 | 5.21 |
| HPD | 13.75 | 14.25 | 21.80 | 7.23 | 5.84 |
結果與分析。 如表 3 所示,在所有蒸餾方法中,HPD 表現最佳,特別在保留多輪對話能力上優勢顯著。它在 MT-1T 與 MT-2T 任務上獲得整體最高分數,展現其在保有對話一致性與上下文理解上的優越能力。HPD 也在如 AE-LC、AE-WR、Arena-WR 等關鍵對齊效能指標上領先,進一步驗證其穩健性。
5.3. 程式碼任務的離策略資料
設定。 (1) 模型與資料集。 我們以 Qwen2.5-Coder-7B-Instruct (Hui et al., 2024) 與 DeepSeek-Coder-6.7B-Instruct (Guo et al., 2024) 為教師模型,Qwen2.5-Coder-1.5B 與 DeepSeek-Coder-1.3B 為對應學生模型。對於蒸餾,我們透過用 WizardCoder 資料集 (Luo et al., 2024) 中的範例 prompt,使用每個模型的 Instruct 版本生成訓練資料。(2) 評估。 評估在 EvalPlus 框架下進行 (Liu et al., 2023),採用 greedy decoding,對 HumanEval (Chen, 2021) 與 MBPP (Austin et al., 2021) 進行評估。額外實作細節見附錄 H。
表 4. 程式碼離策略資料的詳細結果。HumanEval (HEval) 與 MBPP 基準上 pass@1 分數的比較。
| DS-Coder (6.7B → 1.3B) HEval | MBPP | AVG | Qwen-Coder (7B → 1.5B) HEval | MBPP | AVG | |
|---|---|---|---|---|---|---|
| $\mathcal{M}_T$ | 76.20 | 74.90 | 75.55 | 91.50 | 82.30 | 86.90 |
| $\mathcal{M}_S$ | 62.80 | 61.10 | 61.95 | 71.30 | 68.50 | 69.90 |
| SFT | 61.00 | 61.90 | 61.45 | 73.80 | 67.70 | 70.75 |
| KD | 65.20 | 64.00 | 64.60 | 77.40 | 67.50 | 72.45 |
| RKLD | 61.60 | 61.60 | 61.60 | 76.80 | 74.90 | 75.85 |
| JSD | 67.10 | 61.10 | 64.10 | 77.40 | 74.60 | 76.00 |
| HPD | 69.50 | 63.20 | 66.35 | 79.30 | 75.40 | 77.35 |
結果與分析。 如表 4 所示,HPD 在兩個模型家族上獲得最佳平均效能。雖然 HPD 在 DS-Coder 的每個個別基準上不一定獲得最高分,但其改善穩定。相對地,KD 與 JSD 在不同任務與模型家族間呈現較大變異,顯示穩健性較弱。這些結果指出 HPD 提供更平衡且可靠的蒸餾目標。
5.4. 推理任務的在策略資料
5.4.1. 設定
(1) 模型與資料集。 本節中,我們依循 5.1 節相同的模型與資料集配置,但切換至線上學生 rollout 設定。(2) 實作細節。 我們使用訓練批次大小 256,對應 64 個 prompt,每個 prompt 重複 rollout 4 次。我們考量 MiniLLM (Gu et al., 2023) 與 GKD (Agarwal et al., 2024),兩者皆屬於 OPD 範式。主要差異在於 MiniLLM 強調反向 KL 在改進蒸餾上的作用,而 GKD 聚焦於使用學生產生的線上序列。額外實作細節見附錄 I。
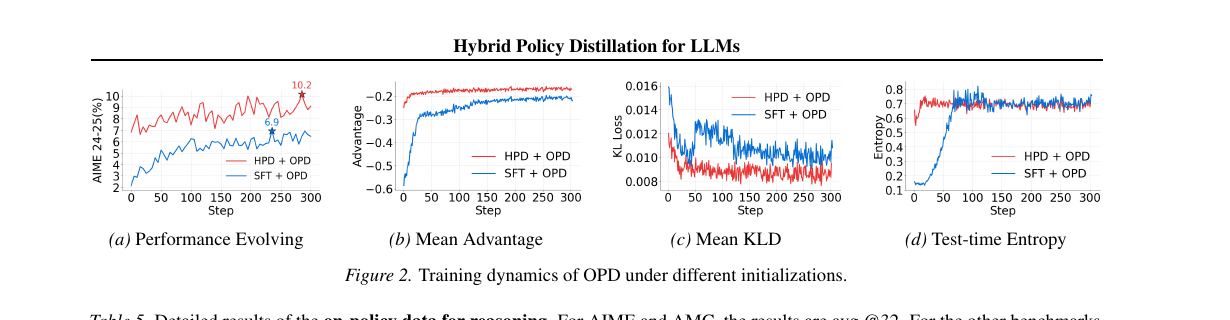
表 5. 推理任務在策略資料的詳細結果。AIME 與 AMC 為 avg.@32,其他為 avg.@8。
| 方法 | Qwen2.5 (7B → 1.5B) AIME24 | AIME25 | AMC | Math | Obly. | GPQA | Avg. | LLaMA3 (8B → 1B) AIME24 | AIME25 | AMC | Math | Obly. | GPQA | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $\mathcal{M}_T$ | 28.13 | 27.19 | 71.72 | 87.48 | 58.50 | 43.43 | 52.74 | 14.27 | 18.02 | 55.23 | 77.78 | 47.74 | 36.23 | 41.55 |
| SFT | 2.81 | 6.04 | 28.83 | 55.25 | 24.87 | 19.02 | 22.80 | 0.83 | 1.04 | 17.34 | 33.30 | 12.52 | 18.24 | 13.88 |
| ↪ + OPD | 6.98 | 8.33 | 39.30 | 63.88 | 32.94 | 25.95 | 29.56 | 0.63 | 1.67 | 22.89 | 40.93 | 15.83 | 20.45 | 17.06 |
| HPD | 7.71 | 9.89 | 39.84 | 63.40 | 32.53 | 28.09* | 30.24 | 1.25* | 2.08 | 21.80 | 41.73 | 17.24 | 23.93 | 18.01 |
| ↪ + OPD | 10.63* | 10.10* | 43.98* | 69.93* | 38.59* | 27.21 | 33.41 | 1.04 | 2.60* | 28.68* | 46.50* | 19.93* | 23.67 | 20.40 |
5.4.2. 結果與分析
HPD 展現穩定的優化動態與有效的策略對齊。 HPD 在訓練過程中一致達成更高的任務效能 (圖 2a),這與較不負且較穩定的平均優勢估計 (圖 2b) 相關,指出學生與教師策略間更好的對齊。同時,HPD 維持顯著較低的 KL 散度對教師 (圖 2c),顯示 HPD 提供比 SFT 更受控且高效的分佈失配修正。重要地,HPD 避免了測試時過度的 entropy 崩塌 (圖 2d),產生更一致的推理行為,更貼近教師分佈。
HPD 的有效性與穩健性。 HPD 在不同模型家族與基準上一致優於 SFT,展現強大穩健性與可擴展性。即使在純離策略資料設定下,HPD 單獨即可獲得高於兩階段基線(先 SFT 後 OPD)的效能。當與 OPD 結合,HPD 進一步放大此增益,獲得最高平均分數,並大幅超越對應基線。值得注意的是,這些改善在領域內與領域外評估 (GPQA) 上皆一致,顯示 HPD 不僅是過擬合教師行為,而是轉移更通用的決策訊號。
6. 消融研究
如方程式 (14) 所形式化,HPD 包含兩個關鍵元件:(i) 允許學生採樣自己偏好的動作;(ii) 當不合理動作被抑制時強化專家 token。為解離各自貢獻,我們依序移除每個元件進行消融研究。值得注意的是,HPD 沒有引入額外超參數。
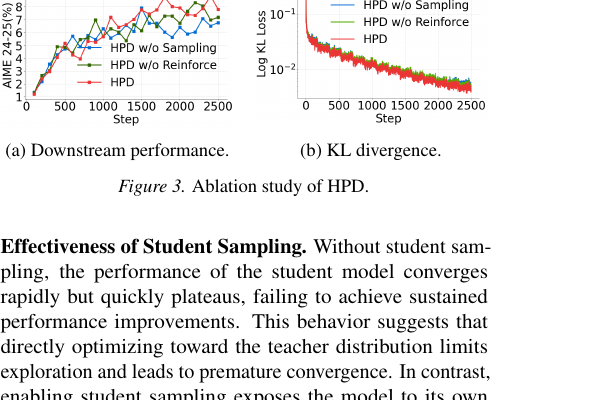
學生採樣的有效性 (Effectiveness of Student Sampling)。 沒有學生採樣時,學生模型的效能迅速收斂但很快達到平台期,無法獲得持續的效能提升。此行為表明,直接朝教師分佈優化會限制探索並導致過早收斂。相對地,啟用學生採樣使模型暴露於自身誘發的分佈,允許探索多元軌跡並持續精煉策略,產生穩定的效能增益。
Reinforce 操作的必要性。 如圖 3 所示,移除 Reinforce 操作會減慢 KL 損失下降。透過在不合理動作被抑制時明確增加專家 token 的機率,Reinforce 操作提供更穩定的優化訊號,加速與教師分佈對齊,產生一致的效能提升。
7. 更廣泛的影響
此外,我們展示 HPD 多元的應用範圍,證明其廣泛多功能性與未來使用潛力。
7.1. HPD + DPO 的補充結果
設定。 在偏好對齊框架下 (Ouyang et al., 2022),模型訓練通常分兩階段:SFT 與透過如 RLHF 或 DPO (Rafailov et al., 2023) 等方法進行的偏好微調。因此,初始階段同等關鍵。我們選取 SFT 與 RKLD 作為比較,並選 Qwen2.5-3B-Base 模型分析。詳細設定見附錄 J。
表 6. Qwen2.5-3B 上不同初始化方法的 DPO 階段結果 (AlpacaEval2 / Arena-Hard)。
| 方法 | AE-LC(%) | AE-WR(%) | Arena-WR(%) | Δ |
|---|---|---|---|---|
| $\mathcal{M}_T$ | 18.46 | 14.35 | 26.80 | – |
| SFT | 10.10 | 7.36 | 7.20 | – |
| ↪ + DPO | 10.42 | 9.27 | 10.40 | +1.81 |
| RKLD | 11.13 | 9.35 | 13.80 | +3.21 |
| ↪ + DPO | 15.45 | 16.78 | 21.80 | +9.74 |
| HPD | 13.78 | 10.88 | 15.80 | +5.27 |
| ↪ + DPO | 17.68 | 13.82 | 25.10 | +11.92 |
結果。 如表 6 所示,HPD 為後續優化奠定基礎,建構強小型模型。由於 HPD 在不引發 entropy 崩塌的情況下將學生與教師分佈對齊,較有助於後續對齊階段 (Xiao, 2024)。我們的方法達到可與教師模型相比的效能。
7.2. 迭代式自蒸餾演進
設定。 我們交替進行 DPO 訓練與自蒸餾,其中教師為前一階段 DPO 得到的模型。整個訓練過程中,我們保留原始 SFT 資料集,這與一些以 DPO 訓練模型生成的回應替代 SFT 資料的方法不同 (GLM, 2025)。訓練流程見圖 4。
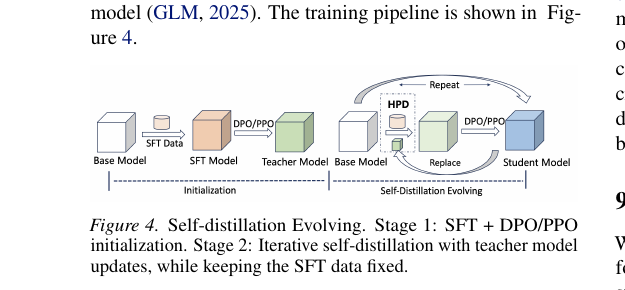
表 7. 迭代更新教師後的 DPO 階段結果 (AlpacaEval2 / Arena-Hard) (Qwen2.5-3B)。
| 方法 | AE-LC(%) | AE-WR(%) | Arena-WR(%) | Δ |
|---|---|---|---|---|
| SFT | 10.10 | 7.36 | 7.20 | – |
| ↪ + DPO | 10.42 | 9.27 | 10.40 | +1.81 |
| HPD-iter1 | 11.77 | 9.76 | 12.50 | +3.12 |
| ↪ + DPO | 13.67 | 13.83 | 16.30 | +6.38 |
| HPD-iter2 | 13.31 | 13.30 | 19.00 | +6.98 |
| ↪ + DPO | 14.06 | 13.82 | 20.60 | +7.94 |
結果。 如表 7 所示,HPD 能將教師模型效能轉移至基底模型而無效能下降。透過對 HPD 模型應用 DPO,對齊效能持續提升,產生可擴展的效能。隨著迭代週期增加,效能增益受限。它也進一步證明強到弱蒸餾作為起始模型的有效性。
8. 相關工作
離策略蒸餾 (Off-policy Distillation)。 KD (Hinton et al., 2015) 有效壓縮神經網路,使較小的學生模型能匹配較大教師模型的效能。LLMs KD 的一個熱門方向是直接利用教師生成作為 SFT 資料 (Zhu et al., 2026)。當教師模型可存取時,可利用散度損失對齊學生與教師分佈。近期研究 (Wang et al., 2025; Wen et al., 2023) 聚焦於尋找適當目標以改進離策略蒸餾。Wen et al. (2023) 在自迴歸 LM 中檢視多種 f-divergence,包括 total variation distance 與 JSD。Wu et al. (2025) 也提供自適應 KL 以平衡 FKLD 與 RKLD 的早期階段行為。Wang et al. (2025) 以 $\alpha$-$\beta$ 散度形式化 KD,能對教師與學生分佈間的機率質量分配進行原則性控制。
在策略蒸餾 (On-policy Distillation)。 OPD 鼓勵學生聚焦於教師分佈中有限的模式集合。MiniLLM (Gu et al., 2023) 與 GKD (Agarwal et al., 2024) 皆利用 RKLD 或 JSD 緩解學生模型對教師低機率區域的過度估計傾向。DistillLM-2 (Ko et al., 2025) 提出對比蒸餾形式化,同時提升教師生成回應的似然並降低學生生成回應的似然,利用離策略與在策略資料。
9. 結論
我們提出了 LLMs KD 的統一重新加權對數似然觀點,闡明散度方向、優化策略與資料機制如何共同決定蒸餾行為。我們進而提出 HPD,將前向與反向 KL 訊號結合於離策略資料與輕量級 token 層級在策略採樣。在推理、對話與程式碼任務上的實驗展示了 HPD 的強效能。未來工作可探索將 HPD 應用於訓練的更早階段,例如中段訓練或預訓練,以評估其對 LLMs 的潛在效益。
Impact Statement
本論文呈現旨在推進機器學習領域、特別是 LLMs 效率與效能的工作。我們工作的潛在社會後果有許多,但我們認為無一在此特別強調。
附錄
A. 我們工作的定位
我們的工作聚焦於使用離策略資料的蒸餾,並輔以一種輕量級的線上下一個 token 採樣近似,避免完整序列 rollout。雖然我們承認完整 rollout(如 OPD (Lu & Lab, 2025) 或強化學習 (RL) (Schulman et al., 2017; Shao et al., 2024) 中所用)對於進一步提升蒸餾模型效能是必要的,但我們的方法旨在為後續訓練提供更穩健且高效的初始化,且在某些情況下,無需這些以 rollout 為基礎的方法即可達成強效能。
B. 限制
我們的工作侷限於教師與學生模型共用相同 tokenizer 的設定,這是白盒 KD 中常見的假設 (Jiao et al., 2020; Wang et al., 2025; Ko et al., 2024, 2025)。由於計算完整 KL 散度的不可行性,我們改採對應的估計器在 token 層級上提供蒸餾訊號。
B.1. $K_1$ 獎勵的梯度分析
本節中,我們研究 $K_1$ 作為獎勵訊號在梯度分析中的角色。令 $\tau = (s_1, a_1, s_2, a_2, \ldots, s_T, a_T)$ 為從學生策略 $q_\theta$ 採樣的軌跡,其中每個狀態 $s_t$ 對應前綴 $s_t = \mathbf{a}_{<t} = (a_1, \ldots, a_{t-1})$,$a_t \in \mathcal{V}$ 為步 $t$ 從有限詞彙 $\mathcal{V}$ 採樣的 token。令 $\widehat{\text{KL}}$ 表示 KL 散度的 MC 估計。
$$ \nabla_\theta \mathbb{E}_{\tau \sim q_\theta}[\widehat{\text{KL}}] = \nabla_\theta \sum_\tau q_\theta(\tau) \widehat{\text{KL}}(\tau) \tag{16} $$
$$ = \sum_\tau (\nabla_\theta \widehat{\text{KL}}(\tau)) q_\theta(\tau) + \sum_\tau \widehat{\text{KL}}(\tau) \nabla_\theta q_\theta(\tau) \tag{17} $$
$$ = \underbrace{\mathbb{E}_{\tau \sim q_\theta}\left[\sum_{t=1}^{T} \nabla_\theta \widehat{\text{KL}}_t\right]}_{\text{path-wise derivative}} + \underbrace{\mathbb{E}_{\tau \sim q_\theta}\left[\left(\sum_{t=1}^{T} \widehat{\text{KL}}_t\right) \nabla_\theta \log q_\theta(\tau)\right]}_{\text{score function derivative}}. \tag{18} $$
此處,path-wise derivative 對應將估計器直接反向傳播至損失中,而 score function derivative 對應將估計器視為獎勵訊號。我們採用方程式 (8) 中 $N = 1$ 定義的 $K_1$ 估計器:
$$ K_1 \triangleq \sum_{t=1}^{T} \log \frac{q_\theta(a_t \mid s_t)}{p(a_t \mid s_t)}, \quad a_t \sim q_\theta(\cdot \mid s_t), $$
其 path-wise derivative 為 $\mathbb{E}_{\tau \sim q_\theta}\left[\nabla_\theta \sum_t^T K_{1t}\right] = 0$,其 score function derivative 為:
$$ \mathbb{E}_{\tau \sim q_\theta}\left[\left(\sum_{t=1}^{T} K_{1t}\right) \cdot \nabla_\theta \log q_\theta(\tau)\right] = \mathbb{E}_{\tau \sim q_\theta}\left[\log \frac{q_\theta(\tau)}{p(\tau)} \cdot \nabla_\theta \log q_\theta(\tau)\right]. \tag{19} $$
因此,將 $K_1$ 估計器作為獎勵納入時,可提供 KLD 目標梯度的不偏估計,而直接將 $K_1$ 用於損失則否。
C. Jensen-Shannon 散度的梯度
令 $p(a_t \mid s_t)$ 與 $q_\theta(a_t \mid s_t)$ 為給定狀態 $s_t$ 下,教師與學生對 token $a_t \in \mathcal{V}$ 的分佈。Jensen-Shannon 散度 (JSD) 定義為:
$$ \text{JSD}(p \| q_\theta) = \frac{1}{2}\mathbb{D}_{\text{KL}}(p \| M) + \frac{1}{2}\mathbb{D}_{\text{KL}}(q_\theta \| M), \quad M(a_t \mid s_t) = \frac{p(a_t \mid s_t) + q_\theta(a_t \mid s_t)}{2}. $$
對離散分佈,JSD 可寫作:
$$ \text{JSD}(p \| q_\theta) = \frac{1}{2} \sum_{a_t} p(a_t \mid s_t) \log \frac{p(a_t \mid s_t)}{M(a_t \mid s_t)} + \frac{1}{2} \sum_{a_t} q_\theta(a_t \mid s_t) \log \frac{q_\theta(a_t \mid s_t)}{M(a_t \mid s_t)}. $$
對 $\theta$ 的梯度只取決於第二項,因第一項不涉及 $\theta$:
$$ \begin{aligned} \nabla_\theta \text{JSD}(p \| q_\theta) &= \frac{1}{2} \sum_{a_t} \nabla_\theta q_\theta(a_t \mid s_t) \log \frac{q_\theta(a_t \mid s_t)}{M(a_t \mid s_t)} \\ &= \sum_{a_t} q_\theta(a_t \mid s_t) \nabla_\theta \log q_\theta(a_t \mid s_t) \cdot \underbrace{\frac{1}{2}\log \frac{q_\theta(a_t \mid s_t)}{M(a_t \mid s_t)}}_{w_{\text{JSD}}(a_t \mid s_t)} \\ &= \mathbb{E}_{a_t \sim q_\theta(\cdot \mid s_t)}\left[\nabla_\theta \log q_\theta(a_t \mid s_t) \cdot w_{\text{JSD}}(a_t \mid s_t)\right]. \end{aligned} $$
此處 $w_{\text{JSD}}(a_t \mid s_t) = \frac{1}{2} \log \frac{q_\theta(a_t \mid s_t)}{M(a_t \mid s_t)}$ 可解讀為 token 層級權重,類似 SFT、FKLD 與 RKLD 中的獎勵權重。
D. 梯度貢獻
採樣 token $a_t$ 上方程式 (9) 的合成梯度可表為:
$$ -\frac{\partial \mathcal{L}(\theta)}{\partial z_v} \propto \begin{cases} \hat{w}_t \cdot q_v \cdot (1 - q_v), & \text{若 } v = a_t, \\ -\hat{w}_t \cdot q_{a_t} \cdot q_v, & \text{若 } v \neq a_t, \end{cases} \tag{20} $$
其中 $z_v$ 表 token $v$ 的 logit,$\hat{w}_t$ 為 $w(a_t \mid s_t)$ 的縮寫。
證明。 對 $z_v$ 計算梯度,套用鏈式法則:
$$ \frac{\partial \mathcal{L}_t}{\partial z_v} = \frac{\partial \mathcal{L}_t}{\partial q_{a_t}} \cdot \frac{\partial q_{a_t}}{\partial z_v}. \tag{21} $$
由於
$$ \frac{\partial \mathcal{L}_t}{\partial q_{a_t}} = -\hat{w}_t \frac{1}{q_{a_t}}, \tag{22} $$
剩下計算 softmax 函數的導數。我們考量兩種情況。
Case 1: $v = a_t$。 用商法則:
$$ \frac{\partial q_{a_t}}{\partial z_{a_t}} = \frac{\partial}{\partial z_{a_t}}\left(\frac{e^{z_{a_t}}}{\sum_k e^{z_k}}\right) = \frac{e^{z_{a_t}} \sum_k e^{z_k} - e^{z_{a_t}} e^{z_{a_t}}}{(\sum_k e^{z_k})^2}. \tag{23} $$
簡化得:
$$ \frac{\partial q_{a_t}}{\partial z_{a_t}} = q_{a_t}(1 - q_{a_t}). \tag{24} $$
代回:
$$ \frac{\partial \mathcal{L}_t}{\partial z_{a_t}} = -\hat{w}_t (1 - q_{a_t}), \tag{25} $$
因此
$$ -\frac{\partial \mathcal{L}_t}{\partial z_{a_t}} \propto \hat{w}_t q_{a_t}(1 - q_{a_t}). \tag{26} $$
Case 2: $v \neq a_t$。 同樣:
$$ \frac{\partial q_{a_t}}{\partial z_v} = \frac{\partial}{\partial z_v}\left(\frac{e^{z_{a_t}}}{\sum_k e^{z_k}}\right) = -\frac{e^{z_{a_t}} e^{z_v}}{(\sum_k e^{z_k})^2}. \tag{27} $$
以 softmax 機率改寫:
$$ \frac{\partial q_{a_t}}{\partial z_v} = -q_{a_t} q_v. \tag{28} $$
因此:
$$ \frac{\partial \mathcal{L}_t}{\partial z_v} = \hat{w}_t q_v, \tag{29} $$
等價地,
$$ -\frac{\partial \mathcal{L}_t}{\partial z_v} \propto -\hat{w}_t q_{a_t} q_v, \quad v \neq a_t. \tag{30} $$
合併兩種情況得方程式 (20) 的梯度表達式。$\square$
E. 基線
這裡我們呈現多個基線:
- SFT 是學生模型在固定資料集上使用真實標籤的監督微調(採用預定義的輸入—輸出配對)。
- KD (Hinton et al., 2015) 訓練學生分佈在固定資料集上模仿教師分佈,使用 FKLD。
- SeqKD (Kim & Rush, 2016) 最大化教師生成的高機率序列的似然,可視為對教師生成輸出的 SFT。
- RKLD。 MiniLLM (Gu et al., 2023) 對學生生成資料進行蒸餾,使用在策略方法最小化教師與學生分佈間的 RKLD。相對地,我們在 5.1 至 5.3 節將此目標延伸至離策略設定,並在 5.4 節額外提供在策略實驗。
- JSD。 GKD (Agarwal et al., 2024) 使用廣義 Jensen-Shannon 散度 ($\mathbb{D}_{\text{JSD}(\beta)}(p \| q_\theta) = \beta \mathbb{D}(p \| \beta p + (1 - \beta) q_\theta) + (1 - \beta) \mathbb{D}(q_\theta \| \beta p + (1 - \beta) q_\theta)$),在資料集混合上訓練,可為教師生成、真實或在策略學生生成序列。我們在 5.1 節對真實資料、5.2 與 5.3 節對教師生成資料、5.4 節在策略設定下執行 GKD。
F. 推理任務的離策略資料
F.1. 學習率
我們使用 5.1 節描述的 40k 資料對相應基底模型微調 10 epoch。基底模型與初始學習率列於表 8。我們採用 cosine decay 學習率排程器,將學習率逐步降至初始的十分之一。最大上下文長度為 10240 token,批次大小為 256。
表 8. 學習率配置
| 模型 | 初始學習率 | min_lr_ratio |
|---|---|---|
| Qwen2.5-1.5B | $1 \times 10^{-4}$ | 0.1 |
| Qwen2.5-3B | $8 \times 10^{-5}$ | 0.1 |
| Llama3.2-1B | $8 \times 10^{-5}$ | 0.1 |
| Llama3.2-3B | $5 \times 10^{-5}$ | 0.1 |
F.2. 教師模型
我們選 Qwen-2.5-7B 與 Llama-3.1-8B 模型在 OpenR1-Math-8192 資料集 (Face, 2025) 上執行 SFT 學習,並使用 DAPO (Yu et al., 2025) 搭配穩定化 GPPO 變體的 clip-higher 值 0.28。RL 訓練使用 DAPO-MATH-17k 資料集,採用 verl 框架的詳細訓練配置 (Sheng et al., 2024):
表 9. RL 實驗配置
| Config | RL |
|---|---|
| lr | 1e-6 |
| kl_coef | 0.0 |
| max_prompt_length | 2k |
| max_response_length | 10k 0k |
| overlong_buffer.len | 2k |
| train_batch_size | 256 |
| ppo_mini_batch_size | 32 |
| clip_ratio_low | 0.2 |
| clip_ratio_high | 0.28 |
| temperature | 1.0 |
| rollout.n | 8 |
| total_training_steps | 100 |
由於 RL 主要微調 LLMs 內的小子網路 (Mukherjee et al., 2025) 並引發相對小的 KL 偏差 (Shenfeld et al., 2025),可進一步改善教師模型效能。
F.3. 評估基準
(i) 領域內任務: AIME24、AIME25、AMC、MATH-500 (Hendrycks et al., 2021) 與 OlympidBench (He et al., 2024)。
(ii) 領域外任務: GPQA (Rein et al., 2024)。
對所有評估,我們以最大序列長度 10,240 生成回應,採 top-$p$ 採樣 0.95 與溫度 0.7。
G. 個人化的離策略資料
G.1. 學習率
我們在 UltraFeedback 資料集 (Cui et al., 2023) 上對相應基底模型微調 10 epoch,包含 4,096-token 教師生成資料,如 5.2 節所述。我們使用學習率 $5 \times 10^{-6}$、最大上下文長度 4,096、批次大小 256。
G.2. 評估基準
我們在三個對齊基準上評估模型:MT-Bench (Zheng et al., 2024a)、AlpacaEval (Dubois et al., 2024) 與 Arena-Hard (Li et al., 2024)。我們以 Qwen3-30B-A3-Instruct-2507 (Yang et al., 2025) 作為評審模型提供對齊評估。
對所有評估,我們以最大序列長度 4,096、top-$p$ 採樣 $p = 0.95$ 與溫度 0.7 生成回應。LLM-as-a-Judge 評估設溫度為 0.0。
H. 程式碼任務的離策略資料
H.1. 學習率
我們在 WizardCode 資料集 (Luo et al., 2024) 上對相應基底模型微調 10 epoch,包含 4,096-token 教師生成資料 (5.3 節)。Qwen 與 DeepSeek 模型皆使用學習率 $5 \times 10^{-6}$、最大上下文長度 4,096、批次大小 256。
I. 推理任務的在策略資料
Qwen 與 LLaMA 皆使用學習率 $3 \times 10^{-6}$,搭配在策略學生 rollout,評估按照 F.3 節所述進行。我們使用訓練批次大小 256,對應 64 個 prompt,每個 prompt 重複 rollout 4 次,遵循 (Lu & Lab, 2025) 相同設定。
J. 更廣泛影響
於第 7 節,我們選 Qwen2.5-7B-Base 模型作教師。我們先 SFT 所有基底模型,並使用 DPO 演算法 (Rafailov et al., 2023) 在 LLama-Factory (Zheng et al., 2024b) 中實作對齊模型。DPO 詳細訓練配置匯總於表 10。
表 10. DPO 實驗配置
| 方法 | Train batch size | $\beta$ | Learning rate | Train epochs | Cutoff_len |
|---|---|---|---|---|---|
| DPO | 64 | 0.01 | 5e-7 | 1 | 4k |
J.1. 系統提示
對於推理任務,我們使用以下系統提示:Please reason step by step, and put your final answer within \boxed{}.。對於對齊任務與程式碼任務,我們使用以下系統提示:You are a helpful assistant.。
K. 案例研究
從 UltraFeedback 採樣的 prefix,我們以教師模型與蒸餾學生模型透過 greedy decoding 生成回應。下方展示代表性案例。我們以以下提示給模型:Could you recommend a hotel in Istanbul with a rooftop pool and bar for relaxation?
Teacher: Qwen2.5-7B-Instruct
Certainly! In Istanbul, one of the hotels that offers a rooftop pool and bar where you can relax while enjoying panoramic views is the Park Hyatt Istanbul.
Park Hyatt Istanbul:
- Location: The hotel is located in the heart of Istanbul, near Tophane Square and the Bosphorus.
- Rooftop Facilities:
- Pool: The hotel features an adults-only infinity pool on its rooftop, offering stunning views of the city and the Bosphorus.
- Bar: The rooftop bar, named "Tophane Bar," provides a perfect spot to unwind with cocktails while taking in the breathtaking views.
- Additional Amenities:
- Spa and wellness center
- Multiple dining options including Turkish cuisine, Italian restaurant, and a gourmet food hall
- Fitness center
- Concierge services
This hotel is highly recommended for its luxurious accommodations, exceptional service, and the unique feature of its rooftop pool and bar...
Student: Qwen2.5-1.5B-SFT
Certainly! One highly recommended hotel in Istanbul that offers a rooftop pool and bar is the Park Hyatt Istanbul.
Park Hyatt Istanbul:
- Location: Istiklal Avenue, Sultanahmet, Istanbul, Turkey
- Rooftop Pool & Bar: The hotel features an expansive rooftop garden with a stunning infinity pool...
Student: Qwen2.5-1.5B-KD
Certainly! One highly recommended hotel in Istanbul that offers a rooftop pool and bar is the Park Hyatt Istanbul.
Park Hyatt Istanbul:
- Location: Located in the heart of Istanbul's Grand Bazaar district, this luxurious hotel provides easy access to the city's vibrant attractions.
- Rooftop Pool & Bar: The hotel features an expansive rooftop pool with stunning views of the city skyline...
Student: Qwen2.5-1.5B-HPD
Certainly! One highly recommended hotel in Istanbul with a rooftop pool and bar is the Park Hyatt Istanbul. This luxurious hotel offers stunning views of the Bosphorus Strait from its rooftop pool area, which provides guests with a perfect spot to relax and enjoy the city skyline.
Key Features:
- Rooftop Pool: The hotel's rooftop pool offers breathtaking views and is a great place to unwind after a day exploring Istanbul.
- Bar: The bar on the rooftop also serves as a vibrant social hub where you can enjoy drinks and snacks while taking in the panoramic views.
- Luxury Amenities: The hotel itself is known for its high-end amenities, including 24-hour room service, a spa, and multiple dining options.
Location: The Park Hyatt Istanbul is conveniently located near key attractions such as the Hagia Sophia, Topkapi Palace, and the Grand Bazaar...
Student: Qwen2.5-1.5B-JSD
Certainly! One highly recommended hotel in Istanbul with an excellent rooftop pool and bar is the Four Seasons Hotel Istanbul...
Student: Qwen2.5-1.5B-RKLD
Certainly! One highly recommended hotel in Istanbul with a rooftop pool and bar is the Park Hyatt Istanbul...
Other Options:
- Istiklal Avenue Hotel:...
- Grand Hyatt Istanbul:...
- Marmara Hotel:...
分析。 如上所示,採用 SFT、KD、HPD 與 RKLD 的蒸餾方法皆推薦 Park Hyatt Istanbul。相對地,JSD 給出了不同的推薦。值得注意的是,RKLD 除了推薦單一飯店外,還列出了替代選項。整體而言,HPD 傾向提供更詳細的資訊,其回應包含貼心的問候,依不同使用者需求量身訂做,類似教師模型生成的回應。
參考文獻
Achiam, J., Adler, S., Agarwal, S., Ahmad, L., Akkaya, I., Aleman, F. L., Almeida, D., Altenschmidt, J., Altman, S., Anadkat, S., et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Agarwal, R., Vieillard, N., Zhou, Y., Stanczyk, P., Garea, S. R., Geist, M., and Bachem, O. On-policy distillation of language models: Learning from self-generated mistakes. In The Twelfth International Conference on Learning Representations, 2024.
Amini, A., Vieira, T., and Cotterell, R. Better estimation of the kullback–leibler divergence between language models. In The Thirty-ninth Annual Conference on Neural Information Processing Systems, 2025.
Austin, J., Odena, A., Nye, M., Bosma, M., Michalewski, H., Dohan, D., Jiang, E., Cai, C., Terry, M., Le, Q., et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
Binici, K., Pham, N. T., Mitra, T., and Leman, K. Preventing catastrophic forgetting and distribution mismatch in knowledge distillation via synthetic data. In Proceedings of the IEEE/CVF winter conference on applications of computer vision, pp. 663–671, 2022.
Brown, T., Mann, B., Ryder, N., Subbiah, M., Kaplan, J. D., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., et al. Language models are few-shot learners. Advances in neural information processing systems, 33: 1877–1901, 2020.
Chen, M. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
Cho, J. H. and Hariharan, B. On the efficacy of knowledge distillation. In Proceedings of the IEEE/CVF international conference on computer vision, pp. 4794–4802, 2019.
Cui, G., Yuan, L., Ding, N., Yao, G., Zhu, W., Ni, Y., Xie, G., Liu, Z., and Sun, M. Ultrafeedback: Boosting language models with high-quality feedback, 2023.
Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al-Dahle, A., Letman, A., Mathur, A., Schelten, A., Yang, A., Fan, A., et al. The llama 3 herd of models. arXiv e-prints, pp. arXiv–2407, 2024.
Dubois, Y., Galambosi, B., Liang, P., and Hashimoto, T. B. Length-controlled alpacaeval: A simple way to debias automatic evaluators. arXiv preprint arXiv:2404.04475, 2024.
Face, H. Open r1: A fully open reproduction of deepseek-r1, 2025. URL https://huggingface.co/blog/open-r1.
Gemma, Kamath, A., Ferret, J., Pathak, S., Vieillard, N., Merhej, R., Perrin, S., Matejovicova, T., Ramé, A., Rivière, M., et al. Gemma 3 technical report. arXiv preprint arXiv:2503.19786, 2025.
GLM. Glm-4.5: Agentic, reasoning, and coding (arc) foundation models, 2025. URL https://arxiv.org/abs/2508.06471.
Gu, Y., Dong, L., Wei, F., and Huang, M. Minillm: Knowledge distillation of large language models. arXiv preprint arXiv:2306.08543, 2023.
Guo, D., Zhu, Q., Yang, D., Xie, Z., Dong, K., Zhang, W., Chen, G., Bi, X., Wu, Y., Li, Y., et al. Deepseek-coder: When the large language model meets programming–the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., et al. Deepseek-r1 incentivizes reasoning in llms through reinforcement learning. Nature, 645(8081):633–638, 2025.
He, C., Luo, R., Bai, Y., Hu, S., Thai, Z. L., Shen, J., Hu, J., Han, X., Huang, Y., Zhang, Y., et al. Olympiadbench: A challenging benchmark for promoting agi with olympiad-level bilingual multimodal scientific problems. arXiv preprint arXiv:2402.14008, 2024.
Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., and Steinhardt, J. Measuring mathematical problem solving with the math dataset. arXiv preprint arXiv:2103.03874, 2021.
Hinton, G., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. arXiv preprint arXiv:1503.02531, 2015.
Hui, B., Yang, J., Cui, Z., Yang, J., Liu, D., Zhang, L., Liu, T., Zhang, J., Yu, B., Lu, K., et al. Qwen2. 5-coder technical report. arXiv preprint arXiv:2409.12186, 2024.
Jiao, X., Yin, Y., Shang, L., Jiang, X., Chen, X., Li, L., Wang, F., and Liu, Q. Tinybert: Distilling bert for natural language understanding. In Findings of the association for computational linguistics: EMNLP 2020, pp. 4163–4174, 2020.
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., and Amodei, D. Scaling laws for neural language models. arXiv preprint arXiv:2001.08361, 2020.
Kim, Y. and Rush, A. M. Sequence-level knowledge distillation. In Proceedings of the 2016 conference on empirical methods in natural language processing, pp. 1317–1327, 2016.
Ko, J., Kim, S., Chen, T., and Yun, S.-Y. Distillm: Towards streamlined distillation for large language models. arXiv preprint arXiv:2402.03898, 2024.
Ko, J., Chen, T., Kim, S., Ding, T., Liang, L., Zharkov, I., and Yun, S.-Y. DistiLLM-2: A contrastive approach boosts the distillation of LLMs. In Forty-second International Conference on Machine Learning, 2025. URL https://openreview.net/forum?id=rc65N9xIrY.
Li, T., Chiang, W.-L., Frick, E., Dunlap, L., Wu, T., Zhu, B., Gonzalez, J. E., and Stoica, I. From crowdsourced data to high-quality benchmarks: Arena-hard and benchbuilder pipeline. arXiv preprint arXiv:2406.11939, 2024.
Liu, J., Xia, C. S., Wang, Y., and Zhang, L. Is your code generated by chatGPT really correct? rigorous evaluation of large language models for code generation. In Thirty-seventh Conference on Neural Information Processing Systems, 2023. URL https://openreview.net/forum?id=1qvx610Cu7.
Lu, K. and Lab, T. M. On-policy distillation. Thinking Machines Lab: Connectionism, 2025. doi: 10.64434/tml.20251026. https://thinkingmachines.ai/blog/on-policy-distillation.
Luo, Z., Xu, C., Zhao, P., Sun, Q., Geng, X., Hu, W., Tao, C., Ma, J., Lin, Q., and Jiang, D. Wizardcoder: Empowering code large language models with evol-instruct. In The Twelfth International Conference on Learning Representations, 2024. URL https://openreview.net/forum?id=UnUwSIgK5W.
Mirzadeh, S. I., Farajtabar, M., Li, A., Levine, N., Matsukawa, A., and Ghasemzadeh, H. Improved knowledge distillation via teacher assistant. In Proceedings of the AAAI conference on artificial intelligence, volume 34, pp. 5191–5198, 2020.
Mukherjee, S., Yuan, L., Hakkani-Tur, D., and Peng, H. Reinforcement learning finetunes small subnetworks in large language models. arXiv preprint arXiv:2505.11711, 2025.
Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., Zhang, C., Agarwal, S., Slama, K., Ray, A., et al. Training language models to follow instructions with human feedback. Advances in neural information processing systems, 35:27730–27744, 2022.
Rafailov, R., Sharma, A., Mitchell, E., Manning, C. D., Ermon, S., and Finn, C. Direct preference optimization: Your language model is secretly a reward model. In Thirty-seventh Conference on Neural Information Processing Systems, 2023. URL https://openreview.net/forum?id=HPuSIXJaa9.
Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J., and Bowman, S. R. Gpqa: A graduate-level google-proof q&a benchmark. In First Conference on Language Modeling, 2024.
Schulman, J. Approximating kl divergence. http://joschu.net/blog/kl-approx.html, 2020. Accessed: 2025-12-23.
Schulman, J., Wolski, F., Dhariwal, P., Radford, A., and Klimov, O. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
Shah, V., Obando-Ceron, J., Jain, V., Bartoldson, B., Kailkhura, B., Mittal, S., Berseth, G., Castro, P. S., Bengio, Y., Malkin, N., et al. A comedy of estimators: On kl regularization in rl training of llms. arXiv preprint arXiv:2512.21852, 2025.
Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., Bi, X., Zhang, H., Zhang, M., Li, Y., Wu, Y., et al. Deepseekmath: Pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
Shenfeld, I., Pari, J., and Agrawal, P. Rl's razor: Why online reinforcement learning forgets less. arXiv preprint arXiv:2509.04259, 2025.
Sheng, G., Zhang, C., Ye, Z., Wu, X., Zhang, W., Zhang, R., Peng, Y., Lin, H., and Wu, C. Hybridflow: A flexible and efficient rlhf framework. arXiv preprint arXiv: 2409.19256, 2024.
Song, K., Sun, H., Tan, X., Qin, T., Lu, J., Liu, H., and Liu, T.-Y. Lightpaff: A two-stage distillation framework for pre-training and fine-tuning. arXiv preprint arXiv:2004.12817, 2020.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., and Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Wang, G., Yang, Z., Wang, Z., Wang, S., Xu, Q., and Huang, Q. ABKD: Pursuing a proper allocation of the probability mass in knowledge distillation via $\alpha$-$\beta$-divergence. In Forty-second International Conference on Machine Learning, 2025. URL https://openreview.net/forum?id=vt65VjJakt.
Wang, Y., Kordi, Y., Mishra, S., Liu, A., Smith, N. A., Khashabi, D., and Hajishirzi, H. Self-instruct: Aligning language models with self-generated instructions. In Proceedings of the 61st annual meeting of the association for computational linguistics (volume 1: long papers), pp. 13484–13508, 2023.
Wen, Y., Li, Z., Du, W., and Mou, L. F-divergence minimization for sequence-level knowledge distillation. arXiv preprint arXiv:2307.15190, 2023.
Wu, T., Tao, C., Wang, J., Yang, R., Zhao, Z., and Wong, N. Rethinking kullback-leibler divergence in knowledge distillation for large language models. In Proceedings of the 31st International Conference on Computational Linguistics, pp. 5737–5755, 2025.
Xiao, L. Rethinking conventional wisdom in machine learning: From generalization to scaling. arXiv preprint arXiv:2409.15156, 2024.
Yang, A., Li, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Gao, C., Huang, C., Lv, C., et al. Qwen3 technical report. arXiv preprint arXiv:2505.09388, 2025.
Yu, Q., Zhang, Z., Zhu, R., Yuan, Y., Zuo, X., Yue, Y., Dai, W., Fan, T., Liu, G., Liu, L., et al. Dapo: An open-source llm reinforcement learning system at scale. arXiv preprint arXiv:2503.14476, 2025.
Zhang, Y., Liu, Y., Yuan, H., Yuan, Y., Gu, Q., and Yao, A. C.-C. On the design of kl-regularized policy gradient algorithms for llm reasoning. arXiv preprint arXiv:2505.17508, 2025.
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E., et al. Judging llm-as-a-judge with mt-bench and chatbot arena. Advances in Neural Information Processing Systems, 36, 2024a.
Zheng, Y., Zhang, R., Zhang, J., Ye, Y., Luo, Z., Feng, Z., and Ma, Y. Llamafactory: Unified efficient fine-tuning of 100+ language models. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 3: System Demonstrations), Bangkok, Thailand, 2024b. Association for Computational Linguistics. URL http://arxiv.org/abs/2403.13372.
Zhu, W., Hao, H., He, Z., Ai, Y., and Wang, R. Improving open-ended text generation via adaptive decoding. In Forty-first International Conference on Machine Learning, 2024. URL https://openreview.net/forum?id=aXD94eAttT.
Zhu, W., Xie, R., Wang, R., Sun, X., Wang, D., and Liu, P. Proximal supervised fine-tuning. In The Fourteenth International Conference on Learning Representations, 2026. URL https://openreview.net/forum?id=hQtwQqYikp.
術語對照表
| 英文 | 中文 |
|---|---|
| Knowledge Distillation (KD) | 知識蒸餾 |
| Large Language Models (LLMs) | 大型語言模型 |
| Hybrid Policy Distillation (HPD) | 混合策略蒸餾 |
| Supervised Fine-Tuning (SFT) | 監督微調 |
| Forward KL (FKLD) | 前向 KL 散度 |
| Reverse KL (RKLD) | 反向 KL 散度 |
| Kullback–Leibler divergence (KLD) | Kullback–Leibler 散度 |
| Jensen-Shannon Divergence (JSD) | Jensen-Shannon 散度 |
| f-divergence | f-散度 |
| total variation distance | 總變差距離 |
| divergence direction | 散度方向 |
| optimization strategy | 優化策略 |
| data regime | 資料機制 |
| reweighted log-likelihood | 重新加權對數似然 |
| token level | token 層級 |
| black-box | 黑盒 |
| white-box | 白盒 |
| mode coverage | 模式覆蓋 |
| mode-seeking | 模式尋找 |
| multimodality | 多模性 |
| label smoothing | 標籤平滑 |
| on-policy | 在策略 |
| off-policy | 離策略 |
| On-Policy Distillation (OPD) | 在策略蒸餾 |
| rollout | rollout |
| auto-regressive | 自迴歸 |
| teacher forcing | 教師強制 |
| cross-entropy loss | 交叉熵損失 |
| Monte Carlo (MC) | 蒙地卡羅 |
| chain-of-thought (CoT) | 思維鏈 |
| reward | 獎勵 |
| policy | 策略 |
| trajectory | 軌跡 |
| state | 狀態 |
| action | 動作 |
| logit | logit |
| softmax | softmax |
| gradient | 梯度 |
| unbiased estimator | 不偏估計器 |
| variance | 變異 |
| log-ratio | 對數比 |
| expert token | 專家 token |
| non-expert token | 非專家 token |
| masking | 遮罩 |
| reinforcement | 強化 |
| reward weighting | 獎勵加權 |
| Direct Preference Optimization (DPO) | 直接偏好優化 |
| Proximal Policy Optimization (PPO) | 近端策略優化 |
| GRPO | GRPO |
| RLHF | RLHF |
| Reinforcement Learning (RL) | 強化學習 |
| greedy decoding | 貪婪解碼 |
| top-$p$ sampling | top-$p$ 採樣 |
| temperature | 溫度 |
| cosine decay | cosine decay |
| epoch | epoch |
| batch size | 批次大小 |
| learning rate | 學習率 |
| context length | 上下文長度 |
| checkpoint | 檢查點 |
| benchmark | 基準 |
| in-domain | 領域內 |
| out-of-domain | 領域外 |
| pass@1 | pass@1 |
| LLM-as-a-Judge | LLM 作為評審 |
| infinity pool | 無邊際泳池 |
| entropy collapse | entropy 崩塌 |
| ablation study | 消融研究 |
| score function derivative | 評分函數導數 |
| path-wise derivative | 路徑導數 |
| chain rule | 鏈式法則 |
| quotient rule | 商法則 |
| tokenizer | tokenizer |
| self-distillation | 自蒸餾 |
| iterative | 迭代式 |
| preference alignment | 偏好對齊 |