思考增強預訓練 (Thinking Augmented Pre-training)
原始論文:Thinking Augmented Pre-training 作者:Liang Wang, Nan Yang, Shaohan Huang, Li Dong, Furu Wei arXiv ID:2509.20186v4 日期:2025-10-17 標籤:LLM Pre-training Reasoning Synthetic Data Data Augmentation Mid-training
摘要
本文提出一個簡潔且具可擴展性的方法,透過將既有文字資料以思考軌跡 (thinking trajectories) 進行擴增,來提升大型語言模型 (Large Language Model, LLM) 訓練的資料效率 (data efficiency)。隨著前沿模型對訓練資料規模的需求快速膨脹,網路上人類撰寫、自然產生的資料已大致被現有模型耗盡。我們觀察到:某些高價值的 token 之所以難以學習,是因為它們本質上是複雜、多步驟推理過程的結果。為此,我們提出 Thinking augmented Pre-Training (TPT):對每一份原始文件,使用一個開源 LLM 自動生成「思考軌跡」並附加在後,再以標準的下一個 token 預測 (next-token prediction) 目標進行訓練。
實驗顯示 TPT 將 LLM 預訓練的資料效率提升約 3 倍。在 100B token 規模下,使用 8B 參數從零開始預訓練的模型,在 GSM8k 與 MATH 等推理 benchmark 上的表現大幅優於 vanilla 基線;在中期訓練 (mid-training) 與監督式微調 (Supervised Fine-Tuning, SFT) 場景下亦觀察到一致的提升。
1. 引言
LLM 已在多個領域取得顯著成功,但其訓練極度仰賴大量資料。當前主流的開源模型動輒在超過 1 兆 (1T) token 的語料上訓練,且絕大多數來自網路爬蟲。這帶來一個根本性的瓶頸:網路上由人類撰寫、自然累積的資料是有限的,且已被現有前沿模型大致耗盡。在此情況下,僅靠堆疊更多原始 token 來提升模型能力的策略已逐漸觸頂。
更進一步地,我們觀察到並非所有 token 都同等容易學習。網路文本中存在許多「高價值但難以學習」的 token——它們是專家經由多步驟、複雜推理後寫下的最終結論,模型在訓練時僅看到結果而看不到過程,因此難以建立起對應的內部推理鏈。例如數學定理的證明結尾、物理推導的最終公式、程式設計中的關鍵抽象等,皆屬此類。
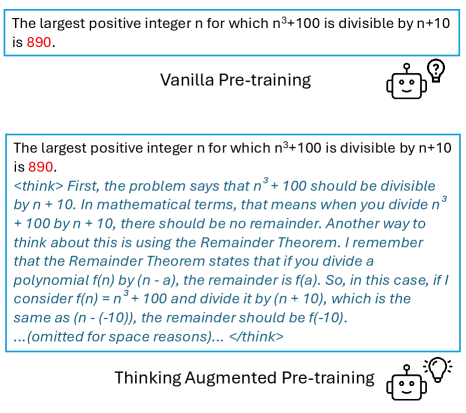
為解決此問題,我們提出 思考增強預訓練 (Thinking Augmented Pre-Training, TPT):在訓練每一份文件之前,先由一個開源 LLM 為其生成一段「思考軌跡」(thinking trajectory),將原始文件背後隱藏的推理過程明確展開出來,再將「原始文件 + 思考軌跡」作為一個訓練樣本,套用標準的下一個 token 預測損失。
此方法具備數項關鍵優勢:
- 可擴展性 (Scalability):完全不需要人工標註,僅需呼叫開源 LLM 即可大規模生成。
- 動態運算分配 (Dynamic Compute Allocation):推理密集的高價值內容(如數學、物理)會自然產生較長的思考軌跡,相當於對這些 token 進行隱式的上採樣 (up-sampling),類似於將測試時擴展 (test-time scaling) 提前到訓練階段。
- LLM 親和格式:思考軌跡本身即由 LLM 生成,格式天然適合語言模型學習。
- 資料效率提升 3 倍:在我們的實驗中,TPT 訓練的模型僅需 vanilla 訓練約 1/3 的 token 即可達到相同表現。
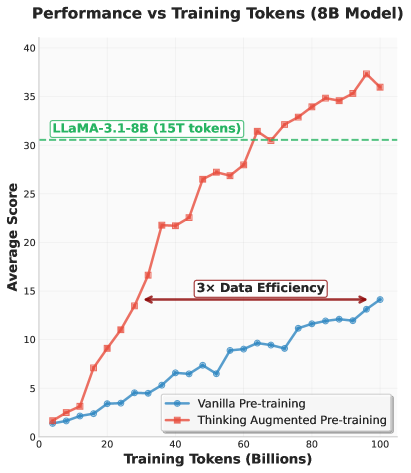
如 Figure 1 所示,在 GSM8k 與 MATH 上,TPT 模型的學習曲線在訓練早期即顯著超越 vanilla 基線,且兩條曲線之間的差距持續擴大。Figure 1(b) 則展示了一個典型的思考增強樣本格式:原始文件之後緊接著由生成器模型補上的詳細思考過程。
我們的主要貢獻如下:
- 提出 TPT,一個簡潔、可擴展、不需人工標註的預訓練資料擴增方法。
- 在從零預訓練、中期訓練與 SFT 三種場景下均驗證了 TPT 的有效性,最大規模達 100B 訓練 token、8B 模型參數。
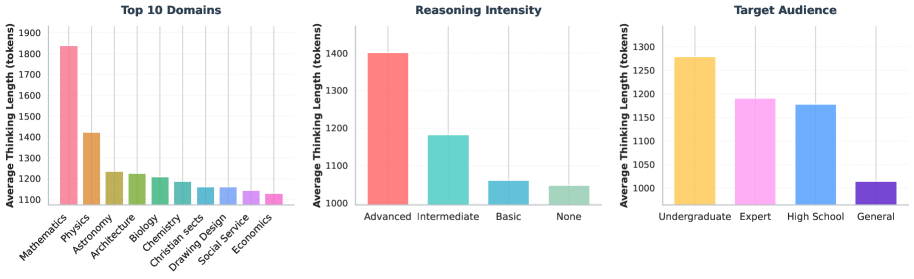
- 對思考軌跡的長度分布進行系統性分析,揭示其與領域 (domain)、推理強度 (reasoning intensity) 與目標讀者 (target audience) 之間的關聯,解釋 TPT 為何能自動聚焦於高價值資料。
- 進行廣泛的消融研究 (Ablation Study),包括思考軌跡生成方式、生成器模型大小、訓練 token 預算等。
2. 思考增強預訓練
2.1 方法概述
給定一份原始文件 $d$ 與一個用於生成思考軌跡的 LLM $\mathcal{M}_\text{gen}$,我們先以下列提示 (prompt) 對 $\mathcal{M}_\text{gen}$ 進行查詢,得到一段思考軌跡 $t$:
Simulate an expert's in-depth thought process as they analyze the above context, focusing on complex and informative aspects. Skip trivial details. Use Feynman technique whenever possible to ensure a deep understanding.
(模擬一位專家分析上述脈絡時的深度思考過程,聚焦於複雜且資訊量大的面向。略過瑣碎細節。盡可能採用費曼技巧 (Feynman technique) 以確保深入理解。)
接著將原始文件與思考軌跡串接成一個訓練樣本 $\langle d, t \rangle$,並對其套用標準的下一個 token 預測損失:
$$ \mathcal{L} = -\frac{1}{N} \sum_{i=1}^{N} \log p(x_i \mid x_{<i}) $$
其中 $x_i$ 是串接後序列的第 $i$ 個 token。
2.2 為何此方法有效
(1) 將隱式推理顯式化。 原始文件的作者(例如數學家、物理學家或工程師)在寫下結論之前已在腦中進行大量推理,但這些推理通常不會出現在文本中。對於以網路文本為主的訓練語料,模型只能看到「答案」而看不到「思路」,這對複雜 token 的學習極為不利。透過 $\mathcal{M}_\text{gen}$ 生成思考軌跡,我們相當於把這些隱含的推理步驟顯式化、補回語料中。
(2) 自動化的訓練運算分配。 推理密集的內容(例如一段數學證明)會自然引導 $\mathcal{M}_\text{gen}$ 產出較長的思考軌跡;瑣碎或低資訊密度的內容(例如一段廣告文字)則僅產出較短的思考軌跡。最終結果是:模型在訓練時對高價值內容投入更多運算量,而對低價值內容投入較少,無需任何顯式的品質過濾器即可達到類似資料重採樣 (data resampling) 的效果。
(3) 與測試時擴展類似的機制。 近年的測試時擴展 (test-time scaling) 研究顯示,允許模型在推論時生成更長的思考鏈可顯著提升其推理能力。TPT 將同一觀念前移到訓練階段:模型在訓練時即看見大量「題目 → 詳細思考 → 結論」的範例,從而在內部習得這種推理風格。
2.3 實作細節
我們採用 DeepSeek-R1-Distill-Qwen-7B(或在預訓練階段採用 Qwen3-8B)作為 $\mathcal{M}_\text{gen}$。輸入文件被截斷至最多 2k token,思考軌跡的最大生成長度為 8k token,溫度 (temperature) 設為 0.6,top-p 設為 0.9。整條資料管線生成 100B 訓練 token 約需 20k A100 GPU 小時。
3. 實驗
3.1 充足資料下的預訓練
設定。 我們從零開始預訓練兩個 8B 參數的 LLaMA-3 架構模型,分別採用 vanilla 下一個 token 預測與 TPT,各訓練 100B token。語料來自 FineWeb-Edu 與 MegaMath-Web-Pro-Max,於兩者之間做平衡權重採樣,並將文件打包 (pack) 為 8k token 一個樣本。批次大小 (batch size) 為 4M token,總步數約 25k 步,學習率 (learning rate) 為 3e-4,使用 Adam 最佳化器 ($\beta_1 = 0.9$, $\beta_2 = 0.95$)。訓練在 MI300 GPU 上進行,8B 模型 100B token 約需 1 週。
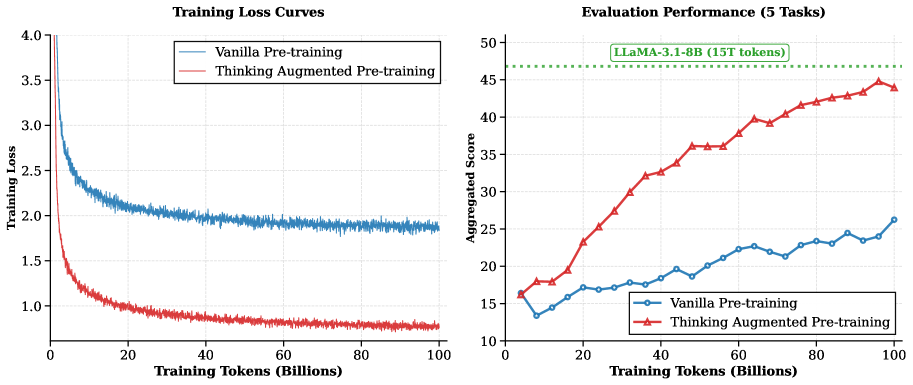
結果。 如 Figure 2 所示,TPT 在預訓練損失 (pre-training loss) 與 5 個 benchmark 的彙總分數上均顯著優於 vanilla 基線。值得注意的是,TPT 模型在 100B token 即可達到 LLaMA-3.1-8B(在 15T token 上預訓練)的 GSM8k 表現等級,顯示其資料效率約為 vanilla 訓練的 3 倍。具體而言,GSM8k 由 19.2% 提升至 50.1%,MATH 分數翻倍以上。
3.2 受限資料下的預訓練
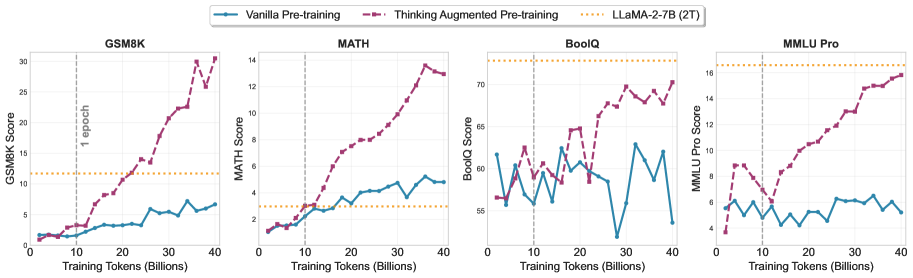
設定。 為驗證 TPT 在資料受限場景下的價值,我們將原始文件 token 隨機抽樣限制為 10B,並透過思考增強將總訓練 token 擴展至 40B。其餘超參數 (hyperparameter) 與 §3.1 相同。
結果。 如 Figure 3 所示,vanilla 訓練在 token 用盡後迅速進入 plateau;TPT 則因為每份文件都被擴增為更長的訓練序列,在受限的原始 token 預算下持續取得效能提升。此結果意味著 TPT 對於小語言、垂直領域或受版權限制等「資料受限」場景特別有用。
3.3 思考增強的中期訓練
我們進一步將 TPT 套用於既有開源模型的中期訓練 (mid-training) 階段。中期訓練介於預訓練與 SFT 之間,目的是強化模型的特定能力(例如推理)。
設定。 我們選用 Qwen2.5 與 LLaMA-3 系列、參數量介於 1.5B 至 7B 之間的多個 base 模型,於 100B 思考增強 token 上做中期訓練,學習率為 6e-5 至 3e-5。
結果。 如 Figure 4 所示,TPT 中期訓練在 MATH-500、AIME24、AIME25、HMMT、GPQA-Diamond、HumanEval、LiveCodeBench v4/v5、JEEBench 等 benchmark 上對所有模型均帶來一致的提升,尤其在數學與推理密集的任務上提升最為顯著。
4. 思考模式分析
我們從 essential-web-v1.0 資料集隨機抽樣 20k 份文件,利用該資料集附帶的中介資料 (metadata) 對思考軌跡的長度分布做系統性分析。如 Figure 4 所示,分析從三個維度切入:
- 領域 (Domain):Mathematics、Physics 等高價值領域明顯產生較長的思考軌跡;娛樂、商業等領域則較短。
- 推理強度 (Reasoning Intensity):Advanced Reasoning 群組的平均思考 token 數量比 No Reasoning 群組多約 50%。兩者之間呈現清楚的正相關。
- 目標讀者 (Target Audience):有趣的是,Expert 級內容反而比 Undergraduate 級內容產生較短的思考軌跡,可能因為專家級文件本身已足夠精煉,思考時不需展開太多前置脈絡。
此分析支持我們在 §2.2 提出的論點:TPT 自動聚焦於高價值資料——推理密集的內容會自然吸收更多訓練運算量,無需任何顯式的品質過濾器。
5. 消融研究
5.1 思考軌跡的生成方式
我們比較三種思考軌跡生成策略:
- Default:直接使用 §2.1 的提示。
- Customized back-thinking model:用一份附 think tag 的 SFT 資料集訓練一個專用的「反向思考」模型,能夠在看到答案後反推思考過程。
- Random focus point:在原始文件中隨機選取一個位置
<<<READING HERE>>>,要求生成器以「專家當下讀到此處」的視角生成思考。
結果(詳見原論文 Table 4)顯示替代方案僅帶來邊際改善,因此我們在主要實驗中保留最簡單、最易重現的 default 設定。
5.2 思考生成模型的規模
一個出乎意料的發現是:使用較小的 DeepSeek-R1-Distill-Qwen-1.5B 作為生成器,效果反而優於 7B 版本。此觀察與 OpenThoughts 等工作的結論一致——對於合成資料生成而言,更小但專注的模型有時反而能產生更穩定、風格更一致的軌跡。
5.3 中期訓練的 token 預算
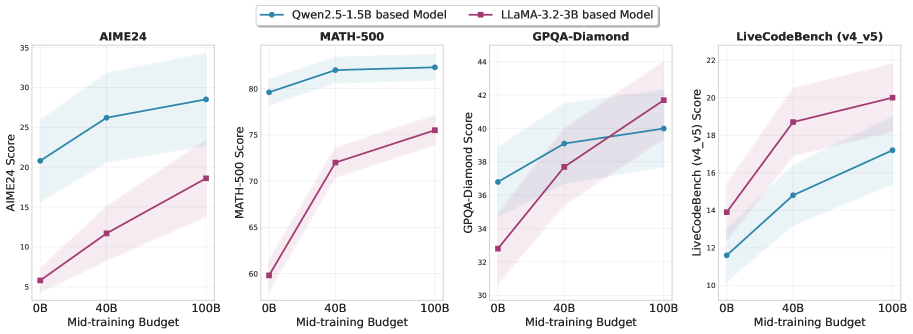
如 Figure 5 所示,從 0 到 100B token,下游任務分數持續提升,未觀察到任何收斂跡象。這暗示僅以 350k 樣本進行 SFT 並不足以充分激發模型的推理能力,思考增強中期訓練可在更大尺度上補足這個缺口。
5.4 SFT 資料規模
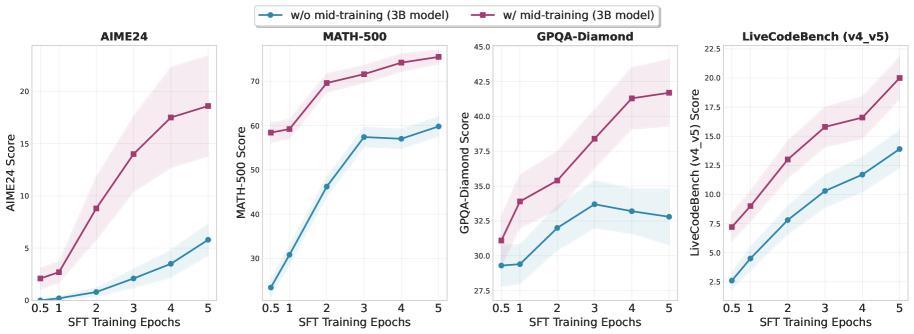
如 Figure 6 所示,將 SFT epoch 從 1 提升到 5,多數 benchmark 持續改善,且未出現嚴重的過擬合 (overfitting)。這與一般「SFT 過久會傷害泛化」的直覺不同,可能因為思考增強的中期訓練已經為模型建立穩固的推理先驗。
6. 相關工作
6.1 大規模預訓練的資料工程
當代 LLM 的成功高度依賴精細的資料工程:包括去重 (deduplication)、品質過濾 (quality filtering) 與合成資料 (synthetic data) 生成等。然而,網路上由人類撰寫、自然產生的資料是有限的,且已被現有前沿模型大致耗盡,這使合成資料的角色愈來愈關鍵。Phi 系列(Textbooks Are All You Need)展示了高品質教科書式合成資料的價值,而 Reasoning CPT 與 BoLT 等工作則嘗試「為文件補上隱藏思考」的方向。
與這些先前工作相比,本文有兩項關鍵差異:(1) 規模——我們將實驗推進到 100B 訓練 token,而 Reasoning CPT 與 BoLT 多在 150M–8B 規模驗證;(2) 方法簡潔性——TPT 不需要 EM 演算法或複雜的反向推理流程,僅需一個 LLM 與一段提示。
6.2 思考鏈推理
思考鏈 (Chain-of-Thought, CoT) 提示讓 LLM 在解題時先產生中介步驟,已被廣泛證實能引發其推理能力。OpenAI o1、DeepSeek-R1 等近期工作則進一步透過強化學習 (Reinforcement Learning, RL) 鼓勵模型生成更長的思考軌跡。TPT 與這些方法是互補而非競爭關係:CoT 與 R1 風格的 RL 著力於推論階段;TPT 則將「生成思考軌跡」這個操作前移到預訓練資料的層級,讓模型在最早的訓練階段就見到大量推理範例。
7. 結論
我們提出 Thinking augmented Pre-Training (TPT)——一個簡潔且具可擴展性的方法,透過將既有文字資料以自動生成的思考軌跡擴增,提升 LLM 預訓練的資料效率。在最高 100B 訓練 token 的實驗中,TPT 大幅提升資料效率與最終模型表現,並在不同模型規模、不同訓練設定下展現一致的增益,特別是在推理密集任務上提升尤為明顯。
未來方向包括:(1) 將 TPT 擴展到更大的訓練語料與模型規模;(2) 探索自動提示最佳化 (automatic prompt optimization) 以進一步提升思考軌跡的品質;(3) 將思考增強與其他資料合成技巧(例如多智能體討論 (multi-agent discussion))結合。
附錄 A
A.1 訓練細節
- 預訓練語料:FineWeb-Edu 與 MegaMath-Web-Pro-Max 的混合
- 資料打包:每樣本 8k token
- 思考生成:最大長度 8k token,溫度 0.6,top-p 0.9
- 資料管線運算量:100B 訓練 token 約需 20k A100 GPU 小時
- 生成器模型:預訓練階段使用 Qwen3-8B;中期訓練階段使用 DeepSeek-R1-Distill-Qwen-7B
A.2 評測細節
- Base 模型評測:MMLU、MMLUPro、BoolQ、GSM8k、MATH(few-shot prompt)
- 指令調整模型評測:MATH-500、AIME24、AIME25、HMMT、GPQA-Diamond、HumanEval、LiveCodeBench v4/v5、JEEBench 共 10 項
- 思考 token 上限:32k
A.3 提示模板
- Default:「Simulate an expert's in-depth thought process as they analyze the above context...」
- Random focus point variant:「An expert is focused at the
<<<READING HERE>>>position. Simulate the expert's in-depth thought process...」
A.4 額外結果
Vanilla 中期訓練(不使用思考增強)對多數 benchmark 影響甚微,反而在程式設計任務上出現顯著的退步。這進一步凸顯思考增強對中期訓練不可或缺。
A.5 範例
附錄列出三個生成思考軌跡的範例,分別來自數學、電腦科學理論與一般知識領域,展示生成器如何針對不同類型的內容自動調整思考的深度與風格。
A.6 LLM 使用聲明
LLMs were used solely to assist with the writing of this paper. No LLMs were involved in generating the research ideas or analyzing the results.
【譯註:本聲明說明作者僅使用 LLM 協助論文寫作,研究構想與結果分析皆由人類完成。】
參考文獻
- AI et al. (2025). Essential-web v1.0: 24T tokens of organized web data.
- Allen-Zhu, Z., & Li, Y. (2024). Physics of language models: Part 3.1, knowledge storage and extraction.
- Arora, D., et al. (2023). Have LLMs Advanced Enough? A Challenging Problem Solving Benchmark.
- Balunović, M., et al. (2025). MathArena: Evaluating LLMs on uncontaminated math competitions.
- Brown, T., et al. (2020). Language models are few-shot learners. NeurIPS.
- Chen, M., et al. (2021). Evaluating Large Language Models Trained on Code.
- Clark, C., et al. (2019). BoolQ: Exploring the surprising difficulty of natural yes/no questions. NAACL.
- Cobbe, K., et al. (2021). Training verifiers to solve math word problems (GSM8k).
- Dong, L., et al. (2025). Reinforcement pre-training.
- Dubey, A., et al. (2024). The LLaMA 3 herd of models.
- Guha, E., et al. (2025). OpenThoughts: Data Recipes for Reasoning Models.
- Gunasekar, S., et al. (2023). Textbooks Are All You Need.
- Guo, D., et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.
- Hendrycks, D., et al. (2020). Measuring Massive Multitask Language Understanding (MMLU).
- Hendrycks, D., et al. (2021). Measuring mathematical problem solving with the MATH dataset.
- HuggingFace (2025). Open R1: A fully open reproduction of DeepSeek-R1.
- Hurst, A., et al. (2024). GPT-4o System Card.
- Ishibashi, Y., et al. (2025). Mining Hidden Thoughts from Texts: Reasoning CPT.
- Jaech, A., et al. (2024). OpenAI o1 system card.
- Jain, N., et al. (2024). LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code.
- Kaplan, J., et al. (2020). Scaling laws for neural language models.
- Penedo, G., et al. (2024). FineWeb: Decanting the web for the finest text data.
- Qwen Team (2024). Qwen2.5 Technical Report.
- Qwen Team (2025). Qwen3 Technical Report.
- Wang, Y., et al. (2025). MegaMath: Pushing the limits of open math corpora.
- Wei, J., et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models.
- Yang, A., et al. (2024). Qwen2 Technical Report.
術語對照表
| 英文 | 中文 |
|---|---|
| Thinking Augmented Pre-training (TPT) | 思考增強預訓練 |
| Thinking Trajectory | 思考軌跡 |
| Large Language Model (LLM) | 大型語言模型 |
| Pre-training | 預訓練 |
| Mid-training | 中期訓練 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Reinforcement Learning (RL) | 強化學習 |
| Chain-of-Thought (CoT) | 思考鏈 |
| Next-token Prediction | 下一個 token 預測 |
| Data Efficiency | 資料效率 |
| Test-time Scaling | 測試時擴展 |
| Reasoning Intensity | 推理強度 |
| Target Audience | 目標讀者 |
| Domain | 領域 |
| Up-sampling | 上採樣 |
| Synthetic Data | 合成資料 |
| Deduplication | 去重 |
| Quality Filtering | 品質過濾 |
| Token Budget | token 預算 |
| Hyperparameter | 超參數 |
| Batch Size | 批次大小 |
| Learning Rate | 學習率 |
| Overfitting | 過擬合 |
| Plateau | 收斂高原(效能停滯) |
| Few-shot | 少樣本 |
| Pack | 打包(將多份短文件串接到固定長度) |
| Feynman Technique | 費曼技巧 |
| Multi-agent Discussion | 多智能體討論 |
| Automatic Prompt Optimization | 自動提示最佳化 |
| Prompt | 提示 |
| Metadata | 中介資料 |