OpenThoughts:推理模型的資料配方
原始論文:OpenThoughts: Data Recipes for Reasoning Models 作者:Etash Guha, et al. arXiv ID:2506.04178v2 日期:2025-06-05 標籤:LLM Reasoning Data Recipe SFT Open Dataset Distillation Benchmark
目錄
- 1. 引言
- 2. 相關工作
- 3. OpenThoughts 專案
- 4. OpenThoughts3 資料管線
- 5. 將管線擴展至 OpenThoughts3-1.2M
- 6. 結論
- 參考文獻
- 術語對照表
摘要
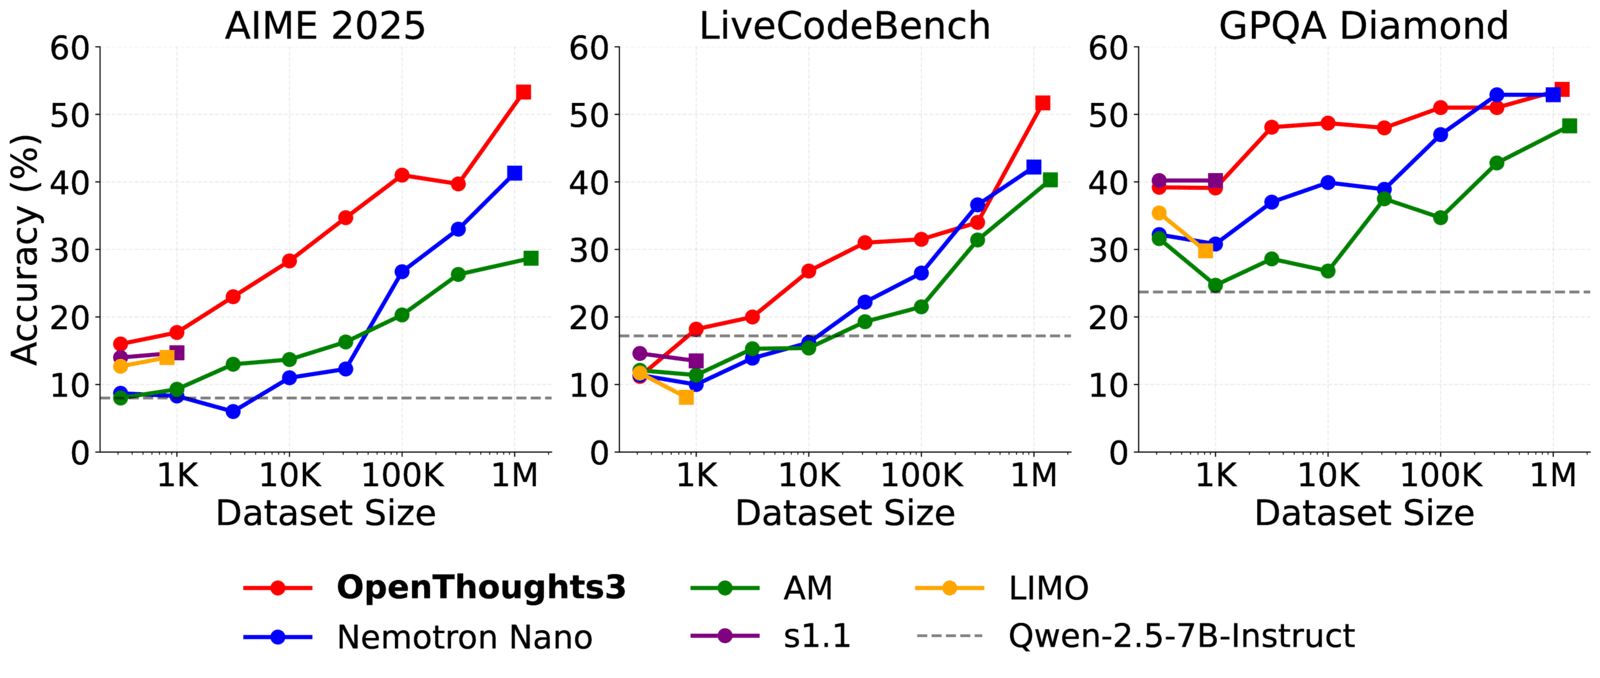
OpenThoughts 專案旨在為訓練推理模型 (Reasoning Models) 建立開源資料集 (Open-Source Datasets)。研究團隊在資料生成管線 (Data Generation Pipeline) 的各個步驟上進行了超過 1,000 次受控實驗,最終得到 OpenThoughts3 資料配方 (Data Recipe)。將此管線擴展到 1.2M 筆樣本,並使用 QwQ-32B 作為教師模型 (Teacher Model),產生了 OpenThinker3-7B 模型,在 AIME 2025 取得 53%、LiveCodeBench 06/24-01/25 取得 51%,以及 GPQA Diamond 取得 54% 的最先進 (State-of-the-art, SOTA) 開放資料推理結果。
1. 引言
近期的前沿模型 (Frontier Models) 例如 DeepSeek-R1 與 o3 在數學、程式碼與科學等推理密集領域展現出強大效能。這些模型通常從具備能力的基礎模型 (Base Models) 出發,再透過後訓練 (Post-training) 技巧,例如監督式微調 (Supervised Fine-tuning, SFT) 或強化學習 (Reinforcement Learning, RL),以發展出推理能力。
然而,前沿推理模型的完整訓練配方並未公開,這使得研究社群在自行打造推理模型時面臨困難。OpenThoughts 專案的目標就是要彌合此一缺口:透過建立開源、可重現的資料配方與資料集,讓任何人都能訓練具備推理能力的模型。
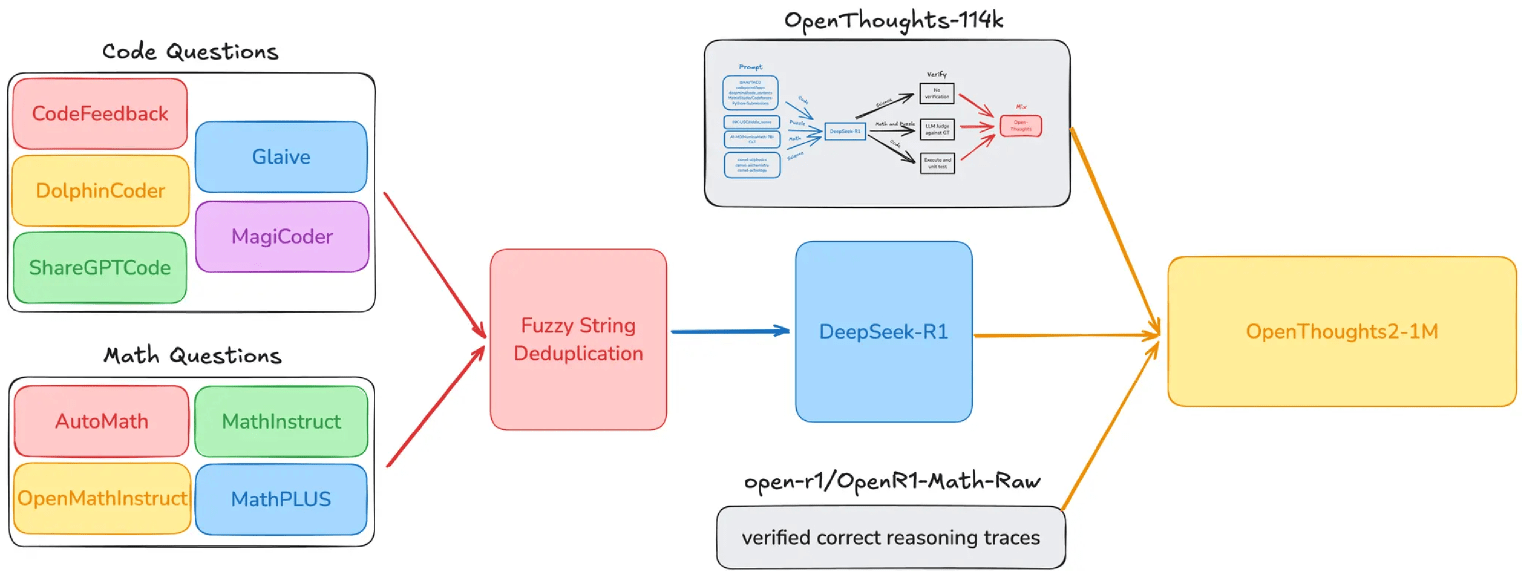
OpenThoughts 專案歷經多個迭代。早期工作 (OpenThoughts-114K) 探討了將 Sky-T1 管線結合自動化驗證的擴展方法。OpenThoughts2-1M 則透過增強問題多樣性與合成生成策略,將規模擴展到 100 萬筆樣本。本文最終呈現 OpenThoughts3-1.2M —— 這是一份 120 萬筆推理資料集,搭配 OpenThinker3-7B 模型,是在開放資料條件下 7B 規模的 SOTA。
研究團隊從超過 1,000 次消融研究 (Ablation Studies) 中歸納出五個關鍵發現:
- 多答案取樣 (Multiple Answer Sampling):對每個問題從教師模型取樣多個答案,是有效將資料來源規模擴展至少 16 倍 (16×) 的方法。
- 教師模型強弱不等於蒸餾效果:表現較佳的模型不一定是更好的教師;QwQ-32B 雖然在基準上分數較低,作為教師卻優於 DeepSeek-R1。
- 驗證與過濾收益有限:各種驗證 (Verification) 與過濾方法對於最終效能的提升微乎其微。
- 品質高於多樣性:使用前 1-2 個高品質來源優於混用 8-16 個來源。
- LLM 過濾優於傳統方法:以 LLM 標註的難度 (Difficulty) 或 LLM 回應長度 (Response Length) 來過濾問題,比起預訓練資料常用的 embedding 或 fastText 過濾器效果更佳。
2. 相關工作
Gemini、QwQ 與 DeepSeek-R1 等模型的發布,使得長推理軌跡 (Long Reasoning Traces) 變得可見,讓小模型透過從大型教師模型蒸餾 (Distillation) 進行訓練成為可能。DeepSeek 已釋出強大的蒸餾變體,展現了此一策略的潛力。
許多資料集鎖定數學、程式碼與科學領域,以發展推理能力。例如 OpenR1、OpenMathReasoning、OpenCodeReasoning 等資料集從 CodeForces、AoPS、StackOverflow 等公共論壇與競賽網站收集問題。
其他工作則著重於小型資料集 (約 1K 樣本) 的人工精選 (Manual Curation),篩選出具挑戰性、高品質的提示詞。DeepMath-103K、OpenR1、Nvidia Nemotron 等專案在資料來源、過濾與擴展等多個階段引入創新。除了 SFT 之外,AceReason 與 Skywork-OR1 等工作則為強化學習方法構建推理資料集。
3. OpenThoughts 專案
OpenThoughts 計畫的目標是透過系統化探索資料策展 (Data Curation) 設計空間,建立 SOTA 的開放推理資料集。專案經由多個迭代演進,從 BespokeStratos-17K 開始,最終以 OpenThoughts3-1.2M 搭配 OpenThinker3-7B 作為集大成之作。
- OpenThoughts-114K:展示了將 Sky-T1 管線結合 DeepSeek-R1 作為標註者 (Annotator),並加上 LLM 驗證的有效性,涵蓋 89K 數學、20K 程式碼、4K 科學與 1K 益智題目。
- OpenThoughts2-1M:透過引入新的問題來源 —— 包括 AutoMathText、OpenR1 與 CodeFeedback —— 將規模擴展至 100 萬筆。此資料集表現匹敵或超越 DeepSeek-R1-Distill-32B,在 AIME25 上甚至超越其 6%。
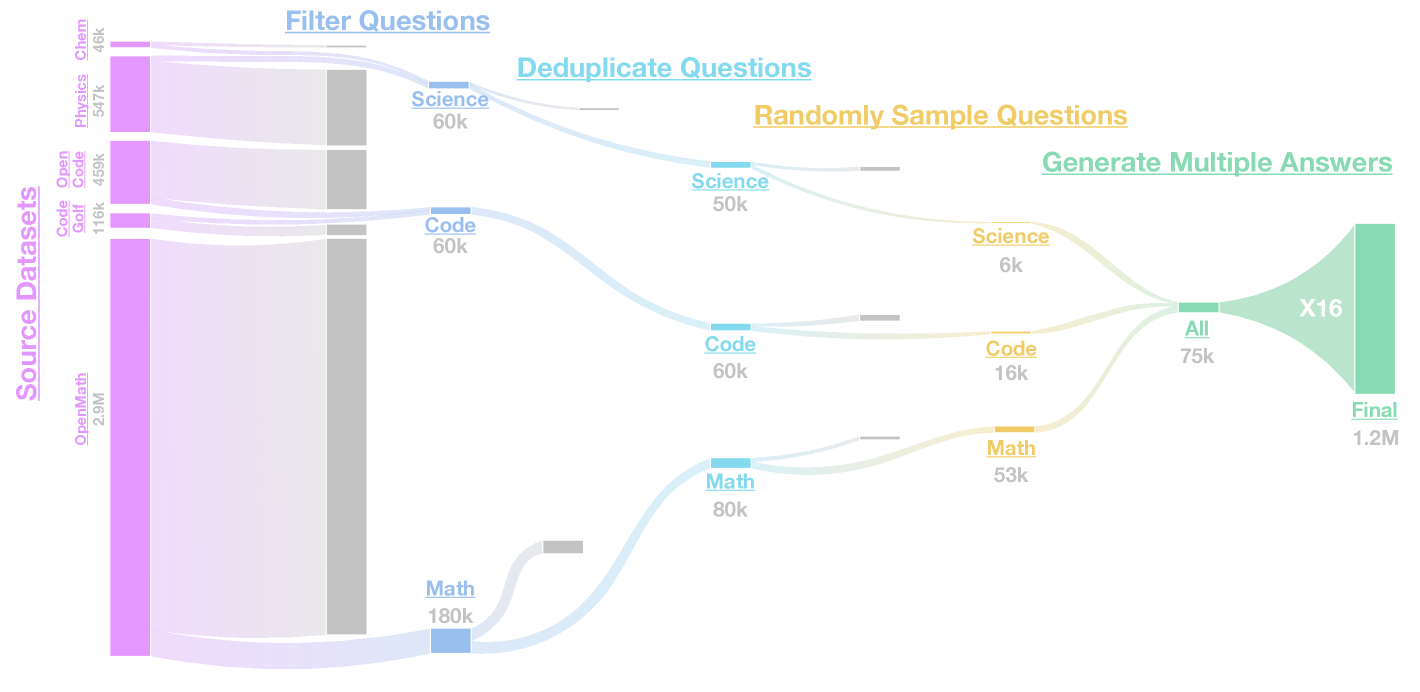
- OpenThoughts3-1.2M:本文的核心,是 1,000 多次受控實驗的成果,包含 850,000 筆數學、250,000 筆程式碼以及 100,000 筆科學資料。
4. OpenThoughts3 資料管線
訓練與評估框架
研究團隊以每次實驗 31,600 筆樣本進行系統化消融,這是在 10K 與 100K 之間幾何平均的計算上平衡規模。所有模型皆從 Qwen2.5-7B-Instruct 微調,採用一致的超參數 (Hyperparameters)。
評估基準 (Evaluation Benchmarks) 包括:
- 數學 (Math):AIME24、AMC23、MATH500
- 程式碼 (Code):CodeElo、CodeForces、LiveCodeBench
- 科學 (Science):GPQA Diamond、JEEBench
另外保留評估集 (Held-out Evaluation Set) 用以衡量在管線優化期間未使用的基準上的泛化能力,包括 AIME 2025、HMMT 02/25 等。
4.1 問題來源
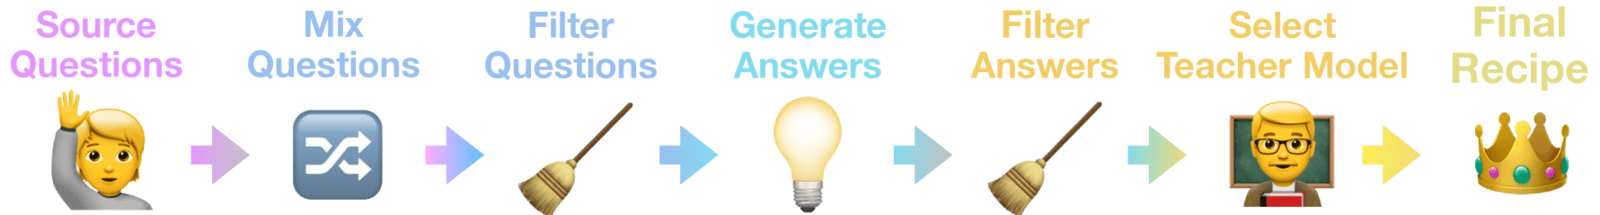
研究團隊評估了 27 個程式碼來源、21 個數學來源以及 14 個科學來源,並依據完全合成 (Fully Synthetic)、半合成 (Semi-synthetic)、人工撰寫 (Human-written) 進行分類。結果顯示沒有單一方法明顯佔優 —— 合成與精選方法表現相近。
各領域表現最佳來源:
- 程式碼:StackExchange-CodeGolf (平均分 25.3)、OpenCodeReasoning (27.5)
- 數學:OpenMath-2-Math (58.8)、NuminaMath-1.5 (58.5)
- 科學:OrganicChemistry-PDF (45.3)、StackExchange-Physics (43.2)
問題品質會大幅影響最終效能,最強與最弱程式碼資料集之間在表現上有 17.2 個百分點的差距。
4.2 混合問題
一個關鍵發現是:「在所有資料領域中,混合至多兩個來源產生最佳結果。」 在測試 N∈{1,2,4,8,16} 個來源後發現,混合愈多來源實際上反而會降低效能 —— 使用兩個高品質來源相對於 16 個來源帶來了平均約 5% 的準確度提升。
最終選定來源:
- 數學:OpenMath-2-Math
- 程式碼:CodeGolf 與 OpenCodeReasoning
- 科學:StackExchange-Physics 與 OrganicChemistry-PDFs
4.3 問題過濾
LLM 為基底的過濾方法明顯優於傳統 embedding 或 fastText 方法。兩個策略表現出色:
- 基於難度的篩選 (Difficulty-based Selection):由 LLM 對問題難度評分,保留較難的問題對程式碼領域最佳。
- 基於回應長度的篩選 (Response Length Selection):選擇能引發較長模型回應的問題,對數學與科學領域最佳。
當應用 LLM 過濾方法時,相較於隨機過濾基線,平均提升 4-6%。
4.4 去重與多答案取樣
實驗對三種去重水準 (無、模糊 (Fuzzy)、精確 (Exact)) 與三種答案取樣率 (1×、4×、16×) 的組合進行了掃描。一個反直覺的發現浮現:「對每個問題從教師模型取樣多個答案,是有效將資料來源規模擴展至少 16 倍的方法。」
- 數學與科學:精確去重搭配每題 16× 答案表現最佳。
- 程式碼:不去重搭配每題 16× 答案表現最佳。
更重要的是,結果顯示當答案多樣性 (Answer Diversity) 顯著提升時,問題多樣性 (Question Diversity) 提供的好處有限。
4.5 答案過濾
對驗證方法進行的廣泛實驗 —— 包括多數共識過濾、LLM 驗證、基於回應長度的篩選 —— 得到一個令人意外的結論:「沒有任何過濾策略能超越使用所有答案的基線。」
隨機過濾微幅優於驗證方法,而以 GPT 為基底的驗證實際上反而降低了效能。因此,研究團隊在最終管線中省略了答案過濾這一步驟。
4.6 教師模型
一個顛覆傳統假設的驚人發現是:「QwQ-32B 是最強的教師模型,儘管它本身是個比 DeepSeek-R1 更弱的模型。」
在所有領域中,QwQ-32B 都產生了更優異的訓練資料 —— 即使它在 CodeElo 上比 DeepSeek-R1 低 9%,在 GPQA Diamond 上低 8%,在 JEEBench 上低 23%。在下游任務上反而帶來 1.9-2.6% 的提升。
這項結果挑戰了「直接以最強的模型作為教師」的常見假設,意味著訓練資料的某些特性 —— 例如推理軌跡的風格、長度或結構 —— 比教師本身的基準分數更為重要。
5. 將管線擴展至 OpenThoughts3-1.2M
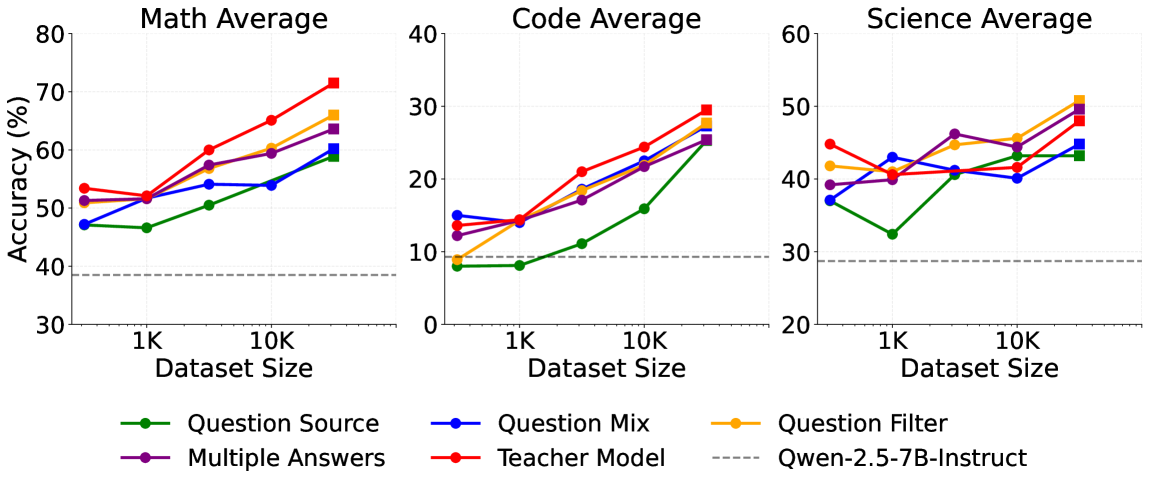
研究團隊展示,「當我們連續堆疊管線各階段的最佳選擇時,擴展行為 (Scaling Behavior) 也會持續改善。」 從 316 到 31,600 筆樣本之間,效能持續擴展,而最強的提升歸因於問題來源選擇、過濾策略與教師模型的選擇。
為了達到 1.2M 規模,研究團隊從目標領域組成 (850K 數學、250K 程式碼、100K 科學) 反推每個管線階段所需的輸入量。例如,要產生 850K 筆數學樣本,需要先取得 3M 筆原始問題作為起點,再逐步過濾。
OpenThinker3-7B 結果 (在 OpenThoughts3-1.2M 上訓練):
| 基準 (Benchmark) | OpenThinker3-7B | DeepSeek-R1-Distill-7B | 提升 |
|---|---|---|---|
| AIME 2025 | 53.3 | 38.0 | +15.3 |
| LiveCodeBench 06/24-01/25 | 51.7 | 34.5 | +17.2 |
| GPQA Diamond | 53.7 | 33.2 | +20.5 |
模型在 7B 規模於開放資料條件下,跨多個領域達到 SOTA,並對保留基準展現出強大的泛化能力。
5.1 補充分析
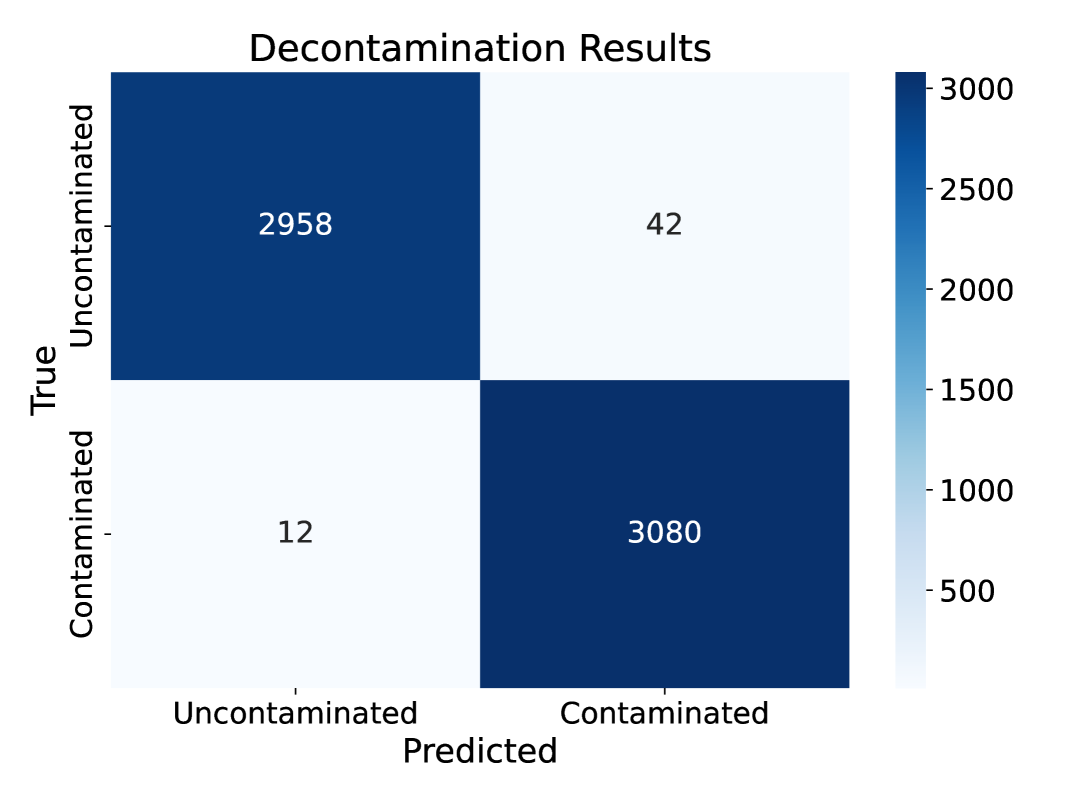
汙染去除 (Decontamination) 結果:在 6,092 筆樣本上的去汙染流程混淆矩陣顯示分類器召回率 99.6%(3080/3092 真汙染樣本被正確識別),假陽性率僅 1.4%(42/3000)。這表示去汙染流程在保留真實乾淨資料的同時,能可靠地過濾掉與評估基準重疊的問題。
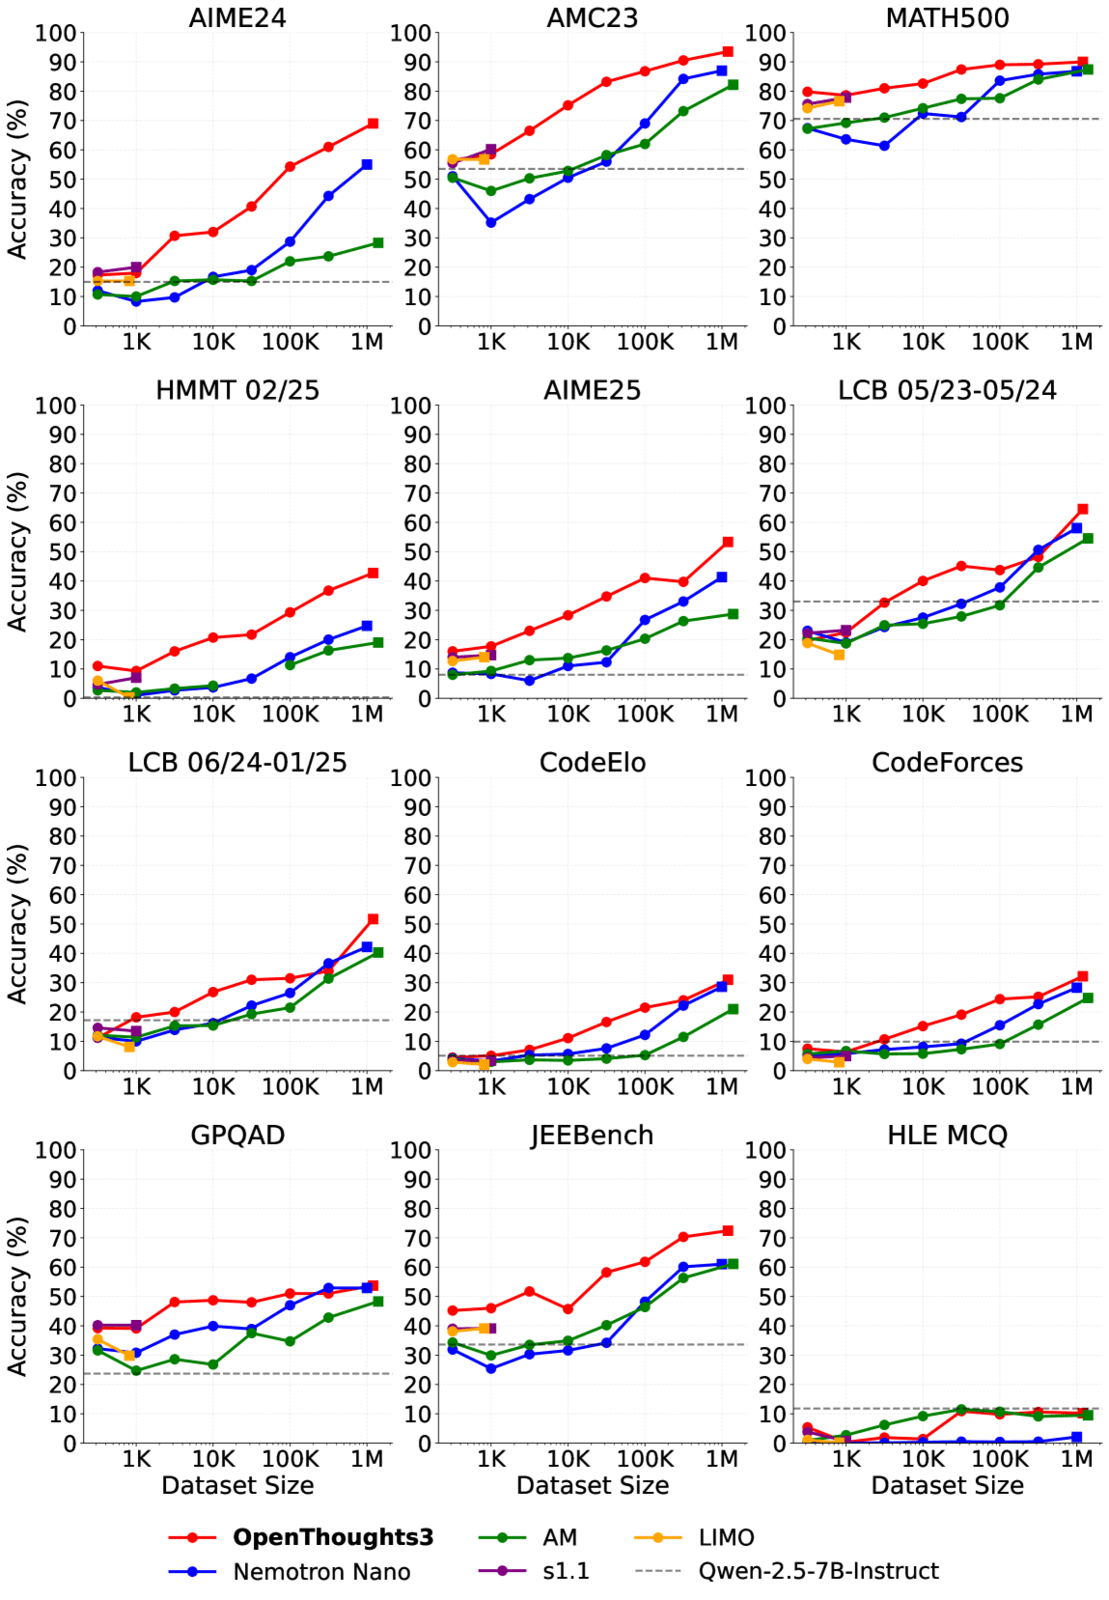
跨基準的擴展曲線:OpenThoughts3 在 12 個推理基準(AIME24/AIME25/AMC23/MATH500/HMMT、LCB 兩個窗口、CodeElo/CodeForces、GPQA Diamond、JEEBench、HLE MCQ)的擴展曲線一致優於 AM、Nemotron Nano、s1.1、LIMO 與 Qwen-2.5-7B-Instruct 基線。除了 HLE MCQ(人類最後考試 MCQ 子集,所有方法都接近 0)以外,OpenThoughts3 在所有基準上於 1M 規模都領先。
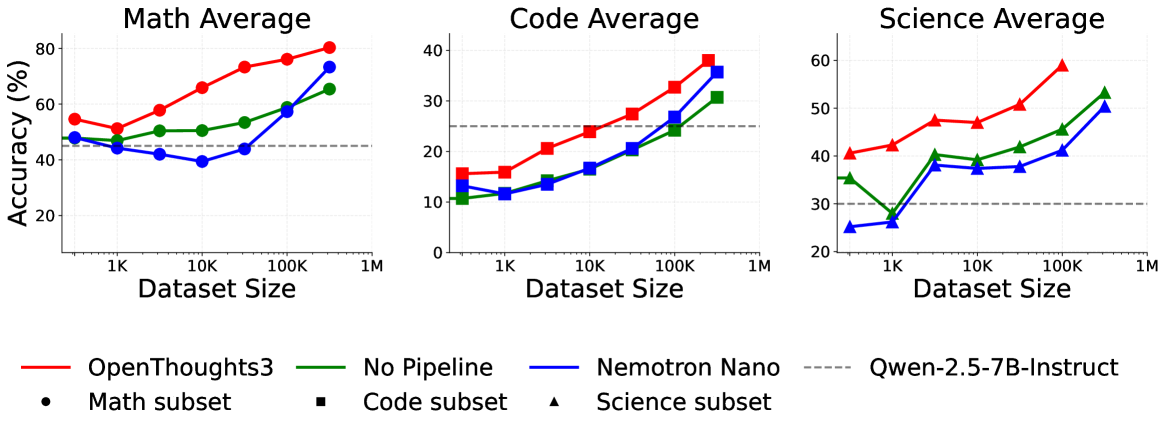
領域聚合分析:將 12 個基準聚合為 Math、Code、Science 三個領域平均,OpenThoughts3 在所有領域都一致超越基線。Math 領域差距最大;Code 與 Science 也有顯著但較小的提升。
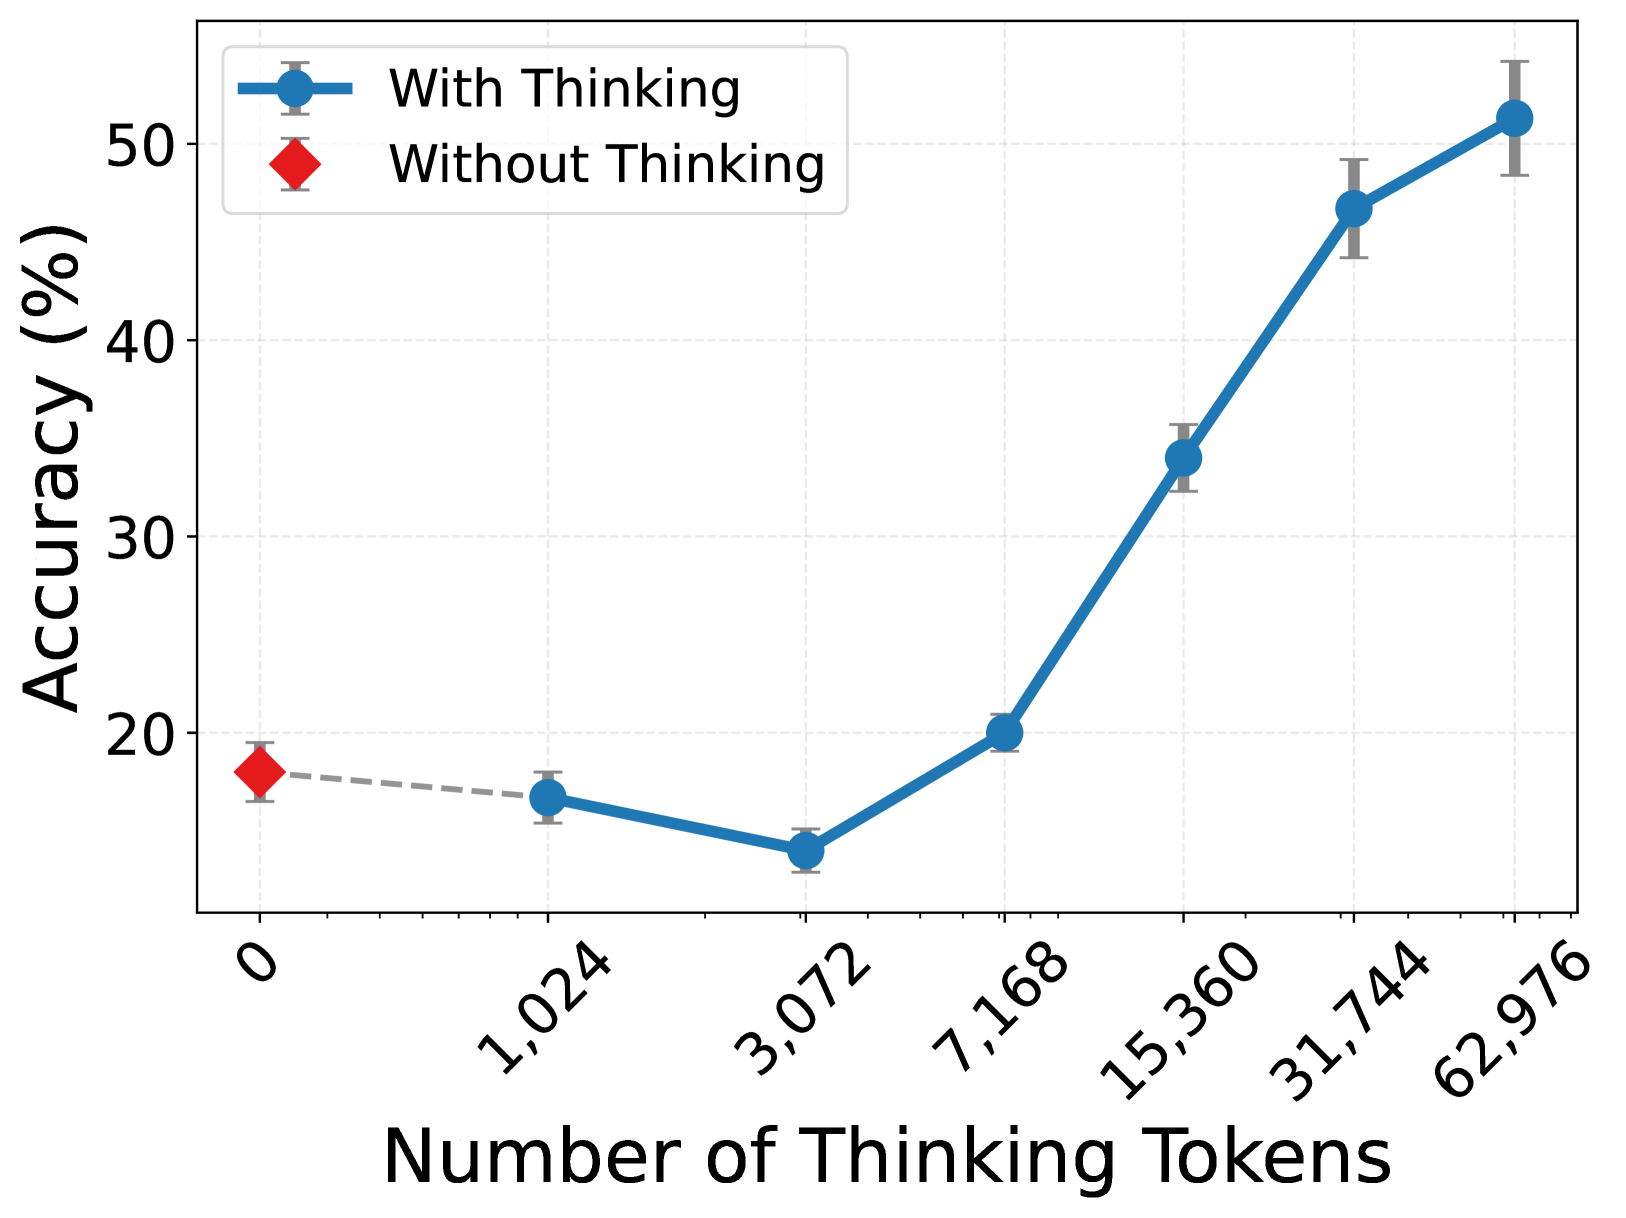
Thinking Token 預算的影響:在 AIME 24/25 上以不同思考長度評估 OpenThinker3-7B。增加思考 token 從 1,024 到 ~63K,準確率從 ~17% 上升至 ~51%,呈現強烈的測試時運算(test-time compute)擴展曲線。
6. 結論
透過 1,000 多次消融實驗的系統化研究,研究團隊得到五個重塑資料策展實踐的關鍵見解:
- 對每個問題取樣多個答案能讓資料集擴展 16×,並帶來效能提升。
- 較強的基準效能並不保證更佳的教學能力 (Teaching Capability)。
- 答案過濾雖然直觀上看似合理,但實際提供的收益微乎其微。
- 1-2 個來源的品質集中性,優於 8-16 個來源的多樣性。
- 基於 LLM 難度與回應長度的過濾方法,超越了 embedding/fastText 方法。
承認的限制 (Acknowledged Limitations):本工作專注於監督式微調,未探索強化學習、課程學習 (Curriculum Learning) 或階段式訓練 (Staged Training)。團隊選擇能最大化整體平均效能的策略,而非針對特定領域最佳化,這假設了跨領域遷移 (Cross-domain Transfer) 的存在 —— 此假設值得進一步驗證。
開放研究方向 (Open Research Directions) 包括:
- 跨領域遷移的動態
- 學生模型 (Student Model) 效能是否最終會超越教師模型 (Surpassing the Teacher)
- 問題與答案多樣性的交互作用如何隨領域、規模、模型大小而變
所有模型、資料集、程式碼與補充資料皆透過 Hugging Face 與 GitHub 在 openthoughts.ai 上釋出。
參考文獻
References preserved in original English. For the complete bibliography, please refer to the original paper at https://arxiv.org/abs/2506.04178v2.
Key works referenced include:
- DeepSeek-R1 and DeepSeek-R1-Distill series
- QwQ-32B (Qwen team)
- Sky-T1
- s1, s1.1, LIMO
- OpenR1, OpenMathReasoning, OpenCodeReasoning
- AutoMathText, NuminaMath-1.5, OpenMath-2-Math
- DeepMath-103K, Nvidia Nemotron Nano, AM
- AceReason, Skywork-OR1
- Benchmarks: AIME 2024/2025, AMC23, MATH500, GPQA Diamond, JEEBench, HMMT, LiveCodeBench, CodeElo, CodeForces
術語對照表
| English | 繁體中文 |
|---|---|
| Reasoning Model | 推理模型 |
| Data Recipe | 資料配方 |
| Data Curation | 資料策展 |
| Data Generation Pipeline | 資料生成管線 |
| Supervised Fine-tuning (SFT) | 監督式微調 |
| Reinforcement Learning (RL) | 強化學習 |
| Post-training | 後訓練 |
| Base Model | 基礎模型 |
| Frontier Model | 前沿模型 |
| Teacher Model | 教師模型 |
| Student Model | 學生模型 |
| Distillation | 蒸餾 |
| Annotator | 標註者 |
| Long Reasoning Trace | 長推理軌跡 |
| Question Sourcing | 問題來源 |
| Synthetic | 合成的 |
| Semi-synthetic | 半合成的 |
| Human-written | 人工撰寫 |
| Mixing Questions | 混合問題 |
| Question Filtering | 問題過濾 |
| Difficulty-based Selection | 基於難度的篩選 |
| Response Length Selection | 基於回應長度的篩選 |
| Embedding | 嵌入向量 |
| Deduplication | 去重 |
| Fuzzy Deduplication | 模糊去重 |
| Exact Deduplication | 精確去重 |
| Multiple Answer Sampling | 多答案取樣 |
| Answer Filtering | 答案過濾 |
| Verification | 驗證 |
| Majority Consensus | 多數共識 |
| Hyperparameters | 超參數 |
| Ablation Study | 消融研究 |
| Held-out Evaluation Set | 保留評估集 |
| Evaluation Benchmark | 評估基準 |
| State-of-the-art (SOTA) | 最先進 |
| Cross-domain Transfer | 跨領域遷移 |
| Curriculum Learning | 課程學習 |
| Staged Training | 階段式訓練 |
| Scaling Curve | 擴展曲線 |
| Scaling Behavior | 擴展行為 |
| Open-Source Dataset | 開源資料集 |
| Manual Curation | 人工精選 |
| Teaching Capability | 教學能力 |
| Question Diversity | 問題多樣性 |
| Answer Diversity | 答案多樣性 |
| Surpassing the Teacher | 超越教師 |