Self-Distilled RLVR:以自我蒸餾改進可驗證獎勵的強化學習
原始論文:Self-Distilled RLVR 作者:Chenxu Yang, Chuanyu Qin, Qingyi Si, Minghui Chen, Naibin Gu, Dingyu Yao, Zheng Lin, Weiping Wang, Jiaqi Wang, Nan Duan arXiv ID:2604.03128v2 日期:2026-04-08 標籤:LLM RLVR Self-Distillation Reasoning RL Multimodal Credit Assignment
摘要
線上策略蒸餾 (On-policy Distillation, OPD) 在 LLM 社群中已成為一個受歡迎的訓練範式。此範式選擇一個較大的模型作為教師 (Teacher),為每條取樣的軌跡 (Trajectory) 提供密集且細粒度的訊號,相對之下,可驗證獎勵的強化學習 (Reinforcement Learning with Verifiable Rewards, RLVR) 僅能從環境中可驗證的結果取得稀疏訊號。然而,OPD 必須額外維護一個獨立且通常規模更大的教師模型,造成顯著的計算與架構負擔。線上策略自我蒸餾 (On-Policy Self-Distillation, OPSD) 試圖解決此問題,讓單一模型同時扮演教師與學生 (Student),其中教師會以學生無法取得的特權資訊 (Privileged Information) 為條件。
本文證明,僅依賴特權教師所衍生的學習訊號會導致嚴重的資訊洩漏 (Information Leakage) 與長期訓練的不穩定。據此,我們指出自我蒸餾的最佳定位,並提出 RLSD(RLVR with Self-Distillation)。具體而言,我們利用自我蒸餾來取得 token 層級 (Token-level) 的策略差異,藉此決定細粒度的更新幅度;同時繼續採用 RLVR,從環境回饋(如回答正確性)取得可靠的更新方向。這使得 RLSD 能同時兼具 RLVR 與 OPSD 的優點,達到更高的收斂上限與更佳的訓練穩定性。
1. 引言
近期 LLM 在推理 (Reasoning) 任務上的進展,很大程度上得益於後訓練 (Post-training) 階段中強化學習 (Reinforcement Learning, RL) 的應用。其中,可驗證獎勵的強化學習 (RLVR) 是一個典型代表:模型對提示 (Prompt) 取樣多條候選軌跡,由一個確定性的驗證器 (Verifier) 給予 0/1 獎勵,再以策略梯度 (Policy Gradient) 更新模型。RLVR 對於數學推理、程式碼生成等任務都展現了顯著的成效。
然而,RLVR 的學習訊號是稀疏的 (Sparse):整條軌跡只有一個結果獎勵 (Outcome Reward),且該獎勵在所有 token 上被均勻分配,導致缺乏 token 層級的鑑別力,造成信用分配 (Credit Assignment) 困難。
為了補足訊號密度,社群轉向線上策略蒸餾 (OPD):以一個較強的教師模型對學生取樣的軌跡逐 token 提供分布式 (Distributional) 監督。儘管 OPD 能提供豐富的密集訊號,但它需要一個獨立、且通常較大的教師模型同時駐留於記憶體中,計算與架構成本高昂。
線上策略自我蒸餾 (OPSD) 試圖以同一模型作為教師與學生,其中教師被授予學生在推理時看不到的特權資訊(例如參考解答、驗證後的推理鏈),藉以提供有意義的密集監督。看似精巧,但本文發現 OPSD 在實務上會產生兩個嚴重問題:
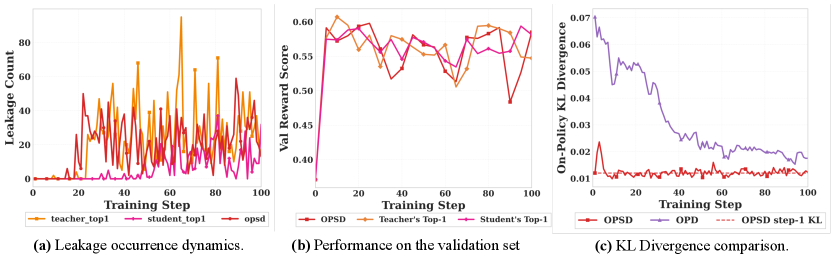
特權資訊洩漏 (Privileged Information Leakage):訓練後的模型在推理時會明確援引那些它根本無法觀察到的「參考解答」。如圖 2 所示,模型輸出中會出現「根據參考解答……」之類的措辭,揭示模型已將不可見的特權資訊以某種形式編碼進參數中。
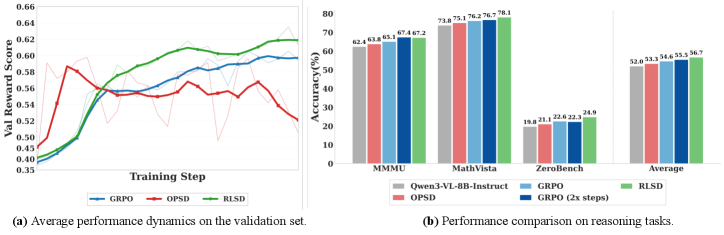
長期訓練不穩定:OPSD 的驗證準確率僅在前 10–20 步迅速上升,隨後便單調衰退。這種「先升後降」的曲線意味著 OPSD 無法持續累積進步。
我們的關鍵洞見是:當教師條件於學生無法取得的特權資訊 r 時,分布匹配 (Distribution Matching) 目標會變得ill-posed。我們在第 3 節從理論上證明:OPSD 的損失可以分解成「理想目標」加上一個「不可消除的條件互資訊 (Conditional Mutual Information) 殘差」,學生無論容量多大都無法將其消除。優化器在「不可達成」的目標下持續吸收 r 帶來的雜訊,最終學到 x → r 的虛假關聯,這正是洩漏的數學起源。
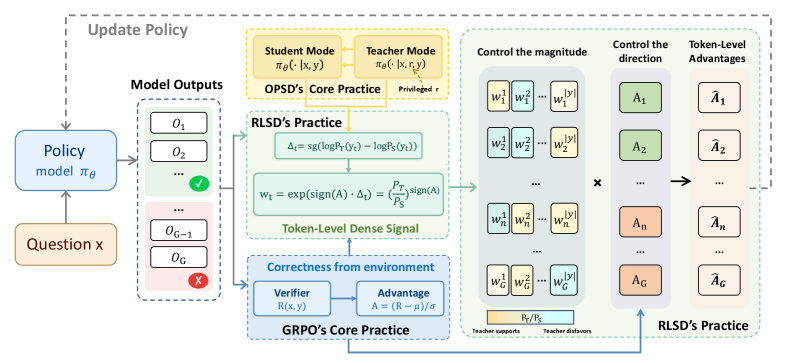
基於這個診斷,我們提出 RLSD(RLVR with Self-Distillation),不再讓自我蒸餾單獨主導學習方向,而是讓它只負責調整更新幅度:
- 更新方向 (Direction):完全由環境的可驗證獎勵決定,繼承 RLVR 的可靠性;
- 更新幅度 (Magnitude):由教師相對於學生的證據比 (Evidence Ratio) $P_T(y_t)/P_S(y_t)$ 來細緻地分配 token 層級信用。
這個解耦讓 RLSD 同時擁有 RLVR 的環境錨定與 OPSD 的密集訊號,但不再受洩漏與不穩定所苦。實驗顯示在五個多模態推理基準上,RLSD 比基底模型平均提升 4.69%,比 GRPO 平均提升 2.32%,並維持訓練穩定性。
本文貢獻:
- 我們從理論上證明 OPSD 因資訊不對稱而具有不可消除的互資訊殘差,並由此推導出梯度層級的洩漏機制。
- 我們提出 RLSD,將更新方向(由環境獎勵決定)與更新幅度(由教師證據比決定)解耦。
- 我們在多個多模態推理基準上驗證了 RLSD 的有效性與穩定性,並提供 token 層級的信用分配可視化。
2. 預備知識
2.1 RLVR 與 GRPO
給定提示 $x$,模型自迴歸地生成回應 $y = (y_1, \ldots, y_T)$。一個確定性驗證器提供二元獎勵 $R(x, y) \in \{0, 1\}$。為了估計優勢 (Advantage),群組相對策略優化 (Group Relative Policy Optimization, GRPO) 對同一提示取樣 $G$ 條軌跡,計算群組相對優勢:
$$ A^{(i)} = \frac{R(x, y^{(i)}) - \mu_G}{\sigma_G} $$
其中 $\mu_G$、$\sigma_G$ 為群組獎勵的均值與標準差。GRPO 的目標函數可寫為:
$$ \mathcal{L}_{\text{GRPO}}(\theta) = \mathbb{E}\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|y^{(i)}|}\sum_{t=1}^{|y^{(i)}|}\min\!\left(\rho_t^{(i)} A^{(i)},\ \mathrm{clip}(\rho_t^{(i)}, 1-\epsilon, 1+\epsilon) A^{(i)}\right)\right] $$
其中 $\rho_t^{(i)}$ 為現策略與舊策略間的重要性取樣比 (Importance Sampling Ratio)。關鍵限制:同一條軌跡的所有 token 共用同一個優勢 $A^{(i)}$,缺乏 token 層級的鑑別力。
2.2 OPD 與 OPSD
線上策略蒸餾類方法(包含 OPD 與 OPSD)皆沿著學生取樣的軌跡,最小化教師與學生之間的逐 token 散度 (Divergence):
$$ \mathcal{L}_{\text{OP(S)D}}(\theta) = \mathbb{E}_{(x, r) \sim \mathcal{S}}\,\mathbb{E}_{\hat{y} \sim P_S(\cdot \mid x)}\!\left[\frac{1}{|\hat{y}|}\sum_{t=1}^{|\hat{y}|} D\!\left(P_T \,\|\, P_S\right)\right] $$
學生分布定義為:
$$ P_S(\cdot \mid y_{<t}) := \pi_\theta(\cdot \mid x, y_{<t}) $$
兩者差別在於教師分布定義:
- OPD 教師:$P_T(\cdot \mid y_{<t}) := \pi_{\hat{\theta}}(\cdot \mid x, y_{<t})$,其中 $\hat{\theta}$ 為一個獨立的(通常更大的)外部教師模型。
- OPSD 教師:$P_T(\cdot \mid y_{<t}) := \pi_\theta(\cdot \mid x, r, y_{<t})$,與學生為同一組參數,差別僅在於額外條件於特權資訊 $r$(如參考解答)。
從外觀上看,OPSD 顯得簡潔且高效——免去了維護外部教師的成本——但下一節將揭示,這種「資訊不對稱」的設計會讓目標本身陷入結構性失效。
3. 線上策略自我蒸餾的失效分析
3.1 經驗觀察
我們在多模態推理任務上對 OPSD 進行了訓練,觀察到三個與 OPD 截然不同的現象(見圖 3):
- 特權資訊洩漏隨訓練單調增長:模型輸出中明確援引「參考解答」、「正確答案」等不可見資訊的頻率隨步數遞增。
- 驗證準確率早期攀升、後期衰退:在 10–20 步內達到峰值,之後持續下滑。
- KL 散度停滯:OPD 的教師–學生 KL 會穩定下降;但 OPSD 的 KL 在初期短暫下降後便長期維持在較高水位,無論再如何優化也不再下降。
3.2 理論分析:資訊不對稱導致目標 ill-posed
我們將上述三個現象統一解釋為一個結構性問題。
定理 1(KL 分解):OPSD 的目標可以分解為
$$ \mathcal{L}_{\text{OPSD}} = \mathcal{L}^* + I(Y_t;\,R \mid X, Y_{<t}) $$
其中:
- $\mathcal{L}^* = \mathbb{E}_x\!\left[D_{\text{KL}}\!\left(\bar{P}_T(\cdot) \,\|\, P_S(\cdot \mid x)\right)\right]$ 是匹配教師「邊際分布」$\bar{P}_T = \mathbb{E}_r[P_T(\cdot \mid r)]$ 的理想目標;
- $I(Y_t;\,R \mid X, Y_{<t})$ 是當前 token $Y_t$ 與特權資訊 $R$ 在已給定 $X, Y_{<t}$ 條件下的互資訊。
核心洞見:互資訊項完全由教師的條件分布與 $P(r \mid x)$ 決定,與參數 $\theta$ 無關。換言之,這是一個學生無論如何訓練都無法消除的下界 (Lower Bound)。在學生可行集合 $\mathcal{F} = \{Q : Q(\cdot \mid x, y_{<t}) \text{ 不條件於 } r\}$ 中,全域最優解為 $P_S^* = \bar{P}_T$,此時殘差恰為 $I(Y_t;\,R \mid X, Y_{<t}) > 0$。
為何 KL 停滯? 學生會迅速收斂到教師的邊際分布 $\bar{P}_T$,之後損失便卡在不可消除的殘差項上,再也無法下降——這正是圖 3c 中觀察到的「平台 (Plateau)」現象。
為何發生洩漏? 當目標仍有非零殘差但又無法靠 $\theta$ 縮小時,優化器持續收到的「梯度」其實是把 $r$ 的雜訊吸收進參數的力矩。學生無法直接條件於 $r$,唯一的途徑就是學會「從輸入 $x$ 推測 $r$」的統計關聯——也就是把 $x \to r$ 的對應編碼進 $\theta$。這正是洩漏的數學起源。
相對的,在 OPD 中,外部教師並不條件於學生看不到的資訊,因此互資訊殘差不會出現。
3.3 梯度結構:每樣本分解
命題 1(每樣本梯度分解):對於特定的 $r$,由 log-derivative trick 推得的每樣本梯度可分解為:
$$ g(\theta;\,r) = \underbrace{-\sum_v \bar{P}_T(v)\, \nabla_\theta \log P_S(v)}_{g^*(\theta):\ \text{邊際匹配}} + \underbrace{-\sum_v \left[P_T(v \mid r) - \bar{P}_T(v)\right]\, \nabla_\theta \log P_S(v)}_{\delta(\theta;\,r):\ r\text{-specific 偏差}} $$
其中:
(i) $\mathbb{E}_r[\delta(\theta;\,r)] = 0$(期望為零);
(ii) $\mathbb{E}_r\!\left[\|\delta(\theta;\,r)\|^2\right] = \sum_v \mathrm{Var}_r[P_T(v \mid r)] \cdot \|\nabla_\theta \log P_S(v)\|^2$。
偏差項的變異數會隨著 $I(Y_t;\,R \mid X)$ 單調增長。
兩階段訓練動態 (Two-Phase Training Dynamics):
- 早期:$P_S$ 距離 $\bar{P}_T$ 較遠,$\|g^*(\theta)\| \gg \|\delta(\theta;\,r)\|$,邊際匹配項主導,驗證準確率快速上升。
- 後期:$P_S$ 接近 $\bar{P}_T$ 後 $\|g^*(\theta)\|$ 趨近於零,但 $\|\delta(\theta;\,r)\|$ 仍受互資訊下界保護而不會消失。偏差項主導後續更新,路徑相依的雜訊累積會把模型推向編碼 $x \to r$ 關聯的參數區域,觸發自我增強的退化。
3.4 洩漏頻寬的對照實驗
我們進一步測試了三種 OPSD 變體,考察「教師 $r$ 進入梯度方向」的不同頻寬:
- 完整 OPSD:對所有詞彙位置以 $P_T(v \mid r)$ 加權——頻寬最廣。
- 教師 Top-1:只把目標縮成 $\arg\max_v P_T(v \mid r)$——頻寬最窄但 $r$ 的注入最集中。
- 學生 Top-1:限制支撐集為 $\arg\max_v P_S(v)$——中等頻寬。
理論預測這三種變體都應該出現洩漏,因為梯度方向都仍依賴 $r$。實驗結果(圖 3a)證實了預測:三者的洩漏率皆隨步數單調上升,其中「教師 Top-1」由於 $r$ 的注入最集中、最劇烈,反而表現出最嚴重的洩漏。
4. RLSD 方法
4.1 設計原則
第 3 節的分析顯示,OPSD 的問題不在「教師訊號本身有用與否」,而在讓教師訊號決定方向。我們的設計原則是:
方向(direction)由環境獎勵決定,幅度(magnitude)由教師證據比調整。
證據比 $P_T(y_t)/P_S(y_t)$ 衡量「特權資訊把對 $y_t$ 的信念修正了多少」,本質上是 token 層級的信用分配訊號;只要不讓它影響「往哪個方向更新」,就能保留它的細粒度資訊而不引入洩漏。
4.2 RLSD 的構造
步驟 1:特權資訊增益 (Privileged Information Gain)
$$ \Delta_t = \mathrm{sg}\!\left(\log P_T(y_t) - \log P_S(y_t)\right) $$
其中 $\mathrm{sg}(\cdot)$ 為 stop-gradient。$\Delta_t > 0$ 表示 $r$ 支持該 token;$\Delta_t < 0$ 表示 $r$ 不支持。stop-gradient 確保 $\Delta_t$ 純粹作為加權,不引入額外梯度通道。
步驟 2:方向感知的證據再加權 (Direction-Aware Evidence Reweighting)
$$ w_t = \exp\!\left(\mathrm{sign}(A) \cdot \Delta_t\right) = \left(\frac{P_T(y_t)}{P_S(y_t)}\right)^{\mathrm{sign}(A)} $$
- 當 $A > 0$(軌跡正確):$w_t = P_T/P_S$,將更多正向信用集中到「特權資訊支持的 token」。
- 當 $A < 0$(軌跡錯誤):$w_t = P_S/P_T$,將更多負向責備加在「特權資訊不支持的 token」,而對被支持的 token 減輕懲罰。
由於 $\exp(\cdot) > 0$ 恆正,加權只會調整相對幅度而不會翻轉符號——強化或懲罰的決定權仍完全屬於環境獎勵。
步驟 3:裁剪後的信用分配 (Clipped Credit Assignment)
$$ \hat{A}_t = A \cdot \mathrm{clip}\!\left(w_t, 1-\epsilon_w, 1+\epsilon_w\right) $$
裁剪界限了 token 層級的信用偏離,類似 PPO/GRPO 中的重要性比裁剪,扮演信賴域 (Trust Region) 的角色。
最終目標函數:
$$ \mathcal{L}_{\text{RLSD}}(\theta) = \mathbb{E}\!\left\{\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|y^{(i)}|}\sum_{t=1}^{|y^{(i)}|}\min\!\left[w_t A^{(i)},\ \mathrm{clip}(w_t, 1-\epsilon_w, 1+\epsilon_w) A^{(i)}\right]\right\} $$
4.3 與 GRPO 的整合
RLSD 是 GRPO 的「即插即用 (Drop-in)」替換:把 GRPO 中對所有 token 共用的均勻優勢,換成由 $w_t$ 重新加權的 token 層級優勢。每條回應只需多做一次教師前向傳播 (Forward Pass) 以取得 $P_T(y_t)$,相對於 rollout 生成的代價可忽略不計。
4.4 訓練範式比較
下表(Table 1)對比了主要的後訓練範式:
| 方法 | Trajectory | 效率 | 洩漏風險 | 訊號 | 方向來源 |
|---|---|---|---|---|---|
| SFT | 離線策略 (Off-policy) | 高 | N/A | 豐富 | 教師 |
| RLVR (GRPO) | 線上策略 (On-policy) | 高 | N/A | 弱 | 環境 |
| OPD | 線上策略 | 低 | N/A | 豐富 | 教師 |
| OPSD | 線上策略 | 高 | 嚴重 | 豐富 | 教師 |
| RLSD(本文) | 線上策略 | 高 | N/A | 豐富 | 環境 |
RLSD 是唯一同時兼具「線上策略 + 高效率 + 環境錨定 + 豐富訊號 + 無洩漏風險」的設定。
5. 實驗
5.1 設定
訓練資料:採用 MMFineReason-123K 的難度過濾子集,僅保留 Qwen3-VL-4B-Thinking 在 4 次 rollout 全部失敗的樣本,以確保訓練集中於模型尚未掌握的困難案例。
評估基準:五個多模態推理基準
- MMMU:大學程度的跨學科多模態理解與推理。
- MathVista:視覺脈絡下的數學推理。
- MathVision:競賽等級的視覺數學題。
- ZeroBench:對前沿多模態模型的壓力測試。
- WeMath:分難度結構化的數學題。
基底模型:Qwen3-VL-8B-Instruct。
訓練設定:批次大小 256,每個提示取樣 8 條 rollout(溫度 1.0)。最大上下文長度 8192(提示 4096、回應 4096)。GRPO 類方法學習率 $1\times 10^{-6}$;OPSD/SDPO 類方法學習率 $1\times 10^{-5}$。裁剪參數 $\epsilon_{\text{low}} = 0.2$、$\epsilon_{\text{high}} = 0.28$。實驗在 4 個節點、每節點 8 張 NVIDIA H200 GPU 上完成。
比較方法:Base LLM(無後訓練)、GRPO、OPSD、SDPO(自我蒸餾搭配環境回饋)、GRPO+OPSD(兩者結合)、RLSD(本文)。
5.2 主要結果
下表呈現 Table 2 在五個基準上的準確率(%):
| 方法 | MMMU | MathVista | MathVision | ZeroBench | WeMath | Avg. |
|---|---|---|---|---|---|---|
| Base LLM | 62.44 | 73.80 | 47.37 | 19.76 | 54.10 | 51.49 |
| GRPO | 65.11 | 76.20 | 48.82 | 22.60 | 56.57 | 53.86 |
| OPSD | 63.82 | 75.10 | 47.53 | 21.06 | 54.95 | 52.49 |
| SDPO | 65.11 | 74.00 | 47.27 | 25.15 | 52.19 | 52.74 |
| GRPO+OPSD | 63.22 | 75.90 | 48.52 | 22.16 | 54.76 | 52.91 |
| RLSD(本文) | 67.22 | 78.10 | 52.73 | 24.85 | 58.00 | 56.18 |
關鍵觀察:
- RLSD 平均較基底模型提升 4.69%,較 GRPO 提升 2.32%。
- OPSD 在多數基準上反而低於 GRPO,與我們在第 3 節觀察到的後期衰退一致。
- 數學領域提升最為顯著:MathVision +3.91%、MathVista +1.9%(相對於 GRPO)。
5.3 訓練動態
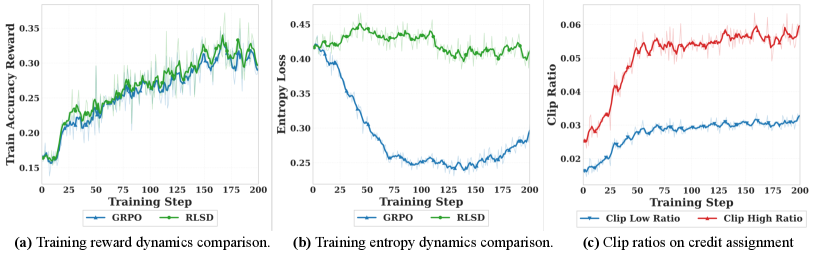
從訓練曲線(圖 5)可以觀察:
- 更陡的早期上升:RLSD 比 GRPO 更快收斂,比 OPSD 更穩定,沒有後期衰退。
- 保持較高的策略熵 (Entropy):避免均勻獎勵把所有 token 位置一起壓縮,保留探索能力。
- 裁剪機制持續啟動:訓練中裁剪率穩定維持在 3–6%,扮演信賴域約束的角色,避免單一 token 的極端權重破壞訓練。
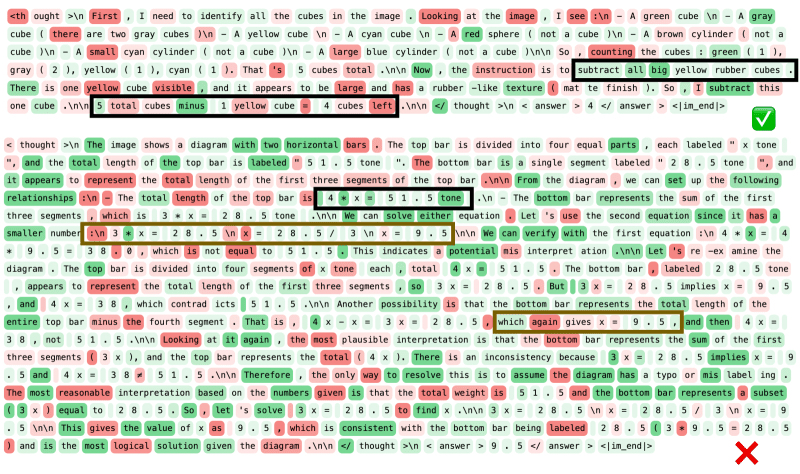
5.4 質性分析:Token 層級信用熱圖
[Figure 6: Token 層級信用熱圖(RLSD 下兩個多模態推理範例)。上:在正確軌跡中,較大的信用集中在關鍵的計數與減法步驟。下:在錯誤軌跡中,最強的責備被分配到誤讀的 bar-model 關係與導出的錯誤答案。]
熱圖顯示 RLSD 並未把獎勵均勻地散佈在整條序列上,而是把信用集中於「決定推理對錯」的關鍵 token,這種集中度正是密集訊號相對於稀疏訊號的價值所在。
6. 相關工作
RLVR 中的信用分配:許多工作試圖把序列層級的稀疏獎勵轉成 token 或步驟層級的密集訊號,包括過程獎勵模型 (Process Reward Model, PRM)、步驟層級的價值估計、以及利用模型內部代理(熵、不確定性、注意力動態)的方法(Lightman et al., 2024; Wang et al., 2024b; Luo et al., 2024; Xie et al., 2025; Li et al., 2026 等)。RLSD 與這些工作不同,它無需訓練輔助網路,僅以一次教師前向便得到 token 層級的細粒度訊號。
線上策略蒸餾:包含使用外部教師的 OPD(Agarwal et al., 2024; Lu & Thinking Machines Lab, 2025)、自我蒸餾 OPSD(Zhao et al., 2026; Hübotter et al., 2026),以及 context-conditioned teaching、推理壓縮等方向。本文揭露了 OPSD 在資訊不對稱下的結構性失效,並指出自我蒸餾的合理位置。
特權資訊蒸餾:與本文同期的若干工作也注意到教師–學生間的不對稱問題,並提出不同的緩解方案。
7. 結論
本文揭示了線上策略自我蒸餾 (OPSD) 在資訊不對稱下的本質困境:教師若條件於學生不可見的特權資訊 $r$,分布匹配目標便存在不可消除的條件互資訊殘差,導致 KL 停滯、特權資訊洩漏與長期訓練不穩定。從梯度結構出發,我們進一步證明 OPSD 的更新會在訓練後期被 $r$-specific 偏差主導,自我增強地把 $x \to r$ 的虛假關聯編碼進參數。
基於此診斷,我們提出 RLSD,將「方向」與「幅度」解耦:環境的可驗證獎勵獨佔強化或懲罰的方向決策,而教師證據比 $P_T(y_t)/P_S(y_t)$ 僅作為 token 層級的相對幅度調整。RLSD 同時保留了 RLVR 的環境錨定可靠性與 OPSD 的密集訊號豐富性,在五個多模態推理基準上以 4.69%(vs. base)/ 2.32%(vs. GRPO)的平均提升證實其有效性與穩定性。
侷限性:本文版本主要驗證於多模態推理任務。作者表示在文字推理、影片理解與其他模型家族上的初步驗證亦觀察到一致的提升,將於後續版本中呈現。
參考文獻
- Shao et al. (2024). DeepSeekMath: Pushing the limits of mathematical reasoning in open language models. arXiv:2402.03300
- DeepSeek-AI et al. (2025). DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning. arXiv:2501.12948
- Kimi Team et al. (2026a). Kimi K2.5: Visual agentic intelligence. arXiv:2602.02276
- Agarwal et al. (2024). On-policy distillation of language models: Learning from self-generated mistakes. In Proceedings of ICLR 2024.
- Lu & Thinking Machines Lab (2025). On-policy distillation. Thinking Machines Lab: Connectionism.
- Core Team et al. (2026b). MIMO-V2-Flash technical report. arXiv:2601.02780
- Zhao et al. (2026). Self-distilled reasoner: On-policy self-distillation for large language models. arXiv:2601.18734
- Hübotter et al. (2026). Reinforcement learning via self-distillation. arXiv:2601.20802
- Schulman et al. (2017). Proximal policy optimization algorithms. arXiv:1707.06347
- Xie et al. (2025). Unlocking exploration in RLVR: Uncertainty-aware advantage shaping for deeper reasoning. arXiv:2510.10649
- Li et al. (2026). Outcome-grounded advantage reshaping for fine-grained credit assignment in mathematical reasoning. arXiv:2601.07408
- Kingma & Ba (2017). Adam: A method for stochastic optimization. arXiv:1412.6980
- Lin et al. (2026). MMFineReason: Closing the multimodal reasoning gap via open data-centric methods. arXiv:2601.21821
- Yue et al. (2024). MMMU: A massive multi-discipline multimodal understanding and reasoning benchmark for expert AGI. arXiv:2311.16502
- Lu et al. (2024). MathVista: Evaluating mathematical reasoning of foundation models in visual contexts. arXiv:2310.02255
- Wang et al. (2024a). Measuring multimodal mathematical reasoning with Math-Vision dataset. arXiv:2402.14804
- Roberts et al. (2025). ZeroBench: An impossible visual benchmark for contemporary large multimodal models. arXiv:2502.09696
- Qiao et al. (2024). WE-Math: Does your large multimodal model achieve human-like mathematical reasoning? arXiv:2407.01284
- Bai et al. (2025). Qwen3-VL technical report. arXiv:2511.21631
- Sheng et al. (2025). HybridFlow: A flexible and efficient RLHF framework. In Proceedings of EuroSys 2025.
- Zheng et al. (2025). EasyR1: An efficient, scalable, multi-modality RL training framework. GitHub repository.
- Lightman et al. (2024). Let's verify step by step. In Proceedings of ICLR 2024.
- Wang et al. (2024b). Math-Shepherd: Verify and reinforce LLMs step-by-step without human annotations. In Proceedings of ACL 2024.
- Yang et al. (2025a). Test-time prompt intervention. arXiv:2508.02511
- Luo et al. (2024). Improve mathematical reasoning in language models by automated process supervision. arXiv:2406.06592
術語對照表
| 英文 | 中文 |
|---|---|
| On-policy Distillation (OPD) | 線上策略蒸餾 |
| On-Policy Self-Distillation (OPSD) | 線上策略自我蒸餾 |
| Reinforcement Learning with Verifiable Rewards (RLVR) | 可驗證獎勵的強化學習 |
| Group Relative Policy Optimization (GRPO) | 群組相對策略優化 |
| Privileged Information | 特權資訊 |
| Privileged Information Leakage | 特權資訊洩漏 |
| Information Asymmetry | 資訊不對稱 |
| Credit Assignment | 信用分配 |
| Token-level | token 層級 |
| Trajectory | 軌跡 |
| Distribution Matching | 分布匹配 |
| Conditional Mutual Information | 條件互資訊 |
| Evidence Ratio | 證據比 |
| Policy Gradient | 策略梯度 |
| Importance Sampling Ratio | 重要性取樣比 |
| Advantage | 優勢 |
| Outcome Reward | 結果獎勵 |
| Verifier | 驗證器 |
| Teacher | 教師(模型) |
| Student | 學生(模型) |
| Direction | 更新方向 |
| Magnitude | 更新幅度 |
| Stop-gradient | stop-gradient(停止梯度) |
| Process Reward Model (PRM) | 過程獎勵模型 |
| Trust Region | 信賴域 |
| Two-Phase Training Dynamics | 兩階段訓練動態 |
| Plateau | 平台(停滯) |
| Forward Pass | 前向傳播 |
| Drop-in | 即插即用 |
| Off-policy | 離線策略 |
| On-policy | 線上策略 |
| Lower Bound | 下界 |
| Sparse | 稀疏 |
| Post-training | 後訓練 |
| Reasoning | 推理 |
| Rollout | rollout(取樣展開) |
| Entropy | 熵 |
| Ill-posed | 病態(無良定) |