MiniCPM:以可擴展的訓練策略揭示小型語言模型的潛力
原始論文:MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies 作者:Shengding Hu、Yuge Tu、Xu Han、Chaoqun He、Ganqu Cui、Xiang Long、Zhi Zheng、Yewei Fang、Yuxiang Huang 等(清華大學 電腦科學與技術系、Modelbest Inc.;通訊作者 Xu Han、Zhiyuan Liu、Maosong Sun) arXiv ID:2404.06395v3 日期:2024 年 4 月 9 日 標籤:Small Language Model WSD Scheduler Scaling Law Pre-training MoE Long Context 開源模型
【譯註】本文是 MiniCPM(清華 OpenBMB / Modelbest)的技術報告,主打「用可擴展的訓練策略,讓 1.2B/2.4B 的小型語言模型 (SLM) 達到 7B–13B 模型的能力」。兩個核心貢獻:模型風洞實驗 (Model Wind Tunnel Experiments)(用小模型窮盡搜尋超參數再遷移到大模型)與 WSD(Warmup-Stable-Decay,暖身-穩定-衰減)學習率排程(讓 scaling law 的量測成本從 $O(m^2)$ 降到 $O(m)$,並得出遠高於 Chinchilla 的最佳資料-模型比)。授權 CC BY 4.0,站上公開。
摘要
開發參數量高達兆級的大型語言模型 (LLM) 所引發的蓬勃興趣,也伴隨著對資源效率與實際花費的顧慮,特別是考慮到實驗的巨大成本。這個情境凸顯了探索小型語言模型 (Small Language Models, SLM) 作為資源高效替代方案之潛力的重要性。在此脈絡下,我們推出 MiniCPM,具體而言是 1.2B 與 2.4B 非嵌入參數 (non-embedding parameter) 的變體,它們不僅在各自的類別中表現優異,還展現出與 7B–13B LLM 相當的能力。雖然聚焦於 SLM,我們的方法在模型與資料兩個維度上都對未來的 LLM 研究展現可擴展性。在模型縮放方面,我們採用廣泛的模型風洞實驗以達成穩定且最佳的縮放。在資料縮放方面,我們引入 WSD(Warmup-Stable-Decay,暖身-穩定-衰減)學習率排程 (LRS),有利於持續訓練與領域適應。我們對 WSD LRS 中出現的有趣訓練動態做了深入分析。有了 WSD LRS,我們現在能夠在模型與資料兩軸上都不必大量重新訓練就高效地研究資料-模型 scaling law,並由此推導出遠高於 Chinchilla Optimal 的計算最佳資料-模型比。此外,我們引入 MiniCPM 家族,包括 MiniCPM-DPO、MiniCPM-MoE 與 MiniCPM-128K,它們的出色表現進一步鞏固了 MiniCPM 在多樣 SLM 應用中的基礎。MiniCPM 模型已公開釋出:https://github.com/OpenBMB/MiniCPM 。
1 引言
在 scaling law [Kaplan et al., 2020] 揭示之後,大型語言模型 (LLM) 領域展開了旺盛的追逐 [Hoffmann et al., 2022; Bai et al., 2023; Gemini et al., 2023; Chowdhery et al., 2023; Achiam et al., 2023],涵蓋參數量達到驚人兆級的模型 [Fedus et al., 2022]。這些模型已成為人工智慧演進中的關鍵推力。
儘管如此,訓練這種大規模模型既在財務上沉重、又在營運上低效。一方面,關於 LLM 訓練底層機制的經驗性理解仍然難以捉摸。考慮到顯著的經濟與環境成本,對大多數研究者與企業而言,LLM 實驗的花費高得令人卻步。另一方面,在日常情境(例如個人電腦或智慧型手機上)部署這些龐然大物,要嘛低效、要嘛不可行。這兩個面向都凸顯了「把心力重新聚焦於全面探索更小、卻強大的語言模型 (SLM)」的必要性。這些模型一方面為實際部署提供高效的解決方案,另一方面,若以可擴展的策略訓練,它們有可能指引未來更大模型的開發。
近來,SLM 領域出現了興趣的復甦,一系列創新模型的問世可為佐證,例如 Phi 系列 [Gunasekar et al., 2023; Li et al., 2023b; Javaheripi & Bubeck, 2023]、TinyLlama [Zhang et al., 2024a]、MobileLLM [Liu et al., 2024]、Gemma [Banks & Warkentin, 2024] 等。雖然這些模型顯著貢獻於 SLM 版圖的擴展與多樣化,仍有兩個關鍵領域尚未完全滿足當前的關切:(1) 發展出類似 LLM 所展現的全面能力;以及 (2) 制定透明且可擴展的訓練方法論,能進一步推動 SLM 與 LLM 兩者的演進。
在本文中,我們引入 MiniCPM,一系列 SLM,主要建立在兩個模型上,分別具有 2.4B 與 1.2B 非嵌入參數,它們在各自的 2B 與 1B 規模類別中名列前茅。MiniCPM 也展現出與 7B$\sim$13B 語言模型相當的能力,例如 Llama2-7B [Touvron et al., 2023]、Mistral-7B [Jiang et al., 2023]、Gemma-7B、Llama-13B 等。儘管模型尺寸小,我們的訓練方法論經過縝密設計,以促進模型規模與資料範圍兩者的無縫縮放。這透過我們涵蓋全面超參數最佳化的模型風洞實驗(第 3 節)、以及 WSD(Warmup-Stable-Decay)學習率排程的部署(第 4 節)得以體現。後者為「預訓練 token 數未預先定義的持續訓練」量身打造,並使模型中間檢查點 (checkpoint) 的重用高度可行。我們呈現對 MiniCPM 訓練動態的詳細分析,暗示 WSD 排程揭示了模型預訓練有趣的損失地景。有了 WSD 排程,我們現在也能夠以「模型軸上線性、資料軸上可忽略」的努力研究資料-模型 scaling law,而傳統方法考慮兩軸的縮放需要平方級的努力。scaling law 的結果指出,相較於 Chinchilla Optimal [Hoffmann et al., 2022],一個高得多的資料-模型比。
此外,我們引入 MiniCPM 家族,包括 MiniCPM-DPO、MiniCPM-128K 與 MiniCPM-MoE。我們對照既有基準評測 MiniCPM 家族,並闡明它們作為 SLM 的傑出能力:(1) 基礎模型超越 Mistral-7B 與 LLama-13B。(2) DPO 模型在 MTBench [Zheng et al., 2024] 上超越 zephyr-7B。(3) 2.4B 的 MiniCPM-128K 模型展現出超越或匹配 Yarn-Mistral-7B-128K、ChatGLM3-6B-128K 等模型的效能。(4) MiniCPM-MoE 以 4B 激活參數與 Llama2-34B 相當。
總結來說,MiniCPM 為小型語言模型的發展提出一個新階段,體現 SLM 內在的潛力,並倡議一種更科學、更可持續的 LLM 放大途徑。
2 相關研究
小型語言模型。 「小型語言模型 (SLM)」是一個隨時間顯著轉變的演進概念。目前 SLM 一般被理解為規模相較於著名 LLM 更小的模型,通常不超過 70 億參數。這些模型的特點是能夠部署在終端使用者裝置上,例如個人電腦與智慧型手機,即使沒有 GPU。當前 SLM 版圖中的顯著例子包括 Phi 系列、TinyLlama、MobileLLM、Gemma 等。已有多種方法論被探索以增強 SLM 的效能,包括納入高品質資料 [Gunasekar et al., 2023 等]、應用結構化剪枝技術 [Xia et al., 2023]、以及重新配置模型架構 [Liu et al., 2024] 等。MiniCPM 透過縝密地融合超參數最佳化、策略性訓練方法論、架構設計與高品質資料來增強 SLM 的能力。
可擴展的預訓練策略。 自從 scaling law 被發現 [Kaplan et al., 2020; Rae et al., 2021; Aghajanyan et al., 2023],科學地、可預測地放大 LLM 已從多樣視角被追求,尤其是預訓練階段。在訓練穩定性方面,Tensor Program 系列 [Yang et al., 2022; Yang et al., 2023] 被引入以確保跨不同模型規模的最佳超參數一致性,這技術用於訓練 CerebrasGPT [Dey et al., 2023]。此外,Wortsman et al. (2023) 建議利用較小的模型來預期並緩解較大模型訓練中的不穩定。從訓練資料的角度,各種以資料為中心的策略被倡議。在訓練方法論領域,先前研究鑽研過多樣的學習率排程 (LRS),其中 Cosine LRS [Loshchilov & Hutter, 2016] 成為 LLM 中的主流選擇。Kaplan et al. (2020) 與 Hoffmann et al. (2022) 縝密地檢視了 Cosine LRS 的超參數,為後續預訓練工作奠定基礎。其中,DeepSeek [Bi et al., 2024] 與我們提出的 WSD LRS 最為相似。關於批次大小排程,Smith et al. (2017) 倡議增大批次大小作為降低學習率的替代方案,這策略近來被 Yi-9B [Young et al., 2024] 採用。
3 模型風洞實驗
雖然我們的目標是訓練能快速部署到終端裝置的 SLM,我們設想模型訓練的許多面向是跨規模通用的。應該透過一個 SLM 進行廣泛實驗以探索 SLM 的極限,然後再把經驗遷移到 LLM。這些實驗取「開發飛機時風洞測試」的精神,因此我們把它命名為模型風洞實驗 (Model Wind Tunnel Experiments, MWTE)。在本文中,MWTE 包含三部分:(1) 超參數;(2) 最佳批次大小縮放;以及 (3) 最佳學習率穩定性。
3.1 縮放超參數不變的 LM
超參數對模型效能有顯著影響。然而,在傳統訓練中為每個模型調整超參數對 LLM 而言不可行。即使對 MiniCPM 這樣的 SLM,廣泛的超參數搜尋實驗也耗費大量資源。Tensor Program [Yang et al., 2022; 2023] 提出一個框架來為不同規模的模型穩定超參數。Tensor Program 的主要部分是寬度縮放 (width scaling) [Yang et al., 2022] 與深度縮放 (depth scaling) [Yang et al., 2023]。前者支撐 CerebrasGPT 更準確地預測 LLM 的損失。在 MiniCPM 中,我們使用這兩種縮放技術,具體縮放操作列於表 6。我們不套用注意力 softmax 縮放技術。儘管 Yang et al. (2023) 觀察到「區塊深度大於二的網路」深度縮放不甚令人滿意,我們發現由此得到的最佳學習率在經驗上是穩定的。超參數與 Tensor Program 操作的細節見附錄 A.1。
3.2 最佳批次大小
批次大小決定了模型收斂速度與運算資源消耗之間的平衡。若批次太大,會導致大量的資料與運算成本;反之,若批次太小,會需要大量訓練步數、且可能導致損失函數只有有限的下降。我們遵循 Kaplan et al. (2020) 從期望損失決定批次大小,並對其設定稍作修改(見附錄 A.2)。我們分別在 0.009B、0.03B、0.17B 模型上進行實驗。每個模型尺寸在 6 個批次大小上訓練,全域學習率為 $0.01$、採用 cosine 學習率排程。我們觀察最佳批次大小隨 C4 [Raffel et al., 2019] 資料集損失的趨勢(圖 2 中的紅線)。
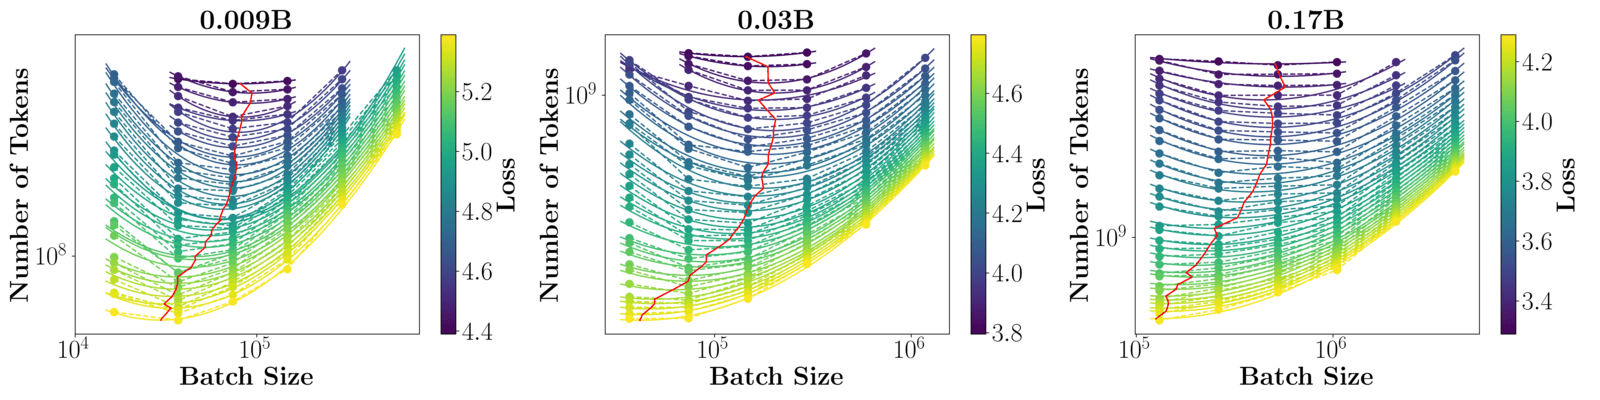
圖 1: 我們展示三個尺寸的模型用不同批次大小訓練的損失曲線。每條由漸層色點形成的垂直線代表一條訓練曲線,較淺的顏色表示較高的損失。圖 2: 連接後的最佳批次大小。
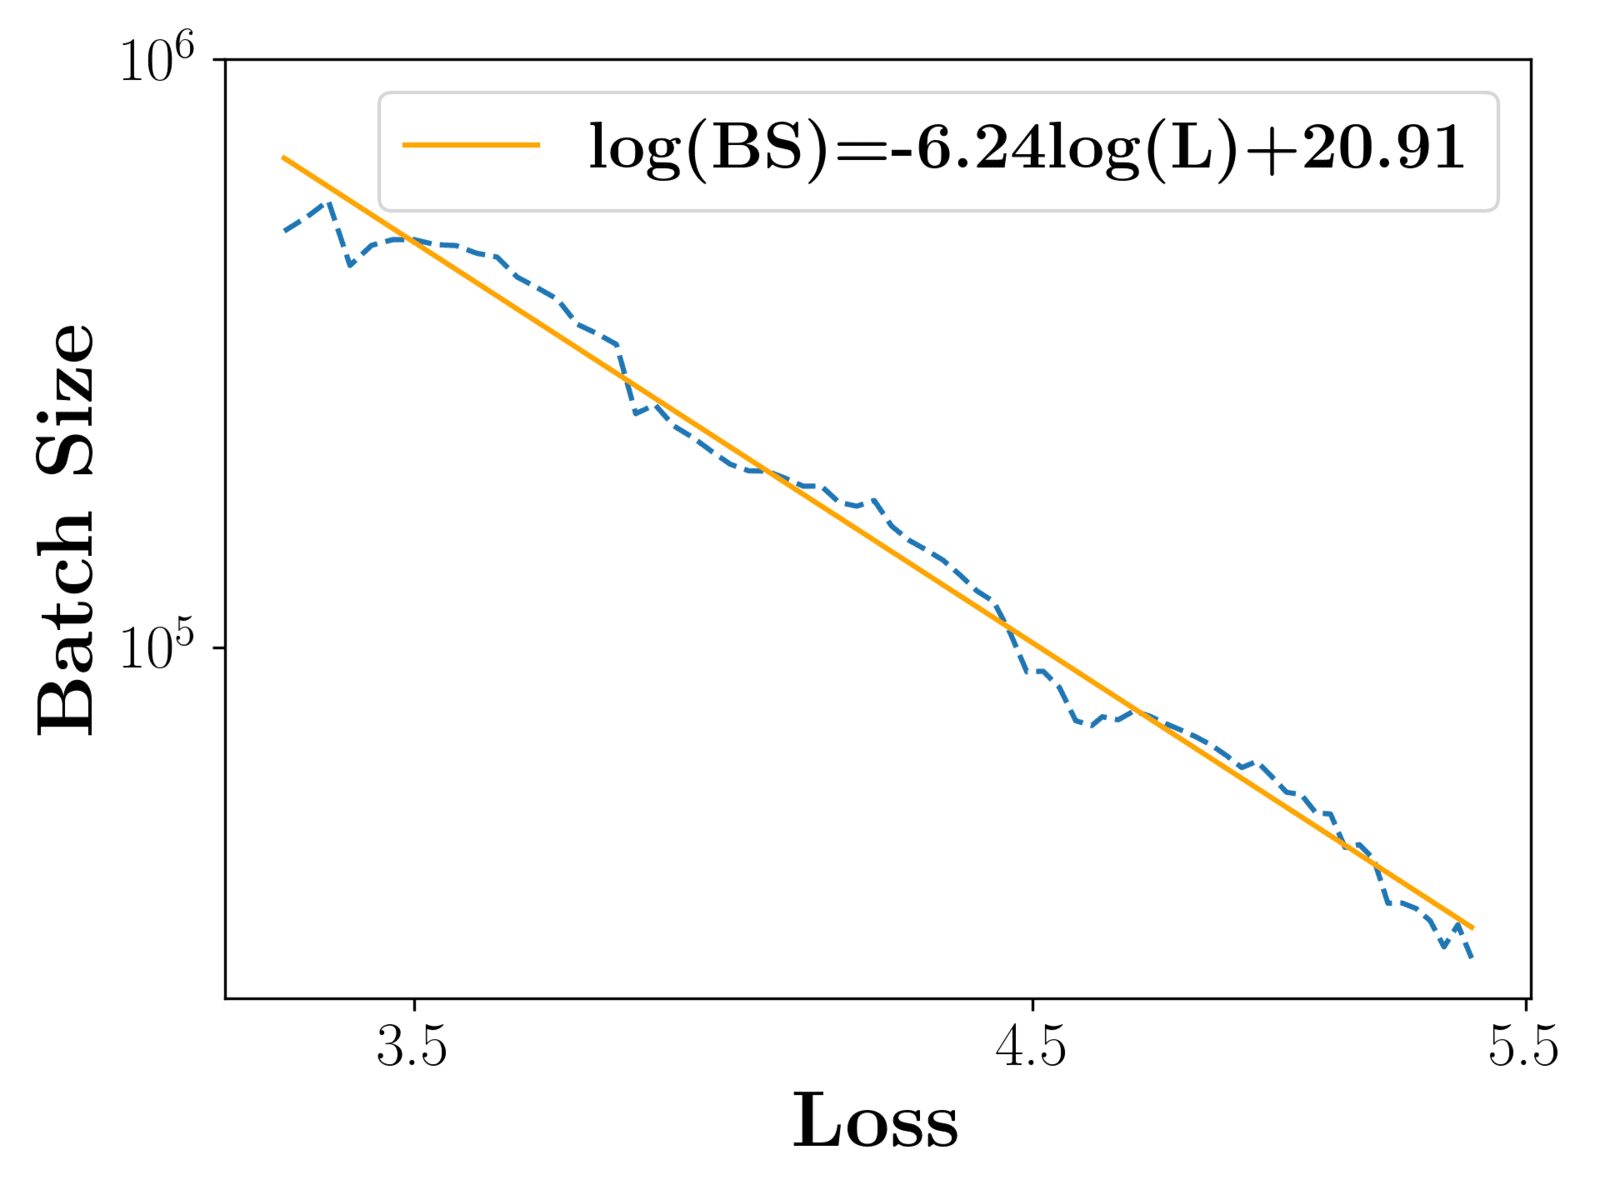
如圖 2 所示,我們把批次大小畫在 x 軸、token 消耗畫在 y 軸,點的顏色代表損失,因此由色點形成的一條水平線代表一條訓練曲線。我們用拋物線擬合等損失的點,並用紅線連接拋物線的極小值。這些線顯示最佳批次大小隨損失下降而變大。接著我們連接這三條線(見圖 2),發現它們在對數空間中很好地相互連成一個線性關係,由此得到批次大小 $bs$ 與 C4 損失 $L$ 之間的關係:$bs=\frac{1.21\times 10^{9}}{L^{6.24}}$。我們注意到「批次大小應該由一個只有在訓練後才能得到的粗略損失預測來估計」這件事看似奇怪,我們在附錄 A.2 提供評論。
3.3 最佳學習率
由於我們使用 Tensor Program,我們預期學習率在模型縮放期間不會經歷顯著變化。為驗證這點,我們在 0.04B、0.1B、0.3B、0.5B 上進行六組學習率實驗。在圖 4 中,我們發現雖然模型尺寸增大了十倍,最佳基礎學習率(【譯註】2 維張量的實際學習率會依 Tensor Program 縮放)沒有顯示明顯的偏移、仍維持在 0.01 左右。我們進一步在 2.1B 規模上做了簡單驗證,確認 0.01 的學習率確實達到最低損失。
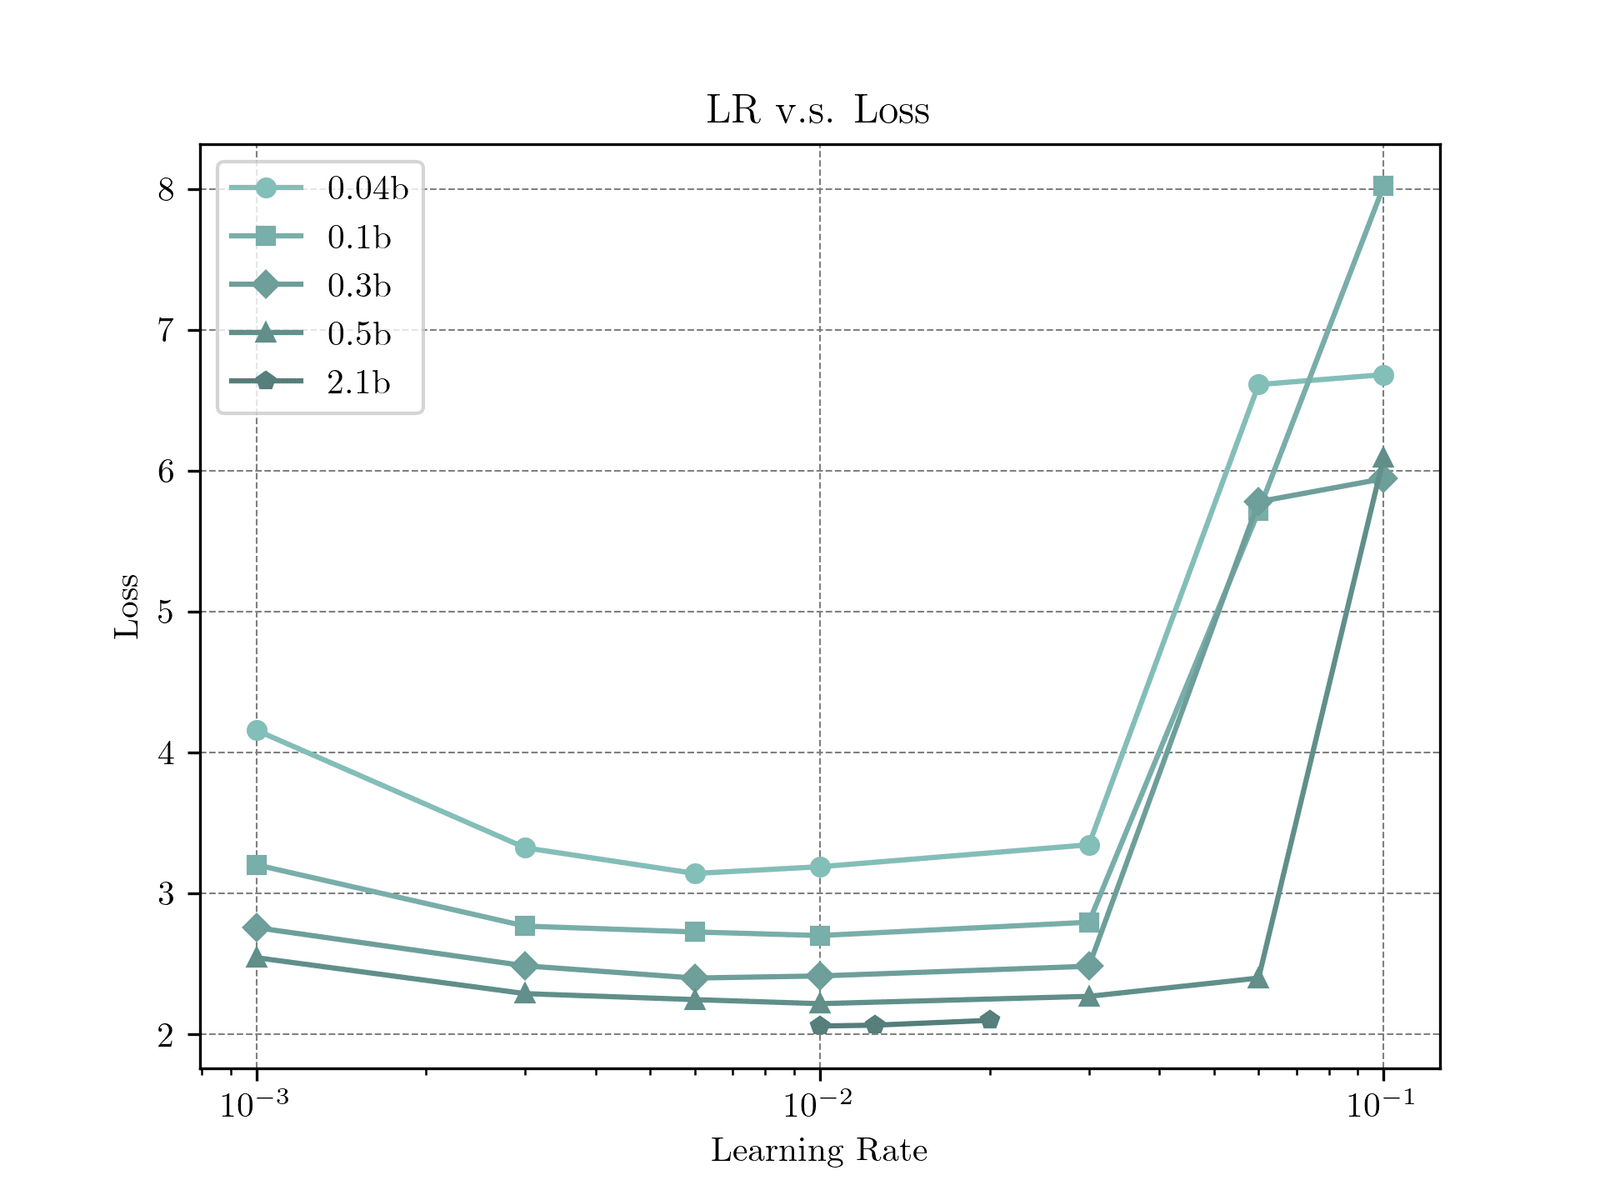
圖 3: 損失 vs 學習率。套用 Tensor Program 之後,學習率偏移變得極小。
4 WSD 學習率排程
4.1 分析 Cosine LRS
學習率排程 (LRS)——在訓練不同階段調整所用的學習率——對模型效能至關重要。目前常用的學習率策略是 Cosine LRS,它在暖身階段之後達到最大值,然後依 cosine 曲線逐漸降低學習率。
Cosine LRS 的一個關鍵超參數是 cosine 首次降到最小值的步數 $T$。通常,對於「訓練步數預先定義」的訓練,$T$ 被設為總訓練步數 $S$。一般認為學習率應該高以促成充分的探索。例如,Kaplan et al. (2020) 證明當整個訓練加總的學習率增加時損失會下降,這暗示設 $T<S$ 不是最佳的。但另一方面,Hoffmann et al. (2022) 做出一個關鍵觀察:設 $T>S$ 會導致效能下降,而設 $S=T$ 會改善訓練效率,確認學習率不應在整個訓練中維持高值。為重現這些觀察,我們在 0.036B 模型上進行實驗,嘗試 $Cosine(T)$ 與 $CosineLoop(T)$ LRS(公式見附錄 B.1)。結果見圖 4:當訓練步數為 $S=20N,40N,60N,80N$ 時,最低損失總是由 $T=S$ 的 $Cosine(T)$ 達到;$T<S$ 與 $T>S$ 都不是最佳。
我們假設 Cosine LR 在 $T=S$ 時表現特別好,原因有二:(1) $T=S$ 的 Cosine LRS 相較於 $T<S$ 與 Constant LRS 有更長的高學習率訓練時段;(2) 它有學習率衰減。這種學習率衰減可能涉及使模型找到更好局部最佳的獨特訓練動態。
4.2 WSD LRS
有鑑於上述觀點,我們提出明確地把訓練階段分成「高學習率階段」與「學習率衰減階段」。我們把它命名為 Warmup-Stable-Decay(暖身-穩定-衰減,WSD)LRS。具體而言,WSD LRS 包含三個階段:暖身階段(結束步數記為 $W$)、穩定訓練階段(結束步數記為 $T$)、以及其餘的衰減階段。WSD 的函數形式為:
$$WSD(T;s)=\begin{cases}\frac{s}{W}\eta, & s<W \quad\text{(暖身)}\\ \eta, & W<s<T \quad\text{(穩定)}\\ f(s-T)\eta, & T<s \quad\text{(衰減)}\end{cases} \tag{1}$$
其中 $0<f(s-T)\le 1$ 是一個關於 $s$ 的遞減函數,$\eta$ 是最大學習率。
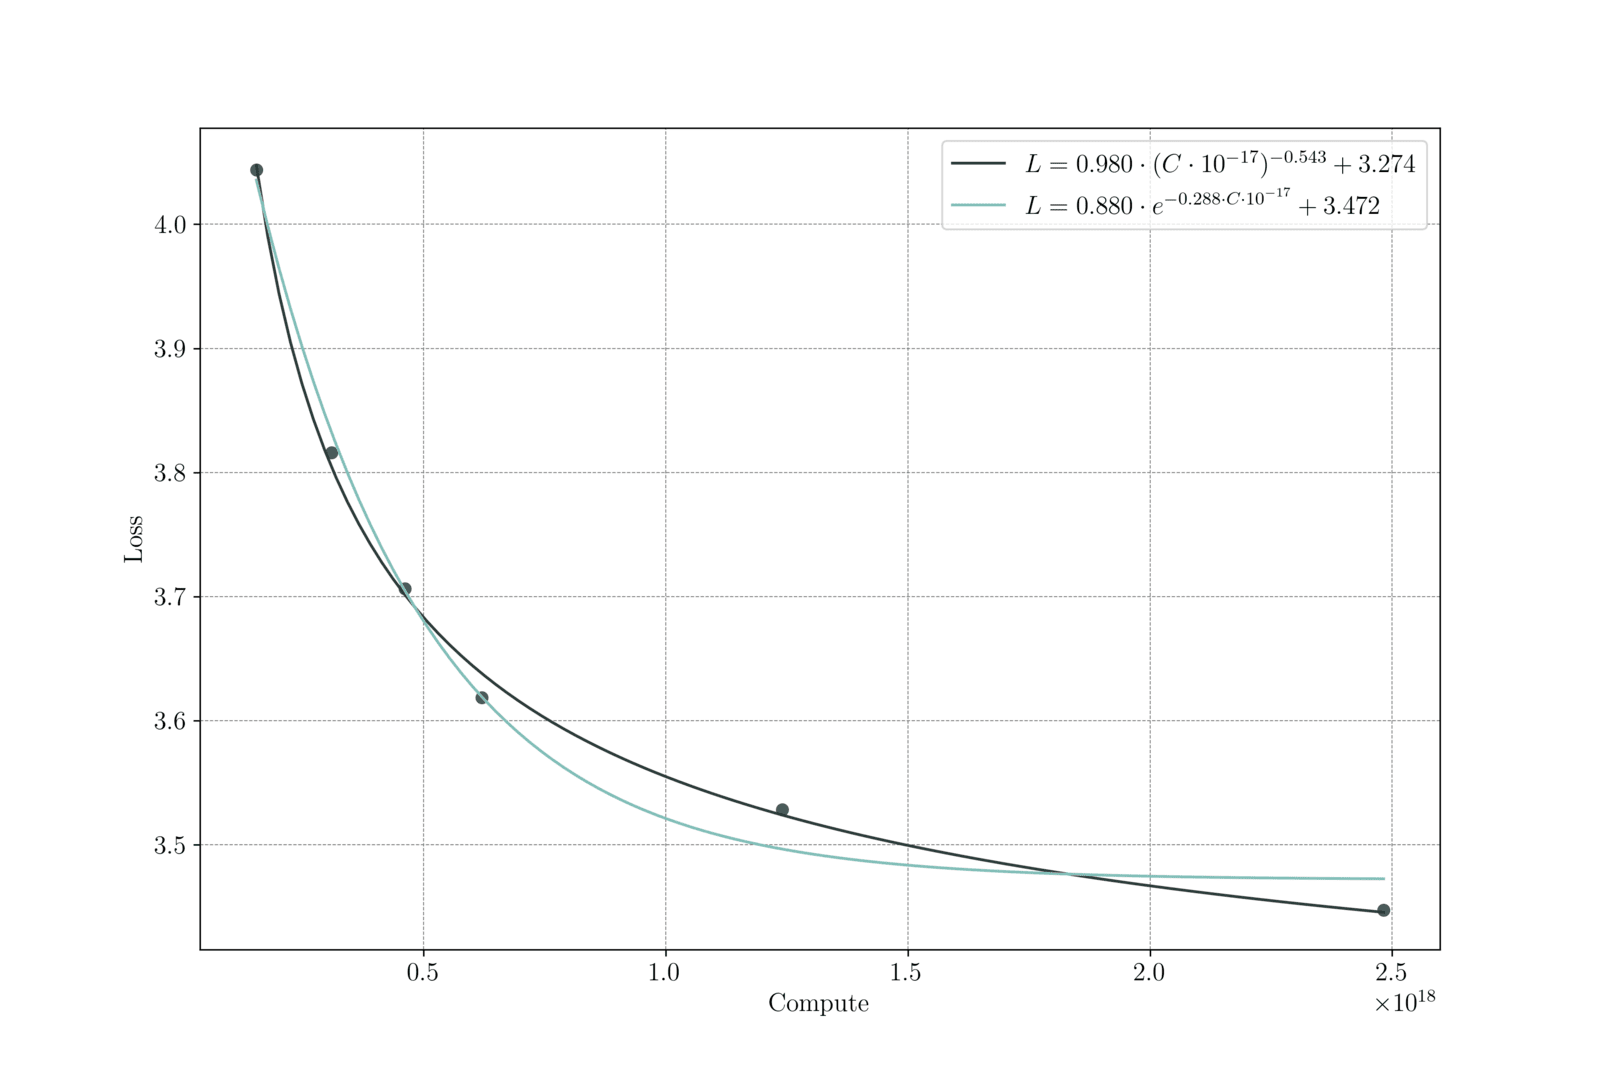
圖 4: 不同週期的 Cosine 學習率排程。Y 軸是 C4 語料上的損失。圖 5: 在 WSD LRS 的衰減階段,模型訓練損失突然下降。圖 6: 持續訓練一個 0.036B 模型可以在訓練計算量可接受地增加下,匹配 0.17B 模型的效能。
4.3 實驗
接著我們呈現 WSD LRS 的幾個實驗發現。
損失在衰減階段急遽下降。 我們在 0.036B 模型上嘗試 WSD LRS。如圖 6 所示,在衰減階段,隨著學習率開始下降,損失經歷了顯著的快速下滑,並迅速降到等於或低於 $T=S$ 的 Cosine LRS。同時,我們可以重用衰減前的模型、以先前的高學習率繼續訓練。在多訓練 $S'$ 步之後,我們也能進行退火 (annealing) 以達到 $Cosine(S')$ 的相同損失。這驗證了我們的假設:訓練階段可以明確地分成穩定訓練與衰減兩階段。
10% 的步數就足夠。 從兩階段訓練的角度看,縮短衰減階段會大大有利於快速測試穩定訓練的不同模型檢查點。因此,我們進行從相同穩定訓練檢查點開始、但有不同衰減步數的實驗。同樣如圖 6 所示,在 40N、60N、80N 訓練資料的三個穩定訓練檢查點中,「衰減佔總 token 數的 10%」足以達到最佳結果,而「衰減佔 2.5%」則不足。因此,在後續訓練實驗中,我們使用約 10% 的衰減以確保充分收斂。
用 WSD LRS 進行有效的資料縮放。 有了 WSD LRS,我們可以持續訓練 LM 至極度收斂。為進一步展現「把固定尺寸模型訓練到收斂」的潛力,我們比較「持續訓練一個 0.036B LM」與「用 40N 資料的 0.17B 模型」。在圖 6 中,綠線代表用不同穩定訓練 token 數訓練的 0.036B 模型。儘管 0.036B 系列的最後一點用的 token 數遠多於 Chinchilla Optimal,它仍有效能改善的空間。
為找出持續訓練這個固定尺寸 LM 的極限,我們估計模型在持續訓練期間其最佳效能如何隨計算量變化。所謂最佳效能,是指 token $D$ 的損失由 ${WSD}(D,0.1D)$ 達到。給定一系列 $D$,這些損失會形成最佳損失包絡線 (loss envelope)。由於不確定損失包絡線的函數形式,我們嘗試兩個擬合公式:(1) 指數式 $L(C)=\alpha e^{-\beta C}+L_{0}$;(2) 冪律 $L(C)=\beta C^{-\alpha}+L_{0}$。兩個函數的擬合結果在附錄 B.2。我們發現冪律形式擬合得更好(與 Cosine LRS [Kaplan et al., 2020] 相似)。為直觀估計與理解持續訓練這種固定尺寸模型的效果,我們也用 $WSD(40N,4N)$ 訓練了一個 0.17B 模型(圖 6 中的粉紅色)。我們看到一個 0.036B 模型能以「訓練計算量可接受的增加(約 4 倍)」匹配一個 0.17B 模型的效能,同時節省大量推論運算(每次推論呼叫節省約 5 倍),指出一個更好的「推論-計算最佳」設定。
4.4 衰減階段的分析
在本節中,我們對衰減階段的損失下降提供簡短分析,透過檢查點更新與梯度資訊的稜鏡來檢視它。我們計算 MiniCPM-2.4B(第 6 節介紹)所有權重矩陣的最大權重元素更新 $\max_{ij}(W_{ij}^{(t+1)}-W_{ij}^{(t)})$。如圖 7 所示,這些更新與學習率的大小呈現穩健的相關。儘管圖示只有兩個子模組(第 25 層的 gate_proj 與 q_proj 模組),這個模式在網路中的每一層與每個子模組都很普遍。這個觀察或許並不平凡:模型檢查點在學習率衰減之前經歷顯著的更新,然而損失只呈現極小的降低;相對地,在衰減階段,儘管權重變動較不明顯,損失卻加速下降。
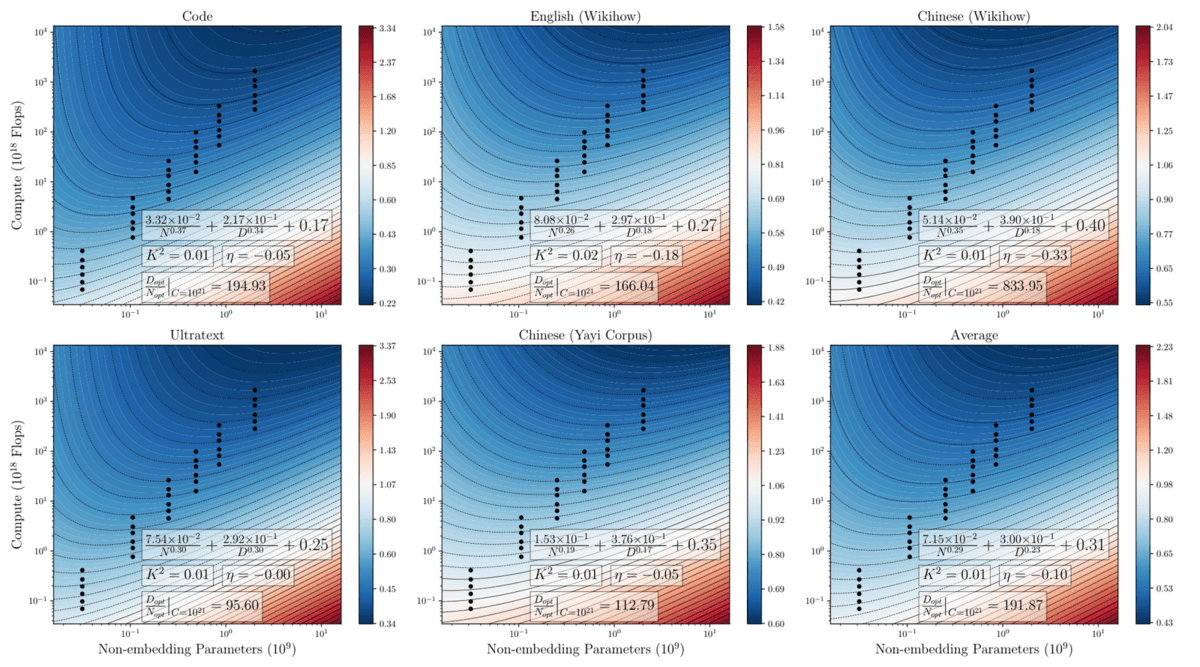
圖 7: 檢查點的最大差異(Max Difference of Checkpoints)。圖 8: 用 WSD LRS 訓練一個 0.2B 模型的梯度統計。指數衰減階段從第 8000 步開始。圖 9/10: WSD 排程的縮放實驗結果與擬合的縮放曲線(x 軸是計算量 Flops $C=6ND$)。可以看到 Flops 小時較小的模型優於較大的模型、Flops 大時則相反,因此不同尺寸的模型會在計算最佳區間附近彼此相交。
我們進一步藉由「訓練一個 0.2B 模型、縝密記錄每一步的梯度資訊、評估連續步之間的差異(從而提供二階梯度資訊的近似)」來檢視梯度資料。把第 $t$ 步的梯度視為攤平向量 $\mathbf{g}^{(t)}$,第 $t$ 與 $t+1$ 步之間的參數更新為 $\mathbf{v}^{(t)}=\mathbf{x}^{(t+1)}-\mathbf{x}^{(t)}$。梯度範數取 $L2$ 範數 $\|\mathbf{g}^{(t)}\|$,梯度內積為 $\mathbf{g}^{(t+1)}\cdot\mathbf{g}^{(t)}$,梯度夾角餘弦為 $\frac{\mathbf{g}^{(t+1)}\cdot\mathbf{g}^{(t)}}{\|\mathbf{g}^{(t+1)}\|\|\mathbf{g}^{(t)}\|}$。把最佳化過程想像成高維流形上的一條軌跡,沿軌跡的一階方向導數為 $D_{1}=\frac{\mathbf{g}^{(t+1)}\cdot\mathbf{v}^{(t)}}{\|\mathbf{v}^{(t)}\|}$,二階方向導數為 $D_{2}=\frac{(\mathbf{g}^{(t+1)}-\mathbf{g}^{(t)})\cdot\mathbf{v}^{(t)}}{\|\mathbf{v}^{(t)}\|^{2}}$。$D_{1},D_{2}$ 讓我們能近似估計軌跡上的損失曲率 $K=\frac{|D_{2}|}{(1+D_{1}^{2})^{3/2}}$。這些統計隨時間的結果見圖 8。我們看到梯度範數在衰減階段減小,且此階段一開始梯度之間的餘弦主要為正值,暗示在衰減階段模型參數跨步經歷一致的變化。關於方向導數,值得注意的是一階方向導數隨每步指數式減小、與學習率密切一致,而二階方向導數的大小則略微增加。損失函數的曲率也增加了一個量級,指出接近某個局部最佳。這些發現可能為最佳化空間的形狀提供更深入的洞見,這是留待未來探索的主題。
4.5 用 WSD LRS 量測 scaling law
Scaling law 是 LLM 開發中的一個基本指導原則。雖然這些 scaling law 因不同模型系列的多樣配置而在具體係數上有變異,「計算最佳的資料-模型比」仍是跨不同 scaling law 函數有意義的度量,它把損失的具體值「邊際化」掉。關於這個比值,Kaplan et al. (2020) 主張模型規模增大十倍應對應資料規模增大一倍。相反地,Hoffmann et al. (2022) 主張模型大小與資料大小之間相同的縮放率。此外,目前的模型如 LLama 2 訓練的資料遠多於 Hoffmann et al. (2022) 所主張的,仍產生可觀的效能增益,指向一個更高的資料-模型比。
這個未解決的不確定性源自傳統縮放實驗中「訓練多個不同尺寸與不同資料量的模型」所固有的挑戰。過去,若在一個資料量上訓練一個模型尺寸的平均成本是 $C$,那麼用 $m$ 個模型尺寸與 $m$ 個資料量進行縮放實驗需要約 $O(m^{2})C$。
在本節中,我們引入 WSD 排程作為一個以線性成本 ($O(mC)$) 探索 scaling law 的有效途徑。由於 WSD 排程有「從任何步數的穩定階段檢查點衰減後都能達到 Cosine LRS 最佳損失」的優勢,我們現在能夠精確地量測最佳縮放性質,而不必從頭把模型重新訓練到不同的 token 量,從而使 scaling law 的量測在資料軸上高效得多。
我們藉由「訓練 6 個尺寸(0.04B 到 2B)的 SLM,每個都有 6 個從穩定訓練階段的 $10N$ 到 $60N$ 資料檢查點開始衰減的模型」來量測沿資料與模型軸的 scaling law。最終損失在五個保留評測資料集上評估。為了能在模型使用不同 tokenizer 時比較損失,我們遵循 Achiam et al. (2023) 用「每位元組」而非「每 token」取損失平均。每對「資料大小 × 模型大小」的最終損失如圖 17 的藍線所示。
接著我們遵循 Hoffmann et al. (2022) 用 scipy curvefit 以模型大小 $N$ 與資料大小 $D$ 擬合損失:
$$L(N,D)=C_{N}N^{-\alpha}+C_{D}D^{-\beta}+L_{0} \tag{2}$$
給定固定計算量 $C=6ND$ [Rae et al., 2021],最佳模型大小 $N_{opt}$、資料大小 $D_{opt}$ 為:
$$\frac{N_{opt}}{D_{opt}}=K^{2}\left(\frac{C}{6}\right)^{\eta}, \tag{3}$$
其中 $K=(\frac{\alpha C_{N}}{\beta C_{D}})^{\frac{1}{\alpha+\beta}}$、$\eta=\frac{\beta-\alpha}{\alpha+\beta}$。$N_{opt}$ 的推導緊隨 Hoffmann et al. (2022):在方程式 2 中用 $\frac{C}{6N}$ 代 $D$、給定 $C$ 最小化 $L(N)$;$D_{opt}$ 也用類似方式。由方程式 3,當 $\alpha=\beta$ 時 $N_{opt}/D_{opt}$ 是常數,支持 Hoffmann et al. (2022) 的主張;當 $\alpha<\beta$ 時我們應把更多算力放到模型大小上(即 Kaplan et al. 2020 的主張),反之亦然。
在我們的實驗中,損失與 $N,D$ 的擬合關係如圖 10 的等損失等高線圖所示。我們發現在所有評測語料上都有 $\beta<\alpha$,代表資料應該比 Hoffmann et al. (2022) 更被強調。至於具體的資料-模型比 $\frac{D_{opt}}{N_{opt}}$,我們注意到儘管 $\frac{D_{opt}}{N_{opt}}$ 隨計算量 $C$ 的趨勢在我們與他們之間一致,計算最佳區間卻有巨大差距。具體而言,資料大小平均應該比模型大小大 192 倍,而 Hoffmann et al. (2022) 是 20 倍。我們注意到這與第 4.3 節和圖 6 的觀察一致。
關於與 Chinchilla Optimal $\frac{N_{opt}}{D_{opt}}$ 的巨大偏離,我們注意到他們的縮放實驗是在一個不太近期的配置下進行的。為與較近期的配置(如 Llama2)比較,我們從 Llama2 論文提取訓練損失資料(附錄圖 18 左),並用圖 18 右估計其論文中計算最佳的 $\frac{D_{opt}}{N_{opt}}$。由於他們用 Cosine LRS,訓練中段的損失不是最佳的。我們用直線填補凹陷部分以估計「若他們用 WSD LRS 的最佳損失包絡線」。由此直覺,13B 模型在 $10^{5}$ EFlops 附近即將與 34B 模型相交、34B 模型在 $5\times 10^{5}$ EFlops 附近即將與 70B 相交。因此我們估計 $\frac{D_{opt}}{N_{opt}}$ 大約是 $70\sim 100$。在這個近似比較下,他們的資料-模型比更接近我們的。而我們的配置相較於先前能把更多資料吸收進一個更小的模型。不過我們指出上述估計只是粗略的。
較大的資料-模型比意謂我們能把比先前所想更多的資料吸收進一個更小的模型,這對推論與部署更高效。我們希望 WSD LRS 能幫助更多研究者以更少的努力探索 $L(N,D)$,並使 LLM 中的這個關係更清晰。
5 兩階段預訓練策略
通常,訓練指令遵循的 LLM 包含預訓練階段與監督式微調 (SFT) 階段。在預訓練階段,資料由大規模無標註資料組成,而在 SFT 階段,高品質標註資料成為最佳化目標。有鑑於在 WSD LRS 衰減階段觀察到的顯著損失下降,我們假設「在此階段整合高品質標註資料」有雙重優勢:
- 在退火階段(退火 = annealing,即衰減階段)而非只在 SFT 階段引入這些資料,能促成更全面的模型學習。具體而言,它促成相對於「SFT 資料分布」(而非「預訓練資料分布」)更顯著的損失降低,這種做法更貼合實際使用者情境。
- 相較於「在整個預訓練過程中均勻分布高品質資料」,這種方法藉由聚焦資料並維持持續的預訓練來增強訓練。若我們不預先決定訓練步數,就會在持續的預訓練過程中重複一個小資料集,這可能導致負面效果。
基於這兩個假設,我們提出以下訓練策略:在預訓練階段只用大規模粗品質預訓練資料,這種資料充足、能在提供更多算力時支持持續訓練;在退火階段,我們使用多樣且高品質的、以知識與能力為導向的 SFT 資料,混入預訓練資料。
為驗證我們訓練策略的優勢,我們用 (A) MiniCPM-2.4B 穩定階段的中間檢查點;與 (B) MiniCPM-1.2B 穩定階段的最後檢查點進行比較實驗。具體比較:A-1(2.4B,只用預訓練資料衰減,接 4B token SFT);A-2(2.4B,用前述高品質無標註資料與 SFT 資料混入預訓練資料衰減,也接 4B token SFT);B-1(1.2B,只用預訓練資料衰減,接 6B token SFT);B-2(1.2B,只用預訓練資料衰減,接 12B token SFT);B-3(1.2B,用高品質資料 + SFT 資料混入預訓練資料退火,接 6B token SFT)。
表 1:不同訓練策略的消融研究。
| C-Eval | CMMLU | MMLU | GSM8K | MATH | HumanEval | MBPP | |
|---|---|---|---|---|---|---|---|
| A-1 | 40.0 | 41.5 | 44.6 | 27.7 | 5.1 | 27.7 | 24.4 |
| A-2 | 52.6 | 51.1 | 50.9 | 42.3 | 5.4 | 30.4 | 30.3 |
| B-1 | 40.9 | 41.5 | 47.9 | 34.2 | 7.9 | 43.9 | 30.5 |
| B-2 | 41.2 | 42.0 | 47.9 | 34.4 | 7.3 | 43.9 | 29.8 |
| B-3 | 49.1 | 46.8 | 49.6 | 31.8 | 10.5 | 44.5 | 32.8 |
結果如表 1 所示。我們看到,儘管 A-2 與 A-1 經歷相同的 SFT 分布,把 SFT 資料加到衰減階段推進了邊界。B-2 與 B-3 之間的比較顯示「只做 SFT 的不足」並非源於 SFT 階段 token 不足。結果指出「在衰減階段開始時引入高品質資料」的好處,遠高於單純在 SFT 階段加入。因此,我們建議模型能力的專門化與增強應從衰減階段開始。
6 模型
在本節中,我們開始介紹匯集上述觀察與技術的 MiniCPM 模型。
表 2:MiniCPM 的模型配置。 $N$(非嵌入參數數)、$d_m$(隱藏維度)、$d_{ff}$(前饋層瓶頸維度)、$d_h$(注意力頭維度)、$n_q$(query 數)、$n_{kv}$(key/value 數)、$L$(層數)、Batch size(訓練批次大小)、Tokens(總訓練 token)。
| 模型 | $N$ | $d_m$ | $d_{ff}$ | $d_h$ | $n_q$ | $n_{kv}$ | $L$ | 批次大小 | Tokens |
|---|---|---|---|---|---|---|---|---|---|
| MiniCPM-1.2B | 1,247,442,432 | 1,536 | 3,840 | 64 | 24 | 8 | 52 | 2M → 4M | 1.1T |
| MiniCPM-2.4B | 2,442,057,984 | 2,304 | 5,760 | 64 | 36 | 36 | 40 | 4M | 1.1T |
6.1 模型細節
- 詞彙表。 我們對 MiniCPM-2.4B 用 122,753 詞彙量、對 MiniCPM-1.2B 用 73,440 詞彙量的兩個 tokenizer。1.2B 用小詞彙表有利於效率、又不太損害效能(細節見附錄 C)。含嵌入參數會分別增加 0.3B 與 0.2B 總參數。
- 共享輸入-輸出層。 對 SLM,嵌入佔用很大的參數空間。為讓模型參數更小,我們對 MiniCPM-2.4B 與 1.2B 都使用嵌入共享 (Embedding Sharing) 技術。
- 深而窄的網路。 我們在訓練 MiniCPM-1.2B 之前先訓練 MiniCPM-2.4B。訓練 2.4B 時,我們採用相較於 Phi-2 更深更窄的架構(40 層 vs 32 層)。近來 Liu et al. (2024) 提出為 SLM 訓練深而窄的網路,與我們的觀點一致,因此我們對 MiniCPM-1.2B 進一步讓架構更深更窄。
- 分組查詢注意力 (Group Query Attention)。 我們訓練 MiniCPM-2.4B 時不修改注意力層;而受 Liu et al. (2024) 啟發,對 MiniCPM-1.2B 套用 GQA [Ainslie et al., 2023] 以進一步減少參數量。
6.2 訓練階段
MiniCPM 基礎模型的整體訓練包含三階段:穩定訓練階段、衰減階段、SFT 階段。全程使用 Adam 最佳化器。
- 穩定訓練階段。 我們使用約 1T 資料(分布見第 6.3 節),大多來自開放資料集。我們使用模型風洞實驗中發掘的最佳配置——WSD LRS,批次大小 393 萬、最大學習率 0.01。
- 衰減階段。 我們使用預訓練資料與高品質 SFT 資料的混合。對 WSD 排程的具體退火形式,我們採用指數退火 $f(s-T)=0.5^{(s-S)/T}$,其中 $T$ 設為 5000 步(20B tokens)。
- SFT 階段。 我們發現仍有必要進行一個獨立的 SFT 階段。我們使用與退火階段相似(但排除預訓練資料)的 SFT 資料,訓練約 60 億 token。SFT 學習率與退火結束時的一致,同樣採用指數衰減的 WSD 排程。
6.3 訓練資料分布
我們在圖 11 介紹訓練資料分布。CommonCrawl_Chn 是從 CommonCrawl 原始語料衍生並經徹底清洗的中文語料。Dolma、C4、Pile 是英文語料,用 MinHash 演算法做語料內與跨語料去重。程式碼預訓練資料含 the stack 與 StarCoder,同樣做內部與跨語料去重。在衰減階段,資料混合包含更多樣的資料與專有資料,包括 UltraChat、SlimOrca、OssInstruct、EvolInstruct。帶 SFT 後綴的資料是我們的專有資料,包括 LeetCode 題目、K12(幼稚園到 12 年級)教科書與題目等。
6.4 訓練損失
C4 資料集上的整體訓練損失如圖 12 所示。如初步實驗所預期,損失在衰減階段急遽下降。由於我們用指數衰減,即使學習率降到最大學習率的 10% 以下,損失仍持續下降。然而,由於我們在衰減階段後繼續對模型做 SFT,我們不使用最終檢查點。MiniCPM-1.2B 的第一次下降是擴大批次大小的結果,可能有類似降低學習率的效果 [Smith et al., 2017]。
6.5 評估
整體評估使用我們開源的工具 UltraEval(底層推論與加速用開源框架 vLLM)。資料集包括:MMLU(英文知識)、CMMLU 與 C-Eval(中文知識)、HumanEval 與 MBPP(程式)、GSM8K 與 MATH(數學)、HellaSwag / ARC-e / ARC-c(常識推理)、BBH(邏輯推理)。由於大模型評估難以標準化、且許多模型評估缺乏公開的 prompt 與測試碼,我們盡力調整評估方法以適配各種模型類型。測試 QA 任務(ARC-e、ARC-c、HellaSwag)時通常有兩種做法:困惑度 (PPL) 與直接生成。我們觀察到兩法結果差異顯著,回報分數時我們採用能得到最高分的評估法以確保公平。
表 3:MiniCPM-2.4B 與 MiniCPM-1.2B 的基準分數(皆未經 RLHF)。 Avg 為表中所有資料集平均;Avg_chn 為 C-Eval 與 CMMLU 的平均;Avg_en 為其餘資料集平均。粗體為 SLM 中最佳。(節錄主要對照。)
| 模型 | C-Eval | CMMLU | MMLU | HumanEval | MBPP | GSM8K | MATH | BBH | ARC-e | ARC-c | HellaSwag | Avg |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Llama2-7B | 32.42 | 31.11 | 44.32 | 12.20 | 27.17 | 13.57 | 1.80 | 33.23 | 75.25 | 42.75 | 75.62 | 35.40 |
| Mistral-7B | 46.12 | 42.96 | 62.69 | 27.44 | 45.20 | 33.13 | 5.00 | 41.06 | 83.92 | 70.73 | 80.43 | 48.97 |
| Llama2-13B | 37.32 | 37.06 | 54.71 | 17.07 | 32.55 | 21.15 | 2.25 | 37.92 | 78.87 | 58.19 | 79.23 | 41.48 |
| Gemma-7B | 42.57 | 44.20 | 60.83 | 38.41 | 50.12 | 47.31 | 6.18 | 39.19 | 89.35 | 76.79 | 79.47 | 52.22 |
| TinyLlama-1.1B | 25.02 | 24.03 | 24.3 | 6.71 | 19.91 | 2.27 | 0.74 | 28.78 | 60.77 | 28.15 | 58.33 | 25.36 |
| Qwen1.5-1.8B | 55.00 | 50.85 | 43.81 | 5.49 | 24.82 | 26.16 | 3.25 | 28.82 | 64.86 | 45.56 | 59.39 | 37.09 |
| Phi-2 (2B) | 23.37 | 24.18 | 52.66 | 47.56 | 55.04 | 57.16 | 3.50 | 43.39 | 86.11 | 71.25 | 73.07 | 48.84 |
| Gemma-2B | 29.26 | 28.56 | 38.49 | 24.39 | 29.74 | 16.83 | 3.34 | 30.93 | 74.33 | 40.70 | 69.51 | 35.10 |
| MiniCPM-1.2B | 49.14 | 46.81 | 49.63 | 44.51 | 32.75 | 31.77 | 10.60 | 34.70 | 80.93 | 66.81 | 54.72 | 45.67 |
| MiniCPM-2.4B | 51.13 | 51.07 | 53.46 | 50.00 | 47.31 | 53.83 | 10.24 | 36.87 | 85.44 | 68.00 | 68.25 | 52.33 |
整體評估的幾個觀察:(1) 平均而言,MiniCPM-2.4B 在所有 SLM 中名列最高。(2) MiniCPM-2.4B 在英文上與 Mistral-7B-v0.1 相似,但在中文上顯著優於它。(3) MiniCPM-2.4B 除了 MMLU、BBH、HellaSwag 外都優於 Llama2-13B,而 MiniCPM-1.2B 除 HellaSwag 外都優於 Llama2-7B。(4) 一般而言 BBH 對 SLM 比對 LLM 更難,顯示推理能力可能比知識更依賴模型大小。(5) SLM 中 Phi-2 在學術導向資料集上與 MiniCPM 相當,可能因為其訓練資料多為強調教育與學術的教科書式資料;由於我們的預訓練資料涵蓋更多分布,我們認為 MiniCPM 在知識與能力覆蓋上更佳。
7 MiniCPM 家族
在本節中,我們介紹建立在 MiniCPM 基礎模型上的其他模型。具體而言,我們為 MiniCPM 2.4B 訓練了對齊模型、長脈絡模型與 MoE 模型。
7.1 MiniCPM-DPO
SFT 之後,我們採用 DPO [Rafailov et al., 2024] 進行人類偏好對齊。此階段以 UltraFeedback 為主要對齊資料集,並構建一個專有偏好資料集以增強模型的程式與數學能力。我們以學習率 $1\times10^{-5}$ 進行一個 epoch 的 DPO 訓練,並採用 Cosine LRS(因為有預先定義的訓練步數)。套用 DPO 後,模型在 MTBench 上的分數從 SFT 後的 6.89 提升到 7.25,甚至超越 Llama2-70B-Chat 等大模型(見圖 13)。然而我們也注意到基準效能略有折損,即所謂的對齊稅 (alignment tax)。
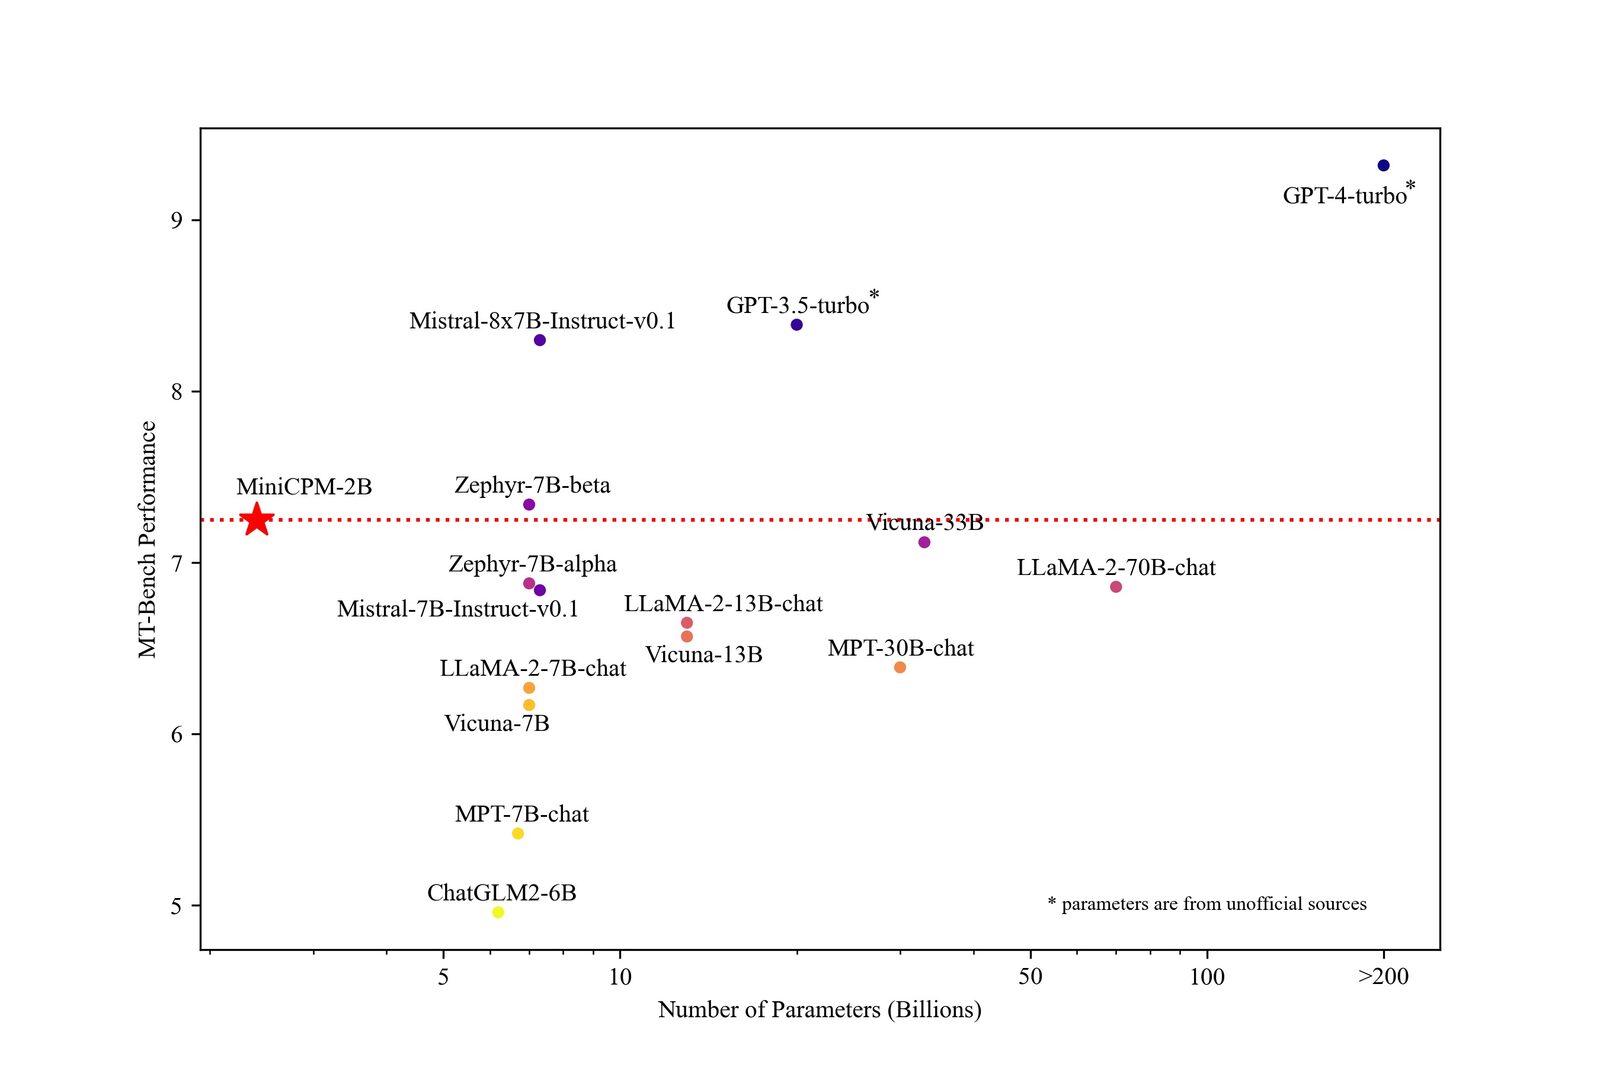
圖 13: MiniCPM-DPO-2.4B 的 MTBench 分數超越許多更大尺寸的模型。
7.2 MiniCPM-128K
涉及長脈絡的任務仰賴脈絡內的隱含資訊,繞過了 SLM 常缺乏的廣泛知識的需求。在本節中,我們把 MiniCPM-2.4B 的脈絡長度從 4,096 擴展到 128,000 token,說明 SLM 有效處理長脈絡的能力。
- 初始化。 我們停用輸入與輸出之間的嵌入共享,主要為容納長脈絡訓練必需的詞彙平行化。LM head 從輸入嵌入初始化。
- 訓練。 MiniCPM-2.4B-128K 用 WSD 作為學習率排程、並重用 MiniCPM-2.4B 穩定訓練階段的最後檢查點。我們把 6.3 節的資料集分布分為「短資料」與「長資料」(書、wiki、論文為長資料),持續訓練用 44% 長資料 + 56% 短資料。長脈絡擴展在 4K 到 32K 範圍套用 Adjusted Base Frequency (ABF),並在 32K 到 128K 採用 NTK-Aware RoPE Scaling 與課程學習 (curriculum learning)。我們也使用合成長 QA 資料,顯著增強模型在脈絡感知任務的效能。
- 評估。 我們在 ∞Bench(一個長脈絡評估的先驅基準)評估。如表所示,我們達到與 Mistral-7B-Instruct-v0.2 (ABF1000w) 相當的結果,並超越 ChatGLM3-6B-128K,儘管小 2.5 倍。
7.3 MiniCPM-MoE
我們進一步用專家混合 (Mixture-of-Expert) 擴展 MiniCPM 的能力。
- 初始化。 MiniCPM-MoE 利用稀疏升級再造 (Sparse Upcycling) 初始化。從 MiniCPM 穩定階段衍生的稠密模型檢查點經歷一個轉換:每個 MLP 層被一個 MoE 層取代,這些新 MoE 層是原始 MLP 層的精確複製。路由器參數依均值 0、變異 0.01 的常態分布隨機初始化。
- 路由機制。 MiniCPM-MoE 的非嵌入參數總數為 13.6B。訓練與推論時每個 token 從八個專家中激活兩個,使激活參數約為 4B。為防訓練崩潰,最終訓練目標套用額外的負載平衡損失(乘以 0.01)。
- 訓練。 同樣採用 WSD 排程,訓練資料嚴格遵循 6.3 節的分布。穩定與衰減階段批次大小維持 4M token,SFT 階段降到 2M。預訓練階段(含持續預訓練與衰減)跨 130K 步,之後改善遞減。MiniCPM-MoE(4B 激活參數)與 Llama2-34B 相當。
8 結論
本文引入 MiniCPM,包含分別具有 2.4B 與 1.2B 非嵌入參數的兩個 SLM。這些模型展現出優於更大同儕的效能。我們的訓練方法論在模型與資料大小上都可擴展,對 LLM 開發有潛在適用性。我們的 WSD 排程值得注意,因為它促進持續訓練、展現引人入勝的訓練動態、並使 scaling law 的高效研究成為可能。我們進一步引入 MiniCPM 家族,包括 DPO、長脈絡、MoE 版本。未來方向包括深入分析衰減階段的損失下降,以及透過在模型大小與資料大小上縮放來增強 MiniCPM 的能力。
限制
雖然我們對用 SLM 研究 scaling law 提出了徹底的探討,本文並未延伸到訓練一個 LLM 來驗證該 scaling law。WSD LRS 在 LLM 上的應用至今尚未充分探索。不過,我們對其潛在優勢仍抱持樂觀。
致謝
MiniCPM 最初於 2024 年 2 月 1 日以技術部落格形式發表。此後我們從社群收到眾多有見地的回饋,顯著貢獻於本文的發展。感謝 Chunting Zhou 與 Armen Aghajanyan 的寶貴討論,特別感謝 Peiqin Sun 與 Yan Wang 對釐清部落格模糊之處的縝密回饋,也感謝開源社群把 MiniCPM 整合進 llama.cpp 等推論框架的努力。
附錄概覽
【譯註】以下附錄以摘要呈現,逐字全文請參閱原論文。
- 附錄 A 模型風洞實驗的補充結果。 A.1:μP 超參數網格搜尋(圖 14、表 7)。A.2:關於最佳批次大小的評論(為何能從粗略損失預測批次大小)。A.3:模型風洞實驗中的模型架構(表 8)。
- 附錄 B WSD LRS 的補充說明。 B.1:不同 LRS 的學習率範式(Cosine、CosineLoop、WSD 的公式,圖 15)。B.2:擬合資料 scaling law(比較指數式與冪律,選冪律,圖 16)。B.3:模型-資料 scaling law 的個別圖(圖 17)。B.4:分析 Llama2 的資料-模型比(圖 18)。
- 附錄 C MiniCPM 的詞彙表。 壓縮率比較(表 9)。
- 附錄 D 量化。 模型量化細節。
- 附錄 E 邊緣裝置基準測試。 MiniCPM-2.4B 在不同終端裝置上的速度(表 10)。
- 附錄 F 案例展示。 翻譯(圖 19)、數學與推理(圖 20)、指令遵循(圖 21)、emoji 理解(圖 22)等示例。
參考文獻
採原文作者-年份引用;內文的「作者 (年份)」對應下列條目。書目保留原文。
Achiam et al. (2023). GPT-4 technical report. arXiv:2303.08774 · Aghajanyan et al. (2023). Scaling laws for generative mixed-modal language models. · Ainslie et al. (2023). GQA: Training generalized multi-query transformer models from multi-head checkpoints. · Almazrouei et al. (2023). The Falcon series of open language models. · Askell et al. (2021). A general language assistant as a laboratory for alignment. · Austin et al. (2021). Program synthesis with large language models (MBPP). · Bai et al. (2023). Qwen technical report. · Banks & Warkentin (2024). Gemma: Introducing new state-of-the-art open models. · Bi et al. (2024). DeepSeek LLM: Scaling open-source language models with longtermism. · Biderman et al. (2022). Datasheet for the Pile. · bloc97 (2023). NTK-Aware Scaled RoPE. · Broder (1997). On the resemblance and containment of documents (MinHash). · Chen et al. (2021). Evaluating large language models trained on code (HumanEval). · Chowdhery et al. (2023). PaLM: Scaling language modeling with pathways. · Clark et al. (2018). Think you have solved question answering? Try ARC. · Cobbe et al. (2021). Training verifiers to solve math word problems (GSM8K). · Cui et al. (2023). UltraFeedback: Boosting language models with high-quality feedback. · Dey et al. (2023). Cerebras-GPT: Open compute-optimal language models trained on the Cerebras wafer-scale cluster. · Ding et al. (2023). Enhancing chat language models by scaling high-quality instructional conversations (UltraChat). · Du et al. (2021). GLM: General language model pretraining. · Du et al. (2024). Understanding emergent abilities of language models from the loss perspective. · Fedus et al. (2022). Switch Transformers: Scaling to trillion parameter models. · Gao et al. (2020). The Pile: An 800GB dataset of diverse text for language modeling. · Gemini et al. (2023). Gemini: A family of highly capable multimodal models. · Gunasekar et al. (2023). Textbooks are all you need (Phi-1). · Hendrycks et al. (2020). Measuring massive multitask language understanding (MMLU). · Hendrycks et al. (2021). Measuring mathematical problem solving with the MATH dataset. · Hoffmann et al. (2022). Training compute-optimal large language models (Chinchilla). · Howard & Ruder (2018). Universal language model fine-tuning for text classification. · Hu et al. (2023). Predicting emergent abilities with infinite resolution evaluation. · Huang et al. (2024). C-Eval: A multi-level multi-discipline Chinese evaluation suite. · Hundt et al. (2019). sharpDARTS. · Javaheripi & Bubeck (2023). Phi-2: The surprising power of small language models. · Jiang et al. (2023). Mistral 7B. · Kaplan et al. (2020). Scaling laws for neural language models. · Kingma & Ba (2014). Adam: A method for stochastic optimization. · Kocetkov et al. (2022). The Stack: 3TB of permissively licensed source code. · Komatsuzaki et al. (2022). Sparse upcycling: Training mixture-of-experts from dense checkpoints. · Kwon et al. (2023). Efficient memory management for large language model serving with PagedAttention (vLLM). · Li et al. (2023a). StarCoder: May the source be with you! · Li et al. (2023b). Textbooks are all you need II (phi-1.5). · Li et al. (2024). CMMLU: Measuring massive multitask language understanding in Chinese. · Lian et al. (2023a; 2023b). SlimOrca. · Liu et al. (2024). MobileLLM: Optimizing sub-billion parameter language models for on-device use cases. · Loshchilov & Hutter (2016). SGDR: Stochastic gradient descent with warm restarts. · Peng et al. (2023). YaRN: Efficient context window extension of large language models. · Rae et al. (2021). Scaling language models: Methods, analysis & insights from training Gopher. · Rafailov et al. (2024). Direct preference optimization (DPO). · Raffel et al. (2019/2020). Exploring the limits of transfer learning with a unified text-to-text transformer (T5/C4). · Sardana & Frankle (2023). Beyond Chinchilla-optimal: Accounting for inference in language model scaling laws. · Shi et al. (2023). In-context pretraining. · Smith et al. (2017). Don't decay the learning rate, increase the batch size. · Soldaini et al. (2024). Dolma. · Song et al. (2023). Zebra. · Suzgun et al. (2022). Challenging BIG-Bench tasks (BBH). · Touvron et al. (2023). Llama 2: Open foundation and fine-tuned chat models. · Tunstall et al. (2023). Zephyr: Direct distillation of LM alignment. · Wei et al. (2021). Finetuned language models are zero-shot learners (FLAN). · Wei et al. (2023). Magicoder: Source code is all you need (OssInstruct). · Wortsman et al. (2023). Small-scale proxies for large-scale transformer training instabilities. · Xia et al. (2023). Sheared LLaMA: Accelerating language model pre-training via structured pruning. · Xie et al. (2024). DoReMi: Optimizing data mixtures speeds up language model pretraining. · Xiong et al. (2023). Effective long-context scaling of foundation models (ABF). · Xu et al. (2023). WizardLM: Empowering large language models to follow complex instructions (EvolInstruct). · Yang et al. (2022). Tensor Programs V: Tuning large neural networks via zero-shot hyperparameter transfer (μP). · Yang et al. (2023). Tensor Programs VI: Feature learning in infinite-depth neural networks. · Ye et al. (2024). Data mixing laws. · Young et al. (2024). Yi: Open foundation models by 01.AI. · Zellers et al. (2019). HellaSwag: Can a machine really finish your sentence? · Zhang et al. (2023). Instruction tuning for large language models: A survey. · Zhang et al. (2024a). TinyLlama: An open-source small language model. · Zhang et al. (2024b). ∞Bench: Extending long context evaluation beyond 100K tokens. · Zheng et al. (2024). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena.
術語對照表
| English | 繁體中文 |
|---|---|
| Small Language Model (SLM) | 小型語言模型 |
| Large Language Model (LLM) | 大型語言模型 |
| Non-embedding parameters | 非嵌入參數 |
| Model Wind Tunnel Experiments (MWTE) | 模型風洞實驗 |
| Warmup-Stable-Decay (WSD) | 暖身-穩定-衰減 |
| Learning rate scheduler (LRS) | 學習率排程 |
| Cosine LRS | Cosine 學習率排程 |
| Scaling law | scaling law(縮放律) |
| Compute optimal | 計算最佳 |
| Data-to-model ratio | 資料-模型比 |
| Chinchilla Optimal | Chinchilla Optimal |
| Checkpoint | 檢查點 |
| Decay stage / annealing | 衰減階段 / 退火 |
| Loss envelope | 損失包絡線 |
| Loss landscape | 損失地景 |
| Tensor Program | Tensor Program |
| Width / depth scaling | 寬度 / 深度縮放 |
| Batch size | 批次大小 |
| Directional derivative | 方向導數 |
| Curvature | 曲率 |
| Supervised fine-tuning (SFT) | 監督式微調 |
| DPO (Direct Preference Optimization) | 直接偏好最佳化 |
| Alignment tax | 對齊稅 |
| Embedding Sharing | 嵌入共享 |
| Group Query Attention (GQA) | 分組查詢注意力 |
| Mixture-of-Expert (MoE) | 專家混合 |
| Sparse Upcycling | 稀疏升級再造 |
| Load balancing loss | 負載平衡損失 |
| Adjusted Base Frequency (ABF) | 調整基頻 |
| NTK-Aware RoPE Scaling | NTK 感知 RoPE 縮放 |
| Curriculum learning | 課程學習 |
| Perplexity (PPL) | 困惑度 |
| Tokenizer | 分詞器 |