LongAct:利用內在激活模式實現長上下文強化學習
原始論文:LongAct: Harnessing Intrinsic Activation Patterns for Long-Context Reinforcement Learning 作者:Bowen Ping, Zijun Chen, Tingfeng Hui, Qize Yu, Chenxuan Li, Junchi Yan, Baobao Chang arXiv ID:2604.14922v1 日期:2026-04-16 標籤:LLM Long Context Reinforcement Learning Activation Sparse Update GRPO
1. 引言
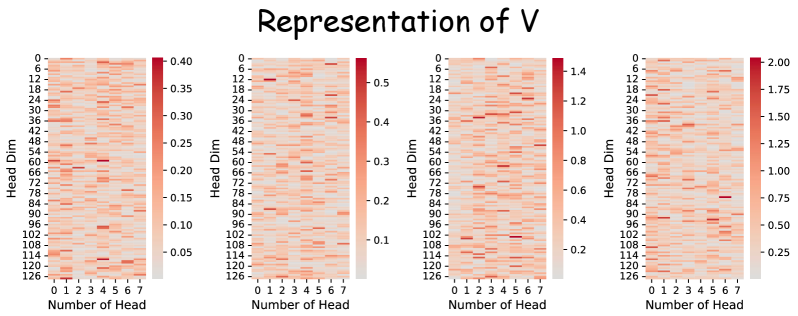
長上下文推理中,Q/K 向量存在稀疏的高幅值激活 (high-magnitude activations)。這些激活是長上下文推理的結構性「錨點」(anchors)。
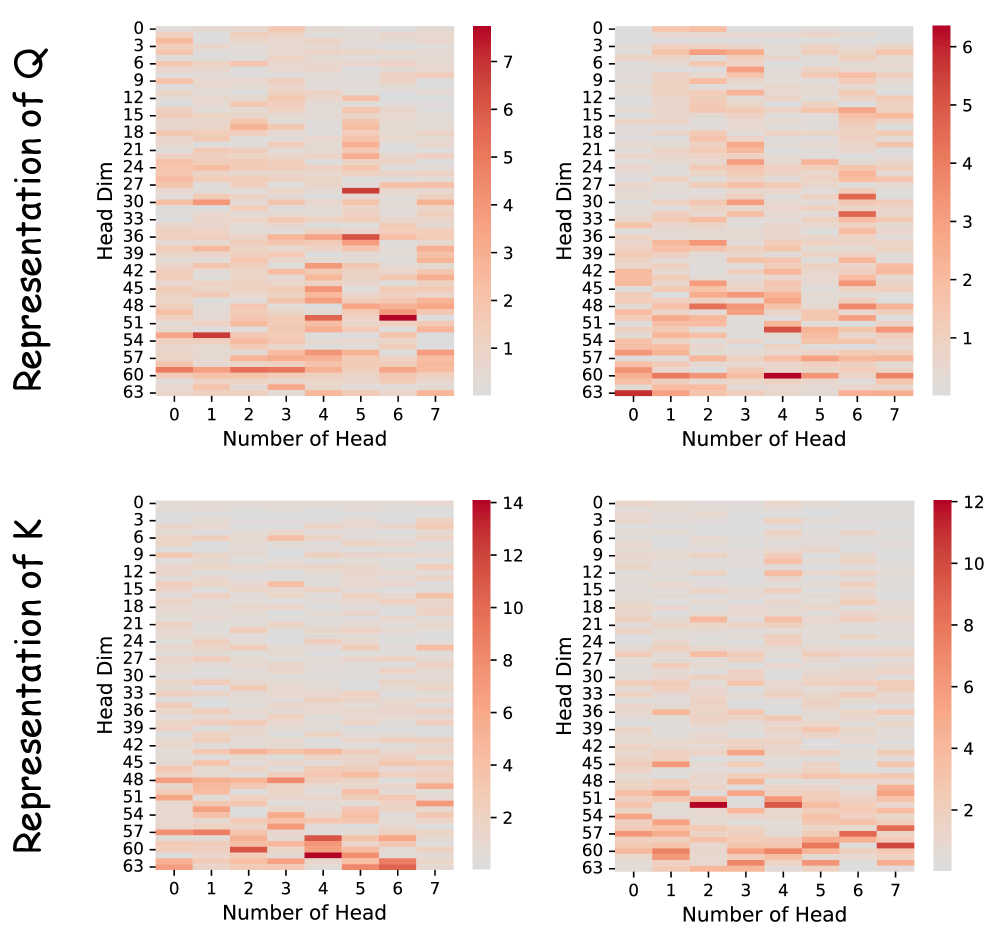
本文提出 LongAct,利用這些激活模式引導稀疏參數更新的強化學習策略:
- 只更新與高幅值激活相關的權重(前 30%)
- 在 LongBench v2 上提升約 8%
- 在 RULER-128K 上提升 4%
- 適用於 GRPO、DAPO 等多種 RL 演算法
- 推理時零延遲增加(遮罩在訓練後丟棄)
兩個互補洞見:
- 高幅值激活編碼了不成比例的關鍵資訊(來自量化文獻)
- 長上下文在 token 層級本質上具有稀疏性,這延伸到隱藏維度
2. 方法
2.1 高幅值激活
對 query 和 key 投影:$Q = H_{in} W_Q^T$,$K = H_{in} W_K^T$
幅值計算(L2 norm):
$$M^Q_{h,d} = \frac{1}{B} \sum_i \sqrt{\sum_s (Q^{(i)}_{s,h,d})^2}$$
幅值矩陣 $M$ 識別異常值維度,用於選擇性權重更新。
RL 目標為標準 KL 正則化獎勵最大化:
$$\max_{\pi_\theta} \mathbb{E}[r_\phi(x, c, y)] - \beta D_{KL}[\pi_\theta(y|x,c) \| \pi_{ref}(y|x,c)]$$
其中 $c$ 為長上下文,$x$ 為問題,$y$ 為輸出。
2.2 監督式微調(冷啟動)
初始階段在標註推理軌跡上最佳化交叉熵損失,格式使用 <think> 和 <answer> 標籤。使用 AM-DeepSeek-R1-0528-Distilled 資料集的 20K 樣本,學習率 $2 \times 10^{-5}$。
2.3 LongAct 訓練框架
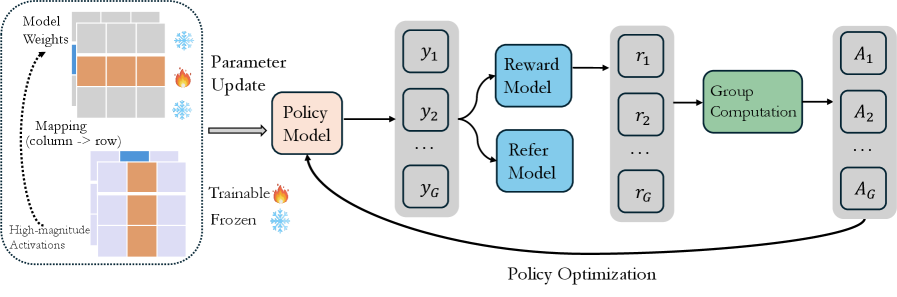
動態顯著性引導更新:
- 對每個頭計算幅值矩陣 $M^Q$
- 頭內選擇:$K_h = \{d \mid d \in \text{argmax}_k \{M^Q_{h,d'}\}\}$,其中 $k = \lfloor \lambda D \rfloor$
- 建立二元梯度遮罩 $G^Q \in \{0, 1\}^{H_Q \times D \times d_{model}}$
- 反向傳播時套用:$\nabla W_Q \leftarrow \nabla W_Q \odot G^Q$
關鍵設計:
- 只有 $W_Q$ 和 $W_K$ 做稀疏更新;$W_V$、$W_O$ 和 MLP 做完整更新
- 預設稀疏率 $\lambda = 0.3$(每頭更新前 30% 的權重)
- 計算開銷可忽略(顯著性計算在 $H \times D$ 張量上,非全序列)
- 推理時零延遲(遮罩丟棄)
獎勵函數:$r(y) = r_{fmt}(y) + r_{ans}(y)$
- 格式獎勵:包含必要標籤 = 1,否則 = 0
- 答案獎勵:匹配正確答案 = 1,否則 = 0
3. 實驗結果
訓練設定
- 骨幹:Qwen3-8B-Base 和 Qwen3-4B-Base
- 硬體:8 張 NVIDIA H800 80GB GPU
- SFT:LLaMA-Factory,20K 樣本,900 步,最大序列 16,384
- RL:verl 框架 + DAPO,2.6K 樣本,學習率 $1 \times 10^{-6}$,最大序列 32,768
3.1 主要結果
LongBench v2:
| 模型 | 整體 | Easy | Hard | Short | Medium | Long |
|---|---|---|---|---|---|---|
| Qwen3-8B-SFT | 27.04 | 28.65 | 26.05 | 32.22 | 24.65 | 23.15 |
| + DAPO | 32.80 | 40.10 | 28.30 | 38.33 | 28.37 | 32.41 |
| + LongAct | 36.73 | 38.02 | 35.93 | 41.94 | 33.37 | 34.72 |
| Qwen3-8B* (官方) | 33.60 | - | - | - | - | - |
LongAct 比 DAPO 基線高 3.93 分,比官方 Qwen3-8B 高 3.13 分。在 Hard 子集上提升最大(+7.63 vs. DAPO)。
4B 模型也有效:Qwen3-4B 達 34.24(vs. DAPO 30.42,vs. 官方 31.41)。
RULER 與 InfiniteBench:
| 模型 | RULER-128K | RULER-64K |
|---|---|---|
| Qwen3-8B-SFT | 44.42 | 43.65 |
| + DAPO | 49.63 | 45.26 |
| + LongAct | 51.15 | 46.37 |
InfiniteBench:LongAct 達 49.39(8B)、46.36(4B),全面超越基線。
3.2 消融研究
RL 演算法通用性:LongAct 在 DAPO、GRPO、CLIP-conv、KL-conv 上均保持一致增益。
激活選擇策略:
| 策略 | 8B 整體 | 4B 整體 |
|---|---|---|
| 隨機 | 28.63 | 29.03 |
| 最小值(後 30%) | 29.82 | 30.22 |
| 最大值(前 30%) | 36.73 | 34.24 |
高幅值與低幅值之間的 6.91 分差距驗證了顯著性假設。
稀疏率:
| 比例 | 8B 整體 | 4B 整體 |
|---|---|---|
| 20% | 32.41 | 30.42 |
| 30% | 36.73 | 34.24 |
| 40% | 35.98 | 32.80 |
30% 為最優稀疏率。
短上下文泛化:
| Benchmark | SFT | DAPO | LongAct |
|---|---|---|---|
| GSM8K | 71.94 | 78.08 | 80.13 |
| HumanEval | 68.90 | 69.51 | 73.17 |
| TruthfulQA | 67.76 | 68.95 | 69.52 |
LongAct 在短上下文 benchmark 上也全面超越,說明方法不限於長上下文。
4. 分析
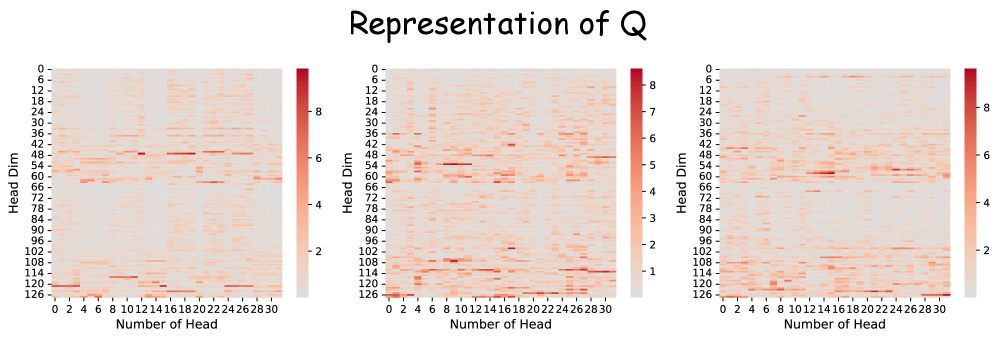
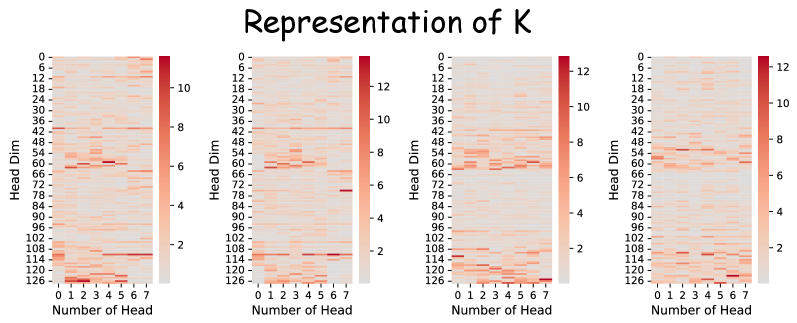
擾動研究:
- 移除前 30% 高幅值激活:模型崩潰成重複模式(「3333...」),503 題測試集正確 0 題
- 移除後 30% 低幅值激活:模型保持邏輯連貫,503 題正確 108 題
鮮明對比證明高幅值激活對長上下文推理至關重要。
5. 結論
LongAct 是一種利用模型內部表示增強長上下文推理的方法:透過顯著性引導的稀疏更新,只更新與高幅值激活相關的 30% 權重。方法與現有架構和演算法改進互補,且不增加推理延遲。
限制:受限於計算資源,未能在更大模型上進行強化學習驗證。
參考文獻
Lin, J., et al. AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, 2024.
Jin, X., et al. Understanding the Role of High-Magnitude Activations in Large Language Models, 2025.
Yu, Q., et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale, 2025.
Shao, Z., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning with GRPO, 2024.
Bai, Y., et al. LongBench v2: Towards Deeper Understanding and Reasoning on Long Contexts, 2025.
Hsieh, C., et al. RULER: What's the Real Context Size of Your Long-Context Language Models?, 2024.
Zhang, X., et al. InfiniteBench: Extending Long Context Evaluation Beyond 100K Tokens, 2024.
Yang, A., et al. Qwen3 Technical Report, 2025.
Zheng, Y., et al. LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models. ACL, 2024.
Sheng, Y., et al. verl: An Open-Source Framework for Scalable LLM RL Training, 2025.
術語對照表
| 英文 | 中文 |
|---|---|
| High-Magnitude Activation | 高幅值激活 |
| Saliency-Guided Sparse Update | 顯著性引導的稀疏更新 |
| Long-Context Reasoning | 長上下文推理 |
| Gradient Mask | 梯度遮罩 |
| Sparsity Ratio | 稀疏率 |
| Query / Key / Value Projection | 查詢 / 鍵 / 值投影 |
| Reinforcement Learning (RL) | 強化學習 |
| GRPO | 群組相對策略最佳化 |
| DAPO | 解耦獎勵策略最佳化 |
| Perturbation Study | 擾動研究 |
| Cold Start | 冷啟動 |
| Outlier Dimension | 異常值維度 |
| Model Collapse | 模型崩潰 |
| Context Window | 上下文視窗 |