訓練 LLM 智能體透過世界知識探索實現自發、無獎勵的自我演化
原始論文:Training LLM Agents for Spontaneous, Reward-Free Self-Evolution via World Knowledge Exploration 作者:Qifan Zhang, Dongyang Ma, Tianqing Fang, Jia Li, Jing Tang, Nuo Chen, Haitao Mi, Yan Wang arXiv ID:2604.18131v1 日期:2026-04-20 標籤:LLM Agent Self-Evolution Reinforcement Learning Web Agent 世界知識
1. 引言
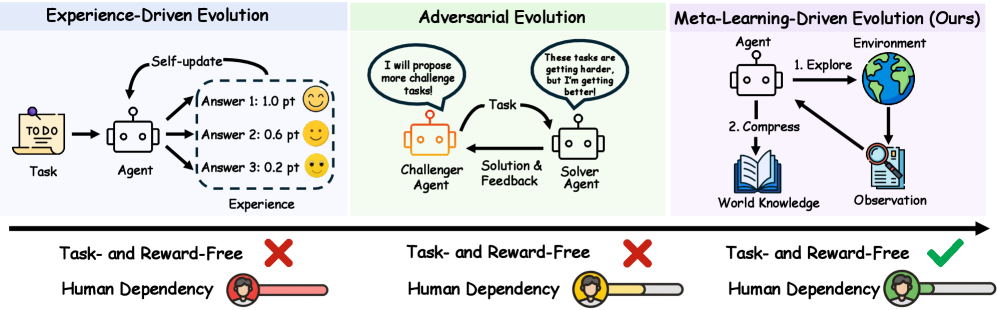
當前「自我演化」的智能體仍然依賴人類定義的獎勵和工作流程。本文提出 Native Agency——賦予智能體內在能力,自主探索陌生環境並將觀察蒸餾為結構化的世界知識 (World Knowledge, $\mathcal{K}$)。
核心挑戰:如何在沒有人類提供獎勵的情況下訓練智能體有效探索?
解法:基於結果的獎勵機制 (outcome-based reward),衡量智能體自生成的世界知識對下游任務成功率的改善程度。此獎勵僅用於訓練;推理時智能體完全自主,不需要外部引導。
核心成果:
- WebVoyager 和 WebWalker 上提升約 20%
- 配備生成知識的 14B 模型超越未輔助的 Gemini-2.5-Flash
- 執行步數平均減少 17%
2. 相關工作
自我演化智能體三個範式
| 範式 | 特點 | 限制 |
|---|---|---|
| 經驗驅動 | 人類設計任務 + 預定義獎勵 + 迭代解題 | 依賴手動工程 |
| 對抗式 | 挑戰者-解題者動態、合成更難任務 | 將負擔轉到編排複雜工作流 |
| 元學習驅動(本文) | 自發探索環境、壓縮觀察為可重用知識 | 真正無任務、無獎勵 |
測試時訓練 (Test-Time Training)
傳統 TTT 需要推理時梯度更新權重,與主流框架不相容。本文方法將環境觀察蒸餾為結構化知識做為外部 context 輸入。
3. 方法
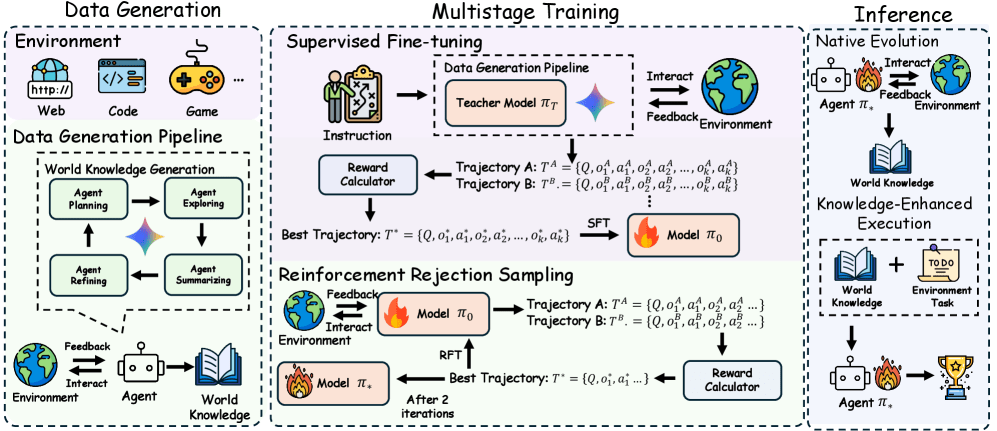
框架將智能體生命週期分為兩個階段:
- 原生演化階段 (Native Evolution):進入新環境 $E$ 時,智能體自發探索並摘要:$\mathcal{K} \leftarrow \pi_{evolve}(\mathcal{K} | E)$。完全無任務、無獎勵
- 知識增強執行 (Knowledge-Enhanced Execution):接到下游任務時,利用 $\mathcal{K}$ 引導行動:$a_t \sim \pi_{task}(a_t | o_t, \mathcal{K}, Task)$
3.1 基於結果的獎勵設計
世界知識 $\mathcal{K}$ 的品質由功能效用定義——它多大程度「賦能」智能體:
$$R_{evolve}(\mathcal{K}) = \text{Success}(\mathcal{T}_E | \mathcal{K}) - \text{Success}(\mathcal{T}_E | \varnothing)$$
在 20 個網站的 600 個深度搜尋問題上實證衡量。此獎勵信號僅用於訓練。
3.2 監督式微調
初始階段:用教師模型 (Gemini-2.5-Pro) 的模仿學習預熱基礎策略 $\pi_{\theta_0}$。
資料生成管線引導教師與多樣 web 環境互動,建構結構化世界知識。每個環境生成三個候選,根據下游任務效能選最佳(平均 10.72% 準確率提升)。
3.3 強化拒絕取樣
避免線上 RL 的計算成本,採用 Rejection Sampling Fine-Tuning (RFT):
- 更新後的策略 $\pi_{\theta_1}$ 自主探索環境,產生候選世界知識
- 選擇最高分軌跡做為下一輪訓練資料
- 兩輪迭代精煉,漸進修正次優探索路徑
4. 實驗
設定
- 智能體框架:Cognitive Kernel-Pro + Playwright
- 動作空間:click、scroll、goto、goback、stop
- 骨幹模型:Qwen3-30B-A3B-Instruct-2507、Seed-OSS-36B-Instruct
- Benchmark:WebWalker(40 網站、4 領域)、WebVoyager(4 網站),共 1,427 個評估樣本
- 評估:LLM judge(Qwen-2.5-32B、Gemini-2.5-Flash)
4.1 主要結果
| 方法 | WebWalker | WebVoyager |
|---|---|---|
| Qwen3-30B 基線 | 22.04% | 41.08% |
| + Prompt-only(教師知識) | 30.71% | 49.72% |
| + SFT | 35.30% | 53.88% |
| + RFT(完整方法) | 40.91% | 57.44% |
RFT 模型在兩個 benchmark 上大幅提升,且執行步數平均減少 17%。
4.2 跨模型遷移
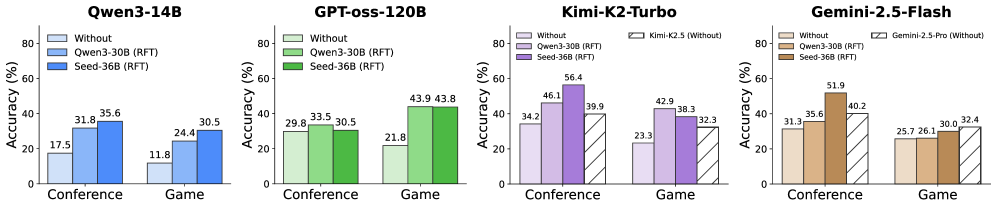
生成的世界知識在不同模型間通用遷移(Qwen3-14B、GPT-OSS-120B、Kimi-K2-Turbo、Gemini-2.5-Flash),改善幅度 18-21%。
關鍵發現:Qwen3-14B 配合世界知識超越未輔助的 Gemini-2.5-Flash(35.6% vs. 31.3%,會議領域)。
4.3 消融與敏感度
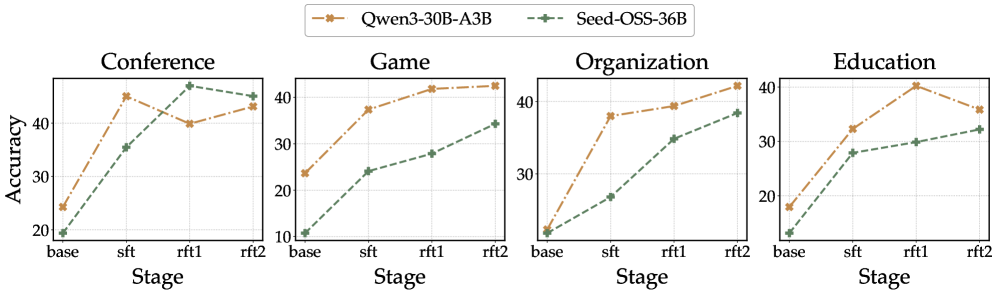
效能在訓練階段間逐步上升:base → SFT → RFT1 → RFT2。SFT 和 RFT1 提供實質提升;RFT2 提供邊際增益。
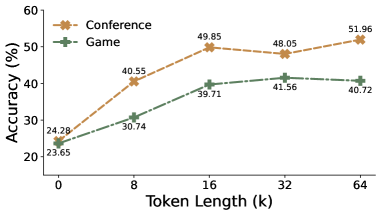
世界知識長度的影響:
| 長度 | 效果 |
|---|---|
| 4K-8K | 基線 |
| 8K-16K | 顯著增益(30.74% → 39.71%) |
| 16K-32K | 增益趨緩 |
| 32K-64K | 邊際或略微下降 |
過長 context 引入冗餘噪音;中等長度知識最優。
案例研究
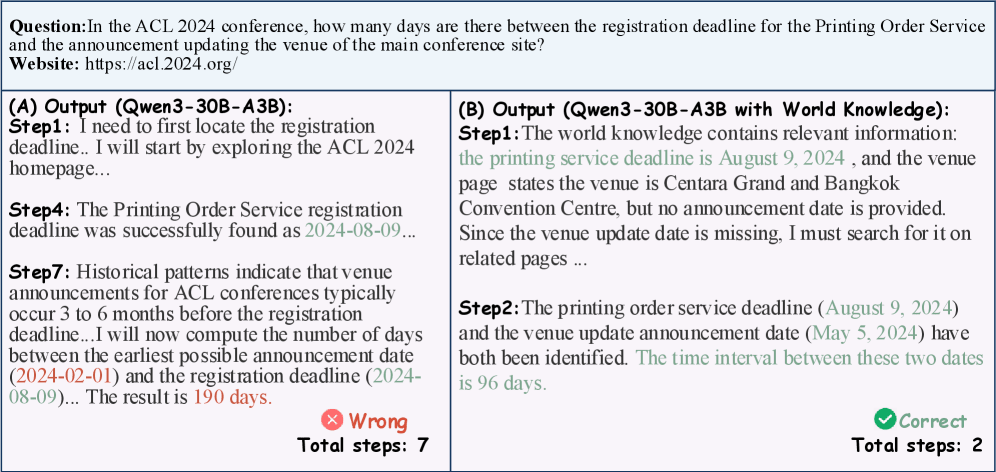
ACL 2024 網站範例:沒有知識時,智能體從首頁開始探索需多步,無法定位會場更新資訊。有知識時,第一步就檢索到關鍵資訊,第二步即識別所需日期。
5. 結論
本文證明智能體可以具備內在元演化能力,實現真正自主的自我演化——不需人類干預或推理時獎勵。框架將「自我演化」從依賴外部訊號的範式轉向利用內在探索和知識合成能力的範式。
代表了從參數規模擴展到探索與學習能力擴展的範式轉移。
參考文獻
Yao, S., et al. ReAct: Synergizing Reasoning and Acting in Language Models. ICLR, 2023.
Zhou, S., et al. WebArena: A Realistic Web Environment for Building Autonomous Agents, 2023.
He, J., et al. WebVoyager: Building an End-to-End Web Agent with Large Multimodal Models, 2024.
Ma, D., et al. WebWalker: Benchmarking Multi-Step Web Browsing with LLM Agents, 2024.
Google DeepMind. Gemini-2.5-Flash Technical Report, 2025.
Yang, A., et al. Qwen3 Technical Report, 2025.
Yuan, L., et al. Agent Workflow Memory. NeurIPS, 2024.
Pan, J., et al. Autonomous Evaluation and Refinement of Digital Agents. ICLR, 2025.
Xu, A., et al. Environment Curriculum for Automated Web Agents, 2024.
Sun, Z., et al. PRINCIPLE: Learning from Mistakes via Self-Reflection, 2023.
Wang, L., et al. A Survey on Large Language Model Based Autonomous Agents, 2024.
術語對照表
| 英文 | 中文 |
|---|---|
| World Knowledge ($\mathcal{K}$) | 世界知識 |
| Native Agency | 原生智能體能力 |
| Self-Evolution | 自我演化 |
| Meta-Learning-Driven Evolution | 元學習驅動演化 |
| Outcome-Based Reward | 基於結果的獎勵 |
| Rejection Sampling Fine-Tuning (RFT) | 拒絕取樣微調 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Knowledge-Enhanced Execution | 知識增強執行 |
| Native Evolution Phase | 原生演化階段 |
| Experience-Driven Evolution | 經驗驅動演化 |
| Adversarial Evolution | 對抗式演化 |
| Test-Time Training (TTT) | 測試時訓練 |
| Cross-Model Transfer | 跨模型遷移 |
| Web Agent | 網頁智能體 |
| Action Space | 動作空間 |
| LLM Judge | LLM 評審 |