Kimi K3:開放的前沿智慧
原始論文:Kimi K3: Open Frontier Intelligence 作者:Kimi Team 機構:Moonshot AI 日期:2026 年 8 月 6 日 標籤:LLM MoE Kimi Agent Linear Attention RL 開源模型
模型權重:huggingface.co/moonshotai/Kimi-K3 程式碼:github.com/MoonshotAI/Kimi-K3 授權:Kimi K3 License;Copyright (c) 2026 Moonshot AI。完整授權條款見附錄 G。
【譯註 — 來源與授權】這篇同時存在兩份拷貝,授權不同:
- arXiv 版(2607.24653v2)是
CC BY-NC-ND 4.0,ND 條款禁止衍生作品,不能翻譯。- GitHub 版(
MoonshotAI/Kimi-K3的k3_tech_report.pdf)附有 Kimi K3 License,授權標的明列 "associated documentation",並明確授予 "modify... publish, distribute... and create derivative works from it" 的權利。本譯文依據的是 GitHub 那份拷貝,並依授權條件 1 於附錄 G 附上完整的版權與授權聲明。條件 2(Model-as-a-Service 且 12 個月營收逾 2000 萬美元)與條件 3(月活逾 1 億或月營收逾 2000 萬美元)皆不適用於本站。
目錄
- 摘要
- 1 引言
- 2 模型架構
- 3 預訓練
- 4 後訓練
- 5 基礎設施
- 6 評測
- 7 案例研究
- 8 結論
- 附錄 A 貢獻者
- 附錄 B Sigmoid Tanh Unit GLU 的細節
- 附錄 C Quantile Balancing 的推導
- 附錄 D 基於直方圖的分位數估計
- 附錄 E MoonEP 上界證明
- 附錄 F 對話範本
- 附錄 G 原始授權條款
- 參考文獻
- 術語對照表
摘要
我們推出 Kimi K3,一個 2.8 兆參數的混合專家 (Mixture-of-Experts, MoE) 模型,啟用參數 1040 億、具備原生視覺能力、上下文窗口達 100 萬 token。Kimi K3 建立在 Kimi Delta Attention [64] 與 Attention Residuals [58] 之上,這兩者改善了資訊在序列長度與模型深度上的流動。再加上 Stable LatentMoE——它讓每個 token 有效啟用 896 個路由專家中的 16 個——以及精煉過的訓練與資料配方,這些進展帶來相對於 Kimi K2 [59] 約 2.5 倍的整體 scaling 效率提升。後訓練的重點是在通用、agentic 與程式碼領域、以及多個推理投入 (reasoning-effort) 等級上進行強化學習,藉此實現組合式泛化與穩健的長程執行。在 2.8T 的規模上,Kimi K3 由多方面的基礎設施進展支撐:KDA 的演算法與系統協同設計、具高效記憶體管理的完美平衡專家平行訓練、具持久化 rollout 與 sandbox 狀態的百萬 token agentic RL,以及部署面的創新。大量評測顯示 Kimi K3 在長程程式開發、agentic、知識、推理與視覺任務上達到前沿水準。雖然整體表現仍落後於最強的閉源模型——Claude Fable 5 與 GPT-5.6 Sol——但 Kimi K3 一致地勝過我們評測套件中的其他開源與閉源模型。我們釋出完整的 Kimi K3 模型權重,以促進後續研究,並加速前沿智慧的廣泛部署與採用。
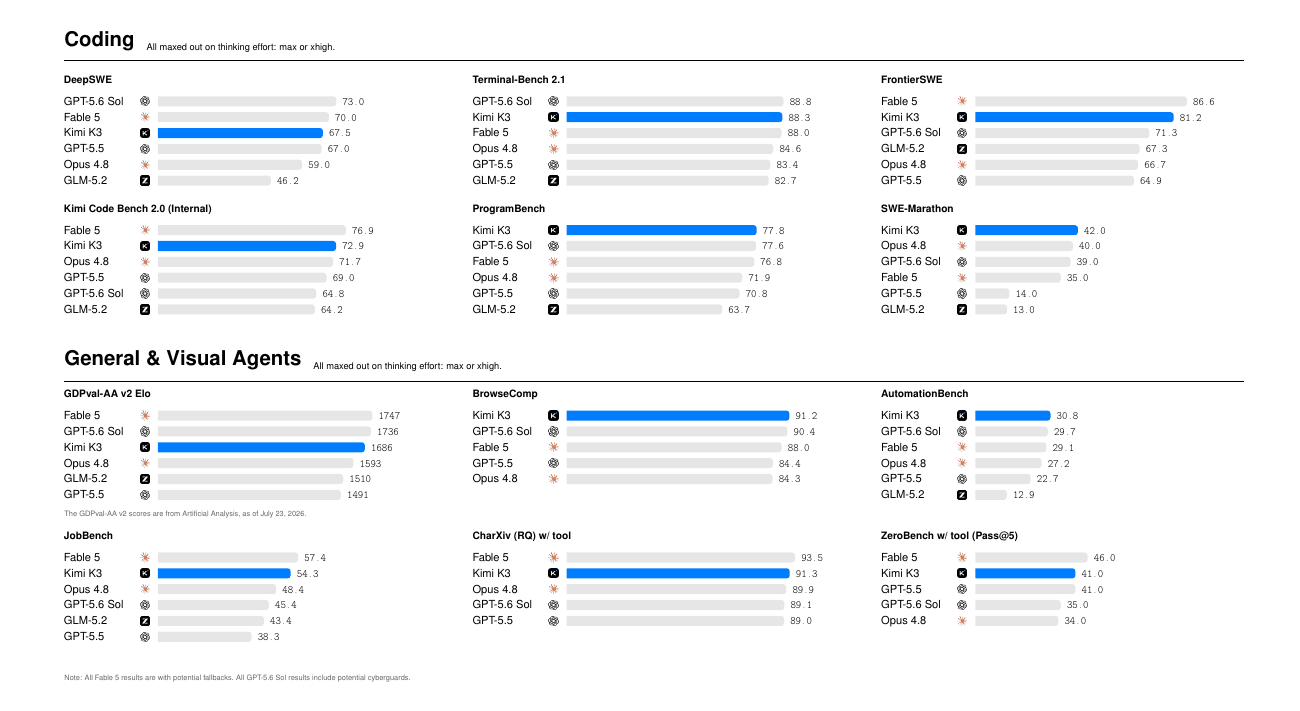
圖 1:Kimi K3 主要結果。(所有模型皆以最高思考投入執行:max 或 xhigh。GDPval-AA v2 分數取自 Artificial Analysis,截至 2026 年 7 月 23 日。註:所有 Claude Fable 5 的結果都可能含 fallback,所有 GPT-5.6 Sol 的結果都可能含 cyberguard。)
1 引言
在大型語言模型 (LLM) 發展的大部分時間裡,scaling 指的是在部署之前投入更多計算——用更多資料訓練更大的模型 [55, 46]。推理模型的興起確立了測試時計算作為第二條 scaling 軸線:OpenAI 的 o 系列擴展強化學習與測試時推理 [85, 84];Anthropic 的延伸思考模型分配自適應的思考預算,並把推理與工具使用交錯進行 [6, 7];DeepSeek-R1 [41] 與 Kimi K1.5 [120] 顯示大規模強化學習能從強大的預訓練基礎中引出精緻的推理行為;而 Kimi K2.5 Agent Swarm [60] 更把測試時 scaling 從循序推理延伸到平行的 agent 協調。這些進展讓測試時 scaling 成為前沿研究的核心焦點。
然而,開源模型生態雖然在第二條軸線上快速推進,在第一條軸線上卻進展緩慢:許多近期模型仍停留在 1T 級參數區間之內或略高一些 [147, 29, 137, 122]。當越來越精緻的推理與 agentic 強化學習方法被套用在規模相近的預訓練基礎上時,開源的進展有收斂的風險,而與最強閉源系統之間的差距則持續擴大。我們用 Kimi K3 同時把兩條 scaling 軸線推向前沿:把預訓練基礎擴展到前所未有的 3T 級參數,同時在 100 萬 token 的上下文長度上擴展強化學習、推理投入與長程互動。
我們推出 Kimi K3,一個原生多模態的混合專家模型,總參數 2.8 兆、啟用參數 1040 億、上下文窗口最高 100 萬 token。它的架構在序列長度、網路深度與模型寬度三個維度上擴展資訊流動。Kimi Delta Attention (KDA) [64] 提供高效的長序列混合,並週期性穿插 Gated MLA 層以保留全域互動。Attention Residuals (AttnRes) [58] 讓每一層都能選擇性地關注所有先前層的表示。Stable LatentMoE 把路由專家空間擴展到 896 個專家、每個 token 啟用 16 個,同時以正規化、SiTU-GLU 與 Quantile Balancing 在極端稀疏下穩定最佳化。這些架構進展結合精煉的資料與訓練配方,帶來相對於 Kimi K2 [59] 約 2.5 倍的整體 scaling 效率提升。
我們把這個預訓練基礎,與專為 100 萬 token 測試時 scaling 設計的後訓練配對。Kimi K3 在長程程式開發、通用 agent、通用推理與知識任務上進行強化學習,每一項都橫跨多個推理投入等級。訓練環境包括可驗證的搜尋與專業知識工作、軟體工程與 kernel 最佳化、帶視覺回路 (vision-in-the-loop) 工具使用的多模態推理、持久化的助理工作流程、網頁開發,以及自主執行任務。這些環境訓練出一個「推理、行動、觀察、驗證、調適」的通用迴路,往往橫跨數百到數千次工具呼叫與累計數百萬 token 的上下文。領域專精與投入等級專精的策略,最後透過多教師 on-policy 蒸餾 [76, 136, 29] 整併成一個統一模型。
要實現這個範式,需要能隨架構複雜度、模型大小與軌跡長度一起 scale 的基礎設施。在 KDA 的系統協同設計上,我們開發了融合 kernel、KDA Context Parallelism 與狀態感知的前綴快取,讓 KDA 在裝置內、跨裝置、跨請求三個層次上都高效。在 2.8T 參數的 MoE 預訓練上,MoonEP 以靜態計算形狀與零拷貝通訊提供完美平衡的專家執行,而記憶體高效訓練與多模態編碼器最佳化則在有限記憶體內維持高利用率。在百萬 token 的 agentic RL 上,我們的共置 (co-located) 系統結合部分 rollout、外部 KV 快取保留、自適應節流與可恢復的 microVM sandbox,以保存長壽命的模型與環境狀態。最後,專用 kernel 與具快取/預算感知的機群排程,把這些創新轉化為可預測的正式服務。
由此得到的模型確立了一個新的開放前沿。在橫跨長程程式開發、agentic、知識、推理與視覺任務的基準上,Kimi K3 整體落後最強的閉源系統——Claude Fable 5 與 GPT-5.6 Sol——但一致地領先我們評測套件中的其他開源與閉源模型,如圖 1 所示。
我們的貢獻摘要如下:
- 在開放前沿上的預訓練。 我們訓練了一個 2.8T 參數的原生多模態 MoE 模型,啟用參數 1040 億、上下文窗口 100 萬 token。KDA、AttnRes、Stable LatentMoE 以及精煉的資料與訓練配方,共同把整體 scaling 效率相對於 Kimi K2 提升約 2.5 倍。
- 面向多投入等級測試時 scaling 的強化學習。 我們在通用、agentic 與程式碼領域、以及多個推理投入等級上進行 RL,再把由此得到的能力整併進一個統一模型。
- 面向兆級參數、百萬 token 智慧的基礎設施。 我們提出 KDA 的系統協同設計;用於 2.8T 參數 MoE 預訓練的 MoonEP 與記憶體高效基礎設施;用於百萬 token agentic 軌跡、具可恢復 sandbox 的共置 RL 系統;以及更多基礎設施創新。
- 一個開放的前沿模型。 我們釋出完整的 Kimi K3 模型權重,讓前沿智慧可供研究、部署與進一步創新使用。
2 模型架構
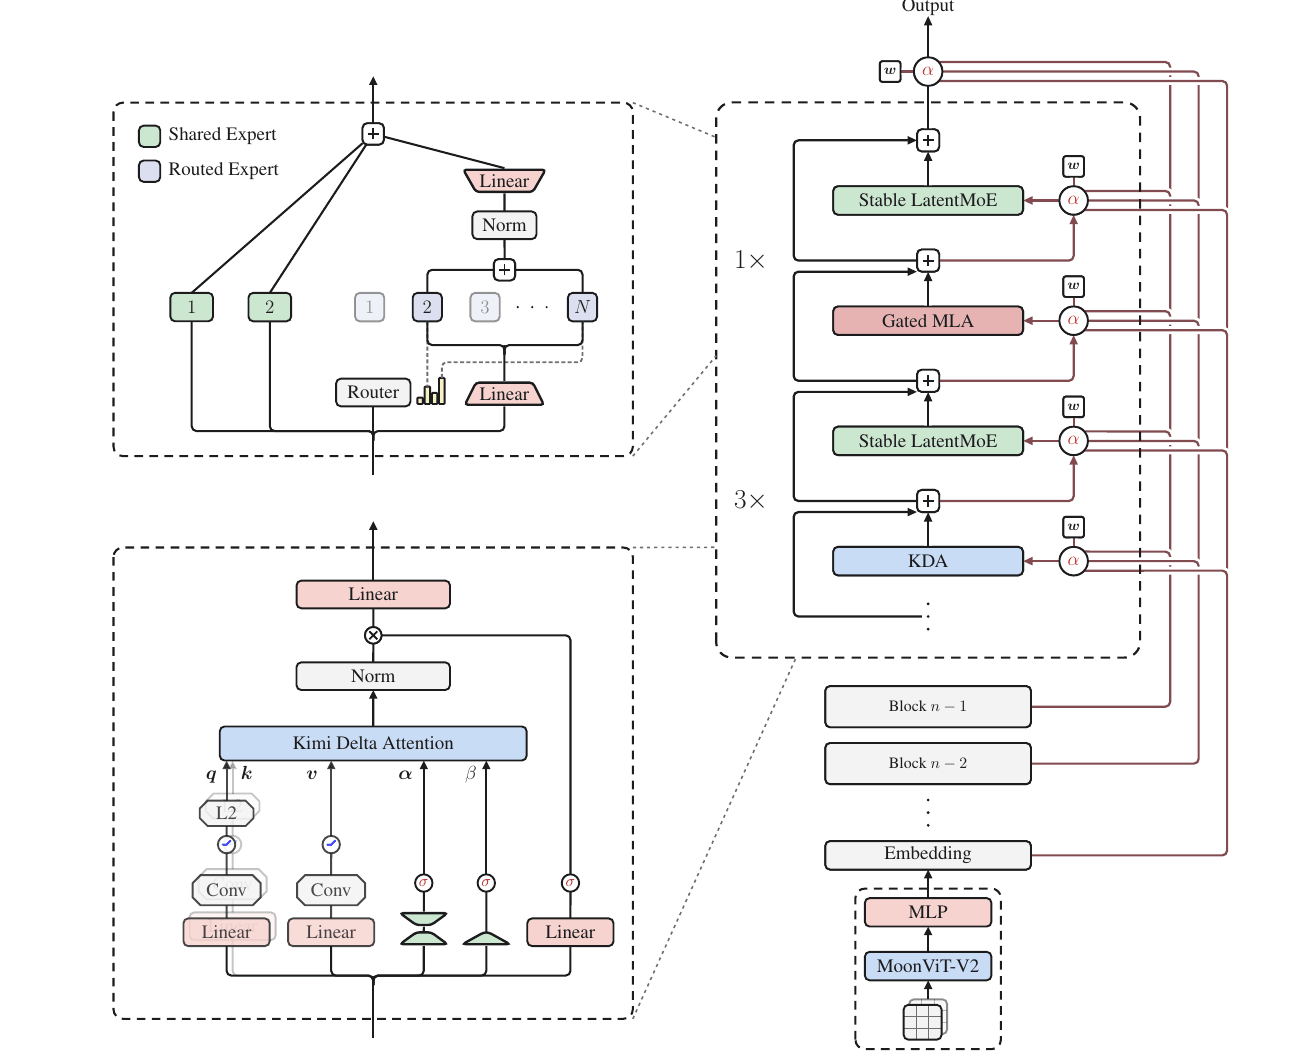
圖 2:Kimi K3 架構,圍繞 token 混合、通道混合與層混合組織,並在輸入端配置原生視覺路徑。每個 block 包含三層 Kimi Delta Attention (KDA) 後接一層 Gated MLA,每層注意力都搭配一個 Stable LatentMoE 前饋網路。Attention Residuals (AttnRes) 使用學習到的偽 query (w) 導出對 embedding 與先前各 block 輸出的注意力權重 (α),讓資訊能跨深度選擇性流動。左上:含共享與路由專家的 Stable LatentMoE 模組。左下:KDA 模組。右下:原生視覺路徑。
Kimi K3 的架構設計目標,是沿三個互補維度擴展資訊流動:序列長度、網路深度與模型寬度。在序列維度上,混合注意力 (Hybrid Attention) 在每個 block 中把三層 Kimi Delta Attention (KDA) [64] 與一層 Gated MLA 組合起來,提供高效的長上下文 token 混合機制,同時保留選擇性的高容量注意力(§2.1)。在深度維度上,Attention Residuals (AttnRes) [58] 讓每個模組能選擇性地從 embedding、當前 block 與先前各 block 取回表示,把資訊存取範圍延伸到傳統循序殘差累加之外(§2.2)。在寬度維度上,每層注意力之後接一層 Stable LatentMoE 執行稀疏通道混合,讓每個 token 有效啟用 896 個路由專家中的 16 個(§2.3)。在原生視覺方面,MoonViT-V2 編碼影像與影片,再由一個輕量投影器把得到的視覺特徵映射進共享的 embedding 空間,之後才交給骨幹處理(§2.4)。加上 Per-Head Muon(§2.5),這些元件構成一個統一的架構,用來跨 token、跨層、跨通道擴展資訊流動。結合精煉的訓練與資料配方,它們帶來相對於 Kimi K2 約 2.5 倍的整體 scaling 效率提升。圖 2 給出架構總覽。
2.1 混合注意力
Kimi K3 使用線性注意力與全域注意力的逐層混合,把 KDA [64] 與 Gated MLA 組合起來。每個 block 包含 3 層 KDA 後接 1 層 Gated MLA,混合比為 3:1,這個模式在整個骨幹中重複。以下分別描述這兩種注意力機制。骨幹末端額外再放一層 Gated MLA,確保最後一層一定執行全域注意力。
2.1.1 Kimi Delta Attention
KDA 以一個逐通道的遺忘閘擴展 delta-rule 遞迴 [106, 140, 64]。考慮一串隱藏狀態 $x_t \in \mathbb{R}^{d}$,其中 $t$ 是 token 位置索引、$d$ 是模型隱藏維度。為求清晰,我們先描述單一個注意力頭:query 與 key 向量 $q_t, k_t \in \mathbb{R}^{d_k}$、value 向量 $v_t \in \mathbb{R}^{d_v}$、遞迴狀態 $S_t \in \mathbb{R}^{d_k \times d_v}$。KDA 在 delta-rule 更新之前先套用逐通道衰減:
$$S_t = \left(I - \beta_t k_t k_t^{\top}\right)\mathrm{Diag}(\alpha_t) S_{t-1} + \beta_t k_t v_t^{\top}, \qquad \tilde{o}_t = S_t^{\top} q_t. \tag{1}$$
這裡 $\alpha_t \in (0,1)^{d_k}$ 是逐通道的單步保留因子,$\beta_t \in (0,1)$ 控制 delta-rule 的寫入強度。承襲 Kimi Linear [64],KDA 把每個頭的相關量參數化為
$$q_t^{h}, k_t^{h} = \mathrm{L2Norm}\left(\mathrm{Swish}\left(\mathrm{ShortConv}\left(W_{q/k}^{h} x_t\right)\right)\right) \in \mathbb{R}^{d_k},$$
$$v_t^{h} = \mathrm{Swish}\left(\mathrm{ShortConv}\left(W_v^{h} x_t\right)\right) \in \mathbb{R}^{d_v},$$
$$\beta_t^{h} = \mathrm{Sigmoid}\left(W_{\beta}^{h} x_t\right) \in (0,1),$$
$$z_t^{h} = W_{\alpha}^{\uparrow} W_{\alpha}^{\downarrow} x_t + b_{\alpha}^{h} \in \mathbb{R}^{d_k}. \tag{2}$$
query、key、value 的投影都先做 ShortConv 再接 Swish [140],而 query 與 key 還會再用 L2 正規化 [143]。低秩投影與頭專屬的偏置 $b_{\alpha}^{h} \in \mathbb{R}^{d_k}$ 為每個 key 通道產生細粒度的衰減 logit $z_t^{h}$。從 $z_t^{h}$ 到 $\alpha_t^{h}$ 的下界映射會在下面的分塊形式之後介紹。
分塊平行形式。 承襲 Kimi Linear [64],KDA 在分塊之間是遞迴的、在每個分塊之內是平行的。對分塊大小 $C$,$X_{[t]}$ 堆疊第 $t$ 個分塊中的 token 向量,$X \in \{Q, K, V, O, U, W\}$。矩陣 $S_{[t]} \in \mathbb{R}^{d_k \times d_v}$ 表示進入分塊 $t$ 的遞迴狀態。對位置 $1 \leq i \leq j \leq C$,定義逐通道的累積衰減
$$\gamma_{[t]}^{i \to j} := \prod_{r=i}^{j} \alpha_{[t]}^{r}, \qquad \gamma_{[t]}^{r} := \gamma_{[t]}^{1 \to r}. \tag{3}$$
如同 Kimi Linear,$\Gamma_{[t]} \in \mathbb{R}^{C \times d_k}$ 逐列堆疊 $\gamma_{[t]}^{1}, \dots, \gamma_{[t]}^{C}$。UT 變換產生 $U_{[t]}$ 與 $W_{[t]}$,由此定義偽 value 項 $\tilde{V}_{[t]} := U_{[t]} - W_{[t]} S_{[t]}$。給定進入的狀態 $S_{[t]}$,分塊 $t$ 中的所有輸出可平行計算為
$$A_{[t]} = \mathrm{Tril}\left[\left(Q_{[t]} \odot \Gamma_{[t]}^{1 \to C}\right)\left(K_{[t]} / \Gamma_{[t]}^{1 \to C}\right)^{\top}\right],$$
$$O_{[t]} = \underbrace{\left(\Gamma_{[t]}^{1 \to C} \odot Q_{[t]}\right) S_{[t]}}_{\text{分塊間}} + \underbrace{A_{[t]} \tilde{V}_{[t]}}_{\text{分塊內}}. \tag{4}$$
對矩陣 $M$,$\mathrm{Tril}(M)$ 把嚴格上三角的元素全設為零、保留下三角(含對角線)。這個遮罩強制分塊內的因果互動,而保留對角線是因為每個輸出讀取的是當前 token 更新之後的狀態。$O_{[t]}$ 的第一項攜帶來自先前分塊的資訊,第二項則處理當前分塊內的互動。UT 變換與分塊形式的完整推導請參閱 Kimi Linear [64]。
下界化的衰減。 式 4 用倒數累積衰減 $1/\Gamma_{[t]}^{1 \to C}$ 重新縮放每個分塊中的 key。由於 $\Gamma_{[t]}^{1 \to C}$ 是一串落在 $(0,1)$ 的保留因子的乘積,這個倒數可能無上界地成長,在有限精度下溢位 [142, 64]。Kimi Linear 的控制方式是在對數空間計算相對衰減,並把每個分塊再切成 16-token 的次級 tile [142, 64]。非對角的 tile 因此可以直接用 Tensor Core 的密集矩陣乘法計算;但對角 tile 仍需要顯式的位置對計算,這仍是分塊內的主要瓶頸。
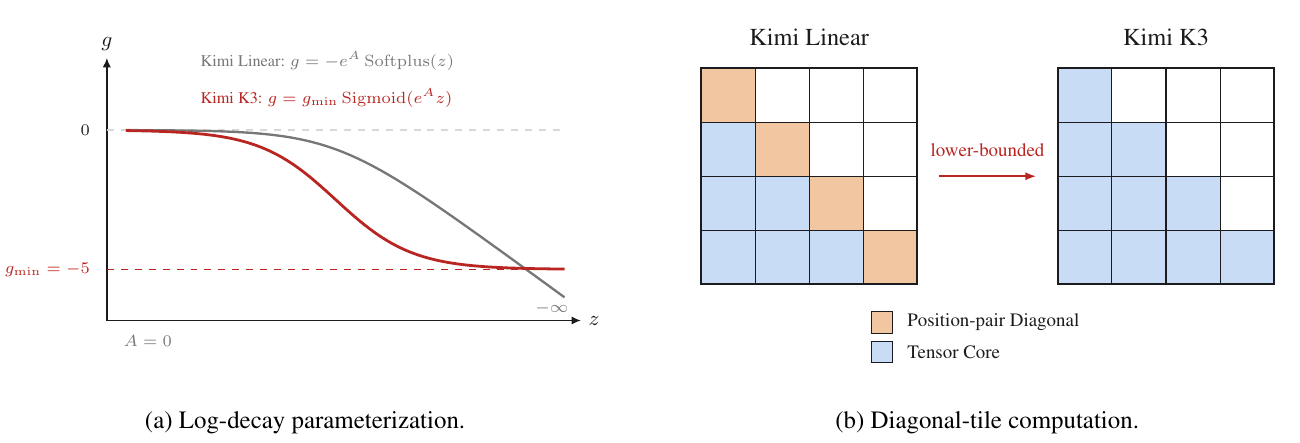
圖 3:下界化衰減及其對分塊 KDA 計算的影響。(a) Kimi Linear 使用無界的負 Softplus 映射,而 Kimi K3 用一個縮放後的 sigmoid 為對數衰減設下界;曲線取 $A = 0$、$g_{\min} = -5$。(b) Kimi Linear 對每個對角 tile 都用顯式的位置對計算,而 Kimi K3 的有界範圍讓所有因果 tile 都能使用密集的 Tensor Core 矩陣乘法。
Kimi K3 處理這個瓶頸的方式,是改變從衰減 logit $z_t^{h}$ 到每步對數衰減 $g_t^{h}$ 的映射。承襲 GDN 與 Mamba-2,Kimi Linear 使用負 Softplus 映射 $g_t^{h} = -e^{A_h}\mathrm{Softplus}(z_t^{h}) \in (-\infty, 0)^{d_k}$ [140, 24, 64]。Kimi K3 改用一個縮放後的 sigmoid,為對數衰減設下界:
$$g_t^{h} = g_{\min}\,\mathrm{Sigmoid}\left(e^{A_h} z_t^{h}\right) \in (g_{\min}, 0)^{d_k}, \qquad \alpha_t^{h} = \exp(g_t^{h}) \in \left(e^{g_{\min}}, 1\right)^{d_k}, \tag{5}$$
其中 $A_h$ 是可學習的每頭對數尺度,$g_{\min} = -5$ 固定不變。我們初始化 $A_h = 0$,每個偏置 $b_{\alpha}^{h}$ 依 [64, 24, 140] 初始化。在 $g_{\min} = -5$ 之下,每個保留因子都滿足 $\alpha_{t,j}^{h} > e^{-5} \approx 6.7 \times 10^{-3}$,而 16-token tile 上的累積對數衰減落在 $(-80, 0)$。對應的倒數重新縮放因子因此小於 $e^{80}$,仍落在 BF16 的動態範圍內。這個有限範圍讓對角與非對角 tile 都能使用密集的 Tensor Core 矩陣乘法,消除了位置對的對角路徑。這種參數化與先前工作中的下界化遞迴閘密切相關 [98, 27, 92]。圖 3 說明了衰減參數化的改變及其計算上的後果。
全秩閘。 最後,Kimi K3 把 KDA 的輸出閘從 Kimi Linear [64] 所用的低秩參數化,改成輸入相依的全秩投影。對遞迴輸出套用逐頭 RMSNorm [148] 之後,KDA 施加資料相依的輸出閘控 [100]:
$$y_t = W_o\left[\mathrm{Sigmoid}(W_g x_t) \odot \mathrm{RMSNorm}(\tilde{o}_t)\right]. \tag{6}$$
2.1.2 Gated MLA
多頭潛在注意力 (Multi-head Latent Attention, MLA) 由 DeepSeek-V2 [28] 提出,它把每個 token 的 key–value 表示壓縮成一個低維潛在向量 $c_t = W_c x_t$。MLA 不快取完整的、頭專屬的 key 與 value,而是快取 $c_t$,並在注意力計算時透過學習到的上投影重建內容 key 與 value。這種分解在保留全域 token 對 token 注意力的同時,降低了 KV 快取的佔用。MLA 隨後被 Kimi K2 與 Kimi K2.5 採用 [59, 60],Kimi K3 也在其週期性的全域注意力層中保留它。
與 Kimi K2 和 Kimi K2.5 不同,Kimi K3 遵循 Kimi Linear [64] 的混合設計,對所有 MLA 層套用無位置編碼 (No Position Encoding, NoPE)。因此,它們的 query 或 key 上都不施加任何顯式位置編碼。夾在其間的 KDA 層提供位置敏感、且具近期性偏好的序列混合,而 MLA 層提供不受限制的全域內容互動。這種分工也讓延伸上下文長度時不必修改位置編碼參數,例如重調 RoPE 頻率基底或套用 YaRN [93]。
此外,Kimi K3 為 MLA 加上一個輸入相依、逐通道的全秩輸出閘。令 $\tilde{o}_t$ 表示位置 $t$ 未加閘的 MLA 輸出,加閘後的輸出為
$$y_t = W_o\left[\mathrm{Sigmoid}(W_g x_t) \odot \tilde{o}_t\right]. \tag{7}$$
閘投影 $W_g$ 是全秩的,與 Kimi K3 中 KDA 所用的新參數化一致。這個閘讓每個 token 能調變它從全域注意力讀取的通道 [100]。
為了修正 [99] 所指出的 flash attention 中有偏的捨入誤差,我們在訓練時把注意力輸出保持在 FP32。這個選擇讓輸出 tile 的晶片上佔用加倍;因此我們重新設計訓練 kernel,讓它與 KV staging 緩衝區重疊而不是與 query tile 重疊,藉此釋放共享記憶體給更深的 KV 流水線,提高訓練吞吐量。
2.2 Attention Residuals
標準的殘差連接 [44] 會把所有先前資訊沿深度壓縮進單一個狀態 $h_l$——這個瓶頸讓人聯想到 RNN 沿時間的處理方式。在序列建模上,Transformer 用注意力取代了遞迴 [10, 127],讓每個位置都能以資料相依的權重選擇性存取所有先前位置。Attention Residuals (AttnRes) [58] 把同樣的方法論套用到深度上:每一層都選擇性地從所有先前層取回表示,而不是均勻地累加它們。
完整 Attention Residuals。 對每一層 $l$,我們定義一個層專屬的可學習偽 query $q_l = w_l \in \mathbb{R}^{d}$,以及 key 與 value
$$k_i = v_i = \begin{cases} h_1 & i = 0\\ f_i(h_i) & 1 \leq i \leq l-1 \end{cases} \tag{8}$$
其中 $f_i(h_i)$ 是第 $i$ 層的輸出、$h_1$ 是 token embedding。注意力權重遵循 softmax 核 $\phi(q,k) = \exp\left(q^{\top}\mathrm{RMSNorm}(k)\right)$ [56, 148],其中 RMSNorm 防止輸出量級大的層主導權重:
$$\alpha_{i \to l} = \frac{\phi(q_l, k_i)}{\sum_{j=0}^{l-1}\phi(q_l, k_j)}, \qquad h_l = \sum_{i=0}^{l-1}\alpha_{i \to l}\cdot v_i. \tag{9}$$
由於網路深度不大($L < 100$),這種完整形式 $O(L^2 d)$ 的算術是可負擔的;實務上的開銷在於要讓所有層輸出保持存活的 $O(Ld)$ 記憶體(以及在流水線平行下的跨階段通訊)。
Block Attention Residuals。 為了降低這個開銷,我們把 $L$ 層切成 $N$ 個 block,每個 $S = L/N$ 層。在 block $n$(層索引集 $B_n$)之內,各層輸出以加總歸約成單一個表示 $b_n = \sum_{j \in B_n} f_j(h_j)$,並以 $b_n^{i}$ 表示該 block 前 $i$ 層的部分和;我們設 $b_0 = h_1$,讓 token embedding 永遠是一個來源。跨 block 則只對這 $N$ 個 block 層級的表示做完整注意力:對 block $n$ 中的第 $i$ 層,value 矩陣為
$$V = \begin{cases}[b_0, b_1, \dots, b_{n-1}]^{\top} & i = 1\ (\text{block } n\text{ 的第一層})\\ [b_0, b_1, \dots, b_{n-1}, b_n^{i-1}]^{\top} & i \geq 2\ (\text{後續各層})\end{cases} \tag{10}$$
key 與注意力權重仍依式 8 與式 9。在 Block AttnRes 之下,記憶體與通訊開銷從 $O(Ld)$ 降到 $O(Nd)$;這個 block 結構同時也為推論時的狀態設下界,讓平行的跨 block 結果能透過 online softmax [80] 更好地與循序的 block 內部分和合併,顯著降低推論時間成本。
實證上,$N \approx 8$ 在各種模型規模上就能取回大部分的好處 [58];對 Kimi K3,我們把它的層切成 8 個 block、每個 12 層,因此有一個不完整的最後 block;若把 embedding 層也算進去,總共是 9 個 block。
2.3 Stable LatentMoE
同時擴大專家池與啟用專家數,能擴張專家特化的空間;但在傳統 MoE 中,每個被選中的專家都會收到完整 $d$ 維的 token 表示,因此通訊量與專家權重流量都會隨路由重數成長。LatentMoE [32] 讓這種擴張變得可負擔,做法是把模型全寬與路由專家寬度分離:共享專家保留全寬路徑處理共通變換,而特化的路由專家則在寬度為 $\ell$ 的緊湊潛在空間中運作。這讓 Kimi K3 能把通道混合擴展到 896 個路由專家、每個 token 啟用 16 個,稀疏度為 56。
這種極端稀疏放大了原始設計的兩種失效模式。第一,路由路徑把 $W_{\downarrow}$、一個帶閘的多分支專家前饋網路,與 $W_{\uparrow}$ 串成將近四次連續矩陣乘法的鏈。這種病態結構加上 2.8 兆參數的規模,會讓路由分支的內部激活值爆炸。第二,要平衡將近 $10^3$ 個專家的負載,已經超出既有的無輔助損失偏置更新仍能良好運作的範圍。Stable LatentMoE 用三個元件處理這兩種失效模式:在上投影之前加一個 RMSNorm、Sigmoid Tanh Unit GLU (SiTU-GLU) 來抑制激活爆炸,以及用於負載平衡的 Quantile Balancing (QB)。
如圖 2 所示,這一層遵循 DeepSeekMoE [23] 的共享與路由專家組織。對 $x \in \mathbb{R}^{d}$,共享專家直接處理 $x$,而路由路徑把它投影成 $z = W_{\downarrow}x \in \mathbb{R}^{\ell}$、把 $z$ 派送給選中的專家,再透過 $W_{\uparrow}$ 把它們的加權彙總映射回 $\mathbb{R}^{d}$:
$$u = \sum_{i \in T_k(x)} p_i E_i^{\mathrm{routed}}(W_{\downarrow}x),$$
$$y = \sum_{j=1}^{N_s} E_j^{\mathrm{shared}}(x) + W_{\uparrow}\,\mathrm{RMSNorm}(u). \tag{11}$$
這裡 $u \in \mathbb{R}^{\ell}$ 是彙總後的路由表示,$E_j^{\mathrm{shared}}: \mathbb{R}^{d} \to \mathbb{R}^{d}$ 與 $E_i^{\mathrm{routed}}: \mathbb{R}^{\ell} \to \mathbb{R}^{\ell}$ 分別是共享與路由專家的前饋網路,而 $p_i$ 是下面 Quantile Balancing 規則所定義的路由器權重。Kimi K3 在每一層都固定使用 $N_s = 2$ 個全寬共享專家。
2.3.1 Normalized LatentMoE
原始的 LatentMoE 直接對彙總後的路由表示 $u$ 套用 $W_{\uparrow}$,而 $u$ 的尺度會隨被選中的專家及其路由權重而變動。如式 11 所示,Kimi K3 改為在專家彙總與上投影之間插入一個 RMSNorm [148]。這個正規化降低了路由分支在與全寬共享分支合併之前對尺度變動的敏感度。除了穩定訓練之外,這個額外的 RMSNorm 也一致地改善驗證損失與下游基準。
2.3.2 Sigmoid Tanh Unit GLU
閘控線性單元 (Gated Linear Unit, GLU) 用一個 sigmoid 激活的閘來調變線性 value 分支,計算 $\mathrm{Sigmoid}(W_g x) \odot W_u x$ [26]。SwiGLU 把 sigmoid 閘換成 $\mathrm{Swish}(x) = x\,\mathrm{Sigmoid}(x)$,在 Transformer 中取得強勁的實證表現 [108]。SwiGLU 隨後成為大型語言模型中廣泛採用的 FFN 設計,儘管對其實證效果的完整解釋仍是開放問題。
然而 SwiGLU 的兩個乘法因子都是無界的,因此同時出現的大座標值可能產生激活離群值,並在低精度算術中提高溢位風險。原始 GLU 的 sigmoid 閘避免了閘值無界成長,但它沒有保留 Swish 在正值區近似線性的特性。這促成我們去尋找一種既能控制大值成長、又能保留 SwiGLU 局部與正值側特徵響應的激活函數。近期也有其他工作探索過這個取捨的替代參數化 [52]。
為滿足這些需求,我們提出 Sigmoid Tanh Unit GLU (SiTU-GLU)。SiTU-GLU 把平滑的截斷 $\mathrm{softcap}(x, \beta) = \beta\tanh(x/\beta)$ 套用在 Swish 閘的線性因子上,並獨立地套用在 up 分支上:
$$\mathrm{SiTU\text{-}GLU}(x) = \left[\beta_1\tanh\left(\frac{W_g x}{\beta_1}\right) \odot \mathrm{Sigmoid}(W_g x)\right] \odot \beta_2\tanh\left(\frac{W_u x}{\beta_2}\right). \tag{12}$$
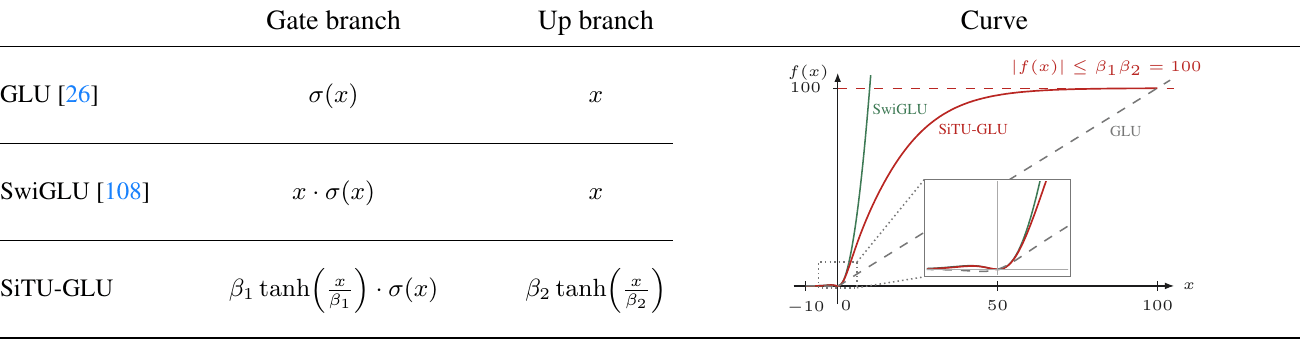
圖 4:GLU、SwiGLU 與 SiTU-GLU 的閘分支與 up 分支,以及它們的純量響應,其中 $\sigma$ 表示 sigmoid 函數。兩個分支都接受純量輸入 $x$,所有曲線共用定義域 $x \in [-10, 100]$;內嵌小圖放大原點附近。以紅色顯示的 SiTU-GLU($\beta_1 = 4$、$\beta_2 = 25$)在原點附近緊貼 SwiGLU,而在大正值輸入時趨近上界 $|f(x)| \leq \beta_1\beta_2 = 100$,SwiGLU 則維持無界。
對 Kimi K3,我們把 soft-cap 超參數設為閘分支 $\beta_1 = 4$、up 分支 $\beta_2 = 25$。縮放後的 tanh 在原點附近近似線性、在大量級處有界,讓 SiTU-GLU 能保留 SwiGLU 的局部響應,同時控制乘積中的兩個因子。圖 4 在同一切面上比較 GLU、SwiGLU 與 SiTU-GLU 的分支定義與純量響應。附錄 B 給出局部展開、極限情形、形式化的輸出上界,以及與硬截斷的比較。
2.3.3 Quantile Balancing
與基於輔助損失的路由 [33] 不同,Kimi K3 採用無輔助損失的路由 [30]。負載平衡的實作方式,是在用於 Top-k 選擇的路由器分數上加一個專家專屬的偏置 $b_j$。對 token $x_i$,路由器計算 $s_i = \mathrm{Sigmoid}(W_r x_i)$ 並套用
$$T_i = \operatorname{argtopk}\left(s_i + b\right), \qquad p_{i,j} = \frac{s_{i,j}}{\sum_{r \in T_i} s_{i,r}},\quad j \in T_i. \tag{13}$$
由於 $b$ 未被納入 $p_{i,j}$,它只調節派送,而不改變混合權重或路由器基於梯度的最佳化。原始方法用固定步長規則 $b_j^{(t+1)} = b_j^{(t)} + \gamma\,\mathrm{sign}(\bar{\ell} - \ell_j)$ 更新 $b$ [30],其中 $\gamma$ 要在「調整太慢」與「負載震盪」之間取捨。當 LatentMoE 把每層的路由專家池擴大到 896 個,維持平衡負載變得更困難。不平衡的路由會拖慢專家平行訓練,也可能讓某些專家訓練不足 [48]。
為了處理這個限制,我們提出 Quantile Balancing (QB):從與目標負載相符的路由器分數分位數 [113, 114] 直接設定每個專家的偏置。考慮一個含 $m$ 個 token、路由到 $n$ 個專家、採 Top-k 選擇的訓練批次,則每個專家的目標負載為 $q := mk/n$。QB 只需一次前向傳遞就能導出下一個偏置。路由時把 Top-k 選擇換成對加了偏置的分數 $s_i + b^{(t)}$ 取 Top-(k+1):前 $k$ 個是實際採用的路由,而第 $(k+1)$ 個則是某個專家要進入 token $i$ 的 Top-k 所必須超越的截止值 $\alpha_i^{(t)}$。從 Top-(k+1) 路由取得截止值,避免了另外再算一次 token 側的分位數。接著我們選擇每個專家的偏置,使專家 $j$ 恰好收到它的目標負載:在截止值固定的情況下,候選偏置 $\hat{b}_j^{(t+1)}$ 之下路由到專家 $j$ 的 token 數為
$$\sum_{i=1}^{m}\mathbb{1}\left[s_{i,j} + \hat{b}_j^{(t+1)} > \alpha_i^{(t)}\right],$$
它對門檻 $-\hat{b}_j^{(t+1)}$ 是單調遞減的。在無平手的假設下,把這個計數設為 $q$,就會讓 $-\hat{b}_j^{(t+1)}$ 等於第 $(q+1)$ 大的邊際值 $s_{i,j} - \alpha_i^{(t)}$,於是恰好有 $q$ 個邊際值高於門檻。由於 $q/m = k/n$,這正是跨 token 的邊際值的 $(1 - k/n)$ 分位數,給出 QB 的更新
$$\hat{b}_j^{(t+1)} \leftarrow -\,\mathrm{quantile}_{1-k/n}\left(s_{:,j} - \alpha^{(t)}\right),$$
$$b^{(t+1)} \leftarrow \hat{b}^{(t+1)} - \mathrm{mean}\left(\hat{b}^{(t+1)}\right)\mathbb{1}. \tag{14}$$
邊際值把加了偏置的截止值 $\alpha_i^{(t)}$ 從原始分數 $s_{i,j}$ 中減去,因此舊的偏置只透過截止值進入更新;第二行則移除一個不改變 Top-k 選擇的共同偏移。為了因果性,更新只在下一步生效 [30],也就是說一個批次絕不會用從它自己導出的偏置來路由。圖 5 說明 $m = 8$、$n = 4$、$k = 1$ 的情形,其中每個專家都收到目標負載 $q = 2$。最終偏置在推論時凍結。平衡指派的推導見附錄 C。
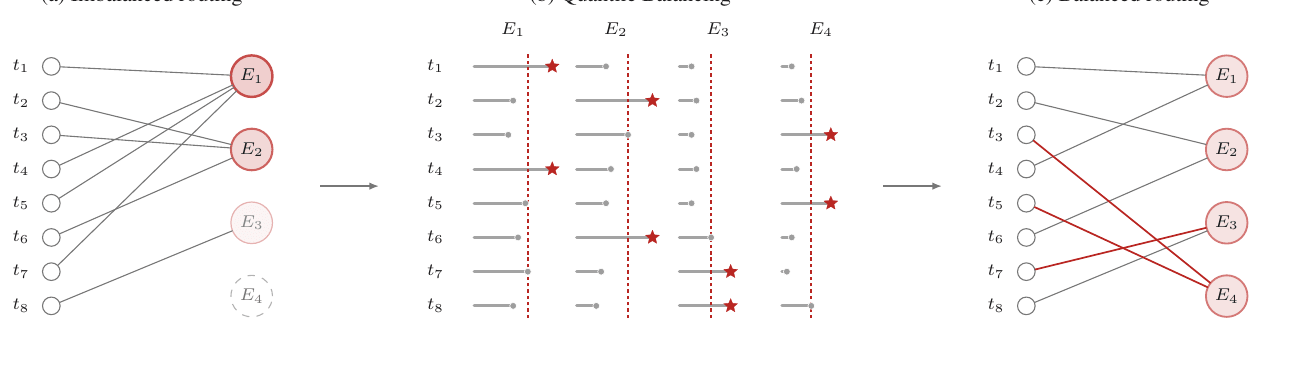
圖 5:Quantile Balancing 示意,取 $m = 8$ 個 token、$n = 4$ 個路由專家、每個 token 選 $k = 1$ 個專家。(a) 逐 token 的 Top-k 路由(左為 token、右為專家)產生負載 $(4,3,1,0)$;深色圓圈表示過熱的專家,淡色與虛線圓圈分別表示利用不足與瀕死的專家。(b) 每根灰色長條是當前加了偏置的分數的邊際值 $s_{i,j} + b_j^{(t)} - \alpha_i^{(t)}$,因此逐列的最大值重現了 (a) 的路由。每一欄中的紅色虛線是偏置調整 $b_j^{(t)} - \hat{b}_j^{(t+1)}$,它被放在第 $(q+1)$ 大的邊際值上,使恰好 $q = 2$ 個邊際值超過它。星號 ⋆ 表示減去各欄調整量之後逐列的 Top-k 選擇,也就是 (c) 中的路由。(c) 保留下來的選擇產生平衡負載 $(2,2,2,2)$;紅色連線是被 QB 改變的指派。
直方圖估計。 在大規模下,式 14 中的分位數橫跨整個全域批次,其邊際值以百萬計,且散布在各 rank 與梯度累積步之間,因此在訓練時把它們收集起來算精確分位數並不可行。我們改為從每個專家的邊際值直方圖讀出分位數:一次 all-reduce 把各 rank 的分箱計數相加,再從彙總後的計數還原分位數。由於計數是可加的,這個直方圖不論 token 如何分片都代表彙總後的全域批次,因此估計值在分箱寬度的誤差內反映整批的分位數,而通訊成本僅為每個專家幾百個分箱。這個直方圖估計器就是我們實務上採用的方法;更詳細的描述與誤差界見附錄 D。
2.4 原生視覺
Kimi K3 是原生多模態的:文字、影像與影片由單一個共享骨幹在同一個上下文中處理,沒有事後的模態對齊階段。這個設計是 §1 所述長程、視覺回路行為的架構基礎。渲染出來的輸出與產生它的程式碼活在同一條 token 串流中,模型可以寫程式、檢視結果的截圖或影格,並反覆精修視覺產物——使用者介面、圖形、影片——完全不需要跨模型交接。
MoonViT-V2。 與 Kimi K2.5 的一個關鍵差異是,我們把 Kimi K3 的視覺編碼器 MoonViT-V2 完全從零開始以 next-token prediction 訓練。先前的做法(包括 Kimi K2.5 本身)會用像 SigLIP 這樣以對比學習預訓練的模型來初始化視覺編碼器,前提是預訓練的視覺知識能給模型一個好的起點。我們偏離這個做法,主要是為了訓練穩定性。當一個預訓練編碼器被接到 LLM 上時,聯合最佳化會變得不穩定:以 SigLIP 初始化的 MoonViT-3D 持續呈現較高的梯度範數並頻繁出現尖峰,而 MoonViT-V2 在整個訓練過程中維持穩定(圖 6)。以 next-token prediction 訓練也讓編碼器的表示能直接被語言建模目標塑形,而不是被一個偏好全域語意、忽略細粒度文字與結構線索的對比損失塑形。值得注意的是,我們發現 MoonViT-V2 在各項視覺評測上與 SigLIP 初始化的基準相當,顯示在規模化的多模態語言模型上,對比預訓練作為初始化並非必要。
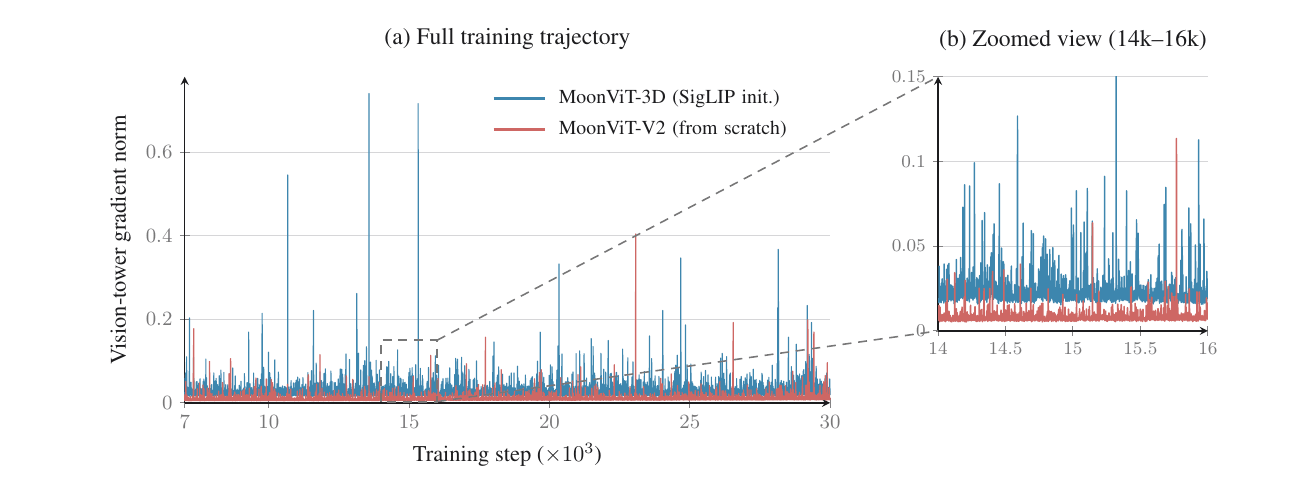
圖 6:我們預訓練消融中的視覺塔梯度範數。相較於以 SigLIP 初始化的 MoonViT-3D,從零訓練的 MoonViT-V2 維持較低的梯度範數、尖峰也較少,顯示最佳化更穩定。
架構。 這套訓練配方建立在一條沿襲 Kimi K2.5 [60, 62] 整體設計的視覺路徑上:視覺輸入先由 MoonViT-V2 編碼,再由一個輕量 MLP 投影器映射進 LLM。MoonViT-V2 是一個 27 層、約 4 億參數的 vision transformer,採用 RMSNorm 並移除其線性與注意力投影中的所有偏置項——這個設計進一步穩定了上述的從零最佳化。影像與影片以完全共享的參數處理,如同 MoonViT-3D:注意力被分解為影格內的空間傳遞與影格間的時間傳遞,而時間池化進一步沿時間維度壓縮 token。在投影之前,一個 $2 \times 2$ 下採樣的 pixel-shuffle 操作把視覺 token 數減為四分之一,讓最高 $3584 \times 3584$ 像素的輸入在 100 萬 token 的上下文內仍可負擔。
2.5 Per-Head Muon
承襲 Kimi K2,Kimi K3 採用 Muon [54] 作為其矩陣參數的優化器。對注意力投影,我們進一步把它精煉成一個逐頭變體 [112, 147]:不對完整的 Q、K、V 投影矩陣做 Newton–Schulz 正交化,而是沿頭維度切分它們的動量矩陣,對每個頭的區塊分別正交化。直覺是:全矩陣正交化把所有頭當成單一個耦合區塊,於是梯度或動量尺度較大的頭會主導共享的更新方向,而尺度較小的頭得到的更新正規化不足;逐頭正交化則讓各頭的更新尺度均等。實務上,這個設計在各頭之間帶來更平衡的學習動態,並在更大規模上改善訓練穩定性。它也略微降低優化器開銷,因為在高瘦的逐頭區塊上做 Newton–Schulz 迭代,比在完整投影矩陣上便宜。
3 預訓練
3.1 預訓練資料
Kimi K3 在一個精心策劃的語料庫上預訓練,涵蓋四個主要文字領域——網頁文字、程式碼、數學與知識——以及一個大規模的視覺語料庫。視覺資料涵蓋圖說、圖文交錯文件、OCR、感知、影片與視覺程式碼資料。我們的資料流水線建立在 Kimi K2 [59] 所發展、並在 Kimi K2.5 [60] 中精煉的基礎上。
文字資料。 每個領域都以規則式啟發法、分類器式品質評分與去重的組合來過濾,領域專屬的取樣率則由小模型上的消融研究決定。承襲 Kimi K2 [59] 的改寫配方,我們用風格與視角多樣的提示、逐塊自迴歸生成,以及對照原始文件的保真度驗證,來改寫知識與數學語料。
視覺資料。 視覺語料庫遵循 Kimi K2.5 [60] 的分類體系,結合開源集合與自建的過濾、合成與去重流水線。訓練時,座標監督同時以絕對與正規化([0,1])兩種格式提供,讓定位既精確又對解析度穩健。除了傳統的文字配圖之外,我們大幅擴充了程式化的多模態資料,把程式碼片段與其渲染出的視覺結果配對,涵蓋 SVG、3D 資產、網頁、遊戲與 CAD 圖等領域專屬格式。
3.2 Scaling Law
綜合起來,前面各節所述的架構、資料與訓練改良定義了我們新的模型家族。由於這些改動也改變了最佳的訓練區間,我們進行專門的 scaling law 研究來重新調校關鍵超參數,包括批次大小、學習率、每參數 token 數 (TPP) 與模型形狀。在保留的分布外驗證資料上評估,圖 7 的 scaling law 曲線顯示這些改良合起來帶來相對於 Kimi K2 約 2.5 倍的整體 scaling 效率提升。表 1 提供 Kimi K2 與 Kimi K3 的詳細架構比較,凸顯促成這項提升的結構改動。
我們的 scaling law 研究一致偏好餘弦衰減勝於 Warmup Stable Decay (WSD) [47],因此我們採用餘弦衰減作為預設的學習率排程。我們在固定的最小學習率下比較餘弦衰減與 WSD。雖然先前工作曾回報 WSD 能追平甚至勝過餘弦衰減,我們觀察到兩種排程的最佳超參數截然不同。即使在相同的模型大小與訓練 token 預算下,它們的最佳峰值學習率與批次大小也相差甚遠。因此,用一組共享的超參數比較這兩種排程,可能只是因為那些超參數比較契合其中一方而不公平地偏袒它。為了確保公平比較,我們為每種排程各自進行獨立的 scaling law 搜尋。在各自的最佳超參數設定下,餘弦衰減一致地取得比 WSD 更低的最終損失。
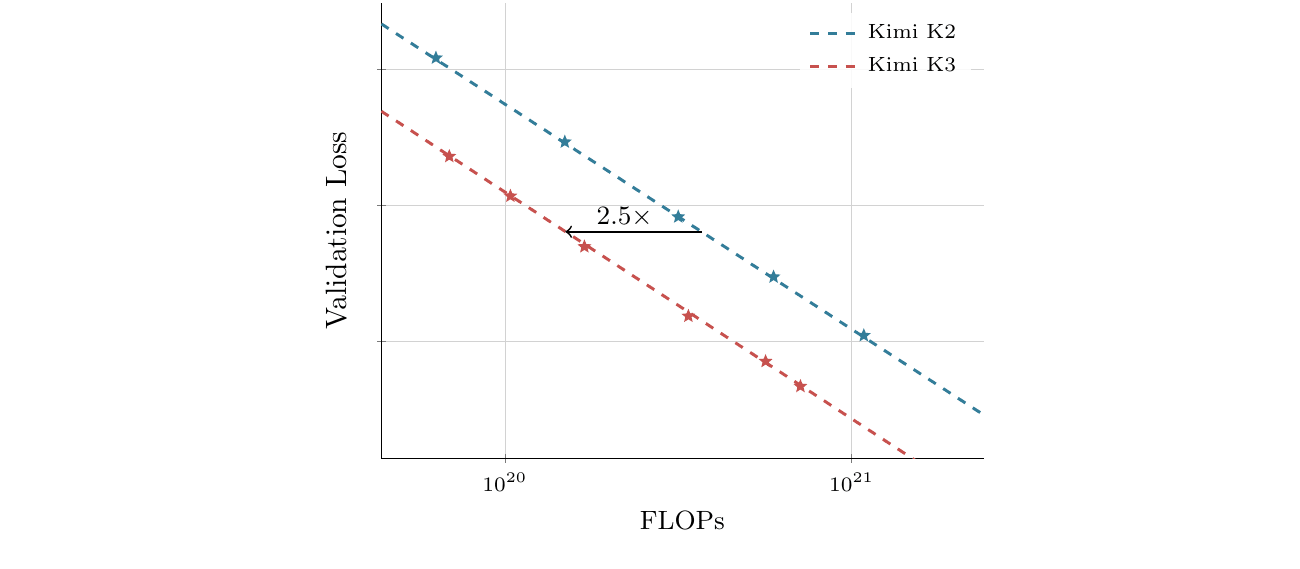
圖 7:Kimi K2 與 Kimi K3 的 scaling law 擬合曲線。Kimi K3 相對於 Kimi K2 取得 2.5 倍的 scaling 效率提升。
表 1:Kimi K2 與 Kimi K3 的架構比較。
| Kimi K2 | Kimi K3 | Δ | |
|---|---|---|---|
| 架構 | MoE | MoE | – |
| 層數 | 61 | 93 | ↑ 52% |
| 總參數量 | 1.04T | 2.78T | ↑ 167% |
| 啟用參數量 | 32.6B | 104.2B | ↑ 220% |
| 隱藏維度 | 7,168 | 7,168 | = |
| Latent MoE 維度 | – | 3584 (0.5×) | – |
| 每專家 MoE 隱藏維度 | 2,048 | 3,072 | ↑ 50% |
| 路由專家數 | 384 | 896 | ↑ 133% |
| 每 token 啟用專家數 | 8 | 16 | ↑ 100% |
| 共享專家數 | 1 | 2 | ↑ 100% |
| 注意力頭數 | 64 | 96 | ↑ 50% |
| 密集層數 | 1 | 1 | = |
| 詞彙表大小 | 160K | 160K | = |
| 訓練上下文長度 | 128K | 1M | 8× |
| 注意力機制 | MLA | 混合 KDA–MLA | – |
| 激活函數 | SwiGLU | SiTU-GLU | – |
| 注意力層組成 | 61 MLA | 69 KDA + 24 MLA | – |
| MTP 層數 | 1 層 | 1 層 | = |
| ViT 總參數量 | – | 401M | – |
| ViT 層數 | – | 27 層 | – |
| ViT patch 大小 | – | 14 | – |
| ViT 注意力頭數 | – | 12 | – |
3.3 訓練配方
Kimi K3 採用原生多模態的訓練策略:語言與視覺從訓練一開始就聯合最佳化,而不是透過事後的對齊階段把視覺編碼器嫁接到一個已預訓練的語言模型上。在這個範式下,視覺與文字 token 在單一個 next-token prediction 目標中交錯,讓共享骨幹從一開始就學到統一的多模態表示。
我們用 Per-Head Muon 優化器(§2.5)搭配 Kimi K2 引入的權重裁剪機制來最佳化模型,並採用 QB(§2.3.3)做 MoE 負載平衡。我們使用餘弦學習率排程搭配 1% 的線性暖身,權重衰減全程設為 0.1。
我們的預訓練從 8k token 的上下文長度開始,後續階段再延伸到 64k token。
3.4 長上下文延伸
位置編碼。 Kimi K3 不使用任何顯式位置嵌入 (NoPE),而是透過 KDA 的遞迴閘控與衰減機制隱式編碼位置資訊。因此,模型能直接外推到 100 萬 token 的上下文,不需要任何位置編碼上的修改,例如 RoPE 重新縮放或內插 [93]。
長上下文資料。 來自自然來源的長文件與長影片含有大量低品質內容,包括近似重複、二進位 blob、截斷的檔案、影片片段與無效的機器生成日誌。我們因此讓它們通過一條專門的清理流水線,結合精確與模糊去重(影片再輔以逐影格的感知雜湊)、啟發式與分類器式的品質過濾,以及結構驗證。由於真正長而連貫的文件與影片相對於短文本相當稀缺,我們對它們上採樣,好讓長上下文的分布在 cooldown 期間不被短序列淹沒。然而,光有長度並不賦予長程能力。為此,我們透過謹慎地排列與串接多模態文件與子任務來合成額外的長上下文資料,使嵌入其中的任務只有關注散布在整個 100 萬 token 上下文中的資訊才能解出。這在預期的規模上訓練注意力機制,防止它退化成局部模式。
漸進式上下文延伸。 Kimi K3 支援最高 100 萬 token 的上下文窗口。我們透過在訓練推進時漸進地延伸上下文窗口達成這點,遵循一個四階段的課程:窗口在預訓練期間從 8K 成長到 64K token,在 cooldown 階段從 256K 成長到 1M token。把昂貴的長序列計算集中在整體訓練預算的一小部分中,讓這套課程既經濟、又能讓模型逐步適應越來越長程的依賴關係。讓百萬 token 訓練對 KDA 層變得可行的序列維度切分,描述於 §5.1.2。
4 後訓練
4.1 方法
我們的後訓練流水線遵循一個三階段範式:透過監督式微調 (SFT) 初始化基礎 agent 能力、透過強化學習 (RL) 在不同推理投入下培養領域專精的專家,再用多教師 on-policy 蒸餾 (MOPD) 把這些領域專屬的策略整併成單一個模型。
4.1.1 監督式微調
SFT 階段為後續的 RL 階段建立一個高品質的冷啟動策略。建立在先前 Kimi 模型 [59, 60] 的 SFT 流水線之上,我們為 Kimi K3 擴充了 SFT 資料集,大幅拓寬其對複雜 agentic 任務的涵蓋。具體來說,我們用先前 Kimi 系列中領域專精的模型合成資料軌跡,再經過多階段驗證與人在迴路的標註。為了一致地表示這些複雜的 agentic 軌跡,我們用基於 XTML 的對話範本(eXtensible Token Markup Language,細節見附錄 F)序列化所有資料。整體而言,這些步驟產生一個大規模的指令資料集,賦予 Kimi K3 自適應推理、精確的工具呼叫,以及在長程 agentic 情境下穩健的執行能力。此外,我們從 SFT 階段起就套用量化感知訓練 (QAT),權重為 MXFP4、激活為 MXFP8(§4.1.4)。
4.1.2 強化學習
雖然 SFT 提供了紮實的冷啟動基礎,但要解鎖更高階的推理與執行能力,RL 至關重要。我們並不為個別任務訓練專門的 RL 模型,而是把 RL 擴展到三個廣泛領域、每個領域涵蓋一整個光譜的子任務,並為每個領域在每個推理投入等級各訓練一個專家:(i) 通用任務,涵蓋通用體驗、視覺、推理、忠實度、搜尋能力與知識工作任務;(ii) 通用 agent,涵蓋長程助理任務、深度研究與段落級寫作;(iii) 程式碼 agent,涵蓋軟體工程 (SWE)、程式開發體驗、kernel 任務與網頁開發。如圖 8 所示,擴展 RL FLOPs 一致地改善知識、推理、視覺、通用 agent 與程式碼等多方面能力。把這三個領域專家與 {low, high, max} 三個推理投入等級交叉,總共得到九個專家模型。
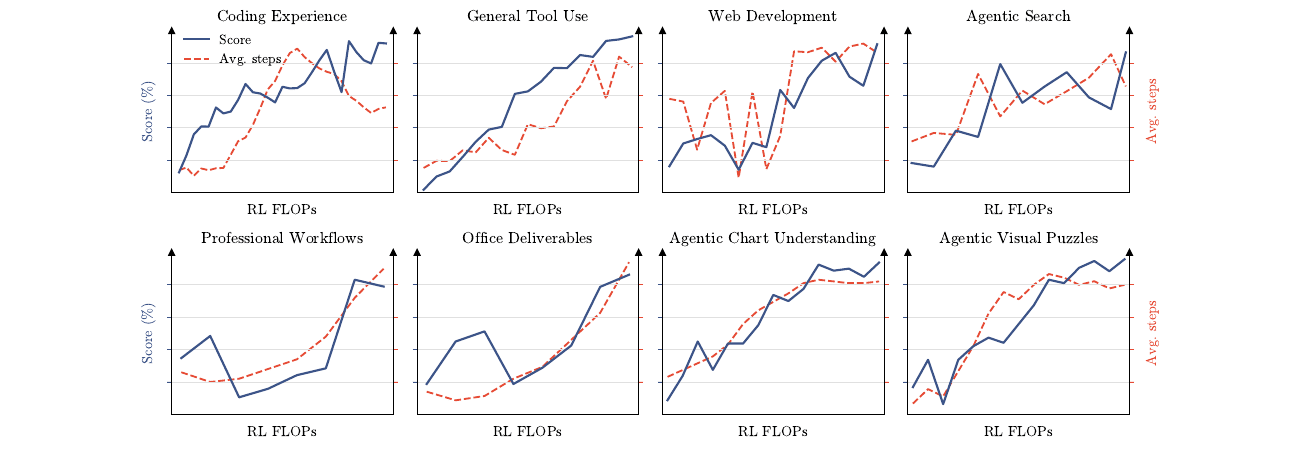
圖 8:RL 期間,在各式公開與內部評測上的分數與平均助理步數。隨著 RL FLOPs 擴展,工具呼叫步數一致地增加,並伴隨模型整體能力的全面提升。
演算法。 為了緩解在長程任務中更加嚴重的長尾延遲,我們把部分 rollout 機制從我們的同步 RL 框架 [120, 60] 延伸出來。在每次迭代的 rollout 階段,我們為 $N$ 個提示各取樣 $K$ 個完成,維持 $N \times K$ 條軌跡的活躍工作量。生成階段不等所有 rollout 結束,而是在完成比例達到 $\lambda \in (0,1)$(即 $\lambda NK$)時就暫停,讓策略最佳化不必被執行落後者拖住。被暫停的 rollout 進入佇列,並在下一次迭代開始時優先恢復,這由我們的 sandbox 基礎設施(§5.3.2)支撐。一旦某個提示的全部 $K$ 個回應都完成,它們就立刻被派給策略最佳化,其演算法遵循 Kimi K2.5 [60]。
在我們的部分 rollout 機制下,單一條長程軌跡自然會橫跨多次迭代,引入威脅訓練穩定性的資料陳舊 (staleness)。我們的策略最佳化演算法透過一個逐 token 的正則化,本質上就能容忍這種極端的 off-policy 狀態。藉由把策略更新約束在一個局部鄰域內,這個正則化讓演算法能穩健地處理高度陳舊的資料,並維持訓練穩定。
推理投入 RL。 為了在最大化 token 效率的同時微調推理投入,我們在 RL 期間實作了逐題的預算控制機制 [60]。我們為每道題 $x$ 關聯一個由冷啟動模型估計的初始 token 預算 $b_0(x)$,並對總 token 預算 $T(y)$ 超過縮放門檻 $\tau \cdot b_0(x)$ 的軌跡,把任務獎勵覆寫為 $-1$。對通用任務,$T(y)$ 計算的是思考 token 數;對 agentic 任務,$T(y)$ 計入累計輸出 token,包含推理軌跡與工具呼叫參數。訓練遵循一套針對預算乘數 $\tau$ 的分階段課程。我們先用相對較大的 $\tau$ 訓練一個 max 預算變體,同時仍為最大預算設上限以抑制過度思考。接著我們把 $\tau$ 退火到較小的值,得到 high 與 low 投入的專家模型。$\tau$ 的調整依領域、在人在迴路的指導下設定。所有推理等級的專家所產生的軌跡,會一起被收集起來用於監督式微調與多教師 on-policy 蒸餾。
Agentic 生成式獎勵模型。 對於不可驗證的通用任務,我們採用 agentic 生成式獎勵模型 (GRM),保留 Kimi K2.5 [59, 60] 的錦標賽式群組獎勵與二元比較。除了為提升判斷力所需的通用 agentic 能力之外,這個 agentic judge 必須遵循一套強制協定:(1) 讀取結果、產物或文字輸出;(2) 生成評分準則 (rubric);(3) 依準則為每個候選評分;(4) 把準則給出的分數記錄在計分板上。為了緩解朝「輸出越來越冗長」的獎勵駭客,我們套用一個與上述推理投入控制類似的、基於預算的冗長度控制:給定由冷啟動模型估計的初始冗長度 $\ell_0$ 與乘數 $\sigma$,輸出長度超過 $\sigma \cdot \ell_0$ 的候選會自動輸掉二元比較。
4.1.3 多教師 on-policy 蒸餾
我們採用多教師 on-policy 蒸餾 (MOPD),把這些橫跨不同推理投入的領域專精能力整併進一個統一模型 [76, 136, 29]。訓練時,對給定的領域 $d$ 與取樣到的推理投入等級 $e \in \{\text{low}, \text{high}, \text{max}\}$,最佳化由九個專家中對應的教師模型 $\pi_{\mathrm{teacher}}^{(d,e)}$ 引導。給定輸入查詢 $x$ 與前綴回應 $y_{<t}$,教師 $\pi_{\mathrm{teacher}}^{(d,e)}$ 與學生 $\pi_{\theta}$ 之間在 $y_t$ 上評估的逐 token OPD 獎勵定義為:
$$r_{\mathrm{opd}}^{d}(y_t \mid e, x, y_{<t}) = \mathrm{clip}\left(\mathrm{sg}\left(\log\frac{\pi_{\mathrm{teacher}}^{(d,e)}(y_t \mid x, y_{<t})}{\pi_{\theta}(y_t \mid e, x, y_{<t})}\right), -R_{\max}, R_{\max}\right), \tag{15}$$
其中 $\mathrm{sg}(\cdot)$ 表示停止梯度運算子,$R_{\max} > 0$ 是用來約束極端優勢訊號的裁剪門檻,藉此穩定 RL 訓練。這個密集的獎勵訊號能無縫整合進我們的 RL 框架,自然地啟用如長程任務的部分 rollout 訓練等基礎設施層級的最佳化。我們也實驗過更細粒度的 top-k 蒸餾目標,但在我們的設定中,無論是收斂速度或最終效能都沒有觀察到明顯優勢。
4.1.4 面向部署的後訓練
MXFP4 量化感知後訓練。 為了降低部署時的記憶體佔用與服務成本,我們把主導模型參數記憶體的 MoE 專家權重量化到 MXFP4 [104]、激活以 MXFP8 計算,而所有非專家元件(注意力投影、latent MoE 投影、共享專家與 MoE router)維持較高精度。我們在整個後訓練階段(涵蓋 SFT 與 RL)執行量化感知訓練 (QAT) [50],讓模型適應量化造成的精度損失。在 RL 期間,rollout 與訓練共用同一套量化方案——消除了訓練與推論之間的不一致。
草稿模型微調。 對於服務複雜的長程 agentic 模型,最佳化推論效率至關重要。Kimi K3 預訓練時帶有一個多 token 預測 (MTP) 層,其結構與骨幹 block 相同。由於 EAGLE-3 [72] 的草稿模型由單一個 decoder 層構成、結構與 MTP 層相符,我們把預訓練好的 MTP 層微調成 EAGLE-3 式的草稿模型:凍結目標模型,只更新草稿層與其特徵融合投影。遵循 EAGLE-3 的訓練時測試協定,草稿在訓練期間展開七步;第一步之後,由於最新位置的目標側特徵不可得,草稿會消費自己在先前步驟的輸出,與推論時的遞迴起草流程一致。
草稿的輸入融合目標模型的低、中、高層特徵,分別取自第 1、第 4 與最後一個 AttnRes block 的輸出(§2.2)。這些特徵被串接起來,再由一個無偏置矩陣 $W_{E3}$ 投影到隱藏維度,其初始化為 $[\,0\ \ 0\ \ I\,]$,使融合表示在初始化時恰好等於高層特徵 $h_h$——也就是 MTP 層預訓練時所依據的輸入——並在微調過程中逐漸學會納入低層與中層特徵。
推測解碼的加速由無損推測取樣下的逐 token 接受率 $\sum_{x \in V}\min(p(x), q(x))$ 決定,其中 $p$ 與 $q$ 分別是目標與草稿模型的 next-token 分布。由於對容量受限的草稿模型而言,最小化傳統的 KL 散度代理並不保證最大化這個接受率,我們直接最佳化基於似然的 LK 損失 [105],也就是接受率本身的負對數:
$$L_{\mathrm{LK}} = -\log\sum_{x \in V}\min(p(x), q(x)), \tag{16}$$
$p$ 與 $q$ 都在溫度 1 下評估,且不加任何輔助的 ground-truth 交叉熵項。草稿微調沿用後訓練的 QAT 配置(§4.1.4),MoE 專家權重為 MXFP4、其輸入激活為 MXFP8,非專家模組維持較高精度。
4.2 RL 任務合成與 agentic 環境
我們 RL 框架的成效高度仰賴豐富、多樣且可穩健驗證的環境。為了支撐跨複雜長程任務的可擴展訓練,我們設計了一系列專門的白箱環境與任務合成範式。
4.2.1 統一白箱 RL 環境
用單一個固定的 agent harness 訓練,會使模型過擬合到某一套特定的工具 schema、系統提示、上下文管理機制或互動協定。為此,我們開發了一個統一的白箱 RL 環境,把 agent harness 表示成一組可配置、可組合的模組,包括工具介面、系統提示、上下文管理策略、skills、memories、subagents 等元件。透過配置組合這些模組,這個環境能實例化如 Kimi Code [57]、Claude Code [15]、Codex [20]、OpenClaw [87] 與 Hermes [45] 等主流 harness,也能組出全新的 harness。在 RL 訓練期間,我們為不同任務群組動態建構不同的 harness 配置,讓 Kimi K3 接觸到這些模組的多樣組合,而不是任何單一 harness 的慣例。同一套抽象也順理成章地支援跨各種任務領域的 RL,為訓練更通用的 agent 提供可擴展的基礎。
4.2.2 知識圖譜引導的任務合成
動機與概觀。 後訓練任務的品質與多樣性,很大程度取決於其來源素材。由細粒度概念引導的檢索能挖出專業且代表性不足的知識,而跨多樣概念的取樣則拓寬領域涵蓋。為了在規模化的同時控制粒度與涵蓋,我們建立一個自我演化、階層化組織的知識圖譜,由 agent 透過網路規模的探索,在知識密集與程式碼領域中持續擴張它。圖 9 說明任務合成流水線。
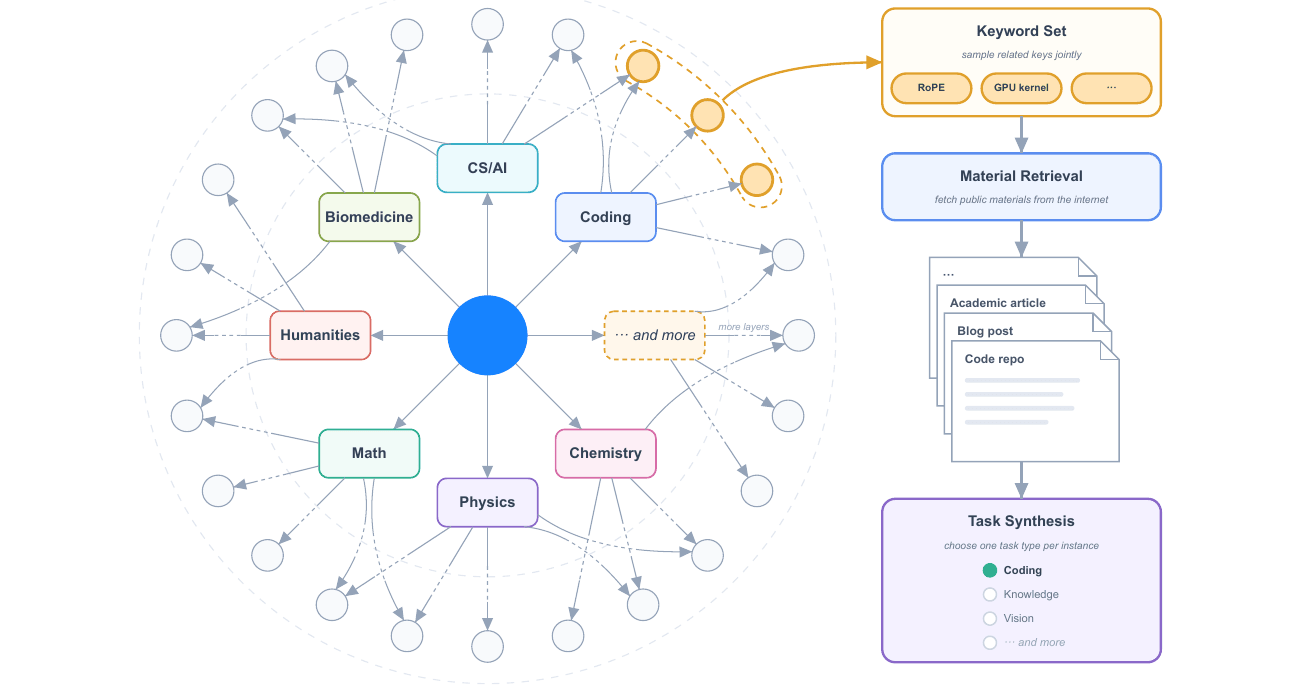
圖 9:知識圖譜引導的任務合成總覽。階層化組織的知識圖譜在多個層次上表示概念,從廣泛的領域到細粒度的概念。相關節點被取樣出來形成關鍵詞集合,用以引導公開來源素材的檢索。對每個合成實例,系統選定一種任務類型,並用檢索到的素材合成對應的任務。
Agentic 知識圖譜建構。 我們把知識圖譜建構成一個有向無環圖,透過遞迴的、agent 驅動的擴張進行。擴張過程從一組預先定義的粗粒度種子節點開始。接著為每個節點指派一個 agent 實例,執行多次網路搜尋來調查對應的概念。在加入新節點之前,agent 會先探索既有圖譜以辨識等價或相關的概念、在適當時重用既有節點,並把重複降到最低。邊一律從較粗的概念指向較細的概念,不論 agent 先發現哪一端。新加入的節點隨後又被指派給 agent 做進一步探索。當被指派的 agent 判定當前概念已足夠原子時,該分支停止擴張。
素材檢索與任務合成。 為了瞄準跨領域與跨任務類型的目標分布,系統會在不同粒度層次上取樣節點,可以單獨取樣、也可以取相關組合。從取樣節點導出的關鍵詞,會與其在知識圖譜中祖先節點的脈絡資訊結合,用來構造網路查詢。檢索到的真實世界素材被組裝起來,供合成 agent 產生各種任務類型的訓練任務。
4.2.3 Agentic 環境中的可驗證問題
我們在 agentic 環境中的可驗證問題上訓練 Kimi K3;代表性的例子包括:多步驟的複雜資訊搜尋,模型規劃自己的研究、逐步從網路蒐集證據,並產出一個可驗證的答案;專業人士的日常實際工作,例如投資銀行、資料分析與法律實務,模型分解一個複雜請求、在 sandbox 中操作領域工具,並在數十到數百個步驟中完成一份交付物;以及對 STEM 問題、視覺謎題與圖表理解的多步驟可驗證視覺推理。每條視覺推理軌跡都在一個配有隔離 sandbox 中 Python 直譯器的 agent 環境裡產生:模型反覆撰寫並執行程式碼來裁切、放大或變換輸入影像、進行精確計算或驗證中間結果,並在多個互動步驟中把執行輸出(包含生成的影像)當作新的觀察接收回來。隨著模型學會執行更多影像操作、蒐集更多觀察,它在複雜視覺推理任務上的表現穩定提升。
4.2.4 Kernel 最佳化任務
為了強化 Kimi K3 的 GPU kernel 最佳化能力,我們建立了一個大規模的 kernel 任務套件,從單一算子 kernel 到融合的 mega-kernel,來源包括 Flash Linear Attention [141] 等高品質 GitHub repo。這套題目橫跨多樣的 GPU 程式撰寫途徑,例如 CUDA、Triton、CuTe DSL、Gluon、ThunderKittens [111] 與 TileLang [131],並涵蓋廣泛使用的 GPU 架構與數值格式,包括 BF16、FP8 與 FP4。獎勵同時評估正確性與效能:每個 kernel 都提供一份 PyTorch 參考實作,數值誤差超過預定門檻的解答得零分。效能則對照專家實作評分,追平專家得 0.5 分,越接近硬體 roofline 獎勵越趨近 1。為了確保獎勵反映真正的最佳化,我們開發了一套作弊偵測系統,懲罰如 CUDA graph replay、輸入快取與降低精度等獎勵駭客策略,並在 Kimi K3 開發期間持續隨新出現的作弊手法擴充它。
4.2.5 個人助理任務
對於長程的個人助理任務,我們為 Gmail、Notion、Slack、Canvas 等廣泛使用的應用程式開發了逼真的模擬實作。它們保留真實對應物的核心語義,同時讓大規模、可重現的互動不需要外部 API 或受限於速率限制。基於這些模擬應用,我們設計了受人力資源、法律服務與金融等真實專業工作流程啟發的複雜任務。在每個任務中,agent 在一個持久、演化的環境中跨多個模擬日運作,並遭遇散布在各應用之間、數十個彼此相依的事件。單一次 rollout 可能涉及多達數千次工具呼叫與數百萬 token 的上下文。每個事件都有自己的評估標準,由確定性規則或 LLM 評估器判定。初始工作區由 agent 自主搜尋網路上的參考素材、並把它們轉化成連貫且與任務相關的環境而建構。我們也擴展了 RL 框架以支援這類「活的環境」,對複雜事件流與其誘發的世界狀態轉移進行建模。
4.2.6 自主執行任務
我們提出自主執行任務 (Autonomous Execution Tasks, AET),一種透過「驗證在迴路中」的最佳化來訓練長程 agent 智慧的環境範式。每個任務指定一個初始狀態、一個受約束的目標、一個基於工具的動作空間、執行預算,以及一個獨立的驗證器。Agent 只看得到目標、脈絡、約束與驗證介面,沒有參考軌跡或預先定義的程序,必須自主完成任務分解、工具選擇、規劃、錯誤復原與終止判斷。獎勵以驗證器對最終環境狀態的評估為依據,而不是 agent 自己宣稱的完成度。我們設計了多種支援不同環境的驗證器,包括黑箱系統復刻(圖 10)、量化因子發現與稅務稽核。在每個環境中,agent 反覆提交解答、接收驗證器回饋並精修策略,訓練出一個「假設、行動、分析回饋、調適」的通用迴路。獎勵駭客則透過以下方式緩解:把 agent 與驗證器隔離、把提供診斷回饋的公開驗證器與評估保留情境的隱藏驗證器配對,以及在有限提交預算下套用懲罰式獎勵。
4.2.7 網頁開發任務
我們建構了一套由專家策劃、涵蓋典型情境的多樣網頁開發任務。輸入從一行場景描述到多段落規格書都有;產物橫跨網站、互動遊戲、3D/WebGL 場景、資料視覺化、SVG 與全端應用。每個任務都在容器化的 sandbox 中執行,並在多樣的 agent scaffold 下 rollout,而不是單一個固定 harness,以促進跨 scaffold 的泛化。獎勵由兩部分組成:確定性檢查與內部獎勵模型的模型評判。確定性檢查對應用行為做功能測試,並對需要復刻參考的任務評估結構與像素層級的相似度。當專案建置失敗、執行出錯,或只是假裝而非真正實作出該產物時,獎勵歸零。模型評判則用其他模型來檢視原始碼,或實際觀看並與輸出產物互動。
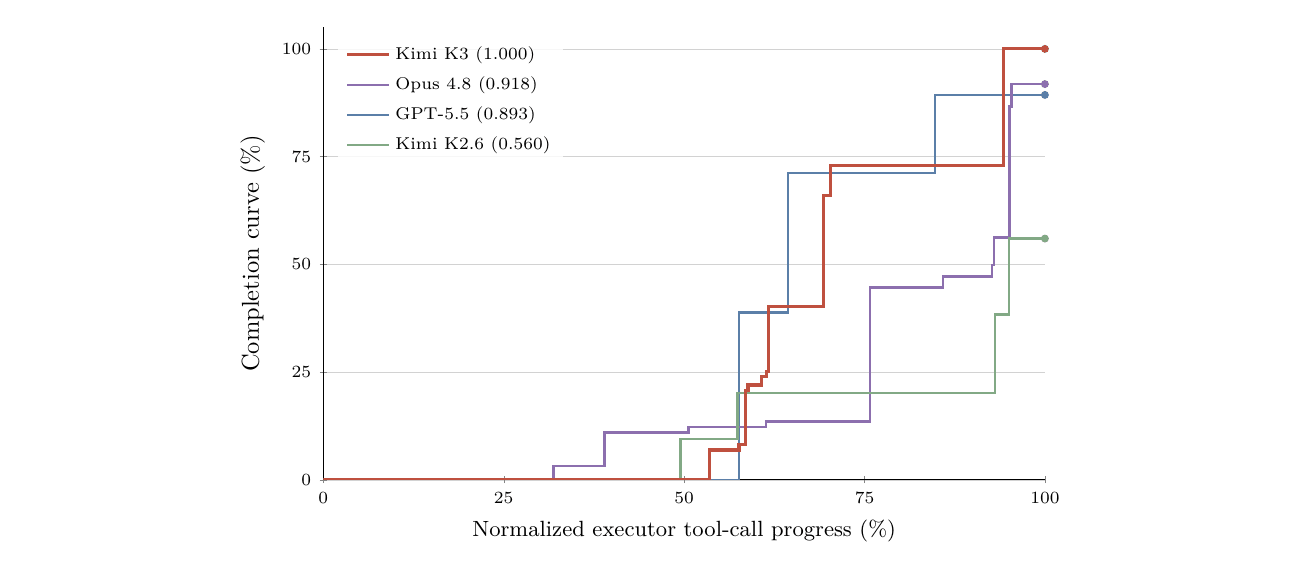
圖 10:Camera Repair Management System 上的完成度曲線——這是一個黑箱系統復刻任務,agent 必須透過 oracle 查詢,把一個隱藏的 3D 相機維修系統重建成一個 web 應用。完成度指的是驗證器評估的任務進度。
5 基礎設施
Kimi K3 把三個很少同時出現在單一模型上的系統挑戰結合在一起:混合式 KDA 注意力、3T 級的稀疏多模態訓練與推論,以及百萬 token 的 agentic 工作負載。我們的基礎設施跨模型生命週期與這些挑戰協同設計。在架構層級,高效能的 KDA kernel 與 Context Parallelism 讓遞迴形式在裝置內與跨裝置、在訓練與推論中都高效。在預訓練期間,平衡的專家執行、更小的記憶體佔用與通訊重疊的排程,在大規模下維持高利用率。在 1M token 的 agentic RL 期間,階層式狀態管理與可恢復的 sandbox 執行,讓長軌跡能跨迭代保存。最後,狀態感知的 KDA 前綴快取、專用推論 kernel,以及具快取與預算感知的排程,把這些效率轉化為可預測的正式服務。
5.1 KDA 的演算法與系統協同設計
KDA 用一個固定大小的遞迴狀態 $S \in \mathbb{R}^{d_k \times d_v}$(§2.1.1)取代了 softmax 注意力不斷成長的 key–value 快取,代價是它的串行更新為平行執行帶來挑戰,換來的是一個轉移與重用都便宜的固定大小狀態。以下的設計在兩個執行層級上處理前者、利用後者:裝置內用融合 kernel,跨裝置用 KDA Context Parallelism。
5.1.1 各種執行區間下的 KDA kernel
KDA 狀態的串行依賴與 GPU 偏好寬而均勻的平行性相衝突,且在每個執行區間中表現為不同的瓶頸。我們為每個區間設計專用的 kernel。
用於訓練與 prefill 的分塊 kernel。 KDA 的分塊形式在每個分塊內平行、跨分塊串行,因為遞迴狀態必須逐塊傳遞。天真地執行時,這兩個階段會交替進行,在串行傳遞期間讓 SM 閒置。我們因此開發了 FlashKDA [14],一個基於 CUTLASS 的分塊 kernel,把分塊內計算與跨分塊的狀態傳遞重疊起來。這個 kernel 把工作分解成 token 平行的階段與頭平行的遞迴,各自獨立排程與調校,效能大幅超越 Triton 參考實作。FlashKDA 同時服務訓練與推論 prefill,並作為 flash-linear-attention [141] 的一個後端被自動派發。
用於長上下文 prefill 的裝置內 context parallelism。 張量平行把頭切分到各裝置上,但從不縮短遞迴;因此在純 TP 部署下,對超長序列做 prefill 時,每個 rank 只持有少數幾個頭,會讓大多數 SM 閒置。關鍵觀察是:每個片段的狀態轉移可以獨立於進入狀態被評估,事後再精確地合成。因此,一個自動的 SM 層級 context-parallel (CP) 規劃器 [144, 141] 把序列切分到單一個 rank 的各 SM 上,平行評估各片段的轉移,再把它們合併以還原每個片段的精確初始狀態。與 §5.1.2 的跨裝置 KCP 不同,這種平行完全在裝置內,不產生任何跨裝置通訊。
KDA 的解碼所面臨的挑戰,與訓練及 prefill 截然不同。我們在 §5.4.2 詳細討論這些挑戰。
5.1.2 KDA Context Parallelism
Context parallelism 的通訊開銷在 softmax 注意力與線性注意力之間有根本差異。Softmax 注意力要求各 rank 交換大小隨序列長度成長的 key–value 區塊 [73]。線性注意力則把先前的脈絡攜帶在一個固定大小的遞迴狀態 $S \in \mathbb{R}^{d_k \times d_v}$ 中。先前的 context-parallel 方法利用一般線性注意力的可加遞迴性,在每個 rank 上計算局部 token 從 $S = 0$ 出發所產生的狀態,再把先前各 rank 的局部狀態相加以還原進入狀態 [116, 115]。
然而這種直接相加對 KDA 並不成立。回顧式 1,KDA 更新其狀態的方式是 $S_t = M_t S_{t-1} + \beta_t k_t v_t^{\top}$,其中 $M_t := I - \beta_t k_t k_t^{\top}\mathrm{Diag}(\alpha_t)$。KDA 的 delta 規則會把一個 token 相依的矩陣 $M_t$ 作用在進入狀態上,然後才加上當前的寫入。因此,一個局部序列片段的效果取決於進入該片段的狀態,無法只從 $S = 0$ 算出的狀態決定。
為了保留這種依賴關係,我們提出 KDA Context Parallelism (KCP),把每個片段的效果分解成兩個可局部計算的量:一個作用在進入狀態上的累積轉移,以及一個從零局部生成的狀態。沿用 §2.1.1 的分塊記號,我們以 $S_{[i]}^{t}$ 表示 rank $i$ 的片段中經過 $t$ 個局部 token 後的遞迴狀態,因此 $S_{[i]}^{T_i}$ 是離開 rank $i$、進入 rank $i+1$ 的狀態。我們以 $\tilde{S}_{[i]}^{t}$ 表示同一個遞迴改從 $S = 0$ 出發的狀態。對進入 $P$ 個 context-parallel rank 中第 $(i+1)$ 個 rank 的任意狀態,經過 $t$ 個局部 token 後的狀態為
$$M_{[i+1]}^{t \leftarrow 1} := \prod_{r \leftarrow 1}^{t} M_r \in \mathbb{R}^{d_k \times d_k}, \qquad S_{[i+1]}^{t} = \tilde{S}_{[i+1]}^{t} + M_{[i+1]}^{t \leftarrow 1} S_{[i]}^{T_i}$$
$$= \tilde{S}_{[i+1]}^{t} + M_{[i+1]}^{t \leftarrow 1}\sum_{j=1}^{i}\left(\prod_{l=j+1}^{i} M_{[l]}^{T_l \leftarrow 1}\right)\tilde{S}_{[j]}^{T_j} \in \mathbb{R}^{d_k \times d_v}, \tag{17}$$
其中 $M_{[i+1]}^{t \leftarrow 1}$ 表示前 $t$ 個局部 token 的累積轉移。第一項包含局部 token 所產生的狀態,第二項則把先前各 rank 的脈絡透過局部的 KDA 更新傳播過來。在 $t = T_{i+1}$ 時,$M_{[i+1]}^{T_{i+1} \leftarrow 1}$ 與 $\tilde{S}_{[i+1]}^{T_{i+1}}$ 都可以只用局部 token 計算,在 $S_{[i]}^{T_i}$ 可得之前就算好,而它們正是各 rank 彼此交換的片段。
式 17 中的求和顯示每個狀態都純粹由局部計算的片段組合而成。這些 rank 層級的更新具結合律,因此每個 rank 的進入狀態可以用一次前綴掃描 (prefix scan) [78] 還原。每個 rank 先在本地計算 $M_{[i]}^{T_i \leftarrow 1}$ 與 $\tilde{S}_{[i]}^{T_i}$,再用一次 all-gather 把這兩個張量與其他 rank 交換。All-gather 之後,rank $i+1$ 依序處理同一份文件的先前片段來重建 $S_{[i]}^{T_i}$:從 $S = 0$ 出發,對每個片段套用 $S \leftarrow M_{[j]}^{T_j \leftarrow 1}S + \tilde{S}_{[j]}^{T_j}$。因此 KCP 對遞迴狀態同步只需要一次固定大小的 all-gather,並達成線性的計算擴展。
5.2 3T 級預訓練的基礎設施
Kimi K3 的預訓練結合了帶虛擬階段 (VP) 的流水線平行 (PP) [49, 82]、專家平行 (EP) [67]、ZeRO-1 資料平行 [101]、Pipeline ZeRO-2 梯度分片 [147],以及 context parallelism(CP,§5.1.2)[51]。MoE 層採用跨 EP rank 複製的共享專家,而專家派送與合併的 all-to-all 通訊則與計算重疊以隱藏其延遲。
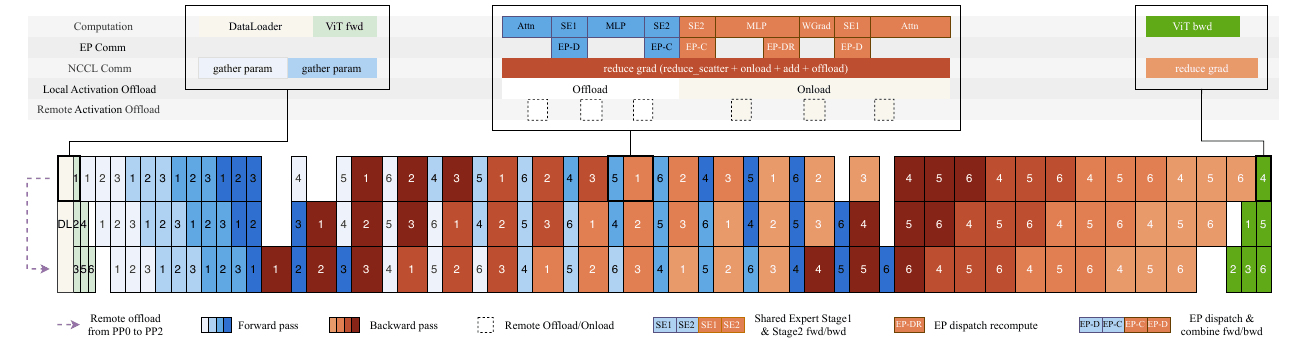
圖 11:不同 PP 階段中重疊的計算、通訊與卸載。
在 3T 級進行原生多模態預訓練帶來三個關鍵問題:(i) token 負載在各 EP rank 之間不平衡;(ii) 激活、梯度與優化器狀態超出記憶體預算;(iii) 視覺編碼器高度變動的計算量暴露在關鍵路徑上。以下小節依序處理這些問題:完美平衡的專家平行 MoE 訓練(§5.2.1)、記憶體高效訓練(§5.2.2),以及多模態編碼器最佳化(§5.2.3)。圖 11 描繪由此得到的執行排程。
5.2.1 完美平衡的專家平行 MoE 訓練
在傳統的 EP 方案中,token 負載在各 rank 之間不平衡。由此造成的計算不平衡拖慢訓練吞吐量,而路由專家激活動態變動的形狀也造成大量記憶體碎片。我們因此提出 MoonEP,一種以動態冗餘專家達成完美負載平衡的 EP 方案。MoonEP 保留 DeepEP [149] 等傳統方案的整體計算流程,並額外引入冗餘專家的線上規劃與遷移。在前向傳遞中,我們從當前 micro-batch 與當前層的 router 輸出規劃冗餘專家,並在路由專家計算之前預取它們。在反向傳遞中,我們把它們的梯度暫存在一個本地 reduce 緩衝區,待計算完成後再歸約回其歸屬 rank 的梯度緩衝區。
在有界冗餘專家下的完美平衡。 MoonEP 要求每個 rank 恰好收到 $S \times K$ 個 token($S$ 為序列長度、$K$ 為每 token 選中的專家數),使所有 rank 執行等量的計算。關鍵問題是:多少冗餘專家才足以保證這種平衡?令 $E$ 為專家數、$R$ 為 EP 大小。我們證明,每個 rank 最多 $E/R$ 個冗餘專家就一定存在可行的平衡方案,而且這個界基本上是緊的(附錄 E)。因此,每個 rank 預留 $E/R$ 個冗餘專家槽位,就保證規劃永遠有可行解,訓練絕不會被打斷。相對地,ECHO [139] 與 UltraEP [134] 等先前工作會預設冗餘專家數或施加每 rank 的 token 上限;一旦在上限內找不到可行方案,訓練就被迫停止,而這個上限本身還需要人工調校、卻仍留有殘餘的不平衡。
線上規劃。 在每個訓練步都算出精確最優解代價過高。我們因此用整數線性規劃 (ILP) 離線求出代表性案例的精確解作為參照,並設計一個 GPU 規劃 kernel:它接近最優、開銷可忽略,且永遠尊重 $E/R$ 的上界。
零拷貝通訊。 完美平衡也簡化了通訊路徑。我們實作了一個融合的 permute/unpermute 運算子,由規劃 kernel 預先算出每個 token 的目的地,於是 token 被直接送到遠端 rank 上依專家分組的位置,而通訊緩衝區的 view 直接回傳給計算使用,消除中間拷貝。在最壞的不平衡情況下,DeepEP 若要支援同樣的免拷貝資料路徑,需要大小為 $S \times K \times R$ 的通訊緩衝區,而 MoonEP 由於完美平衡只需要固定的 $S \times K$ 緩衝區。
靜態形狀下的免同步執行。 在傳統 MoE 實作中,每個專家的 token 數會隨步驟與層而變,主機必須在每一層與裝置同步以取得實際的計算形狀,才能啟動專家計算,這會在層與層之間讓流水線停頓。有了完美平衡,每個 rank 恰好收到 $S \times K$ 個 token,所有層的計算形狀在靜態時期就已知。這消除了每層的 MoE 主機同步,也緩解了主機端的 kernel 啟動開銷。
專家 GEMM 排程與重疊。 即使各 rank 的總負載完美平衡,每個 rank 內部各專家的 token 數仍然偏斜,而一個固定順序、無視工作量的排程會把這種偏斜轉化成各 SM worker 之間不平衡的完成時間。我們因此用一個工作量感知的排程器來排程路由專家的 GEMM:它在啟動前依當前 token 分布調整參數,並在執行期間保持固定。一個輕量啟發法用硬體指標的分析成本模型選出這些參數,關鍵係數則透過離線自動調校校準。至於共享專家,我們把它們的 GEMM 派到另一條 stream,好與其他 kernel 重疊。
5.2.2 記憶體高效訓練
統一激活管理器。 我們為激活設計了一個統一的儲存抽象,其中每個為反向傳遞保存的張量都關聯到一個可插拔的儲存後端。重計算、量化與卸載/遠端卸載都只是這個抽象下的儲存策略,可以在張量粒度上自由組合;策略透過張量上的輕量註記宣告,與模型程式碼完全解耦。重計算以函式為粒度執行,因此支援跨層重計算。在我們的實作中,所有 GPU 記憶體都在主計算 stream 上配置、並在單一個記憶體池中管理,避免多 stream 的碎片與主機端開銷;激活以層為粒度預取回來、並與計算重疊,額外開銷可忽略。在 Kimi K3 中,大多數激活採用逐塊 FP8 量化 [59, 30] 搭配卸載/遠端卸載,而逐元素算子則配置為重計算。
記憶體高效的 MoE。 在原生 MoE 實作中,permuted probs 的梯度計算依賴前向輸出 output。受 SonicMoE [42] 啟發,我們透過數學變換把這個梯度改寫成只依賴中間激活 act_output 與上游梯度 doutput 的形式,代價是多一點輕量的逐元素計算,藉此消除反向傳遞對 output 的依賴。此外,在 group GEMM 的前向傳遞中我們只保存 dispatch 操作的輸入;反向傳遞時再透過重算 dispatch 還原 group GEMM 的輸入。如圖 11 所示,這次重算引入的通訊可以與部分 group-GEMM 的反向計算重疊,於是這部分的激活儲存以可忽略的代價被消除。
記憶體高效的 Attention Residual。 對 attention residual,我們基於 Block AttnRes 設計了一項配套最佳化。Block 表示在邊界層產生一次,之後由所有後續層共享,並直接常駐 GPU。AttnRes 的計算完全被 checkpointing 包起來,所以每一層為反向傳遞保存的激活與標準殘差架構完全相同。至於流水線平行,我們採用基於快取的流水線通訊 [58],只在階段之間增量傳輸新產生的 block,並在 micro-batch 結束後立即釋放,達到記憶體佔用的理論下界。
跨 PP rank 平衡激活。 在交錯式 1F1B 流水線平行下,激活因為流水線暖身而在各 PP rank 之間分布不均,且常駐激活數隨 PP rank 增加而遞減。為避免記憶體不足 (OOM),我們用 Mooncake Transfer Engine [97] 把激活遠端卸載到其他 PP rank 的記憶體,達成跨 PP rank 的激活記憶體平衡。
Pipeline ZeRO-2 梯度分片與卸載。 在激活之外,我們用 Pipeline ZeRO-2 梯度分片 [147] 把梯度切分到各資料平行 (DP) rank 上。此外,我們把分片後的梯度存放在 CPU 記憶體以降低 GPU 記憶體峰值,同時把 double grad buffer 保留在 GPU 上。梯度跨 DP rank 歸約進 double grad buffer 之後,再累加到 CPU 的分片中。
基於 P2P 的 Muon 正交化。 分散式優化器把參數均勻切分到各 DP rank 上,而 Muon 的 Newton–Schulz 正交化需要完整的參數矩陣,因此每次更新前都需要一次通訊來收集完整參數。天真的做法是在每個 rank 上對整個參數緩衝區做 all-gather [74],這除了讓通訊在大規模下成為主要瓶頸之外,還帶來可觀的記憶體佔用。我們改為讓每個 rank 只透過與對應 owner rank 的點對點 (P2P) 通訊取回它本地所擁有參數的分片,消除了完整參數緩衝區,同時降低記憶體用量與通訊量。通訊與計算進一步以 model-chunk 緩衝區為粒度做流水線化,藏起通訊開銷。
5.2.3 多模態編碼器最佳化
多模態編碼器中的動態 CP。 在長上下文多模態訓練中,大圖與長影片會大幅增加視覺編碼器的計算時間,並造成跨裝置的顯著負載不平衡。為此,我們把 context parallelism 延伸到這類大樣本上。單張大圖沿 patch 維度切分到多個裝置,注意力則透過跨 CP rank 收集 key–value(gather-KV)來計算。此外,我們把每個 CP 群組再分成數個 sub-CP 群組,並把多張大圖以負載平衡的方式分配到它們之上,避免通訊佔比隨規模成長。這同時降低了大型視覺樣本的編碼器延遲與跨裝置負載不平衡,讓剩餘的編碼器計算能藏進流水線氣泡中。
把編碼器計算塞進 PP 氣泡。 在 Kimi K2.5 中,我們引入了解耦編碼器流程 (Decoupled Encoder Process, DEP) [60],把 ViT 與文字訓練切成不同階段,並在各 PP 階段之間平衡視覺的前向與反向傳遞。我們觀察到,在交錯式 1F1B 流水線排程下,最前面幾個 PP micro-batch 的文字前向傳遞全都排在最開頭,而最後幾個 PP micro-batch 的文字反向傳遞則要到最末才結束。我們因此進一步分解 ViT 的計算 [34]:最前面幾個 PP micro-batch 的 ViT 前向傳遞在一開始同步執行,其餘前向傳遞被排進流水線氣泡,反向傳遞則以類似方式處理。結果是大部分 ViT 計算被藏在流水線氣泡中,視覺編碼器的有效開銷幾乎被完全消除。
5.3 百萬 token agentic RL 的基礎設施
要在有限計算預算下,把像 Kimi K3 這麼大的模型的 agentic RL 擴展到百萬 token 上下文,資源效率就是首要目標。我們因此開發了用於高效訓練與 rollout 的長上下文 RL 基礎設施,以及用於長程環境互動的高效能、可恢復 sandbox。
5.3.1 長上下文 RL 基礎設施
我們採用共置式 RL 訓練 [59],把每個 1M 上下文的 Kimi K3 RL 實驗控制在數百張 GPU 之內,並用部分 rollout [120] 降低超長軌跡帶來的尾端延遲。這個設計改善了硬體利用率,但長上下文 rollout 為 KV 快取保留帶來額外的 DRAM 需求,與訓練側的狀態相互競爭。此外,要讓 prefill 與解碼都高效,需要謹慎的前綴管理與請求排程。
外部 KV 快取池。 在 1M 上下文的多步 rollout 中,前綴 KV 快取 miss 的代價極高。部分 rollout 在每次迭代開始時會加劇這個問題,因為前一次迭代大量未完成的長 prefill 請求會同時到達。推測解碼又在相對固定的工具呼叫間隔內加速請求周轉,增加前綴區塊的churn。這些問題可能觸發搶占並降低快取命中率,而命中率對長上下文 RL 至關重要。
我們因此用一個回寫 (write-back) 設計,把前綴保留與 GPU 常駐解耦。活躍的解碼區塊留在 GPU KV 快取中,而可重用的閒置前綴只在被逐出 GPU 時才寫回 CPU DRAM 中的外部 KV 快取池,並在下次重用前預取回來。KDA 狀態與對應的 MLA KV 快取區塊一起卸載與預取,讓它們的生命週期保持一致。相較於直寫 (write-through) 策略,這個政策只為真正離開活躍解碼路徑的前綴付出 CPU DRAM 用量與傳輸頻寬,避免為那些仍常駐且活躍於 GPU 上的區塊做多餘的 CPU 拷貝。
為了給外部池足夠的 DRAM,我們在訓練迭代結束後把訓練狀態(模型權重與優化器狀態)卸載到 NVMe。而在 rollout 迭代結束後,這個池會被釋放,以免與訓練工作負載爭用。
Rollout 自動節流排程器。 在多步 rollout 中,上下文隨軌跡推進而逐步成長,因此以「整條軌跡的平均長度」為基礎的固定並行度既難以估計、在早期又過於保守。反過來說,把並行度設得太高,會在後期造成 KV 快取壓力並可能觸發搶占。我們因此在 LLM 請求排程層設計了一個自動節流機制,利用活躍請求數、排隊請求數與 KV 快取使用率等執行期訊號,動態控制送進推論引擎的請求數量。這讓早期 rollout 保持良好利用率,並在 KV 快取壓力上升時降低並行度,不需人工調校就能同時避免吃不飽與過載。
非策略模型前向的梯度緩衝區重用。 RL 的損失計算常常需要只做前向的非策略模型,例如參考模型,而它們的權重太大無法常駐 GPU。我們把這些權重保留在 CPU 記憶體,只在需要時才具體化,並用策略模型的 FP32 梯度緩衝區儲存空間來承載它們的參數張量。這重用了既有的 GPU 記憶體,不需額外配置也不造成碎片,而且是安全的——因為這些緩衝區在稍後計算真正的梯度時本來就會被覆寫。
在 ZeRO-2 梯度分片與卸載(§5.2.2)之下,Kimi K3 的 RL 訓練中每張 GPU 只保留兩個 VPP chunk 的梯度緩衝區。我們把參考權重逐 chunk 串流進這些槽位:一個槽位用於當前的前向計算,另一個預取下一個 chunk,在不增加 GPU 記憶體的前提下藏起拷貝開銷。
5.3.2 Sandbox 基礎設施
我們採用多種 sandbox 執行環境來支援 Kimi K3 後訓練與評測的多樣需求,包括傳統的容器式執行環境、GPU sandbox 執行環境,以及最值得一提的、一個新的基於 microVM 的 sandbox 執行環境 AgentENV。
AgentENV 與我們的夥伴合作開發,是專為 agentic AI 工作負載設計的 sandbox 系統,圍繞三個核心設計目標建構:
- 高保真的隔離 sandbox 執行環境。 隨著 agent 能力增強、任務變難,它們傾向更積極地探索,甚至可能嘗試獎勵駭客。一方面,這帶來獨特的安全挑戰:在我們早期用傳統容器式 sandbox 執行環境的實驗中,就觀察到數次由 agent 非預期操作造成的 kernel panic 與死鎖。另一方面,我們希望盡可能允許探索以免限制 agent 能力,而複雜任務又需要一個接近真實世界的 sandbox——例如 agent 應該能隨意掛載磁碟、執行容器,甚至啟動虛擬機。透過用 Firecracker [3] 執行隔離的 microVM,AgentENV 提供了容器式執行環境無法企及的隔離度與保真度。
- 面向 agentic RL 的彈性 sandbox 生命週期。 在底層,AgentENV 支援 sandbox 狀態的增量檢查點與恢復,檢查點時只保存自上次檢查點以來被弄髒的記憶體頁,達到低至 133 毫秒的檢查點延遲與 49 毫秒的恢復延遲。在此之上,AgentENV 提供三個有助於提升 agentic RL 效率的高層操作。(a) 暫停與恢復:被暫停的 sandbox 不消耗記憶體或 CPU 資源;因此可以在 agent 等待模型推論結果時把 sandbox 暫停,而那可能佔 sandbox 生命週期的 98%。(b) Fork:fork 從原始 sandbox 的精確狀態建立一個新 sandbox,同時讓原始的繼續執行,這對「不產生副作用的獎勵評判」很有用。(c) Snapshot:可以定期保存 sandbox 的快照以供錯誤復原。
- 高效率與高密度。 在我們的工作負載中,可能需要在幾秒之內建立數萬個各有獨特映像的 sandbox。我們採用 OverlayBD [69] 作為映像格式,搭配自訂的 ublk driver 實作、儲存層共享與 P2P 傳輸,在大規模下達成次秒級的啟動延遲。我們進一步以寫時複製記憶體與 page cache 最佳化降低記憶體用量,在真實工作負載中達到最高 6.5 倍的記憶體超額配置比。
在 Kimi K3 的整個訓練與評測過程中,總共建立了 51,219,741 個 sandbox,橫跨 1,505,678 個映像。
5.4 推論與線上服務
服務 Kimi K3 從正式環境端暴露出同樣的挑戰:混合式 KDA–MLA 架構維護兩種根本不同的快取,必須在百萬 token 上下文下被聯合管理;它的新模組與高度稀疏的專家需要各自量身打造的 kernel;而正式流量混雜著每請求成本相差三個數量級的請求。以下的設計在三個層級處理這些挑戰。在引擎層級,KDA 感知的前綴快取把固定大小的遞迴狀態打包進與 MLA KV 快取相同的分頁池,讓長前綴能跨請求重用。在裝置層級,為 KDA 解碼、Block AttnRes 與稀疏 latent MoE 打造的專用 kernel,把每 token 的延遲與記憶體流量降到最低。在機群層級,快取感知的親和性排程與基於預算的准入控制,把這些效率轉化成可預測的服務。
5.4.1 KDA 感知的前綴快取管理
Kimi K3 的混合架構讓前綴快取變得複雜:KDA 遞迴狀態與 MLA KV 快取在大小與生命週期上根本不同,但一個被快取的前綴只有在兩者能在同一個邊界上一起還原時才可重用。我們因此設計了一個 KDA 感知的前綴快取,把兩種快取類型聯合管理——從統一的分頁佈局,到細粒度的前綴重用與並行排程下的一致性——讓百萬 token 的前綴既便宜保留、又能跨請求重用。
混合 KDA–MLA 注意力的統一快取佈局。 每個 Kimi K3 block 由三層 KDA 與一層 Gated MLA 構成,兩者的快取根本不同。MLA KV 快取隨序列長度成長、逐 token 分頁,而 KDA 遞迴狀態大小固定、每個請求只有一份。為兩者各維護一個管理器會重複配置、逐出與傳輸的邏輯。我們因此把 KDA 狀態打包進與 MLA KV 相同的分頁區塊池,把兩種頁統一成相同的位元組大小,讓它們共用同一套配置、引用計數與逐出的實作。在一頁之內,所有頭的狀態逐頭連續存放,使每個頭的位元組串流自成一體,並作為跨節點傳輸的最小單位。在 prefill/decode 分離部署下,當 prefill 與 decode 節點採用不同的 TP 度時,重新佈局在傳輸路徑上完成,GPU 端零重排。這種不對稱在開發期間意外有用:任何型別混淆的存取都會得到垃圾而非看似合理的資料——是這個共用佈局上一個零開銷的健全性檢查。
KDA 前綴快取最佳化。 基於區塊雜湊的前綴快取以一個實體區塊為粒度重用 KV 快取:只有完整的區塊會被雜湊,所以只有區塊對齊的前綴可重用。
這種耦合在 Kimi K3 上失效了。區塊雜湊比對要求所有層共用同一個區塊大小,而一次前綴命中只有在命中邊界上的 KDA 狀態已被持久化時才可重用。KDA 層為每個序列維護單一個大的遞迴狀態、而非逐 token 的條目,因此狀態快照只有在稀疏的邊界上才負擔得起;共用的區塊大小於是被迫落在 1024–6144 token——而由於雜湊與儲存區塊綁定,雜湊粒度也一併被迫如此,儘管單就 MLA 的逐 token 條目而言可以容忍細得多的區塊。在這麼粗的粒度下,快取幾乎沒有用:短於一個區塊的請求永遠無法被重用,而分塊 prefill 在跨過一個完整區塊邊界之前不會輸出任何可快取的前綴。
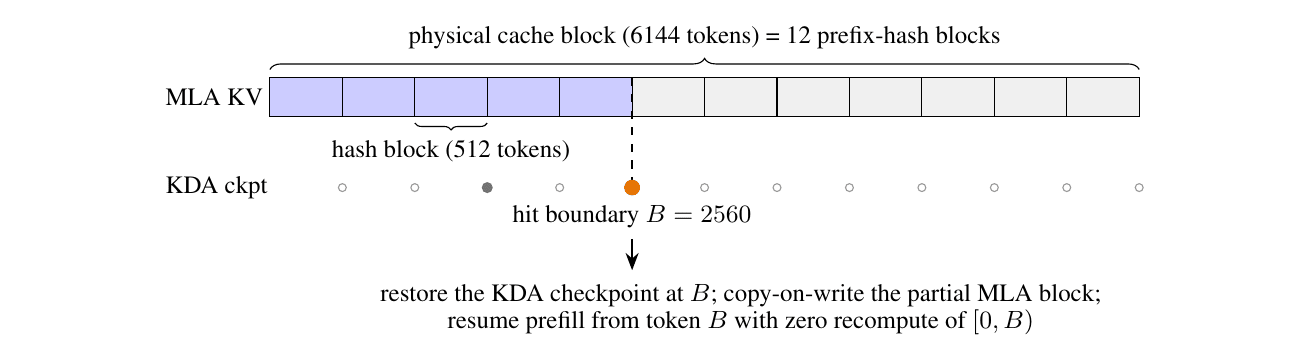
圖 12:實體快取區塊內的細粒度前綴快取。一個 6144-token 的實體區塊包含十二個 512-token 的雜湊區塊,已快取的 MLA 區塊以藍色顯示、空區塊以淺灰顯示。下方的標記顯示每個雜湊邊界上的 KDA 檢查點狀態:空心圓(◦)表示該邊界沒有儲存檢查點,灰點(•)表示已持久化的 KDA 檢查點,橘點(•)標示在 $B = 2560$ 命中的檢查點。持久化的檢查點是稀疏的,且通常落在對話輪次的邊界上。該請求重用五個 MLA 雜湊區塊與 $B$ 處的 KDA 檢查點,然後從 token $B$ 恢復 prefill,完全不必重算 $[0, B)$。
我們因此把兩種粒度解耦。前綴雜湊在 MLA 頁內的細雜湊區塊(例如 512 token)上執行,而實體區塊仍是粗粒度的配置單位。對 KDA 則反向對齊:遞迴狀態的檢查點只在 MLA 雜湊端點(的一個稀疏子集)上保存——那是查找唯一可能參照到的位置。
在 prefill 期間,一個部分填滿的 MLA 頁會以其最後一個完整雜湊區塊的鏈式雜湊註冊進前綴快取索引,其中每個雜湊都涵蓋所有先前的雜湊區塊,因此比對到一個端點就等於認證了到該處為止的整個前綴;已註冊的端點隨著頁被填滿而前進。同時,每次前向傳遞之後,KDA kernel 在最後一個雜湊對齊的位置持久化遞迴狀態。檢查點很大,因此隨請求推進而被取代的中間檢查點會被回收,而落在對話輪次邊界上的則保留供跨請求重用。被快取的檢查點是唯讀快照:命中時會先把它拷貝進請求私有的執行狀態,之後才做下一次前向傳遞,而新的檢查點則寫進全新的槽位,因此一個對其他請求可見的檢查點絕不會被就地修改。
查找分兩階段進行(圖 12)。MLA 階段以鏈式雜湊比對完整的實體區塊,並在第一個缺失的區塊處退回到該區塊內部的雜湊端點,讓部分填滿的頁仍然可命中。KDA 階段接著要求候選邊界上在每一個 KDA 快取群組中都存在檢查點——每個群組各自維護一份獨立的遞迴狀態。命中的是同時滿足兩階段的最長邊界,它一定是雜湊區塊的倍數,而不必是實體區塊的倍數。在圖 12 中,一個前 2800 個 token 與快取前綴相符的請求,會在 $B = 2560 = 5 \times 512$ 處命中——深在一個 6144-token 的實體區塊內部——並從 token $B$ 恢復 prefill,而不是重算 $[0, B)$。
並行排程下的一致性。 其餘的設計要點,各自對應一種「共享部分填滿區塊」的具體失效模式;在這個場景中,一個被命中的區塊同時是共享的快取條目與某個私有請求的成長點,而 MLA 與 KDA 快取群組又必須在每個命中邊界上取得一致。第一,所有快取群組都從同一個共享的 free list 取區塊,因此為某個群組配置私有副本時,可能逐出另一個群組剛剛命中的區塊;所以在配置任何東西之前,每個被命中的區塊都會在所有群組中被 pin 住。第二,拷貝進私有區塊的動作是在前向傳遞之前立即在 GPU 上執行的,所以在當前排程步驟內才被配置或註冊的區塊,仍可能把前一個擁有者的位元組交給讀者;這類區塊在其拷貝落地之前會被排除在比對之外。第三,一個檢查點只有在每一個 KDA 群組中都存在時才能還原請求,因此逐出某一個群組的檢查點會原子性地使其兄弟失效——一個檢查點要嘛在每個群組中都可命中、要嘛哪裡都不可命中。有了這些機制,每個已註冊的狀態永遠精確對應它所宣稱的 token 前綴,而混合 KDA–MLA 模型的前綴快取達到與全注意力模型同等的通用性:任何共享前綴都能在任何 512-token 邊界上被重用,與請求長度、分塊方式或排程交錯無關。
5.4.2 高效能 kernel
Kimi K3 引入了數個新的架構模組:KDA(§2.1.1)、Block AttnRes(§2.2)與 Stable LatentMoE(§2.3)。我們為每一個都最佳化了 kernel 實作。
KDA。 相較於 KDA 的 prefill(§5.1),KDA 的解碼帶來一組截然不同的挑戰:主要瓶頸從「發掘平行度」轉向「高效管理不斷演進的遞迴狀態」——它在每個解碼步都被就地更新。這種就地更新在基於 MTP 的推測解碼中會成為問題:如果驗證拒絕了部分草稿 token,狀態已經推進到最後一個被接受的 token 之後,無法輕易回滾。為每個草稿位置維護一份狀態快照確實可以回滾,但也會讓狀態流量成倍增加——在線上服務常見的大批次下,這個代價會成為主導。
然而,任何已接受草稿前綴之後的狀態,完全由這些草稿 token 的投影輸入決定,而那些投影輸入遠小於狀態本身。我們因此只快取這些投影輸入,在晶片上重建已接受 token 的狀態,並寫回已驗證 token 與 bonus token 的狀態——這個設計與同期工作 ReplaySSM [25] 獨立提出的相同。被重播的 token、bonus token 與下一個草稿窗口共用單一個融合 kernel 內的同一個遞迴迴圈,涵蓋短卷積、輸入正規化、閘控、KDA 遞迴與輸出正規化。驗證延遲隨被驗證 token 數呈次線性成長,並維持在狀態快取式基準之下。由於投影快取從不離開解碼階段,前綴快取與 prefill–decode 分離處理的 payload 與非推測式服務完全相同。
Block AttnRes。 Block AttnRes [58] 遵循兩階段排程:一次批次化的跨 block 傳遞,每個 block 只讀取一次快取的 block 表示;之後每一層再透過 online-softmax 合併 [80] 把 block 內的部分和折進來。記憶體存取在 prefill 與解碼兩階段都佔這些 kernel 成本的相當比例,因此我們在兩階段的最佳化都主要聚焦於記憶體效率。
對 prefill,在每個張量平行 (TP) rank 上具體化 block 表示會造成大量冗餘記憶體消耗。我們因此對激活採用序列平行 (SP):把 TP 的 all-reduce 分解成 reduce-scatter 與 all-gather,並把 block 內 kernel 插在兩個集合通訊之間,讓它作用在沿序列分片的隱藏狀態上,使每個 token 的 block 表示只在恰好一個 rank 上被具體化。這消除了額外的記憶體消耗,也降低了 Block AttnRes 在 prefill 期間的 I/O 開銷。
對解碼,我們把跨 block 的 kernel 啟動在一條側 stream 上,讓它與主 stream 上的獨立計算重疊。block 內的 kernel 則透過融合精簡:把 AttnRes 輸出與其部分和更新的合併、連同後續的 RMSNorm,一起融合進前面的 TP all-reduce,消除了 block 內階段的專用 kernel。合起來,這些最佳化藏起了跨 block 傳遞的延遲,並降低了 block 內階段的記憶體流量。
Stable LatentMoE。 Stable LatentMoE 同時增加了專家總數與每 token 的啟用專家數。專家空間與每 token 專家數雙雙成長,抬高了排程與協調開銷,讓傳統 MoE kernel 難以維持高硬體利用率。這些挑戰促成了針對這個模組的專用 kernel 最佳化。
為了緩解 latent GEMM 的開銷,我們採用三項最佳化。第一,把 latent 下投影與 MoE router 融合成單一個 GEMM。第二,把 latent 權重矩陣切分到各 rank 上,並用 multimem store 指令把輸出的 all-gather 融合進 GEMM 的 epilogue。最後,把由此產生的通訊與共享專家計算等其他算子重疊。合起來,這些最佳化消除了冗餘的權重流量與重複計算,同時把通訊延遲藏在計算之後。
對路由專家,在小批次下 group GEMM 退化成權重矩陣的記憶體受限串流——這個區間並不適合傳統以 tile 為中心的 kernel,因為它們的設計取向是計算導向、還有前處理開銷。我們改為把 MoE 解碼 kernel 建立在 WarpDecode [12] 的 token 中心設計之上:每個 warp 負責一個輸出神經元,並直接從記憶體串流對應的權重。為了進一步提高平行度,我們把每個 warp 再細分成更細粒度的 lane team,各自處理一組互斥的專家子集,最後再做一次 warp 層級的部分結果歸約。此外,權重佈局在離線時以一次性的前處理成本重排,大幅降低了執行期的反量化開銷。
5.4.3 機群層級排程
超出單一個服務實例之後,挑戰就從「單請求效率」轉向「可預測性」:一次前綴快取 miss 的代價比命中高出數個數量級,而一波百萬 token 的請求可能餓死短請求。我們提出兩項機群層級的排程政策來處理:快取感知的親和性排程把每個 session 路由到持有其前綴快取的叢集,同時為叢集故障的代價設下界;而基於預算的准入控制則給每個請求類別各自的資源預算,使突發的長上下文流量無法拖垮全系統的 SLO。
快取感知的親和性排程。 在 1M 上下文下,一個典型的程式開發輸入攜帶 40 萬 token 的前綴,卻只需要 4K token 的 prefill 增量,因此前綴快取命中避免了重新 prefill 整個前綴,代價比 miss 低數個數量級。我們因此把每個請求路由到持有其前綴快取的叢集,因為把快取搬到另一個叢集需要經過遠比叢集內網路慢的跨叢集連線。然而這種快取親和性把每個 session 綁定在單一個叢集上,該叢集故障就會中斷所有綁在它上面的 session。因此我們用一致性雜湊把每個 session 釘在兩個叢集上:一個主叢集服務其流量,一個預先指派的次叢集在主叢集故障時接手。次叢集不持有該 session 的任何前綴快取,接手時必須重新 prefill。由於一致性雜湊把不同 session 的次叢集指派均勻分散到整個機群,這些重新 prefill 的工作會被分攤到許多叢集,而不是集中在某一個。如此一來,常見情況下的快取局部性得以保留,而任何單一叢集故障的衝擊也維持有界。
基於預算的准入控制。 正式流量把 2K token 以下的短請求與最高 1M token 的超長請求混在一起,因此每請求成本橫跨大約三個數量級,任何固定請求數所帶來的總負載都高度不可預測。以「平均請求」為基礎的容量規劃、排隊模型與速率限制配額,在這種變異下全部失效。一種典型的失效模式是:一波長上下文請求把可用計算吃滿,之後到達的短請求無法及時被排程,讓所有流量的首 token 時間 (TTFT) 都變差。我們因此採用基於預算的准入控制,為不同請求類別配置各自的資源預算,使突發的長上下文流量最多只消耗它自己那一份容量,無法拖垮其他類別所體驗到的全系統 SLO。
6 評測
6.1 主要結果
6.1.1 評測基準
我們在一套涵蓋四大能力軸線的完整基準套件上評測 Kimi K3:
- 推理與知識:GPQA Diamond [102]、CritPt [8]、AA-LCR [9],以及 Humanity's Last Exam(HLE-Full,含與不含工具)[94]。
- 程式碼:DeepSWE [31]、ProgramBench [96]、Terminal-Bench 2.1 [79]、FrontierSWE [36]、SWE-Marathon [119]、PostTrainBench [95]、MLS-Bench-Lite [77] 與 SciCode [123, 8]。
- Agentic:BrowseComp [133]、DeepSearchQA [128]、ResearchRubrics [107]、Toolathlon-Verified [70]、MCPMark-Verified [135]、MCP-Atlas [11]、AutomationBench [109]、JobBench [71]、GDPval-AA v2 [91]、AA-Briefcase [8, 2]、Agents' Last Exam (ALE) [4, 117]、APEX-Agents [129]、OfficeQA Pro [88]、SpreadsheetBench 2 [152]、OSWorld-Verified [138] 與 OSWorld 2.0 [145]、SaaS-Bench [110]、$\tau^3$-Banking [1, 8]、Harvey Lab-AA [8, 43]、CorpFin v2 [21]、Finance Agent v2 [35] 與 Legal Research Bench [66]。
- 視覺:WorldVQA [151]、OmniDocBench [89]、PerceptionBench [63]、Video-MME [37]、MMVU [150],以及配 Python 工具的 BabyVision [13]。MMMU-Pro [146]、CharXiv (RQ) [132]、Math-Vision [130] 與 ZeroBench-main [103],各自都測有與沒有 Python 工具增強的版本。
6.1.2 對照基準模型
我們對照最先進的閉源與開源模型。閉源方面我們比較 Claude Fable 5 [16]、GPT-5.6 Sol [40]、Claude Opus 4.8 [17] 與 GPT-5.5 [39]。Claude Fable 5 的結果包含 fallback 行為,GPT-5.6 Sol 的結果包含可能的 cyberguard。開源方面我們納入 GLM-5.2 [38]。所有模型都以最高推理投入評測,GPT-5.5 除外,它使用「xhigh」設定。
6.1.3 評測配置
所有 Kimi K3 的評測都使用推理投入 max 與 temperature = 1.0。對單步任務(如 GPQA Diamond、HLE-Full 與不含工具的視覺基準)我們設 top-p = 0.95;對 agentic 任務設 top-p = 1.0。一般而言,我們建議推理與知識任務用 top-p = 0.95,程式碼與 agentic 情境用 top-p = 1.0。
程式碼。 每個模型都在三種 agentic harness 之一下評測:Kimi Code [57]、Claude Code [15] 或 Codex [20]。在 DeepSWE 上,我們回報 v1.1 任務的結果,並附帶參照官方排行榜(Kimi K3 在 mini-SWE-agent harness 下取得 67.3)。在 Terminal-Bench 2.1 上,我們為所有模型回報跨 harness 的最佳分數。我們的 SWE-Marathon 評測基於官方任務在 2026 年 7 月 9 日、即 v1.1 正式發布之前的一個 H20 校準分支,其中 Docker 映像、效能門檻與 GPU 任務的參考 oracle 都為 H20 重新校準,但正確性與反作弊驗證器未更動;Claude Fable 5 在 35% 的任務上觸發 fallback。對 PostTrainBench,我們用官方 Harbor 實作、以最高投入評測 Kimi K3、Claude Fable 5 與 GPT-5.6 Sol,在 H20 GPU(而非官方設定的 H100)上取三次執行的平均。FrontierSWE 的 dominance 分數以官方評測腳本(截至 2026 年 7 月 16 日)從原始分數重新計算。
Agentic。 對 OfficeQA Pro,每個測試案例都把整個 PDF 語料以影像形式提供給 agent,沒有任何機器可讀的文字。MCP-Atlas 在 500 題的公開子集上評測,回合上限 100,以 Gemini 3.1 Pro 為評審。AutomationBench 在 600 題的公開子集上評測。對 BrowseComp 我們採用在 30 萬 token 觸發的上下文壓縮策略;若以完整的 100 萬 token 上下文窗口、不做任何上下文管理來評測,Kimi K3 取得 90.4%。
視覺。 分數取三次執行的平均,ZeroBench-main 除外——依官方設定執行五次。MMMU-Pro 遵循官方協定,保留原始輸入順序並把影像前置於文字輸入之前。對 WorldVQA,我們觀察到各模型都有一致的拒答行為,因此透過提示工程強制其作答。
第三方結果。 GDPval-AA v2、AA-Briefcase、$\tau^3$-Banking、Harvey Lab-AA、APEX-Agents、SciCode、AA-LCR 與 CritPt 的分數引用自 Artificial Analysis [8],截至 2026 年 7 月 23 日。Harvey Lab-AA 我們回報 criterion pass rate。CorpFin v2、Finance Agent v2 與 Legal Research Bench 的分數引用自 Vals AI [126]。Agents' Last Exam 的分數引用自官方排行榜 [4],截至 2026 年 7 月 23 日;我們回報排行榜的主要 pass-rate 指標。在該排行榜上,每個模型都配一個特定 harness:Kimi K3 配 Kimi Code;GPT-5.6 Sol、GPT-5.5 配 Codex;Claude Fable 5、Claude Opus 4.8 與 GLM-5.2 配 Claude Code。Toolathlon-verified 與 JobBench 的分數引用自各自的官方排行榜 [121, 53],截至 2026 年 7 月 24 日。
6.1.4 結果
表 2 提供 Kimi K3 對照閉源與開源基準的完整比較。整體而言,Kimi K3 緊隨最強的閉源模型 Claude Fable 5 與 GPT-5.6 Sol 之後,並在整個基準套件上一致地勝過 Claude Opus 4.8、GPT-5.5 與 GLM-5.2。以下摘出各核心能力領域的關鍵觀察。
表 2:Kimi K3 對照閉源與開源模型的效能比較。粗體表示各基準的最佳結果、底線表示次佳。除另有註明外,Kimi K3 的結果都在推理投入 max、temperature = 1.0 下取得。對 HLE-Full、MMMU-Pro、CharXiv (RQ)、Math-Vision 與 ZeroBench,每格依序回報「不含工具/含工具增強」的分數(HLE-Full 為通用工具、視覺基準為 Python)。† 在官方 Agents' Last Exam 排行榜上,Claude Fable 5 的條目以 xhigh 投入執行,且有 40% 的任務被標註為降級。
| 基準 | Kimi K3 (max) | Claude Fable 5 (max, 含 fallback) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| 推理與知識 | ||||||
| GPQA Diamond | 93.5 | 92.6 | 94.1 | 91.0 | 93.5 | 91.2 |
| CritPt | 23.4 | 28.6 | 32.3 | 20.9 | 27.1 | 20.9 |
| AA-LCR | 74.7 | 70.0 | 73.7 | 67.7 | 74.3 | 71.3 |
| HLE-Full | 43.5 / 56.0 | 53.3 / 63.0 | 44.5 / 58.0 | 49.8 / 57.9 | 41.4 / 52.2 | – |
| 程式碼 | ||||||
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 | 67.0 | 46.2 |
| ProgramBench | 77.8 | 76.8 | 77.6 | 71.9 | 70.8 | 63.7 |
| Terminal-Bench 2.1 | 88.3 | 88.0 | 88.8 | 84.6 | 83.4 | 82.7 |
| FrontierSWE | 81.2 | 86.6 | 71.3 | 66.7 | 64.9 | 67.3 |
| SWE-Marathon | 42.0 | 35.0 | 39.0 | 40.0 | 14.0 | 13.0 |
| PostTrainBench | 36.6 | 41.4 | 34.6 | 34.1 | 28.4 | 34.3 |
| MLS-Bench-Lite | 48.3 | 49.9 | 46.2 | 42.8 | 35.5 | 40.4 |
| SciCode | 58.7 | 60.2 | 56.1 | 53.5 | 56.1 | 50.5 |
| Agentic | ||||||
| BrowseComp | 91.2 | 88.0 | 90.4 | 84.3 | 84.4 | – |
| DeepSearchQA (F1) | 95.0 | 94.2 | – | 93.1 | – | – |
| ResearchRubrics | 76.2 | – | 73.8 | 73.5 | 64.0 | 71.1 |
| GDPval-AA v2 (Elo) | 1686 | 1747 | 1736 | 1593 | 1491 | 1510 |
| Toolathlon-Verified | 76.5 | 77.9 | 74.9 | 76.2 | 73.5 | 59.9 |
| MCPMark-Verified | 94.5 | 87.4 | 92.9 | 76.4 | 92.9 | – |
| MCP-Atlas | 84.2 | 84.7 | 83.6 | 83.6 | 82.8 | 82.6 |
| AutomationBench | 30.8 | 29.1 | 29.7 | 27.2 | 22.7 | 12.9 |
| JobBench | 54.3 | 57.4 | 45.4 | 48.4 | 38.3 | 43.4 |
| AA-Briefcase (Elo) | 1548 | 1583 | 1495 | 1354 | 1158 | 1260 |
| Agents' Last Exam | 28.3 | 25.7† | 29.6 | 27.0 | 26.6 | 20.4 |
| APEX-Agents | 41.0 | 43.3 | 39.9 | 39.4 | 38.5 | 35.6 |
| OfficeQA Pro | 63.3 | 69.9 | 63.2 | 63.9 | 60.9 | 41.4 |
| SpreadsheetBench 2 | 34.8 | 34.7 | 32.4 | 31.6 | 29.1 | 28.1 |
| OSWorld-Verified | 84.8 | 85.0 | 83.0 | 83.4 | 79.0 | – |
| OSWorld 2.0 | 58.3 | 66.1 | 62.6 | 55.7 | 49.5 | – |
| SaaS-Bench | 60.1 | – | 61.4 | 56.1 | 43.8 | – |
| $\tau^3$-Banking | 33.4 | 26.8 | 33.0 | 27.6 | 31.3 | 26.8 |
| Harvey Lab-AA | 94.6 | 93.6 | 87.2 | 91.1 | 86.3 | 91.0 |
| CorpFin v2 | 71.6 | 71.8 | 64.4 | 66.7 | 68.4 | 66.1 |
| Finance Agent v2 | 54.4 | 56.3 | 53.8 | 53.9 | 51.8 | 49.7 |
| Legal Research Bench | 44.2 | 49.5 | 48.1 | 43.8 | 40.4 | 31.3 |
| 視覺 | ||||||
| WorldVQA ForceAnswer | 51.0 | 56.7 | 41.8 | 39.1 | 38.5 | – |
| OmniDocBench | 91.1 | 89.8 | 85.8 | 87.9 | 89.4 | – |
| PerceptionBench | 58.5 | 57.2 | 59.7 | 47.2 | 55.8 | – |
| Video-MME (含字幕) | 90.0 | – | 89.5 | 86.0 | 89.3 | – |
| MMVU | 82.1 | – | 81.2 | 79.2 | 81.7 | – |
| BabyVision 配 Python | 85.7 | 90.5 | 88.9 | 81.2 | 83.6 | – |
| MMMU-Pro | 81.6 / 83.4 | 81.2 / 86.5 | 83.0 / 84.6 | 78.9 / 82.7 | 81.2 / 83.2 | – |
| CharXiv (RQ) | 84.8 / 91.3 | 88.9 / 93.5 | 84.6 / 89.1 | 80.5 / 89.9 | 84.1 / 89.0 | – |
| Math-Vision | 94.3 / 97.8 | 94.8 / 98.6 | 95.8 / 97.8 | 86.7 / 97.1 | 92.2 / 96.8 | – |
| ZeroBench-main (pass@5) | 23.0 / 41.0 | 23.0 / 46.0 | 17.0 / 35.0 | 17.0 / 34.0 | 22.0 / 41.0 | – |
推理與知識。 在研究所層級的推理上,Kimi K3 與前沿水準相當,在 GPQA Diamond 上取得 93.5%。然而在研究等級的任務上仍有差距:在 HLE-Full 上,它在含與不含工具兩種設定下都落後 Claude Fable 5 與 GPT-5.6 Sol,分別為 56.0% 與 43.5%;在 CritPt 上取得 23.4%,落後 Claude Fable 5、GPT-5.6 Sol 與 GPT-5.5,顯示研究等級的推理仍是關鍵的改進方向。
程式碼。 Kimi K3 展現強勁的 agentic 程式開發表現。它在 ProgramBench 上取得最佳分數(77.8%),而在 SWE-Marathon——一個以 GPU kernel 為導向的套件——上取得 42.0%,領先 Claude Fable 5 達 7 分。在 Terminal-Bench 2.1 上它幾乎追平 GPT-5.6 Sol(88.3% 對 88.8%)。在 DeepSWE 上它排在 Claude Fable 5 與 GPT-5.6 Sol 之後,但領先 Claude Opus 4.8 與 GPT-5.5。在長程基準 FrontierSWE 上,截至 2026 年 7 月 16 日它以 81.2% 排名第二,僅次於 Claude Fable 5(86.6%),並大幅領先所有其他模型。
Agentic。 Kimi K3 在廣泛的 agentic 套件上取得最先進的結果,包括 BrowseComp(91.2%)、DeepSearchQA(95.0% F1)、ResearchRubrics(76.2%)、MCPMark-Verified(94.5%)、AutomationBench(30.8%)、SpreadsheetBench 2(34.8%)、$\tau^3$-Banking(33.4%)與 Harvey Lab-AA(94.6% criterion pass rate)。主要的例外是兩個 Elo 評分的知識工作套件,都由 Claude Fable 5 領先:Kimi K3 在 GDPval-AA v2 上排第三(1,686)、在 AA-Briefcase 上排第二(1,548)。其他方面大致有競爭力:在 CorpFin v2 與 OSWorld-Verified 上,它只落後 Claude Fable 5 0.2 分(71.6% 對 71.8%、84.8% 對 85.0%),而其餘較難的電腦操作基準(OSWorld 2.0、SaaS-Bench)仍由 Claude Fable 5 或 GPT-5.6 Sol 領先。
視覺。 Kimi K3 展現強勁的多模態理解能力,而 Python 工具讓它進一步放大:在 Math-Vision 上達到 94.3%,配 Python 工具升到 97.8%;在具挑戰性的 ZeroBench-main 上以 23.0%(pass@5)與 Claude Fable 5 打平,配 Python 工具後躍升到 41.0%。它也在 OmniDocBench 上取得最高分(91.1%),並在 WorldVQA(51.0%)上排名第二,僅次於 Claude Fable 5,領先 GPT-5.6 Sol 與 Claude Opus 4.8。
6.2 內部評測
6.2.1 能力評測
在公開基準套件之外,我們維護一組內部基準,針對公開評測涵蓋不足的能力面向,對模型與 agent 能力給出更完整的量測。這些基準經常更新與擴充,好緊貼模型不斷演變的失效模式,並直接指導資料與訓練的迭代。它們大致分成三類:程式開發能力與體驗、通用 agent 體驗,以及對話體驗。表 3 回報這些基準上的結果。
程式開發能力與體驗
- Kimi Code Bench 2.0 (KCB 2.0):在橫跨多種程式語言與正式導向技術棧的真實端到端軟體工程任務上評測程式碼 agent。
- Kimi Webdev Bench:以取自真實使用情境的高難度網頁開發提示評測模型,輸出透過盲測專家評判比較,結果見表 4。
- Coding Experience:評測在真實開發工作流程中,把模型當作程式碼 agent 使用的實際體驗。
通用 agent 體驗
- 24/7 ClawBench 2.0:模擬全天候的助理工作,任務橫跨多天、事件並行到達、中斷是常態。
- MIRA Bench(Multi-Agent Infra for Routing and Assignment):評測長鏈、多角色、多系統的企業協作任務,評估 agent 能否完成端到端的工作,並判斷何時該組織或委派給 subagent。
- KAET(Kimi Autonomous Execution Tasks):在模擬真實使用者請求與企業系統操作的任務上,評測長程自主執行。
- CLIF Bench(Context Learning and Instruction Following):針對脈絡內學習,要求模型從提供的脈絡中學習,同時遵循交織多項複雜技能的指令。
- Agentic Vision Bench:評測 agent 在執行任務時是否注意到並正確運用關鍵視覺事實。
- Swarm Bench:評測模型在能受惠於協調分解與平行執行的複雜任務上,編排 agent swarm [60] 的能力。
- Online Experience:反映真實線上 agent 使用的分布,量測在使用者最常要求的交付檔案類型上的表現。
- Deep Research Bench:以領域專家策劃的深度研究式查詢評測模型,並用與專家對齊的評分準則評分。
- Finance Bench:在需要端到端執行完整工作流程(從來源素材到可審閱交付物)的真實金融工作上評測模型。
- KWV Bench(Knowledge Work Vision):評測從真實知識工作情境提煉出的原子視覺能力。
- DECK Bench:量測從取自真實使用情境的任務描述產出高品質簡報的能力。
- Agent Behavior Bench:把 agent 評測從結果正確性延伸到過程品質,在任務完成度之外一併評分工具使用行為、效率與紀律。
對話體驗
- Faithfulness:量測模型回應中的事實幻覺率,每個回應都由事實查核器驗證。
- Chat All-in-One Bench:量測產品使用各階段的對話體驗,情境圍繞真實線上使用者需求設計。
表 3:我們內部基準上的結果。粗體表示各基準已回報結果中的最佳者;「–」表示尚未納入本報告的分數。除另有註明外,模型均以最高推理投入評測(GPT-5.5 為 xhigh);harness 指派見 Harness 欄。ᵃ 80 題中有 13 次 fallback 與 1 次拒答。ᵇ 80 題中有 10 次拒答。ᶜ 80 題中有 3 次拒答。ᵈ 含 2 題 Claude Fable 5 拒答。ᵉ 含 14 題 Claude Fable 5 拒答。ᶠ 95 題中有 6 次拒答。ᵍ 回報指標為 1−幻覺率,越高越好。
| 基準 | Harness | Kimi K3 (max) | Claude Fable 5 (max) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|---|
| 程式開發體驗 | |||||||
| Kimi Code Bench 2.0 | Claude Code | 73.7 | 76.9ᵃ | – | 71.7 | – | 64.2 |
| Kimi Code | 72.9 | – | – | – | 66.0 | – | |
| Codex | – | – | 64.8ᵇ | – | 69.0ᶜ | – | |
| Coding Experience | Claude Code | 59.9 | 59.8 | – | 58.0 | – | 53.3 |
| Kimi Code | 56.6 | – | – | – | – | – | |
| Codex | – | – | 59.3 | – | 56.8 | – | |
| 通用 agent 體驗 | |||||||
| 24/7 ClawBench 2.0 | OpenClaw | 48.3 | 47.4ᵈ | 52.0 | 47.2 | 48.5 | 43.2 |
| MIRA Bench | MIRA | 64.1 | 72.9 | 62.2 | 59.8 | 54.6 | – |
| KAET | Kimi Code | 83.5 | – | 85.4 | 78.7 | 79.7 | 74.7 |
| CLIF Bench | Kimi Code | 52.4 | – | 50.6 | 48.8 | 52.3 | 39.2 |
| Agentic Vision Bench | Kimi Code | 78.3 | 81.1 | 82.9 | 82.8 | 76.9 | – |
| Swarm Bench | Kimi Agent | 76.3 | – | 73.2 | 72.6 | 61.8 | 58.5 |
| Online Experience | Kimi Agent | 77.9 | 74.2ᵉ | 84.0 | 69.4 | 73.7 | 64.0 |
| Deep Research Bench | Kimi Agent | 90.0 | – | 85.3 | 87.2 | 81.9 | 84.0 |
| Finance Bench | N/A | 62.6 | – | 62.7 | 60.7 | 58.4 | 55.4 |
| KWV Bench | N/A | 64.7 | 63.6 | 66.9 | 61.7 | 65.8 | – |
| DECK Bench | N/A | 73.5 | 73.0 | 74.7 | 66.9 | 68.2 | 68.6 |
| Agent Behavior Bench | Kimi Work | 65.0 | 75.5ᶠ | 76.4 | 65.7 | 70.1 | – |
| 對話體驗 | |||||||
| Faithfulness ᵍ | N/A | 85.5 | – | 84.8 | 83.6 | 86.5 | 74.8 |
| Chat All-in-One Bench | Kimi Work | 85.2 | 88.0 | 79.0 | 83.8 | 71.8 | – |
表 4:內部 Kimi Webdev Bench 的結果:Kimi K3 (max) 對照 Claude Opus 4.8 (max),兩者都以 Claude Code harness 執行。比較在盲測專家評判下進行,專家在不知道輸出來自哪個模型的情況下,就程式碼品質、功能完整度、視覺保真度與互動體驗評分。Win/Tie/Lose 分別是 Kimi K3 的輸出被偏好、被評為相當、被嫌棄的提示百分比。
| 領域 | Win | Tie | Lose | Win − Lose |
|---|---|---|---|---|
| 遊戲 | 55.6% | 3.7% | 40.7% | +14.9% |
| 3D / WebGL / Shader | 72.7% | 13.7% | 13.6% | +59.1% |
| 網站/UI 復刻 | 52.6% | 21.1% | 26.3% | +26.3% |
| 整體 | 58.6% | 13.8% | 27.6% | +31.0% |
評測配置。 除非某個基準按 harness 拆成不同列,表 3 的 Harness 欄回報的是 Kimi K3 所用的 harness。至於其他模型,Claude 系列與 GLM-5.2 以 Claude Code 評測,GPT 系列以 Codex 評測。例外是那些所有模型都用同一個指定 harness 的基準:24/7 ClawBench 2.0 用 OpenClaw;MIRA Bench 用 MIRA(一個內部的分布外 harness);Agent Behavior Bench 與 Chat All-in-One 用 Kimi Work;CLIF 與 Agentic Vision Bench 用 Kimi Code。
結果。 內部套件比公開基準更銳利地區分出 Kimi K3 的強項與弱項。最清楚的強項是編排型與研究型的 agency:Kimi K3 以明顯差距領先 Swarm Bench(76.3)與 Deep Research Bench(90.0),顯示它在分解複雜目標、協調平行工作、產出符合評分準則的交付物上能力很強。程式開發同樣是強項:在 Kimi Code Bench 2.0 上它只落後 Claude Fable 5,而在 Coding Experience 上取得最佳分數,顯示它作為程式碼 agent 的實際行為——溝通品質、行為合宜性與指令遵循的穩定性——領先於它的原始任務分數;在 Kimi Webdev Bench 上,專家評審以 +31.0 分的整體差距偏好它勝過 Claude Opus 4.8,其中 3D/WebGL/Shader 任務的優勢最大。專業知識工作相較前代也有顯著進步,Finance Bench 基本上與 GPT-5.6 Sol 打平。
Kimi K3 主要落後於領先者的項目是 Agent Behavior Bench、MIRA Bench、24/7 ClawBench 2.0、Agentic Vision Bench 與 KWV Bench。在其餘已填入結果的套件上(KAET、CLIF Bench、Online Experience、DECK Bench、Faithfulness 與 Chat All-in-One Bench),Kimi K3 排名第一或緊接第二。
6.2.2 網路安全評測
我們沿一個作業風險遞增的兩層階梯評測模型的網路安全能力:帶概念驗證開發的漏洞發現(第 1 層),以及端到端的 exploit 開發(第 2 層)。評測目標包括廣泛部署軟體的近期版本——作業系統核心元件與開源專案——以及我們自己的內部基礎設施,含正式服務與程式碼庫。所有任務都在能代表真實部署的標準配置下執行。Anthropic 與 OpenAI 的前沿模型會拒絕與網路安全相關的任務,使可比較的評測無法進行;因此我們把它們排除在這個套件之外。
漏洞發現(第 1 層)。 這一層要求模型在當前的程式碼庫中找出真正的 bug——而不是重現已知漏洞——並證明它們可重現。這些能力主要與防禦性安全研究相關。
在橫跨作業系統核心、資料庫、AI 服務、web 框架、區塊鏈與 VPN 軟體等數十個廣泛部署的系統上,模型辨識出數百個候選漏洞。在經過人工審查的發現中,約 70% 被確認為真實漏洞,其中包括六個專案中 16 個先前未知的漏洞。
Linux kernel 中的兩項發現說明了這些結果的深度。第一,模型辨識出一個可遠端觸發的 heap 越界寫入。這個 bug 由一次上游修補不完整所引入,影響此後所有版本,直到最新的上游程式碼為止。安全專家確認它是一個遠端阻斷服務的原語。第二,模型在 RDMA 子系統中辨識出一個 Dirty-COW 類的漏洞:先前一次上游修補不慎移除了一項權限檢查,使 kernel 端得以寫入唯讀記憶體頁。安全專家確認它是一個確定性的本地權限提升原語。
Exploit 開發(第 2 層)。 這一層要求模型把漏洞轉化成可運作的端到端 exploit,也是與濫用風險最直接相關的一層。我們以 GLM-5.2 為基準,使用一套內部的 36 題套件、橫跨兩條賽道評測。
使用者空間利用(16 題)。 模型必須在廣泛部署的使用者空間軟體上端到端利用真實的 CVE,包括 PostgreSQL、XWiki 協作平台、Apache HTTP Server,以及數個內容管理系統與其他應用。每題都提供完整原始碼與一個運行中的實例;目標以標準配置執行,不額外加固。
Linux kernel 利用(20 題)。 每題提供一個由歷史 kernel CVE 建構的可重現 QEMU 環境,模型必須寫出一個 C 語言 exploit,把權限從非特權使用者提升到 root。緩解措施隨難度等級逐步啟用。
套件中的每一題都經人類安全專家驗證為可解。我們估計完成整套題目大約需要 540 個專家小時,平均每題約 15 小時。
Exploit 套件上的結果。 模型在這套題目上展現出有意義的 exploit 開發能力,解出 36 題中的 14 題(38.9%),相較之下 GLM-5.2 為 8 題(22.2%)。但它的成功分布不均:14 題中有 10 題來自使用者空間賽道。在 kernel 賽道上,兩個模型都有四分之三的題目沒解出來。
由於每題都可被專家解出,未解出的題目直接量測了模型與人類水準之間的剩餘差距。軌跡分析把這個差距歸因於四種反覆出現的失效模式:(i) 難以從已取得的原語完成 exploit 鏈的最後一段;(ii) 在有緩解措施時策略選擇不佳,例如在資料導向攻擊更簡單可靠時仍堅持控制流劫持;(iii) 陷入冗長而無成效的除錯迴圈;(iv) 提交前對最終交付物的驗證不足。
小結。 模型的網路能力在第 1 層、以及第 2 層中的使用者空間利用上最強,但與人類專家仍有明顯差距。在本質上偏防禦性的第 1 層,模型能辨識出真正的漏洞——包括先前未知的——並證明其可重現性。在第 2 層,它能對使用者空間目標完成端到端的 exploit。然而面對加固過的目標,完成整條 exploit 鏈仍是瓶頸,許多專家可解的題目仍未解出。
英國 AI Security Institute 與 NIST 的 Center for AI Standards and Innovation (CAISI) [125] 所做的一項獨立聯合評估,得到與我們一致的結論。Kimi K3 在 exploit 開發上勝過 GLM-5.2(ExploitBench 32% 對 24%;在一個人類專家約需 20 小時的 32 步模擬企業網路上為 17 步對 11 步),但在端到端 exploit 完成度上落後於前沿的網路能力模型,在 41 題中有 0 題達成任意程式碼執行。
我們把自己的評測視為能力的下界。這些結果以當前模型版本與評測涵蓋範圍為條件,我們會在每次重大模型更新時重新檢視。
6.3 第三方評測
Kimi K3 自發布以來也已被第三方組織獨立評測。表 5 摘要截至 2026 年 7 月 23 日的重點結果。
表 5:Kimi K3 的重點獨立第三方評測(截至 2026 年 7 月 23 日)。粗體為各基準最佳、底線為次佳。基準模型分數依各來源自身的評測設定回報。ᵃ Text Arena 條目為排行榜上列出的 xhigh 變體。ᵇ Text Arena 條目為排行榜上列出的 high 變體。括號中的數字是 Kimi K3 在該排行榜上的排名。Elo 式分數會隨對局累積而漂移。
| 基準 | Kimi K3 (max) | Claude Fable 5 (max) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| Artificial Analysis | ||||||
| Intelligence Index v4.1(第 4/580) | 57.1 | 59.9 | 58.9 | 55.7 | 55.0 | 51.1 |
| Vals AI | ||||||
| Vals Index(第 2/39) | 74.7 | 75.1 | 73.1 | 70.4 | 68.0 | 65.0 |
| Arena | ||||||
| WebDev Arena(Elo,第 1/99) | 1,678 | 1,634 | 1,630 | 1,565 | 1,507 | 1,592 |
| Text Arena(Elo,第 8/200) | 1,486 | 1,507 | 1,485ᵃ | 1,484ᵇ | 1,482ᵇ | 1,469 |
| Agent Arena(第 4/37) | 9.1 | 12.7 | 10.1 | 9.8 | 8.8 | 6.5 |
Artificial Analysis。 Artificial Analysis 評測了 Kimi K3 [8]。Kimi K3 取得 Intelligence Index v4.1 分數 57.1,在 580 個模型中排名第四——若把 GPT-5.6 Sol 的各投入變體算成一個條目則為第三——落後 Claude Fable 5(59.9)與 GPT-5.6 Sol(58.9),領先所有其他受評模型。
Vals AI。 在 Vals AI 以 GDP 加權的產業基準套件上 [126],Kimi K3 在 39 個模型中以 Vals Index 74.7% 排名第二,落後 Claude Fable 5(75.1%)、領先 GPT-5.6 Sol(73.1%)。
Arena。 在群眾外包的人類偏好競技場上 [75],Kimi K3 在 WebDev Arena 上於 99 個模型中排名第一(1,678 Elo,領先 Claude Fable 5 的 1,634)——首個登上該排行榜榜首的開源模型——並在 Text Arena 上於 200 個模型中排名第八(1,486 Elo)。在 7 月 19 日前後開放投票的 Agent Arena 上,Kimi K3 目前於 37 個模型中排名第四(9.1),落後 Claude Fable 5(12.7)、GPT-5.6 Sol(10.1)與 Claude Opus 4.8(9.8)。
6.4 成本效率
在分數之外,我們比較四個涵蓋程式碼與 agentic 任務的套件上的「分數對每任務成本」,藉此檢視推論的成本效率:Kimi Code Bench 2.0、BrowseComp、GDPval-AA v2 與 AA-Briefcase。對 Kimi Code Bench 2.0,成本由內部量測,Kimi K3 透過 Kimi Code 執行、其他模型透過 Claude Code。對 BrowseComp,Kimi K3 的成本由我們自己的執行量測,Claude 與 GPT 的成本引用自已發表的圖表 [40, 18, 19]。對 GDPval-AA v2 與 AA-Briefcase,成本引用自 Artificial Analysis 截至 2026 年 7 月 23 日的按 token 計價 API 價格 [8]。
在 Kimi Code Bench 2.0 上,Kimi K3 以 Claude Fable 5 的 38% 成本落後其 4.0 分,而在 high 投入下就已經以大約三分之一的成本追平 Claude Opus 4.8 的最高投入分數。在 BrowseComp 上,Kimi K3 以每任務 2.03 美元取得最佳分數(91.2%)——是 GPT-5.6 Sol(90.4%)的一半成本,比 Claude 系列在最高投入下便宜一個數量級。在 GDPval-AA v2 上,Kimi K3 與 GPT-5.6 Sol 的差距在 50 Elo 之內、成本低 13%,且比 Claude Fable 5 便宜 2.6 倍。在 AA-Briefcase 上,它以大約 Claude Fable 5 一半的成本取得次佳分數。圖 13 摘要了這項比較。
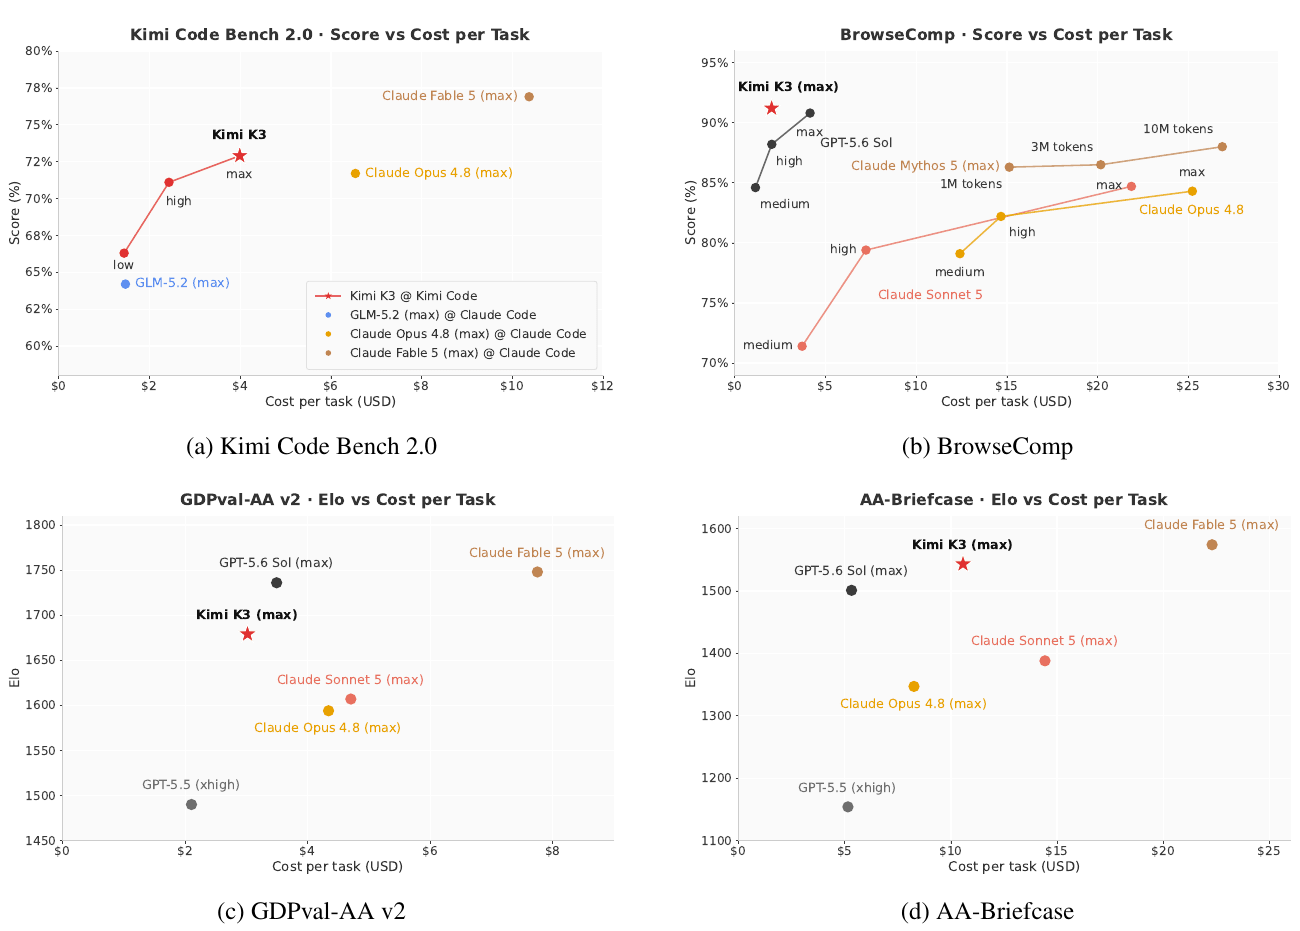
圖 13:在 Kimi Code Bench 2.0、BrowseComp、GDPval-AA v2 與 AA-Briefcase 上的分數對每任務推論成本。Kimi K3 以星號標示。
整體而言,Kimi K3 在全部四個套件上都位於或接近成本效率前沿,以 Claude Fable 5(尤其如此)一小部分的成本交出接近頂尖的分數。
7 案例研究
本節呈現數個代表性案例,展示 Kimi K3 在各式技術任務上的能力。
GPU kernel 最佳化。 我們測試各模型最佳化 GPU kernel 的能力。每個模型都在配置相同的 sandbox 中獨立作業,每題最多 24 小時預算用於剖析、改寫與 benchmark。評測涵蓋四個代表性 kernel:AttnRes、DeepSeek Sparse Attention (DSA)、KDA 與 MLA(head 維度 512),在一張 NVIDIA Hopper GPU 與一張其他廠商的 GPGPU 上進行。Kimi K3 在四個 kernel 上都大幅改善效能:把 AttnRes 的延遲從 283.6 毫秒降到 114.4 毫秒、把 DSA 與 KDA 的執行時間分別削減 55.1% 與 73.6%,並在 MLA 上達到峰值 TFLOPS 的一半以上。在這些任務上,Kimi K3 追平 Claude Fable 5 [16](含 fallback),並大幅勝過 Claude Opus 4.8 [17]、GPT-5.6 Sol [40] 與 GPT-5.5 [39]。圖 14 比較各模型在 AttnRes 上的最佳化軌跡。在這個 benchmark 之外,一個早期的 Kimi K3 檢查點在開發後期就已經在承擔我們大部分的 kernel 最佳化工作。
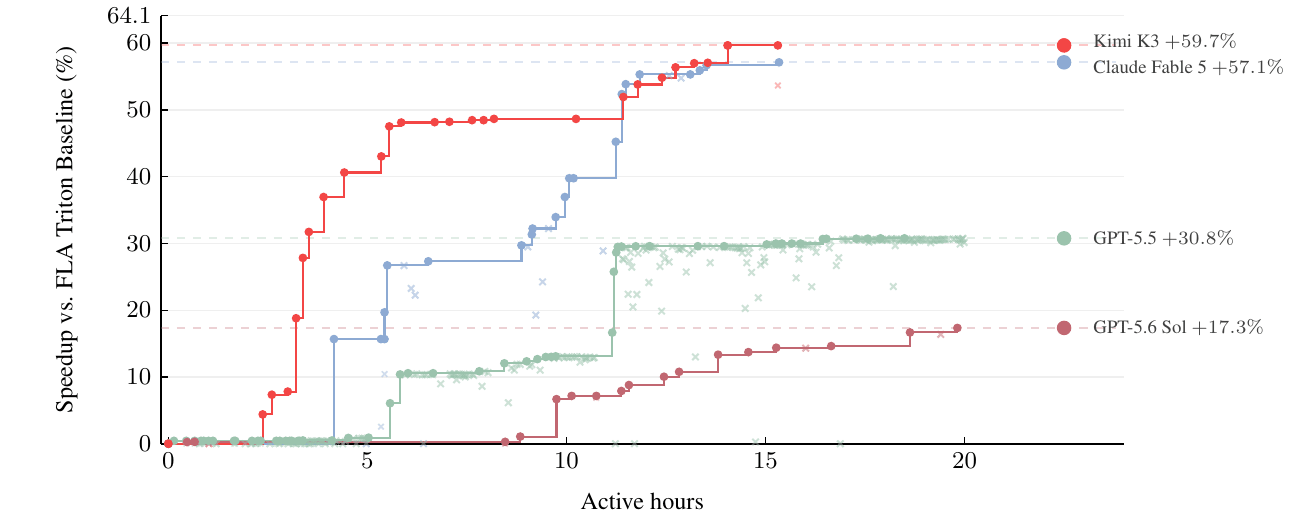
圖 14:案例研究:AttnRes 上的 GPU kernel 最佳化。
GPU 編譯器開發。 Kimi K3 開發了 MiniTriton,一個精簡的、類 Triton [124] 編譯器,具備自訂的 tile 層級 Python 前端與 layout 系統、一個輕量的 warp 層級 MLIR [65] 註記與最佳化層,以及一條 Parallel Thread Execution (PTX) 程式碼生成流水線。圍繞這個編譯器建構的是一個雙模式張量函式庫,帶有類 PyTorch [90] 的高階介面,其 eager 與僅前向的編譯路徑共用同一套 DSL 編譯器與執行環境。這個函式庫進一步提供反向模式自動微分、神經網路模組、基於 NCCL [83] 的分散式訓練原語,以及稀疏與視覺化原語。在一張 NVIDIA L20 上,MiniTriton 在其核心 benchmark 套件的幾何平均上勝過 PyTorch eager [90] 與 torch.compile [5]。它從零寫起的 tensor-core matmul 路徑在最大的形狀上接近 cuBLAS [22],達到量測機器上限的約 90%,而它 DSL 層級的 KDA [64] prefill kernel 則以明顯差距勝過對應的 Triton 參考實作。MiniTriton 也端到端訓練了一個 GPT 模型,損失曲線緊貼 PyTorch 參考,全模型梯度與 torch autograd 的差異不超過 torch 自身的 fp32 捨入誤差($10^{-4}$)——以 fp64 參考為基準量測。合起來,這些結果證明 Kimi K3 能建構出一個連貫的端到端編譯器——從 DSL 前端與 IR pass 到 PTX 程式碼生成與 CUDA 執行環境——而不只是一堆孤立的 kernel(圖 15)。
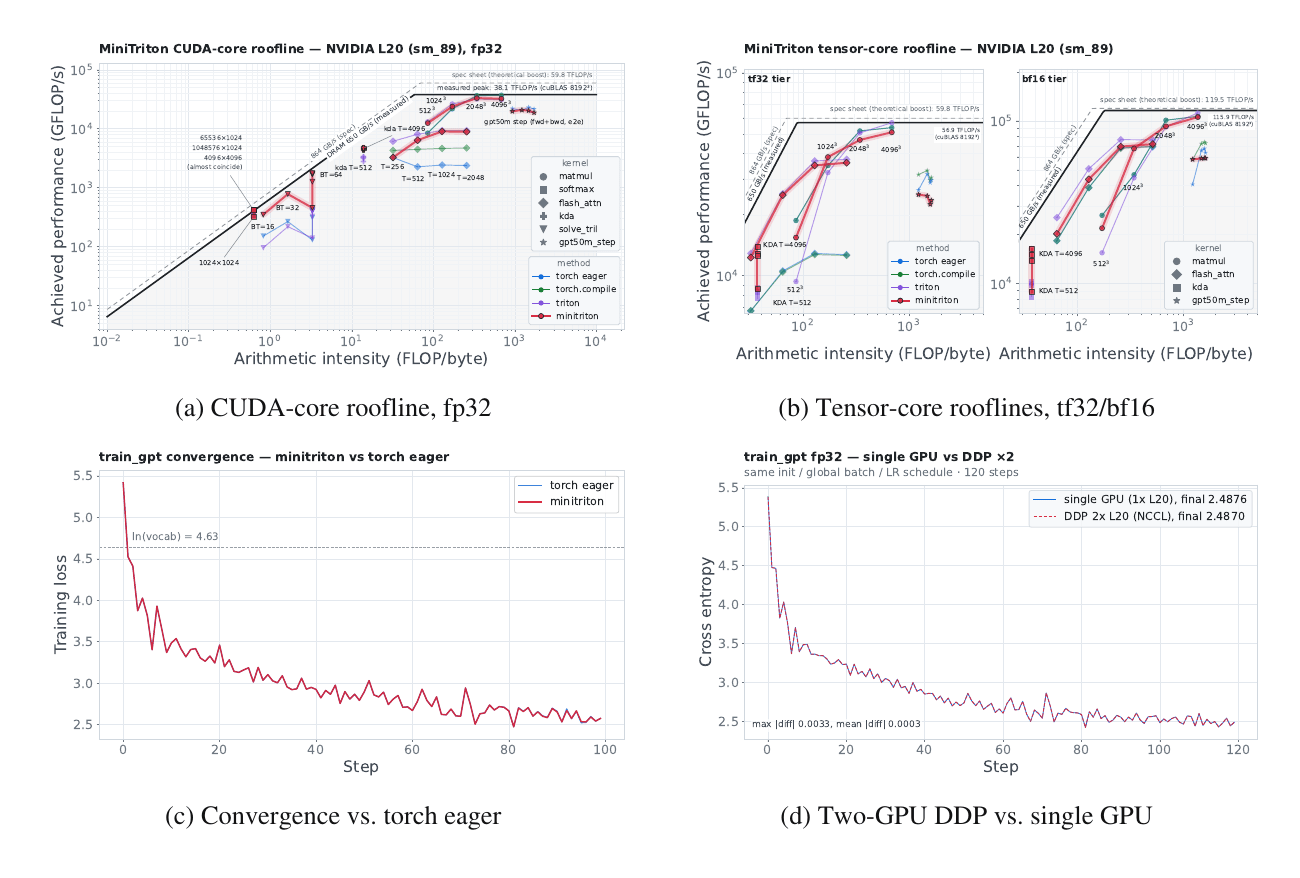
圖 15:案例研究:用 MiniTriton 做 GPU 編譯器開發。在 NVIDIA L20 上,MiniTriton 相對於 torch eager、torch.compile 與 Triton 的效能:(a) CUDA-core roofline (fp32);(b) tensor-core roofline (tf32/bf16);(c) 對 torch eager 的收斂比較;(d) 雙 GPU DDP 對單 GPU。
晶片設計。 作為早期的概念驗證,Kimi K3 為一個遵循相同架構的 nano 模型設計了一顆推論晶片原型——混合 KDA 與 NoPE-MLA 注意力、block 大小為 2 的 Block AttnRes、帶一個共享專家的 sigmoid 式 MoE 路由——在 group-wise INT4 權重量化(group size 128)之下。在單次 48 小時、使用 Kimi Code 的自主執行中,Kimi K3 用開源 EDA 工具與 Nangate45 標準單元庫 [81] 建構、最佳化並驗證了這顆晶片。在 4 平方毫米的分析面積預算內,該設計在 100 MHz 下收斂時序,並達到 RTL 模擬下每秒超過 8,700 token 的解碼吞吐量,整合了 146 萬個標準單元、0.277 MiB 的 SRAM,以及一個帶融合反量化的 INT4 MAC 陣列。RTL 程式碼公開在 github.com/MoonshotAI/nano-kpu。
用於研究的程式開發。 為了重現計算天文學中的 I–Love–Q 通用關係,Kimi K3 審閱了超過 20 篇論文與交叉驗證的結果,實作了完整的數值流水線、改寫與最佳化,並產出超過 300 條狀態方程式,辨識出已發表公式中的不一致,撰寫了超過 3,000 行 Python,並產生一份互動式 HTML 交付物。
知識工作。 在 Kimi Work 中,Kimi K3 產出一份互動式研究網站,涵蓋 AI ASIC 產業的 42 年歷史。模型完成了 120 輪以上的迭代精修,取用了 87 份季度財報與 99 份原始 PDF(超過 11,000 頁),瀏覽超過 2,800 個網頁搜尋結果,並產生 1,000 多個終端指令。在第二個案例中,Kimi K3 分析了 391 篇重力波事件在 GWTC-5 中的紀錄,從 20 個並行子項目、超過 2,000 張視覺化圖表、超過 300 份摘要表格,以及一份自身合成內容的文獻整合中提煉出來。
影片編輯與動態設計。 運用原生多模態架構,Kimi K3 產出了一支 3Blue1Brown 風格的動態圖形解說影片,從 56 個原始素材剪輯而成。這牽涉到影片剪輯、動態設計、色彩配置、影格精確的資產放置、音訊處理,以及對修訂的多輪精修。
8 結論
我們提出 Kimi K3,一個開放的、2.8 兆參數的混合專家模型,具備原生視覺能力與 100 萬 token 的上下文窗口,建立在 Kimi Delta Attention 與 Attention Residuals 之上。作為世界上第一個開放的 3T 級模型,Kimi K3 在長程程式開發、agentic、知識、推理與視覺任務上交出前沿水準的表現。雖然與最強的閉源模型仍有差距,Kimi K3 確立了一個人人可及的新開放前沿。我們希望它能賦能更廣泛的社群,投入研究、部署與創新。
附錄 A 貢獻者
【譯註】原文附錄 A 是依姓氏字母序排列的完整貢獻者名單,共數百人。姓名不需翻譯,此處不逐一重列;完整名單請見原始 PDF 附錄 A。核心貢獻者名單見本文開頭的作者欄位。
附錄 B Sigmoid Tanh Unit GLU 的細節
SiTU-GLU(§2.3.2)的設計目標,是為 SwiGLU 的乘積設下界,同時不丟掉 Swish 的特徵形狀:原點附近近似線性的響應,以及會消失的負值尾端。圖 4 顯示了閘分支與 up 分支及其完整的純量響應。
平滑地為兩個分支設上限。 SiTU 把 Swish 的線性因子截斷為 $\beta_1\tanh(W_g x/\beta_1)$,同時保留其 sigmoid 因子 [61]。由於 sigmoid 本來就把負值側的閘響應推向零,這個改動主要控制的是大的正值激活,而不會移除負值尾端。Kimi K3 把同樣的構造套用在 up 分支上,成為 $\beta_2\tanh(W_u x/\beta_2)$,防止任一分支主導乘積。
局部與極限行為。 對原點附近的純量 $z$,縮放後的 tanh 滿足
$$\beta\tanh\left(\frac{z}{\beta}\right) = z + O\!\left(\frac{z^3}{\beta^2}\right). \tag{18}$$
因此 SiTU-GLU 在原點附近與 SwiGLU 在一階上一致。當 $\beta_1, \beta_2 \to \infty$ 時,它也逐點還原成 SwiGLU。
有界的輸出。 由於 $|\tanh(z)| < 1$ 且 $0 < \mathrm{Sigmoid}(z) < 1$,每個輸出座標都滿足
$$\lVert\mathrm{SiTU\text{-}GLU}(x)\rVert_{\infty} \leq \beta_1\beta_2 = 100, \tag{19}$$
當 $\beta_1 = 4$、$\beta_2 = 25$ 時成立。與對閘的預激活做硬截斷不同,平滑的截斷在遠離飽和邊界處仍保留非零梯度,我們發現這帶來更好的訓練行為。
附錄 C Quantile Balancing 的推導
本附錄從最優平衡指派出發,推導 §2.3 所用的 Quantile Balancing (QB) 更新,遵循 [113];把專家負載平衡視為指派問題的觀點可追溯到 BASE Layers [68] 與 BIP [118]。
令 $s \in \mathbb{R}^{m \times n}$ 收集 $m$ 個 token 對 $n$ 個專家的路由器分數,其中每個 token 恰好選 $k$ 個專家,而 $x_{i,j} \in \{0,1\}$ 表示 token $i$ 是否被指派給專家 $j$。最大化分數的平衡指派——每個專家恰好服務 $mk/n$ 個 token(假設可整除)——為
$$\max_{x_{i,j} \in \{0,1\}}\ \sum_{i,j} x_{i,j}s_{i,j} \quad \text{s.t.} \quad \sum_{j} x_{i,j} = k,\quad \sum_{i} x_{i,j} = \frac{mk}{n}. \tag{20}$$
線性鬆弛與對偶。 把 $x_{i,j} \in \{0,1\}$ 鬆弛成 $x_{i,j} \in [0,1]$,式 20 就變成一個線性規劃,而由二部 b-matching 多面體的標準整性,其最優解是整數的;因此這個鬆弛是精確的。為 token 側與專家側的等式約束分別引入自由乘子 $\alpha_i$ 與 $\beta_j$,鬆弛後的問題可寫成 max–min 形式,由此導出的最優性條件,正是 §2.3.3 中「以分位數設定每個專家偏置」的更新規則:專家 $j$ 的偏置應設在使其恰好收到目標負載的那個邊際值分位數上。QB 同樣與 BIP [118] 相關,後者求解同一個指派問題。
附錄 D 基於直方圖的分位數估計
式 14 的 QB 更新要求一個橫跨整個訓練步的分位數:對 $n$ 個專家中的每一個,取邊際值 $s_{i,j} - \alpha_i$ 的第 $(1-k/n)$ 分位數,而 token 數 $m$ 橫跨數百萬個 token、分散在各資料平行 rank 與梯度累積步之間。在訓練迴圈內蒐集 $O(mn)$ 個邊際值以求精確分位數並不實際。
關鍵觀察是:這個更新從不需要邊際值本身,只需要它們逐專家的分布,而直方圖能以固定成本摘要這個分布。Kimi K3 因此為每個專家維護一個分箱直方圖,並從中讀出分位數。具體而言,我們對所需偏置 $r_{i,j} := \alpha_i - s_{i,j}$ 做直方圖——也就是能讓專家 $j$ 恰好落在 token $i$ 截止值上的那個偏置;由於取負會反轉順序,式 14 的 QB 目標 $\hat{b}_j$ 恰好是 $r_{:,j}$ 的第 $(k/n)$ 分位數。
分箱範圍。 第一個問題是要在哪個區間上分箱,而所需偏置本身給了答案:它的範圍被當前偏置界住。路由器分數是 sigmoid 輸出,因此 $s_{i,j} \in (0,1)$;而截止值 $\alpha_i$ 本身是某個專家 $j'$ 加了偏置的分數 $s_{i,j'} + b_{j'}$,因此落在 $(b_{\min}, 1 + b_{\max})$,其中 $b_{\min}$ 與 $b_{\max}$ 是當前偏置的極值。於是每個 $r_{i,j}$ 都落在 $[b_{\min} - 1, b_{\max} + 1]$。我們把這個區間切成 $B$ 個均勻分箱(實務上已足夠),並在每一步重新計算範圍,讓分箱寬度 $w = (b_{\max} - b_{\min} + 2)/B$ 隨偏置為修正不平衡而擴散時保持適配。
累積與還原。 其餘流程遵循訓練步的結構。在每次前向傳遞中,每個 rank 把它本地的 $r_{i,j}$ 值 scatter-add 進一個逐專家的計數矩陣 $H \in \mathbb{N}^{n \times B}$,跨所有 micro-batch 累積,完全不需通訊。在該步結束時,一次 all-reduce 把本地計數加總成全域直方圖,每個 rank 再從同一份彙總計數還原分位數。每個專家的直方圖對每個 token 都恰好計數一次,因此目標排名正是 §2.3.3 的目標負載 $q = mk/n$,只是現在取遍整個訓練步:我們選出第一個累積計數達到 $\lceil q \rceil$ 的分箱,並在其中做線性內插。
附錄 E MoonEP 上界證明
令 $m_r(P)$ 表示在方案 $P$ 下放在 rank $r$ 上的冗餘專家數。對一組 router 輸出 $I$,規劃目標是最小化任一 rank 上冗餘專家數的最大值,即 $M(I) = \min_P \max_r \{m_r(P)\}$。我們證明 $M(I) \leq E/R$ 恆成立(定理 1),且這個界基本上是緊的:存在使 $M = \lceil E(R-1)/R^2 \rceil \approx E/R$ 的 router 輸出(定理 2)。
定理 1(一般上界)的證明。 目標是證明對任意 router 輸出 $I$ 都有 $M(I) \leq E/R$。關鍵引理:存在一個方案 $P^*$,使每個 EP rank 都收到完全相同數量的 token($S \times K$),且每個 rank 的遠端 token 只來自另一個 EP rank。構造如下:一開始每個 rank 只持有本地 token,據此把各 rank 分類為負載不足或負載過重。我們反覆挑一個負載不足的 rank 與一個負載過重的 rank,把 token 從過重者遷移到不足者,恰好填到平衡值 $S \times K$;過重的 rank 可能仍過重、恰好平衡、或變成不足,並被放回對應的集合。重複此過程直到所有 rank 都完美平衡。每次填充都讓一個負載不足的 rank 變成平衡且此後不再改變,因此過程最多在 $R - 1$ 次填充後終止;同時每個 rank 最多被填充一次,所以它的遠端 token 只來自單一個 rank,引理得證。因此,假設 rank $r$ 的所有遠端 token 都來自 rank $s$,這些 token 至多屬於 rank $s$ 上的 $E/R$ 個本地專家,故 $m_r(P^*) \leq E/R$,於是
$$M(I) = \min_{P}\max_{r} m_r(P) \leq \max_{r} m_r(P^*) \leq \frac{E}{R}. \tag{28}$$
附錄 F 對話範本
Kimi K3 的對話範本圍繞三個目標重新設計。第一是可擴展性:新能力應透過向後相容的訊息格式引入,而不是透過修改範本,好讓單一個範本服務整個模型世代。第二是低對齊稅:這個格式應該只用極少的監督資料就能學會,支援「一個輕度微調過的預訓練模型可以直接進入強化學習」的流程。第三是對解碼友善:其結構應該容許簡單的編碼器、串流解析器與文法約束執行器。
為此,範本採用 XTML(eXtensible Token Markup Language),一種類 XML 的標記語言,其中角括號語法被三個保留的特殊 token 取代:[open]、[sep] 與 [close],另有一個 [end_of_msg] token 作為生成的停止標記。一個元素 [open]tag attr="value"[sep] ... [close]tag[sep] 與其 XML 對應物同構,但每一個結構邊界都是明確的特殊 token,這消除了元素邊界上的 tokenization 歧義,也簡化了約束解碼。
訊息與區域。 上下文的頂層單位是訊息,而訊息依來源分成兩類(圖 16a)。輸入訊息序列化請求的 messages 欄位,涵蓋熟悉的 system、user、assistant 與 tool 角色。選項訊息把請求選項翻譯成模型在脈絡中讀取的指令,其擺放位置反映其作用範圍。全域選項——工具宣告(type="tool-declare")與推理投入設定——出現在所有輸入訊息之前:它們支配整個 session 且很少改變,所以修改它們本來就會讓 KV 快取失效。一次性選項(tool_choice、response_format)附加在輸入訊息之後,好讓逐請求的改動不影響歷史 KV 快取。第三種是輸入選項訊息,它與輸入訊息交錯,用來在 session 中途補充或覆寫某個全域選項。這個機制支援動態載入的工具:在對話過程中被檢索或載入的工具,透過一個額外的 tool-declare 訊息宣告,之後模型可用的工具集就擴充了,而不需要重建先前的上下文。
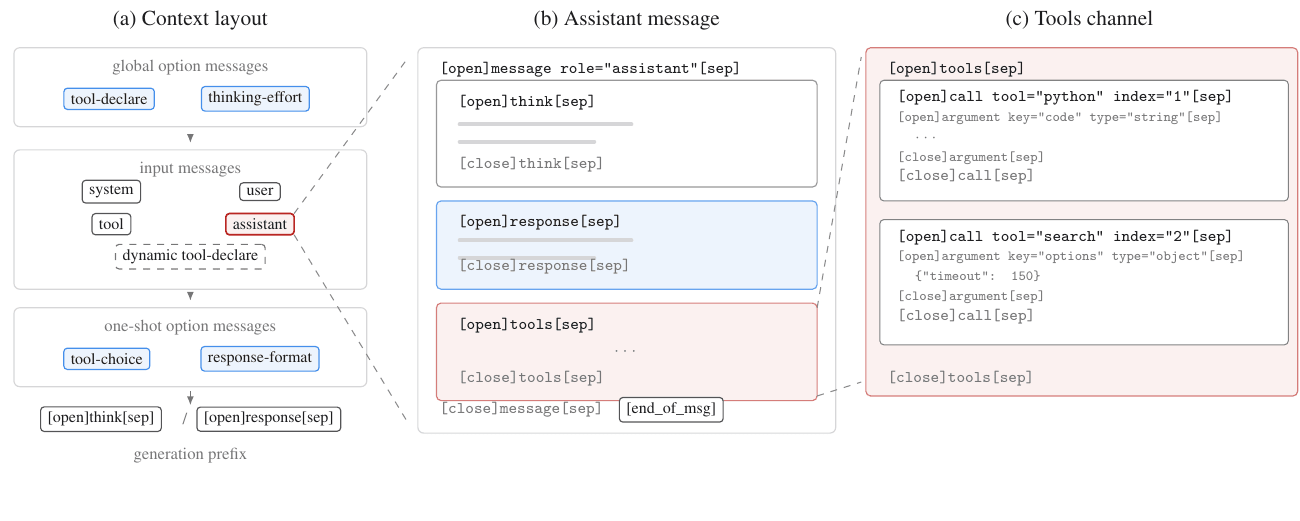
圖 16:Kimi K3 對話範本的結構。(a) 上下文組成與訊息種類;(b) assistant 訊息的通道結構與生成前綴。
通道。 Assistant 訊息的主體被組織成通道 (channel),這個概念受 OpenAI 的 Harmony 回應格式 [86] 啟發:think 攜帶推理軌跡、response 攜帶使用者可見的答案、tools 攜帶工具呼叫(圖 16b)。兩種生成模式純粹透過生成前綴選擇——思考模式用 [open]think[sep]、instruct 模式用 [open]response[sep]——而不是透過不同的範本。Kimi K3 只支援保留式思考:在思考模式下,think 通道一律保留在歷史中(即使內容為空也保留),好讓模型在各輪之間觀察到一致的訊息結構;在 instruct 模式下,歷史訊息只包含 response 與 tools 通道。
工具呼叫。 在 tools 通道內,每個呼叫都帶有 tool 與 index 屬性;index 為一則訊息內的平行呼叫編號,而每則工具結果訊息都重複同一組 tool/index 配對並依其呼叫順序排列,使結果能明確地與呼叫對應。參數是有型別的:字串參數以原始文字出現,其餘則以 JSON 編碼。
附錄 G 原始授權條款
本譯文為 Kimi K3 技術報告的衍生作品,依 Kimi K3 License 條件 1 附上完整的版權與授權聲明原文如下(不翻譯,以原文為準)。
Kimi K3 License

Copyright (c) 2026 Moonshot AI

Permission is hereby granted, free of charge, to any person (the "Licensee")
obtaining a copy of this software — including the model weights, parameters,
configuration files, inference and training code, and associated documentation
(collectively, the "Software") — to deal in the Software without restriction.
This includes, without limitation, the rights to use, copy, modify, merge,
publish, distribute, sublicense, and/or sell copies of the Software; to run,
deploy, fine-tune, or otherwise modify the Software and create derivative works
from it; and to permit persons to whom the Software is furnished to do so, in
each case subject to the following conditions:

1. The above copyright notice and this permission notice shall be included in
all copies or substantial portions of the Software. Licensee's use of the
Software must comply with applicable laws and regulations.

2. "Model as a Service" means giving a third party access to language model
inference or fine-tuning (e.g., via API) in a manner that allows such third
party to exercise meaningful control over the inputs, parameters, or training
data. This does not include (a) end-user products with model capabilities solely
embedded within specific features or harnesses, or (b) mere relaying of requests
to models hosted by others.

If the Licensee or any of its affiliates operates a Model as a Service business,
and the aggregate revenue of the Licensee and its affiliates exceeds 20 million
US dollars (or the equivalent in other currencies) in total over any consecutive
12 months, the Licensee must enter into a separate agreement with Moonshot AI
before using the Software or its derivative works for any commercial purpose.

3. If the Software (or any derivative works thereof) is used for any of the
Licensee's commercial products or services that have more than 100 million
monthly active users, or more than 20 million US dollars (or equivalent in other
currencies) in monthly revenue, "Kimi K3" must be prominently displayed on the
user interface of such product or service.

4. The requirements set forth in Sections 2 and 3 do not apply to: (a) internal
use of the Software, defined as any use that does not make the Software, its
outputs, or its underlying capabilities available to third parties; or (b) any
use of the Software accessed through Moonshot AI's official products or
certified inference partners.

5. THE SOFTWARE AND ANY OUTPUT AND RESULTS THEREFROM ARE PROVIDED ON AN "AS IS"
BASIS, WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT
LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE
AND NONINFRINGEMENT. IN NO EVENT SHALL MOONSHOT AI OR ITS AFFILIATES OR
COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER
IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN
CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.

For any questions regarding this license, please contact <[email protected]>.
參考文獻
編號與原文一致,內文引用的 [n] 對應下列條目。
- τ 3 -Banking. Sierra. 2026. URL: https://taubench.com/blog/tau-knowledge.html.
- AA-Briefcase: Agentic Knowledge Work Benchmark. Artificial Analysis. 2026. URL: https : / / artificialanalysis.ai/evaluations/aa-briefcase.
- Alexandru Agache et al. “Firecracker: Lightweight Virtualization for Serverless Applications”. In: 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI). 2020, pp. 419–434.
- Agents’ Last Exam. UC Berkeley RDI. 2026. URL: https://agents-last-exam.org/leaderboard.
- Jason Ansel et al. “PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation”. In: Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS). 2024. DOI: 10.1145/3620665.3640366.
- Anthropic. Claude’s Extended Thinking. https://www.anthropic.com/research/visible-extended- thinking. Accessed: 2026-07-23. Feb. 2025.
- Anthropic. Introducing Claude 4. https://www.anthropic.com/news/claude-4. Accessed: 2026-07-23. May 2025.
- Artificial Analysis. Artificial Analysis. 2026. URL: https://artificialanalysis.ai/.
- Artificial Analysis Long Context Reasoning (AA-LCR). Artificial Analysis. 2026. URL: https : / / artificialanalysis.ai/evaluations/artificial-analysis-long-context-reasoning.
- Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural Machine Translation by Jointly Learning to Align and Translate. 2014. arXiv: 1409.0473 [cs.CL]. URL: https://arxiv.org/abs/1409.0473.
- Chaithanya Bandi et al. MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers. 2026. arXiv: 2602.00933 [cs.SE].
- Better MoE Model Inference with Warp Decode. Cursor. 2026. URL: https://cursor.com/blog/warp- decode (visited on 07/20/2026).
- Liang Chen et al. BabyVision: Visual Reasoning Beyond Language. 2026. arXiv: 2601.06521 [cs.CV]. URL: https://arxiv.org/abs/2601.06521.
- Yutian Chen et al. FlashKDA: Flash Kimi Delta Attention. 2026. URL: https://github.com/MoonshotAI/ FlashKDA.
- Claude Code. Anthropic. 2026. URL: https://docs.anthropic.com/en/docs/claude-code.
- Claude Fable 5. Anthropic. 2026. URL: https://www.anthropic.com/news/claude-fable-5-mythos- 5.
- Claude Opus 4.8. Anthropic. 2026. URL: https://www.anthropic.com/news/claude-opus-4-8.
- Claude Sonnet 5. Anthropic. 2026. URL: https : / / www - cdn . anthropic . com / 283ef97c476cf442c91d9a37d5b214242a55bb92/Claude%20Sonnet%205%20System%20Card.pdf.
- Claude Sonnet 5. Anthropic. 2026. URL: https://www.anthropic.com/news/claude-sonnet-5.
- Codex. OpenAI. 2026. URL: https://github.com/openai/codex.
- CorpFin v2. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/corp_fin_v2.
- cuBLAS. NVIDIA. 2026. URL: https://developer.nvidia.com/cublas.
- Damai Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. arXiv: 2401.06066 [cs.CL]. URL: https://arxiv.org/abs/2401.06066.
- Tri Dao and Albert Gu. “Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality”. In: CoRR abs/2405.21060 (2024). DOI: 10.48550/ARXIV.2405.21060. arXiv: 2405.21060. URL: https://doi.org/10.48550/arXiv.2405.21060.
- Dao AI Lab. ReplaySSM: Cache SSM Inputs, Not State. https://tridao.me/blog/2026/replayssm/. June 2026.
- Yann N. Dauphin et al. “Language Modeling with Gated Convolutional Networks”. In: Proceedings of the 34th International Conference on Machine Learning. Vol. 70. Proceedings of Machine Learning Research. PMLR, 2017, pp. 933–941. URL: https://proceedings.mlr.press/v70/dauphin17a.html.
- Soham De et al. Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models. 2024. arXiv: 2402.19427 [cs.LG]. URL: https://arxiv.org/abs/2402.19427.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. arXiv: 2405.04434 [cs.CL]. URL: https://arxiv.org/abs/2405.04434.
- DeepSeek-AI. “DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence”. In: arXiv preprint arXiv:2606.19348 (2026).
- DeepSeek-AI et al. DeepSeek-V3 Technical Report. 2024. arXiv: 2412.19437 [cs.CL]. URL: https:// arxiv.org/abs/2412.19437.
- DeepSWE Benchmark. Datacurve. 2026. URL: https://deepswe.datacurve.ai/.
- Venmugil Elango et al. LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts. 2026. arXiv: 2601.18089 [cs.LG]. URL: https://arxiv.org/abs/2601.18089.
- William Fedus, Barret Zoph, and Noam Shazeer. “Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity”. In: Journal of Machine Learning Research 23.120 (2022), pp. 1–39.
- Weiqi Feng et al. “Optimus: Accelerating Large-Scale Multi-Modal LLM Training by Bubble Exploitation”. In: 2025 USENIX Annual Technical Conference (USENIX ATC 25). Boston, MA: USENIX Association, July 2025, pp. 161–177. ISBN: 978-1-939133-48-9. URL: https://www.usenix.org/conference/atc25/ presentation/feng.
- Finance Agent v2. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/fabv2.
- FrontierSWE. 2026. URL: https://www.frontierswe.com/.
- Chaoyou Fu et al. Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis. 2024. arXiv: 2405.21075 [cs.CV]. URL: https://arxiv.org/abs/2405.21075.
- GLM-5.2. Z.ai. 2026. URL: https://z.ai/blog/glm-5.2.
- GPT-5.5. OpenAI. 2026. URL: https://openai.com/index/introducing-gpt-5-5/.
- GPT-5.6 Sol. OpenAI. 2026. URL: https://openai.com/index/previewing-gpt-5-6-sol/.
- Daya Guo et al. “DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning”. In: Nature 645.8081 (2025), pp. 633–638. ISSN: 1476-4687. DOI: 10 . 1038 / s41586 - 025 - 09422 - z. URL: http : //dx.doi.org/10.1038/s41586-025-09422-z.
- Wentao Guo et al. SonicMoE: Accelerating MoE with IO and Tile-aware Optimizations. 2025. arXiv: 2512. 14080 [cs.LG]. URL: https://arxiv.org/abs/2512.14080.
- Harvey LAB: Legal Agent Benchmark. Harvey. 2026. URL: https://www.harvey.ai/blog/introducing- harveys-legal-agent-benchmark.
- Kaiming He et al. Deep Residual Learning for Image Recognition. 2015. arXiv: 1512.03385 [cs.CV]. URL: https://arxiv.org/abs/1512.03385.
- Hermes Agent. Nous Research. 2026. URL: https://hermes-agent.nousresearch.com/docs/.
- Jordan Hoffmann et al. Training Compute-Optimal Large Language Models. 2022. arXiv: 2203 . 15556 [cs.CL]. URL: https://arxiv.org/abs/2203.15556.
- Shengding Hu, Yuge Tu, Xu Han, et al. “MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies”. In: (2024). arXiv: 2404.06395 [cs.CL].
- Ailin Huang, Ang Li, Aobo Kong, et al. “Step 3.5 Flash: Open Frontier-Level Intelligence with 11B Active Parameters”. In: arXiv preprint arXiv:2602.10604 (2026).
- Yanping Huang et al. “Gpipe: Efficient training of giant neural networks using pipeline parallelism”. In: Advances in neural information processing systems 32 (2019).
- Benoit Jacob et al. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference”. In: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR). 2018, pp. 2704–2713.
- Sam Ade Jacobs et al. DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models. 2023. arXiv: 2309.14509 [cs.LG]. URL: https://arxiv.org/abs/2309. 14509.
- Peijie Jiang et al. PowLU: An Activation Function for Stable Pre-Training of LLMs. 2026. arXiv: 2605.25704 [cs.CL]. URL: https://arxiv.org/abs/2605.25704.
- JobBench: Aligning Agent Work with Human Will. July 24, 2026. URL: https://job-bench.github.io/.
- Keller Jordan et al. Muon: An Optimizer for Hidden Layers in Neural Networks. 2024. URL: https : / / kellerjordan.github.io/posts/muon/.
- Jared Kaplan et al. Scaling Laws for Neural Language Models. 2020. arXiv: 2001.08361 [cs.LG]. URL: https://arxiv.org/abs/2001.08361.
- Angelos Katharopoulos et al. “Transformers are RNNs: Fast Autoregressive Transformers with Linear Atten- tion”. In: Proceedings of ICML. Ed. by Hal Daumé III and Aarti Singh. PMLR, 2020, pp. 5156–5165. URL: https://proceedings.mlr.press/v119/katharopoulos20a.html.
- Kimi CLI. Moonshot AI. 2026. URL: https://www.kimi.com/code.
- Kimi Team. Attention Residuals. Preprint. 2026.
- Kimi Team. Kimi K2: Open Agentic Intelligence. 2025. arXiv: 2507.20534 [cs.LG].
- Kimi Team. “Kimi K2.5: Visual Agentic Intelligence”. In: arXiv preprint arXiv:2602.02276 (2026). com/blog/kimi-k3.
- Kimi Team. Kimi K3: Open Frontier Intelligence. Moonshot AI. July 16, 2026. URL: https://www.kimi.com/blog/kimi-k3.
- Kimi Team. “Kimi-vl technical report”. In: arXiv preprint arXiv:2504.07491 (2025).
- Kimi Team. PerceptionBench: Evaluating Atomic Visual Perception in Multimodal Large Language Models. 2026. arXiv: 2607.24957 [cs.CV]. URL: https://arxiv.org/abs/2607.24957.
- Kimi Team et al. Kimi Linear: An Expressive, Efficient Attention Architecture. 2025. arXiv: 2510.26692 [cs.CL].
- Chris Lattner et al. “MLIR: Scaling Compiler Infrastructure for Domain Specific Computation”. In: 2021 IEEE/ACM International Symposium on Code Generation and Optimization (CGO). 2021, pp. 2–14. DOI: 10.1109/CGO51591.2021.9370308.
- Legal Research Bench. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/legal_research.
- Dmitry Lepikhin et al. “Gshard: Scaling giant models with conditional computation and automatic sharding”. In: arXiv preprint arXiv:2006.16668 (2020).
- Mike Lewis et al. “BASE Layers: Simplifying Training of Large, Sparse Models”. In: Proceedings of ICML. 2021.
- Huiba Li et al. “DADI: Block-Level Image Service for Agile and Elastic Application Deployment”. In: 2020 USENIX Annual Technical Conference (USENIX ATC). 2020, pp. 727–740.
- Junlong Li et al. The Tool Decathlon: Benchmarking Language Agents for Diverse, Realistic, and Long-Horizon Task Execution. ICLR 2026. 2025. arXiv: 2510.25726 [cs.CL].
- Yuetai Li et al. “JobBench: Aligning Agent Work With Human Will”. In: (2026). arXiv: 2605.26329 [cs.AI].
- Yuhui Li et al. EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test. 2025. arXiv: 2503.01840 [cs.CL]. URL: https://arxiv.org/abs/2503.01840.
- Hao Liu, Matei Zaharia, and Pieter Abbeel. “Ring Attention with Blockwise Transformers for Near-Infinite Context”. In: (2023). arXiv: 2310.01889 [cs.CL]. URL: https://arxiv.org/abs/2310.01889.
- Jingyuan Liu et al. Muon is Scalable for LLM Training. 2025. arXiv: 2502.16982 [cs.LG]. URL: https: //arxiv.org/abs/2502.16982.
- LMArena Leaderboard. LMArena. 2026. URL: https://lmarena.ai/leaderboard.
- Kevin Lu and Thinking Machines Lab. On-policy distillation. Thinking Machines Lab: Connectionism. 2025. URL : https://thinkingmachines.ai/blog/on-policy-distillation/.
- Bohan Lyu et al. “MLS-Bench: A Holistic and Rigorous Assessment of AI Systems on Building Better AI”. In: (2026). arXiv: 2605.08678 [cs.LG].
- Eric Martin and Chris Cundy. “Parallelizing Linear Recurrent Neural Nets Over Sequence Length”. In: Pro- ceedings of ICLR. 2018. URL: https://openreview.net/forum?id=HyUNwulC-.
- Mike A Merrill et al. “Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces”. In: arXiv preprint arXiv:2601.11868 (2026).
- Maxim Milakov and Natalia Gimelshein. Online normalizer calculation for softmax. 2018. arXiv: 1805.02867 [cs.PF]. URL: https://arxiv.org/abs/1805.02867.
- Nangate, Inc. Nangate 45nm Open Cell Library. https : / / si2 . org / open - cell - library/. Version PDKv1_3_v2010_12. Donated to and distributed by the Silicon Integration Initiative (Si2). 2010. (Visited on 07/27/2026).
- Deepak Narayanan et al. “Efficient large-scale language model training on gpu clusters using megatron-lm”. In: Proceedings of the international conference for high performance computing, networking, storage and analysis. 2021, pp. 1–15.
- NCCL: The NVIDIA Collective Communications Library. NVIDIA. 2026. URL: https://developer.nvidia. com/nccl.
- OpenAI. Introducing OpenAI o3 and o4-mini. Apr. 2025. URL: https://openai.com/index/introducing- o3-and-o4-mini/.
- OpenAI. Learning to Reason with LLMs. https://openai.com/index/learning- to- reason- with- llms/. Accessed: 2026-07-23. 2024.
- OpenAI Harmony Response Format. OpenAI. 2025. URL: https://github.com/openai/harmony.
- OpenClaw. OpenClaw. 2026. URL: https://docs.openclaw.ai/.
- Krista Opsahl-Ong et al. “OfficeQA Pro: An Enterprise Benchmark for End-to-End Grounded Reasoning”. In: (2026). arXiv: 2603.08655.
- Linke Ouyang et al. OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations. 2025. arXiv: 2412.07626 [cs.CV]. URL: https://arxiv.org/abs/2412.07626.
- Adam Paszke et al. PyTorch: An Imperative Style, High-Performance Deep Learning Library. 2019. arXiv: 1912.01703 [cs.LG].
- Tejal Patwardhan et al. GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks. 2025. arXiv: 2510.04374 [cs.LG]. URL: https://arxiv.org/abs/2510.04374.
- Bo Peng et al. RWKV-7 "Goose" with Expressive Dynamic State Evolution. 2025. arXiv: 2503.14456 [cs.CL].
- Bowen Peng et al. “Yarn: Efficient context window extension of large language models”. In: arXiv preprint arXiv:2309.00071 (2023).
- Long Phan et al. Humanity’s Last Exam. 2025. arXiv: 2501.14249 [cs.LG]. URL: https://arxiv.org/ abs/2501.14249.
- PostTrainBench. 2026. URL: https://posttrainbench.com/.
- ProgramBench. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/programbench.
- Ruoyu Qin et al. Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving. 2024. arXiv: 2407.00079 [cs.DC].
- Zhen Qin et al. HGRN2: Gated Linear RNNs with State Expansion. 2024. arXiv: 2404.07904 [cs.CL]. URL: https://arxiv.org/abs/2404.07904.
- Haiquan Qiu and Quanming Yao. “Why Low-Precision Transformer Training Fails: An Analysis on Flash Attention”. In: International Conference on Learning Representations (ICLR). 2026. arXiv: 2510.04212 [cs.LG].
- Zihan Qiu et al. Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free. 2025. arXiv: 2505.06708 [cs.CL].
- Samyam Rajbhandari et al. “Zero: Memory optimizations toward training trillion parameter models”. In: SC20: International Conference for High Performance Computing, Networking, Storage and Analysis. IEEE. 2020, pp. 1–16.
- David Rein et al. “Gpqa: A graduate-level google-proof q&a benchmark”. In: First Conference on Language Modeling. 2024.
- Jonathan Roberts et al. ZeroBench: An Impossible Visual Benchmark for Contemporary Large Multimodal Models. 2025. arXiv: 2502.09696 [cs.CV]. URL: https://arxiv.org/abs/2502.09696.
- Bita Darvish Rouhani et al. “Microscaling Data Formats for Deep Learning”. In: arXiv preprint arXiv:2310.10537 (2023). arXiv: 2310.10537 [cs.LG].
- Alexander Samarin et al. LK Losses: Direct Acceptance Rate Optimization for Speculative Decoding. 2026. arXiv: 2602.23881 [cs.LG]. URL: https://arxiv.org/abs/2602.23881.
- Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. “Linear Transformers Are Secretly Fast Weight Program- mers”. In: Proceedings of ICML. Ed. by Marina Meila and Tong Zhang. PMLR, 2021, pp. 9355–9366. URL: https://proceedings.mlr.press/v139/schlag21a.html.
- Manasi Sharma et al. “ResearchRubrics: A Benchmark of Prompts and Rubrics For Evaluating Deep Research Agents”. In: The Fourteenth International Conference on Learning Representations. 2026. URL: https : //openreview.net/forum?id=ErnvfmSX0P.
- Noam Shazeer. GLU Variants Improve Transformer. 2020. arXiv: 2002 . 05202 [cs.LG]. URL: https : //arxiv.org/abs/2002.05202.
- Daniel Shepard and Robin Salimans. “AutomationBench”. In: (2026). arXiv: 2604.18934 [cs.AI].
- Kean Shi et al. SaaS-Bench: Can Computer-Use Agents Leverage Real-World SaaS to Solve Professional Workflows? 2026. arXiv: 2605.15777 [cs.AI]. URL: https://arxiv.org/abs/2605.15777.
- Benjamin F. Spector et al. “ThunderKittens: Simple, Fast, and Adorable Kernels”. In: The Thirteenth Inter- national Conference on Learning Representations. 2025. URL: https://openreview.net/forum?id= 0fJfVOSUra.
- Jianlin Su. Muon Optimizer Guide: Quick Start and Key Details. Blog post (in Chinese). Nov. 2025. URL: https://kexue.fm/archives/11416.
- Jianlin Su. Travels in MoE: 6. Promoting Load Balance via Optimal Assignment. Blog post (in Chinese). Feb. 2026. URL: https://spaces.ac.cn/archives/11619.
- Hanchi Sun et al. Expert Threshold Routing for Autoregressive Language Modeling with Dynamic Computation Allocation and Load Balancing. 2026. arXiv: 2603.11535 [cs.AI].
- Weigao Sun et al. “LASP-2: Rethinking Sequence Parallelism for Linear Attention and Its Hybrid”. In: (2025). arXiv: 2502.07563 [cs.LG]. URL: https://arxiv.org/abs/2502.07563.
- Weigao Sun et al. “Linear Attention Sequence Parallelism”. In: (2024). arXiv: 2404.02882 [cs.LG]. URL: https://arxiv.org/abs/2404.02882.
- Yiyou Sun et al. Agents’ Last Exam. 2026. arXiv: 2606.05405 [cs.AI]. URL: https://arxiv.org/abs/ 2606.05405.
- Yuan Sun. Binary-Integer-Programming Based Algorithm for Expert Load Balancing in Mixture-of-Experts Models. 2025. arXiv: 2502.15451 [cs.LG].
- SWE Marathon. 2026. URL: https://www.swe-marathon.org/.
- Kimi Team. Kimi k1.5: Scaling Reinforcement Learning with LLMs. 2025. arXiv: 2501.12599 [cs.AI]. URL: https://arxiv.org/abs/2501.12599.
- The Tool Decathlon: Benchmarking Language Agents for Diverse, Realistic, and Long-Horizon Task Execution. July 24, 2026. URL: https://toolathlon.xyz/introduction.
- Thinking Machines Lab. Inkling: Our Open-Weights Model. https : / / thinkingmachines . ai / news / introducing-inkling/. Accessed: 2026-07-23. July 2026.
- Minyang Tian et al. SciCode: A Research Coding Benchmark Curated by Scientists. 2024. arXiv: 2407.13168 [cs.AI]. URL: https://arxiv.org/abs/2407.13168.
- Philippe Tillet, Hsiang-Tsung Kung, and David Cox. “Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations”. In: Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages (MAPL). 2019.
- UK AI Security Institute and U.S. Center for AI Standards and Innovation. Preliminary Assessment of Kimi K3’s Cyber Capabilities. https://www.aisi.gov.uk/blog/preliminary-assessment-of-kimi-k3s- cyber-capabilities. July 2026.
- Vals AI. Vals AI. 2026. URL: https://www.vals.ai/.
- Ashish Vaswani et al. “Attention is All you Need”. In: Advances in NeurIPS. Ed. by I. Guyon et al. Curran Associates, Inc., 2017. URL: https://proceedings.neurips.cc/paper_files/paper/2017/file/ 3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf.
- Nikhita Vedula et al. DeepSearchQA: Bridging the Comprehensiveness Gap for Deep Research Agents. 2025. URL: https://storage.googleapis.com/deepmind- media/DeepSearchQA/DeepSearchQA_ benchmark_paper.pdf.
- Bertie Vidgen et al. APEX-Agents. 2026. arXiv: 2601.14242 [cs.CL].
- Ke Wang et al. “Measuring Multimodal Mathematical Reasoning with MATH-Vision Dataset”. In: Advances in NeurIPS. Ed. by A. Globerson et al. Vol. 37. Curran Associates, Inc., 2024, pp. 95095–95169. DOI: 10. 52202/079017-3014. URL: https://proceedings.neurips.cc/paper_files/paper/2024/file/ ad0edc7d5fa1a783f063646968b7315b-Paper-Datasets_and_Benchmarks_Track.pdf.
- Lei Wang et al. “TileLang: A Composable Tiled Programming Model for AI Systems”. In: arXiv preprint arXiv:2504.17577 (2025). URL: https://arxiv.org/abs/2504.17577.
- Zirui Wang et al. CharXiv: Charting Gaps in Realistic Chart Understanding in Multimodal LLMs. 2024. arXiv: 2406.18521 [cs.CL]. URL: https://arxiv.org/abs/2406.18521.
- Jason Wei et al. BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents. 2025. arXiv: 2504.12516 [cs.CL]. URL: https://arxiv.org/abs/2504.12516.
- Xinming Wei et al. UltraEP: Unleash MoE Training and Inference on Rack-Scale Nodes with Near-Optimal Load Balancing. 2026. arXiv: 2606.04101 [cs.DC]. URL: https://arxiv.org/abs/2606.04101.
- Zijian Wu et al. “MCPMark: A benchmark for stress-testing realistic and comprehensive mcp use”. In: arXiv preprint arXiv:2509.24002 (2025).
- B. Xiao et al. “MiMo-V2-Flash Technical Report”. In: arXiv preprint arXiv:2601.02780 (2026).
- Xiaomi MiMo Team. MiMo-V2.5-Pro. https://huggingface.co/collections/XiaomiMiMo/mimo-v25. 2026.
- Tianbao Xie et al. “Introducing OSWorld-Verified”. In: xlang.ai (July 2025). URL: https://xlang.ai/blog/ osworld-verified.
- Zijie Yan et al. Scalable Training of Mixture-of-Experts Models with Megatron Core. 2026. arXiv: 2603.07685 [cs.DC]. URL: https://arxiv.org/abs/2603.07685.
- Songlin Yang, Jan Kautz, and Ali Hatamizadeh. “Gated Delta Networks: Improving Mamba2 with Delta Rule”. In: Proceedings of ICLR. 2025. URL: https://openreview.net/forum?id=r8H7xhYPwz.
- Songlin Yang and Yu Zhang. FLA: A Triton-Based Library for Hardware-Efficient Implementations of Linear Attention Mechanism. Jan. 2024. URL: https://github.com/fla-org/flash-linear-attention.
- Songlin Yang et al. “Gated Linear Attention Transformers with Hardware-Efficient Training”. In: Proceedings of ICML. PMLR, 2024.
- Songlin Yang et al. “Parallelizing Linear Transformers with the Delta Rule over Sequence Length”. In: Proceedings of NeurIPS. 2024.
- Yaoyu Wang. Context Parallelism for DeltaNet. 2025. URL: https://yywangcs.notion.site/DeltaNet- 2a9fc9f5d8058013a498f34e0b25bd52.
- Mengqi Yuan et al. OSWorld2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks. 2026. arXiv: 2606.29537 [cs.AI]. URL: https://arxiv.org/abs/2606.29537.
- Xiang Yue et al. MMMU-Pro: A More Robust Multi-discipline Multimodal Understanding Benchmark. 2024. arXiv: 2409.02813 [cs.CL]. URL: https://arxiv.org/abs/2409.02813.
- Aohan Zeng et al. GLM-5: from Vibe Coding to Agentic Engineering. 2026. arXiv: 2602.15763 [cs.LG]. URL : https://arxiv.org/abs/2602.15763.
- Biao Zhang and Rico Sennrich. “Root mean square layer normalization”. In: Advances in NeurIPS 32 (2019).
- Chenggang Zhao et al. DeepEP: an efficient expert-parallel communication library. https://github.com/ deepseek-ai/DeepEP. 2025.
- Yilun Zhao et al. “MMVU: Measuring Expert-Level Multi-Discipline Video Understanding”. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). June 2025, pp. 8475–8489.
- Runjie Zhou et al. WorldVQA: Measuring Atomic World Knowledge in Multimodal Large Language Models. 2026. arXiv: 2602.02537 [cs.CV]. URL: https://arxiv.org/abs/2602.02537.
- Jian Zhu et al. “SpreadsheetBench 2: Evaluating Agents on End-to-End Business Spreadsheet Workflows”. In: (2026). arXiv: 2606.29955 [cs.SE].
術語對照表
| English | 繁體中文 |
|---|---|
| Activated Parameters | 啟用參數 |
| Admission Control | 准入控制 |
| Attention Residuals (AttnRes) | 注意力殘差 |
| Auxiliary-Loss-Free Routing | 無輔助損失的路由 |
| Chunkwise Parallel Form | 分塊平行形式 |
| Co-located RL | 共置式 RL |
| Context Parallelism (CP) | 上下文平行 |
| Cumulative Decay | 累積衰減 |
| Delta Rule | delta 規則 |
| Expert Parallelism (EP) | 專家平行 |
| Forget Gate | 遺忘閘 |
| Gated Delta Rule | 閘控 delta 規則 |
| Gated Linear Unit (GLU) | 閘控線性單元 |
| Harness | (agent 的)執行框架 |
| Kimi Delta Attention (KDA) | (保留原名) |
| Latent Attention (MLA) | 潛在注意力 |
| Load Balancing | 負載平衡 |
| Micro-batch | 微批次 |
| Mixture-of-Experts (MoE) | 混合專家 |
| Multi-Teacher On-Policy Distillation (MOPD) | 多教師 on-policy 蒸餾 |
| Multi-Token Prediction (MTP) | 多 token 預測 |
| Newton–Schulz Iteration | Newton–Schulz 迭代 |
| No Position Encoding (NoPE) | 無位置編碼 |
| Orthogonalization | 正交化 |
| Partial Rollout | 部分 rollout |
| Pipeline Parallelism (PP) | 流水線平行 |
| Prefix Cache | 前綴快取 |
| Pseudo-query | 偽 query |
| Quantile Balancing (QB) | 分位數平衡 |
| Quantization-Aware Training (QAT) | 量化感知訓練 |
| Reasoning Effort | 推理投入 |
| Recurrent State | 遞迴狀態 |
| Redundant Expert | 冗餘專家 |
| Reward Hacking | 獎勵駭客 |
| Rollout | (保留原文,指一次完整的取樣軌跡) |
| Router | 路由器 |
| Sandbox | (保留原文,指隔離執行環境) |
| Scaling Efficiency | scaling 效率 |
| Speculative Decoding | 推測解碼 |
| Staleness | (資料)陳舊 |
| Straggler | 落後者 |
| Tokens per Parameter (TPP) | 每參數 token 數 |
| Verifier | 驗證器 |
| Vision-in-the-Loop | 視覺回路 |