Agent Seer:從規格理解合成評測情境
原始論文:Agent Seer: Synthesizing Scenarios from Specification Understanding 作者:Harish Karumuri、Mahesh Vemula、David Lopes Pegna(Apple) arXiv ID:2608.26133v1 日期:2026 年 6 月 24 日 標籤:AI Agent Tool Use MCP Evaluation Synthetic Data LLM-as-Judge Benchmark
【譯註】本文(Apple)提出 Agent Seer——一個「只吃工具規格、就能合成 AI agent 評測情境」的四階段流程。核心觀察:工具規格本身(函式名、自然語言描述、帶型別的參數 schema)已編碼了足夠的語意資訊,不需人工策劃、也不需真的執行工具,就能合成出「有正確工具呼叫、且對話連貫」的多輪評測情境。這解決了「新/私有/快速演變的工具套件沒有現成評測資料」的冷啟動 (cold-start) 評測問題。授權 CC BY 4.0,站上公開。MCP = Model Context Protocol(Anthropic 提出的工具整合標準協定)。
摘要
評估使用外部工具的 AI 代理 (AI agent),需要能捕捉「實務工作者如何組合工具、並跨對話輪次迭代」的現實測試情境。手工構建這類情境需要深厚的領域專業、無法跨工具生態系擴展、且產生無法追蹤 API 演變的靜態基準。我們觀察到,工具規格 (tool specification)——函式名、自然語言描述、帶型別的參數 schema——已經編碼了足夠的語意資訊,無需人工策劃或即時 (live) 工具執行就能合成現實的評測情境。Agent Seer 建立在這個潛在資訊之上:僅從單一 Model Context Protocol (MCP) 規格出發,不需範例、不需即時工具存取、不需領域特定調校。這個流程豐富化原始 schema、生成帶合成工具輸出的分級情境、並把它們擴展成「以模擬資料為根基」的多輪對話,這些對話展現出強大的工具呼叫正確性與對話連貫性。我們在橫跨多樣領域與工具套件規模的七個 MCP 規格上套用此流程、量測工具呼叫正確性與對話連貫性,藉此衡量評測品質。該流程跨所有領域都達到強品質,在小型與中型規格上達到完整的工具覆蓋。分析中浮現兩個發現:參數 schema 複雜度是品質變異最強的相關因子——工具套件大小扮演較小、正交的角色——而參數值準確性 (argument value accuracy) 是不完美情境中的主要失效模式,這是一個粗粒度的「名稱比對」指標看不見的子維度。
1 引言
能自主呼叫外部工具的大型語言模型 (LLM) 代理,在企業軟體環境中的部署越來越普遍。由行事曆 API、專案管理系統、通訊平台、內部資料庫支撐的代理,正被用來自動化過去需要人工介入的工作流程。儘管代理能力快速進展,這類系統的評估仍然費力且脆弱。三個問題限制了當前代理評估的狀態:
- 策劃瓶頸 (curation bottleneck)。 現實的評測情境必須把使用者意圖連結到特定工具呼叫、用合理的值填入參數、並捕捉工具如何跨輪次串接。手工撰寫的基準能產生高保真情境,但其覆蓋受策劃工作量所限;要在工具路徑的組合空間上擴展這種努力,手工並不實際。
- 靜態基準問題 (static benchmark problem)。 一個固定的基準會隨工具 API 演變而不再反映現實。一個在快照基準上得高分的代理,可能是對照「已不符生產環境的工具描述」被評估的。
- 多輪評估落差 (multi-turn evaluation gap)。 對話代理需要跨互動序列(而非只單輪提示)評估。生成「後續輪次會回應特定工具輸出、而非重複通用指令」的多輪情境,在沒有真實工具回應的情況下特別困難。
這三者共同定義了冷啟動評測問題 (cold-start evaluation problem):為一個「沒有任何評測資料的工具套件」產生現實的評測資料。對新的、私有的、或快速演變的 API 而言短缺最尖銳,並持續存在於「包裝或擴展公開描述系統」的企業工具套件長尾中。我們藉由觀察「工具規格已編碼了合成評測資料所需的大部分語意資訊」來解決它:足以讓 LLM 推斷合理的工作流程、用現實值填入參數、合成工具回應的樣子、並構建以那些合成資料為根基的多輪對話。瓶頸從人工策劃轉移到結構化萃取。
Agent Seer 把這實現為一個四階段流程——語意詮釋、情境生成、模擬輸出合成、多輪擴展——它把原始 MCP 工具規格轉換成自足的評測框架 (harness)。每個階段消費前一階段的「經驗證的結構化輸出」,所以 schema 違規在邊界處被抓到、而非往下傳播。得到的框架與任何執行後端解耦:任何 MCP 相容的框架都能消費它們來執行並評分代理。
主要貢獻: (1) 一個「規格到框架」的生成流程,僅從 MCP 工具規格就能產生完整的評測情境(預期工具序列、校準過的模擬工具輸出、以資料為根基的多輪對話),不需即時工具執行或人工標註。(2) 一種結構化的框架產物格式(第 3.5 節),帶保留的 oracle 與模擬輸出,讓任何 MCP 相容的評測框架都能把生成情境當成自足產物來執行代理。(3) 跨七個橫跨多樣企業領域的 MCP 規格對生成品質與工具覆蓋的經驗刻畫,顯示品質變異與參數 schema 複雜度的相關性強於與工具套件大小的相關性、且在小型與中型規格上可達成完整覆蓋。(4) 一個失效模式刻畫,辨識出參數子維度串聯 (argument sub-dimension cascading) 是主要的生成失效機制——一個粗粒度名稱比對指標看不見的失效類別——並帶有描述「流程在何處與為何不足」的領域特定特徵。
2 背景與相關研究
評估工具呼叫代理需要評測資料——情境、預期工具序列、代表性工具輸出。對已建立的公開 API,這可以手工策劃或從使用日誌挖掘,但對新的、私有的、或快速演變的工具套件,並不存在這種資料,而現有的也可能無法涵蓋利基或具挑戰性的用例。即使策劃可行,辨識「重要的使用者目標」並把它們連結到「反映實務工作者如何組合工具、處理部分結果、跨輪次迭代」的工具序列,仍需深厚領域專業。Agent Seer 藉由「從結構化工具規格進行免執行 (execution-free) 的框架合成」來解決這個冷啟動落差。
- 代理基準。 代理評估已從單函式預測、經過在策劃 API 語料上的多步工具使用、進展到帶模擬使用者的多輪、政策為根基的評估。GAIA、AgentBench、WorkArena 等通用基準提供豐富的評測環境,而近期以 MCP 為中心的套件——MCPVerse、MCP-AgentBench、Toolathlon——反映 MCP 作為標準工具整合層的日益採用。所有這些基準都透過人工策劃構建、或需要即時工具存取,且一經釋出就靜態不變,冷啟動問題仍未解。
- 合成資料生成。 先前工作分三群,以其對即時工具執行的依賴區分。從即時執行的訓練軌跡: 最大的一群透過真實工具執行生成微調軌跡(APIGen 用基於執行的驗證、TOUCAN 從即時 MCP 伺服器擴展到 150 萬條軌跡等),多數需要即時工具呼叫。模擬工具環境: 第二群用模擬環境取代即時工具(訓練用 Simia、Gecko、LOGIGEN;評估用 τ-bench、τ²-bench、ToolSandbox)。僅規格生成: 一個新興群純從規格生成合成資料(DiGiT-TC 把工具呼叫序列反向翻譯成使用者請求;FuncBenchGen 用 DAG 建模的呼叫依賴定義無汙染任務基準)。
- 評估方法論。 LLM-as-judge 範式已相當成熟。對工具使用評估,先前工作用精確比對、執行成功率、單呼叫二元 AST 比對。Agent GPA 把軌跡分解成目標-計畫-行動階段但在即時任務環境上評估。FuncBenchGen 發現模型會系統性地跨串接呼叫傳播陳舊或錯誤的參數(儘管語法有效)——這是粗粒度名稱比對指標完全錯過的多步失效模式,這激發了我們此處採用的「逐參數子維度分解」。
- 定位。 Agent Seer 只吃工具規格作為輸入(像僅規格系統),但用 LLM 合成合理的工具回應、而非需要執行期環境(像評估用的模擬環境)。貢獻不在於提示驅動的生成機制(與 APIGen、TOUCAN 等共享),而在於加諸其上的結構:一個「每個邊界都有經驗證的結構化輸出」的四階段流程,產生與任何執行後端解耦的框架。
3 流程階段
流程有四個階段(schema 流見圖 2)。每個階段消費前一階段經驗證的結構化輸出;schema 約束確保畸形產物在邊界處被抓到、而非往下游傳播。
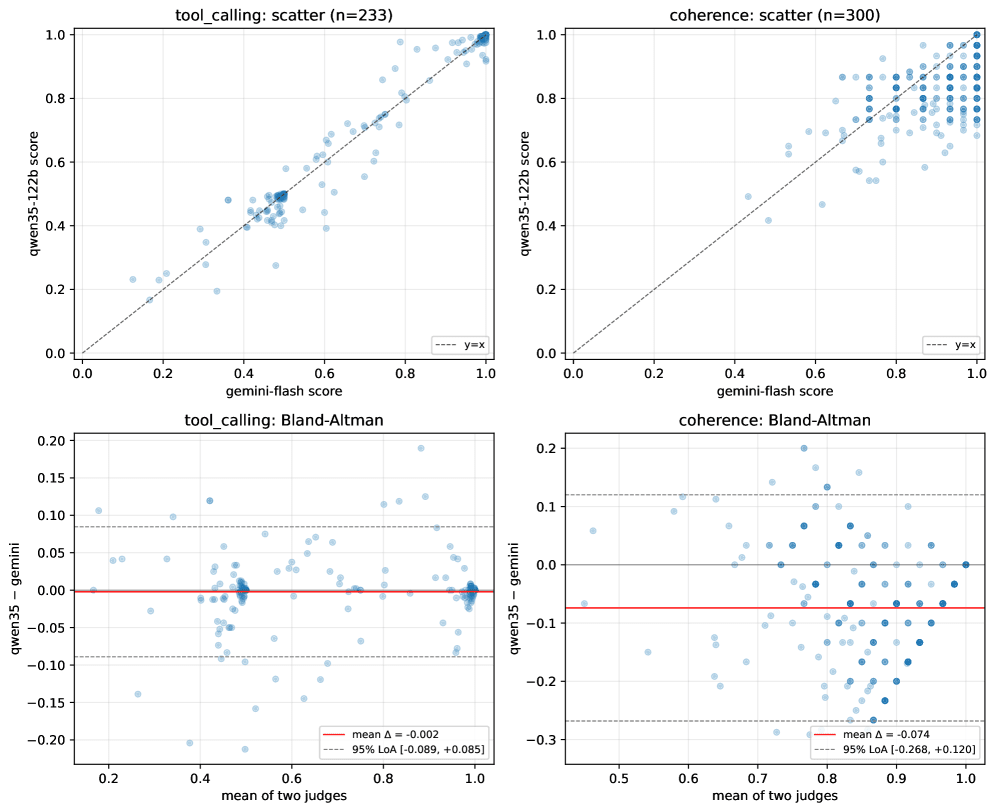
圖 2: 四個流程階段的結構化輸出 schema。實線箭頭表示資料流;虛線箭頭表示 schema 繼承(MockOutput 擴展 AgentCall,後者被 Scenario 引用)。
3.1 工具詮釋
第一階段把原始 MCP 工具規格轉換成語意豐富化的描述。對每個工具,模組向 LLM 發出一個結構化提示,要求四個語意欄位:功能描述、帶語意角色的必要參數、主要用例、以及組織脈絡。這把簡略的 API 文件連結到更豐富的情境。
3.2 情境生成
情境生成模組在兩個複雜度層級產生現實的企業工作流程情境。簡單情境 (simple) 針對日常操作任務:單一領域、短工具呼叫鏈。複雜情境 (complex) 針對新穎、多領域的工作流程,以精巧方式組合工具。兩個層級都透過提示工程而非結構約束實現。每個生成情境包含標題、面向使用者的指令、帶參數值的有序預期工具呼叫清單、新穎性解釋、以及一個自然的後續問題。輸出 schema 嵌入了結構化推理軌跡欄位:每個工具呼叫帶一個 quick_explanation(說明為何做這個呼叫),每個情境包含一個 novelty_reason(解釋其評測價值)。這些欄位強迫 LLM 在生成期間推理工具選擇與工作流程組合。
3.3 模擬輸出生成
對序列中每個函式呼叫,模組產生一個合成工具輸出。流程接受一個可選的「範例輸出」欄位,使它成為一個光譜:完全無監督地只從規格生成,但也能納入可用的軌跡以改善保真度。有提供範例時,生成器匹配其結構;沒有時,生成只仰賴工具描述。每個模擬輸出帶一個根基層級 (grounding tier)(high/medium/low),記錄參考材料的可用性。
3.4 多輪情境擴展
多輪擴展階段吃一個情境與其模擬輸出,發出一串對話輪次(提示不規定要產生多少輪)。分割針對自然的階段邊界,使得到的輪次演練 BFCL v3 形式化的兩種多輪工具呼叫模式:多步 (multi-step) 序列(每個呼叫依賴前一個的輸出)與多跳 (multi-hop) 模式(獨立呼叫蒐集必須被綜合的資訊)。在階段邊界(而非任意點)分割,能跨輪次保留這些依賴結構。當擴展只產生單一輪次時,它被丟棄(依「該情境缺乏足夠實質可分割」的啟發式)。擴展成功時,後續提示引用合成輸出的具體值——實體名、計數、狀態碼——而非抽象任務描述,產生以資料為根基的多輪對話。
3.5 框架產物格式
四個階段產生一個自足的評測框架(表 1)。下游框架呈現提示、把模擬輸出作為工具回應餵入、並把代理發出的呼叫對照「作為保留 oracle 的情境工作流程」評分——使在一個先前未見的工具套件上評測成為可能、無需即時存取。
表 1:生成的評測框架的欄位。
| 欄位 | 階段 | 內容 |
|---|---|---|
prompt |
2 | 自然語言任務目標 |
expected_tools |
2 | 有序的 AgentCall 物件(名稱 + 帶型別參數) |
mock_outputs |
3 | 每個呼叫一個帶根基層級的合成 JSON 回應 |
conversation |
4 | 多輪對話;每輪引用模擬輸出值 |
oracle |
2 | expected_tools,對代理保留以供評分 |
4 生成品質評估
我們用 LLM-as-judge 評分沿兩個互補的品質維度評估生成品質:工具呼叫正確性 (tool-calling correctness, TC) 與對話連貫性 (conversational coherence, Coh)。框架也支援「有參考資料時的 oracle 為根基評估」;此處我們專用無監督路徑,因為生成情境同時作為輸出與 oracle。
4.1 工具呼叫評分
工具呼叫評估器獨立評分四個維度,把大多數先前工作用的粗粒度通過/失敗訊號分解成正交軸。LLM 評判者對每個子維度評 0–10 分,聚合前正規化到 0–1。
- 工具使用正確性 (usage) 捕捉必要性——是否根本需要用工具——過度使用被記錄為診斷但排除於聚合外,因為必要性主導了適當性。
- 工具選擇正確性 (selection) 對所選工具的正確性、特異性、完整性取平均。
- 工具排序正確性 (ordering) 對序列邏輯、依賴處理、執行效率取平均。只呼叫一個工具時標記為不適用、並排除於輪級聚合外。
- 工具參數正確性 (arguments) 對六個子維度取平均(完整性、名稱、值、型別、格式、相關性)。透過對評判者的提示指令強制串聯懲罰 (cascading penalties):錯誤參數名或缺少必要參數會把值、型別、格式歸零;錯誤的值會串聯到型別、格式、相關性。因此單一關鍵錯誤就會使參數平均崩塌。
四個維度每輪以算術平均組合;對話分數是輪分數的算術平均。
4.2 連貫性評分
連貫性評估器評估五個子面向——邏輯流、完整性、簡潔性、主題相關性、脈絡保留——以 1–3 分制評分、正規化到 0–1、以算術平均聚合。
5 實驗評估
我們在七個公開可用的 MCP 規格上評估 Agent Seer,分析生成評測情境的品質、覆蓋與失效模式。
5.1 實驗設定
- MCP 規格。 七個開源 MCP 伺服器規格橫跨多樣領域、工具數與 schema 複雜度(表 2),來源是官方 MCP 參考伺服器儲存庫與 MCP 伺服器登錄。
- 生成模型。 所有情境用 Gemini 2.5 Flash Lite 生成(每階段啟用結構化輸出模式做 schema 約束生成,溫度 0.7)。結構化輸出驗證失敗會觸發最多三次重試,之後丟棄該記錄。
- 評估方法。 生成情境用 Gemini 2.5 Flash(溫度 0,做確定性評分)作為 LLM 評判者評分。完整語料另外用一個跨家族 (out-of-family) 評判者(Qwen3.5-122B-A10B-FP8,Alibaba)重新評分以探測評判者穩健性。
- 規模。 流程在七個 MCP 上生成 337 個情境,產生 391 個評測記錄。多輪擴展對 54 個情境成功(整體 16.0%),大幅偏向複雜情境(擴展率 30.8% vs 簡單情境 2.8%),因為擴展階段需要足夠的工作流程實質才能生成有意義的後續輪次。
表 2:用於評估的 MCP 規格。 $\bar{p}$ = 每工具平均參數數;Schema 刻畫主導的參數結構(Flat = 簡單鍵值或基元參數;Nested obj/DSL = 含巢狀物件或領域特定查詢語言;Deep opt. = 有許多可選欄位的深巢狀 schema;Flat state = 扁平參數但有狀態的序列語意;Mixed = 跨工具的扁平與結構化參數組合)。
| MCP | 領域 | 工具數 | $\bar{p}$ | Schema |
|---|---|---|---|---|
| Illustrator | 創意 | 64 | 3.6 | Nested obj |
| Selenium | 瀏覽器自動化 | 56 | 1.8 | Flat state |
| Redis | 資料儲存 | 47 | 2.1 | Flat k-v |
| Git | 版本控制 | 33 | 11.2 | Deep opt. |
| Elasticsearch | 搜尋 | 20 | 1.8 | Nested DSL |
| Slack | 通訊 | 16 | 2.2 | Mixed |
| Filesystem | 檔案操作 | 14 | 1.8 | Flat |
5.2 品質結果
整體品質。 流程達到無監督工具呼叫平均分 0.911(95% bootstrap CI [0.897, 0.925];中位數 0.979)與連貫性平均 0.855(95% CI [0.838, 0.872];中位數 0.933)。31.7% 的記錄達到完美工具呼叫分,只有 2.3% 低於 0.5。分布集中在上半段,反映跨規格一致的生成品質。
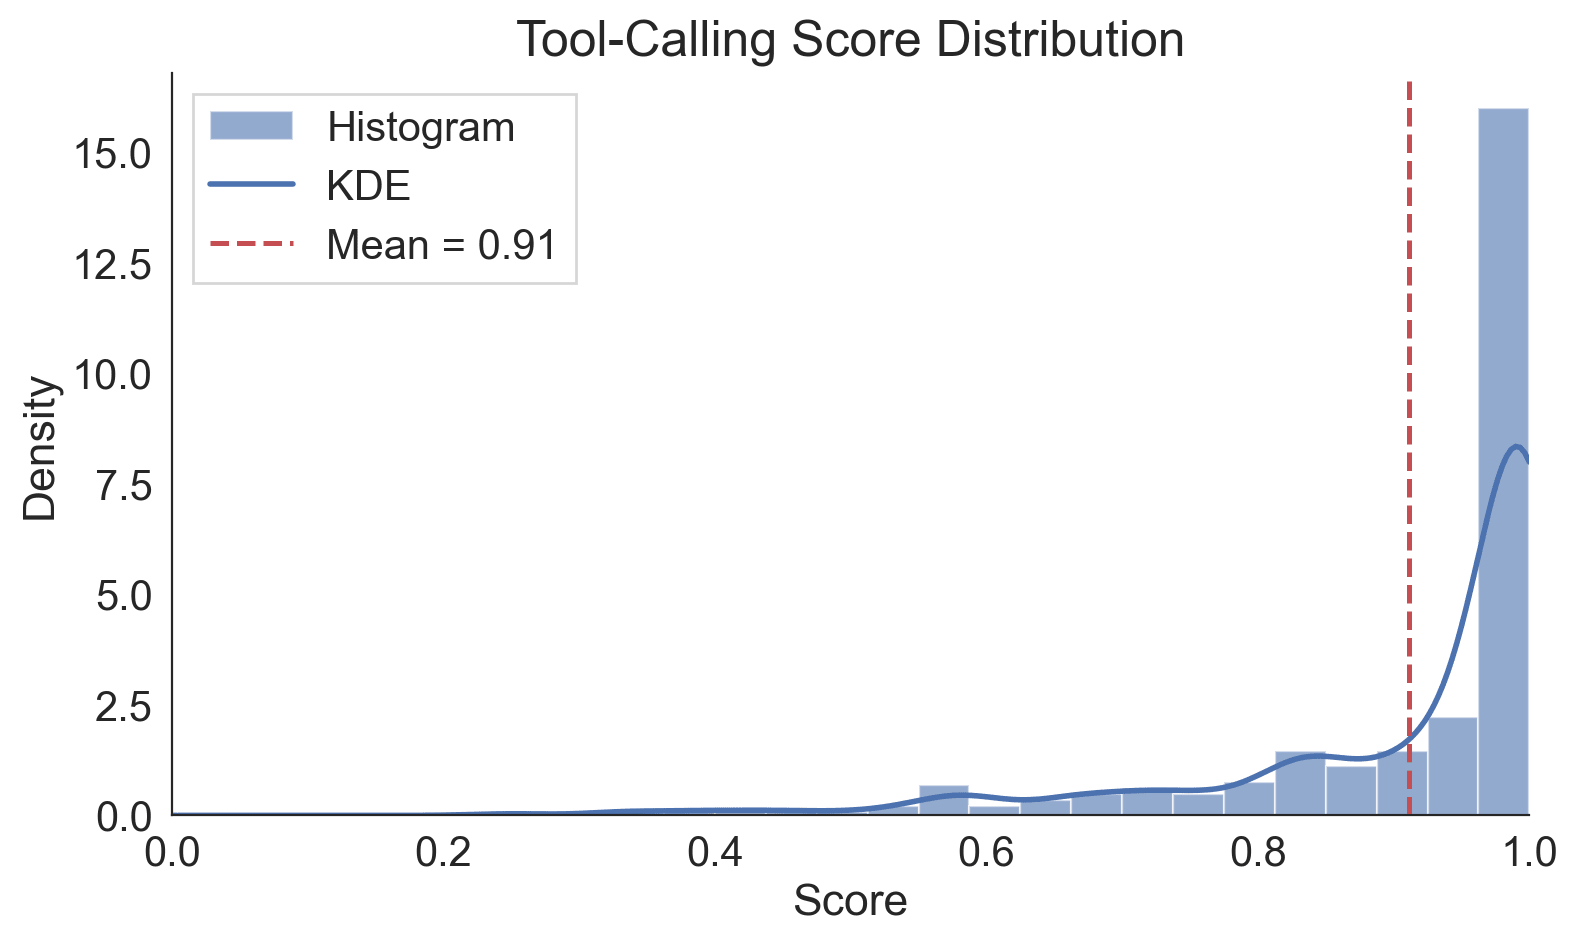
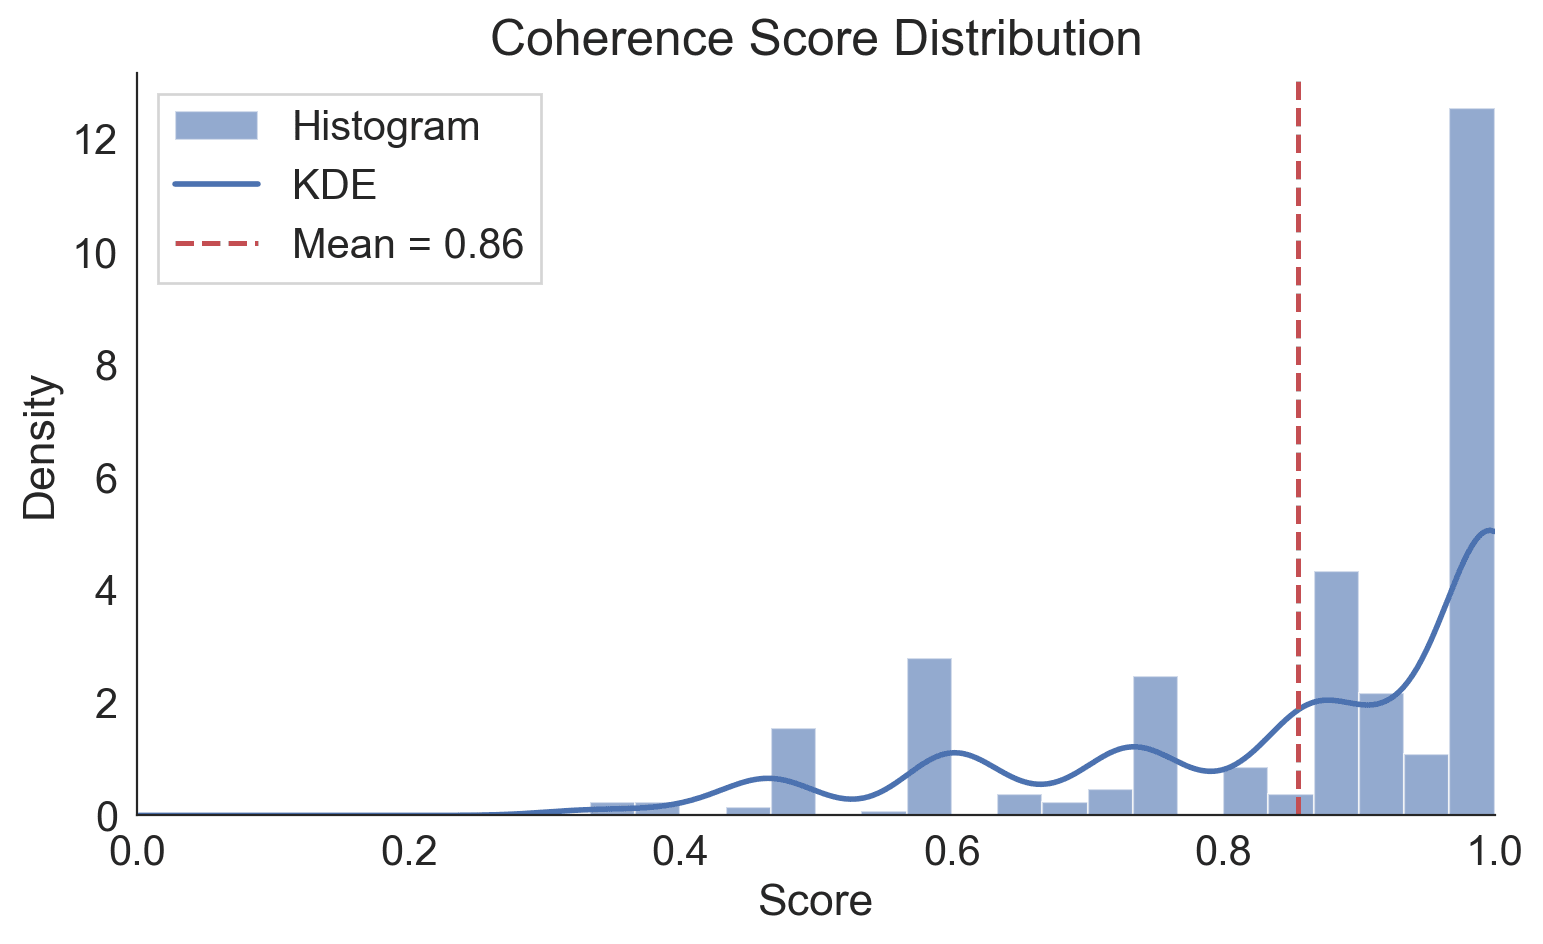
圖 3: 全部 391 個評測記錄的分數分布(上:工具呼叫分數與 KDE;下:連貫性分數與 KDE)。
跨家族共同評估。 為檢查這些分數反映生成資料而非單一評判者家族,語料被跨家族評判者(Qwen3.5)重新評分。工具呼叫在每個粒度都一致:無均值偏移($\Delta\mu_{\text{TC}}\approx 0$)、記錄級配對 $r=0.79$、七個 MCP 的每-MCP CI 都重疊、MCP 排名保留($\rho=0.86$)。失效模式分類雙邊複製:參數值準確性是兩個評判者下的主要子失效、差距 4–5 倍。兩個評判者在連貫性的絕對水準上分歧($\Delta\mu_{\text{Coh}}\approx -0.16$、配對 $r=0.42$),因此連貫性水準以「依評判者而定」回報。
依 MCP 規格的品質。 表 3 報告每-MCP 分數。工具數與參數 schema 複雜度在此樣本的品質變異中扮演不同、正交的角色。在每-MCP 粒度($n=7$),工具數正相關但幅度中等($r=+0.40$),而參數 schema 複雜度負相關——每工具平均參數($r=-0.60$)與可選參數比例($r=-0.66$)。兩個效應作用於 MCP 的不同軸、不會抵消:Selenium(56 工具)得 0.935、Filesystem(14 工具)得 0.876,但 Git(33 工具、平均 11.2 參數)最低、僅 0.857。工具層級的細分($n=222$)確認了 schema 複雜度方向($p<0.001$)。連貫性說的是不同的故事:Slack 連貫性最高(0.938,因其情境遵循結構化訊息模式產生自然對話流),Git 最低(0.757,因版本控制工作流程涉及帶技術脈絡的複雜多步操作)。TC 與連貫性在評測單位上仍弱相關(記錄級 $r=+0.23$),提供大致獨立的診斷訊號。
表 3:各 MCP 的無監督分數。 TC = 工具呼叫,Coh = 連貫性,Simp. = 簡單情境 TC,$\bar{w}$ = 平均工作流程長度(每情境工具數)。95% 區間為百分位 bootstrap($B=10{,}000$)。七個 MCP 整體都超過 0.85、簡單情境都超過 0.91。
| MCP | $n$ | TC [95% CI] | $\sigma$ | Coh [95% CI] | Simp. | $\bar{w}$ |
|---|---|---|---|---|---|---|
| Illustrator (64t) | 36 | 0.898 [.85,.94] | 0.131 | 0.855 [.80,.91] | 0.934 | 3.3 |
| Selenium (56t) | 47 | 0.935 [.90,.96] | 0.095 | 0.850 [.80,.90] | 0.932 | 9.7 |
| Redis (47t) | 98 | 0.966 [.95,.98] | 0.089 | 0.902 [.87,.93] | 0.986 | 1.3 |
| Git (33t) | 85 | 0.857 [.82,.90] | 0.186 | 0.757 [.71,.80] | 0.910 | 2.2 |
| Elasticsearch (20t) | 49 | 0.930 [.90,.96] | 0.108 | 0.902 [.86,.94] | 0.987 | 1.9 |
| Slack (16t) | 35 | 0.886 [.84,.93] | 0.135 | 0.938 [.91,.97] | 0.934 | 1.4 |
| Filesystem (14t) | 41 | 0.876 [.82,.92] | 0.163 | 0.825 [.77,.87] | 0.925 | 2.0 |
複雜度分解。 複雜情境相對簡單情境在工具呼叫上退化 −7.3pp(0.949 → 0.877)、連貫性 −5.3pp(0.883 → 0.830),兩個維度的簡單/複雜 CI 都不重疊。效果依領域而異:Elasticsearch 退化最大(−12.2pp)、Git 次之(−11.1pp)。Selenium 穩定(0.932 → 0.935),暗示其長序列工作流程在更高複雜度下也不更難組合。
5.3 失效模式分析
工具呼叫維度失效。 表 4 報告每維度失效率。使用近乎完美;選擇在 77% 記錄上正確(4% 為零,反映在語意相似工具間選擇的成本);排序在 10% 的多工具情境上失敗。參數正確性是主要挑戰:只有 42% 記錄得滿分、57% 得部分分,由「降低分數但不使其崩塌」的值準確性錯誤驅動。
表 4:工具呼叫維度失效率。 † 排序只在呼叫多個工具時評估($n=181$)。
| 維度 | 完美 | 部分 | 零 |
|---|---|---|---|
| 使用 (Usage) | 98% | 1% | 1% |
| 選擇 (Selection) | 77% | 19% | 4% |
| 排序 (Ordering)† | 71% | 19% | 10% |
| 參數 (Arguments) | 42% | 57% | 1% |
參數失效模式。 值準確性主導參數失效(223 記錄),其次為相關性(44)、格式(35)、型別(31)、完整性(16)、名稱準確性(11)。流程可靠地生成正確的參數名與型別,但在精確的值上掙扎,尤其是語意模糊的可選參數。
兩個示例失效:
- Redis 參數模糊。 Redis 的幾個命令帶「當脈絡暗示時流程會省略」的可選參數。例如
set工具接受一個可選的expiration欄位,情境暗示有時限儲存時常被跳過。流程一貫生成正確的函式名、key、value 但省略這個過期參數,被參數評分框架標記為完整性子維度失效;粗粒度名稱比對指標會把這些記錄評為完全正確。這說明了為何參數正確性必須被分解到函式呼叫層級之下。 - Git 的兩個機制。 Git 失效分解成兩個在不同情境複雜度運作的機制。第一,可在簡單情境觀察到的是工具名幻覺:在三個 Git 情境中流程發出了「不在 MCP 規格內」的真實 Git CLI 命令(
fetch、revert、filter-repo),一種越過規格的預訓練知識洩漏。第二,可在複雜情境觀察到的是參數超載——局限於特定高參數工具。Git 工具平均 11.2 參數(下一名的 3 倍)、95% 可選,且ref參數出現在七個工具中、語意各不同(log 中「從哪個 commit 開始」、diff 中「與什麼比較」、show 中「顯示哪個物件」)。流程選對工具(選擇分 0.802)但生成錯誤參數值,產生任何 MCP 中最低的平均參數分 0.780。
連貫性分類與跨維度模式。 最頻繁的連貫性問題是「缺資訊或回應淺薄」(373 記錄)、離題(130)、非邏輯跳接(86)、自相矛盾或幻覺(85)。記錄級 TC 與 Coh 仍弱相關($r=0.23$),而「工具對、但連貫性差」的象限(0.75 閾值下佔 23% 記錄)橫跨所有 MCP、而非集中於單一領域——連貫性不足是流程的一個普遍性質。
5.4 領域群集分析
按目標系統類型把 MCP 分組,讓每群內的結構差異充當一個自然實驗。資料儲存(Redis、Elasticsearch)配對近乎相同的檔案、產生近乎相同的品質(ΔTC 0.036)。開發者/檔案(Filesystem、Git)橫跨 6 倍的參數密度差(1.8 vs 11.2),但 TC 只差 0.019,成本局限於參數正確性(Git 0.780、Filesystem 0.894),強選擇與排序補償了它。應用/UI(Illustrator、Selenium)是語意上最遠的一對:Selenium(0.935 TC,56 工具)勝過 Illustrator(0.898 TC,64 工具),因為其低參數密度使長序列鏈中的參數生成可靠。
5.5 覆蓋與多樣性
工具覆蓋。 表 5 報告被演練工具的比例。在小到中的範圍內(14–56 工具),Redis、Selenium、Git、Elasticsearch、Slack、Filesystem 的每個工具都出現在至少一個生成情境中。唯一超出該範圍的規格 Illustrator(64 工具)達 56%——本實驗中唯一的覆蓋天花板證據。
表 5:工具覆蓋與使用均勻性。 Gini 係數量測不均(越低越均勻)。
| MCP | 規格工具數 | 用到 | 覆蓋 | Gini |
|---|---|---|---|---|
| Illustrator | 64 | 36 | 56% | 0.331 |
| Selenium | 56 | 56 | 100% | 0.676 |
| Redis | 47 | 47 | 100% | 0.146 |
| Git | 33 | 33 | 100% | 0.340 |
| Elasticsearch | 20 | 20 | 100% | 0.198 |
| Slack | 16 | 16 | 100% | 0.177 |
| Filesystem | 14 | 14 | 100% | 0.294 |
使用均勻性。 各 MCP 工具使用頻率分布的 Gini 係數從 0.146(Redis)到 0.340(Git)——近乎均勻取樣。Selenium 是離群值(0.676),其長序列工作流程(平均 9.7 呼叫)把使用集中在核心導覽與互動工具上。跨所有 MCP,流程從 138 個多工具情境產生 781 個獨特共現對、108 個獨特情境類別。
5.6 發現總結
跨七個 MCP 的 337 個情境,流程達到平均 TC 0.911、平均連貫性 0.855,在小型與中型規格上完整工具覆蓋。主要觀察:(1) 參數 schema 複雜度是此樣本品質變異最強的相關因子;工具套件大小扮演較小、正交的角色。(2) 七個 MCP 在簡單情境上都超過 0.91(含平均 11.2 參數的 Git),複雜情境平均退化 7.3pp。(3) TC 與連貫性提供大致獨立的診斷訊號,帶特徵性反轉(Slack 高連貫低 TC;Selenium 最佳排序)。(4) 參數正確性是主要挑戰:57% 記錄在參數上得部分分、值準確性主導。(5) 頭條的工具呼叫與主要的參數值準確性失效模式對跨家族評判者交換是穩健的(TC 配對 $r\approx 0.79$、MCP 排名 $\rho=0.86$);絕對連貫性水準與 MCP 級連貫性排名保留則依評判者而定。
6 結論
我們提出 Agent Seer,一個把 MCP 工具規格轉換成完整評測框架(分級情境、模擬工具輸出、多輪對話)的四階段流程,不需即時工具執行或人工標註。跨七個結構多樣的規格,流程在小型與中型 MCP 上達到完整工具覆蓋,並浮現一致的診斷模式:參數 schema 複雜度是此樣本品質變異最強的相關因子,而參數值準確性是主要的剩餘子失效。這些發現基於 $n=7$ 個規格,應被讀作實驗內的觀察而非普遍宣稱;持久的貢獻是這個方法論——它把框架產生為可重用的產物,能餵入即時工具環境或模擬代理,為 MCP 相容的工具套件關閉冷啟動評測落差。
限制
- 標準答案可靠性。 最顯著的限制是仰賴 LLM 生成的標準答案,這引入了生成模型的系統性偏誤。此框架最好被理解為一個「辨識廣泛能力落差與相對效能差異」的代理 (proxy) 評估工具。
- 跨呼叫指涉完整性。 序列呼叫的模擬輸出目前獨立生成,意謂 ID 或值可能在依賴呼叫間不對齊。跨工作流程的共享狀態字典可解決這點。
- 覆蓋天花板。 在 64 工具(Illustrator)時覆蓋降到 56%。更大的規格需要有針對性的生成策略(如帶覆蓋感知工具取樣的迭代生成)。
- 規格範圍。 跨領域框架生成與跨多個 MCP 規格的分析在現有流程內結構上也直接可行,但超出本評估範圍。擴展到其他規格格式(OpenAPI、gRPC、函式呼叫 schema)同樣結構上直接——同樣的「名稱 + 帶型別參數」骨架都在。
- 複雜度分層。 簡單/複雜的區分用提示框架而非結構強制。基於結構複雜度指標的生成後過濾能改善分層。
- 實驗範圍。 七個 MCP 規格與單一生成模型(Gemini 2.5 Flash Lite)無法建立普遍宣稱。多輪評測記錄有限($n=54$)、擴展大幅偏向複雜情境,這限制了統計檢定力。
附錄概覽
【譯註】以下附錄以摘要呈現,逐字全文(含所有流程提示與評估提示)請參閱原論文。
- 附錄 A 延伸實驗結果。 評估規模(表 6)、複雜度分解(表 7)、連貫性子維度(表 8)、根基層級(表 9)、工作流程組合與類別多樣性、失效細節、每-MCP 維度分數(表 11)、以及跨家族評判者複製(A.8,含 Gemini vs Qwen3.5 的每-MCP 均值、記錄級一致、系統性偏移、失效模式分類複製、圖 1 Bland–Altman 診斷)。
- 附錄 B 聚合敏感度。 算術/調和/最小三種聚合下的每-MCP TC 均值(表 16),確認排名穩健。
- 附錄 C 新穎性總結。 貢獻 vs 先前文獻,按主題落差組織(表 17)。
- 附錄 D 流程提示。 四階段的完整提示模板(工具詮釋、情境生成之簡單/複雜/覆蓋提示、模擬輸出生成、多輪擴展)。
- 附錄 E 評估提示。 工具呼叫評估(表 18,含四維度與串聯規則)與連貫性評估(表 19,五維度 1–3 分制)的完整提示。
- 附錄 F 結構化輸出 schema。 四階段的結構化輸出 schema 定義。
- 附錄 G 分數分布與每領域分析。 整體分數分布(圖 3)與七個 MCP 各自的情境類別、工作流程長度、工具共現圖、序列鄰接圖(圖 4–10)。
參考文獻
書目保留原文,採作者-年份引用;內文的「作者 (年份)」對應下列條目。本文共 36 筆參考文獻,以下列出正文引用的主要條目:
- Anthropic (2024). Model Context Protocol (MCP).
- Barres et al. (2025). τ²-bench.
- Chen et al. (2024). Multi-step tool use over curated API corpora.
- Crouse et al. (2026). DiGiT-TC: Back-translating tool-call sequences into user requests.
- Drouin et al. (2024). WorkArena.
- Es et al. (2024). RAGAS / LLM-as-judge evaluation.
- Froger et al. (2026). GAIA benchmark.
- Guo et al. (2026). MCP-AgentBench.
- Huang et al. (2023). Tool necessity in agent evaluation.
- Jia et al. (2026). Agent GPA (Goal-Plan-Action).
- Kim et al. (2024). LLM-as-judge.
- Lei et al. (2025). MCPVerse.
- Li et al. (2025). Simia: Simulated tool environments.
- Li et al. (2026). Toolathlon.
- Liu et al. (2023a). AgentBench.
- Liu et al. (2023b). LLM-as-judge (G-Eval / MT-Bench 類).
- Liu et al. (2024); Prabhakar et al. (2025). APIGen: Execution-based verification.
- Lu et al. (2025). ToolSandbox.
- Maekawa et al. (2026). FuncBenchGen: DAG-modelled call dependencies.
- Model Context Protocol (2024). Official MCP reference server repository.
- Model Context Protocol (2025). MCP server registry.
- Patil et al. (2024; 2025a; 2025b). Gorilla / BFCL (Berkeley Function Calling Leaderboard) v3.
- Qin et al. (2024). ToolLLM / tool-use evaluation with exact match & execution success.
- Wang et al. (2024). Multi-turn policy-grounded evaluation.
- Wang et al. (2026). Agent World Model: Synthesizing RL environments.
- Xu et al. (2025). TOUCAN: 1.5M trajectories from live MCP servers.
- Xu et al. (2026). GEM: Mining trajectories from text corpora.
- Yao et al. (2025). τ-bench.
- Zeng et al. (2026). LOGIGEN.
- Zhang et al. (2026). Gecko.
術語對照表
| English | 繁體中文 |
|---|---|
| AI agent | AI 代理 |
| Tool specification | 工具規格 |
| Tool calling / tool use | 工具呼叫 / 工具使用 |
| Model Context Protocol (MCP) | Model Context Protocol(工具整合標準協定) |
| Cold-start evaluation | 冷啟動評測 |
| Evaluation harness | 評測框架 |
| Scenario | 情境 |
| Mock output | 模擬輸出 |
| Multi-turn dialogue | 多輪對話 |
| Multi-step / multi-hop | 多步 / 多跳 |
| Parameter schema | 參數 schema |
| Argument (correctness / value accuracy) | 參數(正確性 / 值準確性) |
| Cascading penalty | 串聯懲罰 |
| Tool coverage | 工具覆蓋 |
| Grounding tier | 根基層級 |
| Oracle | oracle(保留的標準答案) |
| Held-out | 保留(不給代理看) |
| LLM-as-judge | LLM 作為評判者 |
| Tool-calling correctness (TC) | 工具呼叫正確性 |
| Conversational coherence (Coh) | 對話連貫性 |
| Out-of-family judge | 跨家族評判者 |
| Bootstrap CI | bootstrap 信賴區間 |
| Gini coefficient | Gini 係數 |
| Co-occurrence | 共現 |
| Sequential adjacency | 序列鄰接 |
| Execution-free | 免執行 |
| Structured output | 結構化輸出 |
| Tool-name hallucination | 工具名幻覺 |
| Parameter overload / density | 參數超載 / 密度 |
| Necessity | 必要性 |
| KDE (kernel density estimate) | 核密度估計 |