LLM 代理的外部化:記憶體、技能、協定與 harness 工程的統一綜述
原始論文:Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering 作者:Chenyu Zhou, Huacan Chai, Wenteng Chen, Zihan Guo, Rong Shan, Yuanyi Song, Tianyi Xu, Yingxuan Yang, Aofan Yu, Weiming Zhang, Congming Zheng, Jiachen Zhu, Zeyu Zheng, Zhuosheng Zhang, Xingyu Lou, Changwang Zhang, Zhihui Fu, Jun Wang, Weiwen Liu, Jianghao Lin, Weinan Zhang arXiv ID:2604.08224v1 日期:April 9, 2026 標籤:LLM Agent Memory Skills Protocols Harness Engineering Survey Tool Use MCP
目錄
- 摘要
- 1. 引言
- 2. 背景:從權重到上下文到 harness
- 3. 外部化的狀態:記憶體 (Memory)
- 4. 外部化的專業:技能 (Skills)
- 5. 外部化的互動:協定 (Protocols)
- 6. 統一的外部化:harness 工程
- 7. 跨切面分析
- 8. 未來討論
- 9. 結論
- 參考文獻
- 術語對照表
摘要
大型語言模型 (Large Language Model, LLM) 代理 (Agent) 越來越不是透過修改模型權重來打造,而是透過重新組織模型周圍的執行時環境 (Runtime) 來打造。早期系統期望模型內部能夠回復的能力,如今正被外部化 (Externalize) 到記憶體儲存 (Memory Stores)、可重用技能 (Skills)、互動協定 (Protocols),以及讓這些模組在實務上可靠運作的周邊 harness 中。本文透過外部化的視角綜述這個轉變。借鑑認知工件 (Cognitive Artifacts) 的概念,我們論證代理基礎設施之所以重要,並非僅因為它新增了輔助元件,而是因為它把困難的認知負擔轉換成模型能夠更可靠地解決的形式。在這個觀點下,記憶體外部化跨時間的狀態,技能外部化程序性的專業,協定外部化互動的結構,而 harness 工程則扮演把它們協調成受治理執行的統一層。我們追溯一條從權重到上下文再到 harness 的歷史進程,分析記憶體、技能與協定作為三種彼此獨立但互相耦合的外部化形式,並檢視它們如何在更大的代理系統中互動。我們進一步討論參數化能力與外部化能力之間的權衡,指出諸如自我演化 harness 與共享代理基礎設施等新興方向,並討論評估、治理以及模型與外部基礎設施長期共演化中的開放挑戰。最終結果是一個系統層級的框架,用以解釋為什麼實務上的代理進展不僅取決於更強的模型,更取決於更好的外部認知基礎設施。
1. 引言
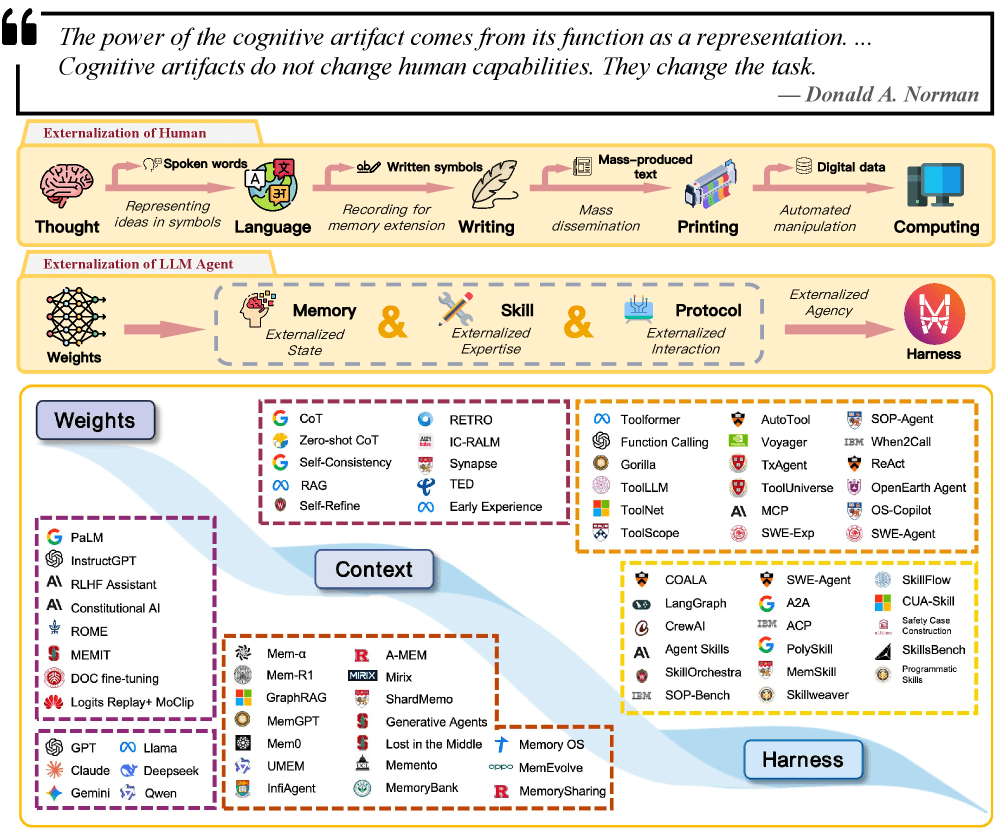 圖 1:外部化作為 LLM 代理設計的組織原則。 上面板:人類認知外部化的歷程,從思考到語言、書寫、印刷,再到數位計算。中間面板:LLM 代理對應的外部化弧線,從權重出發,經過三個外部化維度——記憶體 (外部化的狀態)、技能 (外部化的專業) 與協定 (外部化的互動)——再到統一它們的 harness。下面板:將代表性研究映射到三層能力——權重 (Weights)、上下文 (Context) 與 harness——的文獻地景,展示研究脈絡如何漸進地向外移動。兩條弧線之間的對應蘊含一個遞迴主張:LLM 代理透過沿著驅動人類認知史的相同表徵維度去外部化認知負擔,而獲得可靠的代理性。
人類文明史也可以被讀成一部認知外部化的歷史。口說語言把私人思想轉成可分享的符號形式。書寫把知識從脆弱的生物記憶移到持久的物質紀錄。印刷把知識的複製機械化到社會尺度。數位計算把算術與符號操作從神經勞動轉移到可程式化的機器。在這些轉變之中,關鍵改變並不是人類在沒有工件時變得較不能幹。而是工件透過把選定的負擔向外移動,重新組織了認知系統,並釋放有限的內部資源去做規劃 (Planning)、抽象 (Abstraction) 與創造 (Norman, 1993)。同樣的向外委派 (Outward Delegation) 模式如今正在機器智慧的最前線重現,也就是大型語言模型代理的設計。
這個觀點在認知工件的概念中找到天然的理論錨點 (Norman, 1991, 1993)。其核心洞見是:外部輔助並非僅是放大某種未變的內部能力;它們往往會改變任務本身。一張購物清單並沒有擴展生物記憶的容量,而是把困難的回想 (Recall) 問題轉成識別 (Recognition) 問題。一張地圖並沒有單純地讓導航「更強」,而是把隱藏的空間關係轉成可見的結構。工件的力量因此在於表徵轉換 (Representational Transformation):它重構問題,使得代理能用既有的能力更可靠地解決問題 (Norman, 1991)。
我們主張,同樣的邏輯如今主導著基於 LLM 的代理中最關鍵的設計選擇。我們的核心論點是:外部化——把認知負擔從模型的內部計算漸進地遷移到持久、可檢視且可重用的外部結構——正是統一近期語言代理在記憶體、技能、協定與 harness 工程上各項進展的轉變邏輯 (Transition Logic),亦即解釋為何每個架構轉變發生、以及它試圖保留哪些可靠性的機制。這不僅是工程上的便利主張。這是一個關於可靠代理性從何而來的主張:不僅來自越來越大的模型,更來自系統性地重構任務需求,使得內部能力與外部基礎設施共同涵蓋所需的全部能力 (Norman, 1991; Sumers et al., 2024)。
圖 1 總結了這個論點。上面板追溯人類認知外部化那條熟悉的弧線;中間面板呈現 LLM 代理對應的弧線,從權重出發,經過三個外部化維度——記憶體、技能與協定——到統一它們的 harness;下面板把資料文獻映射到三層能力——權重、上下文與 harness。圖 3 用一張代理外部化的架構鳥瞰圖補充這個觀點,展示 harness 居於中央,三個外部化維度與其運作元件繞著它運轉。記憶體跨時間外部化狀態,技能外部化程序性的專業,而協定外部化互動的結構。兩條弧線之間的對應蘊含一個遞迴的主張:LLM 代理本身就是運作在人類最新一次重大外部化——數位計算——之內的工件。共同機制是 Norman 意義上的表徵轉換 (Norman, 1991):回想變成識別、即興生成變成組合、特設協調變成結構化契約。
這個視角對於理解當下實踐特別有澄清效果。當代進展常被敘述成一場追求更大模型、更好訓練程序、或更精緻推理軌跡的競賽。這些因素確實重要,但無法完全解釋實際系統中觀察到的模式。許多最大的可靠性增益根本不是來自改變基礎模型,而是來自改變模型周圍的環境:加上持久記憶、組織可重用技能、標準化工具介面、約束執行、檢測行為,以及把工作路由到顯式的控制邏輯之中 (Sumers et al., 2024; Wang et al., 2024a; Li, 2025; Luo et al., 2025)。在實務中,問題日益不再僅是「模型有多強?」,而是「哪些負擔已經被外部化,使得模型不必每次都在內部解決它們?」
未經輔助的 LLM 仍會面對三種反覆出現的不匹配 (Mismatch),它們直接對應到 harness 的三個維度。其上下文視窗 (Context Window) 是有限的,session 記憶 (Session Memory) 微弱或不存在,造成記憶體外部化要解決的連續性 (Continuity) 問題。長的多步驟程序往往是被一再重新推導,而不是被一致地執行,造成技能外部化要解決的變異性 (Variance) 問題。與外部工具、服務與協作者的互動,若僅靠自由形式的提示往往脆弱,造成協定外部化要解決的協調 (Coordination) 問題 (Sumers et al., 2024; Packer et al., 2023)。外部化之所以重要,正是因為它把上述每個負擔轉成模型能夠更可靠處理的形式。
一個具體例子有助於釐清直覺。考慮一個被要求在大型 repository 中實作功能、執行測試並開啟 pull request 的軟體工程代理。沒有外部化時,模型必須把 repository 結構、專案慣例、工作流狀態與工具互動全都活躍地保留在脆弱的提示詞中。有了外部化之後,持久的專案記憶供應上下文,可重用的技能文件編碼慣例與工作流,協定化的工具介面強制正確的 schema,而 harness 把步驟排序、驗證輸出並處理失敗。基礎模型可以維持不變;改變的是它被要求解決的任務的表徵。
這個更廣的觀點也與分散認知 (Distributed Cognition) 與延伸認知 (Extended Cognition) 背後的直覺一致:一旦記憶、引導行動與協調互動的關鍵部分被委派到外部結構,智慧就不再僅僅定位於模型本身 (Clark and Chalmers, 1998)。我們借鑑這個傳統的核心工程洞見——「代理」與「環境」之間的界線是一個對效能有真實影響的設計選擇——而不去採納其更強的本體論主張。我們的焦點是務實的:我們把外部化視為一種設計原則,其價值由所產生系統的可靠性 (Reliability)、可組合性 (Composability) 與可治理性 (Governability) 來衡量。
我們現在轉向構成 harness 的三個外部化維度,每一個都對應到圖 1 (中間面板) 強調的某種表徵轉換:
記憶體系統跨時間外部化狀態。
記憶體系統不再依賴上下文視窗作為歷史的唯一載體,而是讓累積的知識——使用者偏好、過往軌跡、已解決的歧義、領域事實——能在任何單一 session 之外持續存在,並在相關時被選擇性地擷取。核心轉換是從回想到識別:代理不再需要從潛在權重中重新生成過去的知識;它從一個持久、可搜尋的儲存中擷取它 (Lewis et al., 2020; Park et al., 2023; Packer et al., 2023; Chhikara et al., 2025; Xu et al., 2025b)。
技能系統外部化程序性的專業。
技能系統不再依賴模型的權重在每次調用時都重新生成任務專屬的 know-how,而是把程序、最佳實踐與操作指引打包成可重用的工件 (Artifact)。核心轉換是從生成到組合:代理是從預先驗證過的元件來組裝行為,而不是每一步都從頭即興 (OpenAI, 2023a; Schick et al., 2023; Wang et al., 2023a; Anthropic, 2025, 2026; Jiang et al., 2026b)。
協定外部化互動的結構。
協定不再依賴於提示詞層級對工具、服務與其他代理的特設協調,而是定義機器可讀 (Machine-Readable) 的明確契約,用於發現 (Discovery)、調用 (Invocation)、委派 (Delegation) 與權限管理 (Permission Management)。核心轉換是從特設到結構化:模糊、脆弱的通訊變成可互通、可治理的交換 (Anthropic, 2024; Google Cloud, 2025a; Ehtesham et al., 2025c)。
harness 是承載這三個維度的工程層,提供讓外部化認知能在實務上協調運作的協同邏輯 (Orchestration Logic)、約束、可觀測性與回饋迴路。它不是與記憶體、技能與協定並列的第四種外部化。它是這些外部化形式運作與互動所在的執行時環境。
這些維度並非孤立演化。記憶體擴張可能跟技能載入競爭稀缺的上下文預算 (Context Budget)。協定標準化可能改善互通性,同時又限制了能力如何被打包與調用。技能執行產生軌跡,這些軌跡之後成為記憶體;而記憶體擷取又能影響後續選擇哪些技能與協定路徑。harness 必須居中調解所有這些互動。我們在此先預覽這些系統層級的耦合,並在第 7 節做更詳細的分析。
這幾個方向都各自發展出實質的技術生態。記憶體研究已從簡單的擷取增強進步到更具選擇性與分層的記憶體架構 (Lewis et al., 2020; Packer et al., 2023; Chhikara et al., 2025; Xu et al., 2025b)。技能相關的工作已從狹義的 function calling 與工具學習,擴展到可重用的能力套件、註冊表 (Registry) 與漸進式揭露 (Progressive Disclosure) 機制 (OpenAI, 2023a; Schick et al., 2023; Wang et al., 2023a; Anthropic, 2025, 2026; Jiang et al., 2026b)。協定的工作已從客製化的工具 schema 與框架專屬的膠水程式碼,移動到對代理-工具與代理-代理互動更標準化的介面層 (Anthropic, 2024; Google Cloud, 2025a; Ehtesham et al., 2025c)。既有的綜述照亮了這個地景的重要切片,包括擷取增強生成 (Retrieval-Augmented Generation, RAG) (Gao et al., 2024)、深度搜尋 (Xi et al., 2025)、工具學習與使用 (Qu et al., 2024)、廣義代理架構 (Wang et al., 2024a; Li, 2025; Luo et al., 2025) 與協定互通性 (Ehtesham et al., 2025c)。最接近的概念橋樑是 CoALA (Sumers et al., 2024)。仍然不夠成熟的是:對於這些發展為何正在以外部化的形式收斂,以及這個收斂如何重塑「代理」的定義,目前還缺乏一個共通的論述。
因此我們的目標並不是再做一份元件層級的孤立綜述,也不是把代理進展化約到單一框架。相反地,我們提供一份系統層級的綜述,圍繞四個主張展開:
- 記憶體系統跨時間外部化代理的狀態,並把長時程連續性轉成選擇性的擷取。
- 技能系統外部化程序性專業,並把隱性 know-how 轉成顯式可重用的操作指引。
- 協定外部化互動結構,並把模糊的通訊轉成可互通、機器可讀的契約。
- harness 工程把這些外部化模組統一成一個帶有約束、可觀測性、回饋迴路與控制點的連貫執行時環境。
本文其餘部分的結構如下。第 2 節追溯從權重到上下文到 harness 的歷史路徑。第 3 至 5 節分析記憶體、技能與協定這三種獨立但互補的外部化形式。第 6 節把 harness 工程呈現為外部化代理設計的整合學科,而第 7 節檢視模組之間主要的跨切面互動。第 8 節討論朝向更具適應性與自我演化的外部化形式之未來方向,而第 9 節以對代理研究更廣泛的涵義作結。
2. 背景:從權重到上下文到 harness
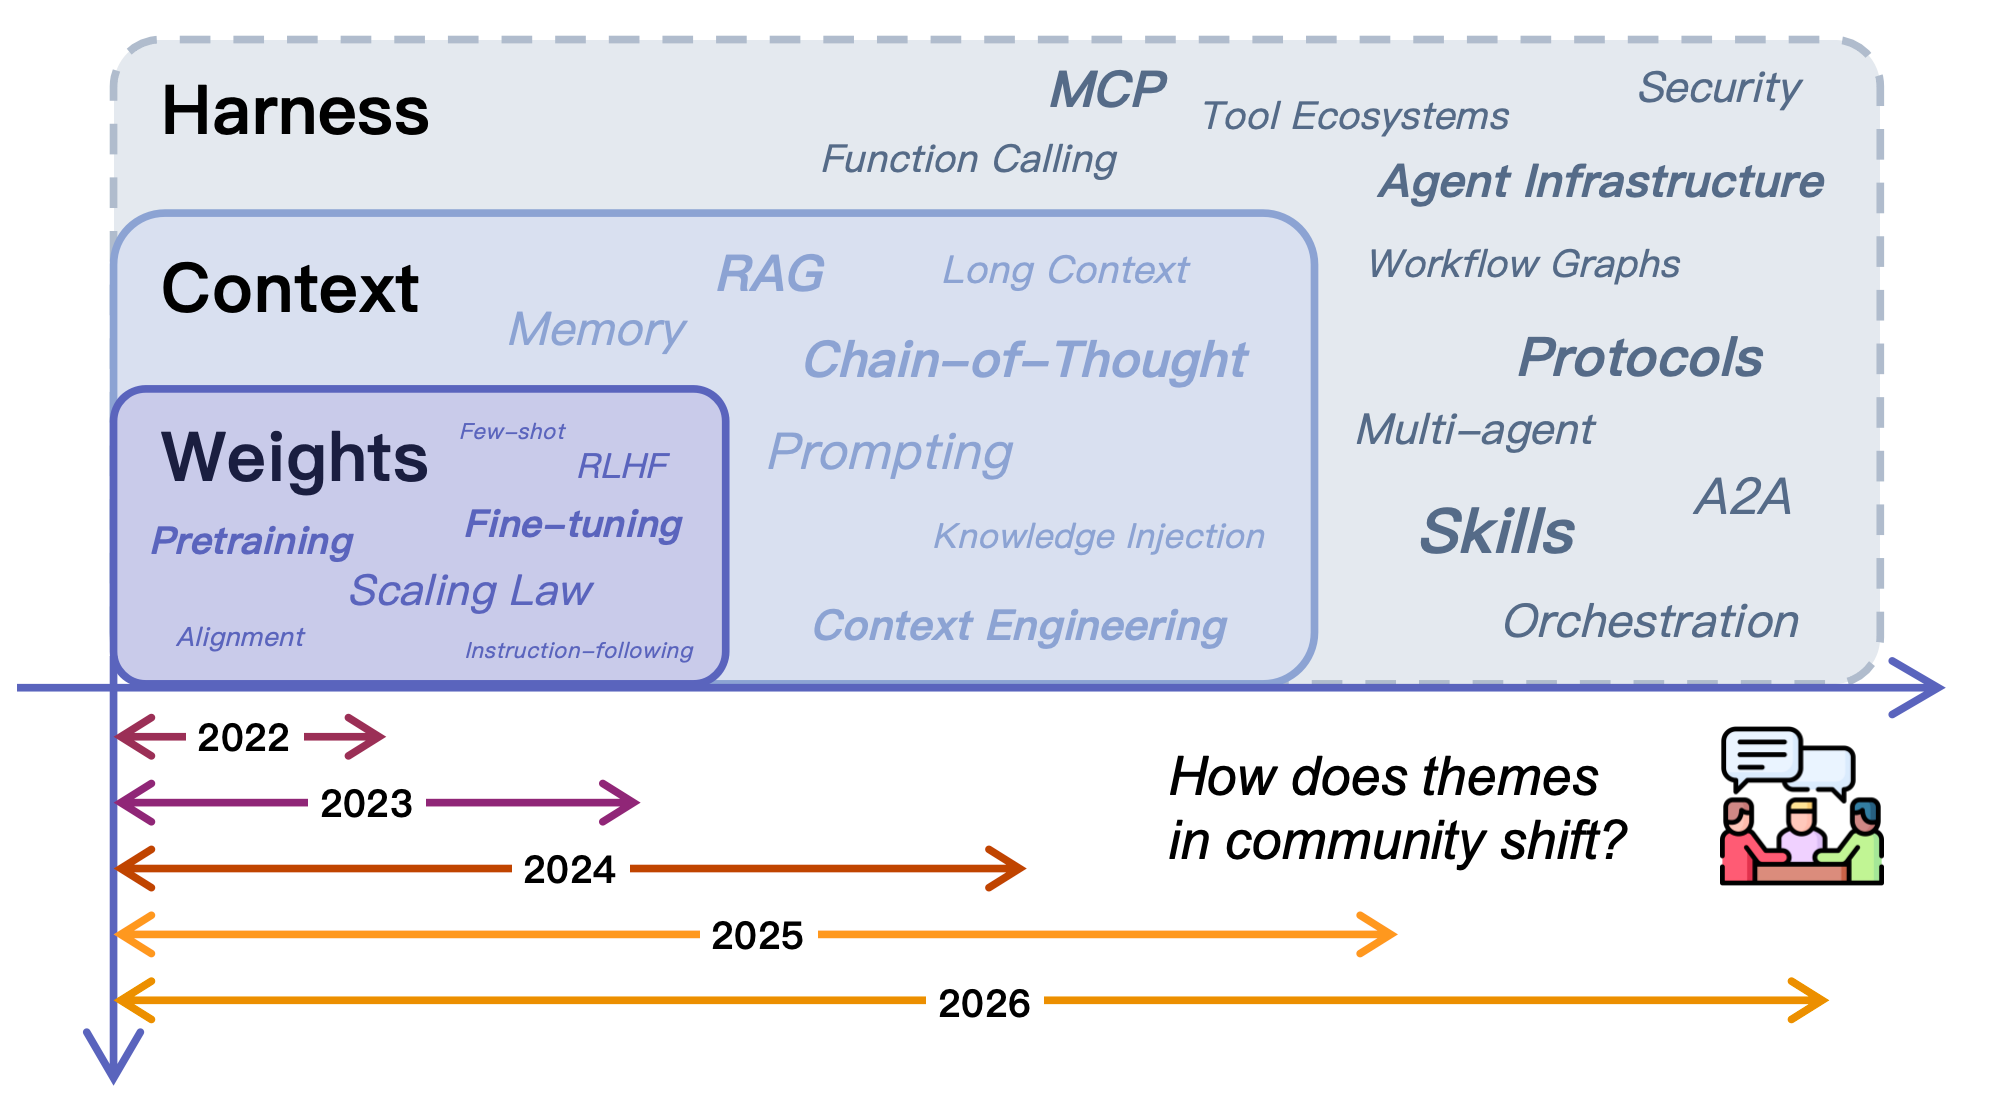 圖 2:跨三層能力的社群主題演化。 堆疊的層——權重、上下文與 harness——展示了 LLM 代理社群的重心如何隨時間向外移動,從參數化知識與提示,移向 harness 層級的基礎設施 (例如工具生態、協定、技能與多代理協同)。
LLM 代理近期的歷史可以被理解為一個從模型本身向外漸進移動的過程。能力起初被視為權重的屬性,接著被視為提示與上下文視窗的屬性,而現在則越來越被視為模型運作所在的更廣基礎設施的屬性。圖 2 把這個軌跡視覺化為三個堆疊層——權重、上下文與 harness——在 2022 到 2026 的時間軸上展開,說明社群中研究主題如何隨時間轉移。圖 1 的下面板用一張文獻地景補充這個觀點,將代表性研究映射到這三層上。各階段是分層而非互斥——即使在最依賴基礎設施的系統中,權重仍然重要——但每個階段改變了開發者把系統的可變智慧 (Mutable Intelligence) 放在哪裡,並因此改變他們把工程精力主要投入哪裡。
2.1 能力寓於權重
圖 2 與圖 1 中的權重層對應現代 LLM 部署的最初一波,當時能力幾乎完全等同於模型參數。在大型語料上的預訓練 (Pretraining) 把廣泛的統計規律、世界知識與潛在的推理習慣壓縮進權重中 (Brown et al., 2020; Chowdhery et al., 2023; Touvron et al., 2023)。縮放律 (Scaling Laws) 揭示了參數量、資料量與損失之間的可預測關係,強化了「進展直接追隨模型規模」的直覺 (Kaplan et al., 2020; Hoffmann et al., 2022)。當 GPT-4 (OpenAI, 2023b)、Gemini (Gemini Team et al., 2023)、DeepSeek-V3 (DeepSeek-AI, 2025) 與 Qwen2.5 (Qwen Team, 2025) 這類系統展示出廣泛的多任務能力時,該領域大部分的主流敘事把更好的代理等同於更大、訓練更好的模型。監督式微調 (Supervised Fine-Tuning, SFT) 與偏好優化 (Preference Optimization) 接著透過教模型遵循指令、對話風格、拒答行為與領域慣例,把它們塑造成更有用的助理 (Ouyang et al., 2022; Bai et al., 2022a);直接偏好優化 (Direct Preference Optimization, DPO) 進一步簡化了這個對齊階段,免去訓練獨立獎勵模型的需要 (Rafailov et al., 2023)。從這個觀點來看,改善大致等於修改或替換模型本身。
這個範式仍然是基礎,且權重空間的能力提供了幾項優勢:無需外部查詢的快速推論、緊湊的部署方式,以及在許多任務之間的強泛化能力,無需任務專屬的水管工程 (Plumbing)。同一個模型可以回答醫療問題、寫詩、除錯程式或摘要法律契約,而周圍系統不需任何改變。對於單次性、上下文自含的任務而言,權重中心觀往往已足夠。
然而,權重空間編碼也把知識、程序與政策過於緊密地耦合到一個靜態工件之中。要更新一條事實——例如某國的現任元首——就需要重新訓練、進行知識編輯 (Knowledge Editing) (Meng et al., 2022; Mitchell et al., 2022; Yao et al., 2023b),或透過額外的對齊層做修補,而這些都有可能對其他能力造成意外副作用。要稽核模型為何如此行為也很困難,因為相關知識散布在數十億參數中,而非編碼為可檢視的模組 (Zhao et al., 2024)。個人化 (Personalization) 同樣彆扭:一組權重被要求服務數百萬具有不同歷史、偏好與限制的使用者,但它在參數層級沒有區分這些使用者的機制。
參數化知識的核心限制是難以選擇性地更新、組合與治理。只要代理被局限在單輪問答之中,這些弱點通常還能管理。一旦系統移入長時程的任務執行——其中狀態會累積、程序必須被可靠遵循、且必須協調多個工具——在權重中模組化地管理知識、技能與互動規則的困難就會在運作上更為突出。這個轉變鼓勵開發者把這些負擔的一部分搬到下一層,而不是僅依賴模型參數。
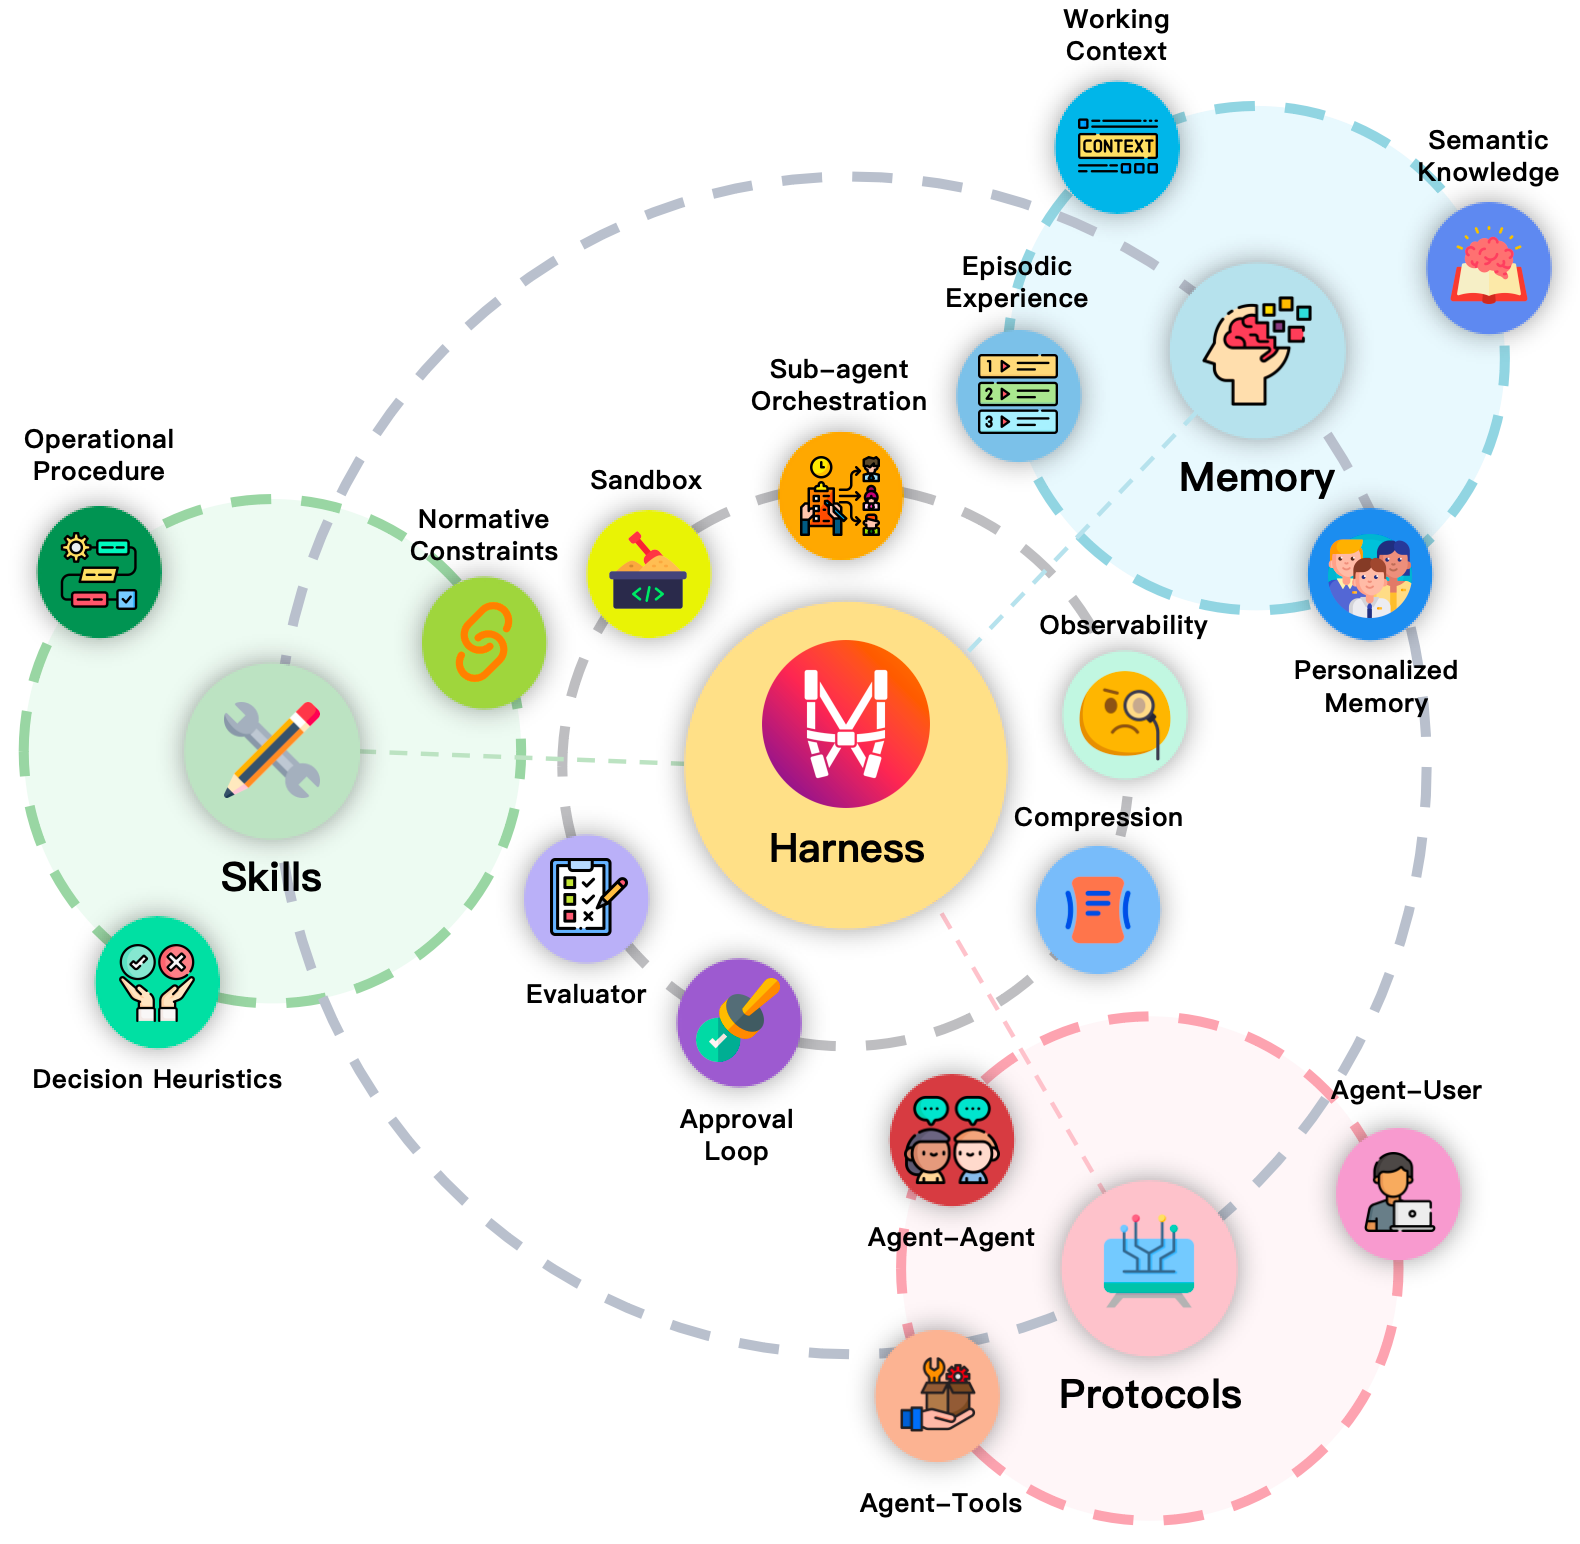 圖 3:受 harness 馴化的 LLM 代理之外部化架構。 harness 居於中央;三個外部化維度——記憶體 (工作上下文、語意知識、情節經驗、個人化記憶)、技能 (操作程序、決策啟發式、規範性約束) 與協定 (代理-使用者、代理-代理、代理-工具)——繞著它運轉。沙盒 (Sandboxing)、可觀測性 (Observability)、壓縮 (Compression)、評估 (Evaluation)、批准迴路 (Approval Loops) 與子代理協同 (Sub-agent Orchestration) 等運作元件,居中調解 harness 核心與外部化模組之間的互動。
2.2 能力寓於上下文
上下文層代表注意力從修改模型轉向設計輸入的階段。提示工程 (Prompt Engineering) 證明了模型行為可以在不觸及權重的情況下被大幅改變:少樣本範例 (Few-shot Examples)、角色描述、思維鏈 (Chain-of-Thought, CoT) 分解與自我一致性 (Self-Consistency) 軌跡都改變了同一模型在同一基礎任務上的表現 (Wei et al., 2022; Wang et al., 2023b; Kojima et al., 2022)。更具結構化推理的技術隨後出現。ReAct 在單一生成迴路內把推理軌跡與工具動作交錯在一起,展示僅靠提示就能在不改變架構的情況下產生類代理行為 (Yao et al., 2023a)。Tree of Thoughts 把思維鏈泛化為對中間推理狀態的審慎搜尋 (Yao et al., 2024)。Self-Refine 引入反覆的自我批評,展示模型可以透過多輪提示迴路改善自己的輸出 (Madaan et al., 2023)。自動提示優化 (Automatic Prompt Optimization) 進一步透過用模型本身搜尋提示空間,降低了人工負擔 (Zhou et al., 2023; Pryzant et al., 2023)。擷取增強生成 (RAG) 引入了一種更系統的外部化形式,在查詢時動態地把外部文件注入上下文 (Lewis et al., 2020; Borgeaud et al., 2022; Ram et al., 2023; Gao et al., 2024)。注意力因此從「模型已內化什麼」轉移到「圍繞每次調用的資訊管線」。
這個階段使代理設計變得實質上更靈活。開發者可以在執行時附上本地指令、領域知識、輸出 schema 與擷取到的證據,而無需任何梯度更新。上下文成為開發者為模型搬演認知的媒介——一張工作檯面,能在模型需要之前正好集結對的資訊。在許多實務系統中,反覆迭代提示與擷取管線比微調更便宜也更快。模型可以維持凍結,而周圍的提示模板、擷取邏輯與工具規格能夠快速演化。
上下文中心階段也可以透過 Norman 的表徵轉換概念來解讀。一個困難的回想問題——「模型是否知道事實 $X$?」——被轉成一個識別問題:「假設事實 $X$ 已被放入上下文,模型能否使用它?」這類似於人類外部化弧線中與書寫相關的「回想到識別」轉變 (圖 1 上面板)。模型不需要記住答案;它只需要一旦相關段落被提供,就能識別並應用它。在圖 2 中,這個轉變對應於上下文層中提示、RAG、CoT 等相關技術的興起 (Zhang et al., 2024; Ram et al., 2023)。
上下文中心的設計也有重要的限制。上下文視窗是有限的、在規模上昂貴,且在被邊際相關材料填滿時往往充滿雜訊。長提示會降低而非改善效能:「中間遺失」(Lost in the Middle) 現象顯示模型對長輸入的注意力分布不均,對放在上下文中段的資訊,擷取準確度會急劇下降 (Liu et al., 2024a)。即使上下文長度已大幅擴張——從 2K tokens 到超過 100K 甚至更多 (Chen et al., 2023; Peng et al., 2024)——根本的張力仍然存在:更大的容量並不能消除選擇性策展的需要。上下文也是短暫的:除非狀態被顯式地外部化到別處,否則每個新 session 開始時都帶著部分失憶。隨著系統變得更複雜,僅靠提示組裝可能成為脆弱且特設的控制機制。模型可以被給予更多指令,但這不代表系統知道如何跨 session 持久化狀態、排程多步驟工作流、在子代理之間協調、從部分失敗中復原,或長期強制執行行為約束。這些限制有助於解釋下一個向外的階段。
2.3 能力寓於基礎設施
harness 層——即圖 2 中最上方的條帶與圖 1 (下面板) 中最右側的區域——代表當前的階段,能力延伸超出提示管理進入持久基礎設施。隨著上下文視窗變得飽和、提示模板變得更難以駕馭,工程注意力越來越從「我們應該對模型說什麼?」轉向「模型應該在什麼環境中運作?」在成熟的代理系統中,可靠性越來越仰賴外部記憶體儲存、工具註冊表、協定定義、沙盒、子代理協同、壓縮管線、評估器、測試 harness 與批准迴路 (Wang et al., 2024a; Li, 2025; Luo et al., 2025; Xi et al., 2023)。
這個轉變最早的徵兆雖然簡單但很有啟發性。Auto-GPT (Richards, 2023) 與 BabyAGI (Nakajima, 2023) 等專案把 LLM 包在一個帶任務佇列、持久記憶與網路存取的迴路中,展示即使最小的 harness 也能維持任何單一提示無法支撐的行為。更具原則的框架隨即跟進:AutoGen 形式化了多代理訊息交換 (Wu et al., 2023),MetaGPT 加入基於角色的協作與顯式程序 (Hong et al., 2023),CAMEL 探討為任務分解所做的結構化對話 (Li et al., 2023),而 Reflexion 跨情節持久化回饋 (Shinn et al., 2023)。在這些系統之間,共同的動作是把負擔從模型移到周圍結構之中。
同樣的動作如今也橫跨各個部署領域可見。程式設計代理把模型嵌入帶有檔案、shell、版本控制、測試與可重用技能工件的開發 harness 之中;SWE-agent 與 OpenHands 是代表性的例子 (Yang et al., 2024a; Wang et al., 2024b)。研究與企業代理增加了擷取、批准、瀏覽與長時程協同管線,例如 Deep Research 風格系統 (OpenAI, 2025b; Google, 2024)。具身與工作流系統如 Voyager、LangGraph、CrewAI 與 OS-Copilot 同樣把控制流、環境存取與重用顯式化 (Wang et al., 2023a; LangChain, 2024; CrewAI, 2024; Wu et al., 2024)。一再出現的模式是:可靠性問題越來越是透過改變環境而非僅靠提示來解決。
如圖 3 所示,harness 涵蓋三個主要的外部化類別——記憶體、技能與協定——它們對應於 harness 所吸收的三大類負擔。記憶體系統跨時間外部化狀態,使連續性不再依賴於短暫的上下文。技能系統外部化程序性專業,使複雜工作流是被載入而不是被重新發明。協定外部化互動結構,使工具與代理協調遵循受治理的契約而非特設的提示。這些元素共同構成 harness:包覆模型並把它面對的任務轉成其內部能力能更可靠處理之形式的持久基礎設施。
在這個框架下,「代理工程」越來越採取「harness 工程」的形式。模型仍然是核心的推理引擎,但它不再是智慧的唯一所在。能力被分散到塑造模型所看到、記憶、調用與被允許做的事情的各種結構之中。
2.4 外部化作為轉變邏輯
整體看,從權重到上下文到 harness 的路徑是一個 Norman 意義上的外部化故事 (Norman, 1991):難以在模型內部管理的負擔,逐步地被搬到模型之外的顯式工件中,而模型所見的任務也對應地被轉換。可變的知識從權重移到擷取系統與執行時上下文,把回想轉成識別。可重用的程序從隱性習慣移到顯式技能,把即興生成轉成結構化組合。互動規則從特設提示移到協定,把模糊的協調轉成受治理的契約。執行時的可靠性反過來又移到 harness 邏輯之中,在那裡約束、可觀測性與回饋迴路可以被顯式化。
這種重分配最好被理解為對不匹配的回應。LLM 擅長對所提供資訊進行靈活的綜合與推理;但在穩定的長期記憶、程序性的可重複性,以及與外部系統的受治理互動上不太可靠。因此外部化是在模型周圍建構一個更大的認知系統,而非取代它,這個觀點與諸如 CoALA 之類的認知架構論述一致 (Sumers et al., 2024)。三個 harness 維度直接從這個框架推導出來:記憶體解決時間上的連續性,技能解決程序的一致性,而協定解決互動的結構。接下來幾節將分別詳細檢視它們。
3. 外部化的狀態:記憶體 (Memory)
記憶體外部化解決的是代理性的時間負擔。一個赤裸的語言模型必須在短暫的提示中承載連續性、過去經驗、使用者專屬的事實,以及部分完成的工作。一旦任務跨越多個 session、分支或中斷,這個負擔就同時變得不穩定且昂貴。記憶體把它外部化為可在模型外被寫入、更新與擷取的持久狀態。
在 harness 化的代理中,記憶體不只是檔案庫。它供應可恢復執行的檢查點,提供可供從中蒸餾出技能的軌跡,提供影響協定路由的統計,並提供治理機制可以檢視與約束的持久狀態。為了精確說明這個角色,本節提出三個相連的問題:記憶體外部化了什麼負擔、設計空間是如何演化的,以及記憶體如何跟更廣的 harness 耦合。3.1 節釐清哪些種類的狀態是被外部化的;3.2 節綜述主要的架構選擇;3.3 節轉向 harness 化代理系統所施加的需求;而 3.4 節以從認知工件視角解讀記憶體作結。
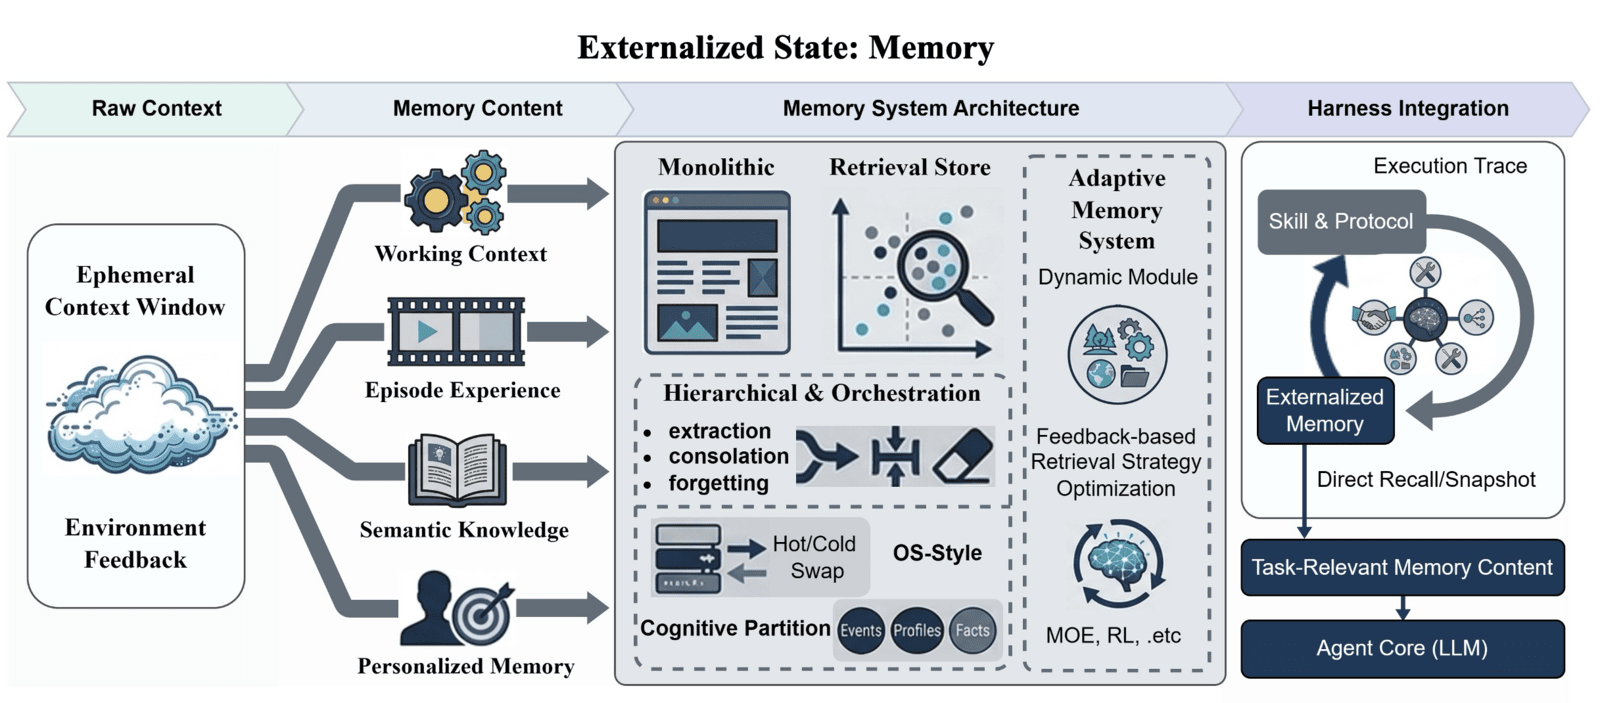 圖 4:記憶體作為外部化的狀態。 來自短暫上下文視窗的原始上下文與環境回饋,被轉換成四個持久的記憶體維度——工作上下文 (Working Context)、情節經驗 (Episodic Experience)、語意知識 (Semantic Knowledge) 與個人化記憶 (Personalized Memory)。這些維度透過漸進地更受管理的架構被組織起來:單體上下文 (Monolithic Context)、擷取儲存 (Retrieval Stores)、階層式協同 (Hierarchical Orchestration,含抽取、整併、遺忘與作業系統式 hot/cold 換頁),以及自適應記憶體系統 (Adaptive Memory Systems,含動態模組與基於 MOE、RL 等回饋的策略優化)。在 harness 這一側,來自技能與協定的執行軌跡流入外部化記憶體,後者再透過直接回想與經過策展的快照,把任務相關的內容供給代理核心。
3.1 外部化了什麼:狀態的內容
記憶體的本質在於把代理跨時間的狀態與其短暫上下文解耦。相關的內容並不是 harness 中所有外部工件,而是那些保留連續性的紀錄:當前任務狀態、過往執行經驗、抽象化知識,以及持久的使用者或環境上下文。為了在長時程互動中維持連貫的行為,記憶體系統必須依其時間屬性與擷取需求把這些紀錄分類與管理。從人類記憶的經典分類取得靈感並把它調整到 LLM 代理上,我們區分以下四個外部化狀態的維度:
工作上下文 (Working context)。
工作上下文是當前任務的鮮活中間狀態:開啟的檔案、暫存變數、活躍的假設、部分計畫與執行檢查點 (Checkpoint)。它變化快速,過時就會失去價值,但若不外部化,它會在上下文視窗重置或行程被中斷時立刻消失。程式設計代理是這個觀點的好例子。透過把草稿、終端機狀態與工作區工件物質化在提示之外,OpenHands 與 SWE 風格代理等系統可以從當前的運作狀態恢復,而不必從零重建 (Wang et al., 2025a; Yang et al., 2024b)。
情節經驗 (Episodic experience)。
情節經驗紀錄過去執行中發生的事:決策點、工具呼叫、失敗、結果與反思。它的價值不僅在於檔案性。被擷取的情節可作為具體先例使用,幫助代理避免重蹈已知錯誤,並為後續的抽象化提供原材料。Reflexion 透過把失敗嘗試的反思摘要儲存為可重用經驗,明確化了這個模式 (Shinn et al., 2023)。AriGraph 進一步擴展這個概念,把陌生環境中的局部互動軌跡視為情節記憶,並從中建構出更廣的世界模型 (Anokhin et al., 2024)。
語意知識 (Semantic knowledge)。
語意知識儲存超越任何單一情節的抽象:領域事實、一般啟發式、專案慣例與穩定的世界知識。與情節記憶不同,它不是以特定時間與地點為組織單位 (Li and Li, 2024; De Brigard et al., 2022)。差別不僅在於粒度,更在於功能。情節記憶說的是某一案例中發生了什麼;語意記憶說的是橫跨案例傾向於成立什麼。在當前系統中,知識庫與 RAG 語料是最常見的外部化語意記憶形式。較長期的趨勢更具雄心:代理越來越嘗試從累積的軌跡中蒸餾出語意指引,而不是只依賴靜態的人類撰寫文件。
個人化記憶 (Personalized memory)。
個人化記憶追蹤關於特定使用者、團隊或環境的穩定資訊:偏好、習慣、反覆出現的限制與過去的互動。這種狀態不應被併入代理一般的自我改進儲存,因為使用者專屬的軌跡遵循不同的保留、擷取與隱私規則 (Xi et al., 2024; Lin et al., 2025a)。最近的系統把這個分隔顯式化。IFRAgent 從行動環境中的示範裡建立使用者習慣的庫 (Wu et al., 2025);網頁代理使用外部化的個人檔案來推斷隱含偏好 (Cai et al., 2025);像 VARS 這樣的對話系統把跨 session 的偏好卡片儲存在隔離的使用者記憶體空間中 (Hao et al., 2026)。個人化記憶因此是讓代理隨時間調適、又不會把長期的使用者建模與一般任務知識混淆在一起的那一層。
這四層並沒有窮盡之後可能對代理有用的所有東西。反覆出現的程序性規律,也許先以情節軌跡中的模式形式出現,但一旦 harness 把它們提升為顯式可重用的指引,它們就不再是記憶體本身的東西。在那一刻,它們屬於技能層而非記憶體層。
整體看,這幾層顯示記憶體外部化的並不是單一同質的資料庫,而是不同抽象層級上的時間連續性負擔。工作上下文支撐立即的恢復,情節紀錄支撐反思與復原,語意記憶支撐抽象與遷移,而個人化記憶支撐跨 session 的對使用者與環境的調適。harness 必須以不同方式對待這些儲存,因為每一個都改變了模型本來就必須在內部回復的某個不同部分。
3.2 如何被外部化:記憶體架構
當這些層被外部化時,主要的設計問題就是「把活躍推理與被儲存的狀態分離得多徹底」。沿用 Du (2026a) 的分類,當前的系統可以被讀成四個廣義的架構範式:單體上下文 (Monolithic Context)、帶擷取儲存的上下文 (Context with Retrieval Storage)、階層式記憶與協同 (Hierarchical Memory and Orchestration),以及自適應記憶系統 (Adaptive Memory Systems)。這個進程不只是朝向更大的儲存而已,更是朝向對「什麼被寫入、被提升、被擷取、被壓縮或被遺忘」有更顯式的政策。
3.2.1 單體上下文
早期系統依賴單體上下文:所有相關歷史,或它的摘要,都直接保留在提示中。這個設計透明且容易快速做出原型,因為不需要分離的記憶體服務,而對於短任務它甚至效果驚人。它的限制是結構性的。容量擴展不佳、摘要漂移,且模型必須花掉稀缺的 tokens 同時承載歷史與解決當前的步驟。最重要的是,狀態會隨 session 消失,因此代理無法累積耐久經驗。
3.2.2 帶擷取儲存的上下文
主流的下一步是把短期工作狀態保留在上下文中,而把更長時程的軌跡儲存在外部,並按需擷取。這個「上下文加擷取儲存」的模式構成大多數實用記憶體系統的基礎 (產品 copilot、助理與程式設計代理)。它解決了原始容量問題,但它把記憶體品質變成擷取問題。如果出現的是錯誤的紀錄,模型會分心;如果該出現的紀錄被漏掉,系統會表現得像它從未記得它們。
近期工作從幾個方向攻擊這個瓶頸。GraphRAG (Edge et al., 2024) 加上圖結構與社群層級的擷取,ENGRAM (Cheng et al., 2026) 把記憶體壓縮成潛在狀態表徵,而 SYNAPSE (Zheng et al., 2023) 在統一的情節-語意圖上使用擴散啟動 (Spreading Activation) 來找回較不局部的相關性。這些做法在機制上不同,但它們共享同一目標:用一個更貼合長時程推理的表徵取代扁平的相似度搜尋。
3.2.3 階層式記憶與協同
當扁平擷取被證明不足,系統便轉向階層式記憶與協同。其關鍵概念是:並非每條軌跡都該套用同樣的保留政策或擷取路徑。Mem0 (Chhikara et al., 2025)、Memory-R1 (Yan et al., 2025b) 與 Mem-α (Wang et al., 2025b) 等框架引入了抽取、整併與遺忘的明確操作,把記憶體變成一個被管理的生命週期,而不是被動的儲存。兩個設計傾向主導了這個空間:
時空維度上的資源解耦。 一個分支借用作業系統的邏輯,把記憶體視為必須被主動管理的受限資源。MemGPT (Packer et al., 2023) 與 MemoryOS (Kang et al., 2025) 把熱的工作狀態與較冷的長尾儲存分開,並隨任務需求變化在不同層之間換進換出資訊。其收益是在固定的上下文預算下擁有更高的有效容量。
認知功能維度上的語意解耦。 第二個分支按功能或內容類型來組織記憶體,使異質紀錄不被全部路由到同一通道。MemoryBank (Zhong et al., 2024) 與 MIRIX (Wang and Chen, 2025) 分離事件、使用者個人檔案與世界知識;MemOS (Li et al., 2025) 區分顯式記憶與隱式記憶;而 xMemory (Hu et al., 2026) 建立主題-事件階層。其目標不僅是整齊的分類學,更是在複雜任務條件下取得更精確的擷取。
3.2.4 自適應記憶系統
上述架構仍然很倚賴人類設計的啟發式。自適應記憶系統更進一步,讓模組、路由決策或擷取策略對經驗做出反應。兩個方向特別明顯:
動態模組。 一些系統在執行時調適架構本身。MemEvolve (Zhang et al., 2025a) 把記憶體生命週期分解為可獨立演化的編碼、儲存、擷取與管理模組。MemVerse (Liu et al., 2025a) 維持一個短期快取與一個多模態知識圖,並週期性地把碎片化經驗蒸餾為更抽象的知識與輕量神經元件。
基於回饋的策略優化。 其他系統大致保持架構固定,但學習更好的控制策略。MemRL (Zhang et al., 2026c) 透過非參數化強化學習更新擷取行為。Zhang et al. (2025c) 提出的自適應框架使用 mixture-of-experts 閘控動態地路由查詢,而 GAM (Yan et al., 2025a) 透過多輪互動精修擷取條件。
跨越這些階段,主要的轉變是從儲存到控制。單體上下文解決存在性問題,擷取儲存解決容量問題,階層系統解決組織問題,而自適應系統開始解決政策問題。記憶體因此不再是提示詞的被動附錄。在成熟代理中,它變成決定模型能對哪些過去有效行動的 harness 控制面 (Control Surface) 的一部分。
3.3 harness 時代的記憶體需求
當代理演化進入 harness 時代,記憶體系統不再只是孤立的儲存模組;它變成執行時用以協調連續性、程序重用與受治理互動的基底。問題不再僅是如何儲存更多資訊,而是如何讓時間狀態能被規劃、執行與復原迴路選擇性地讀懂。
因此 harness 環境要求記憶體系統顯式地把狀態與上下文分開。在時間視野極長的任務中,session 歷史的無限制累積會讓模型失去注意力的著力點。InfiAgent (Yu et al., 2026) 等框架提出以檔案為中心的狀態抽象,主張檔案系統作為任務狀態的唯一權威紀錄,從高層計畫到中間變數與工具輸出都必須即時寫入。在每個決策步驟,代理不再讀取冗長的歷史,而是讀一份策展過的工作區快照與少量近期動作。這正是記憶體核心表徵角色在 harness 層級的展現:不是把所有歷史保留在提示中,而是把當前狀態物質化成模型能行動的形式。
記憶體也必須與技能系統整合,但這兩層扮演不同的角色。記憶體儲存過去執行的證據:軌跡、結果、失敗以及使用者或任務專屬的上下文。技能只在那些證據中的某一部分被提升為顯式可重用程序時才開始。反過來說,每次技能執行都會產生新軌跡,而這些軌跡必須被寫回記憶體。記憶體因此本身並不是程序性指引;它是後續可從中導出此類指引的證據庫。
協定耦合施加了進一步的需求。工具結果、批准、委派事件與外部狀態轉變可能透過協定化介面到達,但它們只在被正規化並寫入持久狀態之後才成為記憶體。反過來說,記憶體擷取可能影響接下來該選擇哪條協定路徑。在一個成熟的 harness 中,記憶體與協定是由一個受治理的讀寫迴路相連的,但它們在概念上保持區分:協定治理交換,而記憶體治理跨時間的持久化。
最後,當多個代理依賴共同的外部化狀態時,分享與治理機制成為強制性。建立記憶體的讀寫權限、解決儲存事實之間的衝突,以及控制每個代理對共享知識的存取配額,都需要與作業系統可比的低層控制能力。harness 時代的記憶體因此最好被理解為被管理的狀態基礎設施:它外部化時間負擔,重塑模型內部必須記住的東西,並提供 harness 其餘部分賴以運作的持久基底。
3.4 記憶體作為認知工件
前面幾節綜述了記憶體系統的內容、架構與 harness 整合。本節最後退一步,借鑑 Norman 的認知工件理論 (Norman, 1993) 與 Kirsh 對互補策略 (Complementary Strategies) 的論述 (Kirsh, 1995),解讀記憶體外部化作為一種表徵轉換到底達成了什麼。
當代 LLM 是無狀態的生成器:每次呼叫都從新鮮的上下文開始,因此連續性必須被重建,而非被向前承載。在短互動中,這個限制可以被藏在提示之內。在長時程工作中,它變成結構性的。過去嘗試、部分完成的工作、使用者專屬事實與環境狀態無法全部即時保留在上下文中而沒有成本、漂移與最終的截斷。因此一個有界模型所面對的原始任務在原則上是難解的:在仍能對當下做出清晰推理的前提下,保有實質上無界的歷史可供使用。
記憶體外部化改變了該任務的結構。在 Norman 的術語中,這個表徵轉換把內部回想問題轉成外部識別與擷取問題。模型不再需要從其參數中復原相關歷史;它需要識別並使用記憶體系統已策展好的歷史切片。這跟 Norman 對「外部清單如何改變記憶之本質」的分析非常相似:關鍵不是新增了額外資訊,而是認知任務的形式本身被重新組織了 (Norman, 1991)。同樣的轉變我們在 2.2 節已在上下文層級上識別過;記憶體把它延伸到任何單一上下文視窗無法跨越的 session 與時間視野上。
這個解讀澄清了為什麼擷取品質比原始儲存容量更重要。一個儲存空間巨大但擷取貧弱的系統,仍然把錯的問題表徵呈給模型:歷史存在,但任務並未被轉換。反過來,一個容量適度但具備強索引、摘要與情境選擇的系統,能讓下游推理顯著變容易。記憶體的成功標準因此不是「我們存了多少?」而是「我們有沒有讓當下的決策變得清晰可讀?」
同樣的觀點也照亮了 Kirsh 的互補策略概念,根據該概念,代理改善效能的方式不僅是內部更努力地思考,也透過重新組織外部環境,使一些認知工作被卸載到環境之中 (Kirsh, 1995)。記憶體系統正是在時間維度上實作這個策略。它不是強迫模型在內部承載所有相關狀態,而是讓 harness 外部化持久化、新鮮度管理與相關性過濾,同時把詮釋與情境判斷留給模型。這個分工是互補的:每一邊都負責它最擅長的部分。
認知工件的觀點也把常見的失敗模式解釋為表徵設計的失敗,而非單純的實作 bug。陳舊記憶以提供過時的問題表徵的方式錯誤呈現現在。過度抽象的記憶失去當前決策所需的操作細節。抽象不足的記憶以雜訊淹沒提示,反而退化了外部化原本要簡化的識別任務。被毒化或彼此矛盾的記憶把不正確的前提嵌入擷取切片中污染未來推理。在每種情況下,記憶體系統的失敗都不是因為它存的太少或太多,而是因為它沒有把歷史轉換成可用的當下。
在這個視角下,記憶體不只是用來擴張有效上下文的工程便利。它是一種重塑代理時間負擔的認知工件。透過把無界回想轉成有界、經策展的擷取,它在每個決策點上改變了模型所面對的任務。那種轉換正是把本節綜述的架構進程——從單體上下文到自適應系統——連到單一根本設計目標的東西:在對的時刻讓對的歷史被讀懂,使模型固定的推理容量花在推理上而非花在記憶上。
4. 外部化的專業:技能 (Skills)
技能外部化解決的是代理性的程序性負擔。一個語言模型在原則上可能知道如何解決一項任務,然而可靠的執行仍然要求每次嘗試任務時都重建工作流、預設值與約束。這個負擔隨任務長度、環境特殊性與分支決策數量而增長,並表現為變異性:被遺漏的步驟、不穩定的工具使用,以及不一致的停止條件。
技能引入的表徵轉換因此是從重複合成到可重用程序。技能系統不再要求模型每次執行都從權重或特設提示中重新生成任務專屬的 know-how,而是把該 know-how 打包成顯式工件,可以被發現、載入、修訂與組合。這主要不是擴張代理可用的動作集合;它把模型在執行時所面對的任務從「發明工作流」改為「選擇並遵循一個工作流」(Xu and Yan, 2026b; Wang et al., 2026a)。
在 harness 化的代理中,技能位於記憶體與動作之間。它們常基於擷取到的狀態被選擇,並透過協定化介面綁定到工具與子代理,然後由執行軌跡與事後反思更新。如第 3 節所述,記憶體外部化「跨時間學到了什麼」;技能外部化「該累積經驗如何成為可重用的運作結構」(Sumers et al., 2024; Wu and Zhang, 2026)。本章因此聚焦於三個相連問題:技能外部化了什麼負擔、技能如何重組任務執行,以及它們如何在更大的 harness 之內變得可被執行。
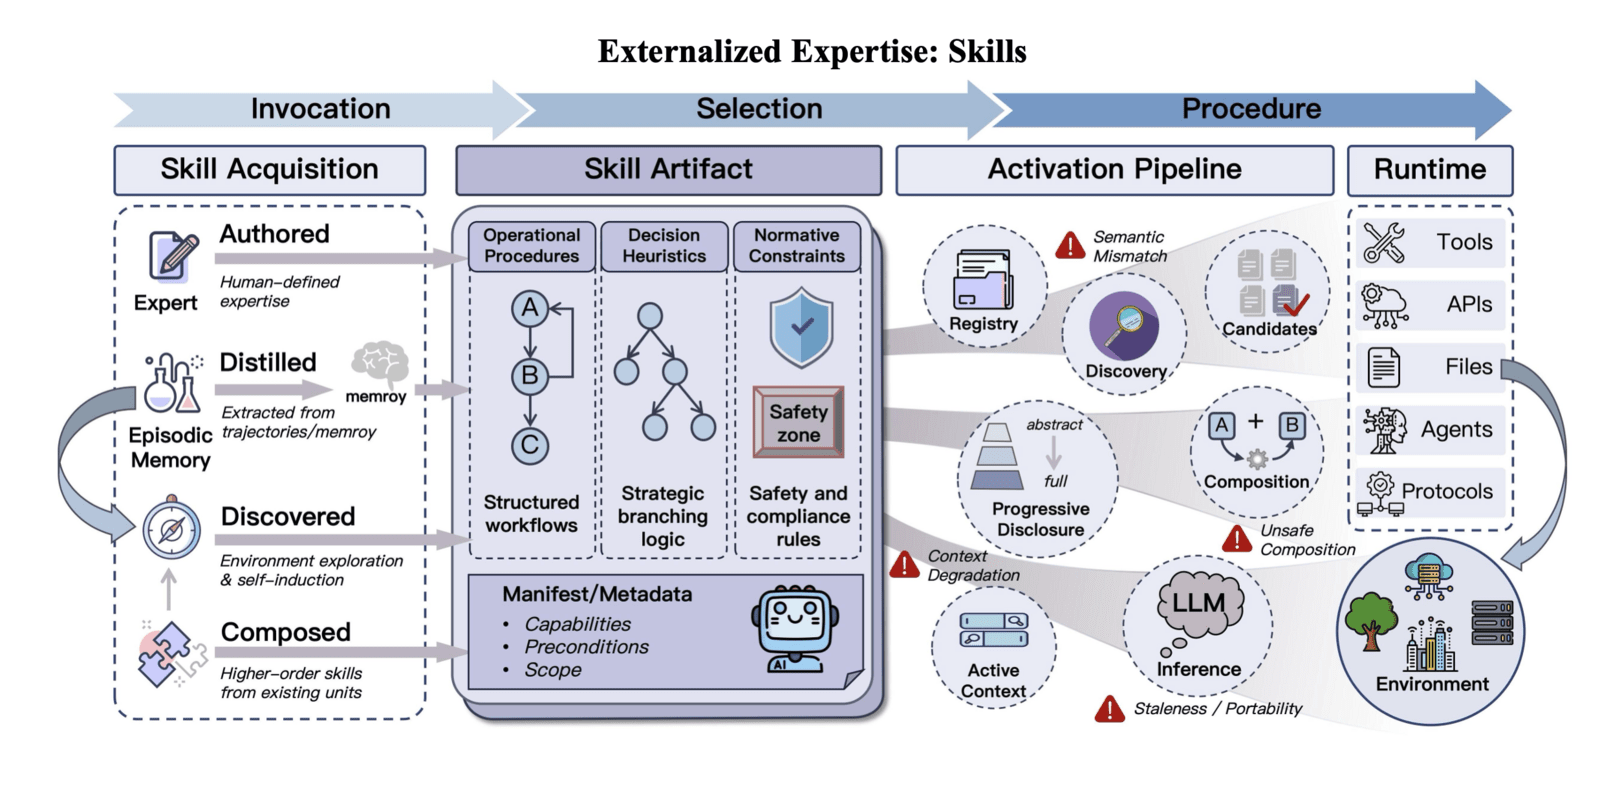 圖 5:技能作為外部化的專業。 此圖追溯一個技能的完整生命週期,分為三個階段——調用、選擇與程序。技能取得 (Skill Acquisition) 顯示程序性 know-how 進入系統的四條路徑:由專家撰寫、從情節記憶與軌跡中蒸餾、透過環境探索與自我歸納發現,或從既有單元組合而成。技能工件 (Skill Artifact) 把該 know-how 打包成操作程序、決策啟發式與規範性約束,並附上一份宣告能力、前置條件與範圍的清單。啟動管線 (Activation Pipeline) 處理基於註冊表的語意抽象發現、從抽象摘要到完整指南的漸進式揭露,以及把技能綁定到工具、API、檔案、代理與協定的組合。執行時 (Runtime) 顯示活躍上下文與 LLM 如何執行所選技能,而陳舊性、可攜性限制、上下文相依的退化以及不安全組合等邊界條件則限制了可靠性。
4.1 外部化了什麼:程序性專業
技能外部化關心的是程序性專業,而非孤立的動作介面。這裡的「專業」意指在反覆出現的假設與約束下、執行任務的可重複方式,而不是一個模糊宣稱「模型可以做到」。一個有用的邊界從這個定義出發:工具暴露操作、協定治理這些操作如何被描述與調用、而技能編碼某類任務該如何用它們執行。實務上,那種專業有三個彼此耦合的成分:操作程序、決策啟發式與規範性約束。它們共同定義 harness 可以外部化的可重用 know-how 單元。
4.1.1 操作程序
操作程序是任務的骨架:一項複雜工作的分解,其步驟、階段、相依關係與停止條件。它解決了 LLM 代理常見的失敗模式。許多錯誤並非來自動作層級的能力不足,而是來自過程層級的不穩定,例如步驟被略過、操作順序錯亂或過早終止 (Hsiao et al., 2025; Nandi et al., 2026)。把程序外部化會把脆弱的過程知識轉成顯式的運作路徑。
這個轉變在 LLM 推理的更廣演化中有深遠根源。Chain-of-Thought 把中間推理顯式化 (Wei et al., 2023);ReAct 把推理與動作耦合 (Yao et al., 2023a);後續的提示串接 (Prompt-chaining) 與協同系統把反覆出現的模式打包成被工程化的工作流。這些方法常缺少的是持久性。程序存在於當下這一執行中,但還不是可重用的工件。技能系統透過把工作流結構變成可被儲存、修訂與再應用的東西,填補了這個缺口 (Ye et al., 2025)。
一旦程序被外部化,執行就變得較不即興。代理可以在中斷後恢復、把工作跨上下文或協作者交接,並從狀態中復原而不必從記憶中重建整個工作流。這在長時程、多代理與生產環境中最為重要,因為過程穩定性往往比片刻的流暢更重要。
4.1.2 決策啟發式
如果程序定義了執行的骨架,那麼決策啟發式 (Decision Heuristics) 治理的是分支處發生的事。真實的任務很少以固定管線展開。工具會失敗、觀察會帶雜訊,且幾個局部上看似合理的動作可能彼此競爭。在這些條件下,良好的效能仰賴從經驗導出的實務性經驗法則,而非僅靠窮舉搜尋 (Gigerenzer and Gaissmaier, 2011)。
把這些啟發式外部化會改變推理努力的分佈。系統可以編碼已被證明有用的預設選擇、升級規則或偏好順序,而不是強迫模型在每個轉折處重新發現局部政策。這降低了審慎成本,也讓行為更穩定。啟發式因此並非次要的便利。它們是技能捕捉專家風格的主要方式之一:先嘗試什麼、何時退場、什麼證據夠用,以及當多條路徑仍然可行時偏好哪個取捨。
4.1.3 規範性約束
第三個成分是規範性約束 (Normative Constraint):一個程序在何種條件下算是可被接受。一個工作流可能技術上有效卻仍然不合規、不安全或在運作上錯誤。在真實部署中,執行受測試需求、範圍限制、存取限制、可追蹤性期待與領域專屬的運作規則所界定 (Chen et al., 2021; Bai et al., 2022b; Wei et al., 2023; Schick et al., 2023; Madaan et al., 2023)。
一旦被外部化,這些約束就不再只是事後評估的標準,而成為技能本身的一部分。它們可以塑造前置條件、阻斷不安全的分支、要求中間驗證,或定義必須在完成前產生的證據。這正是技能能編碼「不僅如何完成任務,而且如何在組織與安全邊界內完成任務」的方式。在成熟系統中,技能因此既是能力的載體,也是治理的載體。
整體看,操作程序提供結構,決策啟發式提供局部政策,而規範性約束提供可接受邊界。一個技能只有在這三者都被指定得夠好以致能跨任務、跨情境與跨執行存活時才是可重用的。這就是為什麼技能位於動作介面之上、與記憶體並列:它們外部化的不是過去狀態也不是原始執行原始體 (Primitives),而是可重複的任務 know-how。
4.2 從執行原始體到能力套件
技能系統並非孤立出現,但也不應與工具使用混為一談。歷史上,技能在兩項較早的發展之下游:可靠的動作調用,以及大規模的動作選擇。那些階段擴張了代理能做的事情,但還不到「某類任務該如何被反覆完成」的程度。技能只有在程序組織本身成為顯式可重用工件時才出現。
4.2.1 階段 1:原子執行原始體
第一階段為語言模型裝備可靠的動作執行,例如透過結構化的工具調用與 function-calling 介面。Toolformer 是這個階段的代表,它展示模型能學會何時呼叫工具、如何構造參數、以及如何納入結果 (Schick et al., 2023)。這個階段的關鍵成就是穩定地存取原子動作單元。它沒有提供的是一個用於完成更廣任務類別的顯式可重用程序。其單元是動作原始體,而不是技能。
4.2.2 階段 2:大規模原始體選擇
當可呼叫工具的數量增長後,問題從調用轉向選擇。Gorilla、ToolLLM、ToolNet、ToolScope 與 AutoTool 等工作展示了模型可以擷取、排序,並動態地在大型工具集合中做選擇 (Patil et al., 2023; Qin et al., 2023; Liu et al., 2024b, 2025b; Zou et al., 2025)。這是邁向可擴展動作選擇的重要一步,但其單元仍是工具而非程序。即使多步驟行為開始浮現,完成一類任務所需的 know-how 仍主要隱含在提示或參數中,而不是被外部化為一個有界、可重用的工件。
4.2.3 階段 3:技能作為打包好的專業
第三階段標誌著抽象上的進一步轉移。中心問題不再是模型是否能調用某個 function 或擷取某個合適的 API,而是「完成一類任務所需的 know-how 能否被打包成可重用的能力單元」。在這個階段,能力的根本單元不再是孤立的工具呼叫,而是以可重用程序指引與執行結構為中心的更高層工件 (Wang et al., 2025c; Chen et al., 2026b)。一個技能不只指定可以做什麼,而越來越捕捉一項任務該如何透過可重用的程序組織來執行 (Li et al., 2026c)。
近期的工作越來越明顯地呈現這個轉變。基於程式的技能歸納把原始動作編譯成更高層可重用的技能,顯示代理能力可以被表徵為可執行的程序性抽象,而非一次性的調用 (Wang et al., 2025c)。在網頁環境中,互動軌跡可以被蒸餾成可重用的技能庫或技能 API,讓代理跨任務累積與精修可遷移的 know-how (Zheng et al., 2025a)。在電腦使用場景中,技能進一步被組織成參數化的執行與組合圖,擷取、引數實例化與失敗復原都在技能層級而非個別介面動作層級運作 (Chen et al., 2026b)。SOP 引導的代理相關工作同樣顯示,領域專業可以被外部化為依領域專屬程序引導執行的顯式程序結構 (Ye et al., 2025)。
與較早階段相比,此處的關鍵轉變是表徵性的而非僅是運作上的。能力不再主要被視為對工具或 API 的存取,而越來越被視為打包好的程序性知識,可以跨任務被載入、重用與組合 (Li et al., 2026c; Xu and Yan, 2026b)。在這個意義上,階段 3 並非僅讓工具使用變得更複雜,而是反映出一種把代理能力表徵為外部化、可重用程序性 know-how 的轉移。
4.3 技能如何被外部化
技能外部化並未在「寫下指令」這個動作上窮盡。在成熟代理系統中,關鍵問題是程序性專業是否能以一種在執行時可被發現、可被載入、可被解讀、可被綁定且可被執行的形式被表徵出來。因此技能外部化同時涉及一個表徵層與一個執行時層。前者決定一個技能如何被描述與界定,而後者決定它在任務執行中是否能真正作為可重用能力發揮作用 (Xu and Yan, 2026b)。用 harness 的術語來說,一個技能只有在執行時能決定何時載入它、要以哪段記憶體去條件化它,以及要把它綁到哪些工具、檔案或子代理時,才算是真實。這個綁定要求並沒有讓技能等同於工具或協定;它只是意味著程序性專業最終必須被接到可執行的介面上。
4.3.1 規格 (Specification)
一個技能的外部化從規格層開始。典型的形式包括 SKILL.md、指令檔、清單 (Manifest) 或其他宣告式規格工件。這些工件描述一個技能做什麼、它適用於哪些場景、它假設了什麼相依、它必須滿足什麼約束,以及它應該在哪種輸入輸出條件下運作。一份技能規格更像 API 文件而不是 API 實作。它的價值在於把程序性專業從一個不透明的內部狀態變成一個可被檢視、討論、修訂與治理的顯式物件 (Ling et al., 2026)。
一份良好的技能規格在理想上至少應該涵蓋五類資訊:能力邊界、適用範圍、前置條件、執行約束,以及範例與反例。前兩類釐清這個技能是為了解決什麼類型的問題。接下來的兩類釐清它在什麼條件下能被安全使用、以及在什麼運作假設下使用。最後一類有助於把預期的使用模式錨在具體案例上,從而減少模型對它的不充分指定詮釋。透過這樣的結構化規格,一個技能就從非結構化的提示伎倆提升為一段有界的能力描述,這又為發現、載入、版本控制與治理提供了基礎。
4.3.2 發現 (Discovery)
一旦技能成為顯式工件,它們就自然引入了註冊與發現問題。在實際情境中,代理不能對每個任務都不加區分地載入每一個可用技能。因此它需要某種註冊與發現機制以支持選擇性擷取。一個技能可能被發布到本地倉庫、組織註冊表或平台層級的市集,而代理則根據任務目標、上下文狀態與環境條件搜尋相關候選 (Zheng et al., 2025a)。
這個發現過程可能仰賴語意擷取、結構化中繼資料、任務分解或這些策略的組合,依系統設計而定。關鍵在於:系統不僅僅在問「哪個工具可被呼叫」。它在問「哪一個程序性專業單元適合當前的問題」。這使得技能發現成為更高層的匹配問題。它不僅必須考量主題相似度,還要考量任務複雜度、環境假設、操作約束與風險條件。因此一個技能應該被擷取,不是因為其關鍵字與任務描述重疊,而是因為它在語意與運作結構上真的與當前任務相容 (Ross et al., 2025)。技能外部化若僅止於儲存就尚未完成。它還必須在現實任務條件下能被擷取到。
4.3.3 漸進式揭露 (Progressive Disclosure)
技能被發現並不意味著它的全部內容應該立刻被注入活躍上下文。因為長上下文不可靠地對應到更好的效能,詳細指令可能成為推理雜訊的來源而非指引的來源。為此,當前的技能系統常受惠於漸進式揭露策略,先暴露技能的存在,更深的細節只在需要時才被載入 (Xu and Yan, 2026b)。
在當前的工業實作中,這常採用分層形式。在最小層級,模型只看到技能的名稱與一段簡短描述,這已足以表示該能力存在。較深的層級可以暴露清單式資訊,例如適用條件、必要前置條件與主要約束。只有在最深的層級,系統才會載入完整指南,包括詳細程序、例外處理、範例與支援檔案。這種分階段載入的目的不僅在於壓縮文件。更根本地,它把「是否需要更多技能細節」這個問題本身變成執行時的決策。在這種方式下,技能的資訊密度可以被匹配到當前任務的複雜度,而不是從一開始就把不必要的細節塞滿上下文。這個設計在當前技能的工業實作中尤其明顯,例如 Claude Code 的技能系統 (Anthropic, 2025)。
4.3.4 執行綁定 (Execution Binding)
一個技能在被連到可執行的動作之前都仍是一段認知層級的描述。實際的任務完成因此倚賴一個綁定流程,把技能的自然語言或結構化規格翻譯成當前環境中的具體操作。正是在這一點上,技能、工具與協定之間的區別變得清楚。
一個技能通常本身並不是動作執行器。相反地,它必須被綁定到一個更低層的執行時基底上,例如工具、檔案、API、子代理、協定端點或其他執行介面。一個技能可能指定代理應該搜尋相關程式碼、執行測試並摘要產生的 diff,但動作本身是由搜尋工具、檔案操作、shell 命令與測試執行器來執行的。因此工具提供可執行操作;協定治理這些操作如何被描述與調用;技能則為把它們組合成可重複任務完成提供更高層的策略。
這個綁定通常需要一個中間的詮釋層,在當前情境下決定哪些技能步驟應該被啟動、哪些原始體應該被綁定、哪些條件應該觸發分支,以及哪些約束應該優先。沒有這樣的詮釋與綁定流程,一個技能很容易停留在原則上可讀但實務上無法使用的靜態工件。更廣泛地說,諸如 MCP (Anthropic, 2024) 之類基於 schema 的介面藉由讓能力可被發現與調用,又不把技能塌陷成工具或協定本身的方式,支撐這個執行時綁定層。
4.3.5 組合 (Composition)
一個技能系統的價值在能組合技能時才被最完整地實現。與原子工具不同,技能可以參與更高階的結構化協調,使複雜任務能被分解成多個能力套件之間的合作。常見的組合模式包括序列執行、並行分工、條件路由與在更高層技能內遞迴調用子技能 (Wang et al., 2023a)。
這種組合性意味著一個技能不只是給模型消耗的文件,更是代理架構內可被排程的執行時單元。更重要的是,組合並不只是把多個程序片段串接起來。它是程序性專業本身在更高層級上的重用。例如,一個產生資料分析報告的技能不必被實作為單體式的端到端程序。它可以被組織為由更小的技能——資料清洗、統計分析、視覺化與敘事合成——所協調而成。在這種方式下,系統不僅獲得更強的任務效能,還獲得更好的可維護性、可替換性與可審計性。組合因此標誌著技能成為真正能力層的時刻,而不只是孤立食譜的集合 (Yu et al., 2025)。
整體看,技能外部化不應被理解為只是發布一份靜態的指令檔。它是一個被協調好的流程,其中程序性專業被指定、可被發現、被選擇性揭露、被綁定到可執行基底,並被組合成更大的能力結構。重要的不僅是技能能否被寫下來,而是它能否可靠地進入代理的執行時、作為與擷取狀態與協定化介面互通的可用動作單元。因此,技能的外部化標誌著從非正式提示走向代理系統更顯式能力層的轉變。
4.4 技能取得與演化
一個技能系統之所以重要,不僅是因為它儲存了被撰寫的指令,更是因為它提供一條把成功行為轉成可重用專業的路徑。技能取得因此最好被理解為一個演化過程,其中程序性知識隨時間被撰寫、抽取、發現與重新組合 (Xu and Yan, 2026b)。
作者撰寫 (Authored)。
人工撰寫仍然是技能進入當前系統最常見且穩定的途徑。無論是 SKILL.md、AGENTS.md、專案層指令檔,或是組織的 SOP 模板形式,這些工件都是人類設計的程序性能力套件。它們的重要性不僅在於提供初始能力,更在於支撐反覆修訂。當一個代理在部署中反覆出現某種失敗模式時,工程師可以更新對應的技能,使一次觀察到的失敗變成被釐清的程序或被新增的約束。在這種方式下,被撰寫的技能文件不僅是描述性的。它也作為一個實務介面,透過它把運作經驗逐步轉成可重用的行為結構 (Ling et al., 2026)。
蒸餾 (Distilled)。
技能也可以從歷史軌跡、實踐軌跡或其他被儲存的經驗中歸納出來。情節紀錄保留代理過去做了什麼,以及為什麼某條軌跡成功或失敗。當某些成功結構在跨任務間反覆出現時,系統可以把這些模式抽象成更穩定的程序單元。在這個意義上,記憶體保存經驗,而技能歸納抽取其中可重用的結構。當這個過程被框架成「從互動軌跡的歸納」而非「記憶體會自動變成技能」這種廣義主張時,現有證據對它的支持最直接。例如 Skill Set Optimization 從帶獎勵的子軌跡中抽取可遷移技能 (Nottingham et al., 2024)。在記憶體管理的場景中,MemSkill 進一步顯示一些記憶體操作本身可以被重新表述為可學習與可演化的技能 (Zhang et al., 2026a)。
發現 (Discovered)。
除了人工撰寫與事後蒸餾之外,代理還可以透過環境互動自主地發現新技能。Voyager 在 Minecraft 場景中提供了一個有影響力的例子,其中探索、執行回饋、自我驗證與課程驅動的任務選擇共同產生了一個不斷成長的可執行程式碼技能庫 (Wang et al., 2023a)。更近期的工作顯示,這個發現過程也能被導向泛化。例如 PolySkill 透過把抽象目標與具體實作分開來改善技能重用 (Yu et al., 2025)。一旦代理能識別反覆成功的行為模式並把它們提升為顯式技能,技能庫就不僅是儲存層,也成為能力成長的機制。
組合 (Composed)。
最後,技能也可以透過組合演化。許多更高層的能力並不是從零發明出來,而是從既有的低層或中層技能組裝而來。一個複雜工作流,例如報告生成或程式修復,可能從更小能力的反覆協調中浮現。組合在此重要的不只是執行策略,也是取得機制。一旦某個既有技能的特定組合反覆地被驗證為有效,那個組合本身可以被打包成一個新的更高層技能。在這種方式下,組合產生新的可重用單元,逐步形成階層式的技能曲目,而不是孤立能力的扁平列表 (Wang et al., 2025c)。
整體看,技能取得不是一次性的設計步驟,而是一個持續的撰寫、抽取、發現與重組程序性知識的過程。一個成熟的技能系統因此不是由它儲存了多少指令來定義,而是由它如何把經驗轉成可重用的外部化專業來定義。在 harness 化的代理中,這個演化迴路本身被系統化:記憶體提供證據,評估器決定什麼值得被提升,而協定化的執行介面決定一個候選技能是否真的能被部署。
4.5 邊界條件
技能外部化改善重用與治理,但它並不保證可靠性。一旦程序性專業被外部化為顯式工件,它的有效性就取決於該工件與任務、環境與所使用的執行時的契合程度。在實務上,主要的邊界條件涉及語意對齊、可攜性與陳舊性、不安全組合,以及上下文相依的退化。
語意對齊 (Semantic alignment)。
一份技能規格以自然語言或輕量結構化形式表達意圖與指引,而真正的執行則仰賴具體工具、API 與環境約束。結果是模型可能在字面上遵循技能的措辭,卻仍然錯失任務的真正目標。現有證據顯示技能的有效性大幅取決於任務意圖、技能描述與調用決策之間的對齊。SkillProbe 把語意-行為不一致 (Semantic-Behavioral Inconsistency) 識別為現有技能市集中的根本缺陷 (Guo et al., 2026)。工具使用決策的相關工作同樣顯示,關鍵的困難往往不僅在於某個外部能力是否能被呼叫,而在於它在當前對任務的詮釋下是否應該被呼叫 (Ross et al., 2025)。這顯示外部化的技能對於描述與使用之間的不匹配仍然敏感。
可攜性與陳舊性 (Portability and staleness)。
即使一個技能在內部是連貫的,它跨環境的有效性也不能被假定。網站、API、相依、工作流或執行時慣例的變化可能讓一個曾經有效的技能變得部分誤導或完全過時。更廣泛地說,跨代理框架、工具基底與基礎模型的異質性意味著同樣的技能可能在不同場景中行為不一致。程式技能的工作已經顯示,一些被歸納出的技能可以跨網站遷移,而不相容的則必須被更新以容納環境變化 (Wang et al., 2025c)。SkillsBench 進一步指出技能效用在不同領域與不同模型-代理配置中差異顯著 (Li et al., 2026c)。更廣的涵義是:技能可攜性最好被視為一個有條件的經驗性質,而不是外部化的內在特徵。
不安全組合 (Unsafe composition)。
組合讓技能更強大,但它也創造新的風險。在孤立時看似無害的技能在被組合時可能不安全地交互,特別是當它們捆綁了長篇指令、可執行腳本與外部相依時。在這種情況下,問題不局限於單一技能工件,而是從多個工件以及把它們連結起來的介面之間的互動中浮現。這是其中一個目前已有直接證據的邊界條件。對公開技能生態的大規模實證研究報告了相當高的漏洞比率,包括 prompt injection、資料外洩、權限提升與供應鏈風險 (Liu et al., 2026)。攻擊導向的研究進一步顯示,技能檔案本身可以成為當前代理現實中的 prompt-injection 表面 (Wang et al., 2026c)。技能組合因此應被視為對安全敏感的流程,而非單純良性的模組重用。
上下文相依的退化 (Context-dependent degradation)。
進一步的困難是技能執行可能在延長互動中退化。即使技能檔案已被更新,代理仍可能因為殘留的 session 上下文、被快取的摘要或先前被強化的動作模式而繼續遵循過時的運作邏輯。同時,當太多局部程序細節被注入上下文時,詳細的技能指南可能會干擾整體任務追蹤。在這些情況下,模型可能小心地執行指令卻失去對真正成功條件的視野。對這些效應的技能特定直接證據仍然有限,但關於多輪漂移、長時程可靠性與長上下文推理的相鄰工作強烈顯示這些是真實的邊界條件 (Lee, 2026)。技能載入因此不應只被視為擷取問題,也要被視為上下文配置與執行穩定性的問題。
整體看,這些邊界條件顯示一個技能不是寫好之後就能保持穩定的自足模組。它的有效性仰賴與任務、環境、執行時條件與安全約束的持續對齊。技能因此不應被視為孤立工件,而應被視為嵌在更廣工程框架之中的元件。這正是為什麼技能設計最終會超越工件本身而指向 harness 工程。
4.6 harness 中的技能
上述邊界條件顯示技能無法被當作獨立工件來評估。它們的可靠性取決於它們如何被置於一個運行中的系統內。本節檢視一旦技能被嵌入 harness 之後它們如何變得可運作,焦點放在把它們連到記憶體、協定與執行時治理的耦合上。
以記憶體為條件 (Conditioning on memory)。
一個技能是基於擷取到的狀態被選擇與參數化的。harness 向記憶體查詢任務歷史、過去結果、使用者專屬上下文與環境約束,然後用那證據決定要載入哪個技能、要實例化哪些參數,以及要偏好哪些分支。沒有這個條件迴路,技能選擇就會退化為對任務描述的關鍵字匹配。有了它,同一個技能可以根據代理過去學到的東西被以不同方式應用。記憶體因此供應使技能選擇有情境而非通用的處境證據。
透過協定綁定 (Binding through protocols)。
一旦被選中,技能必須被接到可執行的動作上。這個接合通過協定化的介面:工具 schemas、子代理委派契約、檔案操作與批准工作流。harness 透過解析目前可用的協定端點、檢查權限,以及把技能步驟路由到合適的執行基底來中介這個綁定。技能與協定因此互補:技能指定該做什麼;協定指定產生的動作要如何被描述、調用與治理。
執行時治理 (Runtime governance)。
在生產設定中,harness 也對技能執行施加治理。這包括在敏感操作之前的權限檢查、對高風險步驟的批准門檻、紀錄哪個技能被載入並產生了什麼動作的稽核日誌,以及在多步驟程序的中途失敗時的回滾機制。這些控制不是技能工件本身的一部分;它們是技能執行所在的 harness 環境的屬性。一個在沙盒化開發情境中安全有效的技能在生產部署中可能需要額外約束,而 harness 是執行那些約束的層。
生命週期回饋 (Lifecycle feedback)。
最後,harness 閉合技能執行與技能演化之間的迴路。執行軌跡、成功率、失敗模式與使用者更正都會被寫回記憶體。隨時間,那證據可能觸發技能修訂、棄用或新候選技能的提升。harness 因此不僅承載技能;它提供了讓技能改善的回饋基礎設施。這個迴路把技能取得 (4.4 節) 連到執行時運作:被撰寫或被發現的技能進入 harness,harness 治理它們的執行,而執行結果回饋進未來技能的證據庫。
4.7 技能作為認知工件
接下來的解讀主要是理論性的而非直接經驗性的。它借鑑關於認知工件的經典工作來解釋為什麼外部化的技能能改善程序性專業的組織方式,而不是聲稱這些理論本來就是為 LLM 代理發展的。
從 Norman 認知工件理論的視角來看,技能系統可以被理解為在能力組織維度上的表徵轉換 (Norman, 1993)。沒有外部化的技能時,模型必須在任務執行期間反覆從內部參數重建程序性知識。有了技能後,那部分程序性負擔被搬到一個顯式的外部表徵中,可以被載入、檢視與遵循。這把任務從不穩定的潛在程序回想轉移到一個更穩定的「識別適用指引並在指引下行動」的過程。在這方面,技能檔案的角色與 Norman 對「外部清單如何改變記憶之本質」的分析非常相似。關鍵不只是新增了額外資訊,而是認知任務的形式本身被重新組織了。
這個重新組織之所以重要,是因為它改變了模型在推論時必須做的事。沒有技能時,模型必須在當前情境的壓力下從其參數機率性地復原一個合適的進行方式。一旦技能被外部化,程序結構就以環境中的一個物件形式預先存在。模型的負擔轉向詮釋當前情境、識別技能是否適用、遵循相關指引,以及處理局部例外。程序性知識因此不再是必須在每次執行時從零重建的東西。它變成一個可以被直接操作的外部物件 (Li et al., 2026c; Xu and Yan, 2026b)。
這個解讀也與 Kirsh 的互補策略概念一致,根據該概念,代理改善效能的方式不僅是內部更努力地思考,還可以透過重新組織外部環境,使一些認知工作被卸載到環境之中 (Kirsh, 1995)。LLM 在以穩定且可重複的方式重現長的多步驟程序上往往並不特別可靠。相同的提示在不同執行中可能產生不同的分解、分支決策或停止條件。相對地,它們在閱讀顯式指引、把它匹配到當前情境、並在所述約束下局部地調整執行上反而更為擅長。一個技能因此可以被理解為一種被工程化的互補策略。它把程序定義、約束與部分最佳實踐外部化為一個工件,同時把詮釋、情境匹配與例外處理留給模型本身。
技能並不是只是把更多資訊加到系統裡。它改變了能力被組織的方式。程序性專業從一個不透明且難以稽核的參數空間移到一個可檢視、可修訂、可組合的外部結構之中。這就是為什麼技能的意義不在於工程便利,而在於對「know-how 寓於何處,以及它如何成為可重用的」這個問題的更深層重新分配。在這個視角下,技能不應只被視為提示或工具包裝,而應被視為在代理系統中組織程序能力的認知工件。在系統規模上,它們透過把反覆的工作流發明轉成在執行時控制下的選擇、載入與組合,外部化了程序性負擔。
5. 外部化的互動:協定 (Protocols)
協定外部化代理性的互動負擔。一個赤裸的模型可能能夠推論出某個工具該被呼叫、某個子代理該被委派、或某個回應該被展示給使用者,但若沒有顯式契約,它也必須臨場即興各種訊息格式、引數結構、生命週期語意、權限與復原行為。那個負擔把每個外部動作變成一場脆弱的提示遵循練習。
在 harness 之內,這個協定層是互動變成可治理之處。它中介工具如何被發現、子代理如何被聯繫、面向使用者的狀態如何被暴露、session 進度如何被表徵,以及權限與失敗如何被執行。協定因此既不是記憶體儲存也不是技能描述:它指定狀態、請求與動作如何在系統邊界之間移動所遵循的契約。本節因此檢視協定外部化了什麼互動負擔、為什麼這個外部化重要、目前協定地景如何被組織、協定如何在 harness 之內變得可運作,以及這個轉變如何透過認知工件的視角被理解。第 6 節之前的內容識別被外部化的互動的內容;5.1 節說明其益處的動機;5.2 節綜述各個協定家族;5.3 節檢視 harness 層級的整合;而 5.4 節以一個認知工件的解讀作結。
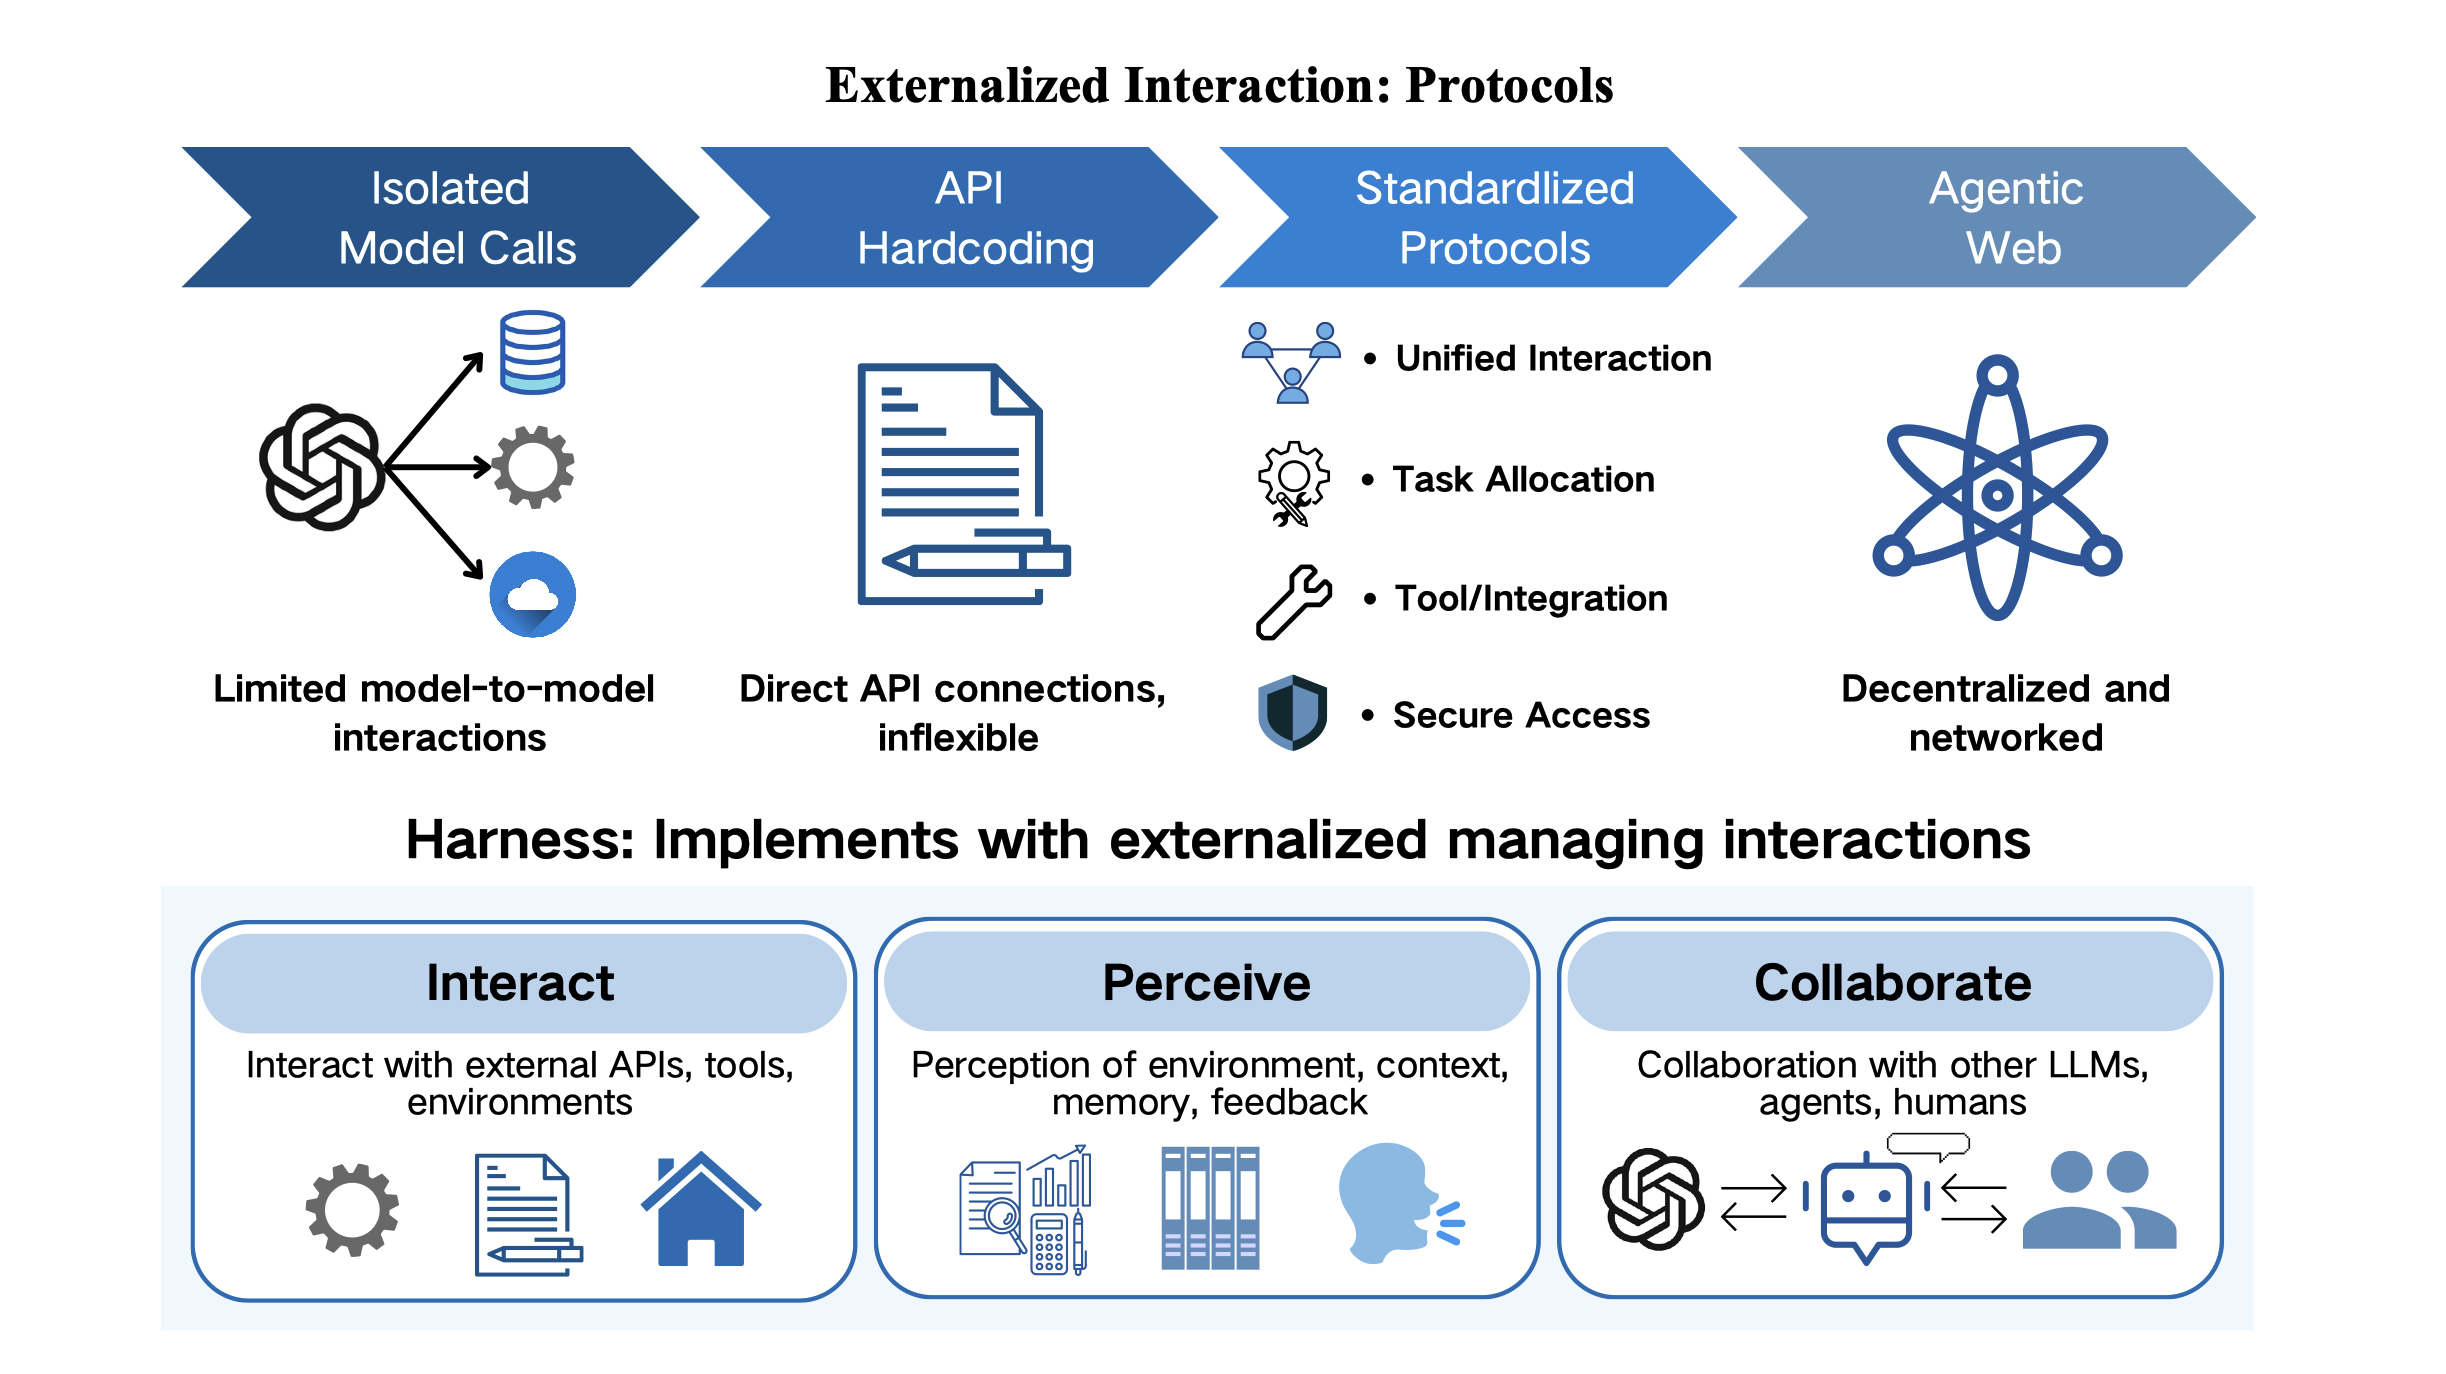 圖 6:協定作為外部化的互動。 上面板:代理互動的演化軌跡——從具有有限模型對模型通訊的孤立模型呼叫,經過硬編碼的 API 連線,到提供統一互動、任務分配、工具整合與安全存取的標準化協定,並最終朝向去中心化、網路化的代理網 (Agentic Web)。下面板:harness 透過三個功能表面實現外部化的互動管理:Interact (與外部 API、工具與環境介面)、Perceive (對環境、上下文、記憶體與回饋的感知) 與 Collaborate (與其他 LLM、代理與人類的協作)。
如果記憶體外部化時間狀態,技能外部化程序性專業,那麼協定就外部化了治理代理如何與自身之外的實體交換資訊與動作的契約。其表徵轉換是從自由形式的通訊推論到結構化交換。協定不再要求模型在執行時發明互動的句法與語意,而是提供型別化的表面、狀態轉移與機器可讀的約束,模型只要去填充與遵循。在那個意義下,協定不只是加速通訊;它們把任務從協商特設介面變成在顯式契約之內運作。
更具體地說,協定外部化的東西可以沿四個維度組織:
調用語法 (Invocation grammar)。
每一次工具呼叫、API 請求或委派訊息都需要一種格式:引數名稱、型別、順序與回傳結構。若沒有協定,模型必須在每次呼叫時推論或重新發明這個語法。協定把它外部化為 schema 與型別化介面,讓模型只需填充欄位而不是猜句法。
生命週期語意 (Lifecycle semantics)。
多步驟互動需要協調:誰下一步行動、允許哪些狀態轉移、何時任務完成或失敗。協定把這些排序規則外部化為顯式的狀態機或事件流,把它們從模型的推論負擔中移除。
權限與信任邊界 (Permission and trust boundaries)。
真實世界的代理動作受誰被授權、什麼資料能流到哪裡,以及必須產生什麼證據所界定。協定把這些約束外部化為可被執行時強制執行的可檢視規則,而不是依賴模型自我規範。
發現中繼資料 (Discovery metadata)。
在代理能與某個工具或另一個代理互動之前,它必須知道有什麼能力可用、以及如何聯繫它們。協定把這個發現問題外部化為註冊表、能力卡 (Capability Cards) 與 schema 端點,把隱含在提示中的知識替換為可被查詢的中繼資料。
這四個維度並不獨立——一個協定可能同時涵蓋好幾個——但它們釐清了被外部化的範疇。工具暴露操作;技能編碼某類任務該如何用那些操作執行;協定指定互動語法、生命週期、權限與發現機制,藉以使操作與技能能跨系統邊界被執行。
5.1 為什麼協定重要
代理協定 (Agent Protocols) 的重要性直接源自它們所外部化的負擔:沒有它們,每個互動都有一部分是關於格式、合法性與協調的推論問題。它們的好處最容易沿三個維度看到。
統一的互動標準 (Unified interaction standards)。
協定給工具、代理與前端一個共享的語法,用於發現、調用、交接與狀態交換。沒有那一層,生態會碎裂成不能跨執行時遷移的局部「提示加 parser」整合 (Yang et al., 2025a)。標準化的互動讓互通性成為被設計出來的屬性而不是幸運的偶然 (Ehtesham et al., 2025a)。它也是穩定的多代理協作的前提,因為委派與上下文轉移需要先有共同的表徵才能被自動化。
改善的安全性、治理與可審計性 (Improved security, governance, and auditability)。
一旦代理在真實環境中運作,問題不再只是它們是否能行動,還包括那些動作是否仍然是受界、可被檢視且可復原的 (Phiri, 2025)。協定透過讓權限、身分、執行軌跡、失敗狀態與責任邊界顯式化來幫助這件事。它把先前隱含的膠水邏輯變成執行時可以驗證、操作員可以稽核的東西。
降低供應商依賴 (Reduced vendor dependence)。
開放的互動契約也保留了架構彈性。如果系統把能力累積在協定層而不是廠商專屬的介面內,模型、廠商與執行時元件就可以在較少重新接線的情況下被替換。協定因此不僅是工程便利;它們是讓代理生態長期保持可攜與可演化的機制之一 (Yang et al., 2025a)。
5.2 代理協定綜述
在本節中,我們依不同實體對社群中流行的代理協定進行分類,分為代理-工具、代理-代理、代理-使用者,以及其他協定家族,並簡要介紹每個類別中幾個代表性與常用的協定。本綜述的目的不是列舉每一個新興標準,而是顯示當代協定外部化了不同切片的互動負擔:有些穩定工具調用、有些穩定代理之間的委派、有些穩定代理-使用者邊界,有些則治理高風險的垂直工作流。
5.2.1 代理-工具協定
代理-工具協定是最早成熟的協定家族之一,因為工具存取是介面碎裂最先出現之處。MCP (Anthropic, 2024) 是最清楚的代表。它提供了一個標準化方式讓代理跨異質服務發現工具、檢視它們的 schema 並調用它們。它解決的問題很直接:沒有共享契約時,每個新工具都需要客製化的整合邏輯、重複的 schema 定義以及廠商專屬的調適。
與相鄰層的邊界很重要。MCP 與相關協定指定工具如何被描述與調用;它們不指定該用那些工具遵循哪一個多步驟程序,且它們本身不在結果產出後保留跨 session 的認知。那些角色分別屬於技能與記憶體。
從架構上看,MCP 把工具存取轉成基於協定的整合,而不是逐介面工程。伺服器通常透過 JSON-RPC 2.0 以共同結構暴露工具與上下文資源,而客戶端則對該共享規格進行發現與調用。這把工具生態與模型廠商專屬的 function-calling 格式解耦,並降低新增能力的成本。實務上的收益很直接:動態能力發現、對複雜外部系統的標準化存取、結構化的請求/回應交換,以及模組化的可擴展性。
同樣的分離也改善治理。因為調用是由協定層中介而非以未受約束的模型生成呼叫的方式發出,敏感資料處理、權限檢查與稽核邊界可以被更顯式地管理。ToolUniverse 與相關系統用更專門的工具 schema 與互動慣例擴展了這個邏輯 (Gao et al., 2025b, a)。廣義來看,代理-工具協定外部化調用語法,使工具使用變得可攜、可檢視與可擴展,而不是大量客製轉接器的累積。
5.2.2 代理-代理協定
一旦多個代理協作,互動本身就成為系統問題。代理-代理協定定義能力如何被發現、任務如何被委派、進度與部分狀態如何被交換,以及結果如何回到呼叫者。它們把否則就會被埋在提示慣例或框架專屬膠水中的協調外部化。
A2A (Google, 2025a) 是當前最顯眼的例子。它透過 Agent Card 之類的工件把能力發現標準化,並支援異質代理之間的任務導向通訊、狀態更新、協商與串流進度。它的重要性不僅在於代理可以互相發訊,而是委派變成結構化的:呼叫者可以發現另一個代理提供什麼、在已知契約下交接工作,並追蹤執行而不必依賴硬編碼假設。
其他協定做出不同取捨。ACP (IBM Research, 2025) 透過熟悉的 REST/HTTP 模式強調輕量採用,並適合那些「與既有服務的相容性比豐富協商更重要」的場景。ANP (Chang et al., 2025) 朝相反方向推進,瞄準開放、互聯網規模的互通性,並具備去中心化身分、跨域發現與安全的端到端通訊。
整體看,這些協定顯示多代理系統需要的不僅是訊息傳輸。它們需要關於委派、身分、狀態與交接的標準化語意。這正是讓協調能從本地協同擴展到開放代理生態的東西 (Yang et al., 2025a; Ehtesham et al., 2025b)。
5.2.3 代理-使用者協定
代理-使用者協定形式化代理執行時與面向使用者的系統之間的邊界。它們解決的問題與工具或代理-代理協定不同:不是動作如何在他處執行,而是執行狀態、輸出與介面結構如何以前端能 render、使用者能理解的形式被暴露給人類 (Google, 2025b; CopilotKit, 2025)。
A2UI (Google, 2025b) 代表的是介面生成的分支。它讓代理用一種受限的宣告式格式描述 UI 結構,宿主應用可以跨平台地安全 render。這個協定之所以重要,是因為它把介面構造本身視為受治理的輸出而非任意的類 HTML 文字。
AG-UI (CopilotKit, 2025) 代表的是串流狀態的分支。它把型別化的執行事件標準化,例如執行開始、文字發出、工具呼叫引數、工具呼叫結果、完成與錯誤。前端可以訂閱該事件流並 render 執行時狀態,而不必學習每個框架的私有事件格式。
這兩個方向互補。A2UI 外部化介面組合;AG-UI 外部化該介面背後的鮮活狀態轉移。它們共同顯示協定化如何使人類-代理互動跨宿主變得更可觀測、可重用與可攜。
5.2.4 其他協定
除了一般互動家族之外,一些協定瞄準通用介面不夠用的高風險垂直工作流。UCP (Google, 2026) 為代理商務做這件事,把目錄、請求與結帳流程標準化,使代理、商家與支付提供者能在不需為每家店做客製整合的情況下互通。AP2 (Google Cloud, 2025b) 為支付做同樣的事,強調授權、簽章、可審計性以及可帶證據的交易物件,例如 IntentMandate、PaymentMandate 與 PaymentReceipt。
這些領域協定之所以重要,是因為它們外部化的是工作流專屬的治理,而非僅僅是通用通訊。在購物、支付、身分或合規等垂直設定中,協定必須編碼誰被授權、必須產生什麼證據,以及責任如何在流程中被追蹤 (UCP Documentation, 2026)。在所有家族之間,共同的模式是協定使協調問題顯式化。工具協定外部化調用語法、代理-代理協定外部化委派、代理-使用者協定外部化呈現與狀態串流,而領域協定外部化專業的治理。
5.3 harness 工程中的代理協定
如果上面的綜述顯示生態中正在外部化哪些互動負擔,那麼 harness 工程則顯示這些協定表面如何成為一個運行中代理的一部分。問題不再只是代理應該如何與其他實體通訊,而是這些通訊契約如何在代理被嵌入執行時之後治理執行、持久化、委派與復原。
傳統的 LLM 管線依賴模型推論格式、記住近期互動狀態,並猜外部動作該如何被組成。對於短的、鬆耦合的請求那樣或許足夠,但當工作跨越許多步驟、工具、代理或批准邊界時就會崩潰。harness 工程把那個負擔外部化到協定表面之中。模型輸出被當作結構化意圖捕捉,對權限與生命週期狀態做驗證,路由通過型別化介面,並以受治理事件而非自由形式猜測的方式被反映回執行時。
5.3.1 意圖捕捉與正規化
意圖捕捉與正規化是這些表面中的第一個。這層的工作是把模型產生的語言翻譯成執行時可以驗證並執行的顯式命令或事件。沒有它,執行語意仍然隱含:系統猜測模型是什麼意思,而小的語言變動可能導致大的運作差異。
成熟的 harness 因此在執行之前正規化意圖。自由文字的提案被映射到協定物件,對照當前情境與權限邊界做檢查,若不符契約則被拒絕或修訂。這並未移除模型的判斷;它把互動中脆弱的部分從潛在推論移到一個可檢視的介面上。其結果是長時程執行中更高的可靠性、更強的治理,以及在工具、代理與使用者之間更乾淨的交接。
5.3.2 能力發現與工具描述
能力發現與工具描述形成第二個表面。在較舊的系統中,對可用工具的知識常常一部分活在提示中、一部分活在開發者假設中。協定化的發現用顯式中繼資料取代它。在 session 開始或階段轉換時,執行時透過標準化訊息暴露當前可用的工具、它們的 schema 與輸入/輸出結構。
那個轉移有兩個效果。它降低了上下文膨脹,因為模型不需要在提示中攜帶每個工具契約;它使能力邊界變得可治理,因為權限、版本管理與稽核可以針對結構化中繼資料被執行,而不是從模型行為中推論。換句話說,代理停止猜測什麼可以被呼叫,並開始閱讀一個被宣告的能力表面。
5.3.3 Session 與生命週期管理
harness 協定也需要顯式的 session 與生命週期管理,因為長時程代理並不像孤立的單次呼叫那樣運作 (Chai et al., 2025)。執行時必須跨多輪、多個上下文視窗與多個執行階段保留互動狀態。這裡保留的不是完整意義上的耐久記憶,而是協定狀態:識別碼、角色、待處理動作、階段轉移與允許的下一步動作。
因此大多數長時運行的系統把一次執行視為一個有具名狀態與轉移規則的生命週期物件。協定層推進該物件、發出狀態變更,並協調檢查點或復原事件。當輸出或檢查點被寫入持久儲存時,它們就成為記憶體。差別很重要:協定維持互動的連續性;記憶體維持跨時間的連續性。
5.4 協定作為認知工件
前面幾節綜述了代理協定的內容、地景與 harness 整合。本節用前章在記憶體與技能上應用過的同一個認知工件框架來解讀協定外部化作為一種表徵轉換到底達成了什麼。
在 Norman 的術語中,認知工件透過改變一個任務的表徵結構來轉換它 (Norman, 1993)。協定為互動做了這件事。沒有它們時,每個外部動作都有一部分是自然語言推論問題:模型必須推論意圖中的操作、猜對的格式、重建可接受的約束,並希望接收系統正確詮釋結果。協定把那種開放式推論替換成一個有界、結構化的任務:填型別化的欄位、遵循一個被宣告的狀態轉移,並接收結構化的回饋。模型仍然需要對「是否要行動以及何時行動」做判斷,但它不再需要在每一步都重新發明互動的句法與語意。
這是代理系統中最強的外部化形式之一,因為它把整類推理從關鍵路徑中移除。其轉換類似於記憶體在時間狀態上引入的轉變 (3.4 節) 與技能在程序性專業上引入的轉變 (4.7 節),但它運作在另一個維度:不是要記住什麼或要怎麼進行,而是如何通訊與協調。標準化的協定減少了必須在模型內部做的決策數量。它們讓正確的互動更容易、不正確的互動更難——這正是 Norman 框架在外部表徵與任務良好契合時所預測的結果。
Kirsh 對互補策略的論述進一步澄清這點 (Kirsh, 1995)。LLM 在詮釋意圖、在選項中做選擇與順應情境上很強,但在不同介面要求下一致地產生良構結構化輸出上不可靠。協定實作一個互補的分工:模型貢獻判斷與意圖,而協定表面貢獻格式、驗證與生命週期控制。任何一邊單獨都不夠;放在一起,它們產生既靈活又有紀律的互動。
這個解讀也說明為什麼協定扮演的獨特角色不能被化約為記憶體或技能。記憶體外部化跨時間學到了什麼;技能外部化任務該如何被完成;協定外部化的是讓記憶體與技能以受治理動作的形式進入世界的紀律。記憶體需要受治理的讀寫路徑;技能需要可被綁定的介面;兩者都仰賴協定以可檢視、可審計、可復原的形式跨越系統邊界。協定因此不是圍繞「真正的智慧核心」的次要管線。它們是互動的認知工件——使其他形式的外部化智慧成為可運作的表徵基礎設施。
6. 統一的外部化:harness 工程
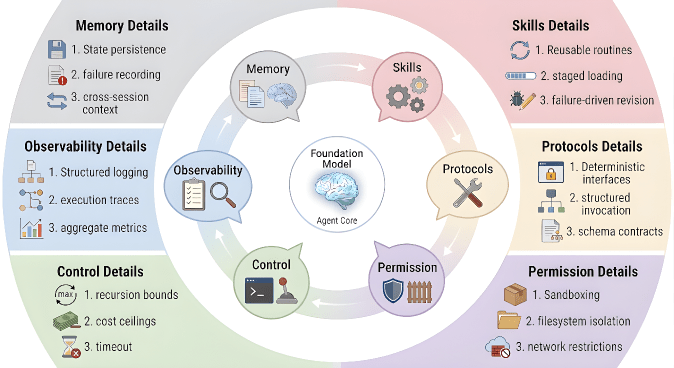 圖 7:harness 作為認知環境。 基礎模型 (Foundation Model,代理核心) 居於中央;六個 harness 維度形成圍繞它的協調環。三個外部化模組——記憶體 (狀態持久化、失敗紀錄、跨 session 上下文)、技能 (可重用例程、分階段載入、由失敗驅動的修訂) 與協定 (確定性介面、結構化調用、schema 契約)——供應外部化的認知內容。三個運作表面——權限 (Permission,沙盒、檔案系統隔離、網路限制)、控制 (Control,遞迴邊界、成本上限、超時) 與可觀測性 (Observability,結構化日誌、執行軌跡、聚合指標)——治理該內容如何在執行時被存取、被約束與被監測。箭頭指示 harness 迴路內各維度之間的持續流動。
圖 7 提供一個鳥瞰:基礎模型居於中央,被六個 harness 維度包圍,這些維度把外部化的認知協調成連貫的代理性。其中三個維度——記憶體、技能與協定——是前章 (3-5 節) 分析過的外部化模組。剩下的三個——權限、控制與可觀測性——是治理那些模組在執行時如何被存取、被約束與被監測的運作表面。本章把這三個表面解開為六個更細粒度的分析維度,這些維度共同刻畫 harness 設計。每一個前章在結尾都提到,其模組只有在被嵌入更廣執行時內部才完全可運作。3.3、4.6 與 5.3 節各自從其模組的視角識別了具體的 harness 需求。本章把那些線索統合起來。它問:要把外部化的記憶體、技能與協定組成連貫的代理性需要什麼樣的系統,以及該系統該如何被分析地理解。
中心主張是:harness 不只是堆疊在一個能幹模型之上的實作便利層。它是讓外部化模組共同變得有效的被設計的認知環境。這個框架推動本章的結構。6.1 節定義 harness 的概念並把它放回前章模組層級分析的脈絡中。6.2 節識別 harness 設計變動所沿的反覆出現的分析維度。6.3 節檢視這些維度在當代代理系統中如何呈現。6.4 節以從分散認知與認知工件理論的視角解讀 harness 為認知環境作結。
6.1 什麼是 harness?
外部化逐模組地推進,能改善局部能力,但代理性要求全域協調。記憶體累積經驗卻不指定哪些軌跡與當前任務相關。技能封裝有效例程卻不會自動納入過去互動的教訓。協定規範化調用格式卻不決定何時、在何種政策下該呼叫一個工具。各模組都在,但能讓它們共同有效的認知迴路仍未被指定。缺少的是一個有原則的結構,能夠隨時間協調它們的互動——把感知、記憶體存取、動作選擇、執行、監測與修訂在單一運作包絡 (Operational Envelope) 內對齊。
「harness」這個詞指的就是那個結構。它最近進入實務,作為描述把原始模型能力轉成可靠代理行為的鷹架 (Scaffolding) 的詞。例如 OpenAI 對 Codex 的工程討論明確使用該詞來描述使系統可用的代理迴路、執行邏輯、回饋路徑與周邊運作機械 (OpenAI, 2025a)。因為這個概念仍在收斂中,我們在此提供的刻畫最好被理解為對當前系統反覆模式的綜合,而非一個封閉的定義。
依此論述,一個實用的代理最好被理解為一個運作在 harness 內部的模型,而不是一個附加了周邊能力的模型。一個基礎模型本身保有通用推論能力,但缺少決定它能存取什麼、能如何行動、如何被約束,以及其行為如何被跨時間觀察與修訂的運作結構。harness 提供那個結構。它治理模型遭遇情境、調用工具、保留狀態與回應回饋的路徑。代理性因此並不只位於模型之中;它從模型與把其認知組織成行動的環境之間的耦合中浮現。
從功能上描述,harness 包含使這種耦合成為可能的外部系統:持久記憶體與專案層級的上下文、可重用技能與可執行例程、用於與工具與服務做確定性互動的協定化介面,以及這些元素得以運作的更廣執行時基礎設施。關鍵點不在於元件的精確清單——它在不同實作中各異並會持續演化——而在於它們的集體角色:它們創造了模型的推理能足以支撐持續工作的條件。這把分析注意力的所在從只看模型能力,轉移到模型在其下感知、決定與行動的表徵、程序與運作條件。代理性的改善因此不只可能來自更好的基礎模型,也可能來自更好的記憶體組織、更銳利的約束體制、更可讀的回饋通道與更謹慎設計的執行環境。
6.2 harness 設計的分析維度
前章討論的模組——記憶體儲存、技能工件與協定介面——供應外部化認知的原材料,但它們本身並未指定執行時如何隨時間協調感知、動作、約束與回饋。那個協調是 harness 的職責。圖 7 強調的三個運作表面——權限、控制與可觀測性——可以被分解成六個反覆出現的設計變化維度。每個維度處理外部化模組如何被組成一個運作中代理的某個面向;它們共同提供一個用於比較 harness 架構的分析框架,而非一份實作清單。
6.2.1 代理迴路與控制流
代理迴路是 harness 的時間骨幹。在最簡形式下,它實作一個感知-擷取-規劃-行動-觀察迴圈,其中模型接收當前狀態的結構化視圖、決定一個動作、透過工具或協定介面執行它、觀察結果並對應更新內部計畫 (Yao et al., 2023a; Shinn et al., 2023)。實用系統大幅變動了這個迴路結構。單迴路設計把推理與動作交錯在一次生成中;階層式設計把分解目標的規劃代理與執行個別步驟的執行代理分開;而多代理設計把子任務路由到具有不同工具集與權限範疇的專門代理 (Wu et al., 2023; Hong et al., 2023; LangChain, 2024)。
harness 在裸迴路之外加入的是對終止、遞迴與資源消耗的治理。沒有顯式控制時,一個代理迴路可能無限循環、透過無界工具呼叫升高成本,或遞迴生出耗盡上下文或計算預算的子代理。生產 harness 因此強制執行最大步數、遞迴深度限制、每步成本上限與超時約束。這些控制不是次要的安全措施;它們定義了代理推理展開所在的運作包絡。一個被良好調校的迴路使代理更可靠,並非靠讓模型更聰明,而是靠界定可能執行路徑的空間。
6.2.2 沙盒與執行隔離
只要代理對世界有所行動——寫檔、執行 shell 命令、呼叫外部 API——harness 就必須決定要暴露多少環境,以及如何容納非預期副作用。沙盒是這個要求的工程回應。它創造一個受控的執行邊界,限制代理能讀、能寫、能修改的東西,並提供讓失敗可被診斷與回滾的可重現性保證。
當代系統在不同粒度上實作隔離。Codex 風格的代理把每個任務在自己的雲端沙盒中執行,具有自己的檔案系統快照、網路限制與資源配額,使一次執行不會污染另一次 (Wang et al., 2025a; Yang et al., 2024a)。Claude Code 採取互補做法,暴露分級的權限模式——從完全自主執行到對每個工具呼叫的強制使用者批准——使同一個代理可以根據任務與運作者的風險容忍度在不同信任層級下運作 (Anthropic, 2026)。在這兩種情況下,沙盒都不只是安全圍欄。它是一個認知邊界,透過移除無關狀態、限制危險動作並讓工作區可被檢視來簡化代理的運作環境。隔離因此扮演著與其他外部化形式相同的表徵角色:它改變了模型必須推理的事情。
6.2.3 人類監督與批准門檻
對部署的代理而言完全自主很少是合適的。因此大多數生產系統會在代理迴路中插入介入點,讓人類運作者可以檢視被提議的動作、批准或拒絕它們、提供更正或重新導引執行。設計問題是這些門檻該被放在哪裡,以及在它們之間要授予多少自主性。
三種模式很常見。執行前批准在每次潛在造成後果的動作之前暫停代理並要求顯式確認。執行後審查讓代理行動,但在提交或繼續之前把結果浮上來供檢視。升級觸發允許代理在正常情況下自主執行,但在偵測到特定風險訊號時停下並請求人類介入——例如涉及敏感資料、不可逆操作或低於閾值的信心的動作。Hook 系統把這個模式一般化,讓運作者把任意邏輯——shell 腳本、驗證檢查、通知派發——附加到代理迴路中的特定生命週期事件,例如工具調用、檔案寫入或子代理生成 (Lazaros et al., 2026; Fernandez, 2026)。自主性層級因此不是代理的二元屬性,而是 harness 的可配置參數,可以依任務、依工具、依組織政策調整。
6.2.4 可觀測性與結構化回饋
一個在沒有留下可檢視軌跡的情況下行動的代理是無法被除錯、稽核或改善的代理。可觀測性是讓代理內部軌跡對開發者、運作者與代理本身可見的 harness 表面 (Zhu and Lu, 2026; Zheng et al., 2025b)。
在實作層級,可觀測性通常涉及對每次模型調用、工具呼叫、記憶體讀寫與決策分支的結構化日誌;把每個動作連到其因果前提的執行軌跡;以及聚合指標例如步數、token 消耗、錯誤率與延遲分佈。這些紀錄服務於兩個不同目的。對外,它們支撐除錯、合規稽核與事後分析 (Phiri, 2025)。對內,它們閉合把執行結果連回產生它們的模組的回饋迴路。一次失敗的工具呼叫可以觸發紀錄失敗情境的記憶體寫入;反覆失敗的模式可以標示某個技能需要修訂;延遲尖峰可以讓 harness 切換協定路徑。沒有結構化的可觀測性,這些回饋迴路就無法運作,而 harness 仍是一個靜態鷹架而不是一個自適應系統。可觀測性因此不是一個輔助便利;它是 harness 從自身運作中學習的機制。
6.2.5 配置、權限與政策編碼
一個 harness 必須編碼的不只是代理能做什麼,還有它在什麼條件下被允許做什麼。這要求一個把政策與執行邏輯分離、並讓治理規則顯式、可版本化、可審計的配置層。
實務上,配置通常分層在多個範疇中。使用者層級設定編碼個人偏好與信任邊界。專案層級設定指定哪些工具可用、哪些檔案路徑可被存取,以及哪些命令需要批准。組織層級設定強加個別專案無法覆寫的合規約束、成本上限與資料處理規則。這個分層模型意味著同一個基礎代理可以在不同政策體制下運作,而不需修改模型或它載入的技能工件 (Anthropic, 2026; Lee et al., 2026)。權限與政策因此最好被理解為外部化的治理:那些原本必須被嵌入提示或透過事後過濾來執行的約束,被改編碼為 harness 在執行時強制執行的宣告式規則。
6.2.6 上下文預算管理
上下文視窗在任何代理系統中都仍是最稀缺的共享資源。記憶體擷取、技能載入、協定 schema、工具描述與模型自身的推理軌跡都競爭同一個有限 token 預算。那個預算如何被配置是一個 harness 層級的協調問題,沒有任何單一模組能單獨解決。
有效的上下文管理通常結合幾個策略。摘要把較舊的對話輪與執行歷史壓縮成更短的、保留決策相關資訊但釋放當前步驟用 tokens 的表徵 (Packer et al., 2023)。基於優先順序的逐出 (Priority-based eviction) 移除或降級對活躍子任務的相關性已衰退的上下文項目。分階段載入——已在 4 節中討論過——確保詳細的程序指引只在偵測到匹配任務模式時進入上下文,而不是從 session 開始就佔用預算。harness 共同協調這些策略,因為最佳配置取決於執行的當前階段:早期規劃階段可能需要更多記憶體與較少技能細節,而晚期執行階段可能需要相反。上下文預算管理因此不是孤立的壓縮問題。它是動態的資源配置問題,其解必須由代理當前目標、它依賴的模組與它所在約束來告知。
整體看,這六個維度——迴路控制、沙盒、人類監督、可觀測性、配置與上下文管理——提供了一個刻畫 harness 架構的分析框架。它們本身都不是一種外部化的形式;每一個都是讓記憶體、技能與協定作為連貫系統運作的協同基礎設施的一部分。下一節用這個框架檢視當代代理系統如何在實務上實例化這些維度。
6.3 實務中的 harness:當代代理系統
上述分析維度不是抽象理想;它們對應到部署代理系統中可觀察到的具體設計選擇。當代生產代理——例如 OpenAI Codex (OpenAI, 2025a) 與 Anthropic Claude Code (Anthropic, 2026)——在產品表面、實作淵源與目標工作流上有相當差異,但它們收斂到一組驚人相似的 harness 結構。那種收斂在分析上很重要:它顯示這六個維度不是偶發的實作選擇,而是外部化代理性的結構性要求。下面的討論檢視這些反覆出現的模式而不細究任何單一系統。
迴路與控制流。
成熟的代理系統一致地把執行組織為一個顯式的迴路,把模型推理與工具調用、環境觀察交錯。harness 與底層模型被區分開,並被刻畫為提供核心代理迴路、執行邏輯與回饋路徑。關鍵地,迴路包含顯式的終止控制——步數限制、遞迴深度上限與資源上限——這些定義了模型推理展開所在的運作包絡。
沙盒。
當前系統在不同粒度上實作執行隔離。一些把每個任務在自己具備檔案系統快照、網路限制與資源配額的雲端沙盒中執行;其他則暴露分級的權限模式,讓同一個代理依情境在不同信任層級下運作。這些設計佔據隔離設計空間中不同的點,但它們共享一個共通原則:沙盒作為一個認知邊界,透過移除無關狀態與限制危險動作來簡化代理的運作環境,而不僅僅是作為安全周界。
人類監督。
部署的 harness 並非把自主性視為二元屬性,而是實作可配置的批准門檻——把驗證邏輯附加到工具調用、檔案寫入或子代理生成等特定生命週期事件的 hook 系統,以及把高風險動作路由通過批准工作流的應用層 (Lazaros et al., 2026; Fernandez, 2026)。自主性層級成為 harness 的參數,可以依任務、依工具、依組織政策調整。
可觀測性。
生產系統產生結構化的執行軌跡——對每次模型調用、工具呼叫、記憶體讀寫與決策分支的日誌——支撐除錯、合規稽核與事後分析 (Phiri, 2025; Zhu and Lu, 2026)。這些軌跡也閉合內部回饋迴路:失敗的工具呼叫可以觸發記憶體寫入,反覆失敗的模式可以標示需要修訂的技能。可觀測性因此是 harness 從自身運作中學習的機制。
配置與治理。
部署的 harness 通常把配置在多個範疇上分層——使用者、專案與組織——使同一個基礎代理在不同政策體制下運作而無需修改模型或其技能工件。權限與政策作為外部化的治理:那些原本必須被嵌入提示的約束改被編碼為執行時強制執行的宣告式規則 (Lee et al., 2026)。
上下文預算。
上下文視窗在任何代理系統中都仍是最稀缺的共享資源。當前 harness 透過摘要較舊歷史、把詳細技能指引延遲到偵測到匹配任務時才載入的分階段載入,以及對相關性已衰退項目的優先順序逐出,主動管理它。harness 共同協調這些策略,因為最佳配置取決於當前的執行階段。
獨立開發的系統收斂到同一組 harness 維度這件事本身就有啟發性。它表示外部化代理性的主要設計挑戰並不是從模型引出更好的完成,而是安排讓完成成為有效介入的運作條件。harness 工程因此既不是記憶體系統的同義詞,也不是工具呼叫的重新命名。它是關注於建構一個外部化模組能組成連貫代理性所在的認知與運作環境的更廣學科。
6.4 harness 作為認知環境
前面幾節從定義、反覆出現的設計維度與在當前系統中的呈現分析了 harness。本節最後退一步,從理論層級解讀 harness,問它是什麼樣的物件,而不是它如何被建造。
harness 的意義超出尋常軟體工程意義上的基礎設施。harness 並不只是支撐一個已成形的智慧;它透過決定推理展開所在的環境來塑造代理的有效認知。它規範了什麼進入代理的感知場、什麼跨輪與跨 session 被保留、哪些操作可被呼叫、哪些動作需要批准、哪些中間狀態被暴露以供修訂,以及哪些失敗形式可被偵測與復原。harness 因此設定了代理的實務認知邊界。代理能知道、記住與行動的東西並不是只由模型權重決定,而是由周邊系統所提供的存取、持久化與行動的條件決定。
這個主張可以在 Norman 的認知工件論述中被定位 (Norman, 1993)。Norman 把認知工件刻畫為被設計用來維持、展示或操作資訊以轉換認知效能的人造裝置——不是僅透過加速內部計算,而是透過改變任務本身的結構。harness 在系統規模上符合這個描述。它不只是用更多上下文或更多工具增強模型;它重新組織模型所面對的表徵問題。透過把記憶體外部化、把程序形式化、引入顯式控制點並約束執行,harness 把一個無界的任務轉成一個由引導動作組成的結構化環境。模型表面上的智慧因此被改變了,不只是因為它有更多資源,而是因為認知工作量已被重新分配到模型之外的工件、表徵與程序之上。在前章中我們已逐維度地分析過這個重新分配:記憶體把回想轉成擷取 (3.4 節)、技能把程序重建轉成被引導的執行 (4.7 節),而協定把特設互動轉成結構化交換 (5.4 節)。harness 是把這些個別轉換組成單一認知環境的系統層級工件。
Kirsh 對「對空間的智慧使用」(Intelligent Use of Space) 的論述讓這個解讀更銳利 (Kirsh, 1995)。他的核心觀察是:認知是被環境如何被安排所塑造的:空間與表徵的組織可以卸載搜尋、簡化選擇並降低內部計算負擔。harness 對代理扮演類似的角色。它是一個認知壁龕 (Cognitive Niche),其中資訊、工具、權限與程序被排列,使期望的行為更容易執行、不期望的行為更難產生。預設值、hooks、檔案邊界、技能調用模式與審查門檻,都作為縮窄合理動作空間的結構化規律。代理的能力因此部分是一種生態成就:它從被嵌入到一個其組織方式能順暢引導認知的環境中而生。
分散認知的框架把這個觀點一般化。Hutchins 的論述拒絕「認知只存在於個體心智中」的觀點,把認知過程改放在人、工件、表徵與被協調的實踐之間 (Hutchins, 1995)。一個配備 harness 的代理系統正可以用這種方式被理解。其運作中的智慧分散在模型參數、外部記憶體儲存、可執行技能、協定定義、工具表面、監測系統與治理它們互動的執行時約束之間。harness 是這個分散系統被協調所通過的媒介。把 harness 描述為認知環境而非僅是基礎設施層因此更準確。基礎設施是它的一個顯現;環境結構化——對認知展開所在條件的設計——才是它更深的功能。
7. 跨切面分析
三個外部化模組在分析上是區分的,但真實系統的力量來自它們之間的互動。3-5 節大致孤立地處理記憶體、技能與協定;第 6 節主張 harness 統一它們。本節檢視這些模組在被放入 harness 之後浮現的系統層級耦合,問它們在模型邊界如何呈現,並考慮參數化能力與外部化能力之間的邊界該被劃在哪裡。
7.1 模組互動圖
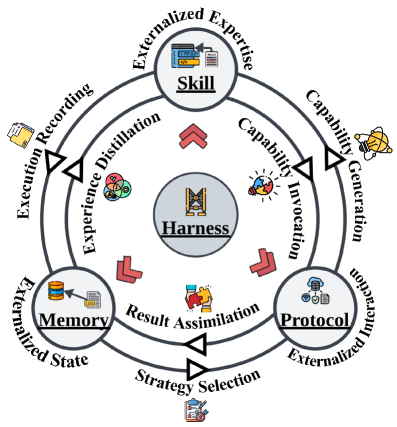 圖 8:記憶體、技能與協定之間的耦合。 六個箭頭總結了在 harness 內這三個外部化模組如何彼此強化。記憶體為技能形成與協定路由提供證據;技能把儲存的經驗轉成可重用程序並調用協定化動作;協定約束執行並把正規化結果寫回記憶體。
記憶體到技能:經驗蒸餾 (Memory to skill: experience distillation)。
反覆出現的軌跡可以被蒸餾成可重用程序,這是累積經驗成為被編碼專業的主要路徑。TED 與 UMEM 等系統展示了情節軌跡可以被群聚、抽象並被提升為技能工件,而不必修改基礎模型權重 (Yuan et al., 2026; Ye et al., 2026)。Voyager 在終身學習中把同樣的邏輯具體化:成功的行為被保留為可重用的程式碼層級技能,可以稍後被重新組合 (Wang et al., 2023a; Zhang et al., 2025b)。
這個流動的跨切面意義是:記憶體不僅保存過去;它提供讓 harness 決定什麼值得成為可重用運作模式的證據。蒸餾步驟的品質——系統如何決定哪些軌跡能被泛化、哪些是情境特定的——因此制約了下游整個技能層的可靠性。如果蒸餾過於激進,雜訊或情境相依的行為就會被固化為技能;如果過於保守,系統就無法善用得來不易的經驗。
技能到記憶體:執行紀錄 (Skill to memory: execution recording)。
這個流動也以相反方向運作。每次技能執行都會產生軌跡、中間失敗與執行時細節,這些東西若不寫回就會隨活躍上下文視窗一同消失。可觀測性與日誌基礎設施把這些軌跡捕捉為持久證據,讓系統驗證哪些技能仍然可靠、哪些該被修訂、分割或被約束 (Chen et al., 2025; Wang et al., 2026f, d)。
這個流動是讓技能層自我修正而不是僅自我擴張的東西。一個成熟的技能系統不能與記憶體管理分開:可重用程序只有在它們真實的執行歷史被持續地寫回外部狀態時才能保持可信。沒有這個紀錄,harness 對技能維護就沒有經驗基礎,而從記憶體到技能的蒸餾路徑 (前一個流動) 就會在越來越陳舊的證據上運作。
技能到協定:能力調用 (Skill to protocol: capability invocation)。
技能只有在從抽象程序跨越到被治理動作的邊界時才變得可運作。那個過渡通過協定發生,協定把高層意圖翻譯成型別化呼叫、生命週期事件與經權限檢查的互動表面 (Takyar, 2025; JSON-RPC Working Group, 2010; Hou et al., 2025)。一個技能可能指定代理應該搜尋程式碼、執行測試並摘要 diff,但個別的操作是透過協定化的搜尋工具、shell 命令與測試執行器介面完成的。
這個耦合對安全性與功能都重要。OpenClaw 對「致命三項組合」(Lethal Trifecta)——敏感資料存取結合不受約束的對外通訊與未經驗證的執行——的分析顯示,即使程序指引本身是穩健的,未受約束的執行仍然是個安全問題 (McKerchar, 2026)。協定層級的驗證因此作為一個獨立於技能自身正確性的邊界檢查:即使一個寫得很好的技能,如果它試圖調用被禁止的操作或畸形呼叫,也可以被攔截。
協定到技能:能力生成 (Protocol to skill: capability generation)。
一旦介面被標準化,要把使用它的最佳實踐編碼下來就會大幅變容易。OpenAPI 與 MCP 不只是讓工具可被呼叫;它們提供足夠的結構規律性,讓系統能把介面專屬的 know-how 打包成可重用的技能工件 (OpenAPI Initiative, 2021; Hou et al., 2025)。HashiCorp Agent Skills 生態是個具體例子:一旦基礎設施管理的底層介面透過協定契約被變得可讀且穩定,領域程序就可以被外部化為可攜的技能檔案,而不是在每次執行時被特設地重新導出 (Baghel and Chandna, 2026)。
這個流動凸顯了外部化過程中一個重要的非對稱性。協定標準化不僅消耗技能;它主動擴張新技能可被撰寫或被歸納所在的表面。每個新的穩定介面都是一個可供一系列可重用程序的潛在種子。技能工件的生態成長因此部分取決於協定標準化的速度與品質。
記憶體到協定:策略選擇 (Memory to protocol: strategy selection)。
被儲存的情境也可以影響 harness 接下來選擇哪條協定路徑。歷史成功率、使用者偏好與過去的失敗可以決定一個請求應該保留在本地、呼叫外部工具,或被委派給另一個代理 (Xu et al., 2026b; Zhou et al., 2025)。在具有多條互動路徑可用的系統中,記憶體把協定選擇從一個靜態配置轉成一個經驗知情的路由決策。
這個耦合在多代理設定中特別明顯,其中 harness 必須在本地執行、透過 MCP 調用工具、與透過 A2A 委派給遠端代理之間做選擇。如果過去與某個工具的互動對某類任務一致地失敗,路由邏輯可以學會偏好替代路徑。記憶體因此告知的不僅是模型推理什麼,還包括哪個互動通道把該推理帶入動作。
協定到記憶體:結果同化 (Protocol to memory: result assimilation)。
最後,每一次協定互動都產生狀態,這狀態如果要成為代理持續認知的一部分就必須被保留。工具輸出、批准事件、錯誤負載與委派結果以結構化回應的形式到達,常常以比純文字更豐富的格式 (Qin et al., 2023)。harness 必須把這些結果正規化進記憶體,使之後的推理能依賴經驗證的外部狀態,而不是依賴被重建或被幻覺出來的假設。
這個流動閉合了循環。協定層提供記憶體儲存的證據,而後者後來條件化新的技能選擇與新的協定路由。沒有可靠的結果同化,代理的記憶體就會與其實際的互動歷史脫節,而下游流動——尤其是經驗蒸餾與策略選擇——就會在不可靠的前提上運作。
系統層級動態 (System-level dynamics)。
上面六個流動是兩兩成對的,但有幾個重要的動態只在系統層級浮現。第一,循環是自我強化的:更好的記憶體促成更好的技能蒸餾,更好的技能產生更豐富的執行軌跡,更豐富的軌跡改善記憶體,依此類推。這個正回饋可以加速能力成長,但也可以放大錯誤。一個被毒化的記憶體項目可能導致一個有缺陷的技能,其執行軌跡進一步污染記憶體——這個級聯沒有任何單一模組的品質控制能在沒有 harness 層級介入的情況下打斷。
第二,這些模組競爭同一個稀缺資源:模型的上下文視窗。記憶體擷取、技能載入與協定 schema 都佔用 tokens。擴大某個模組的上下文足跡必然壓縮其他模組。harness 因此必須管理的不僅是每個模組的內容,還有它們在執行的每一步上彼此之間的相對預算配置,這個協調問題在第 6 節有更進一步的分析。
第三,這些流動運作在不同的時間尺度上。協定互動通常是同步且快速的;技能載入發生在任務或子任務邊界;記憶體蒸餾與技能演化在 session 或更長的時間上展開。一個為某個時間尺度做優化的 harness——例如快速工具執行——可能忽略了決定長期能力成長的較慢迴路。有效的 harness 設計需要在快迴路的回應性與慢迴路的連貫性之間取得平衡。
7.2 LLM 輸入/輸出視角
另一個有用的觀點是問每個模組在模型邊界上如何呈現。從上下文視窗與輸出表面的視角看,harness 不只是新增更多元件;它把進入與離開模型的東西重新組織成功能上不同的層。
記憶體作為情境式輸入 (Memory as contextual input)。
記憶體塑造在決策時可用的歷史與情境輸入。擷取機制不是用完整執行日誌淹沒模型,而是選出當前步驟相關的小段狀態、過去軌跡或實體關係 (Du, 2026b)。這把長時程連續性轉成有針對性的情境化問題,並降低上下文浪費。這個選擇的品質直接決定模型推理時所看到的過去是準確的還是被扭曲的。
技能作為指示性輸入 (Skills as instructional input)。
技能塑造給予模型的程序指引。harness 不是把每個工作流編碼進單一系統提示,而是只在相關任務模式出現時才載入專門指令、範例與約束 (Jiang et al., 2026a)。模型因此較少被要求從零發明工作流,而較常被要求詮釋與遵循一個已準備好的工作流。風險 (在 4 節討論過) 是過度詳細或耗費上下文的技能檔案會擠掉其他輸入;好處是當對的技能在對的時刻被載入時,程序變異被降低。
協定作為動作 schema (Protocols as action schema)。
協定塑造輸出邊界。透過強制執行結構化契約例如 JSON schema、MCP 訊息或 OpenAPI 對齊呼叫,它們約束模型的生成空間,使下游執行確定到能被治理 (Hasan et al., 2026)。輸出不再只是稍後要被詮釋的語言;它變成位於顯式介面內的機器可讀動作提案。這個約束降低了畸形工具呼叫與被幻覺出的引數的發生率,雖然它也意味著動作的表達力受協定 schema 的約束。
這個輸入/輸出分解在分析上很有用,因為它釐清了分工與失敗分類學。擷取錯誤呈現為輸入選擇錯誤:模型推理是正確的但對著錯誤的情境。技能失敗呈現為程序指引錯誤:模型忠實地遵循指令,但指令本身有缺陷或不匹配。協定失敗呈現為動作 schema 錯誤:模型的意圖是合理的,但輸出違反介面契約。harness 讓這些失敗類別足夠分離以便獨立地除錯、歸因與優化——這對於每個決策都有多個模組共同貢獻的系統是個重要屬性。
從更廣的視角看,這個對模型邊界的三分組織——情境式輸入、指示性輸入與動作 schema——可以被理解為一種結構化的上下文工程 (Context Engineering)。harness 不是把提示視為一個未分化的文字緩衝區,而是把它分成具有不同更新速率、治理需求與失敗模式的層。每一層都可以在不打擾其他層的情況下被修訂:記憶體擷取可以在不重寫技能的情況下被改善、技能工件可以在不改變協定 schema 的情況下被更新、協定表面可以在不更動記憶體政策的情況下被擴張。在模型邊界這種模組化是外部化做法的主要實務優勢之一。
7.3 參數化 vs. 外部化:取捨空間
相關的設計問題不是「智慧該位於模型還是基礎設施中」。而是給定特定負擔的更新速率、重用模式、治理需求與執行成本,它們應該住在哪裡。下面的維度構成這個切分決策。
更新頻率與時間衰減 (Update frequency and temporal decay)。
快速變化的知識與程序是外部化的強候選。API、組織結構與鮮活環境狀態衰退太快,無法在模型權重中可靠維持。試圖透過持續微調讓模型保持最新會冒著災難性遺忘 (Catastrophic Forgetting) 的風險,並且在所需更新頻率上往往不切實際 (Cheng et al., 2024; Qiu et al., 2025; Zhang et al., 2025d; Chen et al., 2026a)。相比之下,外部儲存可以立即被更新而無需重新訓練,並可以維護顯式的來源 (Provenance) 與版本管理 (Oelen et al., 2025; Chinthareddy, 2026)。穩定的背景能力——語言理解、廣泛推理、常識推論——衰退速率慢得多,仍然更自然地以參數化方式承載,在那裡它們得益於快速擷取與和模型表徵結構的深度整合。
可重用性與多代理可攜性 (Reusability and multi-agent portability)。
如果某個能力在跨任務、使用者或代理間反覆需要,外部化會改善可攜性與組合 (Tagkopoulos et al., 2025; Xu and Yan, 2026a; Liu et al., 2025d)。顯式的技能、腳本與介面工件可以在異質執行時之間被分享、版本化與重用,而不需要每個代理都重新發現或重新訓練同樣的程序。在多代理設定中,為一個代理撰寫的技能可以被廣播到整個群體,前提是技能對工具與協定的假設被滿足。一次性或高度特異的行為可能不值得外部化、打包與維護的開銷 (Zhao et al., 2026a)。
可審計性、治理與對齊 (Auditability, governance, and alignment)。
只要檢視、批准、回滾或政策強制是重要的,外部化的工件相對於不透明的參數化行為都有清楚的優勢 (Li et al., 2026b; Lazaros et al., 2026; Lee et al., 2026; Fernandez, 2026; Zhu and Lu, 2026)。符號介面 (Symbolic Interfaces) 以權重本身做不到的方式支撐熔斷器 (Circuit Breaker)、schema 驗證與可追蹤的執行紀錄。對齊微調 (例如 RLHF) 提供機率性的行為塑形,但外部化的約束在介面層級提供確定性的強制執行。高風險部署因此把架構邊界往外推:代理動作的後果越大,把治理邏輯顯式化、可檢視化的論據就越強。
延遲、簡單性與上下文負擔 (Latency, simplicity, and context burden)。
外部化把計算與組織成本從模型的前向傳遞 (Forward Pass) 轉移到周邊系統。擷取、路由、解析與工具調用都引入延遲 (Park et al., 2026; Xu et al., 2025a)。每個被擷取的工件都競爭有限的上下文預算,而過度的上下文載入會透過資訊過載或「中間遺失」現象退化效能 (Corallo and Papotti, 2026; Mishra et al., 2026; Esmi et al., 2025)。對於超快速、低變異或純語意的任務,讓模型依賴其內部參數化知識仍然實質上更簡單也往往更可靠。
結果不是模型智慧與基礎設施智慧之間的零和競爭。它是個系統切分問題。強的 harness 把得益於持久化、重用與控制的負擔外部化,而把穩定、快速與通用的能力留在模型內。最佳切分不是靜態的:隨著模型變得更能幹、外部化基礎設施變得更成熟,邊界會持續移動——這個動態在 8.1 節有進一步的探索。
8. 未來討論
前面幾節檢視了記憶體、技能與協定如何外部化各自不同的認知負擔,以及 harness 如何把它們統一成一個可運作的代理。那些分析描述了已被外部化的東西。本節問接下來會發生什麼,沿著外部化邏輯本身追問六個相連的問題:
- 參數化能力與外部化能力之間的邊界正往哪裡移動,多模態感知如何擴張那個前線?
- 同樣的邏輯是否從數位代理延伸到具身系統?
- 外部化過程如何能變得更自主?
- 隨著更多東西被向外移動,會累積什麼成本與風險?
- 外部化的工件如何在生態尺度上重塑互動?
- 外部化的品質該如何被衡量?
下面的子節逐一處理這些問題,從外部化不斷移動的邊界,經其具身延伸,到其益處與成本該如何被評估的問題。
8.1 不斷擴張的前線
前面幾節反覆出現的教訓是:什麼留在模型內、什麼被外部化的邊界並非固定。它隨模型、任務與基礎設施共演化而移動。理解那條邊界——並預期它接下來會移到哪裡——因此是代理系統設計的核心問題。
在一個方向上,模型的改善可以把能力拉回內部。一個能可靠產生結構化輸出的模型在 harness 中需要較少的格式驗證;一個有更大有效上下文視窗的模型可以容忍較簡單的記憶體架構;一個有更強內在工具使用能力的模型可能需要較不複雜的意圖捕捉邏輯。每一個這樣的進展都讓某一片外部基礎設施變得多餘。在相反方向上,更豐富的 harness 對模型提出新需求:在結構化執行時內運作要求尊重 schema、與權限檢查合作、與分階段上下文注入協調 (Zhang et al., 2025d; Cheng et al., 2024)。前線因此同時往兩個方向移動,而知道何時要進一步外部化、何時要回收,是核心工程挑戰。
在這個移動的地景中,幾類今天仍大致隱含的認知工作是可能被進一步外部化的候選。
規劃與目標管理 (Planning and goal management)。
當前代理通常透過情境內推理產生計畫,產生的分解是短暫的——它們只在活躍生成中存在,並在上下文重置時被遺失。早期代理框架例如 BabyAGI 已實驗過持久任務佇列 (Nakajima, 2023),而像 InfiAgent 這樣以檔案為中心的狀態抽象把規劃工件物質化在提示之外 (Yu et al., 2026)。方向指向把計畫作為 harness 一級物件 (First-class objects):持久、可檢視、可修訂,並可以在代理之間或代理與人類之間被分享。那會把規劃從一個短暫的推理動作轉成一個被管理的狀態工件——這正是記憶體已對歷史情境執行的同樣表徵轉移。
評估與驗證 (Evaluation and verification)。
當今的多數評估邏輯要不活在模型的思維鏈中,要不活在事後執行的外部基準 harness 中。把評估標準、評鑑準則 (Rubrics) 與驗證程序作為執行時 harness 元件外部化——而不是把它們留在模型判斷的隱含中——將讓代理在執行期間能對照顯式標準檢查自己的輸出。這個方向的早期跡象在強調可驗證性的工程框架 (Zhu and Lu, 2026) 與把生成與批評分開的 self-refine 迴路 (Madaan et al., 2023) 中可見。更廣的機會是把評估視為被外部化的品質基礎設施而不是事後測量。
協同邏輯本身 (Orchestration logic itself)。
最遞迴的外部化形式是把 harness 自身的配置、政策與執行邏輯變成代理可以檢視、批評與修訂的物件。一旦協同邏輯被外部化,代理系統可以調適的不僅是它知道什麼與做什麼,還包括它如何組織知道與做。這個方向直接連到下一個子節。
多模態外部化 (Multi-modal externalization)。
到目前為止發展的外部化框架假設文字是主要表徵媒介:記憶體儲存文字軌跡、技能編碼自然語言程序、協定交換結構化文字訊息。當基礎模型變得原生多模態 (Multi-modal)——能與文字一起處理影像、影片、聲音與螢幕內容時——每個外部化維度都面臨新的設計需求。多模態技能必須編碼的不只是文字程序,還要編碼視覺感知工作流與跨模態決策邏輯;早期例子包括把 GUI 互動序列打包成可重用單元的電腦使用技能 (Chen et al., 2026b)。多模態記憶體必須對視覺與聽覺經驗做索引與擷取,而不只是基於文字的情節軌跡;例如 MemVerse 維持一個多模態知識圖,週期性地把碎片化的感知經驗蒸餾成更抽象的表徵 (Liu et al., 2025a),而 MuSEAgent 累積有狀態的多模態經驗以告知未來推理 (Wang et al., 2026d)。多模態推理蒸餾把技能取得迴路延伸到非文字模態:TED 展示成功的多模態推理軌跡可以被蒸餾成可重用經驗而無需額外訓練 (Yuan et al., 2026)。更廣的涵義是:多模態外部化不是僅僅把新資料類型加到既有儲存中。它改變了技能規格、記憶體索引與協定 schema 的設計假設,並開啟了一個對認知負擔外部化來說實質上更廣的前線 (Wang et al., 2026e; Xu et al., 2026a)。
8.2 從數位代理到具身外部化
本文發展的外部化框架適用於讀寫並呼叫 API 的數位代理。一個自然的問題是同樣的架構邏輯是否延伸到具身系統 (Embodied Systems)——也必須感知、移動並與世界做物理互動的機器人。最近在機器人學習上的發展顯示確實如此,且具身領域正在經歷一個與此處分析的非常平行的分解。
單體式起點 (The monolithic starting point)。
具身智慧的早期做法追求一個與外部化前 LLM 代理類似的端到端策略。視覺-語言-動作 (Vision-Language-Action, VLA) 模型 (Brohan et al., 2023; Kim et al., 2024) 被定位為單體式的「腦」:給定一段自然語言指令與一個視覺觀察,模型直接輸出連續的動作序列,在單次前向傳遞內處理感知、推理、規劃與動作控制。這個設計與早期 LLM 代理試圖完全透過情境內推理管理記憶體、技能與協同的模式相呼應——它也遭遇了同一類型的限制。複雜的多步驟任務超出模型的規劃視野;中間步驟的失敗無法被診斷或復原;高層認知與低延遲動作控制的緊密耦合對推論速度與模型容量造成不可調和的需求。
分解:腦-小腦分裂 (Decomposition: the cerebrum-cerebellum split)。
新興的架構回應在整個身體層級重演了外部化邏輯。一個高層機器人代理——通常是一個 LLM 或多模態模型——擔任腦的角色:它詮釋目標、把任務分解成子任務序列、跨步驟維護狀態、處理例外,並在執行回饋指出失敗時修訂計畫 (Ahn et al., 2022; Singh et al., 2023; Liang et al., 2023)。VLA 模型則被重新定位為小腦:每一個都成為一個可被呼叫的技能模組,負責單一原子操控原始體——抓取、放置、倒、插入——以即時感知運動回饋與低延遲控制執行。VLA 不再決定要做什麼;它確保「做的方式」是精確、穩定且能對局部物理擾動做調適。
這個分解直接對應到本文的外部化維度。任務規劃與目標管理從 VLA 隱含的參數化推理遷移到一個顯式、可檢視的代理迴路——正是 8.1 節討論的從情境內規劃到外部化計畫物件的轉移。每一個 VLA 技能模組都作為一個外部化的技能工件運作:一個可重用、可組合、有定義介面的單元,類似於 4 節分析的技能檔案與工具規格。代理與技能之間的通訊——結構化的動作請求、執行狀態回報、錯誤代碼——構成一個協定層,使代理能在不嵌入實作細節的情況下協同異質的動作能力。
為什麼這個對應重要 (Why the parallel matters)。
這種收斂不是巧合。數位與具身代理都面臨同樣的根本張力:單一模型無法同時為慢的、審慎的認知與快的、反應性的執行做優化。外部化透過把每一類認知工作路由到最適合它的基底來化解這個張力——對規劃與記憶用持久、可檢視的結構;對執行用專門、低延遲的模組。在數位情況下,執行模組是工具呼叫與程式直譯器;在具身情況下,它們是視覺運動策略 (Visuomotor Policies)。harness 模式——一個載入上下文、派發技能、強制協定並管理狀態的執行時——同樣適用於兩者,這顯示具身與數位代理架構最終可能不僅共享一種設計哲學,還共享一個具體的工程堆疊。
開放挑戰 (Open challenges)。
具身外部化引入了數位情況不會面對的約束。物理動作以 API 呼叫所沒有的方式不可逆:被掉落的物體無法被「回滾」。即時控制要求的延遲預算比文字生成緊好幾個數量級。感知是有雜訊的,且模擬訓練環境與物理部署之間的差距仍然相當大。這些約束會塑造為具身 harness 設計記憶體、技能與協定的方式,但它們不改變根本論證:外部化的邏輯——把單體能力分解成專門、可組合、可治理的外部結構——從數位認知自然延伸到物理動作。
8.3 朝向自我演化的 harness
當前大多數代理系統仍然依賴人類在失敗之後修訂記憶體政策、改寫技能工件並收緊執行邏輯。如果協同邏輯本身被外部化——如前一子節所示——那麼 harness 就成為一個可以被程式化地調適而不僅被人工調適的物件。問題是如何讓那個調適變得可靠。
從系統視角看,自我演化可以發生在三個層級。在模組層級,架構保持固定,但內部政策——擷取粒度、技能排序啟發式、協定路由規則——根據觀察到的失敗被調整。在系統層級,執行管線本身被重組:當日誌揭示局部調校無法解決的反覆瓶頸時,排程策略、執行順序或資源配置可能改變。在邊界層級,隨著模型與任務改變,harness 的範疇會擴張或收縮,在需要時新增外部化元件並修剪冗餘元件——這正是 8.1 節討論的前線動態。
幾種技術路徑正在出現。強化學習可以根據任務成功、延遲或資源成本等獎勵優化離散執行時策略——搜尋深度、壓縮比、重試策略。程式合成把 harness 調適視為程式碼修復:模型在失敗軌跡之後提出修補,而沙盒測試在部署前驗證它們。演化方法在 harness 的拓撲——模組如何被連結與以何種順序被調用——之上做搜尋。當探索成本太高時,模仿學習透過把人類專家或強模型的執行日誌蒸餾成更好的協同模式,提供更強的先驗。這些路徑瞄準不同的搜尋空間——政策、程式、結構與先驗經驗——並可能被合併使用而非孤立地使用。
自我演化之所以吸引人,是因為它直接瞄準基礎設施失敗模式,但它也放大下一節討論的成本與風險:一個沒有足夠治理就漂移的自適應 harness 可能比解決舊失敗模式更快引入新的失敗模式。
8.4 成本、風險與治理
當更多認知負擔被向外移動時,兩類成本會累積:來自外部化基礎設施本身的認知開銷,以及來自擴張攻擊面的安全風險。
認知開銷 (Cognitive overhead)。
外部化不是免費的 (Wang et al., 2026b)。每多一個記憶體層、API schema 或安全規則都會強加延遲與推理開銷,且過了某個點之後,模型花在發現、解析與協同模組上的精力會比解決任務本身還多。在記憶體上,過度擷取會用邊際相關的軌跡淹沒上下文。在技能上,冗長或重疊的檔案會競爭上下文預算,並可能讓模型遵循局部程序卻失去全域目標的視野。在協定上,工具蔓生 (Tool Sprawl) 會把動作選擇變成不必要的消歧問題。
這些失敗模式顯示設計目標應該是有效且效用為正的外部化,而不是最大化的外部化 (Liu et al., 2025c)。最小充分性 (Minimal sufficiency) 問一個給定模組是否真的降低了模型的認知負擔還是僅僅又加上了一個。延遲載入 (Lazy loading) 把詳細指引推遲到任務結構需要它時。預算感知路由 (Budget-aware routing) 把上下文配置視為顯式的優化變數,動態地在任務階段改變時調整給予記憶體、技能與協定中繼資料的空間 (Zhang et al., 2026b; Patel et al., 2025; Sui et al., 2026)。一個好的 harness 簡化模型的決策問題;它不會創造第二個。
安全與完整性風險 (Security and integrity risks)。
認知開銷是效能成本;安全維度更為嚴重。一旦認知與程序負擔被搬到外部工件之中,那些工件就成為攻擊目標——而威脅直接對應到三個 harness 維度。記憶體中毒 (Memory Poisoning) 可以透過被破壞的情節軌跡或事實儲存默默地扭曲未來推理。惡意技能注入 (Malicious Skill Injection) 可以把對抗程序嵌入代理可重用的曲目之中。協定欺騙 (Protocol Spoofing)——偽造的工具清單或被操弄的端點——可以在合法互動的外觀下造成未授權的動作 (Liu et al., 2026; Guo et al., 2026; Wang et al., 2026c; Lin et al., 2025b)。當外部化變得自我演化時 (8.3 節),這些風險被進一步加劇:對新任務的調適可能退化舊任務、累積的修補可能模糊系統行為,而當人類監督減弱時,優化目標可能被扭曲。
治理作為基礎設施 (Governance as infrastructure)。
涵義是:外部化必須與治理配對——不是作為事後諸葛,而是作為 harness 共同設計的一層。對關鍵更新的強制審查門檻、對記憶體與技能變更的來源追蹤、確定性的回滾機制與回歸測試,全都成為基礎設施的一部分。一個外部化系統的品質因此不僅要由它能做什麼來衡量,還要由它做這件事的透明度與可逆性來衡量。這個標準也告知評估,如 8.6 節所述。
8.5 從私有鷹架到共享基礎設施
至此所述的外部化大致是以代理為中心的:記憶體服務於某個代理的連續性,技能作為本地套件被載入,協定常被綁在框架之內。然而隨著協作鏈拉長,外部化開始從私有鷹架轉向共享基礎設施 (Wang and Chen, 2025; Li et al., 2026a; Nie et al., 2026)。這把分析單位從個別代理改為生態。
共享工件 (Shared artifacts)。
最清楚的徵兆是跨三個維度都浮現了可分享的工件。共享記憶體把問題從「我記得什麼」轉成「我們知道什麼」,把記憶體變成一個共享狀態、索引與共同基礎的可交換系統 (Wegner, 1987; Zhao et al., 2026b)。共享技能把程序性專業變成可被跨代理重用、分叉與維護的公共能力單元 (Ling et al., 2026)。共享協定提供讓這種協調跨平台與組織可互通的共同語法 (Yang et al., 2025b)。
分工與集體學習 (Division of labor and collective learning)。
一旦這些結構被分享,代理系統就能分化角色,而不是在每處複製同樣的整個堆疊。借鑑共棲 (Stigmergy) (Theraulaz and Bonabeau, 1999),失敗軌跡可以累積在共享記憶體中,而成功路徑可以結晶為共享技能。學習於是透過外部結構擴散,而不只透過聯合的參數化訓練。
制度化及其張力 (Institutionalization and its tensions)。
當記憶體 schema、技能規格與協定綁定反覆被驗證時,它們開始的功能不再像臨時鷹架,而更像制度:在生態尺度上協調行為的共享運作程序與標準 (Hutchins, 1995)。但共享基礎設施也引入新的治理問題 (Deng et al., 2025; Liu et al., 2026; Kong et al., 2025)。基礎設施漂移、惡意或低品質工件,以及過早或延後的標準化都可能讓生態不穩定 (Guo et al., 2026; Timmermans and Epstein, 2010)。8.4 節中識別的治理成本因此在外部化變得集體時被加大:版本控制、權限稽核、來源管理與回滾成為代理系統制度設計的一部分,而不僅是個別 harness 的工程。
8.6 衡量外部化
當前大多數基準主要透過在固定提示與固定模型設定下的任務完成來評估代理 (Zhu et al., 2025; Mishra et al., 2026)。那對於比較基礎模型能力是有用的,但它系統性地低估了外部化基礎設施的貢獻。一個透過更好的記憶體擷取、更精確的技能載入或更緊的執行治理改善了可靠性的 harness,只會以更高的通過率呈現出來,沒有辦法把該增益歸因到其真實來源。
更豐富的評估議程會沿著當前基準大致忽略的維度評估外部化的品質。可遷移性 (Transferability) 問同一個 harness 配置在底層模型被替換時是否仍維持有效性——這是對「能力住在外部基礎設施還是住在權重」的一個直接測試。可維護性 (Maintainability) 衡量當技能、記憶體政策或協定 schema 被更新時系統如何優雅地退化。復原韌性 (Recovery robustness) 測試代理是否能偵測失敗、回滾部分動作並從檢查點恢復。上下文效率 (Context efficiency) 量化有多少上下文預算被 harness 開銷消耗 vs. 多少被任務相關的推理消耗。治理品質 (Governance quality) 評估外部化系統是否符合 8.4 節識別的透明度與可逆性需求。
具體的評估策略可能包括移除個別 harness 元件並衡量結果退化的消融研究;保持 harness 不變但變動基礎模型的跨模型遷移測試;以及在延長多 session 互動上追蹤成功率、成本與漂移而非單輪完成的長時程可靠性指標。直到這些方法成熟之前,這個領域會繼續把部分屬於外部化設計成就的東西歸因到模型智慧。例如,Agent Humanization Benchmark (AHB) 顯示代理評估應該超越任務完成,延伸到使用者介面邊界上可觀察行為的擬人化,特別是對在以人為中心環境中運作的行動 GUI 代理 (Zhu et al., 2026)。
整體看,這六個方向追蹤外部化邏輯超越其當前狀態的延續。前線正在擴張,因為新的認知負擔——包括多模態感知與跨模態推理——正成為外部化的候選;同樣的分解邏輯正從數位代理延伸到具身系統,其中腦-小腦分裂重演了規劃與執行的分離;過程透過自我演化的 harness 變得更自主;隨著認知開銷與安全風險累積,取捨變得更銳利;範疇從私有鷹架擴張到共享基礎設施;而隨著外部化的貢獻對以模型為中心的基準來說仍是不可見的,評估挑戰變得更為迫切。共同的線索是:外部化不是一次性的架構決策,而是一個其邊界、機制、成本與品質標準都會與其所服務的模型與生態共演化的持續設計過程。
9. 結論
本文論證了外部化是連接 LLM 代理許多最重要發展的轉變邏輯。可靠的代理性越來越倚賴把選定的認知負擔搬出模型、放入顯式的基礎設施:記憶體跨時間外部化狀態,技能外部化程序性專業,協定外部化互動結構,而 harness 把這些層協調成一個運作中的執行時。
從這個視角看,從權重到上下文到 harness 的移動不只是一連串工程伎倆。它標誌著代理能力被組織之處的轉變。一些負擔仍然以參數化方式被良好處理,但其他負擔在被持久化、可檢視、可重用且可治理地置於模型外部時變得更可靠。
統一這些外部化形式的是表徵轉換。記憶體把回想轉成擷取、技能把即興生成轉成被引導的組合,而協定把特設協調轉成結構化交換。其效應不僅是把更多元件加在模型周圍,而是改變了模型被要求解決的任務。
這個重新框架也釐清了未來的議程。關鍵問題不再僅僅是如何打造更強的模型,而是如何在模型與基礎設施之間切分能力、如何評估外部化系統的貢獻,以及如何治理代理日益依賴的共享工件。
參考文獻
本論文的完整參考文獻請參閱原始論文 PDF 或 HTML 版本。為避免過度膨脹本譯本檔案,此處不重複列出所有 200+ 條引用條目。引用格式為 (Author, Year),可在原文中查詢對應的完整書目資料。
關鍵引用包括但不限於:
- Norman, D. A. (1991). Cognitive artifacts. In Designing Interaction.
- Norman, D. A. (1993). Things That Make Us Smart.
- Sumers et al. (2024). Cognitive Architectures for Language Agents (CoALA).
- Lewis et al. (2020). Retrieval-Augmented Generation (RAG).
- Yao et al. (2023a). ReAct: Synergizing Reasoning and Acting in Language Models.
- Shinn et al. (2023). Reflexion.
- Wang et al. (2023a). Voyager.
- Schick et al. (2023). Toolformer.
- Anthropic (2024). Model Context Protocol (MCP).
- Google (2025a). A2A (Agent-to-Agent Protocol).
- Packer et al. (2023). MemGPT.
- Chhikara et al. (2025). Mem0.
- Kirsh (1995). The Intelligent Use of Space.
- Hutchins (1995). Cognition in the Wild.
- Clark and Chalmers (1998). The Extended Mind.
完整書目請見:https://arxiv.org/abs/2604.08224
術語對照表
| English | 繁體中文 |
|---|---|
| Externalization | 外部化 |
| Cognitive Artifact | 認知工件 |
| Representational Transformation | 表徵轉換 |
| Harness | harness (馴具/執行時環境框架) |
| Harness Engineering | harness 工程 |
| Memory | 記憶體 |
| Skills | 技能 |
| Protocols | 協定 |
| Working Context | 工作上下文 |
| Episodic Experience | 情節經驗 |
| Semantic Knowledge | 語意知識 |
| Personalized Memory | 個人化記憶 |
| Monolithic Context | 單體上下文 |
| Retrieval Storage | 擷取儲存 |
| Hierarchical Memory | 階層式記憶 |
| Adaptive Memory | 自適應記憶 |
| Operational Procedure | 操作程序 |
| Decision Heuristics | 決策啟發式 |
| Normative Constraints | 規範性約束 |
| Specification | 規格 |
| Discovery | 發現 |
| Progressive Disclosure | 漸進式揭露 |
| Execution Binding | 執行綁定 |
| Composition | 組合 |
| Authored | 作者撰寫 |
| Distilled | 蒸餾 |
| Discovered | 發現 (式取得) |
| Composed | 組合 (式取得) |
| Semantic Alignment | 語意對齊 |
| Portability | 可攜性 |
| Staleness | 陳舊性 |
| Unsafe Composition | 不安全組合 |
| Context-dependent Degradation | 上下文相依的退化 |
| Agent-Tool Protocol | 代理-工具協定 |
| Agent-Agent Protocol | 代理-代理協定 |
| Agent-User Protocol | 代理-使用者協定 |
| Invocation Grammar | 調用語法 |
| Lifecycle Semantics | 生命週期語意 |
| Permission Boundary | 權限邊界 |
| Discovery Metadata | 發現中繼資料 |
| Intent Capture | 意圖捕捉 |
| Capability Discovery | 能力發現 |
| Session Management | session 管理 |
| Lifecycle Management | 生命週期管理 |
| Agent Loop | 代理迴路 |
| Sandboxing | 沙盒 |
| Execution Isolation | 執行隔離 |
| Human Oversight | 人類監督 |
| Approval Gate | 批准門檻 |
| Observability | 可觀測性 |
| Structured Feedback | 結構化回饋 |
| Configuration | 配置 |
| Policy Encoding | 政策編碼 |
| Context Budget | 上下文預算 |
| Cognitive Environment | 認知環境 |
| Distributed Cognition | 分散認知 |
| Extended Mind | 延伸心智 |
| Complementary Strategy | 互補策略 |
| Cognitive Niche | 認知壁龕 |
| Cognitive Overhead | 認知開銷 |
| Memory Poisoning | 記憶體中毒 |
| Malicious Skill Injection | 惡意技能注入 |
| Protocol Spoofing | 協定欺騙 |
| Lethal Trifecta | 致命三項組合 |
| Self-Evolving Harness | 自我演化的 harness |
| Shared Infrastructure | 共享基礎設施 |
| Stigmergy | 共棲 |
| Transferability | 可遷移性 |
| Maintainability | 可維護性 |
| Recovery Robustness | 復原韌性 |
| Context Efficiency | 上下文效率 |
| Governance Quality | 治理品質 |
| Catastrophic Forgetting | 災難性遺忘 |
| Vision-Language-Action (VLA) | 視覺-語言-動作 |
| Cerebrum-Cerebellum Split | 腦-小腦分裂 |
| Visuomotor Policy | 視覺運動策略 |
| Embodied System | 具身系統 |
| Multi-modal | 多模態 |
| First-class Object | 一級物件 |
| Provenance | 來源 |
| Circuit Breaker | 熔斷器 |
| Symbolic Interface | 符號介面 |
| Forward Pass | 前向傳遞 |
| Lost in the Middle | 中間遺失 (現象) |
| Scaling Laws | 縮放律 |
| Knowledge Editing | 知識編輯 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Few-shot | 少樣本 |
| Self-Consistency | 自我一致性 |
| Tree of Thoughts | 思維樹 |
| Self-Refine | 自我精修 |
| Retrieval-Augmented Generation (RAG) | 擷取增強生成 |
| Function Calling | 函式呼叫 |
| Tool Sprawl | 工具蔓生 |
| Lazy Loading | 延遲載入 |
| Minimal Sufficiency | 最小充分性 |
| Budget-aware Routing | 預算感知路由 |
| Capability Card | 能力卡 |
| Spreading Activation | 擴散啟動 |
| Mixture of Experts (MoE) | 專家混合 |
| Reinforcement Learning (RL) | 強化學習 |
| Direct Preference Optimization (DPO) | 直接偏好優化 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| RLHF | 基於人類回饋的強化學習 |