Autogenesis:自我演化的智能體協定
原始論文:Autogenesis: A Self-Evolving Agent Protocol 作者:Wentao Zhang, Zhe Zhao, Haibin Wen, Yingcheng Wu, Ming Yin, Bo An, Mengdi Wang arXiv ID:2604.15034v2 日期:2026-04-21 標籤:Agent Self-Evolution Protocol LLM Multi-Agent Tool Use MCP
1. 引言
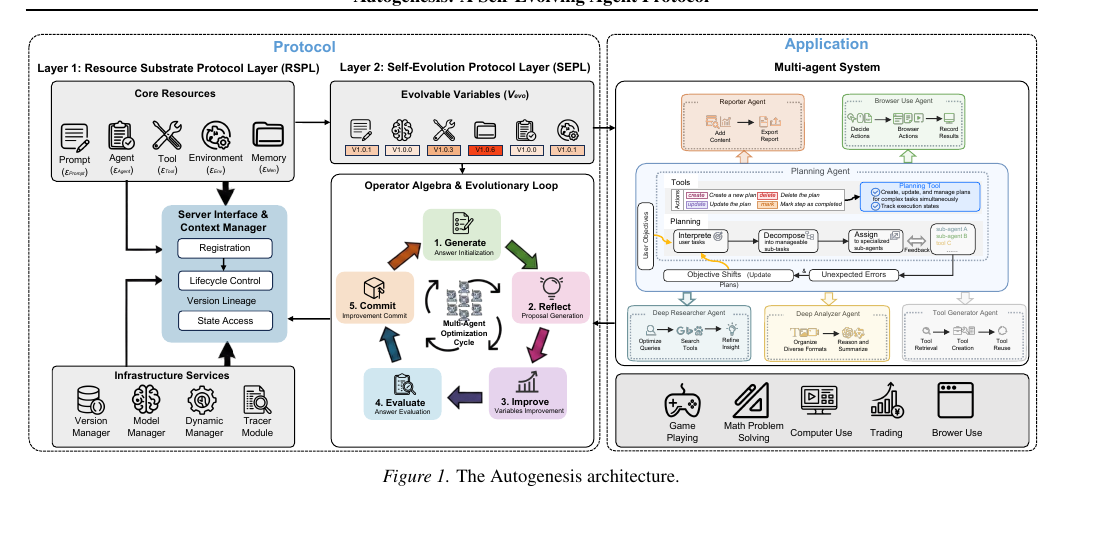
近期基於 LLM 的智能體系統在處理複雜長期 (long-horizon) 任務上展現顯著潛力。然而靜態的智能體設計在面對真實環境的多樣性與隨機性時往往不足。賦予智能體自我演化 (Self-Evolution) 能力——讓它們根據環境回饋自動調整策略、精煉指令、更新工具——已成為實現自主性的關鍵途徑。
儘管興趣高漲,目前的實作多半零散且臨時 (ad hoc)。現有系統缺乏共享標準,使得演化過程既不可組合也不可審計。開發者經常依賴脆弱的「膠水程式碼 (glue code)」,導致難以維護的單體架構。沒有明確的生命週期管理與安全更新介面,自我修改會帶來嚴重的執行時不穩定風險。
雖然像 Anthropic 的 Model Context Protocol (MCP) 和 Google 的 Agent-to-Agent (A2A) 等協定已標準化連線層,但直接套用到自我演化情境存在概念不匹配——它們設計用於解決連線問題(模型-工具呼叫或智能體間通訊),而自我演化的核心在於狀態變動與管理,而非呼叫。
為了從連線層橋接到演化層,需要一個專門協定處理三個關鍵問題:
- 解耦 (Decoupling):資源(如 prompt、工具、記憶體)必須從智能體核心邏輯抽象出來,轉換為獨立管理的實體
- 安全與可審計性:必須引入嚴格版本控制與回滾機制,確保每個演化步驟可追溯且可逆
- 形式化 (Formalism):需定義一組標準化算子(如 reflect、propose、verify)嚴格管理演化流程,將啟發式文字修改轉變為嚴謹的控制迴圈
核心貢獻:提出 AUTOGENESIS Protocol (AGP)——兩層協定架構,嚴格解耦演化基礎與演化邏輯:
- Layer 1: Resource Substrate Protocol Layer (RSPL):定義演化基礎,將 Prompt、Agent、Tool、Environment、Memory 建模為協定註冊資源
- Layer 2: Self-Evolution Protocol Layer (SEPL):建立閉迴圈算子介面(Reflect、Select、Improve、Evaluate、Commit)
基於此協定,本文呈現 AUTOGENESIS-AGENT (AGS),一個推理-行動的工具呼叫智能體。在 GPQA、AIME、GAIA 與 LeetCode 上取得相對於強基線的一致改進。
2. 相關工作
2.1 基於 LLM 的智能體系統與工具使用
LLM 智能體展現處理複雜、長期、多步推理與外部工具互動的能力。GAIA 等基準凸顯了結構化工具使用的重要性。多數現有框架將 prompt、工具、記憶體嵌入為緊耦合的內部組件,工具被視為手動策展且整合的固定功能模組。Autogenesis 將工具(含原生腳本、MCP 工具、Anthropic agent skills)建模為協定註冊資源 (protocol-registered resources),具有明確介面與狀態表示。
2.2 連線與互通協定
A2A 標準化智能體間溝通;MCP 標準化模型與外部工具/資料源的連線。它們處理呼叫與訊息傳遞,但對智能體與資源的內部狀態保持不透明。它們不定義資源生命週期管理、版本血統 (version lineage),或約束狀態變動隨時間的機制。
2.3 自我修正與最佳化機制
平行研究包括 TextGrad(將自然語言回饋當作梯度)、Reinforce++、GRPO(將智能體組件視為策略),以及 Reflexion、Self-Refine、STAR 等。這些方法雖能改進智能體行為,但通常套用於範圍狹窄的設定,缺乏管理異質智能體組件的共享抽象。
3. Autogenesis 協定
AGP 是一個兩層協定架構:
- RSPL 規範演化什麼 (what evolves):哪些資源可以變動,如何表示、版本化與存取
- SEPL 規範如何演化 (how evolution occurs):如何提出、評估、提交更新
這種分離受介面標準化(如 MCP)啟發,乾淨地解耦演化基礎與機制,實現模組化、可追溯、安全保留的演化。
3.1 Layer 1:資源基礎協定層 (RSPL)
RSPL 將演化基礎定義為一組具有明確狀態、生命週期、版本血統的協定註冊資源。本文中這些資源涵蓋五類實體:
| 實體類型 | 對應內容 |
|---|---|
| Prompt | 指令 |
| Agent | 決策策略 |
| Tool | 動作介面(原生腳本、MCP 工具、agent skills) |
| Environment | 任務/世界動態 |
| Memory | 持久狀態 |
Definition 3.1 (Resource Entity):類型 $\tau$ 的資源實體及其類型級集合可表示為:
$$e_{\tau,i} = (n_{\tau,i}, d_{\tau,i}, \phi_{\tau,i}, g_{\tau,i}, m_{\tau,i}), \quad \mathcal{E}_\tau = \{e_{\tau,i} \mid i \in \mathcal{I}_\tau\}$$
其中 $n_{\tau,i}$ 是唯一資源名稱,$d_{\tau,i}$ 是簡短描述,$\phi_{\tau,i}: \mathcal{X}_\tau \to \mathcal{Y}_\tau$ 是輸入到輸出對應,$g_{\tau,i} \in \{0, 1\}$ 是可訓練標記,$m_{\tau,i}$ 是輔助 metadata 字典。
將 prompt、tool、memory 顯式化為 RSPL 資源的關鍵動機是「解耦」:許多智能體系統將其包裝為內部組件,讓智能體邏輯與任務指令糾纏,限制了可遷移性。將其外部化為一級、版本化資源後,同一個工具呼叫智能體策略可以搭配不同 prompt 與工具集,無需修改即可跨任務與環境部署。
Context manager:每種資源類型的管理面,維護物化資源的活動註冊表與版本歷史。其輸出 API 包含一組功能分組的算子:
| 類別 | 算子 |
|---|---|
| Lifecycle & Registration | init、build、register、unregister |
| Retrieval & Inspection | get、get_info、list、retrieve、get_state |
| Evolution & Versioning | update、copy、restore、get_variables、set_variables |
| Execution & Contract | run、save_contract、load_contract |
| Serialization | save_to_json、load_from_json |
契約生成 (Contract Generation):管理者明確支援為受管實體產生整合的能力與約束規格。例如工具的契約可採 skills.md 格式枚舉動作、引數、前置條件、使用約束,實現系統化的情境工程 (context engineering) 並降低 prompt 膨脹。
Infrastructure Services:Model manager(統一 API 層,跨 OpenAI、Anthropic、Google、OpenRouter 等)、Version manager(版本血統,可回滾、分支、比對)、Dynamic manager(序列化/反序列化,支援熱抽換)、Tracer Module(細粒度執行追蹤)。
3.2 Layer 2:自我演化協定層 (SEPL)
SEPL 為智能體系統演化建立控制論形式化框架。將持續改進視為異質狀態空間上的廣義最佳化問題。形式上,SEPL 將演化動態建模為由嚴格類型化算子代數控制的狀態轉移函數。
SEPL 五個必要的輔助空間:
- $\mathcal{Z}$:trace space(軌跡空間,確保系統可觀察性)
- $\mathcal{H}$:hypothesis space(假設空間,語義錯誤歸因基礎)
- $\mathcal{D}$:modification space(修改空間,形式化修改原語)
- $\mathcal{G}$:objective specification(目標規格)
- $\mathcal{S}$:evaluation space(評估空間,含效能指標與安全狀態)
五個算子(Operator Algebra):
- Reflect ($\rho$):$\rho: \mathcal{Z} \times \mathcal{V}_{evo} \to \wp(\mathcal{H})$,將原始觀察與最佳化方向銜接,近似系統的「語義梯度」
- Select ($\sigma$):$\sigma: \mathcal{V}_{evo} \times \wp(\mathcal{H}) \to \wp(\mathcal{D})$,將診斷假設轉譯為具體的更新提案
- Improve ($\iota$):$\iota: \mathcal{V}_{evo} \times \wp(\mathcal{D}) \to \mathcal{V}_{evo}'$,變異算子,套用離散更新產生候選狀態
- Evaluate ($\varepsilon$):$\varepsilon: \mathcal{V}_{evo}' \times \mathcal{G} \to \mathcal{S}$,目標函數,將候選狀態與目標規格映射到評估空間
- Commit ($\kappa$):$\kappa: \mathcal{V}_{evo}' \times \mathcal{S} \to \mathcal{V}_{evo}$,條件閘控機制,僅在滿足成功標準時接受候選
演化迴圈 (Algorithm 1):
Input: Agentic system A, Objective G, Budget T
Output: Optimized state V_evo*

1. V_evo^(0) ← VariableLifting(A)
2. Z^(0) ← Execute(A, V_evo^(0))
3. for t = 0, ..., T-1 do
4.   # Phase 1: Diagnosis & Proposal
5.   H^(t) ← ρ(Z^(t), V_evo^(t))   ▷ Reflect
6.   D^(t) ← σ(V_evo^(t), H^(t))   ▷ Select
7.   # Phase 2: Mutation & Verification
8.   V_evo^(t+1) ← ι(V_evo^(t), D^(t))   ▷ Improve
9.   S^(t+1) ← ε(V_evo^(t+1), G)         ▷ Evaluate
10.  # Phase 3: Gating & Transition
11.  V_evo^(t+1) ← κ(V_evo^(t+1), S^(t+1))   ▷ Commit
12.  # Phase 4: Next Iteration
13.  Z^(t+1) ← Execute(A, V_evo^(t+1))
14.  if Converged(S^(t+1)) then break
15. end for
16. return V_evo^(t)
確保自我演化不是隨機漫步,而是建立在執行資料之上、可追溯、嚴格安全不變式下單調改進的有向軌跡。
4. AGS 與最佳化策略
4.1 AGS 架構
基於 AGP,作者實例化雙層協定為 AGS——一個圍繞 Agent Bus 架構組織的多智能體系統。所有智能體僅透過標準化 bus 訊息溝通,prompt、工具、記憶體一律視為 first-class RSPL 資源。
三個交織機制:
- 透過 Plan Generation 編排:Orchestrator 接收任務後產生結構化
plan.md——人類可讀流程圖、有序子任務步驟、每個子任務指派給對應子智能體(deep researcher、browser-use agent、tool generator 等) - 平行子智能體執行與迭代重新規劃:子智能體獨立從 RSPL 註冊表透過語義搜尋取得 prompt 與工具資源,透過 bus 並行執行
- Self-Evolution:與 bus 協調迴圈交織,AGS 在觀察軌跡顯示可修正失敗或次優效能時觸發 SEPL 演化迴圈
4.2 最佳化器實例化
Reflection Optimizer(預設):透過自然語言反思實現 SEPL 迴圈。Reflect 算子提示骨幹 LLM 用自然語言分析失敗(如「prompt 缺乏邊緣案例處理的明確指令」、「排序演算法在關鍵路徑上有 $O(n^2)$ 複雜度」)。
替代策略:
- TextGrad:將自然語言回饋視為「文字梯度」並套用類梯度下降式更新到字串值變數
- Reinforce++/GRPO:採取 RL 觀點,將可演化變數視為策略,評估訊號視為獎勵
5. 實驗
5.1 科學與數學基準
設定:在 GPQA-Diamond(198 題,閉卷)、AIME24/25(每個 30 題)上比較三種演化策略:evolve prompt only、evolve solution only、combined evolve prompt+solution。最多 3 輪反思。
Table 1:科學與數學基準結果
| 骨幹 | 策略 | GPQA-Diamond | AIME24 | AIME25 |
|---|---|---|---|---|
| gpt-4o | vanilla | 47.98 | 13.34 | 6.67 |
| evolve prompt+solution | 58.08 | 16.67 | 13.34 | |
| Improvement (%) | 21.05↑ | 24.97↑ | 100↑ | |
| gpt-4.1 | vanilla | 65.17 | 23.34 | 20.00 |
| evolve prompt+solution | 67.67 | 40.00 | 33.33 | |
| Improvement (%) | 3.87↑ | 71.38↑ | 66.65↑ | |
| grok-4.1-fast | vanilla | 83.33 | 96.67 | 90.00 |
| evolve prompt+solution | 89.34 | 96.67 | 96.67 | |
| claude-sonnet-4.5 | vanilla | 78.28 | 76.67 | 73.33 |
| evolve prompt+solution | 81.44 | 86.67 | 90.00 | |
| gemini-3-flash-preview | vanilla | 88.38 | 83.33 | 83.33 |
| evolve prompt+solution | 90.40 | 93.33 | 93.33 |
四個關鍵觀察:
- 弱模型受益更多;強模型受益較少:gpt-4.1 在 AIME24/25 改進 71.4% 與 66.7%,gemini-3-flash-preview 因接近天花板僅改進 2-12%
- 組合演化主導 prompt-only 與 solution-only:跨所有模型,prompt+solution 一致最佳
- 數學基準比科學 QA 反應更強:長程符號推理暴露更多中間失敗點,反思可針對;閉卷科學 QA 更依賴事實回憶
- 天花板效應限制飽和基準:grok-4.1-fast 在 AIME24 96.7% 已無頭部空間
5.2 一般智能體基準 (GAIA)
設定:頂層規劃智能體 ($m=50$) + 多個專門子智能體(deep researcher $m=3$、browser-use $m=3$、report agent $m=3$、tool generator $m=3$、deep analyzer $m=3$)。所有智能體使用 gemini-3-flash-preview。自我演化主要由工具產生器驅動。
Table 2:GAIA Test 基準結果
| Agent | Level1 | Level2 | Level3 | Average |
|---|---|---|---|---|
| o4-mini-DR (OpenAI, 2025) | 67.59 | 59.10 | 44.28 | 59.30 |
| JoyAgent (Liu et al., 2025) | 77.42 | 67.30 | 46.94 | 67.11 |
| o3-DR (OpenAI, 2025) | 79.42 | 68.97 | 47.48 | 68.70 |
| Langfun (Google, 2024) | 84.95 | 73.58 | 48.98 | 73.09 |
| Alita (Qiu et al., 2025) | 92.47 | 71.70 | 55.10 | 75.42 |
| DeSearch (Desearch-ai, 2024) | 91.40 | 75.47 | 61.22 | 78.07 |
| h2o (H2O.ai, 2025) | 89.25 | 79.87 | 61.22 | 79.73 |
| Su-Zero-Ultra | 93.55 | 77.36 | 65.31 | 80.84 |
| AWorld (Yu et al., 2025) | 95.70 | 81.13 | 57.14 | 81.73 |
| HALO (Hou et al., 2025) | 94.62 | 84.91 | 61.22 | 81.46 |
| ToolOrchestra (Su et al., 2025) | 95.70 | 82.39 | 87.76 | 87.38 |
| vanilla | 91.40 | 77.36 | 61.22 | 79.07 |
| AGS(evolve tool) | 98.92 | 85.53 | 81.63 | 89.04 |
| Improvement(%) | 8.23↑ | 10.56↑ | 33.34↑ | 12.61↑ |
三個關鍵觀察:
- AGS 達到 SOTA 效能:平均 89.04% 超越所有公開排行榜,比次佳的 ToolOrchestra(87.38%)高 1.66 個百分點
- 工具演化在困難任務上取得大量增益:Level 1 增益 8.2%、Level 2 增益 10.6%、Level 3 增益 33.3%
- 層級資源管理緩解規劃複雜度:透過將 prompt、工具、環境視為 first-class RSPL 資源,AGS 保留會話關鍵狀態跨智能體邊界
5.3 演算法程式設計基準 (LeetCode)
從 LeetCode 收集 3,822 個程式設計問題,篩選後選 100 個最近發布的多樣分類測試問題(200 個訓練問題保留),跨 5 種語言(Python3、C++、Java、Go、Kotlin)評估。
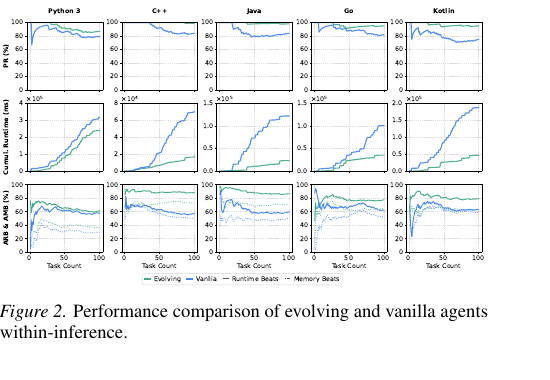
Table 4:LeetCode 評估指標:
- 能力指標:PR(通過題數)、TLE(超時)、MLE(記憶體超限)、CE(編譯錯誤)、RE(執行時錯誤)、WA(錯誤輸出)、TO(模型逾時)、RpE(無效回應)
- 效率指標:AR(平均執行時間)、AM(平均記憶體)、APC(平均接受通過數)
- 人類參考指標:ARB(runtime beats 百分位)、AMB(memory beats 百分位)
Table 3:gemini-3-flash-preview 跨語言結果(vanilla → evolve solution)
| 語言 | PR | Improvement | AR (ms) | ARB (%) |
|---|---|---|---|---|
| Python3 | 79 → 87 | 10.1↑ | 7.8↑ | 4.1↓ |
| C++ | 84 → 99 | 17.9↑ | 46.4↑ | 30.8↑ |
| Java | 84 → 98 | 16.7↑ | 23.0↑ | 24.4↑ |
| Go | 82 → 95 | 15.9↑ | 19.8↑ | 7.0↑ |
| Kotlin | 75 → 95 | 26.7↑ | 28.6↑ | 0.1↑ |
四個關鍵發現:
- 自我演化跨所有語言一致改進通過率(10.1%-26.7%),編譯型語言受益最多
- 演化改進執行時間效率,但對記憶體效應不一:執行時間在所有語言降低 7.8%-46.4%
- 演化解答相對人類提交更具競爭力:runtime beats 在 C++/Java 大幅增加(30.8%、24.4%)
- 推理內軌跡顯示複合改進動態:Figure 2 展示演化智能體與 vanilla 之間的差距隨任務累積擴大而非平台化
6. 結論
本文提出 AGP——兩層自我演化協定,解耦「演化什麼」與「如何演化」。RSPL 將 prompt、智能體、工具、環境、記憶體建模為具有明確生命週期與介面契約的 first-class 版本化資源。SEPL 規範閉迴圈算子代數,用於提出、評估、提交改進,具備可審計血統與回滾。基於此協定,作者實例化 AGS——動態檢索、精煉、演化異質資源的推理-行動智能體。
協定層級的自我演化方法為打造模組化、可追溯、可安全改進的智能體系統提供了原則性基礎。
參考文獻
Anthropic. Equipping agents for the real world with agent skills. 2025a.
Anthropic. Introduction to agent skills. October 2025b.
Brown, T., Mann, B., Ryder, N., Subbiah, M., Kaplan, J. D., et al. Language models are few-shot learners. NeurIPS, 2020.
Chen, M., Tworek, J., Jun, H., Yuan, Q., et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
Chen, W., Su, Y., Zuo, J., et al. Agentverse: Facilitating multi-agent collaboration and exploring emergent behaviors. ICLR, 2023.
Chen, Z., Deng, Y., Yuan, H., Ji, K., and Gu, Q. Self-play fine-tuning converts weak language models to strong language models. arXiv preprint arXiv:2401.01335, 2024.
Gao, H.-a., Geng, J., Hua, W., et al. A survey of self-evolving agents: What, when, how, and where evolve on the path to artificial super intelligence. arXiv preprint arXiv:2507.21046, 2025.
Google. Langfun: Object-Oriented Programming for Language Models. 2024.
Google. A2a: A new era of agent interoperability. April 2025.
Hong, S., Zhuge, M., Chen, J., et al. Metagpt: Meta programming for a multi-agent collaborative framework. ICLR, 2023.
Hou, Z., Tang, J., and Wang, Y. Halo: Hierarchical autonomous logic-oriented orchestration for multi-agent llm systems. arXiv preprint arXiv:2505.13516, 2025.
Hu, J. Reinforce++: A simple and efficient approach for aligning large language models. arXiv preprint arXiv:2501.03262, 2025.
Jimenez, C. E., Yang, J., Wettig, A., Yao, S., et al. Swe-bench: Can language models resolve real-world github issues? arXiv preprint arXiv:2310.06770, 2023.
Liu, J., Xu, S., Liu, S., Li, Y., Liu, W., et al. Joyagent-jdgenie: Technical report on the gaia. arXiv preprint arXiv:2510.00510, 2025.
Madaan, A., Tandon, N., Gupta, P., et al. Self-refine: Iterative refinement with self-feedback. NeurIPS, 2023.
Mialon, G., Fourrier, C., Wolf, T., LeCun, Y., and Scialom, T. Gaia: a benchmark for general ai assistants. ICLR, 2023.
OpenAI. Introducing Deep Research. February 2025.
Ouyang, L., Wu, J., Jiang, X., et al. Training language models to follow instructions with human feedback. NeurIPS, 2022.
Pryzant, R., Iter, D., Li, J., Lee, Y., Zhu, C., and Zeng, M. Automatic prompt optimization with "gradient descent" and beam search. EMNLP, 2023.
Qin, Y., Liang, S., Ye, Y., et al. Toolllm: Facilitating large language models to master 16000+ real-world apis. arXiv preprint arXiv:2307.16789, 2023.
Qiu, J., Qi, X., Zhang, T., et al. Alita: Generalist agent enabling scalable agentic reasoning with minimal predefinition and maximal self-evolution. arXiv preprint arXiv:2505.20286, 2025.
Rein, D., Hou, B. L., Stickland, A. C., et al. Gpqa: A graduate-level google-proof q&a benchmark. COLM, 2024.
Schick, T., Dwivedi-Yu, J., et al. Toolformer: Language models can teach themselves to use tools. NeurIPS, 2023.
Schulman, J., Wolski, F., Dhariwal, P., Radford, A., and Klimov, O. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., Bi, X., et al. Deepseekmath: Pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
Shinn, N., Cassano, F., Gopinath, A., Narasimhan, K., and Yao, S. Reflexion: Language agents with verbal reinforcement learning. NeurIPS, 2023.
Su, H., Diao, S., Lu, X., et al. Toolorchestra: Elevating intelligence via efficient model and tool orchestration. arXiv preprint arXiv:2511.21689, 2025.
Touvron, H., Lavril, T., Izacard, G., et al. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023.
Wei, J., Wang, X., Schuurmans, D., Bosma, M., Xia, F., Chi, E., Le, Q. V., Zhou, D., et al. Chain-of-thought prompting elicits reasoning in large language models. NeurIPS, 2022.
Wu, Q., Bansal, G., Zhang, J., et al. Autogen: Enabling next-gen llm applications via multi-agent conversations. COLM, 2024.
Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K. R., and Cao, Y. React: Synergizing reasoning and acting in language models. ICLR, 2022.
Yu, C., Lu, S., Zhuang, C., Wang, D., et al. Aworld: Orchestrating the training recipe for agentic ai. arXiv preprint arXiv:2508.20404, 2025.
Yuksekgonul, M., Bianchi, F., Boen, J., Liu, S., Lu, P., Huang, Z., Guestrin, C., and Zou, J. Optimizing generative ai by backpropagating language model feedback. Nature, 639(8055):609-616, 2025.
Zelikman, E., Wu, Y., Mu, J., and Goodman, N. Star: Bootstrapping reasoning with reasoning. NeurIPS, 2022.
Ziegler, D. M., Stiennon, N., Wu, J., et al. Fine-tuning language models from human preferences. arXiv preprint arXiv:1909.08593, 2019.
術語對照表
| 英文 | 中文 |
|---|---|
| Autogenesis Protocol (AGP) | 自我演化協定 |
| Resource Substrate Protocol Layer (RSPL) | 資源基礎協定層 |
| Self-Evolution Protocol Layer (SEPL) | 自我演化協定層 |
| Autogenesis System (AGS) | Autogenesis 系統 |
| Self-Evolution | 自我演化 |
| Long-Horizon Task | 長期任務 |
| Glue Code | 膠水程式碼 |
| Decoupling | 解耦 |
| Auditability | 可審計性 |
| Formalism | 形式化 |
| Protocol-Registered Resource | 協定註冊資源 |
| Resource Entity | 資源實體 |
| Lifecycle | 生命週期 |
| Version Lineage | 版本血統 |
| Context Manager | 情境管理器 |
| Contract Generation | 契約生成 |
| Context Engineering | 情境工程 |
| Tracer Module | 追蹤模組 |
| Operator Algebra | 算子代數 |
| Reflect / Select / Improve / Evaluate / Commit | 反思 / 選擇 / 改進 / 評估 / 提交 |
| Trace Space | 軌跡空間 |
| Hypothesis Space | 假設空間 |
| Modification Space | 修改空間 |
| Evolvable Variable | 可演化變數 |
| Variable Lifting | 變數提升 |
| Learnability Mask | 可學習性遮罩 |
| Closed-Loop Evolution | 閉迴圈演化 |
| Reflection Optimizer | 反思最佳化器 |
| Semantic Gradient | 語義梯度 |
| Operatorized Update | 算子化更新 |
| Agent Bus | 智能體匯流排 |
| Plan Generation | 規劃生成 |
| Agent-as-Tool | 智能體即工具 |
| Model Context Protocol (MCP) | 模型情境協定 |
| Agent-to-Agent (A2A) | 智能體對智能體 |
| Agent Skill | 智能體技能 |
| Long-Horizon Symbolic Reasoning | 長程符號推理 |
| Compounding Improvement | 複合改進 |
| Runtime Beats (ARB) | 執行時間勝率 |
| Memory Beats (AMB) | 記憶體勝率 |
| Pass Rate (PR) | 通過率 |