TW-LegalBench:衡量台灣法律理解能力
原始論文:TW-LegalBench: Measuring Taiwanese Legal Understanding 作者:Fei-Yueh Chen, Chun Huang Lin, Chan Wei Hsu, Kuan Hsuan Yeh, Zih-Ching Chen, Kuan-Ming Chen, Patrick Chung-Chia Huang arXiv ID:2606.18699v1 日期:2026-06-17 標籤:LLM Benchmark 法律 NLP 繁體中文 台灣法律 LLM-as-Judge 判決預測
目錄
License: CC BY 4.0 arXiv:2606.18699v1 [cs.CL] 2026 年 6 月 17 日
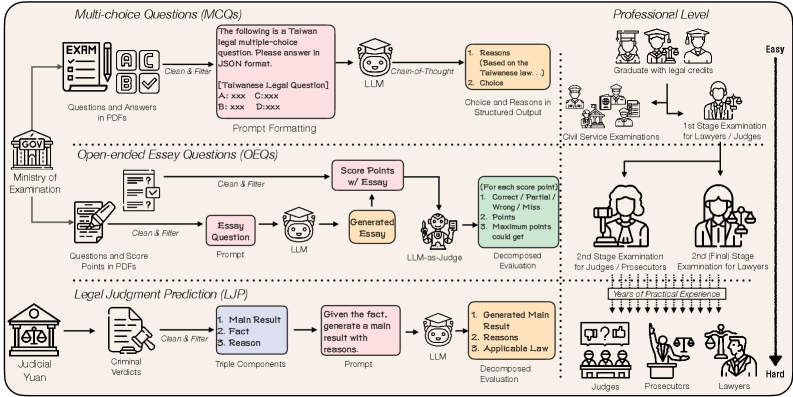
圖 1. TW-LegalBench 的主要框架
摘要
大型語言模型 (Large Language Models, LLMs) 已在多元任務上展現出令人印象深刻的能力,然而它們在「特定法域之法律推理 (jurisdiction-specific legal reasoning)」上的表現仍鮮少被探討。我們提出 TW-LegalBench,運用台灣法律體系豐富、且公開於大眾的官方語料,填補在台灣法律上評估 LLM 的空缺——相對於聚焦英文來源的英美法系基準,以及聚焦簡體中文來源的大陸法系基準而言。TW-LegalBench 包含三種任務類型:(1) 橫跨五年官方考試、涵蓋 18 個專業領域的逾 16,000 道選擇題 (Multiple-Choice Questions, MCQs);(2) 取自法律專業人員考試、附有官方評分標準的 117 道申論題 (Open-Ended Essay Questions, OEQs);以及 (3) 涵蓋數百種罪名類別的逾 14,000 筆法律判決預測 (Legal Judgment Prediction, LJP) 實例。我們評估 13 個 LLM,分別以準確率衡量選擇題、以基於評分要點 (scoring rubric points) 的分解式 LLM-as-Judge 框架衡量申論題,並以量刑準確率與法條引用等指標衡量法律判決預測。我們的結果顯示,表現最佳的模型超越了律師的及格門檻(及格率:11%),但未達法官與檢察官的標準(及格率:1~2%)。對於法律判決預測,雖然模型展現出合理的判決類型準確率與刑度預測能力,但它們難以引用正確的法條。這些發現凸顯出:即使 LLM 在資格考試上的表現逼近人類水準,可靠的法律文本生成對它們而言仍然是一大挑戰。
關鍵字:Generative AI、Large Language Models、Benchmark、繁體中文、法律考試、判決預測
1. 緒論
大型語言模型 (LLMs),包括 LLaMA (Meta AI, 2024)、Qwen (Team, 2024, 2025) 與 GPT (OpenAI, 2023, 2025b) 等模型家族,其開發形式或為供廣泛重用的開放模型,或為可透過微調 (fine-tuning) 適配至特定領域的專有系統。在各類高影響力的應用領域中,法律是一個格外具前景卻也極具挑戰的文本生成領域。一方面,LLM 被期待能促進那些無力負擔法律服務者的「近用司法 (access to justice)」;另一方面,法律推理這類任務需要精確的解釋、結構化的推理,以及對特定法域之法理 (jurisdiction-specific doctrines) 的敏感度。因此,一個能評估 LLM 在此類任務上表現的基準,無論在技術面或政策面都至關重要。
英文基準如 MMLU (Hendrycks et al., 2021) 與 LegalBench (Guha et al., 2023) 納入了關於英美法系 (common law system) 的任務。在與台灣文化相關的繁體中文基準方面,TMLU (Chen et al., 2024) 收錄了某一年的律師考試選擇題,而 TMMLU+ (Tam et al., 2024) 則蒐集了數種涵蓋審計與財經法的標準化測驗。先前的研究也曾針對其他法域與語言提出法律基準,例如 LegalBench (Guha et al., 2023)(英美法系任務)、LawBench (Fei et al., 2024),以及針對簡體中文模型(大陸法系任務)的 LawShift (Han et al., 2025)。
儘管近期已有進展,現有法律基準仍存在三項可能掩蓋模型真實專業就緒度的系統性限制。第一,許多基準 (Chen et al., 2024; Hendrycks et al., 2021; Tam et al., 2024) 過於粗略,將相異的法理歸併到過於寬泛的類別中。舉例而言,TMMLU+ (Tam et al., 2024) 將《行政訴訟法》與《公務員懲戒法》合併於單一的行政法類別之下,限制了其提供精確且量身打造之答案的能力。第二,多數與法律相關的基準過度倚賴封閉式題型,造成明顯的評估落差。這類題型雖便於評分,卻無法模擬現實世界的問題解決——後者往往涉及開放式、客製化的事實樣態 (fact patterns)。最後,明顯存在法域失衡 (jurisdictional imbalance)。多數基準是依據英美法系與英語系法域的素材設計的,這使得像台灣這樣的大陸法系 (civil-law) 法域,缺乏用以檢驗模型是否對在地化法理對齊 (alignment) 所必需的大規模、高保真資源。
為解決這些限制,我們提出一個植基於台灣大陸法傳統獨特之開放資料生態系 (open-data ecosystem) 的「多層級基準 (multi-tiered benchmark)」。具體而言,我們從官方考試題目與法院判決中策展任務,這些素材代表了跨法域廣受認可的資格里程碑,以及不同層級的法律服務:規則的釐清與背誦、假設情境的問題解決,以及現實世界的爭端解決。第一,我們透過 16,493 道附有法條層級 (statute-level) 標註的題目,建立起以規則為本的辨識基礎,得以對模型橫跨 43 種不同法律類型的專業能力進行高解析度診斷。第二,我們透過 117 道開放式律師考試申論題挑戰模型進行複雜的綜合論述,並運用一套經驗證的 LLM-as-Judge 框架來評估其建構連貫法律論證的能力。最後,我們透過一個涵蓋 14,325 件刑事判決的大規模語料評估模型與現實世界的對齊程度,要求模型預測橫跨 107 個罪名類別的司法結果。綜上所述,我們的貢獻如下:
選擇題的法條層級標註。 我們蒐集橫跨五年(2020–2024)的官方法律考試,涵蓋 18 個專業領域、共 16,493 道選擇題,包括公務人員、司法人員與專技人員考試。我們手動為每道題目標註其相關法條(例如《民法》、《刑法》等),辨識出橫跨 6 個法律大類的 43 種不同法律類型。這使我們能進行比過往基準更細緻的能力分析。
針對開放式任務的 LLM-as-Judge 評估框架。 我們為開放式法律推理建立了一套嚴謹的評估協定,採用一個對照官方評分標準校準過的 LLM-as-Judge 框架。
大規模判決預測資料集。 我們策展了 2013 至 2024 年的 14,325 件刑事判決,在保守的標準化處理後涵蓋 107 個罪名類別。我們設計了一個平衡的評估切分,每個罪名類型取 5 個樣本(共 535 個測試案例),確保在所有類別上的評估都公平,而不受其在現實資料中出現頻率的影響。
2. 相關研究
我們的基準旨在填補一項空缺:在一個非英語、且遵循大陸法傳統的法域中評估模型的法律推理能力。現有的基準若非聚焦於遵循英美法傳統的英語系法域,便是即使在大陸法的脈絡下,也缺乏全面的任務範疇(表 1)。
2.1 以英美法系為基礎的基準
早期用以評估 LLM 多面向能力的基準,主要以英文為基礎,導致這些基準偏重英美法系。受英美法規則主導之科目的題目,著重於與先例 (precedents) 的比較,並從中發掘其隱含的規則。這一點可在 MMLU (Hendrycks et al., 2021) 的律師考試任務中觀察到——其中「專業法 (Professional Law)」部分的侵權行為 (Torts) 題目會給出假設情境,要求模型將當前情境與過往案例比較,以判定適用的規則並預測最可能的結果。同樣地,LegalBench (Guha et al., 2023) 中的「規則適用 (Rule-application)」類別(六種推理類型之一)涵蓋了多樣的案例,期待模型能據以進行健全的法律推理。簡言之,運用英美法系資料的基準似乎著重於案例與先例的比較。誠然,英美法系的基準也必須處理法條解釋,例如 LegalBench (Guha et al., 2023) 中依稅法計算應納稅額;然而,此類任務佔比相對較小、頻率也較低。鑑於這些基準從根本上奠基於英美法體系與英美文化,諸如 MMLU 之類的標準可能不易推廣至非英語系法域 (Singh et al., 2025)。
2.2 以大陸法系為基礎的基準
在大陸法體系中,規則以抽象法條的形式被明文規定。大陸法系法院的法官不是將手邊案件的事實樣態與先例相比較,而是直接將規則適用於案件。就此意義而言,大陸法傳統的法律推理展現出與英美法傳統不同的樣貌。也就是說,至少在考試中,當前案件與先例之間的比較較不相關。此外,大陸法系的法律推理對法條措辭十分敏感。這一點在 LawBench (Fei et al., 2024)——一個以中國(大陸法系)法律體系為基礎的基準——中已被觀察到。它在「有提供」與「未提供」相關法條文本兩種條件下,評估模型背誦法條與預測判決的能力。其結果顯示,當提供相關文本時模型普遍表現較佳,這表明模型可能難以正確背誦法條。再者,大陸法系的法律推理不僅倚賴法條本身,也仰賴其脈絡,例如立法歷史與修正沿革。法條措辭的變動在法條解釋中可能扮演重要角色。這對當前的 LLM 構成重大挑戰,因為它們的訓練資料可能缺乏對法條修正歷史的全面涵蓋。模型也可能難以辨識法律修正前後版本之間的差異,或無法將前後相繼的版本視為一個連貫的法律演進整體。LawShift (Han et al., 2025) 是首個專門設計用以評估模型在「法條變動」上之表現的基準,並以中國《刑法》的歷史演進作為基礎。作者發現,最先進的模型出奇地脆弱:它們的推理無法反映新頒布條文所帶來的變化,反而退回到嵌入其原始訓練資料中的過時法律概念。
2.3 繁體中文與台灣法律
為解決這些限制,我們運用台灣法律體系的資料;台灣法律遵循大陸法傳統,並深受德國與日本影響。雖然台灣政府已公布豐富而高品質的法律資料,但就我們所知,尚無專門針對台灣法律評估模型的基準被開發出來。TMLU (Chen et al., 2024) 編纂了數量有限、難度不一的法律考試題目,包括從一系列國家考試(如律師考試、駕照測驗,以及國中與高中公民考試)中擷取的數百道選擇題。TMMLU+ (Tam et al., 2024) 納入了一些與審計相關的題目以及一般法律題項,然而這些行政法題目主要評估的是基礎法律知識,而非前述那種源自法條規定與案例分析的法律推理。儘管如此,TMLU 與 TMMLU+ 所收錄的題目範疇有限,且往往過於抽象,難以對具體案件提供足夠資訊。據我們所知,LLAWA (Chen et al., 2025) 是唯一一個聚焦繁體中文、納入法律語料進行微調,並以法律推理任務為目標的現有研究。其任務分為取自律師考試與《台灣法學雜誌 (Taiwan Jurist Journal)》的選擇題、取自律師考試的刑法申論題,以及取自司法研討會的法律推理問題。LLAWA 的主要貢獻在於它探索了各種微調方法以增強模型推理能力,並討論了選擇題與申論題表現之間的權衡 (trade-off)。然而,該研究並未進一步檢視模型在法律推理過程中特定步驟的表現,也未分析所出現之錯誤的樣態。僅透過最終分數來評估不同的訓練策略,仍難以判定模型是真正理解法律邏輯,抑或僅是基於記憶下來的語料進行樣態比對 (pattern matching)。
表 1. 台灣法律基準之比較。僅計入專業題目。申論題 (OEQs) 與法律判決預測 (LJP) 計為開放式題目。
| 基準 | 選擇題 | 開放式題目 | 總計 |
|---|---|---|---|
| TMLU (Chen et al., 2024) | 279 | 0 | 279 |
| TMMLU+ (Tam et al., 2024) | 1,890 | 0 | 1,890 |
| LLAWA (Chen et al., 2025) | 904 | 1,894 | 2,798 |
| TW-LegalBench(本研究) | 16,493 | 117 + 14,325 | 30,935 |
3. 資料集
TW-LegalBench 由三個主要部分組成:選擇題 (MCQs)、申論題 (OEQs),以及法律判決預測 (LJP)。
3.1 資料來源
我們從兩個主要來源蒐集資料:
考選部 (Ministry of Examination, Taiwan)。 我們從考選部官方網站取得選擇題與申論題。^1 該網站公布台灣所有國家考試的試題與答案,包括律師考試、公務人員考試與專技人員資格考試。
司法院法學資料檢索系統 (Judicial Yuan Law and Regulations Retrieving System)。 我們從司法院的開放資料 (opendata) 平台蒐集刑事法院判決。^2 這些判決均為公開可取得,並已去識別化以保護個人資訊。
3.2 選擇題 (MCQs)
關於選擇題,我們首先從考選部下載試題與答案。我們僅保留單選的法律題目,排除官方接受多個正確答案的題項,以及在同一份試卷上將法律知識與其他科目結合的題目(例如法律知識與英文結合)。我們蒐集了 2020 至 2024 年間所有正式舉辦的專業法律考試,總計 360 份檔案,涵蓋橫跨 18 個專業領域的 85 種不同考試科目。這些考試分為四大類:公務人員 (Civil Service)、司法人員 (Judicial Personnel)、警察人員 (Police Personnel),以及專門職業及技術人員 (Professional and Technical Personnel)。應注意的是,由於並非所有考試皆逐年舉辦,且某些初等考試已被整併,考試科目因而逐年有所不同。表 2 顯示按年度劃分的資料分布。
題目: 甲已喪偶,有乙、丙二子。乙留學時甲給與新臺幣(下同)150 萬元,丙開店營業時甲亦給與 150 萬元。不久甲死亡,留有現金 300 萬元。遺產分割時,繼承人乙得分得多少金額之遺產?
選項: A:75 萬元 B:150 萬元 C:225 萬元 D:250 萬元
答案:C
圖 2. 一個取自《民法》選擇題的錯誤分析範例,所有受評模型皆未能預測出正確答案。13 個模型中有 11 個選擇 B,其餘 2 個選擇 A。
【譯註:原文圖 2 為上方所引之文字題目範例,非圖檔,故以引用區塊完整呈現題目內容,無對應圖片。】
在初步資料清理之後,我們招募了兩名研究助理^3 為每道選擇題進行標註。我們要求標註者辨識:(1) 該題目屬於國內法或國際法(值得注意的是,我們未發現任何同時涉及國內法與國際法的題目),以及 (2) 該題目所對應的具體法源(國內法條或國際公約)。在所有選擇題中,92.3% 涉及國內法,0.8% 涉及國際法,其餘題目則不涉及特定法律(例如法律的基本概念或司法實務)。總計,我們標註了 781 種不同的國內法與 46 種國際法或公約;然而,其中有 534 條法律規定在資料集中僅出現一至四次。
為了探究語言是否會影響生成品質,我們使用 Claude-Sonnet-4.5 將所有題目翻譯成簡體中文與英文。對於英文翻譯,提示 (prompt) 中納入了司法院的官方翻譯,以確保術語一致性。
表 2. 選擇題與申論題按年度之分布。
| 年度 | 選擇題 | 申論題 |
|---|---|---|
| 2020 | 3,604 | 24 |
| 2021 | 3,331 | 24 |
| 2022 | 3,433 | 23 |
| 2023 | 3,398 | 23 |
| 2024 | 2,727 | 23 |
| 總計 | 16,493 | 117 |
關於人類基準 (human baseline),考選部目前僅公布各專業類別考試的最終加權錄取分數。這些綜合分數納入了英文、作文與其他專業科目的成績,而法律考試僅佔總成績的一小部分。因此,我們無法取得各別法律主題的科目別人類表現分數。若直接平均錄取最低分數,所需的大致準確率約落在 70–80% 的區間。
3.3 申論題 (OEQs)
在我們所蒐集資料涵蓋的所有職業中,僅法官、檢察官與律師需要作答申論題(司法官與律師考試的第二試),其他職業則僅以選擇題或加考口試評量。我們同樣從考選部下載原始試題;然而,與附有具體答案的選擇題不同,申論題僅提供概述評分要點的評分標準。考試科目自 2020 至 2024 年維持穩定,唯一例外是稅法題目數量在 2022 年由三題減為兩題。表 2 顯示選擇題與申論題按年度之分布。
關於人類基準,我們蒐集了 2021 至 2024 年應試者的分數及相關表現統計。2020 年申論題的資料予以排除,因為其統計方式與現行制度不同。
3.4 法律判決預測 (LJP)
對於判決預測任務,我們選取 2013 至 2024 年的第一審刑事法院判決作為來源資料。我們套用了下列篩選條件。第一,我們僅保留結構清晰、包含「主文 (Main Result)」、「事實 (Facts)」與「理由 (Reasoning)」三部分的判決,因為某些判決類型(例如簡易判決)可能將事實與理由合併於單一部分。第二,我們為判決的各部分設定了最低字數門檻。在套用分層抽樣 (stratified sampling) 後,我們取得了 14,325 件涵蓋逾 700 個罪名類別的判決。^4 接著,我們選出包含至少 10 件案例的 107 個罪名類別,並為每個類別抽取 5 件判決作為測試集。經此處理後,我們得到 13,790 件判決作為訓練資料,以及 535 件判決作為測試資料。
4. 實驗設定
我們評估四個閉源模型與九個開源模型在 TW-LegalBench 全部三項任務上的「零樣本思維鏈 (zero-shot chain-of-thought, CoT)」(Wei et al., 2022) 能力。我們的模型選擇策略旨在涵蓋三種不同類別的 LLM。第一,我們納入代表當前大型語言模型能力前沿的閉源模型(claude-sonnet-4.5 (claude-sonnet-4-5-20250929)、gpt-5 (gpt-5-2025-08-07)、gpt-5.2 (gpt-5.2-2025-12-11),以及 gpt-4o (gpt-4o-2024-08-06))。第二,我們選擇針對推理任務最佳化的開源模型,範圍從 qwen3-235b (Team, 2025) 與 llama-3.1-405b (Meta AI, 2024) 等大規模系統,到 qwen2.5-7b (Team, 2024)、gpt-oss-120b、gpt-oss-20b (OpenAI, 2025a),以及 nemotron-3-nano-30b-a3b (NVIDIA, 2025) 等較精簡的變體。第三,為評估特定語言預訓練的重要性,我們納入主要以繁體中文資料訓練的模型,包括 llama-taiwan-70b-instruct、llama-taiwan-8b-128k (Lin and Chen, 2023),以及 breeze-7b-instruct (Hsu et al., 2024)。
值得注意的是,由於發布日期較早,這些繁體中文模型建立於 Llama3 (Meta AI, 2024) 與 Mistral (Jiang et al., 2023) 等較早期的架構之上,並在預訓練或監督式微調 (supervised fine-tuning, SFT) 階段優先納入繁體中文與台灣特有的文化資料,這與較新、透過強化學習 (reinforcement learning) 強調推理能力的模型形成對比。除 llama-taiwan-8b-128k 外,所有開源模型皆透過 NVIDIA NIM API 存取。
在實驗配置方面,除 gpt-5 與 gpt-5.2 外,我們將所有模型的溫度 (temperature) 設為 0,並在支援之處套用貪婪解碼 (greedy decoding)。對於 gpt-5 與 gpt-5.2,溫度設為 1,因為這些模型不允許溫度值為 0。
4.1 提示策略
我們為三項任務各自設計了不同的系統提示 (system prompt) 與使用者提示 (user prompt),要求所有模型以 JSON 格式生成輸出。對於涉及不同語言設定的選擇題,我們相應地翻譯了提示範本,以確保整段提示在語言上的一致性。若模型未能產出所要求格式的輸出,該回應將被標記為錯誤答案。
4.2 評估指標
4.2.1 選擇題 (MCQs)
由於我們排除了具有多個正確答案的題目,並確保每道題目都包含四個選項、且在 A、B、C、D 中恰有一個正確答案,準確率得以直接計算。除整體準確率外,我們還跨多個維度分析表現,包括考試年度(2020–2024)、考試類型(84 種不同類型)、法律類別與語言。
4.2.2 申論題 (OEQs)
我們採用 LLM-as-Judge 方法,將整體評估分解為多個組成部分並輸出離散結果,以避免直接為整道題目生成數值分數所帶來的不穩定性 (Gu et al., 2026)。為減緩潛在的「自我偏好偏誤 (self-favoritism bias)」,我們使用兩個評審模型——gpt-5 與 claude-sonnet-4.5——並回報兩位評審的平均分數。首先,由於每道題目對應一個或多個評分要點,且每個評分要點對應到答案中的特定步驟,我們指示評審模型為每個評分要點輸出一個離散標籤與相應分數。並非所有評分要點都附有明確的配分。在這類情況下,我們指示評審模型依據評分要點的數量與相對重要性,分配該題的總分。此標籤方案包含四個類別,如表 3 所示,用以指示模型對每個評分要點的回應狀態。
近期的實證研究已驗證以詳細評分標準進行的 LLM 評分,在多元法律申論題上與人類專家評分達到了 r = 0.78–0.93 的相關性 (Frankenreiter et al., 2024),支持了我們的分解式評分方法。此外,我們並未要求模型計算總分;此計算改於後處理 (post-processing) 階段進行。
表 3. 申論題評分要點的評估狀態標籤與計分規則。
| 狀態 | 描述 | 計分規則 |
|---|---|---|
| correct | 完全正確 | 該要點配分的 70–100% |
| partial | 部分正確 | 該要點配分的 30–70% |
| wrong | 答案錯誤 | 該要點配分的 0–30% |
| miss | 未涵蓋/遺漏 | 0 分 |
4.2.3 法律判決預測 (LJP)
給定一件刑事案件的事實,我們要求模型生成適用的法條規定、判決理由與判決主文。由於台灣刑事判決缺乏標準化的書寫範本,加上其高度複雜性與相當的篇幅長度,我們將判決理由的評估留待未來研究,在此聚焦於評估較不易受統計偏誤影響的適用法條規定與判決主文。
在評估判決主文時,我們同時考量文本生成品質指標與量刑準確率。對於生成品質,我們採用 ROUGE-1/2/L 以及使用 Jieba^5 進行中文斷詞的詞元層級 (token-level) F1 分數。對於量刑準確率,我們計算判決準確率 (verdict accuracy) 與量刑精確度 (sentencing precision)。
關於量刑精確度與準確率,我們採用一套類別特定 (category-specific) 的評估策略來評量數值預測的準確性。對於有期徒刑刑期,考量到對刑期長短的「非線性感知」(亦即對長刑期與短刑期的容錯程度不同),我們沿用 LawBench (Fei et al., 2024) 的做法,採用對數尺度上的「正規化對數距離 (normalized log-distance)」指標,並以 216 個月作為正規化邊界,產出範圍介於 0 到 1、更具鑑別力的分數。對於拘役、罰金與緩刑,我們則回歸直接的數值比較,在絕對門檻(例如拘役 ±7 天、緩刑 ±1 年)或相對比例(例如罰金 ±10% 或 ±50%)內評估預測準確率與平均偏差。透過這些指標,我們得以精確量化模型在預測各類司法制裁上的熟練度。
最後,對於適用法條規定,我們考量法條準確率、第一型錯誤 (Type I error)(引用不存在/幻覺的法條)、第二型錯誤 (Type II error)(引用真實但不適用的法條),以及總錯誤率(第一型 + 第二型)。我們以正規表示式 (regular expressions) 從原始判決書中擷取相關法條,捕捉法律規定的階層結構,包括條 (Article)、項 (Paragraph)、款 (Subparagraph) 與目 (Item)。同樣的擷取程序接著套用於模型生成的輸出,之後再計算前述四項指標。
5. 實驗結果
5.1 選擇題整體表現
表 4 呈現所有模型橫跨 6 個法律領域的表現。我們觀察到,幾乎所有模型都在憲法與未標註法律類別的題目上達到最佳表現,而在行政法上表現較弱。這些發現與我們對法律題目特性的預期一致:許多未標註的題目涉及初等考試,主要評估一般法律概念,而非適用源自特定法條的規則。相較於其他領域,憲法的變異性相對較低、涵蓋的條文也較少,這有助於模型獲得較佳表現。相對地,行政法包含大量晦澀的法條,且時常修正,對閉源與開源模型皆構成更大挑戰。
表 4. 各法律領域的選擇題準確率 (%),依模型可取得性區分。模型在各自類別內依總分 (Total) 排序。各類別最佳分數以粗體標示。(Const.=憲法,Crim.=刑法,Civil=民法,Admin.=行政法,Intl.=國際法,No Law=無法律類別)
| 模型 | 發布 | Const. | Crim. | Civil | Admin. | Intl. | No Law | Total |
|---|---|---|---|---|---|---|---|---|
| 閉源模型 | ||||||||
| claude-sonnet-4.5 | 2025-09 | 89.4 | 82.6 | 80.9 | 78.1 | 75.8 | 88.6 | 81.0 |
| gpt-5 | 2025-08 | 87.6 | 78.7 | 77.7 | 72.3 | 75.8 | 88.9 | 76.7 |
| gpt-5-2 | 2025-12 | 84.8 | 76.2 | 74.0 | 69.7 | 76.6 | 86.4 | 73.9 |
| gpt-4o | 2024-08 | 79.9 | 68.6 | 64.9 | 61.5 | 67.7 | 81.5 | 66.2 |
| 開源模型 | ||||||||
| qwen3-235b | 2025-04 | 78.5 | 75.3 | 69.1 | 64.4 | 69.4 | 82.2 | 69.1 |
| llama-taiwan-70b-instruct | 2024-04 | 71.5 | 65.2 | 60.2 | 61.0 | 64.5 | 74.4 | 63.4 |
| llama-3.1-405b | 2024-07 | 72.2 | 63.9 | 57.6 | 56.6 | 67.7 | 73.1 | 60.5 |
| gpt-oss-120b | 2025-08 | 67.2 | 58.5 | 52.7 | 52.1 | 62.1 | 73.0 | 56.0 |
| nemotron-3-nano-30b-a3b | 2025-12 | 63.5 | 57.2 | 49.2 | 48.7 | 56.5 | 66.3 | 52.6 |
| qwen2.5-7b | 2024-09 | 59.3 | 52.1 | 46.8 | 46.7 | 53.2 | 61.2 | 49.7 |
| gpt-oss-20b | 2025-08 | 59.1 | 51.9 | 44.4 | 44.9 | 55.6 | 60.5 | 48.3 |
| llama-taiwan-8b-128k | 2024-04 | 53.6 | 47.0 | 40.5 | 42.6 | 41.1 | 57.1 | 44.9 |
| breeze-7b-instruct | 2024-03 | 46.2 | 41.6 | 35.9 | 37.4 | 46.0 | 50.5 | 39.6 |
5.2 申論題整體表現
我們在表 5 中回報各狀態標籤的計數。我們的發現揭示了以下觀察:(1) 任務之間在準確率上存在顯著的表現落差,且模型間的差異化在申論題上遠比在選擇題上更為明顯。例如,gpt-4o 與 qwen3-235b 在選擇題的總分差距不到 3%,且在所有學科領域的表現都相當接近。然而,在申論題上,qwen3-235b 取得了超過 gpt-4o 兩倍的正確標籤計數。(2) 主要以簡體中文或繁體中文資料訓練的模型[^6],在以 partial 與 wrong 標籤為主的評估上,能勝過更大型的通用模型。例如,breeze-7b-instruct 勝過 gpt-oss-20b、llama-taiwan-70b-instruct 勝過 gpt-oss-120b,而 qwen3-235b 甚至超越 gpt-4o,凸顯了中文語料的重要性。(3) 由於我們採用貪婪解碼,llama-taiwan-8b 在生成過程中時常出現推理失敗,例如產生重複的答案。我們推測,此檢查點 (checkpoint) 在 SFT 階段可能接受了不足的推理導向文本訓練。雖然此一限制在選擇題上並不明顯,但在申論題上被大幅放大。
[^6]: 此處指預訓練以外的階段,例如在 SFT 或 RL 過程中使用更高比例的中文資料。
表 5. 申論題上的評估狀態標籤數量。模型依 Correct 排序。
| 模型 | Correct | Partial | Wrong | Miss |
|---|---|---|---|---|
| gpt-5 | 166 | 187 | 42 | 185 |
| gpt-5-2 | 160 | 195 | 42 | 183 |
| claude-sonnet-4.5 | 160 | 176 | 59 | 185 |
| qwen3-235b | 115 | 204 | 88 | 173 |
| gpt-4o | 52 | 214 | 94 | 220 |
| llama-taiwan-70b-instruct | 55 | 184 | 104 | 237 |
| gpt-oss-120b | 53 | 185 | 126 | 216 |
| nemotron-3-nano-30b-a3b | 39 | 163 | 106 | 272 |
| llama-3.1-405b | 21 | 171 | 133 | 255 |
| qwen2.5-7b | 17 | 160 | 147 | 256 |
| breeze-7b-instruct | 10 | 124 | 168 | 278 |
| gpt-oss-20b | 17 | 132 | 92 | 339 |
| llama-taiwan-8b-128k | 5 | 50 | 55 | 470 |
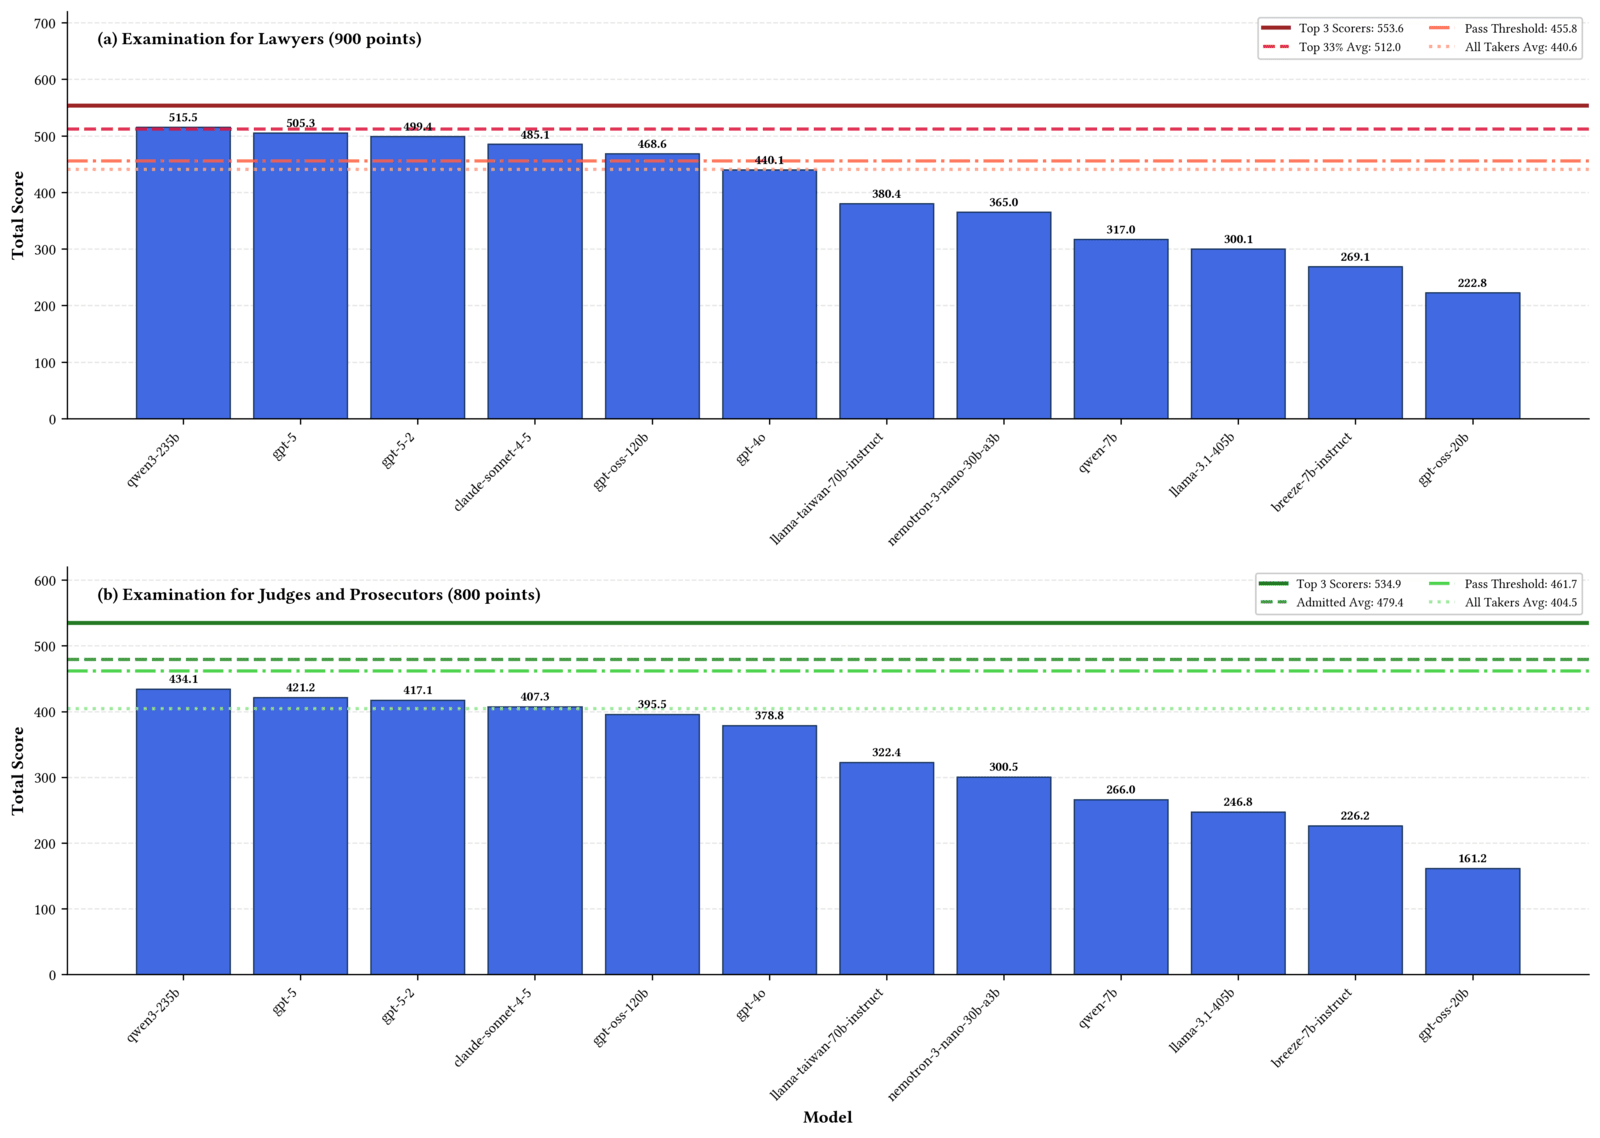
圖 3. 模型在申論題上的表現與人類應試者(2021–2024 平均)的比較。(a) 顯示律師考試 (Examination for Lawyers)(900 分)的結果,(b) 顯示司法官(法官與檢察官)考試 (Examination for Judges and Prosecutors)(800 分)的結果。水平參考線代表人類基準統計值,並依各層級扣除中文作文分數(例如,「Admitted Avg」分數已扣除錄取平均應試者的中文作文分數)。
接著,我們依律師考試與司法官考試,匯總評審模型輸出的分數。為確保公平,我們做了兩項調整。第一,由於僅 2021–2024 有詳細統計,我們以四年平均計算模型表現統計值,而前述回報的狀態標籤計數則是以橫跨全部五年的完整資料集計算。第二,由於兩項考試皆包含我們未予評估的國文作文部分,我們無法直接將模型分數與人類應試者的分數比較。因此,我們以「各百分位排名 (percentile rank) 之分數減去相應百分位排名之國文作文分數」回報分數。例如,我們從前 33 百分位應試者的平均總分中減去其平均國文作文分數,以得到該百分位群組的平均法律科目總分。
要通過律師考試,考生須名列前 33 百分位且總分超過 400 分(此分數包含國文作文;若僅計法律科目,門檻約為 350 分)。對於司法官考試,及格門檻設定為最終錄取人數的 1.2 倍,相當於約所有進入第二試應試者的前 5–10%。^7 這兩項考試共用相同試題,但在計入最終成績的科目權重上有所不同。圖 3 呈現模型生成結果與人類表現的比較,其中模型分數代表兩個評審模型的平均。我們觀察到 qwen3-235b 在兩項考試中皆達到最佳表現,勝過所有閉源模型。有五個模型達到律師考試的錄取門檻,其中 qwen3-235b、gpt-5 與 gpt-5.2 逼近錄取者的平均分數。然而,沒有任何模型達到司法官考試的及格門檻。前 3% 應試者的分數超過 qwen3-235b 逾 100 分,揭示出顯著的表現落差。
5.3 法律判決預測整體表現
表 6 呈現法律判決預測的評估結果。我們回報以下發現:(1) Claude-sonnet-4.5 在幾乎所有指標上都取得最高分,尤其在量刑預測方面。(2) 幾乎所有模型都顯示出對台灣《刑法》刑事制裁的理解不足,導致它們無法在我們評估框架所定義的門檻內,於一項或多項量刑指標上產生準確的量刑預測。(3) 相對地,breeze-7b-instruct 與 llama-taiwan-8b 取得了明顯偏高的分數。然而,鑑於它們在申論題與選擇題上的表現,我們合理推論其優異結果源自訓練資料中包含相當比例的法院判決,使它們得以透過記憶(而非真正的法律推理)進行量刑。
表 6. 法律判決預測上主文結果預測的綜合表現。模型依 ROUGE-L 排序。(R-1/R-2/R-L=ROUGE-1/2/L,T-F1=詞元層級 F1,Pri.±3m=量刑精確度(誤差 ±3 個月內),Norm Log-Dist=正規化對數距離,Det.±7d=拘役(±7 天),Prob.±1y=緩刑(±1 年),Fine±50%=罰金(±50%))
| 模型 | R-1 | R-2 | R-L | T-F1 | Pri.±3m | Norm Log-Dist | Det.±7d | Prob.±1y | Fine±50% |
|---|---|---|---|---|---|---|---|---|---|
| 閉源模型 | |||||||||
| claude-sonnet-4.5 | 0.563 | 0.412 | 0.535 | 0.564 | 0.503 | 0.907 | 0.214 | 0.146 | 0.265 |
| gpt-5-2 | 0.462 | 0.303 | 0.427 | 0.463 | 0.394 | 0.876 | 0.129 | 0.219 | 0.000 |
| gpt-5 | 0.432 | 0.267 | 0.399 | 0.433 | 0.404 | 0.872 | 0.057 | 0.219 | 0.000 |
| gpt-4o | 0.306 | 0.160 | 0.284 | 0.306 | 0.165 | 0.834 | 0.000 | 0.274 | 0.042 |
| 台灣開源模型 | |||||||||
| llama-taiwan-8b-128k | 0.414 | 0.260 | 0.387 | 0.417 | 0.568 | 0.898 | 0.103 | 0.604 | 0.102 |
| breeze-7b-instruct | 0.399 | 0.279 | 0.383 | 0.399 | 0.319 | 0.886 | 0.000 | 0.106 | 0.000 |
| 其他開源模型 | |||||||||
| qwen3-235b | 0.358 | 0.209 | 0.325 | 0.358 | 0.215 | 0.846 | 0.029 | 0.500 | 0.000 |
| llama-3.1-405b | 0.319 | 0.169 | 0.298 | 0.319 | 0.181 | 0.829 | 0.000 | 0.219 | 0.000 |
| gpt-oss-120b | 0.300 | 0.138 | 0.263 | 0.302 | 0.043 | 0.753 | 0.000 | 0.208 | 0.041 |
| gpt-oss-20b | 0.262 | 0.130 | 0.246 | 0.262 | 0.013 | 0.704 | 0.000 | 0.000 | 0.000 |
| nemotron-3-nano-30b-a3b | 0.239 | 0.115 | 0.225 | 0.240 | 0.065 | 0.741 | 0.000 | 0.053 | 0.000 |
| qwen2.5-7b | 0.235 | 0.107 | 0.217 | 0.235 | 0.067 | 0.777 | 0.000 | 0.125 | 0.000 |
我們進一步在表 7 中檢視適用法條規定的錯誤率,出現了幾項發現:(1) 雖然 claude-sonnet-4.5 在閉源模型中取得最佳表現,但其第一型錯誤率 (0.2406) 相對偏高,顯示出傾向幻覺出不存在之法條的現象。(2) 雖然 gpt-oss-120b 的準確率極低 (0.0031),但它在所有模型中達到最低的第一型(不存在法條)錯誤率 (0.0992)。這表明,儘管它的預測大多錯誤,但這些錯誤主要涉及引用不相關但存在的法條(第二型錯誤高達 0.8976),而非完全捏造法條。(3) llama-taiwan-8b 達到最高的準確率 0.0993 與最低的總錯誤率 (0.9007)。與我們先前的結論一致,這顯示出以台灣特有語料訓練的模型,在法條引用上的準確率明顯高於其他模型,我們將此歸因於記憶效應。
表 7. 法條引用幻覺率 (%)。各類別最佳分數以粗體標示(Acc 取最高;錯誤取最低)。
| 模型 | Acc | TypeI | TypeII | Total |
|---|---|---|---|---|
| 閉源模型 | ||||
| claude-sonnet-4.5 | 5.7 | 24.1 | 70.2 | 94.3 |
| gpt-5-2 | 3.9 | 12.3 | 83.8 | 96.1 |
| gpt-5 | 2.6 | 15.5 | 81.8 | 97.4 |
| gpt-4o | 2.0 | 24.3 | 73.7 | 98.0 |
| 台灣模型 | ||||
| llama-taiwan-8b-128k | 9.9 | 15.1 | 75.0 | 90.1 |
| breeze-7b-instruct | 2.6 | 13.8 | 83.6 | 97.4 |
| 其他開源模型 | ||||
| qwen3-235b | 2.4 | 16.8 | 80.7 | 97.6 |
| llama-3.1-405b | 1.1 | 12.2 | 86.7 | 98.9 |
| qwen2.5-7b | 0.6 | 15.8 | 83.6 | 99.4 |
| gpt-oss-20b | 0.4 | 28.3 | 71.3 | 99.6 |
| nemotron-3-nano-30b | 0.3 | 18.7 | 81.0 | 99.7 |
| gpt-oss-120b | 0.3 | 9.9 | 89.8 | 99.7 |
6. 討論
6.1 選擇題中的極難題目
我們分析了幾乎所有模型都答錯的選擇題。在 16,493 道題目中,有 290 道(1.76%)難倒了所有模型,而 550 道(3.33%)僅有不到 10% 的模型答對。在所有模型皆失敗的題目中,民法出現最頻繁,但也僅佔 11 道題,而只有三個法律類別包含超過 10 道題。值得注意的是,這 290 道題目橫跨 149 條獨特法條,其中絕大多數涉及複雜且鮮為人知的法規,例如《國立故宮博物院組織法》或《耕地三七五減租條例》,這些都高度特定於公務人員考試。
難倒所有模型的民法題目主要涉及遺產分配或消滅時效,需要先進行初步計算才能解答。圖 2 描繪了一道關於遺產分配的民法題目。此題涉及《民法》第 1173 條,該條處理「將投資歸類為特種贈與並視為繼承之預付(歸扣)」的概念。在受評的 13 個模型中,11 個選擇選項 B,2 個選擇選項 A。
6.2 語言與術語效應
為探究語言與術語是否影響模型表現,我們使用 claude-sonnet-4.5 將 2024 年的選擇題翻譯成英文與簡體中文。英文翻譯參照司法院發布的《法院常用法律詞彙與訴訟程序(Commonly Used Legal Vocabularies in Courts and Litigation Procedures)》。^8 我們回報 gpt-4o 的結果。雖然各語言間的整體平均準確率維持相近,但在各別法律領域中觀察到了顯著差異。
當題目被翻譯成英文時,與公務員相關之法條的表現有所提升,包括《公職人員財產申報法》與《公平交易法》。我們將此提升歸因於這些法條的法律淵源:台灣的《公職人員財產申報法》大量借鑑美國的陽光法案 (Sunshine Laws) 與 1978 年《政府倫理法 (Ethics in Government Act)》,產生了精確的英中術語對應。相反地,在涉及特定法域數值門檻的領域,表現則下降,例如《身心障礙者權益保障法》、《勞資爭議處理法》、稅法以及邊境管制法規。
Claude-sonnet-4.5 在簡體中文翻譯中傾向將正式法律術語改寫為較口語化的表達。這類簡化提升了對某些法條的理解,例如《遺產及贈與稅法》。然而,對於包含難以簡化之領域特定術語的台灣特有法規——例如《營利事業所得稅查核準則》與《平均地權條例》——表現則明顯下降。針對不同法律體系之法源與術語慣例的系統性比較分析,留待未來研究。
6.3 時間不敏感性與資料洩漏
表 8 呈現所有模型在選擇題上按考試年度劃分的表現。我們觀察到,模型在選擇題上的表現並未呈現時間敏感性,即使某一檢查點是在試題發布之前訓練的。我們推測這可歸因於考試政策。命題委員會通常會避免涉及爭議性或高度時效性主題的題目,或對此類題目允許多個正確答案——而這些題目在我們的資料前處理階段已被排除——以避免因應試者對近期修正法條不夠熟悉而予以扣分。
表 8. 選擇題按考試年度的準確率。模型依 2024 年題目的分數排序。
| 模型 | 2020 | 2021 | 2022 | 2023 | 2024 |
|---|---|---|---|---|---|
| claude-sonnet-4.5 | 81.3 | 81.0 | 80.1 | 82.1 | 80.1 |
| gpt-5 | 75.9 | 77.6 | 75.8 | 77.5 | 76.7 |
| gpt-5-2 | 74.2 | 73.4 | 72.8 | 74.3 | 74.9 |
| qwen3-235b | 68.5 | 69.5 | 68.1 | 69.4 | 70.5 |
| gpt-4o | 65.7 | 66.4 | 65.9 | 67.1 | 66.1 |
| llama-taiwan-70b-instruct | 64.6 | 61.8 | 63.9 | 64.0 | 62.3 |
| llama-3.1-405b | 60.5 | 59.8 | 59.9 | 61.4 | 60.7 |
| gpt-oss-120b | 56.9 | 55.6 | 55.8 | 55.4 | 56.2 |
| nemotron-3-nano-30b-a3b | 51.2 | 52.8 | 51.6 | 53.9 | 53.9 |
| gpt-oss-20b | 47.0 | 48.3 | 47.5 | 48.6 | 50.4 |
| qwen2.5-7b | 49.7 | 50.1 | 48.9 | 50.4 | 49.4 |
| llama-taiwan-8b-128k | 44.5 | 44.9 | 45.2 | 44.5 | 45.8 |
| breeze-7b-instruct | 39.8 | 39.3 | 39.9 | 39.0 | 39.8 |
同樣地,此表使我們得以評估資料洩漏 (data leakage) 的潛在問題,因為這些試題在網路平台上被公開討論,可能已被蒐集進這些 LLM 的訓練語料中。若曾發生此類污染,我們會預期在訓練截止日 (training cutoffs) 之前的較早題目上有顯著較高的準確率,而在較晚的題目上有較低的準確率。然而,我們發現 2024 年考試的表現與其他年度並無顯著差異。
7. 限制
雖然我們的評估在申論題上使用了考選部的官方評分標準,且近期研究顯示以 LLM 進行的評分能與人類專家高度相關 (Frankenreiter et al., 2024),但我們本質上是將「由 AI 評審評估的 AI 生成答案」與「人類評分者對人類應試者的評估」相互比較。因此,我們申論題評估的主要價值在於理解模型是否準確處理了命題委員會在深度推理任務中所重視的推理過程,而非在於判定 AI 模型能否在人類評分者面前勝過人類法學院畢業生。
此外,資料洩漏對於法律判決預測而言仍是無法避免的疑慮,因為判決資料長久以來一直被視為繁體中文與台灣文化中寶貴的開源資料集。雖然法律知識記憶在 LawBench (Fei et al., 2024) 等大陸法基準中是一項重要任務,但我們建議不要評估 LLM 的記憶能力,因為資料洩漏可能會產生過於樂觀的結果。
8. 結論
我們提出 TW-LegalBench,一個用以評估 LLM 在台灣華語法律推理能力的基準,包含逾 16,000 道附有法條層級標註、橫跨 43 種法律類型的選擇題、117 道取自專業考試並附有官方評分標準的申論題,以及涵蓋 107 個罪名類別的逾 14,000 筆法律判決預測實例。
我們對 13 個 LLM 的評估揭示了幾項發現。第一,表現最佳的模型(如 claude-sonnet-4.5 與 qwen3-235b)超越了律師考試的錄取門檻,然而所有模型都未達司法官的及格標準,顯示出模型與人類專家之間存在顯著落差。第二,模型在判決類型預測與量刑估計上展現出合理的表現,但在法條引用上表現掙扎;表現最佳的模型其準確率不到 10%。第三,以更多繁體中文或台灣特有法律語料訓練的模型,在開放式任務與判決預測上持續勝過更大型的通用模型,凸顯了特定法域訓練資料的重要性。
9. 致謝
我們感謝譚志瑞 (Zhi Rui Tam) 先生對本研究貢獻的精闢討論。本研究部分受惠於國立臺灣大學行為與資料科學研究中心 (Behavioral and Data Science Research Center) 提供的運算資源。
參考文獻
P. Chen, D. Lian, J. Chi, S. Hsieh, S. Huang, H. Shao, J. Chiu, Y. Lin, Z. Chen, C. Lee, E. T. Huang, and S. See (2025). Continual pre-training is (not) what you need in domain adaptation. In Proceedings of the Asian Conference on Machine Learning, H. Lee and T. Liu (Eds.), Proceedings of Machine Learning Research, Vol. 304.
P. Chen, S. Cheng, W. Chen, Y. Lin, and Y. Chen (2024). Measuring taiwanese mandarin language understanding. CoRR abs/2403.20180.
Z. Fei, X. Shen, D. Zhu, F. Zhou, Z. Han, A. Huang, S. Zhang, K. Chen, Z. Yin, Z. Shen, J. Ge, and V. Ng (2024). LawBench: benchmarking legal knowledge of large language models. In Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, Y. Al-Onaizan, M. Bansal, and Y. Chen (Eds.), Miami, Florida, USA, pp. 7933–7962.
J. Frankenreiter, K. L. Cope, S. Hirst, E. A. Posner, D. Schwarcz, and D. Thorley (2024). Grading machines: can ai exam-grading replace law professors?. SSRN Electronic Journal.
J. Gu, X. Jiang, Z. Shi, H. Tan, X. Zhai, C. Xu, W. Li, Y. Shen, S. Ma, H. Liu, S. Wang, K. Zhang, Z. Lin, B. Zhang, L. Ni, W. Gao, Y. Wang, and J. Guo (2026). A survey on llm-as-a-judge. The Innovation, pp. 101253.
N. Guha, J. Nyarko, D. E. Ho, C. Ré, A. Chilton, A. Narayana, A. Chohlas-Wood, A. Peters, B. Waldon, D. N. Rockmore, D. Zambrano, D. Talisman, E. Hoque, F. Surani, F. Fagan, G. Sarfaty, G. M. Dickinson, H. Porat, J. Hegland, J. Wu, J. Nudell, J. Niklaus, J. Nay, J. H. Choi, K. Tobia, M. Hagan, M. Ma, M. Livermore, N. Rasumov-Rahe, N. Holzenberger, N. Kolt, P. Henderson, S. Rehaag, S. Goel, S. Gao, S. Williams, S. Gandhi, T. Zur, V. Iyer, and Z. Li (2023). LEGALBENCH: a collaboratively built benchmark for measuring legal reasoning in large language models. In Proceedings of the 37th International Conference on Neural Information Processing Systems, NIPS '23, Red Hook, NY, USA.
Z. Han, Y. Yang, Y. Feng, W. Huang, X. Ding, C. Li, J. Ge, and V. Ng (2025). LawShift: benchmarking legal judgment prediction under statute shifts. In The Thirty-ninth Annual Conference on Neural Information Processing Systems Datasets and Benchmarks Track.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt (2021). Measuring massive multitask language understanding. Proceedings of the International Conference on Learning Representations (ICLR).
C. Hsu, C. Liu, F. Liao, P. Hsu, Y. Chen, and D. Shiu (2024). Breeze-7b technical report. arXiv:2403.02712.
A. Q. Jiang, A. Sablayrolles, A. Mensch, C. Bamford, D. S. Chaplot, D. de las Casas, F. Bressand, G. Lengyel, G. Lample, L. Saulnier, L. R. Lavaud, M. Lachaux, P. Stock, T. L. Scao, T. Lavril, T. Wang, T. Lacroix, and W. E. Sayed (2023). Mistral 7b. arXiv:2310.06825.
Y. Lin and Y. Chen (2023). Taiwan llm: bridging the linguistic divide with a culturally aligned language model. arXiv:2311.17487.
Meta AI (2024). The llama 3 herd of models. arXiv preprint arXiv:2407.21783.
NVIDIA (2025). Nemotron 3 Nano: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning. arXiv:2512.20848.
OpenAI (2023). GPT-4 Technical Report. arXiv:2303.08774.
OpenAI (2025a). Gpt-oss-120b & gpt-oss-20b model card. arXiv:2508.10925.
OpenAI (2025b). OpenAI gpt-5 system card. arXiv:2601.03267.
S. Singh, A. Romanou, C. Fourrier, D. I. Adelani, J. G. Ngui, D. Vila-Suero, P. Limkonchotiwat, K. Marchisio, W. Q. Leong, Y. Susanto, R. Ng, S. Longpre, S. Ruder, W. Ko, A. Bosselut, A. Oh, A. Martins, L. Choshen, D. Ippolito, E. Ferrante, M. Fadaee, B. Ermis, and S. Hooker (2025). Global MMLU: understanding and addressing cultural and linguistic biases in multilingual evaluation. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), W. Che, J. Nabende, E. Shutova, and M. T. Pilehvar (Eds.), Vienna, Austria, pp. 18761–18799. ISBN 979-8-89176-251-0.
Z. R. Tam, Y. T. Pai, Y. Lee, H. Shuai, J. Chen, W. M. Chu, and S. Cheng (2024). TMMLU+: an improved traditional chinese evaluation suite for foundation models. In First Conference on Language Modeling.
Q. Team (2024). Qwen2.5 technical report. ArXiv abs/2412.15115.
Q. Team (2025). Qwen3 technical report. arXiv:2505.09388.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, B. Ichter, F. Xia, E. H. Chi, Q. V. Le, and D. Zhou (2022). Chain-of-thought prompting elicits reasoning in large language models. In Proceedings of the 36th International Conference on Neural Information Processing Systems, NIPS '22, Red Hook, NY, USA. ISBN 9781713871088.
術語對照表
| English | 繁體中文 |
|---|---|
| Large Language Models (LLMs) | 大型語言模型 |
| Benchmark | 基準 |
| jurisdiction-specific legal reasoning | 特定法域之法律推理 |
| Multiple-Choice Questions (MCQs) | 選擇題 |
| Open-Ended Essay Questions (OEQs) | 申論題 |
| Legal Judgment Prediction (LJP) | 法律判決預測 |
| common law system | 英美法系 |
| civil-law (system/jurisdiction) | 大陸法系 |
| jurisdiction | 法域 |
| jurisdiction-specific doctrines | 特定法域之法理 |
| access to justice | 近用司法 |
| fact patterns | 事實樣態 |
| precedents | 先例 |
| statute | 法條/法律規定 |
| statute-level annotation | 法條層級標註 |
| statutory interpretation | 法條解釋 |
| statutory amendments | 法條修正 |
| LLM-as-Judge | LLM-as-Judge(以 LLM 為評審) |
| scoring rubric (points) | 評分標準(評分要點) |
| self-favoritism bias | 自我偏好偏誤 |
| fine-tuning | 微調 |
| supervised fine-tuning (SFT) | 監督式微調 |
| reinforcement learning (RL) | 強化學習 |
| zero-shot chain-of-thought (CoT) | 零樣本思維鏈 |
| greedy decoding | 貪婪解碼 |
| temperature | 溫度 |
| checkpoint | 檢查點 |
| system prompt / user prompt | 系統提示/使用者提示 |
| post-processing | 後處理 |
| stratified sampling | 分層抽樣 |
| token-level | 詞元層級 |
| normalized log-distance | 正規化對數距離 |
| verdict accuracy | 判決準確率 |
| sentencing precision | 量刑精確度 |
| Type I error | 第一型錯誤 |
| Type II error | 第二型錯誤 |
| data leakage | 資料洩漏 |
| training cutoffs | 訓練截止日 |
| percentile rank | 百分位排名 |
| human baseline | 人類基準 |
| pattern matching | 樣態比對 |
| open-data ecosystem | 開放資料生態系 |
| multi-tiered benchmark | 多層級基準 |
| jurisdictional imbalance | 法域失衡 |
| alignment | 對齊 |
| Ministry of Examination | 考選部 |
| Judicial Yuan | 司法院 |
| Civil Service (examination) | 公務人員(考試) |
| Judicial Personnel | 司法人員 |
| Police Personnel | 警察人員 |
| Professional and Technical Personnel | 專門職業及技術人員 |
| Examination for Lawyers / Bar Examination | 律師考試 |
| Examination for Judges and Prosecutors | 司法官考試 |
| Civil Code | 民法 |
| Criminal Code | 刑法 |
| constitutional law | 憲法 |
| administrative law | 行政法 |
| imprisonment term | 有期徒刑刑期 |
| detention | 拘役 |
| fine | 罰金 |
| probation | 緩刑 |
| advancement of inheritance (歸扣) | 歸扣 |
| Main Result / Facts / Reasoning | 主文/事實/理由 |
| Article / Paragraph / Subparagraph / Item | 條/項/款/目 |