如何微調推理模型?師生合作框架合成學生一致的 SFT 資料
原始論文:How to Fine-Tune a Reasoning Model? A Teacher-Student Cooperation Framework to Synthesize Student-Consistent SFT Data 作者:Zixian Huang, Kaichen Yang, Xu Huang, Feiyang Hao, Qiming Ge, Bowen Li, He Du, Kai Chen, Qipeng Guo arXiv ID:2604.14164v1 日期:2026-03-23 標籤:LLM Reasoning SFT Knowledge Distillation Catastrophic Forgetting 資料合成
1. 引言
用更強的教師模型生成合成資料做 SFT 是標準做法,但在推理模型上經常失敗。以 Qwen3-8B 為例,直接用教師生成的資料做 SFT 不但沒提升,反而造成嚴重的效能退化。
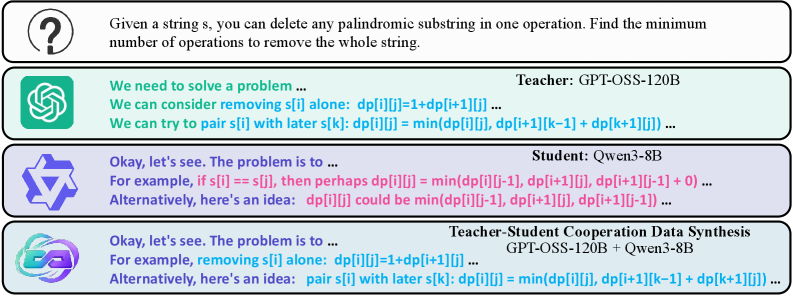
核心發現:教師與學生之間的風格分歧 (stylistic divergence) 是主要障礙。推理模型有來自不同訓練來源的獨特風格模式;強迫學生適應教師的寫作風格會導致災難性遺忘 (catastrophic forgetting)。
本文提出 TESSY (Teacher-Student Cooperation Data Synthesis),一個師生合作的資料合成框架:
- 教師和學生交替生成 token
- 教師負責「能力 token」(解決問題的核心內容)
- 學生負責「風格 token」(語氣、論述方式)
- 維持風格一致性的同時引入教師的推理能力
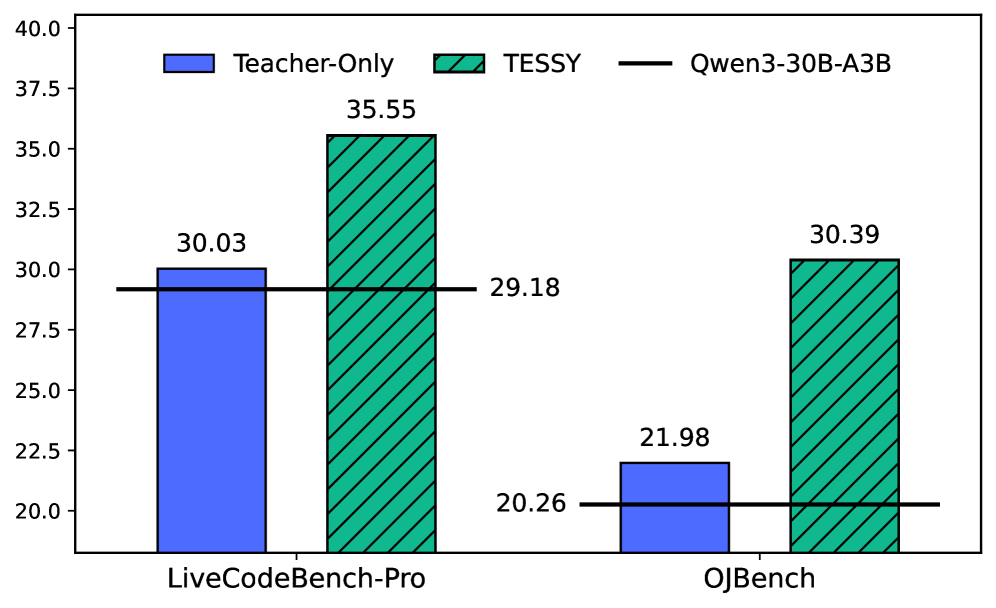
核心成果:在程式碼生成任務上,TESSY 在 LiveCodeBench-Pro 提升 11.25%,OJBench 提升 6.68%。相比之下,純教師資料分別下降 3.25% 和 10.02%。
2. 方法
2.1 研究目標
訓練目標分解為兩個組件:
- 能力損失 $\mathcal{L}_{Cap}$:直接解決任務的 token(程式碼、數值)
- 風格損失 $\mathcal{L}_{Sty}$:與任務無關、表達語氣或論述的 token
目標是合成「能力 token 來自教師、風格 token 遵循學生分佈」的資料。
2.2 師生合作框架
三個核心組件:
1. 交替生成 (Alternating Generation):模型輪流生成片段——學生產生風格 token $s^i$,教師產生能力 token $t^i$,交替排列:$[s^1, t^1, s^2, t^2, \ldots]$
2. 生成回滾策略 (Generation Rollback):解決生成邊界問題:
- 固定長度生成 $k$ 個 token(經驗值 $k=20$)
- 邊界預測器 (boundary predictor) 識別適當的截斷點
- 能力 token 邊界預測器 $\mathcal{B}_T$ 用於教師輸出
- 風格 token 邊界預測器 $\mathcal{B}_S$ 用於學生輸出
3. 邊界預測器:以 token 級序列標註模型實作,在 100K 標註片段上訓練。使用 Qwen3-0.6B-Base,足夠小以最小化效率影響。
2.3 演算法細節
完整合成流程:
- 以學生模型起始
- 學生和教師迭代交替生成
- 每次生成 $k=20$ 個 token
- 邊界預測器偵測 token 類型切換時觸發角色交換
- 最終答案完全由學生模型生成(確保格式一致性)
教師參與比例 77.65% 為最優(過高或過低都非最佳)。
3. 實驗
實作細節
- 單次迭代最大長度:$k=20$ token
- 訓練:9 epochs,batch size 128,學習率 $5 \times 10^{-5}$
- 硬體:32 張 H200 GPU,vLLM 推理,XTuner 訓練
- 教師:GPT-OSS-120B(主要);DeepSeek-R1、Qwen3-235B(次要)
- 學生:Qwen3-8B(主要);Qwen3-30B-A3B(消融)
- 訓練資料:80K 題(37K 不重複),從 OpenThoughts 和 NVIDIA Nemotron 過濾
3.1 主要結果
| 方法 | LCB-V5 | LCB-V6 | LCB-Pro | OJBench |
|---|---|---|---|---|
| 基線 (Qwen3-8B) | 55.09 | 49.58 | 25.35 | 18.75 |
| Teacher-Only | 41.32 | 36.57 | 22.10 | 8.73 |
| Teacher-Reference | 52.69 | 48.13 | 27.73 | 16.22 |
| Teacher-Score | 53.25 | 47.33 | 28.01 | 15.55 |
| Teacher-Answer | 54.18 | 50.33 | 29.56 | 17.66 |
| Teacher-Think | 57.08 | 50.88 | 32.71 | 21.65 |
| Teacher-Mix | 55.09 | 48.05 | 26.03 | 15.86 |
| TESSY | 62.87 | 55.43 | 36.69 | 25.43 |
TESSY 在所有 benchmark 上大幅領先。Teacher-Only 甚至比基線更差,驗證了純教師資料的危害性。
3.2 分析
不同學生模型:
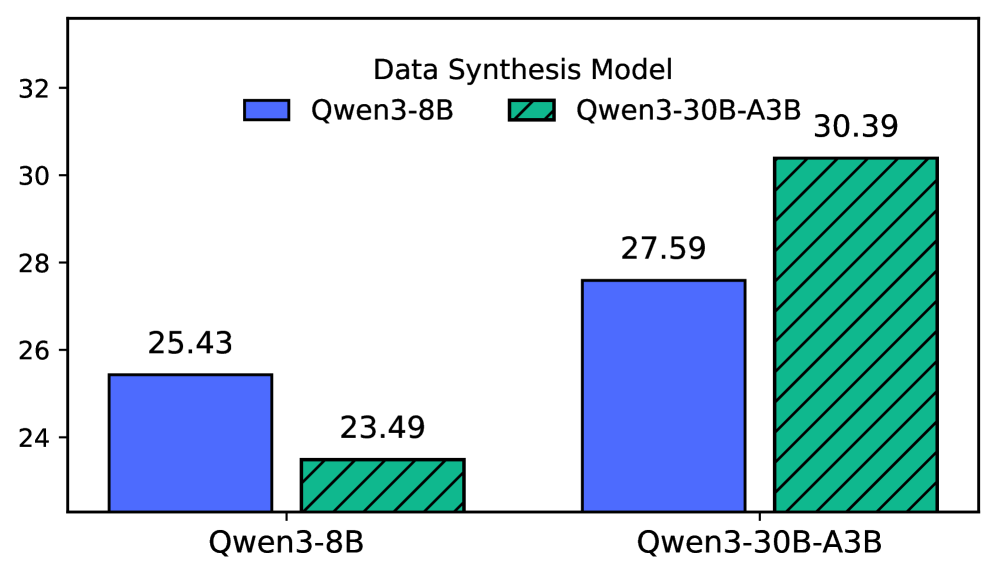
TESSY 在 Qwen3-30B-A3B 上同樣有效:LCB-Pro +6.37%,OJBench +10.13%。
學生模型一致性:即使在同一模型家族內,訓練資料分佈與目標模型不匹配也會顯著降低效能。
不同教師模型:
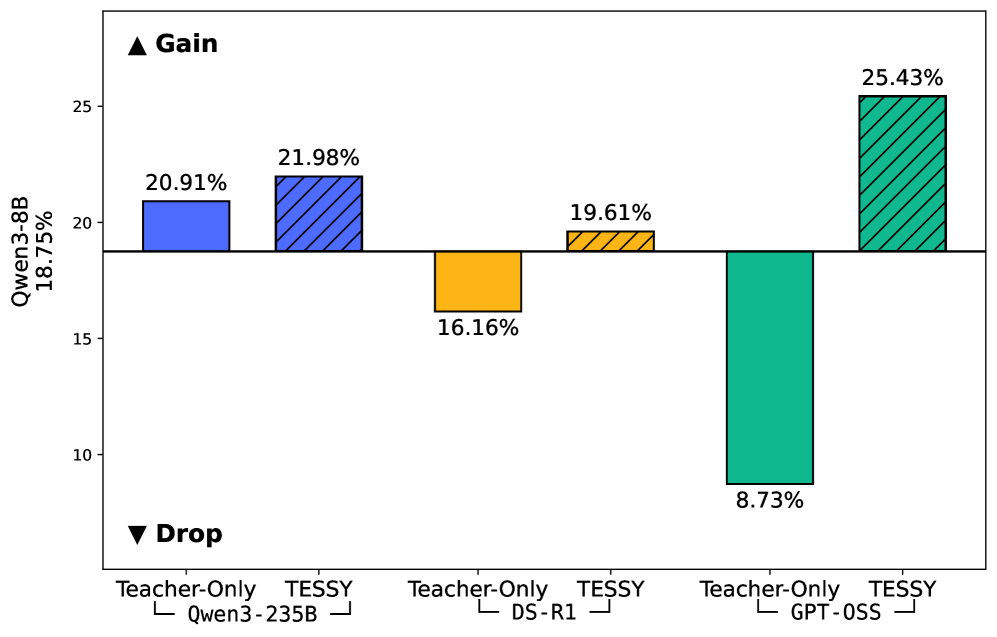
TESSY 在所有教師上都優於 Teacher-Only:
- Qwen3-235B:+1.07%
- DeepSeek-R1:+3.45%
- GPT-OSS-120B:+16.79%
教師越強,TESSY 的優勢越明顯。
資料品質:
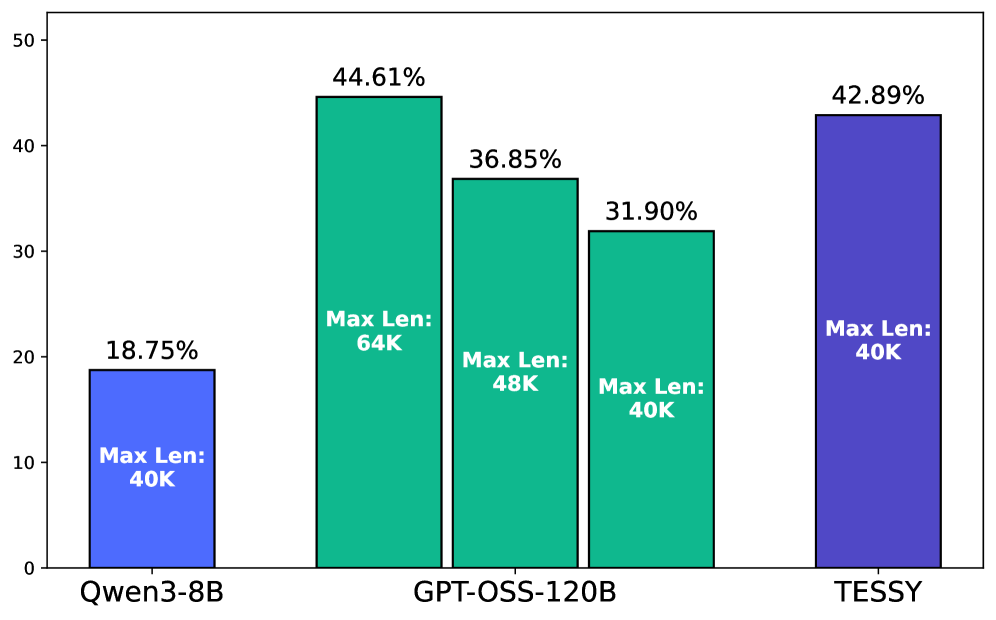
在等長 40K token 限制下,TESSY 超越 GPT-OSS-120B 純教師資料 10.99%,儘管包含 22.4% 的學生生成 token。
推理模型 vs. 基礎模型:
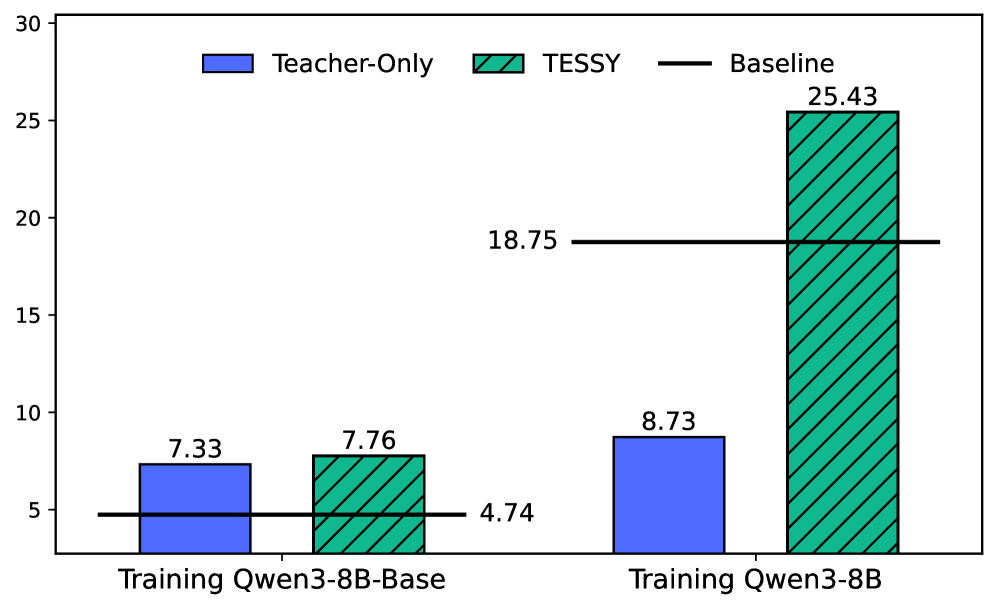
用 TESSY 資料訓練推理模型 Qwen3-8B 比訓練基礎模型 Qwen3-8B-Base 高 17.67%,確認推理模型是更有效的 SFT 起點。
資料分佈:
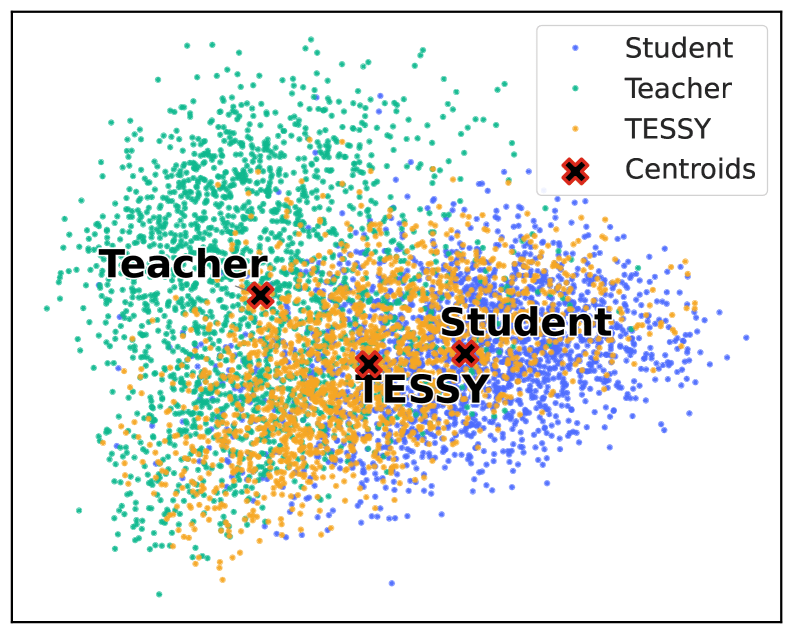
PCA 可視化顯示 TESSY 分佈在所有教師變體上都向學生模型偏移,有效減緩分佈衝突。
4. 結論
TESSY 透過師生交替合成回應,讓學生保持風格一致性的同時引入教師的推理能力。解決了推理模型 SFT 中的根本挑戰——風格分歧導致的災難性遺忘。
限制:
- 無限制生成長度下,Teacher-Only 有更高的能力上界
- 未整合品質優化技術(reject sampling)
- 分佈不匹配是主因,但品質仍然重要
參考文獻
Agarwal, R., et al. On-policy distillation of language models: Learning from self-generated mistakes. ICLR, 2024.
Guo, D., et al. DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning, 2025.
Guha, E., et al. OpenThoughts: Data recipes for reasoning models, 2025.
Yang, A., et al. Qwen3 Technical Report, 2025.
NVIDIA. Nemotron 3: Efficient and open intelligence, 2025.
Hinton, G., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. NIPS Workshop, 2015.
Jain, N., et al. LiveCodeBench: Holistic and contamination free evaluation of LLMs for code, 2024.
Wang, X., et al. OpenHands: An open platform for AI software developers. ICLR, 2025.
Kirkpatrick, J., et al. Overcoming catastrophic forgetting in neural networks. PNAS, 2017.
Hu, E.J., et al. LoRA: Low-rank adaptation of large language models. ICLR, 2022.
術語對照表
| 英文 | 中文 |
|---|---|
| Teacher-Student Cooperation | 師生合作 |
| TESSY (Teacher-Student Cooperation Data Synthesis) | 師生合作資料合成 |
| Capability Token | 能力 token |
| Style Token | 風格 token |
| Stylistic Divergence | 風格分歧 |
| Alternating Generation | 交替生成 |
| Generation Rollback | 生成回滾 |
| Boundary Predictor | 邊界預測器 |
| Catastrophic Forgetting | 災難性遺忘 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| On-Policy | 同策略 |
| Off-Policy | 離策略 |
| Knowledge Distillation | 知識蒸餾 |
| Reject Sampling | 拒絕取樣 |
| Token-level Sequence Labeling | token 級序列標註 |