TREX:以智能體驅動的樹狀探索自動化 LLM 微調
原始論文:TREX: Automating LLM Fine-tuning via Agent-Driven Tree-based Exploration 作者:Zerun Ma, Guoqiang Wang, Xinchen Xie, Yicheng Chen, He Du, Bowen Li, Yanan Sun, Wenran Liu, Kai Chen, Yining Li arXiv ID:2604.14116v1 日期:2026-04-15 標籤:LLM Fine-tuning Multi-Agent MCTS AutoML AI Scientist
1. 引言
LLM 已為 AI 研究智能體 (research agent) 在孤立任務上賦予了強大能力,但自動化複雜的工作流程——尤其是 LLM 訓練——仍然是一個挑戰。LLM 訓練方案的設計是開放式的,涉及多個相互作用的因素(資料、演算法、超參數);訓練資料的龐大規模讓直接納入 context 變得不可行;巨大的計算開銷也讓快速驗證變得困難。
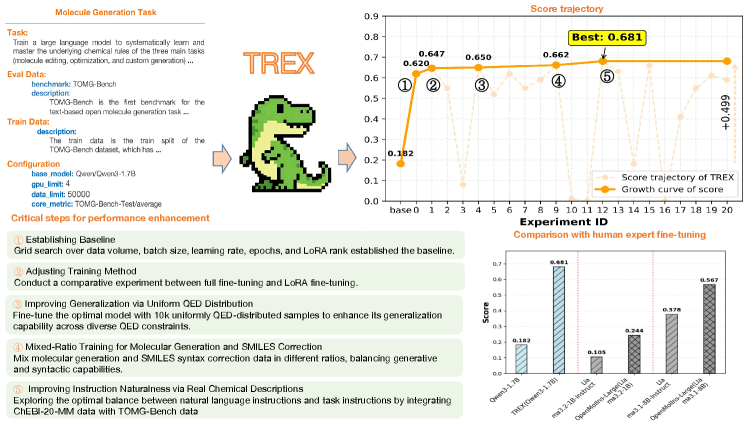
本文提出 TREX,一個自動化完整 LLM 訓練生命週期的多智能體系統。它協調兩個核心模組的合作:
- Researcher(研究員):進行文獻研究、策略規劃
- Executor(執行者):實作訓練與評估
TREX 將實驗過程建模為一棵搜尋樹,用 Monte Carlo Tree Search (MCTS) 引導擴展,兼顧高效能解的利用 (exploitation) 和新穎方法的探索 (exploration)。系統還配備學術搜尋、實驗追蹤,以及自家的 AIDP (AI Data Processing) 函式庫來組合資料管線。
同時提出 FT-Bench,一個包含 10 個真實任務的 benchmark,涵蓋從基礎能力優化到特定領域適配的範疇。實驗證明,TREX 可在所有任務上穩定提升基礎模型效能,在多個任務上甚至匹配或超越人類專家設計的微調管線。
2. 相關工作
2.1 AI 增強的研究
LLM 協助文獻搜尋(DeepResearch、RAG 系統)、學術寫作、想法生成與實作(Dolphin、InternAgent、AI-Scientist)。從輔助工具到協作夥伴的演進是關鍵趨勢。
2.2 自主研究智能體
端到端 AI 研究員(AI Scientist v1 & v2、AI Researcher)和演化式搜尋智能體(結合演化演算法、樹搜尋)。現有 benchmark(MLE-bench、RE-bench、IdeaBench)缺乏專門針對 LLM 訓練的系統性評估資料集。
2.3 自動化模型訓練
AutoML 方法仍受限於預定義的搜尋空間。AI 在資料建構(合成、精煉、過濾)上的應用越來越多,但 TREX 提出了更全面、完全自動化的範式——將資料準備整合進自主迴圈中。
3. TREX 框架
3.1 概覽
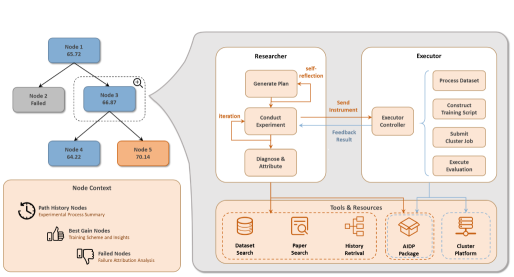
系統採用雙迴圈 (dual-loop) 工作流程:
內迴圈 (Inner Loop):Researcher 與 Executor 針對單一實驗輪次合作。Researcher 根據任務目標和歷史制定計畫;Executor 在 GPU 叢集上實作並回傳結果供分析。
外迴圈 (Outer Loop):多輪實驗建模為一棵樹,由 MCTS 引導擴展,平衡高效能解的利用與新穎方法的探索。
3.2 智能體框架
Researcher Agent:採用 coarse-to-fine 方法。先決定高層策略(資料增強、演算法探索),再細化為 3-5 個並行訓練配置的具體計畫。可存取學術搜尋引擎和 Hugging Face 資料集。
Executor Agent:基於 OpenHands 框架實作,將叢集任務排程 API 整合為工具。具備沙盒化環境隔離。
AIDP Library:模組化工具包,提供高效能、決定性的 LLM 資料管線運算子。建立在 HuggingFace Datasets 上,提供語義清晰的模組化組合,便於智能體編排。
實驗診斷 (Experiment Diagnostics):全面分析策略,檢視驗證集失敗案例、歸因分析、比較性 benchmark 分析、跨實驗綜合分析,最大化每輪迭代的資訊量。
3.3 訓練方案的迭代探索
MCTS 實作:從 root 節點的基線實驗出發,後續迭代選擇 Upper Confidence Bound for Trees (UCT) 分數最高的節點:
$$\text{UCT}(v) = \frac{Q_v}{N_v} + c \sqrt{\frac{\ln N_{P(v)}}{N_v}}$$
其中 $N_v$ 為訪問次數,$Q_v$ 為累積獎勵,$N_{P(v)}$ 為父節點訪問次數。
記憶 context 管理:歷史資訊從三個來源濃縮:
- 從 root 到當前節點的軌跡(血緣,lineage)
- 兄弟節點(避免重複)
- 關鍵節點(重大收益或失敗,全域洞察)
4. FT-Bench Benchmark
4.1 Benchmark 建構
FT-Bench 包含 10 個源自真實情境的任務,具可控的計算開銷:
- ACI-Bench:對話臨床筆記生成
- TOMG-Bench:基於文字的分子生成
- oMeBench:化學反應機理推理
- HoC:癌症特徵分類
- CS-Bench:電腦科學能力評估
- OpenFinData:金融問答
- SST-2:情感分類
- EconlogicQA:經濟邏輯順序推理
- GTA:智能體工具使用
- LawBench:法律知識評估
4.2 與現有 Benchmark 比較
FT-Bench 是首個專門針對端到端 LLM 微調的 benchmark,要求自主導航完整管線。現有 benchmark 聚焦孤立子任務(MLAgentBench、ScienceAgentBench)或傳統 ML 範式(MLEBench),錯失了現代 LLM 訓練的挑戰。
5. 實驗
5.1 實驗設定
- 基礎模型:Qwen3-1.7B,每次實驗最多 50,000 個訓練樣本
- Researcher 後端:Qwen3-Next-80B-Thinking 和 Gemini 3 Pro 兩個版本
- Executor 後端:Claude 4.5 Sonnet
- 評估指標:標準化相對效能增益:
$$G_T = \frac{\mathcal{E}_T(M_{FT}) - \mathcal{E}_T(M_{Base})}{\mathcal{E}_T(M_{Ref}) - \mathcal{E}_T(M_{Base})}$$
其中 Qwen3-235B-2507 為參考模型。
5.2 主要結果
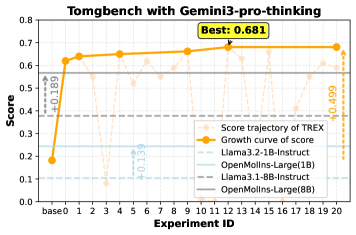
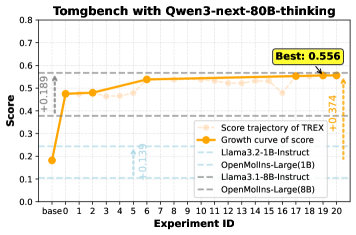
TREX 在所有任務上穩定提升基礎模型效能。Gemini 3 Pro 後端在多數任務上優於 Qwen3-Next-80B-Thinking,說明底層 LLM 的推理能力直接影響系統效能。
關鍵發現:
- 提供初始訓練集的任務(ACI-Bench、TOMG-Bench)更容易建立基線、有效率迭代
- 需要從零建構資料集的任務(CS-Bench、GTA)需要更多研究和迭代
與人類微調比較:
- TOMG-Bench:TREX 達 0.498 效能增益,優於人類專家 OpenMolIns-Large 的 0.189-0.139
- OpenFinData:TREX 達 0.205 增益,接近人類專家 FEVO 方法的 0.025-0.207
節點擴展策略:TREX 在資料處理和訓練方法上探索多樣化的優化方向。Gemini 3 Pro 展現更好的策略多樣性和執行成功率。
5.3 消融研究
樹搜尋策略比較:
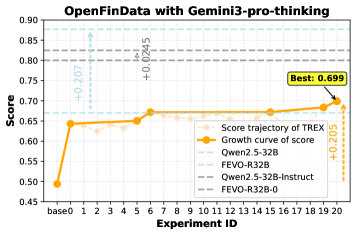
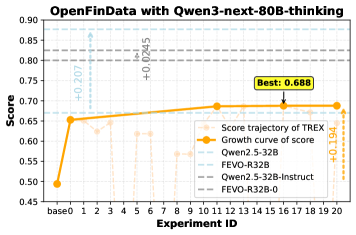
MCTS 相比 Greedy Best-First Search (GBFS) 和 Sequential Expansion Search (SES) 展現更高的穩定性:波動更小、效能提升更一致。
AIDP Library 影響:
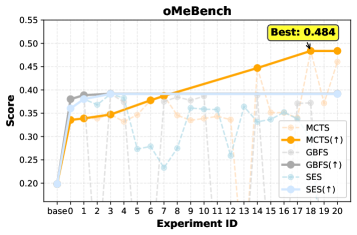
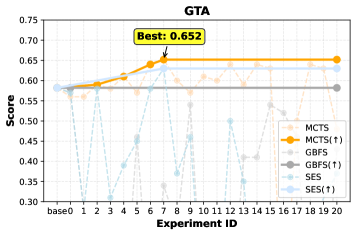
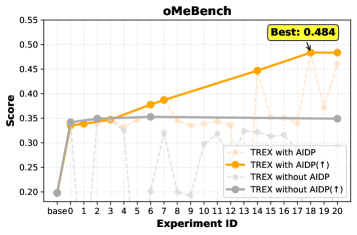
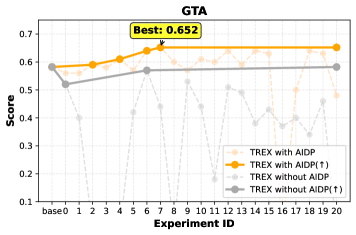
沒有 AIDP 工具的系統效能提升顯著較低,且更容易在資料處理步驟中中斷。
Bad-case 分析:
在實驗診斷中納入失敗案例分析能實現更有效的迭代,產生更高的最終效能分數。
6. 結論
TREX 是一個多智能體框架,透過協調的規劃、執行和迭代精煉自動化完整的 LLM 微調生命週期。將訓練優化表述為基於 MCTS 的樹搜尋,系統能在計算限制下高效探索訓練策略空間。TREX 穩定提升模型效能,在多個案例中匹配或超越專家設計的管線,展示了智能體系統作為自動化 AI 研究可擴展範式的潛力。
參考文獻
Lewis, P., et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS, 2020.
Karpukhin, V., et al. Dense Passage Retrieval for Open-Domain Question Answering. EMNLP, 2020.
Lu, C., et al. The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery, 2024.
Yamada, K., et al. The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search, 2025.
Wang, X., et al. OpenHands: An Open Platform for AI Software Developers as Generalist Agents. ICLR, 2025.
Coulom, R. Efficient Selectivity and Backup Operators in Monte-Carlo Tree Search. Computers and Games, 2006.
Le, Q.V. and Zoph, B. Neural Architecture Search with Reinforcement Learning. ICLR, 2017.
Erickson, N., et al. AutoGluon-Tabular: Robust and Accurate AutoML for Structured Data, 2020.
Yang, Z., et al. Qwen3 Technical Report, 2025.
Anthropic. Claude 4.5 Sonnet, 2025.
Google DeepMind. Gemini 3 Pro Technical Report, 2026.
AI-MO. MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering, 2024.
Chan, J.S., et al. MLE-Bench, 2024.
METR. RE-bench: Evaluating Frontier AI R&D Capabilities, 2024.
Ruan, J., et al. IdeaBench: Benchmarking Large Language Models for Research Idea Generation, 2024.
Yuan, Y., et al. ACI-Bench: A Novel Ambient Clinical Intelligence Dataset, 2023.
Li, J., et al. TOMG-Bench: Evaluating LLMs on Text-based Open Molecule Generation, 2024.
Liu, Y., et al. oMeBench: Benchmarking LLMs for Organic Mechanism Reasoning, 2025.
Baker, S., et al. HoC: The Hallmarks of Cancer Corpus, 2016.
Zhou, G., et al. CS-Bench: Computer Science Benchmark, 2024.
OpenCompass Team. OpenFinData: A Financial Data Benchmark, 2024.
Socher, R., et al. SST-2: Stanford Sentiment Treebank, 2013.
Quan, S., et al. EconlogicQA: Economic Sequential Reasoning, 2024.
Wang, J., et al. GTA: A Benchmark for General Tool Agents, 2024.
Fei, Z., et al. LawBench: Benchmarking Legal Knowledge of Large Language Models, 2023.
HuggingFace. Datasets: A Community Library for Natural Language Processing, 2021.
術語對照表
| 英文 | 中文 |
|---|---|
| Fine-tuning | 微調 |
| Multi-Agent System | 多智能體系統 |
| Research Agent | 研究智能體 |
| Monte Carlo Tree Search (MCTS) | 蒙地卡羅樹搜尋 |
| Upper Confidence Bound for Trees (UCT) | 樹上信賴區間上界 |
| Tree-based Exploration | 樹狀探索 |
| Dual-loop Workflow | 雙迴圈工作流程 |
| Inner Loop / Outer Loop | 內迴圈 / 外迴圈 |
| Researcher Agent | 研究員智能體 |
| Executor Agent | 執行者智能體 |
| AIDP (AI Data Processing) | AI 資料處理函式庫 |
| Experiment Diagnostics | 實驗診斷 |
| Bad-case Analysis | 失敗案例分析 |
| Greedy Best-First Search (GBFS) | 貪婪最佳優先搜尋 |
| Sequential Expansion Search (SES) | 順序擴展搜尋 |
| Exploitation / Exploration | 利用 / 探索 |
| AutoML | 自動化機器學習 |
| Data Pipeline | 資料管線 |
| FT-Bench | 微調基準測試 |
| Data Augmentation | 資料增強 |
| Hyperparameter | 超參數 |
| Lineage | 血緣 |