DFlash:用區塊擴散模型實現閃電推測解碼
原始論文:DFlash: Block Diffusion for Flash Speculative Decoding 作者:Jian Chen, Yesheng Liang, Zhijian Liu arXiv ID:2602.06036v1 日期:2025-02-09 標籤:LLM Speculative Decoding Diffusion Model Inference 加速 推測解碼
1. 引言
推測解碼 (speculative decoding) 是加速 LLM 推理的有效方法:用一個小的 draft model 快速產生候選 token,再由大模型驗證。但傳統的自迴歸 draft model 是逐 token 生成的,draft 成本隨候選長度線性增長,實務上加速比通常限制在 2-3 倍。
DFlash 的核心洞見是:大型自迴歸 LLM 的隱藏特徵隱含了關於多個未來 token 的資訊。利用這一點,DFlash 用輕量級的區塊擴散模型 (block diffusion model) 在單次前向傳播中並行生成整個 token 區塊,而非逐一生成。
核心成果:
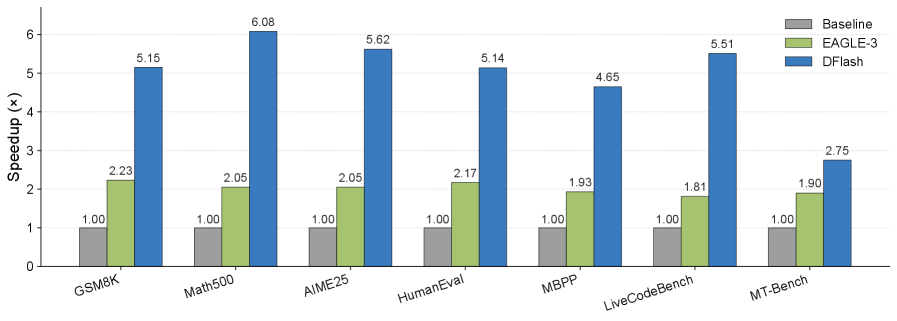
- 在 Qwen3-8B 上達到 4.86 倍無損加速,接受長度 6.49
- 在 SGLang 實際部署中達到 5.1 倍加速(低並發度)
- 比 SOTA 的 EAGLE-3 快 2-2.5 倍
加速比公式
推測解碼的延遲為:
$$L = \frac{T_{\text{draft}} + T_{\text{verify}}}{\tau}$$
其中 $\tau \in [1, \gamma+1]$ 是每個週期的期望接受 token 數。加速比 $\eta = L_{\text{target}} / L$。
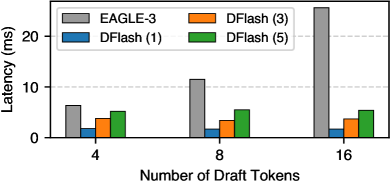
自迴歸 drafting 的成本是 $T_{\text{draft}} = \gamma \cdot t_{\text{step}}$(線性增長),而擴散 drafting 的成本是 $T_{\text{draft}} = t_{\text{parallel}}$(常數成本)。這就是 DFlash 能大幅超越自迴歸 draft model 的根本原因。
2. 方法
2.1 上下文特徵注入
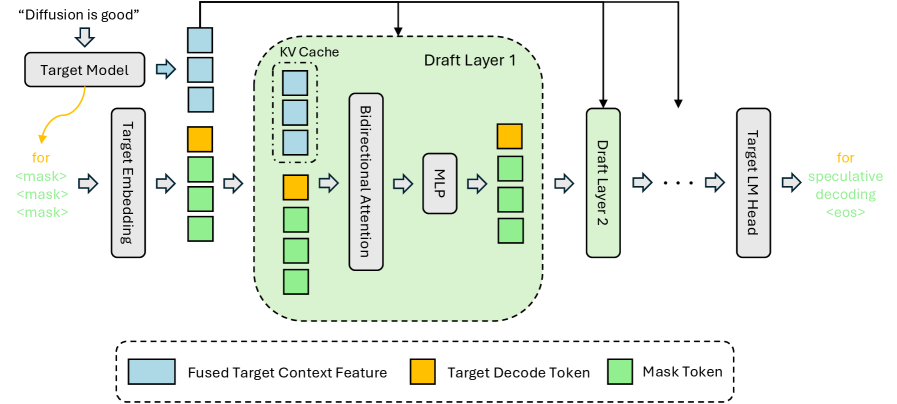
從目標模型的多個層提取隱藏表示(5 個均勻取樣的層,從第 2 層到倒數第 3 層),通過投影層串接為「目標上下文特徵」(target context feature),然後注入到 draft model 每一層的 Key-Value cache 中。
這比只注入輸入嵌入要好得多,因為:
- 跨層特徵包含不同抽象層級的未來 token 資訊
- 直接注入 KV cache 讓 draft model 的每一層都能存取目標模型的知識
- 凍結共享的嵌入層和 LM head,draft model 與目標模型共享詞彙表
2.2 區塊擴散訓練
訓練過程:
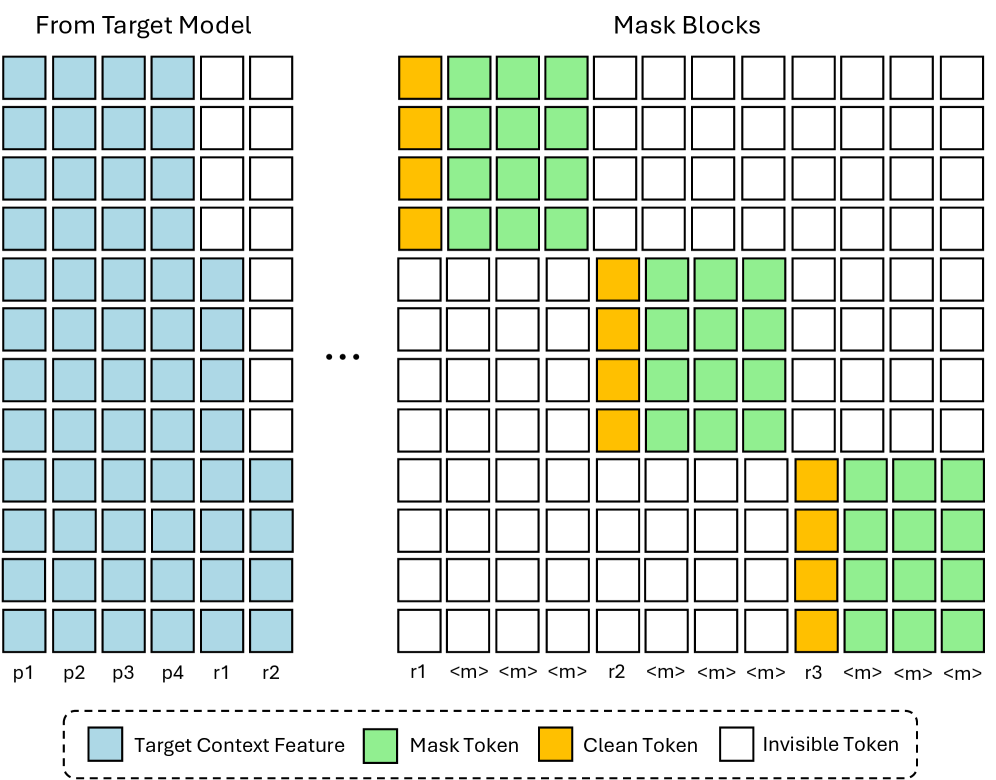
- 從回應中隨機取樣錨定 token (anchor token)
- 遮蔽每個錨定後的 block_size-1 個位置
- 用 Flex Attention 在單次前向傳播中處理多個遮蔽區塊(稀疏注意力)
- 模型學習在給定錨定和目標上下文特徵的情況下,並行預測整個區塊
推理過程:
- 從目標模型取得隱藏特徵
- 以最後一個已確認 token 為錨定
- Draft model 在單次前向傳播中生成整個區塊(如 16 個 token)
- 目標模型驗證,接受正確的前綴
2.3 損失函數設計
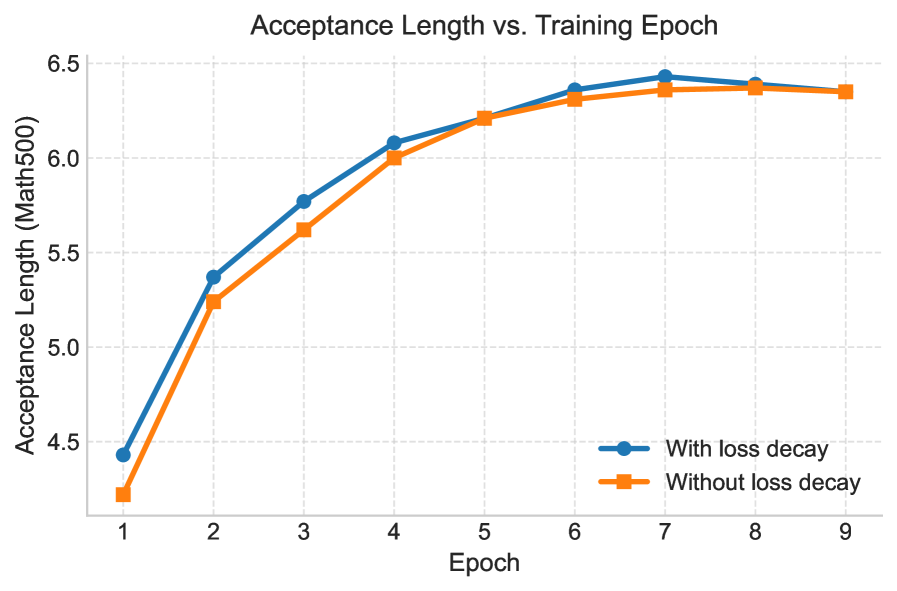
使用位置相依的指數衰減權重:
$$w_k = \exp\left(-\frac{k-1}{\gamma}\right)$$
強調區塊內靠前位置的預測(這些位置被接受的機率更高)。$\gamma$ 隨 block size 調整:block size 16 用 $\gamma=7$,block size 10 用 $\gamma=5$,block size 8 用 $\gamma=4$。
3. 實驗結果
Qwen3 模型(Temperature=0)
| 模型 | 方法 | 加速比 | 接受長度 τ |
|---|---|---|---|
| Qwen3-4B | DFlash | 4.91× | 6.54 |
| Qwen3-4B | EAGLE-3 (γ=16) | 1.81× | - |
| Qwen3-8B | DFlash | 4.86× | 6.49 |
| Qwen3-8B | EAGLE-3 (γ=16) | 1.76× | - |
DFlash 的加速比是 EAGLE-3 的 2.7 倍。
推理模式
| 模型 | 加速比 | 接受長度 τ |
|---|---|---|
| Qwen3-4B (Reasoning) | 4.23× | 5.23 |
| Qwen3-8B (Reasoning) | 4.17× | 5.17 |
推理模式下加速比略低但仍然很高,因為推理 token 的可預測性稍低。
SGLang 生產環境部署(Qwen3-8B,Math500)
| 並發度 | 加速比 |
|---|---|
| 1 | 5.1× |
| 32 | 2.8× |
低並發度下加速比最高(GPU 計算有空餘),隨並發度增加下降但仍然顯著。
4. 消融研究
Draft 模型深度
5 層 draft model 是最佳平衡。8 層的接受長度更高但延遲也更高,整體加速比反而下降。
目標特徵數量
注入更多目標層的隱藏特徵能提升接受率。5 個層是效益與成本的良好平衡點。
Block Size 泛化
用更大 block size 訓練的模型可以泛化到更小的推理 block size,但反向不行。這說明大 block 訓練學到了更通用的並行生成能力。
損失加權
指數衰減加權優於均勻加權,因為區塊靠前的位置更重要(它們決定了接受前綴的長度)。
5. 結論
DFlash 用區塊擴散模型取代自迴歸 draft model,實現了推測解碼的質的飛躍。核心設計是從目標模型提取跨層隱藏特徵並注入 draft model 的每一層 KV cache,讓 5 層的輕量 draft model 能在單次前向傳播中並行生成 16 個高品質候選 token。在 Qwen3-8B 上達到近 5 倍無損加速,是 EAGLE-3 的 2.5 倍,且在 SGLang 生產環境中也保持高加速比。
程式碼和模型權重均已在 GitHub 和 HuggingFace 上開放。
參考文獻
Leviathan, Y., Kalman, M., and Matias, Y. Fast Inference from Transformers via Speculative Decoding. ICML, 2023.
Chen, C., et al. Accelerating Large Language Model Decoding with Speculative Sampling, 2023.
Li, Y., et al. EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty. ICML, 2024.
Li, Y., et al. EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees, 2024.
Li, Y., et al. EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Efficient Attention Distillation, 2025.
Gloeckle, F., et al. Better & Faster Large Language Models via Multi-token Prediction. ICML, 2024.
Dao, T. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, 2023.
Sahoo, S.S., et al. Simple and Fast Distillation of Diffusion Models, 2024.
Austin, J., et al. Structured Denoising Diffusion Models in Discrete State-Spaces. NeurIPS, 2021.
Qwen Team. Qwen3 Technical Report, 2025.
NVIDIA. Nemotron-CC dataset, 2024.
術語對照表
| 英文 | 中文 |
|---|---|
| Speculative Decoding | 推測解碼 |
| Block Diffusion | 區塊擴散 |
| Draft Model | 草稿模型 |
| Target Model | 目標模型 |
| Acceptance Length (τ) | 接受長度 |
| Context Feature Injection | 上下文特徵注入 |
| KV Cache | 鍵值快取 |
| Anchor Token | 錨定 token |
| Block Size | 區塊大小 |
| Lossless Acceleration | 無損加速 |
| Flex Attention | 彈性注意力 |
| Exponential Decay Weight | 指數衰減權重 |
| Autoregressive Drafting | 自迴歸草稿生成 |
| Parallel Generation | 並行生成 |
| Concurrency | 並發度 |