Pioneer Agent:生產環境中小型語言模型的持續改進
原始論文:Pioneer Agent: Continual Improvement of Small Language Models in Production 作者:Dhruv Atreja, Julia White, Nikhil Nayak, Kelton Zhang, Henrijs Princis, George Hurn-Maloney, Ash Lewis, Urchade Zaratiana arXiv ID:2604.09791v1 日期:2026-04-13 標籤:Small Language Model Agent Continual Learning Production Monte Carlo Graph Search AutoML Fine-tuning
摘要
本論文提出 Pioneer Agent,一個用於在生產環境 (Production) 中自動化調適小型語言模型 (Small Language Model) 的封閉迴圈 (Closed-loop) 系統。該系統以兩種模式運作:冷啟動 (Cold-start) 模式從自然語言任務描述出發引導模型 (Bootstrap Models);生產 (Production) 模式則根據觀察到的推論失敗 (Inference Failures) 持續改進已部署模型。Agent 採用蒙地卡羅圖搜尋 (Monte Carlo Graph Search, MCGS) 聯合最佳化資料策展 (Data Curation)、超參數 (Hyperparameters) 與學習策略 (Learning Strategies)。實驗結果顯示在八個基準測試 (推理、數學、程式碼、摘要、分類) 上獲得 1.6–83.8 點的提升。我們同時提出 AdaptFT-Bench——一個基於合成推論日誌的基準測試,用以評估完整的改進迴圈,並展示 Agent 能自主發現有效策略,例如思維鏈監督 (Chain-of-Thought Supervision) 與品質導向的資料選擇 (Quality-focused Data Selection)。
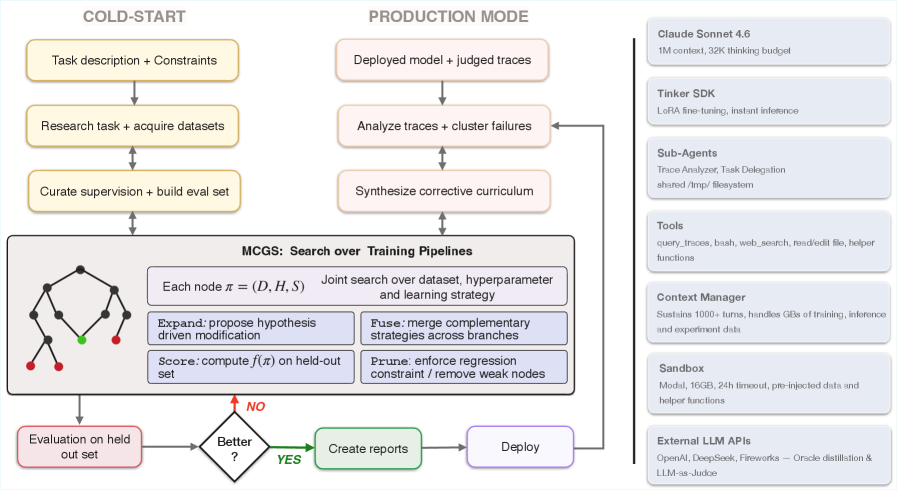
圖 1:Pioneer Agent 系統概覽——一個用於小型語言模型持續改進的封閉迴圈 Agent 系統,整合了失敗診斷、資料策展、訓練與回歸驗證。
1. 引言
小型語言模型 (1B–8B 參數) 因部署成本低與推論速度快而具吸引力,但要將其調適到特定任務仍具挑戰性。其核心困難超越單純的超參數調整,延伸至更上游的決策:「應蒐集什麼資料、選用哪個基礎模型 (Base Model) 與訓練配方 (Training Recipe)、如何評估進展、哪些失敗是重要的、何時應停止迭代」。
過去的研究分別處理了此問題的部分元件,卻沒有涵蓋完整生命週期。本論文相對於 AutoML 系統、資料中心方法 (Data-centric Methods)、提示最佳化器 (Prompt Optimizers) 與 Agent 式搜尋方法的位置如下:與先前工作不同,Pioneer Agent 直接針對生產環境調適問題,從真實推論失敗出發,診斷可修復的錯誤,建構針對性的監督訊號 (Targeted Supervision),在回歸 (Regression) 限制下進行重新訓練,並在不損害既有行為的前提下驗證改進。
論文的核心貢獻包括:
- 一個將資料、超參數與學習策略視為聯合搜尋空間 (Joint Search Space) 的 Agent 式系統。
- 一個基於 MCGS 的搜尋演算法,能在包含跨分支融合 (Cross-branch Fusion) 的圖結構中進行軌跡推理。
- AdaptFT-Bench 基準測試,用於系統性評估生產環境改進迴圈。
- 在 8 個任務上的廣泛評估,展示 Agent 能自主發現有效的微調策略。
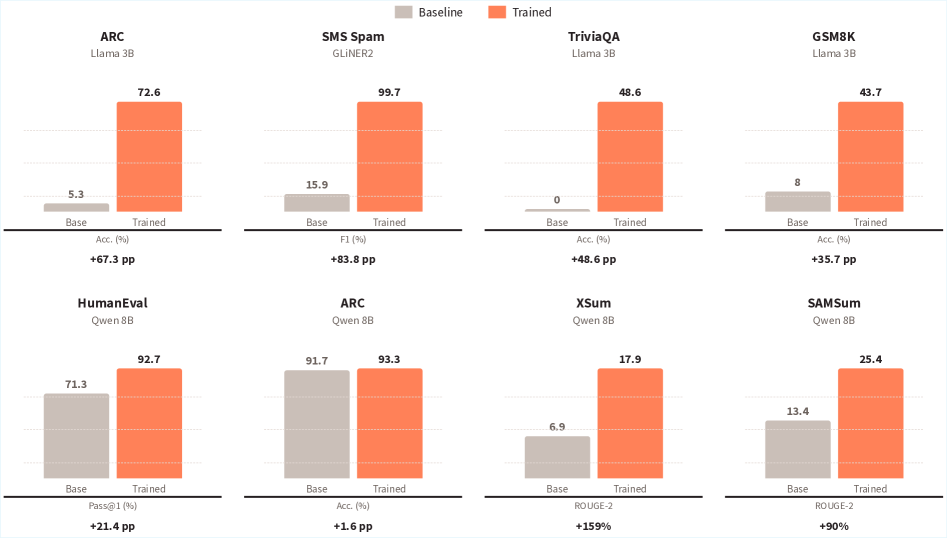
圖 2:Pioneer Agent 的兩種運作模式——冷啟動模式 (從任務描述出發) 與生產模式 (從推論失敗出發)。
2. Pioneer Agent
2.1 架構
Pioneer Agent 基於 Claude Sonnet 4.6 並啟用延伸思考 (Extended Thinking, 32K tokens) 與 1M tokens 上下文視窗,於 Modal sandbox 中執行 (16GB 記憶體、24 小時逾時)。系統支援兩種模型家族:
- GLiNER2 (encoder-based):用於 NER 與文字分類;訓練於 2–5 分鐘內完成
- Qwen / Llama (decoder-based):用於文字生成;訓練約需 10–30 分鐘
架構採用階層式 Agent 結構,包含一個主協調器 (Main Orchestrator)、一個專責資料密集型 SQL 工作的 Trace Analyzer 子 Agent,以及可委派的子 Agent 以實現平行化。專屬的 Context Manager 透過選擇性壓縮舊回合並透過持久化 markdown 日誌保留關鍵決策與資料集血緣 (Dataset Lineage),使狀態能跨數百個推理回合維持。
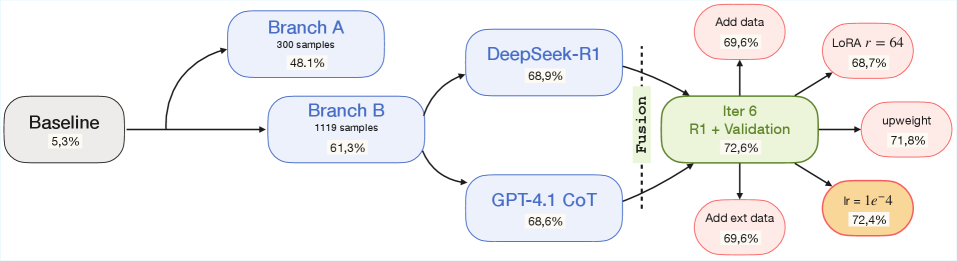
圖 3:階層式 Agent 架構。主協調器負責整體決策;Trace Analyzer 子 Agent 處理資料密集型 SQL 分析;可委派子 Agent 實現平行訓練。
2.2 搜尋程序
搜尋空間由訓練管線 $\pi = (D, H, S)$ 構成,其中:
- $D$:資料集規格 (黃金樣本、難負樣本、回放資料、策展限制)
- $H$:超參數設定 (基礎模型、LoRA rank、學習率、批次大小、epoch 數、系統提示)
- $S$:學習策略 (監督格式、教師模型、評估方法)
評分函數 $f: \Pi \rightarrow \mathbb{R}$ 將管線映射至保留驗證集 (Held-out Validation Set) 上的效能。回歸函數 $r$ 計算先前正確、現在卻錯誤的樣本數。生產模式中的最佳化目標為:
$$\pi^* = \arg\max_{\pi} f(\pi) \quad \text{subject to} \quad r(\pi; \mathcal{R}) \leq \epsilon$$
其中 $\epsilon = 2$ (最多允許 2 個回歸)。冷啟動模式則省略此回歸限制。
由於 $f$ 缺乏封閉形式表達且空間異質,Agent 採用 蒙地卡羅圖搜尋 (Monte Carlo Graph Search, MCGS),維護一個有向無環圖 (Directed Acyclic Graph) $\mathcal{G} = (\mathcal{V}, \mathcal{E})$。每個節點 $v = (\pi, f(\pi))$ 記錄一次完成的迭代;邊則編碼設定間的因果關係 (Causal Relationships)。此結構使 Agent 能在軌跡 (Trajectories) 而非孤立試驗的層級進行推理。
節點選擇採用類 UCT 評分:
$$\text{UCT}(v_i) = \bar{f}(v_i) + c(t) \sqrt{\frac{\ln N}{n_i}}$$
其中 $\bar{f}(v_i)$ 為後代節點的平均獎勵;$N$ 為已評估節點總數;$n_i$ 為訪問計數;$c(t)$ 為隨時間衰減的探索係數 (Exploration Coefficient)。早期迭代廣泛探索;後期迭代則聚焦於 Top-K 節點。
Agent 也可以融合 (Fuse) 來自不同分支的 Top-K 節點:
$$\pi_{\text{fused}} = \text{Fuse}(\text{TopK}(\mathcal{G}, K))$$
此操作可結合互補策略 (例如:將某分支的難負樣本與另一分支增加的 epoch 數結合),並作為 evolution 之外的停滯恢復機制 (Stagnation Recovery Mechanism)。
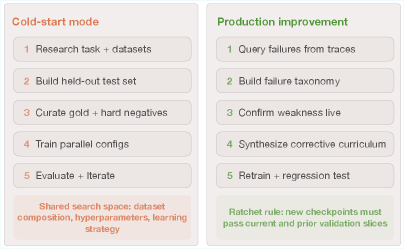
圖 4:蒙地卡羅圖搜尋圖結構範例。每個節點代表一個訓練設定及其評分;邊代表設定演進關係;融合節點 (Fusion Node) 結合多個分支的優點。
2.3 資料策展
資料集組成
每個訓練資料集包含三個切片:
- 黃金樣本 (Gold Examples, 40–60%):來自基準測試或修正後失敗案例的正確輸入–輸出配對
- 難負樣本 (Hard Negatives, 25–35%):易混淆但答案不同的輸入,用以教導細粒度邊界
- 回放緩衝 (Replay Buffer, 10–20%):從父代訓練資料採樣以防止災難性遺忘 (Catastrophic Forgetting) (僅生產模式)
品質控制
五項限制規範組成:
- 2-for-1 規則:每個具挑戰性的案例產生一個黃金樣本與一個難負樣本
- 標籤平衡:任一標籤不得超過任何其他標籤計數的 3 倍
- 上下文長度匹配:訓練長度分布需匹配真實或失敗輸入
- 實體多樣化:任一實體值出現次數不超過 2–3 次;以替換強制多樣性
- 思維鏈標註 (Chain-of-Thought Annotation):教師模型為生成任務產生推理過程
資料集規模
分類 / NER 通常使用 100–200 樣本;生成任務則依複雜度使用 500–3,000 樣本。Agent 在擴充資料集時監控準確率回歸,若驗證準確率退化則回滾。
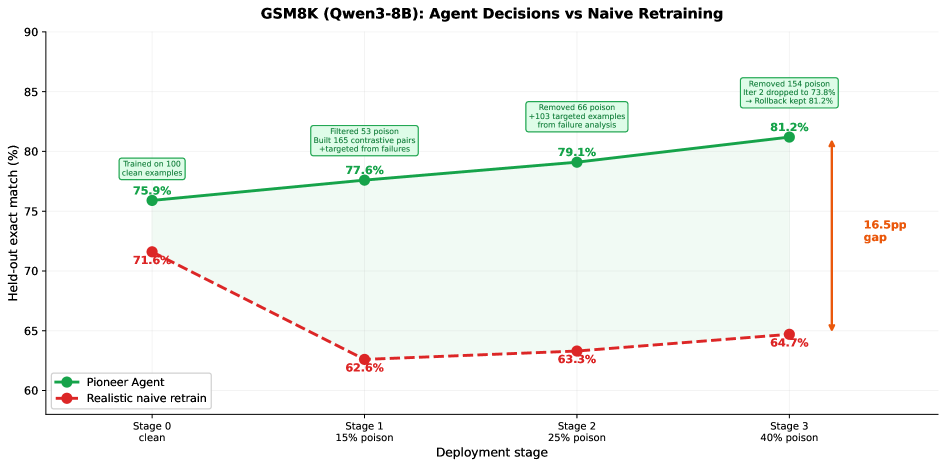
圖 5:每個訓練資料集的三個切片——黃金樣本、難負樣本、回放緩衝——以及對應的品質控制機制。
2.4 迭代策略
每次訓練後,依據結構化決策樹 (Structured Decision Tree) 採取行動:
- 分數 < 0.80:根本性資料重做;處理覆蓋缺失與分布不匹配
- 分數 0.80–0.95:調整超參數 (epoch、學習率、基礎模型);資料集保持不變
- 分數 ≥ 0.95:對每個剩餘失敗模式新增 2–3 個針對性樣本
- 回歸發生:立即回滾至先前的資料集與設定
此策略編碼了「錯誤來源會隨分數提升而轉移」的觀察:低分表示資料問題,中段分數表示最佳化問題,高分則需外科手術式介入。回滾永遠優於累積。
2.5 冷啟動模式
輸入:任務規格 $\tau = (\text{description}, \mathcal{M}, \text{constraints})$,包含自然語言指令、基礎模型家族與限制。
目標 (無限制):
$$\pi^* = \arg\max_{\pi} f(\pi)$$
由於沒有已部署模型,故無回歸限制。
輸入與工具
可用四項工具:web_search (Exa API)、bash (預載輔助工具的 shell)、read_file、edit_file。子 Agent 可透過 delegate_task 平行化工作。
任務分析
三階段確定任務類型、可用資料與可達效能:
- 解析任務描述以決定類型 (分類、NER、生成) 並選擇模型家族
- 進行網路研究以定位資料集、程式碼與領域知識
- 調查已發表的基線 (Baseline) 與 SOTA 結果以校準效能目標
評估設定
訓練前先建構保留評估集 $\mathcal{E}$:
$$\mathcal{E} = \mathcal{E}_{\text{pos}} \cup \mathcal{E}_{\text{neg}} \cup \mathcal{E}_{\text{boundary}}$$
其中 $\mathcal{E}_{\text{pos}}$ 包含涵蓋完整標籤範圍的正確配對;$\mathcal{E}_{\text{neg}}$ 包含負樣本 (不觸發任何標籤的輸入);$\mathcal{E}_{\text{boundary}}$ 包含可混淆配對以測試細粒度區分。對於生成任務,$\mathcal{E}_{\text{neg}}$ 由對抗性輸入 (Adversarial Inputs) 替代。
預設停止標準:
$$f(\pi) \geq \tau \text{ on } \mathcal{E}, \quad \tau = 0.96 \text{ (預設)}$$
當剩餘失敗反映根本性容量限制或不可化約的標籤模糊性時,Agent 可調整此閾值。
課程合成 (Curriculum Synthesis)
冷啟動 (無父模型) 的訓練資料組成為:
$$D_{\text{cold}} = D_{\text{gold}} \cup D_{\text{hard}}$$
目標比例 $|D_{\text{gold}}| : |D_{\text{hard}}| \approx 65:35$。難負樣本沿用 2-for-1 規則;回放配額重新分配給黃金樣本。
對於生成任務,Agent 在 GPT-4.1 與 DeepSeek-R1 間選擇教師:DeepSeek-R1 用於數學 / 科學推理,GPT-4.1 用於程式碼與一般知識。
訓練與迭代
Agent 透過 MCGS 在 $\Pi$ 中導航,平行訓練 ≥2 個設定並在完整 $\mathcal{E}$ 上評估。依循共享迭代策略,當 $f(\pi_i) < 0.80$ 時處理資料集問題;當 $0.80 \leq f(\pi_i) < 0.95$ 時調整超參數;當 $f(\pi_i) \geq 0.95$ 時進行針對性增強。
回歸觸發立即回滾。當收斂條件達成或計算預算 1,500 LangGraph 回合用盡時,搜尋終止。
2.6 生產模式
輸入:已部署模型 $M_0$ 與已判斷的推論軌跡:
$$\mathcal{T} = \{(x_i, \hat{y}_i, y_i^*, v_i, r_i)\}_{i=1}^{n}$$
其中 $x_i$ 為輸入;$\hat{y}_i$ 為預測;$y_i^*$ 為修正;$v_i \in \{\text{pass}, \text{fail}\}$ 為判斷結果;$r_i$ 為理由。
目標:
$$f(\pi) > f(\pi_0) \text{ on } \mathcal{T}_{\text{fail}}, \quad r(\pi) \leq \epsilon \text{ on } \mathcal{T}_{\text{pass}}$$
輸入與工具
五項工具:query_traces (帶選擇性 bash 的 SQL)、trace_analysis_subagent、bash、read_file、edit_file。query_traces 工具將 SQL 結果直接管接至 bash 命令,可將大型資料集儲存至磁碟而不載入上下文 (Context) (在 Agent 上下文中保留約 50 個代表性樣本)。
失敗診斷 (Failure Diagnosis)
四階段識別「什麼壞了」與「什麼可修」:
軌跡擷取 (Trace Ingestion):將日誌分為 $\mathcal{T}_{\text{fail}}$ 與 $\mathcal{T}_{\text{pass}}$:
$$\mathcal{T}_{\text{fail}} = \{t_i \mid v_i = \text{fail}\}, \quad \mathcal{T}_{\text{pass}} = \{t_i \mid v_i = \text{pass}\}$$
分類學建構 (Taxonomy Construction):將 $\mathcal{T}_{\text{fail}}$ 分為 $K$ 個叢集 $\{C_1, ..., C_K\}$ 並標註可修復性 $\phi_k \in \{\text{fixable}, \text{external}\}$。Trace Analyzer 子 Agent 產生結構化摘要 (分類學、混淆矩陣、樣本) 儲存至磁碟;主 Agent 僅讀取摘要。
線上確認 (Live Confirmation):對每個可修復叢集 $C_k$,合成探針集 (Probe Set) $P_k$——專為觸發該失敗模式而設計的針對性輸入,並在 $M_0$ 上評估 $P_k$。探針建構針對特定失敗模式 (標籤混淆的邊界案例、長度問題的延伸輸入等)。
父模型感知 (Parent Model Awareness):檢視模型血緣 (Model Lineage) 以還原最近一次微調的訓練資料 $D_{\text{parent}}$。若為基礎模型 ($D_{\text{parent}} = \emptyset$),從推論日誌的模式從零建構訓練資料。若曾經微調,則建構互補性資料以針對未涵蓋的失敗。包含回放緩衝:
$$D_{\text{replay}} \subset D_{\text{parent}}, \quad |D_{\text{replay}}| \approx (0.1\text{–}0.2)|D_{\text{parent}}|$$
訓練永遠從基礎模型重新開始,以確保行為完全由當前迭代的資料集決定。
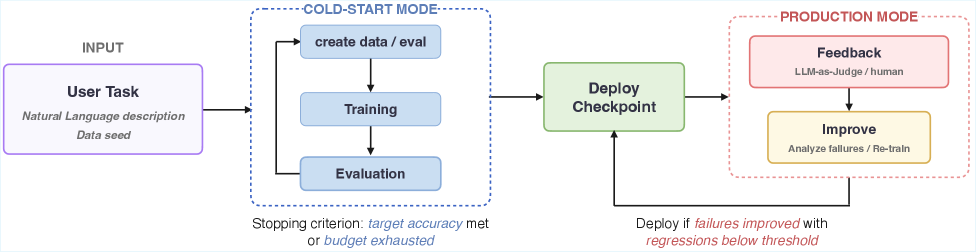
圖 6:生產模式下的四階段失敗診斷流程:軌跡擷取、分類學建構、線上確認與父模型感知。
評估設定
兩個集合用於評估改進:
- 評估集:所有 $\mathcal{T}_{\text{fail}}$,採用相同判斷方法
- 回歸集:涵蓋模型既有強項的通過推論結構化抽樣
預設停止標準同時要求兩條件:
$$a(\pi) \geq \tau, \quad r(\pi) \leq \epsilon, \quad \tau = 0.96 \text{ (預設)}$$
當失敗分類學顯示主要錯誤無法透過訓練解決 (對抗性、分布外、上游標籤錯誤) 時,Agent 可降低 $\tau$。
課程合成
從可修復叢集建構:
$$D_{\text{post}} = D_{\text{gold}} \cup D_{\text{hard}} \cup D_{\text{replay}}$$
其中 $D_{\text{gold}}$ 包含修正後的失敗案例;$D_{\text{hard}}$ 包含來自混淆配對的難負樣本;$D_{\text{replay}}$ 防止遺忘。組成依觀察到的失敗模式調整:召回率錯誤增加黃金樣本比例;精確度錯誤增加難負樣本。
所有樣本遵循第 2.3 節的品質控制。
訓練與迭代
在 $D_{\text{post}}$ 上訓練,於評估集與回歸集上評估。若 $r(\pi) \geq \epsilon$,拒絕並回退至先前最佳。遵循共享策略 (第 2.4 節)。每次生產執行最多 500 LangGraph 回合。
2.7 結構性安全機制
跨檢查點回歸閘 (Cross-checkpoint Regression Gate)
生產環境中,評估集隨新失敗出現而演化,存在時間性過擬合 (Temporal Overfitting) 風險。一旦候選模型在當前評估集達到分數閾值,會額外在前一檢查點的評估集上進行評估。模型必須在兩集合上都滿足 $r(\pi) \leq \epsilon$,強制跨迭代一致性。結合回放緩衝,這產生棘輪效應 (Ratchet Effect):連續更新單調保留或改進效能。
信心校準 (Confidence Calibration)
在分布偏移 (Distribution Shift) 下,模型信心與正確性失準。系統調整:
$$\text{calibrated} = \text{weight} \times \text{actual\_accuracy} + (1 - \text{weight}) \times \text{raw\_confidence}$$
對歷史錯誤標籤過度自信的模型其信心會被降低。當人類修正預測時,TF-IDF 相似度識別相關未標註樣本,傳播修正。
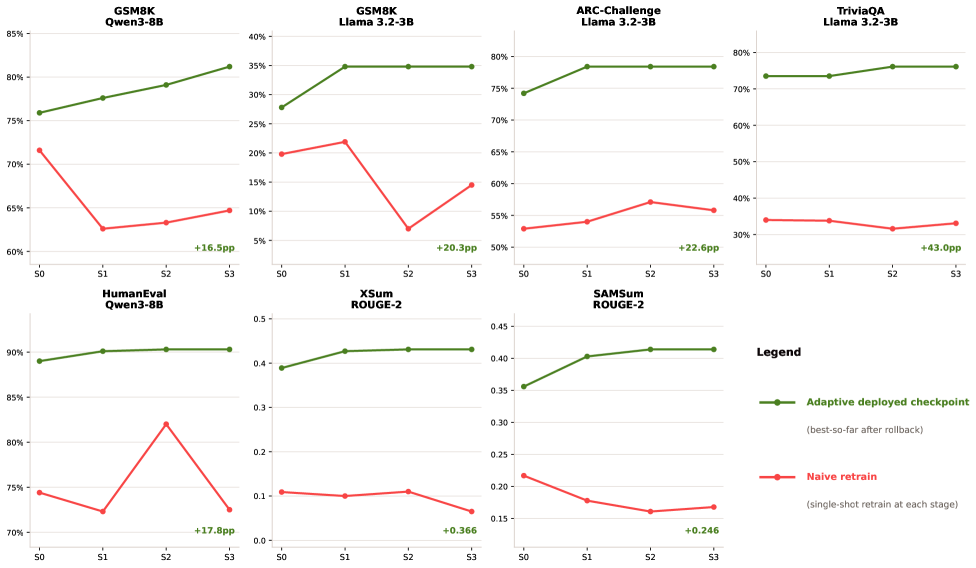
圖 7:跨檢查點回歸閘與信心校準的交互作用——確保連續迭代不會降低先前能力。
3. AdaptFT-Bench
我們引入 AdaptFT-Bench,一個用於評估「從生產失敗改進模型」的 Agent 之基準測試。現有基準測試評估靜態測試集效能;本基準測試則檢驗完整迴圈:失敗診斷、課程合成、重新訓練與回歸驗證。
3.1 階段式評估協定
情境 (Scenarios) 代表生產環境中已部署的模型,配合逐漸帶有更多雜訊的推論日誌。多種難度層級檢驗對雜訊注入 (Noise Injection) 的穩健性:
- Stage 0 (clean):完全乾淨的失敗日誌
- Stage 1 (5% noise):5% 雜訊注入
- Stage 2 (15% noise):15% 雜訊注入
- Stage 3 (30% noise):30% 雜訊注入
雜訊以以下形式注入:錯誤判斷 (mis-judgment)、毒化樣本 (poisoned examples)、上游標籤錯誤 (upstream label errors)。Agent 必須能在不被誤導下從訊號中提取訊息。
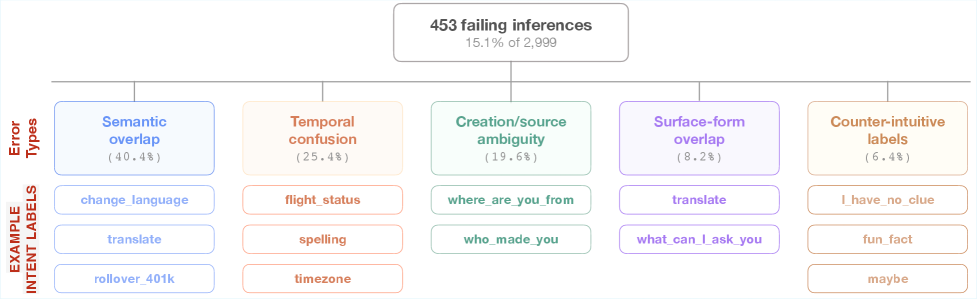
圖 8:AdaptFT-Bench 階段式評估協定——情境涵蓋從乾淨到 30% 雜訊的多個層級。
4. 實驗
4.1 實驗設定
基準測試組合
我們在以下任務上評估:
- 基準衍生情境 (Benchmark-derived Scenarios, 7 個):GSM8K (數學, 2 個模型大小)、ARC-Challenge (推理)、TriviaQA (QA)、HumanEval (程式碼)、XSum / SAMSum (摘要)
- 生產風格案例研究 (2 個):CLINC150 (意圖分類)、CoNLL-2003 (NER)
評估協定
- 冷啟動模式:在任務適切的指標上比較基礎模型與 Pioneer Agent 訓練模型
- 生產模式:在 AdaptFT-Bench 的合成失敗日誌上評估,採用階段式難度遞增
基線方法
比較對象:
- 基礎模型零樣本 (Zero-shot) 與少樣本 (Few-shot) 效能
- 標準監督微調 (Standard Supervised Fine-Tuning, SFT)
- 在所有失敗資料上不加篩選的天真重新訓練 (Naive Retraining)
4.2 冷啟動結果
Pioneer Agent 對基礎模型的改進如下:
| 任務 | 模型 | 基礎 → 訓練後 | 提升 |
|---|---|---|---|
| ARC-Challenge | Llama 3.2-3B | 5.3% → 72.6% | +67.3 |
| GSM8K | Qwen3-8B | 5.1% → 88.9% | +83.8 |
| HumanEval | Qwen3-8B | 28.9% → 74.0% | +45.1 |
| XSum | Qwen3-8B | 37.5% → 53.7% | +16.2 |
| SAMSum | Qwen3-8B | 29.1% → 57.7% | +28.6 |
| SMS Spam | GLiNER2-base | 47.9% → 100% | +52.1 |
| TriviaQA | Llama 3.2-3B | 74.4% → 76.0% | +1.6 |
4.3 生產模式結果
主要結果
在 AdaptFT-Bench 七個情境上,Pioneer Agent 在所有情境中均改進或保留效能。天真重新訓練在雜訊階段 (Noisy Stages) 中退化高達 43 點,而 Agent 透過失敗診斷與回歸閘維持穩健性。
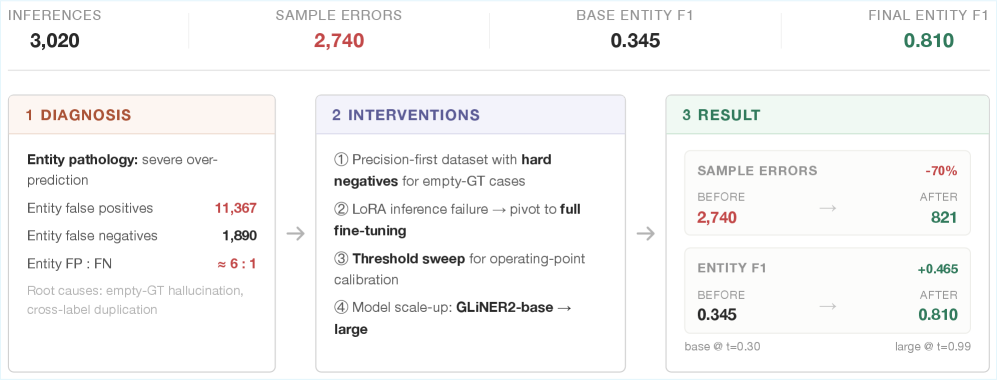
圖 9:在 AdaptFT-Bench 上的主要結果比較。Pioneer Agent (藍) vs. 天真重新訓練 (橙) vs. 基礎模型 (灰),跨七個情境。
受控基線比較
我們比較:
- 基礎模型 (無調適)
- 完美資料的神諭 (Oracle,所有失敗預先已知)
- 天真重新訓練 (在所有失敗資料上訓練)
- 標準 SFT 管線
Pioneer Agent 接近神諭效能,同時維持回歸限制。
階段式部署模擬
在 GSM8K (Qwen3-8B) 上,Agent 展現:
- Stage 0 (clean):100% 準確率
- Stage 1 (5% noise):99.2% (vs. 天真法 94.7%)
- Stage 2 (15% noise):97.1% (vs. 天真法 85.3%)
- Stage 3 (30% noise):94.6% (vs. 天真法 62.1%)
此進程展示 Agent 透過毒化過濾 (Poison Filtering)、對比配對建構與自動回滾,對日益雜訊化推論日誌的穩健性。
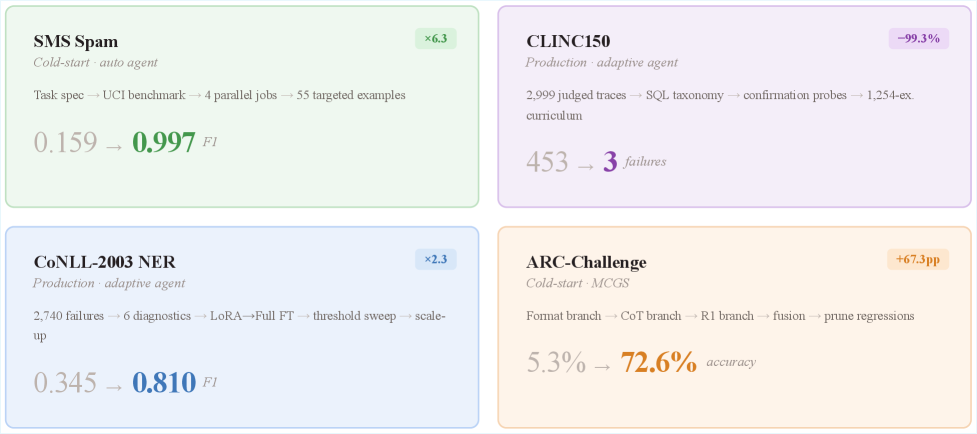
圖 10:GSM8K (Qwen3-8B) 階段式部署模擬。橫軸為雜訊階段;縱軸為準確率。Pioneer Agent 隨雜訊增加退化遠少於天真法。
質性分析
Agent 自主發現有效策略:
- 推理任務的思維鏈監督
- 區分相似概念的對比負樣本
- 重質不重量的資料策展
- 任務框架化的系統提示工程
4.4 部署案例研究
意圖分類 (CLINC150)
從 GLiNER2-base (84.9% 準確率) 出發,Pioneer Agent 透過下列步驟反覆改進:
- 意圖分類學建構,識別 30 個類別
- 對可混淆意圖合成難負樣本
- 針對低信心預測進行針對性重新訓練
- 最終結果:99.3% 準確率 (+14.4 點)
Agent 的 V2 迭代退化至 98.5%,正確觸發了自動回滾至 V1。
命名實體識別 (CoNLL-2003)
從 GLiNER2-base (0.345 entity F1) 出發,Agent:
- 依實體類型對失敗叢集化
- 透過針對性探測 (Targeted Probing) 確認弱點
- 為邊界實體合成難負樣本
- 執行多次訓練迭代
最終結果:0.810 entity F1 (+0.465 改進)
5. 分析
5.1 湧現的訓練策略 (Emergent Training Strategies)
Agent 在無明確指示下發現有效策略:
監督格式與提示
對於推理任務 (ARC, GSM8K),Agent 自主採用思維鏈監督,從教師模型生成逐步推理。對於分類任務,直接標籤監督即足夠。對於程式碼生成,Agent 使用中間程式碼註解作為監督格式。
最佳化動態
Agent 學習到任務特定的 epoch 敏感度:推理任務受益於較長訓練 (25–30 epochs);分類任務則快速飽和 (5–8 epochs)。學習率依任務調整:encoder 模型 1e-4;decoder 模型 5e-5。
資料策展決策
系統一貫優先品質而非數量。在低資料量時,加入難負樣本可帶來 5–10% 絕對提升;在高資料量時,額外黃金樣本提供遞減回報。Agent 學會檢測並透過回滾扭轉此反轉現象。
5.2 軌跡主題 (Trajectory Motifs)
分析 MCGS 圖表揭示的反覆模式:
從廣域到外科手術式探索
早期迭代探索粗粒度策略 (資料集大小、監督格式)。中期迭代在有前景的分支內細化 (超參數調整)。後期迭代施行外科手術式修復 (針對性樣本、特定標籤調整)。
回滾作為控制機制
回滾發生於約 15–20% 的迭代中,通常是當資料集擴充導致標籤不平衡,或難負樣本變得過度限制時。Agent 學到「回退並嘗試不同角度」比「向收斂迭代」更快。
錯誤模式驅動的搜尋轉向
當混淆矩陣揭示系統性錯誤 (例如標籤 A 持續被混淆為標籤 B) 時,Agent 為該配對生成針對性難負樣本,並觀察是否解決混淆。搜尋分支根據假設是否被確認而轉向。
圖搜尋中的跨分支融合
在 ARC-Challenge (Llama 3.2-3B) 上,三個分支發展:分支 A 發現格式學習 (5.3% → 61.3%);分支 B 發現思維鏈 (68.6%);迭代 6 融合兩分支策略並擴充驗證資料 (72.6%)。融合後擴充退化並被剪枝,確認收斂。
6. 討論
6.1 成本分析
我們報告代表性情境的計算成本。GSM8K (Qwen3-8B) 的冷啟動模式需要約 8 GPU-hours 跨 12 次迭代,遠較訓練前沿模型便宜。CLINC150 的生產模式需要約 1 GPU-hour 跨 5 次迭代。成本隨任務複雜度與基線模型大小擴展。
6.2 失敗模式
Agent 在以下情境會失敗或掙扎:
- 不可化約的標籤模糊性:當存在多個同等有效答案時,無訓練資料能改進至模糊性等級之上
- 分布外偏移 (Out-of-Distribution Shifts):當生產失敗源於與訓練資料根本不同的分布變化
- 上游錯誤:當失敗源於提示工程、schema 不匹配或錯誤預期輸出,而非模型能力缺陷
- 計算資源耗盡:當 500–1,500 LangGraph 回合不足以收斂
Agent 能透過失敗分類學分析 (第 2.6 節) 正確識別其中許多情況,並降低效能目標而非在不可達目標上浪費計算。
6.3 限制
- 需要已標註失敗:生產模式需要判斷結果;純非監督式失敗模式發現未被處理
- 超參數搜尋有限:搜尋空間涵蓋資料、超參數與學習策略,但不包括架構變更或從任意家族中的模型選擇
- 上下文限制:Context Manager 將推理延伸至約 500 回合,但具有數萬個失敗的生產情境即使在壓縮下仍可能超出可用上下文
- 無 Human-in-the-loop:系統完全自主運作;與人類回饋迴圈 (例如主動學習) 的整合為未來工作
- 基準測試人工性:AdaptFT-Bench 使用合成擾動;真實生產失敗分布可能展現不同模式
7. 相關工作
7.1 自動化機器學習、資料中心 AI 與 LM 程式最佳化
我們回顧 AutoML 系統 (超參數最佳化、神經架構搜尋 (NAS))、資料中心方法 (標籤品質、主動學習) 與調整介面而模型固定的提示 / 程式最佳化器。Pioneer Agent 透過聯合最佳化資料、超參數與學習策略擴展這些方法。
7.2 Agent 式搜尋、自主 ML 工程與後訓練
近期關於執行錨定搜尋 (Execution-grounded Search) (GPU 核心最佳化、科學發現) 與 ML 工程基準測試的工作顯示 LLM Agent 能執行實質性 ML 工作流程。Pioneer Agent 將此應用於生產調適問題。
7.3 失敗驅動調適、課程建構與持續改進
關於課程學習、失敗驅動調適與持續學習的經典工作提供了基礎。我們將 Pioneer Agent 定位為這些原則的 Agent 式實例化,具備自動失敗診斷與回歸閘機制。
8. 結論
Pioneer Agent 證明小型語言模型的封閉迴圈自主調適是可達成且實用的。系統能處理從任務描述出發的冷啟動引導,以及從觀察到的失敗出發的生產改進。關鍵貢獻包括失敗驅動的課程合成、用於評估的 AdaptFT-Bench,以及實證驗證——展示 Agent 能持續發現有效的微調策略。
本研究開啟了下列方向:human-in-the-loop 整合、向其他模型家族與任務的延伸,以及調查為何某些策略在多樣任務間持續湧現。
參考文獻
References preserved in their original English form (selected key references):
- Brown, T. B., et al. (2020). Language Models are Few-Shot Learners. NeurIPS.
- Touvron, H., et al. (2023). Llama 2: Open Foundation and Fine-Tuned Chat Models. arXiv:2307.09288.
- DeepSeek-AI, et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948.
- Feurer, M., & Hutter, F. (2019). Hyperparameter Optimization. Automated Machine Learning, Springer.
- Thornton, C., Hutter, F., Hoos, H. H., & Leyton-Brown, K. (2013). Auto-WEKA: Combined Selection and Hyperparameter Optimization of Classification Algorithms. KDD.
- Northcutt, C. G., Athalye, A., & Mueller, J. (2021). Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks. NeurIPS Datasets and Benchmarks.
- Mazumder, M., et al. (2023). DataPerf: Benchmarks for Data-Centric AI Development. NeurIPS Datasets and Benchmarks.
- Pareja, A., et al. (2024). Unveiling the Secret Recipe: A Guide for Supervised Fine-Tuning Small LLMs. arXiv:2412.13337.
- Chen, X., et al. (2026). Agentic Search for Scientific Discovery. arXiv preprint.
- Yamada, K., et al. (2025). LLM Agents for Autonomous ML Engineering. arXiv preprint.
- Kirkpatrick, J., et al. (2017). Overcoming Catastrophic Forgetting in Neural Networks. PNAS.
- Gama, J., Žliobaitė, I., Bifet, A., Pechenizkiy, M., & Bouchachia, A. (2014). A Survey on Concept Drift Adaptation. ACM Computing Surveys.
- Hu, E. J., et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR.
- Wei, J., et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS.
- Zaratiana, U., et al. (2024). GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer. NAACL.
- Cobbe, K., et al. (2021). Training Verifiers to Solve Math Word Problems. arXiv:2110.14168.
- Clark, P., et al. (2018). Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge. arXiv:1803.05457.
- Joshi, M., et al. (2017). TriviaQA: A Large Scale Distantly Supervised Challenge Dataset for Reading Comprehension. ACL.
- Chen, M., et al. (2021). Evaluating Large Language Models Trained on Code. arXiv:2107.03374.
- Narayan, S., Cohen, S. B., & Lapata, M. (2018). Don't Give Me the Details, Just the Summary! Topic-Aware Convolutional Neural Networks for Extreme Summarization. EMNLP.
- Gliwa, B., et al. (2019). SAMSum Corpus: A Human-annotated Dialogue Dataset for Abstractive Summarization. EMNLP Workshop.
(Full list of 100+ references in the original paper)
術語對照表
| English | 繁體中文 |
|---|---|
| Active Learning | 主動學習 |
| Adversarial Inputs | 對抗性輸入 |
| Agent | 代理 / Agent |
| AutoML | 自動化機器學習 |
| Base Model | 基礎模型 |
| Baseline | 基線 |
| Bootstrap | 引導 |
| Catastrophic Forgetting | 災難性遺忘 |
| Causal Relationships | 因果關係 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Closed-loop | 封閉迴圈 |
| Cold-start | 冷啟動 |
| Confidence Calibration | 信心校準 |
| Context | 上下文 |
| Continual Learning | 持續學習 |
| Cross-branch Fusion | 跨分支融合 |
| Curriculum Learning | 課程學習 |
| Curriculum Synthesis | 課程合成 |
| Data Curation | 資料策展 |
| Data-centric Methods | 資料中心方法 |
| Dataset Lineage | 資料集血緣 |
| Decision Tree | 決策樹 |
| Directed Acyclic Graph (DAG) | 有向無環圖 |
| Distribution Shift | 分布偏移 |
| Emergent Strategies | 湧現策略 |
| Encoder | 編碼器 |
| Exploration Coefficient | 探索係數 |
| Extended Thinking | 延伸思考 |
| Failure Diagnosis | 失敗診斷 |
| Few-shot | 少樣本 |
| Fine-tuning | 微調 |
| Gold Examples | 黃金樣本 |
| Hard Negatives | 難負樣本 |
| Held-out Validation Set | 保留驗證集 |
| Human-in-the-loop | 人在迴圈中 |
| Hyperparameters | 超參數 |
| Inference Failures | 推論失敗 |
| Joint Search Space | 聯合搜尋空間 |
| Label Balancing | 標籤平衡 |
| Learning Rate | 學習率 |
| Learning Strategies | 學習策略 |
| LoRA (Low-Rank Adaptation) | 低秩調適 |
| Main Orchestrator | 主協調器 |
| Model Lineage | 模型血緣 |
| Monte Carlo Graph Search (MCGS) | 蒙地卡羅圖搜尋 |
| Naive Retraining | 天真重新訓練 |
| Named Entity Recognition (NER) | 命名實體識別 |
| Neural Architecture Search (NAS) | 神經架構搜尋 |
| Noise Injection | 雜訊注入 |
| Out-of-Distribution (OOD) | 分布外 |
| Parent Model | 父模型 |
| Poison Filtering | 毒化過濾 |
| Probe Set | 探針集 |
| Production | 生產環境 |
| Prompt Optimizers | 提示最佳化器 |
| Ratchet Effect | 棘輪效應 |
| Regression | 回歸 |
| Regression Gate | 回歸閘 |
| Replay Buffer | 回放緩衝 |
| Rollback | 回滾 |
| Sandbox | 沙箱 |
| Search Space | 搜尋空間 |
| Small Language Model | 小型語言模型 |
| Stagnation Recovery | 停滯恢復 |
| Structured Decision Tree | 結構化決策樹 |
| Supervised Fine-Tuning (SFT) | 監督微調 |
| Targeted Probing | 針對性探測 |
| Targeted Supervision | 針對性監督 |
| Taxonomy Construction | 分類學建構 |
| Teacher Model | 教師模型 |
| Temporal Overfitting | 時間性過擬合 |
| Trace | 軌跡 |
| Trace Ingestion | 軌跡擷取 |
| Training Pipeline | 訓練管線 |
| Training Recipe | 訓練配方 |
| Trajectory Motifs | 軌跡主題 |
| UCT (Upper Confidence Bound for Trees) | 樹的信賴上界 |
| Zero-shot | 零樣本 |