Nemotron 3 Nano:開放高效的 MoE 混合 Mamba-Transformer 智能體推理模型
原始論文:Nemotron 3 Nano: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning 作者:NVIDIA(300+ 位貢獻者) arXiv ID:2512.20848v1 日期:2025-12-23 標籤:LLM MoE Mamba Hybrid Architecture Agentic RLHF 開源模型
1. 引言
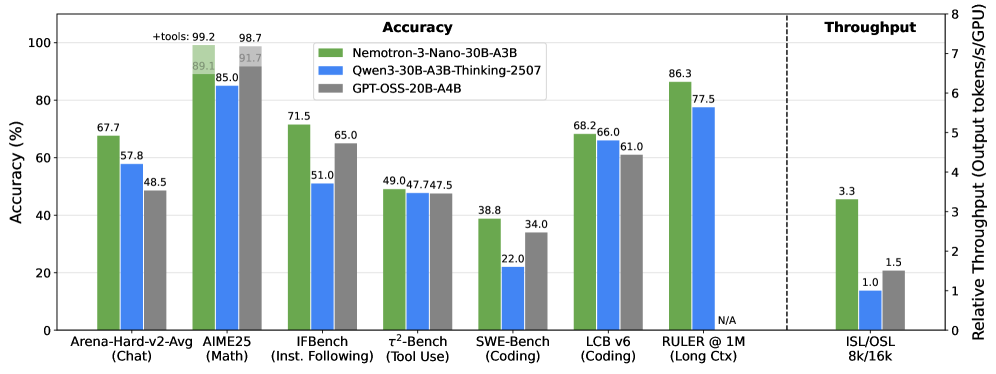
NVIDIA 發布 Nemotron 3 Nano 30B-A3B,一個開源的混合專家 (Mixture-of-Experts, MoE) 語言模型,結合 Mamba 和 Transformer 架構:
- 31.6B 總參數,每次前向傳播僅激活 3.2B(<10%)
- 在 25 兆 (trillion) 個文字 token 上預訓練
- 比同規模競品高 3.3 倍推理吞吐量
- 支援最長 1M token 上下文
- 在推理和智能體任務上表現出色
2. 架構與預訓練
2.1 模型架構
| 特性 | 規格 |
|---|---|
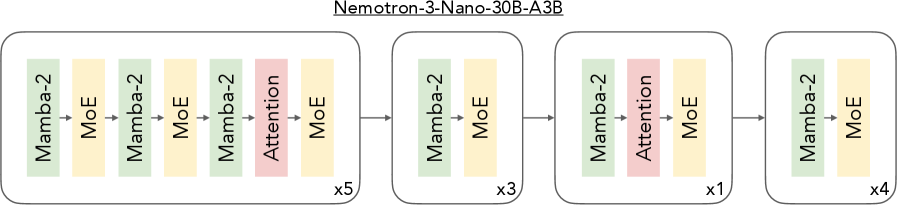
| 總層數 | 52 |
| 模型維度 | 2,688 |
| 可路由專家數 | 128 |
| 每次激活專家數 | 6 |
| 混合架構 | Mamba-2 + Grouped-Query-Attention |
| 激活函數 | Squared ReLU |
| 路由器 | 可學習 MLP + Sigmoid gating |
| 最大上下文 | 1M tokens |
2.2 預訓練資料
兩階段課程學習 (curriculum learning):
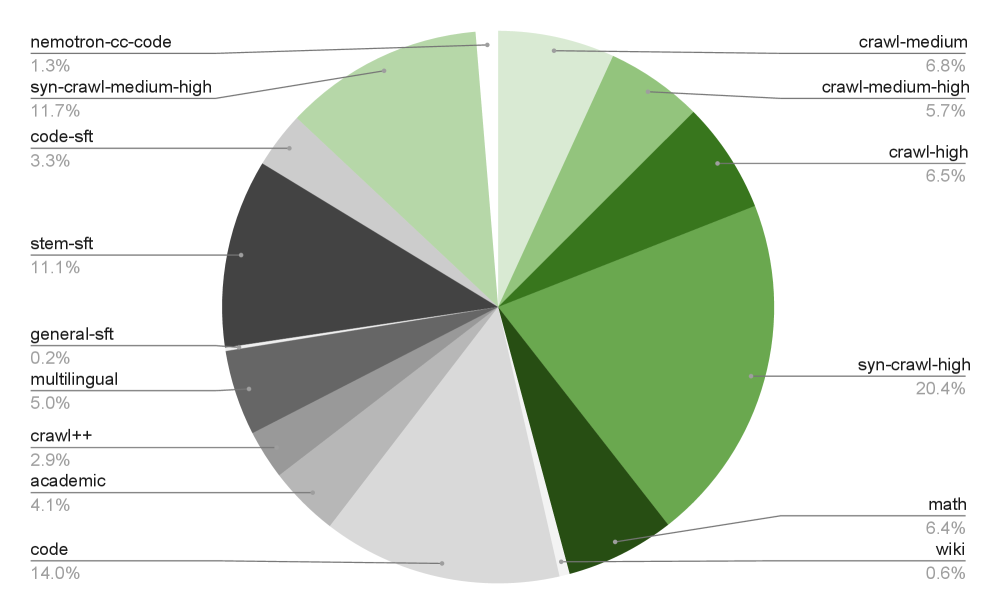
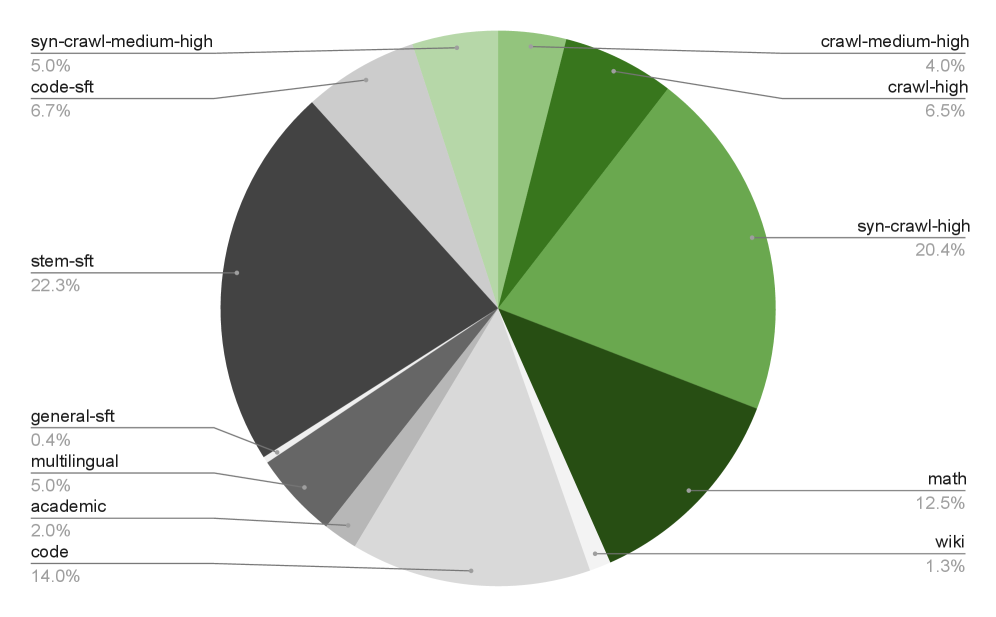
- Phase 1(23.5T tokens):強調多樣性,在 94% 完成點轉換
- Phase 2(1.5T tokens):聚焦高品質資料
關鍵預訓練資料集:
- Nemotron-CC-Code-v1:428B 高品質程式碼 token(來自 Common Crawl)
- Nemotron-CC-v2.1:2.5T 新英文 token(含翻譯來源)
- Nemotron-Pretraining-Specialized-v1:合成 STEM、數學、科學資料集
訓練超參數:Warmup-Stable-Decay 學習率排程,最大學習率 $10^{-3}$,序列長度 8,192,batch size 3,072(≈25M tokens/batch),DeepSeek 的 aux-loss-free 負載均衡策略。
2.3 長上下文擴展
新增 121B token 的專用階段,混合序列長度(4K 和 512K),同時改善短和長上下文效能。
3. 後訓練
3.1 監督式微調 (SFT)
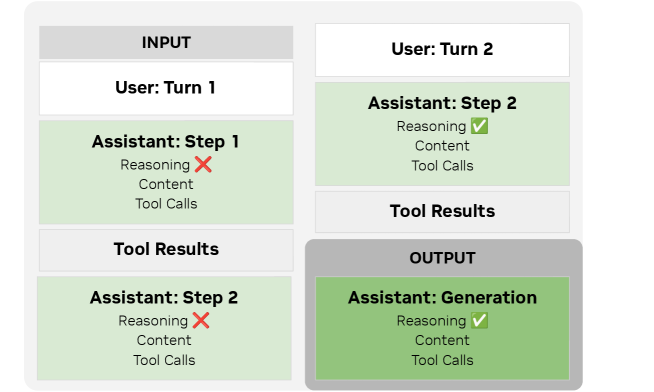
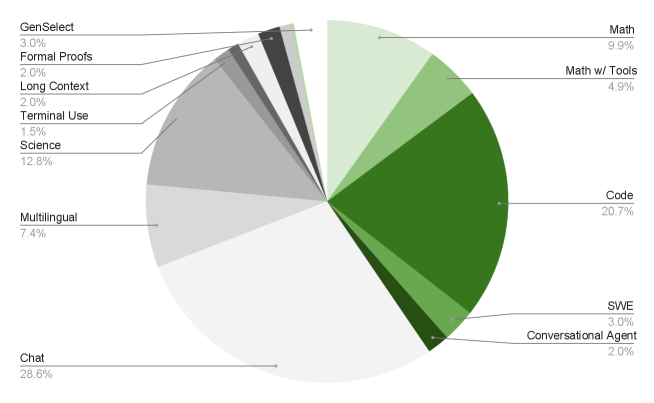
多樣化資料類別,1,800 萬個樣本:
- 競賽數學(含工具整合推理軌跡)
- 競賽程式
- 多輪對話工具使用(LLM 生成的軌跡)
- Lean 4 形式化證明(300K 範例)
- 長上下文合成資料(128K-256K 平均長度)
- 終端自主任務
- 安全 prompt(含適當拒絕策略)
- 軟體工程任務(真實 GitHub issues)
- 科學資料集(物理、化學、生物)
訓練配置:13,000 步,batch size 64,序列打包到 256K,學習率 $5 \times 10^{-5}$,800 步 warmup。
推理控制功能:推理開關(10% 樣本去除推理過程)、token 預算控制(3% 軌跡隨機截斷)、XML 式特殊標籤用於工具呼叫。
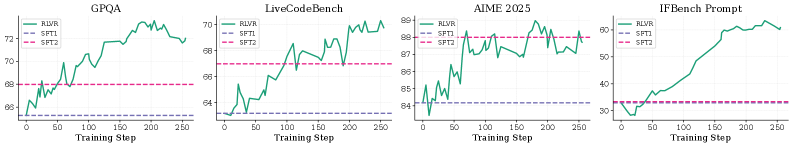
3.2 多環境強化學習 (RLVR)
八個訓練環境同時訓練:
- 競賽數學(DAPO + SkyWorks)
- 競賽程式
- STEM 問答(135K 任務)
- 結構化 JSON 輸出生成(9K 任務)
- 指令遵循變體(46K + 3K 任務)
- 長上下文問答(12K 任務,5+ 文件)
- 工作場所助手工具使用(690 任務)
- 多輪對話銀行智能體(1K 任務)
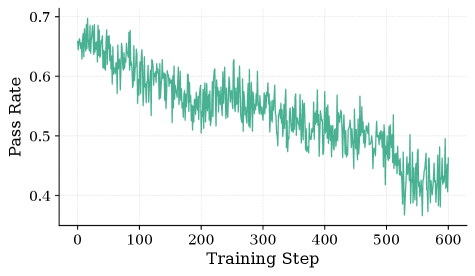
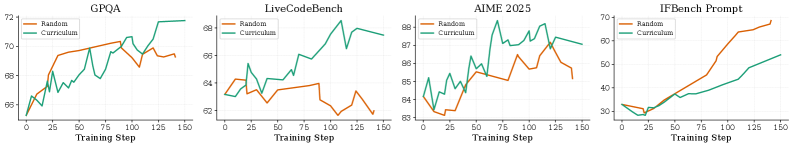
訓練策略:
- 高斯取樣策略的課程學習
- 動態難度調整
- 128 prompts/步,16 generations/prompt
- Batch size 2,048(同策略更新)
- 同步 GRPO + 遮罩重要性採樣
- 最大生成長度 49K tokens
- MoE 路由器權重凍結
3.3 人類回饋強化學習 (RLHF)
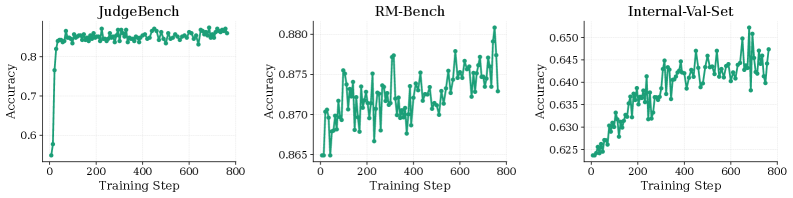
生成式獎勵模型 (GenRM):基於 Qwen3-235B-A22B-Thinking-2507 用 GRPO 訓練。
創新的長度控制機制:
長度正規化獎勵調整:計算零均值、組內相對長度獎勵以鼓勵簡潔。正規化思考和回答部分的長度,維持組間的零和性質。
品質閘控簡潔獎勵:只對達到頂級品質分數(80th 百分位閾值)的最短回應獎勵,防止為簡短而犧牲品質。
效率最佳化:環形比較策略,將 GenRM 呼叫從 $O(N^2)$ 減到 $O(N)$。結果:30% 冗贅度降低,準確率不損失。
4. 量化
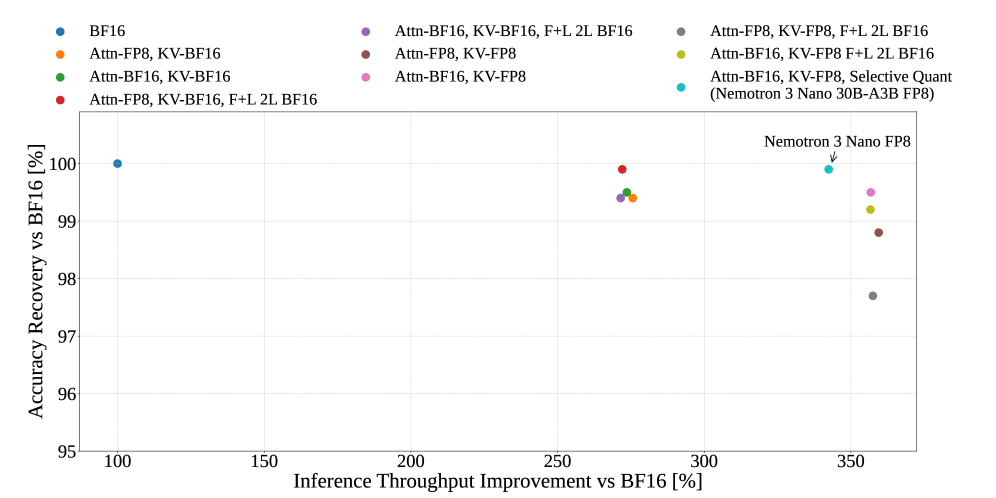
選擇性精度的 FP8 後訓練量化:
| 組件 | 精度 |
|---|---|
| 自注意力層(6/52 層) | BF16 |
| 前置 Mamba 層 | BF16 |
| 其餘組件 | FP8 |
| KV cache | FP8 |
| Mamba Conv1D 層 | BF16 |
結果:相比 BF16 基線約 99% 的中位準確率恢復,顯著吞吐量提升。
5. 實驗結果
基礎模型效能(vs. Qwen3-30B-A3B-Base)
| Benchmark | Nemotron 3 Nano | Qwen3-30B-A3B |
|---|---|---|
| MMLU-Pro | 65.05 | 61.71 |
| HumanEval | 78.05 | 70.73 |
| GSM8K | 92.34 | 89.01 |
| MATH | 82.88 | 61.14 |
| RULER@256K | 75.44 | 60.69 |
後訓練效能
| Benchmark | Nemotron 3 Nano | Qwen3-30B-A3B | GPT-OSS-20B |
|---|---|---|---|
| MMLU-Pro | 78.30 | 80.90 | 75.00 |
| AIME25(含工具) | 99.17 | - | 98.7 |
| SWE-Bench | 38.76 | 22.00 | 34.00 |
| RULER@1M | 86.34 | 77.50 | - |
推理吞吐量
- 比 Qwen3-30B-A3B-Thinking-2507 快 3.3 倍
- 比 GPT-OSS-20B 快 2.2 倍
- 在 H200 GPU 上測量(8K 輸入/16K 輸出)
6. 結論
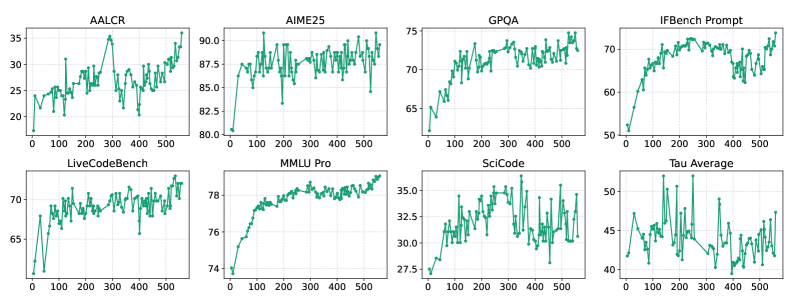
Nemotron 3 Nano 證明了 MoE 混合 Mamba-Transformer 架構在激活 <10% 參數的同時能維持競爭力準確率。關鍵創新包括多環境同時 RL 訓練(防止 benchmark 退化)、群組相對長度控制(防止回應膨脹)、課程學習策略(穩定多領域訓練)。
開源發布:模型權重(BF16 和 FP8)、NeMo-Gym/NeMo-RL 框架、預訓練資料集、SFT/RL 資料集合、生成式獎勵模型。
限制:多語言能力不如 Qwen3(MMLU-ProX:59.50 vs. 77.60)、部分智能體 benchmark 改善幅度有限、FP8 量化在某些推理任務上有微小準確率退化。
參考文獻
Gu, A. and Dao, T. Mamba: Linear-Time Sequence Modeling with Selective State Spaces, 2023.
Dao, T. and Gu, A. Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. ICML, 2024.
Fedus, W., Zoph, B., and Shazeer, N. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. JMLR, 2022.
Shazeer, N. Fast Transformer Decoding: One Write-Head is All You Need, 2019.
DeepSeek-AI. DeepSeek-V3 Technical Report, 2024.
Yu, Q., et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale, 2025.
Shao, Z., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning with GRPO, 2024.
Ouyang, L., et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS, 2022.
Yang, A., et al. Qwen3 Technical Report, 2025.
Jain, N., et al. LiveCodeBench: Holistic and Contamination Free Evaluation of LLMs for Code, 2024.
Jimenez, C.E., et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR, 2024.
Hsieh, C., et al. RULER: What's the Real Context Size of Your Long-Context Language Models?, 2024.
NVIDIA. NeMo-Gym: Multi-Environment RL Training Framework, 2025.
NVIDIA. NeMo-RL: Scalable RL Training with Megatron-Core Integration, 2025.
術語對照表
| 英文 | 中文 |
|---|---|
| Mixture-of-Experts (MoE) | 混合專家 |
| Mamba | Mamba(選擇性狀態空間模型) |
| Hybrid Architecture | 混合架構 |
| Grouped-Query-Attention (GQA) | 分組查詢注意力 |
| Routable Expert | 可路由專家 |
| Activated Parameters | 激活參數 |
| Curriculum Learning | 課程學習 |
| Multi-Environment RL | 多環境強化學習 |
| RLVR (RL from Verifiable Rewards) | 可驗證獎勵的強化學習 |
| RLHF (RL from Human Feedback) | 人類回饋強化學習 |
| Generative Reward Model (GenRM) | 生成式獎勵模型 |
| Length-Normalized Reward | 長度正規化獎勵 |
| Quality-Gated Conciseness Bonus | 品質閘控簡潔獎勵 |
| Circular Comparison | 環形比較 |
| Post-Training Quantization | 後訓練量化 |
| Sequence Packing | 序列打包 |
| Aux-Loss-Free Load Balancing | 無輔助損失的負載均衡 |
| Warmup-Stable-Decay | 預熱-穩定-衰減 |
| Agentic Reasoning | 智能體推理 |
| Tool-Integrated Reasoning | 工具整合推理 |