自蒸餾實現持續學習
原始論文:Self-Distillation Enables Continual Learning 作者:Idan Shenfeld, Mehul Damani, Jonas Hübotter, Pulkit Agrawal arXiv ID:2601.19897v1 日期:2025-01-31 標籤:LLM Continual Learning Knowledge Distillation On-Policy Learning Inverse RL 災難性遺忘
1. 引言
基礎模型在部署後是靜態的。雖然可以透過檢索或提示在推理時調整行為,但它們不會更新參數來獲取新技能、吸收新知識或從經驗中改進。要實現下一代基礎模型,我們需要解決持續學習 (continual learning) 問題:讓 AI 系統像人類一樣,隨時間不斷累積知識和精進技能。
近期研究指出,同策略學習 (on-policy learning) 對持續學習至關重要。當模型從自身當前策略生成的資料中學習時,災難性遺忘 (catastrophic forgetting) 會大幅減輕。但目前成功的同策略方法都依賴顯式獎勵函數的強化學習 (RL)。在許多現實場景中,獎勵不可得或難以定義,只有專家示範 (demonstrations) 可用。而主流的示範學習方法 SFT 本質上是離策略 (off-policy) 的,先前研究已證明連續 SFT 會導致嚴重的災難性遺忘。
這就產生了一個核心問題:當只有示範可用時,如何獲得同策略學習的好處?
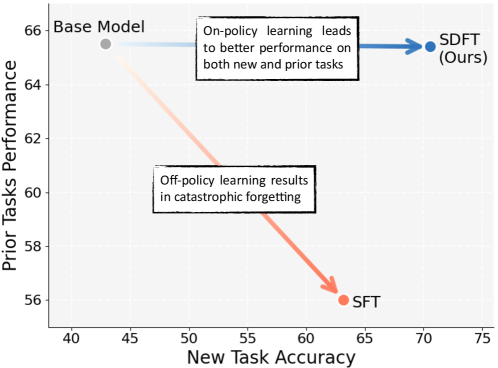
逆向強化學習 (Inverse RL, IRL) 可以先從示範中推斷獎勵函數再做 on-policy RL,但實務上需要很強的結構性假設,限制了應用。
本文提出 自蒸餾微調 (Self-Distillation Fine-Tuning, SDFT),一個從示範直接進行同策略蒸餾學習的框架。核心觀察是:大型預訓練模型具有強大的上下文學習 (In-Context Learning, ICL) 能力。SDFT 利用同一個模型扮演兩個角色:
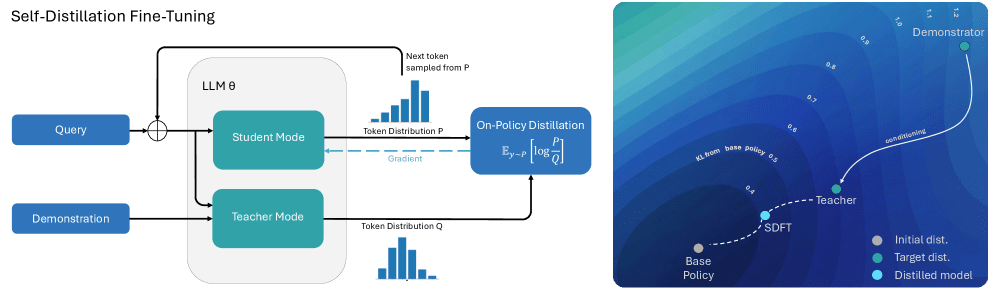
- 教師:同時以任務輸入和專家示範為條件,$\pi(\cdot \mid x, c)$
- 學生:只以任務輸入為條件,$\pi_\theta(\cdot \mid x)$
在學生自身生成的軌跡上,將教師的預測蒸餾到學生中。這產生了同策略更新,從示範中提取資訊,不需要顯式獎勵推斷或離線模仿。
2. 相關工作
離策略 vs. 同策略學習
Ross et al. (2011) 的經典結果表明,離策略模仿學習在推理時會累積複合誤差 (compounding errors):學到的策略偏離示範覆蓋的狀態,誤差急速放大。近期實證研究進一步強化了這一區分:on-policy RL 訓練的模型比純離策略訓練的模型有更好的泛化和遷移能力,在持續學習設定中也更少遺忘。
逆向強化學習
IRL 不直接模仿專家行為,而是推斷讓示範最優的底層獎勵函數。Maximum-entropy IRL 假設專家遵循 soft-optimal Boltzmann 策略;對抗式 IRL 假設專家和學習者軌跡可被分類器區分;基於偏好的 IRL(如 RLHF)假設有正-負示範對。這些方法都需要強先驗假設。SDFT 的做法是利用模型自身的上下文學習能力,不做顯式獎勵推斷。
上下文蒸餾 (Context Distillation)
SDFT 與上下文蒸餾相關但有兩個關鍵差異:(1) SDFT 是同策略的,學生在自身誘導的軌跡分佈上訓練,教師可以即時修正錯誤;(2) 提供給教師的上下文不是固定的 prompt prefix,而是針對每個查詢動態選擇的示範。這讓上下文蒸餾不只是 prompt 壓縮,而是一種類 IRL 機制。
3. 自蒸餾微調 (SDFT)
SDFT 建立在學生-教師蒸餾框架上。關鍵創新是同一個模型同時做教師和學生:教師透過條件化示範來構造 $\pi(\cdot \mid x, c)$,學生是不帶示範的基礎模型 $\pi_\theta(\cdot \mid x)$。
教師的 prompt 構造方式:
<問題>
以下是此問題的回應範例:
<示範>
現在請用你自己的方式回答,包含思考過程:
這種 prompt 足以防止模型照搬示範 $c$,而是引發模型基於示範意圖生成自己的回應。
對每個 prompt $x$,SDFT 從學生策略採樣回應 $y \sim \pi_\theta(\cdot \mid x)$,並最小化學生與教師分佈之間的逆向 KL 散度:
$$\mathcal{L}(\theta) = D_{\text{KL}}\left(\pi_\theta(\cdot \mid x) \| \pi(\cdot \mid x, c)\right) = \mathbb{E}_{y \sim \pi_\theta(y \mid x)}\left[\log \frac{\pi_\theta(y \mid x)}{\pi(y \mid x, c)}\right]$$
利用模型的自迴歸結構,分解為 token-level 損失,梯度為:
$$\nabla_\theta \mathcal{L}(\theta) = \mathbb{E}_{y \sim \pi_\theta}\left[\sum_t \sum_{y_t \in \mathcal{V}} \log \frac{\pi_\theta(y_t \mid y_{<t}, x)}{\pi(y_t \mid y_{<t}, x, c)} \nabla_\theta \log \pi_\theta(y_t \mid y_{<t}, x)\right]$$
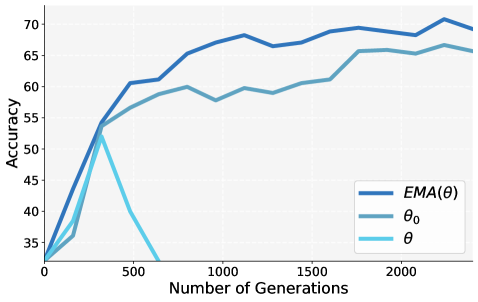
教師權重使用學生參數的指數移動平均 (EMA)。
3.1 自蒸餾即逆向強化學習
雖然 SDFT 從蒸餾角度呈現,但它在數學上等價於最大化一個隱式獎勵函數。
從信賴域正則化 RL 出發,第 $k+1$ 步的策略更新為:
$$\pi_{k+1} = \arg\max_\pi \mathbb{E}_{y \sim \pi}[r(y, x)] - \beta \, D_{\text{KL}}(\pi(\cdot \mid x) \| \pi_k(\cdot \mid x))$$
最優策略的閉合解為 tilted distribution:
$$\pi_{k+1}^*(y \mid x) \propto \pi_k(y \mid x) \exp\left(\frac{1}{\beta} r(y, x)\right)$$
重排後可得獎勵為策略散度的函數:
$$r(y, x) = \beta\left[\log \pi_{k+1}^*(y \mid x) - \log \pi_k(y \mid x)\right] + C$$
上下文學習 (ICL) 假設:給定示範 $c$,模型條件化在 $c$ 上近似最優的下一步策略:
$$\pi_{k+1}^*(y \mid x) \approx \pi(y \mid x, c)$$
代入得到內在獎勵函數 (intrinsic reward):
$$r(y, x, c) = \log \pi(y \mid x, c) - \log \pi_k(y \mid x)$$
分解為 token-level 獎勵:
$$r_t(y_t \mid y_{<t}, x, c) = \log \frac{\pi(y_t \mid y_{<t}, x, c)}{\pi_k(y_t \mid y_{<t}, x)}$$
用此獎勵做策略梯度,可以證明與逆向 KL 蒸餾的梯度在期望下等價。因此 SDFT 可視為一個 on-policy RL 演算法,最大化由學生當前行為與「更聰明的」示範感知版本之間差異所定義的獎勵。
3.2 驗證上下文學習假設
ICL 假設的有效性取決於兩個條件:
1. 最優性 (Optimality):教師的期望獎勵必須接近未知最優策略:
$$\mathbb{E}_{y \sim \pi(y \mid x, c)}[r(y, x)] \approx \mathbb{E}_{y \sim \pi_{k+1}^*}[r(y, x)]$$
2. 最小偏離 (Minimal Deviation):教師在 KL 意義下應接近當前策略:
$$D_{\text{KL}}(\pi(\cdot \mid x, c) \| \pi_k(\cdot \mid x)) \approx D_{\text{KL}}(\pi_{k+1}^*(\cdot \mid x) \| \pi_k(\cdot \mid x))$$
第二個條件至關重要。如果教師只是逐字抄襲示範,它會大幅偏離基礎模型,喪失 on-policy 學習的好處。教師的價值在於產生新的、任務適切的行為,同時保持錨定在基礎模型附近。
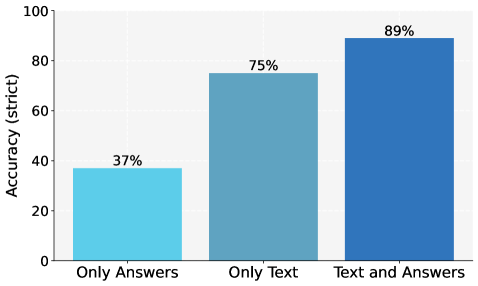
實驗驗證:以 Qwen-2.5-7B-Instruct 為基礎策略,在 ToolAlpaca 資料集上驗證。基礎模型只解決 42% 的例子,但示範條件化的教師達到 100% 成功率。人工檢查 50 條教師推理軌跡,所有情況下推理過程都正確且語義合理。量化 KL 散度:SFT 模型偏離基礎模型 1.26 nats,而教師僅偏離 0.68 nats,幾乎是一半。
4. 實驗
4.1 技能學習
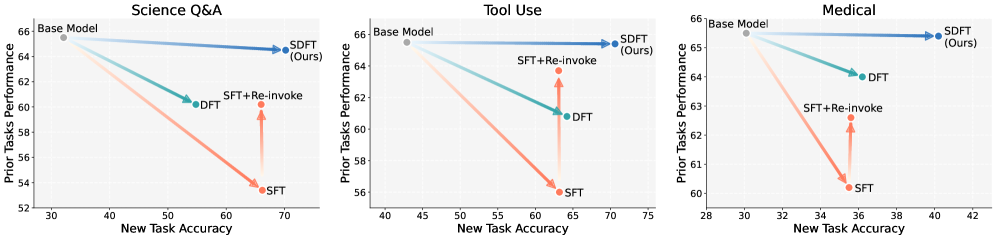
在三個技能學習任務上評估(基礎模型:Qwen2.5-7B-Instruct):
Science Q&A(化學問答):
| 方法 | 化學 Q&A | HellaSwag | HumanEval | IFEval | MMLU | TruthfulQA | Winogrande | 先驗平均 |
|---|---|---|---|---|---|---|---|---|
| Base | 32.1 | 62.0 | 65.8 | 74.3 | 71.7 | 47.9 | 71.1 | 65.5 |
| SFT | 66.2 | 55.0 | 54.8 | 35.3 | 64.6 | 36.8 | 73.7 | 53.4 |
| SFT + re-invoke | 66.0 | 61.6 | 63.4 | 52.9 | 68.7 | 45.2 | 70.0 | 60.2 |
| DFT | 54.8 | 57.6 | 67.0 | 60.4 | 69.4 | 38.8 | 68.2 | 60.2 |
| SDFT | 70.2 | 60.9 | 68.9 | 66.8 | 70.7 | 46.5 | 73.1 | 64.5 |
Tool Use(工具使用):
| 方法 | 工具使用 | HellaSwag | HumanEval | IFEval | MMLU | TruthfulQA | Winogrande | 先驗平均 |
|---|---|---|---|---|---|---|---|---|
| Base | 42.9 | 62.0 | 65.8 | 74.3 | 71.7 | 47.9 | 71.1 | 65.5 |
| SFT | 63.2 | 57.3 | 50.0 | 49.8 | 70.2 | 37.5 | 73.1 | 56.0 |
| SFT + re-invoke | 63.1 | 61.7 | 68.9 | 59.1 | 71.5 | 49.1 | 71.6 | 63.7 |
| DFT | 64.2 | 59.7 | 61.4 | 60.2 | 71.6 | 40.2 | 71.5 | 60.8 |
| SDFT | 70.6 | 61.6 | 68.3 | 71.9 | 71.5 | 47.3 | 71.7 | 65.4 |
Medical(醫學推理):
| 方法 | 醫學 | HellaSwag | HumanEval | IFEval | MMLU | TruthfulQA | Winogrande | 先驗平均 |
|---|---|---|---|---|---|---|---|---|
| Base | 30.1 | 62.0 | 65.8 | 74.3 | 71.7 | 47.9 | 71.1 | 65.5 |
| SFT | 35.5 | 59.5 | 62.1 | 56.6 | 70.5 | 39.8 | 72.9 | 60.2 |
| SFT + re-invoke | 35.6 | 61.5 | 63.1 | 67.6 | 70.0 | 42.3 | 71.4 | 62.6 |
| DFT | 36.2 | 61.9 | 64.6 | 74.6 | 71.6 | 40.1 | 71.3 | 64.0 |
| SDFT | 40.2 | 61.4 | 67.7 | 72.3 | 71.5 | 47.3 | 71.9 | 65.4 |
核心觀察:
- SDFT 在所有新任務上都比 SFT 高 4-7 個百分點
- 更關鍵的是,SDFT 幾乎完全保留了先驗能力(平均 64.5-65.4 vs. 基線 65.5),而 SFT 的先驗能力嚴重退化(53.4-60.2)
- IFEval(指令遵循)是 SFT 退化最嚴重的,從 74.3% 暴跌到 35.3%,而 SDFT 只降到 66.8%
4.2 知識獲取
用 2025 年自然災害的 Wikipedia 文章(~200K tokens)作為新知識,生成約 5 倍的 Q&A 對。
| 方法 | 嚴格準確率 | 寬鬆準確率 | OOD 準確率 |
|---|---|---|---|
| Base | 0 | 0 | 0 |
| Oracle RAG | 91 | 100 | 100 |
| CPT | 9 | 37 | 7 |
| SFT | 80 | 95 | 80 |
| SDFT | 89 | 100 | 98 |
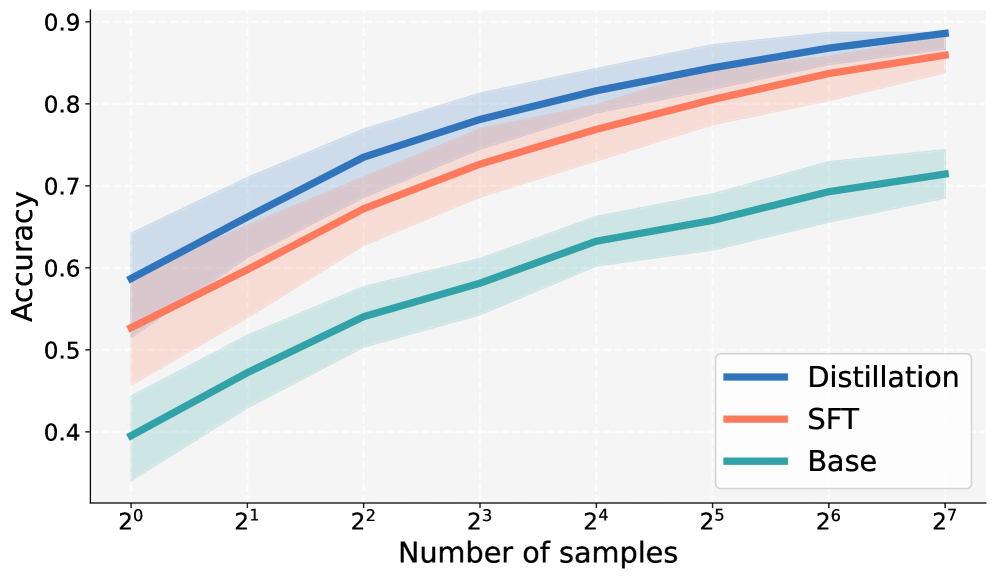
SDFT 接近完美的 Oracle RAG,且在分佈外 (OOD) 泛化上遠超 SFT(98% vs. 80%)。
4.3 推理模型
在推理模型 Olmo-3-7B-Think 上測試,只用化學任務的示範(不含推理過程):
| 模型 | 準確率 | 平均 token 數 |
|---|---|---|
| Olmo-3-7B-Think | 31.2 | 4612 |
| + SFT | 23.5 | 3273 |
| + SDFT | 43.7 | 4180 |
SFT 不僅沒提升反而降低了準確率(31.2% → 23.5%),且破壞了推理模式(回應長度大幅縮短)。SDFT 則顯著提升(31.2% → 43.7%),同時保留了推理行為。這說明 SDFT 可以在沒有顯式推理監督的情況下訓練推理模型。
4.4 連續多任務學習
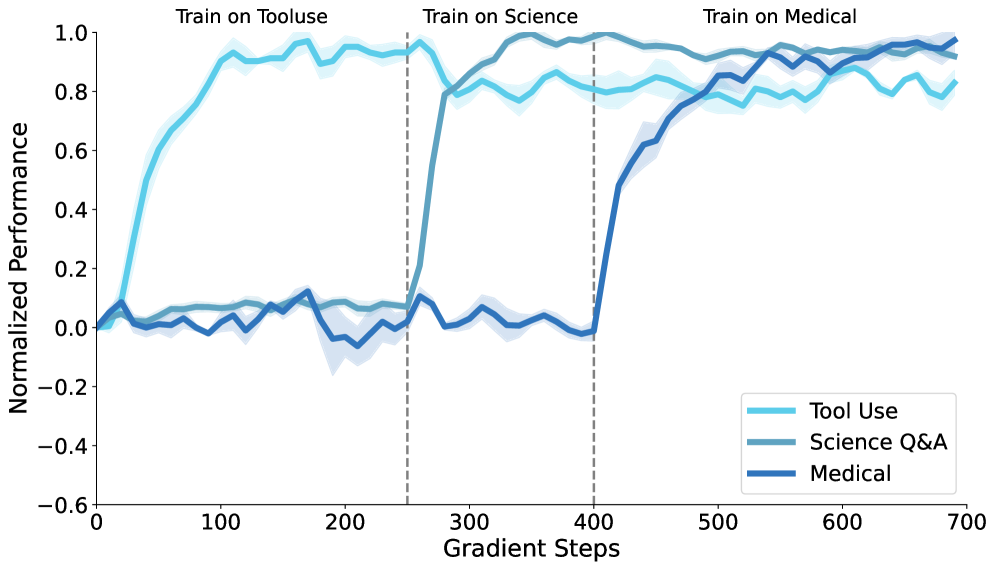
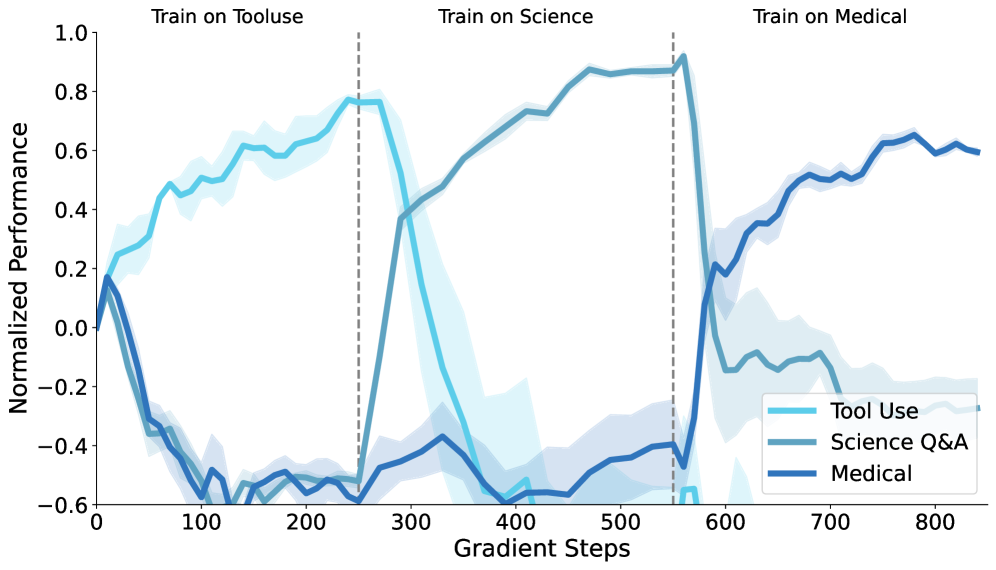
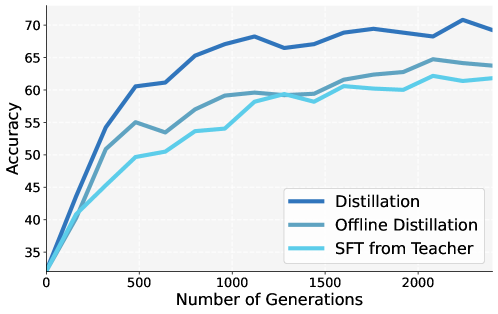
依序學習三個技能(Science Q&A → Tool Use → Medical),觀察持續學習效果。SDFT 使單一模型能依序獲取每個技能,同時保留先前學到的技能和預存能力。SFT 則表現出嚴重的任務干擾:學了新技能就忘了舊技能。
4.5 縮放行為
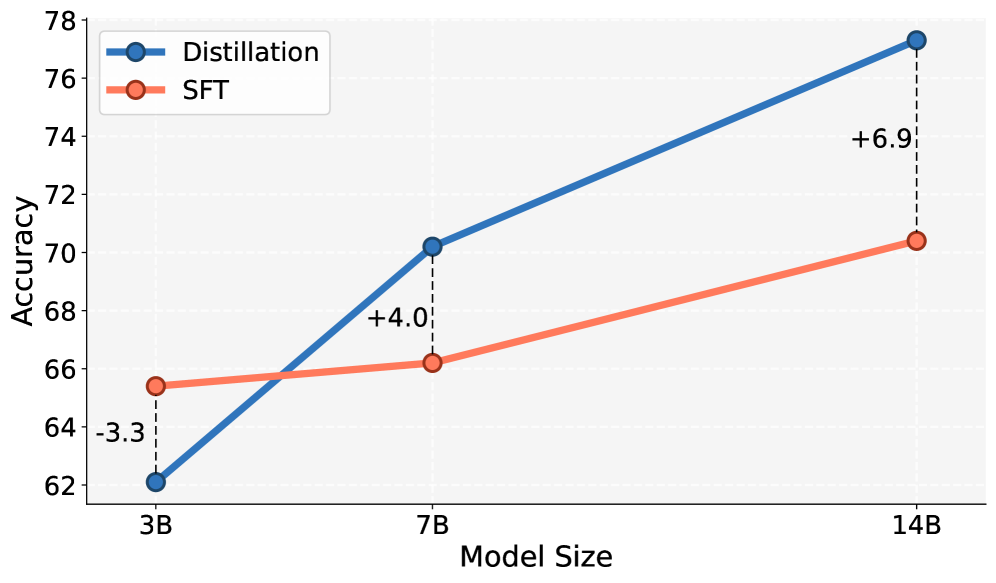
在 Qwen2.5 系列(3B、7B、14B)上測試。SDFT 的效能提升隨模型規模單調增長,與上下文學習能力正相關。3B 模型的上下文學習能力不足,SDFT 反而表現不佳。這符合理論預期:ICL 假設在上下文學習能力強的大模型上更成立。
5. 結論
SDFT 是一個利用模型自身上下文學習能力,從示範進行同策略學習的框架。它在數學上等價於隱式逆向強化學習,在技能學習和知識獲取任務上都顯著優於 SFT,且大幅減少災難性遺忘。
限制:
- 計算成本約為 SFT 的 2.5 倍 FLOP、4 倍牆鐘時間(需要生成 on-policy rollout)
- 需要模型具備強大的上下文學習能力(3B 以下效果不好)
- 學生可能繼承教師輸出中的虛假語言模式
- 對根本性行為轉變(如非推理→推理模式)效果有限
參考文獻
Ross, S., Gordon, G.J., and Bagnell, D. A reduction of imitation learning and structured prediction to no-regret online learning. AISTATS, 2011.
Agarwal, R., et al. On-policy distillation of language models: Learning from self-generated mistakes. ICLR, 2024.
Rafailov, R., et al. Direct preference optimization: Your language model is secretly a reward model. NeurIPS, 2023.
Schulman, J., et al. Proximal policy optimization algorithms, 2017.
Brown, T.B., et al. Language models are few-shot learners. NeurIPS, 2020.
Ng, A.Y. and Russell, S. Algorithms for inverse reinforcement learning. ICML, 2000.
Ziebart, B.D., et al. Maximum entropy inverse reinforcement learning. AAAI, 2008.
Ouyang, L., et al. Training language models to follow instructions with human feedback. NeurIPS, 2022.
Hinton, G., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. NIPS Deep Learning Workshop, 2015.
Kirkpatrick, J., et al. Overcoming catastrophic forgetting in neural networks. PNAS, 2017.
De Lange, M., et al. A continual learning survey: Defying forgetting in classification tasks. IEEE TPAMI, 2022.
Snell, C., et al. Scaling LLM test-time compute optimally can be more effective than scaling model parameters. ICML, 2024.
Stiennon, N., et al. Learning to summarize with human feedback. NeurIPS, 2020.
Ho, J. and Ermon, S. Generative adversarial imitation learning. NeurIPS, 2016.
Hendrycks, D., et al. Measuring massive multitask language understanding. ICLR, 2021.
Hui, B., et al. Qwen2.5 technical report, 2024.
術語對照表
| 英文 | 中文 |
|---|---|
| Self-Distillation Fine-Tuning (SDFT) | 自蒸餾微調 |
| Continual Learning | 持續學習 |
| Catastrophic Forgetting | 災難性遺忘 |
| On-Policy Learning | 同策略學習 |
| Off-Policy Learning | 離策略學習 |
| In-Context Learning (ICL) | 上下文學習 |
| Inverse Reinforcement Learning (IRL) | 逆向強化學習 |
| Knowledge Distillation | 知識蒸餾 |
| Context Distillation | 上下文蒸餾 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Reverse KL Divergence | 逆向 KL 散度 |
| Trust Region | 信賴域 |
| Exponential Moving Average (EMA) | 指數移動平均 |
| Compounding Errors | 複合誤差 |
| Intrinsic Reward | 內在獎勵 |
| Tilted Distribution | 傾斜分佈 |
| Demonstration | 示範 |
| Rollout | 展開(策略採樣) |
| Skill Learning | 技能學習 |
| Knowledge Acquisition | 知識獲取 |