MeMo:記憶即模型
原始論文:MeMo: Memory as a Model 作者:Ryan Wei Heng Quek, Sanghyuk Lee, Alfred Wei Lun Leong, Arun Verma, Alok Prakash, Nancy F. Chen, Bryan Kian Hsiang Low, Daniela Rus, Armando Solar-Lezama arXiv ID:2605.15156v2 日期:2026-05-20(v2) 標籤:LLM Knowledge Integration Memory RAG Model Merging 知識整合 黑盒模型
摘要
大型語言模型 (Large Language Models, LLMs) 在各式各樣的任務上都展現出強大的效能,但在預訓練之後直到後續更新之前,它們實際上都處於凍結 (frozen) 狀態。許多真實世界的應用需要即時、領域特定的資訊,這促使我們需要有效的機制來整合新知識。本文中,我們提出 MeMo(記憶即模型,Memory as a Model),一個模組化框架,它將新知識編碼進一個專用的記憶模型 (Memory model),同時讓 LLM 的參數保持不變。相較於既有方法,MeMo 提供了數項優勢:
- (a) 它能捕捉複雜的跨文件 (cross-document) 關係;
- (b) 它對檢索雜訊 (retrieval noise) 具有強健性 (robust);
- (c) 它避免了 LLM 中的災難性遺忘 (catastrophic forgetting);
- (d) 它不需要存取 LLM 的權重或輸出 logits,使其能與開源及專有的閉源 LLM 即插即用 (plug-and-play) 地整合;
- (e) 在推論時,它的檢索成本與語料庫 (corpus) 大小無關。
我們在三個基準測試上的實驗結果——BrowseComp-Plus、NarrativeQA 與 MuSiQue——顯示 MeMo 在多樣化的情境下相較既有方法都達到了強勁的效能。
1 緒論
大型語言模型 (LLMs) 已在各種任務上展現出卓越的能力 (Kojima et al., 2023; Zhao et al., 2023; Jiang et al., 2026)。儘管成果斐然,這些模型在預訓練之後的相當長一段時間內實際上都處於凍結狀態 (Xu et al., 2024),直到後續更新為止,使其預訓練的知識隨著世界的演變而日益過時。對於那些需要最新 (Cheng et al., 2024; Kasai et al., 2024) 或領域特定 (Singhal et al., 2022; Wu et al., 2023) 知識的應用而言,這種對靜態知識的依賴構成了一項根本性的架構限制 (Lewis et al., 2021; Kandpal et al., 2023)。重新訓練 (Retraining) 是一個自然的解法,但在現代規模下仍然昂貴得難以負擔 (Wu et al., 2022a),這促使我們需要一個有效的機制,在不進行完整重新訓練的情況下將新的外部知識整合進 LLM。
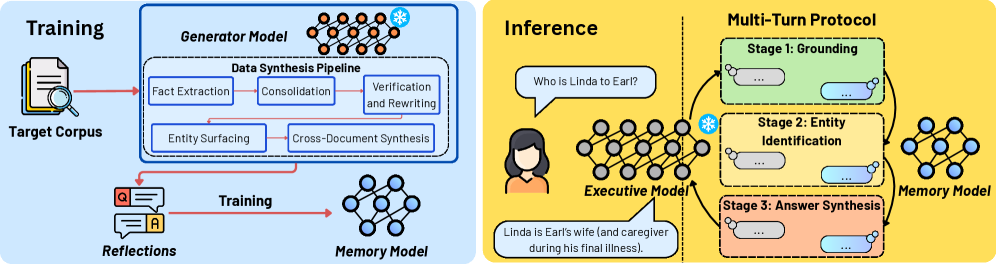
圖 1: MeMo 的訓練與推論流程概覽。在記憶模型訓練階段(左),一個凍結的生成器模型 (Generator model) 透過事實抽取 (fact extraction)、整併 (consolidation)、驗證 (verification)、實體浮現 (entity surfacing) 與跨文件合成 (cross-document synthesis),將目標語料庫轉換為一個反思 (reflection) QA 資料集,接著用它來訓練一個專用的記憶模型。在推論階段(右),凍結的執行模型 (Executive model) 透過一個結構化的多輪 (multi-turn) 協定來查詢記憶模型,藉此回答複雜的使用者查詢:它將輸入分解為更簡單、更有針對性的子查詢 (sub-queries),從記憶模型檢索中間回應,並對它們進行推理以產生對使用者查詢的最終答案。
既有將新知識整合進 LLM 的方法可分為三大類。
- 非參數化方法 (Non-parametric methods) 在推論時透過詞彙式 (lexical) (Robertson and Walker, 1994)、稠密式 (dense) (Lee et al., 2024) 或圖式 (graph-based) 檢索器 (Lewis et al., 2020; Edge et al., 2024; Gutiérrez et al., 2024, 2025) 從外部儲存中檢索相關資訊,再透過上下文學習 (in-context learning) (Brown et al., 2020; Dong et al., 2024) 將其納入。然而,這些方法受限於有限的上下文視窗 (context window),當相關資訊分散於多份文件時,難以綜合跨文件關係 (Tang and Yang, 2024; Lin et al., 2025)。
- 參數化方法 (Parametric methods) 透過直接在目標語料庫上進行持續預訓練 (continual pretraining) (Ke et al., 2023) 或微調 (fine-tuning) (Ouyang et al., 2022; Wang et al., 2023; Chung et al., 2024),將知識直接內化進模型參數中。雖然有效,但它們計算成本高昂、容易發生災難性遺忘 (Luo et al., 2025),並且傾向於記憶訓練分布而非習得可遷移的知識,限制了對未見查詢的泛化能力 (Chu et al., 2025)。
- 潛在記憶方法 (Latent memory methods) (Chevalier et al., 2023; Mu et al., 2023; Ge et al., 2024; Zhang et al., 2026a) 將知識壓縮成軟標記 (soft tokens) 或其他模型特定的表徵,但會受到表徵耦合 (representation coupling) 之苦:記憶與用來產生這些表徵的特定模型緊密綁定,限制了跨 LLM 的可遷移性。
我們提出 MeMo(記憶即模型),一個模組化框架,其中一個專用的記憶模型在新知識上訓練,而執行模型在推論時透過有針對性的子查詢從記憶模型檢索相關資訊,接著對檢索到的資訊進行推理以回應使用者查詢。MeMo 結合了上述三種範式的互補優勢,同時緩解了它們各自的限制。如同非參數化方法,它能透過將記憶與推理模型分離來原封不動地利用現成的前沿模型;它與參數化方法共享將知識內化進模型參數的能力;它也與潛在記憶方法共享一個精簡、可查詢的記憶產物的好處。因此,MeMo 提供以下優勢:(a) 它能捕捉複雜的跨文件關係,(b) 它對檢索雜訊具有強健性,(c) 它透過保持執行模型參數不變來避免災難性遺忘,(d) 它不需要存取執行模型的權重或輸出 logits,使其能與開源及專有 LLM 即插即用地整合,以及 (e) 由於記憶模型的大小固定,其檢索成本在推論時與語料庫大小無關。然而,要設計 MeMo 使其在訓練時全面捕捉跨文件關係,同時在推論時準確回答任意查詢,引入了兩項關鍵挑戰,我們在下面概述並以新方法加以解決。
1⃝ 訓練記憶模型。 記憶模型的一個核心挑戰是確保它能在推論時準確回答多樣的、未見過的查詢,包括那些需要跨文件推理與長上下文理解的查詢。一個自然的做法是使用標準的資料增強 (data augmentation) 技術(例如改寫 (paraphrasing) (Li et al., 2022; Chen et al., 2023; Allen-Zhu and Li, 2024)、額外取樣所生成的 QA 對 (Alberti et al., 2019; Puri et al., 2020),或有針對性的填補空缺 (gap-filling),亦即模型辨識並補齊語料庫中缺失的知識 (Feng et al., 2024; Jie et al., 2024))直接在原始語料庫上訓練。然而,這些做法無法將相關事實整併成穩健泛化至未見查詢所必需的組合式 (compositional) 表徵 (Chu et al., 2025)。考量到這項挑戰,我們設計了一個由生成器模型引導的新穎五步驟資料合成 (data synthesis) 流程(第 4.1 節),它將語料庫蒸餾 (distill) 成一個由反思組成的問答 (QA) 資料集:反思是揭露底層語料庫知識、並能在多樣查詢變體下展現出來的組合式表徵(如圖 1(左)所示,細節見第 4.1 節)。我們透過監督式微調 (supervised fine-tuning) 在合成的反思 QA 資料集上訓練記憶模型(見第 4.2 節),使記憶模型能夠捕捉比基於檢索的方法更複雜的跨文件關係與組合式結構。
2⃝ 查詢記憶模型。 在推論時,複雜或組合式的查詢往往需要跨多份文件進行多步推理與資訊聚合。若以單輪 (single-turn) 或無結構的多輪互動天真地查詢記憶模型,將無法可靠地檢索出回答這類查詢所需的知識。為此,我們設計了一個三階段推論流程,其中執行模型透過一個結構化的多輪協定來查詢並從記憶模型檢索資訊,將複雜的使用者查詢分解為與共享的反思介面 (reflection interface) 對齊的、有針對性的子查詢(如圖 1(右)所示,更多細節見第 4.4 節)。與基於檢索的方法不同,此做法所產生的檢索成本與語料庫大小無關,並且對檢索雜訊具有強健性(見第 5.2 節)。至關重要的是,由於 MeMo 將執行模型視為黑盒 (black box) 且不存取其權重、梯度或輸出 logits,它支援與任何 LLM 的即插即用整合,包括開源與專有閉源模型。
我們的方法由單一的設計原則所引導:反思——這些源自語料庫的結構不需要任何關於未來查詢的知識,卻能自然地充當精確的介面,讓任何查詢都能在從不直接觀察語料庫的情況下存取其底層內容。在訓練時,記憶模型內化這些反思;在推論時,執行模型透過有針對性的子查詢檢索相關知識。基於上述概述的挑戰以及為解決它們所提出的方法,我們將本文的主要貢獻總結如下:
- 新穎的資料合成流程。 我們提出一個五步驟的資料合成流程,使用一個生成器模型(一個可能與執行模型相同或更小的 LLM)將目標語料庫蒸餾成反思,使一個專用的記憶模型能以組合式形式內化知識,捕捉更複雜的跨文件關係,並在推論時穩健地泛化到多樣的、未見過的查詢變體(見第 4.1 與 4.2 節)。
- 結構化多輪協定。 我們引入一個結構化的多輪協定,系統性地將複雜查詢分解為與共享反思介面對齊的、有針對性的子查詢。此協定支援與任何任意 LLM(包括專有閉源 LLM)的即插即用整合,且其檢索成本與語料庫大小無關(見第 4.4 節)。
- 實證驗證。 我們在 BrowseComp-Plus、NarrativeQA 與 MuSiQue 上評估 MeMo,展示其相對於參數化與非參數化基線的強勁效能。我們進一步實證驗證 MeMo 對檢索雜訊的強健性(見第 5 節)。
2 相關工作
非參數化方法。 非參數化的替代方案 (Robertson and Walker, 1994; Lee et al., 2024; Gutiérrez et al., 2025) 完全避免參數更新,改為在推論時提供新知識。特別是上下文學習 (in-context learning, ICL) (Brown et al., 2020; Dong et al., 2024) 將相關知識直接插入提示 (prompt) 中,從而避免災難性遺忘。然而,ICL 隨著上下文長度增加而擴展性不佳:自迴歸生成 (autoregressive generation) (Vaswani et al., 2017) 的計算成本會隨著知識庫的增長導致大量的標記 (token) 額外開銷與推論延遲 (Gelada et al., 2025),而且即使是明確的長上下文模型,在上下文長度增加時也會展現出顯著的效能衰退 (Liu et al., 2024; Hsieh et al., 2024)。檢索增強生成 (Retrieval-augmented generation, RAG) (Lewis et al., 2020; Edge et al., 2024; Gutiérrez et al., 2024, 2025) 透過在推論時選擇性地檢索相關的知識區塊 (chunks) 來解決此擴展性瓶頸。然而,RAG 系統對檢索雜訊高度敏感 (Cuconasu et al., 2024),不相關或誤導性的段落會大幅降低生成品質 (Liu et al., 2026; Zhang et al., 2026b)。此外,RAG 系統往往難以對複雜的跨文件依賴關係進行推理 (Tang and Yang, 2024),因為它們缺乏綜合分散於多個區塊或大型語料庫中資訊的穩健機制 (Lin et al., 2025)。
參數化方法。 既有的後訓練 (post-training) 做法,例如在新語料庫上進行持續預訓練 (Ke et al., 2023; Sun et al., 2020) 或在精選的指令資料上進行監督式微調 (SFT) (Ouyang et al., 2022; Wang et al., 2023; Chung et al., 2024),試圖在後訓練期間將新知識納入 LLM 來解決此限制。雖然概念上直觀,這些參數化方法卻常常受災難性遺忘之苦,亦即對新觀察到的知識的適應會降低先前習得的知識、學到的能力 (Luo et al., 2025; Li and Hoiem, 2018; Harmon et al., 2025),以及 LLM 後訓練期間習得的安全對齊 (safety alignment) (Qi et al., 2024)。此外,現代 LLM 的規模使得頻繁的微調計算成本高昂 (Zhang et al., 2023; Xia et al., 2024),而且對於專有的閉源模型而言,微調往往不可行 (Manchanda et al., 2025),這大幅限制了參數化方法在真實世界、大規模應用中的實用性。
潛在記憶方法。 另一種儲存知識的做法是透過壓縮的潛在表徵,它介於非參數化檢索與完全參數化方法之間。脈絡壓縮 (context compression) 技術,例如 AutoCompressor (Chevalier et al., 2023)、Gist tokens (Mu et al., 2023) 與 ICAE (Ge et al., 2024),將知識編碼成精簡的軟標記並在推論時前置 (prepend),在不丟棄資訊的情況下降低 ICL 的標記開銷。然而,這些表徵與編碼器緊密耦合,無法被其他模型家族 (model families) 消化,限制了與黑盒 LLM 的相容性。類似地,循環狀態模型 (recurrent-state models) (Gu and Dao, 2023; Sun et al., 2023) 與最近鄰記憶方法(例如 Memorizing Transformers (Wu et al., 2022b) 與 $k$NN-LM (Khandelwal et al., 2020))依賴模型特定的表徵或架構,無法在預訓練 LLM 上事後 (post hoc) 使用。雖然 Memory Decoder (Cao et al., 2025a) 是一個即插即用的預訓練記憶模組,無需修改模型參數即可整合,但它僅限於共享同一分詞器 (tokenizer) 的架構,因而只能在此子集內重複使用。這些方法的核心限制是表徵耦合:潛在記憶與產生它的模型密不可分。相對地,MeMo 允許與任何 LLM(包括閉源模型)的即插即用整合。
表 1: 不同記憶範式之間理想特性的比較,顯示 MeMo 透過其模組化的記憶建構與記憶增強的推理同時滿足了這些特性。
| 方法 | 凍結基礎 LLM | 無檢索索引 | 黑盒相容 | 無災難性遺忘 | 固定大小記憶 | 跨 LLM 可遷移 |
|---|---|---|---|---|---|---|
| 非參數化 (RAG, ICL) | ✓ | ✗ | ✓ | ✓ | ✗ | ✓¹ |
| 參數化 (CPT, SFT) | ✗ | ✓ | ✗ | ✗ | ✓ | ✗ |
| 潛在記憶 (AutoCompressor, Gist, ICAE) | ✓ | ✓ | ✗ | ✓ | ✗ | ✗ |
| MeMo(本文) | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
¹ 我們假設 RAG 使用一個與執行模型解耦、固定且任務無關的嵌入 (embedding) 模型,使檢索索引能跨模型重複使用。對於 ICL,我們假設提示是基於原始文字、不含模型特定格式的。
3 預備知識
問題設定。 令 $\mathcal{M}_{\theta}$ 表示一個具凍結參數 $\theta\in\mathbb{R}^{p}$ 的大型語言模型,預訓練於語料庫 $\mathcal{D}_{\text{pre}}$ 之上。我們將 $\mathcal{M}_{\theta}$ 視為一個條件分布,它將提示 $x$ 映射到回應 $\mathcal{M}_{\theta}(x)$,並假設僅有黑盒存取權;特別地,$\mathcal{M}_{\theta}$ 可以是白盒 (white-box) 模型,也可以是透過 API 存取的閉源模型。令 $\mathcal{D}=\{d_{1},\ldots,d_{N}\}$ 表示一個包含 $N$ 份文件的目標語料庫,其中含有 $\mathcal{M}_{\theta}$ 無法可靠回想起的知識²。令 $\mathcal{Q}$ 為一組查詢,每個 $q\in\mathcal{Q}$ 都關聯到一個真實答案 (ground-truth answer) $a^{\star}(q)$ 與一組支持文件 (supporting documents) $\mathcal{S}(q)\subseteq\mathcal{D}$。注意 $\mathcal{S}(q)$ 是一個用來刻畫查詢複雜度的理論構造。
² 我們不假設 $\mathcal{D}$ 與 $\mathcal{D}_{\text{pre}}$ 互斥,因為模型提供者鮮少揭露訓練資料。若模型無法回答以某份文件為基礎的問題(無論是因為它從未出現在 $\mathcal{D}_{\text{pre}}$,或是訓練過程不足以保留它),則該文件被視為實際上不存在於 $\mathcal{M}_{\theta}$ 的知識中。更多資訊見附錄 I。
知識整合機制。 一個知識整合機制是一對 $(\Phi,f)$,其中 $\Phi$ 將語料庫映射到一個表徵 $\mathcal{K}\doteq\Phi(\mathcal{D})$,而 $f$ 在推論時將 $\mathcal{K}$ 與 $\mathcal{M}_{\theta}$ 結合以產生回應 $f(\mathcal{M}_{\theta},\mathcal{K},q)$。我們將目標形式化如下。
定義 1(知識整合問題)。 給定一個凍結模型 $\mathcal{M}_{\theta}$ 與一個目標語料庫 $\mathcal{D}$,在不修改 $\theta$ 的情況下,找出一個機制 $(\Phi,f)$ 使 $$\mathbb{E}_{q\sim\mathcal{Q}}\bigl[\mathbb{P}\left\{f(\mathcal{M}_{\theta},\Phi(\mathcal{D}),q)=a^{\star}(q)\right\}\bigr]$$ 最大化。
既有做法。 既有方法在 $(\Phi,f)$ 的選擇上各有不同。ICL 設定 $\mathcal{K}=\mathcal{D}$ 且 $f(\mathcal{M}_{\theta},\mathcal{K},q)=\mathcal{M}_{\theta}([\mathcal{D};q])$,亦即直接將語料庫附加到提示中。RAG 將 $\mathcal{K}$ 建構為一個檢索索引,並定義 $f$ 在將 $[\hat{\mathcal{S}};q]$ 傳給 $\mathcal{M}_{\theta}$ 之前先檢索一個子集 $\hat{\mathcal{S}}\subseteq\mathcal{D}$。微調設定 $\mathcal{K}=\emptyset$ 且 $f=\mathcal{M}_{\theta^{\prime}}$,其中 $\theta^{\prime}$ 是透過在 $\mathcal{D}$ 上更新 $\theta$ 得到的。相對地,MeMo 將 $\mathcal{K}$ 定義為一個小型專用記憶模型 $\mathcal{M}_{\varphi}$($\varphi\ll\theta$)的參數,該模型訓練於從 $\mathcal{D}$ 衍生的反思 QA 資料集上,並在推論時由一個凍結的執行模型 $\mathcal{M}_{\theta}$ 查詢。表 1 總結了這些範式在理想特性上的比較。
4 MeMo:記憶即模型
MeMo 透過兩個元件來解決知識整合問題(定義 1):一個凍結模型 $\mathcal{M}_{\theta}$(執行模型),負責推理並回應使用者查詢;以及一個記憶模型 $\mathcal{M}_{\varphi}$,訓練其從目標語料庫 $\mathcal{D}$ 將知識編碼進其參數中。我們的流程分為兩個階段運作:(i) 從 $\mathcal{D}$ 建構記憶模型的訓練階段,以及 (ii) 執行模型查詢並從記憶模型檢索資訊以回答知識密集型問題的推論階段(見第 4.1、4.2 與 4.4 節)。
4.1 資料合成流程
給定一個文件語料庫 $\mathcal{D}$,我們在資料生成過程中的目標是建構一個反思 QA 資料集 $\mathcal{Q}_{\text{final}}$,它同時捕捉單文件事實與跨文件關係。此過程由一個生成器模型 $\mathcal{M}_{\text{gen}}$ 驅動,並經過五個步驟(如演算法 1 所總結、圖 1 所示):(1) 從原始文件抽取事實,(2) 整併冗餘或重疊的資訊,(3) 驗證與重寫以確保正確性與清晰度,(4) 實體浮現以明確表示關鍵實體,以及 (5) 跨文件合成以整合跨語料庫的證據。重要的是,在任何步驟中都不會在生成的 QA 對裡嵌入文件識別碼或浮水印,以防止記憶模型在評估時利用捷徑訊號 (shortcut signals)。
演算法 1 從目標語料庫生成反思 QA 資料集的流程
輸入: 語料庫 $\mathcal{D}$、生成器 $\mathcal{M}_{\text{gen}}$、文件分組 $\mathcal{G}=\{G_{1},\ldots,G_{R}\}$($G_{i}\subseteq\mathcal{D}$)
- $\mathcal{Q}_{\text{final}}\leftarrow\emptyset$
- 對所有文件 $d\in\mathcal{D}$:
- $C\leftarrow\mathrm{Chunk}(d)$ ▷ 切分成區塊
- $\mathcal{Q}_{\text{ver}}^{d}\leftarrow\emptyset$
- 對所有區塊 $c\in C$:
- $\mathcal{Q}_{\text{dir}},\,\mathcal{Q}_{\text{indir}}\leftarrow\mathcal{M}_{\text{gen}}(c)$ ▷ 步驟 1:直接與間接抽取
- $\mathcal{Q}_{\text{raw}}\leftarrow\mathcal{Q}_{\text{dir}}\cup\mathcal{Q}_{\text{indir}}$ ▷ 步驟 2a:合併直接與間接
- $\mathcal{Q}_{\text{mrg}}\leftarrow\mathcal{M}_{\text{gen}}(\mathcal{Q}_{\text{raw}})$ ▷ 步驟 2b:整併相關的對
- $\mathcal{Q}_{\text{con}}\leftarrow\mathcal{Q}_{\text{raw}}\cup\mathcal{Q}_{\text{mrg}}$ ▷ 步驟 2c:完整合併集合
- $\mathcal{Q}_{\text{ver}}\leftarrow\mathcal{M}_{\text{gen}}(\mathcal{Q}_{\text{con}},\,c)$ ▷ 步驟 3:驗證自我完備性;重寫或丟棄
- $\mathcal{Q}_{\text{ver}}^{d}\leftarrow\mathcal{Q}_{\text{ver}}^{d}\cup\,\mathcal{Q}_{\text{ver}}$
- 結束迴圈
- $\mathcal{Q}_{\text{ent}}^{d}\leftarrow\mathcal{M}_{\text{gen}}(\mathcal{Q}_{\text{ver}}^{d})$ ▷ 步驟 4:實體浮現對
- $\mathcal{Q}_{\text{final}}\leftarrow\mathcal{Q}_{\text{final}}\cup\,\mathcal{Q}_{\text{ver}}^{d}\cup\mathcal{Q}_{\text{ent}}^{d}$
- 結束迴圈
- 對所有 $G_{i}\in\mathcal{G}$:
- $\mathcal{Q}_{\text{cross}}\leftarrow\mathcal{M}_{\text{gen}}\!\Bigl(\bigcup_{d\in G_{i}}\bigl(\mathcal{Q}_{\text{ver}}^{d}\cup\mathcal{Q}_{\text{ent}}^{d}\bigr)\Bigr)$ ▷ 步驟 5:跨文件合成
- $\mathcal{Q}_{\text{final}}\leftarrow\mathcal{Q}_{\text{final}}\cup\,\mathcal{Q}_{\text{cross}}$
- 結束迴圈
- 回傳 $\mathcal{Q}_{\text{final}}$
步驟 1:事實抽取。 每份文件 $d\in\mathcal{D}$ 被切分成區塊 $C$,其中每個區塊對應於一整份文件或較長文件中的一段連續片段。對每個區塊,$\mathcal{M}_{\text{gen}}$ 執行兩個平行的抽取過程:直接抽取 (direct extraction),捕捉明確陳述的事實(產生 $\mathcal{Q}_{\text{dir}}$);以及間接抽取 (indirect extraction),針對超越表面文字的推斷或綜合資訊(產生 $\mathcal{Q}_{\text{indir}}$)。這種雙重抽取過程確保事實回想與推斷推理都能呈現在記憶模型的訓練訊號中。
步驟 2:整併。 生成器模型 $\mathcal{M}_{\text{gen}}$ 透過辨識共享某個共同底層脈絡(例如實體、時間段或關係類型)的 QA 對,並將它們組合成涵蓋多個事實的 QA 對(記為 $\mathcal{Q}_{\text{mrg}}$),來整併 $\mathcal{Q}_{\text{dir}}\cup\mathcal{Q}_{\text{indir}}$。此合併過程產生需要整合同一脈絡區塊中多個事實的訓練實例,超越了單一事實的問答對。合成的 QA 對隨後與原始集合統一,形成整併後的資料集 $\mathcal{Q}_{\text{con}}=\mathcal{Q}_{\text{dir}}\cup\mathcal{Q}_{\text{indir}}\cup\mathcal{Q}_{\text{mrg}}$。
步驟 3:驗證與重寫。 $\mathcal{Q}_{\text{con}}$ 中的每個 QA 對都由 $\mathcal{M}_{\text{gen}}$ 評估其自我完備性 (self-containment),亦即它是否能在不存取來源區塊的情況下被完整理解並正確回答。常見的失敗模式包括未解析的代名詞(例如「他們提出了什麼?」)與隱含的指涉(例如「如上表所述……」)。非自我完備的 QA 對由 $\mathcal{M}_{\text{gen}}$ 使用來源區塊 $C$ 作為脈絡加以重寫;重寫後仍然模稜兩可的 QA 對則被丟棄。此檢查並重寫的程序產出驗證集 $\mathcal{Q}_{\text{ver}}$,這是一組無需存取來源區塊就能作為訓練範例使用的 QA 對。
步驟 4:實體浮現。 對 $\mathcal{Q}_{\text{ver}}$ 中的每個命名實體 (named entity),$\mathcal{M}_{\text{gen}}$ 生成一組實體浮現 QA 對,其中問題編碼了該實體的屬性與關係(包括與其他命名實體的連結),而答案揭露其身分。在生成之前,每個實體的事實會跨區塊內所有 QA 對加以聚合,使得來自多個來源對的資訊得以整合與組合。問題以不同的複雜度層級生成,範圍從單一事實到多事實查詢。這些對(記為 $\mathcal{Q}_{\text{ent}}$)旨在透過訓練記憶模型從間接或部分指定的描述中推斷實體,來緩解反轉詛咒 (reversal curse) (Berglund et al., 2023; Allen-Zhu and Li, 2023)。此能力支援推論時的實體識別輪 (entity identification turn)(第 4.4 節)。
步驟 5:跨文件合成。 最後一個步驟在預先定義的文件分組 $\mathcal{G}=\{G_{1},\ldots,G_{R}\}$ 上運作,其中每個分組 $G_{i}$ 內的區塊在主題上相關。這類分組會自然產生,例如當一份大型文件被切分成區塊時(形成單一分組),或來自人工提供的標籤。對每個分組 $G_{i}$,$\mathcal{M}_{\text{gen}}$ 會獲得該組所有成員文件 $d\in G_{i}$ 的驗證對 $\mathcal{Q}_{\text{ver}}^{d}$ 與實體浮現對 $\mathcal{Q}_{\text{ent}}^{d}$,並辨識兩類跨文件連結:
- 匯聚線索 (Converging clues): 多份文件提供關於同一實體的互補事實,它們共同促成該實體的識別。
- 平行屬性 (Parallel properties): 跨文件的不同實體共享一個共同的屬性或角色,從而促成比較式與類比式推理。
這兩類都產出支持集大小 $\mathcal{S}(q)>1$(第 3 節)的 QA 對,直接針對跨文件合成目標。最終資料集為 $\mathcal{Q}_{\text{final}}=\mathcal{Q}_{\text{ver}}\cup\mathcal{Q}_{\text{ent}}\cup\mathcal{Q}_{\text{cross}}$,它共同捕捉了自我完備的、以實體為中心的、以及跨文件的反思,用於訓練記憶模型。流程設計的消融實驗 (ablations) 見附錄 E。
4.2 訓練記憶模型
給定 $\mathcal{Q}_{\text{final}}$,記憶模型透過監督式微調進行訓練,學習將問題直接映射到答案,在推論時無需存取來源文件。記憶模型從一個小型預訓練語言模型初始化,其規模遠小於執行模型(例如 1.5B 對 32B 參數),並透過最小化僅針對答案標記的下一標記預測損失 (next-token prediction loss) 來優化。
$$\mathcal{L}(\varphi)\;=\;-\!\!\!\sum_{(q_{i},\,a_{i})\,\in\,\mathcal{Q}_{\text{final}}}\;\;\sum_{t=1}^{|a_{i}|}\log\mathcal{M}_{\varphi}\!\left(a_{i}^{(t)}\;\middle|\;q_{i},\,a_{i}^{(1:t-1)}\right).$$
僅以問題與先前的答案標記為條件,而從不以來源文件為條件,這迫使記憶模型以參數化的方式內化知識,而非依賴從檢索到的脈絡中複製。這構成了與基於 RAG 的閱讀器 (reader) 的關鍵區別:在推論時,記憶模型僅從其內化的參數化知識生成答案,無需存取任何外部語料庫。關於超參數選擇的更多細節見附錄 F,訓練範式(完整 SFT 對 LoRA)見附錄 O。
4.3 透過模型合併進行持續知識整合
任何知識整合系統的一個實務上的理想特性,是能夠在不對所有先前已攝入來源重新訓練或重建的情況下,增量地整合新的語料庫。對於參數化模型,整合新知識通常需要在所有已觀察語料庫的聯集上重新訓練,這個成本會隨著來源數量的增加而變得難以負擔。相對地,非參數化系統(例如知識圖譜 (knowledge graphs) 與向量資料庫 (vector databases))支援有效的增量更新。我們探索模型合併 (model merging) (Yang et al., 2024) 作為為參數化模型彌平此差距的一種做法。模型合併旨在保留來自多個來源的知識,而不需要在它們的聯集上進行聯合訓練,方法是將 $K$ 個各自獨立在不同語料庫上訓練的記憶模型合併成單一模型。
持續知識整合。 令 $\{\mathcal{D}_{1},\dots,\mathcal{D}_{K}\}$ 為一組兩兩互斥的目標語料庫。對每個語料庫 $\mathcal{D}_{i}$,我們生成一個反思 QA 資料集 $\mathcal{Q}^{(i)}_{\text{final}}$(第 4.1 節)並透過 SFT 訓練一個對應的記憶模型 $\mathcal{M}_{\varphi_{i}}$(第 4.2 節),所有 $K$ 個模型都從同一個預訓練基礎 $\mathcal{M}_{\varphi_{0}}$ 初始化。我們將 $\mathcal{D}_{i}$ 的任務向量 (task vector) 定義為 $\tau_{i}\;{=}\;\varphi_{i}-\varphi_{0}$,捕捉僅在 $\mathcal{D}_{i}$ 上訓練所誘發的參數偏移。合併後的記憶模型隨後得到為
$$\varphi_{\text{merged}}\;{=}\;\mathrm{Merge}(\varphi_{0},\,\{\tau_{i}\}_{i=1}^{K};\,\Theta),$$
其中 $\Theta$ 表示方法特定的超參數(例如合併係數、稀疏化密度)。我們在附錄 H 中討論替代的合併方法及其各自的限制。
4.4 推論時整合
在推論時,執行模型透過一個結構化的多輪協定查詢並從記憶模型檢索資訊,執行模型將記憶模型視為一個外部知識神諭 (knowledge oracle)。此流程有三個依序進行的階段,每個都旨在逐步提升產生正確最終答案的可能性,如圖 1(右)所示。每個階段使用不同的提示、取樣溫度 (sampling temperatures) 與獨立的預算來控制執行模型與記憶模型之間的互動次數。
階段 1:接地 (Grounding)。 給定一個查詢 $q$,執行模型將其分解為一組原子性的、探查線索的子問題 $\{q_{1}^{\prime},\ldots,q_{J}^{\prime}\}$,其中每個子問題針對 $q$ 中的單一識別性約束,而 $J$ 由執行模型適應性地決定。記憶模型獨立回答每個子問題(無共享脈絡),產生接地回應 $\{m_{1},\ldots,m_{J}\}$。這些回應汲取記憶模型的參數化知識,為後續階段的互動提供額外的脈絡接地。
階段 2:實體識別 (Entity identification)。 以接地回應作為脈絡,執行模型透過跨多次互動向記憶模型發出有針對性的後續子查詢,反覆縮小一組候選實體。此過程持續進行,直到執行模型收斂到單一實體 $e^{\star}$ 或階段預算耗盡。若沒有識別出任何候選,則跳過階段 3,執行模型僅從接地回應合成最終答案。此階段利用了記憶模型在實體浮現 QA 對 $\mathcal{Q}_{\text{ent}}$(第 4.1 節)上的訓練。
階段 3:答案尋求與合成 (Answer seeking and synthesis)。 以已識別的實體 $e^{\star}$ 為條件,執行模型透過有針對性的後續問題向記憶模型查詢額外的支持事實。一旦蒐集到足夠的證據,或階段預算耗盡,執行模型便將累積的回應合成為最終答案:
$$\hat{a}\;=\;\mathcal{M}_{\theta}\!\bigl(q,\;\{m_{j}\}_{j=1}^{J},\;e^{\star},\;m_{\text{seek}}\bigr).$$
值得注意的是,記憶模型的回應 $m_{j}$ 與 $m_{\text{seek}}$ 是精簡的自然語言片段,其長度與語料庫大小無關,從而確保常數時間 (constant-time) 推論。由於與 $\mathcal{M}_{\theta}$ 的所有互動都透過其輸入—輸出介面進行,MeMo 仍完全相容於黑盒執行模型,包括專有 API,無需存取內部參數。完整的實作細節見附錄 J 與補充材料。
5 實驗
資料集。 我們在三個知識密集型基準測試上評估 MeMo。BrowseComp-Plus (Chen et al., 2025) 是一個需要多跳 (multi-hop)、多文件檢索與推理的深度研究基準;我們以 LangDetect (Danilák, 2021) 過濾非英語實例,取樣 300 個問題,並將每個問題的證據文件與等量的負面文件配對³,總共產出 3,541 份文件。NarrativeQA (Kočiskỳ et al., 2018) 測試對書籍與電影劇本等長文件的話語理解 (discourse understanding);我們使用橫跨 10 份文件⁴的 293 個問題。MuSiQue (Trivedi et al., 2022) 需要跨多個維基百科段落組合 2–4 個推理步驟;我們使用 1,000 個問題,並依照與 BrowseComp-Plus 相同的程序建構目標語料庫,產出 5,296 份文件。更多細節見附錄 D;資料集與程式碼見補充材料。
³ BrowseComp-Plus 與 MuSiQue 提供 gold(正確)、evidence(支持)與 negative(干擾項)文件的標註。Gold 文件是 evidence 文件的子集。 ⁴ 我們依循 HippoRAG2,在 NarrativeQA 驗證集的 10 份此類文件(294 個問題)上評估;為求一致性,移除了一個重複項。
基線 (Baselines)。 我們將 MeMo 與四個基線比較:BM25 (Robertson and Walker, 1994)(詞彙式檢索)、NV-Embed-V2 (Lee et al., 2024)(稠密式檢索)、HippoRAG2 (Gutiérrez et al., 2025)(基於圖的 RAG,目前最先進),以及 Cartridges (Eyuboglu et al., 2025)(一個在推論時載入執行模型的訓練過的 KV-cache;最接近 MeMo 的既有參數化基線)。有更新的方法存在 (Chevalier et al., 2023; Cao et al., 2025b),但通常需要對執行模型的白盒存取權,因此無法直接比較。我們另外納入「完美檢索」(Perfect Retrieval) 作為實證上界 (empirical upper bound),其中執行模型在脈絡中僅接收證據文件 (Brown et al., 2020)。檢索基線使用 top-$k{=}9$ 並搭配適應性回退 (adaptive backoff):逐步降低 $k$ 直到檢索到的脈絡能放進執行模型的上下文視窗。
實作與評估。 (a) 資料生成。我們使用 Qwen2.5-32B-Instruct (Yang et al., 2025) 作為生成器模型,透過 vLLM (Kwon et al., 2023) 提供服務並搭配 YaRN RoPE 縮放 (Su et al., 2024; Peng et al., 2024),以在長上下文生成期間支援 131K 標記的上下文視窗。(b) 訓練。我們訓練記憶模型,它從 Qwen2.5-14B-Instruct 初始化,以融合式 AdamW (Loshchilov and Hutter, 2017) 與 DeepSpeed 2 (Rajbhandari et al., 2020) 在學習率 $2{\times}10^{-5}$ 下訓練 3 個週期 (epochs);完整超參數見附錄 F。(c) 評估。我們以 Qwen2.5-32B-Instruct 或 Gemini-3-Flash (Google DeepMind, 2025) 來實例化執行模型,以在不同推理能力的模型上評估同一個訓練好的記憶模型;兩個模型對評估資料集都只有極少的先驗知識(附錄 I)。執行模型透過第 4.4 節描述的多輪協定查詢記憶模型。我們回報由 Gemini-2.5-Flash-Lite (Comanici et al., 2025) 透過 DeepEval (Ip and Vongthongsri, 2025) 判定的二元準確率,對 Qwen2.5-32B-Instruct 回報三次執行的平均值 $\pm$ 標準差,對 Gemini-3.0-Flash 回報單次執行。(d) 持續整合。對於模型合併實驗(第 5.5 節),我們將 NarrativeQA 切分為兩個兩兩互斥的子集($K{=}2$,每個約 640k 個 QA 對),各自 SFT 一個 Qwen2.5-14B-Instruct 記憶模型,並在三種密度下掃描六種合併方法(總共產出 14 種配置)。
5.1 實驗結果
MeMo 在各基準測試上達到強勁效能。 如表 2 所示,MeMo 在 NarrativeQA 與 MuSiQue 上跨兩種執行模型都一致地勝過所有基線。在最具挑戰性的基準 NarrativeQA(附錄 I)上,MeMo 以 Qwen2.5-32B-Instruct 達到 $26.85\%$,以 Gemini-3-Flash 達到 $53.58\%$,大幅超越所有基線。這點值得注意:NarrativeQA 需要對具複雜連結的長段落進行推理,基於檢索的方法受限於上下文視窗,且難以跨長文件綜合資訊;MeMo 則在訓練時透過反思捕捉這些連結,並在推論時透過其多輪協定檢索它們。同樣的趨勢在 MuSiQue 上也成立,MeMo 分別達到 $48.30\%$ 與 $58.70\%$,勝過那些難以跨獨立檢索段落進行多跳推理的基線。在 BrowseComp-Plus 上,MeMo 以 Gemini-3-Flash($66.67\%$)領先,並以 Qwen2.5-32B-Instruct($54.22\%$,些微落後於 HippoRAG2 的 $56.11\%$)保持競爭力。此差距反映了 BrowseComp-Plus 的本質:其答案不在執行模型的參數化知識中(附錄 I),使得對證據文件的直接存取格外有價值,從而偏好那些將原始文件傳給執行模型的檢索方法。
表 2: 在 BrowseComp-Plus、NarrativeQA 與 MuSiQue 上,兩種執行模型 Qwen2.5-32B-Instruct(Qwen2.5-32B-I)與 Gemini-3-Flash(Gemini-3-F)的準確率(%)。粗體值表示每欄中的最佳結果(不含完美檢索)。MeMo 使用 Qwen2.5-14B-Instruct 作為記憶模型,結果回報於最佳訓練週期。⋆完美檢索代表一個實證上界。
| 方法 | BCP / Qwen2.5-32B-I | BCP / Gemini-3-F | NarrativeQA / Qwen2.5-32B-I | NarrativeQA / Gemini-3-F | MuSiQue / Qwen2.5-32B-I | MuSiQue / Gemini-3-F |
|---|---|---|---|---|---|---|
| 完美檢索⋆ | $79.67\pm 1.45$ | $88.33$ | $51.42\pm 0.52$ | $60.41$ | $62.83\pm 0.90$ | $73.00$ |
| BM25 | $1.11\pm 0.69$ | $27.00$ | $10.24\pm 0.34$ | $14.33$ | $20.00\pm 0.30$ | $23.20$ |
| NV-Embed-V2 | $50.67\pm 0.33$ | $57.00$ | $20.59\pm 0.86$ | $26.62$ | $37.47\pm 0.15$ | $46.60$ |
| HippoRAG2⁵ | $\mathbf{56.11\pm 0.51}$ | $66.33$ | $21.39\pm 0.20$ | $23.21$ | $42.17\pm 0.12$ | $57.00$ |
| Cartridges⁶ | $0.00\pm 0.00$ | - | $3.75\pm 0.11$ | - | $8.57\pm 0.40$ | - |
| MeMo | $54.22\pm 0.84$ | $\mathbf{66.67}$ | $\mathbf{26.85\pm 0.39}$ | $\mathbf{53.58}$ | $\mathbf{48.30\pm 1.25}$ | $\mathbf{60.20}$ |
⁵ 這些結果與原論文 (Gutiérrez et al., 2025) 不同,後者使用 Llama3.3-70B-Instruct 而非 Qwen2.5-32B-Instruct。 ⁶ Cartridges 同樣需要對執行模型的白盒存取權;因此省略其對 Gemini-3-Flash 的結果。
MeMo 支援即插即用整合。 在三個基準測試中,MeMo 在搭配更強大的執行模型(Gemini-3-Flash)時一致地達到更高的效能:從 Qwen2.5-32B-Instruct 切換到 Gemini-3-Flash,在 BrowseComp-Plus、NarrativeQA 與 MuSiQue 上分別帶來 12.45%、26.73%、11.90% 的增益。這證明 MeMo 可以用一個較弱的生成器模型訓練一次,然後在推論時無縫地與任何 LLM(包括 Gemini-3-Flash 這類專有模型)配對。此即插即用能力讓 MeMo 能在不需任何額外訓練或開銷的情況下,直接利用最先進的模型。
5.2 對資料集雜訊量的消融實驗
表 3: 以 Qwen2.5-32B-Instruct 作為執行模型,在 BrowseComp-Plus 與 MuSiQue 上的準確率(%)。MeMo 結果基於 Qwen2.5-14B-Instruct,回報於最佳訓練週期。$N=N_{\text{evidence}}^{\text{dataset}}$ 表示語料庫中真實證據文件的數量;欄標題表示新增的額外負面(干擾項)文件數量,以 $N$ 的倍數表示。$\Delta$ 表示相對於 $0N$ 的準確率差異(%)。
| 方法 | 資料集 | $0\times N$ Acc.(%) | $1\times N$ Acc.(%) | $\Delta$ |
|---|---|---|---|---|
| NV-Embed-V2 | BrowseComp-Plus | $56.89\pm 0.51$ | $50.67\pm 0.33$ | ↓6.22 |
| NV-Embed-V2 | MuSiQue | $42.30\pm 0.53$ | $37.47\pm 0.15$ | ↓4.83 |
| HippoRAG2 | BrowseComp-Plus | $62.33\pm 1.15$ | $56.11\pm 0.51$ | ↓6.22 |
| HippoRAG2 | MuSiQue | $47.33\pm 0.74$ | $42.17\pm 0.12$ | ↓5.16 |
| MeMo | BrowseComp-Plus | $53.67\pm 1.15$ | $54.22\pm 0.84$ | ↑0.55 |
| MeMo | MuSiQue | $50.07\pm 0.81$ | $48.30\pm 1.25$ | ↓1.77 |
我們研究 MeMo 相對於兩個強檢索基線(NV-Embed-V2 與 HippoRAG2)在遞增檢索雜訊下的強健性,雜訊由新增到目標語料庫中的負面(干擾項)文件數量控制,以每個資料集中真實證據文件總數的倍數表示(BrowseComp-Plus 為 $N_{\text{evidence}}^{\text{dataset}}=1{,}775$,MuSiQue 為 $N_{\text{evidence}}^{\text{dataset}}=2{,}648$)。本文通篇使用的資料集(詳見附錄 D)對應於 $1\times N_{\text{evidence}}^{\text{dataset}}$ 的比例;我們另外在 $0\times N_{\text{evidence}}^{\text{dataset}}$(無干擾項)的比例下評估,作為一個理想化的無雜訊參考,以隔離干擾項的影響。
表 3 的結果顯示基於檢索的方法展現出對雜訊的明顯敏感性。當從 $0\times N$ 擴展到 $1\times N$ 時,NV-Embed-V2 與 HippoRAG2 在 BrowseComp-Plus 上跌幅高達 6.22%、在 MuSiQue 上高達 5.16%,證實這些系統在真實的語料庫條件下難以過濾不相關的文件。相對地,MeMo 在兩個基準上都維持穩定的效能,在 BrowseComp-Plus 上有 0.55% 的微小提升、在 MuSiQue 上僅下降 1.77%,兩者都在一個標準差之內,證明 MeMo 對遞增的檢索雜訊具強健性。我們將這種強健性歸因於 MeMo 的設計:儘管記憶模型在含負面文件的語料庫上訓練,它對執行模型子查詢提供的資訊比直接文件檢索更精確。關於基於檢索方法效能衰退的額外分析見附錄 L。
5.3 對記憶模型大小的消融實驗
我們透過在 Qwen2.5 家族中比較 1.5B 與 14B 參數的模型,研究記憶模型的大小如何影響下游任務效能。實作細節見附錄 M。表 4 的結果顯示出一致的正向擴展趨勢:較大的記憶模型在所有基準與執行模型上都帶來改善的效能。然而結果也顯示,更強的執行模型推理能力會以非均勻的方式調節此差距:記憶模型大小之間的效能差異在 NarrativeQA 上擴大,但在 BrowseComp-Plus 與 MuSiQue 上縮小。這顯示執行模型推理能力與記憶模型大小之間的交互作用是任務相依的。
表 4: Qwen2.5 家族內記憶模型大小的消融實驗。粗體結果表示該欄中表現最佳的結果。
| 記憶模型 | BCP / Qwen2.5-32B | BCP / Gemini-3-Flash | NarrativeQA / Qwen2.5-32B | NarrativeQA / Gemini-3-Flash | MuSiQue / Qwen2.5-32B | MuSiQue / Gemini-3-Flash |
|---|---|---|---|---|---|---|
| Qwen2.5-1.5B-Instruct | $44.11\pm 2.22$ | $61.00$ | $24.00\pm 0.20$ | $47.44$ | $42.90\pm 1.39$ | $59.70$ |
| Qwen2.5-14B-Instruct | $\mathbf{54.22\pm 0.84}$ | $\mathbf{66.67}$ | $\mathbf{26.85\pm 0.39}$ | $\mathbf{53.58}$ | $\mathbf{48.30\pm 1.25}$ | $\mathbf{60.20}$ |
5.4 對記憶模型家族的消融實驗
我們透過比較三個參數規模相近(約 1–2B)但架構與預訓練血統不同的模型——Qwen2.5-1.5B-Instruct (Yang et al., 2025)、Gemma3-1B-IT (Team et al., 2025) 與 LFM2.5-1.2B-Instruct (Amini et al., 2025)——來研究記憶模型家族的選擇是否影響效能。實作細節見附錄 N。表 5 的結果顯示 MeMo 的效能在很大程度上對記憶模型架構的選擇具強健性,證明此框架在相近的參數規模下對記憶模型的特定預訓練血統並不敏感,而且我們的訓練程序所誘發的參數化知識壓縮能跨多樣的模型家族泛化。
表 5: 跨相近參數規模(約 1–2B)記憶模型的消融實驗。粗體結果表示該欄中表現最佳的結果。
| 記憶模型 | BCP / Qwen2.5-32B-I | BCP / Gemini-3-F | NarrativeQA / Qwen2.5-32B-I | NarrativeQA / Gemini-3-F | MuSiQue / Qwen2.5-32B-I | MuSiQue / Gemini-3-F |
|---|---|---|---|---|---|---|
| Qwen2.5-1.5B-Instruct | $\mathbf{44.11\pm 2.22}$ | $61.00$ | $\mathbf{24.00\pm 0.20}$ | $47.44$ | $42.90\pm 1.39$ | $\mathbf{59.70}$ |
| Gemma3-1B-IT | $41.67\pm 2.03$ | $59.00$ | $22.30\pm 2.47$ | $\mathbf{48.81}$ | $41.17\pm 1.20$ | $56.20$ |
| LFM2.5-1.2B-Instruct | $37.33\pm 1.86$ | $59.67$ | $21.96\pm 1.97$ | $46.42$ | $\mathbf{45.23\pm 2.49}$ | $58.30$ |
5.5 透過模型合併進行持續整合
我們在 NarrativeQA 上測試第 4.2 節描述的串流更新 (streaming-update) 情境,比較模型合併與在第二個子集到達時於兩個子集聯集上完整重新訓練記憶模型。在 14 種掃描配置中(見附錄 H 的表 12),我們在正文中回報表現最佳的 TIES (Yadav et al., 2023)($\rho{=}0.3$)。令 $X$ 與 $Y$ 表示各子集單獨的 SFT 成本(成本約與 QA 對數量呈線性,因此聯集的成本為 $X{+}Y$),兩次到達的累積計算成本,合併為 $X{+}Y$,完整重新訓練則為 $X{+}(X{+}Y)$。
表 6: 在 NarrativeQA 上模型合併對完整重新訓練。記憶模型 = Qwen2.5-14B-Instruct。Merge-TIES($\rho{=}0.3$)是 14 種掃描配置(表 12,附錄 H)中最佳者。累積計算成本以 8$\times$H100 GPU 小時回報,針對 $K{=}2$ 個各約 640k 反思 QA 對的子集。$\Delta$ 表示相對於完整重新訓練的準確率差異(%)。
| 方法 | 累積計算 (8$\times$H100 GPU-h) | Qwen2.5-32B-I Acc.(%) | $\Delta$ | Gemini-3-F Acc.(%) | $\Delta$ |
|---|---|---|---|---|---|
| 完整重新訓練 ($X{+}(X{+}Y)$) | $\approx 72$ h | $\mathbf{26.85\pm 0.39}$ | — | $\mathbf{53.58}$ | — |
| Merge-TIES ($\rho{=}0.3$, $X{+}Y$) | $\approx 48$ h | $15.81\pm 0.39$ | ↓11.04 | $34.47$ | ↓19.11 |
合併在 $K{=}2$ 時削減 33% 的計算量,並在規模上有遞增的回報。 如表 6 所示,完整重新訓練基線產生 $X{+}(X{+}Y)\approx 72$ GPU 小時的累積計算量,而合併僅累積 $X{+}Y\approx 48$ GPU 小時——減少了 $33\%$(圖 2)。此差距隨 $K$ 擴大:在相同的每語料庫成本下,合併以 $\Theta(K)$ 擴展,而完整重新訓練以 $\Theta(K^{2})$ 擴展,在 $K{=}10$ 時產生 $5.5{\times}$ 的節省(240 對 1,320 GPU 小時)。
合併以可衡量的準確率差距換取計算節省,但仍勝過檢索。 Merge-TIES($\rho{=}0.3$)在 Qwen2.5-32B-Instruct 下落後完整重新訓練的記憶模型 $11.0$%,在 Gemini-3-Flash 下落後 $19.1$%(表 6);橫跨完整的 14 種配置掃描,準確率範圍從 $7.85\%$(SLERP,最差)到 $15.81\%$(TIES,最佳),如圖 2 所示。儘管有此差距,合併後的記憶模型在 NarrativeQA 上仍勝過每一個檢索基線(BM25、NV-Embed-V2、HippoRAG2、Cartridges;見表 2),這顯示即使是更積極壓低成本的合併程序,也保留了 MeMo 相對於基於檢索方法的大部分質性優勢。TIES 與 DARE-Linear 在 $\rho{=}0.3$ 時主導了掃描,顯示積極稀疏化結合符號衝突解析 (sign-conflict resolution) 是此情境下最可靠的合併配方。
6 結論
我們提出了 MeMo,一個透過在合成的反思 QA 資料集上訓練的記憶模型,將更新的或領域特定的知識整合進 LLM 的模組化框架。MeMo 解決了既有方法的關鍵限制:它繞過了基於檢索方法中的脈絡約束與有限的跨文件推理,避免了昂貴且脆弱的參數化更新(包括災難性遺忘),並消除了潛在記憶方法中的表徵耦合。其核心元件是一個捕捉明確事實與隱含關係的資料合成流程,以及一個將複雜查詢分解為有針對性子查詢以從記憶模型檢索所需資訊的多輪推論協定。雖然 MeMo 展現出強勁的效能,它在訓練成本、評估範圍,以及記憶模型隨語料庫大小擴展的容量方面仍有限制(見附錄 B)。實證上,MeMo 在多樣的基準測試上勝過強基線。它也提供了一條可擴展的知識整合途徑,支援有效的更新以及與開源及專有閉源 LLM 的即插即用部署。未來工作包括更有效的記憶建構、對動態語料庫的延伸,以及執行模型與記憶模型之間更緊密的協調。我們將 MeMo(記憶即模型)視為通往更具彈性、可更新、且具知識感知能力的 AI 系統的一個有前景的基礎。
附錄
附錄 A 影響聲明
MeMo 推進了 LLM 在大型、領域特定語料庫上內化知識的能力,且無需存取模型權重,降低了在法律、醫學與科學研究等知識密集領域部署強大 AI 系統的門檻。透過實現與任何 LLM(包括專有模型)的即插即用整合,MeMo 使原本需要大量計算資源或白盒模型存取權的強大知識整合能力得以普及。同時,此可及性也引入了雙重用途 (dual-use) 的顧慮,因為使有益應用成為可能的同一能力,也可能被用來大規模內化錯誤資訊、未經授權的專有資料或有害內容。此外,由於 MeMo 減少了對顯式檢索的依賴,它可能會模糊所檢索資訊的來源出處 (provenance),使得歸因 (attribute) 模型回應底層來源變得更困難。我們鼓勵未來工作研究基於記憶系統的歸因機制與存取控制,並敦促從業者審慎考量用於訓練記憶模型的文件性質。
附錄 B 限制
MeMo 為每個新語料庫帶來前期的訓練成本,且效能可能在我們實驗所涵蓋之外的領域、文件類型或 LLM 家族間有所差異。此外,MeMo 的效能本質上受限於記憶模型內化目標語料庫的表徵容量。雖然我們的實驗並未顯示記憶模型已達到其容量極限的明確跡象,我們假設足夠大或資訊密集的語料庫將會超出一個固定大小記憶模型所能正確壓縮與表徵的限度。
附錄 C 未來工作
我們概述數個未來工作方向。資料生成流程計算成本高昂,演算法 1 中的步驟 5 以 $O(k\cdot C^{2}\cdot Q^{2})$ 呈二次方擴展,降低此成本仍是一個開放問題。對切分策略 (chunking strategies) 及其相關權衡(附錄 D)的系統性評估同樣是一個開放方向。在訓練方面,使記憶模型隨語料庫大小擴展,以及開發更有效的模型合併策略以降低每語料庫的訓練成本(第 5.5 節),都是有前景的方向。其他後訓練方法,例如強化學習 (Reinforcement Learning) [67] 也已被證明能有效提升模型任務效能 [42],將這類方法應用於記憶模型訓練值得未來探究。
更適合特定架構的 LoRA 配置,包括對秩 (rank) 與學習率的逐架構調整,也值得進一步研究(附錄 O)。最後,對執行模型推理能力與記憶模型大小之間交互作用更系統性的研究(第 5.3 節),以及每個階段的最佳互動預算與執行模型選擇(第 J.2 節),是其他有前景的未來方向。
附錄 D 資料集的準備
語料庫建構。 延伸第 5 節的描述,我們區分兩類文件⁷:證據文件 (evidence documents),含有與回答某個問題相關的資訊;以及負面文件 (negative documents),不相關並充當雜訊。對 BrowseComp-Plus,我們使用了 $1{,}775$ 份唯一證據文件與 $1{,}766$ 份唯一負面文件(移除非英語文件後),總共產出 $3{,}541$ 份文件。對 MuSiQue,我們各使用 $2{,}648$ 份證據與負面文件,產出 $5{,}296$ 份文件。NarrativeQA 沒有負面文件。
⁷ 注意對於 BrowseComp-Plus,gold 文件是 evidence 文件的子集。
切分策略。 如表 7 所示,NarrativeQA 完整文件橫跨 $32{,}769$–$131{,}072$ 標記的範圍,中位長度為 $65{,}925$ 標記,反映出來源小說的長篇性質。在不切分的情況下處理這類文件,會有降低演算法 1 步驟 1 中可抽取 QA 對覆蓋率的風險,因為已知注意力品質會隨上下文變長而劣化 [29]。因此我們使用固定的滑動視窗($6{,}400$ 詞,$640$ 詞重疊,即 $10\%$ 重疊比例)切分 NarrativeQA 文件,產出 $75$ 個集中在 $4{,}097$–$16{,}384$ 標記範圍的區塊(佔所有區塊的 $96\%$),每份文件的中位分組大小為 $7$(如表 8 所示)。與 NarrativeQA 不同,MuSiQue 文件較精簡,$99.70\%$ 低於 $512$ 標記,每份 MuSiQue 文件被視為單一區塊。
表 7: 跨語料庫在區塊層級的標記長度分布,其中 $n$ 表示演算法 1 處理的個別區塊總數。每個項目反映單一文字區塊的標記計數。NarrativeQA 的統計同時回報切分前後。(標記範圍涵蓋 $0$–$512$、$513$–$4{,}096$、$4{,}097$–$16{,}384$、$16{,}385$–$32{,}768$、$32{,}769$–$131{,}072$ 等區間;BrowseComp-Plus $n=3{,}541$、NarrativeQA 完整文件 $n=10$、NarrativeQA 區塊 $n=75$、MuSiQue $n=5{,}296$。詳細數值見原文。)
【譯註:原文表 7 與表 8 為各語料庫在不同標記長度區間的分布統計,此處因 HTML 結構過於分散僅保留說明,完整數值請參照原論文。】
附錄 E 資料生成流程各步驟的討論
E.1 資料合成步驟的消融
我們對資料生成流程進行實驗,以展示每個步驟的重要性。我們對資料合成的每個步驟執行留一法 (leave-one-out, LOO) 消融,並在生成的合成 QA 對上訓練模型。表 9 回報在 NarrativeQA 與 MuSiQue 資料集上的結果,使用 Qwen2.5-32B-Instruct 作為執行模型、Qwen2.5-1.5B-Instruct 作為記憶模型。
表 9: 跨資料集在最佳表現的 Qwen2.5-1.5B-Instruct 週期下的 LOO 消融準確率。資料比例 (Data ratio) 表示相對於基線保留的 QA 對數量。對每個被移除的步驟,重新訓練 Qwen2.5-1.5B-Instruct,並回報在與基線相同訓練週期下 3 次執行的平均值 $\pm$ 標準差。
| 消融 | NarrativeQA 資料比例 | NarrativeQA Acc.(%) | MuSiQue 資料比例 | MuSiQue Acc.(%) |
|---|---|---|---|---|
| 基線(所有步驟) | $1.000\times$ | $24.00\pm 0.20$ | $1.000\times$ | $42.90\pm 1.39$ |
| 移除步驟 1a | $0.434\times$ | $20.48\pm 0.90$ | $0.381\times$ | $30.00\pm 0.17$ |
| 移除步驟 1b | $0.598\times$ | $22.98\pm 1.04$ | $0.651\times$ | $37.33\pm 0.25$ |
| 移除步驟 2 | $0.739\times$ | $24.69\pm 1.10$ | $0.621\times$ | $37.10\pm 1.76$ |
| 移除步驟 3 | $2.078\times$ | $28.90\pm 0.86$ | $1.128\times$ | $41.70\pm 0.78$ |
| 移除步驟 4 | $0.378\times$ | $23.21\pm 1.56$ | $0.501\times$ | $39.10\pm 0.02$ |
| 移除步驟 5 | $0.002\times$ | $6.37\pm 0.39$ | $0.195\times$ | $24.17\pm 0.25$ |
步驟 5(跨文件合成)是流程中最關鍵的元件。移除它會使 NarrativeQA 與 MuSiQue 的準確率分別崩跌到 $6.37\%$ 與 $24.17\%$(對比基線分數 $24.00\%$ 與 $42.90\%$),並伴隨訓練資料近乎全失($0.002\times$ 與 $0.195\times$ 保留率)。如第 4.1 節所述,步驟 5 實現了跨文件合成,其中 $\mathcal{M}_{\text{gen}}$ 建構橫跨文件間連結與單一長文件內跨區塊連結的 $\mathcal{Q}_{\text{cross}}$ 對,使其成為 $\mathcal{Q}_{\text{final}}$ 中訓練對的主要來源,並直接針對兩個基準核心的多來源合成目標。
步驟 2 與步驟 3 出現了一個有趣的異常現象,其移除並未一致地損害效能,反而提升了 NarrativeQA 的準確率。步驟 2 透過辨識共同點(例如共享實體、重疊時間段與順序事件)將來自單一文件區塊的相關 QA 對合併成多事實問題。對 MuSiQue,這些共同點反映了真正的知識關係,直接類似該基準所評估的多跳事實推理,因此移除步驟 2 會消除大量有用的訓練對,導致準確率從 $42.90\%$ 跌到 $37.10\%$。然而對 NarrativeQA,同樣的整併模式作用於表面的敘事共現 (co-occurrences) 而非有意義的知識關係。主要的共同點類別是 NarrativeQA 並不評估的事件或場景分組,以及由於核心角色普遍存在於各場景中而被輕易滿足的實體共現模式。移除步驟 2 消除了這些低品質的對,導致準確率從 $24.00\%$ 微幅提升到 $24.69\%$。
移除步驟 3 保留了比基線更多的資料(NarrativeQA 與 MuSiQue 分別為 $2.078\times$ 與 $1.100\times$),但對效能的影響卻有分歧。對 MuSiQue,效能從 $42.90\%$ 跌到 $41.78\%$,而對 NarrativeQA,效能從 $24.00\%$ 提升到 $28.90\%$。步驟 3 套用一個自我完備性過濾器,重寫或丟棄那些不存取來源區塊就無法理解的問題對。對 MuSiQue,違規大多是局部且淺層的,因此易於過濾;所提出的過濾器能有效辨識並移除有缺陷的對。對 NarrativeQA,長篇敘事文字經常含有橫跨許多段落的代名詞與時間指涉,這些是該領域的結構性特徵而非可修復的缺陷。這導致重寫迴圈引入替代的不相關內容,並破壞了早期步驟產生的對。因此對 NarrativeQA 移除步驟 3 避免了這種領域誘發的破壞,並完整保留了原始的對,解釋了資料保留比例的增加與準確率的提升。這顯示步驟 3 在自我完備性違規定義明確且可解決的領域中套用時最為有益。
其餘步驟遵循一致的趨勢:移除步驟 1a、步驟 1b 或步驟 4 在兩個資料集上都會同時降低資料量與準確率,證實每個步驟對最終訓練語料庫的品質都貢獻了一個獨特且有意義的角色。
E.2 曾考慮但被排除的額外步驟
有三個額外步驟曾被考慮但最終排除於流程之外。它們包括改寫 [56]、增加演算法 1 步驟 1 的取樣試驗次數,以及一個有針對性的填補,其中 $\mathcal{M}_{\text{gen}}$ 審視生成的 QA 對並重寫它們以納入額外遺漏的資訊。改寫被排除是因為生成對的規模已提供充分的覆蓋(三個資料集約 600k–1.6M,見表 11),且潛在增益被額外的計算開銷所抵消。增加取樣試驗被證明不可靠,因為額外的試驗並未一致地抽取出初次嘗試未能抽取的事實。有針對性的填補同樣只提供有限的增益,將既有 QA 對作為脈絡附加來提示修訂,只會在模型原本就未能從原始區塊抽取出某事實時延長脈絡,可能進一步加劇長輸入上的注意力衰退 [29],使推論時相關資訊的檢索更不可靠。
附錄 F 記憶模型超參數設定
訓練在 H100 與 H200 GPU 上進行,使用表 10 回報的超參數設定。每個資料集的有效批次大小 (effective batch size) 總結於表 11。
表 10: 記憶模型 SFT 訓練配置
| 參數 | 值 |
|---|---|
| 優化器 | Fused AdamW |
| 梯度檢查點 (Gradient checkpointing) | True |
| 學習率 (LR) | $2\times 10^{-5}$ |
| 訓練週期數 | 3 |
| LR 排程器類型 | 帶 warmup 的常數 (Constant with warmup) |
| Warmup 比例 | 0.05 |
| 權重衰減 (Weight decay) | 0.01 |
| 最大梯度範數 (Max gradient norm) | 1.0 |
| 最大序列長度 | 8096 |
| 精度 (Precision) | BF16 |
| 注意力實作 | Flash Attention 2 |
【譯註:原文另有表 11,列出各資料集(BrowseComp-Plus、NarrativeQA、MuSiQue)的 QA 對總數(約 600k–1.6M)與有效批次大小,詳細數值請參照原論文。】
附錄 G 計算資源
所有實驗皆使用 NVIDIA H200 GPU 進行。我們以 GPU 小時回報計算成本。
資料生成。 為 BrowseComp-Plus、NarrativeQA 與 MuSiQue 生成完整的反思資料集分別約耗費 240、200 與 150 GPU 小時。
訓練。 記憶模型(Qwen2.5-14B-Instruct)在 BrowseComp-Plus、NarrativeQA 與 MuSiQue 上單次訓練分別約耗費 180、150、90 GPU 小時。
附錄 H 模型訓練討論
我們考慮了三種訓練範式:CPT、SFT 與基於 LoRA 的 SFT。CPT 被排除,因為它有降低指令遵循 (instruction-following) 能力的風險 [76],而這對下游 QA 評估至關重要。完整 SFT 被選用,因為它直接針對目標任務優化,同時保留對齊 [55]。基於 LoRA 的 SFT 作為一個參數高效的替代方案,我們在附錄 O 納入了與這些訓練方法的比較。
模型合併針對新語料庫隨時間到達、記憶模型必須持續整合它們的實務串流場景。在所有已觀察語料庫的聯集上從頭重新訓練記憶模型是自然的基線,但在規模上很快變得難以負擔,因為其成本隨累積語料庫大小而增長。模型合併改為在每個新語料庫上訓練一個獨立的記憶模型,並在參數空間中將其與既有模型結合,因此每次更新的成本只隨新語料庫的大小擴展,而非整個歷史。這種解耦相對於完整重新訓練帶來可衡量的準確率成本,我們在圖 2 中加以量化。我們假設待合併的語料庫兩兩互斥。
H.1 模型合併
合併方法。 我們考慮以下方法,它們都在從不於 $\mathcal{D}_{1}\cup\dots\cup\mathcal{D}_{K}$ 上訓練的情況下產生 $\varphi_{\text{merged}}$:
- 線性合併 (Linear merging) [73] 計算任務向量的加權和:$\varphi_{\text{merged}}=\varphi_{0}+\sum_{i=1}^{K}\lambda_{i}\tau_{i}$,其中 $\lambda_{i}>0$ 為合併係數。
- SLERP [62] 沿單位球面在兩個任務向量之間插值,保留它們的大小:$\varphi_{\text{merged}}=\varphi_{0}+\mathrm{SLERP}(\tau_{1},\tau_{2};\,t)$,以 $t\in[0,1]$ 控制插值因子。
- 任務算術 (Task arithmetic) [31] 直接相加任務向量而不做進一步處理,在 $\lambda_{i}$ 均勻時恢復為線性合併的特例。
- TIES [80] 在求和前透過以下方式解決任務向量間的干擾:(i) 將每個 $\tau_{i}$ 修剪 (trim) 至其最大幅度項目的前 $\rho$ 比例,(ii) 在每個座標以幅度加權多數投票選出一個符號,以及 (iii) 僅對與所選符號一致的項目進行不相交合併。
- DARE [83] 透過隨機丟棄每個任務向量 $1-\rho$ 比例的項目,並以 $1/\rho$ 重新縮放倖存者以保留期望幅度,然後進行線性合併。
- DARE-TIES [83] 結合 DARE 式的隨機稀疏化與 TIES 符號衝突解析,保留隨機 dropout 的多樣性同時過濾掉衝突的更新。
避免災難性遺忘。 由於沒有任何單一記憶模型 $\mathcal{M}_{\varphi_{i}}$ 曾在另一個語料庫的資料上微調,模型合併無法誘發那種驅動序列式微調中災難性遺忘的分布干擾 [52]。來自每個語料庫的知識被保存在它自己的任務向量 $\tau_{i}$ 內,任務向量之間的衝突在合併時透過上述方法解決,而非在梯度更新期間。
可擴展性。 當一個新語料庫 $\mathcal{D}_{K+1}$ 到達時,我們在其反思 QA 資料集上訓練輔助模型 $\mathcal{M}_{\varphi_{K+1}}$、推導 $\tau_{K+1}$,並以相對於完整集合 $\mathcal{O}(1)$ 的額外成本重新合併。這使得能在連續的互斥知識來源串流上進行模組化、即插即用的整合,不同於在 $\bigcup_{i}\mathcal{D}_{i}$ 上從頭重新訓練(其隨累積語料庫大小線性擴展)。
推論。 合併後的記憶模型透過第 4.4 節描述的結構化多輪協定,以與單一語料庫記憶模型完全相同的方式被查詢。由於合併完全在參數空間中運作,並產生一個與 $\mathcal{M}_{\varphi_{0}}$ 具相同架構與介面的模型,它繼承了 MeMo 的即插即用特性,無需更改執行模型或推論協定。重要的是,執行模型在推論時查詢的是單一合併記憶模型,而非分派至 $K$ 個各別的逐語料庫記憶模型,使得無論已整合多少語料庫,多輪檢索流程都保持不變。
程序。 在我們的實驗中,我們將 NarrativeQA 切分為兩個兩兩互斥的子集 NarrativeQA.1 與 NarrativeQA.2,各約 640k 反思 QA 對。每個子集用於從同一個 Qwen2.5-14B-Instruct 基礎透過 SFT 微調一個獨立的記憶模型 3 個週期,分別以 $X$ 與 $Y$ GPU 小時的 SFT 成本產生 $\mathcal{M}_{\varphi_{1}}$ 與 $\mathcal{M}_{\varphi_{2}}$(在 8$\times$H100 上各約 $24$ GPU 小時;在聯集 NarrativeQA.1 $\cup$ NarrativeQA.2 上完整重新訓練依線性擴展成本為 $X{+}Y\approx 48$ GPU 小時)。我們在保留的 NarrativeQA 評估集上評估每次執行的每個保存的檢查點 (checkpoint),並為每個子集選擇表現最佳的檢查點;對應的任務向量 $\tau_{1}$ 與 $\tau_{2}$ 是合併步驟的輸入。我們接著在三種稀疏化密度 $\rho\in\{0.3,0.5,0.7\}$(或 SLERP 的三種插值因子 $t\in\{0.3,0.5,0.7\}$)下掃描上述列出的全部六種合併方法(Linear、Task arithmetic、SLERP、TIES、DARE、DARE-TIES),總共給出 $14$ 種合併記憶模型配置。每種配置在 NarrativeQA 上以 Qwen2.5-32B-Instruct 作為執行模型評估(3 次執行的平均值 $\pm$ 標準差)。我們在第 5 節中回報為 Merge-TIES 的配置是掃描中的最佳者(TIES,$\rho{=}0.3$)。
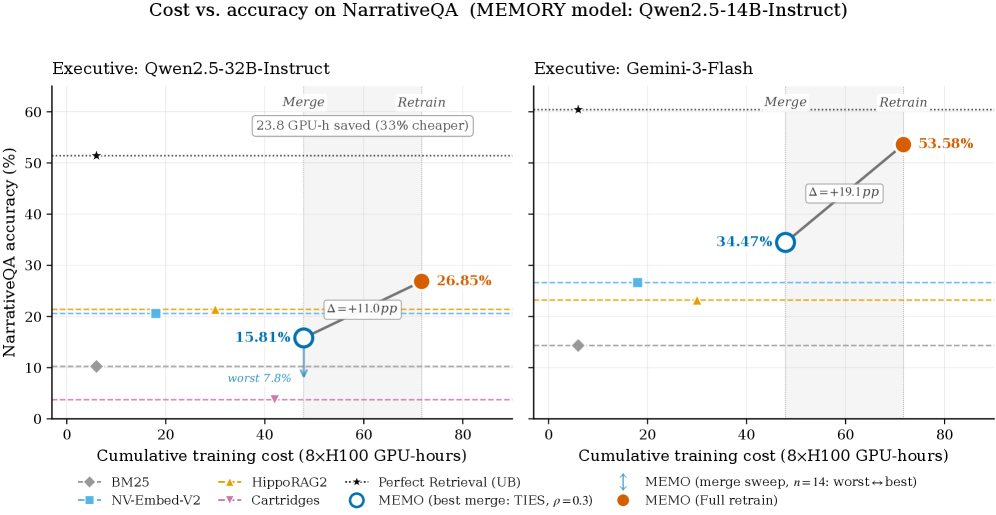
圖 2: 當第二個語料庫到達時($K{=}2$,記憶模型 = Qwen2.5-14B-Instruct,8$\times$H100),NarrativeQA 上的成本—準確率權衡。累積訓練成本顯示於 $x$ 軸(一次 Qwen-14B SFT 執行在 640k QA 對語料庫上約耗 $24$ GPU 小時)。合併只在新語料庫上訓練記憶模型,成本為 $X{+}Y\approx 48$ GPU 小時,而完整重新訓練在聯集上重新執行,成本為 $X{+}(X{+}Y)\approx 72$ GPU 小時——節省 33%。Merge-TIES($\rho{=}0.3$)以 Qwen2.5-32B-Instruct 作為執行模型時落後完整重新訓練 $11.0$%,以 Gemini-3-Flash 時落後 $19.1$%,但仍勝過所有檢索基線(BM25、NV-Embed-V2、HippoRAG2、Cartridges)。合併成本處的垂直 $\updownarrow$ 顯示 14 種掃描合併配置的最差至最佳範圍(表 12)。完美檢索顯示為上界。
結果。 單次 SFT 執行在 8$\times$H100 上消耗約 $24$ GPU 小時;兩次到達後,完整重新訓練產生 $X{+}(X{+}Y){=}72$ GPU 小時的累積計算量,而合併僅累積 $X{+}Y{=}48$ GPU 小時——減少 33%(圖 2)。漸近差距隨 $K$ 擴大:在相同的每語料庫成本下,合併以 $\Theta(K)$ 擴展,而完整重新訓練以 $\Theta(K^{2})$ 擴展,在 $K{=}10$ 時產生 $5.5{\times}$ 的節省(240 對 1,320 GPU 小時)。在準確率上,Merge-TIES($\rho{=}0.3$)以 Qwen2.5-32B-Instruct 作為執行模型時落後完整重新訓練 $11.0$%($15.81\%$ 對 $26.85\%$),以 Gemini-3-Flash 時落後 $19.1$%($34.47\%$ 對 $53.58\%$),使合併記憶模型低於聯集重訓的記憶模型但高於每一個檢索基線。完整的逐方法掃描回報於表 12:TIES($\rho{=}0.3$)與 DARE-Linear($\rho{=}0.3$)分別以 $15.81\%$ 與 $15.47\%$ 領先,而 SLERP($t{=}0.5$)是最差的配置,為 $7.85\%$。跨家族的模式顯示,在低 $\rho$ 下的積極稀疏化搭配符號衝突解析(TIES、DARE-Linear)是此情境下最可靠的合併配方。這些結果證實了預測的計算—準確率權衡:合併以大幅較低的累積成本恢復了記憶模型相對於檢索方法的大部分餘裕。
表 12: NarrativeQA 上全部 14 種合併配置的掃描。兩個記憶模型(Qwen2.5-14B-Instruct)各自獨立在互斥的 NarrativeQA.1 與 NarrativeQA.2 子集上 SFT 訓練;每個子集表現最佳的檢查點提供進入合併的任務向量。執行模型 = Qwen2.5-32B-Instruct;結果為 3 次執行的平均值 $\pm$ 標準差。最佳合併以粗體表示;完整重訓準確率($26.85\pm 0.39$)顯示供參考。
| 方法家族 | 超參數 | 準確率(%) |
|---|---|---|
| Linear | — | $11.60\pm 1.02$ |
| Task arithmetic | — | $12.74\pm 1.75$ |
| SLERP | $t=0.3$ | $11.60\pm 2.24$ |
| SLERP | $t=0.5$ | $7.85\pm 1.71$ |
| SLERP | $t=0.7$ | $11.60\pm 2.13$ |
| TIES | $\rho=0.3$ | $\mathbf{15.81\pm 0.39}$ |
| TIES | $\rho=0.5$ | $12.17\pm 1.94$ |
| TIES | $\rho=0.7$ | $12.06\pm 2.58$ |
| DARE-Linear | $\rho=0.3$ | $15.47\pm 0.79$ |
| DARE-Linear | $\rho=0.5$ | $9.78\pm 1.20$ |
| DARE-Linear | $\rho=0.7$ | $13.65\pm 2.08$ |
| DARE-TIES | $\rho=0.3$ | $11.72\pm 0.52$ |
超參數慣例:$t\in[0,1]$ 是沿連接兩個任務向量的單位球面的 SLERP 插值因子($t{=}0$ 恢復 NarrativeQA.1 上的記憶模型,$t{=}1$ 恢復 NarrativeQA.2 上的記憶模型,$t{=}0.5$ 是測地線中點);$\rho\in(0,1]$ 是稀疏化密度——保留的最大幅度任務向量項目比例(TIES)或隨機丟棄稀疏化的保留機率(DARE、DARE-TIES)。Linear 與 Task arithmetic 以均勻權重($\lambda_{i}=1$)合併,無超參數。【譯註:表 12 原文含 14 列,此處列出主要配置;DARE-TIES 於 $\rho=0.5$、$\rho=0.7$ 等其餘配置數值請參照原論文。】
附錄 I 驗證評估資料集的適用性
表 13: 跨資料集與執行模型,無脈絡 (No Context) 與完美檢索之間的效能差距。
| BCP / Qwen2.5-32B | NarrativeQA / Qwen2.5-32B | MuSiQue / Qwen2.5-32B | BCP / Gemini-3-Flash | NarrativeQA / Gemini-3-Flash | MuSiQue / Gemini-3-Flash | |
|---|---|---|---|---|---|---|
| 無脈絡 | $0.00\pm 0.00$ | $5.35\pm 0.20$ | $17.03\pm 0.40$ | $1.33$ | $26.62$ | $41.80$ |
| 完美檢索 | $79.67\pm 1.45$ | $51.42\pm 0.52$ | $62.83\pm 0.90$ | $88.33$ | $60.41$ | $73.00$ |
為評估評估資料集對執行模型的適用性,以及執行模型是否已從訓練資料記憶答案,我們在無任何脈絡(無脈絡)與提供證據文件(完美檢索,後者作為假設完美檢索相關文件的實證上界)兩種情況下評估效能。如表 13 所示,無脈絡與完美檢索之間效能的巨大落差證實這些資料集需要存取證據文件才能取得正確答案,驗證了它們用於評估 MeMo 的適用性。
不意外地,MuSiQue 產生最高的無脈絡分數,因為其以維基百科為基礎的問題落在模型的參數化知識範圍內。NarrativeQA 被證明最具挑戰性,因為它在兩種執行模型上都取得最低的完美檢索分數,反映出對全篇書籍與電影劇本進行審慎推理的需求。BrowseComp-Plus 產生無脈絡與完美檢索之間最大的落差,無脈絡效能近乎零,但在提供證據文件時強勁恢復。這些發現證實執行模型在所有三個資料集上都高度依賴證據文件才能表現良好。MuSiQue 測試多跳事實推理(參數化知識提供部分訊號),NarrativeQA 測試即使有完美脈絡仍具挑戰性的敘事理解,而 BrowseComp-Plus 測試利用檢索文件取得模型原本完全無法存取之事實的能力。
附錄 J 評估細節
J.1 實作細節
目前的溫度設定描述於表 14。階段 1 只有 $1$ 次互動的預算,階段 2 有 $7$ 次互動的預算,階段 3 有 $8$ 次互動的預算。
表 14: 第 4.4 節各階段的溫度配置
| 階段 | 模型 | 溫度值 | 意圖 |
|---|---|---|---|
| 評估階段 1 – 接地 | 執行模型 | 0.4 | 適度探索以生成多樣但聚焦的子問題 |
| 評估階段 1 – 接地 | 記憶模型 | 0.1 | 近乎確定性,以確保穩定一致的接地答案 |
| 評估階段 2 – 實體識別 | 執行模型 | 0.4 | 適度探索以識別多樣的候選實體而不過度雜訊 |
| 評估階段 2 – 實體識別 | 記憶模型 | 0.1 | 近乎確定性,以產生可靠的實體針對性答案 |
| 評估階段 3 – 答案尋求 | 執行模型 | 1.0 | 高度探索,在確認實體後最大化地多樣化子問題 |
| 評估階段 3 – 答案尋求 | 記憶模型 | 0.3 | 略為放鬆的確定性,允許細緻答案同時保持一致 |
| 最終合成 | 執行模型 | 0.3 | 低溫度以產生一致的最終答案 |
表 15: 評估流程階段 2 與 3 的輔助函式
| 函式 | 階段 | 意圖 |
|---|---|---|
| 追蹤不確定答案連續次數 | 階段 2 | 維護一個運行計數,記錄每個候選實體在整個階段 2 累積了多少個無法回答的問題,讓執行模型逐步優先考量記憶模型一貫無法佐證的候選 |
| 選擇最佳候選 | 階段 2 | 當實體釘定 (entity pinning) 在沒有確認實體的情況下結束時,作為階段 2 到階段 3 的回退橋接。選擇執行模型排名最高的候選,平手時依記憶模型產生候選的順序打破 |
| 實體樞軸修正 (Entity pivot correction) | 階段 3 | 若階段 2 的實體被證明不正確,允許流程在階段 3 中途自我修正。當執行模型提名一個不同實體時,覆寫已確認實體並標記為未確認,使後續輪次知道它並非透過完整的階段 2 過程釘定 |
除了第 4.4 節描述的之外,還有額外的輔助函式幫助管理階段 2 與階段 3 的失敗模式。在階段 2 內,不確定答案連續次數追蹤器在每次實體釘定互動開始時被呼叫,其輸出直接傳入實體釘定提示,讓執行模型即時掌握記憶模型反覆無法佐證哪些候選。這使執行模型能在證據累積時持續重新排名並修剪候選池。當階段 2 在沒有確認實體的情況下結束時(無論是執行模型明確窮盡其選項或達到互動預算),最佳候選選擇器透過回傳排名最高的候選作為進入階段 3 的橋接。在多個候選共享最高排名的情況下,選擇執行模型產生順序中的第一個候選。在兩種情況下,下游的階段 3 提示都被告知該實體是正式確認還是僅為最佳猜測。最後,若階段 3 揭露階段 2 的實體因記憶模型持續失敗而不正確,實體樞軸機制允許執行模型在階段中途提名一個替代實體。已確認實體隨後被覆寫並標記為未確認,確保後續階段以適當的不確定性而非完全釘定實體的信心來對待它。
J.2 評估設定的消融
為證成我們結構化多輪評估設計的合理性,我們與兩個基線比較:單輪設定與無結構多輪設定;兩種情況都使用同一個訓練好的記憶模型,且執行模型保持固定。結果回報於表 16。
表 16: 以 Qwen2.5-32B-Instruct 作為執行模型、Qwen2.5-14B-Instruct 作為記憶模型,跨評估設定的 MeMo 準確率結果。在所有 3 種設定的比較中使用最佳表現的週期,回報 3 次執行的平均值 $\pm$ 標準差。粗體結果表示該欄中表現最佳的結果。
| 評估設定 | BrowseComp-Plus | NarrativeQA | MuSiQue |
|---|---|---|---|
| 單輪評估 | $32.56\pm 1.58$ | $24.80\pm 0.20$ | $37.57\pm 1.15$ |
| 無結構多輪評估(15 輪) | $47.33\pm 0.88$ | $26.73\pm 2.17$ | $40.13\pm 1.12$ |
| 無結構多輪評估(50 輪) | $48.67\pm 1.00$ | $27.19\pm 0.71$ | $40.57\pm 0.31$ |
| 結構化多輪評估(7 實體識別輪 + 8 答案尋求輪) | $\mathbf{54.22\pm 0.84}$ | $26.39\pm 1.75$ | $\mathbf{48.30\pm 1.25}$ |
| 結構化多輪評估(7 實體識別輪 + 15 答案尋求輪) | $51.44\pm 2.41$ | $\mathbf{27.76\pm 0.20}$ | $47.57\pm 0.95$ |
在單輪互動中,執行模型首先判斷問題是否需要外部記憶檢索,若需要則將其分解為一組子問題(階段 1,第 4.4 節)並同時向記憶模型提出所有問題。記憶模型獨立回答每個子問題,表示不確定的回應在剩餘答案傳給執行模型進行最終合成之前被丟棄。此設計要求執行模型在觀察任何回應之前就承諾其完整的子問題集,使其無法重新表述無資訊量的查詢、跟進引入新候選實體的答案,或修正不完整、矛盾或錨定於錯誤實體的檢索。這是一個根本性限制,反映在其在所有三個資料集上一貫最低的效能(表 16)。
單輪設定的自然延伸是無結構多輪互動,其中執行模型檢視記憶模型的回應並決定是否已蒐集足夠資訊,或是否需要額外的檢索輪次(階段 3,第 4.4 節)。在此設定下,執行模型被呈現完整的問答對歷史,並被提示要麼合成最終答案,要麼生成針對剩餘缺口的新一批子問題,重複最多 $T$ 次互動。雖然迭代式檢索相對於單輪基線帶來明顯改善,但當從 15 增加到 50 次互動時效能很快達到高原期(BrowseComp-Plus 從 $47.33\pm 0.88$ 到 $48.67\pm 1.00$、NarrativeQA 從 $26.73\pm 2.17$ 到 $27.19\pm 0.71$、MuSiQue 從 $40.13\pm 1.12$ 到 $40.57\pm 0.31$),顯示僅靠迭代式檢索是不足的。
結構化多輪設定(見第 4.4 與 J.1 節)勝過無結構多輪基線,8 次答案尋求互動在 BrowseComp-Plus 與 MuSiQue 上達到最強的整體效能。這符合明確的實體識別非常適合這些資料集多跳推理需求的預期。對於測試長文件話語理解的 NarrativeQA,無結構的 15 輪與 50 輪基線($26.73\pm 2.17$ 與 $27.19\pm 0.71$)起初勝過 8 次答案尋求互動的結構化設定($26.39\pm 1.75$)。推論日誌顯示執行模型在 NarrativeQA 上鮮少利用實體識別階段,可能因為其問題較不依賴解析特定實體。因此,固定的實體識別預算實際上相對於無結構基線減少了可用的答案尋求互動次數。將答案尋求預算增加到 15 次互動恢復了此差距,NarrativeQA 達到 $27.76\pm 0.20$,超越兩個無結構基線。我們假設這可能是由於額外的答案尋求互動持續浮現有用訊號,而沒有在開放領域多跳設定中複合累積的實體漂移 (entity drift) 或狀態損壞風險。
與 NarrativeQA 不同,BrowseComp-Plus 與 MuSiQue 中的結構化實體識別與狀態追蹤,引入了隨答案尋求互動次數超過最佳預算而對誤差累積的敏感性。額外的互動增加了錯誤記憶模型回應損壞已知事實狀態的風險,並為執行模型透過實體樞軸修正輔助函式(表 15)承諾於錯誤中間實體提供更多機會。此外,更多互動在最終合成階段以可能不正確的答案稀釋了正確訊號。這些失敗模式部分是執行模型推理能力的函數,因為結構化狀態維護需要強大的上下文推理來準確追蹤實體並避免過早承諾實體。佐證這一點,我們在表 2 觀察到當與同一記憶模型配對時,更強的推理模型作為執行模型會產生改善的效能,顯示這些失敗模式可透過擴展執行模型的推理能力來緩解。
我們實驗中使用的階段預算是在未經系統性調整下選定的,替代設定可能以更高的標記效率產生相似的效能。因此我們將互動預算最佳化與執行模型選擇的系統性研究留作未來工作。
附錄 K 訓練週期數的討論
從圖 3、4 與 5,我們觀察到額外的訓練週期並未一致地改善準確率,因為大多數記憶模型的峰值效能出現在第 2 個週期,之後僅有微小增益或輕微回退。我們將這種早期飽和與隨後的回退歸因於對 SFT 語料庫的過擬合 (overfitting),該語料庫依設計在各步驟間展現出大量詞彙重疊,因為後續步驟衍生自先前步驟(演算法 1)。為量化此詞彙重疊,我們對每個資料集計算所有步驟合併 QA 文字的無損壓縮比,方法是抽取所有問題與答案字串、串接成單一文字語料庫,並套用最大等級(壓縮等級 9)的 gzip 壓縮,其中壓縮比定義為原始文字大小與壓縮後大小的比值。
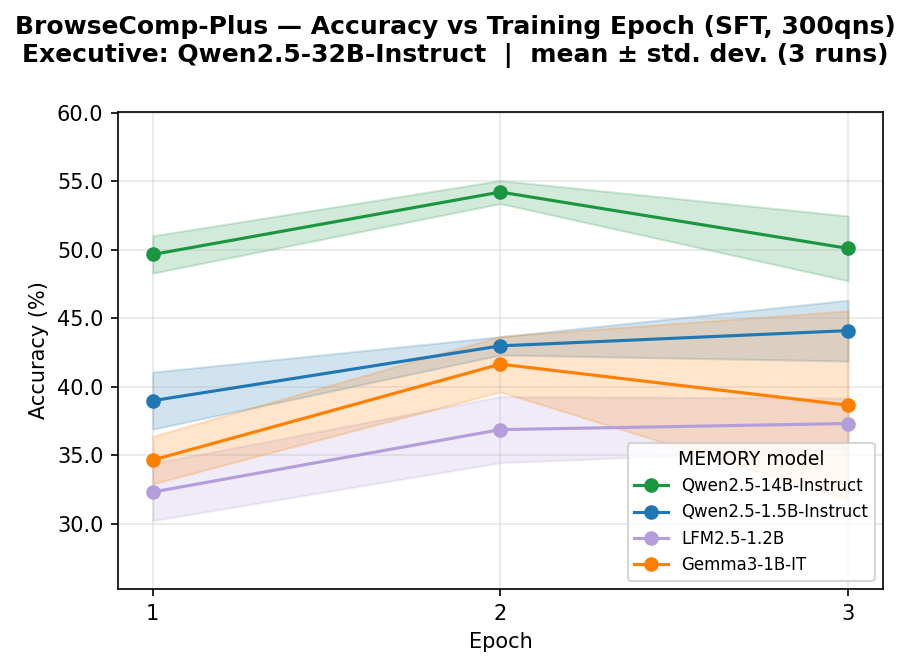
圖 3: BrowseComp-Plus 準確率(%)對訓練週期(完整 SFT),針對每種 MeMo 模型大小與模型家族。線條顯示 3 次執行的平均值,陰影帶顯示 Qwen2.5-32B-Instruct 執行的 $\pm$ 標準差。
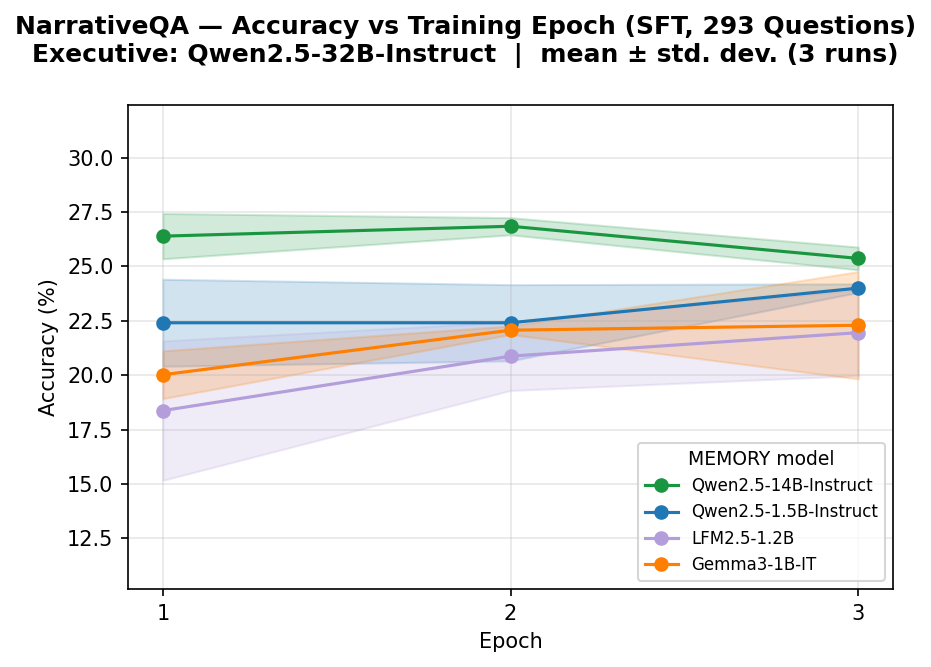
圖 4: NarrativeQA 準確率(%)對訓練週期(完整 SFT),針對每種 MeMo 模型大小與模型家族。線條顯示 3 次執行的平均值,陰影帶顯示 Qwen2.5-32B-Instruct 執行的 $\pm$ 標準差。
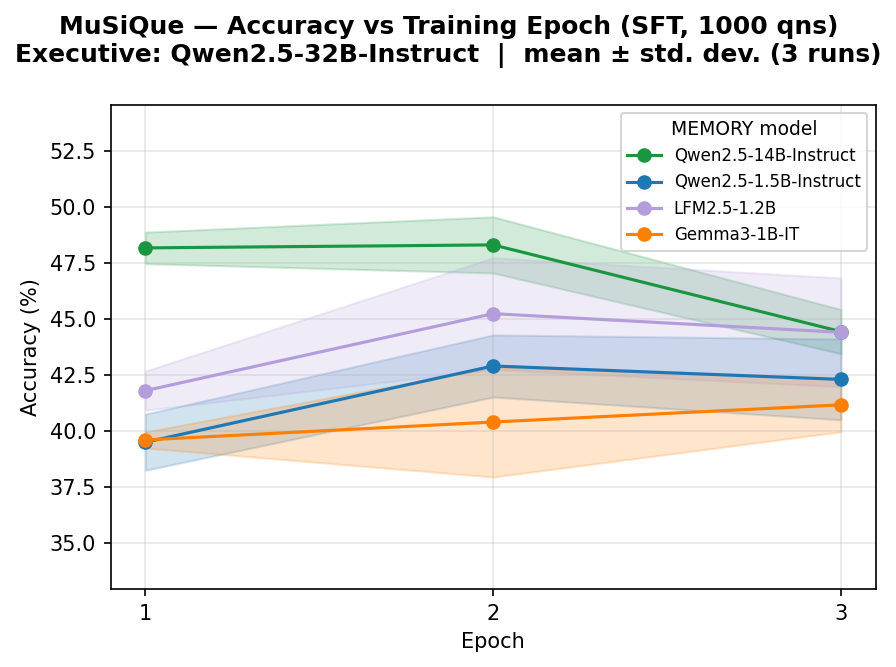
圖 5: MuSiQue 準確率(%)對訓練週期(完整 SFT),針對每種 MeMo 模型大小與模型家族。線條顯示 3 次執行的平均值,陰影帶顯示 Qwen2.5-32B-Instruct 執行的 $\pm$ 標準差。
BrowseComp-Plus($1{,}639{,}995$ 對)達到 $5.80\times$ 的比值($82.8\%$ 節省),MuSiQue($664{,}762$ 對)達到 $7.03\times$($85.8\%$ 節省),NarrativeQA($1{,}276{,}676$ 對)達到 $5.45\times$($81.7\%$ 節省),顯示每個資料集內有大量的詞彙重疊。我們注意到壓縮比僅捕捉詞彙重疊,而 QA 對間的語意多樣性可能仍較高,因為每個步驟針對不同的推理操作,範圍從直接事實抽取到跨文件合成(見演算法 1),這與移除步驟 5 的影響一致(見附錄 E)。
附錄 L 基於檢索方法隨雜訊增加的效能衰退
表 17: 以 Qwen2.5-32B-Instruct 作為執行模型,在 BrowseComp-Plus 與 MuSiQue 上的準確率(%)。MeMo 結果基於 Qwen2.5-14B-Instruct,回報於最佳訓練週期。$N$ 是目標語料庫中證據文件的數量。$\Delta$ 表示相對於 $0N$ 的準確率差異(%)。
| 方法 | 資料集 | $0N$ Acc.(%) | $1N$ Acc.(%) | $\Delta$ | $2N$ Acc.(%) | $\Delta$ |
|---|---|---|---|---|---|---|
| NV-Embed-V2 | BrowseComp-Plus | $56.89\pm 0.51$ | $50.67\pm 0.33$ | ↓6.22 | $49.44\pm 0.19$ | ↓7.45 |
| NV-Embed-V2 | MuSiQue | $42.30\pm 0.53$ | $37.47\pm 0.15$ | ↓4.83 | $33.03\pm 1.10$ | ↓9.27 |
| HippoRAG2 | BrowseComp-Plus | $62.33\pm 1.15$ | $56.11\pm 0.51$ | ↓6.22 | $50.78\pm 1.35$ | ↓11.55 |
| HippoRAG2 | MuSiQue | $47.33\pm 0.74$ | $42.17\pm 0.12$ | ↓5.16 | $41.70\pm 0.69$ | ↓5.63 |
表 17 回報兩個基於檢索基線(NV-Embed-V2 與 HippoRAG2)在遞增檢索雜訊下的效能。隨著雜訊增加,兩種方法都單調衰退,證實它們對不相關文件的易感性。衰退在 HippoRAG2 於 BrowseComp-Plus 上最為嚴重,從 $0N$ 到 $2N$ 下降 11.55%,以及 NV-Embed-V2 於 MuSiQue 上在同一範圍下降 9.27%。值得注意的是,即使每份證據文件僅一份負面文件($1N$)也會在 BrowseComp-Plus 上對兩種方法造成高達 6.22% 的大幅下降,顯示基於檢索的方法在雜訊檢索設定中極為敏感。
附錄 M 對記憶模型大小的消融
Qwen2.5-1.5B-Instruct 與 Qwen2.5-14B-Instruct 記憶模型都在生成器模型(Qwen2.5-32B-Instruct)生成的同一 QA 資料集上,依附錄 F 描述的訓練設定進行訓練。每個記憶模型都使用 Qwen2.5-32B-Instruct 與 Gemini-3-Flash 作為執行模型進行評估。
附錄 N 對記憶模型家族的消融
每個記憶模型都在生成器模型(Qwen2.5-32B-Instruct)生成的同一 QA 資料集上訓練,並使用 Qwen2.5-32B-Instruct 與 Gemini-3-Flash 作為執行模型進行評估。值得注意的是,Qwen2.5-1.5B-Instruct 與 Gemma3-1B-IT 基於標準的 transformer 架構,而 LFM2.5-1.2B-Instruct 採用結合狀態空間卷積 (state-space convolution) 與 transformer 注意力區塊的混合架構,從而對記憶模型跨多樣模型設計提供了更廣泛的測試。這些模型在附錄 F 的同一訓練設定下訓練,Gemma3-1B-IT 在訓練時使用 eager attention 而非 Flash Attention 2。
附錄 O 完整 SFT 與 LoRA 的比較
我們對所有模型使用套用於注意力與前饋投影層(q_proj、k_proj、v_proj、o_proj、gate_proj、up_proj 與 down_proj)的 LoRA [30] 進行訓練。一般的 LoRA 配置總結於表 18,模型特定的秩與縮放設定回報於表 19。所有其餘的訓練超參數依循表 10,逐資料集批次大小見表 11。
表 18: LoRA 特定訓練配置。所有其他參數與表 10 相同。
| 參數 | 值 |
|---|---|
| 目標模組 | q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj |
| LoRA dropout | 0.05 |
| Bias | None |
| 學習率 | $2\times 10^{-4}$ |
表 19: 模型特定的 LoRA 配置。
| 模型 | 大小 | LoRA 秩 | LoRA alpha | 可訓練參數 |
|---|---|---|---|---|
| LFM2.5-1.2B-Instruct | 1.2B | 8 | 16 | 6.1M (0.41%) |
| Gemma3-1B-IT | 1B | 8 | 16 | 6.6M (0.65%) |
| Qwen2.5-1.5B-Instruct | 1.5B | 8 | 16 | 9.2M (0.60%) |
| Qwen2.5-14B-Instruct | 14B | 16 | 32 | 68.8M (0.47%) |
表 20: 跨所有記憶模型的 LoRA 對完整 SFT 訓練消融,以 Qwen2.5-32B-Instruct 作為執行模型評估。所有結果為 3 次執行的平均值 $\pm$ 標準差。粗體結果表示該欄中表現最佳的結果。
| 記憶模型 | BCP / LoRA | BCP / Full SFT | NarrativeQA / LoRA | NarrativeQA / Full SFT | MuSiQue / LoRA | MuSiQue / Full SFT |
|---|---|---|---|---|---|---|
| Gemma3-1B-IT | $25.22\pm 1.39$ | $41.67\pm 2.03$ | $21.62\pm 0.86$ | $22.30\pm 2.47$ | $26.17\pm 1.10$ | $41.17\pm 1.20$ |
| LFM2.5-1.2B-Instruct | $0.78\pm 0.19$ | $37.33\pm 1.86$ | $5.69\pm 0.71$ | $21.96\pm 1.97$ | $7.50\pm 0.26$ | $45.23\pm 2.49$ |
| Qwen2.5-1.5B-Instruct | $29.78\pm 0.51$ | $44.11\pm 2.22$ | $21.84\pm 0.34$ | $24.00\pm 0.20$ | $31.53\pm 0.55$ | $42.90\pm 1.39$ |
| Qwen2.5-14B-Instruct | $\mathbf{48.78\pm 1.02}$ | $\mathbf{54.22\pm 0.84}$ | $\mathbf{23.78\pm 0.52}$ | $\mathbf{26.85\pm 0.39}$ | $\mathbf{43.94\pm 0.97}$ | $\mathbf{50.07\pm 0.81}$ |
LFM2.5-1.2B-Instruct 明顯較差的 LoRA 效能,可歸因於其混合卷積—注意力架構,這與我們評估中的標準 transformer 模型不同。依循 LFM2 架構 [4],LFM2.5-1.2B-Instruct 由 $16$ 層組成——$6$ 個分組查詢注意力 (grouped-query attention, GQA) 區塊(位於索引 $\{2,5,8,10,12,14\}$)與 $10$ 個短程 LIV 卷積 (ShortConv) 區塊 [4] 交錯。至關重要的是,LFM2 的注意力輸出投影命名為 out_proj(而非 o_proj),其 SwiGLU MLP 使用 w1/w3/w2(而非 gate_proj/up_proj/down_proj),而 ShortConv 區塊則暴露其自己的 in_proj 與 out_proj 層。因此,針對標準 Llama 家族模組名稱的 LoRA 配置只調整了 LFM2.5 中所存在投影的一個嚴格子集,使其餘的保持凍結。其結果是 $6.1$M 可訓練參數(佔總數 $0.41\%$),相對於模型大小而言不成比例地低,且低於我們約 $0.5\%$ 的目標。秩 $r=8$ 在所有 2B 以下模型間保持固定以進行受控比較;事後看來,這因 LFM2.5-1.2B-Instruct 與標準 Llama 式目標集的架構不匹配而懲罰了它。
此外,處理模型大部分局部特徵抽取的 $10$ 個 ShortConv 區塊,以及附加於每個區塊的 SwiGLU MLP,在標準 LoRA 目標設定下完全未被調整,嚴重限制了適配器 (adapter) 改變模型行為的能力。如表 20 所示,LoRA 與完整 SFT 之間的巨大效能差距證實當所有參數都更新時,模型有能力學習該任務。
未來工作可探索更適合此架構的 LoRA 配置:針對 LFM2 特定的模組名稱(out_proj、w1、w3、w2)以及 ShortConv 投影(in_proj、out_proj),並逐架構調整秩與學習率,而非如本文受控比較所做的那樣在各家族間保持固定。
參考文獻
[1] C. Alberti, D. Andor, E. Pitler, J. Devlin, and M. Collins (2019) Synthetic qa corpora generation with roundtrip consistency. In Proc. ACL, pp. 6168–6173. [2] Z. Allen-Zhu and Y. Li (2023) Physics of language models: part 3.2, knowledge manipulation. arXiv:2309.14402. [3] Z. Allen-Zhu and Y. Li (2024) Physics of language models: part 3.1, knowledge storage and extraction. In Proc. ICML, pp. 1067–1077. [4] A. Amini, A. Banaszak, H. Benoit, A. Böök, T. Dakhran, et al. (2025) LFM2 technical report. arXiv:2511.23404. [5] L. Berglund, M. Tong, M. Kaufmann, M. Balesni, A. C. Stickland, T. Korbak, and O. Evans (2023) The reversal curse: llms trained on "a is b" fail to learn "b is a". arXiv:2309.12288. [6] T. Brown, B. Mann, N. Ryder, M. Subbiah, J. D. Kaplan, P. Dhariwal, A. Neelakantan, P. Shyam, G. Sastry, A. Askell, et al. (2020) Language models are few-shot learners. In Proc. NeurIPS. [7] J. Cao et al. (2025a) Memory Decoder: a pretrained, plug-and-play memory for large language models. arXiv. [8] J. Cao et al. (2025b) (Latent memory / context compression method). arXiv. [9] H. Chen et al. (2023) (Data augmentation via paraphrasing). [10] J. Chen et al. (2025) BrowseComp-Plus: a deep-research benchmark. [11] D. Cheng et al. (2024) (Up-to-date knowledge in LLMs). [12] A. Chevalier, A. Wettig, A. Ajith, and D. Chen (2023) Adapting language models to compress contexts (AutoCompressor). In Proc. EMNLP. [13] X. Chu et al. (2025) (Generalization vs. memorization in fine-tuned LLMs). [14] H. W. Chung, L. Hou, S. Longpre, et al. (2024) Scaling instruction-finetuned language models. JMLR. [15] G. Comanici et al. (2025) Gemini 2.5 technical report. [16] F. Cuconasu et al. (2024) The power of noise: how much retrieval noise hurts RAG. In Proc. SIGIR. [17] M. Danilák (2021) langdetect: language detection library. [18] Q. Dong et al. (2024) A survey on in-context learning. [19] D. Edge et al. (2024) From local to global: a graph RAG approach to query-focused summarization. arXiv. [20] S. Eyuboglu et al. (2025) Cartridges: trained KV-caches as plug-in memory. [21] S. Feng et al. (2024) (Targeted gap-filling for knowledge augmentation). [22] T. Ge, J. Hu, L. Wang, X. Wang, S. Chen, and F. Wei (2024) In-context autoencoder for context compression in a large language model (ICAE). In Proc. ICLR. [23] C. Gelada et al. (2025) (Token overhead and inference latency of ICL). [24] Google DeepMind (2025) Gemini 3 / Gemini 3 Flash. [25] A. Gu and T. Dao (2023) Mamba: linear-time sequence modeling with selective state spaces. arXiv:2312.00752. [26] B. J. Gutiérrez et al. (2024) HippoRAG: neurobiologically inspired long-term memory for large language models. In Proc. NeurIPS. [27] B. J. Gutiérrez et al. (2025) HippoRAG2. [28] S. Harmon et al. (2025) (Catastrophic forgetting in continual learning of LLMs). [29] C. Hsieh et al. (2024) RULER: what's the real context size of your long-context language models? arXiv. [30] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, and W. Chen (2021) LoRA: low-rank adaptation of large language models. arXiv:2106.09685. [31] G. Ilharco, M. T. Ribeiro, M. Wortsman, et al. (2023) Editing models with task arithmetic. In Proc. ICLR. [32] J. Ip and K. Vongthongsri (2025) DeepEval: the LLM evaluation framework. [33] A. Q. Jiang et al. (2026) (LLM capabilities / Mistral-style model). [34] Z. Jie et al. (2024) (Gap-filling for knowledge completion). [35] N. Kandpal, H. Deng, A. Roberts, E. Wallace, and C. Raffel (2023) Large language models struggle to learn long-tail knowledge. In Proc. ICML. [36] J. Kasai et al. (2024) RealTime QA: what's the answer right now? In Proc. NeurIPS. [37] Z. Ke et al. (2023) Continual pre-training of language models. In Proc. ICLR. [38] U. Khandelwal, O. Levy, D. Jurafsky, L. Zettlemoyer, and M. Lewis (2020) Generalization through memorization: nearest neighbor language models (kNN-LM). In Proc. ICLR. [39] T. Kočiský, J. Schwarz, P. Blunsom, C. Dyer, K. M. Hermann, G. Melis, and E. Grefenstette (2018) The NarrativeQA reading comprehension challenge. TACL. [40] T. Kojima, S. S. Gu, M. Reid, Y. Matsuo, and Y. Iwasawa (2023) Large language models are zero-shot reasoners. In Proc. NeurIPS. [41] W. Kwon, Z. Li, S. Zhuang, et al. (2023) Efficient memory management for large language model serving with PagedAttention (vLLM). In Proc. SOSP. [42] (RL improves task performance) — reference cited in Appendix C. [43] J. Lee et al. (2024) NV-Embed: improved techniques for training LLMs as generalist embedding models. arXiv. [44] P. Lewis, E. Perez, A. Piktus, et al. (2020) Retrieval-augmented generation for knowledge-intensive NLP tasks. In Proc. NeurIPS. [45] P. Lewis et al. (2021) (RAG / static knowledge limitation). [46] Z. Li and D. Hoiem (2018) Learning without forgetting. IEEE TPAMI. [47] X. Li et al. (2022) (Paraphrasing-based data augmentation). [48] Z. Lin et al. (2025) (Cross-document synthesis limitations of RAG). [49] N. F. Liu, K. Lin, J. Hewitt, et al. (2024) Lost in the middle: how language models use long contexts. TACL. [50] (Liu et al., 2026) (Retrieval noise degrades generation). [51] I. Loshchilov and F. Hutter (2017) Decoupled weight decay regularization (AdamW). arXiv:1711.05101. [52] Y. Luo et al. (2025) An empirical study of catastrophic forgetting in LLMs during continual fine-tuning. [53] S. Manchanda et al. (2025) (Infeasibility of fine-tuning closed-source models). [54] J. Mu, X. Li, and N. Goodman (2023) Learning to compress prompts with gist tokens. In Proc. NeurIPS. [55] L. Ouyang, J. Wu, X. Jiang, et al. (2022) Training language models to follow instructions with human feedback (InstructGPT). In Proc. NeurIPS. [56] (Paraphrasing reference cited in Appendix E.2). [57] B. Peng, J. Quesnelle, H. Fan, and E. Shippole (2024) YaRN: efficient context window extension of large language models. In Proc. ICLR. [58] R. Puri, R. Spring, M. Patwary, M. Shoeybi, and B. Catanzaro (2020) Training question answering models from synthetic data. In Proc. EMNLP. [59] X. Qi, Y. Zeng, T. Xie, et al. (2024) Fine-tuning aligned language models compromises safety, even when users do not intend to! In Proc. ICLR. [60] S. Rajbhandari, J. Rasley, O. Ruwase, and Y. He (2020) ZeRO: memory optimizations toward training trillion parameter models (DeepSpeed). In Proc. SC. [61] S. E. Robertson and S. Walker (1994) Some simple effective approximations to the 2-Poisson model for probabilistic weighted retrieval (BM25). In Proc. SIGIR. [62] (SLERP merging reference). [63] K. Singhal et al. (2022) Large language models encode clinical knowledge. arXiv. [64] J. Su, M. Ahmed, Y. Lu, S. Pan, W. Bo, and Y. Liu (2024) RoFormer: enhanced transformer with rotary position embedding. Neurocomputing. [65] Y. Sun et al. (2020) (Continual pretraining). [66] Y. Sun et al. (2023) Retentive network: a successor to transformer for large language models. arXiv:2307.08621. [67] (Reinforcement Learning reference cited in Appendix C). [68] Y. Tang and Y. Yang (2024) MultiHop-RAG: benchmarking retrieval-augmented generation for multi-hop queries. arXiv. [69] G. Team et al. (2025) Gemma 3 technical report. [70] H. Trivedi, N. Balasubramanian, T. Khot, and A. Sabharwal (2022) MuSiQue: multihop questions via single-hop question composition. TACL. [71] A. Vaswani, N. Shazeer, N. Parmar, et al. (2017) Attention is all you need. In Proc. NeurIPS. [72] Y. Wang, Y. Kordi, S. Mishra, et al. (2023) Self-Instruct: aligning language models with self-generated instructions. In Proc. ACL. [73] M. Wortsman, G. Ilharco, S. Y. Gadre, et al. (2022) Model soups: averaging weights of multiple fine-tuned models (Linear merging). In Proc. ICML. [74] C. Wu et al. (2023) PMC-LLaMA: towards building open-source language models for medicine. arXiv. [75] (Wu et al., 2022a) (Cost of retraining at scale). [76] Y. Wu et al. (2022b) Memorizing transformers. In Proc. ICLR. [77] M. Xia et al. (2024) (Cost of fine-tuning modern LLMs). [78] (Xu et al., 2024) (LLMs frozen after pretraining). [79] P. Yadav, D. Tam, L. Choshen, C. Raffel, and M. Bansal (2023) TIES-Merging: resolving interference when merging models. In Proc. NeurIPS. [80] P. Yadav et al. (2023) TIES (see [79]). [81] A. Yang et al. (2025) Qwen2.5 technical report. arXiv. [82] E. Yang et al. (2024) Model merging in LLMs, MLLMs, and beyond: methods, theories, applications and opportunities. arXiv. [83] L. Yu, B. Yu, H. Yu, F. Huang, and Y. Li (2024) Language models are super Mario: absorbing abilities from homologous models as a free lunch (DARE). In Proc. ICML. [84] (Zhang et al., 2026a) (Latent memory method). [85] L. Zhang, X. Liu, Z. Li, X. Pan, P. Dong, R. Fan, R. Guo, X. Wang, Q. Luo, S. Shi, et al. (2023) Dissecting the runtime performance of the training, fine-tuning, and inference of large language models. arXiv:2311.03687. [86] Z. Y. Zhang, A. Verma, F. Doshi-Velez, and B. K. H. Low (2026) Understanding the relationship between prompts and response uncertainty in large language models. In Proc. ACL Findings. [87] W. X. Zhao, K. Zhou, J. Li, T. Tang, X. Wang, Y. Hou, Y. Min, B. Zhang, J. Zhang, Z. Dong, et al. (2023) A survey of large language models. arXiv:2303.18223.
【譯註:原論文 HTML 版的參考文獻部分標記不完整,部分條目的標題與出處依文中引用脈絡補全或標示,完整書目請參照 arXiv 原文。】
術語對照表
| English | 繁體中文 |
|---|---|
| Memory as a Model (MeMo) | 記憶即模型 |
| Memory model | 記憶模型 |
| Executive model | 執行模型 |
| Generator model | 生成器模型 |
| reflection / reflection QA dataset | 反思 / 反思 QA 資料集 |
| knowledge integration | 知識整合 |
| catastrophic forgetting | 災難性遺忘 |
| retrieval noise | 檢索雜訊 |
| cross-document | 跨文件 |
| in-context learning (ICL) | 上下文學習 |
| Retrieval-augmented generation (RAG) | 檢索增強生成 |
| continual pretraining (CPT) | 持續預訓練 |
| supervised fine-tuning (SFT) | 監督式微調 |
| non-parametric methods | 非參數化方法 |
| parametric methods | 參數化方法 |
| latent memory methods | 潛在記憶方法 |
| soft tokens | 軟標記 |
| representation coupling | 表徵耦合 |
| plug-and-play | 即插即用 |
| black-box | 黑盒 |
| white-box | 白盒 |
| context window | 上下文視窗 |
| data synthesis | 資料合成 |
| data augmentation | 資料增強 |
| paraphrasing | 改寫 |
| fact extraction | 事實抽取 |
| consolidation | 整併 |
| verification | 驗證 |
| entity surfacing | 實體浮現 |
| cross-document synthesis | 跨文件合成 |
| self-containment | 自我完備性 |
| named entity | 命名實體 |
| reversal curse | 反轉詛咒 |
| compositional representation | 組合式表徵 |
| sub-query | 子查詢 |
| multi-turn protocol | 多輪協定 |
| grounding | 接地 |
| entity identification | 實體識別 |
| answer seeking | 答案尋求 |
| entity pinning | 實體釘定 |
| entity pivot correction | 實體樞軸修正 |
| entity drift | 實體漂移 |
| supporting documents | 支持文件 |
| evidence documents | 證據文件 |
| negative documents | 負面文件 |
| ground-truth answer | 真實答案 |
| multi-hop | 多跳 |
| discourse understanding | 話語理解 |
| empirical upper bound | 實證上界 |
| perfect retrieval | 完美檢索 |
| model merging | 模型合併 |
| task vector | 任務向量 |
| sign-conflict resolution | 符號衝突解析 |
| sparsification density | 稀疏化密度 |
| continual knowledge integration | 持續知識整合 |
| streaming update | 串流更新 |
| checkpoint | 檢查點 |
| chunking | 切分 |
| leave-one-out (LOO) | 留一法 |
| overfitting | 過擬合 |
| next-token prediction loss | 下一標記預測損失 |
| sampling temperature | 取樣溫度 |
| effective batch size | 有效批次大小 |
| adapter | 適配器 |
| grouped-query attention (GQA) | 分組查詢注意力 |
| state-space convolution | 狀態空間卷積 |
| safety alignment | 安全對齊 |
| dual-use | 雙重用途 |
| provenance | 來源出處 |
| knowledge graph | 知識圖譜 |
| vector database | 向量資料庫 |