AutoData:一個用於開放網路資料蒐集的多代理人系統
原始論文:AutoData: A Multi-Agent System for Open Web Data Collection 作者:Tianyi Ma, Yiyue Qian, Zheyuan Zhang, Zehong Wang, Xiaoye Qian, Feifan Bai, Yifan Ding, Xuwei Luo, Shinan Zhang, Keerthiram Murugesan, Chuxu Zhang, Yanfang Ye (University of Notre Dame, Amazon, University of Washington, Purdue University, IBM Research, University of Connecticut) arXiv ID:2505.15859v1 日期:2025-05-21 標籤:Multi-Agent System LLM Agent Web Scraping Data Collection Information Extraction Benchmark Hypergraph
目錄
- 摘要
- 1 緒論
- 2 預備知識
- 3 AutoData:用於網路資料蒐集的多代理人系統
- 4 Instruct2DS:開放網路資料蒐集的基準資料集
- 5 實驗
- 6 相關研究
- 7 結論
- 附錄 A 新資料集 Instruct2DS
- 附錄 B 基準資料集
- 附錄 C 基線方法
- 附錄 D 實作細節
- 附錄 E 額外實驗
- 附錄 F 兒童繪本蒐集的補充討論
- 附錄 G 限制
- 附錄 H 更廣泛的影響
- 參考文獻
- 術語對照表
摘要
資料驅動 (data-driven) 系統與 AI 技術的指數型成長,加劇了對高品質、來自網路的資料集的需求。儘管既有資料集已展現其價值,傳統的網路資料蒐集方法在人力投入與可擴展性 (scalability) 上仍面臨顯著限制。目前的資料蒐集解決方案可分為兩類:基於包裝器 (wrapper-based) 的方法,這類方法在適應性與可重現性 (reproducibility) 上有困難;以及基於大型語言模型 (Large Language Model, LLM) 的方法,這類方法則會帶來可觀的運算與財務成本。為了解決這些挑戰,我們提出 AutoData,一個用於自動化網路資料蒐集 (Automated web Data collection) 的全新多代理人系統 (Multi-Agent System),它只需要極少的人為介入,亦即只需給定一段指定目標資料集的自然語言指令。此外,AutoData 採用了一個穩健的多代理人架構,其特色是由一個中央任務管理者 (central task manager) 協調的全新導向訊息超圖 (oriented message hypergraph),以高效地組織橫跨研究小隊 (research squad) 與開發小隊 (development squad) 的各個代理人。除此之外,我們引入一個全新的超圖快取系統 (hypergraph cache system) 來推進多代理人協作流程,使自動化資料蒐集更有效率,並緩解既有 LLM 系統普遍存在的 token 成本問題。再者,我們提出 Instruct2DS,一個支援從網路來源進行即時 (live) 資料蒐集的全新基準資料集 (benchmark dataset),涵蓋三個領域:學術、金融與運動。在 Instruct2DS 以及三個既有基準資料集上的全面評估,證明了 AutoData 相較於基線方法 (baseline methods) 的卓越效能。針對繪本蒐集與從綜述論文中萃取論文等高難度任務的案例研究 (case studies),進一步驗證了它的適用性。我們的原始碼與資料集已公開。
1 緒論
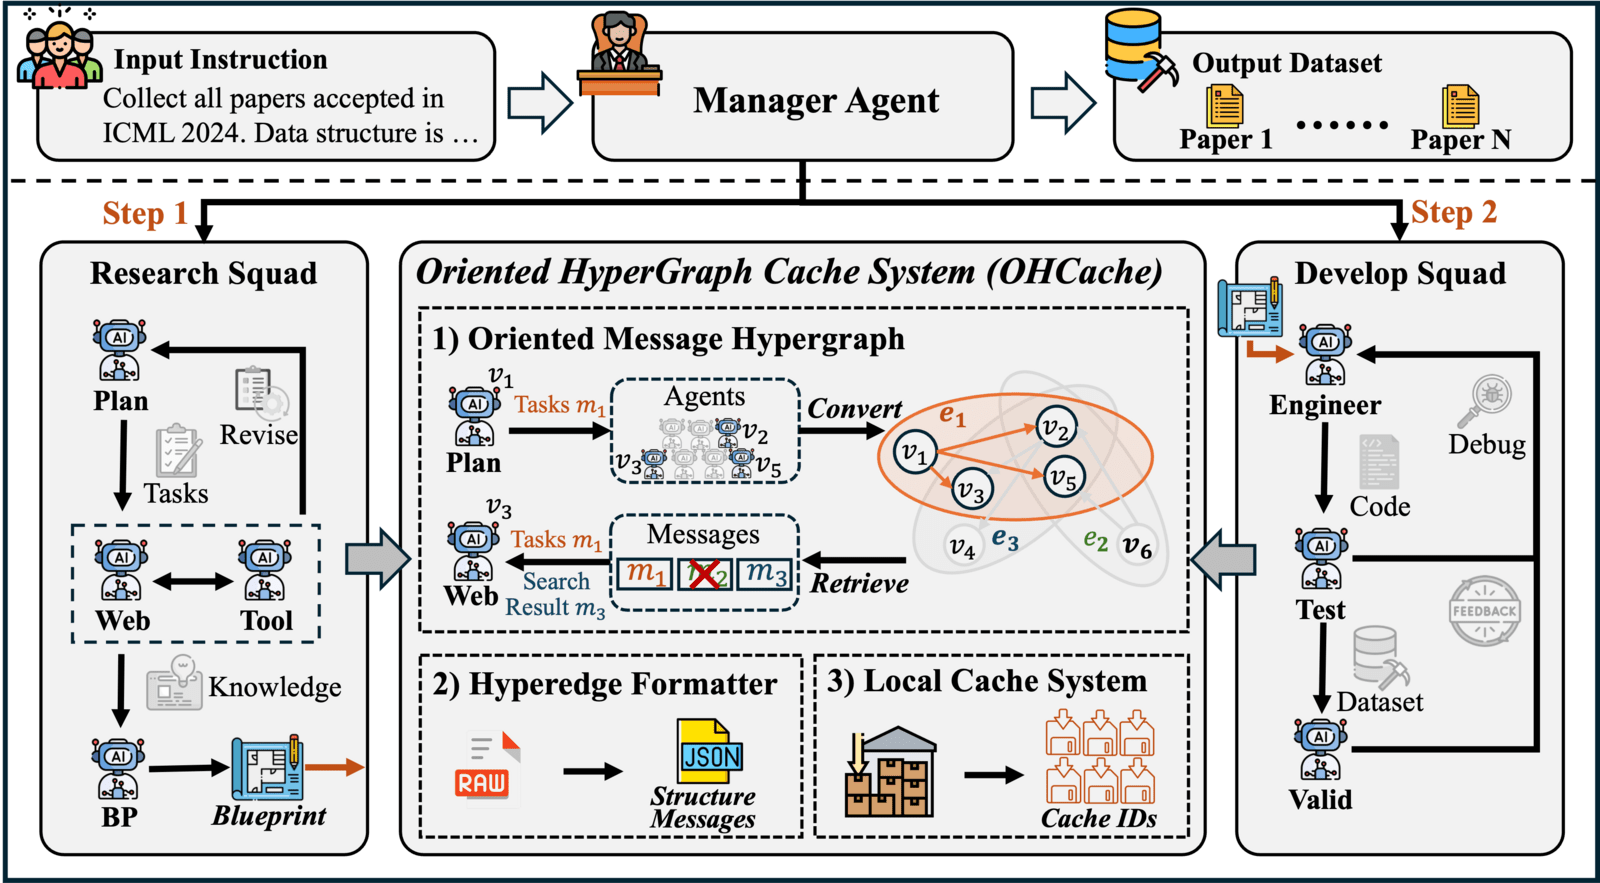
圖 1:AutoData 的整體框架。 給定輸入指令後,研究小隊中的代理人透過瀏覽網頁協作產生一份開發藍圖 (development blueprint)。隨後,開發小隊根據藍圖建構程式並執行該程式,以取得所需的資料集。為了確保高效且有效的多代理人協作,我們引入一個全新的導向超圖快取系統 (oriented hypergraph cache system) 來進行資訊共享。如圖所示,計畫代理人 (plan agent,$v_1$) 將訊息 $m_1$ 送往代理人 $v_2$、$v_3$ 與 $v_5$,形成一條導向超邊 (oriented hyperedge) $e_1$。接著,網路代理人 (web agent,$v_3$) 從導向訊息超圖 $\vec{\mathcal{G}}$ 中取回訊息 $m_1$ 與 $m_3$ 以進行決策。此外,我們設計了一個超邊格式化器 (hyperedge formatter) 來規範化代理人訊息,以及一個本地快取系統 (local cache system) 來儲存有價值的產物 (artifacts),供後續代理人以隨需 (on-demand) 方式取回。
資料是驅動現代以資料為中心 (data-centric) 的智慧系統的燃料 [1, 2]。最先進 (state-of-the-art) 的 AI 模型嚴重仰賴高品質資料來學習模式、預測趨勢並進行自我優化。由於全球資訊網 (World Wide Web) 承載著無與倫比廣度的真實世界訊號,它已成為大規模資料取得的預設儲存庫。具有里程碑意義、來自網路的資料 [3, 4, 5, 6, 7, 8, 9, 10] 已經加速了各領域的研究,例如自然語言處理 (natural language processing)、電腦視覺 (computer vision) 與推薦系統 (recommendation systems)。
然而,對更豐富、更具領域特定性、且規模不斷擴大的資料集之需求正在爆炸性成長 [11]。傳統的網路爬取 (web-scraping) 管線在三大瓶頸下不堪負荷:(i) 基於包裝器的爬蟲十分脆弱,亦即每出現一個新網站或新版面,都需要耗時的人工規則工程 (manual rule engineering)。(ii) 基於 LLM 的爬取工具雖將剖析邏輯外包給專有模型,卻會產生可觀的時間與財務開銷。(iii) REST-API 採集工具仍需要人類專家去詮釋每個端點 (endpoint) 參數,並受限於速率規則 (rate rules)。因此,學界面臨一個關鍵問題:「我們如何能建構一個端到端 (end-to-end) 且全自動的開放網路資料蒐集系統,同時最大化涵蓋率、準確率與效率?」
為回應此問題,受到為 LLM 配備任務特定工具的 AI 代理人 (AI agents) 快速進展之啟發 [12, 13, 14],我們引入一個用於從網路來源自動蒐集資料 (Automatic Data collection) 的全新多代理人系統,稱為 AutoData。AutoData 在一個中央任務管理者 (MGR) 的統籌下,協調兩支專責代理人小隊,亦即研究小隊與開發小隊。具體而言,在接收到資料蒐集指令後,研究小隊中的專責代理人會把指令拆解成小步驟,依步驟從網路來源萃取知識並設計開發藍圖。隨後,開發小隊將藍圖轉換為可執行程式碼、執行該程式,並驗證所蒐集的資料。不同於既有那些忽略開放網路資料蒐集任務龐大 token 成本的通用多代理人系統,我們引入一個全新的導向超圖快取系統 (Oriented HyperGraph Cache System),稱為 OHCache,以在開放網路資料蒐集任務中進行有效且具成本效益的多代理人協作。OHCache 由以下部分組成:(i) 一個導向訊息超圖,將代理人間的訊息流建模為導向超邊。(ii) 一個導向超邊格式化器,用以強制執行結構化的通訊綱要 (communication schema) 並進行超邊訊息累積。(iii) 一個本地快取系統,儲存可重用的產物供代理人隨需取回。
除了系統面的貢獻之外,我們發現缺乏可用於評估模型在開放網路資料蒐集任務上效能的基準資料集。最相關的基準資料集 [15, 16],亦即網路資訊萃取 (web information extraction) 任務,僅是在靜態、已封存的網頁上爬取,無法測試開放網路資料蒐集。有鑑於此,我們引入一個全新蒐集的「指令到資料集 (Instruction to DataSet)」基準,稱為 Instruct2DS,這是首個開放網路資料蒐集基準,涵蓋三個領域,亦即學術 (Academic)、金融 (Finance) 與運動 (Sport)。
在 Instruct2DS 以及三個既有基準資料集上的廣泛實驗,證明了 AutoData 的有效性與效率。此外,兩個額外的案例研究進一步凸顯了它的適用性與隨插即用 (plug-and-play) 的適應性。我們將貢獻總結如下:
- 全新的多代理人系統:我們開發了一個全自動的多代理人系統,由八個專責代理人與一個全新的導向超圖快取系統組成,以進行高效且有效的多代理人協作,能把一句話的資料需求轉化為可直接使用的資料集。
- 全新的基準資料集:我們引入一個全新蒐集的基準 Instruct2DS,涵蓋三個領域,亦即學術、金融與運動。據我們所知,這是首個用於評估模型在開放網路資料蒐集任務上效能的基準資料集。
- 全面的評估:我們在 Instruct2DS 以及三個既有基準資料集(亦即 Swde、Extended Swde 與 HumanEval)上,對 AutoData 與基線方法進行了全面實驗。實驗結果證明了 AutoData 在開放網路資料蒐集任務上的有效性、效率與適用性。
2 預備知識
定義 2.1(導向超圖, Oriented Hypergraph)。 令 $\mathcal{G}=\{\mathcal{V},\mathcal{E}\}$ 表示一個超圖 (hypergraph),其中 $\mathcal{V}=\{v_1,\dots,v_N\}$ 是節點集合,$\mathcal{E}=\{e_1,\dots,e_M\}$ 是超邊 (hyperedges) 集合。不同於圖中的成對邊 (pairwise edges) [17, 18, 19],每條超邊 $e_j\in\mathcal{E}$ 連接多個節點,表示節點間的複雜互動。在一個導向超圖 $\vec{\mathcal{G}}=\{\mathcal{V},\vec{\mathcal{E}}\}$ 中,每條超邊 $\vec{e}_j\in\vec{\mathcal{E}}$ 包含兩個節點子集 $\vec{e}_j=(S,T)$,其中子集 $S\subseteq\mathcal{V}$ 包含來源節點 (source nodes),子集 $T\subseteq\mathcal{V}$ 包含目標節點 (target nodes),以描繪 $\vec{e}_j$ 中節點之間的方向。
問題 1(開放網路資料蒐集, Open Web Data Collection)。 給定一段自然語言形式的資料指令 $\text{Instruct}$,目標是設計一個全自動系統 $f(\text{Instruct},\mathcal{W})=\text{DS}$,能夠有效且高效地從開放網路來源 $\mathcal{W}$ 中蒐集滿足 $\text{Instruct}$ 中需求的資料 $\text{DS}$。
3 AutoData:用於網路資料蒐集的多代理人系統
AutoData 是一個多代理人系統 (Multi-Agent System, MAS),不僅能透過網路爬取,也能透過 REST API 呼叫 [20] 來進行開放網路資料蒐集,且兼具有效性與效率。具體而言,AutoData 由八個專責代理人組成,這些代理人進一步劃分為研究小隊與開發小隊,以協作方式執行網路資料蒐集工作流程。AutoData 的設計受到傳統網路資料蒐集流程 [21, 22, 23, 24] 的啟發:在該流程中,個人首先從網路來源中提煉出資料蒐集邏輯並萃取該邏輯,接著撰寫並執行程式以取得資料集。在本節中,我們首先討論 AutoData 中的專責代理人。隨後,我們呈現我們全新的多代理人協作機制——導向超圖快取系統 (OHCache) 的細節,該機制旨在優化代理人之間的協同作用並提供無可比擬的運作效率。整體框架如圖 1 所示。
3.1 專責代理人
近期進展凸顯了多代理人協作的顯著效力,尤其當各代理人具備多樣化技能與領域專業時,在處理複雜任務上特別有效,例如軟體開發 [25, 26, 27]、科學辯論 [28, 29] 與推薦系統 [30, 31]。受此啟發,我們設計了 AutoData,它由八個專責代理人組成,策略性地組織成兩支協同的小隊(亦即研究與開發),並由一個中央管理者代理人 (manager agent, MGR) 進行協調,透過自適應的代理人互動來進行開放網路資料蒐集。
研究小隊 (Research Squad)。 研究小隊記為 $\mathcal{V}_{\text{res}}$,旨在協作地萃取、綜整並操作化對網路資料蒐集工作流程至關重要的知識。此群組由四個專責代理人組成:(i) 計畫代理人 (plan agent) $v_{\text{plan}}$、(ii) 網路代理人 (web agent) $v_{\text{web}}$、(iii) 工具代理人 (tool agent) $v_{\text{tool}}$,以及 (iv) 藍圖代理人 (blueprint agent) $v_{\text{bp}}$。每個代理人都被賦予一個獨特、互補的角色。具體而言,計畫代理人 $v_{\text{plan}}$ 將整體的資料蒐集目標分解為細緻、可執行的步驟。網路代理人 $v_{\text{web}}$ 自主地瀏覽各種網路來源,以萃取關鍵知識與程序邏輯。工具代理人 $v_{\text{tool}}$ 善用進階工具(例如 Google search、檔案轉換與 HTML 清理器)來增強小隊的運作能力。此外,藍圖代理人 $v_{\text{bp}}$ 將取得的洞見整合為一份連貫、可執行的開發藍圖,為下游執行奠定基礎。
開發小隊 (Development Squad)。 開發小隊 $\mathcal{V}_{\text{dev}}$ 善用研究小隊綜整出的完整藍圖,運用其程式撰寫能力進行程式建構、除錯、執行與資料驗證。此小隊由以下組成:(i) 工程代理人 (engineering agent) $v_{\text{engr}}$、(ii) 測試代理人 (test agent) $v_{\text{test}}$,以及 (iii) 驗證代理人 (validation agent) $v_{\text{val}}$。工程代理人 $v_{\text{engr}}$ 嚴格依照規定的藍圖實作資料蒐集管線。測試代理人 $v_{\text{test}}$ 負責對程式進行除錯與執行,而驗證代理人 $v_{\text{val}}$ 則設計並執行精密的測試案例,以確保資料的完整性與可靠性。
管理者代理人 (Manager Agent)。 除了專責的研究與開發代理人外,我們引入一個中央管理者代理人 (MGR) $v_{\text{mgr}}$,它統籌端到端的工作流程並協調群組間的互動,如圖 1 所示。MGR 確保所有代理人角色之間能無縫地進行任務分配、進度追蹤與動態調適。
這些專責代理人共同作為一個整合、自適應的集體運作,以應對開放網路資料蒐集的多面向挑戰。每個代理人 $v_i$ 都由一個獨特的設定檔 (profile) 來刻劃,該設定檔封裝其目標、名稱與運作限制,並以一段提示 (prompt) $P_i$ 形式化表示。各代理人遵循 ReAct 範式 [32],在行動前進行深思熟慮的推理,以最小化幻覺 (hallucinations) 並提升穩健性。形式上,代理人 $v_i$ 在時間 $t$ 的執行為:
$$m^t_i = \text{LLM}(\mathcal{M}_i^t, P_i, \mathcal{F}_i), \tag{1}$$
其中 $m_i^t$ 是代理人 $v_i$ 在時間 $t$ 透過函式 $\text{LLM}(\cdot)$ 所產生的輸出,$\mathcal{M}_i^t$ 表示訊息歷史 (message history)(見 3.2 節),而 $\mathcal{F}_i$ 則指定代理人 $v_i$ 可用的函式工具 (function tools)。
3.2 多代理人協作
有效的通訊是多代理人協作成功的關鍵 [33, 34]。然而,目前的 MAS 範式呈現出一些關鍵限制,阻礙了它們在開放網路資料蒐集情境中的實際部署:(i) 廣播式通訊造成的資訊過載。 傳統 MAS 方法經常仰賴廣播式 (broadcast-style) 訊息傳遞,亦即每則訊息都被散播給所有代理人,而每個代理人都要處理整個訊息歷史以進行決策。此策略不僅造成顯著的資訊負擔,也增加了幻覺與認知過載 (cognitive overload) 的風險,尤其當訊息歷史不斷增長時 [35]。(ii) 非結構化的自然語言介面。 大多數既有 MAS 框架 [36, 37, 38] 使用非結構化的自然語言進行代理人間通訊。雖然靈活,但此做法使後續代理人難以萃取顯著資訊,阻礙了在複雜、多階段任務中的高效問題解決 [26]。(iii) 內嵌產物之訊息的傳播。 在開放網路資料蒐集中,代理人可能無意間在訊息中傳輸龐大的產物(例如 HTML 檔案、原始網路資料),使通訊通道變得雜亂,進一步加劇效率低落。
為解決這些挑戰,我們提出一個全新的導向超圖快取系統,稱為 OHCache,一個專門設計用以優化資訊流、結構化訊息內容並在 MAS 環境中高效管理產物的通訊架構。具體而言,OHCache 包含三個元件:(i) 導向訊息超圖 (Oriented Message Hypergraph)、(ii) 導向超邊格式化器 (Oriented Hyperedge Formatter),以及 (iii) 本地快取系統 (Local Cache System)。OHCache 背後的核心洞見是:天真的一對一或廣播式通訊拓樸引入了不必要的複雜度與效率低落 [34, 39]。此外,實務上僅有少數代理人需要存取同一個資訊來源。舉例而言,工程代理人 $v_{\text{engr}}$ 與驗證代理人 $v_{\text{val}}$ 都依賴藍圖代理人 $v_{\text{bp}}$ 所產生的開發藍圖,以分別執行其在程式建構與驗證上的角色。超圖中的導向超邊優雅地捕捉了這種多接收者的通訊,實現有針對性的資訊散播,減少訊息冗餘並緩解過載風險。整體而言,OHCache 精簡了通訊,並提升整體系統的可擴展性與精確度。接下來,我們將詳細介紹 OHCache 中的各個元件。
導向訊息超圖 (Oriented Message Hypergraph)。 為克服廣播所引發的資訊過載,我們引入導向訊息超圖 $\vec{\mathcal{G}}$,它實現了選擇性且高效的訊息路由 (message routing):
$$\vec{\mathcal{G}}=(\mathcal{V},\vec{\mathcal{E}},\mathcal{M}),\ \vec{e}_j=(S_j,T_j)\in\vec{\mathcal{E}},\ \text{其中 } S_j,T_j\subseteq\mathcal{V},\ S_j\neq\emptyset,\ T_j\neq\emptyset,\ \text{且 } S_j\cap T_j=\emptyset. \tag{2}$$
此處,$\mathcal{V}$ 表示 3.1 節中的代理人節點集合,亦即 $\mathcal{V}_{\text{res}}\cup\mathcal{V}_{\text{dev}}\cup\{v_{\text{mgr}}\}=\mathcal{V}$,其大小為 $|\mathcal{V}|=8$,而訊息超邊 $\vec{\mathcal{E}}$ 描繪代理人之間訊息 $\mathcal{M}$ 的資訊交換。特別地,一條超邊 $\vec{e}_j=(S_j,T_j)\in\vec{\mathcal{E}}$,對應於時間 $t$ 的訊息 $m_j^t\in\mathcal{M}$,包含一個來源節點集合 $S_j\subseteq\mathcal{V}$ 與一個目標節點集合 $T_j\subseteq\mathcal{V}$。來源節點集合 $S_j$ 包含負責發送訊息的代理人,其大小恆為 1,亦即 $\forall\vec{e}_j\in\vec{\mathcal{E}},|S_j|=1$。相對地,目標節點集合 $T_j$ 標示出被指定接收該訊息的代理人群組。此設計模擬了真實世界的情境:來自單一代理人的訊息只與特定的代理人子集相關。對任何排定在時間 $t$ 執行的代理人 $v_i$,其決策脈絡由依時間順序、且導向給它的訊息集合 $\mathcal{M}_i^t$ 所構成:
$$\mathcal{M}_i^t=\{m_j^{t'}\mid\vec{e}_j=(S_j,T_j)\in\vec{\mathcal{E}};\ v_i\in T_j,\ t'<t\}. \tag{3}$$
此外,導向訊息超圖 $\vec{\mathcal{G}}$ 會隨著新訊息被記錄而動態擴增。詳細而言,在一次代理人執行後,透過式 (1) 產生的訊息 $m_i^t$ 將透過導向超邊格式化器(如下討論)被納入導向訊息超圖 $\vec{\mathcal{G}}$。值得注意的是,訊息傳遞並不會立即觸發代理人執行;相反地,MGR $v_{\text{mgr}}$ 統籌整個工作流程,利用導向訊息超圖來確保高效、循序的資訊流。
導向超邊格式化器 (Oriented Hyperedge Formatter)。 為解決非結構化自然語言的歧義性,我們引入導向超邊格式化器 $g(\cdot)$,它規範化訊息內容並管理超邊的插入。當代理人 $v_i$ 產生一則訊息 $m_i^t$ 時,格式化器將其轉換為一則結構化訊息 $\hat{m}_i^t$,並將該結構化訊息插入超圖:
$$\mathcal{M}'=\mathcal{M}\cup\{\hat{m}_i^t\},\ \mathcal{E}'=\mathcal{E}\cup\{\vec{e}_i\},\ \text{其中 } \hat{m}_i^t=g_i(m_i^t)\text{ 且 }\vec{e}_i=(S_i,T_i). \tag{4}$$
格式化器套用代理人特定的規則,以確保所有關鍵資訊都是明確且機器可解讀的,從而促進下游處理。隨後,導向超邊格式化器將導向訊息超圖更新為 $\vec{\mathcal{G}}'=(\mathcal{V},\vec{\mathcal{E}}',\mathcal{M}')$。實務上,各代理人的結構化格式是依據其在系統中的角色而設計的,並要求個別代理人提供必要資訊,以供格式化器產生結構化訊息。此外,訊息 $m_i^t$ 之間的關係(亦即超邊 $\vec{e}_i$)是依據角色特定的需求而產生。舉例而言,對於一條來源節點集合包含計畫代理人 $v_{\text{plan}}$(亦即 $S_i=\{v_{\text{plan}}\}$)的超邊 $\vec{e}_i$,其目標節點集合為 $T_i=\{v_{\text{web}},v_{\text{tool}},v_{\text{bp}},v_{\text{mgr}}\}$。
本地快取系統 (Local Cache System)。 為避免不必要的內嵌產物之訊息,我們設計了一個本地快取系統,它在導向訊息超圖 $\vec{\mathcal{G}}$ 中作為一個特殊節點 $v_{\text{lcs}}$,用以儲存必要的產物。舉例而言,當網路代理人 $v_{\text{web}}$ 遇到一個有價值的產物(亦即一個能協助工程代理人 $v_{\text{engr}}$ 撰寫程式的 HTML 檔案)時,節點 $v_{\text{lcs}}$ 會在本地儲存該檔案,並廣播一則包含快取識別碼 (cache identifier) 的精簡全域訊息。對應的超邊 $\vec{e}_j$ 形式化為:
$$\vec{e}_j=(S_j,T_j),\ \text{其中 } S_j=\{v_{\text{lcs}}\}\text{ 且 }T_j=\mathcal{V}/v_{\text{lcs}}. \tag{5}$$
此方法確保產物能在所有代理人需要時被存取,而不污染通訊通道。此外,代理人後續可透過引用快取 ID 來取回產物,實現高效的、具產物感知 (artifact-aware) 的協作。
4 Instruct2DS:開放網路資料蒐集的基準資料集
如前所述,目前並不存在一個專為從開放網路來源進行資料蒐集任務而量身打造的公開可用基準資料集。為填補此空白並能對 AI 代理人效能進行全面評估,我們引入一個全新的「指令到資料集」基準,稱為 Instruct2DS,專為跨三個領域(學術、金融與運動)的網路資料蒐集而設計。在本節中,我們以學術領域作為代表性範例來說明。關於 Instruct2DS 另外兩個領域的更多細節,請見附錄 A。
4.1 任務定義
Instruct2DS 的主要目標,是評估模型依據任務指令從真實世界網路來源完成資料蒐集任務的能力。我們設計符號化模板 (symbolic templates) 以產生多樣的指令變體,並調整複雜度層級,以更好地探究模型在資料蒐集任務中的穩健性能力。具體而言,資料集 Instruct2DS 包含以下組成部分:
資料庫 (Database)。 資料庫 $\mathcal{D}$ 作為建構真值資料集 (ground truth dataset) GT-DS 的權威資料來源,GT-DS 是依據指定的任務指令 $\text{Instruct}$ 產生的。所產生的真值資料集 GT-DS 被用作參考,以評估模型所蒐集資料集 DS 的品質與完整性。在學術領域中,我們全面蒐集選定會議的所有論文以充實資料庫。重要的是,在資料蒐集過程中,MAS 方法僅獲得任務指令 $\text{Instruct}$,無法存取底層資料庫。相反地,這些方法被要求直接從開放網路來源自主蒐集資料。資料庫中一筆論文條目的示意範例如圖 2 所示。
指令模板 (Instruction Templates)。 這些是預先定義的模板 $\mathcal{T}$,用以建構資料蒐集的任務指令 $\text{Instruct}$。圖 2 列出三個用於學術論文蒐集任務的指令模板 $\mathbf{T}_{\{1,2,3\}}$。模板 $\mathbf{T}_*$ 中的佔位變數 (placeholder variables) $\mathcal{P}$,例如 [Conference]、[Year] 等,代表任務的特定需求。
資料集建構演算法 (Dataset Construction Algorithm)。 我們進一步手動建構一個演算法 $g(\cdot)$,用以從資料庫 $\mathcal{D}$ 建構真值資料集。形式上,給定一個指令模板 $\mathbf{T}_i\in\mathcal{T}$ 與對應的佔位變數 $\mathcal{P}$,真值資料集 GT-DS 由下式得到:
$$\text{GT-DS}=g(\mathbf{T}_i,\mathcal{P},\mathcal{D}). \tag{6}$$
舉例而言,把指令模板 $\mathbf{T}_1$ 與佔位變數「conference=NeurIPS」與「year=2017」餵入演算法 $g(\cdot)$,將得到一個包含 NeurIPS 2017 所有錄取論文的真值資料集 GT-DS,論文範例如圖 2 所示。
圖 2:Instruct2DS 中的一個樣本以及指令模板 $\text{Instruct}$ 的範例。
論文資訊範例:
TITLE: Attention is All you Need
AUTHORS: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit,
         Llion Jones, Aidan N Gomez, Łukasz Kaiser, Illia Polosukhin
ABSTRACT: The dominant sequence … (為清楚起見而省略)
CONFERENCE: Advances in Neural Information Processing Systems 30 (NIPS 2017)
ABBR: NeurIPS
TRACK: Main Conference Track
PAPER_LINK: Paper Link
BIBTEX_LINK: Bibtex Link
SUPP_LINK: None
學術論文資料蒐集的指令模板:
- $\mathbf{T}_1$:蒐集 [Conference] [Year] 中所有被錄取的論文。
- $\mathbf{T}_2$:蒐集 [Conference] [Year] [Track] 中所有被錄取的論文。
- $\mathbf{T}_3$:蒐集 [Conference] 從 [Start Year] 到 [End Year] 中所有被錄取的論文。
4.2 資料蒐集
為確保 Instruct2DS 的長期可用性與穩定性,我們選擇了三個以持久且可存取之資料來源為特徵的領域:學術、金融與運動。對於學術領域,我們鎖定數個頂級會議,並開發了客製化的 Python 網路爬蟲,直接從官方會議網站系統性地蒐集所有論文。隨後,研究人員執行徹底的交叉驗證 (cross-validation),以確認所產生資料庫的完整性、品質與完整無誤。之後,為驗證資料集建構演算法的正確性,這些研究人員進一步各自獨立撰寫程式碼,並透過測試每個有效任務指令所產生的資料集來交叉驗證該演算法。此嚴謹流程確保了 Instruct2DS 的可靠性與可重現性。關於資料蒐集的更多細節請見附錄 A。
4.3 與既有研究的比較
Instruct2DS 引入了一組獨特的研究挑戰,推進了面向真實世界網路環境的 MAS 方法之發展。不同於既有的基準資料集 [15, 16, 40, 41],Instruct2DS 在數個關鍵面向上脫穎而出:(i) 開放網路設定 (Open Web Setting): Instruct2DS 要求 MAS 代理人與即時、動態的網路來源互動以蒐集資料,這與先前那些把代理人限制在靜態、本地封存頁面的資料集形成對比。(ii) 多樣的資料取得模態 (Diverse Data Acquisition Modalities): 此基準超越了傳統從 HTML 來源進行網路爬取的範疇,納入了需要透過 REST API 呼叫進行資料蒐集的任務,從而拓寬了運作範圍並測試 MAS 解決方案的多功能性。(iii) 符號化資訊萃取 (Symbolic Information Extraction): Instruct2DS 支援符號式的資訊萃取(見圖 2 中的佔位符),挑戰代理人對結構化表示進行萃取與推理,而既有基準則侷限於從網頁萃取固定、預先定義的資訊。此外,Instruct2DS 中所策劃的資料庫,作為一項對更廣泛研究社群有價值的資源,能支援各種下游應用,包括學術推薦系統、金融的時間序列預測、運動分析中的比賽分數預測等等。
5 實驗
5.1 在 Instruct2DS 資料集上的實驗
我們在表 1 中呈現 AutoData 與基線方法在資料集 Instruct2DS 上的效能。粗體數字為最佳結果,底線數字表示次佳結果。我們選擇既有的通用 MAS 方法作為基線方法,包括 Manus [42]、AutoAgent [43]、OpenManus [44] 與 AutoAgents [45]。除了文獻中的通用 AI 代理人外,我們也在表 1 中呈現透過 Cline [46] 與 Cursor [47] 進行人力資料蒐集的效能。關於基線方法的詳細討論請見附錄 C。
根據此表,我們發現:(i) 人工網路資料蒐集相較於大多數通用 MAS 系統展現出更優越的效能,但代價是更長的實作時間,這正是我們研究的主要動機;(ii) 基線方法 Manus 相對於所有通用 MAS 方法展現出更強的效能,但它需要更多時間並產生更高的費用來完成任務;(iii) 我們的方法 AutoData 在每個領域上都超越所有基線方法,同時需要更少的實作時間並產生更低的費用,凸顯了我們所提方法相較於既有 MAS 方法在效率與成本效益上的優勢。
表 1:在 Instruct2DS 上與基線方法的效能比較。(Prec. 為精確率,Reca. 為召回率;Time 與 Expense 越低越好)
| 模型 | Academic F1 | Prec. | Reca. | Stock F1 | Prec. | Reca. | Sport F1 | Prec. | Reca. | Time (分) ↓ | Expense (USD $) ↓ |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Human | 85.57 | 90.63 | 80.81 | 91.66 | 95.62 | 88.95 | 89.50 | 93.40 | 85.46 | 186.98 | – |
| Cline [46] | 83.50 | 89.65 | 77.12 | 91.37 | 95.20 | 87.17 | 87.07 | 91.38 | 84.53 | 83.29 | – |
| Cursor [47] | 84.37 | 88.53 | 81.02 | 90.23 | 94.24 | 86.31 | 88.70 | 92.98 | 84.38 | 71.60 | – |
| Manus [42] | 69.27 | 72.76 | 66.10 | 95.24 | 97.10 | 93.47 | 87.48 | 93.12 | 81.80 | 15.37 | 2.49 |
| AutoAgent [43] | 65.79 | 67.67 | 63.84 | 73.54 | 94.37 | 52.71 | 75.72 | 88.30 | 63.62 | 10.46 | 1.28 |
| OpenManus [44] | 67.39 | 69.54 | 64.40 | 79.75 | 97.30 | 66.85 | 85.74 | 90.21 | 80.45 | 6.84 | 1.08 |
| AutoAgents [45] | 63.42 | 70.80 | 57.34 | 75.52 | 95.45 | 55.81 | 79.83 | 87.50 | 71.48 | 9.12 | 1.36 |
| AutoData | 91.85 | 93.74 | 90.51 | 96.75 | 98.37 | 94.17 | 90.14 | 95.63 | 85.28 | 5.58 | 0.57 |
5.2 在程式撰寫基準資料集上的實驗
由於我們的方法包含一個用以開發網路資料蒐集程式的程式撰寫機制,我們在程式撰寫基準資料集 HumanEval [52] 上進行了另一項實驗。實驗設定見附錄 D.6,效能列於表 3。根據此表,我們觀察到:(i) 儘管 AutoData 並非專為程式碼產生任務而設計,但透過 LLM 骨幹 GPT-4,其效能可與基線方法 MetaGPT 相當。(ii) 我們所提方法 AutoData 搭配 GPT-4 時顯著優於 GPT-4,而當使用 GPT-4o 作為骨幹時,它相對於 GPT-4o 也展現出漸進式的提升,凸顯了它在程式撰寫上的有效性。
表 3:在資料集 HumanEval 上與基線方法的效能比較。
| 模型 | Pass@1 | 模型 | Pass@1 |
|---|---|---|---|
| PaLM [51] | 36.0 | Codex-175B [52] | 47.0 |
| Self-Col [27] | 74.4 | MetaGPT [26] | 85.9 |
| GPT-4 [53] | 67.0 | GPT-4o [54] | 90.2 |
| Ours + GPT-4 | 86.9 | Ours + GPT-4o | 92.5 |
5.3 在 IE 基準資料集上的實驗
為進一步驗證我們所提方法 AutoData 的有效性,我們在資訊萃取 (Information Extraction, IE) 基準資料集(亦即 Swde [15] 與 Extended Swde [40, 41])上針對網路爬取任務進行實驗,結果列於表 2。我們採用與 AutoScraper [50] 相同的評估指標來評估我們所提方法與基線方法。關於基線方法、評估指標與實驗設定的詳細討論,分別見附錄 C、附錄 D.2 與附錄 D.5。
根據表 2,我們發現:(i) 基線方法 Manus 在許多指標上展現出具競爭力的效能。然而,它的結果在這些基準資料集上仍有改進空間,凸顯了開發一個專為網路爬取任務量身打造之系統的益處。(ii) 我們所提方法 AutoData 在大多數評估準則上都優於基線方法,證明了它在網路爬取任務上的有效性。
表 2:在 Swde 與 Extended Swde 上與基線方法的效能比較。 Exec-P. 與 Exec-R. 分別表示執行精確率 (execution precision) 與執行召回率 (execution recall)。
| 模型 | Swde F1 | Prec. | Reca. | Correct | Exec-P. | Exec-R. | Ext-Swde F1 | Prec. | Reca. | Correct | Exec-P. | Exec-R. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| COT [48] | 76.95 | 87.75 | 79.90 | 61.88 | 12.50 | 7.19 | 65.08 | 85.15 | 68.35 | 56.10 | 2.44 | 7.32 |
| Reflexion [49] | 82.40 | 93.28 | 82.76 | 67.50 | 13.75 | 4.37 | 75.85 | 87.39 | 77.81 | 64.81 | 4.18 | 5.57 |
| Manus [42] | 89.22 | 93.60 | 88.52 | 73.59 | 14.85 | 4.86 | 75.64 | 81.70 | 79.66 | 63.53 | 4.20 | 6.04 |
| AutoScraper [50] | 88.69 | 92.49 | 89.13 | 71.56 | 14.06 | 5.31 | 76.21 | 82.71 | 80.25 | 64.11 | 3.48 | 6.27 |
| AutoData | 89.25 | 92.43 | 90.59 | 74.17 | 14.51 | 5.12 | 77.44 | 80.81 | 81.40 | 65.39 | 3.82 | 5.52 |
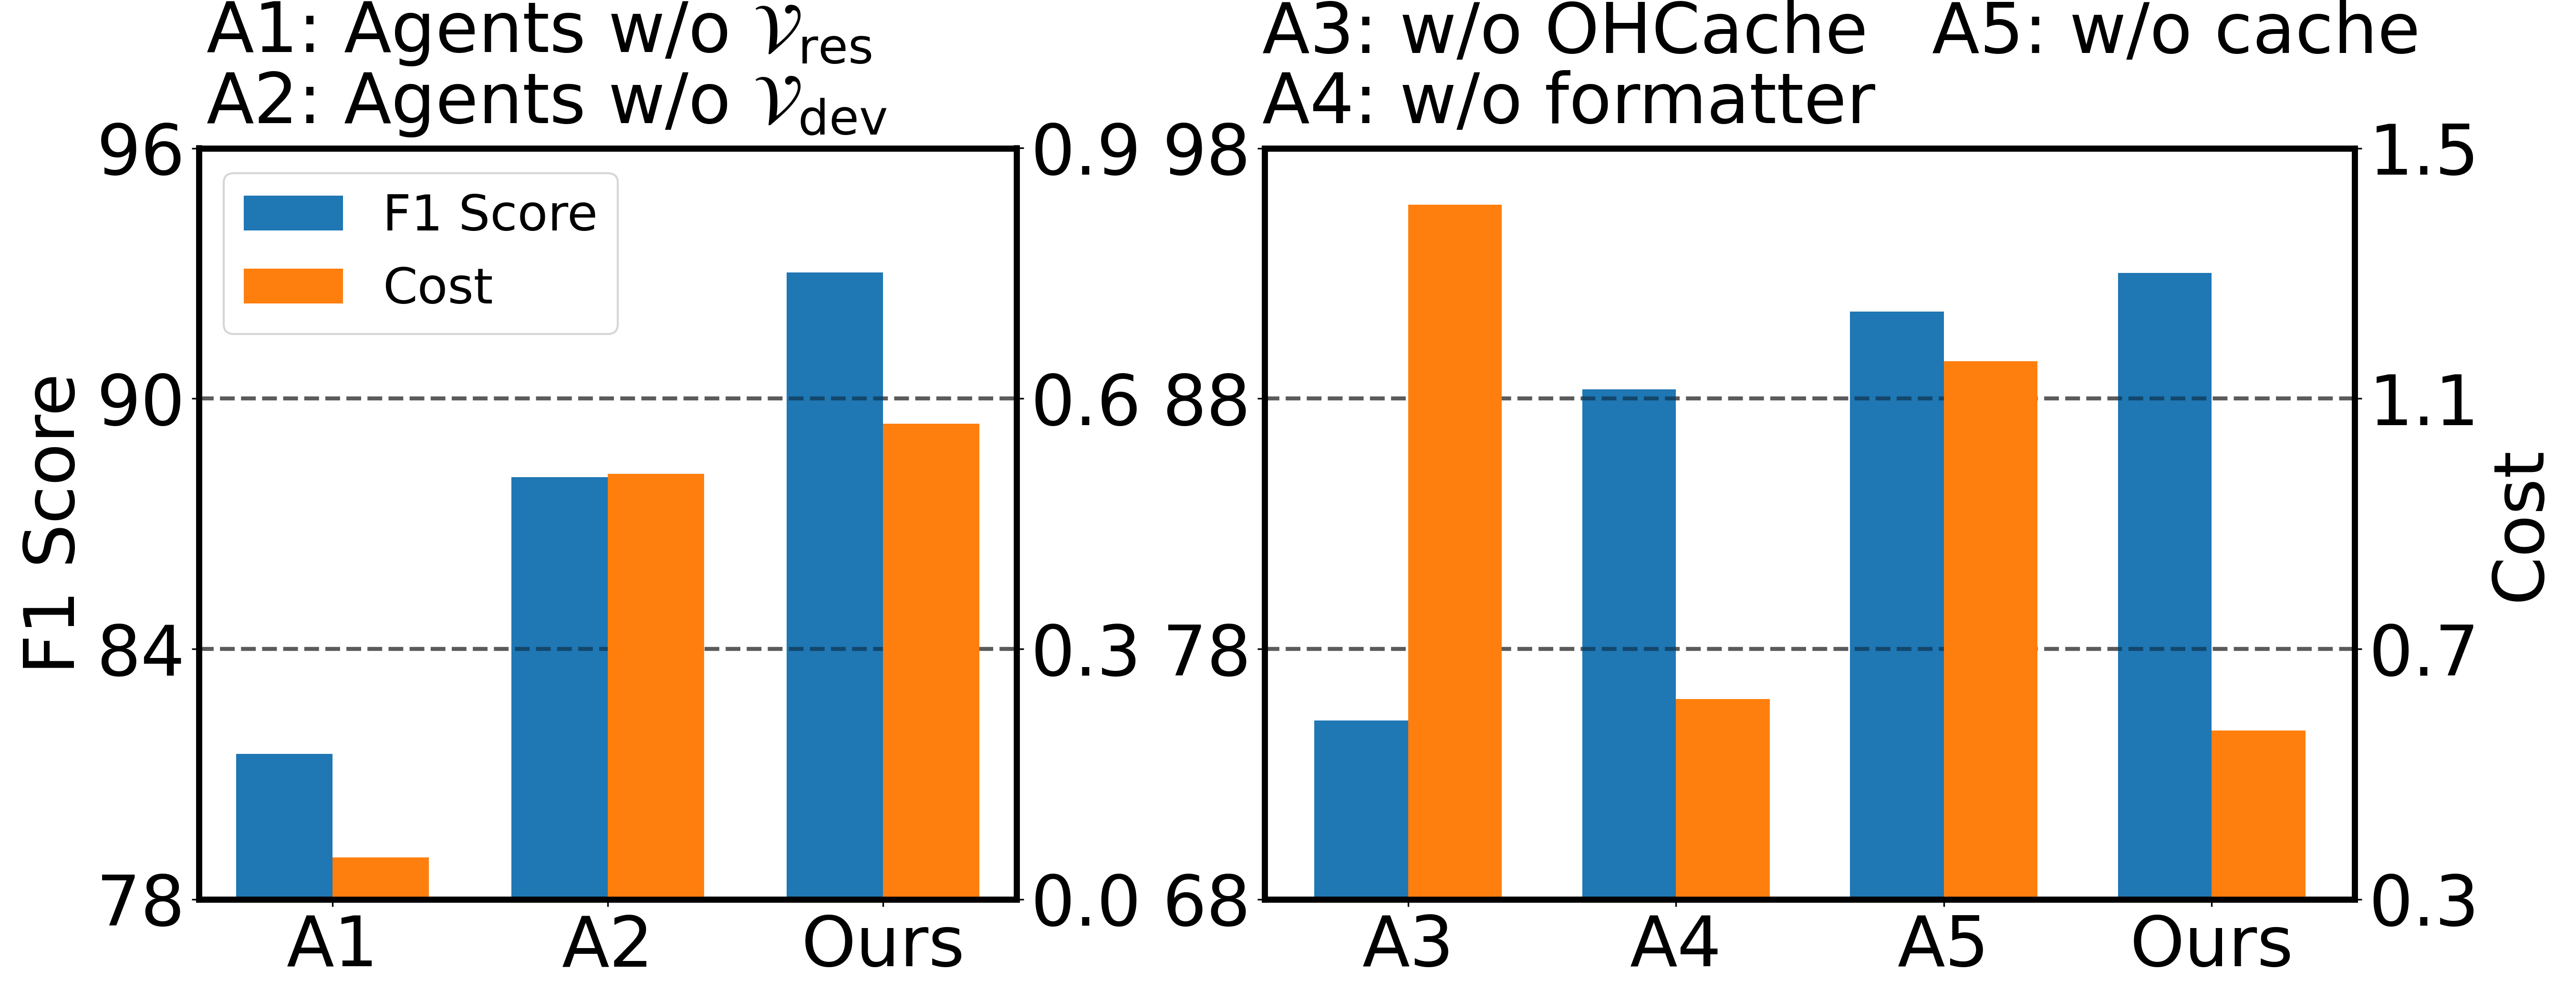
圖 3:AutoData 的消融研究 (ablation studies)。
5.4 消融研究
我們進行消融研究,以分析各代理人以及 OHCache 中各元件的貢獻,如圖 3 所示。
代理人的有效性。 由於移除某些代理人會導致無法運作的程式碼,我們保留了最基本的代理人,亦即 MGR $v_{\text{mgr}}$、網路代理人 $v_{\text{web}}$ 與工程代理人 $v_{\text{engr}}$,並依小隊分別移除其餘代理人,亦即研究小隊 $\mathcal{V}_{\text{res}}$(A1)與開發小隊 $\mathcal{V}_{\text{dev}}$(A2)。根據圖 3,儘管成本較低,所有消融設定的表現都比我們原始的設定差,這表明每組代理人在某種程度上都對我們的多代理人系統有所貢獻。
OHCache 的有效性。 我們進一步透過分別移除各元件,來驗證 OHCache 中每個元件的有效性,亦即整個 OHCache(A3)、導向超邊格式化器(A4),以及本地快取系統(A5)。首先,我們移除整個 OHCache(A3),此時系統切換為廣播式通訊、省略訊息格式化,並停用本地快取系統。效能的明顯下降與成本的增加,確認了 OHCache 的有效性與成本效益。接著,我們移除導向超邊格式化器(A4),這意味著我們改用純自然語言進行通訊,而效能的下降表明了導向超邊格式化器的有效性。然後,我們移除本地快取系統(A5),這意味著產物被內嵌於通訊之中。儘管效能變化甚微,但成本的大幅降低證明了本地快取系統在我們系統中的成本效益。
5.5 案例研究
為驗證我們方法 AutoData 的適用性,我們進行兩個網路資料蒐集任務作為案例研究,亦即兒童繪本蒐集與從綜述論文中蒐集論文。相較於 Instruct2DS 中的任務,這兩個任務更具挑戰性,涉及多層次、深入的 HTML 爬取以及對個別來源的個別爬取。
表 4:繪本蒐集任務的人工評估,指標為準確度 (Accuracy, Acc)、完整性 (Completeness, Comp)、唯一性 (Uniqueness, Uniq) 與成本 (Cost)。
| 模型 | Acc. (↑) | Comp. (↑) | Uniq. (↓) | Cost (↓) |
|---|---|---|---|---|
| Manus | 63.93 | 79.76 | 1.51 | 1.86 |
| AutoData | 89.58 | 98.13 | 0.00 | 0.91 |
兒童繪本蒐集 (Children Picture Book Collection)。 我們與教育領域的研究人員合作進行兒童繪本蒐集。繪本對於幼齡學習者的發展至關重要,而兒童繪本資料集對教育領域的貢獻者具有重大價值 [55, 56]。更多討論見附錄 F。依據領域專家的請求,我們選擇 Miami University 的 Children's Picture Book Database 作為網路來源,它提供一個可依主題、概念與技能搜尋的繪本摘要集合,用以建立橫跨所有學科領域的內容識讀能力 (content area literacy) [57]。我們將所提系統 AutoData 與最佳基線方法 Manus 進行比較,以蒐集該網路來源所提供的所有繪本。隨後,我們從每個資料集中隨機抽取 500 個樣本並進行人工評估。人工評估設定見附錄 D.3,結果見表 4。
根據此表,我們發現:(i) 在繪本蒐集任務的所有人工評估面向上,我們的方法都一致地優於 Manus,凸顯了我們方法的有效性;(ii) AutoData 相較於 Manus 展現出顯著更低的資料蒐集成本,凸顯了它的成本效益;(iii) 具體而言,AutoData 僅產生 $0.91 的成本,僅為 Manus 的一半,強調了它的適用性與成本優勢。需提及的是,所蒐集的繪本資料集已分享給教育領域的研究人員以供進一步運用。
表 5:從綜述蒐集論文的效能。
| 模型 | F1 (↑) | Prec. (↑) | Reca. (↑) | Cost (↓) |
|---|---|---|---|---|
| Manus | 74.70 | 87.96 | 61.52 | 2.55 |
| AutoData | 91.16 | 94.28 | 88.46 | 1.40 |
從綜述蒐集論文 (Paper Collection from Survey)。 我們進行另一項案例研究,從 ArXiv(實驗性 HTML)的論文中爬取 BibTeX 格式的參考文獻。為使該研究更具挑戰性,並考量到綜述 (surveys) 通常比一般論文含有更多參考文獻的事實,我們選擇了 MAS 領域的五篇綜述 [58, 59, 60, 61, 62]。從綜述中爬取 BibTeX 對研究人員極具價值,因為它提供了一個廣泛、結構化的引用集合,能精準指出該領域中的關鍵研究與新興趨勢。實驗設定與評估指標見附錄 D.7,結果列於表 5。
如表 5 所示,(i) AutoData 在所有評估指標上都一致地超越 Manus,凸顯了我們方法卓越的有效性與實際適用性。(ii) 我們的方法相較於 Manus 產生更低的整體成本,凸顯了它在高難度網路資料蒐集任務中提升的成本效益。
6 相關研究
面向網路應用的自主代理人 (Autonomous Agents for Web Applications)。 網站瀏覽器一直是 LLM 代理人的主要驅動力之一,因為網路來源包含了所有可用的應用,以及最新、領域特定且多樣的資訊資源。一些最為人所知的商用網路應用包括 AI co-scientist [63] 與 Manus [42]。在大致相近的時期,開源的替代方案 [44, 43, 64] 也作為競爭對手被提出,以加速此領域的發展。然而,大多數既有網路應用是基於通用目的而建立的,因而忽略了開放網路資料蒐集任務的特定脈絡與挑戰,例如 token 密集型運作的需求。因此,這些基於 LLM 的網路代理人有著明顯的效能落差與冗餘的 LLM 呼叫。受此啟發,本研究的目標是開發一個基於 LLM 的多代理人系統,以有效且高效地從開放網路來源自動蒐集資料集。
網路資訊萃取 (Web Information Extraction)。 大多數網站具有半結構化版面(例如 HTML 版面),需要具備強泛化能力 (generalizability) 的模型來理解結構與語意脈絡,以萃取準確的結果 [65]。傳統方法主要將此問題形式化為基於跨度 (span-based) 的資訊萃取任務 [66],例如命名實體辨識 (named entity recognition) [67] 與實體連結 (entity linking) [68],並以序列標註 (sequential labeling) [69] 來解決。這些方法主要在預訓練語言模型 (pre-trained language models, PLMs) 上進行微調 (fine-tune)。因此,需要高品質的標註標籤或弱監督 (weakly supervised) 標籤,這限制了其自動理解不同網站多樣版面的能力。近期研究 [50] 利用生成式 LLM,以脈絡內學習 (in-context learning) 或提示微調 (prompt tuning) 來萃取網路資訊。然而,這些方法需要讀取每一個網頁來進行資訊萃取,這既昂貴又不適用於大規模資料蒐集。有鑑於此,我們提出一個多代理人系統,它首先從網路來源萃取知識以建構資料蒐集程式,並進一步運用開發代理人來建構可擴展之開放網路資料蒐集的腳本。
7 結論
在本研究中,我們提出一個全新的多代理人系統 (MAS),稱為 AutoData,用於全自動的開放網路資料蒐集。它由八個專責代理人組成,劃分為研究與開發小隊,以進行有效且高效的開放網路資料蒐集。為應對既有 MAS 方法在開放資料蒐集任務之多代理人協作上的限制,我們引入一個全新的導向超圖快取系統 OHCache,它包含:一個用以描繪代理人間複雜訊息共享流程的導向超圖、一個依據代理人設定檔來結構化訊息的導向超邊格式化器,以及一個用以儲存必要產物供代理人隨需存取的本地快取系統。在一個全新蒐集的資料集 Instruct2DS 以及三個既有基準資料集上的廣泛實驗,證明了我們所提方法相較於 SOTA 基線方法的有效性、效率與適用性。
參考文獻
[1] Yuqi Wang, Ke Cheng, Jiawei He, Qitai Wang, Hengchen Dai, Yuntao Chen, Fei Xia, and Zhao-Xiang Zhang. Drivingdojo dataset: Advancing interactive and knowledge-enriched driving world model. In NeurIPS, 2024.
[2] Zhen Huang, Zengzhi Wang, Shijie Xia, Xuefeng Li, Haoyang Zou, Ruijie Xu, Run-Ze Fan, Lyumanshan Ye, Ethan Chern, Yixin Ye, et al. Olympicarena: Benchmarking multi-discipline cognitive reasoning for superintelligent ai. In NeurIPS, 2024.
[3] Yiyue Qian, Tianyi Ma, Chuxu Zhang, and Yanfang Ye. Adaptive graph enhancement for imbalanced multi-relation graph learning. In CIKM, 2025.
[4] Guilherme Penedo, Hynek Kydlíček, Anton Lozhkov, Margaret Mitchell, Colin A Raffel, Leandro Von Werra, Thomas Wolf, et al. The fineweb datasets: Decanting the web for the finest text data at scale. In NeurIPS, 2024.
[5] Zheyuan Zhang, Zehong Wang, Shifu Hou, Evan Hall, Landon Bachman, Jasmine White, Vincent Galassi, Nitesh V Chawla, Chuxu Zhang, and Yanfang Ye. Diet-odin: A novel framework for opioid misuse detection with interpretable dietary patterns. In KDD, 2024.
[6] Keiran Paster, Marco Dos Santos, Zhangir Azerbayev, and Jimmy Ba. Openwebmath: An open dataset of high-quality mathematical web text. In ICLR, 2023.
[7] Yiyue Qian, Tianyi Ma, Chuxu Zhang, and Yanfang Ye. Dual-level hypergraph contrastive learning with adaptive temperature enhancement. In WWW, 2024.
[8] Tianyi Ma, Yiyue Qian, Chuxu Zhang, and Yanfang Ye. Hypergraph contrastive learning for drug trafficking community detection. In ICDM, 2023.
[9] Zheyuan Zhang, Yiyang Li, Nhi Ha Lan Le, Zehong Wang, Tianyi Ma, Vincent Galassi, Keerthiram Murugesan, Nuno Moniz, Werner Geyer, Nitesh V Chawla, et al. Ngqa: A nutritional graph question answering benchmark for personalized health-aware nutritional reasoning. arXiv preprint arXiv:2412.15547, 2024.
[10] Zehong Wang, Sidney Liu, Zheyuan Zhang, Tianyi Ma, Chuxu Zhang, and Yanfang Ye. Can llms convert graphs to text-attributed graphs? In NACCL, 2025.
[11] Minghao Liu, Zonglin Di, Jiaheng Wei, Zhongruo Wang, Hengxiang Zhang, Ruixuan Xiao, Haoyu Wang, Jinlong Pang, Hao Chen, Ankit Shah, et al. Automatic dataset construction (adc): Sample collection, data curation, and beyond. arXiv preprint arXiv:2408.11338, 2024.
[12] Yanming Liu, Xinyue Peng, Jiannan Cao, Shi Bo, Yuwei Zhang, Xuhong Zhang, Sheng Cheng, Xun Wang, Jianwei Yin, and Tianyu Du. Tool-planner: Task planning with clusters across multiple tools. In ICLR, 2025.
[13] Yujia Qin, Shengding Hu, Yankai Lin, Weize Chen, Ning Ding, Ganqu Cui, Zheni Zeng, Xuanhe Zhou, Yufei Huang, Chaojun Xiao, Chi Han, Yi Ren Fung, Yusheng Su, Huadong Wang, Cheng Qian, Runchu Tian, Kunlun Zhu, Shihao Liang, Xingyu Shen, Bokai Xu, Zhen Zhang, Yining Ye, Bowen Li, Ziwei Tang, Jing Yi, Yuzhang Zhu, Zhenning Dai, Lan Yan, Xin Cong, Yaxi Lu, Weilin Zhao, Yuxiang Huang, Junxi Yan, Xu Han, Xian Sun, Dahai Li, Jason Phang, Cheng Yang, Tongshuang Wu, Heng Ji, Guoliang Li, Zhiyuan Liu, and Maosong Sun. Tool learning with foundation models. ACM Comput. Surv., 57(4), December 2024. doi: 10.1145/3704435.
[14] Tianyi Ma, Yiyue Qian, Zehong Wang, Zheyuan Zhang, Shinan Zhang, Chuxu Zhang, and Yanfang Ye. Llm-empowered class imbalanced graph prompt learning for online drug trafficking detection. In ACL, 2025.
[15] Qiang Hao, Rui Cai, Yanwei Pang, and Lei Zhang. From one tree to a forest: a unified solution for structured web data extraction. In SIGIR, 2011.
[16] Adi Omari, Sharon Shoham, and Eran Yahav. Synthesis of forgiving data extractors. In WSDM, pages 385–394, 2017.
[17] Tianyi Ma, Yiyue Qian, Shinan Zhang, Chuxu Zhang, and Yanfang Ye. Adaptive expansion for hypergraph learning. arXiv preprint arXiv:2502.15564, 2025.
[18] Zehong Wang, Zheyuan Zhang, Tianyi Ma, Nitesh V Chawla, Chuxu Zhang, and Yanfang Ye. Towards learning generalities across graphs via task-trees. In ICML, 2025.
[19] Zehong Wang, Zheyuan Zhang, Tianyi Ma, Nitesh V Chawla, Chuxu Zhang, and Yanfang Ye. Neural graph pattern machine. In ICML, 2025.
[20] Yujia Qin, Shihao Liang, Yining Ye, Kunlun Zhu, Lan Yan, Yaxi Lu, Yankai Lin, Xin Cong, Xiangru Tang, Bill Qian, et al. Toolllm: Facilitating large language models to master 16000+ real-world apis. In ICLR, 2024.
[21] Ryan Mitchell. Web scraping with Python: Collecting more data from the modern web. O'Reilly Media, Inc., 2018.
[22] Daniel Glez-Peña, Anália Lourenço, Hugo López-Fernández, Miguel Reboiro-Jato, and Florentino Fdez-Riverola. Web scraping technologies in an api world. Briefings in bioinformatics, 15(5):788–797, 2014.
[23] Moaiad Ahmad Khder. Web scraping or web crawling: State of art, techniques, approaches and application. International Journal of Advances in Soft Computing & Its Applications, 13(3), 2021.
[24] Yang Liu, Jiahuan Cao, Chongyu Liu, Kai Ding, and Lianwen Jin. Datasets for large language models: A comprehensive survey. arXiv preprint arXiv:2402.18041, 2024.
[25] Chen Qian, Wei Liu, Hongzhang Liu, Nuo Chen, Yufan Dang, Jiahao Li, Cheng Yang, Weize Chen, Yusheng Su, Xin Cong, Juyuan Xu, Dahai Li, Zhiyuan Liu, and Maosong Sun. ChatDev: Communicative agents for software development. In ACL, 2024.
[26] Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, Liyang Zhou, Chenyu Ran, Lingfeng Xiao, Chenglin Wu, and Jürgen Schmidhuber. MetaGPT: Meta programming for a multi-agent collaborative framework. In ICLR, 2024.
[27] Yihong Dong, Xue Jiang, Zhi Jin, and Ge Li. Self-collaboration code generation via chatgpt. ACM Transactions on Software Engineering and Methodology, 33(7):1–38, 2024.
[28] Yilun Du, Shuang Li, Antonio Torralba, Joshua B Tenenbaum, and Igor Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2023.
[29] Chi-Min Chan, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu, and Zhiyuan Liu. Chateval: Towards better llm-based evaluators through multi-agent debate. In ICLR, 2024.
[30] Junjie Zhang, Yupeng Hou, Ruobing Xie, Wenqi Sun, Julian McAuley, Wayne Xin Zhao, Leyu Lin, and Ji-Rong Wen. Agentcf: Collaborative learning with autonomous language agents for recommender systems. In WWW, 2024.
[31] Zheyuan Zhang, Zehong Wang, Tianyi Ma, Varun Sameer Taneja, Sofia Nelson, Nhi Ha Lan Le, Keerthiram Murugesan, Mingxuan Ju, Nitesh V Chawla, Chuxu Zhang, et al. Mopi-hfrs: A multi-objective personalized health-aware food recommendation system with llm-enhanced interpretation. In KDD, 2025.
[32] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, and Yuan Cao. React: Synergizing reasoning and acting in language models. In ICLR, 2023.
[33] Xiaohe Bo, Zeyu Zhang, Quanyu Dai, Xueyang Feng, Lei Wang, Rui Li, Xu Chen, and Ji-Rong Wen. Reflective multi-agent collaboration based on large language models. In NeurIPS, 2024.
[34] Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin, and Bernard Ghanem. Camel: Communicative agents for "mind" exploration of large scale language model society. In NeurIPS, 2023.
[35] Genki Kusano, Kosuke Akimoto, and Kunihiro Takeoka. Are longer prompts always better? prompt selection in large language models for recommendation systems. arXiv preprint arXiv:2412.14454, 2024.
[36] Xu Li, Mingming Sun, and Ping Li. Multi-agent discussion mechanism for natural language generation. In AAAI, 2019.
[37] Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Beibin Li, Erkang Zhu, Li Jiang, Xiaoyun Zhang, Shaokun Zhang, Jiale Liu, et al. Autogen: Enabling next-gen llm applications via multi-agent conversation. arXiv preprint arXiv:2308.08155, 2023.
[38] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang, and Michael S Bernstein. Generative agents: Interactive simulacra of human behavior. In UIST, 2023.
[39] Hongxin Zhang, Weihua Du, Jiaming Shan, Qinhong Zhou, Yilun Du, Joshua B Tenenbaum, Tianmin Shu, and Chuang Gan. Building cooperative embodied agents modularly with large language models. In ICLR, 2024.
[40] Colin Lockard, Prashant Shiralkar, and Xin Luna Dong. Openceres: When open information extraction meets the semi-structured web. In NAACL, 2019.
[41] Colin Lockard, Prashant Shiralkar, Xin Luna Dong, and Hannaneh Hajishirzi. Zeroshotceres: Zero-shot relation extraction from semi-structured webpages. In ACL, 2020.
[42] Manus Team. Leave it to manus, 2025. URL https://manus.im.
[43] Jiabin Tang, Tianyu Fan, and Chao Huang. Autoagent: A fully-automated and zero-code framework for llm agents. arXiv e-prints, pages arXiv–2502, 2025.
[44] Xinbin Liang, Jinyu Xiang, Zhaoyang Yu, Jiayi Zhang, Sirui Hong, Sheng Fan, and Xiao Tang. Openmanus: An open-source framework for building general ai agents, 2025. URL https://doi.org/10.5281/zenodo.15186407.
[45] Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Sesay Jaward, Karlsson Börje, Jie Fu, and Yemin Shi. Autoagents: The automatic agents generation framework. In IJCAI, 2024.
[46] Cline Team. Cline, the collaborative ai coder, 2024. URL https://cline.bot/.
[47] Cursor Team. Cursor ide, 2025. URL https://cursor.com.
[48] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. In NeurIPS, 2022.
[49] Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. In NeurIPS, 2023.
[50] Wenhao Huang, Zhouhong Gu, Chenghao Peng, Zhixu Li, Jiaqing Liang, Yanghua Xiao, Liqian Wen, and Zulong Chen. Autoscraper: A progressive understanding web agent for web scraper generation. In EMNLP, 2024.
[51] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. Journal of Machine Learning Research, 24(240):1–113, 2023.
[52] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
[53] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
[54] Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt-4o system card. arXiv preprint arXiv:2410.21276, 2024.
[55] Maria Nikolajeva. Verbal and visual literacy: the role of picturebooks in the reading experience of young children. Handbook of early childhood literacy, pages 235–248, 2003.
[56] Rudine Sims Bishop. Mirrors, windows, and sliding glass doors. perspectives: Choosing and using books for the classroom, 6(3). Perspectives: Choosing and using books for the classroom, 6(3):ix–xi, 1990.
[57] Children's picture book database at miami university. https://dlp.lib.miamioh.edu/picturebook/.
[58] Zeyu Zhang, Xiaohe Bo, Chen Ma, Rui Li, Xu Chen, Quanyu Dai, Jieming Zhu, Zhenhua Dong, and Ji-Rong Wen. A survey on the memory mechanism of large language model based agents. arXiv preprint arXiv:2404.13501, 2024.
[59] Haolin Jin, Linghan Huang, Haipeng Cai, Jun Yan, Bo Li, and Huaming Chen. From llms to llm-based agents for software engineering: A survey of current, challenges and future. arXiv preprint arXiv:2408.02479, 2024.
[60] Taicheng Guo, Xiuying Chen, Yaqi Wang, Ruidi Chang, Shichao Pei, Nitesh V Chawla, Olaf Wiest, and Xiangliang Zhang. Large language model based multi-agents: A survey of progress and challenges. arXiv preprint arXiv:2402.01680, 2024.
[61] Lijun Sun, Yijun Yang, Qiqi Duan, Yuhui Shi, Chao Lyu, Yu-Cheng Chang, Chin-Teng Lin, and Yang Shen. Multi-agent coordination across diverse applications: A survey. arXiv preprint arXiv:2502.14743, 2025.
[62] Tula Masterman, Sandi Besen, Mason Sawtell, and Alex Chao. The landscape of emerging ai agent architectures for reasoning, planning, and tool calling: A survey. arXiv preprint arXiv:2404.11584, 2024.
[63] Google Research. Accelerating scientific breakthroughs with an ai co-scientist, 2024.
[64] Shuyan Zhou, Frank F Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Yonatan Bisk, Daniel Fried, Uri Alon, et al. Webarena: A realistic web environment for building autonomous agents. In NeurIPS, 2023.
[65] Alireza Mika. AutoScraper: A smart, automatic, fast and lightweight web scraper for python, 2022. URL https://github.com/alirezamika/autoscraper.
[66] Yifan Ding, Michael Yankoski, and Tim Weninger. Span-oriented information extraction–a unifying perspective on information extraction. arXiv preprint arXiv:2403.15453, 2024.
[67] Jing Li, Aixin Sun, Jianglei Han, and Chenliang Li. A survey on deep learning for named entity recognition. IEEE transactions on knowledge and data engineering, 34(1):50–70, 2020.
[68] Wei Shen, Jianyong Wang, and Jiawei Han. Entity linking with a knowledge base: Issues, techniques, and solutions. IEEE Transactions on Knowledge and Data Engineering, 27(2):443–460, 2014.
[69] Xuezhe Ma and Eduard Hovy. End-to-end sequence labeling via bi-directional LSTM-CNNs-CRF. In Katrin Erk and Noah A. Smith, editors, ACL, 2016.
[70] Jeremy J Siegel and Jeremy D Schwartz. The Long-term Returns on the Original S & P 500 Firms. Rodney L. White Center for Financial Research, 2004.
[71] Xiao-Yang Liu, Hongyang Yang, Qian Chen, Runjia Zhang, Liuqing Yang, Bowen Xiao, and Christina Dan Wang. Finrl: A deep reinforcement learning library for automated stock trading in quantitative finance. In NeurIPS, 2022.
附錄 A 新資料集 Instruct2DS
A.1 概述
為全面評估 AI 代理人從開放網路來源進行資料蒐集的效能,我們建立一個全新的「指令到資料集」基準,稱為 Instruct2DS。此基準資料集的目標是評估 AI 代理人在完成網路資料蒐集中複雜、多步驟任務上的效能。基準資料集 Instruct2DS 包含來自各種領域的全面資料,我們將在接下來的章節中討論。Instruct2DS 中的所有資料皆為人工蒐集,並由研究人員交叉驗證,以確保資料的完整性、品質與完整無誤。這些資料作為依據指令 $\text{Instruct}$ 建構真值資料集的錨定資料庫 (anchor database)。給定 $\text{Instruct}$ 作為輸入,AI 代理人依循指令從網路來源蒐集資料集 DS。此外,我們的基準資料集依據 $\text{Instruct}$ 建構 GT-DS,並透過將蒐集到的資料集 DS 與真值資料集 GT-DS 進行比較來評估模型的效能。需提及的是,所有模型僅以 $\text{Instruct}$ 作為輸入,且在蒐集過程中無法存取 Instruct2DS 中的資料。所建構的真值資料集 GT-DS 僅用於評估。$\text{Instruct}$ 與 GT-DS 的範例如圖 4 所示。
圖 4:指令 $\text{Instruct}$ 範例以及對應 GT-DS 中的一個樣本。
任務指令: 蒐集 NeurIPS 2017 Main Conference Track 中所有被錄取的論文。
真值資料集中的一個樣本:
TITLE: Attention is All you Need
AUTHORS: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit,
         Llion Jones, Aidan N Gomez, Łukasz Kaiser, Illia Polosukhin
ABSTRACT: The dominant sequence transduction models are based on complex
         recurrent or convolutional neural networks ... achieving a BLEU
         score of 41.1.
CONFERENCE: Advances in Neural Information Processing Systems 30 (NIPS 2017)
ABBR: NeurIPS
TRACK: Main Conference Track
PAPER_LINK: Paper Link
BIBTEX_LINK: Bibtex Link
SUPP_LINK: None
在基準資料集建構中有若干考量:
- 網路來源的靜態性 (Static of Web Sources): 由於網路內容持續演變,真值資料可能隨時間改變,可能損及實驗結果的可重現性。舉例而言,在社群媒體平台上,貼文可被編輯或刪除,導致在不同時期所蒐集的真值出現不一致。
- 倫理與隱私考量 (Ethical and privacy concern): 從開放網路蒐集資料必須遵守倫理準則並尊重使用者隱私。應排除敏感或可識別個人身分的資訊,以防止倫理違規並確保符合相關的資料保護法規。
基於上述考量,我們選擇三個提供靜態網路來源的領域以確保可重現性,亦即學術、金融與運動。接下來,我們將詳細討論每個領域。
A.2 學術 (Academic)
我們選擇三個領域共九個會議,亦即機器學習 (NeurIPS、ICLR、ICML)、自然語言處理 (ACL、EMNLP、NAACL) 與電腦視覺 (CVPR、ICCV、ECCV),並依循圖 5 提供的資料結構蒐集這些會議的所有論文資料。為系統性地評估模型在學術論文資料蒐集任務上的效能,我們定義了三個指令模板 $\mathbf{T}_{\{1,2,3\}}$ 來建構指令 $\text{Instruct}$,列於圖 5。透過這些指令模板,我們實作一個真值資料集建構演算法,以從 Instruct2DS 取得滿足指令需求(亦即 [Conference]、[Year]、[Track]、[Start Year] 與 [End Year])的真值資料集 GT-DS。
圖 5:學術論文資料結構與指令模板。
學術論文資料結構:
TITLE: # 論文標題
AUTHORS: # 作者姓名,以逗號分隔
ABSTRACT: # 論文摘要
CONFERENCE: # 會議全名
ABBR: # 會議名稱縮寫,亦即 NeurIPS
TRACK: # 論文所屬的會議軌道 (track)
PAPER_LINK: # 會議提供的永久論文連結
BIBTEX_LINK: # 會議提供的永久 bibtex 連結
SUPP_LINK: # 會議提供的永久補充資料來源連結
學術論文資料蒐集的指令模板:
- $\mathbf{T}_1$:蒐集 [Conference] [Year] 中所有被錄取的論文。
- $\mathbf{T}_2$:蒐集 [Conference] [Year] [Track] 中所有被錄取的論文。
- $\mathbf{T}_3$:蒐集 [Conference] 從 [Start Year] 到 [End Year] 中所有被錄取的論文。
A.3 金融 (Finance)
除了學術論文外,我們的基準資料集納入了來自 S&P 500 指數的金融市場資料。該資料集涵蓋一段完整的時間區間,從 2015 年 1 月 1 日到 2024 年 12 月 31 日,捕捉所有 S&P 500 成分公司的每日交易資訊 [70]。股票資料集同時包含標準的 OHLCV(Open 開盤、High 最高、Low 最低、Close 收盤、Volume 成交量)資料 [71] 以及經企業行動 (corporate action) 調整的屬性,包括:調整後開盤價 (adjOpen)、調整後當日最高價 (adjHigh)、調整後當日最低價 (adjLow)、調整後收盤價 (adjClose)、調整後成交量 (adjVolume),以及每股現金股利 (divCash)。完整的資料結構與指令模板呈現於圖 6。我們的真值資料集建構演算法依循指令 $\text{Instruct}$,以取得滿足需求(包括 [Stock]、[Year]、[Start Date]、[End Date]、[Stocks] 與 [Date])的真值資料集 GT-DS。
圖 6:股票資料結構與指令模板。
股票市場資料結構:
Date: # 日期,格式為 YYYY-MM-DD
Open: # 交易日開盤價
High: # 交易日內最高價
Low: # 交易日內最低價
Close: # 交易日收盤價
Volume: # 交易日內成交的總股數
adjOpen: # 經企業行動調整的開盤價
adjHigh: # 經企業行動調整的當日最高價
adjLow: # 經企業行動調整的當日最低價
adjClose: # 經企業行動調整的收盤價
adjVolume: # 經股票分割調整的當日總成交股數
divCash: # 每股分配的現金股利
股票市場資料蒐集的指令模板:
- $\mathbf{T}_4$:蒐集 [Stock] 在 [Year] 的每日股票資訊。
- $\mathbf{T}_5$:蒐集 [Stock] 在 [Start Date] 與 [End Date] 之間的每日股票資訊。
- $\mathbf{T}_6$:蒐集 [Stocks] 在 [Date] 的每日股票資訊。
A.4 運動 (Sports)
運動是另一個符合我們需求的資料來源。我們在兩個熱門的運動聯盟上建立基準資料集,包括 National Basketball Association (NBA) 與 Major League Baseball (MLB)。
NBA。 我們的基準 NBA 資料集來自 NBA 官方網站 (www.NBA.com)。該資料集涵蓋從 1946 年到 2024 年的全面統計數據,涵蓋兩個不同層級:球隊 (team) 與球員 (player)。為了一致性與可比性,我們僅專注於常規賽 (regular season) 資料,排除季前賽與季後賽,因為並非所有球隊都會參與這些額外的賽事。球隊與球員層級的資料結構,以及對應的指令模板,分別提供於圖 7 與圖 8。
圖 7:NBA 球隊層級的資料結構與指令模板。
NBA 資料結構 — 球隊層級:
TEAM_NAME: # 球隊城市與球隊名稱
YEAR: # 賽季的曆年,亦即 1949 代表 1949-50 賽季
GP: # 本年出賽場次     W: # 本年總勝場     L: # 本年總敗場
MIN: # 總上場時間
FGM: # 投籃命中     FGA: # 投籃出手
FG3M: # 三分球命中   FG3A: # 三分球出手
FTM: # 罰球命中      FTA: # 罰球出手
OREB: # 進攻籃板     DREB: # 防守籃板    REB: # 總籃板
AST: # 助攻          TOV: # 失誤         STL: # 抄截
BLK: # 阻攻          BLKA: # 被阻攻
PF: # 個人犯規       PFD: # 製造對手犯規
PTS: # 總得分
NBA 球隊層級資料蒐集的指令模板:
- $\mathbf{T}_7$:蒐集 NBA [Team Name] 直到 2024 年的所有常規賽數據。
- $\mathbf{T}_8$:蒐集 NBA [Team Name] 從 [Start Year] 到 [End Year] 的常規賽數據。
- $\mathbf{T}_9$:蒐集 [Year] 的所有 NBA 常規賽數據。
圖 8:NBA 球員層級的資料結構與指令模板。
NBA 資料結構 — 球員層級:
PLAYER_NAME: # 球員全名     YEAR: # 統計數據所記錄的年份
BIRTHDATE: # 球員生日       COUNTRY: # 原籍國家
HEIGHT: # 球員身高 (英尺-英寸)   WEIGHT: # 球員體重 (磅)
DRAFT_YEAR: # 球員被選入 NBA 的年份
DRAFT_ROUND: # 球員被選中的輪次   DRAFT_NUMBER: # 球員的選秀總順位
TEAM_ABBR: # 球員在 YEAR 期間所屬球隊的縮寫
GP: # 出賽場次   GS: # 先發場次   MIN: # 總上場時間
FGM/FGA: # 投籃命中/出手   FG3M/FG3A: # 三分命中/出手   FTM/FTA: # 罰球命中/出手
OREB/DREB/REB: # 進攻/防守/總籃板
AST: # 助攻  STL: # 抄截  BLK: # 阻攻  TOV: # 失誤  PF: # 個人犯規  PTS: # 得分
NBA 球員層級資料蒐集的指令模板:
- $\mathbf{T}_{10}$:蒐集 NBA 球員 [Name] 直到 2024 年的所有常規賽數據。
- $\mathbf{T}_{11}$:蒐集 NBA 球員 [Name] 從 [Start Year] 到 [End Year] 的常規賽數據。
- $\mathbf{T}_{12}$:蒐集 NBA 球員 [Names] 在 [Year] 的常規賽數據。
MLB。 同樣地,我們的資料集取自 MLB 官方網站 (https://www.mlb.com/)。該資料集涵蓋從 1876 年到 2024 年的全面統計數據,涵蓋球隊層級的兩個面向:打擊 (hitting) 與投球 (pitching)。同樣地,我們僅專注於常規賽資料。打擊與投球的資料結構以及對應的指令模板,分別提供於圖 9 與圖 10。
圖 9:MLB 打擊資料結構與指令模板。
MLB 資料結構 — 打擊:
TEAM_NAME: # 球隊全名   TEAM_ABBR: # 球隊縮寫   YEAR: # 賽季曆年
AB: # 官方打數         R: # 得分          HR: # 全壘打
H: # 安打 (至少上到一壘)
2B: # 二壘安打 (上到二壘)   3B: # 三壘安打 (上到三壘)
RBI: # 打點   BB: # 保送 (四壞球)   SO: # 三振
SB: # 盜壘成功   CS: # 盜壘被刺
MLB 打擊資料蒐集的指令模板:
- $\mathbf{T}_{13}$:蒐集 MLB [Team] 直到 2024 年的所有常規賽打擊數據。
- $\mathbf{T}_{14}$:蒐集 MLB [Team] 從 [Start Year] 到 [End Year] 的常規賽打擊數據。
- $\mathbf{T}_{15}$:蒐集 [Year] 所有 MLB 球隊的常規賽打擊數據。
圖 10:MLB 投球資料結構與指令模板。
MLB 資料結構 — 投球:
TEAM_NAME: # 球隊全名   TEAM_ABBR: # 球隊縮寫   YEAR: # 賽季曆年
W: # 勝場   L: # 敗場   ERA: # 自責分率 (每九局所失分數)
G: # 出賽場次   GS: # 先發場次   CG: # 完投場次   SHO: # 完封場次   SV: # 救援成功
IP: # 投球局數   H: # 被安打   R: # 失分   ER: # 自責分   HR: # 被全壘打
HB: # 觸身球   BB: # 保送 (四壞球)   SO: # 三振
MLB 投球資料蒐集的指令模板:
- $\mathbf{T}_{16}$:蒐集 MLB [Team] 直到 2024 年的所有常規賽投球數據。
- $\mathbf{T}_{17}$:蒐集 MLB [Team] 從 [Start Year] 到 [End Year] 的常規賽投球數據。
- $\mathbf{T}_{18}$:蒐集 [Year] 所有 MLB 球隊的常規賽投球數據。
附錄 B 基準資料集
SWDE [15]。 SWDE 是一個大型、真實世界的網頁集合,旨在支援關於從網路自動萃取結構化資料(例如實體的屬性-值對 (attribute-value pairs))的研究。它包含來自 8 個領域、80 個網站的 124,291 個網頁。同一領域的每個網站聚焦於網頁中的 3-5 個屬性。
Extended SWDE [40, 41]。 此擴充版本為橫跨 3 個領域的 21 個網站提供了額外的標註,標註每個頁面上涉及主要實體的所有二元關係 (binary relations),而非如原始 SWDE 僅標註有限的屬性集合。新基準同時包含萃取出的物件值與謂語字串 (predicate strings),為評估萃取系統提供了更豐富、更全面的真值。
HumanEval [52]。 HumanEval 資料集是 OpenAI 開發的基準,用以評估 LLM 的程式碼產生能力。它由 164 個手工打造的問題組成,已成為評估 AI 模型理解、推理並產生正確程式碼解決方案能力的標準參考。
附錄 C 基線方法
為評估我們所提方法的有效性,我們將 AutoData 與文獻及業界中的基線方法進行比較,這些方法可分為以下幾組。
通用多代理人系統 (Generic Multi-Agent Systems)。 我們選擇業界與文獻中的四個 SOTA 多代理人系統作為基線方法。
- Manus [42]。 Manus 是一個 AI 代理人,設計用以協助廣泛的任務,包括資訊蒐集、程式撰寫、流程自動化,以及運用電腦與網路資源的一般問題解決。鑑於 Manus 的高成本,我們在一個具代表性的任務子集上進行實驗,以確保成本效益並維持實驗有效性。Manus 採用專有的、基於點數 (credit-based) 的定價系統,而非傳統的基於 token 的計費。依據其定價結構,我們以點數來量化費用,每點價值 $0.01。
- AutoAgent [43]。 它引入一個由自然語言驅動的系統,讓非技術使用者能透過對話式指令自動建立、客製化並部署 LLM 代理人,藉由其模組化架構與自我管理的工作流程消除程式撰寫需求。
- OpenManus [44]。 它是一個開源的通用多代理人系統,用以解決複雜任務。我們從 GitHub 取得其原始碼。
- AutoAgents [45]。 它是一個框架,能動態地產生、協調並精煉具有不同角色的多個專責代理人,以形成為特定任務量身打造的協作 AI 團隊,實現自適應且連貫的多代理人問題解決。
程式撰寫助理與人工程式撰寫。 傳統的資料蒐集方法涉及程式撰寫,以高效地從網路來源蒐集原始資料,並把原始資料清理成可直接使用的資料集 [8, 9]。我們採用業界既有的程式撰寫助理方法進行資料蒐集,包括:
- Cursor [47]。 一個 AI 賦能的程式碼編輯器,作為程式撰寫助理,協助開發者高效工作。
- Cline [46]。 Cline 是一個開源的 AI 程式撰寫助理 (Copilot),具有 Plan/Act 雙模式、終端機執行,以及用於 VS Code (https://code.visualstudio.com/) 的 Model Context Protocol (MCP)。
- Human。 除了業界的程式撰寫助理外,我們也透過人力進行資料蒐集作為一個基線方法。具體而言,我們要求三位網路爬取專家依據指令 $\text{Instruct}$ 手動撰寫資料蒐集腳本以取得資料集 DS。與 Manus 類似,我們運用一個具代表性的任務子集,以確保人力效益並維持實驗有效性。
對每個資料蒐集任務,我們把指令餵給程式撰寫助理,以產生資料蒐集的 Python 腳本。隨後,我們執行該程式碼以蒐集資料作為輸出。需注意的是,由於這些方法在撰寫程式時通常無法直接存取網路來源,除了資料集指令外,我們也向程式撰寫助理提供指引,包括目標資料來源或偏好的蒐集方式(例如網路爬取或 REST API)。
網路爬蟲 (Web Crawler)。 我們也在 IE 基準資料集(包括 Swde [15] 與 Extended Swde [40, 41])上將我們的方法與三個基線方法進行比較。
- AutoScraper [50]。 一個 SOTA 的、由 LLM 驅動的框架,透過階層式 HTML 分析與漸進式學習來產生可適應的網路爬蟲。
- COT [48]。 此研究引入思維鏈 (chain-of-thought) 提示,讓 LLM 把問題分解為中間推理步驟,以提升 LLM 在複雜任務上的效能。
- Reflexion [49]。 它是一個框架,讓語言代理人能透過依其行動的回饋來產生並儲存口語化的自我反思 (self-reflections),以改善其決策與任務效能,使其能在不更新模型權重的情況下,從經驗中反覆學習。
附錄 D 實作細節
D.1 環境
所有實驗皆在配備四張 Nvidia A40 GPU 的 Linux 伺服器上進行。模型使用 PyTorch 2.4.0、CUDA 12.1 與 Python 3.11.5 實作。我們選擇 GPT-4o [53] 作為我們預設的 LLM 骨幹 (backbone)。
D.2 評估指標
由於我們的焦點是文字資料蒐集,我們採用資訊萃取任務中常用的標準評估指標,亦即 F1 分數、精確率 (precision) 與召回率 (recall)。此外,我們也報告完成任務所需的時間。需提及的是,我們不考慮程式執行的時間,因為它因若干因素(例如網路來源、REST API 呼叫限制等)而高度不可控。相反地,我們專注於涉及人力的時間,亦即從任務指令發布到開始資料蒐集的這段期間。對於 IE 基準資料集(亦即 Swde [15] 與 Extended Swde [40, 41]),除了標準評估指標外,我們也採用執行評估指標 [50],包括 correct、執行精確率 (Exec-Prec.) 與執行召回率 (Exec-Reca.)。我們將資料樣本中的每個屬性視為一個獨立單元,評估並報告橫跨真值資料集 GT-DS 與蒐集資料 DS 的平均分數。為維持數值比較的一致性,我們將所有數值屬性四捨五入到小數點後四位。
D.3 案例研究的人工評估設定
我們與教育領域的研究人員合作進行兒童繪本蒐集的案例研究。在所蒐集的資料集中,我們隨機抽取 500 個樣本,並依據以下面向進行全面的人工評估:
- 完整性 (Completeness): 樣本是否包含網路來源中提供的所有屬性。
- 準確度 (Accuracy): 每個屬性的值是否正確反映網路來源上的對應資訊。
- 唯一性 (Uniqueness): 屬性值中是否存在任何不必要的重複,以確保每個屬性都代表唯一的資訊。
我們將每個面向視為一個二元分類 (binary classification) 任務,由三位研究人員分別進行評估。隨後,我們在三位研究人員之間進行多數決 (majority vote) 作為最終的標註結果。
D.4 Instruct2DS 資料集的實驗設定
為確保跨不同領域的全面評估,我們從每個指令模板抽樣有效任務,其中有效任務定義為能產生非空結果、且包含指令所指定之必要資料樣本的任務。具體而言,對於學術論文蒐集,我們為每個會議產生 3 個不同的任務,總計 81 個學術論文蒐集任務。同樣地,對於股票市場資料蒐集,我們為每個模板建立 27 個獨特任務,產生 81 個股票市場蒐集任務。在運動領域,我們為每個指令模板抽樣 6 個有效任務,產生 72 個運動相關的資料蒐集任務。此抽樣策略產生了一個多樣的評估集合,在我們的資料集 Instruct2DS 中橫跨三個不同領域,共計 234 個獨特任務。
D.5 基準資料集 Swde 與 Extended Swde 的實驗設定
對於 IE 基準資料集(亦即 Swde [15] 與 Extended Swde [40, 41])上的實驗,我們依循 AutoScraper [50] 中的設定,選擇三個種子網頁 (seed webpages) 供模型識別用於網路爬蟲程式撰寫的知識,其餘則用於測試。我們嚴格依循 AutoScraper 的原始碼以重現實驗結果。此外,為確保與 AutoScraper 的公平比較,我們在所有方法的實驗中也採用 GPT4-Turbo,唯一例外是 Manus,因為其骨幹 LLM 的選擇無法取得。
D.6 基準資料集 HumanEval 的實驗設定
我們依循 MetaGPT [26] 中的設定以重現實驗結果。對於 AutoData,我們僅把程式撰寫任務指令傳給管理者代理人,並要求它管理研究與開發小隊之間的工作流程以進行程式碼產生。此外,與 MetaGPT 類似,我們稍微修改提示以符合資料集中的格式需求,以解決格式特定的問題,亦即 Python 問題。
D.7 案例研究「從綜述蒐集論文」的實驗設定
對於綜述論文的案例研究,我們重用附錄 D.2 中定義的精確率、召回率與 F1 指標。由於缺乏權威的參考集合,兩位研究人員獨立萃取了目標綜述中所引用的每個 BibTeX 條目,然後進行交叉驗證以確保 BibTeX 的正確性。我們以人工蒐集的 BibTeX 作為真值資料集 GT-DS,以評估透過 AutoData 與基線方法 Manus 所蒐集的資料集 DS。
附錄 E 額外實驗
E.1 AutoData 搭配不同 LLM 的效能
為進一步驗證 AutoData 搭配不同 LLM 骨幹的效能,我們從資料集 Instruct2DS 中每個獨特的指令模板隨機抽樣一個任務描述,並評估各 LLM 骨幹的效能,亦即 GPT-4o、GPT-4o-mini、DeepSeek R1 70B 與 DeepSeek R1 450B。此外,為了更好的比較,我們也在表 6 中提供最佳基線方法 Manus 的效能。
根據此表,我們發現:(i) 對於簡單任務,例如 Stock 與 Sport,所有 LLM 變體的表現相近,但 GPT-4o-mini 達成了更快的執行時間與更低的成本。(ii) 開源 LLM DeepSeek R1 70B 在所有 LLM 中表現最低;然而,它仍與最佳基線方法 Manus 相當。(iii) GPT-4o 提供了最佳的整體效能,但代價是在所有 LLM 中相對較高的費用。
表 6:AutoData 搭配不同 LLM 骨幹在 Instruct2DS 上的效能。
| 模型 | Academic F1 | Prec. | Reca. | Stock F1 | Prec. | Reca. | Sport F1 | Prec. | Reca. | Time (分) ↓ | Expense (USD $) ↓ |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Manus | 69.27 | 72.76 | 66.10 | 95.24 | 97.10 | 93.47 | 87.48 | 93.12 | 81.80 | 15.37 | 2.49 |
| DeepSeek R1 70B | 78.33 | 85.45 | 72.43 | 94.64 | 96.90 | 91.83 | 85.75 | 90.94 | 80.63 | 13.30 | – |
| DeepSeek R1 450B | 90.20 | 92.52 | 88.19 | 95.74 | 98.46 | 93.26 | 87.70 | 94.27 | 80.36 | 4.45 | 0.14 |
| GPT-4o-mini | 86.97 | 90.32 | 83.10 | 95.84 | 97.36 | 93.94 | 88.18 | 93.97 | 83.40 | 3.71 | 0.01 |
| GPT-4o | 91.85 | 93.74 | 90.51 | 96.75 | 98.37 | 94.17 | 90.14 | 95.63 | 85.28 | 5.58 | 0.57 |
E.2 錯誤分析
我們透過將 AutoData 蒐集的資料集 DS 與真值資料集 GT-DS 進行比對來進行分析,並識別出以下常見的失敗模式。
不明確的會議名稱與軌道。 某些會議並不在個別論文頁面上揭露會議名稱或軌道。舉例而言,在 NLP 場合中,頁面僅列出一個「Volume」字串,例如「Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers)」,而軌道資訊則隱含地編碼在該欄位內。在這些情況下,AutoData 會遺漏或錯誤剖析這些屬性。更多任務特定的提示或許有幫助,但由於我們的目標是一個用於開放網路資料蒐集的通用 MAS,我們並不硬編碼 (hard-code) 此類啟發式規則。
資料蒐集方法。 儘管系統既能爬取 HTML 也能呼叫 REST API,它偶爾會選擇較不可靠的途徑。對於 MLB 統計數據,(i) 從 URL 直接爬取 HTML 與 (ii) 維護良好的第三方 API 都是可行的。AutoData 有時會選擇較易出錯的爬取方式,而非較乾淨的 API 路徑。更好的決策策略或明確的使用者提示,或許能緩解此問題。
附錄 F 兒童繪本蒐集的補充討論
繪本以其富創意的圖像與引人入勝的敘事,幫助幼齡學習者將閱讀與視覺化連結起來,使他們能透過圖像理解文字。繪本也能作為學生探索其所生活世界的強大工具 [55]。此外,一項較早的研究 [56] 討論了繪本如何能作為窗戶、鏡子與滑門 (windows, mirrors, and sliding doors)——提供窺見他人生活的機會、反映讀者自身的身分認同,並開啟通往新觀點的道路。
該資料集對教育者、作者、插畫家與出版商具有重大價值,作為一項引導內容選擇並形塑未來出版的強大資源。開發一個用以識別與特定教學主題相符之繪本的資料庫,為分析兒童文學中反覆出現的主題提供了一個不可或缺的工具。這不僅支援教育者選擇能在課堂中促進正面影響的書籍,也幫助內容創作者(例如作者、插畫家或出版商)認知該領域的空白,並開發出更相關、更具代表性的內容。
附錄 G 限制
儘管有著強大的實證結果,AutoData 仍有若干限制。首先,整個管線依賴大規模的專有語言模型(我們實驗中的 GPT-4 / GPT-4o)。定價、速率限制或模型品質的任何改變,都會立即影響延遲、可重現性與成本,這對專有基線方法(亦即 Manus)也是如此。儘管我們的抽象層 (abstraction layer) 允許使用如 DeepSeek-R1 等開放權重 (open-weight) 模型,但卓越的效能並無保證,如附錄 E.1 所示。其次,我們的基準與案例研究聚焦於可公開存取的 HTML 頁面或透過 REST API。完全由客戶端渲染 (client-side rendered)、受登入牆 (login walls)、CAPTCHA 或激進反爬蟲政策保護的網站,仍大多無法觸及。納入無頭瀏覽器 (headless-browser) 代理人與憑證管理模組,留待未來工作。第三,目前的系統假設所請求的資料是合法可取得的。因此,存在無意間違反著作權或契約限制的風險。使用者必須留意倫理考量,例如資料中的偏見,並確保在不同應用中負責任地使用 AutoData。第四,我們所提系統僅聚焦於以文字為中心的資料蒐集。多模態 (multimodal) 資產(圖像、音訊、影片)來源並不被支援,我們將其留作未來工作。
附錄 H 更廣泛的影響
AutoData 將單一句子轉化為一個策劃完善之資料集的能力,同時帶來了大有可為的益處與不可忽視的風險。在正面方面,此系統降低了缺乏大量工程支援的研究人員、教育者、記者與 NGO 取得資料的門檻。透過自動化重複的爬取與清理工作,它釋放了人類的時間以進行更高層次的分析,並可能加速科學領域中的後設研究 (meta-studies) 或可重現性審查。我們的繪本案例研究說明了領域專家如何能快速建構出原本需耗費數週人工才能完成的專門語料庫。在經濟方面,此框架可能提升效率並培育新的資料驅動產品,但它也威脅到傳統的網路爬取或資料標註工作。若採用規模擴大,謹慎設計再技能培訓 (re-skilling) 計畫將很重要。
然而,這也存在嚴重的雙重用途 (dual-use) 疑慮。不受控制的採集可能擷取個人資料、付費牆 (pay-walled) 內容或受著作權保護的媒體,使操作者與下游使用者暴露於法律責任之中。蓄意的對手可能利用 AutoData 來組裝大型的不實資訊 (disinformation) 語料庫,或餵養產生逼真深度偽造 (deepfakes) 的模型。環境足跡是另一個隱憂:多代理人 LLM 推論若以網路規模執行,會消耗不可忽視的能源。為緩解這些問題,在我們釋出程式碼之前,我們將選擇性納入 (opt-in) 以下保護措施:(i) 一個可擴充的模組,用以剖析常見授權條款,對不合規的請求發出警告或予以封鎖;(ii) 一個 PII(可識別個人身分資訊)偵測器,在儲存前遮蔽敏感屬性;(iii) 速率限制並尊重 API 配額;以及 (iv) 透過 OHCache 提供可稽核的來源溯源日誌 (provenance logs),使第三方能驗證資料來源。我們預設也僅分享任務描述與所蒐集產物的校驗碼 (checksums),將原始傾印資料留在其原始授權條款之下。最終,我們希望社群將 AutoData 視為一個研究平台——對探索負責任的自動化很有用,但在能安全地大規模部署之前,需要對法律、倫理與技術上的保護措施進行持續的精煉。
術語對照表
| English | 繁體中文 |
|---|---|
| Multi-Agent System (MAS) | 多代理人系統 |
| Oriented Hypergraph | 導向超圖 |
| Oriented Message Hypergraph | 導向訊息超圖 |
| Oriented Hyperedge Formatter | 導向超邊格式化器 |
| Local Cache System | 本地快取系統 |
| Oriented HyperGraph Cache System (OHCache) | 導向超圖快取系統 |
| hyperedge | 超邊 |
| source nodes / target nodes | 來源節點 / 目標節點 |
| Open Web Data Collection | 開放網路資料蒐集 |
| web scraping / web crawling | 網路爬取 |
| wrapper-based | 基於包裝器的 |
| research squad / development squad | 研究小隊 / 開發小隊 |
| plan agent | 計畫代理人 |
| web agent | 網路代理人 |
| tool agent | 工具代理人 |
| blueprint agent | 藍圖代理人 |
| engineering agent | 工程代理人 |
| test agent | 測試代理人 |
| validation agent | 驗證代理人 |
| manager agent (MGR) | 管理者代理人 |
| development blueprint | 開發藍圖 |
| artifact | 產物 |
| cache identifier | 快取識別碼 |
| broadcast-style communication | 廣播式通訊 |
| message routing | 訊息路由 |
| message history | 訊息歷史 |
| hallucination | 幻覺 |
| cognitive overload | 認知過載 |
| ReAct paradigm | ReAct 範式 |
| ground truth dataset | 真值資料集 |
| instruction template | 指令模板 |
| placeholder variables | 佔位變數 |
| symbolic information extraction | 符號化資訊萃取 |
| benchmark dataset | 基準資料集 |
| Information Extraction (IE) | 資訊萃取 |
| named entity recognition | 命名實體辨識 |
| entity linking | 實體連結 |
| sequential labeling | 序列標註 |
| span-based | 基於跨度的 |
| pre-trained language models (PLMs) | 預訓練語言模型 |
| in-context learning | 脈絡內學習 |
| prompt tuning | 提示微調 |
| chain-of-thought | 思維鏈 |
| cross-validation | 交叉驗證 |
| reproducibility | 可重現性 |
| scalability | 可擴展性 |
| generalizability | 泛化能力 |
| backbone | 骨幹 |
| precision / recall / F1 score | 精確率 / 召回率 / F1 分數 |
| execution precision / execution recall | 執行精確率 / 執行召回率 |
| ablation study | 消融研究 |
| case study | 案例研究 |
| baseline method | 基線方法 |
| regular season | 常規賽 |
| corporate action | 企業行動 |
| binary classification | 二元分類 |
| majority vote | 多數決 |
| dual-use | 雙重用途 |
| disinformation | 不實資訊 |
| provenance logs | 來源溯源日誌 |
| headless-browser | 無頭瀏覽器 |
| open-weight model | 開放權重模型 |
| plug-and-play | 隨插即用 |