SERA:軟驗證的高效程式碼倉庫智能體
原始論文:SERA: Soft-Verified Efficient Repository Agents 作者:Ethan Shen, Daniel Tormoen, Saurabh Shah, Ali Farhadi, Tim Dettmers arXiv ID:2601.20789v1 日期:2025-01-31 標籤:LLM Code Agent SWE-bench Synthetic Data Software Engineering 開源模型
1. 引言
訓練開源的程式碼智能體 (coding agent) 一直是個昂貴的事。先前方法如 SWE-smith 需要 64+ GPU、大型團隊和複雜的測試基礎設施。SERA 提出了一種簡化的合成資料生成方法,用遠低於先前的成本訓練出開源 SOTA 的程式碼倉庫智能體。
核心數據:
- SWE-bench Verified 上 49.5%(32K 上下文)/ 54.2%(64K 上下文),開源全模型 SOTA
- 訓練成本:$2,000,40 GPU-days
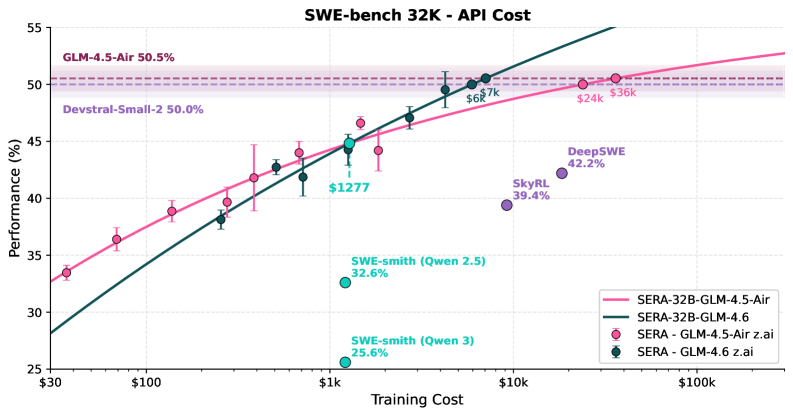
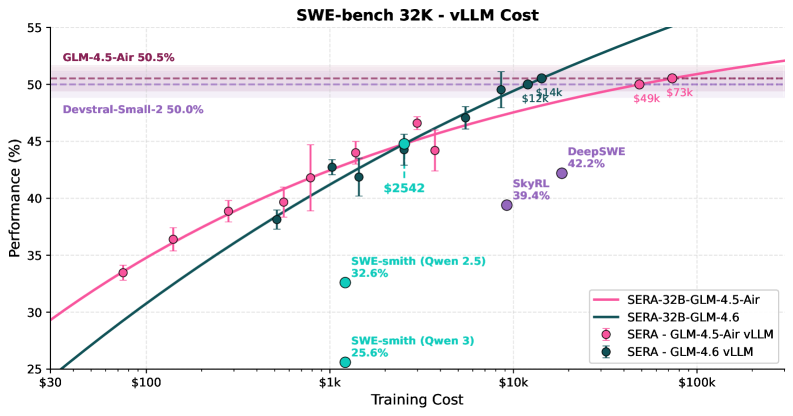
- 比先前方法便宜 26-57 倍
- 釋出 200,000+ 合成軌跡、模型權重和完整評估腳本
2. 方法:軟驗證生成 (SVG)
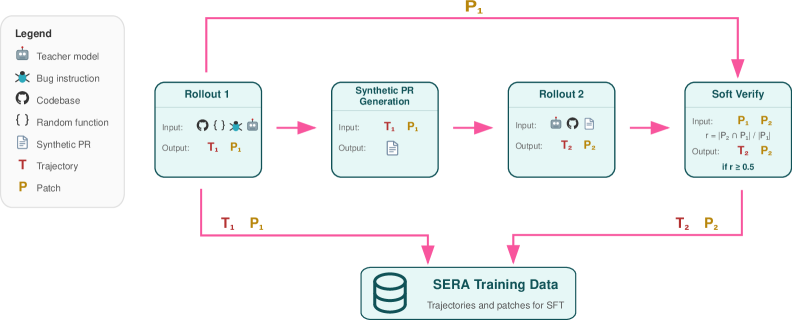
SERA 的核心創新是 軟驗證生成 (Soft Verified Generation, SVG),用行級別 (line-level) 的 patch 比較取代單元測試驗證。這讓資料生成可以在任何倉庫上進行,不需要測試基礎設施。
SVG 管線
- 第一次展開 (Rollout 1):教師模型收到一個隨機函數和 bug 類型的模糊描述,生成軌跡 $T_1$ 和 patch $P_1$
- PR 描述生成:將 $T_1$ 轉換為合成 PR 描述(用示範範例指導格式)
- 第二次展開 (Rollout 2):教師模型只根據 PR 描述嘗試重現 patch,產生 $T_2$ 和 $P_2$
- 軟驗證:計算行級別召回率 $r = |P_2 \cap P_1| / |P_1|$,用來判斷訓練資料品質
這個設計的巧妙之處在於:第一次展開生成了「答案」,第二次展開模擬了真實的 bug-fixing 場景。軟驗證用行重疊率取代了昂貴的單元測試執行,使得在任意倉庫上都能生成訓練資料。
訓練設定
- 基礎模型:Qwen 3-32B
- 教師模型:GLM-4.5-Air、GLM-4.6
- 只用 SFT,不用 RL
- 原生 32768 token 上下文
- 訓練:3 epochs,學習率 $1 \times 10^{-5}$
3. 實驗結果
3.1 主要結果
控制比較(相同教師模型條件下):
- SERA 在 SWE-bench 上用硬驗證軌跡達 30%,vs. SWE-smith 的 25.27%
- 樣本數接近時,效能接近 BugPilot
完整模型對比:
- SERA 在 SWE-bench Verified 32K 上下文達 49.5%,64K 達 54.2%
- 匹配 Devstral-Small-2 等商業模型的效能
- 完全開源 SOTA
3.2 縮放實驗
生成三個資料集:
- Sera-4.5A-Lite(36k 軌跡)
- Sera-4.5A-Full(70k 軌跡)
- Sera-4.6-Lite(36k 軌跡)
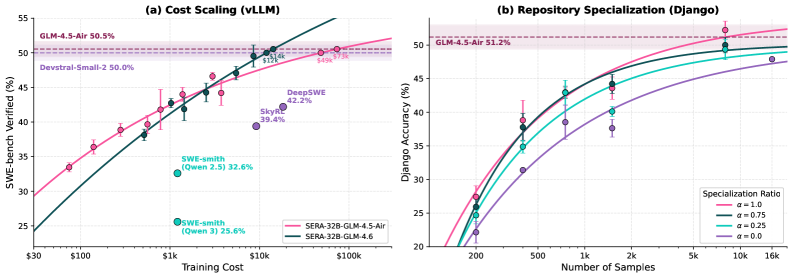
縮放曲線呈現可預測的冪律 (power-law) 效能提升($R^2 > 0.95$)。SVG 的成本優勢隨規模增大而增加。
3.3 倉庫專精化
針對特定倉庫訓練專精模型:
| 倉庫 | SERA 專精 | 教師基線 | 樣本數 |
|---|---|---|---|
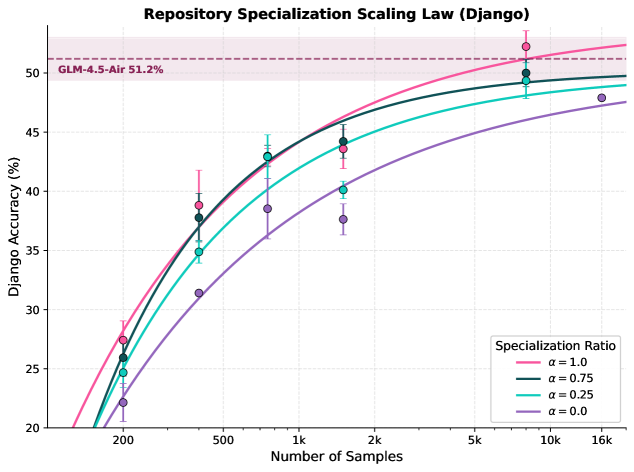
| Django | 52.23% | 51.20% | ~8,000 |
| Sympy | 51.11% | 48.89% | ~8,000 |
| Sphinx | 37.14% | 43.51% | ~8,000 |
Django 和 Sympy 上,學生模型匹配甚至超越了教師,只需約 8,000 個樣本($1,300 成本)。專精化資料的樣本效率是通用資料的 3.5 倍。
4. 消融研究
驗證的必要性
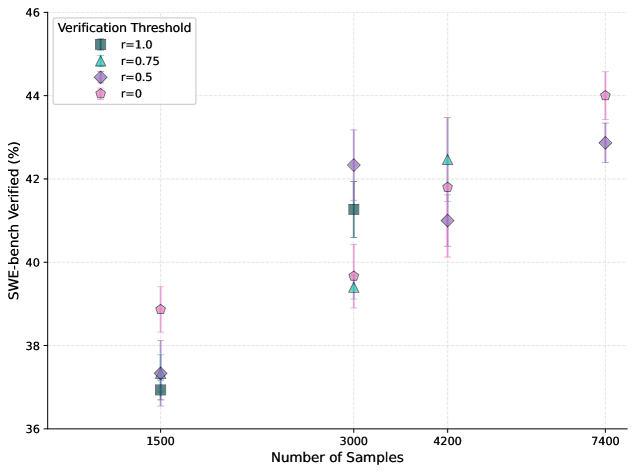
一個反直覺的發現:在最多 7,400 個樣本的規模下,硬驗證($r=1.0$)、軟驗證($0<r<1$)和未驗證($r=0$)的軌跡之間沒有顯著效能差異。這挑戰了「驗證是必要的」這個傳統觀點。
截斷研究
包含約 95% 步驟的截斷軌跡效能最好(43%),優於完整軌跡(40.6%)和隨機截斷(37.47%)。適度截斷的高品質軌跡比短的完整軌跡更好。
推理痕跡的重要性
從 GLM-4.5-Air 軌跡中移除推理過程,效能從 41% 暴跌到 23%。詳細的推理解釋對訓練品質至關重要。
倉庫特定過濾
倉庫特定的過濾(如 patch 大小 ≤40 行)在 Django (+2.3%) 和 Sympy (+4.4%) 上有效,但在 Sphinx 上沒用,說明需要針對不同程式碼庫做特定優化。
統計穩健性
- 條件間標準差:0.5-3.0%(中位 1.2%)
- 使用信噪比 (SNR) 框架:SNR > 3 為高信心
- 3 個種子足以偵測 3%+ 的效果;1% 的改善需要 15+ 個種子
- 冪律預測的平均誤差只有 0.4%
5. 結論
SERA 證明了用簡單的軟驗證方法可以在極低成本下訓練出 SOTA 的開源程式碼智能體。SVG 管線不需要測試基礎設施,可在任意倉庫上生成訓練資料。倉庫專精化進一步展示了組織可以用自家程式碼訓練專用模型而不需將程式碼暴露給第三方 API。
部署需求:SERA 只需一張 80GB GPU(A100/H100+),搭配 vLLM 和 Hermes tool-calling parser。
研究民主化:將團隊規模需求從 12 人降到 5 人,GPU 需求從 64+ 降到 16,成本從數萬美元降到 $2,000 以下。
限制:
- 硬驗證在更大規模下可能變得必要
- 專精化在 8,000 樣本以上的優勢尚未充分驗證
- 評估僅限 SWE-bench Verified
- 結果可能無法泛化到 Qwen/GLM 以外的模型族
參考文獻
Yang, J., et al. SWE-agent: Agent-computer interfaces enable automated software engineering. NeurIPS, 2024.
Jimenez, C.E., et al. SWE-bench: Can language models resolve real-world GitHub issues? ICLR, 2024.
Mundler, N., et al. SWE-smith: Scaling data curation for training software engineering agents, 2025.
BugPilot team. BugPilot: Efficient synthetic data generation for real-world software engineering, 2025.
Du, W., et al. SWE-RL: Scaling reinforcement learning for real-world software engineering, 2025.
Wang, X., et al. OpenHands: An open platform for AI software developers as generalist agents. ICLR, 2025.
GLM Team. GLM-4.5: Agentic, reasoning, and coding foundation models, 2025.
Qwen Team. Qwen3 technical report, 2025.
Mistral AI. Devstral-Small: An open-source model for software engineering, 2025.
Jain, N., et al. R2E-Gym: Procedural environments and hybrid verifiers for scaling open-weights SWE agents, 2025.
Tormoen, D., et al. Repo2Run: A large-scale auto-executable repository dataset, 2025.
術語對照表
| 英文 | 中文 |
|---|---|
| Soft Verified Generation (SVG) | 軟驗證生成 |
| Repository Agent | 倉庫智能體 |
| Coding Agent | 程式碼智能體 |
| SWE-bench | 軟體工程基準測試 |
| Trajectory | 軌跡 |
| Rollout | 展開(策略採樣) |
| Patch | 程式碼修補 |
| Pull Request (PR) | 拉取請求 |
| Line-level Recall | 行級別召回率 |
| Hard Verification | 硬驗證 |
| Soft Verification | 軟驗證 |
| Repository Specialization | 倉庫專精化 |
| Power-law Scaling | 冪律縮放 |
| Signal-to-Noise Ratio (SNR) | 信噪比 |
| Truncation | 截斷 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Synthetic Data | 合成資料 |