Lightning OPD:利用離線同策略蒸餾實現大型推理模型的高效後訓練
原始論文:Lightning OPD: Efficient Post-Training for Large Reasoning Models with Offline On-Policy Distillation 作者:Yecheng Wu, Song Han, Han Cai arXiv ID:2604.13010v1 日期:2026-04-14 標籤:LLM Knowledge Distillation Post-Training On-Policy Reasoning 訓練效率
1. 引言
同策略蒸餾 (On-Policy Distillation, OPD) 已成為大型語言模型後訓練的有效方法。在 OPD 中,學生模型從自身生成的軌跡出發,學習匹配更強教師的逐 token 分佈,利用密集的 per-token 優勢信號 (advantage signal)。然而,標準 OPD 需要一台即時運行的教師推理伺服器貫穿整個訓練過程,基礎設施開銷巨大。
一個自然的想法是:能不能把教師的 log-probability 預先計算好,離線使用?實務中,這種 naive 的離線方式無法可靠地匹配標準 OPD 的效能。
本文找出了一個之前被忽略的關鍵條件:教師一致性 (teacher consistency),即 SFT 階段和 OPD 階段必須使用同一個教師模型。違反這個條件會引入不可消除的梯度偏差 (irreducible gradient bias),導致線上和離線 OPD 都收斂到次優的不動點。
基於此洞見,作者提出 Lightning OPD,一個離線同策略蒸餾框架:
- 在 SFT rollout 上預先計算教師 log-probability,之後訓練時不再需要教師伺服器
- 在教師一致性條件下,Lightning OPD 與標準 OPD 共享相同的最優解
- 離線目標自然帶有隱式正則化效果,防止策略漂移 (policy drift)
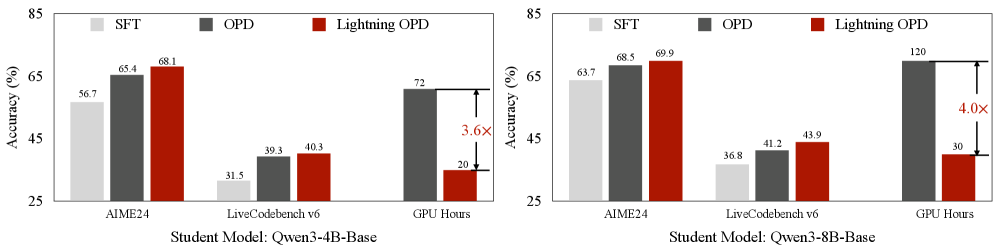
核心數據:從 SFT 初始化的 Qwen3-8B-Base 出發,Lightning OPD 只用 30 GPU 小時就在 AIME 2024 上達到 69.9%,比標準 OPD 快 4.0 倍。
2. 相關工作
LLM 後訓練
後訓練通常由 SFT + RL 兩階段組成。RL 方法大致分兩類:
- 基於結果 (outcome-based):GRPO、DAPO 等,優化稀疏的可驗證獎勵信號
- 基於過程 (process-based):PPO 等,提供密集的逐步監督
近期越來越多工作認識到 SFT 和 RL 階段並非獨立,而是需要共同設計。本文從 OPD 角度出發,證明兩個階段必須共用同一個教師。
同策略蒸餾 (On-Policy Distillation)
知識蒸餾 (Knowledge Distillation) 把大模型的能力轉移到小模型。標準 KD 在教師生成的固定資料上訓練,而 OPD 則從學生自身生成的軌跡出發,用教師的 token-level 分佈做監督。這讓 OPD 比離線 KD 更有效,因為教師在學生實際會遇到的分佈上提供了校正信號。
現有 OPD 管線常忽略教師一致性。例如 Thinking Machines Lab 在 OpenThoughts-3 上用 QwQ-32B 生成 SFT 資料,但用 Qwen3-32B 做 OPD 教師。本文證明這種不匹配會引入不可消除的梯度偏差。
離策略強化學習 (Off-Policy RL)
Lightning OPD 與離策略 RL 表面相似(都在固定資料集上優化),但本質不同。離策略 RL 的核心挑戰是 OOD 動作過估計和稀疏獎勵的高變異度,需要保守主義 (conservatism) 機制。Lightning OPD 不存在這些問題,因為教師在所有 token 序列上提供密集監督,沒有 OOD 區域。Lightning OPD 的真正障礙是教師不一致性,這是梯度場本身的結構性問題,不是估計偏差。
3. 方法
3.1 預備知識
設 $\pi_T$ 為固定的教師模型,$\pi_\theta$ 為可訓練的學生模型。給定 prompt $q$,回應 $x = (a_1, \ldots, a_T)$ 自迴歸生成:
$$\pi_\theta(x \mid q) = \prod_{t=1}^{T} \pi_\theta(a_t \mid s_t)$$
其中 $s_t = (q, a_1, \ldots, a_{t-1})$。設 $\pi_{\text{ref}}$ 為 SFT 初始化的學生。Per-token OPD 優勢 (advantage) 定義為:
$$A_t(\theta) = \log \pi_T(a_t \mid s_t) - \log \pi_\theta(a_t \mid s_t)$$
教師比學生更有信心的地方為正,反之為負。
標準 OPD 優化:
$$J_{\text{on}}(\theta) = \mathbb{E}_{q \sim p, \, x \sim \pi_\theta} \left[\sum_{t=1}^{T} A_t(\theta)\right]$$
rollout 來自當前學生策略 $\pi_\theta$。
Lightning OPD 將 rollout 分佈固定為 $\pi_{\text{ref}}$:
$$J_{\text{off}}(\theta) = \mathbb{E}_{q \sim p, \, x \sim \pi_{\text{ref}}} \left[\sum_{t=1}^{T} A_t(\theta)\right]$$
兩者共享相同的優勢函數,只差在回應分佈。通過重要性採樣 (IS) 分解,$\nabla J_{\text{on}}(\theta) = \mathbb{E}_{x \sim \pi_{\text{ref}}}[w(x;\theta) \cdot \nabla J_{\text{off}}(\theta)]$,其中 $w(x;\theta) = \pi_\theta(x) / \pi_{\text{ref}}(x)$,離線梯度是 $w \equiv 1$ 的特例。
3.2 Lightning OPD 流程
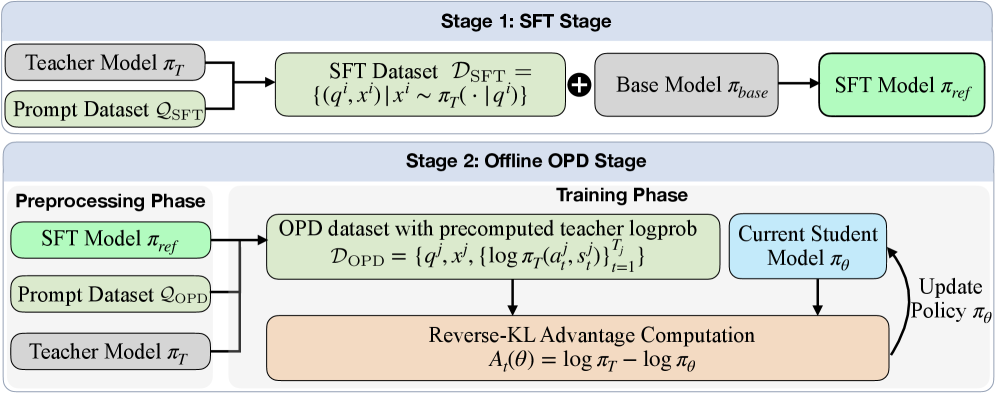
Lightning OPD 分兩個階段:
階段 1:SFT
給定基礎模型 $\pi_{\text{base}}$、教師 $\pi_T$ 和 prompt 資料集 $\mathcal{Q}_{\text{SFT}}$,收集教師生成的監督資料集:
$$\mathcal{D}_{\text{SFT}} = \{(q^i, x^i) \mid x^i \sim \pi_T(\cdot \mid q^i), \, q^i \in \mathcal{Q}_{\text{SFT}}\}$$
用最大似然估計微調基礎模型,得到參考策略 $\pi_{\text{ref}}$。
關鍵差異:標準 OPD 可以用任何高品質 SFT 資料集,但 Lightning OPD 要求 $\mathcal{D}_{\text{SFT}}$ 必須由 OPD 階段同一個教師 $\pi_T$ 生成。這就是教師一致性條件。
階段 2:離線同策略蒸餾
分為預處理 (preprocessing) 和訓練 (training) 兩個 phase:
預處理 phase:對每個 OPD prompt $q^j$,從 $\pi_{\text{ref}}$ 採樣一條 rollout $x^j$,然後一次性查詢教師取得所有 token 的 log-probability $\log \pi_T(a_t^j \mid s_t^j)$,形成離線資料集 $\mathcal{D}_{\text{OPD}}$。
訓練 phase:學生從 $\pi_{\text{ref}}$ 初始化,在 $\mathcal{D}_{\text{OPD}}$ 上訓練。每步計算優勢:
$$A_t(\theta) = \log \pi_T(a_t \mid s_t) - \log \pi_\theta(a_t \mid s_t)$$
其中教師項直接從 $\mathcal{D}_{\text{OPD}}$ 讀取(預計算好的),學生項線上計算。不需要教師伺服器。
在 8B 規模下,Lightning OPD 把總訓練成本從 120 GPU 小時降到 30 GPU 小時(4.0 倍加速)。
3.3 理論分析
本文建立了嚴格的理論基礎。以下是核心定理摘要:
定理 3.5(梯度差異界):在標準假設下,
$$\|\nabla J_{\text{on}}(\theta) - \nabla J_{\text{off}}(\theta)\|_2 \leq G \cdot \sigma_A \cdot \sqrt{\chi^2(\pi_\theta \| \pi_{\text{ref}})}$$
其中 $G$ 是 score function 的上界,$\sigma_A$ 是累積優勢的 $L^2$ 範數,$\chi^2$ 是 $\pi_\theta$ 相對 $\pi_{\text{ref}}$ 的卡方散度。
關鍵觀察:在初始化時 $\pi_\theta = \pi_{\text{ref}}$,$\chi^2 = 0$,兩個梯度完全一致。隨著訓練進行 $\chi^2$ 會增長,但在標準 KL 正則化下保持很小。
定理 3.7(共享不動點):$J_{\text{on}}$ 和 $J_{\text{off}}$ 的駐點條件一致。每個駐點 $\theta^*$ 都最小化 $\text{KL}(\pi_{\theta} \| \pi_T)$,且被標準 OPD 和 Lightning OPD 共享。
備註 3.8:Lightning OPD 的效能天花板完全由模型容量 $\Pi_\Theta$ 相對教師決定,而非 rollout 分佈的選擇。
定理 3.9(隱式正則化):離線梯度分解為:
$$\nabla J_{\text{off}}(\theta) = \nabla J_{\text{on}}(\theta) - \text{Cov}_{\pi_{\text{ref}}}[w(x;\theta), f(x;\theta)]$$
協方差項在 $\pi_\theta = \pi_{\text{ref}}$ 時為零,當學生偏離時增長,充當一個隱式的 trust-region penalty,自動約束策略漂移。不需要顯式的 KL penalty 或超參數。
定理 3.11(教師一致性與離線-線上差距):設 SFT 和 OPD 階段分別使用教師 $\pi_T^{\text{SFT}}$ 和 $\pi_T^{\text{OPD}}$:
$$\|\nabla J_{\text{on}}(\theta) - \nabla J_{\text{off}}(\theta)\|_2 \leq G \cdot \left(\sigma_A\sqrt{\chi^2(\pi_\theta \| \pi_{\text{ref}})} + \sigma_\Delta\right)$$
當 $\sigma_\Delta > 0$(教師不一致)時,多出一個不可消除的 $G\sigma_\Delta$ 偏差項,即使在初始化時也存在。
定理 3.13(教師一致性下的等價性):當教師一致($\pi_T^{\text{SFT}} = \pi_T^{\text{OPD}}$),在 $\pi_{\text{ref}}$ 可達的任何 $\theta$ 上:
$$\|\nabla J_{\text{on}}(\theta) - \nabla J_{\text{on}}^{\delta=0}(\theta)\|_2 \leq G \cdot \sigma_\Delta$$
標準 OPD 在教師不一致時同樣收斂到次優不動點。
3.4 討論
與離策略 RL 的關係:表面相似但本質不同。離策略 RL 的挑戰是 OOD 動作過估計和稀疏獎勵,需要保守主義。Lightning OPD 有密集的 per-token 教師監督,沒有 OOD 和稀疏獎勵問題。它的挑戰是教師不一致性,這是梯度場的結構性問題。兩者的不動點性質也不同:離策略 RL 是資料受限的,Lightning OPD 是容量受限的。
與離線知識蒸餾的關係:離線 KD 只在教師生成的序列上訓練學生,學生永遠不會在自己的錯誤上獲得回饋。Lightning OPD 收集學生策略 $\pi_{\text{ref}}$ 的 rollout,讓教師在學生實際會遇到的分佈上提供校正信號。實驗上,OPD 階段在所有 benchmark 上都比 SFT 基線有顯著提升,確認同策略監督比離線 KD 提取了更多教師資訊。
4. 實驗
4.1 實驗設定
模型:兩組學生-教師配對:
- Qwen3-4B-Base(學生)+ Qwen3-8B(教師)
- Qwen3-8B-Base(學生)+ Qwen3-32B(教師)
訓練資料:
- SFT 階段:OpenThoughts-3 的 prompt,由對應教師生成回應
- OPD 階段(數學推理):DAPO-Math-17k,17K 競賽級數學題
- OPD 階段(程式碼生成):EpiCoder-func-380k 的 30K 子集
Benchmark:數學推理用 AIME 2024、AIME 2025、HMMT 2025;程式碼生成用 LiveCodeBench v5 和 v6。
訓練設定:
- SFT:LlamaFactory 實作,3000 步
- OPD:slime 框架,150 步(足以收斂)
- 標準 OPD 和 Lightning OPD 使用完全相同的訓練設定,唯一差異是 rollout 來源
4.2 主要結果
| 方法 | AIME 2024 | AIME 2025 | HMMT 2025 | 推理平均 | LCB v5 | LCB v6 | 程式碼平均 |
|---|---|---|---|---|---|---|---|
| Student: Qwen3-4B-Base, Teacher: Qwen3-8B | |||||||
| + SFT | 56.7 | 52.1 | 34.0 | 47.6 | 33.8 | 31.5 | 32.6 |
| + OPD | 65.4 | 57.9 | 39.9 | 54.4 | 44.2 | 39.3 | 41.8 |
| + Lightning OPD | 68.1 | 58.4 | 39.8 | 55.4 | 42.8 | 40.3 | 41.5 |
| + ExOPD | 61.0 | 56.0 | 34.4 | 50.5 | - | 29.0 | - |
| Student: Qwen3-8B-Base, Teacher: Qwen3-32B | |||||||
| + SFT | 63.7 | 51.7 | 36.9 | 50.8 | 44.7 | 36.8 | 40.8 |
| + OPD | 68.5 | 59.0 | 39.4 | 55.6 | 47.3 | 41.2 | 44.2 |
| + Lightning OPD | 69.9 | 59.2 | 41.9 | 57.0 | 49.5 | 43.9 | 46.7 |
核心發現:Lightning OPD 在完全去除教師即時伺服器的情況下,在所有 benchmark 上匹配甚至超越標準 OPD。在 4B 規模下大幅超越 ExOPD(AIME 2024: 68.1% vs 61.0%)。
4.3 訓練成本
| 方法 | Qwen3-4B-Base | Qwen3-8B-Base |
|---|---|---|
| OPD | 72 GPU 小時 | 120 GPU 小時 |
| Lightning OPD | 20 GPU 小時 | 30 GPU 小時 |
| 加速比 | 3.6× | 4.0× |
Lightning OPD 的成本拆解(8B 規模):
- Rollout 收集:10 GPU 小時
- 教師 logprob 預計算:4 GPU 小時
- OPD 訓練:16 GPU 小時
Rollout 收集和教師 logprob 預計算都是一次性的離線操作,不需要特殊基礎設施。相比之下,標準 OPD 需要一台專用的多 GPU 教師伺服器在整個訓練過程中持續運行。
4.4 訓練動態
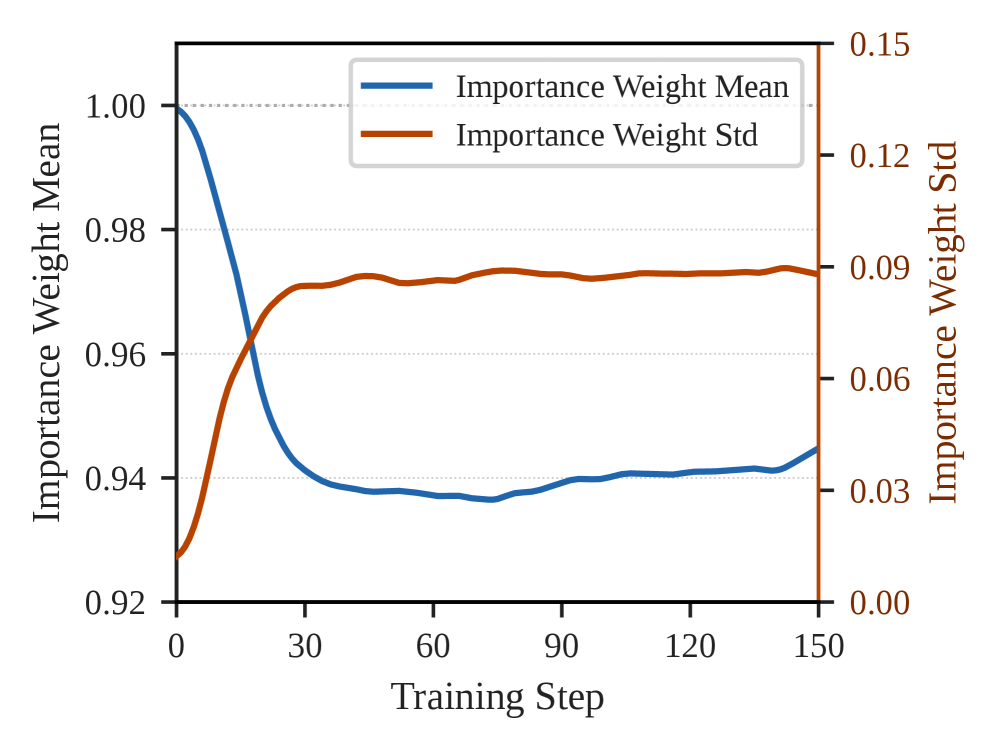
重要性權重 (importance weight):per-token 重要性權重 $w_t = \pi_\theta / \pi_{\text{ref}}$ 的平均值從 1 迅速降到約 0.94 並穩定,標準差始終低於 0.1。這說明學生策略停留在參考分佈附近,驗證了定理 3.9 的隱式正則化效果。
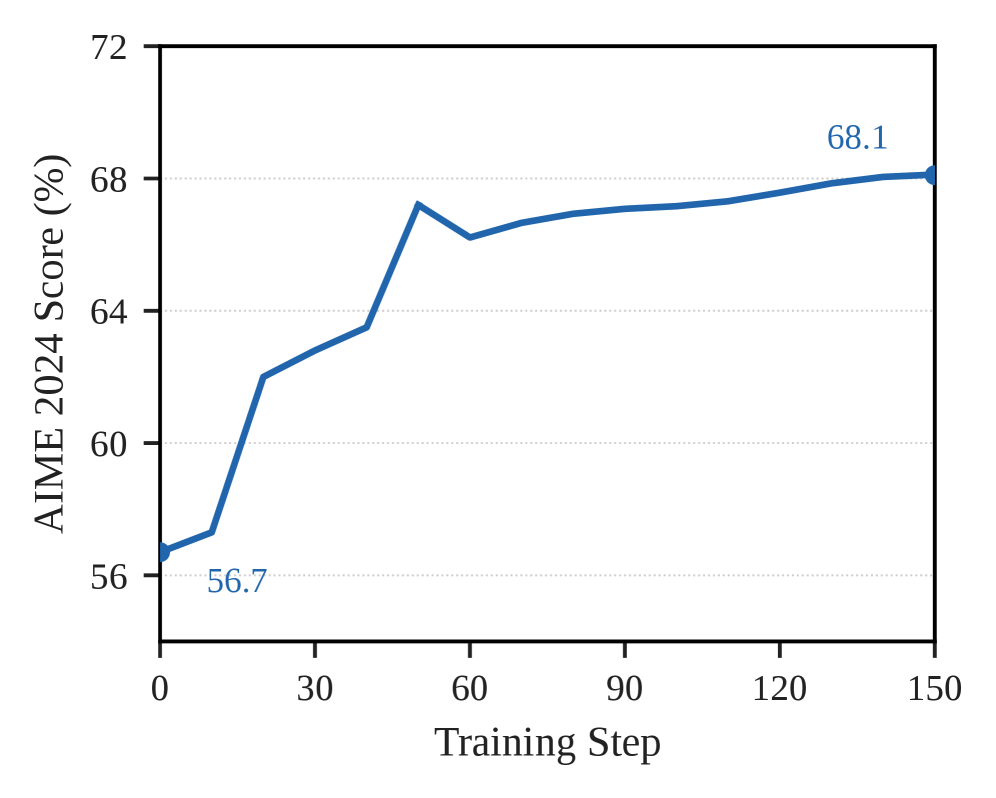
收斂速度:AIME 2024 分數在前 50 步內就獲得幾乎全部增益,之後趨於穩定。150 步足以收斂。
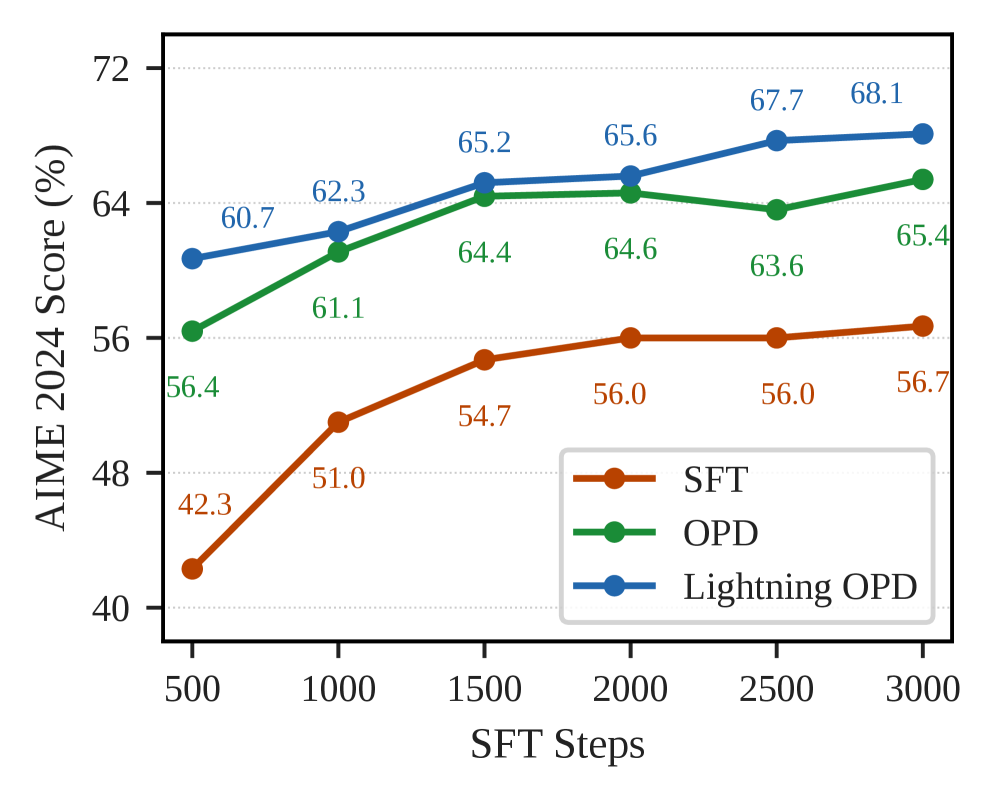
SFT checkpoint 品質的影響:SFT、OPD 和 Lightning OPD 三條曲線隨 SFT 步數增加都持續改善,三者的相對排序在所有 SFT 預算下保持一致。Lightning OPD 對 SFT 訓練長度具有穩健性。
4.5 消融研究
教師一致性消融:引入 QwQ-32B 做為額外教師,在 4B 和 8B 規模上分別測試 SFT 教師 × OPD 教師的完整網格。
結果一致確認:
- 對角線設定(同一教師)總是最好
- 教師不一致對 Lightning OPD 的懲罰比標準 OPD 更大(8B 規模:Lightning OPD 掉 6.8 分 vs 標準 OPD 掉 3.7 分)
- 這正是定理 3.11 預測的:不一致的 SFT 教師同時腐蝕了參考分佈和 rollout 來源,造成複合效應
這確立了教師一致性不只是 Lightning OPD 的需求,而是所有 OPD 管線的設計原則。
5. 結論
Lightning OPD 是一個離線同策略蒸餾框架,通過預計算教師 log-probability,將 OPD 的基礎設施從持續運行的教師伺服器簡化為一個標準訓練任務。核心洞見是教師一致性:SFT 和 OPD 階段必須用同一個教師,否則兩種範式(線上和離線)都會收斂到次優不動點。在教師一致性下,Lightning OPD 可證明地與標準 OPD 等價。
實證上,Lightning OPD 在 8B 模型上只用 30 GPU 小時就訓出 AIME 2024 的 69.9%,比標準 OPD 快 4.0 倍,大幅降低了學術界進行 LLM 後訓練研究的門檻。
參考文獻
Daya Guo, Dejian Yang, Haowei Zhang, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025.
Aaditya Singh, Adam Fry, Adam Perelman, et al. Openai gpt-5 system card, 2025.
Kimi Team, Tongtong Bai, Yifan Bai, et al. Kimi k2.5: Visual agentic intelligence, 2026.
NVIDIA. Nvidia nemotron 3: Efficient and open intelligence, 2025.
Bangjun Xiao, Bingquan Xia, et al. Mimo-v2-flash technical report, 2026.
Long Ouyang, Jeff Wu, Xu Jiang, et al. Training language models to follow instructions with human feedback. NeurIPS, 2022.
Etash Guha, Ryan Marten, et al. Openthoughts: Data recipes for reasoning models, 2025.
Rishabh Agarwal, Nino Vieillard, et al. On-policy distillation of language models: Learning from self-generated mistakes. ICLR, 2024.
Kevin Lu and Thinking Machines Lab. On-policy distillation, 2025.
Wenkai Yang, Weijie Liu, et al. Learning beyond teacher: Generalized on-policy distillation with reward extrapolation, 2026.
Siyan Zhao, Zhihui Xie, et al. Self-distilled reasoner: On-policy self-distillation for large language models, 2026.
Idan Shenfeld, Mehul Damani, et al. Self-distillation enables continual learning, 2026.
Jonas Hübotter, Frederike Lübeck, et al. Reinforcement learning via self-distillation, 2026.
Zhuolin Yang, Zihan Yang, et al. Nemotron-cascade 2: Post-training llms with cascade rl and multi-domain on-policy distillation, 2026.
John Schulman, Filip Wolski, et al. Proximal policy optimization algorithms, 2017.
Zhihong Shao, Peiyi Wang, et al. Deepseekmath: Pushing the limits of mathematical reasoning in open language models, 2024.
Qiying Yu, Zheng Zhang, et al. Dapo: An open-source llm reinforcement learning system at scale, 2025.
An Yang, Anfeng Li, et al. Qwen3 technical report, 2025.
Yang Yue, Zhiqi Chen, et al. Does reinforcement learning really incentivize reasoning capacity in llms beyond the base model? 2025.
Idan Shenfeld, Jyothish Pari, and Pulkit Agrawal. RL's razor: Why online reinforcement learning forgets less, 2025.
Jason Wei, Xuezhi Wang, et al. Chain-of-thought prompting elicits reasoning in large language models. NeurIPS, 2022.
Jian Hu. REINFORCE++, 2025.
Arash Ahmadian, Chris Cremer, et al. Back to basics: Revisiting REINFORCE-style optimization for learning from human feedback in LLMs, 2024.
Ziniu Li, Tian Xu, et al. ReMax: A simple, effective, and efficient reinforcement method for aligning large language models, 2023.
Zichen Liu, Changyu Chen, et al. Understanding R1-Zero-like training: A critical perspective, 2025.
Chujie Zheng, Shixuan Liu, et al. Group sequence policy optimization, 2025.
MiniMax, Aonian Shan, et al. MiniMax-M1: Scaling test-time compute efficiently with lightning attention, 2025.
Ganqu Cui, Lifan Yuan, et al. Process reinforcement through implicit rewards, 2025.
Yufeng Yuan, Yu Yue, et al. What's behind PPO's collapse in long-CoT? 2025.
Yu Yue, Yufeng Yuan, et al. VAPO: Efficient and reliable reinforcement learning for advanced reasoning tasks, 2025.
Amirhossein Kazemnejad, Milad Aghajohari, et al. VinePPO: Refining credit assignment in RL training of LLMs, 2024.
Aixin Liu, Bei Feng, et al. DeepSeek-V3 technical report, 2024.
Kimi Team, Angang Du, et al. Kimi k1.5: Scaling reinforcement learning with LLMs, 2025.
Jingcheng Hu, Yinmin Zhang, et al. Open-reasoner-zero, 2025.
An Yang, Beichen Zhang, et al. Qwen2.5-Math technical report, 2024.
Jianhao Yan, Yafu Li, et al. Learning to reason under off-policy guidance, 2025.
Lu Ma, Hao Liang, et al. Learning what reinforcement learning can't, 2026.
Wenhao Zhang, Yuexiang Xie, et al. On-policy RL meets off-policy experts, 2025.
Liang Chen, Xueting Han, et al. Beyond two-stage training: Cooperative SFT and RL for LLM reasoning, 2025.
Mingyang Liu, Gabriele Farina, and Asuman Ozdaglar. UFT: Unifying supervised and reinforcement fine-tuning, 2025.
Zeyu Huang, Tianhao Cheng, et al. Blending supervised and reinforcement fine-tuning with prefix sampling, 2025.
Geoffrey Hinton, Oriol Vinyals, and Jeff Dean. Distilling the knowledge in a neural network. NIPS Deep Learning Workshop, 2015.
Yoon Kim and Alexander M Rush. Sequence-level knowledge distillation. EMNLP, 2016.
Yuxian Gu, Li Dong, Furu Wei, and Minlie Huang. MiniLLM: Knowledge distillation of large language models. ICLR, 2024.
Tianzhu Ye, Li Dong, et al. Black-box on-policy distillation of large language models, 2025.
Kun Liang, Clive Bai, et al. Orbit: On-policy exploration-exploitation for controllable multi-budget reasoning, 2026.
Emiliano Penaloza, Dheeraj Vattikonda, et al. Privileged information distillation for language models, 2026.
Sergey Levine, Aviral Kumar, et al. Offline reinforcement learning: Tutorial, review, and perspectives on open problems, 2020.
Ronald J Williams. Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning, 1992.
Aviral Kumar, Aurick Zhou, et al. Conservative Q-learning for offline reinforcement learning. NeurIPS, 2020.
Ilya Kostrikov, Ashvin Nair, and Sergey Levine. Offline reinforcement learning with implicit q-learning. ICLR, 2022.
Scott Fujimoto, David Meger, and Doina Precup. Off-policy deep reinforcement learning without exploration. ICML, 2019.
Rafael Rafailov, Archit Sharma, et al. Direct preference optimization: Your language model is secretly a reward model. NeurIPS, 2023.
Zheng Yuan, Hongyi Yuan, et al. Scaling relationship on learning mathematical reasoning with large language models, 2023.
Hanze Dong, Wei Xiong, et al. RAFT: Reward ranked finetuning for generative foundation model alignment. TMLR, 2023.
Daniel Ritter, Owen Oertell, et al. LLMs can learn to reason via off-policy RL, 2026.
Yao Lu, Dengdong Fan, et al. PCL-Reasoner-V1.5: Advancing math reasoning with offline reinforcement learning, 2026.
Yaoxiang Wang, Haoling Li, et al. Encompassing diversity and complexity in code generation, 2025.
AI-MO. AIME 2024, 2024.
OpenCompass. AIME 2025, 2025.
Mislav Balunović, Jasper Dekoninck, et al. MathArena: Evaluating LLMs on uncontaminated math competitions, 2025.
Naman Jain, King Han, et al. LiveCodeBench: Holistic and contamination free evaluation of large language models for code, 2024.
Yaowei Zheng, Richong Zhang, et al. LlamaFactory: Unified efficient fine-tuning of 100+ language models. ACL, 2024.
THUDM. slime: An SGLang-native post-training framework for RL scaling, 2025.
Qwen Team. Qwq-32b: Embracing the power of reinforcement learning, 2025.
Yang Chen, Zhuolin Yang, et al. Nemotron-cascade: Scaling cascaded reinforcement learning for general-purpose reasoning models, 2025.
術語對照表
| 英文 | 中文 |
|---|---|
| On-Policy Distillation (OPD) | 同策略蒸餾 |
| Lightning OPD | 閃電同策略蒸餾 |
| Teacher Consistency | 教師一致性 |
| Knowledge Distillation (KD) | 知識蒸餾 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Advantage | 優勢(函數) |
| Log-probability / Logprob | 對數機率 |
| Rollout | 展開(策略採樣) |
| Reference Policy | 參考策略 |
| Importance Sampling (IS) | 重要性採樣 |
| Policy Drift | 策略漂移 |
| Gradient Bias | 梯度偏差 |
| Stationary Point / Fixed Point | 駐點 / 不動點 |
| Implicit Regularization | 隱式正則化 |
| Trust Region | 信賴域 |
| Chi-squared Divergence | 卡方散度 |
| Off-Policy RL | 離策略強化學習 |
| Conservatism | 保守主義 |
| Out-of-Distribution (OOD) | 分佈外 |
| Proximal Policy Optimization (PPO) | 近端策略最佳化 |
| GRPO | 群組相對策略最佳化 |