Self-Anchor:透過逐步注意力對齊改進 LLM 推理
原始論文:Self-Anchor: LLM Reasoning via Step-by-step Attention Alignment 作者:Hongxiang Zhang, Yuan Tian, Tianyi Zhang arXiv ID:2510.03223v1 日期:2025-10-04 標籤:LLM Reasoning Attention Chain-of-Thought Prompt Engineering 推理對齊
1. 引言
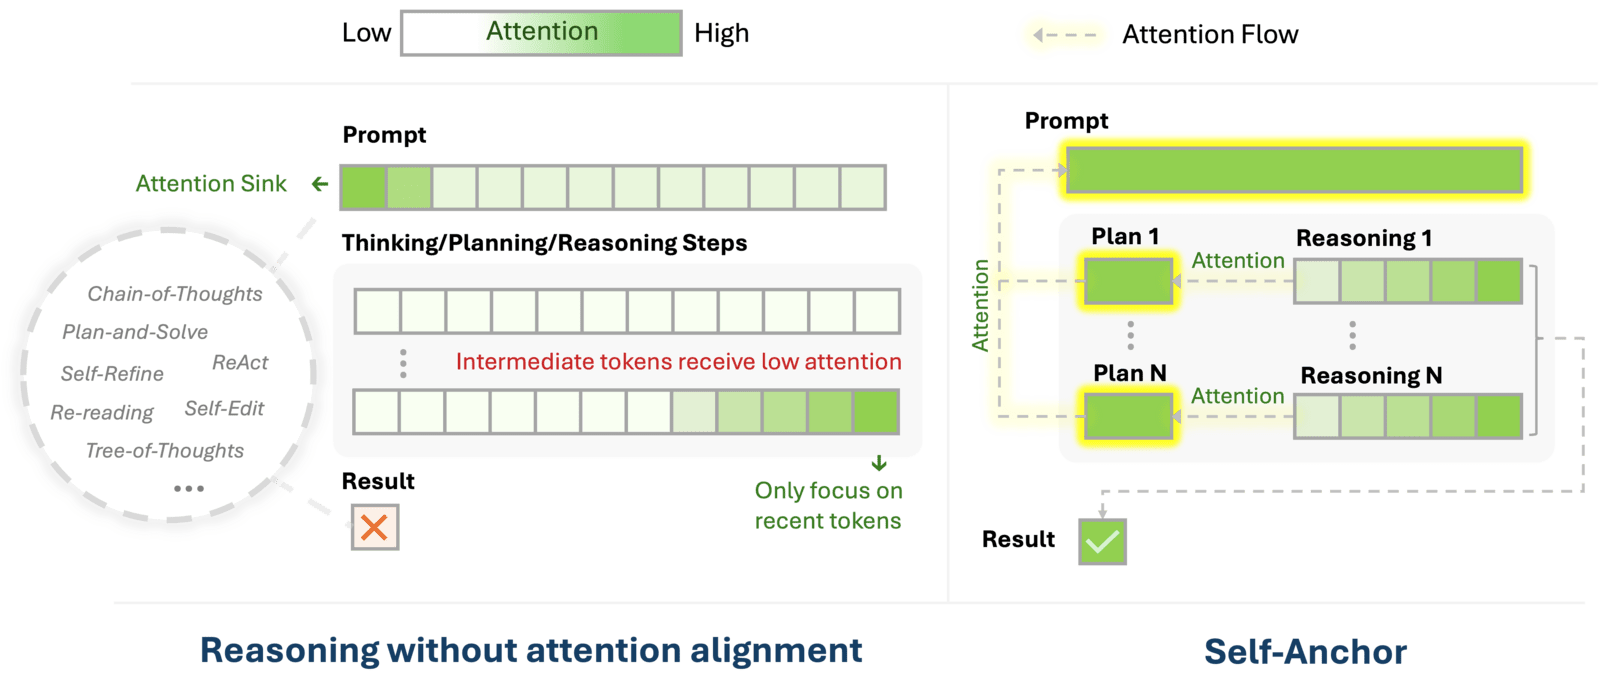
LLM 在長推理鏈 (extended reasoning chains) 中會出現注意力錯位 (attention misalignment) 的問題:隨著生成的推理步驟越來越多,模型的注意力逐漸偏離原始問題和關鍵推理步驟,導致後續推理走偏。
Self-Anchor 提出一個免訓練 (training-free) 的管線來解決這個問題,核心思路:
- 複雜推理可以分解為結構化計劃 (structured plans)
- 分解後的計劃天然地可以做為注意力對齊的錨點 (anchors)
方法在計劃步驟和推理步驟之間交替生成,並用選擇性提示錨定 (Selective Prompt Anchoring, SPA) 引導注意力指向原始問題和當前計劃。
2. 方法
2.1 計劃-推理交替生成
Self-Anchor 將推理過程分解為交替的計劃和推理步驟:
計劃生成:
$$\text{plan}_i = f(\text{concat}(\text{sys}, Q, \text{plan}_1 \ldots \text{plan}_{i-1}), Q)$$
給定系統提示、原始問題 $Q$ 和之前的計劃步驟,生成下一個計劃步驟。SPA 錨定在原始問題 $Q$ 上。
推理生成:
$$\text{reason}_i = f(\text{concat}(\text{sys}, Q, \text{plan}_1 \ldots \text{plan}_{i-1}), \text{concat}(Q, \text{plan}_i))$$
執行當前計劃步驟的具體推理。SPA 錨定在原始問題 $Q$ 和當前計劃 $\text{plan}_i$ 上。
2.2 選擇性提示錨定 (SPA)
SPA 透過修改注意力分佈來引導模型關注重要的錨定 token:
$$\text{logits}_i^{\text{steered}} = \omega_i \cdot \text{logits}_i^{\text{original}} + (1 - \omega_i) \cdot \text{logits}_i^{\text{mask}}$$
其中 $\text{logits}_i^{\text{mask}}$ 是對非錨定 token 施加遮罩後的 logits,$\omega_i$ 是置信度調整的轉向係數。
直覺上:當 $\omega_i$ 接近 1 時,保持原始注意力;當 $\omega_i$ 接近 0 時,強制注意力集中在錨定 token 上。
2.3 動態強度調整
用預測機率的調和平均 (harmonic mean) 做為置信度信號:
$$p_{\text{avg}} = \frac{n}{\sum_{i=1}^{n} \frac{1}{p_i}}$$
高置信度(預測機率高)→ 生成可靠,注意力可能已正確 → 減少轉向強度。 低置信度 → 可能注意力錯位 → 增加轉向強度。
選擇調和平均而非幾何平均是因為調和平均對低機率值更敏感,能更好地偵測注意力錯位。
3. 實驗結果
主要結果
在 6 個 benchmark 上測試 6 種 LLM 架構(準確率 %):
| 模型 | 方法 | GSM8K | AQuA | MATH | StratQA | T4D | BBH |
|---|---|---|---|---|---|---|---|
| Llama3.2-3B | CoT | 63.84 | 46.06 | 42.5 | 66.64 | 32.98 | 35.09 |
| Llama3.2-3B | Self-Anchor | 77.86 | 48.43 | 45.0 | 67.55 | 43.79 | 50.48 |
| Phi-4-mini-4B | CoT | 75.36 | 61.81 | 51.0 | 67.03 | 39.54 | 60.51 |
| Phi-4-mini-4B | Self-Anchor | 88.02 | 68.50 | 59.0 | 68.69 | 49.47 | 62.42 |
| Qwen3-4B | CoT | 86.66 | 73.62 | 82.0 | 68.03 | 70.21 | 73.33 |
| Qwen3-4B | Self-Anchor | 87.26 | 79.92 | 86.5 | 70.13 | 71.56 | 75.31 |
| Llama3.1-8B | CoT | 61.85 | 50.79 | 44.5 | 70.24 | 26.77 | 49.45 |
| Llama3.1-8B | Self-Anchor | 76.72 | 55.51 | 52.5 | 73.54 | 40.01 | 58.53 |
| Phi-4-15B | CoT | 73.16 | 68.11 | 74.5 | 77.51 | 73.94 | 72.08 |
| Phi-4-15B | Self-Anchor | 82.41 | 79.13 | 81.0 | 77.82 | 85.99 | 75.31 |
| Qwen3-30B | CoT | 84.46 | 81.10 | 78.0 | 78.60 | 84.92 | 67.69 |
| Qwen3-30B | Self-Anchor | 87.41 | 83.46 | 87.0 | 79.65 | 85.56 | 69.30 |
所有模型在所有 benchmark 上都有提升,平均提升 5.44%+。
與推理模型比較
| 模型 | 方法 | GSM8K | AQuA | MATH | StratQA | T4D | BBH |
|---|---|---|---|---|---|---|---|
| Phi-4-mini-4B | CoT | 75.36 | 61.81 | 51.0 | 67.03 | 39.54 | 60.51 |
| Phi-4-mini-4B | Self-Anchor | 88.02 | 68.50 | 59.0 | 68.69 | 49.47 | 62.42 |
| Phi-4-mini-4B | Reasoning 模式 | 81.27 | 60.62 | 75.0 | 66.38 | 45.04 | 59.85 |
Self-Anchor 在 6 個 benchmark 中的 5 個上超越了 RL 增強的推理模式,且不需要任何額外訓練。MATH 除外(推理模式 75% vs. Self-Anchor 59%),因為 MATH 需要更深層的數學推理。
效率
| 模型 | Self-Anchor | CoT | PS+ | RE2 |
|---|---|---|---|---|
| Llama3.2-3B | 9.97 | 10.87 | 10.84 | 12.01 |
| Phi-4-mini-4B | 11.02 | 12.25 | 12.24 | 12.21 |
| Llama3.1-8B | 7.54 | 8.38 | 8.26 | 8.19 |
| Qwen3-30B | 1.07 | 1.39 | 1.39 | 1.37 |
Self-Anchor 比 CoT 慢 1-2 tokens/秒,計算開銷極小。
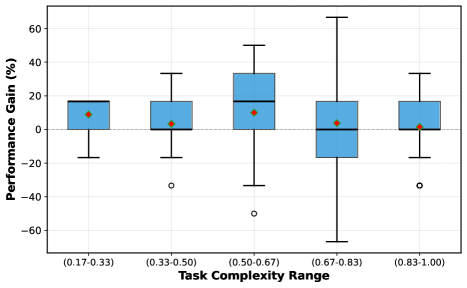
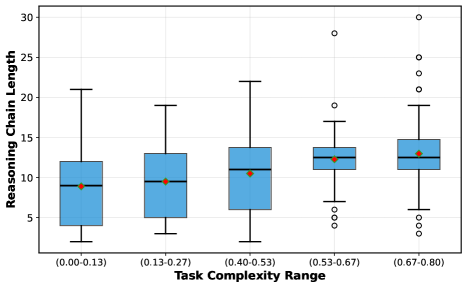
哪些類型的任務 Self-Anchor 幫助最大?
4. 消融研究
移除注意力轉向
| 模型 | 無轉向 | Self-Anchor | 差異 |
|---|---|---|---|
| Llama3.1-8B (MATH) | 40.9 | 52.5 | +11.6 |
| Phi-4-mini (GSM8K) | 78.77 | 88.02 | +9.25 |
| Phi-4-mini (T4D) | 38.83 | 49.47 | +10.64 |
注意力轉向貢獻了顯著的提升,證明僅有計劃分解不夠,注意力對齊是必要的。
置信度計算方法
| 模型 | CoT | 調和平均 | 幾何平均 |
|---|---|---|---|
| Llama3.1-8B (AQuA) | 50.79 | 55.51 | 55.11 |
| Llama3.1-8B (T4D) | 26.77 | 40.01 | 35.28 |
調和平均顯著優於幾何平均,尤其在 T4D 上(40.01 vs. 35.28)。
錨定範圍設計
| 設計 | AQuA | T4D |
|---|---|---|
| CoT 基線 | 50.79 | 26.77 |
| 主要 Self-Anchor(錨定 Q + 當前 plan) | 55.51 | 40.01 |
| 錨定所有先前計劃 | 53.54 | 32.62 |
只錨定原始問題 + 當前計劃比錨定所有先前計劃更好。過多的錨定反而引入噪音。
失敗模式分析
手動分析 200 個失敗案例:
- 推理錯誤:42%(邏輯推導本身有誤)
- 問題理解錯誤:36.5%(沒正確理解題意)
- 計算錯誤:21.5%(數學計算出錯)
Self-Anchor 主要解決注意力錯位問題,但無法完全修復更深層的邏輯或語義理解缺陷。
5. 結論
Self-Anchor 是一個免訓練的 LLM 推理增強管線,透過計劃-推理交替生成和選擇性提示錨定,解決長推理鏈中的注意力錯位問題。在 6 個 benchmark、6 種模型上一致提升,平均 5.44%+,計算開銷極小(1-2 tokens/秒),且在多數 benchmark 上接近或超越 RL 增強的推理模型。
參考文獻
Wei, J., et al. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS, 2022.
Wang, L., et al. Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models. ACL, 2023.
Xu, X., et al. Re-Reading Improves Reasoning in Large Language Models, 2024.
Tian, Y. and Zhang, T. Selective Prompt Anchoring for Code Generation, 2024.
Zhang, Q., et al. Tell Your Model Where to Attend: Post-hoc Attention Steering for LLMs (PASTA), 2023.
Yao, S., et al. Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS, 2023.
Besta, M., et al. Graph of Thoughts: Solving Elaborate Problems with Large Language Models, 2023.
Kojima, T., et al. Large Language Models are Zero-Shot Reasoners. NeurIPS, 2022.
術語對照表
| 英文 | 中文 |
|---|---|
| Attention Misalignment | 注意力錯位 |
| Selective Prompt Anchoring (SPA) | 選擇性提示錨定 |
| Self-Anchor | 自錨定 |
| Attention Steering | 注意力轉向 |
| Chain-of-Thought (CoT) | 思考鏈 |
| Structured Plan | 結構化計劃 |
| Harmonic Mean | 調和平均 |
| Confidence Signal | 置信度信號 |
| Training-free | 免訓練 |
| Reasoning Chain | 推理鏈 |
| Anchor Token | 錨定 token |
| Steering Coefficient | 轉向係數 |