DataComp-LM:探索下一代語言模型訓練集
原始論文:DataComp-LM: In search of the next generation of training sets for language models 作者:Jeffrey Li, Alex Fang, et al. arXiv ID:2406.11794v4 日期:2025-04-21 標籤:LLM Pretraining Data Benchmark Open Dataset Data Curation Common Crawl
目錄
- 1. 引言
- 2. 相關工作
- 3. DCLM 基準測試
- 4. 訓練與評估設定
- 5. 建構高品質訓練集
- 6. DCLM-baseline 的擴展
- 7. 與其他資料集和模型的比較
- 8. 限制與更廣泛的影響
- 9. 結論
- 參考文獻
- 術語對照表
摘要
我們提出 DataComp for Language Models (DCLM),這是一個用於受控資料集實驗 (Controlled Dataset Experiments) 的測試平臺,旨在改進語言模型 (Language Models)。作為 DCLM 的一部分,我們提供了一個從 Common Crawl 抽取出來、規模達 240 兆 (trillion) tokens 的標準化語料庫,基於 OpenLM 的有效預訓練 (Pretraining) 配方,以及 53 個下游評估任務 (Downstream Evaluations) 的完整套件。參與 DCLM 基準測試的研究者可以在從 412M 到 7B 參數的多種模型規模下,實驗各種資料策展 (Data Curation) 策略,例如去重 (Deduplication)、過濾 (Filtering) 與資料混合 (Data Mixing)。
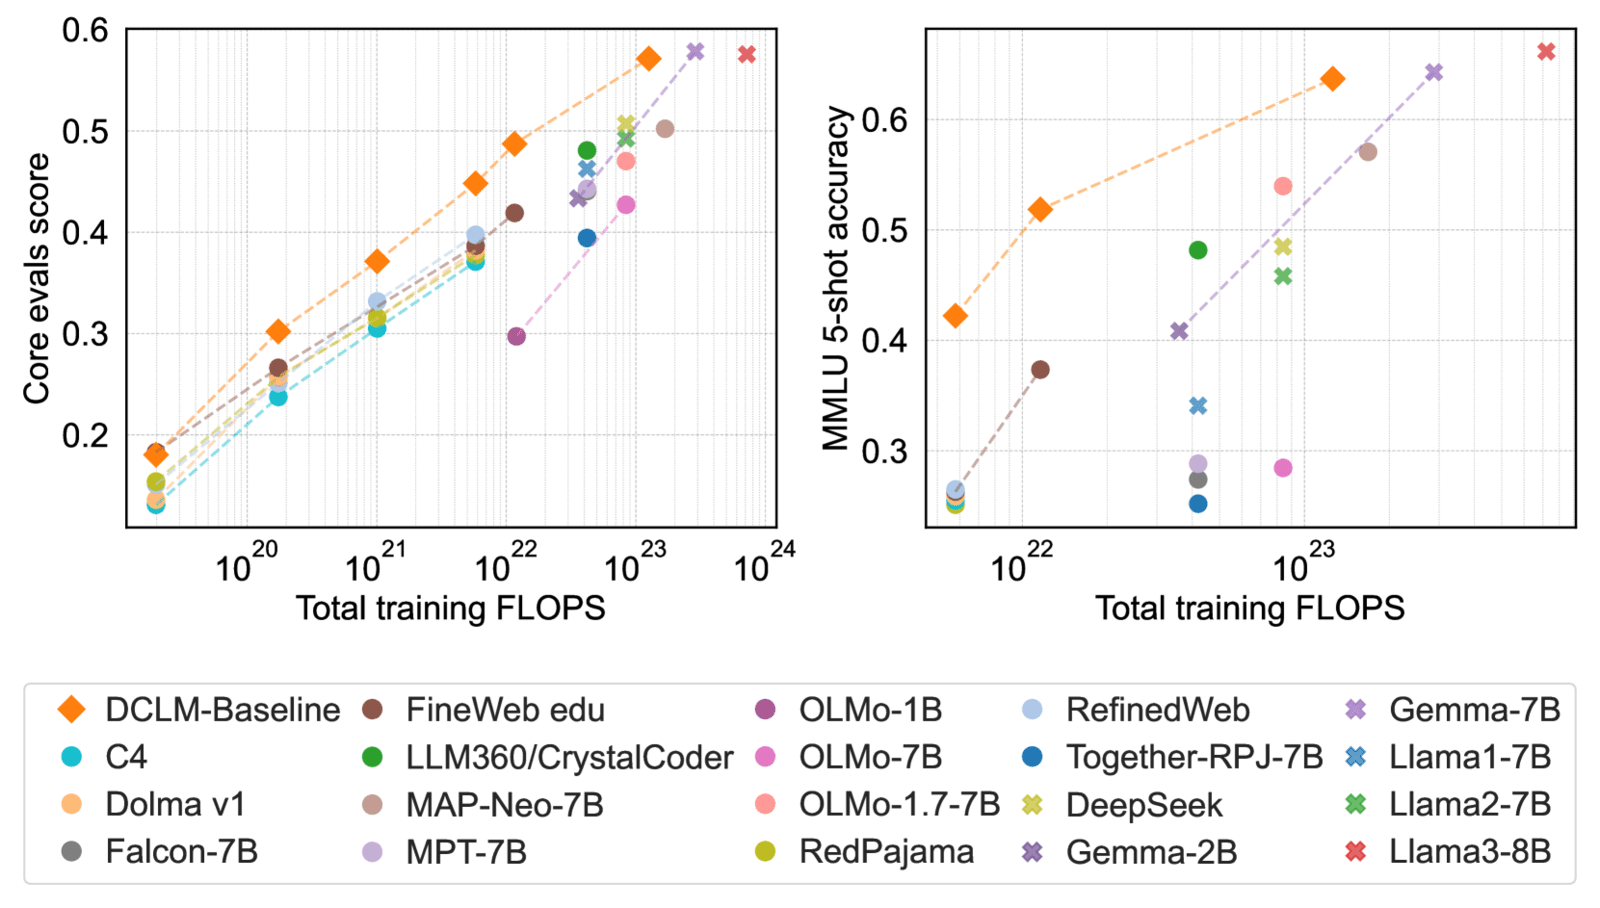
我們以 DCLM 為基礎進行的實驗顯示,基於模型的過濾 (Model-Based Filtering) 是組成高品質訓練集的關鍵。所得到的資料集 DCLM-baseline 使我們能夠從零開始訓練一個 7B 參數的語言模型,僅用 2.6T 訓練 tokens 就達到 64% 5-shot MMLU 準確度。相較於 MAP-Neo(先前公開資料訓練語言模型的最先進水準),DCLM-baseline 在 MMLU 上取得了 6.6 個百分點的改進,且訓練使用的計算資源減少 40%。我們的基線模型在 MMLU 上的表現也與 Mistral-7B-v0.3 和 Llama 3 8B 相當(分別為 63%、66%),並在 53 個自然語言理解任務的平均上取得類似表現,但所需訓練計算量為 Llama 3 8B 的 1/6.6。我們的結果突顯了資料集設計對於訓練語言模型的重要性,並為進一步的資料策展研究提供了起點。
1. 引言
過去數年中,語言模型的訓練資料集 (Training Datasets) 規模快速擴張,從早期的 C4 (160B tokens)、The Pile (300B tokens) 一路成長到 RefinedWeb (600B)、Dolma (3T)、FineWeb (15T) 和 RedPajama-v2 (30T)。然而,社群在「什麼樣的資料策展策略最有效」這個問題上仍然缺乏共識。我們識別出兩個阻礙進展的核心挑戰:
(1) 缺乏受控比較。 不同的訓練集提案經常使用不同的模型架構、計算預算與超參數 (Hyperparameter) 設定,使得效能差異是來自資料品質還是其他因素變得難以判斷。這種混淆讓「哪些資料策展策略最佳」變得撲朔迷離。
(2) 訓練資料的透明度不足。 Llama、Mistral、Gemma 等主流模型的訓練集細節仍是專有的 (proprietary),公開文件僅提供「粗略描述」。整個領域對於什麼構成最先進 (state-of-the-art) 的資料集仍處於不確定狀態。
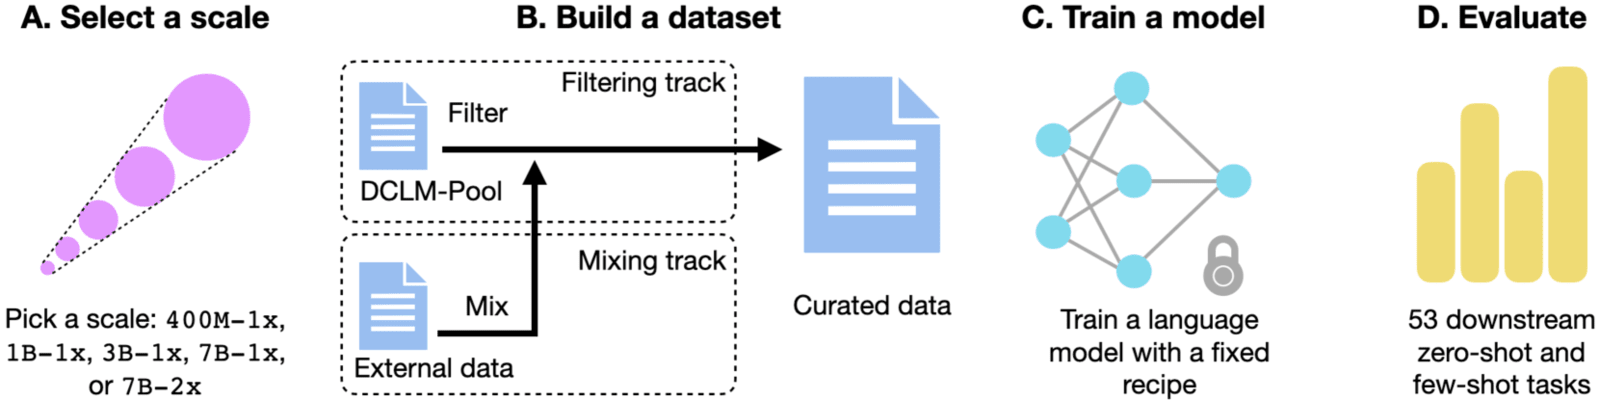
DCLM 解決這些問題的方式是建立一個基準測試 (Benchmark):參與者提出資料集,並使用固定的訓練配方訓練模型。圖 2 顯示工作流程:參與者選擇規模 (scale)、過濾/混合資料、用標準化程式碼訓練模型,並在 53 個下游任務上評估結果。
主要貢獻
- DCLM-Pool:目前最大的公開語料庫,從 Common Crawl (200B 文件、壓縮後 370TB) 抽取出 240 兆 GPT-NeoX tokens。我們使用 resiliparse 重新抽取文字,而非直接使用 Common Crawl 預先抽取的 WET 檔案。
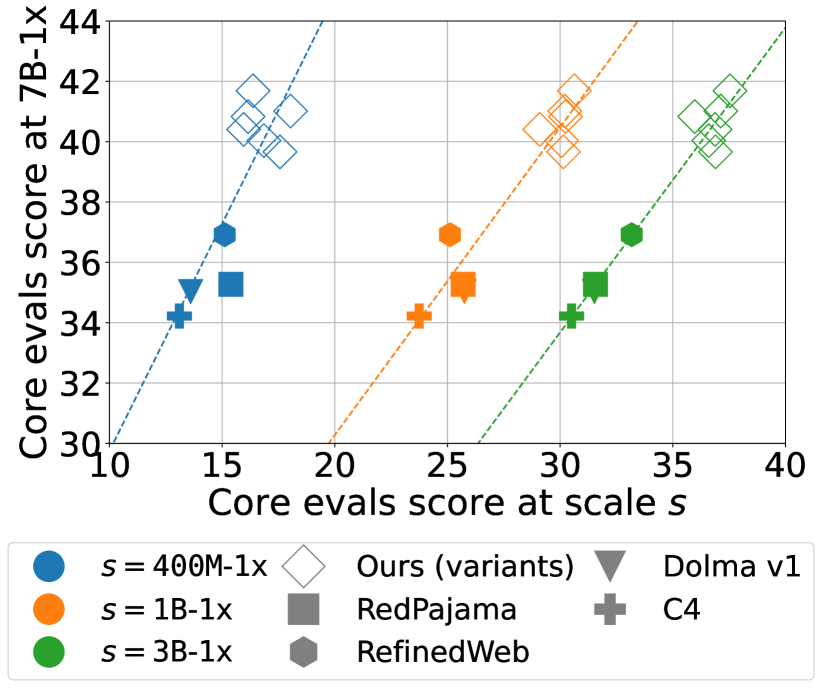
- 多規模設計:五個競賽規模 (competition scales),計算量範圍跨越約 600×(從 400M 到 7B 參數,搭配 Chinchilla 倍數)。圖 3 顯示小規模與大規模的排名相關性 (rank correlation) 很高,意味著實驗結論可在不同計算預算間轉移。
- 完整基線:透過 416 次實驗,我們確認模型基於過濾是資料品質的關鍵。DCLM-baseline 將多種技術組合成單一的高效資料集。
2. 相關工作
語言模型的資料策展
過往工作涵蓋語言過濾、啟發式規則 (Heuristic Rules)、去重以及資料混合等多種策略。然而,先前研究只比較了「有限的過濾子集」,我們的工作則進行了「公開規模最大的資料策展調查」。後續工作如 WebOrganizer、Nemotron-CC 和 Olmo-2 也以本基準測試或我們的策展策略為基礎。
開源資料集
公開資料集隨著模型成長而擴張:早期的 C4 (160B tokens)、The Pile (300B);近期的 RefinedWeb (600B)、Dolma (3T)、FineWeb (15T)、RedPajama-v2 (30T)。我們將 DCLM-Pool 定位為「目前最大的原始文字資料池,包含 240T 網路爬取 tokens」,且 DCLM-baseline 「比先前資料集產出更佳的模型」。
以資料為中心的基準測試
先前以資料為中心的基準測試 (Data-Centric Benchmark) 包括:視覺領域的 DataComp 與 DataPerf、用於微調 (fine-tuning) 資料清理與混合的 Data-Juicer、以及聚焦於 125M-220M 參數模型的 BabyLM 挑戰賽。我們強調,DCLM 以 240T tokens 與 7B 模型,是「目前語言模型上規模最大的以資料為中心的基準測試」。
3. DCLM 基準測試
3.1 DCLM-Pool
DCLM-Pool 是 240 兆 GPT-NeoX tokens 的語料庫,從 2023 年以前的 Common Crawl 資料抽取而來,包含 200B 文件 (壓縮後 370TB)。我們不直接使用 Common Crawl 預先抽取的 WET 檔案,而是用 resiliparse 重新從 HTML 抽取文字以提升品質。
3.2 競賽規模 (Competition Scales)
我們提供五個競賽規模,跨越約 600× 的計算量。這允許不同預算的研究者進行有意義的實驗。
Table 1: DCLM 競賽規模
| 規模 | 模型參數 | 訓練 tokens | 訓練 FLOPs | 訓練 H100 時數 | Pool 大小 |
|---|---|---|---|---|---|
| 400M-1x | 412M | 8.2B | 2.0e19 | 26 | 469B |
| 1B-1x | 1.4B | 28.8B | 2.4e20 | 240 | 1.64T |
| 3B-1x | 2.8B | 55.9B | 9.4e20 | 740 | 3.18T |
| 7B-1x | 6.9B | 138B | 5.7e21 | 3,700 | 7.85T |
| 7B-2x | 6.9B | 276B | 1.1e22 | 7,300 | 15.7T |
3.3 跨規模可轉移性
一個關鍵的設計考量是:在小規模上表現較佳的策展方法是否能轉移到大模型?我們的分析顯示跨規模有強烈的排名相關性 (Pearson r = 0.838、0.956、0.982,分別為 400M、1B、3B 對 7B-1x 的比較)。這驗證了多規模設計的有效性,使計算資源有限的研究者能在小規模上迭代,並合理預期結果可轉移至更大部署。
3.4 兩個賽道
- 過濾賽道 (Filtering Track):參與者從規模對應的 DCLM-Pool 子集挑選最佳資料。
- 混合賽道 (Mixing Track):參與者可納入 Common Crawl 以外的外部來源。
3.5 評估任務
DCLM 包含 53 個下游評估任務,分為三個指標:
- Core 中心化準確度 (Core Centered Accuracy):22 個任務的子集 (例如 HellaSwag、ARC-E),在小規模即有低變異訊號。
- MMLU 5-shot 準確度:廣泛使用的基準。
- Extended 中心化準確度 (Extended Centered Accuracy):所有 53 個任務的中心化效能平均。
評估框架基於 LLM-Foundry,涵蓋從問答到開放式生成的多種格式,跨越數學、教科書知識和常識推理等多元領域。
4. 訓練與評估設定
4.1 OpenLM 訓練框架
我們使用 OpenLM 框架,採用解碼器專用 Transformer (Decoder-Only Transformer) 架構 (類似 GPT-2、Llama),並以 GPT-NeoX 作為主要 tokenizer。訓練 token 數依 Chinchilla 倍數配置 (典型為 20× 模型參數 × Chinchilla 倍數)。
4.2 文字抽取方法比較
我們在 1B-1x 規模上系統性地比較了三種對 Common Crawl HTML 的文字抽取方法:
| 抽取方法 | Core 分數 | Extended 分數 |
|---|---|---|
| resiliparse | 24.1 | 13.4 |
| trafilatura | 24.5 | 12.5 |
| WET 檔 | 20.7 | 12.2 |
雖然 trafilatura 略勝一籌,但 resiliparse 速度快 8×,更適合大規模處理。因此 DCLM-Pool 採用 resiliparse。
4.3 去重 (Deduplication)
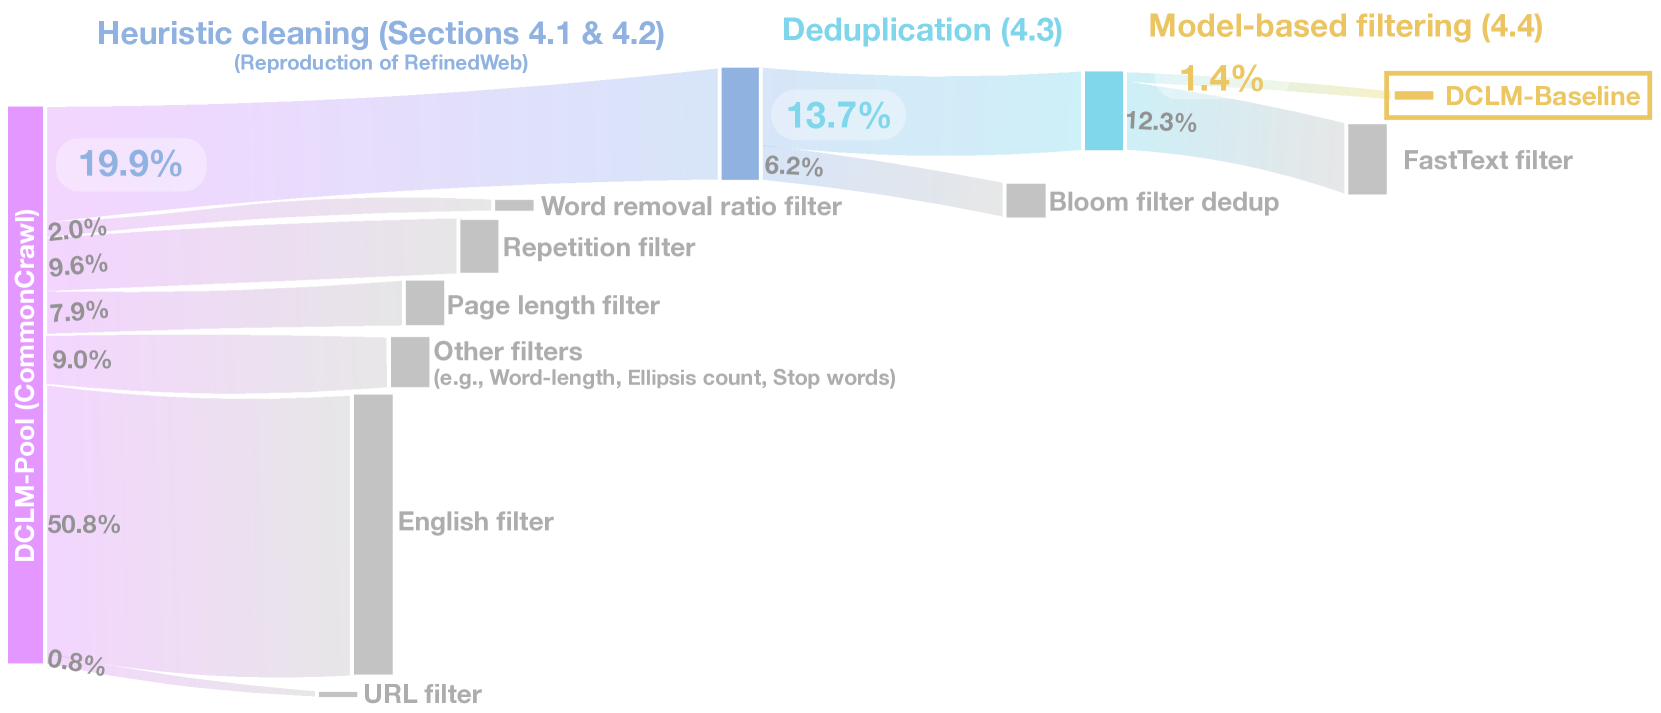
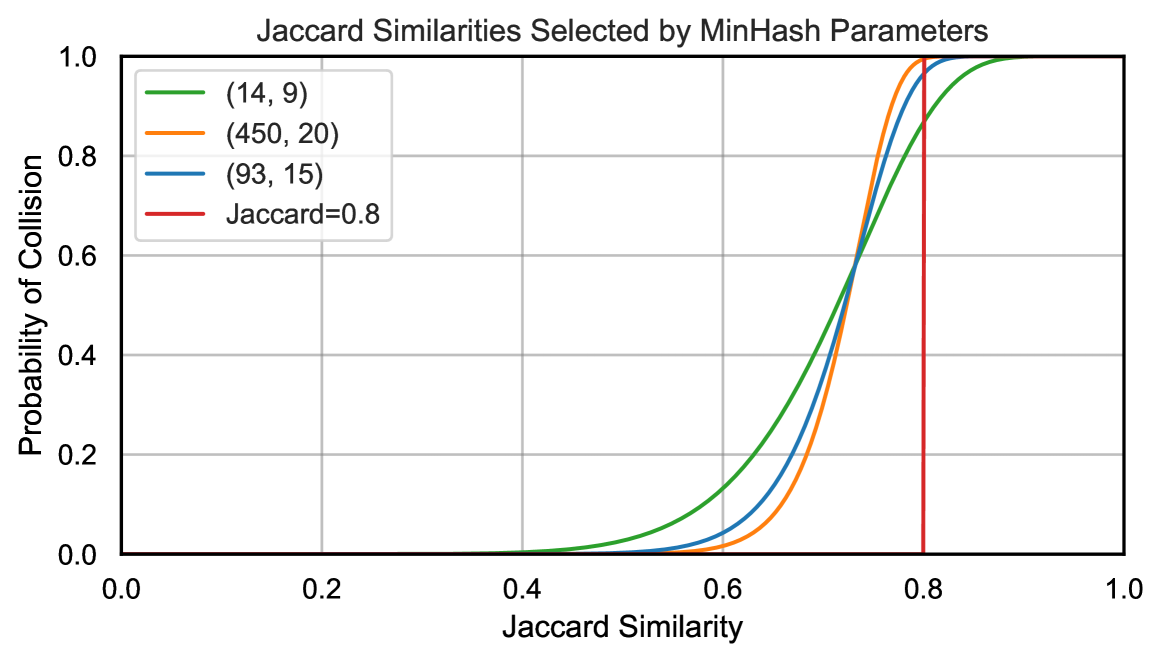
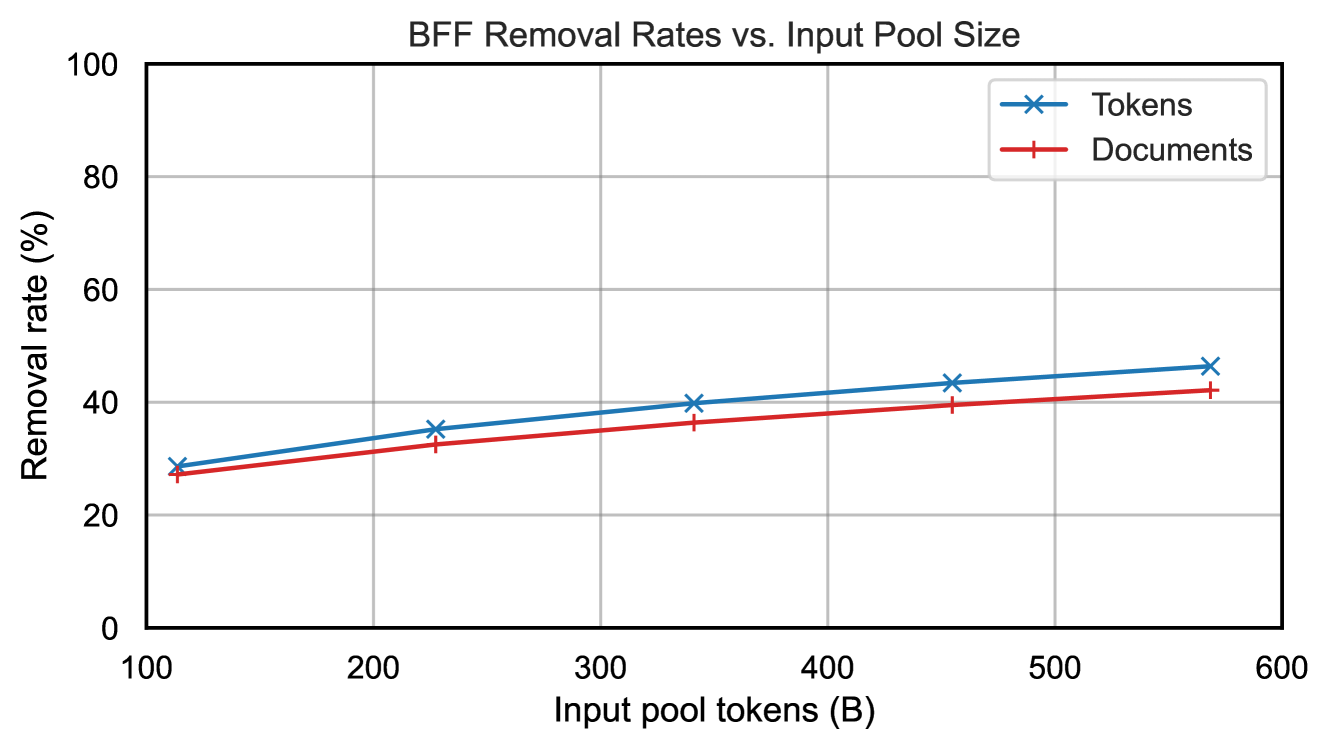
我們評估兩種主要去重策略:MinHash 結合 suffix array 的管線,以及為近似重複偵測 (Near-Duplicate Detection) 修改的 Bloom 過濾。結果顯示「兩者下游效能可比較:在 7B-2x 規模上 Core 差距在 0.2 個百分點以內」。然而 Bloom 過濾在處理超過 10TB 資料集時擴展性較佳,因此被選為 DCLM-baseline 的方法。
5. 建構高品質訓練集
5.1 啟發式過濾 (Heuristic Filtering)
我們以 RefinedWeb 的管線作為基線,包含 Common Crawl 文字抽取、啟發式選擇規則 (例如移除垃圾內容)、以及重複內容的去重。
5.2 模型基於過濾的比較
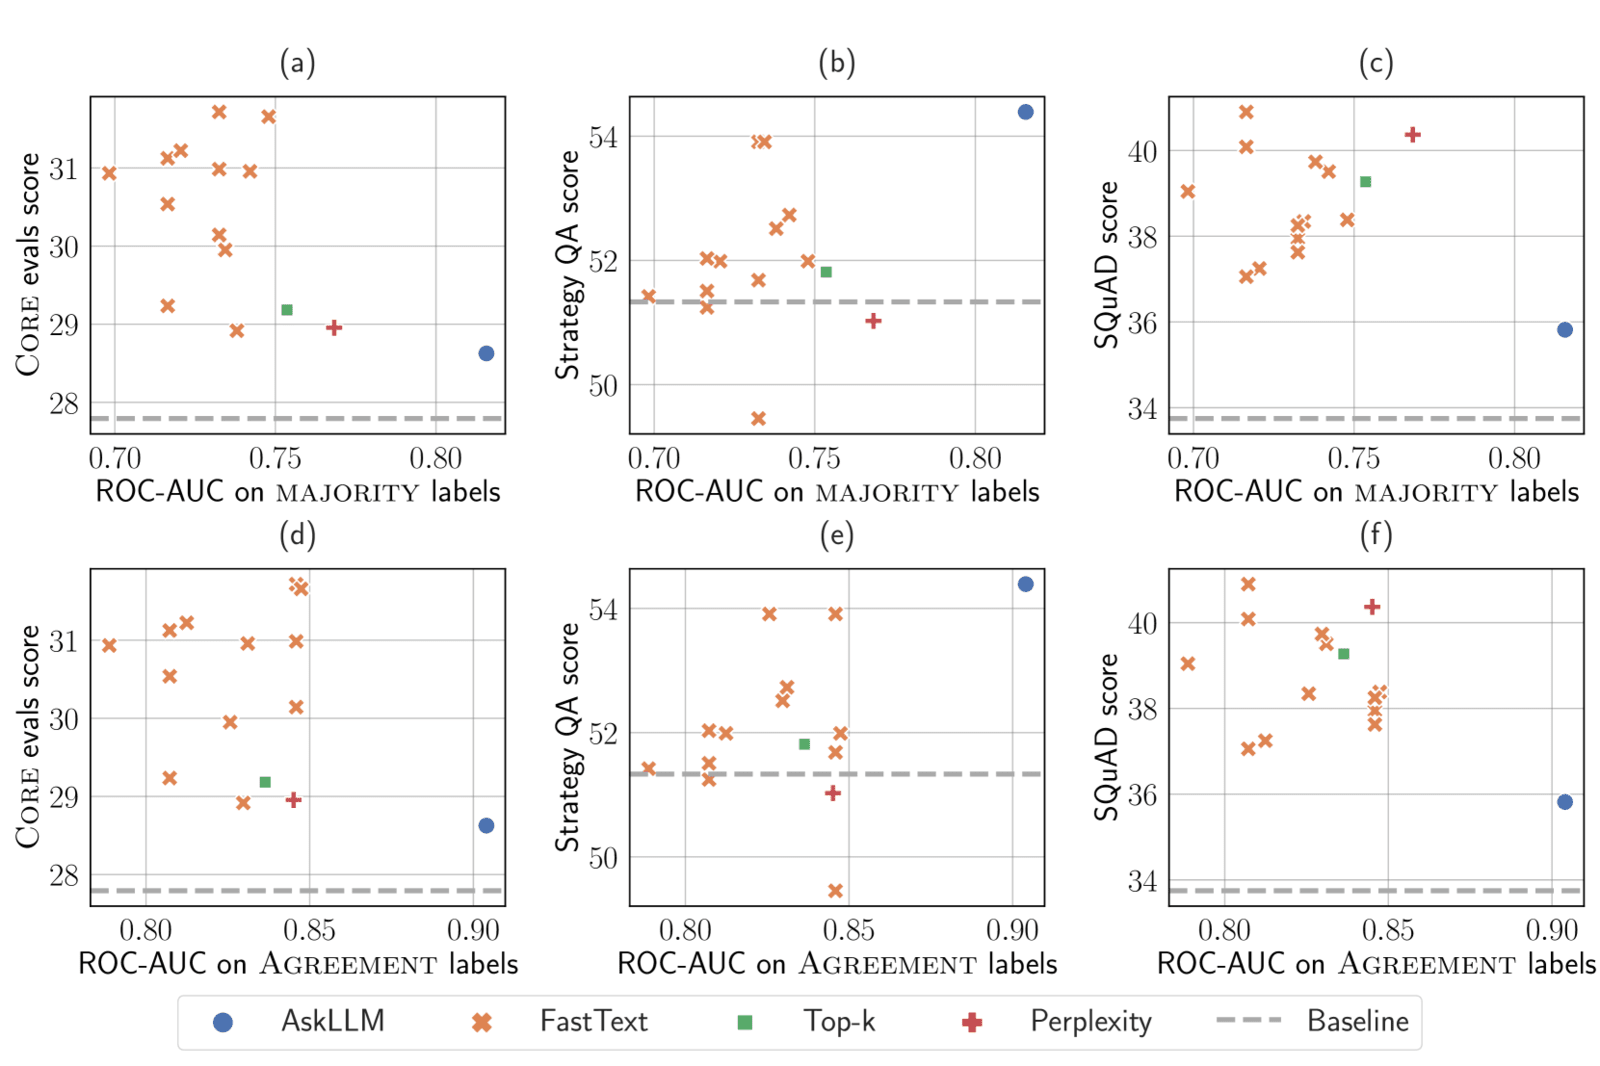
廣泛實驗確認模型基於過濾是資料集品質的關鍵。我們在 1B-1x 規模上比較七種過濾方法:
| 過濾方法 | Core | Extended |
|---|---|---|
| RefinedWeb baseline | 27.5 | 14.6 |
| PageRank 過濾 | 26.1 | 12.9 |
| 語意去重 (Semantic Deduplication) | 27.1 | 13.8 |
| BGE 特徵分類器 | 27.2 | 14.0 |
| AskLLM | 28.6 | 14.3 |
| Perplexity 過濾 | 29.0 | 15.0 |
| Top-k 平均 logits | 29.2 | 14.7 |
| fastText (OH-2.5+ELI5) | 30.2 | 15.4 |
以 OpenHermes 2.5 與 ELI5 subreddit 資料訓練的 fastText 分類器明顯勝出。
5.3 fastText 分類器消融研究
我們進一步在 7B-1x 規模研究訓練資料組成與閾值對分類器效能的影響:
| 訓練資料 | 閾值 | Core | MMLU |
|---|---|---|---|
| OH-2.5+ELI5 | 10% | 41.0 | 29.2 |
| Wikipedia | 10% | 35.7 | 27.0 |
| OpenWebText2 | 10% | 34.7 | 25.0 |
| GPT-3 近似 | 10% | 37.5 | 24.4 |
| OH-2.5+ELI5 | 15% | 39.8 | 27.2 |
| OH-2.5+ELI5 | 20% | 38.7 | 24.2 |
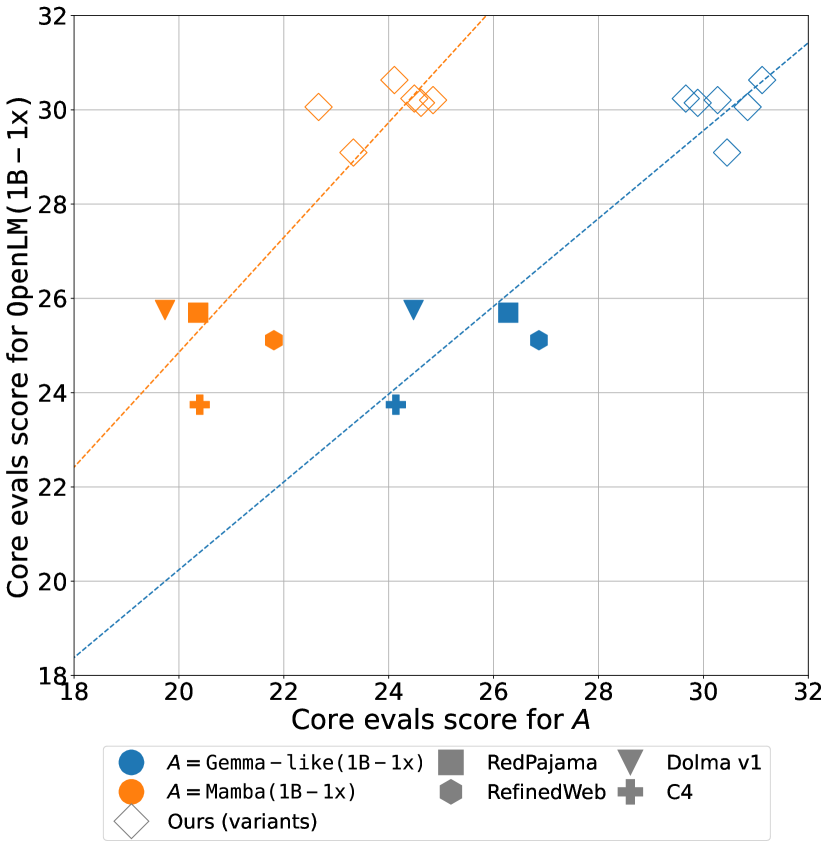
指令格式 (Instruction-Formatted) 訓練資料相較於 Wikipedia 等更傳統的選擇,在 Core 上提升 3.5 個百分點。嚴格的 top-10% 過濾閾值最佳。
5.4 資料混合分析
當把過濾後的 Common Crawl 與外部高品質來源 (Wikipedia、StackExchange、arXiv、GitHub,按 33% 比例混合) 結合時,得到了一個值得注意的發現:雖然混合可改善低品質的 Common Crawl 子集,但對 DCLM-baseline 而言「平均反而傷害效能」。這暗示在基底過濾品質已經夠高時,來源多樣化的邊際效益遞減 (Diminishing Returns)。
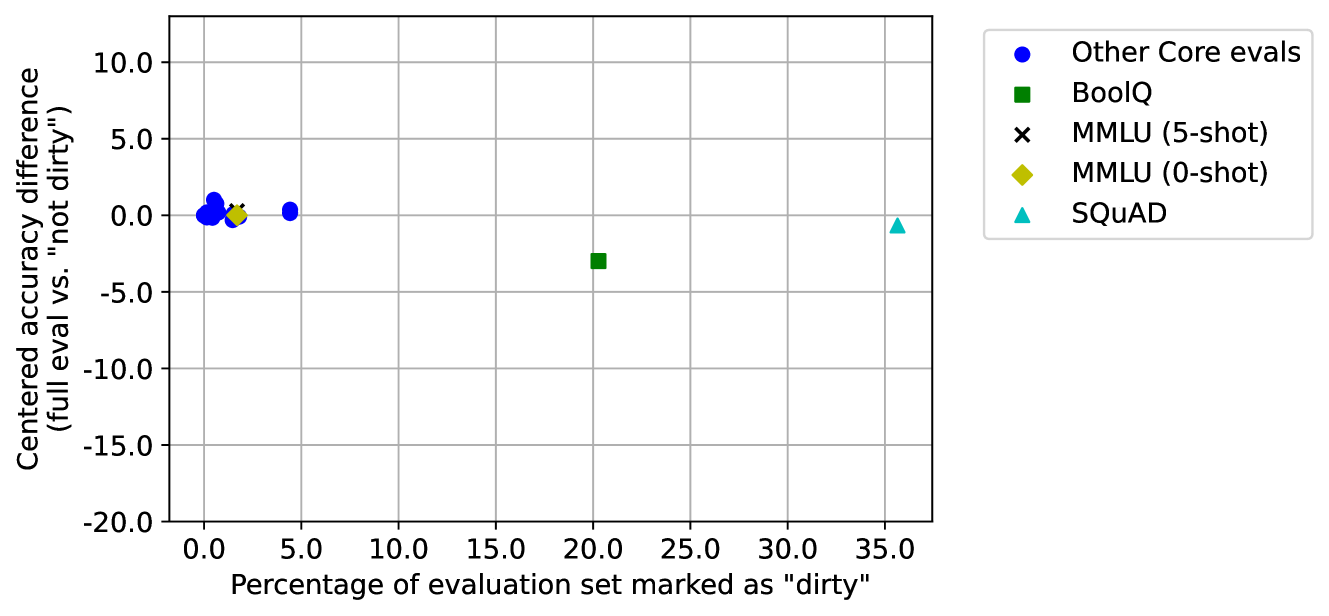
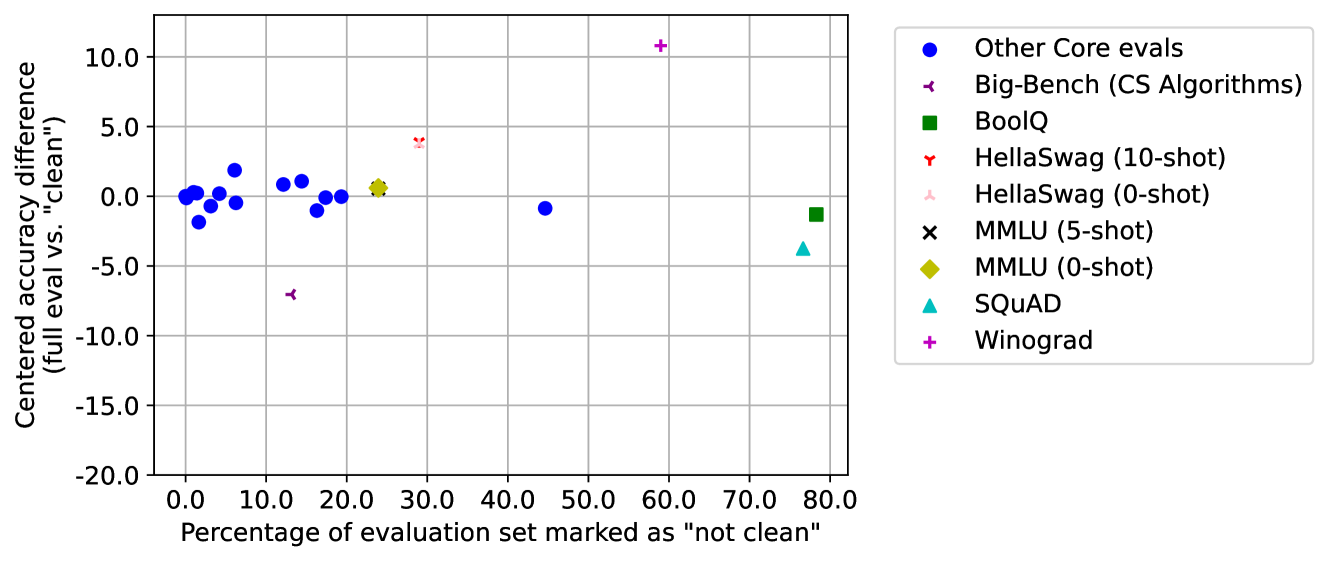
5.5 去汙染驗證 (Decontamination)
我們評估訓練資料與評估基準間的重疊。針對 MMLU 與 HellaSwag,移除偵測到的測試樣本後重新訓練模型,結果「效能並未下降」,反而略有提升:
- MMLU 移除汙染後:52.7%(vs. 基線 51.8%)
- HellaSwag 移除汙染後:78.4%(vs. 基線 77.9%)
這證實基準測試上的提升並非資料洩漏 (Data Leakage) 的偽影 (artifact)。
6. DCLM-baseline 的擴展
成功策展的 DCLM-baseline (3.8 兆 tokens) 透過結合領域特定資源 (Domain-Specific Resources) 擴展至更大模型。我們訓練了一個 7B 參數模型,使用 2.6 兆 tokens 並結合 StarCoder 與 ProofPile2,達到競爭力結果:
| 模型 | 參數 | tokens | Core | MMLU | Extended |
|---|---|---|---|---|---|
| DCLM-baseline (僅 baseline) | 7B | 0.28T | – | 50.8 | – |
| DCLM-baseline + StarCoder + ProofPile2 | 7B | 2.6T | 57.1 | 63.7 | 45.4 |
| Llama 3 8B | 8B | 15T | 57.6 | 66.2 | 46.3 |
| Mistral-0.3 | 7B | 未知 | 57.0 | 62.7 | 45.1 |
DCLM 模型在公開訓練集訓練的 7B 模型中表現最佳,且使用的計算量比封閉源競爭者大幅減少,證明系統性的資料策展可部分補償計算資源。
指令微調 (Instruction Tuning)
DCLM-baseline 7B 在指令微調後達成 AlpacaEval2.0 LC Win-rate 16.6,超越 Gemma-Instruct (10.4),逼近 Mistral-v0.2-7B (17.1) 與 Llama3-Instruct (22.9)。
7. 與其他資料集和模型的比較
7.1 7-8B 模型總比較
DCLM-baseline 在公開資料訓練的同等規模模型中達到最先進水準:
- MMLU 5-shot:DCLM-baseline 7B (63.7%) vs. MAP-Neo 7B (57.1%) — 提升 6.6pp,計算量減 40%
- 與封閉資料模型對比:Llama 3 8B (66.2%, 15T tokens)、Gemma 8B (64.3%, 6T)、Mistral-0.3 (62.7%)
- DCLM-baseline 7B 使用的計算量為 Llama 3 8B 的 1/6.6
7.2 與其他開源資料集的比較
在相同的 OpenLM + 7B-1x 控制設定下,DCLM-baseline 顯著優於 RefinedWeb、Dolma、FineWeb、RedPajama-v2 等:
- 同樣的 138B token 預算下,DCLM-baseline Core 與 MMLU 均勝過上述資料集 4-8 個百分點。
- 結果表明資料策展的差異而非規模本身才是 DCLM 領先的主因。
8. 限制與更廣泛的影響
限制
- 由於計算資源限制,多數設計維度只能個別消融 (ablate individually),缺乏 run-to-run 變異 (run-to-run variation) 的充分探索。
- 在 DCLM-baseline 上訓練的模型「在程式碼 (code) 與數學 (math) 上表現不如語言理解任務」,這視為對語言理解的聚焦選擇而非方法本身的限制。
- DCLM-Pool 僅源自 Common Crawl 與英文資料;其他來源 (例如 PDF、書籍) 與多語言情境留待未來工作。
更廣泛的影響 (Broader Impacts)
- 公開大型資料集可能引入偏見 (bias) 與有害內容 (toxic content)。我們釋出 DCLM-baseline 時提供有毒內容過濾結果與個人資訊偵測,並建議下游使用者考慮應用情境的合適性。
- 標準化基準測試可能讓研究者過度針對特定指標進行最佳化 (Overfitting to Metrics)。我們鼓勵社群提案新評估,並在 53 個任務外進一步擴張評測。
9. 結論
DCLM 提供了第一個大規模、受控的語言模型資料策展基準測試。透過 240T 原始 tokens 池、五個競賽規模與 53 個評估任務,我們執行了 416 次受控實驗,並萃取出 DCLM-baseline——一個 3.8T token 的高品質資料集。基於 DCLM-baseline 訓練的 7B 模型僅用 2.6T tokens 即達到 64% MMLU,與 Llama 3 8B 相當,但計算量減少 6.6×。這些結果突顯資料品質對於現代 LLM 訓練的關鍵地位,並為下一代訓練集的探索奠定基礎。我們公開所有資料、訓練程式碼與評估管線,邀請社群在 DCLM 上提出新的策展策略。
參考文獻
References are kept in the original English. Please refer to the original paper at https://arxiv.org/abs/2406.11794v4 for the full list of citations including but not limited to:
- Brown et al., "Language Models are Few-Shot Learners," NeurIPS 2020.
- Touvron et al., "Llama 2: Open Foundation and Fine-Tuned Chat Models," 2023.
- Penedo et al., "The RefinedWeb Dataset for Falcon LLM," 2023.
- Soldaini et al., "Dolma: An Open Corpus of Three Trillion Tokens for Language Model Pretraining Research," 2024.
- Computer (Together), "RedPajama: An Open Dataset for Training Large Language Models," 2023.
- Penedo et al., "FineWeb: decanting the web for the finest text data at scale," 2024.
- Hoffmann et al., "Training Compute-Optimal Large Language Models" (Chinchilla), 2022.
- Raffel et al., "Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer" (T5/C4), JMLR 2020.
- Gao et al., "The Pile: An 800GB Dataset of Diverse Text for Language Modeling," 2020.
- Hendrycks et al., "Measuring Massive Multitask Language Understanding" (MMLU), ICLR 2021.
- Zellers et al., "HellaSwag: Can a Machine Really Finish Your Sentence?" ACL 2019.
- Joulin et al., "Bag of Tricks for Efficient Text Classification" (fastText), 2016.
- Lee et al., "Deduplicating Training Data Makes Language Models Better," 2022.
- Gadre et al., "DataComp: In search of the next generation of multimodal datasets," NeurIPS 2023.
術語對照表
| 英文 | 中文 |
|---|---|
| Language Model | 語言模型 |
| Pretraining | 預訓練 |
| Training Set / Dataset | 訓練集/資料集 |
| Data Curation | 資料策展 |
| Controlled Dataset Experiments | 受控資料集實驗 |
| Benchmark | 基準測試 |
| Common Crawl | Common Crawl (網路爬取資料來源,保留原名) |
| Token | token (保留原文) |
| Deduplication | 去重 |
| Filtering | 過濾 |
| Data Mixing | 資料混合 |
| Model-Based Filtering | 基於模型的過濾 |
| Heuristic Rules | 啟發式規則 |
| Heuristic Filtering | 啟發式過濾 |
| Near-Duplicate Detection | 近似重複偵測 |
| Bloom Filter | Bloom 過濾器 |
| MinHash | MinHash (保留原文) |
| Suffix Array | 後綴陣列 |
| Decoder-Only Transformer | 解碼器專用 Transformer |
| Hyperparameter | 超參數 |
| Downstream Evaluations | 下游評估 |
| Downstream Task | 下游任務 |
| Few-shot / 5-shot | 少樣本/5 樣本 |
| Centered Accuracy | 中心化準確度 |
| Rank Correlation | 排名相關性 |
| Pearson's r | Pearson 相關係數 |
| Chinchilla Multiplier | Chinchilla 倍數 |
| FLOPs | 浮點運算次數 |
| State-of-the-Art | 最先進 |
| Proprietary | 專有的 |
| Open-Source | 開源 |
| Decontamination | 去汙染 |
| Data Leakage | 資料洩漏 |
| Artifact | 偽影/人為偽差 |
| Diminishing Returns | 邊際效益遞減 |
| Instruction Tuning | 指令微調 |
| Instruction-Formatted | 指令格式 |
| Fine-tuning | 微調 |
| Data-Centric Benchmark | 以資料為中心的基準測試 |
| Domain-Specific Resources | 領域特定資源 |
| Bias | 偏見 |
| Toxic Content | 有害內容 |
| Overfitting to Metrics | 對特定指標過度最佳化 |
| Run-to-Run Variation | 多次執行間變異 |
| Ablate | 消融 |
| Competition Scale | 競賽規模 |
| Filtering Track | 過濾賽道 |
| Mixing Track | 混合賽道 |