LLMRouterBench:一個大規模基準與用於 LLM 路由的統一框架
原始論文:LLMRouterBench: A Massive Benchmark and Unified Framework for LLM Routing 作者:Hao Li, Yiqun Zhang, Zhaoyan Guo, Chenxu Wang, Shengji Tang, Qiaosheng Zhang, Yang Chen, Biqing Qi, Peng Ye, Lei Bai, Zhen Wang, Shuyue Hu(Shanghai Artificial Intelligence Laboratory) arXiv ID:2601.07206v1 日期:2026-01-12 標籤:LLM Routing Benchmark LLM Model Ensemble Performance-Cost 開源模型
摘要
大型語言模型 (Large Language Model, LLM) 路由 (Routing) 會把每一個查詢 (query) 指派給模型集成 (ensemble) 中最合適的模型來處理。我們提出 LLMRouterBench,一個大規模的基準 (benchmark) 與統一框架 (unified framework),專門用於 LLM 路由。它包含來自 21 個資料集、33 個模型、超過 40 萬筆的實例 (instances)。此外,它對「以效能為導向 (performance-oriented)」與「效能-成本權衡 (performance-cost tradeoff)」兩種設定都提供了全面的評估指標,並整合了 10 個具代表性的路由基線方法 (baselines)。
我們使用 LLMRouterBench 對整個領域進行系統性的重新評估。在確認了「強烈的模型互補性 (model complementarity)」——這正是 LLM 路由的核心前提——的同時,我們發現:(1)在統一評估之下,許多路由方法展現出相近的效能;(2)多個近期方法,包含商用路由器在內,無法可靠地勝過一個簡單的基線;(3)相對於 Oracle(最佳路由上限)仍存在顯著差距,而此差距主要由持續存在的「模型召回失敗 (model-recall failures)」所驅動。我們進一步指出:細緻的模型篩選 (model curation) 比單純擴大集成規模更為重要;以及嵌入模型 (embedding models) 的選擇對路由效能影響有限。所有程式碼與資料皆已開源於 https://github.com/ynulihao/LLMRouterBench。
1 引言
大型語言模型 (LLM) 的快速演進,導致公開可用的模型大量增加。在此背景下,LLM 路由已成為一個重要的研究方向:與其只依賴單一模型,路由方法會在一個 LLM 集成上運作,動態地把每一個查詢指派給最適合處理它的模型。自 2023 年早期的研究(主要聚焦於提升 LLM 集成的整體效能,見 Jiang et al., 2023;Lu et al., 2024;Huang et al., 2025a)以來,此領域已擴展到處理效能-成本權衡(Ding et al., 2024;Wang et al., 2025b;Ding et al., 2025;Jitkrittum et al., 2025);最近,將即時路由整合進生產系統(如 GPT-5(OpenAI, 2025a)與 HuggingChat-Omni(Hugging Face, 2025))更進一步推升了學術界、業界乃至公眾的興趣(圖 1 (a))。
儘管有這些學術上的起源,此領域的進展卻有在研究社群中日益被邊緣化的風險,主要有兩個原因。第一,開發一個路由方法通常需要在大量資料集上評估一個 LLM 集成;這會帶來可觀的計算成本(部署多個大型模型於專用硬體上)或可觀的財務成本(依賴線上服務供應商,例如 OpenRouter)。第二,缺乏開源基礎設施 (open-source infrastructure) 導致研究版圖高度碎片化:各個研究各自實作量身打造的路由流程,使用不同的模型集成、資料集與評估協定,妨礙了公平比較、可重現性以及領域知識的累積。
為了替社群降低這些門檻,我們提出 LLMRouterBench,一個用於 LLM 路由的基準與框架(圖 1 (b))。如表 1 所總結,不同於既有基準大多依賴較早世代的開源模型、或僅評估某一狹隘類別的路由方法,LLMRouterBench 提供了「即時 (timely)、大規模、高品質」的資料,這些資料精選自 21 個資料集與 33 個模型。這些模型包含 13 個近期釋出的旗艦模型 (flagship models) 與 5 個被廣泛使用的專有模型 (proprietary models),合計超過 40 萬筆實例,約 2,771.84 美元的 API 成本,以及約 1,000 GPU 小時。除了規模之外,LLMRouterBench 原生支援此領域的兩大主流研究範式(亦即以效能為導向的路由與效能-成本權衡路由),為每種設定定義了一整套完整的指標,並提供轉接器 (adapters),使其能以最小幅度的改動就與公開可用的路由實作對接;最關鍵的是,它讓我們得以在 10 個具代表性的路由基線上進行可重現的、統一的評估。
藉由 LLMRouterBench,我們系統性地重新檢視 LLM 路由的版圖,並揭露了數項關鍵發現。第一,我們重申了此領域的核心前提:模型在效能與成本效率兩方面都展現出明顯的互補性,沒有任何單一模型取得全面性的支配地位。第二,藉由在一個統一的模型集成與資料集套件上評估各路由基線,我們發現了一個令人意外的模式:儘管方法不斷推陳出新,當代的路由方法在各項指標上交出了幾乎難以區分 (indistinguishable) 的效能。這個模式也延伸到效能-成本權衡的設定:數個近期的路由方法,甚至包括商用路由器 OpenRouter 在內,都無法勝過一個簡單的基線(Best Single 模型,即「最佳單一模型」),也無法在不犧牲效能的前提下相較於 Best Single 可靠地降低成本。這些發現顯示,在統一、大規模的評估之下,當前路由方法帶來的實際增益,可能不如先前所假設的那麼顯著。
第三,雖然上述結果乍看之下可能令人氣餒,但我們發現 LLM 路由距離其能力上限其實還很遠:相對於一個 Oracle 基線(總是事後選出每個查詢的最佳模型),仍存在可觀的效能差距。此差距主要由持續存在的「模型召回失敗」所驅動:對許多查詢而言,只有單一候選模型能產生正確回應,但當前的路由器卻經常無法找出它,這凸顯了未來改進的明確機會。第四,雖然數個路由方法依賴嵌入模型,但我們的消融研究 (ablation study) 顯示嵌入對路由效能的影響有限。第五,雖然擴大模型集成常被假設能提升整體效能(Huang et al., 2025b),但我們觀察到加入更多模型會帶來明顯的「邊際遞減 (diminishing returns)」;相對地,一個精挑細選的子集卻能帶來顯著更好的結果。這顯示模型篩選應與路由一起研究,因為細緻的篩選可勝過單純擴大集成規模。最後,我們展示 LLMRouterBench 也能支援「延遲感知 (latency-aware) 分析」,為未來路由研究開啟一條邁向「效能-成本-延遲」聯合最佳化的道路。
我們的主要貢獻總結如下:
- 即時、高品質、大規模的資料:精選自 21 個具挑戰性的資料集與 33 個近期釋出模型的 40 萬筆以上實例,降低成本門檻並提升 LLM 路由研究的可及性;
- 開源、統一的路由框架:整合 10 個具代表性的路由基線,並為「以效能為導向」與「效能-成本權衡」兩種設定提供全面的量化指標,達成公平、可重現的評估;
- 對 LLM 路由的系統性重新檢視:對主流路由方法進行廣泛的比較研究,系統性地分析其優劣、刻畫能力上限、嚴謹地檢驗常見做法與既有假設,並勾勒出未來研究的可行方向。
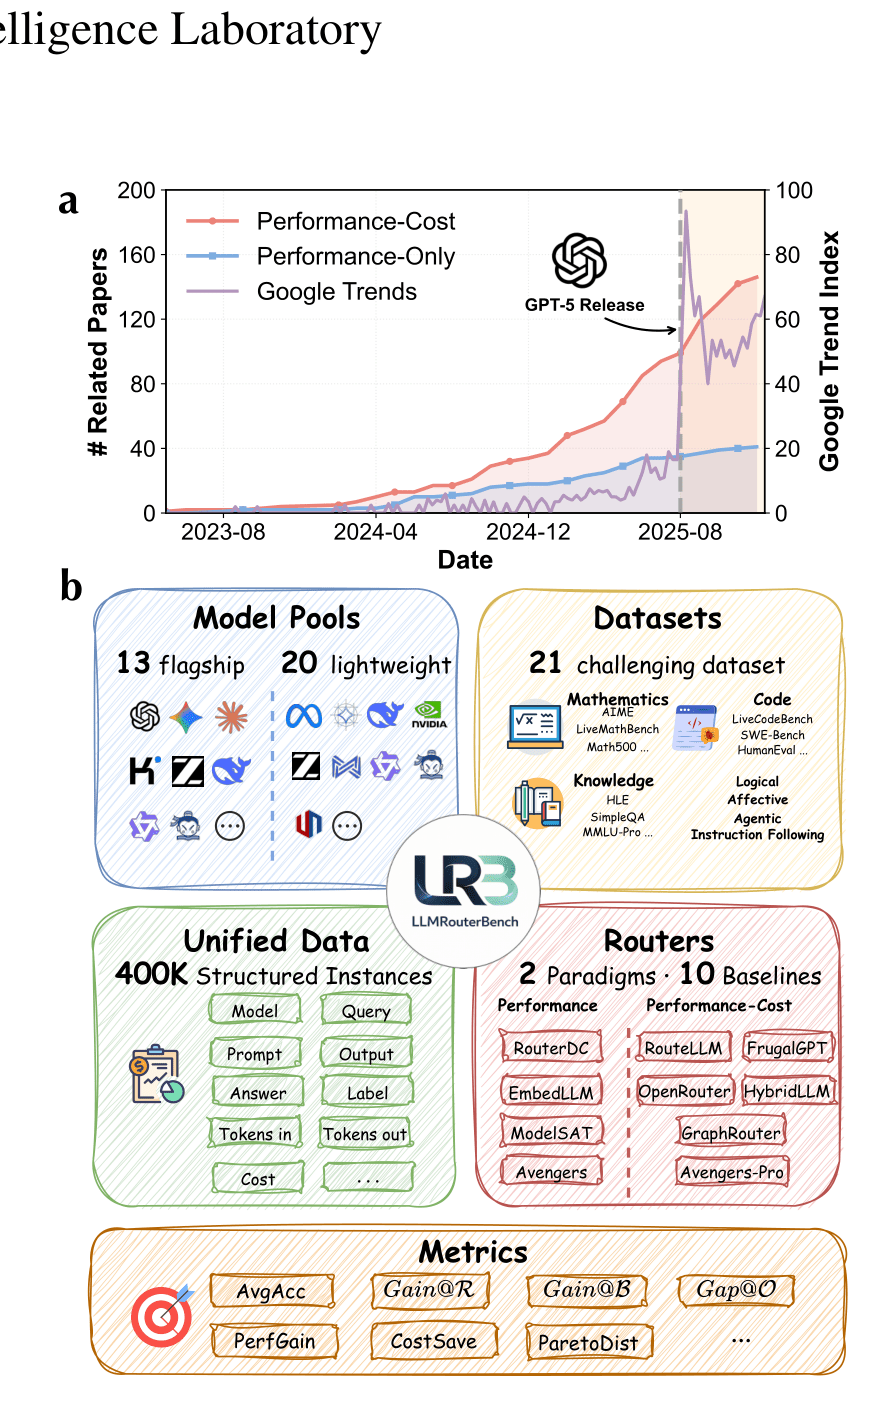
圖 1:(a) LLM 路由隨時間的關注度,以相關論文累積數量與 Google Trends 衡量。(b) LLMRouterBench 概覽。
2 相關工作
以效能為導向的路由 (Routing for Performance)。 此範式旨在透過把每個查詢路由到最可能產生正確答案的模型,來提升一個 LLM 集成的整體效能(Yue et al., 2025;Zhang et al., 2025a;Fein-Ashley et al., 2025;Wang et al., 2025a)。LLM-Blender(Jiang et al., 2023)透過成對排序 (pairwise ranking) 選出頂尖候選模型,並融合其輸出。RouterDC(Chen et al., 2024b)採用雙重對比學習 (dual contrastive learning) 來提升路由準確度。EmbedLLM(Zhuang et al., 2024)利用精簡的模型與查詢嵌入。MODEL-SAT(Zhang et al., 2025b)建構與能力對齊的嵌入,以訓練一個輕量級 LLM 作為路由器。Avengers(Zhang et al., 2025d)則展示了結合聚合 (aggregation) 方法的、基於聚類 (clustering-based) 的路由,能讓一組小型 LLM 超越專有模型。
以效能-成本權衡為目標的路由 (Routing for Performance-Cost Tradeoff)。 此範式把查詢路由到能在效能與成本之間取得平衡的模型(Song et al., 2025;Jin et al., 2025;Patel et al., 2025;Fernandez et al., 2025;Guo et al., 2025b),因為能力較強的模型通常伴隨較高的財務與計算成本。早期研究主要聚焦於在「只有兩個模型(通常是一小一大)」之間進行路由。HybridLLM(Ding et al., 2024)根據預測的查詢難度來鎖定此權衡。FrugalGPT(Chen et al., 2024a)採用從小到大的級聯推論 (cascaded inference)。RouteLLM(Ong et al., 2024)從偏好資料 (preference data) 訓練路由器。最近,研究已擴展到更大的模型集成。Avengers-Pro(Zhang et al., 2025c)建立在基於聚類的路由之上。GraphRouter(Feng et al., 2025a)採用一個異質圖 (heterogeneous graph) 來表示「任務-查詢-LLM」互動,把模型路由表述為一個邊預測 (edge prediction) 問題。
3 LLMRouterBench
我們建構 LLMRouterBench,以系統性地支援 LLM 路由研究中的兩大主流範式:以效能為導向的路由,以及以效能-成本權衡為目標的路由。
3.1 模型池 (Model Pools)
在以效能為導向的設定中,我們對路由方法「在規模相近的 LLM 之間善用互補強項」的能力進行基準測試。【1】相對地,效能-成本設定則刻意納入在規模、能力與成本上有顯著差異的模型,以反映真實的效能-成本權衡。這產生了兩個模型池,合計 33 個模型:
- 對於以效能為導向的設定,我們建構一個由 20 個最先進的約 7B 輕量級 LLM 組成的池,例如 DS-Qwen3 與 Qwen3-8B(細節見附錄表 7)。
- 對於效能-成本設定,我們建構另一個由來自 8 個供應商的 13 個旗艦 LLM 組成的池,這些模型在能力與成本上有顯著差異,例如 GPT-5 與 Gemini-Flash,成本資訊取自 OpenRouter(OpenRouter, Inc., 2025b)與官方 API(細節見附錄表 8)。
【1】考慮規模差異顯著的模型是無意義的,因為較大的模型通常會比較小的模型產生更好的效能。
3.2 資料集 (Datasets)
我們精選了橫跨多個領域的 21 個資料集(完整清單見附錄表 9),包括:數學 (Mathematics)(如 AIME、LiveMathBench(Liu et al., 2024c))、程式碼 (Code)(如 HumanEval(Chen et al., 2021a)、SWE-Bench(Jimenez et al., 2023))、邏輯 (Logic)(如 BBH(Suzgun et al., 2022)、KORBench(Ma et al., 2024))、知識 (Knowledge)(如 HLE(Phan et al., 2025)、SimpleQA(Wei et al., 2024))、情感 (Affective)(如 MELD(Poria et al., 2019))、指令遵循 (Instruction Following)(如 ArenaHard(Li et al., 2024))、以及工具使用 (Tool Use)(如 τ²-Bench(Barres et al., 2025))。
對於效能-成本設定下的旗艦模型,我們選用 10 個資料集,並排除已飽和的資料集,以有效衡量前沿能力。對於以效能為導向設定下的輕量級模型,我們選用 15 個資料集,並排除「所有模型都一致表現很差」的過難資料集,以確保有意義的比較(細節見附錄表 9)。
3.3 模組化設計 (Modular Design)
為支援多樣模型、資料集與路由演算法的彈性整合,LLMRouterBench 採用一個圍繞三個關鍵模組建構的模組化設計(見圖 2):Collector(收集器)、Evaluator(評估器)與 Adaptor(轉接器)。Collector 對候選 LLM 暴露一個統一的 API,處理快取 (caching)、重試 (retries) 與成本追蹤,並把所有模型輸出整合成上述的標準化格式。Evaluator 實作嚴謹的、針對特定資料集的評估指標(細節見附錄表 9),以確保跨模型的公平比較。Adaptor 把標準化格式轉換成每個路由方法所需的演算法特定輸入,並在使用相同隨機種子的情況下維持一致的訓練-測試切分。這個模組化設計讓 LLMRouterBench 能以最小幅度的改動對接公開可用的路由實作,便於統一評估並忠實對齊其原始實作。
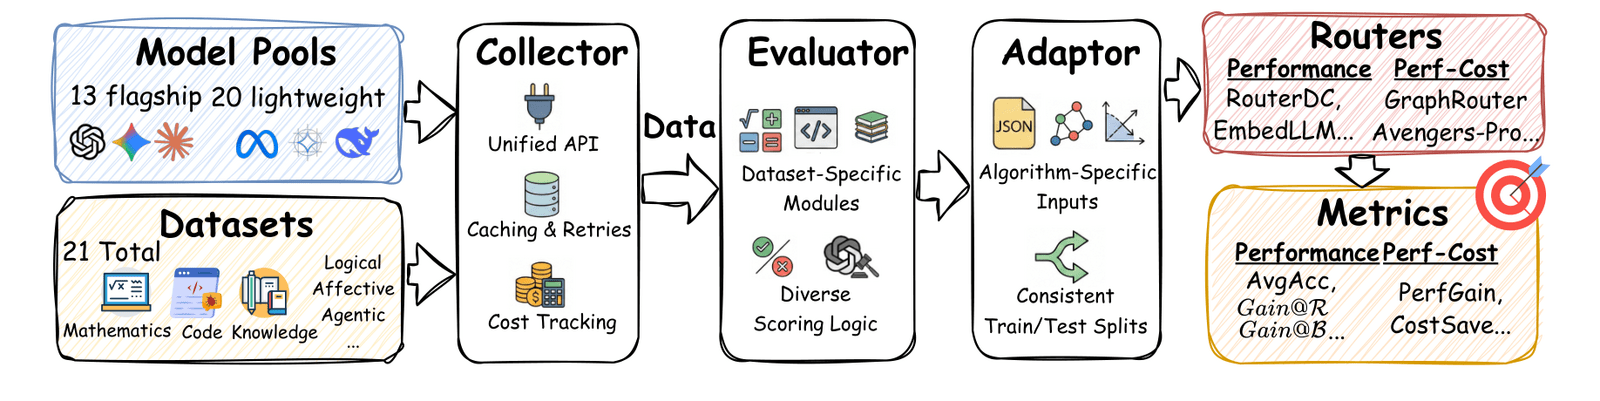
圖 2:LLMRouterBench 框架,整合 Collector、Evaluator 與 Adaptor 三個元件,以對 LLM 路由方法進行標準化評估。
3.4 評估指標 (Evaluation Metrics)
效能指標 (Performance metrics)。 令 $\mathcal{D}$ 為評估資料集的集合,$d \in \mathcal{D}$ 為一個一般化的資料集。對每個路由方法 $a$,令 $\mathrm{Acc}(a,d)$ 表示其在 $d$ 上的準確度,根據「由 $a$ 為 $d$ 中每個查詢所選出之模型」產生答案的正確性來計算。路由方法 $a$ 的平均準確度 (Average Accuracy, AvgAcc) 則由 $\mathrm{AvgAcc}=\frac{1}{|\mathcal{D}|}\sum_{d\in\mathcal{D}}\mathrm{Acc}(a,d)$ 給出。
我們提出把每個路由方法與三個基線比較:(1)Random Router(隨機路由器,$\mathcal{R}$):每個實例從候選池中隨機選一個模型;(2)Best Single(最佳單一模型,$\mathcal{B}$):事後選出在所有資料集上平均準確度最高的單一模型;(3)Oracle($\mathcal{O}$):對每個實例,若事後存在某個能正確預測的模型,便選出它(若有多個則選成本最低者)。Random Router 作為效能下界基線,而 Best Single 與 Oracle 提供有意義的、可達成的效能參考點。我們基於這些基線提出三個指標。我們定義
$$\mathrm{Gain@b}=\frac{1}{|\mathcal{D}|}\sum_{d\in\mathcal{D}}\left(\frac{\mathrm{Acc}(a,d)}{\mathrm{Acc}(b,d)}-1\right)$$
以及
$$\mathrm{Gap@\mathcal{O}}=\frac{1}{|\mathcal{D}|}\sum_{d\in\mathcal{D}}\left(1-\frac{\mathrm{Acc}(a,d)}{\mathrm{Acc}(\mathcal{O},d)}\right)$$
其中 $\mathrm{b}\in\{\mathcal{R},\mathcal{B}\}$。$\mathrm{Gain@\mathcal{R}}$ 與 $\mathrm{Gain@\mathcal{B}}$ 分別衡量相對於 Random Router 與 Best Single 的相對效能增益,而 $\mathrm{Gap@\mathcal{O}}$ 衡量相對於 Oracle 的差距。
效能-成本指標 (Performance-cost metrics)。 在效能-成本設定中,每個路由方法 $a$ 通常都有一個可調參數,能誘導出具有不同效能-成本權衡的配置集合 $\Theta$。對於配置 $\theta\in\Theta$,我們以 $\mathrm{Cost}(\theta)$ 表示其總推論成本。我們把每個路由方法與 Best Single($\mathcal{B}$)比較,聚焦於兩個配置:(i) $\theta^*=\arg\max_{\theta\in\Theta}\mathrm{AvgAcc}(\theta)$,即平均準確度最高(忽略成本)的配置;以及 (ii) $\theta^\dagger=\arg\min_{\theta\in\Theta}\mathrm{Cost}(\theta)$ 且滿足 $\mathrm{AvgAcc}(\theta)\geq\mathrm{AvgAcc}(\mathcal{B})$,即在準確度不低於 $\mathrm{AvgAcc}(\mathcal{B})$ 的前提下成本最低的配置。基於此,我們定義兩個指標:$\mathrm{PerfGain}=\frac{\mathrm{AvgAcc}(\theta^*)}{\mathrm{AvgAcc}(\mathcal{B})}-1$,衡量可達成的最佳效能提升;以及 $\mathrm{CostSave}=1-\frac{\mathrm{Cost}(\theta^\dagger)}{\mathrm{Cost}(\mathcal{B})}$,衡量在不犧牲相對於 Best Single 之效能的前提下,可達成的最大成本縮減。
此外,我們進行帕累托分析 (Pareto analysis),這是一種用於評估多目標最佳化中權衡的技術。我們定義 $S$ 包含 (i) 所有路由方法的配置,以及 (ii) 所有單一模型。我們說 $x\in S$ 帕累托支配 (Pareto-dominates) $y\in S$,當且僅當 $\mathrm{AvgAcc}(x)\geq\mathrm{AvgAcc}(y)$ 且 $\mathrm{Cost}(x)\leq\mathrm{Cost}(y)$,且至少其中一個不等式嚴格成立。帕累托前沿 (Pareto frontier) $\mathcal{P}$ 是 $S$ 中不被任何其他配置帕累托支配的配置集合。對每個路由方法,我們衡量其到帕累托前沿的距離。令 $\bar{\theta}$ 與 $\bar{y}^*$ 分別表示正規化後的座標與前沿配置。對於配置集合為 $\Theta$ 的路由方法 $a$,我們定義距離為 $\mathrm{ParetoDist}=\frac{1}{|\Theta|}\sum_{\theta\in\Theta}\min_{y^*\in\mathcal{P}}\|\bar{\theta}-\bar{y}^*\|_1$。$\mathrm{ParetoDist}$ 值越小,表示該方法的配置平均而言越接近帕累托前沿。
3.5 整體基準統計 (Overall Benchmark Statistics)
表 2 總結了 LLMRouterBench 跨兩種路由設定的關鍵統計。在以效能為導向的設定中,我們在 15 個具挑戰性的資料集上評估 20 個輕量級(約 7B)模型,合計 745.0M tokens。效能-成本設定則在 10 個資料集上評估 13 個旗艦模型,合計 1,030.3M tokens。整體而言,LLMRouterBench 包含 23,945 個 prompts、391,645 筆實例,以及約 18 億 (1.8B) tokens,需要可觀的資料收集工作(輕量級模型推論需 1K GPU 小時,加上 2,771.84 美元的 API 成本)。值得注意的是,相較於近期研究,LLMRouterBench 包含的總 token 數約為 FusionFactory(Feng et al., 2025b)的 18 倍(18 億對 1.04 億),prompts 數量約為 RouterArena(Lu et al., 2025)的 3 倍(23,945 對 8,400)。
表 2:LLMRouterBench 的整體統計。†約有 500 美元來自基於 LLM 的評判 (LLM-based judging)。
| 指標 | 以效能為導向 | 效能-成本 |
|---|---|---|
| 資料集數 | 15 | 10 |
| 模型數 | 20 | 13 |
| Prompts | 11,480 | 12,446 |
| 實例 (Instances) | 229,600 | 161,520 |
| Tokens (M) | 745.0 | 1,030.3 |
| 總成本 | A800 1000 GPU 小時 | $2,771.84† |
4 實驗
4.1 實驗設定 (Experimental Setup)
我們評估了 9 個來自近期已發表研究、且有開源實作的代表性路由方法,並額外納入 OpenRouter 作為一個商用路由器:
- 以效能為導向的設定:RouterDC(Chen et al., 2024b)、EmbedLLM(Zhuang et al., 2024)、MODEL-SAT(Zhang et al., 2025b)、GraphRouter(Feng et al., 2025a)與 Avengers(Zhang et al., 2025d)。
- 效能-成本設定:HybridLLM(Ding et al., 2024)、FrugalGPT(Chen et al., 2024a)、RouteLLM(Ong et al., 2024)、GraphRouter(Feng et al., 2025a)、Avengers-Pro(Zhang et al., 2025c)與 OpenRouter。
附錄 B.2 與 B.3 提供了詳細的描述與實作細節。
4.2 結果與分析 (Results and Analyses)
由於篇幅限制,我們在附錄表 4、5、6 中呈現橫跨所有受評模型與資料集的詳細基準結果。本文報告的結果是跨資料集平均;附錄表 11、12、13 另外報告了「以五個不同隨機種子的五次執行取平均」的逐資料集結果。以下,我們凸顯並討論關鍵發現。
4.2.1 以效能為導向的設定
沒有單一模型主宰所有領域;模型展現出互補強項。 以效能為導向的路由的核心前提是:不同模型在不同領域各擅勝場。如圖 3 所示,我們發現此互補性的明確證據:數學基準常由 Intern-S1-mini 或 Qwen3-8B 等模型領先,程式碼基準由 Qwen-Coder 或 Fin-R1 領先,邏輯與情感基準則由其他模型領先。這確認了此領域的核心前提。
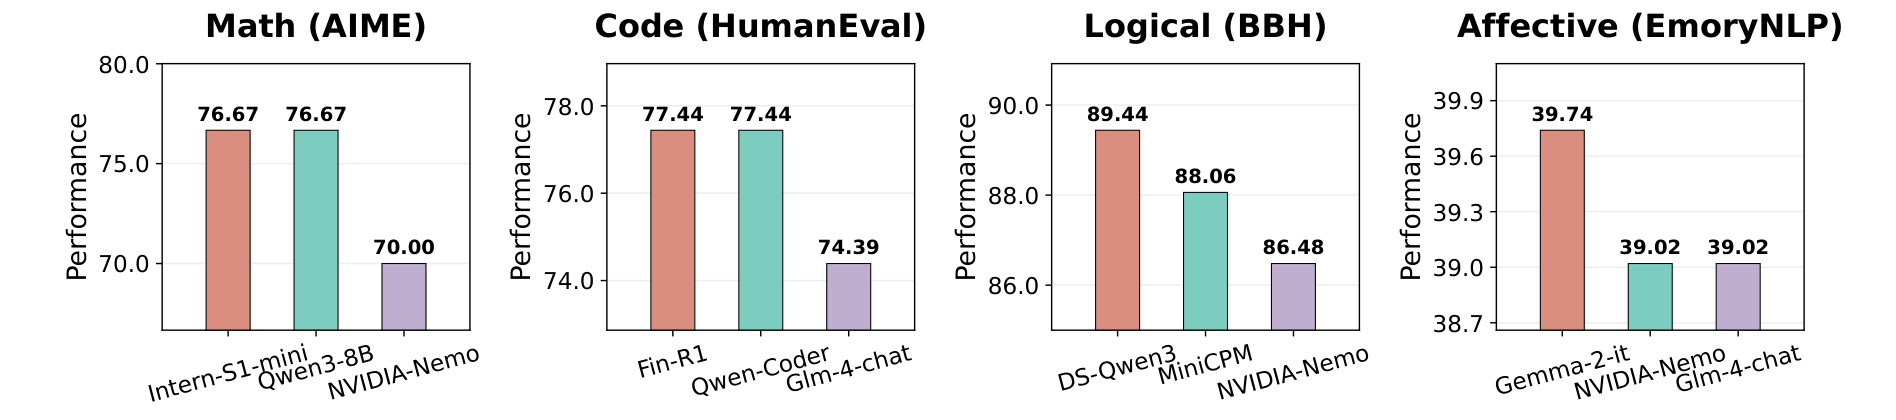
圖 3:各模型跨領域的效能。沒有任何單一模型主宰所有領域。
頂尖的路由方法效能相當,但可以無需神經網路訓練。 LLM 路由並非新概念,已有大量文獻。儘管如此,我們的結果顯示,儘管方法持續創新,許多路由做法在實務上達到了大致相當的效能。如圖 4 所示,橫跨多個指標($\mathrm{Gain@\mathcal{R}}$、AvgAcc、$\mathrm{Gain@\mathcal{B}}$ 與 $\mathrm{Gap@\mathcal{O}}$),領先的路由方法(EmbedLLM、GraphRouter、MODEL-SAT 與 Avengers)產生了相近的結果。值得注意的是,Avengers 主要透過聚類達成此效能,並不需要神經網路訓練。
這個觀察有兩個意涵。第一,從部署的角度來看這是好消息:輕量、開發成本低且易於更新的路由器,在實務上可能已經足夠。另一方面,領先方法之間缺乏差異化的事實,顯示路由增益中很大一部分可能來自捕捉粗粒度的領域結構(例如區分數學與程式碼),而非學習高度細緻的決策邊界。這一點由「這些方法與 Dataset Oracle(圖 4 中的斜線柱)的接近程度」所佐證——Dataset Oracle 是把每個資料集整個指派給「在該資料集上準確度最高的單一模型」。
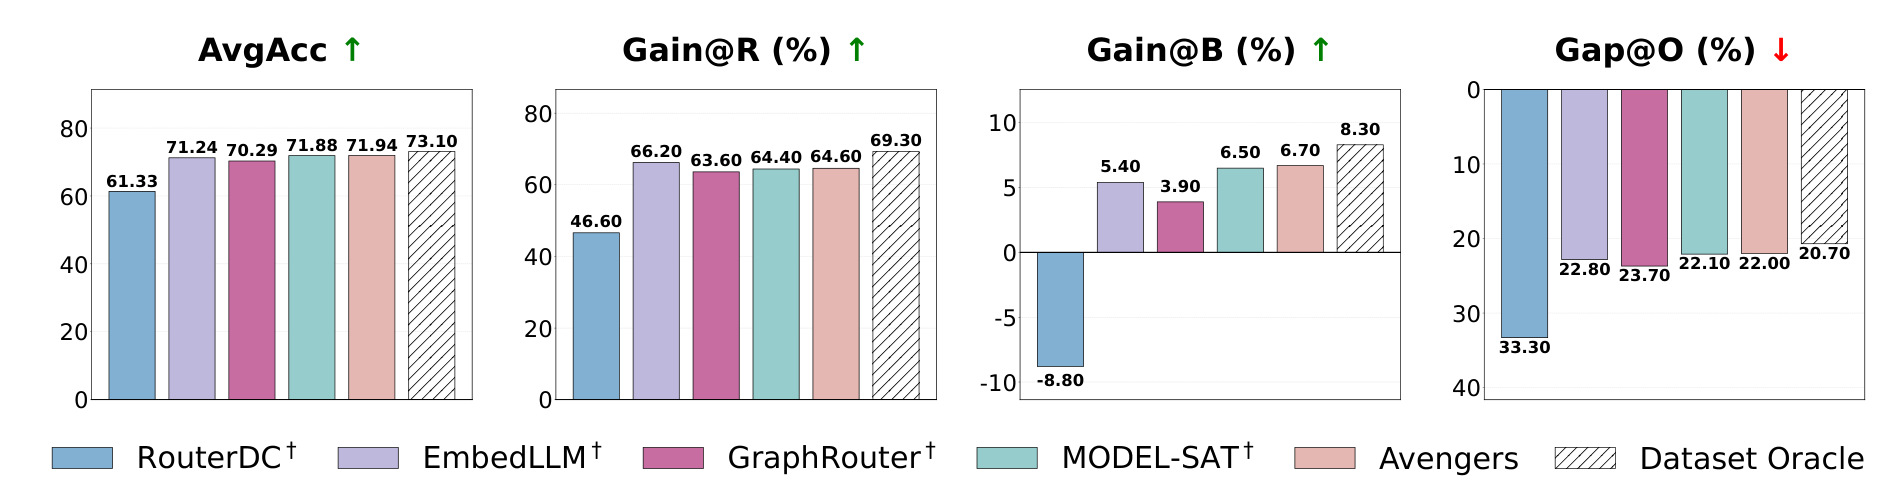
圖 4:在 LLMRouterBench 上的效能指標。†表示測試集上的最高分數。
路由距離其能力上限還很遠:當前方法常常錯過那個唯一正確的模型。 雖然頂尖路由方法效能相近,這可能引出「是否還有進一步增益空間」的問題。圖 4 (d) 顯示的 $\mathrm{Gap@\mathcal{O}}$ 揭露了相對於 Oracle(由 Oracle 基線給出的路由上界)的顯著差距。一個關鍵成因是模型召回失敗:當只有一個或少數候選模型能產生正確答案時,當前路由器常常無法選中它們。如圖 5 所分析,此問題佔了剩餘誤差中相當可觀的一部分。例如,在「最多三個專家能正確作答」的查詢上(佔測試集 11.9%,即 410 個查詢),Avengers 與 EmbedLLM 的準確度都很低(分別為 24.6% 與 23.2%)。
縮小此差距很可能需要能更可靠地偵測並優先處理這些情況的路由器,例如透過改進的不確定性或難度估計、或顯式機制來提升對「罕見但關鍵的專家」的召回,這構成一個有前景的未來工作方向。
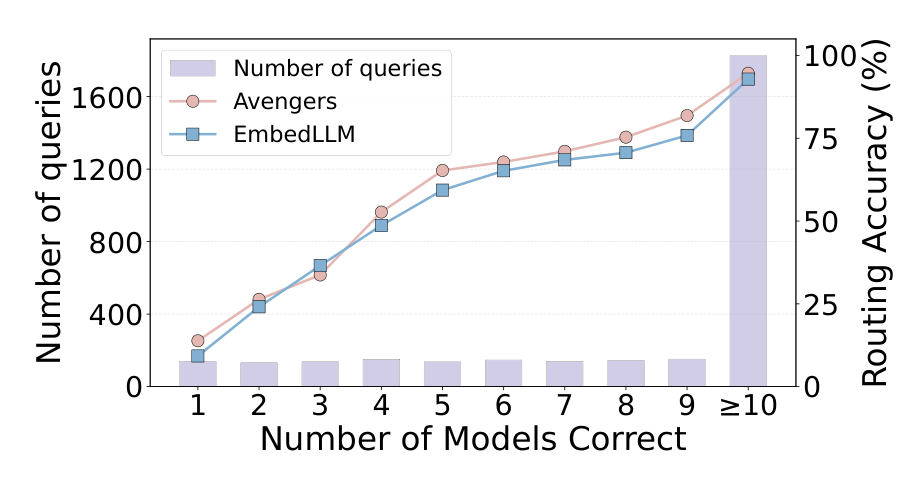
圖 5:查詢難度分佈(依正確模型數量),以及路由器準確度。
嵌入模型對路由效能影響甚微。 由於許多路由方法依賴嵌入模型,我們檢視此選擇如何影響效能。令人意外的是,嵌入模型在各路由方法之間一致地只造成很小的差異。附錄表 10 顯示,把 gte-qwen2-7B-instruct 換成 nli-bert-base(Reimers and Gurevych, 2019)與 all-MiniLM-L6-v2(Wang et al., 2020)後,我們並未在 GraphRouter、EmbedLLM 與 Avengers(皆依賴嵌入)之間觀察到顯著的效能差異。注意這兩個替代品都是較弱的骨幹:all-MiniLM-L6-v2 只有 2270 萬參數,而 nli-bert-base 因句嵌入品質不佳已在 Sentence-Transformers 中被棄用。
這顯示嵌入品質可能並非當前基於嵌入之路由器的主要瓶頸。未來的增益可能較少來自改進語意表徵本身,而更多來自開發「能把表徵更可靠地轉化為模型選擇」的路由機制,尤其是在分佈偏移 (distribution shift) 與罕見情況下(這些情況的正確效能取決於是否選中特定的專才模型)。
加入更多模型帶來邊際遞減,但精選的子集能造成顯著差異。 此領域常見的一個假設(Jiang et al., 2023)是:擴大候選池應能增加互補性,因而提升整體效能。然而,使用 Oracle 基線,我們發現隨著加入更多模型,存在明顯的邊際遞減(圖 6)。最大的增益出現在「從非常小的池擴大到中等規模的池」時,之後額外的模型只貢獻邊際性的改進。相對地,「如何選擇一個小子集」卻有相當大的影響:比較「隨機選擇」與「依平均準確度選取 top-k 模型」,後者一致地帶來更強的效能。
這顯示細緻的篩選可勝過單純擴大池規模;一個精選的中等規模池加上一個穩健的路由器,可能在不需要維護超大池的開銷下,就提供大部分可達成的效益。未來工作應與路由一起研究模型池的篩選:選出一個能最大化互補性的小集合,可能透過覆蓋率 (coverage) 或多樣性 (diversity) 風格的選取方式。
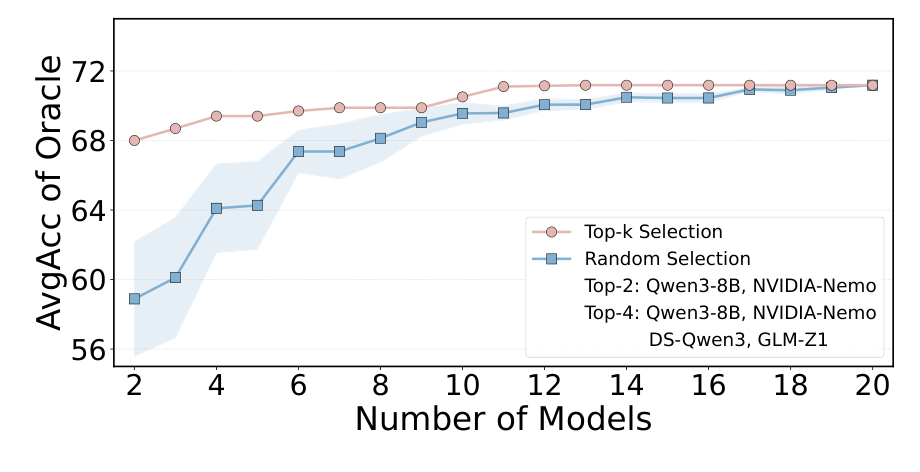
圖 6:在「精選子集」對「隨機子集」下 Oracle 效能的比較。加入更多模型帶來邊際遞減,但一個精挑細選的小子集能勝過更大的隨機池。
4.2.2 效能-成本設定
模型在效能與成本效率上互相補足。 與以效能為導向的設定類似,我們在效能與成本兩方面都觀察到模型間的互補性。如附錄表 5 所示,雖然 GPT-5 取得最佳平均準確度並在 HLE 上領先,但顯著更便宜的模型(如 Qwen3-235B 與 DeepSeek-R1)在某些數學與問答任務上可達到專有模型等級的準確度。這些結果支持了效能-成本權衡路由背後的核心前提。
有效的路由能勝過 Best Single 並降低成本而不犧牲效能,但並非所有路由器都能成功。 如圖 7 所示,善用模型互補性,頂尖路由方法相對於 Best Single 模型可達到最高約 4% 的平均準確度增益,並在維持 Best Single 效能的同時達到最高 31.7% 的成本縮減。然而這些增益並非普遍:數個路由器無法勝過 Best Single,而某些路由器(尤其是二元路由器,如 HybridLLM 與 FrugalGPT)難以在保留 Best Single 準確度的同時用成本換取節省。值得注意的是,商用路由器 OpenRouter 相對於 Best Single 模型產生了最小(事實上為負)的效能改進(-24.7%),並且無法達到其效能,儘管它運作於一個大得多的候選池上。【2】
這些結果強化了「Best Single 作為基線」的適當性:相當可觀比例的路由策略並未勝過這個簡單的替代方案。更廣泛地說,各路由器之間的變異性顯示,穩健的效能-成本路由仍有可觀的進步空間,尤其是對能在不犧牲準確度的情況下達成成本縮減的方法而言。
【2】OpenRouter 使用一個由平台定義、與我們不同且使用者不可配置的模型池(OpenRouter, Inc., 2025a);我們在附錄表 14 中提供其模型池的細節。
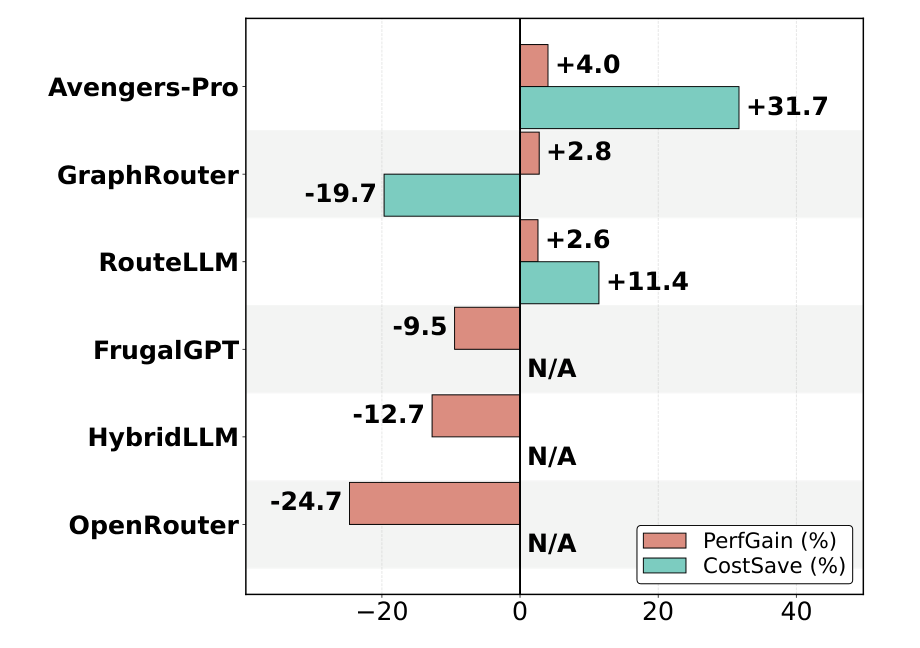
圖 7:各路由方法相對於 GPT-5 的效能增益與成本節省。成本節省僅對「準確度等於或高於 GPT-5」的方法回報;否則標記為 N/A。
Avengers-Pro 達成帕累托最佳的效能-成本權衡。 我們在圖 8 中以帕累托前沿這種多目標最佳化的精緻分析方式來視覺化。不同於以效能為導向的設定(其中數個路由方法都具競爭力),Avengers-Pro 幾乎主宰了整條前沿。也就是說,相對於任何單一模型或其他路由方法,Avengers-Pro 幾乎總是「在相當效能下更便宜」,或「在相當成本下取得更高效能」。沒有其他方法或單一模型能同時比 Avengers-Pro 更便宜且更準確。這一點由圖 8 中的 ParetoDist 指標進一步佐證:Avengers-Pro 的 ParetoDist 接近零,普遍是帕累托最佳的,而其他路由器則展現出顯著更大的距離。
這些結果有兩個意涵。第一,它們證明了強的效能-成本路由在實務上是可達成的:帕累托前沿並非僅是理論建構,一個設計良好的路由器可以接近它運作。第二,它們顯示未來進展不僅應以平均準確度來評估,也應評估「新方法是否能推移前沿」——亦即擴展可達成的操作點集合,使其朝向同時更低成本與更高效能。
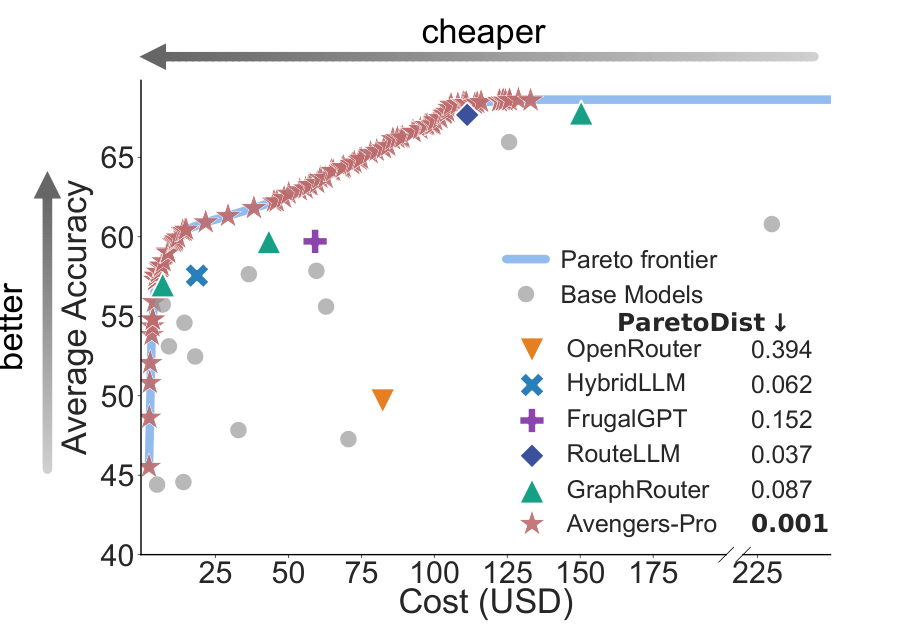
圖 8:所有基礎模型與路由方法的「平均準確度對總推論成本」,並標出經驗性帕累托前沿。
LLMRouterBench 能把路由延伸到效能-成本-延遲最佳化。 我們注意到 LLMRouterBench 也能支援延遲感知分析。透過追蹤所消耗的 token 數(由 LLMRouterBench 支援),並結合標準的服務統計(由 OpenRouter 提供,例如首 token 時間 (time-to-first-token) 與每秒 token 數 (tokens-per-second)),便可在統一協定下近似不同模型的端到端回應時間。然而,迄今為止路由研究大多聚焦於最佳化準確度與/或成本,據我們所知,並沒有任何方法顯式地鎖定「效能-成本-延遲」的聯合權衡。
在圖 9 中,我們說明了不同模型如何沿這三個維度變化。在準確度與成本上相近的模型,在延遲上仍可能有明顯差異。例如,Qwen3-Thinking 與 GLM-4.6 效能相近、成本相近,但延遲差異顯著(262.1 秒對 32.4 秒)。這引入了一個與使用者體驗直接相關的額外互補性軸。從實務角度來看,當兩個模型在相近成本下提供相當的準確度時,使用者往往會偏好回應較快的那一個。因此,我們的資料集提供了支援此三目標設定之系統性探索所需的訊號。
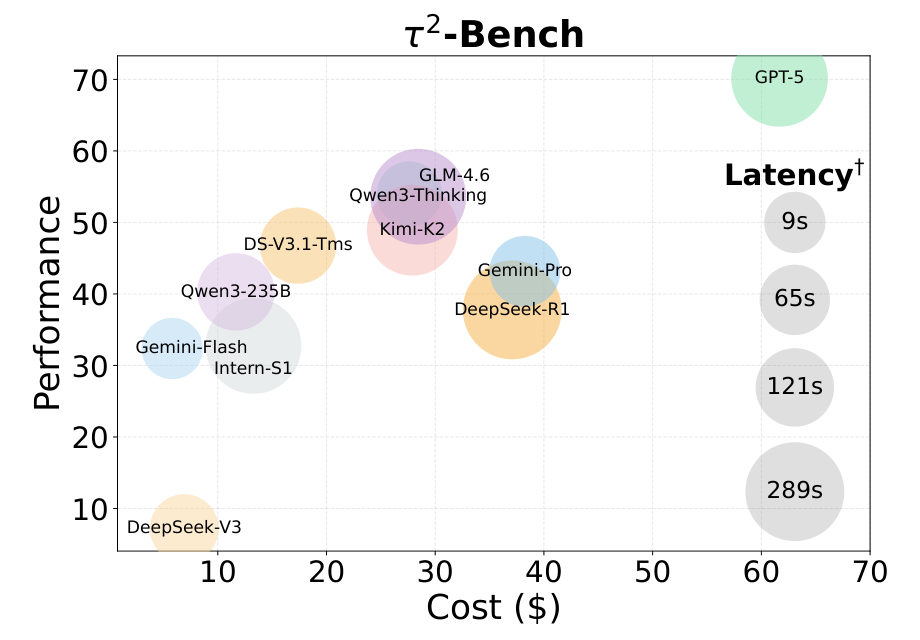
圖 9:在 τ²-Bench 上的模型效能-成本-延遲權衡。†延遲量測收集自 OpenRouter 平台(2026 年 1 月 5 日)。
5 結論
我們提出 LLMRouterBench,一個用於 LLM 路由的大規模基準與統一框架,涵蓋以效能為導向與效能-成本權衡兩種設定。透過整合涵蓋 21 個資料集、33 個模型的超過 40 萬筆實例,並引入全面的指標與 10 個代表性基線,LLMRouterBench 為這個快速演進的領域提供了一個系統性研究的堅實基礎。我們的結果重申了 LLM 路由的核心動機——模型間強烈的互補性——但也挑戰了文獻中數個既有主張。在統一評估之下,大多數路由方法的效能會收斂到相近水準,且包含被廣泛部署的商用路由器在內的多個近期方法,都無法可靠地勝過一個簡單的基線。相對於 Oracle 仍存在一個大且持續的差距,此差距主要由系統性的模型召回失敗、而非集成能力不足所驅動。我們進一步證明,常見的設計選擇(如骨幹嵌入模型的選擇、或集成規模的激進擴張)在實務上只帶來有限的增益。此外,我們展示我們的基準能把路由延伸到延遲方面的權衡。
限制
我們的工作有三個限制。第一,雖然我們評估了廣泛的路由方法,但並未涵蓋所有既有方法。鑑於路由方法數量龐大且持續增加,我們聚焦於有公開實作的近期方法。LLMRouterBench 採模組化設計,允許透過輕量轉接器整合額外的路由器,而無需重新實作整個流程。
第二,本基準建立在 21 個被廣泛使用、反映當代輕量與旗艦 LLM 常見評估範式的資料集上。其他設定,如領域特定的垂直領域、超長上下文任務、以及多模態基準,並未納入。LLMRouterBench 所用的路由表述、指標與分析流程都是通用的,可透過加入新的資料集評估器套用到這些設定。
第三,延遲分析是近似的。我們以 token 層級的用量統計結合 OpenRouter 回報的吞吐量數字來估計延遲。這些估計對應於某個特定供應商配置,應被解讀為指示性而非定論性。
致謝
本工作由上海市科技重大專項 (Shanghai Municipal Science and Technology Major Project) 支持。
參考文獻
Anthropic. 2025. System card: Claude opus 4 and claude sonnet 4. https://www.anthropic.com/news/claude-4.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, and 1 others. 2021. Program synthesis with large language models. arXiv preprint arXiv:2108.07732.
Lei Bai, Zhongrui Cai, Yuhang Cao, Maosong Cao, Weihan Cao, Chiyu Chen, Haojiong Chen, Kai Chen, Pengcheng Chen, Ying Chen, and 1 others. 2025. Intern-s1: A scientific multimodal foundation model. arXiv preprint arXiv:2508.15763.
Victor Barres, Honghua Dong, Soham Ray, Xujie Si, and Karthik Narasimhan. 2025. τ²-Bench: Evaluating conversational agents in a dual-control environment. arXiv preprint arXiv:2506.07982.
Akhiad Bercovich, Itay Levy, Izik Golan, Mohammad Dabbah, Ran El-Yaniv, Omri Puny, Ido Galil, Zach Moshe, Tomer Ronen, Najeeb Nabwani, Ido Shahaf, Oren Tropp, Ehud Karpas, Ran Zilberstein, Jiaqi Zeng, Soumye Singhal, Alexander Bukharin, Yian Zhang, Tugrul Konuk, and 114 others. 2025. Llama-nemotron: Efficient reasoning models. Preprint, arXiv:2505.00949.
Mats Byrkjeland, Frederik Gørvell de Lichtenberg, and Björn Gambäck. 2018. Ternary twitter sentiment classification with distant supervision and sentiment-specific word embeddings. In Proceedings of the 9th workshop on computational approaches to subjectivity, sentiment and social media analysis, pages 97–106.
Zheng Cai, Maosong Cao, Haojiong Chen, Kai Chen, Keyu Chen, Xin Chen, Xun Chen, Zehui Chen, Zhi Chen, Pei Chu, Xiaoyi Dong, Haodong Duan, Qi Fan, Zhaoye Fei, Yang Gao, Jiaye Ge, Chenya Gu, Yuzhe Gu, Tao Gui, and 81 others. 2024. Internlm2 technical report. Preprint, arXiv:2403.17297.
Lingjiao Chen, Matei Zaharia, and James Zou. 2024a. FrugalGPT: How to use large language models while reducing cost and improving performance. Transactions on Machine Learning Research.
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, Alex Ray, Raul Puri, Gretchen Krueger, Michael Petrov, Heidy Khlaaf, Girish Sastry, Pamela Mishkin, Brooke Chan, Scott Gray, and 39 others. 2021a. Evaluating large language models trained on code. Preprint, arXiv:2107.03374.
Shuhao Chen, Weisen Jiang, Baijiong Lin, James Kwok, and Yu Zhang. 2024b. Routerdc: Query-based router by dual contrastive learning for assembling large language models. Advances in Neural Information Processing Systems, 37:66305–66328.
Zhiyu Chen, Wenhu Chen, Charese Smiley, Sameena Shah, Iana Borova, Dylan Langdon, Reema Moussa, Matt Beane, Ting-Hao Huang, Bryan Routledge, and William Yang Wang. 2021b. Finqa: A dataset of numerical reasoning over financial data. Proceedings of EMNLP 2021.
Deep Cogito. 2025. Cogito v1 preview - llama 8b. https://huggingface.co/deepcogito/cogito-v1-preview-llama-8B. Hugging Face model card.
Dujian Ding, Ankur Mallick, Chi Wang, Robert Sim, Subhabrata Mukherjee, Victor Ruhle, Laks VS Lakshmanan, and Ahmed Hassan Awadallah. 2024. Hybrid llm: Cost-efficient and quality-aware query routing. arXiv preprint arXiv:2404.14618.
Dujian Ding, Ankur Mallick, Shaokun Zhang, Chi Wang, Daniel Madrigal, Mirian Del Carmen Hipolito Garcia, Menglin Xia, Laks V. S. Lakshmanan, Qingyun Wu, and Victor Rühle. 2025. BEST-route: Adaptive LLM routing with test-time optimal compute. In Forty-second International Conference on Machine Learning.
Jacob Fein-Ashley, Dhruv Parikh, Rajgopal Kannan, and Viktor Prasanna. 2025. Mixture of thoughts: Learning to aggregate what experts think, not just what they say. arXiv preprint arXiv:2509.21164.
Tao Feng, Yanzhen Shen, and Jiaxuan You. 2025a. Graphrouter: A graph-based router for LLM selections. In The Thirteenth International Conference on Learning Representations.
Tao Feng, Haozhen Zhang, Zijie Lei, Pengrui Han, Mostofa Patwary, Mohammad Shoeybi, Bryan Catanzaro, and Jiaxuan You. 2025b. Fusionfactory: Fusing llm capabilities with multi-llm log data. arXiv preprint arXiv:2507.10540.
Nigel Fernandez, Branislav Kveton, Ryan A Rossi, Andrew S Lan, and Zichao Wang. 2025. Radar: Reasoning- and difficulty-aware routing for reasoning llms. arXiv preprint arXiv:2509.25426.
Gemini Team. 2025. Gemini 2.5: Pushing the frontier with advanced reasoning, multimodality, long context, and next generation agentic capabilities. arXiv preprint arXiv:2507.06261.
Team GLM, Aohan Zeng, Bin Xu, Bowen Wang, Chenhui Zhang, Da Yin, Diego Rojas, Guanyu Feng, Hanlin Zhao, Hanyu Lai, Hao Yu, Hongning Wang, Jiadai Sun, Jiajie Zhang, Jiale Cheng, Jiayi Gui, Jie Tang, Jing Zhang, Juanzi Li, and 37 others. 2024. Chatglm: A family of large language models from glm-130b to glm-4 all tools. Preprint, arXiv:2406.12793.
Granite Team, IBM. 2025. Granite-3.3-8b-instruct. https://huggingface.co/ibm-granite/granite-3.3-8b-instruct. Hugging Face model card, release date: 2025-04-16.
Aaron Grattafiori, Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Alex Vaughan, and 1 others. 2024. The llama 3 herd of models. arXiv preprint arXiv:2407.21783.
Etash Guha, Ryan Marten, Sedrick Keh, Negin Raoof, Georgios Smyrnis, Hritik Bansal, Marianna Nezhurina, Jean Mercat, Trung Vu, Zayne Sprague, Ashima Suvarna, Benjamin Feuer, Liangyu Chen, Zaid Khan, Eric Frankel, Sachin Grover, Caroline Choi, Niklas Muennighoff, Shiye Su, and 31 others. 2025. Openthoughts: Data recipes for reasoning models. Preprint, arXiv:2506.04178.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, and 1 others. 2025a. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948.
Xiyu Guo, Shan Wang, Chunfang Ji, Xuefeng Zhao, Wenhao Xi, Yaoyao Liu, Qinglan Li, Chao Deng, and Junlan Feng. 2025b. Towards generalized routing: Model and agent orchestration for adaptive and efficient inference. arXiv preprint arXiv:2509.07571.
Qitian Jason Hu, Jacob Bieker, Xiuyu Li, Nan Jiang, Benjamin Keigwin, Gaurav Ranganath, Kurt Keutzer, and Shriyash Kaustubh Upadhyay. 2024. Routerbench: A benchmark for multi-llm routing system. arXiv preprint arXiv:2403.12031.
Canbin Huang, Tianyuan Shi, Yuhua Zhu, Ruijun Chen, and Xiaojun Quan. 2025a. Lookahead routing for large language models. arXiv preprint arXiv:2510.19506.
Zhongzhan Huang, Guoming Ling, Yupei Lin, Yandong Chen, Shanshan Zhong, Hefeng Wu, and Liang Lin. 2025b. Routereval: A comprehensive benchmark for routing llms to explore model-level scaling up in llms. arXiv preprint arXiv:2503.10657.
Hugging Face. 2025. HuggingChat Omni. https://huggingface.co/chat/settings/omni. [Accessed: 2026-1-06].
Binyuan Hui, Jian Yang, Zeyu Cui, Jiaxi Yang, Dayiheng Liu, Lei Zhang, Tianyu Liu, Jiajun Zhang, Bowen Yu, Keming Lu, Kai Dang, Yang Fan, Yichang Zhang, An Yang, Rui Men, Fei Huang, Bo Zheng, Yibo Miao, Shanghaoran Quan, and 5 others. 2024. Qwen2.5-coder technical report. Preprint, arXiv:2409.12186.
Naman Jain, King Han, Alex Gu, Wen-Ding Li, Fanjia Yan, Tianjun Zhang, Sida Wang, Armando Solar-Lezama, Koushik Sen, and Ion Stoica. 2024. Livecodebench: Holistic and contamination free evaluation of large language models for code. arXiv preprint arXiv:2403.07974.
Dongfu Jiang, Xiang Ren, and Bill Yuchen Lin. 2023. LLM-blender: Ensembling large language models with pairwise ranking and generative fusion. In Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 14165–14178, Toronto, Canada. Association for Computational Linguistics.
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik Narasimhan. 2023. Swe-bench: Can language models resolve real-world github issues? arXiv preprint arXiv:2310.06770.
Di Jin, Eileen Pan, Nassim Oufattole, Wei-Hung Weng, Hanyi Fang, and Peter Szolovits. 2021. What disease does this patient have? a large-scale open domain question answering dataset from medical exams. Applied Sciences, 11(14):6421.
Ruihan Jin, Pengpeng Shao, Zhengqi Wen, Jinyang Wu, Mingkuan Feng, Shuai Zhang, and Jianhua Tao. 2025. RadialRouter: Structured representation for efficient and robust large language models routing. In Findings of the Association for Computational Linguistics: EMNLP 2025, pages 14587–14600, Suzhou, China. Association for Computational Linguistics.
Wittawat Jitkrittum, Harikrishna Narasimhan, Ankit Singh Rawat, Jeevesh Juneja, Zifeng Wang, Chen-Yu Lee, Pradeep Shenoy, Rina Panigrahy, Aditya Krishna Menon, and Sanjiv Kumar. 2025. Universal model routing for efficient llm inference. arXiv preprint arXiv:2502.08773.
Tianle Li, Wei-Lin Chiang, Evan Frick, Lisa Dunlap, Tianhao Wu, Banghua Zhu, Joseph E Gonzalez, and Ion Stoica. 2024. From crowdsourced data to high-quality benchmarks: Arena-hard and benchbuilder pipeline. arXiv preprint arXiv:2406.11939.
Zehan Li, Xin Zhang, Yanzhao Zhang, Dingkun Long, Pengjun Xie, and Meishan Zhang. 2023. Towards general text embeddings with multi-stage contrastive learning. arXiv preprint arXiv:2308.03281.
Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. 2023. Let's verify step by step. arXiv preprint arXiv:2305.20050.
Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, and 1 others. 2024a. Deepseek-v3 technical report. arXiv preprint arXiv:2412.19437.
Hongwei Liu, Zilong Zheng, Yuxuan Qiao, Haodong Duan, Zhiwei Fei, Fengzhe Zhou, Wenwei Zhang, Songyang Zhang, Dahua Lin, and Kai Chen. 2024b. Mathbench: Evaluating the theory and application proficiency of llms with a hierarchical mathematics benchmark. arXiv preprint arXiv:2405.12209.
Junnan Liu, Hongwei Liu, Linchen Liu, Ziyi Wang, Kuikun Liu, Songyang Gao, Wenwei Zhang, Songyang Zhang, and Kai Chen. 2024c. Are your llms capable of stable reasoning? arXiv preprint arXiv:2412.13147.
Zhaowei Liu, Xin Guo, Fangqi Lou, Lingfeng Zeng, Jinyi Niu, Zixuan Wang, Jiajie Xu, Weige Cai, Ziwei Yang, Xueqian Zhao, Chao Li, Sheng Xu, Dezhi Chen, Yun Chen, Zuo Bai, and Liwen Zhang. 2025. Fin-r1: A large language model for financial reasoning through reinforcement learning. Preprint, arXiv:2503.16252.
Keming Lu, Hongyi Yuan, Runji Lin, Junyang Lin, Zheng Yuan, Chang Zhou, and Jingren Zhou. 2024. Routing to the expert: Efficient reward-guided ensemble of large language models. In Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), pages 1964–1974, Mexico City, Mexico. Association for Computational Linguistics.
Yifan Lu, Rixin Liu, Jiayi Yuan, Xingqi Cui, Shenrun Zhang, Hongyi Liu, and Jiarong Xing. 2025. Router-arena: An open platform for comprehensive comparison of llm routers. arXiv preprint arXiv:2510.00202.
Kaijing Ma, Xinrun Du, Yunran Wang, Haoran Zhang, Zhoufutu Wen, Xingwei Qu, Jian Yang, Jiaheng Liu, Minghao Liu, Xiang Yue, Wenhao Huang, and Ge Zhang. 2024. Kor-bench: Benchmarking language models on knowledge-orthogonal reasoning tasks. Preprint, arXiv:2410.06526.
NVIDIA Nemotron Nano. 2025. Efficient hybrid mamba-transformer reasoning model. arXiv preprint arXiv:2508.14444.
Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E Gonzalez, M Waleed Kadous, and Ion Stoica. 2024. Routellm: Learning to route llms with preference data. arXiv preprint arXiv:2406.18665.
OpenAI. 2025a. GPT-5. https://openai.com/gpt-5/. [Accessed: 2026-1-06].
OpenAI. 2025b. Gpt-5 system card. https://cdn.openai.com/gpt-5-system-card.pdf.
OpenRouter, Inc. 2025a. Auto router - api, providers, stats. https://openrouter.ai/openrouter/auto.
OpenRouter, Inc. 2025b. Openrouter: A unified interface for large language models. https://openrouter.ai. Accessed: 2025-11-13.
Shivam Patel, Neharika Jali, Ankur Mallick, and Gauri Joshi. 2025. Proxrouter: Proximity-weighted llm query routing for improved robustness to outliers. arXiv preprint arXiv:2510.09852.
Long Phan, Alice Gatti, Ziwen Han, Nathaniel Li, Josephina Hu, Hugh Zhang, Mohamed Shaaban, John Ling, Sean Shi, and 1 others. 2025. Humanity's last exam. arXiv preprint arXiv:2501.14249.
Soujanya Poria, Devamanyu Hazarika, Navonil Majumder, Gautam Naik, Erik Cambria, and Rada Mihalcea. 2019. Meld: A multimodal multi-party dataset for emotion recognition in conversations. Preprint, arXiv:1810.02508.
Nils Reimers and Iryna Gurevych. 2019. Sentence-bert: Sentence embeddings using siamese bert-networks. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing. Association for Computational Linguistics.
David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R. Bowman. 2024. GPQA: A graduate-level google-proof q&a benchmark. In First Conference on Language Modeling.
Wei Song, Zhenya Huang, Cheng Cheng, Weibo Gao, Bihan Xu, GuanHao Zhao, Fei Wang, and Runze Wu. 2025. IRT-router: Effective and interpretable multi-LLM routing via item response theory. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 15629–15644, Vienna, Austria. Association for Computational Linguistics.
Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, and Jason Wei. 2022. Challenging big-bench tasks and whether chain-of-thought can solve them. arXiv preprint arXiv:2210.09261.
Gemma Team, Morgane Riviere, Shreya Pathak, Pier Giuseppe Sessa, Cassidy Hardin, Surya Bhupatiraju, Léonard Hussenot, Thomas Mesnard, Bobak Shahriari, Alexandre Ramé, and 1 others. 2024. Gemma 2: Improving open language models at a practical size. arXiv preprint arXiv:2408.00118.
Kimi Team, Yifan Bai, Yiping Bao, Guanduo Chen, Jiahao Chen, Ningxin Chen, Ruijue Chen, Yanru Chen, Yuankun Chen, Yutian Chen, and 1 others. 2025a. Kimi k2: Open agentic intelligence. arXiv preprint arXiv:2507.20534.
MiniCPM Team, Chaojun Xiao, Yuxuan Li, Xu Han, Yuzhuo Bai, Jie Cai, Haotian Chen, Wentong Chen, Xin Cong, Ganqu Cui, and 1 others. 2025b. Minicpm4: Ultra-efficient llms on end devices. arXiv preprint arXiv:2506.07900.
Ryan Teknium, Jeffrey Quesnelle, and Chen Guang. 2024. Hermes 3 technical report. Preprint, arXiv:2408.11857.
Chenxu Wang, Hao Li, Yiqun Zhang, Linyao Chen, Jianhao Chen, Ping Jian, Peng Ye, Qiaosheng Zhang, and Shuyue Hu. 2025a. Icl-router: In-context learned model representations for llm routing. arXiv preprint arXiv:2510.09719.
Wenhui Wang, Furu Wei, Li Dong, Hangbo Bao, Nan Yang, and Ming Zhou. 2020. Minilm: Deep self-attention distillation for task-agnostic compression of pre-trained transformers. Advances in neural information processing systems, 33:5776–5788.
Xinyuan Wang, Yanchi Liu, Wei Cheng, Xujiang Zhao, Zhengzhang Chen, Wenchao Yu, Yanjie Fu, and Haifeng Chen. 2025b. Mixllm: Dynamic routing in mixed large language models. arXiv preprint arXiv:2502.18482.
Yubo Wang, Xueguang Ma, Ge Zhang, Yuansheng Ni, Abhranil Chandra, Shiguang Guo, Weiming Ren, Aaran Arulraj, Xuan He, Ziyan Jiang, and 1 others. 2024. Mmlu-pro: A more robust and challenging multi-task language understanding benchmark. arXiv preprint arXiv:2406.01574.
Jason Wei, Nguyen Karina, Hyung Won Chung, Yunxin Joy Jiao, Spencer Papay, Amelia Glaese, John Schulman, and William Fedus. 2024. Measuring short-form factuality in large language models. arXiv preprint arXiv:2411.04368.
LLM-Core-Team Xiaomi. 2025. Mimo: Unlocking the reasoning potential of language model – from pretraining to posttraining. Preprint, arXiv:2505.07608.
Chulin Xie, Yangsibo Huang, Chiyuan Zhang, Da Yu, Xinyun Chen, Bill Yuchen Lin, Bo Li, Badih Ghazi, and Ravi Kumar. 2024. On memorization of large language models in logical reasoning. arXiv preprint arXiv:2410.23123.
An Yang, Anfeng Li, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Gao, Chengen Huang, Chenxu Lv, and 1 others. 2025. Qwen3 technical report. arXiv preprint arXiv:2505.09388.
Yanwei Yue, Guibin Zhang, Boyang Liu, Guancheng Wan, Kun Wang, Dawei Cheng, and Yiyan Qi. 2025. Masrouter: Learning to route llms for multi-agent systems. arXiv preprint arXiv:2502.11133.
Aohan Zeng, Xin Lv, Qinkai Zheng, Zhenyu Hou, Bin Chen, Chengxing Xie, Cunxiang Wang, Da Yin, Hao Zeng, Jiajie Zhang, and 1 others. 2025. Glm-4.5: Agentic, reasoning, and coding (arc) foundation models. arXiv preprint arXiv:2508.06471.
Haozhen Zhang, Tao Feng, and Jiaxuan You. 2025a. Router-r1: Teaching llms multi-round routing and aggregation via reinforcement learning. In The Thirty-ninth Annual Conference on Neural Information Processing Systems.
Kaiyan Zhang, Sihang Zeng, Ermo Hua, Ning Ding, Zhang-Ren Chen, Zhiyuan Ma, Haoxin Li, Ganqu Cui, Biqing Qi, Xuekai Zhu, and 1 others. 2024. Ultramedical: Building specialized generalists in biomedicine. Advances in Neural Information Processing Systems, 37:26045–26081.
Yi-Kai Zhang, De-Chuan Zhan, and Han-Jia Ye. 2025b. Capability instruction tuning: A new paradigm for dynamic llm routing. arXiv preprint arXiv:2502.17282.
Yiqun Zhang, Hao Li, Jianhao Chen, Hangfan Zhang, Peng Ye, Lei Bai, and Shuyue Hu. 2025c. Beyond gpt-5: Making llms cheaper and better via performance-efficiency optimized routing. arXiv preprint arXiv:2508.12631.
Yiqun Zhang, Hao Li, Chenxu Wang, Linyao Chen, Qiaosheng Zhang, Peng Ye, Shi Feng, Daling Wang, Zhen Wang, Xinrun Wang, and 1 others. 2025d. The avengers: A simple recipe for uniting smaller language models to challenge proprietary giants. arXiv preprint arXiv:2505.19797.
Richard Zhuang, Tianhao Wu, Zhaojin Wen, Andrew Li, Jiantao Jiao, and Kannan Ramchandran. 2024. Embedllm: Learning compact representations of large language models. arXiv preprint arXiv:2410.02223.
附錄 A 延伸相關工作
路由基準 (Routing Benchmark)。 近期工作已提出數個用於評估 LLM 路由的基準。RouterBench(Hu et al., 2024)鎖定多 LLM 路由,但侷限於早期世代的模型與八個相對簡單的資料集。EmbedLLM(Zhuang et al., 2024)、RouterEval(Huang et al., 2025b)與 FusionFactory(Feng et al., 2025b)在開源模型上對路由進行基準測試,其中 EmbedLLM 與 RouterEval 並未提供推論成本資訊。RouterArena 把路由系統視為黑盒,並建構一個用於比較路由系統的資料集;然而,它在不同路由器之間使用不同的模型池,破壞了跨方法的可比較性,且不提供逐 prompt、逐模型的資料。如表 1 與附錄表 3 所總結,既有基準狹隘地聚焦於少數相對簡單的任務、缺乏對「具真實推論成本之旗艦模型」的涵蓋、且不提供用於公平跨方法比較的統一介面。這些缺口促成了 LLMRouterBench——一個橫跨多樣且具挑戰性任務、在真實成本下聯合評估輕量與旗艦模型、並提供即插即用比較介面的大規模路由基準。
附錄 B 實作細節
B.1 資料收集 (Data Collection)
所有約 7B 的開源模型都部署在 NVIDIA A800-80G GPU 上,使用 vLLM 0.8.4 進行高效的批次推論。旗艦模型的輸出透過 OpenRouter 收集,但 GLM-4.6 與 Intern-S1 例外,它們透過官方 API 存取。所有模型生成都使用 temperature 0.2 與 top_p 1.0,其餘解碼參數設為其預設值。每個 API 請求在失敗時最多重試 10 次;超過此上限的請求標記為失敗並給予 0 分。
B.2 實驗設定 (Experimental Setup)
為確保跨基線的公平且一致的比較,我們把實驗設定標準化如下:(i) 所有實驗以 70% 訓練、30% 測試切分進行,並以五個不同隨機種子(42、999、2024、2025、3407)重複五次。(ii) 依賴嵌入的方法一律使用 gte-qwen2-7B-instruct(Li et al., 2023)嵌入。(iii) 對於二元路由器(RouteLLM、HybridLLM、FrugalGPT),我們在 Qwen3-235B 與 GPT-5 之間路由,因為 GPT-5 是我們池中最強的模型,而 Qwen3-235B 以低得多的成本提供具競爭力的準確度。本文使用的所有資料集與模型都公開可用且妥善引用。我們的使用符合其原始授權與預期研究目的。
B.3 基線 (Baselines)
RouterDC。 我們採用 RouterDC(Chen et al., 2024b)的官方實作,把原始編碼器替換為 gte-qwen2-7B-instruct,以在統一嵌入骨幹下進行公平比較。訓練使用 DeepSpeed 在八張 NVIDIA A800-80G GPU 上以分散式多 GPU 平行進行,每裝置批次大小 (batch size) 為 8。其餘超參數與原始配置一致。最終模型約含 7B 可訓練參數。
MODEL-SAT。 由於官方實作(Zhang et al., 2025b)尚未完整釋出,我們重新實作了 MODEL-SAT 的核心元件。我們使用 gte-qwen2-7B-instruct 作為嵌入模型、Qwen2.5-7B-Instruct 作為語言模型,透過一個兩層 MLP 投影器 (projector) 連接。訓練使用 DeepSpeed 在八張 NVIDIA A800-80G GPU 上以資料平行進行,每裝置批次大小 4。嵌入與語言模型的學習率設為 1e-6,投影器設為 1e-5。我們先只微調投影器約 1,000 步,然後聯合微調所有元件。全程使用 0.1 的 warmup 比例。最終模型約含 14B 可訓練參數。
EmbedLLM。 我們使用 EmbedLLM(Zhuang et al., 2024)的官方實作,以 gte-qwen2-7B-instruct 生成的查詢嵌入確保跨方法一致性。輸入層維度相應調整。訓練使用增大的批次大小 32,768 以提升穩定性,其餘超參數遵循原始設定。模型約含 12M 可訓練參數。
HybridLLM。 我們採用 HybridLLM(Ding et al., 2024)的官方實作,把原始編碼器替換為 gte-qwen2-7B-instruct 以與其他基線一致。訓練使用 DeepSpeed 在八張 NVIDIA A800-80G GPU 上以分散式多 GPU 設定進行,每裝置批次大小 8。其餘超參數遵循原始配置。全程使用 GPT-5 作為強模型、Qwen3-235B 作為弱模型。
RouteLLM。 我們採用 RouteLLM(Ong et al., 2024)的官方實作,使用矩陣分解 (Matrix Factorization, MF) 路由器,並用 gte-qwen2-7B-instruct 生成查詢嵌入。全程使用 GPT-5 作為強模型、Qwen3-235B 作為弱模型。依照官方程式碼的預設設定,我們把勝率門檻 (win-rate threshold) 設為 0.5——亦即,當估計勝率超過此門檻時選用強模型,否則使用弱模型。在我們的配置下(dim=128,由 3584 維的 gte-qwen2-7B-instruct 嵌入投影而來),MF 路由器本身極其輕量,只有約 $4.6\times10^5$ 個可訓練參數,並訓練 100 個 epoch,使得路由開銷相對於查詢底層 LLM 可忽略不計。
FrugalGPT。 我們遵循 FrugalGPT 的官方訓練流程,微調一個衍生自 gte-Qwen2-7B-Instruct 的、基於嵌入的評分器 (scorer)。訓練使用 AdamW 搭配線性 warmup 排程進行兩個 epoch。我們把學習率設為 $3\times10^{-5}$,套用 0.01 的權重衰減 (weight decay),固定 warmup 比例為 0.03,每裝置批次大小 4。對於路由,我們採用 FrugalGPT 的級聯策略。模型依其在訓練集上的平均成本排序,級聯評估以預設門檻 0.5 啟用。模型特定的決策門檻自動學習,且級聯深度上限為每查詢 2 個模型,以平衡成本與效能。全程使用 GPT-5 作為強模型、Qwen3-235B 作為弱模型。
GraphRouter。 我們使用 GraphRouter(Feng et al., 2025a)的官方實作。所有查詢、任務與模型描述嵌入皆以 gte-qwen2-7B-instruct 生成,輸入層維度相應調整。為緩解「平手預測」造成的標籤偏差,我們把基於 argmax 的 one-hot 標籤替換為「包含每查詢所有平手最佳模型」的 multi-hot 監督。為提升訓練穩定性,我們把訓練 epoch 數增加到 10,000。模型約含 0.1M 可訓練參數。我們遵循原始論文採用其三個配置:Performance First (PF)、Balance (BL) 與 Cost First (CF)。
Avengers(-Pro)。 我們採用 Zhang et al. (2025c) 提出之基於聚類方法的官方實作。查詢嵌入以 gte-qwen2-7B-instruct 生成,並套用 $k$-means 聚類,$k=64$。此方法不涉及神經網路訓練。對於 Avengers-Pro,依照原始論文,我們把效能係數(亦即 $1-$ 成本係數)從 0 到 1 以 0.01 為增量變化,產生 101 個配置。
OpenRouter。 我們使用 OpenRouter 提供的官方 API,採用 openroute/auto 模型,這是目前可用的一個先進商用 LLM 路由器。所有模型生成使用 temperature 0.2 與 top_p 1.0,其餘解碼參數設為預設值。每個 API 請求在失敗時最多重試 10 次;超過此上限的請求標記為失敗並給予 0 分。OpenRouter 支援的詳細模型池總結於表 14。注意 GPT-5 與 Gemini-2.5-pro(LLMRouterBench 中使用的最強模型)都包含在內,且 OpenRouter 的模型池甚至更大。因此我們把 OpenRouter 視為一個具代表性的商用路由器基線。
附錄表格
表 1:與既有路由基準的比較。†RouterArena 把路由系統視為黑盒,只回報整體效能而無逐 prompt、逐模型細節,因此無法直接支援開發新的路由演算法。‡每個路由系統使用不同的模型。
| 基準 | 以效能為導向 | 效能-成本 | 資料集數 | 專有模型 | 統一模型池 | 路由基線數 | 資料釋出 |
|---|---|---|---|---|---|---|---|
| RouterBench | ✗ | ✓ | 8 | GPT-4&3.5, Claude v1&2 | ✓ | 3 | ✓ |
| EmbedLLM | ✓ | ✗ | 10 | ✗ | ✓ | 1 | ✓ |
| RouterEval | ✓ | ✗ | 12 | ✗ | ✓ | 4 | ✓ |
| FusionFactory | ✗ | ✓ | 14 | ✗ | ✓ | 5 | ✓ |
| RouterArena | ✗ | ✓ | 23† | ✓‡ | ✗ | ✗ | ✗ |
| LLMRouterBench | ✓ | ✓ | 21 | GPT-5, GPT-5-Chat, Claude 4, Gemini 2.5 Pro... | ✓ | 10 | ✓ |
表 3:各基準在其官方程式碼庫中提供的路由基線。
| 基準 | 路由基線 |
|---|---|
| RouterBench | KnnRouter, MLPRouter, SvmRouter |
| EmbedLLM | EmbedLLM |
| RouterEval | KnnRouter, MLPRouter, Multi-class classification, RoBERTa-Kmeans Router |
| FusionFactory | KnnRouter, BertRouter, MLPRouter, SvmRouter, GraphRouter |
| RouterArena | ✗ |
| LLMRouterBench | RouterDC, EmbedLLM, Model-SAT, Avengers, HybridLLM, FrugalGPT, RouteLLM, GraphRouter, Avengers-Pro, OpenRouter |
表 7:以效能為導向設定的模型池:約 7B 參數的開源模型。
| 模型 | 縮寫 | 參數量 |
|---|---|---|
| DeepHermes-3-Llama-3-8B-Preview | DH-Llama3-it | 8B |
| DeepSeek-R1-0528-Qwen3-8B | DS-Qwen3 | 8B |
| DeepSeek-R1-Distill-Qwen-7B | DS-Qwen | 7B |
| Fin-R1 | Fin-R1 | 7B |
| GLM-Z1-9B-0414 | GLM-Z1 | 9B |
| Intern-S1-mini | Intern-S1-mini | 8B |
| Llama-3.1-8B-Instruct | Llama-3.1-it | 8B |
| Llama-3.1-8B-UltraMedical | UltraMedical | 8B |
| Llama-3.1-Nemotron-Nano-8B-v1 | Llama-Nemo | 8B |
| MiMo-7B-RL-0530 | MiMo-RL | 7B |
| MiniCPM4.1-8B | MiniCPM | 8B |
| NVIDIA-Nemotron-Nano-9B-v2 | NVIDIA-Nemo | 9B |
| OpenThinker3-7B | OpenThinker | 7B |
| Qwen2.5-Coder-7B-Instruct | Qwen-Coder | 7B |
| Qwen3-8B | Qwen3-8B | 8B |
| Cogito-v1-preview-llama-8B | Cogito-v1 | 8B |
| Gemma-2-9b-it | Gemma-2-it | 9B |
| Glm-4-9b-chat | Glm-4-chat | 9B |
| Granite-3.3-8b-instruct | Granite-3.3-it | 8B |
| Internlm3-8b-instruct | Internlm3-it | 8B |
表 8:效能-成本設定的模型池:旗艦模型。
| 模型 | 縮寫 | 輸入價格 | 輸出價格 |
|---|---|---|---|
| Claude-sonnet-4 | Claude-v4 | $3.00/1M | $15.00/1M |
| Gemini-2.5-flash | Gemini-Flash | $0.30/1M | $2.50/1M |
| Gemini-2.5-pro | Gemini-Pro | $1.25/1M | $10.00/1M |
| GPT-5-chat | GPT-5-Chat | $1.25/1M | $10.00/1M |
| GPT-5-medium | GPT-5 | $1.25/1M | $10.00/1M |
| Qwen3-235b-a22b-2507 | Qwen3-235B | $0.09/1M | $0.60/1M |
| Qwen3-235b-a22b-thinking-2507 | Qwen3-Thinking | $0.30/1M | $2.90/1M |
| Deepseek-v3-0324 | DeepSeek-V3 | $0.25/1M | $0.88/1M |
| Deepseek-v3.1-terminus | DS-V3.1-Tms | $0.27/1M | $1.00/1M |
| Deepseek-r1-0528 | DeepSeek-R1 | $0.50/1M | $2.15/1M |
| GLM-4.6 | GLM-4.6 | $0.60/1M | $2.20/1M |
| Kimi-k2-0905 | Kimi-K2 | $0.50/1M | $2.00/1M |
| Intern-s1 | Intern-S1 | $0.18/1M | $0.54/1M |
表 9:資料集詳細資訊(含縮寫)。「LLM as judge」†表示我們使用一個輔助 LLM 以官方 prompts 為模型輸出評分:對 HLE 與 SimpleQA 採用 o3-mini 作為評判模型,對 ArenaHard 採用 deepseek-v3-0324。
以效能為導向的資料集
| 資料集 | 縮寫 | 類別 | 指標 | 大小 |
|---|---|---|---|---|
| AIME | AIME | 數學 | Accuracy, 0-shot | 60 |
| MATH500 | M500. | 數學 | Accuracy, 0-shot | 500 |
| MathBench | MBen. | 數學 | Accuracy, 0-shot | 150 |
| MBPP | MBPP | 程式碼 | Pass@1, 0-shot | 974 |
| HumanEval | HE. | 程式碼 | Pass@1, 0-shot | 164 |
| LiveCodeBench | LCB. | 程式碼 | Pass@1, 0-shot | 1055 |
| KORBench | KOR. | 邏輯 | Accuracy, 3-shot | 1250 |
| Knights and Knaves | K&K. | 邏輯 | Accuracy, 0-shot | 700 |
| BBH | BBH | 邏輯 | Accuracy, 3-shot | 1080 |
| MMLU-Pro | MP. | 知識 | Accuracy, 0-shot | 1000 |
| GPQA | GPQA | 知識 | Accuracy, 0-shot | 198 |
| FinQA | FQA. | 知識 | Accuracy, 0-shot | 1147 |
| MedQA | MQA. | 知識 | Accuracy, 0-shot | 1273 |
| EmoryNLP | Emory. | 情感 | Accuracy, 0-shot | 697 |
| MELD | MELD | 情感 | Accuracy, 0-shot | 1232 |
| 總計 | 11,480 |
效能-成本資料集
| 資料集 | 縮寫 | 類別 | 指標 | 大小 |
|---|---|---|---|---|
| AIME | AIME | 數學 | Accuracy, 0-shot | 60 |
| LiveMathBench | LMB. | 數學 | Accuracy, 0-shot | 121 |
| LiveCodeBench | LCB. | 程式碼 | Pass@1, 0-shot | 1055 |
| SWE-Bench | SWE. | 程式碼 | Pass@1, 0-shot | 500 |
| GPQA | GPQA | 知識 | Accuracy, 0-shot | 198 |
| HLE | HLE | 知識 | LLM as judge†, 0-shot | 2158 |
| MMLU-Pro | MP. | 知識 | Accuracy, 0-shot | 3000 |
| SimpleQA | SQA. | 知識 | LLM as judge†, 0-shot | 4326 |
| ArenaHard | AHARD. | 指令遵循 (IF) | LLM as judge†, 0-shot | 750 |
| τ²-Bench | TAU2. | 工具使用 | Success Rate, 0-shot | 278 |
| 總計 | 12,446 |
表 10:GraphRouter、EmbedLLM 與 Avengers 在不同嵌入模型上的效能比較。
| 嵌入模型 | GraphRouter | EmbedLLM | Avengers |
|---|---|---|---|
| nli-bert-base | 69.60 | 70.55 | 70.43 |
| all-MiniLM-L6-v2 | 68.05 | 70.95 | 71.03 |
| gte-Qwen2-7B-instruct | 70.29 | 71.24 | 71.94 |
表 14:OpenRouter 上 openroute/auto 路由方法支援的模型池。可用模型可能隨時間變動;我們採用 2025 年 12 月 1 日的模型池。
| 供應商 | 模型 |
|---|---|
| OpenAI | gpt-5, gpt-5-mini, gpt-5-nano, gpt-4.1, gpt-4.1-mini, gpt-4.1-nano, gpt-4o-mini, chatgpt-4o-latest |
| Anthropic | claude-3.5-haiku, claude-opus-4-1, claude-sonnet-4-0, claude-3-7-sonnet-latest |
| gemini-2.5-pro, gemini-2.5-flash | |
| Mistral | mistral-large-latest, mistral-medium-latest, mistral-small-latest, mistral-nemo |
| X.AI | grok-3, grok-3-mini, grok-4 |
| DeepSeek | deepseek-r1 |
| Meta-Llama | llama-3.1-70b-instruct, llama-3.1-405b-instruct |
| MistralAI | mixtral-8x22b-instruct |
| Perplexity | sonar |
| Cohere | command-r-plus, command-r |
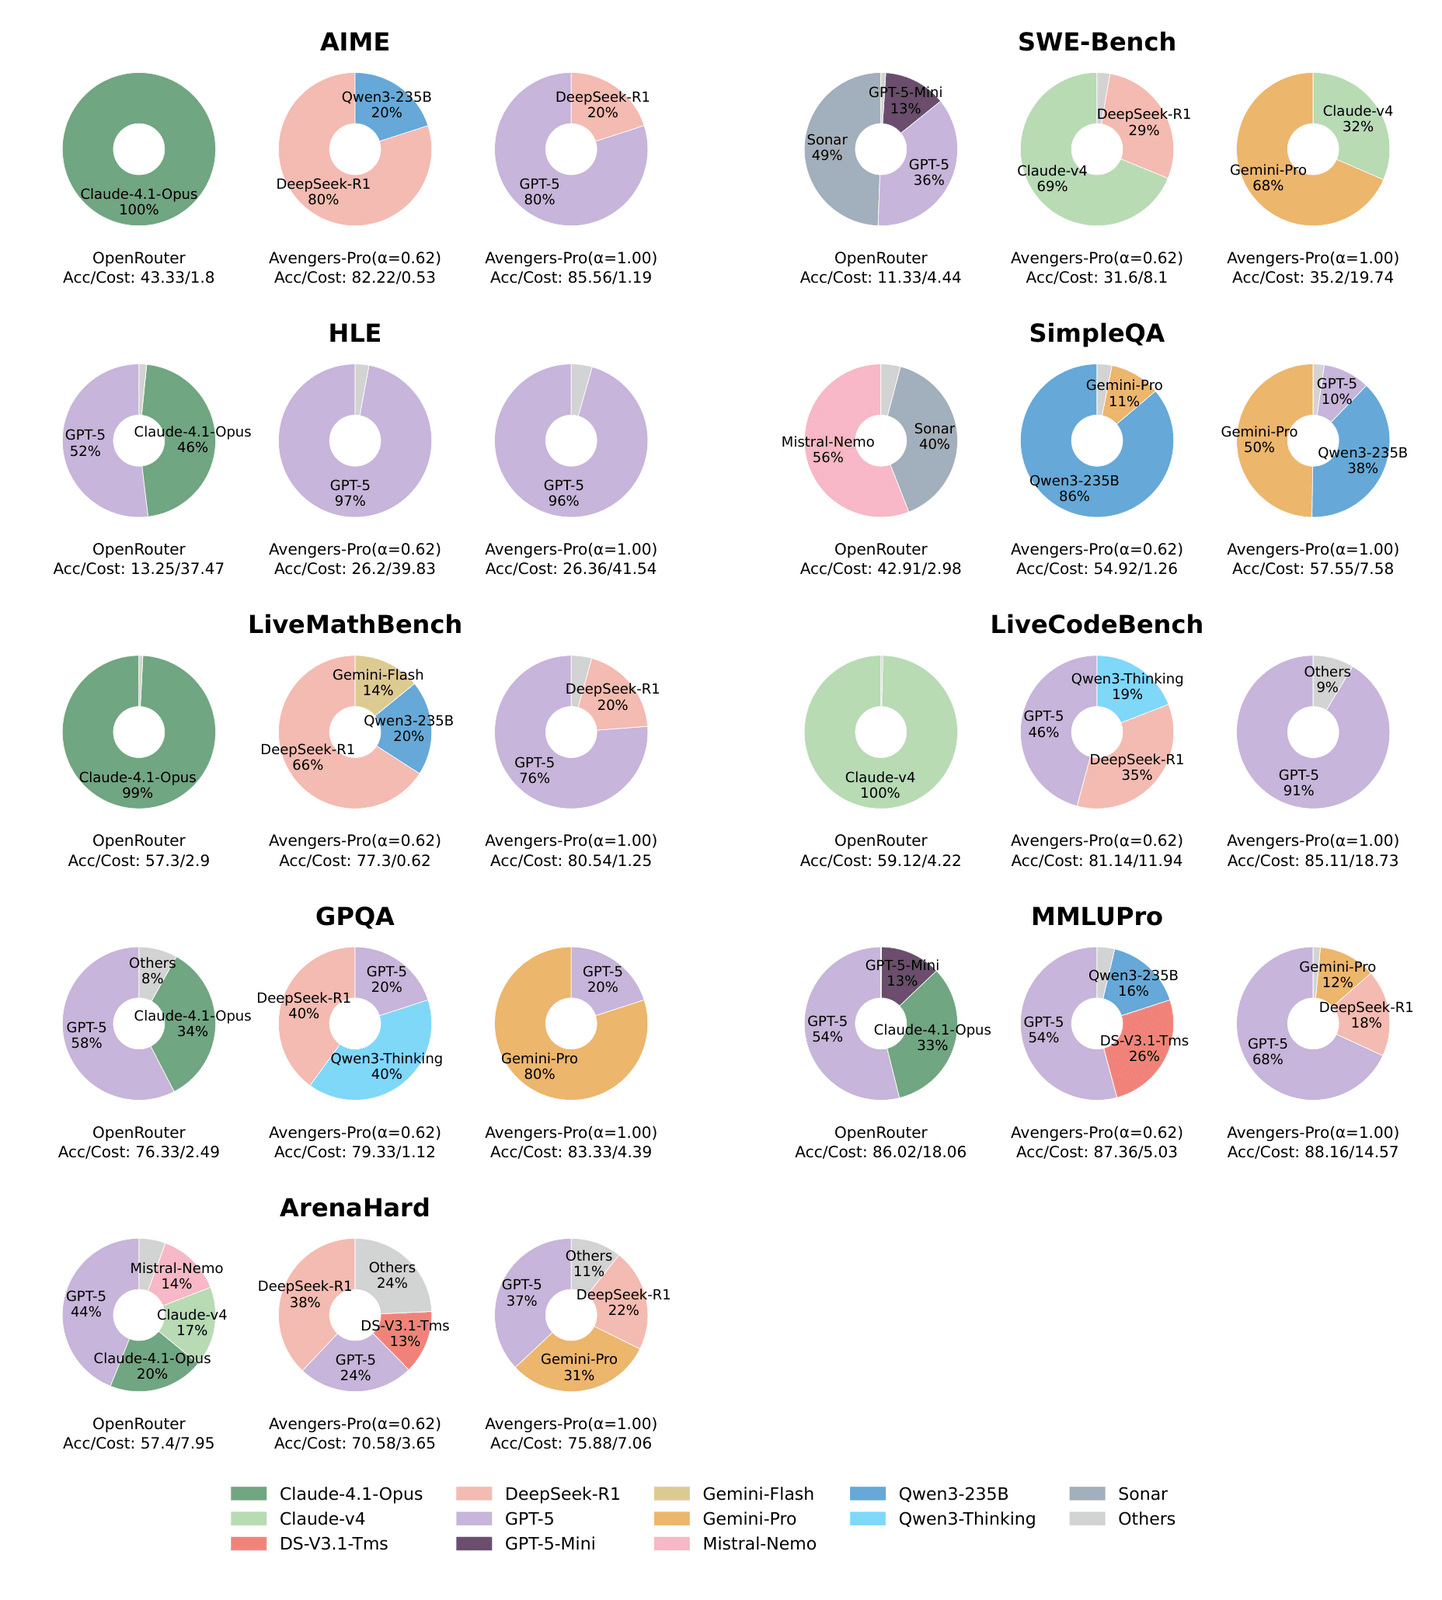
圖 10:OpenRouter 與 Avengers-Pro 的路由分佈;Avengers-Pro 顯示兩個配置(成本匹配:$\alpha=0.62$;最高準確度:$\alpha=1.00$)。被選用於少於 5% 查詢的模型歸入「Others」。
【譯註】原文附錄另含表 4、表 5、表 6(各模型在各資料集上的效能與成本明細)以及表 11、表 12、表 13(所有基礎模型與路由方法在各資料集上、以五個隨機種子取平均的逐資料集結果)。這些為大型數值矩陣,完整數據請參閱原始論文 PDF 第 15–20 頁。其核心結論已由本文圖 3、圖 4、圖 7、圖 8 及內文呈現。各表標題翻譯如下:
- 表 2 已於正文第 3.5 節呈現。
- 表 4:以效能為導向設定下,各模型在各資料集上的效能。深紅與淺紅標記分別表示最佳與次佳結果。
- 表 5:效能-成本設定下,各模型在各資料集上的效能。深紅與淺紅標記分別表示最佳與次佳結果。注意 GPT-5-Chat 在 τ²-Bench 上無分數,因為該模型不支援工具呼叫。
- 表 6:效能-成本權衡設定下,各模型跨資料集的推論成本比較(單位:$/1M tokens)。深紅與淺紅標記分別表示最低與次低成本。
- 表 11:以效能為導向設定下,所有基礎模型與路由方法在各資料集上的效能。所有結果以 30% 測試切分計算,並以實驗中使用的五個隨機種子取平均。
- 表 12:效能-成本權衡設定下,所有基礎模型與路由方法在各資料集上的效能(同樣以 30% 測試切分、五種子取平均)。GraphRouter 報告 PF/BL/CF 三個配置;Avengers-Pro 報告以 0.05 為增量變化效能係數所得的 21 個配置。
- 表 13:效能-成本設定下,所有基礎模型與路由方法跨資料集的推論成本比較(單位:$/1M tokens)。
術語對照表
| English | 繁體中文 |
|---|---|
| LLM Routing | LLM 路由 |
| Benchmark | 基準 |
| Unified Framework | 統一框架 |
| Ensemble | 集成 |
| Model Pool | 模型池 |
| Query | 查詢 |
| Instance | 實例 |
| Model Complementarity | 模型互補性 |
| Model Curation | 模型篩選 |
| Model-recall Failure | 模型召回失敗 |
| Performance-oriented | 以效能為導向 |
| Performance-Cost Tradeoff | 效能-成本權衡 |
| Baseline | 基線 |
| Flagship Model | 旗艦模型 |
| Proprietary Model | 專有模型 |
| Embedding Model | 嵌入模型 |
| Open-source Infrastructure | 開源基礎設施 |
| Pairwise Ranking | 成對排序 |
| Dual Contrastive Learning | 雙重對比學習 |
| Clustering-based | 基於聚類的 |
| Aggregation | 聚合 |
| Cascaded Inference | 級聯推論 |
| Preference Data | 偏好資料 |
| Heterogeneous Graph | 異質圖 |
| Edge Prediction | 邊預測 |
| Average Accuracy (AvgAcc) | 平均準確度 |
| Random Router | 隨機路由器 |
| Best Single | 最佳單一模型 |
| Oracle | Oracle(最佳路由上限) |
| Pareto Analysis | 帕累托分析 |
| Pareto Frontier | 帕累托前沿 |
| Pareto-dominate | 帕累托支配 |
| Diminishing Returns | 邊際遞減 |
| Distribution Shift | 分佈偏移 |
| Latency-aware | 延遲感知 |
| Time-to-first-token | 首 token 時間 |
| Tokens-per-second | 每秒 token 數 |
| Ablation Study | 消融研究 |
| Matrix Factorization | 矩陣分解 |
| Projector | 投影器 |
| Win-rate Threshold | 勝率門檻 |
| Batch Size | 批次大小 |
| Weight Decay | 權重衰減 |
| Coverage | 覆蓋率 |
| Diversity | 多樣性 |