大型語言模型代理人的工具創建與工具使用聯合最佳化
原始論文:Joint Optimization of Tool Creation and Use for Large Language Model Agents 作者:Zhi Rui Tam、Chieh-Yen Lin、Yun-Nung Chen、Shao-Hua Sun、Hung-yi Lee 機構:Appier AI Research、National Taiwan University arXiv ID:2608.24571v1 日期:2026 年 8 月 25 日 標籤:LLM Agent Tool Use RLVR DAPO Reward Design 工具創建
程式碼:github.com/appier-research/smith 專案頁:tool-use-smith.github.io
【譯註】本文出自台灣團隊(Appier AI Research 與台大)。文中的 schema 一律保留英文不譯——它指的是 OpenAI function calling 格式裡描述函式名稱、參數與型別的那份 JSON 結構描述,是本文的核心概念,中文譯名反而容易失焦。build task 與 use task 譯為「建構任務」與「使用任務」。
目錄
- 摘要
- 1 引言
- 2 SMITH 基於 schema 的多任務迭代式工具打磨
- 3 實驗
- 4 限制與討論
- 5 結論
- 致謝
- 附錄 A 相關研究
- 附錄 B 設計驗證器獎勵與 LLM-as-Judge 的經驗教訓
- 附錄 C LLM-as-Judge 提示詞 v5.0
- 附錄 D 建構與使用任務的提示詞範本
- 附錄 E 工具池設計
- 附錄 F 13 個訓練任務的完整難度切分
- 附錄 G TabMWP-Hard 與 GQA 的分布外推論協定
- 附錄 H GQA 視覺工具設定
- 附錄 I ReTool 評測設定
- 附錄 J LATM 蒸餾 GPT-4.1 基準設定
- 附錄 K Agentic loop 比較 KTCE CRAFT TroVE 與 SMITH
- 附錄 L 基準方法的失效分析
- 附錄 M TabMWP-Hard 資料集建構與增強
- 附錄 N 計算資源與訓練成本
- 附錄 O TroVE 基準 一個受控的提示詞調校消融
- 參考文獻
- 術語對照表
摘要
工具增強的語言模型,其能力上限被「人類願意動手寫出來的那些 API」所侷限;現有的工具創建 (Tool Creation) 系統只是打了個補丁——在推論時去提示一個凍結的 LLM,於是「寫工具的模型」和「用工具的模型」彼此脫鉤,沒有任何訊號告訴前者:它產出的 schema 是不是它自己叫得動的 schema。我們提出 SMITH (Schema-grounded Multi-task Iterative Tool Honing,基於 schema 的多任務迭代式工具打磨),一個把工具創建與工具使用放進單一策略裡聯合訓練的強化學習框架。每一次 rollout 不是建構任務(從幾個範例寫出一個工具),就是使用任務(用工具池裡的工具去回答一個保留問題)。三條獨立的獎勵軸分別捕捉 schema、程式碼與結果三種失敗,因此每一種失敗模式都貢獻自己的梯度。用 SMITH 在 13 個具備精確驗證器的程序性推理任務上訓練出的 4B Qwen3,在保留任務上達到 79.8 的巨觀平均準確率,是所有受評方法中最好的,也勝過一個未經訓練的 30B-A3B 工具撰寫者。它在 TabMWP-Hard 上達到 40.4、在領域外的 GQA 上達到 42.6(比同骨幹模型下最好的推論時基準高出 7.6),而且完全沒有用到任何視覺或表格訓練資料。我們 4B 模型所寫出的工具,也拉高了 LFM-2.5-350M 與 Qwen3-30B-A3B 在相同推理任務上的表現。
1 引言
人類的進步仰賴累積下來的工具。人們不會每個問題都從第一原理重新解一遍,而是依靠世代打磨出來的器具 [11, 4]。大型語言模型 (LLM) 面臨類似的侷限:只依賴參數化記憶,會限制它們執行精確計算 [5]、取得最新知識 [3]、以及進行可靠符號推理 [9] 的能力。工具增強的 LLM 正是為了突破這些限制而被提出 [12, 27, 26]。透過呼叫計算機、程式碼直譯器、搜尋引擎等外部介面,模型能解決超出其凍結權重所編碼範圍的問題。
然而,現有的工具增強系統仍舊依賴固定的、人工設計的工具集。這些預先定義的 API 可能不完整、與新任務搭配不良,或根本不存在,對模型能力形成硬上限。這促成了一個轉向:從靜態的工具使用,走向動態的工具創建——讓模型按需合成可重複使用的可呼叫函式。LATM [2] 最早探索這個方向,用提示讓 GPT-4 從示範中生成 JSON schema 工具,後續工作則加入了檢索、驗證與多階段生成流水線 [35, 31, 17]。儘管有這些進展,既有方法並未在 LLM 訓練期間明確地為工具品質或可重用性做最佳化。更重要的是,它們把工具創建與工具使用分開了:由一個較強的模型寫工具,再由一個較弱的模型去呼叫 [2, 35]。結果就是,工具的創建者從來沒有被激勵去設計「它自己也能可靠使用」的 schema。因此,一個關鍵的開放問題是:如何訓練單一模型,讓它同時成為更好的工具創建者與更好的工具使用者。
強化學習為這個目標提供了一個自然的框架 [1, 23, 34]:模型可以創建一個工具、把它套用到保留查詢上,然後直接針對答案正確性做最佳化。然而,在這個範式下訓練會引入兩個主要挑戰。第一是獎勵分解 (Reward Decomposition):一個生成的工具同時包含 schema(例如函式名稱、參數與型別)與後端實作(例如可執行的 Python 程式碼)。這兩個元件的失敗需要不同的修正訊號,使得獎勵指派變得不平凡。第二是循環評估 (Circular Evaluation):評估工具品質需要一個 judge,但自我評估本質上不可靠 [19],而固定的外部評估器又會引發可信度與對齊的疑慮 [36]。此外,一個稱職的評估器本身必須夠懂工具使用,才能判斷一個 schema 在實務上是否叫得動、是否能在更難的下游查詢上重複使用。
為了解決這些挑戰,我們提出 SMITH(基於 schema 的多任務迭代式工具打磨),一個在單一策略內聯合訓練工具創建與工具使用的強化學習框架。SMITH 用三種互補的獎勵訊號把 schema 失敗與實作失敗拆開:執行準確率、LLM-as-judge 品質分數,以及格式一致性。為了減輕循環評估,judge 並不共用即時的訓練權重,而是週期性地從演進中的策略同步過來,讓評估器能與策略一同進步,同時維持穩定性。最後,SMITH 用更難的下游查詢去評估那些在較簡單任務上創建出來的工具,明確獎勵可重用的抽象,而不是針對特定任務的捷徑。
我們在 Reasoning-Gym [25] 的 13 個程序性任務家族上訓練 SMITH,並同時評估領域內泛化與對未見基準的零樣本轉移。我們的 4B 模型取得了整體最佳的保留 Reasoning-Gym 表現($79.8\%$ 巨觀準確率),勝過 LATM [2]、CRAFT [35]、Trove [31]、KTCE [17] 等推論時工具撰寫框架,也勝過那些從大得多的 oracle 蒸餾而來的模型。在使用遠少的解碼 token 的同時,SMITH 在未見任務上也超越了一個 30B 的推論時工具撰寫者。在程序性推理之外,SMITH 能零樣本轉移到全新的模態:它在 TabMWP-Hard 上達到最先進的表現,在 GQA 視覺問答上比同骨幹基準最多高出 $+7.6$ 分,儘管它從未在表格或視覺資料上訓練過。學到的工具還能跨模型泛化:由我們 4B 策略寫出的工具,讓一個凍結的 350M 模型達到與 30B 工具撰寫者相當的水準。最後,同一套訓練配方在 Qwen3-8B 與 Granite-3.3-8B 上都能穩定帶來改善,顯示在結構化獎勵下聯合最佳化工具創建與工具使用,是通往可重用、可轉移的工具打造能力的一條可擴展路徑。
2 SMITH 基於 schema 的多任務迭代式工具打磨
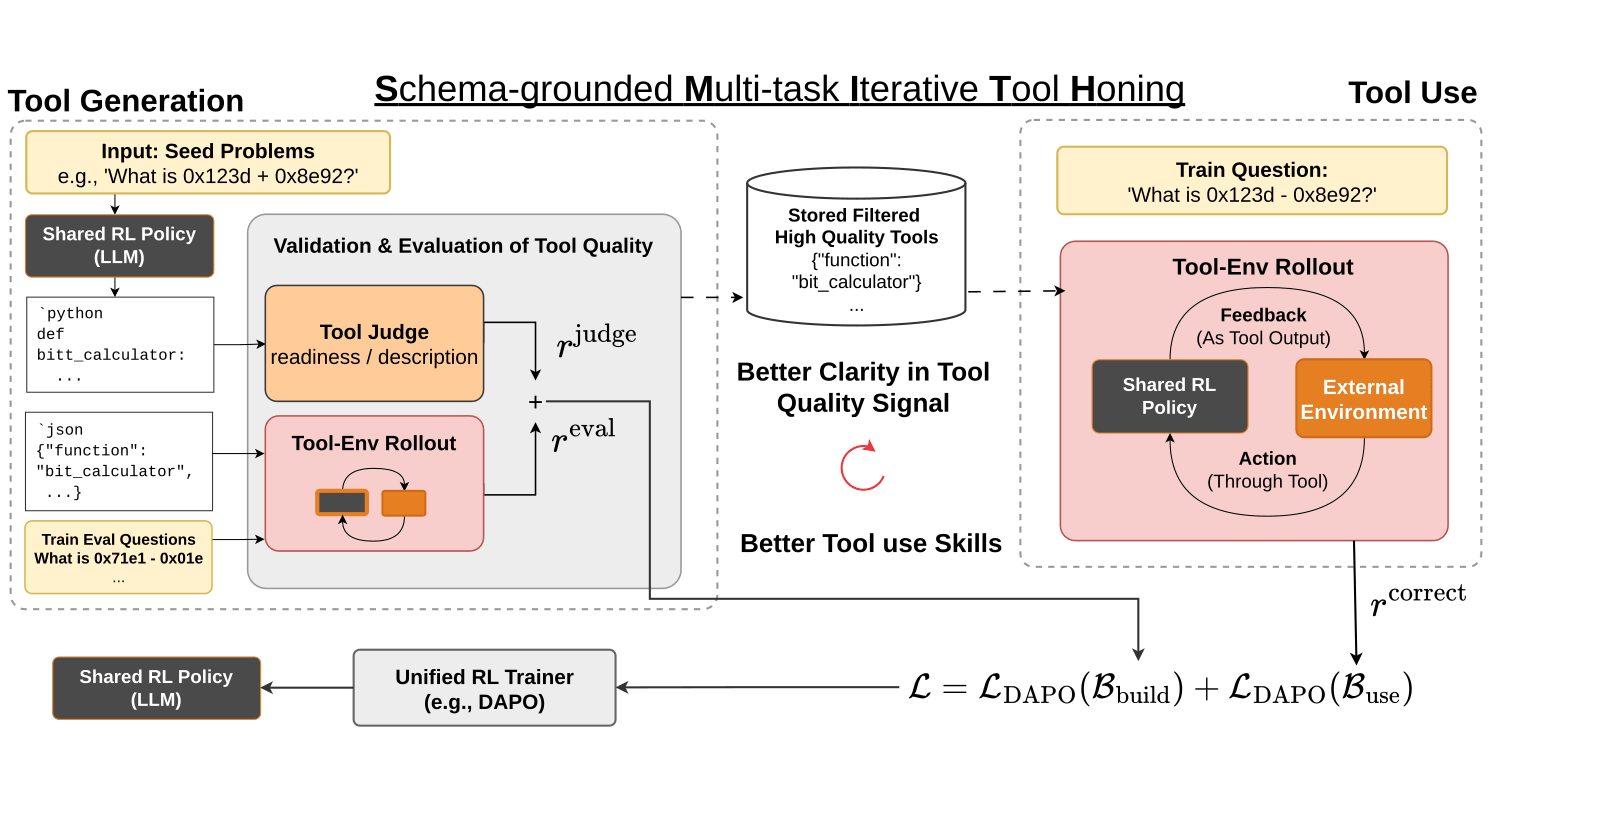
圖 1:SMITH 在單一共享策略中聯合訓練工具創建與工具使用。建構任務獎勵 schema 正確性與執行準確率;使用任務則只憑 schema 來獎勵答案正確性。因為寫工具的是同一個模型、叫用工具的也是同一個模型,模稜兩可或壞掉的 schema 會被直接懲罰——這是只靠提示的做法無法提供的回饋迴路。
SMITH 是一個多任務 RL 框架,聯合訓練兩種互補的技能:工具創建(建構)與工具使用。在建構任務中,模型合成一個可重用的工具,同時以 Python 函式與 OpenAI 相容的 JSON schema 兩種形式表達——後者是一份描述函式名稱、參數與型別的結構化說明,透過標準呼叫介面把工具暴露出來。在使用任務中,模型只看得到這份精簡的 JSON schema(看不到底層程式碼),必須呼叫該工具來回答一個保留問題。這種以 schema 為基礎的設計,迫使模型產出簡潔、自我完備的介面:一個 schema 若模稜兩可或不完整,在使用時就會失敗,直接為 schema 品質提供訓練訊號。
我們使用 DAPO [34] 訓練這個共享策略,它是 GRPO [23] 的 clip-higher 變體,能在 on-policy rollout 期間穩定熵值並避免獎勵崩潰。每個訓練步驟取樣一批提示 $\mathcal{B}$,切成相等的兩半,$|\mathcal{B}_{\mathrm{build}}|=|\mathcal{B}_{\mathrm{use}}|=B/2$。讓兩條獎勵流在結構上保持分離、卻訓練同一個策略,能使兩種技能互相強化。
任務形式化
對每一個工具生成的訓練實例,策略會收到 $N{=}4$ 組問答對 $\{(q_{i},a_{i})\}_{i=1}^{N}$ 作為問題歸納 (Problem Induction) 的脈絡:模型必須推斷出一個通用的解題策略,並把它同時表達為 Python 函式 $\mathcal{C}$ 與 OpenAI 相容的 JSON schema $\mathcal{S}$。接著會用一組互斥的 $K{=}16$ 個保留問題 $\mathcal{T}=\{(q_{j},a_{j})\}_{j=1}^{K}$ 來評估生成的工具,而模型在生成時從未看過這些標準答案。至於使用任務,模型改為收到單一個目標問題,必須從工具池中呼叫一個工具(若該類別已有工具),或先從同樣的 $N$ 個脈絡範例建構一個再呼叫。
2.1 建構任務的獎勵
評估獎勵
生成的工具 $(\mathcal{C},\mathcal{S})$ 會被拿去對隱藏測試集 $\mathcal{T}$ 做評估。每個問題 $q_{j}$ 會呈現給一個評估器模型 $\pi^{\mathrm{eval}}$,它可以呼叫這個生成的工具;一個答案要算正確,必須同時滿足「工具成功被呼叫」與「輸出經 LLM 等價性 judge 驗證通過」。$\pi^{\mathrm{eval}}$ 由與策略相同的基礎檢查點初始化,並週期性地複製最新的策略權重來更新,提供一個穩定但持續進步的評估目標,同時避開直接拿即時訓練權重去評估的不穩定性。評估獎勵是測試問題答對的比例:
$$r^{\mathrm{eval}}=\frac{1}{|\mathcal{T}|}\sum_{j=1}^{|\mathcal{T}|}\mathbf{1}\!\left[\pi^{\mathrm{eval}}\!\left(q_{j}\mid\mathcal{C},\mathcal{S}\right)\approx a_{j}\right]. \tag{1}$$
只計算「經由成功工具呼叫而得到的答案」,可以防止策略鑽漏洞——退回純文字推理來作答會完全繞過寫工具這個目標。
格式獎勵
當回應恰好包含一個 Python 區塊與一個 JSON 區塊,且兩者的函式名稱與參數簽名彼此一致時,我們給予格式獎勵 $r^{\mathrm{fmt}}\in\{0,r_{f}\}$($r_{f}=0.5$)。若生成的回應無法被解析成一組合法的 $(\mathcal{C},\mathcal{S})$(例如缺了程式碼或 schema),該 rollout 會提早終止,所有獎勵軸歸零;但單單 $r^{\mathrm{fmt}}=0$ 並不會終止 rollout。建構任務的環境獎勵把格式與評估兩個訊號合在一起:
$$r^{\mathrm{env}}_{\mathrm{build}}=r^{\mathrm{fmt}}+r^{\mathrm{eval}}. \tag{2}$$
Judge 獎勵
另外有一個 LLM judge $\pi^{\mathrm{judge}}$ 從三個面向為生成的工具評分:程式碼正確性 $s_{\mathrm{code}}$、schema 品質 $s_{\mathrm{schema}}$,以及整體品質分數 $s_{\mathrm{overall}}\in[0,1]$。評分後會再做一次 schema–程式碼對齊檢查:若 $\mathcal{C}$ 與 $\mathcal{S}$ 的函式簽名不一致,分數砍半;若 $\mathcal{C}$ 有語法錯誤,則給一個固定的負獎勵來懲罰壞掉的程式碼:
$$r^{\mathrm{judge}}=\begin{cases}-0.5&\text{若 }\mathcal{C}\text{ 含語法錯誤,}\\ 0.5\cdot s_{\mathrm{overall}}&\text{若 schema 與程式碼簽名不一致,}\\ s_{\mathrm{overall}}&\text{其他情況.}\end{cases} \tag{3}$$
關鍵在於,$r^{\mathrm{judge}}$ 不會被折進 $r^{\mathrm{env}}_{\mathrm{build}}$;它是以自己的係數作為一條獨立的獎勵軸傳給 DAPO,讓執行訊號與語意品質訊號保持解耦。因此建構任務為 DAPO 貢獻兩條獨立的獎勵軸:
$$\bigl(\,r^{\mathrm{env}}_{\mathrm{build}}=r^{\mathrm{fmt}}+r^{\mathrm{eval}},\hskip 10pt r^{\mathrm{judge}}\,\bigr), \tag{4}$$
這使得格式一致性、執行準確率與 judge 品質成為主導建構任務學習的三個獎勵訊號,再加上來自使用任務的單一條正確性軸。任何 $r^{\mathrm{eval}}>0$ 的工具都會被加入共享的工具池 $\mathcal{P}$,供後續的使用任務 rollout 重複取用(見 2.2 節)。
2.2 使用任務的獎勵
在使用任務中,模型會與工具進行最多 $T{=}5$ 輪的多輪對話,當模型產出最終答案或無法發出合法工具呼叫時提早結束。
正確性獎勵
令 $c\in\{0,1\}$ 表示最終答案是否與標準答案 $a^{*}$ 相符,先以字串正規化驗證,並以 LLM 等價性 judge 作為後備。為了懲罰把輪數預算耗盡的行為,正確性分數會乘上一個效率乘數 $\eta(\rho)$,它隨輪次比例 $\rho=\min(n/T,1)$ 增加而衰減。我們定義一個最低獎勵下限 $\eta_{\min}$,確保即使到了輪數上限,策略也絕不會對正確性完全無感:
$$r^{\mathrm{correct}}=2\,c\cdot\eta(\rho),\hskip 20pt \eta(\rho)=\begin{cases}1-2(1-\eta_{\text{mid}})\rho&\rho\leq 0.5,\\ \max\!\bigl(\eta_{\min},\;\eta_{\text{mid}}\,(1-2(\rho-0.5))^{2}\bigr)&\rho>0.5.\end{cases} \tag{5}$$
這個分段形式在 $\rho=0.5$ 處依構造是連續的:兩個分支在邊界都等於 $\eta_{\text{mid}}$。我們設定 $\eta_{\min}=0.3$、$\eta_{\text{mid}}=0.7$;在這組數值下,下限會在 $\rho\approx 0.83$(第 5 輪之後)啟動。這些值是根據小規模的前導實驗選定,並在所有實驗中固定不變。因此使用任務為 DAPO 貢獻單一條獎勵軸:式 5 定義的、經效率加權的最終答案正確性 $r^{\mathrm{correct}}$;工具執行是否成功則是隱含的,因為正確性本身就要求一次合法的工具呼叫。加上建構任務的兩條軸(式 4),總共構成三條獨立的獎勵軸供聯合策略最佳化。
聯合策略更新
每個訓練批次是一個不交聯集 $\mathcal{B}=\mathcal{B}_{\mathrm{build}}\sqcup\mathcal{B}_{\mathrm{use}}$,其中 $|\mathcal{B}_{\mathrm{build}}|=|\mathcal{B}_{\mathrm{use}}|=B/2$,$B$ 是每次迭代的批次大小。這讓兩種任務的梯度貢獻維持平衡。DAPO 在每個生成群組內獨立計算 per-prompt 優勢值,並在單一次反向傳遞中累積兩種任務型別的梯度:
$$\mathcal{L}=\mathcal{L}_{\mathrm{DAPO}}(\mathcal{B}_{\mathrm{build}})+\mathcal{L}_{\mathrm{DAPO}}(\mathcal{B}_{\mathrm{use}}). \tag{6}$$
由於兩個損失共用同一組策略參數 $\theta$,來自建構與使用提示的梯度會在每一步共同更新模型,不需要跨任務型別做任何顯式的優勢值合併。
3 實驗
3.1 訓練任務
我們在 Reasoning-Gym (RG) [25] 的 13 個任務類別上訓練,挑選標準有三:答案是精確且可自動驗證的(讓獎勵計算不需要人工標註)、每個任務都有難度梯度可用(讓 3.4 節的由易到難協定得以成立),以及問題可以程序化生成。這些類別涵蓋算術(bitwise arithmetic、cryptarithmetic)、演算法(bit counting、LCM、GCD、base conversion、isomorphic string)、代數(polynomial equations、polynomial multiplication)、遊戲(countdown、Tower of Hanoi)與邏輯推理(knights-and-knaves、Caesar cipher)。這樣的設計把「寫工具的品質」與「題目實例的難度」分離開來:一個從簡單範例歸納出來的正確工具,必須在不做任何額外調整的情況下推廣到困難範例——這種分離在固定標註的基準上做不到,因為那裡無法按需生成更難的實例。
3.2 評測基準
我們在三個與訓練距離遞增的層次上衡量轉移能力:RG (Seen) 與 RG (Unseen)。
RG (Seen)。 在 13 個訓練任務類別上的巨觀平均準確率,於最難的難度層級評估。這衡量的是學到的策略所產出的工具,能否從簡單的歸納脈絡推廣到同一任務家族中更難的實例。
RG (Unseen)。 在 10 個完全排除於 RL 訓練之外的 RG 任務上的巨觀平均準確率,涵蓋:算術(calendar arithmetic、complex arithmetic、time intervals)、代數(Chinese remainder theorem、simple equations)、演算法(group anagrams)、以及邏輯與遊戲(ab、self-referential sequence、syllogism、Puzzle-24)。雖然這些大類別在 RG (Seen) 中出現過,但這些特定的題型完全不曾出現在訓練裡,因此探測的是 Reasoning-Gym 內部的跨任務泛化。
領域外基準。 TabMWP-Hard:TabMWP [16] 的強化版;原版在 CoT 下輕易被解掉(96.8% EM),因為表格平均不到 10 列、2 欄,所以我們把列數擴充到最多 5,000 並加入不相關的欄位(附錄 M)。GQA [10]:視覺問答,需要視覺工具。這兩者合起來涵蓋了 Wang et al. [30] 所指出最相關的三類工具使用(計算、知識取用、非文字模態)。
3.3 模型與訓練設定
我們以 Qwen3-4B-Instruct [33] 為主要目標,因為它的指令遵循與工具使用能力都很強。所有訓練都用 LoRA($r{=}64$、$\alpha{=}128$)微調以降低訓練計算量。我們用 DAPO [34] 在 13 個任務類別上訓練 60 個梯度步,每個批次內生成任務與使用任務維持 1:1 比例,每個提示 $n_{\mathrm{gen}}{=}8$ 次 rollout、溫度 $0.7$、$\beta{=}0.01$(KL 係數),學習率為 $6{\times}10^{-5}$(4B)與 $1{\times}10^{-5}$(8B)。工具池(附錄 E)每個類別最多快取 20 個經驗證的工具;每次使用任務的 rollout 會在提示中注入 1 個領域工具(來自正確類別)與 2 個干擾工具(來自不相關的類別,迫使模型辨識並呼叫正確的 schema)。
3.4 由易到難的訓練測試切分設計
我們把工具歸納的難度與工具評估的難度分開。對每個 RG 任務,歸納脈絡取自較簡單的難度帶(train),而工具評估集取自最難的難度帶(test);確切的對應關係因任務而異。因此,任何只是照著簡單歸納脈絡做模式比對、而沒有抽象出底層演算法的工具,其獎勵 $r^{\mathrm{eval}}$(2.1 節)都會被大幅拉低,把策略推向簡潔、可讀、可重用的工具。與先前那些在「與創建工具時相同的難度分布」上評估工具的推論時工具生成框架 [2, 35, 31, 17] 不同,我們的協定在每一步都強制存在一個由易到難的泛化落差。
13 個類別的完整逐任務切分見附錄 F。
3.5 比較的基準方法
除非另有說明,所有基準都使用 Qwen3-4B-Instruct。標準 CoT 提供無工具的天花板。不過在 GQA 上,由於 LLM 沒有外部視覺工具就無法處理視覺資訊,它們只能根據從文字世界學到的知識作答。
LATM [2]、CRAFT [35]、Trove [31] 與 KTCE [17] 都是在推論時以凍結的 Qwen3-4B-Instruct 骨幹創建工具,彼此只差在鷹架 (Scaffolding) 的複雜度;在同一個骨幹上比較它們,可以檢驗 RL 訓練是否帶來超越提示工程的價值。[^1] 我們另外用 Qwen3-30B-A3B 評測 LATM,作為刻意設計的規模探針,藉此隔離出「單純把模型放大、跑同一套推論時框架」能否追平 RL 訓練。ReTool(4B 蒸餾自 Qwen-32B)[6] 是一個多輪程式碼執行策略(最多 10 輪),從 Qwen-32B 的軌跡蒸餾而來,但從不產出可重用的 schema;納入它可以隔離出「以 schema 為基礎的工具表徵」的貢獻,因為兩者都使用執行回饋,但只有 SMITH 產出可重用的可呼叫 schema。LATM(4B 蒸餾自 GPT-4.1)則是在 GPT-4.1 生成的寫工具軌跡上微調骨幹;與它比較,可以檢驗「在明確獎勵訊號上做 RL 訓練」是否比「從更強的凍結 oracle 做行為複製」產出更好的工具。
[^1]: 我們改寫了 LATM 的提示詞,讓 schema 更清楚。
評估協定
我們回報巨觀平均準確率,並給出兩個 Reasoning-Gym 平均:RG (Seen) 涵蓋 13 個訓練類別,RG (Unseen) 涵蓋 10 個保留類別。
3.6 主要結果
我們在同一套評估協定下,把 SMITH 與推論時工具創建基準(LATM、CRAFT、TroVE、KTCE)、蒸餾基準(ReTool 由 Qwen-32B 蒸餾;LATM 由 GPT-4.1 蒸餾)以及一個更大的模型(在 LATM 框架下的 Qwen3-30B-A3B)做比較。表 1 中有兩個發現特別突出。第一,對上蒸餾:SMITH(4B、RL)比那些從大得多的 oracle 蒸餾而來的 4B 模型泛化得更可靠,取得整體最高的保留 RG 準確率($79.9$),相對於 ReTool 的 $63.2$ 與 LATM 蒸餾版的 $65.8$。ReTool 尤其明顯:它在 RG (Seen) 領先($92.2$,我們是 $85.2$),卻在 RG (Unseen) 上掉了將近 $30$ 分,顯示拒絕取樣蒸餾過擬合到示範者的訓練分布,而沒有學到一個可轉移的建構—使用策略。第二,對上更精緻的鷹架:SMITH 的鷹架很簡單(LATM 不過就是寫出多個版本的工具再挑最好的),卻在 RG (Seen) 上以 $85.2$ 取得最強結果,並在 RG (Unseen) 上打敗每一個鷹架式基準,包括 CRAFT($76.5$)、KTCE($65.1$)與 TroVE($55.9$)。此外它也勝過更大的 Qwen3-30B-A3B Instruct,以及用拒絕取樣微調從 GPT-4.1 回應蒸餾出來的 Qwen3 4B 版本。這些結果顯示,從可驗證的獎勵中學會如何打造工具,勝過從更強 oracle 做行為複製,也勝過手工設計的檢索/精修迴路。
第三,在 token 效率上:SMITH 以最小的輸出預算取得最強的整體準確率,平均只用 $100$ 個 token,約為標準 CoT($3{,}206$)的 $1/32$、ReTool($633$)的 $1/6$,而輸入用量也維持在適中的 $664$ token,與 LATM($607$)相當,遠低於 CRAFT($1{,}226$)與 ReTool($1{,}707$)。這種不對稱很有啟發性:CRAFT 這類鷹架基準與經蒸餾訓練的 ReTool,把大量輸入 token 花在檢索到的範例或拼接的提示上,CoT 則把預算花在冗長而無條件的推理上,卻沒有一個能追上 SMITH 的保留準確率。這說明 RL 目標把工作從「解碼時的推理」搬進了「可重用的工具程式碼」,於是每個查詢都由一次簡短的工具呼叫解決,而不是一條漫長的思維鏈。
表 1:Reasoning-Gym 結果(Qwen3-4B-Instruct);CRAFT、TroVE、KTCE、ReTool、LATM-distill 與 SMITH 回報的是多個隨機種子重新評估的平均值 $\pm$ 標準差。SMITH 在保留任務的泛化上領先(RG Unseen 79.9),勝過蒸餾模型(ReTool 63.2、LATM-distill 65.8)與所有鷹架式基準,且輸出 token 只有標準 CoT 的 1/32。修正基準方法的評分錯誤後,TroVE 的 RG (Unseen) 從 40.6 升到 55.9、KTCE 從 48.7 升到 65.1。RG (Seen/Unseen):訓練/保留任務的巨觀平均。* 表示 LATM 提示詞經改寫以提升 schema 清晰度。I/O:輸入/輸出 token 數。
| 方法 | Seen 平均 | Logic | Game | Algebra | Arith | Algo | Unseen 平均 | I/O |
|---|---|---|---|---|---|---|---|---|
| Standard CoT | 58.0 | 49.9 | 60.3 | 56.8 | 62.7 | 48.6 | 55.7 | 173 / 3,206 |
| LATM* [2] | 77.6 | 53.9 | 55.5 | 38.6 | 53.0 | 90.2 | 58.3 | 607 / 174 |
| LATM* – Qwen3-30B-A3B | 74.0 | 68.7 | 64.2 | 97.3 | 56.5 | 84.0 | 74.1 | 659 / 405 |
| CRAFT [35] | 74.1 ± 0.7 | 27.4 ± 1.3 | 89.5 ± 0.0 | 94.2 ± 1.2 | 76.6 ± 1.1 | 95.0 ± 0.0 | 76.5 ± 0.4 | 1,226 / 418 |
| Trove [31] | 52.6 ± 0.4 | 60.7 ± 2.4 | 10.6 ± 1.3 | 51.2 ± 3.5 | 59.8 ± 0.8 | 97.0 ± 0.0 | 55.9 ± 0.6 | 347 / 575 |
| KTCE [17] | 61.0 ± 1.5 | 60.2 ± 1.5 | 79.8 ± 1.6 | 70.6 ± 0.3 | 45.6 ± 0.4 | 69.3 ± 1.8 | 65.1 ± 0.2 | 319 / 404 |
| ReTool(蒸餾 Qwen-32B) | 92.2 ± 0.8 | 50.3 ± 2.3 | 55.0 ± 0.8 | 48.7 ± 0.6 | 79.8 ± 2.7 | 82.4 ± 0.1 | 63.2 ± 0.4 | 1,707 / 633 |
| LATM(蒸餾 GPT-4.1) | 81.7 ± 4.4 | 37.6 ± 15.2 | 58.1 ± 12.2 | 91.3 ± 7.7 | 51.6 ± 10.4 | 93.2 ± 5.9 | 65.8 ± 4.1 | 638 / 207 |
| SMITH | 85.2 ± 2.7 | 74.2 ± 0.6 | 63.7 ± 1.1 | 97.9 ± 2.6 | 70.6 ± 2.1 | 93.0 ± 0.4 | 79.9 ± 2.2 | 664 / 100 |
對於 TroVE、CRAFT 與 KTCE 這幾個基準,我們都人工檢視過原始程式碼,發現它們在 Qwen3-4B 上執行時有一些 Python 程式碼解析問題,因此我們在自己的版本中修掉了這些問題。我們也嘗試修改 TroVE 的原始提示詞,發現效果並沒有比較好,甚至明顯更差。
3.7 工具能跨模型規模轉移
一個自然的問題是:SMITH 合成出來的工具,究竟編碼了真正通用的解法,還是只對寫出它的那個策略模型有用?我們雙向測試:把 SMITH 的 4B 撰寫者分別配上一個小得多與一個大得多的使用者。
較小的學生。 我們把最好的微調 4B 工具生成模型,配上 LFM2.5-350M [15]——一個 3.5 億參數、但工具使用能力很強的小模型——讓它在推論時使用這些工具。表 2 顯示,把 LFM2.5-350M 配上我們的 RL 4B 工具生成模型,可以把保留 RG 準確率從 $11.6$ 拉到 $42.9$,追平大得多的 Qwen3-30B-A3B-Instruct 撰寫者($41.5$);在訓練任務上,我們的 4B 模型($21.1$)甚至超越了未經訓練的 30B 模型($10.4$)。我們也試著用 LFM2.5 當作工具生成的獎勵訊號來訓練 SMITH,它在 RG Seen 上表現最好,但在 RG Unseen 上表現不足。
表 2:SMITH 的 RL 訓練 4B 撰寫者所寫出的工具,讓一個 350M 模型(LFM2.5)在保留任務上追平 30B 工具撰寫者(42.9 對 41.5 RG Unseen),顯示 SMITH 的工具編碼了真正可泛化、可跨模型家族轉移的解法。第一列是無工具基準。RG (Seen)/(Unseen):巨觀平均準確率(%)。每欄最佳以粗體表示。
| 方法 | RG (Seen) | RG (Unseen) | TabMWP | GQA |
|---|---|---|---|---|
| LFM2.5-350M(無工具) | 14.2 | 11.6 | 0.0 | 0.1 |
| + Qwen3-4B-Instruct(工具撰寫者) | 36.8 | 23.4 | 4.2 | 0.1 |
| + Qwen3-30B-A3B(工具撰寫者) | 10.4 | 41.5 | 4.1 | 0.1 |
| + 在 LFM2.5-350M 上做 RL | 39.1 | 30.2 | 4.2 | 0.1 |
| + RL 4B(本文) | 38.9 | 42.9 | 4.1 | 0.1 |
較大的使用者。 反過來的問題是:當已經有一個強得多的工具使用者時,這個 4B 撰寫者還有用嗎?這正是實際部署的情境——你大可讓那個更大的模型自己寫工具就好。我們把 RL 訓練的 4B 撰寫者所生成的工具,配上 Qwen3-30B-A3B-Instruct 作為工具使用者,並與 LATM* 比較(後者是同一個 30B 模型自己寫、自己用),比較範圍是兩種配置共有的 25 個任務(10 個保留 RG、13 個已見 RG、TabMWP-Hard、GQA)。表 3 顯示,SMITH-4B 寫出的工具在每一組上都拉高了 30B 使用者的表現,其中 TabMWP-Hard 最為劇烈($0.7\to 38.8$),並把任務加權的整體分數從 $70.2$ 提高到 $76.6$。因此,工具使用者更強,並不會讓「自己寫的工具」變成比較好的選擇:RL 訓練的 4B 撰寫者依然是比 30B 模型自身更好的工具來源。綜合這兩個結果,SMITH 的工具在兩個方向上都能轉移——向下到 350M 模型、向上到 30B 模型——所以不論最終由哪個模型消費這些工具,這個 4B 撰寫者都是一個可直接替換上場的工具提供者。
表 3:SMITH 的 RL 訓練 4B 撰寫者所寫的工具,在每一組上都讓 Qwen3-30B-A3B-Instruct 使用者超越同一個 30B 模型自己寫工具(LATM*)的表現,其中 TabMWP-Hard 的增益最大(0.7 $\to$ 38.8),顯示即使有更大的模型可以消費工具,這個 4B 撰寫者仍是可行的直接替換方案。整體:在 25 個共有任務(10 個保留 RG+13 個已見 RG+TabMWP-Hard+GQA)上按任務數加權的平均。每欄最佳以粗體表示。
| 方法 | 保留 RG(10 任務) | 已見 RG(13 任務) | TabMWP-Hard | GQA | 整體 |
|---|---|---|---|---|---|
| LATM*(30B 自己寫工具) | 71.9 | 78.1 | 0.7 | 20.2 | 70.2 |
| SMITH-4B 給 30B 使用者 | 74.5 | 84.6 | 38.8 | 30.2 | 76.6 |
3.8 分布外評測
為了探測 Reasoning-Gym 之外的轉移能力,我們在一個表格推理基準(TabMWP-Hard)與一個視覺推理基準(GQA)上評測,兩者在訓練中都完全沒有出現過。表 4 顯示 SMITH 以 $40.4$ 領先 TabMWP-Hard,勝過最接近的基準 TroVE($36.4$),並在 GQA 上以 $42.6$ 位居第二,僅次於從 GPT-4.1 蒸餾的 LATM($56.0$)。我們並不宣稱在感知能力上打平:GPT-4.1 蒸餾把我們自我訓練的撰寫者在 RL 期間從未見過的視覺原語嵌了進去,而這個差距正是「不使用 oracle 監督」所付出的代價。真正在沒有蒸餾的情況下轉移過去的,是那個自監督的工具創建迴路。SMITH 在兩個分布外基準上都勝過所有鷹架式基準,也是唯一一個不靠 oracle 蒸餾就在其中一欄拿下第一的 4B 同骨幹方法。
表 4:分布外泛化(Qwen3-4B-Instruct)。SMITH 在 TabMWP-Hard 上領先(40.4,次佳 TroVE 為 36.4),在 GQA 上排名第二(42.6),是唯一不靠 oracle 蒸餾就在其中一欄居首的 4B 方法。粗體為最佳,底線為次佳。
| 任務 | CoT | LATM | LATM* (30B) | CRAFT | TroVE | KTCE | ReTool | LATM(蒸餾) | SMITH |
|---|---|---|---|---|---|---|---|---|---|
| TabMWP-Hard | 7.2 | 19.7 | 0.7 | 30.0 | 36.4 | 27.2 | 3.0 | 7.1 | 40.4 |
| GQA | 11.5 | 35.0 | 29.8 | 21.9 | 21.4 | 0.0 | 26.1 | 56.0 | 42.6 |
3.9 跨骨幹模型的擴展性
為了測試 SMITH 的訓練訊號能否跨模型規模與家族轉移,我們把同一套 RL 配方套用到 Qwen3-8B 與 Granite-3.3-8B。表 5 顯示,對 Qwen3-8B 而言,SMITH 同時改善了分布內準確率($72.6\to 79.4$)與保留 RG 準確率($72.2\to 81.7$),並把分布外的 TabMWP-Hard 從 $42.4$ 提升到 $56.7$。Granite-3.3-8B 的起點弱得多(RG Seen $31.2$、Unseen $22.0$),卻遵循同樣的趨勢:SMITH 把 RG (Seen) 拉到 $39.1$、RG (Unseen) 拉到 $28.5$、GQA 從 $7.8$ 拉到 $11.7$。
我們還進一步測試,當 judge 訊號來自策略自己(而非外部的 30B-A3B 模型)時 SMITH 是否仍然有效。Self-Judge 變體用與 30B-A3B 相同的 judge 範本去提示 Qwen3-8B,讓它為自己的 rollout 評分。自我評判改善了保留 RG($81.7\to 85.9$,全表最佳),但在分布內準確率與分布外 GQA 上有所退讓($28.7\to 16.3$),顯示較小的 judge 是一個較弱、但在訓練任務分布上偏差較小的訊號。
表 5:SMITH 在測試過的每一個骨幹上都優於基礎模型。在 Qwen3-8B 上,它把保留 RG 從 72.2 拉到 81.7、TabMWP-Hard 從 42.4 拉到 56.7;Granite-3.3-8B 儘管起點較弱,仍遵循同樣趨勢,確認這個訓練訊號並非特定模型家族專屬。RG (Seen/Unseen):訓練/保留任務的巨觀平均。每欄最佳以粗體表示。
| 方法 | RG (Seen) | RG (Unseen) | TabMWP | GQA |
|---|---|---|---|---|
| Qwen3-8B(基準) | 72.6 | 72.2 | 42.4 | 17.3 |
| SMITH:Qwen3-8B | 79.4 | 81.7 | 56.7 | 28.7 |
| SMITH:Self-Judge | 74.7 | 85.9 | 54.5 | 16.3 |
| Granite-3.3-8B(基準) | 31.2 | 22.0 | 3.9 | 7.8 |
| SMITH:Granite-3.3-8B | 39.1 | 28.5 | 4.5 | 11.7 |
3.10 對外部工具呼叫的泛化
除了讓模型自己寫工具的基準之外,我們還用 BFCL v4(no-web 子集)[20] 測試 SMITH 的「建構—使用」目標能否轉移到外部給定的 function-calling API。表 6 顯示 SMITH 在兩個 Qwen 骨幹上都提升了 BFCL 整體準確率,Qwen3-4B 從 $45.1$ 到 $48.6$、Qwen3-8B 從 $43.3$ 到 $55.8$,後者是全表最大的絕對增益。由於 BFCL 的 schema、多輪軌跡與 judge 在 RL 期間從未出現過,這個改善隔離出的是一個學到的工具使用先驗,而不是對特定基準的擬合。
表 6:SMITH 在所有骨幹上都改善了外部工具呼叫(BFCL v4, no-web),其中 Qwen3-8B 增益最大(43.3 $\to$ 55.8),儘管它在 RL 訓練中從未見過 BFCL 的 schema、多輪軌跡或 judge。粗體為最佳,底線為次佳。
| 指標 | Qwen3-4B-Instruct 基礎 | Qwen3-4B-Instruct SMITH | Qwen3-8B 基礎 | Qwen3-8B SMITH | Granite-3.3-8B 基礎 | Granite-3.3-8B SMITH |
|---|---|---|---|---|---|---|
| BFCLv4 | 45.1 | 48.6 | 43.3 | 55.8 | 36.3 | 38.7 |
3.11 消融實驗
為了釐清是哪些因素在驅動 SMITH 的增益,我們在 Qwen3-4B-Instruct 上對獎勵結構做消融,與四種配置比較:(1) Tool Create,獎勵只取決於生成程式碼的品質;(2) Decoupled Build/Use,把第一列的 30B-A3B 建構者與一個獨立訓練的 4B 工具使用專家配成一對,測試起作用的究竟是聯合訓練還是專業分工;(3) SMITH: No LLM Judge,把工具創建與執行成功耦合起來,但拿掉 judge 訊號;(4) 完整的 SMITH 目標,把 LLM-as-judge 訊號保留為一條獨立的軸。表 7 顯示每個元件都有增量貢獻:單靠工具創建能讓 RG (Seen) 大幅提升,但分布外的 GQA 表現不佳;解耦的配對在 RG Unseen 上打不過單一模型的 Tool Create($58.9$ 對 $68.8$),證實驅動增益的是聯合訓練而非專業分工;把建構與使用聯合耦合起來能拉高分布內準確率,卻傷害保留轉移;只有完整的 SMITH 目標取得最佳的整體分數,顯示把過程品質與結果正確性解耦,對跨領域的穩健性至關重要。
表 7:獎勵結構消融(Qwen3-4B-Instruct)。$\pi^{\mathrm{eval}}$:在評估時呼叫生成工具的模型(30B-A3B/4B:獨立模型;self:同一個經 RL 訓練的策略)。Tool Use:$\pi^{\mathrm{eval}}$ 是否真的呼叫工具,而不只是寫出工具。解耦的建構/使用在 RG (Unseen) 上打不過單一模型的 Tool Create($58.9$ 對 $68.8$),所以驅動增益的是聯合訓練而非專業分工;只有完整的 SMITH 目標在整體上勝出,個別基準則由 K=1(TabMWP)與 No LLM Judge(GQA)分別拿下。粗體為最佳,底線為次佳。RG(S)/(U):Seen/Unseen。
| 方法 | $\pi^{\mathrm{eval}}$ | Tool Use | RG (S) | RG (U) | TabMWP | GQA |
|---|---|---|---|---|---|---|
| Qwen3-4B-Instruct | – | – | 61.85 | 47.01 | 19.70 | 20.86 |
| Tool Create | 30B-A3B | 否 | 77.43 | 59.39 | 15.60 | 37.01 |
| Tool Create | 4B | 否 | 73.88 | 68.80 | 17.70 | 35.82 |
| Decoupled Create/Use | 30B-A3B | 是 | 76.44 | 58.93 | 13.90 | 35.04 |
| SMITH:No Sync | 4B | 是 | 80.29 | 66.89 | 25.81 | 24.58 |
| SMITH:No LLM Judge | self | 是 | 82.57 | 67.81 | 18.30 | 42.63 |
| SMITH:K=1 | self | 是 | 78.64 | 73.93 | 46.77 | 32.30 |
| SMITH:Full | self | 是 | 86.61 | 78.33 | 40.40 | 42.62 |
4 限制與討論
規模、judge 依賴與基礎模型先驗
所有訓練出來的策略都不超過 8B 參數,而品質 judge 有 30B 啟用參數,這個規模區間是為了計算可行性而選定的;這些增益在 70B 以上的規模是否還存在、會飽和還是反轉,仍是開放問題,而我們的 Self-Judge 消融(表 5)只是對 judge 規模依賴性的部分探測,因為拿掉外部 judge 會改善保留 RG,卻讓分布外的 GQA 退步。最後,SMITH 每一步都在沙箱中執行生成的 Python,但我們並未正式證明對抗性提示無法誘導出不安全的工具,也沒有對 schema 的可讀性或面向開發者的可重用性做任何人工評估。
開放問題
在 SMITH 中,一個工具就是一個 Python 函式加一份 JSON schema。本文並未評估更豐富的產物形式。舉例來說,skills 會把工作流程說明打包在一個 SKILL.md 檔案裡,另外附上選擇性的腳本、參考資料、範本與其他資源。相對地,MCP server 使用 Model Context Protocol 把工具、資源、提示與指令暴露給模型;它們本身並不是一包程序與腳本的集合。要支援生成這類多檔案或以 server 為後端的產物,需要擴充 SMITH 的輸出表徵與驗證流水線。迭代式或多輪生成在這個情境下可能有用,但並非本質上必要。我們把這個延伸留給未來工作。
在整個 SMITH 訓練過程中,我們從未觀察到模型在單一輪中發出平行工具呼叫,或一次生成多個工具。我們推測這同時反映了基礎模型偏好單一工具使用的傾向,以及我們的獎勵設計並未鼓勵多工具生成或平行執行。由於平行呼叫在深度研究等真實情境中很常見,我們相信 SMITH 可以自然地延伸到這些設定,這同樣留給未來工作。
5 結論
我們提出了 SMITH,一個強化學習框架,聯合訓練單一語言模型去創建並使用可重複利用的工具,把工具撰寫者與工具使用者之間的回饋迴路閉合起來,使策略直接針對自己的執行結果做最佳化。在 $13$ 個 Reasoning-Gym 任務上訓練後,我們的 4B 模型在所有受評方法中取得最高的保留 RG 準確率($79.8$)、在 TabMWP-Hard 上領先,並寫出能轉移給一個訓練期間從未見過的 $350$M 學生的工具,其品質與一個大上一個數量級的模型所產出的工具相當。同一套配方在不做任何修改的情況下也提升了 Qwen3-8B 與 Granite-3.3-8B,顯示把創建與使用耦合進單一個被訓練的策略,是一條通往泛化的可擴展路徑:模型寫出來的工具,恰恰就是它能可靠呼叫的工具——不需要更大的凍結教師、更複雜的鷹架,也不需要領域外的監督訊號。
致謝
本工作部分由台灣國家科學及技術委員會補助,計畫編號 115-2628-E-002-023-MY4、112-2223-E-002-012-MY5、115-2628-E-002-006、115-2223-E-002-005-MY3 與 115-2634-F-002-012,以及台灣人工智慧卓越中心、台大資料智慧技術應用與系統中心(計畫編號 115L900901)支持。Shao-Hua Sun 由台灣教育部玉山學者計畫支持。
附錄 A 相關研究
早期的工具增強 LLM 透過呼叫搜尋引擎或自監督的 API 呼叫來擴充參數化記憶 [12, 27, 22],但仍受限於固定的、人工策劃的工具集。
LATM [2] 引入了動態工具創建,用一個強大的 LLM 寫出較弱模型可以呼叫的可重用工具,在 BIG-Bench [24] 上取得更好的表現。後續工作加上了愈來愈複雜的鷹架:CRAFT [35] 建立一個帶驗證的檢索增強工具庫;Trove [31] 引入工具歸納與驗證流水線;KTCE [17] 透過多階段分解自動化創建與評估。儘管彼此有差異,這些系統全都把工具撰寫當成推論時的提示問題,讓工具品質從生成過程中順帶浮現,而不是來自一個明確的目標函數;而且沒有任何一個把工具創建與工具使用耦合進一個聯合的學習目標。
另一條平行的路線把 RL 應用到程式碼與工具生成:CodeRL [13]、RLEF [8] 用執行回饋訓練更好的程式碼生成器,ToolRL [21] 顯示量身設計的獎勵有助於工具使用,而 ReTool [6] 訓練模型更可靠地呼叫工具,但沒有處理創建。最接近的工作是 SAGE [28],它把技能創建框定為一個 RL 目標;然而 SAGE 用單一問題來創建、單一問題來驗證,限制了跨多樣任務類別的泛化。我們的工作在三個關鍵點上不同:我們在 13 個程序性任務類別上聯合訓練工具創建與使用;我們用最多 16 個保留問題驗證每一個生成的工具;我們把一個為正確性、schema 品質與整體工具品質評分的 LLM judge,當作一條獨立的獎勵訊號。
SMITH 位於程式輔助推理 [7, 29] 與程式歸納 [32] 的交會處,繼承了它們對可執行程式碼的運用、對可重用程序的合成,以及工具在任務之間複利累積的效用。它與這三者的差異在於,它把這些能力變成明確的 RL 目標:建構任務直接獎勵簡潔、可讀、可重用的工具合成,而使用任務則閉合迴路,確保模型寫出來的東西正是它能可靠呼叫的東西。
附錄 B 設計驗證器獎勵與 LLM-as-Judge 的經驗教訓
B.1 系統概觀
這套訓練系統以 DAPO 損失與 LoRA($r=64$)在兩種交錯的任務型別上微調 Qwen3-4B-Instruct。在建構任務中,模型寫出一個 Python 函式與一份對應的 OpenAI 相容 JSON schema,由三個獨立訊號驗證與評分:一個結構驗證器、一個 LoRA 同步的評估器(把保留測試問題丟給生成的工具跑),以及一個為程式碼品質評分的 LLM judge。在使用任務中,模型拿到一份預先建好的工具 schema,必須正確呼叫它來回答問題;獎勵是規則式的答案比對。
在本節分析的這個配置中(它與最終系統不同),LLM judge 是一個固定的外部模型(Qwen3-30B),而不是最終 SMITH 設計所採用的自我同步策略檢查點。
一條建構軌跡的總獎勵為:
$$r_{\mathrm{build}}=\underbrace{r_{\mathrm{format}}}_{\text{驗證器}}+\underbrace{r_{\mathrm{eval}}}_{\text{LoRA 評估器}}+\underbrace{w_{j}\cdot r_{\mathrm{judge}}}_{\text{LLM judge}},\hskip 10pt w_{j}=0.5 \tag{7}$$
其中 $r_{\mathrm{format}}\in\{0,0.5,1.0\}$ 編碼 schema 與函式名稱的對齊(0.5)以及參數的對齊(0.5),$r_{\mathrm{eval}}\in[0,1]$ 是生成工具答對測試問題的比例,$r_{\mathrm{judge}}\in[-0.5,1]$ 是正規化後的 LLM judge 分數。注意最終系統把 $r_{\mathrm{format}}$ 收緊成一個二元的 $\{0,0.5\}$ 訊號,只有在函式名稱與參數同時對齊時才給(2.1 節);上面這個可加的 $\{0,0.5,1.0\}$ 形式是本附錄所分析配置特有的。
B.2 觀察到的失效 env_reward 崩潰
量化軌跡
表 8 顯示訓練期間逐步記錄的指標。LoRA 同步發生在第 5 步(檢查點每 5 步儲存一次)。從第 6 步開始可以看到明顯的退步。
表 8:建構任務每個優化步驟的關鍵指標。把 eval_lora_step5 載入評估器伺服器的那次 LoRA 同步,是在第 5 步的指標記錄完之後才觸發。第 6–7 步是第一批使用同步後評估器的 rollout。
| 步驟 | env_reward | eval_reward | step1_fail | fn_mismatch | param_mismatch | judge_reward |
|---|---|---|---|---|---|---|
| 1 | 1.363 | 0.386 | 34.9% | 23.4% | 11.5% | 0.460 |
| 2 | 1.809 | 0.466 | 10.4% | 8.3% | 2.1% | 0.614 |
| 3 | 2.026 | 0.557 | 2.1% | 1.0% | 1.0% | 0.670 |
| 4 | 2.043 | 0.684 | 9.4% | 5.2% | 3.6% | 0.710 |
| 5 | 2.123 | 0.662 | 2.6% | 0.0% | 2.6% | 0.722 |
| (第 5 步後套用 LoRA 同步) | ||||||
| 6 | 1.641 | 0.500 | 23.9% | 13.5% | 10.4% | 0.561 |
| 7 | 1.402 | 0.332 | 28.6% | 14.1% | 14.1% | 0.453 |
崩潰的歸因
由於 $r_{\mathrm{eval}}$ 是對所有建構狀態取平均,包含那些 step1 就失敗、被強制記為 $r_{\mathrm{eval}}=0$ 的狀態,$r_{\mathrm{eval}}$ 的崩潰直接來自 step1_fail 的暴增。我們檢查 rollout 事件記錄檔驗證了這點:第 6 步時 238 個建構狀態中有 46 個 step1 失敗(19.3%),而第 5 步是 197 個中的 5 個(2.5%)。那 46 個失敗中,26 個是 schema_function_mismatch、20 個是 schema_param_mismatch。
關鍵是,評估器並沒有故障。工具評估期間沒有出現任何連線錯誤或例外。真正送達評估器的項目,在第 6 步平均答對 8 題中的 5.26 題,與第 5 步的 5.44 題相當接近。build_eval_reward 的下滑,幾乎完全可以用「step1 失敗、被強制記零的狀態比例上升」來解釋。
B.3 根因分析
B.3.1 命名漂移
在第 6 步,模型開始生成帶有數個看似合理函式名稱的程式碼,而 schema 引用的那一個卻不存在於頂層可呼叫函式中。我們稱之為命名漂移 (Naming Drift)。下面是一個代表性的失敗案例。
def _gcd(a: int, b: int) -> int:
    while b:
        a, b = b, a % b
    return a

def calculate_lcm(a: int, b: int) -> int:
    return (a * b) // _gcd(a, b)

def find_lcm_of_numbers(a: int, b: int) -> int:
    return calculate_lcm(a, b)
[{"type": "function", "function": {
  "name": "find_lcm",
  "parameters": {"type": "object",
    "properties": {"a": {"type": "integer"},
                   "b": {"type": "integer"}},
    "required": ["a", "b"]}}}]
圖 2:命名漂移範例。schema 引用了 find_lcm,但它並未以頂層可呼叫函式的形式出現在生成的程式碼中。
B.3.2 獎勵訊號不對齊
這個漂移之所以持續存在,是因為驗證器與 judge 對同一個錯誤施加了不一致的懲罰:
表 9:對於「schema 指名了一個程式碼中不存在的函式」的懲罰。
| 元件 | 條件 | 懲罰 |
|---|---|---|
| 結構驗證器 | 函式名稱不存在 | $r=0$,軌跡終止 |
| LLM judge | 函式名稱不存在 | $r\times 0.5$(部分給分) |
由於 step1 失敗的軌跡在 judge 評分階段之前就被終止,judge 從來沒有直接觀察到命名漂移的失敗。於是它系統性地獎勵了那些伴隨第 5 步高分輸出而來的多函式程式碼風格,並透過第 5 步的梯度更新加以強化。到了第 6 步,漂移已經嚴重到 schema 的函式名稱完全不再出現在生成的程式碼裡。
觀察。 當一個驗證器與一個 LLM judge 共同決定獎勵時,任何被驗證器視為硬失敗的性質,也必須在 judge 端得到零分。對驗證器眼中的硬失敗給予部分分數,會製造出一道朝向「過得了 judge、卻過不了驗證器」的梯度。
B.3.3 次要因素:LoRA 同步的評估器
第 5 步的 LoRA 同步把基礎模型評估器換成當前的訓練檢查點,理由是更好的工具打造能力能為 $r_{\mathrm{eval}}$ 提供更強的可用性訊號。實務上,同步後的評估器並不是崩潰的主因:每個項目的平均測試分數只是輕微下滑(8 題中 5.44 $\to$ 5.26),而 step1 失敗率的上升才是主導因素。不過,同步後立刻出現短暫的準確率下滑仍在預期之內,因為在 RL 訓練的早期,工具使用能力往往落後於工具打造能力的提升。
觀察。 讓評估器與訓練檢查點做 LoRA 同步在原理上是合理的,但每次同步時都應監控評估器的訊號品質,以便區分「評估器退化」與「策略退步」。
B.4 獎勵與 judge 設計的教訓
我們從這次失敗導出五條具體教訓。
B.4.1 教訓 1:硬失敗必須在每個地方都是硬的
陷阱。 一個會讓整條軌跡獎勵歸零的驗證器條件,也應該讓 judge 元件歸零,而不只是砍半。
在我們的案例中,judge 原本的做法是:
if not aligned:
    if reason.startswith("syntax error in code:"):
        score = -0.5        # 硬性負分
    else:
        score *= 0.5        # 軟性砍半 —— 函式不存在被當成
                            # 跟輕微參數不符同一級
圖 3:原本(有問題的)不對齊處理:函式不存在只受到軟性懲罰。
修正版則區分了各種不對齊的嚴重程度:
if not aligned:
    if reason.startswith("syntax error in code:"):
        score = -0.5    # 無法解析 —— 維持強負分
    elif "not found in code" in reason:
        score = 0.0     # schema 函式不存在:硬性歸零,與驗證器一致
    else:
        score *= 0.5    # 較輕微的問題:參數不符、過度承諾
圖 4:修正後的不對齊處理:函式不存在現在是硬性歸零。
教訓。 對於驗證器以獎勵 $=0$ 強制執行的每一個二元約束,都要去稽核 judge 的評分路徑,確保在該約束被違反的狀態下它也給出同樣的零(或負值)。對致命的結構性錯誤給部分分數,會製造出一道假梯度。
B.4.2 教訓 2:把 judge 的提示詞對齊到驗證器的硬約束
原本的 judge 提示詞獎勵「描述性命名」與「良好分解的函式」,卻沒有指明 schema 的 name 欄位必須以頂層可呼叫函式的形式存在。結果 judge 給了多函式輸出很高的 code_clarity 分數,完全不管 schema 指名的那個函式在不在。
我們在提示詞中補上了:
- 一條明確的 Step 3 指示:「schema 的 name 必須逐字出現為一個頂層
def,這件事要在任何其他分析之前檢查。若不成立,立即給schema_code_alignment=0與overall_quality=0。」 - 兩個評分範例(D 與 E),分別示範命名漂移與薄包裝 (Thin Wrapper) 這兩種反模式。
- 更新後的
code_clarity評分標準文字,明確懲罰薄包裝(給 1–2 分),以及「schema 指名的函式不是直接實作」的多函式程式碼。
教訓。 驗證器強制執行的每一個結構性約束,都應該明確出現在 judge 的提示詞裡,最好還附上一個評過分的反例。judge 無法懲罰一個沒有人告訴它要注意的失敗模式。
B.4.3 教訓 3:驗證器與 judge 之間的獎勵落差是一道梯度洩漏
令 $\mathcal{S}_{\mathrm{bad}}$ 為那些違反驗證器硬約束(schema 函式不存在於程式碼中)的輸出集合。在一次 GRPO 更新中,$\mathcal{S}_{\mathrm{bad}}$ 裡的輸出得到的是:
$$r_{\mathrm{total}}(\mathbf{y})=0+0+w_{j}\cdot r_{j}(\mathbf{y})\hskip 10pt \mathbf{y}\in\mathcal{S}_{\mathrm{bad}}, \tag{8}$$
其中驗證器項與評估器項都是零,但只要 judge 給了部分分數,judge 項 $w_{j}\cdot r_{j}>0$。若 judge 給 $r_{j}=0.4$ 且 $w_{j}=0.5$,那麼 $\mathcal{S}_{\mathrm{bad}}$ 中的輸出總獎勵是 $0.2$(正值),儘管驗證器認定它完全壞掉。
在 GRPO 下,優勢值 $A(\mathbf{y})=r_{\mathrm{total}}(\mathbf{y})-\bar{r}$ 只要 $r_{j}(\mathbf{y})>2\bar{r}$ 就是正的(因為 $w_{j}=0.5$)。這代表當這些輸出在 judge 上拿高分時,策略正在被積極地推向產出 $\mathcal{S}_{\mathrm{bad}}$。我們把這稱為獎勵落差 (Reward Gap):judge 的非零下限製造出一道梯度洩漏,部分抵銷了驗證器的硬性零分。
陷阱。 當 $N$ 個獎勵元件以相加方式組合時,任何一個會對「驗證器判失敗」的輸出給正獎勵的元件,都會造成梯度洩漏。judge 權重 $w_{j}$ 越大、judge 對壞掉輸出給的部分分數越高,朝向結構性失敗的梯度就越強。
教訓。 當你把一個硬性驗證器與一個軟性 LLM judge 組合起來時,請考慮對 judge 訊號加閘:只要驗證器給 $r=0$,就令 $r_{j}=0$,不管 judge 打幾分。或者,只把 judge 訊號當作「通過驗證器的輸出之間的排序破平手」,而不要當成一條獨立的相加軸。
B.4.4 教訓 4:把結構性子指標當成一等公民訊號來記錄
第 1–5 步的總獎勵軌跡看起來很健康:build/env_reward 在上升,judge_reward 也很穩定(表 8)。即將發生的失敗在這些總量指標上完全看不見。 它只在兩個子指標欄位上看得到:fn_mismatch 從 23.4%(第 1 步)一路降到 0.0%(第 5 步),而 param_mismatch 收斂在 1–3%。一個只追蹤總獎勵的監控系統,會在第 5 步宣告這次訓練健康無虞;第 6 步的結構性失敗則會顯得突如其來又無從解釋。
陷阱。 總量獎勵指標(env_reward、eval_reward、judge_reward)反映的是所有約束維度同時取平均的結果。一個模型如果在某個約束上學得更好、同時悄悄地在另一個約束上退化,它的總分可以維持不變甚至上升,直到那個被忽略的約束越過臨界點。總量指標無法把這種模式與「真正的全面進步」區分開來。
在我們的案例中,正確的監控面應該是:
- step1_fail 率。 建構 rollout 在第一道檢查就沒過結構驗證器的比例。這是命名漂移或格式崩壞最早可觀察到的症狀;它應該每一步都被記錄,而不是從
eval_reward反推。 - fn_mismatch 率。 schema 的
name欄位沒有以頂層可呼叫函式出現在生成程式碼中的 rollout 比例。這個約束非滿足即違反;訓練穩定後它的比率應該接近零。 - param_mismatch 率。 schema 的參數列表與函式簽名不符的 rollout 比例。這是一個獨立、可分開追蹤的約束。
這些子指標正是表 10 中原則 3 的具體例子:它們讓你有辦法偵測出是哪一個特定的結構約束正在退化,並用針對性的修正(如教訓 1 與教訓 2)來回應,而不是去做全域的超參數調整。
一個實務上的實作註記:由於 step1 失敗的 rollout 在評估器與 judge 執行之前就被終止,step1_fail 是唯一能捕捉到它們的訊號。若在 step1_fail $>10\%$ 設一個監控警報,第 6 步就會立刻觸發,遠早於 eval_reward 崩到第 7 步那種數值。
教訓。 把每一個結構約束的違反率當成獨立的時間序列指標記錄,而不是折進總獎勵裡的一個成分。把門檻警報設在違反率上,而不是只設在總獎勵上。當一個原本在下降的違反率突然飆升(哪怕只有幾個百分點),立刻調查:這是教訓 1–3 所描述的獎勵不對齊失效的早期警訊。
B.4.5 教訓 5:湧現的風格轉移會侵蝕結構約束
用組合獎勵做 RL 有一個微妙的後果:策略可能學到一種與高獎勵輸出相關聯的風格,然後把那個風格轉移到「會導致結構失敗」的輸出上。
在我們的案例中,帶輔助函式的多函式程式碼,在第 3–5 步與高 $r_{\mathrm{eval}}$ 相關(結構較好的工具答對更多測試問題)。策略把「輔助函式 $\rightarrow$ 高獎勵」學成了一個潛在啟發法。到了第 6 步,這個啟發法壓過了 schema 命名約束:模型寫出精緻的輔助結構,但 schema 的函式名稱不再錨定到其中任何一個。
這是一種很難單從獎勵軌跡偵測出來的獎勵駭客 (Reward Hacking),因為造成失敗的那個風格,在訓練早期是與正確行為相關聯的。這個失敗只在結構性子指標(fn_mismatch 率)上看得見。
教訓。 監控子指標跨訓練步的軌跡,而不只是它們的終點值。當一個原本在下降的結構約束違反率突然上升,就要懷疑策略學到了某個相關的風格特徵,而且它正在越過約束邊界向外泛化。結構性約束應該被硬編碼進獎勵(驗證器)裡,而不是透過軟性的代理訊號(LLM judge)來表達。
B.5 設計原則彙總
表 10 把這五條教訓整理成可操作的設計原則,供實務工作者在打造「驗證器 + LLM-as-judge」獎勵流水線時參考。
表 10:在程式碼生成的 RL 訓練中,把結構驗證器與 LLM-as-judge 獎勵訊號結合起來的設計原則。
| # | 原則 | 意涵 |
|---|---|---|
| 1 | 硬失敗必須在每個地方都是硬的 | 若驗證器把一條軌跡歸零,judge 對該條件也必須回傳零。絕不對致命的結構性錯誤給部分分數。 |
| 2 | 把 judge 提示詞對齊到驗證器約束 | 驗證器強制執行的每一個二元約束,都應逐字出現在 judge 提示詞中,並附一個評過分的負面範例。 |
| 3 | 把結構性子指標當成一等公民訊號記錄 | 獨立追蹤每一個約束的違反率。把警報設在違反率上,而不只是總獎勵。 |
| 4 | 以「通過驗證器」為 judge 訊號加閘 | 只要驗證器給 $r=0$,就令 $r_{j}=0$,以防 judge 的部分給分造成梯度洩漏。 |
| 5 | 結構約束屬於驗證器,不屬於 judge | RL 策略會轉移與高獎勵相關的風格。若一個結構性質可以用規則精確強制執行,就把它做成硬性的驗證器檢查,而不是 judge 的軟性偏好。 |
附錄 C LLM-as-Judge 提示詞 v5.0
以下重現我們建構任務獎勵流水線中,供給 LLM-as-judge 元件的完整系統提示詞(2.1 節)。judge 會收到每一個生成的工具(一個 Python 函式加上它的 OpenAI 相容 JSON schema),並回傳一個帶有五個數值品質分數的結構化 JSON 物件。
【譯註】原始提示詞是英文,以下為譯文,方便閱讀理解其設計;其中的程式碼與 JSON 範例保留原樣未動。要復現實驗請以論文原文或官方 repo 的英文版本為準——提示詞是餵給模型的字面輸入,翻譯過的版本並不等價。
角色設定:你是一位程式碼審查者,負責評估 Python 工具實作與它們的 OpenAI function-calling schema。這些工具會被 LLM 用來透過工具呼叫解決數學與推理任務。
重要:該看什麼。 不要試圖在腦中執行程式碼、或驗證它是否產出正確的數值輸出;那種做法並不可靠。你應該根據可以在程式碼與 schema 中直接觀察到的結構性訊號來評估這個工具。
必要的分析流程(評分前先完成這些步驟):
Step 1:檢查程式碼結構的紅旗。 找出以下這些具體問題(每找到一個都要列出):
- 實作不完整:
pass、TODO、NotImplementedError、空的分支、只處理部分情況的函式(例如任務是通用多項式,卻只處理二次式)。 - 脆弱的解析:用正則表達式解析數學,而不是用像樣的函式庫(
sympy、numpy、ast);寫死的模式,無法泛化。 - 方法錯誤:演算法與任務型別不匹配(例如需要符號運算的任務卻用暴力搜尋)。
- 缺少錯誤路徑:裸的
except: pass把錯誤悄悄吞掉;失敗時回傳空值/None卻沒有任何提示。 - 寫死的限制:魔術數字、固定大小的假設、只對特定輸入維度有效。
- 程式碼被截斷:函式突然結束,程式碼在實作到一半時被切掉。
Step 2:檢查程式碼是否涵蓋任務。 把任務型別與範例問題,對照程式碼實際實作了什麼。一個在 Q1 是三次式時卻只處理線性方程式的工具,是根本上不適任的,不管程式碼看起來多乾淨。
Step 3:schema 與程式碼的比對。 把 schema 的參數名稱、型別與描述,對照函式簽名。逐一記下每一處不符。
Step 4:評估工具的 API 設計。 如果一個 LLM 只看得到 schema(看不到程式碼),它能不能構造出正確的函式呼叫?參數名稱與描述是否夠清楚?
評分範例
仔細研讀這些範例。它們展示了常見的陷阱,特別是那些看起來很體面、結構上卻是壞的工具。
範例 A:好工具(高分)。 任務:count_bits。Q1:「76,778,227 的二進位表示中有幾個 1 bit?」預期答案:14。
def count_one_bits(n):
    return bin(n).count('1')
{
  "name": "count_one_bits",
  "parameters": {
    "properties": {
      "n": {
        "type": "integer",
        "description": "The non-negative integer whose binary
          representation is to be analyzed for the count of 1 bits."
      }
    },
    "required": ["n"]
  }
}
正確的評分:
{
  "red_flags": "none",
  "task_coverage": "yes -- bin().count() handles any non-negative integer",
  "code_correctness": 4, "code_clarity": 4,
  "schema_quality": 4, "schema_code_alignment": 5, "overall_quality": 4
}
理由:做法簡單正確,使用一個可靠的內建函式,能泛化到所有輸入。schema 與程式碼完全相符。之所以不是 5,是因為沒有輸入驗證(負數會得到錯誤結果)。
範例 B:體面但壞掉的工具(外觀好看,分數卻低)。 任務:polynomial_equations。Q1:「解 q**5 + 21*q**4 + 44*q**3 + 45 = 0」預期答案:$-18.6398,\ -2.0423,\ -1.3908$。
import math

def solve_quadratic_equation(a, b, c):
    """Solves a*q^2 + b*q + c = 0 and returns real decimal solutions."""
    if abs(a) < 1e-10:
        if abs(b) < 1e-10:
            return "0.0" if abs(c) < 1e-10 else ""
        return f"{-c/b:.4f}"
    discriminant = b**2 - 4*a*c
    if discriminant < 0:
        return ""
    ...
{
  "name": "solve_quadratic_equation",
  "parameters": {
    "properties": {
      "a": {"type": "number"},
      "b": {"type": "number"},
      "c": {"type": "number"}
    },
    "required": ["a", "b", "c"]
  }
}
正確的評分:
{
  "red_flags": "function only handles quadratic (degree 2) equations
    but Q1 is degree 5; hardcoded to 3 coefficients",
  "task_coverage": "no -- cannot solve any polynomial above degree 2,
    which is the primary task requirement",
  "code_correctness": 1, "code_clarity": 4,
  "schema_quality": 4, "schema_code_alignment": 2, "overall_quality": 1
}
理由:程式碼看起來很乾淨(命名良好、參數有型別、docstring 完整),但它根本解不了這個任務:它只處理二次多項式,而任務要求通用的多項式求解。schema_code_alignment 給 2,是因為 schema 沒有警告使用者它只處理二次式。
範例 C:難看但可用的工具(中等分數)。 任務:polynomial_equations。Q1 同上。
def solve_equation(equation_str):
    from sympy import symbols, solve, Eq, sympify
    q = symbols('q')
    expr = sympify(equation_str.replace('= 0', '').strip())
    solutions = solve(Eq(expr, 0), q)
    real_sols = [complex(s).real for s in solutions
                 if abs(complex(s).imag) < 1e-6]
    return ', '.join(f'{s:.4f}' for s in sorted(real_sols))
{
  "name": "solve_equation",
  "parameters": {
    "properties": {
      "equation_str": {
        "type": "string",
        "description": "The equation to solve"
      }
    },
    "required": ["equation_str"]
  }
}
正確的評分:
{
  "red_flags": "uses sympify on raw string input (fragile); schema
    description is vague; single string argument instead of structured
    input",
  "task_coverage": "yes -- sympy.solve handles arbitrary polynomial
    degrees",
  "code_correctness": 3, "code_clarity": 1,
  "schema_quality": 1, "schema_code_alignment": 4, "overall_quality": 2
}
理由:做法是對的(sympy.solve 能處理任意次數的多項式),但 API 很弱:一個不透明的字串參數,加上模糊的 schema 描述。LLM 可能會用 sympify 解析不了的格式把方程式傳進去。code_correctness 給 3(而非更高),是因為對原始字串做 sympify 很脆弱。整體給 2:儘管 API 有缺陷,核心演算法是能動的。
範例給我們的關鍵教訓。 範例 B 是要避開的陷阱:不要只因為程式碼結構良好、命名漂亮、參數分解得好就給高分。 如果那個做法根本無法處理任務(Step 2 沒過),code_correctness 就必須是 0–2,無論程式碼品質多好。範例 C 則展示了反面:做法正確的難看程式碼,其 code_correctness 應該高於做法錯誤的體面程式碼。
評分標準(0–5)
code_correctness(0–5):結構健全性——程式碼是否為這個任務實作了一個可行的做法?
| 分數 | 說明 |
|---|---|
| 0 | 沒有實作、有語法錯誤,或完全不可執行。 |
| 1 | 致命的結構缺陷:分支不完整、實作被截斷,或做法對這個任務型別根本是錯的。 |
| 2 | 做法看似可行但有顯著缺口:只處理部分情況、解析脆弱,或悄悄吞掉錯誤。 |
| 3 | 紮實的實作,但有輕微的結構疑慮(例如沒有輸入驗證、寫死的限制可能涵蓋不了所有情況)。 |
| 4 | 乾淨的實作,使用適當的函式庫/演算法;完整處理該任務型別。 |
| 5 | 穩健的實作,有明確的錯誤處理、輸入驗證,以及恰當的演算法選擇。 |
code_clarity(0–5):命名品質與參數設計對 LLM 的可用性
| 分數 | 說明 |
|---|---|
| 0 | 沒有真正的函式:只是一段裸程式碼,或寫死答案且沒有參數。 |
| 1 | 函式名稱難以理解(例如 f、run);所有輸入擠在一個不透明的字串參數裡。 |
| 2 | 名稱過於籠統(例如 solve、process);參數命名不良或被塞進單一個 dict/字串。 |
| 3 | 名稱表達得出用途(例如 calculate_area);參數有拆開,但還可以再分解。 |
| 4 | 名稱具描述性;參數良好地拆成有型別的參數(例如 operator: str, a: float, b: float,而不是 expression: str)。 |
| 5 | 自我說明:函式名稱精確;每個參數都是原子的、型別明確、命名到 LLM 不看範例就能呼叫。 |
schema_quality(0–5):OpenAI schema 的完整性與準確性
| 分數 | 說明 |
|---|---|
| 0 | 沒有 schema,或 JSON 格式錯誤。 |
| 1 | 缺少必要欄位、型別錯誤、沒有描述。 |
| 2 | 描述模糊或誤導;型別部分錯誤。 |
| 3 | 描述堪用、型別正確,但缺少格式細節或限制條件。 |
| 4 | 描述精確、型別正確、required 列表正確。 |
| 5 | 描述指明了確切的輸入格式、限制條件、數值範圍與範例。 |
schema_code_alignment(0–5):schema 是否準確代表程式碼實際的行為?
| 分數 | 說明 |
|---|---|
| 0 | schema 描述的是一個完全不同的函式。 |
| 1 | 參數名稱或型別與函式簽名相牴觸。 |
| 2 | schema 描述的是程式碼並未實作的理想化行為。 |
| 3 | 大致對齊,但 schema 過度承諾(例如宣稱能處理程式碼跳過的情況)。 |
| 4 | 只有輕微出入(例如某個描述稍有偏差)。 |
| 5 | schema 是實際實作的精確契約。 |
overall_quality(0–5):整體判斷——一個 LLM 用這個工具能不能得到正確答案?
重要:
overall_quality不得超過code_correctness+ 1。 程式碼壞掉的工具,不會因為 schema 漂亮就被救回來。
| 分數 | 說明 |
|---|---|
| 0 | 無法使用:沒有能動的程式碼或沒有 schema。 |
| 1 | 壞掉:致命的結構缺陷使它無法可靠使用。 |
| 2 | 勉強:做法看似可行,但缺口太多,得不到可靠結果。 |
| 3 | 堪用:做法紮實,能處理常見情況。 |
| 4 | 好:做法正確、API 清楚、schema 準確。 |
| 5 | 優秀:穩健的實作,搭配優秀的 API 設計。 |
輸出格式
只回傳一個 JSON 物件:
{
  "red_flags":             "<list every structural problem found in Step 1,
                             or 'none' if clean>",
  "task_coverage":         "<yes/partially/no -- does the code cover the
                             task type and sample questions?>",
  "reasoning":             "<1-2 sentences justifying scores based on the
                             red flags and task coverage above>",
  "code_correctness":      <int 0-5>,
  "code_clarity":          <int 0-5>,
  "schema_quality":        <int 0-5>,
  "schema_code_alignment": <int 0-5>,
  "overall_quality":       <int 0-5>
}
附錄 D 建構與使用任務的提示詞範本
本附錄記錄 SMITH 訓練期間使用的提示詞範本。所有提示詞在整個訓練過程中固定不變;訓練回合之間不做任何提示工程。
D.1 建構任務提示詞
建構任務採用兩段式訊息結構:一則建立模型角色的 system message,以及一則把詳細的寫工具指示與 $N{=}4$ 組脈絡問答對合併起來的 user message。
user message 的結構。 user message 依序串接三個部分:
- 工具製作指示區塊。 一段固定的多段落提示詞(以下為節略),指明:
- 核心原則:模型提出、執行驗證(「Model Proposes, You Dispose」);參數必須是原子且有型別的;函式名稱必須遵循動詞—名詞的命名慣例。
- 最佳實務:使用標準函式庫(
sympy、numpy)而非脆弱的正則表達式;明確處理邊界情況;絕不寫死與特定輸入相關的值。 - schema 需求:
name欄位必須與頂層的 Python 函式相符。
- 脈絡範例。 從當前任務類別的簡單難度帶取出的 $N{=}4$ 組問答對,格式為:
Question 1: {q_1} \n Answer: {a_1} \n\n Question 2: {q_2} \n Answer: {a_2} \n\n … - 隱藏中繼資料。 一個
<tool_rl_metadata>…</tool_rl_metadata>區塊,內含 JSON 編碼的任務中繼資料(任務類別、測試集、標準答案)。這個區塊由訓練框架附加,並在提示送給策略之前被剝除,所以模型在生成期間絕不會看到測試集的標準答案。
工具的約束。 每個建構任務實例還額外指定兩條由結構驗證器檢查的命名約束:生成的函式必須命名為 solve,且必須接受單一個名為 question 的參數。這些約束會寫在指示區塊中,並由格式獎勵 $r^{\mathrm{fmt}}$ 強制執行。
D.2 使用任務提示詞
使用任務給模型一個工具(以 JSON schema 形式),要它呼叫該工具來回答問題。模型只看得到 OpenAI 相容的 schema,永遠看不到底層的 Python 程式碼,藉此測試 schema 是否清楚到足以驅動正確的呼叫。
工具注入。 可用的工具 schema 透過 OpenAI chat-completion API 的標準 tools 參數注入。每次使用任務的 rollout 最多收到 $m{=}3$ 份 schema:1 個領域工具(來自正確類別)與 2 個干擾工具(來自隨機選出的其他類別)。這迫使模型必須辨識並呼叫正確的 schema,而不是預設呼叫第一個可用的工具。
user message。 user message 只包含目標問題。
多輪對話。 模型以一則 OpenAI tool_calls 訊息回應,指明要呼叫哪一份 schema、帶什麼參數。訓練框架執行該 Python 函式,把回傳值格式化成一則 role: tool 訊息,附加到對話中。這個過程最多持續 $T{=}5$ 輪;最終答案必須放在 \boxed{} 分隔符內呈現。
D.3 $r^{\mathrm{eval}}$ 的評估器提示詞
評估器模型 $\pi^{\mathrm{eval}}$(2.1 節)使用生成的工具回答 $K{=}16$ 個保留測試問題中的每一個,遵循上述相同的使用任務提示結構。關鍵在於:
- 只會顯示 JSON schema;評估器永遠拿不到 Python 實作。
- 正確性由 LLM 等價性 judge(2.1 節)驗證,它比對評估器的最終答案與標準答案;精確字串比對作為快速路徑的後備。
- 計分規則:一個問題只有在評估器的最終答案是經由一次成功的工具呼叫產生時才算正確。純文字的答案(沒有呼叫工具)不計入 $r^{\mathrm{eval}}$,以防評估器靠自己的推理能力繞過工具使用這個目標。
- LoRA 同步:$\pi^{\mathrm{eval}}$ 會週期性地複製最新的訓練檢查點權重來更新(每 5 個梯度步一次),隨著策略成為更好的工具使用者,提供一個持續進步的評估目標。這種同步可能引入的假影,詳見附錄 B 的討論。
附錄 E 工具池設計
工具池 $\mathcal{P}$ 是一個輕量的快取機制,讓工具創建與工具使用在同一個訓練批次內解耦。一旦某次建構任務的 rollout 產出一個合法工具,後續(同一批次或未來批次的)使用任務 rollout 就能直接呼叫它,不必重跑建構步驟。本節記錄工具池的內部結構、納入準則、淘汰政策、干擾項選擇與初始化。
E.1 池的結構
$\mathcal{P}$ 是一個以任務類別為鍵的執行緒安全字典:
$$\mathcal{P}:\text{category}\;\to\;\bigl[\,\{\texttt{python\_code},\;\texttt{openai\_tools},\;\texttt{quality}\}\,\bigr]$$
每筆條目儲存原始的 Python 函式字串、OpenAI 相容工具 schema 字典的列表,以及納入當下的評估品質分數 $r^{\mathrm{eval}}$。存取由單一個可重入鎖保護,讓並行的 rollout worker 能在不發生資料競爭的情況下讀寫。
每個 rollout 的任務類別是從資料列識別碼解析出來的(例如鍵 "bitwise_arithmetic-train-build-42" 對應到類別 "bitwise_arithmetic")。
E.2 納入準則
一個在建構任務 rollout 期間生成的工具,若且唯若 $r^{\mathrm{eval}}>0$ 才會被納入池中,也就是說該工具至少答對 $K{=}16$ 個保留測試問題中的一題。$r^{\mathrm{eval}}=0$ 的工具(包含格式失敗與執行錯誤)會被丟棄,永不快取。
E.3 容量上限與淘汰政策
每個類別的桶最多存 $C{=}20$ 筆。當一個新工具要被納入而桶已滿時,$r^{\mathrm{eval}}$ 分數最低的那筆會被淘汰以騰出空間。若有多筆並列最低分,則選最舊的那筆(最早插入的)作為破平手依據,實現「品質優先、時間新舊作為 tiebreaker」的政策。
這個淘汰政策有一個天然的難度課程效果:隨著訓練推進、策略寫出更好的工具,池的最低品質門檻會有機地上升。因此後期訓練步的使用任務 rollout,會面對一個品質更高、競爭更激烈的池,等於在沒有任何顯式排程的情況下提供了一套隱含的難度課程。
E.4 檢索與干擾項選擇
當類別 $k$ 的使用任務 rollout 到來時:
- 領域工具。 從 $\mathcal{P}[k]$ 取出最多 $m_{d}{=}1$ 個工具,取自最近納入的條目(最後插入的)。若 $\mathcal{P}[k]$ 是空的,該次使用任務 rollout 會先執行一次全新的建構流程。
- 干擾工具。 從桶非空的類別 $k^{\prime}\neq k$ 中取出最多 $m_{\mathrm{dist}}{=}2$ 個工具。每個合格類別均勻隨機抽出一個工具,選中的類別在注入前會被打亂,讓跨 rollout 的多樣性最大化。
- 提示注入。 領域工具與干擾工具會被串接成單一個
tools列表傳給 OpenAI API,就好像這三個都是模型自己建的一樣。模型必須透過檢視 schema 辨識出正確的工具,並用正確的參數呼叫它。
1 個領域工具搭配 2 個干擾項的組合,意味著模型不能靠隨便呼叫第一個工具矇混過關:它必須解析 schema、判斷哪個函式與問題相關,並構造出合法的參數字典。
E.5 初始化
池在訓練開始時是空的。在最初幾個訓練步,所有需要「池中尚未涵蓋的類別」的使用任務 rollout,都必須先執行一次建構流程。每個批次中建構與使用任務 1:1 的比例(2.1 節)確保建構任務在早期就頻繁觸發,讓池快速被填滿。
一旦某個類別的桶跨過「至少有一個合法工具」的門檻,該類別後續的使用任務 rollout 就會切換到池檢索路徑、跳過建構步驟,替每個受影響的 rollout 省下大約一次 LLM 前向傳遞。
附錄 F 13 個訓練任務的完整難度切分
3.4 節描述了由易到難的訓練協定,並以 cryptarithm 任務為例做了詳細說明。本附錄提供全部 13 個訓練類別的完整對應:歸納難度帶($N{=}4$ 個脈絡範例從這裡抽取)與評估難度帶($r^{\mathrm{eval}}$ 針對這裡計算)。
難度帶由 Reasoning-Gym 程序生成器中逐步變難的實例化參數逐任務定義。帶標籤沿用生成器的內部尺度:數字越高代表實例越難。對每個任務而言,歸納脈絡使用最簡單的帶(Band 2),評估集使用可用的最難帶。這種分離確保一個只是背下歸納範例的工具會拿到接近零的分數。
表 11:13 個 SMITH 訓練任務的歸納脈絡與評估難度帶。歸納帶定義了建構任務中 $N{=}4$ 個脈絡範例的難度。評估帶定義了用來計算 $r^{\mathrm{eval}}$ 的實例難度。關鍵難度軸是那個從易到難成長的參數。
| 任務 | 類別 | 歸納帶(易) | 評估帶(難) | 關鍵難度軸 |
|---|---|---|---|---|
| Bitwise arithmetic | 算術 | 運算式深度 2 | 運算式深度 4–5 | 位元運算式樹的巢狀深度 |
| Cryptarithmetic | 算術 | $\leq\!8$ 個相異字母(易/中等謎題) | $\geq\!9$ 個相異字母,含 10 字母謎題如 FORTY+TEN+TEN=SIXTY | 相異字母數(搜尋空間指數成長) |
| Bit counting | 演算法 | 整數值 $1$–$10^{6}$ | 整數值 $10^{7}$–$10^{8}$ | 輸入整數的量級 |
| LCM | 演算法 | 2 個數,值 1–50 | 3–4 個數,值 100–500 | 運算元的個數與量級 |
| GCD | 演算法 | 2 個數,值 1–500 | 3–4 個數,值 1,000–5,000 | 運算元的個數與量級 |
| Base conversion | 演算法 | 基數 2–10,值 1–500 | 基數 2–16,值 2,000–5,000 | 目標基數範圍與數字量級 |
| Isomorphic string | 演算法 | 字串長度 10–19 | 字串長度 31–40 | 字串長度(越長要追蹤越多字元映射) |
| Polynomial equations | 代數 | 2–3 項,次數 1–2,係數 1–10 | 5–6 項,次數 3–5,係數 1–50 | 多項式次數與項數 |
| Polynomial multiplication | 代數 | 每個多項式 2–3 項,次數 1–2,2 個多項式,係數 1–5 | 5–6 項,次數 3–5,2–3 個多項式,係數 1–12 | 次數、項數與要相乘的多項式數量 |
| Countdown | 遊戲 | 4 個數,目標 10–100 | 6 個數,目標 10–200 | 可用運算元數量與目標範圍 |
| Tower of Hanoi | 遊戲 | 3 個盤(7 步最佳解) | 5 個盤(31 步最佳解) | 盤數(解長度以 $2^{n}-1$ 成長) |
| Knights and Knaves | 邏輯 | 2 個角色,深度 2,寬度 3 | 4 個角色,深度 4,寬度 5 | 角色數與邏輯推導樹的深度 |
| Caesar cipher | 邏輯 | 3–10 個字,位移 1–10 | 12–20 個字,位移 15–25 | 文字長度與位移量(位移越大越難猜) |
訓練集與評估集大小
每個任務的訓練集(歸納帶)由難度 Band 2 的 500 個實例組成。對於易到難落差夠大、值得如此處理的任務,訓練集會額外納入 Band 3(中等)的 500 個實例,但評估集永遠取自可用的最難帶。用來在每個 rollout 步計算 $r^{\mathrm{eval}}$ 的評估集,由推論時取樣的 $K{=}16$ 個實例組成。
任務—類別對應
13 個訓練類別橫跨五個較高層次的群組:算術(bitwise arithmetic、cryptarithmetic)、演算法(bit counting、LCM、GCD、base conversion、isomorphic string)、代數(polynomial equations、polynomial multiplication)、遊戲(countdown、Tower of Hanoi)與邏輯(knights and knaves、Caesar cipher)。這樣的分布確保 RL 策略接觸到多種演算法型別。
附錄 G TabMWP-Hard 與 GQA 的分布外推論協定
3.2 節描述了兩個分布外基準,但沒有交代確切的推論流程。本附錄記錄 TabMWP-Hard 與 GQA 所用的協定,它盡可能貼近 Reasoning-Gym 的評估迴路,好讓效能差異能歸因於領域偏移,而不是評估方式的不對稱。
G.1 單次「建構後使用」迴路
在評估時,對每個基準模型都執行一次建構流程,然後把得到的工具套用到每一個測試實例:
- 建構流程。 從基準自己的訓練(或驗證)切分中取樣一小組參考問答對,用標準的建構任務提示(附錄 D)呈現給模型。模型在單次前向傳遞中生成一個 Python 函式與一份對應的 OpenAI 相容 JSON schema。
- 不重試。 若建構失敗(語法錯誤、schema 與程式碼不符,或執行錯誤),該工具被丟棄,這一輪的每個測試實例都記為零分。不會有額外的建構嘗試。
- 使用流程。 每個測試問題連同生成工具的 JSON schema,以標準 OpenAI function-calling 格式呈現給模型。模型在給出最終答案前最多可發出 $T{=}5$ 次工具呼叫。若模型呼叫了工具且回傳答案與標準答案相符,該題得 1 分,否則得 0 分。
這種「單次建構後使用」的結構,與 RG (Seen) 與 RG (Unseen) 所用的 Reasoning-Gym 評估迴路完全相同:從簡單脈絡範例歸納出來的同一個工具,不做任何修改就套用到所有測試實例。
G.2 脈絡範例
建構流程的脈絡範例取自各基準自己的訓練切分,確保模型有一個領域合適的歸納脈絡:
TabMWP-Hard
我們從原始的 TabMWP 訓練切分(增強前)取樣 $N{=}4$ 組(問題、表格、答案)三元組。表格被序列化成以管線符號分隔的純文字字串,前置到問題文字之前,格式與測試實例一致。每一次評估回合都使用同一組範例。
GQA
我們從 GQA 訓練切分取樣 $N{=}10$ 組問答對。如附錄 H 所述,建構脈絡中不顯示任何圖片;模型只看得到問題字串,必須推斷如何組合視覺原語來回答它們。GQA 使用較大的脈絡集($N{=}10$ 而非 $N{=}4$),是因為視覺問題型別的多樣性更高,需要更多範例。
G.3 與 RG 訓練迴路的協定差異
分布外評估協定與訓練時的 Reasoning-Gym 迴路有三點不同:
- 沒有由易到難的落差。 對 Reasoning-Gym 而言,歸納脈絡取自簡單難度帶、評估集取自困難帶(3.4 節)。分布外基準沒有這種難度分層;脈絡範例與測試實例取自同一個分布。
- 不使用工具池。 評估時不會注入任何來自訓練工具池的預建工具。模型永遠從提供的脈絡範例做一次全新的建構。
- 不計算評估獎勵 $r^{\mathrm{eval}}$。 $r^{\mathrm{eval}}$ 是訓練時用來對照一組保留 RG 實例評分工具的訊號。分布外評估時唯一的訊號是最終的測試切分準確率。
綜合起來,這些差異意味著分布外表現反映的是模型把寫工具策略泛化到新領域的能力,而不是利用訓練分布捷徑的能力。
附錄 H GQA 視覺工具設定
由於 SMITH 完全在文字型的 Reasoning-Gym 任務上訓練,模型在評估時沒有直接的感知能力。為了讓它仍能回答 GQA 問題,我們提供一組固定的三個視覺原語函式,它們已預先實作好並透過本地 API 提供服務。模型在建構任務中的工作,是把這些原語組合成一個可重用的工具;它從不需要自己處理像素。
H.1 視覺原語函式
模型可以使用三個原語:
locate_objects(image_b64, object_name):使用 OWL-ViT [18](owlvit-base-patch16)進行開放詞彙的物件偵測。對 base64 編碼的 JPEG 圖片image_b64,回傳所有偵測到的object_name實例的邊界框列表,格式為 $[\,x_{1},y_{1},x_{2},y_{2}\,]$。visual_qa(image_b64, question):使用 BLIP-VQA [14](Salesforce/blip-vqa-base)回答關於圖片的自由形式自然語言問題。回傳一個簡短的自由文字答案字串。crop_region(image_b64, boxes):一個純 Python 工具(不含神經網路模型),把圖片裁切到boxes中的第一個邊界框,帶 $1.5\times$ 的留白邊界,並把裁切區域以新的 base64 JPEG 字串回傳。
這三個原語都由 localhost:8000 上的一個 FastAPI 伺服器提供(可用 $GQA_SERVER_URL 環境變數設定)。
H.2 圖片編碼
GQA 測試圖片從 HuggingFace 資料集 [anonymous]/gqa-testdev-balanced 載入。在每次工具呼叫之前,當前問題的 PIL 圖片會被編碼成 base64 JPEG 字串,並綁定到 Python 全域變數 IMAGE。生成的工具程式碼一律從這個全域變數讀取;它不接受圖片路徑或 URL 參數。這個設計讓工具介面保持簡單。
# 工具介面(所有 GQA 工具共用且固定)
def solve(question: str) -> str:
    # IMAGE 已預先載入為 base64 編碼的 JPEG 全域變數
    objects = locate_objects(IMAGE, ...)
    answer  = visual_qa(IMAGE, question)
    return answer
H.3 GQA 的建構任務提示詞
在標準的工具製作指示區塊之前,建構任務提示詞會前置一個原語脈絡區塊,它 (a) 宣告三個可用函式及其完整簽名與 docstring,並 (b) 指示模型必須組合這些原語,而不是自己重新實作視覺邏輯。注入提示的關鍵約束是:
「你生成的工具只能接受
question: str,依需要組合上述原語,並以純字串回傳答案。不要重新實作locate_objects、visual_qa或crop_region;直接呼叫它們。」
建構任務中給模型看的 $N{=}10$ 個脈絡範例,從 GQA 訓練切分中均勻隨機取樣。每個範例是一組(問題、答案)對;建構任務提示本身不顯示任何圖片,所以模型只能透過可用原語這面透鏡去推理圖片內容。
H.4 工具挑選與評估
由於視覺工具的生成比純文字工具更嘈雜(模型在寫工具時得不到直接的視覺回饋),我們生成 $M{=}10$ 個候選工具提案,再挑出表現最好的那一個:
- 從 GQA 訓練切分取樣 $N{=}10$ 組參考問答對作為脈絡建構情境。
- 用建構任務提示詞生成 $M{=}10$ 個候選 Python 工具。
- 在一組取自 GQA 訓練切分、與前者互斥的 100 題驗證集上評估每個候選;記錄各候選的驗證準確率。
- 選出驗證準確率最高的候選作為最終工具。
- 把選定的工具套用到完整的 GQA 測試切分;回報測試切分準確率。
建構失敗(語法錯誤或 schema 不符)的候選其驗證準確率記為零,除非全部 $M$ 個候選都失敗,否則永遠不會被選中;若全部失敗,則回傳一個空回應的後備,每個測試題都得零分。
H.5 答案驗證
GQA 的答案是簡短的自由形式字串(例如「yes」、「blue」、「3」)。我們在轉小寫並去除空白後使用精確字串比對。不套用 LLM 等價性 judge;GQA 答案的簡單性使得規則式精確比對已經足夠,也避免了在 2,516 個測試問題規模下的 judge 開銷。
附錄 I ReTool 評測設定
ReTool [6] 作為蒸餾基準納入,用來隔離出「以 schema 為基礎的工具表徵」的貢獻:ReTool 與 SMITH 都使用執行回饋,但只有 SMITH 產出可重用的可呼叫 schema。本附錄記錄我們 ReTool 結果所用的檢查點、訓練設定與評估協定。
I.1 檢查點與訓練設定
我們在官方的 ReTool-SFT 資料集(HuggingFace 上的 JoeYing/ReTool-SFT)上微調 Qwen3-4B-Instruct,該資料集包含從 Qwen-32B 蒸餾而來的程式碼執行軌跡。訓練使用 QLoRA,超參數如下:
表 12:ReTool 微調超參數。
| 超參數 | 數值 |
|---|---|
| 基礎模型 | Qwen3-4B-Instruct |
| 訓練資料集 | JoeYing/ReTool-SFT |
| Adapter | QLoRA(4-bit NF4,double quantisation) |
| LoRA rank $r$ | 64 |
| LoRA $\alpha$ | 128 |
| LoRA dropout | 0.05 |
| LoRA 目標模組 | 所有線性層 |
| Epochs | 6 |
| 序列長度 | 5,120 tokens |
| 梯度累積 | 8 |
| Micro-batch size | 2 |
| 優化器 | paged_adamw_32bit |
| LR 排程 | Cosine |
| 學習率 | $4\times 10^{-5}$ |
| Warmup 比例 | 0.1 |
這與 SMITH 所用的 LoRA 設定($r{=}64$、$\alpha{=}128$)一致,因此 ReTool 與 SMITH 之間的任何效能差異,都可歸因於訓練目標而非 adapter 容量。
I.2 在 Reasoning-Gym 與分布外基準上的評估協定
程式碼執行
ReTool 以多輪迴路運作:模型在 ```python … ``` 區塊中生成程式碼,沙箱執行每個區塊並回傳包在 <interpreter>output</interpreter> 標籤中的輸出,模型再從執行軌跡繼續推理。我們允許每題最多 $T_{\mathrm{rt}}{=}10$ 輪程式碼執行。
Reasoning-Gym 與 TabMWP-Hard
每個測試問題直接連同 ReTool 的標準系統提示呈現給模型;不提供任何工具 schema 或脈絡範例。由於 ReTool 生成的是逐題的程式碼而非可重用的 schema,這裡沒有建構流程也沒有工具池:每一題都觸發一次全新的程式碼生成回合。
GQA 的適配
回答 GQA 問題需要取用視覺原語。我們為 GQA 調整 ReTool 的方式是:(a) 在系統提示中加入三個視覺原語函式的說明(locate_objects、visual_qa、crop_region;見附錄 H),並 (b) 把原語的實作程式碼前置到每一個沙箱執行區塊,讓程式碼不需 import 就能呼叫它們。
I.3 與 SMITH 的關鍵差異
ReTool 與 SMITH 都使用執行回饋,但在兩個結構性面向上不同,而這正是本文比較的核心軸線:
- 可重用性。 ReTool 逐題生成一次性的程式碼;程式碼在每輪之後就被丟棄。SMITH 生成一份可呼叫的 JSON schema,那是一個結構化的介面,可以存進工具池並在許多題目間重複使用,不必重跑建構步驟。
- 訓練訊號。 ReTool 由一個 32B oracle 以行為複製訓練。SMITH 則是從可驗證的獎勵端到端訓練,訓練時完全不需要強大的 oracle。
ReTool 在分布內的 RG (Seen) 上取得最高準確率($92.0$,我們是 $86.6$),反映出 32B 蒸餾 oracle 在已見任務家族上的優勢。SMITH 的優勢則展現在保留轉移上(RG Unseen、GQA、TabMWP-Hard),那裡可重用的 schema 與 RL 訓練出的泛化能力,提供了勝過逐題程式碼生成的結構性優勢。
附錄 J LATM 蒸餾 GPT-4.1 基準設定
LATM(4B 蒸餾 GPT-4.1)這個基準用來檢驗「從強大的凍結 oracle 做行為複製」能否追平「在明確獎勵訊號上做 RL 訓練」。oracle 是 GPT-4.1,它為 13 個訓練任務類別各生成寫工具的軌跡;接著在這些軌跡上微調一個 Qwen3-4B 模型。
J.1 軌跡收集
Oracle 模型
寫工具的軌跡由 GPT-4.1 透過 OpenAI API 生成。對每個任務類別,GPT-4.1 收到與 SMITH 相同的建構任務指示區塊(附錄 D),連同從簡單難度帶取樣的 $N{=}5$ 組問答對。
軌跡數量
每個任務類別、每個技能組樣本收集 $M{=}8$ 次生成嘗試,其中「技能組」指的是一次特定的 $N$ 個脈絡範例抽樣。工具製作軌跡(oracle 回應=Python 程式碼+JSON schema)與工具使用 rollout(成功呼叫工具並產出正確答案的多輪對話)都會被保留。
工具使用 rollout 收集
工具生成之後,一個凍結的 Qwen3-4B-Instruct 模型會用 oracle 生成的 schema,對每個訓練問題執行最多 10 輪工具呼叫。多輪對話只在以下兩個條件都成立時保留:(a) 工具呼叫執行無誤,且 (b) 產出的答案與標準答案相符。每個任務最多收集 1,000 段這樣的對話。
干擾項增強
為了教會學生模型在多個候選中挑出正確的工具,每段保留下來的工具使用對話會以兩種比例加入干擾 schema:50% 的樣本加入一個干擾項(來自隨機選出的不同類別),90% 加入第二個。增強套用與 SMITH 相同的池檢索邏輯(附錄 E)。
最終資料集包含全部 13 個訓練類別的工具製作對話與加了干擾項的工具使用對話。
J.2 微調設定
我們在收集到的 SFT 資料集上,用全參數微調(不使用 LoRA adapter)微調 Qwen3-4B-Instruct。訓練超參數如下:
表 13:LATM(蒸餾 GPT-4.1)微調超參數。
| 超參數 | 數值 |
|---|---|
| 基礎模型 | Qwen3-4B-Instruct |
| Adapter | 無(全參數微調) |
| Epochs | 4 |
| 序列長度 | 16,000 tokens |
| 梯度累積 | 18 |
| Micro-batch size | 2 |
| 優化器 | adamw_torch |
| LR 排程 | Cosine |
| 學習率 | $4\times 10^{-5}$ |
| Warmup 比例 | 0.1 |
| 訓練格式 | 對話範本;只在 assistant 輪上計算損失 |
微調使用全參數更新(而非 LoRA),與 SMITH 的 LoRA 設定($r{=}64$、$\alpha{=}128$)形成對比。這意味著 LATM 蒸餾模型會修改所有模型權重,可能有更大的有效容量去背下 oracle 的風格。因此這個比較檢驗的是訓練訊號的品質(RL 獎勵 vs. 行為複製)。
J.3 評估協定
評估時,微調後的 LATM 模型使用標準的「建構後使用」推論協定(附錄 G)評測。測試時不涉及任何 oracle 模型;學生模型自行從 $N{=}4$ 個脈絡範例生成工具。結果在表 1 與表 4 中以 RG (Seen)、RG (Unseen)、TabMWP-Hard 與 GQA 回報。
J.4 與 SMITH 的比較
LATM(蒸餾 GPT-4.1)與 SMITH 的關鍵結構差異在於訓練訊號的來源:
- LATM(蒸餾 GPT-4.1) 透過模仿 GPT-4.1 的輸出來訓練。學生學會複製 GPT-4.1 寫出來的東西,不管那些工具在保留實例上是否真的能正確執行。
- SMITH 從可驗證的執行獎勵訓練。每一次梯度更新都取決於生成的工具是否答對了保留測試問題;完全不需要 oracle 示範。
LATM(蒸餾 GPT-4.1)在分布內取得很強的準確率(RG Seen $83.3$),因為 GPT-4.1 為訓練任務類別生成了高品質的工具。SMITH 的優勢則出現在轉移基準上(RG Unseen $79.8$ 對 $66.4$;GQA $42.6$ 對 $\mathbf{56.0}$†),那裡執行獎勵把策略推向能泛化的工具。
† GQA 上的 GPT-4.1 蒸餾差距,反映的是 GPT-4.1 具備原生的視覺理解能力,能生成 4B 學生可以模仿的視覺原語;SMITH 的 GQA 分數則完全靠自監督的工具創建迴路取得,沒有任何視覺 oracle 資料。
附錄 K Agentic loop 比較 KTCE CRAFT TroVE 與 SMITH
本附錄對 3.5 節評測的三個基準系統(KTCE [17]、CRAFT [35]、TroVE [31])與我們自己的 SMITH 框架,提供實作層級的 agentic 設計比較。變異的核心軸線是:工具創建發生在測試時推論的哪個時間點。
K.1 定位總覽
表 14 先把每個系統放到工具創建的時間軸上,再逐一討論各系統的迴路。
表 14:各系統的工具創建時機、模型是否被修改、以及工具能否跨題目重複使用。
| 系統 | 工具創建時機 | 權重是否改變? | 工具能否跨題目存活? |
|---|---|---|---|
| KTCE | 完全離線(在任何測試題之前) | 否 | 是(固定工具集) |
| CRAFT | 完全離線(在任何測試題之前) | 否 | 是(固定工具庫) |
| TroVE | 線上/串流(測試推論期間) | 否 | 是(工具庫依序成長) |
| SMITH | 透過 RL 離線訓練 | 是 | 是(品質過濾後的池) |
K.2 KTCE:離線演化式創建 + 線上檢索後求解
KTCE 用一道硬邊界把工具創建與推論分開。所有工具相關的工作都在看到任何測試題之前完成。
離線階段
訓練題目先用 BGE-M3 嵌入與 $k$-means 分群,依數學子領域分組。對每個子領域群集,由一個 LLM 生成候選 Python 函式;語意上近乎重複的候選會用階層式分群收攏(相似度 $\geq 0.80$),每群挑一個經驗證的工具。接著進入演化迴路:
- 評估:把該子領域所有訓練題目跑過當前工具集;記錄每個工具的使用頻率(Freq)與工具成功率(TSR)。計算複合損失 $\alpha\sum Q_{\text{tool}}+\beta Q_{\text{set}}+\gamma\max(0,n-k)$。
- 刪除:由 LLM 根據低頻率與低成功率決定移除哪些工具(最多 3–5 個)。
- 修改:對每個 $\text{TSR}/\text{Freq}\leq 0.90$ 的工具,以失敗案例為脈絡生成一個演化版本;替換前先以執行驗證。
- 新增:由 LLM 為目前未被涵蓋的題目提出新工具;插入前先以執行驗證。
- 回滾:若損失上升,回退到前一次迭代,並把失敗脈絡傳給下一次的修改/新增步驟。
每筆工具記錄都帶有一個自然語言的 experience_pool:評估步驟中累積下來的使用範例。最終工具集組織成兩層映射:$\text{領域}\to\text{子領域}\to[\text{工具}]$。
線上階段(每個測試題)
- 從逐題中繼資料取得子領域。
- LLM 呼叫 1:模型讀取一份編號的子領域工具清單並選出要用的工具;輸出被解析成工具索引。
- LLM 呼叫 2:模型生成呼叫選定工具的 Python 程式碼,並以 BGE-M3 排序的 few-shot 範例(來自 experience pool)增強。程式碼被執行,輸出(hint)被擷取。
- LLM 呼叫 3:以思維鏈從 hint 中抽取最終答案。
測試時的 LLM 呼叫次數:3(檢索選擇+程式碼生成+CoT 抽取)。
K.3 CRAFT:離線多樣性取樣創建 + 多視角檢索
CRAFT 用 GPT-4 離線建構工具庫(創建與抽象兩個步驟都用它),推論時再換成 GPT-3.5-turbo。
離線階段
訓練題目以「最大化多樣性」的方式分回合取樣:第 0 回合隨機抽 200 題;之後每回合把剩餘題目依「與已取樣題目的最小 SimCSE 餘弦相似度」排序,取最不相似的 100 題。對每個取樣到的題目:
- LLM 呼叫 1(GPT-4):為這一題生成一個具體的 Python 解法。執行並評分;答錯就丟棄。
- LLM 呼叫 2(GPT-4):把具體解法抽象成一個帶 docstring 的通用參數化函式。執行這個抽象工具;無法執行就丟棄。
存活下來的工具再依函式名稱相似度去重。每個工具接著被編碼成四個 SimCSE 向量:(i) 函式名稱、(ii) 一行說明、(iii) 完整 docstring、(iv) 產生該工具的原始題目。這些存成 vector_library.pt 供檢索使用。
線上階段(每個測試題)
- 用 SimCSE 編碼測試問題;對工具庫的四種向量視角評分;取回前 $k$ 個工具(若脈絡溢出則 $k=3\to 2\to 1$)。
- LLM 呼叫 1:問題+取回的工具程式碼(直接貼進提示)$\to$ 生成一個可能呼叫或擴充這些函式的新具體解法。
- LLM 呼叫 2:問題+新解法 $\to$ 生成 API 呼叫運算式。
- 執行「取回的工具+新程式碼+API 呼叫」,對照標準答案評分。
測試時的 LLM 呼叫次數:2(程式碼生成+API 呼叫)。
K.4 TroVE:線上串流式創建 + 基於頻率的遺忘
TroVE 沒有離線前處理階段。工具庫從一個最小的預設工具箱(標準 import)出發,隨著測試題目依序被處理而成長。
線上階段(每個測試題,依序處理)
每一題平行跑三種模式:
- Import 模式:把當前完整工具庫注入提示;LLM 用既有函式生成解法。
- Create 模式:只顯示預設(初始)工具庫;LLM 生成解法,並定義它認為可以重複使用的新輔助函式。
- Skip 模式:不顯示任何工具庫;LLM 生成一份純 Python 解法。
每種模式的回應都被執行並評分。依「正確性優先、其次可執行性」選出最佳回應:
- 若 import 勝出:為每個被呼叫的函式增加使用頻率計數。
- 若 create 勝出且執行成功:把新函式加入工具庫。
週期性遺忘
每 500 題,頻率低於 $\log_{20}(n)$($n$ 為目前已處理題數)的工具會從工具庫中剪除。那些「勝出工具被剪掉」的題目會排入佇列,等所有題目處理完後,只用 import 與 skip 模式重新生成一次。
測試時的 LLM 呼叫次數:每題 3 次(每種模式一次,平行執行)。後面的題目會受惠於為前面題目創建的工具;因此結果取決於題目順序。
K.5 SMITH:RL 訓練的工具創建與工具使用耦合
SMITH 不在測試時提示一個凍結的模型去寫工具。它透過 RL 訓練一個 4B 模型成為有能力的工具創建者,並把工具創建與工具使用放在單一個學習目標內聯合最佳化。
訓練迴路
訓練在 Reasoning-Gym 的 13 個程序性任務類別上交替進行兩種任務型別:
- 建構任務:給定任務描述與一小組脈絡範例,在單次前向傳遞中生成一個 Python 函式與一份對應的 OpenAI 相容 JSON schema。計算三個獨立的獎勵訊號:保留問題上的執行準確率($r_{\text{eval}}$)、LLM-as-judge 的程式碼品質($r_{\text{judge}}$),以及格式一致性。
- 使用任務:給定共享池中的一個工具,正確呼叫它來回答一個保留問題;獎勵是規則式的答案比對。
共享池只納入通過執行評估的工具。隨著池被填滿,較弱的工具會被淘汰,形成一套隱含的難度課程,讓策略面對越來越強的競爭。
線上階段(每個測試題)
- 建構:1 次 LLM 傳遞生成 Python 函式與 JSON schema。
- 使用:LLM 透過 schema 呼叫工具;執行回傳結果;LLM 綜合出最終答案。
測試時的 LLM 呼叫次數:$\sim$3(建構+呼叫+答案綜合)。與所有基準不同的是,這個模型已經被訓練成「寫出它自己也能可靠呼叫的那種工具」。
K.6 完整比較表
表 15:agentic 工具創建設計的實作層級比較。
| 面向 | KTCE | CRAFT | TroVE | SMITH |
|---|---|---|---|---|
| 工具創建觸發點 | 每個知識子領域的訓練資料群集 | 每個訓練題目(跨回合多樣性取樣) | 每個能產出新穎、可執行函式的測試題 | 建構任務的 RL 訓練 rollout |
| 工具結構 | Python 函式+名稱/docstring/experience_pool | Python 函式+docstring+4 個 SimCSE 嵌入向量 | Python 函式+docstring+頻率計數器 | Python 函式+OpenAI JSON schema |
| 工具驗證 | 創建時執行+多數投票;最佳化時追蹤損失 | 具體與抽象兩階段都做執行+答案正確性 | 隱含:只有整份解法執行正確並在三選一中勝出,工具才進入工具庫 | 執行準確率作為 RL 獎勵;格式一致性為獨立訊號 |
| 最佳化/精修 | 明確的 5 次演化迴路:評估 $\to$ 算損失 $\to$ LLM 刪除/修改/新增 $\to$ 變差就回滾 | 無(一次性:創建、驗證、去重) | 隱含的頻率式遺忘:每 500 例剪除低重用工具 | RL 訓練本身就是最佳化迴路;靠梯度 |
| 檢索機制 | 兩階段:(1) 從中繼資料查子領域;(2) LLM 讀編號清單挑工具 | 跨 4 視角(名稱、說明、docstring、原始題目)的 SimCSE 相似度 | 無;整個當前工具庫注入 import 模式提示,靠修剪控制庫的大小 | 測試時無檢索 |
| 工具跨題重用 | 是(固定工具集共用於所有測試題) | 是(固定工具庫共用於所有測試題) | 是(為第 $i$ 題創建的工具,第 $i{+}1$ 題起可用) | 是(共享的、經執行驗證的池) |
| 順序依賴性 | 否(離線工具集與順序無關) | 否(離線工具庫與順序無關) | 是;後面的題目受惠於前面創建的工具,打亂順序會改變結果 | 推論時否(池是預先建好的) |
| 推論時的 agent 迴路 | 線性:查子領域 $\to$ LLM 選工具 $\to$ LLM 生成程式碼 $\to$ 執行 $\to$ LLM CoT 抽取 | 線性:多視角檢索 $\to$ LLM 生成程式碼(可擴充工具) $\to$ LLM 生成 API 呼叫 $\to$ 執行 | 每題三路平行(import/create/skip) $\to$ 選最佳 | 建構 $\to$ 呼叫 $\to$ 綜合 |
| 測試時的 LLM 呼叫 | 3(檢索選擇+程式碼生成+CoT 抽取) | 2(程式碼生成+API 呼叫) | 3(每種平行模式一次) | $\sim$3(建構+呼叫+答案綜合) |
| 工具創建期間的 LLM 呼叫 | 總計數百至數千(5 次迭代 $\times$ $N$ 題 $\times$ 每次迭代多次呼叫,逐子領域) | 每個訓練樣本 2 次(具體解法+抽象化),都用 GPT-4 | 0(沒有離線階段) | RL 訓練 rollout(攤提進模型權重) |
| 語意嵌入 | BGE-M3(分群、去重、few-shot 檢索) | SimCSE(多樣性取樣+多視角檢索) | 無 | 無 |
| 需要訓練? | 否 | 否 | 否 | 是(RL 微調) |
| 主要模型 | GPT-3.5-turbo(檢索、求解、演化);BGE-M3 做嵌入 | GPT-4(建構);GPT-3.5-turbo(推論);SimCSE(檢索) | CodeLlama-7b(預設)或任何 OpenAI 相容模型 | 4B RL 訓練模型 |
K.7 關鍵概念差異
LLM 在推論時看到的東西
這四個系統在「求解時工具如何呈現給模型」上有本質差異:
- KTCE 把工具程式碼、docstring 與 experience-pool 範例直接貼進解題提示;LLM 寫出直接呼叫這些工具函式的新程式碼。
- CRAFT 把檢索到的工具程式碼直接貼進提示;LLM 寫出可能呼叫或擴充這些函式的新程式碼。
- TroVE 把整個當前工具庫的函式定義貼進 import 模式提示;LLM 寫出按名稱從工具箱 import 的程式碼。
- SMITH 把工具呈現為 OpenAI function-calling schema(不是原始程式碼);LLM 發出一則
tool_calls訊息,Python 函式在外部被呼叫,結果以tool角色訊息回傳,LLM 再據以綜合出最終答案。
最佳化的目標
KTCE 與 TroVE 都維護一個演進中的工具庫,但兩者的最佳化策略是正交的:KTCE 套用一個由 LLM 驅動、帶損失導引回滾的明確刪除/修改/新增迴路,而 TroVE 則透過基於頻率的遺忘施加隱含的族群壓力。CRAFT 在創建後不做任何最佳化。SMITH 的最佳化則發生在權重裡。
檢索瓶頸
KTCE 與 CRAFT 在任何工具能被使用之前都需要一個檢索步驟;因此檢索品質構成了解法品質的上限。TroVE 靠著把整個工具庫塞進提示來繞開這點,但這只有在頻率式修剪讓工具庫小到塞得進脈絡時才行得通。SMITH 則完全消除了檢索。
附錄 L 基準方法的失效分析
本附錄記錄我們用 Qwen3-4B-Instruct-2507 在自己的基準套件上評測 KTCE [17] 與 TroVE [31] 時,觀察到的實作層級失效模式。這些觀察為表 1 中的 token 成本與準確率數字提供背景,也解釋了我們評估流水線中幾個方法上的選擇。
L.1 KTCE:三種相互疊加的失效模式
檢視全部 24 個任務的逐題推論輸出,可以看出三種截然不同的失效模式,它們合起來解釋了 KTCE 起伏不定的任務側寫。
失效模式 1:程式化求解器繞道
當沒有設定 LLM、或工具檢索步驟回傳空集合時,KTCE 的推論程式碼會退回到一個手寫的 solve 分派器。像 bitwise_arithmetic、count_bits、tower_of_hanoi 與 isomorphic_string 這些任務,完全是由這個分派器解掉的,一次 LLM 呼叫都沒有就達到 100% 準確率。
反過來說,那些程式化求解器不完整或根本不存在的任務則掉到接近零:cryptarithm(5.7%)、knights_knaves(4.8%)與 polynomial_equations(1.1%)都屬於這一類。GQA 是 0%,因為分派器沒有視覺問答的實作。
失效模式 2:生成空殼工具
在我們套件中大約一半的任務上,KTCE 的離線演化迴路產出了退化的工具——具體來說,就是函式主體只有 return ""。以下是 ab 任務的代表案例:
def solve_ab(problem: str) -> str:
    return ""
當 LLM 隨後生成呼叫 solve_ab 的程式碼時,程式碼執行成功,卻回傳空字串,導致評分器判定答案錯誤。因此空殼工具任務的準確率,完全取決於 _extract_final_answer 能否從原始模型回應中救回一個可用的答案。
失效模式 3:LLM 端點不穩定
檢視個別的推論輸出檔可以發現,許多回合遭遇了間歇性的 LLM 失敗:API 呼叫回傳空回應,導致 _solve_with_llm 提早返回,既沒有生成程式碼也沒有 token 用量記錄。例如 ab 任務在 210 筆條目中只有 64 筆有真正的 LLM 回應。
逐任務細目
表 16 彙整了整個任務套件上的這三種失效模式。
表 16:KTCE 逐任務診斷細目(Qwen3-4B-Instruct-2507)。「真實 LLM 呼叫」計算逐題推論輸出檔中 completion_tokens $>0$ 的條目數。「空殼工具」表示生成的工具主體無條件回傳空字串。
| 任務 | 準確率 (%) | N | 真實 LLM 呼叫 | 空殼工具 | 失效模式 |
|---|---|---|---|---|---|
| ab | 0.0 | 210 | 64 / 210 | 是 | FM2 + FM3 |
| base_conversion | 0.0 | 210 | 0 / 210 | 是 | FM2 + FM3 |
| bitwise_arithmetic | 100.0 | 280 | 0 / 280 | N/A | FM1(求解器) |
| caesar_cipher | 82.4 | 210 | 0 / 210 | 否 | FM1(求解器) |
| calendar_arithmetic | 66.7 | 198 | 198 / 198 | 是 | FM2 |
| chinese_theorem | 100.0 | 100 | 0 / 100 | 否 | FM1(求解器) |
| complex_arithmetic | 25.0 | 200 | 200 / 200 | 是 | FM2 |
| count_bits | 100.0 | 210 | 0 / 210 | 否 | FM1(求解器) |
| countdown | 78.6 | 210 | 210 / 210 | 是 | FM2 |
| cryptarithm | 5.7 | 210 | 0 / 210 | 否 | FM1(求解器不完整) |
| gcd | 96.2 | 210 | 210 / 210 | 是 | FM2 |
| gqa | 0.0 | 2516 | 0 / 2516 | 否 | FM1(無求解器) |
| group_anagrams | 0.0 | 200 | 200 / 200 | 是 | FM2 |
| gsm8k | 50.9 | 1319 | 0 / 1319 | 否 | FM1(求解器) |
| isomorphic_string | 100.0 | 350 | 0 / 350 | 否 | FM1(求解器) |
| knights_knaves | 4.8 | 210 | 0 / 210 | 否 | FM1(求解器不完整) |
| lcm | 18.1 | 210 | 210 / 210 | 是 | FM2 |
| polynomial_equations | 1.1 | 280 | 0 / 280 | 否 | FM1(求解器不完整) |
| polynomial_mult. | 66.1 | 280 | 0 / 280 | 否 | FM1(求解器) |
| puzzle24 | 40.1 | 382 | 382 / 382 | 是 | FM2 |
| self_reference | 75.6 | 234 | 234 / 234 | 是 | FM2 |
| simple_equations | 16.0 | 16 | 16 / 16 | 是 | FM2 |
| syllogism | 96.7 | 210 | 210 / 210 | 是 | FM2 |
| tabmwp | 56.0 | 3152 | 0 / 3152 | 否 | FM1(求解器) |
| tower_of_hanoi | 100.0 | 210 | 0 / 210 | 否 | FM1(求解器) |
L.2 TroVE:缺失的 token 用量記錄
TroVE 採用兩階段流水線:Phase 1(validate 切分)讓工具庫成長;Phase 2(test 切分,工具庫凍結)用來計分。token 用量只有在 OpenAI 相容後端有記錄時才會存進結果檔。檢視 20 個任務的 Phase 2 結果,有 12 個任務完全沒有存下 token_usage。
load_trove_token_average 函式原本會退回去用「以最初三個函式的工具箱渲染 TroVE 的 Mako 範本」來重建提示。然而 Phase 2 的提示實際上包含 Phase 1 學到的工具庫,可能大上許多。用初始工具箱重建會低估 token 數。
我們的修正方式是:只在真正有 API 記錄用量的任務上(20 個中的 8 個)計算巨觀平均 token 數,得到 829 個 token。這個數字本身仍是下界:被排除的 12 個任務因為學到的工具庫更大,提示很可能更長,所以 TroVE 真實的每題平均應該超過 829 個 token。
附錄 M TabMWP-Hard 資料集建構與增強
標準 CoT 在原版 TabMWP 基準上達到 $96.8\%$(表 1),使它成為一個不可靠的表格推理能力訊號:一個只要在小而乾淨的表格中找出被點名的實體、讀出它的值的模型,就能拿到接近滿分。本附錄記錄用來建構 TabMWP-Hard 的增強流水線。
M.1 表格型別涵蓋
TabMWP 的表格先由一個確定性的規則式分類器指派到七種結構型別之一(依優先序:Stem-and-Leaf、Financial Ledger、Two-Way、Function Table、Price Rate、Price List、Named Count)。我們選出三種型別做完整增強:Financial Ledger、Price List 與 Two-Way。
Stem-and-Leaf 表格被排除,因為它的鍵空間本質上有界:stem 是 0–9 的單一數字,所以最多只能加入 $10-|\text{既有 stems}|$ 個干擾列。一個已有五個 stem 的表格最多只能再加五個,遠遠不足以把目標列埋起來、或挑戰模型的查找能力。
M.2 增強流水線
每個選中的條目依序通過四個階段:
- 干擾列注入。 在隨機位置插入最多 2,000 個型別相容的列,讓表格從寥寥幾列長成數百甚至數千列。
- 近似列插入。 由 LLM(或規則式後備)生成第一欄鍵值與問題所問的鍵相似但不同的列,並把它們放在目標列的緊鄰位置。
- LLM 欄位增強。 由一個語言模型提出 3–4 個額外欄位,它們在該表格的領域中看起來合情合理,卻對回答問題毫無幫助。對於原始格式沒有表頭的 Price List 表格,LLM 會同時為既有欄位命名並發明新欄位,一併注入表頭。
- 兩步有效性把關。 LLM 先從原始表格回答問題,確認它能得到正確答案,接著驗證增強後的表格仍然包含必要資訊。任一步失敗的條目就被丟棄。
通過全部四個階段的條目,還會再檢查鍵值碰撞(M.6 節),才寫入最終資料集。
M.3 完整範例 A:Two-Way 表格
原始表格
原始條目是一份五列三欄的慈善捐款表。問題問的是兩個特定人物對某個特定用途的捐款差額。
Person         | Animal rights | Clean water
Eve            | $4            | $15
Eli            | $12           | $5
Bridgette      | $9            | $11
Kamal          | $18           | $11
Janelle        | $13           | $13
回答只需要在一份乾淨的五列表格中做兩次查找,對任何能解析基本表格文字的語言模型來說都是小事。
干擾注入之後
系統要求生成 2,000 列;生成器從全資料集的實體名稱池取樣名字,依每欄觀察到的型別與範圍產生數值(本表為整數貨幣),並把所有列打散到隨機位置。目標列(Eve 與 Eli)被埋在任意偏移處。
近似列插入之後
LLM 辨識出「Eve」與「Eli」是問題所引用的兩個鍵,並在每個目標的緊鄰位置插入名字相似的列。由於這是人名表,生成的近似鍵在讀音或拼寫上都很接近(例如「Ev」、「Elliot」),而金額則刻意不同。
LLM 欄位增強之後
LLM 提出四個符合慈善情境、但不編碼答案的額外欄位:Membership Year、Donation Method、Annual Giving Level 與 Recurring Donor。由 LLM 提供的 Python 片段為所有列填入合理數值。最終表格有 7 欄、308 列。
Person         | Animal rights | Clean water | Membership Year | Donation Method | Annual Giving Level | Recurring
...            | ...           | ...         | ...             | ...             | ...                 | ...
Patty          | $11           | $6          | 2013            | Check           | Silver              | F
Sports         | $4            | $13         | 2018            | Bank Transfer   | Platinum            | T
Eve            | $4            | $15         | 2018            | PayPal          | Gold                | T  ← 目標
Ev             | $6            | $9          | 2019            | Bank Transfer   | Silver              | F  ← 近似
Elliot         | $10           | $11         | 2021            | Credit Card     | Bronze              | F  ← 近似
Trisha         | $7            | $10         | 2015            | Check           | Platinum            | T
...            | ...           | ...         | ...             | ...             | ...                 | ...
一個閱讀這張表的模型必須:(1) 在數百列中定位到正確的列,(2) 忽略四個不相關的欄位以讀取正確的值,(3) 不被那些名字只差一兩個字元的緊鄰近似條目誤導。
M.4 完整範例 B:Price List 表格(缺表頭)
原始表格
原始 TabMWP 資料集中的 Price List 表格沒有表頭列:每一行都是資料列,格式為 item name | $price。以下這個條目有四列,問的是兩項商品的合計花費。
orange cone shell  | $0.05
spiral snail shell | $0.03
purple clam shell  | $0.03
scallop shell      | $0.08
干擾注入之後
新的「商品—價格」列從全資料集的商品池生成,並比照既有的整分錢價格格式與 $0.03–$0.08 的區間。商品名稱會被兩兩配對成複合名稱(例如 "bag of peanuts digital camera"),確保干擾鍵絕不會意外與某個單字的原始鍵相符。
近似列插入之後
LLM 生成語意相關但與兩個答案商品(「spiral snail shell」與「scallop shell」)不同的列。由於提示中明確禁止使用尺寸或變體後綴(例如「spiral snail shell (small)」),LLM 改為發明自然語言的變體,例如 spiral whelk shell。
LLM 欄位增強之後(含表頭注入)
由於原始表格沒有表頭,LLM 被要求同時完成兩件事:(a) 為兩個既有欄位命名,(b) 提出 3–4 個新欄位。它回傳既有欄位的名稱(Shell Type、Unit Price)加上新欄位(Inventory Count、Origin Region、Shell Grade、Supplier ID),並補上一列表頭。
Shell Type           | Unit Price | Inventory Count | Region  | Grade | Supplier ID
...                  | ...        | ...             | ...     | ...   | ...
bag of peanuts ...   | $0.06      | 126             | Arctic  | C     | SUP-1083
scallop shell        | $0.08      | 405             | Atlantic| C     | SUP-1084   ← 目標
night's stay at ...  | $0.05      | 158             | Pacific | B     | SUP-1085
...                  | ...        | ...             | ...     | ...   | ...
spiral snail shell   | $0.03      | 400             | Arctic  | C     | SUP-1232   ← 目標
spiral whelk shell   | $0.06      | 10              | Atlantic| B     | SUP-1240   ← 近似
striped snail shell  | $0.04      | 316             | Arctic  | C     | SUP-1241   ← 近似
scallop valve        | $0.07      | 175             | Indian  | C     | SUP-1242   ← 近似
giant scallop shell  | $0.12      | 260             | Pacific | C     | SUP-1243   ← 近似
...                  | ...        | ...             | ...     | ...   | ...
這個例子同時展現了兩種難度:缺表頭迫使 LLM 必須先推斷欄位語意才能建出表頭;而兩個目標列周圍都圍著一群名稱貌似合理、價格卻是錯的近似貝殼名。
M.5 LLM 欄位提案機制
欄位增強由 gpt-oss-120b 透過 Together API 執行。為了讓提示的長度不受「加了多少干擾列」影響,只把**原始(未增強)**的表格顯示給 LLM 作為領域脈絡;要填的列數 $n$ 則從完整的增強後表格推導。
對每個提出的欄位,LLM 提供一段簡短的 Python 片段,用來建立一個剛好有 $n$ 個元素、名為 values 的列表。片段可以使用標準函式庫的 random、math 與 string,讓輸出既多樣又具確定性(每個條目有固定種子)。一道嚴格的去重流程會丟棄任何名稱重複的提案欄位。
對 Price List 表格,提示會擴充成同時索取既有欄位的名稱,格式如下:
{"existing_column_names": ["Shell Type", "Unit Price"],
 "columns": [{"column_name": "Inventory Count",
              "python_code": "values = [random.randint(1,500) for _ in range(n_rows)]"}, ...]}
注入的表頭接著依序串接既有欄位名稱與新欄位名稱建成,確保即使原本沒有表頭的表格也能有一個格式正確的表頭。
M.6 碰撞避免
有兩道獨立的機制,確保沒有任何干擾列或近似列會引入模稜兩可或錯誤的標準答案。
鍵層級的碰撞防護
干擾項生成器會維護原始表格中出現過的第一欄鍵值集合,並在納入前逐一過濾每個候選鍵。對 Price List 表格,複合商品名稱(例如把池中的「apple」與「bread」配成「apple bread」)可防止意外的單字比對。對 Financial Ledger 表格也採用類似做法。
答案值的近似列驗證器
近似列的設計目的是混淆模型的選列,而不是攜帶數值上正確的值。近似列插入之後,LLM 會拿到新增列的清單、問題與標準答案,並被要求對每一列做出「保留」或「移除」的決定,依據四項準則,其中包括該列的值是否會意外構成一個正確答案。
附錄 N 計算資源與訓練成本
所有 SMITH 訓練回合都在單張 NVIDIA RTX 6000 Pro GPU 上完成。每個訓練回合(涵蓋一種模型大小與一種工具池配置)依 rollout 長度、池中工具數量與策略骨幹大小(Qwen3-4B、Qwen3-8B 或 Granite-3.3-8B)不同,耗時 36 至 72 小時。我們回報這點是為了讓復現本文結果的成本一目瞭然:這套配方在單張工作站等級的 GPU 上就搆得到,不需要多節點叢集。
附錄 O TroVE 基準 一個受控的提示詞調校消融
附錄 K.4 描述了 TroVE [31] 的線上 import/create/skip 迴路,附錄 L 記錄了我們在 TroVE 與 KTCE 中發現的實作層級失效模式。另一個獨立的疑慮是:TroVE 的提示詞會不會只是調校不足?本文中每個基準都使用該框架自己的預設、未修改提示詞,所以審稿人有理由提出這個問題。
O.1 比較的版本
- v1(基準)。 原始、未修改的提示詞(
online_create/online_import/online_skip),與本文其他所有非消融的 TroVE 結果所用的版本逐位元組相同,也是 TroVE 在未明確指定其他版本時的註冊預設值。 - v2(打包修訂)。 v1 加上三項同時進行的修改:(a) 一條使用純 ASCII 標點的指示,這是在觀察到模型生成的彎引號在執行時觸發
SyntaxError之後加入的;(b) 一句明確的「若工具箱為空,仍要從頭寫程式碼」的後備說明;(c) 在online_import中加入第二個完整範例。 - v3(僅標點)。 v1 只加上修改 (a)。
- v4(僅完整範例)。 v1 只加上修改 (c)。修改 (b) 在目前的框架下是有記錄可查的無效操作——注入的工具箱在每次呼叫前都會與一組 3 筆的標準函式庫 import 種子集(
toolbox/reasoning.py)合併,所以它永遠不會真的是空的——因此兩個消融組都省略了它。
由於 v2 打包了三項獨立修改,觀察到的退步無法歸因於其中任何一項;v3 與 v4 分別隔離出修改 (a) 與 (c),好讓我們能指認出負責的那一項。
O.2 結果
表 17 回報四個版本在八個資料完整、無假影的推理任務上的嚴格精確比對準確率(相同的凍結工具箱、每個任務 100–350 個測試實例、依題目配對)。顯著性採用雙尾精確 McNemar 檢定,對照 v1 的配對正確/錯誤結果。
表 17:TroVE 提示詞調校消融(Qwen3-4B-Instruct-2507,凍結工具箱的 import/skip 評估,嚴格精確比對評分)。∗:與 v1 有顯著差異($p<0.05$,雙尾精確 McNemar 檢定,依題目配對)。caesar_cipher 的 v2 磁碟記錄是一次早於完整掃描的 8 例冒煙測試,已排除。
| 任務 | N | v1 | v2(打包) | v3(標點) | v4(範例) |
|---|---|---|---|---|---|
| bitwise_arithmetic ᵃ | 280 | 55.0 | 27.5* | 40.4* | 45.4* |
| caesar_cipher | 196 | 59.2 | 排除 | 49.5* | 51.5* |
| chinese_theorem | 100 | 96.0 | 100.0 | 96.0 | 96.0 |
| count_bits | 210 | 100.0 | 100.0 | 100.0 | 100.0 |
| isomorphic_string | 350 | 100.0 | 100.0 | 100.0 | 100.0 |
| knights_knaves | 210 | 51.0 | 50.5 | 51.0 | 52.9 |
| polynomial_equations | 280 | 37.9 | 36.1 | 31.4* | 38.9 |
| polynomial_multiplication ᵃ | 275 | 52.7 | 36.4* | 45.8* | 51.3 |
八個任務中有三個在每個版本上都已達到或接近天花板(count_bits 與 isomorphic_string 全程 100.0%;chinese_theorem 在 96–100% 之間,其中 v2 從 96.0% 到 100.0% 的表面躍升並不顯著,$p=0.125$,因為它總共只來自 4 個錯誤),而 knights_knaves 在四個版本間持平(50.5–52.9%)。
評分的但書
標記 ᵃ 的兩個任務使用對格式選擇敏感的精確字串比對評分,而那些格式差異與推理品質無關。對 polynomial_multiplication,改用符號式(sympy)等價而非精確字串重新評分,會拉高每個版本的準確率(v1: 68.0%、v2: 53.1%、v3: 54.5%、v4: 59.6%),但 v1–v2、v1–v3、v1–v4 之間差距的顯著性依然成立($p=5.7\times 10^{-6}$、$3.8\times 10^{-5}$、$0.028$)。至於 bitwise_arithmetic,我們發現整個嚴格準確率的落差根本是一個假影:只要預測值省略了標準答案的 0x 十六進位前綴(例如標準答案 0x7975b8c1 對上數值完全相同的預測 7975b8c1),就會被判為錯誤。改以數值而非精確字串重新評分後,四個版本在統計上無法區分且都接近天花板(v1: 99.3%、v2: 99.3%、v3: 97.5%、v4: 100.0%;每個版本對 v1 都是 $p\geq 0.18$),所以 bitwise_arithmetic 其實完全沒有真正的提示詞效應。
被排除的任務與更大規模的抽查
另外兩個推理任務 tower_of_hanoi 與 cryptarithm 未列入表 17,因為它們的評估記錄在許多底層實例上重複了完全相同的題目文字(例如同一段「3 盤河內塔」提示出現 70 次),使得以題目為鍵的配對顯著性檢定,從各 210 筆記錄實例塌縮到只剩 3 個與 10 個實質上相異的比較——太少,不足以支撐任何結論。作為在我們最大的推理任務上進行的高檢定力抽查,GSM8K($N=1319$,約為表 17 中任一任務的 $4$–$13$ 倍)在 v1 上達到 91.1%,v2 的 90.2%($p=0.25$)與 v3 的 90.8%($p=0.78$)都與之相當——與上述模式一致,我們測試過的任何版本都不曾顯著勝過原始提示詞。
結論
在每一個比較具有統計意義的任務上,v2 中的兩項孤立修改(以及 v2 本身)都不曾顯著優於 v1;而在那些已知 v2 會退步的任務上,兩項孤立修改相對於 v1 也仍然退步,只是沒那麼嚴重。這就是為什麼本文所有非消融的 TroVE 結果(表 1、表 4)都使用原始的 v1 提示詞:在我們測試過的四個版本中,它是可取得的最強版本,因此 TroVE 與 SMITH 之間的差距,並不是「TroVE 提示詞調校不足」造成的假影。
參考文獻
編號與原文一致,內文引用的 [n] 對應下列條目。
- Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. (2022) Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862.
- T. Cai, X. Wang, T. Ma, X. Chen, and D. Zhou (2024) Large language models as tool makers. In International Conference on Learning Representations,
- J. Cheng, M. Marone, O. Weller, D. Lawrie, D. Khashabi, and B. Van Durme (2024) Dated data: tracing knowledge cutoffs in large language models. In First Conference on Language Modeling,
- A. Clark and D. Chalmers (1998) The extended mind. Analysis.
- K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. (2021) Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168.
- J. Feng, S. Huang, X. Qu, G. Zhang, Y. Qin, B. Zhong, C. Jiang, J. Chi, and W. Zhong (2025) ReTool: reinforcement learning for strategic tool use in llms. arXiv preprint arXiv:2504.11536.
- L. Gao, A. Madaan, S. Zhou, U. Alon, P. Liu, Y. Yang, J. Callan, and G. Neubig (2023) PAL: program-aided language models. In International Conference on Machine Learning,
- J. Gehring, K. Zheng, J. Copet, V. Mella, T. Cohen, and G. Synnaeve (2025) RLEF: grounding code llms in execution feedback with reinforcement learning. In International Conference on Machine Learning,
- Z. Gou, Z. Shao, Y. Gong, Y. Yang, M. Huang, N. Duan, W. Chen, et al. (2024) ToRA: a tool-integrated reasoning agent for mathematical problem solving. In International Conference on Learning Representations,
- D. A. Hudson and C. D. Manning (2019) GQA: a new dataset for real-world visual reasoning and compositional question answering. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition,
- E. Hutchins (1995) Cognition in the wild. MIT Press.
- M. Komeili, K. Shuster, and J. Weston (2022) Internet-augmented dialogue generation. In Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics,
- H. Le, Y. Wang, A. D. Gotmare, S. Savarese, and S. C. H. Hoi (2022) CodeRL: mastering code generation through pretrained models and deep reinforcement learning. In Advances in Neural Information Processing Systems,
- J. Li, D. Li, C. Xiong, and S. Hoi (2022) Blip: bootstrapping language-image pre-training for unified vision-language understanding and generation. In International conference on machine learning, pp. 12888–12900.
- Liquid AI (2025) LFM2 technical report. arXiv preprint arXiv:2511.23404.
- P. Lu, L. Qiu, K. Chang, Y. N. Wu, S. Zhu, T. Rajpurohit, P. Clark, and A. Kalyan (2023) Dynamic prompt learning via policy gradient for semi-structured mathematical reasoning. In International Conference on Learning Representations,
- Z. Ma, Z. Huang, J. Liu, M. Wang, H. Zhao, and X. Li (2025) Automated creation of reusable and diverse toolsets for enhancing llm reasoning. In Proceedings of the AAAI Conference on Artificial Intelligence,
- M. Minderer, A. Gritsenko, A. Stone, M. Neumann, D. Weissenborn, A. Dosovitskiy, A. Mahendran, A. Arnab, M. Dehghani, Z. Shen, et al. (2022) Simple open-vocabulary object detection. In European conference on computer vision, pp. 728–755.
- A. Panickssery, S. R. Bowman, and S. Feng (2024) LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems,
- S. G. Patil, H. Mao, C. Cheng-Jie Ji, F. Yan, V. Suresh, I. Stoica, and J. E. Gonzalez (2025) The berkeley function calling leaderboard (bfcl): from tool use to agentic evaluation of large language models. In International Conference on Machine Learning,
- C. Qian, E. C. Acikgoz, Q. He, H. WANG, X. Chen, D. Hakkani-Tür, G. Tur, and H. Ji (2025) ToolRL: reward is all tool learning needs. In Neural Information Processing Systems,
- T. Schick, J. Dwivedi-Yu, R. Dessì, R. Raileanu, M. Lomeli, E. Hambro, L. Zettlemoyer, N. Cancedda, and T. Scialom (2023) Toolformer: language models can teach themselves to use tools. In Advances in Neural Information Processing Systems,
- Z. Shao, P. Wang, Q. Zhu, R. Xu, J. Song, X. Bi, H. Zhang, M. Zhang, Y. Li, Y. Wu, et al. (2024) DeepSeekMath: pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300.
- A. Srivastava, A. Rastogi, A. Rao, A. A. M. Shoeb, A. Abid, A. Fisch, A. R. Brown, A. Santoro, A. Gupta, A. Garriga-Alonso, et al. (2023) Beyond the imitation game: quantifying and extrapolating the capabilities of language models. Transactions on Machine Learning Research.
- Z. Stojanovski, O. Stanley, J. Sharratt, R. Jones, A. Adefioye, J. Kaddour, and A. Köpf (2025) Reasoning gym: reasoning environments for reinforcement learning with verifiable rewards. In Advances in Neural Information Processing Systems,
- R. Taylor, M. Kardas, G. Cucurull, T. Scialom, A. Hartshorn, E. Saravia, A. Poulton, V. Kerkez, and R. Stojnic (2022) Galactica: a large language model for science. arXiv preprint arXiv:2211.09085.
- R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. (2022) LaMDA: language models for dialog applications. arXiv preprint arXiv:2201.08239.
- J. Wang, Q. Yan, Y. Wang, Y. Tian, S. S. Mishra, Z. Xu, M. Gandhi, P. Xu, and L. L. Cheong (2025) Reinforcement learning for self-improving agent with skill library. arXiv preprint arXiv:2512.17102.
- X. Wang, Y. Chen, L. Yuan, Y. Zhang, Y. Li, H. Peng, and H. Ji (2024) Executable code actions elicit better llm agents. In International Conference on Machine Learning,
- Z. Wang, Z. Cheng, H. Zhu, D. Fried, and G. Neubig (2024) What are tools anyway? a survey from the language model perspective. In First Conference on Language Modeling,
- Z. Wang, G. Neubig, and D. Fried (2024) TroVE: inducing verifiable and efficient toolboxes for solving programmatic tasks. In International Conference on Machine Learning,
- Z. Z. Wang, A. Gandhi, G. Neubig, and D. Fried (2025) Inducing programmatic skills for agentic tasks. In Second Conference on Language Modeling,
- A. Yang, A. Li, B. Yang, B. Zhang, B. Hui, B. Zheng, B. Yu, C. Gao, C. Huang, C. Lv, et al. (2025) Qwen3 technical report. arXiv preprint arXiv:2505.09388.
- Q. Yu, Z. Zhang, R. Zhu, Y. Yuan, X. Zuo, Y. Yue, W. Dai, T. Fan, G. Liu, L. Liu, et al. (2025) DAPO: an open-source llm reinforcement learning system at scale. In Advances in Neural Information Processing Systems,
- L. Yuan, Y. Chen, X. Wang, Y. Fung, H. Peng, and H. Ji (2024) CRAFT: customizing llms by creating and retrieving from specialized toolsets. In International Conference on Learning Representations,
- L. Zheng, W. Chiang, Y. Sheng, S. Zhuang, Z. Wu, Y. Zhuang, Z. Lin, Z. Li, D. Li, E. P. Xing, H. Zhang, J. E. Gonzalez, and I. Stoica (2023) Judging LLM-as-a-judge with MT-bench and chatbot arena. In Advances in Neural Information Processing Systems,
術語對照表
| English | 繁體中文 |
|---|---|
| Admission Criterion | 納入準則 |
| Agentic Loop | agentic 迴路 |
| Behavioural Cloning | 行為複製 |
| Build Task | 建構任務 |
| Circular Evaluation | 循環評估 |
| Curriculum | 難度課程 |
| Distractor | 干擾項 |
| Easy-to-Hard | 由易到難 |
| Eviction Policy | 淘汰政策 |
| Execution Feedback | 執行回饋 |
| Function Calling | 函式呼叫 |
| Gradient Leak | 梯度洩漏 |
| Held-out | 保留(未參與訓練的) |
| In-Context Example | 脈絡範例 |
| Judge Reward | judge 獎勵 |
| LLM-as-Judge | 以 LLM 作為評分者 |
| Macro-average | 巨觀平均 |
| Naming Drift | 命名漂移 |
| Out-of-Distribution (OOD) | 分布外 |
| Policy | 策略 |
| Problem Induction | 問題歸納 |
| Procedural Reasoning | 程序性推理 |
| Reward Decomposition | 獎勵分解 |
| Reward Gap | 獎勵落差 |
| Reward Hacking | 獎勵駭客 |
| Rollout | rollout(一次完整的取樣軌跡) |
| Scaffolding | 鷹架 |
| Schema | schema(描述函式名稱、參數與型別的結構描述) |
| Schema-grounded | 以 schema 為基礎 |
| Structural Verifier | 結構驗證器 |
| Thin Wrapper | 薄包裝 |
| Tool Creation | 工具創建 |
| Tool Pool | 工具池 |
| Tool Use | 工具使用 |
| Use Task | 使用任務 |
| Verifier | 驗證器 |
| Visual Primitive | 視覺原語 |