MoE 的持續預訓練:你的路由器有多穩健?
原始論文:Continual Pre-training of MoEs: How robust is your router? 作者:Benjamin Thérien、Charles-Étienne Joseph、Zain Sarwar、Ashwinee Panda、Anirban Das、Shi-Xiong Zhang、Stephen Rawls、Sambit Sahu、Eugene Belilovsky、Irina Rish 機構:Université de Montréal、Mila – Quebec AI Institute、Capital One、University of Chicago、Concordia University arXiv ID:2503.05029v2 日期:2025 年 11 月 10 日(v2) 授權:CC BY-NC-SA 4.0;本譯文為原文的衍生作品,依相同條款釋出 標籤:MoE LLM 持續預訓練 Routing Load Balancing Catastrophic Forgetting Replay
【譯註】本文已於 OpenReview 公開審稿:https://openreview.net/forum?id=dR7C1K71Rs
目錄
- 摘要
- 1 引言
- 2 背景
- 3 相關研究
- 4 方法與實證研究
- 5 結果
- 6 結論
- 致謝
- 附錄 A 延伸背景
- 附錄 B 延伸相關研究
- 附錄 C 訓練耗時
- 附錄 D 延伸實驗結果
- 附錄 E 資料集大小與取樣比例
- 附錄 F 模型超參數
- 參考文獻
- 術語對照表
摘要
稀疏啟用的混合專家 (Mixture of Experts, MoE) transformer 是很有前景的基礎模型架構。相較於每次前向傳遞需要相同浮點運算量 (FLOPs) 的密集 (Dense) transformer,MoE 在訓練時享有更好的樣本效率 (Sample Efficiency),也能達到強得多的效能。因此,許多閉源與開源的前沿語言模型都採用了 MoE 架構。很自然地,實務工作者會想用大量新蒐集到的資料來擴充這些模型的能力,而不是把它們整個重新訓練一遍。先前的研究已經指出,只要把重播 (Replay)、學習率重新暖身 (Re-warming) 與重新衰減 (Re-decaying) 這幾招簡單組合起來,就能對密集的 decoder-only transformer 做持續預訓練 (Continual Pre-training, CPT),而效能相對於完整重新訓練幾乎沒有退化。然而,對 decoder-only 的 MoE transformer 來說,路由演算法會如何影響持續預訓練的表現仍不清楚:1) MoE transformer 的路由器會不會讓遺忘比密集模型更嚴重?2) 路由器在 CPT 之後,還能不能對先前的分布維持平衡的負載?3) 套用在密集模型上的那套策略,足以拿來持續預訓練 MoE LLM 嗎?在接下來的內容裡,我們進行了一項大規模研究,訓練了一個 500M 參數的密集 transformer,以及四個 500M 啟用參數/2B 總參數的 MoE transformer,分別遵循 Switch Transformer 架構與一個受 DeepSeek 啟發的細粒度架構。每個模型都訓練了 600B tokens。我們的結果確立了一件出人意料的事:不論使用 Sinkhorn 平衡式或 Z-loss 與 Aux-loss 平衡式的路由演算法,MoE 對分布偏移都相當穩健——即使是在完全沒有重播的情況下持續預訓練的 MoE 也是如此。此外,我們證明 MoE LLM 在 CPT 期間仍能保有(相對於 FLOP 對齊的密集模型的)樣本效率,而且能夠以完整重新訓練的一小部分成本,達到與完整重新訓練的 MoE 相當的效能。
1 引言
稀疏啟用的 MoE transformer 效能顯著優於 FLOP 對齊的密集模型(例如每次前向傳遞需要相同浮點運算量的密集模型)。在今日的基礎模型生命週期中,模型絕大部分的 FLOPs 是花在推論上,這一點格外有利。因此,許多閉源與開源的前沿語言模型都採用了 MoE 架構 (Dai et al., 2024; DeepSeek-AI et al., 2024; Jiang et al., 2024; Abdin et al., 2024; DeepSeek-AI et al., 2025b; DeepSeek-AI et al., 2025a)。既然 MoE 相對於密集 transformer 有這麼明顯的優勢,實務工作者當然也會想像現在對待密集 transformer 那樣,用新資料去更新 MoE。
以重播、學習率重新暖身與重新衰減來做持續預訓練,已被證實是一個簡單卻有效的方案,可以用大量新資料更新已預訓練的密集自迴歸 transformer (Ibrahim et al., 2024; Gupta et al., 2023; Parmar et al., 2024),其效能足以和完整重新訓練競爭 (Ibrahim et al., 2024),成本卻低得多。一個尚未回答的問題是:同一套策略是否足以持續預訓練 MoE LLM?MoE 的預訓練向來以困難著稱,因為路由演算法會帶來不穩定性,而且必須維持專家之間的負載平衡 (Lepikhin et al., 2021; Shazeer et al., 2017; Fedus et al., 2022; Zoph et al., 2022)。在持續預訓練期間,這些挑戰可能會因為分布偏移而更加嚴重。
若不謹慎處理,MoE transformer 會學到貪婪的路由策略,過度使用某些專家,導致下游效能變差、加速器利用率也變差。在 MoE 預訓練期間,人們用負載平衡策略來避免這類後果 (Fedus et al., 2022; Zoph et al., 2022; Clark et al., 2022; Anthony et al., 2024; Dai et al., 2024)。然而,SOTA MoE 所使用的負載平衡演算法,並不是專為持續預訓練期間會遇到的非獨立同分布 (non-IID) 資料而設計的。在 CPT 期間為了適應新分布而調整路由器的決策,可能會破壞先前分布上的負載平衡,進而導致遺忘加劇與加速器利用率低落。要在不需完整重新訓練的前提下成功更新 MoE 基礎模型,避免這些失效模式至關重要,但文獻中對 MoE 的持續預訓練尚未有徹底的研究。
在這份工作中,我們填補了這個空缺,提供一份對 MoE 持續預訓練的系統性研究。具體來說,我們從既有的 SOTA 工作中挑出兩種熱門的路由演算法與兩種熱門的 MoE 架構 (Dai et al., 2024; Muennighoff et al., 2024; Fedus et al., 2022; Clark et al., 2022),組合出四種不同的 MoE 作為研究對象。接著我們在 $400$B tokens 的 FineWeb 上預訓練每個 MoE 語言模型,再在 $200$B tokens 的程式碼資料與德語網路爬取資料上持續預訓練它們。我們取表現最強的 MoE 架構,在兩個資料集上與完整重新訓練的基準做比較。我們的貢獻可以摘要如下。
- 我們確立了重播與無限學習率 (Infinite Learning Rate, LR) 排程,對 MoE transformer 語言模型在 CPT 期間的遺忘與路由不平衡動態所造成的影響。
- 我們證明一個採用 DeepSeek 架構的懲罰式平衡 (Penalty-Balanced,例如使用 Z-loss 與 Aux-loss) MoE,能夠以完整重新訓練的一小部分成本,成功追平完整重新訓練基準的效能。
- 我們證明使用懲罰式平衡或 Sinkhorn 平衡式路由演算法的 MoE,在以下三個面向對分布偏移都出人意料地穩健:1) 語言建模效能、2) 評測基準、3) 最大路由不平衡度。
- 我們針對路由決策在持續預訓練期間如何改變,提供一份完整的分析,讓我們得以洞察 MoE 如何適應新分布、又如何遺忘舊分布。
2 背景
本節簡要整理本研究相關的背景知識,更詳細的版本可見附錄 A 節。
LLM 的持續預訓練。 持續預訓練 (CPT) 把預訓練延伸到一個或多個新分布上。具體而言,當一個模型在一連串分布各異的資料集 ${\mathcal{D}}_{0},{\mathcal{D}}_{1},\dots,{\mathcal{D}}_{N}$($N\geq 2$)上訓練,而且每個資料集都足夠大(以語言來說,例如 $>100$B tokens),這就是持續預訓練。近期 Ibrahim et al. (2024) 確立了 CPT 的 LLM 可以追平完整重新訓練的效能,做法只要在 CPT 時重複一次預訓練的排程(餘弦退火),並重播先前的資料即可。不過,如果你對最初的預訓練也有控制權,那麼改用無限學習率排程還能讓 CPT 更好 (Janson et al., 2025)。
稀疏啟用的 MoE transformer 與其密集版本的差別,在於它會把序列中的 token 動態路由到不同的參數集合,也就是專家 (Expert)。因此,動態選擇專家的演算法(稱為路由演算法)是 MoE 的核心,而且可能會被分布偏移以非平凡的方式影響。本文聚焦於近期 SOTA 工作中兩種重要的 Top-$k$ 路由演算法:懲罰式平衡 Top-$k$ (Penalty-Balanced Top-$k$, PBT$k$) 路由 (Shazeer et al., 2017; Dai et al., 2024; Zoph et al., 2022; Fedus et al., 2022) 與 Sinkhorn 平衡式 Top-$k$ (Sinkhorn-Balanced Top-$k$, SBT$k$) 路由 (Clark et al., 2022; Anthony et al., 2024)。PBT$k$ 方法藉由在整體損失上加一個懲罰項(稱為 Aux Loss)來鼓勵專家之間的負載平衡。近期數個 SOTA 工作 (Dai et al., 2024; Team, 2024) 還加上第二個項——z-loss——來懲罰過大的路由器 logits,這已被證實有助於穩定性 (Zoph et al., 2022)。在我們的實驗中,我們把兩個損失合併使用,並統稱這個方法為 PBT$k$ 路由。SBT$k$ 方法則把 token 對專家的指派視為一個線性指派問題 (Clark et al., 2022)。Sinkhorn-Knopp 演算法 (Knopp and Sinkhorn, 1967) 為這個問題提供了一個近似解,可以在 GPU 上高效計算,而且透過選擇有利的初始條件還能再加速 (Anthony et al., 2024)。本文中我們把採用 Anthony et al. (2024) 初始化方式的 Sinkhorn 路由稱為 SBT$k$。
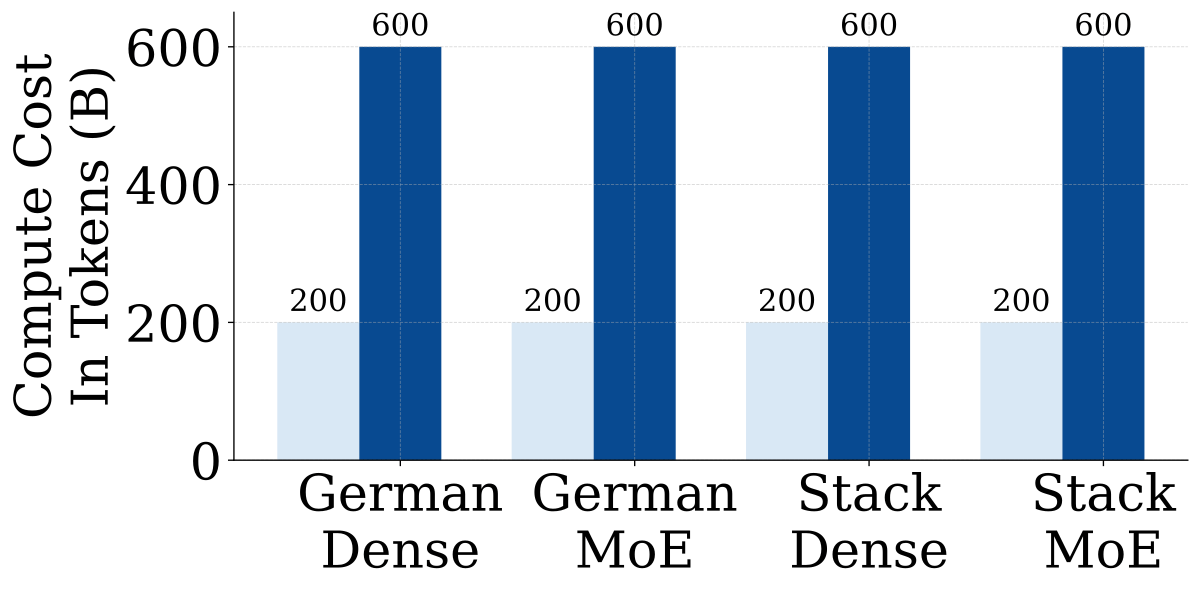
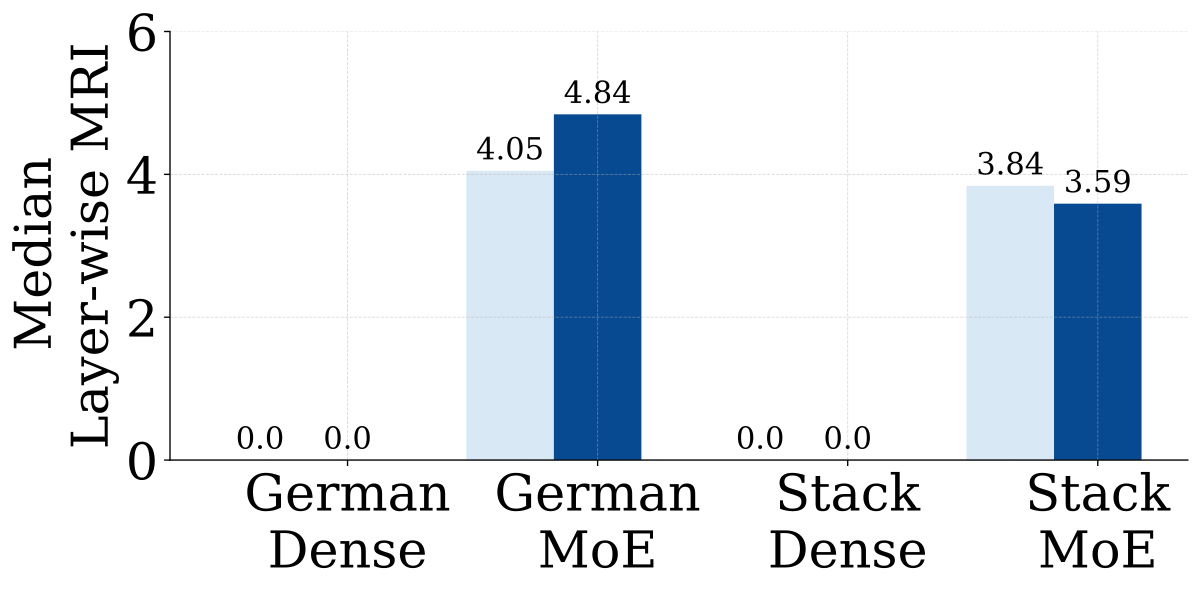
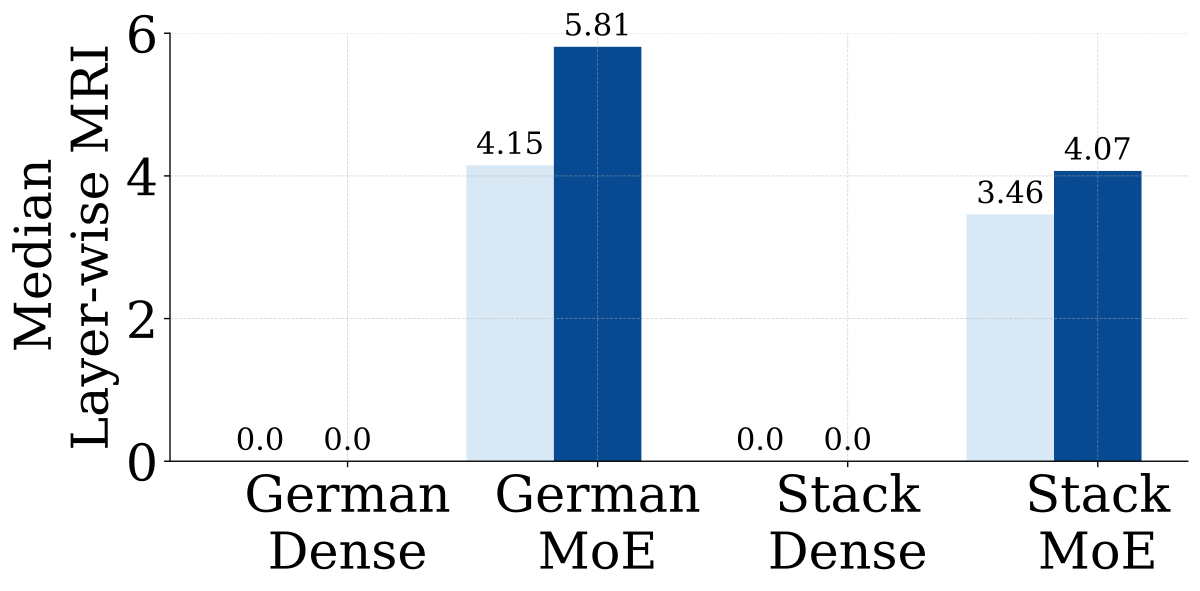
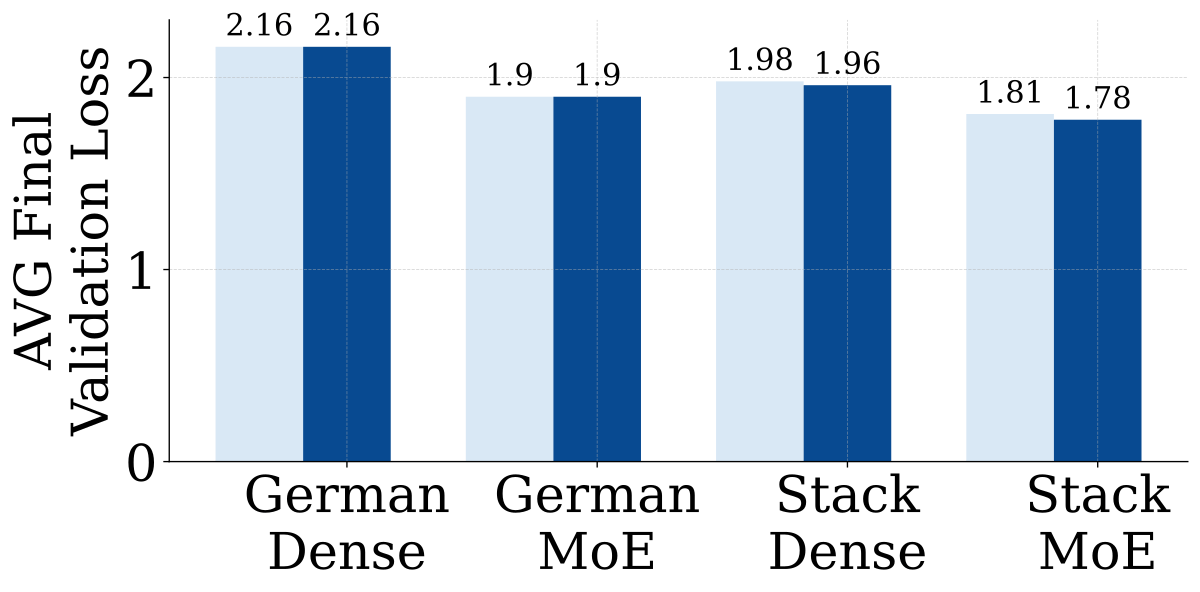
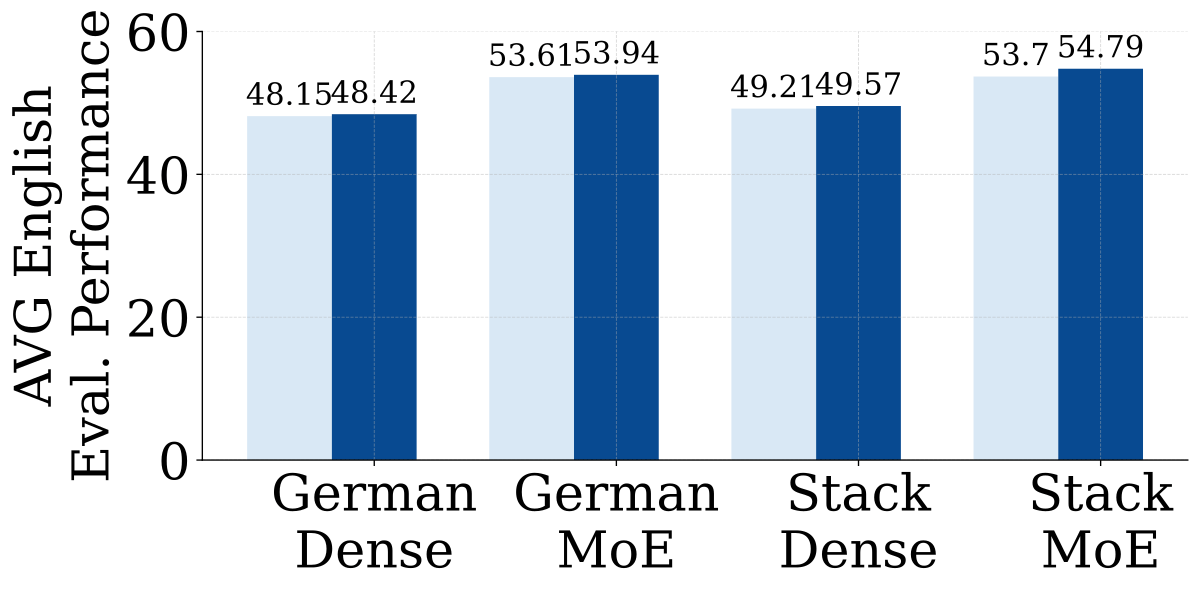
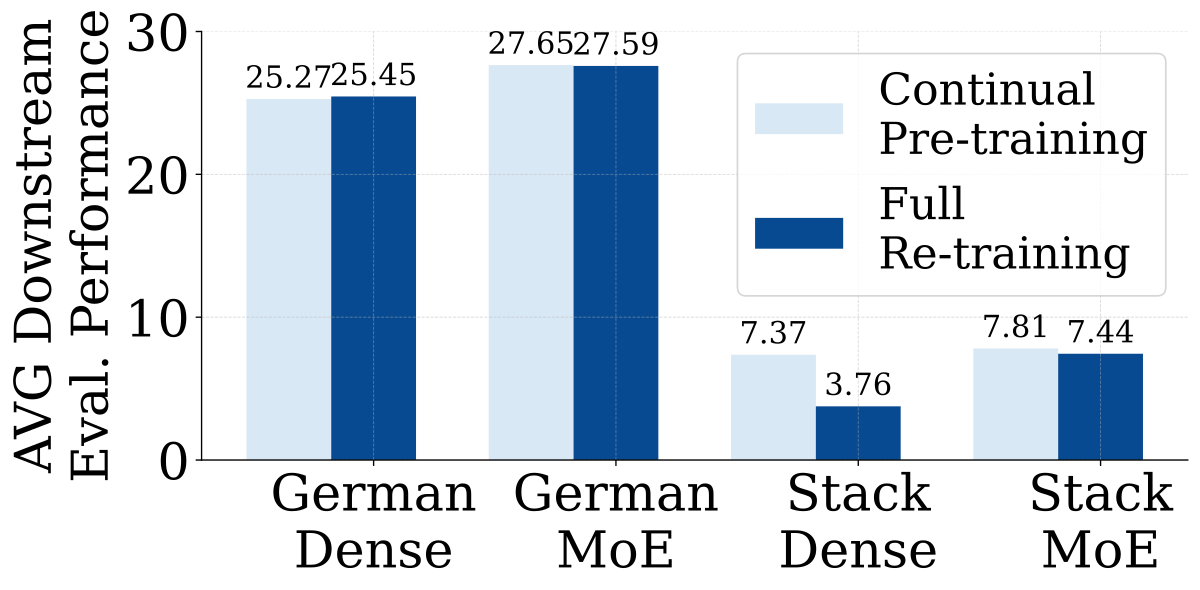
圖 1:持續預訓練 (CPT) 的 MoE 在兩種資料集轉換上都追平了完整重新訓練的效能:400B 英文 $\rightarrow$ 200B 德文($40\%$ 重播)與 400B 英文 $\rightarrow$ 200B Stack(30% 重播)。我們比較了完整重新訓練(例如在 400B 英文與 200B Stack 或 200B 德文的聯集上訓練)的懲罰式平衡 Top-$k$ MoE 與密集基準,以及它們對應的 CPT 版本。儘管只付出完整重新訓練那筆龐大成本的三分之一,CPT 的 MoE 仍追平了完整重新訓練模型的效能,在某些情況下中位數最大路由不平衡度 (MRI) 甚至還更好。這顯示 MoE 的 CPT 能力與密集 transformer 不相上下。注意子圖 (b)、(c)、(f) 是在不同資料集上評估德文與 Stack 模型,各自對應它們的訓練領域。
3 相關研究
本節回顧最相關的文獻,更完整的回顧則補充在附錄 B 節。
密集基礎模型的持續預訓練
已有數項研究在與 CPT 相關的情境下探討持續學習,發現:自監督預訓練能減輕遺忘 (Cossu et al., 2022; Davari et al., 2022)、預訓練模型比隨機初始化的模型遺忘得更少 (Mehta et al., 2023)、遺忘會隨模型規模增大而改善 (Ramasesh et al., 2022),以及較寬的模型往往比較深的模型遺忘得少 (Mirzadeh et al., 2022)。在 LLM 大規模 CPT 的脈絡下,Gupta et al. (2023) 強調當模型是從已衰減到很小學習率的檢查點開始預訓練時,重新暖身學習率的重要性。承接他們的工作,Ibrahim et al. (2024) 確立了學習率重新暖身、重新衰減與重播在 LLM 大規模 CPT 上的有效性。
MoE LLM 的持續預訓練
據我們所知,探討 MoE LLM 大規模持續預訓練的工作只有一篇,而文獻中大多數研究關注的是為了持續預訓練而對 MoE 做升級再造 (Upcycling) 或擴增。在一份同期的預印本 DeepSeek-CoderV2 (DeepSeek-AI et al., 2024) 中,作者展示了可以從檢查點接續訓練一個 MoE LLM。然而這只在單一個案上展示,也沒有討論 MoE 路由行為的分析。此外,該工作沒有與 FLOP 對齊的密集模型比較,因此難以判斷 MoE LLM 的樣本效率在持續預訓練期間是否得以維持。與我們較不相關的 MoE 持續預訓練方法,一般聚焦於用少量資料微調 MoE LLM (Wang et al., 2024c) 或擴增 MoE (Komatsuzaki et al., 2023; Zhu et al., 2024; Sukhbaatar et al., 2024; Gritsch et al., 2024)。
4 方法與實證研究
我們的目標是研究 MoE LLM 的大規模持續預訓練,因此主要的方法論貢獻在於:找出實務上有代表性的 MoE 架構來研究、把它們與 SOTA 的 CPT 技術(例如 (Ibrahim et al., 2024))適當結合,並從實證結果中導出簡潔的 MoE 持續預訓練指引。在接下來的小節中,我們會描述在建構這份研究時,於 MoE 架構、資料集與 CPT 技術上所做的關鍵設計選擇,並介紹一個衡量 MoE 延遲的新指標。MoE 的 CPT 指引則會在結果一節中列出。
4.1 本研究選用的架構
FLOP 對齊的密集基準。 我們選用一個 $24$ 層、570M 參數的密集 decoder-only transformer,遵循 Llama3 架構(差別在於我們使用 GeLU 激活函數),並使用 Llama3 tokenizer (Dubey et al., 2024)(細節見附錄 F 節)。
Granular MoE。 鑑於 DeepSeek MoE 近期的高人氣與強勁效能 (DeepSeek-AI et al., 2024; Dai et al., 2024; DeepSeek-AI et al., 2025b; DeepSeek-AI et al., 2025a),我們納入了一種會啟用多個細粒度專家並搭配一個共享專家的 MoE 架構。具體來說,每個 Granular MoE 有 $E=31$ 個被路由的專家、$K=3$ 個啟用專家,以及 $1$ 個共享專家。這個模型遵循與上述密集模型相同的 Llama3 架構。值得注意的是,它的專家是中間層維度為密集模型 $\frac{1}{4}$ 大小的 GEGLU FFN。我們訓練了兩個 Granular MoE,分別使用懲罰式平衡與 Sinkhorn 平衡式 Top-$k$ 路由演算法。我們不丟棄 token。
Switch MoE。 鑑於 MoE 過去慣用全尺寸 FFN,我們的研究也納入一種類似 (Jiang et al., 2024; Fedus et al., 2022) 的架構:全尺寸專家、沒有共享專家。我們稱之為 Switch MoE,同樣訓練兩個,分別使用懲罰式平衡與 Sinkhorn 平衡式路由演算法。每個 Switch MoE 有 $E=8$ 個被路由的專家、$K=1$ 個啟用專家、沒有共享專家。這個模型遵循與上述密集模型相同的 Llama3 架構。值得注意的是,它的專家是與密集模型 FFN 同樣大小的 GEGLU FFN。我們不丟棄 token。
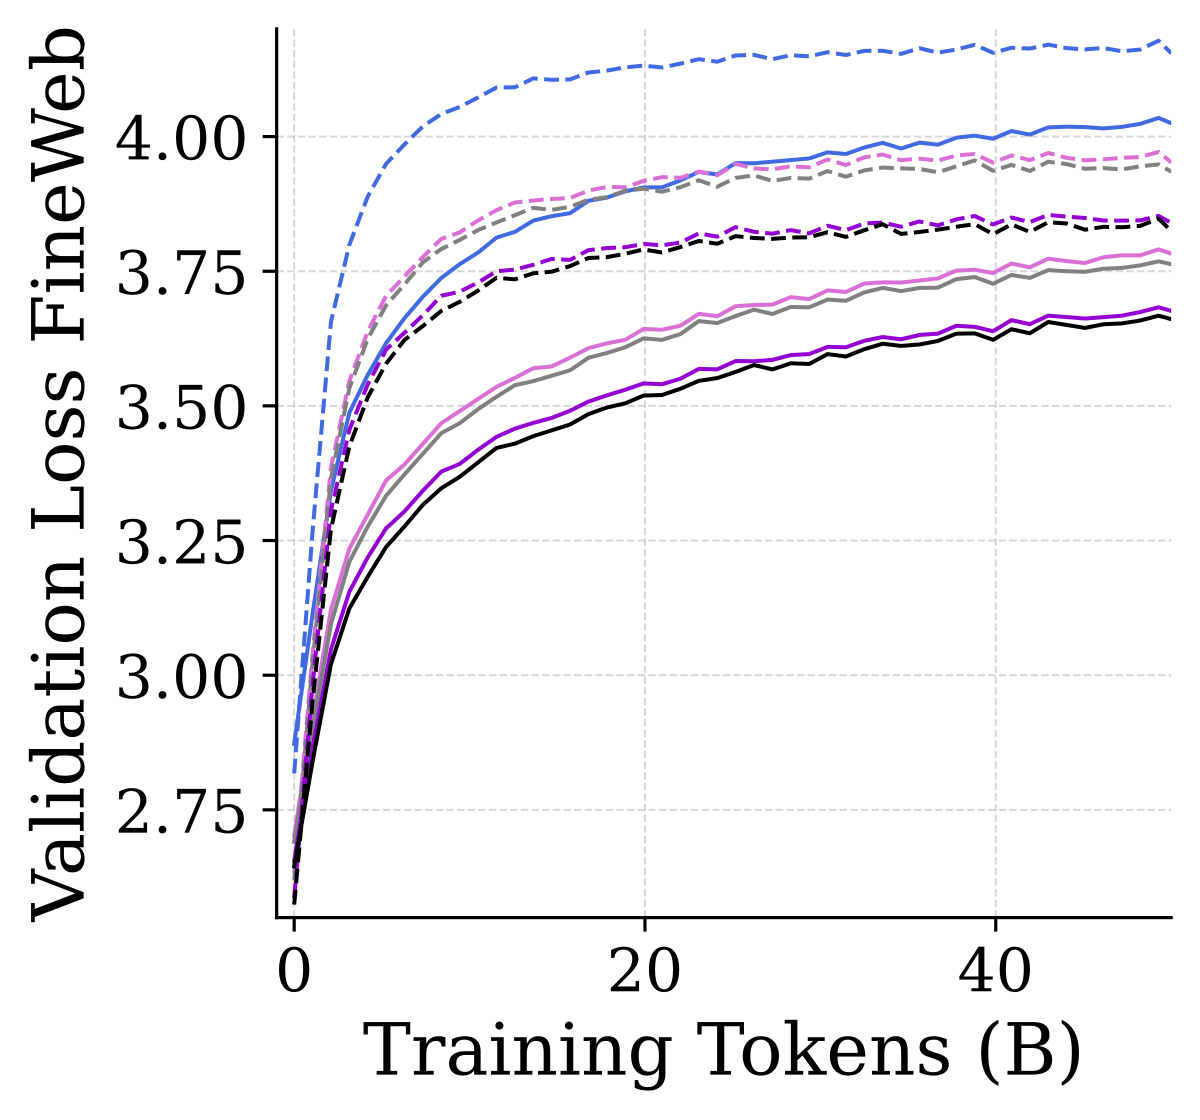
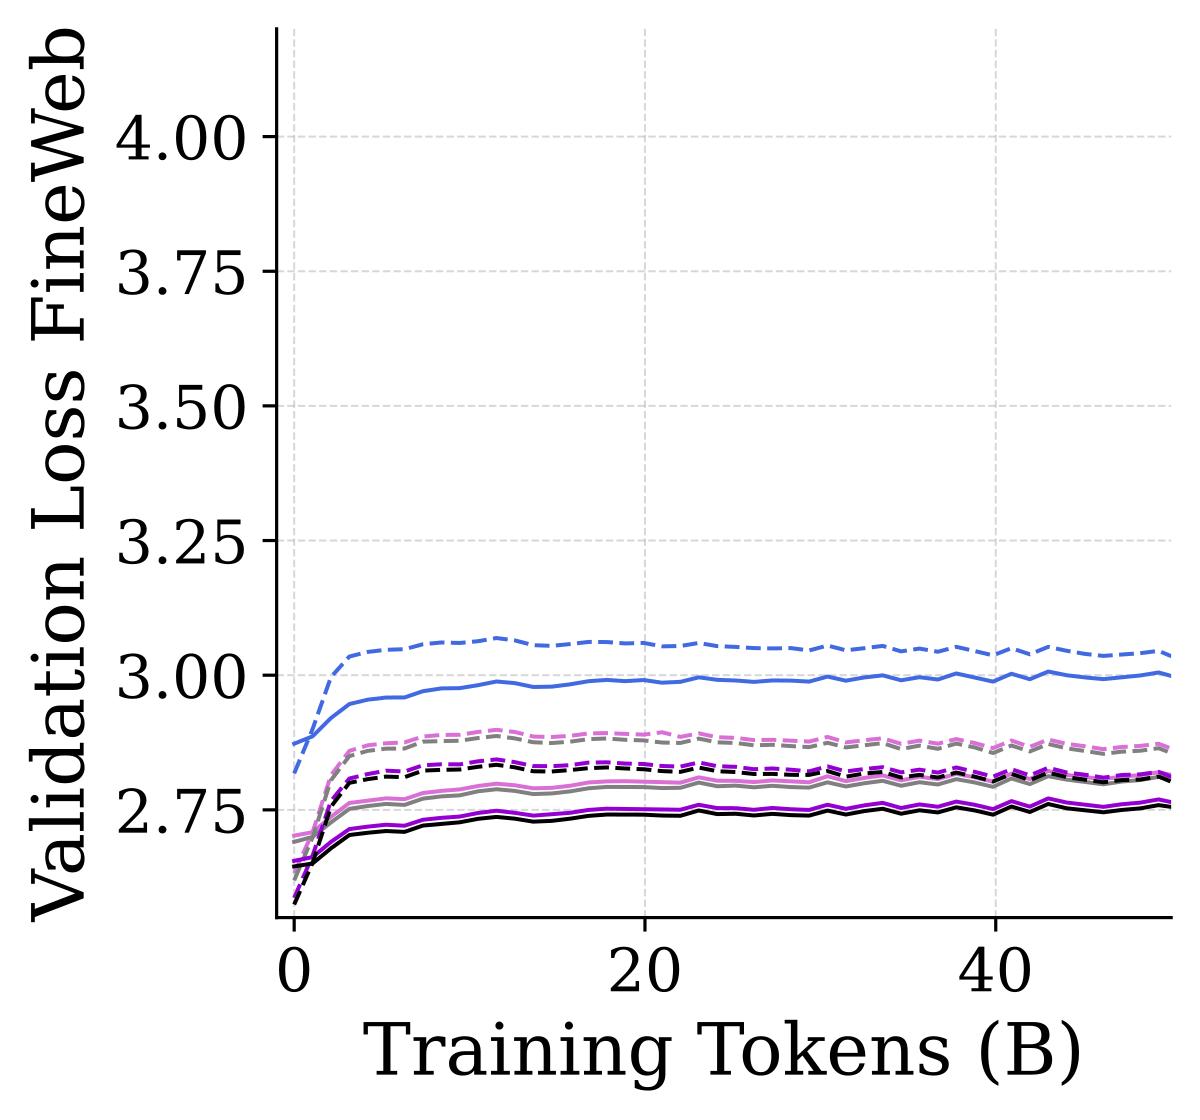
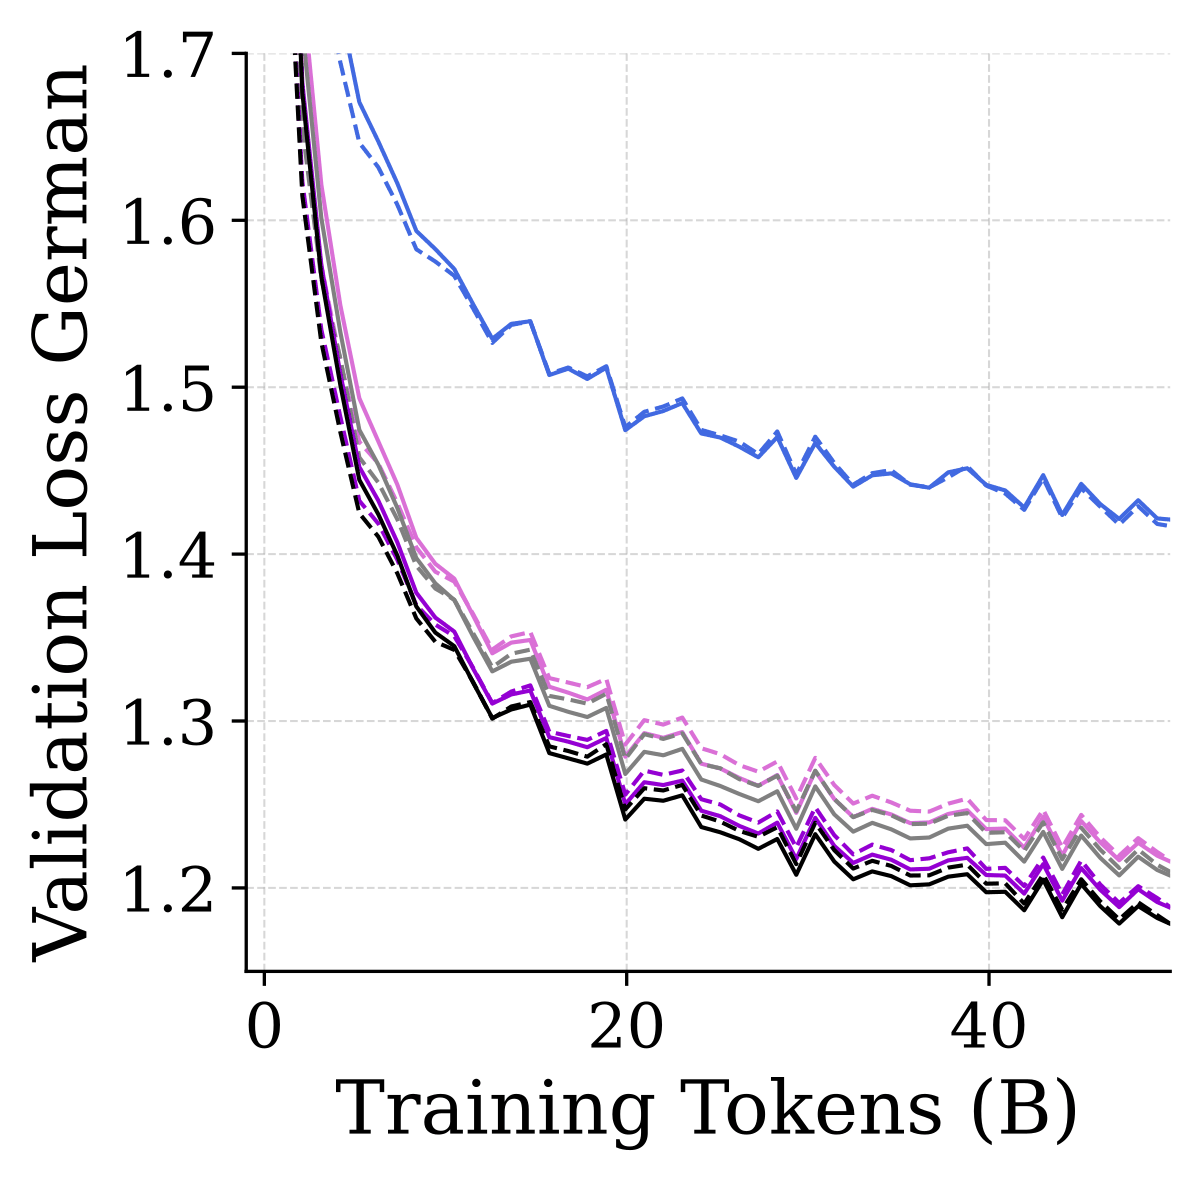
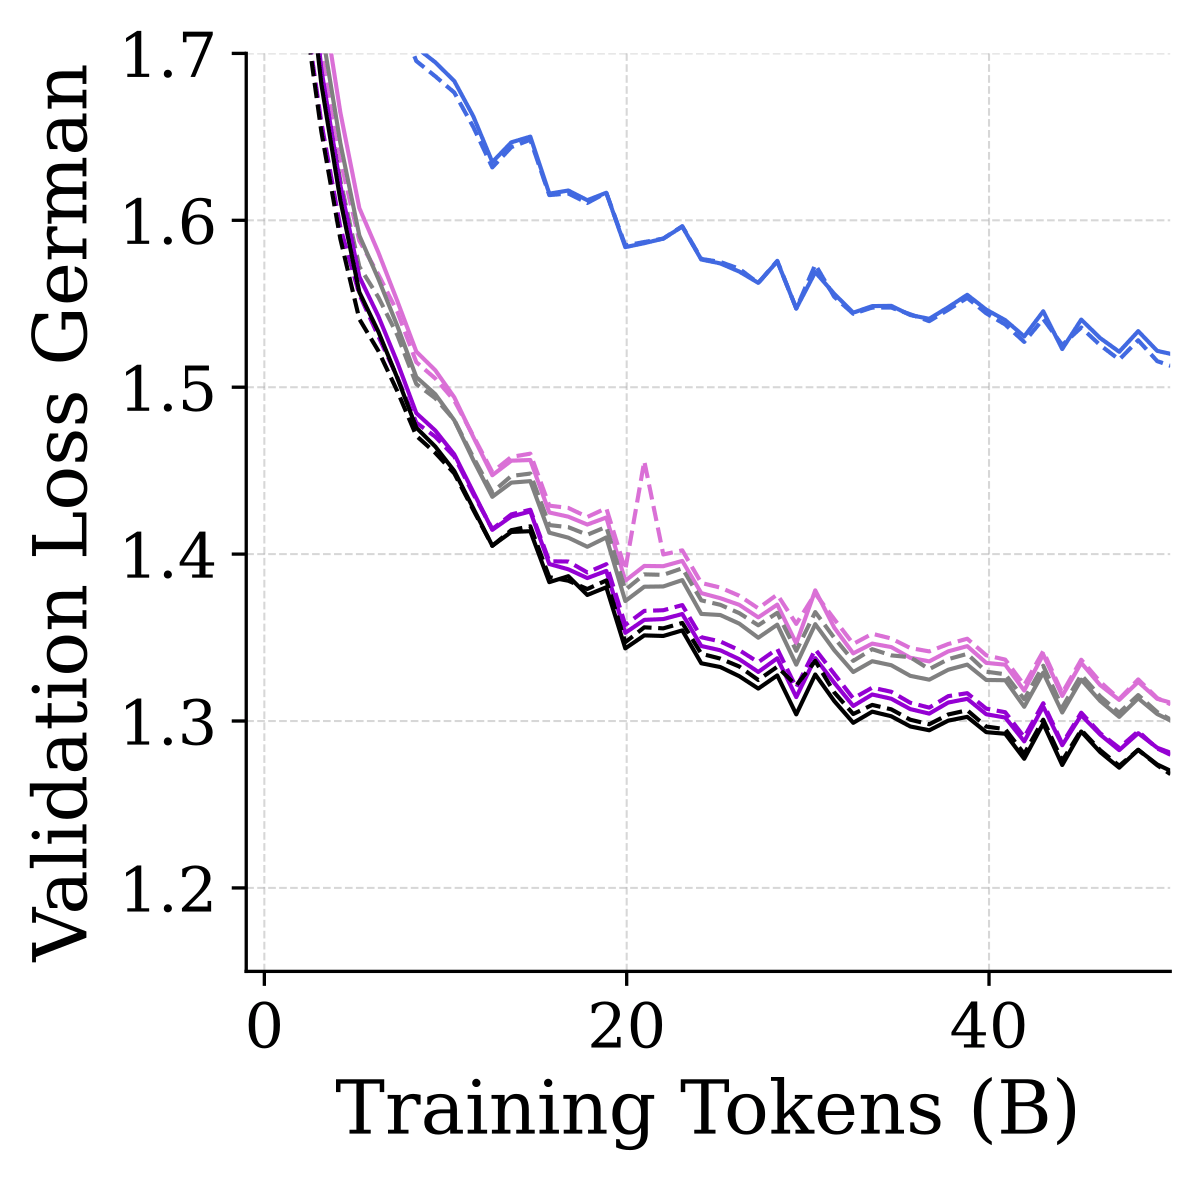
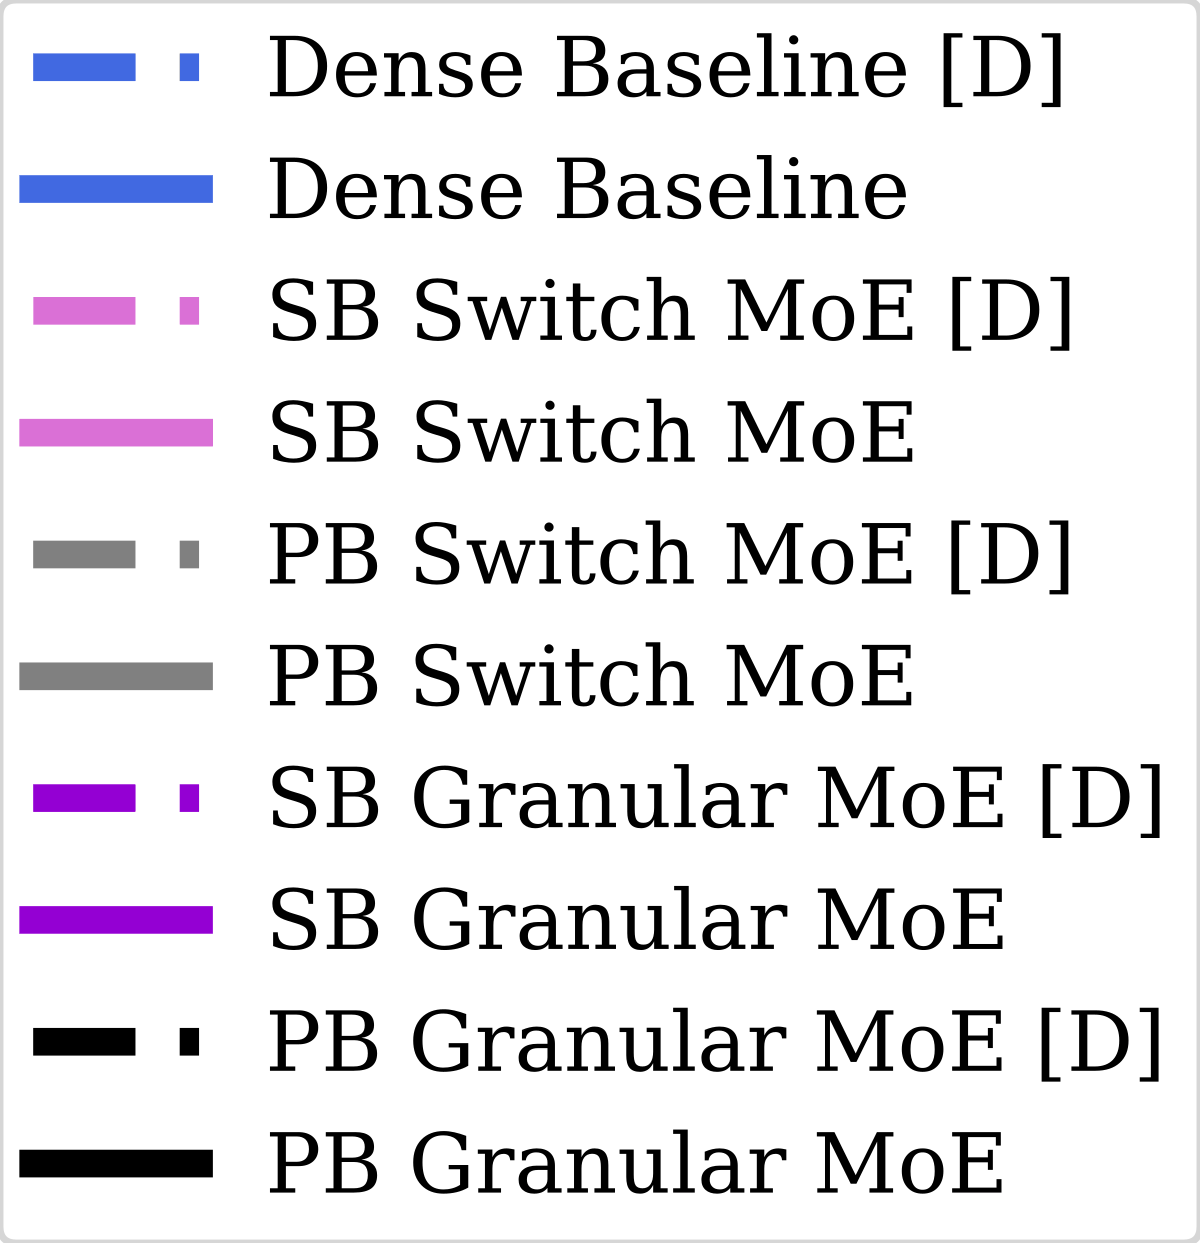
圖 2:在德文資料上持續預訓練時,對重播與衰減策略的消融。 我們從完全衰減的檢查點(虛線,[D])或未衰減的檢查點(實線)出發,對 MoE 與密集基準做 CPT。圖中回報的是在任務 2 上做 CPT 期間,模型在任務 1 (FineWeb) 與任務 2(德文)上的效能。我們觀察到:同一架構下,兩種檢查點對任務 2 的適應情形相近;從未衰減的檢查點做 CPT 可改善遺忘;重播能減輕遺忘。
4.2 持續預訓練策略與資料集
為了先做初始預訓練、再做持續預訓練,我們使用三個資料集:FineWeb (Penedo et al., 2024)、the Stack (Kocetkov et al., 2023),以及 German Common Crawl (Abadji et al., 2022)。我們先在 FineWeb 上以 $400$B tokens 預訓練所有模型(任務 1),以模擬開源與閉源模型常見的大規模英文網路爬取資料預訓練。接著,我們用無限學習率排程與重播(分別為 $30\%$ 與 $40\%$)在 $200$B tokens 的程式碼或德文資料(任務 2)上持續預訓練這些基礎模型,以減輕遺忘。我們遵循先前的 SOTA 工作 (DeepSeek-AI et al., 2024) 為完整的持續預訓練選用較大量的重播,但也在 5.1 節展示調整重播比例的影響。我們之所以選擇轉往多語言與程式碼資料,是因為它們相對於英文預訓練資料構成相當劇烈的分布偏移,同時又貼近現實(例如 Llama3 tokenizer 在這些領域仍然可用)。要注意的是,我們 600B tokens 的總訓練預算,就密集模型的 Chinchilla 最佳 token 預算而言,嚴格落在過度訓練 (Overtraining) 的區間 (Hoffmann et al., 2022)。對密集基準來說,這相當於過度訓練到 Chinchilla 建議值的約 40 倍;對 MoE 來說,這相當於一個 2B 參數密集模型計算最佳量的約 10 倍。作為對照,DeepSeekV3 (DeepSeek-AI et al., 2025b) 訓練到 671B 密集模型 Chinchilla 最佳值的約 1.1 倍,而熱門的 Qwen3 系列在 MoE 上達到 7.66–58.06 倍、在較大的($8$B 以上)密集模型上達到 54.55–225 倍的 Chinchilla 最佳訓練倍數。這些模型經常被當作持續預訓練的起點,可見我們密集模型 40 倍、MoE 10 倍的 Chinchilla 最佳倍數,確實能代表真實應用情境。
計算量對等的重播 (Compute Equivalent Replay)。 重播先前見過的資料,長久以來一直是減輕災難性遺忘的工具 (Wang et al., 2024b)。在我們的實驗中,我們基於這個目的重播先前見過的資料,並在使用該技術的模型後面標註「$X\%$ Replay」。這裡的 $X$ 代表某個批次中,從先前分布重播而來的樣本百分比。為了讓不同重播預算之間的計算量對齊,我們在增加重播量時並不增加 token 預算;相反地,我們減少 CPT 期間看到的新資料量。
4.3 訓練細節
我們研究中的所有模型(重新訓練基準除外)都預訓練了 $192{,}720$ 步梯度下降,批次大小為 $1024$、序列長度為 $2048$,使用 AdamW 優化器與 Cosine Inf 排程 (Ibrahim et al., 2024)。至於持續預訓練,主研究中的每個模型都遵循 Cosine Inf 排程,從未衰減的檢查點續訓;消融一節中的部分模型則是從已衰減的檢查點依餘弦衰減排程做持續預訓練(例如複製 Ibrahim et al. (2024) 的設定)。我們用與預訓練相同的批次大小與序列長度,持續預訓練了 $95{,}370$ 步。每個模型都在 $64$ 張 A100 GPU 上以資料平行與 zero-1 (Rajbhandari et al., 2020) 訓練。為了加速無丟棄 (dropless) MoE 的前向傳遞,我們使用 Megablocks kernel (Gale et al., 2023)。各實驗確切排程的更多細節提供於附錄 F 節。此外,圖 22 描繪了 (a) 預訓練、(b) 持續預訓練、(c) 完整重新訓練,以及 (d) 5.1 節重新暖身消融所使用的學習率排程。
4.4 最大路由不平衡度 MoE 最壞延遲的代理指標
效能只是穩健度的其中一個面向;對 MoE 基礎模型來說,維持專家之間的負載平衡同樣重要。若沒有平衡的負載,以專家平行化且不丟棄 token 的方式做推論的 MoE transformer(例如 SOTA 模型的做法 (DeepSeek-AI et al., 2025b; Zhao et al., 2025)),可能會被單一個接收了所有 token 的加速器拖慢,導致硬體利用率不足、吞吐量下降、成本上升。為了量化評估分布偏移對負載平衡的影響,我們提出最大路由不平衡度 (Maximum Routing Imbalance, MRI):在某個 MoE 層中,被路由到單一專家的 token 的最大比例。具體來說,在訓練迭代 $t$ 與 MoE 層 $j$ 的 MRI 定義為
$$\text{MRI}(t,j):=\max_{i\in[1,\dots,E]}\left[\frac{\sum_{\mathbf{x}\in B}\mathbb{1}\{i\in I_{k}(\mathbf{x})\}}{|B|}\right]. \tag{1}$$
其中 $B$ 是包含某批次中所有 token 的集合,$\mathbb{1}$ 是指示函數 (Indicator Function),$E$ 是被路由專家的數量,$k$ 是啟用專家的數量。由於延遲會隨計算量增加,而在一個 MoE 層中,某個裝置所需的計算量會隨該裝置上專家的負載增加,因此依據某個分布上的路由決策所計算出的 MRI,就是該分布上一個 MoE 層最壞延遲的代理指標。我們會在後續各節中用 MRI 來衡量持續預訓練的演算法改動對路由不平衡的影響。在圖 3 中,我們回報 MoE 所有層中最大的 MRI(例如 $\max_{j\in[L]}\text{MRI}(t,j)$,其中 $L$ 是層數),時間點取在分布偏移發生前後緊鄰的訓練迭代。在圖 4 中,我們回報持續預訓練前後,MoE transformer 每一層的 MRI。
MRI 與延遲的關係
MRI 本身雖然不回報延遲,但它是一個忠實的行為指標,可以作為延遲模型的輸入來估計延遲。延遲永遠取決於特定硬體與實作,MRI 則與這些考量無關,因此在不同部署環境之間更具可比性。
5 結果
5.1 消融 replay 比例與 CPT 起始檢查點
在本節中,我們對持續預訓練所用的重播比例做消融,並考慮從兩種不同的檢查點出發做持續預訓練:(a) 在預訓練期間已衰減到 $\eta_{\textit{min}}$ 的檢查點(大多數開源 MoE 的情況),或 (b) 遵循無限學習率排程、尚未衰減的檢查點(當你對預訓練階段有控制權時可達成的理想情況)。(a) 組的模型以線性暖身加餘弦衰減排程做持續預訓練,先把學習率重新暖身到 $\eta_{\textit{max}}$ 再重新衰減(例如 Ibrahim et al. (2024) 的做法);(b) 組的模型則從 $\eta_{\textit{const}}$ 出發,依無限學習率排程做持續預訓練(確切數值提供於附錄 F 節)。
驗證損失。 圖 2 回報這些模型在持續預訓練前 50B tokens 期間的驗證損失。雖然礙於資源限制我們只展示前 50B tokens,但排程設定的衰減點是在 $200$B tokens,模擬的是一次更長的持續預訓練的開頭。子圖 (a) 與 (c) 顯示使用 $0\%$ 重播時的遺忘與適應曲線,子圖 (b) 與 (d) 則顯示使用 $40\%$ 重播的對應曲線。我們觀察到,隨著重播比例提高,以 FineWeb 驗證損失衡量的遺忘會減輕,但對下游資料集的適應會受損。把注意力轉到所使用的檢查點,我們觀察到在所有重播比例、所有模型上,使用未衰減的檢查點都能改善 FineWeb 上的遺忘,同時不損害適應。這些結果顯示,與密集 transformer 相似,MoE 也能用重播在遺忘與適應之間做取捨,並從無限學習率排程中獲益。
路由不平衡。 圖 3 (a,b) 回報 SBT$k$ 與 PBT$k$ Granular MoE 在 $0\%$ 重播下做 CPT 期間,跨所有 transformer block 計算的中位數 MRI;子圖 (c) 回報不同重播比例下的結果;Switch MoE 的結果則回報在附錄的圖 19 與圖 18。這些圖精確地刻畫了分布偏移:它們回報的是從英文資料轉換到德文資料前後緊鄰時刻的 MRI。我們觀察到 SBT$k$ MoE 對分布偏移始終穩健,在不同重播比例、以及已衰減與未衰減的檢查點上,MRI 都只有小幅上升。這很可能歸功於 Sinkhorn 路由中顯式的平衡步驟。相對地,未衰減與已衰減的 PBT$k$ MoE 檢查點在分布偏移之後,都會經歷一段路由高度不平衡的時期。然而這段時期很短暫:PBT$k$ 檢查點會在 $500$ 個訓練步之內恢復到良好的 MRI 水準,甚至比 SBT$k$ 更好。子圖 (c) 顯示這個 MRI 尖峰可以用重播來緩解,不過效益微乎其微,因為即使是零重播的模型也恢復得很快。這些結果暗示,雖然 SB 對分布偏移比 PB 更穩健,但這種穩健性也限制了它所能達到的 MRI 下限。我們推測 PB 模型普遍較高的 MRI,可能導致訓練期間 MoE 參數被不平均地使用。訓練期間專家使用率的這種差異,或許可以解釋 PB 與 SB 之間的效能差距。最後,PBT$k$ 檢查點所經歷的混亂期並不長,不足以抵銷這些模型的強勁效能。
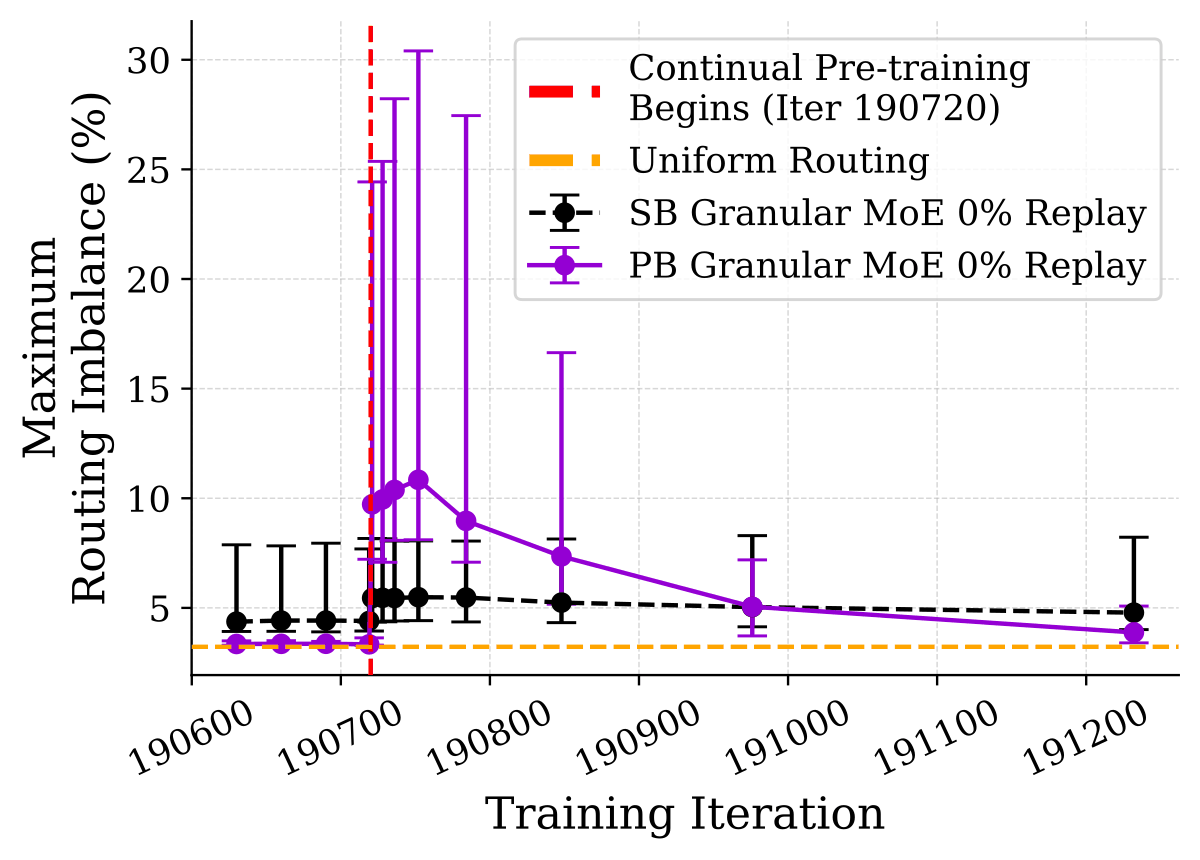
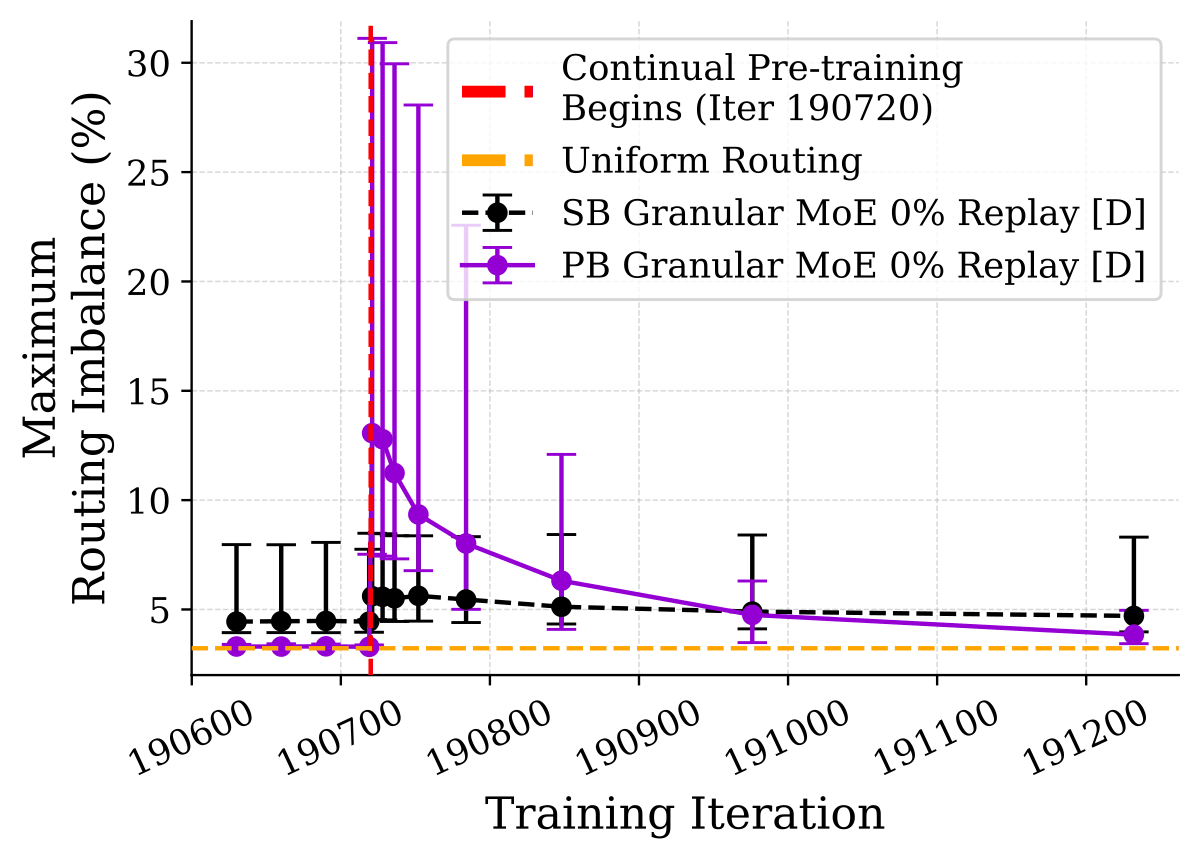
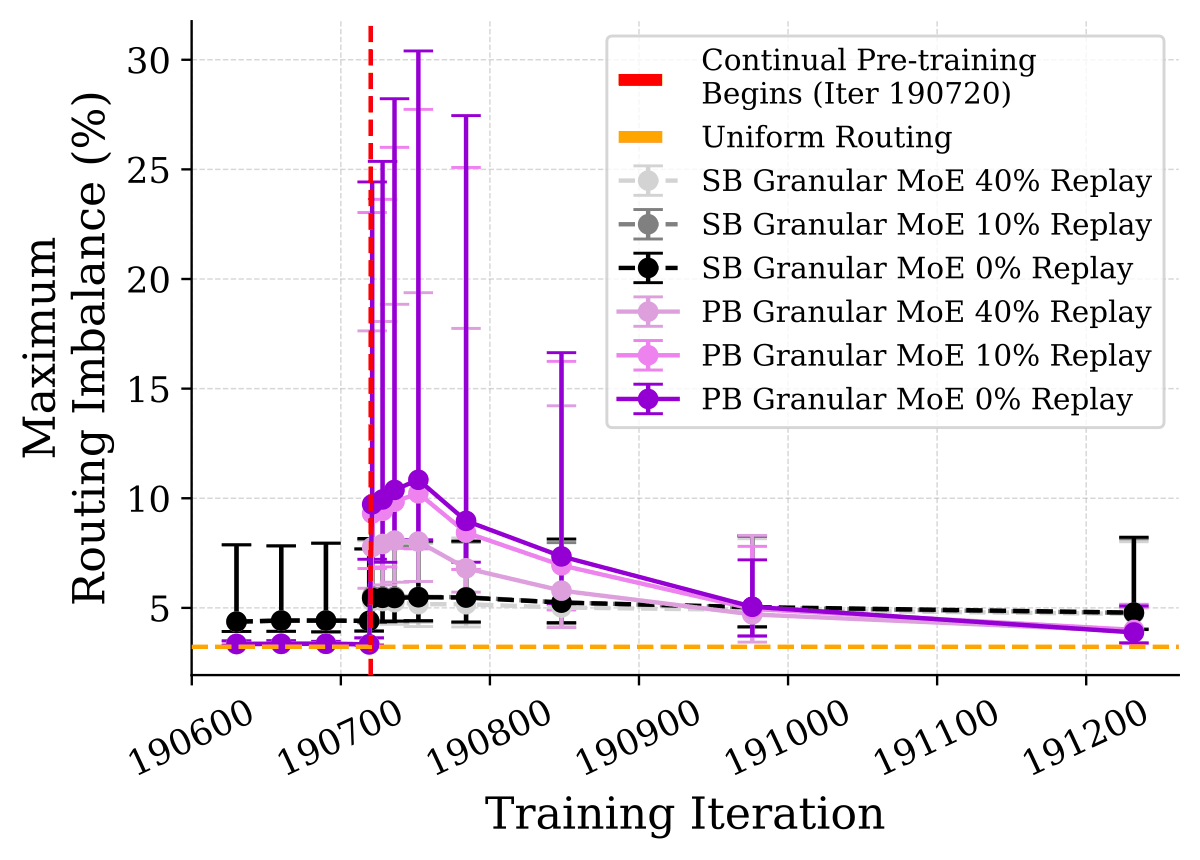
圖 3:FineWeb $\rightarrow$ 德文 CPT 的檢查點與重播消融。 我們回報跨 MoE 各層的中位數最大路由不平衡度 (MRI),並附上最小/最大誤差棒。Sinkhorn 平衡式 (SBT$k$) MoE 在分布偏移期間 MRI 只有小幅上升,而 PBT$k$ MoE 會經歷一次短暫的尖峰,隨後恢復到比 SBT$k$ 更低、更接近均勻基準線的平衡水準。均勻路由基準線(橘色線)對應的是所有層中每個專家都收到相同數量 token 的情況,因此代表完美平衡。
5.2 語言建模效能
在確立了重播與無限學習率排程對持續預訓練 MoE 的好處之後,我們現在要量化驗證這些技術的效果:把我們的 MoE 在 $200$B tokens 的程式碼與 German Common Crawl 資料上持續預訓練,並評估它們相對於兩個基準的效能。具體來說,我們會把研究中四個持續預訓練的 MoE,與一個 FLOP 對齊的密集基準、以及一個完整重新訓練的 PBT$k$ Granular MoE 基準(本研究中表現最好的架構)做比較。效能會從 $4$ 個面向衡量:預訓練與 CPT 資料集上的驗證損失、英文評測基準(任務 1)、德文與程式碼評測基準(任務 2),以及最終檢查點的 MRI。注意本節的主要結論已簡潔地摘要在圖 1 中。
驗證損失。 表 1 回報本研究主要模型的驗證損失(例如在固定的保留驗證集上的對數困惑度),延伸結果則回報在附錄的表 6。我們觀察到所有 MoE 在預訓練與 CPT 期間都勝過 FLOP 對齊的密集基準。在 MoE 之間,我們觀察到 PBT$k$ MoE 一致地勝過 SBT$k$ MoE,而 Granular MoE 在預訓練與 CPT 上都一致地勝過 Switch MoE。這些發現與 Granular MoE 的文獻一致 (Ludziejewski et al., 2024; Dai et al., 2024),但我們相信這是第一次有研究顯示 SBT$k$ 路由的表現不如 PBT$k$ 路由。由於 PBT$k$ Granular MoE 取得最佳效能,我們用它作為完整重新訓練的基準。與完整重新訓練相比,我們的 Granular CPT MoE 在 FineWeb 上的驗證損失一致偏高,但在下游資料集上的驗證損失更低,平均驗證損失則相近。把 CPT 的密集基準與其完整重新訓練版本相比,也得到類似的結果。這些結果證明,MoE 在驗證損失上的持續學習能力,適應方面與密集模型不相上下,遺忘方面則略勝一籌,很可能是因為它們的總參數量更大。
英文評測結果。 表 1 呈現平均準確率,表 4 則列出每個基準的詳細結果。我們挑選那些在我們這個規模($570$M 啟用參數)下模型能取得非平凡準確率的基準,以最大化訊號量。每個模型都以 zero-shot 方式在涵蓋常識推理、閱讀理解、科學問答與數學的基準上評估:HellaSwag (Zellers et al., 2019)、Winogrande (Sakaguchi et al., 2019)、PIQA (Bisk et al., 2019)、ARC-Easy、ARC-Challenge (Clark et al., 2018)、SWAG (Zellers et al., 2018)、LAMBADA (OpenAI) (Storks et al., 2019)、SciQ (Johannes Welbl, 2017)、PubMedQA (Jin et al., 2019) 與 MathQA (Amini et al., 2019)(細節見附錄 D.1 節)。我們發現只在 FineWeb 上訓練的模型勝過其他所有模型,包括完整重新訓練的基準。Granular MoE 勝過 Switch MoE。在 Stack 上訓練的 CPT 模型與在德文上訓練的表現相近。與完整重新訓練相比,CPT 模型取得幾乎相同的結果(差距在 $\sim 1\%$ 以內)。密集基準同樣追平了它的完整重新訓練版本,顯示 MoE 在預訓練類評測上具備與密集模型相似的持續學習能力,同時還享有更好的樣本效率。
表 1:匯總評測結果。 MoE 一致地勝過 FLOP 對齊的密集基準,且在驗證損失上遺忘更少。與重新訓練基準(藍色)相比,MoE 與密集模型都追平或超越其效能。這些結果顯示 MoE 的適應能力與密集模型相當,但遺忘更少,很可能是因為參數量更大。所有驗證損失回報的都是保留驗證集上的對數困惑度;遺忘(等同於 Lopez-Paz and Ranzato (2017) 中的反向遷移)以驗證損失計算;下游任務回報的是準確率。前五個數值欄屬於「最終驗證損失(越低越好)」,後三個屬於「下游評測(越高越好)」。
| 訓練 tokens | 模型 | FineWeb | Stack | German | 遺忘 | AVG | English | German | Stack |
|---|---|---|---|---|---|---|---|---|---|
| $400$B FineWeb | Dense Baseline | 2.881 | 4.028 | 3.741 | – | – | 49.84% | 23.54% | 0.00% |
| SB Switch MoE | 2.711 | 3.861 | 3.495 | – | – | 54.14% | 23.11% | 0.00% | |
| PB Switch MoE | 2.699 | 3.872 | 3.451 | – | – | 54.45% | 23.37% | 0.00% | |
| SB Granular MoE | 2.664 | 3.690 | 3.404 | – | – | 55.71% | 22.83% | 0.00% | |
| PB Granular MoE | 2.653 | 3.715 | 3.370 | – | – | 55.59% | 23.40% | 0.00% | |
| $400$B FineWeb $\rightarrow$ $200$B Stack($30\%$ 重播) | Dense Baseline | 2.939 | 1.026 | – | 0.059 | 1.982 | 49.21% | – | 7.37% |
| SB Switch MoE | 2.757 | 0.944 | – | 0.046 | 1.850 | 51.76% | – | 9.09% | |
| PB Switch MoE | 2.749 | 0.945 | – | 0.050 | 1.847 | 52.59% | – | 8.22% | |
| SB Granular MoE | 2.708 | 0.925 | – | 0.044 | 1.816 | 53.51% | – | 7.45% | |
| PB Granular MoE | 2.699 | 0.924 | – | 0.046 | 1.811 | 53.70% | – | 7.81% | |
| $400$B FineWeb $\cup$ $200$B Stack(完整重新訓練) | Dense Baseline | 2.866 | 1.050 | – | – | 1.958 | 49.57% | – | 3.76% |
| PB Granular MoE | 2.630 | 0.935 | – | – | 1.782 | 54.79% | – | 7.44% | |
| $400$B FineWeb $\rightarrow$ $200$B German($40\%$ 重播) | Dense Baseline | 2.946 | – | 1.367 | 0.066 | 2.157 | 48.15% | 25.27% | – |
| SB Switch MoE | 2.749 | – | 1.142 | 0.039 | 1.946 | 51.99% | 27.57% | – | |
| PB Switch MoE | 2.741 | – | 1.129 | 0.042 | 1.935 | 51.25% | 26.50% | – | |
| SB Granular MoE | 2.701 | – | 1.118 | 0.037 | 1.910 | 53.35% | 28.57% | – | |
| PB Granular MoE | 2.690 | – | 1.099 | 0.037 | 1.895 | 53.61% | 27.65% | – | |
| $400$B FineWeb $\cup$ $200$B German(完整重新訓練) | Dense Baseline | 2.938 | – | 1.390 | – | 2.164 | 48.42% | 25.45% | – |
| PB Granular MoE | 2.669 | – | 1.120 | – | 1.895 | 53.94% | 27.59% | – |
德文評測結果。 表 1 顯示德文評測的平均效能,附錄表 5 則提供每個基準的細分。我們使用以 GPT-3 翻譯的德文版 HellaSwag、ARC-Challenge 與 TruthfulQA,全部以 zero-shot 方式評估 (Plüster, 2023)。在德文上訓練的模型勝過只用英文訓練的模型,而在德文上訓練的 MoE 勝過 FLOP 對齊的密集基準。在 MoE 之間,使用相同訓練 token 的模組表現相近。CPT MoE 與完整重新訓練基準的差距小於 $1\%$ 準確率,沒有明顯的贏家。密集基準同樣與完整重新訓練表現相當,證明 MoE 在德文評測上的持續學習能力與密集模型不相上下,同時享有更好的樣本效率。
程式碼評測結果。 表 1 呈現程式碼評測的平均效能,附錄表 3 則提供 pass@k 的細分($k\in\{1,10,50,100,150,200\}$)。我們的模型在 HumanEval (Chen et al., 2021) 的 Python 程式碼生成任務上評估,因為 Python 在我們的 Stack CPT 資料集中占比很高(表 10)。只用英文訓練的模型一題都解不出來,而在 Stack 上訓練的模型則取得非平凡的準確率。與其他效能指標不同的是,CPT 的 Switch MoE 在這裡略勝其 Granular 對手。與完整重新訓練相比,所有 CPT MoE 都稍微好一些,而 CPT 的密集模型更是超出其基準 $3\%$ 以上。考慮到這些模型的驗證損失相近,我們把這個出乎意料的改善歸因於評測雜訊與訓練變異。這些結果顯示,在把 MoE 更好的樣本效率納入考量後,MoE 在程式碼評測上的持續學習能力與密集模型相當。
持續預訓練期間與之後的路由不平衡。 圖 4 顯示 Granular MoE 在 FineWeb (a)、德文 (b) 與 Stack (c) 上逐層的最大路由不平衡度 (MRI),圖 16 則回報所有 MoE 的 MRI。我們為每個在德文上做 CPT 的 MoE 都納入一條 $0\%$ 重播的基準線,以凸顯重播對 MRI 的影響。
在子圖 (a) 中,懲罰式平衡 MoE 在所有架構上的 MRI 都一致低於 Sinkhorn 平衡式 MoE,而在同一架構內,Granular MoE 的 MRI 更低也更穩定。在 FineWeb 上,持續預訓練相對於預訓練檢查點只造成 MRI 些微上升,即使是 $0\%$ 重播的模型也是如此,只有它的第一層例外。有趣的是,所有在德文上訓練的 MoE 在 FineWeb 上的 MRI 都高於在 Stack 上訓練的對應模型,而其中最高的,出乎意料地是完整重新訓練基準。這暗示英文與德文資料集之間可能存在更多路由干擾,也暗示持續預訓練可能有助於降低跨分布的 MRI——這或許是因為 CPT 與重新訓練分別使用了 CosineInf 與餘弦退火排程。
Granular MoE 在德文 (b) 與 Stack (c) 資料集上同樣降低了路由不平衡。MoE 在面對分布外資料時最不平衡(例如 (b) 中非德文模型與 (c) 中非程式碼模型)。Switch MoE 也呈現類似趨勢,但多了一項發現:與 Granular MoE 不同,Switch MoE 的早期層普遍有高 MRI,而且與訓練/測試分布無關。這些結果顯示 PBT$k$ 與 SBT$k$ MoE 在 MRI 上對分布偏移都很穩健,甚至能勝過重新訓練基準,暗示持續預訓練 MoE 對推論延遲應該不會有負面影響。
總結來說,我們發現在三種效能衡量標準上,以重播與無限學習率排程持續預訓練的 MoE 都能追平完整重新訓練基準的效能;因此,它們的 CPT 能力與 FLOP 對齊的密集基準相當,路由器完全沒有造成阻礙。此外,我們也證明持續預訓練 MoE 相較於重新訓練,對 MRI 沒有負面影響。
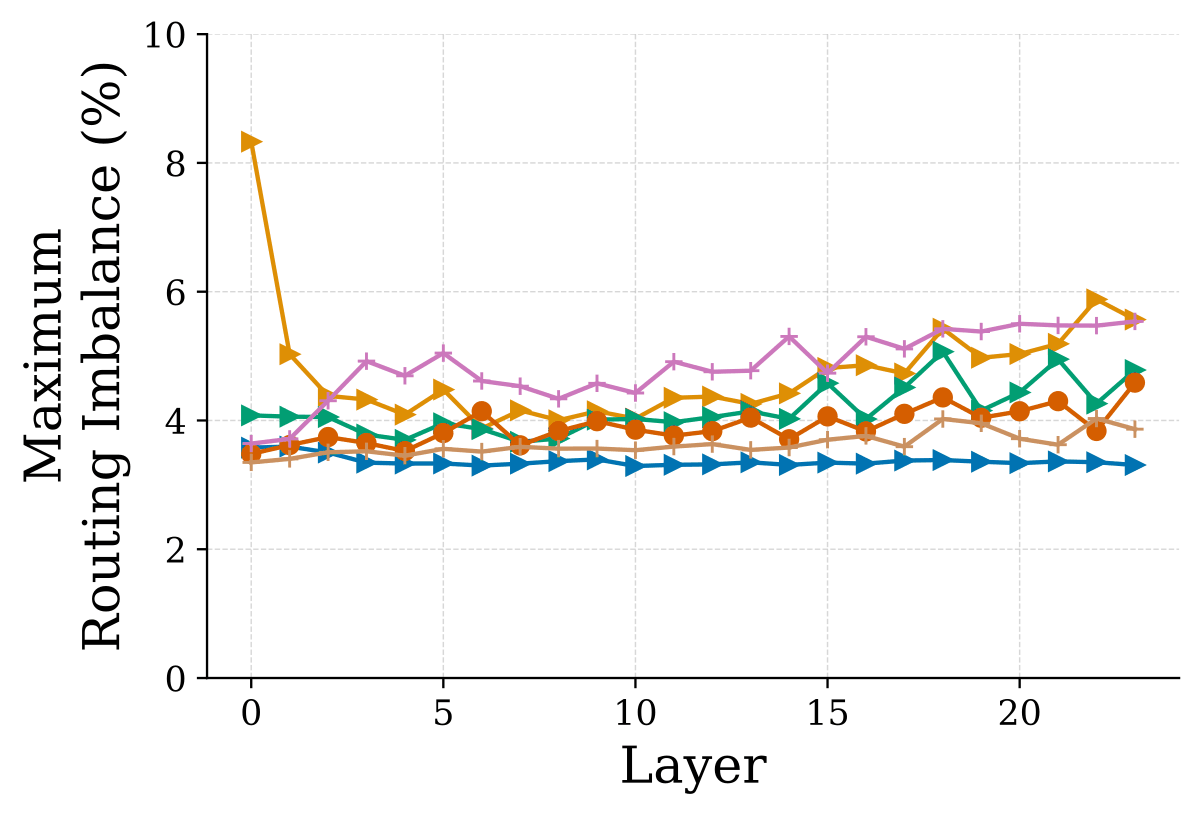
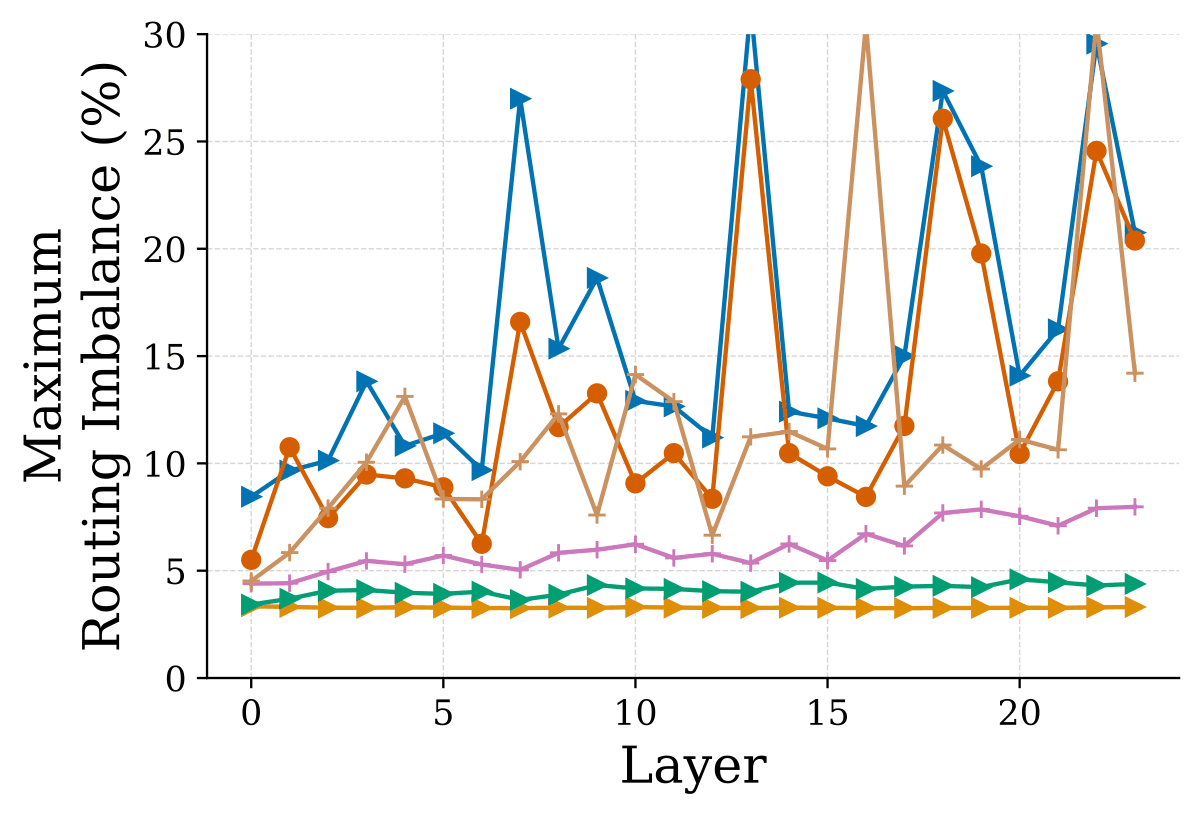
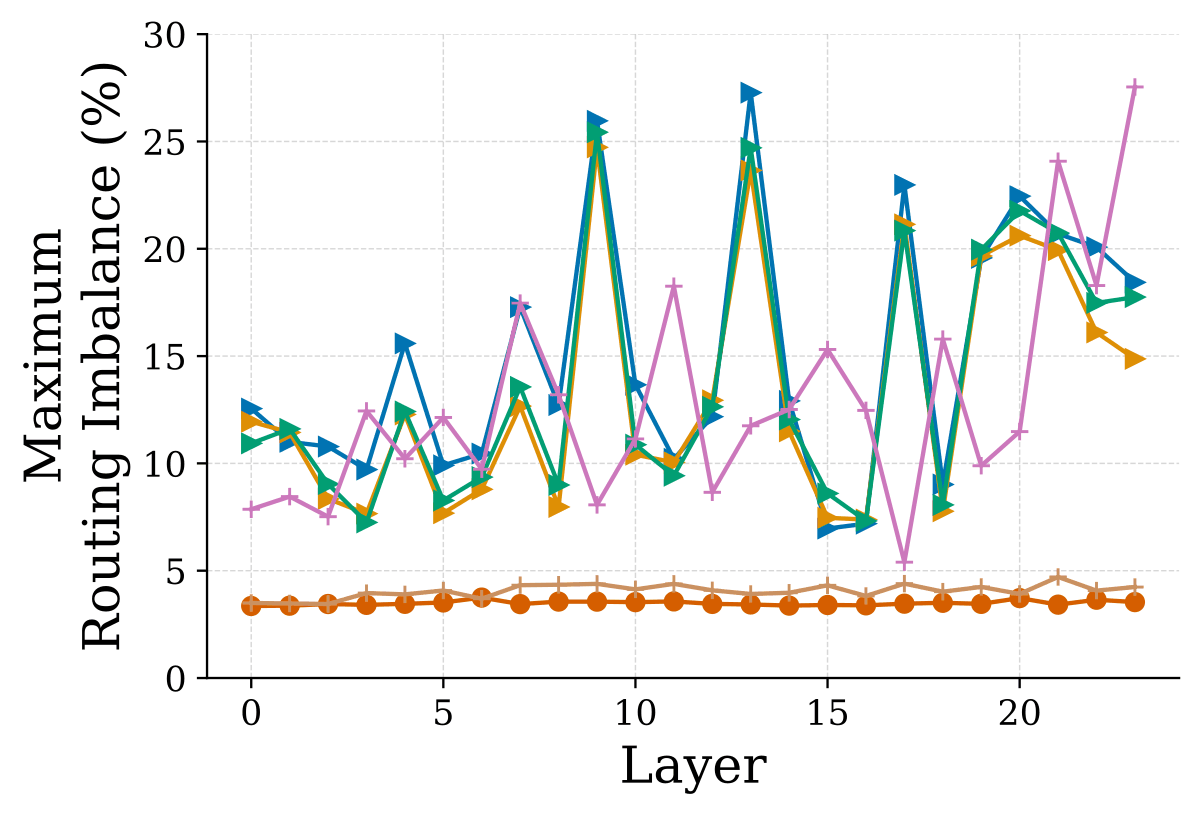
圖 4:Granular MoE 的逐層最大路由不平衡度 (MRI)。 我們在每個資料集的 20M token 測試集上回報 MRI(式 1)。懲罰式平衡 MoE 的 MRI 一致低於 Sinkhorn 平衡式 MoE。在 FineWeb 上,持續預訓練只造成極小的 MRI 上升,即使是 $0\%$ 重播也一樣。MoE 面對分布外資料時最不平衡(例如 (b) 中非德文模型與 (c) 中非程式碼模型)。
5.3 分析 CPT 造成的路由行為改變
在本節中,我們分析持續預訓練所導致的路由行為改變。具體來說,我們記錄 MoE 檢查點在持續預訓練前後,對 FineWeb、Stack 與德文各 $20{,}000{,}000$ tokens 保留測試資料的路由決策。為了理解路由決策在 CPT 期間如何改變,我們把 Muennighoff et al. (2024) 的三個路由行為指標調整到持續預訓練情境:路由器飽和度 (Router Saturation)、詞彙專精化 (Vocabulary Specialization) 與專家共同啟用 (Expert Co-activation)。以下我們簡短描述每一項,正式定義見附錄(D.3.1、D.3.2、D.3.3 節)。
持續路由器飽和度。 路由器飽和度 (RS) 是指在迭代 $t$ 的路由決策中,與最終檢查點一致的比例 (Muennighoff et al., 2024)。我們把這個指標延伸到持續預訓練的多個訓練階段。圖 5 (c) 顯示 Stack 與德文 Granular PBT$k$ MoE 在預訓練與 CPT 檢查點之間的 RS。RS 在早期層最低,在第 $2$–$13$ 層達到高峰,第 $13$ 層之後略為下降。$0\%$ 重播的德文檢查點在所有層的 RS 都比 $40\%$ 重播的版本低 $10$–$15\%$。要注意的是,儘管兩者都能良好適應德文,只有零重播的檢查點在 FineWeb 上出現顯著遺忘。這些結果暗示 CPT 的適應在第 $0$–$2$ 層與第 $13$–$23$ 層最為明顯,遺忘也呈現同樣的模式,但與整體較低的路由器飽和度相關。
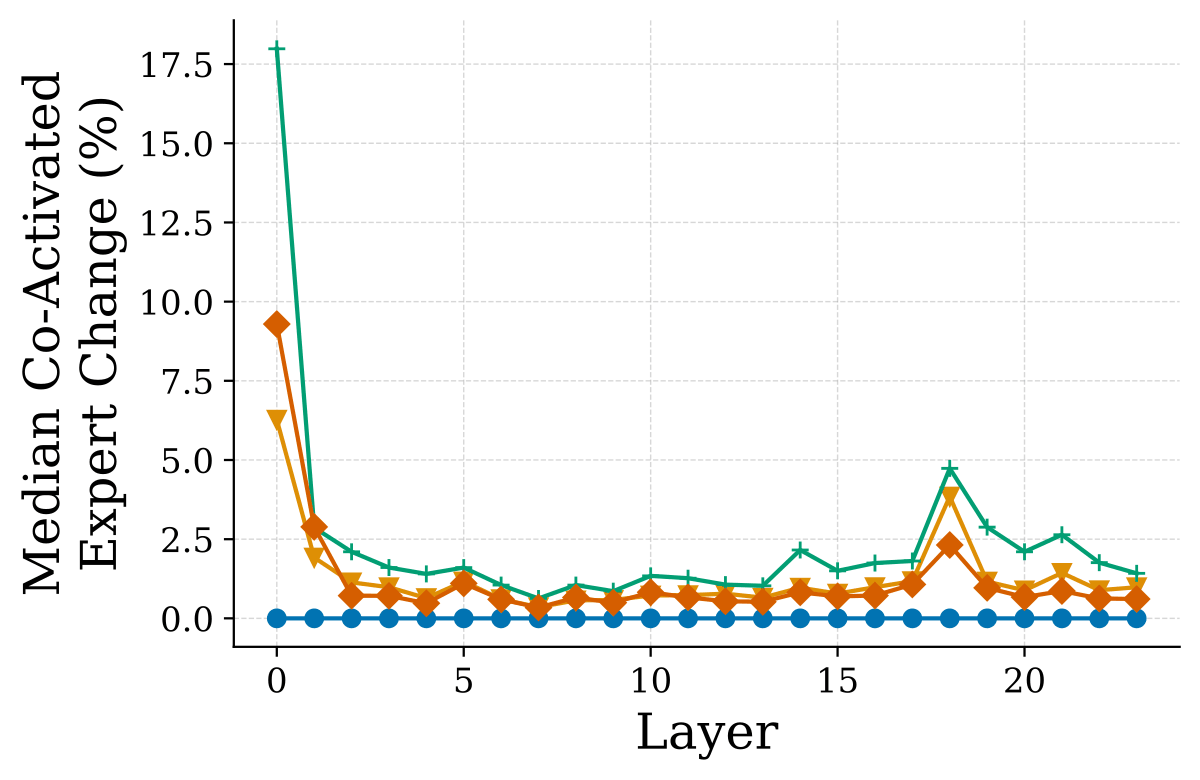
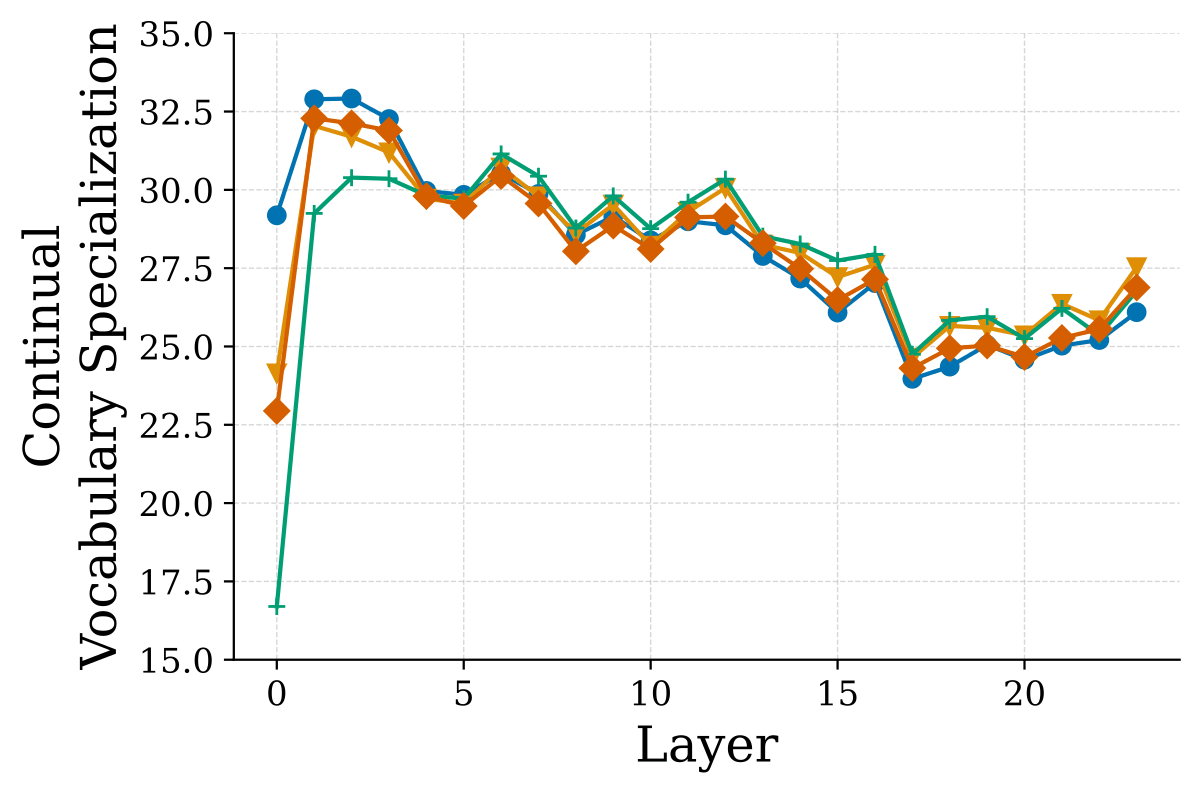
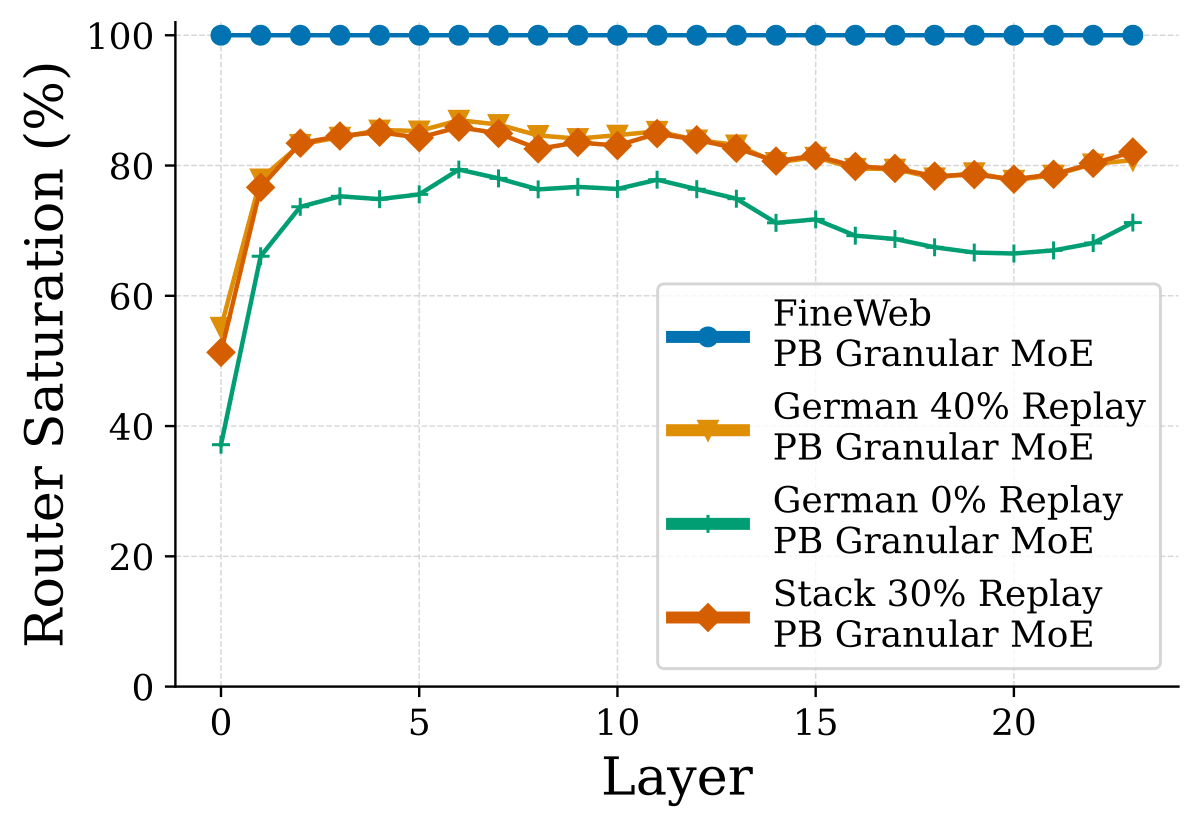
圖 5:CPT 期間路由變化的逐層分析。 我們的目標是理解路由決策從預訓練檢查點到持續預訓練後最終檢查點之間如何改變。為此,我們從 $3$ 個角度分析路由行為的變化:哪些專家傾向被一起啟用 (a)、特定詞彙 token 被路由到特定專家的傾向 (b),以及預訓練檢查點的路由決策與 CPT 檢查點有多接近 (c)。為了給這些指標一個脈絡,我們在圖中也提醒讀者每個模型的遺忘程度(取自表 1)。我們觀察到零重播基準在早期層變化最大、遺忘也最多,暗示初始層較劇烈的變化可能與遺忘有關。
持續詞彙專精化。 詞彙專精化 (VS) 量化的是某個資料集中的一個 token 被路由到某個特定 MoE 專家的次數,相對於它總出現次數的比例 (Muennighoff et al., 2024)。把模型詞彙表中的每個 token 都指派給最常處理它的那個專家,我們就能為一個 MoE 層建立專家與詞彙條目之間的一對多映射。接著,我們可以把每個專家在其被指派 token 上的詞彙專精化取平均,得到該專家的平均 VS。一層之內的詞彙專精化,就是該層所有專家平均 VS 的均值。要跨檢查點比較專精化程度,我們可以沿用前一個檢查點的一對多映射,衡量相對於這個映射的專精化在 CPT 期間如何改變。圖 5 顯示以 FineWeb 資料、相對於預訓練檢查點計算的 VS。CPT 之後,第 $0$–$4$ 層的 VS 明顯較低,而第 $5$–$23$ 層的 VS 幾乎沒有可辨識的變化。零重播的檢查點在第 $0$–$4$ 層的 VS 最低,這與它在 FineWeb 上較差的效能相符,暗示早期層過度的 VS 偏移可能是造成遺忘的原因之一。
共同啟用專家的變化。 兩個專家 $E_{i}$ 與 $E_{j}$ 之間的專家共同啟用,定義為它們在某資料集上被一起啟用的次數,相對於 $E_{i}$ 總啟用次數的比值 (Muennighoff et al., 2024)。這個指標只適用於啟用專家數 $k\geq 2$ 的 MoE。我們可以為一層中每個有序專家對建立一個共同啟用矩陣。要跨檢查點比較專家共同啟用,我們計算兩個檢查點所有層的共同啟用矩陣 (${\mathbf{C}}^{(1)},{\mathbf{C}}^{(2)}$),並藉由計算其元素級絕對差矩陣 ($|{\mathbf{C}}^{(1)}-{\mathbf{C}}^{(2)}|$) 中各項的統計量來衡量絕對變化。圖 5 (a) 顯示預訓練與 CPT 檢查點之間共同啟用變化的中位數。早期層(0–1)呈現最大的變化,所有 CPT 模型在第 $18$ 層都有一致的尖峰,第 $13$–$23$ 層的中位數變化也略高。在 CPT 檢查點之中,零重播版本的共同啟用偏移最為顯著。儘管所有檢查點都能良好適應新分布,只有零重播的檢查點在 FineWeb 上出現大幅遺忘。這些發現暗示 CPT 期間的適應與早期層($0$–$2$)及後期層($13$–$23$)的共同啟用變化相關,而變化越劇烈,遺忘也越嚴重。
總結來說,三個指標的結果都顯示路由決策在 Granular MoE transformer 的早期層改變最多;至於其他 MoE 層,專家共同啟用與路由器飽和度有變化,但詞彙專精化沒有。在所有模型中,零重播基準在早期層變化最大、遺忘也最多,暗示初始層較劇烈的變化可能與遺忘有關。
6 結論
我們對 decoder-only MoE transformer 語言模型的持續預訓練,進行了一項全面的實證研究。我們的大規模實驗涉及 2B 參數的 MoE、訓練 600B tokens,證明懲罰式平衡 (PBT$k$) 與 Sinkhorn 平衡式 (SBT$k$) 兩種路由演算法對分布偏移都展現出出人意料的系統層級韌性,以我們提出的最大路由不平衡度指標衡量都能維持平衡的負載。我們確立了 MoE 在 CPT 期間仍保有相對於 FLOP 對齊密集模型的樣本效率優勢;而在使用無限學習率排程與重播時,Granular PBT$k$ MoE 能以完整重新訓練一小部分的計算成本,在德文與程式碼的轉換上追平完整重新訓練基準的效能。最後,我們看到 MoE 的早期層在 CPT 期間變化最大,暗示未來工作可以研究對這些層做特別處理以提升效能。整體而言,我們的發現確立了 MoE 是文字領域中強大的持續學習者,與密集模型不相上下,也凸顯了它們作為可擴展、可適應的語言基礎模型的潛力。
致謝
我們感謝 NSERC Discovery Grant RGPIN-2021-04104 [E.B.]、FRQNT New Scholar [E.B.]、Canada CIFAR AI Chair Program [I.R.]、Canada Excellence Research Chairs Program [I.R.],以及 FRQNT Doctoral (B2X) 獎學金 [B.T.] 的支持。本研究部分得益於 Mila (mila.quebec) 提供的計算資源。我們也要感謝 Capital One 的 GenAI 支援團隊,特別是 Dhantha Gunarathna。同時感謝 Akshaj Kumar Veldanda、Andrei Mircea、Hanyang Zhao 與 Supriyo Chakraborty 在整個過程中的有益討論。
附錄 A 延伸背景
本節補充正文第 2 節,為本文提供更多背景。
A.1 LLM 的持續預訓練
持續預訓練把預訓練延伸到多個新分布上。具體而言,當一個模型在一連串分布各異的資料集 ${\mathcal{D}}_{0},{\mathcal{D}}_{1},\dots,{\mathcal{D}}_{N}$($N\geq 2$)上訓練,而且每個資料集都足夠大(以語言來說,例如 $>100$B tokens),這就是持續預訓練 (Ibrahim et al., 2024)。要注意的是,這裡龐大的資料規模,正是本情境與監督式微調或指令微調的區別所在——後者的資料量小得多。持續預訓練典型的應用情境,是把既有的預訓練模型適配到新取得的資料上,或強化它們在特定領域的能力。接下來我們討論持續預訓練密集 transformer 的成熟技術。
學習率重新暖身與重新衰減。 許多開源 LLM 在預訓練時遵循線性暖身加餘弦退火的排程:在訓練早期達到一個很大的最大學習率 $\eta_{\textit{max}}$,隨後把學習率衰減到一個很小的最小值 $\eta_{\textit{min}}$ (Hoffmann et al., 2022; Loshchilov and Hutter, 2017; Rae et al., 2021)。天真地以 $\eta_{\textit{min}}$ 或 $\eta_{\textit{max}}$ 繼續訓練,會分別導致適應不足或遺忘過多。相反地,Ibrahim et al. (2024) 顯示在 CPT 期間重新暖身與重新衰減學習率,對強勁的持續學習效能至關重要。
無限學習率排程。 雖然依餘弦衰減排程重新暖身與重新衰減學習率,在從完全衰減的檢查點出發時是個不錯的方案,但 Ibrahim et al. (2024) 指出這個策略會因為學習率大幅上升而造成遺忘,即使是在同一個分布上做持續預訓練也一樣。為了迴避這點,作者提出無限學習率排程,讓學習率能在持續學習的各階段之間平滑過渡,而且不受固定訓練步數的束縛。這些技術後續也被確認在多次分布偏移的情境下運作良好 (Janson et al., 2025)。
重播。 重播先前的資料長久以來一直是減輕災難性遺忘的工具 (Wang et al., 2024b)。在我們的實驗中,我們基於這個目的重播先前見過的資料,並在使用該技術的模型後面標註「$X\%$ Replay」。這裡的 $X$ 代表某個批次中,從先前分布重播而來的樣本百分比。為了讓不同重播預算之間的計算量對齊,我們在增加重播量時並不增加 token 預算;相反地,我們減少 CPT 期間看到的新資料量。
A.2 Mixture of experts transformer 語言模型
稀疏啟用的 MoE transformer 與其密集版本的差別,在於它會把序列中的 token ${\mathbf{X}}\in\mathbb{R}^{S\times H}$ 動態路由到不同的專家 $\{\text{FFN}_{i,j}(\cdot)\}_{i=0}^{N}$,而不是單一個 FFN。這裡 $S$ 是序列長度、$H$ 是 transformer 的隱藏維度、$j$ 索引 transformer 的 block、$N$ 是每個 block 的專家數。這通常被稱為 MoE 層 (Shazeer et al., 2017)。這些層一般會取代每個 transformer block 中的前饋網路 (Feed Forward Network, FFN) (Fedus et al., 2022; Dai et al., 2024),不過近期也有工作 (Shen et al., 2024; Zhang et al., 2022) 把多頭自注意力層的 query 與 output 矩陣換成 MoE 層。以下我們只研究在每個 block 用 MoE 層取代 FFN 的 MoE transformer,與近期的 SOTA 工作一致 (Dai et al., 2024; Team, 2024; Muennighoff et al., 2024; DeepSeek-AI et al., 2025b; DeepSeek-AI et al., 2025a)。此外,我們也研究近期使用更細粒度專家與共享專家的趨勢 (Dai et al., 2024; Team, 2024; Muennighoff et al., 2024; He, 2024; Liu et al., 2023b; Ludziejewski et al., 2024; Rajbhandari et al., 2022; DeepSeek-AI et al., 2025b; DeepSeek-AI et al., 2025a)。
動態選擇專家的演算法,也就是路由演算法 (Roller et al., 2021; Shazeer et al., 2017; Zoph et al., 2022; Clark et al., 2022; Lewis et al., 2021),是 MoE 的核心。對 token-choice 路由演算法(我們不考慮 expert-choice,因為它與自迴歸生成不相容)來說,一個關鍵考量是讓某一層中的專家達成平衡的負載。若不強制負載平衡,路由器可能會塌縮成只選擇單一或少數幾個專家,導致參數利用率低落,以及與負載最重的專家成正比的較高延遲 (Zhou et al., 2022)。
本文聚焦於近期 SOTA 工作中兩種重要的 Top-$k$ 路由演算法,我們稱之為懲罰式平衡 Top-$k$ (PBT$k$) 路由 (Shazeer et al., 2017; Dai et al., 2024; Zoph et al., 2022; Fedus et al., 2022) 與 Sinkhorn 平衡式 Top-$k$ (SBT$k$) 路由 (Clark et al., 2022; Anthony et al., 2024)。兩種演算法都把路由器定義為一個到專家空間的簡單線性投影 $R({\mathbf{x}})={\mathbf{W}}{\mathbf{x}}:\mathbb{R}^{H}\rightarrow\mathbb{R}^{e}$。專家機率由對路由器輸出取 softmax 得到:$p({\mathbf{x}})=\texttt{softmax}(SB(R({\mathbf{x}})))$。其中 $SB(\cdot)$ 在 SBT$k$ 路由時是 Sinkhorn 負載平衡函數,否則就是恆等函數。
依 $p({\mathbf{x}})$ 排名後,每個 token 會選出前 $k$ 個專家,$k$ 是訓練前選定的超參數。對單一個 token 而言,MoE 層 $j$ 的輸出 $f_{\text{MoE}_{j}}$ 計算如下:
$$f_{\text{MoE}_{j}}({\mathbf{x}})=\text{SFFN}_{j}({\mathbf{x}})+\frac{\sum_{i\in I_{k}({\mathbf{x}})}p_{i}({\mathbf{x}})\cdot\text{FFN}_{i,j}({\mathbf{x}})}{\sum_{i\in I_{k}({\mathbf{x}})}p_{i}({\mathbf{x}})}.$$
其中 $I_{k}({\mathbf{x}})=\{i\mid p_{i}({\mathbf{x}})\in p({\mathbf{x}})\text{ 的前 }k\text{ 大元素}\}$,而 SFFN 在有使用共享專家時 (Rajbhandari et al., 2022; Dai et al., 2024) 是共享專家,否則是恆等函數。雖然兩者都把 token 路由到前 $k$ 個專家,PBT$k$ 與 SBT$k$ 路由演算法在如何平衡專家負載上有所不同。
懲罰式平衡 Top-$k$ 路由。 文獻中的 PBT$k$ 方法 (Shazeer et al., 2017; Fedus et al., 2022; Zoph et al., 2022; Dai et al., 2024) 會在整體損失上加入懲罰項,以鼓勵專家之間的負載平衡。輔助損失 (Auxiliary Loss) 已成為最流行的這類懲罰,並在數個近期 SOTA MoE 中與 z-loss 搭配使用 (Dai et al., 2024; Team, 2024)。簡言之,輔助損失在路由器把某批次中相同比例的 token 指派給某個 block 中每個專家時最小化,而 z-loss 則懲罰過大的路由器 logits。後者已被證實有助於較大模型的數值穩定性 (Zoph et al., 2022)。鑑於近期 SOTA MoE LLM 把兩者合併使用 (Zoph et al., 2022; Dai et al., 2024),我們只研究同時結合輔助損失與 z-loss 的 MoE,並稱之為 PBT$k$ MoE。
Sinkhorn 平衡式 Top-$k$ 路由。 SBT$k$ 路由把 token 對專家的指派視為一個線性指派問題,這對應到最佳傳輸 (Optimal Transport) 中一個被充分研究的問題,也就是「正則化的 Kantorovich 最佳傳輸問題」(Clark et al., 2022)。Sinkhorn-Knopp 演算法 (Knopp and Sinkhorn, 1967) 提供這個問題的近似解,可以在 GPU 上高效計算。實務上這相當於調整路由機率(例如依 $SB(\cdot)$,細節見 (Clark et al., 2022) 的 B.2.1 節),使得在不過度偏離貪婪 Top-$k$ 路由的前提下,取得相對平衡的負載。
附錄 B 延伸相關研究
本節補充正文第 3 節,提供相關研究更完整的整理。
B.1 Mixture of experts 語言模型
混合專家語言模型有很長的歷史,其基本構想可追溯至數十年前 (Collobert et al., 2003; Jacobs et al., 1991)。較近期,在大規模語言建模的脈絡下,混合專家層 (Shazeer et al., 2017) 被提出來大幅增加 LSTM 語言模型的容量,同時幾乎不損害效率。作者同時引入了一個負載平衡懲罰項,以鼓勵專家被均勻使用。隨後,Fedus et al. (2022) 精煉了這個懲罰項,並更名為輔助損失 (Auxiliary Loss),它已成為現代 MoE 的核心元件。後續工作聚焦於大幅擴展 MoE LLM 的規模、改進這些模型的路由演算法、改善路由器梯度估計的品質,以及對模型做架構上的改良。Lepikhin et al. (2021) 把 MoE 層引入 transformer 架構,使用兩個啟用專家(當時認為這是取得非平凡路由器梯度所必需的),並擴展到前所未有的 $600$B 參數規模。隨後,Fedus et al. (2022) 提出 Switch Transformer,證明即使只用單一個啟用專家訓練,也能把 MoE 擴展到超過 1T 參數。
其他工作則專注於開發新的路由演算法。Lewis et al. (2021) 把路由視為線性指派問題,並在路由演算法中運用匈牙利匹配。Clark et al. (2022) 使用 Sinkhorn 演算法在 GPU 上近似求解指派問題,得到更快的演算法。Anthony et al. (2024) 引入一個有利的初始條件來改善迭代式 Sinkhorn 求解器的收斂,進一步降低 Sinkhorn 路由的成本。Roller et al. (2021) 提出以 hash layer 為基礎的確定性路由演算法。Zoph et al. (2022) 引入一個損失懲罰項來提升大規模 MoE 路由的穩定性。Wang et al. (2024a) 提出第一個既不使用熵正則化項、也不採用指派式做法,就能在 token-choice 路由中平衡專家使用率的可學習路由機制。Zhou et al. (2022) 提出 Expert Choice Routing,這是一種由每個專家取得平衡負載、並由路由演算法決定要把哪些 token 送給每個專家的路由範式;雖然它效能強勁且能自動達成負載平衡,但 ECR 與自迴歸生成不相容,因此我們在本文中不予考慮。另有工作提出更好地近似完整路由器梯度的方法 (Panda et al., 2024; Liu et al., 2024; Liu et al., 2023a)。
最後,近期使用中間層維度更細粒度的 MoE 專家的趨勢,相較於原本使用完整 FFN 中間層維度的做法 (Shazeer et al., 2017; Fedus et al., 2022; Lepikhin et al., 2021),展現出顯著的效能提升。Liu et al. (2023b) 首先觀察到使用較小的專家層能改善困惑度。隨後,研究者探討了小規模下細粒度 MoE 的 scaling law (Ludziejewski et al., 2024),預訓練並釋出了採用細粒度專家架構的 SOTA MoE (Dai et al., 2024; Team, 2024; Muennighoff et al., 2024),並把更瘦的專家這個構想推到極限,探索擁有數百萬個專家的 MoE (He, 2024)。雖然我們已回顧最相關的工作,仍有許多研究無法在此一一提及。我們把有興趣的讀者導向一份近期且完整的領域綜述 (Cai et al., 2024)。
B.2 密集基礎模型的持續預訓練
基礎模型的持續預訓練與持續學習 (French, 1999) 有相同的目標,差別在於它應用在大規模、且主要是自監督的預訓練任務上。已有數項研究在與持續預訓練相關的情境下探討持續學習,發現:自監督預訓練能減輕遺忘 (Cossu et al., 2022; Davari et al., 2022)、預訓練模型比隨機初始化的模型遺忘得更少 (Mehta et al., 2023)、遺忘會隨模型規模增大而改善 (Ramasesh et al., 2022),以及較寬的模型往往比較深的模型遺忘得少 (Mirzadeh et al., 2022)。在 LLM 微調的脈絡下,(Scialom et al., 2022) 顯示在少量指令微調資料上微調時,只需要很少的重播就能避免遺忘。在 LLM(就資料而言)大規模持續預訓練的脈絡下,Gupta et al. (2023) 強調當模型是從已衰減到很小學習率的檢查點開始預訓練時,重新暖身學習率的重要性。承接他們的工作,Ibrahim et al. (2024) 確立了學習率重新暖身、重新衰減與重播在 LLM 大規模持續預訓練上的有效性。同期,Garg et al. (2023) 確立了同一套技術在 CLIP 模型上的效果。此後不久,Parmar et al. (2024) 把密集 decoder-only transformer 的持續預訓練推到更大規模,證明一個以 $8$T tokens 預訓練的 15B 參數模型,能有效地在 $1$T tokens 的新進資料上做預訓練。
B.3 MoE LLM 的持續預訓練
據我們所知,探討 MoE LLM 大規模持續預訓練的工作只有一篇,而文獻中大多數研究關注的是為了持續預訓練而對 MoE 做升級再造或擴增。
在一份同期的預印本 DeepSeek-CoderV2 (DeepSeek-AI et al., 2024) 中,作者展示了可以從檢查點接續訓練一個 MoE LLM。然而這只在單一個案上展示,也沒有討論 MoE 路由行為的分析。此外,該工作沒有與 FLOP 對齊的密集模型比較,因此難以判斷 MoE LLM 的樣本效率在持續預訓練期間是否得以維持。
與我們較不相關的 MoE 持續預訓練方法,一般聚焦於用少量資料微調 MoE LLM (Wang et al., 2024c) 或擴增 MoE (Komatsuzaki et al., 2023; Zhu et al., 2024; Sukhbaatar et al., 2024; Gritsch et al., 2024; Chen et al., 2023)。Wang et al. (2024c) 研究 MoE 專屬的參數高效微調 (PEFT) 技術。Zhu et al. (2024) 提出一種把既有密集 transformer 的 FFN 切分開來以建立 MoE、再對其做持續預訓練的技術。Sukhbaatar et al. (2024) 提出先把一個密集 LLM 在多個不同資料集上持續預訓練,再蒐集不同持續預訓練模型的 FFN 層來組成 MoE 層,把 FFN 以外的參數張量做合併,最後對合併後的模型做持續預訓練以學習 MoE 部分的路由。Gritsch et al. (2024) 提出一個類似的方法來訓練新的專家層,它使用預訓練嵌入模型產生的領域嵌入作為某領域專家的識別符,讓領域嵌入提供有助於新增專家的歸納偏差。雖然這些方法能用新資料提升 MoE 的能力,但它們的重點是先對密集模型做升級再造,而我們關注的是更新從零開始預訓練的 MoE。
附錄 C 訓練耗時
為求完整,我們提供本研究中每種模型架構的訓練耗時。在本節開始前先聲明:我們回報的所有步驟時間都是針對我們的程式碼與所用函式庫而言,並不代表可達成的最佳效能。耗時會隨模型大小、互連速度、訓練精度、所用加速器、實作方式等因素而變動。在此前提下,表 2 回報在 64 張 A100 GPU 上、跨 $1000$ 個訓練步的不同操作耗時(毫秒)的平均值與標準差。具體來說,我們計時前向傳遞、反向傳遞、優化器步驟與資料載入時間,最後一欄回報總和時間。我們也回報以 TFLOPs 表示的 MFU,以及以每秒樣本數表示的吞吐量。我們所有實驗都使用 GPT-NeoX 函式庫 (Andonian et al., 2023) 的程式碼,並運用 megablox grouped GEMM kernel(github.com/tgale96/grouped_gemm)(Gale et al., 2023)。我們觀察到,在我們這個特定實作中,所有 MoE 的每步耗時大約是密集模型的兩倍;Granular MoE 的前向與反向時間比 Switch MoE 慢;Sinkhorn 平衡式 MoE 的前向與反向時間比懲罰式平衡 MoE 慢。這揭露了相較於 FLOP 對齊的密集模型,訓練 MoE 有一些不可忽略的缺點(例如反映在步驟時間上),包括:更高的記憶體需求、更長的優化器步驟,以及更高的通訊成本。儘管有這些缺點,Du et al. (2024) 發現即使把訓練 MoE 的額外開銷計入,MoE 的效能優勢仍然超過密集模型。
表 2:本研究中每種模型架構在預訓練期間不同操作的耗時。 我們回報在 64 張 A100 GPU 上、跨 $1000$ 個訓練步的不同操作耗時(毫秒)的平均值與標準差。我們使用 $1024$ 的全域批次大小與 $2048$ 的序列長度。
| 模型 | 前向 | 反向 | 優化器 | 資料 | 樣本/秒 | MFU (TFLOPs) | 總時間 (ms) |
|---|---|---|---|---|---|---|---|
| Dense Baseline | 318.02 ± 1.86 | 518.60 ± 17.73 | 39.48 ± 5.55 | 3.72 ± 0.44 | 1156.88 ± 52.63 | 111.32 ± 5.06 | 879.83 |
| PB Switch MoE | 449.36 ± 14.97 | 963.53 ± 4.06 | 101.66 ± 0.69 | 2.42 ± 0.33 | 671.93 ± 24.63 | 86.21 ± 3.16 | 1516.97 |
| SB Switch MoE | 494.28 ± 11.35 | 1012.38 ± 6.87 | 101.58 ± 0.70 | 2.59 ± 1.36 | 631.14 ± 33.90 | 80.97 ± 4.35 | 1610.83 |
| PB Granular MoE | 485.05 ± 13.66 | 1091.38 ± 3.68 | 100.66 ± 3.08 | 2.42 ± 0.33 | 606.85 ± 21.53 | 77.86 ± 2.76 | 1679.50 |
| SB Granular MoE | 541.62 ± 7.14 | 1144.85 ± 5.72 | 100.27 ± 1.47 | 2.37 ± 0.33 | 569.72 ± 19.27 | 73.09 ± 2.47 | 1789.10 |
附錄 D 延伸實驗結果
在本節中,我們以未經摘要的形式提供本文的延伸實驗結果,以增進本文的可重現性,也讓讀者能深入自己最感興趣的細節。
D.1 語言模型評測基準
我們在英文、程式碼與德文評測任務上評估本研究中的語言模型。請注意我們的目標不是在這些基準上取得 SOTA 效能;我們的模型都沒有經過對齊或微調來提升表現。相反地,我們是在這份受控科學研究的脈絡下評估它們的效能。考慮到我們語言模型的規模(最多 $570$M 啟用參數),我們謹慎挑選能呈現非平凡評測結果的任務;也就是說,我們挑選那些我們這組模型能取得高於隨機猜測準確率的任務。
選用的英文評測任務:
- 常識推理 (0-shot):HellaSwag (Zellers et al., 2019)、Winogrande (Sakaguchi et al., 2019)、PIQA (Bisk et al., 2019)、ARC-Easy、ARC-Challenge (Clark et al., 2018)、SWAG (Zellers et al., 2018)
- 閱讀理解 (0-shot):LAMBADA (OpenAI) (Storks et al., 2019)
- 科學問答 (0-shot):SciQ (Johannes Welbl, 2017)、PubMedQA (Jin et al., 2019)
- 數學 (0-shot):MathQA (Amini et al., 2019)
選用的德文評測任務,由對應的英文任務以 GPT-3.5 API 翻譯而來 (Plüster, 2023)。
- 常識推理 (0-shot):HellaSwag-DE (Zellers et al., 2019)、ARC-Challenge-DE (Clark et al., 2018)
- 閱讀理解 (0-shot):TruthfulQA-DE (Joshi et al., 2017)
程式碼評測任務:
- Python:HumanEval (pass@1–200)
表 4、表 3 與表 5 分別回報本研究模型在英文、程式碼與德文評測基準上的效能。
表 3:在 FineWeb 上預訓練、在 Stack 上持續預訓練之後的 HumanEval 結果。 我們回報至少有一個生成解答通過全部測試的題目百分比。我們觀察到所有只用英文訓練的模型都只生成錯誤解答,而在程式碼上持續預訓練的模型與完整重新訓練基準都取得非平凡的準確率。有趣的是,SB Switch MoE 在所有 pass 門檻上表現最好。不過鑑於這些模型整體表現普遍不佳,我們把同一資料類型內部的差異歸因於隨機性。
| 訓練 tokens | 模型 | pass@1 | pass@10 | pass@50 | pass@100 | pass@150 | pass@200 | 平均 |
|---|---|---|---|---|---|---|---|---|
| $400$B FineWeb | Dense Baseline | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% |
| SB Switch MoE | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | |
| PB Switch MoE | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | |
| SB Granular MoE | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | |
| PB Granular MoE | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | |
| $400$B FineWeb $\rightarrow$ $200$B Stack | Dense Baseline | 0.21% | 1.94% | 6.87% | 9.96% | 11.85% | 13.41% | 7.37% |
| SB Switch MoE | 0.24% | 2.19% | 8.06% | 12.15% | 14.85% | 17.07% | 9.09% | |
| PB Switch MoE | 0.21% | 1.93% | 7.28% | 11.10% | 13.56% | 15.24% | 8.22% | |
| SB Granular MoE | 0.18% | 1.69% | 6.50% | 10.01% | 12.30% | 14.02% | 7.45% | |
| PB Granular MoE | 0.16% | 1.51% | 6.30% | 10.40% | 13.24% | 15.24% | 7.81% | |
| $400$B FineWeb $\cup$ $200$B Stack | Dense Baseline | 0.14% | 1.20% | 3.57% | 4.99% | 5.98% | 6.71% | 3.76% |
| PB Granular MoE | 0.20% | 1.82% | 6.84% | 10.21% | 12.13% | 13.41% | 7.44% |
表 4:預訓練(英文網路資料)、持續預訓練(程式碼與德文網路資料)與完整重新訓練之後的語言模型評測基準結果。 我們回報所有選用基準的準確率。我們觀察到所有 MoE 與密集基準在分布偏移前後都維持相似的相對效能,顯示 MoE LLM 的持續預訓練動態,就評測任務上的遺忘而言與密集模型相似。把 PB Granular MoE 的平均評測效能與完整重新訓練基準相比,我們觀察到最終效能被追平或非常接近,而計算成本卻低得多。
| 訓練 tokens | 模型 | ARC-C | ARC-E | HellaSwag | LAMBADA OAI | MathQA | PIQA | PubMedQA | SciQ | SWAG | WinoGrande | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $400$B FineWeb(已退火) | Dense Baseline | 23.55% | 54.25% | 39.99% | 47.55% | 23.52% | 71.98% | 51.80% | 82.70% | 47.59% | 55.49% | 49.84% |
| SB Switch MoE | 26.79% | 60.48% | 45.60% | 53.44% | 24.52% | 74.16% | 62.00% | 84.80% | 50.31% | 59.27% | 54.14% | |
| PB Switch MoE | 28.75% | 61.15% | 46.16% | 54.22% | 25.86% | 74.37% | 58.20% | 87.20% | 50.67% | 57.93% | 54.45% | |
| SB Granular MoE | 26.19% | 65.19% | 48.10% | 56.24% | 24.66% | 74.92% | 61.10% | 89.30% | 51.35% | 60.06% | 55.71% | |
| PB Granular MoE | 28.75% | 62.92% | 48.45% | 56.08% | 24.62% | 75.24% | 60.00% | 88.90% | 51.36% | 59.59% | 55.59% | |
| $400$B FineWeb(未退火) | Dense Baseline | 22.35% | 52.02% | 39.12% | 49.04% | 23.15% | 70.46% | 52.50% | 81.90% | 47.09% | 54.14% | 49.18% |
| SB Switch MoE | 24.23% | 57.91% | 44.26% | 51.72% | 24.52% | 73.12% | 60.30% | 83.50% | 49.32% | 56.67% | 52.55% | |
| PB Switch MoE | 26.54% | 60.86% | 44.59% | 53.21% | 23.99% | 73.39% | 52.30% | 85.80% | 49.98% | 56.27% | 52.69% | |
| SB Granular MoE | 26.54% | 62.63% | 46.85% | 55.87% | 24.56% | 73.67% | 58.60% | 87.70% | 50.72% | 59.04% | 54.62% | |
| PB Granular MoE | 27.82% | 61.20% | 46.52% | 55.46% | 24.36% | 74.97% | 58.80% | 86.80% | 50.87% | 58.64% | 54.54% | |
| $400$B FineWeb $\rightarrow$ $200$B German($40\%$ 重播) | Dense Baseline | 22.87% | 51.43% | 36.97% | 46.75% | 23.75% | 70.18% | 48.80% | 80.70% | 45.87% | 54.22% | 48.15% |
| SB Switch MoE | 24.66% | 56.90% | 42.99% | 52.94% | 24.22% | 73.07% | 57.40% | 83.50% | 48.85% | 55.41% | 51.99% | |
| PB Switch MoE | 25.34% | 56.94% | 42.59% | 53.43% | 25.06% | 73.23% | 49.40% | 84.20% | 48.76% | 53.51% | 51.25% | |
| SB Granular MoE | 25.43% | 60.02% | 44.67% | 55.23% | 25.13% | 73.01% | 55.10% | 84.60% | 49.89% | 60.46% | 53.35% | |
| PB Granular MoE | 27.05% | 60.52% | 44.66% | 54.43% | 24.56% | 73.88% | 58.40% | 85.70% | 49.70% | 57.22% | 53.61% | |
| $400$B FineWeb $\cup$ $200$B German CC | Dense Baseline | 23.29% | 51.35% | 36.77% | 46.17% | 24.19% | 70.08% | 54.00% | 80.30% | 45.51% | 52.57% | 48.42% |
| PB Granular MoE | 27.99% | 60.06% | 45.06% | 55.23% | 25.16% | 73.50% | 56.20% | 86.20% | 49.88% | 60.14% | 53.94% | |
| $400$B FineWeb $\rightarrow$ $200$B Stack($30\%$ 重播) | Dense Baseline | 22.01% | 52.95% | 37.49% | 46.98% | 22.91% | 71.06% | 55.40% | 83.70% | 45.76% | 53.83% | 49.21% |
| SB Switch MoE | 22.87% | 55.98% | 42.51% | 52.84% | 24.12% | 72.80% | 55.80% | 85.10% | 48.78% | 56.83% | 51.76% | |
| PB Switch MoE | 26.28% | 59.01% | 42.78% | 53.17% | 24.32% | 73.50% | 55.10% | 86.20% | 49.07% | 56.43% | 52.59% | |
| SB Granular MoE | 26.54% | 60.19% | 44.57% | 55.44% | 24.39% | 73.01% | 55.60% | 85.90% | 49.83% | 59.59% | 53.51% | |
| PB Granular MoE | 25.43% | 60.27% | 44.88% | 54.94% | 25.36% | 73.78% | 56.90% | 88.00% | 49.62% | 57.85% | 53.70% | |
| $400$B FineWeb $\cup$ $200$B Stack | Dense Baseline | 22.18% | 52.78% | 38.68% | 48.50% | 24.49% | 71.00% | 51.70% | 83.40% | 47.01% | 55.96% | 49.57% |
| PB Granular MoE | 27.82% | 62.67% | 46.43% | 56.39% | 25.66% | 75.35% | 56.60% | 89.40% | 50.85% | 56.75% | 54.79% |
表 5:預訓練(英文網路資料)、持續預訓練(程式碼與德文網路資料)與完整重新訓練之後的德文語言模型評測基準結果。 我們回報所有選用基準的準確率。我們觀察到所有 MoE 與密集基準在持續預訓練之後,德文效能都有提升。與完整重新訓練基準相比,我們觀察到持續預訓練模型的平均效能與之相當。
| 訓練 tokens | 模型 | ARC-C DE | HellaSwag DE | TruthfulQA DE (MC1) | 平均 |
|---|---|---|---|---|---|
| $400$B FineWeb | Dense Baseline | 18.52% | 26.78% | 25.34% | 23.54% |
| SB Switch MoE | 18.60% | 26.87% | 23.87% | 23.11% | |
| PB Switch MoE | 18.94% | 26.56% | 24.60% | 23.37% | |
| SB Granular MoE | 18.34% | 26.78% | 23.38% | 22.83% | |
| PB Granular MoE | 18.43% | 27.05% | 24.72% | 23.40% | |
| $400$B FineWeb $\rightarrow$ $200$B German CC | Dense Baseline | 19.28% | 32.53% | 23.99% | 25.27% |
| SB Switch MoE | 21.76% | 35.74% | 25.21% | 27.57% | |
| PB Switch MoE | 20.73% | 35.77% | 23.01% | 26.50% | |
| SB Granular MoE | 22.61% | 36.90% | 26.19% | 28.57% | |
| PB Granular MoE | 22.70% | 37.23% | 23.01% | 27.65% | |
| $400$B FineWeb $\cup$ $200$B German CC | Dense Baseline | 20.05% | 31.45% | 24.85% | 25.45% |
| PB Granular MoE | 21.33% | 35.74% | 25.70% | 27.59% |
D.2 訓練與驗證損失
在以下小節中,我們呈現本研究所有模型在預訓練與持續預訓練期間與之後的驗證損失曲線。具體來說,我們在表 6 回報最終驗證損失,並在圖 6、7、8 中呈現訓練期間的驗證曲線。
表 6:MoE 與密集模型在預訓練(英文網路資料)與持續預訓練(程式碼與德文網路資料)之後的最終驗證損失。 如預期,我們觀察到所有 MoE transformer 在預訓練與持續預訓練期間的驗證損失都勝過密集基準。此外,我們觀察到 MoE 遺忘得比密集版本略少。綜合來看,這些結果顯示 MoE 的持續學習能力在適應上與密集模型相當,在遺忘上則略勝一籌,可能是因為它們的總參數量更大。
| 訓練 tokens | 模型 | FineWeb | Stack | German | 遺忘 | AVG |
|---|---|---|---|---|---|---|
| $400$B FineWeb(未退火) | Dense Baseline | 2.881 | 4.028 | 3.741 | – | – |
| SB Switch MoE | 2.711 | 3.861 | 3.495 | – | – | |
| PB Switch MoE | 2.699 | 3.872 | 3.451 | – | – | |
| SB Granular MoE | 2.664 | 3.690 | 3.404 | – | – | |
| PB Granular MoE | 2.653 | 3.715 | 3.370 | – | – | |
| $400$B FineWeb(已退火) | Dense Baseline | 2.825 | 4.028 | 3.741 | – | – |
| SB Switch MoE | 2.640 | 3.861 | 3.495 | – | – | |
| PB Switch MoE | 2.628 | 3.872 | 3.451 | – | – | |
| SB Granular MoE | 2.595 | 3.690 | 3.404 | – | – | |
| PB Granular MoE | 2.582 | 3.715 | 3.370 | – | – | |
| $400$B FineWeb $\rightarrow$ $200$B Stack($30\%$ 重播) | Dense Baseline | 2.939 | 1.026 | – | 0.059 | 1.982 |
| SB Switch MoE | 2.757 | 0.944 | – | 0.046 | 1.850 | |
| PB Switch MoE | 2.749 | 0.945 | – | 0.050 | 1.847 | |
| SB Granular MoE | 2.708 | 0.925 | – | 0.044 | 1.816 | |
| PB Granular MoE | 2.699 | 0.924 | – | 0.046 | 1.811 | |
| $400$B FineWeb $\cup$ $200$B Stack | Dense Baseline Union | 2.866 | 1.050 | – | – | 1.958 |
| PB Granular MoE Union | 2.630 | 0.935 | – | – | 1.782 | |
| $400$B FineWeb $\rightarrow$ $200$B German($0\%$ 重播) | Dense Baseline | 4.028 | – | 1.279 | 1.399 | 2.654 |
| SB Switch MoE | 3.810 | – | 1.062 | 1.180 | 2.436 | |
| PB Switch MoE | 3.782 | – | 1.059 | 1.152 | 2.420 | |
| SB Granular MoE | 3.701 | – | 1.038 | 1.071 | 2.369 | |
| PB Granular MoE | 3.685 | – | 1.028 | 1.055 | 2.356 | |
| $400$B FineWeb $\rightarrow$ $200$B German($40\%$ 重播) | Dense Baseline | 2.946 | – | 1.367 | 0.066 | 2.157 |
| SB Switch MoE | 2.749 | – | 1.142 | 0.039 | 1.946 | |
| PB Switch MoE | 2.741 | – | 1.129 | 0.042 | 1.935 | |
| SB Granular MoE | 2.701 | – | 1.118 | 0.037 | 1.910 | |
| PB Granular MoE | 2.690 | – | 1.099 | 0.037 | 1.895 | |
| $400$B FineWeb $\cup$ $200$B German | Dense Baseline Union | 2.938 | – | 1.390 | – | 2.164 |
| PB Granular MoE Union | 2.669 | – | 1.120 | – | 1.895 |
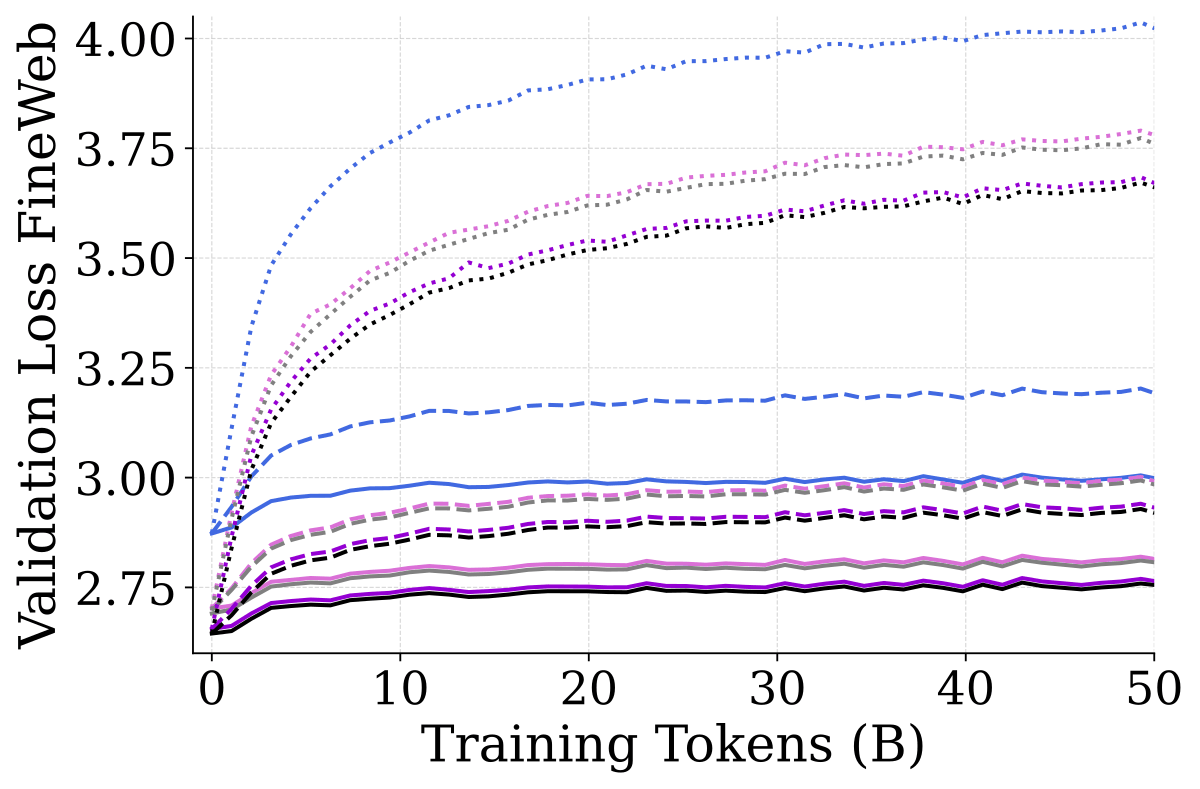
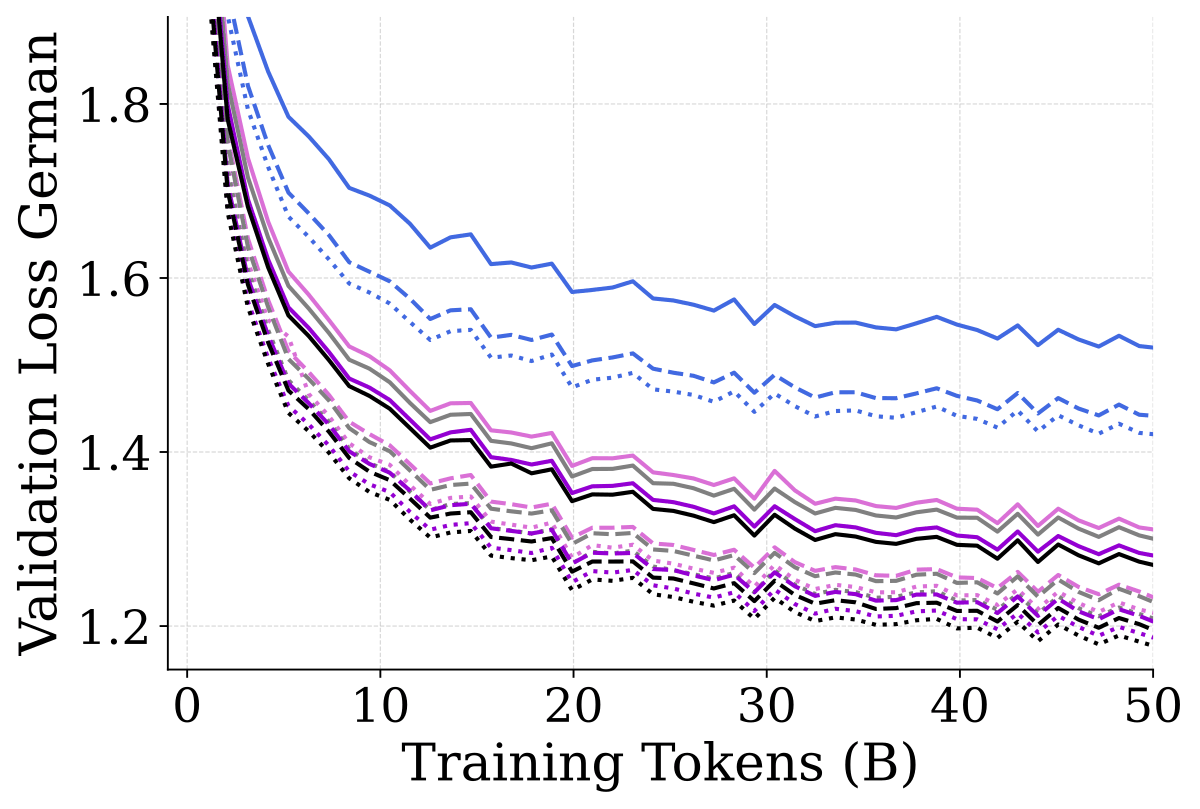
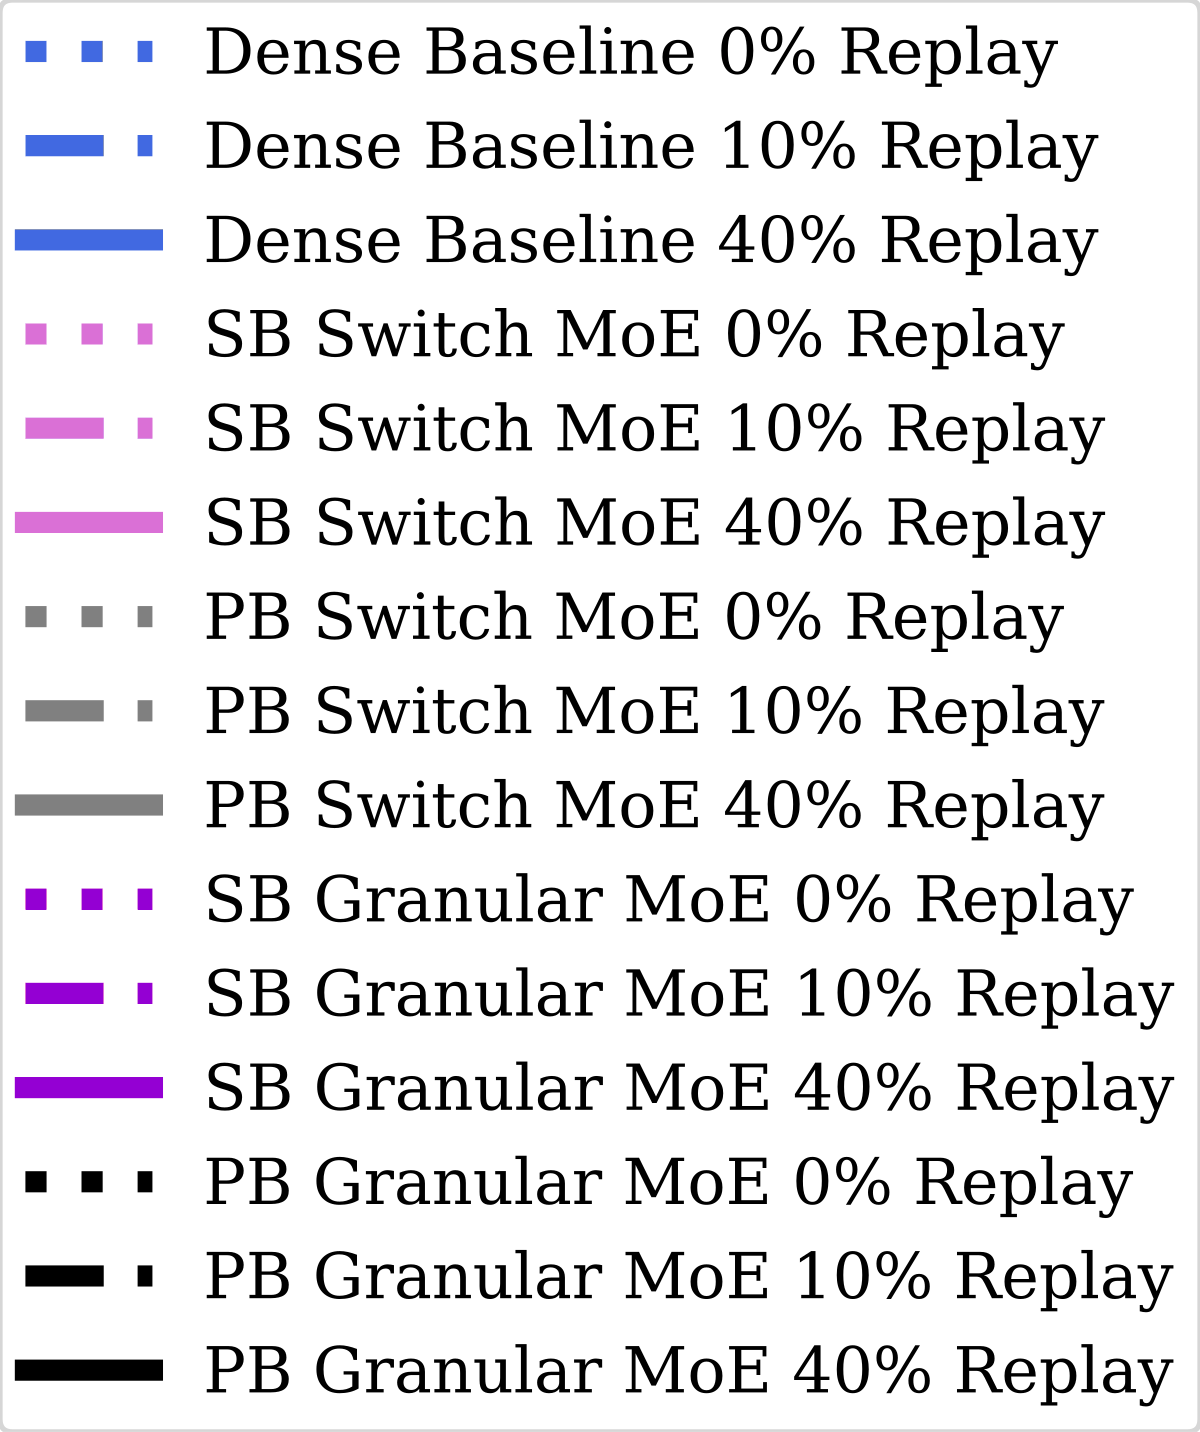
圖 6:在以不同重播量做持續預訓練時,懲罰式平衡 (PB) 與 Sinkhorn 平衡式 (SB) Top-$k$ MoE 的行為與 FLOP 對齊的密集基準相似。 我們用不同重播量持續預訓練 MoE 與密集基準:0%(點線)、10%(虛線)與 $40\%$(實線)。我們觀察到重播大幅降低所有模型的遺忘,同時略微損害適應;也就是說,重播對 MoE 的作用與對密集模型相同。
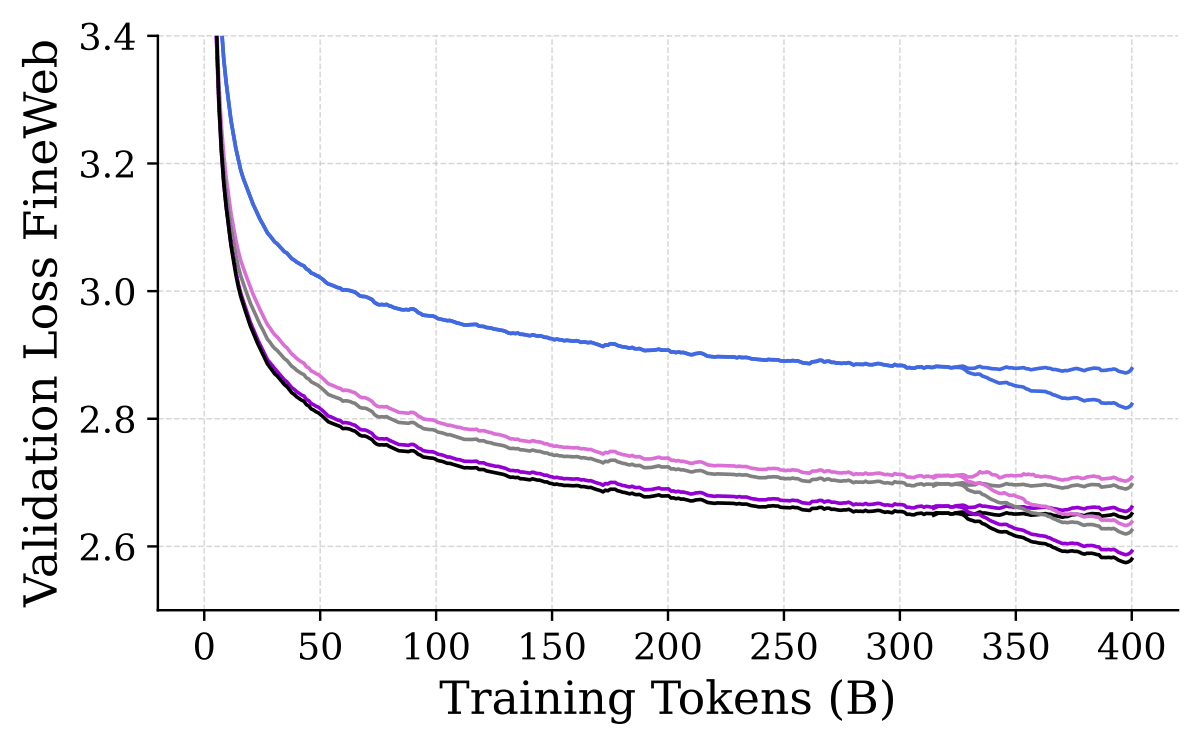
圖 7:以無限學習率排程在 FineWeb 上做初始預訓練期間的驗證損失。 我們回報衰減階段與常數階段直到結束。我們觀察到所有 MoE transformer 在整個預訓練期間都穩定地降低驗證損失,且如預期般勝過密集模型。有趣的是,PBT$k$ MoE 相對於 SBT$k$ 有小幅改善。
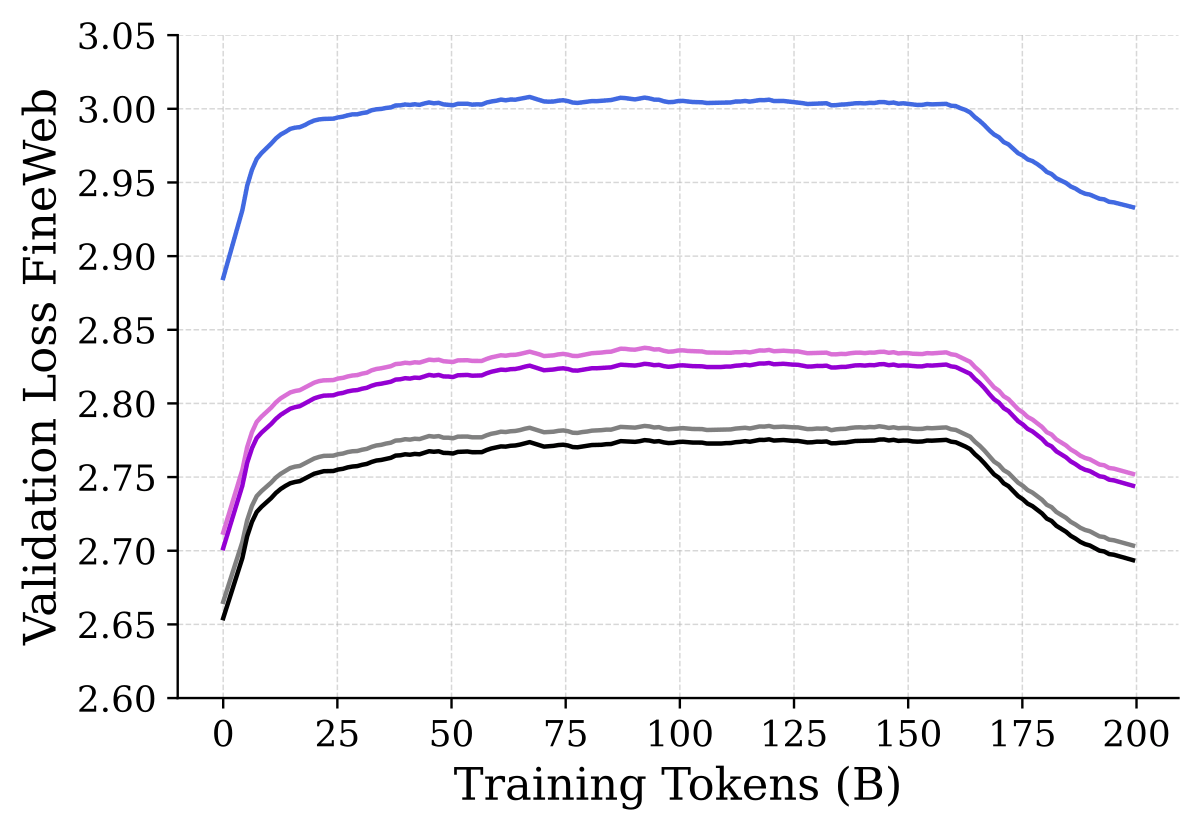
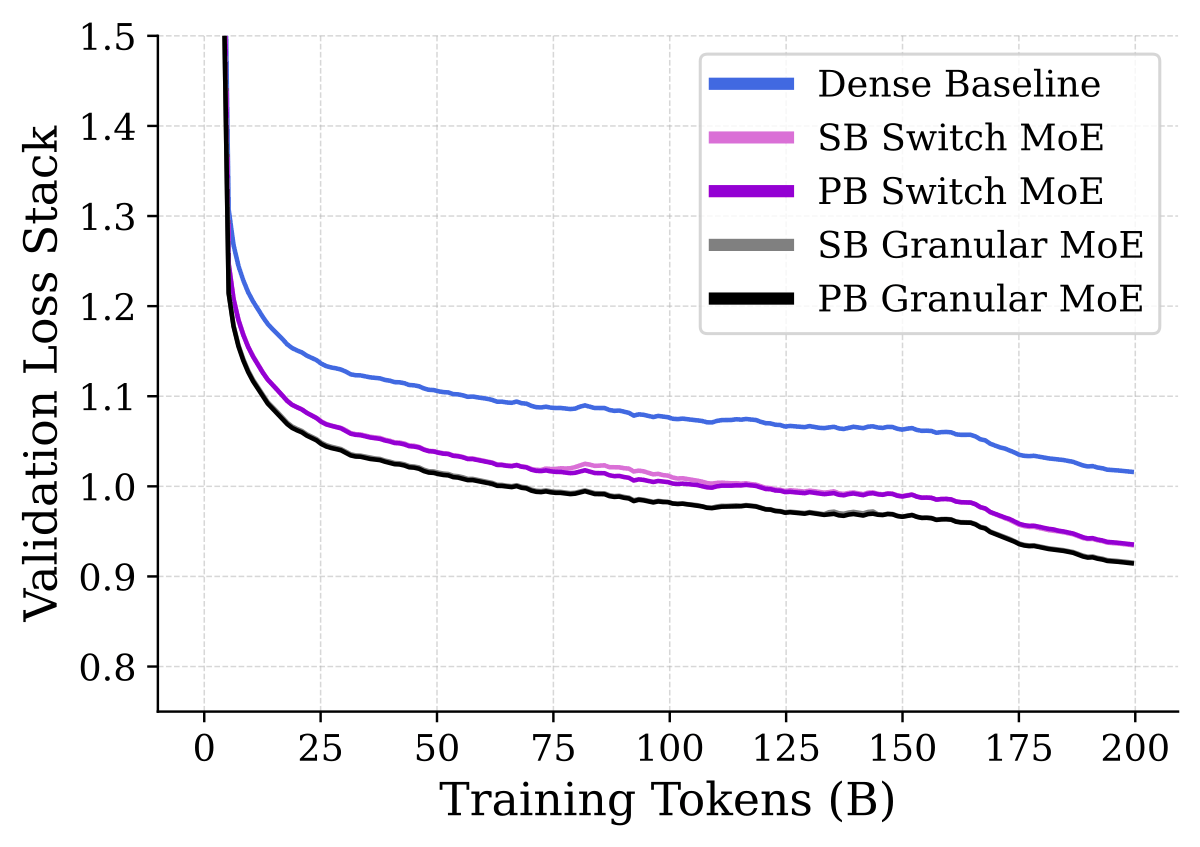
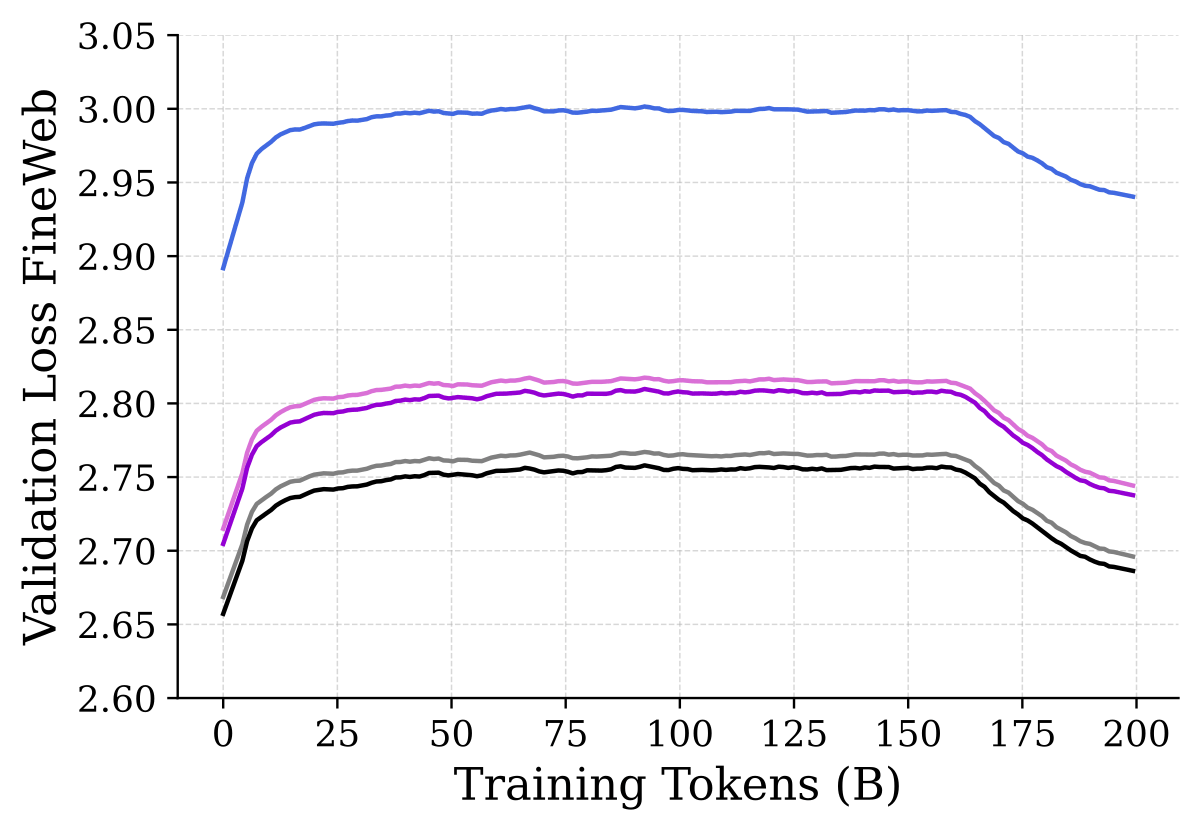
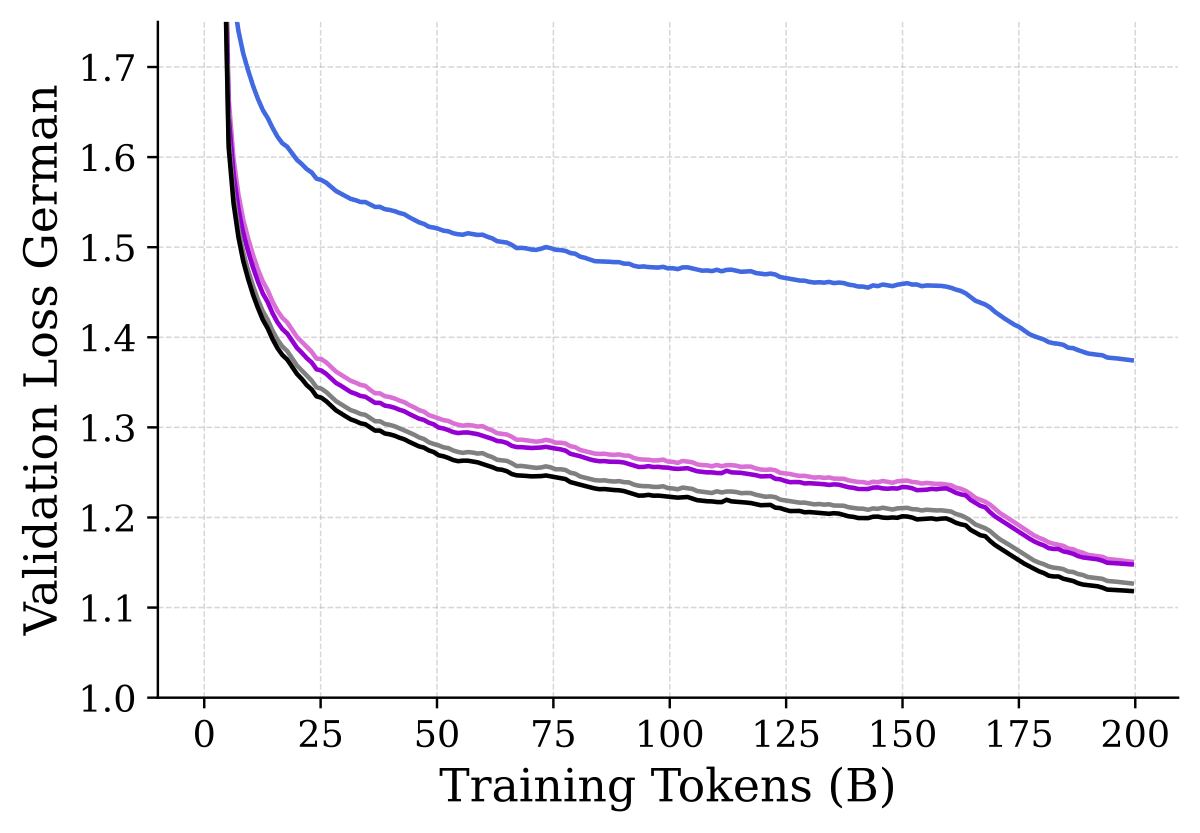
圖 8:CPT 期間在 CPT 與預訓練資料集上的驗證損失。 子圖 (a) 與 (c) 回報 FineWeb 驗證損失,子圖 (b) 與 (d) 則分別回報在 Stack 與德文上訓練的模型在對應資料集上的驗證損失。我們觀察到所有 MoE 在分布偏移之後都保有樣本效率,用遠少於 FLOP 對齊密集基準的迭代次數就達到更低的損失。
D.3 定性分析
在本節中,我們提出一些用來分析本研究 MoE 路由決策的新指標,並解讀它們在持續預訓練期間如何改變。為此,我們取持續預訓練前後的檢查點,在 20M tokens 的 FineWeb 測試資料(預訓練資料集)、20M tokens 的德文測試資料(持續預訓練資料集)與 20M tokens 的 Stack 測試資料(持續預訓練資料集)上記錄它們的路由決策、損失、路由不平衡度與若干指標。我們的結果可分為四大類:1) 路由飽和度分析、2) 詞彙專精化分析、3) 專家共同啟用分析、4) 路由不平衡分析。
D.3.1 持續路由飽和度分析
我們把 Muennighoff et al. (2024) 的路由器飽和度分析調整到持續學習情境。注意以下我們會直接引用並稍作修改 Muennighoff et al. (2024) 對路由器飽和度的定義,以求清晰並方便讀者在兩篇論文的符號之間轉換。具體來說,我們定義持續路由器飽和度為:
$$\texttt{Continual Router Saturation}(t,h,j)=\frac{1}{N}\sum_{i=1}^{N}\frac{|\mathcal{E}_{i}^{({\mathcal{T}}_{h})}\cap\mathcal{E}_{i}^{({\mathcal{T}}_{j})}|}{k}, \tag{2}$$
其中:
- ${\mathcal{T}}_{h}$ 與 ${\mathcal{T}}_{j}$:選擇檢查點時所考慮的任務。注意 $h\leq j$。在我們的情況中 $j,h\in\{0,1,2\}$,${\mathcal{T}}_{0}$ 代表預訓練任務 (FineWeb),${\mathcal{T}}_{1},{\mathcal{T}}_{2}$ 分別代表德文與 Stack 的持續預訓練任務。雖然我們的實驗只考慮一次轉換,一般而言可以有更多次。
- $N$:資料集中的 token 總數。
- $k$:每個輸入 token 啟用的專家數。
- $\mathcal{E}_{i}^{({\mathcal{T}}_{h})}$:在第 $h$ 個任務的最終檢查點上,為第 $i$ 個 token 啟用的 $k$ 個專家所成的集合。
- $\mathcal{E}_{i}^{({\mathcal{T}}_{j})}$:在第 $j$ 個任務的最終檢查點上,為第 $i$ 個 token 啟用的 $k$ 個專家所成的集合。
- $|\mathcal{E}_{i}^{({\mathcal{T}}_{h})}\cap\mathcal{E}_{i}^{({\mathcal{T}}_{j})}|$:第 $h$ 個與第 $j$ 個任務的最終檢查點之間,為第 $i$ 個 token 共同啟用的專家數。
圖 9 與圖 10 分別針對 Granular MoE(31 個被路由專家、3 個啟用、1 個共享)與 Switch MoE(8 個被路由專家、1 個啟用)考慮 $h=0$ 與 $j\in\{0,1\}$,也就是比較持續預訓練之前與之後所得到的檢查點。右側子圖回報 PBT$k$ MoE 跨模型層的路由器飽和度,左側子圖則回報 SBT$k$ MoE 的同一指標。每一列對應一個不同的資料集。我們做出以下觀察:
- 最前面幾層一直都在路由器飽和度最低之列,
- 對某個任務 $h$ 訓練的檢查點,在以 $h$ 的 token 衡量時,路由器飽和度較低,
- 在自己的持續預訓練資料集上測試時,模型的路由器飽和度似乎會隨著層索引增加而以小斜率持續下降。
觀察 (1) 暗示早期層在持續預訓練期間可能經歷最多變化。注意最前面幾層路由器飽和度低的趨勢,在子圖 (a) 與 (b) 中特別明顯,暗示持續預訓練期間大部分的遺忘可能發生在早期層。觀察 (2) 顯示 MoE 對自己正在訓練的分布(在德文與 Stack 的情況下)改變了更多路由決策,這很直覺。觀察 (3) 暗示越接近 MoE 最後一層的層,必須改變得越多才能適應新分布。
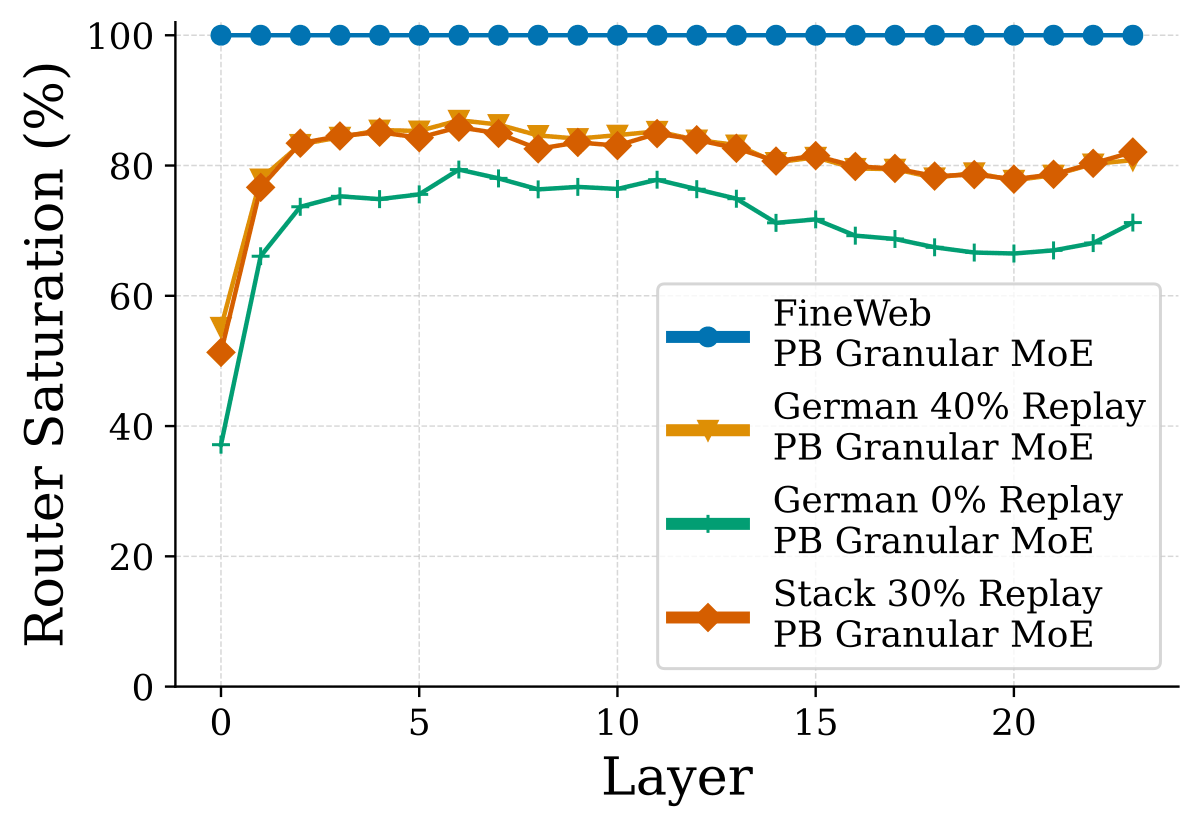
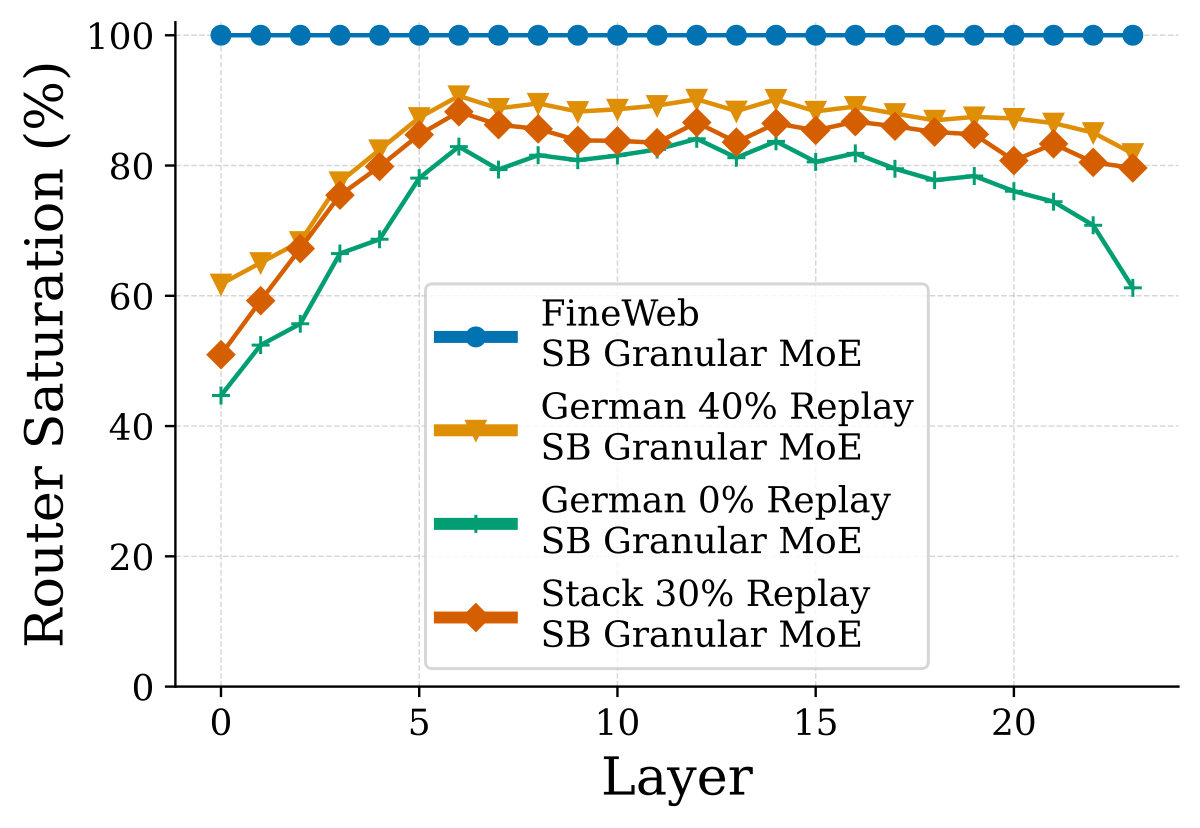
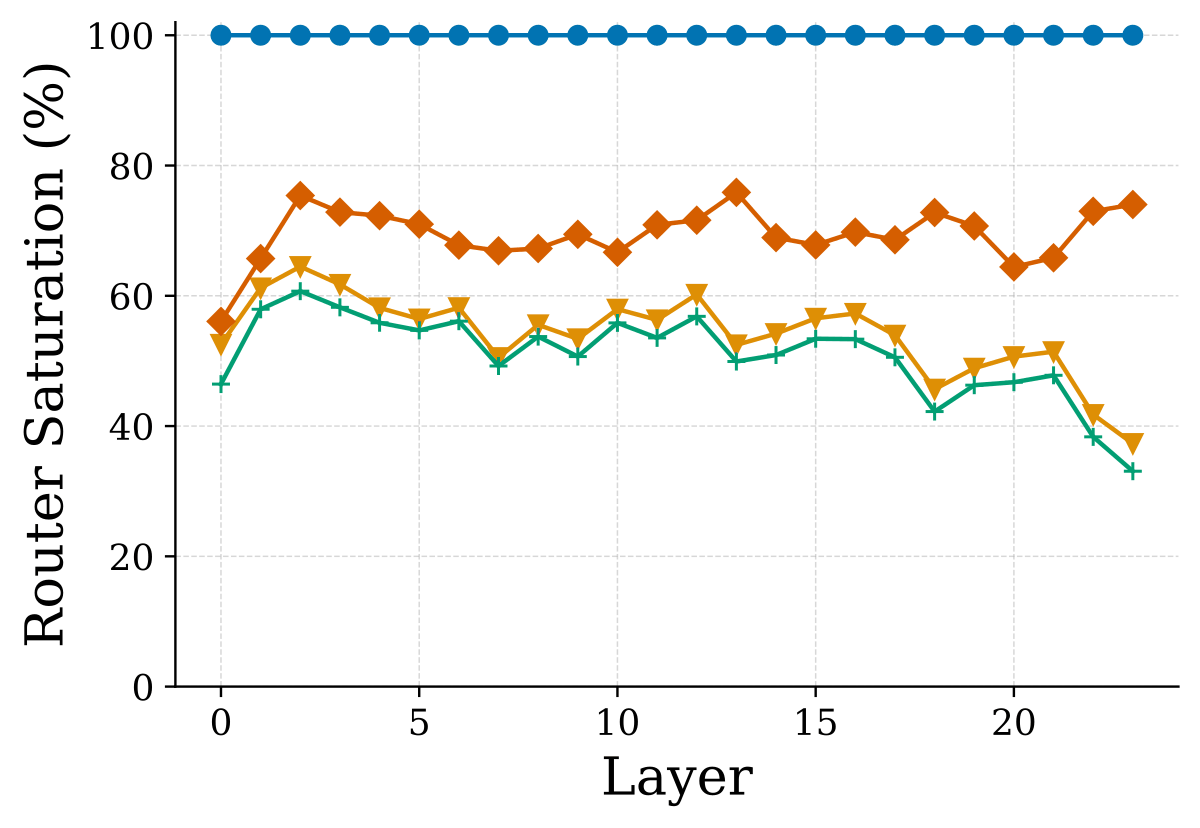
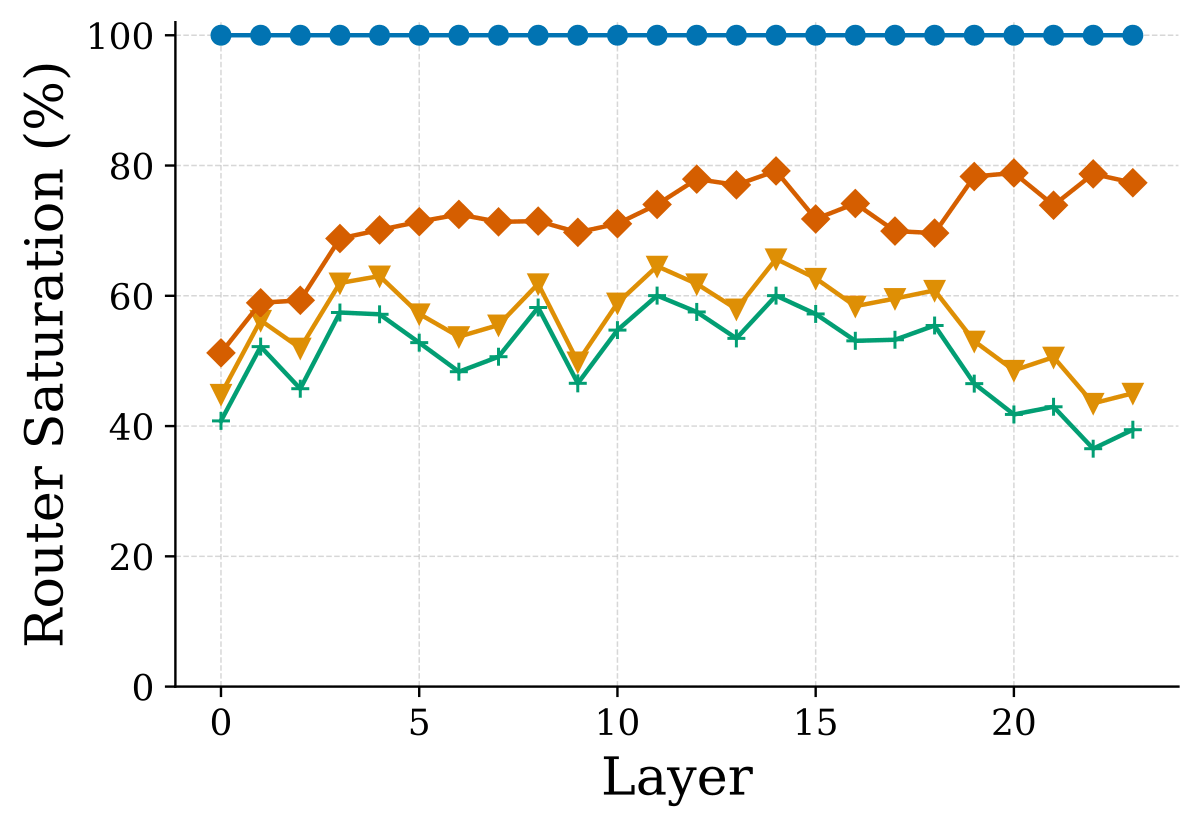
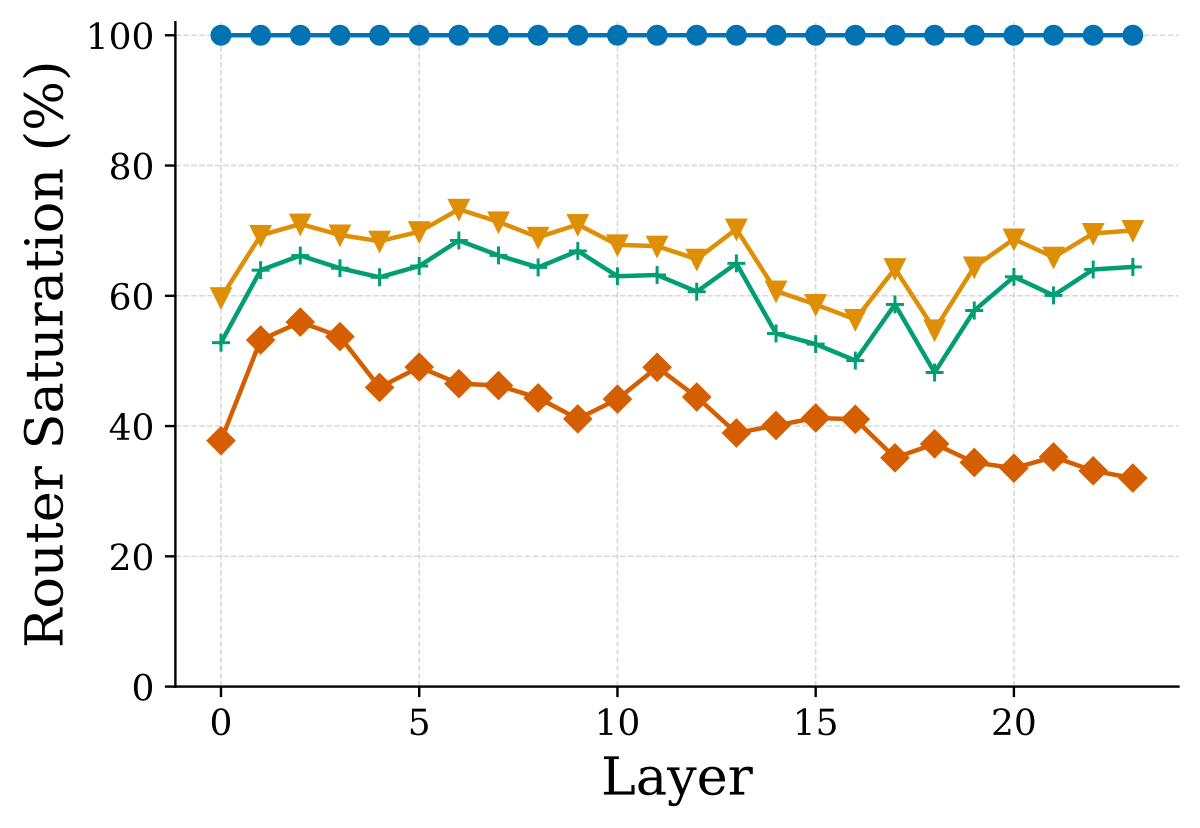
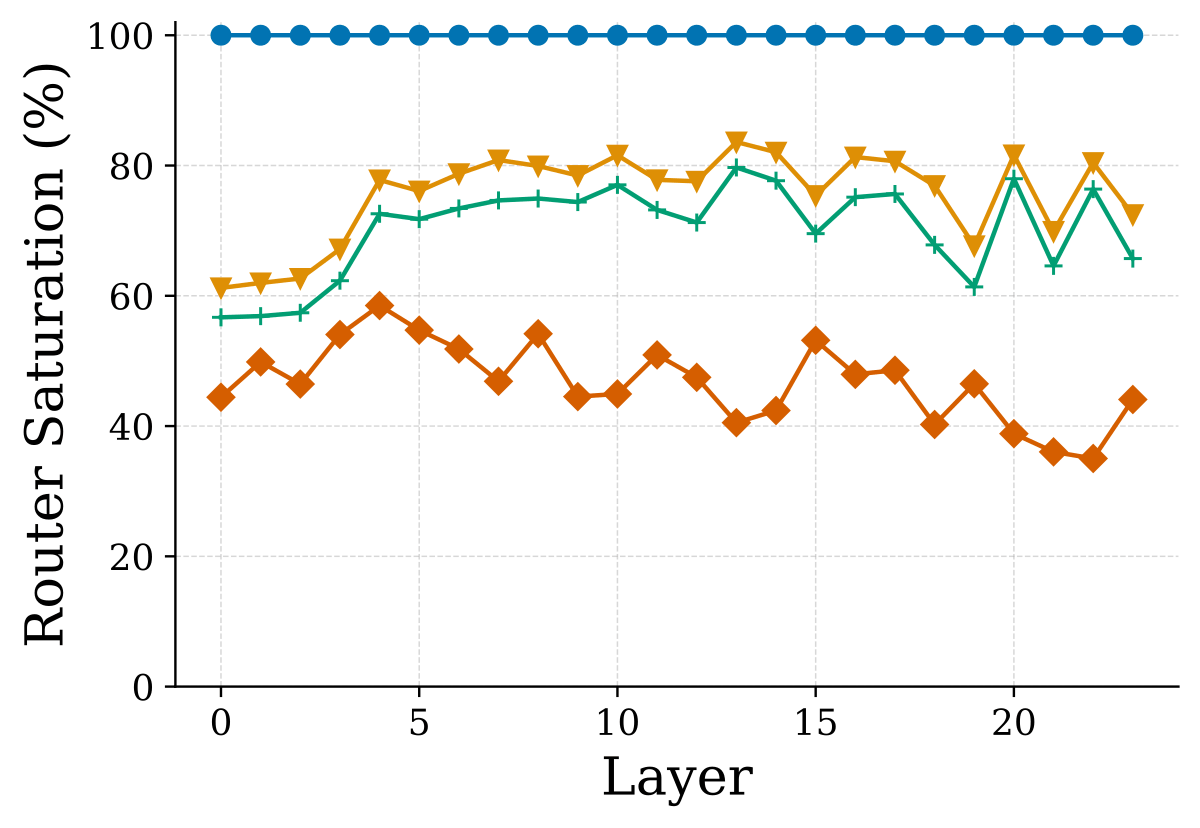
圖 9:Granular MoE 在持續預訓練開始時的路由器飽和度。 子圖 (a,c,e) 回報 PBT$k$ MoE 的逐層路由器飽和度,子圖 (b,d,f) 回報 SBT$k$ MoE 的結果。(a) 與 (b) 以 FineWeb 的測試 token 衡量,(c) 與 (d) 以德文的測試 token 衡量,(e) 與 (f) 以 Stack 的測試 token 衡量。我們觀察到幾個趨勢:1) 最前面幾層一直都在路由器飽和度較低之列,2) 在測試分布上做 CPT 的檢查點,路由器飽和度一致較低,顯示這些檢查點對該分布適應得更多,3) 在自己的持續預訓練資料集上測試時,路由器飽和度似乎會隨層索引增加而以小斜率持續下降,4) 零重播的檢查點路由器飽和度一致低於其 40% 重播的版本。
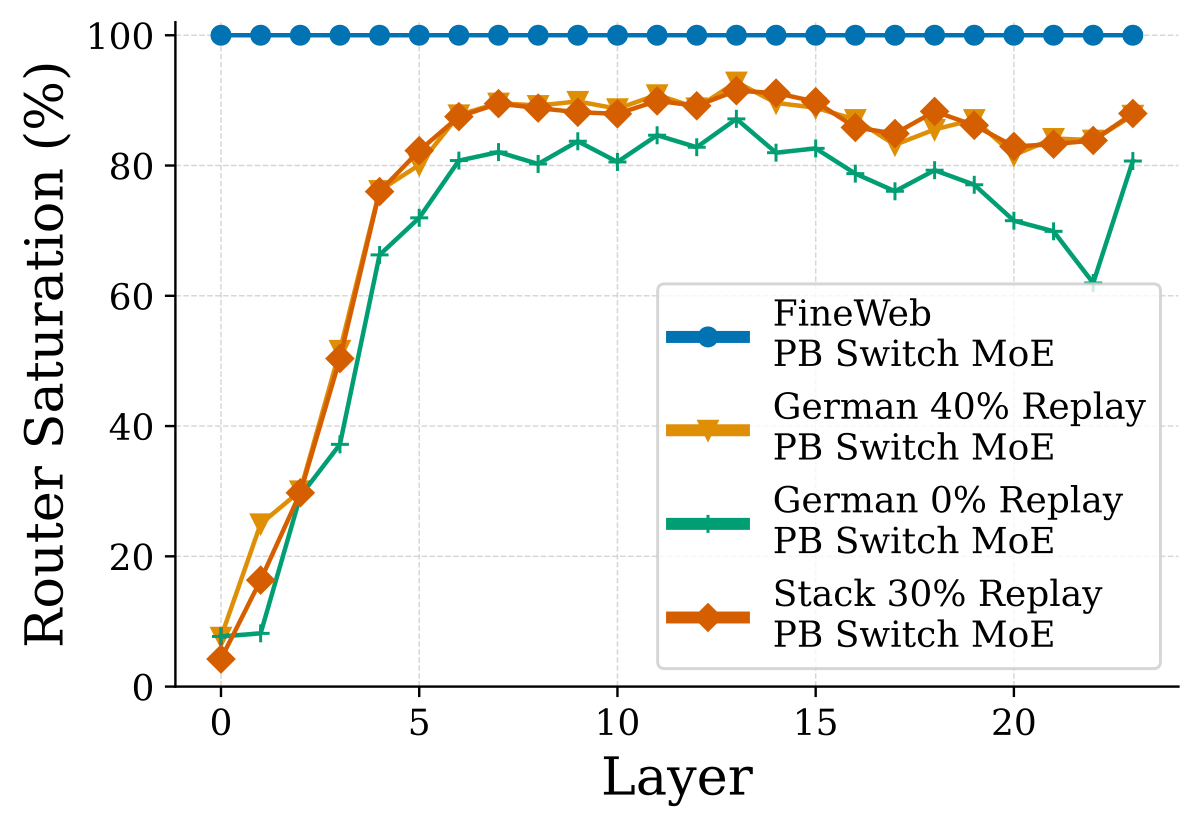
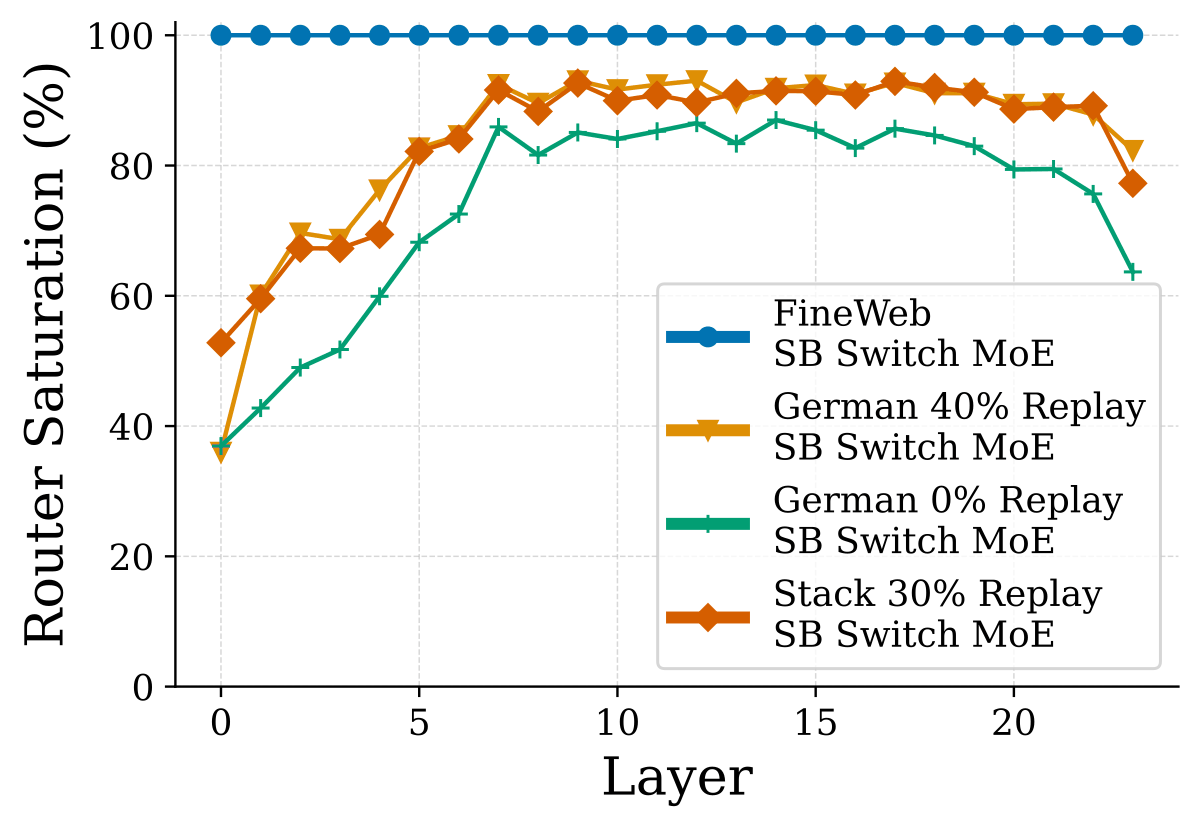
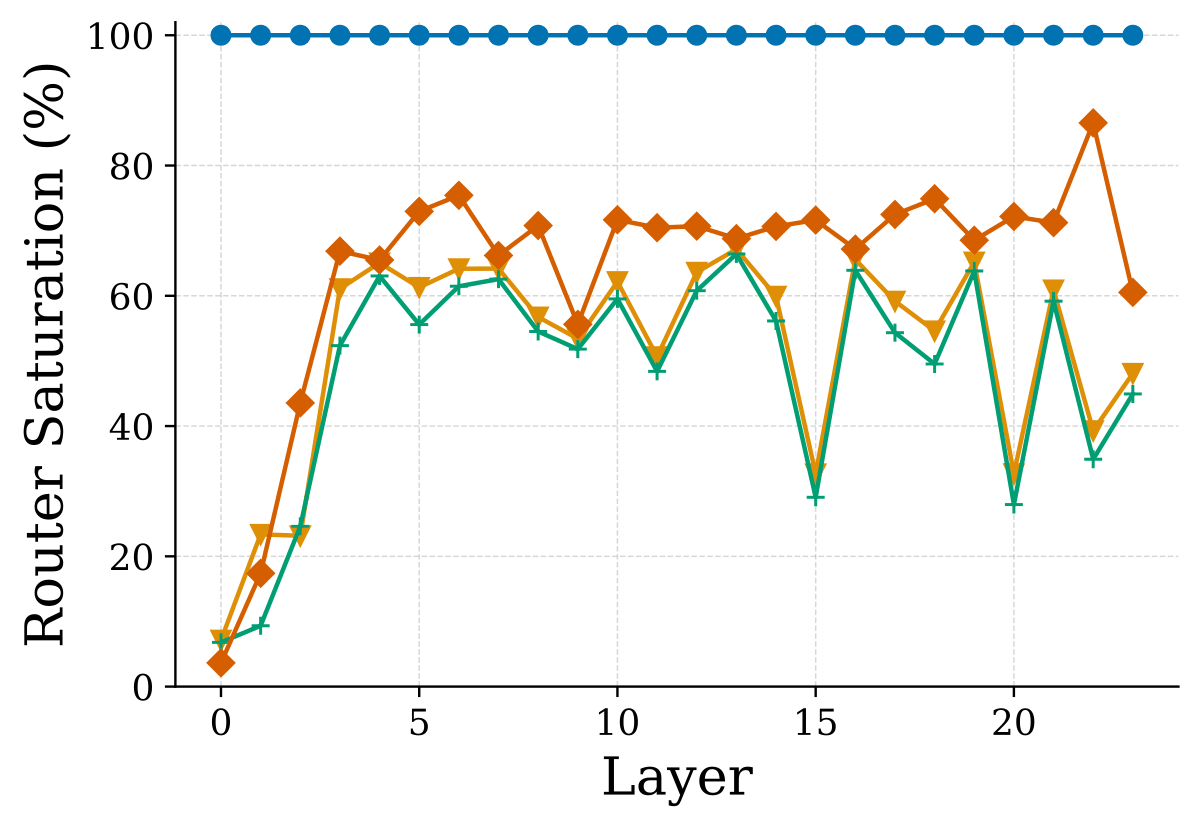
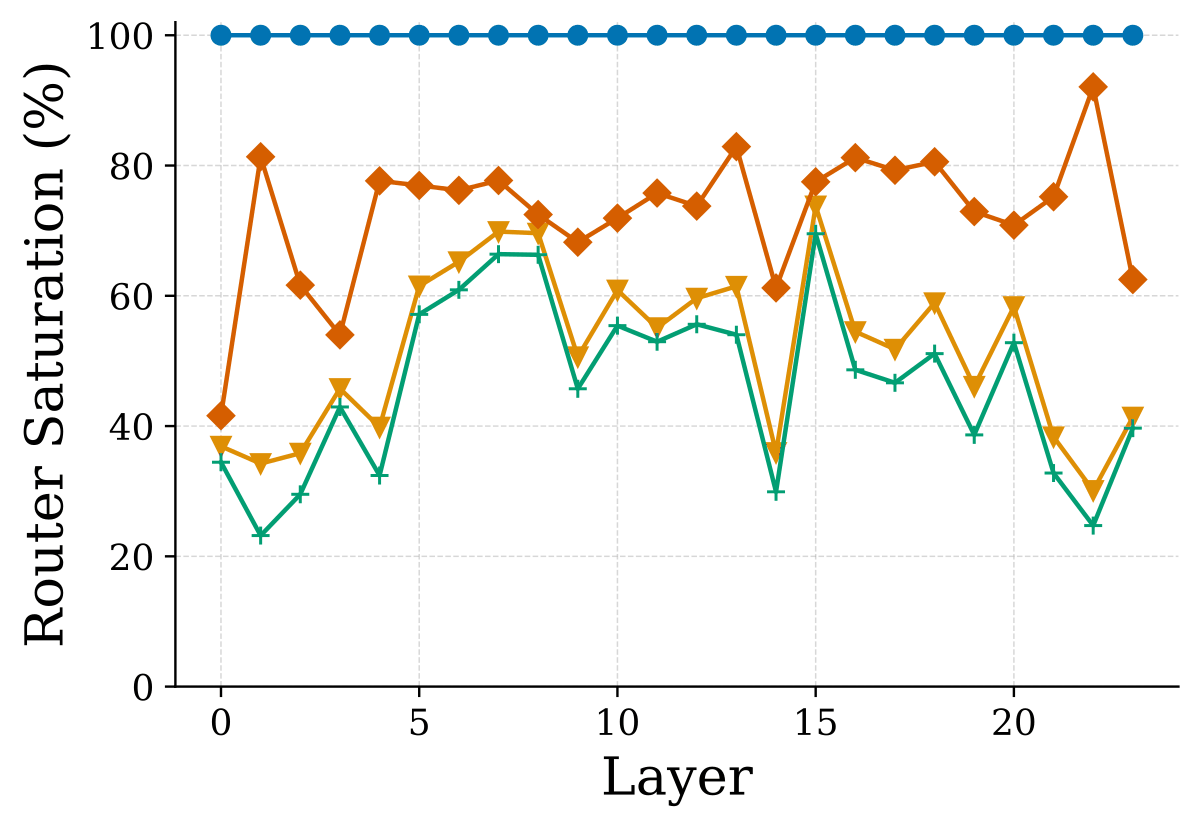
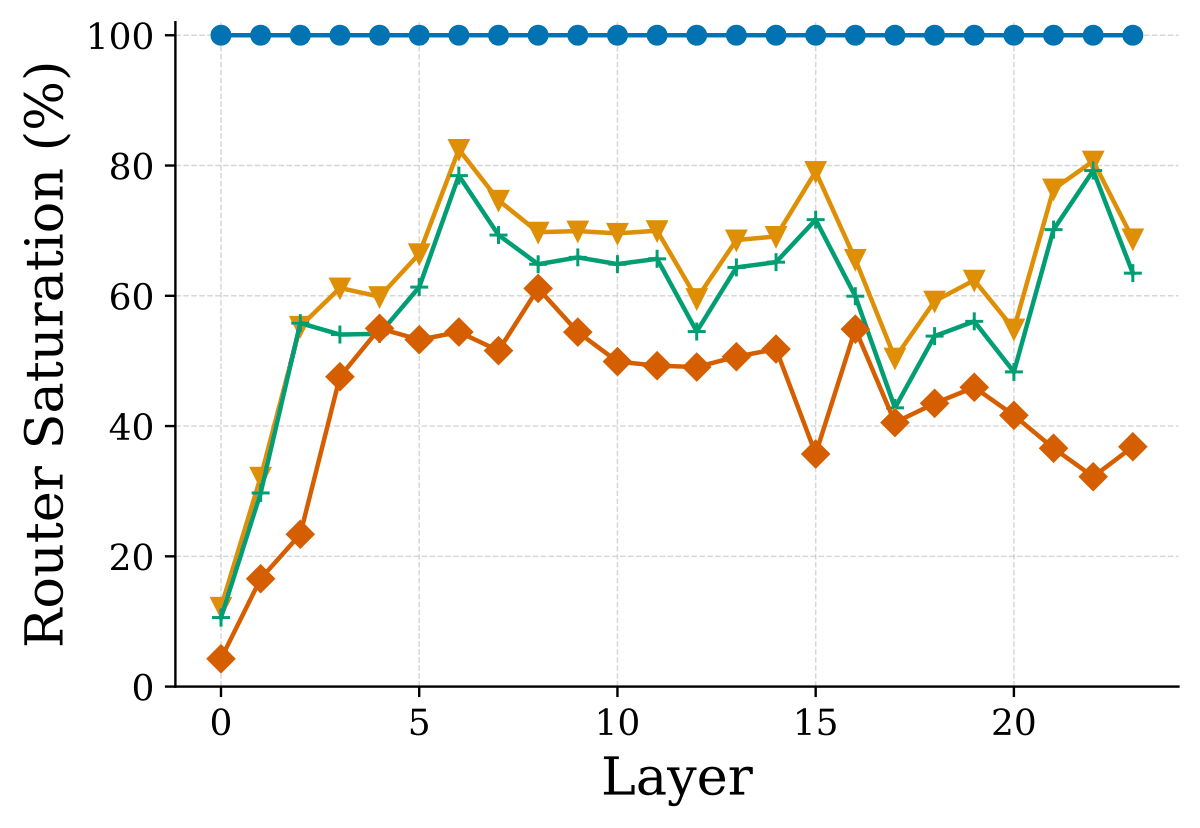
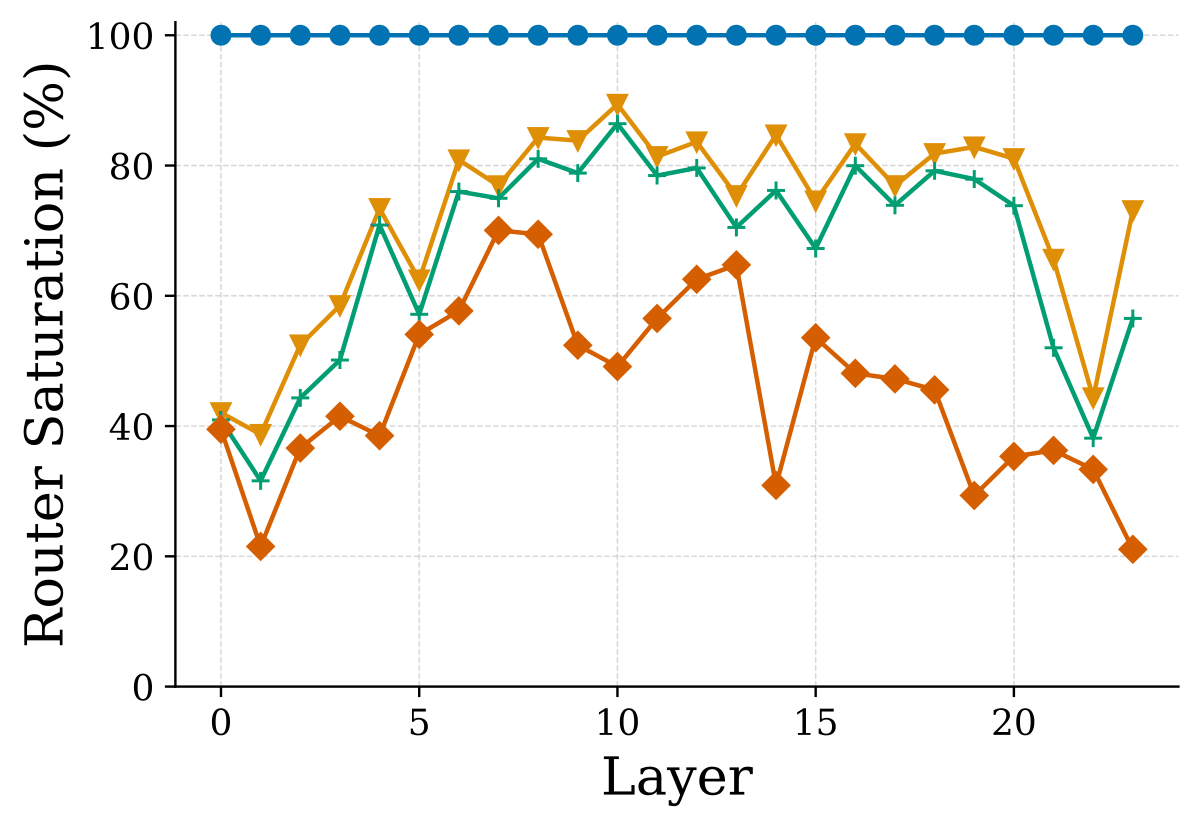
圖 10:Switch MoE 在持續預訓練開始時的路由器飽和度。 子圖 (a,c,e) 回報 PBT$k$ MoE 的逐層路由器飽和度,子圖 (b,d,f) 回報 SBT$k$ MoE 的結果。(a) 與 (b) 以 FineWeb 的測試 token 衡量,(c) 與 (d) 以德文的測試 token 衡量,(e) 與 (f) 以 Stack 的測試 token 衡量。我們觀察到的趨勢與 Granular MoE 相同:1) 最前面幾層路由器飽和度較低,2) 在測試分布上做 CPT 的檢查點飽和度一致較低,3) 飽和度隨層索引增加而緩慢下降,4) 零重播檢查點的飽和度一致低於 40% 重播版本。
D.3.2 持續詞彙專精化分析
我們把 Muennighoff et al. (2024) 的詞彙專精化分析調整到持續學習情境。同樣地,以下我們會直接引用並稍作修改 Muennighoff et al. (2024) 對詞彙專精化的定義。具體來說,我們定義詞彙專精化為:
$$\texttt{Vocabulary Specialization}(j,E_{i},x)=\frac{N_{j,x,E_{i}}^{(k)}}{N_{j,x}}, \tag{3}$$
其中:
- $E_{i}$:某個 MoE 層中的第 $i$ 個專家。
- $j$:任務索引,指定要使用哪一個最終檢查點(例如指定任務 1、任務 2……之後的最終檢查點)。
- $x$:被分析的 token ID。
- $k$:所考慮的專家數(Granular MoE 用 $k=3$,Switch MoE 用 $k=1$)。
- $N_{j,x,E_{i}}^{(k)}$:使用任務 $j$ 的最終檢查點時,輸入資料中 $x$ 被路由到 $E_{i}$ 的次數。
- $N_{j,x}$:使用任務 $j$ 的最終檢查點時,$x$ 被路由到所有專家的總次數。
因此,詞彙專精化可以針對模型每一層的每個專家、以及模型詞彙表中的每個 token 計算。把詞彙表中的每個 token 都指派給最常處理它的那個專家,我們就能為 MoE 的每一層建立專家與詞彙條目之間的一對多映射。接著,我們可以把每個專家在其被指派 token 上取平均,得到該專家的平均詞彙專精化,再跨專家取平均以衡量一層之內的專精化。要跨檢查點比較專精化,我們可以沿用前一個檢查點的一對多映射,衡量相對於這個映射的專精化在持續預訓練期間如何改變。具體來說,MoE 層 $l$ 的持續詞彙專精化 (CVS) 定義如下:
$$\texttt{CVS}(j,h)=\frac{1}{N_{E}}\sum_{x\in{\mathcal{V}}}\texttt{Vocabulary Specialization}(h,E_{\alpha_{j,x}},x) \tag{4}$$
$$\alpha_{j,x}:=\operatorname{argmax}_{i\in[N_{E}]}\left\{\texttt{Vocabulary Specialization}(j,E_{i},x)\right\} \tag{5}$$
- $N_{E}$:MoE 層 $l$ 中的專家數。
- ${\mathcal{V}}$:模型詞彙表中的 token 集合(我們使用 Llama3 tokenizer)。
- $h$:任務索引,指定要從哪個檢查點計算映射。
- $j$:任務索引,指定用來計算持續詞彙專精化的最終檢查點。
注意為了簡潔,用來計算 CVS 的 token 資料集在式中被省略了。不過專家的專精化會取決於 token 的分布,因為同一個輸入 token 可能因為所處上下文不同而被路由到不同專家,而上下文又會隨分布而變。舉例來說,「for」這個詞在英文語料與程式碼語料中的隱藏表徵可能天差地遠。
圖 11 與圖 12 分別回報 Granular 與 Switch MoE 的 CVS。每張圖的一對多映射 $\alpha_{j,x}$ 都是由在 FineWeb 上預訓練的檢查點(也就是我們開始持續預訓練的起點)建立。所有專精化都是相對於輸入 token 計算。在 FineWeb 上評估時,我們觀察到在所有架構與平衡策略下,持續預訓練模型最前面幾層的持續詞彙專精化都低於預訓練檢查點,而後續各層的詞彙專精化則與預訓練檢查點非常接近。即使是使用 $0\%$ 重播的模型也是如此,暗示 MoE 在預訓練期間學到的路由策略,相對而言不太受持續預訓練影響。在德文與 Stack 上評估時,我們觀察到所有在這些資料集上持續預訓練的 MoE,詞彙專精化都低於未在該分布上訓練的模型,顯示它們確實有所適應。在德文上,零重播模型的 CVS 最小。我們推測這是因為這些模型對德文分布適應得最多,剛好學到了與 FineWeb 上所用的不同的新路由模式。把圖 11 與圖 12 中子圖 (a)、(b) 的結果與其他子圖對照,我們觀察到在預訓練資料集上,詞彙專精化只在最前面幾層改變,而對持續預訓練期間看到的資料,則是所有層都改變——即使是完全不使用重播的模型也一樣。再對照零重播模型在德文上較強、在 FineWeb 上較弱的效能,可知它對德文較好的適應,與整個模型的詞彙專精化改變相關;而它在先前分布上較差的效能,則與最前面幾層詞彙專精化較大的改變相關。
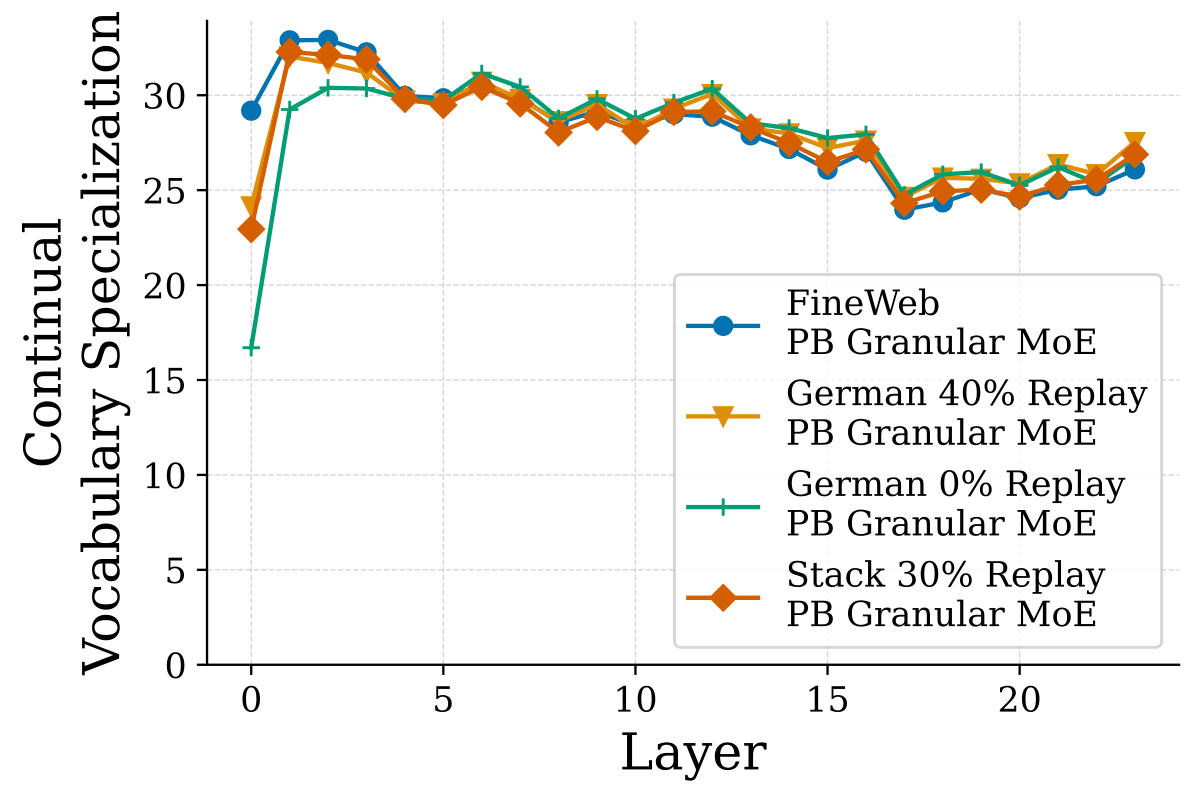
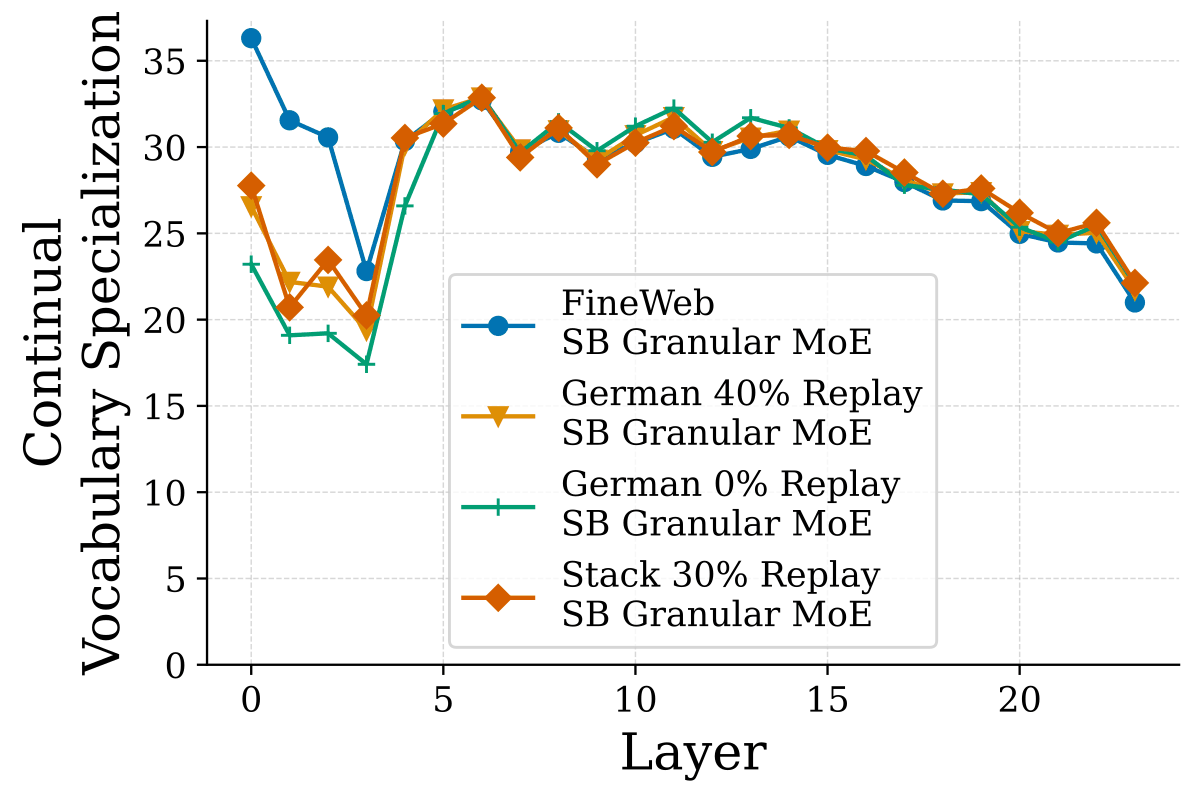
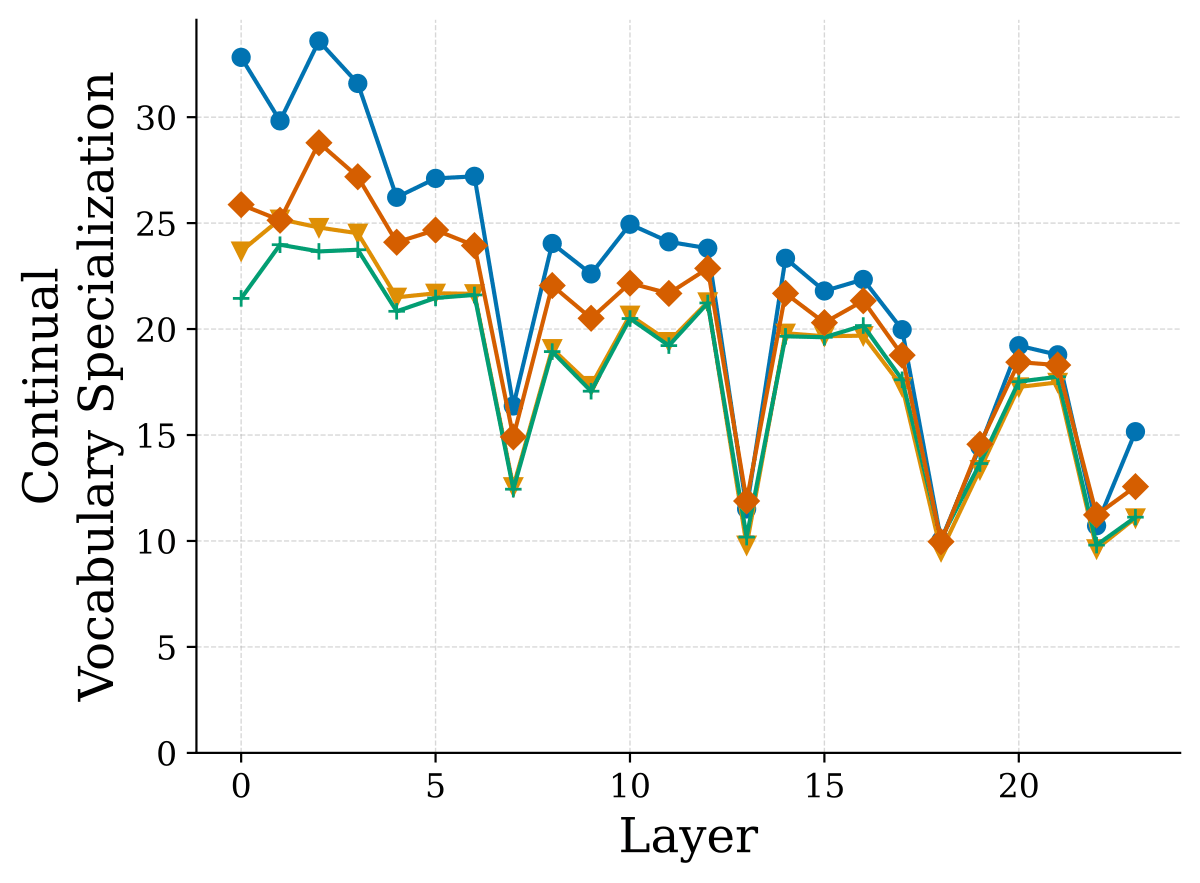
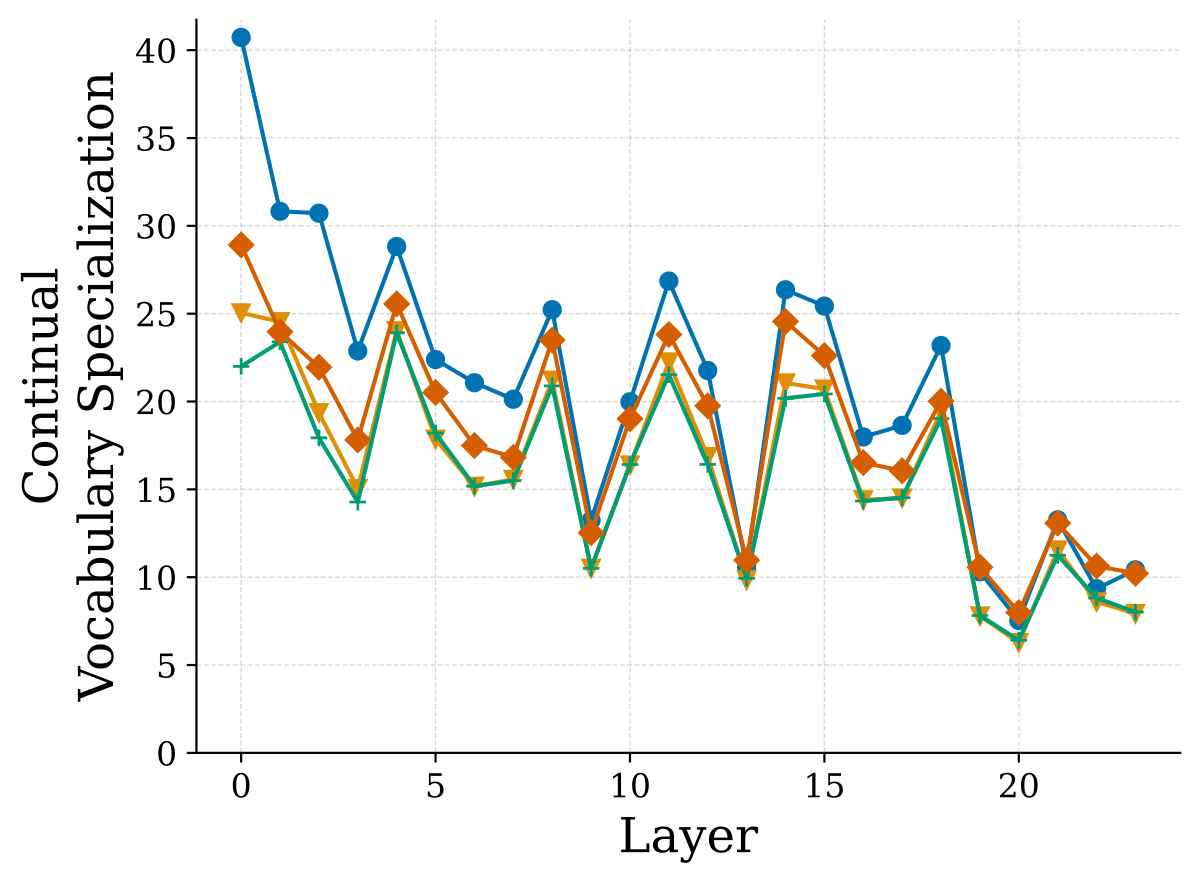
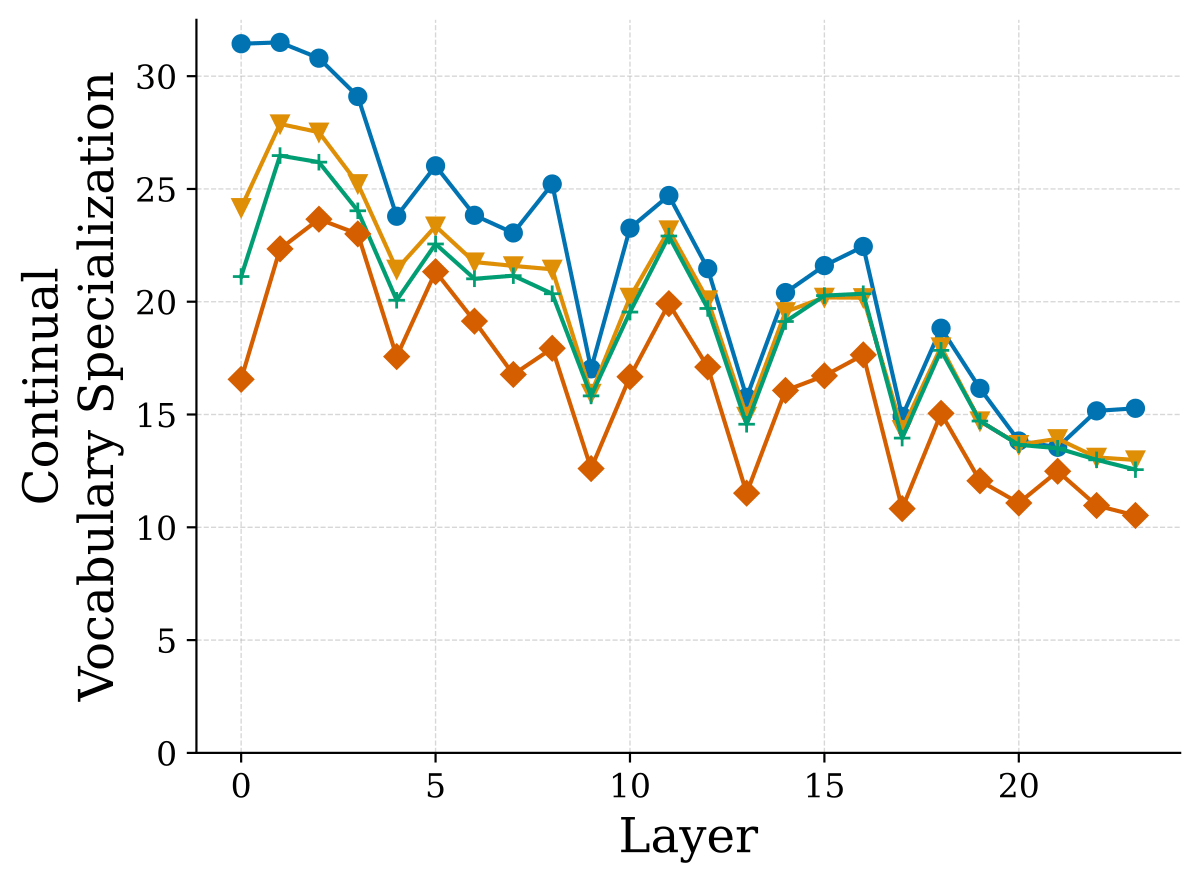
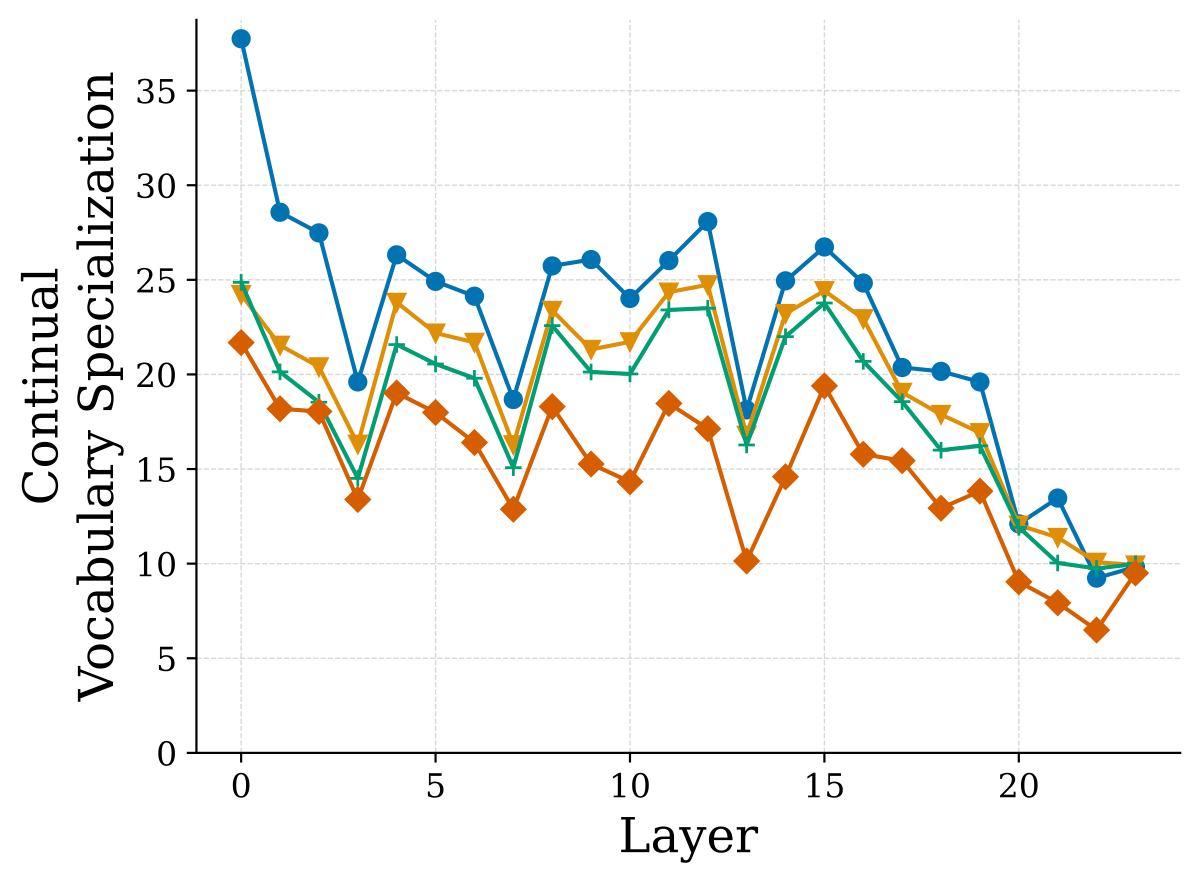
圖 11:Granular MoE 的持續詞彙專精化。 我們回報在 FineWeb、德文與 Stack 上測試模型時,MoE 每一層的 CVS。我們觀察到早期層偏離預訓練後的檢查點最多,而持續預訓練 MoE 的後期層幾乎與第一階段預訓練後檢查點的詞彙專精化相同。即使是不重播先前資料的檢查點也是如此,暗示對預訓練資料的詞彙專精化,主要在最初的預訓練階段就已決定。
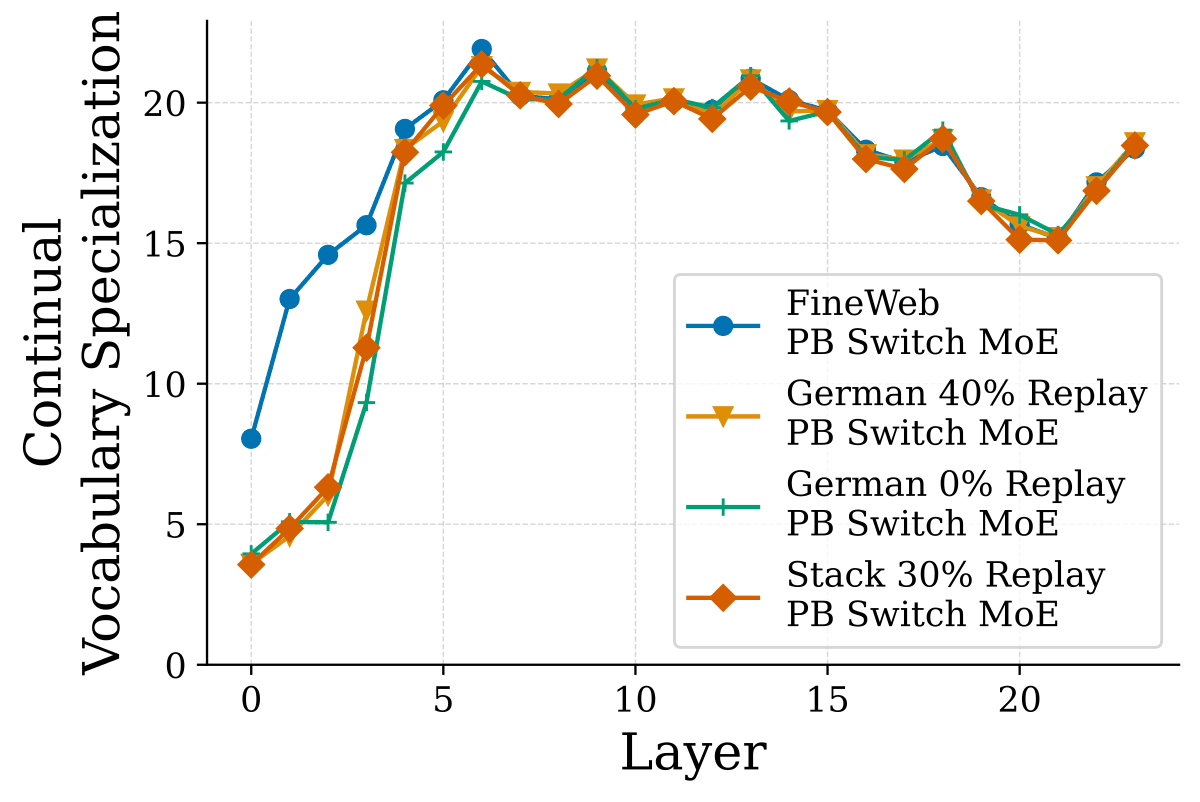
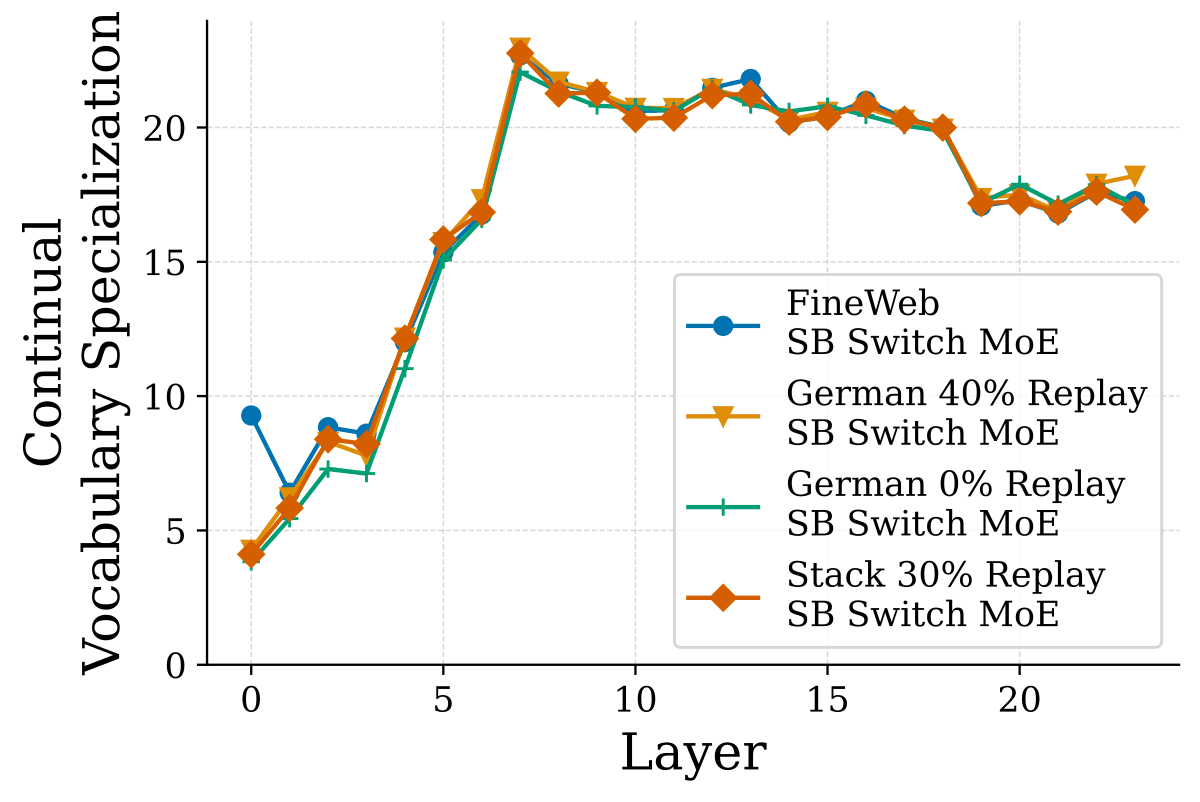
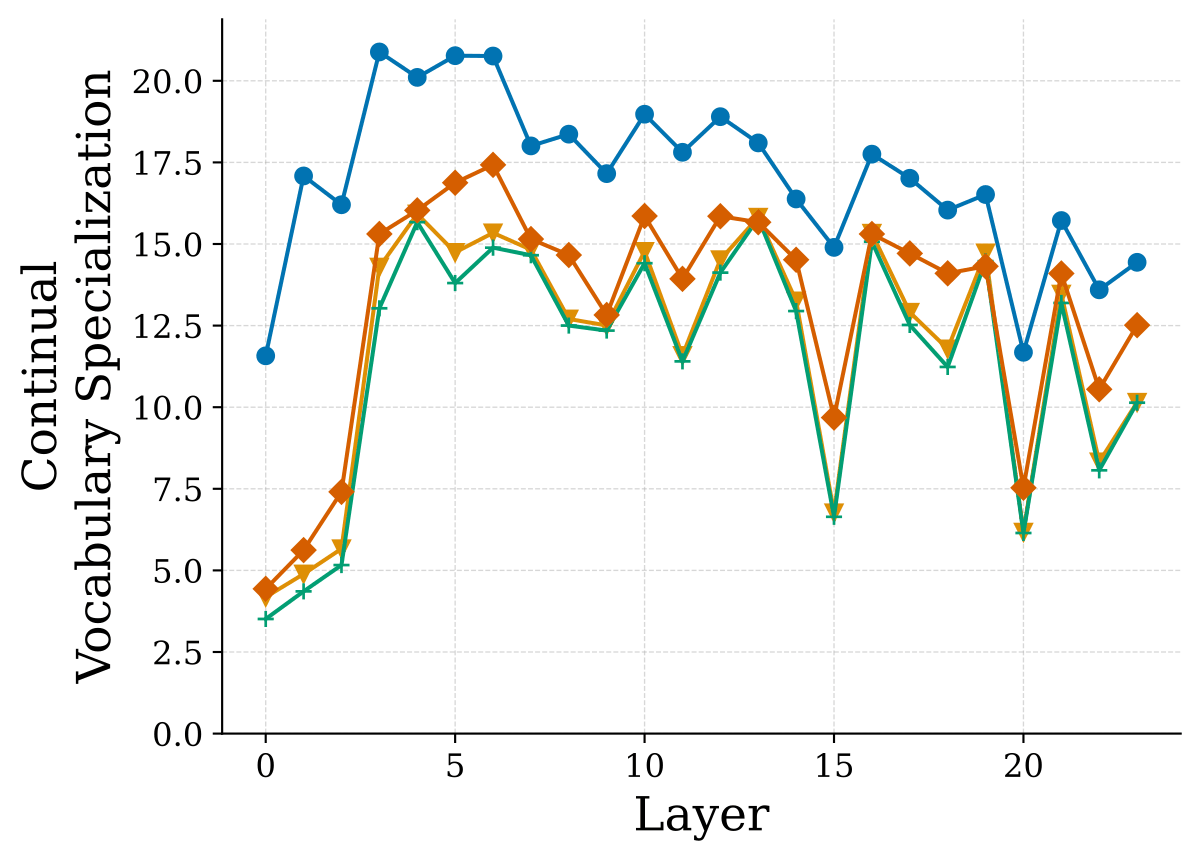
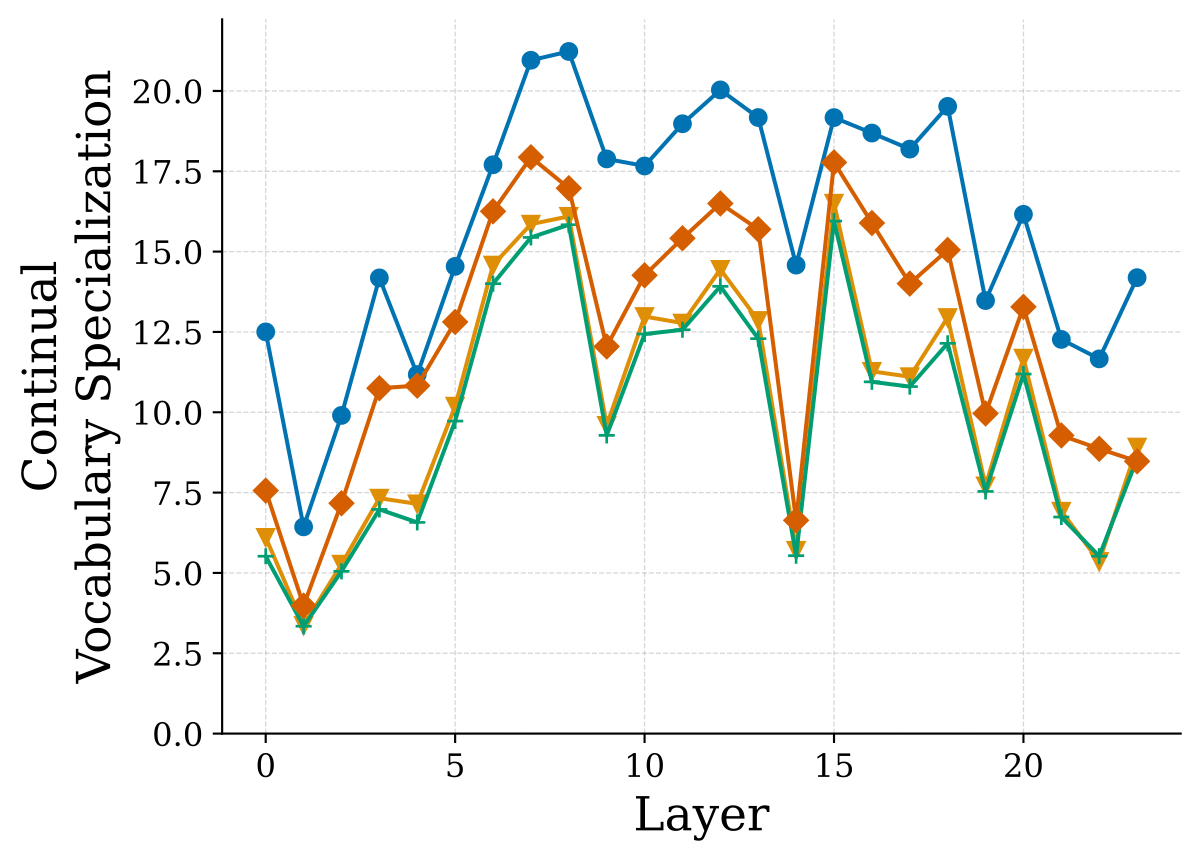
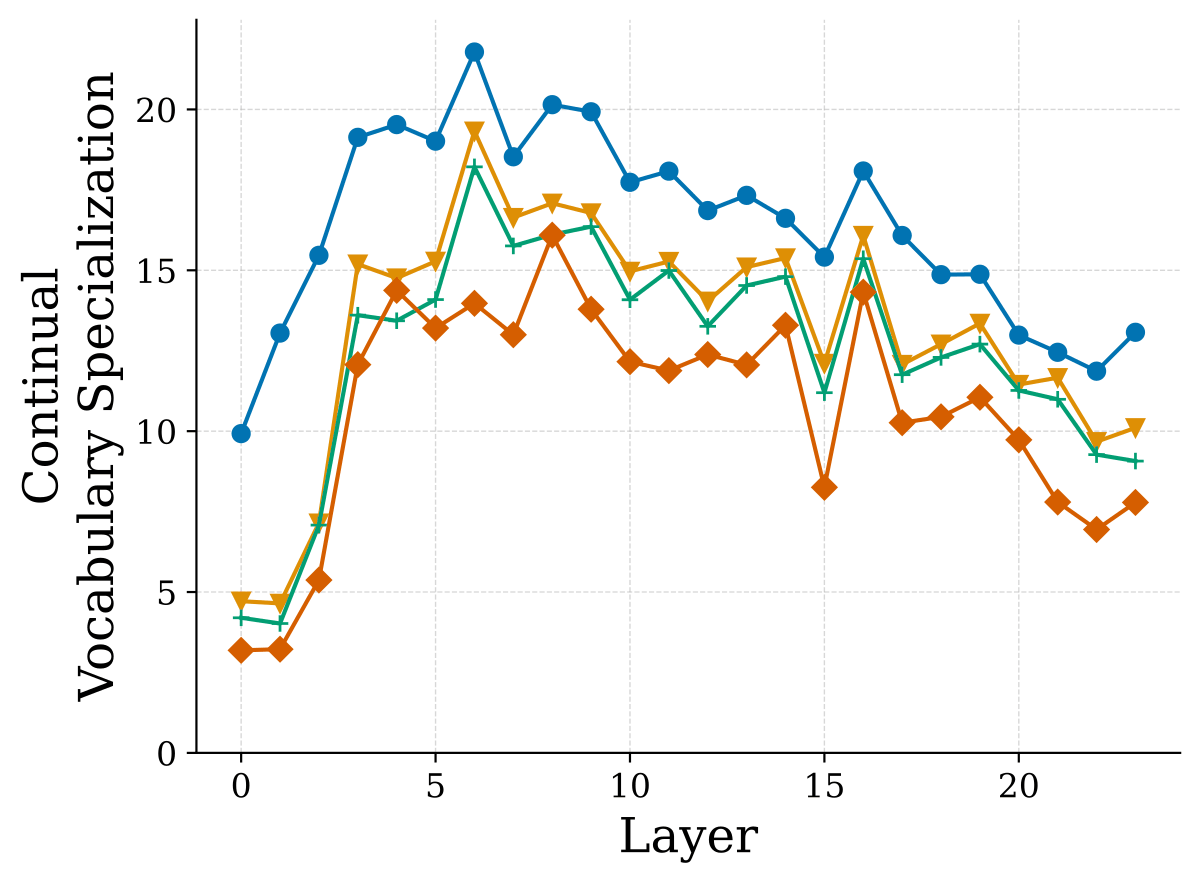
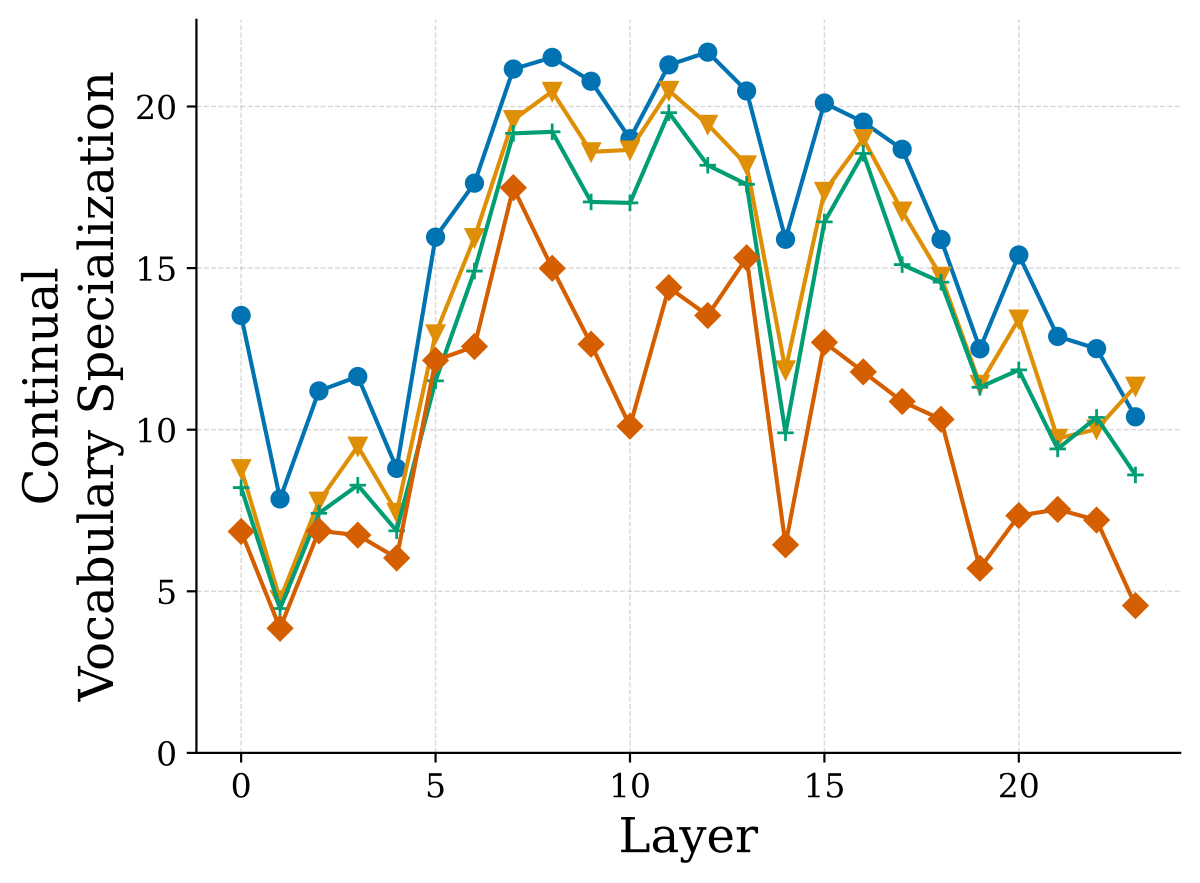
圖 12:Switch MoE 的持續詞彙專精化。 我們回報在 FineWeb、德文與 Stack 上測試模型時,MoE 每一層的 CVS。觀察結果與 Granular MoE 相同:早期層偏離預訓練檢查點最多,後期層幾乎維持不變,即使不使用重播亦然。
D.3.3 持續專家共同啟用分析
我們把 Muennighoff et al. (2024) 的專家共同啟用分析調整到持續學習情境。同樣地,以下我們會直接引用並稍作修改 Muennighoff et al. (2024) 對專家共同啟用的定義。具體來說,我們定義專家共同啟用為:
$$\texttt{Expert co-activation}(E_{i},E_{j})=\frac{N_{E_{i},E_{j}}}{N_{E_{i}}}, \tag{6}$$
其中:
- $E_{i}$:第一個專家。
- $E_{j}$:第二個專家。
- $N_{E_{i},E_{j}}$:專家 $E_{i}$ 與 $E_{j}$ 被一起啟用的次數。
- $N_{E_{i}}$:專家 $E_{i}$ 被啟用的總次數。
因此,MoE 中任一層的共同啟用矩陣 ${\mathbf{C}}$ 可以透過設定 ${\mathbf{C}}_{i,j}=\texttt{Expert co-activation}(E_{i},E_{j})$ 來建立。接著我們可以定義共同啟用差異如下:
$$\texttt{Co-activation Difference}(p,q)=|{\mathbf{C}}^{(p)}-{\mathbf{C}}^{(q)}|. \tag{7}$$
其中 $|\cdot|$ 是逐座標的絕對值函數。共同啟用差異的每個座標 $i,j$,衡量的是專家 $i,j$ 在任務 $p$ 與 $q$ 的最終 MoE 檢查點之間,共同啟用程度的變化。取共同啟用差異矩陣各項的統計量,就能全域地衡量持續預訓練期間每一層的專家共同啟用如何改變。
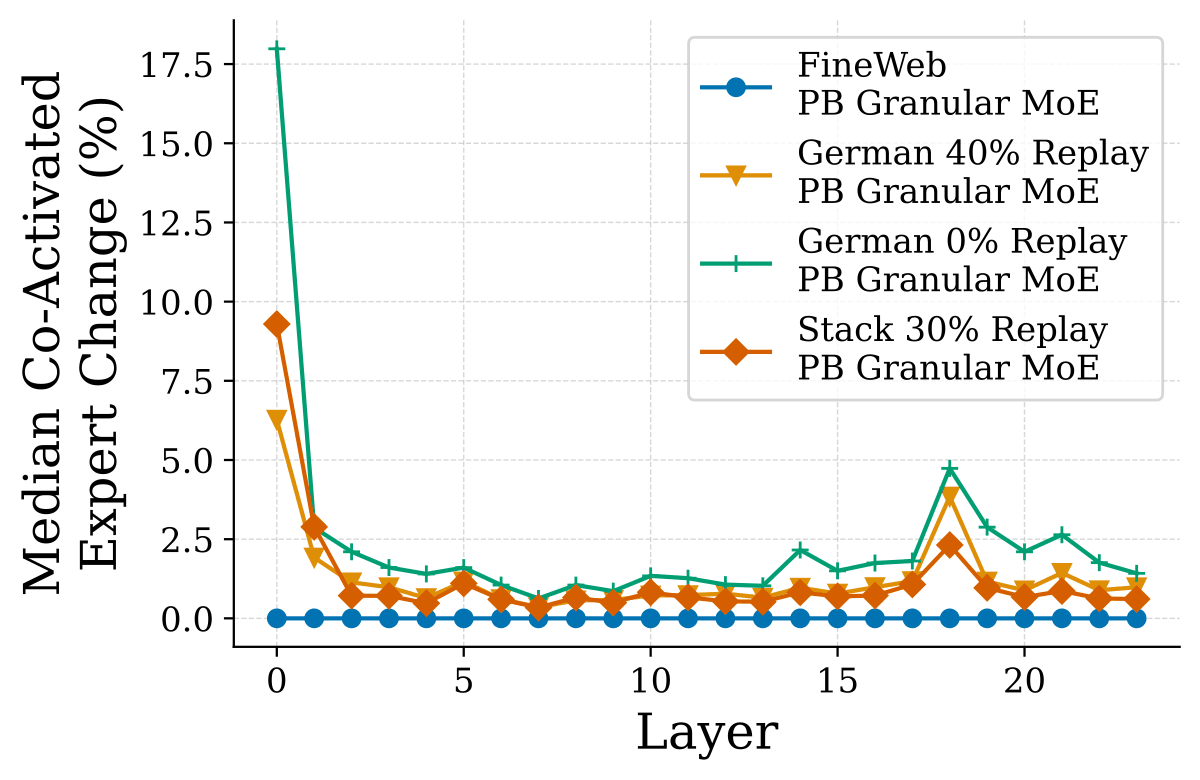
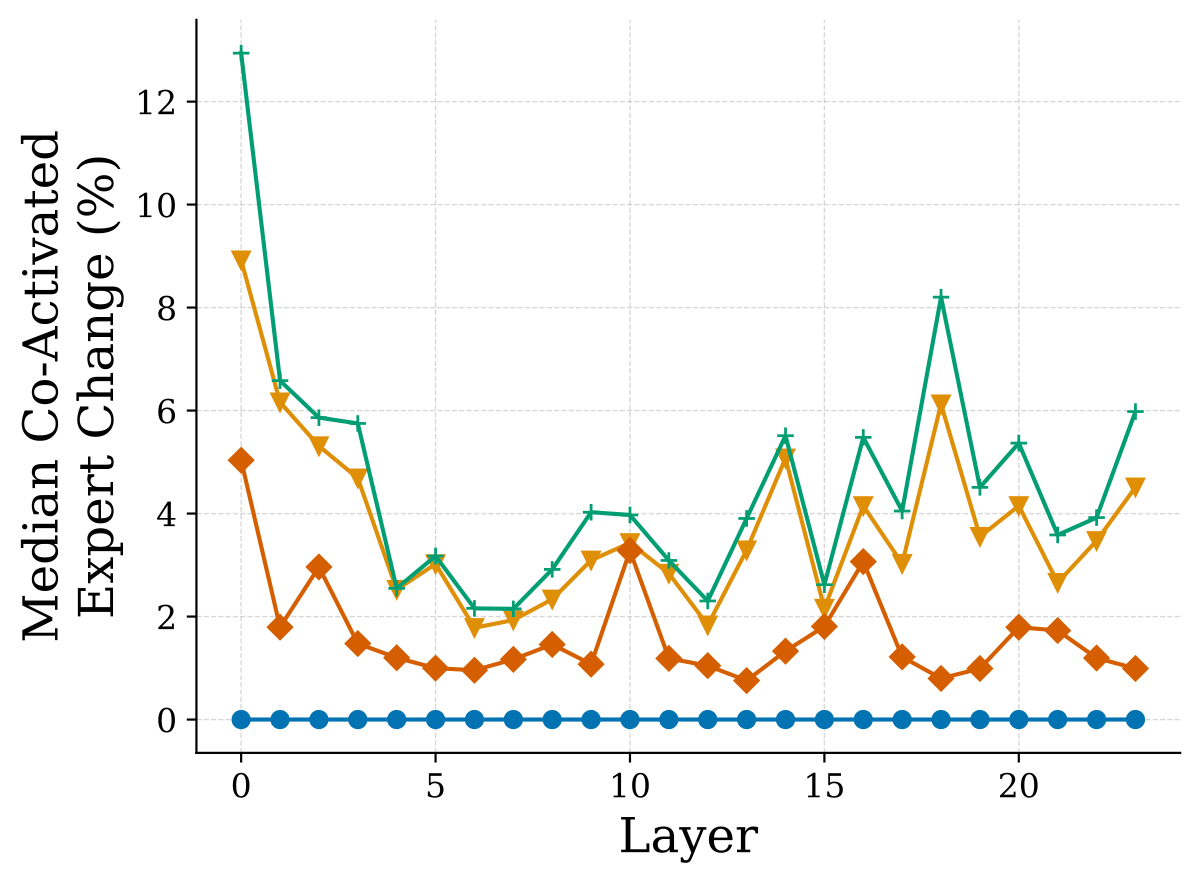
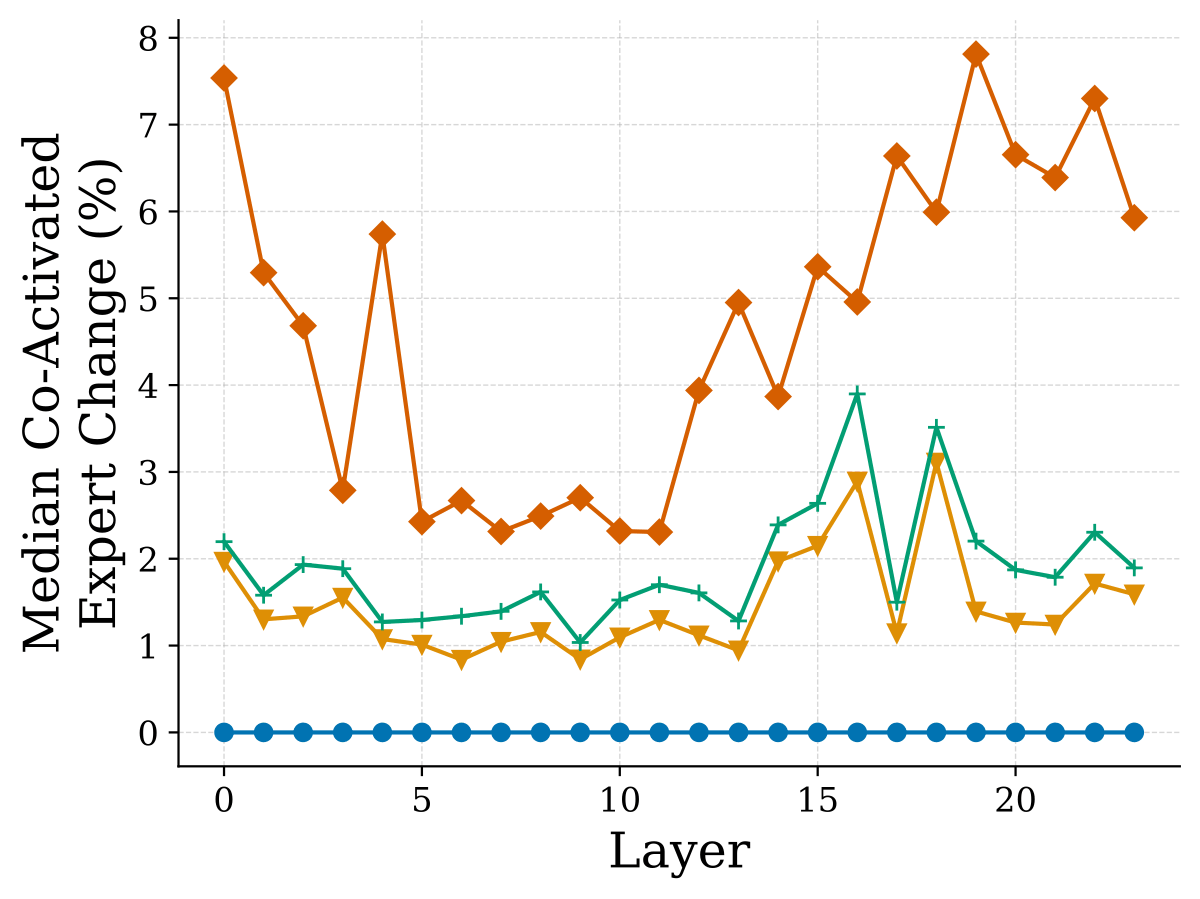
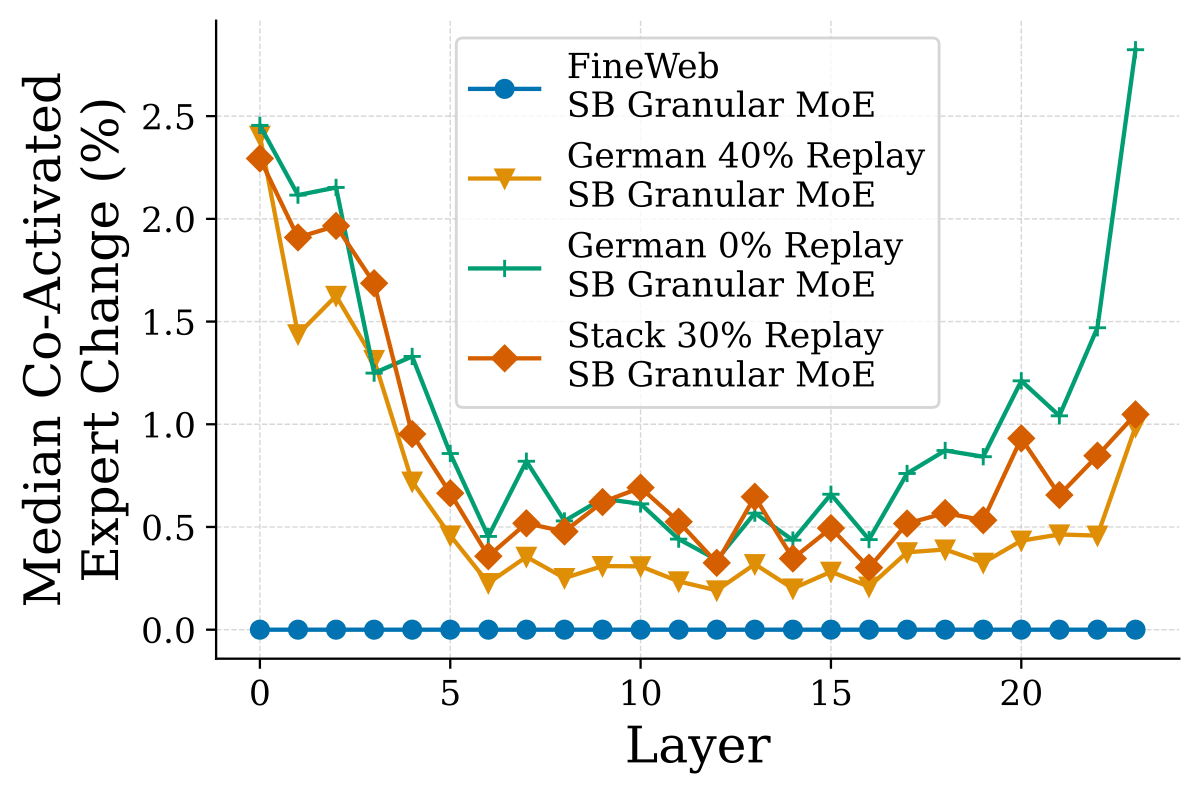
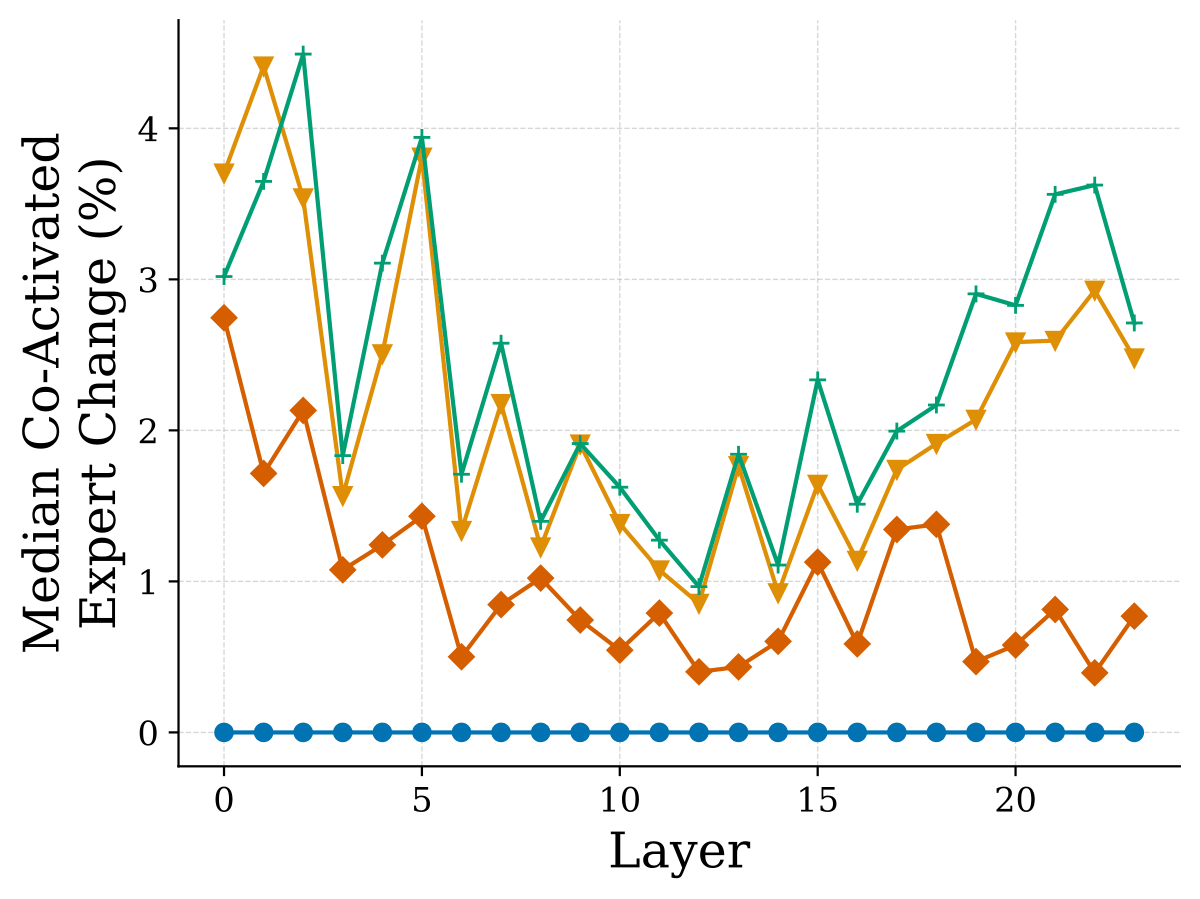
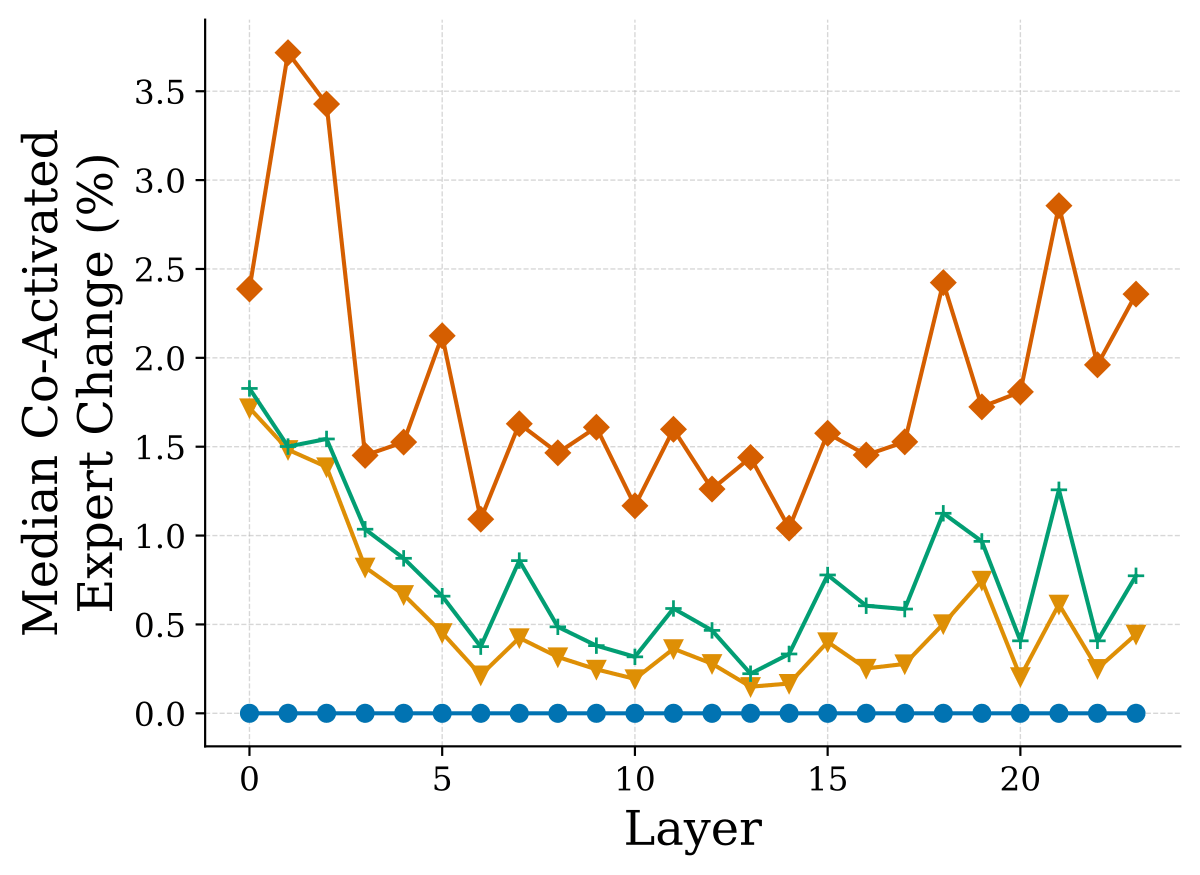
圖 13:Granular MoE 的逐層中位數路由器共同啟用差異。 我們回報圖例中每個模型與其對應預訓練檢查點之間,共同啟用差異矩陣各座標的中位數。我們觀察到在 FineWeb 上,懲罰式平衡 MoE 的中位數差異整體最大,並在前兩層與第 $18$ 層最為明顯。在德文上,我們觀察到在德文上持續預訓練的模型中位數差異最大,而懲罰式平衡 MoE 差異較大的傾向依然存在。在 Stack 上也觀察到類似趨勢。
在圖 13 中,我們回報本研究每個持續預訓練的 Granular MoE(Switch MoE 只啟用單一專家,因此沒有共同啟用)與其初始預訓練階段後檢查點之間,共同啟用差異矩陣各座標的中位數。我們觀察到在 FineWeb 測試集上評估時,懲罰式平衡 MoE 的中位數差異整體最大,並在前兩層與第 $18$ 層最為明顯。在德文測試集上評估時,我們觀察到在德文上持續預訓練的模型中位數差異最大,而懲罰式平衡 MoE 差異較大的傾向依然存在。在 Stack 測試集上評估時,也觀察到類似趨勢。
在圖 14 與圖 15 中,我們分別視覺化了懲罰式平衡與 Sinkhorn 平衡式 MoE 完整專家共同啟用矩陣的一個子集。具體來說,我們展示共同啟用值最大的 $16$ 個專家的共同啟用情形。最左邊的圖顯示在 FineWeb 上未衰減持續預訓練的檢查點的共同啟用矩陣,中間的圖顯示在 Stack 上持續預訓練後檢查點的共同啟用矩陣,最右邊的圖顯示共同啟用差異矩陣。子圖 (a) 顯示第 $0$ 層,(b) 顯示第 $11$ 層,(c) 顯示最後一層。我們觀察到不論是懲罰式平衡還是 Sinkhorn 平衡式 MoE,共同啟用差異都在第 $0$ 層最大。值得注意的是,對 Sinkhorn 平衡式 Granular MoE 的預訓練檢查點來說,大部分共同啟用權重都集中在第 $15$ 號專家上。然而這種對第 $15$ 號專家的強烈偏重,在持續預訓練期間被減弱了。相對地,懲罰式平衡 MoE 的共同啟用分布得更分散。至於第 $11$ 層與第 $23$ 層,預訓練與持續預訓練之間的變化極小。
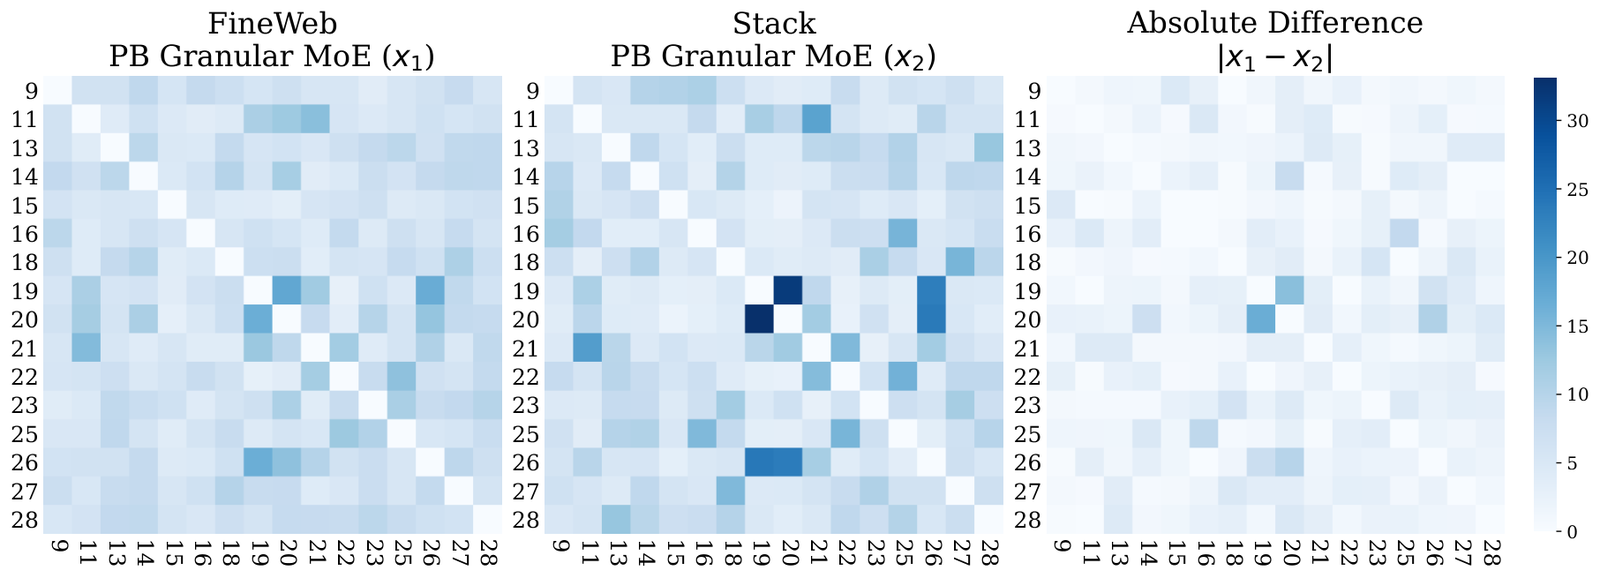
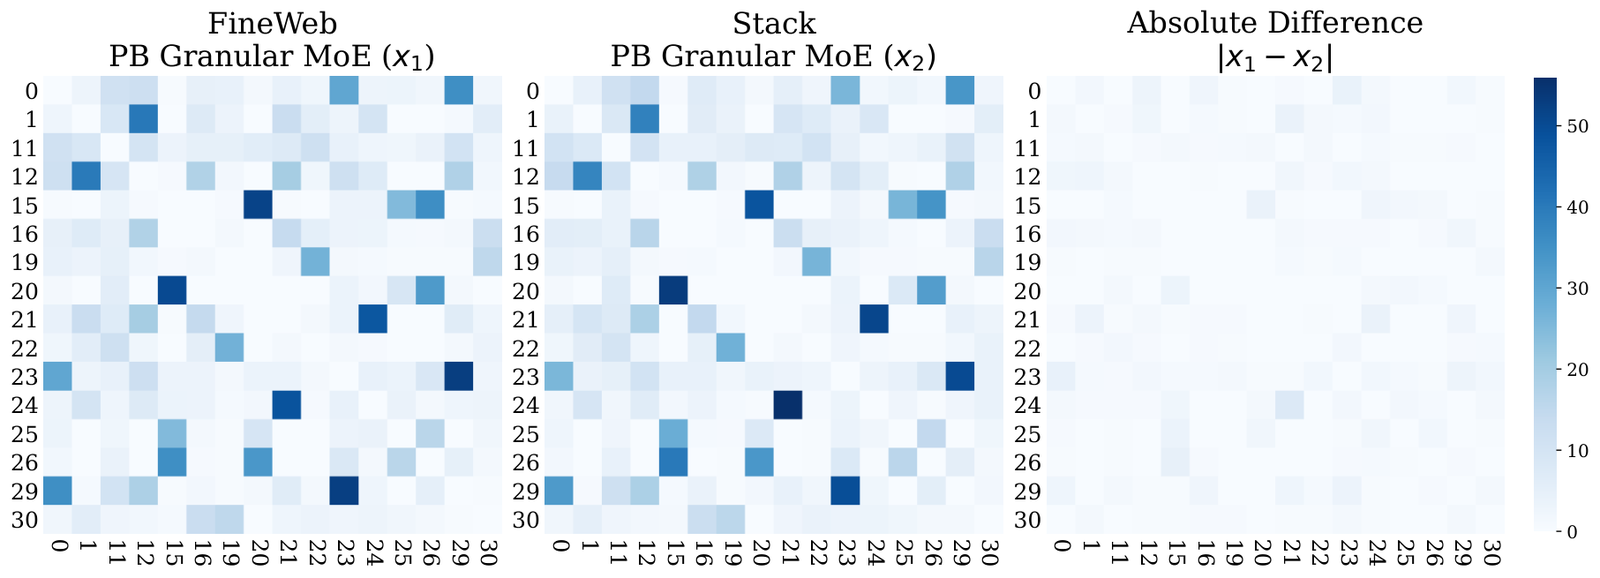
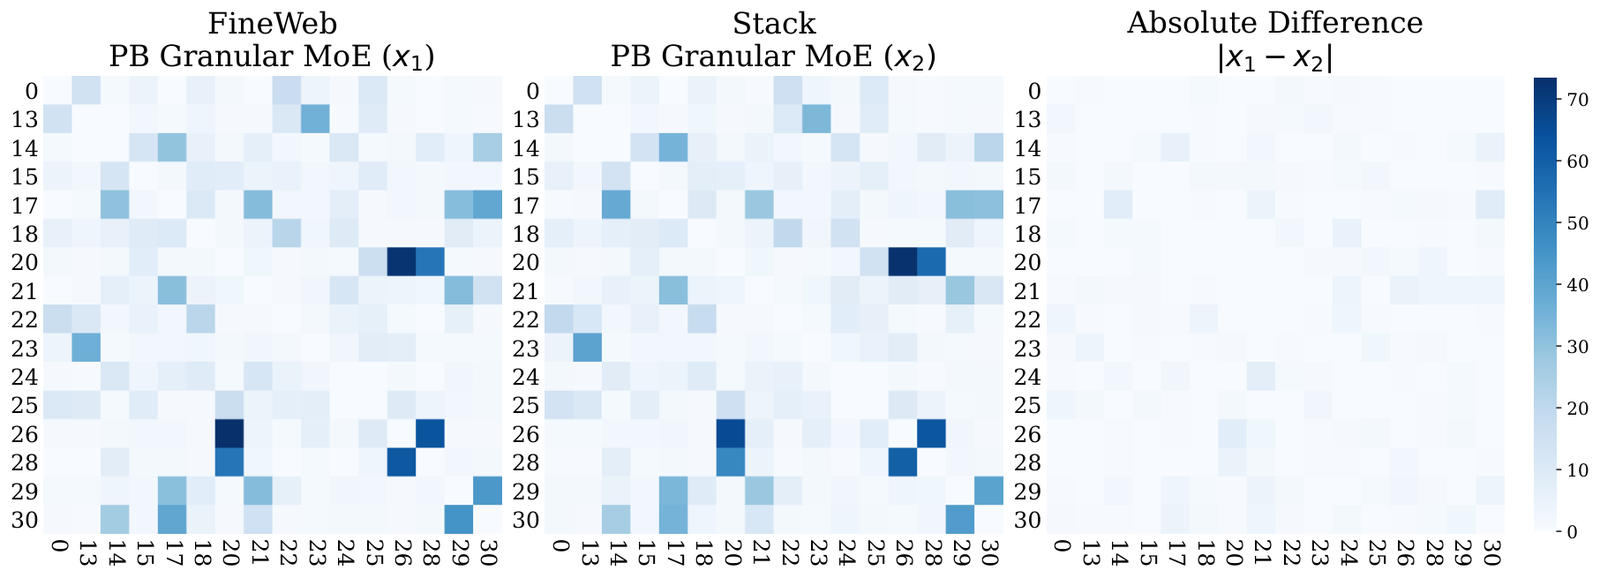
圖 14:在 Stack 上持續預訓練的 PB Granular MoE 於 FineWeb 上的路由器共同啟用矩陣。 最左邊的圖顯示在 FineWeb 上未衰減持續預訓練的檢查點的共同啟用矩陣,中間的圖顯示在 Stack 上持續預訓練後檢查點的共同啟用矩陣,最右邊的圖顯示共同啟用差異矩陣。子圖 (a) 顯示第 $0$ 層,(b) 顯示第 $11$ 層,(c) 顯示最後一層。我們觀察到共同啟用差異在第 $0$ 層最大,其他層變化極小。
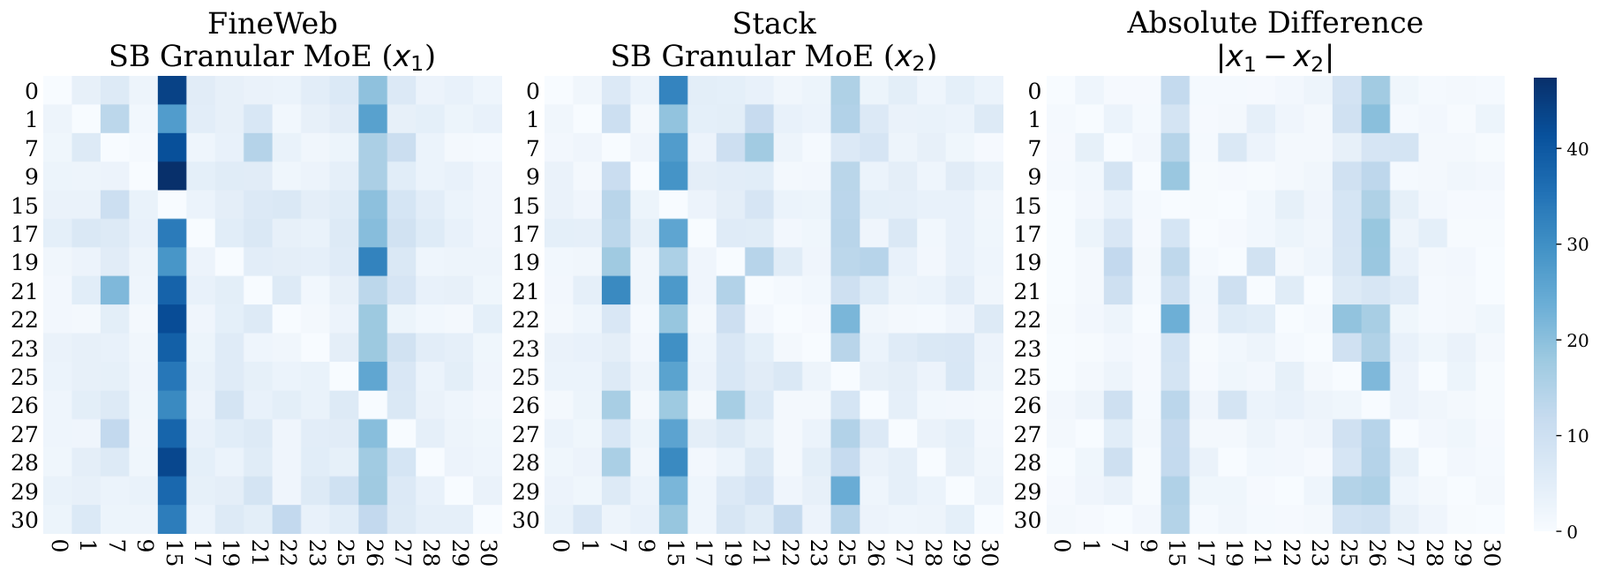
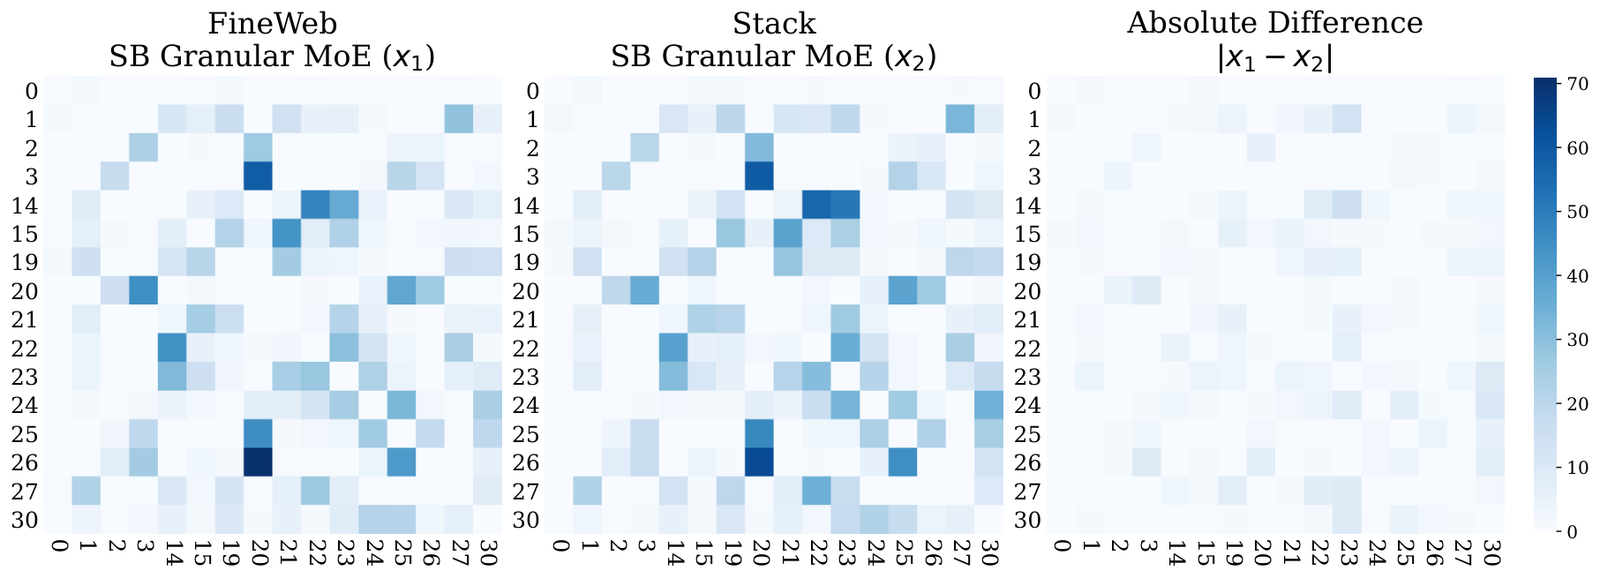
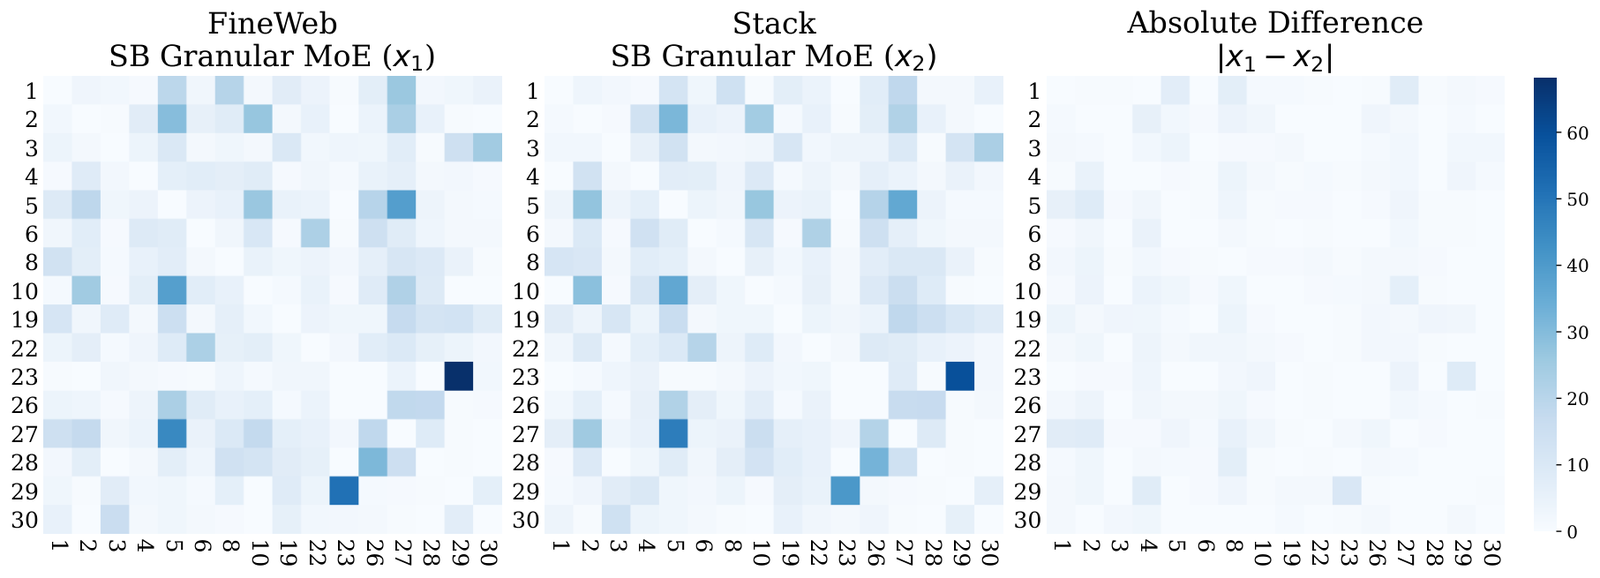
圖 15:在 Stack 上持續預訓練的 SB Granular MoE 於 FineWeb 上的路由器共同啟用矩陣。 圖的排列方式同圖 14。我們觀察到共同啟用差異在第 $0$ 層最大,且大部分權重集中在第 $15$ 號專家上。我們觀察到這種對第 15 號專家的強烈偏重在持續預訓練期間被減弱。其他層在預訓練與持續預訓練之間的共同啟用變化極小。
D.3.4 持續路由不平衡分析
效能只是穩健度的其中一個面向;對 MoE 基礎模型來說,維持專家之間的負載平衡同樣重要。若沒有平衡的負載,以專家平行化且不丟棄 token 的方式做推論的 MoE transformer(例如 SOTA 模型的做法 (DeepSeek-AI et al., 2025b; Zhao et al., 2025)),可能會被單一個接收了所有 token 的加速器拖慢,導致硬體利用率不足、吞吐量下降、成本上升。為了量化評估分布偏移對負載平衡的影響,我們提出最大路由不平衡度 (MRI):在某個 MoE 層中,被路由到單一專家的 token 的最大比例。具體來說,在訓練迭代 $t$ 與 MoE 層 $j$ 的 MRI 定義為
$$\text{MRI}(t,j):=\max_{i\in[1,\dots,E]}\left[\frac{\sum_{\mathbf{x}\in B}\mathbb{1}\{i\in I_{k}(\mathbf{x})\}}{|B|}\right]. \tag{8}$$
其中 $B$ 是包含某批次中所有 token 的集合,$\mathbb{1}$ 是指示函數,$E$ 是被路由專家的數量,$k$ 是啟用專家的數量。由於延遲會隨計算量增加,而在一個 MoE 層中,某個裝置所需的計算量會隨該裝置上專家的負載增加,因此依據某個分布上的路由決策所計算出的 MRI,就是該分布上一個 MoE 層最壞延遲的代理指標。我們會在後續各節中用 MRI 來衡量持續預訓練的演算法改動對路由不平衡的影響。
在圖 16 與圖 17 中,我們把 $t$ 設為每個模型在預訓練與(若適用)持續預訓練期間的最後一次迭代。圖的 x 軸是層編號,y 軸是 MRI。左欄回報 PBT$k$ MoE 的 MRI,右欄回報 SBT$k$ MoE 的 MRI。圖 16 是 Granular MoE,圖 17 是 Switch MoE。對 Granular MoE,我們觀察到懲罰式平衡 MoE 的 MRI 一致低於 Sinkhorn 平衡式 MoE;持續預訓練在 FineWeb 上只造成很小的 MRI 上升,即使是 $0\%$ 重播的模型也是如此;而 MoE 在看到分布外資料時最不平衡(例如 (b) 中的非德文模型與 (c) 中的非程式碼模型)。對 Switch MoE,我們同樣觀察到懲罰式平衡 MoE 的 MRI 一致低於 Sinkhorn 平衡式 MoE;與 Granular MoE 類似,持續預訓練在 FineWeb 上只造成很小的 MRI 上升,即使 $0\%$ 重播亦然;Switch MoE 在看到分布外資料時最不平衡(例如 (c,d) 中的非德文模型與 (e,f) 中的非程式碼模型);而且與 Granular MoE 不同,高 MRI 在早期層很普遍,且與所用的訓練與測試分布無關。把這些差異與 Granular MoE 較優的語言建模效能對照,可以推測 Switch 模型早期層那種 Granular MoE 所沒有的不穩定 MRI,可能是效能差異的成因之一。
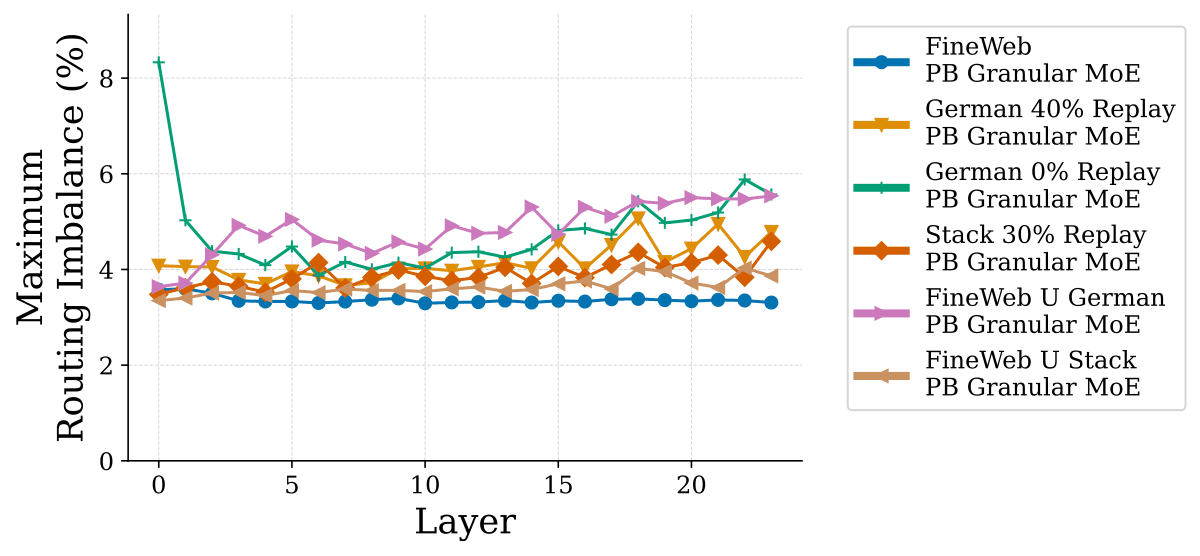
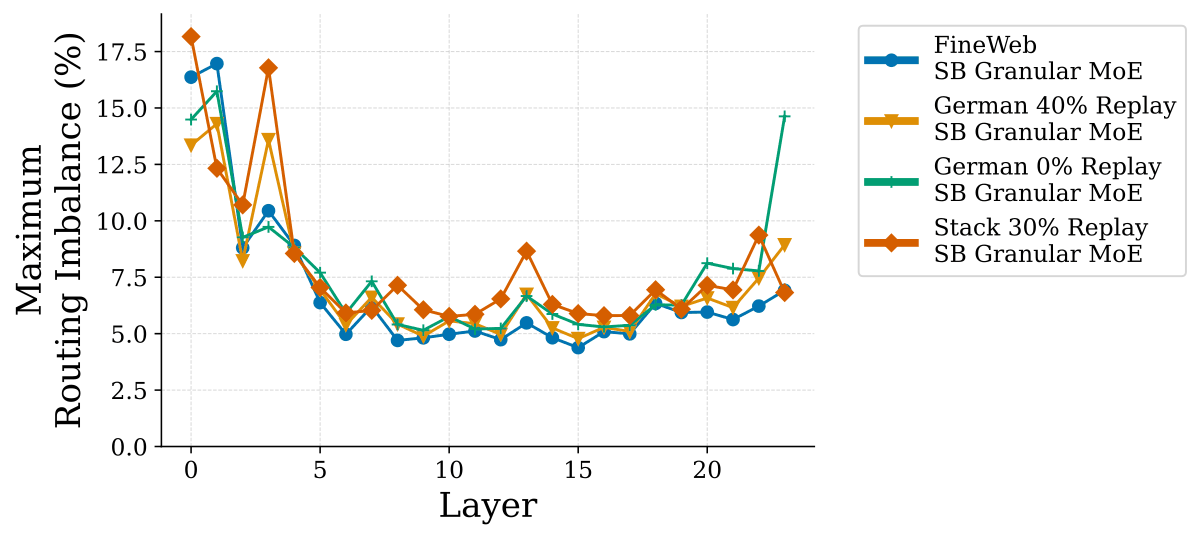
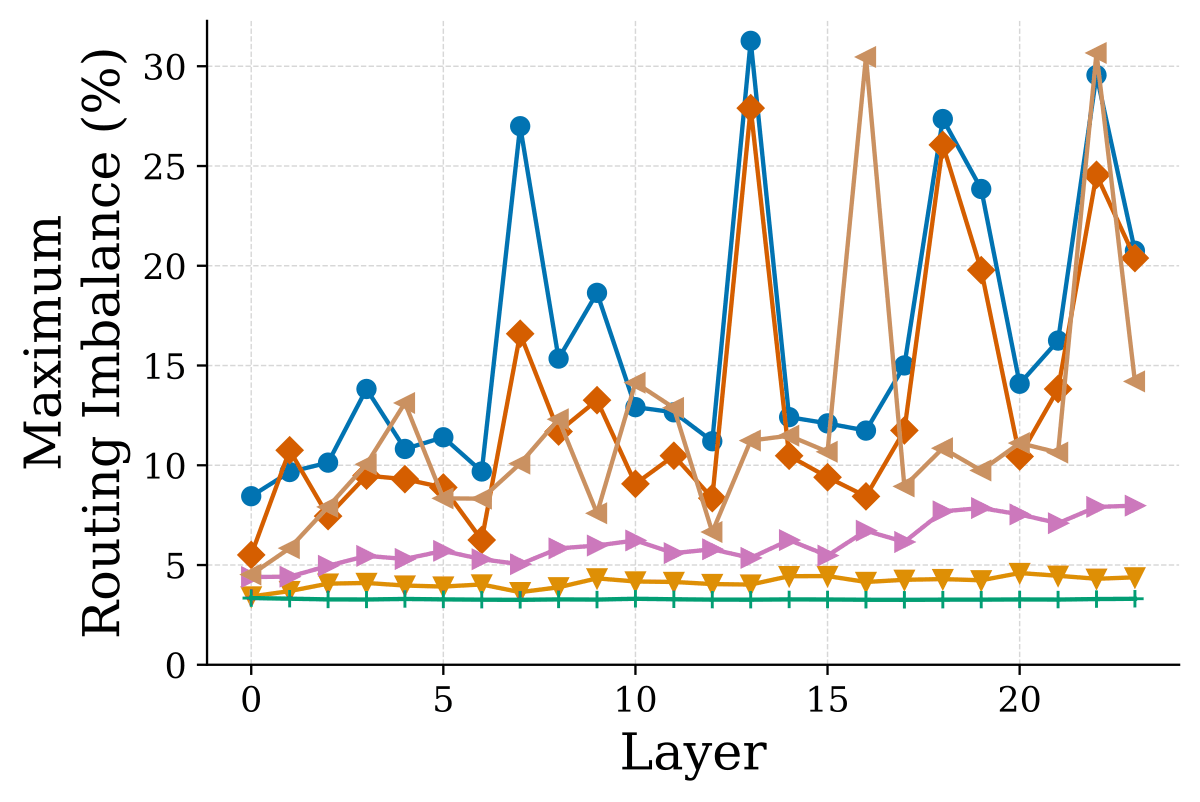
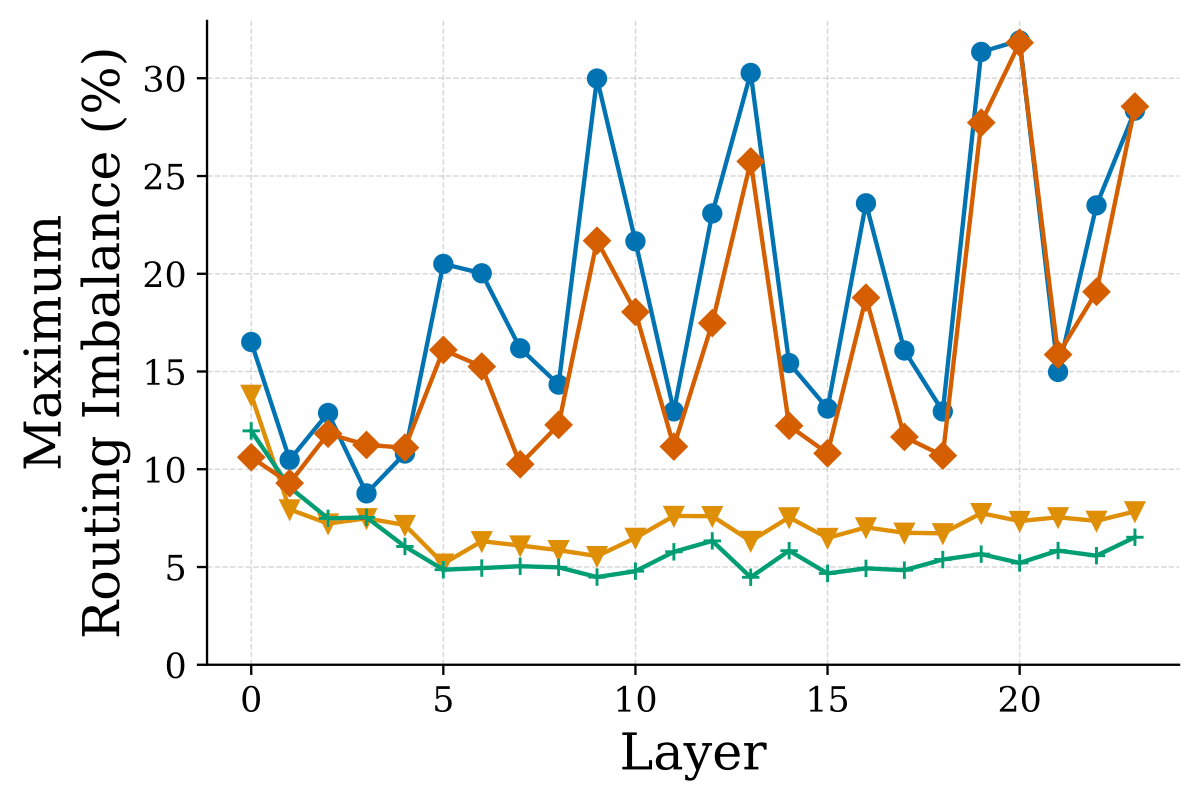
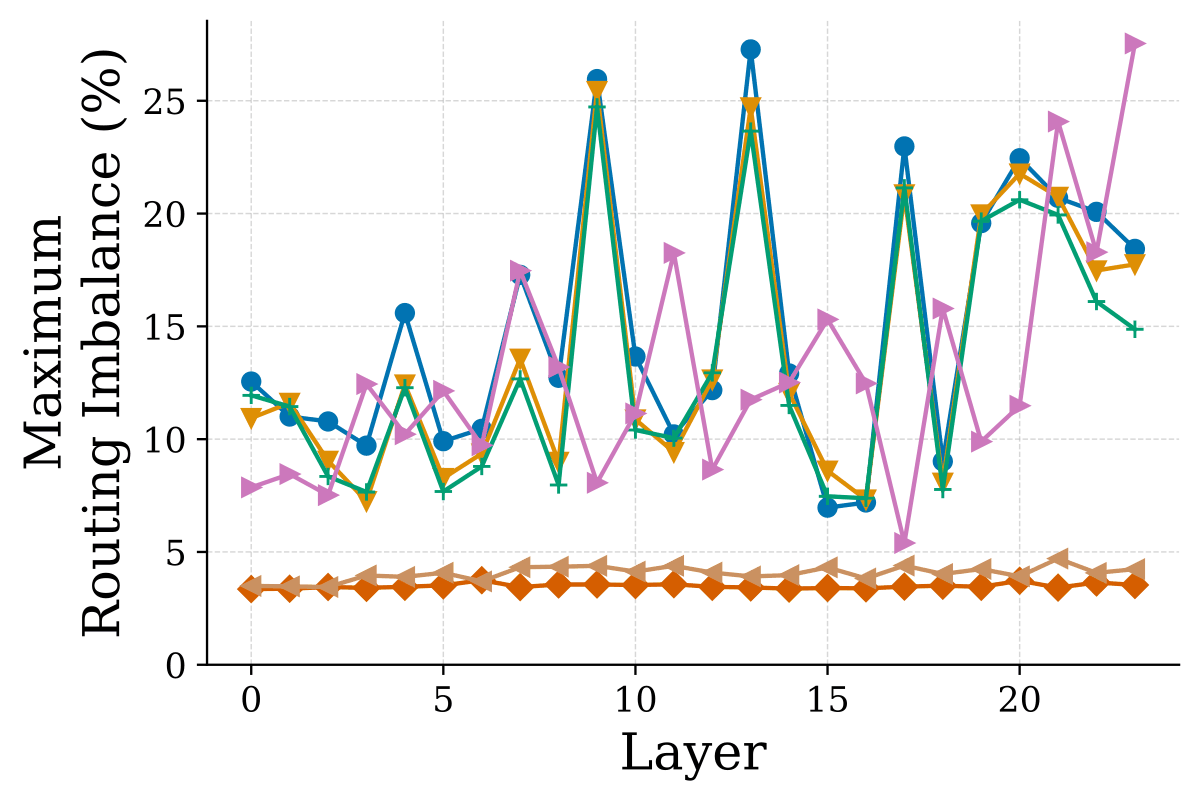
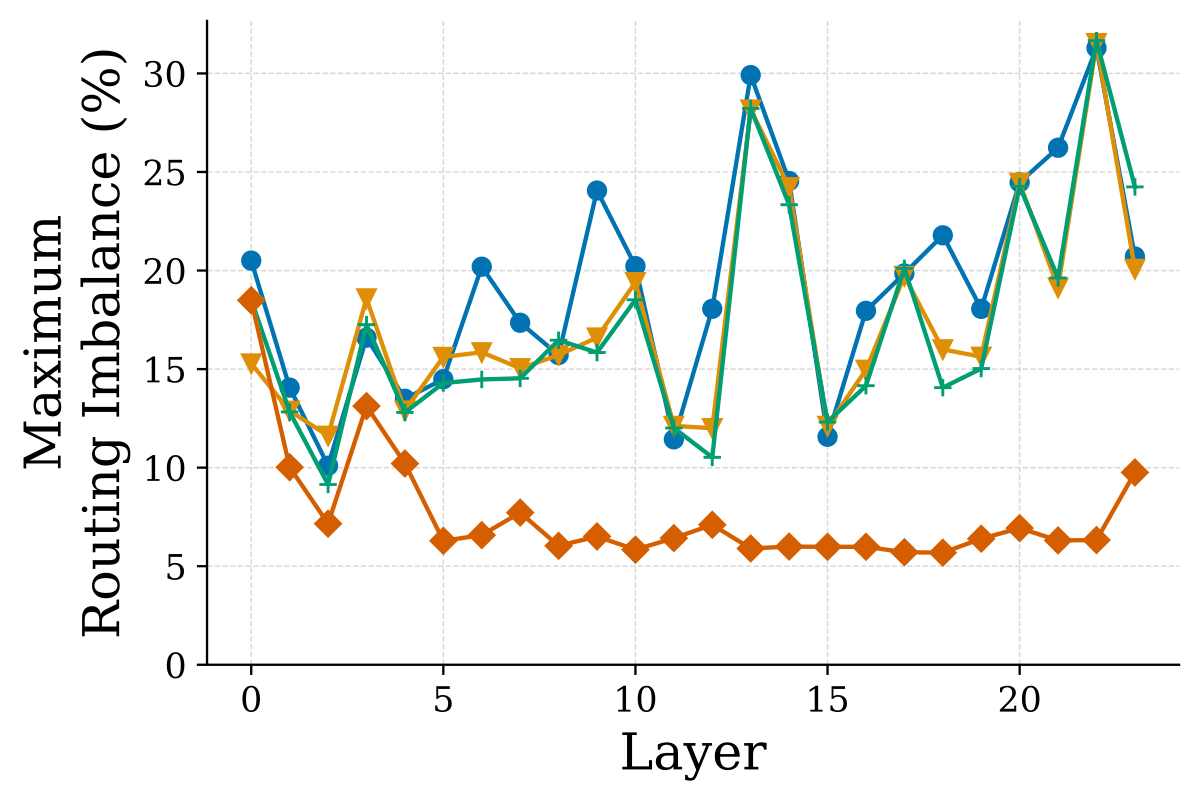
圖 16:Granular MoE 的逐層最大路由不平衡度 (MRI)。 我們回報 MoE 每一層的 MRI,以在各資料集 $20$M token 測試集上所有路由決策的百分比表示((a,b) FineWeb、(c,d) 德文、(e,f) Stack)。左欄為 PBT$k$ MoE,右欄為 SBT$k$ MoE。我們觀察到懲罰式平衡 MoE 的 MRI 一致低於可比的 Sinkhorn 平衡式 MoE;持續預訓練在 FineWeb 上只造成很小的 MRI 上升,即使 $0\%$ 重播的模型也是如此(其第一層除外);MoE 在看到分布外資料時最不平衡。
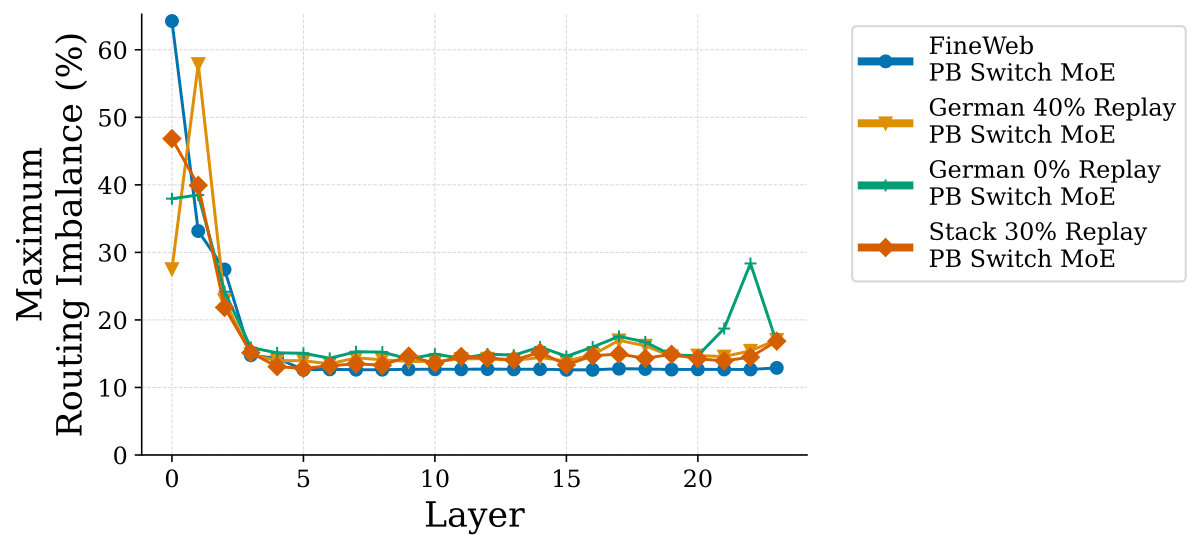
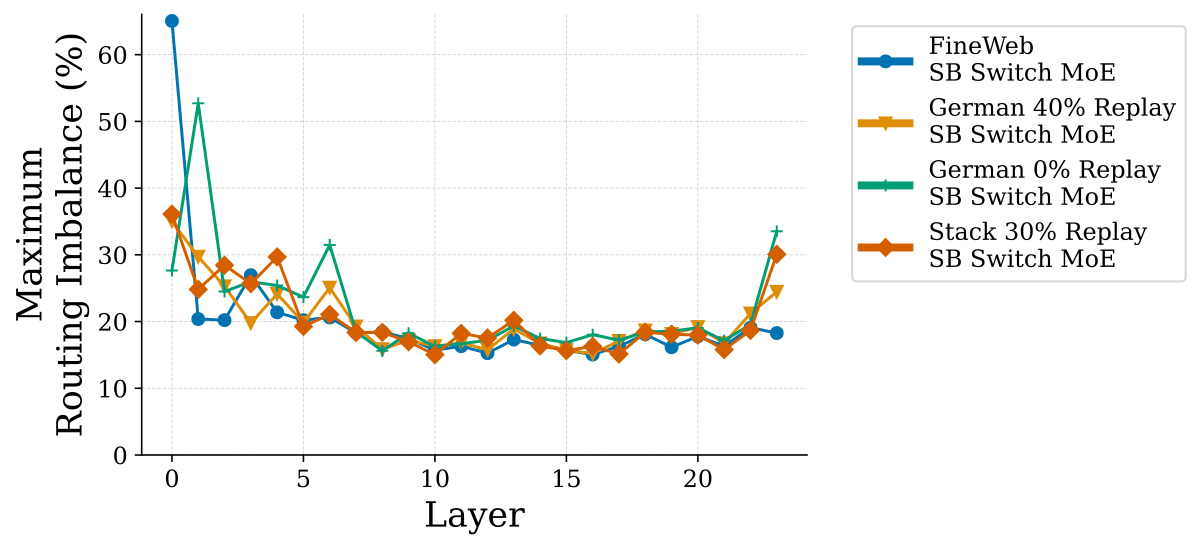
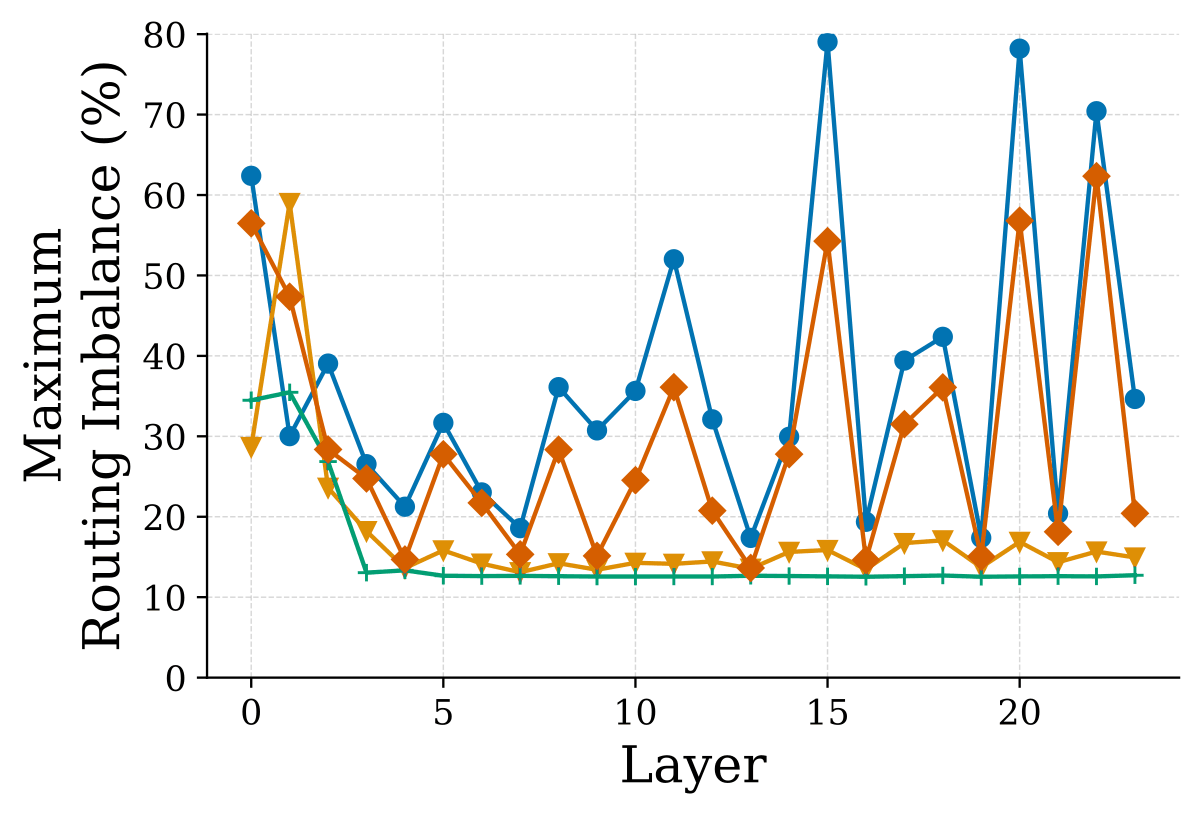
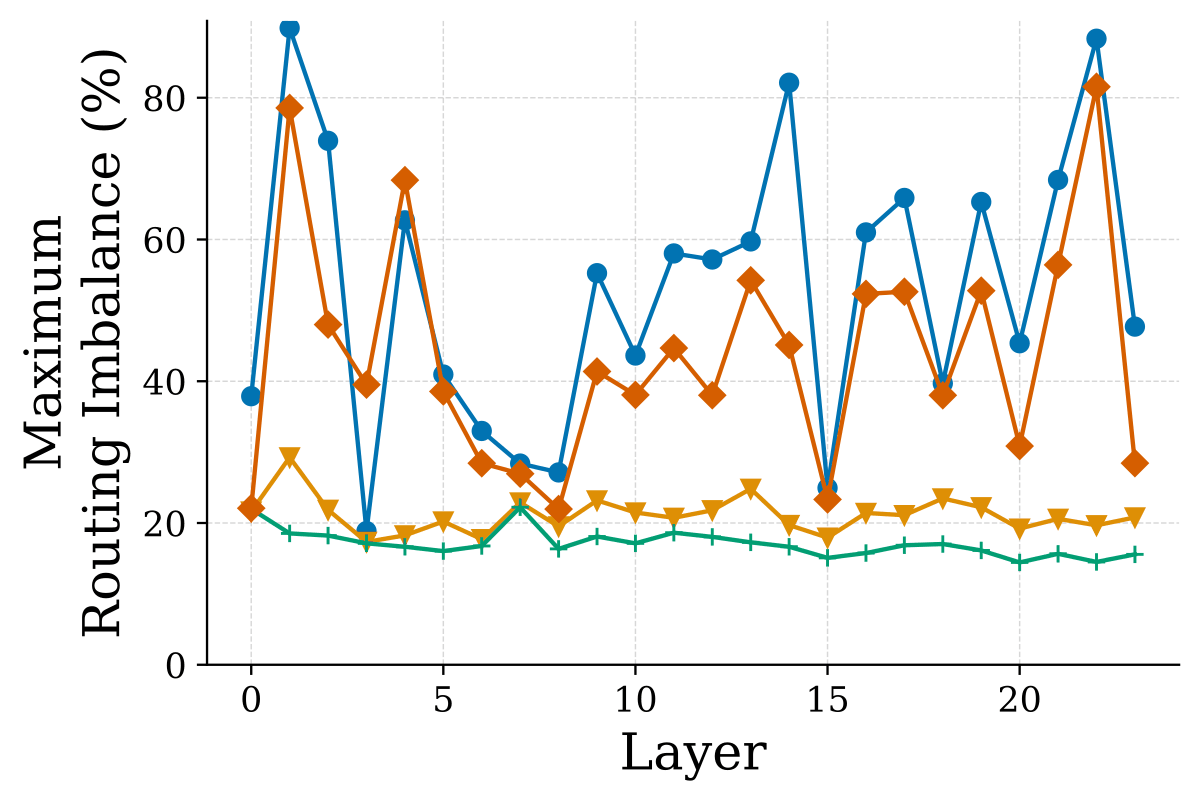
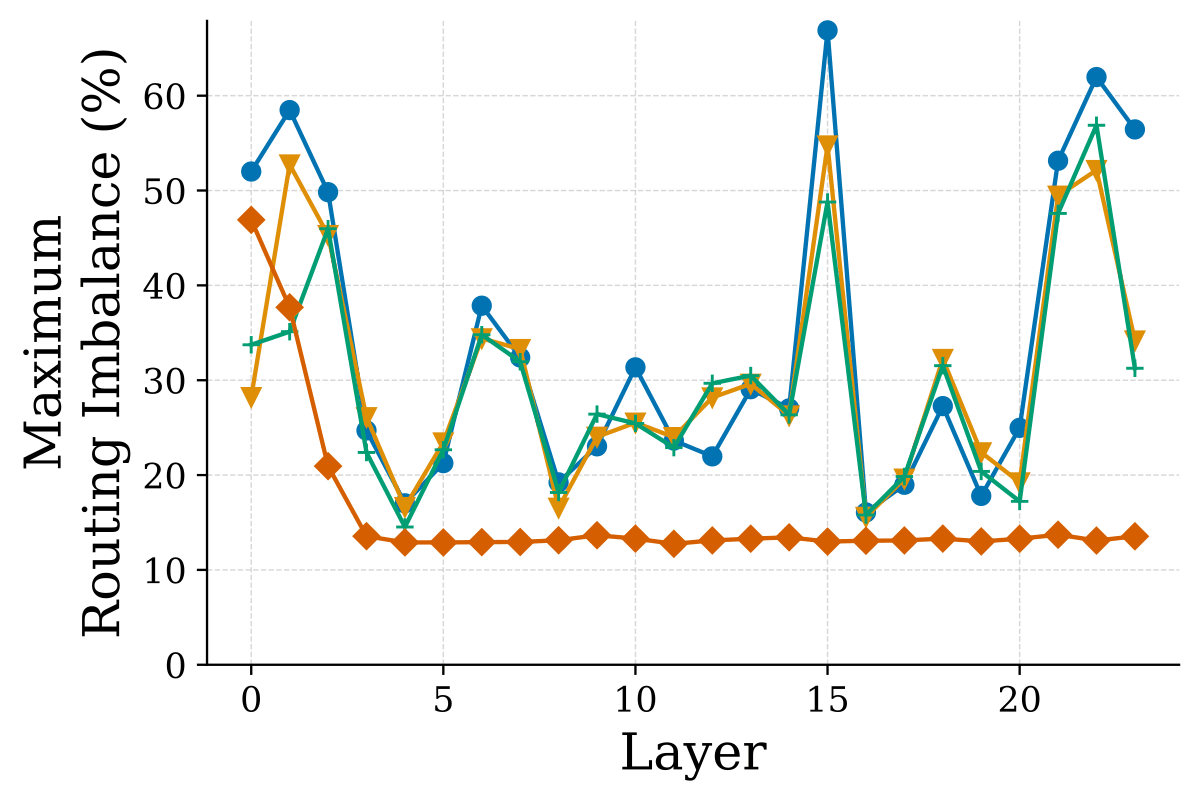
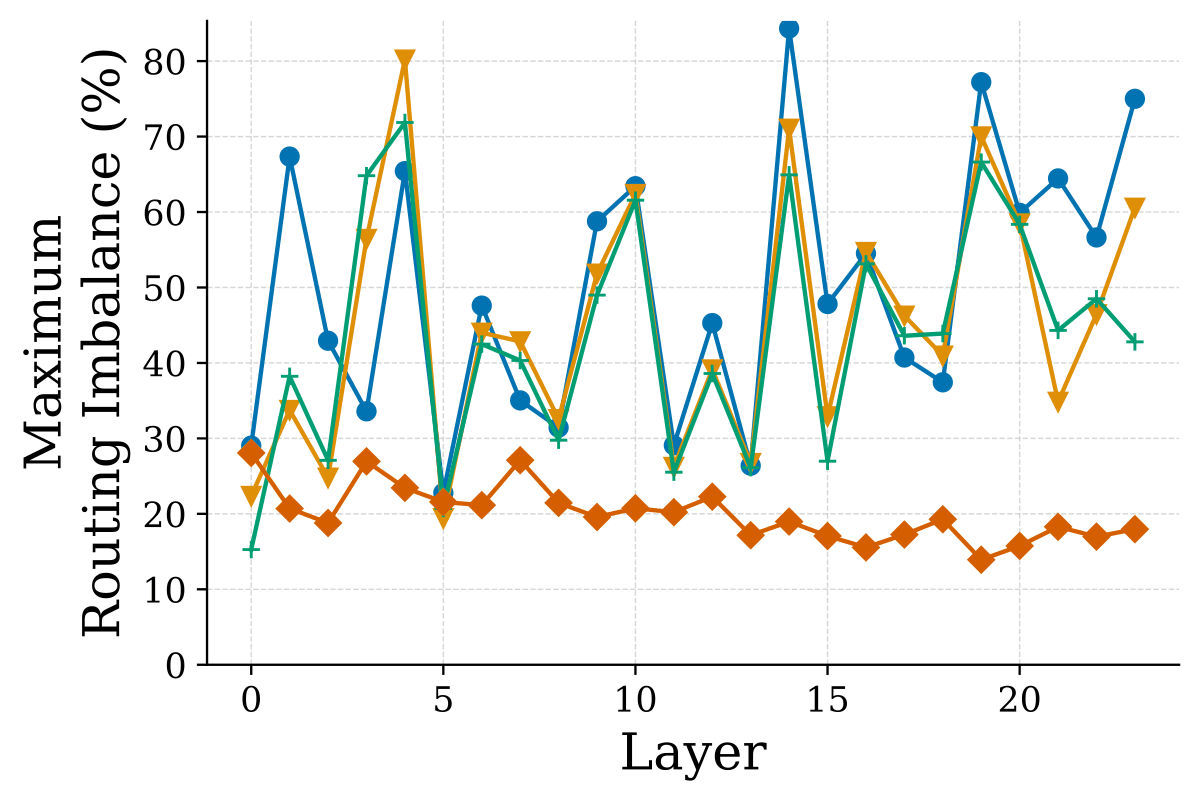
圖 17:Switch MoE 的逐層最大路由不平衡度 (MRI)。 圖的組織方式同圖 16。除了與 Granular MoE 相同的趨勢外,我們還觀察到 Switch MoE 的早期層普遍有高 MRI,且與所用的訓練與測試分布無關。
D.4 MoE 在持續預訓練期間的最大路由不平衡度
在本節中,我們回報 MoE 在 CPT 期間的最大路由不平衡度。具體來說,圖 18 與圖 19 回報分布偏移前後緊鄰時刻的路由情形,圖 20 與圖 21 則分別回報 Granular 與 Switch MoE 在訓練期間的 MRI。
訓練期間的路由不平衡
透過稀疏地啟用權重矩陣,MoE 取得了相對於 FLOP 對齊密集模型的效能優勢。然而,當模型的前向傳遞被單一專家的延遲卡住時,這個優勢的代價是延遲上升。如果 MoE 任一層的路由器決定把大部分 token 負載派送給某個特定專家,這就會成為問題。因此,我們可以透過追蹤 MoE 每一層最糟的負載不平衡——也就是式 1 所定義的最大路由不平衡度——來估計持續預訓練對 MoE 延遲的影響。
在圖 20 與圖 21 中,我們分別繪製 Granular 與 Switch MoE 在預訓練 (FineWeb) 與持續預訓練 (German CC) 全程的 MRI。子圖 (a) 顯示 PB MoE 訓練時與推論時的 MRI,子圖 (b) 顯示 SB MoE 訓練時的 MRI,子圖 (c) 顯示 SB MoE 推論時的 MRI。我們之所以區分 Sinkhorn 平衡的訓練與推論,是因為 Sinkhorn 平衡演算法與自迴歸生成不相容,所以在子圖 (c) 中我們展示不含平衡步驟的 SB 模型 MRI(也就是自迴歸生成時實際會用到的版本)。
對所有 MoE 來說,早期層(0–6)的 MRI 似乎最大。不論 Switch 或 Granular MoE,我們都觀察到 SB 路由在整個預訓練期間都遵循非常相似的模式。到了持續預訓練階段,我們觀察到這個模式略有改變——不論是推論時或訓練時的路由不平衡,實際上在持續預訓練過程中都變得更平衡了。把注意力轉到 PB MoE,我們觀察到 Switch MoE 在早期層的路由不平衡比它們的 Granular 對手嚴重得多。然而,對 PB Switch MoE 的大多數層與 PB Granular MoE 的所有層來說,MRI 在預訓練與持續預訓練期間都很快就降到比 SB 對應版本更小的值,顯示 PB MoE 同樣對分布偏移穩健,而 Granular MoE 架構更適合持續預訓練。
總結來說,PB 與 SB Top-$k$ 路由演算法都對分布偏移穩健,PB 一開始受分布偏移的擾動較大,但很快就恢復到比 SB 更好的平衡水準。這些結果證明,使用無限學習率排程與重播,就足以在不造成 MRI 大幅上升的情況下持續預訓練 MoE LLM。
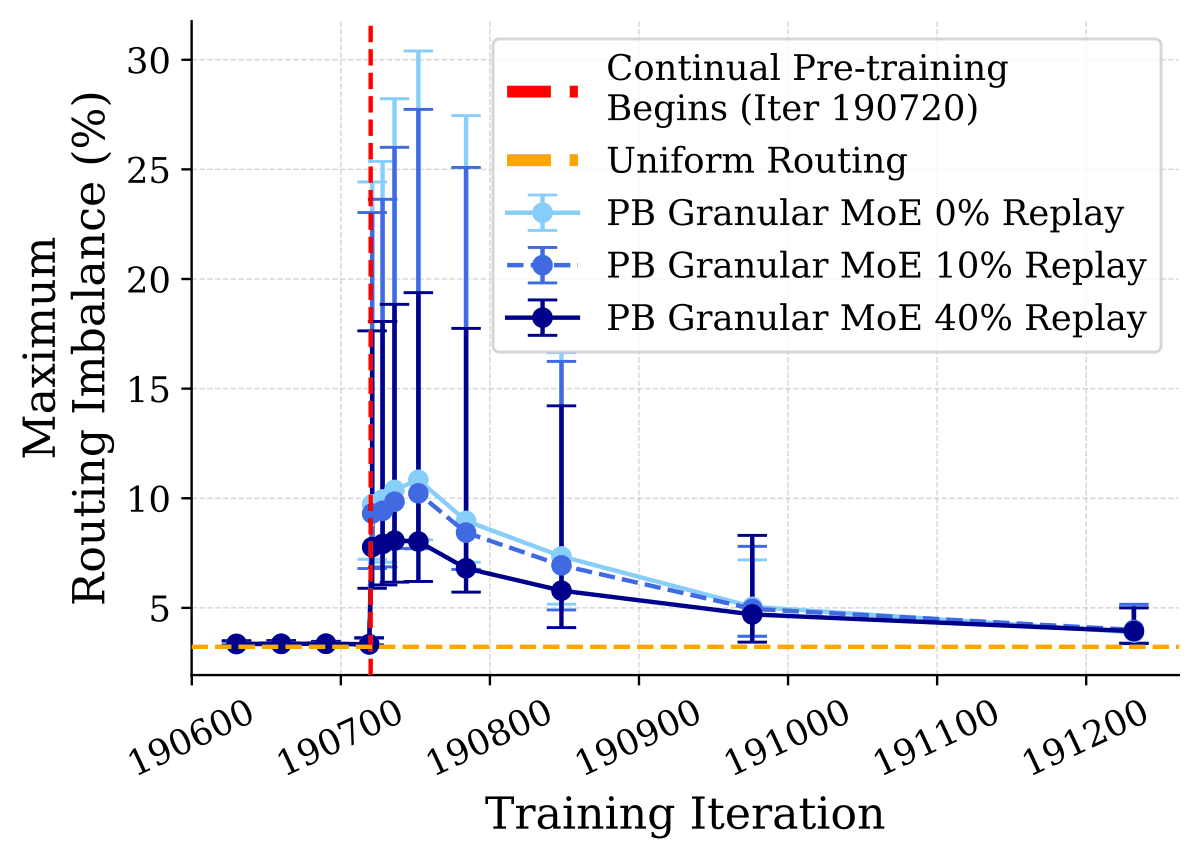
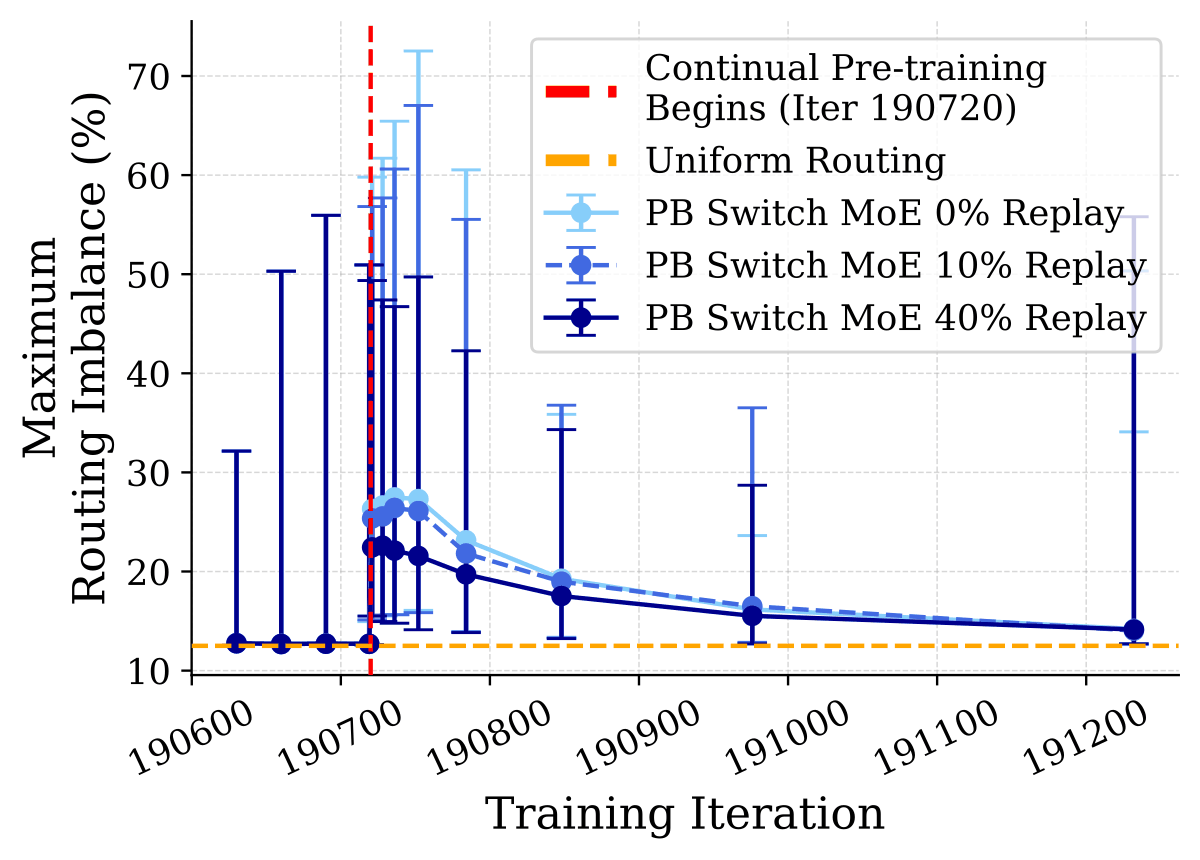
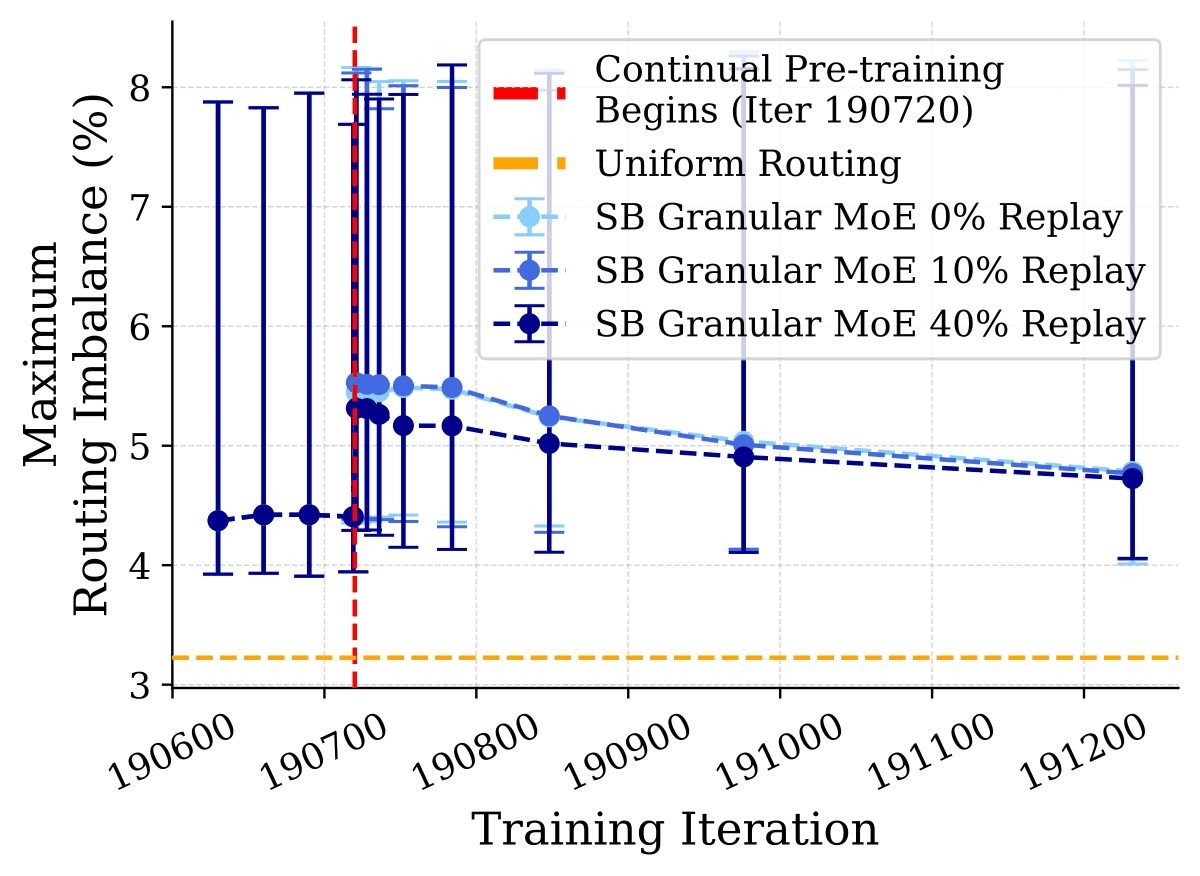
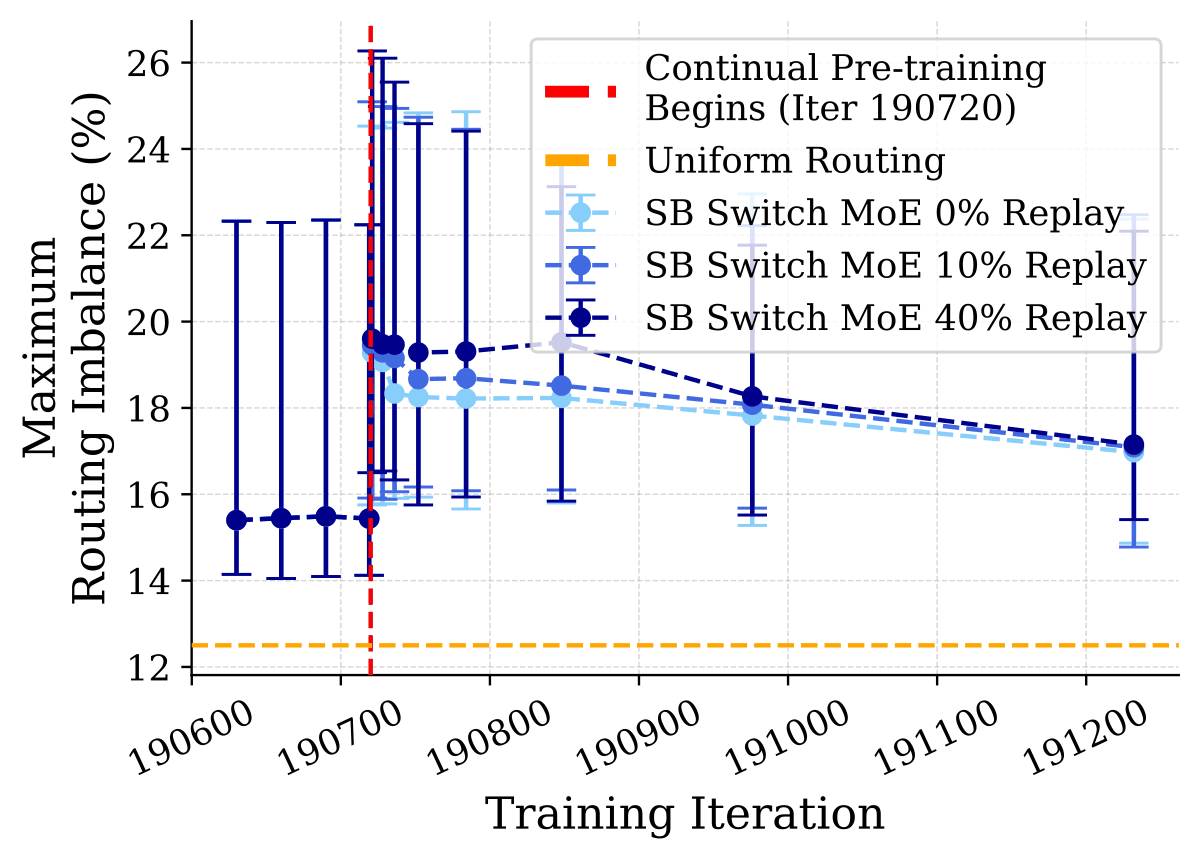
圖 18:調整重播比例對 Sinkhorn 平衡式 (SB) 與懲罰式平衡 (PB) Top-$k$ MoE 訓練時最大路由不平衡度的影響很小。 我們回報在 German CC 上持續預訓練時,分布偏移前後不久跨 MoE 各層的中位數 MRI,並附上最小與最大誤差棒。我們觀察到不論使用何種重播比例,MoE 都在持續預訓練的 $1000$ 次迭代內恢復到預訓練水準的中位數 MRI。不過,重播確實在 PB MoE 上小幅減輕了分布偏移造成的 MRI 上升。相對地,SB MoE 對分布偏移相當穩健,其路由模式似乎與所用的重播比例無關。
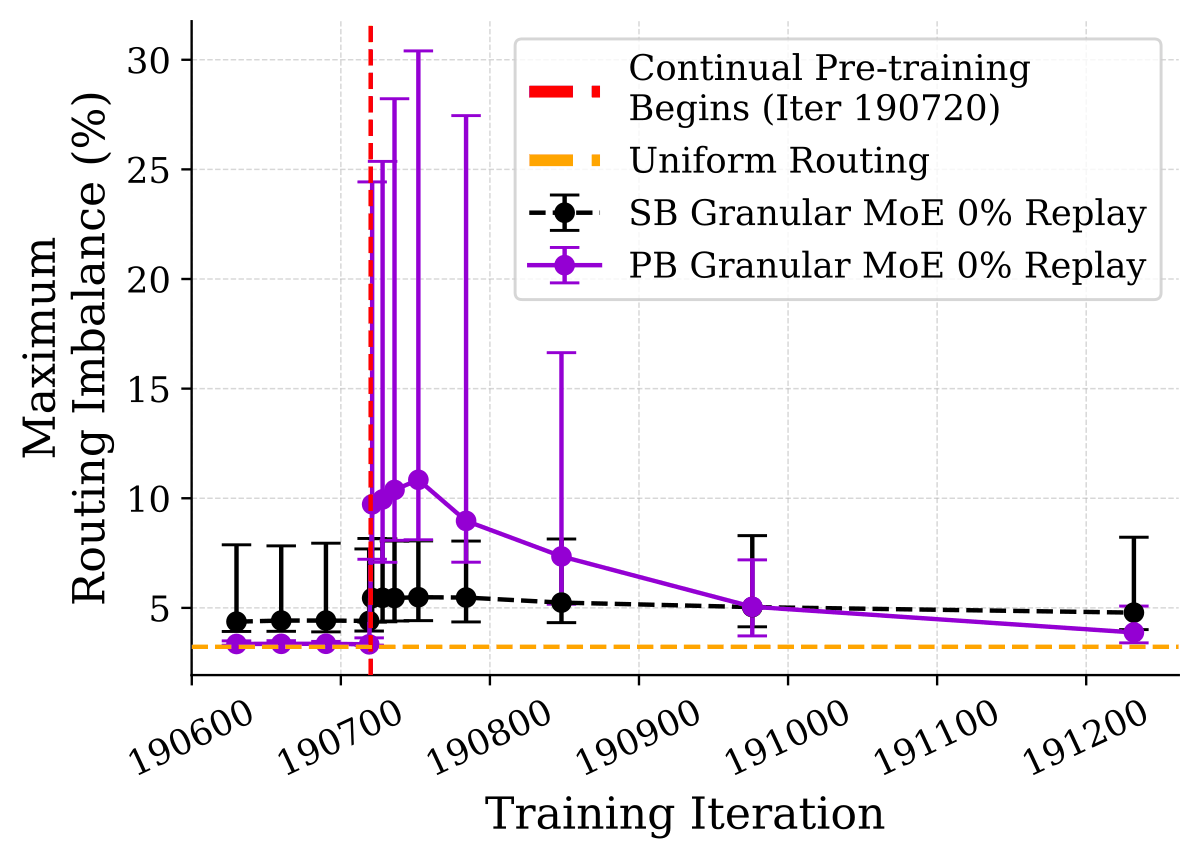
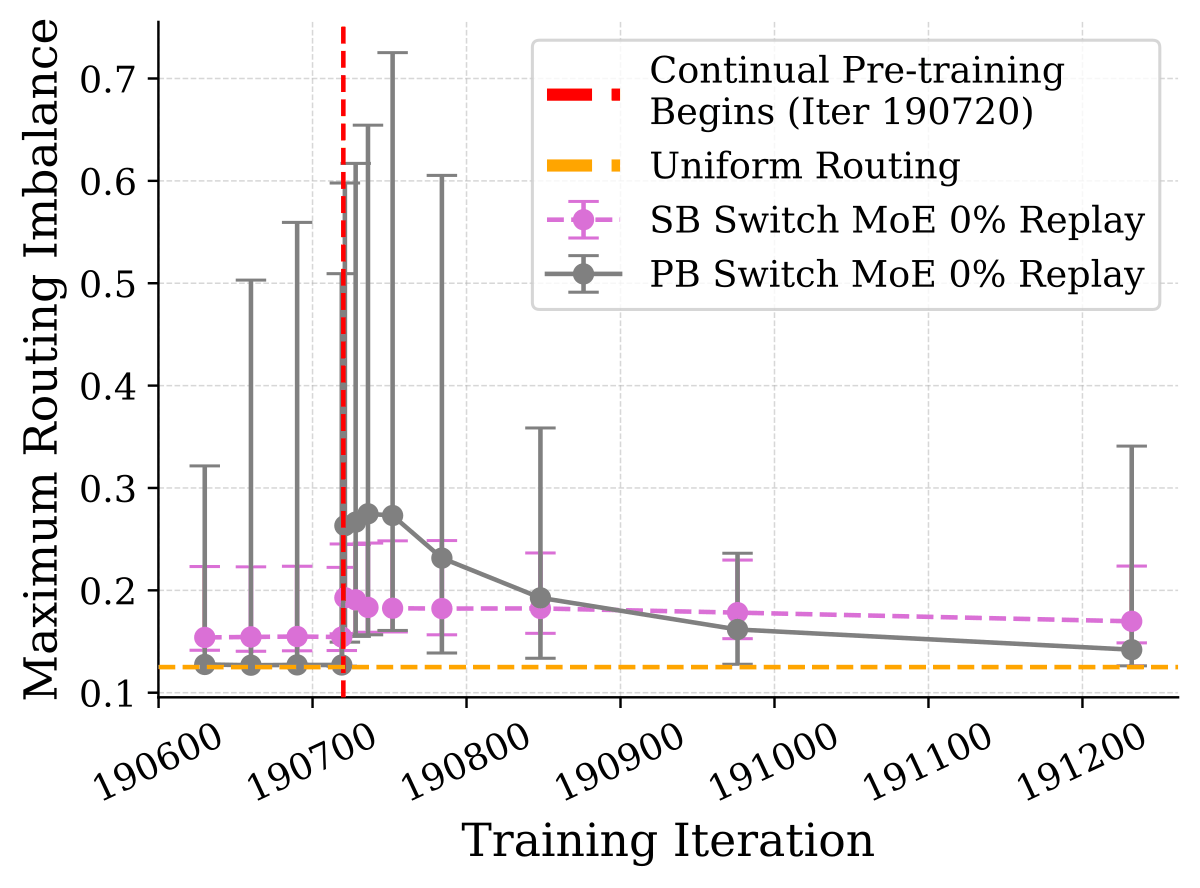
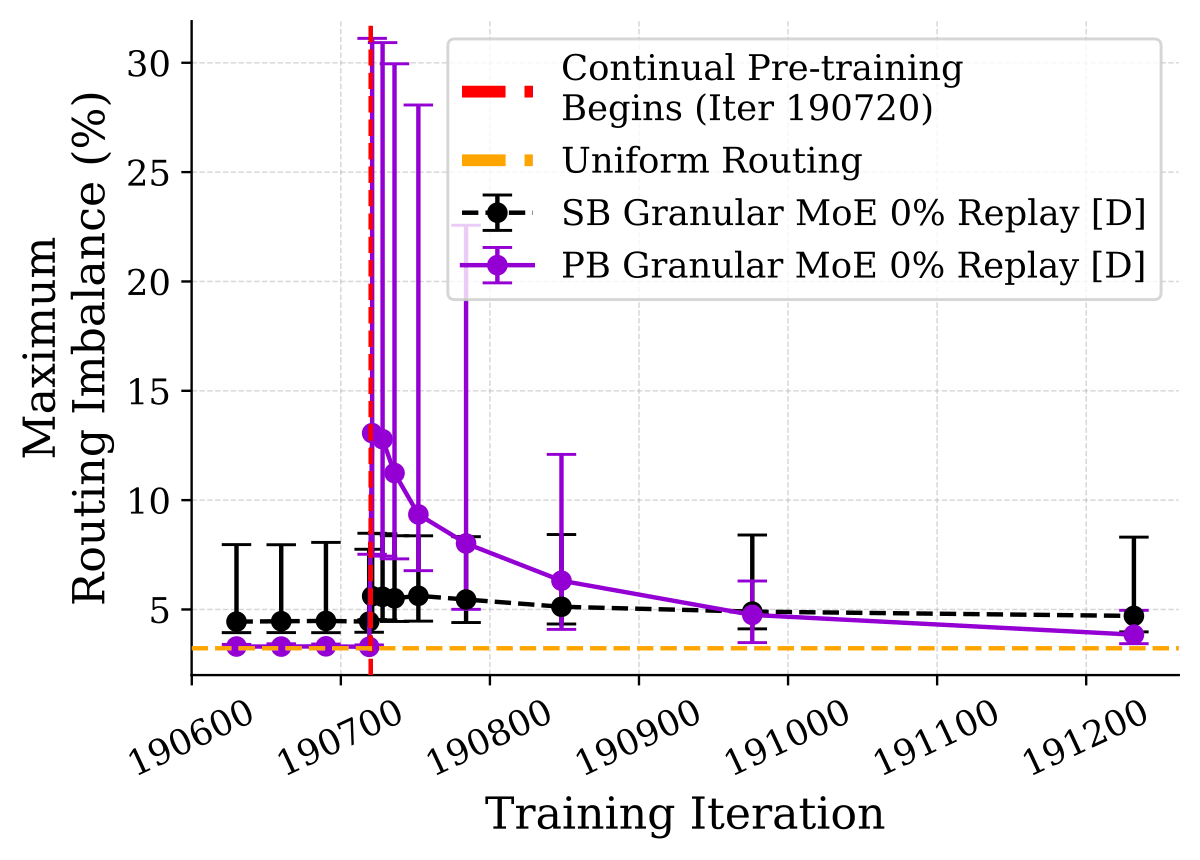
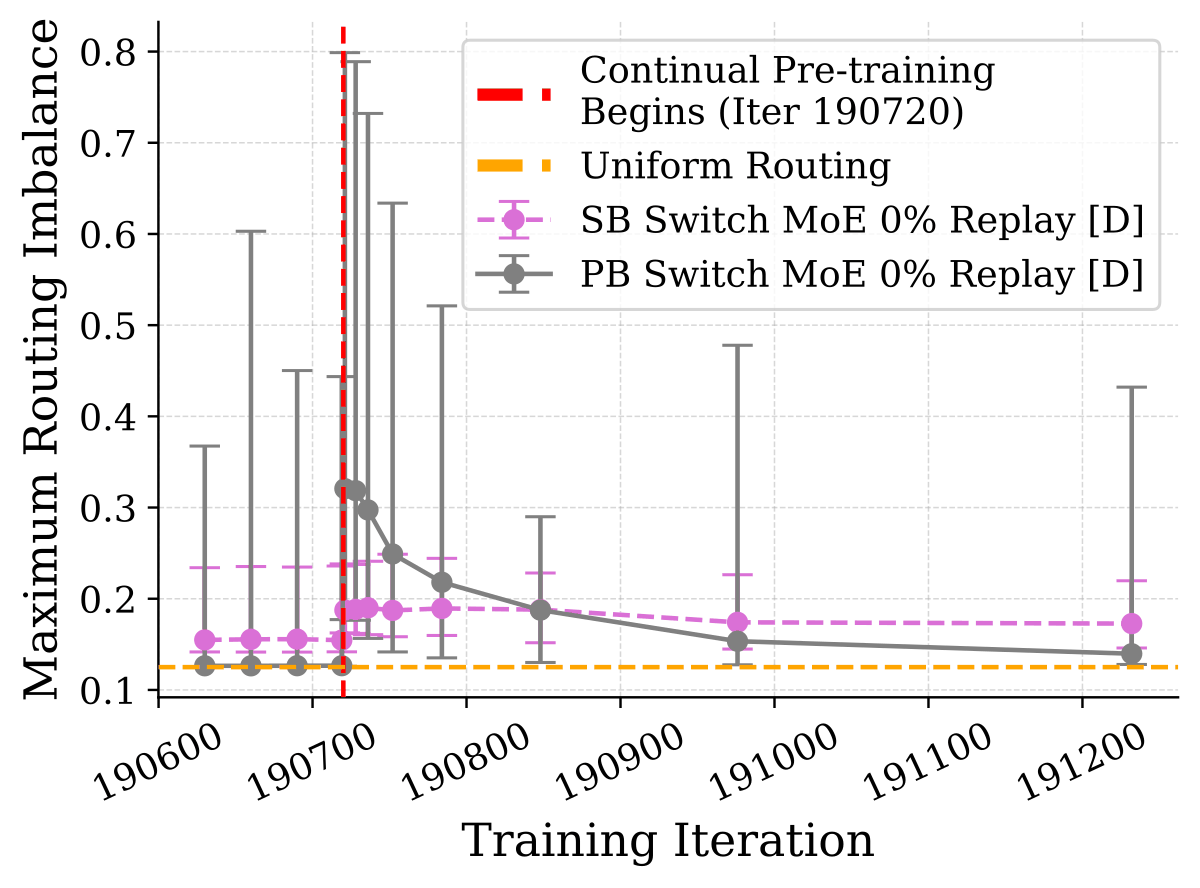
圖 19:已衰減的懲罰式平衡 (PB) Top-$k$ MoE 在分布偏移期間的 MRI 略高於未衰減的版本。 我們回報在 German CC 上持續預訓練時,分布偏移前後不久跨 MoE 各層的中位數 MRI,並附上最小與最大誤差棒。我們觀察到所有 SB MoE 在整個分布偏移期間都維持穩定的 MRI,顯示它們幾乎不受影響。相對地,PB 檢查點在分布偏移後遭遇強烈的路由不平衡,但恢復得很快,其中已衰減的檢查點達到的 MRI 略高一些。
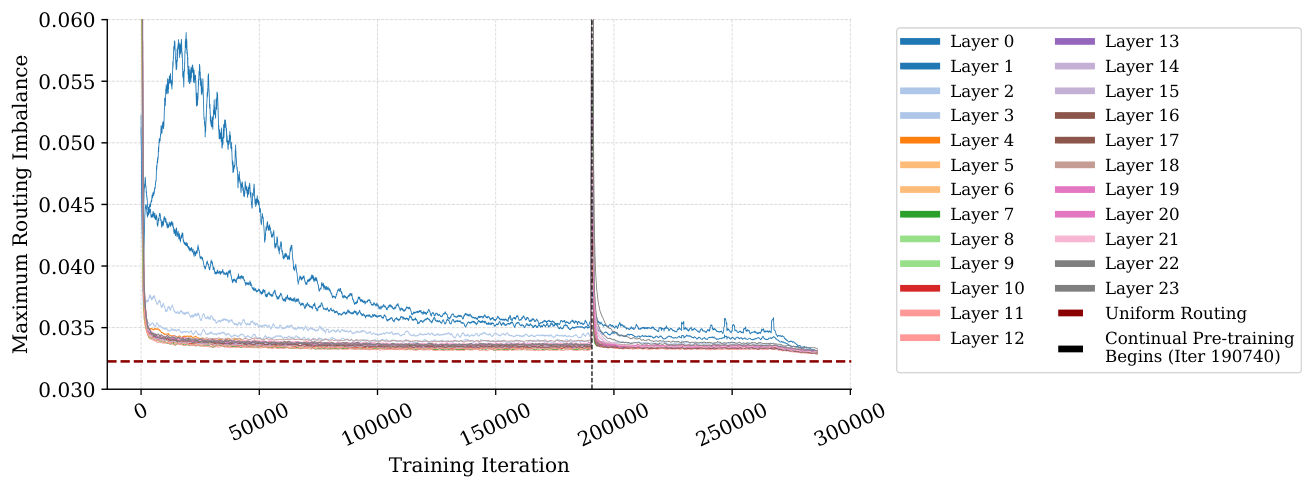
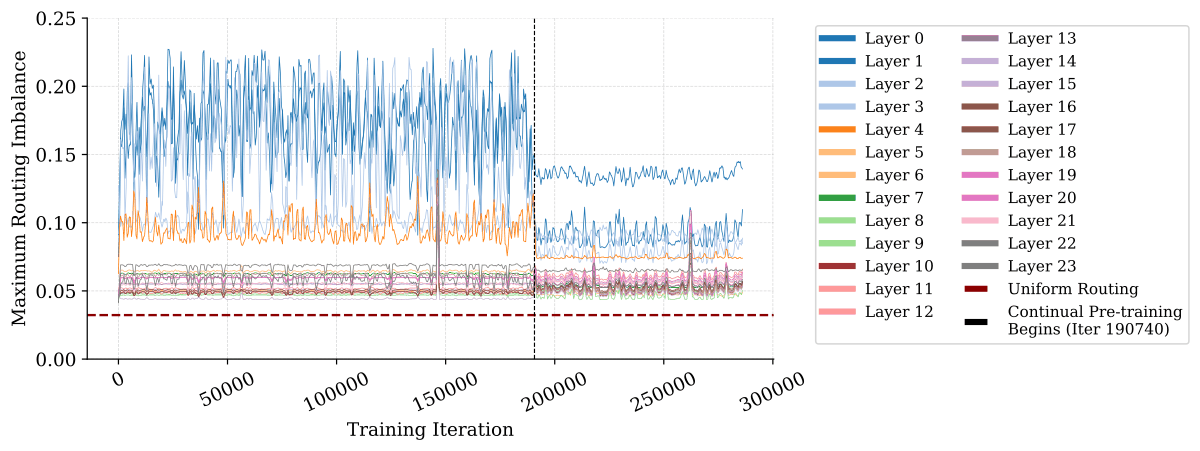
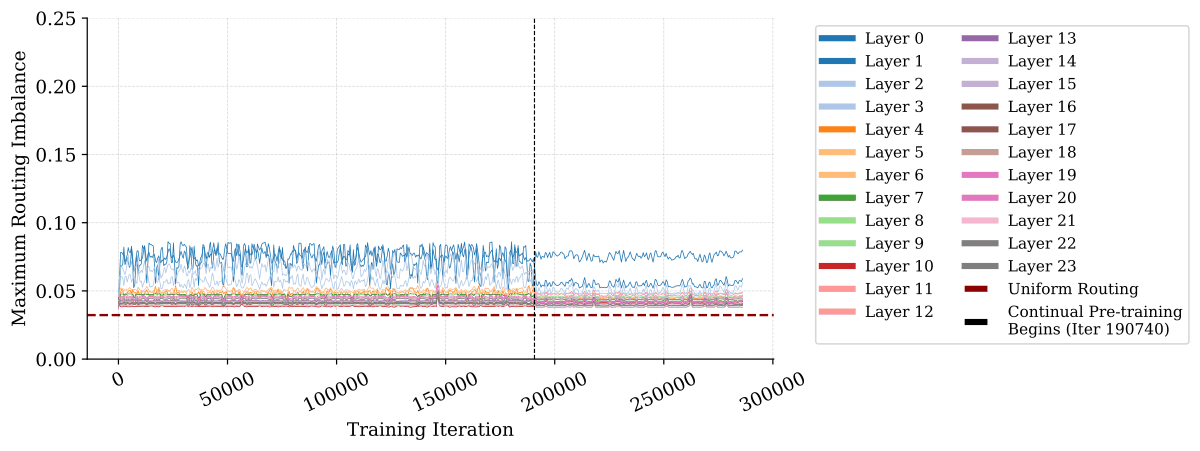
圖 20:Granular MoE 在預訓練與持續預訓練全程的訓練時與推論時 MRI。 我們展示預訓練與持續預訓練期間逐層的最大路由不平衡度。懲罰式平衡 MoE 在訓練時與推論時的路由動態相同,但 Sinkhorn 平衡與自迴歸生成不相容,因此我們對 SB 模型同時展示推論時與訓練時的 MRI。我們觀察到不論 PB 或 SB MoE,早期層的 MRI 一致最大;PB MoE 的 MRI 表現好得多;而在分布偏移之後,SB 模型的 MRI 變得更穩定。
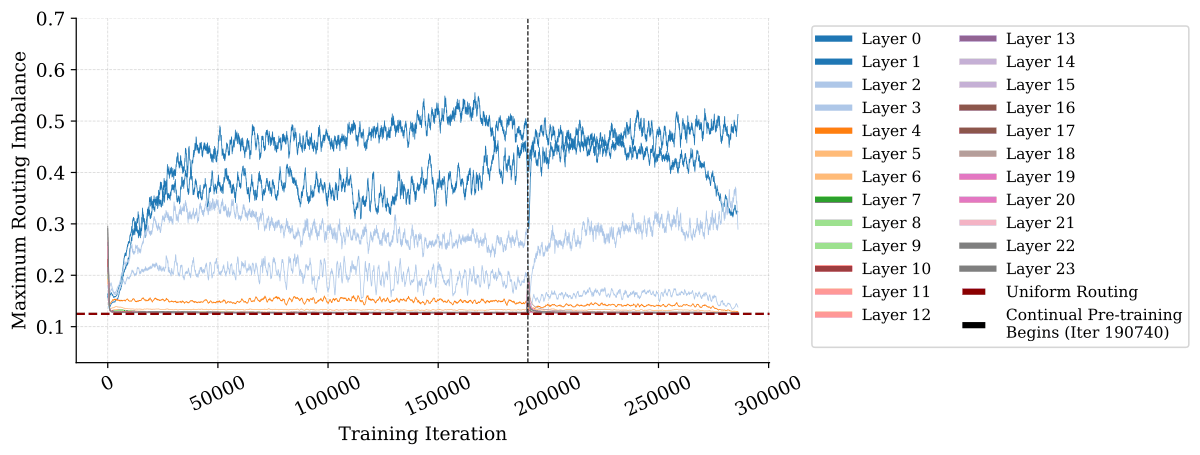
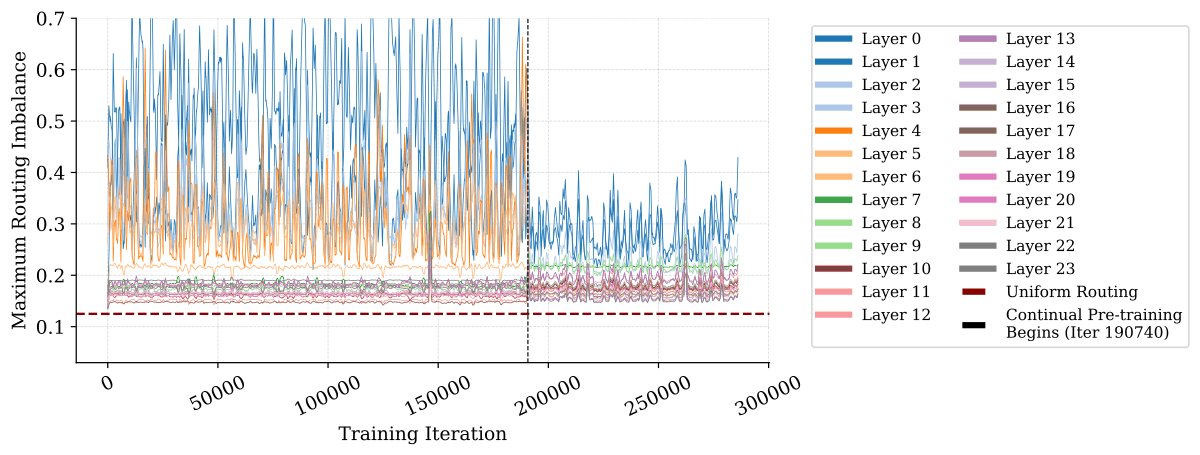
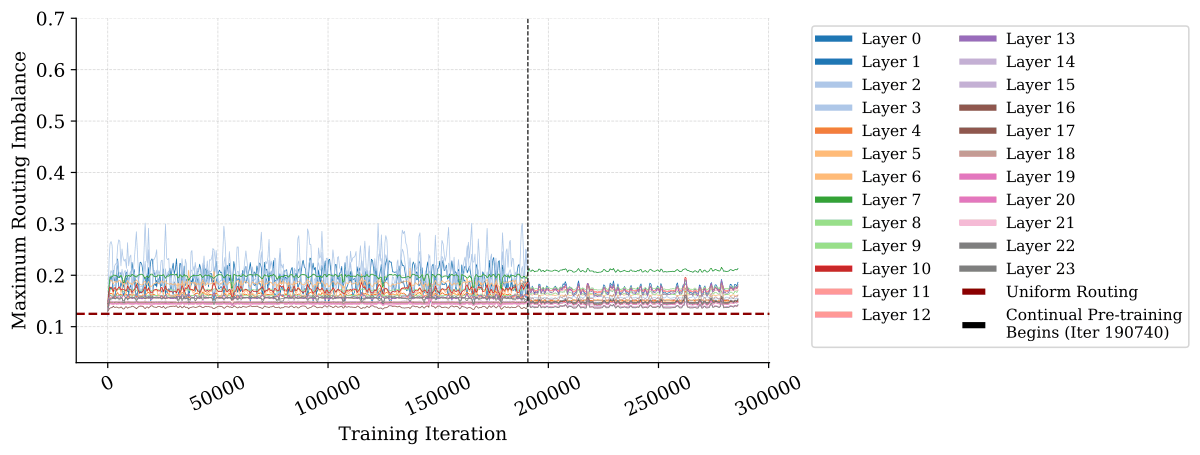
圖 21:Switch MoE 在預訓練與持續預訓練全程的訓練時與推論時 MRI。 圖的組織方式同圖 20,觀察到的趨勢也相同。
附錄 E 資料集大小與取樣比例
在本節中,我們回報所使用的訓練 token 數、訓練資料集大小與取樣比例。具體來說,表 7 回報不同預訓練階段所用的資料量與其確切組成;表 8、9、10 則分別回報 FineWeb、德文與 Stack 的訓練 token 數與取樣比例。
表 7:預訓練與持續預訓練的 token 數。 我們回報本文所有不同模型訓練設定的訓練 token 數。在持續預訓練期間,每個批次都包含一定比例來自預訓練資料集的重播 token,以及來自持續預訓練資料集的新 token。
| 階段 | 訓練 tokens | 新 tokens | 重播 tokens |
|---|---|---|---|
| 預訓練 | $400$B FineWeb | 400B | – |
| 持續預訓練 | $400$B FineWeb $\rightarrow$ $200$B Stack(30% 重播) | 140B | 60B |
| $400$B FineWeb $\rightarrow$ $200$B German(40% 重播) | 120B | 80B | |
| $400$B FineWeb $\rightarrow$ $200$B German(0% 重播) | 200B | – |
表 8:FineWeb CC:本實驗所用的訓練、驗證與測試資料集大小。 為了讓研究更好操作,我們把 FineWeb 中每個 Common Crawl dump 再抽樣成較小的子集,藉此建立一個規模較可控的 FineWeb 子集,然後依各子集大小按比例取樣。我們回報訓練期間取樣所用子集的完整大小(注意我們只在這個子集中訓練了 $400$B tokens)。各切分確切的大小與取樣比例因為超過一頁而略去,但可依需求提供。
| 來源 | 訓練 tokens (B) | 測試 tokens (B) | 驗證 tokens (B) | 取樣權重 |
|---|---|---|---|---|
| FineWeb CC | 2916.650 | 26.442 | 26.426 | 1.000 |
表 9:German CC:本實驗所用的訓練、驗證與測試資料集大小。
| 來源 | 訓練 tokens (B) | 測試 tokens (B) | 驗證 tokens (B) | 取樣權重 |
|---|---|---|---|---|
| German CC | 169.291 | 0.489 | 0.491 | 1.000 |
表 10:Stack:本實驗所用的訓練、驗證與測試資料集大小。
| 來源 | 訓練 tokens (B) | 測試 tokens (B) | 驗證 tokens (B) | 取樣權重 |
|---|---|---|---|---|
| YAML | 9.039 | 0.613 | 0.609 | 0.017 |
| Java | 19.730 | 0.587 | 0.587 | 0.174 |
| C | 17.988 | 0.594 | 0.597 | 0.159 |
| Markdown | 21.699 | 0.477 | 0.474 | 0.017 |
| PHP | 16.660 | 0.450 | 0.447 | 0.146 |
| C# | 9.245 | 0.552 | 0.553 | 0.084 |
| JSON | 120.669 | 0.709 | 0.695 | 0.017 |
| TypeScript | 6.892 | 0.418 | 0.414 | 0.063 |
| C++ | 13.998 | 0.538 | 0.539 | 0.124 |
| Python | 15.898 | 0.458 | 0.457 | 0.200 |
| 總計 | 251.819 | 5.396 | 5.372 | 1.000 |
附錄 F 模型超參數
本節列出本研究中訓練 MoE 與密集 transformer 所用的超參數。具體來說,表 11 回報排程的超參數,表 12 回報模型的超參數。我們也在圖 22 中展示一個無限學習率排程的範例。
表 11:學習率排程的超參數。 所有模型都使用相同的學習率排程超參數。關於這些排程更完整的說明,請讀者參閱 Ibrahim et al. (2024) 的 7.2 節。
| 說明 | 數值 |
|---|---|
| 預訓練 | |
| 排程類型 | CosineInf |
| 總迭代次數 | 192720 |
| 最大學習率 ($\eta_{\textit{max}}$) | $3\cdot 10^{-4}$ |
| 最小學習率 ($\eta_{\textit{min}}$) | $3\cdot 10^{-5}$ |
| 常數學習率 ($\eta_{\textit{const}}$) | $1.65\cdot 10^{-4}$ |
| 暖身百分比 ($T_{\textit{warmup}}$) | 1 |
| 冷卻迭代百分比 ($T_{\textit{cd}}$) | 70 |
| 常數迭代百分比 ($T_{\textit{ann}}$) | 0.10 |
| 持續預訓練 | |
| 排程類型 | CosineInf |
| 總迭代次數 | 95370 |
| 最大學習率 ($\eta_{\textit{max}}$) | $3\cdot 10^{-4}$ |
| 最小學習率 ($\eta_{\textit{min}}$) | $3\cdot 10^{-5}$ |
| 常數學習率 ($\eta_{\textit{const}}$) | $1.65\cdot 10^{-4}$ |
| 暖身百分比 ($T_{\textit{warmup}}$) | 1 |
| 冷卻迭代百分比 ($T_{\textit{cd}}$) | 0 |
| 常數迭代百分比 ($T_{\textit{ann}}$) | 80 |
| 完整重新訓練 | |
| 排程類型 | Cosine Annealing |
| 總迭代次數 | 288090 |
| 最大學習率 ($\eta_{\textit{max}}$) | $3\cdot 10^{-4}$ |
| 最小學習率 ($\eta_{\textit{min}}$) | $3\cdot 10^{-5}$ |
| 暖身百分比 ($T_{\textit{warmup}}$) | 1 |
| 持續預訓練消融(5.1 節) | |
| 排程類型 | Cosine Annealing |
| 總迭代次數 | 95370 |
| 最大學習率 ($\eta_{\textit{max}}$) | $3\cdot 10^{-4}$ |
| 最小學習率 ($\eta_{\textit{min}}$) | $3\cdot 10^{-5}$ |
| 暖身百分比 ($T_{\textit{warmup}}$) | 1 |
表 12:本研究 MoE 與密集 Transformer 的超參數。
| 說明 | 數值 |
|---|---|
| MoE Transformer 共通 | |
| 啟用參數量 | 571,148,288 |
| 總參數量 | 2,025,236,480 |
| 非嵌入層參數量 | 1,893,902,336 |
| MoE SM-FFN(Granular) | |
| 共享專家數 | 1 |
| 啟用專家數 | 3 |
| 被路由專家數 | 31 |
| 專家總數 | 32 |
| FFN 中間層維度 | 704 |
| MoE R-FFN(Switch) | |
| 共享專家數 | 0 |
| 啟用專家數 | 1 |
| 被路由專家數 | 8 |
| 專家總數 | 8 |
| FFN 中間層維度 | 2816 |
| Top-$k$ | |
| Z-loss 係數 | 0.001 |
| AUX-loss 係數 | 0.01 |
| Sinkhorn | |
| 容差 | 0.01 |
| 密集 Transformer | |
| 參數量 | 571,148,288 |
| 非嵌入層參數量 | 439,814,144 |
| 注意力頭數 | 16 |
| 共通設定 | |
| 層數 | 24 |
| 隱藏維度 | 1024 |
| FFN 隱藏維度 | 2816 |
| FFN 類型 | GeGLU |
| 優化器 | AdamW |
| $\beta_{1}$, $\beta_{2}$ | 0.9, 0.95 |
| 批次大小 | 1024 |
| 序列長度 | 2048 |
| 隱藏層激活函數 | GeLU |
| 權重衰減 | 0.1 |
| 梯度裁剪 | 1.0 |
| 衰減 | Cosine |
| 位置嵌入 | Rotary |
| GPT-J-Residual | True |
| 權重共享 (Weight tying) | False |
| 詞彙表大小 | 128000 |
| Rotary PCT | 0.25 |
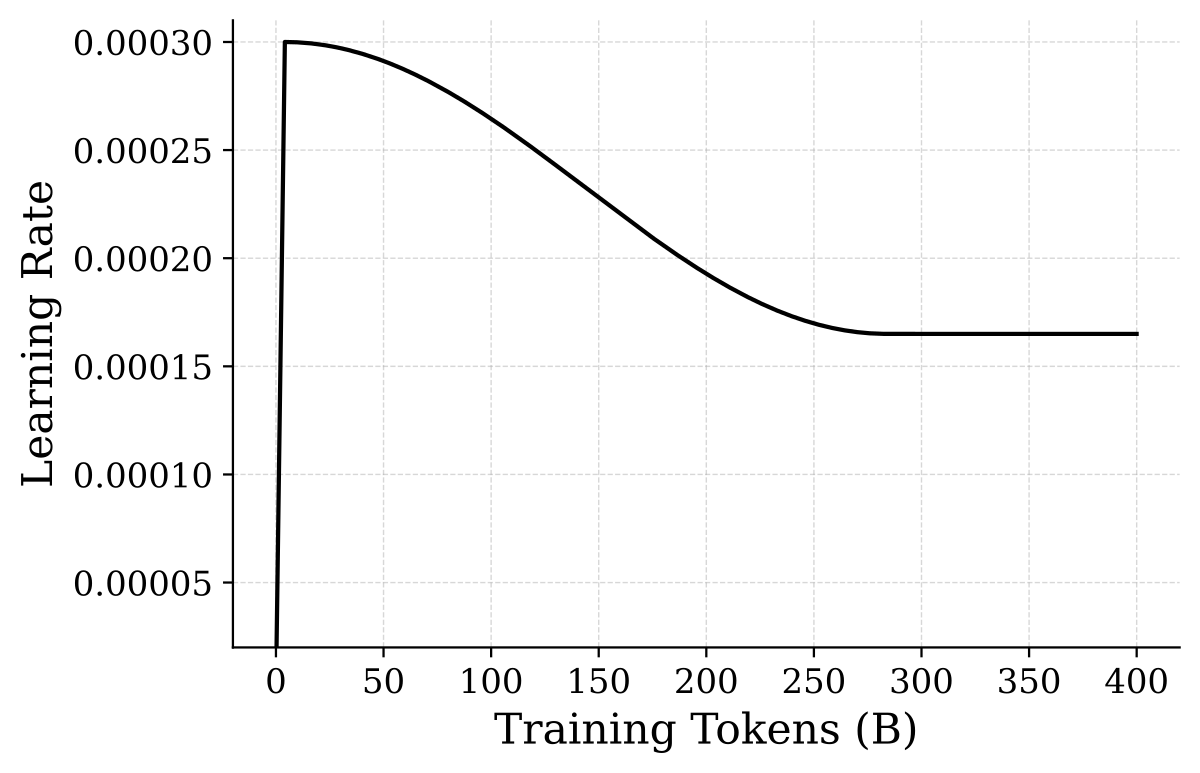
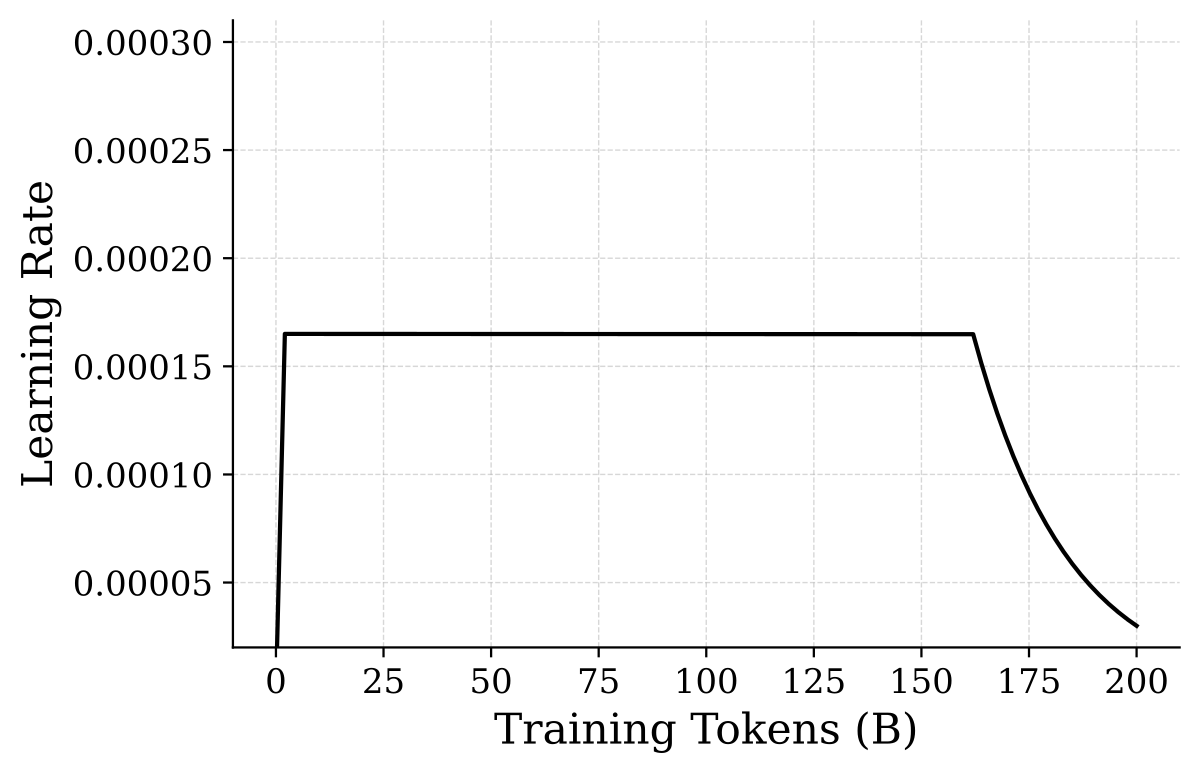
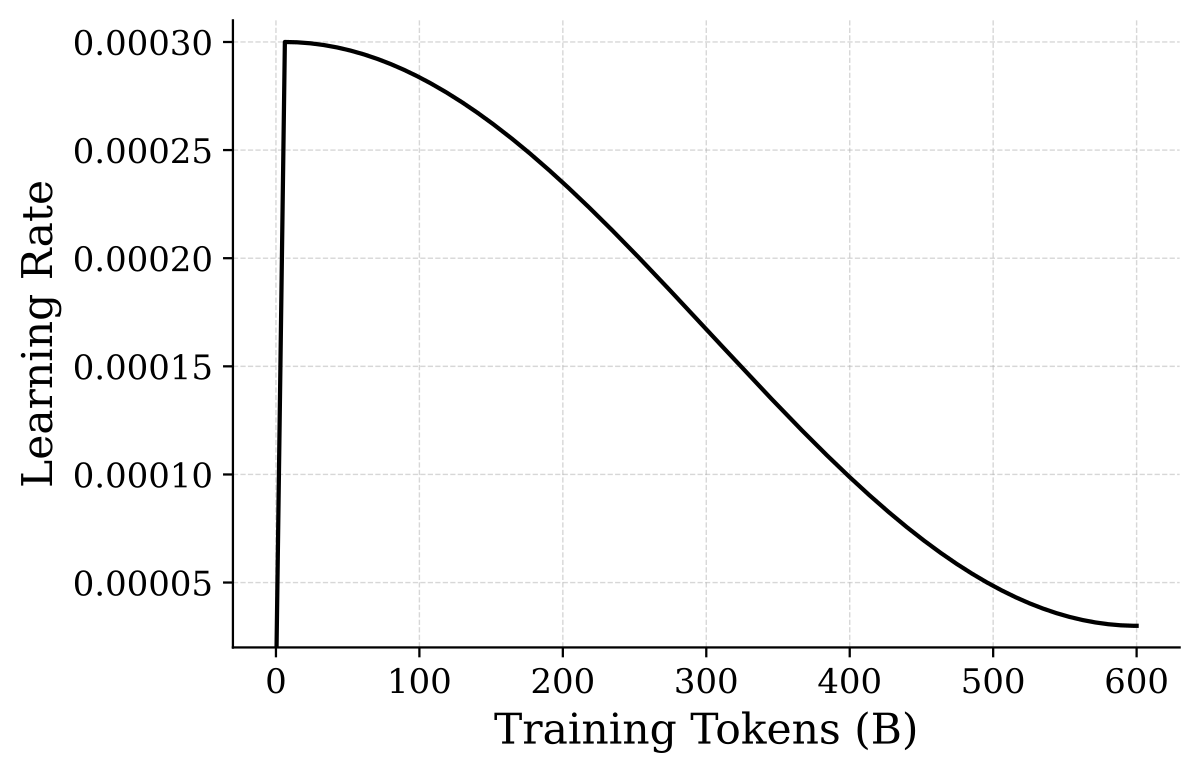
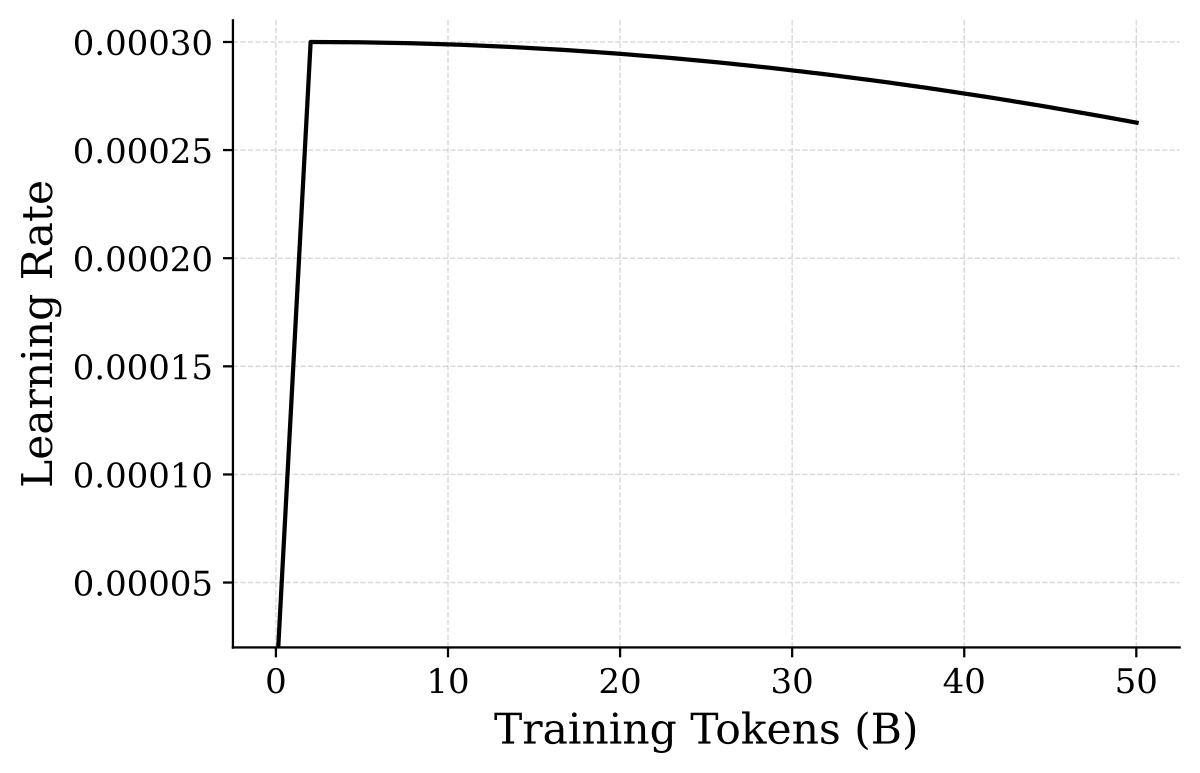
圖 22:本研究所用的學習率排程範例:(a) 預訓練、(b) 持續預訓練、(c) 完整重新訓練、(d) 5.1 節的重新暖身消融。
參考文獻
依原文順序(作者姓氏字母序)編號。原文內文採用「作者 (年份)」的引用格式,譯文保留該格式;下列編號僅供查找對照之用。
- Abadji et al. (2022) J. Abadji, P. J. O. Suárez, L. Romary, and B. Sagot Towards a cleaner document-oriented multilingual crawled corpus. In Proceedings of the Thirteenth Language Resources and Evaluation Conference, LREC 2022, Marseille, France, 20-25 June 2022, N. Calzolari, F. Béchet, P. Blache, K. Choukri, C. Cieri, T. Declerck, S. Goggi, H. Isahara, B. Maegaard, J. Mariani, H. Mazo, J. Odijk, and S. Piperidis (Eds.), pp. 4344–4355.
- Abdin et al. (2024) M. I. Abdin, S. A. Jacobs, A. A. Awan, J. Aneja, A. Awadallah, H. Awadalla, N. Bach, A. Bahree, A. Bakhtiari, H. S. Behl, A. Benhaim, M. Bilenko, J. Bjorck, S. Bubeck, M. Cai, C. C. T. Mendes, W. Chen, V. Chaudhary, P. Chopra, A. D. Giorno, G. de Rosa, M. Dixon, R. Eldan, D. Iter, A. Garg, A. Goswami, S. Gunasekar, E. Haider, J. Hao, R. J. Hewett, J. Huynh, M. Javaheripi, X. Jin, P. Kauffmann, N. Karampatziakis, D. Kim, M. Khademi, L. Kurilenko, J. R. Lee, Y. T. Lee, Y. Li, C. Liang, W. Liu, E. Lin, Z. Lin, P. Madan, A. Mitra, H. Modi, A. Nguyen, B. Norick, B. Patra, D. Perez-Becker, T. Portet, R. Pryzant, H. Qin, M. Radmilac, C. Rosset, S. Roy, O. Ruwase, O. Saarikivi, A. Saied, A. Salim, M. Santacroce, S. Shah, N. Shang, H. Sharma, X. Song, M. Tanaka, X. Wang, R. Ward, G. Wang, P. Witte, M. Wyatt, C. Xu, J. Xu, S. Yadav, F. Yang, Z. Yang, D. Yu, C. Zhang, C. Zhang, J. Zhang, L. L. Zhang, Y. Zhang, Y. Zhang, Y. Zhang, and X. Zhou Phi-3 technical report: A highly capable language model locally on your phone. CoRR abs/2404.14219.
- Amini et al. (2019) A. Amini, S. Gabriel, P. Lin, R. Koncel-Kedziorski, Y. Choi, and H. Hajishirzi MathQA: towards interpretable math word problem solving with operation-based formalisms.
- Andonian et al. (2023) GPT-NeoX: Large Scale Autoregressive Language Modeling in PyTorch
- Anthony et al. (2024) Q. Anthony, Y. Tokpanov, P. Glorioso, and B. Millidge BlackMamba: mixture of experts for state-space models. CoRR abs/2402.01771.
- Bisk et al. (2019) Y. Bisk, R. Zellers, R. L. Bras, J. Gao, and Y. Choi PIQA: reasoning about physical commonsense in natural language.
- Cai et al. (2024) W. Cai, J. Jiang, F. Wang, J. Tang, S. Kim, and J. Huang A survey on mixture of experts. CoRR abs/2407.06204.
- Chen et al. (2021) M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. de Oliveira Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, A. Ray, R. Puri, G. Krueger, M. Petrov, H. Khlaaf, G. Sastry, P. Mishkin, B. Chan, S. Gray, N. Ryder, M. Pavlov, A. Power, L. Kaiser, M. Bavarian, C. Winter, P. Tillet, F. P. Such, D. Cummings, M. Plappert, F. Chantzis, E. Barnes, A. Herbert-Voss, W. H. Guss, A. Nichol, A. Paino, N. Tezak, J. Tang, I. Babuschkin, S. Balaji, S. Jain, W. Saunders, C. Hesse, A. N. Carr, J. Leike, J. Achiam, V. Misra, E. Morikawa, A. Radford, M. Knight, M. Brundage, M. Murati, K. Mayer, P. Welinder, B. McGrew, D. Amodei, S. McCandlish, I. Sutskever, and W. Zaremba Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374.
- Chen et al. (2023) W. Chen, Y. Zhou, N. Du, Y. Huang, J. Laudon, Z. Chen, and C. Cui Lifelong language pretraining with distribution-specialized experts. In Proceedings of the 40th International Conference on Machine Learning, A. Krause, E. Brunskill, K. Cho, B. Engelhardt, S. Sabato, and J. Scarlett (Eds.), Proceedings of Machine Learning Research, Vol. 202, pp. 5383–5395.
- Clark et al. (2022) A. Clark, D. de Las Casas, A. Guy, A. Mensch, M. Paganini, J. Hoffmann, B. Damoc, B. A. Hechtman, T. Cai, S. Borgeaud, G. van den Driessche, E. Rutherford, T. Hennigan, M. J. Johnson, A. Cassirer, C. Jones, E. Buchatskaya, D. Budden, L. Sifre, S. Osindero, O. Vinyals, M. Ranzato, J. W. Rae, E. Elsen, K. Kavukcuoglu, and K. Simonyan Unified scaling laws for routed language models. In International Conference on Machine Learning, ICML 2022, 17-23 July 2022, Baltimore, Maryland, USA, K. Chaudhuri, S. Jegelka, L. Song, C. Szepesvári, G. Niu, and S. Sabato (Eds.), Proceedings of Machine Learning Research, Vol. 162, pp. 4057–4086.
- Clark et al. (2018) P. Clark, I. Cowhey, O. Etzioni, T. Khot, A. Sabharwal, C. Schoenick, and O. Tafjord Think you have solved question answering? try arc, the ai2 reasoning challenge.
- Collobert et al. (2003) R. Collobert, Y. Bengio, and S. Bengio Scaling large learning problems with hard parallel mixtures. Int. J. Pattern Recognit. Artif. Intell. 17 ( 3 ), pp. 349–365.
- Cossu et al. (2022) A. Cossu, T. Tuytelaars, A. Carta, L. Passaro, V. Lomonaco, and D. Bacciu Continual pre-training mitigates forgetting in language and vision.
- Dai et al. (2024) D. Dai, C. Deng, C. Zhao, R. X. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, Z. Xie, Y. K. Li, P. Huang, F. Luo, C. Ruan, Z. Sui, and W. Liang DeepSeekMoE: towards ultimate expert specialization in mixture-of-experts language models. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thailand, August 11-16, 2024, L. Ku, A. Martins, and V. Srikumar (Eds.), pp. 1280–1297.
- Davari et al. (2022) M. Davari, N. Asadi, S. Mudur, R. Aljundi, and E. Belilovsky Probing representation forgetting in supervised and unsupervised continual learning. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pp. 16712–16721.
- DeepSeek-AI et al. (2025a) DeepSeek-AI, D. Guo, D. Yang, H. Zhang, J. Song, R. Zhang, R. Xu, Q. Zhu, S. Ma, P. Wang, X. Bi, X. Zhang, X. Yu, Y. Wu, Z. F. Wu, Z. Gou, Z. Shao, Z. Li, Z. Gao, A. Liu, B. Xue, B. Wang, B. Wu, B. Feng, C. Lu, C. Zhao, C. Deng, C. Zhang, C. Ruan, D. Dai, D. Chen, D. Ji, E. Li, F. Lin, F. Dai, F. Luo, G. Hao, G. Chen, G. Li, H. Zhang, H. Bao, H. Xu, H. Wang, H. Ding, H. Xin, H. Gao, H. Qu, H. Li, J. Guo, J. Li, J. Wang, J. Chen, J. Yuan, J. Qiu, J. Li, J. L. Cai, J. Ni, J. Liang, J. Chen, K. Dong, K. Hu, K. Gao, K. Guan, K. Huang, K. Yu, L. Wang, L. Zhang, L. Zhao, L. Wang, L. Zhang, L. Xu, L. Xia, M. Zhang, M. Zhang, M. Tang, M. Li, M. Wang, M. Li, N. Tian, P. Huang, P. Zhang, Q. Wang, Q. Chen, Q. Du, R. Ge, R. Zhang, R. Pan, R. Wang, R. J. Chen, R. L. Jin, R. Chen, S. Lu, S. Zhou, S. Chen, S. Ye, S. Wang, S. Yu, S. Zhou, S. Pan, S. S. Li, S. Zhou, S. Wu, S. Ye, T. Yun, T. Pei, T. Sun, T. Wang, W. Zeng, W. Zhao, W. Liu, W. Liang, W. Gao, W. Yu, W. Zhang, W. L. Xiao, W. An, X. Liu, X. Wang, X. Chen, X. Nie, X. Cheng, X. Liu, X. Xie, X. Liu, X. Yang, X. Li, X. Su, X. Lin, Y. K. Li, Y. Q. Wang, Y. X. Wei, Y. Zhang, Y. Xu, Y. Li, Y. Zhao, Y. Sun, Y. Wang, Y. Yu, Y. Zhang, Y. Shi, Y. Xiong, Y. He, Y. Piao, Y. Wang, Y. Tan, Y. Ma, Y. Liu, Y. Guo, Y. Ou, Y. Wang, Y. Gong, Y. Zou, Y. He, Y. Xiong, Y. Luo, Y. You, Y. Liu, Y. Zhou, Y. X. Zhu, Y. Xu, Y. Huang, Y. Li, Y. Zheng, Y. Zhu, Y. Ma, Y. Tang, Y. Zha, Y. Yan, Z. Z. Ren, Z. Ren, Z. Sha, Z. Fu, Z. Xu, Z. Xie, Z. Zhang, Z. Hao, Z. Ma, Z. Yan, Z. Wu, Z. Gu, Z. Zhu, Z. Liu, Z. Li, Z. Xie, Z. Song, Z. Pan, Z. Huang, Z. Xu, Z. Zhang, and Z. Zhang DeepSeek-r1: incentivizing reasoning capability in llms via reinforcement learning.
- DeepSeek-AI et al. (2025b) DeepSeek-AI, A. Liu, B. Feng, B. Xue, B. Wang, B. Wu, C. Lu, C. Zhao, C. Deng, C. Zhang, C. Ruan, D. Dai, D. Guo, D. Yang, D. Chen, D. Ji, E. Li, F. Lin, F. Dai, F. Luo, G. Hao, G. Chen, G. Li, H. Zhang, H. Bao, H. Xu, H. Wang, H. Zhang, H. Ding, H. Xin, H. Gao, H. Li, H. Qu, J. L. Cai, J. Liang, J. Guo, J. Ni, J. Li, J. Wang, J. Chen, J. Chen, J. Yuan, J. Qiu, J. Li, J. Song, K. Dong, K. Hu, K. Gao, K. Guan, K. Huang, K. Yu, L. Wang, L. Zhang, L. Xu, L. Xia, L. Zhao, L. Wang, L. Zhang, M. Li, M. Wang, M. Zhang, M. Zhang, M. Tang, M. Li, N. Tian, P. Huang, P. Wang, P. Zhang, Q. Wang, Q. Zhu, Q. Chen, Q. Du, R. J. Chen, R. L. Jin, R. Ge, R. Zhang, R. Pan, R. Wang, R. Xu, R. Zhang, R. Chen, S. S. Li, S. Lu, S. Zhou, S. Chen, S. Wu, S. Ye, S. Ye, S. Ma, S. Wang, S. Zhou, S. Yu, S. Zhou, S. Pan, T. Wang, T. Yun, T. Pei, T. Sun, W. L. Xiao, W. Zeng, W. Zhao, W. An, W. Liu, W. Liang, W. Gao, W. Yu, W. Zhang, X. Q. Li, X. Jin, X. Wang, X. Bi, X. Liu, X. Wang, X. Shen, X. Chen, X. Zhang, X. Chen, X. Nie, X. Sun, X. Wang, X. Cheng, X. Liu, X. Xie, X. Liu, X. Yu, X. Song, X. Shan, X. Zhou, X. Yang, X. Li, X. Su, X. Lin, Y. K. Li, Y. Q. Wang, Y. X. Wei, Y. X. Zhu, Y. Zhang, Y. Xu, Y. Xu, Y. Huang, Y. Li, Y. Zhao, Y. Sun, Y. Li, Y. Wang, Y. Yu, Y. Zheng, Y. Zhang, Y. Shi, Y. Xiong, Y. He, Y. Tang, Y. Piao, Y. Wang, Y. Tan, Y. Ma, Y. Liu, Y. Guo, Y. Wu, Y. Ou, Y. Zhu, Y. Wang, Y. Gong, Y. Zou, Y. He, Y. Zha, Y. Xiong, Y. Ma, Y. Yan, Y. Luo, Y. You, Y. Liu, Y. Zhou, Z. F. Wu, Z. Z. Ren, Z. Ren, Z. Sha, Z. Fu, Z. Xu, Z. Huang, Z. Zhang, Z. Xie, Z. Zhang, Z. Hao, Z. Gou, Z. Ma, Z. Yan, Z. Shao, Z. Xu, Z. Wu, Z. Zhang, Z. Li, Z. Gu, Z. Zhu, Z. Liu, Z. Li, Z. Xie, Z. Song, Z. Gao, and Z. Pan DeepSeek-v3 technical report.
- DeepSeek-AI et al. (2024) DeepSeek-AI, Q. Zhu, D. Guo, Z. Shao, D. Yang, P. Wang, R. Xu, Y. Wu, Y. Li, H. Gao, S. Ma, W. Zeng, X. Bi, Z. Gu, H. Xu, D. Dai, K. Dong, L. Zhang, Y. Piao, Z. Gou, Z. Xie, Z. Hao, B. Wang, J. Song, D. Chen, X. Xie, K. Guan, Y. You, A. Liu, Q. Du, W. Gao, X. Lu, Q. Chen, Y. Wang, C. Deng, J. Li, C. Zhao, C. Ruan, F. Luo, and W. Liang DeepSeek-coder-v2: breaking the barrier of closed-source models in code intelligence. CoRR abs/2406.11931.
- Du et al. (2024) X. Du, T. Gunter, X. Kong, M. Lee, Z. Wang, A. Zhang, N. Du, and R. Pang Revisiting moe and dense speed-accuracy comparisons for LLM training. CoRR abs/2405.15052.
- Dubey et al. (2024) A. Dubey, A. Jauhri, A. Pandey, A. Kadian, A. Al-Dahle, A. Letman, A. Mathur, A. Schelten, A. Yang, A. Fan, A. Goyal, A. Hartshorn, A. Yang, A. Mitra, A. Sravankumar, A. Korenev, A. Hinsvark, A. Rao, A. Zhang, A. Rodriguez, A. Gregerson, A. Spataru, B. Rozière, B. Biron, B. Tang, B. Chern, C. Caucheteux, C. Nayak, C. Bi, C. Marra, C. McConnell, C. Keller, C. Touret, C. Wu, C. Wong, C. C. Ferrer, C. Nikolaidis, D. Allonsius, D. Song, D. Pintz, D. Livshits, D. Esiobu, D. Choudhary, D. Mahajan, D. Garcia-Olano, D. Perino, D. Hupkes, E. Lakomkin, E. AlBadawy, E. Lobanova, E. Dinan, E. M. Smith, F. Radenovic, F. Zhang, G. Synnaeve, G. Lee, G. L. Anderson, G. Nail, G. Mialon, G. Pang, G. Cucurell, H. Nguyen, H. Korevaar, H. Xu, H. Touvron, I. Zarov, I. A. Ibarra, I. M. Kloumann, I. Misra, I. Evtimov, J. Copet, J. Lee, J. Geffert, J. Vranes, J. Park, J. Mahadeokar, J. Shah, J. van der Linde, J. Billock, J. Hong, J. Lee, J. Fu, J. Chi, J. Huang, J. Liu, J. Wang, J. Yu, J. Bitton, J. Spisak, J. Park, J. Rocca, J. Johnstun, J. Saxe, J. Jia, K. V. Alwala, K. Upasani, K. Plawiak, K. Li, K. Heafield, K. Stone, and et al. The llama 3 herd of models. CoRR abs/2407.21783.
- Fedus et al. (2022) W. Fedus, B. Zoph, and N. Shazeer Switch transformers: scaling to trillion parameter models with simple and efficient sparsity. J. Mach. Learn. Res. 23, pp. 120:1–120:39.
- French (1999) R. M. French Catastrophic forgetting in connectionist networks. Trends in Cognitive Sciences 3 ( 4 ), pp. 128–135.
- Gale et al. (2023) T. Gale, D. Narayanan, C. Young, and M. Zaharia MegaBlocks: Efficient Sparse Training with Mixture-of-Experts. Proceedings of Machine Learning and Systems 5.
- Garg et al. (2023) S. Garg, M. Farajtabar, H. Pouransari, R. Vemulapalli, S. Mehta, O. Tuzel, V. Shankar, and F. Faghri Tic-clip: continual training of clip models. arXiv preprint arXiv:2310.16226.
- Gritsch et al. (2024) N. Gritsch, Q. Zhang, A. Locatelli, S. Hooker, and A. Üstün Nexus: specialization meets adaptability for efficiently training mixture of experts.
- Gupta et al. (2023) K. Gupta, B. Thérien, A. Ibrahim, M. L. Richter, Q. G. Anthony, E. Belilovsky, I. Rish, and T. Lesort Continual pre-training of large language models: how to re-warm your model?. In Workshop on Efficient Systems for Foundation Models @ ICML2023,
- He (2024) X. O. He Mixture of A million experts. CoRR abs/2407.04153.
- Hoffmann et al. (2022) J. Hoffmann, S. Borgeaud, A. Mensch, E. Buchatskaya, T. Cai, E. Rutherford, D. de Las Casas, L. A. Hendricks, J. Welbl, A. Clark, T. Hennigan, E. Noland, K. Millican, G. van den Driessche, B. Damoc, A. Guy, S. Osindero, K. Simonyan, E. Elsen, J. W. Rae, O. Vinyals, and L. Sifre Training compute-optimal large language models. CoRR abs/2203.15556.
- Ibrahim et al. (2024) A. Ibrahim, B. Thérien, K. Gupta, M. L. Richter, Q. G. Anthony, E. Belilovsky, T. Lesort, and I. Rish Simple and scalable strategies to continually pre-train large language models. Transactions on Machine Learning Research. Note:
- Jacobs et al. (1991) R. A. Jacobs, M. I. Jordan, S. J. Nowlan, and G. E. Hinton Adaptive mixtures of local experts. Neural Comput. 3 ( 1 ), pp. 79–87.
- Janson et al. (2025) P. Janson, V. Singh, P. Mehrbod, A. Ibrahim, I. Rish, E. Belilovsky, and B. Thérien Beyond cosine decay: on the effectiveness of infinite learning rate schedule for continual pre-training. arXiv preprint arXiv:2503.02844.
- Jiang et al. (2024) A. Q. Jiang, A. Sablayrolles, A. Roux, A. Mensch, B. Savary, C. Bamford, D. S. Chaplot, D. de Las Casas, E. B. Hanna, F. Bressand, G. Lengyel, G. Bour, G. Lample, L. R. Lavaud, L. Saulnier, M. Lachaux, P. Stock, S. Subramanian, S. Yang, S. Antoniak, T. L. Scao, T. Gervet, T. Lavril, T. Wang, T. Lacroix, and W. E. Sayed Mixtral of experts. CoRR abs/2401.04088.
- Jin et al. (2019) Q. Jin, B. Dhingra, Z. Liu, W. Cohen, and X. Lu PubMedQA: a dataset for biomedical research question answering. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP), pp. 2567–2577.
- Johannes Welbl (2017) M. G. Johannes Welbl Crowdsourcing multiple choice science questions. arXiv:1707.06209v1.
- Joshi et al. (2017) M. Joshi, E. Choi, D. Weld, and L. Zettlemoyer TriviaQA: a large scale distantly supervised challenge dataset for reading comprehension. In Proceedings of the 55th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), R. Barzilay and M. Kan (Eds.), Vancouver, Canada, pp. 1601–1611.
- Knopp and Sinkhorn (1967) P. Knopp and R. Sinkhorn Concerning nonnegative matrices and doubly stochastic matrices.. Pacific Journal of Mathematics 21 ( 2 ), pp. 343 – 348.
- Kocetkov et al. (2023) D. Kocetkov, R. Li, L. B. Allal, J. Li, C. Mou, Y. Jernite, M. Mitchell, C. M. Ferrandis, S. Hughes, T. Wolf, D. Bahdanau, L. von Werra, and H. de Vries The stack: 3 TB of permissively licensed source code. Trans. Mach. Learn. Res. 2023.
- Komatsuzaki et al. (2023) A. Komatsuzaki, J. Puigcerver, J. Lee-Thorp, C. R. Ruiz, B. Mustafa, J. Ainslie, Y. Tay, M. Dehghani, and N. Houlsby Sparse upcycling: training mixture-of-experts from dense checkpoints. In The Eleventh International Conference on Learning Representations, ICLR 2023, Kigali, Rwanda, May 1-5, 2023,
- Lepikhin et al. (2021) D. Lepikhin, H. Lee, Y. Xu, D. Chen, O. Firat, Y. Huang, M. Krikun, N. Shazeer, and Z. Chen GShard: scaling giant models with conditional computation and automatic sharding. In 9th International Conference on Learning Representations, ICLR 2021, Virtual Event, Austria, May 3-7, 2021,
- Lewis et al. (2021) M. Lewis, S. Bhosale, T. Dettmers, N. Goyal, and L. Zettlemoyer BASE layers: simplifying training of large, sparse models. In Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, M. Meila and T. Zhang (Eds.), Proceedings of Machine Learning Research, Vol. 139, pp. 6265–6274.
- Liu et al. (2023a) L. Liu, J. Gao, and W. Chen Sparse backpropagation for moe training. CoRR abs/2310.00811.
- Liu et al. (2024) L. Liu, Y. J. Kim, S. Wang, C. Liang, Y. Shen, H. Cheng, X. Liu, M. Tanaka, X. Wu, W. Hu, V. Chaudhary, Z. Lin, C. Zhang, J. Xue, H. Awadalla, J. Gao, and W. Chen GRIN: gradient-informed moe. CoRR abs/2409.12136.
- Liu et al. (2023b) Z. Liu, T. Dettmers, X. Lin, V. Stoyanov, and X. Li Towards A unified view of sparse feed-forward network in pretraining large language model. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapore, December 6-10, 2023, H. Bouamor, J. Pino, and K. Bali (Eds.), pp. 15038–15061.
- Lopez-Paz and Ranzato (2017) D. Lopez-Paz and M. Ranzato Gradient episodic memory for continual learning. In Advances in Neural Information Processing Systems 30: Annual Conference on Neural Information Processing Systems 2017, December 4-9, 2017, Long Beach, CA, USA, I. Guyon, U. von Luxburg, S. Bengio, H. M. Wallach, R. Fergus, S. V. N. Vishwanathan, and R. Garnett (Eds.), pp. 6467–6476.
- Loshchilov and Hutter (2017) I. Loshchilov and F. Hutter SGDR: stochastic gradient descent with warm restarts. In 5th International Conference on Learning Representations, ICLR 2017, Toulon, France, April 24-26, 2017, Conference Track Proceedings,
- Ludziejewski et al. (2024) J. Ludziejewski, J. Krajewski, K. Adamczewski, M. Pióro, M. Krutul, S. Antoniak, K. Ciebiera, K. Król, T. Odrzygózdz, P. Sankowski, M. Cygan, and S. Jaszczur Scaling laws for fine-grained mixture of experts. In Forty-first International Conference on Machine Learning, ICML 2024, Vienna, Austria, July 21-27, 2024,
- Mehta et al. (2023) S. V. Mehta, D. Patil, S. Chandar, and E. Strubell An empirical investigation of the role of pre-training in lifelong learning. J. Mach. Learn. Res. 24, pp. 214:1–214:50.
- Mirzadeh et al. (2022) S. Mirzadeh, A. Chaudhry, D. Yin, H. Hu, R. Pascanu, D. Görür, and M. Farajtabar Wide neural networks forget less catastrophically. In International Conference on Machine Learning, ICML 2022, 17-23 July 2022, Baltimore, Maryland, USA, K. Chaudhuri, S. Jegelka, L. Song, C. Szepesvári, G. Niu, and S. Sabato (Eds.), Proceedings of Machine Learning Research, Vol. 162, pp. 15699–15717.
- Muennighoff et al. (2024) N. Muennighoff, L. Soldaini, D. Groeneveld, K. Lo, J. Morrison, S. Min, W. Shi, P. Walsh, O. Tafjord, N. Lambert, Y. Gu, S. Arora, A. Bhagia, D. Schwenk, D. Wadden, A. Wettig, B. Hui, T. Dettmers, D. Kiela, A. Farhadi, N. A. Smith, P. W. Koh, A. Singh, and H. Hajishirzi OLMoE: open mixture-of-experts language models. CoRR abs/2409.02060.
- Panda et al. (2024) A. Panda, V. Baherwani, Z. Sarwar, B. Thérien, S. Rawls, S. Sahu, S. Chakraborty, and T. Goldstein Dense backpropagation improves routing for sparsely-gated mixture-of-experts. In Workshop on Machine Learning and Compression, NeurIPS 2024,
- Parmar et al. (2024) J. Parmar, S. Satheesh, M. Patwary, M. Shoeybi, and B. Catanzaro Reuse, don’t retrain: A recipe for continued pretraining of language models. CoRR abs/2407.07263.
- Penedo et al. (2024) G. Penedo, H. Kydlícek, L. B. Allal, A. Lozhkov, M. Mitchell, C. Raffel, L. von Werra, and T. Wolf The fineweb datasets: decanting the web for the finest text data at scale. CoRR abs/2406.17557.
- Plüster (2023) B. Plüster German Benchmark Datasets.
- Rae et al. (2021) J. W. Rae, K. Millican, S. M. Jayakumar, D. Menick, A. Berglund, T. Hennigan, R. Ring, M. Korpusik, M. Hechtman, J. Hilton, J. S. Garcıa, J. Norman, S. Borgeaud, T. Cai, J. Hoffmann, K. Krawczyk, A. Mensch, T. Scialom, E. Alford, J. D. L. Ho, D. Hesslow, T. Gunter, J. Phang, B. Millidge, F. Yang, M. Lachaux, L. de Souza Schmerling, N. McAleese, H. Khlaaf, S. Osindero, O. Vinyals, K. Hausman, L. Sifre, A. M. Dai, G. Irving, M. C. Mozer, J. Dean, and K. Kavukcuoglu Scaling language models: methods, analysis & insights from training gopher. arXiv preprint arXiv:2112.11446.
- Rajbhandari et al. (2022) S. Rajbhandari, C. Li, Z. Yao, M. Zhang, R. Y. Aminabadi, A. A. Awan, J. Rasley, and Y. He DeepSpeed-moe: advancing mixture-of-experts inference and training to power next-generation AI scale. In International Conference on Machine Learning, ICML 2022, 17-23 July 2022, Baltimore, Maryland, USA, K. Chaudhuri, S. Jegelka, L. Song, C. Szepesvári, G. Niu, and S. Sabato (Eds.), Proceedings of Machine Learning Research, Vol. 162, pp. 18332–18346.
- Rajbhandari et al. (2020) S. Rajbhandari, J. Rasley, O. Ruwase, and Y. He ZeRO: memory optimizations toward training trillion parameter models. In Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, SC 2020, Virtual Event / Atlanta, Georgia, USA, November 9-19, 2020, C. Cuicchi, I. Qualters, and W. T. Kramer (Eds.), pp. 20.
- Ramasesh et al. (2022) V. V. Ramasesh, A. Lewkowycz, and E. Dyer Effect of scale on catastrophic forgetting in neural networks. In The Tenth International Conference on Learning Representations, ICLR 2022, Virtual Event, April 25-29, 2022,
- Roller et al. (2021) S. Roller, S. Sukhbaatar, A. Szlam, and J. Weston Hash layers for large sparse models. In Advances in Neural Information Processing Systems 34: Annual Conference on Neural Information Processing Systems 2021, NeurIPS 2021, December 6-14, 2021, virtual, M. Ranzato, A. Beygelzimer, Y. N. Dauphin, P. Liang, and J. W. Vaughan (Eds.), pp. 17555–17566.
- Sakaguchi et al. (2019) K. Sakaguchi, R. L. Bras, C. Bhagavatula, and Y. Choi WinoGrande: an adversarial winograd schema challenge at scale.
- Scialom et al. (2022) T. Scialom, T. Chakrabarty, and S. Muresan Fine-tuned language models are continual learners. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, pp. 6107–6122.
- Shazeer et al. (2017) N. Shazeer, A. Mirhoseini, K. Maziarz, A. Davis, Q. V. Le, G. E. Hinton, and J. Dean Outrageously large neural networks: the sparsely-gated mixture-of-experts layer. In 5th International Conference on Learning Representations, ICLR 2017, Toulon, France, April 24-26, 2017, Conference Track Proceedings,
- Shen et al. (2024) Y. Shen, Z. Guo, T. Cai, and Z. Qin JetMoE: reaching llama2 performance with 0.1m dollars. CoRR abs/2404.07413.
- Storks et al. (2019) S. Storks, Q. Gao, and J. Y. Chai Recent advances in natural language inference: a survey of benchmarks, resources, and approaches. arXiv: Computation and Language.
- Sukhbaatar et al. (2024) S. Sukhbaatar, O. Golovneva, V. Sharma, H. Xu, X. V. Lin, B. Rozière, J. Kahn, D. Li, W. Yih, J. Weston, and X. Li Branch-train-mix: mixing expert llms into a mixture-of-experts LLM. CoRR abs/2403.07816.
- Team (2024) Q. Team Qwen1.5-moe: matching 7b model performance with 1/3 activated parameters".
- Wang et al. (2024a) L. Wang, H. Gao, C. Zhao, X. Sun, and D. Dai Auxiliary-loss-free load balancing strategy for mixture-of-experts. CoRR abs/2408.15664.
- Wang et al. (2024b) L. Wang, X. Zhang, H. Su, and J. Zhu A comprehensive survey of continual learning: theory, method and application. IEEE Trans. Pattern Anal. Mach. Intell. 46 ( 8 ), pp. 5362–5383.
- Wang et al. (2024c) Z. Wang, D. Chen, D. Dai, R. Xu, Z. Li, and Y. Wu Let the expert stick to his last: expert-specialized fine-tuning for sparse architectural large language models. CoRR abs/2407.01906.
- Zellers et al. (2018) R. Zellers, Y. Bisk, R. Schwartz, and Y. Choi SWAG: A large-scale adversarial dataset for grounded commonsense inference. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, Brussels, Belgium, October 31 - November 4, 2018, E. Riloff, D. Chiang, J. Hockenmaier, and J. Tsujii (Eds.), pp. 93–104.
- Zellers et al. (2019) R. Zellers, A. Holtzman, Y. Bisk, A. Farhadi, and Y. Choi HellaSwag: can a machine really finish your sentence?.
- Zhang et al. (2022) X. Zhang, Y. Shen, Z. Huang, J. Zhou, W. Rong, and Z. Xiong Mixture of attention heads: selecting attention heads per token. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, Y. Goldberg, Z. Kozareva, and Y. Zhang (Eds.), Abu Dhabi, United Arab Emirates.
- Zhao et al. (2025) C. Zhao, S. Zhou, L. Zhang, C. Deng, Z. Xu, Y. Liu, K. Yu, J. Li, and L. Zhao DeepEP: an efficient expert-parallel communication library. GitHub. Note: github.com/deepseek-ai/DeepEP
- Zhou et al. (2022) Y. Zhou, T. Lei, H. Liu, N. Du, Y. Huang, V. Y. Zhao, A. M. Dai, Z. Chen, Q. V. Le, and J. Laudon Mixture-of-experts with expert choice routing. In Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, New Orleans, LA, USA, November 28 - December 9, 2022, S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, and A. Oh (Eds.),
- Zhu et al. (2024) T. Zhu, X. Qu, D. Dong, J. Ruan, J. Tong, C. He, and Y. Cheng LLaMA-moe: building mixture-of-experts from llama with continual pre-training. CoRR abs/2406.16554.
- Zoph et al. (2022) B. Zoph, I. Bello, S. Kumar, N. Du, Y. Huang, J. Dean, N. Shazeer, and W. Fedus ST-moe: designing stable and transferable sparse expert models. CoRR.
術語對照表
| English | 繁體中文 |
|---|---|
| Adaptation | 適應 |
| Auxiliary Loss (Aux Loss) | 輔助損失 |
| Backward Transfer | 反向遷移 |
| Batch Size | 批次大小 |
| Catastrophic Forgetting | 災難性遺忘 |
| Checkpoint | 檢查點 |
| Chinchilla Optimal | Chinchilla 最佳(計算最佳) |
| Co-activation Difference | 共同啟用差異 |
| Compute Equivalent Replay | 計算量對等的重播 |
| Continual Learning | 持續學習 |
| Continual Pre-training (CPT) | 持續預訓練 |
| Continual Router Saturation | 持續路由器飽和度 |
| Continual Vocabulary Specialization (CVS) | 持續詞彙專精化 |
| Dense Transformer | 密集 transformer |
| Distribution Shift | 分布偏移 |
| Expert | 專家 |
| Expert Choice Routing (ECR) | 專家選擇式路由 |
| Expert Co-activation | 專家共同啟用 |
| Expert Parallelism | 專家平行化 |
| Feed Forward Network (FFN) | 前饋網路 |
| FLOP-matched | FLOP 對齊 |
| Forgetting | 遺忘 |
| Gradient Clipping | 梯度裁剪 |
| Granular Expert | 細粒度專家 |
| Hidden Dimension | 隱藏維度 |
| Indicator Function | 指示函數 |
| Infinite Learning Rate Schedule | 無限學習率排程 |
| Linear Assignment Problem | 線性指派問題 |
| Load Balancing | 負載平衡 |
| Log Perplexity | 對數困惑度 |
| Maximum Routing Imbalance (MRI) | 最大路由不平衡度 |
| Mixture of Experts (MoE) | 混合專家 |
| Non-Embedding Parameters | 非嵌入層參數 |
| Optimal Transport | 最佳傳輸 |
| Overtraining | 過度訓練 |
| Parameter-Efficient Fine-tuning (PEFT) | 參數高效微調 |
| Penalty-Balanced Top-$k$ (PBT$k$) | 懲罰式平衡 Top-$k$ |
| Positional Embedding | 位置嵌入 |
| Re-decaying | 重新衰減 |
| Replay | 重播 |
| Re-warming | 重新暖身 |
| Router | 路由器 |
| Router Saturation (RS) | 路由器飽和度 |
| Routing Algorithm | 路由演算法 |
| Sample Efficiency | 樣本效率 |
| Shared Expert | 共享專家 |
| Sinkhorn-Balanced Top-$k$ (SBT$k$) | Sinkhorn 平衡式 Top-$k$ |
| Sparsely-activated | 稀疏啟用 |
| Supervised Fine-tuning | 監督式微調 |
| Token Dropping | 丟棄 token |
| Upcycling | 升級再造 |
| Validation Loss | 驗證損失 |
| Vocabulary Specialization (VS) | 詞彙專精化 |
| Weight Decay | 權重衰減 |
| Weight Tying | 權重共享 |
| z-loss | z-loss(路由器 logit 懲罰項) |