模型自適應的工具必要性揭示了 LLM 工具使用中的「知行落差」
原始論文:Model-Adaptive Tool Necessity Reveals the Knowing-Doing Gap in LLM Tool Use 作者:Yize Cheng, Chenrui Fan, Mahdi JafariRaviz, Keivan Rezaei, Soheil Feizi(University of Maryland, College Park) arXiv ID:2605.14038v2 日期:2026-05-17 標籤:LLM Tool Use Agent Probing Meta-cognition Interpretability 知行落差
目錄
- 摘要
- 1 引言
- 2 相關工作
- 3 定義模型自適應的工具必要性與工具呼叫的兩階段建模
- 4 資料集建構
- 5 從後設認知到執行能力:到底出了什麼問題?
- 6 結論
- 參考文獻
- 附錄 A 算術資料集建構的更多細節
- 附錄 B 以顯式提示引出對工具必要性的口語化信念
- 附錄 C 限制
- 術語對照表
摘要
大型語言模型 (Large Language Models, LLMs) 正越來越多地扮演自主代理人 (autonomous agent) 的角色,必須決定何時直接作答、何時呼叫外部工具。先前研究自適應工具使用 (adaptive tool use) 的工作,大多把工具必要性 (tool necessity) 當成一個與模型無關 (model-agnostic) 的屬性,由人類或 LLM 評審 (LLM judge) 來標註,而且大多只涵蓋答案顯而易見的情況(例如抓取天氣資訊相對於改寫文字)。然而,真實世界中的工具必要性其實更加微妙,因為不同模型的能力邊界 (capability boundary) 彼此分歧:一個強模型能靠自己解決的問題,對較弱的模型而言可能仍然需要工具。
在這項工作中,我們提出一個模型自適應 (model-adaptive) 的工具必要性定義,奠基於每個模型的實證表現 (empirical performance)。依循這個定義,我們在算術 (arithmetic) 與事實型問答 (factual QA) 資料集上,跨四個模型比較了必要性與觀察到的工具呼叫行為,發現分別存在 26.5–54.0% 與 30.8–41.8% 的顯著落差。為了診斷此一失敗,我們把工具使用拆解成兩個階段:一個內部認知 (cognition) 階段,反映模型是否「相信」工具是必要的;以及一個執行 (execution) 階段,決定模型是否真的做出工具呼叫的動作。透過探測 (probing) LLM 的隱藏狀態 (hidden state),我們發現這兩種訊號往往都是線性可解碼 (linearly decodable) 的,然而它們的探針方向 (probe direction) 在驅動下一個 token 動作的「晚期層、末位 token」區域中卻變得近乎正交 (orthogonal)。透過追蹤樣本在這個兩階段流程中的軌跡,我們進一步發現大多數的落差集中在「從認知到行動」的轉換上,而非認知本身。這些結果揭示了 LLM 工具使用中的一道知行落差 (knowing-doing gap):要提升工具使用的可靠性,不僅需要更好地辨識何時需要工具,更需要把這份辨識轉化為實際行動。
1 引言
大型語言模型 (LLMs) 越來越多地被部署為自主代理人,與搜尋引擎、計算機、API 等外部工具互動 [20, 24, 26, 19]。建構可靠的自主 LLM 代理人的一個核心挑戰,是達成自適應工具使用:LLM 需要判斷何時該倚賴這些工具、何時該直接作答 [8, 22, 27]。先前研究自適應工具使用的工作 [8, 22, 13] 大多把工具必要性當成一個靜態、與模型無關的屬性,通常仰賴人類標註者或強大的 LLM 評審來判斷一個查詢是否需要工具,且主要聚焦於答案顯而易見的兩極化案例,例如抓取即時天氣資料相對於改寫一段靜態段落。
然而,真實世界中的工具必要性本質上更為微妙,這源自不同模型之間能力邊界的自然分歧。一個最先進模型僅靠其內部權重就能輕鬆解決的問題,可能完全超出較小型或能力較弱模型的能力範圍,因而使得工具使用對後者而言嚴格必要,對前者卻是多餘的。
在這項工作中,我們主張工具必要性必須與所討論模型的特定能力本質地綁定。我們提出一個模型自適應的工具必要性定義,它不是奠基於靜態標註,而是奠基於每一個模型自身的實證表現。透過相對於模型內在能力來評估必要性,我們為「一個特定 LLM 何時應該尋求外部協助」建立了更準確的刻劃。依循這個定義,我們在算術與事實型問答 (factual question-answering, QA) 資料集上,跨四個不同的模型比較了實際必要性與觀察到的工具呼叫行為。我們的發現揭示了顯著的落差:模型在算術任務上展現出 26.5–54.0% 的必要性-行動落差 (necessity-action mismatch),在事實型 QA 上展現出 30.8–41.8% 的必要性-行動落差,常常在自己其實能直接作答時呼叫工具,或在缺乏所需內部知識時卻試圖直接作答。
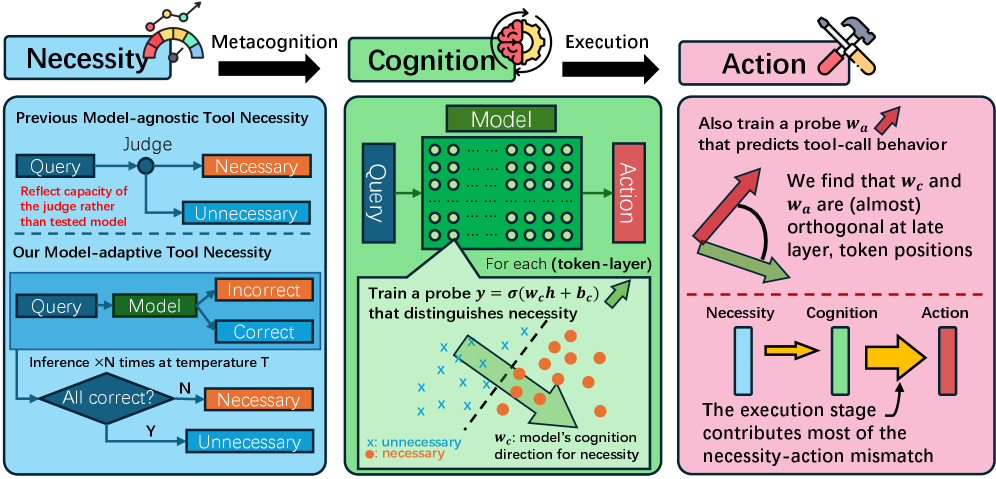
圖 1: LLM 工具使用的兩階段認知-執行建模概觀。(左)必要性 (Necessity):我們提出一個模型自適應的工具必要性定義,奠基於模型自己一致地正確回答一個查詢的實證能力,與先前與模型無關的做法形成對比。(中)認知 (Cognition):透過探測模型內部的隱藏狀態 $h$,我們辨識出一個線性的認知方向 $w_{c}$,能成功區分工具何時是必要的。(右)行動 (Action):我們也訓練一個探針 $w_{a}$ 來預測實際的工具呼叫執行。我們發現 $w_{c}$ 與 $w_{a}$ 在晚期層中變得近乎正交,且大多數的必要性-行動落差源自執行階段(把覺察轉化為行動),而非內部認知階段。
為了診斷此一失敗的底層機制,我們提出對工具使用流程的兩階段拆解:一個內部認知階段,反映模型的內部表徵是否編碼了「工具是必要的」這個信念;以及一個執行階段,決定模型是否真的輸出觸發工具的 token。建立在先前機制可解釋性 (mechanistic interpretability) 與表徵工程 (representation engineering) [35] 的進展之上,並依循近期關於自適應工具使用的文獻 [13, 28],我們探測 LLM 的隱藏狀態,發現對必要性的認知與執行的意圖往往都是線性可解碼的。然而耐人尋味的是,它們各自的探針方向在「晚期層、末位 token」的區域中卻變得近乎正交。
透過追蹤樣本在這個兩階段流程中的軌跡,我們揭示了 LLM 工具使用中的一道知行落差:觀察到的大多數必要性-行動落差案例,源自從認知到行動的轉換,而非認知階段。模型常常生成顯示出「覺察到自身侷限」的內部表徵,卻無法把這份覺察轉化為工具呼叫的語法執行。我們的主要貢獻可總結如下:
我們提出一個奠基於實證表現的模型自適應工具必要性定義,挑戰了傳統上對靜態、與模型無關標註的倚賴。
我們在算術與事實型 QA 資料集上評估四個不同的 LLM,揭示出實際工具必要性與觀察到的工具呼叫行為之間存在顯著的行為落差(高達 54.0%)。
透過把工具使用劃分為一個內部認知階段與一個執行階段,我們運用表徵探測 (representation probing) 證明:雖然意圖與必要性都是線性可解碼的,它們的探針方向在「晚期層、末位 token」的區域中卻變得近乎正交。
透過軌跡追蹤 (trajectory tracing),我們發現工具使用失敗主要發生在從認知到行動的轉換期間,凸顯出 LLM 工具使用中的一道知行落差。
2 相關工作
LLM 代理人中的工具呼叫。
為了把 LLM 的能力擴展到參數化知識 (parametric knowledge) 之外,研究者引入了函式/工具呼叫 (function/tool calling) [20, 24, 26, 19],使其能與外部資源互動並擴大任務涵蓋範圍。MCP [1] 與 A2A [6] 等標準化協定進一步精簡了工具生態系內的通訊與存取。與此同時,各種工作檢視了工具使用的準確性 [12, 21]、幻覺式呼叫 (hallucinated calls) [33, 23],以及對工具描述的穩健性 [25, 5]。然而,雖然這些努力旨在教導與評估「如何」使用工具,但在建構可靠 LLM 代理人時,一個重要且常被低估研究的挑戰是判斷「何時」使用工具。確實研究此一挑戰的既有工作 [8, 22, 13],把工具必要性當成查詢的一個靜態屬性,使用人類標註者或某個專有 (proprietary) LLM 把樣本標記為工具必要 (tool-necessary) 或工具非必要 (tool-unnecessary)。這忽略了不同模型之間能力邊界的內在差異。雖然 Wang 等人 [27] 也倡導模型相依 (model-dependent) 的工具必要性,但就我們所知,我們是第一個擁有「把工具必要性實證地奠基於特定模型實際能力」這套流程的工作。
LLM 的後設認知與「知行落差」。
LLM 準確評估自身能力邊界的能力——常被稱為後設認知 (meta-cognition) 或自我評估 (self-assessment)——一直是長久以來備受關注的主題 [10, 30]。為了衡量這種自我覺察 (self-awareness),早期工作主要仰賴衡量顯式自我評估,方法是教導模型表達其知識邊界 [2, 31] 或直接口語化信心 (verbalize confidence) [15]。然而,近期工作顯示模型口語化其內部活化 (internal activation) 的能力是有限的 [17, 9]。此外,自我評估的任務與實際解題本質上是不同的任務。當被顯式地問及其能力邊界時,模型會聚焦於自我評估;但當面對實際解題時,提示通常是任務導向 (task-oriented) 的,因而自我評估的過程變成隱式且潛意識的。這類似於系統一 (system I) 與系統二 (system II) 思考之間的區別 [14]。因此,在這項工作中,我們依循一些近期使用內部狀態探測 (internal state probing) 來衡量模型對工具必要性認知的工作 [13, 28],並在附錄 B 中也實證地展示當被顯式提示進行自我評估時,模型的工具呼叫行為如何改變。
與此同時,LLM 其他領域中利用隱藏狀態研究模型內部認知的論文發現,模型的行動可能會偏離其內部信念。例如,Zhao 等人 [34] 發現 LLM 可能在內部辨識出有害查詢的有害性後,仍未能拒絕;Zhang 等人 [32] 顯示模型可以在內部辨識出自己無法解決某些數學問題,卻仍在無建設性的推理上耗費 token。在這項工作中,我們顯示這種「知行落差」同樣存在於工具呼叫中,而且它甚至可以構成端到端 (end-to-end) 錯誤中更大的比例。
3 定義模型自適應的工具必要性與工具呼叫的兩階段建模
為了研究 LLM 中的工具使用行為,我們引入一個簡單的拆解,把「辨識出對工具的需求」與「對這份辨識採取行動」分開。這個區分將作為本文其餘部分評估、診斷與分析的基礎。
定義模型自適應的工具必要性。
既有工作通常假設一個固定的工具必要性概念,為每個查詢指派一個獨立於被評估模型的靜態標籤。然而,我們主張,既然不同模型有不同的能力邊界,工具必要性標籤就應該隨模型而自適應。為了刻劃一個模型的能力邊界,給定一個模型 $f$ 與查詢 $x$,我們在溫度 (temperature) $T$ 下,在沒有外部工具存取的情況下執行 $N$ 次獨立的推論 (inference)。如果模型 $f$ 能在 $N$ 次執行中一致地正確解決問題 $x$,我們就假設這個 $x$ 落在 $f$ 的能力邊界之內,因此工具必要性 $n_{f}(x)$ 為 $0$。否則,模型無法可靠地解決這個查詢,因此 $n_{f}(x)$ 為 $1$。參數 $N$ 與 $T$ 控制了這個準則的嚴格程度。具體而言,較大的 $N$ 與 $T$ 值會產生對「一個查詢是否真正落在模型能力邊界之內」更保守且更穩健的估計,因為它們要求模型更一致地輸出正確答案。
這個公式化捕捉了真實世界部署的一個關鍵面向:不確定性下的可靠性 (reliability under uncertainty)。在實務場景中,一個沒有工具時只能偶爾產生正確答案的模型,仍可能受益於外部協助以確保表現的一致性。透過把工具必要性奠基於實證行為而非靜態標註,我們的做法為「對某個給定模型而言,何時工具使用是真正必要的」提供了更忠實的刻劃。
工具呼叫的認知-執行建模。
我們把工具使用概念化為一個兩階段流程:
$$x\rightarrow z_{f}(x)\rightarrow a_{f}(z_{f}(x)), \tag{1}$$
其中 $z_{f}(x)$ 代表模型對「是否需要工具」的內部認知,而 $a_{f}(z_{f}(x))$ 代表模型是否真的基於其認知去呼叫工具。這個兩階段拆解映照了人類的認知過程,以及我們對模型所期望的樣貌。它區分了後設認知——模型對其能力邊界的內部信念,以及執行能力——模型如何基於其認知採取行動。
端到端錯誤診斷。
在我們的模型相依工具必要性定義 $n_{f}(x)$ 與如 Equation 1 的兩階段建模之下,我們可以把端到端的必要性-行動落差 $D(n_{f}(x),a_{f}(z_{f}(x)))$ 拆解為:實際必要性與認知之間的落差 $D(n_{f}(x),z_{f}(x))$,以及模型認知與實際決策之間的落差 $D(z_{f}(x),a_{f}(z_{f}(x))$,其中 $D(m,n)$ 表示 $m$ 與 $n$ 之間的差異。
4 資料集建構
我們涵蓋兩個具代表性的領域:數學算術與事實型問答,使用兩個被廣泛採用的模型家族:Qwen3-8B 與 Qwen3-4B [29],以及 Llama-3.1-8B-Instruct 與 Llama-3.2-3B-Instruct [7]。這些領域提供了天然的測試平台,其中有些查詢可以由模型獨力可靠地解決,而另一些則可能需要外部協助(亦即算術任務用計算機、事實型查詢用搜尋 API)。對於數學算術資料集,我們混合了在表面形式 (surface form) 與實際難度上都各異的問題類型。它包含簡單的一步與兩步加減法問題,以及涉及多位數乘法、取模 (modulo)、括號、運算子優先序 (operator precedence) 與較長加減法鏈的較難範例,總共 4,000 個實例。這給了我們從非常簡單到極度困難、涵蓋一系列難度等級的問題,使我們能衡量模型的能力邊界。關於我們算術資料集建構的更多細節可在附錄 A 中找到。對於事實型問答,我們採用 TruthfulQA [16],這是一個被廣泛使用、含 817 個實例、設計用來評估語言模型事實可靠性的資料集。
4.1 把工具必要性奠基於模型特定的能力邊界
我們依循第 3 節的定義,在溫度 $T=0.7$ 下執行 $N=10$ 次無外部工具存取的獨立推論。對於某個特定模型,我們把至少失敗一次的樣本計為工具必要,而把在全部 $N=10$ 次執行中一致給出正確答案的樣本計為工具非必要。圖 2 顯示不同模型有顯著不同的能力邊界,這些邊界會被與模型無關的工具必要性定義所掩蓋。具體而言,第一列中乾淨的邊界是由我們的排序程序所造成的,而跨列之間的紅綠分歧則顯示同一組樣本可以落在不同模型能力邊界的不同側。這個模式在算術與事實型問答中都會出現,顯示工具必要性不僅取決於任務類型或資料集歸屬,也取決於所部署的特定模型。這促使我們在評估工具使用判斷與下游呼叫行為時,使用 $n_{f}(x)$ 而非單一的全域必要性標籤。
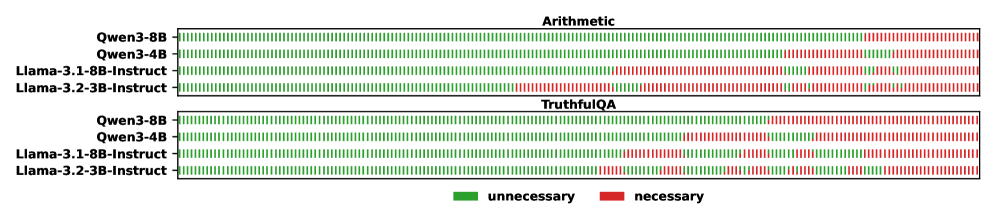
圖 2: 模型相依的工具呼叫必要性。每一條垂直長條代表 0.5% 的樣本。綠色表示在全部 $N=10$ 次無工具執行中皆正確回答的樣本;紅色表示至少失敗一次。在每個資料集內,樣本跨列共用相同的順序,此順序是透過在每個前一個模型的正確性劃分內遞迴排序所得到的。
4.2 在工具必要與工具非必要實例上收集工具呼叫行為
我們在第 4.1 節中得到的工具必要與工具非必要實例上對 LLM 執行推論。在此設定下,模型被提供外部工具的存取:算術問答用計算機、事實型查詢用搜尋 API。為了便於第 5 節中的診斷詮釋工作,收集工具呼叫行為時使用貪婪解碼 (greedy decoding)。為了更貼近真實世界的部署,我們依循既有實務 [21, 3],實作了模型特定的處理器 (handler),以每個模型所期望的語法揭露這些工具。接著我們進一步根據模型實際的工具呼叫行為,把工具必要與工具非必要樣本再細分,得到 4 組資料:必要-已呼叫 (Necessary-Called, N-C)、必要-未呼叫 (Necessary-NotCalled, N-NC)、非必要-已呼叫 (Unnecessary-Called, UN-C),以及非必要-未呼叫 (Unnecessary-NotCalled, Un-NC)。第一組與最後一組與我們模型相依必要性定義下的最佳行為一致,而中間兩組則對應於第 3 節中定義的端到端必要性-行動落差 $D(n_{f}(x),a_{f}(z_{f}(x)))$。
表 1: 依模型相依必要性 $n_{f}(x)$ 與觀察到的行動所定義的四個類別之工具呼叫行為細分。對齊的格子(N-C:必要-已呼叫;UN-NC:非必要-未呼叫)以綠色標示;未對齊的格子(N-NC、UN-C)以紅色標示,兩者共同構成端到端落差,總結於灰色的 Mis.(落差)欄。
| 模型 | Arithmetic N-C | N-NC | UN-C | UN-NC | Mis. | TruthfulQA N-C | N-NC | UN-C | UN-NC | Mis. |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-8B | 438 (11.0%) | 140 (3.5%) | 1526 (38.2%) | 1896 (47.4%) | 41.7% | 69 (8.4%) | 146 (17.9%) | 108 (13.2%) | 494 (60.5%) | 31.1% |
| Qwen3-4B | 253 (6.3%) | 581 (14.5%) | 481 (12.0%) | 2685 (67.1%) | 26.5% | 103 (12.6%) | 153 (18.7%) | 189 (23.1%) | 372 (45.5%) | 41.8% |
| Llama-3.1-8B-Instruct | 419 (10.5%) | 1204 (30.1%) | 335 (8.4%) | 2042 (51.1%) | 38.5% | 98 (12.0%) | 130 (15.9%) | 122 (14.9%) | 467 (57.2%) | 30.8% |
| Llama-3.2-3B-Instruct | 526 (13.2%) | 1559 (39.0%) | 600 (15.0%) | 1315 (32.9%) | 54.0% | 58 (7.1%) | 164 (20.1%) | 104 (12.7%) | 491 (60.1%) | 32.8% |
端到端落差相當顯著。
表 1 報告了四個類別在四個模型與兩個領域上的分布。彙總後的落差率(灰色 Mis. 欄)在算術上介於 26.5% 到 54.0%,在 TruthfulQA 上介於 30.8% 到 41.8%,顯示在模型特定的工具必要性概念下,大約四分之一到一半的查詢會導致與模型實際能力不一致的工具使用行動。這個介於實際工具必要性與模型工具使用行動之間的落差率,進一步凸顯了判斷「何時」使用工具的重要性——這是先前只強調「如何」使用工具的工作常常忽略的議題。
主導性的失敗模式高度取決於模型與領域。
除了整體落差率之外,特定的錯誤類型在不同模型與不同領域之間也有顯著差異。在算術上,Qwen3-8B 苦於工具過度使用 (tool-overuse)(UN-C 達 38.2%,相對 N-NC 僅 3.5%)。相對地,Qwen3-4B 與兩個 Llama 模型則展現出明顯的工具使用不足 (tool underuse),其 N-NC 率分別為 14.5%(Qwen3-4B)、30.1%(Llama-3.1-8B-Instruct)與 39.0%(Llama-3.2-3B-Instruct),都超過各自的 UN-C 率。有趣的是,這些傾向即使在單一模型內也並非一致。在 TruthfulQA 上,Qwen3-8B 完全反轉了它的趨勢,展現出工具使用不足(N-NC 達 17.9%,相對 UN-C 為 13.2%),而 Qwen3-4B 現在則展現出工具過度使用(UN-C 達 23.1%,相對 N-NC 為 18.7%)。由於這些模型會依情境在「過度急於」與「過度保守」於工具呼叫之間擺盪,顯然沒有單一、統一的偏誤能完全解釋這些落差錯誤。因此,在下一節中,我們利用第 3 節定義的 LLM 工具使用兩階段建模,進行更細緻的診斷。
5 從後設認知到執行能力:到底出了什麼問題?
在衡量了每個模型的模型相依工具必要性(亦即其能力邊界)並收集了它們實際的工具呼叫行為後,我們現在依循第 3 節的兩階段拆解,檢視實際必要性與最終行動之間的崩解發生在哪裡。我們首先顯示每個階段——對必要性的內部認知,以及被執行的行動——各自都能從模型的隱藏狀態中線性可分(第 5.1 與 5.2 節),接著刻劃兩者之間的幾何關係(第 5.3 節)。最後,我們透過逐樣本追蹤發現大多數的錯誤源自執行階段(第 5.4 節)。
5.1 探測模型的認知
線性探測 (linear probing) 是研究概念如何在模型隱藏狀態空間中被表徵的標準方法。近期工作 [13, 28] 已把它用作模型「對工具必要性內部信念」的代理 (proxy),並報告稱:儘管存在顯著的端到端落差,工具必要與工具非必要樣本的隱藏狀態幾乎是線性可分的。由於該結論是在靜態、僅基於查詢的工具必要性定義下得出的,因此並不清楚它在第 3 節引入的模型相依定義下是否仍然成立——在該定義下,必要性標籤 $n_{f}(x)$ 會隨著具有不同能力邊界的模型而變化。
具體而言,我們在模型的隱藏狀態上訓練一個帶權重 $\mathbf{w}_{c}$ 與偏置 $b_{c}$ 的線性分類器,使用 $0.01$ 的學習率搭配 Adam [11] 最佳化器,最小化以下目標:
$$\mathcal{L}=-\frac{1}{K}\sum_{k=1}^{K}\left[n_{f}(x_{k})\log\sigma(\mathbf{w}_{c}^{\top}h_{t}^{(l)}(x_{k})+b_{c})+(1-n_{f}(x_{k}))\log(1-\sigma(\mathbf{w}_{c}^{\top}h_{t}^{(l)}(x_{k})+b_{c}))\right], \tag{2}$$
其中 $x_{k}$ 是資料集中的一個樣本,而 $h_{t}^{(l)}(x_{k})$ 是在 token 位置 $t$ 與層 $l$ 的隱藏狀態。$\mathbf{w}_{c}$ 同時也作為分隔超平面 (separating hyperplane) 的法向量 (normal vector),指出模型表徵空間中從「非必要」到「必要」的方向。我們在所有層以及最後 $20$ 個查詢 token 上掃描 $(t,l)$;負索引表示相對於生成起點的 token 位置,例如 $t=-1$ 是最後一個查詢 token。由於類別分布是不平衡的(表 1),我們在保留測試集 (held-out test set,佔 30% 的資料) 上使用 Matthews 相關係數 (Matthews Correlation Coefficient, MCC) [18] 來報告探針表現,它在標籤偏斜的情況下是比準確率或 F1 更穩健的指標:
$$\text{MCC}=\frac{TP\cdot TN-FP\cdot FN}{\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \tag{3}$$
通常,介於 $0.3$–$0.5$ 之間的 MCC 值被視為中等到良好的表現,而 $0.5$ 或以上的 MCC 被視為良好到強的表現。圖 3 顯示四個模型在 Arithmetic 與 TruthfulQA 上,於每個 $(t,l)$ 位置訓練的探針之 MCC。
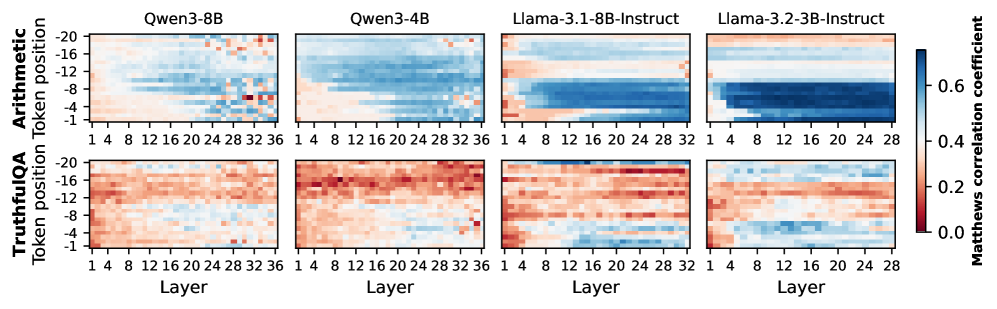
圖 3: 跨 token-層位置的必要性探針表現。每個格子報告一個線性探針的保留 MCC,該探針被訓練來從給定層與 token 位置的隱藏狀態預測模型自適應的必要性。藍色越深表示線性可分性越強。線性可分性高度取決於任務,且熱圖結構在同一模型家族內看起來相似。
必要性的線性可分性高度取決於任務。 在我們的模型自適應定義下,先前「幾乎線性可分」的圖像部分成立。在 Arithmetic 上,對大多數模型而言必要性是線性可分的,中到晚期層的廣闊區域跨越了 $\mathrm{MCC}=0.4$。這與先前工作 [13, 28] 的發現一致。然而在 TruthfulQA 上,MCC 超過 $0.4$ 的區域明顯較小,只有 Llama 模型中到晚期層的近末位 token 仍展現出尚可的可分性。這個對比顯示出區分模型自適應的工具必要與工具非必要樣本的挑戰性,它比先前工作所聚焦的顯而易見案例 [8, 13, 28] 更為微妙。它也顯示,在「問題難度反映於輸入表面結構」的任務(例如算術,其複雜度隨運算式本身而增長)中,工具必要性訊號較容易被浮現出來。然而在開放領域的事實型 QA 中,表面形式提供了關於底層難度的極少線索,使得工具必要性或知識不確定性 (epistemic uncertainty) 更難被線性可分。熱圖結構在同一模型家族內看起來也相似,兩個 Qwen 模型與兩個 Llama 模型分別共享相似的模式。
尚可的內部訊號與龐大的端到端落差並存。 探針在許多 $(t,l)$ 位置達到尚可的 MCC,顯示關於模型能力邊界的資訊確實存在於殘差流 (residual stream) 中。然而同樣的這些模型卻仍然展現出顯著的端到端必要性-行動落差(表 1),意味著這個內部訊號並未在生成時被有效地轉換為正確的工具呼叫決策。這種「隱藏狀態知道什麼」與「模型做了什麼」之間的落差,是知行落差的第一個徵兆,並引出接下來兩個問題:模型是否以類似可分的方式編碼其行動(第 5.2 節)?以及行動表徵與認知表徵之間有何關係(第 5.3 節)?
5.2 探測行動
在刻劃了必要性如何被內部表徵之後,我們現在對模型的實際決策提出平行的問題:被執行的行動——模型是否呼叫工具——從同樣的隱藏狀態中有多線性可分?具體而言,我們以與 Equation 2 相同的目標訓練一個線性分類器 $(\mathbf{w}_{a},b_{a})$,只是把 $(\mathbf{w}_{c},b_{c})$ 換成 $(\mathbf{w}_{a},b_{a})$。保留測試集(佔 30% 的資料)上以 MCC 表示的探針表現顯示於圖 4。
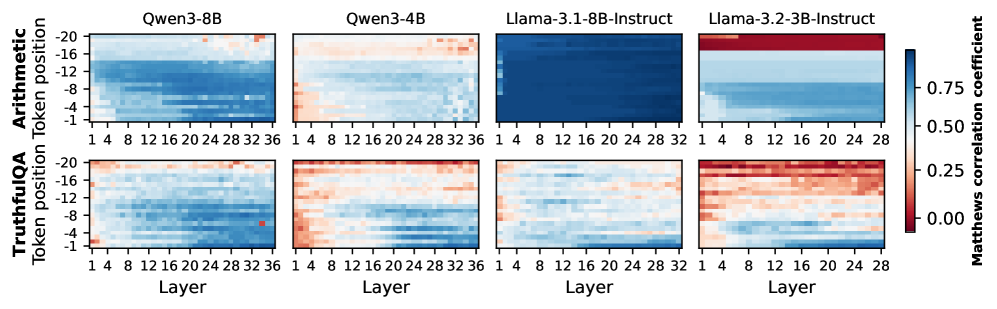
圖 4: 不同位置上以 Matthews 相關係數表示的行動探針表現。每個格子報告一個線性探針的保留 MCC,該探針被訓練來從給定層與 token 位置的隱藏狀態預測工具呼叫行動。藍色越深表示線性可分性越強。行動訊號在隱藏狀態中顯得高度線性可分,尤其是在近末位 token 與晚期層。
行動從隱藏狀態中高度可分。 圖 4 顯示,在 Arithmetic 與 TruthfulQA 資料集上,行動探針在幾乎每個模型的廣闊區域中都達到 $\mathrm{MCC}\geq 0.4$。這個訊號橫跨大多數層與 token 位置,而非侷限於狹窄的帶狀區域,顯示「模型是否即將呼叫工具」是一個能從其殘差流中強力解碼的特徵,這與近期的發現 [4] 一致。
5.3 認知與執行之間的落差
兩個探針在每一個 $(t,l)$ 給了我們一對方向向量:$\mathbf{w}_{c}$ 指向模型表徵空間中從「非必要」到「必要」的方向,而 $\mathbf{w}_{a}$ 指向從「不呼叫」到「呼叫」的方向。如果工具使用行為是模型內部必要性評估的直接讀出 (readout),那麼這兩個方向應該對齊——至少在兩個探針都成功的那些層中。我們透過計算每個位置上 $\mathbf{w}_{c}$ 與 $\mathbf{w}_{a}$ 之間的餘弦相似度 (cosine similarity) $\mathrm{CosSim}(\mathbf{w}_{c},\mathbf{w}_{a})$ 來檢驗這點:接近 $\pm 1$ 的值表示必要性與行動沿著(反)平行的方向被編碼,而接近 $0$ 的值則表示兩者在幾何上獨立的子空間中被表徵。
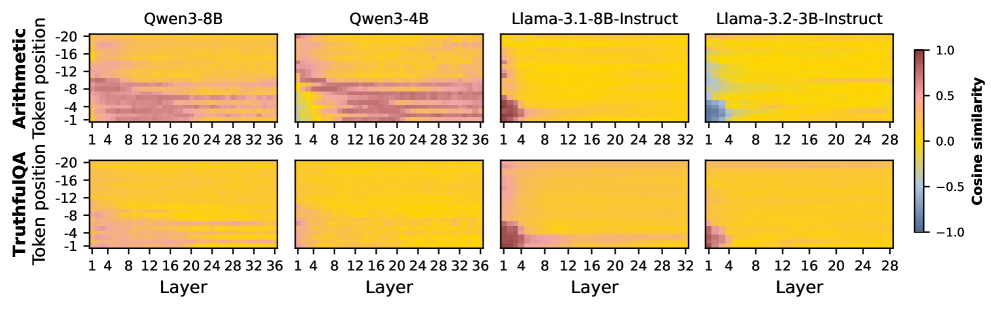
圖 5: 不同位置上 $\mathbf{w_{c}}$ 與 $\mathbf{w_{a}}$ 之間的餘弦相似度分數。兩個探針方向之間的相似度分數在大多數區域都很小。雖然對某些模型而言,在晚期 token 與中間層位置存在中等的相似度分數,但兩個方向在末位 token 的晚期層(右下角)又退回到近乎正交的關係。
$\mathbf{w}_{c}$ 與 $\mathbf{w}_{a}$ 之間的部分對齊存在於中間的 token-層位置。 圖 5 顯示 $\mathbf{w}_{c}$ 與 $\mathbf{w}_{a}$ 之間的餘弦相似度在數個熱圖的顯著區域中相當高,尤其是涵蓋了兩個 Qwen 模型在 Arithmetic 上的相當大面積。因此必要性與行動並非在完全不相交的子空間中被編碼:在某些中間的 token-層位置,這些方向共享有意義的對齊。
對齊在驅動生成的位置崩解。 這幅圖像在真正決定下一個 token 的位置——也就是最後一個查詢 token 的晚期層($t=-1$,大的 $l$)——急遽改變。對於中段對齊最強的兩個模型 Qwen3-8B 與 Qwen3-4B,餘弦相似度恰恰在熱圖的右下角退回到很小的值,因此 $\mathbf{w}_{c}$ 與 $\mathbf{w}_{a}$ 恰恰在它們需要互動以把「我應該呼叫工具」轉化為實際呼叫 token 的地方變得近乎正交。「在晚期層/末位 token 趨向低餘弦」的相同趨勢,在其他模型與 TruthfulQA 上更為一致地成立。因此,無論早期層中存在何種部分耦合,都無法存續到讀出階段。
前兩個小節確立了:模型的隱藏狀態往往含有可用的必要性訊號,卻仍產生不匹配的工具呼叫行動。圖 5 解釋了原因:即使必要性與行動在中間表徵中共享某些結構,這兩個方向在最終驅動下一個 token 決策的「晚期層/末位 token」區域中也會變得近乎正交。
5.4 兩階段錯誤診斷與歸因
至此我們已確立兩個事實:端到端必要性-行動落差相當顯著(表 1),且認知與行動方向在讀出階段近乎正交(第 5.3 節)。然而,第 5.3 節的結果只告訴我們這兩個階段是解耦 (decoupled) 的,並未告訴我們其中哪一個要為我們所觀察到的落差負責。為了歸因錯誤,我們沿著「事實 (Factual) $\rightarrow$ 認知 (Cognition) $\rightarrow$ 行動 (Action)」的建模追蹤每個樣本,把「認知」取為在最後一個查詢 token 與最後一層讀出的必要性探針 $(\mathbf{w}_{c},b_{c})$——也就是驅動下一個 token 決策的同一個位置。每個樣本因而落入以下四個類別之一:兩個階段皆正確(綠色)、僅第一階段錯誤(紅色)、僅第二階段錯誤(橘色,即知行落差),或在行動處相互抵消的補償性錯誤(紫色)。我們在圖 6 中展示完整的 Sankey 流向圖。
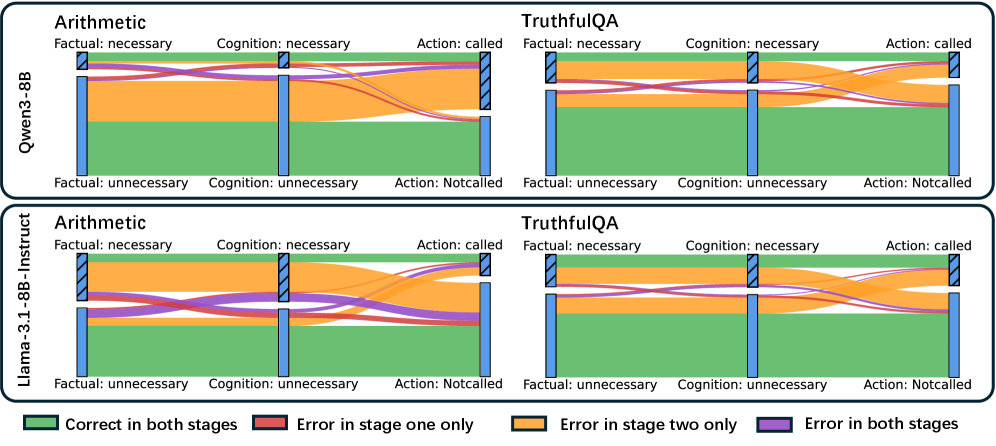
圖 6: 在 Arithmetic 與 TruthfulQA 上,對 Qwen3-8B(上)與 Llama-3.1-8B-Instruct(下)的工具呼叫行為之逐樣本兩階段拆解。每一道流向追蹤一個樣本通過三個節點:真實必要性 (ground-truth necessity,事實 Factual)、模型對必要性的內部認知 (Cognition),以及被執行的行動 (Action)。端到端錯誤由橘色流向所主導,在橘色流向中認知是正確的,但行動卻翻轉偏離了它——這就是知行落差。
第二階段承載了大多數錯誤。 在圖 6 的全部四個面板中,橘色流向(僅有第二階段錯誤的樣本)是目前為止最大的錯誤類別,而紅色(僅有第一階段錯誤的樣本)則相當稀薄。鑑於認知與行動是解耦的,這種「橘色 $\gg$ 紅色」的不對稱性定位了失敗:端到端落差絕大多數是在「認知 $\rightarrow$ 行動」階段中產生的,而非在形成認知本身的過程中。因此瓶頸不在於「知道」是否需要工具,而在於把這份知識轉化為「呼叫/不呼叫」的行動。這顯示做出正確的「何時使用工具」決策不僅僅關乎擁有正確的工具必要性認知,更重要的是還關乎把那份認知轉化為實際相匹配的行動。
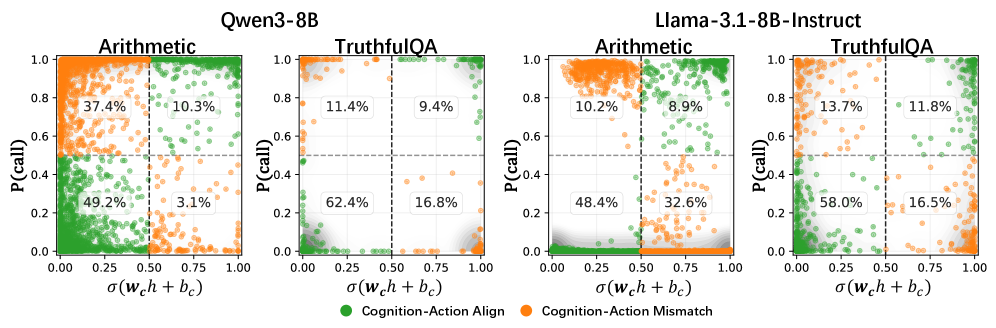
圖 7: 認知的信心相對於工具呼叫行為。x 軸表示經 sigmoid 函式後的探針輸出,y 軸表示由 Equation 4 量化的工具呼叫機率。即使內部表徵強烈指出某個樣本是工具必要或工具非必要,落差仍可能存在。
認知-執行落差與認知信心無關。
鑑於模型內部認知與其最終工具呼叫行為之間存在顯著落差(如圖 6 中龐大的橘色帶所示),一個自然的問題是:這個落差是否由後設認知信念本身的不確定性所造成?換言之,這個落差是否主要發生在模型對「是否需要工具」感到不確定的樣本上?為了探究這個問題,我們使用認知探針經 sigmoid 後的輸出 $\sigma(\mathbf{w}_{c}h+b_{c})$ 來量化後設認知的信心。接著我們在圖 7 中,對所有樣本繪製「工具必要性的信心」與「做出工具呼叫的機率」之間的關係。做出工具呼叫的機率定義為
$$\mathrm{P}(\text{call})=\frac{\mathrm{p}(\langle\text{tool-token}\rangle)}{\mathrm{p}(\langle\text{tool-token}\rangle)+\mathrm{p}(\text{best non-tool token})}, \tag{4}$$
其中 $p(\cdot)$ 表示語言模型指派給一個候選下一個 token 的 softmax 機率,$\langle\text{tool-token}\rangle$ 表示啟動工具呼叫的模型特定 token(例如 Qwen 模型中的 <tool_call>),而「最佳非工具 token (best non-tool token)」指的是所有非工具呼叫 token 中 logit 最高的 token。這個公式化巧妙地把機率正規化到 $[0,1]$ 的範圍。由於收集工具呼叫行為時使用貪婪解碼(第 4.2 節),$P(\text{call})>0.5$ 的值對應於實際生成了一個工具呼叫。如圖 7 所示,認知-執行落差並非主要發生在 $\sigma(\mathbf{w}_{c}h+b_{c})\approx 0.5$ 的不確定區域附近。相反地,許多橘色點出現在 $\sigma(\mathbf{w}_{c}h+b_{c})$ 接近 $0$ 或 $1$ 的區域。這個觀察顯示認知-執行落差並非由模型內部認知的低信心所驅動。反之,即使內部表徵強烈指出某個樣本是工具必要或工具非必要,落差仍可能存在。
6 結論
在這項工作中,我們提出了一個模型自適應的工具必要性定義,把評估奠基於實證能力之上,並揭示了「模型實際何時需要工具」與「模型何時呼叫工具」之間的顯著落差。透過把工具使用流程拆解為內部認知與執行兩個階段,並分析隱藏狀態表徵,我們辨識出 LLM 中一道根本性的「知行落差」。雖然模型有時會在內部辨識出工具必要性,這些認知表徵卻在較晚的層中與執行意圖正交地錯位,導致在採取適當行動上的失敗。我們的發現證明,改進自主代理人不僅需要更好的內部後設認知,更需要彌合知行落差,以確保自我覺察能轉化為可靠的執行。
致謝
本工作部分由以下單位支持:NSF CAREER Award 1942230、ONR PECASE Award N00014-25-1-2378、ARO Early Career Program Award 310902-00001、Army Grant W911NF-21-2-0076、NSF Award CCF-2212458、NSF Award 2229885(NSF Institute for Trustworthy AI in Law and Society, TRAILS)、MURI Grant 14262683、DARPA AIQ Grant HR00112590066,以及一項 Meta Research Award 314593-00001。
參考文獻
[1] Anthropic (2024-11-25). Introducing the model context protocol. External Links: Link. Cited by: §2.
[2] L. Chen, Z. Liang, X. Wang, J. Liang, Y. Xiao, F. Wei, J. Chen, Z. Hao, B. Han, and W. Wang (2024). Teaching large language models to express knowledge boundary from their own signals. External Links: 2406.10881, Link. Cited by: §2.
[3] Y. Cheng, A. S. Moakhar, C. Fan, P. Hosseini, K. Faghih, Z. Sodagar, W. Wang, and S. Feizi (2026). Your llm agents are temporally blind: the misalignment between tool use decisions and human time perception. External Links: 2510.23853, Link. Cited by: §4.2.
[4] E. Esakkiraja, S. Rajeswar, D. Akhiyarov, and R. Venkatesaramani (2026). Therefore i am. i think. External Links: 2604.01202, Link. Cited by: §5.2.
[5] K. Faghih, W. Wang, Y. Cheng, S. Bharti, G. Sriramanan, S. Balasubramanian, P. Hosseini, and S. Feizi (2025). Gaming tool preferences in agentic llms. arXiv preprint arXiv:2505.18135. Cited by: §2.
[6] Google (2025). Agent2Agent (a2a) protocol. Note: https://google.github.io/A2A/. Cited by: §2.
[7] A. Grattafiori, A. Dubey, A. Jauhri, A. Pandey, A. Kadian, A. Al-Dahle, A. Letman, A. Mathur, A. Schelten, A. Vaughan, et al. (2024). The llama 3 herd of models. arXiv preprint arXiv:2407.21783. Cited by: §4.
[8] Y. Huang, J. Shi, Y. Li, C. Fan, S. Wu, Q. Zhang, Y. Liu, P. Zhou, Y. Wan, N. Z. Gong, and L. Sun (2024). MetaTool benchmark for large language models: deciding whether to use tools and which to use. External Links: 2310.03128, Link. Cited by: Appendix B, Appendix B, §1, §2, §5.1.
[9] L. Ji-An, H. Xiong, R. C. Wilson, M. G. Mattar, and M. K. Benna (2025). Language models are capable of metacognitive monitoring and control of their internal activations. External Links: 2505.13763, Link. Cited by: Appendix B, §2.
[10] S. Kadavath, T. Conerly, A. Askell, T. Henighan, D. Drain, E. Perez, N. Schiefer, Z. Hatfield-Dodds, N. DasSarma, E. Tran-Johnson, S. Johnston, S. El-Showk, A. Jones, N. Elhage, T. Hume, A. Chen, Y. Bai, S. Bowman, S. Fort, D. Ganguli, D. Hernandez, J. Jacobson, J. Kernion, S. Kravec, L. Lovitt, K. Ndousse, C. Olsson, S. Ringer, D. Amodei, T. Brown, J. Clark, N. Joseph, B. Mann, S. McCandlish, C. Olah, and J. Kaplan (2022). Language models (mostly) know what they know. External Links: 2207.05221, Link. Cited by: §2.
[11] D. P. Kingma and J. Ba (2017). Adam: a method for stochastic optimization. External Links: 1412.6980, Link. Cited by: §5.1.
[12] M. Li, Y. Zhao, B. Yu, F. Song, H. Li, H. Yu, Z. Li, F. Huang, and Y. Li (2023). Api-bank: a comprehensive benchmark for tool-augmented llms. arXiv preprint arXiv:2304.08244. Cited by: §2.
[13] W. Li, D. Li, K. Dong, C. Zhang, H. Zhang, W. Liu, Y. Wang, R. Tang, and Y. Liu (2025). Adaptive tool use in large language models with meta-cognition trigger. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pp. 13346–13370. Cited by: Appendix B, Appendix B, Appendix B, §1, §1, §2, §2, §5.1, §5.1.
[14] Z. Li, D. Zhang, M. Zhang, J. Zhang, Z. Liu, Y. Yao, H. Xu, J. Zheng, P. Wang, X. Chen, Y. Zhang, F. Yin, J. Dong, Z. Li, B. Bi, L. Mei, J. Fang, X. Liang, Z. Guo, L. Song, and C. Liu (2025). From system 1 to system 2: a survey of reasoning large language models. External Links: 2502.17419, Link. Cited by: §2.
[15] S. Lin, J. Hilton, and O. Evans (2022). Teaching models to express their uncertainty in words. External Links: 2205.14334, Link. Cited by: §2.
[16] S. Lin, J. Hilton, and O. Evans (2022). TruthfulQA: measuring how models mimic human falsehoods. External Links: 2109.07958, Link. Cited by: §4.
[17] J. Lindsey, W. Gurnee, E. Ameisen, B. Chen, A. Pearce, N. L. Turner, C. Citro, D. Abrahams, S. Carter, B. Hosmer, J. Marcus, M. Sklar, A. Templeton, T. Bricken, C. McDougall, H. Cunningham, T. Henighan, A. Jermyn, A. Jones, A. Persic, Z. Qi, T. B. Thompson, S. Zimmerman, K. Rivoire, T. Conerly, C. Olah, and J. Batson (2025). On the biology of a large language model. Transformer Circuits Thread. External Links: Link. Cited by: Appendix B, §2.
[18] B.W. Matthews (1975). Comparison of the predicted and observed secondary structure of t4 phage lysozyme. Biochimica et Biophysica Acta (BBA) - Protein Structure 405 (2), pp. 442–451. External Links: ISSN 0005-2795, Document, Link. Cited by: §5.1.
[19] G. Mialon, R. Dessì, M. Lomeli, C. Nalmpantis, R. Pasunuru, R. Raileanu, B. Rozière, T. Schick, J. Dwivedi-Yu, A. Celikyilmaz, et al. (2023). Augmented language models: a survey. arXiv preprint arXiv:2302.07842. Cited by: §1, §2.
[20] A. Parisi, Y. Zhao, and N. Fiedel (2022). Talm: tool augmented language models. arXiv preprint arXiv:2205.12255. Cited by: §1, §2.
[21] S. G. Patil, H. Mao, F. Yan, C. C. Ji, V. Suresh, I. Stoica, and J. E. Gonzalez (2025). The berkeley function calling leaderboard (bfcl): from tool use to agentic evaluation of large language models. In Forty-second International Conference on Machine Learning. Cited by: §2, §4.2.
[22] C. Qian, E. C. Acikgoz, H. Wang, X. Chen, A. Sil, D. Hakkani-Tür, G. Tur, and H. Ji (2025). SMART: self-aware agent for tool overuse mitigation. External Links: 2502.11435, Link. Cited by: §1, §2.
[23] H. Ross, A. S. Mahabaleshwarkar, and Y. Suhara (2025). When2Call: when (not) to call tools. arXiv preprint arXiv:2504.18851. Cited by: §2.
[24] T. Schick, J. Dwivedi-Yu, R. Dessì, R. Raileanu, M. Lomeli, E. Hambro, L. Zettlemoyer, N. Cancedda, and T. Scialom (2023). Toolformer: language models can teach themselves to use tools. Advances in Neural Information Processing Systems 36, pp. 68539–68551. Cited by: §1, §2.
[25] J. Shi, Z. Yuan, G. Tie, P. Zhou, N. Z. Gong, and L. Sun (2025). Prompt injection attack to tool selection in llm agents. arXiv preprint arXiv:2504.19793. Cited by: §2.
[26] Y. Song, W. Xiong, D. Zhu, W. Wu, H. Qian, M. Song, H. Huang, C. Li, K. Wang, R. Yao, et al. (2023). Restgpt: connecting large language models with real-world restful apis. arXiv preprint arXiv:2306.06624. Cited by: §1, §2.
[27] H. Wang, C. Qian, M. Li, J. Qiu, B. Xue, M. Wang, H. Ji, A. Storkey, and K. Wong (2026). Position: agent should invoke external tools only when epistemically necessary. External Links: 2506.00886, Link. Cited by: §1, §2.
[28] Y. Wang, R. Zhou, R. Fu, S. Cao, H. Zeng, J. Lu, S. Fan, J. Zhao, and L. Pan (2026). ASA: training-free representation engineering for tool-calling agents. External Links: 2602.04935, Link. Cited by: Appendix B, Appendix B, §1, §2, §5.1, §5.1.
[29] A. Yang, A. Li, B. Yang, B. Zhang, B. Hui, B. Zheng, B. Yu, C. Gao, C. Huang, C. Lv, C. Zheng, D. Liu, F. Zhou, F. Huang, F. Hu, H. Ge, H. Wei, H. Lin, J. Tang, J. Yang, J. Tu, J. Zhang, J. Yang, J. Yang, J. Zhou, J. Zhou, J. Lin, K. Dang, K. Bao, K. Yang, L. Yu, L. Deng, M. Li, M. Xue, M. Li, P. Zhang, P. Wang, Q. Zhu, R. Men, R. Gao, S. Liu, S. Luo, T. Li, T. Tang, W. Yin, X. Ren, X. Wang, X. Zhang, X. Ren, Y. Fan, Y. Su, Y. Zhang, Y. Zhang, Y. Wan, Y. Liu, Z. Wang, Z. Cui, Z. Zhang, Z. Zhou, and Z. Qiu (2025). Qwen3 technical report. External Links: 2505.09388, Link. Cited by: §4.
[30] Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang (2023-07). Do large language models know what they don’t know?. In Findings of the Association for Computational Linguistics: ACL 2023, A. Rogers, J. Boyd-Graber, and N. Okazaki (Eds.), Toronto, Canada, pp. 8653–8665. External Links: Link, Document. Cited by: §2.
[31] H. Zhang, S. Diao, Y. Lin, Y. R. Fung, Q. Lian, X. Wang, Y. Chen, H. Ji, and T. Zhang (2024). R-tuning: instructing large language models to say ‘i don’t know’. External Links: 2311.09677, Link. Cited by: §2.
[32] Q. Zhang, Y. Fu, Y. Wang, L. Yan, T. Wei, K. Xu, M. Huang, and H. Qiu (2026). Stop before you fail: operational capability boundaries for mitigating unproductive reasoning in large reasoning models. External Links: 2509.24711, Link. Cited by: §2.
[33] Y. Zhang, J. Chen, J. Wang, Y. Liu, C. Yang, C. Shi, X. Zhu, Z. Lin, H. Wan, Y. Yang, et al. (2024). Toolbehonest: a multi-level hallucination diagnostic benchmark for tool-augmented large language models. arXiv preprint arXiv:2406.20015. Cited by: §2.
[34] J. Zhao, J. Huang, Z. Wu, D. Bau, and W. Shi (2025). LLMs encode harmfulness and refusal separately. External Links: 2507.11878, Link. Cited by: §2.
[35] A. Zou, L. Phan, S. Chen, J. Campbell, P. Guo, R. Ren, A. Pan, X. Yin, M. Mazeika, A. Dombrowski, S. Goel, N. Li, M. J. Byun, Z. Wang, A. Mallen, S. Basart, S. Koyejo, D. Song, M. Fredrikson, J. Z. Kolter, and D. Hendrycks (2025). Representation engineering: a top-down approach to ai transparency. External Links: 2310.01405, Link. Cited by: §1.
附錄 A 算術資料集建構的更多細節
我們生成被分組成三種類型的數學算術問題。Easy(簡單) 組包含一步加減法、短的兩步鏈,以及小取模問題。這些給出通常不需要計算機的案例。Larger short(較大但簡短) 組保持運算式簡單,但使用較大的運算元,包括多位數減法、四位數加減法,以及兩位或三位數乘法。這些問題仍然短到足以引誘人直接作答,但更可能造成數字錯誤。Multi-step(多步) 組包含優先序鏈、帶括號的運算式、乘法鏈,以及長加減法鏈。這些範例測試模型是否能追蹤中間值並套用運算順序,尤其是在那些看似簡單卻容易算錯的案例中。我們以一個固定的隨機種子 (random seed) 對資料集進行抽樣。在生成期間,我們跳過重複的運算式並重新抽樣,直到每個家族達到其指派的抽樣份額。表 2 給出問題家族及其抽樣份額。
表 2: 數學算術資料集的細分。份額顯示每個問題家族的固定抽樣份額。我們總共使用 $4000$ 個樣本。
| 組別 | 問題家族 | 份額 | 細節 | 範例 |
|---|---|---|---|---|
| Easy | 單步算術 | 8% | 兩個來自 1–99 的運算元,配一個加法或減法運算子。 | 21 + 59 |
| 兩步算術 | 5% | 三個來自 1–99 的運算元,配加法或減法運算子。 | 70 - 47 + 68 | |
| 小取模 | 5% | 三位數被除數,除數來自 3–19。 | 562 % 8 | |
| Larger short | 負值減法 | 7% | 一個三位或四位數運算元減去一個更大的運算元。 | 390 - 554 |
| 四位數加減法 | 6% | 兩個四位數運算元。 | 4921 - 9108 | |
| 兩位數乘法 | 9% | 兩個兩位數運算元。 | 34 * 75 | |
| 三乘二乘法 | 9% | 一個三位數因數與一個兩位數因數。 | 504 * 61 | |
| 三乘三乘法 | 7% | 兩個三位數因數。 | 867 * 671 | |
| Multi-step | 優先序鏈 | 12% | 五個兩位或三位數運算元,配加法、減法或乘法運算子。 | 84 * 82 - 755 - 805 - 29 |
| 一位數加減法鏈 | 11% | 16–39 個一位數項,配加法或減法運算子。 | 3 + 4 + 1 + 3 - 8 - … | |
| 小數加減法鏈 | 10% | 21–27 個來自 1–30 的項,配加法或減法運算子。 | 9 + 5 - 1 - 3 + 23 + … | |
| 帶括號運算式 | 6% | 四個兩位數運算元,呈 $(a+b)\times(c-d)$ 形式。 | (67 + 68) * (52 - 88) | |
| 乘法鏈 | 5% | 五個兩位數運算元,呈 $a+b\times c-d\times e$ 形式。 | 94 + 40 * 50 - 24 * 87 |
演算法 1–13 指明了用於生成每個家族資料樣本的確切程序。在這些演算法中,$\mathcal{U}\{m,\ldots,n\}$ 表示在整數 $m$ 到 $n$ 上的離散均勻分布 (discrete uniform distribution),而 $\mathcal{U}(0,1)$ 表示在單位區間上的連續均勻分布 (continuous uniform distribution)。
演算法 1 SingleStepArithmetic(單步算術) 1: $a,b\sim\mathcal{U}\{1,\ldots,99\}$ 2: $op\sim\{+,-\}$ 3: return「$a\ op\ b$」
演算法 2 TwoStepArithmetic(兩步算術) 1: $a,b,c\sim\mathcal{U}\{1,\ldots,99\}$ 2: $u\sim\mathcal{U}(0,1)$ 3: if $u<0.5$ then 4: return「$a+b-c$」 5: else 6: return「$a-b+c$」 7: end if
演算法 3 SmallModulo(小取模) 1: $a\sim\mathcal{U}\{100,\ldots,999\}$ 2: $b\sim\mathcal{U}\{3,\ldots,19\}$ 3: return「$a\ \%\ b$」
演算法 4 NegativeSubtraction(負值減法) 1: $u\sim\mathcal{U}(0,1)$ 2: if $u<0.5$ then 3: $a\sim\mathcal{U}\{100,\ldots,500\}$ 4: $b\sim\mathcal{U}\{a+10,\ldots,a+250\}$ 5: else 6: $a\sim\mathcal{U}\{1000,\ldots,5000\}$ 7: $b\sim\mathcal{U}\{a+100,\ldots,a+3000\}$ 8: end if 9: return「$a-b$」
演算法 5 FourDigitAdditionSubtraction(四位數加減法) 1: $a,b\sim\mathcal{U}\{1000,\ldots,9999\}$ 2: $u\sim\mathcal{U}(0,1)$ 3: if $u<0.5$ then 4: return「$a+b$」 5: else 6: return「$a-b$」 7: end if
演算法 6 TwoDigitMultiplication(兩位數乘法) 1: $u\sim\mathcal{U}(0,1)$ 2: if $u<0.5$ then 3: $a,b\sim\mathcal{U}\{15,\ldots,50\}$ 4: else 5: $a,b\sim\mathcal{U}\{30,\ldots,99\}$ 6: end if 7: return「$a\times b$」
演算法 7 ThreeByTwoMultiplication(三乘二乘法) 1: $a\sim\mathcal{U}\{100,\ldots,999\}$ 2: $b\sim\mathcal{U}\{10,\ldots,99\}$ 3: return「$a\times b$」
演算法 8 ThreeByThreeMultiplication(三乘三乘法) 1: $a,b\sim\mathcal{U}\{100,\ldots,999\}$ 2: return「$a\times b$」
演算法 9 PrecedenceChain(優先序鏈) 1: $a_{1},\ldots,a_{5}\sim\mathcal{U}\{10,\ldots,999\}$ 2: $op_{1},\ldots,op_{4}\sim\{+,-,\times\}$ 3: return「$a_{1}\ op_{1}\ a_{2}\ op_{2}\ a_{3}\ op_{3}\ a_{4}\ op_{4}\ a_{5}$」
演算法 10 OneDigitAdditionSubtractionChain(一位數加減法鏈) 1: $u\sim\mathcal{U}(0,1)$ 2: if $u<0.5$ then 3: $n\sim\mathcal{U}\{16,\ldots,22\}$ 4: else 5: $n\sim\mathcal{U}\{29,\ldots,39\}$ 6: end if 7: $a_{1},\ldots,a_{n}\sim\mathcal{U}\{1,\ldots,9\}$ 8: 對每個 $i$,以 $\Pr(op_{i}=+)=0.53$ 與 $\Pr(op_{i}=-)=0.47$ 抽樣 $op_{i}$ 9: return「$a_{1}\ op_{1}\ a_{2}\ op_{2}\ \cdots\ op_{n-1}\ a_{n}$」
演算法 11 SmallAdditionSubtractionChain(小數加減法鏈) 1: $n\sim\mathcal{U}\{21,\ldots,27\}$ 2: $a_{1},\ldots,a_{n}\sim\mathcal{U}\{1,\ldots,30\}$ 3: $op_{1},\ldots,op_{n-1}\sim\{+,-\}$ 4: return「$a_{1}\ op_{1}\ a_{2}\ op_{2}\ \cdots\ op_{n-1}\ a_{n}$」
演算法 12 ParenthesizedExpression(帶括號運算式) 1: $a,b,c,d\sim\mathcal{U}\{10,\ldots,99\}$ 2: return「$(a+b)\times(c-d)$」
演算法 13 MultiplicationChain(乘法鏈) 1: $a,b,c,d,e\sim\mathcal{U}\{10,\ldots,99\}$ 2: return「$a+b\times c-d\times e$」
【譯註:原文 HTML 中演算法 2、4、5、6、10 的 if 條件閾值在轉檔過程中遺失(顯示為 if u then),此處依各演算法上下文補為慣例的 u<0.5,實際閾值請以原始論文 PDF 為準。】
附錄 B 以顯式提示引出對工具必要性的口語化信念
由於 LLM 在口語化內部決策過程上的限制 [17, 9],以及自我評估任務與實際解題之間的根本差異,在本文中我們依循近期工作的做法,使用內部狀態探測來衡量模型對工具必要性的認知 [13, 28]。儘管如此,為求完整,我們也報告使用顯式自我評估提示所得到的結果。
具體而言,我們採用一個兩階段推論程序。在第一階段,模型被給予來自 Arithmetic 與 TruthfulQA 資料集的相同問題,但不是直接解題,而是被提示先決定「是否有必要呼叫一個外部工具」,並只以「yes」或「no」作答。在第二階段,模型被指示「現在回答原始的使用者請求」。
表 3 報告:(1) 模型的「yes」/「no」回應與第 4.1 節定義的「實際奠基於能力的工具必要性」之間的 MCC;(2) 認知-執行落差率,定義為「模型回答『yes』卻未呼叫工具,或回答『no』卻最終呼叫了工具」的樣本比例;以及 (3) 相對於第 4.2 節使用的直接任務導向提示設定,最終工具呼叫行為發生改變的樣本比例。
結果顯示,顯式「yes」/「no」判斷的 MCC 在捕捉「實際奠基於能力的工具必要性概念」上明顯較差。特別是,Llama-3.2-3B-Instruct 在 TruthfulQA 上達到負的 MCC,而 Llama-3.1-8B-Instruct 對每一個 TruthfulQA 樣本都單純回答「no」,導致 MCC 未定義 (undefined)。這個行為意味著該模型判斷沒有任何樣本需要工具,這顯然與第 4.1 節報告的能力衡量結果不一致。這個糟糕的 MCC 結果進一步顯示了區分模型自適應的工具必要與工具非必要樣本的挑戰性,它比先前工作所聚焦的顯而易見案例 [8, 13, 28] 更為微妙。
相對地,認知-執行落差率明顯低於第 5.4 節報告的數值。Llama-3.1-8B-Instruct 甚至達到 0 落差率,意味著它不僅對所有樣本都回答「no」,也一致地避免做出任何工具呼叫。這個結果在某種程度上是可預期的:一旦「yes」/「no」回應成為模型上下文的一部分,模型在後續生成中就更可能與那個較早的承諾保持一致。
然而最重要的是,表 3 顯示每個資料集的第三欄都有很大的「Changed(已改變)」率。相對於我們主要實驗中使用任務導向提示的直接解題,顯式自我評估在高達近 50% 的樣本上改變了工具呼叫行為。在實務部署中,提示通常是任務導向的,設計用來最大化任務表現,而非引出顯式自我評估。因此,這個顯著的行為轉變顯示,奠基於諸如「決定是否有必要呼叫一個外部工具並回答『yes』或『no』」這類顯式提示的評估(如某些先前工作 [8, 13] 所使用),可能產生與「模型在現實任務設定下實際工具使用行為」顯著分歧的結果。
表 3: 跨資料集的工具呼叫評估總結。對於每個模型與資料集,我們報告 Matthews 相關係數 (MCC)、落差率 $(\text{yes,false})+(\text{no,true})$,以及跨變體的工具呼叫行為改變比例。
| 模型 | Arithmetic MCC | Cog-Exe-Mis. (%) | Changed (%) | TruthfulQA MCC | Cog-Exe-Mis. (%) | Changed (%) |
|---|---|---|---|---|---|---|
| Llama-3.1-8B-Instruct | 0.0712 | 5.42 | 18.20 | n/a | 0.00 | 26.93 |
| Llama-3.2-3B-Instruct | 0.2251 | 19.62 | 29.18 | -0.0400 | 9.67 | 27.05 |
| Qwen3-4B | 0.2330 | 3.85 | 29.55 | 0.1915 | 36.35 | 34.64 |
| Qwen3-8B | 0.2016 | 2.12 | 49.27 | 0.0538 | 13.34 | 20.93 |
附錄 C 限制
在本文中,我們使用 $N=10$ 與 $T=0.7$(如第 4.1 節所定義)來實例化模型自適應的工具必要性定義。涵蓋此定義在不同 $N$、$T$ 值下的其他實例化,以觀察必要性-行動落差率在不同設定下可能如何變化,可能會是有益的。此外,由於本工作的一個不可或缺的部分仰賴探測模型隱藏狀態,這使得我們的工作不適用於 GPT 或 Gemini 等閉源 (close-source) 的最先進 LLM。
術語對照表
| English | 繁體中文 |
|---|---|
| Large Language Model (LLM) | 大型語言模型 |
| autonomous agent | 自主代理人 |
| tool necessity | 工具必要性 |
| tool use / tool calling | 工具使用/工具呼叫 |
| adaptive tool use | 自適應工具使用 |
| model-adaptive | 模型自適應 |
| model-agnostic | 與模型無關 |
| model-dependent | 模型相依 |
| capability boundary | 能力邊界 |
| empirical performance | 實證表現 |
| necessity-action mismatch | 必要性-行動落差 |
| knowing-doing gap | 知行落差 |
| cognition | 認知 |
| execution | 執行 |
| meta-cognition | 後設認知 |
| self-assessment | 自我評估 |
| self-awareness | 自我覺察 |
| hidden state | 隱藏狀態 |
| probing / linear probing | 探測/線性探測 |
| probe direction | 探針方向 |
| representation probing | 表徵探測 |
| representation engineering | 表徵工程 |
| mechanistic interpretability | 機制可解釋性 |
| residual stream | 殘差流 |
| linearly decodable / separable | 線性可解碼/線性可分 |
| orthogonal | 正交 |
| cosine similarity | 餘弦相似度 |
| separating hyperplane | 分隔超平面 |
| normal vector | 法向量 |
| readout | 讀出 |
| decoupled | 解耦 |
| factual QA | 事實型問答 |
| arithmetic | 算術 |
| greedy decoding | 貪婪解碼 |
| temperature | 溫度 |
| inference | 推論 |
| parametric knowledge | 參數化知識 |
| function/tool calling | 函式/工具呼叫 |
| hallucinated calls | 幻覺式呼叫 |
| proprietary | 專有 |
| epistemic uncertainty | 知識不確定性 |
| reliability under uncertainty | 不確定性下的可靠性 |
| Matthews Correlation Coefficient (MCC) | Matthews 相關係數 |
| held-out test set | 保留測試集 |
| internal activation | 內部活化 |
| verbalize confidence | 口語化信心 |
| tool-overuse | 工具過度使用 |
| tool underuse | 工具使用不足 |
| Necessary-Called (N-C) | 必要-已呼叫 |
| Necessary-NotCalled (N-NC) | 必要-未呼叫 |
| Unnecessary-Called (UN-C) | 非必要-已呼叫 |
| Unnecessary-NotCalled (UN-NC) | 非必要-未呼叫 |
| Sankey diagram | Sankey 流向圖 |
| trajectory tracing | 軌跡追蹤 |
| end-to-end | 端到端 |
| operator precedence | 運算子優先序 |
| modulo | 取模 |
| discrete uniform distribution | 離散均勻分布 |
| random seed | 隨機種子 |
| surface form | 表面形式 |
| system I / system II thinking | 系統一/系統二思考 |