改進大型視覺語言模型中的模態對齊
原始論文:Improved Alignment of Modalities in Large Vision Language Models 作者:Kartik Jangra, Aman Kumar Singh, Yashwani Mann, Geetanjali Rathee arXiv ID:2503.19508v1 日期:2025-03-25 標籤:VLM Vision-Language Attention Mask Image Captioning 多模態 訓練策略
1. 引言
本文探討如何在自迴歸視覺語言模型 (Vision-Language Model, VLM) 中更好地對齊視覺和語言模態。核心問題是:語言模型應該如何「注意」圖像 patch?
作者提出一個四階段訓練策略,搭配不同的注意力遮罩 (attention mask),有四個關鍵發現:
- 注意力遮罩不應施加在視覺輸入上(圖像 patch 之間應保持雙向注意力)
- 模型在 AI 生成的資料上收斂更快
- 預訓練階段的對齊 (alignment) 很關鍵
- 模型能良好適應下游任務
用一個僅 9 億參數的模型,在 COCO 和 Flickr30k 上的 CIDEr 分數超過了 VILA-13B 等更大的模型,且訓練只需 12 小時。
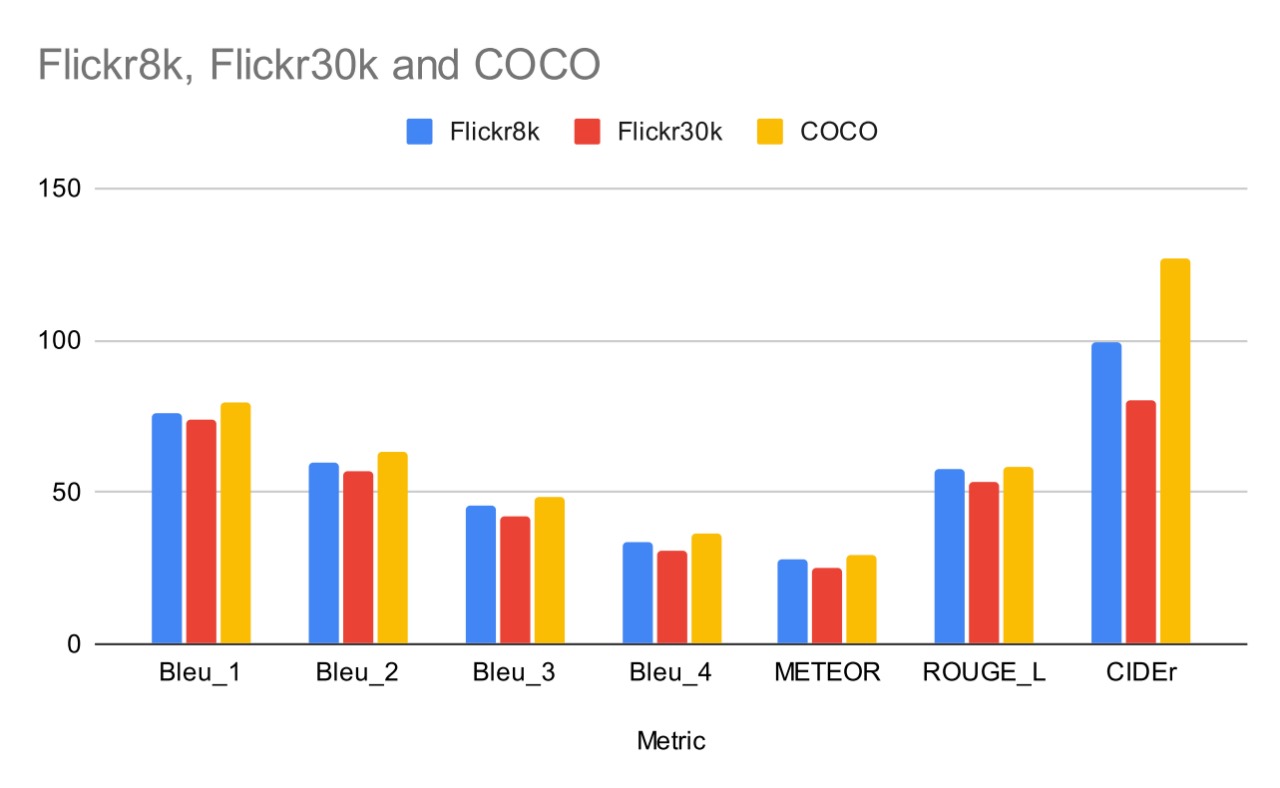 圖 1:模型在不同資料集上的效能表現。
2. 相關工作
VLM 大致分兩類:
- 融合式 (fusion-based):用交叉注意力 (cross-attention) 整合視覺和文字,如 Flamingo
- 自迴歸式 (auto-regressive):將視覺和文字特徵串接為序列,用 decoder-only transformer 處理,如 LLaVA
| 作者 | 方法 | 關鍵發現 |
|---|---|---|
| Radford et al. | 對比式預訓練 | 圖像和文字共享嵌入空間 |
| Wang et al. | Seq2Seq 語言建模 | 自迴歸視覺語言訓練可行 |
| Alayrac et al. | Perceiver resampler | 模型可適應多種視覺語言任務 |
| Liu et al., Li et al. | 合成指令生成 | 合成文字能提升效能 |
| Li et al. | Q-Former | 兩階段訓練達 SOTA |
| Beyer et al. | Seq2Seq 遮罩 | 改善視覺語言結果品質 |
3. 方法
3.1 模型架構
三組件架構,總參數 9 億:
| 組件 | 參數量 | 模型 |
|---|---|---|
| 視覺編碼器 | 4 億 | SigLIP ViT(隱藏維度 1152,27 層,16 注意力頭) |
| 投影器 (Projector) | 1,800 萬 | 兩層 MLP + GeLU |
| 語言模型 | 5 億 | Qwen-2.5(隱藏維度 896,24 層,14 注意力頭) |
輸入流程:
- 視覺編碼器將 224×224 圖像分割為 14×14 的 patch,產生 256 個視覺特徵 $V = [V_1, V_2, \ldots, V_{256}]$
- 投影器將視覺維度 $d_V$ 映射到語言維度 $d_L$:$P = [p_1, p_2, \ldots, p_{256}]$
- 與文字 token 串接形成輸入:$I = [p_1, \ldots, p_{256}, L_1, \ldots, L_{\text{seqLen}}]$
選擇 SigLIP 而非 CLIP-ViT 是因為 SigLIP 在 image-text 對比損失上表現更優。
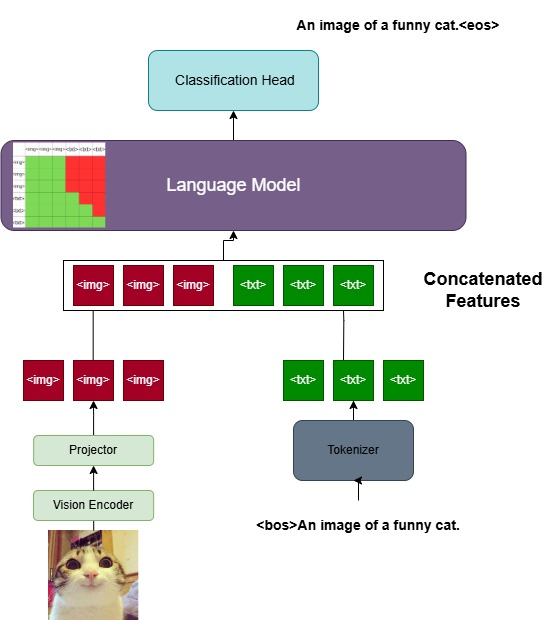 圖 2:模型架構,由視覺編碼器、多模態投影器和語言模型組成。
3.2 注意力遮罩策略
兩種遮罩方式:
Stage-0 遮罩:所有 token 之間雙向注意力(圖像 patch 和文字 token 都能互相看到)。
Stage 1-3 遮罩:圖像 patch 之間保持雙向注意力,文字 token 使用因果遮罩 (causal masking)。圖像 patch 可以注意到所有其他 patch,但不能注意到未來的文字 token。
這個設計的洞見是:LLaVA 的圖像切割方法可以用注意力遮罩取代,不需要實際分割圖像,從而減少視覺 token 數量。
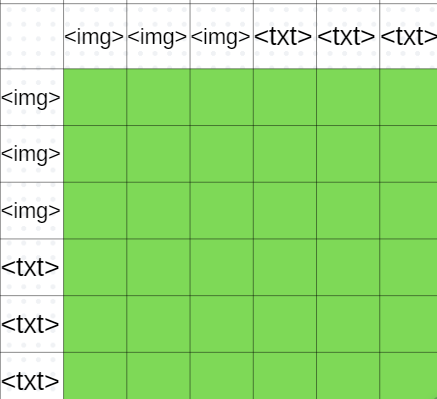 圖 3(a):Stage-0 訓練的注意力遮罩。
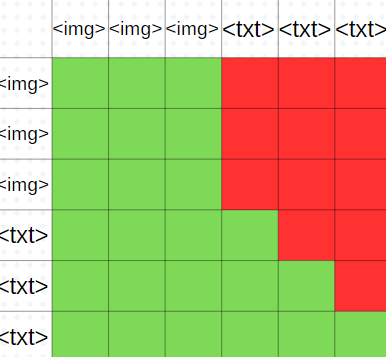 圖 3(b):Stage 1、2、3 訓練的注意力遮罩。
3.3 四階段訓練
Stage-0(對齊預訓練):
- 遮罩:全雙向注意力
- 凍結:語言模型凍結,只訓練投影器
- 資料:COCO-Recap-118k
- 技巧:隨機遮蔽 20% 的輸入 token 防止投影器學到恆等函數
- 時間:~1 小時
Stage-1(對齊微調):
- 遮罩:文字單向 + 圖像雙向
- 凍結:語言模型凍結,只訓練投影器
- 資料:COCO-Recap-118k
- 時間:~1 小時
Stage-2(全模型預訓練):
- 遮罩:同 Stage-1
- 全模型可訓練(視覺編碼器 + 投影器 + 語言模型)
- 資料:BLIP558k-Recap
- 時間:~12 小時
Stage-3(指令微調):
- 遮罩:同 Stage-1
- 全模型可訓練
- 資料:LLaVA-Next-790k(指令式問答資料)
損失函數為標準交叉熵損失:
$$L = -\frac{1}{M}\sum_{j=1}^{M}\sum_{i=1}^{N} y_{ij} \log(\hat{y}_{ij})$$
訓練使用 AdamW 優化器($\beta_1=0.9, \beta_2=0.999$, weight decay=0.01),餘弦衰減學習率排程,bfloat16 精度。
4. 實驗結果
硬體與時間
- GPU:NVIDIA A800(80GB)
- 總訓練時間:約 14 小時
圖像描述生成效能
| 指標 | Flickr8k | Flickr30k | COCO |
|---|---|---|---|
| BLEU-1 | 76.0 | 74.1 | 79.2 |
| BLEU-4 | 33.7 | 30.8 | 36.7 |
| METEOR | 27.8 | 25.2 | 29.1 |
| ROUGE-L | 57.8 | 53.6 | 58.4 |
| CIDEr | 99.4 | 80.5 | 127.1 |
與大模型比較(CIDEr 分數)
| 模型 | 參數量 | Flickr30k | COCO |
|---|---|---|---|
| GIT | - | 49.6 | 144.8 |
| Flamingo-80B | 80B | 67.2 | - |
| BLIP-2 | 13B | 71.6 | - |
| InstructBLIP | 13B | 82.8 | - |
| VILA | 13B | 74.7 | 118.5 |
| 本文模型 | 0.9B | 80.5 | 127.1 |
9 億參數的模型在 Flickr30k 上比 VILA-7B 高 25 分,比 VILA-13B 高 6 分。在 COCO 上比 VILA 高 8.6 分。不過 GIT 在 COCO 上仍以 144.8 領先。
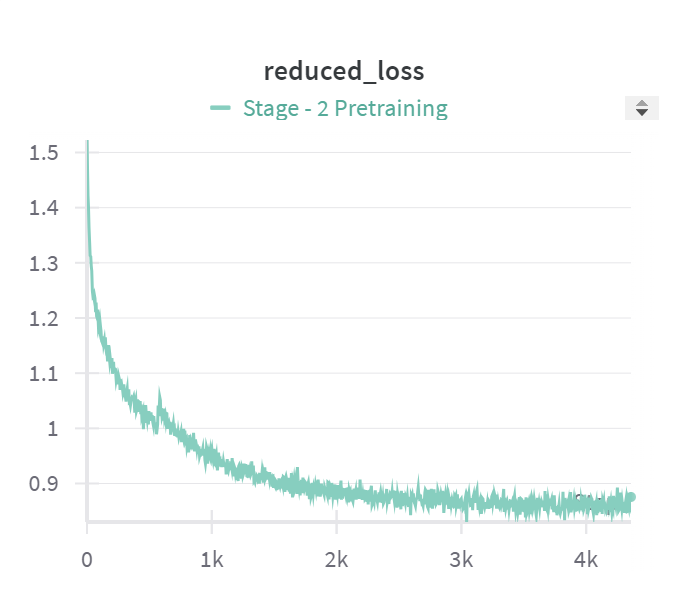 圖 4(a):Stage-2 訓練的損失曲線。
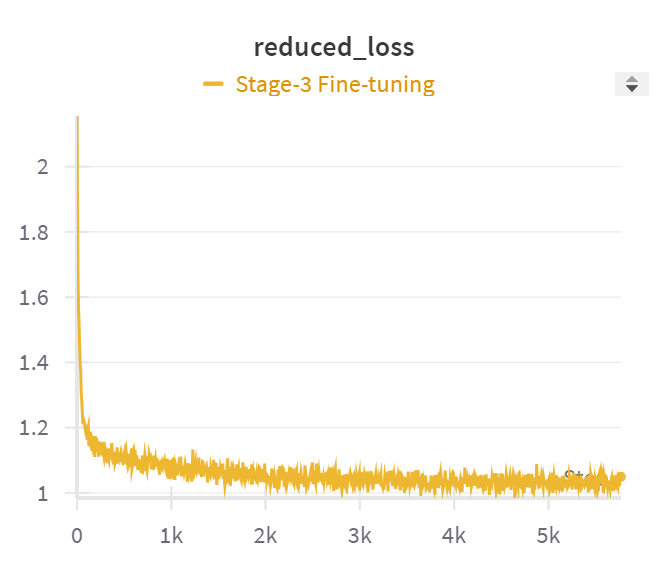 圖 4(b):Stage-3 訓練的損失曲線。
AI 生成 vs. 人工生成文字
模型在 AI 生成的描述上收斂更快:人工描述資料收斂到損失 ~5,而 AI 生成描述達到更低的損失值。AI 生成文字在語義相似的輸入上一致產生更低的損失,說明其語義一致性和簡潔性有利於模型學習。
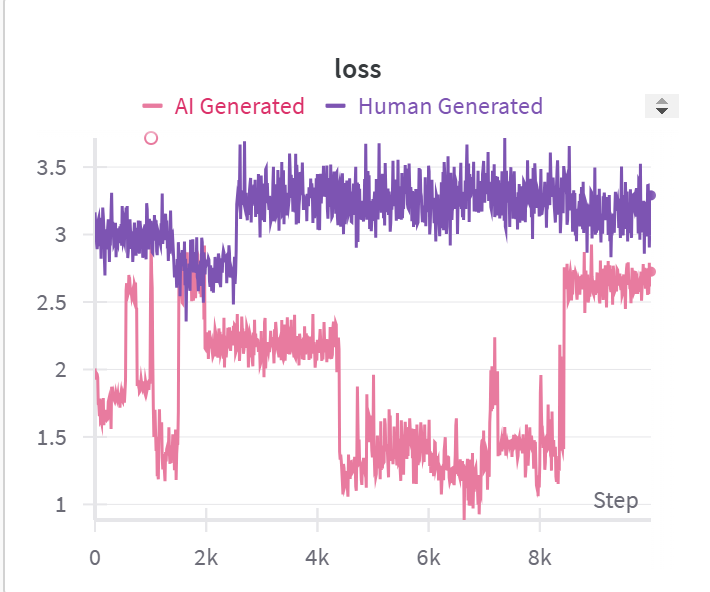 圖 5:AI 生成文字資料與人工撰寫文字資料的訓練損失比較。
醫學視覺問答 (PathVQA)
模型在病理學 VQA 上表現良好,能正確回答如「是否有肌肉組織?」(是)、「這是哪裡?」(泌尿系統)、「三色染色中什麼被染成藍色?」(膠原蛋白)等問題。
5. 結論
本文證明了從投影器到語言模型的漸進式學習很重要,不會降低語言模型的效能。四階段訓練策略搭配精心設計的注意力遮罩,使一個 9 億參數的模型在圖像描述生成、VQA 和醫學 VQA 上都有良好表現。
限制:目前只處理單張圖像-文字對,未支援多圖像交錯格式(如 MMC4、Flamingo 風格)。
未來方向:將注意力遮罩技術擴展到多圖像交錯資料集。
參考文獻
Vaswani, A., et al. Attention is All You Need. NeurIPS, 2017.
Dosovitskiy, A., et al. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR, 2021.
Radford, A., et al. Learning Transferable Visual Models from Natural Language Supervision. ICML, 2021.
Wang, Z., et al. SimVLM: Simple Visual Language Model Pretraining with Weak Supervision, 2021.
Beyer, L., et al. PaliGemma: A Versatile 3B VLM for Transfer, 2024.
Liu, H., et al. Visual Instruction Tuning. NeurIPS, 2023.
Li, J., et al. BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models. ICML, 2023.
Wang, J., et al. GIT: A Generative Image-to-Text Transformer for Vision and Language, 2022.
Alayrac, J.-B., et al. Flamingo: A Visual Language Model for Few-Shot Learning, 2022.
Lin, J., et al. VILA: On Pre-training for Visual Language Models. CVPR, 2024.
Zhai, X., et al. Sigmoid Loss for Language Image Pre-training. ICCV, 2023.
He, X., et al. PathVQA: 30000+ Questions for Medical Visual Question Answering, 2020.
Li, J., et al. BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding and Generation. ICML, 2022.
術語對照表
| 英文 | 中文 |
|---|---|
| Vision Language Model (VLM) | 視覺語言模型 |
| Modality Alignment | 模態對齊 |
| Attention Mask | 注意力遮罩 |
| Vision Encoder | 視覺編碼器 |
| Projector | 投影器 |
| Causal Masking | 因果遮罩 |
| Bidirectional Attention | 雙向注意力 |
| Image Captioning | 圖像描述生成 |
| Visual Question Answering (VQA) | 視覺問答 |
| Cross-Entropy Loss | 交叉熵損失 |
| Contrastive Pre-training | 對比式預訓練 |
| Auto-regressive | 自迴歸 |
| Fusion-based | 融合式 |
| Instruction Tuning | 指令微調 |
| Cosine Decay | 餘弦衰減 |
| Gradient Checkpointing | 梯度檢查點 |
| CIDEr | 共識型圖像描述評估 |