透過循環語言模型擴展潛在推理 / Ouro
原始論文:Scaling Latent Reasoning via Looped Language Models 作者:Rui-Jie Zhu, Zixuan Wang, Kai Hua, Tianyu Zhang, Ziniu Li, Haoran Que, Boyi Wei, Zixin Wen, Fan Yin, He Xing, Lu Li, Jiajun Shi, Kaijing Ma, Shanda Li, Taylor Kergan, Andrew Smith, Xingwei Qu, Mude Hui, Bohong Wu, Qiyang Min, Hongzhi Huang, Xun Zhou, Wei Ye, Jiaheng Liu, Jian Yang, Yunfeng Shi, Chenghua Lin, Enduo Zhao, Tianle Cai, Ge Zhang, Wenhao Huang, Yoshua Bengio, Jason Eshraghian 機構:ByteDance Seed, UC Santa Cruz, Princeton University, Mila - Quebec AI Institute, University of Montreal, Peking University, CMU, University of Pennsylvania, Conscium, University of Manchester, M-A-P arXiv ID:2510.25741v4 日期:2025-11-17 標籤:LoopLM Latent Reasoning Parameter Efficiency Pre-training Adaptive Computation Universal Transformer LLM 開源模型
目錄
摘要
現代大型語言模型 (Large Language Models, LLM) 主要透過顯式的文字生成來「思考」,例如思維鏈 (Chain-of-Thought, CoT),這把推理推遲到後訓練 (post-training) 階段,並未充分利用預訓練 (pre-training) 資料。我們提出並開源了 Ouro——以遞迴的銜尾蛇 (Ouroboros) 命名——一個預訓練的循環語言模型 (Looped Language Models, LoopLM) 家族。它把推理直接建構進預訓練階段,方法包括:(i) 在潛在空間 (latent space) 中進行迭代計算 (iterative computation);(ii) 用熵正則化 (entropy regularization) 目標學習深度配置;(iii) 將訓練擴展到 7.7T tokens。Ouro 1.4B 和 2.6B 模型在多項基準測試 (benchmark) 上展現出與 12B SOTA LLM 相當的優異表現。透過受控實驗 (controlled experiments),我們證明這個優勢並非來自更大的知識容量 (knowledge capacity),而是來自更出色的知識操弄 (knowledge manipulation) 能力。我們也展示 LoopLM 產生的推理軌跡比顯式 CoT 更貼合最終輸出。我們希望這些結果能展現 LoopLM 作為新穎擴展方向的潛力。
專案頁面與基礎/推理模型:http://ouro-llm.github.io
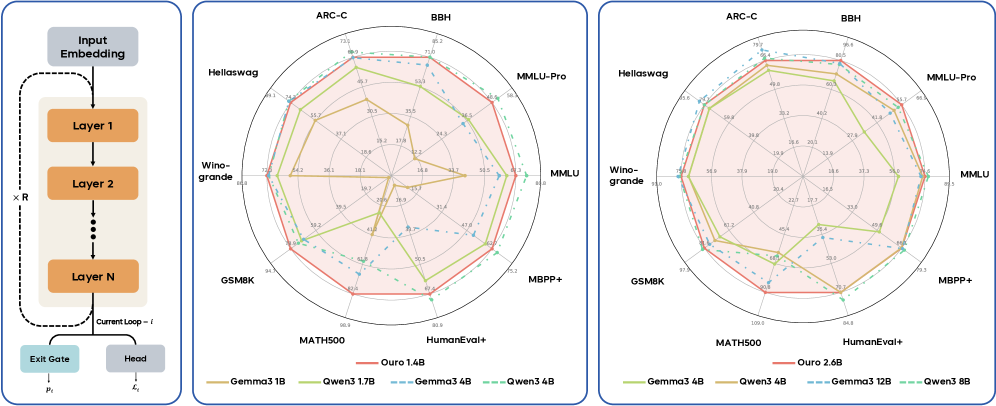
圖 1:Ouro 循環語言模型效能。(左)參數共享的循環架構。(中與右)Ouro 1.4B 和 2.6B 模型(皆為 4 個循環步驟,紅色)與獨立 transformer 基準模型的雷達比較圖。我們的模型表現可比擬甚至超越遠大於它們的基準模型。
1 介紹
大型語言模型 (LLM) 的進步歷來主要依賴擴展模型規模,並伴隨資料與算力的同步增長 [1, 2, 3, 4]。然而,部署擁有數千億參數的模型需要龐大的基礎設施,會增加延遲與成本,同時限制可及性。這些因素使「參數效率 (parameter efficiency)」變得至關重要:在固定的參數預算內取得更好的模型能力。這類模型不僅在有限資料集上更不容易過擬合 (overfitting),也能用更輕量的基礎設施實際部署。要達成參數效率,過去主要走兩條路。第一條是不論模型大小都擴大訓練語料 [5],但資料稀缺性逐漸限制了這條路。第二條是透過思維鏈 (CoT) 推理 [6] 利用推論時算力 (inference-time compute),讓模型藉由延長 token 生成在難題上花更多算力。
我們探索的是第三條路徑:基於架構創新,在固定參數預算內達成動態計算 (dynamic computation)。做法是把共享參數遞迴地套用——一組權重綁定 (weight-tied) 的層在前向傳播中被反覆重用。我們稱之為循環語言模型 (Looped Language Model, LoopLM)。這個設計帶來幾個優勢:第一,LoopLM 透過學習得到的早退 (early-exit) 機制實現自適應計算 (adaptive computation)——簡單輸入可以在較少的循環步驟後就終止,而複雜輸入則分配更多迭代。這把計算深度與參數量解耦了。第二,與 CoT 這類推論時方法不同,LoopLM 是藉由加深內部計算圖而非延長輸出序列來擴展,避免了上下文長度膨脹。第三,LoopLM 在相同資料下訓練時,可以提升每參數的容量 (capacity per parameter),並且超越更大規模的標準 transformer。
過去已有一系列研究在中等規模上探索 LoopLM [7, 8, 9, 10, 11, 12, 13, 14],從開創性的 Universal Transformer [15] 到遞迴 transformer [16] 與潛在推理方法 [17, 18, 19] 都是。然而,LoopLM 是否能在實際有意義的規模上轉化成前沿級的增益,仍未被驗證過。為此我們問:
LoopLM 在能力、效率與安全性上,是否相較於非遞迴的 transformer 模型展現出更有利的擴展行為?
我們的答案是:是。我們刻畫了 LoopLM 的擴展軌跡與飽和行為,證明 LoopLM 提供了更有效率的高效能路徑。這些主張在數兆 token 的訓練規模下被評估,遠超過先前工作。除了實驗上的增益外,我們也分析了這些改進背後的機制:
- 權重的遞迴重用是否能帶來通常需要靠增加非共享深度才能取得的能力提升?
- LoopLM 的增益是否隨循環次數單調 (monotonic) 增長?哪些因素會影響?
我們的貢獻
我們以一個多面向的研究來回答上述問題。我們把 LoopLM 預訓練擴展到 7.7T tokens,並徹底調查它在多個軸上的擴展行為。為了實現自適應計算,我們引入了能在保留尖峰效能的同時讓計算高效遞迴的訓練目標。我們也透過受控消融實驗 (controlled ablation) 隔離 LoopLM 增益的來源。具體貢獻如下:
- 規模上的卓越參數效率。在 7.7T tokens 上預訓練的 1.4B 和 2.6B LoopLM,在多數基準測試上可媲美 4B 和 8B 標準 transformer,達到 2-3 $\times$ 的參數效率增益,這對資源受限環境的部署至關重要(圖 1、圖 2)。
- 熵正則化的自適應計算。自適應退出容易塌陷到淺層,或過度使用長迴圈。我們以「在退出步驟上採用均勻先驗 (uniform prior)」的熵正則化避免這種塌陷,做到無偏的深度探索;之後再用一個聚焦訓練階段調整「算力—效能」權衡,並依輸入難度分配步數。
- 遞迴的機制理解。我們以「LM 物理學 (Physics of LMs)」框架啟發的受控實驗發現:遞迴並未提升原始知識儲存量(不論循環或非循環模型,每參數約 2 bits),但它戲劇性地強化了在事實組合 (fact composition) 與多跳推理 (multi-hop reasoning) 任務上的知識操弄能力。
- 改善的安全性與忠實性。LoopLM 在 HEx-PHI [20] 上降低了有害率 (harmfulness),安全性會隨循環步驟增加而提升(包括外推 (extrapolation) 步驟)。相較於 CoT,我們的迭代潛在更新所產生的推理軌跡與最終輸出對齊度更高,意味著更強的因果忠實性 (causal faithfulness),而不是事後合理化 (post-hoc rationalization)。
我們的研究將「迴圈深度」確立為超越模型大小與資料的第三條擴展軸,並公開釋出 Ouro 模型家族(1.4B 和 2.6B)以展示 LoopLM 在規模上的好處。
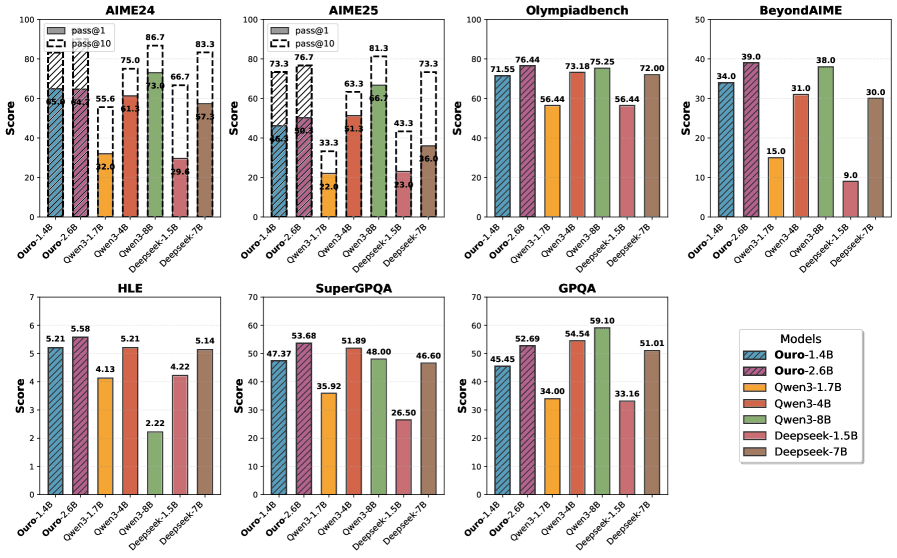
圖 2:在進階推理基準上的表現。Ouro-Thinking 模型與 Qwen3、DeepSeek-Distill 等強基準的比較。Ouro-1.4B-Thinking R4 與 4B 模型競爭,Ouro-2.6B-Thinking R4 在多個數學和科學資料集上達到甚至超越 8B 模型。
2 相關工作
這個架構的核心想法在最近的文獻中重新浮現,其中遞迴深度結構被用來提升現代 LLM 的效率與推理能力。例如,Geiping 等人 [17] 採用「遞迴深度 (recurrent depth)」在潛在空間中擴展測試時計算 (test-time computation)。同樣地,Saunshi 等人 [7] 證明「循環 transformer (looped transformers)」可以在推理任務上達到深度更深的非循環模型的水準,在形式上把循環與潛在思考的生成連結起來。這個方法在 [16] 中被進一步精煉成「Relaxed Recursive Transformers」:標準模型被轉換成共用同一基礎區塊,但在每個遞迴步驟中注入獨特的 LoRA adapter。類似概念在其他術語下出現,例如連續空間中的「pondering」[18] 與自適應計算的「inner thinking」[21]。更先進的變體如 Mixture-of-Recursions [22] 結合了遞迴的參數效率與自適應的 token 級路由。
從原始 Universal Transformer 到它的現代後裔,這條新興架構線可從兩個互補角度理解。其一,它像是一個所有層權重都被綁定的深度 transformer。其二,迭代的功能類似潛在推理 (latent reasoning),隱藏狀態 (hidden states) 形成一條潛在的思維鏈 (latent CoT),逐步精煉表徵 (representation) 來解任務。整體而言,這些結果顯示模型可以透過內部計算重用而非增加參數量來提升推理能力,把擴展從「規模」轉向「實質」。
觀點 1:把參數共享當作模型效率手段
這個觀點把 LoopLM 視為參數共享:一個或多個 transformer 區塊,甚至子模組(例如 attention、FFN)在模型深度方向上被重用,從而減少參數而不改變計算。現代 transformer 時代最知名的例子是 ALBERT [23],它結合參數重用與嵌入分解 (embedding factorization) 以大幅降低總參數量。在 LLM 廣泛採用之前,參數共享在機器翻譯領域被廣泛探索 [24];Takase 等人 [25] 系統地研究了平衡壓縮與準確度的共享策略。隨著模型變大,對參數重用的關注下降,但它最近又重新復興,用以縮小 LLM 的記憶體佔用。例如 Megrez2 [26] 在標準 Mixture-of-Experts (MoE) 模型中跨層重用 expert,並展示了在記憶體有限的邊緣 LLM 部署上的可行路徑。
觀點 2:潛在推理與迭代精煉
這裡 LoopLM 的迭代被視為潛在推理,每一步都是非語言的「思考」,用來精煉模型的內部表徵。經驗上,增加循環步驟數能改善複雜推理任務的表現 [17, 7]。有些模型把這個過程顯式化,把隱藏狀態回饋到輸入。Coconut 插入一個「連續思考 (continuous thought)」token,由前一步最後一層的隱藏狀態衍生,讓模型可以在連續潛在空間「思忖」[27]。CoTFormer 把 activation 交織回輸入後再套用共享層 [28]。這些顯式回饋迴圈與隱式 LoopLM 變體形成對比——後者整個思考過程都包含在從前一遞迴步到當前步的隱藏狀態演化中。所以,無論是觀點 1(模型壓縮)還是觀點 2(潛在推理),都是在利用共享參數的迭代來改進參數效率,並且都在被探索用於增強推理與高效率序列長度擴展(例如 PHD-Transformer [29])。
3 用 LoopLM 學習自適應潛在推理
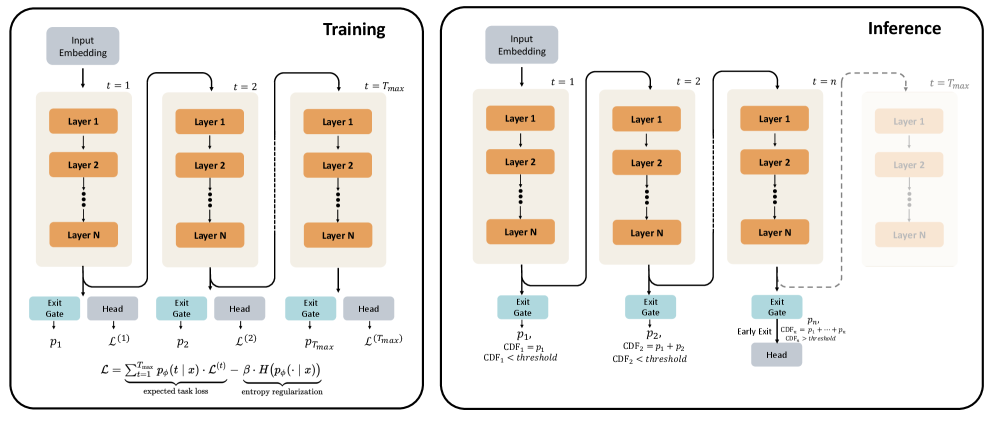
圖 3:循環語言模型 (LoopLM) 架構概覽。左(訓練):訓練時模型把一疊 $N$ 層反覆套用 $T_{max}$ 個遞迴步。在每個遞迴步 $\ell$,一個退出閘 (exit gate) 預測退出機率 $p_{\ell}$,而語言建模頭 $\mathcal{L}_{\ell}$ 計算語言建模損失。右(推論):在推論時,模型可基於累積退出機率提早退出。
本節我們在因果 transformer 上正式定義 LoopLM 架構,並提出我們用於自適應潛在推理的訓練方案。圖 3 描繪了訓練與推論時的架構。我們的目標是讓模型按 token 與按樣本選擇遞迴步數,在簡單輸入上花更少算力,在困難輸入上花更多,並且在可使用許多步驟時不犧牲準確度。
3.1 LoopLM 架構
設 $\mathrm{emb}(\cdot):\mathbb{R}^{|V|}\to\mathbb{R}^{d}$ 為 token 嵌入;$\mathcal{T}_{\theta}(\cdot):\mathbb{R}^{M\times d}\to\mathbb{R}^{M\times d}$ 為由 $\theta$ 參數化的因果 transformer 層,隱藏維度 $d$、輸入長度 $M$;$\mathrm{lmhead}(\cdot):\mathbb{R}^{d}\to\mathbb{R}^{|V|}$ 為詞彙量為 $V$ 的反嵌入層。一個非循環 LM 把 $L$ 層堆疊起來($\circ$ 表示函數合成):
$$F(\cdot):=\mathrm{lmhead}\circ\mathcal{M}^{L}\circ\mathrm{emb}(\cdot),\quad \mathcal{M}^{L}(\cdot):=\mathcal{T}_{\theta_{L}}\circ\cdots\circ\mathcal{T}_{\theta_{1}}(\cdot)$$
設 $t\in\{1,\dots,T_{\max}\}$ 為迴圈步數(即遞迴深度)。循環模型 $F^{(t)}$ 重用同一個深度為 $L$ 的層堆疊 $t$ 次:
$$F^{(t)}(\cdot)=\mathrm{lmhead}\circ\underbrace{\mathcal{M}^{L}\circ\mathcal{M}^{L}\circ\cdots\circ\mathcal{M}^{L}}_{t\text{ 次迭代}}\circ\ \mathrm{emb}(\cdot). \tag{1}$$
當 $t=1$ 時即為非循環模型 $F^{(1)}\equiv F$。如圖 3(左)所示,在每個遞迴步 $t$,模型產出一個語言建模頭輸出。我們在單一步 $t$ 的標準交叉熵損失定義為:
$$\mathcal{L}^{(t)}=\mathbb{E}_{x_{1:M}}\Bigg[\sum_{\ell=1}^{M-1}-\log\,p^{(t)}_{\theta}\!\big(x_{\ell+1}\mid x_{1:\ell}\big)\Bigg], \tag{2}$$
其中 $p^{(t)}_{\theta}(\cdot\mid x_{1:\ell})=\mathrm{softmax}\!\big(\mathrm{lmhead}(h^{(t)}_{\ell})\big)$,$x_{1:\ell}$ 表示輸入的長度為 $\ell$ 的前綴,而 $h^{(t)}_{\ell}$ 是位置 $\ell$ 經過 $t$ 次迴圈後的隱藏狀態。注意這只是單一遞迴步的損失;結合所有步驟的總訓練目標於後面定義。
先前文獻 [11, 7] 已顯示,擴大 $t$ 對推理任務有益。然而這會增加計算量,而且不是所有 token 都需要很多步 [30, 31]。因此把計算預算花在對的 token 上至關重要。這透過下節描述的閘控機制 (gating mechanism) 達成。
3.2 透過閘控機制實現自適應計算
為了實現自適應計算,我們在每一步 $t\leq T_{\max}$ 加入一個與 LM head 並行的退出閘(圖 3)。在每個迴圈 $t$,閘輸出一個瞬時(每步)的退出機率:
$$\lambda_{t}(x)=\sigma\left(\mathrm{Linear}_{\phi}\left(h^{(t)}\right)\right)\in(0,1)$$
其中 $h^{(t)}$ 是步驟 $t$ 最後一層的隱藏狀態,$\phi$ 是閘的參數。我們定義
$$S_{t}(x)=\prod_{j=1}^{t}\bigl(1-\lambda_{j}(x)\bigr),\qquad S_{0}(x)\equiv 1,$$
為「存活機率 (survival)」,即在前 $t$ 步沒退出的機率。在第 $t$ 步首次退出的未正規化機率為:
$$\tilde{p}_{t}(x)=\lambda_{t}(x)\,S_{t-1}(x),\qquad t=1,\dots,T_{\max}-1.$$
為了得到有效的離散分布,我們把剩餘質量分配到最後一步:
$$p_{\phi}(t\mid x)=\begin{cases}\tilde{p}_{t}(x),&t=1,\dots,T_{\max}-1,\\ S_{T_{\max}-1}(x),&t=T_{\max},\end{cases}\qquad \sum_{t=1}^{T_{\max}}p_{\phi}(t\mid x)=1. \tag{3}$$
帶早退的推論
如圖 3(右)所示,我們從學到的退出分布 $\{p_{\phi}(t\mid x)\}_{t=1}^{T_{\max}}$ 推斷出退出步驟,達成高效推論。到第 $n$ 步的累積退出機率為:
$$\mathrm{CDF}(n\mid x)=\sum_{t=1}^{n}p_{\phi}(t\mid x)=1-\prod_{j=1}^{n}\bigl(1-\lambda_{j}(x)\bigr),\quad n<T_{\max},\qquad \mathrm{CDF}(T_{\max}\mid x)=1.$$
給定門檻 $q\in[0,1]$,我們在累積機率首次跨越 $q$ 的那一步終止:
$$t_{\mathrm{exit}}(x)=\min\{\,m\in\{1,\dots,T_{\max}\}\,\;:\;\mathrm{CDF}(m\mid x)\geq q\,\}.$$
門檻 $q$ 控制算力—準確度的權衡:$q$ 越小越偏好早退(更省算力),$q$ 越大則允許更深的計算。實務上,$q$ 可以全域選擇、每任務校準,或排程搭配步數的下限/上限。這個確定性的、基於分位數的策略避免了取樣,又保持與學到的分布一致。
閘的參數 $\phi$(也就是 $p_{\phi}$)分兩階段學習:
- 第一階段:在預訓練期間,閘與 LM 一起以熵正則化目標聯合最佳化(第 3.3 節)。
- 第二階段:凍結 LM 並微調 $\phi$,以銳化 $p_{\phi}$(即調整深度配置)而不改變 token 級預測。
完整訓練目標見下節。
3.3 第一階段:學習熵正則化目標
在僅靠樸素梯度下降最佳化下一個 token 的損失時,越深的迴圈通常會把單步損失 $\mathcal{L}^{(t)}$(公式 2)降到某個深度為止;超過後增益遞減,梯度會把機率質量推向更晚的步驟。隨著 $p_{\phi}$ 集中在後段步驟,這些步驟得到更多訓練訊號,其損失進一步下降,結果又把更多質量拉到末端。這種自我強化會把 $p_{\phi}$ 塌陷到 $t=T_{\rm max}$。熵項懲罰塌陷到最深步驟,維持 $p_{\phi}$ 的足夠分散度以反映輸入難度。
給定單步損失 $\mathcal{L}^{(t)}$ 和退出步驟分布 $p_{\phi}(t\mid x)$,我們的訓練目標結合下一個 token 預測與熵正則化:
$$\mathcal{L}=\underbrace{\sum_{t=1}^{T_{\max}}p_{\phi}(t\mid x)\,\mathcal{L}^{(t)}}_{\text{期望任務損失}}-\underbrace{\beta\,H\!\left(p_{\phi}(\cdot\mid x)\right)}_{\text{熵正則化}}, \tag{4}$$
其中 $H\!\left(p_{\phi}(\cdot\mid x)\right)=-\sum_{t=1}^{T_{\max}}p_{\phi}(t\mid x)\log p_{\phi}(t\mid x)$。
直觀上,期望任務損失把每個 $\mathcal{L}^{(t)}$ 用第 $t$ 步退出機率加權。係數 $\beta$ 控制探索—利用的權衡:較大的 $\beta$ 鼓勵更高熵(更具探索性)的 $p_{\phi}$;較小的 $\beta$ 則允許 $p_{\phi}(t\mid x)$ 在模型對最佳深度有信心時把多數質量放在某一步。
另一種視角:以均勻先驗做變分推斷
公式 4 中的目標可視為證據下界 (Evidence Lower Bound, ELBO) 損失,其中退出步驟 $z\in\{1,\dots,T_{\max}\}$ 是潛變量,其變分後驗 (variational posterior) 是學到的退出分布 $p_{\phi}(z{=}t\mid x)$,先驗為 $\pi(t)$。負 ELBO 為:
$$\mathcal{L}_{\text{ELBO}}=\sum_{t=1}^{T_{\max}}p_{\phi}(t\mid x)\,\mathcal{L}^{(t)}\;+\;\beta\,\mathrm{KL}\!\big(p_{\phi}(\cdot\mid x)\,\|\,\pi(\cdot)\big).$$
當用均勻先驗 $\pi_{t}=1/T_{\max}$,KL 變成
$$\mathrm{KL}\!\big(p_{\phi}(\cdot\mid x)\,\|\,\pi\big)=-H\!\left(p_{\phi}(\cdot\mid x)\right)+\log T_{\max},$$
所以最小化 ELBO 等價於(差一個常數 $\log T_{\max}$)最佳化公式 4 的目標。這把熵項與 KL 正則項連結起來,並澄清「期望損失」是對退出步驟做邊緣化。它也與 PonderNet [32] 等自適應計算方法有關——後者也在最佳化動態暫停的 ELBO。
為什麼用均勻先驗?
不同先驗編碼不同的深度偏好。幾何先驗(如 [32])或泊松對數常態先驗 (Poisson-lognormal) 軟性偏好較早暫停 [17],而均勻先驗則對深度無偏。我們採用均勻先驗以把由輸入難度驅動的退出決策與任何全域算力偏好解耦;熵項則防止總是塌陷到 $T_{\rm max}$。與幾何先驗的實證比較見附錄 A。
3.4 第二階段:聚焦自適應閘訓練
在這個階段我們凍結 LM 參數,只訓練退出閘,讓終止決策基於實際觀察到的效能增益。我們用一個貪婪訊號平衡「多做一輪迴圈的邊際改進」與「額外算力」。
為了確保閘不會改變 LM 表徵,我們在每個 token $i$ 計算一個 detached 的每步損失 $\mathcal{L}_{i,\mathrm{stop}}^{(t)}$,並把第 $t-1$ 到 $t$ 步的損失改進定義為:
$$I^{(t)}_{i}=\max\!\big(0,\ \mathcal{L}_{i,\mathrm{stop}}^{(t-1)}-\mathcal{L}_{i,\mathrm{stop}}^{(t)}\big) \tag{5}$$
其中較大的 $I_{i}^{(t)}$ 表示仍在進步;較小的值表示增益已停滯,LoopLM 應該選擇早退。我們透過計算「理想繼續機率 (ideal continuation probability)」來實作這個概念,這是一個訓練標籤,指示是否繼續(接近 1)或退出(接近 0):
$$w^{(t)}_{i}=\sigma(k\cdot(I^{(t)}_{i}-\gamma))$$
斜率 $k=50.0$,門檻 $\gamma=0.005$,因此 $w^{(t)}_{i}\!\approx\!1$ 推薦繼續,$w^{(t)}_{i}\!\approx\!0$ 推薦退出。第 $t$ 步的自適應退出損失是閘預測的繼續機率 $1-\lambda^{(t)}_{i}$ 與理想標籤 $w^{(t)}_{i}$ 間的二元交叉熵 (binary cross-entropy),並對序列長度 $M$ 取平均:
$$\mathcal{L}^{(t)}_{\text{adaptive}}=-\frac{1}{M}\sum_{i=1}^{M}\!\Big[w^{(t)}_{i}\,\log(1-\lambda^{(t)}_{i})+(1-w^{(t)}_{i})\,\log\lambda^{(t)}_{i}\Big]. \tag{6}$$
總自適應損失對遞迴步驟取平均:
$$\mathcal{L}_{\text{adaptive}}=\frac{1}{T_{\max}}\sum_{t=2}^{T_{\max}}\mathcal{L}_{\text{adaptive}}^{(t)}$$
自適應損失的意義
公式 6 中的自適應損失訓練第 $t$ 步的閘,使其預測對齊由實際效能改進推導出的理想行為:
- 預測機率:閘產生 $\lambda^{(t)}_{i}$(退出機率)和 $1-\lambda^{(t)}_{i}$(繼續機率)
- 目標標籤:理想行為被編碼為 $w^{(t)}_{i}$(目標繼續機率)和 $1-w^{(t)}_{i}$(目標退出機率)
這個式子同時懲罰兩種失效模式:
- 想得不夠 (Underthinking):閘該繼續時退出(標籤 $w^{(t)}_{i}$ 大,但預測退出 $\lambda^{(t)}_{i}$ 大)
- 想得太多 (Overthinking):閘該退出時繼續(標籤 $w^{(t)}_{i}$ 小,但預測繼續 $1-\lambda^{(t)}_{i}$ 小)
最佳化公式 6 訓練閘做出貪婪的退出選擇,把額外算力換成可量測的改進。實證評估見第 5.4.1 節。
4 訓練循環語言模型
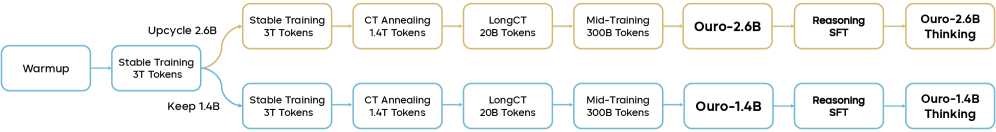
圖 4:端到端 Ouro 訓練流程:共享 warmup → 穩定訓練 → 分叉成 1.4B 保留路徑與 2.6B upcycled 路徑 → 四個共享階段 → Reasoning SFT 產生 Ouro-Thinking。
我們的端到端訓練流程顯示於圖 4。總共用 7.7T tokens 訓練基礎模型 Ouro-1.4B 和 Ouro-2.6B。最終的 Reasoning SFT (Supervised Fine-Tuning) 產生 Ouro-1.4B-Thinking 和 Ouro-2.6B-Thinking 變體。本節詳述每個訓練階段所用的架構、資料組成和具體配置。前四階段的訓練配方總結於表 1。
表 1:Ouro 1.4B 和 2.6B 的訓練配方。
| 超參數 | Stage 1a Pre-train I | Stage 1b Pre-train II | Stage 2 CT Annealing | Stage 3 LongCT | Stage 4 Mid-training |
|---|---|---|---|---|---|
| 學習率(最終) | $3.0\times 10^{-4}$ | $3.0\times 10^{-4}$ | $3.0\times 10^{-5}$ | $3.0\times 10^{-5}$ | $1.0\times 10^{-5}$ |
| LR scheduler | Constant | Constant | Cosine Decay | Constant | Cosine Decay |
| Weight decay | 0.1 | ||||
| Gradient norm clip | 1.0 | ||||
| Optimizer | AdamW ($\beta_{1}=0.9$, $\beta_{2}=0.95$) | ||||
| Batch size (tokens) | 4M $\to$ 8M | 8M | |||
| Sequence length | 4K | 4K | 16K | 64K | 32K |
| 訓練 tokens | 3T | 3T | 1.4T | 20B | 300B |
| 遞迴步數 | 8 | 4 | |||
| KL 散度 $\beta$ | 0.1 | 0.05 | |||
| RoPE base | 10K | 10K | 40K | 1M | 1M |
| Web 資料 | 高 | 高 | 中 | 低 | 低 |
| 數學與程式碼 | 低 | 低 | 高 | 低 | 高 |
| 長上下文 | 無 | 無 | 低 | 高 | 中 |
| SFT 品質 | 無 | 無 | 低 | 低 | 高 |
4.1 Transformer 架構
Ouro 模型用標準的 decoder-only Transformer [33],優先採用乾淨的循環計算機制實作而不做多餘修改。核心架構包含一疊遞迴套用的 transformer block。每個 block 用 Multi-Head Attention (MHA) 加上 Rotary Position Embeddings (RoPE) [34]。每個 block 的前饋網路 (FFN) 採用 SwiGLU activation [35]。為了提升訓練穩定性(這對深度遞迴計算尤其關鍵),我們採用三明治 (sandwich) 正規化結構,在 attention 和 FFN 兩個子層前都放一個 RMSNorm 層 [17]。兩個模型都用 SmolLM2 模型 [36] 的 49,152 token 詞表,這個 tokenizer 對程式碼與拉丁字母語言做了優化。架構細節見表 2。
表 2:Ouro 模型架構配置。兩個模型共用相同詞表與核心元件類型,差別在參數量與層深度。
| 模型 | 參數量 | 層數 | Hidden Size ($d_{\text{model}}$) | Attention | FFN | Pos. Embed. | 詞表大小 |
|---|---|---|---|---|---|---|---|
| Ouro 1.4B | 1.4B | 24 | 2048 | MHA | SwiGLU | RoPE | 49,152 |
| Ouro 2.6B | 2.6B | 48 | 2048 | MHA | SwiGLU | RoPE | 49,152 |
4.2 資料
資料決定了基礎模型的能力上限。我們的語料涵蓋網路文字、數學、程式碼和長上下文文件,跨多個階段,建立核心語言理解的同時強化推理、編碼和長上下文能力。除了標準網路爬蟲外,我們還包含針對性的數學推理和程式碼生成資料集,以改善複雜問題求解。表 3 總結了每個訓練階段的組成與規模。
表 3:訓練語料統計。因為預訓練時隨機抽樣,資料集大小不直接對應總共看到的 token 數。
| 資料來源 | 階段 | Tokens (B) | 使用 Tokens (B) |
|---|---|---|---|
| Nemotron-CC (Web) | Stage 1 | 6386 | 4404 |
| MAP-CC (Web) | Stage 1 | 800 | 780 |
| Ultra-FineWeb-zh (Web) | Stage 1 | 120 | 120 |
| OpenCoder-pretrain | Stage 1 | 450 | 450 |
| MegaMath-web | Stage 1 | 247 | 246 |
| MegaMath-high-quality | Stage 2 | 64 | 64 |
| Nemotron-CC-Math-v1 | Stage 2 | 210 | 210 |
| Nemotron-Code | Stage 2 | 53 | 53 |
| Nemotron-SFT-Code | Stage 2 | 48 | 48 |
| Nemotron-SFT-General | Stage 2 | 87 | 87 |
| OpenCoder-Annealing | Stage 2 | 7 | 7 |
| ProLong-64K | Stage 3 | 20 | 20 |
| Mid-training SFT Mix | Stage 4 | 182 | 90 |
表 4:Stage 1(Stable Training I & II)的資料組成。資料集總大小:6T tokens。
| 資料來源 | Nemotron-CC | MAP-CC | Ultra-FineWeb-zh | OpenCoder-pretrain | MegaMath-web |
|---|---|---|---|---|---|
| 比例 (%) | 73.4 | 13.0 | 2.0 | 7.5 | 4.1 |
為了確保可重現性,訓練語料完全由開源資料集組成。我們把資料分成四個階段,每個階段都採用與現代預訓練常用的 Warmup-Stable-Decay (WSD) 學習率排程器 [37] 對齊的構造策略。
Stage 1:預訓練
這個階段支援訓練的 warmup 與 stable 階段。語料主要由 Web CommonCrawl (CC) 資料組成。因為我們希望在 >2T tokens 上訓練,許多熱門的開源語料太小(例如 Fineweb-Edu 1.3T tokens [38],DCLM 2.6T tokens [39])。所以我們用 Nemotron-CC [40](6.3T tokens)做為 stable 階段的主要資料集。為了給模型基本的中文能力,我們納入 Ultra-FineWeb-zh [41] 與 MAP-CC [42]。但是由於 tokenizer 沒有中文詞表,中文字會被拆成多個 byte 級子 token,所以我們從 Stage 2 起移除了中文。為了強化編碼與數學能力,我們納入 OpenCoder [43] 與 MegaMath [44]。
Stage 2:持續訓練 (CT) 退火
CT 退火階段在退火學習率下納入更高品質的資料以增強模型。Token 序列長度延伸到 16K tokens,超過大多數樣本長度以最小化截斷。我們從 Nemotron-CC 的高品質子集構建語料,並補充 HQ MegaMath、Nemotron-CC-Math-v1 [45, 46]、OpenCoder-Annealing [43]、Nemotron-pre-training-Code-v1 [46] 和 Nemotron-pre-training-SFT-v1 [46]。
表 5:Stage 2 (CT Annealing) 的資料組成。資料集總大小:1.4T tokens。
| 資料來源 | 比例 (%) |
|---|---|
| Nemotron-CC-high-quality | 66.5 |
| Nemotron-CC-Math-v1 | 15.0 |
| MegaMath-high-quality | 4.6 |
| OpenCoder-LLM/opc-annealing-corpus | 0.5 |
| Nemotron-pre-training-Code-v1/Synthetic-Code | 3.8 |
| Nemotron-pre-training-SFT-v1/Nemotron-SFT-Code | 3.4 |
| Nemotron-pre-training-SFT-v1/Nemotron-SFT-General | 6.2 |
Stage 3:長上下文訓練 (LongCT)
LongCT 階段延伸模型的長上下文能力。我們採用 ProLong [47] 的 64K 長度子集(20B tokens)來訓練模型處理較長序列。
Stage 4:Mid-training
這個階段使用一組極高品質的資料,由 $\langle$Question, Answer$\rangle$ 和 $\langle$Question, CoT, Answer$\rangle$ 樣本組成,進一步發展進階能力。我們整合了 20+ 開源 SFT 資料集以擴大資料廣度,並徹底去汙染以避免與主流評估基準重疊。所有樣本都轉換成 ChatML 以降低後續後訓練階段的對齊稅 (alignment tax)。處理後得到 182B tokens,從中隨機抽樣 90B tokens。為了穩定訓練分布,我們從 Stage 1 重播 30B tokens,從 Stage 2 重播 180B tokens,得到 300B tokens 的有效量。
4.3 訓練穩定性與自適應配置
我們用 flame [48] 框架做預訓練,建構在 torchtitan [49] 上。訓練時我們把穩定性優先於激進的擴展,根據訓練動態的實證觀察做了幾個關鍵調整。這些決定對於遞迴架構達到穩定收斂至關重要——遞迴架構表現出與標準 transformer 不同的最佳化特性。
為穩定性而減少遞迴步數
我們在 Stage 1a (Stable Training I) 用 8 個遞迴步的初始實驗導致了 loss spike 和梯度震盪。我們推測這源於梯度流經多個遞迴迭代的複合效應,會放大小擾動。所以我們在 Stage 1b 把遞迴步數從 8 減到 4,平衡了計算深度與訓練穩定性。
Batch Size 縮放
為了進一步增強穩定性,我們漸進地把 batch size 從 4M 增加到 8M tokens。較大的 batch size 提供更穩定的梯度估計,這對遞迴架構特別重要。
KL 散度係數降低
我們策略性地把公式 4 中的 $\beta$ 從 Stage 1a 的 0.1 降到後續階段的 0.05。這個降低有雙重目的:(1) 降低任務損失與 KL 懲罰之間的衝突梯度,使最佳化更穩定;(2) 降低均勻先驗的「拉力」,讓模型有更大自由探索有益的深度模式。
最佳化配置
所有階段都用 AdamW,weight decay 設為 0.1,$\beta_{1}=0.9$、$\beta_{2}=0.95$,梯度裁剪在 1.0。這些保守設定是為了維持遞迴架構的穩定性。
學習率考量
我們經驗上發現,遞迴架構需要比參數量相當的 transformer 更小的學習率。
序列長度漸進
序列長度跨階段漸進增加:兩個預訓練階段都是 4K tokens,CT 退火為 16K,長上下文訓練為 64K,mid-training 為 32K。
4.3.1 階段性訓練細節
Stage 1a:預訓練第一階段(探索)。初始化用 8 個遞迴步。學習率採用 Warmup-Stable 排程,峰值為 $3\times 10^{-4}$。序列長度 4K,初始 batch size 4M tokens,逐步增加到 8M。此階段觀察到訓練不穩定性,促使後續架構調整。
Stage 1b:穩定性驅動的 upcycling 第二階段。我們把遞迴步數從 8 降到 4。為了維持計算效率同時改善穩定性,我們分成兩個變體:
- 1.4B Ouro:使用原始的 24 層預訓練層,4 個遞迴步
- 2.6B Ouro:透過層複製把 24 層 upcycle 到 48 層,4 個遞迴步
我們架構的遞迴本質讓這個 upcycling 過程特別平順,因為跨迭代共享的權重自然促成層複製,避免標準 transformer upcycling 常見的不穩定性。
Stage 2:CT 退火。學習率退火到 $3\times 10^{-5}$。遞迴步維持 4。
Stage 3:LongCT。Batch size 維持 8M tokens,降低後的 KL 係數($\beta=0.05$)即使在 64K 長度序列下也提供穩定的訓練動態。
Stage 4:Mid-training。學習率進一步降到 $1\times 10^{-5}$,配合 cosine scheduler。
4.4 監督式微調
資料組成
我們在約 8.3M 範例的多元語料上做 SFT,這些範例來自高品質公開資料集。如表 6 所示,訓練混合強調數學推理(3.5M 範例)和程式碼生成(3.2M 範例),同時納入科學推理(808K 範例)和對話能力(767K 範例)。
對於數學推理,我們結合 OpenThoughts3 [50] 和 AceReason-1.1-SFT [51]。程式碼訓練資料整合多個來源,包括 AceReason-1.1-SFT、OpenCodeReasoning [52]、Llama-Nemotron-Post-Training-Dataset [53] 和 OpenThoughts3。科學推理能力透過 OpenThoughts3 和 Llama-Nemotron-Post-Training-Dataset 發展,而對話熟練度則用 OO1-Chat-747K 和 DeepWriting-20K [54] 資料集增強。
訓練配置
我們訓練 2 個 epoch,最大序列長度 32K tokens,使用 LlamaFactory codebase [55]。Adam optimizer,學習率 $2\times 10^{-5}$、$\beta=(0.9,0.95)$,採用 cosine decay schedule。
表 6:監督式微調資料組成。總計 8.3M 範例,跨四個關鍵能力域。
| 主題 | 資料來源 | 規模 |
|---|---|---|
| Math | OpenThoughts3, AceReason-1.1-SFT | 3.5M |
| Code | AceReason-1.1-SFT, OpenCodeReasoning, Llama-Nemotron-Post-Training-Dataset, OpenThoughts3 | 3.2M |
| Science | OpenThoughts3, Llama-Nemotron-Post-Training-Dataset | 808K |
| Chat | OO1-Chat-747K, DeepWriting-20K | 767K |
4.5 強化學習嘗試
SFT 之後,我們用 DAPO [56] 和 GRPO [57] 在 DAPO-17K 資料集上做了探索性 RLVR (Reinforcement Learning with Verifiable Rewards) 對齊實驗。這些嘗試並沒有帶來相對於最終 SFT checkpoint 的顯著效能增益。主要問題源於模型的動態早退機制。vLLM/SGLang 透過固定執行路徑提供快速 rollout,而 LoopLM 的可變深度計算打破了這個假設。
我們試了兩個方法,都不成功:
- Off-policy rollouts:在 vLLM 中產生完整四步 rollout,每個 token 得到四個 logit 候選。然後選第一個超過終止門檻的 token 來模擬早退。對於更新,我們用累積到該步的損失,丟棄後續 tokens 與損失。這種 off-policy 不匹配(token 用最終深度產生,但損失在更早深度計算)並未改善效能。
- 固定 4-Round RL:為了避免 off-policy 問題,我們在固定四個遞迴步上做 rollout 與更新。訓練正常進行但效能未超過 SFT checkpoint。一個可能原因是規模:經過大量 SFT 之後,這些較小的模型可能 RL 增益空間有限。有趣的是,模型在推論時仍會在有益時用較少回合,儘管它是用四回合訓練的。這個泛化背後的機制仍不清楚。
我們會在開發出能完整支援 LoopLM 動態計算的基礎設施後,繼續探索這個架構的 RL 對齊。
5 實驗
5.1 基礎模型評估
我們對在 7.7T tokens 上用 LoopLM 架構訓練的 Ouro 基礎模型做全面評估。評估聚焦於它們在通用知識、推理、數學、科學、編碼和多語能力上的表現。所有基準都用 lm-eval-harness [58] 和 evalplus [59] 框架評估。
對於基礎模型基準,我們將 Ouro 模型與領先的開源基礎模型比較,包括 Qwen2.5 [2]、Qwen3 [3]、Gemma3 [4]、Llama3.1 [5] 和 Llama3.2 [5] 系列。所有模型都用相同的評估流程以確保公平比較。
表 7:1.4B LoopLM 模型與 1-4B 參數基準的比較。最佳分數粗體,次佳分數_底線_。
| Gemma3 1B | Llama3.2 1.2B | Qwen2.5 1.5B | Qwen3 1.7B | Qwen2.5 3B | Llama3.2 3B | Qwen3 4B | Gemma3 4B | Ouro 1.4B R4 | |
|---|---|---|---|---|---|---|---|---|---|
| 架構 | Dense | Dense | Dense | Dense | Dense | Dense | Dense | Dense | LoopLM |
| 參數 | 1.0B | 1.0B | 1.5B | 1.7B | 3.0B | 3.0B | 4.0B | 4.0B | 1.4B |
| Tokens | 2T | 9T | 18T | 36T | 18T | 9T | 36T | 4T | 7.7T |
| General | |||||||||
| MMLU | 39.85 | 45.46 | 60.99 | 62.46 | 65.62 | 59.69 | 73.19 | 58.37 | 67.35 |
| MMLU-Pro | 11.31 | 11.80 | 29.11 | 37.27 | 37.87 | 33.34 | 51.40 | 34.61 | 48.62 |
| BBH | 30.26 | 30.72 | 43.66 | 53.51 | 55.37 | 39.45 | 70.95 | 66.32 | 71.02 |
| ARC-C | 39.25 | 41.98 | 54.44 | 55.72 | 55.46 | 52.47 | 63.65 | 60.92 | 60.92 |
| HellaSwag | 56.12 | 59.35 | 67.73 | 67.09 | 74.54 | 73.09 | 75.66 | 75.58 | 74.29 |
| Winogrande | 58.72 | 62.75 | 66.77 | 66.30 | 70.17 | 69.14 | 71.19 | 71.07 | 72.30 |
| Math & Code | |||||||||
| GSM8K | 2.05 | 7.05 | 60.73 | 70.28 | 74.60 | 67.20 | 72.86 | 68.69 | 78.92 |
| MATH500 | 41.00 | 7.40 | 17.60 | 25.80 | 42.60 | 40.80 | 59.60 | 68.60 | 82.40 |
| HumanEval | 6.70 | 19.50 | 52.40 | 66.50 | 68.90 | 29.90 | 77.40 | 34.80 | 74.40 |
| HumanEval+ | 5.50 | 17.40 | 46.30 | 59.80 | 62.20 | 26.20 | 70.70 | 29.30 | 67.40 |
| MBPP | 12.40 | 35.70 | 60.30 | 68.00 | 63.00 | 50.30 | 78.80 | 60.60 | 73.00 |
| MBPP+ | 10.10 | 29.10 | 50.00 | 58.50 | 54.20 | 39.70 | 65.90 | 51.10 | 62.70 |
表 8:2.6B LoopLM 模型與 3-12B 參數基準的比較。
| Qwen2.5 3B | Llama3.2 3B | Qwen3 4B | Gemma3 4B | Qwen2.5 7B | Llama3.1 8B | Qwen3 8B | Gemma3 12B | Ouro 2.6B R4 | |
|---|---|---|---|---|---|---|---|---|---|
| 參數 | 3.0B | 3.0B | 4.0B | 4.0B | 7.0B | 8.0B | 8.0B | 12.0B | 2.6B |
| Tokens | 18T | 9T | 36T | 4T | 18T | 15T | 36T | 12T | 7.7T |
| MMLU | 65.62 | 59.69 | 73.19 | 58.37 | 74.20 | 73.02 | 76.63 | 72.14 | 74.60 |
| MMLU-Pro | 37.87 | 33.34 | 51.40 | 34.61 | 43.55 | 43.24 | 53.72 | 49.21 | 55.73 |
| BBH | 55.37 | 39.45 | 71.14 | 66.32 | 53.72 | 71.56 | 77.65 | 78.41 | 80.46 |
| ARC-C | 55.46 | 52.47 | 63.65 | 60.75 | 63.65 | 60.75 | 66.10 | 72.44 | 66.40 |
| GSM8K | 74.60 | 67.20 | 72.86 | 68.69 | 81.50 | 78.17 | 83.09 | 77.18 | 81.58 |
| MATH500 | 42.60 | 40.80 | 59.60 | 68.60 | 61.20 | 52.90 | 62.30 | 83.20 | 90.85 |
| HumanEval | 68.90 | 29.90 | 77.70 | 34.80 | 79.30 | 38.40 | 84.80 | 46.30 | 78.70 |
| HumanEval+ | 62.20 | 26.20 | 70.70 | 29.30 | 70.60 | 31.10 | 75.30 | 37.20 | 70.70 |
| MBPP | 63.00 | 50.30 | 78.80 | 60.60 | 73.80 | 62.40 | 79.00 | 73.50 | 80.40 |
| MBPP+ | 54.20 | 39.70 | 65.90 | 51.10 | 63.50 | 51.60 | 67.90 | 66.10 | 66.60 |
評估結果摘要
基於整體評估結果,我們強調基礎模型的關鍵結論:
- 我們的 1.4B Ouro 模型(4 個遞迴步)在大多數基準上達到與 4B Qwen3-Base 相當的效能。在 BBH (71.02 vs 70.95)、GSM8K (78.92 vs 72.86) 和 MATH500 (82.40 vs 59.60) 等困難推理任務上特別突出。
- 2.6B Ouro 模型在推理密集基準上超越多達 8B 參數的 dense 模型。它在 MMLU-Pro 達到 55.73、BBH 80.46、MATH500 90.85,超越 8B Qwen3-Base(53.72、77.65、62.30)。
- 遞迴架構在需要多步推理與知識操弄的任務上展現特別強的優勢,最顯著的增益在 MMLU-Pro、BBH、GSM8K 和 MATH500 上,驗證了「迭代計算增強推理能力」的假設。
5.2 推理模型評估
我們評估 Ouro-Thinking 推理模型(4 個遞迴步)在挑戰性數學與科學基準上的能力,這些基準需要多步問題解決與深度推理。評估包括 AIME 2024/2025、OlympiadBench、GPQA、SuperGPQA、BeyondAIME 和 HLE。
表 9:跨基準的效能比較。對 AIME24 和 AIME25,我們報告 pass@1/pass@10 指標。
| Model | AIME24 pass@1 | AIME24 pass@10 | AIME25 pass@1 | AIME25 pass@10 | Olympiad bench | Beyond AIME | HLE | Super GPQA | GPQA |
|---|---|---|---|---|---|---|---|---|---|
| Ouro-1.4B-Thinking-R4 | 65.0 | 83.3 | 46.3 | 73.3 | 71.6 | 34.0 | 5.21 | 47.4 | 45.5 |
| Ouro-2.6B-Thinking-R4 | 64.7 | 90.0 | 50.3 | 76.7 | 76.4 | 39.0 | 5.58 | 53.7 | 52.7 |
| Qwen3-1.7B | 32.0 | 55.6 | 22.0 | 33.3 | 56.4 | 15.0 | 4.13 | 35.9 | 34.0 |
| Qwen3-4B | 61.3 | 75.0 | 51.3 | 63.3 | 73.2 | 31.0 | 5.21 | 51.9 | 54.5 |
| Qwen3-8B | 73.0 | 86.7 | 66.7 | 81.3 | 75.3 | 38.0 | 2.22 | 48.0 | 59.1 |
| DeepSeek-Distill-Qwen-1.5B | 29.6 | 66.7 | 23.0 | 43.33 | 56.44 | 9.0 | 4.2 | 26.5 | 33.2 |
| DeepSeek-Distill-Qwen-7B | 57.3 | 83.3 | 36.0 | 73.3 | 72.0 | 30.0 | 5.14 | 46.6 | 51.0 |
評估結果:表 9 摘要結果。LoopLM 架構中的迭代推理在這些任務上提供一致的增益。1.4B 4 步 Ouro 模型在 OlympiadBench 達到 71.55(相對 Qwen3-4B 的 73.18),在 BeyondAIME 達到 34.0(vs Qwen3-4B 的 31.0)。2.6B 4 步變體在 OlympiadBench 達到 76.44(vs Qwen3-8B 的 75.25),在 BeyondAIME 達到 39.0(vs Qwen3-8B 的 38.0)。
5.3 各遞迴深度與外推效能
表 10:Ouro 1.4B 基礎模型在不同遞迴步上的表現(C-QA 是 CommonsenseQA [66])。Steps 5-8 是外推 (extrapolation),因為模型訓練最多到 4 步。效能在訓練深度 ($T=4$) 達峰值後逐漸退化。
| UT Step | ARC-C | ARC-E | C-QA | HellaSwag | MMLU | Winogrande |
|---|---|---|---|---|---|---|
| 1 | 37.63 | 63.85 | 44.64 | 55.24 | 41.21 | 56.99 |
| 2 | 54.86 | 80.30 | 67.98 | 71.15 | 60.43 | 66.69 |
| 3 | 59.47 | 83.33 | 74.37 | 74.07 | 66.71 | 71.35 |
| 4 | 60.92 | 83.96 | 75.43 | 74.29 | 67.45 | 72.30 |
| 5 (外推) | 58.96 | 82.91 | 75.35 | 73.72 | 66.64 | 70.32 |
| 6 (外推) | 59.73 | 82.58 | 74.94 | 72.77 | 65.77 | 71.03 |
| 7 (外推) | 58.96 | 81.99 | 74.28 | 72.35 | 65.28 | 70.09 |
| 8 (外推) | 58.19 | 82.07 | 73.55 | 71.60 | 64.49 | 69.30 |
表 11:Ouro 2.6B 基礎模型在不同遞迴步上的表現。
| UT Step | ARC-C | ARC-E | C-QA | HellaSwag | MMLU | Winogrande |
|---|---|---|---|---|---|---|
| 1 | 47.95 | 72.39 | 57.58 | 68.94 | 51.55 | 61.48 |
| 2 | 62.37 | 85.23 | 76.90 | 77.61 | 67.63 | 70.48 |
| 3 | 65.36 | 87.33 | 79.77 | 79.12 | 73.57 | 74.35 |
| 4 | 66.38 | 86.95 | 81.65 | 79.56 | 74.60 | 75.53 |
| 5 (外推) | 65.36 | 86.83 | 81.24 | 79.57 | 74.43 | 75.93 |
| 6 (外推) | 65.02 | 86.74 | 81.08 | 79.63 | 73.79 | 75.37 |
| 7 (外推) | 65.44 | 86.57 | 80.75 | 79.59 | 72.92 | 75.77 |
| 8 (外推) | 64.76 | 86.49 | 81.08 | 79.50 | 72.24 | 74.59 |
基礎模型效能:對於兩個基礎模型,標準基準上的效能通常在訓練深度 $T=4$ 達峰值。$T=5$ 到 $T=8$ 是訓練配置外的外推。如表所示,外推時基準效能有中等退化,相對 $T=4$ 的峰值有明顯下降。然而,這種任務專屬效能的退化與模型的安全性對齊形成鮮明對比——如第 7.1 節所述,模型的安全性會隨遞迴步數增加而提升,即使在外推範圍 ($T>4$) 也是如此。這意味著即使模型在基準上的細粒度知識超過訓練深度後可能下降,迭代精煉過程仍持續強化它的安全對齊。
表 12:Ouro-1.4B-Thinking 的遞迴步表現。模型在 $T=4$ 訓練。效能在 $T=4$ 或 $T=5$ 達峰值。
| Benchmark | T=1 | T=2 | T=3 | T=4 | T=5 | T=6 | T=7 | T=8 |
|---|---|---|---|---|---|---|---|---|
| OlympiadBench | 2.22 | 59.70 | 70.67 | 71.55 | 72.30 | 69.48 | 69.04 | 66.81 |
| SuperGPQA | 2.03 | 33.07 | 44.50 | 47.37 | 48.73 | 46.15 | 45.29 | 42.88 |
| AIME 2024 | 0.00 | 37.33 | 62.33 | 65.00 | 60.67 | 50.67 | 42.33 | 38.67 |
| AIME 2025 | 0.33 | 25.00 | 43.33 | 46.30 | 47.00 | 43.00 | 41.00 | 38.00 |
表 13:Ouro-2.6B-Thinking 的遞迴步表現。
| Benchmark | T=1 | T=2 | T=3 | T=4 | T=5 | T=6 | T=7 | T=8 |
|---|---|---|---|---|---|---|---|---|
| OlympiadBench | 18.96 | 68.59 | 75.56 | 76.44 | 71.85 | 69.19 | 57.63 | 39.26 |
| SuperGPQA | 15.66 | 48.58 | 56.70 | 53.68 | 56.45 | 55.44 | 53.32 | 46.84 |
| AIME 2024 | 3.00 | 52.00 | 70.33 | 64.70 | 57.00 | 56.33 | 49.67 | 39.00 |
| AIME 2025 | 2.00 | 40.67 | 50.67 | 50.30 | 49.33 | 46.00 | 38.00 | 24.33 |
SFT 模型效能:對於兩個 SFT 模型,$T=1$ 的表現非常低,證實迭代精煉對這些複雜任務不可或缺。1.4B 模型 (表 12) 在 $T=4$ 或 $T=5$ 附近達峰值。2.6B 模型 (表 13) 傾向稍早達到峰值,在 $T=3$ 或 $T=4$。
5.4 早退與自適應計算效率
5.4.1 早退策略
我們探索三種不同的方法來決定模型何時應該終止其迭代計算並產生最終輸出。
- 基準:靜態退出 (Static Exit)。最簡單的策略強制模型在預先設定的遞迴步退出,不論輸入特徵。
- 隱藏狀態差異門檻:監控連續遞迴步之間表徵變化的幅度。在每步 $t$ 計算 $\Delta h_{t}=\|h_{t}-h_{t-1}\|_{2}$,當 $\Delta h_{t}<\epsilon$ 觸發早退。
- 學習閘控搭配 Q-Exit 準則:我們的主要方法,使用第 4 節描述的學習退出閘。在推論時,我們套用 Q-exit 準則:在每步 $t$ 計算 CDF,當 CDF 超過門檻 $q\in[0,1]$ 時退出。
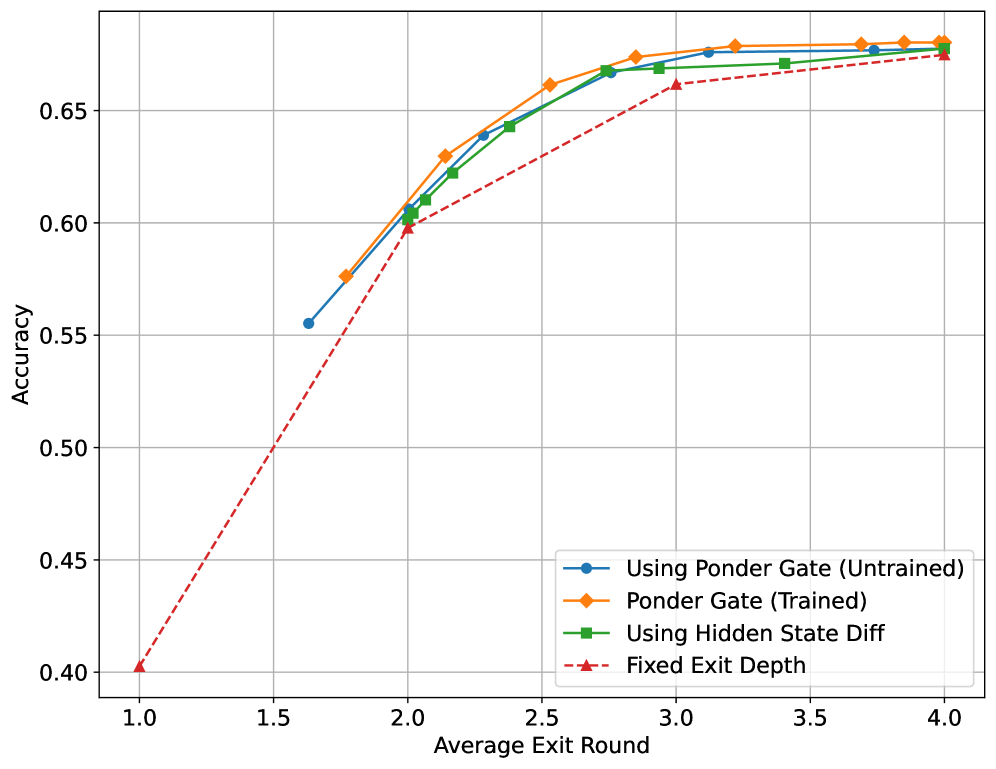
圖 5:MMLU 上早退策略的比較。我們在不同平均退出回合下評估四種方法:靜態基準(紅色三角形)、隱藏狀態差異門檻(綠色方塊)、標準預訓練的 Ponder gate(藍色圓圈)、加上第 3.4 節專門自適應退出訓練的 Ponder gate(橙色菱形)。
實驗結果:圖 5 展現了 MMLU 基準上所有策略的「準確度—效率」權衡曲線。
幾個關鍵發現:
- 加上專門自適應退出訓練的 Ponder gate 在每個算力預算下都達到最佳準確度。在平均退出回合 2.5 時,專門訓練達到 66% 準確度,而標準閘約 64%。
- 即使沒有專門訓練,標準預訓練的 Ponder gate 也大幅超越靜態基準,驗證了帶均勻先驗的熵正則化目標成功實現了自適應計算。
- 隱藏狀態差異門檻策略表現出乎意料地有競爭力,在大多數算力預算下緊跟兩個閘配置。
- 比較未訓練與訓練閘配置揭示了專門訓練程序的價值,差距約 2-3% 準確度。
- 基準從 1 到 4 回合的單調改進確認了「越深越好」的特性,同時揭示了報酬遞減。從 1 到 2 回合的戲劇性跳躍(40% 到 60% 準確度)對比 3 到 4 回合的微小增益(67.35% 準確度)。
5.4.2 推論效率的 KV cache 共享
我們架構的遞迴本質帶來一個挑戰:天真地,每個遞迴步都需要維護自己的 KV cache,導致 4 個步驟模型有 4$\times$ 記憶體開銷。我們調查了透過 KV cache 重用減少這個開銷的策略。
- Prefilling 階段:在處理輸入 prompt 時,我們發現所有四個遞迴步都需要自己的 KV cache。試圖在 prefilling 重用會導致效能退化(GSM8K 上 >10 點)。
- Decoding 階段:然而,在自迴歸生成的 decoding 階段,KV cache 重用變得可行。
表 14:Decoding 時的 KV cache 共享策略。Last-step 與 averaged 策略都達到最小效能損失,同時減少 4$\times$ 記憶體。
| 策略 | GSM8K | MATH-500 | 記憶體減少 |
|---|---|---|---|
| Full (4$\times$ cache) | 78.92 | 82.40 | 1.00$\times$ |
| First-step only | 18.73 | 8.43 | 4.00$\times$ |
| Last-step only | 78.85 | 80.40 | 4.00$\times$ |
| Averaged | 78.73 | 78.52 | 4.00$\times$ |
如表 14 所示,這些策略產生戲劇性不同的結果。只重用第一步的 cache 導致效能災難性崩塌(GSM8K 從 78.92 降到 18.73),意味著初始表徵不足以支撐後續 decoding。相對地,last-step 和 averaged 重用策略達到幾乎相同(GSM8K 內 0.3 點以內)的效能,同時成功將記憶體需求減少 4$\times$。
6 從參數化知識視角理解 LoopLM 的優越性
為什麼 LoopLM 在參數量沒有增加的情況下達到遠優於對方的表現? 雖然 [7] 中觀察到潛在的增強推理能力,但優勢的來源仍不清楚。具體來說,LoopLM 表現較好是因為相同參數量下知識容量增加?還是因為它們有更好的能力來提取與組合參數中編碼的知識?為了理解這個現象,我們探究:簡單地多迴圈幾次到底強化了哪些能力?
6.1 LoopLM 並未增加知識容量
設定:遵循「Physics of language models」[67, 68] 的 Capo 任務設定,我們建構合成傳記 (synthetic biographies) 來測試模型記憶多少資訊。具體而言,我們生成不同人數 $N$ 的合成傳記資料集 $\operatorname{bioS}(N)$,並訓練一系列語言模型來記憶資料集中的資訊。每個傳記包含個人姓名與五個屬性 $a_{1},\ldots,a_{5}$:性別、生日、大學、主修、雇主。
我們訓練了從 1M 到 40M 參數的 GPT-2 風格模型,並測量每個模型學到的知識位元數。
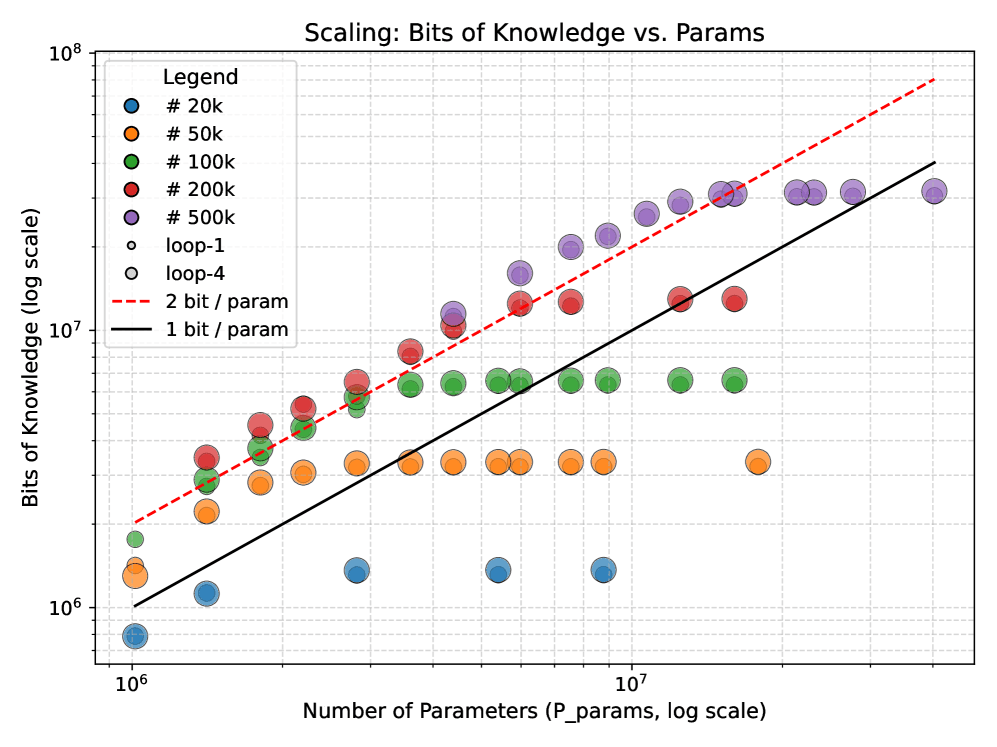
結果:在「bits vs. # of parameters」圖中,我們可以觀察到 iso-parameter 循環與非循環模型的比較。我們的結果顯示在圖 6(左):循環並未增加知識容量也未改善容量擴展。有循環和沒循環的模型都達到相似的容量比 $\approx 2$ bits/parameter。所以,參數量本身可被視為知識容量的直接指標,單純增加循環無法增強知識容量本身。
| $L=10$ | $L=16$ | $L=24$ | |
|---|---|---|---|
| Base $(12\otimes 1)$ | 93.6 | 94.4 | 34.8 |
| Base $(2\otimes 1)$ | 21.5 | 8.4 | 7.5 |
| Loop $(2\otimes 6)$ | 98.1 | 96.3 | 78.0 |
| Base $(3\otimes 1)$ | 75.4 | 29.8 | 11.0 |
| Loop $(3\otimes 4)$ | 97.9 | 95.8 | 92.2 |
| Base $(6\otimes 1)$ | 84.7 | 59.5 | 20.0 |
| Loop $(6\otimes 2)$ | 93.4 | 88.5 | 35.1 |
6.2 LoopLM 在知識操弄上勝出
我們已展示重用參數無法幫助模型記憶更多原子事實知識。但自然語言不只是單跳事實知識。在多數情境下,預測下一個 token 需要結合不同的知識片段,這稱為知識操弄 (knowledge manipulation) [67]。我們進一步考慮兩個合成任務來研究這個假設:基於模算術的合成 Mano 任務 [68],和組合個別事實的自然語言多跳 QA 任務 [69]。
Mano 任務:基於受限模算術知識的複雜樹結構。模型需要在沒有中間思考過程下解決任務。例如,<bos> + * a b c <eos> 要求模型直接輸出 $(a*b)+c$ mod 23。
我們考慮跨不同難度的測試準確度,以最大表達式長度 $L$ 為依據。我們準備三個難度等級 $L=[10,16,24]$ 來測試 LoopLM 對非循環模型的優越性。
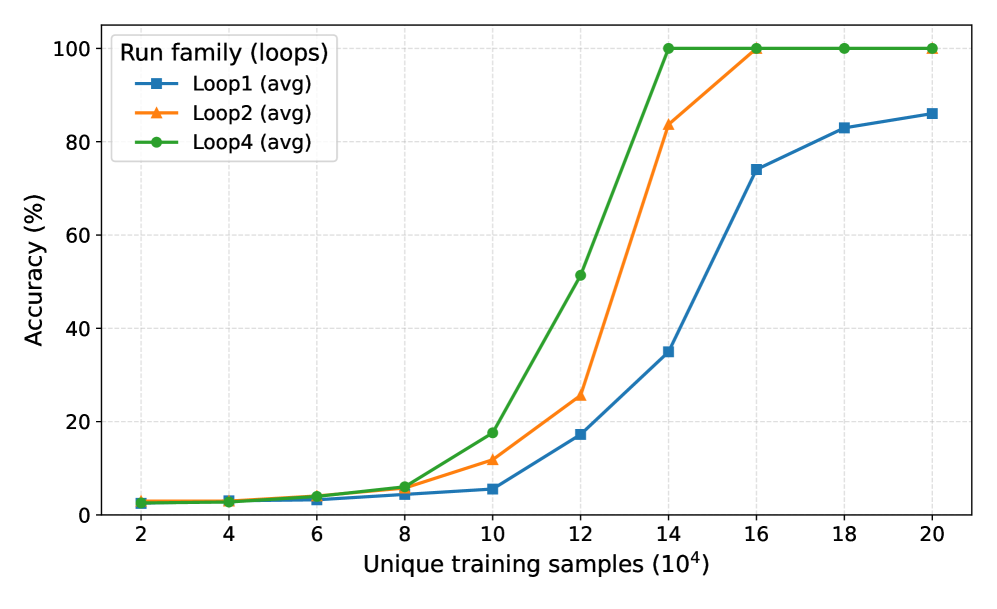
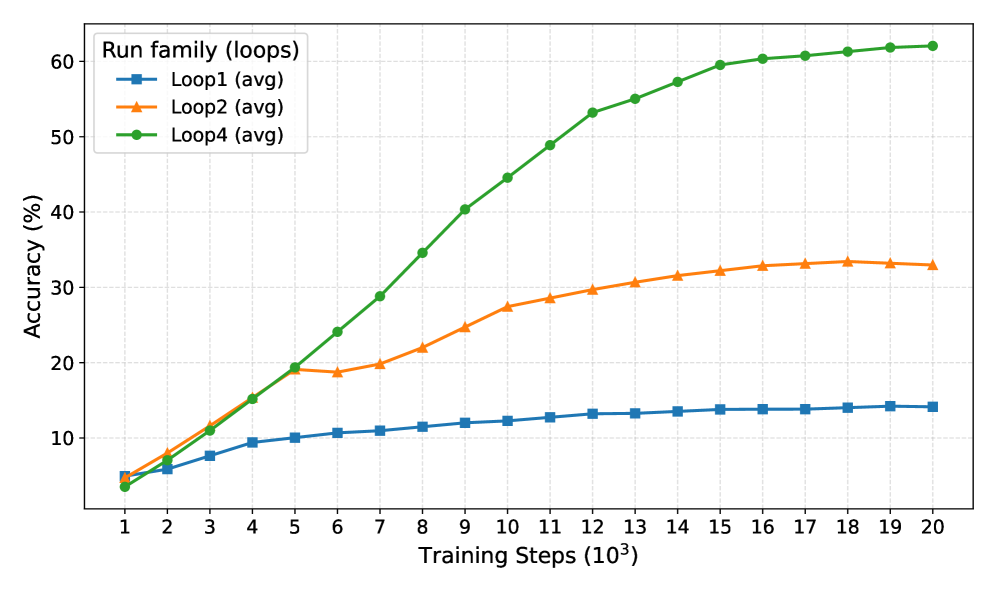
圖 7:我們在 Multi-hop QA 任務上訓練 LoopLM 與標準 transformer 基準。左:有更多迴圈的模型需要更少樣本來學習 3-hop QA 任務。右:以 15% 的所有可能 QA 對訓練 20000 步,迴圈更多的模型學得更快、表現更好。
結果:圖 6 的結果顯示,給定相同參數,循環模型對所有可能的 $k\in\{2,3,6\}$ 都優於它們的非循環對應。即使 FLOPs 相同,循環模型也常常表現更好。這意味著 LoopLM 對知識操弄有更好的歸納偏置 (inductive bias):在相同訓練樣本與計算預算下,當任務需要操弄能力(例如解析算術樹)但需要的知識量有限時,LoopLM 能達到相當甚至更好的表現。
Multi-hop QA:基於 [69] 提出的合成事實,例如 "The instructor of A is B" 和 "The teacher of B is C",目標是回答多跳問題如「誰是 A 的指導老師的老師?」結果(圖 7)顯示 LoopLM 用更少的範例學會 multi-hop QA 任務。
基於 Mano 和 multi-hop QA 的結果,我們得出結論:LoopLM 對更靈活的學到知識操弄有更好的歸納偏置,而非增加知識容量。這也對應於對既有基準(如 MMLU)的分析(見附錄 B.4):增加遞迴步數顯著改善推理密集類別的效能,而知識密集任務的改進有限。
6.3 討論:理解為什麼 LoopLM 有助於知識操弄
為什麼 LoopLM 自然偏向更好的參數空間知識操弄?我們推測原因在於 LoopLM 固有的遞迴結構。給定知識容量受參數量限制,迴圈讓 LoopLM 能更好地利用編碼在參數中的知識。LoopLM 可以在每個循環區塊中重用知識,檢索新的必要事實資訊,或套用結構化程序以獲得最終預測。
參數化知識圖上的搜尋:在預訓練期間,語言模型常獲得大量事實知識,並學到淺層思考深度的分析程序。為了執行更具挑戰性的任務,模型需要使用參數空間中的多個知識片段,這要求模型在由原子事實或知識形成、具方向性依賴關係的知識圖上做深度搜尋。LoopLM 自然地支援參數空間中知識與演算法的高效重用。
定理 1(非正式)
固定 $n$ 為合併知識圖 $G$ 的最大大小。給定 context graph $G_{\text{ctx}}$ 的鄰接矩陣與查詢對 $(s,t)$,存在一個獨立於 $G_{\text{ctx}}$ 的單層 transformer,循環 $O(\log_{2}D)$ 次,能檢查在合併知識圖 $(G+G_{\text{ctx}})$ 中是否存在從 $s$ 到 $t$ 的路徑,其中 $D$ 是 $(G+G_{\text{ctx}})$ 的直徑。
| 潛在推理方法 | Discrete CoT | Continuous CoT | Universal Transformer |
|---|---|---|---|
| 順序計算步驟 | $O(n^{2})$ | $O(D)$ | $O(\log D)$ |
Universal transformer 把全對連通性 (all-pair connectivity) 探索的並行性最大化,把順序計算步驟從 $O(n^{2})$ 指數地降到 $O(\log D)$,使得潛在推理比傳統 CoT 觀點 [7] 和連續 CoT [70] 高效得多。
遞迴改善樣本效率:對於沒有循環的深度 transformer 模型,它們潛在上必須探索一個大的函數類,其中每個區塊的參數沒有綁定。參數共享層可以幫助模型探索一個小得多的可實現假設類別,從而降低學習這些操弄任務的樣本複雜度。
7 安全性、忠實性與一致性
7.1 安全性
我們用 HEx-PHI 資料集 [20] 評估模型安全性,它包含 330 個範例,涵蓋 11 個禁止類別。HEx-PHI 用 GPT-4o 作為裁判,給每個模型回應一個 1 到 5 的有害分數。我們也計算有害率 (harmfulness rate),定義為收到最高有害分數 5 的測試案例比例。
我們評估 Ouro 1.4B 和 2.6B 在遞迴步從 1 到 8 的結果,並在圖 8(a) 報告。值得注意的是,雖然我們的模型只在 4 個遞迴步訓練,但兩個模型都展現出外推能力——在推論時把遞迴步延伸到 5-8。Ouro Thinking checkpoints 進一步增強安全對齊,在 4 個遞迴步把 Ouro 1.4B Thinking 的有害率降到 0.009,Ouro 2.6B Thinking 降到 0.003,與 Qwen3-4B-Thinking (0.009) 相當。
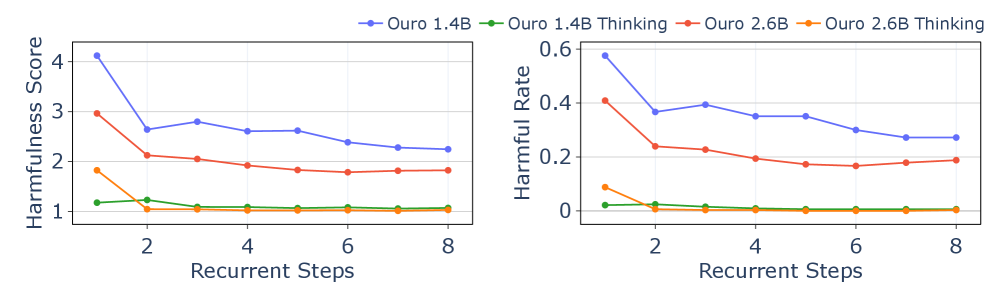
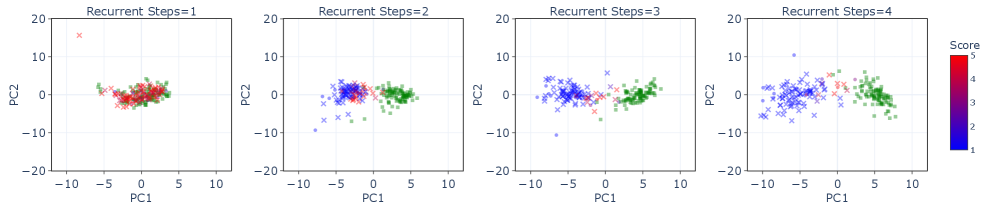
圖 8:(a) 對 1.4B 和 2.6B 模型,Ouro 隨遞迴步增加在 HEx-PHI 上展現改善的安全對齊。注意模型只在 4 個遞迴步訓練;步驟 5-8 的評估展現了成功的外推。(b) 隨遞迴步增加,Ouro 1.4B 能更好地區分良性與有害 prompt,產生更安全的回應。
為了進一步調查增加遞迴步如何影響安全對齊,我們對最頂層模型層上輸入最後一個 token 的隱藏表徵做主成分分析 (PCA)。我們選 100 個良性和 100 個有害問題(都是 "How to" 開頭的問題)。從圖 8(b) 我們觀察到:第一,隨著遞迴步數增加,模型變得更能分離良性與有害 prompt,產生更安全的回應;第二,與不安全回應相關的點大多出現在「良性」與「有害」群集邊界附近,這意味著區分有害性的困難可能導致不安全回應,而這可以透過增加遞迴步數來緩解。
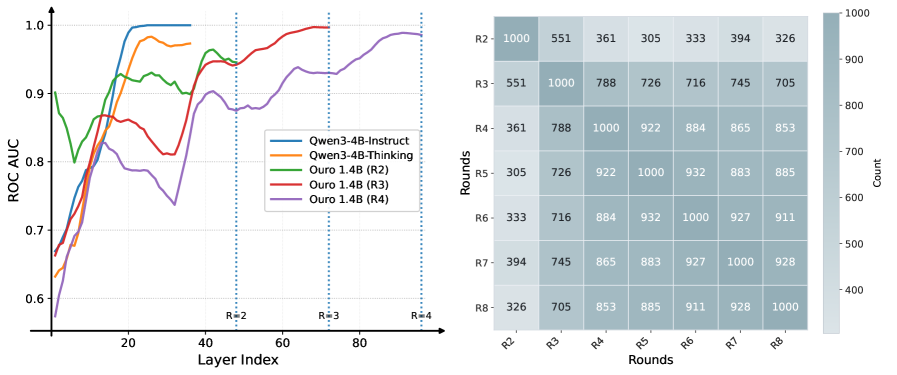
圖 9:左:Quora Question Pairs 上各層線性 probe 的 ROC AUC。每條色彩曲線顯示一個在 2 到 8 遞迴步內的隱藏狀態上訓練的 probe,預測該迴圈的答案。右:跨遞迴步的一致性。1000 個 Quora Question Pairs 的熱度圖 (A)。$A[i,j]$ 是步驟 $i$ 與 $j$ 賦予相同標籤的項目數。
7.2 忠實性
我們稱模型的思考過程為「忠實的 (faithful)」,如果它 (i) 程序上正確且 (ii) 與最終答案有因果耦合 (causally coupled)。具體而言,忠實的過程應該滿足反事實準則 (counterfactual criterion):如果對理由做介入(例如改成不同的中間狀態),最終預測也應該相應改變。越來越多的研究 [73, 74, 75, 76] 顯示,標準 LLM 常常先決定答案再生成 CoT 文字來合理化已成形的決定。
在 LoopLM 中,推理基底是潛在狀態的序列 $h^{(1)}\!\rightarrow\!h^{(2)}\!\rightarrow\!\cdots\!\rightarrow\!h^{(T)}$。每個轉移 $h^{(k)}\!\rightarrow\!h^{(k+1)}$ 用相同共享權重區塊執行非平凡計算,每一步都被訓練以改善任務目標。所以,通往答案的因果路徑是這條潛在軌跡,而不是任何可選的自然語言追蹤。
我們無法操弄潛在推理過程,所以採用一個觀察性代理:我們讀出中間隱藏表徵,並測試在允許多個合理標籤的輸入上預測是否隨遞迴加深而改變。我們用 Quora Question Pairs 資料集 [77],它問兩個短問題在語意上是否等價——這是一個有歧義且決策邊界弱定義的設定。
範例:Quora 資料集中的歧義問題
Pair 1:
- What are the questions should not ask on Quora?
- Which question should I ask on Quora?
答案:False
Pair 2:
- How do we prepare for Union Public Service Commission?
- How do I prepare for civil service?
答案:True
如果思考過程只是合理化預先承諾的答案,即使問題很歧義,答案也不會在推理過程後改變。這已在 Gemma-2 9B 上被報告,並且我們在 Qwen-3-4B-Thinking 上重現。如圖 9 左所示,Qwen3-4B-Thinking 模型最終 token logits 上的簡單線性 probe 顯示 0.99 ROC AUC 預測模型最終答案,意味著思考過程幾乎不影響結果。
在我們的模型中,情況非常不同。我們的 $1.4\mathrm{B}\!\times\!4$ 模型每個遞迴步用 24 層。我們在第 1 到 $24i$ 層的隱藏狀態上訓練線性 probe 預測第 $i$ 步答案。在單一遞迴步內,第 $i$ 步答案被第 $24i$ 層內表徵的 probe 良好預測,意味著狀態與決策之間有強烈的步內對齊。關鍵地,先前表徵(第 $24(i\!-\!1)$ 層)的 probe 對 $i\!\in\!\{2,3,4\}$ 並不能可靠地預測第 $i$ 步決定,顯示新的遞迴傳遞執行了能修正臨時選擇的額外計算。
我們進一步在 1000 個 Quora Question Pairs 上計算逐步一致性矩陣 $A$,其中 $A[i,j]$ 計算步驟 $i$ 和步驟 $j$ 之間相同標籤的數量。鄰近步驟從未達到完全一致;例如 $A[2,4]\!=\!361$ 顯示只有 36.1% 的步驟 2 答案與步驟 4 匹配。$A[2,3]\!=\!551$ 顯示只有 55.1%。我們也注意到當 $i\geq 4$,$A[i,i+1]$ 接近 1000——這個現象來自:(1) 模型沒學會在 $i>4$ 時遞迴推理;(2) 隨著迴圈增加,答案漸漸收斂到固定點。
總之,當 $i\leq 4$ 時跨步驟的系統性不一致正是忠實潛在過程應該展現的:模型隨遞迴加深而更新決定,中間預測不是凍結的最終輸出合理化。
7.3 更多討論
LoopLM 架構透過暴露一系列與最終預測強烈對齊的中間預測器,縮小了模型的表達推理與其最終答案之間可能分歧的鴻溝。我們總結三個部署優勢:
內建草稿模型用於投機解碼 (Speculative Decoding)
設 $\text{Text}(R_{t})$ 表示連到遞迴步 $t$ 後的潛在狀態的 LM head,設 $T$ 為部署時使用的最大步驟。
$$\bigl(\underbrace{\text{Text}(R_{s})}_{\text{proposal}},\;\underbrace{\text{Text}(R_{T})}_{\text{verifier}}\bigr),\qquad 1\leq s<T.$$
形成一個原生的「提案—驗證 (proposal-verification)」分解,用於投機解碼,無需訓練外部草稿模型。提案從 $\text{Text}(R_{s})$ 取樣,並在 $\text{Text}(R_{T})$ 下用標準接受測試驗證;被拒絕的 token 照常 roll back。
聯合加速與預先安全 (Pre-emptive Safety)
用相同的提案—驗證分割,安全檢查可以與投機解碼交織進行而不需額外模型。在步驟 $s$:
- 用 $\text{Text}(R_{t})$ 生成草稿 token,計算它們在 $\text{Text}(R_{T})$ 下的接受度。
- 在任何 token 浮現給使用者之前,對草稿分布或抽樣的草稿做安全篩查。
- 如果偵測到違規,在串流之前停止或重新導向回應。
任意時刻生成與單調精煉 (Anytime Generation)
第 3.4 節的訓練目標最佳化跨步驟的期望任務損失,同時保留「越深越好」的特性。所以對下一個 token 預測損失:
$$\mathbb{E}\big[\mathcal{L}^{(t+1)}\big]\leq\mathbb{E}\big[\mathcal{L}^{(t)}\big],\qquad 1\leq t<T,$$
每多一個迴圈都把分布精煉向更高品質的預測。這產生一個 anytime 演算法:解碼可以從任何中間步驟 $s$ 開始,並在後續步驟繼續驗證或修正時持續串流。
8 結論
在這項工作中,我們介紹了 Ouro,一個透過將迭代計算與自適應深度直接整合進 7.7T tokens 預訓練的循環語言模型家族,展示了卓越的參數效率。我們的 1.4B 和 2.6B 模型一致地匹配或超越 4B 和 8B 標準 transformer 的效能,達到 2-3$\times$ 的效率增益。我們證明這個優勢並非來自增加的知識儲存,而是來自根本上更優越的知識操弄能力,由合成實驗和理論分析支持。我們也提出了用熵正則化加均勻先驗學習自適應深度的實用訓練目標,並驗證了高效的 KV cache 共享策略,使 LoopLM 在真實世界部署上可行。
除了效能之外,LoopLM 架構展現獨特特性:其迭代精煉過程提供因果忠實的推理軌跡,緩解了標準 CoT 中的事後合理化問題;其安全對齊在遞迴步增加時獨特地改善,即使在外推時也是如此。這項工作將迭代潛在計算確立為超越參數與資料的關鍵第三條擴展軸。未來研究應該聚焦於增強更深層深度的效能外推,並探索更複雜的遞迴機制,使這個參數高效方法在資料受限時代成為必要方向。
致謝
我們衷心感謝 Zeyuan Allen-Zhu 在 LM 物理學部分的深入討論與對知識操弄的啟發性見解。感謝 Yuekun Yao 對 multi-hop QA 任務的寶貴見解與討論。我們也感謝 Yonghui Wu、Guang Shi、Shu Zhong、Tenglong Ao、Chen Chen、Songlin Yang、Wenhao Chai、Yuhong Chou 的洞見討論。特別感謝 Wenjia Zhu,他的話語讓我們看清當前模型的真正問題,並啟發我們探索這個方向。
貢獻
- 專案領導:Rui-Jie Zhu, Zixuan Wang, Kai Hua, Ge Zhang
- 核心貢獻者:
- Rui-Jie Zhu:提出專案並領導 Ouro 預訓練。最佳化預訓練與推論基礎設施,開發初始 vLLM 實作,探索 RLVR。
- Zixuan Wang:領導 LoopLM 優越性的理解分析與相關實驗。貢獻自適應早退策略設計、訓練與安全分析。
- Kai Hua:設計並策劃所有預訓練資料混合,並在預訓練過程中提供關鍵見解。
- Ge Zhang:共同領導並監督 Ouro。
- Tianyu Zhang:領導 Ouro 的一致性、安全與忠實性分析。
- Ziniu Li:領導後訓練階段,發展 SFT 並對 RLVR 探索做出關鍵貢獻。
- Haoran Que:領導 LoopLM 的擴展定律 (scaling law) 分析。
- Boyi Wei:貢獻安全分析,在 HEx-PHI 上做評估並對模型表徵做 PCA。
- Zixin Wen:貢獻理論分析、自適應退出策略設計、LM 物理學實驗、論文撰寫與 RLVR。
- Fan Yin:最佳化 vLLM 與 SGLang 對 Ouro 的實作。
- He Xing:貢獻 vLLM 基礎設施開發與最佳化。
- 監督:Ge Zhang, Wenhao Huang, Yoshua Bengio, Jason Eshraghian
附錄速覽
完整論文包含五個附錄,這裡簡要說明每個的內容(細節見原論文):
- 附錄 A(先驗選擇的實證驗證):在 776M LoopLM 上比較均勻先驗與幾何先驗 ($\eta\in\{0.1,\ldots,0.9\}$) 的訓練動態。在 FineWeb-Edu 20B tokens 上訓練。發現均勻先驗一致達到較低的訓練損失與更乾淨的收斂;幾何先驗的塌陷會把質量集中在淺步驟,削弱「越深越好」的特性。圖 10。
- 附錄 B(LoopLM 的物理學):B.1 知識容量 (Capo) 任務的合成傳記資料集 $\mathrm{bioS}(N)$ 細節,定義知識容量比 $R(F)$。B.2 知識操弄 (Mano) 任務的模算術設定。B.3 多跳 QA 任務的合成關係資料集細節。B.4 在 MMLU 不同類別上的案例研究(推理密集類別在多迴圈下提升大;知識密集類別提升有限)。B.5 LoopLM 表達能力的理論:證明在合併知識圖上 reachability 的單層 transformer 帶 $O(\log D)$ 迴圈即可解決。
- 附錄 C(評估設定):基礎模型評估(lm-eval-harness、evalplus 設定)與推理模型評估(in-house harness、LLM-as-judge)的詳細設定。
- 附錄 D(LoopLM 的擴展定律):研究三個問題:RQ1 標準模型與 LoopLM 之間的效能差距;RQ2 遞迴步如何影響總損失與步式損失;RQ3 總損失與步式損失之間的內在連結。
- 附錄 E(擴展定律細節):總損失與步式損失擴展定律的可推廣性分析。
【譯註:附錄 D-E 提出了 LoopLM 特有的擴展定律公式,把「迴圈深度」加進傳統「參數量 × 資料量」的縮放模型,是論文裡比較數學重的部分。對細節有興趣的讀者建議去看原論文與 https://arxiv.org/html/2510.25741v4。】
參考文獻
References preserved in original English. See the original paper on arXiv for the complete list.
Key references referenced in this translation:
- Tom Brown et al. Language models are few-shot learners. NeurIPS 2020.
- Qwen Team. Qwen2 technical report. arXiv:2407.10671, 2024.
- An Yang et al. Qwen3 technical report. arXiv:2505.09388, 2025.
- Gemma Team. Gemma 3 technical report. arXiv:2503.19786, 2025.
- Abhimanyu Dubey et al. The Llama 3 herd of models. arXiv:2407, 2024.
- Jason Wei et al. Chain-of-thought prompting elicits reasoning in large language models. NeurIPS 2022.
- Saunshi et al. Looped transformers... (formal connection between looping and latent thoughts).
- Dehghani et al. Universal Transformers. ICLR 2019.
- Bae et al. Relaxed Recursive Transformers.
- Geiping et al. Recurrent depth for scaling test-time computation in latent space.
- Banino et al. PonderNet.
- Qi et al. HEx-PHI: A safety benchmark for prohibited content.
- Mixture-of-Recursions.
- Lan et al. ALBERT: A Lite BERT.
- Hao et al. Coconut: Continuous thought.
- Banino et al. PonderNet.
- Vaswani et al. Attention is all you need. NeurIPS 2017.
- Su et al. RoFormer: Enhanced transformer with rotary position embedding.
- Shazeer. GLU variants improve transformer.
- SmolLM2.
- Hu et al. MiniCPM (WSD scheduler).
- Nemotron-CC.
- DAPO.
- GRPO. 67-68. Allen-Zhu & Li. Physics of language models.
- Quora Question Pairs.
完整文獻清單請參考原論文 (arXiv:2510.25741)。
術語對照表
| English | 繁體中文 |
|---|---|
| Looped Language Model (LoopLM) | 循環語言模型 |
| Latent Reasoning | 潛在推理 |
| Latent Space | 潛在空間 |
| Iterative Computation | 迭代計算 |
| Adaptive Computation | 自適應計算 |
| Early Exit | 早退 |
| Recurrent Step | 遞迴步驟 |
| Recurrent Depth | 遞迴深度 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Pre-training | 預訓練 |
| Post-training | 後訓練 |
| Mid-training | 中段訓練 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Reinforcement Learning with Verifiable Rewards (RLVR) | 可驗證獎勵強化學習 |
| Entropy Regularization | 熵正則化 |
| Uniform Prior | 均勻先驗 |
| Geometric Prior | 幾何先驗 |
| KL Divergence | KL 散度 |
| ELBO (Evidence Lower Bound) | 證據下界 |
| Variational Posterior | 變分後驗 |
| Variational Inference | 變分推斷 |
| Latent Variable | 潛變量 |
| Survival Probability | 存活機率 |
| CDF (Cumulative Distribution Function) | 累積分布函數 |
| Hidden State | 隱藏狀態 |
| Representation | 表徵 |
| Token Embedding | Token 嵌入 |
| Unembedding Layer | 反嵌入層 |
| Cross-entropy Loss | 交叉熵損失 |
| Binary Cross-entropy | 二元交叉熵 |
| Gating Mechanism | 閘控機制 |
| Exit Gate | 退出閘 |
| Gate Parameters | 閘參數 |
| Q-Exit Criterion | Q-Exit 準則 |
| Static Exit | 靜態退出 |
| Hidden State Difference Threshold | 隱藏狀態差異門檻 |
| Underthinking / Overthinking | 想得不夠 / 想得太多 |
| Knowledge Capacity | 知識容量 |
| Knowledge Manipulation | 知識操弄 |
| Multi-hop Reasoning | 多跳推理 |
| Synthetic Biographies | 合成傳記 |
| Multi-Head Attention (MHA) | 多頭注意力 |
| Rotary Position Embeddings (RoPE) | 旋轉位置嵌入 |
| Feed-Forward Network (FFN) | 前饋網路 |
| SwiGLU Activation | SwiGLU 激活函數 |
| RMSNorm | 均方根層歸一化 |
| Sandwich Normalization | 三明治正規化 |
| Decoder-only Transformer | 純解碼器 Transformer |
| Universal Transformer | 通用 Transformer |
| Weight-Tied / Parameter Sharing | 權重綁定 / 參數共享 |
| Upcycling / Layer Duplication | Upcycling / 層複製 |
| Ouroboros | 銜尾蛇 |
| Warmup-Stable-Decay (WSD) | Warmup-Stable-Decay 排程 |
| Continual Training (CT) Annealing | 持續訓練退火 |
| LongCT (Long Context Training) | 長上下文訓練 |
| AdamW | AdamW 最佳化器 |
| Weight Decay | 權重衰減 |
| Gradient Clipping | 梯度裁剪 |
| Loss Spike | 損失尖峰 |
| Gradient Oscillation | 梯度震盪 |
| Batch Size | 批次大小 |
| Learning Rate | 學習率 |
| Cosine Decay | 餘弦衰減 |
| Sequence Length | 序列長度 |
| Context Length | 上下文長度 |
| ChatML | ChatML 對話格式 |
| Alignment Tax | 對齊稅 |
| Speculative Decoding | 投機解碼 |
| Draft Model / Verifier | 草稿模型 / 驗證器 |
| Anytime Generation | 任意時刻生成 |
| Monotone Refinement | 單調精煉 |
| KV Cache | KV 快取 |
| Prefilling Phase | Prefilling 階段 |
| Decoding Phase | Decoding 階段 |
| Auto-regressive Generation | 自迴歸生成 |
| Inference-Time Compute | 推論時算力 |
| Test-Time Computation | 測試時計算 |
| FLOPs (Floating Point Operations) | 浮點運算次數 |
| Iso-parameter | 同參數量 |
| Iso-flop | 同 FLOP |
| Inductive Bias | 歸納偏置 |
| Sample Efficiency | 樣本效率 |
| Scaling Law | 擴展定律 |
| Scaling Axis | 擴展軸 |
| Parameter Efficiency | 參數效率 |
| Capacity per Parameter | 每參數容量 |
| Knowledge Graph | 知識圖 |
| Graph Reachability | 圖可達性 |
| All-pair Connectivity | 全對連通性 |
| Diameter (graph) | 直徑(圖) |
| Adjacency Matrix | 鄰接矩陣 |
| Causal Faithfulness | 因果忠實性 |
| Counterfactual Criterion | 反事實準則 |
| Post-hoc Rationalization | 事後合理化 |
| Linear Probe | 線性 Probe |
| ROC AUC | ROC 曲線下面積 |
| PCA (Principal Component Analysis) | 主成分分析 |
| Harmfulness Rate | 有害率 |
| Pre-emptive Safety | 預先安全 |
| Safety Alignment | 安全對齊 |
| Extrapolation | 外推 |
| Interpolation | 內插 |
| Convergence | 收斂 |
| Gradient Descent | 梯度下降 |
| Self-reinforcement | 自我強化 |
| Collapse | 塌陷 |
| Exploration-Exploitation Trade-off | 探索—利用權衡 |
| Compute-Accuracy Trade-off | 算力—準確度權衡 |
| Pareto Frontier | 帕雷托前緣 |
| Sliding Average | 滑動平均 |
| Logit | logit |
| Off-policy / On-policy | 離策略 / 在策略 |
| Rollout | rollout |
| Reward | 獎勵 |
| Halting | 暫停 |
| Pondering | 思忖 |
| Fact Composition | 事實組合 |
| Multi-hop Question Answering | 多跳問答 |