大型語言模型推論硬體的挑戰與研究方向
原始論文:Challenges and Research Directions for Large Language Model Inference Hardware 作者:Xiaoyu Ma, David Patterson arXiv ID:2601.05047v3 機構:Google DeepMind 日期:2026-01-08(v1)/2026-02-06(v3) 標籤:LLM Inference Hardware Memory Wall HBM HBF Processing-Near-Memory 3D Stacking Datacenter AI TCO
目錄
摘要
我們指出四個有潛力的研究機會,能改善資料中心 AI 的大型語言模型 (Large Language Model, LLM) 推論:用 高頻寬快閃記憶體 (High Bandwidth Flash, HBF) 來把記憶體容量做到 10 倍、同時維持類似 HBM 的頻寬;用近記憶體運算 (Processing-Near-Memory) 與 3D 記憶體—邏輯堆疊來取得高記憶體頻寬;以及用低延遲互連來加速通訊。本文聚焦在資料中心 AI,但也回顧這些技術在行動裝置上的適用性。
1. 引言 (Introduction)
當其中一位作者在 1976 年踏入這個領域時,計算機架構研討會大約 40% 的論文來自業界。到 2025 年的 ISCA (International Symposium on Computer Architecture) 上,這個比例掉到 4% 以下,暗示研究與實務之間有一道接近斷裂的鴻溝。我們希望藉由本文提出的研究方向,重新接上這條歷史紐帶——這些方向若被認真追求,將有機會解決 AI 產業面對的最大硬體挑戰。
大型語言模型推論已經是一場危機。 硬體的快速進步推動了 AI 進展。預測顯示,未來 5–8 年內推論晶片的年銷售額將成長為 4–6 倍 [1]。儘管訓練展現了驚人的 AI 突破,推論成本決定了經濟可行性。當公司使用這些模型的需求劇增時,承擔最先進模型的服務成本會變得非常昂貴 [2,3]。
新趨勢使推論變得更難。 近期 LLM 進展增加了推論所需的資源:
混合專家 (Mixture of Experts, MoE):與單一密集 (dense) 前饋區塊不同,MoE 使用數十到數百個專家——例如 DeepSeek v3 用了 256 個——並選擇性地呼叫其中一部分。這種稀疏性 (sparsity) 讓模型尺寸能大幅成長以追求更高品質,而訓練成本只增加一些。雖然 MoE 對訓練有幫助,它惡化了推論:放大了記憶體與通訊需求。
推理模型 (Reasoning models):推理是一種「先想後做 (think-before-act)」的技巧,用來提升品質。額外的「思考」步驟在最終回答之前產生一長串「想法 (thoughts)」,類似人類逐步解題的方式。思考會大幅增加生成延遲,並且這條長長的想法序列會壓榨記憶體。
多模態 (Multimodal):LLM 已經從文字進化到圖像、音訊與影片生成。較大的資料型別比文字生成需要更多資源。
長脈絡 (Long context):脈絡視窗 (context window) 是指 LLM 在生成回答時可以一次看的資訊量。較長的脈絡有助於品質,但會增加運算與記憶體需求。
檢索增強生成 (Retrieval-Augmented Generation, RAG):RAG 存取使用者特定的知識庫,在 LLM 結果中加入額外的脈絡,增加資源需求。
擴散 (Diffusion):與循序生成 token 的自回歸方法不同,新的擴散方法在一步內生成所有 token(例如整張圖像),然後反覆 去雜訊 (denoise) 直到達成期望品質。和上面其他項目不同,擴散只增加運算需求。
LLM 推論這個成長中的市場與挑戰,預示著創新的巨大機會與必要性!
2. 目前的 LLM 推論硬體與其低效之處
我們先回顧 LLM 推論的基本流程,以及主流 AI 架構在資料中心情境下的主要瓶頸。LLM 在行動裝置上有不同的限制(例如不能用 HBM),因此會走不同路線。
LLM 的核心是 Transformer,其推論有兩個特性差異很大的階段:Prefill 與 Decode(圖 1)。Prefill 類似訓練——同時處理輸入序列的所有 token,因此本質上是高度平行、且通常為運算瓶頸 (compute bound)。相對地,Decode 本質上是循序的,每個步驟產生一個輸出 token(「自回歸 (autoregressive)」),這使它變成記憶體瓶頸 (memory bound)。Key Value (KV) Cache 把這兩個階段串接起來,其大小與輸入加輸出的序列長度成正比。雖然在圖 1 一起呈現,但 Prefill 和 Decode 並沒有緊耦合,並且通常跑在不同伺服器上。拆解式推論 (disaggregated inference) 允許像批次處理 (batching) 這類軟體最佳化把 Decode 變得比較不那麼受記憶體限制。一份高效 LLM 推論的調查回顧了眾多軟體最佳化方法 [4]。
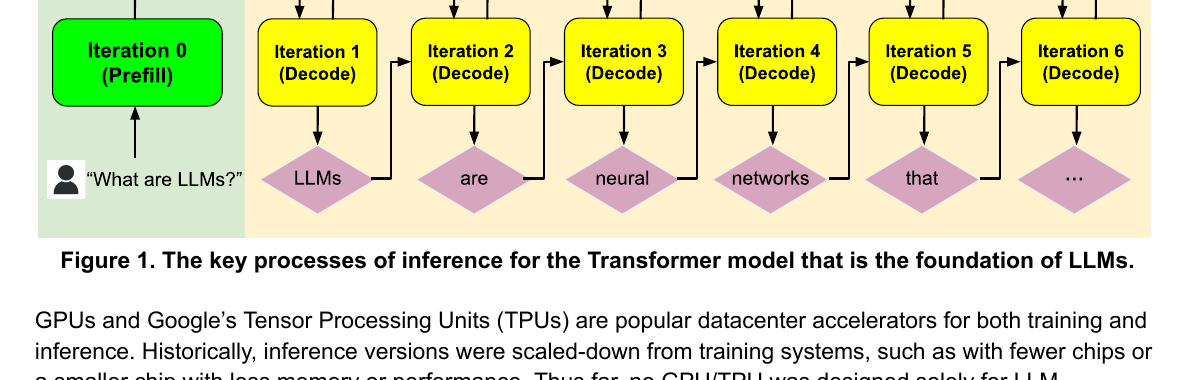
圖 1. Transformer 模型推論的關鍵流程,這個模型是 LLM 的基礎。
GPU 與 Google 的 Tensor Processing Units (TPU) 是資料中心最常用的加速器,訓練與推論皆然。歷史上,推論版本是訓練系統的縮小版——例如更少的晶片或更小的晶片,記憶體或效能也較低。到目前為止,沒有任何 GPU 或 TPU 是專為 LLM 推論而設計的。因為 Prefill 跟訓練類似,但 Decode 差異極大,有兩個挑戰使 GPU/TPU 對 Decode 階段特別低效。
2.1 解碼挑戰 #1:記憶體
自回歸式的 Decode 本質上是記憶體瓶頸,新的軟體趨勢還在加重這個挑戰。相反地,硬體趨勢卻往完全相反的方向前進。
AI 處理器面臨記憶體牆 (Memory Wall)。 目前的資料中心 GPU/TPU 依賴 高頻寬記憶體 (High Bandwidth Memory, HBM),並用幾顆 HBM 堆疊連到單一 monolithic 加速器特殊應用積體電路 (Application-Specific Integrated Circuit, ASIC) 上(見圖 2 與表 1)。然而,記憶體頻寬的進步速度遠慢於浮點運算 (floating-point operations per second, FLOPS) 的進步。例如 NVIDIA GPU 64-bit FLOPS 從 2012 到 2022 年成長了 80×,但頻寬只成長 17×,這個差距還會持續擴大。
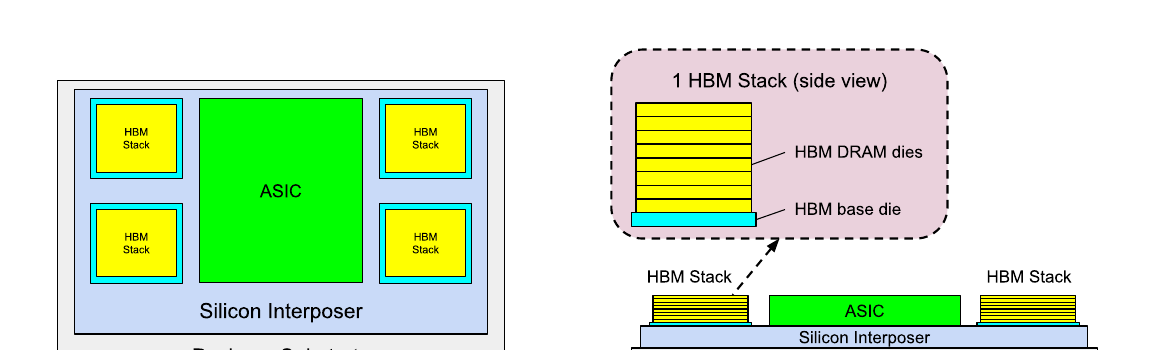
圖 2. (a) 高頻寬記憶體 (HBM) 封裝俯視圖,(b) HBM 側視圖。
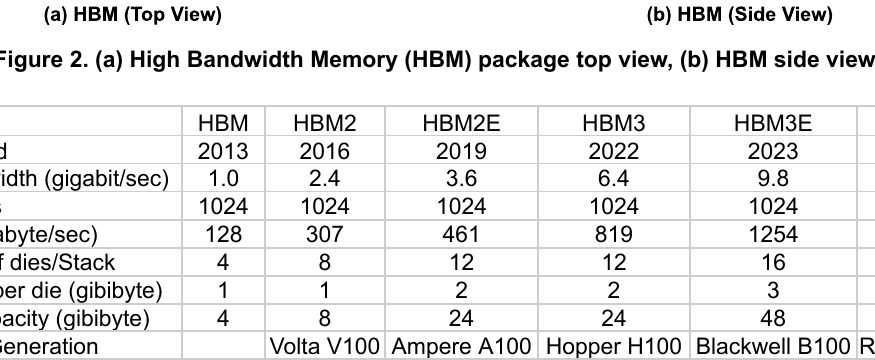
表 1. 六代 HBM 的關鍵特性。
| HBM | HBM2 | HBM2E | HBM3 | HBM3E | HBM4 | |
|---|---|---|---|---|---|---|
| 推出年份 | 2013 | 2016 | 2019 | 2022 | 2023 | 2026 |
| 每 pin 最大頻寬 (Gbit/s) | 1.0 | 2.4 | 3.6 | 6.4 | 9.8 | 8 |
| pin 數 | 1024 | 1024 | 1024 | 1024 | 1024 | 2048 |
| 堆疊頻寬 (GB/s) | 128 | 307 | 461 | 819 | 1254 | 2048 |
| 每堆疊 die 數 | 4 | 8 | 12 | 12 | 16 | 16 |
| 每 die 容量 (GiB) | 1 | 1 | 2 | 2 | 3 | 4 |
| 堆疊容量 (GiB) | 4 | 8 | 24 | 24 | 48 | 64 |
| NVIDIA GPU 世代 | Volta V100 | Ampere A100 | Hopper H100 | Blackwell B100 | Rubin R100 | |
| 每 GPU HBM 堆疊數 | 4 | 5 | 5 | 8 | 8 |
HBM 越來越貴。 看單一 HBM 堆疊,標準化的容量價格 ($/GB) 與頻寬價格 ($/GBps) 隨時間 上升。圖 3(a) 顯示在 2023–2025 年,這兩者都成長了約 1.35× [5]。這個上升趨勢來自製造與封裝的困難——每堆疊 die 數越多、動態隨機存取記憶體 (Dynamic RAM, DRAM) 密度成長越來越慢。相反地,圖 3(b) 顯示標準雙倍資料率 (Double Data Rate, DDR4) DRAM 的等效成本是隨時間 下降 的。從 2022 到 2025 年,容量成本縮小到 0.54×、頻寬成本縮小到 0.45×。雖然由於 2026 年意外的需求暴增,所有記憶體與儲存裝置價格都飆升,但我們認為 HBM 與 DRAM 之間這種背道而馳的價格趨勢長期仍會持續。
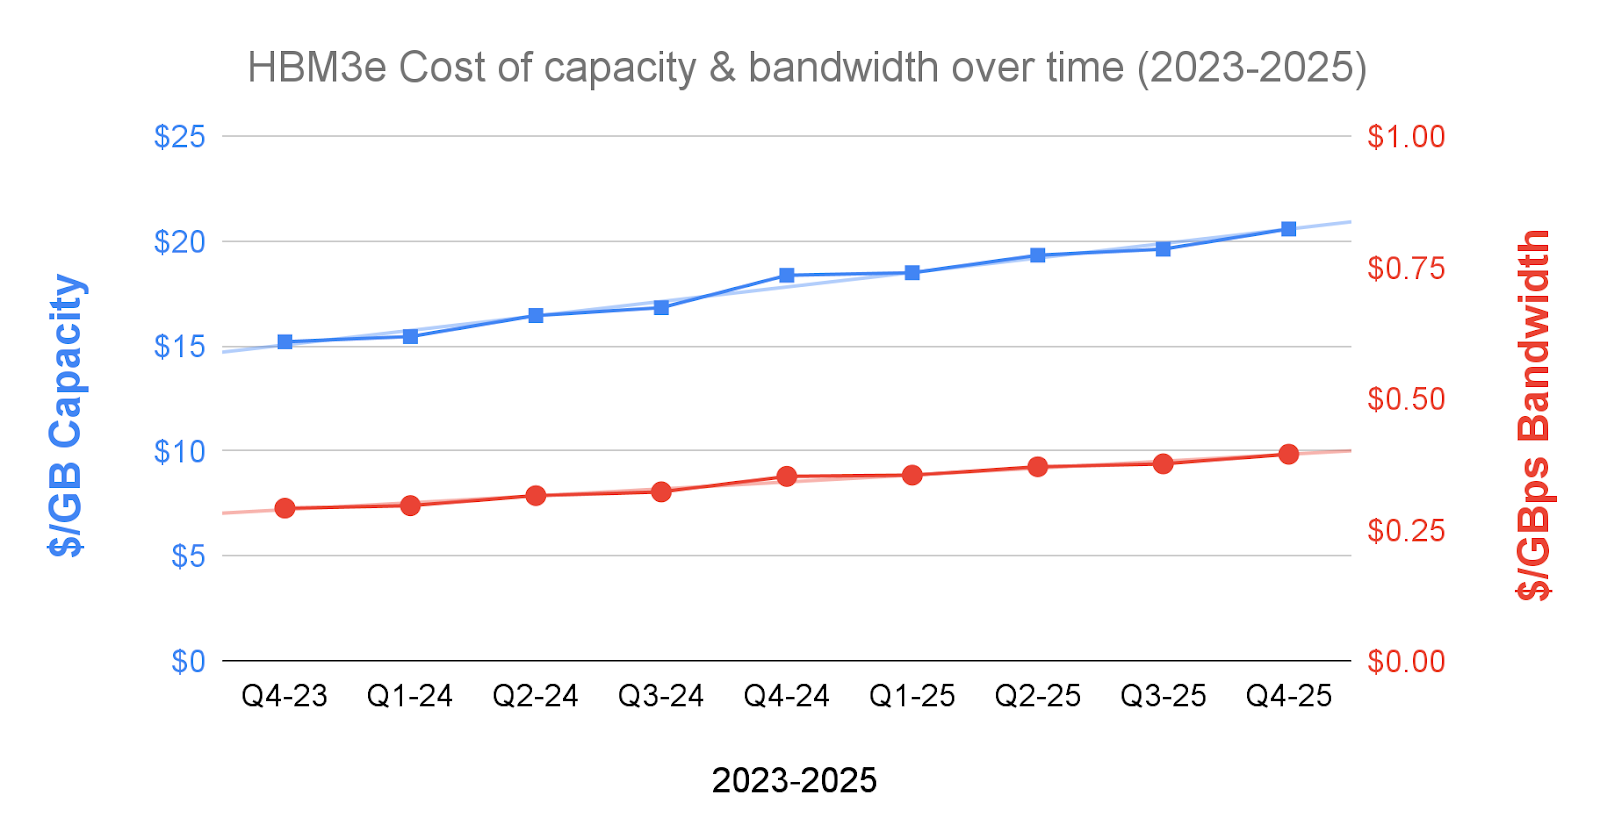
(a) HBM 容量單位 $/GB 與頻寬單位 $/GBps 都在上升。
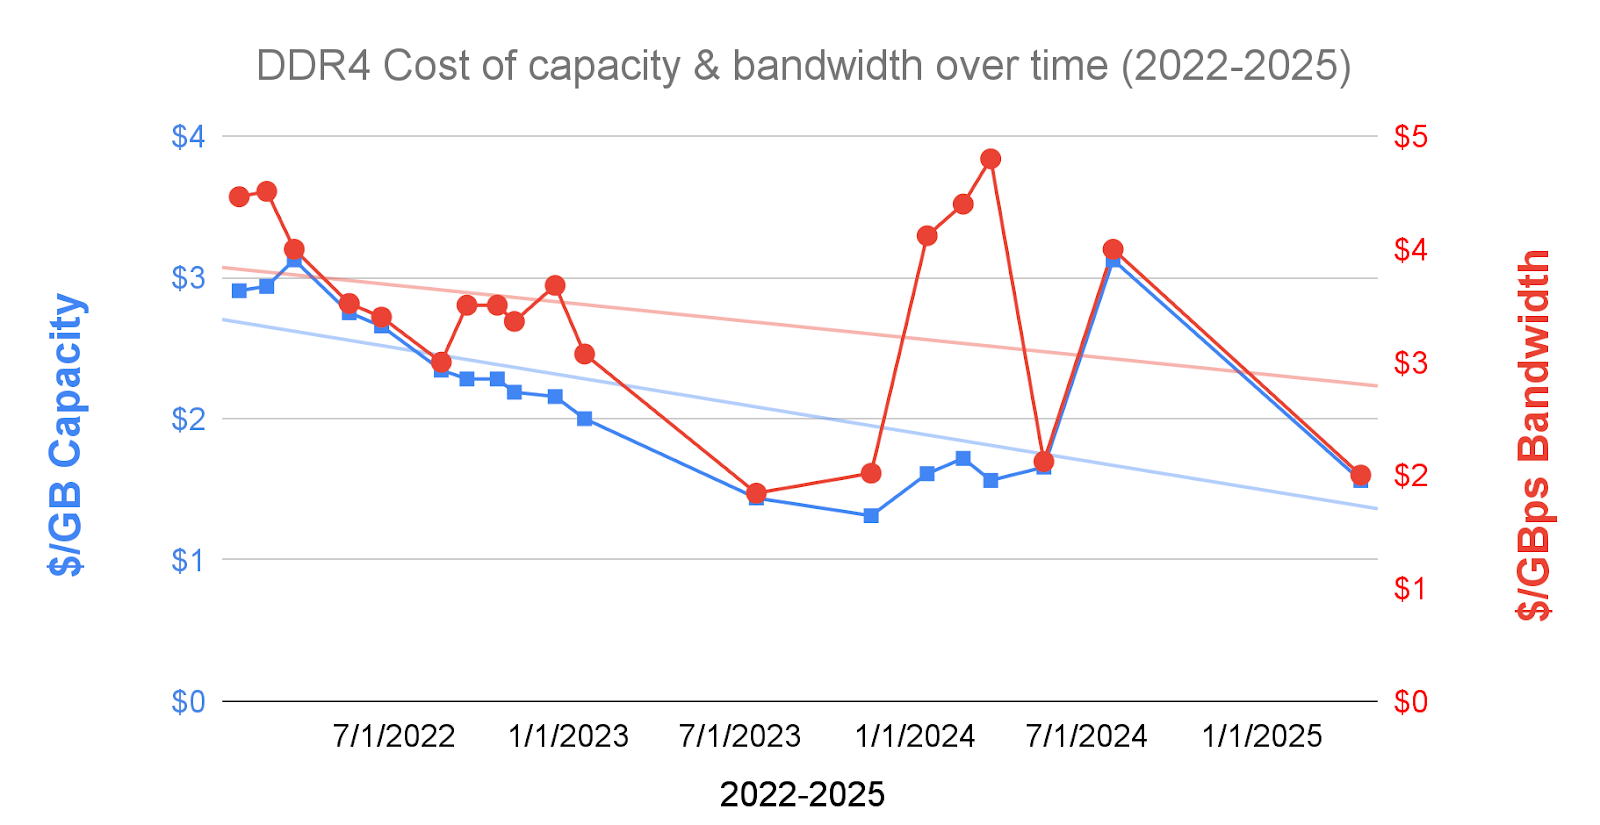
(b) DDR 容量單位 $/GB 與頻寬單位 $/GBps 都在下降(資料來源:見附錄)。
圖 3. HBM (a) 與 DDR (b) 隨時間的容量與頻寬單位成本及趨勢線。
DRAM 密度成長正在減速。 即使從單一 DRAM die 看,scaling 也令人擔憂。從 2014 年首次推出的 8-gigabit DRAM die 開始,要做到 4 倍密度的成長花了超過 10 年。先前 4 倍的成長每 3–6 年就會出現一次。
只有 SRAM 的方案不夠用。 Cerebras 與 Groq 嘗試過用塞滿 SRAM 的全光罩 (full reticle) 晶片來避開 DRAM 與 HBM 的挑戰(Cerebras 甚至用了 wafer scale integration)。十年前這兩家公司剛成立時這方案還算合理,但隨後 LLM 很快就把片上 SRAM 容量塞爆了。兩家後來都被迫加上外部 DRAM。
2.2 解碼挑戰 #2:端到端延遲
面向使用者意味著低延遲。 與一次跑數週的訓練不同,推論綁在即時請求上,需要在幾秒甚至更短時間內回應。低延遲對面向使用者的推論非常關鍵(批次或離線推論則沒有低延遲需求)。依應用的不同,延遲可以用 time-to-completion(所有輸出 token 完成的時間)或 time-to-first-token(生成第一個 token 的時間)來衡量。兩者都有挑戰:
Time-to-completion 挑戰:Decode 一次只產生一個 token,所以輸出越長、延遲越高。長輸出序列會拉長延遲,但長輸入序列同樣會變慢——因為 Decode 與 Prefill 過程中存取 KV Cache 需要更多時間。每個 Decode iteration 都有高記憶體存取延遲,因為它是記憶體瓶頸。
Time-to-first-token 挑戰:長輸入序列與 RAG 都會在生成前增加工作量,因此拉長 time-to-first-token。推理模型也會拉長這個延遲——它們在第一個對使用者可見的 token 之前生成許多「思考」token。
互連延遲已經比頻寬更重要。 在 LLM 出現之前,資料中心推論通常跑在一顆晶片上,而訓練需要超級電腦。超級電腦的互連設計理所當然地專注於頻寬而非延遲。LLM 推論改變了這個遊戲規則:
因為大權重,LLM 推論現在需要多晶片系統,搭配軟體 sharding,這意味著頻繁通訊。MoE 與長序列模型還會進一步擴大系統規模以容納更大的記憶體需求。
與訓練不同,網路訊息的大小通常很小,因為 Decode 的可見批次大小很小。在大型網路裡頻繁的小訊息中,延遲遠比頻寬重要。
表 2 摘要了 Decode 推論的主要挑戰。只有 Diffusion 需要更多運算——這相對容易交付——因為它本質上不像 Transformer Decode。因此我們聚焦在改善 記憶體 與 互連延遲 而非運算的方向。表 2 最後四列就是滿足這些需求的研究機會,下節會涵蓋。
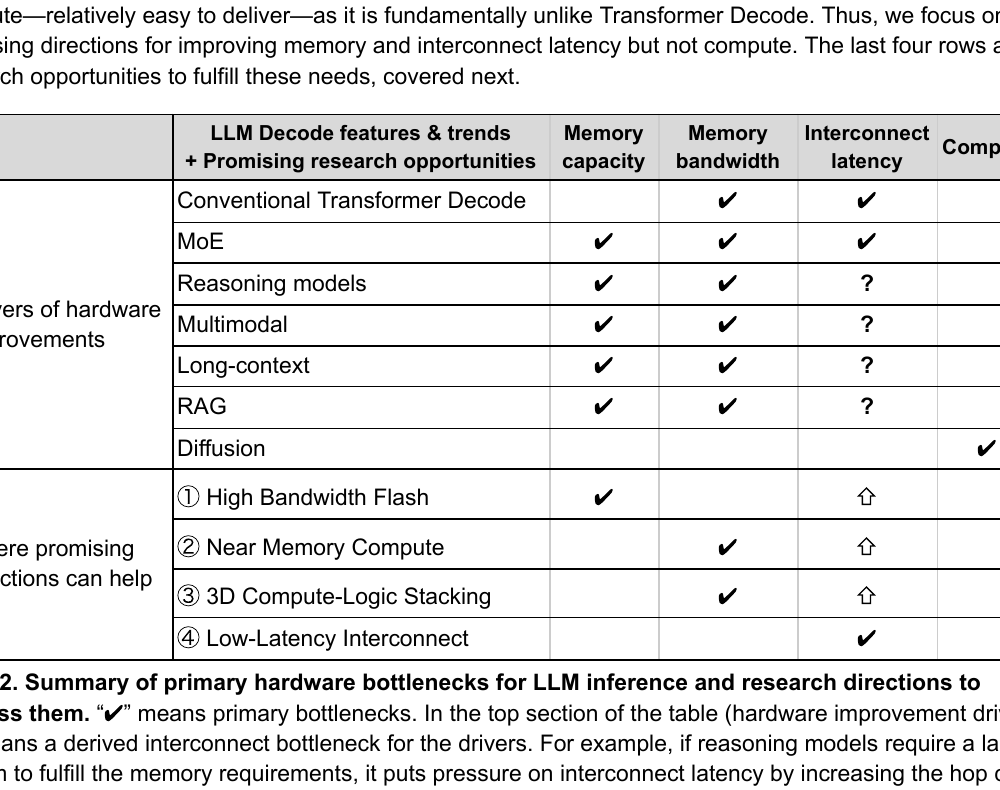
表 2. LLM 推論主要硬體瓶頸與對應研究方向摘要。「✔」代表主要瓶頸(硬體改進的驅動因子);「?」代表由驅動因子衍生出來的互連延遲瓶頸。例如推理模型若需要更大系統來滿足記憶體需求,就會藉由增加 hop 數對互連延遲產生壓力。同樣地,若記憶體容量或頻寬有所改善、可用更少加速器晶片做相同模型推論,也會幫助降低互連延遲。對表格下方「有潛力的方向」段落,「⇧」代表能藉由縮小整體系統規模、進而減少 hop 數的方向,藉此幫助互連延遲。
3. 重新思考 LLM 推論硬體的四個研究機會
效能/成本指標衡量 AI 系統效率。現代指標——強調實際效能、normalized 後的 總體擁有成本 (Total Cost of Ownership, TCO)、平均功耗 (average power consumption),以及二氧化碳當量排放 (carbon dioxide equivalent emissions, CO₂e)——為設計系統提供了新標的 [6]:
效能必須有意義。 對 LLM Decode 推論來說,巨大 die 上的高 FLOPS 並不必然代表高效能。我們必須有效率地擴展記憶體頻寬與容量,並最佳化互連速度。
效能必須在資料中心容量限制內交付——通常受限於電力、空間與 CO₂e 預算。
電力與 CO₂e 是一階最佳化目標。 電力會影響 TCO 與資料中心容量;電力與能源潔淨度決定營運期間的 CO₂e;製造良率與生命週期決定包含於產品 (embodied) 的 CO₂e。
接下來,我們描述四個有潛力的研究方向,來解決 Decode 挑戰(見表 2 下方)。雖然分開描述,但它們是相輔相成的——一個架構可以結合多個方向。所有方向都會改善 efficiency/TCO、efficiency/CO₂e,以及 efficiency/power。
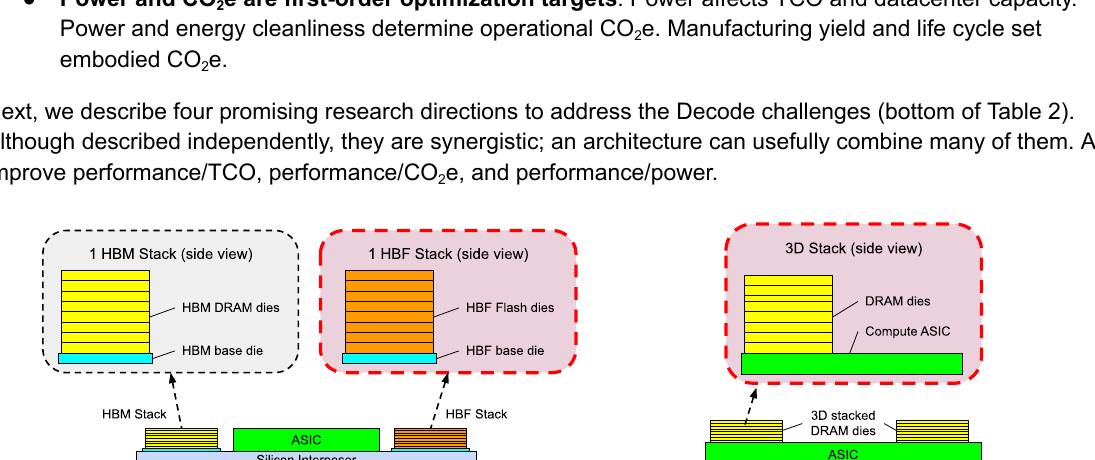
圖 4. (a) 高頻寬快閃記憶體 (HBF) 側視圖,(b) 3D 運算—DRAM 堆疊側視圖。
3.1 ① 為 10× 容量設計的高頻寬快閃記憶體 (HBF)
高頻寬快閃記憶體 (High Bandwidth Flash, HBF) 用堆疊快閃 die(類似 HBM 的方式)將 HBM 等級的頻寬與快閃記憶體的容量結合起來(圖 4(a))[7]。HBF 提供每節點 10× 的記憶體容量,能縮小系統規模以節省電力、TCO、CO₂e 與網路開銷。表 3 比較 HBF 與 HBM、DDR、低功耗 DDR (LPDDR) DRAM。其他選項的弱點是頻寬(DDR5)、容量(HBM)、寫入次數限制與高讀取延遲(HBF)。HBF 的另一個優勢是可持續的容量擴展:快閃記憶體的容量持續每三年翻倍,但 DRAM 成長正在減速。
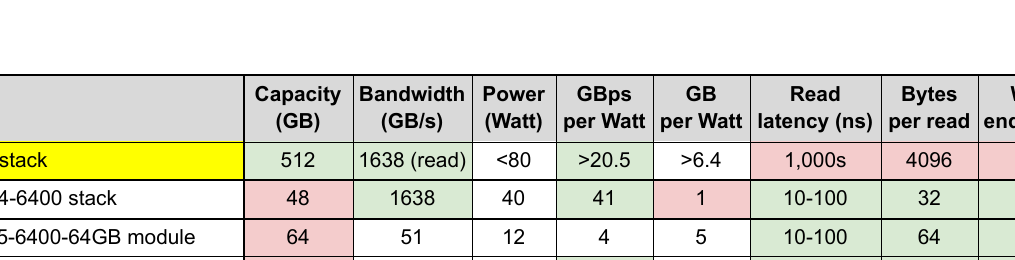
表 3. HBF、HBM、DDR、LPDDR 與快閃卡的概略比較。
| 容量 (GB) | 頻寬 (GB/s) | 功率 (Watt) | GBps/Watt | GB/Watt | 讀取延遲 (ns) | 每次讀取 bytes | 寫入次數壽命 | |
|---|---|---|---|---|---|---|---|---|
| 1 顆 HBF 堆疊 | 512 | 1638 (read) | <80 | >20.5 | >6.4 | 1,000s | 4096 | low |
| 1 顆 HBM4-6400 堆疊 | 48 | 1638 | 40 | 41 | 1 | 10–100 | 32 | high |
| 1 顆 DDR5-6400-64GB 模組 | 64 | 51 | 12 | 4 | 5 | 10–100 | 64 | high |
| 1 顆 LPDDR5-6400-16GB 模組 | 16 | 51 | 3 | 17 | 5 | 10–100 | 64 | high |
| 1 張 Flash card | 4096 | 4 (read) | 50 | 0.1 | 82 | 10,000s | 4096 | low |
兩個眾所周知的快閃限制必須處理:
寫入耐用度有限。 寫入/抹除週期會把快閃記憶體用壞。因此 HBF 必須持有不常更新的資料,例如推論時的權重,或變動緩慢的脈絡 (slow-changing context)。
以 page 為單位的讀取且高延遲。 快閃以 page 為粒度讀取(10 KB 等級),延遲明顯比 DRAM 差(微秒等級)。小讀取會降低有效頻寬。
這些問題意味著 HBF 不能取代所有 HBM;系統仍需要一般 DRAM 來存放不適合 HBF 的資料。
加入 HBF 為 LLM 推論啟用了令人興奮的能力:
10× 權重記憶體。權重在推論時是凍結的,所以 HBF 的 10× 容量能容納更多權重——例如更大的 MoE——讓更大的模型能在合理價格下使用。
10× 脈絡記憶體。寫入耐用度有限使 HBF 不適合做每筆查詢都更新的 KV Cache 資料,但對於變動緩慢的脈絡很合適。例如:
- LLM 搜尋使用的 web corpus,存著數十億的網際網路文件
- AI 寫程式工具使用的 code database,存著數十億行程式碼
- AI 教學使用的 paper corpus,追蹤數百萬篇研究論文
更小的推論系統。記憶體容量決定了存放模型的最小硬體量。HBF 縮小了系統,減少通訊、提高可靠度與資源分配。
更大的資源容量。HBF 會減少對僅 HBM 架構的依賴,並緩解全球主流記憶體裝置的短缺。
HBF 也開啟了新的研究問題:
- 軟體要怎麼處理寫入耐用度限制以及 page 為單位、高延遲的讀取?
- 系統中傳統記憶體與 HBF 的比例該是多少?
- 我們能否減少 HBF 技術自身的限制?
- HBF 在行動裝置與資料中心的配置會有何不同?
3.2 ② 為高頻寬設計的近記憶體運算 (PNM)
記憶體中運算 (Processing-in-Memory, PIM) 是幾十年前提出的構想 [8],藉由把小的低功率處理器附加到記憶體 bank 上來取得高頻寬。雖然 PIM 提供超高頻寬,主要挑戰是軟體分區 (software sharding) 與記憶體—邏輯耦合:前者限制了能跑在 PIM 上的軟體 kernel 種類,後者則傷害運算邏輯的 power 與面積效率。相對地,近記憶體運算 (Processing-Near-Memory, PNM) 把記憶體與邏輯放在附近、但仍是分開的 die 上。PNM 的一個版本就是 3D 運算—邏輯堆疊(見 ③)。
很可惜,最近一些論文模糊了 PIM 與 PNM 的區別,無論運算邏輯是否直接放在記憶體 die 上都統稱 PIM。我們在這裡用一個簡單但鮮明的區別:PIM 指處理器與記憶體在同一 die 上的設計;PNM 指它們在附近、但分開的 die 上。這個區別讓 PIM 與 PNM 不會混淆。
如果軟體無法輕易使用,硬體的優勢就毫無意義——這正是我們在 PIM 與資料中心 LLM 上的經驗。表 4 列出為什麼對 LLM 推論而言 PNM 比 PIM 更好,儘管在頻寬與電力上略遜。具體來說,PIM 需要軟體把 LLM 的記憶體結構分割 (shard) 到許多小區塊(32–64 MB 的 bank)才能塞進去;PNM 上的 shard 可以大上 1000 倍,更容易以低通訊負擔分區 LLM。同時,PIM 給定 DRAM 製程節點的電力與熱預算非常有限,是否有足夠的運算量也不明朗。
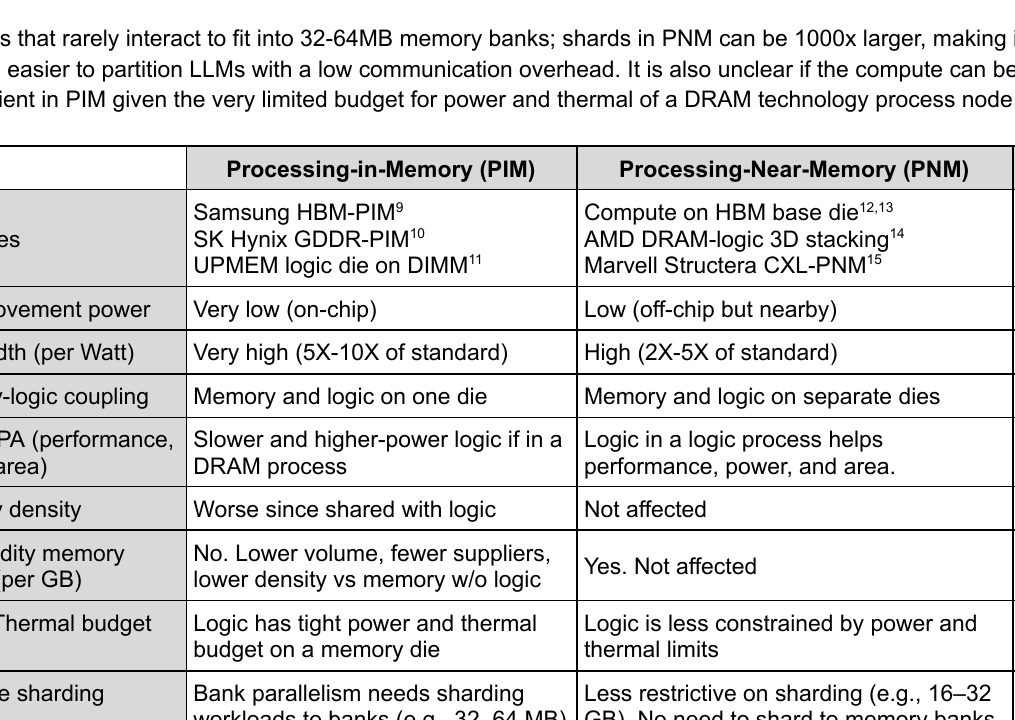
表 4. 資料中心 LLM 推論:PIM vs PNM。
| 記憶體中運算 (PIM) | 近記憶體運算 (PNM) | 勝出 | |
|---|---|---|---|
| 範例 | Samsung HBM-PIM [9]、SK Hynix GDDR-PIM [10]、UPMEM logic die on DIMM [11] | Compute on HBM base die [12,13]、AMD DRAM-logic 3D stacking [14]、Marvell Structera CXL-PNM [15] | — |
| 資料移動電力 | 非常低(在晶片上) | 低(晶片外但接近) | PIM |
| 頻寬 (per Watt) | 非常高(標準的 5×–10×) | 高(標準的 2×–5×) | PIM |
| 記憶體—邏輯耦合 | 同一 die | 分開 die | — |
| 邏輯 PPA(performance, power, area) | 較慢、功耗高(DRAM 製程) | 邏輯製程節點上的邏輯,PPA 較佳 | PNM |
| 記憶體密度 | 較差(與邏輯共享) | 不受影響 | PNM |
| 商品記憶體訂價 ($/GB) | 沒有,量小、供應商少、密度比無邏輯版差 | 是,不受影響 | PNM |
| Power/Thermal 預算 | 邏輯有嚴格 power 與熱預算 | 邏輯較不受 power 與熱限制 | PNM |
| 軟體 sharding | bank 平行需要分區到 bank(如 32–64 MB) | sharding 限制較少(如 16–32 GB),不必 shard 到記憶體 bank | PNM |
雖然 PNM 對資料中心 LLM 比 PIM 好,但對行動裝置就沒那麼明確。行動裝置受能源限制更嚴、且跑的 LLM 權重少很多、脈絡較短、資料型別較小,且因為單一使用者、批次大小較小。這些差異讓 sharding 比較簡單,也降低了運算與熱需求,使 PIM 在行動端的弱點看起來沒那麼嚴重。
3.3 ③ 為高頻寬設計的 3D 記憶體—邏輯堆疊
與 2D 硬體(記憶體 IO 在 shoreline 上)不同,3D 堆疊(見圖 4(b))改用垂直 貫穿矽穿孔 (Through Silicon Vias, TSV) 取得寬而密集的記憶體介面,達成低功耗的高頻寬。
3D 記憶體—邏輯堆疊有兩個版本:
Compute-on-HBM-base-die 重複使用 HBM 設計,把運算邏輯插到 HBM base die 上 [12,13]。因為記憶體介面沒變、頻寬與 HBM 相同,但因為資料路徑更短,電力降到 2–3× 低。
客製化 3D 解決方案能透過更寬更密的記憶體介面與更先進封裝技術,達到比 reusing HBM 更高的頻寬與 bandwidth-per-watt。
儘管頻寬與電力更佳,3D 堆疊面臨幾個挑戰:
熱。冷卻 3D 設計比 2D 困難,因為表面積較少。一個解法是降低運算邏輯的時脈與電壓來限制其 FLOPS,正好 LLM Decode 推論本身的算術強度 (arithmetic intensity) 也不高。
記憶體—邏輯耦合。3D 運算—邏輯堆疊的記憶體介面可能需要產業標準。
3D 堆疊開啟新的研究問題:
- 記憶體頻寬與容量、或運算 FLOPS 的比例與既有系統相當不同。軟體要怎麼適應?
- 想像一個有許多記憶體類型的系統。我們要如何高效對應 LLM?
- 要怎麼跟其他記憶體—邏輯堆疊或主 AI 處理器(如果需要的話)通訊?
- 在頻寬、power、熱與可靠性之間,各種設計選擇的取捨是什麼?例如運算 die 放在上方還是下方、每堆疊的記憶體 die 數……?
- 對行動裝置與資料中心 LLM 加速器,這些機會有何不同?
3.4 ④ 低延遲互連
技巧 ①–③ 在減少延遲同時也提升了吞吐量:更高的記憶體頻寬會減少每個 Decode iteration 的延遲;每個加速器更高的記憶體容量能縮小系統規模、節省通訊開銷。另一個有潛力的方向是針對資料中心 重新思考網路延遲—頻寬取捨——因為推論對互連延遲更敏感。例如:
高連線度拓樸。具有高連線度(如 tree、dragonfly、高維度 tori)的拓樸會需要較少 hop,從而減少延遲。這些拓樸也許會降低頻寬,但會改善延遲。
網路內運算 (Processing-in-network)。LLM 用到的通訊集合運算——broadcast、all-reduce、MoE dispatch and collect——很適合做網路內加速來改善頻寬與延遲。例如,tree 拓樸搭配網路內 aggregation 能讓 all-reduce 同時擁有低延遲與高吞吐量。
AI 晶片最佳化。聚焦延遲會影響晶片設計的好幾個面向:
- 把抵達的小封包直接存到 on-chip SRAM,而非 off-chip DRAM;
- 把運算引擎放到靠近網路介面的地方以減少傳輸時間。
可靠性。共同設計可靠性與互連能同時幫助兩者:
- 一個本地的備援零件能掩蓋系統失敗,避開沒有 standby 時把失敗工作遷移到另一個健康節點所造成的延遲與吞吐量負擔。
- 如果 LLM 推論不需要完美通訊,可以用假資料 (fake data) 或前一步結果換得低延遲、且有令人滿意的品質結果,不必等 timeout 過後 straggler 訊息來。
4. 相關研究
高頻寬快閃記憶體 (HBF)。 SanDisk 最早提出 HBF,一個用快閃突破頻寬上限的 HBM-like 架構 [7](SK Hynix 後來也加入開發)。Microsoft 研究員提出了一種新型記憶體類別,聚焦在高效能與高密度的讀取 / 保留 (retention) 上,而非寫入效能與耐用度,主打 AI 推論 [16]。儘管沒有特別提到,HBF 是這個提案的具體實現。另一篇研究論文提出將快閃整合到行動處理器,做端側 LLM 推論——LPDDR 介面負擔 Prefill 的低頻寬需求,Processing-Near-Flash 滿足 Decode 的高頻寬需求 [17]。
近記憶體運算 (Processing-Near-Memory)。3D 運算—邏輯堆疊作為一種比 HBM 更高頻寬的技術,越來越受關注,例如 compute-on-HBM-base-die 提案 [12,13] 與 AMD 概念 [14]。在非 3D 空間中,Samsung AXDIMM [9] 與 Marvell Structera-A [15] 把處理器掛到商品 DDR DRAM 上。前者把運算邏輯整合進 DIMM buffer chip;後者透過 CXL 介面以強化可程式性與系統整合。一份調查論文提供更多 PNM/PIM 的範例 [18]。許多論文討論在行動裝置上使用 PIM/PNM——但這不是本文的主要關注。
低延遲互連。許多論文描述低 hop 數的網路拓樸,包括 tree、dragonfly 與高維度 tori(本期刊只允許 20 個參考文獻,無法逐一引用)。商用網路內運算的例子包含 NVIDIA NVLink 與支援 in-switch reduction 的 Infiniband switch、以及透過 SHARP (Scalable Hierarchical Aggregation and Reduction Protocol) 的 multicast 加速 [19]。最近以太網路也出現了 AI workload 的類似能力 [20]。
軟體創新。除了本文聚焦的硬體創新之外,還有軟硬體 codesign 演算法與軟體創新的豐富空間,可以改善 LLM 推論。例如,根本原因是 Transformer Decode 的自回歸本質。一個避開自回歸生成的新演算法——例如圖像生成的 Diffusion——可以大幅簡化 AI 推論硬體。
5. 結論
LLM 推論的重要性與難度正在上升——它迫切需要更低成本與更低延遲——是一個有吸引力的研究目標。自回歸式 Decode 早已是記憶體與互連延遲的主要挑戰,而 MoE、推理、多模態、RAG 與長輸入/輸出序列只會加劇這個挑戰。
當有實際的 simulator 可用時,計算機架構社群在挑戰問題上做出了巨大貢獻——以前對 branch prediction 與 cache design 都是這樣。既然 LLM 推論的主要瓶頸是記憶體與延遲,一個基於 roofline 的推論 simulator 在許多情境下能提供一階估計。此外,這樣的框架應追蹤記憶體容量、探索各種對效能至關重要的 sharding 技巧,並使用更現代的效能/成本指標。我們希望學術研究員會回應這個機會,加速 AI 研究。
目前的 AI 硬體哲學——full-reticle die 配高 FLOPS、許多 HBM 堆疊、頻寬最佳化的互連——與 LLM Decode 推論並不匹配。雖然有研究員探索資料中心的運算,我們建議改善記憶體與網路、沿著四個方向:HBF、PNM、3D 堆疊,以及低延遲互連。此外,新的效能/成本指標——聚焦資料中心容量、系統電力、與碳足跡——比起傳統指標提供新的機會。HBF、PNM、PIM、與 3D 堆疊的受限版本可能也適用於行動裝置 LLM。
這些進展將解鎖協同合作,朝向世界迫切需要的、能負擔的 AI 推論的重要創新。
致謝
我們感謝 Martin Abadi、Jeff Dean、Norm Jouppi、Amin Vahdat 與 Cliff Young 對本文的意見。
參考文獻
- Verified Market Reports, AI Inference Chip Market Insights, 2025.
- Field, H., OpenAI sees roughly $5 billion loss this year on $3.7 billion in revenue, 2024, CNBC.
- Tangermann, V., Microsoft Is Losing a Staggering Amount of Money on AI, 2024.
- Zhou, Z., et al., A survey on efficient inference for large language models, 2024, arXiv:2404.14294.
- Lee, P. and Yang, J., Global Semiconductors, Citi Research, 2024.
- Vahdat, A., Ma, X. and Patterson, D., New Computer Evaluation Metrics for a Changing World, 2024, CACM.
- Shilov, A., SanDisk's new High Bandwidth Flash memory, 2025, Tom's Hardware.
- Kozyrakis, C., et al., Scalable processors in the billion-transistor era: IRAM, 1997, Computer.
- Kim, J., et al., Aquabolt-XL: Samsung HBM2-PIM, 2021, Hot Chips.
- Kwon, Y., et al., System architecture and software stack for GDDR6-AiM, 2022, Hot Chips.
- Gómez-Luna J., et al., Benchmarking a new paradigm: An experimental analysis of a real processing-in-memory architecture, 2021, arXiv:2105.03814.
- Yun, S., et al., Duplex: A Device for Large Language Model Inference with Mixture of Experts, Grouped Query Attention, and Continuous Batching, 2024, MICRO.
- Park, N., et al., High-throughput Near-memory Processing on CNNs with 3D HBM-like Memory, 2021, TODAES.
- Su, L. and Naffziger, S., Innovation For the Next Decade of Compute Efficiency, 2023, ISSCC.
- Marvell, Structera™ A 2504 Memory-Expansion Controller, 2024.
- Legtchenko, S., et al., Managed-Retention Memory: A New Class of Memory for the AI Era, 2025, arXiv:2501.09605.
- Sun, W., et al., Lincoln: Real-Time 50~100B LLM Inference on Consumer Devices with LPDDR-Interfaced, Compute-Enabled Flash Memory, 2025, HPCA.
- Oliveira, N., et al., Tutorial on Memory-Centric Computing: Processing-Near-Memory, 2024, MICRO.
- Schultz, S., Advancing Performance with NVIDIA SHARP In-Network Computing, 2024.
- Yang, M., et al., Using Trio: Juniper networks' programmable chipset for emerging in-network applications, 2022, SIGCOMM.
作者
XIAOYU MA 是 Google DeepMind(位於 Mountain View, California, 94043)的 Senior Staff Engineer。研究興趣包含 domain-specific computer architectures。Ma 在 The University of Texas at Austin 取得 Electrical and Computer Engineering 博士學位。聯絡:[email protected]。
DAVID PATTERSON 是 Google DeepMind(位於 Mountain View, California, 94043)的 Distinguished Engineer;Laude Institute 董事會主席;以及 University of California, Berkeley 的 Pardee 名譽教授。研究興趣包含 domain-specific computer architectures、AI 對環境的影響,以及把 AI 用於公共福祉。Patterson 在 University of California, Los Angeles 取得 Computer Science 博士學位。聯絡:[email protected]。
術語對照表
| English | 中文 |
|---|---|
| Large Language Model (LLM) | 大型語言模型 |
| Inference | 推論 |
| Prefill | Prefill(不譯,預填階段) |
| Decode | Decode(不譯,解碼階段) |
| Autoregressive | 自回歸 |
| Memory bound | 記憶體瓶頸 |
| Compute bound | 運算瓶頸 |
| Key Value (KV) Cache | 鍵—值快取 |
| Disaggregated inference | 拆解式推論 |
| Mixture of Experts (MoE) | 混合專家 |
| Reasoning models | 推理模型 |
| Multimodal | 多模態 |
| Long context | 長脈絡 |
| Context window | 脈絡視窗 |
| Retrieval-Augmented Generation (RAG) | 檢索增強生成 |
| Diffusion | 擴散 |
| Batching | 批次處理 |
| Tensor Processing Unit (TPU) | 張量處理器 |
| Application-Specific Integrated Circuit (ASIC) | 特殊應用積體電路 |
| Memory Wall | 記憶體牆 |
| High Bandwidth Memory (HBM) | 高頻寬記憶體 |
| Floating-point operations per second (FLOPS) | 每秒浮點運算 |
| Dynamic RAM (DRAM) | 動態隨機存取記憶體 |
| Double Data Rate (DDR) | 雙倍資料率 |
| Static RAM (SRAM) | 靜態隨機存取記憶體 |
| Wafer scale integration | 整片晶圓整合 |
| Time-to-completion | 完成時間(time-to-completion) |
| Time-to-first-token | 首字 token 時間(time-to-first-token) |
| Total Cost of Ownership (TCO) | 總體擁有成本 |
| Carbon dioxide equivalent (CO₂e) | 二氧化碳當量 |
| Embodied (carbon) | 包含於產品的(碳) |
| High Bandwidth Flash (HBF) | 高頻寬快閃記憶體 |
| Page-based read | 以 page 為單位的讀取 |
| Write endurance | 寫入耐用度 |
| Slow-changing context | 變動緩慢的脈絡 |
| Web corpus | 網路語料庫 |
| Code database | 程式碼資料庫 |
| Paper corpus | 論文語料庫 |
| Processing-in-Memory (PIM) | 記憶體中運算 |
| Processing-Near-Memory (PNM) | 近記憶體運算 |
| Sharding | 分片/sharding |
| Software sharding | 軟體分區 |
| Bank parallelism | bank 平行 |
| Through Silicon Via (TSV) | 貫穿矽穿孔 |
| 3D memory-logic stacking | 3D 記憶體—邏輯堆疊 |
| Compute-on-HBM-base-die | 在 HBM base die 上做運算 |
| HBM base die | HBM 基底 die |
| Power, Performance, Area (PPA) | 功耗、效能與面積 |
| Arithmetic intensity | 算術強度 |
| Roofline model | roofline 模型 |
| Hop count | hop 數 |
| Topology | 拓樸 |
| Tree / Dragonfly / Tori | 樹狀/蜻蜓型/環面型 |
| All-reduce | 全歸約 |
| Broadcast | 廣播 |
| In-network computing | 網路內運算 |
| In-switch reduction | 交換器內歸約 |
| Aggregation | 聚合 |
| Standby spare | 備援零件 |
| Straggler | 落後者 |
| Codesign | 協同設計 |
| Reliability | 可靠性 |
| Datacenter | 資料中心 |
| Mobile devices | 行動裝置 |
| Reticle | 光罩 |
| Die | die(晶粒) |
| Stack | 堆疊 |
| Interconnect | 互連 |
| Network message | 網路訊息 |
| Latency | 延遲 |
| Bandwidth | 頻寬 |
| Throughput | 吞吐量 |
| Power consumption | 功耗 |
| Embodied CO₂e | 包含於產品的 CO₂e |
| Operational CO₂e | 營運期間的 CO₂e |