Cosmos 3:面向物理 AI 的全模態世界模型
原始論文:Cosmos 3: Omnimodal World Models for Physical AI 作者:NVIDIA arXiv ID:2606.02800v4 日期:2026-06-01(v1),2026-06-23(v4 修訂) 標籤:World Model Physical AI 多模態 影片生成 機器人 自動駕駛 擴散模型
本文依 CC BY 4.0 授權條款翻譯自原始論文,並依授權要求註明出處。貢獻者名單詳見原論文附錄 G。
目錄
摘要
我們推出 Cosmos 3,一個全模態世界模型 (Omnimodal World Model) 家族,設計用於在單一的混合 Transformer (Mixture-of-Transformers) 架構中,聯合處理與生成語言、影像、影片、音訊與動作序列。透過支援高度彈性的輸入—輸出組態,Cosmos 3 無縫整合了物理 AI (Physical AI) 所需的關鍵模態——實質上將視覺語言模型 (Vision-Language Model, VLM)、影片生成器、世界模擬器與世界—動作模型 (World-Action Model) 統合進單一框架。我們的評估顯示,Cosmos 3 在多樣的理解與生成任務上建立了新的最先進水準 (State-of-the-Art),證明全模態世界模型可作為具身代理 (Embodied Agent) 可擴展的通用骨幹。在本技術報告撰寫之時,我們經過後訓練 (Post-Training) 的 Cosmos 3 模型被 Artificial Analysis 評為最佳開源文字生成影像 (Text-to-Image) 與影像生成影片 (Image-to-Video) 模型,並在 RoboArena 上獲評為最佳策略模型。為加速物理 AI 的開放研究與部署,我們以 Linux Foundation 的 OpenMDW-1.1 授權釋出程式碼、模型檢查點 (Checkpoint)、精選合成資料集與評估基準,發布於 github.com/nvidia/cosmos 與 huggingface.co/collections/nvidia/cosmos3。專案網站位於 research.nvidia.com/labs/cosmos-lab/cosmos3。
開源程式碼
| 專案 | 連結 |
|---|---|
| Cosmos | github.com/nvidia/cosmos |
| Cosmos-Framework | github.com/nvidia/cosmos-framework |
開放權重模型檢查點
| 模型 | 連結 |
|---|---|
| Cosmos3-Super | huggingface.co/nvidia/Cosmos3-Super |
| Cosmos3-Nano | huggingface.co/nvidia/Cosmos3-Nano |
| Cosmos3-Super-Text2Image | huggingface.co/nvidia/Cosmos3-Super-Text2Image |
| Cosmos3-Super-Image2Video | huggingface.co/nvidia/Cosmos3-Super-Image2Video |
| Cosmos3-Nano-Policy-DROID | huggingface.co/nvidia/Cosmos3-Nano-Policy-DROID |
開放合成資料集
| 資料集 | 連結 |
|---|---|
| SDG-PhyxSim | PhysicalAI-WorldModel-Synthetic-Physical-Interaction-Scenes |
| SDG-RobotSim | PhysicalAI-WorldModel-Synthetic-Embodied-Robot-Scenes |
| SDG-DriveSim | PhysicalAI-WorldModel-Synthetic-Autonomous-Driving-Scenarios |
| SDG-SynHuman | PhysicalAI-WorldModel-Synthetic-Digital-Human-Scenes |
| SDG-Warehouse | PhysicalAI-WorldModel-Synthetic-Warehouse-Operations-Scenes |
開放評估基準
| 基準 | 連結 |
|---|---|
| Cosmos-HUE | huggingface.co/datasets/nvidia/Cosmos-HumanEval-v1 |
1 引言
物理 AI 代理需要感知、推理並採取行動來與真實世界互動。然而,直接在真實世界中訓練這類代理不僅緩慢、昂貴,還可能帶來危險。為了克服這些瓶頸,我們必須建構一座訓練設施,讓物理 AI 代理能在模擬世界中安全且可擴展地學習,並習得兩項根本上相互耦合的能力:理解 (Understanding) 與生成 (Generation)。理解讓代理能從部分觀測中推斷潛在表徵 (Latent Representation)、語意與動態;生成則賦予代理預測與模擬合理未來的能力,預想世界將如何演變、以及代理應如何採取相應行動。先前的研究大多將這兩大支柱分開處理,導致出現各自獨立的模型:用於感知與推理的判別式模型,例如視覺語言模型 (Vision-Language Model, VLM);用於世界模擬的生成式模型,例如影片生成模型與前向動力學模型 (Forward Dynamics Model);以及動作預測模型,例如視覺-語言-動作模型 (Vision-Language-Action Model, VLA) 與世界—動作模型 (World-Action Model, WAM)。
我們主張這種範式分離存在根本上的侷限:理解需要推理世界的未來演變與動作的後果,而生成則仰賴對世界與代理行為的緊湊、結構化表徵。因此,將兩者統一到單一可擴展框架中,對物理 AI 而言至關重要。想像一台通用家用機器人被指示在晚餐後清理餐桌。在當前的範式下,機器人必須拼湊一套彼此割裂的模型:以 VLM 定位餐具並產生可執行的計畫、以 VLA 或 WAM 生成動作序列,再以前向動力學模型或「世界模型 (World Model)」模擬與評估未來狀態。這種碎片化的架構既非最佳,也浪費運算資源。我們能否設計出一個單一的統一模型,原生支援物理 AI 代理所需的全部關鍵能力?
我們推出 Cosmos 3,一個全模態世界模型家族,能聯合建模語言、影像、影片、音訊與動作,同時支援理解與生成。作為物理 AI 的通用骨幹,Cosmos 3 將多種截然不同的模型類別統一到單一框架中(圖 1)。依據輸入—輸出組態的不同,Cosmos 3 可以在多種運行模式間無縫切換:它可以作為視覺語言模型執行多模態理解與推理;作為文字生成影像模型;作為影片生成器執行文字生成影片 (Text-to-Video)、影像動畫化(影像生成影片)、未來預測(影片生成影片)或同步音訊—影片生成;也可以作為世界—動作模型,聯合執行動作預測與環境模擬。透過在不更動架構的前提下統一感知、模擬與執行,Cosmos 3 消除了對碎片化、任務特定管線的需求,藉由共享表徵與聯合多任務監督實現可擴展的學習。
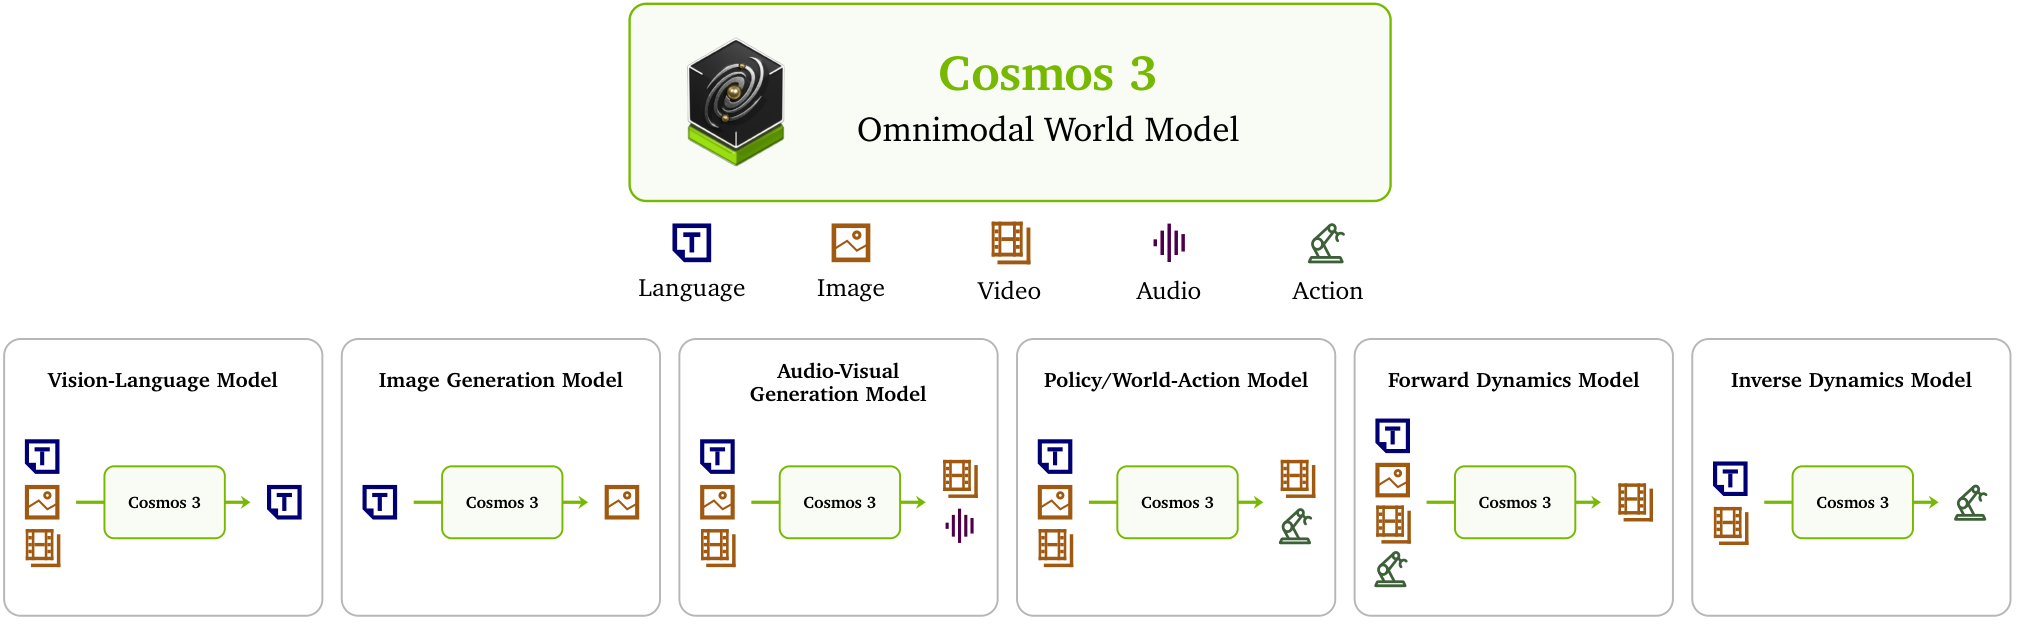
圖 1:Cosmos 3 作為物理 AI 的通用骨幹。透過聯合建模語言、影像、影片、音訊與動作以同時支援理解與生成,Cosmos 3 在單一網路架構中統一了廣泛的模型類別,包括視覺語言模型、影像生成模型、視聽生成模型、策略或世界—動作模型、前向動力學模型與逆向動力學模型 (Inverse Dynamics Model)。
為物理 AI 代理擴展訓練資料與環境,始終是一個難解的瓶頸。Cosmos 3 從三個面向為此挑戰提供了強力的起點:(i) 合成資料生成 (Synthetic Data Generation)、(ii) 任務特定的專門化,以及 (iii) 訓練環境(圖 2)。短期而言,Cosmos 3 可合成高擬真、多樣化的視覺資料,強化物理 AI 代理的訓練。我們在第 4.2.3 節與第 4.2.4 節展示如何將 Cosmos 3 後訓練成更好的合成資料生成器。由於代理透過多樣的具身形式 (Embodiment) 與任務來感知並與環境互動,Cosmos 3 支援在共享模型之上進行任務與具身形式特定的專門化。作為物理 AI 的強大中期訓練 (Mid-Training) 模型,Cosmos 3 藉由建模通用世界動態與動作先驗,建立了更好的起點,同時對下游調適保持高度的可塑性。實務上,模型可以在不更動架構的情況下,針對不同應用以目標資料進行後訓練,實現資料驅動的專門化,並得益於其全模態設計而保留共通的世界表徵。第 4.2.5 節描述我們如何將 Cosmos 3 後訓練成在 DROID 上表現卓越的世界—動作模型。長期而言,Cosmos 3 有望為物理 AI 代理生成高品質、複雜的訓練環境。為了加速物理 AI 的開放研究與部署,我們以 OpenMDW-1.1 授權在 github.com/nvidia/cosmos 與 huggingface.co/collections/nvidia/cosmos3 釋出程式碼、模型檢查點、精選合成資料集與評估基準。
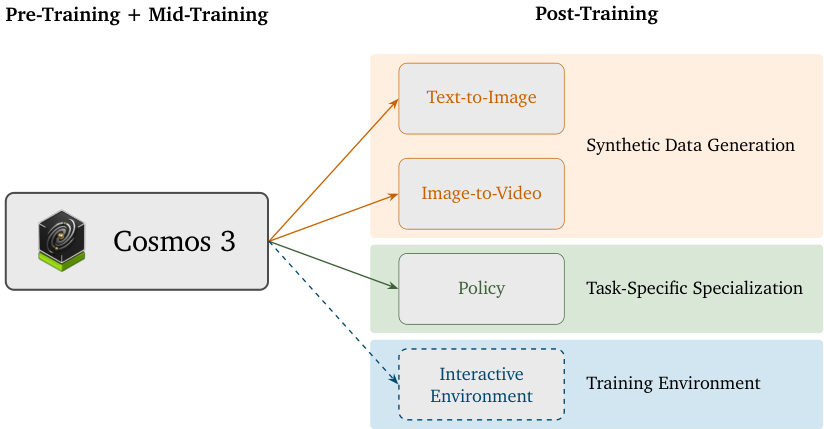
圖 2:Cosmos 3 為訓練物理 AI 代理提供了強力起點。Cosmos 3 可以在不更動架構的情況下,針對不同應用以目標資料進行後訓練。本文展示我們如何將 Cosmos 3 後訓練以獲得更好的合成資料生成能力(第 4.2.3 節與第 4.2.4 節)與更好的機器人策略(第 4.2.5 節)。未來,我們預期 Cosmos 3 將在生成高品質、複雜的物理 AI 代理訓練環境上扮演關鍵角色。
| 模型 | 推理:General | 推理:Robotics | 推理:Smart infra. | 推理:Driving | 生成:Text2Image | 生成:Text2Video | 生成:Image2Video | 生成:Audio | 生成:FD: Robot | 生成:Policy: Robot |
|---|---|---|---|---|---|---|---|---|---|---|
| Cosmos3-Super | 73.7 | 57.8 | 62.6 | 79.3 | 91.36∗ | 80.0 | 82.8 | 7.31 | 26.0∗ | - |
| Cosmos3-Nano | 69.6 | 55.1 | 61.0 | 76.0 | 84.61 | 79.4 | 82.7 | 7.34 | 25.5∗ | 39.7∗ |
| Gemini 3.1 Pro† | 77.5 | 58.2 | 58.6 | 47.2 | ||||||
| Qwen3-VL-32B | 72.8 | 52.6 | 56.1 | 40.7 | ||||||
| Qwen3-VL-8B | 68.9 | 48.5 | 52.7 | 46.4 | ||||||
| Gemma-4-31B | 69.8 | 51.0 | 51.3 | 36.6 | ||||||
| Gemma-4-E4B | 53.1 | 39.3 | 29.4 | 26.0 | ||||||
| Gemini 3 Pro Image† | 90.85 | |||||||||
| Qwen-Image-2512 | 84.25 | |||||||||
| Veo-3.1† | 79.1 | 82.6 | 7.45 | |||||||
| Wan2.2-A14B | 78.0 | 81.3 | ||||||||
| Ctrl-World | 23.0 | |||||||||
| π0.5 | 28.1 |
表 1:Cosmos 3 結果總覽。Cosmos 3 在所有能力面向上皆持續超越專門化的開源基線模型。詳細結果見第 6 節。表中 ∗ 表示經後訓練的 Cosmos 3 變體;† 表示閉源模型;空白欄位表示該模型不具備對應能力。
我們在廣泛的基準上評估 Cosmos 3 及其後訓練變體,涵蓋物理 AI 所需的關鍵理解與生成能力。表 1 摘要了我們的基準結果,詳見第 6 節。如表所示,Cosmos 3 在大多數能力上建立了新的最先進水準,與專門化模型相比極具競爭力甚至更勝一籌。
Cosmos 3 的技術細節安排如下。第 2 節介紹模型架構,包括各模態的編碼器 (Encoder)、支援不同生成模式的多模態 token 排列方式、Mixture-of-Transformers (MoT) 骨幹、多模態位置嵌入 (Position Embedding) 與模型變體。第 3 節概述 Reasoner 與 Generator 訓練所用的資料。第 4 節詳述 Reasoner 與 Generator 的訓練配方。第 5 節描述基礎設施,包括資料、訓練、服務與評估。第 6 節呈現實驗結果。第 7 節討論相關工作,第 8 節總結全文。
2 模型架構
Cosmos 3 能夠處理多模態輸入並生成多模態輸出。除了語言、視覺(影像與影片)與音訊之外,Cosmos 3 將動作 (Action) 視為核心模態,引入了一類專屬的動作 token。這些動作 token 將物理世界與基於語言的推理、基於影片的世界建模橋接起來,直接連結到物理落地的控制訊號以進行真實世界互動。Cosmos 3 整合各模態專屬的編碼器,將不同模態投影到統一的表徵空間,再交由 Mixture-of-Transformers (MoT) 骨幹處理。推論時,語言 token 以下一個 token 預測 (Next-Token Prediction) 生成,其他模態則透過疊代去噪 (Iterative Denoising) 生成。
2.1 編碼器
給定由語言、視覺、音訊與動作組成的輸入序列,第一步是使用各模態專屬的編碼器將它們嵌入到統一的表徵空間。為了讓共享的 Transformer 參數與位置嵌入能區分不同模態,我們在每個非語言模態送入 MoT 骨幹之前,加上一個可學習的模態專屬嵌入向量。
2.1.1 影像與影片
我們對視覺輸入採用兩個獨立的編碼器。視覺理解使用一個以視覺—語言對齊預訓練的 ViT 編碼器;視覺生成則使用來自 Wan2.2-TI2V-5B([277])的影片 VAE 編碼器。ViT 編碼器採用 $16\times 16$ 的 patch 大小,其後接一個兩層 MLP,將 $2\times 2$ 的 token 合併並投影到 Transformer 的潛在空間。仿照 Qwen3-VL([13]),我們也透過 DeepStack([181])彙聚 ViT 的視覺特徵,並在影片幀之間交錯插入文字形式的影片時間戳([43])。VAE 將輸入影片在時間上壓縮 $4\times$、空間上壓縮 $32\times 32$,實作方式為 $16\times 16$ 空間壓縮再接 $2\times 2$ 的 patch 合併。我們使用一個線性層將每個 VAE token 投影到 Transformer 的隱藏維度,再將潛變量送入 MoT 骨幹。用於理解的 ViT 編碼器與骨幹聯合訓練,用於生成的 VAE 編碼器則在訓練期間保持凍結。
2.1.2 音訊
音訊生成採用 [135] 的音訊 VAE 架構。以 48 kHz 取樣的原始立體聲音訊,以 1920 個樣本的 hop size 編碼,得到每秒 25 個音訊 token。音訊 VAE 在訓練期間凍結。與其他非文字模態相同,音訊 token 先經線性層投影到 Transformer 的隱藏維度,再進入 MoT 骨幹。
2.1.3 動作
我們支援跨多種具身形式的動作建模,包括自動駕駛車、相機運動、機器人與第一人稱 (Egocentric) 人體運動(頭部與雙手)。由於每個領域都有各自原生的控制空間——例如關節軌跡、轉向指令、身體姿態或相機變換——我們將它們映射到統一的動作介面,使跨領域的多模態推理、生成與策略學習得以一致進行。
動作表徵
我們以動作指稱引發世界狀態改變的因果變數。給定連續的影片 token,動作 token $a_{t}$ 表示從前一狀態 $v_{t{-}1}$ 到當前狀態 $v_{t}$ 的轉移。每種具身形式的來源都被轉換為緊湊表徵,捕捉不同動作領域間共享的底層幾何結構,如圖 3 所示。概括而言,動作最多可包含三個組成部分:代理主觀測座標系的自我姿態 (Ego Pose)、代理效應器的效應器姿態 (Effector Pose),以及表示操作狀態的抓取狀態 (Grasp State)。為避免受具身形式特定的控制器細節影響——例如比例—積分—微分 (Proportional–Integral–Derivative, PID) 參數或底層致動介面——自我與效應器姿態以由狀態差分導出的偽動作 (Pseudo-Action) 表示。對於連續的 $\mathrm{SE}(3)$ 姿態 $\mathbf{T}_{t-1}$ 與 $\mathbf{T}_{t}$,我們將運動表示為相對變換 $\Delta\mathbf{T}_{t}=\mathbf{T}_{t-1}^{-1}\mathbf{T}_{t}$。我們依循 [354] 採用 6D 旋轉表徵,並使用 OpenCV 慣例:z 軸沿手指/夾爪方向,x 軸朝右。抓取狀態的處理則不同:它不表示時間差分,而是直接編碼時刻 t 的當前操作狀態。
對相機與自動駕駛車而言,動作僅由自我姿態表示,不含效應器姿態或抓取狀態。對第一人稱資料,我們以頭戴相機姿態差分作為自我姿態、腕部姿態差分作為效應器姿態、各腕座標系中的指尖位置作為抓取狀態([323])。對機器人資料,我們以頭部相機姿態差分作為自我姿態、末端效應器法蘭姿態差分作為效應器姿態([171])、連續的夾爪開合值作為抓取狀態。
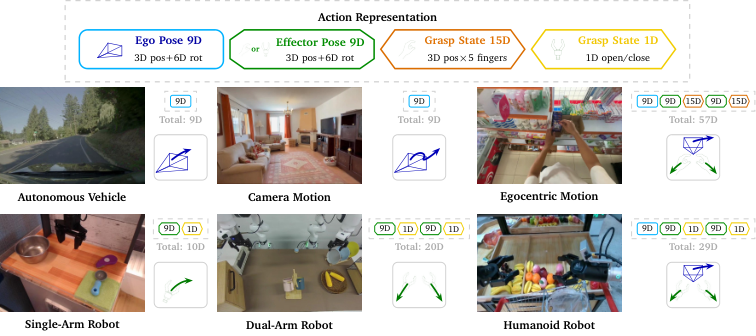
圖 3:統一動作表徵。我們將異質的具身形式控制映射為由共享幾何組件構成的緊湊動作向量。自我與效應器運動以相對姿態偽動作編碼,使用 3D 平移與 6D 旋轉(Zhou [354] 提出的過參數化旋轉表徵,因旋轉自由度為 3);抓取狀態則直接編碼當前操作狀態,例如手的指尖位置或機器人夾爪開合值。領域感知的輸入與輸出投影處理異質的動作向量長度,同時保留共享的語意空間。
動作 tokenization
我們的動作表徵將多樣的具身形式映射到共享的潛在動作空間,同時保留具身形式特定的結構與語意。因此,我們對每個具身形式領域使用獨立權重矩陣的領域感知輸入與輸出投影層([349]),而共享 MoT 骨幹。對於輸入 $\mathbf{x}\in\mathbb{R}^{d_{\text{in}}^{(k)}}$(例如串接頭部姿態差分、左右腕姿態差分與指尖座標的第一人稱動作向量)與領域識別碼 $k\in\{1,\ldots,K\}$,輸入投影為:
$$\mathbf{z}=\mathbf{W}_{\mathrm{in}}^{(k)}\mathbf{x}+\mathbf{b}_{\mathrm{in}}^{(k)} \tag{1}$$
其中 $\mathbf{z}\in\mathbb{R}^{d_{\text{model}}}$ 為潛在動作 token,$\mathbf{x}$ 為正規化後的動作向量,$\mathbf{W}_{\mathrm{in}}^{(k)}\in\mathbb{R}^{d_{\text{model}}\times d_{\text{in}}^{(k)}}$ 與 $\mathbf{b}_{\mathrm{in}}^{(k)}\in\mathbb{R}^{d_{\text{model}}}$ 為領域特定的輸入投影矩陣與偏置。
要將 token 解碼回原始動作空間,我們使用領域特定的輸出投影:
$$\mathbf{x}=\mathbf{W}_{\mathrm{out}}^{(k)}\mathbf{z}+\mathbf{b}_{\mathrm{out}}^{(k)} \tag{2}$$
其中 $\mathbf{W}_{\mathrm{out}}^{(k)}\in\mathbb{R}^{d_{\text{in}}^{(k)}\times d_{\text{model}}}$ 與 $\mathbf{b}_{\mathrm{out}}^{(k)}\in\mathbb{R}^{d_{\text{in}}^{(k)}}$ 為領域特定的輸出投影矩陣與偏置。所有投影參數皆從頭初始化,並與 MoT 骨幹聯合最佳化。我們以奇異值分解 (Singular Value Decomposition, SVD) 將預測的 6D 旋轉轉換回 $3\times 3$ 的 $\mathrm{SO}(3)$ 旋轉矩陣。
2.2 Token 排列與生成模式
Cosmos 3 是支援多種模態與任務的統一模型。不同任務可表述為交錯的多模態序列,每個序列由來自不同模態的一系列片段組成。給定一項任務,所有片段先以上述模態專屬編碼器編碼為嵌入。嵌入後,來自不同模態的 token 以一套適用於所有任務的統一格式打包,說明如下。
2.2.1 Token 排列
輸入 token 序列由兩個子序列組成:自迴歸 (Autoregressive, AR) 子序列在前,擴散 (Diffusion, DM) 子序列在後。
AR 子序列負責推理與理解。它包含語言 token 以及由 ViT 編碼器嵌入的影片與影像 token。所有 AR token 被路由至 Transformer 解碼器層中一組專屬的參數。
擴散子序列接在 AR 子序列之後,包含來自 VAE 編碼器的影片與影像 token,以及音訊與動作 token。生成時,模型對帶噪的擴散 token 進行疊代去噪,產生對應的乾淨 token。擴散 token 被路由至與 AR token 不同的參數集,但仍透過每層 Transformer 解碼器中的聯合注意力 (Joint Attention) 與 AR token 互動。
對任何給定任務,我們都以相同格式排列這些 token:(1) 自迴歸 token 置於擴散 token 之前;(2) 在擴散子序列內,對每個模態,乾淨的條件 token 置於帶噪的擴散 token 之前;(3) 在條件與擴散子序列內,token 皆按視覺、音訊、動作的模態順序排列。透過這套統一格式,Cosmos 3 可支援多種生成任務,詳述如下。
2.2.2 生成模式
Cosmos 3 支援多種模態:語言、視覺、音訊與動作。我們以 $v$、$s$、$a$ 分別表示乾淨的視覺、音訊與動作 token,其帶噪版本以波浪號表示:$\tilde{v}$、$\tilde{s}$、$\tilde{a}$。基於這些模態,支援的生成模式如下:
語言。 語言生成時,輸入僅包含自迴歸子序列,不啟動生成專用的擴散參數。若有影像與影片輸入,則由 ViT 編碼器嵌入並置於自迴歸子序列中。在此設定下,Cosmos 3 的運作方式如同標準 VLM。
文字生成影像。 此模式下,自迴歸子序列包含語言 token,擴散子序列則包含由 VAE 編碼器嵌入的帶噪目標影像 token。整個 token 序列為:
$$\mathbf{S}_{\mathrm{T2I}}=[\mathbf{S}_{\mathrm{AR}},\;\tilde{v}_{1}], \tag{3}$$
其中 $\mathbf{S}_{\mathrm{AR}}\triangleq[l_{1},\ldots,l_{n},\langle\text{EOS}\rangle,\langle\text{BOG}\rangle]$ 是以下所有模式共享的 AR 前綴($l_{1},\ldots,l_{n}$ 為語言 token;$\langle\text{EOS}\rangle$ 與 $\langle\text{BOG}\rangle$ 分別為句尾與生成起始特殊 token),$\tilde{v}_{1}$ 為帶噪影像 token。
文字生成影片(+音訊)。 此模式與文字生成影像類似,但擴散子序列改為包含帶噪的目標影片 token。當(可選地)同時生成音訊時,帶噪音訊 token 附加在帶噪視覺 token 之後。總結而言,打包後的序列為:
$$\mathbf{S}_{\mathrm{T2V+Audio}}=[\mathbf{S}_{\mathrm{AR}},\;\tilde{v}_{1:N},\;\tilde{s}], \tag{4}$$
其中 $N$ 為潛在影片幀數。
影像生成影片/影片生成影片(+音訊)。 此模式引入一張初始條件影像或若干初始影片幀,模型在其與文字提示的條件下生成完整的後續內容。在擴散子序列中,乾淨的條件影像或影片 token 之後接著帶噪的目標影片 token:
$$\mathbf{S}_{\mathrm{V2V}}=[\mathbf{S}_{\mathrm{AR}},\;v_{1:P},\;\tilde{v}_{P+1:N}], \tag{5}$$
其中 $P$ 為條件潛在幀數。當 $P=1$ 時任務為影像生成影片,$P>1$ 則對應影片生成影片。同時生成音訊時,音訊 token 的附加方式與文字生成影片相同。
影片轉換 (Video Transfer)。 此任務的輸入為一段控制影片(例如邊緣或深度)與一段文字描述,模型生成對應的 RGB 影片。Token 布局與影片生成影片類似,控制影片 token 作為條件 token,RGB 影片 token 作為帶噪目標 token:
$$\mathbf{S}_{\mathrm{Transfer}}=[\mathbf{S}_{\mathrm{AR}},\;v^{\mathrm{ctrl}}_{1:N},\;\tilde{v}_{1:N}], \tag{6}$$
其中 $v^{\mathrm{ctrl}}_{1:N}$ 為控制影片經 VAE 編碼的乾淨 token。
動作。 Cosmos 3 支援三種動作生成模式——前向動力學、逆向動力學,以及聯合影片—動作預測(策略)。對於一條含連續影片 token 的軌跡,每個動作 token $a_{t}$ 表示從 $v_{t{-}1}$ 到 $v_{t}$ 的轉移。前向動力學在觀測脈絡與乾淨動作 token 的條件下預測未來視覺狀態;逆向動力學則推斷可解釋觀測到的視覺轉移的動作 token。在策略模式下,模型聯合預測動作與影片 token,使其能在同一序列模型下同時生成介入行為及其預期的視覺後果。各條件方向總結於圖 4。
[Figure 4: 動作序列組態示意圖。對一筆影片—動作資料樣本,Cosmos 3 透過調整哪些 token 為乾淨、哪些為帶噪來構建不同的訓練模式。圖中顯示一個局部時間窗口,動作 token 位於相鄰影片 token 之間:$a_{t}$ 連接 $v_{t-1}$ 與 $v_{t}$,$a_{t+1}$ 連接 $v_{t}$ 與 $v_{t+1}$。前向動力學模式在乾淨動作 token 條件下對視覺 token 去噪;逆向動力學模式在乾淨視覺 token 條件下對動作 token 去噪;影片—動作(策略)模式同時對視覺與動作 token 去噪。為求簡潔,圖中省略語言與特殊 token。]
2.3 Mixture-of-Transformers(MoT)架構
Cosmos 3 採用 Mixture-of-Transformers (MoT) 架構,處理由不同模態 token 組成的統一序列。在層的層級上,每個 Transformer 解碼器層包含兩組參數:一組用於推理任務,處理 AR 子序列的 token(Reasoner);另一組用於生成任務,處理擴散子序列的 token(Generator)。雖然 Cosmos 3 在解碼器層結構上與 [60] 等統一生成模型相似,但其訓練策略、位置嵌入與整體能力皆有不同。
[Figure 5: Cosmos 3 的 Mixture-of-Transformers (MoT) 架構示意圖。左:單一 Transformer 在一條包含自迴歸(AR)與擴散(DM)子序列的 token 序列上運作:AR 承載離散文字 token 與(可選的)ViT 編碼視覺 token,以 <EOS> 與生成起始 token <BOG> 結尾;DM 承載來自各自編碼器的連續 token,訓練時加入噪聲擾動。為求簡明,圖中將所有輸入 token 都畫成帶噪;在影像生成影片或影片轉換等生成模式中,乾淨的條件 token 位於帶噪目標之前(見第 2.2.2 節)。在每個 Transformer 區塊內,AR token 與 DM token 由獨立的 LayerNorm 與 MLP 處理(皆由預訓練 VLM 共同初始化),僅在共享的自注意力運算中交會。令 $\mathbf{Q}$、$\mathbf{K}$、$\mathbf{V}$ 為注意力中的 query、key、value 向量,下標表示所屬的塔。$\mathbf{Q}_{\text{AR}}$ 僅對 $\mathbf{K}_{\text{AR}}$、$\mathbf{V}_{\text{AR}}$ 做因果注意力,而 $\mathbf{Q}_{\text{DM}}$ 對串接後的 $[\mathbf{K}_{\text{AR}}; \mathbf{K}_{\text{DM}}]$ 與 $[\mathbf{V}_{\text{AR}}; \mathbf{V}_{\text{DM}}]$ 做雙向注意力。如此一來,擴散以 AR 脈絡為條件,而 AR 保持自迴歸的自足性。輸出方面,Reasoner 為下一個 token 預測,Generator 為去噪後的 token(實務上以預測速度的流匹配 (Flow Matching) 目標訓練;此處為清楚起見顯示乾淨目標)。右:注意力遮罩,AR 為因果、擴散為全連接。]
2.3.1 雙塔層結構
標準的 Transformer 解碼器層由自注意力運算、前饋網路與若干正規化層組成。MoT 設計不以同一組參數處理所有 token 類型,而是使用兩條路徑,如圖 5 所示。每條路徑都是一個具有獨立參數的標準 Transformer 層,包括層正規化模組、注意力投影矩陣與前饋網路。兩條路徑皆以預訓練視覺語言模型的權重初始化,使 Cosmos 3 得以繼承強大的語言與視覺推理能力,同時學習生成高擬真影片。在訓練與推論中,位於前段的 AR 子序列被路由至 Reasoner 塔,位於後段的擴散子序列被路由至 Generator 塔。
2.3.2 雙流聯合注意力
雖然兩座塔使用獨立參數,擴散子序列的 token 仍透過雙流聯合注意力 (Dual-Stream Joint Attention) 運算與 AR 子序列互動。此處我們將 AR 與擴散子序列的 query、key、value 向量分別記為 $\mathbf{Q}_{\text{AR}}$、$\mathbf{K}_{\text{AR}}$、$\mathbf{V}_{\text{AR}}$、$\mathbf{Q}_{\text{DM}}$、$\mathbf{K}_{\text{DM}}$、$\mathbf{V}_{\text{DM}}$。
自迴歸子序列注意力
AR 子序列中的 token 僅以因果自注意力 (Causal Self-Attention) 關注 AR 子序列內的 token;亦即每個 token 只能關注同一序列中在其之前的 token。這與繼承自 VLM 骨幹的自迴歸特性完全一致,使模型能保留預訓練 VLM 的文字生成能力:
$$\mathbf{O}_{\text{AR}}=\operatorname{Attn}_{\text{causal}}\!\bigl(\mathbf{Q}_{\text{AR}},\;\mathbf{K}_{\text{AR}},\;\mathbf{V}_{\text{AR}}\bigr). \tag{7}$$
擴散子序列注意力
DM 子序列的 token 使用完全雙向注意力 (Full Bidirectional Attention),以 AR 與 DM token 的聯集作為 key 與 value。這讓每個擴散 token 都能自由關注自迴歸子序列中的文字提示,以及序列中所有其他條件與擴散 token,從而維持時間與空間一致性:
$$\mathbf{O}_{\text{DM}}=\operatorname{Attn}_{\text{full}}\!\bigl(\mathbf{Q}_{\text{DM}},\;[\mathbf{K}_{\text{AR}};\,\mathbf{K}_{\text{DM}}],\;[\mathbf{V}_{\text{AR}};\,\mathbf{V}_{\text{DM}}]\bigr), \tag{8}$$
其中 $[\cdot\,;\cdot]$ 表示沿序列維度串接。值得注意的是,AR token 永遠不會基於 DM token 更新,維持了條件路徑的因果完整性。
2.4 多模態位置嵌入
位置嵌入將時間與空間結構注入注意力機制 (Attention Mechanism),鼓勵 token 更強烈地關注語意與幾何上相關(通常在空間或時間上鄰近)的 token。由於 Cosmos 3 在統一的注意力框架中聯合建模語言、視覺、音訊與動作 token,設計一套能跨模態一致泛化的位置嵌入方案本質上頗具挑戰。受 3D 多模態 RoPE(Multimodal RoPE, MRoPE)([12])啟發,我們設計了具備絕對時間索引的 3D MRoPE,將影片、音訊與動作 token 對齊到同一條物理時間軸。原始 3D MRoPE 將每個注意力頭的隱藏維度切分為時間、高度與寬度分量,其中時間分量僅記錄離散的 token 索引。這對影像與影片理解任務已然足夠,但在我們的情境下並不適用:影片、音訊與動作 token 可能以不同的幀率或取樣率同時生成。此時,不同模態的 token 必須對齊到絕對的物理時間軸。我們先介紹依循原始 3D MRoPE 設計的基礎表述,再說明我們的延伸與修改,尤其是對齊絕對時間軸的絕對時間調變 (Absolute Temporal Modulation)。
2.4.1 位置索引分配
自迴歸 token
為了與語言生成及影像/影片理解模型向後相容,AR 子序列中所有語言 token 與 ViT 編碼媒體 token 的位置索引皆依循原始 3D MRoPE 設計。對語言 token,$t=h=w$ 設為同一個單調遞增值,使 3D MRoPE 退化為標準 1D RoPE 行為。對來自 ViT 編碼器的 token,同一幀的所有 token 共享 $t$,而 $h$ 與 $w$ 索引則依各 token 的空間位置獨立變化。自迴歸子序列的位置索引分配與 Qwen3-VL([12])的 3D MRoPE 設計完全相同。
[Figure 6: 3D MRoPE 下的座標分配示意圖。左:一條打包的 token 序列,包含語言、影片(兩幀,各為 2×2 空間網格)、音訊與動作 token。每個 token 獲得一組 $(t, h, w)$ 三元組。語言 token 使用 $t=h=w$;影片 token 在三個軸上皆變化;動作與音訊 token 僅使用時間座標($h=w=0$)。模態偏移量 $k$ 分隔文字與視覺的時間範圍。右:FPS 調變將幀索引映射為縮放後的時間位置,使得在 16、24、30 FPS 下相等的真實世界時長佔據相等的位置範圍,其中 24 FPS 為我們的基準幀率。]
擴散 token
如圖 6 所示,影片 token 在三個軸上皆變化:$t$ 隨時間潛在幀索引推進,$h$ 與 $w$ 則在每幀內獨立鋪滿空間網格 $(0\ldots H{-}1,\;0\ldots W{-}1)$。影像 token 被視為單幀影片,僅在 $(h,w)$ 上變化。空間與時間索引在每個視覺片段開頭皆重設為零,因此模型將 $t$、$h$、$w$ 視為影片內的絕對座標,而非全域序列中的位置。例如,在影片轉換任務中,使用者提供文字提示與受控影片幀(如深度圖),乾淨的控制影片 token 與帶噪的生成影片 token 皆從自迴歸子序列最後一個 token 的時間偏移量開始。所有音訊 token 與動作 token 僅攜帶時間座標,空間索引設為零($h=w=0$)。音訊 token 的時間索引隨每個音訊 hop 推進;動作 token 的時間索引隨每個取樣步推進。
自迴歸與擴散 token 的間隔
實務上,我們發現若直接讓擴散 token 從自迴歸最後一個 token 的時間偏移量開始,會導致初始影片幀出現過飽和與棋盤格狀瑕疵 (Checkerboard Artifacts)。此現象在較大的 Cosmos 3 變體(如 Super 模型)中尤其明顯。我們推測這是因為最後一個語言 token 與第一幀的視覺 token 佔據相鄰的時間位置,導致時間嵌入幾乎相同。為解決此問題,受 [34] 啟發,我們在自迴歸與擴散子序列之間插入一段固定的時間間隔,將後續所有視覺、音訊與動作 token 的時間索引一致平移。這在位置空間中創造出一個緩衝區,提供更清晰的文字到視覺轉換訊號,且無需更動架構或增加可學習的嵌入。在我們所有模型中,此間隔設為 $15000$。
2.4.2 絕對時間調變
沿時間維度的一個單位步長,在不同模態或資料來源中可能對應不同的物理時間間隔。例如,分別以 60 FPS 與 24 FPS 編碼影片時,24-FPS 影片 token 的一次時間索引增量所對應的物理時間,是 60-FPS 影片 token 的 2.5 倍。動作與音訊 token 也有類似的差異,因為不同資料來源可能使用不同取樣率。FPS 調變的設計目的,是透過調變每個時間增量的有效大小,將不同時間解析度的 token 對齊到共享的物理時間軸。
我們先定義每秒時間步數 (Temporal Steps Per Second, TPS) 來刻畫物理時間解析度。對影片 token,TPS 為影片幀率除以時間壓縮因子(在我們的設定中因影片 VAE 編碼器而為 4)。對音訊 token,TPS 為 $\mathrm{TPS}_{\mathrm{audio}}=\frac{48000}{1920}\approx 25$(48 kHz,hop size 1920)。對動作 token,TPS 即為動作資料的取樣頻率。
接著我們將時間維度上的單位長度關聯到一個基準 TPS,記為 $\mathrm{TPS}_{\mathrm{base}}$。對給定擴散子序列中的 token,我們計算其對應的 TPS。當時間索引需要增加一個單位步長時,經調變的時間增量 $\delta t$ 計算如下:
$$\delta t=\frac{\mathrm{TPS}_{\mathrm{base}}}{\mathrm{TPS}}. \tag{9}$$
由於影片構成我們訓練資料的主體,且 24 FPS 是我們設定中最常見的幀率,我們設 $\mathrm{TPS}_{\mathrm{base}}=\frac{24}{4}=6$,其中 $4$ 為影片 tokenizer 的時間壓縮比。
2.5 模型變體
Cosmos 3 以三種模型規模訓練:Edge、Nano 與 Super,涵蓋從裝置端部署到大型資料中心推論的廣泛運算預算。Edge 是建立在稠密 2B 參數 Transformer 之上的 4B 參數模型;Nano 是建立在稠密 8B 參數 Transformer 之上的 16B 參數模型;Super 是建立在稠密 32B 參數 Transformer 之上的 64B 參數模型。所有變體皆以預訓練視覺語言模型初始化,並採用上述 MoT 架構。表 2 總結了各變體的關鍵架構超參數。本文釋出 Cosmos3-Nano 與 Cosmos3-Super 模型;Cosmos3-Edge 模型將於後續版本納入。
Cosmos3-Edge 採用 2B 稠密 Transformer 設計:$28$ 層、$2048$ 隱藏維度、$16$ 個注意力頭、$8$ 個 key-value 頭、頭維度 $128$、FFN 維度 $9216$。我們使用 Megatron 程式碼庫從頭訓練該 LLM。此 LLM 的設計大體依循 Qwen3-1.7B 架構,但有兩處顯著差異:移除 QK 正規化,並使用 ReLU 平方作為 FFN 激活函數,搭配表 2 所列的 Edge FFN 維度。
Cosmos3-Nano 改編自 Qwen3-VL 8B([13])架構:LLM 有 $36$ 層、隱藏維度 $4096$、$32$ 個注意力頭、8 個 key-value 頭、頭維度 $128$、FFN 維度 $12{,}288$。
Cosmos3-Super 改編自 Qwen3-VL 32B([13])架構:LLM 有 $64$ 層、隱藏維度 $5120$、$64$ 個注意力頭、$8$ 個 key-value 頭、頭維度 $128$、FFN 維度 $25{,}600$。
| 變體 | LLM 層數 | 隱藏維度 | 注意力頭 | KV 頭 | 頭維度 | FFN 維度 |
|---|---|---|---|---|---|---|
| Cosmos3-Edge | 28 | 2,048 | 16 | 8 | 128 | 9,216 |
| Cosmos3-Nano | 36 | 4,096 | 32 | 8 | 128 | 12,288 |
| Cosmos3-Super | 64 | 5,120 | 64 | 8 | 128 | 25,600 |
表 2:Cosmos 3 MoT 模型變體。所有模型共享雙塔 MoT 架構。「LLM 層數」指 Transformer 解碼器層數;每層為 Reasoner 與 Generator 塔各攜帶獨立的參數集。Edge 使用從頭訓練的稠密 2B 參數 Transformer,Nano 與 Super 則以預訓練的 Qwen3-VL 權重初始化。
3 資料
訓練 Cosmos 3 需要服務於兩個互補目標的資料:Reasoner 路徑學習理解與推理世界,Generator 路徑則學習合成與模擬世界、或在其中行動。雖然兩條路徑共享同一個 Transformer 與 token 表徵,它們仰賴的訓練資料類型不同。Reasoner 以成對的視覺—語言資料訓練,例如影像—文字與影片—文字對,以支援問答、空間定位 (Spatial Grounding)、時間推理與動作理解等任務。相對地,Generator 以大規模的影像、影片、音訊與動作多模態語料訓練,採用基於重建的目標函數而非顯式標註。
因此,兩條路徑遵循不同但互補的訓練課程 (Curriculum)。兩者皆採用多階段訓練策略,資料組成隨時間演進。Reasoner 從廣泛的視覺—語言預訓練開始,之後透過監督式微調 (Supervised Fine-Tuning, SFT) 專精於涵蓋機器人、自動駕駛與空間智慧的物理 AI 任務。這種分階段課程先建立強大的通用能力,再逐步引入更專門的領域知識。Generator 從大規模影像、影片與音訊預訓練開始,隨後逐步納入動作、控制條件轉換與針對性合成資料等額外模態,以提升特定能力。
3.1 Reasoner 資料
我們的 Reasoner 資料課程包含約 $24.2$M 筆樣本:$22.0$M 用於預訓練,$2.2$M 來自領域特定的物理 AI 資料集與合成資料,用於監督式微調。表 3 總結了兩個階段所用的資料模態。預訓練階段以影像—文字與純文字資料為主,提供廣泛的通用視覺理解。相對地,監督式微調階段轉向物理 AI 專精,影片—文字樣本佔混合資料的 50%,以強化時空理解以及機器人、智慧基礎設施 (Smart Infrastructure) 與自動駕駛領域的能力。圖 7 按能力類別總結了兩個階段的資料混合。
[Figure 7: Cosmos 3 Reasoner 依能力類別的資料組成。我們總結用於訓練 Cosmos 3 Reasoner 的精選資料混合,涵蓋預訓練與監督式微調兩階段。混合資料含 22.0M 筆預訓練樣本與 2.2M 筆監督式微調樣本,橫跨影像—文字、影片—文字與純文字類別;每個環圈顯示 OCR、視覺問答、推理、描述、定位與指令微調等主要能力流的相對貢獻。]
| 模態 | 預訓練 | 監督式微調 |
|---|---|---|
| 影像—文字 | 18,814,952 | 1,051,513 |
| 影片—文字 | 1,016,299 | 1,079,200 |
| 純文字 | 2,170,762 | 40,960 |
| 總計 | 22,002,013 | 2,171,673 |
表 3:Cosmos 3 Reasoner 依模態與訓練階段的資料課程。表中數值在影像—文字與影片—文字列代表媒體樣本數(影像或影片),在純文字列代表對話數。
3.1.1 預訓練
我們的預訓練資料混合包含從 Nemotron Nano 2 資料集([192])中子選的 19.7M 筆樣本,以及為強化數學、影片、空間定位與指令遵循能力額外精選的 2.3M 筆樣本,詳見表 3。我們取得的資料集會先經過兩階段的資料策展 (Data Curation) 管線——語意去重 (Semantic Deduplication) 再接 AI 評審品質過濾——才納入最終訓練混合。
語意去重
第一階段在對話層級移除多模態近重複樣本,其中「對話」指完整的訓練範例:一張影像或一段影片與其指令—回應文字配對,或在沒有媒體時的純文字指令—回應樣本。對每筆對話,我們計算一個聯合嵌入,結合媒體表徵(若有)與對應的指令—回應文字表徵。影像—文字與純文字對話以 Qwen3-VL-Embedding-8B([142])嵌入,影片—文字對話以 Perception Encoder PE-Core-G14-448([27])嵌入。所得的串接嵌入同時捕捉視覺與語言語意,使管線能區分「視覺相似但任務意圖不同」的樣本與真正冗餘的監督訊號。
為了讓重複偵測擴展到生產級規模的資料集,我們採用聚類 (Clustering)。影像—文字、影片—文字與純文字樣本先以 K-means 聚類分區,接著在每個聚類內以對話嵌入空間中的餘弦相似度找出近重複群組。相似度高於 $0.95$ 高門檻的樣本會被移除。這種階層式設計讓大規模重複偵測變得可行,同時保留對視覺內容與任務語意冗餘的敏感度。
AI 評審品質過濾
第二階段對去重後的語料施加 AI 評審 (AI Judge) 來評估標註品質。我們使用 Gemma-4 作為視覺—語言評審([89]),具體為 Gemma-4-31B-it 模型([88])。評審被提示為訓練資料稽核員,依評分準則在三個主要品質維度上給出 $1$ 到 $5$ 的整數分數:
- 忠實性 (Faithfulness):回應中的所有主張是否皆有所提供的影像、影片或文字脈絡佐證。
- 完整性 (Completeness):回應是否完整回答了指令,沒有重要遺漏。
- 正確性 (Correctness):回應在事實、邏輯與任務層面是否準確。
忠實性對 Cosmos 3 尤其重要,因為缺乏佐證的視覺主張可能教會模型幻覺 (Hallucinate) 出物理狀態、物體屬性或時間事件。同時,完整性過濾掉描述不足或不完整的回應,正確性則移除最終答案或推理與輸入不一致的監督訊號。除了純量分數外,評審也產出簡短的、基於證據的理由,以便進行針對性抽查與過濾行為稽核。
基於門檻的資料集建構
我們對同一份去重後的基礎語料,以三個品質維度的最低門檻規則建構多個經評審過濾的資料集變體。只有當樣本的完整性、正確性與忠實性分數皆達到或超過指定門檻時才被保留。換句話說,每個保留的範例必須同時滿足三個維度的最低品質要求。
這種過濾策略刻意比取平均分數更嚴格:任何單一維度出現嚴重缺陷的樣本,即使其他準則分數很高也會被移除。例如,一則細節豐富、邏輯正確但含有無佐證視覺主張的回應,仍會因忠實性偏低而被過濾。實務上,我們採取保守的門檻設定,在消除明顯低品質監督的同時,盡量減少各能力領域的分布偏移。
多模態去重移除了 $4.23\%$ 的近重複監督資料。AI 評審的分數分布顯示品質缺陷在各維度上並不均勻。我們也按能力類別分析保留率,確保品質過濾在改善語料的同時不會意外壓縮技能分布。在較嚴格的門檻下,剪除呈現強烈的類別選擇性:例如當門檻從 $2$ 升到 $5$ 時,指代表達定位 (Referring-Expression Grounding) 被移除得最多,影像描述與視覺問答也大幅下降。此處門檻指各品質維度上可接受的最低 AI 評審分數:只有完整性、正確性與忠實性分數皆高於門檻的樣本才被保留。OCR 資料在門檻 $2$ 下相對穩健,但在 $5$ 時明顯下降。這些趨勢促使我們對主要混合採用最低的非平凡評審門檻,即 $2$:它能過濾明顯的標註失誤,同時保留推理、定位、OCR、描述與 VQA 能力的原始覆蓋度,在預訓練資料集上取得最佳的品質—數量權衡。然而在 SFT 階段,我們採用門檻 $5$,只保留最高信心的監督範例,因為此時標註精確度與回應可靠度比廣泛覆蓋更為關鍵。AI 評審過濾在門檻 $2$ 與 $5$ 下分別保留 $78\%$ 與 $46\%$ 的資料。
最終的預訓練混合包含約 22M 筆樣本,涵蓋 OCR、定位、問答、推理、描述與指令遵循資料,如表 3 所示。就組成而言,OCR 是最大的成分,貢獻 $9.44$M 筆樣本($42.9\%$),其次是 2D 定位 $3.62$M 筆($16.5\%$)、視覺問答 $2.48$M 筆($11.3\%$)與影像推理 $1.66$M 筆($7.5\%$)。其餘混合透過文字問答($1.35$M,$6.1\%$)、影像描述($1.30$M,$5.9\%$)、影片問答($0.99$M,$4.5\%$)、文字指令資料($0.82$M,$3.7\%$)、視覺指令資料($0.34$M,$1.5\%$)以及少量影片描述與影片推理資料(各 $0.01$M)提供廣泛的多模態覆蓋。此組成強調強健的影像—文字對齊、閱讀與空間定位能力,同時保留輕量的影片成分,為後續在時間與影片推理任務上的監督式微調做準備。
3.1.2 監督式微調
在監督式微調階段,我們強化通用的空間與時間理解能力,並聚焦於以下三個領域的資料策展:自動駕駛、機器人與智慧基礎設施。此階段總計以 2.2M 筆樣本訓練。
通用空間理解
我們透過 2D 與 3D 定位強化通用空間理解,並以真實與模擬資料雙管齊下。
2D 與 3D 定位。 2D 定位支援需要定位(物體、區域、部件與地標)、指點 (Pointing)、計數與多影像對應的物理 AI 任務。我們策展的樣本橫跨偵測、指代表達、OCR/版面、視覺提示描述與 VQA、指點、軌跡、計數與密集定位。方框與點座標經正規化後轉為統一的 JSON 格式。2D 定位資料來自合成與既有資料,大部分來自 LocateAnything([284])資料,我們從中抽取高品質子集。3D 定位資料方面,我們將 3D 掃描場景轉換為帶有相機相對 3D 方框的指令遵循訓練樣本。每個物體在標準化 (Canonicalization) 與內參正規化後,以標籤、中心、尺寸與朝向標註([28])。我們不採取串接 2D 定位與 3D 推斷的做法([48];[174]),而是直接以最終的結構化方框監督。
真實世界空間理解與定位。 我們組合多種互補的問答類型。影像指代問答任務要求依自然語言表達,以正規化影像座標指向目標物體或空白自由空間([351])。機器人空間問答要求預測自由空間中的擺放點,並回答跨自我中心、世界中心與物體中心參考系的二元相對位置與可達性問題([259])。我們進一步納入具位姿場景的多影像問答、影片幀空間問答,以及從固定集合中預測兩物體關係(例如左邊、後面、上方)的多選題,包括視角替換的觀點([160])。這些資料合計涵蓋物體指代、自由空間、跨視角對應、相機運動、大小、距離、方向、路線、計數與房間尺度推理。
模擬器落地的具身空間推理。 我們從可執行的模擬器狀態導出標籤,以橋接視覺空間問答與具身動作。答案由相機、物體位姿/方框、深度、遮罩、可見性與可行區域計算而得,再由程式化與 VLM 評審檢核。課程橫跨度量幾何、空間參考系、物理語意、可行動定位、視角動態與具身組合,輸出形式包括多選題、數值、點、方框、二元與文字。
通用時間理解
我們沿三個軸向擴增時間能力:時間事件理解、物理合理性判斷,以及結構化時空場景上採樣。
時間事件理解。 我們以三種互補的監督資料來源強化時間與運動理解。第一,人工標註者建立密集時間描述:日常室內任務的第一人稱影片被標註原子級人類動作描述與起訖時間戳,動作平均長 1.8 秒、14.2 個詞。此外,一個含 55K 部影片(2.6K 小時)的更廣影片語料提供 743K 筆事件三元組 $(t_{\text{start}},t_{\text{end}},\text{caption})$,用於事件枚舉與查詢條件定位。第二,為增加問題多樣性,我們以 FoundationMotion 管線([74])策展訓練資料,每段片段產生十道四選一的多選題,探測動作類別、時間演變與細粒度運動差異。最後,我們標註平移 (Panning)、變焦 (Zooming) 等相機運動模式,讓模型學習自我相機運動。
物理合理性判斷。 我們以兩種互補的監督來源強化 Cosmos 3 Reasoner 判斷生成影片物理合理性的能力。第一,我們納入附錄 F 所述 Cosmos 人工評估的標註,包含來自 1K 部生成影片的 13.5K 筆人工評分 $(\text{影片},\text{問題},\text{答案})$ 三元組,以是/否/不確定的分類答案涵蓋視覺完整性、時間穩定性、幾何、解剖結構、運動合理性與物理常識。第二,我們採用 VideoPhy-2([18]),其提供橫跨 $200$ 種動作的 3.4K 部以動作為中心的影片,每部以 $1$–$5$ 分評定對物理定律的遵循程度;其標註涵蓋守恆定律、重力、碰撞動力學、時間因果與空間約束,並被轉換為監督式問答對,由模型預測物理遵循分數。
結構化時空場景上採樣。 我們策展「描述不足的使用者輸入」與「密集結構化描述」的成對資料。輸入可以是文字提示、影像或兩者兼具,目標則是第 3.2.1 節所述的結構化描述標註。上採樣 (Upsampler) 能力能還原輸入中隱含的空間、時間與視覺細節,例如主體屬性、場景布局、相機取景、物體互動與合理的未來運動。為了讓模型對不同請求格式保持穩健,我們合成多種指令變體,其中一種為標準形式(取樣頻率較高),並將不同的輸入提示長度(例如描述應多詳細;簡短、詳細等)與多種提示風格(例如描述應如何刻畫場景;請求式、陳述式等)交叉組合。所得監督鼓勵模型遵循緊湊、直接、風格化的使用者請求,生成詳細的場景描述,同時保持相同的結構化輸出契約。第 6.3.2 節描述如何將此能力用於 Cosmos 3 影像/影片生成。
自動駕駛(AV)
我們納入的 AV 資料集橫跨人工標註與自動標註的思維鏈 (Chain-of-Thought, CoT) 推理、時間事件理解與 3D 車輛定位。
動作 CoT。 來自內部駕駛紀錄的人工標註 CoT 資料包含超過 10K 部帶有明確駕駛決策的影片,涵蓋天氣、光照、路況、交通規則、自車行為、關鍵物體,以及場景元素與自車行為之間的因果連結。為了擴大此訊號的規模,我們對內部紀錄中約 1.1M 部富含決策的影片進行自動標註。對每部影片,我們找出元動作 (Meta-Action) 轉換關鍵幀作為決策時刻,並運用最先進的 VLM、原始影片、自車軌跡、動態狀態與元動作,產生結構化決策、關鍵組件與精簡的推理軌跡。
時間事件定位。 我們從 Nexar 行車記錄器影片([190])導出時間事件定位資料,超過 24K 部影片涵蓋碰撞、近碰撞、急煞、急加速與急轉彎。片段以 6 FPS 取樣,上限 300 秒。我們以場景、參與者、互動、自車行為與時空脈絡的密集描述來擴充人工/自動標註資料。
3D 車輛定位。 我們以 MADS 資料集([237])訓練度量式 3D 車輛定位,其提供同步多相機序列、世界場景圖 3D 標註、相機內外參與自車位姿。我們以約 $1$ FPS 取樣幀,建立開放詞彙偵測與指代定位問答,要求模型枚舉車輛或依相對位置、車道、運動狀態或距離定位個體。答案為以位置、尺寸、roll、pitch、yaw 與類別標籤參數化的相機座標系 3D 方框,過濾為 $100$ 公尺內可見或輕微遮擋的物體,橫跨多樣地區、光照與天氣。
機器人與具身 AI
我們為機器人操作的動作 CoT、具身推理與醫療機器人手術理解策展資料。
機器人動作思維鏈。 動作 CoT 教導 Cosmos 3 Reasoner 將高階具身指令與當前幀轉換為機器人末端效應器控制的 2D 影像平面運動計畫。它不使用自由形式的推理說明,而是以任務相關位置、定位點、移動推理與 2D 途經點 (Waypoint) 來結構化推理,以緊湊、可檢視的軌跡從感知走向動作。該軌跡識別被操作物體、脈絡物體、可供性 (Affordance) 點與無碰撞區域,將其定位為座標,並將計畫解析為像素空間的末端效應器途經點。由於定位、局部化與操作規劃需要不同技能,資料以模組化管線建構:Qwen3-VL-72B-Instruct([12])生成定位理由與移動推理,Molmo-7B([59])定位指代表達,運動計畫目標則來自 MolmoAct([134])或追蹤的 DROID([120])操作片段。
具身推理。 我們以時間定位、任務規劃與機器人具身問答資料強化 Cosmos 的具身推理。在機器人操作方面,我們針對 MimicGen([175])將示範切分為以物體為中心、具精確時間戳邊界的子任務這一瓶頸,使用 60 部保留影片做零樣本 (Zero-Shot) 評估,並建立含 3.6K 部 Omniverse 重新渲染影片、橫跨六項任務的監督式微調集,時間戳由物體軌跡與關節運動學導出並經人工驗證。在長程規劃方面,我們策展 83K 筆 BEHAVIOR-1K([137])樣本,將場景幀與候選動作清單映射到真值動作。我們也加入 EO-Data-1.5M([231])的 ERQA 機器人問答,涵蓋任務規劃、可供性、失敗偵測、物理常識、定位、指代、關係與軌跡預測。
醫療機器人手術理解。 我們策展一個機器人輔助手術 VQA 資料集,含 2.2M 張影像上的 398K 筆多輪對話。資料收集自手術室外部相機、機器人第一人稱細節相機與控制台顯示器,設計靈感來自 ORQA([215])。多數樣本結合多個視角,並包含追蹤器詮釋資料(工具狀態、3D 平移、Euler 旋轉)與機器人詮釋資料(手術階段與步驟)作為脈絡提示。任務涵蓋工具辨識、定位、是/否分類、場景圖、螢幕文字轉錄、人員計數、距離/時間估計、動作標記與手術步驟辨識。
智慧基礎設施
我們策展三種互補的智慧基礎設施資料來源,涵蓋倉儲空間智慧、密集行人定位,以及交通與異常推理。
倉儲空間智慧。 我們使用 PhysicalAI-Spatial-Intelligence-Warehouse([264]),一個橫跨 44 個倉儲場景集合與 40 個相機視角的合成 Omniverse 語料。從 93K 張 RGB–D 影像與 873K 筆問答對中,我們子抽樣 80K 筆平衡範例,涵蓋物體計數、度量距離、定位,以及棧板、箱子、堆高機、貨架與作業員區域之間的二元空間關係。
密集行人定位。 我們策展的標註包含來自 44 個場景的 208K 張影像與 5.6M 個人工標註的人物方框。所有人物邊界框皆由人工標註者手動標記,且在標註與釋出前以模糊方式遮除個人可識別資訊,確保對象匿名。
交通與異常推理。 我們結合合成 ITS 碰撞監督、真實交通事件推理與監控異常驗證。CARLA([63])片段訓練無保護左轉與側撞 (T-bone) 情境中標記車輛對之間的二元碰撞預測,經 Cosmos-Transfer2.5([196])擴增後產生 3.4K 筆標註的車輛對查詢。TAR([205])貢獻 3.6K 部交通監視器影片(26 小時)與 44K 筆標註,橫跨問答、時間推理、因果連結、場景描述與摘要,其階層式 CoT 自動標籤經人工標註交叉檢核。為了將異常覆蓋範圍擴展到交通以外,我們也策展 1K 部內部監控片段用於二元尾隨 (Tailgating) 驗證。
3.2 Generator 資料
我們的 Generator 訓練遵循漸進式多階段課程,在訓練過程中逐步引入新模態:預訓練階段從影像、影片與音訊開始,中期訓練再納入動作與交錯的多模態內容。Cosmos 3 定位為各種物理 AI 應用的良好起點。為展示其能力,我們取中期訓練完成的 Cosmos3-Nano 與 Cosmos3-Super 檢查點,以專門的後訓練資料集後訓練出領域專家模型,包括 Cosmos3-Super-Text2Image、Cosmos3-Super-Image2Video 與 Cosmos3-Nano-Policy-DROID。這些模型與其對應的中期訓練模型共享相同架構。圖 8 總結了 Generator 跨模態與階段的訓練課程。
[Figure 8: Generator 資料課程。每列為一種訓練模式;每欄為一個訓練階段。彩色格子顯示該階段使用的訓練樣本數;灰色格子(—)表示該模式未啟用。影片列涵蓋文字生成影片、影像生成影片與影片到影片的延續;V2V 使用乾淨的條件影片前綴與帶噪的未來影片目標。動作與影片轉換資料在中期訓練首次引入。中期訓練產出基礎的 Cosmos3-Nano 與 Cosmos3-Super 模型(顯示於中期訓練與後訓練欄之間),隨後進入後訓練。後訓練針對各模態獨立進行,產出右側所列的專門化模型:Cosmos3-Super-Text2Image、Cosmos3-Super-Image2Video 與 Cosmos3-Nano-Policy-DROID。這些專門化模型與其對應的中期訓練模型架構完全相同。]
3.2.1 影像與影片
影像與影片資料策展遵循一套精心設計的處理、標註與過濾管線:(1) 收集原始資料並進行前處理;(2) 計算嵌入並去重;(3) 樣本分類與基本過濾;(4) 資料標註;(5) 依解析度與時長將樣本分組為可直接訓練的分片 (Shard)。為改善物理 AI 情境與其他困難案例的生成品質,我們在視覺生成資料混合中引入合成資料。所得資料被組織為預訓練資料,以及品質更高的中期訓練與後訓練資料。
預訓練
預訓練階段使用從 $7.8$B 張原始影像與 $3$B 部原始影片處理而得的 $767$M 張影像與 $347.7$M 段影片片段。在最終語料中,影像與影片皆以 $720$p 與 $480$p 為主流解析度。具體而言,$720$p 佔影像的 $26.8\%$、影片的 $36.4\%$;$480$p 佔影像的 $26.0\%$、影片的 $30.8\%$。此外,$25.2\%$ 的影像與 $12.2\%$ 的影片為 1080p 或更高解析度。最常見的長寬比為 16:9,佔影像的 $52.0\%$、影片的 $97.3\%$。影像的第二常見長寬比為 1:1,佔保留影像語料的 $25.2\%$。原始資料以下列管線處理與過濾:
原始資料收集與處理。 我們從多樣的資料來源收集數十億張原始影像與影片,記錄原始媒體內容及其詮釋資料,例如原始描述文字。影片方面,我們額外以 TransNetV2([260])進行場景切換偵測,將長影片切分為時間上一致的片段。接著以 ffmpeg cropdetect 偵測並移除黑邊,並將所有影片片段重新編碼為標準格式,以統一儲存並確保播放完整性。
嵌入與去重。 原始資料含有大量重複的影像與影片內容,且概念分布往往高度不均衡。為移除重複內容並為概念平衡與評估奠定基礎,我們將媒體內容嵌入為向量。影像使用 Qwen3-VL-Embedding-8B([142]);影片使用 nvidia/Cosmos-Embed1-448p([194])。我們從完整語料中抽樣 $147$M 張影像與 $400$M 段影片片段,對每種資料類型獨立執行 $20{,}000$ 個聚類的 cuML KMeans([234];[180])。接著將每張影像或每段影片指派到最近的聚類,並在每個聚類內依餘弦相似度分數移除近重複樣本。
分類與基本過濾。 我們使用一小組內部 VLM 模型進行語意標記與品質過濾。影像與影片資料皆被分類為 $47$ 個階層式類別,包括通用與物理 AI 領域。影像過濾方面,一個專用模型標註拼貼 (Collage) 等屬性,並產出美學與照片真實感分數。只有美學分數超過預定門檻的影像才會保留。被標記為拼貼、浮水印、白色背景或 NSFW 的影像會被捨棄。對於非文字渲染用途的合成影像,我們額外依其照片真實感分數過濾,只保留高於指定門檻者。影片過濾方面,我們使用三個連續品質分數——DOVER 美學品質([300])、DOVER 技術品質與 VTSS 訓練適用性([283]),各為 0–9 分——搭配約 $100$ 個二元瑕疵標籤。主要瑕疵(分割畫面版面、旋轉影片、靜態影片)導致樣本被拒絕,次要瑕疵(文字覆蓋、動態模糊、壓縮雜訊)則被標記但保留在預訓練資料中。
中期訓練
中期訓練階段旨在利用精選的高品質資料提升生成品質,並賦予模型額外能力,包括領域特定能力(如物理 AI)與新任務(如影片轉換)。資料來自三個來源:(1) 高品質影像與影片;(2) 合成影像與影片;(3) 影片轉換資料。
高品質影像與影片。 我們以更嚴格的過濾規則選取資料,並對困難案例概念加重抽樣,以緩解長尾分布。真實影像必須滿足各長寬比對應的解析度門檻與嚴格的 DOVER 美學分數下限。我們也納入合成與文字渲染子集。經謹慎拒絕抽樣 (Rejection Sampling) 策展的合成影像,擴大了罕見視覺概念與物體組合的覆蓋範圍;文字渲染影像則解決影像內可讀文字代表性不足的問題。最終的中期訓練影像混合有效比例為 $60\%$ 真實影像、$36\%$ 合成影像與 $4\%$ 文字渲染影像。影片方面,我們同樣以更嚴格的解析度與美學過濾從預訓練資料池選取片段,佔中期訓練影片混合的 $46.0\%$。接著納入來自機器人、自動駕駛、人類活動與第一人稱人—物互動序列的額外高品質領域特定片段,鎖定具身 AI 與操作情境;這些片段佔混合的另外 $43.9\%$。為進一步提升在困難與極端案例概念上的穩健性——例如人體運動、高速複雜運動與細粒度操作——我們收集聚焦這些難例的能力導向資料,佔中期訓練影片其餘的 $10.1\%$。
合成資料。 儘管我們的預訓練語料高度多樣,其概念分布仍呈長尾。因此,模型對罕見但重要的物理 AI 領域與情境(如機器人、自動駕駛與倉儲環境)的接觸相對有限。在這些情境中,模型往往難以理解場景動態、物理互動與長程行為。為解決這些限制,我們建構了大規模合成資料語料,包含以下子集:1) 物理互動場景(SDG-PhyxSim),聚焦剛體碰撞、關節物體動力學、可變形材料、流體動力學與光學效應;2) 具身機器人場景(SDG-RobotSim),涵蓋 6–8 種機器人具身形式與多樣任務類別的操作與移動序列;3) 自動駕駛情境(SDG-DriveSim),涵蓋常規與極端交通情境;4) 數位人類場景(SDG-SynHuman),旨在改善人體動態、相機運動先驗與多角色互動的建模;5) 倉儲作業場景(SDG-Warehouse),針對倉儲安全,包含人與堆高機互動情境。合成資料的建構與分析詳見附錄 C。我們釋出所有 SDG 資料集以支持社群。
影片轉換資料。 轉換資料賦予 Generator 控制條件生成能力。給定空間控制訊號——例如邊緣圖、模糊幀、深度圖、分割圖或世界場景圖 (World-Scenario Map)——以及文字描述,模型被訓練生成 RGB 影片。我們從預訓練影片池中選取 $3$M 部影片,聚焦高品質影片與機器人、自動駕駛等物理 AI 領域。邊緣與模糊控制的訊號在訓練時即時計算,使用 Canny 邊緣偵測、高斯模糊與隨機取樣參數的雙邊濾波。深度與分割控制訊號則分別以 Video Depth Anything([44])與 SAMv2([235])預先計算。世界場景圖控制使用由 Cosmos-Drive-Dreams([237])收集的 MADS 資料集。MADS 包含 $1.1$M 筆樣本,每筆有七個同步相機視角:前廣角、前望遠、左交叉、右交叉、左後、右後與後望遠。影片以 $30$ FPS 錄製,並附有各相機的世界場景圖控制輸入,編碼車道線、道路邊界、交通號誌,以及車輛與行人的動態 3D 邊界框。資料集涵蓋 14 個地理區域,包括美國、德國、日本與英國,共 25 個國家—時長分區。
後訓練
我們建構後訓練資料集,用於訓練領域專門化的 Cosmos 3 模型,例如 Cosmos3-Super-Text2Image 與 Cosmos3-Super-Image2Video。
後訓練影像語料是一個緊湊、精心策展的集合,取自三個來源:合成影像、文字渲染影像與高品質真實影像。完全排除一般網路規模的預訓練資料,改用直接針對生成品質與能力缺口的高擬真內容。
後訓練影片語料由兩部分組成。第一部分是預訓練影片語料的子抽樣子集,作為正則化器 (Regularizer),防止模型過擬合於較窄的後訓練分布,同時保留預訓練習得的更廣泛視覺知識。第二也是主要部分,是一組緊湊的監督式微調影片,專門策展以彌合系統性評估中發現的生成品質缺口。SFT 影片集由三個子來源構成:其一為合成影片,涵蓋難以從真實影片取得的多樣視覺概念、運動類型與場景組合;其二為人工策展的真實 SFT 影片,由人工挑選與標註,為關鍵視覺領域的生成擬真度提供直接的品質訊號;其三為從預訓練語料檢索的真實影片,透過嵌入相似度選取,確保涵蓋常見失敗案例。
結構化描述標註
描述文字 (Caption) 品質是生成品質的關鍵因素。高品質的描述應忠實刻畫影像或影片中的實體、屬性、關係與整體場景內容。對影片而言,描述還應捕捉時間動態,包括物體運動、人類動作、物理變化、互動與相機運動。為提升描述品質,我們經過多次設計疊代,對所有訓練階段的所有資料採用結構化 JSON 標註格式,而非密集的自由形式自然語言描述。實驗顯示,自由形式描述往往精確但不完整:它們能準確描述可見內容,卻在複雜場景中遺漏重要細節。相對地,豐富的預定義結構鼓勵系統性地涵蓋物體、屬性、關係與場景層級資訊,在維持高精確率 (Precision) 的同時提升召回率 (Recall)。
我們的結構化格式捕捉廣泛的視覺屬性,包括主體、背景、光照、美學與攝影構圖 (Cinematography)。對影片,我們額外引入時間動態欄位,範圍從物理變換、物體互動到複雜人體運動。我們在結構化標註資料上微調了兩個 Qwen3-VL-8B 模型,分別作為影像與影片的內部描述器 (Captioner)。描述模型與完整結構化描述綱要的細節詳見附錄 A。
為了定量且嚴謹地評估標註品質,我們為影像與影片設計了專門的描述品質基準。此基準聚焦於難以描述的範例,強調物理 AI 等領域——在這些領域中,準確描述物體、空間關係、動作與時間動態至關重要。對每則模型生成的描述,我們以兩種不同方法在斷言 (Assertion) 層級計算精確率與召回率。精確率直接對照來源媒體評估,以懲罰幻覺:由 VLM 將生成的描述分解為原子主張,並驗證每個主張是否有影像或影片本身的視覺佐證。召回率則衡量全面性,仰賴人工策展的真值。為實現可靠且可追溯的召回率評估,我們將影片或影像的視覺內容分解為一份原子斷言清單,涵蓋實體、屬性、關係、事件與其他相關細節。接著由 LLM 將生成的描述與此真值斷言清單交叉比對,判斷哪些關鍵細節被成功捕捉。這套協定讓我們不僅能評估描述的事實準確性,也能評估其是否包含訓練高品質生成模型所需的關鍵視覺資訊。在此基準上,我們的結構化標註方法在維持高精確率的同時顯著提升了召回率。
3.2.2 音訊
音訊—影片成對資料教導 Generator 的不只是「該有什麼聲音」,還有「該聲音相對於可見事件應在何時發生」。原始網路影片的音訊在這方面頗具挑戰:旁白與配音常在描述影片而非由影片引發,人為添加的背景音樂 (BGM) 則可能掩蓋畫面事件產生的物理聲音。因此我們在不同訓練階段以不同方式使用音訊:預訓練保留廣泛的聲學覆蓋,中期訓練則透過針對語音與非語音音訊的明確篩選策略,建構更高精度的音訊—影片配對。
預訓練
音訊預訓練語料完全來自預訓練影片池。共有 138.9M 段預訓練片段含有可用音軌,涵蓋劇情內 (Diegetic) 與劇情外語音、旁白、BGM、環境音、音樂與物理事件的廣泛混合。其中 62.5M 段短於 30 秒;對此子集,我們使用 Qwen3-Omni-Captioner([313])生成合成音訊描述。此階段偏重規模與多樣性,讓模型在中期訓練施加更嚴格策展之前,先接觸真實影片音訊的長尾分布。
中期訓練
中期訓練音訊池由預訓練音訊—影片語料過濾而來,以改善因果性的視聽對齊。最終資料池含 18.8M 段片段:12.8M 段非語音片段用於環境與物理聲音生成,6M 段語音同步片段用於視覺落地的語音生成。策展管線圍繞一個簡單原則:只保留與可見人臉同步的語音、從非語音範例中移除畫面外語音、並在非樂器演奏的 BGM 會主導目標音訊時將其移除。
音源分離。 對每個候選片段,SAM-Audio([251])將原始音訊分離為語音主幹 (Stem) 與其餘主幹。語音主幹用於識別視覺落地的語音,其餘主幹則提供人聲抑制後的非語音音訊生成候選。
唇形同步評分。 對語音主幹與原始影片執行 SyncNet([51]),產出 has_face 與 lip_sync_confidence。我們定義 speech_synced 為 has_face $=$ True 且 lip_sync_confidence $\geq 3.0$(如 LatentSync([138])所示)。
音訊事件偵測。 對原始音訊執行 FireRedASR2S([314]),估計 speech_ratio(被標為語音或歌唱的時間比例)與 music_ratio(被標為音樂的比例)。我們定義 high_music 為 music_ratio $\geq 0.1$。
樂器偵測。 對所有 high_music 片段(含語音同步者),由 Qwen3-VL([13])預測 is_music_instrument。這保護了樂器演奏影片——其音樂是可見事件的一部分,而非可移除的 BGM。
語音分支。 滿足 speech_synced 的片段構成語音中期訓練池。我們保留原始音訊,除非該片段為 high_music 且 is_music_instrument 為 False;此時由 SAM-Audio 從原始波形中移除音樂。此編輯路徑只有在對候選音訊的第二次 FireRedASR2S 檢測回報 speech_ratio $\geq 0.05$ 且 music_ratio $=0$、且候選音訊依 max_abs $\geq 0.007$、p50_db $\geq-80$、active_ratio $\geq 0.2$ 判定不近乎靜音時才保留。這在抑制非樂器演奏 BGM 的同時保留唇形同步的語音。
非語音分支。 未被指派到語音同步分支的片段,被策展用於非語音的視聽生成。我們先選擇基底波形:若 speech_ratio $\geq 0.05$,使用 SAM-Audio 的其餘主幹以移除人聲;否則保留原始音訊以保存物理聲音。若片段為 high_music 且 is_music_instrument 為 False,則對所選基底波形施加 SAM-Audio 音樂移除。源自其餘主幹的候選必須通過第二次 FireRedASR2S 檢測且 speech_ratio $<0.05$;若施加了音樂移除,其 music_ratio 必須 $=0$,否則須 $<0.1$。源自原始波形且經音樂移除的候選,其 music_ratio 必須 $=0$。處理後的候選也必須通過與語音分支相同的非靜音門檻。
描述標註。 描述文字與最終用於訓練的波形綁定。若所選波形為原始音訊,我們保留原始音訊描述。若音源分離或音樂移除改變了波形,我們對最終候選音訊重新生成描述,使文字不會描述已被移除的語音或伴奏。對語音同步池,我們以 Qwen3-ASR([254])轉錄每條選定的語音音軌,再用 GPT-OSS-120B([2])將逐字稿與音訊描述合併。所得描述同時指明說話內容與非語言的聲學脈絡,並忠實於與影片配對的音訊。
3.2.3 動作
動作提供了跨時間連接觀測世界狀態的因果變數。僅以影片訓練雖能教會生成器外推可能的運動,卻無法讓模型接觸可控的介入:相同的初始觀測在不同的機器人指令、相機軌跡、車輛路線或人手運動下可能有不同的演變。因此我們在中期訓練引入文字—影片—動作成對資料,讓 Cosmos 3 能學習世界—動作關係的雙向性:在動作條件下預測未來觀測、推斷解釋觀測軌跡的動作,以及聯合生成動作與未來影片。
資料統計
我們將動作中期訓練聚焦於四大物理 AI 支柱:第一人稱運動、機器人、自動駕駛車與相機運動。最終策展資料涵蓋這些支柱,共 $8.4$M 個操作片段 (Episode)、$61.3$K 小時,如圖 9 所總結。
[Figure 9: 動作資料分布。小時數彙總自最終策展的動作中期訓練集中四大動作資料支柱,共含 8.4M 個操作片段與 61.3K 小時。]
| 具身形式 | 資料來源 | 任務數 | 操作片段 | 小時數 |
|---|---|---|---|---|
| AgiBot | [32] | 338 | 239.4K | 4.37K |
| Franka Panda | [302]; [120] | 67.5K | 76.3K | 442 |
| Google Robot | [30] | 599 | 87.2K | 351 |
| WidowX-250 | [276] | 21.8K | 50.4K | 100.1 |
| UMI | [151]; [96]; [164]; [50]; [156]; [305] | 43 | 38.3K | 67 |
| UR | [302] | 114 | 25.0K | 35 |
| 總計 | – | 90.4K | 516.7K | 5.36K |
表 4:機器人資料細目。依機器人具身形式分組。
第一人稱運動。 第一人稱運動資料貢獻 $41.3$K 小時($67.4\%$),為最大組成。它包含來自專有資料集的 $1.7$M 個操作片段,內容為以頭戴式 RGB 相機捕捉的雙手操作。每一幀皆標註同步的頭部相機位姿,且每隻手有 21 個關鍵點的 3D 姿態([358];[256]),提供相機座標系中每個關節的位置與朝向,使模型能聯合學習第一人稱自我運動與細粒度的靈巧手部運動。
自動駕駛車。 自動駕駛資料貢獻 $10.0$K 小時($16.3\%$),來自以 NVIDIA Hyperion 平台收集的高品質內部駕駛紀錄。資料集透過在大規模語料中挖掘以符合橫跨多樣駕駛情境的目標分布而建構。選定的情境涵蓋廣泛的條件,包括多樣的天氣、光照與路況,以及各種縱向與橫向操駕行為,而非侷限於以近直線巡航為主。為與其他領域對齊,我們將駕駛軌跡從車輛座標系轉換到前廣角相機座標系。
機器人。 機器人資料貢獻 $5.4$K 小時($8.7\%$),彙整自開源資料集。此子集包含 $90.4$K 項任務與 $516.7$K 個操作片段,依具身形式與來源細分於表 4。為避免受具身形式特定的控制器細節(如 PID 參數或底層致動介面)影響,我們使用由狀態差分導出的偽動作。我們同時策展成功與失敗的操作片段,使模型不只觀察到預期的完成,也觀察到非常規的動作效果。
相機運動。 相機運動資料貢獻 $4.6$K 小時($7.5\%$),從我們的預訓練影片資料集挖掘而得。我們以 ViPE([111])與 DepthAnything3([153])估計相機位姿,將這些影片轉換為動作軌跡。為確保資料品質,我們嚴格過濾資料集,移除位姿估計不可靠的片段,例如抖動過度或相機內參異常者。所有相機位姿保持度量尺度,並轉換為統一的動作座標慣例。此策展流程產出 $1.9$M 段片段的資料集。
資料處理管線
我們以第 2.1.3 節所述的統一動作 tokenization 轉換每個資料來源。為了在轉換後平衡各具身形式的動作幅度,我們從訓練資料計算各維度的正規化因子,將動作通道縮放到約 $[-1,1]$ 的可比範圍。對於有多個同步視角的資料,我們將視角串接成一張畫布,並將相機布局存於詮釋資料中,如圖 30 所示。我們不過濾閒置操作,而是保留它們並在詮釋資料中記錄閒置步數,讓下游取樣能明確平衡活動與非活動片段。
4 訓練
我們分兩個主要階段訓練 Cosmos 3。首先,Reasoner 在大規模影像—文字與影片—文字語料上預訓練,隨後在精選的物理 AI 混合資料上微調,產出強大的多模態視覺理解與推理骨幹。由於 Reasoner 與 Generator 共享相同的 Transformer 區塊架構,訓練完成的 Reasoner 權重隨後用於初始化 Generator,將語意與世界知識轉移到能夠合成像素、音訊與動作的模型中。Generator 以漸進式多階段課程訓練:先進行大規模影像、影片與音訊預訓練,接著在中期訓練逐步引入動作與轉換資料,最後在較小但精心策展的物理 AI 資料集上後訓練,以改善下游行為、物理一致性與動作擬真度。
4.1 Reasoner 訓練
Cosmos 3 Reasoner 分兩階段訓練:大規模多模態預訓練,接著在精選的物理 AI 任務上監督式微調。預訓練期間,模型從大規模影像—文字與影片—文字語料學習通用多模態表徵。監督式微調則讓模型專精於物理 AI 領域,包括機器人、自動駕駛與智慧基礎設施應用,同時保留預訓練習得的廣泛能力。
4.1.1 預訓練
Reasoner 預訓練從一個語言模型與一個透過多模態投影器連接的 ViT 編碼器開始。初始化方面,我們同時實驗了附錄 D 所述的內部預訓練模型與開源 Qwen3-VL 模型:Edge 模型使用我們自己的模型,Nano 模型使用 Qwen3-VL-8B,Super 模型使用 Qwen3-VL-32B。與先前只訓練投影器、凍結其餘 VLM 參數的獨立對齊階段做法([12])不同,我們發現這種分階段對齊並非必要,因此從預訓練一開始就聯合訓練所有組件。
模型以下一個 token 預測目標,在第 3.1.1 節所述的大規模多模態語料上訓練。我們使用不放回抽樣器均勻串接所有資料集,對完整預訓練混合訓練兩個 epoch。由於許多物理 AI 應用需要高效推理與低延遲推論,我們將訓練限制在最長 $16$k token 的序列,每筆樣本的上限為 $2048$ 個影像 token 與 $8192$ 個影片 token。
依循先前工作([12];[286]),我們採用平方根正規化的逐 token 損失加權,以平衡短序列與長序列的貢獻。我們發現此正規化策略顯著改善了下游基準分數與整體訓練穩定性。
最佳化使用 AdamW,語言模型與投影器的峰值學習率為 $5{\times}10^{-5}$,ViT 為 $5{\times}10^{-6}$。所有學習率在 $10\%$ 的線性暖身 (Warm-up) 階段後,依餘弦衰減排程降至峰值的 $0.1{\times}$。Adam 係數為 $(\beta_{1},\beta_{2})=(0.9,0.999)$。訓練另使用 $0.05$ 的權重衰減與全域範數門檻 $1.0$ 的梯度裁剪。
4.1.2 監督式微調
為使模型適應下游物理 AI 任務,我們在精選的高品質多模態混合資料上進行監督式微調。與預訓練跨 epoch 均勻抽樣資料集不同,監督式微調採用重要性感知的抽樣策略:每個資料集依其重要性、品質與規模被指派固定的抽樣預算。這讓最佳化能聚焦於高價值的下游任務,同時維持跨領域與跨能力的多樣性。
為防止下游專門化損害模型的通用推理與視覺理解能力,我們額外混入經過濾的高品質預訓練資料子集,預訓練對 SFT 的抽樣預算比固定為 1:4。保留少量預訓練資料流可提升穩健性、保留指令遵循行為,並在多項基準上維持強勁的通用領域能力。我們也在監督式微調混合中納入一個輕量的指令遵循資料集(800K 筆樣本),以進一步穩定任務調適期間的對話與指令遵循能力。
訓練共 8200 次疊代,全域批次大小 512。我們使用 AdamW 最佳化器,語言模型與投影器的峰值學習率為 $1{\times}10^{-5}$,ViT 為 $1{\times}10^{-6}$。所有學習率在 $1000$ 步線性暖身後依餘弦衰減排程降至峰值的 $0.1{\times}$。Adam 係數為 $(\beta_{1},\beta_{2})=(0.9,0.95)$。權重衰減為 $0.1$,梯度裁剪全域範數門檻為 $1.0$。
4.2 Generator 訓練
Cosmos 3 Generator 以漸進式多模態課程訓練,旨在跨多樣解析度、時長與條件模態,聯合建模視覺、聽覺與動作條件下的世界動態。訓練配方強調可擴展性、高擬真生成與高效的長脈絡學習。預訓練期間,模型從橫跨影像、影片與音訊的大規模資料學習通用生成先驗。後續訓練階段逐步引入更豐富的多模態監督,包括動作與轉換序列,使模型能學習時間上連貫的世界演變與物理落地的互動。
訓練目標
Cosmos 3 Generator 在所有模態上以修正流匹配 (Rectified Flow Matching) 目標最佳化。對任一模態的目標潛變量,我們以直線內插建構帶噪潛變量 $x_{\sigma}=\sigma\cdot\epsilon+(1-\sigma)\cdot x_{0}$,其中 $x_{0}$ 為乾淨目標,$\epsilon\sim\mathcal{N}(0,I)$,$\sigma\in[0,1]$ 為噪聲水準。單一去噪器 $v_{\theta}(x_{\sigma},\sigma,c)$ 被訓練以帶遮罩的均方誤差預測恆定速度 $v^{*}=\epsilon-x_{0}$,其中條件 token(例如影像生成影片任務中的乾淨條件幀)被排除在損失之外。我們採用逐模態時間抽樣,對每個模態(影像、影片、音訊與動作)獨立抽取噪聲水準 $\sigma$。依循 Waver([345]),影像、音訊與動作批次使用 logit-normal 噪聲分布,影片批次使用眾數抽樣 (Mode Sampling)。我們發現使用眾數抽樣可獲得更好的生成品質。我們進一步將 $t$ 透過修正流平移重參數化 $\sigma=s\cdot\bar{t}/(1+(s-1)\cdot\bar{t})$(其中 $\bar{t}=1-t$)映射,$s\geq 1$ 使邊際分布偏向較高噪聲。
4.2.1 預訓練
在預訓練階段,我們聯合訓練模型跨多樣解析度與生成任務生成影像、影片與音訊。為此,我們採用多解析度訓練策略,並在多個生成任務上聯合最佳化模型,包括文字生成影像、文字生成(影片+音訊)、影像生成(影片+音訊)與影片生成(影片+音訊)。
多解析度訓練
我們不固定單一輸出解析度,而是同時在三個解析度層級(256p、480p、720p)、五種長寬比與可變幀數上訓練,如表 5 所示。這讓模型接觸高擬真內容,同時鼓勵解析度無關的表徵。訓練資料相應分區:256p 資料流取自完整資料集(所有原生解析度皆可);480p 資料流限制為原生解析度 480p 以上的素材;720p 資料流僅使用 720p 以上的內容,在最高層級保留銳利度與細節。各解析度層級有不同的最大幀數預算:256p 與 480p 最多 400 幀,720p 為 300 幀。720p 限制為 300 幀是出於序列長度約束。訓練批次以 1:1:2:1 的比例組成四個層級:純影像、影片-256p、影片-480p 與影片-720p。我們發現此分布在高擬真學習與樣本多樣性之間取得良好平衡,讓模型能觀察更多訓練範例,同時仍強調較高解析度的內容。我們使用解析度自適應的平移值:256p 為 $s=1$,480p 為 $s=3$,720p 為 $s=5$。
| 解析度 | FPS | 幀數 | 16:9 | 4:3 | 1:1 | 3:4 | 9:16 |
|---|---|---|---|---|---|---|---|
| 256p | 10–30 | 5–400 | (320, 192) | (320, 256) | (256, 256) | (256, 320) | (192, 320) |
| 480p | 10–30 | 5–400 | (832, 480) | (736, 544) | (640, 640) | (544, 736) | (480, 832) |
| 720p | 10–30 | 5–300 | (1280, 720) | (1104, 832) | (960, 960) | (832, 1104) | (720, 1280) |
表 5:影像/影片模型規格。影像與影片模態支援的組態。每列顯示各解析度下的 FPS 範圍、幀數(僅影片)與五種支援長寬比的影像/影片尺寸 (w, h)。
為了在支援可變序列長度的同時避免不必要的重編譯開銷,我們使用 token 打包 (Token Packing),每條序列固定預算 74,000 個 token。不同解析度的序列被打包在一起填滿每個批次,最大化 GPU 使用率且無需填充 (Padding)(如圖 10 所示)。
[Figure 10: 左:多解析度訓練與序列打包。三個解析度層級(256p、480p、720p)在最大幀數預算、可用素材與修正流噪聲平移值上各不相同;來自不同層級的可變長度序列被打包在一起,填滿固定的 74,000-token 脈絡窗口,最大化 GPU 使用率且無需填充。右:Generator 預訓練使用的資料混合。我們採用影像—影片聯合訓練,影片佔 80% 的抽樣時間,影像佔其餘 20%。在每個分割內,我們以多種解析度訓練:256p、480p 與 720p。對影片批次,我們額外在三種條件模式——文字生成影片、影像生成影片與影片生成影片——之間均勻抽樣。]
訓練模式
對形狀為 $C\times T\times H\times W$ 的潛在影片張量,令 $T_{\textrm{cond}}$ 為條件潛在幀數、$T_{\textrm{noised}}$ 為帶噪潛在幀數($T=T_{\textrm{cond}}+T_{\textrm{noised}}$)。訓練時,前 $T_{\textrm{cond}}$ 幀不加噪聲,作為條件輸入;只有其餘 $T_{\textrm{noised}}$ 幀被加噪,模型學習對其去噪。$T_{\textrm{cond}}$ 與 $T_{\textrm{noised}}$ 的不同選擇產生不同的訓練模式。我們使用四種生成模式——文字生成影像、文字生成影片、影像生成影片與影片生成影片——僅以每筆樣本前置的條件視覺幀數區分,抽樣比例分別為 $20\%$、$56\%$、$16\%$ 與 $8\%$。所有模式皆使用第 3.2 節所述的結構化 JSON 描述格式。
文字生成影像(T2I)。 影像被視為時間維度限制為 $T=1$ 的特殊影片。此模式下,影像從全部三個解析度層級與各長寬比中隨機抽取,經序列打包後送入模型。由於一筆影像樣本產生的 token 遠少於影片,典型序列包含的樣本數遠多於影片序列。
文字生成影片(T2V)。 文字生成影片訓練中,$T_{\textrm{cond}}=0$。模型學習僅以文字為條件對整部影片去噪。除描述文字外,模型還在 JSON 描述中接收時長、FPS 與時間戳詮釋資料作為額外欄位,使其能生成指定長度與時間範圍的影片。
影像生成影片(I2V)。 單幀條件($T_{\textrm{cond}}=1$)下,第一個潛在幀保持乾淨,後續幀被加噪。模型學習生成與初始幀及描述文字皆一致的未來幀。
影片生成影片(V2V)。 多幀條件($T_{\textrm{cond}}=2$)下,模型以影片的前五幀(等價於前兩個潛在幀)為條件,學習預測與條件幀及輸入提示皆一致的未來幀。
FPS 調變
我們以不同的 FPS 值訓練模型,因此 token 之間的物理時間間距因樣本而異:以 30 FPS 取樣的片段在真實時間中比同樣 token 數、16 FPS 取樣的片段包裝得更密。為反映這一點,我們調變 3D MRoPE 位置編碼的時間軸,使時間座標與真實世界時間成正比、而非 token 索引,基準率為 24 FPS(見第 2 節)。時長與 FPS 也會附加到文字提示中,讓模型在推論時能以特定時間特性為條件。
最佳化
Generator 預訓練期間僅更新生成專用參數。Reasoner 塔保持凍結,保留語言與視覺理解能力。我們使用 FusedAdamW,學習率 $10^{-4}$、$(\beta_{1},\beta_{2})=(0.9,0.99)$、權重衰減 $0.05$、梯度裁剪範數 1.0。學習率排程為帶暖身的線性衰減,在 $n$ 次疊代內從峰值降至 $0.30\times$ 的下限。為支援分類器無關引導 (Classifier-Free Guidance, CFG),我們在所有模態上使用 $10\%$ 的文字丟棄率。
訓練 token 數
在預訓練階段,Cosmos3-Nano 使用 $1024$ 顆 NVIDIA GB200 GPU 訓練了 $31.05$T token;Cosmos3-Super 使用 $2048$ 顆 NVIDIA GB200 GPU 訓練了 $17.86$T token。
4.2.2 中期訓練
中期訓練橋接了廣泛預訓練與下游部署之間的差距。此時 Generator 已從大規模資料學會通用的影像、影片與音訊生成,但目標物理 AI 應用需要更強的罕見動態、具身場景、控制介面與高品質視覺領域覆蓋。因此我們從預訓練檢查點繼續訓練,使用一份既保留原有視覺生成模式、又引入新監督來源的精選混合資料。此階段有兩個互補目標:領域專門化——增加高價值物理 AI 領域的曝露;以及多模態整合——將模型從視覺與音訊生成延伸到動作與控制條件的世界建模。
領域專門化
在保留通用知識的同時,模型接觸高度策展的專門資料集,以提升應用關鍵的物理 AI 情境中的品質與可靠性。影像方面,我們使用 15.6M 筆樣本的中期訓練池,強調高品質真實影像,並加入合成與文字渲染資料以擴大概念覆蓋並保留可讀文字生成。影片方面,我們納入 74.7M 段精選片段,橫跨機器人、自動駕駛、人類活動、物理與合成模擬資料。這些來源鎖定在一般網路規模預訓練中代表性不足的失敗模式,例如長程互動、細粒度的人類與機器人運動、物理物體動態,以及攸關安全的駕駛或倉儲情境。透過將這些領域聚焦資料集與既有的影像及影片訓練模式混合,中期訓練在不拋棄預訓練習得的廣泛視覺先驗的前提下,提升了物理 AI 相關性,如第 3.2.1 節所述。
多模態整合
中期訓練將 Generator 從影像、影片與音訊生成,擴展為也能消化與合成動作及控制訊號的統一物理 AI 模型。我們對 T2I、T2V、I2V 與 V2V 保持與預訓練相同的「乾淨前綴/帶噪目標」表述,使既有視覺能力保持活躍,同時在擴散子序列中引入新的模態專屬 token。這讓動作、音訊、控制與影片 token 共享第 2 節所述的相同時間座標系與雙向注意力模式。在預訓練模式之外,我們增加兩類額外的多模態監督:動作與影片轉換。
動作。 我們以第 2.1.3 節的統一動作表徵引入文字—影片—動作成對訓練資料。模型不僅被訓練在動作條件下預測未來影片,也被訓練從觀測軌跡推斷動作、以及聯合生成動作與視覺未來。這教會 Generator 一個連接可控介入與世界演變的因果介面。
影片轉換。 我們加入控制條件轉換資料:乾淨的控制訊號作為輸入,模型對相應的目標影像或影片去噪。控制訊號包括來自高品質影片語料的邊緣、模糊、深度與分割圖,以及駕駛場景的世界場景圖。這讓模型接觸空間落地的約束,同時保留文字條件與視覺生成品質。
各模態的混合比例如表 6 所示。
| 訓練資料流 | 模式/條件 | 佔比 |
|---|---|---|
| 影像 | T2I | 10% |
| 影片 | T2V、I2V、V2V | 32% |
| 影片+音訊 | T2(V+Audio)、I2(V+Audio)、V2(V+Audio) | 8% |
| 動作 | 前向動力學、逆向動力學、策略 | 25% |
| 通用轉換 | 邊緣、模糊、深度與分割控制 | 20% |
| 駕駛轉換 | 世界場景圖控制 | 5% |
表 6:Generator 中期訓練資料混合。預訓練完成後,我們在中期訓練階段以上列資料比例引入新模態(動作與轉換)。
多解析度訓練
與預訓練類似,中期訓練在固定的 74K 脈絡窗口內跨 256p、480p 與 720p 使用多解析度。為更好地處理動態並減少時間與高解析度瑕疵,我們將修正流平移值提高為 256p 的 $3$、480p 的 $5$ 與 720p 的 $10$。
訓練目標
與預訓練類似,我們對所有模態使用修正流目標。動作繼承視覺的噪聲排程。中期訓練的總損失為各模態速度 MSE 依模態特定損失尺度加權之和,其中動作損失放大 $10\times$,以補償正規化動作向量較小的逐元素 MSE。
最佳化
與預訓練類似,我們使用 FusedAdamW,學習率 $10^{-4}$、權重衰減 $0.05$、梯度裁剪範數 1.0、損失尺度 10。學習率遵循 LambdaLinear 排程,起始因子 $0.4$、週期長度 $100{,}000$。
訓練 token 數
在中期訓練階段,Cosmos3-Nano 模型使用 $1024$ 顆 NVIDIA GB200 GPU 訓練了 $2.4$T token;Cosmos3-Super 模型使用 $2048$ 顆 NVIDIA GB200 GPU 訓練了 $1.9$T token。
4.2.3 文字生成影像後訓練
為展示 Cosmos3-Super 的全模態能力,我們進一步將模型專門化為文字生成影像檢查點 Cosmos3-Super-Text2Image。我們的目標是將模型物理落地的世界理解轉移到高品質影像生成,在追求強勁開源 T2I 成績的同時,改善物理合理性與場景層級的對齊。
我們以兩階段 SFT 進行文字生成影像專門化,依循常見的文字生成影像基礎模型訓練範式:先強化語意,再進行偏好導向的精修。
階段 1:廣泛 T2I 專門化。 我們在精選的高品質 SFT 資料集上微調模型 20k 訓練步。訓練混合以受控比例抽樣:$45\%$ 通用真實影像資料、$40\%$ 合成影像資料與 $15\%$ 純文字渲染資料,平衡視覺擬真度、描述對齊與語言保留。我們使用基礎學習率 $1\times 10^{-4}$、2k 暖身疊代與線性學習率衰減排程,其他超參數與 Cosmos 3 中期訓練階段一致。
階段 2:高品質精修。 我們以 $470$k 筆精心策展的超高品質影像—描述對,執行最後 2k 步的 SFT。此階段進一步改善視覺美學、提示遵循、文字渲染品質與人類偏好對齊。
解析度與脈絡長度。 兩階段皆使用 70k token 的固定脈絡窗口,且僅以解析度高於 720p 的影像訓練。
整體而言,Cosmos3-Super-Text2Image 在語意對齊與英文文字渲染基準上皆取得強勁的文字生成影像成果。在 UniGenBench 上,它在受評模型中取得最佳總分,完整基準達 $91.36$(見表 11)。搭配代理式工作流程 (Agentic Workflow),該模型在 Artificial Analysis 文字生成影像排行榜上名列開放權重模型第一(第 6.2.1 節)。這些結果顯示,從 Cosmos 3 出發的下游 T2I 模態調適非常有效:它在保留模型物理落地生成能力的同時,改善了場景層級的提示對齊。
4.2.4 影像生成影片後訓練
影像生成影片能力對全面的視覺理解至關重要。它探測模型對物理定律、物體恆存性 (Object Permanence) 與複雜場景幾何的理解,同時也是具身 AI 與機器人規劃的關鍵預測機制——模擬合理的未來幀即構成有效的世界模型([298];[41])。雖然 Cosmos 3 天生設計為原生處理多樣任務,我們利用 SFT 明確展示並專門化其在 I2V 領域的潛力。為展示這些能力,我們採用以下程序:
資料與訓練混合。 我們以經過濾、為更平衡的主題多樣性而精修的預訓練資料微調模型,並透過一套辨識模型弱點、從預訓練集中檢索針對性範例的代理式工作流程加以擴增。此外還結合 1,000 部高品質人工策展影片與約 20k 段橫跨多樣主題的合成影片片段(約佔總 token 的 6%)。所有影片序列僅以 I2V 表述訓練,但訓練混合亦納入 20% 的 T2I 影像 token 以保留模型的語意對齊。
解析度與時長。 我們將模型專門化為 480p 目標解析度、189 幀目標時長的時間生成,約相當於 24fps 下的 8 秒。此組態平衡了推論速度與時間脈絡,能在有意義的時間跨度上快速生成物理上合理的影片。
訓練排程。 I2V 後訓練階段執行 10k 次疊代,學習率 $1\times 10^{-5}$。模型在 SFT 過程中處理約 50B token。
透過後訓練,Cosmos3-Super-Image2Video 在影像生成影片上達到領先品質。特別地,該模型在 Artificial Analysis 影像生成影片排行榜上名列開放權重模型第一(第 6.2.2 節)。此模型的使用細節請參閱第 6.3.1 節。
4.2.5 機器人策略後訓練
我們進行機器人策略後訓練,以探究 Cosmos 3 全模態世界模型能否延伸為強大的機器人策略模型。中期訓練使 Cosmos 3 能建模包括語言、視覺觀測與動作在內的多模態序列,並聯合生成動作與影片。我們進一步為機器人策略學習客製化模型:納入本體感覺 (Proprioceptive) 訊號、降低推論延遲,並使模型能產生可執行的動作以進行閉迴路控制。
作為先導研究,我們選用 DROID 機器人平台與資料集([120]),因其廣受歡迎且被社群廣泛採用。DROID 平台使用 Franka Panda 7 自由度機械臂搭配 Robotiq 2F-85 平行夾爪,在多樣的真實世界環境中執行桌面操作任務。DROID 資料集包含 76k 條軌跡、350 小時互動資料、86 項任務與 564 個場景,為真實世界機器人策略學習提供了可觀的規模與廣泛的任務多樣性。我們以 360$\times$640 的高解析度載入 DROID,套用社群提供的閒置幀過濾與失敗示範移除,並在訓練時使用隨機影像擴增。
我們從中期訓練的 Cosmos3-Nano 模型繼續訓練 Cosmos3-Nano-Policy-DROID,並全新初始化動作編碼器、動作解碼 MLP 與動作嵌入 token。我們對動作相關參數套用 5$\times$ 學習率乘數以加速調適。策略輸入包含當前的本體感覺機器人狀態與三視角視覺觀測。具體而言,原始解析度 360$\times$640 的腕部視角影像置於上方,兩張原始解析度各為 180$\times$320 的外部視角影像並排串接於左下與右下,最終畫布為 540$\times$640。策略被訓練以 15Hz 預測 32 個未來的絕對關節位置動作,並輔以 RGB 影片幀作為額外輸出。此後訓練研究使用官方 DROID 簡短任務指令作為提示。學習率為 $2\times 10^{-4}$,其他超參數依循中期訓練設定。
推論時,我們以 4 個擴散步、噪聲排程平移 5 對模型取樣。我們也套用 CFG 平行化的分類器無關引導,引導尺度為 3,並跳過影片潛變量解碼以進一步降低推論開銷。這些最佳化合計帶來顯著的推論加速,使策略伺服器得以部署在 2 顆 NVIDIA RTX Pro 6000 GPU 上。下游關節位置控制器以 Franky([245])實作,以 15Hz 執行預測的 32 個動作。
整體而言,Cosmos3-Nano-Policy-DROID 在機器人策略任務上取得強勁成果。如第 6.2.5 節所詳述,在我們提交排行榜時,它在 RoboLab([325])、RoboArena([9])與 MolmoSpaces([122])上皆名列第一,展現了 Cosmos 3 作為機器人策略學習基礎模型骨幹的有效性。
5 基礎設施
本節描述為支援 Cosmos 3 端到端生命週期而設計的整合式基礎設施堆疊。如圖 11 所示,該平台統一了四大核心支柱:
- 資料工程。 攝取原始多模態資料,將其轉換為 WebDataset 格式的精選資料集,為可擴展的分散式訓練最佳化。
- 大規模訓練。 透過高效的平行化策略、最佳化的資料載入、快速檢查點與集體通訊原語,最大化 NVIDIA GPU 叢集使用率。
- 模型服務。 為生成與推理工作負載提供高效、低延遲的部署與推論執行。
- 基準測試與驗證。 提供統一的評估框架,跨多樣任務評估模型能力,實現自動化的回歸追蹤與系統性模型比較。
[Figure 11: Cosmos 3 基礎設施堆疊總覽。平台橫跨四大支柱。「資料基礎設施」攝取原始多模態串流並將其策展為 WebDataset 格式的訓練分片。「訓練基礎設施」在 NVIDIA GPU 叢集上以高效的平行化、資料載入與檢查點機制消化這些分片。產出的檢查點進入兩條平行路徑(以虛線分隔):「服務基礎設施」將其部署為低延遲的生成與推理推論,「基準測試基礎設施」則以標準化基準資料集評估同一批檢查點,以追蹤回歸並實現系統性驗證。]
5.1 資料基礎設施
Cosmos 3 訓練語料來自橫跨多樣模態、領域與任務的數百億張影像與影片候選。以此規模運作,資料基礎設施必須同時能:(1) 透過大規模分散式處理將原始多模態資料轉換為可直接訓練的樣本;(2) 支援基於嵌入的檢索、聚類與去重;(3) 支援互動式的資料集視覺化、檢視與除錯。為滿足這些需求,我們開發了 SILA(Scalable Infrastructure for Large-scale data processing and Annotation),一個可擴展的多模態資料基礎設施平台,將儲存、詮釋資料管理、分散式處理、語意檢索與資料集視覺化整合到單一可延伸框架中,用於大規模資料策展與管理。
SILA 的核心是管線邏輯與基礎設施機制之間的清楚分離。研究人員宣告帶型別的處理階段——指定每個階段消耗的欄位與產出的輸出——平台則透明地處理資料集分片、分散式執行、容錯、檢查點、詮釋資料更新與資產註冊。這種抽象讓納入新的資料來源、基礎模型與處理階段(包括過濾、描述、嵌入生成、評分與標記)變得簡單直接,研究人員不必具備分散式系統專業知識。其結果是一個讓策展能跟上研究步伐的平台:隨著模型、品質準則與訓練配方演變,新訊號可以增量地加入、重新計算或替換。
5.1.1 大規模資料處理
多模態資料策展是一個疊代的豐富化過程,而非單次離線前處理。隨著模型、品質準則、標籤與訓練配方演變,原始文字、影像與影片樣本被反覆轉換、過濾、標註與重新處理。要擴展此工作流程頗具挑戰,因為管線既低產出率又高度疊代:只有一小部分原始候選最終進入訓練,意味著低效的掃描、複製或模型推論被不成比例地耗費在後來被捨棄的樣本上。同時,攝取、切分與轉碼、嵌入生成、去重、過濾、分類標記、描述與分片等階段反覆作用於同一批樣本。支援此工作流程因此需要在數十億筆多模態樣本上高效進行重複轉換與增量重算的機制。
這些挑戰在分散式執行下更加明顯。策展工作負載必須在共享叢集上持續運行,面對碎片化且動態變化的 GPU 可用性,而非假設一次性的單體式資源配置。基礎設施必須協調眾多分散式工作者、避免重複計算、從失敗中復原、管理異質的 CPU 與 GPU 密集階段,並在資源可用時繼續處理未完成的工作。為支援此執行模型,SILA 結合了統一資料層、片段層級協調與故障復原、分階段分散式執行、節點本地模型服務、機會式叢集使用,以及對代理友善的操作介面。
統一資料層
SILA 將資料策展組織為統一的欄式 Lance 資料集([216]),每列代表一筆資料樣本,每個帶型別的欄位代表一種策展訊號,例如描述文字、標籤、品質分數或標註。這取代了早期基礎設施 Cosmos-Predict 1.0([195])與 2.5([196])中的「每管線一表」舊架構——每條管線寫入自己的 Postgres 表,輸出稍後透過變更資料擷取 (Change Data Capture, CDC) 同步到 Databricks。隨著管線與詮釋資料欄位數量成長,每管線一表的設計需要跨大型資料表進行日益複雜的聯結 (Join) 才能重建單一樣本的狀態。這些聯結在規模化時成本高昂,且若不熟悉聯結鍵、表間關係與各管線專屬綱要,連簡單的操作查詢都難以表達。相對地,SILA 透過向共享的 Lance 表附加新的帶型別欄位,增量地豐富同一個邏輯樣本。這種統一表示天然匹配多模態策展工作負載——大多數階段是為既有樣本增添詮釋資料,而非創建新實體。透過將資料集內容、詮釋資料與處理狀態共置,系統能直接從 Lance 片段詮釋資料高效支援大規模掃描、單點查詢、增量重算與未完成工作的發現,無需昂貴的啟動聯結。
片段層級協調與故障復原
此規模的策展以高並行度運行:單一作業內的許多分散式工作者、以及許多平行的獨立作業,同時讀寫同一個持續演變的 Lance 資料集。若無明確協調,工作者必須仰賴昂貴的啟動查詢、隨機抽樣或對已處理樣本的事後過濾來避免重疊。這些做法延遲作業啟動、允許重複工作,並使長時間作業被搶占或中斷時的復原變得複雜。SILA 改為直接在 Lance 片段層級協調分散式策展。工作者從 Lance 詮釋資料發現未完成的片段,並在處理前取得有時限的租約 (Lease),而 Lance 資料集本身仍是完成狀態的唯一真實來源。租約所有權透過週期性心跳維持;心跳停止時租約過期,另一個工作者可以接手該片段,實現故障、搶占或端點崩潰後的自動復原,無需人工清理。由於單一片段可能包含許多樣本、需要數小時的模型推論,SILA 進一步將已認領的片段切分為較小的處理區段,將完成的區段寫為持久檢查點,並在所有區段完成後透過單次詮釋資料更新,將完整片段原子性地提交回 Lance。這將復原單位與可見性單位解耦:中斷的作業從已完成的區段恢復,下游讀取者則只看到完整提交的片段輸出。
分階段 Ray 執行
策展管線結合了資源需求截然不同的異質操作,包括資料載入、解碼、模型推論、後處理、寫入與提交。若這些操作透過單一無差別的控制迴圈執行,快速的上游階段可能累積中間輸出,而較慢的推論或提交階段成為瓶頸。SILA 改為透過分階段的 Ray 管線引擎([187])執行每個已認領的片段。框架管理的階段負責載入、寫入與提交,使用者定義的前處理、計算與後處理階段則在獨立的 Ray actor 池中執行,各自配置工作者數量與資源需求。背壓 (Backpressure) 限制跨階段邊界的進行中工作量,防止快速的 I/O 密集階段壓垮較慢的下游階段、迫使 Ray 物件儲存溢寫到磁碟。
節點本地模型端點
基礎模型策展工作負載常需要在許多管線工作者並行處理資料的同時,提供大型描述、嵌入、標記或評分模型的服務。集中式推論服務在規模化時可能成為瓶頸,而要求一次大型連續 GPU 配置則削弱了利用碎片化叢集可用性的能力。SILA 改為使用 vLLM([129])等系統啟動節點本地的模型服務端點,並將本地端點資訊直接傳給階段工作者。工作者隨後呼叫節點本地服務進行推論,使模型密集的策展階段能跨可用節點擴展,同時將資料平行的管線執行與模型服務的放置解耦。
機會式叢集使用
大規模策展必須與訓練工作負載在共享叢集上持續並行運行,而 GPU 可用性往往碎片化且動態變化。SILA 不要求一次大型單體式配置,而是將策展分解為細粒度的分散式作業,可隨資源可用性增量執行。系統支援 DGX Cloud Lepton([203])與 Slurm([117])等執行後端,讓管線能機會式地利用閒置或部分可用的 GPU 容量。這提升了叢集使用率,並在無需大型連續 GPU 保留的情況下實現持續的資料處理。
代理式作業編排
隨著 AI 代理在工具使用與長程執行上日益強大,SILA 透過對代理友善的操作介面——包括可重用技能、命令列介面 (CLI) 與結構化作業詮釋資料——開放大規模策展工作流程。長時間運行的編排代理會定期監控策展作業、檢視日誌與執行詮釋資料、重新啟動失敗的階段,並自動協調操作復原。透過這個持續監控迴圈,代理可以追蹤管線進度、識別停滯或不健康的工作者、驗證資料集覆蓋率、在引入新模型或過濾準則時觸發增量重算,並隨著分散式作業的演變向工程師通報失敗、復原與執行狀態。
這些設計選擇合計大幅提升了大規模策展的效率。透過消除昂貴的啟動表聯結、以片段層級的發現與協調取代隨機工作選擇,SILA 將作業啟動延遲從 30–60 分鐘降至約 5 分鐘(依階段與模型組態而異)。結合分階段執行、檢查點與更好的叢集使用率,新基礎設施相較先前架構達成 $10\times$ 的吞吐量提升。在生產高峰期,單一 SILA 階段每天處理數十億筆列層級標註,將大型描述與策展作業從月級操作縮短為週級疊代週期。
除了提升可擴展性與吞吐量,SILA 也透過以資料集為中心的介面隱藏大部分操作複雜度,簡化了管線開發。管線作者只需指定消耗的輸入欄位與產出的輸出欄位,框架負責綱要註冊、欄位建立、片段發現、工作協調、檢查點與將結果提交回共享資料集。因此,新增描述、評分、標記或過濾階段不再需要建立新的儲存表、撰寫同步邏輯或手動協調分散式工作者。研究人員可以透過增量新增帶型別欄位、重用先前計算的輸出、只重算缺少必要欄位的樣本來疊代。
5.1.2 嵌入儲存與語意檢索
語意檢索工作負載需要在數十億筆多模態資料上同時進行向量相似度搜尋與詮釋資料感知的過濾。在先前的架構中,將高維嵌入直接存於 SQL 表大幅膨脹了表的大小,增加聯結、掃描與操作查詢的 I/O 開銷。因此,嵌入被匯出到獨立的向量資料庫,而用於前置過濾、後置過濾與結果解讀的詮釋資料仍留在關聯式儲存中。然而,嵌入、詮釋資料與過濾準則在策展過程中持續演變,每當引入新的嵌入模型、詮釋資料欄位或搜尋過濾器時,都需要在兩個系統之間頻繁同步與遷移。
SILA 改為將嵌入直接與樣本詮釋資料一同存於 Lance,讓 LanceDB 在主資料集上建立向量索引,而不需要獨立的向量資料庫([130])。由於嵌入存於 Lance 資料檔案而非內嵌的關聯式資料列,大型嵌入負載不會膨脹詮釋資料表或拖慢操作查詢。透過將嵌入、詮釋資料與向量索引共置於同一儲存層,SILA 直接在策展資料集上支援語意檢索、聚類與去重,同時使搜尋結果與最新的策展狀態保持一致。
在生產環境中,SILA 使用 LanceDB IVF_PQ 索引與餘弦相似度,在涵蓋數百億列的 4096 維嵌入欄位上執行語意檢索、聚類與去重。部署的近似最近鄰 (Approximate Nearest Neighbor, ANN) 組態使用 64K 個 IVF 分區搭配 PQ 壓縮嵌入,以高效支援十億級檢索工作負載。由於向量索引直接建立在主要 Lance 資料集之上,語意檢索與維護最新策展詮釋資料及過濾狀態的儲存層是同一個。這讓詮釋資料感知過濾、最近鄰檢索與下游資料集分析能與持續演變的嵌入、標註及策展輸出保持同步,無需在獨立的向量與詮釋資料系統之間同步。
5.1.3 資料集視覺化、檢視與除錯
在生產規模下,資料策展不僅要可擴展,還要可觀測:研究人員需要理解管線覆蓋率、追蹤策展輸出如何隨時間演變,並診斷個別樣本通過或未通過品質準則的原因。因此 SILA 將視覺化、檢視與除錯視為資料基礎設施的一等公民。其工具直接在 Lance 表上運作,在同一個共享策展基底內串連整體管線進度、代表性開發子集、樣本層級檢視與下游分析視圖。
開發與管線驗證。 SILA 提供從生產資料集建構小型開發 Lance 表的工具,同時保留完整語料的綱要與代表性操作特性。由於這些開發表與生產資料高度相似,相同的管線可以在兩種環境中不加修改地運行,讓研究人員在啟動大規模生產作業前驗證正確性與執行行為。
資料集檢視與進度分析。 為支援大規模策展監控,SILA 直接在 Lance 表上提供整體進度分析器與互動式檢視工具。片段層級詮釋資料用於估計各欄位覆蓋率與管線完成度,無需完整表掃描;互動式檢視器則讓研究人員抽樣資料列、渲染媒體,並檢視相關的描述、分數、標註與綱要詮釋資料。由於 Lance 支援高效的隨機列層級存取,這些檢視工作流程能直接在主要策展表上運作,避免傳統 Parquet 資料湖常見的昂貴掃描與受限的列層級檢索模式。這讓研究人員能在同一個資料集內,快速從管線層級的進度監控切換到樣本層級的除錯。
分析查詢整合。 對大型分析工作負載,SILA 支援用於大規模彙總、報表與儀表板的線上分析處理 (Online Analytical Processing, OLAP) 查詢。由於 SILA 將每筆樣本及其策展訊號存於一張寬 Lance 表,這些查詢更容易表達:描述、標籤、分數、嵌入、過濾決策與處理狀態可以從一個邏輯資料集選取與過濾,而非透過跨管線專屬表的聯結重建。選取相關欄位與群組後,分析後端即可為覆蓋率報告、品質儀表板、資料集稽核與訓練集分析計算所需彙總。SILA 讓 Lance 表作為策展狀態、媒體、詮釋資料、嵌入、向量索引與列層級檢視的唯一真實來源,並將下游分析執行視為部署選擇。實務上,SILA 可以掃描權威 Lance 表以具體化可查詢的快照或投影(包括 Parquet 檔案([131])),並使用可用的計算後端執行 OLAP 工作負載,例如 Databricks、Spark 叢集([336])或以 Slurm 支撐的批次作業。
橫跨處理、檢索與檢視,SILA 完成了定義 Cosmos 3 資料基礎設施的三大目標的閉環:將原始多模態語料轉換為可直接訓練的樣本、為語意檢索與去重組織它們,並使其在整個策展生命週期中保持可檢視。透過將資產、策展訊號、嵌入、向量索引與執行狀態統一於單一 Lance 支撐的基底,SILA 將資料策展從一系列一次性前處理作業轉變為持續演進的生產工作流程。新模型與品質準則可以增量套用,分散式豐富化階段可以在共享的異質叢集上復原與擴展,研究人員也能從語料層級的進度監控無縫切換到樣本層級的除錯。這套整合式工作流程使 Cosmos 3 訓練語料能擴展到數百億筆多模態候選,同時保持可搜尋、可稽核與可持續改進。
5.2 訓練基礎設施
Cosmos 3 使用為多模態基礎模型訓練擴展而打造的客製化基礎設施平台。這個統一堆疊協調 Reasoner 與 Generator 訓練的端到端生命週期,橫跨原始多模態樣本攝取、訓練計算與持久化檢查點,並圍繞以下階段構成。
資料載入器。 資料載入器以任意原生解析度與長寬比攝取多模態樣本——影像、影片、動作、音訊、文字。它套用即時擴增(例如縮放、空間裁切、色彩抖動與影片時間子抽樣)、將文字條件 token 化,並將可變長度樣本打包成批次。為隱藏 I/O 與前處理延遲,載入器在平行工作程序中非同步運行,並透過釘選記憶體 (Pinned-Memory) 暫存緩衝區預取批次到裝置上。
分散式訓練。 訓練以混合分片資料平行 (Hybrid Sharded Data Parallelism, HSDP) 與脈絡平行 (Context Parallelism, CP) 的組合平行化。此方法能擴展到大型模型與超長輸入序列。HSDP 在每個副本群組內分片最佳化器狀態、梯度與模型參數,並跨群組複製。CP 沿序列維度跨裝置分片,以處理否則會超出單一 GPU 記憶體容量的巨大脈絡窗口。這兩種策略正交組合,並依實驗動態配置,以最佳化目標模型大小、序列長度與叢集拓撲。
訓練迴圈。 以 TorchTitan([149])的風格編排,訓練迴圈執行標準的前向、反向、最佳化與學習率排程週期。它原生支援多種最佳化器(例如 AdamW 與融合變體)、排程器(例如帶暖身的餘弦、帶暖身的常數)與損失函數(Reasoner 文字用交叉熵損失、Generator 用 EDM 損失)。管線也整合即時的變分編碼器(例如 Wan2.2 VAE),對原始多模態輸入端到端運作。此設計消除了離線潛變量抽取階段,確保擴增、編碼與訓練在各次運行間保持同步。
檢查點儲存。 檢查點以可配置的頻率記錄,並使用非同步、脫離關鍵路徑的持久化機制,防止磁碟與網路 I/O 拖慢訓練迴圈。模型參數、最佳化器狀態與 RNG/資料載入器狀態在裝置上快照後,移交給背景寫入器,序列化到遠端儲存,訓練不中斷地繼續。
Reasoner 與 Generator 皆以此統一框架訓練,共享共同的訓練器、平行化架構、最佳化器、學習率排程器、tokenizer、資料載入器與監控工具。
5.2.1 資料載入器
資料載入器橋接持久儲存與訓練迴圈:它攝取原始多模態訓練資料、套用即時擴增,並組成每個訓練步消耗的批次。在 Cosmos 3 中,資料載入器必須同時滿足三個需求:
- 管線飽和。 必須非同步串流批次,防止訓練迴圈因資料 I/O 而停滯或阻塞。
- 分散式負載平衡。 必須跨分散式 rank 輸出平衡的批次,最小化跨 rank 同步停滯並最大化整體 GPU 使用率。
- 分布保真。 必須保證長期的模態與解析度混合嚴格遵循配置的目標分布。
在傳統 LLM 訓練中,這三個需求都有成熟的解法:
- 管線飽和。 透過調校工作者數量、預取深度並使用釘選記憶體暫存緩衝區使主機到裝置的傳輸與計算重疊。
- 負載平衡。 由於每筆樣本貢獻固定數量的 token,這變得簡單:維持相同的每 rank 樣本數即可保證各 rank 的計算與激活記憶體輪廓一致。
然而,Cosmos 3 在全部三個軸向上都推翻了這套配方。由於其聯合訓練語料橫跨高度異質的模態,每筆樣本的 token 數相差超過兩個數量級,使 token 量成為計算與記憶體成本的主要驅動因素。例如,單一段 720p 兩秒影片片段產生的 token 比數十則短文字描述加總還多。在此不對稱工作負載下,分配相同的每 rank 樣本數會引入嚴重的系統性低效:(a) 固定批次形狀導致大量填充浪費;(b) 模態指派不同時各 rank 工作負載嚴重失衡;(c) 在規模化時因步時間差異極端而導致 NCCL 集體通訊逾時。
為解決這些挑戰,Cosmos 3 資料載入器圍繞四個協同機制構建:(i) token 預算打包序列,以 token 預算而非固定樣本數限制每個 rank 每步的工作量;(ii) 聯合資料載入器,將各資料流載入器多工為單一統一訓練批次;(iii) rank 同步資料流選擇,使用全域種子選擇器讓所有 rank 在每一步對齊到同一資料流;(iv) 前瞻打包 (Look-ahead Packing),提升 token 預算 $T_{\max}$ 的平均使用率。
Token 預算打包序列
我們不固定每步樣本數,而是以嚴格的 token 預算 $T_{\max}$ 限制每個 rank 的工作量。載入器貪婪地將樣本串接成單一打包序列——每筆樣本貢獻其序列化形式所需的確切 token 數,樣本間不插入填充——直到附加下一個候選會超出 $T_{\max}$ 為止。透過消除跨樣本填充,此設計使每步計算成本成為 $T_{\max}$ 的直接可預測函數,使硬體免受波動的模態混合引起的執行差異。作為防禦性的次要約束,每步樣本數也以 $N_{\max}$ 為上限。
聯合資料載入器
每個模態、資料集或更細粒度的資料流封裝在自己的載入器中,帶有私有預取緩衝區以隱藏儲存延遲。聯合資料載入器(如圖 12 所示)跨這些各資料流載入器多工,每步組裝單一統一訓練批次,同時完整保留各資料流的緩衝、預取與可觀測性。
[Figure 12: 聯合資料載入器總覽。各資料流專屬的載入器將資料送入每個 rank 上的本地緩衝區。在每次全域疊代中,rank 同步選擇器在所有分散式 rank 上選擇相同的資料流 $k_i$。每個 rank 隨後在 token 與樣本數預算下,貪婪地將所選本地緩衝區中的樣本打包為 $B_i^{(\rho)}$,並使用有界前瞻減少未使用的 token 容量。]
Rank 同步資料流選擇
基礎模型訓練通常從包含多種空間解析度影像與影片的資料集抽取。這些資料流間每筆樣本的 token 數相差數個數量級。例如,影片樣本常攜帶超過影像 $100\times$ 的 token,720p 影片超過 256p 影片 $10\times$。若允許各 rank 獨立選擇資料流,在 FSDP 下會引發嚴重的工作負載失衡——單一步內各 rank 的注意力 FLOPs(因其二次複雜度)差異巨大。我們透過以疊代索引為鍵、全域種子化的選擇器選擇活躍資料流,確保所有 rank 在每一步處理來自相同模態與解析度桶的樣本。這消除了跨 rank 的計算時間與激活記憶體差異,且確定性的、由種子導出的選擇序列在檢查點與重啟間可位元級精確重現。Rank 同步資料流選擇使端到端訓練吞吐量較未同步基線提升 $54\%$。
前瞻打包
給定疊代 $i$ 選定的資料流 $k_{i}$,聯合資料載入器貪婪地建構本地批次,從資料流緩衝區頭部附加樣本,直到下一個候選會超出 token 預算 $\mathbb{T}_{\max}$。然而,純貪婪打包在下一個候選大到溢出、但緩衝區更深處仍有較小候選時,可能留下不可忽視的未用預算——這些殘餘容量在功能上等同於填充,直接對應吞吐量損失。我們以有界前瞻策略解決此問題。當候選樣本超出總 token 預算 $\mathbb{T}_{\max}$ 時,該樣本在當前組態下不可打包,將被丟棄(並記錄警告)。當候選僅超出剩餘預算但批次已非空時,該候選被暫時移入旁置緩衝區 (Look-aside Buffer),載入器繼續往資料流緩衝區更深處掃描,尋找能放入殘餘容量的較小樣本。
此機制如圖 13 所示。在範例中,樣本 $a_{1}$ 與 $a_{2}$ 放入當前批次;$a_{3}$ 超出剩餘預算,被移入旁置緩衝區;載入器繼續掃描並打包後續較小的樣本如 $a_{4}$ 與 $a_{6}$。疊代結束時,旁置緩衝區中所有剩餘樣本依原到達順序歸還到資料流緩衝區頭部,因此前瞻在不永久重排資料流的情況下減少填充。為限制病態情況的成本——例如資料流暫時被超大樣本主導——每次疊代的連續前瞻次數以可配置的各資料流上限限制。在生產環境中我們使用上限 10;超過此值後,未用容量的額外減少可忽略,而旁置緩衝區的大小(及其記憶體佔用)持續成長。整體而言,前瞻打包使有效序列長度較基線提升 $8\%$,帶來相應的訓練吞吐量改善。
[Figure 13: 聯合資料載入器中的前瞻打包。載入器貪婪掃描所選資料流的樣本,將能放入剩餘 token 預算者打包進當前小批次(薄荷綠)。超出預算的樣本暫置於旁置緩衝區(玫瑰紅),讓後續較小的樣本填滿剩餘容量。疊代結束時,被略過的樣本依原到達順序歸還到資料流緩衝區頭部,在跨疊代保持資料流順序的同時減少填充。]
冷啟動處理
我們的多個資料流有可觀的首批次延遲,主要來自工作程序生成、新開分片的檔案系統詮釋資料快取,以及各資料流專屬的反序列化暖身。若此延遲在第一個訓練步支付,它將與該步的 NCCL 集體通訊競速,極可能在最慢的 rank 上觸發看門狗逾時——尤其在規模化時,跨 rank 的最大值才是相關統計量。為消除此失敗模式,聯合資料載入器在建構時執行明確的預熱階段:從每個資料流取一個批次,使工作者池、檔案控制代碼與反序列化快取完全就緒,然後在將控制權交回訓練迴圈前發出分散式屏障。這保證每個 rank 在第一次前向傳遞前都已支付冷啟動成本,且第一次疊代面對的是完全暖身的資料流。
可觀測性與整合
在每次疊代中,聯合資料載入器向訓練端監控回呼發出結構化的打包統計記錄,該回呼跨分散式群組彙總各 rank 記錄,並將結果記錄到 Weights & Biases。回報的指標包括各資料流的實證抽樣比例(與配置的目標混合比較)、每次疊代打包的樣本數、各資料流緩衝區佔用率與等待時間、前瞻飽和率,以及每次疊代的 token 預算使用率。這些指標揭露最可能在不使訓練崩潰的情況下劣化大規模訓練的失敗模式,使此類問題在發生後數分鐘內浮現於訓練儀表板,而非事後從模型行為中發現。
5.2.2 注意力實作
如第 2.3.1 節所述,Cosmos 3 的 Mixture-of-Transformers 架構在單次前向傳遞中必須並存兩種不同的注意力需求:Reasoner 路徑僅對 Reasoner token 採用因果注意力,Generator 路徑則對 Reasoner 與 Generator token 的串接採用雙向注意力,使每個 Generator token 能以完整脈絡為條件。若以 FlexAttention 等通用運算子天真地表達這些異質遮罩模式,結果雖正確但硬體使用率低:遮罩結構對核心 (Kernel) 不透明,且在原本可跳過的注意力區塊內執行等同填充的工作。這降低張量核心使用率並增加記憶體頻寬壓力。
為此,我們共同設計了客製化的雙向扁平注意力 (Two-Way Flat Attention) 機制,將跨路徑遮罩結構直接暴露給高效能的可變長度注意力核心。圖 14 說明此設計。計算被分解為兩次獨立的核心呼叫。第一次處理 Reasoner 路徑,是標準的可變長度縮放點積注意力 (Scaled Dot-Product Attention, SDPA)([230])呼叫,帶因果遮罩,僅作用於 Reasoner 的 query、key 與 value。第二次處理 Generator 路徑,需要讓同一樣本內的 Reasoner 與 Generator key/value 資料流對每個 Generator query 可見,但在打包批次中跨樣本嚴格分離。我們透過在樣本粒度上將兩條 token 資料流扁平化並交錯排列來達成:
$$[R_{0},G_{0},R_{1},G_{1},\ldots,R_{n},G_{n}]$$
其中 $R_{i}$ 與 $G_{i}$ 分別表示樣本 $i$ 的 Reasoner 與 Generator key/value token。每個 Generator query 對其自身樣本的 $[R_{i},G_{i}]$ 區塊做雙向注意力。此表述以每層兩次可變長度核心啟動表達完整的跨路徑注意力,在單一打包表示內同時支援因果與雙向遮罩,消除固定長度實作固有的填充開銷,並使 Cosmos3-Nano 模型的端到端訓練吞吐量較基於 FlexAttention 的基線提升 $22\%$。
[Figure 14: 雙向扁平注意力。每條路徑以單次可變長度 SDPA 呼叫實作。(a) Reasoner 路徑對打包的 Reasoner token 使用標準因果 varlen 呼叫,產生區塊對角因果遮罩。(b) Generator 路徑將 Generator query 與交錯的 key/value 資料流 $[R_0, G_0, R_1, G_1, \ldots, R_n, G_n]$ 分開打包。所得遮罩為區塊對角但各區塊內為矩形,使每個 Generator query 對其自身樣本的 $[R_i, G_i]$ 脈絡做雙向注意力而不跨越樣本邊界。範例使用三個打包樣本,$(|R_i|,|G_i|)$ = (3, 2)、(2, 3)、(4, 1)。]
可變長度注意力後端依平台選擇,以匹配目標硬體上最高效且經數值驗證的實作。在 Hopper 級 GPU(H100、H200)上,我們使用 FlashAttention-3([248]),它利用 Hopper 架構的 WGMMA 指令與基於 TMA 的非同步資料搬移,提供接近峰值的注意力吞吐量。在 Blackwell 級 GPU(GB200)上,我們使用 NATTEN([104]),其可變長度核心建立於 CUTLASS 模板庫,專為 Blackwell(SM100/SM103)的第五代張量核心與更新的記憶體階層調校。兩個後端透過共同的分派介面存取,因此核心選擇對訓練堆疊其餘部分透明,並可隨新後端成熟而重新評估。
5.2.3 分散式訓練
Cosmos 3 Reasoner 與 Generator 分別以結合混合分片資料平行 (HSDP) 與脈絡平行 (CP) 的分散式訓練堆疊訓練。HSDP 在每個副本群組內分片模型參數、梯度與最佳化器狀態,並跨群組複製,以少量群組內通訊換取在一般每 GPU 記憶體預算下訓練數十億參數模型所需的記憶體餘裕。CP 則解決不同的瓶頸:隨脈絡長度線性成長的每序列激活記憶體,否則會對可訓練的序列大小強加硬性上限。兩種策略正交組合,(HSDP 度, CP 度) 組態依實驗選擇,以配合目標模型大小、序列長度與叢集拓撲。
透過 Ulysses 方案的脈絡平行
CP 方面,我們採用 Ulysses 方案([115]),它在注意力之外沿 token 維度將輸入序列切分到 CP-rank 裝置上,並在每個注意力層使用兩次 all-to-all 集體通訊在分片軸之間轉換。第一次集體通訊將 Q/K/V 激活從序列維度重新分配到注意力頭維度,使每個 rank 持有其不相交頭子集的完整序列,能在本地執行注意力而無需進一步跨 rank 通訊;第二次集體通訊將注意力輸出恢復為原本的序列分片布局。
此方案與序列打包(見第 5.2.1 節)及雙向注意力機制乾淨整合。用於雙向注意力運算的 Reasoner 與 Generator key/value 資料流的扁平化與交錯,延後到頭軸重分配之後進行,此時每個 rank 已持有其指派頭的完整序列,可在本地執行串接。因此相同的可變長度注意力核心在 CP 內原封不動地重用,無需 CP 專屬的核心變體。此實作支援的最大 CP 度受限於模型的 query 頭數——Cosmos3-Nano 為 32、Cosmos3-Super 為 64——就 Cosmos 3 目標的脈絡長度與每 GPU 記憶體預算而言,我們發現此限制在實務上並不構成約束。
為何不用環狀注意力?
我們曾考慮以環狀注意力 (Ring Attention) 實作 CP,但發現在我們的情境下明顯較不理想。環狀注意力需要在跨 CP rank 分片之前,先具體化一條包含交錯 Reasoner 與 Generator token 的單一打包序列,以便向環狀排程暴露連續的 K/V 資料流。這排除了 Ulysses 天然允許的兩條路徑獨立分片,並使旋轉環狀排程下各樣本雙向/因果遮罩的建構變得複雜。加上 all-to-all 在 NVLink 連接節點上的優勢頻寬特性,這些因素使我們採用 Ulysses 作為 Cosmos 3 的 CP 策略。
5.2.4 選擇性激活檢查點
計算 Transformer 的反向傳遞需要前向傳遞產生的中間激活可用,但在 Cosmos 3 目標的模型大小與脈絡長度下,同時將全部激活具體化於 GPU 記憶體是不可行的。標準緩解方法是激活檢查點([45]):前向傳遞只儲存稀疏的「錨點」激活並捨棄其餘,被捨棄的張量在反向傳遞時從最近的已存錨點重新執行相應的前向子圖來重算。預設策略只儲存每個 Transformer 區塊的輸入,區塊內的一切按需重算;這將激活記憶體最小化,但在反向時引入額外的前向傳遞,使每步 FLOPs 膨脹約 $33\%$,並相應降低端到端訓練吞吐量。
為在維持激活記憶體預算的同時降低重算開銷,我們套用選擇性激活檢查點 (Selective Activation Checkpointing, SAC):額外將一組精選的中間張量保留在記憶體中而非重算。選擇由簡單的成本效益啟發式引導:依 FLOPs 對記憶體比值——即每投入一位元組激活記憶體所節省的重算成本——對候選操作排序,優先具體化比值最高者,直到激活記憶體預算用盡。對 Cosmos 3 而言,注意力輸出是此策略最大的受益者。注意力重算昂貴,因其成本隨序列長度二次成長,但注意力輸出張量本身相對小(與序列長度和隱藏維度呈線性),使其成為 FLOPs 對記憶體比值最高的操作。使用者還可透過對操作名稱的正規表達式模式配置自訂保存集,我們在殘餘激活記憶體餘裕允許時用它保留少量次要張量。
在我們的測量中,對 Cosmos3-Nano 在每批次 $74{,}000$ token 預算下套用具體化注意力輸出的 SAC,端到端訓練吞吐量提升 $13\%$,數值結果不變。
5.2.5 Transformer 區塊的 Torch Compile
我們在訓練圖上套用 torch.compile,設定 fullgraph=True 與 dynamic=True。fullgraph 模式消除 CPU 開銷並啟用運算子融合,dynamic=True 則處理混合模態批次產生的可變序列長度——例如 Generator 路徑 token 在不同疊代間遠長於影像批次。Torch compile 使 Cosmos3-Nano Generator 訓練吞吐量提升 $41\%$。
5.2.6 影片 Tokenizer
Cosmos 3 訓練需要將解碼後的影片幀即時由影片 VAE token 化為潛在表徵:我們的組態使用 Wan2.2([278])。在初始實作中,我們觀察到 tokenizer 佔據每個訓練步不成比例的時間——對較小的 Cosmos3-Edge 與 Cosmos3-Nano 模型甚至主導前向傳遞。在這類模型中,Transformer 計算量小到 VAE 無法被該步的其餘部分攤銷。由於 tokenizer 位於資料載入器與訓練迴圈之間的關鍵路徑上,它引入的任何延遲都直接劣化訓練吞吐量。因此我們實作了一系列針對性最佳化,合計顯著降低 tokenizer 的實際時間佔比。
分塊編碼
Wan2.2 因果 tokenizer 先編碼 1 幀的「引導 (prime)」塊,之後每個潛在塊對應 4 個像素幀;預設的每次呼叫粒度為一個潛在塊(即引導幀後的 4 幀)。此預設在訓練使用的空間解析度下讓 GPU 大幅閒置,因為每次核心啟動的工作量太少,無法飽和張量核心。我們改為以可配置的像素幀數呼叫編碼器,用額外的激活記憶體換取每次啟動更高的算術強度。最佳分塊大小取決於解析度:較高空間解析度下每幀已消耗可觀記憶體,觸發 OOM 前可容許的每次呼叫幀數較少;較低解析度下則可行且有利於更大的分塊。我們在訓練硬體上實證確定以下操作點:256p 為 68 幀、480p 為 24 幀、720p 為 12 幀。這些組態將編碼器推向 roofline 曲線的計算受限側,同時保持在每 GPU 記憶體預算內,貢獻了每步加速的大部分。
預先編譯
[Figure 15: Wan2.2 tokenizer 的分片 AOT 編譯。由 {3 種解析度} × {5 種長寬比} × {3 種 tokenizer 呼叫模式} 產生的 45 個靜態形狀圖被分割到各 rank;每個 rank 編譯其指派的圖、將編譯產物寫入共享檔案系統,並在訓練開始前載入完整的產物集。暖身時間從約 15 分鐘(序列式)降至不到 1 分鐘(分片式)。]
在分塊編碼之上,我們對 tokenizer 使用 torch.compile,透過融合逐點操作並為編碼器的卷積與注意力區塊選擇最佳化的核心排程,額外降低 $52\%$ 的編碼延遲。最大化吞吐量需要靜態輸入形狀,因此編碼器須為每種可能被呼叫的形狀分別編譯。Cosmos 3 訓練橫跨三種空間解析度($256\text{p}$、$480\text{p}$、$720\text{p}$)與每種解析度五種長寬比。在每個(解析度, 長寬比)組合內,因果 tokenizer 以兩種模式呼叫:引導塊編碼,以及快取大小為 $1$ 與 $2$ 的分塊編碼。這產生 $3\times 5\times 3=45$ 個必須在訓練開始前編譯的不同圖。在每個 rank 上序列式編譯全部 $45$ 個圖使訓練器啟動膨脹約 $15$ 分鐘。
為消除此開銷,我們如圖 15 所示使用 AOTInductor([229])將編譯分片到資料平行的 rank 上——它執行預先編譯並將產生的核心與主機程式碼序列化到磁碟。只要有至少 $45$ 個 rank(我們所有訓練組態皆滿足),每個 rank 恰好編譯一個圖;編譯產物寫入共享檔案系統,之後每個 rank 從磁碟載入完整的 $45$ 個圖。這將暖身開銷降至一分鐘以內。為了在靜態形狀編譯下容納任意幀數的影片,每段輸入片段在編碼前右側填充到配置的編碼塊大小的下一個倍數,所得潛在張量在被模型消耗前沿時間軸裁切到確切的預期序列長度。
針對已知幀數的特化
對於每段片段幀數固定且事先已知的資料集——例如機器人動作資料集,每個操作片段貢獻等長的片段——我們將編譯特化到運行時出現的確切張量形狀,繞過一般情況使用的填充—裁切後備方案。這消除了填充尾部的計算、移除相應的潛變量裁切步驟,並在此類資料集上帶來小幅但一致的額外吞吐量改善。
5.2.7 檢查點
為消除儲存引起的停滯,檢查點與訓練完全重疊。依循 TorchTitan([149]),檢查點寫入透過專用的 Gloo 程序群組路由,而非承載訓練集體通訊的 NCCL 通訊器,將 I/O 流量與 GPU 端通訊隔離。此非同步設計隱藏了高度變動的物件儲存寫入延遲,幾乎移除全部儲存時間開銷,代價是主機記憶體的小幅增加。表 7 量化了效益:相對於 30 分鐘間隔的同步檢查點,非同步檢查點使 Cosmos3-Nano 的端到端訓練時間減少 $4\%$、Cosmos3-Super 減少 $9\%$。
| 模型 | 檢查點儲存時間(秒):平均 | 最小 | 最大 | 相對同步的加速 |
|---|---|---|---|---|
| Cosmos3-Nano | 72 | 43 | 250 | 4% |
| Cosmos3-Super | 167 | 40 | 736 | 9% |
表 7:非同步檢查點的效益。與 30 分鐘間隔的同步檢查點相比,非同步檢查點使 Cosmos3-Nano 與 Cosmos3-Super 的端到端訓練時間分別減少 4% 與 9%。Cosmos3-Super 節省較多反映了其較長的檢查點儲存時間。
非同步儲存機制
在建構時,檢查點器以 spawn 啟動方法啟動一個長駐子程序,並透過多程序佇列與之通訊。子程序加入 Gloo 程序群組,執行建構儲存計畫所需的 CPU 端歸約,讓 GPU 保持可用於訓練。之後它在輸入佇列上阻塞,直到收到檢查點儲存請求或終止哨兵。
儲存計畫記憶化
為進一步降低開銷,檢查點儲存計畫在第一次儲存操作時計算,後續儲存重複使用。這是可行的,因為儲存計畫是狀態字典拓撲的確定性函數。重用計畫避免了跨 rank 的重複詮釋資料通訊,將檢查點開銷降低約 60%,進一步減少非同步檢查點成為訓練瓶頸的可能性。
針對物件儲存的最佳化
檢查點儲存期間,每個 rank 將其本地的狀態字典分片寫入物件儲存。可能存在於多個 rank 上的複製張量在寫入前去重。在預設的輪詢指派下,複製張量可能由不同 rank 寫入,導致載入時每個 rank 必須讀取所有檢查點檔案才能恢復複製狀態。這引入顯著開銷,因為即使只需要檔案內容的子集也必須載入完整檔案。為降低此開銷,我們設定 dedup_to_lowest_rank = True,將複製張量只存於相應子網格中編號最低的 rank(通常是 rank 0)。載入時,每個 rank 只讀取自己的分片與 rank-0 分片。這大幅縮短檢查點載入時間,尤其是包含許多小型複製張量的最佳化器狀態字典。
隨機狀態還原
訓練器以 rank 感知的方式還原隨機數生成器 (RNG) 狀態。由於 RNG 狀態以 rank 為鍵,恢復的作業先檢查檢查點詮釋資料中是否有對應自身 rank 的鍵,僅在存在時請求該狀態。這保留了與早於 rank 鍵 RNG 格式的舊檢查點的相容性。若 rank 專屬的鍵不存在,該 rank 保留其當前 RNG 狀態。
5.2.8 吞吐量總結
表 8 回報在 NVIDIA GB200 系統上測得的 Cosmos 3 稠密組態穩態每 GPU 訓練吞吐量。雖然 Cosmos 3 支援跨異質模態與任務的多種訓練模式,這些測量使用文字生成影像與文字生成影片的聯合訓練組態,以進行標準化的吞吐量比較。圖 10 說明了所用的預訓練資料混合。Cosmos3-Nano 以 1024 顆 NVIDIA GB200 GPU 進行基準測試,Cosmos3-Super 以 2048 顆。
Nano 模型達到最高的原始 token 吞吐量,每小時處理 507 次疊代,每 GPU 小時達 4.56M 影像 token 與 16.23M 影片 token。相對地,較大的 Super 模型每次疊代執行的計算量大得多,疊代率降至每小時 185 次,吞吐量降至每 GPU 小時 1.66M 影像 token 與 5.91M 影片 token。
儘管 token 吞吐量較低,Cosmos3-Super 達到更高的算術使用率,每 GPU 吞吐量從 520 提升至 673 TFLOPS,MFU 從 0.23 提升至 0.30。這反映了模型規模與訓練吞吐量之間的預期權衡:Cosmos3-Nano 為最大化 token 處理吞吐量而最佳化,Cosmos3-Super 則透過更大的模型容量與每 token 計算量,更有效地飽和 GPU 計算資源。
| 模型 | 疊代(秒) | TFLOPS | MFU | 疊代/時 | 影像 Tok/時/GPU (M) | 影片 Tok/時/GPU (M) |
|---|---|---|---|---|---|---|
| Cosmos3-Nano | 7.1 | 520 | 0.23 | 507 | 4.56 | 16.23 |
| Cosmos3-Super | 19.5 | 673 | 0.30 | 185 | 1.66 | 5.91 |
表 8:Cosmos 3 稠密模型組態的穩態訓練吞吐量。TFLOPS 與 MFU 為每 GPU 數值。影像與影片 token 吞吐量以每 GPU 小時百萬 token 分別回報。實驗在 NVIDIA GB200 GPU 上進行,Nano 與 Super 分別使用 2048 與 4096 顆 GPU。
5.3 服務基礎設施
Cosmos 3 與多個生產級服務框架整合,以支援廣泛的部署情境。Reasoner 由 TensorRT-LLM([193])與 vLLM([129])支援,兩者皆透過分頁 KV 快取管理、連續批次處理與融合注意力核心,提供高度最佳化的自迴歸解碼。Generator 推論由 vLLM-Omni(vLLM 針對擴散式生成的多模態延伸)([330])支援,在峰值吞吐量與多租戶排程效率之間提供互補的權衡。除這些生產後端外,我們提供以原生 PyTorch 撰寫的參考實作,優先考量可讀性與可修改性,既是推論演算法的忠實規格,也是下游調適、研究延伸與整合到客製應用管線的起點。
5.3.1 純 PyTorch
純 PyTorch 服務路徑直接在 eager 模式 PyTorch 中執行模型與周邊推論程序——不依賴專門的服務運行時——並設計為盡可能忠實地鏡像訓練時的計算。此路徑負責完整的端到端推論工作流程,包含以下階段:
- 輸入準備。 解析文字提示、載入任何影像、影片或動作條件、建構模型消耗的模態專屬條件字典,並組裝相應的輸入張量與詮釋資料。
- 自迴歸迴圈。 在 Cosmos 3 Reasoner 中,輸出 token 以自迴歸方式產生,每一步以先前生成的 token 與條件脈絡的快取 key/value 狀態為條件。
- 擴散迴圈。 在 Cosmos 3 Generator 中,PyTorch 路徑建構時間步排程、在每一步呼叫去噪器、套用分類器無關引導 (CFG)、依取樣器更新潛在狀態,並管理去噪過程周圍的請求層級控制流程。
- 解碼與後處理。 去噪完成後,所得潛在表徵被解碼為目標模態——文字、影像、影片、音訊或動作——按需後處理,並透過服務介面回傳給呼叫者。
由於原生 PyTorch 後端保留模型原始的 PyTorch 結構,它是落地新模型功能、取樣器修改、KV 快取與激活快取策略以及除錯儀器的主要目標。新能力先在此後端驗證,之後才移植到生產運行時(TensorRT-LLM 與 vLLM),確保參考實作始終是推論演算法的權威規格。PyTorch 後端提供以下功能與最佳化。
帶 CUDA graph 的 torch compile
由於 PyTorch 原生推論路徑將請求編排與取樣邏輯保留在 Python 中,一個主要的服務瓶頸是重複去噪步驟期間主機端的核心啟動開銷。因此我們使用 torch.compile 與 CUDA graph 重播最佳化 PyTorch 路徑。CUDA graph 最佳化以 Transformer 層粒度實作,捕捉重複的 Transformer 區塊執行。每個區塊以 reduce-overhead 模式的 torch.compile 編譯,讓 PyTorch Inductor 降階該區塊,並在以相容的張量形狀與記憶體布局呼叫時使用 CUDA graph 重播。外層推論迴圈保持在普通 PyTorch 中,即提示處理、時間步排程、取樣器更新、CFG 編排、解碼不在捕捉的圖中。圖包含數值密集且頻繁重複的逐層計算,動態服務邏輯則留在圖外。CUDA graph 的效益在 T2I 式生成中最明顯——較短的生成工作負載與較小的核心使 CPU 啟動開銷佔端到端延遲的比例更大。T2I 生成上的 CUDA Graph 在不同硬體後端帶來 30% 到 60% 的加速。
分散式推論
我們在推論時採用脈絡平行 (CP),以支援超出單 GPU 記憶體容量限制的生成。我們沿用訓練時使用的 Ulysses 方案([115]),確保兩種情境的一致性。除了支援長脈絡推論,CP 也透過將前向傳遞分散到多顆 GPU 而作為降低延遲的機制;即使在單一裝置記憶體足以容納完整脈絡的情境下,此效益仍然存在,使 CP 成為加速推論的通用工具。
除脈絡平行外,我們利用分類器無關引導 (CFG) 平行化進一步降低端到端推論延遲。帶 CFG 的擴散取樣在每個去噪步需要對模型做兩次前向傳遞——一次以輸入提示為條件、一次無條件——其噪聲預測經線性組合產生引導更新。由於條件與無條件傳遞作用於獨立輸入,且每步只需同步一次以形成引導預測,它們是跨兩顆 GPU 平行化的理想目標。實務上,我們並行分派條件與無條件批次,並執行單次輕量的點對點交換來組合兩個預測,之後推進取樣器。這使每步延遲近乎減半,並與脈絡平行乾淨組合,在多 GPU 節點上帶來乘法式的延遲降低。
Reasoner 塔快取
對文字生成影像 (T2I)、文字生成影片 (T2V)、影像生成影片 (I2V) 與影片生成影片 (V2V) 等任務,Reasoner 塔的條件輸入——文字提示,以及(如適用)條件影像或影片——在整條取樣軌跡中固定不變。因此,Reasoner 的輸出跨擴散步不變,只取決於條件而非當前噪聲水準或部分去噪的樣本。我們利用此特性,在推論開始時計算一次 Reasoner 前向傳遞,並快取其輸出供後續所有去噪步重用。由於快取的激活在數學上與每步重算的結果完全相同,此最佳化大幅降低每步延遲而對生成品質毫無影響。
批次處理
推論吞吐量可透過將多筆樣本批次化為單次前向傳遞進一步提升,將每步開銷(核心啟動、權重讀取與集體通訊)攤銷到更大量的有效工作上。我們的推論批次器重用為訓練開發的可變長度序列打包機制:它不將較短序列填充到共同長度——那會在填充 token 上浪費計算與記憶體——而是將異質形狀的樣本串接為單一打包張量,並向注意力等形狀敏感的運算子提供相應的累積序列長度詮釋資料。使用者指定兩種預算模式之一:總 token 預算(批次內允許的最大 token 數)或固定樣本數。給定所選預算,批次器貪婪地打包進入的樣本直到預算用盡,同時遵守任何每裝置記憶體約束。此設計在吞吐量導向的部署(如離線語料生成與大規模評估)中提升 GPU 使用率,但在延遲受限的情境(例如機器人工作負載,單一樣本必須獨立處理)中不提供效益;在那些情境下,批次器配置為樣本數 1,實質上停用。
表 9 回報在 189 幀輸出的文字生成影片 (T2V) 任務上,請求批次化取得的推論吞吐量。在 256p 下,批次化帶來 $8\%$ 到 $55\%$ 的吞吐量增益。在 480p 下效益遞減,因為每筆樣本已提供足以飽和 GPU 的工作量,留給額外平行度的空間有限。在 720p 下,$74{,}000$ 的脈絡窗口只容許 $B{=}1$,排除任何批次化加速。
| 硬體後端 | Cosmos3-Nano T2V-256 | Cosmos3-Nano T2V-480 | Cosmos3-Super T2V-256 | Cosmos3-Super T2V-480 |
|---|---|---|---|---|
| H100 80GB | 8% | 2% | 55% | 5% |
| GB200 | 40% | 2% | 9% | 1% |
表 9:批次化帶來的推論加速。Cosmos3-Nano 與 Cosmos3-Super 在 189 幀輸出的文字生成影片 (T2V) 任務上評估。我們回報 256p 與 480p 的結果,在 74k-token 脈絡限制下分別使用最大可容許批次大小 $B=6$ 與 $B=3$。720p 因在相同預算下僅容許 $B=1$ 而省略。
帶提示詞上採樣的生成
推論還支援提示詞上採樣模式(詳見第 6.3.2 節):一段簡短、自由形式的使用者提示由 Reasoner 擴展為更豐富、結構化的目標輸出 JSON 描述(涵蓋例如場景構成、主體屬性、相機與運動規格、光照與風格)。上採樣後的描述由 Reasoner 自迴歸生成,隨後與使用者提供的任何影像、影片或動作條件一起,作為額外條件輸入供給 Generator 以合成最終輸出。此管線有兩個目的:它將細緻提示詞工程的負擔從終端使用者轉移到模型本身,穩定地提升下游生成品質;並在單次推論呼叫內演練橫跨 Reasoner 與 Generator 兩條路徑的完整全模態端到端流程——證明兩條路徑可以無縫組合,從最少的使用者規格產生高擬真的多模態輸出。
吞吐量與服務考量
推論工作負載通常為兩個相互競爭的目標之一最佳化:吞吐量或延遲。批次推論——對固定的輸入語料生成大量輸出——通常為吞吐量最佳化,因為端到端實際時間與總成本才是關注的指標。相對地,機器人等延遲敏感應用——動作必須在特定起始脈絡下、於嚴格的每步期限內產生——優先考量回應性,相關指標是首 token 時間(或首動作時間)與每步延遲。上述最佳化分別針對這些情境:分散式推論(脈絡平行與 CFG 平行)主要透過將單一請求平行化到多個裝置來降低延遲,批次化主要透過將每步開銷攤銷到多個並行請求來提升吞吐量。其餘最佳化——torch compile 與 Reasoner 輸出快取——同時惠及兩種情境。
5.3.2 Reasoner 推論框架:vLLM 與 TensorRT-LLM
由於 Nano 與 Super Reasoner 建立在 Qwen3-VL([13])骨幹上,它們與 vLLM 及 TensorRT-LLM 的整合重用了兩個框架中已有的上游 Qwen3-VL 支援。這讓我們得以直接繼承兩個後端已為 Qwen3-VL 家族提供的最佳化注意力核心、分頁 KV 快取管理、連續批次處理與多模態輸入處理,只需最少的組態變更即可將 Cosmos 3 模型權重與 tokenizer 綁定到既有執行路徑。
相對地,Edge Reasoner 建立在客製的 Nemotron 骨幹([200])上,vLLM 並不原生支援。因此我們依循 vLLM 模型貢獻者慣例實作了專屬整合。此整合的結構便於上游化,減輕未來維護負擔並促成社群貢獻。
5.3.3 Generator 推論框架:vLLM-Omni
Cosmos 3 Generator 整合進 vLLM-Omni,以利用其為擴散式多模態生成最佳化的服務堆疊。此整合將 Cosmos 3 Generator 實作為一等 vLLM-Omni 模型,支援完整的 Generator 模態集,包括影像、影片、音訊與動作條件生成。它依循 vLLM-Omni 框架的模型貢獻者慣例與程式碼風格,使實作與框架既有的排程、分散式執行、記憶體縮減與量化功能相容。
此整合對 Generator 服務特別重要,因為擴散式生成需要在大型影像、影片或多模態 token 序列上進行多次重複的 Transformer 評估。vLLM-Omni 後端因此聚焦於降低每步延遲、降低峰值記憶體使用並提升吞吐量,同時保持生成品質。Cosmos 3 Generator 整合支援以下 vLLM-Omni 功能:
- Cache-DiT。 一種免訓練的加速方法,在相鄰去噪步之間重用快取的 Transformer 區塊輸出,以可忽略的生成品質影響跳過冗餘計算。
- Ulysses 脈絡平行。 一種脈絡平行執行方案,將長影像與影片 token 序列分片到多顆 GPU,並使用 all-to-all 注意力通訊降低每裝置記憶體使用與延遲。
- CFG-Parallel。 分類器無關引導的平行化策略,將條件與無條件前向傳遞分派到不同的 GPU rank。兩個預測在每個去噪步同步一次以形成引導更新,降低基於 CFG 取樣的延遲。
- HSDP。 一種記憶體高效的分散式推論模式,使用 FSDP2 將 Transformer 權重分片到多顆 GPU,並在前向傳遞期間按需聚集參數,降低大型 Generator 模型的峰值 GPU 記憶體需求。
- CPU 卸載。 一種逐層卸載機制,在推論期間於 CPU 與 GPU 記憶體之間搬移模型參數,以額外的資料傳輸開銷換取大幅降低的峰值 GPU 記憶體使用。
- VAE-Patch-Parallel。 一種平行 VAE 執行模式,將潛在或像素張量切分為空間圖磚 (Tile),跨多個 rank 編碼或解碼,同時降低每裝置記憶體消耗與 VAE 延遲。
- 量化。 一條動態 FP8 量化路徑,降低主要計算操作的精度,以降低推論延遲與峰值 GPU 記憶體使用,同時維持可接受的生成品質。
這些功能合計使 Cosmos 3 Generator 能從記憶體受限的單 GPU 部署擴展到高吞吐量的多 GPU 服務。Cache-DiT 與量化降低重複去噪計算的成本,脈絡平行與 CFG-Parallel 透過將單一請求分散到多顆 GPU 改善延遲,HSDP、CPU 卸載與 VAE-Patch-Parallel 則為高解析度或長時間生成任務降低記憶體壓力。圖 16 透過比較不同硬體後端上的單 GPU 運行以及 B200 上的多 GPU 運行,總結 Cosmos 3 的服務效能。評估針對 PyTorch-OSS 與 vLLM-Omni 框架進行。
[Figure 16: Cosmos 3 服務效能。(a) Cosmos3-Nano 720p T2V 單 GPU 延遲,在 H100 NVL 與 B200 上觀察不同硬體後端的效能。(b) Cosmos3-Nano 720p T2I 單 GPU 延遲,在 H100 NVL 與 B200 上觀察不同硬體後端的效能。(c) B200 上 720p T2V 延遲隨 1 到 8 顆 GPU 的擴展,比較 Cosmos3-Nano 與 Cosmos3-Super。全部指標愈低愈好。]
5.4 基準測試基礎設施
Cosmos 基準系統管理 Cosmos 模型的評估作業,並儲存生成的產物與評估結果。編排層在 Lepton 或 Slurm 叢集上排程生成、評分與端點評估作業,並追蹤每個階段的執行狀態。對每次運行,系統記錄詮釋資料,包括模型檢查點、程式碼版本、所選基準、生成設定、基準專屬參數與相關資料集。這些記錄合計在每個回報分數與產生它的確切模型權重、輸入、參數組態及評估程式碼之間建立完整的可追溯性。
系統支援第 6 節所述的異質基準套件,而不要求所有基準共享共同實作。基準評估 Reasoner 模型生成的影片、音訊、動作軌跡與文字回應,涵蓋多樣準則,包括視覺擬真度、音訊品質、視聽同步、提示與控制遵循、動作或軌跡準確度、任務完成度、物理合理性與推理正確性。評估器包括與開源函式庫及公開基準套件的整合,以及專為 Cosmos 開發的客製評估器。評分方法橫跨基於參考的誤差指標、感知與時間一致性度量、視聽對齊指標、基於 VLM 的評審、人工標註,以及精確匹配或數值答案評估。
Generator 評估方面,基準測試分為生成與評分兩階段。生成作業以 PyTorch 推論管線或第 5.3 節所述服務框架之一執行模型,並將生成輸出寫入物件儲存。評分作業隨後消耗這些儲存的產物,計算逐樣本與彙總指標,並將結果與運行詮釋資料一同記錄。此解耦設計允許以新指標或評估器重新評分輸出,而無需重新生成。
Reasoner 評估方面,我們使用 VLMEvalKit([66])框架搭配 vLLM。這些作業向部署的模型端點發送提示與多模態輸入、處理模型回應,並記錄基準分數與相關詮釋資料。
評估分數與運行詮釋資料存於關聯式資料庫,生成產物存於物件儲存。人工評估標註與受評產物及題組一同儲存,彙總的人工評估結果與自動化指標並列追蹤。基準入口網站透過儀表板、排行榜、範例層級檢視工具,以及模型對模型或檢查點對檢查點的比較,提供對這些記錄的存取。
6 結果
我們在物理 AI 核心的廣泛理解與生成任務上評估 Cosmos 3。與聚焦單一模態或能力的先前系統不同,Cosmos 3 被設計為統一的全模態世界模型,聯合支援推理、感知、模擬與動作生成。因此,我們的評估同時涵蓋 Reasoner 與 Generator 組件,橫跨多模態理解、空間與時間推理、影像與影片生成、視聽生成、轉換生成、前向與逆向動力學,以及機器人策略學習。在這些多樣的基準上,Cosmos 3 相對於專門化開源模型與領先的專有系統皆持續展現強勁成果,凸顯統一世界模型架構對物理 AI 的優勢。以下各節呈現 Reasoner 與 Generator 的詳細結果,並分析其在機器人、自動駕駛、智慧基礎設施與通用多模態領域的能力。
6.1 Reasoner 評估
| 基準 | Cosmos 3 Super | Qwen3-VL 32B | Cosmos-Reason2 32B | Gemma-4 31B | Gemini 3.1 Pro† | Cosmos 3 Nano | Qwen3-VL 8B | Cosmos-Reason2 8B | Gemma-4 E4B | RynnBrain 8B | MiMo-Embodied 7B | Cosmos 3 Edge | Qwen3-VL 2B | Cosmos-Reason2 2B | Gemma-4 E2B | RynnBrain 2B |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| General(19 項基準) | ||||||||||||||||
| MMBench-Dev | 87.4 | 87.8 | 86.3 | 86.7 | 93.2 | 85.1 | 85.3 | 82.2 | 66.2 | 85.5 | 81.4 | 76.6 | 77.2 | 73.6 | 60.2 | 81.9 |
| RealWorldQA | 79.2 | 80.3 | 76.1 | 71.8 | 81.8 | 72.2 | 73.2 | 68.2 | 61.0 | 72.5 | 72.0 | 73.3 | 67.3 | 61.4 | 57.1 | 65.9 |
| CVBench | 88.0 | 86.8 | 88.1 | 84.1 | 88.6 | 86.5 | 85.2 | 85.6 | 68.1 | 87.5 | 87.8 | 84.9 | 78.7 | 78.7 | 56.1 | 85.7 |
| VideoPhy2 | 47.4 | 36.8 | 43.3 | 33.1 | 28.7 | 45.6 | 28.2 | 37.1 | 13.8 | 10.5 | 20.8 | 40.3 | 7.9 | 12.8 | 8.4 | 7.3 |
| CausalVQA | 77.0 | 81.0 | 74.5 | 76.5 | 92.0 | 70.0 | 72.0 | 71.5 | 38.0 | 68.5 | 63.0 | 37.0 | 57.0 | 53.5 | 29.5 | 51.0 |
| MVPBench | 70.3 | 58.6 | 62.2 | 27.0 | 59.4 | 66.9 | 51.6 | 54.2 | 32.8 | 50.1 | 43.3 | 53.3 | 43.6 | 43.7 | 31.9 | 44.9 |
| CountBenchQA | 89.1 | 93.6 | 87.5 | 79.1 | 95.3 | 84.8 | 89.5 | 79.9 | 55.4 | 90.5 | 84.6 | 89.9 | 87.5 | 79.7 | 56.9 | 86.0 |
| AI2D | 87.8 | 88.2 | 87.5 | 88.9 | 93.8 | 85.0 | 84.8 | 83.6 | 78.2 | 85.7 | 83.2 | 75.4 | 76.7 | 75.4 | 73.0 | 79.8 |
| DocVQA | 90.4 | 96.0 | 95.1 | 89.6 | 95.8 | 94.2 | 95.6 | 94.3 | 78.1 | 95.4 | 93.9 | 86.8 | 92.8 | 89.9 | 73.4 | 91.8 |
| InfoVQA | 82.4 | 87.6 | 85.1 | 66.5 | 85.0 | 81.8 | 83.4 | 79.8 | 46.1 | 81.8 | 84.2 | 60.1 | 71.7 | 65.0 | 37.8 | 70.5 |
| OCRBench-v2 | 66.7 | 65.9 | 57.4 | 61.8 | 64.5 | 60.1 | 64.1 | 56.6 | 42.4 | 58.6 | 41.2 | 43.7 | 54.2 | 50.1 | 37.8 | 41.0 |
| LogicVista | 55.9 | 47.9 | 46.1 | 57.0 | 81.9 | 43.2 | 41.8 | 37.4 | 31.5 | 40.3 | 39.6 | 34.7 | 39.4 | 34.0 | 29.5 | 34.9 |
| MMMU-Pro | 48.1 | 49.0 | 45.6 | 70.6 | 76.7 | 41.1 | 41.1 | 38.6 | 46.9 | 42.0 | 37.3 | 26.4 | 32.3 | 26.9 | 39.9 | 30.3 |
| MVBench | 74.5 | 72.6 | 72.5 | 64.4 | 72.8 | 73.2 | 69.1 | 70.1 | 48.9 | 69.5 | 56.1 | 58.2 | 60.3 | 60.5 | 41.2 | 64.7 |
| BlinkSpatial | 88.8 | 88.1 | 87.4 | 90.9 | 92.3 | 81.8 | 87.4 | 83.9 | 76.9 | 76.9 | 83.2 | 72.0 | 77.6 | 75.5 | 62.9 | 79.7 |
| BlinkDepth | 91.9 | 82.3 | 85.5 | 87.1 | 79.8 | 92.7 | 87.1 | 87.9 | 77.4 | 91.1 | 81.5 | 79.8 | 74.2 | 83.1 | 70.2 | 87.9 |
| RefCOCO | 89.5 | 90.6 | 70.7 | 81.8 | 84.3 | 84.3 | 87.3 | 81.1 | 71.5 | 75.9 | 74.3 | 80.1 | 84.5 | 80.8 | 66.3 | 71.2 |
| HallusionBench | 49.0 | 52.8 | 50.8 | 57.8 | 64.2 | 45.3 | 50.5 | 42.0 | 42.0 | 45.7 | 40.2 | 40.7 | 42.6 | 28.6 | 36.0 | 45.0 |
| IFBench | 37.0 | 37.0 | 28.2 | 52.3 | 42.5 | 28.5 | 32.0 | 26.0 | 34.2 | 22.8 | 25.8 | 20.8 | 20.0 | 19.8 | 29.0 | 17.8 |
| General 平均 | 73.7 | 72.8 | 70.0 | 69.8 | 77.5 | 69.6 | 68.9 | 66.3 | 53.1 | 65.8 | 62.8 | 59.7 | 60.3 | 57.5 | 47.2 | 59.9 |
| Robotics(17 項基準) | ||||||||||||||||
| Cosmos-ER | 74.1 | 61.3 | 74.9 | 54.3 | 61.1 | 69.7 | 56.9 | 71.2 | 44.3 | 54.9 | 55.6 | 56.6 | 48.9 | 59.0 | 38.0 | 48.0 |
| Cosmos-CS | 66.4 | 63.4 | 65.2 | 61.1 | 69.5 | 63.9 | 58.4 | 63.1 | 43.2 | 54.1 | 53.8 | 51.5 | 49.7 | 54.8 | 35.3 | 49.0 |
| RefSpatial | 57.0 | 52.7 | 48.0 | 46.6 | 70.0 | 53.1 | 47.6 | 41.1 | 24.6 | 46.6 | 41.3 | 48.4 | 27.1 | 30.7 | 16.2 | 39.0 |
| VSI-Bench | 60.9 | 59.5 | 58.0 | 47.6 | 47.5 | 54.9 | 55.1 | 52.0 | 28.4 | 63.0 | 46.7 | 59.2 | 49.8 | 45.0 | 27.3 | 62.5 |
| SparBench | 54.9 | 48.0 | 42.9 | 46.6 | 51.5 | 54.8 | 40.1 | 38.0 | 28.5 | 49.5 | 41.2 | 52.8 | 34.5 | 35.5 | 30.6 | 47.8 |
| RynnBrain-Area | 53.0 | 53.1 | 50.4 | 58.7 | 65.4 | 52.0 | 33.2 | 43.4 | 35.7 | 56.6 | 47.1 | 39.1 | 24.4 | 31.9 | 31.2 | 58.1 |
| RynnBrain-Spatial | 34.5 | 16.8 | 42.2 | 32.4 | 36.8 | 26.1 | 37.5 | 35.5 | 33.9 | 59.0 | 37.2 | 22.6 | 29.7 | 33.9 | 19.7 | 55.7 |
| RynnBrain-Trajectory | 69.3 | 61.6 | 64.6 | 64.4 | 71.3 | 67.9 | 54.8 | 64.4 | 63.5 | 61.1 | 61.1 | 58.7 | 54.7 | 61.1 | 60.9 | 53.5 |
| RynnBrain-Affordance | 84.6 | 84.2 | 86.8 | 87.8 | 86.8 | 85.1 | 82.6 | 84.6 | 84.4 | 85.3 | 85.7 | 77.6 | 70.5 | 80.0 | 77.0 | 90.4 |
| RynnBrain-Object | 48.3 | 57.0 | 44.9 | 47.2 | 51.5 | 39.8 | 49.2 | 42.0 | 35.2 | 71.6 | 33.5 | 24.0 | 41.2 | 30.1 | 26.7 | 70.7 |
| RynnBrain-Grounding | 74.4 | 77.0 | 76.7 | 72.4 | 82.8 | 72.9 | 68.8 | 72.5 | 59.3 | 74.2 | 57.8 | 51.6 | 33.1 | 54.3 | 31.1 | 45.5 |
| MMSIBench | 41.8 | 33.0 | 31.4 | 32.3 | 40.8 | 36.2 | 26.3 | 29.5 | 37.6 | 38.4 | 30.1 | 32.3 | 28.5 | 28.9 | 33.7 | 33.2 |
| MMSIVideoBench | 26.1 | 33.8 | 29.6 | 33.6 | 38.6 | 27.2 | 28.8 | 29.4 | 39.4 | 28.2 | 30.0 | 24.9 | 25.5 | 23.9 | 32.5 | 24.5 |
| HealthSurgiBench | 44.5 | 24.4 | 53.9 | 19.1 | 24.6 | 56.1 | 23.0 | 46.9 | 20.7 | 23.3 | 24.0 | 62.1 | 26.0 | 31.3 | 17.3 | 18.3 |
| ERQA | 51.2 | 46.5 | 42.8 | 47.8 | 65.2 | 46.0 | 44.0 | 44.2 | 30.2 | 43.0 | 42.0 | 42.0 | 37.8 | 37.2 | 32.5 | 38.8 |
| RoboSpatialHome | 70.0 | 65.1 | 64.3 | 63.0 | 65.1 | 66.3 | 64.8 | 64.5 | 42.0 | 71.4 | 66.1 | 63.4 | 44.6 | 52.0 | 36.3 | 62.9 |
| Where2Place | 71.0 | 56.0 | 59.0 | 52.0 | 61.0 | 64.0 | 53.0 | 50.0 | 17.0 | 11.0 | 58.0 | 55.0 | 32.0 | 33.0 | 15.0 | 11.0 |
| Robotics 平均 | 57.8 | 52.6 | 55.0 | 51.0 | 58.2 | 55.1 | 48.5 | 51.3 | 39.3 | 52.4 | 47.7 | 48.3 | 38.7 | 42.5 | 33.0 | 47.6 |
| Smart Infrastructure(9 項基準) | ||||||||||||||||
| VANTAGE-2DGrounding | 76.2 | 72.4 | 45.7 | 45.1 | 46.9 | 75.6 | 73.3 | 66.9 | 10.1 | 67.6 | 59.4 | 49.8 | 65.1 | 56.3 | 5.5 | 49.2 |
| VANTAGE-Astro2D | 81.5 | 76.8 | 22.6 | 68.7 | 77.7 | 78.3 | 69.2 | 81.1 | 58.8 | 10.5 | 57.8 | 76.7 | 56.6 | 72.5 | 48.4 | 0.0 |
| VANTAGE-2DPointing | 72.9 | 75.6 | 74.0 | 76.8 | 85.6 | 74.8 | 68.6 | 68.7 | 43.4 | 64.9 | 55.0 | 63.0 | 53.1 | 59.7 | 31.7 | 60.3 |
| VANTAGE-DVC | 29.5 | 29.4 | 30.1 | 29.6 | 30.2 | 31.4 | 29.6 | 32.5 | 14.3 | 28.4 | 2.2 | 20.9 | 0.8 | 28.5 | 9.3 | 0.0 |
| VANTAGE-EventVerif | 71.3 | 60.0 | 73.6 | 55.2 | 67.5 | 68.9 | 59.4 | 64.1 | 40.6 | 58.9 | 58.0 | 64.8 | 44.7 | 55.3 | 27.6 | 41.6 |
| VANTAGE-SOT | 62.2 | 44.2 | 33.1 | 54.7 | 72.7 | 59.2 | 33.1 | 37.7 | 16.0 | 4.8 | 9.2 | 18.7 | 29.8 | 26.7 | 11.5 | 4.8 |
| VANTAGE-Temporal | 51.9 | 46.8 | 50.5 | 33.0 | 41.7 | 48.0 | 43.3 | 47.3 | 16.9 | 20.1 | 5.9 | 39.1 | 35.2 | 39.0 | 9.0 | 25.9 |
| VANTAGE-VQA | 69.5 | 71.3 | 70.3 | 67.0 | 71.2 | 69.0 | 66.4 | 68.0 | 51.5 | 65.4 | 67.5 | 64.4 | 63.9 | 64.7 | 46.2 | 62.9 |
| TARBench | 48.4 | 28.1 | 36.6 | 31.9 | 33.6 | 43.6 | 31.5 | 34.1 | 12.8 | 34.8 | 32.6 | 34.1 | 32.7 | 26.6 | 8.5 | 34.2 |
| Smart Infra. 平均 | 62.6 | 56.1 | 48.5 | 51.3 | 58.6 | 61.0 | 52.7 | 55.6 | 29.4 | 39.5 | 38.6 | 47.9 | 42.4 | 47.7 | 22.0 | 31.0 |
| Driving(3 項基準) | ||||||||||||||||
| LingoQA | 76.8 | 66.4 | 70.0 | 57.2 | 71.2 | 71.4 | 68.4 | 71.6 | 24.2 | 60.4 | 70.4 | 58.4 | 59.2 | 58.2 | 19.0 | 50.2 |
| AVSpecialCollision | 79.3 | 37.3 | 77.3 | 32.3 | 54.0 | 79.0 | 34.0 | 74.0 | 33.3 | 33.7 | 37.3 | 66.7 | 36.3 | 74.3 | 33.7 | 33.3 |
| AVSpecialStopBehavior | 81.6 | 18.4 | 69.4 | 20.4 | 16.3 | 77.5 | 36.7 | 59.2 | 20.4 | 36.7 | 42.9 | 53.1 | 32.6 | 34.7 | 20.4 | 36.7 |
| Driving 平均 | 79.3 | 40.7 | 72.2 | 36.6 | 47.2 | 76.0 | 46.4 | 68.3 | 26.0 | 43.6 | 50.2 | 59.4 | 42.7 | 55.7 | 24.4 | 40.1 |
表 10:Cosmos 3 變體與比較模型在通用多模態理解、機器人、智慧基礎設施與自動駕駛基準上的 Reasoner 基準結果。各列回報個別基準或分組平均,各欄回報模型分數。在各分隔的模型區塊內,每列的最佳與次佳分數以粗體與底線標示【譯註:本翻譯的 markdown 表格未保留粗體/底線標示】。† 表示閉源模型。
Cosmos 3 Reasoner 共在 48 項基準上評估。結果彙總為四類:通用、機器人、智慧基礎設施與駕駛。表 10 回報 Edge、Nano 與 Super 模型的結果,及其與既有開源與閉源模型的比較。數值以整合進我們基準基礎設施的 VLMEvalKit [66] 評估。
通用(General)
我們選取以下 19 項基準評估模型的通用能力。
- 廣泛的視覺問答與多模態理解由 MMBench_DEV([163])、RealWorldQA([306])與 AI2D([119])衡量,測試模型能否解讀自然影像、圖表與真實世界場景,並回答多樣的語意與組合性問題。
- 空間、定位與量化推理由 CVBench([269])、BlinkSpatial、BlinkDepth([73])、RefCOCO([332])與 CountBenchQA([217])評估,涵蓋 2D/3D 空間關係、深度感知、指代表達定位與物體計數。
- 富含文字的視覺理解由 DocVQA([178])、InfoVQA([177])與 OCRBench-v2([72])涵蓋,需要閱讀並推理文件、資訊圖表、場景文字與結構化視覺版面。
- 影片、物理與因果推理由 MVBench([140])、VideoPhy2([18])、MVPBench([126])與 CausalVQA([71])評估,測試時間事件理解、物理合理性與跨幀因果推理。
- 進階推理、穩健性與指令遵循由 LogicVista([309])、MMMU_Pro([335])、HallusionBench([92])與 IFBench([228])衡量,探測視覺邏輯、專家級多模態問題求解、幻覺抵抗力與對使用者指令的遵循。
這些基準合計提供模型在感知、定位、文字辨識、時間理解與可靠的指令條件回應生成等通用推理能力的全面視角。
機器人(Robotics)
我們將 17 項機器人與具身推理基準分為幾個能力族群。
- 具身常識與任務推理由 Cosmos Reason 中的 Embodied Reasoning 與 CommonSense([198])、ERQA([80])與 Where2Place([334])衡量,測試模型能否推理具身環境中的物體可供性、可行動作、擺放決策與物理常識。
- 空間定位與場景幾何由 RefSpatial([351])、VSI-Bench([321])、SparBench([342])與 RoboSpatialHome([259])評估,涵蓋指代表達定位、度量與關係空間理解、室內布局推理、自由空間認知與機器人相關定位。
- 機器人導向的感知與動作理解由 RynnBrain([56])與 ERQA([80])捕捉,探測操作相關感知、動作可行性、軌跡推理與真實機器人操作片段上以物體為中心的決策。MMSIVideoBench([154])則要求跨多視角或多幀推理,以推斷物體對應、空間關係、時間變化與場景層級結構。我們策展了 HealthSurgiBench,一個含 23 種題型的手術室理解內部基準。它結合針對結構化輸出(如計數、工具、角色、方框、座標、時間/距離估計、有序清單、場景圖與螢幕文字)的規則式評分,與針對六種自由形式答案類型的本地 Qwen3-4B 評審。最終分數對每筆樣本使用適用的評估器,然後回報所有樣本的未加權平均。
這些基準合計評估模型能否超越靜態視覺辨識、邁向具身推理:理解物體在哪裡、它們如何關聯、哪些動作可行,以及空間證據如何隨視角與時間演變。
智慧基礎設施(Smart infrastructure)
我們在 VANTAGE-Bench([207])與交通異常推理 (Traffic Anomaly Reasoning, TAR)([205])上評估,涵蓋倉儲物流、交通運輸與智慧基礎設施的固定相機情境。VANTAGE-Bench 透過事件驗證、VQA、指代、指點、定位、時間定位、密集描述與 VLM 原生單物體追蹤,衡量語意、空間、時間與時空理解,含 $3{,}346$ 筆資產與 $35{,}027$ 筆專家標註,包括合成異常影片。TAR 為 AI City Challenge 2026 Track 3 套件,以異質問答、時間 IoU 與文字生成指標評估異常驗證、時間定位、場景描述、因果、摘要與領域外泛化。
駕駛(Driving)
我們以 LingoQA([176])與兩個攸關安全的駕駛事件分類內部基準評估駕駛能力。AVSpecialCollisionBench 衡量模型能否將每部影片正確分類為三種事件類別之一:碰撞、近碰撞或無碰撞。基準每類含 100 部影片,計算各類別準確率,最終分數為三類準確率的平均。AVSpecialStopBehaviorBench 評估停車標誌行為的五類分類:完全停止、滑行停止、未停止、不相關與偽標誌。此基準每類含 10 部影片,最終分數為五個類別準確率的平均。
Cosmos 3 在通用基準上與開源模型旗鼓相當,但仍落後 Gemini 3.1 Pro([86])。與 Cosmos-Reason2 相比,Cosmos 3 展現更強的通用能力,受益於增加資料多樣性的額外 20% 預訓練資料。在機器人、智慧基礎設施與駕駛領域,Cosmos 3 超越包括 RynnBrain([56])、MiMo-Embodied([101])與 Gemma-4([89])在內的開源與閉源模型,僅在機器人領域與 Gemini 3.1 Pro 有小幅差距。整體而言,Cosmos 3 在機器人、智慧基礎設施與自動駕駛上展現強勁的領域特定推理,支援廣泛的物理 AI 應用。
6.2 Generator 評估
Cosmos 3 的 Generator 組件在一組多樣的任務上評估,這些任務合計衡量其為物理 AI 模擬與生成多模態世界的能力。與聚焦單一模態的傳統生成模型不同,Cosmos 3 在統一框架內聯合建模影像、影片、音訊與動作,使評估得以橫跨影像生成、影片生成、視聽生成、轉換生成、前向與逆向動力學,以及機器人策略學習。我們進一步評估專門化的後訓練變體——包括 Cosmos3-Super-Text2Image、Cosmos3-Super-Image2Video 與 Cosmos3-Nano-Policy-DROID——以評估從共享全模態基礎模型進行下游調適的有效性。我們的基準套件結合自動化指標、人工評估、領域特定的物理 AI 基準與真實世界機器人評估,涵蓋提示遵循、物理合理性、時間一致性、視聽同步、可控性、動作預測與任務完成等關鍵能力。
6.2.1 影像生成評估
我們將 Cosmos 3 影像生成作為單幀視覺生成來評估,聚焦四個互補軸向:廣泛的語意提示遵循、精確的場景文字渲染、人類偏好對齊與視覺美學。UniGenBench 是主要的提示遵循指標,因為它在測試點層級揭露失敗。我們透過增加物理 AI 子集強化 UniGenBench。CVTG 透過基於 OCR 的 GNED 與 PNED 分數,隔離影像生成器的常見失敗模式——拼錯、遺漏、模糊或重複的場景文字。HPSv3 與 LAION 美學分數則以衡量整體人類偏好與視覺吸引力補足這些針對性檢查,比任何單一綜合分數更能提供可行動的 T2I 品質視角。所有基準皆使用 Claude-Opus-4.7 作為提示改寫器,將評估文字提示轉換為第 6.3.1 節與第 6.3.2 節所述的結構化格式,確保與生成器偏好的訓練提示風格匹配。指令模板見附錄 B.2。我們以 1024x1024 解析度生成並比較所有模型。開源模型依其文件建議的超參數與負面提示執行。定性範例見圖 17。
圖 17:Cosmos3-Super-Text2Image 生成的範例影像。我們的模型生成的影像兼具物理合理性與照片真實感,展現連貫的物體幾何、一致的物體—環境互動等。所有影像皆以單次上採樣的 JSON 提示生成,使用 shift=3.0、guidance=4.0 與 50 個擴散步(另見表 21)。這些結果凸顯該模型作為機器人、自動駕駛及其他必須遵循物理定律情境的有效真實世界影像模擬器的潛力。
UniGenBench
UniGenBench([292])是文字生成影像的統一語意評估基準。它包含橫跨 5 大主題與 20 個子主題的 600 則提示,每則以 MLLM 作為評審 (MLLM-as-Judge) 框架,依 10 個主要與 27 個子評估準則評估。為更好地評估 Cosmos 3 在物理 AI 情境的能力,我們以 570 則針對照片真實感物理世界場景的額外提示(UniGenBench-Phys)擴充基準。這些提示涵蓋六個物理世界子領域:(a) 機器人與工業、(b) 實體標誌與文字、(c) 自動駕駛、(d) 工地、(e) 流體動力學、(f) 醫療/臨床。Gemini 3.1 Pro 以二元通過/不通過判定評估每張生成影像對每個測試點的表現;主要分數為測試點平均準確率,回報完整 1,170 則提示(即 "All"),並額外細分原始與物理子集(即 "Orig" 與 "Phys")。
CVTG
CVTG([65])(Complex Visual Text Generation,複雜視覺文字生成)評估模型在視覺複雜場景中準確渲染文字的能力。此能力對真實世界環境尤其重要——標誌、標籤與說明文字必須清晰可讀且拼寫正確。生成的影像先由 OCR 系統處理以擷取可見文字區域,再以基於正規化編輯距離(即 NED)的 Hungarian 匹配將預測字串與目標字串配對。
我們在兩組提示集上評估:(a) CVTG-500L,從 CVTG-2K 隨機抽樣的 500 則以英文為主的子集,保留文字區域數量的可比覆蓋。我們進一步將每則短提示上採樣為長而密集的描述,以更好反映現代世界模型生成的需求。(b) CVTG-102ch,為評估準確中文字元渲染而設計的 102 則以中文為主的提示集。這些提示取自常見與物理落地的領域,包括公共空間、戶外與風景環境、數位顯示器及其他真實世界情境。
HPSv3。 HPSv3([172])以學習到的人類偏好獎勵模型評估提示感知的文字生成影像品質。它建立在 HPDv3 之上——一個橫跨合成與真實影像、涵蓋廣泛品質水準的偏好資料集。HPSv3 採用以不確定性感知排序損失訓練的 VLM 架構,產出反映人類對語意對齊、真實感與美學品質判斷的提示感知分數。我們直接對 Cosmos 3 的結果套用 HPSv3,取得此互補的人類偏好指標。
Aesthetic V2。 Aesthetic V2([246])使用 LAION 美學預測器衡量與提示無關的視覺吸引力。該預測器以建立在 CLIP 影像嵌入之上的輕量模型,以 1–10 分估計人們對影像的喜愛程度。與 HPSv3 不同,此分數不以輸入提示為條件,因此不直接衡量指令遵循或語意對齊。我們將其作為獨立的影像品質訊號,捕捉一般的視覺吸引力與構圖品質。
| 模型 | 類型 | UniGenBench All (↑) | Orig (↑) | Phys (↑) | CVTG-500L GNED (↑) | PNED (↑) | CVTG-102ch GNED (↑) | PNED (↑) | Aesv2 (↑) | HPSv3 (↑) |
|---|---|---|---|---|---|---|---|---|---|---|
| Cosmos3-Super-Text2Image | 開源 | 91.36 | 93.34 | 89.54 | 80.88 | 89.08 | 32.02 | 41.22 | 5.91 | 11.60 |
| Cosmos3-Super | 開源 | 87.33 | 85.21 | 89.64 | 66.77 | 70.97 | 8.48 | 16.31 | 5.76 | 9.49 |
| Cosmos3-Nano | 開源 | 84.61 | 87.32 | 82.12 | 24.23 | 26.53 | 4.63 | 9.70 | 5.76 | 8.99 |
| Gemini 3 Pro Image | 閉源 | 90.69 | 92.81 | 89.74 | 59.24† | 71.79† | 46.00 | 76.40 | 5.70 | 11.78 |
| FLUX.2-dev | 開源 | 87.60 | 89.77 | 85.61 | 74.71 | 84.98 | 44.33 | 68.74 | 5.75 | 11.38 |
| Qwen-Image-2512 | 開源 | 84.25 | 87.32 | 81.44 | 79.68 | 90.86 | 46.33 | 71.26 | 5.92 | 11.03 |
| Hunyuan 3.0 | 開源 | 84.02 | 87.68 | 80.67 | 71.40 | 87.68 | 49.05 | 71.31 | 5.90 | 11.93 |
| Z-Image-Turbo | 開源 | 78.14 | 81.53 | 75.03 | 75.20 | 86.95 | 49.18 | 73.32 | 5.70 | 11.36 |
† Gemini 3 Pro Image 有很高機率生成大小寫不符的場景文字(例如 "Adventure" → "ADVENTURE")。排除此類錯誤後,其 CVTG-500L 分數升至 GNED = 75.97、PNED = 91.45。
表 11:文字生成影像基準結果。UniGenBench 分數為滿足的評估準則比例;"All (1170)" 彙總原始 600 則提示(Orig)與 570 則物理 AI 提示(Phys)。PNED 與 GNED 為字元層級準確率指標(愈高愈好);CVTG-102ch 測試中文字元渲染,CVTG-500L 測試英文長提示渲染。Aesthetic v2 與 HPSv3 為愈高愈好的影像層級指標。
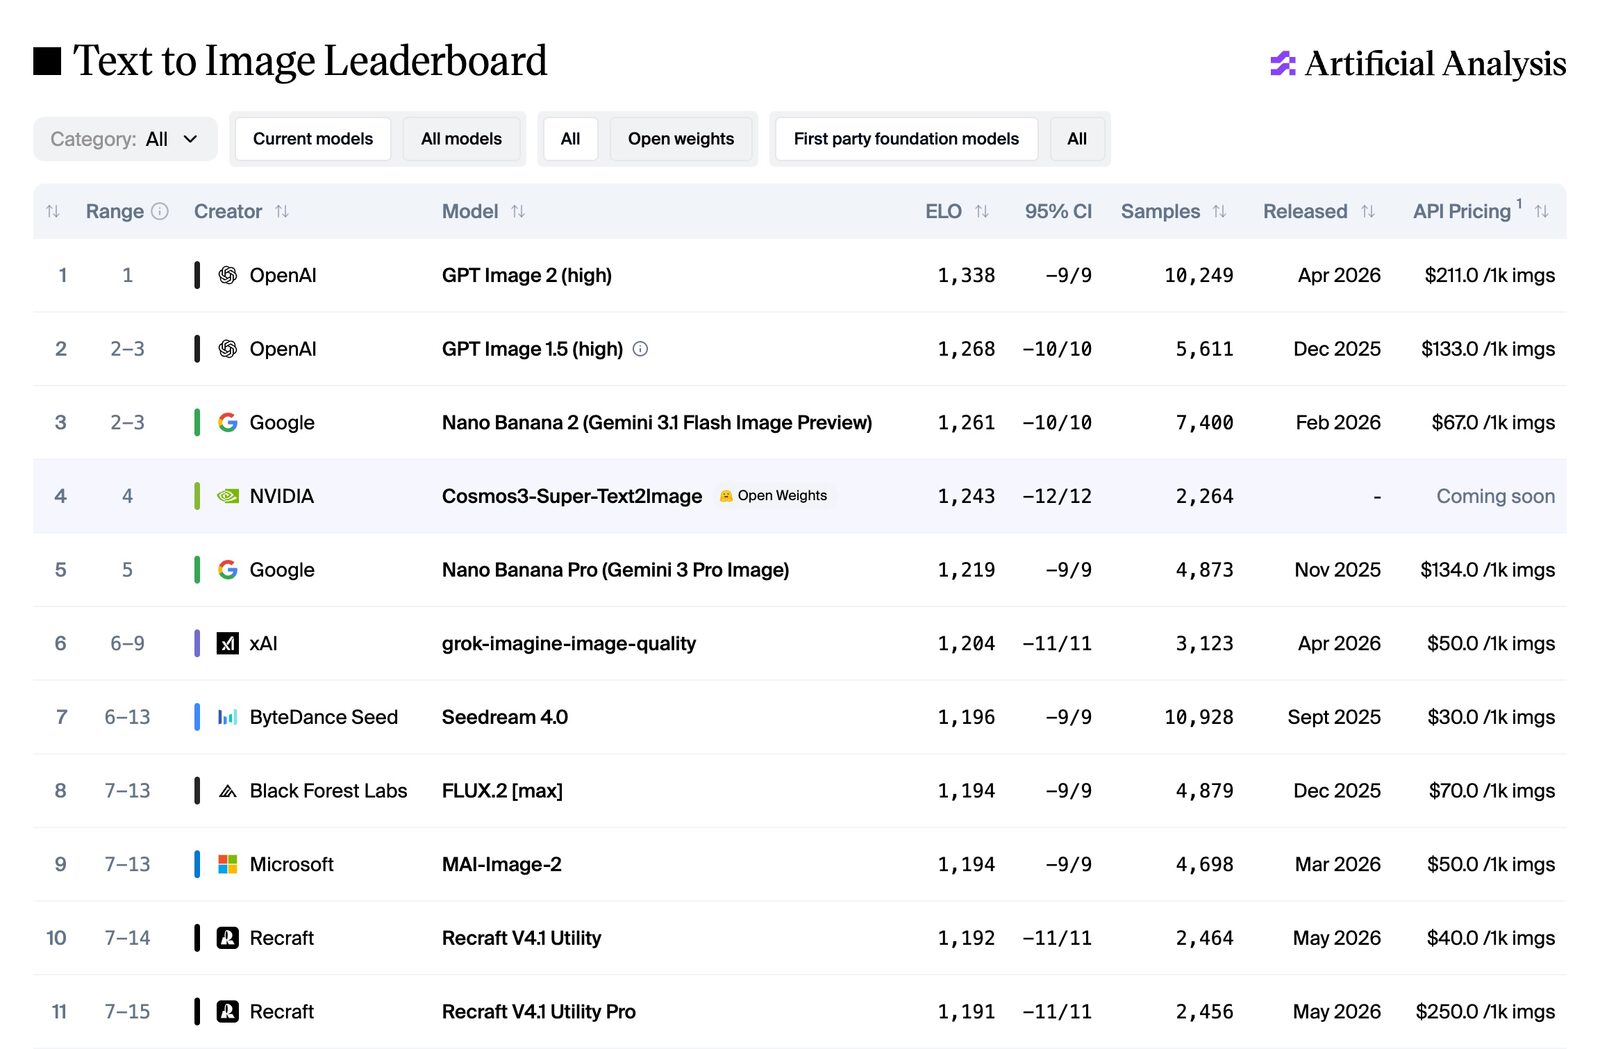
圖 18:Cosmos3-Super-Text2Image 為群眾外包競技場排名的第一名開放權重模型。Cosmos3-Super-Text2Image 在 Artificial Analysis 文字生成影像排行榜上名列開放權重模型第 1(含專有模型則為第 4)(日期:2026-05-28)。
Artificial Analysis 文字生成影像排行榜
為了在真實世界情境下評估 Cosmos 3,我們將專門化的 T2I 模型 Cosmos3-Super-Text2Image 連同代理式框架 (Agentic Harness) 提交至 Artificial Analysis 文字生成影像排行榜進行群眾外包公開投票。該模型在所有開放權重模型中排名第 1,在所有模型(開放+閉源)中排名第 4。提交細節詳見附錄 B.7。
6.2.2 影片生成評估
我們透過互補的自動化與人工基準評估 Cosmos 3 的影片生成能力。自動化基準提供可擴展、可重現的比較,並捕捉廣泛的品質與領域特定訊號,但隨著模型進步,其鑑別力遞減(尤其在領域特定的物理 AI 情境中,此類指標通常對時間性與物理性失敗視而不見)。人工評估則彌補這些缺口:捕捉自動化協定系統性遺漏的長尾物理、具身與語意失敗,同時將分數分散到更有意義的範圍,使最先進模型之間微小但真實的差異仍可被偵測。我們回報三個自動化基準——PAIBench-G、RBench 與 Physics-IQ——接著是 Cosmos HUE(專為物理 AI 影片生成設計的人工評估協定)與 Human World Bench(HWB,針對任務層級指令下真實人體運動的人工評估)。所有基準(自動化或人工評估)皆使用 Claude-Opus-4.6 作為提示改寫器,將文字提示轉換為第 6.3.1 節與第 6.3.2 節所述的結構化格式,確保與訓練提示分布匹配。
PAIBench-G
PAIBench-G 是 Physical AI Benchmark([352])的影片生成賽道,包含橫跨六個物理 AI 領域的 1,044 個影像—文字提示對:人類(299)、自動駕駛(239)、常識(174)、機器人(107)、物理(107)與工業(107)。我們採用它是因其領域覆蓋廣、評分平衡:每個模型獲得品質分數(彙總幀一致性、運動平滑度、美學品質與影片—文字對齊的指標)與領域分數(VLM 作為評審對跨領域物理與語意準確性的二元驗證)。總分兩者等權:$\text{Overall}=0.5\times\text{Quality}+0.5\times\text{Domain}$。PAIBench-G 與人類 ELO 排名的 Pearson 相關係數達 r=0.918,非常適合在訓練早期可靠地衡量進展——在模型收斂到自動化分數開始飽和的前緣之前。對每則提示,我們以 5 個種子生成影片,並以 720p 解析度、16:9 長寬比、189 幀評估。PAIBench-G 原生僅支援影像生成影片評估,我們將其擴展為也計算文字生成影片分數1。表 12 回報使用 Qwen2.5-VL-72B-Instruct 作為 VLM 評審的文字生成影片與影像生成影片 PAIBench-G 結果;Cosmos3-Super 在兩條賽道上皆達到最先進的總分,成為最佳開源模型,超越 Veo-3.1 等強勁的閉源模型。
1 我們發現公開的 PAIBench-G 影像生成影片排行榜結果(由 Qwen3-VL-235B-A22B 評判)無法重現。因此我們在內部評估(表 12)中使用 Qwen2.5-VL-72B-Instruct 作為領域分數評審,並獨立提交至公開排行榜;在兩者上,Cosmos3-Super 與 Cosmos3-Nano 的總分皆分列第一與第二。
| 模型 | 類型 | PAIBench-G T2V Overall | Domain | Quality | PAIBench-G I2V Overall | Domain | Quality | RBench I2V 分數 |
|---|---|---|---|---|---|---|---|---|
| Cosmos3-Super | 開源 | 80.0 | 86.8 | 73.1 | 82.8 | 87.3 | 78.2 | 58.1% |
| Cosmos3-Nano | 開源 | 79.4 | 85.8 | 73.0 | 82.7 | 87.2 | 78.1 | 58.4% |
| Wan2.2-A14B | 開源 | 78.0 | 83.2 | 72.8 | 81.3 | 85.3 | 77.3 | 50.7% |
| HunyuanVideo-1.5 | 開源 | 76.5 | 80.9 | 72.0 | 81.7 | 85.9 | 77.6 | 46.0% |
| Cosmos-Predict2.5-2B | 開源 | 76.5 | 79.9 | 73.2 | 81.2 | 84.6 | 77.9 | 46.4% |
| Cosmos-Predict2.5-14B | 開源 | 76.4 | 79.5 | 73.2 | 81.1 | 84.0 | 78.1 | — |
| Wan2.1-14B | 開源 | 76.4 | 80.1 | 72.7 | 80.2 | 83.6 | 76.8 | — |
| Wan2.2-5B | 開源 | 76.3 | 79.6 | 73.0 | 81.0 | 84.6 | 77.4 | — |
| Veo-3.1 | 閉源 | 79.1 | 85.2 | 72.9 | 82.6 | 87.6 | 77.6 | 56.3% |
| Seedance-1.5-Pro | 閉源 | 76.9 | 82.1 | 71.6 | 80.8 | 84.7 | 76.9 | 58.4% |
| Wan 2.6 | 閉源 | 78.6 | 85.2 | 72.0 | 81.9 | 85.9 | 77.8 | 60.7% |
表 12:PAIBench-G 與 RBench 結果,橫跨文字生成影片與影像生成影片設定。PAIBench-G 評估六個物理 AI 領域的視覺品質與領域特定準確性,RBench 評估具身機器人情境中的任務正確性與物理合理性。Cosmos3-Super 在開源模型中於 PAIBench-G T2V 與 I2V 皆取得最高總分,Cosmos3-Nano 則在 RBench 領先。
RBench
RBench([61])評估具身任務情境中的影片生成,強調機器人—物體互動的任務正確性與物理合理性,而非純粹的感知真實感。PAIBench-G 廣泛覆蓋物理 AI 領域,RBench 則深入機器人這一關鍵物理 AI 應用案例,對模型在多樣機器人形態上生成物理連貫操作序列的能力進行壓力測試。此基準包含來自兩個互補分割的 650 個影像—文字評估案例:橫跨五類(常見操作、長程規劃、多實體協作、空間關係與視覺推理)的 250 個任務導向對,以及涵蓋四種機器人形態(雙臂、人形、單臂與四足)的 400 個具身形式特定對。提示取自 RoVid-X([61]),一個橫跨 1,300 多項技能、含 4M 段機器人片段的精選語料。每部影片以任務完成度(TC,物理—語意合理性與任務遵循一致性的平均)與視覺品質(VQ,機器人主體穩定性與運動平滑度的帶懲罰組合)評分,最終分數為全部 650 個案例上兩者的平均。RBench 在 25 個受評模型上與人類判斷的 Spearman 相關係數達 $\rho=0.96$,為具身生成品質提供可靠訊號。對每則提示,我們以單一種子生成影片,並以 720p 解析度、16:9 長寬比、121 幀評估。表 12 回報 Cosmos 3 在 RBench 上的影像生成影片結果——Cosmos 3 成為最佳開源模型。
如表 12 所示,Cosmos3-Super 在所有模型(含閉源)中於 PAIBench-G 的 T2V 與 I2V 皆取得最高總分,Cosmos3-Nano 則在 RBench 上並列次佳。兩個 Cosmos 3 變體也顯著超越其 Cosmos-Predict2.5 前代,反映全模態架構帶來的增益。雖然兩個基準都將物理合理性納入評分,但並未深入探測。因此我們轉向 Physics-IQ,針對性地評估物理遵循度。
Physics-IQ
Physics-IQ([188])透過以真實世界起始脈絡為條件、並評分生成的後續內容與實際物理結果的吻合程度,評估影片生成模型是否掌握物理原理。與將物理合理性作為眾多評分成分之一的 PAIBench-G 與 RBench 不同,Physics-IQ 將其隔離為唯一評估軸向,沿精確的空間與時間維度衡量生成的運動是否符合真值物理結果。Physics-IQ 涵蓋五個物理類別——固體力學、流體動力學、光學、熱力學與磁學——橫跨從三個固定視角拍攝的 396 個真實世界場景,並為文字條件模型配對文字描述。支援兩種評估模式。在影像生成影片(I2V)中,模型以單一切換幀加可選文字提示為條件,預測後續運動。在影片生成影片(V2V)延續中,模型以 3 秒條件影片加可選文字提示為條件,預測接下來 5 秒的運動。生成的影片沿四個互補軸向(空間重疊、時間對齊、幅度加權空間一致性與像素層級誤差)與真值物理延續比較,並以真實對真實的上界正規化為單一 0–100 分數,可直接跨模型與條件模式比較。
| 模型 | 模式 | 分數 (↑) |
|---|---|---|
| Cosmos3-Super | I2V + WMReward (BoN) | 48.9 |
| Cosmos3-Nano | I2V + WMReward (BoN) | 43.8 |
| Sora2(閉源) | I2V + WMReward (BoN) | 46.4 |
| Wan2.2-A14B(開源) | I2V + WMReward (BoN) | 44.4 |
| Cosmos3-Super | I2V | 43.8 |
| Cosmos3-Nano | I2V | 40.2 |
| Sora2(閉源) | I2V | 42.3 |
| Wan2.2-A14B(開源) | I2V | 38.3 |
(a) 影像生成影片(I2V)。
| 模型 | 模式 | 分數 (↑) |
|---|---|---|
| Cosmos3-Super | V2V + WMReward (BoN) | 63.4 |
| Cosmos3-Nano | V2V + WMReward (BoN) | 57.7 |
| Magi-1(開源) | V2V + WMReward (BoN) | 62.6 |
| Cosmos3-Super | V2V | 59.7 |
| Cosmos3-Nano | V2V | 50.2 |
| Magi-1(開源) | V2V | 56.0 |
| Video-GPT(開源) | V2V | 35.0 |
| VideoPoet(閉源) | V2V | 29.5 |
(b) 影片生成影片(V2V)。
表 13:Physics-IQ 基準結果,依條件模式分開。WMReward (BoN) 表示以 WMReward([333])進行 N 選一 (Best-of-N) 重排序。Physics-IQ 分數愈高愈好。無論是否使用 WMReward+BoN,Cosmos3-Super 在 I2V 與 V2V 上皆達到最先進成果。
我們在表 13 中以 I2V 與 V2V 兩種模式評估 Cosmos3-Super,並在兩種模式下與領先的開源及商業基線比較。V2V 使用完整的 3 秒條件影片作為輸入。我們也使用提示詞上採樣器,依循類似 PhyT2V([317])的疊代精修策略,在 I2V 設定中從切換幀、在 V2V 設定中從 3 秒條件影片生成文字提示。依循公開 Physics-IQ 排行榜與 WMReward 推論時對齊協定([333]),我們另外為 Cosmos3-Super 在 I2V 與 V2V 上運行 WMReward + N 選一(BoN)分數。從表 13 可見,Cosmos3-Super 在 I2V 上達到最先進:其直接分數 $43.8$ 超越各直接 I2V 基線,WMReward+BoN 進一步將分數提升至 $48.9$,高於使用 WMReward+BoN 的最強 I2V 基線。在 V2V 上,Cosmos3-Super 同樣達到最先進,直接分數 $59.7$、搭配 WMReward + BoN 達 $63.4$,高於使用 WMReward+BoN 的最強 V2V 基線。
雖然自動化評估指標對衡量品質、提示對齊與物理合理性頗有價值,即使最強的基於 VLM 的指標也會遺漏某些瑕疵與失敗案例。人工評估在兩方面補足自動化指標:涵蓋自動化協定系統性遺漏的長尾失敗,以及在更寬的評分範圍內的鑑別力。例如,在相同的提示集上,受評的 T2V 生成器在人工評估上相差約 10 分,而在可比的自動化 PAIBench-G 總分上僅相差約 4 分(見附錄 F)。因此我們以兩套人工評估協定補充自動化結果:針對廣泛物理 AI 影片生成的 Cosmos HUE,以及專注於任務層級指令下真實人體運動的 Human World Bench(HWB)。
Cosmos HUE
Cosmos HUE(HUman Evaluation)是一套以相同 PAIBench-G 提示集(第 6.2.2 節)為基礎的人工評分協定。HUE 在兩方面不同於既往的人工評估協定。第一,它以原子級二元驗證取代主觀的 Likert 量表評分:每部影片被分解為一組單一事實的是/否/不確定問題,措辭上「是」永遠代表理想結果,將標註者的任務從整體判斷轉為客觀的事實驗證。每個(影片, 問題)對由兩位標註者獨立評定,分歧升級至品管審核者。第二,每則提示的題組由三層 VLM 管線自動生成:領域策略師 (Domain Strategist) 將提示分類至七個物理 AI 領域之一;場景解析器 (Scene Parser) 從提示(T2V)或配對真值參考影片的抽樣幀(I2V)產生結構化場景清單;稽核器 (Auditor) 輸出最終的原子問題。這確保問題貼合實際的提示與參考場景,而非靜態的評分準則。三層皆運行於 GPT 5.2。VLM 生成的題組再經人工審查補充:審查者檢視排名靠前模型的生成影片,提出針對自動管線尚未涵蓋的失敗模式的額外問題,並將這些問題併回題庫。評估集由從 PAIBench-G 抽樣、保留其原生領域分布的 100 則固定提示組成,每個模型對每則提示以隨機種子生成 5 部影片,每個模型共 500 部;每則提示的題組(最多 20 道二元問題)套用於全部 5 部生成影片。每道問題被分類至四個維度之一:「語意對齊」、「物理定律」、「幾何推理」與「視覺完整性」。各維度與各領域的 T2V 及 I2V 排行榜、正式評分方案與可靠性估計詳見附錄 F。
| 模型 | 類型 | Cosmos HUE T2V (↑) | Cosmos HUE I2V (↑) | Human World Bench I2V (↑) |
|---|---|---|---|---|
| Ground Truth | — | 93.6 | 94.4 | — |
| Cosmos3-Super | 開源 | 89.3 | 89.6 | 71.9 |
| Cosmos3-Nano | 開源 | 87.6 | 88.6 | 66.9 |
| Wan2.2-A14B | 開源 | 88.2 | 88.4 | 60.7 |
| HunyuanVideo-1.5 | 開源 | 86.5 | 85.6 | 54.7 |
| Wan2.1-14B | 開源 | 84.0 | 83.9 | 33.1 |
| Wan2.2-5B | 開源 | 80.8 | 80.4 | 25.4 |
| Cosmos-Predict2.5-14B | 開源 | 82.1 | 83.0 | 38.7 |
| Cosmos-Predict2.5-2B | 開源 | 81.8 | 82.6 | 32.8 |
| Veo-3.1 | 閉源 | 91.3 | 89.7 | 67.8 |
| Seedance-1.5-Pro | 閉源 | 90.0 | 87.6 | — |
表 14:Cosmos HUE 與 Human World Bench(HWB)的人工評估結果。Cosmos HUE 透過四個維度的原子級二元驗證評估廣泛的物理 AI 影片生成品質;HWB 透過指令遵循與物理通過率評估任務層級指令下的真實人體運動。Ground Truth 為與相同提示配對的真實影片評分,作為 Cosmos-HUE 的參考上界。Cosmos3-Super 在開源模型中取得最高的 HUE T2V 分數與最高的 HWB 分數。完整的各維度 HUE 排行榜見附錄 F。
Human World Bench(HWB)
Cosmos HUE 評估廣泛的物理 AI 影片生成,Human World Bench(HWB)則聚焦於一個更針對性且更具挑戰的設定:任務層級指令下人類操作任務的第一人稱影像生成影片。HWB 的基準影片來自 EgoVerse([226]),共 180 筆樣本。HWB 使用絕對失敗模式協定:標註者獨立判斷每部生成影片的指令遵循與物理合理性。我們回報兩個頂層通過率。指令遵循衡量影片是否呈現要求的動作與物體。物理合理性衡量時間連貫性與物理合理性,包括物體動態、接觸與手部解剖結構。HWB 分數為指令遵循與物理通過率的平均。
表 14 回報 T2V 與 I2V 的 Cosmos-HUE 分數,以及 Human World Bench(HWB)結果。在 HUE T2V 上,Cosmos3-Super 以 89.3 為最佳開源模型,落後閉源的 Veo-3.1(91.3)與 Seedance-1.5-Pro(90.0)。在 HUE I2V 上,Cosmos3-Super 再度成為最佳開源模型,與領先的閉源生成器基本持平,僅落後 Veo-3.1 0.1 分(89.6 對 89.7)。Cosmos3-Nano 也頗具競爭力,在 I2V 上為開源模型第二(88.6)、T2V 第三(87.6)。
在 HWB 上,Cosmos3-Super 達到 71.9,為表 14 所有受評模型中的最先進分數,超越所列最強閉源基線 Veo-3.1(67.8)4.1 分,並超越最強非 Cosmos 開源基線 Wan2.2-A14B(60.7)11.2 分。Cosmos3-Nano 也表現強勁,達 66.9,為開源模型第二,超越所有非 Cosmos 開源基線。兩個 Cosmos 3 變體合計包辦 HWB 開源前兩名,展現兩種模型規模上皆強勁的第一人稱人體運動生成能力。
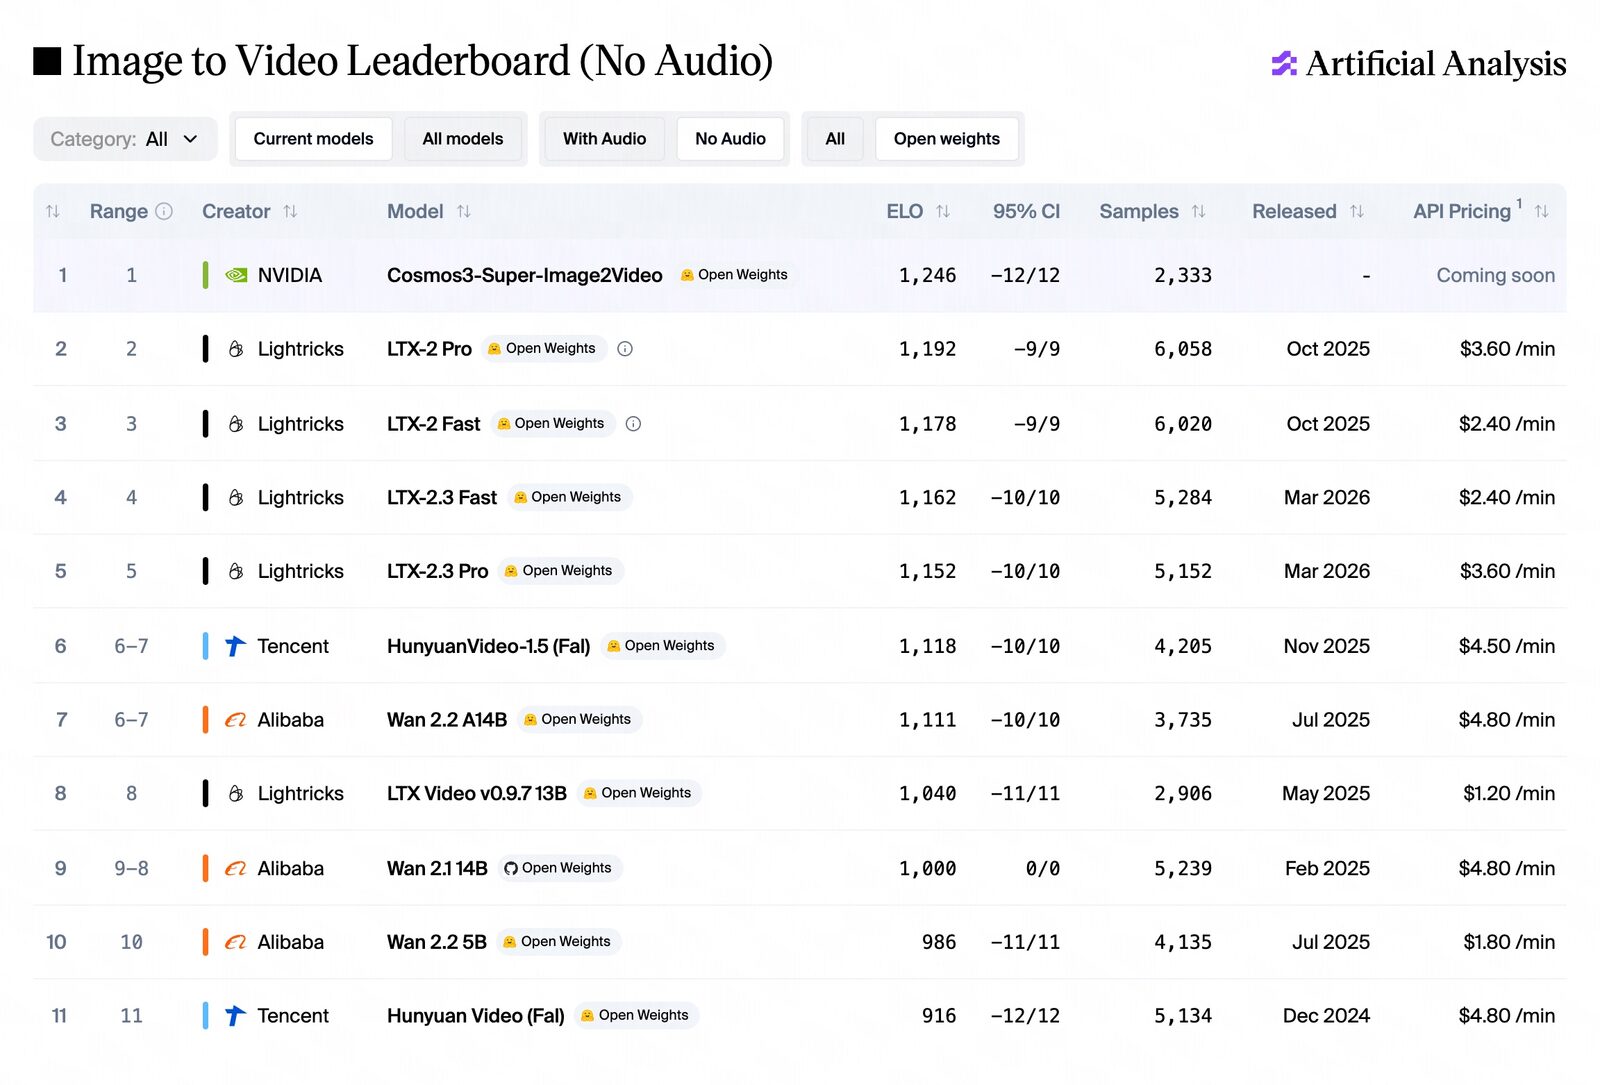
圖 19:Cosmos3-Super-Image2Video 為群眾外包競技場排名的最佳開放權重模型。Cosmos3-Super-Image2Video 在 Artificial Analysis 影像生成影片排行榜(無音訊)上名列開放權重模型第 1(含專有模型則為第 22)(日期:2026-05-28)。
Artificial Analysis 影像生成影片排行榜
為了在真實世界情境下評估 Cosmos 3,我們將專門化的 I2V 模型 Cosmos3-Super-Image2Video 提交至 Artificial Analysis 影像生成影片排行榜(無音訊)進行群眾外包公開投票。該模型在所有開放權重模型中排名第一,全球(含專有模型)排名第 22。特別地,該模型與 Veo 3.1([87])及 Wan 2.5([278])等專有產品不相上下,展現其卓越的時間動態與視覺擬真度。
6.2.3 音訊生成評估
文字到視聽生成必須滿足純影片基準無法捕捉的兩個要求:生成的音訊應包含提示要求的聲音事件,且這些事件應可歸因於正確的視覺來源、時間點合理。因此我們以 Cosmos-SoundBench 評估音訊生成——一個針對視聽提示遵循與同步的基準。此指標將語意上的視聽正確性與不看提示的音訊擬真度分開:一筆樣本可能在正確的時刻包含正確的聲音卻仍有音訊瑕疵,也可能聲學上乾淨卻遺漏要求的事件。
Cosmos-SoundBench
Cosmos-SoundBench 包含取自 FoleyBench([62])的 144 則評估提示。提示涵蓋非語音聲音類別,如環境場景、撞擊、物體互動、工具、車輛、水與其他環境音效。我們聚焦非語音音訊,因為這些訊號對物理 AI 尤其重要:接觸聲揭示材質與碰撞特性,工具聲指示進行中的動作,環境音線索則提供可能僅部分可見的場景脈絡。
視聽品質指標(AVQ)
我們以結構化的 MLLM 作為評審協定評估每筆生成樣本。評審只在需要該資訊的階段看到提示、影片與音訊,使每個評審階段聚焦於預期的證據而非無關的跨模態線索。
提示檢查清單建構。 在檢視任何生成媒體之前,由 Claude Opus 4.7、Gemini 3.1 Pro 與 GPT 5.5 組成的模型組合擷取必要的前景聲音、環境音訊條件與提示關鍵視覺證據。我們以多數決確定下游評分使用的檢查清單。
不看提示的視覺觀察。 Gemini 3.1 Pro Preview 在不看提示的情況下描述可見實體、動作、場景脈絡與可能的聲源。這些觀察為聲源歸因與時間對齊提供證據,而非獨立的視覺品質分數。
語意視聽評分。 評審評估要求的聲音是否存在、是否來源明確、動態是否恰當、是否與可見或合理的動作對齊。這些檢查映射為語意音訊正確性(SA)、視聽對齊(AVAlign)與提示關鍵視覺支持(VisualSupport),組合為:
$$\mathrm{SAV}=0.60\,\mathrm{SA}+0.30\,\mathrm{AVAlign}+0.10\,\mathrm{VisualSupport}.$$
此階段運行三次並取平均,以考量評審的變異性。
我們另外量測 audiobox-aesthetics 的製作品質(Production Quality, PQ)作為感知音訊品質的代理指標,因其試圖量化樣本層級的清晰度與擬真度、動態、頻寬與空間化([268])。
最終的視聽品質分數為:
$$\mathrm{AVQ}=0.5\,\mathrm{SAV}+0.5\,\mathrm{AQ}.$$
每個模型對每則提示評估五個隨機種子的生成。對 Cosmos 3 模型,我們使用 Claude Opus 4.6 將 SoundBench 提示改寫為第 6.3.1 節與第 6.3.2 節所述的結構化生成格式,匹配生成器使用的提示分布。
| 模型 | 類型 | AVQ | SAV | SA | AVAlign | Visual Sup. | PQ |
|---|---|---|---|---|---|---|---|
| Cosmos3-Super | 開源 | 7.31 | 8.34 | 8.30 | 8.14 | 9.18 | 6.28 |
| Cosmos3-Nano | 開源 | 7.34 | 8.35 | 8.33 | 8.16 | 9.10 | 6.32 |
| LTX-2.3 | 開源 | 7.10 | 7.80 | 7.86 | 7.58 | 8.12 | 6.39 |
| Seedance-1.5-Pro | 閉源 | 7.64 | 8.21 | 8.22 | 8.06 | 8.61 | 7.06 |
| Veo-3.1 | 閉源 | 7.45 | 8.21 | 8.21 | 8.01 | 8.85 | 6.68 |
| LTX-2.3 Pro | 閉源 | 7.32 | 7.93 | 7.96 | 7.74 | 8.35 | 6.70 |
| Wan2.6 | 閉源 | 7.23 | 7.90 | 7.99 | 7.54 | 8.45 | 6.55 |
| Sora 2 | 閉源 | 6.90 | 7.94 | 7.97 | 7.70 | 8.49 | 5.85 |
表 15:Cosmos-SoundBench 視聽品質。我們回報整體視聽品質(AVQ)、語意視聽品質(SAV)及其在第 6.2.3 節定義的子分數,以及 audiobox-aesthetics 製作品質(PQ)。Seedance-1.5-Pro 透過較強的 PQ 取得最高 AVQ,Cosmos 3 則達到最強的語意視聽落地與對齊。
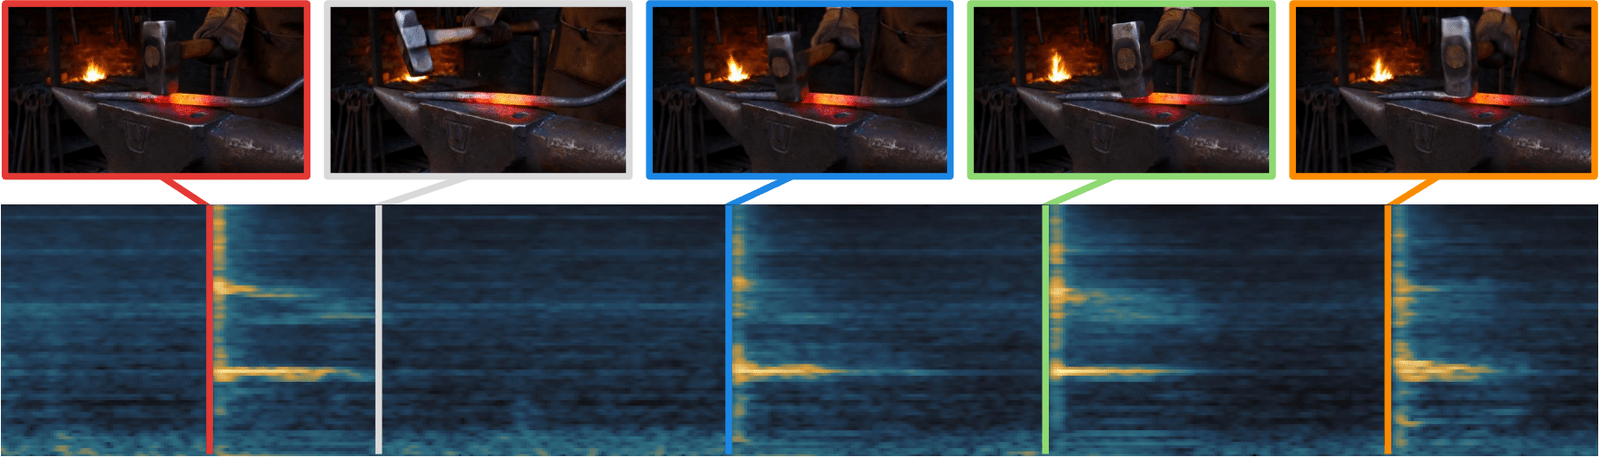
圖 20:視聽事件對齊。Cosmos3-Nano 生成的選定幀與生成音訊的頻譜圖配對。彩色框標記錘擊時刻,其時間標記與尖銳的頻譜瞬變重合。灰色框顯示兩次敲擊之間的非接觸時刻,未觀察到可比的聲學瞬變。此對比提供了定性證據:聲學瞬變與視覺撞擊時刻對齊,而非與其間的運動對齊。
表 15 顯示最強的閉源系統在整體 AVQ 上仍保有優勢,主要來自較高的感知音訊品質。Seedance-1.5-Pro 取得最佳 AVQ($7.64$)與 PQ($7.06$),其次是 Veo-3.1($7.45$ AVQ、$6.68$ AQ)。相對地,Cosmos 3 在衡量聲音是否匹配視覺事件的語意與對齊成分上最強。Cosmos3-Nano 取得最佳的 SAV、SA 與 AVAlign 分數,Cosmos3-Super 取得最佳的視覺支持分數。此模式顯示 Cosmos 3 中期訓練能有效將聲音事件落地於生成的影片,剩餘的進步空間集中在低階音訊擬真度。圖 20 展示 Cosmos3-Nano 生成中視覺與聲學事件強烈時間對齊的範例。
6.2.4 轉換生成評估
雙權重分類器無關引導
影片轉換同時以結構化文字提示與控制影片為條件,而描述忠實度與結構遵循度之間的最佳平衡因模態而異。為獨立控制這兩個因素,我們使用雙權重的分類器無關引導方案,分別為控制影片與文字提示設置獨立的權重。
在每個去噪步,我們對去噪器評估三次——同時帶兩個條件、僅帶提示(去除控制影片),以及保留控制影片但將提示替換為固定的負面描述。接著組合預測結果,使控制權重從僅提示的預測向完整條件的預測外推(強化結構控制),而文字權重從負面提示的預測外推遠離(強化描述忠實度)。將兩個權重作為獨立旋鈕暴露,讓我們能為每個模態調校各自的品質—忠實度甜蜜點,我們發現這種因子化引導比標準的單一引導表述更有效。
通用影片轉換
我們在 PAIBench-C([199])上評估影片轉換——一個涵蓋四種空間控制模態(模糊、邊緣、分割與深度)的控制條件影片到影片基準。此基準包含橫跨三個物理 AI 領域的 $600$ 段片段:來自 AgiBot World([32])的 $200$ 段機械臂操作片段、來自 OpenDV([320])的 $200$ 段駕駛片段,以及來自 Ego-Exo-4D([91])的 $200$ 段第一人稱日常生活片段。
對每個範例,模型接收文字提示與控制影片,必須生成遵循控制、同時保留提示場景語意的照片真實感影片。我們回報單一控制設定(每個範例恰好一種模態),使各模態的貢獻可以獨立衡量。品質評估方式為從生成影片與參考影片重新擷取相關控制訊號,並在對應空間中比較(雙邊濾波後的模糊 SSIM、Canny 邊緣 F1、估計深度上的尺度不變 RMSE、開放詞彙分割遮罩上的 mIoU),再加上 DOVER([300])作為與內容無關的感知真實感度量。
我們將 Cosmos 3 與 Cosmos-Transfer2.5 基線比較——後者以每模態一個專用 ControlNet([343])分支處理不同模態。注意 Cosmos 3 是統一模型,在輸入序列中將控制影片與文字提示一併消化,原生支援任意模態組合,無需各模態的 ControlNet 配接器。
表 16 顯示,儘管將四個專用 ControlNet 分支收合為單一統一骨幹,Cosmos 3 仍透過其兩個變體之一,在每個模態上匹敵或超越 Cosmos-Transfer2.5:Cosmos3-Nano 在感知品質(DOVER)與分割上領先,Cosmos3-Super 拿下幾何要求較高的邊緣與深度任務。三個模型在模糊 SSIM 上實質持平,該指標已接近上界飽和。這些結果顯示,各模態的 ControlNet 配接器並非強控制忠實度的先決條件——單一統一骨幹原生支援全部四種空間控制,且在每個指標上以其兩種規模之一擊敗專用配接器基線。
| 模型 | DOVER ↑ | Seg. mIoU ↑ | Blur SSIM ↑ | Edge F1 ↑ | Depth si-RMSE ↓ |
|---|---|---|---|---|---|
| Cosmos3-Super | 10.14 | 0.71 | 0.91 | 0.50 | 0.58 |
| Cosmos3-Nano | 10.39 | 0.72 | 0.91 | 0.49 | 0.62 |
| Cosmos-Transfer2.5 | 9.49 | 0.68 | 0.90 | 0.45 | 0.68 |
表 16:PAIBench-C 單一控制結果。每次生成以四種控制模態之一(深度、分割、模糊或邊緣)為條件,並以對應的基於真值的指標評分:Depth si-RMSE 為預測與參考深度之間的尺度不變均方根誤差;Seg. mIoU 為預測與參考分割遮罩之間的平均交並比;Blur SSIM 為預測與參考模糊圖之間的結構相似度;Edge F1 為預測與參考邊緣圖之間的 F1 分數。DOVER 為無參考的感知影片品質分數,對四個模態的生成取平均。Depth si-RMSE 愈低愈好;DOVER、Seg. mIoU、Blur SSIM 與 Edge F1 愈高愈好。
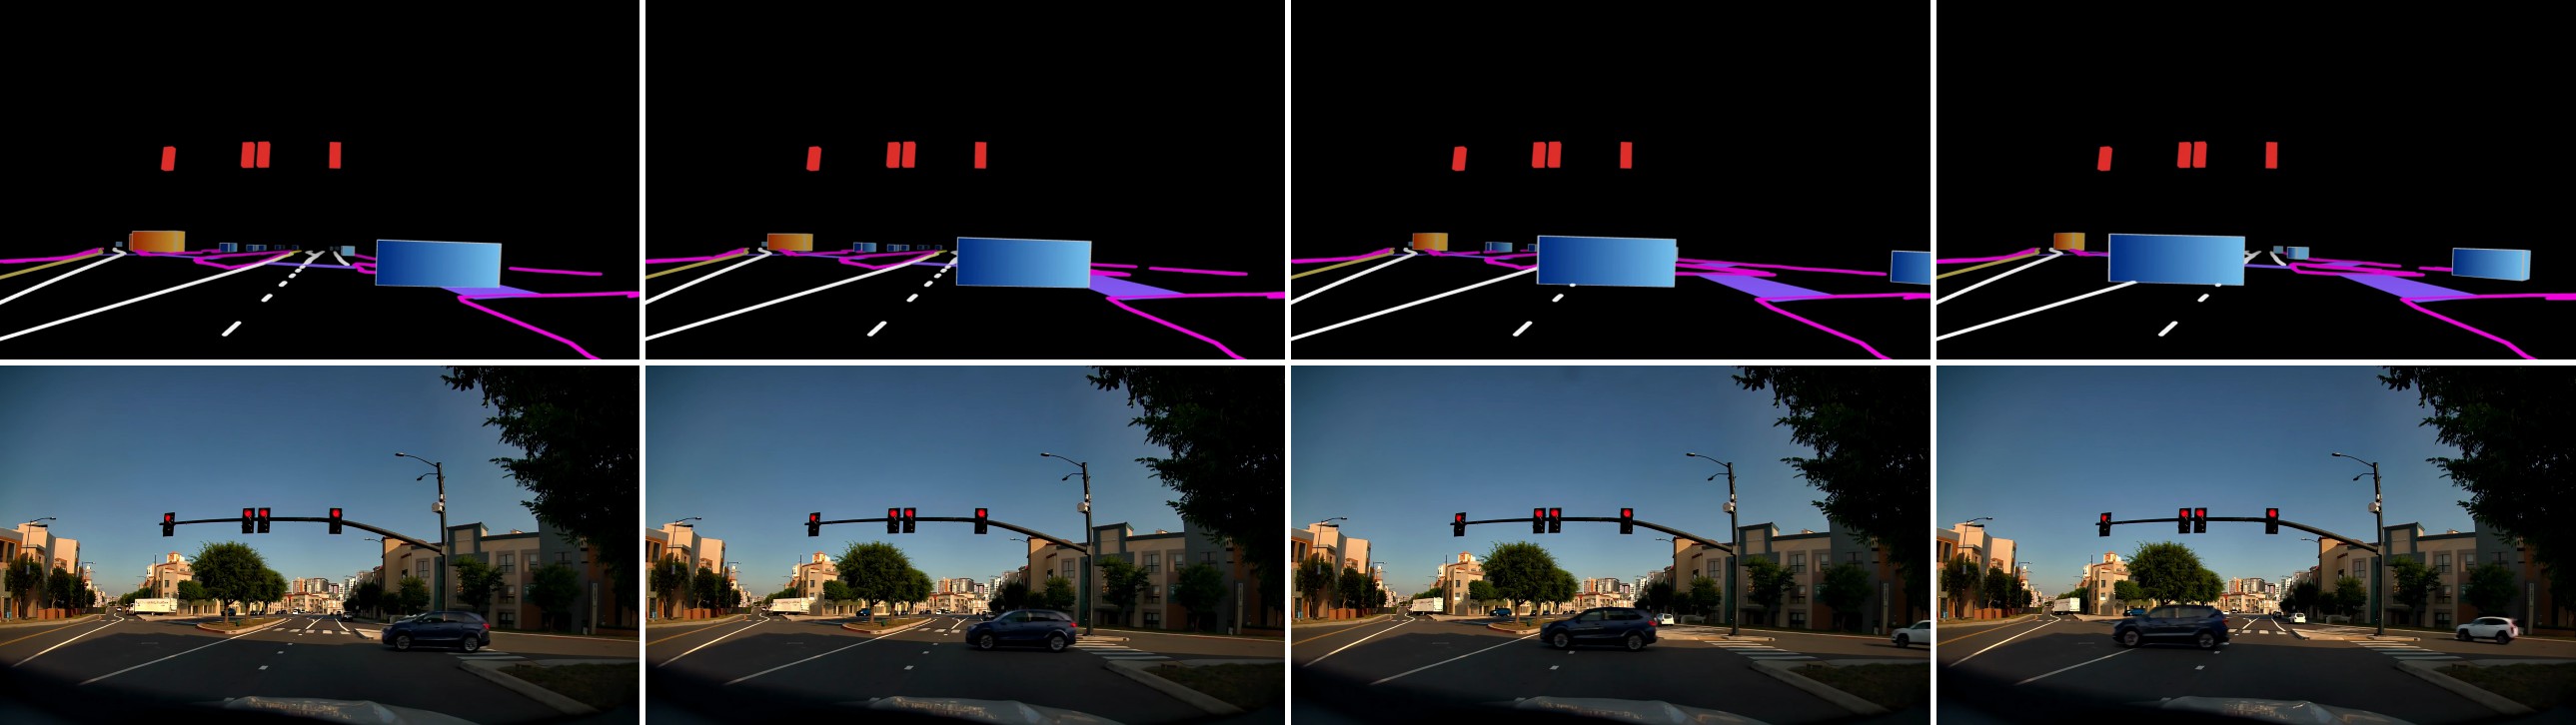
圖 21:駕駛場景影片轉換結果。Cosmos3-Nano 從對應的 720p 控制影片(上)生成幀(下)。控制影片編碼高精地圖元素——車道、道路標線、桿柱與交通號誌(含或不含燈態)——合計表示複雜的道路拓撲(包括高架橋),以及以長方體表示的參與者。每個長方體依粗略類別本體(例如卡車、車輛、行人)著色,並以明暗區分前後。
自動駕駛
PAIBench-C 由一個 AV 專屬基準補充:$486$ 段單視角駕駛片段([196])的世界場景圖條件影片轉換,稱為 AVBench-C。控制輸入是駕駛場景的相機視角渲染,結合靜態地圖結構(車道線、道路邊界、交通號誌與交通標誌)與所有場景物體(車輛、行人與其他參與者),包含靜止與移動者。給定此渲染情境與文字提示,模型必須產生與兩個輸入皆一致的照片真實感駕駛影片。我們以自動與人工評估兩種方式評估結果:
AVBench-C 自動評估。 我們以三個基於真值的自動檢查器評估每次生成。自我運動檢查器使用視覺里程計計算每公尺行駛的軌跡漂移。物體對應檢查器將場景實體與控制輸入匹配,動態參與者對照渲染軌跡、靜態結構對照投影地圖比較。環境檢查器使用 VLM 評審為提示層級的駕駛條件評分,包括天氣、時段、地區與路面狀態。
AVBench-C 人工評估。 受訓標註者沿兩個軸向以 1–3 分評定每部生成影片。影片品質軸衡量整體真實感:3 表示紋理真實且參與者行為時間上一致,2 表示輕微變形或短暫時間卡頓,1 表示明顯不真實的動態或低品質紋理。車道線軸衡量對世界場景圖的忠實度:標註者將生成結果與預期道路布局的參考疊圖並列檢視,車道、路口與實體大多位於正確位置給 3 分,少數車道缺失但多數實體位置正確給 2 分,多數車道或路口缺失或實體錯位給 1 分。
| 模型 | Ego drift ↓ | Dyn. Obj. ↑ | Static Obj. ↑ | Environment ↑ | 影片品質 ↑ | 車道線 ↑ |
|---|---|---|---|---|---|---|
| Cosmos3-Super | 0.003 | 0.64 | 0.41 | 0.90 | 2.86 | 2.45 |
| Cosmos3-Nano | 0.003 | 0.67 | 0.41 | 0.90 | 2.82 | 2.50 |
| Cosmos-Transfer2.5-AV-Singleview | 0.008 | 0.62 | 0.42 | 0.90 | 2.59 | 2.47 |
表 17:AVBench-C 評估分數。我們回報自動與人工評估結果。自動分數由三個基於真值的檢查器計算:Ego drift(愈低愈好)為視覺里程計軌跡漂移;Dyn. Obj. 與 Static Obj.(愈高愈好)為場景實體與控制輸入的吻合程度;Environment(愈高愈好)為提示層級駕駛條件的 VLM 評審分數。人工分數為受訓標註者沿兩軸的 1–3 評分:影片品質衡量整體真實感(紋理、參與者行為與時間一致性),車道線衡量對世界場景圖的忠實度(車道、路口與實體的正確擺放)。兩個人工指標皆愈高愈好。
表 17 顯示 Cosmos 3 透過其兩個變體之一,在每個駕駛場景指標上匹敵或超越 Cosmos-Transfer2.5。自動評估方面,三個模型的自我軌跡漂移一致地小,Cosmos3-Nano 進一步在動態物體對應上領先,靜態結構與環境一致性則實質持平且已接近指標上界飽和。人工評估強化了此圖景:Cosmos3-Super 與 Cosmos3-Nano 提供顯著更高的影片品質($2.86$ 與 $2.82$ 對 $2.59$),車道線忠實度則三個模型相當(差距在 $\pm 0.05$ 內)。綜合而言,這些結果顯示 Cosmos 3 在保留幾何與結構忠實度的同時,提供明顯更高品質的駕駛場景生成,並在每個指標上以其兩種規模之一擊敗基線。圖 21 展示 Cosmos3-Nano 從對應控制輸入生成的駕駛場景影片定性範例。
6.2.5 動作生成評估
我們評估動作中期訓練是否賦予 Cosmos 3 跨領域、跨推論模式的可重用世界—動作先驗。核心問題是:統一的動作中期訓練能否加速對領域特定動作介面的調適,以及短暫的後訓練階段能否將共享的基礎模型轉變為與最先進領域基線相當或更強的專門化模型。表 18 回報相機運動、自動駕駛、機器人與第一人稱運動領域的結果,涵蓋前向與逆向動力學設定。表 19 回報機器人策略設定的結果,評估 Cosmos 3 完成語言指定任務的能力。
設定
我們對每個下游領域比較兩種初始化協定。第一種為預訓練初始化(PT-init),從未經動作領域資料訓練的 Cosmos 3 預訓練檢查點出發。第二種為中期訓練初始化(MT-init),從我們的中期訓練檢查點出發,該檢查點已見過橫跨多個領域與預測模式的動作資料,包括前向動力學(FD)、逆向動力學(ID)與策略。每組比較使用相同的訓練配方,並固定模型大小、資料與計算預算。我們回報 Cosmos3-Nano 與 Cosmos3-Super 的結果。
指標
我們為各動作介面回報指標。對自動駕駛逆向動力學,相對旋轉誤差(RRE)與相對平移誤差(RTE)衡量幀對幀的位姿準確度,絕對軌跡誤差(ATE)衡量全域軌跡一致性。我們也用這些指標衡量相機運動前向動力學的相機跟隨準確度,將真值相機位姿與從生成影片估計的相機軌跡比較。對機器人與第一人稱前向動力學,PSNR 衡量動作條件下未來觀測的重建品質。雖然一段合理的生成推演不必與唯一記錄的真值未來逐像素相同,我們發現在相對短的時間跨度下,PSNR 是時間對齊、運動一致性與重建擬真度的有用代理指標。對機器人策略,成功率衡量成功完成的評估任務百分比。
| 模型 | AV (ID) RRE (∘, ↓) | RTE (m, ↓) | ATE (m, ↓) | 相機運動 (FD) RRE (∘, ↓) | RTE (m, ↓) | ATE (m, ↓) | 第一人稱運動 (FD) PSNR (↑) | 機器人 (FD) PSNR (↑) |
|---|---|---|---|---|---|---|---|---|
| Cosmos3-Super (MT-init) | 0.232 | 0.014 | 0.90 | 0.142 | 0.026 | 0.99 | 16.19 | 26.04 |
| Cosmos3-Nano (MT-init) | 0.211 | 0.014 | 0.98 | 0.147 | 0.029 | 1.24 | 16.12 | 25.52 |
| Cosmos3-Super (PT-init) | 0.284 | 0.018 | 1.32 | 0.293 | 0.036 | 1.82 | 15.34 | 22.69 |
| Cosmos3-Nano (PT-init) | 0.249 | 0.017 | 1.20 | 0.172 | 0.034 | 1.61 | 15.22 | 23.24 |
| Lingbot-World | – | – | – | 0.299 | 0.057 | 2.88 | – | – |
| HY-World1.5 | – | – | – | 0.377 | 0.042 | 1.39 | – | – |
| VGGT | 0.596 | 0.768 | 23.46 | – | – | – | – | – |
| DepthAnything3 | 0.312 | 0.354 | 9.29 | – | – | – | – | – |
| LOME | – | – | – | – | – | – | 9.36 | – |
| Ctrl-World | – | – | – | – | – | – | – | 22.99 |
表 18:跨領域前向與逆向動力學的後訓練比較。FD 表示前向動力學、ID 表示逆向動力學。PT-init 從通用的 Cosmos 3 預訓練檢查點初始化,MT-init 從中期訓練檢查點初始化。領域特定基線僅在其對應應用中回報,Cosmos 3 變體則在所有受評動作設定中比較。
自動駕駛車(ID)
我們使用內部駕駛資料集評估 Cosmos 3 的逆向動力學能力,該資料集由帶有精確自車軌跡的 6 秒影片片段組成,取樣率 10 FPS。在此設定下,模型直接從影片輸入預測自車軌跡。我們與兩個最先進的通用領域基線比較:VGGT([280])與 DepthAnything3([153])。如表 18 所示,以 PT-init 初始化的 Cosmos3-Nano 與 Cosmos3-Super 皆超越基線。套用 MT-init 為 Cosmos3-Nano 帶來進一步改善。值得注意的是,以專門駕駛資料訓練的我們的方法在度量尺度的平移估計上遠勝一籌,通用領域基線則受漂移誤差所苦。整體而言,這些結果證明面向物理 AI 的影片模型能以最少的調適在特定具身應用中表現出色。定性結果視覺化於圖 22。
圖 22:自動駕駛逆向動力學比較。我們定性比較不同方法從輸入影片估計的自車軌跡,紅色軌跡代表真值。Cosmos3-Nano(MT-init)展現估計精確、度量尺度自車位姿的能力。
相機運動(FD)
相機條件影片生成可作為許多應用的世界模擬。我們讓模型在給定初始影像與指定相機軌跡的條件下預測未來幀。為量化相機跟隨準確度,我們用 DepthAnything3([153])從生成的影片估計度量尺度相機軌跡,並與條件輸入比較。若生成影片與條件軌跡高度一致,從預測序列估計的位姿應與輸入位姿密切吻合。我們在一個內部資料集上與 Lingbot-World([240])及 HY-World 1.5([114])的雙向模型比較,該資料集含一百段 5 秒真實影片片段,相機運動由 DepthAnything3([153])估計。定性結果見圖 23。結果顯示 PT-init 的 Cosmos3-Nano 與 Cosmos3-Super 已提供穩健的相機控制。MT-init 進一步改善結果:Cosmos3-Super 達到 0.142∘ RRE、0.026 m RTE 與 0.99 m ATE,在全部三個指標上超越 Lingbot-World(0.299∘ RRE、0.057 m RTE、2.88 m ATE)與 HY-World 1.5(0.377∘ RRE、0.042 m RTE、1.39 m ATE)。
圖 23:相機前向動力學比較。給定複雜的真實軌跡,Cosmos3-Nano(MT-init)在生成影片中忠實重現相同的相機運動。每個運動範例中,第一列顯示序列起始附近的幀,第二列顯示結尾附近的幀。向下箭頭表示從頭到尾的時間推進,旁邊的文字指明指令的相機運動。
第一人稱運動(FD)
我們在前向動力學設定中評估來自 Human World Bench(HWB,見第 6.2.2 節)的影片。我們使用 HWB 的動作標註——包括相機自我運動與手部運動追蹤——並回報生成影片的 PSNR。我們將 PT-init 與 MT-init 檢查點皆調適到第一人稱領域,並與 LOME([75])比較——一個近期專門針對第一人稱手部操作資料的動作條件影片生成方法。雖然 LOME 是此設定最接近的可用基線之一,它在 HWB 上表現不佳,PSNR 僅 9.36dB,可能因其訓練資料與 HWB 基準之間的分布偏移。相對地,Cosmos 3 在兩種模型規模與初始化協定下皆達到顯著更高的 PSNR。使用 PT-init 時,Cosmos3-Nano 達到 15.22dB、Cosmos3-Super 達到 15.34dB。從 MT-init 出發進一步將分數提升至 Cosmos3-Nano 的 16.12dB 與 Cosmos3-Super 的 16.19dB。這些結果顯示 MT-init 帶來一致的增益,表明統一的動作中期訓練為第一人稱前向動力學提供了顯著更強的起點。整體而言,這些結果支持統一動作中期訓練的核心假設:跨機器人具身形式、相機運動、自動駕駛運動與第一人稱運動的共同訓練,誘導出可轉移的動作領域先驗,使第一人稱領域的收斂更快、下游調適更強。
機器人(FD)
機器人前向動力學開啟了以影片模型進行策略評估等應用。我們在 DROID 資料集([120])上進行實驗——一個場景與物體多樣的大規模真實機器人操作資料集。給定初始幀與大小為 16 的機器人末端效應器動作塊,模型預測後續 16 幀。我們對 PT-init 與 MT-init 檢查點皆在 DROID 資料集上後訓練,並以 Ctrl-World([94])為主要基線。定性結果見圖 24,定量結果見表 18。如表 18 所示,從預訓練檢查點後訓練在 Nano 規模已匹敵基線,PSNR 達 23.24dB,Ctrl-World 為 22.99dB。從中期訓練檢查點後訓練產生顯著更強的結果,Cosmos3-Nano 達 25.52dB、Cosmos3-Super 達 26.04dB。這些結果證明 Cosmos 3 是前向動力學預測的強大且靈活的骨幹。
圖 24:機器人前向動力學定性比較。生成的幀緊密跟隨動作指令,機械臂與布料之間的互動比基線更真實。綠框標示基線輸出中有明顯變形或瑕疵的區域,以及 Cosmos3-Nano(MT-init)中對應且無這些瑕疵的區域。
機器人操作(策略)
為評估策略模式,我們後訓練 Cosmos3-Nano-Policy-DROID 並將其提交至 RoboLab 模擬基準([325])、RoboArena 真實世界基準([9])與 MolmoSpaces 模擬基準([122])。如表 19、圖 26 與圖 27 所示,我們的模型在全部三個基準上取得新的最先進成果,證明 Cosmos 3 全模態世界模型能被有效地後訓練為強大的機器人操作策略。
RoboLab([325])是一個高擬真、與機器人及策略無關的模擬基準,包含 120 項語言條件任務,用於評估任務通才機器人操作策略在視覺、關係與程序性能力上的表現。RoboLab 對每項任務以三種指令具體度層級評估:模糊提示、預設提示與具體提示。此劃分測試對語言措辭的穩健性,而非單一標準指令。在 RoboLab 上,我們後訓練的策略在任務成功率上以明顯差距超越所有先前模型(表 19),包括 $\pi_{0.5}$([221])等強勁的視覺-語言-動作(VLA)模型與 DreamZero([328])等世界—動作模型(WAM),橫跨所有任務指令粒度與任務難度層級。例如,在具體任務指令下,我們的策略在 120 項任務、每任務 10 次推演中達到 39.7% 的平均成功率,超越 $\pi_{0.5}$ 的 28.1% 與 DreamZero 的 25.2%。此外,與直接從預訓練檢查點後訓練的模型 Cosmos3-Nano(PT-init)相比,我們的最終策略表現更好,證明將來自多樣來源的動作模態資料納入中期訓練的有效性。
| 模型 | 整體 Vague | Default | Specific | 簡單 Vague | Default | Specific | 中等 Vague | Default | Specific | 複雜 Vague | Default | Specific |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Cosmos3-Nano-Policy-DROID | 20.6 | 36.8 | 39.7 | 23.3 | 40.6 | 42.0 | 23.3 | 35.4 | 40.3 | 4.1 | 25.3 | 29.4 |
| Cosmos3-Nano (PT-init) | 16.7 | 28.1 | 30.2 | 17.8 | 30.3 | 32.8 | 19.0 | 28.7 | 29.5 | 7.1 | 18.2 | 21.8 |
| π0.5 | 15.2 | 28.0 | 28.1 | 16.2 | 29.7 | 29.8 | 17.9 | 31.5 | 31.0 | 5.3 | 13.5 | 14.7 |
| DreamZero | 14.9 | 25.7 | 23.9 | 15.0 | 26.1 | 25.8 | 19.5 | 30.0 | 26.7 | 4.1 | 14.1 | 10.6 |
| π0-FAST | 9.2 | 15.5 | 14.9 | 9.5 | 20.2 | 19.4 | 12.8 | 13.3 | 12.6 | 0.0 | 2.9 | 3.5 |
| paligemma-binning | 3.1 | 3.4 | 5.5 | 2.2 | 3.4 | 4.1 | 5.9 | 4.9 | 10.3 | 0.0 | 0.0 | 0.0 |
| GR00T N1.6 | 5.4 | 7.2 | 5.3 | 7.2 | 8.8 | 7.5 | 4.9 | 7.9 | 4.1 | 0.0 | 0.0 | 0.0 |
| π0 | 2.8 | 5.0 | 3.5 | 2.8 | 7.2 | 5.3 | 3.8 | 3.6 | 2.1 | 0.0 | 0.0 | 0.0 |
表 19:Cosmos3-Nano-Policy-DROID 在 RoboLab 上建立新的最先進水準。任務成功率(%)於 RoboLab-120 上依語言具體度層級與任務難度層級回報。所有策略皆使用在 DROID 資料集上微調的現成檢查點。
任務:put the screwdriver on the top shelf(把螺絲起子放到最上層架子)
任務:put the screwdriver and the glove in the purple container(把螺絲起子與手套放進紫色容器)
圖 25:Cosmos3-Nano-Policy-DROID 的真實世界評估。我們展示實體機器人推演的快照幀。這些範例證明我們的策略成功部署於實體機器人上執行語言條件操作任務。
RoboArena([9])是一個分散式的真實世界基準,使用群眾外包的成對比較,跨多樣任務與真實世界環境評估並排名通才機器人策略。任何擁有 DROID 平台的人都可以在任何環境、任何任務上,透過雙盲 A/B 比較評估一對策略,最終分數由這些成對偏好彙總,為每個策略產生總體評分。截至 2026 年 5 月 30 日下午 2:40,我們的機器人操作策略位居排行榜第一(圖 26),超越許多先前的強勁策略模型。我們預期將收到更多來自社群的評估,進一步驗證我們的策略。在多項受測任務中,該策略可靠地完成任務並良好遵循語言指令。它能執行簡單的取放任務,也能執行需要多個連續步驟的長程任務。我們觀察到對各種未見過的物體與任務的強泛化能力。策略也能容忍失敗,經常在必要時重試,並在執行期間對人為干預保持穩健。部分定性結果見圖 25。
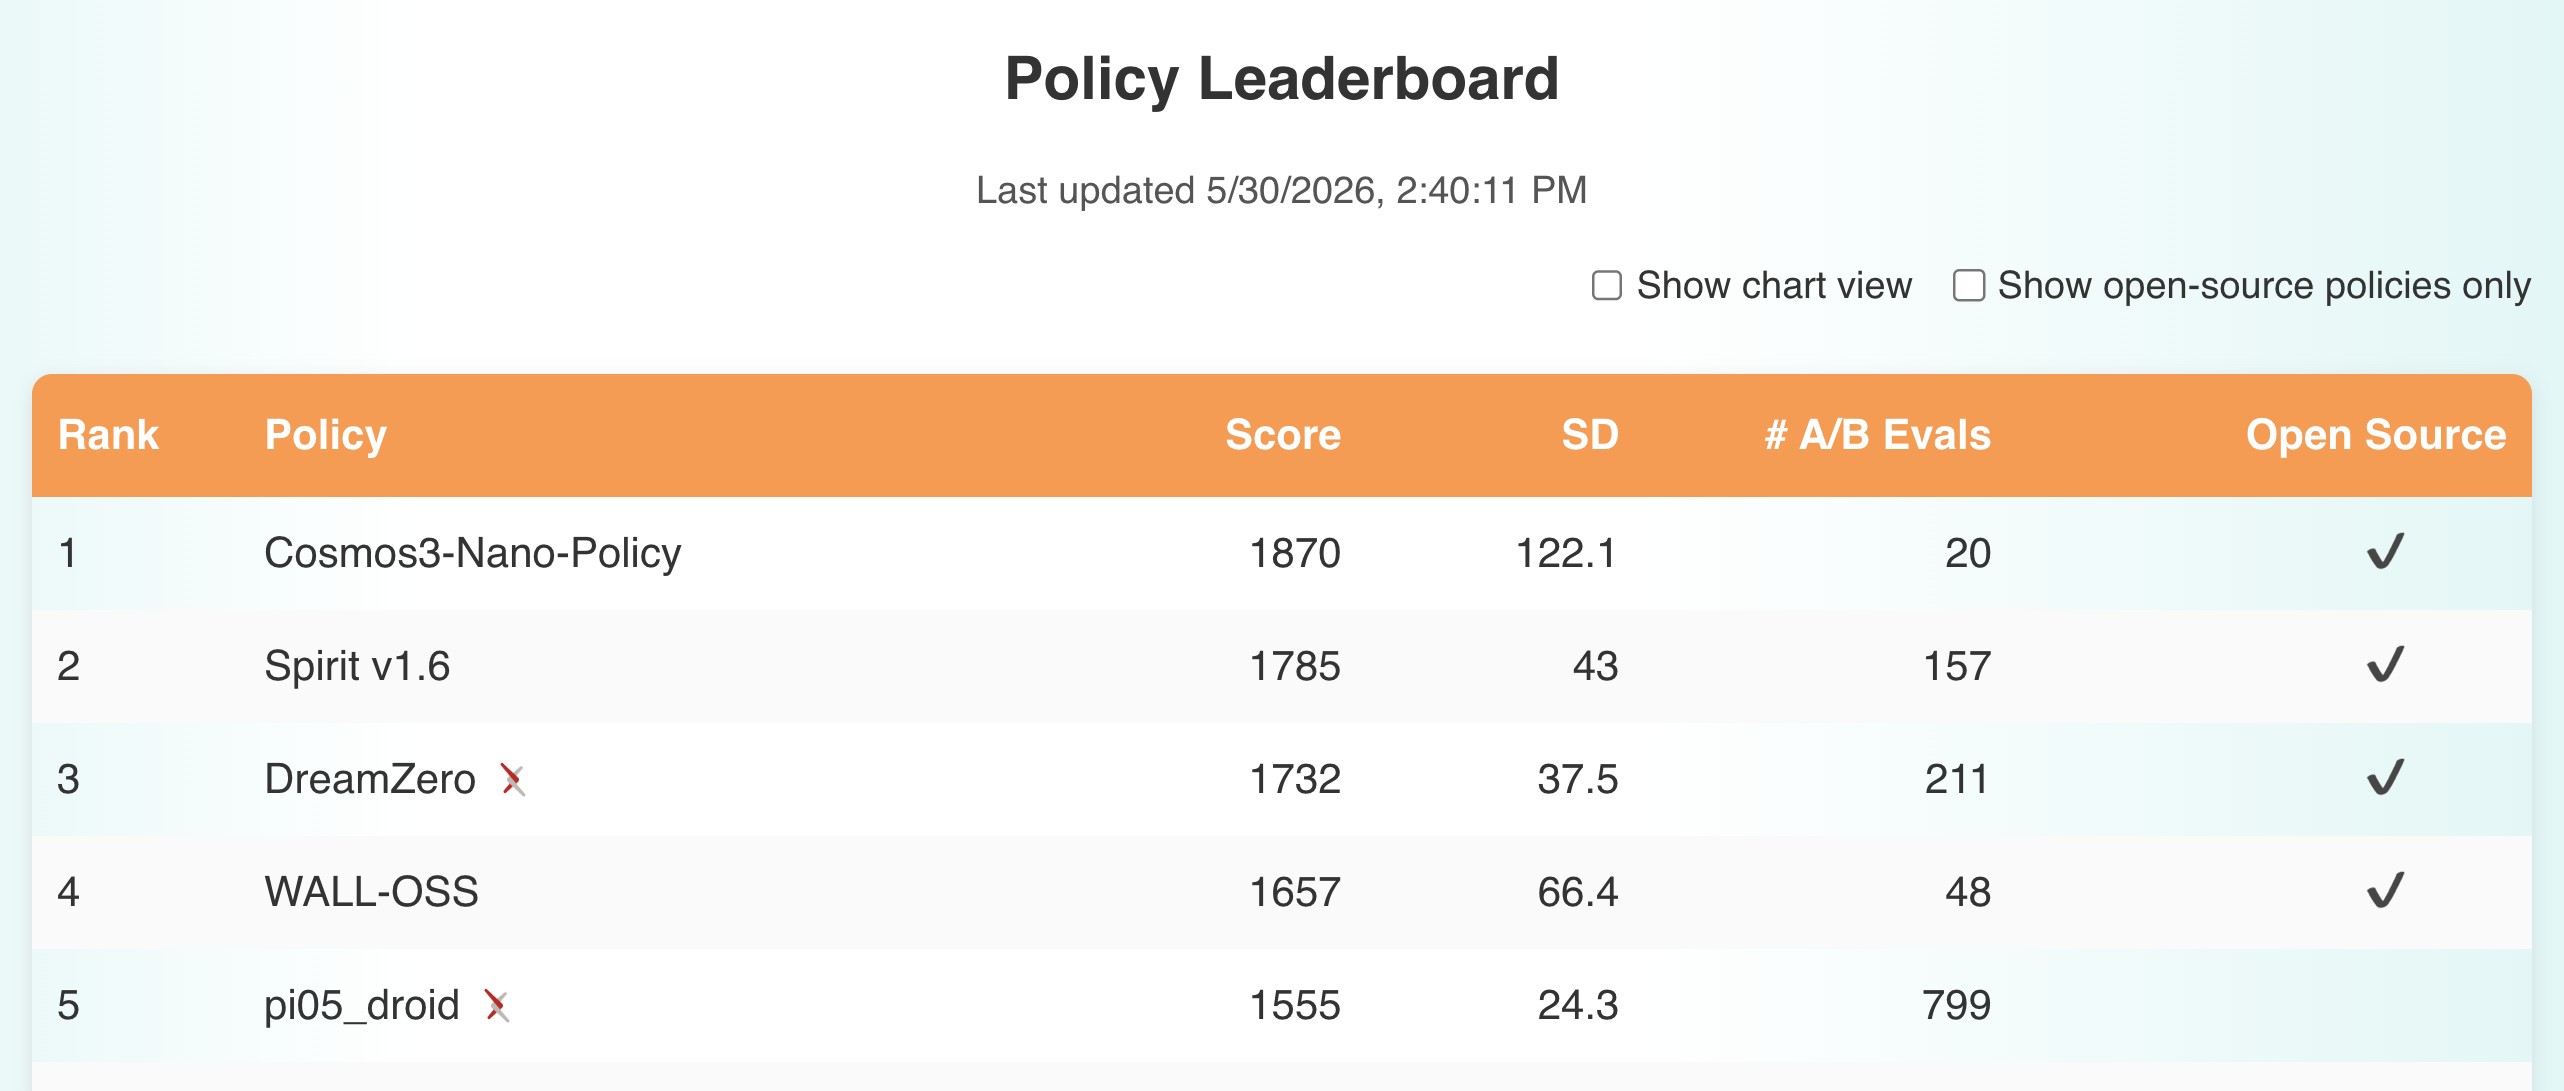
圖 26:Cosmos3-Nano-Policy-DROID 位居 RoboArena 榜首。Cosmos3-Nano-Policy-DROID 在 RoboArena 真實世界基準排行榜上排名第 1(日期:2026-05-30)。
MolmoSpaces([122])是一個評估通才策略的模擬基準,聚焦於系統性受控變化下的泛化能力。我們專注於操作任務,包含兩組任務集:(1) MolmoSpaces Combined 與 (2) MolmoBot Combined。MolmoSpaces Combined 集包含四項基準任務(Pick-v1、Pick & Place-v1、Open-v1 與 Close-v1),MolmoBot Combined 集包含七項基準任務(Pick-v1.5、Pick-v2-classic、Pick-v2-filament、Pick-v2-RandCam、Pick & Place-v2、Pick & Place-NextTo-v2 與 Pick & Place-Color-v2)。截至 2026 年 6 月 20 日,Cosmos3-Nano-Policy-DROID 在 All Combined 設定下位居排行榜第一,達到 39.0% 的 oracle 成功率(圖 27)。該模型超越了 WALL-OSS-0.5([338])與 TiPToP([250])等多個強勁的先前策略模型。值得注意的是,我們為 RoboLab 與 RoboArena 評估提交的是完全相同的模型與超參數,未對 MolmoSpaces 做任何基準特定的調校。
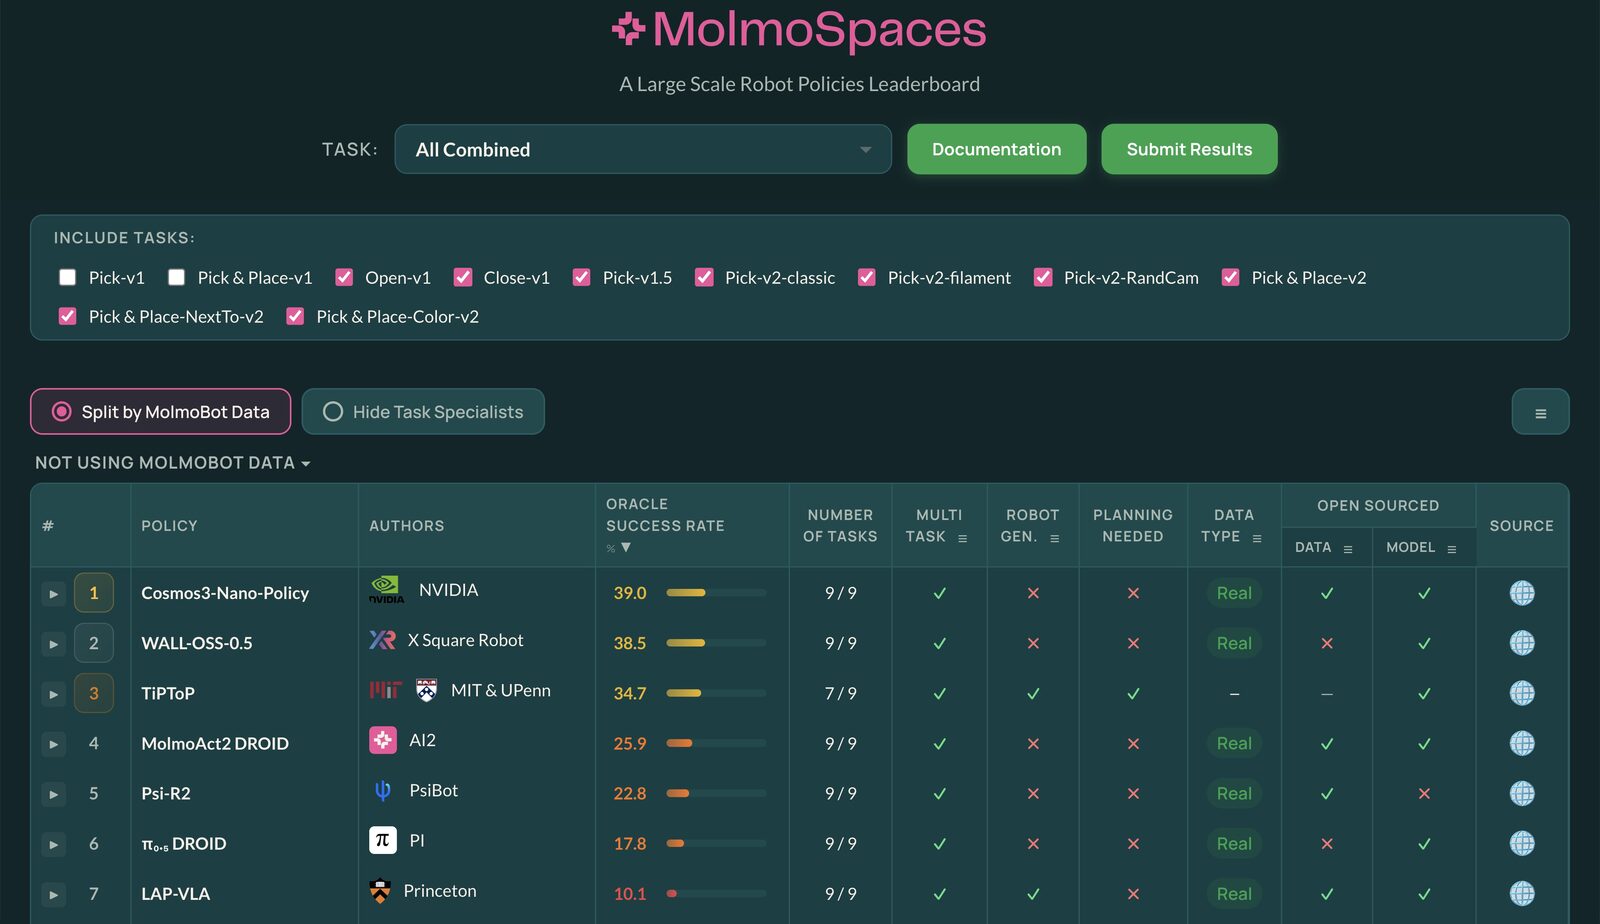
圖 27:Cosmos3-Nano-Policy-DROID 在 MolmoSpaces 上排名第 1。Cosmos3-Nano-Policy-DROID 是 MolmoSpaces 模擬基準排行榜的第一名模型(日期:2026-06-20)。
對新具身形式的調適
我們評估 MT-init 是否使 Cosmos3-Nano 能更快調適到未見過的具身形式與環境。我們使用 LIBERO-10 環境([155]),觀測來自第三人稱相機與腕部相機的多視角。我們透過對每個驗證任務執行 50 次試驗(每個檢查點 500 次推演)回報後訓練疊代過程的進展。
如表 20 所示,後訓練快速提升兩種初始化的閉迴路操作成功率,但 MT-init 在後訓練早期有明顯優勢。在 500 次疊代時,Cosmos3-Nano MT-init 達到 24.6% 成功率,Cosmos3-Nano PT-init 仍為 0.0%。到 2000 次疊代,Cosmos3-Nano MT-init 可達 97.4% 成功率。這些結果顯示 MT-init 能更快調適到新的具身形式與環境。
| 模型 | 500 次疊代 | 1000 | 1500 | 2000 |
|---|---|---|---|---|
| Cosmos3-Nano (MT-init) | 24.6% | 91.4% | 95.8% | 97.4% |
| Cosmos3-Nano (PT-init) | 0.0% | 73.8% | 93.4% | 95.2% |
表 20:使用 LIBERO-10 快速調適到新具身形式。Cosmos3-Nano 從 MT-init 與 PT-init 出發的閉迴路成功率,每個檢查點以 500 次推演評估。結果顯示 MT-init 比 PT-init 調適更快。
動作資料協同效應
選擇哪些動作領域一起訓練是一個實務的混合設計問題:新增的領域可能提供有用的視覺—動作先驗,但也可能稀釋目標領域的監督。受近期語言領域轉移研究([165])啟發——該研究衡量在一種語言上訓練對另一種語言的助益或干擾——我們為動作中期訓練建立了類似的轉移圖,橫跨自我運動領域(相機運動、自動駕駛車)、機器人操作領域(Google Robot、WidowX-250、Franka Panda 單臂、Franka Panda 雙臂、AgiBot)與人類第一人稱運動(Egocentric)。定量的協同矩陣總結於圖 28 與圖 29。FD 回報 PSNR、ID 回報 MSE。策略模式回報 4 次推演中的最小 PSNR 與 MSE,因為推演分布是多峰的。在每個協同矩陣中,非對角格子使用列與欄領域各半的混合訓練 4,000 次疊代,對角格子則是對應的單一領域基線訓練 2,000 次疊代。此設定使單一領域與配對運行之間的每領域訓練預算相匹配。每列固定評估領域,各欄變化單一領域或配對訓練設定。正的差值表示跨領域轉移,負的差值表示干擾。
我們總結主要發現如下:
[Figure 28: 跨自我運動與機器人操作領域的協同研究。列表示評估領域;欄表示新增的共同訓練領域。對角格子為單一領域基線,非對角格子使用列—欄各半的混合並匹配列領域的訓練曝露量。每格回報分數與相對列對角線的差值。綠色表示正向轉移,符號已調整使較高的 PSNR (↑) 與較低的 MSE (↓) 皆為較好。]
相機運動受益於廣泛的動作共同訓練。 圖 28 顯示相機運動——表現較低的領域之一——受益於多個共同訓練夥伴,而不僅是另一個自我運動來源。AV 資料將相機 FD PSNR 從 11.96 提升至 12.82(+0.86),機器人領域也帶來正向 FD 增益,包括 Google Robot(+0.79)、Franka Panda 單臂(+0.73)與 Franka Panda 雙臂(+0.48)。該列中每個所示共同訓練夥伴的 ID MSE 也都改善。這表明相機運動學習受益於一般的動作條件視覺先驗——例如物體恆存、場景幾何與運動對應線索——即使新增領域的具身形式不同。
機器人操作領域共享早期訓練先驗。 圖 28 的機器人領域面板顯示操作資料集之間廣泛的早期轉移,尤其對單一領域基線較弱或資料較異質的領域。WidowX-250 從 Google Robot 大幅受益,FD PSNR 增加 +1.39、策略 PSNR 增加 +2.29,ID 與策略 MSE 也相應改善。Google Robot 也從多個機器人共同訓練夥伴受益,FD PSNR 改善最高 +0.89、策略 PSNR 改善最高 +1.44。相對地,此協同研究中的 Franka Panda 單臂與雙臂條目對應較小的 RoboMIND Franka 子集([302]),分別僅有 23 與 4 小時的資料。與圖 9 所總結的大得多的動作資料來源相比,這些小型目標領域在單一領域訓練下很快飽和,因此加入較大的共同訓練領域對其自身評估產生較小或好壞參半的增益。然而,它們作為共同訓練來源時仍為其他領域提供有用的轉移。
人類第一人稱運動有助於機器人調適。 圖 29(a) 顯示第一人稱運動與 AgiBot 之間適度但一致的轉移。第一人稱資料將 AgiBot 的 FD PSNR 從 23.07 提升至 23.20(+0.13),AgiBot 則將第一人稱 FD PSNR 從 15.13 微幅提升至 15.16(+0.03)。圖 29(b) 的暖身曲線進一步將此轉移作為初始化效應測試:我們先以第一人稱運動暖身基礎 PT-init 檢查點,再調適到 AgiBot,並與從同一 PT-init 檢查點直接調適 AgiBot 比較。從第一人稱暖身檢查點出發,在每個測量步都改善 AgiBot 的 FD PSNR,5K 步時增益 +0.94,訓練後期約 +1.3–1.6。這些結果合計表明,第一人稱人類動作資料為機器人調適提供了有用的操作先驗,而隨著訓練推進,領域感知的取樣或專門化仍然重要。
[Figure 29: 第一人稱運動作為機器人調適先驗。(a) 矩陣衡量 AgiBot 機器人操作與第一人稱運動之間的成對轉移。(b) 曲線比較從第一人稱暖身檢查點調適 AgiBot 與從 PT-init 檢查點直接調適。]
結論
我們證明 Cosmos 3 是跨多樣領域、具身形式與推論模式的強大動作基礎模型。單一基礎模型可以調適為相機控制影片生成、自動駕駛逆向動力學、第一人稱手部前向動力學、機器人前向動力學與機器人策略學習,同時與專門化的領域基線相當或更強。PT-init 與 MT-init 的比較進一步顯示,統一的動作中期訓練不只改善孤立的領域:它產生可重用的動作領域先驗,加速各下游設定的收斂,包括對新具身形式與環境的調適。這尤其值得注意,因為受評領域在具身形式與監督格式上差異巨大——從相機與車輛運動到有關節的人手與機器人末端效應器。協同研究提供了動作領域共享可轉移結構的證據:跨自我運動、機器人操作與第一人稱運動的共同訓練能改善早期調適,特別是對單一領域基線較弱的領域。附錄 E.4 與 E.5 的額外動作專屬消融實驗強化了相同結論:FD、ID 與策略目標在聯合訓練下共享有用結構,且與策略動作一同預測的影片與由這些相同動作驅動的模擬器推演保持對齊。整體而言,這些發現支持 Cosmos 3 作為通用的世界—動作基礎模型,能高效地專門化為廣泛的動作生成與控制任務。
6.3 Generator 使用指南
雖然基準結果提供了生成品質的定量評估,有效使用全模態世界模型還需要理解其推論介面、提示方法與取樣組態。由於 Cosmos 3 支援多樣的模態與生成模式——包括影像、影片、視聽、轉換、前向動力學、逆向動力學與策略生成——輸出品質不僅取決於模型權重,也取決於生成請求如何被指定與設定條件。本節提供使用 Cosmos 3 Generator 的實務指引,包括建議的提示策略、結構化描述格式、取樣超參數,以及 Cosmos 3 Reasoner 作為提示詞上採樣器的角色。這些指引反映了我們評估中使用的組態,可作為在廣泛物理 AI 應用中取得高品質、物理合理生成的參考。
6.3.1 生成指南
Cosmos 3 Generator 支援彈性的視覺(與視聽)生成,涵蓋廣泛的推論範圍:幀率 10–30 FPS、5 到 400 幀、解析度橫跨 256p、480p 與 720p,以及常見長寬比(1:1、3:4、4:3、9:16、16:9)。這讓單一模型能服務從短預覽片段到較長、較高解析度的橫向或直向影片等使用案例,而無需改變取樣介面。Cosmos 3 Generator 針對前向動力學、逆向動力學與策略模式訓練,以支援不同的動作相關應用。動作生成方面,基礎的 Cosmos3-Nano 與 Cosmos3-Super 模型支援原生控制頻率 10–30 FPS 的動作預測,在逆向動力學與策略模式下預測範圍橫跨 16–400 幀。後訓練模型專精於單一模式與頻率——例如 Cosmos3-Nano-Policy-DROID 以 15 FPS 運作、32 步預測範圍。以下詳述使用 Cosmos 3 Generator 成功生成的關鍵組件。這些細節也總結於表 21。
| 模型 | 生成模態 | 取樣超參數 | 負面提示 |
|---|---|---|---|
| Cosmos3-Nano | 視聽 | steps=50, guidance=6, shift=10, full-range CFG | 附錄 B.6 |
| Cosmos3-Super | 視聽 | steps=50, guidance=6, shift=10, full-range CFG | 附錄 B.6 |
| Cosmos3-Super-Text2Image | 視覺 | steps=50, guidance=4, shift=3, full-range CFG | Null |
| Cosmos3-Super-Image2Video | 視覺 | steps=50, guidance=6, shift=5, full-range CFG | 附錄 B.3 |
| Cosmos3-Nano | 前向/逆向動力學 | steps=50, guidance=1, shift=5, full-range CFG | Null |
| Cosmos3-Super | 前向/逆向動力學 | steps=50, guidance=1, shift=5, full-range CFG | Null |
| Cosmos3-Nano-Policy-DROID | 策略 | steps=4, guidance=3, shift=5, full-range CFG | Null |
| Cosmos3-Nano | 轉換 | steps=50, guidance=3, control guidance=1.5, shift=10 | 附錄 B.6 |
| Cosmos3-Super | 轉換 | steps=50, guidance=3, control guidance=1.5, shift=10 | 附錄 B.6 |
表 21:各生成器與生成模態的預設取樣組態與負面提示。我們總結不同 Cosmos 3 Generator 模式的生成設定。各設定的負面提示全文見附錄;"Null" 表示空字串是表現最佳的變體。
媒體規格與提示指南
Cosmos 3 Generator 以結構化 JSON 描述訓練,提供對場景構成的細粒度控制,涵蓋主體、背景、光照、美學、攝影構圖,影片則另有時間性欄位,如動作、狀態變化、相機運動與片段層級描述(完整綱要見附錄 A)。推論時,提示詞上採樣器——由 Claude Opus 4.6 或 Cosmos 3 Reasoner 提供服務——將使用者請求轉換為相同的結構化格式,確保生成提示與訓練時看到的分布匹配(模板指令見附錄 B.1)。上採樣器被指示先描述場景布局與世界狀態,再指定事件的時間推進,最後加入任何音訊描述。具體的上採樣器指令依生成模式略有不同——例如,動作與轉換生成會針對其條件輸入施加額外的任務約束(轉換生成的提示前綴見附錄 B.4,動作提示指南見附錄 B.5)。JSON 規格另外包含明確的媒體控制(時長、FPS、空間高度與寬度、長寬比),使提示解讀與取樣組態可檢視且可重現。
負面提示
我們透過自動化基準疊代,為每個模型與生成模式分別調校負面提示。對每個組態,我們消融比較候選模板,包括自然語言描述、關鍵詞清單、指令式指示、針對物理一致性與身份保留的組合式延伸,以及空字串。依自動化基準分數選出表現最佳的變體。對基礎的 Cosmos3-Nano 與 Cosmos3-Super 生成器,明確的負面提示見附錄 B.6。對後訓練變體,我們發現空字串負面提示對 Cosmos3-Super-Text2Image 效果最好,而由使用者提示自動導出的負面提示對 Cosmos3-Super-Image2Video 產生最佳結果(附錄 B.3)。對動作生成模式,空字串負面提示效果最佳。
生成取樣超參數
我們對不同模態採用以下取樣參數:
視聽生成。 對視聽生成,我們在影像與影片生成的自動化基準(第 6.2.1 節與第 6.2.2 節)上調校取樣超參數。對基礎的 Cosmos3-Nano 與 Cosmos3-Super 生成器,我們使用 50 個去噪步、引導尺度 6、時間平移 10 與全範圍分類器無關引導。對後訓練的 Cosmos3-Super-Text2Image 模型,使用引導尺度 4 與時間平移 3。對後訓練的 Cosmos3-Super-Image2Video 模型,使用平移 5。
動作生成。 動作生成有三種支援模式。前向與逆向動力學使用 50 個去噪步、引導尺度 1、時間平移 5 與全範圍分類器無關引導。策略模式改用 4 個去噪步與引導尺度 3。
轉換生成。 我們在自動化的 PAIBench-C 基準(第 6.2.4 節)上調校影片轉換生成的取樣超參數。使用 50 個去噪步、文字引導尺度 3、控制引導尺度 1.5、時間平移 10 與全範圍分類器無關引導。
6.3.2 Cosmos 3 Reasoner 作為提示詞上採樣器
提示詞上採樣是 Cosmos 3 中生成前的推理步驟,將緊湊的使用者意圖轉譯為結構化的時空場景規格。它不只是改寫提示,而是將稀疏的使用者輸入擴展為物理落地的控制語言,捕捉場景布局、時間演變,以及(如適用)音訊線索。使用者通常提供簡短的自然語言請求,而高品質的影像與影片生成仰賴許多鮮少被明確指定的細節,例如主體屬性、空間布局、相機行為、光照、時間順序、音訊線索,以及解析度、長寬比、時長與幀率等生成控制。上採樣器作為介於使用者介面與生成器之間、遵循指令的 LLM 模組來填補此缺口。它接收簡短請求、輸出的結構模板,加上可選的條件輸入訊號(例如影像生成影片的起始影像),產生一份密集、帶型別的 JSON 場景規格,供下游影像或影片模型渲染。
先前的工作分為兩條脈絡。第一條將簡短的使用者查詢映射為更豐富的影像生成文字提示:DALL-E 3 使用描述性重新標註與描述上採樣,以更好地匹配生成器的描述分布([21]);Prompt Expansion 明確學習將查詢擴展為多個最佳化的文字生成影像提示([57]);Promptist、BeautifulPrompt 與 RePrompt 等提示調適系統則訓練語言模型將使用者輸入改寫為模型偏好的提示,同時最佳化影像層級目標([102];[35];[303])。第二條脈絡將 LLM 用作下游視覺生成器的規劃器,產生物體布局、落地的場景描述、幀層級提示或多場景影片計畫([147];[70];[109];[152])。Cosmos 3 採用相同的基本想法——在生成前插入推理模組——但進一步改變了介面。上採樣器輸出單一帶型別的多模態場景程式,而非僅是改寫的提示或生成器專屬的布局計畫,且該程式橫跨影像、影片與音訊條件生成。某種意義上,上採樣器的流程是先想像場景、考量時間/空間面向、在抽象的語言描述狀態中加入更多多模態內容(例如音訊描述符),再將其轉譯為符合所提供模板的結構化輸出。
我們將上採樣視為對結構化資料、帶有物理先驗的複雜多模態指令遵循。輸入可以是純文字、影像加文字或影片加文字。輸出是受綱要約束的 JSON 控制程式,捕捉語意內容、視覺屬性、任務特定描述、影片任務的時間計畫、影片任務的音訊描述欄位,以及渲染器所需的生成參數。結構化輸出不只是格式選擇——它暴露了生成器必須以之為條件的潛在變數,包括實體、空間關係、動作、時序、相機行為、聲學後果與生成控制。這將提示詞上採樣連結到結構化 LLM 推理與驗證的研究——將自然語言指令轉換為對結構化欄位明確、可檢核的程式([39])。同時,填寫密集的場景綱要需要在不確定性下推理:上採樣器必須從不完整的使用者輸入推斷可能的物體狀態、時間轉換、因果互動與聲學結果([224]),以便沿創意軸擴展而不違背現實施加的物理約束。在 Cosmos 3 中,這些機率與物理先驗透過綱要本身表達。模型先想像一個連貫的世界狀態,再將其映射為時間推演,最後導出與可見事件保持同步的音訊線索。這種分離頗有用處,因為它將提示理解作為可獨立檢視的組件暴露出來,而非與渲染模型糾纏在一起。
提示契約
推論時,上採樣器接收使用者描述與所選的生成控制。對影像生成影片,它還接收條件影像——被視為第一幀的決定性視覺證據。請求被格式化為四個帶標籤的區塊:1) instructions 區塊:介紹所有區塊,定義任務層級行為,例如產生單一 fenced JSON 物件、避免額外評論、將模板視為強制。2) image 或 video_description 區塊:承載原始語意請求;對 I2V 等有條件的請求,附帶的條件內容與此文字一併提供,約束指明視覺事實應如何錨定於它。3) task_constraints 區塊:承載大部分操作細節。它指定欄位順序、時序格式、時長界限、複製的控制項(如解析度、長寬比、時長與幀率)、使用者提供的實體與動作的保留要求,以及任務特定的落地規則(如在 $t=0$ 匹配 I2V 第一幀)。4) output_json_template 區塊:定義綱要表面:哪些鍵必須填寫、預期哪些巢狀欄位,以及場景、時間、音訊、主體、相機、光照、風格與控制資訊應放置何處。換言之,約束描述上採樣器應如何推理與複製值,JSON 模板則定義最終答案必須採取的形狀。系統提示為極簡的 "You are a helpful assistant"。完整模板見附錄 B.1。使用此模板時,描述、FPS、時長、長寬比、解析度等佔位參數必須先相應填寫,再傳給上採樣器。
7 相關工作
物理 AI 的近期進展由多個原本各自獨立的研究領域推動,包括世界模型、多模態理解、影片生成、動作建模、視聽生成與全模態基礎模型。雖然這些方向各自為感知、推理、模擬與控制貢獻了重要能力,物理 AI 系統最終需要這些能力在統一框架內協同運作。本節回顧與 Cosmos 3 最相關的文獻,聚焦世界模擬、多模態推理、生成建模與具身智慧的先前工作。我們強調這些研究脈絡如何朝向日益統一的物理世界表徵演進,並討論 Cosmos 3 如何透過在單一全模態世界模型中聯合建模語言、影像、影片、音訊與動作以同時支援理解與生成,延伸這條軌跡。
7.1 面向物理 AI 的世界模型
世界模型描述世界如何演變,以及代理的動作如何改變未來的觀測。一個有用的區分是預測式潛在世界模型與生成式世界模型:前者為規劃與控制學習緊湊的內部動態,後者將預測的未來以可檢視的多模態模擬形式呈現。
預測式潛在世界模型學習緊湊的隱藏狀態,其價值在於讓規劃與控制更廉價:控制器可以在抽象掉像素層級細節的表徵中搜尋或最佳化。早期的潛在動態系統如 World Models([95])、Embed-to-Control([296])、PlaNet([100])與 Dreamer([99])證明緊湊的預測狀態能支援從像素出發的控制與規劃。較近期的 JEPA 式模型將預測從像素轉移到更契合感知、預測與規劃的潛在抽象([133];[7];[20];[8];[173])。這些方法確立了內部動態建模作為智慧代理的核心要素,但它們通常為緊湊預測或下游控制最佳化,而非高擬真的多模態模擬。
生成式世界模型將模擬本身作為建模介面:模型以影像、影片、音訊或其他落地 token 預測可能的未來觀測。透過直接呈現預測的未來,幾何、接觸、時序與聲音的錯誤變得可觀察,而非只能從任務損失間接推斷。Sora([211])使這一觀點在影片生成與隱式世界模擬([106])中受到矚目。Cosmos 世界模型系列直接為物理 AI 發展此方向([197];[196];[199];[195])。其他領域特定系統研究操作、駕駛與具身導航及互動([288];[347];[148];[116];[237];[353];[76])。近期的互動式系統將此方向延伸至可控環境與面向代理的推演介面([31];[85];[16];[110];[324];[299];[10];[249];[297];[146];[290])。Cosmos 3 建立在此方向之上,但將世界建模視為理解與生成並重的問題,而非僅是影片合成:其 Reasoner 塔解讀多模態脈絡並推斷結構化世界狀態,Generator 塔則從該脈絡合成未來的影像、影片、音訊與動作 token。這讓一個框架能串連場景理解、未來合成、動作推斷與多模態推演,使生成的軌跡能以文字、觀測、動作與音訊為條件,而不僅是提示。
7.2 多模態理解與具身推理
多模態理解模型提供物理智慧所需的感知與推理層。Flamingo([3])與 BLIP-2([139])協助確立了將大型語言模型與視覺輸入耦合的現代模式,LLaVA([159];[136])則使指令微調的開放視覺—語言助手產生廣泛影響([356])。近期的模型家族在規模、定位、時間推理、OCR 與跨影像及影片的指令遵循上持續改進([47];[286];[55];[11];[13];[14];[59];[219];[331];[341];[179];[340];[271];[308];[22];[262])。GPT-4o([210])反映了朝全模態互動的演進。這些能力使視覺語言模型成為具身系統的有用前端,但物理智慧需要的不只是對孤立影像或片段的辨識。它需要時間上持續的狀態、綁定於物體與代理的空間定位、對可能互動的可供性推理,以及隨條件變化的任務進度追蹤。這將推理的單位從一則描述或答案,轉變為一份持續維護、可供行動的場景估計。
因此對物理 AI 而言,相關挑戰不僅是視覺問答,而是在推理空間、時間、可供性、物體狀態與任務進度的同時維持落地的場景狀態。Cosmos-Reason1([198])透過物理常識與具身思維鏈推理處理此設定。相關的機器人與第一人稱研究強調空間定位、具身規劃與人—物或機器人—物互動推理,同時發展模型與任務導向基準([247];[289];[42];[319];[40];[259];[351];[322])。儘管有這些進展,多數理解模型仍主要是判別式或語言輸出系統:它們能描述場景、回答問題或推斷下一步意圖,但通常不會在同一表徵空間中生成未來觀測或可執行的動作。Cosmos 3 透過讓結構化多模態理解直接為世界生成設定條件,解決了這種分離。
7.3 影片生成與視覺世界模擬
影片生成已從簡短的文字生成影片片段,進展到高解析度、時間連貫、遵循指令的合成。早期的擴散與 Transformer 系統確立了文字條件影片的基本配方([108];[257];[107];[273];[26];[19];[98];[124];[83];[327];[209];[82];[345])。Sora([211];[212])、Movie Gen([223])與 Veo 3([58];[87])反映了近期朝向長時程真實感、更強提示遵循與更高擬真視覺動態的轉變([125];[277];[77];[5])。產業系統也使可控性、創作者工作流程與 API 部署成為影片生成版圖的核心([242];[243];[127];[128];[168];[167];[184];[185];[222];[1];[4])。
由此形成的版圖大體以感知式影片生成框定進展:合理的幀、平滑的運動、與文字或視覺條件匹配的輸出。影片世界模擬與物理一致性評估的研究顯示這些目標對世界建模是必要的,但對物理 AI 並不充分([106];[17];[93];[188])。世界模擬施加更強的契約:推演必須保持物體身份與恆存性、尊重時間因果、暴露動作或相機運動等可控因素,並在同一場景於不同介入下被查詢時保持一致。對代理而言,影片只有在變化能追溯到狀態、動作與接觸時才有用;否則真實感並不意味著可靠的模擬器。這一差距在重複提示或閉迴路使用下尤其明顯——微小的不一致會複合成錯誤的下游決策。因此,模擬導向的系統必須將合成與落地的狀態及介入語意耦合。在此背景下,Cosmos 3 將影片置於更廣的世界建模框架中。影片不只是輸出模態,也是推理的輸入、動作推斷的觀測流,以及與動作和控制耦合的狀態軌跡。
7.4 動作建模、VLA 與世界—動作模型
動作提供了代理與變化中的世界狀態之間的因果連結,先前的工作通常組織為三種設定:前向動力學從狀態與動作歷史預測未來觀測;逆向動力學推斷觀測到的轉移背後的動作;策略模式將觀測、目標與指令直接映射為動作。此分類橫跨異質的動作空間——從機器人關節指令與車輛控制,到相機、人體與第一人稱穿戴者運動——各有不同的單位、速率與因果範疇。
當動作被視為未來觀測的條件時,前向動力學模型最為明確。在駕駛領域,GAIA-1([110])、DriveDreamer([288];[347])與 Cosmos-Drive-Dreams([237])展示了如何在自我運動、軌跡或其他控制下生成未來場景。在機器人與相機控制生成領域,相關系統探索動作條件操作影片、機器人感知模擬器、相機軌跡、深度、分割與 3D 一致控制([148];[116];[353];[357];[282];[76];[105];[295];[312];[238])。這些系統顯示生成模型能學到有用的動作條件先驗,但許多專精於特定領域、動作空間或具身形式。
實務上,逆向動力學常問的是哪個動作解釋了觀測到的轉移。VPT([15])研究從影片標註動作,後續工作透過從觀測模仿、潛在動作發現與從無明確動作標註的影片學習延伸此想法([344];[270];[318];[218];[244];[329];[78])。Open X-Embodiment([274])與 DROID([120])等大型具身資料集為跨具身形式、任務、視角與操作情境的學習提供了資料基底([276];[155];[191];[53];[32];[91];[137])。
策略模式系統從觀測、目標與指令預測動作。RT-1/RT-2([30];[29])、PaLM-E([64])、OpenVLA([121])、$\pi_{0}$([25])、Gemini Robotics([80];[81])與 GR00T N1([24])勾勒出從視覺—語言策略到通用機器人基礎模型的演進([144];[208];[221];[162];[355];[349];[323];[252];[134];[301];[38])。相關的具身代理系統將語言或視覺語言模型用於空間價值圖、動作推理與互動感知規劃([112];[337];[319])。世界—動作模型透過將影片動態與動作表徵作為先驗,使策略學習更貼近世界建模([143];[328];[294];[36];[285];[316])。Cosmos 3 將前向動力學、逆向動力學與策略模式視為同一個多模態序列模型在影片、音訊、文字與動作 token 上的條件模式。
7.5 音訊與視聽生成
音訊是物理世界建模的重要部分,因為許多事件不僅由外觀定義,也由聲音定義。AudioLDM 2([158])、AudioCraft([182])與 MusicGen([54])代表文字條件音訊與音樂生成的快速進展,後續系統將此空間延伸至語音、音效與面向創作者的產品([132];[275];[261];[135];[263];[272];[68])。這些模型提升了生成媒體的聲學真實感,但物理世界模擬還需要讓聲音與可見的動態同步。
視聽學習研究聲音與視覺是否對應同一事件、來源或運動。經典脈絡包括跨模態對應、音源分離、同步與語音—唇形對齊,Diff-Foley([169])與相關的影片到音訊系統則聚焦於生成跟隨可見動態的聲音([214];[348];[69];[51];[225];[52];[346];[239];[90];[49];[123])。說話頭像、人體動畫與聯合音訊—影片生成器進一步連結語音、身體運動、場景動態與聲音,包括 Movie Gen([223])與 Veo 3([58];[183];[267];[315];[279];[311];[241];[281];[157];[145];[97];[161])中的同步視聽媒體生成。對物理模擬而言,時序與聲音的類別同等重要:碰撞應在接觸幀產生撞擊聲、腳步聲應匹配步態與地面材質、工具或引擎在可見狀態改變時聲音也應改變。語音同樣需要口型、說話者身份與輪替保持對齊,而警報、馬達、刮擦與其他環境聲音可為部分被遮擋的事件提供因果證據。對物理 AI 而言,音訊應被建模為關於事件、接觸、語音、工具、引擎與環境的同步證據,而非事後的裝飾。Cosmos 3 將音訊視為同一世界建模介面中的另一個模態,支援聯合影片—音訊生成、影片條件音訊生成與音訊條件影片生成。
7.6 理解與生成的全模態模型
一條成長中的研究線研究在單一框架中結合多模態理解與生成的全模態模型 (Omnimodel)。將此目標與兩個相鄰家族區分頗有幫助:視覺語言模型通常將多模態輸入映射為文字,媒體生成器則將提示或條件映射為生成的影像、影片或音訊。全模態模型旨在於一個框架中支援兩個方向,使感知、語言與合成能共享表徵,而非僅靠外部管線連接。
Unified-IO 2([166])與 Chameleon([37])研究統一的多模態建模,GPT-4o([210])與 Gemini([84];[86])則顯示前沿系統正朝向原生的多模態輸入與輸出。其他統一或任意到任意 (Any-to-Any) 系統探索文字、影像、音訊、影片與離散 tokenization 或擴散介面的不同組合,Qwen-Omni([313];[232])代表近期的全模態家族([265];[304];[339];[79];[186];[310];[46];[291])。
在此更廣的全模態家族中,近期的 MoT 式工作尤其相關,因為它探問一個模型如何在共享序列層級脈絡的同時,為不同模態或功能保留專門化容量。Transfusion([350])透過結合文字的下一個 token 預測與基於擴散的影像生成,將此脈絡連結到在混合模態序列上訓練單一 Transformer。Mixture-of-Transformers([150])為多模態基礎模型明確化了此專門化模式,相關工作則將預訓練語言模型調適為多模態生成,並研究異質理解與生成專家之間的非對稱橋接([253];[287])。BAGEL([60])將此方向延伸為以 decoder-only 架構、在大規模交錯多模態資料上訓練的理解與生成統一多模態預訓練。近期的具身延伸將相同的架構問題物理化,為場景理解、視覺預見、潛在動作與控制在 VLA 與世界—動作模型中專門化路徑([170];[33];[255];[23];[189];[141];[266])。
綜合來看,這些全模態模型顯示理解與生成可以在共享的多模態框架內處理,而非由分離的系統負責。然而,既有工作仍偏重文字—影像建模或一般的多模態媒體生成,較少聚焦物理世界動態、動作條件生成、逆向動力學與具身控制。Cosmos 3 透過將負責多模態理解的自迴歸 Reasoner 塔,與以 Reasoner 表徵為條件的擴散 Generator 塔配對,把全模態的想法延伸到物理 AI。此介面支援影片/文字到文字的理解、文字/影片到影片的生成、視聽生成,以及用於動作理解與預測的世界—動作建模。Cosmos 3 不僅是多模態的,更是全功能的:同一個模型可以解讀世界、模擬其演變、推斷觀測到的變化背後的動作,並生成未來的觀測與動作。
8 結論
我們提出了 Cosmos 3,一個面向物理 AI 的全模態世界模型家族。Cosmos 3 在單一架構內統一了橫跨語言、影像、影片、音訊與動作的多模態理解與生成,減少了組合分離的視覺語言模型、影片生成模型、世界模型與動作模型的需求。此統一表述由模態專屬編碼器、結構化的 token 排列,以及將自迴歸推理與基於擴散的生成耦合的 Mixture-of-Transformers 骨幹所實現。配合可擴展的資料、訓練、服務與評估基礎設施,Cosmos 3 為開發物理 AI 代理提供了堅實的基礎。在多樣的理解與生成基準上,Cosmos 3 展現強勁的成果與廣泛的能力覆蓋,同時仍可透過後訓練進行下游專門化。我們期望 Cosmos 3 成為合成世界與真實世界之間的橋樑,為物理 AI 提供更好的合成資料、更好的專門化模型起點,以及更好的閉迴路訓練環境。透過釋出原始碼、預訓練檢查點與精選基準,我們旨在加速通用物理 AI 代理的研究——使其能在真實世界中感知、推理、模擬與行動。
附錄 A 描述文字細節
本附錄詳述我們的內部描述模型設計,以及用於影像與影片訓練資料的完整結構化描述綱要。我們訓練自己的模型而非依賴現成的 VLM,以確保對輸出結構的最大控制,並防止綱要欄位的幻覺或遺漏。我們不單純依賴自由形式的自然語言描述,而是將標註組織為具有預定義語意欄位的 JSON 物件。此設計鼓勵全面涵蓋視覺細節,同時保持表徵的一致性與可解讀性。影像綱要捕捉靜態場景屬性,包括主體、布局、光照、美學、風格與空間構圖;影片綱要則以時間資訊延伸此表徵,例如動作、狀態變化、轉場、相機運動與音訊線索。
A.1 描述模型
為了在影像訓練資料中最大化細節與空間覆蓋,我們採用象限掃描標註策略。每張影像被劃分為四個象限,各象限內容——連同中心區域——被獨立描述。此方法對捕捉多個不同主體與複雜布局非常有效,這類情況在我們的資料集中頻繁出現,但通常被標準描述方法描述不足。
對影片資料,我們引入專門針對時間動態的第二次標註。由於運動與狀態轉換是影片理解的根本,此第二次標註全面標記所有明確追蹤的視覺屬性隨時間的變化。
對於最終的影像與影片描述模型,我們確定對 Qwen3-VL-8B 進行 LoRA 微調可在基準指標與推論效率之間取得最佳平衡。影片輸入以 $8$ FPS 取樣幀,生成溫度設為 $0.7$。我們也使用預設的 Qwen3-VL 最小與最大像素界限,分別為 $131{,}072$ 與 $25{,}165{,}824$。
A.2 影像綱要
我們對文字生成影像訓練資料使用結構化描述表徵,捕捉廣泛的視覺屬性,包括前景主體、場景構成、背景元素、光照、美學、藝術風格、相機視角與攝影特性。描述不依賴密集的自由形式自然語言,而是表示為具有預定義語意欄位的 JSON 物件。此結構化表徵在維持高精確率的同時,改善了細節召回率與標註一致性。
為改善空間覆蓋,描述管線納入基於象限的掃描機制,將每張影像劃分為四個空間象限加一個中心區域。各區域先被獨立描述,再合併為最終描述。此設計對包含多個不同主體、局部互動或複雜空間布局的影像特別有效——這些在傳統描述方法中往往描述不足。
我們按語意類別總結綱要,並在下方提供緊湊的 JSON 骨架。
【譯註:原文此處為以程式碼框呈現的 JSON 綱要圖,包含 background_setting、subjects、subject_details 等欄位定義,詳見原論文。】
subjects 的條目數量與 subject_details 的內容依場景複雜度而異。
人類與類人屬性
對人類或類人主體,綱要可額外包含:
- clothing(服裝)
- expression(表情)
- gender(性別)
- age(年齡)
- skin_tone_and_texture(膚色與質地)
- 細粒度臉部屬性,例如眼型、眼睛顏色、唇型、髮色、皺紋或痣,通常透過 appearance_details 或 subject_details 表示
計數敏感屬性
若主體對應一組或一群相似實體,綱要可額外包含:
- number_of_subjects(主體數量)
- number_of_arms(手臂數量)
- number_of_hands(手的數量)
- number_of_fingers(手指數量)
- number_of_legs(腿的數量)
緊湊 JSON 骨架
為標準化影像標註並防止關鍵視覺細節被遺漏,我們強制執行嚴格的預定義 JSON 結構。下方詳述的綱要列出用於全面捕捉每張影像靜態屬性的具體語意欄位——從背景設定到美學風格。
【譯註:原文此處為完整影像 JSON 骨架的程式碼框,詳見原論文附錄 A.2。】
A.3 影片綱要
影片描述綱要以捕捉時間資訊的欄位延伸影像描述綱要。共享的靜態屬性——如主體、背景、光照、美學、風格與相機視角——依循上述影像描述綱要。此處僅聚焦影片專屬的新增內容。
影片綱要明確記錄場景如何隨時間演變。它捕捉主體層級的動作與狀態變化、全域動作時間軸、時間片段、片段間的轉場、相機運動與可選的音訊描述。這些欄位改善了運動、互動與時間連續性的表徵——這些是純影像描述無法捕捉的。
我們按語意類別總結影片專屬綱要組件,並在下方提供緊湊的 JSON 骨架。
【譯註:原文此處為影片綱要組件的程式碼框,詳見原論文附錄 A.3。】
actions、segments 與 transitions 的條目數量依影片的時間複雜度而異。短或靜態的影片可能僅含少數時間事件,而具有多次場景變化、互動或相機運動的較長影片可能需要更詳細的時間切分。
影片專屬欄位
相較於影像綱要,影片綱要引入以下額外組件:
- action:主體層級的運動或活動。
- state_changes:主體外觀、姿態、位置或狀態隨時間的變化。
- camera_motion:時間性的相機行為,如平移、俯仰、變焦、跟拍或手持晃動。
- actions:影片中重要事件的時間索引描述。
- segments:主要影片區間的時間局部化描述。
- transitions:片段、鏡頭、場景或主體狀態之間的變化。
- temporal_caption:影片時間推進的整體摘要。
- duration 與 fps:基本影片詮釋資料。
- audio_description:語音、音樂、音效或環境音訊的可選描述。
緊湊的影片專屬 JSON 骨架
影像綱要捕捉靜態場景屬性,影片標註則需追蹤隨時間的動態。為避免冗餘,我們對影片資料使用刻意省略前述靜態視覺屬性的緊湊 JSON 骨架。下方詳述的綱要嚴格聚焦於影片專屬的語意欄位,如動作、轉場、相機運動與音訊線索。
【譯註:原文此處為影片專屬 JSON 骨架的程式碼框,詳見原論文附錄 A.3。】
附錄 B Generator 的預設提示詞與提示詞上採樣模板
本附錄提供 Cosmos 3 Generator 在不同條件下推論時使用的提示詞上採樣器指令模板與完整負面提示。我們在各小節指明所用的上採樣器與對應的使用案例。搭配這些模板的取樣組態總結於表 21。
B.1 Cosmos 3 Reasoner 的上採樣提示模板
以下片段展示將 Cosmos 3 Reasoner 作為提示詞上採樣器呼叫的指令模板,在推論時將使用者提示轉換為 Cosmos 3 Generator 預期的結構化 JSON 綱要(細節見第 6.3.2 節)。
【譯註:原文此處為完整指令模板的程式碼框,詳見原論文附錄 B.1。】
B.2 Cosmos3-Super-Text2Image 的上採樣提示模板
我們使用以下指令模板為後訓練的 Cosmos3-Super-Text2Image 產生上採樣的 JSON 提示。詳見第 4.2.3 節。
【譯註:原文此處為完整指令模板的程式碼框,詳見原論文附錄 B.2。】
B.3 Cosmos3-Super-Image2Video 的上採樣提示模板
以下片段展示搭配 Claude Opus 4.7 使用的指令模板,為後訓練的 Cosmos3-Super-Image2Video 模型產生上採樣的 JSON 提示與逐樣本的情境式負面提示(詳見第 4.2.4 節與第 6.3.1 節)。
【譯註:原文此處為完整指令模板的程式碼框,詳見原論文附錄 B.3。】
B.4 影片轉換的提示前綴
對影片轉換任務,我們在使用者描述前加上一段系統提示,指示模型以視覺控制訊號為條件進行生成。具體而言,以下系統提示在訓練與推論時皆透過聊天模板前置於使用者提供的描述之前:
【譯註:原文此處為系統提示的程式碼框,詳見原論文附錄 B.4。】
B.5 動作生成的提示模板
對動作相關任務,模型接受對預期行為的自然語言描述。與動作及影片相關的詮釋資料以 JSON 格式填入。此格式依循影片生成使用的相同結構化描述慣例,並暴露動作專屬欄位:相機取景、時間範圍、條件幀率、輸出解析度與長寬比。所得提示形式如下:
【譯註:原文此處為動作提示模板的程式碼框,詳見原論文附錄 B.5。】
cinematography.framing 欄位用於描述輸入或輸出視角,涵蓋第一人稱、第三人稱、腕載或串接相機視角。動作條目橫跨完整的生成片段,結束時間由測得時長四捨五入;頂層的 duration 截斷為整數秒,以與影片 JSON 描述格式保持一致。長寬比由一組固定的生成器解析度映射而來。可選的 idle_frame 欄位指明多少幀不含動作(閒置幀)。對逆向動力學樣本我們省略閒置幀詮釋資料,因為動作預測應嚴格跟隨影片而非使用者偏好。圖 30 展示一個多視角範例,其中串接的相機布局直接編碼於 JSON 提示中。我們使用 Claude-Opus-4.6 進行提示詞上採樣。
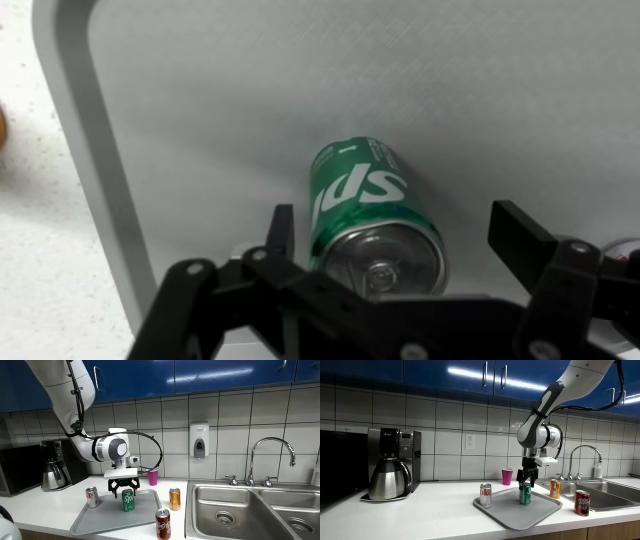
圖 30:多視角動作提示格式。當有多個視角可用時,我們將其串接為單一畫布,並在結構化 JSON 提示中附加視角布局詮釋資料,使模型能將每個像素區域與其相機串流關聯。
B.6 Cosmos 3 Generator 負面提示
我們對基礎的 Cosmos3-Nano 與 Cosmos3-Super 生成器使用以下負面提示。
【譯註:原文此處為完整負面提示的程式碼框,詳見原論文附錄 B.6。】
B.7 Cosmos3-Super-Text2Image 的代理式上採樣
大多數頂尖(閉源)文字生成影像模型都採用某種形式的迴圈內疊代精修與/或多模態推理([213])。Cosmos 3 模型接受 JSON 結構化提示的能力,為細粒度的疊代式代理精修開啟了多種可能。我們在 Artificial Analysis 提交中對此進行了實測。測試時,我們透過一套代理式框架推論 Cosmos3-Super-Text2Image:疊代地上採樣使用者提示、透過列出生成影像的缺陷/問題(若有)並給出 1 到 10 的分數來評分,然後重寫正面與負面提示。輸出結果就是此迴圈中依評審總分最佳的影像。我們最多使用 2 次重寫疊代,若分數至少 9 且評審未指出嚴重問題則提前停止。
第一次疊代使用附錄 B.2 的 LLM 上採樣模板與空的負面提示。VLM 評審提示模板見 Box B.7,LLM 正面/負面重寫提示模板見 Box B.7。我們的提交使用 GPT-5.5 進行描述上採樣與重寫、Gemini3.1-Pro 作為評審。此框架設計上具有彈性,可接受任何 LLM/VLM,包括 Cosmos 3(推理塔)本身。更多資訊與腳本請造訪 nvidia/Cosmos3-Super-Text2Image HuggingFace 儲存庫。
迴圈結構如下:
【譯註:原文此處為代理迴圈結構與評審/重寫提示模板的程式碼框,詳見原論文附錄 B.7。】
附錄 C Generator 訓練用合成資料集
本附錄詳述 Generator 中期訓練使用的各合成資料生成(SDG)資料集、SDG 資料集相對於預訓練影片資料集的分布,以及以這些 SDG 資料集在 Cosmos 3 訓練中進行的詳細消融研究。表 22 總結五個資料集的規模與提供的模態,附 Hugging Face 資料集連結;各資料集卡片隨後說明。
| 資料集 | 片段數 | 解析度/FPS | RGB | 深度 | 分割 | 邊界框 | 物理 | 相機 | 描述 |
|---|---|---|---|---|---|---|---|---|---|
| SDG-PhyxSim | 76,489 | 1920 × 1080 / 30 | ✓ | ✓ | ✓ | — | ✓ | ✓ | ✓ |
| SDG-RobotSim | 208,022 | 不一 | ✓ | 部分 | 部分 | — | 部分 | ✓ | ✓ |
| SDG-DriveSim | 264,000 | 3840 × 2160 / 24 | ✓ | — | — | — | — | — | ✓ |
| SDG-SynHuman | 236,937 | 1920 × 1080 / 30 | ✓ | ✓ | — | — | — | ✓ | — |
| SDG-Warehouse | 122,952 | 1920 × 1080 / 30 | ✓ | ✓ | ✓ | ✓ | — | ✓ | — |
表 22:SDG 資料集總覽。RGB、深度、個體分割(Seg)、邊界框(BBox)、物理狀態(Phys)、相機參數(Cam)與描述文字(Cap)標示是否提供該模態。「部分」表示部分覆蓋(僅部分片段或特定生成器)。
C.1 SDG-PhyxSim
| RGB | 質心 | 旋轉 | 線速度 | 角速度 |
|---|---|---|---|---|
 |
 |
 |
 |
 |
圖 31:SDG-PhyxSim。wrecking_ball 場景撞擊瞬間的單一幀(Corner 相機)。由左至右:RGB、質心位移、累積旋轉、線速度與角速度。
總覽
SDG-PhyxSim(PhysicsAI-WorldModel-Synthetic-Physical-Interaction-Scenes)是一個物理模擬多物體互動場景的大規模合成影片資料集,旨在讓 Cosmos 3 接觸密集、有真值的剛體動力學——這在真實影片中難以取得。每次模擬同時從四個固定相機視角捕捉,每次產生四段同步的 5–8 秒、$1920{\times}1080$、30 FPS 片段,每段配有逐幀個體分割、無損度量深度,以及在渲染時直接從模擬器讀取的結構化逐物體物理標註(線速度、角速度、質心位移、累積旋轉)。此版本涵蓋十個程序化參數化的場景家族(dominoes、ball_mixer、bowling、billiards、towers、wrecking_ball、objects_falling、rolling_ramp_objects、rolling_ramp_obstruct 與 obstruction),每個場景族用於演練一類不同的物理現象——連鎖撞擊、多體混合、彈道軌跡、受約束的擺錘動力學、自由落體與靜置、重力驅動的滾動、中途偏折、物體恆存,以及並發的多向碰撞。
模擬設定
SDG-PhyxSim 以 NVIDIA Isaac Sim([204])搭配 PhysX 剛體引擎生成,並以 NVIDIA Omniverse Replicator 捕捉。每個場景撰寫為自足的 USD 資產,其幾何、材質綁定(含物理屬性)、初始位姿、運動學約束與隨機化參數皆完整記錄於單一 .usda 檔案,因此任一片段僅憑其場景檔即可在 Isaac Sim 中精確重播。模擬精度設定為高——每個渲染幀 16 個 PhysX 子步以穩定解析碰撞——並在捕捉前運行短暫的暖身階段($0.01$ 秒,每步 $0.001$ 秒)使物體靜置到平穩的初始狀態。每段片段以(scene_name, scene_hash, seed)三元組作為鍵;整數種子確定性地控制所有隨機化的場景參數(物體數量、大小、質量、材質、間距、初始速度)。
場景
十個場景家族及其目標現象為:
- dominoes:彎曲鏈中的順序動量傳遞;
- ball_mixer:旋轉槳葉下持續的多體混合,$8$ 秒片段;
- bowling:朝球瓶陣型的定向滾動撞擊;
- billiards:帶邊墊球桌上帶旋轉傳遞的彈性多球碰撞;
- towers:堆疊積木拱門在拋射物下的結構倒塌;
- wrecking_ball:受約束的擺錘動力學與對方塊的高衝量破壞;
- objects_falling:混合道具的自由落體、撞擊、彈跳與靜置;
- rolling_ramp_objects:沿斜坡的滾動與轉動慣量;
- rolling_ramp_obstruct:加入靜態障礙物的斜坡場景,用於中途偏折與物體恆存;
- obstruction:多向滾動的球穿越靜態球柱場,帶反彈與被球柱遮擋的物體恆存。
每個種子隨機化球徑、初始速度、槳葉轉速、圍場大小、物體數量、材質指派、斜坡角度與障礙布局。
資料集統計
SDG-PhyxSim 版本包含 76,489 次獨立模擬。多數場景產生 $5$ 秒($150$ 幀)片段;ball_mixer 產生 $8$ 秒($240$ 幀)片段。所有片段以 $1920{\times}1080$、$30$ fps 渲染,合計約 $57$M RGB 幀。每次模擬從四個固定相機捕捉,相機名稱依場景家族而異——例如 wrecking_ball 場景為 Front、Side、TopDown 與 Corner。此版本共計 1,529,752 個渲染 MP4 檔(RGB 加物理著色變體)、346,147 個深度影片與 47,073,033 張逐幀分割 PNG,總儲存量約 $14.9$ TiB,以無損深度影片為主。
詮釋資料與標註
除表 22 所列模態外,每次模擬的每個相機另提供:
- 動態逐物體物理(NPZ)。 每相機四個檔案——線速度(m/s)、角速度(deg/s)、累積旋轉(rad)與質心位移(m)——每個為以分割顏色索引的(物體 × 幀 × $3$)張量,附各軸界限,用於正規化物理著色影片。
- 靜態逐物體物理(JSON)。 世界重力,以及每個剛體的質量、對角慣性張量、體座標系質心、主軸四元數、靜與動摩擦、恢復係數、密度與碰撞旗標,以 USD prim 路徑與分割顏色為鍵。
- 物理著色影片。 每相機、每物理量的 MP4,其中每個物體的顏色編碼其瞬時物理狀態(紅 = X、綠 = Y、藍 = Z;靜止物體為灰色;飽和度隨幅度增長),依 NPZ 界限正規化,使同一片段內相同顏色映射到相同的物理幅度(見圖 31)。
- 場景檔(USD)。 用於產生該次模擬的自足 .usda,可在 Isaac Sim 中精確重播。
度量深度以每相機 16 位元 FFV1 MKV 編碼,各相機的量化上限 $d_{\max}$ 與觀測範圍記錄於 depth_metadata.json,度量深度可由 $d=(v/65535)\,d_{\max}$ 還原(值 $65535$ 標記無效深度)。個體分割 PNG 附有顏色到 USD prim 路徑的映射以維持跨幀身份,逐幀相機 JSON 記錄內參、外參、FOV、仰角與重力方向。所有標註皆由模擬器與 USD 場景圖確定性地產生。
C.2 SDG-RobotSim
總覽
PhysicalAI-WorldModel-Synthetic-Embodied-Robot-Scenes(此處簡稱 SDG-RobotSim)是一個用於 Cosmos 訓練的全合成機器人影片語料,旨在改善物理合理性、具身形式持續性、接觸理解、長時程機器人影片建模與動作條件推理。公開的 v1.0 版本包含橫跨碰撞、操作與人形運動的 386,270 段 RGB MP4 片段。此版本不深入建模單一平台,而是涵蓋移動機器人、四足、人形、固定基座機械臂、雙臂系統與靈巧手臂具身形式。資料集組成總覽見圖 32。
圖 32:SDG-RobotSim 資料集總覽。片段劃分為三個任務類別——運動、操作與碰撞——每個類別再依其主要的機器人具身形式細分。
生成管線
SDG-RobotSim 由圍繞 NVIDIA Isaac Sim、Omniverse、Isaac Lab 及相關機器人資料生成系統([204];[206])構建的 USD 模擬與渲染管線生成。此版本結合來自 IsaacLab 與 MobilityGen([201])的碰撞片段、來自 DreamZero([328])、MimicGen/DexMimicGen([175];[118])與 Simulario/DextrAH([202])的操作片段,以及橫跨 SAGE([307])與 SceneSmith 場景來源的 SOMA 人形運動片段。生成迴圈定義物理落地的情境、隨機化資產與環境、渲染同步相機視角、附加模擬器導出的詮釋資料,並透過分散式渲染與索引擴展規模;策展使用規則式過濾器、詮釋資料檢查、重複運動序列移除,以及針對可見模擬瑕疵的 VLM 輔助評判。
資料集統計
公開的 v1.0 版本包含 389 個 WebDataset 分片中的 386,270 段 RGB MP4 片段。運動是最大的家族,含 170,735 段 SOMA 片段(44.20%);操作含 110,115 段(28.51%);碰撞含 105,420 段(27.29%)。依來源分組,此版本包含 170,735 段 SOMA 運動片段、103,340 段 IsaacLab 碰撞片段、80,162 段 MimicGen 操作片段、22,926 段 DreamZero 操作片段、16,384 段 Simulario 操作片段與 2,080 段 MobilityGen 片段。SOMA 子集包含 37,709 個精選運動組,組織於 SAGE 與 SceneSmith 分支下,各含 AgiBot A3、Unitree G1 與 Unitree H2 機器人家族。
詮釋資料與標註
每段片段包含 RGB 影片與版本詮釋資料,涵蓋任務家族、生成器家族、具身形式、場景識別碼、任務文字或運動名稱、相機設置、幀率、片段長度與可用的模擬器狀態。生成器特定的詮釋資料可能另含機器人位姿、關節狀態、末端效應器狀態、物體位姿、接觸標籤與任務成功旗標。描述文字由 RGB 片段與可用的模擬器詮釋資料生成。
C.3 SDG-DriveSim
總覽
真實世界的駕駛影片雖多但結構上有偏差:它過度取樣常規巡航,卻對自主駕駛最關鍵、攸關安全的長尾互動取樣不足。SDG-DriveSim(PhysicsAI-WorldModel-Synthetic-Autonomous-Driving-Scenarios)是以 NVIDIA Omniverse 模擬平台生成的大規模自動駕駛場景合成影片資料集,旨在沿真實車隊資料難以提供的兩個軸向填補此缺口。每段片段是一次時間一致的多相機環景捕捉,包含一輛自車與周遭交通參與者,並配有各相機的 VLM 描述。
針對性的長尾覆蓋
此資料集圍繞真實資料中明顯罕見或難以捕捉的情境家族構建——緊急車輛互動、繞行停放障礙物、鄰車道切入、天氣導致的能見度劣化,以及非標準軌跡的行人穿越。由於情境是透過 Scenario Agent 從自然語言提示宣告式撰寫、而非事後從駕駛紀錄挖掘,我們能以可控密度產生同一極端案例的多種排列組合。
環境變化
每個撰寫的情境被展開為時段、雲量、能見度、路面材質與車輛及行人資產選擇的確定性排列組合。相同的底層互動因此在多樣的環境條件下被觀察到,幫助模型將場景內容與環境分離。
 車輛碰撞 |
 緊急車輛+夜間 |
|---|---|
 違規穿越馬路 |
 變換車道 |
 車輛擠行 |
 行人+眩光 |
 警車 |
 天氣變化 |
圖 33:SDG-DriveSim 資料集。SDG-DriveSim 旨在涵蓋真實世界中難以捕捉的長尾罕見情境。此處提供資料集中八個代表性駕駛情境。
模擬設定
SDG-DriveSim 以建立在 OpenUSD 上的代理式情境生成管線產生:由 LLM 支撐的情境代理將自然語言提示轉換為可運行的 USD 世界組態,模擬器隨後渲染並跨確定性排列重複執行,為每則提示產生一批片段。每個情境實例化一張地圖(都市、高速公路、路口、橢圓道或測試賽道)、天氣與時段條件、相機組、自車,以及一組可配置、被指派行為(行駛、跟隨軌跡、變換車道、切入、擠行、靠邊停車、行人動畫)的交通參與者與行人。使用兩種相機組:偏前向的 4 相機組(120° 前廣角、30° 前望遠,加兩個 70° 後角相機),以及 7 相機組,在前者基礎上增加三個 200° 魚眼相機(左、右、後)以達成 360° 環繞覆蓋。每個撰寫的情境被展開為最多十個確定性排列,涵蓋時段、雲量與能見度、路面材質,以及車輛與行人資產選擇。
資料集統計
當前的 SDG-DriveSim 版本包含 264,000 段片段,合計約 1,467 小時影片,以 4K(3840$\times$2160)、24 fps 渲染,每段時長約 20 秒,對應約 1.27 億張 RGB 幀。片段分布於七個情境家族:車輛切入(32.9%)、車輛—行人(21.1%)、車輛變換車道(12.9%)、行人(12.4%)、車輛天氣劣化(9.2%)、車輛擠行(8.8%)與緊急車輛(2.7%)。此版本使用 9 張獨特駕駛地圖、10 類車輛資產、8 個行人資產與 3 種行人動畫變化,每個場景有一到九輛交通車輛與行人。
詮釋資料與標註
資料集依情境類別分區,有獨立的 video/ 與 description/ 子資料夾。每段片段的環景相機組每個相機產生一組(影片, 描述)對:24 fps 的 H.264 編碼 RGB,加上每相機的描述檔,內含幀率、幀數與一份時間窗口化的自然語言描述清單(t2w_windows 條目為 (start_frame, end_frame, caption))。片段層級的場景詮釋資料記錄 weather、time_of_day、surface_type 與 region。
C.4 SDG-SynHuman
總覽
SDG-SynHuman(PhysicsAI-WorldModel-Synthetic-Digital-Human-Scenes)是在多樣 3D 環境中渲染數位人類的大規模合成影片資料集,提供真實世界人類影片鮮少具備的密集幾何監督(逐幀度量深度與相機內外參)。片段在 60–120 秒間保持時間一致,每場景 1–9 個人類,橫跨多樣的人類外觀、動畫、室內外環境、光照條件與相機軌跡取樣。逐幀相機參數由底層場景圖確定性地產生,因此相機位姿既可作為輸入條件訊號、也可作為預測目標,支援世界模型預訓練、相機運動泛化、深度感知學習與人—場景互動建模。
 |
 |
 |
 |
|---|
圖 34:SDG-SynHuman 樣本。由左至右:RGB、深度;室外與室內視角。
模擬設定
SDG-SynHuman 以 NVIDIA 內部 SDG 管線生成,建立於 NeMo Agent Toolkit、Omniverse、OpenUSD 與內部編排後端之上。管線將高階情境規格轉換為結構化的世界組態,定義環境、光照、數位人類、動畫、相機模型、相機軌跡與所需的真值輸出。每個情境實例化一個 3D 環境、一種光照條件、一台相機與多個數位人類,每個角色被指派動畫序列與場景位置。
相機行為透過運動組態控制:結合一種主要相機運動——例如靜態、跟拍、穿越 (Fly-through)、弧線/環繞、第一人稱、之字形或鳥瞰——與可選的次要運動層,如晃動、漂移、呼吸擺動、荷蘭角、變焦、橫移或俯仰。時間重映射與速度輪廓(包括緩入緩出與程序化取樣的自訂曲線)用於變化運動節奏與加速度,同時維持時間連貫的片段。數位人類選擇、動畫、相機行為與場景構成每個情境從世界組態取樣,在人類外觀、運動、場景脈絡與相機軌跡上產生廣泛變化。
環境資產包括 NVIDIA 內部場景、改編自 SceneSmith 範例場景資料集([220])的室內場景,以及以 The City Generator Blender 外掛([67])生成的戶外城市環境。渲染時,模擬器直接從底層 USD 場景產出 RGB 影片、度量深度與逐幀相機校準,實現無需人工標記的確定性相機與幾何監督。
資料集統計
最終的 SDG-SynHuman 版本包含 236,937 段片段、合計 5,841 小時影片。片段以 1080p、30 fps 渲染,時長 60 到 120 秒,平均約 88.8 秒,對應約 6.31 億張 RGB 幀,並以相同時間解析度生成配對的度量深度幀與相機參數。
資料集橫跨 4,050 個獨特數位人類資產、8,184 個獨特動畫、198 個室內環境、200 個戶外城市環境,以及 14 種相機運動情境,包括靜態、穿越、跟拍、弧線、第一人稱、之字形、鳥瞰、俯仰、晃動、漂移、呼吸擺動、荷蘭角、變焦與橫移。每個情境包含一個 3D 環境、一種光照條件、一條相機軌跡與一到九個數位人類,在人類外觀、動畫、場景脈絡與相機運動上提供廣泛變化。此資料集的相機運動統計總結於表 23 與表 24。
| 運動類型 | 場景數 | 百分比 | 描述 |
|---|---|---|---|
| static | 71,006 | 29.97% | 相機在整段序列中位置與朝向固定。 |
| egocentric | 33,070 | 13.96% | 相機表現為角色或代理的視角。 |
| tracking | 36,978 | 15.61% | 相機跟隨主體並維持取景。 |
| flythrough | 36,852 | 15.55% | 相機沿路徑向前穿越場景。 |
| arc | 37,166 | 15.69% | 相機沿弧線繞目標移動。 |
| zigzag | 15,294 | 6.45% | 相機以交替橫向運動前進。 |
| birdseye | 6,571 | 2.77% | 俯視的頂視相機視角。 |
| 總計 | 190,670 | 100.00% | — |
表 23:SDG-SynHuman 的主要相機運動分布。190,670 個場景在七種主要類型間的佔比;每個場景恰有一種主要相機運動類型。重疊的次要相機運動類型見表 24。
| 運動類型 | 活躍時間(小時) | 描述 |
|---|---|---|
| breathing | 1,221.77 | 模仿人類呼吸的輕柔呼吸式運動。 |
| drift | 1,211.96 | 隨時間緩慢細微的位置移動。 |
| dutch_angle | 1,205.72 | 繞前向軸旋轉,產生傾斜的地平線。 |
| shake | 1,197.87 | 快速的位置與旋轉手持抖動。 |
| sway | 1,191.28 | 帶地平線搖擺的鐘擺式振盪運動。 |
| zoom | 1,184.09 | 不改變鏡頭特性的前後移動。 |
| crab | 373.72 | 維持視線方向的橫向平移。 |
| tilt | 195.33 | 繞水平軸的上下旋轉運動。 |
表 24:SDG-SynHuman 的次要相機運動活躍時長。次要運動是可在時間上重疊的組合層,因此回報的時長為各運動的獨立總計,而非固定時長預算的份額。
詮釋資料與標註
資料集以 shards/ 下的 1,215 個 tar 分片交付,每個分片打包 200 筆樣本。每筆樣本(以 UUID 為鍵):RGB 為 video/uuid.mp4 中的 H.264;FFV1 無損 1080p 深度為 depth/uuid.mkv,附一份記錄深度範圍、解析度、幀率與 dtype 的 JSON 以進行度量重建;逐幀相機資料在 meta/uuid_camera.json;場景層級詮釋資料在 metas/uuid.json(環境、光照、代理、相機組態、動畫任務);資產層級詮釋資料在 description/uuid.json(生成的物品清單、運動資產、位置、來源)。所有標註皆由 USD 場景圖確定性地生成。圖 34 展示室外與室內視角的 RGB 與深度輸出樣本。
C.5 SDG-Warehouse
總覽
SDG-Warehouse(PhysicsAI-WorldModel-Synthetic-Warehouse-Operation-Scenes)是在全模擬倉儲環境中渲染的室內工業安全事件合成影片資料集。這類事件的真實監控影片罕見、難以大規模釋出,且鮮少帶有物理 AI 訓練受益的密集真值,因此我們在模擬中生成——事件保證發生、每個參數皆可控,且每一幀都配有確定性的逐像素與逐物體標註。此版本涵蓋四個代表性情境——堆高機—人員驚險擦身(23%)、倉儲火災與人員疏散(36%)、堆高機—貨架碰撞(20%)與倉儲取箱動作(21%)——合計約 $123$K 段片段(約 412 小時影片),$1920{\times}1080$、$30$ fps,每次模擬有多個同步相機視角。
共通模擬基礎設施
四個情境皆建立於 NVIDIA Isaac Sim。程序化場景組合——倉儲布局、貨架擺放、道具變化,以及各光源的色溫、強度、曝光與顏色隨機化——由 Isaac Sim Replicator Object(IRO)處理。代理與感測器配置——工作人員的生成與行為、堆高機的擺放與導航,以及定義資料集多視角的相機組——由 Isaac Sim Replicator Agent(IRA)處理。相機擺放是參數化的,每次模擬取樣高度、距離與俯視角度;工作人員資產與動作從 Isaac Sim 的角色庫取樣,以多樣化人類外觀與步態。每次模擬以唯一的隨機種子播種,控制所有隨機化變數(場景組合、光照、代理身份與動作、相機位姿與事件時序),使各次模擬獨立且可重現。
標註綱要
每個相機視角提供 H.264 RGB 片段與同步的逐幀標註:度量深度(原始加對數正規化著色變體);個體分割(可追溯到特定模擬物體的逐像素 ID,附著色變體);著色分割(帶法線著色的 3D 感知渲染);在著色分割上計算的 Canny 邊緣圖;每個被追蹤代理與道具的 2D 緊密與寬鬆軸對齊邊界框加 3D 有向邊界框;以及逐幀相機內外參。每條標註流也以編碼影片形式與 RGB 片段一同釋出。模擬層級的結構化詮釋資料記錄情境類型、隨機種子、資產與代理清單、事件參數(例如堆高機閃避距離、火災起火位置、出口途經點)與光照隨機化。圖 35 展示每個情境一幀的各模態。
| RGB | 深度 | 分割 | 著色分割 | 邊緣 | |
|---|---|---|---|---|---|
| 驚險擦身 |  |
 |
 |
 |
 |
| 火災 | 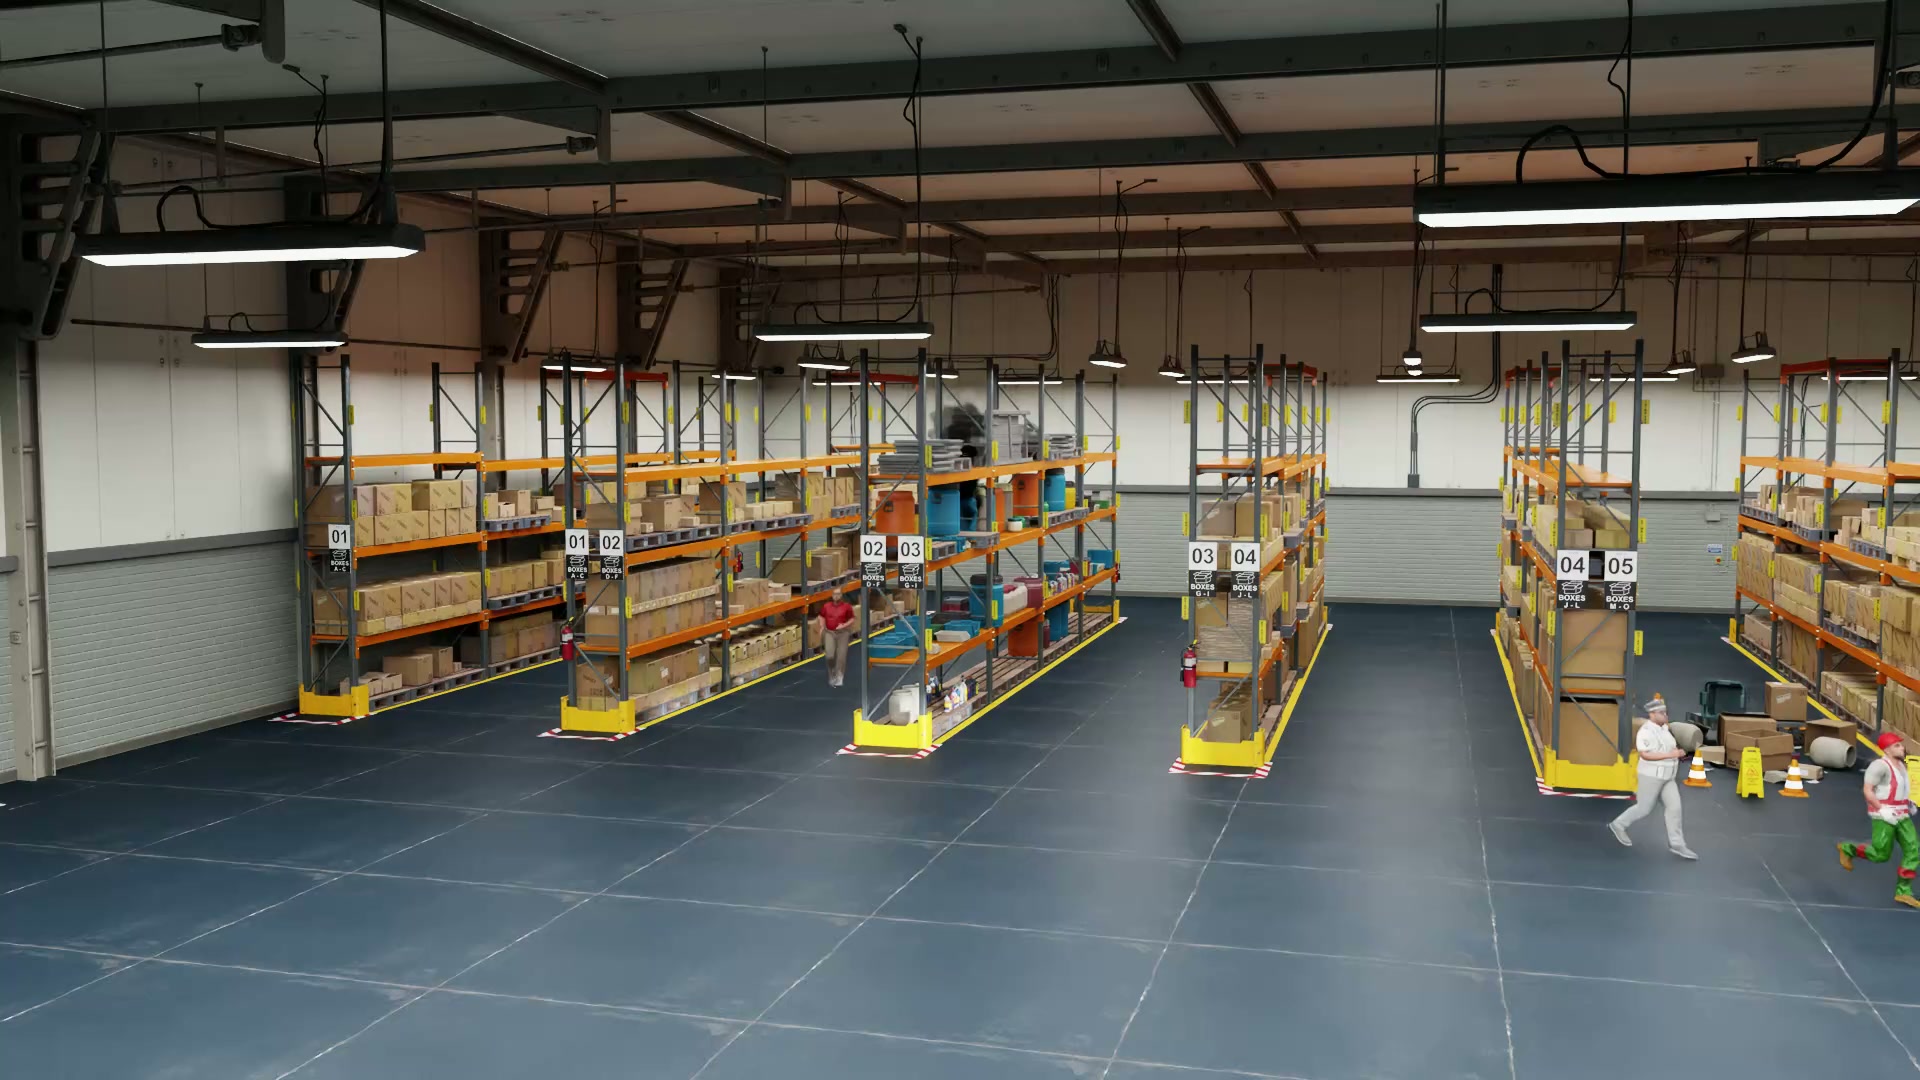 |
 |
 |
 |
 |
| 碰撞 |  |
 |
 |
 |
 |
| 取箱 |  |
 |
 |
 |
 |
圖 35:SDG-Warehouse 資料集。四個情境與標註的樣本視圖(RGB 片段、度量深度、個體分割、著色分割與 Canny 邊緣)。
C.6 SDG 資料集的分布
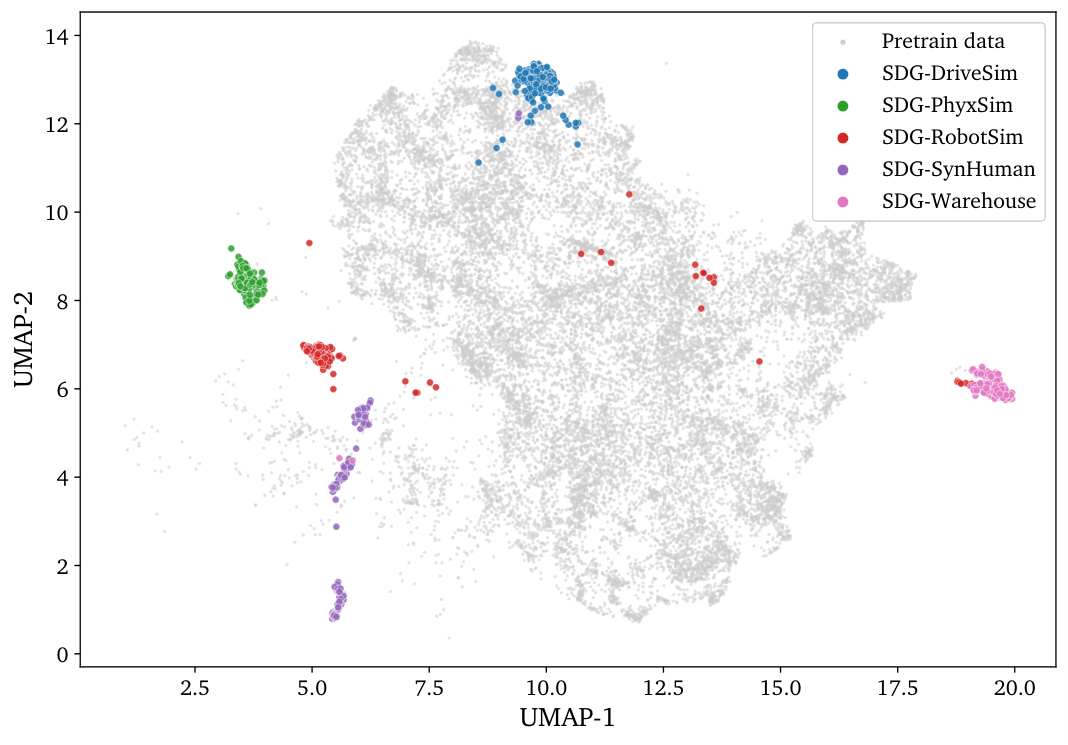
圖 36:預訓練與 SDG 的聯合嵌入幾何。20,000 個預訓練聚類質心(灰色)與每個 SDG 來源隨機抽樣 200 段片段的 PCA→UMAP 投影。每個 SDG 來源形成一個獨特、緊密聚集的區域,與主體預訓練分布僅有狹窄重疊。
| 來源 | CosSim ↑ | MMD² ↓ | #Local |
|---|---|---|---|
| 預訓練(參考) | 0.796 | 0.005 | 19,934 |
| SDG-DriveSim | 0.667 | 0.119 | 5,577 |
| SDG-PhyxSim | 0.589 | 0.221 | 6,644 |
| SDG-RobotSim | 0.627 | 0.162 | 9,760 |
| SDG-SynHuman | 0.650 | 0.191 | 4,975 |
| SDG-Warehouse | 0.712 | 0.361 | 1,920 |
表 25:SDG 到預訓練流形 (Manifold) 的距離。以每個來源 100K 段隨機片段對 20,000 個質心計算。CosSim 為 maxjcos(gi, cj) 的平均。MMD² 為無偏的局部最大平均差異(RBF 核,中位數啟發式帶寬)。#Local 為該來源鄰域橫跨的不同質心數。所有 SDG 來源皆遠離預訓練分布——是必要的互補而非冗餘的子集。
為驗證合成內容對預訓練語料真正具有互補性,我們分析其在 Cosmos-Embed1 影片嵌入空間中相對於預訓練分布聚類的位置。圖 36 視覺化了預訓練與 SDG 嵌入的聯合幾何,表 25 則以分布內的自我參照為基線,量化各 SDG 來源到預訓練流形的距離。這些結果合計顯示,SDG 佔據了嵌入空間中僅靠網路規模預訓練無法充分覆蓋的長尾區域。
C.7 消融研究:SDG 資料集的影響
我們透過將預訓練模型(Cosmos3-Nano)分別在每個 SDG 來源上單獨微調與聯合微調,研究不同合成資料生成來源如何影響影片生成品質與領域理解。我們以 PAIBench-G T2V 基準([352])評估所有變體,該基準回報總分、感知品質分數與六個領域子分數:常識(Comm. Sense)、AV(自動駕駛)、機器人、工業、人類與物理。結果總結於表 26。
| 模型 | Overall | Domain | Quality | Comm. Sense | AV | Robot | Industry | Human | Physics |
|---|---|---|---|---|---|---|---|---|---|
| 基線(預訓練) | 79.67 | 86.87 | 72.46 | 91.89 | 70.86 | 87.37 | 88.66 | 85.46 | 94.58 |
| + SDG-DriveSim | 79.76 (+0.09) | 86.97 (+0.10) | 72.55 (+0.09) | 92.41 (+0.52) | 70.48 (−0.38) | 88.26 (+0.89) | 88.92 (+0.26) | 84.91 (−0.55) | 94.58 (±0.00) |
| + SDG-RobotSim | 79.66 (−0.01) | 86.60 (−0.27) | 72.72 (+0.26) | 92.22 (+0.33) | 69.83 (−1.03) | 87.60 (+0.23) | 87.44 (−1.22) | 84.99 (−0.47) | 94.50 (−0.08) |
| + SDG-Warehouse | 79.74 (+0.07) | 87.00 (+0.13) | 72.48 (+0.02) | 92.34 (+0.45) | 71.15 (+0.29) | 87.97 (+0.60) | 88.63 (−0.03) | 85.01 (−0.45) | 94.79 (+0.21) |
| + SDG-PhyxSim | 79.62 (−0.05) | 86.68 (−0.19) | 72.56 (+0.10) | 91.57 (−0.32) | 69.44 (−1.42) | 88.17 (+0.80) | 89.51 (+0.85) | 84.77 (−0.69) | 94.72 (+0.14) |
| + SDG-SynHuman | 79.79 (+0.12) | 87.16 (+0.29) | 72.41 (−0.05) | 92.55 (+0.66) | 71.33 (+0.47) | 88.60 (+1.23) | 88.51 (−0.15) | 85.08 (−0.38) | 94.56 (−0.02) |
| + SDG-All | 79.77 (+0.10) | 86.97 (+0.10) | 72.56 (+0.10) | 92.40 (+0.51) | 71.19 (+0.33) | 87.68 (+0.31) | 88.79 (+0.13) | 84.99 (−0.47) | 94.67 (+0.09) |
表 26:合成資料生成(SDG)資料集的消融研究,以 PAIBench-G T2V([352])評估。每個模型從相同的預訓練基線以單一 SDG 來源的資料微調;SDG-All 混合全部五個來源。括號內的差值顯示相對基線的變化。
領域特定的改善
所有 SDG 變體的一致模式是:每個來源提升不同的領域分數,反映各模擬器獨特的內容分布。SDG-DriveSim 在機器人領域帶來最大增益($+0.89$)與強勁的常識改善($+0.52$),反映駕駛情境豐富的結構化動態。SDG-RobotSim 在所有來源中最能改善感知品質($+0.26$),並適度提升機器人分數($+0.23$)。SDG-Warehouse 在 Overall、Domain、AV($+0.29$)與物理($+0.21$)上提供廣泛的正向差值,同時在機器人上維持強勁($+0.60$)。SDG-PhyxSim 帶來最大的單一領域增益:工業提升 $+0.85$、機器人提升 $+0.80$,由其物理落地的工業與操作內容驅動。SDG-SynHuman 是最突出的個別來源,繳出最佳總分($79.79$),並在 Domain($+0.29$)、常識($+0.66$)、AV($+0.47$)與機器人($+1.23$)上有最高的正向差值。以人為中心的合成內容之廣度,似乎提供了可跨多個評估領域轉移的強通用訊號。
模擬到真實的差距與領域權衡
所有 SDG 來源最一致的劣化模式是人類領域分數,每個變體無一例外皆下降——從 $-0.38$(SDG-SynHuman)到 $-0.69$(SDG-PhyxSim)。值得注意的是,即使是專門由合成人類場景構建的 SDG-SynHuman 也無法挽回此分數。這表明模擬到真實 (Sim-to-Real) 的差距在人類相關視覺內容上特別明顯:當前的模擬器尚無法以足夠的擬真度重現真實人類細微的外觀、運動與行為特徵,以惠及此評估領域。更廣泛地說,領域專門化的來源也可能劣化正交的類別——SDG-RobotSim 傷害 AV($-1.03$)與工業($-1.22$),SDG-PhyxSim 對物理的強調伴隨明顯的 AV 劣化($-1.42$)——凸顯了混合來源而非依賴任何單一模擬器的必要性。
混合的 SDG-All 帶來廣泛且平衡的增益
混合所有 SDG 來源(SDG-All)在九個指標中的八個帶來一致的正向差值,僅人類仍有殘餘下滑($-0.47$),與上述模擬到真實差距一致。它取得最佳品質分數($72.56$)並在所有其他領域類別上持續改善,證明資料多樣性能抑制個別來源的偏差。基於這些結果,我們的最終模型在專門的中期訓練階段將 SDG 資料集與真實的高品質影片一同納入。此設計讓模型吸收合成資料所編碼的領域特定物理理解,同時保留其在預訓練中從真實影片習得的感知擬真度與視覺真實感。
附錄 D Cosmos3-Edge LLM 模型訓練
Cosmos3-Edge 使用從頭訓練的稠密 2B 骨幹。其訓練遵循兩階段課程:預訓練接監督式微調。預訓練階段再細分為基礎預訓練與長脈絡延伸。全程使用 BF16 精度;最佳化器設定如下。
基礎預訓練
基礎預訓練期間,我們以 8,192 token 的序列長度,在 Nemotron 預訓練語料的共 15T token 上從頭訓練 2B Edge 骨幹。此階段包含兩個子階段:在廣覆蓋資料混合上的一般預訓練,接著在更高品質混合上的持續預訓練。資料混合在訓練中熱切換:持續預訓練從一般預訓練檢查點恢復,保留最佳化器狀態與學習率排程,僅改變資料混合。我們使用 AdamW,峰值學習率 $1.2\times 10^{-3}$、$(\beta_{1},\beta_{2})=(0.9,0.95)$、權重衰減 $0.1$、梯度裁剪範數 1.0。使用暖身—穩定—衰減 (Warmup-Stable-Decay, WSD) 學習率排程,將資料混合切換對齊於穩定階段到衰減階段的轉換。Tokenizer 與 NVIDIA Nemotron-3 模型([200])共用。
長脈絡延伸
長脈絡延伸階段將 Cosmos3-Edge 骨幹的脈絡窗口延伸到 128K token。雖然延伸後的脈絡窗口支援 128K-token 訓練序列,此階段的主要目標是改善部署時 32K-token 序列長度的穩健性與品質。脈絡延伸階段以 128K 序列長度訓練,RoPE base 提高至 1e8。使用 $1.2\times 10^{-5}$ 的固定學習率,長脈絡階段以 90B token 訓練。此階段的資料混合將預訓練混合降採樣至 80%,其餘 20% 加入長文件問答資料。
監督式微調
我們使用 Nemotron-Cascade-2([326])的監督式微調資料,涵蓋數學、程式撰寫、科學、一般對話、指令遵循、工具使用與程式代理任務等廣泛領域。資料集總計約 26M 筆 SFT 樣本。我們將這些範例打包為最長 128K token 的序列,得到約 2.6M 筆打包訓練樣本。模型以單一 SFT 階段訓練,全域批次大小 32。使用 AdamW 最佳化器,學習率 $2\times 10^{-5}$、$(\beta_{1},\beta_{2})=(0.9,0.98)$。經驗上,模型能力在約 1.7 個 epoch 後達到峰值,對應 140K 訓練步。
我們在一組橫跨推理、科學、指令遵循、長脈絡與通用能力的文字基準上評估 SFT 模型:HMMT25 Feb([103])、GPQA([236])、MMLU-Pro([293])、AA-LCR([6])、IFBench([227])與 Scale AI Multi-Challenge([258])。我們與 Qwen3.5-2B([233])比較——一個相同模型大小的強基線。
如表 27 所示,我們的文字 SFT 模型在數學推理與科學基準(如 HMMT25 Feb 與 GPQA)上大幅超越 Qwen3.5-2B。在指令遵循與長脈絡評估(包括 IFBench 與 AA-LCR)上取得可比的結果。然而在 MMLU-Pro 等通用領域基準上落後 Qwen3.5-2B。
| 模型 | HMMT25 Feb | GPQA | MMLU-Pro | AA-LCR | IFBench (prompt) | Scale AI Multi-Challenge |
|---|---|---|---|---|---|---|
| Qwen3.5-2B | 22.9 | 51.6 | 66.5 | 25.6 | 41.3 | 33.7 |
| Cosmos3-Edge | 76.3 | 56.4 | 62.6 | 22.8 | 43.6 | 28.1 |
表 27:文字基準結果。比較 Cosmos3-Edge 與 Qwen3.5-2B 在推理、科學、指令遵循與長脈絡評估上的表現。Cosmos3-Edge 在 HMMT25 Feb 與 GPQA 上大幅改善數學與科學推理能力,同時在 IFBench 與 AA-LCR 上取得可比的分數。
附錄 E 額外消融研究
主要實驗雖已展示 Cosmos 3 在廣泛理解與生成任務上的有效性,卻未能完全隔離各項設計選擇的貢獻。為更深入理解模型能力背後的因素,我們進行一系列消融研究 (Ablation Study),檢驗關鍵的架構、資料與訓練決策。這些研究探究 Reasoner 與 Generator 如何在 Mixture-of-Transformers 框架中互動、音訊與動作資料等多模態訓練訊號的影響、時間條件機制的有效性,以及習得的世界與動作表徵跨領域的可轉移性。這些分析合計為使 Cosmos 3 得以作為統一全模態世界模型服務物理 AI 的設計原則提供更深的洞見。
E.1 Reasoner 如何惠及 Generator
本研究探究 Reasoner 如何惠及 Generator 模型。我們以 Cosmos3-Nano 架構訓練兩個模型:一個以 Qwen3-VL-8B 作為理解塔,另一個以我們的 Cosmos3-Nano Reasoner。兩者的 Generator 塔皆從頭訓練。此消融實驗限制訓練於 256p 與 480p 解析度、片段長度 0–200 幀、序列長度 25K。仿照大規模訓練,我們使用影像—影片聯合訓練。兩個模型皆以 256 顆 GPU 訓練 90K 次疊代。以下回報兩者的 PAIBench 分數。
| 基準 | 理解塔 | Overall | Domain | Quality | C.S. | AV | Rob. | Ind. | Hum. | Phy. | Subj. | Bg. | Motion | Aesth. | Imag. | Cons. | I2V Subj. | I2V Bg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| T2V | Cosmos3 Reasoner | 74.3 | 75.7 | 73.0 | 81.2 | 54.9 | 71.3 | 78.4 | 76.2 | 89.2 | 96.0 | 96.8 | 99.4 | 55.2 | 71.4 | 19.1 | – | – |
| T2V | Qwen-3 VL | 73.3 | 73.7 | 73.0 | 80.5 | 52.6 | 66.5 | 77.4 | 74.0 | 88.7 | 95.8 | 96.6 | 99.4 | 55.0 | 72.2 | 19.0 | – | – |
| I2V | Cosmos3 Reasoner | 79.4 | 80.8 | 78.1 | 89.0 | 59.4 | 77.0 | 84.8 | 79.3 | 91.6 | 92.4 | 94.7 | 99.4 | 53.2 | 68.7 | 20.2 | 98.0 | 98.0 |
| I2V | Qwen-3 VL | 79.0 | 80.0 | 78.0 | 89.7 | 59.8 | 74.0 | 84.0 | 78.3 | 91.4 | 92.0 | 94.5 | 99.4 | 53.1 | 69.3 | 20.1 | 97.9 | 97.9 |
表 28:理解塔消融。我們回報兩個僅在理解塔初始化所用預訓練模型上不同的變體((1) Cosmos 3 Reasoner 與 (2) Qwen3-VL)在 PAIBench T2V 與 I2V 上的領域與品質分數,Generator 塔皆從頭訓練。主體與背景一致性是 I2V 專屬,不適用於 T2V。以 Cosmos3 Reasoner 初始化理解塔,在物理 AI 領域上的領域分數優於 Qwen3-VL 變體。
如表 28 所示,將理解塔的 Qwen3-VL-8B 替換為我們的 Cosmos3-Nano Reasoner,在領域分數上帶來一致改善,尤其在物理 AI 領域。在 T2V 上,Reasoner 將整體 Domain 分數從 73.7 提升至 75.7,最大增益集中在物理落地的類別:機器人(+4.8,66.5 → 71.3)、物理(+0.5,88.7 → 89.2)、AV(+2.3,52.6 → 54.9)與工業(+1.0,77.4 → 78.4)。I2V 上有類似模式,Domain 分數從 80.0 升至 80.8,由常識(+0.7)、工業(+0.8)、人類(+1.0)與物理(+0.2)的增益驅動。這些結果表明 Reasoner 為物理 AI 領域提供更好的嵌入供 Generator 學習。兩個模型的品質分數相當。
E.2 FPS 控制方式的選擇
我們研究兩種互補的機制,用於以目標幀率為條件進行生成:(i) MRoPE FPS 調變——以目標 FPS 縮放統一 3D MRoPE 的時間軸;(ii) 文字控制——將目標時長與 FPS 以自然語言文字注入結構化 JSON 描述。此消融實驗限制訓練於 256p 與 480p 解析度、片段長度 0–200 幀、序列長度 25K。仿照大規模訓練,我們使用影像—影片聯合訓練。我們訓練 4 個模型,各以 128 顆 GPU 訓練 130K 次疊代,僅變化各機制是否啟用:Base(無控制)、文字控制(僅文字)、MRoPE FPS 調變(僅 MRoPE),以及文字控制+MRoPE FPS 調變(兩者兼具)。我們策展一個已知來源時長與 FPS 的評估集,10、15、24、30 FPS 各約 100 部影片(容差 ±2 FPS)。我們以這些評估集影片的結構化描述作為提示,每則提示以 3 個種子在 480p(16:9)解析度生成樣本,每則提示產生一段 5 秒片段。
我們對每段片段以影片品質(VQ;DOVER 感知品質分數([300]))與動態程度(DD;0–1 尺度的運動存在度([113]))評分。從每則提示($p$)的三種子 DD 分數,我們計算正規化的運動控制(MC)項:
$$\text{MC}=\mathbb{E}_{p}\!\left[\frac{\text{var}_{p}}{\text{var}_{p}+\text{mean}_{p}^{2}}\right], \tag{10}$$
MC 表示控制機制的穩健性,即各控制設定下每則提示的變異程度。我們將這些組合為運動保真度 (Motion Fidelity) 分數:
$$\text{MF}=(1-|\text{DD}-\text{DD}_{\text{ref}}|)\,(1-\text{MC}), \tag{11}$$
其中 $\text{DD}_{\text{ref}}$ 為真實影片參考集在各頻帶的平均 DD。最終的綜合分數是影片品質與運動保真度的乘積,反映對運動幅度的遵循且不影響生成影片的感知品質。其計算為 $\mathbb{E}_{\text{FPS-band}}\!\left[(\text{VQ})\cdot\text{MF}\right]$,先按 FPS 頻帶計算再跨頻帶平均。
表 29 回報四個 FPS 頻帶的平均值。兩種機制各自都優於 Base;單獨的 MRoPE FPS 調變比文字控制帶來更大增益(綜合分數 $+1.12$ 對 $+0.77$)。兩者結合產生最佳綜合分數(較 Base $+1.30$)。VQ 在四種設定間保持在 0.2 分的窗口內,表明增益集中於運動保真度而非影片感知品質,即控制主要改善時間行為。基於這些結果,我們為 Cosmos 3 Generator 採用文字控制+MRoPE FPS 調變的組態。
| 模型 | FPS 控制設定 | 平均 VQ (↑) | 平均 MF (↑) | 平均綜合分數 (↑) |
|---|---|---|---|---|
| Cosmos3-Nano | Base(無控制) | 12.89 | 0.6626 | 8.51 |
| Cosmos3-Nano | 文字控制 | 12.99 | 0.7169 | 9.28 |
| Cosmos3-Nano | MRoPE FPS 調變 | 13.03 | 0.7409 | 9.63 |
| Cosmos3-Nano | 文字控制+MRoPE FPS 調變 | 12.84 | 0.7649 | 9.81 |
表 29:Cosmos3-Nano 的 FPS 控制消融。分數為四個 FPS 頻帶(10、15、24、30)的平均。VQ 為 DOVER 影片品質分數;MF 為運動保真度(0–1);綜合分數 = 𝔼band[(VQ) ⋅ MF]。文字控制+MRoPE FPS 調變是最有效的控制設定,展現對參考 FPS 頻帶運動的遵循同時保留感知品質。
E.3 預訓練中的音訊資料
我們探究在持續預訓練中納入音訊對影片指標的影響。從相同的預訓練檢查點出發,我們在預訓練資料集上訓練兩個 Cosmos3-Nano 變體:一個僅用影片資料、一個用影片—音訊聯合資料。這些消融實驗以 128 顆 GPU 訓練 20k 次疊代,訓練限制於 256p 與 480p 解析度。
| 基準 | 變體 | Overall | Domain | Quality | C.S. | AV | Rob. | Ind. | Hum. | Phy. | Subj. | Bg. | Motion | Aesth. | Imag. | Cons. | I2V Subj. | I2V Bg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| T2V | 無音訊 | 78.6 | 83.8 | 73.4 | 90.7 | 64.7 | 81.9 | 84.4 | 82.7 | 94.8 | 95.9 | 97.1 | 99.5 | 57.3 | 70.6 | 19.8 | – | – |
| T2V | 含音訊 | 79.1 | 85.0 | 73.2 | 91.5 | 67.9 | 83.8 | 86.1 | 83.7 | 93.8 | 95.5 | 96.9 | 99.5 | 57.1 | 70.2 | 19.9 | – | – |
| I2V | 無音訊 | 81.7 | 85.1 | 78.4 | 93.2 | 67.5 | 82.0 | 86.0 | 83.2 | 95.1 | 93.3 | 95.1 | 99.5 | 55.0 | 67.6 | 20.4 | 98.4 | 98.3 |
| I2V | 含音訊 | 82.2 | 85.9 | 78.4 | 93.6 | 68.6 | 84.2 | 86.5 | 84.3 | 94.8 | 92.9 | 94.9 | 99.4 | 55.0 | 67.9 | 20.4 | 98.2 | 98.2 |
表 30:預訓練期間引入音訊資料的效果。我們回報兩個僅在訓練是否使用音訊上不同的 Generator 變體,經持續預訓練後的 PAIBench T2V 與 I2V 分數。影片資料在兩個實驗間共用。
表 30 的結果顯示,不含音訊的持續訓練導致 T2V 與 I2V 分數皆下降,表明影片—音訊聯合預訓練不會劣化影片生成品質,且即使以純影片指標評估也可能提供適度的效益。
E.4 動作模式間的協同效應
如第 2.2.2 節所述並總結於圖 4,Cosmos 3 支援三種動作生成模式:前向動力學(FD)、逆向動力學(ID)與聯合影片—動作預測(策略)。我們消融檢驗單一聯合動作模型能否在這些模式間共享有用結構。此實驗使用 PushT 資料集與 Cosmos3-Edge。模型分別訓練三個單一模式動作檢查點各 2K 步,對照一個訓練 6K 步的聯合 FD/ID/策略檢查點,使每個模式的最佳化步數相同。FD 回報 PSNR、ID 回報 MSE。策略模式回報 T 型積木與目標區域的策略覆蓋率,彙總 50 個不同初始化、每個起始點 10 次推演。結果總結於表 31。
| 訓練設定 | FD PSNR ↑ | ID MSE ↓ | 策略覆蓋率 ↑ |
|---|---|---|---|
| 2K 單一模式 | 27.13 | 1.11 × 10⁻³ | 74.1% |
| 6K 聯合 FD/ID/策略 | 26.22 | 3.09 × 10⁻⁴ | 77.3% |
表 31:PushT 動作模式協同效應。我們比較各訓練 2K 步的單一模式 FD、ID 與策略檢查點,對照訓練 6K 步的聯合 FD/ID/策略檢查點。ID MSE 愈低愈好;FD PSNR 與策略覆蓋率愈高愈好。
聯合的 FD/ID/策略檢查點在保持可比的前向動力學品質的同時,改善了動作側的指標。與單一模式檢查點相比,ID MSE 從 $1.11\times 10^{-3}$ 降至 $3.09\times 10^{-4}$,相對減少 72%;策略覆蓋率從 74.1% 提升至 77.3%。FD PSNR 從 27.13 降至 26.22,顯示重建擬真度有適度的取捨。整體而言,在相同的每模式最佳化預算下,聯合檢查點提供最佳的策略覆蓋率與 ID 準確度,表明動作模式共享有用結構,儘管 FD 品質從單一模式專門化中略有受益。
E.5 影片—動作一致性
除了第 6.2.5 節回報的閉迴路成功率,我們評估 Cosmos3-Nano-Policy-DROID 聯合預測的影片與動作串流在 RoboLab 上的對齊程度。Cosmos3-Nano-Policy-DROID 僅在 DROID 上訓練,因此 RoboLab 提供了測試此影片—動作一致性的保留環境。對每個預測的動作塊,我們在 RoboLab 模擬器中執行相同的動作塊,並計算模型預測影片與所得模擬器推演之間的 PSNR,再跨動作塊彙總左側與腕部相機視角的分數。左側第三人稱視角達到 23.19 dB,與我們的機器人前向動力學模型在 DROID 上達到的 PSNR 水準相當(表 18)。腕部(手上眼)視角更具挑戰性,因為相機隨末端效應器移動、模型必須推斷新顯露的內容;儘管如此仍達到 17.33 dB。這些結果顯示預測的動作與預測的影片之間有很強的一致性。圖 37 視覺化此一致性:預測的幀與從相同狀態初始化的模擬器推演對應幀高度吻合。
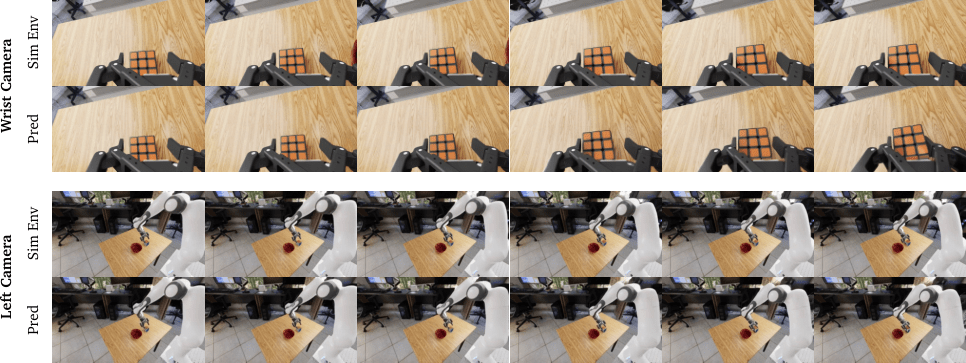
圖 37:RoboLab 上預測影片對模擬器推演的比較。對腕部與左側相機,Sim Env 顯示從相同初始狀態在 RoboLab 模擬器中執行預測動作塊所錄得的影片,Pred 顯示 Cosmos3-Nano-Policy-DROID 與該動作塊聯合預測的影片。我們觀察到預測影片與模擬器推演高度吻合。
附錄 F Cosmos-HumanEval 基準(Cosmos-HUE)
Cosmos-HumanEval(Cosmos-HUE 或 HUE)是主要結果章節引入的影片生成評估基準。HUE 透過 VLM 管線為每部影片生成的原子級二元問題提供人工參考訊號,並沿四個 HUE 維度(語意對齊、物理定律、幾何推理、視覺完整性)評分。本附錄補充該概述,提供正式的二元評分方案、標註協定與可靠性估計,以及各維度與各領域的文字生成影片(T2V)與影像生成影片(I2V)排行榜。
二元回應綱要與評分
每道 Layer 3 問題引出「是」(符合準則)、「否」(明顯違反)或「不確定」(例如區域被遮擋或運動太快無法評估,或影片未呈現問題預設的事件——例如提示要求右轉但前車始終未轉彎,因此關於平滑弧線的後續問題沒有明確的是或否)。不確定視為否:模型不會因未能產生提示的動作而得到獎勵,而信心不足的標註者則保守地計為對模型不利。具體而言,不確定不計入「是」的分子但保留在分母中,因此一部大多為不確定的影片,在相同數量的明確「是」答案下無法得到更高分。令 $\mathcal{Q}_{v}$ 表示對影片 $v$ 發出的問題集,每部影片的 HUE 分數為:
$$\mathrm{HUE}(v)\;=\;\frac{\sum_{q\in\mathcal{Q}_{v}}\mathbf{1}\!\left[\mathrm{ans}(v,q)=\textsc{Yes}\right]}{\lvert\mathcal{Q}_{v}\rvert}\times 100\%, \tag{12}$$
由於「是」永遠是理想結果,$\mathrm{HUE}(v)\in[0,100]\%$。模型層級分數對 $V$ 部測試影片彙總:
$$\mathrm{HUE}(m)\;=\;\frac{\sum_{v=1}^{V}\sum_{q\in\mathcal{Q}_{v}}\mathbf{1}\!\left[\mathrm{ans}(v,q)=\textsc{Yes}\right]}{\sum_{v=1}^{V}\lvert\mathcal{Q}_{v}\rvert}\times 100\%. \tag{13}$$
總平均對每個已回答的(影片, 問題)觀測等權重,避免因某些影片恰好收到較少適用問題而膨脹分數。維度層級的分數以相同方式計算,僅將加總限制在屬於各維度的問題。
標註協定
每部影片從上述三層管線收到最多 16 道原子級二元問題,每個(影片, 問題)對由兩位人工標註者獨立評定。若兩位標註者一致,共識答案記為標準回應;若不一致,該問題升級至第三位品管(QC)審核者,其答案為最終答案。這種雙評分+品管決勝的工作流程為每個(影片, 問題)對產生單一標準答案,限制任何單一標註者的影響,並產出可稽核的回應串流供公式 12–13 的評分計算使用。
問題設計與疊代
撰寫與精修原子問題鎖定兩個目標:低變異(對相同提示重跑相同模型應產生相似分數)與真值飽和(與提示配對的真實影片應接近 $100\%$ 得分)。我們用這些準則評估候選問題並疊代題庫,修訂或刪除不符合任一準則的題目。此過程持續進行:真值分數仍低於 $100\%$(表 32 與 33),因此題庫的精修仍在繼續。
可靠性與信賴區間
當前的 T2V 評估池從 PAIBench-G 抽樣 100 則提示,每則提示 5 個隨機種子生成、每部影片最多 20 道問題,每個模型檢查點最多產生 10,000 個二元觀測。將每個觀測視為底層「是」率 $p=\mathrm{HUE}(m)/100$ 的獨立 Bernoulli 試驗,模型層級 HUE 分數的 95% 信賴區間(以百分點計)為 $\mathrm{HUE}(m)\pm 100\cdot 1.96\sqrt{p(1-p)/N}$,$N$ 為觀測數;實務上,這在表 32 尺度上為頂級分數帶來約 $\pm 0.6$ 分的 CI95 寬度。原子級二元判斷相較 Likert 量表評分降低了標註者內部變異——後者要求標註者整合多個觀察、加以權衡,並映射到任意尺度,這三個操作各自引入雜訊。真實影片真值列在 T2V 提示上得 93.6、I2V 提示上得 94.4,反映 (i) 儘管經過人工審查,抽樣的 PAIBench-G 配對中仍有輕微的提示—影片不匹配殘留;(ii) 自動生成題組的不完美——過於嚴格、模糊或偏題的問題可能在真實影片上得到「否」或「不確定」。我們將真值到 $100\%$ 的差距視為持續精修題庫的北極星指標。
T2V 排行榜
表 32 回報我們的模型陣容與最強外部 T2V 基線的當前 T2V 結果。Veo-3.1 整體領先(91.3)、Seedance-1.5-Pro 第二(90.0);Cosmos3-Super 以 89.3 為最佳開源生成器,領先 Wan2.2-A14B(88.2)與 Cosmos3-Nano(87.6)。各維度的圖景對 Cosmos3-Super 更有利:它在 12 個軸向中的 9 個為最佳開源模型,並在 AV(87.7)與物理(91.5)上擊敗包括閉源在內的所有生成器。最強生成器到真實影片(真實影片真值,93.6)的差距整體約 2.3 分,為下一輪留下可觀的進步空間。
I2V 排行榜
表 33 回報平行的 I2V 評估。Veo-3.1 整體領先(89.7),Cosmos3-Super 僅落後 $0.1$ 分(89.6);Cosmos3-Nano(88.6)險勝 Wan2.2-A14B(88.4)與 Seedance-1.5-Pro(87.6)。Cosmos3-Super 在視覺完整性(94.2)、機器人(91.1)與其他(94.8)上直接擊敗所有生成器,並在語意對齊上與 Veo-3.1 並列第一(皆 90.3);Cosmos3-Nano 在 AV(87.6)上直接獲勝;Wan2.2-A14B 在物理(91.9)上獲勝。完整的 I2V 陣容在各生成器間橫跨約 9 分。
| 模型 | 類型 | Overall | 語意對齊 | 物理定律 | 幾何推理 | 視覺完整性 | C.S. | AV | Rob. | Ind. | Hum. | Phy. | Misc. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 真實影片真值(PAI-Bench) | — | 93.6 | 95.0 | 90.5 | 94.1 | 94.8 | 92.0 | 93.7 | 94.9 | 94.4 | 93.2 | 93.1 | 93.6 |
| Cosmos3-Super | 開源 | 89.3 | 92.4 | 85.4 | 86.6 | 93.7 | 89.5 | 87.7 | 88.4 | 89.4 | 88.6 | 91.5 | 93.0 |
| Cosmos3-Nano | 開源 | 87.6 | 91.5 | 83.6 | 84.1 | 92.5 | 89.5 | 87.0 | 86.6 | 85.8 | 86.2 | 87.9 | 94.0 |
| Wan2.2-A14B | 開源 | 88.2 | 92.1 | 83.4 | 85.6 | 92.6 | 87.8 | 84.9 | 83.7 | 91.1 | 89.9 | 87.5 | 93.4 |
| HunyuanVideo-1.5 | 開源 | 86.5 | 88.4 | 81.8 | 83.6 | 93.6 | 88.3 | 81.0 | 81.3 | 88.0 | 87.9 | 87.4 | 93.3 |
| Wan2.1-14B | 開源 | 84.0 | 87.7 | 77.1 | 78.5 | 92.7 | 85.3 | 79.1 | 78.2 | 87.0 | 85.1 | 85.8 | 90.7 |
| Wan2.2-5B | 開源 | 80.8 | 86.9 | 73.8 | 73.6 | 89.9 | 83.4 | 73.5 | 76.0 | 84.4 | 81.3 | 82.8 | 87.9 |
| Cosmos-Predict2.5-14B | 開源 | 82.1 | 88.1 | 74.6 | 75.8 | 90.7 | 81.3 | 84.4 | 76.8 | 82.4 | 81.3 | 84.5 | 90.2 |
| Cosmos-Predict2.5-2B | 開源 | 81.8 | 88.1 | 74.0 | 75.1 | 90.6 | 81.5 | 81.8 | 79.5 | 82.7 | 80.3 | 82.7 | 89.8 |
| Veo-3.1 | 閉源 | 91.3 | 94.3 | 87.7 | 91.0 | 93.9 | 92.7 | 85.6 | 91.5 | 94.7 | 90.3 | 90.4 | 95.8 |
| Seedance-1.5-Pro | 閉源 | 90.0 | 91.2 | 88.4 | 89.8 | 92.8 | 90.5 | 83.6 | 89.0 | 92.9 | 90.7 | 91.4 | 91.7 |
表 32:Cosmos HUE T2V 排行榜。各維度與各領域細分(%;愈高愈好)。左區塊:整體 HUE 加四個維度(語意對齊、物理定律、幾何推理、視覺完整性)。右區塊:限制於各 PAIBench-G 提示領域的整體 HUE(C.S.、AV、Rob.、Ind.、Hum.、Phy.、Misc. 分別縮寫常識、自動駕駛、機器人、工業、人類、物理、其他)。真實影片真值為參考上界。Cosmos3-Super 在 12 個軸向中的 9 個領先開源模型,並在 AV(87.7)與物理(91.5)上擊敗包括閉源在內的所有生成器。
| 模型 | 類型 | Overall | 語意對齊 | 物理定律 | 幾何推理 | 視覺完整性 | C.S. | AV | Rob. | Ind. | Hum. | Phy. | Misc. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 真實影片真值(PAI-Bench) | — | 94.4 | 94.8 | 93.2 | 95.1 | 95.4 | 94.2 | 96.0 | 94.9 | 93.4 | 92.1 | 96.3 | 98.1 |
| Cosmos3-Super | 開源 | 89.6 | 90.3 | 87.5 | 87.0 | 94.2 | 90.7 | 86.2 | 91.1 | 89.6 | 87.1 | 91.5 | 94.8 |
| Cosmos3-Nano | 開源 | 88.6 | 89.2 | 86.4 | 86.3 | 93.5 | 90.6 | 87.6 | 90.6 | 88.0 | 84.7 | 91.0 | 93.9 |
| Wan2.2-A14B | 開源 | 88.4 | 88.6 | 86.0 | 85.7 | 93.5 | 90.1 | 84.7 | 84.8 | 92.0 | 86.5 | 91.9 | 92.5 |
| HunyuanVideo-1.5 | 開源 | 85.6 | 87.1 | 80.8 | 83.0 | 92.5 | 90.0 | 81.7 | 77.2 | 89.6 | 85.2 | 89.5 | 91.8 |
| Wan2.1-14B | 開源 | 83.9 | 85.0 | 80.2 | 80.6 | 91.2 | 88.1 | 76.8 | 74.8 | 89.9 | 84.3 | 85.8 | 93.2 |
| Wan2.2-5B | 開源 | 80.4 | 83.4 | 74.6 | 75.7 | 89.5 | 86.1 | 74.3 | 68.6 | 88.4 | 79.6 | 84.8 | 90.5 |
| Cosmos-Predict2.5-14B | 開源 | 83.0 | 85.0 | 77.9 | 77.5 | 92.4 | 88.1 | 85.2 | 78.4 | 83.0 | 78.5 | 84.8 | 93.2 |
| Cosmos-Predict2.5-2B | 開源 | 82.6 | 86.1 | 77.3 | 78.2 | 90.2 | 85.6 | 86.0 | 79.0 | 85.6 | 77.1 | 85.1 | 92.4 |
| Veo-3.1 | 閉源 | 89.7 | 90.3 | 87.7 | 89.2 | 93.2 | 92.3 | 86.0 | 88.6 | 93.4 | 87.2 | 91.2 | 94.3 |
| Seedance-1.5-Pro | 閉源 | 87.6 | 87.7 | 85.4 | 86.5 | 91.8 | 89.5 | 82.9 | 85.7 | 90.6 | 85.7 | 90.6 | 93.0 |
表 33:Cosmos HUE I2V 排行榜。各維度與各領域細分(%;協定同表 32,加上影像條件)。版面、領域縮寫與標示慣例同表 32。
附錄 G 貢獻者與致謝
各組內的貢獻者依姓氏字母順序排列。
G.1 貢獻者
【譯註:原論文此節依工作分組(Supervision、模型架構、Reasoner 預訓練/後訓練資料、空間理解、時間理解、2D 定位、機器人、駕駛、智慧基礎設施、醫療、視覺評審、提示詞上採樣、過濾與清理、Generator 影像/影片/音訊/動作/轉換資料、訓練配方、Edge LLM 訓練、Reasoner 預訓練與 SFT、Generator 預訓練/中期訓練/後訓練、基礎設施(資料、訓練、服務、基準)、結果與基準(推理、視覺生成、動作生成、音訊生成、轉換生成)與其他貢獻等)列出數百位 NVIDIA 貢獻者的完整名單。人名保留原文,完整名單請參閱原論文附錄 G.1。】
G.2 致謝
【譯註:原論文此節致謝了 Pranav Atreya、Stan Birchfield、Mike Houston、Andrew Tao、Jonathan Tremblay、Danfei Xu 等五十餘位提供協助的人士,人名保留原文,完整名單請參閱原論文附錄 G.2。】
參考文獻
參考文獻依原論文保留英文。
- Adobe (2025) Adobe Adobe Firefly Video Model. Note: https://news.adobe.com/news/2025/02/firefly-web-app-commercially-safe
- Agarwal et al. (2025) S. Agarwal, L. Ahmad, J. Ai, S. Altman, A. Applebaum, et al. GPT-OSS-120B & GPT-OSS-20B model card. arXiv preprint arXiv:2508.10925.
- Alayrac et al. (2022) J. Alayrac, J. Donahue, P. Luc, A. Miech, I. Barr, Y. Hasson, K. Lenc, A. Mensch, K. Millican, M. Reynolds, et al. Flamingo: a visual language model for few-shot learning. In NeurIPS,
- Amazon (2024) Amazon Amazon Nova Reel. Note: https://docs.aws.amazon.com/nova/latest/userguide/video-generation.html
- Arkhipkin et al. (2025) V. Arkhipkin, V. Korviakov, N. Gerasimenko, D. Parkhomenko, V. Vasilev, A. Letunovskiy, N. Vaulin, M. Kovaleva, I. Kirillov, L. Novitskiy, et al. Kandinsky 5.0: a family of foundation models for image and video generation. arXiv preprint arXiv:2511.14993.
- Artificial Analysis Team (2025) Artificial Analysis Team Artificial analysis long context reasoning benchmark (LCR). Note: Dataset
- Assran et al. (2023) M. Assran, Q. Duval, I. Misra, P. Bojanowski, P. Vincent, M. Rabbat, Y. LeCun, and N. Ballas Self-supervised learning from images with a joint-embedding predictive architecture. In CVPR,
- Assran et al. (2025) M. Assran, A. Bardes, D. Fan, Q. Garrido, R. Howes, M. Muckley, A. Rizvi, C. Roberts, K. Sinha, A. Zholus, et al. V-JEPA 2: self-supervised video models enable understanding, prediction and planning. arXiv preprint arXiv:2506.09985.
- Atreya et al. (2025) P. Atreya, K. Pertsch, T. Lee, M. J. Kim, A. Jain, A. Kuramshin, C. Eppner, C. Neary, E. Hu, F. Ramos, et al. RoboArena: distributed real-world evaluation of generalist robot policies. In CoRL,
- Bahmani et al. (2025) S. Bahmani, T. Shen, J. Ren, J. Huang, Y. Jiang, H. Turki, A. Tagliasacchi, D. B. Lindell, Z. Gojcic, S. Fidler, et al. Lyra: generative 3D scene reconstruction via video diffusion model self-distillation. arXiv preprint arXiv:2509.19296.
- Bai et al. (2023) J. Bai, S. Bai, S. Yang, S. Wang, S. Tan, P. Wang, J. Lin, C. Zhou, and J. Zhou Qwen-VL: a versatile vision-language model for understanding, localization, text reading, and beyond. arXiv preprint arXiv:2308.12966.
- Bai et al. (2025a) S. Bai, Y. Cai, R. Chen, K. Chen, X. Chen, Z. Cheng, L. Deng, W. Ding, C. Gao, C. Ge, et al. Qwen3-VL technical report. arXiv preprint arXiv:2511.21631.
- Bai et al. (2025b) S. Bai, Y. Cai, R. Chen, et al. Qwen3-VL technical report. arXiv preprint arXiv:2511.21631.
- Bai et al. (2025c) S. Bai, K. Chen, X. Liu, J. Wang, W. Ge, S. Song, K. Dang, P. Wang, S. Wang, J. Tang, et al. Qwen2.5-VL technical report. arXiv preprint arXiv:2502.13923.
- Baker et al. (2022) B. Baker, I. Akkaya, P. Zhokhov, J. Huizinga, J. Tang, A. Ecoffet, B. Houghton, R. Sampedro, and J. Clune Video PreTraining (VPT): learning to act by watching unlabeled online videos. In NeurIPS,
- Ball et al. (2025) P. J. Ball, J. Bauer, F. Belletti, et al. Genie 3: a new frontier for world models. Note: https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/
- Bansal et al. (2025a) H. Bansal, Z. Lin, T. Xie, Z. Zong, M. Yarom, Y. Bitton, C. Jiang, Y. Sun, K. Chang, and A. Grover VideoPhy: evaluating physical commonsense for video generation. In ICLR,
- Bansal et al. (2025b) H. Bansal, C. Peng, Y. Bitton, R. Goldenberg, A. Grover, and K. Chang VideoPhy-2: a challenging action-centric physical commonsense evaluation in video generation. arXiv preprint arXiv:2503.06800.
- Bar-Tal et al. (2024) O. Bar-Tal, H. Chefer, O. Tov, C. Herrmann, R. Paiss, S. Zada, A. Ephrat, J. Hur, G. Liu, A. Raj, et al. Lumiere: a space-time diffusion model for video generation. In SIGGRAPH Asia,
- Bardes et al. (2025) A. Bardes, Q. Garrido, J. Ponce, X. Chen, M. Rabbat, Y. LeCun, M. Assran, and N. Ballas Revisiting feature prediction for learning visual representations from video. In ICLR,
- Betker et al. (2023) J. Betker, G. Goh, L. Jing, T. Brooks, J. Wang, L. Li, L. Ouyang, J. Zhuang, J. Lee, Y. Guo, et al. Improving image generation with better captions. OpenAI technical report.
- Beyer et al. (2024) L. Beyer, A. Steiner, A. Susano Pinto, A. Kolesnikov, X. Wang, et al. PaliGemma: a versatile 3B VLM for transfer. arXiv preprint arXiv:2407.07726.
- Bi et al. (2025) H. Bi, H. Tan, S. Xie, Z. Wang, S. Huang, H. Liu, R. Zhao, Y. Feng, C. Xiang, Y. Rong, et al. Motus: a unified latent action world model. arXiv preprint arXiv:2512.13030.
- Bjorck et al. (2025) J. Bjorck, F. Castañeda, N. Cherniadev, X. Da, R. Ding, L. Fan, Y. Fang, D. Fox, F. Hu, S. Huang, et al. Gr00t N1: an open foundation model for generalist humanoid robots. arXiv preprint arXiv:2503.14734.
- Black et al. (2025) K. Black, N. Brown, D. Driess, A. Esmail, M. Equi, C. Finn, N. Fusai, L. Groom, K. Hausman, B. Ichter, et al. Pi0: a vision-language-action flow model for general robot control. In RSS,
- Blattmann et al. (2023) A. Blattmann, T. Dockhorn, S. Kulal, D. Mendelevitch, M. Kilian, D. Lorenz, Y. Levi, Z. English, V. Voleti, A. Letts, et al. Stable video diffusion: scaling latent video diffusion models to large datasets. arXiv preprint arXiv:2311.15127.
- Bolya et al. (2025) D. Bolya, P. Huang, P. Sun, J. H. Cho, A. Madotto, C. Wei, T. Ma, J. Zhi, J. Rajasegaran, H. Rasheed, et al. Perception Encoder: the best visual embeddings are not at the output of the network. arXiv.
- Brazil et al. (2023) G. Brazil, A. Kumar, J. Straub, N. Ravi, J. Johnson, and G. Gkioxari Omni3D: a large benchmark and model for 3D object detection in the wild. In CVPR,
- Brohan et al. (2023a) A. Brohan, N. Brown, J. Carbajal, Y. Chebotar, X. Chen, K. Choromanski, T. Ding, D. Driess, A. Dubey, C. Finn, et al. RT-2: vision-language-action models transfer web knowledge to robotic control. In CoRL,
- Brohan et al. (2023b) A. Brohan, N. Brown, J. Carbajal, Y. Chebotar, J. Dabis, C. Finn, K. Gopalakrishnan, K. Hausman, A. Herzog, J. Hsu, et al. RT-1: robotics transformer for real-world control at scale. In RSS,
- Bruce et al. (2024) J. Bruce, M. D. Dennis, A. Edwards, J. Parker-Holder, Y. Shi, E. Hughes, M. Lai, A. Mavalankar, R. Steigerwald, C. Apps, et al. Genie: generative interactive environments. In ICML,
- Bu et al. (2025) Q. Bu, J. Cai, L. Chen, X. Cui, Y. Ding, S. Feng, S. Gao, X. He, X. Hu, X. Huang, et al. AgiBot World Colosseo: a large-scale manipulation platform for scalable and intelligent embodied systems. In IROS,
- Cai et al. (2026) J. Cai, Z. Cai, J. Cao, Y. Chen, Z. He, L. Jiang, H. Li, H. Li, Y. Li, Y. Liu, et al. InternVLA-A1: unifying understanding, generation and action for robotic manipulation. arXiv preprint arXiv:2601.02456.
- Cao et al. (2025) S. Cao, H. Chen, P. Chen, Y. Cheng, Y. Cui, X. Deng, Y. Dong, K. Gong, T. Gu, X. Gu, et al. HunyuanImage 3.0 technical report. arXiv preprint arXiv:2509.23951.
- Cao et al. (2023) T. Cao, C. Wang, B. Liu, Z. Wu, J. Zhu, and J. Huang BeautifulPrompt: towards automatic prompt engineering for text-to-image synthesis. In EMNLP Industry Track,
- Cen et al. (2025) J. Cen, S. Huang, Y. Yuan, K. Li, H. Yuan, C. Yu, Y. Jiang, J. Guo, X. Li, H. Luo, et al. RynnVLA-002: a unified vision-language-action and world model. arXiv preprint arXiv:2511.17502.
- Chameleon Team (2024) Chameleon Team Chameleon: mixed-modal early-fusion foundation models. arXiv preprint arXiv:2405.09818.
- Cheang et al. (2024) C. Cheang, G. Chen, Y. Jing, T. Kong, H. Li, et al. GR-2: a generative video-language-action model with web-scale knowledge for robot manipulation. arXiv preprint arXiv:2410.06158.
- Chegini et al. (2025) A. Chegini, K. Rezaei, H. Eghbalzadeh, and S. Feizi RePanda: Pandas-powered tabular verification and reasoning. In ACL,
- Chen et al. (2024a) B. Chen, Z. Xu, S. Kirmani, B. Ichter, D. Driess, P. Florence, D. Sadigh, L. Guibas, and F. Xia SpatialVLM: endowing vision-language models with spatial reasoning capabilities. In CVPR,
- Chen et al. (2025a) B. Chen, T. Zhang, H. Geng, K. Song, W. T. Freeman, J. Malik, R. Tedrake, V. Sitzmann, and Y. Du Large video planner. External Links: 2512.15840
- Chen et al. (2025b) K. Chen, S. Xie, Z. Ma, P. R. Sanketi, and K. Goldberg Robo2VLM: visual question answering from large-scale in-the-wild robot manipulation datasets. arXiv preprint arXiv:2505.15517.
- Chen et al. (2024b) S. Chen, X. Lan, Y. Yuan, Z. Jie, and L. Ma TimeMarker: a versatile video-LLM for long and short video understanding with superior temporal localization ability. arXiv preprint arXiv:2411.18211.
- Chen et al. (2025c) S. Chen, H. Guo, S. Zhu, F. Zhang, Z. Huang, J. Feng, and B. Kang Video Depth Anything: consistent depth estimation for super-long videos. In CVPR,
- Chen et al. (2016) T. Chen, B. Xu, C. Zhang, and C. Carlana Training deep nets with sublinear memory cost. arXiv preprint arXiv:1604.06174.
- Chen et al. (2025d) X. Chen, Z. Wu, X. Liu, Z. Pan, W. Liu, Z. Xie, X. Yu, and C. Ruan Janus-Pro: unified multimodal understanding and generation with data and model scaling. arXiv preprint arXiv:2501.17811.
- Chen et al. (2024c) Z. Chen, J. Wu, W. Wang, W. Su, G. Chen, S. Xing, M. Zhong, Q. Zhang, X. Zhu, L. Lu, et al. InternVL: scaling up vision foundation models and aligning for generic visual-linguistic tasks. In CVPR,
- Cheng et al. (2026) A. Cheng, Y. Fu, Y. Ji, L. Zhu, G. Zhan, Z. Zhang, Z. Yang, S. Han, Y. Lu, P. Molchanov, et al. Grounded 3D-aware spatial vision-language modeling. In CVPR,
- Cheng et al. (2025) H. Cheng et al. MMAudio: taming multimodal joint training for high-quality video-to-audio synthesis. In CVPR,
- Chi et al. (2024) C. Chi, Z. Xu, C. Pan, E. Cousineau, B. Burchfiel, S. Feng, R. Tedrake, and S. Song Universal manipulation interface: in-the-wild robot teaching without in-the-wild robots. In RSS,
- Chung and Zisserman (2016) J. S. Chung and A. Zisserman Out of time: automated lip sync in the wild. In ACCV Workshops,
- Comunita et al. (2024) M. Comunita, R. F. Gramaccioni, E. Postolache, E. Rodola, D. Comminiello, and J. D. Reiss SyncFusion: multimodal onset-synchronized video-to-audio foley synthesis. In ICASSP,
- contributors (2024) A. W. C. contributors AgiBot world colosseum. Note: https://github.com/OpenDriveLab/AgiBot-World
- Copet et al. (2023) J. Copet, F. Kreuk, I. Gat, T. Remez, D. Kant, G. Synnaeve, Y. Adi, and A. Defossez Simple and controllable music generation. In NeurIPS,
- Dai et al. (2024) W. Dai, N. Lee, B. Wang, Z. Yang, Z. Liu, J. Barker, T. Rintamaki, M. Shoeybi, B. Catanzaro, and W. Ping NVLM: open frontier-class multimodal LLMs. arXiv preprint arXiv:2409.11402.
- Dang et al. (2026) R. Dang, J. Guo, B. Hou, S. Leng, K. Li, X. Li, J. Liu, Y. Mao, Z. Wang, Y. Yuan, et al. RynnBrain: open embodied foundation models. arXiv preprint arXiv:2602.14979.
- Datta et al. (2024) S. Datta, A. Ku, D. Ramachandran, and P. Anderson Prompt expansion for adaptive text-to-image generation. In ACL,
- DeepMind (2025) G. DeepMind Veo 3. External Links: Link
- Deitke et al. (2025) M. Deitke, C. Clark, S. Lee, R. Tripathi, Y. Yang, J. S. Park, M. Salehi, N. Muennighoff, K. Lo, L. Soldaini, et al. Molmo and PixMo: open weights and open data for state-of-the-art vision-language models. In CVPR,
- Deng et al. (2025) C. Deng, D. Zhu, K. Li, C. Gou, F. Li, Z. Wang, S. Zhong, W. Yu, X. Nie, Z. Song, et al. Emerging properties in unified multimodal pretraining. arXiv preprint arXiv:2505.14683.
- Deng et al. (2026) Y. Deng, Z. Pan, H. Zhang, X. Li, R. Hu, Y. Ding, Y. Zou, Y. Zeng, and D. Zhou Rethinking video generation model for the embodied world. arXiv preprint arXiv:2601.15282.
- Dixit et al. (2026) S. Dixit, K. Saito, Z. Zhong, Y. Mitsufuji, and C. Donahue FoleyBench: a benchmark for video-to-audio models. In ICASSP,
- Dosovitskiy et al. (2017) A. Dosovitskiy, G. Ros, F. Codevilla, A. Lopez, and V. Koltun CARLA: An open urban driving simulator. In CoRL,
- Driess et al. (2023) D. Driess, F. Xia, M. S. Sajjadi, C. Lynch, A. Chowdhery, et al. PaLM-E: an embodied multimodal language model. In ICML,
- Du et al. (2025) N. Du, Z. Chen, Z. Chen, S. Gao, X. Chen, Z. Jiang, J. Yang, and Y. Tai TextCrafter: accurately rendering multiple texts in complex visual scenes. arXiv preprint arXiv:2503.23461.
- Duan et al. (2024) H. Duan, J. Yang, Y. Qiao, X. Fang, L. Chen, Y. Liu, X. Dong, Y. Zang, P. Zhang, J. Wang, et al. VLMEvalKit: an open-source toolkit for evaluating large multi-modality models. In ACM MM,
- Dürr (2026) A. Dürr The city generator. Note: https://superhivemarket.com/products/the-city-generator/
- ElevenLabs (2024) ElevenLabs ElevenLabs Sound Effects. Note: https://elevenlabs.io/sound-effects
- Ephrat et al. (2018) A. Ephrat, I. Mosseri, O. Lang, T. Dekel, K. Wilson, A. Hassidim, W. T. Freeman, and M. Rubinstein Looking to listen at the cocktail party: a speaker-independent audio-visual model for speech separation. ACM TOG.
- Feng et al. (2023) W. Feng, W. Zhu, T. Fu, V. Jampani, A. Akula, X. He, S. Basu, X. E. Wang, and W. Y. Wang LayoutGPT: compositional visual planning and generation with large language models. In NeurIPS,
- Foss et al. (2025) A. Foss, C. Evans, S. Mitts, K. Sinha, A. Rizvi, and J. T. Kao CausalVQA: a physically grounded causal reasoning benchmark for video models. arXiv preprint arXiv:2506.09943.
- Fu et al. (2026) L. Fu, Z. Kuang, J. Song, M. Huang, B. Yang, Y. Li, L. Zhu, Q. Luo, X. Wang, H. Lu, et al. Ocrbench v2: an improved benchmark for evaluating large multimodal models on visual text localization and reasoning. NeurIPS 38.
- Fu et al. (2024) X. Fu, Y. Hu, B. Li, Y. Feng, H. Wang, X. Lin, D. Roth, N. A. Smith, W. Ma, and R. Krishna BLINK: multimodal large language models can see but not perceive. In ECCV,
- Gan et al. (2025) Y. Gan, L. Zhu, D. Shan, B. Shi, H. Yin, B. Ivanovic, S. Han, T. Darrell, J. Malik, M. Pavone, et al. FoundationMotion: auto-labeling and reasoning about spatial movement in videos. arXiv preprint arXiv:2512.10927.
- Gao et al. (2026a) Q. Gao, J. Yang, Q. Xu, L. Chen, and Y. Wang LOME: learning human-object manipulation with action-conditioned egocentric world model. arXiv preprint arXiv:2603.27449.
- Gao et al. (2026b) S. Gao, W. Liang, K. Zheng, A. Malik, S. Ye, S. Yu, W. Tseng, Y. Dong, K. Mo, C. Lin, et al. DreamDojo: a generalist robot world model from large-scale human videos. arXiv preprint arXiv:2602.06949.
- Gao et al. (2025) Y. Gao, H. Guo, T. Hoang, W. Huang, L. Jiang, F. Kong, H. Li, J. Li, L. Li, X. Li, et al. Seedance 1.0: exploring the boundaries of video generation models. arXiv preprint arXiv:2506.09113.
- Garrido et al. (2026) Q. Garrido, T. Nagarajan, B. Terver, N. Ballas, Y. LeCun, and M. Rabbat Learning latent action world models in the wild. arXiv preprint arXiv:2601.05230.
- Ge et al. (2024) Y. Ge, S. Zhao, Z. Zeng, Y. Ge, C. Li, X. Wang, and Y. Shan SEED-X: multimodal models with unified multi-granularity comprehension and generation. arXiv preprint arXiv:2404.14396.
- Gemini Robotics Team et al. (2025) Gemini Robotics Team, S. Abeyruwan, J. Ainslie, J. Alayrac, M. G. Arenas, T. Armstrong, A. Balakrishna, R. Baruch, M. Bauza, et al. Gemini robotics: bringing AI into the physical world. arXiv preprint arXiv:2503.20020.
- Gemini Robotics Team (2025) Gemini Robotics Team Gemini Robotics 1.5: bringing agentic AI further into the physical world. arXiv preprint arXiv:2510.03342.
- Genmo (2024) Genmo Mochi 1: open video generation model. Note: https://github.com/genmoai/mochi
- Girdhar et al. (2024) R. Girdhar, A. El-Nouby, Z. Liu, M. Singh, K. V. Alwala, A. Joulin, and I. Misra Emu Video: factorizing text-to-video generation by explicit image conditioning. In ECCV,
- Google DeepMind (2024a) Google DeepMind Gemini 2.0: our new AI model for the agentic era. Note: https://blog.google/technology/google-deepmind/google-gemini-ai-update-december-2024/
- Google DeepMind (2024b) Google DeepMind Genie 2: a large-scale foundation world model. Note: https://deepmind.google/discover/blog/genie-2-a-large-scale-foundation-world-model/
- Google DeepMind (2025a) Google DeepMind Gemini 3. Note: https://blog.google/products-and-platforms/products/gemini/gemini-3/
- Google DeepMind (2025b) Google DeepMind Veo 3.1. Note: https://deepmind.google/technologies/veo/
- Google DeepMind (2026a) Google DeepMind Gemma 4 31B IT. Note: https://huggingface.co/google/gemma-4-31B-itHugging Face model checkpoint. Accessed: 2026-05-14
- Google DeepMind (2026b) Google DeepMind Gemma 4 model card. Note: https://ai.google.dev/gemma/docs/core/model_card_4Accessed: 2026-05-14
- Gramaccioni et al. (2024) R. F. Gramaccioni, C. Marinoni, E. Postolache, M. Comunita, L. Cosmo, J. D. Reiss, and D. Comminiello Stable-V2A: synthesis of synchronized sound effects with temporal and semantic controls. arXiv preprint arXiv:2412.15023.
- Grauman et al. (2024) K. Grauman, A. Westbury, L. Torresani, K. Kitani, J. Malik, T. Afouras, K. Ashutosh, V. Baiyya, S. Bansal, B. Boote, et al. Ego-Exo4D: understanding skilled human activity from first- and third-person perspectives. In CVPR,
- Guan et al. (2024) T. Guan, F. Liu, X. Wu, R. Xian, Z. Li, X. Liu, X. Wang, L. Chen, F. Huang, Y. Yacoob, et al. HallusionBench: an advanced diagnostic suite for entangled language hallucination and visual illusion in large vision-language models. In CVPR,
- Guo et al. (2025) X. Guo, J. Huo, Z. Shi, Z. Song, J. Zhang, and J. Zhao T2VPhysBench: a first-principles benchmark for physical consistency in text-to-video generation. arXiv preprint arXiv:2505.00337.
- Guo et al. (2026) Y. Guo, L. X. Shi, J. Chen, and C. Finn Ctrl-World: a controllable generative world model for robot manipulation. In ICLR,
- Ha and Schmidhuber (2018) D. Ha and J. Schmidhuber World models. arXiv preprint arXiv:1803.10122.
- Ha et al. (2024) H. Ha, Y. Gao, Z. Fu, J. Tan, and S. Song UMI on legs: making manipulation policies mobile with manipulation-centric whole-body controllers. In CoRL,
- HaCohen et al. (2026) Y. HaCohen, B. Brazowski, N. Chiprut, Y. Bitterman, A. Kvochko, A. Berkowitz, D. Shalem, D. Lifschitz, D. Moshe, E. Porat, et al. LTX-2: efficient joint audio-visual foundation model. arXiv preprint arXiv:2601.03233.
- HaCohen et al. (2025) Y. HaCohen, N. Chiprut, B. Brazowski, D. Shalem, D. Moshe, E. Richardson, E. Levin, G. Shiran, N. Zabari, O. Gordon, et al. LTX-Video: realtime video latent diffusion. arXiv preprint arXiv:2501.00103.
- Hafner et al. (2020) D. Hafner, T. Lillicrap, J. Ba, and M. Norouzi Dream to control: learning behaviors by latent imagination. In ICLR,
- Hafner et al. (2019) D. Hafner, T. Lillicrap, I. Fischer, R. Villegas, D. Ha, H. Lee, and J. Davidson Learning latent dynamics for planning from pixels. In ICML,
- Hao et al. (2026) X. Hao, L. Zhou, Z. Huang, Z. Hou, Y. Tang, L. Zhang, G. Li, Z. Lu, S. Ren, X. Meng, et al. MiMo-Embodied: x-embodied foundation model technical report. External Links: 2511.16518
- Hao et al. (2023) Y. Hao, Z. Chi, L. Dong, and F. Wei Optimizing prompts for text-to-image generation. In NeurIPS,
- Harvard-MIT Mathematics Tournament (2025) Harvard-MIT Mathematics Tournament HMMT February 2025. External Links: Link
- Hassani et al. (2023) A. Hassani, S. Walton, J. Li, S. Li, and H. Shi Neighborhood attention transformer. In CVPR,
- He et al. (2024) H. He, Y. Xu, Y. Guo, G. Wetzstein, B. Dai, H. Li, and C. Yang CameraCtrl: enabling camera control for text-to-video generation. arXiv preprint arXiv:2404.02101.
- He et al. (2026) H. He, Y. Zhang, L. Lin, Z. Xu, and L. Pan Pre-trained video generative models as world simulators. In AAAI,
- Ho et al. (2022a) J. Ho, W. Chan, C. Saharia, J. Whang, R. Gao, A. Gritsenko, D. P. Kingma, B. Poole, M. Norouzi, D. J. Fleet, et al. Imagen video: high definition video generation with diffusion models. arXiv preprint arXiv:2210.02303.
- Ho et al. (2022b) J. Ho, T. Salimans, A. Gritsenko, W. Chan, M. Norouzi, and D. J. Fleet Video diffusion models. In NeurIPS,
- Hong et al. (2023) S. Hong, J. Seo, H. Shin, S. Hong, and S. Kim DirecT2V: large language models are frame-level directors for zero-shot text-to-video generation. arXiv preprint arXiv:2305.14330.
- Hu et al. (2023) A. Hu, L. Russell, H. Yeo, Z. Murez, G. Fedoseev, A. Kendall, J. Shotton, and G. Corrado GAIA-1: a generative world model for autonomous driving. arXiv preprint arXiv:2309.17080.
- Huang et al. (2025) J. Huang, Q. Zhou, H. Rabeti, A. Korovko, H. Ling, X. Ren, T. Shen, J. Gao, D. Slepichev, C. Lin, et al. ViPE: video pose engine for 3D geometric perception. arXiv preprint arXiv:2508.10934.
- Huang et al. (2023) W. Huang, C. Wang, R. Zhang, Y. Li, J. Wu, and L. Fei-Fei VoxPoser: composable 3D value maps for robotic manipulation with language models. arXiv preprint arXiv:2307.05973.
- Huang et al. (2024) Z. Huang, Y. He, J. Yu, F. Zhang, C. Si, Y. Jiang, Y. Zhang, T. Wu, Q. Jin, N. Chanpaisit, et al. VBench: comprehensive benchmark suite for video generative models. In CVPR,
- HunyuanWorld (2025) T. HunyuanWorld HY-World 1.5: a systematic framework for interactive world modeling with real-time latency and geometric consistency. arXiv preprint.
- Jacobs et al. (2023) S. A. Jacobs, M. Tanaka, C. Zhang, M. Zhang, S. L. Song, S. Rajbhandari, and Y. He Deepspeed Ulysses: system optimizations for enabling training of extreme long sequence transformer models. arXiv preprint arXiv:2309.14509.
- Jang et al. (2025) J. Jang, S. Ye, Z. Lin, J. Xiang, J. Bjorck, Y. Fang, F. Hu, S. Huang, K. Kundalia, Y. Lin, et al. DreamGen: unlocking generalization in robot learning through video world models. arXiv preprint arXiv:2505.12705.
- Jette and Wickberg (2023) M. A. Jette and T. Wickberg Architecture of the Slurm workload manager. In Job Scheduling Strategies for Parallel Processing,
- Jiang et al. (2025) Z. Jiang, Y. Xie, K. Lin, Z. Xu, W. Wan, A. Mandlekar, L. Fan, and Y. Zhu DexMimicGen: automated data generation for bimanual dexterous manipulation via imitation learning. In ICRA,
- Kembhavi et al. (2016) A. Kembhavi, M. Salvato, E. Kolve, M. Seo, H. Hajishirzi, and A. Farhadi A diagram is worth a dozen images. In ECCV,
- Khazatsky et al. (2024) A. Khazatsky, K. Pertsch, S. Nair, A. Balakrishna, S. Dasari, S. Karamcheti, S. Nasiriany, M. K. Srirama, L. Y. Chen, K. Ellis, et al. DROID: a large-scale in-the-wild robot manipulation dataset. In RSS,
- Kim et al. (2024) M. Kim, K. Pertsch, S. Karamcheti, T. Xiao, et al. OpenVLA: an open-source vision-language-action model. In CoRL,
- Kim et al. (2026) Y. Kim, W. Pumacay, O. Rayyan, M. Argus, W. Han, E. VanderBilt, J. Salvador, A. Deshpande, R. Hendrix, S. Jauhri, S. Liu, N. M. M. Shafiullah, M. Guru, A. Eftekhar, K. Farley, D. Clay, J. Duan, A. Guru, P. Wolters, A. Herrasti, Y. Lee, G. Chalvatzaki, Y. Cui, A. Farhadi, D. Fox, and R. Krishna MolmoSpaces: a large-scale open ecosystem for robot navigation and manipulation. arXiv preprint arXiv:2602.11337.
- Kling Team (2025) Kling Team Kling-Foley: synchronized video-to-audio generation. arXiv preprint arXiv:2506.19774.
- Kondratyuk et al. (2024) D. Kondratyuk, L. Yu, X. Gu, J. Lezama, J. Huang, R. Hornung, H. Adam, H. Akbari, Y. Alon, et al. VideoPoet: a large language model for zero-shot video generation. In ICML,
- Kong et al. (2024) W. Kong, Q. Tian, Z. Zhang, R. Min, Z. Dai, J. Zhou, J. Xiong, X. Li, B. Wu, J. Zhang, et al. HunyuanVideo: a systematic framework for large video generative models. arXiv preprint arXiv:2412.03603.
- Krojer et al. (2025) B. Krojer, M. Komeili, C. Ross, Q. Garrido, K. Sinha, N. Ballas, and M. Assran A shortcut-aware video-qa benchmark for physical understanding via minimal video pairs. arXiv preprint arXiv:2506.09987.
- Kuaishou (2024) Kuaishou Kling. External Links: Link
- Kuaishou (2025) Kuaishou Kling 2.x. Note: https://klingai.com/
- Kwon et al. (2023) W. Kwon, Z. Li, S. Zhuang, Y. Sheng, L. Zheng, C. H. Yu, J. E. Gonzalez, H. Zhang, and I. Stoica Efficient memory management for large language model serving with PagedAttention. In SOSP,
- LanceDB (2026) LanceDB LanceDB vector indexes documentation. Note: https://docs.lancedb.com/indexing/vector-indexAccessed: 2026-05-20
- Le Dem (2013) J. Le Dem Parquet: columnar storage for the people. Note: Strata + Hadoop World, New York, https://parquet.apache.org/docs/learning-resources/presentations/strata-2013/
- Le et al. (2023) M. Le, A. Vyas, B. Shi, B. Karrer, L. Sari, R. Moritz, M. Williamson, V. Manohar, Y. Adi, J. Mahadeokar, et al. Voicebox: text-guided multilingual universal speech generation at scale. In NeurIPS,
- LeCun (2022) Y. LeCun A path towards autonomous machine intelligence version 0.9. 2, 2022-06-27. Open Review.
- Lee et al. (2025a) J. Lee, J. Duan, H. Fang, Y. Deng, S. Liu, B. Li, B. Fang, J. Zhang, Y. R. Wang, S. Lee, et al. MolmoAct: action reasoning models that can reason in space. arXiv preprint arXiv:2508.07917.
- Lee et al. (2025b) S. Lee, Z. Kong, A. Goel, S. Kim, R. Valle, and B. Catanzaro ETTA: elucidating the design space of text-to-audio models. In ICML,
- Li et al. (2024a) B. Li, Y. Zhang, D. Guo, R. Zhang, F. Li, H. Zhang, K. Zhang, Y. Li, Z. Liu, and C. Li LLaVA-OneVision: easy visual task transfer. arXiv preprint arXiv:2408.03326.
- Li et al. (2023a) C. Li, R. Zhang, J. Wong, C. Gokmen, S. Srivastava, R. Martín-Martín, C. Wang, G. Levine, M. Lingelbach, J. Sun, et al. BEHAVIOR-1K: a benchmark for embodied AI with 1,000 everyday activities and realistic simulation. In CoRL,
- Li et al. (2024b) C. Li, C. Zhang, W. Xu, J. Lin, J. Xie, W. Feng, B. Peng, C. Chen, and W. Xing LatentSync: taming audio-conditioned latent diffusion models for lip sync with SyncNet supervision. arXiv preprint arXiv:2412.09262.
- Li et al. (2023b) J. Li, D. Li, S. Savarese, and S. Hoi BLIP-2: bootstrapping language-image pre-training with frozen image encoders and large language models. In ICML,
- Li et al. (2024c) K. Li, Y. Wang, Y. He, Y. Li, Y. Wang, Y. Liu, Z. Wang, J. Xu, G. Chen, P. Luo, et al. MVBench: a comprehensive multi-modal video understanding benchmark. In CVPR,
- Li et al. (2026a) L. Li, Q. Zhang, Y. Luo, S. Yang, R. Wang, F. Han, M. Yu, Z. Gao, N. Xue, X. Zhu, et al. Causal world modeling for robot control. arXiv preprint arXiv:2601.21998.
- Li et al. (2026b) M. Li, Y. Zhang, D. Long, C. Keqin, S. Song, S. Bai, Z. Yang, P. Xie, A. Yang, D. Liu, et al. Qwen3-VL-Embedding and Qwen3-VL-Reranker: a unified framework for state-of-the-art multimodal retrieval and ranking. arXiv preprint arXiv:2601.04720.
- Li et al. (2025a) S. Li, Y. Gao, D. Sadigh, and S. Song Unified video action model. In RSS,
- Li et al. (2024d) X. Li, M. Liu, H. Zhang, C. Yu, J. Xu, H. Wu, C. Cheang, Y. Jing, T. Kong, H. Li, et al. RoboFlamingo: vision-language foundation models for robot learning. In ICLR,
- Li et al. (2025b) Y. Li, H. Si, F. Landi, P. O. Gallegos, I. Koutsoumpas, O. R. C. Vazquez, R. Fu, Q. Guo, X. Jin, S. Liu, et al. 3MDiT: unified tri-modal diffusion transformer for text-driven synchronized audio-video generation. arXiv preprint arXiv:2511.21780.
- Li et al. (2025c) Z. Li, H. Yu, W. Liu, Y. Yang, C. Herrmann, G. Wetzstein, and J. Wu WonderPlay: dynamic 3D scene generation from a single image and actions. In ICCV,
- Lian et al. (2024) L. Lian, B. Li, A. Yala, and T. Darrell LLM-grounded Diffusion: enhancing prompt understanding of text-to-image diffusion models with large language models. TMLR.
- Liang et al. (2024a) J. Liang, R. Liu, E. Ozguroglu, S. Sudhakar, A. Dave, P. Tokmakov, S. Song, and C. Vondrick Dreamitate: real-world visuomotor policy learning via video generation. arXiv preprint arXiv:2406.16862.
- Liang et al. (2024b) W. Liang, T. Liu, L. Wright, W. Constable, A. Gu, C. Huang, I. Zhang, W. Feng, H. Huang, J. Wang, et al. TorchTitan: one-stop PyTorch native solution for production ready LLM pre-training. arXiv preprint arXiv:2410.06511.
- Liang et al. (2025) W. Liang, L. Yu, L. Luo, S. Iyer, N. Dong, C. Zhou, G. Ghosh, M. Lewis, W. Yih, L. Zettlemoyer, et al. Mixture-of-transformers: a sparse and scalable architecture for multi-modal foundation models. TMLR.
- Lin et al. (2025a) F. Lin, Y. Hu, P. Sheng, C. Wen, J. You, and Y. Gao Data scaling laws in imitation learning for robotic manipulation. In ICLR,
- Lin et al. (2023) H. Lin, A. Zala, J. Cho, and M. Bansal VideoDirectorGPT: consistent multi-scene video generation via LLM-guided planning. arXiv preprint arXiv:2309.15091.
- Lin et al. (2025b) H. Lin, S. Chen, J. Liew, D. Y. Chen, Z. Li, G. Shi, J. Feng, and B. Kang Depth Anything 3: recovering the visual space from any views. arXiv preprint arXiv:2511.10647.
- Lin et al. (2025c) J. Lin, R. Xu, S. Zhu, S. Yang, P. Cao, Y. Ran, M. Hu, C. Zhu, Y. Xie, Y. Long, et al. MMSI-Video-Bench: a holistic benchmark for video-based spatial intelligence. arXiv preprint arXiv:2512.10863.
- Liu et al. (2023a) B. Liu, Y. Zhu, C. Gao, Y. Feng, Q. Liu, Y. Zhu, and P. Stone LIBERO: benchmarking knowledge transfer for lifelong robot learning. In NeurIPS,
- Liu et al. (2025a) F. Liu, C. Li, Y. Qin, A. Shaw, J. Xu, P. Abbeel, and R. Chen ViTaMIn: learning contact-rich tasks through robot-free visuo-tactile manipulation interface. arXiv preprint arXiv:2504.06156.
- Liu et al. (2024a) H. Liu, G. Le Lan, X. Mei, Z. Ni, A. Kumar, V. Nagaraja, W. Wang, M. D. Plumbley, Y. Shi, and V. Chandra SyncFlow: toward temporally aligned joint audio-video generation from text. arXiv preprint arXiv:2412.15220.
- Liu et al. (2024b) H. Liu, Q. Tian, Y. Yuan, X. Liu, X. Mei, Q. Kong, Y. Wang, W. Wang, Y. Wang, and M. D. Plumbley AudioLDM 2: learning holistic audio generation with self-supervised pretraining. IEEE/ACM TASLP.
- Liu et al. (2023b) H. Liu, C. Li, Q. Wu, and Y. J. Lee Visual instruction tuning. In NeurIPS,
- Liu et al. (2025b) J. Liu, Z. Liu, Z. Cen, Y. Zhou, Y. Zou, W. Zhang, H. Jiang, and T. Ruan Can multimodal large language models understand spatial relations?. In ACL,
- Liu et al. (2025c) K. Liu, W. Li, L. Chen, S. Wu, Y. Zheng, J. Ji, F. Zhou, J. Luo, Z. Liu, H. Fei, et al. JavisDiT: joint audio-video diffusion transformer with hierarchical spatio-temporal prior synchronization. arXiv preprint arXiv:2503.23377.
- Liu et al. (2024c) S. Liu, L. Wu, B. Li, H. Tan, H. Chen, Z. Wang, K. Xu, H. Su, and J. Zhu RDT-1B: a diffusion foundation model for bimanual manipulation. arXiv preprint arXiv:2410.07864.
- Liu et al. (2024d) Y. Liu, H. Duan, Y. Zhang, B. Li, S. Zhang, W. Zhao, Y. Yuan, J. Wang, C. He, Z. Liu, et al. MMBench: is your multi-modal model an all-around player?. In ECCV,
- Liu et al. (2024e) Z. Liu, C. Chi, E. Cousineau, N. Kuppuswamy, B. Burchfiel, and S. Song ManiWAV: learning robot manipulation from in-the-wild audio-visual data. arXiv preprint arXiv:2406.19464.
- Longpre et al. (2026) S. Longpre, S. Kudugunta, N. Muennighoff, I. Hsu, I. R. Caswell, A. Pentland, S. O. Arik, C. Lee, and S. Ebrahimi ATLAS: adaptive transfer scaling laws for multilingual pretraining, finetuning, and decoding the curse of multilinguality. In ICLR, Note: ICLR 2026 Poster
- Lu et al. (2024) J. Lu, C. Clark, S. Lee, Z. Zhang, S. Khosla, R. Marten, D. Hoiem, and A. Kembhavi Unified-IO 2: scaling autoregressive multimodal models with vision, language, audio, and action. In CVPR,
- Luma AI (2025) Luma AI Ray2. Note: https://lumalabs.ai/changelog/introducing-ray2
- Luma (2024) Luma Dream Machine. External Links: Link
- Luo et al. (2023) S. Luo, C. Yan, C. Hu, and H. Zhao Diff-Foley: synchronized video-to-audio synthesis with latent diffusion models. In NeurIPS,
- Lv et al. (2025) Q. Lv, W. Kong, H. Li, J. Zeng, Z. Qiu, D. Qu, H. Song, Q. Chen, X. Deng, and J. Pang F1: a vision-language-action model bridging understanding and generation to actions. arXiv preprint arXiv:2509.06951.
- Lyu et al. (2026) J. Lyu, K. Liu, X. Zhang, H. Liao, Y. Feng, W. Zhu, T. Shen, J. Chen, J. Zhang, Y. Dong, et al. LDA-1B: scaling latent dynamics action model via universal embodied data ingestion. In RSS,
- Ma et al. (2025) Y. Ma, X. Wu, K. Sun, and H. Li HPSv3: towards wide-spectrum human preference score. In ICCV,
- Maes et al. (2026) L. Maes, Q. Le Lidec, D. Scieur, Y. LeCun, and R. Balestriero LeWorldModel: stable end-to-end joint-embedding predictive architecture from pixels. arXiv preprint arXiv:2603.19312.
- Man et al. (2025) Y. Man, S. Wang, G. Zhang, J. Bjorck, Z. Li, L. Gui, J. Fan, J. Kautz, Y. Wang, and Z. Yu LocateAnything3D: vision-language 3D detection with chain-of-sight. arXiv preprint arXiv:2511.20648.
- Mandlekar et al. (2023) A. Mandlekar, S. Nasiriany, B. Wen, I. Akinola, Y. Narang, L. Fan, Y. Zhu, and D. Fox MimicGen: a data generation system for scalable robot learning using human demonstrations. In CoRL,
- Marcu et al. (2024) A. Marcu, L. Chen, J. Hünermann, A. Karnsund, B. Hanotte, P. Chidananda, S. Nair, V. Badrinarayanan, A. Kendall, J. Shotton, et al. LingoQA: visual question answering for autonomous driving. In ECCV,
- Mathew et al. (2022) M. Mathew, V. Bagal, R. Tito, D. Karatzas, E. Valveny, and C.V. Jawahar InfographicVQA. In WACV,
- Mathew et al. (2021) M. Mathew, D. Karatzas, and C.V. Jawahar DocVQA: a dataset for VQA on document images. In WACV,
- McKinzie et al. (2024) B. McKinzie, Z. Gan, J. Fauconnier, S. Dodge, B. Zhang, P. Dufter, D. Shah, X. Du, F. Peng, F. Weers, et al. MM1: methods, analysis and insights from multimodal LLM pre-training. In ECCV,
- McQueen (1967) J. B. McQueen Some methods of classification and analysis of multivariate observations. In Proc. of 5th Berkeley Symposium on Math. Stat. and Prob.,
- Meng et al. (2024) L. Meng, J. Yang, R. Tian, X. Dai, Z. Wu, J. Gao, and Y. Jiang DeepStack: deeply stacking visual tokens is surprisingly simple and effective for LMMs. In NeurIPS,
- Meta AI (2023) Meta AI AudioCraft: a generative AI framework for audio and music. Note: https://github.com/facebookresearch/audiocraft
- Microsoft Research (2024) Microsoft Research VASA-1: lifelike audio-driven talking faces generated in real time. Note: https://www.microsoft.com/en-us/research/publication/vasa-1-lifelike-audio-driven-talking-faces-generated-in-real-time/
- MiniMax (2024) MiniMax Hailuo AI Video. External Links: Link
- MiniMax (2025) MiniMax Hailuo 02. Note: https://www.minimax.io/news/minimax-hailuo-02
- Mizrahi et al. (2023) D. Mizrahi, R. Bachmann, O. F. Kar, T. Yeo, M. Gao, A. Dehghan, and A. Zamir 4M: massively multimodal masked modeling. In NeurIPS,
- Moritz et al. (2018) P. Moritz, R. Nishihara, S. Wang, A. Tumanov, R. Liaw, E. Liang, M. Elibol, Z. Yang, W. Paul, M. I. Jordan, et al. Ray: a distributed framework for emerging AI applications. In OSDI,
- Motamed et al. (2026) S. Motamed, L. Culp, K. Swersky, P. Jaini, and R. Geirhos Do generative video models understand physical principles?. In WACV,
- MotuBrain Team et al. (2026) MotuBrain Team, C. Xiang, F. Bao, H. Liu, H. Tan, H. Bi, J. Li, J. Liu, J. Pang, K. Jing, et al. MotuBrain: an advanced world action model for robot control. arXiv preprint arXiv:2604.27792.
- Moura et al. (2025) D. Moura, S. Zhu, and O. Zvitia Nexar dashcam collision prediction dataset and challenge. In CVPRW,
- Nasiriany et al. (2024) S. Nasiriany, A. Maddukuri, L. Zhang, A. Parikh, A. Lo, A. Joshi, A. Mandlekar, and Y. Zhu RoboCasa: large-scale simulation of everyday tasks for generalist robots. In RSS,
- NVIDIA et al. (2025a) NVIDIA, :, A. S. Deshmukh, K. Chumachenko, T. Rintamaki, M. Le, T. Poon, D. M. Taheri, I. Karmanov, G. Liu, et al. NVIDIA Nemotron Nano V2 VL. External Links: 2511.03929
- NVIDIA Corporation (2026) NVIDIA Corporation NVIDIA TensorRT-LLM. Note: https://docs.nvidia.com/tensorrt-llm/index.htmlAccessed 2026-05-25.
- NVIDIA et al. (2025b) NVIDIA, F. Ferroni, P. Chattopadhyay, G. Heinrich, M. Ranzinger, R. Amoroso, A. Luo, A. Wang, and M. Liu Cosmos-Embed1: a joint video-text embedder for physical AI. External Links: Link
- NVIDIA (2025a) NVIDIA Cosmos world foundation model platform for physical AI. arXiv preprint arXiv:2501.03575.
- NVIDIA (2025b) NVIDIA Cosmos-Predict2.5: world simulation with video foundation models for physical AI. arXiv preprint arXiv:2511.00062.
- NVIDIA (2025c) NVIDIA Cosmos-Predict2. Note: https://research.nvidia.com/labs/cosmos-lab/cosmos-predict2/
- NVIDIA (2025d) NVIDIA Cosmos-Reason1: from physical common sense to embodied reasoning. arXiv preprint arXiv:2503.15558.
- NVIDIA (2025e) NVIDIA Cosmos-Transfer1: conditional world generation with adaptive multimodal control. arXiv preprint arXiv:2503.14492.
- NVIDIA (2025f) NVIDIA NVIDIA Nemotron 3: efficient and open intelligence. arXiv preprint arXiv:2512.20856.
- NVIDIA (2026a) NVIDIA Data generation with MobilityGen. Note: https://docs.isaacsim.omniverse.nvidia.com/6.0.0/synthetic_data_generation/tutorial_replicator_mobility_gen.htmlAccessed: 2026-05-09
- NVIDIA (2026b) NVIDIA DextrAH on Isaac Lab. Note: https://github.com/NVlabs/DEXTRAHAccessed: 2026-05-11
- NVIDIA (2026c) NVIDIA NVIDIA DGX Cloud Lepton documentation. Note: https://docs.nvidia.com/dgx-cloud/lepton/get-started/index.html
- NVIDIA (2026d) NVIDIA NVIDIA Isaac Sim: robotics simulation and synthetic data generation. Note: https://developer.nvidia.com/isaac/simAccessed: 2026-05-09
- NVIDIA (2026e) NVIDIA PhysicalAI-Traffic-Anomaly-Reasoning dataset. Note: https://huggingface.co/datasets/nvidia/PhysicalAI-Traffic-Anomaly-ReasoningHugging Face dataset release.
- NVIDIA (2026f) NVIDIA Synthetic manipulation motion generation for robotics. Note: https://build.nvidia.com/nvidia/isaac-gr00t-synthetic-manipulation/blueprintcardAccessed: 2026-05-09
- NVIDIA (2026g) NVIDIA VANTAGE-Bench: evaluating the infrastructure AI gap in vision-language models. Note: https://huggingface.co/datasets/nvidia/PhysicalAI-VANTAGE-BenchHugging Face dataset card
- Octo Model Team et al. (2024) Octo Model Team, D. Ghosh, H. Walke, K. Pertsch, K. Black, O. Mees, S. Dasari, J. Hejna, T. Kreiman, C. Xu, et al. Octo: an open-source generalist robot policy. In RSS,
- Open-Sora Team (2025) Open-Sora Team Open-Sora 2.0: training a commercial-level video generation model in 200k dollars. arXiv preprint arXiv:2503.09642.
- OpenAI (2024a) OpenAI GPT-4o system card. arXiv preprint arXiv:2410.21276.
- OpenAI (2024b) OpenAI Sora. External Links: Link
- OpenAI (2025) OpenAI Sora 2. Note: https://openai.com/sora/
- OpenAI (2026) OpenAI Introducing ChatGPT Images 2.0. External Links: Link
- Owens and Efros (2018) A. Owens and A. A. Efros Audio-visual scene analysis with self-supervised multisensory features. In ECCV,
- Özsoy et al. (2026) E. Özsoy, C. Pellegrini, D. Bani-Harouni, K. Yuan, M. Keicher, and N. Navab Specialized foundation models for intelligent operating rooms. npj Digital Medicine.
- Pace et al. (2025) W. Pace, C. She, L. Xu, W. Jones, A. Lockett, J. Wang, and R. Shah Lance: efficient random access in columnar storage through adaptive structural encodings. arXiv preprint arXiv:2504.15247.
- Paiss et al. (2023) R. Paiss, A. Ephrat, O. Tov, S. Zada, I. Mosseri, M. Irani, and T. Dekel Teaching CLIP to count to ten. In ICCV,
- Pavse et al. (2020) B. S. Pavse, F. Torabi, J. P. Hanna, G. Warnell, and P. Stone RIDM: reinforced inverse dynamics modeling for learning from a single observed demonstration. IEEE RA-L.
- Peng et al. (2024) Z. Peng, W. Wang, L. Dong, Y. Hao, S. Huang, S. Ma, and F. Wei Kosmos-2: grounding multimodal large language models to the world. In ICLR,
- Pfaff et al. (2026) N. Pfaff, T. Cohn, S. Zakharov, R. Cory, and R. Tedrake SceneSmith: agentic generation of simulation-ready indoor scenes. arXiv preprint arXiv:2602.09153.
- Physical Intelligence Team (2025) Physical Intelligence Team Pi0.5: a vision-language-action model with open-world generalization. arXiv preprint arXiv:2504.16054.
- Pika Labs (2025) Pika Labs Pika: AI video generation model. Note: https://pika.art/
- Polyak et al. (2024) A. Polyak, A. Zohar, A. Brown, A. Tjandra, A. Sinha, A. Lee, A. Vyas, B. Shi, C. Ma, C. Chuang, et al. Movie Gen: a cast of media foundation models. arXiv preprint arXiv:2410.13720.
- Pournemat et al. (2025) M. Pournemat, K. Rezaei, G. Sriramanan, A. Zarei, J. Fu, Y. Wang, H. Eghbalzadeh, and S. Feizi Reasoning under uncertainty: exploring probabilistic reasoning capabilities of LLMs. arXiv preprint arXiv:2509.10739.
- Prajwal et al. (2020) K. R. Prajwal, R. Mukhopadhyay, V. Namboodiri, and C. V. Jawahar A lip sync expert is all you need for speech to lip generation in the wild. In ACM MM,
- Punamiya et al. (2026) R. Punamiya, S. Kareer, Z. Liu, J. Citron, R. Qiu, X. Cai, A. Gavryushin, J. Chen, D. Liconti, L. Y. Zhu, et al. EgoVerse: an egocentric human dataset for robot learning from around the world. arXiv preprint arXiv:2604.07607.
- Pyatkin et al. (2025a) V. Pyatkin, S. Malik, V. Graf, H. Ivison, S. Huang, P. Dasigi, N. Lambert, and H. Hajishirzi Generalizing verifiable instruction following. In NeurIPS,
- Pyatkin et al. (2025b) V. Pyatkin, S. Malik, V. Graf, H. Ivison, S. Huang, P. Dasigi, N. Lambert, and H. Hajishirzi Generalizing verifiable instruction following. In NeurIPS,
- PyTorch Contributors (2026a) PyTorch Contributors AOTInductor: ahead-of-time compilation for PyTorch exported models. Note: https://docs.pytorch.org/docs/2.12/user_guide/torch_compiler/torch.compiler_aot_inductor.htmlPyTorch 2.12 documentation. Accessed 2026-05-25.
- PyTorch Contributors (2026b) PyTorch Contributors torch.nn.attention.varlen: variable-length attention using flash attention. Note: https://docs.pytorch.org/docs/2.12/nn.attention.varlen.htmlPyTorch 2.12 documentation. Accessed 2026-05-25.
- Qu et al. (2025) D. Qu, H. Song, Q. Chen, Z. Chen, X. Gao, X. Ye, Q. Lv, M. Shi, G. Ren, C. Ruan, et al. EO-1: interleaved vision-text-action pretraining for general robot control. arXiv preprint arXiv:2508.21112.
- Qwen Team (2026a) Qwen Team Qwen3.5-Omni: towards native multimodal agents. arXiv preprint arXiv:2604.15804.
- Qwen Team (2026b) Qwen Team Qwen3.5: towards native multimodal agents. External Links: Link
- Raschka et al. (2020) S. Raschka, J. Patterson, and C. Nolet Machine learning in python: main developments and technology trends in data science, machine learning, and artificial intelligence. Information.
- Ravi et al. (2025) N. Ravi, V. Gabeur, Y. Hu, R. Hu, C. Ryali, T. Ma, H. Khedr, R. Rädle, C. Rolland, L. Gustafson, et al. SAM 2: segment anything in images and videos. In ICLR,
- Rein et al. (2023) D. Rein, B. L. Hou, A. C. Stickland, J. Petty, R. Y. Pang, J. Dirani, J. Michael, and S. R. Bowman GPQA: a graduate-level google-proof q&a benchmark. arXiv preprint arXiv:2311.12022.
- Ren et al. (2025a) X. Ren, Y. Lu, T. Cao, R. Gao, S. Huang, A. Sabour, T. Shen, T. Pfaff, J. Z. Wu, R. Chen, et al. Cosmos-Drive-Dreams: scalable synthetic driving data generation with world foundation models. arXiv preprint arXiv:2506.09042.
- Ren et al. (2025b) X. Ren, T. Shen, J. Huang, H. Ling, Y. Lu, M. Nimier-David, T. Müller, A. Keller, S. Fidler, and J. Gao GEN3C: 3D-informed world-consistent video generation with precise camera control. In CVPR,
- Ren et al. (2025c) Y. Ren, C. Li, M. Xu, W. Liang, Y. Gu, R. Chen, and D. Yu STA-V2A: video-to-audio generation with semantic and temporal alignment. In ICASSP,
- Robbyant et al. (2026) T. Robbyant, Z. Gao, Q. Wang, Y. Zeng, J. Zhu, K. L. Cheng, Y. Li, H. Wang, Y. Xu, S. Ma, et al. Advancing open-source world models. arXiv preprint arXiv:2601.20540.
- Ruan et al. (2023) L. Ruan, Y. Ma, H. Yang, H. He, B. Liu, J. Fu, N. J. Yuan, Q. Jin, and B. Guo MM-Diffusion: learning multi-modal diffusion models for joint audio and video generation. In CVPR,
- Runway (2024) Runway Gen-3 Alpha. External Links: Link
- Runway (2025) Runway Runway Gen-4. Note: https://runwayml.com/research/introducing-runway-gen-4
- Schmidt and Jiang (2023) D. Schmidt and M. Jiang Learning to act without actions. arXiv preprint arXiv:2312.10812.
- Schneider (2023) T. Schneider franky: High-Level Control Library for Franka Robots. Note: https://github.com/TimSchneider42/frankyLGPL-3.0 license
- Schuhmann and LAION (2022) C. Schuhmann and LAION LAION-Aesthetics. Note: https://laion.ai/blog/laion-aesthetics/Accessed: 2026-05-13
- Sermanet et al. (2024) P. Sermanet, T. Ding, J. Zhao, F. Xia, D. Dwibedi, K. Gopalakrishnan, C. Chan, G. Dulac-Arnold, S. Maddineni, N. J. Joshi, et al. RoboVQA: multimodal long-horizon reasoning for robotics. In ICRA,
- Shah et al. (2024) J. Shah, G. Bikshandi, Y. Zhang, V. Thakkar, P. Ramani, and T. Dao FlashAttention-3: fast and accurate attention with asynchrony and low-precision. In NeurIPS,
- Shen et al. (2026a) T. Shen, S. Bahmani, K. He, S. G. Srinivasan, T. Cao, J. Ren, R. Li, Z. Wang, N. Sharp, Z. Gojcic, et al. Lyra 2.0: explorable generative 3D worlds. arXiv preprint arXiv:2604.13036.
- Shen et al. (2026b) W. Shen, N. Kumar, S. Chintalapudi, J. Wang, C. Watson, E. S. Hu, J. Cao, D. Jayaraman, L. P. Kaelbling, and T. Lozano-Pérez TiPToP: a modular open-vocabulary planning system for robotic manipulation. arXiv preprint arXiv:2603.09971.
- Shi et al. (2025a) B. Shi, A. Tjandra, J. Hoffman, H. Wang, Y. Wu, L. Gao, J. Richter, M. Le, A. Vyas, S. Chen, et al. SAM audio: segment anything in audio. arXiv preprint arXiv:2512.18099.
- Shi et al. (2025b) L. X. Shi, B. Ichter, M. Equi, L. Ke, K. Pertsch, Q. Vuong, J. Tanner, A. Walling, H. Wang, N. Fusai, et al. Hi Robot: open-ended instruction following with hierarchical vision-language-action models. In ICML,
- Shi et al. (2025c) W. Shi, X. Han, C. Zhou, W. Liang, X. V. Lin, L. Zettlemoyer, and L. Yu LMFusion: adapting pretrained language models for multimodal generation. arXiv preprint arXiv:2412.15188.
- Shi et al. (2026) X. Shi, X. Wang, Z. Guo, Y. Wang, P. Zhang, X. Zhang, Z. Guo, H. Hao, Y. Xi, B. Yang, et al. Qwen3-ASR technical report. arXiv preprint arXiv:2601.21337.
- Shou et al. (2026) Q. Shou, F. Zhu, S. Chen, P. Yan, Z. Yan, Y. Miao, X. Pang, Z. Hong, R. Shi, H. Huang, et al. HALO: a unified vision-language-action model for embodied multimodal chain-of-thought reasoning. arXiv preprint arXiv:2602.21157.
- Simon et al. (2017) T. Simon, H. Joo, I. Matthews, and Y. Sheikh Hand keypoint detection in single images using multiview bootstrapping. In CVPR,
- Singer et al. (2023) U. Singer, A. Polyak, T. Hayes, X. Yin, J. An, S. Zhang, Q. Hu, H. Yang, O. Ashual, O. Gafni, et al. Make-a-video: text-to-video generation without text-video data. In ICLR,
- Sirdeshmukh et al. (2025) V. Sirdeshmukh, K. Deshpande, J. Mols, L. Jin, E. Cardona, D. Lee, J. Kritz, W. Primack, S. Yue, and C. Xing MultiChallenge: a realistic multi-turn conversation evaluation benchmark challenging to frontier LLMs. In Findings of ACL,
- Song et al. (2025) C. H. Song, V. Blukis, J. Tremblay, S. Tyree, Y. Su, and S. Birchfield RoboSpatial: teaching spatial understanding to 2D and 3D vision-language models for robotics. In CVPR,
- Souček and Lokoč (2024) T. Souček and J. Lokoč TransNet v2: an effective deep network architecture for fast shot transition detection. In ACM MM,
- Stability AI (2024) Stability AI Stable Audio Open. Note: https://stability.ai/news/introducing-stable-audio-open
- Steiner et al. (2024) A. Steiner, A. Susano Pinto, M. Tschannen, D. Keysers, X. Wang, et al. PaliGemma 2: a family of versatile VLMs for transfer. arXiv preprint arXiv:2412.03555.
- Suno (2024) Suno Suno v4. Note: https://suno.com/blog/v4
- Tang et al. (2025) Z. Tang, S. Wang, D. C. Anastasiu, M. Chang, A. Sharma, Q. Kong, N. Kobori, M. Gochoo, G. Batnasan, M. Otgonbold, et al. The 9th AI city challenge. In ICCVW,
- Tang et al. (2023) Z. Tang, Z. Yang, C. Zhu, M. Zeng, and M. Bansal Any-to-any generation via composable diffusion. In NeurIPS,
- Tencent Robotics X et al. (2026) Tencent Robotics X, HY Vision Team, X. Yu, Z. Liu, Z. Wang, H. Zhang, Y. Rao, F. Liu, Y. Zhang, R. Zhao, et al. HY-Embodied-0.5: embodied foundation models for real-world agents. arXiv preprint arXiv:2604.07430.
- Tian et al. (2024) L. Tian, Q. Wang, B. Zhang, and L. Bo EMO: emote portrait alive – generating expressive portrait videos with audio2video diffusion model under weak conditions. In ECCV,
- Tjandra et al. (2025) A. Tjandra, Y. Wu, B. Guo, J. Hoffman, B. Ellis, A. Vyas, B. Shi, S. Chen, M. Le, N. Zacharov, et al. Meta Audiobox Aesthetics: unified automatic quality assessment for speech, music, and sound. In ASRU,
- Tong et al. (2024) S. Tong, E. Brown, P. Wu, S. Woo, M. Middepogu, S. C. Akula, J. Yang, S. Yang, A. Iyer, X. Pan, et al. Cambrian-1: a fully open, vision-centric exploration of multimodal LLMs. In NeurIPS,
- Torabi et al. (2018) F. Torabi, G. Warnell, and P. Stone Behavioral cloning from observation. In IJCAI,
- Tschannen et al. (2025) M. Tschannen, A. Gritsenko, X. Wang, M. F. Naeem, I. Alabdulmohsin, N. Parthasarathy, T. Evans, L. Beyer, Y. Xia, B. Mustafa, et al. SigLIP 2: multilingual vision-language encoders with improved semantic understanding, localization, and dense features. arXiv preprint arXiv:2502.14786.
- Udio (2024) Udio Udio: AI music generation. Note: https://www.udio.com/
- Villegas et al. (2023) R. Villegas, M. Babaeizadeh, P. Kindermans, H. Moraldo, H. Zhang, M. T. Saffar, S. Castro, J. Kunze, and D. Erhan Phenaki: variable length video generation from open domain textual description. In ICLR,
- Vuong et al. (2023) Q. Vuong, S. Levine, H. R. Walke, K. Pertsch, A. Singh, R. Doshi, C. Xu, J. Luo, L. Tan, D. Shah, et al. Open X-Embodiment: robotic learning datasets and RT-X models. In CoRL2023 Workshop,
- Vyas et al. (2023) A. Vyas, B. Shi, M. Le, A. Tjandra, Y. Wu, B. Guo, J. Zhang, X. Zhang, Y. Adi, W. Hsu, et al. Audiobox: unified audio generation with natural language prompts. arXiv preprint arXiv:2312.15821.
- Walke et al. (2023) H. R. Walke, K. Black, T. Z. Zhao, Q. Vuong, C. Zheng, P. Hansen-Estruch, A. W. He, V. Myers, M. J. Kim, M. Du, et al. BridgeData v2: a dataset for robot learning at scale. In CoRL,
- Wan et al. (2025a) T. Wan, A. Wang, B. Ai, B. Wen, C. Mao, C. Xie, D. Chen, F. Yu, H. Zhao, J. Yang, et al. Wan: open and advanced large-scale video generative models. arXiv preprint arXiv:2503.20314.
- Wan et al. (2025b) T. Wan, A. Wang, B. Ai, B. Wen, C. Mao, C. Xie, D. Chen, F. Yu, H. Zhao, J. Yang, et al. Wan: open and advanced large-scale video generative models. External Links: 2503.20314
- Wang et al. (2025a) A. Wang, Y. Zhang, Y. Xu, K. Li, Y. Zhang, L. Wang, Y. Qiao, and Z. Liu OmniHuman-1: rethinking the scaling-up of one-stage conditioned human animation models. In ICCV,
- Wang et al. (2025b) J. Wang, M. Chen, N. Karaev, A. Vedaldi, C. Rupprecht, and D. Novotny VGGT: visual geometry grounded transformer. In CVPR,
- Wang et al. (2024a) K. Wang, S. Deng, J. Shi, D. Hatzinakos, and Y. Tian AV-DiT: efficient audio-visual diffusion transformer for joint audio and video generation. arXiv preprint arXiv:2406.07686.
- Wang et al. (2025c) L. Wang, K. Zhao, C. Liu, and X. Chen Learning real-world action-video dynamics with heterogeneous masked autoregression. arXiv preprint arXiv:2502.04296.
- Wang et al. (2025d) Q. Wang, Y. Shi, J. Ou, R. Chen, K. Lin, J. Wang, B. Jiang, H. Yang, M. Zheng, X. Tao, et al. Koala-36m: a large-scale video dataset improving consistency between fine-grained conditions and video content. In CVPR,
- Wang et al. (2026a) S. Wang, S. Liu, Y. Kuang, X. Wei, Y. Liu, Z. Li, Y. Man, G. Chen, A. Tao, G. Liu, et al. LocateAnything: fast and high-quality vision-language grounding with parallel box decoding. arXiv preprint arXiv:2605.27365.
- Wang et al. (2026b) S. Wang, J. Shi, Z. Fu, X. He, F. Liu, C. Yang, Y. Zhou, Z. Fei, J. Gong, J. Fu, et al. World action models: the next frontier in embodied AI. arXiv preprint arXiv:2605.12090.
- Wang et al. (2025e) W. Wang, Z. Gao, L. Gu, H. Pu, L. Cui, X. Wei, Z. Liu, L. Jing, S. Ye, J. Shao, et al. InternVL3.5: advancing open-source multimodal models in versatility, reasoning, and efficiency. arXiv preprint arXiv:2508.18265.
- Wang et al. (2025f) X. Wang, Z. Zhang, H. Zhang, Z. Lin, Y. Zhou, Q. Liu, S. Zhang, Y. Li, S. Liu, H. Zheng, et al. HBridge: h-shape bridging of heterogeneous experts for unified multimodal understanding and generation. arXiv preprint arXiv:2511.20520.
- Wang et al. (2024b) X. Wang, Z. Zhu, G. Huang, X. Chen, J. Zhu, and J. Lu DriveDreamer: towards real-world-driven world models for autonomous driving. In ECCV,
- Wang et al. (2023) X. Wang, T. Kwon, M. Rad, B. Pan, I. Chakraborty, S. Andrist, D. Bohus, A. Feniello, B. Tekin, F. V. Frujeri, et al. HoloAssist: an egocentric human interaction dataset for interactive AI assistants in the real world. In ICCV,
- Wang et al. (2025g) X. Wang, L. Liu, Y. Cao, R. Wu, W. Qin, D. Wang, W. Sui, and Z. Su EmbodiedGen: towards a generative 3D world engine for embodied intelligence. arXiv preprint arXiv:2506.10600. External Links: 2506.10600
- Wang et al. (2024c) X. Wang, X. Zhang, Z. Luo, Q. Sun, Y. Cui, J. Wang, F. Zhang, Y. Wang, Z. Li, Q. Yu, et al. Emu3: next-token prediction is all you need. arXiv preprint arXiv:2409.18869.
- Wang et al. (2025h) Y. Wang, Z. Li, Y. Zang, J. Bu, Y. Zhou, Y. Xin, J. He, C. Wang, Q. Lu, C. Jin, et al. UniGenBench++: a unified semantic evaluation benchmark for text-to-image generation. arXiv preprint arXiv:2510.18701.
- Wang et al. (2024d) Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. MMLU-Pro: a more robust and challenging multi-task language understanding benchmark. In NeurIPS,
- Wang et al. (2025i) Y. Wang, X. Li, W. Wang, J. Zhang, Y. Li, Y. Chen, X. Wang, and Z. Zhang Unified vision-language-action model. arXiv preprint arXiv:2506.19850.
- Wang et al. (2024e) Z. Wang, Z. Yuan, X. Wang, Y. Li, T. Chen, M. Xia, P. Luo, and Y. Shan MotionCtrl: a unified and flexible motion controller for video generation. In ACM SIGGRAPH,
- Watter et al. (2015) M. Watter, J. Springenberg, J. Boedecker, and M. Riedmiller Embed to control: a locally linear latent dynamics model for control from raw images. NeurIPS.
- Waymo (2026) Waymo The Waymo world model: a new frontier for autonomous driving simulation. Note: https://waymo.com/blog/2026/02/the-waymo-world-model-a-new-frontier-for-autonomous-driving-simulation/
- Wiedemer et al. (2025) T. Wiedemer, Y. Li, P. Vicol, S. S. Gu, N. Matarese, K. Swersky, B. Kim, P. Jaini, and R. Geirhos Video models are zero-shot learners and reasoners. arXiv preprint arXiv:2509.20328.
- World Labs (2025) World Labs Marble: a multimodal world model. Note: https://www.worldlabs.ai/blog/marble-world-modelWorld Labs blog post, accessed 2026-05-04
- Wu et al. (2023a) H. Wu, E. Zhang, L. Liao, C. Chen, J. Hou, A. Wang, W. Sun, Q. Yan, and W. Lin Exploring video quality assessment on user generated contents from aesthetic and technical perspectives. In CVPR,
- Wu et al. (2023b) H. Wu, Y. Jing, C. Cheang, G. Chen, J. Xu, X. Li, M. Liu, H. Li, and T. Kong GR-1: unleashing the power of large-scale video generative pre-training for visual robot manipulation. arXiv preprint arXiv:2312.13139.
- Wu et al. (2025a) K. Wu, C. Hou, J. Liu, Z. Che, X. Ju, Z. Yang, M. Li, Y. Zhao, Z. Xu, G. Yang, et al. RoboMIND: benchmark on multi-embodiment intelligence normative data for robot manipulation. In RSS,
- Wu et al. (2025b) M. Wu, L. Wang, P. Zhao, F. Yang, J. Zhang, J. Liu, Y. Zhan, W. Han, H. Sun, J. Ji, et al. RePrompt: reasoning-augmented reprompting for text-to-image generation via reinforcement learning. arXiv preprint arXiv:2505.17540.
- Wu et al. (2023c) S. Wu, H. Fei, L. Qu, W. Ji, and T. Chua NExT-GPT: any-to-any multimodal LLM. arXiv preprint arXiv:2309.05519.
- Wu et al. (2024) Z. Wu, T. Wang, Zhaxizhuoma, C. Guan, Z. Jia, S. Liang, H. Song, D. Qu, D. Wang, Z. Wang, et al. Fast-UMI: a scalable and hardware-independent universal manipulation interface. arXiv preprint arXiv:2409.19499.
- xAI (2024) xAI Grok-1.5 vision preview. Note: https://x.ai/news/grok-1.5vRealWorldQA benchmark
- Xia et al. (2026) H. Xia, X. Li, Z. Li, Q. Ma, J. Xu, M. Liu, Y. Cui, T. Lin, W. Ma, S. Wang, et al. SAGE: scalable agentic 3D scene generation for embodied AI. In CVPR,
- Xiao et al. (2024a) B. Xiao, H. Wu, W. Xu, X. Dai, H. Hu, Y. Lu, M. Zeng, C. Liu, and L. Yuan Florence-2: advancing a unified representation for a variety of vision tasks. In CVPR,
- Xiao et al. (2024b) Y. Xiao, E. Sun, T. Liu, and W. Wang LogicVista: multimodal LLM logical reasoning benchmark in visual contexts. arXiv preprint arXiv:2407.04973.
- Xie et al. (2025) J. Xie, W. Mao, Z. Bai, D. J. Zhang, W. Wang, K. Q. Lin, Y. Gu, Z. Chen, Z. Yang, and M. Z. Shou Show-o: one single transformer to unify multimodal understanding and generation. In ICLR,
- Xing et al. (2024) Y. Xing, Y. He, Z. Tian, X. Wang, and Q. Chen Seeing and hearing: open-domain visual-audio generation with diffusion latent aligners. In CVPR,
- Xu et al. (2024a) D. Xu, W. Nie, C. Liu, S. Liu, J. Kautz, Z. Wang, and A. Vahdat CamCo: camera-controllable 3D-consistent image-to-video generation. arXiv preprint arXiv:2406.02509.
- Xu et al. (2025) J. Xu, Z. Guo, H. Hu, Y. Chu, X. Wang, J. He, Y. Wang, X. Shi, T. He, X. Zhu, et al. Qwen3-Omni technical report. arXiv preprint arXiv:2509.17765.
- Xu et al. (2026) K. Xu, Y. Jia, K. Huang, J. Chen, W. Li, K. Liu, F. Xie, X. Tang, and Y. Hu FireRedASR2S: a state-of-the-art industrial-grade all-in-one automatic speech recognition system. arXiv preprint arXiv:2603.10420.
- Xu et al. (2024b) M. Xu, H. Li, Q. Su, H. Shang, L. Zhang, and C. Liu Hallo: hierarchical audio-driven visual synthesis for portrait image animation. arXiv preprint arXiv:2406.08801.
- Xue et al. (2026) H. Xue, Y. Chen, L. Ma, Z. Zhao, L. Moukheiber, Y. Zhu, and Y. Chen ACWM-Phys: investigating generalized physical interaction in action-conditioned video world models. arXiv preprint arXiv:2605.08567.
- Xue et al. (2025) Q. Xue, X. Yin, B. Yang, and W. Gao PhyT2V: LLM-guided iterative self-refinement for physics-grounded text-to-video generation. In CVPR,
- Yang et al. (2019) C. Yang, X. Ma, W. Huang, F. Sun, H. Liu, J. Huang, and C. Gan Imitation learning from observations by minimizing inverse dynamics disagreement. In NeurIPS,
- Yang et al. (2025a) J. Yang, R. Tan, Q. Wu, R. Zheng, B. Peng, and Y. Liang Magma: a foundation model for multimodal AI agents. In CVPR,
- Yang et al. (2024) J. Yang, S. Gao, Y. Qiu, L. Chen, T. Li, B. Dai, K. Chitta, P. Wu, J. Zeng, P. Luo, et al. Generalized predictive model for autonomous driving. In CVPR,
- Yang et al. (2025b) J. Yang, S. Yang, A. W. Gupta, R. Han, L. Fei-Fei, and S. Xie Thinking in space: how multimodal large language models see, remember, and recall spaces. In CVPR,
- Yang et al. (2025c) R. Yang, H. Chen, J. Zhang, M. Zhao, C. Qian, K. Wang, Q. Wang, T. V. Koripella, M. Movahedi, M. Li, et al. EmbodiedBench: comprehensive benchmarking multi-modal large language models for vision-driven embodied agents. arXiv preprint arXiv:2502.09560.
- Yang et al. (2025d) R. Yang, Q. Yu, Y. Wu, R. Yan, B. Li, A. Cheng, X. Zou, Y. Fang, H. Yin, S. Liu, et al. EgoVLA: learning vision-language-action models from egocentric human videos. arXiv preprint arXiv:2507.12440.
- Yang et al. (2023) S. Yang, Y. Du, K. Ghasemipour, J. Tompson, L. Kaelbling, D. Schuurmans, and P. Abbeel UniSim: learning interactive real-world simulators. arXiv preprint arXiv:2310.06114.
- Yang et al. (2026a) X. Yang, R. Dagli, A. Zook, H. Hadfield, A. Goyal, S. Birchfield, F. Ramos, and J. Tremblay RoboLab: a high-fidelity simulation benchmark for analysis of task generalist policies. In RSS,
- Yang et al. (2026b) Z. Yang, Z. Liu, Y. Chen, W. Dai, B. Wang, S. Lin, C. Lee, et al. Nemotron-Cascade 2: post-training LLMs with cascade RL and multi-domain on-policy distillation. arXiv preprint arXiv:2603.19220.
- Yang et al. (2025e) Z. Yang, J. Teng, W. Zheng, M. Ding, S. Huang, J. Xu, Y. Yang, W. Hong, X. Zhang, G. Feng, et al. CogVideoX: text-to-video diffusion models with an expert transformer. In ICLR,
- Ye et al. (2026) S. Ye, Y. Ge, K. Zheng, S. Gao, S. Yu, G. Kurian, S. Indupuru, Y. L. Tan, C. Zhu, J. Xiang, et al. World action models are zero-shot policies. arXiv preprint arXiv:2602.15922.
- Ye et al. (2025) S. Ye, J. Jang, B. Jeon, S. Joo, J. Yang, B. Peng, A. Mandlekar, R. Tan, Y. Chao, B. Y. Lin, et al. Latent action pretraining from videos. In ICLR,
- Yin et al. (2026) P. Yin, J. Zhu, H. Gao, C. Zheng, Y. Huang, T. Zhou, R. Yang, W. Liu, W. Chen, C. Guo, et al. vLLM-Omni: fully disaggregated serving for any-to-any multimodal models. External Links: 2602.02204
- You et al. (2024) H. You, H. Zhang, Z. Gan, X. Du, B. Zhang, Z. Wang, L. Cao, S. Chang, and Y. Yang Ferret: refer and ground anything anywhere at any granularity. In ICLR,
- Yu et al. (2016) L. Yu, P. Poirson, S. Yang, A. C. Berg, and T. L. Berg Modeling context in referring expressions. In ECCV,
- Yuan et al. (2026) J. Yuan, X. Zhang, F. Friedrich, N. Beltran-Velez, M. Hall, R. Askari-Hemmat, X. Han, N. Ballas, M. Drozdzal, and A. Romero-Soriano Inference-time physics alignment of video generative models with latent world models. arXiv preprint arXiv:2601.10553.
- Yuan et al. (2024) W. Yuan, J. Duan, V. Blukis, W. Pumacay, R. Krishna, A. Murali, A. Mousavian, and D. Fox RoboPoint: a vision-language model for spatial affordance prediction for robotics. arXiv preprint arXiv:2406.10721.
- Yue et al. (2025) X. Yue, T. Zheng, Y. Ni, Y. Wang, K. Zhang, S. Tong, Y. Sun, B. Yu, G. Zhang, H. Sun, et al. MMMU-Pro: a more robust multi-discipline multimodal understanding benchmark. In ACL,
- Zaharia et al. (2016) M. Zaharia, R. S. Xin, P. Wendell, T. Das, M. Armbrust, A. Dave, X. Meng, J. Rosen, S. Venkataraman, M. J. Franklin, et al. Apache Spark: a unified engine for big data processing. Communications of the ACM 59 (11).
- Zawalski et al. (2024) M. Zawalski, W. Chen, K. Pertsch, O. Mees, C. Finn, and S. Levine Robotic control via embodied chain-of-thought reasoning. In CoRL,
- Zhai et al. (2025) A. Zhai, B. Liu, B. Fang, C. Cai, E. Ma, E. Yin, H. Wang, H. Zhou, J. Wang, L. Shi, L. Liang, M. Wang, Q. Wang, R. Gan, R. Yu, S. Li, S. Liu, S. Chen, V. Chen, and Z. Xu Igniting VLMs toward the embodied space. arXiv preprint arXiv:2509.11766.
- Zhan et al. (2024) J. Zhan, J. Dai, J. Ye, Y. Zhou, D. Zhang, Z. Liu, X. Zhang, R. Yuan, G. Zhang, L. Li, et al. AnyGPT: unified multimodal LLM with discrete sequence modeling. In ACL,
- Zhang et al. (2025a) H. Zhang, M. Gao, Z. Gan, P. Dufter, N. Wenzel, F. Huang, D. Shah, X. Du, B. Zhang, Y. Li, et al. MM1. 5: methods, analysis & insights from multimodal LLM fine-tuning. In ICLR,
- Zhang et al. (2024) H. Zhang, H. You, P. Dufter, B. Zhang, C. Chen, H. Chen, T. Fu, W. Y. Wang, S. Chang, Z. Gan, et al. Ferret-v2: an improved baseline for referring and grounding with large language models. arXiv preprint arXiv:2404.07973.
- Zhang et al. (2025b) J. Zhang, Y. Chen, Y. Zhou, Y. Xu, Z. Huang, J. Mei, J. Chen, Y. Yuan, X. Cai, G. Huang, et al. From flatland to space: teaching vision-language models to perceive and reason in 3D. arXiv preprint arXiv:2503.22976.
- Zhang et al. (2023) L. Zhang, A. Rao, and M. Agrawala Adding conditional control to text-to-image diffusion models. In ICCV,
- Zhang et al. (2022) Q. Zhang, Z. Peng, and B. Zhou Learning to drive by watching YouTube videos: action-conditioned contrastive policy pretraining. In ECCV,
- Zhang et al. (2025c) Y. Zhang, H. Yang, Y. Zhang, Y. Hu, F. Zhu, C. Lin, X. Mei, Y. Jiang, B. Peng, and Z. Yuan Waver: wave your way to lifelike video generation. arXiv preprint arXiv:2508.15761.
- Zhang et al. (2026) Y. Zhang, Y. Gu, Y. Zeng, Z. Xing, Y. Wang, Z. Wu, and K. Chen FoleyCrafter: bring silent videos to life with lifelike and synchronized sounds. IJCV.
- Zhao et al. (2025) G. Zhao, X. Wang, Z. Zhu, X. Chen, G. Huang, X. Bao, and X. Wang DriveDreamer-2: LLM-enhanced world models for diverse driving video generation. In AAAI,
- Zhao et al. (2018) H. Zhao, C. Gan, A. Rouditchenko, C. Vondrick, J. McDermott, and A. Torralba The sound of pixels. In ECCV,
- Zheng et al. (2026) J. Zheng, J. Li, Z. Wang, D. Liu, X. Kang, Y. Feng, Y. Zheng, J. Zou, Y. Chen, J. Zeng, et al. X-VLA: soft-prompted transformer as scalable cross-embodiment vision-language-action model. In ICLR,
- Zhou et al. (2025a) C. Zhou, L. Yu, A. Babu, K. Tirumala, M. Yasunaga, L. Shamis, J. Kahn, X. Ma, L. Zettlemoyer, and O. Levy Transfusion: predict the next token and diffuse images with one multi-modal model. In ICLR,
- Zhou et al. (2025b) E. Zhou, J. An, C. Chi, Y. Han, S. Rong, C. Zhang, P. Wang, Z. Wang, T. Huang, L. Sheng, et al. RoboRefer: towards spatial referring with reasoning in vision-language models for robotics. In NeurIPS,
- Zhou et al. (2025c) F. Zhou, J. Huang, J. Li, D. Ramanan, and H. Shi PAI-Bench: a comprehensive benchmark for physical AI. arXiv preprint arXiv:2512.01989.
- Zhou et al. (2024) S. Zhou, Y. Du, J. Chen, Y. Li, D. Yeung, and C. Gan RoboDreamer: learning compositional world models for robot imagination. arXiv preprint arXiv:2404.12377.
- Zhou et al. (2019) Y. Zhou, C. Barnes, J. Lu, J. Yang, and H. Li On the continuity of rotation representations in neural networks. In CVPR,
- Zhou et al. (2025d) Z. Zhou, Y. Zhu, M. Zhu, J. Wen, N. Liu, and Z. Xu ChatVLA: unified multimodal understanding and robot control with vision-language-action model. In EMNLP,
- Zhu et al. (2024) D. Zhu, J. Chen, X. Shen, X. Li, and M. Elhoseiny MiniGPT-4: enhancing vision-language understanding with advanced large language models. In ICLR,
- Zhu et al. (2025) F. Zhu, H. Wu, S. Guo, Y. Liu, C. Cheang, and T. Kong IRASim: learning interactive real-robot action simulators. In ICCV,
- Zimmermann and Brox (2017) C. Zimmermann and T. Brox Learning to estimate 3D hand pose from single RGB images. In ICCV,
術語對照表
| 英文 | 中文 |
|---|---|
| Omnimodal World Model | 全模態世界模型 |
| Physical AI | 物理 AI |
| World Model | 世界模型 |
| World-Action Model (WAM) | 世界—動作模型 |
| Vision-Language Model (VLM) | 視覺語言模型 |
| Vision-Language-Action Model (VLA) | 視覺-語言-動作模型 |
| Forward Dynamics | 前向動力學 |
| Inverse Dynamics | 逆向動力學 |
| Policy | 策略 |
| Embodied Agent | 具身代理 |
| Embodiment | 具身形式 |
| Egocentric | 第一人稱(自我中心) |
| Understanding | 理解 |
| Generation | 生成 |
| Latent Representation | 潛在表徵 |
| State-of-the-Art | 最先進水準 |
| Mixture-of-Transformers (MoT) | 混合 Transformer 架構 |
| Dual-Tower | 雙塔 |
| Dual-Stream Joint Attention | 雙流聯合注意力 |
| Causal Self-Attention | 因果自注意力 |
| Full Bidirectional Attention | 完全雙向注意力 |
| Attention Mechanism | 注意力機制 |
| Two-Way Flat Attention | 雙向扁平注意力 |
| Scaled Dot-Product Attention (SDPA) | 縮放點積注意力 |
| Ring Attention | 環狀注意力 |
| Autoregressive (AR) | 自迴歸 |
| Diffusion (DM) | 擴散 |
| Iterative Denoising | 疊代去噪 |
| Next-Token Prediction | 下一個 token 預測 |
| Rectified Flow Matching | 修正流匹配 |
| Flow Matching | 流匹配 |
| Classifier-Free Guidance (CFG) | 分類器無關引導 |
| Mode Sampling | 眾數抽樣 |
| Position Embedding | 位置嵌入 |
| Multimodal RoPE (MRoPE) | 多模態 RoPE |
| Absolute Temporal Modulation | 絕對時間調變 |
| Temporal Steps Per Second (TPS) | 每秒時間步數 |
| FPS Modulation | FPS 調變 |
| Checkerboard Artifacts | 棋盤格狀瑕疵 |
| Encoder | 編碼器 |
| Tokenizer | Tokenizer(分詞器/符記化器) |
| Token Packing | Token 打包 |
| Look-ahead Packing | 前瞻打包 |
| Look-aside Buffer | 旁置緩衝區 |
| Pre-Training | 預訓練 |
| Mid-Training | 中期訓練 |
| Post-Training | 後訓練 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Curriculum | 訓練課程 |
| Warm-up | 暖身 |
| Warmup-Stable-Decay (WSD) | 暖身—穩定—衰減 |
| Data Curation | 資料策展 |
| Semantic Deduplication | 語意去重 |
| AI Judge | AI 評審 |
| Faithfulness | 忠實性 |
| Completeness | 完整性 |
| Correctness | 正確性 |
| Hallucination | 幻覺 |
| Clustering | 聚類 |
| Rejection Sampling | 拒絕抽樣 |
| Caption | 描述文字 |
| Captioner | 描述器 |
| Structured Caption | 結構化描述 |
| Precision | 精確率 |
| Recall | 召回率 |
| Assertion | 斷言 |
| Synthetic Data Generation (SDG) | 合成資料生成 |
| Sim-to-Real Gap | 模擬到真實差距 |
| Long-tail | 長尾 |
| Corner Case | 極端案例 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Spatial Grounding | 空間定位 |
| Referring-Expression Grounding | 指代表達定位 |
| Pointing | 指點 |
| Affordance | 可供性 |
| Waypoint | 途經點 |
| Meta-Action | 元動作 |
| Ego Pose | 自我姿態 |
| Effector Pose | 效應器姿態 |
| Grasp State | 抓取狀態 |
| Pseudo-Action | 偽動作 |
| End-Effector | 末端效應器 |
| Proprioceptive | 本體感覺 |
| Closed-Loop | 閉迴路 |
| Episode | 操作片段 |
| Rollout | 推演 |
| Object Permanence | 物體恆存性 |
| Text-to-Image (T2I) | 文字生成影像 |
| Text-to-Video (T2V) | 文字生成影片 |
| Image-to-Video (I2V) | 影像生成影片 |
| Video-to-Video (V2V) | 影片生成影片 |
| Video Transfer | 影片轉換 |
| World-Scenario Map | 世界場景圖 |
| Prompt Upsampler / Prompt Upsampling | 提示詞上採樣器/提示詞上採樣 |
| Negative Prompt | 負面提示 |
| Agentic Workflow | 代理式工作流程 |
| Agentic Harness | 代理式框架 |
| Smart Infrastructure | 智慧基礎設施 |
| Autonomous Vehicle (AV) | 自動駕駛車 |
| Tailgating | 尾隨 |
| Diegetic | 劇情內(音效) |
| Stem | (音訊)主幹 |
| Lip-Sync | 唇形同步 |
| Shard | 分片 |
| Regularizer | 正則化器 |
| Hybrid Sharded Data Parallelism (HSDP) | 混合分片資料平行 |
| Context Parallelism (CP) | 脈絡平行 |
| Selective Activation Checkpointing (SAC) | 選擇性激活檢查點 |
| Activation Checkpointing | 激活檢查點 |
| Checkpoint | 檢查點 |
| Pinned Memory | 釘選記憶體 |
| Backpressure | 背壓 |
| Lease | 租約 |
| Join | 聯結 |
| Change Data Capture (CDC) | 變更資料擷取 |
| Online Analytical Processing (OLAP) | 線上分析處理 |
| Approximate Nearest Neighbor (ANN) | 近似最近鄰 |
| Kernel | 核心(運算核心) |
| Ahead-of-Time (AOT) Compilation | 預先編譯 |
| Cold Start | 冷啟動 |
| Throughput | 吞吐量 |
| Latency | 延遲 |
| Batching | 批次處理 |
| Tile | 圖磚 |
| Quantization | 量化 |
| CPU Offload | CPU 卸載 |
| Best-of-N (BoN) | N 選一 |
| MLLM-as-Judge | MLLM 作為評審 |
| Likert Scale | Likert 量表 |
| Ablation Study | 消融研究 |
| Motion Fidelity | 運動保真度 |
| Manifold | 流形 |
| Zero-Shot | 零樣本 |
| Panning | (相機)平移 |
| Zooming | (相機)變焦 |
| Fly-through | 穿越(運鏡) |
| Collage | 拼貼 |
| Success Rate | 成功率 |
| Relative Rotation Error (RRE) | 相對旋轉誤差 |
| Relative Translation Error (RTE) | 相對平移誤差 |
| Absolute Trajectory Error (ATE) | 絕對軌跡誤差 |
| Any-to-Any | 任意到任意 |
| Omnimodel | 全模態模型 |