預訓練 LLM 的原地詞元化器擴充
原始論文:In-Place Tokenizer Expansion for Pre-trained LLMs 作者:Jimmy T. H. Smith, Tarek Dakhran, Alberto Cabrera, Simon S. Lee, Paul Pak, Aditya Tadimeti, Tim Seyde, Maxime Labonne, Alexander Amini, Mathias Lechner(Liquid AI) arXiv ID:2607.15232v1 日期:2026-07-16 標籤:LLM Tokenizer 詞彙擴充 多語言 持續預訓練 On-device MoE
目錄
摘要
在預訓練 (Pre-training) 開始時就固定下來的詞元化器 (Tokenizer),會依預訓練語料的分佈比例配置詞彙,反映當時的部署優先順序。當這些優先順序轉移時,較晚才加入的語言會被切分成每個詞更多的詞元 (Token),進而提高這些語言使用者的延遲、運算量與能源消耗。雲端模型負擔得起廣泛的詞彙表 (Vocabulary),因為嵌入 (Embedding) 矩陣與 LM-head 矩陣只佔其參數量的一小部分。但在精簡模型上,這些矩陣佔每詞元解碼頻寬的可觀比例,因此裝置端 (On-device) 模型出貨時通常搭載小型詞彙表,並接受固定語言集合之外的碎片化 (Fragmentation)。我們提出「詞元化器擴充 (Tokenizer Expansion)」——一種當模型產製者能掌控詞元化器設計時,用來升級預訓練模型詞元化器的原地 (In-place) 配方。我們在多語言語料上延續既有詞元化器的 BPE 合併 (BPE Merges),因此多數來源詞元會以單一詞元的身分原封不動地保留下來,而每個新詞元都有一個對來源詞元的精確分解。我們將保留下來的嵌入列原樣複製,並將新的嵌入列初始化為其來源子詞元嵌入的平均值。接著進行兩階段適應——先只訓練嵌入、再進行全模型持續預訓練 (Continued Pre-training)——即可回復來源檢查點 (Checkpoint) 的品質。我們將此配方應用於 LFM2-8B-A1B(一個 8B 參數的混合專家 (Mixture-of-Experts, MoE) 模型)的持續預訓練檢查點,協助產出搭載 128K 詞元化器的 LFM2.5-8B-A1B。擴充後的詞元化器編碼印地語與越南語所需的詞元數,分別約為來源詞元化器的 2.4 分之一與 2.6 分之一(泰語最高達 4.0 分之一)。將這些縮減與較大詞彙表實測的每詞元成本結合後,我們估計在參考裝置上,這些語言可獲得 2.2–3.7 倍的每字元解碼加速。我們釋出模型權重與擴充後的詞元化器,並報告形塑此配方的負面發現 (Negative Findings)。
發表日期:2026 年 7 月 17 日 聯絡方式:[email protected], [email protected] 模型釋出:https://huggingface.co/LiquidAI
1. 簡介
在預訓練開始時選定的詞元化器,通常會依預訓練語料的分佈比例配置詞彙,而這反映了當時的部署優先順序。當優先順序轉移後,那些原本代表性不足、或後來才變得重要的語言,會比詞元化器當初針對的語言被切分成每個詞多出許多的詞元 (Petrov et al., 2023; Rust et al., 2021)。由於生成時每個輸出詞元都要呼叫一次解碼器,這種碎片化會提高這些語言使用者的解碼延遲 (Decode Latency)、運算量與能源消耗。對大型雲端模型而言,嵌入與 LM-head 矩陣在總參數中佔比微不足道,因此可以用較大的詞彙表換取更廣的文字系統 (Script) 覆蓋。裝置端模型的限制則嚴苛得多:輸出端的 LM-head 投影在每一步解碼都要觸及完整的詞彙維度,且在批次大小為 1 時,解碼通常受記憶體頻寬限制 (Memory-bandwidth-bound) (Xu et al., 2024),因此更大的詞彙表會顯著增加裝置端佔用空間(必須常駐記憶體的嵌入/LM-head 矩陣)與每詞元解碼成本。詞彙表大小因此是第一階的設計限制,邊緣模型通常搭載精簡詞彙表出貨,只覆蓋選定的優先語言與領域集合,並接受集合之外的碎片化。
開放模型家族在詞彙表大小與語言覆蓋之間的取捨落點各不相同,從精簡詞元化器到大得多的詞元化器都有 (Abdin et al., 2024; Gemma Team, 2025; Grattafiori et al., 2024; Yang et al., 2025)。LFM2 (Liquid AI Team, 2025) 位於精簡端,符合裝置端模型的預期。它的詞元化器是一個 65K 詞彙的位元組層級 (Byte-level) BPE 詞元化器,針對英文、程式碼與一組固定的額外語言(阿拉伯語、中文、法語、德語、日語、韓語、西班牙語)最佳化。它把極少的預算分配給若干編碼效率不佳的語言,例如印地語與越南語,因此會把這些語言切成相當於可比英文文本數倍的詞元量。兩種標準補救方案都不理想:訓練新詞元化器並從頭預訓練,會拋棄已投入該檢查點的運算資源;而以零樣本 (Zero-shot) 轉移方法事後置換詞元化器 (Minixhofer et al., 2024),則是在解一個比必要更難的問題——它必須為一個任意的目標詞元化器推斷來源到目標的對應關係。
我們提出一種原地詞元化器擴充的方法(圖 1),瞄準一個較窄但常見的生產情境:模型產製者掌控詞元化器的升級。我們以既有詞元化器初始化合併表 (Merge Table),固定既有合併不動,再附加從多語言語料學到的新合併。這種「延續式 BPE (Continued-BPE)」建構讓多數來源詞元一對一地映射進擴充後的詞彙表,並讓每個新詞元都有對來源詞元的精確分解——這兩個性質,對於以獨立訓練的第三方詞元化器為目標的方法而言都不存在。模型的初始化與之對應:保留詞元的嵌入列原樣複製,新列取其來源詞元分解的平均值。接著我們以兩階段適應模型:先凍結模型主體、只訓練嵌入,再於平衡的多語言語料上進行全模型持續預訓練。我們將此程序稱為詞元化器擴充,它是跨語言詞彙適應 (Cross-lingual Vocabulary Adaptation, CVA) (Mundra et al., 2024; Yamaguchi et al., 2024) 的一種形式,差別在於它延伸的是詞元化器的 BPE 合併,而非僅僅附加詞彙表條目。
我們在 LFM2-8B-A1B 檢查點的持續預訓練期間套用此配方。適應後的模型接著經過標準的中期訓練 (Mid-training) 與後訓練 (Post-training) 階段,產出 LFM2.5-8B-A1B (Liquid AI Team, 2025, 2026)。詞元數的縮減相當可觀:對相同文本,擴充後的詞元化器編碼印地語所需詞元數約為來源詞元化器的 2.4 分之一、越南語為 2.6 分之一,縮減幅度最大的是泰語,達 4.0 分之一(圖 2)。結合較大詞彙表實測的每詞元成本後,我們估計此壓縮在參考裝置上為這些語言帶來 2.2–3.7 倍的每字元解碼加速(第 7 節)。
我們的貢獻在模型與部署端。據我們所知,這是第一份在生產規模(8B 參數的裝置端 MoE)上,針對原地、延續式 BPE 詞元化器擴充的模型端配方的完整記述。我們提出一套嵌入初始化與兩階段適應配方,能將詞彙升級套用到既有檢查點而不犧牲已累積的品質(第 6 節);一份把詞元化器壓縮與較大詞彙表的每詞元成本區分開來的裝置端延遲分析(第 7 節);以及形塑此配方的負面發現(第 8 節)。延續式 BPE 建構本身與獨立進行的同期研究 (Purason et al., 2026) 相同,該研究著重其詞元化器端的性質;我們則在其之上建立模型端配方,並釋出模型權重與擴充後的詞元化器。
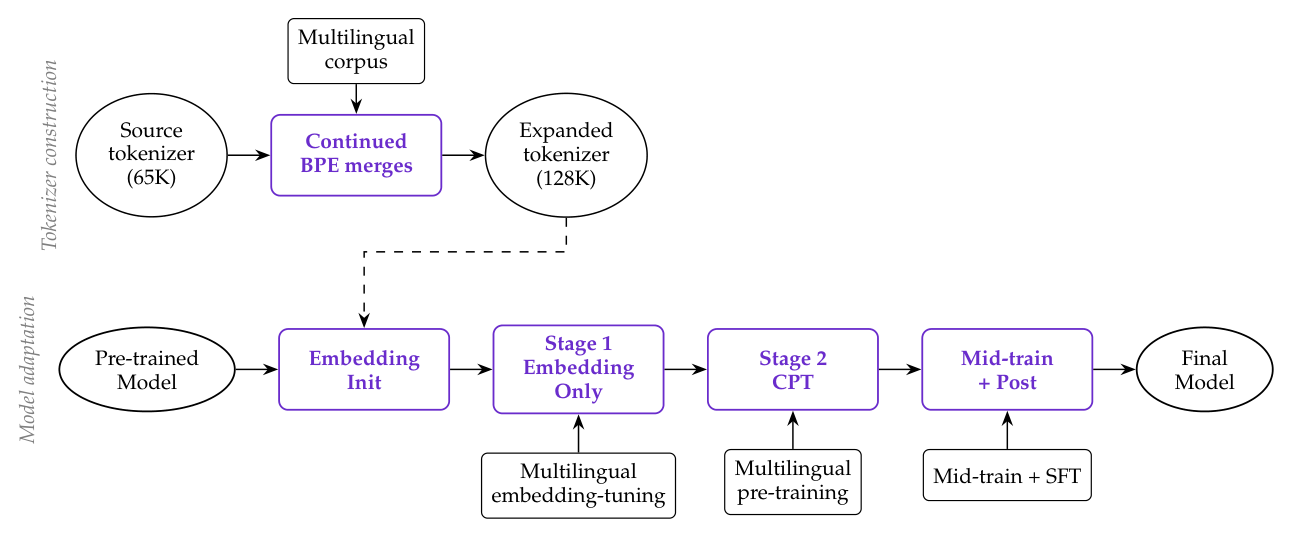
圖 1:詞元化器擴充流程。 上:擴充後的詞元化器透過在多語言語料上延續來源詞元化器的 BPE 合併程序所建構;在此建構下,多數來源詞元會一對一地保留至擴充後的詞彙表。下:針對新詞彙表重新初始化預訓練模型的嵌入矩陣(保留的詞元直接複製其嵌入列,新詞元取其子詞元嵌入的平均值),接著以兩階段適應(先凍結模型其餘部分、只訓練嵌入,再於平衡的多語言混合語料上做全模型持續預訓練),之後進行中期訓練與後訓練以產出最終模型。虛線箭頭表示:擴充後的詞元化器決定了整個適應流程所使用的新嵌入矩陣形狀。
2. 詞元化器建構
擴充後的詞元化器是一個位元組層級 BPE 詞元化器 (Radford et al., 2019; Sennrich et al., 2016),透過在一個往「詞元化不足 (Under-tokenized) 語言」加權的多語言語料上,延續 LFM2 詞元化器的合併訓練而建成。
來源詞元化器。 LFM2 詞元化器擁有 65K 詞元的位元組層級 BPE 詞彙表,其訓練語料偏重英文、程式碼與一組固定的額外語言(阿拉伯語、中文、法語、德語、日語、韓語、西班牙語)(Liquid AI Team, 2025)。它的詞彙表早於促成本研究的更廣泛多語言部署需求。
延伸訓練與映射性質。 我們以 LFM2 詞元化器的合併表為初始值,在一個補足印地語、泰語等代表性不足語言覆蓋、同時保留英文與程式碼以維持既有工作負載壓縮率的多語言語料上,繼續 BPE 訓練,建出擴充後的 128K 詞元化器。既有合併全數保留、新合併依序附加,因此每個新詞元依建構方式必然可分解為一個或多個來源詞元的序列。雖然擴充後的詞彙表重新指派了詞元 ID,64,400 個來源詞元中有 63,151 個在其中仍以單一詞元存在(表 1),其嵌入列因此可直接轉移。其餘每個擴充詞元都會拆分為兩個以上的來源詞元。第 3 節利用此分解進行嵌入初始化。更多建構細節(包括特殊詞元 (Special Tokens) 的處理,以及與其他生產詞元化器的比較)見附錄 C。
為何採延續式 BPE 延伸而非詞彙表聯集。 另一種做法(早期語言特化的 Llama 衍生模型如 Chinese-LLaMA (Cui et al., 2023) 採用)是針對目標語言訓練一個獨立的詞元化器,再取其詞彙表與來源詞彙表的聯集。由於兩個詞元化器是獨立訓練的,新詞元不必然可分解為來源詞元,因此不存在可用來初始化其嵌入的標準來源端分解。延續式 BPE 延伸維持單一合併表,每個新詞元都能決定性地 (Deterministically) 分解為來源詞元——這正是第 3 節嵌入初始化所需要的。
語言覆蓋與繁殖率。 我們依來源詞元化器編碼各語言的糟糕程度來排定優先順序。詞元繁殖率 (Token Fertility) 是詞元化器平均每個詞使用的詞元數,而來源詞元化器恰恰在那些分得極少詞彙預算的語言上繁殖率偏高,把這些語言的詞切成許多詞元。詞元化不足的語言橫跨非拉丁文字系統(例如印地語、泰語與孟加拉語)以及來源詞元化器服務不佳的拉丁文字語言。圖 2 針對每種語言,報告來源詞元化器與擴充詞元化器在同一份保留 (Held-out) 文本上的詞元數比值(非英文網頁文本取自 FineWeb 2 (Penedo et al., 2025),另含保留的英文、程式碼與 JSON 樣本),1.0 倍代表持平,越高代表編碼越短。詞元化不足的語言大幅改善(例如印地語 2.4 倍、泰語 4.0 倍),而英文與程式碼依設計維持持平。由於批次大小 1 的解碼成本由每詞元的權重讀取主導,這種壓縮大部分會直接轉化為解碼時間的加速,詳見第 7 節的討論。
| 指標 | 數值 |
|---|---|
| 擴充詞元化器矩陣大小(名目) | 128,000 |
| 擴充詞元化器有效條目 | 125,017 |
| 來源詞元化器矩陣大小(名目) | 65,536 |
| 來源詞元化器有效條目 | 64,400 |
| 1:1 映射的詞元數 | 63,151 |
| 1:N 映射的詞元數(N ≥ 2) | 61,866 |
| 最大分解長度 | 64 |
表 1:來源與擴充詞元化器之間的映射性質。 全文以名目大小(來源 65K、擴充 128K)作為約整數字,需要精確時則使用有效條目數(64,400 與 125,017)。擴充詞彙表約有一半與單一來源詞元一對一對應;這些詞元在兩個詞彙表中的整數 ID 不同、但表面字串相同,其嵌入列因此直接從對應的來源列複製。其餘詞元分解為兩個以上來源詞元的序列(長度最長 64),其嵌入以平均法初始化(第 3 節)。剩下的 1,249 個來源條目(64,400 減 63,151)是保留槽位或特殊詞元槽位,不作為一般詞元保留;這不影響嵌入初始化。
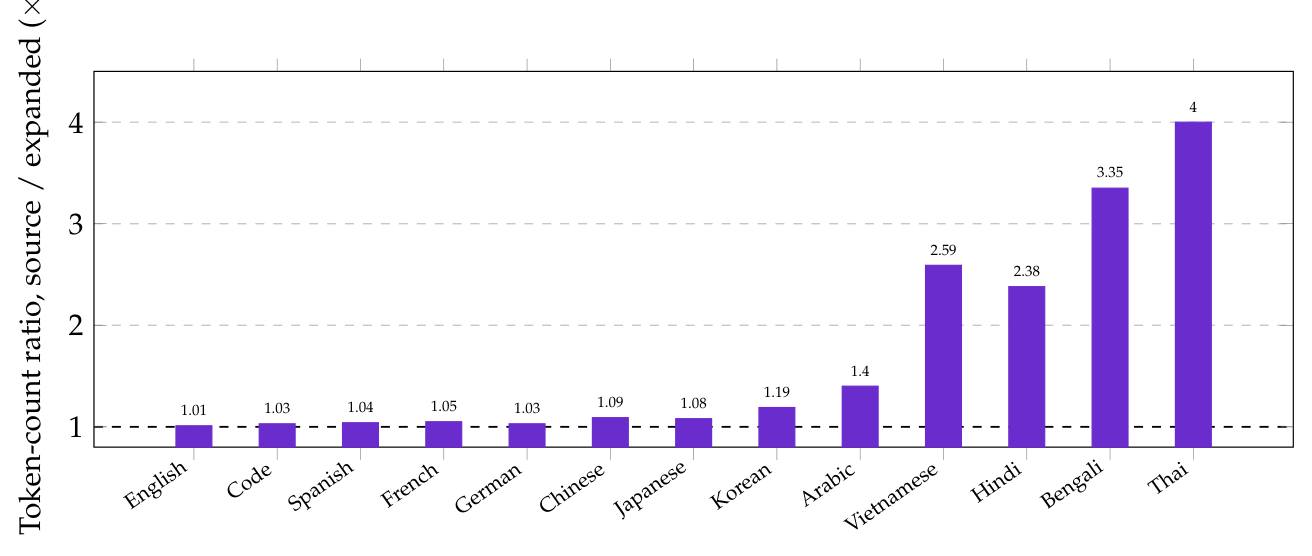
圖 2:擴充詞元化器相對來源詞元化器的編碼長度縮減。 每種語言的長條為來源詞元化器與擴充詞元化器在相同輸入文本上的詞元數比值。1.0 倍代表持平,越高代表編碼越短。英文與程式碼依設計持平,先前已支援的語言小幅改善,詞元化不足的語言則大幅改善。
3. 嵌入初始化
給定 65K 來源詞彙表的預訓練輸入嵌入矩陣 $E_{\text{src}} \in \mathbb{R}^{|V_{\text{src}}| \times d}$,我們用單一規則建構 128K 擴充詞彙表的嵌入矩陣 $E_{\text{new}} \in \mathbb{R}^{|V_{\text{new}}| \times d}$($|V_{\text{new}}| = 125{,}017$ 個有效條目,表 1)。每個新詞元 $t$ 分解為來源詞元序列 $(t'_1, \ldots, t'_N)$(第 2 節),我們將其嵌入列設為對應來源列的平均:
$$E_{\text{new}}[t] = \frac{1}{N} \sum_{i=1}^{N} E_{\text{src}}[t'_i]. \tag{1}$$
對於分解為單一來源詞元($N = 1$)的 63,151 個詞元,這等同於原樣複製來源列;其餘詞元則是兩列以上的平均。
由於 LFM2-8B-A1B 與 LFM2.5-8B-A1B 綁定 (Tie) 輸入嵌入與輸出 LM-head,同一個矩陣 $E_{\text{new}}$ 同時提供兩者,因此初始化一列即同時設定該詞元的輸入表徵與其輸出 logit 向量。同樣的建構也適用於未綁定的模型,只需分別初始化兩個矩陣。
為何取平均。 我們取平均而非加總,是為了讓新列的範數 (Norm) 與既有列相當,而不會隨 $N$ 增長。因為每個新詞元都分解為已知的來源詞元,這個質心 (Centroid) 永遠有定義,沒有任何一列需要隨機初始化。我們並不宣稱質心就是模型對該詞元的內部表徵,只主張它是一個合理的起點,能讓第一階段訓練乾淨地收斂(第 6.1 節)。以既有嵌入的平均值初始化新列是行之有年的既定基準做法 (Hewitt, 2021; Mundra et al., 2024)。更精巧的加權或學習式初始化方法,主要是為詞元化器置換情境開發的——該情境下新詞元化器是獨立訓練的,新詞元沒有對來源詞元的標準分解(第 5 節)。在我們的設定裡,每個新詞元都有這樣的分解,且第一階段會訓練這些新列,因此我們不預期更精巧的初始化會改變結果,也就沒有進一步嘗試。
4. 訓練配方
擴充流程的來源模型是 LFM2-8B-A1B(總參數 8.3B、每詞元啟用 1.5B)的一個內部延續版本:從已釋出的 12T 詞元基礎版 (Liquid AI Team, 2025) 持續預訓練至 35T 詞元,仍使用原本的 65K 詞彙詞元化器。全文將此檢查點稱為來源模型 (Source Model)。配方是否保住了擴充前的品質,我們的主要證據就是擴充後模型與這個來源模型的比較。
嵌入初始化之後,模型分兩階段適應擴充後的詞元化器,如圖 1(流程圖下排)所示、並整理於表 2;之後接續中期訓練與後訓練。這種分階段結構是經驗導向的:一次訓練所有參數會破壞模型原本已運作良好的部分。將第一階段限制在新的嵌入列,可以隔離變更範圍;隨後的全模型持續預訓練,再讓模型在以擴充詞元化器詞元化的資料上重新平衡。作為 MoE 模型,它需要健康的專家路由 (Expert Routing)。我們在整個適應過程中監控專家負載平衡與路由器 (Router) 健康度——路由器在第一階段凍結,在第二階段與中期訓練中可訓練。這些內部診斷(此處不列出)顯示詞彙擴充未造成任何劣化。
4.1 第一階段:僅嵌入訓練
第一階段中,我們在 600B 詞元上只訓練綁定的嵌入/LM-head 矩陣 $E_{\text{new}}$ 的新列,凍結其他所有參數——包括從來源直接複製的列(第 3 節 $N = 1$ 的情形)。由於輸入嵌入與輸出頭綁定,更新一個新列會同時改變該詞元的輸入表徵與其輸出 logit 向量。訓練資料是往「其新列正在受訓的詞元化不足語言」加權的多語言混合語料,採標準的下一詞元預測 (Next-token Prediction) 目標。這 600B 詞元只訓練嵌入,我們不把它計入模型的預訓練詞元總量。我們以 4,096 詞元的序列長度 (Sequence Length) 訓練,與來源模型的預訓練上下文長度 (Context Length) 一致;上下文延伸至 32K 再到 128K 則留待中期訓練(第 4.3 節)。我們重新初始化最佳化器狀態 (Optimizer State),將學習率 (Learning Rate) 暖身 (Warm up) 至相對高的峰值後保持恆定——高峰值適合訓練一小批剛初始化的參數。
這個僅嵌入的步驟最接近 ReTok (Gu et al., 2024),該方法同樣在詞元化器變更後只訓練嵌入(完整比較見第 5 節)。我們的差異在於額外凍結了複製過來的列:它們已經能為那些詞元重現來源模型的查表與 logits,而我們發現在模型主體無法跟進的情況下,讓它們漂移是有害的(第 8 節)。
僅靠第一階段就能回復零樣本詞彙置換造成的多數下滑。在圖 3 的逐階段軌跡上,它收復了置換當下損失的 5.8 個總分中的 4.8 分,英文與程式碼大致回復。詞元化不足的語言也從零樣本下滑中回升,但它們最大的增益來自第二階段。第一階段本身並不足夠:需要第二階段的全模型持續預訓練來收攏剩餘差距,並將新詞彙整合進模型主體(第 6 節)。
4.2 第二階段:持續預訓練
第二階段中,我們解凍所有參數,在以擴充詞元化器詞元化的平衡多語言語料上,以與第一階段相同的序列長度持續預訓練 400B 詞元。與第一階段一樣重新初始化最佳化器狀態、將學習率暖身後保持恆定,但峰值較低,因為全模型是從一個已可運作的組態出發。
第二階段的資料混合比例,是「解凍訓練能否保住第一階段成果」的主要因素。我們以消融實驗直接研究其影響(第 8 節):以英文為主的混合語料保住了多選題準確率,卻在生成式基準上造成全面退化;而含大量多語言內容(包括詞元化不足語言的覆蓋)的混合語料消除了這種退化,產出在總分上追平或超越來源模型的檢查點(第 6 節)。
| 階段 | 可訓練參數 | 詞元數 | 資料混合 |
|---|---|---|---|
| 第一階段:僅嵌入 | $E_{\text{new}}$ 的新列 | 600B | 聚焦詞元化不足語言 |
| 第二階段:CPT | 全部參數 | 400B | 平衡多語言 |
| 中期訓練 | 全部參數 | 2.4T | 先 32K 後 128K 上下文、更高品質 |
表 2:兩個適應階段與後續中期訓練的訓練摘要。 第一階段的 600B 詞元只訓練嵌入,不計入模型的預訓練詞元總量。第一階段的混合語料偏重其新列正在受訓的詞元化不足語言;第二階段的混合語料則在完整語言集合上取得平衡,使全模型訓練不致退化先前已支援的語言(第 4.2 節)。中期訓練分兩個上下文長度階段進行:32K 上下文訓練 2T 詞元,接著 128K 訓練 400B 詞元。後訓練遵循 LFM2.5 流程 (Liquid AI Team, 2026)。
4.3 中期訓練與後訓練
中期訓練與後訓練遵循 LFM2.5 流程 (Liquid AI Team, 2026),此為早期 LFM2 程序 (Liquid AI Team, 2025) 的更新版。詞元化器擴充不需要對此流程做任何變更:第二階段檢查點可直接替換 (Drop-in Replacement) 該流程通常消耗的基礎模型。中期訓練分兩個上下文長度階段進行:先是 32K 上下文、共 2T 詞元的階段,再接 128K 上下文、共 400B 詞元的延伸,兩者皆取材於更高品質且自然長上下文的來源,並對學習率做退火 (Anneal)。聊天模板、特殊詞元與工具使用 (Tool-use) 格式皆遵循已釋出的 LFM2.5 組態。
5. 相關研究
詞元化器擴充介於兩者之間:一邊是跨語言詞彙適應 (CVA)——透過擴充詞彙表並持續預訓練,為預訓練模型增加語言覆蓋;另一邊是詞元化器轉移 (Tokenizer Transfer)——徹底置換模型的詞元化器,並重新訓練或轉移其嵌入。先前研究已確立不良詞元化的部署成本 (Ahia et al., 2023; Petrov et al., 2023),並研究了 CVA 的推論效率與嵌入初始化選擇 (Mundra et al., 2024; Yamaguchi et al., 2024)。以下我們依各研究與本配方共享的元件,將本配方與最直接可比的研究對照定位。
詞元化器建構。 我們使用的延續式 BPE 建構——以來源詞元化器初始化合併表、在目標語料上繼續 BPE 合併訓練——也由獨立同期研究 Purason et al. (2026) 提出,該研究在較小規模上、跨多個基礎模型研究其詞元化器端性質(壓縮率、不可達詞元 (Unreachable Tokens) 的避免、以葉節點為基礎的剪枝),並釋出工具套件。我們的貢獻在模型端:我們在 8B MoE 規模上應用此建構,開發能回復品質的嵌入初始化與兩階段適應,連同裝置端延遲分析與隨附的負面發現。Dagan et al. (2024) 指出,置換或大幅改動預訓練模型的詞元化器,需要大量的持續預訓練才能避免效能劣化——這支持了我們第二階段的全模型持續預訓練。
適應配方。 有兩個模型端研究各自最接近本配方的某一個階段。ReTok (Gu et al., 2024) 在詞元化器變更後凍結模型主體、只訓練嵌入,與我們的第一階段相同;但它置換整個詞元化器,並以舊詞元化器下的啟發式切分 (Heuristic Segmentation) 初始化新列。我們的延續式 BPE 建構讓該分解變得精確,且我們額外在第二階段解凍模型主體——我們發現這在此規模下是必要的(第 8 節)。EEVE (Kim et al., 2024) 跨七個階段漸進式解凍模型,與我們的分階段結構相似,但它附加的是另一個獨立訓練的詞元化器的合併,而非延續來源合併。
嵌入初始化。 我們使用的「子詞平均質心 (Mean-of-subwords Centroid)」是簡單且既定的基準方法 (Hewitt, 2021; Mundra et al., 2024),在此已然足夠,因為延續式 BPE 建構讓來源端分解變得精確。另有大量研究為更困難的情境開發更精巧的初始化器——利用對齊、重疊統計、加權來源組合、超網路 (Hypernetworks) 或蒸餾 (Distillation)——這些情境中新詞元化器獨立於來源訓練,來源—目標關係必須被重新推斷 (Dobler and de Melo, 2023; Dobler et al., 2025; Goddard and Fernandes Neto, 2025; Li et al., 2025; Minixhofer et al., 2022, 2024; Nakash et al., 2025; Ostendorff and Rehm, 2023; Remy et al., 2024; Sharthak et al., 2025)。
詞彙延伸加持續預訓練。 「詞彙延伸後接持續預訓練」已在多種模型上確立:語言特化的 Llama 衍生模型 (Cui et al., 2023; Fujii et al., 2024)、東南亞語言的多語言持續訓練 (Dou et al., 2024, 2025)、低資源語言 (Lin et al., 2024; Yong et al., 2023)、指令微調 (Üstün et al., 2024) 以及翻譯導向 (Alves et al., 2024) 的模型。Yamaguchi et al. (2026) 顯示僅需約 0.01 GB 的持續預訓練文本,即可達到有競爭力的目標語言品質。我們瞄準的是這個空間中較少被探索的一點:對單一已部署的裝置端模型進行原地升級,其核心挑戰是在改善詞元化的同時保住模型的既有品質。
6. 評測
我們沿兩個軸線評測。第一,跨擴充階段的品質回復(第 6.1 節):追蹤一組預訓練式公開基準的總分,從來源模型、經零樣本置換、到第一與第二階段。由於這些基準以英文、程式碼與高資源語言為主,此軸線主要證明擴充保住了來源檢查點的既有能力,而非衡量新增語言。第二,Global-MMLU 的逐語言細節(第 6.2 節)涵蓋目標的兩面:確認先前已支援的語言沒有退化,並量化促成此次擴充的詞元化不足語言之增益。在這兩個軸線之外,釋出的 LFM2.5-8B-A1B 相較 LFM2-8B-A1B 在指令遵循 (Instruction Following)、工具使用、數學與代理 (Agentic) 任務上也有進步;那些增益反映的是額外預訓練與推理導向後訓練的完整流程,而非僅詞元化器擴充,故記載於 LFM2.5 釋出資料 (Liquid AI Team, 2026) 而非本文。
6.1 跨階段的品質回復
圖 3 追蹤一個總體品質分數——八個公開基準(附錄 A)的未加權平均——橫跨四個受控階段:來源 → 零樣本 → 第一階段 → 第二階段。這些階段共享同一個訓練目標,只差在詞彙變更及其回復訓練,因此這條軌跡能單獨隔離出詞元化器擴充流程的影響。中期訓練與後訓練被排除在外,因為它們會把詞元化器變更與後續的能力增益混為一談。
由於來源是未經指令微調的基礎預訓練檢查點,我們把總分限制在基礎模型無需指令遵循即可評分的基準:以模型賦予的機率為固定答案選項排序的對數機率 (Log-probability) 基準、從模型自由輸出中讀取簡短最終答案的答案擷取 (Answer-extraction) 基準,以及以執行為準的程式碼基準。我們排除依賴聊天模板的指令遵循基準(如 IFEval),因為基礎檢查點未受過聊天模板遵循訓練,這些基準會低估其品質。
回復軌跡在零樣本檢查點之後是單調上升的(圖 3)。零樣本檢查點損失 5.8 個總分,反映模型主體尚未適應新詞彙。第一階段(僅嵌入、主體凍結)收復其中 4.8 分,第二階段(全模型持續預訓練)收攏剩餘差距並以 3.6 分超越來源。由於第二階段增加了 400B 詞元的全模型持續預訓練,我們將此超越解讀為潛在來自該額外訓練的效果,而非詞彙變更本身。因此,最主要的結論是「保持不變」:第二階段檢查點在預訓練式基準上追平或超越來源模型,同時已改用 128K 詞元化器。促成此次擴充的詞元化不足語言增益另報告於第 6.2 節。按類別看,第二階段在知識(+4.5)、數學(+2.8)、程式碼(+6.3)與多語言(+1.6)上超越來源(表 3),但少數個別基準微幅下滑,主要在數學與多語言生成。此處的多語言類別是 MMMLU 與 MGSM,涵蓋的多為高資源語言而非詞元化不足的目標語言。這些下滑可能反映第二階段混合語料向詞元化不足語言的再平衡,而非配方本身的性質,但我們未進一步隔離原因。逐基準的跨階段細節見附錄 A 表 8。
| 類別 | 來源 | 零樣本 | 第一階段 | 第二階段 |
|---|---|---|---|---|
| 知識 (MMLU-Pro) | 30.7 | 28.1 | 30.6 | 35.2 |
| 數學 (GSM8K, MATH500, GSM-Plus) | 54.4 | 49.6 | 54.3 | 57.2 |
| 程式碼 (HumanEval+, LiveCodeBench v5) | 30.9 | 20.8 | 27.9 | 37.2 |
| 多語言 (MGSM, MMMLU) | 50.9 | 46.3 | 50.0 | 52.5 |
| 總分(8 基準平均) | 44.7 | 38.9 | 43.7 | 48.3 |
表 3:跨擴充階段的逐類別品質回復。 每個類別是其組成基準的未加權平均。總分是全部八個基準的未加權平均,因此含較多基準的類別貢獻較大。第二階段在全部四個類別上追平或超越來源。
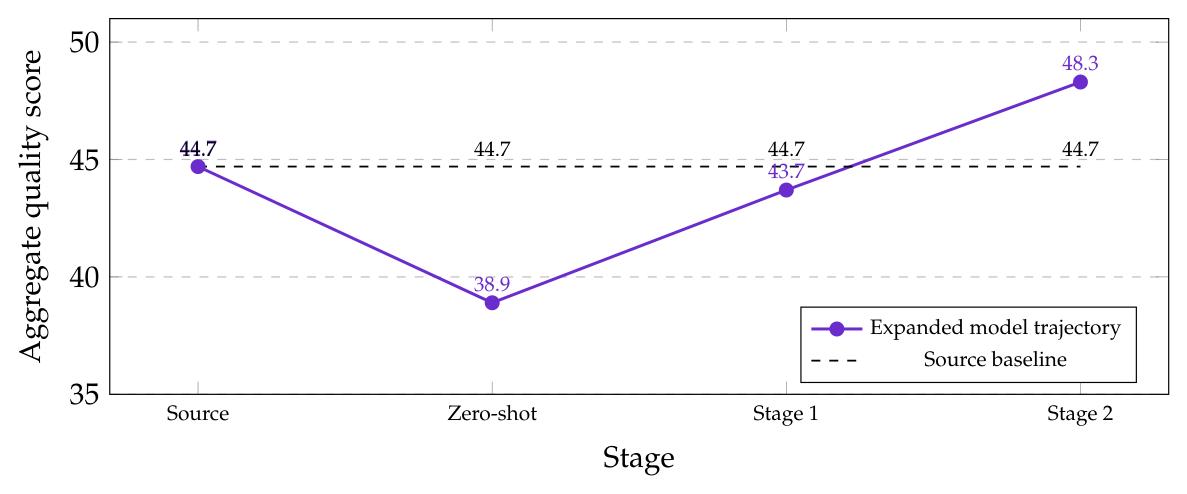
圖 3:跨適應階段的品質回復。 總分定義見第 6.1 節(八個基準的未加權平均,逐基準細節見附錄 A 表 8)。零樣本檢查點損失約六個總分,第一階段收復大部分差距,第二階段收攏剩餘並超越來源。
6.2 多語言基準細節
逐語言結果印證了整體模式:先前已支援的語言守住陣地,詞元化不足的語言則獲得增益——擴充在不退化既有能力的前提下增加了覆蓋。
Global-MMLU(廣域多語言多選題)。 Global-MMLU (Singh et al., 2024) 以專業翻譯、社群驗證翻譯與機器翻譯的組合,將完整 MMLU 測試集(每語言約 14,000 題四選一,隨機水準 25%)轉譯為 42 種語言。我們報告至少有一個檢查點超過 30% 的 39 種語言;其餘 3 種語言全程停留在隨機水準(附錄表 9)。擴充後的模型在第二階段回復並超越來源(39 語言平均:來源 41.4、零樣本 37.0、第一階段 40.6、第二階段 43.7,淨增 +2.3)。零樣本詞彙置換造成短暫下滑(平均 37.0,阿拉伯語降至 32.9),第一、二階段將其回復。到第二階段,先前已支援的語言全數保持,逐語言變化介於 −0.3(西班牙語)至 +1.8(阿拉伯語),在取樣雜訊範圍內;而詞元化不足的語言大幅增益(越南語 +11.6、印尼語 +9.1、印地語 +7.6、馬來語 +6.8)(表 4)。
詞元化不足的語言。 在詞元化不足的語言中,Global-MMLU 涵蓋印地語、孟加拉語、印尼語、馬來語與越南語,全部在第二階段改善。印地語、印尼語、馬來語與越南語列於表 4,孟加拉語改善 +4.8(附錄表 9)。另一個詞元化不足的語言泰語不在 Global-MMLU 中,此處未單獨評測。
| 語言 | 來源 | 零樣本 | 第一階段 | 第二階段 | Δ |
|---|---|---|---|---|---|
| 先前已支援 | |||||
| 阿拉伯語 | 51.4 | 32.9 | 50.1 | 53.2 | +1.8 |
| 德語 | 56.1 | 53.5 | 55.3 | 57.2 | +1.1 |
| 西班牙語 | 57.5 | 53.8 | 56.6 | 57.2 | -0.3 |
| 法語 | 56.5 | 53.1 | 55.6 | 57.4 | +0.9 |
| 日語 | 53.5 | 48.4 | 52.2 | 55.1 | +1.6 |
| 韓語 | 50.7 | 41.4 | 49.8 | 52.4 | +1.7 |
| 中文 | 53.9 | 46.5 | 52.2 | 54.9 | +1.0 |
| 詞元化不足 | |||||
| 印地語 | 32.0 | 26.2 | 33.8 | 39.6 | +7.6 |
| 越南語 | 35.8 | 25.6 | 38.8 | 47.4 | +11.6 |
| 印尼語 | 41.9 | 34.0 | 40.2 | 51.0 | +9.1 |
| 馬來語 | 38.6 | 32.8 | 37.5 | 45.4 | +6.8 |
| 平均(39 語言) | 41.4 | 37.0 | 40.6 | 43.7 | +2.3 |
表 4:跨擴充階段的 Global-MMLU 準確率(5-shot)。 四選一多選題,以答案字母對數機率評分、5-shot 提示,隨機水準為 25%。Δ 為第二階段減來源。平均值取自至少一個檢查點超過 30% 的 39 種語言;3 種全程在隨機水準的語言被排除(附錄表 9)。逐語言分數帶有約半分的取樣雜訊(n ≈ 14,000),因此一分上下的語言間差異不宜視為有意義。此處「零樣本」指未經回復訓練的擴充階段,而非 few-shot 設定。
7. 裝置端延遲
詞元化器擴充工作的主要動機是裝置端解碼效率。使用者感受到的指標是每字元生成文本的實際時鐘時間 (Wall-clock Time),而非原始的每秒詞元數;因此擴充在某個語言上是否為淨勝,取決於其壓縮增益是否超過較大詞彙表新增的每詞元成本。簡言之,我們估計在全部三台參考裝置上,擴充後的詞元化器解碼嚴重詞元化不足的語言(泰語、孟加拉語、越南語、印地語)比來源詞元化器每字元快 2.2 至 3.7 倍,代價是壓縮最少的語言(英文與程式碼)每字元最多慢約 9%。這兩個組成——逐語言壓縮與逐裝置解碼成本——在本節其餘部分分別量測。
為何報告合成估計而非直接端到端量測。 LFM2-8B-A1B 與 LFM2.5-8B-A1B 皆已釋出,所以直接的作法是拿兩個釋出版在同一台裝置上解碼同一段印地語文本並比較。我們不以此作為主要證據,因為它無法隔離詞元化器:兩個釋出版在詞元化器之外還有許多差異,且 LFM2.5-8B-A1B 是會輸出可變長度思考軌跡 (Thinking Traces) 的推理模型,同一個提示會產生不同的輸出長度與詞元分佈。而「只換詞元化器」——把它換進單一後訓練完成的檢查點——若不重跑整個適應流程並不可行,重跑又會引入它自己的變化。兩條路都會把詞元化器變更與其他同時發生的變更混淆。
因此,我們把每字元輸出的解碼時間分解為兩個可獨立量測的組成。在相同模型主體下,擴充詞元化器相對來源詞元化器的解碼加速可乾淨地因式分解:
$$\underbrace{\frac{\text{chars/sec}_{\text{new}}}{\text{chars/sec}_{\text{old}}}}_{\text{每字元解碼加速}} = \underbrace{\frac{\text{chars/token}_{\text{new}}}{\text{chars/token}_{\text{old}}}}_{\text{壓縮(逐語言)}} \times \underbrace{\frac{\text{decode t/s}_{\text{new}}}{\text{decode t/s}_{\text{old}}}}_{\text{詞彙表大小成本(逐裝置)}}$$
壓縮項純粹是詞元化器的性質,不需執行模型即可在多語言文本上量測(圖 2,第 2 節)。詞彙表大小成本項是模型在特定裝置上的性質,在同一個 LFM2-8B-A1B 主體上、只改變嵌入/LM-head 矩陣大小來量測(第 7.1 節)。這個因式分解是恆等式;讓合成加速成為「估計」的原因,是我們只量測一次詞彙表大小成本,並將其當作跨語言與輸出長度的常數重複使用。在此情境這是良好近似:批次大小 1 的解碼受記憶體頻寬限制,每一步由讀取模型權重與 LM-head 矩陣主導——無論生成哪個詞元,每詞元讀取的位元組數幾乎恆定。它主要忽略的是 KV 快取 (KV Cache):其隨上下文長度成長且兩種詞彙表相同,因此在長序列上它佔每步的比重變大,每詞元的詞彙表代價則縮小。
7.1 詞彙表縮放的每詞元解碼成本
為了把詞彙表大小成本從詞元化壓縮中隔離出來,我們固定模型主體,只改變嵌入與 LM-head 矩陣的大小。我們對同一份 LFM2-8B-A1B 權重做基準測試,將該矩陣從來源詞元化器的 65K 條目調整為擴充詞元化器的 128K 條目,並在兩種組態下餵入相同的詞元序列,使量測結果隔離出較大矩陣的每詞元解碼成本,排除任何詞元化引起的詞元數變化。基準測試使用 llama-bench (Gerganov and contributors, 2023),固定解碼長度 128 詞元,全程 Q4_0 量化 (Quantization)。預填充 (Prefill) 在 M4 Max 上以 512 詞元提示量測、在 Snapdragon 8 Elite Gen 5 手機級裝置上以 256 詞元提示量測(較短是為了抑制熱節流),但我們的合成估計只依賴解碼吞吐量 (Throughput)。
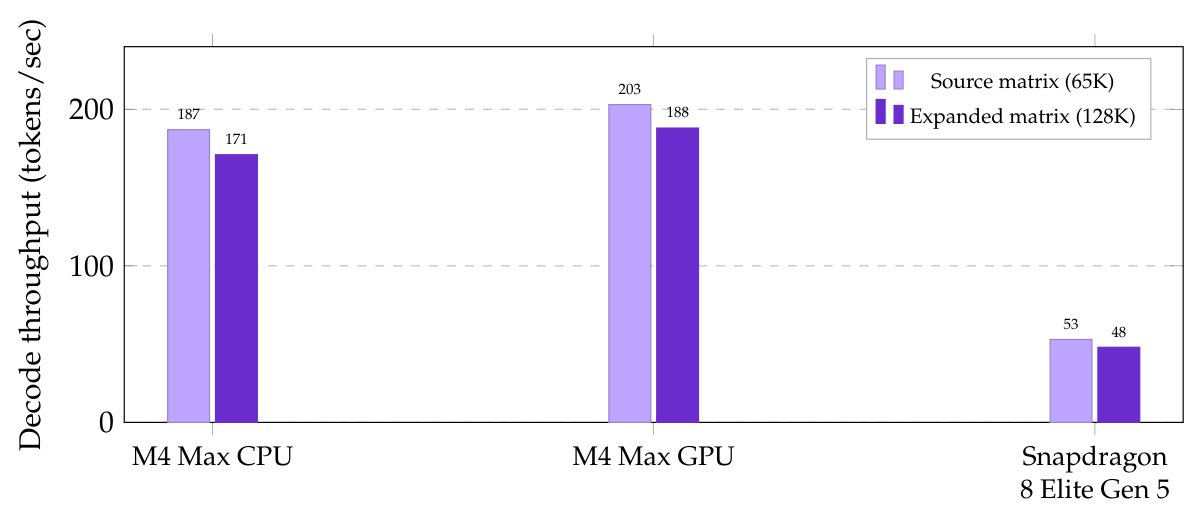
圖 4:在來源(65K)與擴充(128K)嵌入/LM-head 矩陣大小下的每詞元解碼吞吐量,模型主體與輸入詞元完全相同。 以 llama-bench (Gerganov and contributors, 2023) 在 Q4_0 量化、批次大小 1、生成 128 詞元下量測 LFM2-8B-A1B。矩陣從 65K 加倍至 128K 列時,解碼吞吐量在 M4 Max CPU 下降 8.6%、M4 Max GPU 下降 7.4%、Snapdragon 8 Elite Gen 5 手機級裝置下降 9.4%。預填充吞吐量在不同矩陣大小間落在多次執行的變異範圍內,沒有一致方向(完整數字見表 12)。磁碟上的模型大小隨新增的約 62K 嵌入列(65,536 → 128,000)增加約 100 MiB。
預填充與解碼對較大矩陣的反應不同。預填充受運算限制 (Compute-bound),LM-head 的讀取攤提在整段輸入上,因此幾乎不隨詞彙表大小變動。解碼受記憶體頻寬限制,每一步都要支付較大的 LM-head 讀取,每詞元下降 7–10%。完整的逐裝置數字與磁碟大小見附錄 D 表 12。
7.2 每字元解碼加速(合成)
將圖 2 的逐語言壓縮與表 12 的逐裝置解碼成本比值結合,即得每字元輸出的估計解碼加速,見表 5。
| 語言 | 壓縮(圖 2) | M4 Max CPU | M4 Max GPU | Snapdragon 8 Elite Gen 5 |
|---|---|---|---|---|
| 泰語 | 4.00× | 3.66× | 3.70× | 3.62× |
| 孟加拉語 | 3.35× | 3.06× | 3.10× | 3.03× |
| 越南語 | 2.59× | 2.37× | 2.40× | 2.35× |
| 印地語 | 2.38× | 2.18× | 2.20× | 2.16× |
| 阿拉伯語 | 1.40× | 1.28× | 1.30× | 1.27× |
| 韓語 | 1.19× | 1.09× | 1.10× | 1.08× |
| 中文 | 1.09× | 1.00× | 1.01× | 0.99× |
| 日語 | 1.08× | 0.99× | 1.00× | 0.98× |
| 法語 | 1.05× | 0.96× | 0.97× | 0.95× |
| 西班牙語 | 1.04× | 0.95× | 0.96× | 0.94× |
| 德語 | 1.03× | 0.94× | 0.95× | 0.93× |
| 程式碼 | 1.03× | 0.94× | 0.95× | 0.93× |
| 英文 | 1.01× | 0.92× | 0.94× | 0.91× |
表 5:擴充詞元化器相對來源詞元化器的合成每字元解碼加速,按語言與裝置。 每格為逐語言壓縮比(圖 2)與逐裝置解碼吞吐量比(128K 矩陣解碼 t/s 除以 65K 矩陣解碼 t/s,表 12)的乘積。大於 1.0× 表示擴充詞元化器能更快產出相同的字元輸出;小於 1.0× 表示相同輸出會稍慢。
表 5 中有兩個明顯模式。在壓縮最大的泰語、孟加拉語、越南語與印地語上,擴充詞元化器在全部三台參考裝置上每單位時間產出 2.2 至 3.7 倍的字元——這是主要收益。由於較大 LM-head 的每詞元成本對每種語言都相同,淨效果在壓縮足以覆蓋成本之處為增益(上述四種語言,加上阿拉伯語、韓語等先前已支援語言),而在壓縮接近持平之處(英文、程式碼、主要歐洲語言)為每字元最多約 9% 的退化。這是設計上有意的取捨:以小而均勻的每詞元成本,換取服務不足文字系統上的大幅增益。我們在第 9.1 節進一步討論。
7.3 128K 之後的詞彙表縮放
我們考慮過更大的詞彙表,但未採用。圖 5 將圖 4 的實驗延伸到同樣三台裝置上的 192K 與 256K 矩陣大小,以各裝置相對 65K 基線的解碼吞吐量比呈現。
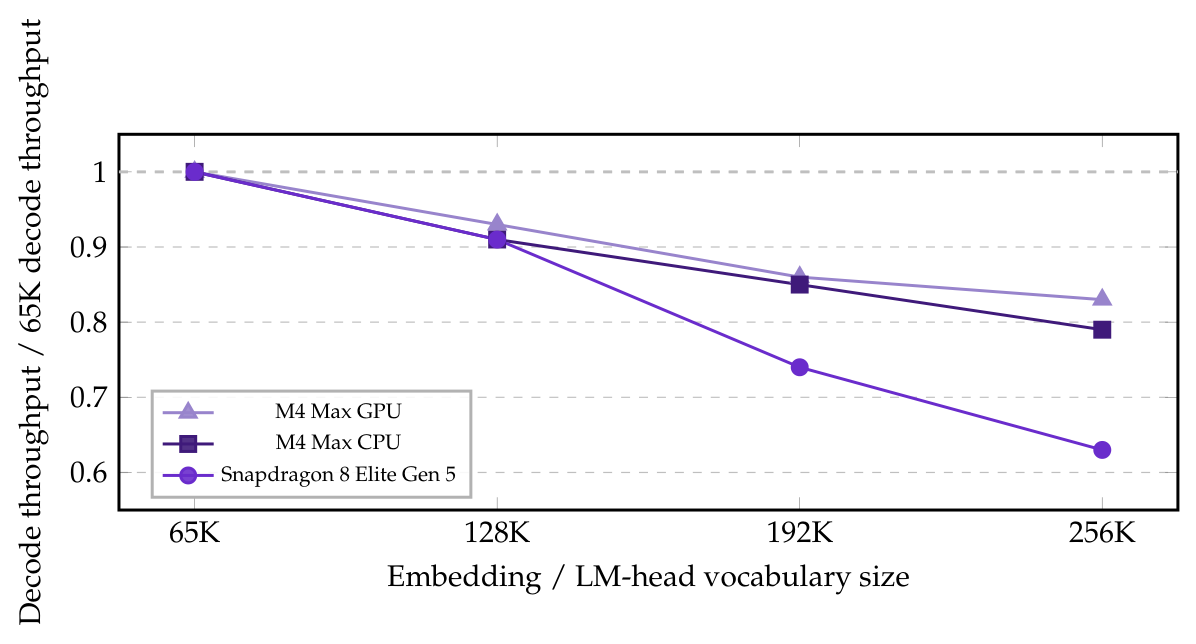
圖 5:在相同 LFM2-8B-A1B 主體權重上,65K 至 256K 的矩陣大小對解碼吞吐量的縮放。 每條曲線為該裝置在指定嵌入/LM-head 矩陣大小下的解碼吞吐量除以其 65K 解碼吞吐量。解碼成本在每台裝置上都隨矩陣大小上升,在 Snapdragon 8 Elite Gen 5 手機級裝置上最陡——LM-head 投影在該裝置佔總解碼頻寬的比例最大。在 256K 時,Snapdragon 8 Elite Gen 5 損失 37% 的 65K 解碼吞吐量。
解碼成本在每台裝置上都隨詞彙表大小上升,Snapdragon 8 Elite Gen 5 最快:加倍至 128K 花費約 9% 的解碼吞吐量、三倍至 192K 花費 26%、四倍至 256K 花費 37%。更大的詞彙表只有在某語言的額外壓縮超過此新增裝置成本時才划算。以 Snapdragon 上的 256K 為例:解碼成本比為 0.63,因此語言的壓縮需超過 1/0.63 ≈ 1.59 倍才能打平。只有泰語、孟加拉語、越南語與印地語達得到,而它們在裝置成本低得多的 128K 就已達標。再把詞彙表加倍(128K 到 256K)所需的增量壓縮必須極大才能蓋過進一步的吞吐量損失,而 BPE 壓縮隨詞彙表增長呈報酬遞減。因此在這些裝置上我們停在 128K。
8. 消融實驗與負面發現
有兩個發現形塑了最終配方。我們在此報告它們,一方面對「什麼行不通」保持透明,一方面為嘗試類似詞元化器擴充工作的實務者提供指引。
第一階段訓練完整嵌入矩陣會劣化效能。 為了決定第一階段要訓練多少嵌入,我們跑了另一種組態:訓練 $E_{\text{new}}$ 的所有列(包括從來源模型複製的列),而非只訓練新增的列,兩種情況下模型其餘部分皆凍結。假說是讓既有列也調整,能幫助模型讓嵌入空間與新詞彙協調。結果反而劣化了模型,且傷害集中在生成上:MATH500、HumanEval+ 與 MGSM 全數下跌,模型開始自我重複,儘管其多選題分數(MMLU 與 MMMLU)不變甚至更高。由於輸入與輸出嵌入綁定,訓練 $E_{\text{new}}$ 也會移動產生輸出 logits 的反嵌入 (Unembedding)。我們沒有直接隔離機制,但最可能的解釋是:複製來的列本來就與凍結的主體匹配,讓它們在主體無法跟進的情況下漂移,破壞了主體與 logit 層之間的匹配。傷害顯現在生成、卻放過多選題排序,正是我們在下方第二階段混合語料消融中分析的同一種不對稱。把第一階段限制在新列即可避免此問題。比較見表 6。
| 基準 | 僅新列(最終配方) | 完整嵌入矩陣 | 解讀 |
|---|---|---|---|
| MMLU | 61.3 | 61.3 | 多選題:知識完好 |
| MMMLU | 39.5 | 42.6 | 多選題:多語言閱讀完好 |
| MATH500 | 49.4 | 27.6 | 生成:崩壞 |
| HumanEval+ | 43.9 | 1.8 | 程式碼生成:崩壞 |
| MGSM | 60.5 | 44.3 | 多語言生成:下滑 |
| 重複分數(↑ 越高越好) | 0.92 | 0.19 | 生成:嚴重迴圈 |
表 6:第一階段凍結策略的消融。 僅新列為最終配方,只有新加入的嵌入列可訓練(即表 8 的同一個第一階段檢查點)。完整嵌入矩陣訓練 $E_{\text{new}}$ 的所有列,包括從來源模型複製的列。兩種情況下模型其餘部分皆凍結。訓練完整矩陣時,多選題準確率(MMLU、MMMLU)不變或更高,但所有生成基準下跌、重複分數 (Repetition Score) 驟降——與第二階段資料混合消融(表 7)討論的失效模式相同。重複分數是內部診斷指標:通過自動 n-gram 迴圈檢查(無退化重複)的保留生成樣本比例,介於 0 到 1,越高越好,越低代表越多迴圈。最終配方的 0.92 基本上就是來源水準(0.93,表 7)。
第二階段資料混合至關重要。 為了量測第二階段混合語料的影響,我們刻意用不平衡、以英文為主的持續預訓練混合語料跑了一次,檢驗「多語言覆蓋已在第一階段建立、英文資料就能保住一般能力」的假說。結果不是多語言品質的緩慢流失,而是全面的生成崩壞。最清楚的證據是英文基準 MATH500:從 61.8 跌到 27.0。MGSM 從 61.2 跌到 28.4,且模型出現明顯更多的退化重複。而這一切發生的同時,模型在對數機率評分的多選題基準(MMLU 與 MMMLU)上反而進步。改用更平衡的多語言混合語料後,退化消除,並產出第 6 節報告的檢查點。比較見表 7。
| 基準 | 來源 | 第二階段(好混合) | 第二階段(壞混合) | 解讀 |
|---|---|---|---|---|
| MMLU | 63.0 | 64.7 | 64.9 | 多選題:知識完好 |
| MMMLU | 39.3 | 43.8 | 48.3 | 多選題:多語言閱讀完好 |
| MMLU-Pro | 30.7 | 35.2 | 20.6 | 多選題推理:劣化 |
| MATH500 | 49.2 | 61.8 | 27.0 | 生成:崩壞 |
| MGSM | 62.5 | 61.2 | 28.4 | 多語言生成:崩壞 |
| 重複分數(↑ 越高越好) | 0.93 | 0.88 | 0.49 | 生成:更多迴圈 |
表 7:第二階段資料混合的消融。 第二階段(好混合)是釋出的 LFM2.5-8B-A1B 所使用的訓練;第二階段(壞混合)是以英文為主的持續預訓練混合語料的消融。對數機率評分的多選題基準(MMLU、MMMLU)不變甚至在壞混合下更好,而生成式基準(MATH500、MGSM)與內部重複分數崩壞(見上方診斷討論)。重複分數與表 6 為同一診斷指標,數值越低代表輸出越退化。
多選題與生成之間的不對稱是關鍵診斷。以 A/B/C/D 選項對數機率評分的多選題基準,量測的是模型是否給正確選項比干擾項更高的機率,並不要求模型生成連貫文本。壞混合的模型保留(甚至微幅提升)這種判別能力,卻失去自由形式數學與多語言推理所需的生成能力。壞混合下 MMMLU 的進步符合這個敘事:模型仍能正確讀懂多語言題幹並合理排序選項,只是失去了產出連貫多語言輸出的能力。MMLU-Pro 是部分例外:雖然形式上是多選題,它隨生成式基準一起下跌(35.2 → 20.6),而非像 MMLU 與 MMMLU 那樣守住。
MGSM 崩壞的逐語言分解,以及「為何拉丁文字的歐洲語言崩壞最劇烈」的文字系統中介 (Script-mediated) 試探性解讀,見附錄 B。
綜合來看,這兩個消融指向一個關於評測的實務教訓:兩種不同的干預——讓綁定嵌入相對凍結主體漂移、以及在不平衡混合語料上持續預訓練——產生了同一種特徵,而只依賴 MMLU 式多選題準確率的實務者會把這兩個壞掉的檢查點都判為健康。詞元化器擴充(以及更廣泛的持續預訓練)可能以多選題準確率偵測不到的方式劣化模型。這正是第 6 節的評測納入生成式基準、而不僅依賴多選題準確率的原因。
9. 結論
我們提出詞元化器擴充:在模型產製者掌控新詞元化器設計的情境下,為已完成預訓練的 LLM 延伸詞元化器的原地配方。透過把新詞元化器建構為來源詞元化器 BPE 合併的延續(既有合併固定不動),嵌入初始化問題就化約為:保留詞元直接複製嵌入列、新詞元取來源子詞元嵌入的平均。兩階段適應(僅嵌入訓練,再解凍持續預訓練),加上後續的中期訓練與後訓練階段,在評測套件上保住了來源檢查點的品質,並大幅縮減詞元化不足語言的詞元數。逐語言結果顯示:先前已支援語言的效能與效率獲得保留,而詞元化不足的語言獲得大幅的詞元化器效率提升(第 7 節),以及來自第二階段資料、在受評語言上的多語言品質增益(第 6.2 節)。
我們用此配方協助產出 LFM2.5-8B-A1B——LFM2-8B-A1B 裝置端 MoE 模型的更新版本,搭載 128K 詞元化器,以開放權重釋出。在來源詞元化器嚴重碎片化的語言上(例如泰語、印地語與越南語),擴充後的詞元化器對相同文本需要更少的詞元;我們的合成估計顯示,在計入較大詞彙表的每詞元成本後,這相當於可觀的每字元解碼加速(第 7 節)。我們記載了形塑此配方的兩個負面發現:第一階段訓練完整嵌入矩陣會劣化效能,且第二階段的資料混合必須在多語言上平衡,以避免解凍步驟的退化。
此配方的適用範圍刻意收窄,針對的是模型產製者希望在不重啟訓練的前提下,將既有檢查點的覆蓋延伸到額外語言或文字系統的情境。對該情境而言,這份詞元化器擴充配方在跨語言詞彙適應與零樣本詞元化器轉移的廣泛文獻旁,提供了一個實用的參考點。
9.1 限制與適用範圍
以下幾項限制界定了此配方適用之處及其成本。
僅限延續式 BPE 建構。 主要限制是新詞元化器必須由「在新語料上延續來源詞元化器的 BPE 合併」得到(而非獨立訓練)。這需要能在固定既有合併表的前提下於新語料上重訓 BPE,進而需要取得原始詞元化器的合併規則與特殊詞元組態。當新詞元化器是第三方設計的現成詞元化器時,此配方不適用;那種情境的合適工具是 Goddard and Fernandes Neto (2025)、Minixhofer et al. (2024) 的零樣本轉移方法。
單一模型家族。 我們只在一個模型家族(LFM2)上驗證此配方——這是我們能掌控詞元化器並端到端套用升級的情境。除了上述延續式 BPE 的要求外,配方不特定於此架構:它只假設一個嵌入可被延伸並繼續訓練的檢查點。因此我們預期它可轉移到其他產製者對詞元化器有同等掌控權的模型家族。
持續預訓練的運算成本。 第二階段是持續預訓練階段,帶有相應的運算成本。在我們的執行中,這只佔原始預訓練預算的一小部分(LFM2-8B-A1B 預訓練 12T 詞元 (Liquid AI Team, 2025),LFM2.5 釋出再加預訓練至共 38T (Liquid AI Team, 2026)),但並非免費。我們沒有測定回復來源檢查點品質所需的最小持續預訓練預算,因此此成本反映的是我們的設定,而非方法的必要條件。當原始預訓練成本大到「即使部分再投資於持續預訓練也優於從頭訓練」時,此配方最具吸引力。
先前已支援語言的解碼退化。 在來源詞元化器已高效編碼的語言上(英文、程式碼與主要歐洲語言),較大詞彙表的每詞元成本沒有壓縮增益可抵銷,顯現為最多約 9% 的每字元解碼退化(第 7.2 節,表 5)。此取捨對我們的部署目標有利,但工作負載以這些語言為主的實務者在套用此配方時應權衡此點。
9.2 釋出
LFM2.5-8B-A1B 已以開放權重釋出於 huggingface.co/LiquidAI/LFM2.5-8B-A1B,採 LFM Open License v1.0,並附上擴充後的 128K 詞元化器,以及 llama.cpp、MLX、vLLM 與 SGLang 的部署指南。
致謝
我們感謝更廣大的 Liquid 團隊提供基礎模型以及本研究所依賴的周邊基礎設施 (Liquid AI Team, 2025)。
參考文獻
- Marah Abdin et al. Phi-3 technical report: A highly capable language model locally on your phone. arXiv preprint arXiv:2404.14219, 2024.
- Orevaoghene Ahia, Sachin Kumar, Hila Gonen, Jungo Kasai, David Mortensen, Noah Smith, and Yulia Tsvetkov. Do all languages cost the same? Tokenization in the era of commercial language models. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 9904–9923, Singapore, 2023.
- Duarte M Alves, José Pombal, Nuno M Guerreiro, Pedro H Martins, João Alves, Amin Farajian, Ben Peters, Ricardo Rei, Patrick Fernandes, Sweta Agrawal, et al. Tower: An open multilingual large language model for translation-related tasks. arXiv preprint arXiv:2402.17733, 2024.
- Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse, and John Schulman. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021.
- Yiming Cui, Ziqing Yang, and Xin Yao. Efficient and effective text encoding for Chinese LLaMA and Alpaca. arXiv preprint arXiv:2304.08177, 2023.
- Gautier Dagan, Gabriel Synnaeve, and Baptiste Rozière. Getting the most out of your tokenizer for pre-training and domain adaptation. In Proceedings of the 41st International Conference on Machine Learning (ICML), pages 9784–9805, 2024. arXiv:2402.01035.
- Konstantin Dobler and Gerard de Melo. FOCUS: Effective embedding initialization for monolingual specialization of multilingual models. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 13440–13454, 2023.
- Konstantin Dobler, Desmond Elliott, and Gerard de Melo. Token distillation: Attention-aware input embeddings for new tokens. arXiv preprint arXiv:2505.20133, 2025.
- Longxu Dou, Qian Liu, Guangtao Zeng, Jia Guo, Jiahui Zhou, Xin Mao, Ziqi Jin, Wei Lu, and Min Lin. Sailor: Open language models for South-East Asia. In Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing: System Demonstrations, pages 424–435, Miami, Florida, USA, 2024. arXiv:2404.03608.
- Longxu Dou, Qian Liu, Fan Zhou, Changyu Chen, Zili Wang, Ziqi Jin, et al. Sailor2: Sailing in South-East Asia with inclusive multilingual LLMs. arXiv preprint arXiv:2502.12982, 2025.
- Kazuki Fujii, Taishi Nakamura, Mengsay Loem, Hiroki Iida, Masanari Ohi, Kakeru Hattori, Hirai Shota, Sakae Mizuki, Rio Yokota, and Naoaki Okazaki. Continual pre-training for cross-lingual LLM adaptation: Enhancing Japanese language capabilities. In Conference on Language Modeling (COLM), 2024. arXiv:2404.17790.
- Gemma Team. Gemma 3 technical report. arXiv preprint arXiv:2503.19786, 2025.
- Georgi Gerganov and contributors. llama.cpp. https://github.com/ggml-org/llama.cpp, 2023. LLM inference in C/C++.
- Charles Goddard and Fernando Fernandes Neto. Training-free tokenizer transplantation via orthogonal matching pursuit. arXiv preprint arXiv:2506.06607, 2025.
- Aaron Grattafiori et al. The Llama 3 herd of models. arXiv preprint arXiv:2407.21783, 2024.
- Shuhao Gu, Mengdi Zhao, Bowen Zhang, Liangdong Wang, Jijie Li, and Guang Liu. ReTok: Replacing tokenizer to enhance representation efficiency in large language model. arXiv preprint arXiv:2410.04335, 2024.
- Yun He, Di Jin, Chaoqi Wang, Chloe Bi, Karishma Mandyam, Hejia Zhang, Chen Zhu, Ning Li, Tengyu Xu, Hongjiang Lv, et al. Multi-IF: Benchmarking LLMs on multi-turn and multilingual instruction following. arXiv preprint arXiv:2410.15553, 2024.
- Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. Measuring mathematical problem solving with the MATH dataset. arXiv preprint arXiv:2103.03874, 2021.
- John Hewitt. Initializing new word embeddings for pretrained language models. https://www.cs.columbia.edu/~johnhew/vocab-expansion.html, 2021.
- Naman Jain, King Han, Alex Gu, Wen-Ding Li, Fanjia Yan, Tianjun Zhang, Sida Wang, Armando Solar-Lezama, Koushik Sen, and Ion Stoica. LiveCodeBench: Holistic and contamination free evaluation of large language models for code. arXiv preprint arXiv:2403.07974, 2024.
- Seungduk Kim, Seungtaek Choi, and Myeongho Jeong. Efficient and effective vocabulary expansion towards multilingual large language models. arXiv preprint arXiv:2402.14714, 2024.
- Chong Li, Jiajun Zhang, and Chengqing Zong. TokAlign: Efficient vocabulary adaptation via token alignment. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 4109–4126, Vienna, Austria, 2025. arXiv:2506.03523.
- Qintong Li, Leyang Cui, Xueliang Zhao, Lingpeng Kong, and Wei Bi. GSM-Plus: A comprehensive benchmark for evaluating the robustness of LLMs as mathematical problem solvers. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 2961–2984, Bangkok, Thailand, 2024.
- Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. Let's verify step by step. In International Conference on Learning Representations (ICLR), 2024. arXiv:2305.20050.
- Peiqin Lin, Shaoxiong Ji, Jörg Tiedemann, André F T Martins, and Hinrich Schütze. MaLA-500: Massive language adaptation of large language models. arXiv preprint arXiv:2401.13303, 2024.
- Liquid AI Team. LFM2 technical report. arXiv preprint arXiv:2511.23404, 2025.
- Liquid AI Team. LFM2.5-8B-A1B: Personal assistant on your laptop. Liquid AI Blog, https://www.liquid.ai/blog/lfm2-5-8b-a1b, 2026. Released May 28, 2026.
- Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang, and Lingming Zhang. Is your code generated by ChatGPT really correct? Rigorous evaluation of large language models for code generation. In Advances in Neural Information Processing Systems (NeurIPS), 2023. arXiv:2305.01210.
- Benjamin Minixhofer, Fabian Paischer, and Navid Rekabsaz. WECHSEL: Effective initialization of subword embeddings for cross-lingual transfer of monolingual language models. In Proceedings of the 2022 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, pages 3992–4006, 2022.
- Benjamin Minixhofer, Edoardo M Ponti, and Ivan Vulić. Zero-shot tokenizer transfer. In Advances in Neural Information Processing Systems (NeurIPS), volume 37, 2024. arXiv:2405.07883.
- Nandini Mundra, Aditya Nanda Kishore Khandavally, Raj Dabre, Ratish Puduppully, Anoop Kunchukuttan, and Mitesh M. Khapra. An empirical comparison of vocabulary expansion and initialization approaches for language models. In Proceedings of the 28th Conference on Computational Natural Language Learning (CoNLL), pages 84–104, Miami, FL, USA, 2024. arXiv:2407.05841.
- Itay Nakash, Nitay Calderon, Eyal Ben David, Elad Hoffer, and Roi Reichart. AdaptiVocab: Enhancing LLM efficiency in focused domains through lightweight vocabulary adaptation. In Conference on Language Modeling (COLM), 2025. arXiv:2503.19693.
- OpenAI. MMMLU: Multilingual massive multitask language understanding. https://huggingface.co/datasets/openai/MMMLU, 2024.
- Malte Ostendorff and Georg Rehm. Efficient language model training through cross-lingual and progressive transfer learning. arXiv preprint arXiv:2301.09626, 2023.
- Guilherme Penedo, Hynek Kydlíček, Vinko Sabolčec, Bettina Messmer, Negar Foroutan, Amir Hossein Kargaran, Colin Raffel, Martin Jaggi, Leandro Von Werra, and Thomas Wolf. FineWeb2: One pipeline to scale them all – adapting pre-training data processing to every language. arXiv preprint arXiv:2506.20920, 2025.
- Aleksandar Petrov, Emanuele La Malfa, Philip H S Torr, and Adel Bibi. Language model tokenizers introduce unfairness between languages. In Advances in Neural Information Processing Systems (NeurIPS), 2023.
- Taido Purason, Pavel Chizhov, Ivan P. Yamshchikov, and Mark Fishel. Teaching old tokenizers new words: Efficient tokenizer adaptation for pre-trained models. In Findings of the Association for Computational Linguistics: EACL 2026, pages 6492–6516, Rabat, Morocco, 2026. arXiv:2512.03989.
- Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. Language models are unsupervised multitask learners. Technical report, OpenAI, 2019.
- François Remy, Pieter Delobelle, Hayastan Avetisyan, Alfiya Khabibullina, Miryam de Lhoneux, and Thomas Demeester. Trans-tokenization and cross-lingual vocabulary transfers: Language adaptation of LLMs for low-resource NLP. In Conference on Language Modeling (COLM), 2024. arXiv:2408.04303.
- Phillip Rust, Jonas Pfeiffer, Ivan Vulić, Sebastian Ruder, and Iryna Gurevych. How good is your tokenizer? On the monolingual performance of multilingual language models. In Proceedings of the 59th Annual Meeting of the Association for Computational Linguistics and the 11th International Joint Conference on Natural Language Processing (Volume 1: Long Papers), pages 3118–3135, 2021.
- Rico Sennrich, Barry Haddow, and Alexandra Birch. Neural machine translation of rare words with subword units. In Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 1715–1725, 2016.
- Shaurya Sharthak, Vinayak Pahalwan, Adithya Kamath, and Adarsh Shirawalmath. Achieving tokenizer flexibility in language models through heuristic adaptation and supertoken learning. arXiv preprint arXiv:2505.09738, 2025.
- Freda Shi, Mirac Suzgun, Markus Freitag, Xuezhi Wang, Suraj Srivats, Soroush Vosoughi, Hyung Won Chung, Yi Tay, Sebastian Ruder, Denny Zhou, et al. Language models are multilingual chain-of-thought reasoners. In International Conference on Learning Representations (ICLR), 2023.
- Shivalika Singh, Angelika Romanou, Clémentine Fourrier, David I. Adelani, Jian Gang Ngui, Daniel Vila-Suero, Peerat Limkonchotiwat, Kelly Marchisio, Wei Qi Leong, Yosephine Susanto, Raymond Ng, Shayne Longpre, Wei-Yin Ko, Sebastian Ruder, Madeline Smith, Antoine Bosselut, Alice Oh, Andre F. T. Martins, Leshem Choshen, Daphne Ippolito, Enzo Ferrante, Marzieh Fadaee, Beyza Ermis, and Sara Hooker. Global MMLU: Understanding and addressing cultural and linguistic biases in multilingual evaluation. arXiv preprint arXiv:2412.03304, 2024.
- Ahmet Üstün, Viraat Aryabumi, Zheng-Xin Yong, Wei-Yin Ko, Daniel D'souza, Gbemileke Onilude, Neel Bhandari, Shivalika Singh, Hui-Lee Ooi, Amr Kayid, et al. Aya model: An instruction finetuned open-access multilingual language model. arXiv preprint arXiv:2402.07827, 2024.
- Yubo Wang, Xueguang Ma, Ge Zhang, Yuansheng Ni, Abhranil Chandra, Shiguang Guo, Weiming Ren, Aaran Arulraj, Xuan He, Ziyan Jiang, Tianle Li, Max Ku, Kai Wang, Alex Zhuang, Rongqi Fan, Xiang Yue, and Wenhu Chen. MMLU-Pro: A more robust and challenging multi-task language understanding benchmark. In Advances in Neural Information Processing Systems (NeurIPS) Datasets and Benchmarks Track, 2024.
- Jiajun Xu, Zhiyuan Li, Wei Chen, Qun Wang, Xin Gao, Qi Cai, and Ziyuan Ling. On-device language models: A comprehensive review. arXiv preprint arXiv:2409.00088, 2024.
- Atsuki Yamaguchi, Aline Villavicencio, and Nikolaos Aletras. An empirical study on cross-lingual vocabulary adaptation for efficient language model inference. In Findings of the Association for Computational Linguistics: EMNLP 2024, pages 6760–6785, Miami, Florida, USA, 2024. arXiv:2402.10712.
- Atsuki Yamaguchi, Aline Villavicencio, and Nikolaos Aletras. How can we effectively expand the vocabulary of LLMs with 0.01GB of target language text? Computational Linguistics, 52(1):295–330, 2026. arXiv:2406.11477.
- An Yang et al. Qwen3 technical report. arXiv preprint arXiv:2505.09388, 2025.
- Zheng-Xin Yong, Hailey Schoelkopf, Niklas Muennighoff, Alham Fikri Aji, David Ifeoluwa Adelani, Khalid Almubarak, M Saiful Bari, Lintang Sutawika, Jungo Kasai, Ahmed Baruwa, Genta Indra Winata, Stella Biderman, Edward Raff, Dragomir Radev, and Vassilina Nikoulina. BLOOM+1: Adding language support to BLOOM for zero-shot prompting. In Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 11682–11703, 2023.
- Jeffrey Zhou, Tianjian Lu, Swaroop Mishra, Siddhartha Brahma, Sujoy Basu, Yi Luan, Denny Zhou, and Le Hou. Instruction-following evaluation for large language models. arXiv preprint arXiv:2311.07911, 2023.
附錄 A:評測基準細節
第 6.1 節的逐階段回復總分(圖 3、表 3)是在一組固定的八個公開基準上計算的,這組基準的選擇是為了隔離詞元化器擴充的貢獻,而非下游中期訓練的增益。基準套件如下:
- 知識(1 個基準)。 MMLU-Pro (Wang et al., 2024)(我們報告以選項集合的對數機率評分的答案排序變體,它在基礎與後訓練檢查點之間比自由形式答案擷取更穩定)。
- 數學(3 個基準)。 GSM8K (Cobbe et al., 2021)、MATH500(MATH (Hendrycks et al., 2021) 中由 Lightman et al. (2024) 選出的 500 題測試子集)與 GSM-Plus (Li et al., 2024)。
- 程式碼(2 個基準)。 HumanEval+ (Liu et al., 2023) 與 LiveCodeBench v5 (Jain et al., 2024)。
- 多語言(2 個基準)。 MMMLU (OpenAI, 2024)(MMLU 的多語言對應版,以多選題選項的對數機率評分,報告於本評測所設定的語言子集)與 MGSM (Shi et al., 2023)(多語言 GSM8K,生成式)。
我們從第 6.1 節總分中排除依賴聊天模板的基準(IFEval (Zhou et al., 2023)、Multi-IF (He et al., 2024) 以及其他工具使用與指令遵循基準),理由如該節所述:來源預訓練檢查點未受過聊天模板遵循或工具使用格式的訓練,這些基準會低估它。釋出的 LFM2.5-8B-A1B 透過後訓練納入了相應能力(第 6 節)。
| 類別 | 基準 | 來源 | 零樣本 | 第一階段 | 第二階段 |
|---|---|---|---|---|---|
| 知識 | MMLU-Pro | 30.7 | 28.1 | 30.6 | 35.2 |
| 數學 | GSM8K | 67.7 | 65.1 | 67.1 | 67.0 |
| MATH500 | 49.2 | 39.0 | 49.4 | 61.8 | |
| GSM-Plus | 46.2 | 44.7 | 46.5 | 42.7 | |
| 程式碼 | HumanEval+ | 51.8 | 34.2 | 43.9 | 60.4 |
| LiveCodeBench v5 | 10.0 | 7.3 | 11.8 | 14.1 | |
| 多語言 | MMMLU | 39.3 | 37.1 | 39.5 | 43.8 |
| MGSM | 62.5 | 55.4 | 60.5 | 61.2 | |
| 8 基準總分 | 44.7 | 38.9 | 43.7 | 48.3 |
表 8:跨擴充階段的逐基準回復。 圖 3 與表 3 背後的細節。MMMLU 與 MGSM 一同歸入多語言類別,與正文表 3 的分類一致。總分是每階段全部八個逐基準值的未加權平均(而非類別平均的平均)。除 LiveCodeBench v5 為 pass@1 外,所有數值皆為百分比準確率。
附錄 B:消融實驗細節
本附錄提供第二階段資料混合消融(第 8 節,表 7)背後的逐語言分解。
MGSM 的逐語言分解(表 10)讓診斷更加鮮明。相對好混合的下跌在各語言間並不均勻:最大的是拉丁文字的歐洲語言——法語從 71.6 跌至 10.4(−61 分)、德語從 66.4 跌至 18.0(−48)、西班牙語從 56.4 跌至 12.4(−44)。CJK 與西里爾文字的語言撐得明顯較好:日語只跌 7 分、俄語 14、中文 22。我們將此解讀為進一步的證據:壞混合下的失效模式是生成行為的問題,而非能力的喪失。觀察到的模式與一種「文字系統中介」的機制一致(雖不足以證實):當模型被以英文為主的混合語料推向英文式輸出時,拉丁文字、與英文共享詞彙的語言與英文之間的邊界較為鬆動,較容易被推往類英文輸出;而文字系統迥異的語言(CJK、西里爾)較能保留其語言特定的生成行為。要讓這個解讀比觀察更有力,需要一個每個文字系統群有更多語言、具統計檢定並定義語言距離度量的受控研究。
| 語言 | 來源 | 第二階段(好混合) | 第二階段(壞混合) | Δ 壞 vs 好 |
|---|---|---|---|---|
| 西班牙語 | 69.6 | 56.4 | 12.4 | −44.0 |
| 法語 | 64.8 | 71.6 | 10.4 | −61.2 |
| 德語 | 60.8 | 66.4 | 18.0 | −48.4 |
| 中文 | 57.2 | 52.0 | 30.0 | −22.0 |
| 日語 | 56.8 | 59.2 | 52.4 | −6.8 |
| 俄語 | 66.0 | 61.6 | 47.2 | −14.4 |
| 平均 | 62.5 | 61.2 | 28.4 | −32.8 |
表 10:第二階段資料混合消融下的逐語言 MGSM。 在這個六語言的 MGSM 子集中,拉丁文字的歐洲語言(西班牙語、法語、德語)崩壞最劇烈(−44 至 −61 分),而 CJK 與西里爾文字的語言撐得較好。此模式與「壞混合模型失去生成與英文文字系統重疊語言的能力、但較能保留文字系統迥異語言的生成」一致。
| 語言 | 來源 | 零樣本 | 第一階段 | 第二階段 | Δ |
|---|---|---|---|---|---|
| 阿拉伯語 | 51.4 | 32.9 | 50.1 | 53.2 | +1.8 |
| 孟加拉語 | 27.4 | 25.0 | 28.5 | 32.2 | +4.8 |
| 中文 | 53.9 | 46.5 | 52.2 | 54.9 | +1.0 |
| 捷克語 | 41.7 | 40.2 | 41.2 | 43.9 | +2.2 |
| 荷蘭語 | 47.9 | 43.5 | 45.3 | 50.8 | +2.9 |
| 英語 | 62.3 | 59.8 | 60.4 | 64.1 | +1.8 |
| 菲律賓語 | 37.7 | 34.8 | 36.7 | 40.8 | +3.1 |
| 法語 | 56.5 | 53.1 | 55.6 | 57.4 | +0.9 |
| 德語 | 56.1 | 53.5 | 55.3 | 57.2 | +1.1 |
| 希臘語 | 32.4 | 27.7 | 32.6 | 33.8 | +1.4 |
| 豪薩語 | 29.9 | 30.0 | 30.3 | 31.1 | +1.2 |
| 希伯來語 | 39.7 | 25.7 | 32.3 | 40.7 | +1.0 |
| 印地語 | 32.0 | 26.2 | 33.8 | 39.6 | +7.6 |
| 伊博語 | 29.7 | 29.4 | 29.1 | 31.6 | +1.9 |
| 印尼語 | 41.9 | 34.0 | 40.2 | 51.0 | +9.1 |
| 義大利語 | 57.0 | 52.0 | 55.0 | 57.4 | +0.4 |
| 日語 | 53.5 | 48.4 | 52.2 | 55.1 | +1.6 |
| 韓語 | 50.7 | 41.4 | 49.8 | 52.4 | +1.7 |
| 吉爾吉斯語 | 32.0 | 30.3 | 31.7 | 32.0 | 0.0 |
| 立陶宛語 | 32.5 | 31.5 | 32.2 | 33.5 | +1.0 |
| 馬拉加斯語 | 30.4 | 30.2 | 30.2 | 32.2 | +1.8 |
| 馬來語 | 38.6 | 32.8 | 37.5 | 45.4 | +6.8 |
| 尼泊爾語 | 30.4 | 25.8 | 28.8 | 33.5 | +3.1 |
| 尼揚賈語 | 30.5 | 30.2 | 30.4 | 31.2 | +0.7 |
| 波斯語 | 42.8 | 27.5 | 36.8 | 41.9 | -0.9 |
| 波蘭語 | 49.3 | 45.1 | 49.1 | 51.1 | +1.8 |
| 葡萄牙語 | 56.6 | 51.8 | 55.9 | 56.7 | +0.1 |
| 羅馬尼亞語 | 44.7 | 40.0 | 43.5 | 46.5 | +1.8 |
| 俄語 | 51.1 | 47.6 | 50.3 | 52.7 | +1.6 |
| 塞爾維亞語 | 38.0 | 36.6 | 37.8 | 37.7 | -0.3 |
| 紹納語 | 31.2 | 30.8 | 31.2 | 32.3 | +1.1 |
| 索馬利語 | 29.5 | 29.0 | 29.6 | 30.8 | +1.3 |
| 西班牙語 | 57.5 | 53.8 | 56.6 | 57.2 | -0.3 |
| 史瓦希里語 | 30.1 | 29.5 | 29.8 | 31.5 | +1.4 |
| 瑞典語 | 44.5 | 40.8 | 44.6 | 47.4 | +2.9 |
| 土耳其語 | 36.7 | 31.4 | 36.1 | 42.1 | +5.4 |
| 烏克蘭語 | 43.0 | 41.7 | 42.6 | 44.1 | +1.1 |
| 越南語 | 35.8 | 25.6 | 38.8 | 47.4 | +11.6 |
| 約魯巴語 | 28.9 | 28.3 | 28.3 | 30.1 | +1.2 |
| 平均 | 41.4 | 37.0 | 40.6 | 43.7 | +2.3 |
表 9:跨擴充階段的 Global-MMLU 逐語言準確率(5-shot、答案字母對數機率、隨機水準 = 25%)。 Δ 為第二階段減來源。逐語言取樣雜訊約半分(n ≈ 14,000)。「零樣本」指未經回復訓練的擴充階段,而非 few-shot 設定。列出的是至少一個檢查點超過 30% 的 39 種語言;省略的 3 種(所有檢查點皆在或接近隨機水準):阿姆哈拉語、僧伽羅語、泰盧固語。
附錄 C:詞元化器建構實作筆記
擴充後的詞元化器是以來源詞元化器的合併初始化 BPE 合併表、再於多語言語料上延續合併訓練所建構。特殊詞元組態(聊天模板特殊詞元、函式呼叫分隔符、BOS/EOS)自來源詞元化器原封保留;位元組層級的預詞元化 (Pre-tokenization) 規則亦沿用。詞彙表上限為 128K,並修剪至該上限內最高頻的合併;目標詞彙表持有 125,017 個有效詞元(表 1),其餘槽位保留供未來擴充。
當來源詞元化器以 tiktoken 或其他非 SentencePiece 的 BPE 框架實作時,合併延伸程序在實作細節上與 SentencePiece 情形不同。關於位元組層級與 SentencePiece 式 BPE 之間實作差異的細緻討論,請參考 Purason et al. (2026)。
與其他生產詞元化器的比較。 表 11 在固定的多語言評測語料上,比較擴充後的 128K 詞元化器與四個廣泛使用的生產詞元化器。有兩個觀察為整張表定調。第一,在整體語料上,擴充後的詞元化器產出所有受測詞元化器中最低的詞元數(11.3M 詞元),儘管其詞彙表比四者都小(gpt-4o 200K、Mistral Small 3.1 131K、Qwen3 151K、gemma-3 262K)。第二,在詞元化不足的語言上,擴充後的詞元化器與所有同儕相比皆具競爭力、且遠優於來源,但它並未取代那些單純為這些文字系統配置更多詞彙槽位的詞元化器:gemma-3(262K 詞彙,超過擴充詞元化器的 2 倍)在印地語(約 2 倍)、孟加拉語(約 2.3 倍)、泰語、印尼語、越南語與日語上勝出——這是擁有兩倍詞彙預算可花的自然結果。僅憑 128K 條目,擴充後的詞元化器仍在多語言平衡語料上取得最佳總壓縮,在阿拉伯語、程式碼與 JSON 上勝出,並在其餘語言上接近最佳同儕,同時保持一個在裝置端服務上小得多的嵌入矩陣。
| 來源 (65K) | 擴充 (128K) | gpt-4o (200K) | Qwen3 (151K) | gemma-3 (262K) | Mistral Small-3.1 (131K) | |
|---|---|---|---|---|---|---|
| 英語 | 953 | 947 | 945 | 938 | 953 | 956 |
| 法語 | 628 | 599 | 588 | 657 | 594 | 591 |
| 西班牙語 | 870 | 838 | 777 | 897 | 781 | 819 |
| 德語 | 752 | 728 | 686 | 817 | 705 | 732 |
| 中文 | 1,094 | 1,000 | 1,017 | 838 | 914 | 1,234 |
| 日語 | 708 | 655 | 834 | 729 | 636 | 827 |
| 韓語 | 1,247 | 1,051 | 1,103 | 1,241 | 1,046 | 1,033 |
| 阿拉伯語 | 3,104 | 2,211 | 2,452 | 2,757 | 2,342 | 2,224 |
| 越南語 | 2,958 | 1,141 | 1,200 | 1,170 | 1,120 | 1,220 |
| 印地語 | 3,036 | 1,278 | 1,728 | 2,264 | 651 | 1,433 |
| 孟加拉語 | 4,259 | 1,272 | 1,685 | 2,276 | 541 | 1,293 |
| 泰語 | 5,708 | 1,426 | 2,060 | 1,792 | 1,145 | 2,005 |
| 印尼語 | 1,733 | 1,204 | 1,153 | 1,428 | 1,088 | 1,258 |
| 程式碼(其他) | 26,138 | 25,432 | 27,300 | 38,480 | 38,747 | 38,865 |
| JSON | 4,775 | 4,227 | 4,842 | 5,108 | 5,389 | 5,157 |
| 整體語料 (M) | 15.7 | 11.3 | 12.0 | 14.8 | 12.7 | 13.9 |
表 11:在保留的多語言評測語料上的詞元化器比較(非英文網頁文本取自 FineWeb 2 (Penedo et al., 2025),另含保留的英文、程式碼與 JSON 樣本)。 每格為該詞元化器在該語言子語料上產出的詞元數(越低越好,各欄為相同文本)。粗體標示六個詞元化器中該列最高效者。
附錄 D:裝置端延遲細節
表 12 報告圖 4 背後完整的逐裝置吞吐量與磁碟大小數字,在其餘完全相同的 LFM2-8B-A1B 主體上比較 65K 與 128K 的嵌入/LM-head 矩陣。
| 裝置 | 詞彙表 | 模型大小 (MiB) | 預填充 (t/s) | 解碼 (t/s) | Δ 解碼 |
|---|---|---|---|---|---|
| M4 Max CPU | 65K | 4516 | 425 | 187 | n/a |
| M4 Max CPU | 128K | 4618 | 450 | 171 | −8.6% |
| M4 Max GPU | 65K | 4516 | 2794 | 203 | n/a |
| M4 Max GPU | 128K | 4618 | 2778 | 188 | −7.4% |
| Snapdragon 8 Elite Gen 5 | 65K | 4514 | 106 | 53 | n/a |
| Snapdragon 8 Elite Gen 5 | 128K | 4617 | 107 | 48 | −9.4% |
表 12:LFM2-8B-A1B 在 65K 與 128K 嵌入/LM-head 矩陣下的吞吐量(Q4_0)。 各列的模型主體權重完全相同,只有嵌入與 LM-head 矩陣大小不同。預填充在 M4 Max 上以 512 詞元提示、在 Snapdragon 8 Elite Gen 5 手機上以 256 詞元提示量測。解碼在批次大小 1 下對 128 個生成詞元量測。
術語對照表
| 英文 | 中文 |
|---|---|
| Tokenizer | 詞元化器 |
| Token | 詞元 |
| Tokenizer Expansion | 詞元化器擴充 |
| In-place | 原地 |
| Pre-training | 預訓練 |
| Continued Pre-training (CPT) | 持續預訓練 |
| Mid-training | 中期訓練 |
| Post-training | 後訓練 |
| Vocabulary | 詞彙表 |
| Embedding | 嵌入 |
| Unembedding | 反嵌入 |
| LM-head | LM-head(輸出投影層) |
| BPE Merges | BPE 合併 |
| Merge Table | 合併表 |
| Continued-BPE | 延續式 BPE |
| Byte-level | 位元組層級 |
| Pre-tokenization | 預詞元化 |
| Fragmentation | 碎片化 |
| Under-tokenized | 詞元化不足 |
| Token Fertility | 詞元繁殖率 |
| Cross-lingual Vocabulary Adaptation (CVA) | 跨語言詞彙適應 |
| Tokenizer Transfer | 詞元化器轉移 |
| Zero-shot | 零樣本 |
| Checkpoint | 檢查點 |
| Mixture-of-Experts (MoE) | 混合專家 |
| Expert Routing | 專家路由 |
| Router | 路由器 |
| On-device | 裝置端 |
| Decode Latency | 解碼延遲 |
| Throughput | 吞吐量 |
| Memory-bandwidth-bound | 受記憶體頻寬限制 |
| Compute-bound | 受運算限制 |
| Prefill | 預填充 |
| Quantization | 量化 |
| KV Cache | KV 快取 |
| Wall-clock Time | 實際時鐘時間 |
| Next-token Prediction | 下一詞元預測 |
| Sequence Length | 序列長度 |
| Context Length | 上下文長度 |
| Learning Rate | 學習率 |
| Warm up | 暖身 |
| Anneal | 退火 |
| Optimizer State | 最佳化器狀態 |
| Special Tokens | 特殊詞元 |
| Tie / Tied Embedding | 綁定/綁定嵌入 |
| Norm | 範數 |
| Centroid | 質心 |
| Mean-of-subwords Centroid | 子詞平均質心 |
| Heuristic Segmentation | 啟發式切分 |
| Deterministically | 決定性地 |
| Held-out | 保留(資料) |
| Benchmark | 基準測試 |
| Log-probability | 對數機率 |
| Answer-extraction | 答案擷取 |
| Multiple-choice (MCQ) | 多選題 |
| Repetition Score | 重複分數 |
| Ablation | 消融實驗 |
| Negative Findings | 負面發現 |
| Script | 文字系統 |
| Script-mediated | 文字系統中介 |
| Unreachable Tokens | 不可達詞元 |
| Hypernetworks | 超網路 |
| Distillation | 蒸餾 |
| Instruction Following | 指令遵循 |
| Tool-use | 工具使用 |
| Agentic | 代理式 |
| Thinking Traces | 思考軌跡 |
| Drop-in Replacement | 直接替換 |
| Sampling Noise | 取樣雜訊 |