門控 Delta 網路:用 Delta 規則改進 Mamba2
原始論文:Gated Delta Networks: Improving Mamba2 with Delta Rule 作者:Songlin Yang(MIT CSAIL,工作於 NVIDIA 實習期間完成)、Jan Kautz(NVIDIA)、Ali Hatamizadeh(NVIDIA) arXiv ID:2412.06464v3 日期:2024 年 12 月 9 日 標籤:Linear Attention Mamba2 DeltaNet Delta Rule Gating Linear RNN Hybrid Model
【譯註】本文提出 Gated DeltaNet(門控 Delta 網路),把兩種互補的記憶機制結合起來:門控 (gating)(快速清除記憶)與 delta 規則 (delta rule)(精準的定點更新)。核心是「門控 delta 規則」$\mathbf{S}_t=\mathbf{S}_{t-1}(\alpha_t(\mathbf{I}-\beta_t \mathbf{k}_t\mathbf{k}_t^\top))+\beta_t\mathbf{v}_t\mathbf{k}_t^\top$,並給出可在現代硬體上平行訓練的分塊 (chunkwise) 演算法。本文為數學密集的線性注意力架構論文,正文(第 1–6 節)含大量公式,均照譯並保留原 LaTeX。圖 1–3 從論文 PDF 裁切補上。授權 CC BY 4.0,站上公開。程式碼:https://github.com/NVlabs/GatedDeltaNet 。
摘要
線性 Transformer (Linear Transformer) 作為標準 Transformer 的高效替代方案而受到關注,但它們在檢索 (retrieval) 與長脈絡 (long-context) 任務上的表現一直有限。為解決這些限制,近期研究探索了兩種不同的機制:用於自適應記憶控制的門控 (gating),以及用於精準記憶修改的 delta 更新規則 (delta update rule)。我們觀察到這兩種機制是互補的——門控能快速清除記憶,而 delta 規則促成有針對性的更新。基於這個洞見,我們引入門控 delta 規則 (gated delta rule),並開發一個為現代硬體最佳化的平行訓練演算法。我們提出的架構 Gated DeltaNet,在多個基準上都持續超越 Mamba2 與 DeltaNet 等現有模型,包括語言模型、常識推理、脈絡內檢索 (in-context retrieval)、長度外推 (length extrapolation) 與長脈絡理解。我們進一步藉由開發「結合 Gated DeltaNet 層與滑動視窗注意力 (sliding window attention) 或 Mamba2 層」的混合架構來增強效能,同時達成更好的訓練效率與更佳的任務表現。
1 引言
Transformer 架構顯著推進了大型語言模型 (LLM) 的能力,因其有效的注意力機制而在廣泛任務上展現卓越表現。這個機制擅長精準的序列建模,並在訓練時利用現代 GPU 的平行處理能力。然而,自注意力 (self-attention) 部分隨序列長度平方級縮放,導致可觀的運算需求,對訓練與推論都構成挑戰。
為緩解這些問題,研究者探索了諸如線性 Transformer [Katharopoulos et al., 2020a] 的替代方案,它把傳統基於 softmax 的注意力替換成核化的、基於點積的線性注意力,藉由重新表述為「具有矩陣值狀態的線性 RNN」,大幅降低推論時的記憶體需求。雖然早期版本的線性 Transformer 在語言模型任務上不如標準 Transformer,近期的增強——例如納入類似 LSTM 的資料相依門控機制,以 GLA [Yang et al., 2024a] 與 Mamba2 [Dao & Gu, 2024a] 為代表——已顯示出有希望的改善。然而,在長序列上管理資訊仍有挑戰,特別是脈絡內檢索任務,傳統 Transformer 在此仍保有優勢。
這個現象並不意外:線性 Transformer 可被詮釋為實作一種基於外積 (outer-product) 的鍵-值 (key-value) 關聯記憶,讓人聯想到張量積表徵 (tensor product representation) [Smolensky, 1990]。然而,它們能儲存的正交鍵-值對數量受模型維度所限。當序列長度超過這個維度時,「記憶碰撞 (memory collision)」變得不可避免,妨礙精確檢索 [Schlag et al., 2021a]。
Mamba2 藉由引入一個簡單的門控更新規則 $\mathbf{S}_{t}=\alpha_{t}\mathbf{S}_{t-1}+\mathbf{v}_{t}\mathbf{k}_{t}^{\intercal}$ 來解決這個限制,它在每個時間步以一個動態比率 $\alpha_{t}\in(0,1)$ 均勻地衰減所有鍵-值關聯。然而,這個做法沒有考慮不同鍵-值關聯的重要性差異,可能導致低效的記憶利用。如果模型需要遺忘某個特定的鍵-值關聯,所有鍵-值關聯都被同等遺忘,使這個過程較不精準也較不高效。
相對地,帶 delta 規則 [Widrow et al., 1960] 的線性 Transformer——即 DeltaNet [Schlag et al., 2021a; Yang et al., 2024b]——藉由(軟性地)以進來的鍵-值對序列式地替換舊的鍵-值對來選擇性地更新記憶。這個方法在脈絡內檢索的合成基準上展現了令人印象深刻的表現。然而,由於這個過程一次只修改單一鍵-值對,模型缺乏快速清除過時或無關資訊的能力,尤其在需要抹除先前資料的脈絡切換時。因此,DeltaNet 被發現在真實世界任務上只有中等表現 [Yang et al., 2024b],很可能是因為缺少一個穩健的記憶清除機制。
認識到門控更新規則與 delta 規則在記憶管理上的互補優勢,我們提出門控 delta 規則——一個結合兩種做法、簡單而直覺的機制。這個統一規則實現靈活的記憶控制:它可以藉由設 $\alpha_{t}\rightarrow 0$ 迅速清除記憶,也可以藉由設 $\alpha_{t}\rightarrow 1$(實際上切換到純 delta 規則)選擇性地更新特定內容而不影響其他資訊。
剩下的挑戰在於以硬體高效的方式實作門控 delta 規則。基於 Yang et al. (2024b) 用 WY 表徵 [Bischof & Loan, 1985] 平行化 delta 規則計算的高效演算法,我們謹慎地擴展他們的做法以納入門控項。我們的擴展保留了分塊平行 (chunkwise parallelism) 的好處,實現硬體高效的訓練。
我們得到的架構 Gated DeltaNet,在一整套全面的基準上持續勝過 Mamba2 與 DeltaNet,包括語言模型、常識推理、脈絡內檢索、長度外推與長脈絡理解。基於這些結果,我們也開發了策略性地結合 Gated DeltaNet 層與滑動視窗注意力或 Mamba2 層的混合架構,進一步增強訓練效率與模型效能。
2 預備知識
2.1 Mamba2:帶衰減的線性注意力
已知線性 Transformer [Katharopoulos et al., 2020b] 在排除正規化與 query/key 激活時,可表述為以下線性遞迴:
$$\mathbf{S}_{t}=\mathbf{S}_{t-1}+\mathbf{v}_{t}\mathbf{k}_{t}^{\intercal}\in\mathbb{R}^{d_{v}\times d_{k}},\qquad \mathbf{o}_{t}=\mathbf{S}_{t}\mathbf{q}_{t}\in\mathbb{R}^{d_{v}}$$
其中 $d_{k}$、$d_{v}$ 分別是 query/key 與 value 的(頭)維度。展開遞迴,我們可以用向量形式(左)與矩陣形式(右)表示:
$$\mathbf{o}_{t}=\sum_{i=1}^{t}(\mathbf{v}_{i}\mathbf{k}_{i}^{\intercal})\mathbf{q}_{t}=\sum_{i=1}^{t}\mathbf{v}_{i}(\mathbf{k}_{i}^{\intercal}\mathbf{q}_{t}),\qquad \mathbf{O}=(\mathbf{Q}\mathbf{K}^{\intercal}\odot\mathbf{M})\mathbf{V}\in\mathbb{R}^{L\times d_{v}}$$
其中 $L$ 是序列長度,$\mathbf{M}\in\mathbb{R}^{L\times L}$ 是因果遮罩 (causal mask),$i<j$ 時 $\mathbf{M}_{ij}=0$。然而這種樸素線性注意力在語言模型上大幅落後 Transformer。為解決這點,常見做法是加入一個衰減項 (decay term) 以遺忘歷史資訊。這裡以 Mamba2 [Dao & Gu, 2024a] 為例,它可表述為以下線性遞迴(至特定參數化):
$$\mathbf{S}_{t}=\alpha_{t}\mathbf{S}_{t-1}+\mathbf{v}_{t}\mathbf{k}_{t}^{\intercal},\qquad \mathbf{o}_{t}=\mathbf{S}_{t}\mathbf{q}_{t}$$
其中 $\alpha_{t}\in(0,1)$ 是隨 $t$ 變化的資料相依純量衰減項。定義累積衰減積 $\gamma_{j}=\prod_{i=1}^{j}\alpha_{i}$,展開遞迴後可得向量形式(左)與矩陣平行形式(右):
$$\mathbf{o}_{t}=\sum_{i=1}^{t}\left(\frac{\gamma_{t}}{\gamma_{i}}\mathbf{v}_{i}\mathbf{k}_{i}^{\intercal}\right)\mathbf{q}_{t},\qquad \mathbf{O}=\left((\mathbf{Q}\mathbf{K}^{\intercal})\odot\Gamma\right)\mathbf{V}$$
這裡 $\Gamma\in\mathbb{R}^{L\times L}$ 是衰減感知的因果遮罩,$i\ge j$ 時 $\Gamma_{ij}=\frac{\gamma_{i}}{\gamma_{j}}$、否則為 0。這種平行形式與遞迴形式之間的等價性也被稱為 Mamba2 中描述的狀態空間對偶 (state space duality, SSD)。這種遞迴結構也出現在 Gated RFA、xLSTM、Gated RetNet 等多個架構中。當 $\gamma_{t}$ 資料無關時,該表述化簡為 RetNet 與 Lightning-Attention。此外,若 $\gamma_{t}$ 擴展為矩陣值而非純量值,只要以外積結構參數化,高效訓練演算法仍然可行 [Yang et al., 2024a]。
分塊訓練。 遞迴形式與平行形式對高效訓練而言都不理想,這促成了分塊平行形式 (chunkwise parallel form) 的使用,以達成硬體高效、線性時間的訓練。簡言之,分塊平行形式把輸入與輸出分成若干大小為 $C$ 的塊 (chunk),並根據「前一塊的最終狀態」與「當前塊的 query/key/value 區塊」計算每一塊的輸出。以 query 區塊為例,記 $\mathbf{Q}_{[t]}$ 為第 $t$ 塊的 query 區塊、$\mathbf{q}_{[t]}^{r}$ 為塊內第 $r$ 個 query,塊 $t$ 的初始狀態 $\mathbf{S}_{[t]}=\mathbf{S}_{[t-1]}^{C}$。部分展開遞迴,得矩陣形式:
$$\mathbf{S}_{[t+1]}=\mathbf{S}_{[t]}+\mathbf{V}_{[t]}\mathbf{K}_{[t]}^{\intercal},\qquad \mathbf{O}_{[t]}=\mathbf{Q}_{[t]}\mathbf{S}_{[t]}^{\intercal}+\left(\mathbf{Q}_{[t]}\mathbf{K}_{[t]}^{\intercal}\odot\mathbf{M}\right)\mathbf{V}_{[t]}$$
這些方程式富含矩陣乘法 (matmul),允許基於張量核心 (tensor core) 的硬體最佳化。這個分塊演算法可輕易擴展到帶衰減的線性注意力(方程式 1,此處用左右箭頭 $\overleftarrow{\cdot}$/$\overrightarrow{\cdot}$ 表示變數衰減到每塊的第一個/最後一個位置):
$$\mathbf{S}_{[t+1]}=\overrightarrow{\mathbf{S}_{[t]}}+\mathbf{V}_{[t]}^{\intercal}\overrightarrow{\mathbf{K}_{[t]}},\qquad \mathbf{O}_{[t]}=\overleftarrow{\mathbf{Q}_{[t]}}\mathbf{S}_{[t]}^{\intercal}+\left(\mathbf{Q}_{[t]}\mathbf{K}_{[t]}^{\intercal}\odot\Gamma_{[t]}\right)\mathbf{V}_{[t]} \tag{1}$$
其中 $\overleftarrow{\mathbf{q}_{[t]}^{r}}=\gamma_{[t]}^{r}\mathbf{q}_{[t]}^{r}$(衰減到塊首)、$\overrightarrow{\mathbf{k}_{[t]}^{r}}=\frac{\gamma_{[t]}^{C}}{\gamma_{[t]}^{r}}\mathbf{k}_{[t]}^{r}$(衰減到塊尾)、$\overrightarrow{\mathbf{S}_{[t]}}=\gamma_{[t]}^{C}\mathbf{S}_{[t]}$(整塊衰減)。Mamba2 引入的 SSD 分解演算法與這個分塊演算法大致等價。 (2)
2.2 Delta 網路:帶 Delta 規則的線性注意力
delta 更新規則 [Widrow et al., 1960; Schlag et al., 2021b] 動態地抹除與當前輸入鍵 $\mathbf{k}_{t}$ 關聯的舊值 $\mathbf{v}_{t}^{\text{old}}$、並寫入一個新值 $\mathbf{v}_{t}^{\text{new}}$——後者是「當前輸入值」與「舊值」根據「寫入強度 $\beta_{t}\in(0,1)$」的線性組合(【譯註】可設 $\beta_{t}\in(0,2)$ 以允許負特徵值,解鎖 DeltaNet 的狀態追蹤能力):
$$\mathbf{S}_{t}=\mathbf{S}_{t-1}-\underbrace{(\mathbf{S}_{t-1}\mathbf{k}_{t})}_{\mathbf{v}_{t}^{\text{old}}}\mathbf{k}_{t}^{\intercal}+\underbrace{(\beta_{t}\mathbf{v}_{t}+(1-\beta_{t})\mathbf{S}_{t-1}\mathbf{k}_{t})}_{\mathbf{v}_{t}^{\text{new}}}\mathbf{k}_{t}^{\intercal}=\mathbf{S}_{t-1}(\mathbf{I}-\beta_{t}\mathbf{k}_{t}\mathbf{k}_{t}^{\intercal})+\beta_{t}\mathbf{v}_{t}\mathbf{k}_{t}^{\intercal}$$
如上所示,DeltaNet 實作了一階線性遞迴,其轉移矩陣是廣義 Householder 變換 $(\mathbf{I}-\beta_{t}\mathbf{k}_{t}\mathbf{k}_{t}^{\intercal})$。儘管展現出優越的關聯回憶 (associative recall) 與語言模型表現,DeltaNet 因運算低效而長期較少受關注,直到 Yang et al. (2024b) 引入一個硬體高效的分塊訓練演算法。
分塊平行形式。 部分展開遞迴,$\mathbf{S}_{[t]}^{r}=\mathbf{S}_{[t]}\mathbf{P}_{[t]}^{r}+\mathbf{H}_{[t]}^{r}$(方程式 3),其中 $\mathbf{P}_{[t]}^{r}$ 涉及廣義 Householder 矩陣的累積積,可用經典的 WY 表徵 [Bischof & Loan, 1985] 最佳化:$\mathbf{P}_{[t]}^{r}=\mathbf{I}-\sum_{i=1}^{r}\mathbf{w}_{[t]}^{i}\mathbf{k}_{[t]}^{i\intercal}$(方程式 4),$\mathbf{H}_{[t]}^{r}=\sum_{i=1}^{r}\mathbf{u}_{[t]}^{i}\mathbf{k}_{[t]}^{i\intercal}$(方程式 5)。用 UT 變換 [Joffrain et al., 2006],可把 $\mathbf{W}$、$\mathbf{U}$ 寫成矩陣形式:
$$\mathbf{T}_{[t]}=\left[\mathbf{I}+\operatorname{strictLower}\left(\operatorname{diag}(\beta_{[t]})\mathbf{K}_{[t]}\mathbf{K}_{[t]}^{\intercal}\right)\right]^{-1}\operatorname{diag}(\beta_{[t]}) \tag{6}$$
$$\mathbf{W}_{[t]}=\mathbf{T}_{[t]}\mathbf{K}_{[t]},\qquad \mathbf{U}_{[t]}=\mathbf{T}_{[t]}\mathbf{V}_{[t]} \tag{7}$$
代回方程式 3,得到一個利用 matmul、可用張量核心 GPU 最佳化的 DeltaNet 硬體高效分塊演算法:
$$\mathbf{S}_{[t+1]}=\mathbf{S}_{[t]}+(\mathbf{U}_{[t]}-\mathbf{W}_{[t]}\mathbf{S}_{[t]}^{\intercal})^{\intercal}\mathbf{K}_{[t]} \tag{8}$$
$$\mathbf{O}_{[t]}=\mathbf{Q}_{[t]}\mathbf{S}_{[t]}^{\intercal}+(\mathbf{Q}_{[t]}\mathbf{K}_{[t]}^{\intercal}\odot\mathbf{M})(\mathbf{U}_{[t]}-\mathbf{W}_{[t]}\mathbf{S}_{[t]}^{\intercal}) \tag{9}$$
3 門控 Delta 網路
3.1 表述:門控 Delta 規則
我們提出的門控 delta 規則簡單而有效:
$$\mathbf{S}_{t}=\mathbf{S}_{t-1}\left(\alpha_{t}(\mathbf{I}-\beta_{t}\mathbf{k}_{t}\mathbf{k}_{t}^{\intercal})\right)+\beta_{t}\mathbf{v}_{t}\mathbf{k}_{t}^{\intercal} \tag{10}$$
其中資料相依的門控項 $\alpha_{t}\in(0,1)$ 控制狀態衰減。這個表述統一了門控機制與 delta 規則兩者的優勢:門控項實現自適應記憶管理,而 delta 更新結構促成有效的鍵-值關聯學習。
我們透過 Liu et al. (2024) 引入的線上學習 (online learning) 框架,對門控 delta 規則做形式化分析。在這個框架中,遞迴狀態更新可作為某個線上學習問題的封閉解 (closed-form solution) 而湧現,如表 1 所示。近期線性 RNN 架構通常在其線上學習目標中納入一個正則化項,以防止狀態偏離先前值,從而實現記憶保留。然而,當狀態被資訊飽和時,這個保留機制會出問題:此時每個狀態會編碼多段資訊的疊加,使精確檢索變得困難。為解決這個限制,Mamba2 與 Gated DeltaNet 引入一個自適應縮放因子 $\alpha_{t}$,放鬆正則化項、允許 $\mathbf{S}_{t}$ 與 $\mathbf{S}_{t-1}$ 之間受控的偏離。這個修改藉由選擇性遺忘實現動態記憶管理,可用於濾除無關資訊(見 §3.2)。
表 1:不同線性 RNN 模型及其對應的線上學習目標(採用 Liu et al. (2024) 的框架;為方便,把 Longhorn 的向量值 $\bm{\beta}$ 簡化為純量 $\beta$)。
| 方法 | 線上學習目標 | 線上更新 |
|---|---|---|
| LA(線性注意力) | $|\mathbf{S}_t-\mathbf{S}_{t-1}|_F^2-2\langle\mathbf{S}_t\mathbf{k}_t,\mathbf{v}_t\rangle$ | $\mathbf{S}_t=\mathbf{S}_{t-1}+\mathbf{v}_t\mathbf{k}_t^\top$ |
| Mamba2 | $|\mathbf{S}_t-\alpha_t\mathbf{S}_{t-1}|_F^2-2\langle\mathbf{S}_t\mathbf{k}_t,\mathbf{v}_t\rangle$ | $\mathbf{S}_t=\alpha_t\mathbf{S}_{t-1}+\mathbf{v}_t\mathbf{k}_t^\top$ |
| Longhorn | $|\mathbf{S}_t-\mathbf{S}_{t-1}|_F^2-\beta_t|\mathbf{S}_t\mathbf{k}_t-\mathbf{v}_t|^2$ | $\mathbf{S}_t=\mathbf{S}_{t-1}(\mathbf{I}-\epsilon\mathbf{k}_t\mathbf{k}_t^\top)+\dots$ |
| DeltaNet | $|\mathbf{S}_t-\mathbf{S}_{t-1}|_F^2-2\langle\mathbf{S}_t\mathbf{k}_t,\beta_t(\mathbf{v}_t-\mathbf{S}_{t-1}\mathbf{k}_t)\rangle$ | $\mathbf{S}_t=\mathbf{S}_{t-1}(\mathbf{I}-\beta_t\mathbf{k}_t\mathbf{k}_t^\top)+\beta_t\mathbf{v}_t\mathbf{k}_t^\top$ |
| Gated DeltaNet | $|\mathbf{S}_t-\alpha_t\mathbf{S}_{t-1}|_F^2-2\langle\mathbf{S}_t\mathbf{k}_t,\beta_t(\mathbf{v}_t-\alpha_t\mathbf{S}_{t-1}\mathbf{k}_t)\rangle$ | 方程式 10 |
另一方面,線性注意力 (LA) 與 Mamba2 使用一個簡單的負內積損失 $-\langle\mathbf{S}_{t}\mathbf{k}_{t},\mathbf{v}_{t}\rangle$,而 Longhorn [Liu et al., 2024] 使用一個更具表達力的線上迴歸目標 $\|\mathbf{S}_{t}\mathbf{k}_{t}-\mathbf{v}_{t}\|^{2}$ 以更好地建模鍵-值關聯。Longhorn 由此得到的更新規則與 delta 更新規則極為相似(【譯註】理論區別在於最佳化途徑:Longhorn 用隱式線上學習導出封閉形式的全域最佳更新,而 DeltaNet 透過一步顯式梯度下降最佳化相同目標),暗示(門控)delta 規則在脈絡內關聯回憶上優於 Mamba2。
從快速權重編程 (fast weight programming) [Irie et al., 2022a]、測試時訓練 (test-time training) [Sun et al., 2024a] 與迴歸的角度,隱藏狀態 $\mathbf{S}$ 可被詮釋為一個(快速)權重矩陣,而 delta 規則透過測試時隨機梯度下降 (SGD) 最佳化線上迴歸目標 $\mathcal{L}(\mathbf{S}_{t})=\frac{1}{2}\|\mathbf{S}_{t}\mathbf{k}_{t}-\mathbf{v}_{t}\|^{2}$:
$$\mathbf{S}_{t+1}=\mathbf{S}_{t}-\beta_{t}\nabla\mathcal{L}(\mathbf{S}_{t})=\mathbf{S}_{t}(\mathbf{I}-\beta_{t}\mathbf{k}_{t}\mathbf{k}_{t}^{\intercal})+\beta_{t}\mathbf{v}_{t}\mathbf{k}_{t}^{\intercal}$$
其中 $\beta_{t}$ 代表(自適應)學習率。從這個角度,門控 delta 規則可被視為「在 SGD 更新中納入一個自適應權重衰減項 $\alpha_{t}$」——一種在深度學習中被廣泛使用的技術。同期的 Titans [Behrouz et al., 2024] 也證明了在 RNN 測試時 SGD 更新中納入權重衰減機制的有效性。
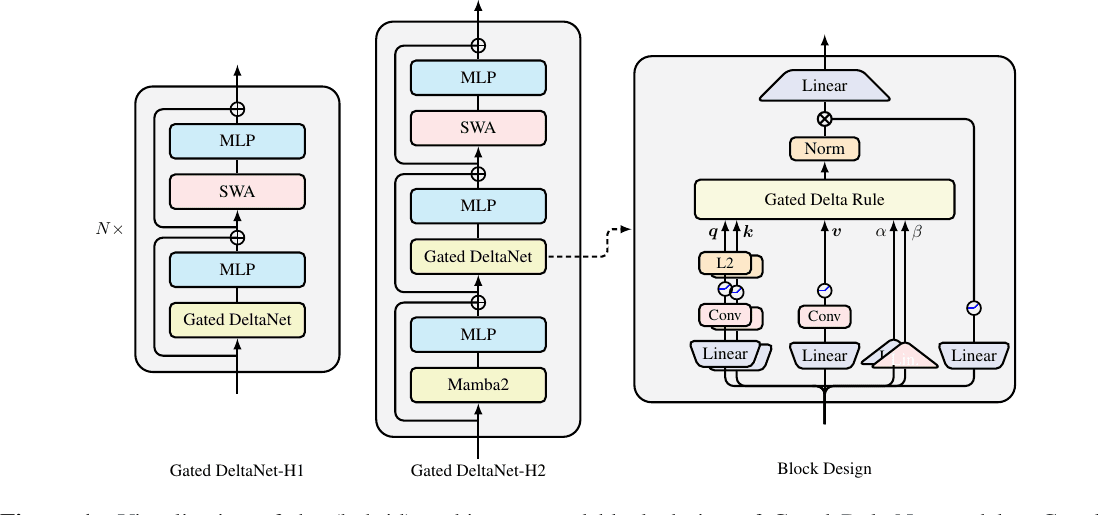
圖 1: Gated DeltaNet 模型的(混合)架構與區塊設計視覺化。Gated DeltaNet-H1 與 H2 分別使用「Gated DeltaNet + SWA」與「Mamba2 + Gated DeltaNet + SWA」的模式。在區塊設計中,query/key 路徑由線性投影、短卷積 (short conv.)、SiLU 與 L2 正規化組成;value 路徑包含線性投影、短卷積與 SiLU;$\alpha,\beta$ 用線性投影;輸出門 (output gate) 套用線性投影加 SiLU。
3.2 案例研究:大海撈針(單針,S-NIAH)
為更好地理解 delta 規則與門控規則之間的互補優勢,我們在 RULER [Hsieh et al., 2024] 的 Single Needle-In-A-Haystack (S-NIAH) 基準套件上做案例研究,其中一個鍵-值對充當大海(脈絡)中的一根針,模型必須在給定鍵時回憶出值。表 2 呈現結果,我們得出三個主要觀察:
表 2:1.3B 模型在 S-NIAH 基準套件上的零樣本效能比較(各欄為序列長度)。
| 模型 | S1-1K | S1-2K | S1-4K | S1-8K | S2-1K | S2-2K | S2-4K | S2-8K | S3-1K | S3-2K | S3-4K |
|---|---|---|---|---|---|---|---|---|---|---|---|
| DeltaNet | 97.4 | 96.8 | 99.0 | 98.8 | 98.4 | 45.6 | 18.6 | 14.4 | 85.2 | 47.0 | 22.4 |
| Mamba2 | 99.2 | 98.8 | 65.4 | 30.4 | 99.4 | 98.8 | 56.2 | 17.0 | 64.4 | 47.6 | 4.6 |
| Gated DeltaNet | 98.4 | 88.4 | 91.4 | 91.8 | 100.0 | 99.8 | 92.2 | 29.6 | 86.6 | 84.2 | 27.6 |
(S1 = S-NIAH-1 pass-key 檢索;S2 = S-NIAH-2 數字藏於乾草堆;S3 = S-NIAH-3 UUID 藏於乾草堆。)
- 衰減有損記憶保留。 在最簡單的 S-NIAH-1 設定(重複的合成脈絡)中,模型記憶最少的資訊,測試長期保留。DeltaNet 在所有序列長度上達到近乎完美的表現。Mamba2 在 2K 序列之後顯著退化,因為它衰減歷史資訊太快;而 Gated DeltaNet 因使用 delta 規則,退化較不嚴重。
- 門控促進過濾。 在使用真實世界文章脈絡的 S-NIAH-2/3 中,模型儲存所有潛在相關的資訊,測試高效的記憶管理。在固定狀態大小下,缺乏清除會導致記憶碰撞——資訊變得疊加、無法區分。DeltaNet 因記憶清除差,在較長序列時效能顯著下降。Mamba2 與 Gated DeltaNet 透過過濾無關資訊的門控機制維持較好的表現。
- Delta 規則有助記憶。 在 S-NIAH-3 中,值從數字改為 UUID,測試複雜的模式記憶。Mamba2 的表現快速下降,而 Gated DeltaNet 表現較好,驗證了 delta 規則確實有更好的記憶能力。
3.3 演算法:硬體高效的分塊訓練
在本小節,我們為 Gated DeltaNet 的訓練推導一個硬體高效的分塊演算法。部分展開方程式 10 的遞迴,$\mathbf{S}_{[t]}^{r}=\mathbf{S}_{[t]}\mathbf{F}_{[t]}^{r}+\mathbf{G}_{[t]}^{r}$。易見 $\mathbf{F}_{[t]}^{r}=\gamma_{[t]}^{r}\mathbf{P}_{[t]}^{r}=\overleftarrow{\mathbf{P}_{[t]}^{r}}$。至於 $\mathbf{G}_{[t]}^{r}$,我們把方程式 5 調整為 $\mathbf{G}_{[t]}^{r}=\sum_{i=1}^{r}\frac{\gamma_{[t]}^{r}}{\gamma_{[t]}^{i}}\tilde{\mathbf{u}}_{[t]}^{i}\mathbf{k}_{[t]}^{i\intercal}$,其中
$$\tilde{\mathbf{u}}_{[t]}^{r}=\beta_{[t]}^{r}\left(\mathbf{v}_{[t]}^{r}-\sum_{i=1}^{r-1}\tilde{\mathbf{u}}_{[t]}^{i}\left(\frac{\gamma_{[t]}^{r}}{\gamma_{[t]}^{i}}\mathbf{k}_{[t]}^{i\intercal}\mathbf{k}_{[t]}^{r}\right)\right)$$
(證明見附錄 A)。用 UT 變換,得矩陣形式:
$$\widetilde{\mathbf{U}_{[t]}}=\left[\mathbf{I}+\operatorname{strictLower}\left(\operatorname{diag}(\beta_{[t]})(\Gamma_{[t]}\odot\mathbf{K}_{[t]}\mathbf{K}_{[t]}^{\intercal})\right)\right]^{-1}\operatorname{diag}(\beta_{[t]})\mathbf{V}_{[t]}$$
類似 Mamba2 擴展線性注意力(方程式 1)的方式,我們可以調整 DeltaNet 的分塊演算法(方程式 8–9)給 Gated DeltaNet,以實現硬體高效訓練:
$$\mathbf{S}_{[t+1]}=\overrightarrow{\mathbf{S}_{[t]}}+(\widetilde{\mathbf{U}_{[t]}}-\overleftarrow{\mathbf{W}_{[t]}}\mathbf{S}_{[t]}^{\intercal})^{\intercal}\overrightarrow{\mathbf{K}_{[t]}}$$
$$\mathbf{O}_{[t]}=\overleftarrow{\mathbf{Q}_{[t]}}\mathbf{S}_{[t]}^{\intercal}+(\mathbf{Q}_{[t]}\mathbf{K}_{[t]}^{\intercal}\odot\mathbf{M})(\widetilde{\mathbf{U}_{[t]}}-\overleftarrow{\mathbf{W}_{[t]}}\mathbf{S}_{[t]}^{\intercal})$$
其中 $\overleftarrow{\mathbf{q}_{[t]}^{r}}=\gamma_{[t]}^{r}\mathbf{q}_{[t]}^{r}$、$\overleftarrow{\mathbf{w}_{[t]}^{r}}=\gamma_{[t]}^{r}\mathbf{w}_{[t]}^{r}$、$\overrightarrow{\mathbf{k}_{[t]}^{r}}=\frac{\gamma_{[t]}^{C}}{\gamma_{[t]}^{r}}\mathbf{k}_{[t]}^{r}$、$\overrightarrow{\mathbf{S}_{[t]}}=\gamma_{[t]}^{C}\mathbf{S}_{[t]}$,一如方程式 2 的定義。
3.4 門控 Delta 網路與混合模型
Token 混合區塊。 基本的 Gated DeltaNet 遵循 Llama 的宏觀架構,堆疊 token 混合層與 SwiGLU MLP 層,但把自注意力替換成門控 delta 規則的 token 混合。對門控 delta 規則(方程式 10),query、key、value $\{\mathbf{q},\mathbf{k},\mathbf{v}\}$ 透過線性投影、短卷積 (short convolution) 與 SiLU 生成,並對 $\mathbf{q},\mathbf{k}$ 套用 L2 正規化以維持訓練穩定。$\alpha,\beta$ 僅用線性投影($\alpha$ 用 Mamba2 的參數化)。遵循 Sun et al. (2023a),輸出在套用輸出投影前先經過正規化與門控處理。
混合模型。 線性 Transformer 在建模局部位移與比較上有限制,其固定狀態大小使檢索任務困難。遵循 Griffin、Samba 等近期混合架構,我們把線性遞迴層與滑動視窗注意力 (SWA) 結合,得到 GatedDeltaNet-H1。我們也堆疊 Mamba2、GatedDeltaNet 與 SWA,得到 GatedDeltaNet-H2。
4 實驗
設定。 我們的實驗全面比較近期 state-of-the-art 架構,包括純 Transformer 模型、基於 RNN 的方法與混合架構。基線包括 RetNet、HGRN2、Mamba、Mamba2、Samba、DeltaNet。為公平比較,所有模型在相同條件下訓練:1.3B 參數、100B token(從 FineWeb-Edu 資料集取樣)。我們用 AdamW 最佳化器,峰值學習率 4e-4、權重衰減 0.1、梯度裁剪 1.0。學習率遵循 cosine 退火排程,1B token 暖身、批次大小 0.5M token。所有模型用 Llama2 tokenizer(詞彙量 32,000)。訓練長度設 4K token,Samba 與我們的混合模型用 2K 的滑動視窗大小。
常識推理。 表 3 呈現 400M 與 1.3B 參數模型的語言模型困惑度 (perplexity) 與常識推理零樣本準確度。Gated DeltaNet 在兩個規模上都持續勝過其他線性模型(RetNet、HGRN2、Mamba、Mamba2、DeltaNet)。如預期,混合變體進一步提升效能。
表 3:語言模型與零樣本常識推理的效能比較(1.3B 模型)。 Wiki. ppl↓、LMB. ppl↓(越低越好);其餘為準確度↑。
| 模型 | Wiki ppl↓ | LMB ppl↓ | LMB acc | PIQA | Hella. | Wino. | ARC-e | ARC-c | SIQA | BoolQ | Avg |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 遞迴模型 | |||||||||||
| RetNet | 19.08 | 17.27 | 40.52 | 70.07 | 49.16 | 54.14 | 67.34 | 33.78 | 40.78 | 60.39 | 52.02 |
| HGRN2 | 19.10 | 17.69 | 39.54 | 70.45 | 49.53 | 52.80 | 69.40 | 35.32 | 40.63 | 56.66 | 51.79 |
| Mamba | 17.92 | 15.06 | 43.98 | 71.32 | 52.91 | 52.95 | 69.52 | 35.40 | 37.76 | 61.13 | 53.12 |
| Mamba2 | 16.56 | 12.56 | 45.66 | 71.87 | 55.67 | 55.24 | 72.47 | 37.88 | 40.20 | 60.13 | 54.89 |
| DeltaNet | 17.71 | 16.88 | 42.46 | 70.72 | 50.93 | 53.35 | 68.47 | 35.66 | 40.22 | 55.29 | 52.14 |
| Gated DeltaNet | 16.42 | 12.17 | 46.65 | 72.25 | 55.76 | 57.45 | 71.21 | 38.39 | 40.63 | 60.24 | 55.32 |
| 注意力或混合模型 | |||||||||||
| Transformer++ | 18.53 | 18.32 | 42.60 | 70.02 | 50.23 | 53.51 | 68.83 | 35.10 | 40.66 | 57.09 | 52.25 |
| Samba | 16.13 | 13.29 | 44.94 | 70.94 | 53.42 | 55.56 | 68.81 | 36.17 | 39.96 | 62.11 | 54.00 |
| Gated DeltaNet-H1 | 16.07 | 12.12 | 47.73 | 72.57 | 56.53 | 58.40 | 71.75 | 40.10 | 41.40 | 63.21 | 56.40 |
| Gated DeltaNet-H2 | 15.91 | 12.55 | 48.76 | 72.19 | 56.88 | 57.77 | 71.33 | 39.07 | 41.91 | 61.55 | 56.18 |
真實世界資料上的脈絡內檢索。 表 4 呈現真實世界密集回憶任務的結果。如預期,線性遞迴模型相較於 Transformer 有顯著的效能差距,而結合線性遞迴與注意力的混合模型在檢索任務上勝過純注意力模型。對純遞迴模型,儘管 DeltaNet 在合成脈絡內檢索任務上表現優越,其真實世界檢索表現落後 Mamba2,與我們在 S-NIAH-2/3 的觀察一致。Gated DeltaNet 因其門控 delta 規則而勝過 DeltaNet 與 Mamba2,不過改善幅度小於表 2。我們把這個較小的差距歸因於「未經指令對齊的小型語言模型容易犯重複錯誤」,那是這些任務的主要錯誤來源,而這問題大致與更新規則的選擇無關。
表 4:真實世界回憶任務的準確度(輸入截斷至 2K token)。 SQD:SQUADE;TQA:Trivia QA。
| 模型 | SWDE | SQD | FDA | TQA | NQ | Drop | Avg |
|---|---|---|---|---|---|---|---|
| RetNet | 14.0 | 28.5 | 7.0 | 54.4 | 16.2 | 17.3 | 22.9 |
| Mamba2 | 19.1 | 33.6 | 25.3 | 61.0 | 20.8 | 19.2 | 29.8 |
| DeltaNet | 17.9 | 30.9 | 18.4 | 53.9 | 17.3 | 18.6 | 26.2 |
| Gated DeltaNet | 25.4 | 34.8 | 23.7 | 60.0 | 20.0 | 19.8 | 30.6 |
| Transformer++ | 29.5 | 38.0 | 52.2 | 58.3 | 22.5 | 21.6 | 37.0 |
| Samba | 33.0 | 39.2 | 50.5 | 57.7 | 23.5 | 20.2 | 37.3 |
| Gated DeltaNet-H1 | 35.6 | 39.7 | 52.0 | 60.1 | 24.6 | 22.2 | 39.0 |
| Gated DeltaNet-H2 | 38.2 | 40.4 | 50.7 | 63.3 | 24.8 | 23.3 | 40.1 |
長序列上的長度外推。 我們評估模型外推到最多 20K token 序列的能力(跨六個長脈絡基準)。Gated DeltaNet 在 RNN 模型中達到跨任務最低的整體困惑度。雖然長度外推的結果好壞參半,Gated DeltaNet 展現相對更穩健的表現,暗示更好的記憶管理。混合模型藉由利用注意力做局部脈絡建模進一步改善,減輕了遞迴部分的記憶管理負擔。
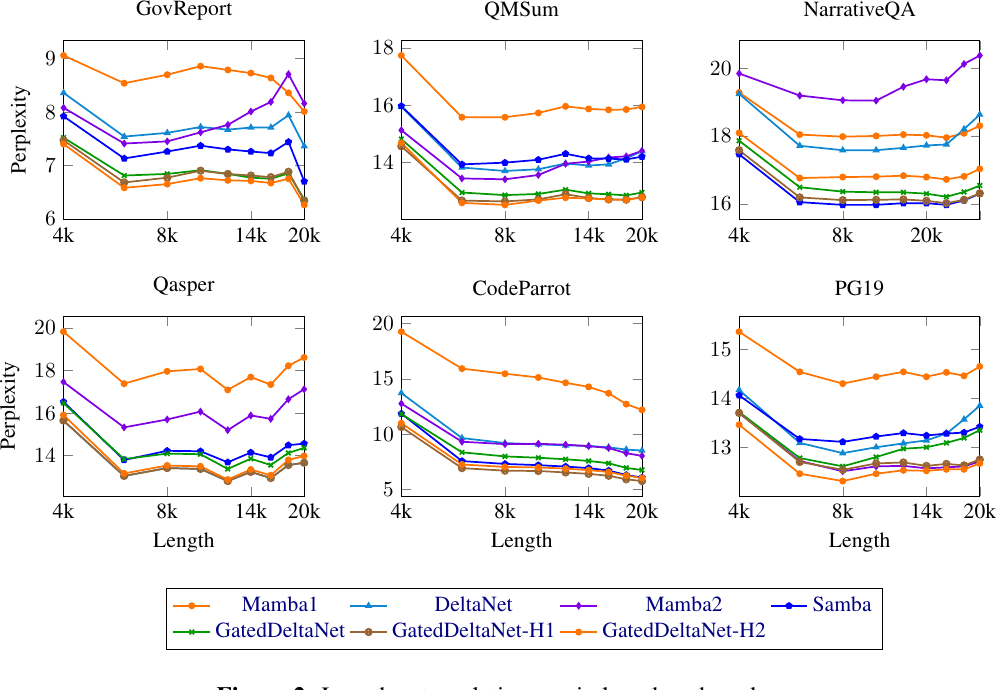
圖 2: 六個長基準(GovReport、QMSum、NarrativeQA、Qasper、CodeParrot、PG19)上的長度外推,x 軸為序列長度(4k–20k)、y 軸為困惑度。
長脈絡理解。 我們在 LongBench [Bai et al., 2023] 上評估。在遞迴模型中,Gated DeltaNet 顯示一致的優勢,尤其在單文件 QA、少樣本脈絡內學習、與程式碼任務上,分別展現其在檢索、脈絡內學習、與狀態追蹤上的優越能力。
表 5:LongBench 14 個任務的準確度(依序:Narrative QA、Qasper QA、MultiField QA、HotpotQA、2WikiMulti QA、Musique、GovReport、QMSum、MultiNews、TREC、Trivia QA、SamSum、LCC、RepoBench-P)。
| 模型 | 單文件QA | 多文件QA | 摘要 | 少樣本 | 程式 | Avg |
|---|---|---|---|---|---|---|
| RetNet | 12.1/10.7/19.1 | 10.7/18.0/5.8 | 4.8/15.8/7.9 | 19.0/18.0/12.8 | 14.1/17.9 | 13.2 |
| Mamba | 13.0/10.1/20.4 | 10.1/16.7/6.0 | 7.2/15.9/8.4 | 23.1/21.9/11.2 | 17.9/19.0 | 14.6 |
| DeltaNet | 12.9/10.8/21.5 | 10.9/13.2/5.1 | 6.5/13.5/7.2 | 15.5/23.3/11.6 | 17.6/20.3 | 13.6 |
| Mamba2 | 11.1/11.3/18.6 | 11.8/15.1/6.7 | 6.7/14.5/7.4 | 13.0/23.6/8.4 | 17.9/20.6 | 13.5 |
| Gated DeltaNet | 14.1/14.0/23.3 | 13.7/14.4/5.8 | 7.5/16.4/7.9 | 30.0/22.4/23.0 | 18.7/22.1 | 16.6 |
| Samba | 12.5/12.9/25.4 | 11.2/19.7/6.8 | 9.1/15.7/11.0 | 20.0/22.7/22.8 | 18.1/21.1 | 15.9 |
| Gated DeltaNet-H1 | 14.5/12.3/26.6 | 12.6/23.6/6.1 | 9.1/16.1/12.8 | 33.5/23.9/26.8 | 15.5/19.2 | 17.8 |
| Gated DeltaNet-H2 | 12.7/13.0/27.1 | 12.7/20.6/7.5 | 10.4/16.2/13.0 | 40.5/22.7/27.9 | 19.9/22.1 | 18.4 |
(每格為該子類別任務的分數,以 / 分隔;欄位為前述 14 任務依序分組。)
吞吐量比較。 提出的門控 delta 規則相較於原始 delta 規則只引入微小的額外開銷,Gated DeltaNet 達到與 DeltaNet 本質上相同的吞吐量。兩者都因為有更具表達力的轉移矩陣而略慢於 Mamba2(2–3K tokens/秒)。Transformer++ 因高度最佳化的 Flash-Attention-2 核心,在 2K 脈絡視窗領域達到最佳效能。因此,結合 2K 視窗 SWA 與其他 token 混合器的混合方法展現比單獨混合器更高的吞吐量:Samba 勝過 Mamba,而 Gated DeltaNet-H1 與 -H2 勝過 Gated DeltaNet。值得注意的是,Gated DeltaNet-H1 在所有序列長度(甚至短序列)上都維持引人注目的訓練吞吐量。
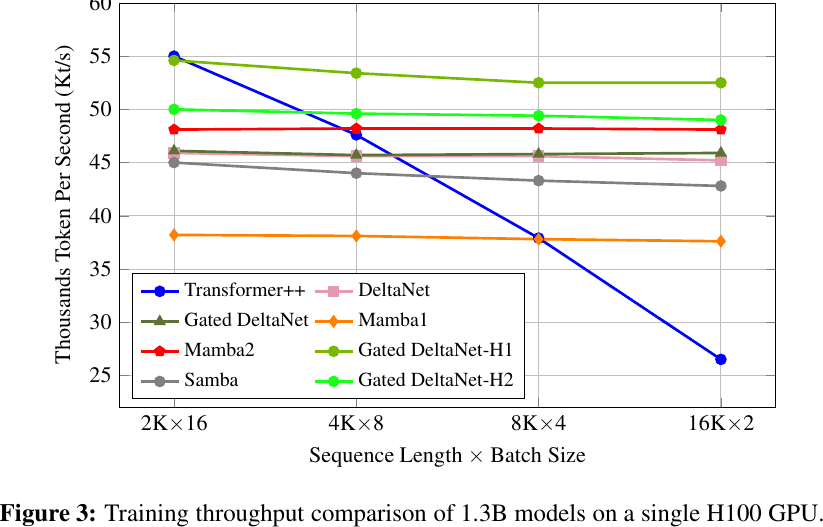
圖 3: 單張 H100 GPU 上 1.3B 模型的訓練吞吐量比較(y 軸為每秒千 token,x 軸為「序列長度 × 批次大小」)。Transformer++ 在短脈絡最快、但隨序列拉長急遽下滑;Gated DeltaNet-H1/H2 在所有長度都維持穩定的高吞吐量。
5 相關研究
門控線性 RNN。 大型線性遞迴語言模型因其訓練與推論效率而備受關注。線性 RNN 領域已從使用資料無關的衰減機制(S4、S5、LRU、RWKV4/5、RetNet)迅速演進到在較近期架構(HGRN1/2、Mamba1/2、RWKV6、GSA)中納入資料相依的衰減機制。這個轉變源自門控/遺忘機制(Mamba 中稱為選擇性機制)已被證實的優勢——一個源自門控 RNN 文獻的經典概念,其重要性一再被重申。現代遺忘門與 LSTM 等傳統設計不同,它移除了對前一隱藏狀態的依賴、僅仰賴輸入資料,這使跨序列長度的高效平行成為可能。缺少遺忘門一直是 DeltaNet 的一個顯著限制,而我們的門控擴展以自然、有效、硬體高效的方式填補了這個空缺。我們也注意到一個近期同期工作 RWKV-7 使用了類似想法,但用「對角加低秩 (diagonal-plus-low-rank)」轉移的更寬鬆形式:$\mathbf{S}_{t}=\mathbf{S}_{t-1}(\operatorname{diag}(\mathbf{d}_{t})-\mathbf{a}_{t}\mathbf{b}_{t}^{\top})+\mathbf{v}_{t}\mathbf{k}_{t}^{\top}$。分塊演算法可類似地調整到這種情況。
Delta 規則。 delta 學習規則相較於 Hebbian 學習展現優越的記憶容量,這是 DeltaNet 所利用的優勢(而線性 Transformer 仰賴類 Hebbian 規則)。這個記憶容量優勢在合成脈絡內學習任務中明顯,並延伸到語言模型、強化學習與影像生成。Yang et al. (2024b) 平行化了 delta 規則計算,並證明 DeltaNet 資料相依的「單位加低秩」結構 $(\mathbf{I}-\beta_{t}\mathbf{k}_{t}\mathbf{k}_{t}^{\intercal})$ 比 Mamba2 資料相依的對角矩陣 $\alpha_{t}\mathbf{I}$ 提供更大的靈活性。這個結構優勢可能實現複雜推理,包括正規語言辨識與超越 $\text{TC}^0$ 複雜度的狀態追蹤——對程式與推理應用至關重要。儘管有這些顯著優勢,delta 規則面臨理論限制、且在真實世界資料集上只有中等表現,暗示有改善空間。先前透過非線性遞迴增強表達力的嘗試解決了一些限制,卻犧牲了訓練平行性,造成效能-效率的權衡。近期工作提出一些不犧牲平行性的增強以獲得更好的狀態追蹤表現,包括使用負特徵值、以及 Householder 轉移矩陣的多重乘積(實現高秩變換)。這些方法都可無縫套用到 Gated DeltaNet。從(線上)學習目標的角度,其他表述可進一步擴展表達力:如 TTT 與 Titans 的非線性迴歸,或如 Mesa layer 考慮整個歷史的迴歸(類比於最小均方 (LMS) 與遞迴最小平方 (RLS) 演算法的差別)。然而,這些更具表達力的變體引入非線性遞迴、需要變通做法。
混合模型。 在本工作中,我們探索跨層交錯混合注意力層,這在 MiniMax-01 與 Hybrid Mamba2-Attention 等處常被使用。研究單層內混合線性/softmax 注意力也很有趣。
6 結論
在本工作中,我們引入 Gated DeltaNet,相較於 Mamba2 它實現更好的鍵-值關聯學習、相較於 DeltaNet 它有更自適應的記憶清除,在各種任務上帶來持續更好的經驗結果。我們把 Yang et al. (2024b) 的平行演算法擴展,以實現 Gated DeltaNet 的硬體高效訓練。我們的混合 Gated DeltaNet 模型達到更高的訓練吞吐量與整體效能,使它很適合實際部署。
致謝
我們感謝 Yu Zhang 協助製圖與模型評估;Kazuki Irie 對草稿提供寶貴回饋;Simeng Sun 與 Zhixuan Lin 對長序列任務評估設定的深刻討論;以及 Eric Alcaide 與 Volodymyr Kyrylov 對 DeltaNet 線上學習觀點的有益討論。
【譯註】原論文附錄 A 給出「門控 delta 規則的擴展 WY 表徵」證明,附錄 B 提供評估細節與消融研究(表 S.1、S.2)。此處從略,詳見原文。
參考文獻
書目保留原文,採作者-年份引用;內文的「作者 (年份)」對應下列條目。本文原始參考文獻共 107 筆,以下列出正文引用的主要條目;完整書目請見原論文。
- Arora et al. (2024a/2024b). Simple linear attention language models balance the recall-throughput tradeoff / Zoology.
- Bai et al. (2023). LongBench: A bilingual, multitask benchmark for long context understanding.
- Behrouz et al. (2024). Titans: Learning to memorize at test time.
- Bischof & Loan (1985). The WY representation for products of Householder matrices.
- Dao (2023). FlashAttention-2: Faster attention with better parallelism and work partitioning.
- Dao & Gu (2024a/2024b). Transformers are SSMs: Generalized models and efficient algorithms through structured state space duality (Mamba2).
- De et al. (2024). Griffin: Mixing gated linear recurrences with local attention for efficient language models.
- Gers et al. (2000). Learning to forget: Continual prediction with LSTM.
- Grazzi et al. (2024). Unlocking state-tracking in linear RNNs through negative eigenvalues.
- Gu & Dao (2023). Mamba: Linear-time sequence modeling with selective state spaces.
- Gu et al. (2022). Efficiently modeling long sequences with structured state spaces (S4).
- Hsieh et al. (2024). RULER: What's the real context size of your long-context language models?
- Hua et al. (2022b). Transformer quality in linear time.
- Irie et al. (2021; 2022a; 2022b; 2023). Going beyond linear transformers with recurrent fast weight programmers 等.
- Joffrain et al. (2006). Accumulating Householder transformations, revisited (UT transform).
- Katharopoulos et al. (2020a/b). Transformers are RNNs: Fast autoregressive transformers with linear attention.
- Liu et al. (2024). Longhorn: State space models are amortized online learners.
- Merrill et al. (2024). The illusion of state in state-space models.
- MiniMax et al. (2025). MiniMax-01: Scaling foundation models with lightning attention.
- Orvieto et al. (2023). Resurrecting recurrent neural networks for long sequences (LRU).
- Penedo et al. (2024). The FineWeb datasets: Decanting the web for the finest text data at scale.
- Peng et al. (2023; 2024). RWKV: Reinventing RNNs for the transformer era / Eagle and Finch (RWKV-5/6).
- Qin et al. (2023b; 2024a; 2024b). HGRN / Lightning Attention / HGRN2.
- Ren et al. (2024). Samba: Simple hybrid state space models for efficient unlimited context language modeling.
- Schlag et al. (2021a/b). Linear transformers are secretly fast weight programmers (DeltaNet).
- Siems et al. (2025). DeltaProduct: Improving state-tracking in linear RNNs via Householder products.
- Smith et al. (2023). Simplified state space layers for sequence modeling (S5).
- Smolensky (1990). Tensor product variable binding and the representation of symbolic structures in connectionist systems.
- Sun et al. (2023a/2023b). Retentive network: A successor to Transformer for large language models (RetNet).
- Sun et al. (2024a). Learning to (learn at test time): RNNs with expressive hidden states (TTT).
- Waleffe et al. (2024). An empirical study of Mamba-based language models (Hybrid Mamba2-Attention).
- Widrow et al. (1960). Adaptive switching circuits (delta rule).
- Yang et al. (2024a). Gated linear attention transformers with hardware-efficient training (GLA).
- Yang et al. (2024b). Parallelizing linear transformers with the delta rule over sequence length.
- Yang & Zhang (2024). FLA: A Triton-based library for hardware-efficient implementations of linear attention.
- Zhang et al. (2024). Gated slot attention for efficient linear-time sequence modeling (GSA).
術語對照表
| English | 繁體中文 |
|---|---|
| Linear Transformer / Linear Attention | 線性 Transformer / 線性注意力 |
| Delta rule / delta update rule | delta 規則 / delta 更新規則 |
| Gated delta rule | 門控 delta 規則 |
| Gating | 門控 |
| Decay term | 衰減項 |
| Forget gate | 遺忘門 |
| Linear RNN | 線性 RNN |
| State space duality (SSD) | 狀態空間對偶 |
| Mamba2 | Mamba2 |
| DeltaNet | DeltaNet |
| Chunkwise (parallel form) | 分塊(平行形式) |
| Chunk | 塊 |
| WY representation | WY 表徵 |
| UT transform | UT 變換 |
| Householder transformation | Householder 變換 |
| Causal mask | 因果遮罩 |
| Key-value association | 鍵-值關聯 |
| Associative recall | 關聯回憶 |
| Memory collision | 記憶碰撞 |
| Outer product | 外積 |
| Tensor product representation | 張量積表徵 |
| In-context retrieval | 脈絡內檢索 |
| Length extrapolation | 長度外推 |
| Long context | 長脈絡 |
| Online learning | 線上學習 |
| Closed-form solution | 封閉解 |
| Fast weight programming | 快速權重編程 |
| Test-time training (TTT) | 測試時訓練 |
| Weight decay | 權重衰減 |
| Sliding window attention (SWA) | 滑動視窗注意力 |
| Hybrid model | 混合模型 |
| Short convolution | 短卷積 |
| Perplexity | 困惑度 |
| Throughput | 吞吐量 |
| Tensor core | 張量核心 |
| Needle-in-a-haystack (NIAH) | 大海撈針 |
| State tracking | 狀態追蹤 |