Attention to Mamba:跨架構蒸餾的配方
原始論文:Attention to Mamba: A Recipe for Cross-Architecture Distillation 作者:Abhinav Moudgil, Ningyuan Huang, Eeshan Gunesh Dhekane, Pau Rodríguez, Luca Zappella, Federico Danieli arXiv ID:2604.14191v1 日期:2026-04-21 標籤:Mamba Knowledge Distillation Cross-Architecture Linear Attention Hedgehog SSM LLM
摘要
State Space Models (SSMs) 例如 Mamba,由於相較於基於 Attention 的對應模型,具有更低的記憶體消耗以及在生成時更高的吞吐量 (Throughput),已成為 Transformer 模型的熱門替代方案。另一方面,社群已累積了大量關於如何訓練 Transformer 的知識,並且許多預訓練的 Transformer 模型也已可隨手取得。為了在利用既有預訓練 Transformer 的同時促進 SSM 的採用,我們的目標是找出一個有效的配方,將基於 Attention 的模型蒸餾為類 Mamba 架構。然而,先前關於跨架構蒸餾 (Cross-architecture Distillation) 的研究指出:從 Transformer 到 Mamba 的單純蒸餾程序無法保留原始的 Teacher 模型表現,這個限制通常透過結合 Attention 與 SSM 區塊的混合 (Hybrid) 解決方案來克服。我們工作中的關鍵論點在於:透過為 Mamba 配備一個有原則的初始化 (Principled Initialization),我們可以恢復出整體更好的跨架構蒸餾配方。為此,我們提出了一個有原則的兩階段方法:第一,我們從傳統 Transformer 中將知識蒸餾為一個線性化版本的 Attention,使用的是 kernel trick (核技巧) 的一種改編。然後,我們將該線性化版本蒸餾為一個改編後的、不使用任何 Attention 區塊的 Mamba 模型。整體而言,蒸餾出的 Mamba 模型能夠在下游任務中保留原始 Pythia-1B Transformer 的效能,達到 14.11 的困惑度 (Perplexity),接近 Teacher 的 13.86。為了展示我們配方的有效性,我們在 1B 規模、10B tokens 上進行了徹底的消融實驗 (Ablation),變化序列混合器 (Sequence Mixer) 架構、對模型大小與總蒸餾 tokens 的擴展分析,以及在階段間 token 分配上的敏感度分析。
通訊作者:Abhinav Moudgil:[email protected]
日期:2026 年 4 月 17 日
1. 引言與動機
過去十年自然語言處理 (Natural Language Processing) 的發展,許多進展可以直接歸因於 Attention 機制 (Bahdanau et al., 2015; Vaswani et al., 2017) 在生成豐富、具上下文感知的 token 表徵 (Token Representation) 以及解鎖平行訓練上的有效性。然而,Attention 的強大能力伴隨著相對於輸入序列長度 $L$ 平方級增長的計算成本。為了抑制這項需求,已觸發了多種 Attention 替代方案的發展,這些方案能保留相對於 $L$ 的線性複雜度。其中最成功的有 Linear Attention (Katharopoulos et al., 2020)、RWKV (Peng et al., 2023),以及 State-Space Models (SSMs),特別是以 Mamba 為代表 (Gu & Dao, 2023; Dao & Gu, 2024)。
一方面,線性 Attention 替代方案承諾的更快推論時間與更低記憶體需求無疑令人嚮往;另一方面,其下游任務表現仍傾向落後於 Transformer,特別是在大規模時。同時,對 Transformer 的研究更加成熟,可用模型數量更多 (Wolf et al., 2020),並且已投入大量計算資源預訓練這些模型 (Castaño et al., 2024)。有鑑於此,與其從零開始訓練 SSMs,一個有前景的方向是蒸餾 (Distillation)(Hinton et al., 2015),它讓我們能直接利用嵌入在現成預訓練 Transformer 模型中的知識。然而,Transformer 與 Mamba 架構之間的單純直接蒸餾已被證明具有挑戰性 (Wang et al., 2024; Bick et al., 2024),且常常無法保留 Teacher 模型的表現。在我們的工作中,我們識別出一個關鍵的缺失部分:透過有原則的初始化進行架構對齊。我們不強迫在根本上不同的計算典範間進行知識遷移,而是提出一個兩階段橋接策略(如圖 2 所示),它利用了序列混合器 (Sequence Mixer) 之間的數學連結。我們首先將標準 Softmax Attention 蒸餾為 Linear Attention,建立在 Zhang et al. (2024) 所示的 Hedgehog 方法之上。這奠基於 kernel trick 的應用,亦即將 Attention 分數計算中的指數函數 (Exponential) 以特定特徵的純量乘積近似。在第一步後恢復的 Linear Attention 權重,會被用作 Mamba 參數的初始化,整個模型再進一步微調 (Fine-tune)。這個配方旨在保證在限制訓練成本至 Teacher Transformer 預訓練成本一小部分的同時,達成有效的知識遷移。作為 Teacher 模型,我們考量預訓練的 Pythia Transformer 家族 (Biderman et al., 2023),並在其架構的 SSM 改編上進行蒸餾。對於蒸餾程序,我們使用來自 OpenWebText 資料集的資料 (Gokaslan et al., 2019)。我們蒸餾配方的表現在純粹困惑度以及來自 lm-eval-harness 的下游任務有效性 (Gao et al., 2021) 兩方面進行衡量。我們的方法保留了 Teacher 模型大部分的效能:對於 1B 模型,學生模型達到 14.11 的困惑度(Teacher 為 13.86),且在下游任務上有良好的整體分數。我們進一步透過對學生架構元件、模型規模與總蒸餾 token 數的擴展分析,以及階段間 token 預算分配的敏感度分析,建立我們方法的穩健性 (Robustness)。
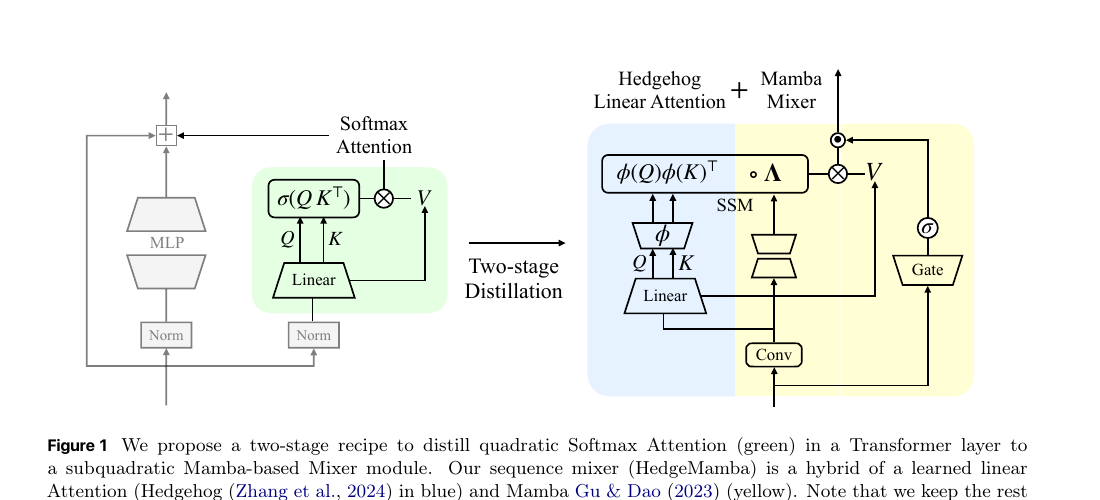
貢獻 整體而言,我們工作的主要貢獻有兩個方面:
- 我們為從 Transformer 到 Mamba 模型的跨架構蒸餾提出了一種新方法。該方法由兩個階段組成:先從 Attention 蒸餾到 Linear Attention,然後再到 Mamba,目的是有利於兩個架構間的知識遷移。
- 我們透過廣泛的消融、擴展與敏感度研究來評估方法的有效性。這些旨在精煉我們蒸餾程序的細節,並驗證其相對於可用蒸餾預算的穩健性。
1.1 先前工作
Attention 線性化 (Attention Linearization) Attention 線性化技術旨在簡化在 Attention 矩陣的組裝與/或應用中所涉及的操作,使其計算複雜度相對於序列長度呈線性(而非二次方)擴展。文獻中提出的一些方法直接修改 Attention 矩陣的結構,要不是透過稀疏化 (Sparsification)(Beltagy et al., 2020; Zaheer et al., 2021),就是將其降為低秩 (Low-rank)(Wang et al., 2020; Xiong et al., 2021)。與我們工作最相關的是另一種不同方法,即基於 kernel 的 Attention 線性化 (Katharopoulos et al., 2020; Choromanski et al., 2022; Peng et al., 2023; Qin et al., 2022; Peng et al., 2021)。這條研究路線將正定 (Positive Semi-Definite) 的 Attention 矩陣詮釋為一個 kernel 應用,該應用會被分解為高維空間中特徵向量的點積。實際上,這允許將 Attention 縮減為一個遞迴神經網路 (Recurrent Neural Network, RNN) 應用。基於 kernel 的方法因此對我們特別相關,因為它有助於彌合我們兩個目標架構(即 Transformer 與 Mamba)之間的差距:後者實際上可被詮釋為一個特定的 RNN 實例化。
State-Space Models State-Space Models 是 RNN 的一種特化,仰賴於在隱藏狀態 (Hidden State) 上純粹線性的遞迴公式。施加線性性具有使遞迴關係的計算可沿輸入序列在訓練期間平行化的優點,從而克服了傳統 RNN 的主要限制之一。分析 SSMs 性質的研究路線特別活躍 (Gu et al., 2020, 2022a,b; Cirone et al., 2025),最終產出了 Mamba 架構 (Gu & Dao, 2023),它作為 Transformer 的替代方案獲得了特別的關注。最近,Dao & Gu (2024) 在 Mamba 與 Linear Attention(配備可學習的因果遮罩)之間建立了直接連結。這一點,連同 Mamba 所展現的表現,作為使用 Mamba 架構作為 Linear Attention 替代方案的代表,並在我們學生模型定義中採用它的主要動機。
跨架構蒸餾 (Cross-architecture Distillation) 知識蒸餾 (Hinton et al., 2015) 是一種已建立的方法,用於有效率地利用嵌入於已訓練 teacher 模型中的知識,以加速 student 模型的訓練,並有許多成功應用的歷史 (Gou et al., 2021; Yang et al., 2024; Mansourian et al., 2025; Busbridge et al., 2025)。雖然大多數可用文獻的焦點都在將 teacher 蒸餾為(通常較小的)相同模型類別的 student,但在我們的工作中,我們關心的是橫跨兩個不同架構的蒸餾,目的是降低 Attention 的計算複雜度。從這個意義上講,二次方到線性 Attention 蒸餾的文獻相對較不發展,但 Linear 替代方案的興起最近也引發了對這個特定領域的興趣。例如,Scavenging Hyena (Ralambomihanta et al., 2024) 將 Transformer 模型蒸餾為 Hyena 模型 (Poli et al., 2023)(但僅在小規模 <70M);SUPRA 直接將 softmax Attention 替換為線性應用 (Mercat et al., 2024);Wang et al. (2024) 提出了用於建立有效率的混合 Transformer-Mamba 模型的蒸餾技術;Mao (2022) 透過衰減快速權重 (Decaying Fast Weights) 簡化了蒸餾;以及 (He & Garner, 2025) 研究跨架構對齊策略。最近,MOHAWK (Bick et al., 2024, 2025) 嘗試了 Transformer 到 Mamba 的蒸餾,提出了一個三階段配方,其中 Attention 與 SSM 的輸出在微調前漸進對齊。我們的工作與 MOHAWK 的直接定量比較受到底層模型架構基本差異(我們的工作基於 Pythia,而 MOHAWK 利用 Phi 作為骨幹)以及訓練集(重要的是,MOHAWK 使用包含已知含有版權材料的 Book3 資料集的 C4)的混淆。然而,方法論上的定性比較具有指導意義。MOHAWK 採用一個複雜的三階段訓練流水線,每階段有不同的目標與凍結模組。相比之下,我們的方法提出一個兩階段配方,理論上奠基於 Transformer 與 SSMs 之間的功能類比,提供更直接且計算上更精簡的方法。同樣相關的是 LoLCATs (Zhang et al., 2025),它建立在來自 Hedgehog (Kasai et al., 2021; Zhang et al., 2024) 的想法之上(其中 softmax Attention 透過可學習的線性 kernel 近似),並旨在透過為其配備視窗 Attention 與 LoRA 微調 (Hu et al., 2021) 來改進架構表現力。雖然我們的工作也建立在 Hedgehog 之上,但 LoLCATs 由於規模差異及其指令微調 (Instruction-finetuning) 損失而不適合直接比較,後者無法應用於我們預訓練式的設定中。
2. 預備知識
在本節中,我們提供了我們蒸餾程序目標架構的概覽,亦即作為 Teacher 模型的 Transformer 與作為 SSM Student 模型的 Mamba。我們還強調了線性化形式的 Attention 與 Mamba 之間的連結,這在我們蒸餾配方的發展中被加以利用,詳見第 3 節。
2.1 目標架構描述
作為 Transformer 架構的代表,我們考量來自 Pythia 套件的模型 (Biderman et al., 2023)。該套件包含參數量從 14M 到 12B 的公開可用模型,全部依循相同的配方一致地訓練。作為目標 Student 模型,我們選擇 Mamba 架構 (Gu & Dao, 2023; Dao & Gu, 2024),可說代表了當前 SSM 表現的最先進水準。為了參考,這兩個架構的示意圖在圖 4 中提供。值得指出的是 Mamba 已用與 Pythia 相同的 tokenizer 訓練,且訓練步驟數量相似。
在最高的抽象層次上,Transformer 與 Mamba 架構共享一個相似的結構,其由兩種模組交織構成:一個負責在序列內混合 tokens(也稱為 sequence mixer),另一個負責混合每個個別 token 嵌入 (Embedding) 的元件(一般由 MLP 執行)。可以說,最顯著的差異在於序列混合在這兩個架構中的執行方式,如下所述。
Attention 在 Transformer 的情境中,是 Self-Attention 機制負責在序列上混合 tokens 嵌入。其對輸入序列 $\boldsymbol{X} \in \mathbb{R}^{L \times d}$($L$ 為序列長度,$d$ 為嵌入維度)的作用表示為
$$ \boldsymbol{Y}_{\text{Attn}} := \boldsymbol{A}_{\text{Attn}} \boldsymbol{V}, \qquad \text{with} \qquad \boldsymbol{A}_{\text{Attn}} := \text{softmax}\left(\frac{\boldsymbol{Q} \boldsymbol{K}^\top}{\sqrt{d}}\right), \tag{1} $$
其中 $\boldsymbol{Q}, \boldsymbol{K}, \boldsymbol{V} \in \mathbb{R}^{L \times d}$ 是 $\boldsymbol{X}$ 的線性變換,分別表示 queries、keys 與 values。
SSM mixer 對於 Mamba,序列混合主要由 SSM 層執行[^1]。這簡化為展開以下形式的線性遞迴關係:
$$ \boldsymbol{h}_l = \boldsymbol{\Lambda}_l \odot \boldsymbol{h}_{l-1} + \boldsymbol{B}_l \otimes \boldsymbol{X}_{l,:}, \qquad \text{for } l = 1 \ldots L, \tag{2} $$
$$ \boldsymbol{Y}_{l,:} = \boldsymbol{C}_l^\top \boldsymbol{h}_l, \qquad \boldsymbol{h}_0 = \boldsymbol{0} \in \mathbb{R}^{N \times d}, $$
對於參數 $\boldsymbol{\Lambda}_l \in \mathbb{R}^{N \times d}$ 與 $\boldsymbol{B}_l, \boldsymbol{C}_l \in \mathbb{R}^N$,$N$ 為隱藏狀態大小。為強調與 (1) 的相似性,上述遞迴的解可以以矩陣形式表達為:
$$ \boldsymbol{Y}_{\text{SSM}} := \boldsymbol{A}_{\text{SSM}} \boldsymbol{X}, \qquad \text{with} \qquad [\boldsymbol{A}_{\text{SSM}}]_{i,j} := \boldsymbol{C}_i^\top \prod_{k=i}^{j+1} \boldsymbol{\Lambda}_k \boldsymbol{B}_j, \tag{3} $$
這也表明在訓練時,SSM mixer 可以類似 Attention 的方式沿序列以平行方式應用。將 Mamba 與其他 SSM 模型區分開來的主要特性,在於遞迴參數 $\boldsymbol{\Lambda}_l, \boldsymbol{B}_l, \boldsymbol{C}_l$ 全都依賴輸入 $\boldsymbol{X}_{l,:}$。事實上,這種公式化使其類似於 Linear Attention 替代方案,如我們接下來概述。
[^1]: 我們注意到 Mamba 中應用於 SSM 之前的卷積層也可以執行序列混合。
Linear Attention 與 SSMs Linear 化的 Attention 替代方案旨在將 Attention 層 (1) 從相對於 $L$ 的二次方複雜度操作轉變為線性複雜度操作。實現這一點的一種方式是透過丟棄 softmax 運算符來簡化該層,得到:
$$ \boldsymbol{Y}_{\text{LinAttn}} := (\hat{\boldsymbol{Q}} \hat{\boldsymbol{K}}^\top) \hat{\boldsymbol{V}} = \hat{\boldsymbol{Q}}(\hat{\boldsymbol{K}}^\top \hat{\boldsymbol{V}}). \tag{4} $$
這個簡化讓我們可以利用矩陣乘法的結合律,先計算 $\hat{\boldsymbol{K}}^\top \hat{\boldsymbol{V}}$,從而只需實例化更小的矩陣 $\hat{\boldsymbol{K}}, \hat{\boldsymbol{Q}}, \hat{\boldsymbol{V}} \in \mathbb{R}^{d \times L}$,而非完整的 Attention 矩陣 $\in \mathbb{R}^{L \times L}$。
透過比較 (4) 與 (3),我們可以得出 Linear Attention 與(依輸入的)SSMs 之間的直接連結:事實上,透過簡化 $\boldsymbol{\Lambda}_k \equiv \boldsymbol{I}$,可以看到 SSM mixer 中的參數 $\boldsymbol{B}, \boldsymbol{C}, \boldsymbol{X}$ 涵蓋了與 Linear Attention 中 $\hat{\boldsymbol{K}}, \hat{\boldsymbol{Q}}, \hat{\boldsymbol{V}}$ 矩陣相似的角色。這個對應關係由 Dao & Gu (2024) 更詳細地概述,並進一步證明了在我們實驗中選擇 Mamba 作為 Attention 線性化形式之代表的合理性。在這項工作中,我們直接利用這樣的對應關係來奠基我們的蒸餾配方,如第 3.2 節中所述。
3. 跨架構蒸餾
在本節中,我們概述了在這個專案中設計與測試的蒸餾配方。其驅動目標是利用 Transformer 與 Mamba 架構之間的高層相似性來改善蒸餾程序。為此,我們將蒸餾配方分為兩個階段。在第一階段,我們訓練一個特徵映射 (Feature Map),將 Attention 的作用有效地蒸餾為 Linear Attention,遵循 Zhang et al. (2024) 引入的 Hedgehog 程序。在第二階段,我們將提取的 Linear Attention 層轉化為 Mamba 的初始化,利用第 2.1 節與 Dao & Gu (2024) 中概述的對應關係,並進行進一步微調以改進整體效能。我們參照圖 2 以獲得每個階段的概覽。
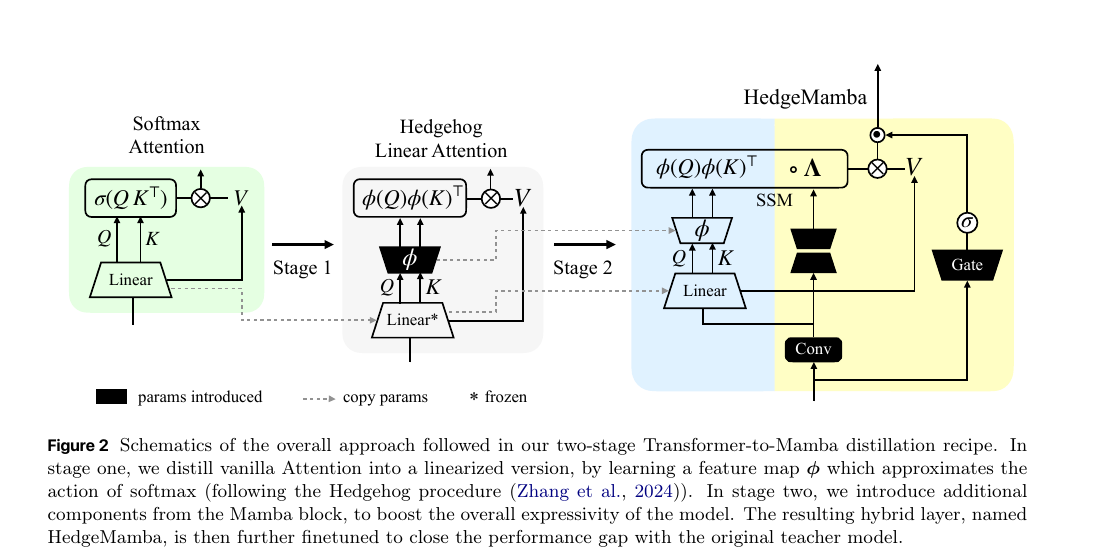
3.1 階段一:Softmax Attention 到 Linear Attention
我們第一步的目的是有效地以一個線性變體替換 softmax Attention,該變體能夠充分近似其作用。然而,如 Zhang et al. (2024) 所強調,原始 softmax Attention 與許多既有線性化之間仍存在顯著的效能差距。受此驅動,Zhang et al. (2024) 的工作專注於透過可學習特徵映射進行的蒸餾。這是 Zhang et al. (2024) 引入的 Hedgehog 程序的核心,我們在我們的蒸餾方法中加以利用。我們接下來簡短定義該程序。
Hedgehog Softmax Attention 分數從各種指數項 $e^{\boldsymbol{Q}_{l,:} \boldsymbol{K}_{l,:}^\top}$ 開始計算,但我們希望去除這個非線性。引用 Mercer 定理 (Mercer, 1909) 允許我們將正定指數運算符重寫為特徵向量的純量乘積:
$$ e^{\boldsymbol{x}^\top \boldsymbol{x}'} =: \kappa(\boldsymbol{x}, \boldsymbol{x}') = \boldsymbol{\phi}(\boldsymbol{x})^\top \boldsymbol{\phi}(\boldsymbol{x}'), \qquad \forall \boldsymbol{x}, \boldsymbol{x}' \in \mathbb{R}^d, \tag{5} $$
對於某個特徵映射 $\boldsymbol{\phi}(\boldsymbol{x}): \mathbb{R}^d \to \mathcal{H}$。具體來說,對於指數 kernel(也稱為 Gaussian kernel),其特徵空間 $\mathcal{H}$ 是無限維的,特徵映射 $\boldsymbol{\phi}(\boldsymbol{x})$ 可以透過 $e^z$ 在 $z = 0$ 周圍的 Taylor 展開來近似。旨在近似這個特徵映射的 Linear Attention 變體傾向於僅保留 Taylor 展開總和中的前幾項 (Katharopoulos et al., 2020)。然而,如 Zhang et al. (2024) 所指出,這些變體通常無法保留 softmax Attention 的某些相關特徵,例如激活的尖峰性 (Spikiness) 與點積單調性 (Dot-product Monotonicity)。為了克服這一點,Zhang et al. (2024) 提議透過一個(單層)MLP 學習特徵映射:
$$ \boldsymbol{\phi}(\boldsymbol{x}) \approx \boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{x}) := \sigma(\boldsymbol{W}\boldsymbol{x} + \boldsymbol{b}), \tag{6} $$
帶有非線性 $\sigma$。可學習權重 $\boldsymbol{W} \in \mathbb{R}^{d \times d}, \boldsymbol{b} \in \mathbb{R}^d$ 透過將每個 Teacher Attention 區塊的輸出與其 Hedgehog 線性化版本的輸出進行匹配,藉由餘弦相似度 (Cosine Similarity) 進行最佳化。在 Zhang et al. (2024) 中,作者展示了這種可學習 MLP 特徵映射如何在保持計算上有效率的同時大幅改進 Linear Attention 的蒸餾效能(我們參照他們的工作以獲得 Hedgehog 程序的額外評估與實作細節)。然而,雖然在 Zhang et al. (2024) 中蒸餾程序在此停止,本工作中我們透過將學到的 Hedgehog 特徵映射納入 Mamba 架構,並進一步將蒸餾精煉到這個改編後的架構,來改進這種方法。更多細節接下來概述。
3.2 階段二:Linear Attention 到 Mamba
透過第一個蒸餾步驟,我們已識別出一種以 Linear Attention 替換 (1) 中 softmax Attention 操作的方式。在第二步中,我們希望使用這個 Linear Attention 解作為 Mamba 的初始化,並透過利用 Mamba 模組提供的額外表達力,進一步微調以改進蒸餾效能。在本節中,我們展示如何改編 Mamba 層以實現這一點。我們將所得的 Hedgehog-Mamba 層稱為 HedgeMamba。
參數初始化 如第 2 節中提到,我們可以透過代換 $\boldsymbol{\Lambda}_l \equiv \boldsymbol{I}$ 並讓參數 $\boldsymbol{B}, \boldsymbol{C}, \boldsymbol{X}$ 涵蓋與 $\hat{\boldsymbol{K}}, \hat{\boldsymbol{Q}}, \hat{\boldsymbol{V}}$ 相似的角色,來將 SSM mixer 的輸出 (2) 與 Linear Attention 層 (4) 的輸出匹配。對於 Hedgehog 的特定情況,這轉化為以下代換:
$$ \boldsymbol{B}(\boldsymbol{X}) \mapsto \hat{\boldsymbol{K}}(\boldsymbol{X}) := \boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{K}(\boldsymbol{X})), \qquad \boldsymbol{C}(\boldsymbol{X}) \mapsto \hat{\boldsymbol{Q}}(\boldsymbol{X}) := \boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{Q}(\boldsymbol{X})) \tag{7} $$
$$ \boldsymbol{\Lambda}_l \mapsto \boldsymbol{I}, \qquad \text{and} \qquad \boldsymbol{X} \mapsto \hat{\boldsymbol{V}}(\boldsymbol{X}) := \boldsymbol{V}(\boldsymbol{X}), $$
其中 $\boldsymbol{K}(\boldsymbol{X}), \boldsymbol{Q}(\boldsymbol{X}), \boldsymbol{V}(\boldsymbol{X})$ 是來自原始 softmax Attention 層 (1) 的 key/query/value 線性映射,而 $\boldsymbol{\phi}_{\text{MLP}}$ 是新學習到的 Hedgehog 特徵映射 (6)。注意原始 Mamba 架構在 SSM mixer 應用之前不允許對 $\boldsymbol{X} \mapsto \boldsymbol{V}(\boldsymbol{X})$ 進行值變換,因此我們修改其實作以容納這一點。此外,為確保整個 Mamba 區塊的輸出在初始化時與 Hedgehog 的輸出匹配,我們也將閘門分支與卷積的參數設定為它們縮減為恆等運算符。額外細節可在附錄 B 中找到。
Attention 分數正規化 根據 (7) 中的代換,SSM mixer 輸出為:
$$ \boldsymbol{Y}_\phi := (\boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{Q}) \boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{K})^\top) \boldsymbol{V}. \tag{8} $$
然而,這個公式中的 Attention 分數是以未正規化的方式呈現的。為了讓 Attention 分數公式更貼近 (1) 中的目標,我們進一步在其定義中包含一個正規化因子:
$$ \boldsymbol{Y}_\phi \mapsto \boldsymbol{Y}_\phi / \bar{\boldsymbol{Y}}_\phi, \qquad \text{with} \qquad \bar{\boldsymbol{Y}}_\phi := (\boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{Q}) \boldsymbol{\phi}_{\text{MLP}}(\boldsymbol{K})^\top) \boldsymbol{1}. \tag{9} $$
注意 $\boldsymbol{Y}_\phi$ 與 $\bar{\boldsymbol{Y}}_\phi$ 兩者都可以透過單次穿過 SSM mixer 計算得出,前提是我們將 $\boldsymbol{V}$ 用一個全為一的張量擴增,並複製狀態矩陣 $\boldsymbol{\Lambda}$,亦即:
$$ \boldsymbol{V} \mapsto \text{concat}[\boldsymbol{V}; \boldsymbol{1}], \qquad \text{and} \qquad \boldsymbol{\Lambda} \mapsto \text{concat}[\boldsymbol{\Lambda}; \boldsymbol{\Lambda}]. \tag{10} $$
微調 在 Mamba 如 (7) 中初始化、並依 (9) 與 (10) 修改以容納正規化後,我們已準備好恢復訓練並進入我們蒸餾程序的第二階段。這引入了對整個架構(嵌入層除外)進行微調,相對於 ground-truth 使用交叉熵 (Cross-Entropy) 損失。特別是,我們也解鎖了原始 Mamba 區塊中可用的額外卷積與閘門分支,完成我們對 HedgeMamba 層的定義:另見圖 2,了解在最後階段微調的元件概要。
我們工作中的關鍵論點是:透過為 Mamba 配備 Hedgehog 初始化,我們可以恢復出整體更好的跨架構蒸餾配方。如本節所示,我們的兩階段方法在理論上奠基於 Mercer 定理,加上 Mamba 相對於原始 Linear Attention 的更優表達能力。在以下章節中,我們也透過對遵循我們配方訓練的模型進行基準測試,從經驗上證明我們的方法。
4. 實驗結果
在本節中,我們呈現對第 3 節中概述的蒸餾程序的廣泛評估。具體來說,我們以 Pythia-1B Teacher 模型與 10B 蒸餾 tokens,沿幾個關鍵軸進行消融、擴展與敏感度研究:(i) mixer 架構,透過從 Mamba (Tab. 2) 系統地擴展 vanilla Hedgehog Linear Attention;(ii) 在不同階段間的 token 預算分配的敏感度分析 (Tab. 3);以及 (iii) 相對於蒸餾 tokens 數量的擴展 (Tab. 4)。我們的預設設定在各自的表格中以高亮顯示。在附錄 A.1 中,我們進一步擴展本節結果,包括將我們的蒸餾程序應用於不同模型大小(160M、410M 與 1B)的結果,以及為 Tab. 2 至 4 的結果報告標準誤差 (Standard Error)。
實驗設定 (Experimental Setup) 所有實驗中,我們使用標準的 Pythia-1B (Biderman et al., 2023) 作為 Teacher 模型。這個模型已被開源社群廣泛採用,並且該套件提供模型權重(不同規模)以及詳細的完整訓練程序。我們在 OpenWebText (Gokaslan et al., 2019) 資料集上蒸餾我們的模型。這是用於訓練 GPT2 (Radford et al., 2019) 的資料集的開源復現品,並且常用於語言建模研究 (Biderman et al., 2023; Sanh et al., 2019; Dao et al., 2022; Shoeybi et al., 2019; Zhuang et al., 2021)。我們使用與原始 Pythia 與 Mamba 模型相同的 GPT-NeoX tokenizer,使我們的結果可以直接比較。這總共可用於訓練的約 9B tokens。我們在資料集上保留了 0.0005% 的分割用於驗證,相當於 4M tokens,依先前工作 (Dao et al., 2022) 的做法。除非另有報告,我們使用 10B tokens 進行訓練(大約對應於 OpenWebText 的 1.1 epochs),據我們所知,這建立了我們的工作為迄今為止關於蒸餾中 token 預算最大規模的敏感度研究。我們在上游的困惑度以及在選定下游任務上的表現兩方面評估最終蒸餾學生模型。對於後者,我們依賴 lm-eval-harness (Gao et al., 2021) 測試套件,並考慮在先前工作中使用的語言理解與常識推理任務 (Biderman et al., 2023; Bick et al., 2024; Gu & Dao, 2023; Dao & Gu, 2024)。具體而言,我們報告 ARC-Easy (Clark et al., 2018)、Social IQA (Sap et al., 2019)、PiQA (Bisk et al., 2020)、Lambada (Paperno et al., 2016)、BoolQ (Clark et al., 2019)、RACE (Lai et al., 2017)、LogiQA (Liu et al., 2020) 與 WinoGrande (Sakaguchi et al., 2019) 的準確度分數,以及對 ARC-Challenge (Clark et al., 2018) 與 HellaSwag (Zellers et al., 2019) 進行序列長度正規化的準確度,依循 (Bick et al., 2024; Gu & Dao, 2023; Dao & Gu, 2024; Sanh et al., 2019)。我們參照 (Gao et al., 2021) 以獲得評估的更多細節。
訓練 (Training) 在配方的第一階段(第 3.1 節)中,我們以 Hedgehog 線性化替換 Teacher 模型中的 Attention 區塊,目的是學習特徵映射 (6)。除了定義這個特徵映射的參數(在階段 1 中從零開始學習)外,所有其他參數都直接從 Teacher 模型複製並保持凍結。這些包括 MLPs、層正規化 (Layer Norms),以及輸入-輸出嵌入矩陣。我們透過餘弦嵌入匹配損失將 Student 模型中每個 Transformer 區塊(由 MLP、序列 mixer 與 Residual stream 組成)的輸出與 Teacher 的輸出進行匹配。我們使用 1B tokens、批次大小 48 與序列長度 1024 進行階段 1,相當於 20K 訓練步驟。在第二階段(第 3.2 節)中,我們引入額外 Mamba 參數,初始化為恆等運算符(見附錄 B)。我們保持輸入-輸出嵌入層凍結,並用標準交叉熵損失微調模型其餘部分。第二階段訓練繼續另外 9B tokens,相當於額外的 180K 訓練步驟。
Table 1:與 Teacher 及先前工作的比較。
| Model (1B) | ↓ PPL | ↑ Arc-C | Arc-E | SIQA | PiQA | Lambada | BoolQ | RACE | LogiQA | WinoG | HSwag |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Pythia (Teacher) | 13.86 | 27.04 | 56.98 | 39.86 | 70.72 | 42.07 | 60.82 | 32.92 | 22.12 | 53.43 | 47.16 |
| Hedgehog (Baseline) | 14.89 | 26.45 | 52.74 | 38.38 | 68.01 | 30.60 | 54.80 | 30.43 | 21.66 | 50.91 | 40.79 |
| HedgeMamba (Ours) | 14.11 | 27.13 | 53.66 | 39.76 | 68.72 | 32.31 | 55.20 | 30.91 | 20.89 | 52.17 | 41.87 |
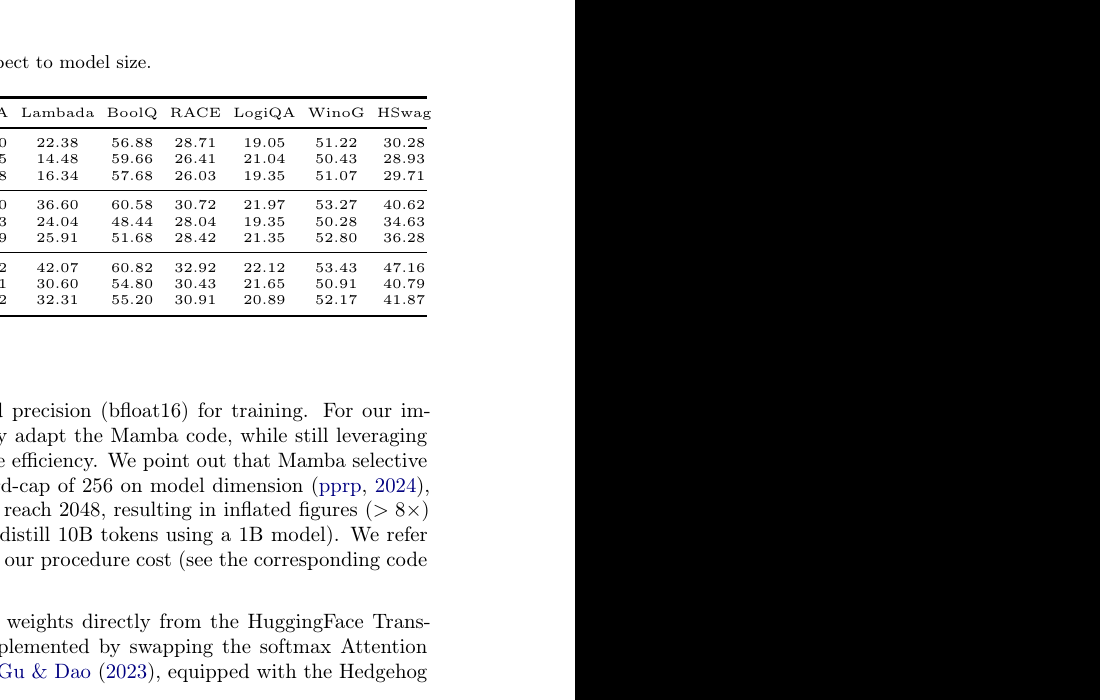
實作備註 對於圖 2 中 HedgeMamba 層的實作,我們直接改編 Mamba 程式碼,同時仍利用其硬體感知 CUDA 選擇性掃描,以避免犧牲效率[^2](見附錄 C 中對應的程式碼)。我們直接從 HuggingFace Transformers 函式庫 (Wolf et al., 2020) 使用 Teacher 模型的實作與預訓練權重。Student 模型的實作方式是將 Teacher 中的 softmax Attention 模組替換為來自 (Gu & Dao, 2023) 的 Mamba Mixer 模組,配備來自 (Zhang et al., 2024) 的 Hedgehog 特徵映射。更多實作細節見附錄 A.2。
[^2]: 我們指出,Mamba 選擇性掃描實作儘管完全平行,但對模型維度施加了 256 的硬性上限 (pprp, 2024),迫使更大值序列化。在我們的實驗中我們達到 2048,導致訓練時間膨脹(>8倍)(在 8xA100 節點上使用 1B 模型蒸餾 10B tokens 大約需要 12d 9h)。我們因此將蒸餾 token 預算作為更可靠的程序成本指標。
基準比較 (Baseline Comparison) 我們的主要目標是展示我們的兩階段配方保留原始 Teacher 模型表現的能力。我們指出這並非有保證,鑒於與 Teacher 架構的顯著差異,以及我們考慮的是純粹的 Linear Attention 變體—而非如某些先前工作中的混合體 (Wang et al., 2024; Bick et al., 2024)。此外,原始的 Pythia-1B Teacher 模型用 300B tokens 訓練 (Biderman et al., 2023),但我們僅以10B 蒸餾,相當於 Teacher 訓練所用 token 預算的約 2.7%(334B tokens)。蒸餾結果在 Tab. 1 中報告。我們將我們的配方與 Hedgehog 基線比較,後者也以階段 1 中的相同餘弦匹配目標與階段 2 中的交叉熵蒸餾,雖然在這種情況下蒸餾 tokens 在兩個階段間 50/50 分割,依其原始工作 (Zhang et al., 2024, 2025)。整體來看,我們的方法在很大程度上設法保留了 Teacher 表現,得到 14.11 的困惑度,相比於原始的 13.86。我們也指出我們的方法在上游與下游表現上均優於使用 10B tokens 擴展的 Hedgehog 基線,凸顯我們方法的有效性。作為額外基準(此處未報告),我們測試了直接蒸餾到 Mamba 架構的單純做法,但結果一直不令人滿意(PPL>100),證實了 Bick et al. (2024) 的發現。
Table 2:Mixer 架構消融:驗證集上的困惑度與下游任務表現。
| Model (1B) | #params | ↓ PPL | ↑ Arc-C | Arc-E | SIQA | PiQA | Lambada | BoolQ | RACE | LogiQA | WinoG | HSwag |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Hedgehog | 1,014M | 14.89 | 26.45 | 52.74 | 38.38 | 68.01 | 30.60 | 54.80 | 30.43 | 21.66 | 50.91 | 40.79 |
| +SSM | 1,020M | 14.89 | 26.54 | 52.90 | 38.02 | 68.23 | 31.24 | 55.63 | 30.05 | 22.73 | 51.38 | 40.77 |
| +Conv | 1,020M | 14.89 | 26.62 | 52.74 | 38.28 | 68.93 | 31.63 | 55.84 | 30.14 | 22.43 | 51.78 | 40.74 |
| +Gate(HedgeMamba) | 1,087M | 14.58 | 26.19 | 53.11 | 39.56 | 68.77 | 32.16 | 57.61 | 31.00 | 24.42 | 50.99 | 41.81 |
消融 Mamba 元件 (Ablating Mamba Components) 在 Tab. 2 的消融研究中,我們調查階段 2 中包含的額外 Mamba 元件在改進 Student 模型最終表現上的角色。具體來說,我們考慮簡單的 Hedgehog 作為基線 (Zhang et al., 2024),並系統地添加來自 Mamba 的以下元件:(+SSM) SSM mixer 參數,特別是可學習的因果遮罩 $\boldsymbol{\Lambda}$ 與 (2) 中的輸入及輸出矩陣 $\boldsymbol{C}$ 與 $\boldsymbol{B}$;(+Conv) 輸入處的短卷積層;(+Gate) 帶有 SiLU 非線性的閘門分支。這些添加的元件被初始化為表現得像恆等運算符,以不影響階段 1 中學到的 Hedgehog 特徵映射(見附錄 B)。其他 SSM mixer 參數 $\boldsymbol{C}$ 與 $\boldsymbol{B}$ 則直接從 Hedgehog 模組中其等價物複製,如 (7) 中所述。為了以有針對性的方式分析新引入的 mixer 元件的影響,所有其他消融參數保持固定:特別是,我們使用 10B 蒸餾 tokens,在階段 1 與 2 之間平均分配(50/50)。對應結果在 Tab. 2 中報告。在那裡,我們可以看到每個額外 Mamba 元件如何貢獻於改進 vanilla Hedgehog 的表現。有趣的是,在困惑度與平均下游表現上的最大改進是由閘門分支帶來的。這個發現與最近的工作 (Qiu et al., 2025; Hua et al., 2022; Bondarenko et al., 2023) 一致,這些工作建議添加閘門分支到 Attention 模組以改進其表現。
Table 3:Token 預算分配的敏感度分析。總共 10B 蒸餾 tokens。在完整 HedgeMamba 上蒸餾,包含卷積層與閘門分支。注意 100/0 分割表示不執行微調,所有 tokens 都用於在階段 1 (S1) 學習 Hedgehog 映射;相反,0/100 表示僅在 HedgeMamba 架構上微調 (S2)。
| Tokens split | ↓ PPL | Arc-C | Arc-E | SIQA | PiQA | Lambada | BoolQ | RACE | LogiQA | WinoG | HSwag | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Hedgehog (no FT) | 100 / 0 | 25.71 | 25.85 | 48.70 | 36.34 | 66.49 | 12.12 | 61.47 | 27.27 | 20.58 | 50.83 | 26.14 |
| 90 / 10 | 16.15 | 25.00 | 52.06 | 38.69 | 68.93 | 28.08 | 56.15 | 30.24 | 22.43 | 51.14 | 39.69 | |
| 75 / 25 | 15.18 | 26.71 | 52.31 | 38.59 | 69.26 | 30.66 | 60.61 | 30.24 | 20.58 | 49.96 | 41.02 | |
| 50 / 50 | 14.58 | 26.19 | 53.11 | 39.56 | 68.77 | 32.16 | 57.61 | 31.00 | 24.42 | 51.81 | 41.59 | |
| 25 / 75 | 14.25 | 26.19 | 53.91 | 39.71 | 68.93 | 31.90 | 55.41 | 30.81 | 21.35 | 51.30 | 41.59 | |
| Default | 10 / 90 | 14.11 | 27.13 | 53.66 | 39.76 | 68.72 | 32.31 | 55.20 | 30.91 | 20.89 | 52.17 | 41.87 |
| Finetune only | 0 / 100 | 17.08 | 26.11 | 50.67 | 37.31 | 67.03 | 27.61 | 54.01 | 30.33 | 21.35 | 50.51 | 40.25 |
階段間 Token 預算分配 (Token Budget Allocation between Stages) 我們配方的一個相關設計選擇在於決定如何在兩個階段間最佳地分配蒸餾 tokens 預算。在 Tab. 3 中,我們以經驗驗證了這一點,並在變化階段 1 與 2 間的蒸餾 tokens 分割時報告 Student 表現評估。注意原始 Hedgehog 論文 (Zhang et al., 2024) 中作者們選擇 50/50 分割;我們的結果反而顯示,將高達 90% 的總 token 預算投資於階段 2 是漸進有利的。儘管如此,兩個階段都需要以保證表現,這由 100/0 與 0/100 分割的極端情況下達到的不佳結果證明。我們指出第二階段在計算上通常更昂貴:總訓練時間[^2] 從 0/100 分割的 12d 9h 增加到 13d 16h。
蒸餾 Tokens 數量的擴展 (Scaling number of distillation tokens) 為了參考,在 Tab. 4 中我們報告我們 Student 模型的最終表現如何相對於可用蒸餾 tokens 的數量擴展。我們在完整 HedgeMamba(含卷積層與閘門分支)上蒸餾 Pythia-1B。兩階段間的 tokens 分割固定在最佳的 10/90,我們僅變化總 token 預算。整體而言,Student 困惑度隨著 token 預算的增加而改善,並在 10B 時尚未達到飽和。
Table 4:蒸餾 token 預算的擴展研究。
| Token budget | ↓ PPL | ↑ Arc-C | Arc-E | SIQA | PiQA | Lambada | BoolQ | RACE | LogiQA | WinoG | HSwag |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1B | 16.56 | 26.19 | 52.27 | 38.74 | 67.68 | 27.32 | 57.49 | 29.76 | 20.43 | 52.25 | 40.67 |
| 2B | 15.61 | 25.94 | 51.05 | 38.79 | 69.04 | 29.30 | 56.45 | 29.57 | 23.04 | 51.85 | 40.29 |
| 3B | 15.15 | 25.09 | 52.69 | 38.43 | 69.10 | 30.56 | 56.57 | 29.28 | 23.04 | 51.93 | 41.03 |
| 10B | 14.11 | 27.13 | 53.66 | 39.76 | 68.72 | 32.31 | 55.20 | 30.91 | 20.89 | 52.17 | 41.87 |
5. 結論
在本論文中,我們提出了一種新穎的配方,將 Transformer 模型蒸餾為基於 SSM 的架構。其目的是允許使用者降低推論時間(從序列長度的二次方,如經典 softmax Attention,降至線性),而無需從零開始訓練新架構,反而適切地利用已可取得的預訓練模型。我們方法的設計依賴於有原則的方法,先以 Linear Attention 變體近似 softmax Attention,然後使用它來初始化一個 Mamba 區塊,以提升其表達力。對應於這些步驟,蒸餾程序也由兩個階段組成:第一個階段的目標是對齊 Attention 權重,而第二個階段允許進一步微調整個架構。特別是,包含這第一個階段已被證明能在 Student 與 Teacher 之間提升輸出對齊,超過天真的直接蒸餾。該程序的有效性在困惑度與下游任務表現兩方面進行評估,展示其整體保留 Teacher 表現的能力。
限制與未來工作 (Limitations and Future Work) 為了維持清晰焦點,我們將分析鎖定在特定的 Transformer 架構(即 Pythia)上。原則上,我們的配方足夠靈活,可以擴展到其他基於 Attention 的模型,但鑒於蒸餾通常需要的計算資源,我們尚未調查其在其他變體上的有效性(見第 4 節)。出於類似原因,我們不隔離蒸餾資料集品質對最終 Student 表現的影響,並將我們的實驗限制於僅 OpenWebText。最後,在這項工作的範圍中,我們調查了一種提升 Student 模型表達力的方式,亦即透過納入來自 Mamba 架構的元件:然而,可能擴展的空間仍對額外探索開放,這可能進一步增加最終表現。儘管如此,我們相信我們的工作代表了在彌合 Attention 與 Mamba 之間差距的探索中一個有意義的步驟,涵蓋了一個先前未探索的方法。
附錄 A:額外結果與實作細節
A.1 擴展結果
摘要 在本節中,我們擴展第 4 節的結果並發現:
- 增加架構規模(從 160M 到 410M 與 1B)會降低 PPL 並增加所有其他表現,如 Tab. 6 所示。
- 雖然階段 2 提供了在降低整體 PPL 上的較大效益,但階段 1 的角色在改進表現上是關鍵的,如圖 3 所示。
在本節中,我們擴展第 4 節中提供的結果。特別是,Tab. 5 收集了 Tab. 2 至 4 的結果及其在 100,000 個自助法 (Bootstrap) 重複下相關聯的標準誤差(依預設 lm-eval 設定[^3])。整體而言,標準偏差在所有任務上均保持低,表示其穩健性。
[^3]: LM harness 評估透過自助法重抽估計平均值的標準誤差 (SEM):它重複抽取多個選擇問題的集合(在我們的情況下為指定數量的自助法迭代,100K),然後計算從這些樣本獲得的指標分數的 SEM。對應的此誤差計算的相關程式碼可在 https://github.com/EleutherAI/lm-evaluation-harness 找到。
在 Tab. 6 中,我們報告對於我們蒸餾程序在不同規模模型(160M 與 410M)上應用的額外分析,加上我們已展示的 1B 結果。整體而言,結果證實 HedgeMamba 持續顯示優於 Hedgehog 方法的改進。
圖 3 提供了在訓練期間驗證困惑度的詳細演變,針對 Tab. 3 中討論的 token 分配分割。作為提醒,我們訓練總共 200K 步驟:每訓練步驟使用 49,200 tokens,因此訓練中所用的總 token 數量為 49,200×200,000 = 9,840,000,000 ≈ 10B。訓練步驟在我們配方的第一與第二階段間的分配,依考慮的分割而定,例如,10/90 分割表示 10% 的訓練步驟(亦即 20K 步驟)用於階段 1,90%(180K 步驟)用於階段 2。從圖 3 我們可以推斷,雖然階段 2 提供了在降低整體 PPL 上的較大效益,但階段 1 的角色在改進表現上是關鍵的。將所有訓練 tokens 分配給階段 2,會導致 PPL 停滯在比即使分配一小部分(如低至 10% 給階段 1)更高的值。
Table 5:第 4 節實驗的結果,包括 LM 評估的標準誤差。
| Model (1B) | ↑ Arc-C | Arc-E | SIQA | PiQA | Lambada | BoolQ | RACE | LogiQA | WinoG | HSwag |
|---|---|---|---|---|---|---|---|---|---|---|
| Pythia(Teacher) | 27.05±1.30 | 56.99±1.02 | 39.87±1.11 | 70.73±1.06 | 42.07±0.69 | 60.82±0.85 | 32.92±1.45 | 22.12±1.63 | 53.43±1.40 | 47.16±0.50 |
| Architecture ablations | ||||||||||
| Hedgehog baseline | 26.45±1.29 | 52.74±1.02 | 38.38±1.09 | 68.01±1.09 | 30.60±0.64 | 54.80±0.87 | 30.43±1.42 | 21.66±1.62 | 50.91±1.40 | 40.79±0.49 |
| +SSM | 26.54±1.29 | 52.90±1.02 | 38.02±1.09 | 68.23±1.09 | 31.24±0.65 | 55.63±0.87 | 30.05±1.42 | 22.73±1.65 | 51.38±1.40 | 40.77±0.49 |
| +Conv | 26.62±1.29 | 52.74±1.02 | 38.28±1.09 | 68.93±1.08 | 31.63±0.65 | 55.84±0.87 | 30.14±1.42 | 22.43±1.64 | 51.78±1.40 | 40.74±0.49 |
| +Gate(HedgeMamba) | 26.19±1.28 | 53.11±1.02 | 39.56±1.10 | 68.77±1.08 | 32.16±0.65 | 57.61±0.86 | 31.00±1.43 | 24.42±1.65 | 50.99±1.40 | 41.81±0.49 |
| Sensitivity: token allocation | ||||||||||
| 100 / 0 | 25.85±1.28 | 48.70±1.03 | 36.34±1.09 | 66.49±1.10 | 12.12±0.45 | 61.47±0.87 | 27.27±1.38 | 20.58±1.40 | 50.83±1.40 | 26.14±0.48 |
| 90 / 10 | 25.00±1.27 | 52.06±1.03 | 38.69±1.10 | 68.93±1.08 | 28.08±0.65 | 56.15±0.87 | 30.24±1.42 | 22.43±1.59 | 51.14±1.40 | 39.69±0.49 |
| 75 / 25 | 26.71±1.29 | 52.31±1.02 | 38.59±1.09 | 69.26±1.08 | 30.66±0.65 | 60.61±0.85 | 30.24±1.42 | 20.58±1.65 | 49.96±1.40 | 41.02±0.49 |
| 50 / 50 | 26.19±1.28 | 53.11±1.02 | 39.56±1.10 | 68.77±1.08 | 32.16±0.65 | 57.61±0.86 | 31.00±1.43 | 24.42±1.65 | 50.99±1.40 | 41.81±0.49 |
| 25 / 75 | 26.19±1.28 | 53.91±1.02 | 39.71±1.10 | 68.93±1.08 | 31.90±0.64 | 55.41±0.87 | 30.81±1.42 | 21.35±1.65 | 51.30±1.40 | 41.59±0.49 |
| 10 / 90 | 27.13±1.30 | 53.66±1.02 | 39.76±1.11 | 68.72±1.08 | 32.31±0.65 | 55.20±0.85 | 30.91±1.42 | 20.89±1.65 | 52.17±1.40 | 41.87±0.49 |
| 0 / 100 | 26.11±1.28 | 50.67±1.03 | 37.31±1.09 | 67.03±1.10 | 27.61±0.62 | 54.01±0.87 | 30.33±1.42 | 21.35±1.65 | 50.51±1.40 | 40.25±0.49 |
| Scaling: overall token budget | ||||||||||
| 1B | 26.19±1.28 | 52.27±1.02 | 38.74±1.10 | 67.68±1.10 | 27.32±0.61 | 57.49±0.87 | 29.76±1.41 | 20.43±1.58 | 52.25±1.40 | 40.67±0.49 |
| 2B | 25.94±1.28 | 51.05±1.03 | 38.79±1.10 | 69.04±1.08 | 29.30±0.66 | 56.45±0.87 | 29.57±1.41 | 23.04±1.65 | 51.85±1.40 | 40.29±0.49 |
| 3B | 25.09±1.27 | 52.69±1.02 | 38.43±1.10 | 69.10±1.08 | 30.56±0.64 | 56.57±0.87 | 29.28±1.41 | 23.04±1.65 | 51.93±1.40 | 41.03±0.49 |
| 10 | 27.13±1.30 | 53.66±1.02 | 39.76±1.11 | 68.72±1.08 | 32.31±0.65 | 55.20±0.85 | 30.91±1.42 | 20.89±1.65 | 52.17±1.40 | 41.87±0.49 |
Table 6:相對於模型規模的擴展分析。
| Model | ↓ PPL | ↑ Arc-C | Arc-E | SIQA | PiQA | Lambada | BoolQ | RACE | LogiQA | WinoG | HSwag | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 160M | Pythia(Teacher) | 39.38 | 23.63 | 43.64 | 36.75 | 62.30 | 22.38 | 56.88 | 28.71 | 19.05 | 51.22 | 30.28 |
| Hedgehog (Baseline) | 35.95 | 18.26 | 42.47 | 37.05 | 61.15 | 14.48 | 59.66 | 26.41 | 21.04 | 50.43 | 28.93 | |
| HedgeMamba (Ours) | 26.84 | 23.04 | 43.27 | 37.36 | 60.88 | 16.34 | 57.68 | 26.03 | 19.35 | 51.07 | 29.71 | |
| 410M | Pythia(Teacher) | 16.50 | 24.32 | 51.89 | 38.95 | 66.70 | 36.60 | 60.58 | 30.72 | 21.97 | 53.27 | 40.62 |
| Hedgehog (Baseline) | 17.66 | 19.97 | 47.31 | 37.97 | 65.23 | 24.04 | 48.44 | 28.81 | 19.35 | 50.28 | 34.63 | |
| HedgeMamba (Ours) | 16.48 | 23.81 | 49.54 | 38.69 | 64.69 | 25.91 | 51.68 | 28.42 | 21.35 | 52.80 | 36.28 | |
| 1B | Pythia (Teacher) | 13.86 | 27.04 | 56.98 | 39.86 | 70.72 | 42.07 | 60.82 | 32.92 | 22.12 | 53.43 | 47.16 |
| Hedgehog (Baseline) | 14.89 | 26.45 | 52.74 | 38.38 | 68.01 | 30.60 | 54.80 | 30.43 | 21.66 | 50.91 | 40.79 | |
| HedgeMamba (Ours) | 14.11 | 27.13 | 53.66 | 39.76 | 68.72 | 32.31 | 55.20 | 30.91 | 20.89 | 52.17 | 41.87 |
A.2 實作細節
我們使用 PyTorch 配合分散式資料平行 (Distributed Data Parallel) 與混合精度 (bfloat16) 進行訓練。對於圖 2 中 HedgeMamba 層的實作,我們直接改編 Mamba 程式碼,同時仍利用其硬體感知 CUDA 選擇性掃描,以避免犧牲效率。我們指出 Mamba 選擇性掃描實作儘管完全平行,但對模型維度施加了 256 的硬性上限 (pprp, 2024),迫使更大值序列化。在我們的實驗中我們達到 2048,導致訓練時間膨脹(>8倍)(在 8xA100 節點上使用 1B 模型蒸餾 10B tokens 大約需要 12d 9h)。我們因此將蒸餾 token 預算作為更可靠的程序成本指標(見附錄 C 中對應的程式碼)。
我們直接從 HuggingFace Transformers 函式庫 (Wolf et al., 2020) 使用 Teacher 模型實作與預訓練權重。Student 模型的實作方式是將 Teacher 中的 softmax Attention 模組替換為來自 (Gu & Dao, 2023) 的 Mamba Mixer 模組,配備來自 (Zhang et al., 2024) 的 Hedgehog 特徵映射。
所有模型都在配備 8 個 NVIDIA A100 GPU 的計算節點上蒸餾。我們使用 AdamW 優化器($\beta_1 = 0.9, \beta_2 = 0.95$),帶有線性熱身與餘弦衰減至峰值 LR 的 0.1 倍的 LR 排程。經驗上,對於規模為 1B 的模型,發現 0.01 的峰值學習率適合階段 1,而 1e-5 範圍的學習率最適合階段 2。依循先前工作 (Gu & Dao, 2023; Dao & Gu, 2024),我們使用 1.0 的梯度裁剪 (Gradient Clipping) 與 0.1 的權重衰減 (Weight Decay)。
附錄 B:額外架構細節
B.1 完整架構示意圖
為了參考,圖 4 中的圖表描述了在這個專案中討論的完整架構。Pythia Transformer (Biderman et al., 2023)(在我們實驗中作為 Teacher 模型使用)出現在頂部。原始 Mamba 架構 (Gu & Dao, 2023) 報告在右下方。注意這兩個架構的主要元件是與 MLPs 交織的序列 mixer(Transformer 的 Attention,Mamba 的 SSM Mixer)(在 Mamba 中,這個角色由閘門分支涵蓋)。在左下中央,我們可以看到 Hedgehog 區塊如何達到 Attention 線性化。最後,在圖 4 的左下中間,我們說明我們提出並用作這項工作中 Student 的 HedgeMamba 混合體:大部分架構直接從 Pythia 繼承,但序列 mixer 被替換為 Hedgehog 與來自 Mamba 元件的組合。
B.2 階段 2 中 Mamba 參數的初始化
Mamba 的一個獨特特徵在於其透過狀態矩陣 $\boldsymbol{\Lambda}$ (3) 規定可學習因果遮罩的能力 (Dao & Gu, 2024)。除此之外,Mamba 區塊還包含一個短的序列向卷積與一個閘門分支。所有這些特徵都使 Mamba 與其他 Linear Attention 替代方案區別開來。我們僅在我們蒸餾方法的第二階段利用這三個額外元件,而在第一階段我們將它們凍結並確保它們對區塊輸出沒有影響(另見圖 2 中的示意圖)。這可以透過適當的參數初始化達成,如下所述。
狀態矩陣 (State Matrix) Mamba 中的狀態矩陣 $\boldsymbol{\Lambda}$ 透過兩個參數的乘積指數化得到:衰減速率 (Rate-of-Decay) $\boldsymbol{\lambda} \in \mathbb{R}^{N \times d}$ 與時間步 (Time-step) $\boldsymbol{\Delta} = \boldsymbol{\Delta}(\boldsymbol{X}) \in \mathbb{R}^N$。特別是,後者透過將一個 MLP 應用於輸入 $\boldsymbol{X} \in \mathbb{R}^{L \times d}$ 來恢復:兩次線性應用,分別具有權重與偏差 $(\boldsymbol{W}_d, \boldsymbol{b}_d) \in \mathbb{R}^{d \times d_r} \times \mathbb{R}^{d_r}$ 與 $(\boldsymbol{W}_u, \boldsymbol{b}_u) \in \mathbb{R}^{d_r \times N} \times \mathbb{R}^N$,緊接著一個 SoftPlus 非線性。整體公式由下式給出:
$$ \boldsymbol{\Lambda}_l = e^{-\boldsymbol{\lambda} \odot (\boldsymbol{\Delta}_l \otimes \boldsymbol{1}^\top)}, \qquad \text{with} \qquad \boldsymbol{\Delta}_l = \texttt{SoftPlus}((\boldsymbol{X}_{l,:} \boldsymbol{W}_d + \boldsymbol{b}_d) \boldsymbol{W}_u + \boldsymbol{b}_u), \qquad \forall l = 1 \ldots L. \tag{11} $$
我們將這個操作降為恆等,方法是強加 $\boldsymbol{\lambda} \equiv \boldsymbol{0}$。注意 $\boldsymbol{\Delta}_l$ 也影響 (3) 中 $\boldsymbol{B}$ 的定義:為了消除其影響,我們必須有 $\boldsymbol{\Delta}_l \equiv \boldsymbol{1}$。為此,我們也強加 $\boldsymbol{W}_u \equiv \boldsymbol{0}$ 與 $\boldsymbol{b}_u \equiv \texttt{SoftPlus}^{-1}(1) \cdot \boldsymbol{1} \approx 0.541324 \cdot \boldsymbol{1}$。
卷積 (Convolution) 卷積元件應用以下操作:給定一個輸入 $\boldsymbol{X} \in \mathbb{R}^{L \times d}$,及其 kernel 權重 $\boldsymbol{W} \in \mathbb{R}^{\kappa \times d}$(kernel 大小為 $\kappa$)與偏差 $\boldsymbol{b} \in \mathbb{R}^d$,輸出由下式給出:
$$ \boldsymbol{Y}_{l,:} = \boldsymbol{b} + \sum_{i=1}^\kappa \boldsymbol{W}_{i,:} \odot \boldsymbol{X}_{l-\kappa+i,:}. \tag{12} $$
要將其崩塌為恆等運算符,足夠選擇 $\boldsymbol{b} \equiv \boldsymbol{0}$、$\boldsymbol{W}_{\kappa,:} \equiv \boldsymbol{1}$ 與 $\boldsymbol{W}_{i \neq \kappa,:} \equiv \boldsymbol{0}$。注意在原始 Mamba 區塊中,卷積後跟隨一個非線性,它在 SSM 混合層之前作用。在我們的架構中,我們移除此非線性,因為它已被 Hedgehog MLP (6) 涵蓋。
閘門 (Gate) 另一方面,閘門分支由一個線性層(權重 $\boldsymbol{W} \in \mathbb{R}^{d \times d}$ 與偏差 $\boldsymbol{b} \in \mathbb{R}^d$)組成,緊接著一個 SiLU 非線性。輸出隨後逐元素乘以 SSM mixer 的輸出(此處表示為 $\boldsymbol{X}_{SSM}$)。整體上,這相當於:
$$ \boldsymbol{Y} = \boldsymbol{X}_{SSM} \odot \texttt{SiLU}(\boldsymbol{X}\boldsymbol{W} + \boldsymbol{b}). \tag{13} $$
要獲得恆等,那麼足夠設定 $\boldsymbol{W} \equiv \boldsymbol{0}$ 與 $\boldsymbol{b} = \texttt{SiLU}^{-1}(1) \cdot \boldsymbol{1} \approx 1.27846 \cdot \boldsymbol{1}$。
附錄 C:偽程式碼
此處我們提供我們實驗中使用的 Student 模型前向傳遞應用的偽程式碼。
更詳細地,Lst. 1 報告了整個改編 Pythia 區塊的實作 (Biderman et al., 2023)。如同原始 Pythia 模型,這個區塊中的操作流程被分為兩個分支(另見圖 4)。一方面,我們有一個帶有預先正規化的 MLP;另一方面,vanilla Attention 層被替換為第 3.2 節中描述的混合 HedgeMamba 層。
HedgeMamba 是我們工作中引入的核心模組,其實作的偽程式碼詳述於 Lst. 2。其程式碼藍圖緊密遵循 Mamba SSM mixer (Gu & Dao, 2023) 的藍圖,包括閘門分支與 mixer 應用前的短卷積,但呈現三個主要差異:(i) SSM 參數 $\boldsymbol{B}, \boldsymbol{C}$(涵蓋 Linear Attention 中 keys 與 queries 的角色)依 (7) 進一步修改;(ii) SSM 的輸入透過額外的線性層映射,以恢復線性化版本 Attention 中的 values;(iii) 為依 (10) 容納正規化項,SSM 隱藏狀態被擴展。
最後,在 Lst. 3 中我們報告我們對 Hedgehog 投影運算符的實作,在 HedgeMamba 層中使用。如同原始 Hedgehog 論文,特徵映射 $\boldsymbol{\phi}$ (6) 的輸出透過拼接其反方向被複製。作為非線性,我們沿嵌入維度應用 softmax 操作,而非如 Zhang et al. (2024) 中的 vanilla 指數運算:這是為了保證更好的數值穩定性。
# --- modified pythia layer powered by hedge-mamba module --- #
class HedgeMambaLayer(GPTNeoXLayer):
    def __init__(
        self,
        config: PretrainedConfig,
    ):
        super().__init__(config)  # standard pythia layer init
        self.mixer_config = mixer_config
        # overwrite attention module with mamba-mixer
        self.attention = HedgeMambaMixer(config)

    def forward(
        self,
        hidden_states: torch.FloatTensor,
        cache_params: Optional[MambaCache] = None,
    ):
        # attention stream
        attn_output = self.input_layernorm(hidden_states)
        attn_output = self.attention(attn_output, cache_params=cache_params)
        attn_output = self.post_attention_dropout(attn_output)

        # mlp stream
        mlp_output = self.mlp(self.post_attention_layernorm(hidden_states))
        mlp_output = self.post_mlp_dropout(mlp_output)

        # pythia layer with parallel MLP and attention streams
        # pseudocode: x = x + attn(ln1(x)) + mlp(ln2(x))
        hidden_states = hidden_states + attn_output + mlp_output
        return hidden_states
Listing 1:我們的 PyMambaLayer 實作,它將 Pythia Transformer 中的 Softmax Attention 模組替換為我們的 HedgeMamba mixer。後者的程式碼在 Lst. 2 中提供。
# --- hedge-mamba mixer module --- #
class HedgeMambaMixer(nn.Module):
    def __init__(self, config):
        super().__init__()
        self.hidden_size_per_head = config.hidden_size // config.num_attention_heads

        # from mamba
        # state_size == hidden_size to mimic attention
        self.gate_proj = nn.Linear(config.hidden_size, config.hidden_size)
        self.conv1d = nn.Conv1d(config.hidden_size, config.hidden_size)
        self.x_proj = nn.Linear(
            config.hidden_size, config.time_step_rank + config.hidden_size * 2
        )
        A = nn.Parameter(self.init_A(config))
        self.dt_proj = nn.Linear(config.time_step_rank, self.hidden_size_per_head)
        self.out_proj = nn.Linear(config.hidden_size, config.hidden_size)

        # additional projections to replicate linear attention
        self.v_proj = nn.Linear(config.hidden_size, config.hidden_size)  # values
        self.hhog_q = HedgehogProjection(config, self.hidden_size_per_head)  # hedgehog
        self.hhog_k = HedgehogProjection(config, self.hidden_size_per_head)
        self.rotary_ndims = int(self.hidden_size_per_head * config.rotary_pct)
        self._init_rope()  # rope positional encoding

    def forward(self, hidden_states: torch.Tensor) -> torch.Tensor:
        gate = F.silu(self.gate_proj(hidden_states))
        hidden_states = self.conv1d(hidden_states)

        # linear proj to recover SSM parameters
        dt, B, C = torch.split(self.x_proj(hidden_states),
                               [time_rank, state_size, state_size],
                               dim=-1)

        # apply hedgehog feature map
        B = self.hhog_k(B.view(batch_size, seq_len, num_heads, hidden_size_per_head))
        C = self.hhog_q(C.view(batch_size, seq_len, num_heads, hidden_size_per_head))

        # rope positional encoding as in pythia
        C = self.rotary_emb(C, seq_len=C.shape[1])  # equivalent to Q from attention
        B = self.rotary_emb(B, seq_len=B.shape[1])  # equivalent to K from attention

        # value projection
        V = self.v_proj(hidden_states)

        # duplicate for score normalization as in attention
        A = torch.cat([self.A, self.A], dim=0)
        dt = torch.cat([dt, dt], dim=1)
        V = torch.cat([V, torch.ones_like(V)], dim=1)

        # leverage Mamba SSM mixer
        scan_outputs = selective_scan_fn(V, dt, A, B, C)

        # apply normalization and gate
        scan_outputs = gate * scan_outputs[:, : self.hidden_size_per_head, :] / \
                       scan_outputs[:, self.hidden_size_per_head :, :]

        return self.out_proj(scan_outputs)
Listing 2:我們 HedgeMamba 序列 mixer 的 PyTorch 風格偽程式碼,它為 vanilla Mamba SSM mixer 配備了用於 Attention 線性化的 Hedgehog 特徵映射 (Zhang et al., 2024)。
# --- hedgehog projection module --- #
class HedgehogProjection(nn.Module):
    def __init__(self, config, head_size, bias=True):
        super().__init__()
        self.config = config
        self.phi = nn.Linear(head_size, head_size, bias=bias)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # x.shape: [B, S, H, D]
        #
        # B: batch size
        # H: number of heads
        # S: sequence length
        # D: per head embedding size
        x = self.phi(x)

        # negative mapping enabled as in hedgehog
        x = torch.cat([x, -x], dim=-1)  # [B, H, S, 2D]

        # NOTE: we use softmax as activation function here instead of
        # default exponential following hedgehog paper appendix to
        # avoid numerical overflows; softmax is applied on embedding
        # dimension here NOT sequence length as in standard softmax attention
        return x.softmax(dim=-1)
Listing 3:用於 Softmax Attention 線性化的 Hedgehog 投影層的實作(詳見第 3.1 節)。
參考文獻
Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. In 3rd International Conference on Learning Representations, ICLR 2015, 2015.
Iz Beltagy, Matthew E. Peters, and Arman Cohan. Longformer: The long-document transformer, 2020. URL https://arxiv.org/abs/2004.05150.
Aviv Bick, Kevin Li, Eric P. Xing, J Zico Kolter, and Albert Gu. Transformers to SSMs: Distilling quadratic knowledge to subquadratic models. In The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024. URL https://openreview.net/forum?id=FJlrSZBMCD.
Aviv Bick, Tobias Katsch, Nimit Sohoni, Arjun Desai, and Albert Gu. Llamba: Scaling distilled recurrent models for efficient language processing, 2025. URL https://arxiv.org/abs/2502.14458.
Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, et al. Pythia: A suite for analyzing large language models across training and scaling. In International Conference on Machine Learning, pp. 2397–2430. PMLR, 2023.
Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. PIQA: Reasoning about physical commonsense in natural language. In Proceedings of the AAAI conference on Artificial Intelligence, volume 34, pp. 7432–7439, 2020.
Yelysei Bondarenko, Markus Nagel, and Tijmen Blankevoort. Quantizable transformers: Removing outliers by helping attention heads do nothing. In Thirty-seventh Conference on Neural Information Processing Systems, 2023. URL https://openreview.net/forum?id=sbusw6LD41.
Dan Busbridge, Amitis Shidani, Floris Weers, Jason Ramapuram, Etai Littwin, and Russ Webb. Distillation scaling laws, 2025. URL https://arxiv.org/abs/2502.08606.
Joel Castaño, Silverio Martínez-Fernández, Xavier Franch, and Justus Bogner. Analyzing the evolution and maintenance of ml models on hugging face, 2024. URL https://arxiv.org/abs/2311.13380.
Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, David Belanger, Lucy Colwell, and Adrian Weller. Rethinking attention with performers, 2022. URL https://arxiv.org/abs/2009.14794.
Nicola Muca Cirone, Antonio Orvieto, Benjamin Walker, Cristopher Salvi, and Terry Lyons. Theoretical foundations of deep selective state-space models, 2025. URL https://arxiv.org/abs/2402.19047.
Christopher Clark, Kenton Lee, Ming-Wei Chang, Tom Kwiatkowski, Michael Collins, and Kristina Toutanova. Boolq: Exploring the surprising difficulty of natural yes/no questions, 2019. URL https://arxiv.org/abs/1905.10044.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try ARC, the AI2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Tri Dao and Albert Gu. Transformers are SSMs: Generalized models and efficient algorithms through structured state space duality. arXiv preprint arXiv:2405.21060, 2024.
Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. FlashAttention: Fast and memory-efficient exact attention with IO-awareness. In Advances in Neural Information Processing Systems (NeurIPS), 2022.
Leo Gao, Jonathan Tow, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Kyle McDonell, Niklas Muennighoff, Jason Phang, Laria Reynolds, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. A framework for few-shot language model evaluation, September 2021. URL https://doi.org/10.5281/zenodo.5371628.
Aaron Gokaslan, Vanya Cohen, Ellie Pavlick, and Stefanie Tellex. OpenWebText corpus. http://Skylion007.github.io/OpenWebTextCorpus, 2019.
Jianping Gou, Baosheng Yu, Stephen J. Maybank, and Dacheng Tao. Knowledge distillation: A survey. International Journal of Computer Vision, 129(6):1789–1819, March 2021. ISSN 1573-1405. doi: 10.1007/s11263-021-01453-z. URL http://dx.doi.org/10.1007/s11263-021-01453-z.
Albert Gu and Tri Dao. Mamba: Linear-time sequence modeling with selective state spaces. arXiv preprint arXiv:2312.00752, 2023.
Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra, and Christopher Re. HiPPO: Recurrent memory with optimal polynomial projections, 2020. URL https://arxiv.org/abs/2008.07669.
Albert Gu, Karan Goel, and Christopher Ré. Efficiently modeling long sequences with structured state spaces, 2022a. URL https://arxiv.org/abs/2111.00396.
Albert Gu, Ankit Gupta, Karan Goel, and Christopher Ré. On the parameterization and initialization of diagonal state space models, 2022b. URL https://arxiv.org/abs/2206.11893.
Mutian He and Philip N. Garner. Joint fine-tuning and conversion of pretrained speech and language models towards linear complexity, 2025. URL https://arxiv.org/abs/2410.06846.
Geoffrey Hinton, Oriol Vinyals, and Jeff Dean. Distilling the knowledge in a neural network, 2015. URL https://arxiv.org/abs/1503.02531.
Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. LoRA: Low-rank adaptation of large language models, 2021. URL https://arxiv.org/abs/2106.09685.
Weizhe Hua, Zihang Dai, Hanxiao Liu, and Quoc Le. Transformer quality in linear time. In Kamalika Chaudhuri, Stefanie Jegelka, Le Song, Csaba Szepesvari, Gang Niu, and Sivan Sabato (eds.), Proceedings of the 39th International Conference on Machine Learning, volume 162 of Proceedings of Machine Learning Research, pp. 9099–9117. PMLR, 17–23 Jul 2022. URL https://proceedings.mlr.press/v162/hua22a.html.
Jungo Kasai, Hao Peng, Yizhe Zhang, Dani Yogatama, Gabriel Ilharco, Nikolaos Pappas, Yi Mao, Weizhu Chen, and Noah A. Smith. Finetuning pretrained transformers into RNNs, 2021. URL https://arxiv.org/abs/2103.13076.
Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, and François Fleuret. Transformers are RNNs: Fast autoregressive transformers with linear attention. In International conference on machine learning, pp. 5156–5165. PMLR, 2020.
Guokun Lai, Qizhe Xie, Hanxiao Liu, Yiming Yang, and Eduard Hovy. RACE: Large-scale ReAding comprehension dataset from examinations. In Martha Palmer, Rebecca Hwa, and Sebastian Riedel (eds.), Proceedings of the 2017 Conference on Empirical Methods in Natural Language Processing, pp. 785–794, Copenhagen, Denmark, September 2017. Association for Computational Linguistics. doi: 10.18653/v1/D17-1082. URL https://aclanthology.org/D17-1082.
Jian Liu, Leyang Cui, Hanmeng Liu, Dandan Huang, Yile Wang, and Yue Zhang. Logiqa: A challenge dataset for machine reading comprehension with logical reasoning, 2020.
Amir M. Mansourian, Rozhan Ahmadi, Masoud Ghafouri, Amir Mohammad Babaei, Elaheh Badali Golezani, Zeynab Yasamani Ghamchi, Vida Ramezanian, Alireza Taherian, Kimia Dinashi, Amirali Miri, and Shohreh Kasaei. A comprehensive survey on knowledge distillation, 2025. URL https://arxiv.org/abs/2503.12067.
Huanru Henry Mao. Fine-tuning pre-trained transformers into decaying fast weights, 2022. URL https://arxiv.org/abs/2210.04243.
Jean Mercat, Igor Vasiljevic, Sedrick Keh, Kushal Arora, Achal Dave, Adrien Gaidon, and Thomas Kollar. Linearizing large language models, 2024. URL https://arxiv.org/abs/2405.06640.
J. Mercer. Functions of positive and negative type, and their connection with the theory of integral equations. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 209:415–446, 1909. ISSN 02643952.
Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Quan Ngoc Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda, and Raquel Fernández. The lambada dataset: Word prediction requiring a broad discourse context, 2016. URL https://arxiv.org/abs/1606.06031.
Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Stella Biderman, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, Xuzheng He, Haowen Hou, Jiaju Lin, Przemyslaw Kazienko, Jan Kocon, Jiaming Kong, Bartlomiej Koptyra, Hayden Lau, Krishna Sri Ipsit Mantri, Ferdinand Mom, Atsushi Saito, Guangyu Song, Xiangru Tang, Bolun Wang, Johan S. Wind, Stanislaw Wozniak, Ruichong Zhang, Zhenyuan Zhang, Qihang Zhao, Peng Zhou, Qinghua Zhou, Jian Zhu, and Rui-Jie Zhu. RWKV: Reinventing RNNs for the transformer era, 2023. URL https://arxiv.org/abs/2305.13048.
Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A. Smith, and Lingpeng Kong. Random feature attention, 2021. URL https://arxiv.org/abs/2103.02143.
Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. Hyena hierarchy: Towards larger convolutional language models. In International Conference on Machine Learning, pp. 28043–28078. PMLR, 2023.
pprp. Runtimeerror: Selective_scan only supports state dimension ≤ 256. https://github.com/state-spaces/mamba/issues/120, 2024. Issue #120, Accessed: 2025-08-01.
Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong. cosformer: Rethinking softmax in attention, 2022. URL https://arxiv.org/abs/2202.08791.
Zihan Qiu, Zekun Wang, Bo Zheng, Zeyu Huang, Kaiyue Wen, Songlin Yang, Rui Men, Le Yu, Fei Huang, Suozhi Huang, Dayiheng Liu, Jingren Zhou, and Junyang Lin. Gated attention for large language models: Non-linearity, sparsity, and attention-sink-free, 2025. URL https://arxiv.org/abs/2505.06708.
Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. Language models are unsupervised multitask learners. 2019.
Tokiniaina Raharison Ralambomihanta, Shahrad Mohammadzadeh, Mohammad Sami Nur Islam, Wassim Jabbour, and Laurence Liang. Scavenging hyena: Distilling transformers into long convolution models, 2024. URL https://arxiv.org/abs/2401.17574.
Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. Winogrande: An adversarial winograd schema challenge at scale. arXiv preprint arXiv:1907.10641, 2019.
Victor Sanh, Lysandre Debut, Julien Chaumond, and Thomas Wolf. DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter. In NeurIPS EMC² Workshop, 2019.
Maarten Sap, Hannah Rashkin, Derek Chen, Ronan Le Bras, and Yejin Choi. Social IQa: Commonsense reasoning about social interactions. In Kentaro Inui, Jing Jiang, Vincent Ng, and Xiaojun Wan (eds.), Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP), pp. 4463–4473, Hong Kong, China, November 2019. Association for Computational Linguistics. doi: 10.18653/v1/D19-1454. URL https://aclanthology.org/D19-1454/.
Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism. arXiv preprint arXiv:1909.08053, 2019.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Junxiong Wang, Daniele Paliotta, Avner May, Alexander M. Rush, and Tri Dao. The mamba in the llama: Distilling and accelerating hybrid models, 2024. URL https://arxiv.org/abs/2408.15237.
Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang, and Hao Ma. Linformer: Self-attention with linear complexity. arXiv preprint arXiv:2006.04768, 2020.
Thomas Wolf, Lysandre Debut, Victor Sanh, Julien Chaumond, Clement Delangue, Anthony Moi, Pierric Cistac, Tim Rault, Rémi Louf, Morgan Funtowicz, Joe Davison, Sam Shleifer, Patrick von Platen, Clara Ma, Yacine Jernite, Julien Plu, Canwen Xu, Teven Le Scao, Sylvain Gugger, Mariama Drame, Quentin Lhoest, and Alexander M. Rush. Transformers: State-of-the-art natural language processing. In Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing: System Demonstrations, pp. 38–45, Online, October 2020. Association for Computational Linguistics. URL https://www.aclweb.org/anthology/2020.emnlp-demos.6.
Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, and Vikas Singh. Nyströmformer: A nyström-based algorithm for approximating self-attention. In Proceedings of the AAAI conference on artificial intelligence, volume 35, pp. 14138–14148, 2021.
Chuanpeng Yang, Wang Lu, Yao Zhu, Yidong Wang, Qian Chen, Chenlong Gao, Bingjie Yan, and Yiqiang Chen. Survey on knowledge distillation for large language models: Methods, evaluation, and application, 2024. URL https://arxiv.org/abs/2407.01885.
Manzil Zaheer, Guru Guruganesh, Avinava Dubey, Joshua Ainslie, Chris Alberti, Santiago Ontanon, Philip Pham, Anirudh Ravula, Qifan Wang, Li Yang, and Amr Ahmed. Big bird: Transformers for longer sequences, 2021. URL https://arxiv.org/abs/2007.14062.
Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi. Hellaswag: Can a machine really finish your sentence? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, 2019.
Michael Zhang, Kush Bhatia, Hermann Kumbong, and Christopher Ré. The hedgehog & the porcupine: Expressive linear attentions with softmax mimicry. arXiv preprint arXiv:2402.04347, 2024.
Michael Zhang, Simran Arora, Rahul Chalamala, Alan Wu, Benjamin Spector, Aaryan Singhal, Krithik Ramesh, and Christopher Ré. LoLCATs: On low-rank linearizing of large language models, 2025. URL https://arxiv.org/abs/2410.10254.
Liu Zhuang, Lin Wayne, Shi Ya, and Zhao Jun. A robustly optimized BERT pre-training approach with post-training. In Sheng Li, Maosong Sun, Yang Liu, Hua Wu, Kang Liu, Wanxiang Che, Shizhu He, and Gaoqi Rao (eds.), Proceedings of the 20th Chinese National Conference on Computational Linguistics, pp. 1218–1227, Huhhot, China, August 2021. Chinese Information Processing Society of China. URL https://aclanthology.org/2021.ccl-1.108/.
術語對照表
| English Original | 繁體中文 |
|---|---|
| Attention | Attention(注意力機制) |
| State Space Models (SSMs) | 狀態空間模型 |
| Knowledge Distillation | 知識蒸餾 |
| Cross-architecture Distillation | 跨架構蒸餾 |
| Linear Attention | 線性 Attention |
| Sequence Mixer | 序列混合器 |
| Feature Map | 特徵映射 |
| Kernel Trick | 核技巧 |
| Perplexity | 困惑度 |
| Token Representation | token 表徵 |
| Recurrent Neural Network (RNN) | 遞迴神經網路 |
| Hidden State | 隱藏狀態 |
| Hybrid | 混合(架構) |
| Principled Initialization | 有原則的初始化 |
| Throughput | 吞吐量 |
| Embedding | 嵌入 |
| Self-Attention | 自注意力 |
| Softmax | softmax |
| Causal Mask | 因果遮罩 |
| Fine-tune / Fine-tuning | 微調 |
| Cross-Entropy | 交叉熵 |
| Positive Semi-Definite | 正定 |
| Gaussian Kernel | Gaussian kernel(高斯核) |
| Taylor Expansion | Taylor 展開 |
| Spikiness | 尖峰性 |
| Dot-product Monotonicity | 點積單調性 |
| Cosine Similarity | 餘弦相似度 |
| Layer Norm | 層正規化 |
| Residual Stream | residual stream(殘差流) |
| Robustness | 穩健性 |
| Ablation | 消融 |
| Sensitivity Analysis | 敏感度分析 |
| Bootstrap | 自助法 |
| Standard Error | 標準誤差 |
| Sparsification | 稀疏化 |
| Low-rank | 低秩 |
| Decaying Fast Weights | 衰減快速權重 |
| Instruction-finetuning | 指令微調 |
| Rate-of-Decay | 衰減速率 |
| Time-step | 時間步 |
| Gradient Clipping | 梯度裁剪 |
| Weight Decay | 權重衰減 |
| Distributed Data Parallel | 分散式資料平行 |
| Hardware-aware | 硬體感知 |
| Selective Scan | 選擇性掃描 |