大型語言模型的代理式推理綜述:邁向遞迴自我改進與集體代理
原始論文:A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents 作者:Tianxin Wei, Ting-Wei Li, Zhining Liu, Xuying Ning, Ze Yang, Jiaru Zou, Zhichen Zeng, Ruizhong Qiu, Xiao Lin, Dongqi Fu, ... Heng Ji, Hanghang Tong, Jingrui He(UIUC 等,共 28 位作者) arXiv ID:2601.12538v2 日期:2026-01-18(v1);2026-09-20(v2) 標籤:綜述 代理式推理 LLM Agent 多代理系統 自我進化 規劃 工具使用
【譯註:這是一篇篇幅極大的綜述(原文含 797 篇參考文獻)。本譯文完整翻譯八個章節的概念框架、分類法與代表性系統的貢獻描述;為維持可讀性,密集羅列系統的段落做了忠實但精簡的處理,系統名一律保留原文。完整的 797 篇參考書目請參閱 CC BY 4.0 原文。】
1 引言
推理是智慧的核心,支撐互動與動態情境下的邏輯推論、問題求解與決策。大型語言模型 (LLM) 在數學求解、程式碼生成等封閉世界 (closed-world) 領域取得顯著進展;把中間推理顯式化的技巧(思維鏈 CoT、分解、程式輔助求解)大幅提升推論效能。然而這些方法通常假設靜態情境與短時程推理,傳統 LLM 缺乏在「資訊隨時間演化的開放式環境」中行動、調適、改進的機制。
本綜述把這個演進系統化為代理式推理 (Agentic Reasoning) 框架:LLM 不再被動生成序列,而是被重新定位成自主推理代理——透過與環境的持續互動來規劃、行動、學習。這把「推理」與「行動」統一起來,把推理定位為感知、規劃、決策、驗證的組織原則。ReAct 等系統交錯「思辨」與「環境互動」;工具使用框架讓模型自主呼叫 API;工作流代理動態編排子任務與可驗證動作。這對應「從靜態一次性推論,到不確定性下的序列決策」的轉變。
代理式推理的定義:代理式推理把推理定位為智慧代理的核心機制,橫跨基礎能力(規劃、工具使用、搜尋)、自我進化的調適(回饋、記憶驅動的調適)、與集體協調(多代理協作),可透過情境內編排 (in-context orchestration) 或後訓練最佳化 (post-training optimization) 兩種模式實現。
本綜述圍繞三個互補的代理式推理範圍組織:
- 基礎代理式推理 (Foundational):建立核心的單代理能力(規劃、工具使用、搜尋),讓代理在穩定但複雜的環境中運作——分解目標、呼叫外部工具、透過可執行動作驗證結果。
- 自我進化的代理式推理 (Self-Evolving):讓代理透過累積經驗持續改進,把調適延伸到「記憶與策略等內部狀態的持久更新」。Reflexion 等反思框架讓代理批判並精修自己的推理;RL-for-memory 把記憶寫入與檢索形式化為策略最佳化。
- 集體多代理推理 (Collective):把智慧從孤立求解者擴展到協作生態——透過顯式角色分派(manager–worker–critic)、通訊協定與共享記憶協調以達成共同目標。協作放大推理多樣性、讓系統能辯論、化解分歧、透過多輪自然語言互動達成一致,但也帶來穩定性、通訊效率與可信度的挑戰。
跨所有層次,本綜述用兩種互補模式分析系統約束與最佳化:情境內推理 (In-context Reasoning) 聚焦擴展推論時算力——透過結構化編排、搜尋式規劃、調適式工作流,讓代理不改參數即可動態導航複雜問題空間;後訓練推理 (Post-training Reasoning) 則把成功的推理樣態或工具使用策略透過 RL 與微調固化進模型權重。兩者共同提供設計代理的可操作路線圖。
貢獻:(1) 概念框架化——形式化代理式推理範式,橫跨基礎、自我進化、集體三層;(2) 系統性回顧——分析單代理、調適、多代理系統,強調以推理為中心的工作流編排;(3) 應用與評測——回顧真實應用與基準;(4) 未來議程——指出強健性、可信度、效率等新興挑戰。本綜述總結至 2025 年的進展。
2 從 LLM 推理到代理式推理
傳統 LLM 推理通常被表述為對靜態輸入的一次性或少樣本預測,仰賴擴展推論時算力 (scaling test-time computation)——靠增大模型或推論預算提升準確度,卻無法互動、記憶或適應變化的目標。代理式推理相對地強調擴展推論時互動 (scaling test-time interaction):不只依賴內部參數,而是透過行動來推理——呼叫工具、探索替代、更新記憶、整合回饋,把推論變成含決策步、反思、經驗學習的迭代過程。推理成為連接模型、記憶、環境的動態迴圈。
表 1(要點):LLM 推理 vs. 代理式推理——前者靠靜態容量擴展、被動序列預測、固定 prompt;後者靠結構化互動擴展,支援跨時間與任務的規劃、調適、協作。
2.1 本綜述的定位
既有綜述多探討 LLM 推理(如何在模型內部計算中引出/增強推理,如 CoT、RL 後訓練、長情境推理)或代理架構(RL、規劃、工具使用模組如何在複雜環境運作)。本綜述定位於「模型中心推理」與「系統層級智慧」的交會處——把推理視為連接單代理強化、多代理協調、自我進化智慧的統一機制,而非架構設計的隱性副產品。
2.2 預備知識
本節把「從靜態語言建模到代理式推理」的轉變形式化,並用單一控制論框架統一三層能力。
代理式推理的潛在空間視角。 把環境建模為部分可觀測馬可夫決策過程 (POMDP),並引入內部推理變數以暴露代理策略的「思考–行動」結構。考慮元組 $\langle\mathcal{X},\mathcal{O},\mathcal{A},\mathcal{Z},\mathcal{M},\mathcal{T},\Omega,\mathcal{R},\gamma\rangle$,其中 $\mathcal{X}$ 是潛在環境狀態(代理不可觀測)、$\mathcal{O}$ 是觀察空間(使用者查詢、API 回傳)、$\mathcal{A}$ 是外部動作空間(工具呼叫、最終答案)、$\mathcal{Z}$ 是推理軌跡空間(潛在計畫,可選地以 CoT 言語化)、$\mathcal{M}$ 是代理內部記憶/情境空間。核心轉變在於:在承諾到 $\mathcal{A}$(行動)之前,先在 $\mathcal{Z}$(思考)中做計算。目標仍是最大化期望回報 $J(\theta)=\mathbb{E}_{\tau}[\sum_{t}\gamma^{t}r_{t}]$。
- 情境內推理:推論時搜尋。 參數 $\theta$ 凍結,代理在 $\mathcal{Z}$ 上搜尋以最大化啟發式價值函數。ReAct 對交替的「思考 $z$」與「行動 $a$」做貪婪解碼;Tree-of-Thoughts (ToT) 與 MCTS 式方法把部分思考當節點、搜尋最佳路徑。這對應「在 $\mathcal{Z}$ 中規劃而不更新策略參數」。
- 後訓練:策略最佳化。 最佳化 $\theta$ 以對齊長時程獎勵,含推理模型(DeepSeek-R1)與 learning-to-search 系統(Search-R1、DeepRetrieval)。PPO 是標準做法,但 GRPO(用組相對獎勵構造優勢、免去價值網路)在推理任務被廣泛使用;ARPO、DAPO 進一步處理稀疏獎勵與複雜工具環境的穩定性。
- 集體智慧:多代理推理。 擴展到去中心化部分可觀測的多代理設定(Dec-POMDP),核心差異在於把每個代理的觀察擴充一個通訊通道 $\mathcal{C}$。在代理式 MARL 中,通訊不只是訊號傳輸而是推理過程的延伸——一個代理的外部動作可作為觸發另一代理內部推理鏈的 prompt。AutoGen、CAMEL 是固定策略的靜態角色扮演;GPTSwarm、MaAS 等試圖最佳化聯合推理分布。挑戰從單代理規劃轉向機制設計:最佳化通訊拓撲與激勵結構,常用 Centralized-Training/Decentralized-Execution (CTDE) 範式穩定合作行為的湧現。
- 自我進化代理:元學習迴圈。 基礎代理在一個 episode 內最佳化推理 $z$,自我進化代理則跨 episodes 最佳化代理系統本身 $\mathcal{S}_k$。依 $\mathcal{S}$ 的性質分為:言語進化($\mathcal{S}$ 是文字反思/指引,如 Reflexion)、程序進化($\mathcal{S}$ 是可執行工具/技能庫,如 Voyager 合成新程式碼技能、永久擴展動作空間 $\mathcal{A}$)、結構進化($\mathcal{S}$ 是代理的原始碼/架構本身,如 AlphaEvolve 用 LLM 當變異運算子搜尋更優推理演算法)。
3 基礎代理式推理
代理式推理源於單一代理的行為。在討論調適與協作前,聚焦個別代理如何透過三個核心元件——規劃、搜尋、工具使用——把推理轉為結構化行動。一個典型的基礎工作流是交錯「規劃(目標分解與任務表述)、工具使用(呼叫外部系統作用於世界)、搜尋(檢索與探索以支援決策)」的迭代循環,推理決定何時規劃、檢索什麼、如何行動。
3.1 規劃推理
本綜述把 LLM 代理規劃分為六種方法風格,並沿「情境內規劃」與「後訓練規劃」組織。
3.1.1 情境內規劃:
- 工作流設計 (Workflow Design):把規劃結構化成不同階段(感知、推理、執行、驗證),或顯式鷹架或隱式學習。這些工作流由一個反應式控制器接地:web 自動化用 inspect-reason-act-observe 迴圈;程式碼代理決定即時執行/API 呼叫、讀輸出或錯誤、逐步精修;機器人用監控器觸發即時安全介入與 VLM 引導的子目標執行。此觀點統一「腳本化階段設計」與「線上調適」,但長時程可能累積錯誤,促成工作流內的增量驗證與記憶。
- 樹搜尋/演算法模擬:BFS、DFS、A*、MCTS、beam search 成為可解釋有效的規劃鷹架。ToT 等應用廣度/深度優先探索思考樹;A* 式引導擴展提供啟發式規劃;MCTS 被大量探索用於受控探索與提升推理保真度;beam search 用來剪枝並優先排序推理軌跡。此「層次搜尋」觀點清楚映射到 web(planner-executor 生成子任務樹並綁定 DOM 動作)、程式碼(層次任務樹與偽碼計畫)、機器人(行為樹與高階目標分解)。
- 過程形式化 (Process Formalization):用符號表示、程式語言或邏輯框架編碼計畫(如 PDDL 程式、CodePlan 的程式合成),確保組合性、可解釋性與泛化,並更乾淨地銜接經典規劃器或機器人控制器。
- 解耦/分解 (Decoupling/Decomposition):把複雜規劃模組化成可分離元件(目標辨識、記憶檢索、計畫精修)。ReWOO 顯式分離觀察與推理模組以最佳化效率;其他工作把推理拆成可重用/層次抽象。
- 外部輔助/工具使用:用 RAG、知識圖譜、世界模型、通用工具輔助規劃。知識增強框架把結構化表示注入 LLM 情境;世界模型代理學習/利用環境模型做 model-based 規劃;HuggingGPT、Tool-Planner 等用外部 API 或模組化工具鏈支援規劃執行。
3.1.2 後訓練規劃——獎勵設計/最優控制:把規劃當最佳化,用 RL 或控制論工具設計獎勵並求最優行為。Reflexion、Reflect-then-Plan 納入基於效用的學習;也有工作強調獎勵塑形、顯式最優控制、擴散模型軌跡最佳化、離線 RL 利用預訓練動態或成本模型。
3.2 工具使用最佳化
工具使用最佳化是代理透過智慧呼叫外部模組增強內在能力的能力,克服知識過時、無法精確計算、無法存取私有資訊等限制。核心挑戰是推理何時用工具、從庫中選哪個、如何生成有效呼叫。分三種風格:
- 3.2.1 情境內工具整合:訓練無關,靠 LLM 的情境內學習能力。交錯推理與工具使用是基礎(把 CoT 與行動能力結合):ChatCoT 把推理軌跡結構化成交替的「思考-工具-觀察」;ReAct introduce「推理+行動」協同;ART 維護成功任務示範庫、檢索多步範例當 few-shot。最佳化工具互動情境:良好的工具文件讓 LLM 零樣本用新工具;GEAR 把工具選擇委派給小模型、保留大模型做最終推理以降成本;AVATAR 用情境內「對比推理」增強穩健性。
- 3.2.2 後訓練工具整合:用 SFT 引導工具使用(Toolformer 自監督生成/驗證/保留有用 API 呼叫;ToolLLM 擴到 16,000+ 真實 API;ToolAlpaca 為小 LLM 自動構造工具集與多輪對話)——但單靠 SFT 易過擬合訓練樣態。用 RL 精通工具使用(SWE-RL 最佳化程式碼編輯策略;ReSearch 把搜尋嵌入多跳推理鏈;ReTool 把即時程式碼執行整合進推理 rollout;ToolRL 用原則性獎勵設計泛化到多樣工具集)——RL 比純 SFT 產生更強健、可泛化的工具使用策略。
- 3.2.3 編排式工具整合:真實應用常需多工具協同。HuggingGPT 用中央代理規劃呼叫哪些工具與時機;TaskMatrix.AI 連接基礎模型與數百萬 API;ToolkenGPT 把每個工具編碼成特殊 token。編排管線多採「plan before action」(ToolPlanner 兩階段 RL;OctoTools 訓練無關、標準化工具卡;Chain-of-Tools 動態組合未見工具;PyVision 動態生成/執行/精修 Python 工具)。工具表示(ToolExpNet 把工具與經驗建模成網路;ToolChain* 把工具動作空間視為決策樹並用 A* 搜尋;ToolRerank 用調適截斷與階層感知重排)。
3.3 代理式搜尋
單代理代理式 RAG 把推理與控制嵌入一個中央代理,管理整個檢索-生成迴圈。不像傳統 RAG 的固定一次性檢索,代理式 RAG 動態控制何時、什麼、如何檢索,能在推論中途調適策略、精修查詢、整合多來源證據。分三類:
- 3.3.1 情境內搜尋:透過 prompting 把檢索行為嵌入推論。ReAct 交錯 CoT 與
<Search>工具呼叫;Self-Ask、IRCoT 遞迴分解問題並檢索子證據;更新的方法引入反思式檢索(每步顯式評估是否需更多資訊)。結構增強搜尋讓單代理對知識圖譜等符號知識源推理:Agent-G 整合非結構化文件檢索與結構化圖推理;GeAR 把圖擴展運算納入代理控制器;ARG 提出完全端到端、透過主動自我反思對 KG 推理的框架。 - 3.3.2 後訓練搜尋:SFT 式(構造交錯檢索與推理的資料集微調,如 Toolformer、INTERS);RL 式(WebGPT 用獎勵建模監督與人類判斷對齊的搜尋鏈;Search-R1、Deep-Researcher 訓練代理動態發出檢索動作、在開放 web 運作,展現迭代分解、再驗證、證據規劃等湧現能力;ReSearch、ReARTeR 追求可解釋忠實的推理軌跡)。
4 自我進化的代理式推理
自我進化的代理式推理指代理透過經驗改進自己推理過程的能力。核心是兩個機制:回饋(提供自我修正的評估訊號)與記憶(儲存、組織、綜合過去互動的持久基底,讓知識跨任務累積與重用)。兩者把推理從靜態過程轉為能持續改進的動態調適迴圈。
4.1 代理式回饋機制
分三種回饋機制:
- 4.1.1 反思式回饋 (Reflective Feedback):不更新參數,在推論時修改推理過程。早期自我批判與理由精修法用顯式的「生成–批判–修訂」迴圈(模型產出答案與推理,同一模型或 critic 角色分析找邏輯錯誤/未支持假設/遺漏步驟,把批判當情境做修訂生成)。更新的自我改進框架跨互動累積批判或失敗案例。搜尋式推理策略生成並比較多條候選路徑(用投票、啟發式分數或學習評估器選擇/聚合)。分解式 prompting 把複雜問題重構成有序子問題序列。
- 4.1.2 參數調適 (Parametric Adaptation):把回饋透過額外訓練併入參數,產生持久的行為改變。軌跡級 SFT(把回饋附到中間推理軌跡而非只是最終答案);蒸餾式(用更強教師的高品質 CoT 或自我修正解訓學生);偏好對齊(用比較判斷區分偏好/不偏好輸出,如獎勵建模或 DPO)。持久性以「額外訓練與較低彈性」為代價。
- 4.1.3 驗證器驅動回饋 (Validator-Driven Feedback):用外部成功/失敗訊號改進輸出,不改推理過程或參數。重試式系統反覆取樣直到通過驗證(在程式合成、軟體工程等有可靠廉價驗證的領域特別有效——生成程式碼可對單元測試執行)。相似機制見於具身互動代理(動作序列反覆執行直到環境訊號任務完成)。限制是回饋非診斷性(只修正個別輸出,不解釋失敗)。
4.2 代理式記憶
近期把記憶從靜態儲存轉向動態互動機制,直接支援代理式推理——把記憶當推理迴圈的一環,用於反思過去經驗、引導未來行動、動態適應長時程任務。沿三個趨勢組織:
- 4.2.1 對平面記憶 (Flat Memory) 的代理式使用:事實記憶——傳統把記憶當被動緩衝(dense retrieval、LangChain/LlamaIndex 模組、MemGPT 快取式設計),只檢索語意相似內容擴充 prompt、不影響內部推理;新興代理式記憶(A-mem 自主生成情境記憶描述、建動態連結、演化記憶內容;Zep、Mirix、MemOS、Nemori 等用 LLM 自動產生情境感知記憶表示;Mem-α、Memory-R1 用 RL 訓練代理取得與組織事實記憶)。經驗記憶——Workflow Memory 追蹤程序軌跡;Sleep-time Compute 讓代理離線預算推理步;Dynamic Cheatsheet 存可重用策略;Atomic reasoning、ACE、Reasoning Bank、Evo-Memory 把經驗重用當核心能力。
- 4.2.2 對記憶的結構化使用:語意圖、工作流、層次樹,常延伸到多模態。GraphRAG 用圖結構推理增強檢索;MEM0、Zep 把記憶組織成動態知識圖;MemTree 用動態樹結構;AutoFlow、AFLOW、FlowMind 在記憶中顯式表示推理工作流。多模態方向:M3-Agent(視-聽-文推理)、Optimus-1(層次有向知識圖 + 多模態經驗池)、RAP(依情境相似度檢索經驗)。
- 4.2.3 後訓練記憶控制:把記憶當策略目標,代理顯式決定存什麼、何時檢索、如何互動。MemAgent 把記憶覆寫當 RL 問題(用 DAPO 學跨對話維持定長記憶);Mem1 端到端 RL 維持緊湊共享內部狀態;Memory-R1 雙代理設計(Memory Manager 決定增/更/刪,Answer Agent 蒸餾最相關檢索);Memory-as-Action 把記憶編輯整合進推理策略(Dynamic Context Policy Optimization);Agent Learning via Early Experience 讓代理從自身軌跡透過自我預測與反思學習,橋接模仿與 RL。
4.3 進化基礎代理能力
- 4.3.1 自我進化規劃:把規劃當進化能力。代表方向是自生成任務構造(SCA 交替生成問題與求解、重用成功軌跡微調;自獎勵框架讓代理評估自己輸出);透過環境塑造進化(AgentGen 構造調適環境誘導課程學習;Reflexion、AdaPlanner 用自我反思/調適策略在 runtime 精修計畫);RL 觀點(RAGEN、DYSTIL 把規劃建模成 MDP 用密集回饋最佳化)。
- 4.3.2 自我進化工具使用——建立與合成工具:情境內推理的頂點是代理自主創造新工具(prompting 凍結 LLM 當程式設計師)。LATM 用強模型當一次性「工具製造者」、廉價模型當頻繁「工具使用者」;CRAFT、CREATOR 為特定領域生成客製工具;ToolMaker 把整個公開程式碼庫轉成可用工具。
- 4.3.3 自我進化搜尋:把搜尋與記憶連成共同進化迴圈——代理任務執行中持續更新記憶庫、同時動態調整搜尋方式。演化記憶庫(Reflexion 批判自己推理軌跡並存蒸餾洞見;Reasoning Bank、ACE 顯式重構記憶表示讓檢索目標本身隨時間調適);動態搜尋與合成(結構化記憶表示如工作流與知識圖提供語意鷹架、支援多跳組合搜尋;MemOS、Memory-as-Action 把搜尋決策直接整合進推理策略)。
5 集體多代理推理
在多代理系統 (MAS) 中,多個推理代理互動以共同解決複雜任務。代理不是相同的求解者,而是承擔互補角色(Manager 做任務分解、Worker 執行、Verifier 評估),實現專門化與認知分工。多代理推理的三大新挑戰:角色分化、協作與通訊、集體記憶與進化。
5.1 多代理系統的角色分類
- 5.1.1 通用角色:Leader/Coordinator(設全域目標、分解任務、仲裁衝突,常表現為 meta-controller);Worker/Executor(呼叫工具、寫/執行程式碼、檢索文件、介接環境);Critic/Evaluator(品保、驗證正確性、red-teaming,常對應 LLM-as-a-judge);Memory Keeper(維護長期知識結構如 episodic log、語意嵌入、KG);Communication Facilitator(治理訊息 schema、管理頻寬、編排共識)。
- 5.1.2 領域特定角色:軟體工程(architects、developers、code reviewers/testers、CI orchestrators、release managers;如 MetaGPT 分解成 PM/Architect/Engineer、ChatDev 強調溝通式協作、EvoMAC 動態重組角色);金融(analysts、risk managers、traders/execution、compliance;如 R&D-Agent-Quant、FinRobot、FinCon);法律(法律諮詢模擬律所結構、法條推理分知識取得與應用代理、法庭模擬 judge/plaintiff/defendant/adversarial lawyer);教育(個人化家教、課程設計);醫療(triage、specialist、doctor、measurement 代理);生醫(de novo 分子設計 actor/evaluator/self-reflector;LIDDIA、DrugAgent、GenoMAS);音樂(ComposerX 的 conductor/melody/harmony/rhythm 代理)。
5.2 協作與分工
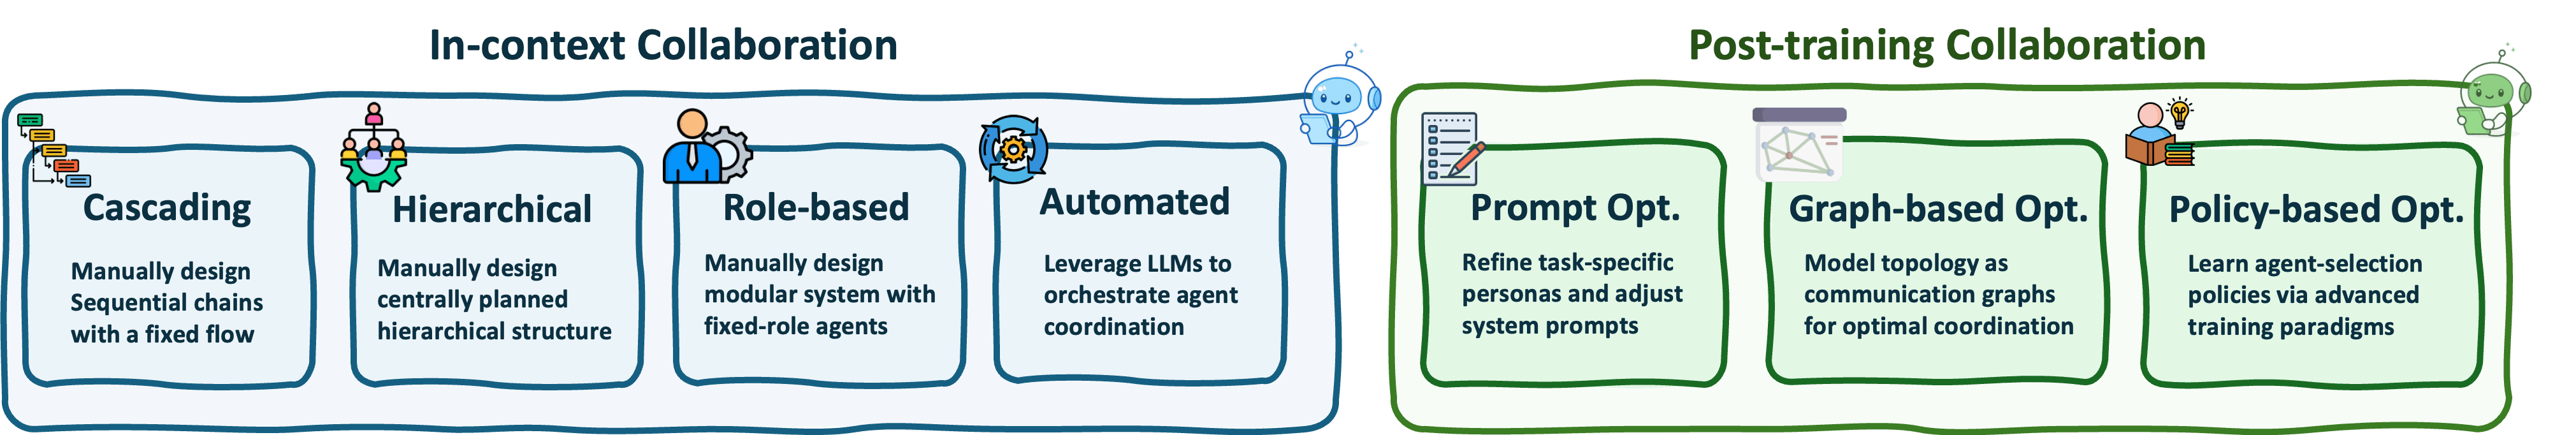
圖 9:多代理系統中的代理式協作——情境內協作(訓練無關、任務特定的協調設計)與後訓練協作(基於最佳化的自動化工作流生成)。
- 5.2.1 情境內協作:手工管線(預定義階層或固定工作流,角色/執行順序/通訊規則執行前定;如 AgentOrchestra、MetaGPT 的中央 planner;Collab-RAG、Chain of Agents 的級聯管線);LLM 驅動管線(LLM 當編排器分解目標、路由給角色專門代理、依中間回饋迭代精修;如 AutoML-Agent、Magentic-One 的中央 Orchestrator、MAS-GPT 訓 LLM 發出可執行 MAS 程式碼、MetaAgent 用 FSM 抽象);Agent Routing(AgentRouter 用知識圖引導路由、Talk to Right Specialists 把路由與規劃統一);心智理論 (ToM) 增強協作(給代理顯式信念狀態表示,如 Hypothetical Minds、MindForge、ToM-agent)。
- 5.2.2 後訓練協作:多代理 prompt 最佳化(AutoAgents 精修角色專門化;SPP 動態選多重 persona;MASS 顯示 prompt 常是 MAS 效能主導因素);拓撲最佳化——把 MAS 建模成圖(代理是節點、通訊是邊):圖生成(GommFormer、G-designer、MCGD 從零構造任務條件圖)、圖剪枝(AgentPrune 空間-時間圖稀疏化;AGP 雙剪枝;G-Safeguard 把剪枝當安全機制)、拓撲搜尋(AFlow 用 MCTS;MaAS 用機率式「代理式超網」;GPTSwarm 把離散拓撲鬆弛成連續邊機率用 RL 最佳化);策略式拓撲生成——相對優勢策略學習(MAGRPO、MHGPO、COPY)、LLM 生成先驗引導(LGC-MARL、LAMARL、MAPoRL、SIRIUS)、人類偏好訊號(M3HF、O-MAPL)。
5.3 多代理進化
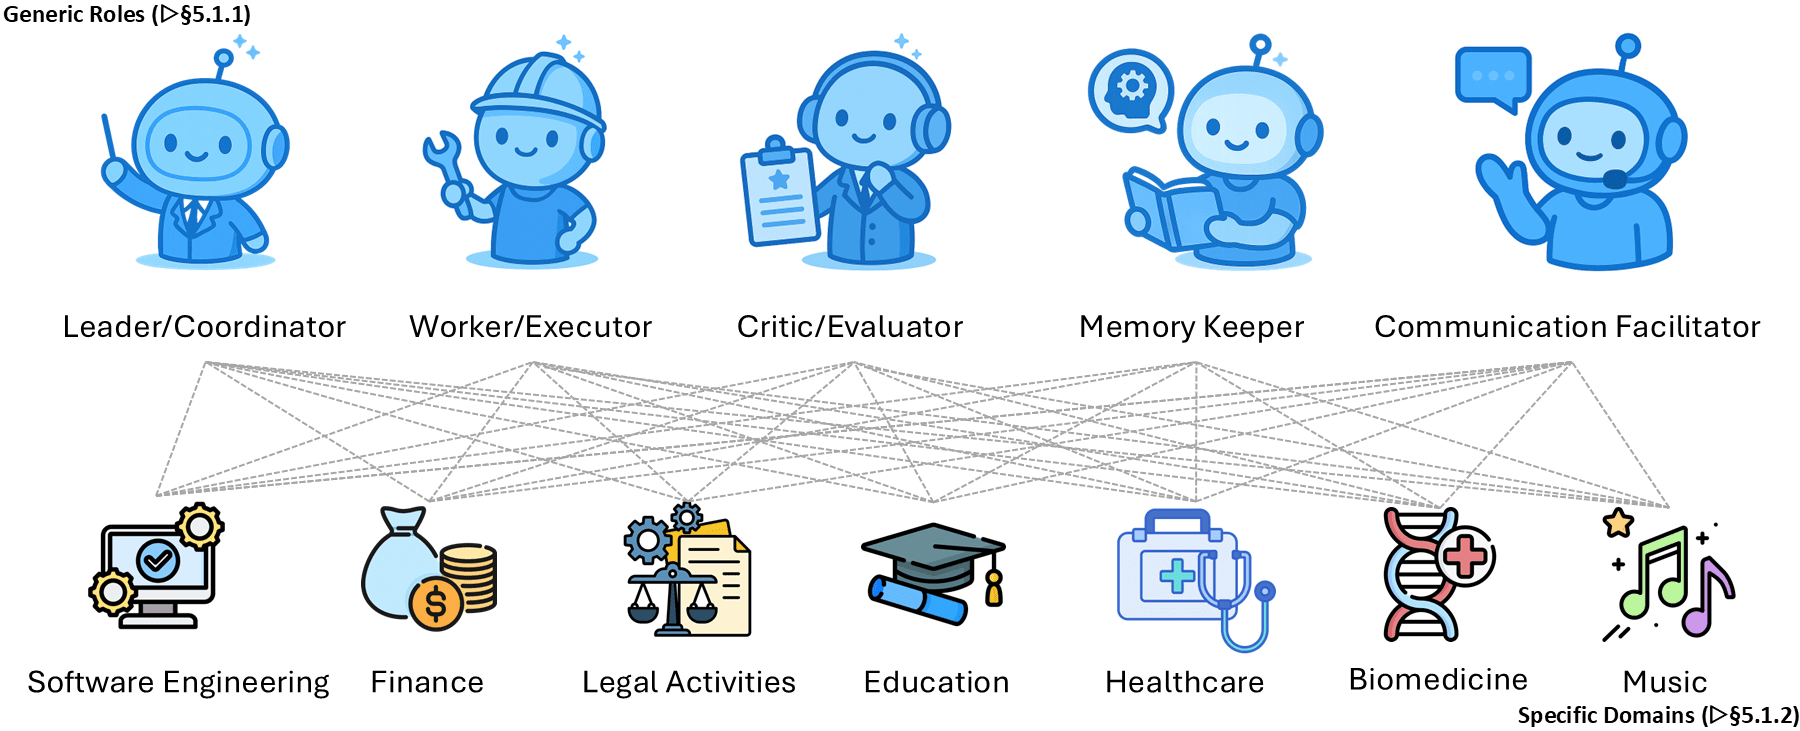
圖 8:代理的通用角色(Leader、Worker、Critic、Memory Keeper、Communication Facilitator)及其在軟體工程、金融、法律、教育、醫療、生醫、音樂等領域的特定適配。
- 5.3.1 從單代理進化到多代理進化:除了「誰進化」,也研究「何時、多快」調適。Intra-test-time 進化(任務執行中即時調適修正失敗,如 Reflexion 存反思回饋、AdaPlanner 中途重規劃、TTRL);Inter-test-time 進化(跨任務學習、把一個任務的調適固化並轉移,如 SELF、STaR、Quiet-STaR 的離線自蒸餾;RAGEN、DYSTIL 的線上 RL;課程機制自動調難度)。
- 5.3.2 多代理記憶管理(四維度):架構(G-Memory 三層圖階層 vs. Intrinsic Memory Agents 的角色對齊模板);儲存拓撲與治理(SEDM 中央式帶驗證閘;Collaborative Memory 用二部圖策略區分私有/共享、每條帶不可變 provenance;Memory Sharing 無控制池化);記憶內容分解(MIRIX 語意分解六型記憶;LEGOMem 任務式分解;MAPLE 認知階段分解 Solver/Checker/Reflector/Archiver);管理策略(Lyfe Agents 的 Summarize-and-Forget;AGENT-KB 把程序軌跡組織成結構化三元組)。
- 5.3.3 訓練多代理進化:透過互動與內在回饋共同進化(Multi-Agent Evolve 的 Proposer/Solver/Judge 閉環;CoMAS 從多代理討論動態提取學習訊號);多代理強化微調(MARFT 形式化;Stronger-MAS 用 agent/turn-wise grouping 擴展 GRPO;MAPoRL 用協作感知驗證器);角色專門化與聯合 credit assignment(MALT 訓練異質代理序列管線;MARS 聯合訓 System 1/2 代理);偏好與對齊驅動的進化(Alignment Waltz 把對齊當生成代理與回饋代理的合作共同進化)。
6 應用
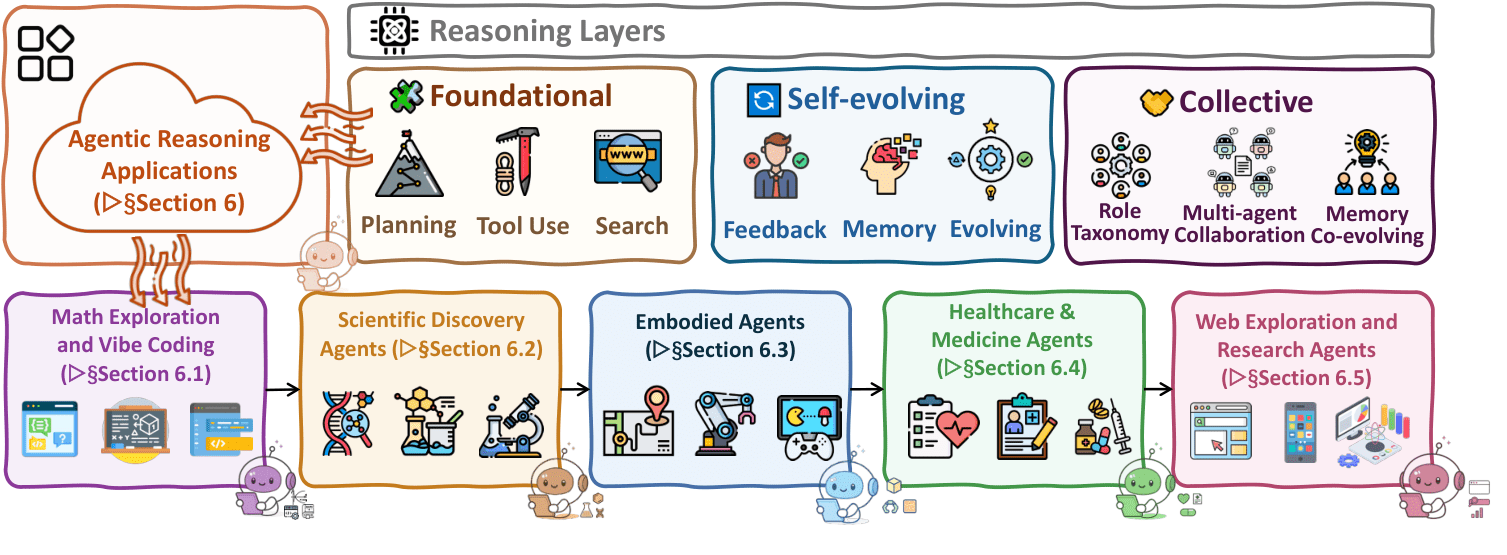
依既定三層分類法,本節橫跨五個關鍵領域檢視代理式推理系統,每個領域都按三層(基礎/自我進化/集體)組織。
6.1 數學探索與 Vibe Coding 代理
數學與程式碼傳統上是評估推理的兩大領域。傳統基準(GSM8K、MATH、AIME)漸趨飽和、只重最終答案準確度。代理式範式下,兩者從靜態求解轉向強調探索、調適、協作的動態過程。
- 6.1.1 基礎:規劃——數學上 Trinh et al. 把奧數幾何分解成構造/引理生成/驗證;程式搜尋法迭代精修候選程式;程式碼上 CodeChain、CodeAct 引入顯式規劃/動作空間、GIF-MCTS 用 MCTS 探索多條生成軌跡、VerilogCoder 用圖結構規劃。工具使用——形式定理證明代理(Thakur et al. 在 Lean 內操作);ChemCrow 鏈接化學工具;程式碼代理用 ToolGen、CodeAgent 整合搜尋/文件/符號導航/執行。搜尋與檢索——程式搜尋把數學發現當導航程式空間;RepoHyper、CodeNav、cAST 做倉庫級檢索。
- 6.1.2 自我進化:回饋與反思——執行候選程式對照約束產生反例/確認;Self-Edit、Self-Repair、LeDeX 用執行訊號精修錯誤程式碼;Self-Refine、Self-Debug 重用早期草稿。記憶——Lean 的演進證明狀態累積 tactics/subgoals;Self-Collaboration 的黑板記憶;L2MAC、Cogito 用專用暫存器/層次記憶克服情境窗限制。
- 6.1.3 集體:數學發現框架把推理組織成多代理/多元件工作流(多面體生成系統、大規模探索框架分模組提猜想/找反例/精修陳述);程式碼生成從角色管線(Self-Collaboration、AgentCoder)進展到層次設計(PairCoder、FlowGen)、彈性系統(SoA)、自我演化結構(SEW、EvoMAC)。
6.2 科學發現代理
科學發現代理加速研究全生命週期(從假設生成到實驗執行),把 LLM 與領域模擬器、實驗室自動化、最新文獻耦合。
- 6.2.1 基礎:規劃——ProtAgents 的 planner 代理制定蛋白質分析計畫並依 critic 回饋修改;Curie 用 rigor engine 把規劃變成推理的引導與規範者;Biomni 把推理約束在動態構造的生醫動作空間。工具使用——SciAgent 把工具增強推理形式化為四步;ChemCrow 鏈接化學工具;TxAgent 跨 211 個工具做治療推理;AtomAgents 規劃並跑原子級工作流。搜尋與檢索——BioDiscoveryAgent 在閉環拉文獻與中間結果;PaperQA/PaperQA2 把檢索當主迴圈、屬性化每個宣稱;LLaMP 把 RAG 延伸到材料 API。
- 6.2.2 自我進化:記憶——ChemAgent 自更新技能庫;MatAgent 短期/長期記憶並用。回饋與反思——Scientific Generative Agent 把離散 LLM 提案與內迴圈模擬綁定;ChemReasoner 用量子化學回饋評分;Curie 把 rigor check 嵌入控制流。
- 6.2.3 集體:ProtAgents(文獻檢索/結構分析/物理模擬/結果分析代理);PiFlow(Planner 傳策略給 Hypothesis 代理與驗證迴圈);CellAgent(planner/executor/evaluator);ARIA(scout/filter/synthesizer/procedure-drafter 四代理)。
6.3 具身代理
具身代理把推理延伸到文字之外,把語言錨定在機器人感知、操作、導航。
- 6.3.1 基礎:規劃——SayCan 把語言映射到技能 affordance;SayPlan 用 3D 場景圖;EmbodiedGPT 用視訊 CoT;DEPS 引入 describe-explain-plan-select 迴圈;Embodied CoT、CoT-VLA、Emma-X 用多模態推理軌跡對齊感知與動作;RL 強化(Robot-R1、ManipLVM-R1、Embodied-R、VIKI-R)。工具使用——GSCE 綁定技能 API 做安全無人機控制;MineDojo 連接網際網路級語料;執行模組把語言指令轉成連續馬達命令(SayCan、Hi Robot、Gemini Robotics、Octopus)。搜尋與檢索——L3MVN、SayNav、SayPlan 查詢語意地圖/場景圖;ReMEmbR 維護時空記憶;Embodied-RAG 把經驗與場景圖當非參數記憶。
- 6.3.2 自我進化:記憶(HELPER-X 索引技能、BrainNav 雙地圖記憶、Ella 終身情節系統);回饋與反思(Matcha 把物件/場景當互動資訊源、KnowNo 不確定時求助、Optimus-1 的 Knowledge-guided Planner + Experience-Driven Reflector、Voyager 迭代精修技能庫)。
- 6.3.3 集體:SMART-LLM 分解指令並分配子任務;CaPo 最佳化合作計畫;COHERENT 的 propose-execute-feedback-adjust 迴圈;MindForge 用 ToM 表示;RoCo 顯示角色協商支援適應性團隊合作。
6.4 醫療與醫學代理
醫療代理支援完整臨床決策管線,須在嚴格安全約束、多模態證據、法律理由下運作。
- 6.4.1 基礎:規劃(EHRAgent 把多表 EHR 推論分解成程式碼執行步;MedAgent-Pro 層次工作流;DoctorAgent-RL 把臨床諮詢建模成不確定性下的動態決策);工具使用(TxAgent 整合 200+ 藥理工具;AgentMD 挖 2000+ 可執行臨床計算器;MMedAgent 學選多模態工具;MedRAX 整合胸片工具);搜尋與檢索(MedReason 發知識圖子查詢錨定每步推理;CLADD 檢索分子圖與先前 assay)。
- 6.4.2 自我進化:記憶(EHRAgent 記錄中間計算、EvoPatient 維護演進臨床狀態);回饋與反思(DynamiCare 依新患者狀態更新治療策略;MedAgentGym 執行並評分生成程式碼)。
- 6.4.3 集體:MDAgents 依任務複雜度自動指派協作結構;AMSC 分階段多專科對話做鑑別診斷;MedAgentSim 共同演化醫生與患者代理;MedAgents 展示零樣本領域專家協作。
6.5 自主 Web 探索與研究代理
Web 代理、GUI 代理、自主研究代理構成三條互聯但相異的軌跡(自主性遞進:web 代理從線上資源檢索證據 → GUI 代理在軟體介面內操作動作 → 自主研究代理端到端編排完整科學工作流)。
- 6.5.1 基礎:規劃——Web:WebGPT 微調 GPT-3;SEEACT 整合視覺與 HTML grounding;Agent Q 整合 MCTS/自我批判/off-policy 偏好最佳化;WebRL 自演化課程、WebAgent-R1 端到端多輪 RL、DeepResearcher 擴展到真實 web。GUI:OS-Copilot 把桌面當統一控制空間;Agent S 經驗增強規劃;OS-ATLAS、UItron 等基礎模型;RL 式(ARPO、ComputerRL、UI-R1、ZeroGUI)。研究:Agent Laboratory 三階段(文獻回顧/實驗/報告);GPT Researcher 的 plan→research→write。工具使用——WebVoyager 端到端多模態執行;AutoDroid 構造功能感知 UI 抽象;Agentic Reasoning 自動路由查詢到工具模組。搜尋與檢索——WebExplorer、WebSailor 在極端不確定下的資訊尋求;GUI 用 Synapse、LearnAct、TongUI 注入外部經驗。
- 6.5.2 自我進化:記憶(AWM 從成功軌跡誘導可重用工作流;ICAL 蒸餾嘈雜軌跡;GUI 的 MobileGPT、Mobile-Agent-E 持久長期記憶);回饋與反思(Agent Q 的 MCTS + 自我批判;GUI-Reflection 端到端反思調優;CycleResearcher 耦合研究代理與 reviewer 代理)。
- 6.5.3 集體:WebPilot 把 web 任務當多代理系統(全域規劃 + 本地 MCTS 執行器);INFOGENT 分 Navigator/Extractor/Aggregator;GUI 的 COLA、Mobile-Agent-v2/E;研究的 AgentRxiv(author/reviewer/editor)、Coscientist(規劃 + 機器人儀器控制 + 分析閉環)、TAIS(project manager/data engineer/domain expert)。
7 基準
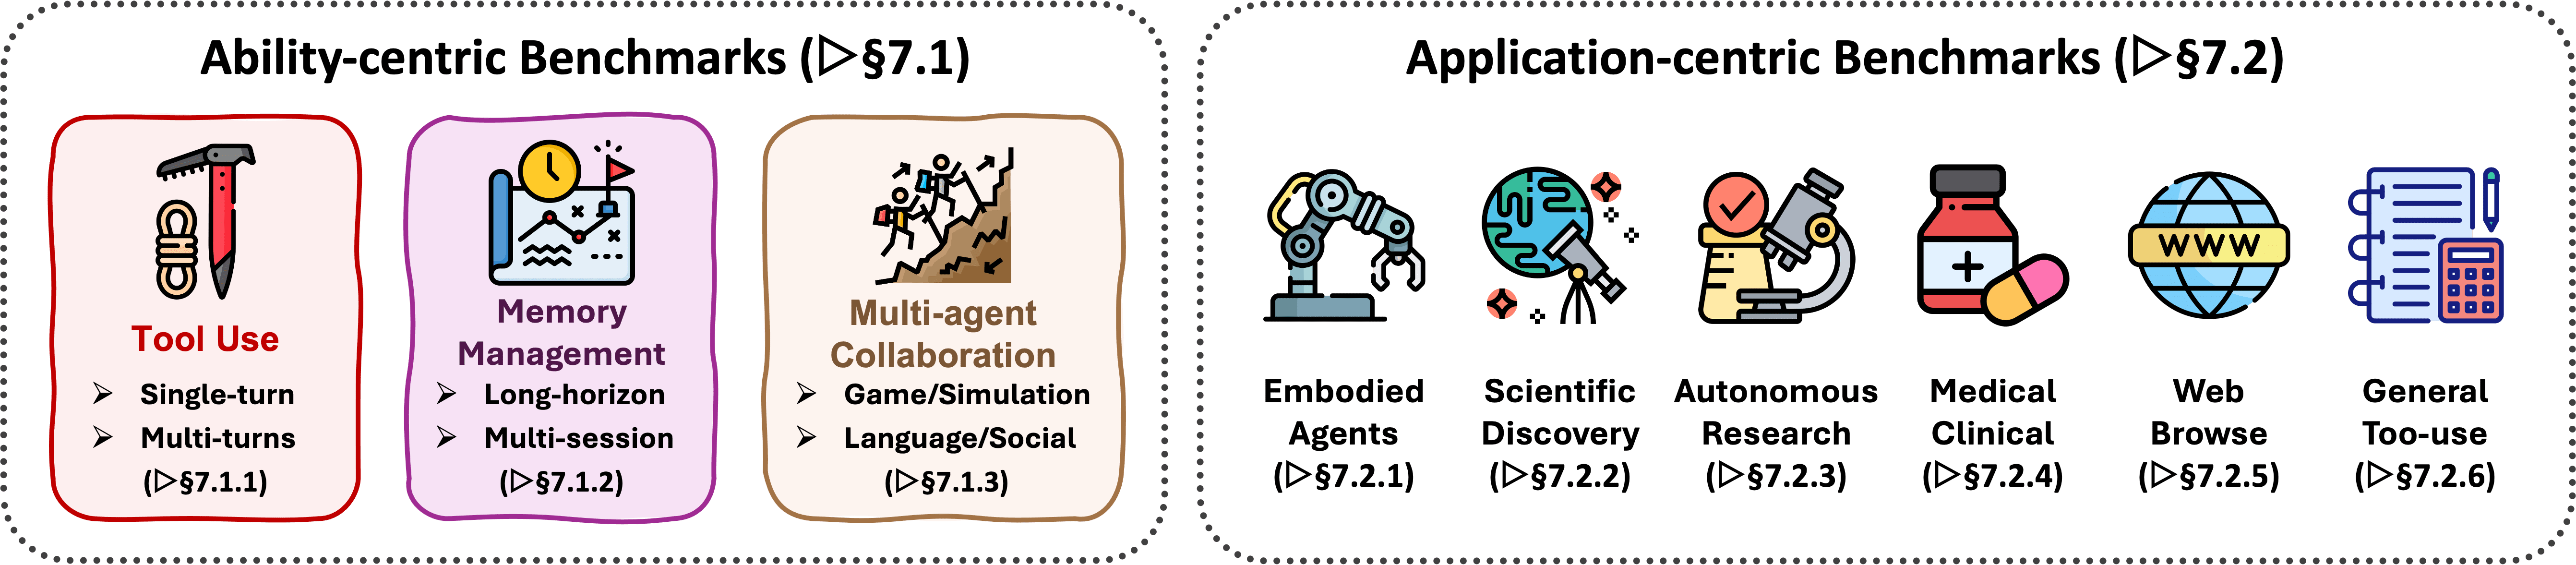
從兩個互補視角組織基準:隔離核心機制的基準、評估端到端應用行為的基準。
7.1 代理式推理的核心機制
- 7.1.1 工具使用:單輪(ToolQA 1,530 對話 13 工具;APIBench 1,645 API;ToolLLM-ToolBench 16,464 真實 API;MetaTool 的 TOOLE;T-Eval 分解成六子過程;GTA 229 真實任務;ToolRet 專注工具檢索);多輪(ToolAlpaca 3,938 例;API-Bank 1,888 對話;UltraTool 六維度;MTU-Bench 多粒度;m&m's 4,000+ 多步多模態)。
- 7.1.2 搜尋:單模態(WebWalker 結構化網站遍歷;InfoDeepSeek 動態 web;Mind2Web 2 長時程瀏覽 + 引用接地;WideSearch/DeepWideSearch 廣度 vs 深度;MedBrowseComp、FinAgentBench、LocalSearchBench 領域特定);多模態(MMSearch、MM-BrowseComp、BEARCUBS、PaperArena、Video-BrowseComp)。
- 7.1.3 記憶與規劃:記憶管理分長時程情節記憶(PerLTQA、ELITR-Bench、Multi-IF、MultiChallenge、MemBench)與多會話回憶(LOCOMO 19 會話、LONGMEMEVAL 至 1.5M token、REALTALK 21 天真人對話、MemoryAgentBench、Evo-Memory);記憶利用聚焦規劃與回饋(ALFWorld、PlanBench、ACPBench、TEXT2WORLD、REALM-Bench、TravelPlanner、FlowBench)。
- 7.1.4 多代理系統:遊戲式 RL 評估(MAgent、Pommerman、SMAC、MineLand、TeamCraft、Melting Pot、BenchMARL、Arena);模擬式真實評估(SMARTS、Nocturne 駕駛;MABIM 庫存;IMP-MARL 基礎設施;POGEMA 路徑;REALM-Bench);語言/通訊/社會推理(LLM-Coordination、AVALONBENCH、Welfare Diplomacy、MAgIC、BattleAgentBench、COMMA、IntellAgent、MultiAgentBench)。
7.2 代理式推理的應用
六類:具身代理(AgentX、BALROG、ALFWorld、AndroidArena、OSWorld);科學發現(DISCOVERYWORLD、ScienceWorld、ScienceAgentBench、The AI Scientist、LAB-Bench、MLAgentBench);自主研究(WorkArena、OfficeBench、TRAIL、CLIN、Agent-as-a-Judge);醫療與臨床(AgentClinic、MedAgentBench、EHRAgent、MedBrowseComp、GuardAgent);Web 代理(WebArena、VisualWebArena、WebVoyager、Mind2Web、BrowseComp-ZH);通用工具使用(GTA、NESTFUL、CodeAct、RestGPT、Search-o1、R-Judge)。
8 開放問題
- 8.1 以使用者為中心的代理式推理與個人化:把使用者當環境的一部分、跨多輪互動持續調適;須動態推斷演進中的使用者意圖、平衡短期任務獎勵與長期使用者體驗/滿意/信任,帶來非平穩目標與長時程 credit assignment 挑戰。
- 8.2 從延伸互動的長時程代理式推理:ReAct、ToT 改善短時程,但長任務中錯誤仍快速累積;RL 訓練代理(WebRL、Agent-R1)依賴大量工程化的領域特定獎勵、且大體上獨立處理各 episode。核心開放問題是如何跨 token、工具呼叫、技能、記憶更新分配 credit,並跨長 episode/任務序列泛化。
- 8.3 帶世界模型的代理式推理:世界模型代理靠內部模擬與前瞻緩解短視推理(DreamerV3 的想像 rollout);但當前設計依賴臨時表示、通常在短時程或環境特定資料上訓練,校準與泛化存疑。開放問題是如何在非平穩環境中聯合訓練、更新、評估世界模型。
- 8.4 多代理協作推理與訓練:多數協作結構仍手工設計;近期 MARL 開始把協作本身當可訓練技能,但群體級 credit assignment 仍理解不足。擴展到更大代理群更帶來拓撲調適、協調開銷、安全的挑戰。
- 8.5 潛在代理式推理:在內部潛在空間(而非顯式自然語言/符號軌跡)做規劃、決策、協作。可提升效率與可擴展性,但降低可解釋性與可控性——當中間推理步不可外部觀測時,診斷失敗特別困難。
- 8.6 代理式推理的治理:跨越時間與元件的互動可能導致失敗,使歸因與稽核困難;既有基準與護欄主要聚焦短時程行為,規劃時失敗與多代理動態尚未充分探索。核心開放問題是發展能同時處理模型級對齊、代理級策略、生態系級互動的治理框架。
術語對照表
| English | 繁體中文 |
|---|---|
| Agentic Reasoning | 代理式推理 |
| Foundational / Self-Evolving / Collective | 基礎 / 自我進化 / 集體 |
| In-context Reasoning | 情境內推理 |
| Post-training Reasoning | 後訓練推理 |
| Planning / Tool Use / Search | 規劃 / 工具使用 / 搜尋 |
| Chain-of-Thought (CoT) | 思維鏈 |
| Tree-of-Thoughts (ToT) | 思考樹 |
| ReAct (Reasoning + Acting) | 推理+行動 |
| POMDP / Dec-POMDP | 部分可觀測馬可夫決策過程 / 去中心化 POMDP |
| GRPO / PPO / DAPO | 組相對策略最佳化 / 近端策略最佳化 / DAPO |
| Reflective feedback | 反思式回饋 |
| Parametric adaptation | 參數調適 |
| Validator-driven feedback | 驗證器驅動回饋 |
| Agentic Memory | 代理式記憶 |
| Flat / Structured memory | 平面 / 結構化記憶 |
| RAG (Retrieval-Augmented Generation) | 檢索增強生成 |
| Agentic RAG / Agentic Search | 代理式 RAG / 代理式搜尋 |
| Multi-Agent System (MAS) | 多代理系統 |
| Role taxonomy | 角色分類 |
| Manager / Worker / Critic | 管理者 / 工作者 / 批判者 |
| Theory of Mind (ToM) | 心智理論 |
| Topology optimization | 拓撲最佳化 |
| Self-evolution / Co-evolution | 自我進化 / 共同進化 |
| Intra/Inter-test-time evolution | 測試時內 / 跨測試時 進化 |
| Credit assignment | 信用分配 |
| World model | 世界模型 |
| Latent reasoning | 潛在推理 |
| Governance | 治理 |
| Vibe coding | Vibe coding(對話式協作編程) |
| Embodied agent | 具身代理 |
| GUI agent | 圖形介面代理 |