深入 Claude Code:當代與未來 AI 智能體系統的設計空間
原始論文:Dive into Claude Code: The Design Space of Today's and Future AI Agent Systems 作者:Jiacheng Liu, Xiaohan Zhao, Xinyi Shang, Zhiqiang Shen arXiv ID:2604.14228v1 日期:2026-04-14 標籤:AI Agent Claude Code System Design Software Architecture Safety 程式碼智能體
目錄
- 1. 引言
- 2. 設計哲學與原則
- 3. 架構概覽
- 4. 迴圈執行:智能體查詢迴圈
- 5. 工具授權與控制邊界
- 6. 擴充性:MCP、Plugins、Skills、Hooks
- 7. 上下文建構與記憶
- 8. 子智能體委派與編排
- 9. 與 OpenClaw 的比較分析
- 10. 討論與未來方向
- 11. 結論
- 參考文獻
- 術語對照表
1. 引言
Claude Code 代表了從建議式工具(如 GitHub Copilot)到完全智能體系統的轉變,能自主執行多步驟修改。本文透過原始碼分析(v2.1.88),識別出驅動設計決策的五個核心人類價值,並追溯它們如何經由十三個設計原則落實到具體實作。
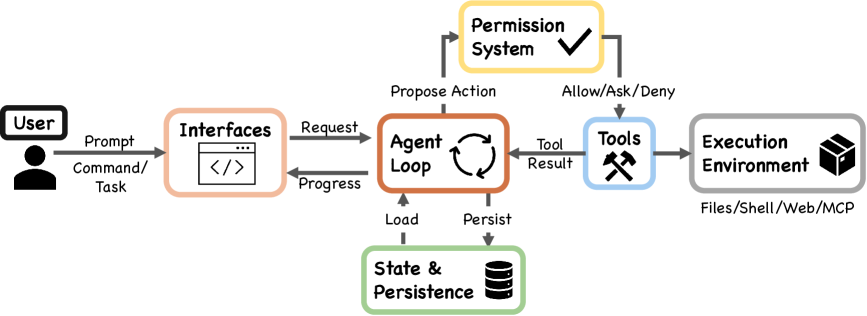
關鍵發現:約 27% 的 Claude Code 輔助任務是「沒有這個工具就不會嘗試的工作」——代表質的能力放大,而非僅僅加速。
分析圍繞三部分展開:
- 設計空間分析,識別反覆出現的架構問題
- 與 OpenClaw 在六個維度上的比較
- 六個未來智能體系統的開放方向
2. 設計哲學與原則
五個核心人類價值
- 人類決策權 (Human Decision Authority):透過知情觀察、審批、中斷、稽核維持使用者控制
- 安全性 (Safety, Security, Privacy):即使使用者注意力下降或犯錯也保護人、程式碼、資料
- 可靠執行 (Reliable Execution):忠實解讀、長對話連貫性、可驗證的完成度
- 能力放大 (Capability Amplification):實質增加單位努力的人類成就量,投資在確定性基礎設施而非決策鷹架
- 情境適應 (Contextual Adaptability):適合特定使用者情境,關係隨時間改善
十三個設計原則
| 原則 | 核心功能 |
|---|---|
| 預設拒絕 + 人類升級 | 未識別的操作升級給使用者而非靜默執行 |
| 漸進信任光譜 | 隨時間演進的自主程度,非固定權限 |
| 縱深防禦 | 多層重疊的安全邊界,使用不同技術 |
| 外部化可程式化策略 | 配置驅動的策略 + 生命週期 hooks |
| Context 是稀缺資源 | 漸進式管理管線,非單次截斷 |
| 僅附加持久狀態 | 不可變的交易日誌,支援稽核 |
| 最少鷹架、最大營運套件 | 基礎設施重於顯式規劃圖 |
| 價值觀優於規則 | 在確定性護欄內的情境判斷 |
| 可組合多機制擴充 | 不同 context 成本的分層機制 |
| 可逆性加權風險評估 | 對可逆和唯讀操作較輕量的監督 |
| 透明檔案式配置 | 使用者可見、版控的記憶 vs. 不透明資料庫 |
| 隔離的子智能體邊界 | 子智能體隔離而非共享 context/權限 |
| 優雅恢復與韌性 | 靜默恢復,保留人類注意力給不可恢復的情況 |
3. 架構概覽
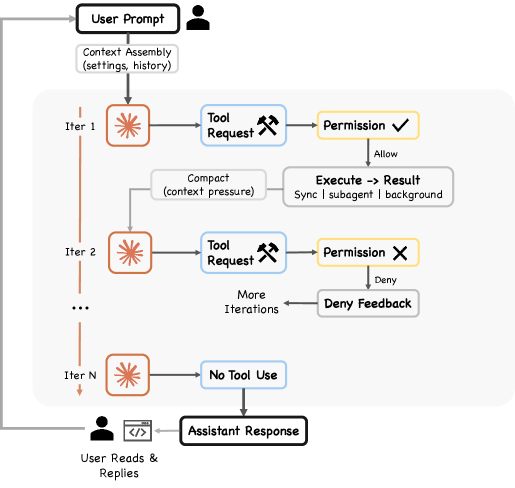
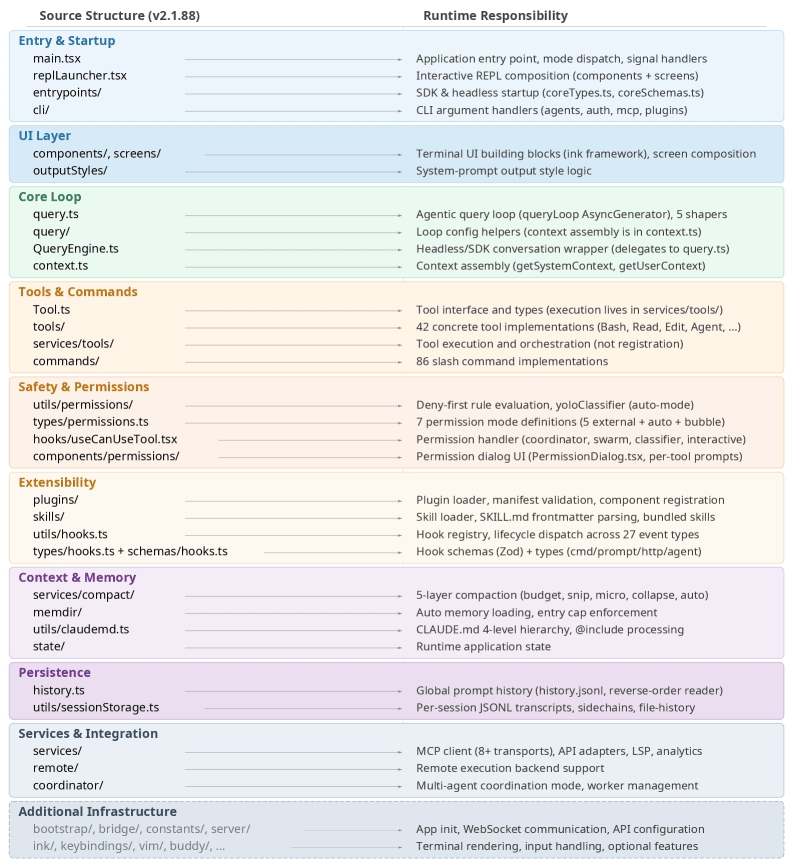
七大組件:使用者、介面(CLI/SDK/IDE)、智能體迴圈、權限系統、工具、狀態與持久化、執行環境。
設計問題:
- 推理在哪裡? 模型推理;套件執行。模型發出
tool_use區塊;套件驗證後執行。約 1.6% AI 決策邏輯,98.4% 營運基礎設施。 - 幾個執行引擎? 單一
queryLoop(),不論介面(終端、headless、SDK、IDE),只有渲染不同。 - 預設安全態勢? 預設拒絕 + 人類升級,跨七個獨立層。
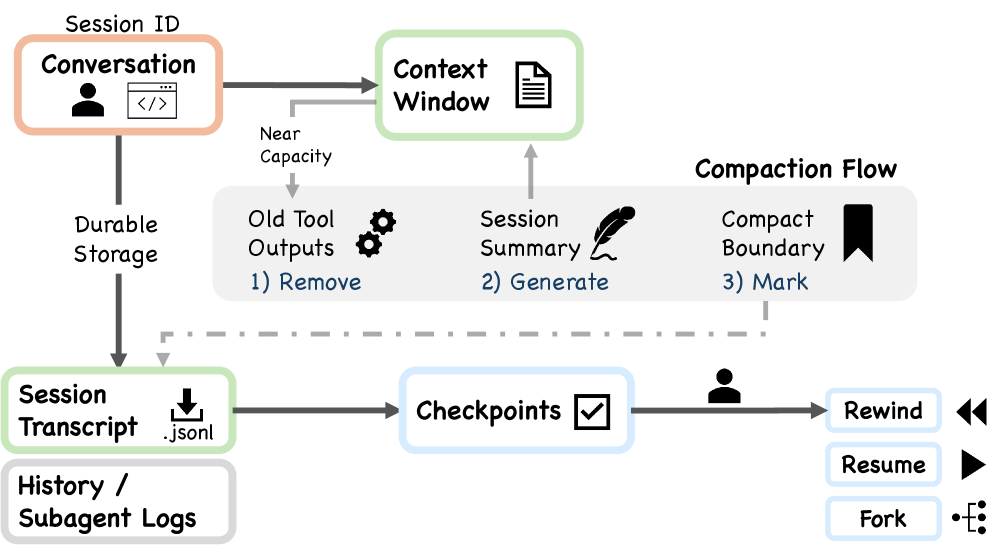
- 綁定資源限制? Context window(200K-1M tokens),透過五層壓縮管線管理。
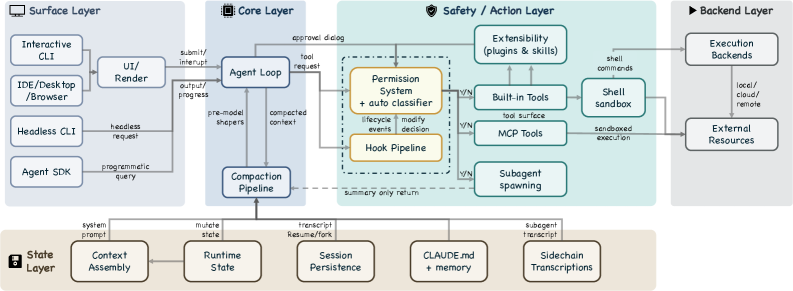
五層子系統分解
4. 迴圈執行:智能體查詢迴圈
管線序列:設定解析 → 可變狀態初始化 → context 組裝 → 前模型 context 整形(五層) → 模型呼叫 → 工具派遣 → 權限閘門 → 工具執行 → 停止條件評估
前模型 Context 整形器(五層漸進管理):
- 預算縮減 (Budget Reduction):工具結果的每訊息大小限制
- 剪裁 (Snip):輕量時間修剪舊歷史段落
- 微壓縮 (Microcompact):細粒度壓縮,有時間和快取感知路徑
- Context 摺疊 (Context Collapse):讀取時投影,保留完整歷史離線
- 自動壓縮 (Auto-compact):模型生成的語義壓縮,最後手段
每層在不同成本-效益權衡下運作;越早、越便宜的層先執行。
工具派遣策略:
StreamingToolExecutor在工具從模型回應串流時開始執行- 唯讀操作並行執行;狀態修改操作序列化
- 結果緩衝後按請求順序發出
停止條件:無工具使用(主要)、達最大輪數、context 溢出、hook 介入、明確中止信號。
5. 工具授權與控制邊界
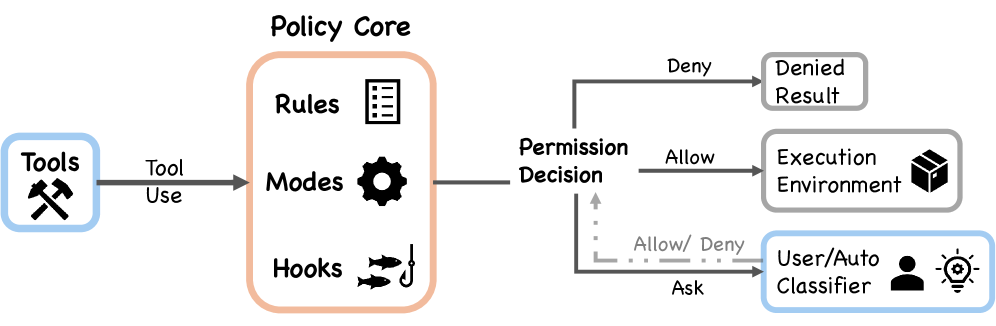
七個獨立安全層:
- 工具前過濾:全面拒絕的工具在模型呼叫前移除
- 預設拒絕規則評估:拒絕規則始終優先
- 權限模式限制:基於啟用模式的基線處理
- Auto 模式分類器:ML 安全評估
- Shell 沙盒:獨立於權限的檔案系統/網路隔離
- 恢復時權限不還原:session 範圍的權限不跨 session 還原
- Hook 攔截:
PreToolUse和PermissionRequesthooks
七個權限模式:plan、default、acceptEdits、auto、dontAsk、bypassPermissions、bubble(內部子智能體模式)。
漸進信任光譜:縱向資料顯示自動核准率從 <50 個 session 的約 20% 增加到 750 個 session 的 >40%。
關鍵發現:使用者核准約 93% 的權限提示,表示核准疲勞讓互動式確認作為唯一安全機制不可靠。因此系統透過預設拒絕、前過濾和沙盒來維持安全,獨立於人類警覺性。
6. 擴充性:MCP、Plugins、Skills、Hooks
四種擴充機制(不同 context 成本):
| 機制 | Context 成本 | 說明 |
|---|---|---|
| MCP Server | 最高 | 完整工具 schema,支援 stdio/SSE/HTTP/WebSocket |
| Plugins | 中 | 透過 skills registry 和 hook 管線整合 |
| Skills | 較低 | 指令 registry 條目 + 可選 hook 整合 |
| Hooks | 最小 | 27 種事件(5 種安全關鍵、22 種生命週期) |
五個安全關鍵 Hook 事件:PreToolUse、PostToolUse、PostToolUseFailure、PermissionDenied、PermissionRequest。
設計理由:可組合多機制擴充以 context 成本彈性換取統一簡單性。
7. 上下文建構與記憶
CLAUDE.md 階層(四層指令堆疊):
- 管理設定(最高優先權)
- 使用者全域 CLAUDE.md
- 專案級 CLAUDE.md
- 目錄特定 CLAUDE.md
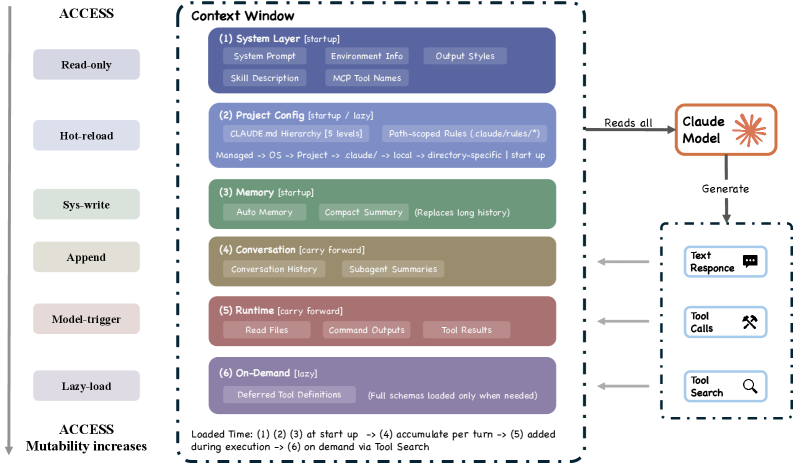
延遲載入防止未使用指令消耗 context。自動記憶條目讓 Claude 在對話中寫入指令更新。
Context 縮減策略:延遲 CLAUDE.md 載入、延遲工具 schema(ToolSearch)、子智能體僅摘要回傳、每工具結果預算上限。
8. 子智能體委派與編排
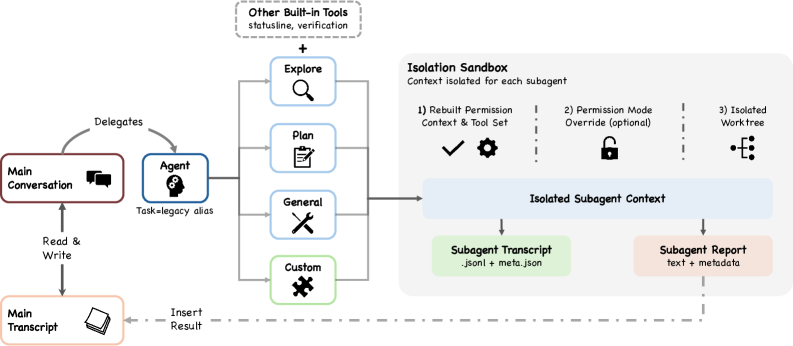
隔離架構:
- 獨立 context window(通常更小)
- 自有 session 轉錄檔
- 隔離的權限狀態(bubble 模式將未識別操作升級給父級)
- 僅摘要回傳(防止子智能體對話膨脹父級 context)
每個子智能體對話存在獨立檔案,遵循相同 queryLoop() 但有受限 context 和隔離權限。
9. 與 OpenClaw 的比較分析
六個比較維度:
| 維度 | Claude Code | OpenClaw |
|---|---|---|
| 範圍 | 每 session 的 CLI 工具 | 多通道閘道 + 協調層 |
| 信任模型 | 每操作預設拒絕 | 邊界級存取控制 |
| 執行時 | 單一反應式迴圈 | 協調控制平面內的嵌入式執行時 |
| 擴充 | 四機制 | 閘道級能力註冊 |
| 記憶 | Context window 擴展 | 持久多 session 知識圖譜 |
| 多智能體 | 子智能體 + 側鏈隔離 | 群組協調 |
核心洞見:相同的設計問題在不同部署情境下產生不同架構答案。Claude Code 強調本地安全和最少假設;OpenClaw 透過協調層集中治理。
10. 討論與未來方向
架構權衡
- 安全 vs. 自主:預設拒絕限制自主操作,邁向更高自主需要更強的自動化安全檢查
- 權限模型的對抗條件:93% 核准率代表習慣性核准,系統透過多層防禦而非單靠人類判斷
- Context 效率 vs. 透明度:五層壓縮管線優先 context 效率,context 摺疊可能遮蔽模型實際看到的內容
- 簡單 vs. 擴充性:四種擴充機制(非統一 API)以簡單性換取 context 成本彈性
六個開放方向
- 可觀察性:優雅恢復隱藏了失敗模式,需要量化壓縮保真度損失的觀察層
- 持久記憶:跨 session 記憶實現「同事」關係
- 套件邊界演進:分散式執行、非同步背景委派、更細粒度的權限
- 視野擴展:從 session 範圍(分鐘到小時)擴展到科學級(數週到數年)
- 治理:多使用者部署的機構策略、稽核追蹤和問責機制
- 評估透鏡:短期能力放大是否能與長期人類能動性和能力共存?
11. 結論
Claude Code 的架構反映五個核心人類價值,透過十三個設計原則落實。系統透過最少決策鷹架結合廣泛營運基礎設施達到顯著的能力放大(27% 未嘗試工作)。
關鍵架構選擇:
- 單一統一
queryLoop(),介面特定渲染 - 七層縱深防禦安全架構
- 五層壓縮管線的 context 管理
- 四種可組合擴充機制(不同 context 成本)
- 僅附加轉錄檔支援稽核和恢復
- 漸進信任光譜,基於時間的自主增長
參考文獻
Anthropic. Claude Code Documentation, 2025.
Wang, X., et al. OpenHands: An Open Platform for AI Software Developers as Generalist Agents. ICLR, 2025.
Yang, J., et al. SWE-Agent: Agent-Computer Interfaces Enable Automated Software Engineering. NeurIPS, 2024.
Schick, T., et al. Toolformer: Language Models Can Teach Themselves to Use Tools. NeurIPS, 2023.
Yao, S., et al. ReAct: Synergizing Reasoning and Acting in Language Models. ICLR, 2023.
Chase, H. LangChain: Building Applications with LLMs through Composability, 2022.
LangGraph Team. LangGraph: Framework for Building Multi-Agent Systems, 2024.
Anthropic. Model Context Protocol (MCP) Specification, 2024.
Ganapini, M.B., et al. Thinking LLMs: General Instruction Following with Thought Generation, 2024.
Chen, M., et al. Evaluating Large Language Models Trained on Code. arXiv, 2021.
術語對照表
| 英文 | 中文 |
|---|---|
| Agentic System | 智能體系統 |
| Query Loop | 查詢迴圈 |
| Permission Gate | 權限閘門 |
| Deny-First | 預設拒絕 |
| Defense in Depth | 縱深防禦 |
| Graduated Trust Spectrum | 漸進信任光譜 |
| Context Compaction | 上下文壓縮 |
| Context Collapse | 上下文摺疊 |
| Microcompact | 微壓縮 |
| Auto-compact | 自動壓縮 |
| Tool Dispatch | 工具派遣 |
| Subagent Delegation | 子智能體委派 |
| Sidechain Transcript | 側鏈轉錄檔 |
| Append-Only | 僅附加 |
| Approval Fatigue | 核准疲勞 |
| Capability Amplification | 能力放大 |
| Human Decision Authority | 人類決策權 |
| Model Context Protocol (MCP) | 模型上下文協定 |
| Hook | 生命週期鉤子 |
| Bubble Mode | 氣泡模式(子智能體升級) |
| Sandbox | 沙盒 |
| Worktree Isolation | 工作樹隔離 |