EndPrompt:透過終端錨定 (Terminal Anchoring) 達成高效長上下文擴展
原始論文:EndPrompt: Efficient Long-Context Extension via Terminal Anchoring 作者:Han Tian, Luxuan Chen, Xinran Chen, Rui Kong, Fang Wang, Jiamin Chen, Jinman Zhao, Yuchen Li, Jiashu Zhao, Shuaiqiang Wang, Haoyi Xiong, Linghe Kong, Dawei Yin(Nankai University、Baidu Inc.、Shanghai Jiao Tong University) arXiv ID:2605.14589v2 日期:2026-06-02 標籤:LLM Long-Context RoPE Position Interpolation Context Extension LLaMA 高效訓練
摘要
擴展大型語言模型 (Large Language Models) 的上下文視窗 (Context Window) 通常需要在目標長度的序列上進行訓練,這會帶來注意力計算的二次方 (quadratic) 記憶體與運算成本,使得長上下文適應 (Long-Context Adaptation) 既昂貴又難以複現。我們提出 EndPrompt,一種僅使用短訓練序列即可達成有效上下文擴展的方法。其核心洞見在於:要讓模型接觸到長距離的相對位置距離,並不需要構建完整長度的輸入;我們將原始的短上下文保留為完整的第一片段 (segment),並附加一段簡短的終端提示 (terminal prompt) 作為第二片段,賦予其接近目標上下文長度的位置索引 (positional indices)。這種雙片段構造在一條短的物理序列 (physical sequence) 內同時引入了局部與長距離的相對距離,同時維持訓練文本的語意連續性 (semantic continuity)——而這正是基於分塊 (chunk-based) 的模擬方法(會切割連續上下文)所欠缺的特性。我們提供了一個立基於旋轉位置嵌入 (Rotary Position Embedding, RoPE) 與 Bernstein 不等式的理論分析,證明位置插值 (Position Interpolation) 會對注意力函數 (Attention Function) 施加一個嚴格的平滑性約束 (smoothness constraint),而共享的 Transformer 參數則進一步抑制了對未觀測中間距離 (unobserved intermediate distances) 的不穩定外推 (extrapolation)。將 EndPrompt 應用於 LLaMA 系列模型、把上下文視窗從 8K 擴展到 64K 時,EndPrompt 取得了 76.03 的平均 RULER 分數以及 LongBench 上的最高平均分,超越了 LCEG (72.24)、LongLoRA (72.95) 與完整長度微調 (full-length fine-tuning, 69.23),且所需運算量顯著更少。這些結果表明,長上下文泛化 (long-context generalization) 能夠由稀疏的位置監督 (sparse positional supervision) 所誘發,挑戰了「可靠的上下文視窗擴展必須依賴密集長序列訓練」這一普遍假設。程式碼已開源於 https://github.com/clx1415926/EndPrompt 。
1 引言
大型語言模型是現代自然語言處理的基礎,也是複雜推理的核心介面。然而,它們可靠的最大上下文長度限制了其效用。諸如長文件問答 (long-document question answering) [13, 23]、儲存庫級程式碼理解 (repository-level code understanding) [22, 16]、法律與科學文件分析 [4]、個人化助理,以及廣泛的證據檢索等應用,都需要對超出預訓練上下文視窗的輸入進行推理。在此情境下,更長的上下文唯有在模型能保持局部連貫性 (local coherence) 並在遠距 token 之間建立可靠互動時才有效。因此,擴展預訓練上下文視窗是語言模型適應中的核心問題。
在目標上下文長度的長序列上持續訓練模型,是一種直接但昂貴的解法。收集高品質的長篇語料相當困難,而訓練因注意力計算的二次方擴展 [30] 而增加了記憶體消耗與執行時間。儘管像 FlashAttention [12] 這類高效實作與分散式系統能緩解此負擔,完整長度微調仍然代價高昂。為了降低成本,近期方法探索了位置插值 [8, 26, 6, 14]、稀疏注意力 (sparse attention) [10]、滑動視窗注意力 (sliding-window attention) [3, 32, 17]、低秩適應 (low-rank adaptation) [20],以及模擬式長上下文訓練 (simulated long-context training) [35, 1]。然而,這些方法往往引入了限制,例如需要大量的長序列訓練、改變注意力的結構,或以破壞語意連續性的方式對文本進行分塊。因此,目前仍不清楚上下文擴展究竟需要在目標長度上的密集監督 (dense supervision),還是一組稀疏的、結構化的位置訊號就已足夠。
本文探討模型是否必須觀測完整長度的序列才能習得長上下文能力。我們透過位置泛化 (positional generalization) 的視角來研究此問題。在採用旋轉位置嵌入 [29] 的模型中,注意力分數 (attention scores) 同時取決於 token 內容與相對位置距離。現有方法假設可靠的外推需要在訓練期間接觸密集的相對距離,而我們則證明:有效的長上下文行為可以從稀疏的訓練訊號中浮現。具體而言,只要範例能保持語意連貫並為遠距位置提供穩定的錨點 (anchors),在短序列上訓練的模型就能獲得對長距離位置的監督。這項發現將上下文適應重新框定為「設計具資訊量的位置監督」,而非僅僅增加物理序列長度。
我們提出 EndPrompt,一種利用位置索引操控 (positional index manipulation) 與附加 end prompt 的高效上下文擴展方法。我們將原始的短上下文保留為第一片段,並附加一段終端提示作為第二片段。第一片段獲得局部位置索引,第二片段則獲得接近目標最大上下文長度的索引。這種配置在一條短的物理序列內同時產生局部與長距離的相對距離。與基於分塊的方法 [35] 不同,我們的做法避免切割連續文本,從而在使模型接觸長距離位置模式的同時保留語意完整性。end prompt 的功能是作為一個穩定的終端錨點。實驗顯示其對各種提示表述都具有穩健性,這表明其效能來自終端線索的結構性位置,而非記憶特定的 token。此設計在不損害短上下文訓練訊號品質的前提下,揭露了長距離的位置互動。
我們分析稀疏監督如何支撐長上下文泛化。在旋轉位置嵌入 [29] 之下,注意力分數表現為相對距離上一系列正弦分量 (sinusoidal components) 的總和,其振幅 (amplitude) 與相位 (phase) 取決於內容。位置插值 [8] 降低了有效位置頻率 (effective positional frequencies),約束了注意力分數沿距離維度的變化率 (variation rate) 與曲率 (curvature)。這種降低在未觀測的中間距離上誘發出一種平滑性偏置 (smoothness bias)。此外,Transformer 並不會為每個距離學習獨立的參數;相同的查詢 (query) 與鍵 (key) 投影同時支撐局部與長距離行為。因此,稀疏的長距離監督與局部監督相結合,約束了共享的參數空間,並將未觀測區域中的不穩定行為降到最低。這個理論觀點解釋了短序列訓練如何產生穩定的長上下文能力。
我們在 LLaMA 系列模型 [31, 15] 上評估 EndPrompt (ET),將上下文視窗從 8K 擴展到 64K。RULER [19] 與 LongBench [2] 的實驗顯示,我們的方法相較於 LCEG [25]、LongLoRA [9] 與完整長度微調等基準,取得了具競爭力或更優越的效能。具體而言,我們的方法取得 76.03 的平均 RULER 分數,勝過 LCEG (72.24)、LongLoRA (72.95) 與完整長度微調 (69.23)。在 LongBench 上,我們的方法取得最高平均分,並在問答、摘要、少樣本學習 (few-shot learning) 與程式碼補全等任務上展現強勁表現。消融研究驗證了 end prompt 設計、基礎模型選擇、擴展長度與訓練 token 數量的影響。這些結果證實,可靠的長上下文適應源於結構化的稀疏位置監督,而無需完整長度的訓練序列。
本工作的主要貢獻歸納如下:
我們提出 EndPrompt (ET),一種高效的上下文擴展方法,利用短訓練序列、位置索引操控以及附加的 end prompt 來模擬長距離的位置監督。
我們證明:將原始上下文保留為不可分割的片段能維持語意連續性,而 end prompt 則提供一個穩定的終端錨點,以在不擾亂下一個 token 預測訊號的前提下建立長距離關係。
我們透過旋轉位置嵌入與位置插值來分析此方法,解釋平滑的位置變化與 Transformer 的共享參數如何支撐對未觀測中間距離的泛化。
我們在 RULER 與 LongBench 上展現強勁的實證效能,我們的方法在避免使用完整長度訓練序列的同時,勝過具代表性的基準。
2 預備知識
本節回顧所提方法的位置機制:RoPE [29] 與 PI [8]。
對於給定的注意力頭 (attention head),令 $\mathbf{q}_{m},\mathbf{k}_{n}\in\mathbb{R}^{D}$ 表示位於位置 $m$ 與 $n$ 的查詢與鍵向量。RoPE 將維度劃分為複數子空間 (complex subspaces)。在第 $j$ 個子空間中,給定指派的位置索引 $p_{m}$ 與 $p_{n}$,RoPE 對內容分量 $q_{m,j}$ 與 $k_{n,j}$ 施加一個與位置相關的相位旋轉 (phase rotation)。由此得到 $\hat{q}_{m,j}=q_{m,j}e^{ip_{m}\theta_{j}}$ 與 $\hat{k}_{n,j}=k_{n,j}e^{ip_{n}\theta_{j}}$,其中 $\theta_{j}$ 為固定的角頻率 (angular frequency)。此子空間貢獻的未正規化注意力分數取決於指派的相對距離 $d=p_{m}-p_{n}$。透過將內容項 $q_{m,j}\bar{k}_{n,j}$ 以極座標形式表示,其振幅為 $a_{j}(\mathbf{x}_{m},\mathbf{x}_{n};\Theta)$、相位偏移為 $\phi_{j}(\mathbf{x}_{m},\mathbf{x}_{n};\Theta)$,整體 RoPE 注意力分數即成為一個有限的三角多項式 (trigonometric polynomial):
$$S_{\mathrm{RoPE}}(d\mid\mathbf{x}_{m},\mathbf{x}_{n};\Theta)=\sum_{j=0}^{D/2-1}a_{j}(\mathbf{x}_{m},\mathbf{x}_{n};\Theta)\cos\left(d\theta_{j}+\phi_{j}(\mathbf{x}_{m},\mathbf{x}_{n};\Theta)\right). \tag{1}$$
由於距離變數僅嵌入於正弦相位之中,調控位置索引便能在不修改物理序列長度的情況下,讓注意力作用於更廣的指派相對距離。
為了使 RoPE 適應擴展後的上下文,PI 以一個目標縮放因子 $s>1$ 對位置索引重新縮放,將 $p$ 映射為 $p/s$。此操作實際上把角頻率降為 $\theta_{j}/s$,將整體注意力分數修改為:
$$S_{\mathrm{PI}}(d\mid\mathbf{x}_{m},\mathbf{x}_{n};\Theta)=\sum_{j=0}^{D/2-1}a_{j}(\mathbf{x}_{m},\mathbf{x}_{n};\Theta)\cos\left(\frac{d\theta_{j}}{s}+\phi_{j}(\mathbf{x}_{m},\mathbf{x}_{n};\Theta)\right). \tag{2}$$
相較於式 1,這種重新縮放降低了沿距離維度的最大變化率。由於 $S_{\mathrm{PI}}$ 是有限三角多項式,最大有效頻率 $\theta_{0}$ 嚴格地約束了該函數的一階變化與二階曲率:
$$\sup_{d}\left|\frac{\partial S_{\mathrm{PI}}}{\partial d}\right|\leq\frac{\theta_{0}}{s}\sup_{d}\left|S_{\mathrm{PI}}(d)\right|,\quad\sup_{d}\left|\frac{\partial^{2}S_{\mathrm{PI}}}{\partial d^{2}}\right|\leq\left(\frac{\theta_{0}}{s}\right)^{2}\sup_{d}\left|S_{\mathrm{PI}}(d)\right|. \tag{3}$$
這些界限並非保證對未見距離的完美重建,而是表明 PI 透過抑制高頻位置變化提供了一種平滑性偏置。所提方法利用這種平滑性,結合針對性的長距離監督,來穩定訓練期間未觀測到的各距離上的注意力分數。
3 方法
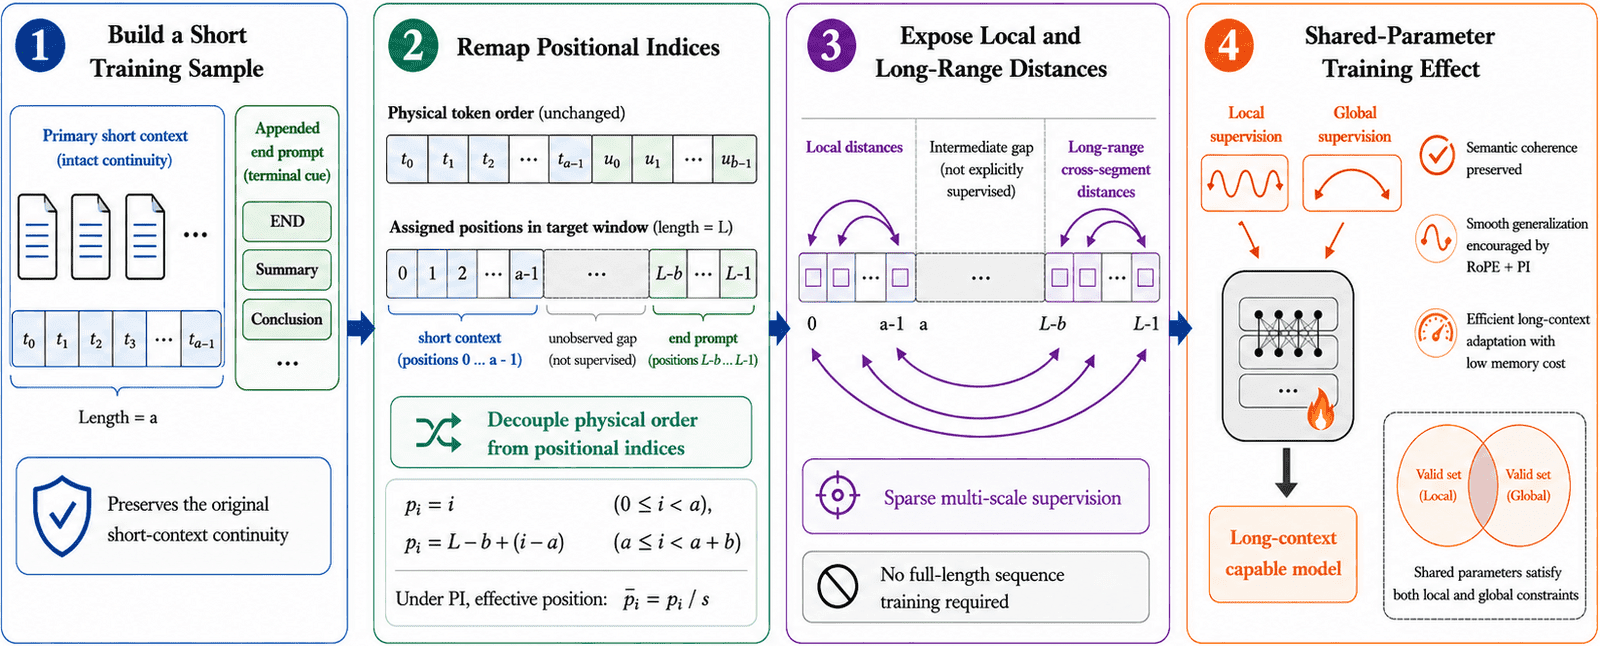
圖 1:所提方法總覽。
3.1 總覽
如圖 1 所示,所提方法旨在達成高效的長上下文適應,同時避免完整長度序列訓練所伴隨的高記憶體與運算成本。此目標透過兩個耦合的組件來實現。首先,位置索引操控將物理 token 順序與指派的位置索引解耦,從而在維持局部注意力的同時建立稀疏的長距離監督。其次,附加的 end prompt 作為一個位於目標上下文視窗邊界附近的終端錨點。此設計保留了原始短上下文的語意完整性。兩者共同作用,使模型能在 RoPE 與 PI 的框架下,從短訓練樣本中獲得長距離的位置能力。
3.2 位置索引操控
令 $L$ 表示目標上下文長度。給定一個長度為 $a$ 的短上下文序列 $\mathbf{x}=(x_{0},x_{1},\ldots,x_{a-1})$,附加一個長度為 $b$ 的 end prompt $\mathbf{e}=(e_{0},e_{1},\ldots,e_{b-1})$ 以構成物理訓練序列:
$$\mathbf{y}=(x_{0},x_{1},\ldots,x_{a-1},e_{0},e_{1},\ldots,e_{b-1}),\quad|\mathbf{y}|=a+b. \tag{4}$$
雖然物理長度為 $a+b$,但指派的位置索引透過以下映射跨越目標上下文視窗的兩端:
$$p_{\ell}=\begin{cases}\ell,&0\leq\ell<a\\ L-b+(\ell-a),&a\leq\ell<a+b\end{cases} \tag{5}$$
因此,短上下文與 end prompt 分別被指派到區間 $[0,a-1]_{\mathbb{Z}}$ 與 $[L-b,L-1]_{\mathbb{Z}}$。在 PI 之下,有效位置索引變為
$$\bar{p}_{\ell}=\frac{p_{\ell}}{s}, \tag{6}$$
其中 $s>1$ 為插值縮放因子。因此,注意力分數評估的是指派的相對距離 $p_{\ell}-p_{r}$,而非物理相對距離 $\ell-r$:
$$S_{\ell r}=\sum_{j=0}^{D/2-1}a_{j,\ell r}(\Theta)\cos\left(\frac{(p_{\ell}-p_{r})\theta_{j}}{s}+\phi_{j,\ell r}(\Theta)\right),\quad r\leq\ell. \tag{7}$$
式 7 將所提的位置映射與式 2 的 PI 分數連結起來,使得注意力機制儘管處理的是短物理序列,仍能接收到對應於長上下文範圍的位置相位。
在因果注意力 (causal attention) 之下,所觀測到的指派相對距離集合由原始上下文與 end prompt 內部的局部區間,以及兩者之間的一段長距離區間所組成:
$$D_{\mathrm{obs}}=[0,a-1]_{\mathbb{Z}}\cup[0,b-1]_{\mathbb{Z}}\cup[L-a-b+1,L-1]_{\mathbb{Z}}. \tag{8}$$
假設 $L-a-b\geq\max(a,b)$,則未觀測的中間區域為
$$D_{\mathrm{gap}}=[\max(a,b),L-a-b]_{\mathbb{Z}}. \tag{9}$$
模型並非顯式地監督 $D_{\mathrm{gap}}$ 中的所有距離,而是在局部距離與選定的長距離上進行訓練。此機制仰賴 RoPE 與 PI 的平滑頻譜結構 (smooth spectral structure) 來約束間隙 (gap) 區域上的行為,從而為長上下文適應提供稀疏但多尺度 (multi-scale) 的監督。
3.3 將 End Prompt 作為終端片段
切割原始上下文以製造長相對距離會破壞語意連續性,因為句法依存 (syntactic dependencies) 與局部語篇關係 (local discourse relations) 都仰賴原始的 token 順序。這種切割可能移除下一個 token 預測所需的關鍵局部證據,從而降低監督的品質。
為了規避此問題,所提方法保留完整的原始上下文,並附加一個 end prompt 作為終端片段,透過式 5 將其指派到區間 $[L-b,L-1]_{\mathbb{Z}}$。這在保留局部依存關係的同時,建立起接近目標上下文長度的跨片段距離。end prompt 僅嚴格地作為一個顯式的終端線索,而非語意上的延續。
形式上,end prompt 從一組簡短的終端線索中抽樣:
$$\mathbf{e}\sim\mathcal{E}, \tag{10}$$
其中 $\mathcal{E}$ 表示線索集合。並不需要唯一的提示字串;關鍵因素在於其結構性地置於指派上下文視窗的末端附近。只要該提示能提供穩定的終端線索且不帶衝突的語意,各種表述形式皆可誘發所需的長距離互動,從而降低提示記憶 (prompt memorization) 的風險並增強穩健性。
3.4 訓練目標
所提方法整合進標準的自迴歸 (autoregressive) 微調。給定擴增後的序列(式 4)與指派的位置(式 5),訓練目標為
$$\mathcal{L}(\Theta)=-\sum_{\ell=0}^{a+b-2}w_{\ell}\log P_{\Theta}\left(y_{\ell+1}\mid y_{\leq\ell};p_{\leq\ell}\right), \tag{11}$$
其中 $w_{\ell}\geq 0$ 表示一個可選的損失權重,而 $p_{\leq\ell}$ 決定注意力相位。在實作上,提示 token 的損失被賦予較小但非零的權重。此設計減少了對提示 token 預測的過度依賴,同時保留終端 token 上的損失訊號——這些終端 token 的因果注意力能夠跨越巨大的指派位置距離去關注原始上下文。
此最佳化對共享的 Transformer 參數同時施加局部與全域約束,防止模型為每個距離學習獨立的參數。局部約束來自原始上下文內部(以及 end prompt 內部、長度為 $b$)的預測,而全域約束則來自非零的終端 token 損失——透過這些損失,終端片段的狀態得以跨越巨大的指派距離去關注原始片段。
以可行參數集 (feasible parameter sets) 來表達這些約束,純局部監督下的可行區域為
$$\Theta_{\mathrm{local}}=\left\{\Theta:\mathcal{L}_{\mathrm{local}}(\Theta)\leq\varepsilon_{\mathrm{local}}\right\}. \tag{12}$$
加入終端長距離監督後,該區域變為
$$\Theta_{\mathrm{valid}}=\left\{\Theta:\mathcal{L}_{\mathrm{local}}(\Theta)\leq\varepsilon_{\mathrm{local}}\right\}\cap\left\{\Theta:\mathcal{L}_{\mathrm{global}}(\Theta)\leq\varepsilon_{\mathrm{global}}\right\}. \tag{13}$$
可行區域的這種縮減消除了無法泛化到長距離的參數配置,作為一種對注意力函數(式 7)的隱式正則化 (implicit regularizer)。
3.5 與平滑長上下文適應的連結
所提方法的有效性源於稀疏距離接觸與 RoPE、PI 頻譜性質之間的協同作用。由於被操控的位置索引僅改變式 7 中的相位項,依賴內容的振幅與相位仍由共享參數所支配。因此,長距離訓練訊號作為一種全域約束,直接正則化了支配局部行為的函數。此外,如式 3 所示,PI 降低了有效角頻率,這約束了位置變化的速率並防止在未觀測間隙區域內出現不穩定的高頻振盪。本質上,所提方法促成了一種受約束的平滑外推 (constrained smooth extrapolation)。局部監督與終端監督錨定了短距離與長距離的行為,PI 抑制了過度的位置曲率,而共享參數則統合了這些多尺度約束,以達成高效的長上下文適應。
4 實驗
4.1 實驗設定
所提方法在 LLaMA-2 7B [31] 與 LLaMA-3 8B [15] 的架構上進行評估。預設配置使用一個十億 (one billion) token 的語料,將上下文視窗從 8K 擴展到 64K。我們採用 LongBench [2] 與 RULER [19] 來評估模型處理擴展上下文的能力。此外,我們也使用標準基準——包括 GSM8K [11]、HumanEval [7]、MMLU [18] 與 HellaSwag [33]——來評估短文本理解能力。評估任務與具體資料集的完整描述見附錄 A.2。
基準方法 (Baselines)
我們將所提方法與四個強基準進行比較:Positional Skip-Embedding [35]、LCEG [25]、LongLoRA [9] 與完整長度微調。Positional Skip-Embedding 透過將輸入分塊並在固定視窗內操控位置索引來擴展上下文視窗。LCEG 為評估長上下文的泛化提供了一套標準化協定。LongLoRA 使用偏移稀疏注意力 (shifted sparse attention) 來加速擴展過程,在保留原始架構的同時將運算成本降到最低。最後,完整長度微調直接在目標上下文長度上訓練模型,作為一個資源密集型的比較標準。
表 1:RULER 合成基準上的結果(4K-64K)。
| 任務 (Task) | ET | LCEG | LongLoRA | Full FT |
|---|---|---|---|---|
| Niah_S1 | 100.00 | 100.00 | 100.00 | 97.56 |
| Niah_S2 | 91.28 | 99.28 | 99.44 | 98.12 |
| Niah_S3 | 92.92 | 79.68 | 86.20 | 72.72 |
| Niah_M1 | 90.20 | 96.12 | 97.36 | 94.52 |
| Niah_M2 | 85.48 | 76.48 | 77.96 | 90.24 |
| Niah_M3 | 62.92 | 45.72 | 51.92 | 56.20 |
| Niah_MV | 81.67 | 77.81 | 81.56 | 62.34 |
| Niah_MQ | 82.06 | 83.88 | 83.79 | 62.56 |
| Vt | 82.00 | 68.18 | 65.70 | 68.56 |
| Cwe | 42.82 | 53.14 | 50.97 | 38.32 |
| Fwe | 83.53 | 63.01 | 58.17 | 58.10 |
| Qa_1 | 51.88 | 53.04 | 52.40 | 55.68 |
| Qa_2 | 41.60 | 42.84 | 42.92 | 45.04 |
| 平均 (Avg.) | 76.03 | 72.24 | 72.95 | 69.23 |
表 2:各類下游任務上的結果。
| 方法 | Single-Doc QA | Multi-Doc QA | Summarization | Few-Shot Learning | Synthetic Task | Code Completion | 平均分 |
|---|---|---|---|---|---|---|---|
| ET | 32.03 | 30.81 | 26.04 | 68.04 | 4.54 | 66.48 | 38.30 |
| LCEG | 27.86 | 28.51 | 23.88 | 61.81 | 5.31 | 46.86 | 36.61 |
| LongLoRA | 26.86 | 27.51 | 22.88 | 60.81 | 4.31 | 45.86 | 36.84 |
| Full FT | 28.86 | 29.51 | 24.88 | 62.81 | 6.31 | 47.86 | 35.63 |
4.2 長上下文基準的主要結果
表 1 與表 2 呈現了模型在 RULER 與 LongBench 上的表現。在主要比較中,模型在一個十億 token 的語料上訓練,將上下文視窗從 8K 擴展到 64K。結果顯示所提方法在長文件理解與檢索上能夠取得優於完整長度微調與參數高效基準的表現。此外,我們也以記憶體佔用與時間消耗來評估所提方法的訓練效能。結果表明我們的方法有效地克服了傳統的時空權衡 (space-time trade-off),在大幅降低記憶體使用的同時,相較於基準方法亦加速了訓練速度。詳細結果與完整分析見附錄 B.2。
跨基準的整體優越表現
ET 在兩個框架上都一致地取得最高的平均表現。在 RULER 上,ET 達到 76.03 的平均分,勝過 LongLoRA (72.95) 與 LCEG (72.24)。在 LongBench 上,標準 ET 取得 38.30 的平均分,超過完整長度微調 (35.63)。這種一致的差距凸顯了 ET 在不同上下文長度與任務上的有效性。
在複雜資訊檢索中的韌性分歧
雖然單針檢索任務(例如 Niah_S1)在 ET、LCEG 與 LongLoRA 上都飽和於 100.00 的完美分數,但隨著複雜度提高,效能出現顯著分歧。ET 在嚴苛設定下展現出可觀的穩健性,在 Vt(82.00 對 65.70)與 Fwe(83.53 對 58.17)上勝過 LongLoRA。在多針場景(Niah_MV 與 Niah_MQ)中,ET 分別維持 81.67 與 82.06 的強勁分數。這些結果表明所提方法在擴展上下文視窗的同時,並未降低提取深埋資訊的能力。
在實際下游應用中的深遠優勢
ET 在實際下游應用中展現顯著優勢。它在所有真實文本處理領域都取得最高分,特別是在程式碼補全(66.48),大幅超越 LCEG (46.86) 與 LongLoRA (45.86)。在少樣本學習上也觀察到類似的差距,ET 得到 68.04,相較於約 61 的基準平均。透過在 Single-Doc QA、Multi-Doc QA 與 Summarization 上領先,ET 證明其架構上的增強能有效轉化為真實世界的語意推理能力。
4.3 消融研究
在本小節中,我們進行廣泛的消融研究,以評估所提方法在多樣化配置下的穩健性與可擴展性。首先,我們驗證所提方法在不同基礎模型上的廣泛適用性,包括 Mistral [21] 的架構。其次,我們探索當上下文視窗擴展到最高 128K token 的極端長度時的效能保持情況。第三,我們研究訓練資料量對效能一致性縮放的影響。最後,我們檢視該框架對 end prompt 特定變體的敏感度。實驗結果系統性地解構了各因素的影響,展現該方法在不同條件下的穩定性。
表 3:RULER 合成基準上跨不同配置的消融研究。
| 方法 | Niah_Single | Niah_Multikey | Niah_Multivalue | Niah_Multiquery | Vt | Cwe | Fwe | Qa | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| 主要 ET | 94.73 | 79.53 | 81.67 | 82.06 | 82.00 | 42.82 | 83.53 | 46.74 | 76.03 |
| 不同基礎模型 | |||||||||
| Mistral-7B-v0.3 | 98.75 | 70.92 | 62.07 | 87.36 | 61.46 | 19.09 | 59.76 | 45.16 | 68.39 |
| LLaMA-2-7B | 66.08 | 38.91 | 48.78 | 55.92 | 54.80 | 21.66 | 36.80 | 31.34 | 45.82 |
| 不同擴展長度 | |||||||||
| ET-32k | 98.23 | 80.00 | 86.65 | 93.45 | 78.03 | 44.85 | 85.58 | 47.73 | 78.36 |
| ET-96k | 97.21 | 72.12 | 86.21 | 91.41 | 86.86 | 41.83 | 83.64 | 45.74 | 76.11 |
| ET-128k | 99.20 | 73.31 | 53.21 | 76.74 | 84.24 | 39.16 | 83.11 | 46.36 | 72.82 |
| 不同 token 數量 | |||||||||
| ET-2.0B | 95.65 | 79.05 | 85.60 | 85.33 | 70.49 | 42.63 | 79.08 | 47.82 | 75.61 |
| ET-0.5B | 94.71 | 74.35 | 89.53 | 88.71 | 78.58 | 38.24 | 83.11 | 43.04 | 74.72 |
表 4:LongBench 上跨不同配置的消融研究。
| 方法 | Single-Doc QA | Multi-Doc QA | Summarization | Few-Shot Learning | Synthetic Task | Code Completion | 平均 |
|---|---|---|---|---|---|---|---|
| 主要 ET | 32.03 | 30.81 | 26.04 | 68.04 | 4.54 | 66.48 | 38.30 |
| 不同基礎模型 | |||||||
| Mistral-7B-v0.3 | 34.90 | 32.76 | 23.88 | 65.79 | 3.25 | 59.05 | 37.29 |
| LLaMA-2-7B | 25.86 | 26.51 | 21.88 | 59.81 | 3.31 | 44.86 | 31.16 |
| 不同擴展長度 | |||||||
| ET-128k | 30.18 | 28.41 | 22.68 | 67.21 | 2.27 | 60.41 | 35.68 |
| ET-96k | 31.51 | 29.80 | 24.90 | 67.89 | 5.43 | 58.49 | 36.88 |
| ET-32k | 30.30 | 26.23 | 26.19 | 68.42 | 4.50 | 60.39 | 36.45 |
| 不同 token 數量 | |||||||
| ET-2.0B | 29.03 | 29.61 | 25.37 | 66.29 | 14.00 | 63.44 | 37.86 |
| ET-0.5B | 28.67 | 27.86 | 25.80 | 67.83 | 12.29 | 65.27 | 37.85 |
跨多樣模型家族的廣泛適用性
所提方法在不同的基礎架構上展現出廣泛的泛化能力。當整合進 Mistral-7B-v0.3 與 LLaMA-2 7B 時,該框架達成一致的上下文縮放。Mistral 的架構在 RULER 基準上達到 68.39、在 LongBench 上達到 37.29 的平均分,而 LLaMA-2 的架構則分別為 45.82 與 31.16。此差異可歸因於底層模型的預訓練品質,而非方法本身的限制。因此,這項擴展技術可作為一種有效、與模型無關 (model-agnostic) 的長上下文處理方法。
跨擴展上下文視窗的穩健效能保持
該框架將上下文視窗擴展到各種長度,同時保持高的整體效能。在 RULER 基準上,模型在 32K 長度取得 78.36、在 96K 取得 76.11、在 128K 的極端上下文取得 72.82 的平均分。這種穩定性也反映在 LongBench 上,分數範圍從 32K 的 36.45 到 128K 的 35.68。極端長度下的些微效能退化是可預期的——考量到上下文視窗的大幅擴張——這證實了其可靠的可擴展性而無災難性遺忘 (catastrophic forgetting)。
隨訓練 token 增加的一致效能縮放
將訓練語料從 0.5 億(billion)token 縮放到 2.0 億 token 帶來一致的效能提升。在 RULER 基準上平均分從 74.72 提升到 75.61,在 LongBench 上從 37.85 提升到 37.86。具體而言,2.0 億 token 的配置在 Multi-Doc QA 上取得 29.61 分,相較於 0.5 億 token 設定的 27.86。【譯註:原文 billion 為「十億」,此處為英文「billion」之直譯換算,0.5B = 5 億、2.0B = 20 億 token。】這些結果表明該方法能有效利用增加的資料量來強化長上下文能力。
跨 End Prompt 變體的一致穩健性
所提框架不論 end prompt 的配置為何都維持穩定的效能。在 LongBench 基準上,平均分從 38.30 (EP_1) 到 37.95 (EP_3) 僅有微不足道的下降。同樣地,在 RULER 上,效能範圍從 76.45 (EP_2) 到 74.63 (EP_3)。這些極小的波動證明了擴展機制具有穩健性、對特定的指令措辭並不敏感,能有效利用通用化的終止訊號,從而將大量提示工程 (prompt engineering) 的需求降到最低。具體 end prompt 的完整描述見附錄 B.1。
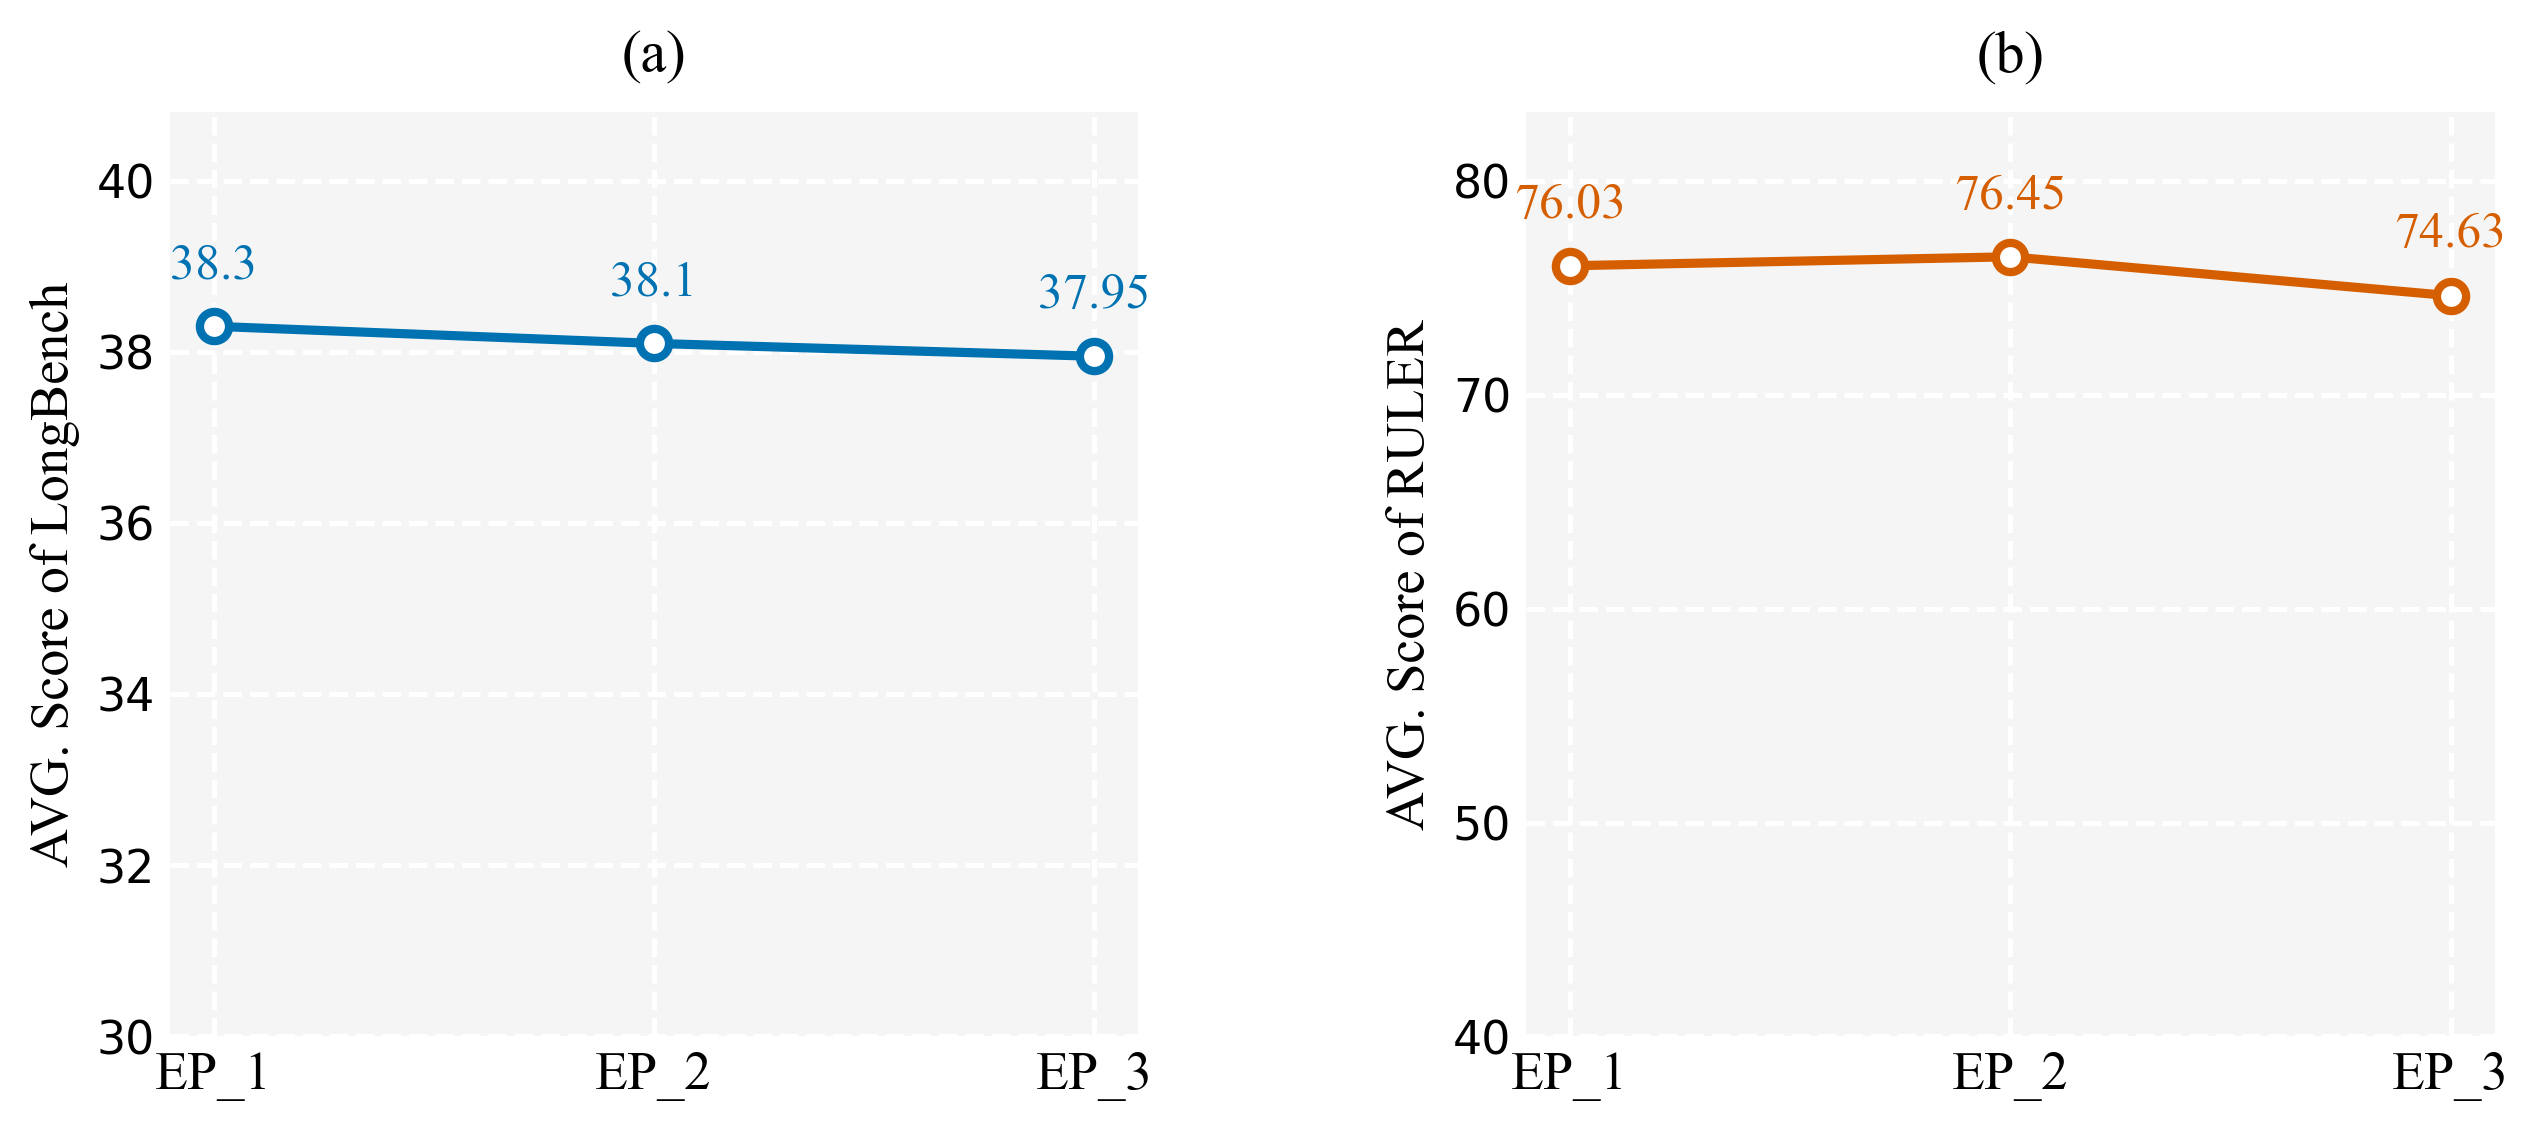
圖 2:不同 end prompt 的消融研究。
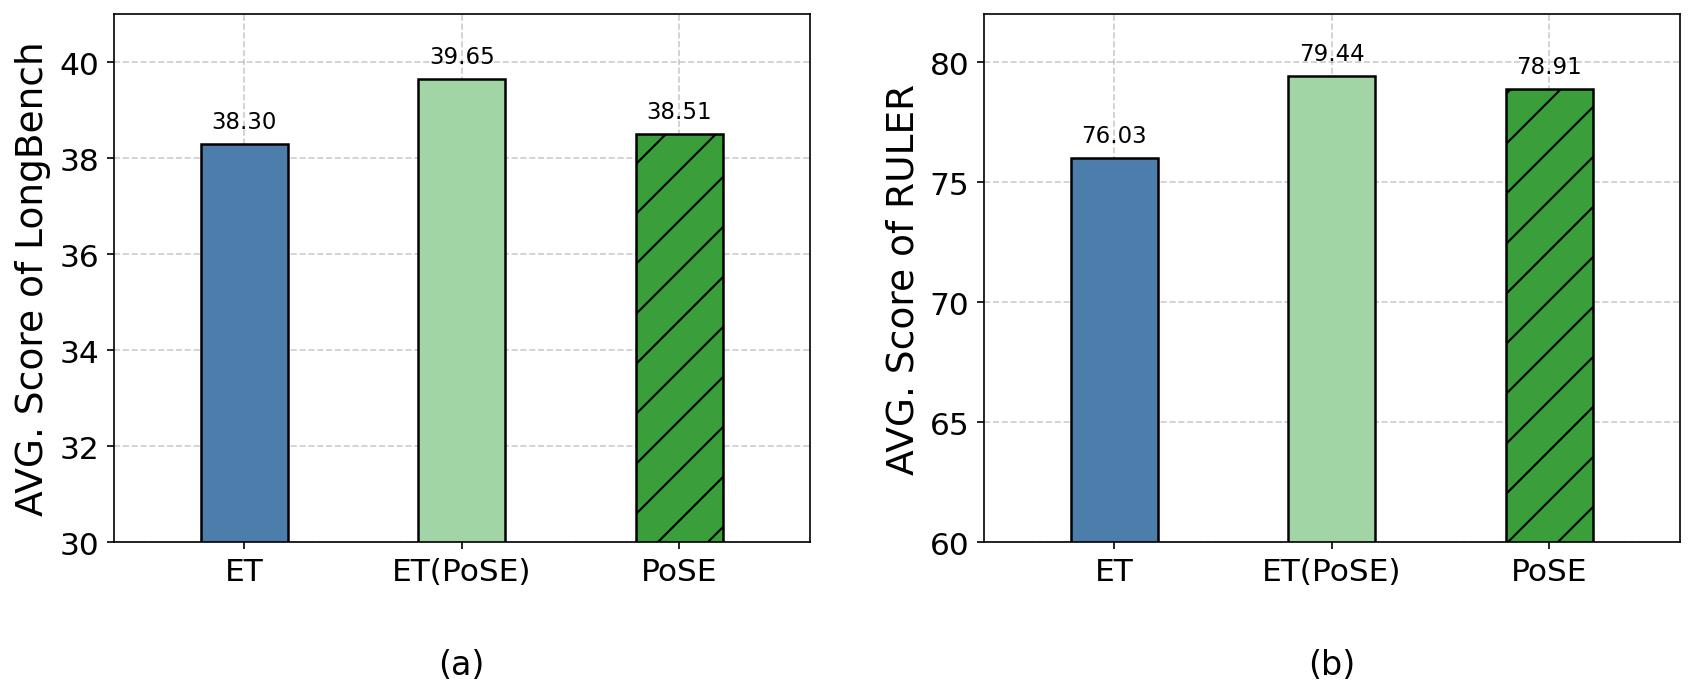
圖 3:標準 ET、Positional Skip-Embedding 與 ET(PoSE) 在 LongBench 與 RULER 基準上的效能比較。
4.4 結構性分析
為了評估相容性,所提方法與 Positional Skip-Embedding 進行比較——後者是一種透過將輸入分割為塊並操控位置索引以模擬擴展長度的方法。我們將這套訓練方法與所提框架整合,將此混合配置記為 ET(PoSE)。標準 ET、Positional Skip-Embedding 與整合後的 ET(PoSE) 之效能在 LongBench 與 RULER 上進行系統性評估。
如圖 3 所示,所提方法展現出與 Positional Skip-Embedding 的強相容性。在 LongBench 上,標準 ET 取得 38.30 的平均分,與 Positional Skip-Embedding 取得的 38.51 相當。在 RULER 上,ET 得到 76.03,與基準取得的 78.91 具競爭力。關鍵在於,混合的 ET(PoSE) 配置產生最高效能,在 LongBench 上達到 39.65 的峰值分數、在 RULER 上達到 79.44。這些發現證實,在 ET 框架內運用 Positional Skip-Embedding 的分塊策略能顯著增強整體效能。
4.5 短文本能力的評估與恢復
本小節使用 LLaMA-3 8B 架構,探討上下文擴展對短文本能力的影響。模型在標準基準上進行評估,包括 GSM8K [11]、HumanEval [7]、MMLU [18] 與 HellaSwag [33]。為了緩解效能退化,我們施加一個監督式微調 (supervised fine-tuning, SFT) 階段。表 5 呈現恢復後的能力。所提方法(記為 sft_ET(PoSE))取得最高平均分 53.56,超越完整微調 (50.98)、LongLoRA (48.64) 與 LCEG (49.74)。在不整合 Positional Skip-Embedding 的情況下,標準 ET 方法仍取得 52.41 的強勁平均分。雖然單獨的 Positional Skip-Embedding 取得 52.32,但其效能差距凸顯了不同訓練機制的影響。標準 Positional Skip-Embedding 會分割實際的訓練資料,有破壞語意連續性的風險。相反地,所提方法僅分割 end prompt,保留了文本的結構與語意完整性,確保在短文本任務上的優越表現。
表 5:監督式微調後在短文本評估任務上的結果。
| 階段 | 變體 (Variant) | MMLU | GSM8K | HS | HE | 平均 |
|---|---|---|---|---|---|---|
| SFT | sft_ET(PoSE) | 56.87 | 46.10 | 78.34 | 32.93 | 53.56 |
| sft_ET | 56.67 | 44.66 | 77.51 | 30.83 | 52.41 | |
| sft_LongLoRA | 55.07 | 38.82 | 77.49 | 23.17 | 48.64 | |
| sft_LCEG | 54.76 | 42.23 | 77.56 | 24.39 | 49.74 | |
| sft_PoSE | 56.62 | 43.59 | 77.95 | 31.10 | 52.32 | |
| sft_Full FT | 55.40 | 42.15 | 77.11 | 29.27 | 50.98 |
5 結論
我們提出 EndPrompt,一種無需在完整長度序列上訓練即可擴展大型語言模型上下文視窗的高效方法。該方法將原始短上下文保留為完整片段,並附加一段簡短的終端提示——其位置索引被置於目標上下文邊界附近。這種構造使模型同時接觸到局部與長距離的相對距離,同時避免了基於分塊的模擬所引入的語意破壞。我們的分析透過 RoPE 與位置插值解釋了這種行為:RoPE 透過共享的頻譜基底 (spectral basis) 表示相對距離,PI 抑制高頻位置變化,而共享的 Transformer 參數則在同一個注意力函數內耦合了局部與終端的長距離監督。在實證上,EndPrompt 將 LLaMA 系列模型從 8K 擴展到 64K 上下文,並在 RULER 與 LongBench 上取得強勁結果,包括 76.03 的平均 RULER 分數——超越了所報告的 LCEG、LongLoRA 與完整長度微調基準。這些發現表明,可靠的長上下文適應能由結構化的稀疏位置監督所誘發,而非密集的完整長度訓練。
目前的表述依賴一個顯式的終端片段。我們未來的工作將研究終端錨定如何與串流 (streaming)、階層式 (hierarchical) 或多模態 (multimodal) 長上下文架構相結合。更廣泛地說,EndPrompt 指向了一個實用的上下文視窗擴展方向——在保持物理訓練序列簡短的同時,設計具資訊量的位置監督。
參考文獻
[1] Y. Bai, X. Lv, J. Zhang, Y. He, J. Qi, L. Hou, J. Tang, Y. Dong, and J. Li (2024) LongAlign: a recipe for long context alignment of large language models. arXiv preprint arXiv:2401.18058.
[2] Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Wu, Y. Mao, et al. (2023) LongBench: a bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508.
[3] I. Beltagy, M. E. Peters, and A. Cohan (2020) Longformer: the long-document transformer. arXiv preprint arXiv:2004.05150.
[4] I. Chalkidis, A. Jana, E. Dirani, et al. (2022) LexGLUE: a benchmark dataset for legal language understanding in english. Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics.
[5] C. Chen et al. (2023) L-eval: instituting standardized evaluation for long context language models. arXiv preprint arXiv:2307.11088.
[6] G. Chen, X. Li, Z. Meng, S. Liang, and L. Bing (2024) CLEX: continuous length extrapolation for large language models. In International Conference on Learning Representations.
[7] M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. d. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. (2021) Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374.
[8] S. Chen, S. Wong, L. Chen, and Y. Tian (2023) Extending context window of large language models via positional interpolation. arXiv preprint arXiv:2306.15595.
[9] Y. Chen, S. Qian, H. Tang, X. Lai, Z. Liu, S. Han, and J. Jia (2024) LongLoRA: efficient fine-tuning of long-context large language models. In International Conference on Learning Representations.
[10] R. Child, S. Gray, A. Radford, and I. Sutskever (2019) Generating long sequences with sparse transformers. arXiv preprint arXiv:1904.10509.
[11] K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. (2021) Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168.
[12] T. Dao, D. Y. Fu, S. Ermon, A. Rudra, and C. Ré (2022) FlashAttention: fast and memory-efficient exact attention with io-awareness. In Advances in Neural Information Processing Systems, Vol. 35, pp. 32082–32098.
[13] P. Dasigi, K. Lo, I. B. Kinney, A. Cohan, N. A. Smith, and H. Hannaneh (2021) A dataset of information-seeking questions and answers anchored in research papers. In Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, pp. 4599–4610.
[14] Y. Ding, L. L. Zhang, C. Zhang, Y. Xu, N. Shang, J. Xu, F. Yang, and M. Yang (2024) LongRoPE: extending LLM context window beyond 2 million tokens. arXiv preprint arXiv:2402.13753.
[15] A. Dubey, A. Jauhri, A. Pandey, A. Kadian, A. Al-Dahle, A. Letman, A. Mathur, A. Schelten, A. Yang, et al. (2024) The llama 3 herd of models. arXiv preprint arXiv:2407.22706.
[16] D. Guo, H. Qi, J. Yin, T. Dong, et al. (2024) DeepSeek-coder: when the large language model meets programming. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition.
[17] C. Han, Q. Wang, H. Peng, W. Xiong, Y. Chen, H. Ji, and S. Wang (2024) LM-Infinite: zero-shot extreme length generalization for large language models. In Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies.
[18] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt (2021) Measuring massive multitask language understanding. In International Conference on Learning Representations.
[19] C. Hsieh, S. Sun, S. Cantrell, D. Rosenberg, T. He, B. Dupuis, R. M. Taylor, J. Ainslie, A. Mahdavi, M. Misra, et al. (2024) RULER: what's the real context size of your long-context language models? arXiv preprint arXiv:2404.06654.
[20] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, and W. Chen (2022) LoRA: low-rank adaptation of large language models. In International Conference on Learning Representations.
[21] A. Q. Jiang, A. Sablayrolles, A. Mensch, C. Bamford, D. S. Chaplot, D. d. l. Casas, F. Bressand, G. Lengyel, G. Lample, et al. (2023) Mistral 7b. arXiv preprint arXiv:2310.06825.
[22] C. E. Jimenez, J. Emmons, C. Brackman, et al. (2024) SWE-bench: can language models resolve real-world github issues? In International Conference on Learning Representations.
[23] T. Kočiský, J. Schwarz, P. Blunsom, C. Dyer, K. M. Hermann, G. Melis, and E. Grefenstette (2018) The narrativeqa reading comprehension challenge. Transactions of the Association for Computational Linguistics 6, pp. 317–328.
[24] H. Liu, M. Zaharia, and P. Abbeel (2024) Ring attention with blockwise transformers for near-infinite context. In International Conference on Learning Representations.
[25] X. Lu et al. (2024) A controlled study on long context extension and generalization in llms. arXiv preprint arXiv:2401.06951.
[26] B. Peng, J. Quesnelle, H. Fan, and E. Shippole (2024) YaRN: efficient context window extension of large language models. In International Conference on Learning Representations.
[27] B. Peng and J. Quesnelle (2023) Ntk-aware scaled rope allows llama models to have extended (8k+) context size without any fine-tuning and minimal perplexity degradation.
[28] U. Shaham, Y. Elazar, M. Ivgi, O. Rubin, J. Berant, and O. Levy (2023) ZeroSCROLLS: a zero-shot benchmark for long text understanding. In Findings of the Association for Computational Linguistics: EMNLP 2023, pp. 7961–7979.
[29] J. Su, M. Ahmed, Y. Lu, S. Pan, W. Bo, and Y. Liu (2024) Roformer: enhanced transformer with rotary position embedding. Neurocomputing 568, pp. 127063.
[30] Y. Tay, M. Dehghani, D. Bahri, and D. Metzler (2022) Efficient transformers: a survey. ACM Computing Surveys (CSUR) 55(6), pp. 1–28.
[31] H. Touvron, L. Martin, K. Stone, P. Albert, A. Almahairi, Y. Babaei, N. Bashlykov, S. Batra, P. Bhargava, S. Bhosale, et al. (2023) Llama 2: open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288.
[32] G. Xiao, Y. Tian, B. Chen, S. Han, and M. Lewis (2024) Efficient streaming language models with attention sinks. In International Conference on Learning Representations.
[33] R. Zellers, A. Holtzman, Y. Bisk, A. Farhadi, and Y. Choi (2019) HellaSwag: can a machine really finish your sentence? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, pp. 3472–3483.
[34] P. Zhang, Z. Zheng, J. Gao, B. Yao, H. Luan, et al. (2024) Soaring from 4k to 400k: extending llm's context with activation beacon. arXiv preprint arXiv:2401.03462.
[35] D. Zhu, N. Yang, L. Wang, Y. Song, W. Wu, F. Wei, and S. Li (2024) PoSE: efficient context window extension of llms via positional skip-wise training. In International Conference on Learning Representations.
附錄 A 技術附錄
A.1 實驗細節
我們採用 Meta-Llama-3-8B 作為基礎模型,並運用位置插值 (PI) 來擴展其上下文視窗。在資料前處理階段,訓練語料的最大序列長度為 8K。我們在單一運算節點(配備 8 張 NVIDIA A800 (80GB) GPU)上進行一個 epoch 的全參數微調 (full-parameter fine-tuning)。為了最佳化記憶體消耗與訓練效率,所有訓練程序皆採用 BF16 混合精度 (mixed precision),並整合 DeepSpeed ZeRO Stage-3、FlashAttention 與梯度檢查點 (gradient checkpointing)。在最佳化超參數方面,我們將峰值學習率 (peak learning rate) 設為 $2\times 10^{-5}$,並採用具 20 步線性暖身 (linear warmup) 的常數學習率排程器 (constant learning rate scheduler)。
A.2 評估任務
為了全面評估模型效能,實驗在多個評估框架中納入了多樣化的資料集。LongBench [2] 提供涵蓋單文件與多文件問答、文件摘要、少樣本學習、合成任務與程式碼補全資料集的全面多任務評估。此外,RULER [19] 用於對有效上下文長度進行細粒度分析。此基準透過特定的資料集配置——包括多針大海撈針 (multi-needle-in-a-haystack) 任務、變數追蹤 (variable tracking)、常見詞提取 (common word extraction)、頻繁詞提取 (frequent word extraction) 與合成問答——來評估模型的資訊檢索能力。這些資料集系統性地測試了在不同上下文視窗大小下,從廣泛背景文本中提取目標資訊的能力。最後,短文本能力的評估採用 GSM8K [11](數學推理)、HumanEval [7](程式碼生成)、MMLU [18](大規模多任務語言理解)與 HellaSwag [33](常識推理)。
附錄 B 補充實驗
B.1 詳細的 End Prompts
本節詳述穩健性分析中所評估的具體 end prompt。第一個配置(記為 EP_1)採用顯式片語「This is the end of text, please pay attention here」。第二個配置 EP_2 採用 LLaMA-3 架構的原生特殊終止 token,表示為 <|eot_id|>。最後,第三個配置 EP_3 由最簡字串「End.」組成。
B.2 訓練效能
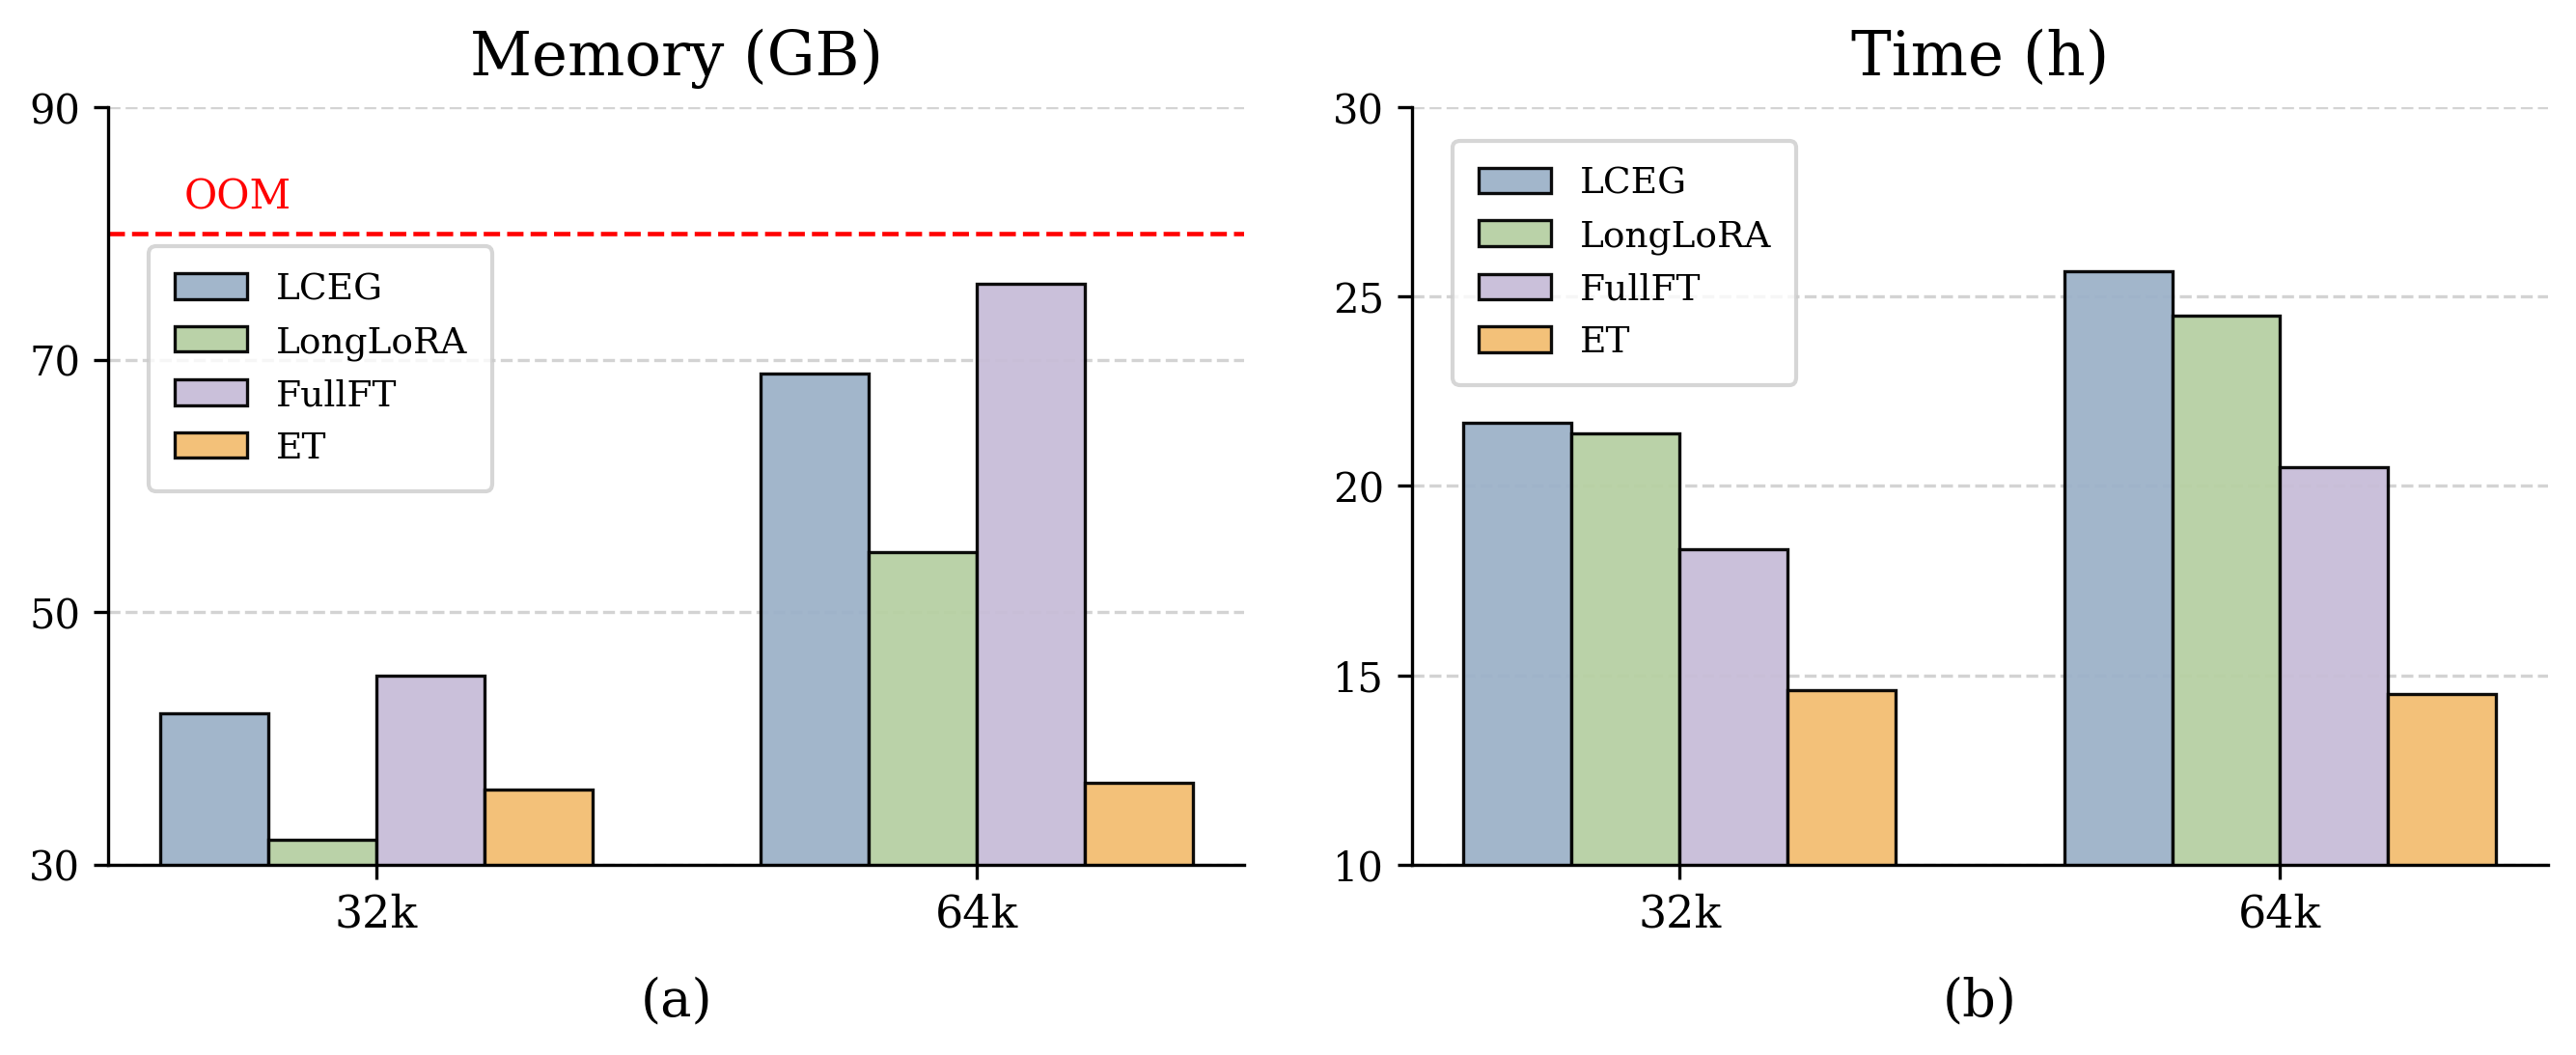
圖 4:不同方法之記憶體佔用與時間消耗的比較。
本小節透過評估記憶體佔用與時間成本來分析訓練效率。如圖 4 所示,ET 方法克服了傳統的時空權衡,在 32K 與 64K 的上下文長度上對基準方法取得了嚴格的優勢 (strict dominance)。在 64K 時,ET 僅需 36.52 GB 記憶體,相較於完整長度微調所需的 76.00 GB 減少了 52%。同時,ET 相較於完整長度微調、LongLoRA 與 LCEG 分別取得 1.41$\times$、1.69$\times$ 與 1.77$\times$ 的加速比 (acceleration ratios)。這種「降低記憶體使用」與「提升運算速度」的雙重優勢,驗證了該方法在擴展上下文視窗時無需高昂額外開銷的效率。
B.3 完整的表 1
表 6:RULER 合成基準上的結果(4K)。
| 任務 | ET | LCEG | LongLoRA | Full FT |
|---|---|---|---|---|
| Niah_S1 | 100.00 | 100.00 | 100.00 | 96.40 |
| Niah_S2 | 100.00 | 98.40 | 98.40 | 99.40 |
| Niah_S3 | 99.40 | 71.00 | 83.40 | 71.20 |
| Niah_M1 | 97.00 | 97.40 | 98.80 | 98.00 |
| Niah_M2 | 99.20 | 93.60 | 92.80 | 99.40 |
| Niah_M3 | 96.80 | 72.80 | 80.80 | 83.80 |
| Niah_MV | 97.20 | 88.90 | 92.40 | 75.40 |
| Niah_MQ | 99.15 | 97.45 | 97.20 | 84.50 |
| Vt | 99.48 | 95.96 | 93.76 | 93.20 |
| Cwe | 91.82 | 88.60 | 83.36 | 82.50 |
| Fwe | 90.07 | 62.40 | 61.13 | 76.90 |
| Qa_1 | 64.60 | 57.80 | 57.20 | 66.40 |
| Qa_2 | 47.20 | 47.00 | 46.00 | 51.80 |
| 平均 | 90.92 | 82.41 | 83.48 | 82.99 |
表 7:RULER 合成基準上的結果(8K)。
| 任務 | ET | LCEG | LongLoRA | Full FT |
|---|---|---|---|---|
| Niah_S1 | 100.00 | 100.00 | 100.00 | 98.00 |
| Niah_S2 | 100.00 | 100.00 | 100.00 | 99.00 |
| Niah_S3 | 98.80 | 89.20 | 93.40 | 72.60 |
| Niah_M1 | 98.80 | 96.20 | 97.40 | 97.60 |
| Niah_M2 | 99.20 | 75.40 | 83.20 | 98.60 |
| Niah_M3 | 92.00 | 59.20 | 63.20 | 78.00 |
| Niah_MV | 96.25 | 93.00 | 94.60 | 87.80 |
| Niah_MQ | 96.85 | 96.50 | 97.30 | 87.50 |
| Vt | 99.20 | 85.20 | 78.96 | 85.00 |
| Cwe | 65.50 | 68.66 | 65.00 | 55.80 |
| Fwe | 80.67 | 67.13 | 66.13 | 57.80 |
| Qa_1 | 59.40 | 53.80 | 53.40 | 57.80 |
| Qa_2 | 45.20 | 46.40 | 46.00 | 50.60 |
| 平均 | 87.07 | 79.28 | 79.89 | 78.93 |
表 8:RULER 合成基準上的結果(16K)。
| 任務 | ET | LCEG | LongLoRA | Full FT |
|---|---|---|---|---|
| Niah_S1 | 100.00 | 100.00 | 100.00 | 98.00 |
| Niah_S2 | 100.00 | 100.00 | 100.00 | 96.40 |
| Niah_S3 | 97.20 | 91.60 | 93.80 | 79.20 |
| Niah_M1 | 95.40 | 95.20 | 96.60 | 95.60 |
| Niah_M2 | 95.00 | 63.80 | 71.00 | 95.80 |
| Niah_M3 | 67.00 | 34.60 | 48.00 | 62.60 |
| Niah_MV | 95.30 | 89.45 | 92.75 | 54.60 |
| Niah_MQ | 92.40 | 93.85 | 94.10 | 45.80 |
| Vt | 94.52 | 79.88 | 72.96 | 74.20 |
| Cwe | 49.76 | 61.94 | 61.22 | 33.30 |
| Fwe | 90.00 | 71.07 | 65.53 | 67.20 |
| Qa_1 | 61.00 | 53.60 | 53.20 | 58.60 |
| Qa_2 | 45.00 | 41.80 | 42.60 | 47.80 |
| 平均 | 83.28 | 75.14 | 76.29 | 69.93 |
表 9:RULER 合成基準上的結果(32K)。
| 任務 | ET | LCEG | LongLoRA | Full FT |
|---|---|---|---|---|
| Niah_S1 | 100.00 | 100.00 | 100.00 | 98.00 |
| Niah_S2 | 100.00 | 99.80 | 100.00 | 99.20 |
| Niah_S3 | 98.00 | 84.60 | 87.80 | 78.40 |
| Niah_M1 | 92.20 | 98.60 | 98.60 | 97.40 |
| Niah_M2 | 77.80 | 79.80 | 77.00 | 88.80 |
| Niah_M3 | 53.00 | 35.60 | 40.00 | 38.60 |
| Niah_MV | 93.75 | 74.85 | 79.60 | 65.30 |
| Niah_MQ | 91.10 | 83.65 | 83.45 | 64.90 |
| Vt | 93.36 | 66.96 | 56.96 | 55.90 |
| Cwe | 6.00 | 41.98 | 39.32 | 14.10 |
| Fwe | 88.13 | 61.27 | 55.60 | 44.70 |
| Qa_1 | 44.40 | 52.60 | 52.20 | 52.80 |
| Qa_2 | 40.20 | 45.20 | 43.40 | 42.20 |
| 平均 | 75.23 | 71.15 | 70.30 | 64.64 |
附錄 C 相關工作
基於位置的上下文擴展
大型語言模型主要採用旋轉位置嵌入 (RoPE) [29] 來編碼位置資訊。為了將上下文長度擴展到預訓練上限之外,位置插值 (PI) [8] 重新縮放位置索引以使其落入原始定義域。進一步的改良——例如 NTK-aware scaling [27] 與 YaRN [26]——基於神經正切核 (neural tangent kernel) 理論修改旋轉頻率,以在插值低頻長距離資訊的同時保留高頻局部資訊。儘管有效,這些方法通常仍需要在長文本序列上微調才能達到最佳效能與對齊 (alignment)。
高效長上下文適應
在完整長度序列上訓練會帶來二次方的運算複雜度。為了緩解此問題,LongLoRA [9] 引入偏移稀疏注意力,在不顯著修改核心架構的前提下實現高效微調。另一方面,像 PoSE [35] 這類模擬式長上下文訓練方法則跨不相交的文本塊操控位置索引以模擬長距離。其他正交 (orthogonal) 的做法包括用於跨多裝置分散式序列處理的 RingAttention [24],以及將上下文壓縮為精簡表示的 Activation Beacons [34]。相較於可能破壞語意連續性的分塊方法,我們的做法保持完整的短上下文,並利用顯式的 end prompt 來高效地錨定長距離位置索引。
長上下文評估
評估擴展後的上下文能力需要嚴謹且標準化的基準。LongBench [2] 與 L-Eval [5] 提供涵蓋摘要、問答與程式碼分析的多樣多任務套件。ZeroSCROLLS [28] 特別聚焦於摘要任務的零樣本長文本理解。較近期的 RULER [19] 透過提升大海撈針任務(具多鍵與多值檢索情境)的複雜度,提供了一個可配置的合成評估框架來測試 LLM 的有效上下文上限。
術語對照表
| English | 繁體中文 |
|---|---|
| Large Language Models (LLMs) | 大型語言模型 |
| Context Window | 上下文視窗 |
| Long-Context Adaptation | 長上下文適應 |
| Context Extension | 上下文擴展 |
| Terminal Anchoring | 終端錨定 |
| Terminal Prompt / End Prompt | 終端提示 / end prompt |
| Segment | 片段 |
| Physical Sequence | 物理序列 |
| Positional Indices | 位置索引 |
| Positional Index Manipulation | 位置索引操控 |
| Semantic Continuity | 語意連續性 |
| Rotary Position Embedding (RoPE) | 旋轉位置嵌入 |
| Position Interpolation (PI) | 位置插值 |
| Attention Function | 注意力函數 |
| Attention Scores | 注意力分數 |
| Attention Head | 注意力頭 |
| Smoothness Constraint / Bias | 平滑性約束 / 偏置 |
| Unobserved Intermediate Distances | 未觀測中間距離 |
| Extrapolation | 外推 |
| Sparse Positional Supervision | 稀疏位置監督 |
| Dense Supervision | 密集監督 |
| Long-Context Generalization | 長上下文泛化 |
| Positional Generalization | 位置泛化 |
| Quadratic (scaling/cost) | 二次方(擴展/成本) |
| Sparse Attention | 稀疏注意力 |
| Sliding-Window Attention | 滑動視窗注意力 |
| Shifted Sparse Attention | 偏移稀疏注意力 |
| Low-Rank Adaptation | 低秩適應 |
| Simulated Long-Context Training | 模擬式長上下文訓練 |
| Chunk-based / Chunking | 基於分塊 / 分塊 |
| Causal Attention | 因果注意力 |
| Angular Frequency | 角頻率 |
| Phase Rotation | 相位旋轉 |
| Amplitude | 振幅 |
| Phase | 相位 |
| Trigonometric Polynomial | 三角多項式 |
| Sinusoidal Components | 正弦分量 |
| Spectral Basis / Structure | 頻譜基底 / 結構 |
| Curvature | 曲率 |
| Variation Rate | 變化率 |
| Complex Subspaces | 複數子空間 |
| Autoregressive | 自迴歸 |
| Implicit Regularizer | 隱式正則化 |
| Feasible Parameter Sets | 可行參數集 |
| Constrained Smooth Extrapolation | 受約束的平滑外推 |
| Multi-scale Supervision | 多尺度監督 |
| Prompt Memorization | 提示記憶 |
| Prompt Engineering | 提示工程 |
| Few-Shot Learning | 少樣本學習 |
| Multi-needle-in-a-haystack | 多針大海撈針 |
| Variable Tracking | 變數追蹤 |
| Common/Frequent Word Extraction | 常見/頻繁詞提取 |
| Supervised Fine-Tuning (SFT) | 監督式微調 |
| Full-parameter Fine-tuning | 全參數微調 |
| Full-length Fine-tuning | 完整長度微調 |
| Mixed Precision | 混合精度 |
| Gradient Checkpointing | 梯度檢查點 |
| Learning Rate Scheduler | 學習率排程器 |
| Linear Warmup | 線性暖身 |
| Acceleration Ratio | 加速比 |
| Space-time Trade-off | 時空權衡 |
| Catastrophic Forgetting | 災難性遺忘 |
| Model-agnostic | 與模型無關 |
| Neural Tangent Kernel | 神經正切核 |
| Local Coherence | 局部連貫性 |
| Syntactic Dependencies | 句法依存 |
| Local Discourse Relations | 局部語篇關係 |