The Art of Building Verifiers for Computer Use Agents
為電腦使用代理打造驗證器的藝術
原始論文:The Art of Building Verifiers for Computer Use Agents 作者:Corby Rosset, Pratyusha Sharma, Andrew Zhao, Miguel Gonzalez-Fernandez, Ahmed Awadallah arXiv ID:2604.06240v1 日期:2026-04-05 機構:Microsoft Research、Browserbase
目錄
- 摘要
- 1. 引言
- 2. 背景與相關工作
- 3. 好的驗證器具備什麼特質?
- 4. 通用驗證器系統
- 5. 實驗
- 6. 結果
- 7. 結論
- 8. 倫理聲明
- 附錄 A:通用驗證器細節
- 附錄 B:結果
- 附錄 C:自動研究細節
- 參考文獻
- 術語對照表
摘要
驗證電腦使用代理 (Computer Use Agent, CUA) 軌跡的成功與否是一項關鍵挑戰:若沒有可靠的驗證機制,無論評估或訓練訊號都無法被信任。本文中,我們呈現從打造一套「同類最佳」的網頁任務驗證器(我們稱之為「通用驗證器 (Universal Verifier)」)所學到的經驗。我們圍繞四個關鍵原則來設計通用驗證器:
- 建構具備有意義、互不重疊條件的評分準則 (Rubric) 以降低雜訊;
- 分離過程獎勵 (Process Reward) 與結果獎勵 (Outcome Reward),使其產生互補的訊號,以涵蓋代理走對步驟卻被阻擋、或經由非預期路徑成功的情境;
- 區分可控與不可控的失敗,並透過「無串聯誤差 (cascading-error-free)」的策略加以評分,以獲得更細緻的失敗理解;
- 採用「分而治之 (divide-and-conquer)」的情境管理機制,可針對軌跡中所有截圖進行有效注意,提升長期任務的可靠性。
我們在 CUAVerifierBench 上驗證以上發現。CUAVerifierBench 是一份新的 CUA 軌跡集,同時包含過程與結果的人工標註。結果顯示,我們的通用驗證器與人類標註的一致程度,達到人類彼此間相互一致的水準。相較於 WebVoyager (≥45%) 和 WebJudge (≥22%) 等基線方法,我們將偽陽性率 (False Positive Rate) 降低至接近零。我們強調這些提升源自上述設計選擇的累積效應。我們也發現自動研究代理 (Auto-Research Agent) 能在 5% 的時間達到專家品質的 70%,但無法獨立發掘出複製通用驗證器所需的全部策略。我們將通用驗證器系統與 CUAVerifierBench 一同開源發布[^1]。
[^1]: 程式碼與資料將公開於 https://github.com/microsoft/fara
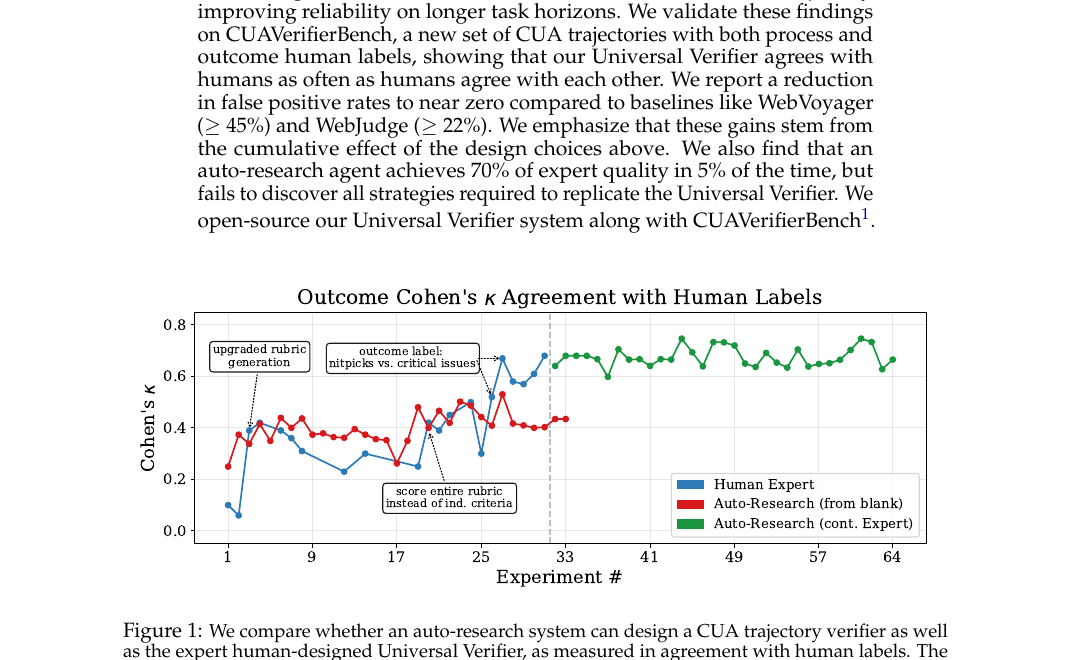
圖 1:我們比較自動研究系統能否設計出與專家人工設計的通用驗證器同樣好的 CUA 軌跡驗證器,以與人類標註的一致性來衡量。人類專家在三週內反覆迭代了 32 次實驗;自動研究代理在大約一天內完成同樣數量的迭代。從質性的角度看,自動研究的編輯傾向保守且漸進式,常常忽略了人類專家做出最高影響力結構性決策背後的設計直覺(圖中已標註)。
1. 引言
AI 代理 (AI Agent) 自主操作電腦的能力 (網頁瀏覽 (Web Browsing)、表單填寫、介面導覽) 已快速進步 (Zhou et al., 2024; He et al., 2024a; Zheng et al., 2024; Koh et al., 2024; Xie et al., 2024; OpenAI, 2025; Agashe et al., 2025; Awadallah et al., 2025b; Gupta et al., 2026)。然而,這些系統的訓練與評估進展卻被一個看似簡單卻極為棘手的問題所卡住:這個代理真的成功了嗎? 不像文字生成任務的輸出可以直接比對,電腦使用軌跡長、視覺內容豐富而模糊,使得人工標註既困難又昂貴。「成功」本身的概念充滿細微差別 (Nuance):成功可能是經由非預期路徑達成,失敗也可能極為隱晦,僅出現在多步互動中某張深埋的截圖。建構一個能可靠回答此問題的驗證器,遠非直截了當;錯誤的後果會層層放大,污染基準測試 (Benchmark) 與訓練資料。
本文中,我們以一組可實踐的設計原則來記錄打造電腦使用代理驗證器所學到的經驗。我們的方法建立在四個核心構想上:
- 好的驗證器需要良好建構的評分準則 —— 包含明確、互不重疊的條件,以實現跨多元任務的一致評分。
- 必須同時回報過程與結果獎勵 —— 兩者提供互補訊號,主要差異在於:當環境阻擋了成功(即便代理行為正確)或當代理透過非預期但有效的路徑達成成功時,這兩種獎勵會出現分歧。
- 必須能將可控失敗與不可控失敗區分開來,並以一條「無串聯誤差 (cascading-error-free)」的評分準則來評分軌跡,避免單一前期障礙不公地懲罰所有後續步驟。
- 必須有效注意軌跡中的所有截圖證據,而非僅最近的幾張畫面,因為長任務常包含系統性截圖時就會被截斷情境而錯過的關鍵狀態變化。
為了嚴謹地驗證這些原則,我們發布了 CUAVerifierBench,一份新的人工標註 CUA 基準。據我們所知,CUAVerifierBench 是第一個專門為衡量驗證器在過程和結果獎勵雙方面的品質而設計的基準,使社群能以標準化的方式比較驗證器與人類判斷的一致程度。我們證明:我們的驗證器(即「通用驗證器」)以 Cohen's κ (Cohen's Kappa) 衡量時,相較於 WebJudge、WebVoyager 等基線顯著提升一致性,同時將偽陽性率從超過 30% 降至 1–8%。
關鍵的是,建構高品質的驗證器並非一次性問題,而是迭代開發的過程,而 CUAVerifierBench 正扮演此角色:每個候選驗證器設計都能用 Cohen's κ 來對人類判斷打分,提供「什麼有效、什麼無效」的清晰且立即的訊號。圖 1 追蹤了這趟跨越 96 次實驗的迭代旅程。專家設計的驗證器一開始與人類幾乎沒有一致性,但透過原則性的實驗逐步進步,到第 32 次實驗時 κ ≈ 0.7,因為四個設計原則被逐步發現並整合進來。
我們也探討了一個自動化研究代理是否能複製這個過程。從一個白板起步,自動研究設計的驗證器一致地不及表現,並在大約 0.55 處(約專家級品質的 70%)進入平台期。從質性的角度看,自動研究代理的編輯傾向保守且漸進式,難以編碼專家驗證器在大幅階躍式改進背後那種評估判斷的能力。不過,當以專家設計的最佳驗證器為起點來初始化時,自動研究代理超越了專家設計的高峰。這暗示著人類專業知識與自動化最佳化扮演互補角色:前者對於發掘核心設計原則至關重要,後者則擅長對剩餘工程問題進行細緻調整。
簡而言之,我們的貢獻為:(1) 我們識別並驗證了建構可靠 CUA 驗證器的四項設計原則,顯示其累積效應產生的驗證器與人類的一致性,達到人類彼此一致的程度。(2) 我們發布 CUAVerifierBench,第一個專門用於評估電腦使用代理驗證器品質的基準,為社群提供標準化的方法來衡量驗證器與人類判斷的一致性。
2. 背景與相關工作
數種系統已被提出用於自動評估 CUA,其差異主要在於它們消耗的輸入以及是否依賴提示式 LLM 或訓練模型。
WebVoyager (He et al., 2024b) 使用基於 GPT-4V 的評估器,會接收所有軌跡截圖以及代理對指定任務的最終答案,以產生二元結果判斷。經 300 個任務的人類標註驗證後,GPT-4V 變體達到 85.3% 的一致率 (κ = 0.70),與人類標註者相互一致率相當。
WebJudge (Xue et al., 2025) 處理上述方法的兩個已知失敗模式:對代理可能產生幻覺 (Hallucination) 的最終答案的依賴,以及把所有截圖未經篩選地通過所引發的 Token Overload。它採用三步驟流程:先從任務描述中萃取關鍵點 (Key Points),根據相關性對每張截圖打分,並僅根據前 k 個被選出的截圖與完整動作歷史來判斷成功與否。在相同的評估設定下,WebJudge (o4-mini) 達到 85.7% 與人類的一致率,相對於 WebVoyager 的 78.7%。
從結果驗證轉向失敗診斷,AgentRx (Barke et al., 2026) 識別關鍵失敗步驟,並從九類分類法中分配根本原因。
AgentRewardBench (Lù et al., 2025) 提供了 1,302 個跨五個基準(WebArena (Zhou et al., 2023)、VisualWebArena (Koh et al., 2024)、AssistantBench (Yoran et al., 2024)、WorkArena (Drouin et al., 2024)、WorkArena++ (Boisvert et al., 2024))和四個代理 LLM(GPT-4o (OpenAI, 2024)、Claude 3.7 Sonnet (Anthropic, 2025)、Llama-3.3-70B (Grattafiori et al., 2024)、Qwen2.5-VL (Bai et al., 2025))的專家標註軌跡。他們引入一個簡化版判斷器,在單次 LLM 完成中預測三個二元標籤:任務成功、副作用、重複循環。他們的關鍵發現是:沒有任何 LLM 為基礎的判斷器(包括 NNetNav (Murty et al., 2025) 和 AER (Pan et al., 2024))的精確率超過 70%。人類標註者間一致率為 89.3%。
數項工作已就過程與結果獎勵在哪些情境下更合適進行討論,例如數學問題求解 (Lightman et al., 2023; Uesato et al., 2022);Wang et al. (2024) 訓練自家過程獎勵模型 (Process Reward Model)。Zhang et al. (2025b) 提煉了為數學任務建構過程驗證器的經驗。其他工作將其延伸至代理式 RAG (Agentic RAG) 領域 (Zhang et al., 2025a)。我們建議讀者參考其他綜述 (Zheng et al., 2025; Stuhlmüller & Byun, 2022)。
| 驗證器 | LLM | 評分準則 | 截圖 | 動作歷史 | 最終答案 |
|---|---|---|---|---|---|
| WebJudge (OM2W) | o4-mini | ✗ 未使用 | ✓ 前 k 個最相關(評 1–5 分,閾值以上保留;上限 5) | ✓ 完整 | ✗ |
| WebVoyager GPT eval | gpt-4o | ✗ 未使用 | ✓ 全部截圖(若超出上限取最後 N 張;預設 N=30) | ✗ | ✓ |
| 通用驗證器 (本文) | gpt-5.2 | ✓ 每任務成功條件 | ✓ 每條件前 k 個最相關 | ✓ 完整 | ✗ |
表 1:不同電腦使用軌跡驗證器特性的比較。
3. 好的驗證器具備什麼特質?
我們基於對 CUA 軌跡日誌的廣泛實作經驗,提煉出我們認為對於建構可靠驗證器至關重要的原則。
3.1 好的評分準則需具備明確且不重疊的條件
評分準則生成是流程的根源:有缺陷的評分準則會造成錯誤層層串聯到下游,且難以在後期被更正。從軼事來看,圖 1 顯示僅憑良好的評分準則設計就能解釋約一半的 Cohen's κ 提升。透過迭代開發,我們識別出五種系統性的失敗模式以及對應的修正措施:
- 幻象條件 (Phantom Criteria):LLM 生成的評分準則經常引入任務從未明說的需求(例:附錄 A.2 表 4),導致分母被膨脹,且過度懲罰那些其實已完成任務的代理。
- 串聯誤差 (Cascading Errors):當評分準則條件之間並非邏輯獨立時,單一上游錯誤會傳播到下游條件,使分數扣除被乘以多倍。
- 生成與評分分離 (Separate Generation and Scoring):在單一 LLM 呼叫中同時生成評分準則並進行評分,會讓模型製造出針對代理行為「量身打造」的條件。我們將評分準則的生成(僅看任務本身、不看軌跡)與評分過程分離。
- 幻覺偵測 (Hallucination Detection):我們對整個評分準則進行兩遍評分 —— 一次有相關截圖證據、一次沒有 —— 以揭示其中的差異。
- 條件式條件 (Conditional Criteria):某些條件可能會也可能不會在現實中適用(例:「買有機藍莓,若無,買非有機」)。因此在評分準則生成時,我們會將部分條件標記為「條件式」,並在嘗試任務後再更新狀態。不滿足條件的條件會被排除,以確保互斥條件不會互相干擾。詳細與範例見附錄 A.2 表 5。
剩餘的子小節討論評分準則的評分過程。有時候評分準則會被修改,例如更新條件式條件,或為未請求的副作用新增條件。
3.2 區分過程獎勵與結果獎勵
在電腦使用情境中,環境在任務成功與否中扮演了過大的角色,特別是當代理被阻擋或無法存取所需資源時。因此,我們驗證框架的核心設計原則是:將「代理在環境條件下的執行品質」與「使用者目標是否達成」加以分離。這兩個問題在許多現實情境中有根本不同的答案,將兩者混為一談會導致獎勵訊號要麼太寬鬆(在使用者最終空手而歸時仍給予代理「努力過了」的點數),要麼太苛刻(因為代理無法掌控的因素而懲罰之)。我們透過每條軌跡兩個獨立訊號正式化這個分離:過程獎勵 (Process Reward)(細緻的評分準則分數,反映在子目標上的成功率)與結果獎勵 (Outcome Reward)(針對目標是否達成的二元成功/失敗判斷)。
過程標籤(評分準則分數):這是一個加權的條件評分準則,每個條件以可獲得的最大分數為權重。它以從 0.0 到 1.0 的歸一化分數來呈現,反映代理在每個子任務上的執行表現。其計算方式為:
$$r_{\text{proc}} = \frac{\sum_{i \in \mathcal{A}} \text{earned\_points}_i}{\sum_{i \in \mathcal{A}} \text{max\_points}_i} \quad (1)$$
其中 $\mathcal{A}$ 是「適用條件 (Applicable Criteria)」的集合 —— 即條件式條件中已滿足的條件,或那些原本就無條件的條件。過程標籤評估代理在每個動作步驟上的執行品質,與這些步驟最終是否導致成功的結果無關。雖然這在技術上是一個純量分數,但評分準則也包含對於為什麼點數被獲得或扣除的詳細理由 —— 這些理由根據完整的動作歷史與截圖。例如一個被登入牆擋住的代理仍能在加入購物車前獲得完整的過程獎勵點數,即使使用者目標尚未達成。範例評分準則可見圖 2 與圖 3。
結果標籤(二元成功/失敗):結果標籤是一個二元的是/否判斷,回答:一個合理的使用者會認為任務完成了嗎? 這個判斷從使用者的角度評估結果,且在審查最終狀態時進行。本身就具挑戰性,因為使用者可能對成功有不同概念,且任務目標模糊(例:是否可以省略 NeurIPS 在墨西哥城的次要場地,當被問「2025 NeurIPS 在哪裡舉辦?」時?),對於約束有不同偏好(例:在 opentable.com 預訂表時可以使用 resy.com 嗎?)。
為了取得進展,我們假設結果標籤應該聚焦於主要意圖 (Primary Intent) —— 若主要意圖是預訂一張桌子,那麼除非另有聲明,使用者應該對於用哪個平台預訂保有彈性。我們也相信大多數使用者對於小細節(如將 5.95 美元四捨五入為 6 美元)是寬容的。然而,我們假設使用者不會寬容未經請求的副作用,例如當他們只想買產品本身時卻買了保固,或表 7 中所述的那類幻覺。我們在表 6 中總結了電腦使用情境的過程與結果獎勵 —— 注意它們僅在第二行中不一致。
3.3 區分可控與不可控因素
由於軌跡是過程成功但結果失敗的主要差異涉及環境,我們明確定義了哪些方面從代理的角度來看是可控與不可控的。每條評分準則的條件描述欄位都試圖預期這些情境,並對如何給予部分點數提供指引。
不可控因素:超出代理控制範圍的條件;於過程評分中不被懲罰。
- 平台/基礎設施問題 (Platform/Infrastructure Issues):CAPTCHA、要求憑證的登入牆、網站當機等。
- 實體不存在 (Entity Non-Existence):產品停產、業務關閉、服務無法使用。
- 可用性限制 (Availability Constraints):缺貨、要求日期沒有保留、售完。
- 搜尋結果限制 (Search Result Limitations):沒有結果符合所有指定條件。
可控因素:代理理應避免的錯誤;於過程評分中應被懲罰。
- 意圖不符 (Intent Mis-match):選擇了完全錯誤的產品、地點、人物、服務等。
- 推理錯誤 (Reasoning Errors):對任務的不正確推理,例如圖 4。
- 幻覺 (Hallucinations):在沒有證據的情況下宣稱成功、虛構資訊。
- 嘗試不足 (Insufficient Attempts):在單次失敗嘗試後就放棄。
- 執行錯誤 (Execution Errors):未使用可用的篩選器、跳過必要步驟。
3.4 螢幕截圖證據的有效情境管理
我們的主要貢獻是設計一個能夠透過更佳的視覺截圖證據管理來對抗幻覺[^2]的驗證器。WebVoyager (He et al., 2024b) 與 WebJudge (Xue et al., 2025) 兩者都會評估「在 LLM 情境窗口中大量的截圖」—— WebVoyager 包含所有截圖,而 WebJudge 通常只送 5–50 張。其他驗證器只分析最後一張 (Pan et al., 2024)。過多的截圖過度拉伸 LLM,迫使其在巨大的情境窗口中解一個「乾草堆裡找針」的問題,這在較長軌跡上的擴展性不佳;而僅看最近幾張則可能漏掉與任務相關的證據。
為了同時解決這些問題,我們的設計為每個評分準則的條件對所有截圖打相關性分數 (Relevance Score),產生一個相關性矩陣 (Relevance Matrix),並按條件分組前 k 個最相關截圖以送至下游進一步分析。這不僅在較長軌跡上更具擴展性,也更聚焦。我們在附錄 A.3.1 中以圖 6 為例詳述截圖評分設計。
3.5 未經請求的副作用
具有實質副作用的多餘動作 —— 例如將未經請求的物品加入購物車(見圖 7)、註冊未經請求的服務 —— 構成的情境通常無法在嘗試任務前預測,因為評分準則不是設計來列舉一條軌跡可能出錯的所有方式。要捕捉這類情況,需要對軌跡專門進行一輪檢查。雖然未經請求的副作用幾乎都會導致結果失敗,但對過程獎勵的懲罰只是部分性的,並依副作用的嚴重程度加權。
[^2]: 我們在附錄 A.5 表 7 中定義幻覺的剖析,並在圖 5 中提供範例。
4. 通用驗證器系統
我們將電腦使用任務建模為一個元組 $(g, \mathcal{E})$,其中 $g$ 是一個自然語言目標(例:「預訂 6 月 3 日從西雅圖到波士頓最便宜的可訂航班」),而 $\mathcal{E}$ 是一個帶有可觀察圖形介面的電腦環境。代理與 $\mathcal{E}$ 互動,產生一條軌跡 $\tau = (s_0, a_1, s_1, a_2, \ldots, a_T, s_T)$,其中 $s_t \in \mathcal{S}$ 是時間 $t$ 時的截圖觀察、$a_t \in \mathcal{A}$ 是動作(如點擊、輸入、捲動)。任務的長度 $T$ 從幾步(表單填寫)到數百步(多階段工作流程)不等。
我們將驗證器定義為一個函數 $V : (g, \tau) \to \mathcal{R}$,將目標與軌跡映射到結構化的評分回應 $r \in \mathcal{R}$。在最簡單的情況下,$\mathcal{R} = \{0,1\}$(二元成功),但我們會論述並表明設計反映出 $\mathcal{R}$ 應該更豐富 —— 為一個元組 $(r_{\text{proc}}, r_{\text{out}}, d)$,包含過程分數 $r_{\text{proc}} \in [0,1]$、結果分數 $r_{\text{out}} \in \{0,1\}$、以及定位失敗位置的診斷報告 $d$。過程分數捕捉代理執行的品質,而結果分數則反映目標 $g$ 是否最終達成。
關鍵挑戰在於 $V$ 必須處理整個觀察序列 $\{s_0, \ldots, s_T\}$,這條序列可能很長、視覺密集,且包含分佈於任意時間戳的關鍵狀態變化。我們將驗證器品質定義為與人類預言機 (Human Oracle) $V^* : (g, \tau) \to \mathcal{R}$ 的一致性,以精確率 (Precision)、召回率 (Recall) 和 Cohen's κ (Artstein & Poesio, 2008) 對固定軌跡集合 $\{s_1, \ldots, s_L\} \subset \tau$ 衡量。一個會檢查只有 $s_T$ 或固定子集 $\{s_1, \ldots, s_L\} \subset \tau$ 的驗證器是 $V^*$ 的嚴格近似。如同我們將以實證方式系統性顯示的,當 $T$ 很大時這種驗證器的表現遜色。可靠的驗證因此需要對所有 $T+1$ 個觀察進行注意。
演算法 1:通用驗證器
輸入:代理軌跡 $\tau$、觀察 $\{s_0, \ldots, s_T\}$、使用者目標 $g$ 輸出:過程分數 $r_{\text{proc}}$、結果分數 $r_{\text{out}}$、診斷報告 $d$
- 生成評分準則 $\mathcal{C} = \{c_1, \ldots, c_N\}$:根據 $g$ 生成 $N$ 條互斥、有意義的條件。見附錄 A.2。
- 多模態相關性評分 (Multimodal Relevance Scoring):對每張截圖根據每條條件評分,產生相關性矩陣 $\mathbf{R} \in \mathbb{R}^{(T+1) \times N}$。詳見附錄 A.3.1。
- 前 k 分組 (Top-k Grouping):對每條 $c_j$,選擇前 $k$ 個最相關 $\mathcal{S}_j \subseteq \{s_0, \ldots, s_T\}, |\mathcal{S}_j| \leq k$。
- 證據分析 (Evidence Analysis):對每個 $(c_j, s_i)$ 配對,其中 $s_i \in \mathcal{S}_j$,萃取出視覺證據 $e_{ij}$。
- 條件式消歧 (Conditional Disambiguation):使用 $\{e_{ij}\}$ 解決條件式條件之間的衝突。
- 現實檢查 (Reality Check):根據截圖證據調整評分準則的假設;產生詮釋現實註記與僅限動作的分數 $r_{\text{proc,action\_only}}$。
- 多模態重新評分 (Multimodal Rescoring):根據表 6 與表 7,整體使用截圖證據(優先於代理宣稱)對 $\mathcal{C}$ 重新評分(前面尚未被 $\mathcal{C}$ 懲罰過的)。
- 副作用偵測 (Side-Effect Detection):偵測並收錄帶有實質副作用、尚未被評分準則懲罰的未經請求的代理動作。
- 結果驗證 (Outcome Verification):執行並回傳程序性結果分數 $r_{\text{out}}$。
- 失敗診斷 (Failure Diagnosis):根據表 10 識別並定位所有失敗點,回傳 $d$。
我們所建構的通用驗證器 (Universal Verifier, UV) 體現了第 3 節的原則,並依三階段運作:評分準則建立、整合截圖證據的多模態評分 (Multimodal Scoring) 以確認 $r_{\text{proc}}$,以及產生最終結果判斷 $r_{\text{out}}$ 與錯誤診斷 $d$ —— 如演算法 1 所示。關鍵設計不變條件 (Design Invariant) 是:沒有相關的截圖證據可在管線中未被偵測地遺漏,特別是不能漏看任何幻覺。為了減少變異,演算法 1 中的步驟 7–9 可以作為多個平行實例執行,過程分數由評分準則分數的中位數決定,結果則由多數投票決定。
最後,我們對 $\tau$ 進行錯誤分析以將失敗模式分類,並識別軌跡中失敗發生的步驟 $t$。我們根據表 10 中的錯誤分類法(涵蓋意圖不符、幻覺、關鍵點違規等 7 類 24 個子類)來開發。
5. 實驗
我們將通用驗證器視為任何其他人類標註者,並對所有研究計算標註者間一致性 (Inter-Annotator Agreement):(1) 與兩個獨立標註資料集上的人類軌跡標籤一致性,(2) 大規模下基準測試原生驗證器與 UV 之間的一致性,以及 (3) 一個自動研究研究,探索 AI 代理是否能取代或增強驗證器設計中的人類專業知識。我們在下面描述每個實驗設定。
CUAVerifierBench:人工標註的資料集
由於 UV 在電腦使用領域同時驗證過程與結果標籤的創新是新穎的,現有基準均未提供這兩種標籤。
我們從 WebTailBench (Awadallah et al., 2025a) 採樣了 140 條軌跡。內部專家標註者根據第 3 節的指引,為每條軌跡標註過程成功與結果成功。此資料集用於所有消融研究(第 6 節)和自動研究實驗(第 6 節)。我們稱之為內部資料集 (Internal Dataset)。
此外,我們透過 Browserbase^3 管理的外部標註者,為從 Fara-7B (Awadallah et al., 2025a) 在 Online-Mind2Web 上採樣的 106 條軌跡標註過程與結果成功,每條軌跡有 2× 標註者重疊。標註者先在 10 條實踐軌跡上以黃金標註校準,然後分兩階段判斷每條評估軌跡:
- UV 盲階段:標註者僅看到輸入任務、未評分的評分準則條件、以及代理的軌跡。他們獨立判斷結果與過程成功,並對每條軌跡提供連續評分準則分數。
- UV 知情階段:標註者隨後看到 UV 的結果判決與評分準則分數,並被詢問是否同意 UV 的結果與過程。
針對任務層級的聚合,結果標籤以多數投票計算,過程標籤則以兩位標註者連續評分準則分數的中位數計算,並以閾值 ≥0.8 二元化。平局由第三方解決。我們從兩階段都報告一致性指標:UV 盲一致性衡量人類獨立判斷與 UV 的一致性,而 UV 知情一致性衡量人類在審視其推理後對 UV 判決的支持程度。
在規範基準的驗證器一致性
上述人工標註資料集規模較小(專家標註成本高昂)。為大規模評估驗證器行為,我們在多個規範基準上重新為相同軌跡打分,並計算每個基準的「原生」驗證器與通用驗證器之間的一致性。我們選擇三個基準 —— WebVoyager、Online-Mind2Web (OM2W) 和 WebTailBench —— 以及兩個代理模型 —— Fara-7B 和 GPT-5 作為 Set-of-Marks 代理 (Yang et al., 2023)。
自動研究研究
通用驗證器約由 3,000 行程式碼與 2,000 行提示 (Prompt) 組成 —— 包括評分準則生成模板、評分指引、結果驗證邏輯、以及錯誤分類規則 —— 全部由人類專家(第一作者)反覆設計。為了研究 AI 代理是否能複製或增強這位人類專家,我們使用 Claude Code v2.1.87,在 Claude Max 訂閱中於 Claude Opus 4.6 (1M 情境) 上設計了一個自動研究系統 (Auto-Research System)。系統獲得與人類專家相同的設計原則(第 3 節),並重用相同實驗基礎設施(在內部集上執行 UV、計算一致性指標,並將提示變更提交至版本控制)。我們評估兩種設定:
- 從空白提示出發 (From-blank prompts):所有約 2,000 行提示被替換為 // TODO 佔位符,留下程式碼骨架。代理獲得高階設計原則但無法存取先前提示版本、之前的提交、或其他分支。為了避免測試案例的記憶,我們設計了一個獨立的合規代理 (Compliance Agent) 在每次迭代中審計,以強化一個原則:「最大化 Cohen's κ 而不增加 FPR;任何提升 FPR 的變更會自動回滾。」
- 延續專家工作 (Continuing expert work):代理從人類專家最佳的提示出發,並以相同的最佳化目標繼續執行。
6. 結果
與人類標籤的一致性:UV vs. 既有驗證器:在表 2 中我們比較 UV 與兩個既有的軌跡判斷器 —— WebVoyager (He et al., 2024b) 和 WebJudge (Xue et al., 2025) —— 在 CUAVerifierBench 上。UV 大幅在兩個資料集的近乎所有指標上超越基線。在結果標籤上,UV 達到的 Cohen's κ 為 0.64(內部)和 0.58(Browserbase),相對於 WebJudge 的 0.44/0.26 和 WebVoyager 的 0.31/0.13。引人矚目的是,UV 達到接近零的 FPR(內部 0.01、Browserbase 0.08)在結果標籤上,意味著當人類標註者會把它標記為失敗時,它幾乎不會把軌跡列為成功。包含三次獨立執行所計算的標準差誤差棒的此表版本在表 15 中。
| 內部資料集 ($n=140$) | Browserbase OM2W ($n=106$) | |||||
|---|---|---|---|---|---|---|
| WebVoy. | WebJudge | UV | WebVoy. | WebJudge | UV | |
| GPT-4o | GPT-5.2 | o4-mini / GPT-5.2 | GPT-4o | GPT-5.2 | o4-mini / GPT-5.2 | |
| 與結果人類標籤的一致性 | ||||||
| 準確率 (↑) | 0.67 | 0.70 | 0.72 | 0.64 | 0.81 | 0.48 |
| F1 (↑) | 0.73 | 0.69 | 0.74 | 0.58 | 0.81 | 0.35 |
| Cohen's κ (↑) | 0.31 | 0.43 | 0.44 | 0.33 | 0.64 | 0.13 |
| FNR (↓) | 0.24 | 0.44 | 0.33 | 0.57 | 0.32 | 0.12 |
| FPR (↓) | 0.45 | 0.10 | 0.22 | 0.07 | 0.01 | 0.60 |
| 與過程人類標籤的一致性 | ||||||
| 準確率 (↑) | 0.62 | 0.66 | 0.66 | 0.61 | 0.81 | 0.55 |
| F1 (↑) | 0.70 | 0.65 | 0.70 | 0.57 | 0.86 | 0.47 |
| Cohen's κ (↑) | 0.17 | 0.34 | 0.32 | 0.30 | 0.59 | 0.22 |
| FNR (↓) | 0.31 | 0.44 | 0.40 | 0.59 | 0.24 | 0.05 |
| FPR (↓) | 0.52 | 0.10 | 0.25 | 0.04 | 0.04 | 0.56 |
表 2:CUAVerifierBench 中三個驗證器與人類在一致性的對比。將外部驗證器升級至 GPT-5.2 只造成些微改善,確認 UV 的優勢是架構性的。
為了測試 UV 的優勢是否單純源自於使用更強的後端模型,我們在表 2 中報告了四個額外的列,將 WebVoyager 的 GPT-4o 與 WebJudge 的 o4-mini 升級至 GPT-5.2。雖然這確實大幅降低了 FPR(內部 WebVoyager 結果 FPR 從 0.45 降至 0.10),但也戲劇性地增加了 FNR(從 0.24 增至 0.44),整體 κ 僅有些微改善。我們因此得出結論:UV 的優勢源自其截圖評分設計,而不僅是使用更強的模型。
Browserbase 標註:使用第 5 節描述的兩階段標註流程,當標註者看到 UV 的推理時,一致性顯著變化。UV 知情階段大幅改善一致性:結果 Cohen's κ 從 0.39 上升到 0.63,結果 FPR 從 0.62 降到 0.35,FPR 維持接近零(0.04)。在過程標籤上,FNR 從 0.32 急降到 0.09。在 UV 識別出他們最初遺漏的失敗後,僅有 16.6% 的標註者結果判斷在審視 UV 的推理後被翻轉,更多的是從成功翻為失敗。
我們也在圖 11 中繪製了 UV 為評分準則分數對人類所給標籤的散點圖。詳細結果見附錄 B.2 與表 13。
標註者間一致性:Browserbase 的拆分包含至少有兩位標註者標註的軌跡。UV 與人類標籤的結果 κ(0.58,表 2)和過程 κ(0.43)落入對應的標註者間範圍(0.53–0.57 和 0.36–0.45),如表 14 所示;表 14 顯示 UV 在兩個維度上與人類的一致性,與人類彼此之間的一致性大致相當(細節見 B.2 節)。
消融:變化評分準則生成器與評分器:我們對通用驗證器進行進一步的消融,完整報告於附錄 B.1。表 11 中我們變化 UV 在端到端的後端 LLM(每個模型生成自己的評分準則並評分),發現 GPT-5.2 在 FPR 上達到最低,而 GPT-5 提供最佳整體一致性。在表 12 中我們再次變化 UV 後端 LLM,但隔離其評分組件(透過 GPT-5.2 生成評分準則),顯示 GPT-5.2 是最保守的評分器,而 GPT-5.1 達到最高整體 κ。
UV 與原生基準驗證器的一致性:我們衡量 UV 與三個基準(WebVoyager、Online-Mind2Web (OM2W) 和 WebTailBench)所附帶的原生驗證器之間的一致性。表 3 顯示原生驗證器與 UV 標籤大幅不一致:相對於 UV 結果標籤的 FPR 一致性高於 20%,其中 WebVoyager (GPT-4o) 的 FPR 最高、Cohen's κ 最低。對應的錯誤分類直方圖見圖 8、9、10。
| WebVoyager | OM2W | WebTailBench | ||||
|---|---|---|---|---|---|---|
| Fara-7B | GPT-5 | Fara-7B | GPT-5 | Fara-7B | GPT-5 | |
| $N$(已評分任務) | 594 | 593 | 298 | 276 | 599 | 597 |
| 未終止 (%) | 4.2 | 3.4 | 5.0 | 7.2 | 17.0 | 7.7 |
| 成功率 (%) | ||||||
| 原生驗證器 | 74.6 | 90.6 | 32.2 | 62.0 | 39.6 | 62.5 |
| UV 過程 | 49.0 | 79.4 | 25.8 | 64.9 | 39.6 | 63.5 |
| UV 結果 | 37.9 | 71.0 | 15.8 | 48.6 | 23.2 | 39.9 |
| 原生 vs. UV 過程$^\dagger$ | ||||||
| FNR (↓) | 0.06 | 0.04 | 0.26 | 0.27 | 0.30 | 0.23 |
| FPR (↓) | 0.56 | 0.68 | 0.18 | 0.42 | 0.20 | 0.45 |
| 準確率 (↑) | 0.69 | 0.83 | 0.80 | 0.67 | 0.76 | 0.72 |
| F1 (↑) | 0.75 | 0.90 | 0.66 | 0.74 | 0.70 | 0.78 |
| Cohen's κ (↑) | 0.38 | 0.36 | 0.52 | 0.33 | 0.50 | 0.40 |
| 原生 vs. UV 結果 | ||||||
| FNR (↓) | 0.01 | 0.02 | 0.17 | 0.24 | 0.14 | 0.17 |
| FPR (↓) | 0.60 | 0.72 | 0.23 | 0.49 | 0.25 | 0.49 |
| 準確率 (↑) | 0.63 | 0.78 | 0.78 | 0.63 | 0.77 | 0.64 |
| F1 (↑) | 0.68 | 0.86 | 0.55 | 0.67 | 0.64 | 0.65 |
| Cohen's κ (↑) | 0.33 | 0.33 | 0.42 | 0.27 | 0.49 | 0.31 |
表 3:跨三個基準和兩個代理模型的原生基準驗證器與通用驗證器 (UV) 之間的一致性。UV 被視為參考標籤。
Mind2Web (OM2W) 和 WebTailBench:表 3 顯示原生驗證器與 UV 標籤大幅不一致:相對於 UV 結果標籤的 FPR 一致性高於 20%,其中 WebVoyager (GPT-4o) 的 FPR 最高、Cohen's κ 最低。對應的錯誤分類直方圖見圖 8、9、10。
自動研究:AI 能取代驗證器設計的人類專家嗎? 一個自然的問題是:AI 自動研究代理是否能複製 —— 甚至改善 —— 設計驗證器的過程 (Lu et al., 2026; Karpathy, 2026; Tie et al., 2025)。圖 1 顯示了人類專家與兩種自動研究設定的結果 Cohen's κ 進展(過程 κ 在圖 13)。空白提示自動研究代理達到約專家品質 70% 的水準,僅 5% 的時間消耗。圖 14–15 顯示對應的 FPR 與 FNR 軌跡。空白提示自動研究代理達到約專家品質的 70%,並僅在 5% 的時間消耗,但仍能在不增加偽陽性率的限制下找到良好的提示並編寫程式碼。表 17 在附錄 C.1 中總結每次「延續專家」迭代的目的,以及它是否被提交或回滾。
對於 AgentRewardBench (Lù et al., 2025),我們在附錄 B.4 中報告:在 30 個被人類標註者標記為成功且在步驟預算內終止的軌跡樣本中,根據我們的結果指引,我們認為其中 8 個為偽陽性 (FPR ≈ 0.27)。
7. 結論
我們呈現了通用驗證器與 CUAVerifierBench,證明我們的四項設計原則累積產生一個 1) 與人類達到的一致性等同人類彼此一致性的驗證器,2) 在我們衡量的任何驗證器中與人類達到的一致性最高,3) 將偽陽性率降低至接近零,相較於 WebVoyager (≥45%) 和 WebJudge (≥22%) 等基線。這些提升是架構性而非模型驅動的:將 WebJudge 與 WebVoyager 使用的後端升級至 UV 所用的相同 LLM,僅產生些微改善。我們的自動研究實驗顯示,雖然 AI 可達到專家級驗證器品質的 70%,僅在 5% 的時間,但它難以獨立發掘那些驅動最大提升的結構性設計決策,這暗示著建構可靠的驗證器仍然既是編碼評估判斷的藝術,也是工程問題。
8. 倫理聲明
我們揭露我們透過外部公司 Browserbase 雇用人類標註者,他們向我們表示這些標註者被支付的薪資高於當地適用的最低工資。我們也代表部分標註者向我們表達對於評判任務經驗的書面意見作為定性回饋。我們未揭露任何關於這些判斷者的個人可識別資訊。我們未給予判斷者任何在心理上有害、冒犯性、或成人性質的任務。
此外,我們揭露此工作的部分內容是由生成式 AI 產生的,包括但不限於自動研究研究、結果、分析和程式碼。我們已盡最大努力驗證結果未被幻覺。
附錄 A:通用驗證器細節
A.1 頂層評分準則與結果範例
我們的通用驗證器的輸出是一個評分準則,顯示每個條件根據動作歷史的初步評分,這些評分隨後用多模態證據更新。它也顯示一個獨立的結果結果,如圖 2 所示。
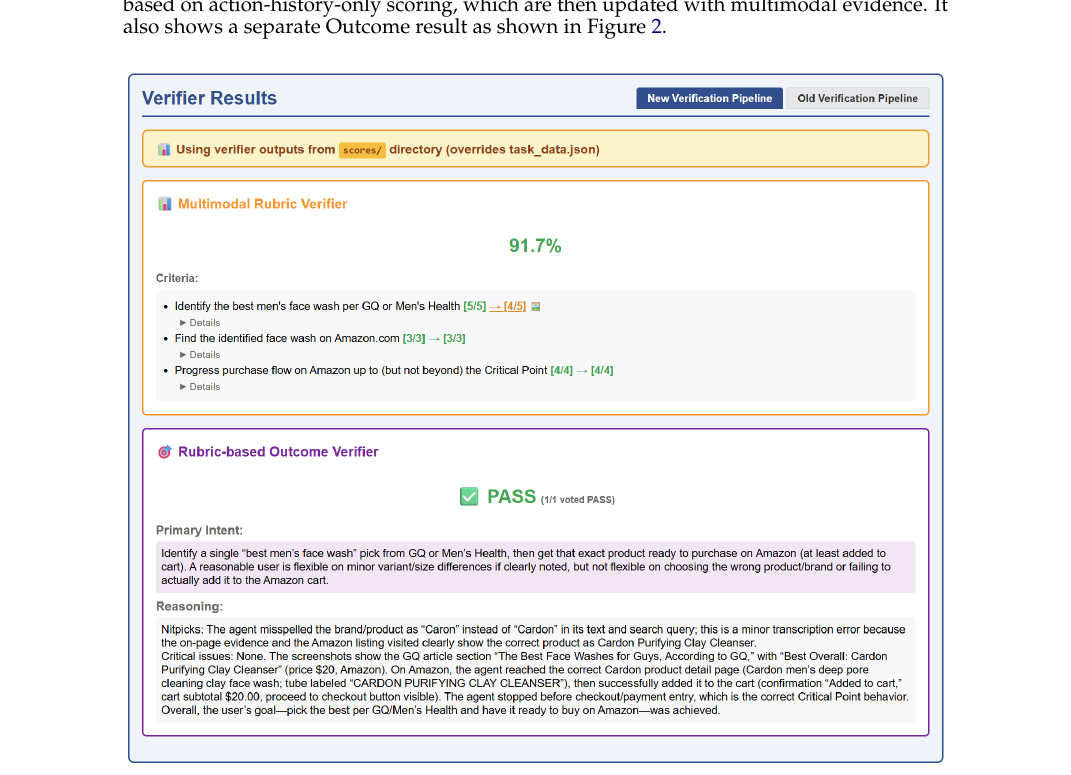
圖 2:我們內部視覺化工具的快照,顯示針對任務「找出 GQ 或 Men's Health 上最佳的男士洗臉乳,然後在 Amazon 上購買」的軌跡之驗證結果。
我們記錄每個個別條件如何被評分的詳細資訊,如圖 3 所示。
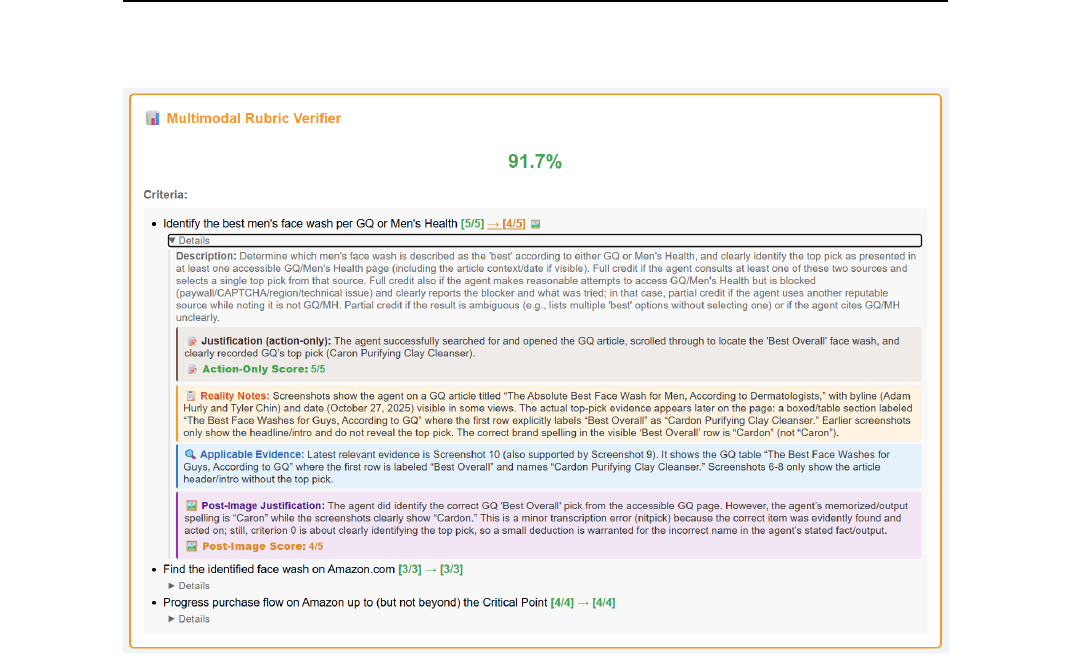
圖 3:相同範例中的個別條件如何被評分的快照,在這個案例中根據多模態證據在動作歷史中將「Cardon」誤拼為「Caron」損失了一點。這類細緻分析幫助我們偵測那些原本可能溜過的幻覺。
A.2 評分準則失敗模式與修正
評分準則生成是驗證流程的根源,有缺陷的評分準則會產生錯誤,這些錯誤會層層串聯到評分與結果決定。透過迭代開發(第 3 節),我們識別了幾種 LLM 生成評分準則中的系統性失敗模式並開發對應的修正。表 4 用三個代表性範例說明舊有評分準則驗證器與改良後通用驗證器的對比。
我們在下方總結關鍵失敗模式與我們的修正:
幻象條件:LLM 生成的評分準則經常引入任務從未明說、也非完成任務所必需的需求。例如,當被要求「在 Eventbrite 上找一個現場音樂活動,並在 Spotify 上找該活動表演藝人的歌曲」時,舊的評分準則加入了關於票券資訊、活動連結、Spotify URL 的條件 —— 這些都不是使用者要求的(表 4,任務 A)。這些幻象條件透過膨脹分母過度懲罰已完成任務的軌跡,導致代理被標記為失敗。我們的修正指示評分準則生成器嚴格錨定條件至任務必要的內容,並明確禁止在使用者未要求的資訊上扣分。
串聯誤差:當評分準則條件並非邏輯獨立時,一個條件中的錯誤會傳播至下游條件,乘以扣分。例如,若評分準則先問「找到正確的鄰里」,再問「找到那個鄰里的飯店」,一個簡單的事實錯誤就會在第一個條件中讓你失去兩個點數 —— 即使代理的下游動作與其(不正確的)上游資料內部一致。另一個更詳細的範例見圖 4。我們的修正要求條件被獨立評估:每個條件根據代理在那個步驟所擁有的資訊判斷其行動是否合理,而不是上游條件是否被正確評分。
生成評分與評分分離:流程的早期版本曾有單一 LLM 同時呼叫生成評分準則並評分。這導致確認偏誤:模型會生成寬鬆的條件以符合代理的實際行為,而非任務需求。將這些分離成兩個獨立階段 —— 先僅從任務(不看軌跡)生成評分準則,再對軌跡進行評分準則打分 —— 消除了這個耦合。
條件式條件:許多現實世界任務包含偶然狀況:「做 X,但若 X 不可能,請改報告。」在評分準則生成時並不知道 X 是否可能,因此我們必須等到一條軌跡被嘗試後才能確定,並判斷是否「計入」或「啟用」某些條件。為處理這些情況,評分準則生成器建立條件式條件,其對分數的貢獻取決於在軌跡執行期間是否滿足條件。當條件未被滿足時,該條件會從過程分數的分子和分母中被排除,確保代理不會因無法控制的結果而被懲罰。表 5 顯示一個具體範例。
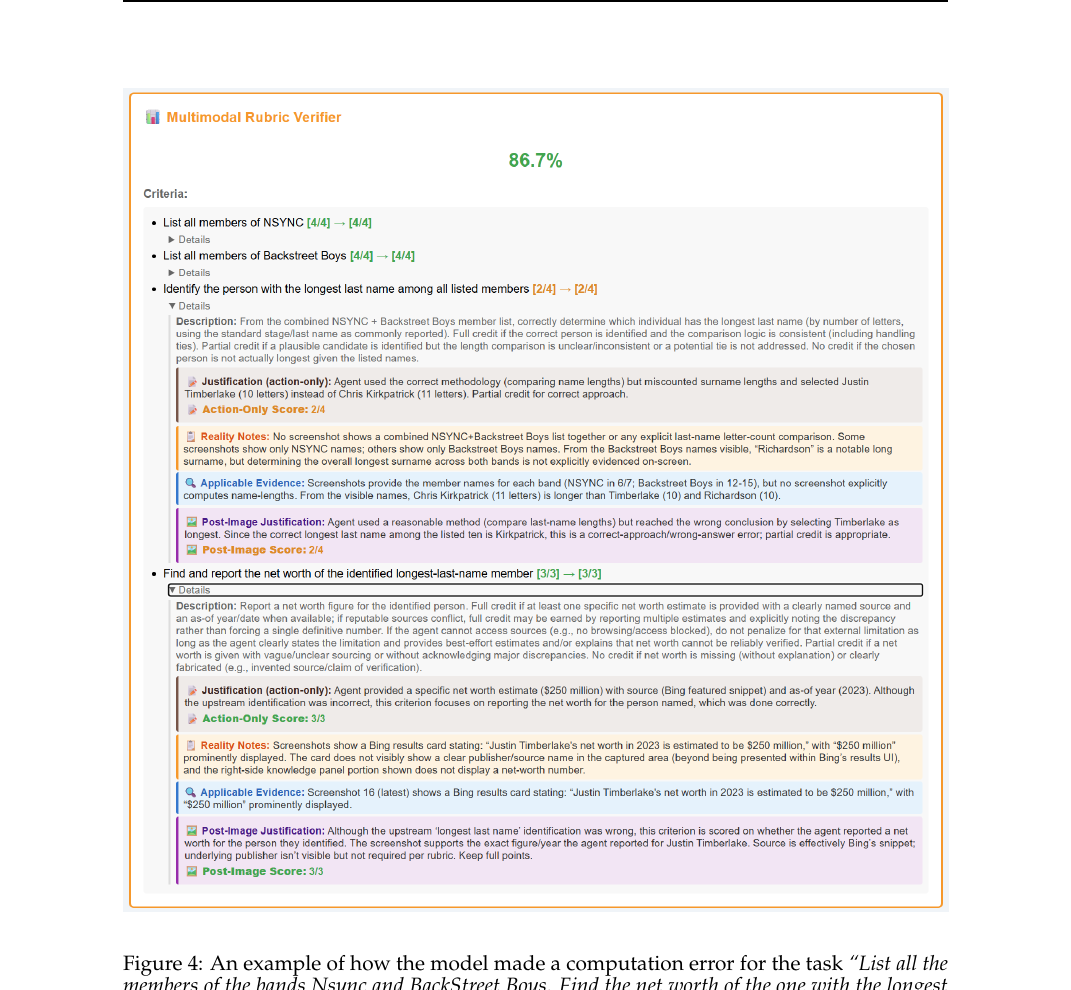
圖 4:模型在任務「列出樂團 NSYNC 與 BackStreet Boys 的所有成員。找到名字最長者的淨資產」中如何犯下計算錯誤的範例 —— 它認為「Timberlake」是最長的,但實際上「Kirkpatrick」才是。這個錯誤被識別了,但值得注意的是,錯誤並沒有串聯到最後一個條件「找到並報告所識別最長姓氏成員的淨資產」。
雙重評分:有截圖與無截圖:當評分器可存取截圖時,幻覺難以被捕捉,因為模型可能無意中使用視覺證據「填充」代理在沒有依據的情況下所做的宣稱。我們的管線對每個條件評分兩次:一次只能存取代理的文字動作(檢查宣稱是否確實根據代理的行動),另一次有完整的截圖存取(驗證視覺狀態)。兩次之間的差異會被標記為潛在幻覺,以供進一步檢查,如附錄 A.3 與圖 5 所示。
A.3 偵測幻覺
我們通用驗證器設計的關鍵原則是不要漏掉任何對任務成功重要的視覺證據,包括那些揭露代理幻覺或捏造的證據。我們對通用驗證器捕捉到的幻覺有多麼微妙卻關鍵感到驚訝。例如在圖 5 中,任務是「調查 Hugging Face 上的 'Salesforce/blip-image-captioning-base' 圖像到文字模型,識別其主要應用與顯著的效能比較」,這會導引到 ArXiv 頁面 https://arxiv.org/abs/2201.12086。在摘要中,作者聲明他們的模型改善了圖像描述 (+2.8% in CIDEr)...。然而,這條軌跡中的代理聲明「+6.2% CIDEr 分數」,這如附錄 A.5 表 7 中所定義是一種矛盾。
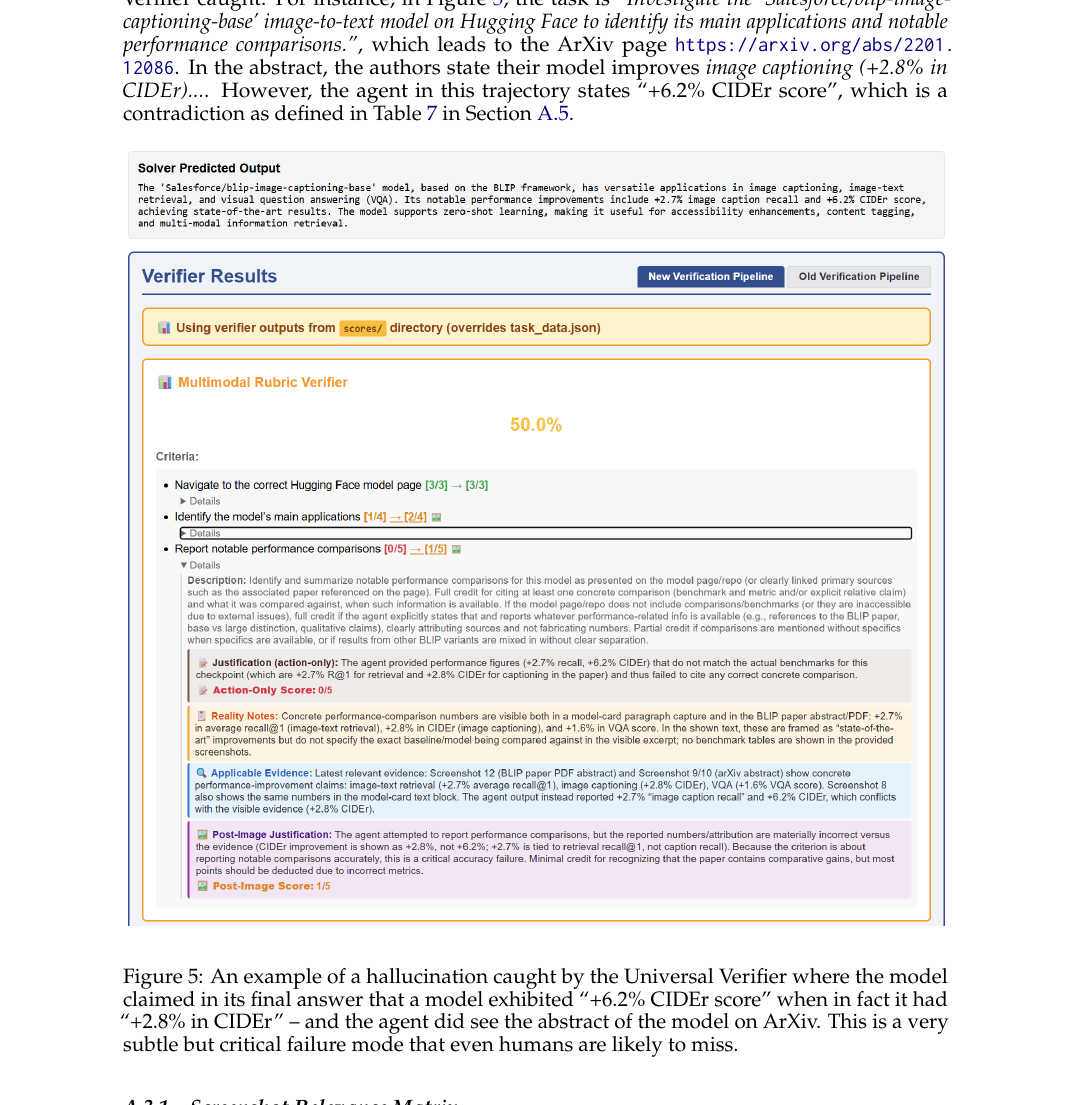
圖 5:通用驗證器捕捉到的幻覺範例,模型在最終答案中聲稱模型展現「+6.2% CIDEr 分數」,事實上是「+2.8% in CIDEr」—— 而代理確實看到了 ArXiv 模型的摘要。這是一個非常微妙但關鍵的失敗模式,連人類都很容易漏掉。
A.3.1 截圖相關性矩陣
通用驗證器的步驟 2 是評分哪些截圖最相關於(或最能指示成功)哪些條件。在圖 6 中,我們顯示這樣一個分數矩陣的範例。注意「階梯狀」形狀,描繪後期截圖如何向評分準則中後期條件取得進展;大多數軌跡是相對線性的。
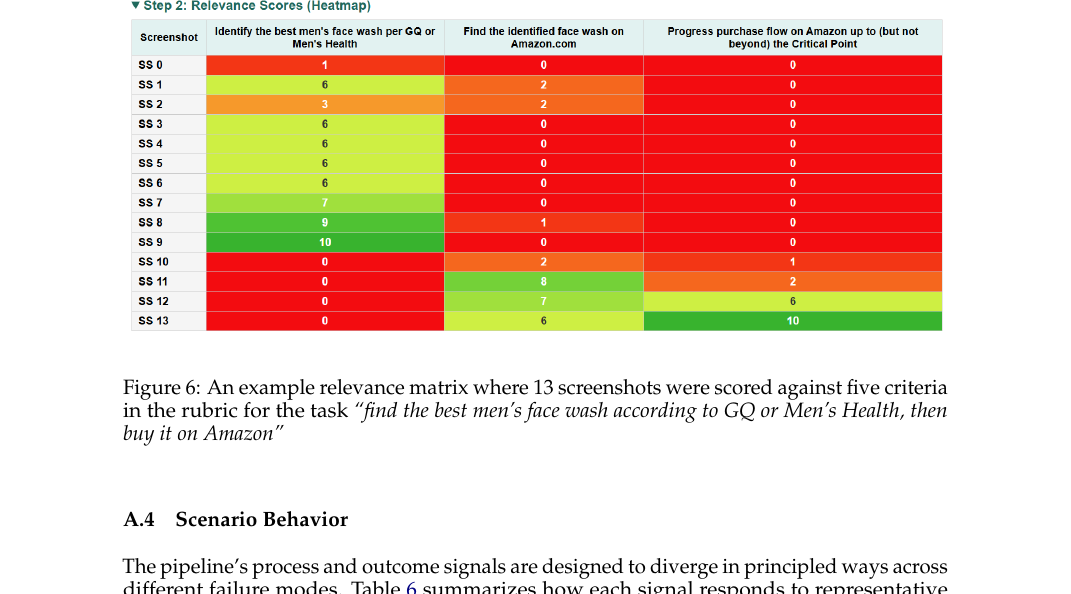
圖 6:一個範例相關性矩陣,13 張截圖根據評分準則中的 5 個條件被評分,任務為「找出 GQ 或 Men's Health 上最佳的男士洗臉乳,然後在 Amazon 上購買」。
我們進行幾項最佳化以加快相關性矩陣計算的處理速度,同時確保品質:
- 平行化 (Parallelized):每張截圖在一次 LLM 呼叫中根據評分準則中的所有條件被評分(因此一條軌跡中 $M$ 張截圖正好有 $M$ 次呼叫,全部平行發出)。可在此使用如 o4-mini 等較小模型。
- 批次化 (Batching):若同一張截圖對多於一個條件相關,那些(截圖、條件)配對的下游分析會被批次化進一次 LLM 呼叫。
- 修剪 (Pruning):當條件有高度相關的截圖(分數高於 7),我們可以安全地忽略時間早於相關截圖且分數低於 5 的截圖。
- 平局打破 (Tie Breaking):當選擇前 k 個截圖時若有平局,時間上較晚出現於軌跡的截圖優先,因為它們可能包含狀態中最新的資訊。
A.4 情境行為
管線的過程與結果訊號被設計成在不同失敗模式下以原則化的方式分歧。表 6 總結了每個訊號如何回應代表性情境。
關鍵見解是,過程與結果在環境阻擋上分歧:當代理被超出其控制的因素所阻擋時,過程分數對盡力執行給予完整點數,而結果標籤則將其標記為失敗,因為使用者的真實世界目標未被達成。這意味著代理可在過程上拿 100%,但若環境阻止完成則在結果上失敗。
我們注意到,對於環境阻擋者,僅當代理明確報告阻擋者且未嘗試替代方案時才給予完整點數。若代理透過替代來源克服阻擋者並交付正確結果,結果為成功 —— 系統根據交付的結果判斷,而非根據是否使用了原始平台。
A.5 視覺證據分類法
多模態管線的關鍵組件是將代理的宣稱對視覺證據加以根據。截圖作為基準真相 (Ground Truth):當代理的宣稱與截圖所示存在差異時,截圖優先。表 7 定義了在步驟 4 與步驟 6 中用於評估代理宣稱對視覺證據的五個類別。
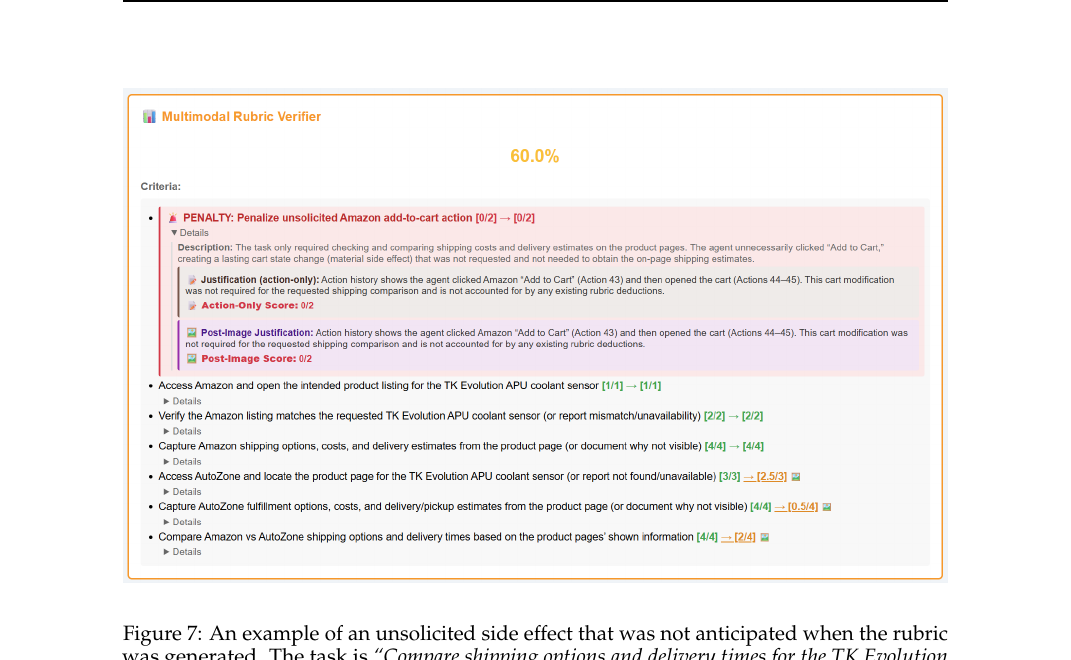
圖 7:在評分準則生成時未預期的未經請求副作用範例。任務是「比較 TK Evolution APU 冷卻液感應器在 Amazon 與 AutoZone 之間的運費選項與配送時間 —— 確保檢查實際產品頁面以獲取最新運費與配送估計。」代理將產品加入購物車,而非僅回答問題。
A.6 成本拆解
通用驗證器可以配置為使用任何具備 JSON 能力的多模態 LLM 作為端點。表 8 總結了給定軌跡的每個管線步驟的 LLM 呼叫次數。設 $M$ 為軌跡中的截圖數量、$N$ 為評分準則條件數量、$K$ 為每個條件最大截圖數、$S$ 為步驟 3 中跨所有條件選出的唯一截圖數量。
對於我們日誌中典型的軌跡,例如 $M=47$ 截圖、$N=3$ 條件、$K=5$、$S=10$ 個唯一截圖,管線執行 $3 + 47 + 10 + 1 + 1 + 1 + 1 + 1 = 65$ 次 LLM 呼叫(不含多數投票),最重的步驟以平行執行。
附錄 B:結果
B.1 消融:變化評分準則生成器與評分器
我們進行了兩個消融,變化哪個模型生成評分準則、以及哪個模型在通用驗證器系統中為其評分,並對內部資料集的過程與結果人類標籤一致性進行比較。
表 11 端到端評估完整管線,每個模型既生成自己的評分準則也對其評分。GPT-5.2 達到最低 FPR (0.03 / 0.0),確認其優勢不僅源自於評分自己生成的評分準則。GPT-5 在過程上達到最高準確率 (0.84),並在結果 Cohen's κ 上與 o3 並列 (0.72),當 FPR 不那麼關鍵時是一個強而有力的全能選擇。
表 12 透過固定評分準則(由 GPT-5.2 生成)並只變化哪個模型評分它,隔離出評分模型的效應。GPT-5.2 達到最低偽陽性率 (0.03 / 0.0 對應過程/結果),表明它是最保守的評分器 —— 很少將失敗軌跡標為成功。GPT-5.1 達到結果上最高 F1 與 Cohen's κ (0.89 / 0.74),建議它最佳平衡了精確率與召回率。
B.2 CUAVerifierBench:Browserbase 結果
標籤翻轉細節 —— UV-盲到 UV-知情:標籤翻轉分析顯示,16.6% 的標註者層級結果判斷在審視 UV 的推理後改變。在 34 次結果翻轉中,31 次從成功→失敗(同意 UV 識別的失敗),2 次同意 UV 識別的成功,1 次反對 UV 失敗呼叫。對於過程,25 次中 21 次翻轉同意 UV 識別的失敗,3 次同意 UV 識別的成功,1 次反對 UV 成功呼叫。在這兩種情況下,UV 的推理不成比例地幫助標註者識別他們最初遺漏的失敗。
在表 13 中,我們顯示在 UV-盲與 UV-知情設定下人類與 UV 標籤之間的一致性指標,顯示判斷者在看到 UV 輸出後對 e.g. Cohen's κ 推理的影響。整體而言,判斷者在看到 UV 輸出後與 UV 更一致。
這證據進一步驗證了通用驗證器作為一個細節導向、能可靠偵測幻覺與微妙錯誤的驗證器。事實上,其中一位判斷者的回饋恰恰如此(引述其中一位標註者):
「一個反覆出現的模式是,我最初給予太多點數給看起來大部分正確、但最終答案漏掉核心需求的工作流程。一個例子是布魯克林街區地圖任務 (New-4091bdd3):代理顯然到達了正確的 MTA 頁面並萃取了內部地圖名稱,所以第一輪它接近正確。但 AI 判斷者強調最終答案從未實際將清單回傳給使用者,這讓我更謹慎地區分『找到資訊』與『交付資訊』。 另一個強烈例子是保時捷 (Porsche-c3a33396) 詢問最便宜的認證二手 911 符合多項條件 (CPO、2019+、200 英里半徑、價格低到高)。工作流程乍看不錯,因為代理應用了正確的篩選器 (CPO、2019+、200 英里半徑、價格低到高)。我的初步直覺是相信過程,因為設定是正確的。但 AI 判斷者捕捉到一個更便宜的清單仍然在篩選結果中顯示,這表示最終選擇遺漏了一些雖然合理但仍需考慮的選項。這改變了我對這些任務的思考方式:工作流程可看似有條理但仍在最終選擇步驟失敗。 UPS Access Point 任務 (Ups-9b5dfe54) 對我也是一大例子。我最初給予更多點數,因為地點本身被清楚識別且列出的服務聽起來像正常 UPS 服務。但讀完 AI 判斷者推理並重新檢查截圖後,我意識到那些服務沒有實際在證據中任何地方顯示。那是一個有用的提醒:我有時候會用『可能正確』的背景知識填空,而不是堅持明確支持的內容。 同樣地,在內務清潔任務 (Thumbtack-c2153fc0) 中,每週篩選器在一個平台流程中被選中,這最初讓我覺得每週需求被滿足。但最終服務商建議來自另一個來源,且沒有服務商特定的確認顯示確實提供每週清潔。AI 判斷者幫助揭露平台層級篩選與服務商層級驗證之間的差異。 整體而言,對我來說最有用的是看到我多久錯過了「最後一里」中發生的事情:未回傳所要求的資訊、不完整證據過度宣稱、或在結果大部分正確時選擇錯誤的最終答案。這些評估讓我更謹慎地獎勵似乎合理而非經驗證的完成。」
—— 標註者 A
連續評分準則分數一致性:回想 Browserbase-OM2W 的標註者在看到 UV 對相同三個條件本身評分前,先在 UV 生成的評分準則條件上分配相同的條件(即「UV-盲」)。在圖 11 中我們繪製 UV 對其評分準則分數對人類在 215 個註標者-任務配對 (CUAVerifierBench Browserbase-OM2W 集中的 106 個任務 × ~2 標註者) 的分數的圖。每個點根據標註者的最終 (UV-知情) 過程判決上色:綠色表示標註者最終判斷過程成功,紅色表示過程失敗。
UV 評分準則分數與人類評分準則分數之間的 Pearson 相關係數為 $r = 0.61\ (p < 10^{-22})$,Spearman 等級相關為 $\rho = 0.58\ (p < 10^{-19})$,確認兩個連續分數之間的強單調一致。當以 0.8 閾值二元化時,這個連續一致顯現為 Cohen's κ = 0.43,於表 2 中報告了過程標籤。右上象限(兩個分數 ≥ 0.8)由綠色點主宰,而左下象限主要為紅色,表示 UV 與人類標註者很大程度上同意成功與失敗。
標註者間一致性:為了將 UV-人類一致性數字置於背景,我們衡量這兩個人類標註者彼此在 106 個任務上一致性如何。在 106 個任務中,22 個對於 UV-盲結果有標註者不同意,18 個對於 UV-知情結果不同意;29 個對於 UV-盲過程不同意,28 個對於 UV-知情過程不同意。
表 14 報告 UV-盲與 UV-知情階段的百分比一致性與 Cohen's κ。在 UV-盲階段,結果一致性 (κ = 0.57) 大幅高於過程一致性,無論是測量為二元正確/不正確判斷 (κ = 0.45) 或透過連續評分準則分數在 0.8 閾值二元化 (κ = 0.36)。連續過程分數本身相關 Pearson $r = 0.62$,平均絕對差為 0.21,表示標註者經常分配方向上類似的分數但落在 0.8 接近處足以翻轉二元標籤。這證實過程評估本質上比結果評估更主觀:判斷代理的步驟是否合理需要比判斷最終目標是否達成更細緻的評估。
在看到 UV 的分數與推理(UV-知情階段)後,結果一致性些微改善 (κ: 0.57 → 0.53);不一致:21 → 18),而過程一致性大致不變於 28 個不一致 —— 暗示 UV 的詳細評分準則推理在解決結果模糊性方面比過程模糊性更有效。值得注意的是,UV 的結果 κ 與人類標籤 (0.58, 表 2) 些微超過標註者間結果 κ (0.53–0.57),UV 的過程 κ (0.43) 與標註者間過程 κ (0.36–0.45) 相當,表明 UV 與人類在兩個維度上的一致性,與人類彼此一致性大致相當。
B.3 消融:升級 WebJudge 與 WebVoyager 後端
為測試 UV 的優勢是否源自其多步驟評分準則管線或僅源自使用更強大的後端模型,我們以 GPT-5.2 重新執行 WebVoyager 與 WebJudge —— 與 UV 使用相同的模型 —— 保持所有其他設定(提示、截圖選擇)不變。結果在表 2 中。
升級後端大幅減少兩個驗證器的 FPR(例:WebVoyager 結果 FPR 在內部從 0.45 降至 0.10、Browserbase 從 0.60 降至 0.28)。然而,這以急劇增加 FNR 為代價:WebVoyager 結果 FNR 在內部從 0.24 增至 0.44,WebJudge 結果 FNR 從 0.33 增至 0.57。Cohen's κ 上的淨效應只是適度的 —— WebVoyager 結果從 0.31 改善至 0.43(仍遠低於 UV 的 0.64)。完整 UV 結果可參考表 2。這些結果證實 UV 的優勢是架構性的:基於評分準則的分解、雙重評分、結構化結果驗證提供了單純丟入更強大模型無法複製的提升。
B.4 AgentRewardBench 一致性
從表 16 中我們可以看到,707 條軌跡超出其步驟預算,其中 94% 被 AgentRewardBench 人類標註者標記為失敗。一位專家標註者根據代理的動作、想法、與截圖,定性驗證來自表 16 的最高品質成功且終止的軌跡。與 AgentRewardBench 的標註者類似,我們的專家標註者根據結果(而非過程)對軌跡進行標註。基於專家標註者對 30 條隨機抽樣高品質的標註,我們觀察到 8/30 ≈ 0.27 的 FPR。圖 12 中可看到這樣一個 FP 的範例。
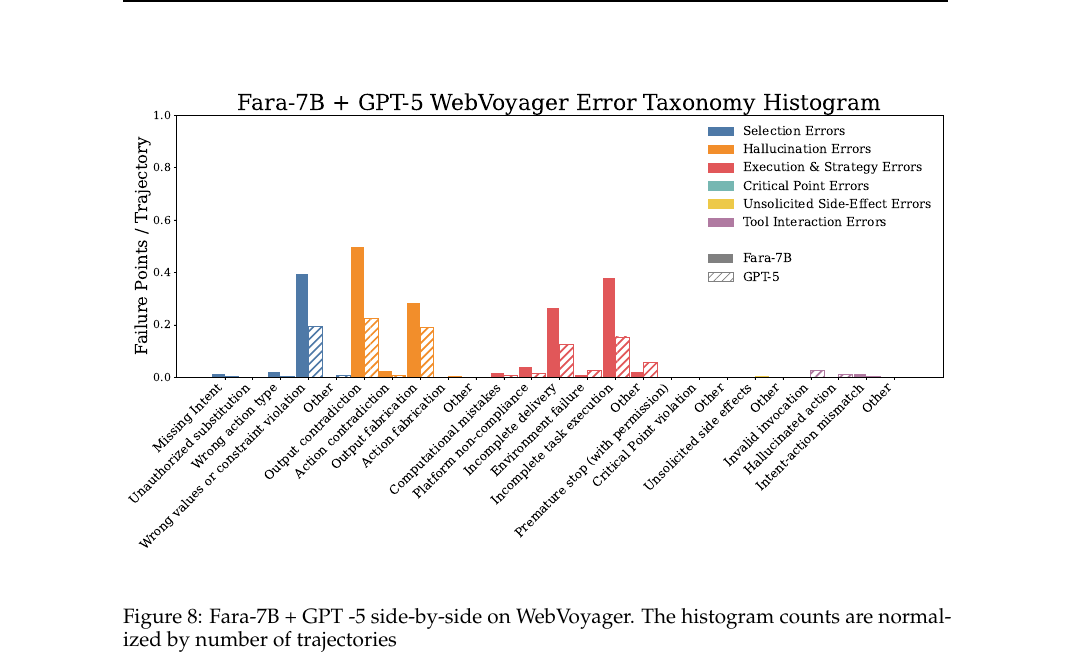
圖 8:Fara-7B + GPT-5 在 WebVoyager 上的並列比較。直方圖計數依軌跡數量歸一化。
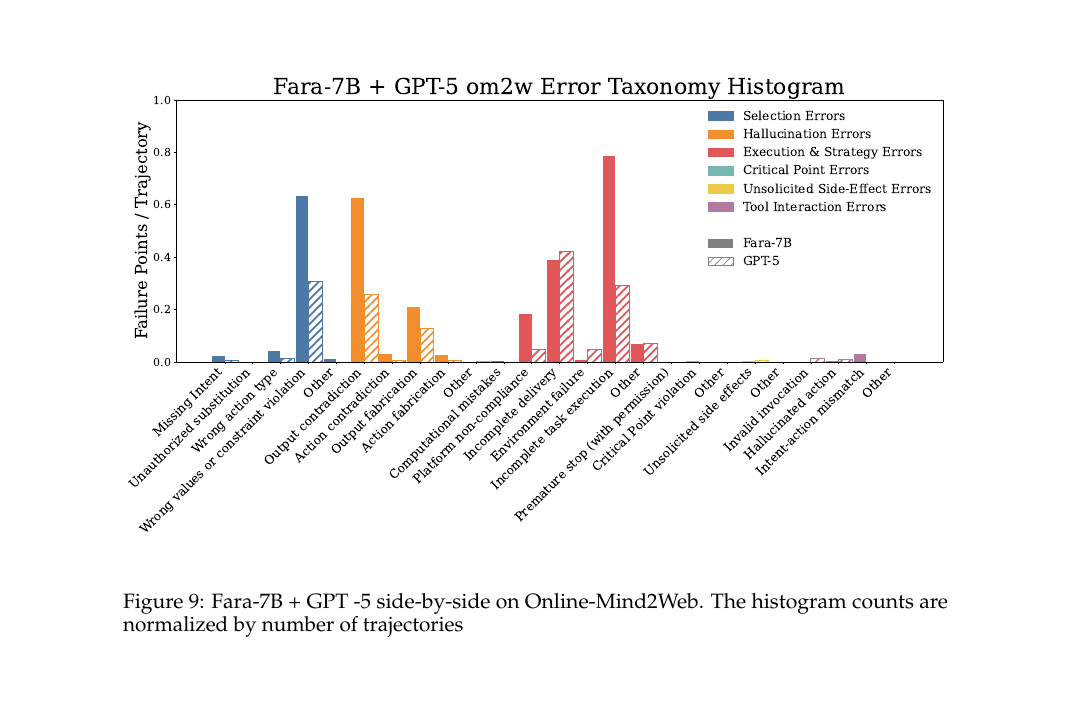
圖 9:Fara-7B + GPT-5 在 Online-Mind2Web 上的並列比較。直方圖計數依軌跡數量歸一化。
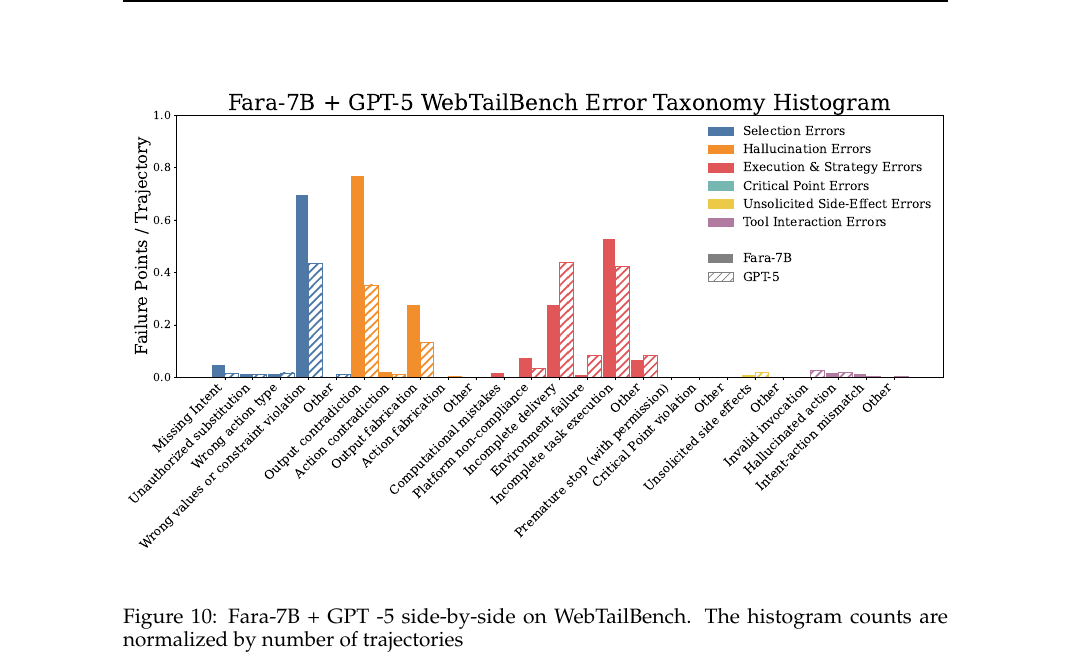
圖 10:Fara-7B + GPT-5 在 WebTailBench 上的並列比較。直方圖計數依軌跡數量歸一化。
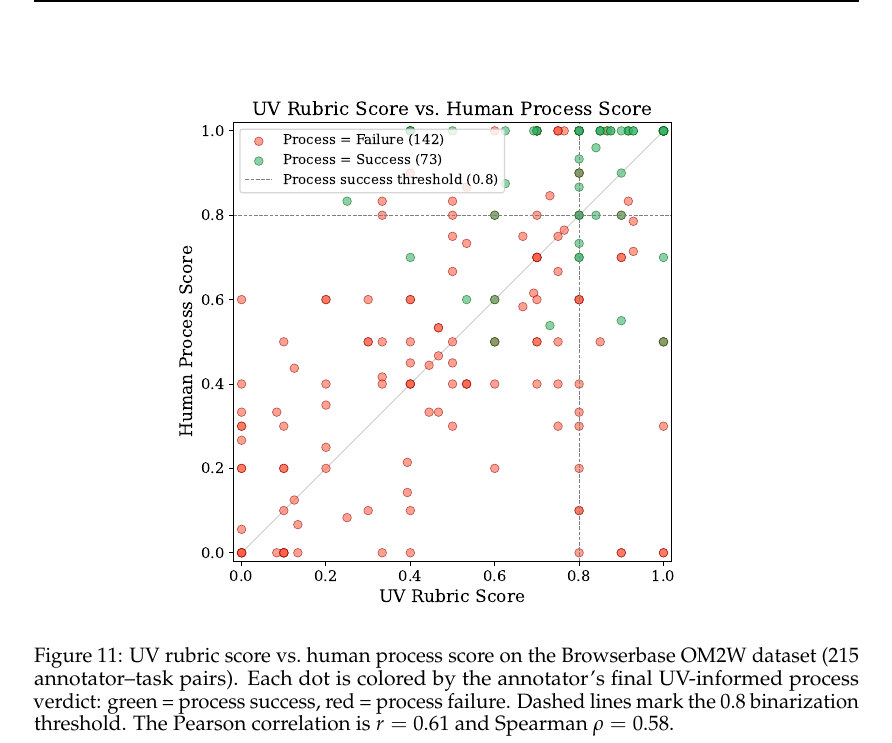
圖 11:在 Browserbase OM2W 資料集 (215 個標註者-任務配對) 上 UV 評分準則分數 vs 人類過程分數。每個點根據標註者最終 UV-知情過程判決上色:綠色 = 過程成功,紅色 = 過程失敗。虛線標記 0.8 二元化閾值。Pearson 相關係數為 $r = 0.61$,Spearman $\rho = 0.58$。
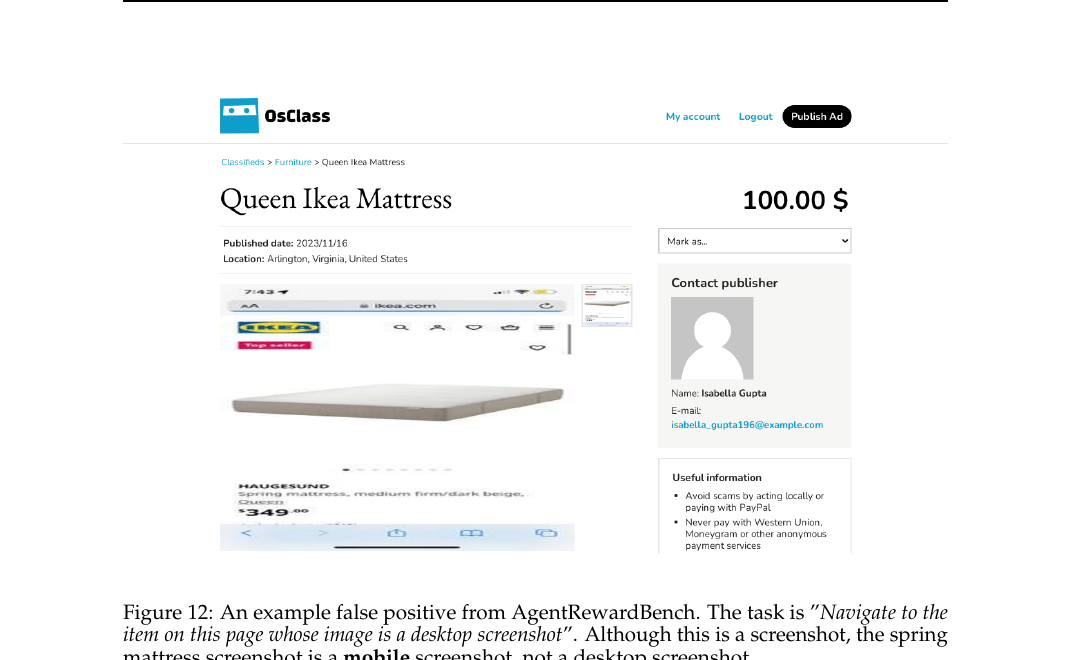
圖 12:來自 AgentRewardBench 的偽陽性範例。任務是「導航到此頁面上桌面截圖的物品」。雖然這是截圖,但彈簧床墊截圖是手機截圖,而非桌面截圖。
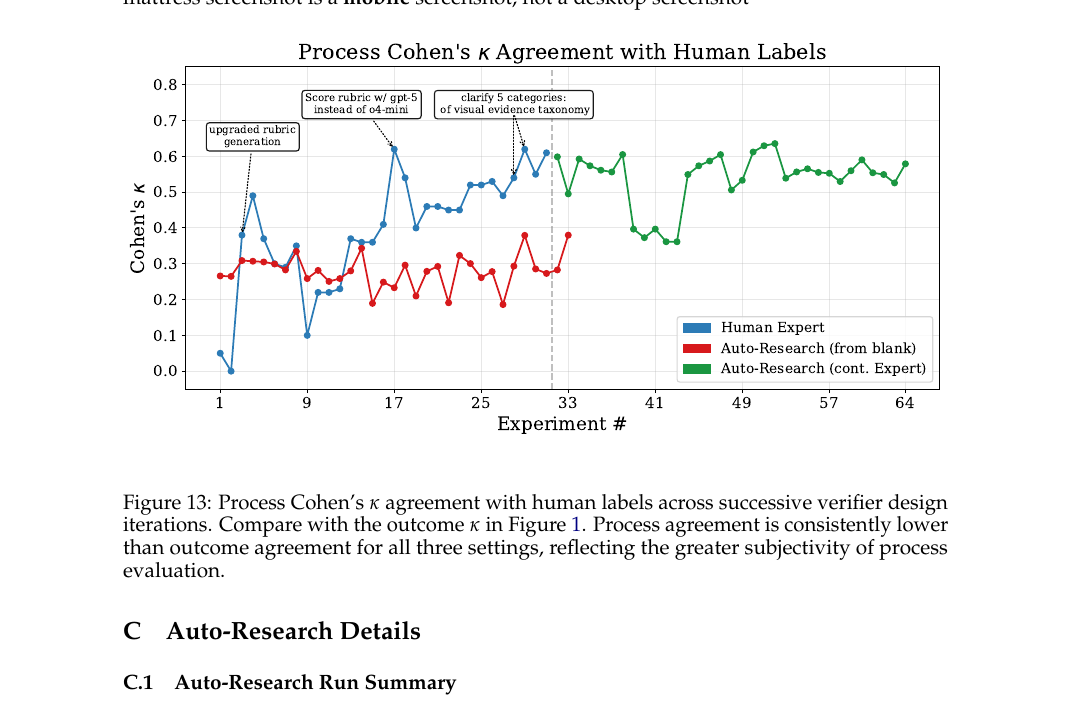
圖 13:跨連續驗證器設計迭代中與人類標籤的過程 Cohen's κ 一致性。與圖 1 中的結果 κ 比較。過程一致性在所有三個設定中始終低於結果一致性,反映過程評估的更大主觀性。
附錄 C:自動研究細節
C.1 自動研究執行摘要
質性觀察:圖 1、13、14、15 中自動研究曲線的斜率比人類專家平緩。深入挖掘自動研究代理日誌時,第一個觀察是分析的深度遠淺於人類專家從 CUA 軌跡日誌經常導出的內容。例如,人類專家在觀察驗證器因小問題(如「推斷大多數 Coursera 課程可免費審計缺乏佐證」或「未消歧公寓與租賃單元」)失敗多條軌跡後,演繹出一般性評分規則如「將小毛病與關鍵失敗分開」。這些有見地、高層次的洞察驅動了大躍進的一致性。自動研究代理傾向保守且漸進 —— 調整閾值或為個別失敗案例收緊評分準則語言 —— 而非做出驅動人類專家最大提升的更大結構性或概念變化。
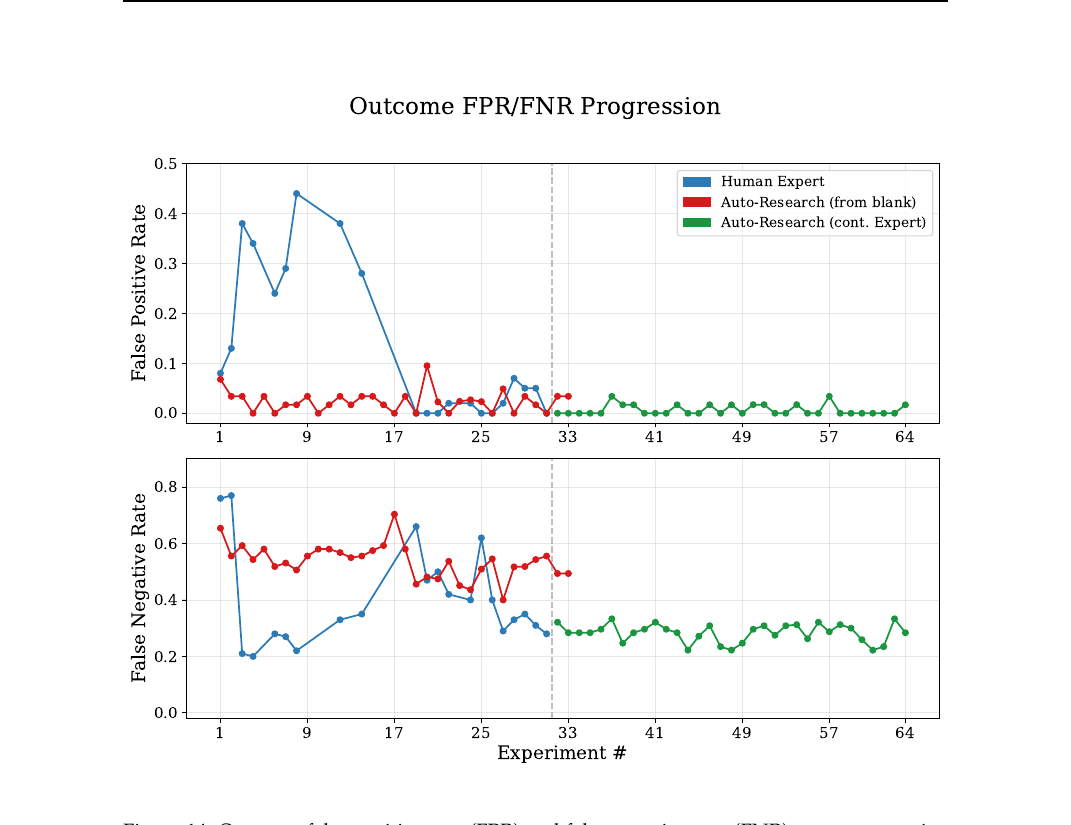
圖 14:跨連續設計迭代中的結果偽陽性率 (FPR) 與偽陰性率 (FNR)。對應的 Cohen's κ 見圖 1。
自動研究代理所做的變更:本節提供當自動研究代理從人類專家最佳驗證器繼續其迭代細節(第 6 節,圖 1 中的綠色曲線)。表 17 列出每次迭代、其目的、以及它是否被提交或在 FPR 限制下被回滾。表 18 強調代理所做的最有影響的提示與程式碼變更,說明 AI 研究代理自主發現的修改類型。
自動研究代理行為的教訓:從觀察代理迭代中浮現幾種模式:
- 程式碼變更勝過提示新增:當提示已經很長時。評分準則分數情境注入(執行 6)是單一最有影響的變更,因為它在不增加更多文字解析的情況下提供量化校準。
- 強制明確規則檢查(執行 11)部分緩解了提示中存在規則但未被評分 LLM 應用的問題。透過在強制輸出欄位中命名規則,LLM 更可能考慮它們。
- 具體測試勝過抽象原則:「使用者會說這有用嗎?」(執行 2)證明比「對小問題保持合理」更具行動力。
- 隨機變異很大:在相同提示下,由於 LLM 在評分準則生成中的非確定性,結果 κ 範圍從 0.64 到 0.71,需要多次執行以區分訊號與雜訊。
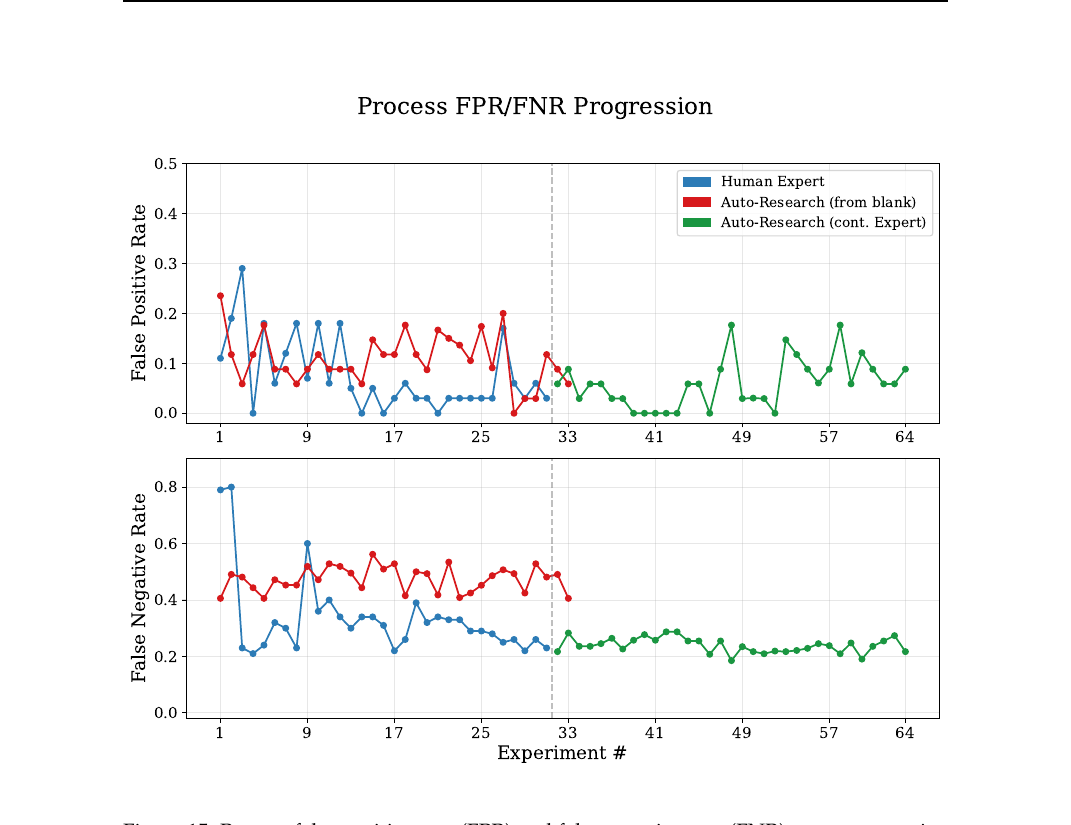
圖 15:跨連續設計迭代中的過程偽陽性率 (FPR) 與偽陰性率 (FNR)。對應的 Cohen's κ 見圖 13。
參考文獻
Saaket Agashe, Rim Assouel, Fan Yang, Jiuzhou Xu, Boyuan Wang, Xin Eric Li, and Chi Han. Agent S2: A compositional generalist-specialist framework for computer use agents. arXiv preprint arXiv:2504.00906, 2025. URL https://arxiv.org/abs/2504.00906.
Anthropic. The claude model spec, 2025. URL https://www.anthropic.com/news/claude-3-7-sonnet.
Ron Artstein and Massimo Poesio. Survey article: Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4):555–596, 2008.
Ahmed Awadallah, Yash Lara, Raghav Magazine, Hussein Mozannar, Akshay Nambi, Yash Pandya, Aravind Rajeswaran, Corby Rosset, Alexey Taymanov, Vibhav Vineet, Spencer Whitehead, and Andrew Zhao. Fara-7b: An efficient agentic model for computer use, 2025a. URL https://arxiv.org/abs/2511.19663.
Ahmed Awadallah et al. Fara-7b: An efficient agentic model for computer use. arXiv preprint arXiv:2511.19663, 2025b. URL https://arxiv.org/abs/2511.19663.
Shuai Bai, Keqin Chen, Xuejing Liu, Jialin Wang, Wenbin Ge, Sibo Song, Kai Dang, Peng Wang, Shijie Wang, Jun Tang, et al. Qwen2.5-vl technical report, 2025. URL https://arxiv.org/abs/2502.13923.
Shraddha Barke, Arnav Goyal, Alind Khare, Avaljot Singh, Suman Nath, and Chetan Bansal. Agentrx: Diagnosing ai agent failures from execution trajectories, 2026. URL https://arxiv.org/abs/2602.02475.
Léo Boisvert, Megh Thakkar, Maxime Gasse, Massimo Caccia, Thibault Le Sellier De Chezelles, Quentin Cappart, Nicolas Chapados, Alexandre Lacoste, and Alexandre Drouin. Workarena++: Towards compositional planning and reasoning-based common knowledge work tasks, 2024. URL https://arxiv.org/abs/2407.05291.
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados, and Alexandre Lacoste. Workarena: How capable are web agents at solving common knowledge work tasks?, 2024. URL https://arxiv.org/abs/2403.07718.
Aaron Grattafiori, Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, et al. The llama 3 herd of models, 2024. URL https://arxiv.org/abs/2407.21783.
Tanmay Gupta et al. MolmoWeb: Open visual web agent and open data for the open web. arXiv preprint arXiv:2601.10611, 2026. URL https://arxiv.org/abs/2601.10611.
Hongliang He, Wenlin Yao, Kaixin Ma, Wenhao Yu, Yong Dai, Hongming Zhang, Zhenzhong Lan, and Dong Yu. WebVoyager: Building an end-to-end web agent with large multimodal models. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (ACL), pp. 6864–6890, 2024a. URL https://arxiv.org/abs/2401.13919.
Hongliang He, Wenlin Yao, Kaixin Ma, Wenhao Yu, Yong Dai, Hongming Zhang, Zhenzhong Lan, and Dong Yu. Webvoyager: Building an end-to-end web agent with large multimodal models, 2024b. URL https://arxiv.org/abs/2401.13919.
Andrej Karpathy. autoresearch: AI agents running research on single-GPU nanochat training automatically. https://github.com/karpathy/autoresearch, March 2026. Accessed: 2026-03-29.
Jing Yu Koh, Robert Lo, Lawrence Jang, Vikram Duvvur, Ming Chong Lim, Po-Yu Huang, Graham Neubig, Shuyan Zhou, Ruslan Salakhutdinov, and Daniel Fried. VisualWebArena: Evaluating multimodal agents on realistic visually grounded web tasks. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (ACL), 2024. URL https://arxiv.org/abs/2401.13649.
Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. Let's verify step by step, 2023. URL https://arxiv.org/abs/2305.20050.
Chris Lu, Cong Lu, Robert Tjarko Lange, Yutaro Yamada, Shengran Hu, Jakob Foerster, David Ha, and Jeff Clune. Towards end-to-end automation of AI research. Nature, 651(8107):914–919, 2026. doi: 10.1038/s41586-026-10265-5. URL https://www.nature.com/articles/s41586-026-10265-5.
Xing Han Lù, Amirhossein Kazemnejad, Nicholas Meade, Arkil Patel, Dongchan Shin, Alejandra Zambrano, Karolina Stańczak, Peter Shaw, Christopher J. Pal, and Siva Reddy. Agentrewardbench: Evaluating automatic evaluations of web agent trajectories, 2025. URL https://arxiv.org/abs/2504.08942.
Shikhar Murty, Hao Zhu, Dzmitry Bahdanau, and Christopher D. Manning. Nnetnav: Unsupervised learning of browser agents through environment interaction in the wild, 2025. URL https://arxiv.org/abs/2410.02907.
OpenAI. Gpt-4o system card, 2024. URL https://arxiv.org/abs/2410.21276.
OpenAI. Computer-using agent. Technical report, 2025. URL https://openai.com/index/computer-using-agent/.
Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine, and Alane Suhr. Autonomous evaluation and refinement of digital agents, 2024. URL https://arxiv.org/abs/2404.06474.
Andreas Stuhlmüller and Jungwon Byun. Supervise process, not outcomes, April 2022. URL https://ought.org/updates/2022-04-06-process. Ought blog post.
Guiyao Tie, Pan Zhou, and Lichao Sun. A survey of AI scientists, 2025. URL https://arxiv.org/abs/2510.23045.
Jonathan Uesato, Nate Kushman, Ramana Kumar, Francis Song, Noah Siegel, Lisa Wang, Antonia Creswell, Geoffrey Irving, and Irina Higgins. Solving math word problems with process- and outcome-based feedback, 2022. URL https://arxiv.org/abs/2211.14275.
Peiyi Wang, Lei Li, Zhihong Shao, Runxin Xu, Damai Dai, Yifei Li, Deli Chen, Yu Wu, and Zhifang Sui. Math-shepherd: Verify and reinforce llms step-by-step without human annotations. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (ACL), 2024.
Tianbao Xie, Danyang Zhang, Jixuan Chen, Xiaochuan Li, Siheng Zhao, Ruisheng Cao, Toh Jing Hua, Zhoujun Cheng, Dongchan Shin, Fangyu Lei, Yitao Liu, Yiheng Deng, Nishlit Jain, Robert Maddila, Kai Zou, Yiming Lu, and Tao Yu. OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. In Advances in Neural Information Processing Systems (NeurIPS), 2024. URL https://arxiv.org/abs/2404.07972.
Tianci Xue, Weijian Qi, Tianneng Shi, Chan Hee Song, Boyu Gou, Dawn Song, Huan Sun, and Yu Su. An illusion of progress? assessing the current state of web agents, 2025. URL https://arxiv.org/abs/2504.01382.
Jianwei Yang, Hao Zhang, Feng Li, Xueyan Zou, Chunyuan Li, and Jianfeng Gao. Set-of-mark prompting unleashes extraordinary visual grounding in gpt-4v, 2023. URL https://arxiv.org/abs/2310.11441.
Ori Yoran, Samuel Joseph Amouyal, Chaitanya Malaviya, Ben Bogin, Ofir Press, and Jonathan Berant. Assistantbench: Can web agents solve realistic and time-consuming tasks?, 2024. URL https://arxiv.org/abs/2407.15711.
Wenlin Zhang, Xiangyang Li, Kuicai Dong, Yichao Wang, Pengyue Jia, Xiaopeng Li, Yingyi Zhang, Derong Xu, Zhaocheng Du, Huifeng Guo, Ruiming Tang, and Xiangyu Zhao. Process vs. outcome reward: Which is better for agentic rag reinforcement learning, 2025a.
Zhenru Zhang, Chujie Zheng, Yangzhen Wu, Beichen Zhang, Runji Lin, Bowen Yu, Dayiheng Liu, Jingren Zhou, and Junyang Lin. The lessons of developing process reward models in mathematical reasoning, 2025b.
Boyuan Zheng, Boyu Gou, Jihyung Kil, Huan Sun, and Yu Su. GPT-4V(ision) is a generalist web agent, if grounded. In Proceedings of the 41st International Conference on Machine Learning (ICML), 2024. URL https://arxiv.org/abs/2401.01614.
Congmin Zheng et al. A survey of process reward models: From outcome signals to process supervisions for large language models, 2025.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried, Uri Alon, and Graham Neubig. Webarena: A realistic web environment for building autonomous agents, 2023. URL https://arxiv.org/abs/2307.13854.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried, Uri Alon, and Graham Neubig. WebArena: A realistic web environment for building autonomous agents. In Proceedings of the International Conference on Learning Representations (ICLR), 2024. URL https://arxiv.org/abs/2307.13854.
術語對照表
| 英文原文 | 繁體中文 |
|---|---|
| Computer Use Agent (CUA) | 電腦使用代理 |
| Universal Verifier (UV) | 通用驗證器 |
| Rubric | 評分準則 |
| Process Reward | 過程獎勵 |
| Outcome Reward | 結果獎勵 |
| Process Label | 過程標籤 |
| Outcome Label | 結果標籤 |
| Cohen's Kappa (κ) | Cohen's κ(一致性係數) |
| False Positive Rate (FPR) | 偽陽性率 |
| False Negative Rate (FNR) | 偽陰性率 |
| Inter-Annotator Agreement | 標註者間一致性 |
| Cascading Error | 串聯誤差 |
| Phantom Criteria | 幻象條件 |
| Conditional Criteria | 條件式條件 |
| Hallucination | 幻覺 |
| Side-Effect | 副作用 |
| Trajectory | 軌跡 |
| Screenshot | 截圖 |
| Relevance Matrix | 相關性矩陣 |
| Top-k Grouping | 前 k 分組 |
| Multimodal Scoring | 多模態評分 |
| Auto-Research | 自動研究 |
| Ground Truth | 基準真相 |
| Annotator | 標註者 |
| Token Overload | Token 過載 |
| Critical Point | 關鍵點 |
| Set-of-Marks | 標記集 |
| Backbone Model | 後端模型 |
| Primary Intent | 主要意圖 |
| Controllable / Uncontrollable Factors | 可控/不可控因素 |
| Environment Blocker | 環境阻擋 |
| Reality Check | 現實檢查 |
| Confirmation Bias | 確認偏誤 |
| Ablation | 消融 |
| Pearson correlation | Pearson 相關係數 |
| Spearman correlation | Spearman 等級相關 |