TurboQuant:具有近最優失真率的線上向量量化
TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate
原始論文:TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate 作者:Amir Zandieh, Majid Daliri, Majid Hadian, Vahab Mirrokni 機構:Google Research, New York University, Google DeepMind arXiv ID:2504.19874v1 日期:2025-04-28
標籤:向量量化 KV Cache LLM推理 近鄰搜尋 資訊理論
摘要
向量量化 (Vector Quantization) 是一個源於 Shannon 資訊源編碼理論的問題,旨在量化高維歐幾里得向量,同時最小化其幾何結構的失真。我們提出 TurboQuant 來同時解決均方誤差 (Mean-Squared Error, MSE) 和內積 (Inner Product) 失真問題,克服了現有方法無法達到最優失真率的限制。
我們的資料無關 (Data-Oblivious) 演算法適用於線上應用場景,在所有位元寬度 (Bit-width) 和維度下均能達到近最優失真率(僅差一個小常數因子)。TurboQuant 透過隨機旋轉輸入向量,在座標上誘導出集中的 Beta 分佈,並利用高維空間中不同座標的近似獨立性,對每個座標簡單地應用最優純量量化器來實現這一目標。
鑒於 MSE 最優量化器在內積估計中會引入偏差,我們提出了一種兩階段方法:先應用 MSE 量化器,再對殘差應用 1-bit 量化 JL (QJL) 變換,從而得到無偏的內積量化器。
我們還提供了任何向量量化器可達最佳失真率的資訊理論下界的嚴格證明,證明 TurboQuant 與這些下界非常接近,僅差約 2.7 倍的小常數因子。
實驗結果驗證了我們的理論發現:在 KV cache 量化方面,我們以 3.5 bits/channel 達到了絕對品質中性,以 2.5 bits/channel 僅有微小的品質下降。此外,在近鄰搜尋任務中,我們的方法在召回率上優於現有的乘積量化技術,同時將索引建構時間降至幾乎為零。
1. 引言
歐幾里得空間中的向量量化 (VQ) 對於在廣泛的計算領域中高效處理高維向量至關重要,從訓練和部署大規模 AI 及深度學習模型,到驅動搜尋/檢索系統的向量資料庫皆是如此。其核心目標是透過量化——將浮點座標值轉換為低位元寬度整數——來壓縮高維向量,同時最小化以均方誤差或內積誤差等指標衡量的失真。透過保持這些特性,內積查詢可以快速回應,延遲極低,且使用更少的運算和通訊資源。
這個問題的根源可追溯至 Shannon 關於資訊源編碼理論的開創性工作 [48, 49],該理論確立了區塊資訊源碼(現稱為向量量化器)可達到的最小失真由 Shannon 失真率函數定義,該函數取決於資訊源的統計特性和所選的失真度量(如 MSE)。
如今,VQ 在基礎計算領域發揮著關鍵作用,包括 AI、深度學習和搜尋系統。
VQ 的一個重要應用是 AI 模型的部署,包括大型語言模型 (Large Language Models, LLM) [5, 18, 7, 52]。由於 LLM 的能力嚴重依賴模型大小和上下文長度 [34],服務這些模型需要大量的記憶體需求和增加的推理延遲。這種延遲主要歸因於加速器上 HBM 和 SRAM 之間,或跨分散式叢集的通訊瓶頸。透過壓縮或量化模型權重和啟動值,我們可以有效緩解這些瓶頸,顯著降低推理成本。
啟動值和權重之間的內積運算是深度學習模型的核心。因此,模型量化方案力求在壓縮權重和/或啟動向量的同時準確保持這些內積。
基於解碼器的 Transformer 模型 [54] 提供了另一個引人注目的用例。這些模型必須在 KV cache 中儲存先前生成 token 的鍵/值 (Key/Value) 嵌入向量,其大小隨模型大小(層數和注意力頭數)及上下文長度而擴展。這種擴展在記憶體使用和運算速度方面是一個重要瓶頸,特別是對於長上下文模型。因此,在不損害精確度的前提下減少 KV cache 大小至關重要。在此背景下,保持嵌入向量的歐幾里得結構——它們的內積和距離——對於維持模型效能至關重要。VQ 成為解決此挑戰最合適的框架,提供了一種壓縮高維嵌入同時保持其基本幾何特性的方法。
此外,具有內積或餘弦相似度的高維空間近鄰搜尋 (Nearest Neighbor, NN) [1, 27] 是向量資料庫 [4, 2, 3] 的基石。這些資料庫是檢索增強生成 (Retrieval-Augmented Generation) [23, 19] 和資訊檢索 [35, 46] 的基礎。VQ(又稱乘積量化 (Product Quantization, PQ))在這些應用中發揮關鍵作用,能夠高效壓縮資料庫向量、最佳化記憶體使用,並促進與查詢向量的低延遲、準確內積估計,從而實現快速精確的近鄰搜尋。
現有的 VQ 演算法面臨一個權衡:要麼缺乏加速器(向量化)相容性且計算緩慢,使其不適合 KV cache 量化等即時 AI 應用;要麼相對於位元寬度存在次優的失真界限。我們的目標是引入一個解決這些限制的演算法。具體而言,我們設計了 TurboQuant:輕量級、能夠線上應用(對於 KV cache 量化等場景至關重要),且高度對加速器友好——這是現代 AI 工作負載的關鍵屬性。
TurboQuant 的核心是一個兩階段過程。首先,我們開發一個在均方誤差方面具有最優失真率的向量量化器。隨後,我們對殘差應用 1-bit 量化器,得到一個無偏且低失真的內積量化器。我們證明了針對 MSE 最佳化的量化器不會產生內積的無偏估計量,而我們的兩階段解決方案有效地彌合了這一差距。
我們的 MSE 最優量化器首先對 $d$ 維輸入向量進行隨機旋轉。觀察到旋轉後向量的每個座標遵循 Beta 分佈這一關鍵事實,我們透過求解連續 k-means 問題來設計每個座標的最優 Lloyd-Max 量化器 [42, 43]。此方法給出最優 MSE 失真界限並最小化殘差的 L2 範數。為了獲得無偏且低失真的內積量化器,我們將量化器與最近開發的量化 Johnson-Lindenstrauss (QJL) 變換 [62] 組合,該變換將殘差向量的每個座標量化為單一位元。我們的演算法為 MSE 和內積提供了可證明的最優失真界限,在位元寬度依賴性方面相對於現有方法實現了指數級改進。
1.1 問題定義
形式上,我們的目標是設計一個量化映射 $Q: \mathbb{R}^d \to \{0,1\}^B$,將 $d$ 維向量轉換為 $B$ 位元的二進位字串。如果我們設 $B = b \cdot d$(其中 $b \geq 0$),則此量化器的位元寬度為 $b$,表示用於編碼 $\mathbb{R}^d$ 每個實值座標的平均位元數。
至關重要的是,我們需要一個反向映射 $Q^{-1}: \{0,1\}^B \to \mathbb{R}^d$ 來執行反量化,從量化表示近似重建原始向量。當然,這個轉換本質上是有損的,因為 $Q$ 不是雙射。因此,我們的主要目標是最小化失真,特別關注均方誤差和內積失真。
我們不對輸入向量資料集做任何假設,考慮最壞情況。我們允許量化器 $Q(\cdot)$ 是隨機化的,導致隨機輸出。考慮隨機化量化器,更合適的做法是定義量化器輸出隨機性上的期望失真。因此,我們的目標是設計量化器,對於任何(最壞情況)向量 $\boldsymbol{x}, \boldsymbol{y} \in \mathbb{R}^d$,最小化以下期望失真度量:
(MSE)
$$D_{\text{mse}} := \mathbb{E}_Q\left[\|\boldsymbol{x} - Q^{-1}(Q(\boldsymbol{x}))\|_2^2\right] \tag{1}$$
(內積誤差)
$$D_{\text{prod}} := \mathbb{E}_Q\left[|\langle \boldsymbol{y}, \boldsymbol{x}\rangle - \langle \boldsymbol{y}, Q^{-1}(Q(\boldsymbol{x}))\rangle|^2\right] \tag{2}$$
此外,對於內積量化器,我們要求內積估計量的無偏性:
(無偏內積)
$$\mathbb{E}_Q\left[\langle \boldsymbol{y}, Q^{-1}(Q(\boldsymbol{x}))\rangle\right] = \langle \boldsymbol{y}, \boldsymbol{x}\rangle$$
我們的目標是設計計算高效的量化器 $Q_{\text{mse}}$ 和 $Q_{\text{prod}}$,對於任何給定的位元寬度 $b$ 達到上述失真度量的最優界限。此外,我們的目標是讓 $Q_{\text{prod}}$ 提供無偏的內積估計。
具體而言,假設我們有 $n$ 個實值向量 $x_1, x_2, \ldots, x_n \in \mathbb{R}^d$,我們設計以下基本操作:
- Quant:高效量化資料集,計算 $Q(\boldsymbol{x}_1), Q(\boldsymbol{x}_2), \ldots, Q(\boldsymbol{x}_n)$。
- DeQuant:給定量化資料集,可高效重建原始向量,對任意 $i \in [n]$ 計算 $Q^{-1}(Q(\boldsymbol{x}_i))$。
1.2 相關工作
向量量化的起源。 向量量化理論始於 Shannon 的開創性工作 [48, 49]。1963 年,Zador [61] 透過高解析度方法推導出了在高速率下固定速率量化的極限操作失真率函數。Gersho [25] 進一步推進了向量量化,推廣了高解析度理論、簡化了 Zador 的結果、引入了格向量量化,並提出了塑造該領域的重要猜想。然而,最直接的編碼方法——暴力近鄰搜尋——計算成本高昂,阻礙了 VQ 的實際採用。
線上 vs 離線量化。 線上(資料無關)量化方法無需資料特定的調整或校準即可即時應用 [16, 8, 41, 47, 28]。相比之下,離線(資料相關)方法需要大量的預處理和學習以將量化映射適配到資料,使其不適合動態資料場景 [37]。例如 [20, 39, 57, 13] 等方法使用二階(Hessian)資訊來調整量化映射。
線上 KV Cache 壓縮。 已有數種壓縮 KV cache 的方法被提出,包括架構修改 [50, 6, 15]、裁剪或驅逐冗餘 token [11, 66, 40, 58, 64, 38, 29],以及量化技術 [60, 59, 17, 33, 65, 41, 30, 36, 28]。最近,QJL [62] 引入了一種基於草圖技術的高效、資料無關的 1-bit 量化方法,提供內積查詢的無偏估計。
乘積量化 (PQ)。 在近鄰搜尋問題中,許多演算法依賴於在索引階段使用 k-means 變體構建量化碼本 [31, 9, 24, 56, 27],因此不適合線上設定。最近,[22] 引入了一種基於網格的 PQ 方法,消除了預處理需求,但其網格投影和二分搜尋演算法計算緩慢,在 GPU 等加速器上效率特別低。
1.3 技術概述與貢獻
MSE 最佳化 TurboQuant。 我們的第一個 VQ 演算法旨在最小化公式 (1) 中定義的 MSE 失真。我們對輸入向量應用隨機旋轉,在每個座標上誘導 Beta 分佈。在高維 $d$ 中,每個座標的分佈收斂到高斯分佈 $\mathcal{N}(0, 1/d)$。此外,任意兩個不同座標變得幾乎不相關,更重要的是幾乎獨立。這種近似獨立性簡化了量化設計,允許我們使用最優純量量化來量化每個座標,同時仍達到近最優失真。
在定理 1 中,我們證明 $b$-bit MSE 最優 TurboQuant $Q_{\text{mse}}: \mathbb{R}^d \to \{0,1\}^{b \cdot d}$ 對任何最壞情況單位向量 $\boldsymbol{x}$ 達到以下失真:
- $D_{\text{mse}}(Q_{\text{mse}}) \leq \frac{\sqrt{3}\pi}{2} \cdot \frac{1}{4^b}$,對任意 $b \geq 0$。
- 對小位元寬度 $b = 1, 2, 3, 4$,$D_{\text{mse}}(Q_{\text{mse}}) \approx$ 0.36, 0.117, 0.03, 0.009。
內積 TurboQuant。 我們證明 MSE 最優量化器對內積估計有偏。我們的解決方案是兩階段演算法:先以比目標預算少一位元的位元寬度應用 $Q_{\text{mse}}$,再對殘差誤差應用 QJL [62]。這被證明是無偏的且具有近最優內積誤差率。
在定理 2 中,$b$-bit 內積最優 TurboQuant 達到:
- 無偏性:$\mathbb{E}[\langle \boldsymbol{y}, Q_{\text{prod}}^{-1}(Q_{\text{prod}}(\boldsymbol{x}))\rangle] = \langle \boldsymbol{y}, \boldsymbol{x}\rangle$
- $D_{\text{prod}}(Q_{\text{prod}}) \leq \frac{\sqrt{3}\pi^2 \cdot \|\boldsymbol{y}\|_2^2}{d} \cdot \frac{1}{4^b}$,對任意 $b \geq 0$。
- 對 $b = 1, 2, 3, 4$,$D_{\text{prod}} \approx \frac{\mathbf{1.57}}{d}, \frac{\mathbf{0.56}}{d}, \frac{\mathbf{0.18}}{d}, \frac{\mathbf{0.047}}{d}$。
下界。 在定理 3 中,我們利用 Shannon 下界和 Yao 極小極大原理證明,對任何隨機量化演算法,存在困難輸入實例使得:
- $D_{\text{mse}}(Q) \geq \frac{1}{4^b}$
- $D_{\text{prod}}(Q) \geq \frac{\|\boldsymbol{y}\|_2^2}{d} \cdot \frac{1}{4^b}$
TurboQuant 的 MSE 失真可證明地在資訊理論下界的 $\frac{\sqrt{3}\pi}{2} \approx$ 2.7 倍以內。對於較小的位元寬度,此因子顯著減小。例如,在 $b = 1$ 時,TurboQuant 達到的失真僅離最優約 1.45 倍。
實驗結果。 我們在多種真實資料集上實證驗證了理論失真界限。在 KV cache 量化中,我們在大海撈針任務中達到完美的長上下文檢索,並在其他長上下文下游任務上保持高效能,同時將 KV cache 壓縮超過 $5\times$。在近鄰搜尋中,TurboQuant 持續優於資料相關的乘積量化,同時將索引時間降至幾乎為零。
2. 預備知識
我們使用粗體小寫字母(如 $\boldsymbol{x}$、$\boldsymbol{y}$)表示向量,粗體大寫字母(如 $\boldsymbol{M}$)表示矩陣。$\boldsymbol{x}_{i:j}$ 表示向量 $\boldsymbol{x}$ 在座標索引 $i$ 到 $j$(含端點)的切片。$\mathbb{S}^{d-1}$ 表示 $\mathbb{R}^d$ 中半徑為 1 的超球面。$h(x)$ 表示隨機變量 $x$ 的微分熵。$I(x; y) = h(x) - h(x|y)$ 表示隨機變量 $x$ 和 $y$ 之間的互資訊。
由於 TurboQuant 使用隨機旋轉來緩解最壞情況輸入,理解超球面上隨機點的統計特性至關重要。
引理 1(超球面上隨機點的座標分佈)。對任何正整數 $d$,若 $\boldsymbol{x} \in \mathbb{S}^{d-1}$ 是均勻分佈在單位超球面上的隨機變量,則對任意 $j \in [d]$,座標 $\boldsymbol{x}_j$ 遵循以下(縮放/平移的)Beta 分佈:
$$\boldsymbol{x}_j \sim f_X(x) := \frac{\Gamma(d/2)}{\sqrt{\pi} \cdot \Gamma((d-1)/2)}(1 - x^2)^{(d-3)/2}$$
在高維中,此 Beta 分佈收斂到正態分佈 $f_X(\cdot) \to \mathcal{N}(0, 1/d)$。
證明。 $f_X(x)$ 等於 $d-1$ 維中半徑為 $\sqrt{1-x^2}$ 的球面面積與 $d$ 維中單位球體積之比,再按 $1/\sqrt{1-x^2}$(由畢達哥拉斯定理)縮放。∎
2.1 Shannon 失真下界
Shannon 下界 (SLB) 是一個源自 Shannon 有損資訊源編碼定理 [49] 的強大工具,為任何有損壓縮方案提供可達失真率的通用下界。
引理 2 (SLB)。令 $\boldsymbol{x} \in \mathbb{R}^d$ 為具有任意機率分佈 $p_X$ 和有限微分熵 $h(\boldsymbol{x})$ 的隨機向量。定義總位元複雜度 $B \geq 0$ 的 MSE 失真率函數為:
$$D(p_X, B) := \inf\left\{\mathbb{E}\left[\|\boldsymbol{x} - \boldsymbol{y}\|_2^2\right] : I(\boldsymbol{x}; \boldsymbol{y}) \leq B\right\}$$
則對任何位元複雜度 $B \geq 0$,以下 Shannon 下界成立:
$$D(p_X, B) \geq \frac{d}{2\pi e} \cdot 2^{(2/d)(h(\boldsymbol{x}) - B)}$$
引理 3(超球面隨機點的 SLB)。令 $\boldsymbol{x} \in \mathbb{S}^{d-1}$ 為均勻分佈在單位超球面上的隨機變量。對任何位元複雜度 $B \geq 0$,以下失真下界成立:
$$D(B) \geq 2^{-2B/d}$$
2.2 QJL:1-bit 內積量化
我們設計了兩個 VQ 演算法:一個最佳化 MSE,另一個最佳化內積誤差。我們證明 MSE 最優量化器不一定提供無偏的內積估計,特別是在較低位元寬度下表現出顯著偏差。我們的內積量化解決方案是兩階段演算法:首先應用 MSE 最優量化器(使用比期望位元寬度預算少一位元),最小化殘差的 L2 範數;然後對殘差應用無偏且最優的單位元量化器。
定義 1 (QJL)。對任何正整數 $d$,QJL 映射 $Q_{\text{qjl}}: \mathbb{R}^d \to \{-1, +1\}^d$ 定義為:
$$Q_{\text{qjl}}(\boldsymbol{x}) := \text{sign}(\boldsymbol{S} \cdot \boldsymbol{x}) \quad \text{for any } \boldsymbol{x} \in \mathbb{R}^d$$
其中 $\boldsymbol{S} \in \mathbb{R}^{d \times d}$ 是一個具有 i.i.d. $\mathcal{N}(0,1)$ 項的隨機矩陣。反向/反量化映射定義為:
$$Q_{\text{qjl}}^{-1}(\boldsymbol{z}) := \frac{\sqrt{\pi/2}}{d} \cdot \boldsymbol{S}^\top \cdot \boldsymbol{z} \quad \text{for any } \boldsymbol{z} \in \{-1, +1\}^d$$
引理 4(QJL 效能保證)。對任何 $\boldsymbol{x} \in \mathbb{S}^{d-1}$ 和任何 $\boldsymbol{y} \in \mathbb{R}^d$:
- 無偏性:$\mathbb{E}\left[\langle \boldsymbol{y}, Q_{\text{qjl}}^{-1}(Q_{\text{qjl}}(\boldsymbol{x}))\rangle\right] = \langle \boldsymbol{y}, \boldsymbol{x}\rangle$
- 變異數界:$\text{Var}\left(\langle \boldsymbol{y}, Q_{\text{qjl}}^{-1}(Q_{\text{qjl}}(\boldsymbol{x}))\rangle\right) \leq \frac{\pi}{2d} \cdot \|\boldsymbol{y}\|_2^2$
3. TurboQuant:高效能量化
我們開發了兩個 VQ 演算法,各針對特定目標。第一個演算法旨在最小化量化後原始與重建向量之間的 MSE。第二個演算法針對無偏內積估計進行最佳化,解決 MSE 最優量化器中固有的偏差。此外,在 3.3 節中,我們建立了任何向量量化器可達最佳失真率的資訊理論下界,證明 TurboQuant 在所有位元寬度下僅與下界相差一個小常數因子,達到近最優性。
3.1 MSE 最優 TurboQuant
令 $\boldsymbol{x} \in \mathbb{S}^{d-1}$ 為 $d$ 維單位球面上的(最壞情況)向量。我們的目標是以每座標 $b$ 位元量化 $\boldsymbol{x}$,同時最小化公式 (1) 中定義的重建 MSE。
我們首先將此向量乘以隨機旋轉矩陣 $\boldsymbol{\Pi} \in \mathbb{R}^{d \times d}$(可透過對具有 i.i.d. 正態項的隨機矩陣應用 QR 分解來生成)進行隨機化。旋轉後的向量 $\boldsymbol{\Pi} \cdot \boldsymbol{x}$ 均勻分佈在單位球面 $\mathbb{S}^{d-1}$ 上。
如引理 1 所示,$\boldsymbol{\Pi} \cdot \boldsymbol{x}$ 的每個座標遵循 Beta 分佈,在高維中收斂到正態分佈。此外,在高維中,$\boldsymbol{\Pi} \cdot \boldsymbol{x}$ 的不同座標變得幾乎獨立 [55],允許我們對每個座標獨立應用最優純量量化器。
因此,我們的任務化簡為對具有分佈 $f_X(x) = \frac{\Gamma(d/2)}{\sqrt{\pi} \cdot \Gamma((d-1)/2)}(1-x^2)^{(d-3)/2}$($x \in [-1, 1]$)的隨機變量設計純量量化器。
最優純量量化問題可以被構造為一維連續 k-means 問題。具體而言,我們的目標是將區間 $[-1, 1]$ 分成 $2^b$ 個簇/桶。最優解遵循 Voronoi 鑲嵌 [42],即區間邊界是按排序順序排列的連續質心之間的中點。因此,以升序排列的質心 $c_i$ 表示,純量量化問題可表述為以下 k-means 最佳化問題:
$$\mathcal{C}(f_X, b) := \min_{-1 \leq c_1 \leq \cdots \leq c_{2^b} \leq 1} \sum_{i=1}^{2^b} \int_{\frac{c_{i-1}+c_i}{2}}^{\frac{c_i+c_{i+1}}{2}} |x - c_i|^2 \cdot f_X(x) \, dx \tag{4}$$
我們用迭代數值方法求解此問題,並預計算和儲存一系列實用位元寬度的最優碼本。例如,在中等高維 $d$ 下(分佈 $f_X(x)$ 近似正態分佈),$b = 1, 2$ 的最優量化質心分別為 $\left\{\pm\frac{\sqrt{2/\pi}}{\sqrt{d}}\right\}$ 和 $\left\{\pm\frac{0.453}{\sqrt{d}}, \pm\frac{1.51}{\sqrt{d}}\right\}$。
演算法 1:TurboQuant_mse(針對 MSE 最佳化)
- 輸入:維度 $d$ 和位元寬度 $b$
- 生成隨機旋轉矩陣 $\boldsymbol{\Pi} \in \mathbb{R}^{d \times d}$
- 透過求解公式 (4) 中的 MSE 最小化問題構建碼本質心 $c_1, c_2, \ldots, c_{2^b} \in [-1, 1]$
- Quant_mse($\boldsymbol{x}$):
- $\boldsymbol{y} \leftarrow \boldsymbol{\Pi} \cdot \boldsymbol{x}$
- 對每個 $j \in [d]$:$\text{idx}_j \leftarrow \arg\min_{k \in [2^b]} |\boldsymbol{y}_j - c_k|$($\text{idx}_j$ 為 $b$-bit 整數)
- 輸出:idx
- DeQuant_mse(idx):
- 對每個 $j \in [d]$:$\tilde{\boldsymbol{y}}_j \leftarrow c_{\text{idx}_j}$
- $\tilde{\boldsymbol{x}} \leftarrow \boldsymbol{\Pi}^\top \cdot \tilde{\boldsymbol{y}}$
- 輸出:$\tilde{\boldsymbol{x}}$
定理 1(TurboQuant_mse 效能保證)。對任何位元寬度 $b \geq 1$ 和任何向量 $\boldsymbol{x} \in \mathbb{S}^{d-1}$,重建向量 $\tilde{\boldsymbol{x}} \in \mathbb{R}^d$ 滿足以下失真界限:
- MSE $D_{\text{mse}} := \mathbb{E}_{\tilde{\boldsymbol{x}}}[\|\boldsymbol{x} - \tilde{\boldsymbol{x}}\|_2^2] \leq \frac{\sqrt{3}\pi}{2} \cdot \frac{1}{4^b}$,對任意 $b \geq 0$。
- 對 $b = 1, 2, 3, 4$,MSE 分別約為 0.36, 0.117, 0.03, 0.009。
證明概要。 首先證明 $D_{\text{mse}} = d \cdot \mathcal{C}(f_X, b)$,其中 $\mathcal{C}(f_X, b)$ 是純量量化器的最優 MSE 代價。利用旋轉矩陣的保距性質 $\|\boldsymbol{x} - \tilde{\boldsymbol{x}}\|_2 = \|\boldsymbol{\Pi} \cdot \boldsymbol{x} - \tilde{\boldsymbol{y}}\|_2$,以及所有 $\boldsymbol{y}_j$ 具有相同的 $f_X(\cdot)$ 分佈(引理 1),可將 MSE 分解為 $d$ 個相同純量量化問題之和。對於 $b > 4$,使用 Panter-Dite [44] 高解析度公式得到 $\mathcal{C}(f_X, b) \leq \frac{\sqrt{3}\pi}{2d} \cdot \frac{1}{4^b}$。∎
熵編碼碼本指標。 TurboQuant 的效率可透過對碼本索引應用熵編碼進一步提高。最顯著的減少出現在 $b = 4$ 時,熵約為 3.8,可將平均位元寬度減少 5%。但考慮到增益有限,我們選擇不將此技術納入 TurboQuant 以保持簡潔和速度。
3.2 內積最優 TurboQuant
對於近鄰搜尋等重要應用,擁有無偏的內積估計量至關重要。然而,3.1 節中介紹的 TurboQuant_mse 不能提供與查詢向量的無偏內積估計。
以 $b = 1$ 為例:最優碼本為 $\left\{\pm\sqrt{\frac{2}{\pi d}}\right\}$,量化映射為 $Q_{\text{mse}}(\boldsymbol{x}) = \text{sign}(\boldsymbol{\Pi} \cdot \boldsymbol{x})$,反量化映射為 $Q_{\text{mse}}^{-1}(\boldsymbol{z}) = \sqrt{\frac{2}{\pi d}} \cdot \boldsymbol{\Pi}^\top \cdot \boldsymbol{z}$。根據引理 4,$\mathbb{E}[\langle \boldsymbol{y}, Q_{\text{mse}}^{-1}(Q_{\text{mse}}(\boldsymbol{x}))\rangle] = \frac{2}{\pi} \cdot \langle \boldsymbol{y}, \boldsymbol{x}\rangle$,具有 $2/\pi$ 的乘性偏差。此偏差隨位元寬度增加而減小。
為解決此偏差,我們提出將 TurboQuant_mse 與 QJL [62] 結合的方案。具體而言,令 $Q_{\text{mse}}$ 為位元寬度 $b-1$ 的 TurboQuant_mse 量化映射。對任何 $\boldsymbol{x} \in \mathbb{S}^{d-1}$,殘差向量 $\boldsymbol{r} := \boldsymbol{x} - Q_{\text{mse}}^{-1}(Q_{\text{mse}}(\boldsymbol{x}))$ 具有小的 L2 範數。然後對此殘差向量應用 QJL 量化映射,得到總位元寬度為 $b$ 的以下無偏內積估計量:
$$\langle \boldsymbol{y}, Q_{\text{mse}}^{-1}(Q_{\text{mse}}(\boldsymbol{x}))\rangle + \|\boldsymbol{r}\|_2 \cdot \langle \boldsymbol{y}, Q_{\text{qjl}}^{-1}(Q_{\text{qjl}}(\boldsymbol{r}))\rangle$$
演算法 2:TurboQuant_prod(針對內積最佳化)
- 輸入:維度 $d$ 和位元寬度 $b$
- 實例化位元寬度 $b-1$ 的 TurboQuant_mse
- 生成隨機投影矩陣 $\boldsymbol{S} \in \mathbb{R}^{d \times d}$,各項 $\boldsymbol{S}_{i,j} \sim \mathcal{N}(0,1)$
- Quant_prod($\boldsymbol{x}$):
- $\text{idx} \leftarrow \text{Quant}_{\text{mse}}(\boldsymbol{x})$
- $\boldsymbol{r} \leftarrow \boldsymbol{x} - \text{DeQuant}_{\text{mse}}(\text{idx})$(殘差向量)
- $\text{qjl} \leftarrow \text{sign}(\boldsymbol{S} \cdot \boldsymbol{r})$(對殘差的 QJL)
- 輸出:$(\text{idx}, \text{qjl}, \|\boldsymbol{r}\|_2)$
- DeQuant_prod(idx, qjl, $\gamma$):
- $\tilde{\boldsymbol{x}}_{\text{mse}} \leftarrow \text{DeQuant}_{\text{mse}}(\text{idx})$
- $\tilde{\boldsymbol{x}}_{\text{qjl}} \leftarrow \frac{\sqrt{\pi/2}}{d} \cdot \gamma \cdot \boldsymbol{S}^\top \cdot \text{qjl}$
- 輸出:$\tilde{\boldsymbol{x}}_{\text{mse}} + \tilde{\boldsymbol{x}}_{\text{qjl}}$
定理 2(TurboQuant_prod 效能保證)。對任何位元寬度 $b \geq 1$、任何向量 $\boldsymbol{x} \in \mathbb{S}^{d-1}$ 和任何 $\boldsymbol{y} \in \mathbb{R}^d$,重建向量滿足:
- 無偏:$\mathbb{E}_{\tilde{\boldsymbol{x}}}[\langle \boldsymbol{y}, \tilde{\boldsymbol{x}}\rangle] = \langle \boldsymbol{y}, \boldsymbol{x}\rangle$
- 內積失真:$D_{\text{prod}} \leq \frac{\sqrt{3}\pi^2 \cdot \|\boldsymbol{y}\|_2^2}{d} \cdot \frac{1}{4^b}$,對任意 $b \geq 0$。
- 對 $b = 1, 2, 3, 4$:$D_{\text{prod}} \approx \frac{1.57}{d}, \frac{0.56}{d}, \frac{0.18}{d}, \frac{0.047}{d}$。
證明概要。 無偏性透過條件期望推導:$\mathbb{E}[\langle \boldsymbol{y}, \tilde{\boldsymbol{x}}\rangle | \tilde{\boldsymbol{x}}_{\text{mse}}] = \langle \boldsymbol{y}, \tilde{\boldsymbol{x}}_{\text{mse}}\rangle + \langle \boldsymbol{y}, \boldsymbol{r}\rangle = \langle \boldsymbol{y}, \boldsymbol{x}\rangle$(利用 QJL 的無偏性和殘差定義)。失真界限透過條件變異數分析得到:$D_{\text{prod}} \leq \frac{\pi}{2d} \cdot \|\boldsymbol{y}\|_2^2 \cdot D_{\text{mse}}$,然後代入定理 1 中位元寬度 $b-1$ 的 MSE 界限。∎
3.3 下界
我們證明 TurboQuant 對任何位元寬度達到最優失真率(最多差一個小常數因子),方法是證明任何壓縮演算法可達最佳失真的下界。
定理 3(可達壓縮失真的下界)。對任何隨機量化演算法 $Q: \mathbb{S}^{d-1} \to \{0,1\}^{b \cdot d}$(位元寬度 $b$)和任何重建映射 $Q^{-1}$,存在困難輸入實例 $\boldsymbol{x} \in \mathbb{S}^{d-1}$ 使得:
$$D_{\text{mse}}(Q) := \mathbb{E}\left[\|\boldsymbol{x} - Q^{-1}(Q(\boldsymbol{x}))\|_2^2\right] \geq \frac{1}{4^b}$$
此外,存在 $\boldsymbol{y} \in \mathbb{S}^{d-1}$ 使得:
$$D_{\text{prod}}(Q) = \mathbb{E}\left[|\langle \boldsymbol{y}, \boldsymbol{x}\rangle - \langle \boldsymbol{y}, Q^{-1}(Q(\boldsymbol{x}))\rangle|^2\right] \geq \frac{1}{d} \cdot \frac{1}{4^b}$$
證明概要。 透過 Yao 極小極大原理,最優隨機壓縮演算法對最壞情況輸入的期望 MSE 等於最優確定性壓縮演算法對最困難隨機分佈(超球面均勻分佈)輸入的期望 MSE。應用引理 3 中的 SLB 得到 MSE 下界。內積下界透過鴿巢原理從 MSE 下界推導。∎
我們注意到,可比較的最壞情況失真下界可以透過「球填充」論證推導,但定理 3 建立的是期望失真下界,與我們的上界完美對齊。
4. 實驗
所有實驗均使用單張 NVIDIA A100 GPU 執行。實驗分為兩部分:一部分實證驗證理論結果,另一部分評估我們方法在下游任務(特別是 KV cache 量化和近鄰向量搜尋)上的效能。
4.1 實證驗證
我們使用 DBpedia 實體資料集進行實驗,該資料集已使用 OpenAI3 嵌入編碼到 1536 維空間。我們隨機取樣 100,000 個資料點作為訓練集,另取 1,000 個不同條目作為查詢集。
我們評估兩種量化方法:TurboQuant_prod 和 TurboQuant_mse。TurboQuant_mse 針對量化與原始向量之間的 MSE 進行最佳化。TurboQuant_prod 則為量化與原始向量之間的內積提供無偏估計。
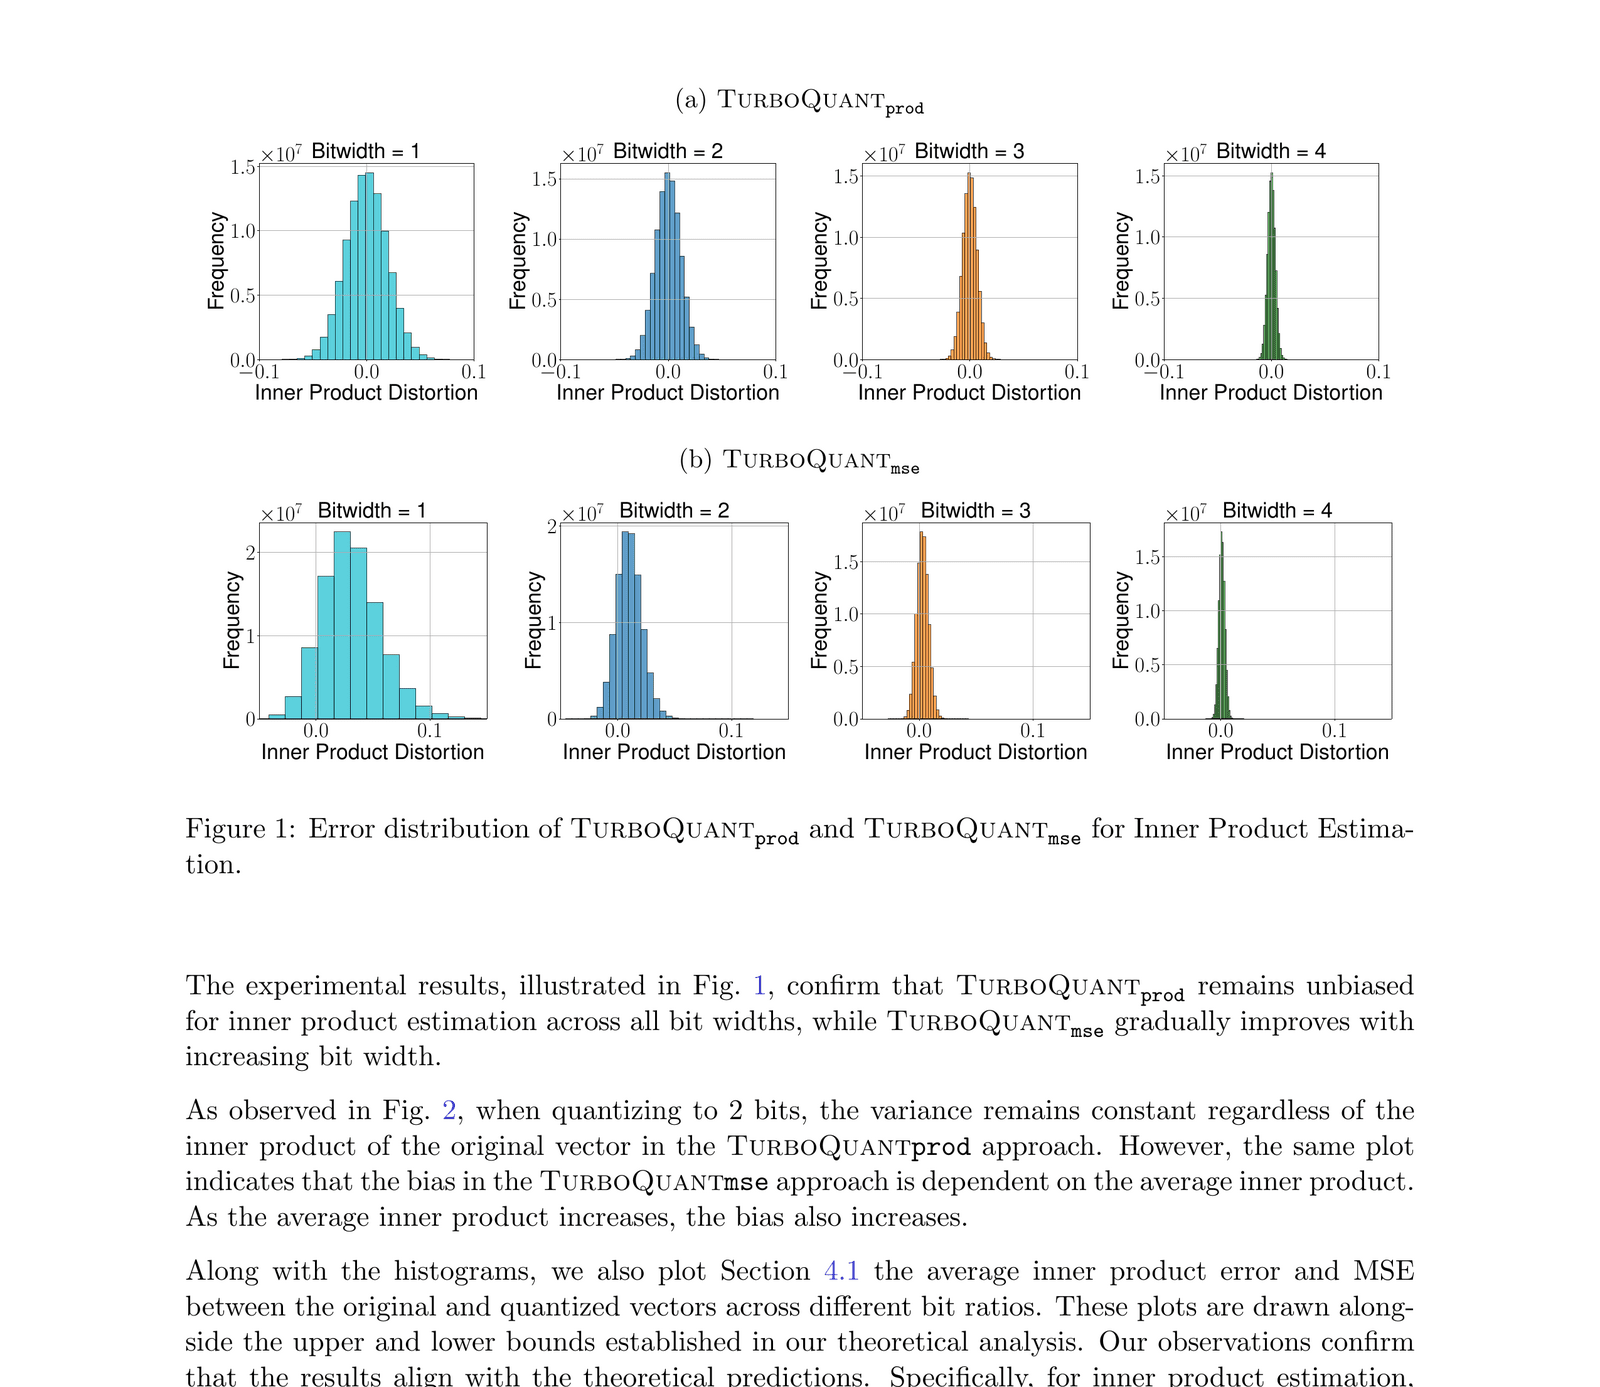
圖 1:TurboQuant_prod 和 TurboQuant_mse 在內積估計中的誤差分佈。
如圖 1 所示,增加位元寬度可降低兩種方法的變異數。然而,TurboQuant_mse 用於內積估計時會引入偏差,此偏差隨位元寬度增加而減小。實驗結果確認 TurboQuant_prod 在所有位元寬度下對內積估計保持無偏,而 TurboQuant_mse 隨位元寬度增加逐漸改善。
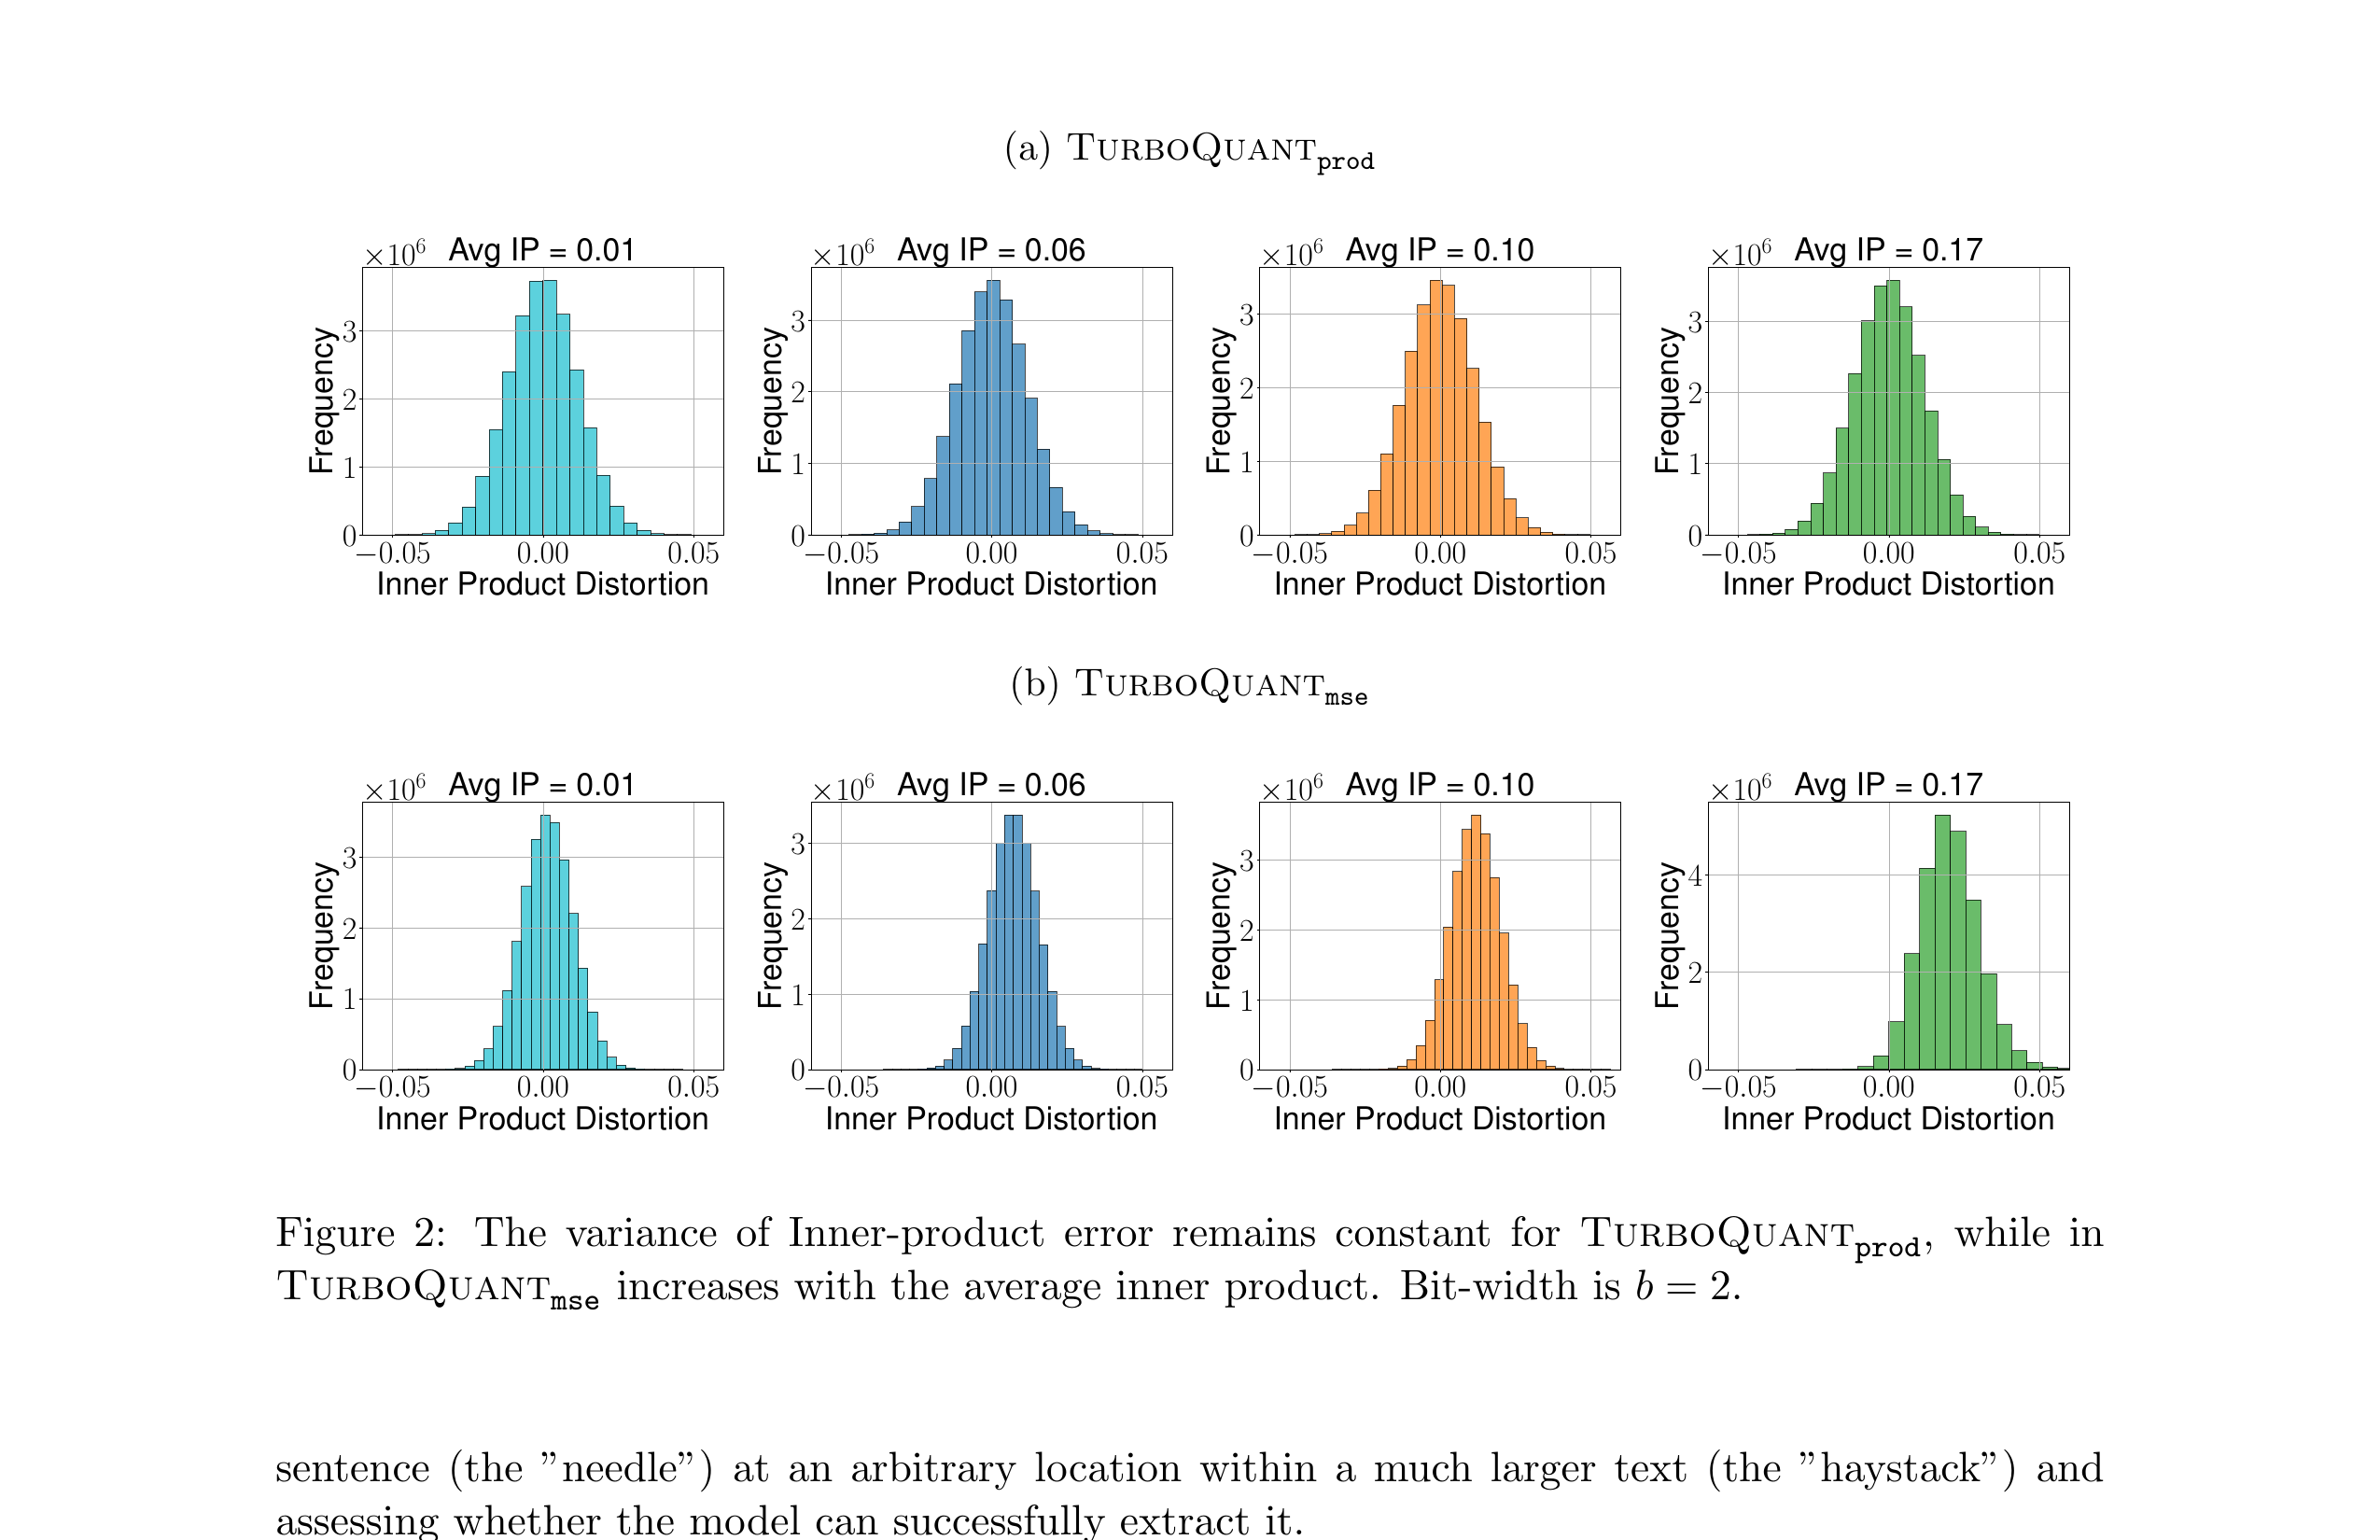
圖 2:內積誤差的變異數在 TurboQuant_prod 中保持恆定,而在 TurboQuant_mse 中隨平均內積增加而增加。位元寬度 b=2。
如圖 2 所示,量化為 2 位元時,TurboQuant_prod 中的變異數不受原始向量內積的影響而保持恆定。然而,TurboQuant_mse 中的偏差取決於平均內積,平均內積越大偏差越大。
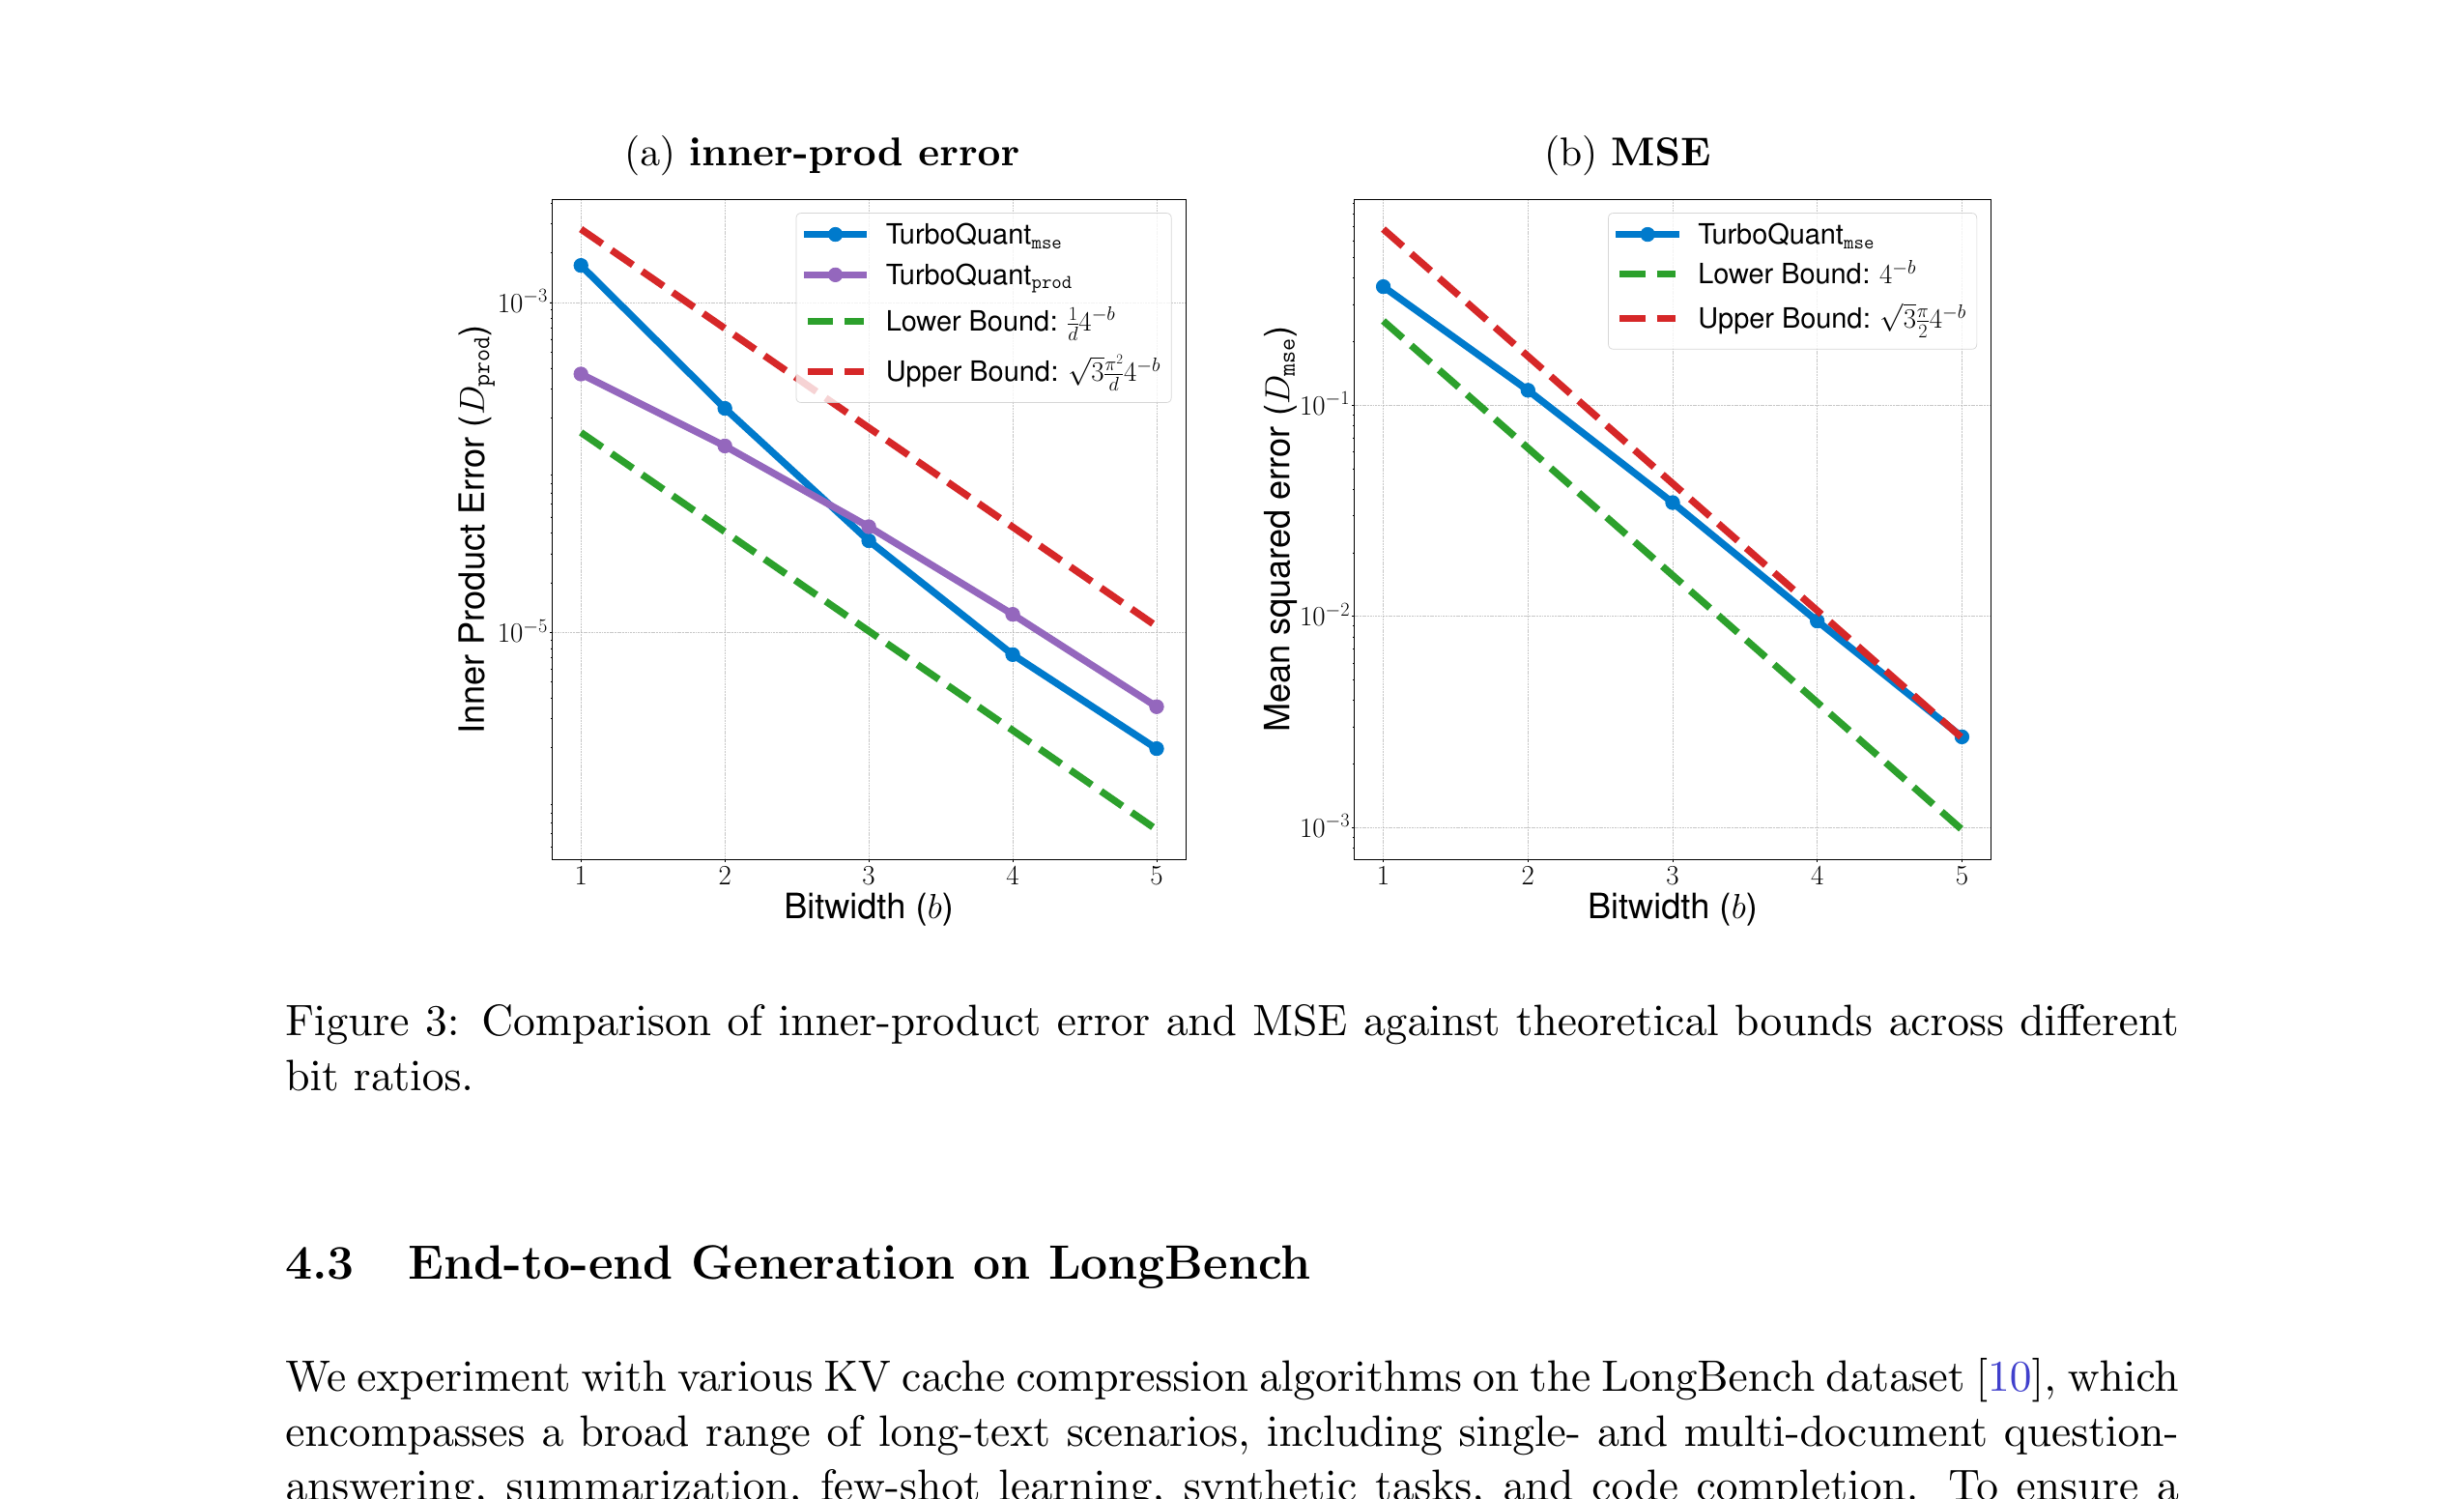
圖 3:不同位元比率下內積誤差和 MSE 與理論界限的比較。
我們還繪製了不同位元比率下原始與量化向量之間的平均內積誤差和 MSE,並與理論分析中建立的上界和下界一同展示。觀察結果確認結果與理論預測一致。具體而言,對於內積估計,TurboQuant_prod 在較低位元比率下表現更好。但隨位元數增加,TurboQuant_mse 的偏差減小,最終在內積估計中達到更優效能。
4.2 大海撈針測試
「大海撈針測試」[32] 是一個評估模型從長文件中檢索特定資訊能力的基準測試。測試將一個獨特句子(「針」)放置在更大文本(「乾草堆」)的任意位置,評估模型是否能成功提取它。
遵循 Fu 等人 [21] 的實驗設定,我們使用 Llama-3.1-8B-Instruct 模型進行評估。文件大小從 4k 到 104k token 變化。主要評估指標是召回分數。
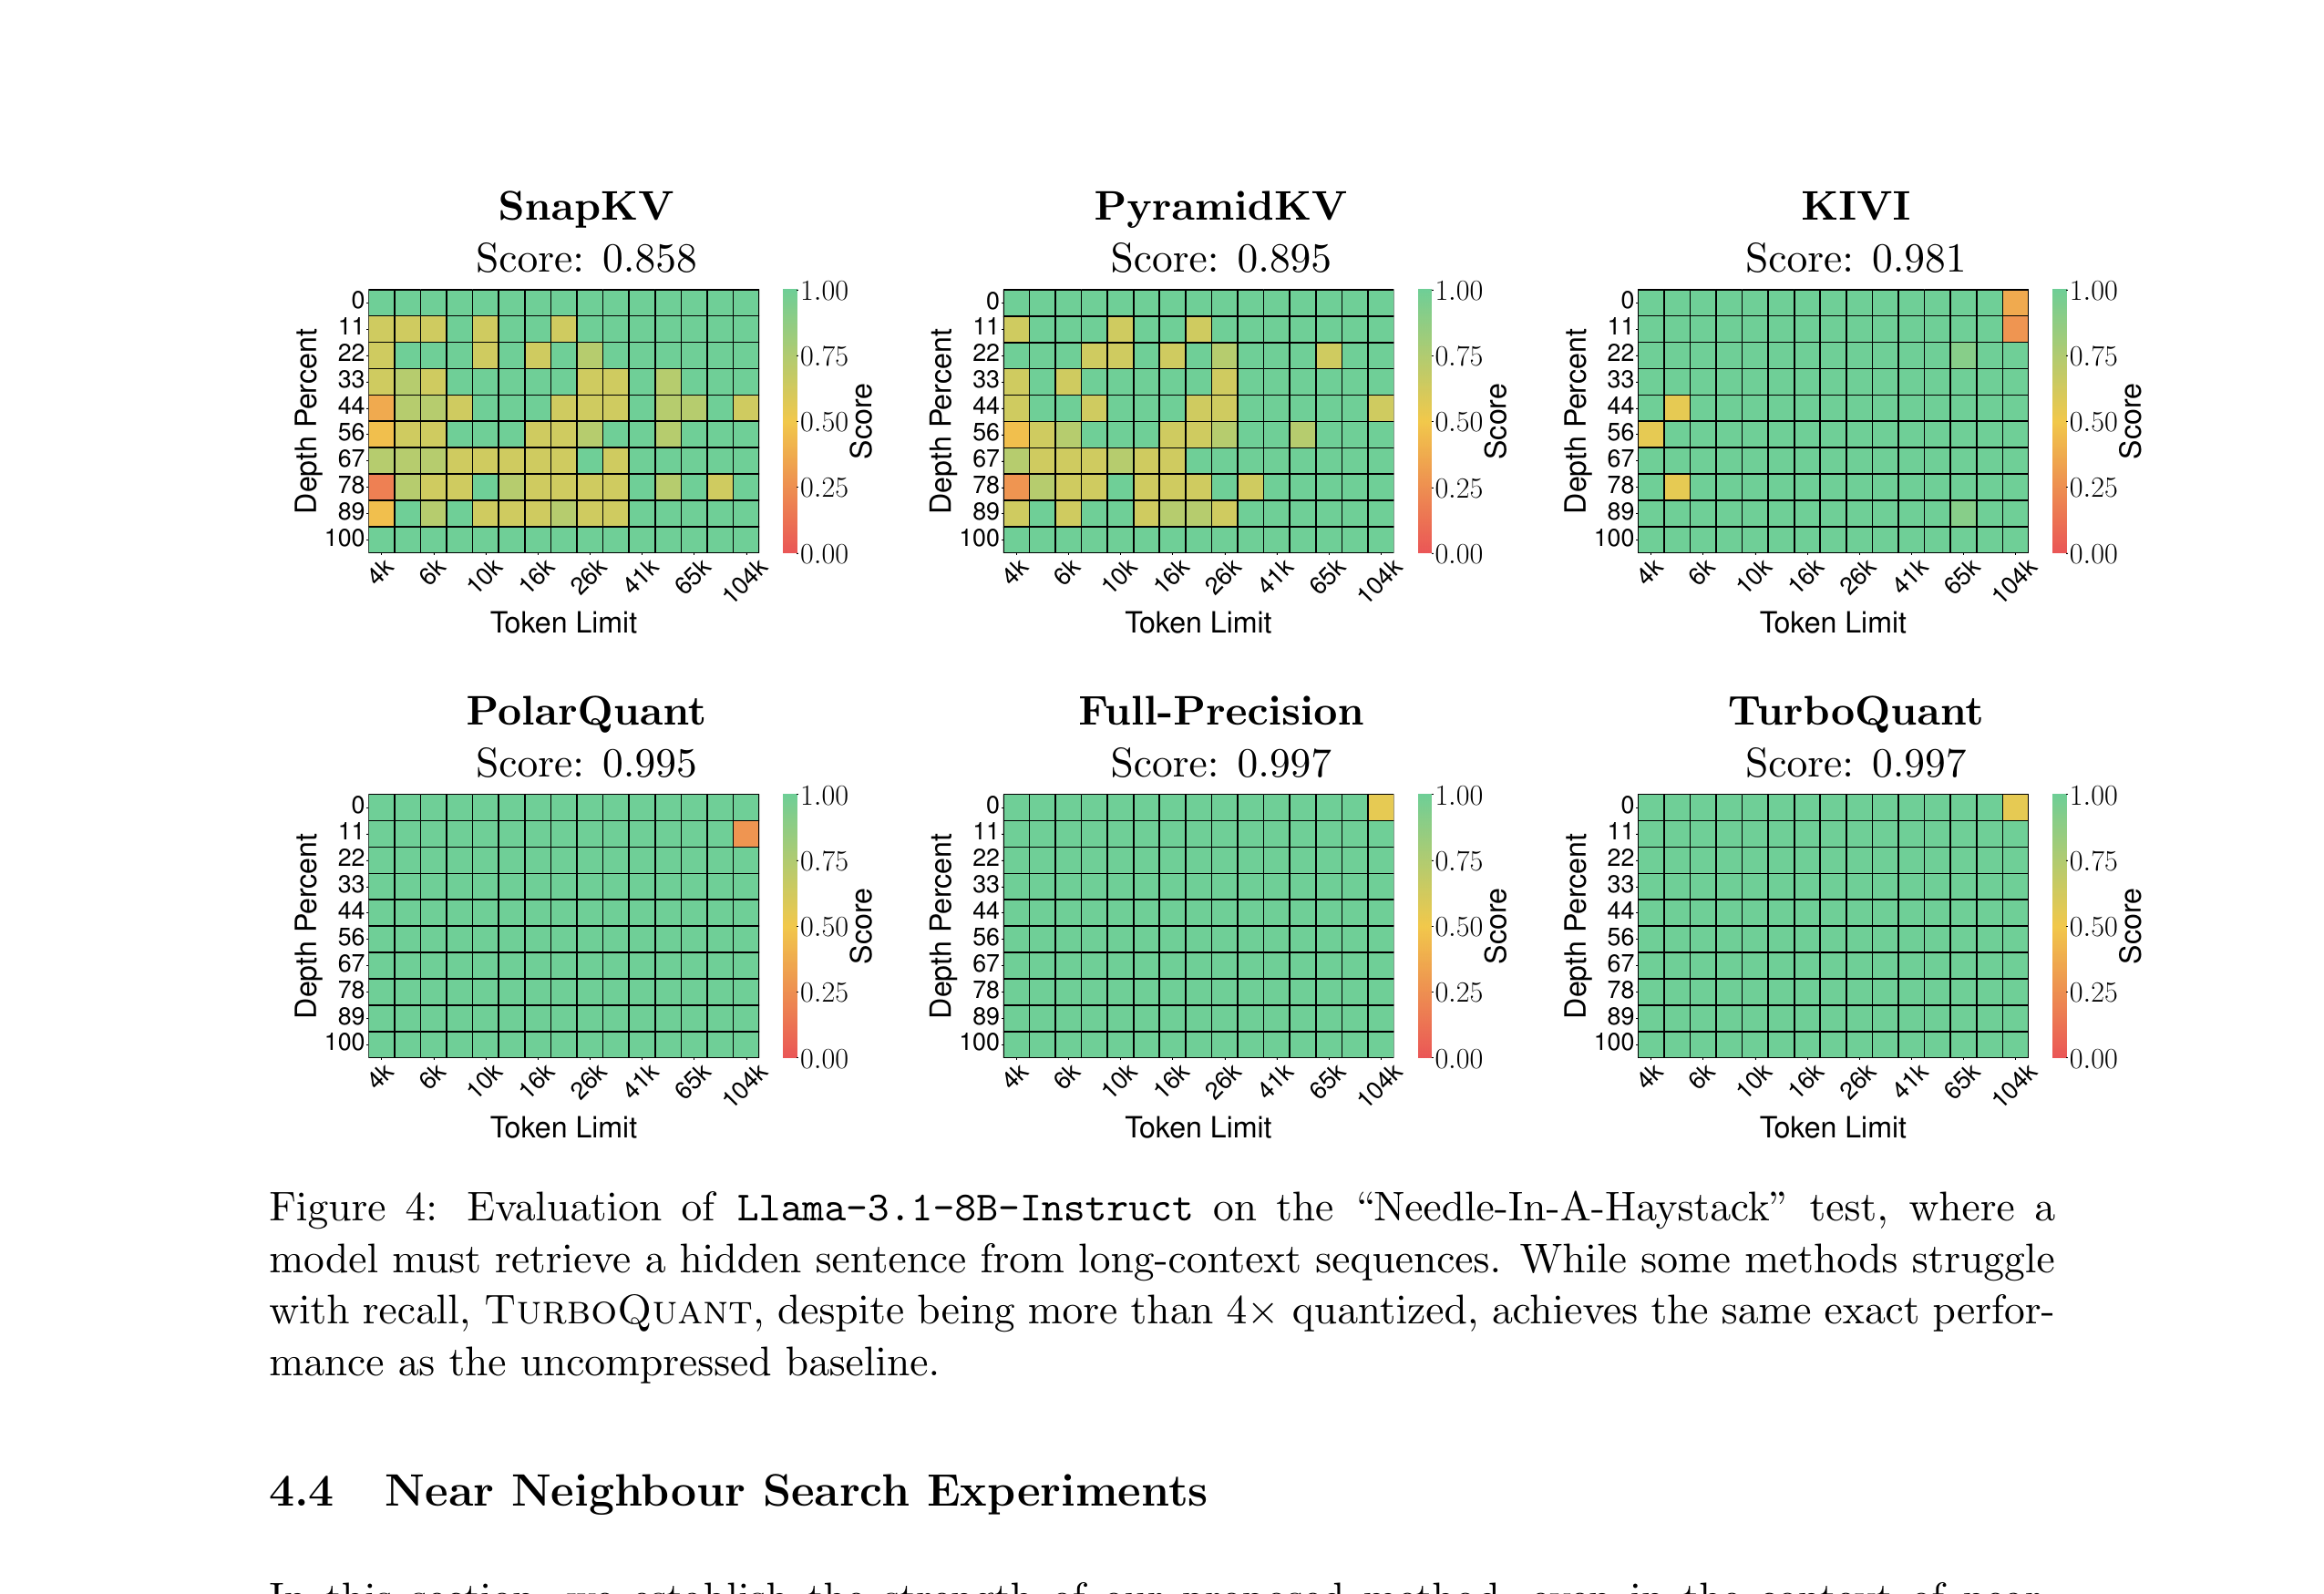
圖 4:在「大海撈針」測試上評估 Llama-3.1-8B-Instruct。雖然某些方法在召回方面有困難,但 TurboQuant 儘管量化超過 4 倍,卻達到了與未壓縮基線完全相同的效能。
各方法得分:SnapKV (0.858)、PyramidKV (0.895)、KIVI (0.981)、PolarQuant (0.995)、Full-Precision (0.997)、TurboQuant (0.997)。
結果顯示,具有理論保證的量化方法(如 PolarQuant 和 TurboQuant)優於 token 級壓縮技術(SnapKV、PyramidKV)和缺乏理論保證的純量量化方法(KIVI)。值得注意的是,TurboQuant 在 $4\times$ 壓縮下達到與全精度模型完全相同的效能。
4.3 LongBench 端到端生成
我們在 LongBench 資料集 [10] 上實驗了各種 KV cache 壓縮演算法,涵蓋單文件和多文件問答、摘要、少樣本學習、合成任務和程式碼補全等場景。我們使用 LongBench-E 子集以確保不同上下文長度間的均衡評估。
與 KIVI 和 PolarQuant 等不量化生成 token 的方法不同,我們的方法即使在串流生成過程中也應用量化。
| 方法 | KV 大小 | SingleQA | MultiQA | 摘要 | 少樣本 | 合成 | 程式碼 | 平均 |
|---|---|---|---|---|---|---|---|---|
| Llama-3.1-8B-Instruct | ||||||||
| Full Cache | 16 | 45.29 | 45.16 | 26.55 | 68.38 | 59.54 | 46.28 | 50.06 |
| KIVI | 3 | 43.38 | 37.99 | 27.16 | 68.38 | 59.50 | 44.68 | 48.50 |
| KIVI | 5 | 45.04 | 45.70 | 26.47 | 68.57 | 59.55 | 46.41 | 50.16 |
| PolarQuant | 3.9 | 45.18 | 44.48 | 26.23 | 68.25 | 60.07 | 45.24 | 49.78 |
| TurboQuant (ours) | 2.5 | 44.16 | 44.96 | 24.80 | 68.01 | 59.65 | 45.76 | 49.44 |
| TurboQuant (ours) | 3.5 | 45.01 | 45.31 | 26.00 | 68.63 | 59.95 | 46.17 | 50.06 |
| Ministral-7B-Instruct | ||||||||
| Full Cache | 16 | 47.53 | 49.06 | 26.09 | 66.83 | 53.50 | 47.90 | 49.89 |
| TurboQuant (ours) | 2.5 | 48.38 | 49.22 | 24.91 | 66.69 | 53.17 | 46.83 | 49.62 |
表 1:LongBench-V1 各 KV cache 壓縮方法結果。
非整數位元精度來自我們的策略:將通道分為異常值和非異常值集合,並對每組應用兩個獨立的 TurboQuant 實例,為異常值分配更高的位元精度。例如,在 2.5-bit 設定中,32 個異常值通道以 3 位元量化,其餘 96 個通道使用 2 位元,有效位元精度為 $(32 \times 3 + 96 \times 2)/128 = 2.5$。
儘管使用的位元數少於競爭方法,TurboQuant 保持了與未量化模型相當的效能,同時壓縮量化向量至少 $4.5\times$。
4.4 近鄰搜尋實驗
我們使用 DBpedia [53] 實體資料集進行實驗,使用 OpenAI3 嵌入編碼到 1536 維和 3072 維空間。此外,我們使用標準 GloVe [45] 嵌入在較低維度的資料集上評估效能。
我們將 TurboQuant 與兩種基線量化方法比較:乘積量化 (PQ) 和 RabitQ [22]。以 top-k 召回率(記為 1@k)評估效能。
| 方法 | d=200 | d=1536 | d=3072 |
|---|---|---|---|
| Product Quantization | 37.04 | 239.75 | 494.42 |
| RabitQ | 597.25 | 2267.59 | 3957.19 |
| TurboQuant | 0.0007 | 0.0013 | 0.0021 |
表 2:不同方法在不同維度下的量化時間(秒),使用 4-bit 量化。
TurboQuant 的索引建構時間比 PQ 快數萬倍,比 RabitQ 快數百萬倍。
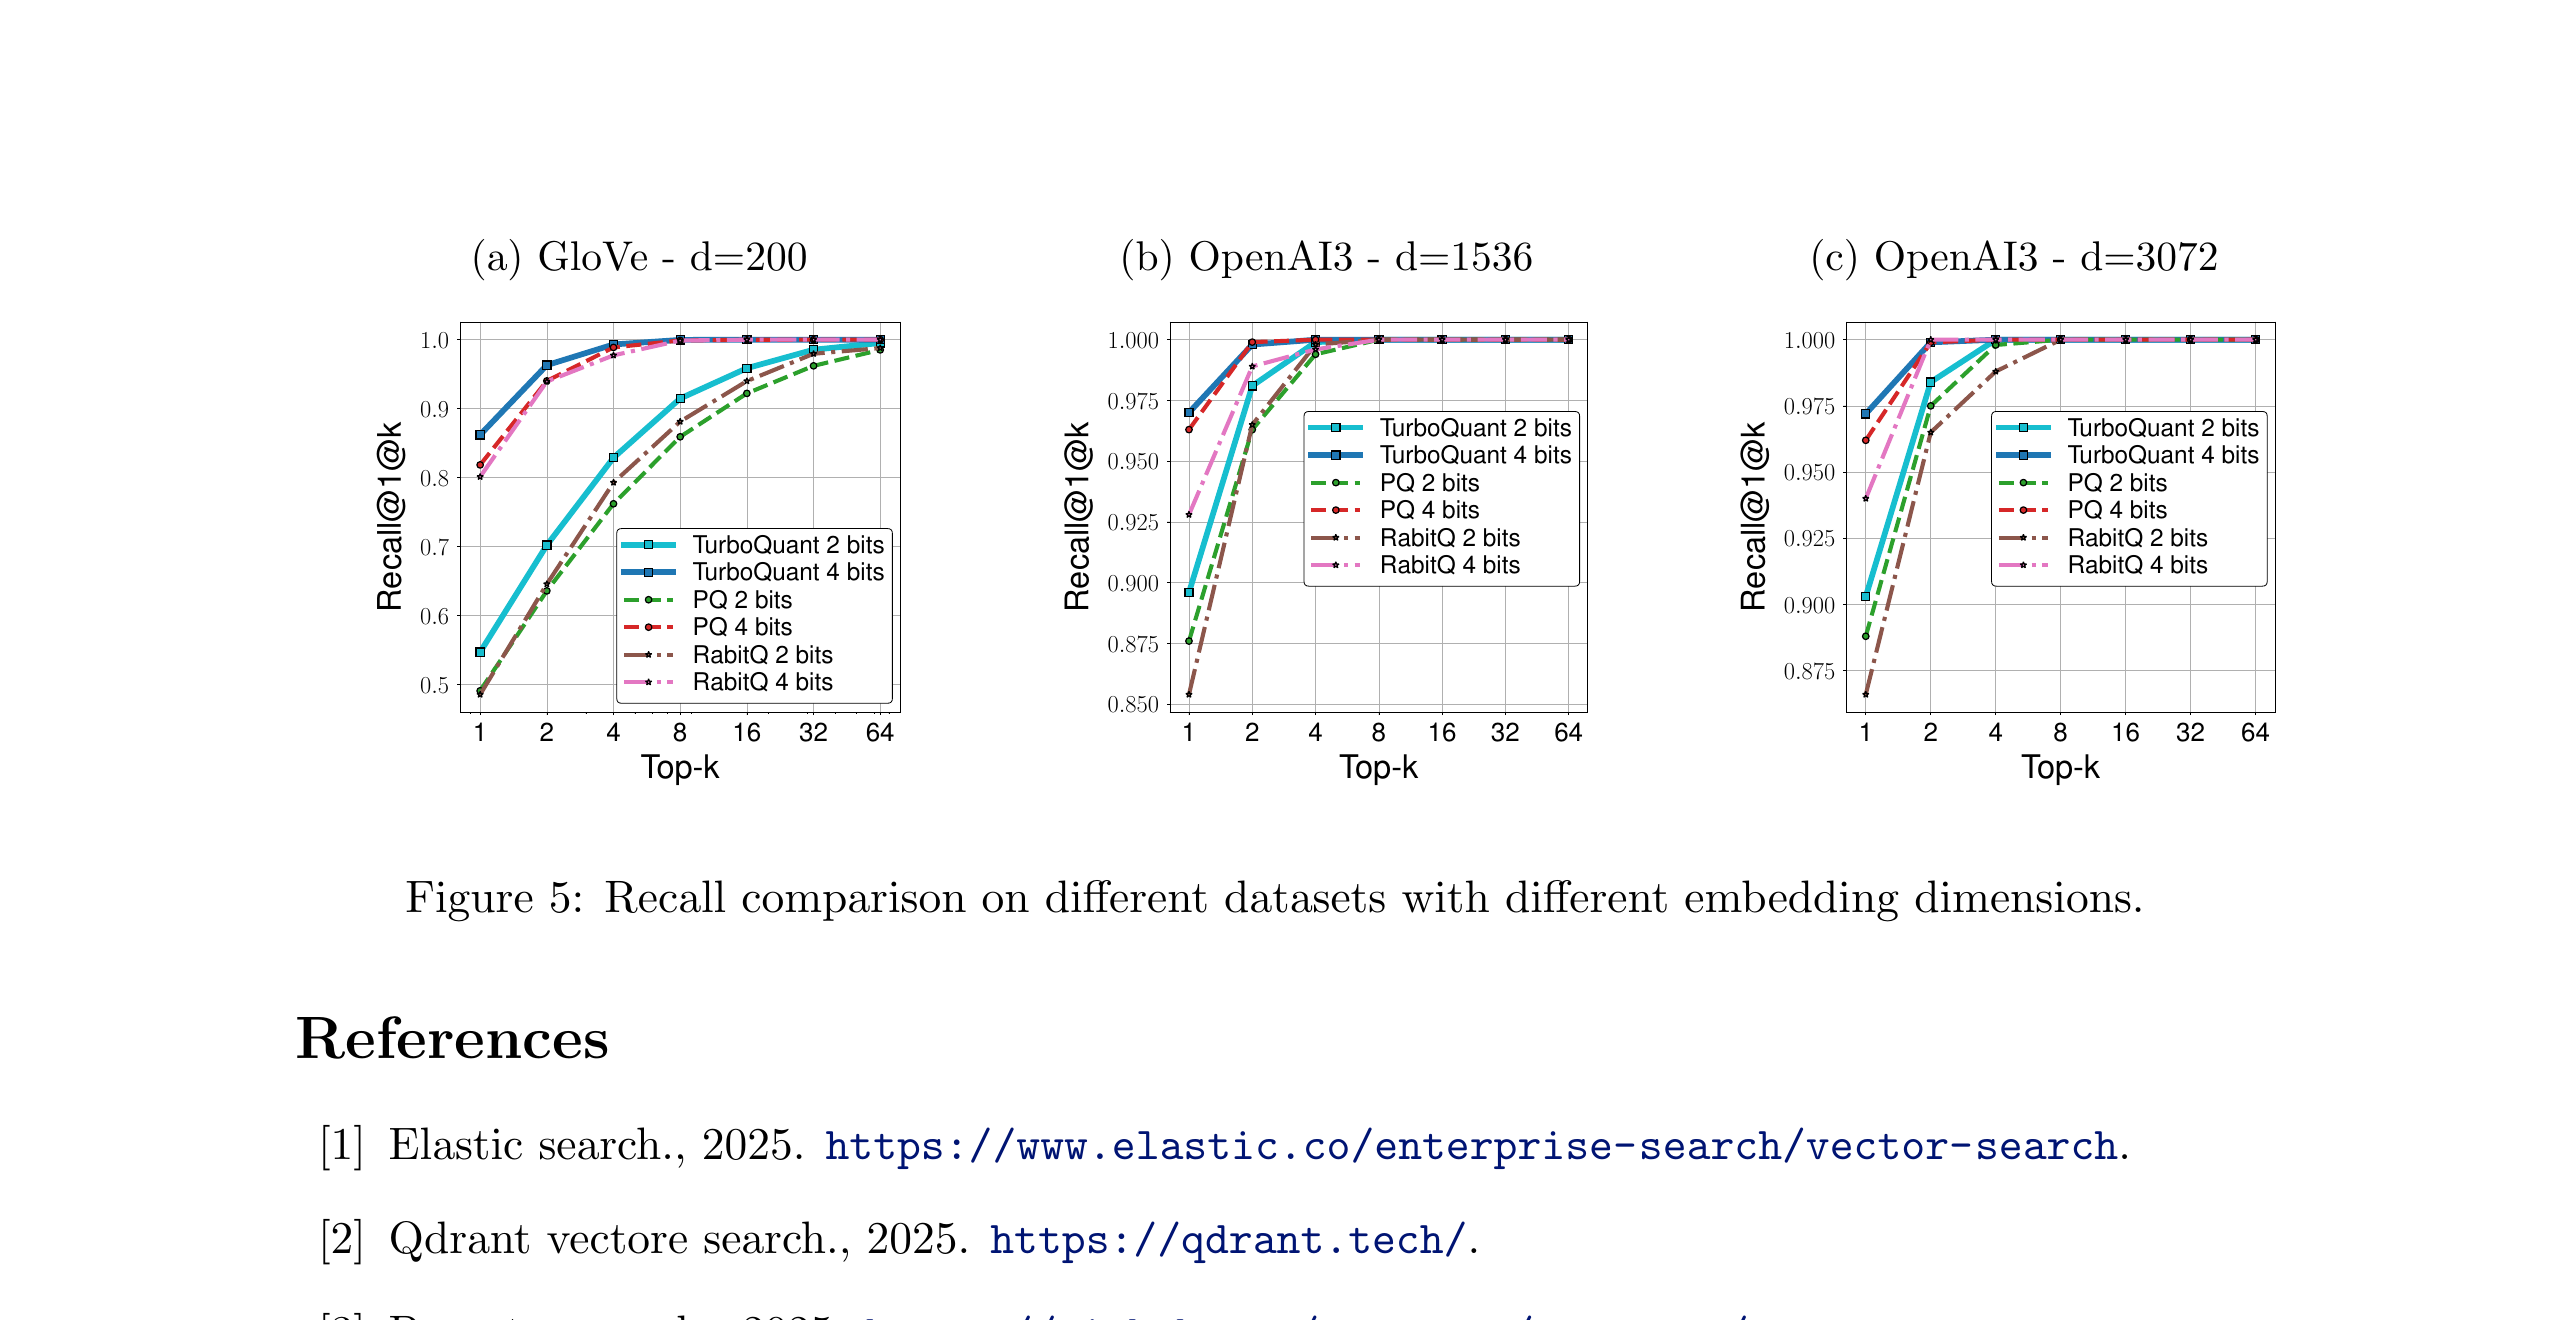
圖 5:不同嵌入維度的資料集上的召回率比較。
乘積量化 (PQ) 依賴 k-means 構建碼本,碼本大小隨位元數指數增長。我們選用具有 256 個碼字的 LUT256 版本以平衡速度和精確度。
RabitQ 缺乏完全向量化的實作,無法利用 GPU 加速,在 CPU 上運行顯著較慢。此外,該方法在實際中使用的位元數多於報告的位元比率。
儘管基線方法享有優勢,TurboQuant 在所有實驗中在召回率方面持續優於 PQ 和 RabitQ,展示了我們方法的穩健性和效率,使其成為高維量化搜尋任務的有力替代方案。
參考文獻
[1] Elastic search., 2025.
[2] Qdrant vectore search., 2025.
[3] Pgvector search., 2025.
[4] Pinecone vectore database., 2025.
[5] Achiam, J., et al. Gpt-4 technical report. arXiv:2303.08774, 2023.
[6] Ainslie, J., et al. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. EMNLP, 2023.
[7] Anthropic. Claude, 2024.
[8] Ashkboos, S., et al. Quarot: Outlier-free 4-bit inference in rotated llms. arXiv:2404.00456, 2024.
[9] Babenko, A. and Lempitsky, V. Additive quantization for extreme vector compression. CVPR, 2014.
[10] Bai, Y., et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv:2308.14508, 2023.
[11] Beltagy, I., et al. Longformer: The long-document transformer. arXiv:2004.05150, 2020.
[12] Cai, Z., et al. Pyramidkv: Dynamic kv cache compression based on pyramidal information funneling. arXiv:2406.02069, 2024.
[13] Chee, J., et al. Quip: 2-bit quantization of large language models with guarantees. NeurIPS, 2023.
[14] Cover, T. M. Elements of information theory. John Wiley & Sons, 1999.
[15] Dai, D., et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv:2401.06066, 2024.
[16] Dettmers, T., et al. Gpt3.int8(): 8-bit matrix multiplication for transformers at scale. NeurIPS, 2022.
[17] Dong, S., et al. Qaq: Quality adaptive quantization for llm kv cache. arXiv:2403.04643, 2024.
[18] Dubey, A., et al. The llama 3 herd of models. arXiv:2407.21783, 2024.
[19] Edge, D., et al. From local to global: A graph rag approach to query-focused summarization. arXiv:2404.16130, 2024.
[20] Frantar, E., et al. Gptq: Accurate post-training quantization for generative pre-trained transformers. arXiv:2210.17323, 2022.
[21] Fu, Y., et al. Data engineering for scaling language models to 128k context. arXiv:2402.10171, 2024.
[22] Gao, J., et al. Practical and asymptotically optimal quantization of high-dimensional vectors in euclidean space for approximate nearest neighbor search. arXiv:2409.09913, 2024.
[23] Gao, Y., et al. Retrieval-augmented generation for large language models: A survey. arXiv:2312.10997, 2023.
[24] Ge, T., et al. Optimized product quantization for approximate nearest neighbor search. CVPR, 2013.
[25] Gersho, A. Asymptotically optimal block quantization. IEEE Trans. Info. Theory, 1979.
[26] Gersho, A. On the structure of vector quantizers. IEEE Trans. Info. Theory, 1982.
[27] Guo, R., et al. Accelerating large-scale inference with anisotropic vector quantization. ICML, 2020.
[28] Han, I., et al. Polarquant: Quantizing kv caches with polar transformation. arXiv:2502.02617, 2025a.
[29] Han, I., et al. Balancekv: Kv cache compression through discrepancy theory. arXiv:2502.07861, 2025b.
[30] Hooper, C., et al. Kvquant: Towards 10 million context length llm inference with kv cache quantization. arXiv:2401.18079, 2024.
[31] Jegou, H., et al. Product quantization for nearest neighbor search. IEEE TPAMI, 2010.
[32] Kamradt, G. Needle in a haystack - pressure testing llms., 2023.
[33] Kang, H., et al. Gear: An efficient kv cache compression recipe for near-lossless generative inference of llm. arXiv:2403.05527, 2024.
[34] Kaplan, J., et al. Scaling laws for neural language models. arXiv:2001.08361, 2020.
[35] Khattab, O. and Zaharia, M. Colbert: Efficient and effective passage search via contextualized late interaction over bert. SIGIR, 2020.
[36] Kim, J., et al. Lexico: Extreme kv cache compression via sparse coding over universal dictionaries. arXiv:2412.08890, 2024.
[37] Kim, S., et al. Squeezellm: Dense-and-sparse quantization. arXiv:2306.07629, 2023.
[38] Li, Y., et al. Snapkv: Llm knows what you are looking for before generation. arXiv:2404.14469, 2024.
[39] Lin, J., et al. Awq: Activation-aware weight quantization for on-device llm compression and acceleration. MLSys, 2024.
[40] Liu, Z., et al. Scissorhands: Exploiting the persistence of importance hypothesis for llm kv cache compression at test time. NeurIPS, 2024a.
[41] Liu, Z., et al. Kivi: A tuning-free asymmetric 2bit quantization for kv cache. arXiv:2402.02750, 2024b.
[42] Lloyd, S. Least squares quantization in pcm. IEEE Trans. Info. Theory, 1982.
[43] Max, J. Quantizing for minimum distortion. IRE Trans. Info. Theory, 1960.
[44] Panter, P. and Dite, W. Quantization distortion in pulse-count modulation with nonuniform spacing of levels. Proc. IRE, 1951.
[45] Pennington, J., et al. GloVe: Global vectors for word representation. EMNLP, 2014.
[46] Santhanam, K., et al. Colbertv2: Effective and efficient retrieval via lightweight late interaction. arXiv:2112.01488, 2021.
[47] Shah, J., et al. Flashattention-3: Fast and accurate attention with asynchrony and low-precision. arXiv:2407.08608, 2024.
[48] Shannon, C. E. A mathematical theory of communication. Bell System Tech. J., 1948.
[49] Shannon, C. E. et al. Coding theorems for a discrete source with a fidelity criterion. IRE Nat. Conv. Rec, 1959.
[50] Shazeer, N. Fast transformer decoding: One write-head is all you need. arXiv:1911.02150, 2019.
[51] Su, Z., et al. Rotatekv: Accurate and robust 2-bit kv cache quantization for llms via outlier-aware adaptive rotations, 2025.
[52] Team, G., et al. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv:2403.05530, 2024.
[53] Thakur, N., et al. BEIR: A heterogeneous benchmark for zero-shot evaluation of information retrieval models. NeurIPS, 2021.
[54] Vaswani, A., et al. Attention is all you need. NeurIPS, 2017.
[55] Vershynin, R. High-dimensional probability: An introduction with applications in data science. Cambridge Univ. Press, 2018.
[56] Wang, J., et al. A survey on learning to hash. IEEE TPAMI, 2017.
[57] Xiao, G., et al. Smoothquant: Accurate and efficient post-training quantization for large language models. ICML, 2023a.
[58] Xiao, G., et al. Efficient streaming language models with attention sinks. arXiv:2309.17453, 2023b.
[59] Yang, J. Y., et al. No token left behind: Reliable kv cache compression via importance-aware mixed precision quantization. arXiv:2402.18096, 2024.
[60] Yue, Y., et al. Wkvquant: Quantizing weight and key/value cache for large language models gains more. arXiv:2402.12065, 2024.
[61] Zador, P. L. Development and evaluation of procedures for quantizing multivariate distributions. Stanford University, 1964.
[62] Zandieh, A., et al. Qjl: 1-bit quantized jl transform for kv cache quantization with zero overhead. arXiv:2406.03482, 2024.
[63] Zandieh, A., et al. Subgen: Token generation in sublinear time and memory. arXiv:2402.06082, 2024c.
[64] Zhang, T., et al. Kv cache is 1 bit per channel: Efficient large language model inference with coupled quantization. arXiv:2405.03917, 2024a.
[65] Zhang, Z., et al. H2o: Heavy-hitter oracle for efficient generative inference of large language models. NeurIPS, 2024b.
[66] Liu, Z., et al. Scissorhands: Exploiting the persistence of importance hypothesis for llm kv cache compression at test time. NeurIPS, 2024.
術語對照表
| 英文術語 | 中文譯名 |
|---|---|
| Vector Quantization (VQ) | 向量量化 |
| Mean-Squared Error (MSE) | 均方誤差 |
| Inner Product | 內積 |
| Distortion Rate | 失真率 |
| Bit-width | 位元寬度 |
| Data-Oblivious | 資料無關 |
| Scalar Quantizer | 純量量化器 |
| Codebook | 碼本 |
| Centroid | 質心 |
| Unbiased Estimator | 無偏估計量 |
| Residual Vector | 殘差向量 |
| Random Rotation | 隨機旋轉 |
| Beta Distribution | Beta 分佈 |
| Shannon Lower Bound (SLB) | Shannon 下界 |
| Yao's Minimax Principle | Yao 極小極大原理 |
| Mutual Information | 互資訊 |
| Differential Entropy | 微分熵 |
| Johnson-Lindenstrauss (JL) Transform | Johnson-Lindenstrauss 變換 |
| KV Cache | 鍵值快取 |
| Product Quantization (PQ) | 乘積量化 |
| Nearest Neighbor (NN) Search | 近鄰搜尋 |
| Recall Ratio | 召回率 |
| Voronoi Tessellation | Voronoi 鑲嵌 |
| Lloyd-Max Quantizer | Lloyd-Max 量化器 |
| Entropy Encoding | 熵編碼 |
| Needle-In-A-Haystack | 大海撈針 |
| Retrieval-Augmented Generation (RAG) | 檢索增強生成 |
| Outlier Channels | 異常值通道 |